
Dans le paradigme contemporain de l’apprentissage automatique et de la modélisation statistique, l’évaluation des algorithmes prédictifs constitue une étape méthodologique fondamentale, souvent bien plus déterminante que le choix initial de l’architecture algorithmique. Trop souvent, les praticiens et chercheurs débutants se limitent à une métrique globale d’exactitude (ou accuracy), qui quantifie naïvement le ratio entre les prédictions conformes et la totalité des instances évaluées. Or, cette simplification outrancière s’avère méthodologiquement trompeuse, voire pernicieuse, en présence de distributions asymétriques ou lorsque le coût inductif associé à différentes typologies d’erreurs présente une disparité marquée. Une telle réduction synthétique masque les mécanismes internes de discrimination du modèle et occulte la nature exacte de ses défaillances systématiques.
Pour dépasser ces limites et appréhender de manière granulaire la dynamique prédictive d’un système de classification, la matrice de confusion s’impose comme la pierre angulaire de l’analyse diagnostique en intelligence artificielle. Ce tableau de contingence offre une cartographie croisée exhaustive entre l’état ontologique réel des entités soumises à examen et le verdict computationnel émis par l’estimateur. En dissociant formellement les réussites et les errements selon leur orientation directionnelle, elle permet d’objectiver l’arbitrage critique entre la sensibilité d’un test et sa spécificité, fournissant les éléments quantitatifs nécessaires à une prise de décision éclairée en contexte d’incertitude.
Le langage de programmation Python, soutenu par son écosystème scientifique de référence incluant notamment NumPy, Scikit-Learn, Matplotlib et Seaborn, propose une infrastructure robuste et hautement paramétrable pour la synthèse, l’exploitation et la restitution visuelle de ces matrices. Ce présent traité méthodologique se propose de guider le chercheur, l’ingénieur de données et le statisticien à travers les arcanes de la matrice de confusion. Des fondements théoriques de l’inférence binaire jusqu’aux extensions polytomiques et aux techniques de normalisation face aux déséquilibres sévères de prévalence, chaque sous-ensemble conceptuel sera disséqué avec une rigueur académique exemplaire et une implémentation logicielle exhaustive.
1. Fondements théoriques de la matrice de confusion et modélisation binaire
1.1 Définition et structure générale d’une matrice de contingence 2×2
La matrice de confusion, également qualifiée au sein de la littérature statistique de table de contingence binaire ou de tableau de croisement diagnostique, formalise la confrontation empirique entre deux variables catégorielles dichotomiques : l’état réel de la nature, couramment désigné sous l’appellation de vérité terrain (ou ground truth), et l’état inféré par un formalisme algorithmique d’apprentissage automatique. Dans sa forme canonique bi-dimensionnelle d’ordre deux, elle segmente l’univers probabiliste de l’échantillon d’évaluation en quatre partitions mutuellement exclusives et exhaustivement collectives. Cette décomposition permet de transcender la simple mesure de l’exactitude brute en dissociant rigoureusement la fidélité de détection des événements d’intérêt de la capacité de discernement des occurrences négatives.
Sur le plan topologique et organisationnel, la convention prédominante dans l’ingénierie statistique contemporaine assigne les classes empiriques réelles aux lignes horizontales de la matrice, tandis que les prédictions générées par l’estimateur algorithmique sont allouées aux colonnes verticales. Bien que certaines écoles épistémologiques inversent ponctuellement cet agencement spatial, cette disposition demeure le standard adopté par les bibliothèques logicielles dominantes. Cette structure orthogonale met immédiatement en exergue la diagonale principale descendante, reliant le quadrant supérieur gauche au quadrant inférieur droit, laquelle rassemble l’ensemble des classifications exactes et témoigne de la puissance discriminatoire intrinsèque de l’algorithme sous observation.
L’utilité méthodologique de cette formalisation matricielle s’avère particulièrement cruciale dans les disciplines expérimentales, biomédicales et psychométriques. Dans le cadre de l’évaluation d’un outil diagnostique ou d’une échelle d’évaluation clinique, l’enjeu épistémologique ne réside pas uniquement dans l’estimation de la conformité générale des réponses, mais bien dans l’isolation des biais asymétriques du classificateur. La matrice 2×2 rend ainsi visible la propension du modèle à sur-détecter une pathologie au détriment de sujets sains, ou à l’inverse, à faillir dans l’identification d’affections critiques, offrant dès lors un substrat indispensable à l’analyse formelle du rapport bénéfice-risque propre à tout protocole d’intervention.
1.2 La régression logistique comme cadre d’application privilégié
L’illustration la plus limpide de la genèse d’une matrice de confusion réside dans l’exploitation de la régression logistique, modèle paradigmatique de classification binaire supervisée. Contrairement aux approches de régression linéaire classique dont le codomaine s’étend sur la totalité de la droite des réels, la régression logistique projette une combinaison linéaire de variables explicatives continues ou discrètes sur un intervalle strictement borné entre zéro et un. Cette opération mathématique est opérée par le truchement de la fonction sigmoïde canonique, dont la dérivée analytique et le profil asymptotique confèrent aux valeurs de sortie une interprétation rigoureuse en termes de probabilité conditionnelle d’appartenance à la classe positive.
Toutefois, l’obtention d’une estimation probabiliste continue ne constitue qu’une étape intermédiaire du processus d’inférence catégorielle. Afin de transformer cette probabilité a posteriori en une décision déterministe pouvant être consignée dans une matrice de confusion, le praticien doit impérativement instaurer un seuil de discrimination probabiliste, conventionnellement établi à la valeur médiane de 0,5 dans les situations de parité distributionnelle. Tout vecteur d’observations dont la probabilité calculée excède ce seuil est irrévocablement assigné à la classe positive, tandis que les valeurs strictement inférieures sont basculées dans le giron de la classe négative.
Cette discrétisation mécanique met en relief la nécessité impérieuse de confronter empiriquement les catégories prédites résultantes aux étiquettes réelles observées dans le corpus de validation. La matrice de confusion matérialise l’interface concrète où les conséquences opérationnelles du seuillage algorithmique sont révélées. Elle permet au chercheur d’examiner si la frontière de décision établie par le vecteur de poids du modèle sépare adéquatement les sous-espaces vectoriels des deux classes ou si, au contraire, le modèle manifeste une indécision caractérisée au voisinage immédiat du seuil, induisant une accumulation d’artefacts classificatoires néfastes à la fidélité globale du système.
2. Configuration de l’environnement Python et bibliothèques requises
2.1 Installation et importation des dépendances scientifiques
L’édification d’un pipeline d’évaluation statistique rigoureux en Python requiert une isolation scrupuleuse des dépendances logicielles au sein d’un environnement virtuel dédié, administré au moyen de gestionnaires de paquets standardisés tels que Pip ou Conda. Cette démarche préventive garantit la reproductibilité absolue des expérimentations algorithmiques, écartant tout conflit de versions susceptible de dénaturer les calculs matriciels ou d’altérer la compatibilité des fonctions d’inférence. Le socle technologique fondamental repose sur la suite scientifique canonique, intégrant NumPy pour les manipulations d’algèbre linéaire computationnelle, Pandas pour la manipulation de structures tabulaires hétérogènes, et la bibliothèque Scikit-Learn en tant que moteur de modélisation et de métrologie.
L’orchestration du code source implique l’importation sélective des modules spécialisés hébergés au sein du sous-paquetage d’évaluation de Scikit-Learn. Le chercheur veille ainsi à charger la fonction fondamentale confusion_matrix, conjointement avec la classe d’assistance graphique ConfusionMatrixDisplay et le générateur synthétique classification_report. Parallèlement, l’arsenal visuel nécessite l’adjonction de l’interface Pyplot issue de Matplotlib ainsi que de la bibliothèque Seaborn, dont les abstractions graphiques de haut niveau simplifient la restitution esthétique et typographique des matrices statistiques destinées aux revues à comité de lecture.
Préalablement à l’exécution de tout calcul numérique, il est impératif d’auditer la cohérence des versions logicielles au sein de la session d’exécution interactive ou du script d’analyse. Des divergences fonctionnelles majeures sont historiquement intervenues entre les itérations successives de Scikit-Learn, notamment en ce qui concerne la dépréciation de certaines routines de traçage matriciel et l’unification des signatures syntaxiques. L’interrogation programmatique des attributs de version des modules importés constitue une bonne pratique méthodologique assurant la pérennité et la transférabilité du code d’évaluation au sein de la communauté scientifique.
2.2 Préparation structurée des données d’analyse
La validité computationnelle d’une matrice de confusion est intrinsèquement tributaire de la rigueur avec laquelle les séries de données empiriques et prédictives sont préalablement agencées en mémoire vive. Scikit-Learn impose que les collections d’entrées soient fournies sous forme de vecteurs unidimensionnels contigus, typiquement implémentés via des tableaux NumPy ou des séries Pandas homogènes. L’introduction de tenseurs multidimensionnels mal aplatis ou de listes imbriquées hétérogènes induit inévitablement des exceptions d’incompatibilité de forme ou des distorsions subtiles lors de l’appariement terme à terme des éléments homologues.
Un soin méticuleux doit être accordé à l’encodage structurel des étiquettes qualitatives. Bien que les estimateurs modernes et les fonctions de calcul tolèrent les vecteurs de chaînes de caractères, la standardisation numérique sous forme d’entiers binaires consécutifs (usuellement 0 pour la classe négative et 1 pour la classe positive) demeure la méthodologie la plus sûre pour prévenir toute ambiguïté sémantique. Les fonctions de pré-traitement telles que le LabelEncoder permettent de convertir formellement des catégories textuelles brutes en index numériques déterministes, tout en conservant une correspondance biunivoque scrupuleuse entre les modalités qualitatives d’origine et leurs représentations scalaires sous-jacentes.
Enfin, une vérification programmatique formelle de l’alignement dimensionnel s’impose impérativement avant toute tentative de calcul matriciel. Les deux vecteurs, représentant respectivement les observations réelles et les inférences prédictives du modèle, doivent présenter une cardinalité strictement identique. Tout décalage d’indexation, tronquage accidentel ou présence non traitée de valeurs manquantes (de type NaN ou valeurs nulles) altère de facto la validité de l’appariement bijectif entre observation et prédiction, ce qui vicierait irrémédiablement l’intégralité des inférences statistiques ultérieures.
3. Implémentation élémentaire avec la fonction confusion_matrix de Scikit-Learn
3.1 Syntaxe de base et paramétrage standard
L’implémentation opérationnelle de la matrice au sein de l’écosystème Scikit-Learn s’articule autour de l’appel à la fonction sklearn.metrics.confusion_matrix. Cette routine algorithmique hautement optimisée requiert au minimum deux arguments positionnels impératifs : le vecteur des étiquettes empiriques réelles, usuellement nommé y_true dans la documentation officielle, et le vecteur des prédictions catégorielles déterministes émises par le classificateur, couramment indexé sous la dénomination y_pred. Le strict respect de cet ordre canonique constitue une règle d’or algorithmique, car une inversion mutuelle de ces deux paramètres permuterait la position des axes matriciels, transformant de facto les faux positifs en faux négatifs et réciproquement.
Au-delà de ces deux arguments minimaux, le paramètre optionnel labels confère au praticien un contrôle total sur l’ordonnancement structurel des classes au sein du tableau résultant. Par défaut, la routine ordonne les modalités selon leur ordre alphanumérique naturel ou leur séquence numérique ascendante. Dans les situations où l’utilisateur manipule des variables binaires codées sous les valeurs 0 et 1, la fonction assigne conventionnellement la classe 0 au premier quadrant (en haut à gauche) et la classe 1 au quadrant opposé (en bas à droite). En stipulant explicitement la liste ordonnée des catégories au sein de l’argument labels, le statisticien garantit l’alignement géométrique strict de la matrice avec les attentes conceptuelles de son protocole expérimental.
Il importe de souligner que cette fonction est conçue pour opérer exclusivement sur des étiquettes catégorielles discrètes et ne saurait accepter directement les scores continus de vraisemblance ou les probabilités calibrées générées par une méthode d’estimation probabiliste. Une phase intermédiaire d’application d’un seuil critique doit impérativement avoir lieu en amont, transformant les probabilités brutes en un vecteur d’entiers binaires ou de modalités textuelles. Cette dissociation opérationnelle entre l’inférence continue et la prise de décision catégorielle assure une séparation nette des responsabilités computationnelles au sein du pipeline de traitement analytique.
3.2 Extraction directe du tableau matriciel brut
L’invocation de la fonction confusion_matrix produit en sortie immédiate un objet de type numpy.ndarray bi-dimensionnel de forme (2, 2) dans un contexte binaire, ou de dimensions (N, N) dans le cadre d’un problème à N classes réparties. Ce tableau d’entiers non signés consigne de manière contiguë en mémoire vive les fréquences absolues d’occurrence correspondant à chaque combinaison croisée. Étant une structure native NumPy, ce tableau autorise toutes les opérations vectorielles classiques, telles que la sommation marginale par lignes ou colonnes, le produit scalaire ou la transposition dimensionnelle immédiate.
Afin de manipuler les valeurs numériques fondamentales au sein de calculs dérivés ou de routines d’affichage personnalisées, il est fréquent d’extraire individuellement chaque scalaire constituant la matrice binaire. La technique la plus élégante et idiomatique en Python consiste à appliquer la méthode ravel() sur le tableau NumPy résultant, laquelle aplatit la structure matricielle bi-dimensionnelle en un vecteur continu à quatre éléments. Ce vecteur peut alors être directement décompacté et assigné séquentiellement à quatre variables distinctes matérialisant respectivement les Vrais Négatifs, les Faux Positifs, les Faux Négatifs et les Vrais Positifs, conformément à l’ordonnancement standard de Scikit-Learn pour des étiquettes orientées (0, 1).
Cette décomposition scalaire granulaire constitue une passerelle incontournable pour l’ingénieur désirant programmer manuellement des indicateurs personnalisés, intégrer des pénalités financières asymétriques dans une fonction de coût métier, ou injecter les effectifs observés au sein d’équations statistiques non implémentées nativement dans les bibliothèques d’usage courant. La maîtrise de cette extraction programmatique garantit ainsi une parfaite autonomie vis-à-vis des interfaces d’évaluation automatisées, autorisant un contrôle analytique sans faille sur les données de vérification.
4. Déconstruction et interprétation des quatre quadrants matriciels
4.1 Vrais Positifs (TP) et Vrais Négatifs (TN)
La validation empirique d’un modèle prédictif repose prioritairement sur la quantification de sa justesse diagnostique, géométriquement localisée le long de la diagonale principale de la matrice de contingence. Le quadrant des Vrais Positifs (notés conventionnellement TP pour True Positives) consigne l’effectif des instances pour lesquelles l’état empirique sous-jacent est objectivement positif et où le classificateur algorithmique a correctement confirmé cette appartenance catégorielle. Sur le plan médical ou épidémiologique, cette cellule matérialise les patients effectivement atteints d’une affection spécifique dont le crible diagnostique automatisé a corroboré l’état clinique avec succès.
À l’autre extrémité de la diagonale principale se situe le quadrant des Vrais Négatifs (dénommés TN pour True Negatives), qui quantifie l’exactitude du modèle dans l’identification des cas indemnes ou non pertinents. Dans cette cellule se trouvent rassemblées les observations où la vérité terrain atteste formellement de l’absence de l’événement d’intérêt, et pour lesquelles l’algorithme s’est abstenu d’émettre une alerte injustifiée. En termes de théorie du signal et de test d’hypothèses statistiques, les Vrais Négatifs représentent le rejet opportun et légitime de l’hypothèse alternative, confirmant la prévalence de l’hypothèse nulle d’invariance.
L’agrégation de ces deux grandeurs numériques forme le numérateur du taux global de concordance de l’estimateur. Toutefois, la valeur intrinsèque des concordances positives et négatives ne doit jamais être évaluée de manière indifférenciée. Dans de multiples domaines d’application, identifier correctement une anomalie rarissime (tel qu’un cas de fraude financière ou une tumeur maligne précoce) requiert une énergie computationnelle et un raffinement de modélisation infiniment plus considérables que la simple détection d’une cohorte majoritaire d’observations régulières constituant l’essentiel des Vrais Négatifs.
4.2 Faux Positifs (Erreur de Type I) et Faux Négatifs (Erreur de Type II)
L’exploration des quadrants situés en dehors de la diagonale principale révèle l’anatomie fonctionnelle des défaillances algorithmiques, traditionnellement assimilées aux deux grandes classes d’erreurs inférentielles théorisées par Jerzy Neyman et Egon Pearson. Les Faux Positifs (notés FP pour False Positives), hébergés dans le quadrant supérieur droit d’une matrice ordonnée selon la convention Scikit-Learn, représentent ce que la statistique inférentielle désigne sous le vocable d’erreur de Type I. Il s’agit d’une erreur d’inclusion injustifiée : le modèle prédit l’occurrence d’un phénomène ou la présence d’une pathologie alors même que la réalité factuelle infirme formellement cette assertion, générant ainsi une alerte fallacieuse.
Symétriquement, le quadrant inférieur gauche compile les Faux Négatifs (notés FN pour False Negatives), lesquels incarnent l’erreur de Type II ou erreur d’omission prédictive. Dans cette configuration dommageable, le système algorithmique classe une entité comme négative ou saine, alors que celle-ci présente de façon avérée la condition pathologique ou l’anomalie recherchée. En matière de sécurité informatique, un faux négatif correspond typiquement à une intrusion furtive contournant victorieusement les mécanismes de détection automatisés, exposant l’infrastructure à une compromission critique sans qu’aucun mécanisme de défense ne soit mobilisé.
L’arbitrage entre ces deux natures d’erreurs révèle l’asymétrie structurelle des coûts décisionnels propres à chaque écosystème d’application. Tandis qu’un faux positif peut simplement occasionner un examen de contrôle bénin ou un désagrément mineur pour l’usager, un faux négatif en oncologie diagnostique peut entraîner un retard thérapeutique fatal pour l’individu concerné. L’analyse détaillée de la matrice de confusion permet de formaliser cette asymétrie et constitue le prérequis absolu à toute démarche d’optimisation économique visant à minimiser une fonction de perte globale pondérée par la gravité respective des erreurs commises.
5. Dérivation mathématique des métriques statistiques associées
5.1 Calcul de la sensibilité (Recall) et de la spécificité
L’exploitation analytique de la matrice de contingence permet d’extraire des ratios mathématiques fondamentaux neutralisant l’impact de la taille brute de l’échantillon. Le premier de ces indicateurs, désigné sous le terme de sensibilité, également nommé rappel (ou recall) au sein de la communauté informatique, mesure la propension intrinsèque de l’algorithme à capturer exhaustivement les événements positifs réels. Sa formulation algébrique s’énonce comme le quotient des Vrais Positifs par la somme exhaustive des observations positives réelles, soit le rapport des Vrais Positifs sur la somme des Vrais Positifs et des Faux Négatifs :
Sensibilité = TP / (TP + FN)
Un estimateur affichant une sensibilité approchant l’unité parfaite témoigne d’une capacité quasi infaillible à traquer l’ensemble des occurrences cibles au sein du corpus d’observation, réduisant à la portion congrue les omissions diagnostiques dommageables.
À l’opposé du spectre de discrimination conditionnelle se trouve la spécificité, couramment qualifiée de taux de vrais négatifs (ou True Negative Rate). Cette métrique évalue l’aptitude mathématique du système de classification à rejeter sans ambiguïté les entités réellement négatives. Sa dérivation analytique correspond au ratio entre l’effectif des Vrais Négatifs et la population globale des entités négatives avérées, ce qui s’exprime par le quotient des Vrais Négatifs sur la somme des Vrais Négatifs et des Faux Positifs :
Spécificité = TN / (TN + FP)
La spécificité s’érige en rempart contre la prolifération des faux signaux d’alarme, garantissant que les sujets ou observations classés comme négatifs ne subissent pas les contrecoups opérationnels d’une fausse alerte algorithmique.
Sur le plan computationnel en Python, ces deux métriques s’implémentent de manière directe à partir du décompactage scalaire du tableau issu de Scikit-Learn. Il suffit d’effectuer les divisions arithmétiques correspondantes en veillant à intercepter les éventuelles divisions par zéro par le biais de structures conditionnelles ou de constantes d’amortissement numérique. Scikit-Learn met également à disposition la fonction dédiée recall_score au sein de son sous-module de métriques pour automatiser le calcul vectoriel de la sensibilité, bien que la spécificité requière fréquemment une formulation explicite de la part du programmeur en raison de conventions historiques axées prioritairement sur la classe cible positive.
5.2 Précision, Valeur Prédictive Positive et Score F1
Tandis que la sensibilité évalue la performance du classificateur conditionnellement à l’état réel des entités, la précision, formellement assimilable à la Valeur Prédictive Positive (VPP) en épidémiologie, inverse la direction logique du conditionnement probabiliste. Elle postule la question fondamentale suivante : sachant que l’algorithme a posé un verdict positif, quelle est la probabilité que cette déclaration soit rigoureusement exacte ? Sur le plan formel, la précision se définit par le ratio des Vrais Positifs sur l’ensemble des prédictions positives formulées, soit les Vrais Positifs divisés par la somme des Vrais Positifs et des Faux Positifs :
Précision = TP / (TP + FP)
Cette mesure se révèle extrêmement sensible à la prévalence basale de la classe d’intérêt dans l’échantillon analysé : dans un environnement où la classe positive est rarissime, même un taux marginal de faux positifs peut éroder catastrophiquement la précision du système.
Afin de concilier de manière unifiée la précision et la sensibilité, qui évoluent généralement en sens inverse selon le réglage de l’agressivité du classificateur, la statistique computationnelle a introduit le score F1 (ou F-measure). Ce coefficient constitue la moyenne harmonique de la précision et du rappel, accordant un poids rigoureusement symétrique à ces deux dimensions contradictoires de la performance :
Score F1 = 2 * (Précision * Sensibilité) / (Précision + Sensibilité)
Le recours à la moyenne harmonique plutôt qu’à l’arithmétique simple induit une propriété analytique remarquable : le score F1 pénalise drastiquement les configurations où l’un des deux composants s’effondre, interdisant à un modèle d’afficher un score synthétique élevé s’il sacrifie entièrement son rappel au profit exclusif de sa précision, ou vice-versa.
Au sein de Scikit-Learn, ces grandeurs peuvent être calculées isolément au moyen des routines precision_score et f1_score, ou faire l’objet d’une synthèse exhaustive par l’entremise de la fonction classification_report. Cette dernière génère une structure textuelle tabulée détaillant simultanément la précision, le rappel, le score F1 et le support (effectif réel d’observations) pour chaque classe d’étiquettes, fournissant ainsi en une fraction de seconde un diagnostic statistique d’une complétude remarquable.
6. Visualisation graphique avancée avec Seaborn et Matplotlib
6.1 Conception d’une carte thermique (Heatmap) explicative
Si la manipulation des représentations numériques brutes sous forme de tableaux NumPy s’avère parfaitement adéquate pour les étapes d’intégration logicielle automatisée, l’esprit humain saisit avec infiniment plus d’acuité les structures de données lorsqu’elles sont retranscrites sous une forme visuelle et chromatique. À cette fin, la bibliothèque Seaborn fournit la méthode sns.heatmap, spécialement configurée pour transcrire une matrice de contingence sous les traits d’une carte thermique intuitive. Cette visualisation assigne à chaque quadrant un gradient d’intensité chromatique proportionnel à l’effectif d’observations consigné, permettant d’identifier d’un simple coup d’œil l’équilibre de masse entre les classifications exactes et les confusions systématiques.
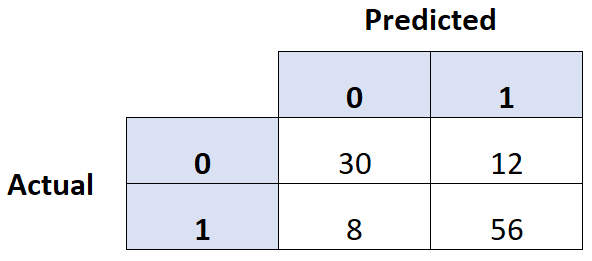
Le paramétrage technique de la fonction sns.heatmap requiert l’activation judicieuse de plusieurs arguments clés pour sublimer la clarté informative de la figure. L’argument booléen annot=True force l’impression numérique textuelle des effectifs directement à l’intérieur des cellules colorées, éliminant toute ambiguïté de lecture relative aux subtilités des nuances de teintes. Conjointement, le paramètre d’encodage textuel fmt=’d’ doit impérativement être spécifié pour contraindre le format d’affichage à des nombres entiers décimaux stricts, prévenant ainsi la bascule par défaut de Matplotlib vers une notation scientifique exponentielle peu lisible face à des contingents volumineux.
Le choix de la carte de couleur, gouverné par le paramètre cmap, revêt une importance méthodologique cruciale pour la transmission de l’information scientifique. Pour des publications académiques ou des restitutions exécutives, il est vivement préconisé d’adopter des palettes séquentielles perceptuellement uniformes et universellement interprétables telles que Blues, Greens ou la rampe perceptuelle viridis. Les palettes divergentes ne devraient quant à elles être convoquées que lorsque la matrice a été préalablement soumise à une transformation de centrage et de réduction statistique autour d’une valeur neutre de référence, telle qu’une proportion d’exactitude théorique issue d’une classification purement aléatoire.
6.2 Personnalisation des repères et éléments de typographie
L’excellence d’une communication visuelle scientifique repose sur le polissage minutieux des composantes graphiques périphériques qui contextualisent la carte thermique. L’utilisation conjointe des primitives de bas niveau de Matplotlib permet d’ordonner la mise en scène textuelle. Il est indispensable de pourvoir la figure d’un titre formellement explicite, instancié via plt.title(), intégrant fréquemment des métadonnées contextuelles telles que l’identité de l’architecture d’apprentissage sous examen, l’étape de validation (entraînement ou test) et, potentiellement, le score synthétique de concordance associé.
Les étiquettes de graduation des axes (ou tick labels) doivent faire l’objet d’un ajustement orthothétique rigoureux afin d’éradiquer les désignations cryptiques ou les indices scalaires nus. L’application des méthodes plt.xlabel() et plt.ylabel() permet de définir explicitement la nature directionnelle des vecteurs représentés, en insérant la mention standardisée « État Réel » (ou « Valeurs Observées ») sur l’axe des ordonnées et « Prédiction Algorithmique » sur l’axe des abscisses. Les libellés nominatifs de chaque modalité catégorielle doivent être injectés textuellement pour chaque ligne et colonne, prévenant toute méprise quant à la localisation des instances positives et négatives.
Enfin, la finalisation du canevas graphique implique une optimisation de la mise en page géométrique via l’appel à la méthode plt.tight_layout(), laquelle recalibre automatiquement les marges extérieures afin d’éviter toute troncature inopinée des annotations textuelles périphériques. En prévision d’une diffusion dans des revues savantes ou des rapports d’expertise industrielle, la sauvegarde vectorielle du tracé doit être opérée via la fonction plt.savefig(), en fixant la résolution graphique minimale à 300 points par pouce (dpi=300) et en sélectionnant des formats vectoriels extensibles (tels que le format PDF ou SVG) assurant une netteté absolue indépendamment du facteur de grandissement visuel appliqué.
7. Visualisation intégrée avec ConfusionMatrixDisplay de Scikit-Learn
7.1 Génération directe à partir d’estimateurs entraînés
Reconnaissant l’ubiquité de la matrice de confusion dans les flux de travail en science des données, les concepteurs de Scikit-Learn ont introduit au sein des versions contemporaines de la bibliothèque la classe spécialisée sklearn.metrics.ConfusionMatrixDisplay. Cette infrastructure unifiée se substitue aux approches artisanales antérieures en encapsulant au sein d’une API standardisée l’ensemble du cycle de vie visuel de l’évaluation matricielle. Sa méthode de fabrique la plus sophistiquée, ConfusionMatrixDisplay.from_estimator, court-circuite totalement les routines manuelles fastidieuses de calcul des prédictions intermédiaires.
Pour mettre en œuvre cette routine, l’opérateur se contente de transmettre à la méthode l’objet classificateur préalablement entraîné, la matrice des variables explicatives de test X_test et le vecteur des étiquettes empiriques associées y_test. De manière totalement transparente, la classe délègue à l’estimateur l’évaluation vectorielle des observations au moyen de sa méthode interne predict(), procède à l’agrégation des fréquences croisées correspondantes, puis bâtit instantanément la scène graphique Matplotlib sous-jacente sans nécessiter une seule ligne d’algèbre matricielle explicite de la part du programmeur.
Cette méthode de fabrique intègre de surcroît des paramètres hautement expressifs pour moduler le comportement d’affichage. L’argument normalize permet d’ordonner une standardisation immédiate des valeurs (par lignes, par colonnes ou globale), tandis que l’argument cmap applique les mêmes cartographies de nuances chromatiques que celles offertes par Matplotlib. L’ingénieur dispose ainsi d’un instrument d’une concision et d’une puissance remarquables, réduisant drastiquement le risque d’erreurs de copie de variables ou de mauvaise manipulation des index lors de la phase cruciale de revue diagnostique du modèle.
7.2 Visualisation à partir de prédictions précalculées
Bien que la génération automatisée à partir d’un objet estimateur natif s’avère particulièrement séduisante par son économie de code, des contraintes d’architecture logicielle imposent fréquemment de découpler la phase d’entraînement algorithmique de l’étape de restitution visuelle. C’est spécifiquement pour répondre à cette exigence méthodologique que Scikit-Learn a doté sa classe de la variante complémentaire ConfusionMatrixDisplay.from_predictions. Cette alternative fonctionnelle opère directement sur les flux de données catégorielles préalablement établis, acceptant comme entrées primaires les vecteurs contigus y_true et y_pred.
Cette dissociation structurelle s’avère inestimable dans une multitude de scénarios avancés. D’une part, elle permet d’incorporer sans friction des prédictions synthétisées par des bibliothèques externes tierces qui n’émulent pas rigoureusement l’interface de programmation des estimateurs Scikit-Learn, à l’instar des réseaux de neurones profonds bâtis sous PyTorch ou TensorFlow. D’autre part, cette approche permet d’évaluer les sorties de modèles ayant fait l’objet d’un ajustement non standardisé de leur seuil d’inférence probabiliste, là où la méthode from_estimator applique immuablement le seuil de décision par défaut inhérent au classificateur inspecté.
L’utilisation de ConfusionMatrixDisplay.from_predictions facilite en outre l’agencement modulaire de canevas graphiques composites. En transmettant un objet d’axe Matplotlib préexistant via le paramètre ax, le chercheur peut intégrer avec une aisance remarquable une série de matrices de confusion au sein d’une grille multi-panneaux ordonnée. Cette capacité autorise une comparaison synoptique directe des performances comparées de plusieurs variantes algorithmiques ou l’examen simultané de l’évolution des matrices le long des différents plis d’un protocole d’évaluation par validation croisée.
8. Cas pratique complet : Modèle de régression logistique en Python
8.1 Scission des données et entraînement du classificateur
Pour ancrer ces concepts abstraits dans une réalité expérimentale tangible, examinons la constitution complète d’une chaîne de traitement prédictive binaire. Le protocole s’amorce conventionnellement par le fractionnement stochastique d’un ensemble de données structuré en deux sous-ensembles indépendants : une cohorte d’entraînement dévolue à l’ajustement des paramètres libres du modèle et une cohorte de test rigoureusement isolée, réservée à l’évaluation impartiale des capacités de généralisation hors-échantillon. Cette dichotomie s’opère par le biais de la fonction train_test_split de Scikit-Learn, en appliquant scrupuleusement le paramètre stratify=y afin de figer la parité des proportions de classes entre les deux partitions.
L’instanciation de l’estimateur de régression logistique s’effectue via l’appel à la classe LogisticRegression, au sein de laquelle il est judicieux de spécifier l’algorithme d’optimisation numérique sous-jacent (tel que le solveur lbfgs) ainsi que le paramètre d’inhibition de la régularisation ou de pondération des pénalités structurelles (usuellement piloté par l’hyperparamètre d’inverse de régularisation C). L’ajustement du modèle est déclenché par l’exécution de la méthode fit(X_train, y_train), laquelle converge par descente de gradient ou approximations de quasi-Newton vers le point selle minimisant la perte d’entropie croisée binaire (ou log-loss).
Une fois les coefficients d’inférence vectoriels stabilisés au sein de l’objet estimateur, celui-ci possède la faculté d’évaluer de nouvelles données non observées au travers de deux modalités distinctes. La méthode predict_proba(X_test) calcule les estimations probabilistes étalonnées associées à chaque profil vectoriel individuel, tandis que la routine predict(X_test) opère immédiatement la projection binaire déterministe en appliquant de facto la barrière standard de probabilité d’un demi. L’accès direct à ces deux niveaux de granularité informationnelle dote le praticien de tous les degrés de liberté nécessaires à l’analyse discriminante subséquente.
8.2 Construction pas à pas de la matrice d’évaluation
Disposant désormais du vecteur d’inférences déterministes y_pred généré par l’estimateur sur la fraction d’évaluation X_test, la formalisation de la matrice de confusion s’exécute par l’invocation canonique de confusion_matrix(y_test, y_pred). Le tableau de contingence brut qui en émane fait l’objet d’une analyse systématique de conformité arithmétique : la sommation intégrale de l’ensemble de ses cellules scalaires doit correspondre rigoureusement à la dimension dimensionnelle du vecteur y_test, attestant qu’aucune observation d’évaluation n’a été indûment omise lors du transit computationnel.
L’interprétation clinique ou industrielle du tableau obtenu suppose d’analyser conjointement les quatre contingents d’effectifs. Si le modèle manifeste une concentration quasi exclusive d’observations au sein de sa diagonale principale, sa validation opérationnelle peut être envisagée avec confiance. Si, en revanche, le contingent des Faux Négatifs accuse une magnitude disproportionnée par rapport aux exigences de sécurité du problème traité, l’ingénieur sait sans équivoque que le paramétrage standard du seuil de décision pénalise indûment la sensibilité de son architecture, exigeant une révision des paramètres d’arbitrage.
Cette démarche analytique culmine par l’extraction des indicateurs de synthèse dérivés et la composition graphique finale. Le couplage harmonieux de ConfusionMatrixDisplay.from_predictions avec les enrichissements typographiques de Matplotlib permet d’ancrer de façon permanente dans le compte-rendu d’expérimentation une synthèse graphique irréprochable. Cette visualisation objective certifie que les propriétés inductives du modèle de régression logistique ont été méthodologiquement vérifiées, validant formellement l’aptitude de l’estimateur à être déployé dans des conditions opérationnelles réelles.
9. Extension méthodologique aux classifications multiclasses
9.1 Structure géométrique d’une matrice dimensionnelle N x N
Bien que le paradigme binaire serve de modèle didactique élémentaire, la majorité des problématiques d’apprentissage supervisé du monde physique — de la reconnaissance de caractères optiques à la spectroscopie analytique — implique la ségrégation conjointe de multiples catégories discrètes. La matrice de confusion s’adapte à cette exigence dimensionnelle en adoptant une structure tensorielle d’ordre deux de cardinalité N par N, où N représente le nombre cardinal total de classes mutuellement exclusives coexistant au sein du système ontologique sous investigation.
Dans ce théâtre géométrique élargi, la diagonale principale descendante continue d’occuper une fonction de centralité théorique absolue, regroupant les fréquences d’accord parfait où la modalité prédite par l’estimateur coïncide rigoureusement avec la modalité réelle de rang identique. L’ensemble des cellules localisées en dehors de cette ligne médiane matérialise les confusions inter-classes spécifiques. Cette cartographie polytomique permet d’identifier immédiatement les erreurs de substitution préférentielles, révélant par exemple qu’un algorithme de vision artificielle ne confond pratiquement jamais une automobile avec un animal, mais éprouve des peines chroniques à différencier un camion lourd d’un autobus de transport urbain.
L’analyse structurelle des lignes et des colonnes individuelles d’une matrice N x N permet de reconduire les concepts de diagnostic binaire au moyen de la technique de réduction « Une contre Toutes » (ou One-vs-Rest). Pour chaque modalité cible spécifique, l’élément diagonal correspondant constitue le contingent de Vrais Positifs. La sommation des éléments restants de la même ligne définit l’agrégat des Faux Négatifs associés à cette catégorie, tandis que la somme des éléments composant le reste de la colonne représente la masse des Faux Positifs induits. Enfin, l’ensemble résiduel de la matrice constitue le gisement des Vrais Négatifs pour la classe examinée.
9.2 Calcul des métriques micro, macro et pondérées
La synthèse des performances globales d’un modèle multiclasse à partir de sa matrice de confusion interdit l’usage d’une formule scalaire unique non pondérée et exige l’adoption de méthodologies d’agrégation formellement définies. La première modalité d’agrégation, désignée sous le terme de moyenne macroscopique (ou macro-average), calcule l’indicateur statistique d’intérêt (qu’il s’agisse de la précision, de la sensibilité ou du score F1) isolément pour chaque catégorie k selon le schéma binaire One-vs-Rest, puis effectue la moyenne arithmétique simple de ces grandeurs individuelles :
Métrique Macro = (1 / N) * Somme(Métrique_k)
Cette approche confère une importance strictement égale à chaque classe thématique au sein de l’évaluation finale, indépendamment de son effectif numérique réel, ce qui en fait un instrument de choix pour évaluer l’équité de discrimination de l’algorithme envers les classes rares.
À l’opposé de cette philosophie égalitaire, l’agrégation microscopique (ou micro-average) mutualise l’ensemble des contingents de la matrice avant d’appliquer les formules des ratios. Elle somme ainsi arithmétiquement la totalité des Vrais Positifs individuels pour constituer un numérateur global, qu’elle rapporte à la somme combinée de l’ensemble des Vrais Positifs et de toutes les erreurs de type I ou II recensées sur l’intégralité du tableau. Dans un système polytomique où chaque observation est obligatoirement assignée à une classe unique, la précision micro, le rappel micro et l’exactitude globale s’avèrent rigoureusement identiques sur le plan algébrique.
Enfin, la moyenne pondérée (ou weighted-average) concilie ces deux perspectives en modulant la contribution de la métrique spécifique de chaque classe par la prévalence proportionnelle de ladite modalité au sein de la cohorte d’évaluation (le support empirique). Cette technique empêche les anomalies prédictives affectant des classes marginales d’altérer démesurément la note de performance globale, offrant une vue pragmatique des rendements statistiques moyens attendus dans un déploiement opérationnel où la distribution des données futures respecte fidèlement celle de l’échantillon de test.
10. Modulation du seuil de discrimination et conséquences matricielles
10.1 Impact de la variation du seuil décisionnel sur les quadrants
L’une des erreurs conceptuelles les plus persistantes consiste à considérer la matrice de confusion comme une entité statique et immuable, intrinsèquement figée par la structure des poids synaptiques ou des coefficients de l’estimateur entraîné. En réalité fondamentale, toute matrice binaire découle du choix contingent d’une valeur seuil de discrimination probabiliste tau, arbitrairement positionnée au sein du continuum ouvert des nombres réels compris entre zéro et un. La translation délibérée de cette frontière décisionnelle engendre une cinématique interne continue au sein des quatre quadrants du tableau de contingence.
Lorsque le statisticien opte pour une politique d’inférence conservatrice en élevant substantiellement le seuil décisionnel (par exemple en le fixant à 0,80), le modèle exige un niveau d’évidence probabiliste considérablement plus drastique avant de proclamer l’appartenance d’une entité à la classe positive. En conséquence directe, le volume global des prédictions positives se contracte sévèrement : les Faux Positifs sont éradiqués de manière spectaculaire, ce qui gonfle artificiellement la précision du système, mais cette exigence accrue s’accompagne inévitablement d’une fuite massive d’observations positives réelles vers le quadrant des Faux Négatifs, dégradant corrélativement la sensibilité.
Inversement, l’abaissement libéral du seuil (par exemple vers 0,20) installe le modèle dans une posture d’extrême vigilance où le moindre signal faible déclenche une catégorisation positive. Si cette manœuvre stratégique permet de recouvrer la quasi-totalité des entités cibles et d’annihiler les Faux Négatifs au bénéfice d’un rappel parfait, elle s’opère au tribut intolérable d’une contamination généralisée du quadrant des Faux Positifs, ruinant la spécificité de l’estimateur. La matrice de confusion se révèle ainsi être un instantané ponctuel résultant d’un arbitrage cinétique entre deux typologies d’erreurs mutuellement conflictuelles.
10.2 Lien théorique avec les courbes ROC et Precision-Recall
Cette dynamique continue de transfert de masse au sein de la matrice de contingence sous-tend la formalisation géométrique des courbes d’évaluation fonctionnelles. La célèbre courbe ROC (pour Receiver Operating Characteristic) ne constitue rien d’autre que la trajectoire continue tracée dans un espace cartésien bi-dimensionnel par l’ensemble infini des matrices de confusion potentielles qu’un modèle probabiliste donné peut engendrer lorsque son seuil tau parcourt de façon monotone l’intégralité de l’intervalle [0, 1]. Chaque coordonnée discrète formant la courbe ROC matérialise le couple associant le taux de faux positifs (1 – spécificité) en abscisse au taux de vrais positifs (sensibilité) en ordonnée, tous deux directement calculés depuis la matrice correspondante à ce seuil spécifique.
La surface sous-tendue par cette trajectoire, l’aire sous la courbe ROC (ou AUC-ROC), synthétise en un scalaire invariant la capacité séparatrice globale de l’algorithme, affranchie de la contingence d’un seuil particulier. L’exploitation de la matrice de confusion permet de matérialiser le point de fonctionnement optimal le long de cette courbe via des critères mathématiques formels, à l’instar de l’indice J de Youden, défini analytiquement comme la maximisation de l’expression :
J = Sensibilité + Spécificité – 1
Le point maximisant cet indice géométrique correspond au compromis matriciel optimal garantissant la divergence maximale vis-à-vis d’une classification purement stochastique.
Dans les contextes d’asymétrie sévère où la classe d’intérêt présente une rareté extrême au sein du corpus, la courbe ROC tend néanmoins à délivrer une appréciation excessivement optimiste en raison de la dilatation mécanique du réservoir des Vrais Négatifs. Dans ces conditions critiques, les statisticiens privilégient l’examen conjoint de la courbe Précision-Rappel (ou PR Curve). Celle-ci isole expressément les quadrants les plus exposés aux distorsions de représentativité, offrant une perspective diagnostique complémentaire dont chaque point demeure l’émanation directe de la décomposition structurelle d’une matrice de confusion sous-jacente.
11. Normalisation matricielle et gestion des classes déséquilibrées
11.1 Normalisation par classe réelle, par prédiction ou totale
L’interprétation des valeurs entières brutes au sein d’une matrice de confusion est intrinsèquement tributaire de la composition démographique de l’échantillon sous observation, ce qui complique notoirement les comparaisons inter-modèles lorsque les volumes de test diffèrent. Pour pallier cette contrainte d’échelle, Scikit-Learn implémente une capacité de standardisation probabiliste via le paramètre normalize au sein de ses fonctions de calcul et de visualisation, autorisant trois modes d’homogénéisation matricielle distincts : la normalisation par les classes réelles (normalize=’true’), la normalisation par les prédictions (normalize=’pred’) et la normalisation par l’effectif total (normalize=’all’).
L’option normalize=’true’ applique une division arithmétique de chaque élément matriciel par la somme marginale de la ligne à laquelle il appartient. Cette transformation substitue aux effectifs bruts des probabilités conditionnelles strictes : la cellule des Vrais Positifs devient alors rigoureusement équivalente à la sensibilité du modèle, tandis que celle des Faux Positifs pour une ligne négative donnée reflète le taux d’erreur de Type I conditionnel. Ce mode de standardisation s’avère indiscutablement le plus robuste sur le plan méthodologique pour apprécier l’impartialité intrinsèque du système sans subir l’influence perturbatrice de l’abondance relative des classes.
À l’inverse, l’argument normalize=’pred’ opère la standardisation le long des colonnes verticales, divisant chaque observation par le contingent global d’assignations émises pour ladite catégorie. Les valeurs résultantes se lisent alors comme des probabilités rétrospectives, transformant la diagonale principale en indicateurs directs de précision et de valeurs prédictives positives. Enfin, la normalisation globale normalize=’all’ divise l’intégralité des cellules par le cardinal de l’échantillon total, convertissant la matrice en une table de probabilités jointes empiriques dont la sommation intégrale converge formellement vers la valeur unitaire.
11.2 Évaluation objective face à une asymétrie sévère de distribution
Le piège méthodologique le plus dévastateur dans l’évaluation des systèmes de classification supervisée réside dans le « paradoxe de l’exactitude » (ou accuracy paradox), qui survient avec acuité lors du traitement de jeux de données hautement déséquilibrés, tels que ceux rencontrés dans la prospection pétrolière, la détection de transactions bancaires frauduleuses ou le diagnostic de maladies orphelines. Dans une cohorte où la classe pathologique ne représente que 0,1 % de la population globale, un classificateur totalement inepte qui prédirait immuablement la négativité pour toute instance afficherait une exactitude brute spectaculaire de 99,9 %, masquant une cécité prédictive absolue.
La matrice de confusion constitue le seul instrument analytique capable de déjouer instantanément cette illusion d’efficience algorithmique. Dans le tableau non normalisé, le chercheur observe d’emblée la vacuité absolue de la cellule des Vrais Positifs combinée à un contingent massif de Faux Négatifs, réduisant à néant la sensibilité du système envers la modalité cible. L’application impérative de la normalisation par ligne (normalize=’true’) permet d’atténuer visuellement la prépondérance écrasante de la classe majoritaire, rendant immédiatement visible le taux d’échec de 100 % affectant la classe minoritaire malgré la flatteuse mesure de concordance globale.
Face à ce constat de défaillance révélé par l’analyse matricielle, des protocoles de remédiation doivent être immédiatement introduits au sein de la boucle d’apprentissage. Ces stratégies correctives oscillent entre la modulation des fonctions de perte algorithmiques — notamment via l’introduction de pénalités asymétriques pilotées par l’argument class_weight=’balanced’ dans Scikit-Learn — et les méthodologies de rééchantillonnage statistique en amont (telles que les techniques de sur-échantillonnage synthétique SMOTE ou de sous-échantillonnage aléatoire de la majorité). L’impact de ces techniques de rééquilibrage sera ultérieurement vérifié par l’examen comparé des matrices de confusion avant et après intervention, documentant avec rigueur le rétablissement de la sensibilité opérationnelle.
12. Erreurs fréquentes, optimisation du code et recommandations académiques
12.1 Inversion des axes et pièges syntaxiques récurrents
Malgré l’apparente simplicité de l’API de Scikit-Learn, la littérature scientifique et les dépôts de code open source regorgent d’inexactitudes analytiques imputables à une inversion des arguments formels au sein de l’appel à la fonction confusion_matrix. La faute la plus répandue consiste à intervertir la position des vecteurs en injectant y_pred en premier lieu, suivi de y_true. Cette interversion a pour conséquence désastreuse de transposer la matrice le long de sa diagonale principale, permutant mécaniquement les Faux Positifs avec les Faux Négatifs sans que l’interpréteur Python ne signale la moindre anomalie d’exécution logicielle.
Une telle bévue syntaxique dénature l’ensemble des inférences statistiques subséquentes : l’expérimentateur interprétera faussement un déficit de sensibilité comme un manque de précision, conduisant à des arbitrages de seuils totalement contradictoires avec les objectifs opérationnels initiaux. Pour prémunir les chaînes de traitement automatisées contre cette méprise insidieuse, il est vivement recommandé d’intégrer des assertions logiques programmatiques vérifiant formellement la cohérence des calculs dérivés, ou de recourir aux arguments nommés de manière explicite lors des appels de fonctions au sein des scripts de production.
Un autre écueil méthodologique récurrent concerne la discordance d’encodage lors de la manipulation de labels textuels hétérogènes. Si les listes de catégories fournies dans y_true et y_pred comportent des divergences typographiques subtiles (telles que des variations de casse ou des espaces insécables) ou si l’argument optionnel labels omet délibérément certaines modalités marginales présentes dans les observations réelles, la matrice verra sa dimensionalité se contracter ou ses alignements de classes se décaler subrepticeusement. Une phase rigoureuse d’assainissement lexical préalable constitue dès lors une mesure d’hygiène logicielle incontournable.
12.2 Bonnes pratiques pour la reproductibilité et la diffusion scientifique
Dans la perspective d’une intégration vertueuse de la matrice de confusion au sein de communications scientifiques destinées à des revues savantes à comité de lecture, le respect scrupuleux des normes de reproductibilité computationnelle s’impose comme un impératif éthique et technique. Tout script générant des matrices doit impérativement figer les générateurs pseudo-aléatoires sous-jacents via l’assignation explicite du paramètre random_state lors des étapes de scission des échantillons et d’initialisation stochastique des estimateurs. Cette précaution garantit qu’un relecteur indépendant pourra reproduire à l’identique les effectifs matriciels et les scores associés.
Sur le plan de l’architecture logicielle, il est hautement conseillé de factoriser les routines d’évaluation et de traçage matriciel au sein de fonctions Python génériques, dûment annotées par des annotations de type (type hints) et pourvues de chaînes de documentation (docstrings) conformes aux standards de l’ingénierie contemporaine. Ces composants modulaires doivent encapsuler l’extraction des grandeurs, l’application des schémas de normalisation pertinents et l’ajustement esthétique des canvas vectoriels, évitant ainsi la prolifération de blocs de code dupliqués propices à la propagation d’erreurs de copier-coller au sein des calepins d’analyse exploratoire.
Enfin, lors de la publication définitive d’un compte-rendu de recherche, il est méthodologiquement inapproprié de présenter une matrice de confusion de manière isolée sans mentionner explicitement le seuil décisionnel exact qui a présidé à sa genèse, ainsi que le volume d’échantillon global déployé pour la validation. L’excellence rédactionnelle commande d’adjoindre systématiquement au tableau croisé ses métriques dérivées fondamentales (sensibilité, spécificité, précision, score F1 pondéré) assorties de leurs intervalles de confiance statistiques respectifs calculés par rééchantillonnage bootstrap. Cette complétude confère aux allégations de performance une robustesse épistémologique irréfutable, permettant à la communauté scientifique de juger en toute transparence de l’adéquation opérationnelle de l’algorithme proposé face aux défis du monde réel.
Références
- Fawcett, T. (2006). An introduction to ROC analysis. Pattern Recognition Letters, 27(8), 861–874. https://doi.org/10.1016/j.patrec.2005.10.010
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830. https://jmlr.org/papers/v12/pedregosa11a.html
- Powers, D. M. W. (2011). Evaluation: From precision, recall and F-measure to ROC, informedness, markedness and correlation. Journal of Machine Learning Technologies, 2(1), 37–63. https://doi.org/10.48550/arXiv.2010.16061
- Provost, F., & Fawcett, T. (2001). Robust classification for imprecise environments. Machine Learning, 42(3), 203–231. https://doi.org/10.1023/A:1007601015854
- Sokolova, M., & Lapalme, G. (2009). A systematic analysis of performance measures for classification tasks. Information Processing & Management, 45(4), 427–437. https://doi.org/10.1016/j.ipm.2009.03.002
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021