
L’analyse des séries temporelles constitue l’un des piliers méthodologiques les plus critiques au sein des sciences quantitatives modernes, qu’il s’agisse de l’économétrie, de l’épidémiologie, de la climatologie, de l’ingénierie financière ou des neurosciences computationnelles. Face à des flux continus ou discrétisés d’observations ordonnées chronologiquement, le chercheur et le statisticien ont besoin d’outils visuels capables non seulement de retranscrire fidèlement la trajectoire d’une variable au fil du temps, mais également de capturer la complexité sous-jacente des dynamiques stochastiques : régimes de volatilité, dérives tendancielles, oscillations périodiques et singularités structurelles. L’art de la sémiologie graphique, théorisé initialement par Jacques Bertin et approfondi par Edward Tufte, trouve dans la dimension temporelle son défi le plus stimulant, car il exige d’harmoniser la linéarité du temps physique avec la granularité multidimensionnelle des données empiriques contemporaines.
Dans l’écosystème du calcul scientifique en langage Python, la bibliothèque Seaborn, conçue sur les fondations programmatiques de Matplotlib et intrinsèquement articulée autour des structures de données de Pandas, s’est imposée comme une référence incontournable pour l’exploration et la communication visuelle de haute volée. Contrairement aux approches impératives purement graphiques qui nécessitent l’explicitation besogneuse de chaque tracé géométrique élémentaire, Seaborn adopte une philosophie résolument déclarative et statistique. Elle permet de lier directement les colonnes d’un tableau de données aux propriétés sémiotiques du graphique — telles que la teinte, la texture ou le calibrage géométrique — tout en automatisant des opérations mathématiques sophistiquées comme l’agrégation locale, le calcul d’intervalles de confiance par rééchantillonnage et la stratification multivariée.
Le présent traité constitue une exploration exhaustive, méthodique et rigoureusement documentée de la création, du perfectionnement et de l’interprétation des graphiques de séries temporelles au moyen de Seaborn. Depuis les fondements épistémologiques de la représentation chronologique jusqu’aux raffinements typographiques les plus pointus exigés par les comités de lecture des revues internationales à comité de lecture, cet ouvrage s’attache à décortiquer l’ensemble des mécanismes algorithmiques, esthétiques et statistiques nécessaires pour transformer des matrices de données temporelles brutes en représentations visuelles intelligibles, robustes et porteuses d’une indiscutable valeur heuristique.
1. Introduction aux séries temporelles et fondements théoriques dans Seaborn
Avant d’aborder la mécanique programmatique d’un tracé graphique, il convient de poser avec exactitude le cadre conceptuel qui gouverne la manipulation des données chronologiques. Une série temporelle n’est pas une simple collection de valeurs scalaires associées à des étiquettes arbitraires ; elle incarne un processus stochastique sous-jacent où l’ordre des réalisations porte en lui-même une charge informationnelle irréductible. La maîtrise de cet ordonnancement impose d’appréhender conjointement la nature mathématique du temps continu ou discrétisé et les spécificités de la grammaire visuelle implémentée dans les bibliothèques d’analyse de données modernes.
1.1 Définition et pertinence épistémologique des séries chronologiques
Sur le plan formel, une série temporelle se définit comme une suite finie ou infinie d’observations d’une variable aléatoire, indicée par un ensemble discret ou continu représentant le temps. Contrairement aux données transversales où les observations sont supposées mutuellement indépendantes et identiquement distribuées, les données chronologiques violent structurellement le postulat d’indépendance. La valeur mesurée à un instant donné se trouve intrinsèquement conditionnée par les réalisations antérieures du système, introduisant le phénomène fondamental d’autocorrélation. L’analyse séquentielle permet ainsi de modéliser des comportements dynamiques où coexistent des tendances déterministes à long terme, des cycles périodiques ou saisonniers d’amplitudes variables, ainsi que des fluctuations aléatoires résiduelles. Les défis inhérents à l’inférence temporelle — tels que la non-stationnarité, les dérives structurelles et les variations de régime — imposent une vigilance accrue dès l’étape initiale de collecte et de transformation.
Dans ce contexte épistémologique, la visualisation exploratoire ne constitue pas un simple exercice d’illustration a posteriori destiné à agrémenter un rapport technique. Elle opère comme un outil d’investigation cognitive de premier ordre, indispensable pour déceler la présence de ruptures de pente, identifier visuellement des dynamiques hétéroscédastiques où la variance s’accroît au cours du temps, ou encore repérer des artéfacts d’échantillonnage. Visualiser adéquatement une série chronologique permet au chercheur de formuler des hypothèses pré-modélisation plausibles, guidant le choix ultérieur entre des architectures autorégressives intégrées, des décompositions spectrales de Fourier ou des modélisations par équations différentielles stochastiques.
1.2 L’écosystème graphique de Seaborn face aux données temporelles
L’architecture logicielle de la science des données en Python s’articule autour d’une hiérarchie de couches complémentaires au sein de laquelle Matplotlib fait office de moteur de rendu fondamental de bas niveau, tandis que Pandas structure le stockage matriciel et l’alignement indiciel. Seaborn s’érige au sommet de cet édifice comme une couche d’abstraction de haut niveau spécifiquement optimisée pour les flux d’analyse statistique. Lorsqu’il s’agit de traiter des séries temporelles, cette position intermédiaire procure des avantages fonctionnels déterminants. Seaborn comprend nativement les objets de type DataFrame, ce qui supprime le besoin d’extraire manuellement des tableaux unidimensionnels et prévient les erreurs récurrentes de désynchronisation chronologique lors de la manipulation d’index hétérogènes.
L’un des apports majeurs de Seaborn réside dans sa capacité à intégrer nativement des opérations d’agrégation statistique et d’estimation d’incertitude directement au sein de l’appel graphique. Là où un développement sous Matplotlib brut exigerait l’écriture laborieuse de boucles explicites pour calculer la moyenne mobile, regrouper les observations selon une maille temporelle cible et tracer manuellement des polygones pour représenter les intervalles de confiance, Seaborn exécute ces routines de manière vectorisée et déclarative. L’ergonomie qui en résulte permet au praticien de concentrer son attention intellectuelle sur la substance sémantique des données plutôt que sur la tuyauterie algorithmique de l’affichage.
1.3 Principes directeurs de conception visuelle pour l’analyse temporelle
La transcription graphique du passage du temps est soumise à des exigences cognitives rigoureuses théorisées notamment par Edward Tufte à travers le concept cardinal du ratio encre-données. Ce principe stipule qu’une fraction maximale de l’encre (ou des pixels actifs à l’écran) doit être consacrée à la transmission de l’information substantielle, au détriment des ornements superflus, des arrière-plans saturés et des grilles redondantes qualifiés de bruit visuel. Dans le cadre précis d’une trajectoire chronologique, l’œil humain procède par extrapolation continue : il relie spontanément les points d’inflexion pour en déduire un mouvement directionnel, une vitesse d’évolution et une volatilité locale. Toute surcharge décorative vient altérer cette fluidité perceptuelle et peut induire en erreur l’interprétation clinique ou économique.
Le choix chromatique revêt une importance tout aussi fondamentale pour préserver l’intégrité cognitive du lecteur. Les séries temporelles impliquent fréquemment l’évaluation simultanée de plusieurs dynamiques concurrentes. L’utilisation inconsidérée de palettes chromatiques agressives, de dégradés continus inappropriés pour des variables discrètes ou de couleurs porteuses de connotations culturelles implicites (comme l’usage systématique du rouge pour désigner une décroissance indépendamment du contexte normatif) peut biaiser insidieusement le jugement analytique. Il est donc impératif d’adopter des palettes perceptuellement uniformes et adaptées aux déficiences visuelles, garantissant que chaque inflexion du signal soit évaluée pour sa pertinence mathématique intrinsèque et non en raison d’un artéfact optique induit par un contraste chromatique excessif.
2. Configuration de l’environnement technique et préparation rigoureuse des données
La robustesse d’une visualisation temporelle repose intégralement sur la qualité de la préparation des structures de données en amont. En programmation déclarative, le graphique n’est que le reflet direct du schéma relationnel du tableau sous-jacent. Si les horodatages sont corrompus, mal typés ou si la structure matricielle s’avère inadaptée aux paradigmes de Seaborn, le rendu visuel sera inévitablement défaillant ou nécessitera des contournements laborieux et sources de bogues.
2.1 Initialisation des bibliothèques et paramétrage global
L’initialisation d’un environnement de travail rigoureux commence par l’importation concertée des trois bibliothèques canoniques : Seaborn pour la syntaxe statistique, Matplotlib pour le contrôle d’infrastructure des figures, et Pandas pour la manipulation des structures de données. Dès cette étape préliminaire, il est hautement recommandé d’appliquer une charte graphique globale via la fonction dédiée de Seaborn, afin d’établir un socle esthétique homogène adapté aux standards de la publication scientifique. Cette configuration initiale détermine la typographie par défaut, l’épaisseur des axes et l’organisation des marges, prévenant ainsi les disparités visuelles entre différents graphiques au sein d’une même étude.
Parallèlement, la gestion des contextes de rendu et des résolutions vectorielles doit être anticipée. Le paramétrage du backend graphique garantit que les exportations ultérieures conserveront une netteté absolue, qu’elles soient destinées à des présentations numériques ou à l’impression sur papier vélin. C’est également à ce stade que l’on configure l’encodage des caractères typographiques pour assurer la parfaite restitution des accents de la langue française dans les titres, légendes et annotations futures, évitant ainsi les désagréments liés aux défaillances de transcodage de chaînes de caractères.
2.2 Typage et parsing strict des indices chronologiques avec Pandas
L’erreur la plus pernicieuse rencontrée lors de l’élaboration de graphiques temporels consiste à traiter les valeurs d’horodatage comme de simples chaînes de caractères textuelles plutôt que comme des types temporels authentiques. Lorsque les dates demeurent sous forme textuelle, les moteurs graphiques sont contraints de les interpréter comme des catégories discrètes équidistantes, ce qui détruit irrémédiablement l’échelle proportionnelle du temps physique. Il est donc fondamental d’appliquer systématiquement les fonctions de conversion rigoureuse de Pandas afin de transformer ces vecteurs en structures temporelles explicites, capables d’appréhender les variations de durée entre les mois, les années bissextiles et les irrégularités de calendrier.
Le traitement des fuseaux horaires constitue un autre point d’attention névralgique, en particulier lors du traitement de données issues de capteurs industriels, d’infrastructures réparties ou de marchés financiers mondiaux. La normalisation vers le temps universel coordonné (UTC) prévient les sauts artificiels et les doublons occasionnés par les transitions vers l’heure d’été ou d’hiver. De surcroît, le praticien doit mettre en œuvre une stratégie transparente pour la gestion des valeurs chronologiques manquantes. Qu’il s’agisse de procéder à une interpolation polynomiale, à un remplissage par la dernière valeur valide ou à une exclusion explicite avec rupture du tracé continu, ce choix méthodologique doit être documenté avec une rigueur absolue afin de ne pas dissimuler des lacunes observationnelles déterminantes.
2.3 Structuration des formats de données : Large versus Long
L’architecture conceptuelle de Seaborn s’enracine profondément dans le paradigme des données bien rangées, formalisé par Hadley Wickham. Dans cette perspective, deux formes d’organisation matricielle s’opposent : le format large et le format long. Le format large, fréquemment privilégié dans les feuilles de calcul traditionnelles, consacre une colonne distincte à chaque série ou entité mesurée au fil des mêmes dates situées en ligne. Bien que séduisant au premier abord pour une lecture humaine directe, ce format limite drastiquement l’expressivité programmatique, car il interdit l’affectation dynamique de variables factorielles à des attributs esthétiques globaux.
Le format long, à l’inverse, consacre chaque ligne à une observation unitaire et unique. Il comporte typiquement une colonne d’horodatage, une colonne catégorielle spécifiant l’identité ou la cohorte du sujet observé, et une colonne numérique consignant la mesure quantitative. La conversion d’une matrice large vers ce format s’effectue avec fluidité grâce aux routines de dépiotage de Pandas. Cette restructuration est la clé de voûte qui déverrouille l’intégralité de la puissance de Seaborn : elle permet d’exprimer des stratifications complexes, des décompositions chromatiques et des calculs d’intervalles statistiques au travers d’une syntaxe concise, élégante et hautement maintenable.
3. Construction fondamentale d’un tracé temporel simple avec sns.lineplot()
Une fois les structures de données rigoureusement typées et agencées selon les préceptes du format long, la construction géométrique de la série peut débuter. La fonction centrale dédiée à cet exercice au sein de l’API de Seaborn est la routine de tracé de lignes, conçue pour modéliser visuellement la trajectoire continue d’une variable quantitative en fonction d’un continuum explicatif, au premier rang desquel figure l’axe du temps chronologique.
3.1 Syntaxe de base et transmission des paramètres essentiels
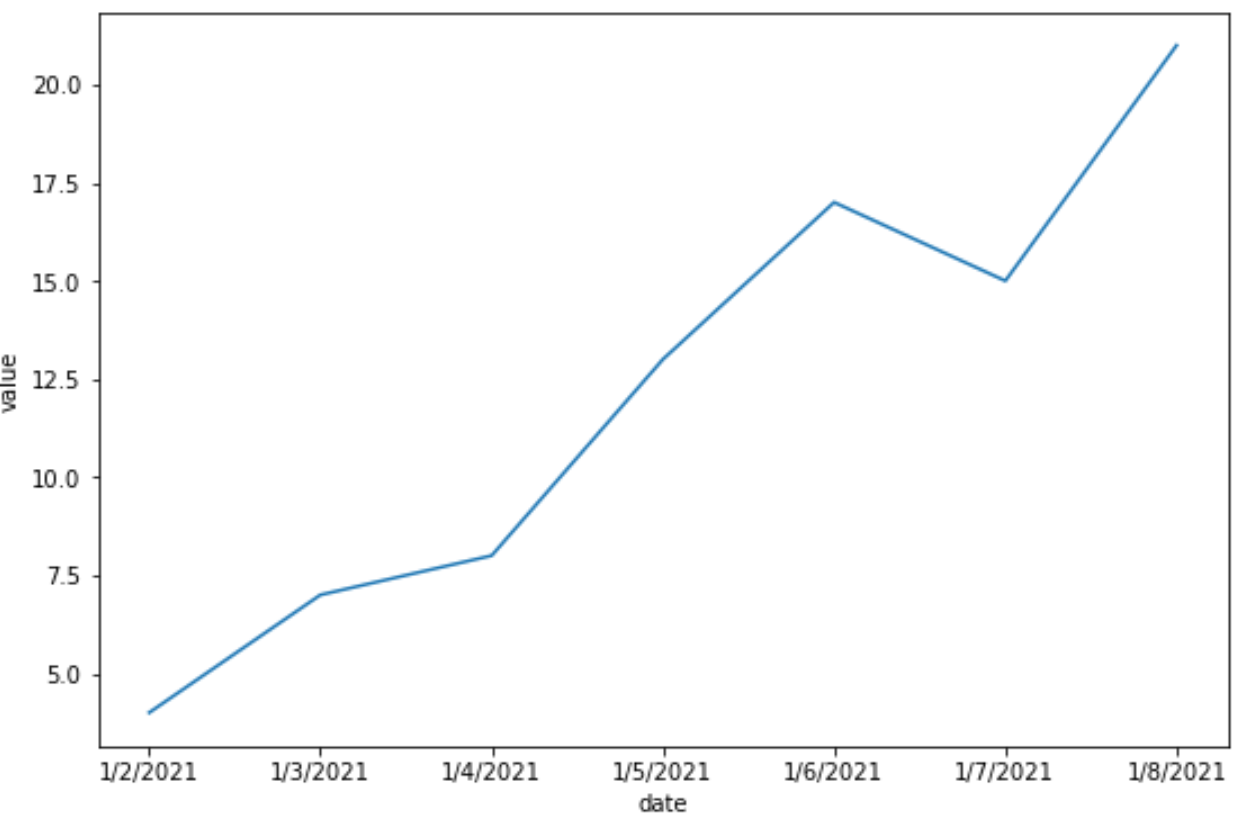
La mobilisation élémentaire de la fonction de tracé repose sur la désignation explicite des variables projetées sur le repère cartésien. La variable temporelle est assignée à l’abscisse horizontale, tandis que la mesure quantitative continue est affectée à l’axe des ordonnées verticales. L’intégralité de cette relation est alimentée par la transmission de l’objet DataFrame source au paramètre désigné. En procédant ainsi, Seaborn extrait de façon autonome les métadonnées relatives aux noms de colonnes et applique des règles d’interprétation contextuelle adaptées aux types de données sous-jacents.
Un aspect fondamental du fonctionnement interne de Seaborn réside dans sa gestion de l’ordonnancement séquentiel. Par défaut, la bibliothèque procède à un tri automatique des enregistrements le long de l’axe des abscisses avant de tracer le segment continu qui relie les coordonnées successives. Cette disposition garantit que la ligne temporelle ne présente pas d’enchevêtrements aberrants ou de retours en arrière graphiques lorsque les données sources ne sont pas triées préalablement dans l’ordre chronologique. Si, dans des cas expérimentaux spécifiques, un ordre arbitraire non chronologique devait être préservé, il demeure possible de désactiver ce comportement automatique via un argument dédié, bien que cette manipulation doive demeurer exceptionnelle lors de l’étude formelle de processus temporels.
3.2 Interprétation analytique du tracé univarié
L’obtention d’un tracé univarié continu constitue le point de départ de l’audit phénoménologique de la série temporelle. Dès le premier coup d’œil, le chercheur doit être en mesure d’extraire des éléments cardinaux de diagnostic que les résumés scalaires classiques — tels que la moyenne arithmétique ou l’écart-type global — sont totalement impuissants à révéler en raison du paradoxe de l’agrégation statique. La courbe permet de repérer immédiatement la présence d’une dérive tendancielle monotone, qu’elle soit linéaire, exponentielle ou logarithmique, traduisant l’existence d’une force d’entraînement structurelle agissant de manière prolongée sur le système.
Au-delà de la tendance globale, l’analyse visuelle de la ligne temporelle permet d’isoler des points d’inflexion majeurs, correspondant à des changements de dynamique ou à des ruptures structurelles brutales provoquées par des chocs exogènes. Les valeurs aberrantes ou extrêmes se manifestent sous la forme de spicules aiguës s’écartant dramatiquement du corridor de variabilité locale. Enfin, la trajectoire continue permet d’inspecter visuellement la continuité de l’échantillonnage : une ligne interrompue ou une section anormalement rectiligne peut signaler une lacune dans l’acquisition des données ou un artéfact d’interpolation silencieux au sein du capteur d’enregistrement, invitant à une vérification méticuleuse de la chaîne de mesure.
4. Personnalisation esthétique et géométrique des tracés élémentaires
Si la syntaxe par défaut de Seaborn produit des figures d’une qualité honorable, la production d’artefacts graphiques destinés à des revues académiques d’excellence ou à des rapports institutionnels exige un contrôle micrométrique de chaque élément géométrique. Ajuster l’épaisseur du trait, introduire des marqueurs de position discrets et normaliser la sémantique textuelle des axes sont autant d’opérations indispensables pour transformer une simple ébauche exploratoire en une figure définitive, lisible sans ambiguïté et exempte de toute approximation sémiotique.
4.1 Ajustement des propriétés scalaires de la ligne
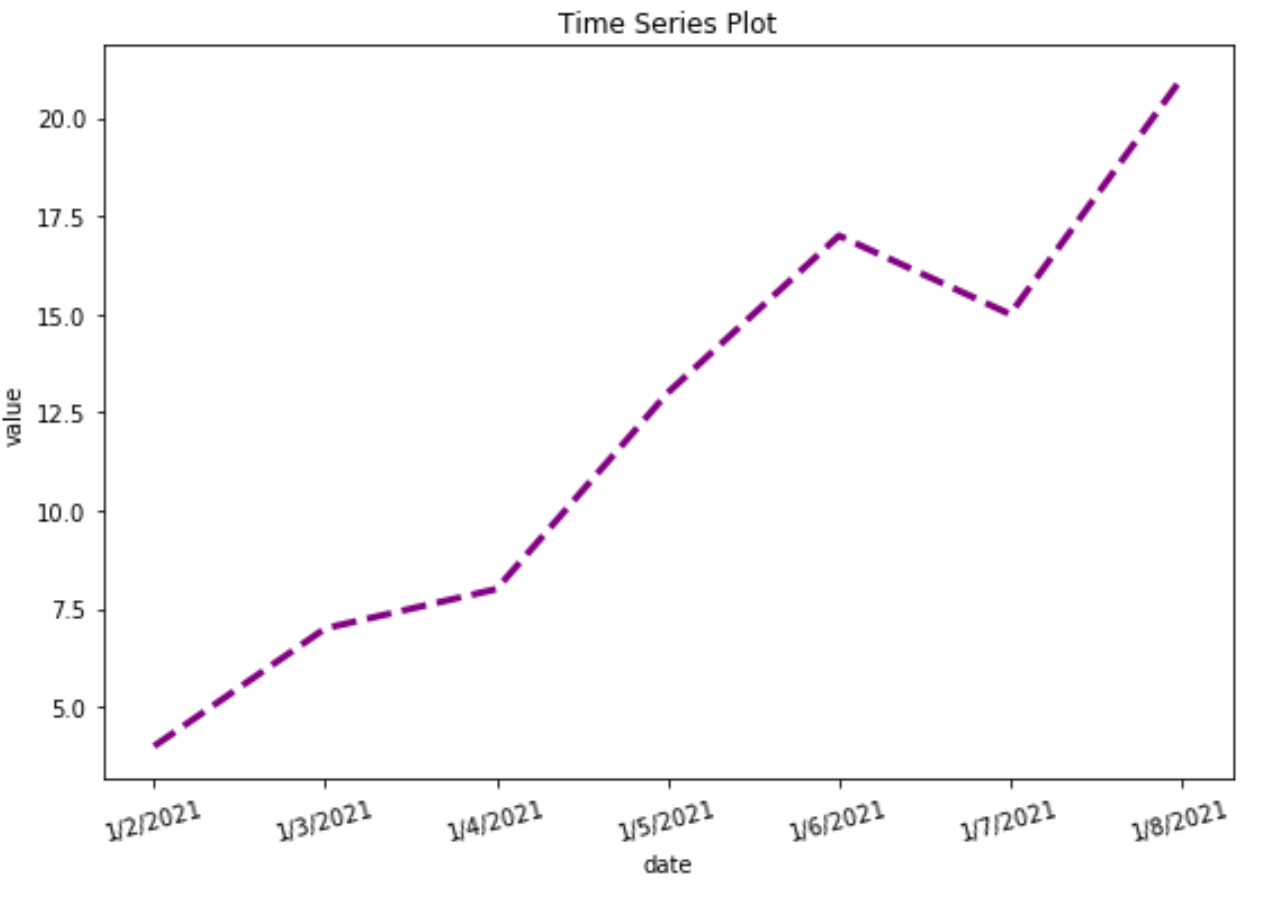
Le paramétrage scalaire du trait géométrique influence directement l’effort cognitif requis pour décrypter le message visuel. L’épaisseur de la ligne, modulable via l’argument dédié hérité du moteur sous-jacent, doit être méticuleusement proportionnée à la densité des données et à la résolution finale de sortie. Une ligne excessivement fine tend à disparaître lors de réductions d’échelle typographiques ou d’impressions à faible contraste, tandis qu’un trait surdimensionné risque de saturer l’espace graphique, occultant les micro-oscillations à haute fréquence et fusionnant artificiellement des extrema locaux contigus.
Le style morphologique du tracé offre un canal supplémentaire de différenciation visuelle. L’introduction de tirets, de pointillés ou de motifs alternés permet de caractériser le statut épistémologique de la série représentée, par exemple pour distinguer sans équivoque une trajectoire historique observée empiriquement d’une projection prospective issue d’un modèle prédictif. De surcroît, la maîtrise de la composante de transparence scalaire s’avère providentielle lorsqu’il s’agit d’atténuer la proéminence visuelle d’un signal extrêmement bruité, permettant de focaliser l’attention du lecteur sur l’enveloppe globale de la distribution temporelle sans saturer le cortex visuel.
4.2 Intégration et configuration sémantique des marqueurs d’observation
Dans de nombreuses applications scientifiques, il est crucial de rappeler à l’observateur que la courbe continue n’est qu’une interpolation géométrique reliant un ensemble d’observations discrètes acquises à des moments déterminés. L’activation des marqueurs d’observation le long de la trajectoire remplit précisément cette fonction probatoire. Elle matérialise sans ambiguïté les instants exacts où la réalité empirique a été échantillonnée, délimitant ainsi les zones de mesure effective des zones d’interpolation pure.
La sélection morphologique des marqueurs doit répondre à des critères d’équilibre formel : cercles, losanges, triangles ou carrés doivent être calibrés avec parcimonie pour éviter de transformer le tracé linéaire en une séquence de gros agrégats distrayants. Si la série temporelle présente une très haute fréquence d’échantillonnage avec des milliers de relevés, l’activation des marqueurs doit être évitée sous peine d’induire une coalescence graphique totale. À l’inverse, pour des séries temporelles à pas de mesure espacé ou irrégulier, le marqueur discret redevient un repère sémantique indispensable, signalant la rareté de l’information et invitant à la circonspection quant aux extrapolations intermédiaires.
4.3 Titrage formel et sémantique des axes d’observation
Un graphique scientifique ne peut prétendre à l’autonomie interprétative sans un appareil textuel précis et dénué de toute ambiguïté sémantique. L’attribution d’un titre formel ne doit pas se cantonner à une formule générique et vague ; elle doit contextualiser la métrique observée, la population ou le système sous revue, ainsi que la fenêtre chronologique globale couverte par l’investigation. Ce niveau d’exigence formelle garantit que la figure demeure intelligible lorsqu’elle est extraite de son manuscrit source pour être projetée en conférence ou citée de façon isolée.
La labellisation des axes orthogonaux constitue un impératif méthodologique tout aussi rigoureux. L’axe des ordonnées doit impérativement préciser la variable exacte ainsi que son unité de mesure physique ou statistique entre crochets ou parenthèses normalisées (par exemple, concentration molaire, pourcentages d’inflation annualisés, flux thermiques en mégawatts). L’axe des abscisses, bien qu’implicitement temporel, doit clarifier l’échelle de temps mobilisée dès lors qu’il s’agit de temps relatif post-intervention ou de datations absolues. L’harmonisation des polices de caractères et de leurs corps typographiques parachève cette rigueur éditoriale, conférant à la visualisation l’autorité et la sobriété requises par les revues académiques de référence.
5. Gestion et formatage typographique de l’axe temporel
Le principal écueil technique rencontré lors du tracé de séries temporelles réside dans le rendu de l’axe horizontal. Les étiquettes chronologiques sont intrinsèquement longues et complexes : combiner l’année, le mois, le jour et éventuellement l’heure au sein d’un espace linéaire restreint engendre presque systématiquement des chevauchements textuels illisibles si l’utilisateur s’en remet aux réglages automatiques de base. Une gestion experte des modules temporels sous-jacents est donc primordiale pour obtenir un rendu irréprochable.
5.1 Rotation et espacement des étiquettes chronologiques
La première réponse opérationnelle face à la saturation de l’axe des abscisses réside dans l’orientation angulaire des étiquettes textuelles. L’application d’une inclinaison méthodique — classiquement calibrée à quarante-cinq ou trente degrés — permet de condenser l’emprise horizontale occupée par chaque mention de date. Toutefois, l’inclinaison seule ne suffit pas : il est impératif d’ajuster l’ancrage spatial de l’alignement typographique horizontal pour que l’extrémité droite du texte coïncide rigoureusement avec le tiret de graduation correspondant, évitant ainsi un décalage optique trompeur entre le point temporel réel et son libellé explicatif.
Parallèlement à la rotation, le praticien doit contrôler la densité globale des graduations visibles. Il est contre-productif d’afficher chaque journée d’un historique s’étendant sur plusieurs décennies, tout comme il est aberrant de n’afficher que les années lorsque l’analyse porte sur un protocole expérimental de quelques jours. L’ajustement du pas d’échantillonnage des graduations permet de garantir un espacement aéré et harmonieux, guidant le regard sans infliger de fatigue cognitive inutile à l’observateur.
5.2 Mise en œuvre des formateurs de dates Matplotlib (DateFormatter)
Pour s’affranchir définitivement des représentations textuelles rigides et redondantes, l’exploitation conjointe du module de gestion temporelle de Matplotlib constitue la solution la plus robuste et élégante. Ce sous-système propose deux abstractions algorithmiques majeures : les localisateurs de graduations et les formateurs syntaxiques de dates. Les localisateurs se déclinent en variantes majeures et mineures, permettant de positionner des repères visuels à des fréquences adaptées aux cycles temporels naturels, qu’il s’agisse d’années civiles, de trimestres fiscaux, de mois, de semaines ou d’heures précises.
Les formateurs de dates offrent quant à eux un contrôle absolu sur la chaîne de caractères finale affichée à chaque graduation grâce à l’usage de motifs de syntaxe standardisés. Le chercheur peut ainsi formater les graduations sous des formes extrêmement condensées et élégantes, par exemple en affichant le nom abrégé du mois suivi des deux derniers chiffres du millésime, ou en masquant l’année sur les graduations secondaires pour ne l’expliciter que lors du franchissement d’un nouveau cycle annuel. Cette granularité typographique apporte une lisibilité comparable aux infographies professionnelles les plus raffinées publiées dans la presse économique internationale.
5.3 Délimitation des bornes temporelles et focalisation analytique
Dans de nombreuses circonstances analytiques, la totalité de la base de données chronologique ne mérite pas d’être exposée simultanément. Présenter un recul historique excessif peut écraser visuellement une dynamique locale hautement critique survenue lors d’une période d’intérêt circonscrite. La délimitation stricte des bornes temporelles inférieures et supérieures sur l’axe des abscisses permet d’opérer un zoom analytique direct sur une fenêtre observationnelle stratégique sans pour autant modifier, tronquer ou corrompre la structure du DataFrame originel en mémoire vive.
Cette approche par focalisation géométrique est particulièrement précieuse pour examiner les transitions de phases, les régimes transitoires consécutifs à une perturbation expérimentale ou les dynamiques de récupération post-crise. Le statisticien doit veiller scrupuleusement à ce que cette troncation n’introduise pas de biais de confirmation ou d’occultation d’événements historiques déterminants, maintenant une déontologie scientifique irréprochable dans la sélection de la fenêtre temporelle soumise à l’évaluation du lecteur.
6. Visualisation comparative de séries temporelles multiples avec le paramètre Hue
L’analyse empirique s’intéresse rarement à une trajectoire isolée du reste de son environnement. La puissance heuristique de la modélisation statistique émerge précisément de la confrontation de plusieurs cohortes, groupes de traitement, marchés financiers ou capteurs évoluant parallèlement au fil du même continuum temporel. Seaborn excelle tout particulièrement dans cette tâche grâce à sa gestion vectorielle des variables de stratification catégorielle par le biais du paramètre de teinte.
6.1 Principe de dissociation catégorielle par la couleur
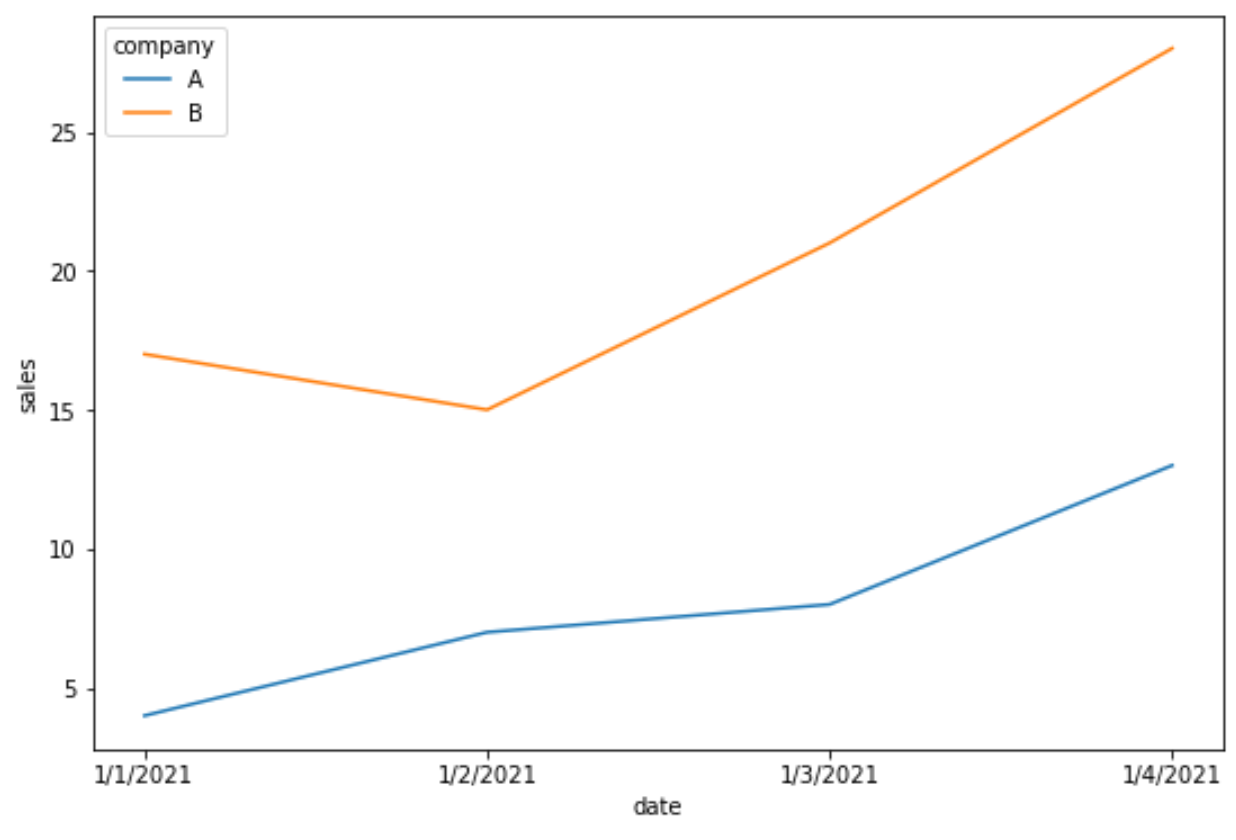
L’attribution d’une variable nominale ou ordinale au paramètre de teinte au sein de la fonction de tracé transforme instantanément un graphique univarié en un espace d’analyse multivarié hautement articulé. En interne, Seaborn identifie automatiquement l’ensemble des modalités uniques présentes dans la colonne factorielle désignée, partitionne le flux de données en sous-ensembles cohérents, puis applique à chacun de ces sous-groupes un segment de tracé continu doté d’une identité chromatique spécifique et différenciée.
Cette ségrégation visuelle permet d’appréhender d’un seul coup d’œil les phénomènes d’homogénéité ou de divergence de trajectoires entre plusieurs entités. Le chercheur peut ainsi discerner immédiatement si deux cohortes de patients réagissent de façon synchrone à un protocole thérapeutique donné, si un groupe expérimental se désolidarise durablement du groupe témoin à partir d’un instant précis, ou si différentes classes d’actifs financiers manifestent des dynamiques de corrélation temporelle robustes ou au contraire des désynchronisations prononcées en période de turbulences économiques.
6.2 Sélection et contrôle des palettes chromatiques
L’automatisation du choix des couleurs ne dispense pas d’une réflexion méthodologique approfondie quant à la palette chromatique mobilisée. Les palettes catégorielles par défaut doivent être choisies de manière à offrir un contraste perceptuel équilibré, évitant qu’une modalité particulière ne capte indûment l’attention en raison d’une saturation outrancière au détriment des autres. Seaborn met à disposition un vaste ensemble de palettes expressément conçues pour préserver la lisibilité de l’information pour les personnes atteintes de daltonisme ou de déficiences visuelles variées, telles que la palette adaptée aux déficients visuels ou les célèbres échelles développées pour le calcul scientifique comme Viridis.
Dans des contextes académiques avancés, il s’avère fréquemment nécessaire de définir des palettes sur mesure, encodées sous la forme de dictionnaires explicites associant formellement chaque valeur catégorielle de la base de données à un code hexadécimal précis. Cette rigueur garantit la parfaite conformité aux normes graphiques d’un consortium de recherche ou d’une institution internationale. Elle assure également la cohérence absolue des codes chromatiques d’une figure à l’autre au sein d’un mémoire ou d’une thèse doctorale, renforçant la clarté pédagogique globale de l’argumentation empirique.
6.3 Optimisation et repositionnement de la légende analytique
L’introduction d’une stratification catégorielle entraîne la génération automatique d’une légende explicative destinée à décoder la correspondance entre chaque modalité et son attribut chromatique. Toutefois, l’agencement par défaut de cette légende au sein du cadre graphique peut engendrer des collisions désastreuses, masquant une partie critique des trajectoires temporelles ou reléguant le cadre de légende dans un coin exigu au détriment du ratio encre-données.
Le praticien expérimenté doit savoir extraire, désactiver ou repositionner méthodiquement cette légende. Déplacer le bloc descriptif à l’extérieur des axes géométriques, sur le flanc droit ou au sommet de la composition, libère l’intégralité du plan cartésien pour l’évaluation des séries temporelles. Par ailleurs, il convient de substituer systématiquement les noms techniques et parfois cryptiques des variables de la base de données par des libellés élégants et immédiatement intelligibles pour le lecteur non spécialiste. Dans les cas où le nombre de séries demeure restreint, une alternative particulièrement raffinée consiste à supprimer totalement le cadre de légende pour annoter directement le nom de chaque cohorte à l’extrémité droite de sa courbe respective, minimisant les allers-retours oculaires entre le graphique et sa clé de lecture.
7. Différenciation structurelle multivariée : Style et Size
Bien que la teinte chromatique constitue le vecteur sémiotique le plus intuitif pour ségréguer des séries temporelles, elle atteint rapidement ses limites lorsque la complexité factorielle de l’expérience augmente ou lorsque la figure est destinée à une reproduction sur un support physique monochrome, telle qu’une impression d’article en noir et blanc. Pour répondre à ce défi, Seaborn propose des canaux de différenciation structurelle complémentaires au premier rang desquels figurent la morphologie des tracés et la modulation de leur calibre géométrique.
7.1 Mobilisation du paramètre Style pour les motifs de traits
Le paramètre de style permet d’assigner une seconde variable catégorielle indépendante aux motifs morphologiques des segments de lignes, générant une combinaison systématique de traits continus, hachurés, pointillés ou mixtes pour chaque groupe d’observations. Ce mécanisme permet de visualiser simultanément des structures factorielles croisées complexes au sein d’une unique représentation bidimensionnelle, sans nécessiter la multiplication fastidieuse de graphiques isolés.
Cette approche prend toute sa pertinence méthodologique dans la prévention des confusions de lecture liées aux contraintes d’accessibilité éditoriale. En attribuant la même variable à la fois à la teinte et au style de trait, on confère au graphique une redondance sémiotique salvatrice : la trajectoire d’une cohorte demeure parfaitement identifiable et traçable même si le lecteur imprime le document sur un support d’impression laser purement achromatique. Cette double codification constitue une norme d’excellence au sein de la littérature scientifique haut de gamme pour garantir l’équité d’accès aux résultats empiriques.
7.2 Modulation de l’épaisseur du tracé avec le paramètre Size
L’exploitation de l’épaisseur géométrique du tracé offre un moyen élégant d’encoder une variable quantitative continue ou ordinale secondaire le long de la série temporelle. Alors que l’abscisse porte le temps physique et l’ordonnée la métrique principale, le calibre du trait peut traduire l’intensité d’un phénomène connexe, tel que le volume monétaire échangé lors d’une transaction financière, le niveau de confiance algorithmique accordé à une mesure par un filtre de Kalman, ou la taille de l’échantillon d’individus ayant contribué à la mesure agrégée à chaque instant.
La mise en œuvre de cette dimension exige toutefois un calibrage rigoureux de l’intervalle de variation des épaisseurs. Si la borne minimale est trop infime, la courbe devient invisible et discontinue ; si la borne supérieure est excessive, le tracé sature l’espace, masquant les trajectoires sous-jacentes et créant des artéfacts d’écrasement visuel préjudiciables. L’étalonnage méticuleux des valeurs extrêmes permet de préserver la continuité séquentielle de la trajectoire tout en offrant une lecture intuitive et fluide du signal volumétrique complémentaire.
7.3 Encodage simultané d’attributs multiples
La conjonction tripartite des dimensions de temps, de couleur, de style morphologique et d’épaisseur permet d’atteindre un niveau d’expressivité multivariée exceptionnel au sein d’une seule et même vue synoptique. Une telle densité informationnelle permet de cartographier des dynamiques d’une rare complexité, croisant simultanément des facteurs environnementaux, des cohortes démographiques et des intensités de traitement au sein d’un même repère cartésien standardisé.
Néanmoins, le chercheur doit demeurer pleinement conscient des limites physiologiques et psychophysiques du système cognitif humain. La loi de saturation perceptuelle impose qu’au-delà de trois ou quatre dimensions graphiques superposées, l’esprit peine à décomposer analytiquement les signaux visuels, conduisant à une surcharge interprétative contre-productive. Avant de déployer simultanément ces multiples attributs esthétiques, une évaluation scrupuleuse de la pertinence informationnelle s’impose : toute complexification visuelle qui n’apporte pas un gain heuristique direct dans la compréhension du phénomène dynamique doit être bannie au profit de solutions plus épurées ou de segmentations en sous-panneaux ordonnés.
8. Agrégation statistique, répétition de mesures et intervalles de confiance
L’une des contributions les plus marquantes de Seaborn à la science des données réside dans son traitement natif des jeux de données comportant de multiples observations répétées pour un même instant temporel donné. Qu’il s’agisse de suivis de cohortes épidémiologiques, d’essais cliniques randomisés ou de simulations stochastiques de Monte-Carlo, Seaborn refuse de considérer l’empilement chaotique de lignes individuelles comme une fatalité et intègre directement un moteur d’estimation statistique inférentielle au sein du rendu graphique.
8.1 Comportement de Seaborn face aux observations multiples par unité temporelle
Lorsqu’un DataFrame structuré au format long contient plusieurs enregistrements partageant la même coordonnée chronologique, la fonction de tracé de Seaborn déclenche automatiquement une routine d’agrégation statistique. Par défaut, elle procède au calcul de la tendance centrale en évaluant la moyenne arithmétique de toutes les valeurs associées à chaque point temporel distinct, produisant ainsi une trajectoire épurée et continue représentant l’évolution globale de la population étudiée.
Cependant, la moyenne arithmétique est notoirement vulnérable aux distributions asymétriques ou à la présence de valeurs extrêmes susceptibles de décaler artificiellement la trajectoire globale du groupe. Seaborn autorise par conséquent la substitution transparente de cet estimateur par la médiane, qui offre un résumé beaucoup plus résistant et robuste pour les dynamiques stochastiques fortement étalées. Dans les situations où le chercheur souhaite examiner l’intégralité des réalisations individuelles sans aucune réduction statistique préalable, la désactivation explicite de l’estimateur demeure parfaitement accessible, transformant alors la fonction en un visualiseur exhaustif de micro-trajectoires.
8.2 Représentation et signification de la bande d’incertitude
La trajectoire moyenne ou médiane ne saurait être dissociée de son incertitude statistique sous-jacente. L’originalité structurelle de Seaborn réside dans sa génération immédiate d’une bande ombrée continue encadrant la courbe centrale, matérialisant visuellement l’incertitude associée à l’estimation statistique le long du continuum temporel. Par défaut, cette enveloppe représente un intervalle de confiance à quatre-vingt-quinze pour cent calculé par des méthodes de rééchantillonnage bootstrap non paramétriques, libérant le statisticien des postulats contraignants de normalité gaussienne des résidus temporels.
Il est tout aussi aisé de reconfigurer cette bande d’incertitude pour qu’elle traduise la dispersion brute des observations individuelles plutôt que l’incertitude d’échantillonnage sur la moyenne. L’affectation de l’écart-type à l’argument d’incertitude génère ainsi une enveloppe reflétant la variabilité intra-populationnelle réelle à chaque instant chronologique. L’ajustement du degré d’opacité de cette zone semi-transparente est fondamental : une opacité convenablement dosée permet d’apprécier la largeur de l’enveloppe de dispersion tout en conservant une vision parfaite de la ligne d’estimation centrale et des éventuelles séries concurrentes tracées en arrière-plan.
8.3 Identification des unités d’échantillonnage par le paramètre Units
Dans le cadre de protocoles longitudinaux ou d’analyses de données de panel, les observations répétées ne sont pas indépendantes les unes des autres : elles proviennent d’identifiants individuels spécifiques suivis au cours du temps, qu’il s’agisse de patients, d’entreprises ou de pays. L’agrégation aveugle sans prise en compte de cette corrélation intra-sujet peut introduire des biais méthodologiques substantiels dans l’estimation de l’incertitude globale.
L’utilisation judicieuse du paramètre d’unités permet d’informer Seaborn de l’existence de cette hiérarchie de données en lui spécifiant la colonne désignant l’identifiant individuel. Lors de la phase de rééchantillonnage bootstrap, l’algorithme procède alors à un rééchantillonnage par grappes au niveau des individus complets plutôt qu’au niveau des points d’observation isolés, préservant scrupuleusement la structure temporelle interne de chaque sujet. Cette rigueur algorithmique évite une sous-estimation artificielle des intervalles de confiance et garantit la parfaite validité inférentielle du tracé final lors de la soumission de l’étude à des revues biomédicales ou économétriques exigeantes.
9. Décomposition et facettage temporel avec relplot() et FacetGrid
Lorsque le volume de données augmente et que le nombre de strates catégorielles excède les capacités d’encodage d’un repère bidimensionnel unique, la superposition de courbes multiples au sein du même tracé conduit inévitablement à un phénomène d’occlusion visuelle dénommé tracé en plat de spaghettis. L’observateur se retrouve confronté à un enchevêtrement illisible de lignes entremêlées, interdisant toute analyse fine des dynamiques individuelles. La solution méthodologique consiste alors à scinder la figure en une matrice ordonnée de sous-graphiques cohérents, technique connue sous le nom de petits multiples.
9.1 Transition fonctionnelle de lineplot() vers relplot(kind=’line’)
Pour orchestrer cette décomposition spatiale sans alourdir le code d’infrastructures répétitives, Seaborn introduit une distinction fondamentale entre les fonctions opérant au niveau de l’axe et les fonctions opérant au niveau de la figure. Alors que la fonction classique de tracé linéaire s’inscrit au sein d’un axe individuel Matplotlib préexistant, la fonction relationnelle de haut niveau prend le contrôle direct de l’ensemble de la figure et gère de manière autonome l’instanciation, la disposition et l’alignement des sous-graphiques.
L’invocation de cette fonction avec l’argument spécifiant la typologie linéaire permet de retrouver l’intégralité des fonctionnalités statistiques et esthétiques tout en bénéficiant de paramètres globaux de mise à l’échelle. Les arguments d’échelle définissent harmonieusement la hauteur unitaire de chaque panneau et son ratio géométrique d’aspect, garantissant une cohérence proportionnelle parfaite quel que soit le nombre de sous-graphiques matriciels instanciés par l’algorithme d’agencement.
9.2 Découpage en sous-graphiques par lignes (row) et colonnes (col)
La puissance du facettage matriciel réside dans sa capacité à ventiler les séries temporelles le long d’une grille cartésienne ordonnée en attribuant des variables catégoriques indépendantes aux lignes et aux colonnes de sous-panneaux. Par exemple, une étude clinique internationale peut ainsi projeter l’évolution temporelle d’un marqueur biologique en organisant les différentes zones géographiques par lignes et les protocoles posologiques par colonnes, isolant chaque modalité expérimentale dans sa propre cellule visuelle dédiée.
Une attention méticuleuse doit être accordée au comportement des échelles géométriques au sein de ces matrices de petits multiples. Par défaut, Seaborn verrouille scrupuleusement l’alignement des axes horizontaux et verticaux sur l’ensemble des panneaux de façon à garantir une comparabilité visuelle absolue : un centimètre de hauteur correspond rigoureusement à la même amplitude quantitative partout sur la planche. Si, pour des raisons scientifiques impérieuses liées à des ordres de grandeur radicalement divergents, le chercheur devait libérer les échelles d’ordonnées, cette décision doit être explicitée avec emphase dans la légende sous-jacente afin de prémunir le lecteur contre toute interprétation fallacieuse des amplitudes relatives.
9.3 Organisation spatiale des panneaux multiples (col_wrap)
Lorsqu’une variable de stratification comporte un nombre important de modalités mais qu’aucune seconde variable factorielle ne justifie une disposition bidimensionnelle en lignes et colonnes, l’alignement de tous les sous-graphiques sur une seule ligne horizontale conduirait à un aplatissement inadmissible de chaque panneau temporel. La fonctionnalité d’enroulement spatial de Seaborn permet de convertir une longue séquence unidimensionnelle de sous-graphiques en une matrice rectangulaire compacte et élégante.
En fixant le nombre maximal de colonnes autorisées avant retour à la ligne suivante, le statisticien rééquilibre l’occupation de la page ou de l’écran, maintenant un ratio géométrique d’aspect optimal pour la lecture de chaque série temporelle individuelle. De surcroît, Seaborn s’assure d’éliminer automatiquement les graduations textuelles redondantes situées entre les panneaux contigus, n’affichant les libellés de dates que sur la bordure inférieure de la matrice et les ordonnées que sur la bordure gauche, aérant ainsi la composition globale selon les préceptes de Jacques Bertin.
10. Enrichissement sémantique : Annotations, événements critiques et seuils
Un tracé de données brutes ou agrégées, aussi esthétiquement parfait soit-il, ne devient un instrument de communication scientifique véritablement persuasif que lorsqu’il est enrichi de repères sémantiques contextualisant les phénomènes observés. Les séries temporelles sont intimement liées à l’histoire concrète du système modélisé : l’introduction d’un changement de législation, l’avènement d’une crise sanitaire, l’administration d’un principe actif ou la défaillance d’un capteur sont autant de faits générateurs qui méritent d’être matérialisés directement au cœur de l’espace graphique.
10.1 Mise en évidence de jalons temporels majeurs
La matérialisation d’événements ponctuels majeurs survenus à des dates précises s’effectue avec rigueur par l’insertion de lignes verticales indicatrices traversant l’intégralité du champ cartésien. Ces jalons verticaux brisent intentionnellement la continuité visuelle horizontale pour signaler à l’esprit critique du lecteur l’instant exact où une rupture structurelle ou une intervention externe a pris effet, facilitant ainsi l’examen comparatif des régimes avant et après l’événement.
Lorsque la perturbation ne se résume pas à un instant ponctuel mais s’étend sur un intervalle temporel continu — telle qu’une période de récession macroéconomique, une phase de confinement sanitaire ou une saison caniculaire — l’application de bandes d’ombrage verticales délimitées par des bornes chronologiques constitue la réponse sémiologique idéale. Ces zones en surbrillance doivent être traitées avec des valeurs de transparence très douces et des teintes neutres pour demeurer discrètes en arrière-plan, évitant absolument d’occulter la trajectoire des séries temporelles qui les traversent.
10.2 Ajout d’annotations textuelles ciblées
L’annotation textuelle directe d’un extremum local, d’un point d’inflexion singulier ou d’une rupture de pente apporte une plus-value didactique inestimable que ne peut fournir une légende générique isolée en périphérie. En ancrant un commentaire explicatif précis directement à proximité des coordonnées spatio-temporelles d’intérêt, le chercheur oriente l’analyse du lecteur vers le cœur de la découverte scientifique.
L’adjonction de flèches indicatrices, paramétrées avec des courbures élégantes et des têtes de flèches discrètes, permet de lier formellement le texte d’annotation à la coordonnée exacte du tracé tout en repoussant le bloc textuel dans une zone dégagée du plan graphique. Cette spatialisation intelligente prévient toute collision préjudiciable entre les caractères typographiques et les courbes de données, garantissant que l’enrichissement documentaire ne se fasse jamais au détriment de l’intégrité de la mesure empirique.
10.3 Insertion de seuils statistiques et lignes de référence
La confrontation directe de la trajectoire observée à des valeurs seuils de référence constitue un standard méthodologique dans de nombreuses disciplines, qu’il s’agisse de limites de toxicité biologique en pharmacovigilance, de plafonds d’émissions de polluants atmosphériques en écologie industrielle ou d’objectifs de stabilité des prix en économie monétaire. Le tracé de lignes horizontales statiques permet d’ancrer ces repères normatifs de manière pérenne sur le graphique.
Ces lignes de référence doivent adopter un profil géométrique distinctif — traditionnellement sous forme de tirets fins ou de pointillés discrets — et être accompagnées d’une annotation textuelle en bordure d’axe explicitant la nature du seuil représenté. Cette confrontation spatiale immédiate permet au lecteur d’évaluer sans calcul mental la proportion du temps durant laquelle le système étudié s’est maintenu dans la zone de conformité ou a au contraire basculé dans un régime de dépassement critique, transformant une simple courbe descriptive en un outil d’aide à la décision opérationnel.
11. Optimisation graphique avancée et intégration au moteur Matplotlib
Si Seaborn procure une surcouche déclarative d’une efficacité redoutable pour la structuration initiale des graphiques, la finalisation d’une figure destinée aux exigences drastiques des presses universitaires et des comités de lecture internationaux nécessite presque invariablement d’interagir avec les objets de bas niveau du moteur sous-jacent. La maîtrise de l’interface de programmation d’application de Matplotlib constitue la clé de voûte permettant de dépasser les automatismes de Seaborn et de sculpter chaque détail visuel avec une précision chirurgicale.
11.1 Accès et manipulation fine des objets Figure et Axes
Chaque appel d’une fonction de niveau axe dans Seaborn retourne une instance d’axe Matplotlib, tandis que les fonctions de niveau figure fournissent un objet conteneur englobant l’intégralité de la composition et de ses panneaux subsidiaires. La capture méthodique de cette instance d’axe dans une variable dédiée permet au développeur d’invoquer immédiatement toute la panoplie des méthodes de configuration fine offertes par Matplotlib, sans aucune restriction syntaxique.
Grâce à cette liaison directe, le praticien peut intervenir sur la géométrie des marges, forcer des décalages d’ancrage, ajuster le ratio dimensionnel des boîtes de tracé ou appliquer des algorithmes d’ajustement automatique des espacements. Ces routines préviennent les troncatures inopinées d’étiquettes périphériques, harmonisent les blancs éditoriaux entre les différents panneaux et assurent que l’occupation de la surface globale réponde aux critères les plus stricts de l’édition typographique de prestige.
11.2 Personnalisation des grilles et du cadre de référence (spines)
Le traitement des bordures du repère graphique — désignées sous le vocable technique d’épines ou d’armatures de coordonnées — conditionne l’esthétique générale de la visualisation. Les conventions contemporaines de la science des données, inspirées par les recommandations de sobriété de Tufte, privilégient l’élimination méthodique des bordures supérieures et droites du tracé. Seaborn met à disposition une routine spécialisée permettant de supprimer ces segments superflus d’un simple appel déclaratif, allégeant immédiatement la charge visuelle de la figure.
La grille de coordonnées internes doit faire l’objet d’une semblable retenue conceptuelle. Si une trame dense et contrastée s’avère perturbante pour l’évaluation de la continuité temporelle, la présence d’une grille extrêmement subtile, articulée autour de traits discontinus et d’une transparence très prononcée, facilite considérablement la projection mentale des coordonnées vers les axes sans alourdir le tracé. Il est particulièrement élégant de ne conserver que la grille horizontale d’ordonnées pour guider l’appréciation des amplitudes numériques tout en laissant l’axe chronologique horizontal dégagé de tout quadrillage vertical invasif.
11.3 Exportation haute résolution pour l’édition scientifique
Le processus de création d’une série temporelle ne s’achève pas à l’écran de l’environnement de développement interactif : il culmine lors de la sérialisation physique du fichier graphique sur le disque de stockage en vue de son intégration dans un manuscrit de recherche ou un système de publication assistée par ordinateur. Le choix de la résolution de trame constitue le premier arbitrage technique. Pour toute exportation vers des formats matriciels tels que le format PNG, une densité minimale de trois cents à six cents pixels par pouce est strictement requise pour garantir que les textes et les lignes conservent un tranchant parfait sous les presses d’imprimerie.
Toutefois, dès que les contraintes éditoriales le permettent, l’exportation vers des formats vectoriels pérennes tels que le SVG (Scalable Vector Graphics) ou le format PDF (Portable Document Format) doit être systématiquement privilégiée. Dans ces représentations vectorielles, les lignes temporelles, les marqueurs géométriques et les glyphes de caractères ne sont plus figés au sein d’une matrice finie de pixels, mais encodés sous forme d’équations géométriques pures. Cette propriété garantit une mise à l’échelle infinie, autorisant l’agrandissement de la figure sur un poster de congrès scientifique ou sa réduction au sein d’une colonne de revue sans la moindre perte de définition ni crénelage parasite. L’inclusion scrupuleuse de l’argument de recadrage strict lors de l’appel de sauvegarde parachève l’opération en supprimant tous les espaces blancs résiduels indésirables en périphérie de la composition.
12. Études de cas appliquées aux données longitudinales et protocoles empiriques
Pour parachever ce traité exhaustif, il est indispensable de confronter l’ensemble des concepts théoriques, esthétiques et techniques exposés jusqu’ici à des situations empiriques concrètes. L’analyse de données temporelles réelles se heurte systématiquement à des imperfections de mesure, à des bruits haute fréquence et à des structures de variance complexes que seule une méthodologie visuelle rigoureuse permet de maîtriser pleinement.
12.1 Suivi temporel continu de biomarqueurs physiologiques et cognitifs
Considérons l’enregistrement à haute fréquence de réponses physiologiques — telles que la variabilité de la fréquence cardiaque, les potentiels évoqués cognitifs ou l’oxygénation cérébrale par spectroscopie proche infrarouge — au cours d’un protocole d’effort cognitif standardisé. La structure brute des données se caractérise par une fréquence d’échantillonnage de plusieurs dizaines de hertz, générant un volume de points d’une densité extrême où le signal d’intérêt se trouve noyé dans un bruit physiologique substantiel.
Dans ce contexte, la préparation méthodique des données impose une étape de lissage temporel contrôlé en amont de la visualisation, matérialisée par l’application d’une moyenne mobile exponentielle ou d’un filtre passe-bas de Butterworth directement calculé sur les structures vectorielles de Pandas. Le tracé sous Seaborn s’articule alors autour d’une division sémantique rigoureuse : une ligne verticale indicatrice matérialise l’instant exact de l’administration du stimulus cognitif, scindant l’affichage entre la phase de référence préalable et la phase de réponse dynamique. L’application d’une bande d’incertitude bootstrap permet de vérifier immédiatement si la chute ou la surélévation du biomarqueur après stimulation s’écarte significativement des fluctuations stochastiques observées durant la ligne de base, offrant un diagnostic visuel sans équivoque.
12.2 Analyse de protocoles expérimentaux intra-sujets à mesures répétées
Un autre défi méthodologique emblématique concerne les essais cliniques randomisés en double aveugle comparant l’évolution temporelle de cohortes de patients sous traitement expérimental versus cohortes sous placebo, avec des évaluations cliniques réparties sur plusieurs semaines ou mois. Le risque majeur réside ici dans la dissimulation de l’hétérogénéité des réponses individuelles derrière un tracé agrégé trompeur : une moyenne de cohorte stable peut résulter soit d’une absence généralisée de réponse chez tous les sujets, soit d’une annulation mathématique artificielle entre des répondeurs spectaculaires et des individus dont l’état clinique s’est gravement détérioré.
Pour transcender ce biais d’agrégation, la méthodologie visuelle avancée exploite une superposition hiérarchisée de tracés. Dans un premier temps, les trajectoires temporelles individuelles de chaque patient sont tracées sous la forme de traits extrêmement fins, semi-transparents et dépourvus de marqueurs proéminents, formant un arrière-plan texturé qui expose sans fard l’amplitude réelle de la variabilité biologique intra- et inter-individuelle. Dans un second temps, Seaborn trace par-dessus cette matrice de fond les courbes maîtresses épaisses et contrastées représentant les tendances centrales agrégées de chaque bras de traitement, accompagnées de leurs intervalles de confiance à quatre-vingt-quinze pour cent. Cette architecture graphique à deux niveaux garantit une transparence scientifique totale : elle livre simultanément l’estimation inférentielle de groupe et la réalité phénoménologique sous-jacente des micro-trajectoires individuelles.
12.3 Synthèse des bonnes pratiques et pièges récurrents à éviter
Au terme de cette analyse approfondie, il importe de synthétiser les règles déontologiques et typographiques incontournables sous la forme d’un audit de conformité préalable à toute diffusion de graphiques temporels. Le premier écueil, omniprésent dans la littérature empirique de second rang, est celui de l’interpolation géométrique abusive. Relier par un segment linéaire continu des observations mesurées à des intervalles temporels très espacés ou irréguliers induit insidieusement le cerveau du lecteur à croire en une continuité déterministe qui n’a jamais été documentée par l’expérience. En présence de données sporadiques, il est impératif d’activer les marqueurs discrets ou de renoncer à la ligne continue au profit d’un graphique en barres ou d’escaliers.
Le second piège névralgique concerne la manipulation délibérée ou inconsciente de l’axe vertical des ordonnées. Bien qu’une troncation de l’origine zéro puisse se justifier pour examiner des micro-variations sur des constantes physiques strictes, elle constitue le vecteur privilégié de la dramatisation fallacieuse de fluctuations triviales dans les sciences sociales et économiques. L’expérimentateur rigoureux doit veiller à ce que l’amplitude visible sur le graphique reflète l’importance clinique ou économique effective du phénomène et non un artéfact d’échelle trompeur. En respectant scrupuleusement ces principes directeurs — alignement indiciel strict, formalisation du ratio encre-données, choix de palettes perceptuellement intègres et explicitation de l’incertitude d’échantillonnage —, le statisticien s’assure que le tracé de séries temporelles sous Seaborn atteigne son objectif suprême : éclairer la compréhension des dynamiques du monde réel avec une clarté esthétique et une probité intellectuelle irréprochables.
Références
Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions de l’École des Hautes Études en Sciences Sociales.
Cleveland, W. S. (1993). Visualizing data. Hobart Press.
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51–56). https://doi.org/10.25080/Majora-92bf1924-00a
Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10