
Dans le domaine de l’analyse exploratoire des données et de l’ingénierie statistique contemporaine, la restitution graphique des distributions univariées constitue une étape charnière du raisonnement analytique. Si l’évaluation des grandeurs absolues s’appuie traditionnellement sur des métriques cartésiennes linéaires, la compréhension immédiate de la décomposition d’un tout en ses parties constitutives mobilise des paradigmes sémiologiques distincts. Au sein de l’écosystème open-source fondé sur le langage Python, la bibliothèque Pandas s’est imposée comme le standard paradigmatique de la manipulation des données tabulaires. Néanmoins, l’usage de son interface de tracé intégrée pour concevoir un diagramme circulaire ou graphique en secteurs exige une maîtrise conjointe des structures matricielles sous-jacentes et des conventions géométriques propres au moteur de rendu.
Le recours au graphique en secteurs — fréquemment désigné sous le vocable vernaculaire de diagramme en camembert — suscite d’importants débats au sein de la communauté scientifique et des théoriciens de la visualisation de données. Bien que sa lisibilité immédiate soit reconnue par le grand public pour des partitions binaires ou ternaires simples, ses fondements psychophysiques se heurtent à des limitations perceptuelles notables dès lors que la cardinalité des modalités s’accroît. Il est donc impératif d’aborder la construction de cet artefact non comme une simple commande procédurale, mais comme une démarche méthodologique rigoureuse impliquant le prétraitement des données, la calibration des surfaces, le contrôle chromatique et l’explicitation des marges d’erreur.
Le présent traité propose une déconstruction exhaustive, théorique et opérationnelle, des mécanismes permettant d’élaborer, de raffiner et d’exporter des diagrammes circulaires rigoureusement paramétrés à partir de structures de données tabulaires. De l’épistémologie de la perception angulaire jusqu’aux architectures avancées de figures en anneau, en passant par la gestion du bruit cognitif et l’exportation vectorielle conforme aux standards typographiques des publications internationales, ce guide exhaustif offre aux chercheurs, analystes et ingénieurs les fondations conceptuelles et logicielles indispensables à l’expression visuelle de la représentativité statistique.
1. Introduction à la visualisation des proportions et fondements conceptuels du graphique en secteurs dans Pandas
L’acte de représenter visuellement des grandeurs quantitatives associées à des classes nominales répond à des contraintes cognitives strictes qui dépassent la simple exécution logicielle. Comprendre l’agencement interne des graphiques circulaires nécessite d’examiner la manière dont le système visuel décode les primitives graphiques, ainsi que le rôle d’intermédiaire que joue le cadriciel Pandas dans la chaîne de traitement numérique.
1.1 Épistémologie du diagramme circulaire et perception cognitive des proportions
L’avènement du diagramme circulaire, traditionnellement attribué aux travaux statistiques pionniers de William Playfair dans son ouvrage Statistical Breviary publié en 1801, repose sur un principe sémiotique fondamental : la partition d’un espace fermé continu — en l’occurrence un disque de deux pi radians — en sous-espaces dont les dimensions géométriques sont rigoureusement homothétiques aux grandeurs scalaires des modalités d’une variable. Cette approche postule que l’observateur humain est capable d’appréhender de manière synoptique le concept de complétude systémique, le cercle figurant l’intégralité inconditionnelle (100 %) d’un échantillon ou d’une population observée.
Néanmoins, l’évaluation psychophysique de ce type de visualisation révèle des biais cognitifs majeurs. Dès le début des années 1980, les travaux fondamentaux de William S. Cleveland et Robert McGill sur la perception graphique ont formellement démontré que le cortex visuel humain ne décode pas les primitives spatiales avec une efficacité homogène. Alors que la position le long d’une échelle alignée commune constitue la tâche cognitive la plus précise, l’évaluation de l’angle et de la surface bidimensionnelle se situe à un rang de précision nettement inférieur. L’œil a tendance à sous-estimer systématiquement les angles obtus et à surestimer les angles aigus, tout en éprouvant d’immenses difficultés à quantifier les deltas surfaciques lorsque deux segments contigus présentent des dimensions proches.
Dès lors, les critères formels d’admissibilité statistique pour recourir légitimement au diagramme circulaire s’avèrent restrictifs. Le tracé d’un tel graphique n’est scientifiquement recevable que si trois conditions fondamentales sont réunies : les données doivent impérativement constituer une partition stricte d’un tout unitaire où chaque observation appartient à une et une seule catégorie, le nombre de classes mutuellement exclusives ne doit pas excéder un seuil critique au-delà duquel la saturation mémorielle oblitère le décodage, et l’objectif visuel doit consister à comparer une fraction à l’ensemble plutôt que d’établir des comparaisons fines d’amplitudes entre classes individuelles.
1.2 Place de la bibliothèque Pandas dans l’écosystème analytique Python
Au cœur du dispositif de calcul scientifique contemporain fondé sur Python, la bibliothèque Pandas agit comme un pivot d’interopérabilité entre les couches computationnelles de bas niveau — incarnées par les matrices multidimensionnelles de NumPy — et les moteurs de restitution graphique vectorielle ou matricielle. Loin d’être un simple outil d’ingestion tabulaire, Pandas encapsule une interface de programmation applicative de haut niveau qui délègue le tracé effectif au cadriciel Matplotlib, tout en automatisant l’extraction des métadonnées structurelles telles que les index, les étiquettes de colonnes et les masques catégoriels.
L’architecture logicielle du wrapper graphique de Pandas repose sur une approche déclarative qui dispense l’analyste de l’instanciation verbeuse des primitives géométriques de Matplotlib. Lorsqu’un praticien invoque l’interface graphique sur un conteneur Pandas, la bibliothèque procède à une inférence contextuelle : elle analyse la typologie des données, résout l’indexation, calcule les sommes marginales et configure dynamiquement les axes de coordonnées. Cette synergie étroite garantit une traçabilité rigoureuse et une reproductibilité optimale des protocoles analytiques, minimisant les risques d’incohérence entre la manipulation des données et leur restitution sémiologique.
La méthode générique de tracé native de Pandas permet ainsi d’appliquer des transformations statistiques immédiates et de les projeter visuellement sans rupture d’état au sein de la session d’exécution. Cette intégration fluide permet de concevoir des scripts d’ingénierie des données où le calcul des distributions de fréquences débouche directement sur une figure prête à l’interprétation, garantissant un contrôle précis de chaque paramètre sans dénaturer la structure des données sous-jacentes.
1.3 Structure des données requises : séries univariées versus DataFrames multivariés
La conception géométrique d’un graphique en secteurs impose des exigences topologiques strictes quant à la structure des conteneurs de données mobilisés. Le diagramme circulaire est, par essence ontologique, une visualisation univariée : il ne peut encoder qu’une seule dimension scalaire continue à travers l’ouverture angulaire de ses segments. Par conséquent, l’objet canonique attendu par l’algorithme de tracé est la Série unidimensionnelle de Pandas, au sein de laquelle les valeurs numériques représentent les amplitudes quantitatives et l’index textuel fournit les étiquettes qualitatives associées à chaque modalité.
Lorsqu’un analyste opère sur un DataFrame bidimensionnel — structure multivariée par excellence —, une ambiguïté structurelle surgit inévitablement. Si le DataFrame comporte plusieurs colonnes de nature quantitative, le moteur de tracé ne peut déterminer de manière autonome quelle variable doit être assignée à la partition de l’angle plein de trois cent soixante degrés. L’analyste se trouve alors confronté à l’obligation explicite d’isoler une colonne cible, soit par une projection unaire extrayant une Série, soit en spécifiant le descripteur de colonne adéquat aux paramètres de la méthode de visualisation.
En outre, la physique du secteur circulaire introduit une contrainte rédhibitoire : l’exigence de positivité stricte de la métrique agrégée. Une surface géométrique euclidienne ne saurait posséder une aire négative ou nulle sans violer les postulats de la géométrie constructive. Si le conteneur de données sous-jacent héberge des soldes financiers déficitaires, des taux de variation négatifs ou des anomalies d’échantillonnage inférieures à zéro, l’algorithme de calcul des ratios sectoriels sombrera dans une incohérence arithmétique majeure, produisant soit une exception d’exécution, soit une déformation aberrante du disque.
2. Préparation rigoureuse des données sous Pandas en amont du tracé
L’obtention d’une figure sectorielle rigoureuse dépend fondamentalement de la qualité des données tabulaires qui lui sont injectées. Une démarche scientifique rigoureuse exclut formellement le traçage direct de données brutes hétérogènes sans un cycle complet de validation, de filtrage et d’agrégation méthodologique.
2.1 Nettoyage, imputation des valeurs manquantes et intégrité structurelle
L’intégrité de la distribution sommative constitue le socle de toute représentation proportionnelle. La présence de données manquantes, encodées sous forme d’indicateurs non définis de type flottant non numérique, est susceptible d’altérer gravement le calcul de l’angle relatif des secteurs. Dans un tableau de données, une modalité associée à une valeur manquante peut soit être omise silencieusement par les fonctions de sommation par défaut, soit provoquer des distorsions imprévues dans l’étiquetage des proportions, faussant ainsi l’axiome fondamental selon lequel la somme des parts doit égaler précisément l’effectif total observé.
Il incombe dès lors au praticien d’appliquer une stratégie de gestion des lacunes statistiques avant toute tentative de rendu graphique. Cette démarche implique l’évaluation systématique de la nature des manques : relèvent-ils d’une absence aléatoire ou traduisent-ils un biais structurel d’acquisition ? En cas de suppression légitime, l’usage des filtres d’exclusion vectorisés permet de purger le tableau des enregistrements incomplets. Dans d’autres circonstances, l’imputation méthodique par une valeur neutre ou la réaffectation explicite des valeurs non renseignées au sein d’une modalité nominale distincte permet de préserver la traçabilité de l’incertitude dans la figure finale.
Parallèlement, une phase d’audit univarié doit impérativement certifier l’absence de valeurs négatives au sein de la colonne de sommation. L’application de conditions booléennes d’assertion garantit que chaque observation respecte le domaine de validité de l’espace géométrique circulaire. Cette vérification prévient les défaillances silencieuses de l’interpréteur graphique et garantit que chaque secteur projeté reflète fidèlement une grandeur quantitative réelle et mesurable.
2.2 Agrégation catégorielle avec la méthode groupby()
Dans la quasi-totalité des scénarios d’ingénierie des données empiriques, les observations ne se présentent pas sous la forme pré-consolidée d’une ligne unique par modalité théorique, mais sous la forme de journaux transactionnels ou de tables d’échantillons où une même catégorie se répète des milliers de fois. Pour agréger ces observations hétéroclites en une série synthétique adaptée à la sectorisation circulaire, la méthode de regroupement partitionné constitue l’outil fondamental de Pandas.
Le formalisme computationnel repose sur le paradigme analytique tripartite formalisé par Hadley Wickham : scinder la table de données en sous-groupes selon les modalités discrètes d’un facteur nominal, appliquer une fonction d’agrégation statistique à chaque sous-ensemble, puis combiner les résultats scalaires en une structure unifiée. Le choix scrupuleux de la variable de catégorisation détermine directement la granularité des partitions angulaires du disque. Une granularité excessive conduit inévitablement à un morcellement visuel illisible, tandis qu’une granularité trop grossière risque de masquer des disparités intra-classes fondamentales.
L’ordonnancement structurel des index résultant de cette étape joue un rôle déterminant dans la sémiologie graphique. Par défaut, le mécanisme de regroupement trie les étiquettes selon un ordre lexicographique alphabétique. Cet arrangement par défaut est rarement optimal d’un point de vue cognitif. L’analyste doit décider s’il convient d’imposer un tri décroissant basé sur les grandeurs quantitatives agrégées — facilitant ainsi la détection des segments prépondérants — ou d’adopter un ordre taxonomique prédéfini via l’usage de types catégoriels ordonnés.
2.3 Sélection des métriques cumulatives via sum(), count() ou mean()
La nature de l’opérateur de réduction mathématique appliqué lors de l’agrégation conditionne la signification statistique de la surface des secteurs. Une confusion conceptuelle fréquente oppose la sommation cumulative de grandeurs extensives et le simple dénombrement des fréquences d’occurrence au sein des classes d’échantillonnage. Le recours à l’opérateur de sommation directe cumule les valeurs mesurées, produisant des surfaces proportionnelles aux masses globales, comme dans le cas de l’analyse de montants budgétaires cumulés ou de volumes d’émissions énergétiques.
Inversement, l’opérateur de comptage calcule les effectifs bruts des classes, accordant à chaque observation individuelle un poids scalaire unitaire égal à un. Dans cette configuration, le diagramme circulaire ne reflète pas une masse matérielle accumulée, mais la distribution fréquentielle de la population au sein de la nomenclature catégorielle. Ce distinguo est fondamental pour l’interprétation : la sommation d’une variable de flux financier révèle la concentration économique, tandis que le décompte des transactions met en lumière la fréquence d’interaction, deux réalités analytiques profondément dissemblables.
L’emploi d’opérateurs statistiques de tendance centrale, tels que la moyenne arithmétique ou la médiane, dans un graphique en secteurs relève en revanche d’une hérésie méthodologique fréquente. Les moyennes ne possédant pas de propriété d’additivité conservative, la somme de leurs grandeurs ne représente en aucun cas un tout tangible de cent pour cent. Tracer des secteurs basés sur des moyennes catégorielles fausse radicalement la perception de l’espace géométrique en suggérant une partition de l’unité qui n’a aucune assise mathématique réelle. L’analyste doit donc impérativement s’assurer de l’extensivité absolue de la métrique avant tout tracé circulaire.
3. Syntaxe fondamentale et génération du premier graphique en secteurs
Une fois les données tabulaires nettoyées et réduites à une distribution univariée valide, leur conversion en un objet graphique exploitable fait intervenir l’architecture interne des méthodes de tracé de Pandas. La compréhension fine de cette syntaxe permet d’éviter les pièges d’exécution classiques et de jeter les bases d’une personnalisation avancée.
3.1 Décomposition syntaxique de df.groupby().sum().plot(kind=’pie’)
L’idiome canonique couramment documenté pour engendrer une représentation circulaire s’énonce selon un enchaînement fonctionnel compact reliant l’extraction des données au tracé de la figure. Dans cette séquence, chaque maillon réalise une mutation de type déterministe. L’opération initiale de regroupement partitionne les enregistrements de la table selon la colonne qualitative choisie ; la méthode de sommation subséquente agrège les colonnes numériques en écrasant la dimension verticale des enregistrements multiples au profit d’un scalaire agrégé par classe.
L’invocation terminale de la fonction de tracé via le paramètre de type de graphe sectoriel matérialise l’intersection entre le calcul matriciel et la génération géométrique. Ce paramètre explicite informe le dispatcheur de Pandas que les coordonnées cartésiennes orthogonales traditionnelles (abscisses et ordonnées) doivent être transposées en coordonnées polaires fermées. L’aire de chaque secteur angulaire est alors calculée de manière unitaire par rapport à la somme totale des éléments constitutifs de la série transmise.
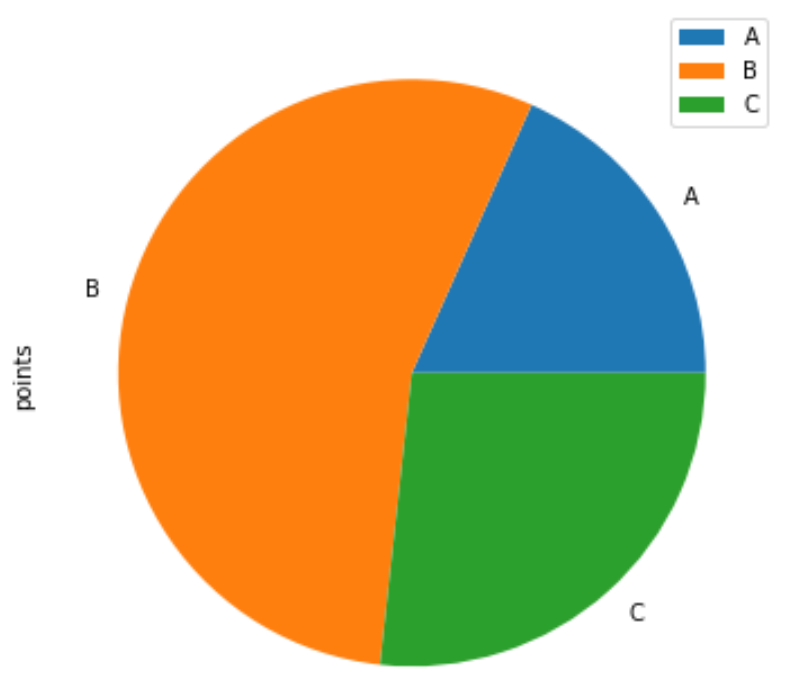
Il existe une équivalence fonctionnelle directe entre la formulation générique utilisant l’argument textuel et l’accès direct par méthode spécialisée d’accès aux tracés sectoriels. Cette dernière variante syntaxique, plus expressive sur le plan de la programmation orientée objet, renforce la lisibilité des pipelines de traitement complexes en explicitant sans ambiguïté la nature de la primitive géométrique sollicitée. Durant cette transition, le moteur extrait implicitement l’index de la série pour forger la liste des étiquettes périphériques et utilise le vecteur numérique associé pour dimensionner les angles sectoriels.
3.2 Différenciation entre l’appel sur Series et l’appel sur DataFrame via le paramètre y
L’une des causes les plus récurrentes de dysfonctionnement logiciel lors de l’initiation d’un tracé circulaire réside dans la confusion entre l’appel d’une méthode de dessin sur un objet de type Série et son appel sur un DataFrame multivarié non projeté. Lorsqu’un tracé sectoriel est appliqué à une Série univariée, l’environnement résout trivialement l’assignation des grandeurs scalaires à l’angle radial, chaque cellule de la série représentant une tranche séquentielle unique du disque.
En revanche, lorsque la méthode de tracé est invoquée directement sur un DataFrame contenant plusieurs colonnes de format flottant ou entier, l’interpréteur de Pandas soulève immédiatement une erreur de valeur ou produit des comportements erratiques. Le moteur de rendu ne dispose en effet d’aucune heuristique pour décider quelle variable numérique doit régir la proportionnalité des angles. Pour lever formellement cette indétermination matricielle, l’analyste doit renseigner de manière impérative le paramètre désignant la variable cible à l’intérieur de l’appel fonctionnel.
L’omission de cette désignation explicite ou la persistance de multiples colonnes sans désignation univoque interrompt brutalement l’exécution du script. La bonne pratique de programmation consiste soit à chaîner une indexation unaire extrayant immédiatement la Série quantitative voulue en amont du tracé, soit à employer le paramètre cible au sein du DataFrame pour garantir que le flux de travail conserve une compatibilité parfaite avec les modifications structurelles ultérieures de la table sous-jacente.
3.3 Analyse de l’objet Axes retourné par Matplotlib sous-jacent
Un principe fondamental — bien que trop souvent occulté — réside dans le fait que les méthodes de restitution graphique de Pandas ne constituent pas un moteur de rendu isolé, mais une surcouche logicielle d’abstraction ergonomique coiffant l’infrastructure complexe de Matplotlib. Lorsque l’analyste exécute une fonction de tracé sectoriel, le retour de cette fonction n’est pas un fichier image inerte, mais une référence vivante vers une instance de classe des axes de Matplotlib.
Cet objet d’axes représente la surface géométrique active du tracé et encapsule l’intégralité des primitives vectorielles composant la figure : les sommets des polygones curvilignes définissant les secteurs, les conteneurs textuels des libellés nominaux, les étiquettes de proportions ainsi que l’ensemble des métadonnées de cadrage. L’interception systématique de cette variable dans l’environnement d’exécution confère à l’analyste un levier de contrôle d’une précision chirurgicale, lui permettant de s’affranchir des limitations des paramètres d’origine de Pandas pour exploiter directement la richesse de l’API de Matplotlib.
Cette architecture orientée objet permet une persistance d’état au sein du script analytique. Tant que la figure courante demeure résidente dans la mémoire vive de l’interpréteur Python, l’analyste conserve la faculté de modifier a posteriori la typographie, d’injecter des annotations fléchées, d’ajuster dynamiquement les limites spatiales du canevas ou d’intégrer le graphique dans une grille de composition multi-panneaux complexe sans avoir à réexécuter le calcul des grandeurs sous-jacentes.
4. Paramétrage textuel et intégration des étiquettes de pourcentage via autopct
Un diagramme circulaire dénué de quantification textuelle explicite perd l’essentiel de sa valeur opérationnelle, contraignant le lecteur à des approximations visuelles hautement imprécises. L’incorporation rigoureuse d’étiquettes numériques relatives et absolues constitue un impératif ergonomique majeur.
4.1 Mécanique de mise en forme des chaînes de formatage numérique
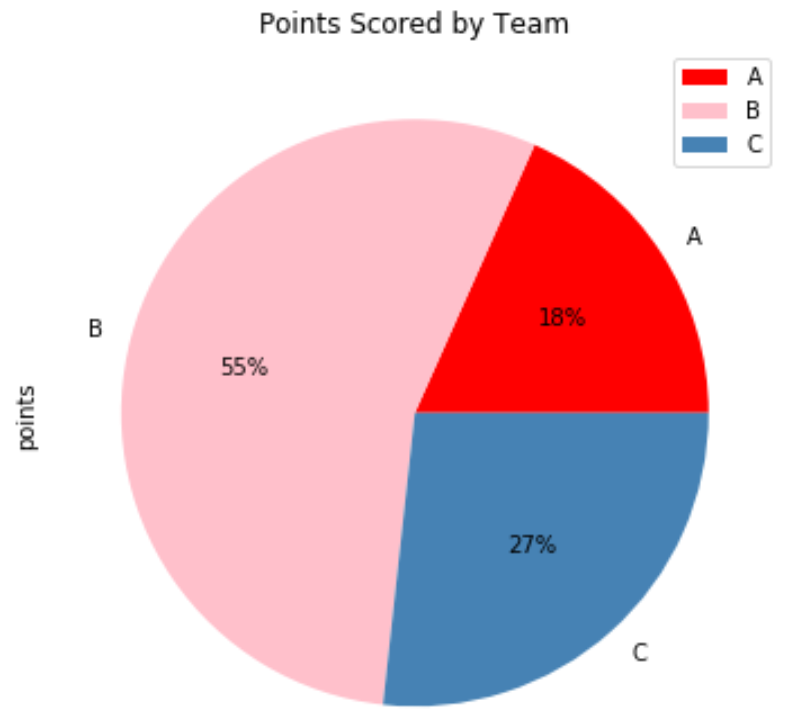
L’injection des valeurs relatives de pourcentage au cœur des différents secteurs géométriques est orchestrée par le paramètre d’étiquetage automatique de l’interface de tracé. Cet argument attend une chaîne de formatage respectant les conventions héritées de l’opérateur d’interpolation de style langage C, ou alternativement une fonction exécutable dynamique. Le moteur de rendu calcule en temps réel la fraction d’angle occupée par chaque modalité vis-à-vis de l’angle plein, convertit ce ratio en une valeur décimale comprise entre zéro et cent, puis la formate selon les directives typographiques transmises.
La formulation conventionnelle d’un gabarit de formatage numérique permet de stipuler la précision requise. L’inclusion d’une commande telle que l’affichage d’un unique chiffre après la virgule suivi de l’échappement du symbole de pourcentage assure une présentation standardisée et épurée des parts relatives. L’arbitrage scientifique relatif au nombre de décimales doit être dicté par la puissance statistique de l’échantillon sous-jacent : prétendre afficher une précision à deux ou trois décimales sur un échantillon restreint de quelques dizaines d’observations relève d’une illusion d’exactitude méthodologiquement condamnable.
Dans de nombreuses applications analytiques, la restitution exclusive des pourcentages s’avère insuffisante et peut induire en erreur sur la magnitude réelle du phénomène quantifié. Il devient alors indispensable d’adopter des gabarits textuels capables de concilier l’expression des fractions relatives et des grandeurs scalaires brutes au sein d’une même balise textuelle. Cette approche évite le piège classique des visualisations trompeuses où des pourcentages impressionnants masquent des effectifs marginaux dénués de significativité statistique.
4.2 Utilisation de fonctions lambdas pour des annotations conditionnelles complexes
Lorsque les exigences de mise en page excèdent les capacités rigides des chaînes de formatage statiques, l’affectation d’une fonction anonyme — ou fonction lambda — au paramètre d’étiquetage automatique offre une flexibilité algorithmique absolue. Le moteur de tracé transmet automatiquement à cette fonction le pourcentage décimal calculé pour chaque secteur unitaire. L’analyste peut alors concevoir une logique conditionnelle exécutée séquentiellement pour chaque portion du disque.
Cette approche algorithmique permet notamment de résoudre l’épineux problème de l’occlusion visuelle des étiquettes au sein des secteurs de dimensions infinitésimales. En intégrant une instruction de disjonction logique à l’intérieur de la fonction anonyme, il est aisé d’ordonner le retour d’une chaîne de caractères vide dès lors que la proportion calculée s’avère inférieure à un seuil d’admissibilité critique, fixé empiriquement entre deux et trois pour cent. Les portions minoritaires ne sont ainsi plus encombrées par des libellés superposés et indéchiffrables.
De surcroît, la fonction anonyme peut capturer par fermeture lexicale la somme totale arithmétique de la série de données calculée en amont. Dès lors, il devient possible d’effectuer un calcul rétrograde dynamique au sein de l’annotation : en multipliant le pourcentage reçu par la somme globale et en divisant par cent, la fonction reconstitue la grandeur absolue d’origine. Elle peut ainsi générer dynamiquement une étiquette textuelle multi-lignes affichant à la fois le décompte brut d’unités et la part proportionnelle correspondante, harmonisant ainsi l’information contextuelle.
4.3 Optimisation de la lisibilité et positionnement des étiquettes textuelles
La disposition spatiale des annotations textuelles constitue une composante critique de l’ergonomie visuelle globale. L’interface de tracé de Pandas met à disposition de l’ingénieur deux paramètres spatiaux cardinaux : la distance relative des étiquettes de pourcentage et la distance relative des libellés nominaux de catégories. Ces deux métriques scalaires s’expriment en unités normalisées calculées par rapport au rayon unitaire du cercle principal tracé dans le système d’axes.
Par défaut, les pourcentages s’implantent à mi-chemin du centre et de la périphérie (généralement à une distance de six dixièmes du rayon), tandis que les désignations textuelles catégorielles sont repoussées légèrement à l’extérieur du pourtour circonférentiel (habituellement à une distance de un virgule un rayon). Si le graphique intègre des couleurs de secteurs particulièrement denses ou si la typographie choisie manque de contraste, le calibrage de cette distance permet de déporter les valeurs chiffrées hors de la zone d’ombre chromatique des polygones pour maximiser leur visibilité sur le fond clair de la figure.
En présence d’un agencement dense comportant des tranches d’amplitudes asymétriques, l’ajustement coordonné de ces coefficients géométriques prévient la collision textuelle entre le nom de la modalité et sa proportion chiffrée. Une stratégie éprouvée consiste à refouler l’ensemble des désignations nominatives au sein d’une légende extérieure structurée, tout en maintenant les étiquettes chiffrées strictement centrées au barycentre géométrique des secteurs angulaires majeurs, allégeant ainsi considérablement la charge visuelle globale.
5. Personnalisation chromatique et principes psychophysiques de la couleur
Le choix des palettes chromatiques dans une visualisation de données ne relève pas d’une préférence cosmétique, mais d’une convention sémiologique rigoureuse régie par les lois de l’optique et de la psychologie cognitive.
5.1 Attribution manuelle des palettes via l’argument colors
L’assignation des teintes aux différents secteurs angulaires d’un diagramme circulaire dans Pandas est opérée via le paramètre dédié aux palettes, qui attend une collection itérable de descripteurs de couleur. Ces spécifications peuvent adopter la forme de dénominations littérales normalisées, de triplets de proportions de synthèse additive, ou, plus communément au sein des protocoles industriels et académiques, de codes hexadécimaux garantissant une restitution chromatique déterministe d’une fidélité absolue.
Il importe de maîtriser le mécanisme d’affectation cyclique intrinsèque au moteur de dessin. Si le nombre de couleurs définies dans la liste transmise est strictement inférieur au nombre de catégories présentes dans la série de données, le générateur ne lève aucune exception mais recycle cycliquement les premières nuances de la collection pour vêtir les modalités excédentaires. Ce phénomène engendre un risque critique de collision sémiotique : deux secteurs disjoints se retrouvent pourvus de la même teinte, induisant chez le lecteur une perception erronée d’apparentement statistique.
Par conséquent, une rigueur méthodologique impose de calibrer la taille de la collection chromatique pour qu’elle corresponde exactement ou surpasse la cardinalité de la variable nominale étudiée. L’ordre séquentiel d’apparition des nuances au sein du vecteur injecté doit faire l’objet d’un alignement méticuleux avec l’ordonnancement de l’index de la série catégorielle, afin de s’assurer que les segments prioritaires reçoivent les tonalités intentionnellement prévues par le protocole de communication graphique.
5.2 Utilisation des palettes perceptuelles de Matplotlib et Seaborn
L’élaboration manuelle de listes de couleurs hexadécimales présente des limites structurelles lorsqu’il s’agit de garantir une uniformité de la luminosité et de la saturation. C’est pourquoi le recours aux nuanciers scientifiquement calibrés issus de l’écosystème Matplotlib et de la bibliothèque Seaborn s’impose comme une démarche méthodologique supérieure. Ces palettes, modélisées selon des critères perceptuels rigoureux, préviennent les distorsions visuelles où certaines couleurs artificiellement vives attirent indûment l’attention au détriment de l’importance statistique réelle du secteur.
Dans le cadre d’un découpage qualitatif où chaque catégorie incarne une modalité nominale sans hiérarchie inhérente (telle qu’une répartition géographique ou taxonomique), il est impératif d’adopter des palettes qualitatives, comme celles issues des conventions de Cynthia Brewer (famille ColorBrewer). Ces nuanciers garantissent que chaque teinte dispose d’une luminance équivalente, interdisant à une modalité d’apparaître trompeusement prépondérante du simple fait d’un éclat chromatique asymétrique.
Pour instancier de manière programmatique ces distributions harmonisées au sein de l’appel de dessin de Pandas, l’analyste fait appel aux modules de gestion des cartes de couleurs de Matplotlib. Il est aisé d’échantillonner un ensemble discret de teintes équidistantes le long d’un gradient continu ou d’extraire une liste formelle de nuances qualitatives en utilisant les fonctionnalités de sélection de palettes offertes par Seaborn. Cette technique garantit une homogénéité chromatique irréprochable sur l’ensemble des figures d’un rapport de recherche ou d’un tableau de bord de production.
5.3 Contraste, accessibilité visuelle et daltonisme dans la restitution graphique
L’universalité de la transmission d’informations scientifiques exige une prise en compte systématique des déficiences de la vision chromatique, qui affectent une fraction substantielle de la population masculine et féminine à l’échelle mondiale (notamment les formes de deutéranopie, protanopie et tritanopie). L’usage de combinaisons chromatiques non différentiables pour un observateur daltonien — au premier rang desquelles figure la confrontation classique et méthodologiquement désastreuse entre le rouge et le vert — doit être formellement proscrit des visualisations quantitatives sérieuses.
L’emploi de palettes perceptuellement uniformes telles que viridis, cividis ou plasma, initialement développées pour la recherche en astrophysique et en imagerie médicale, constitue une réponse technique robuste. Ces nuanciers conservent une gradation de contraste strictement monotone même lorsqu’ils sont convertis en niveaux de gris intégaux, garantissant ainsi l’intelligibilité des rapports imprimés en mode monochrome ou visualisés par des individus présentant des dyschromatopsies sévères.
En outre, l’accessibilité requiert un contrôle strict du ratio de contraste lumineux entre les étiquettes textuelles superposées et la surface sous-jacente des secteurs angulaires. Selon les directives d’accessibilité aux contenus web (WCAG), un ratio minimal de contraste de 4.5:1 doit être scrupuleusement respecté. Lorsque l’analyste déploie des palettes aux tonalités foncées, l’application systématique d’une typographie blanche immaculée ou le recours à des contours géométriques extérieurs permet d’assurer une lisibilité irréprochable des inscriptions chiffrées sans fatigue cognitive pour le lectorat.
6. Contrôle géométrique : angles de départ, direction et explosion des secteurs
La spatialisation des secteurs au sein de l’espace bidimensionnel obéit à des conventions trigonométriques qui, si elles ne sont pas maîtrisées, peuvent perturber la fluidité de lecture et masquer la structure hiérarchique des données.
6.1 Orientation angulaire initiale avec startangle
Par convention mathématique fondamentale héritée de la trigonométrie euclidienne sur le plan cartésien, l’angle d’origine nul (zéro degré) correspond rigoureusement au demi-axe horizontal droit dirigé vers l’est géographique. Dans sa configuration initiale par défaut, le moteur de tracé sectoriel positionne l’arête de départ du premier secteur de données sur ce vecteur horizontal et propage l’ordonnancement des parts de manière séquentielle le long de la circonférence.
Toutefois, les études menées en psychologie de la lecture visuelle démontrent de manière probante que les observateurs humains formés aux cultures typographiques occidentales amorcent spontanément leur parcours d’inspection cognitive au sommet vertical de la composition (l’équivalent de midi sur un cadran horloger conventionnel). Maintenir un angle de départ horizontal brise cet ancrage naturel et contraint le regard à une recherche fastidieuse du point de démarrage de la partition statistique.
L’utilisation concertée de l’argument de rotation initiale fixé précisément à quatre-vingt-dix degrés permet de réaligner l’arête d’amorce du tracé sur le zénith vertical du cercle. Cette configuration positionne la modalité inaugurale — qui gagne grandement à correspondre à la classe statistique dominante issue d’un tri préalable — dans la posture de lecture la plus intuitive, guidant ensuite l’attention de l’analyste dans un parcours séquentiel fluide qui optimise la hiérarchisation perceptive des parts relatives.
6.2 Mise en exergue de modalités spécifiques via le paramètre explode
L’isolation focale d’une modalité particulière — qu’il s’agisse de documenter une anomalie épidémiologique, d’attirer l’attention sur un segment budgétaire en déficit ou d’isoler une classe cible — nécessite une rupture géométrique délibérée au sein de la continuité du contour circulaire. L’argument de décollement mécanique fractionnaire répond précisément à cette exigence fonctionnelle.
Ce paramètre attend une séquence itérable de grandeurs flottantes scalaires dont la dimension vectorielle doit impérativement coïncider avec la cardinalité des tranches représentées. Chaque coefficient numérique stipule la distance radiale d’éloignement accordée au secteur correspondant, exprimée sous la forme d’une fraction décimale du rayon total du disque. Une valeur nulle préserve le secteur dans sa contiguïté spatiale standard, tandis qu’une valeur non nulle repousse le polygone sélectionné vers l’extérieur le long de sa bissectrice angulaire centrale.
L’application d’un décalage radial exige toutefois une extrême modération sémiologique. L’attribution de coefficients disproportionnés (excédant typiquement zéro virgule quinze ou deux dixièmes de rayon) disjoint excessivement la modalité ciblée, au point d’empêcher toute comparaison visuelle d’aire avec les autres composants et de détruire la perception de cohésion d’ensemble du disque unitaire. Le décollement doit agir comme un accent visuel discret et non comme une désarticulation destructive du modèle proportionnel.
6.3 Normalisation des coordonnées et conservation du ratio d’aspect circulaire
Une pathologie graphique courante et pourtant invalidante réside dans l’apparition de distorsions elliptiques altérant les figures sectorielles. Par défaut, le moteur graphique de Matplotlib ajuste dynamiquement l’échelle des axes d’abscisses et d’ordonnées pour occuper l’intégralité du canevas rectangulaire défini par les dimensions physiques de la figure. En conséquence directe de cette interpolation élastique asymétrique, un diagramme circulaire se transforme fréquemment en un ovale déformé.
Cette déformation géométrique s’avère scientifiquement inacceptable car elle détruit instantanément l’homothétie entre la valeur scalaire de la donnée et l’angle sous-tendu : les secteurs orientés le long de l’axe spatial étiré bénéficient artificiellement d’une aire perçue supérieure à celle des secteurs orientés le long de l’axe comprimé, introduisant un biais visuel majeur. Pour neutraliser cette aberration, l’analyste doit formellement imposer un rapport d’aspect strictement unitaire au repère de projection en invoquant l’instruction d’égalisation géométrique sur les axes.
Parallèlement, la définition explicite de la taille du canevas graphique via le paramètre dimensionnel permet d’octroyer une surface matricielle parfaitement symétrique au conteneur de rendu, écartant tout risque de contrainte anisotrope. Enfin, le paramètre booléen régissant le sens de propagation permet, si les conventions du domaine l’exigent, d’inverser le sens trigonométrique anti-horaire par défaut au profit d’un parcours rigoureusement horaire conforme à la rotation usuelle des aiguilles d’une montre.
7. Gestion des éléments périphériques : légendes, titres et annotations
La contextualisation d’un graphique constitue le garant de son autonomie informative. Un graphique scientifiquement exploitable doit porter en lui-même l’ensemble des clés explicatives nécessaires à son interprétation univoque sans dépendre exclusivement du corps du texte environnant.
7.1 Structuration épistémique et typographique du titre via le paramètre title
Le titre attribué à une restitution sectorielle ne saurait se borner à un énoncé évasif ou purement descriptif. Il assume une fonction épistémique de premier ordre en énonçant formellement la variable catégorielle considérée, l’indicateur quantitatif sous-jacent, l’unité de mesure retenue ainsi que le cadre spatiotemporel et la taille de la cohorte d’étude. Ce formalisme garantit que l’observateur dispose immédiatement des repères méthodologiques indispensables à l’évaluation de la pertinence des résultats.
L’interface de Pandas facilite l’injection directe d’un intitulé textuel par l’entremise de son paramètre de titre dédié. Néanmoins, pour des besoins de publication rigoureux, l’accès direct aux méthodes de configuration de l’instance d’axes offre des degrés de liberté considérablement supérieurs. Il devient possible de paramétrer finement le corps typographique, la graisse de la fonte, l’espacement vertical par rapport à la circonférence supérieure du disque, voire de définir des sous-titres hiérarchisés en exploitant les retours à la ligne structurels.
L’incorporation explicite de la taille globale de l’échantillon au sein du bandeau de titre — selon les conventions internationales de standardisation — permet d’ancrer immédiatement les proportions dans leur réalité démographique ou physique. Cette précaution prévient les interprétations abusives où des partitions visuellement spectaculaires dissimulent en réalité des effectifs absolus dérisoires ne permettant aucune inférence causale robuste.
7.2 Configuration avancée de la légende (legend=True, bbox_to_anchor)
L’arbitrage entre l’apposition d’étiquettes nominatives directement sur la circonférence des secteurs et la déportation de ces informations vers une boîte de légende externalisée dépend intimement de la densité textuelle des libellés et du nombre de modalités représentées. Lorsque les désignations catégorielles comportent des intitulés polysyllabiques étendus, leur maintien le long du périmètre circulaire provoque fréquemment des débordements au-delà du canevas de la figure ou des superpositions anarchiques.
L’activation formelle de la légende graphique via le paramètre booléen idoine permet de purger la périphérie du disque de tout encombrement textuel, confiant l’identification des classes à un cartouche indépendant pourvu des pastilles de rappel chromatique. La gestion du positionnement de cette boîte de légende exige cependant une rigueur absolue : laissée à son comportement automatique par défaut, elle s’implante fréquemment à l’intérieur même de l’espace de tracé, occultant partiellement les secteurs angulaires sous son cadre opaque.
Pour déporter de manière pérenne et déterministe la légende hors de l’enveloppe circulaire du disque, l’analyste doit mobiliser l’attribut d’ancrage par boîte englobante de l’objet de légende Matplotlib. En stipulant des coordonnées relatives situées au-delà de l’unité spatiale des axes, le cartouche se positionne harmonieusement sur le flanc latéral de la composition sans entrer en collision avec le cercle, tout en autorisant une personnalisation avancée du nombre de colonnes d’affichage et de la présence ou suppression de l’encadrement périphérique.
7.3 Suppression ou modification des étiquettes d’axe résiduelles
Un artefact particulièrement inélégant — et néanmoins omniprésent lors de l’usage naïf de l’interface de tracé de Pandas — réside dans la persistance involontaire d’une étiquette textuelle verticale accolée au flanc gauche de la composition. En effet, lors de la conversion d’un objet de type Série ou DataFrame en graphique circulaire, le wrapper graphique assigne automatiquement le nom structurel de la colonne quantitative ou de l’index au libellé de l’axe des ordonnées de l’instance d’axes Matplotlib sous-jacente.
Dans le contexte géométrique d’une projection cartésienne traditionnelle, la présence de ce libellé d’ordonnée est indispensable pour expliciter l’échelle de mesure verticale. Cependant, au sein d’une projection polaire fermée où la notion même d’axe orthogonal disparaît au profit d’un rayon et d’un angle circulaire, ce texte résiduel s’avère totalement hors de propos. Il flotte de manière incongrue parallèlement au disque sans aucune fonction sémiotique, parasitant la clarté visuelle et trahissant un manque d’aboutissement technique de la restitution.
Pour éradiquer cet artefact graphique, l’analyste doit impérativement neutraliser cette métadonnée résiduelle dès la finalisation du tracé. Cette opération s’effectue avec une remarquable simplicité en accédant à la méthode de mise à jour du libellé d’axe des ordonnées de l’objet d’axes et en lui assignant une chaîne de caractères strictement vide, ou en procédant à sa suppression directe au sein du flux d’instructions. La zone de tracé retrouve instantanément une pureté géométrique épurée conforme aux canons de l’édition scientifique internationale.
8. Transformation structurelle : conception de graphiques en anneau (Donut Charts)
Le graphique en anneau, ou diagramme circulaire évidé, ne constitue pas une simple variation stylistique du disque classique. Il procède d’une réflexion ergonomique profonde visant à compenser les limitations perceptuelles intrinsèques à l’évaluation des surfaces triangulaires courbées.
8.1 Justification cognitive et réduction du biais d’estimation surfacique
D’un point de vue psychophysique, l’évidement du centre géométrique d’un diagramme circulaire transforme radicalement la tâche perceptive imposée au lecteur. Dans un diagramme sectoriel plein standard, l’appareil cognitif de l’observateur tente simultanément d’évaluer trois stimuli géométriques concurrents : l’angle central au sommet, la surface totale bidimensionnelle du triangle sphérique, et la longueur d’arc périphérique sous-tendue le long de la circonférence extérieure.
Cette multiplicité d’indices contradictoires génère des interférences de décodage notables. En perforant le barycentre de la figure, l’anneau supprime formellement le point de convergence des angles au sommet, contraignant ainsi le cortex visuel à focaliser son attention analytique quasi exclusivement sur la longueur d’arc circonférentielle et l’épaisseur uniforme de la bande courbée. Ce mécanisme cognitif rapproche l’exercice perceptif de l’évaluation d’une échelle linéaire classique — tâche pour laquelle l’œil humain manifeste une précision notoirement supérieure —, réduisant substantiellement les biais d’estimation surfacique.
En outre, l’émergence d’un espace vide central substantiel confère au concepteur un ancrage spatial privilégié pour y consigner une synthèse quantitative synthétique. Loin d’être un espace perdu, cette aire protégée permet d’héberger l’indicateur-clé de performance unifié de la cohorte analysée — par exemple la volumétrie globale absolue, un ratio de performance consolidé ou une moyenne d’ensemble —, évitant la dispersion du regard et structurant la lecture de la figure selon un double niveau de lecture : l’agrégat central macroscopique et sa déclinaison catégorielle microscopique périphérique.
8.2 Implémentation technique via l’insertion d’un cercle central (plt.Circle)
Bien que Pandas n’expose pas d’argument dédié explicitement dénommé sous le vocable d’anneau dans sa méthode de tracé sectoriel directe, la confection d’un graphique en couronne s’effectue avec une remarquable élégance technique grâce à l’interopérabilité offerte par Matplotlib. Le principe computationnel repose sur le paradigme du masquage géométrique par superposition de calques vectoriels sur le même système d’axes.
Le protocole algorithmique s’articule en deux étapes chronologiques séquentielles :
l’analyste commence par générer un tracé sectoriel plein conventionnel via l’appel standard de Pandas en capturant scrupuleusement l’instance d’axes retournée ; subséquemment, il instancie un nouvel objet géométrique vectoriel — spécifiquement un patch circulaire — issu du sous-module des formes de Matplotlib, auquel il confère un centre calé rigoureusement sur l’origine des coordonnées cartésiennes ainsi qu’une teinte de remplissage strictement identique à la couleur d’arrière-plan du canevas de rendu.
L’injection de cette pièce géométrique au sein du conteneur d’axes est ensuite réalisée par l’entremise de la méthode d’adjonction de patch vectoriel. Dès son insertion, le disque central nouvellement projeté vient recouvrir le cœur des différents secteurs polygonaux tracés lors de l’étape initiale. Par simple illusion d’optique euclidienne, le diagramme plein se métamorphose instantanément en une couronne parfaitement découpée, sans qu’aucune modification mathématique complexe des coordonnées polaires des données n’ait été requise.
8.3 Paramétrage du rayon intérieur et de l’épaisseur de la couronne
L’arbitrage géométrique relatif au dimensionnement du rayon intérieur du patch de masquage conditionne tant l’efficacité sémiologique que l’harmonie esthétique de l’anneau final. Ce paramètre dimensionnel s’exprime sous la forme d’un coefficient flottant relatif indexé sur le rayon unitaire du disque externe sous-jacent. Un calibrage rigoureux préconise d’établir ce ratio central dans un intervalle compris entre zéro virgule cinquante et zéro virgule soixante-dix.
Une valeur inférieure à la borne basse préserve une bande périphérique excessivement épaisse qui réintroduit les ambiguïtés d’estimation surfacique propres au disque plein tout en réduisant l’espace textuel intérieur à une exiguïté inexploitable. À l’inverse, un coefficient excédant la borne haute amincit démesurément la bande sectorielle extérieure, transformant les segments en de simples fils colorés au sein desquels il devient techniquement impossible d’inscrire la moindre valeur de pourcentage lisible, reportant intégralement le fardeau identificatoire sur la légende périphérique.
Une fois le rayon central optimal calibré, l’insertion des descripteurs textuels au sein de l’espace vacant s’opère par l’invocation de la commande d’annotation textuelle centrée sur les axes. En spécifiant des coordonnées médianes nulles et en verrouillant les alignements typographiques vertical et horizontal sur le centre, l’analyste compose un message multi-lignes hiérarchisé — associant par exemple un label descriptif en fonte fine et la valeur totale absolue en typographie grasse — conférant à la restitution une lisibilité et une puissance d’évocation maximales.
9. Visualisation de sous-groupes complexes et gestion des catégories multiples
L’un des écueils majeurs rencontrés lors du traitement de jeux de données massifs ou hautement granulaires réside dans la prolifération incontrôlée de catégories résiduelles qui détruisent la lisibilité de la figure.
9.1 Gestion du bruit cognitif face à une cardinalité élevée
La limite d’acceptabilité empirique d’un graphique circulaire en matière de cardinalité d’échantillonnage est fermement ancrée dans les sciences de la mémoire de travail : au-delà de cinq à sept modalités distinctes, la capacité du cerveau humain à maintenir une discrimination différentielle instantanée entre les segments s’effondre de manière drastique. La multiplication des classes entraîne inévitablement un morcellement de l’espace géométrique en une myriade de micro-secteurs d’amplitudes angulaires infinitésimales.
Ce phénomène de dispersion catégorielle — couramment désigné sous le terme de pollution visuelle ou bruit cognitif — génère des pathologies sémiologiques rédhibitoires : chevauchement anarchique des annotations de pourcentages qui deviennent indéchiffrables, saturation des palettes chromatiques contraignant à l’usage de nuances indistinctes les unes des autres, et étalement démesuré de la boîte de légende qui finit par occuper une surface spatiale supérieure à celle du graphique lui-même.
Dès lors, face à une table de données affichant une haute cardinalité sur sa variable de regroupement, le chercheur ne doit pas chercher à forcer la restitution exhaustive de l’ensemble des modalités au sein du disque. Une analyse statistique rigoureuse exige d’opérer une distinction formelle entre les facteurs dominants, qui structurent l’essentiel de la variance de la distribution, et les signaux marginaux ou bruits de fond d’échantillonnage, qui doivent subir une condensation algorithmique préalable avant toute démarche de visualisation.
9.2 Stratégie de regroupement des catégories résiduelles sous l’étiquette ‘Autre’
Le traitement méthodologique standard pour endiguer la dispersion catégorielle consiste à appliquer un algorithme de partitionnement conditionnel selon un seuil d’admissibilité relatif. L’approche consiste à calculer le poids proportionnel de chaque modalité par rapport à la masse totale cumulée et à réassigner systématiquement toutes les entités n’atteignant pas une valeur critique (fixée conventionnellement entre deux et cinq pour cent) au sein d’une unique macro-catégorie résiduelle baptisée conventionnellement du vocable unifié « Autres ».
Sous l’environnement technique de Pandas, cette mutation s’opère avec une remarquable élégance sans rupture de chaîne de traitement. Deux méthodologies vectorisées s’offrent au développeur : le recours à la méthode de remplacement conditionnel, qui substitue les étiquettes originales par le descripteur d’agrégation dès lors que le masque booléen de représentativité s’évalue à faux, ou l’usage de l’indexation par tri décroissant des effectifs où seules les premières modalités sont conservées intactes, le solde résiduel étant aggloméré par une sommation finale.
Cette condensation structurelle préserve scrupuleusement l’exactitude mathématique de la figure finale : la somme vectorielle de l’ensemble des composantes — y compris la modalité agrégée — demeure rigoureusement égale à cent pour cent de la distribution observée, prévenant toute distorsion d’échelle. D’un point de vue sémiologique, il est d’usage constant d’attribuer à ce secteur composite une teinte neutre désaturée (telle qu’un gris moyen) pour signaler visuellement son statut d’amalgame hétérogène et éviter qu’il ne capte indûment l’attention visuelle au détriment des classes d’intérêt théorique premier.
9.3 Tracé de sous-graphiques comparatifs (subplots) pour données stratifiées
L’ambition d’analyser la décomposition proportionnelle d’un phénomène à travers plusieurs strates démographiques, temporelles ou expérimentales distinctes soulève le défi de la multi-dimensionnalité. Tenter d’agréger l’ensemble de ces sous-populations au sein d’un graphique circulaire unique aboutit à une confusion analytique insoluble, le disque ne disposant que d’un plan univarié pour projeter ses grandeurs.
La solution méthodologique préconisée réside dans le déploiement de sous-graphiques multiples agencés au sein d’une même matrice visuelle (concept théorisé sous le vocable de small multiples par Edward Tufte). L’interface de Pandas intègre nativement cette faculté par le biais de son paramètre de génération de sous-tracés. Lorsque la méthode est invoquée sur un DataFrame dont les colonnes représentent des strates temporelles distinctes ou des conditions expérimentales parallèles, le moteur subdivise le canevas en une série ordonnée de diagrammes circulaires autonomes disposés en grille.
Pour assurer la validité scientifique de la comparaison inter-panneaux, l’analyste doit impérativement veiller à l’unification chromatique et taxonomique absolue de la composition : chaque modalité catégorielle doit impérativement conserver une couleur identique, un angle de départ uniforme et une orientation géométrique constante d’un sous-graphique à l’autre. Cette invariance structurelle libère l’effort cognitif du lecteur, lui permettant de concentrer son analyse sur les réallocations réelles de proportions relatives entre les différentes conditions expérimentales observées.
10. Bonnes pratiques statistiques et limites cognitives du diagramme circulaire
Une visualisation de données ne saurait être dissociée d’un examen critique de ses fondements perceptuels et de ses domaines de validité scientifique. L’analyste doit savoir discerner les cas d’usage où le diagramme en secteurs s’avère recevable de ceux où il doit être impérativement supplanté par d’autres constructions graphiques.
10.1 Biais cognitifs associés au décodage de l’angle versus la longueur
L’inadéquation structurelle du graphique en secteurs pour les tâches de jugement quantitatif fin découle directement de la hiérarchie cognitive établie par les sciences psychophysiques de la vision. L’évaluation de l’amplitude d’un angle circulaire nécessite la mobilisation conjointe d’opérations mentales complexes : extrapolation des arêtes rectilignes vers le centre focal virtuel, estimation de la courbure périphérique de l’arc sous-tendu et intégration surfacique de l’enveloppe du polygone curviligne.
Ce processus cognitif à haute intensité de charge mentale induit une variabilité considérable dans le jugement comparatif. Lorsqu’un lecteur est confronté à deux secteurs angulaires présentant des grandeurs légèrement divergentes mais d’ordres de grandeur similaires (par exemple une fraction représentant vingt-quatre pour cent du total et une seconde s’établissant à vingt-six pour cent), le taux d’erreur d’identification de la modalité dominante s’élève de manière spectaculaire si le graphique est dépourvu d’étiquettes alphanumériques directes.
En outre, l’illusion de perspective constitue un facteur d’altération cognitive redoutable. Les artefacts de conception graphique intégrant des faux effets de profondeur tridimensionnelle (graphiques pseudo-3D) courbants le disque vers le bas induisent une distorsion anamorphique sévère : les secteurs situés sur la portion inférieure du premier plan visuel bénéficient artificiellement d’un étalement de surface accru par effet de projection conique, paraissant démesurément plus imposants que les secteurs de dimensions rigoureusement identiques repoussés sur le plan d’arrière-plan supérieur. Cette déformation viole les principes d’éthique de la communication quantitative.
10.2 Analyse comparative : quand préférer le diagramme en barres
Face aux limites inhérentes à l’encodage par secteurs circulaires, le recours au diagramme en barres (qu’il soit orienté verticalement ou horizontalement) s’affirme comme l’alternative méthodologique universellement supérieure dès lors que la restitution vise la comparaison différentielle précise. Dans un diagramme en barres normalisé, chaque grandeur scalaire est traduite en une longueur unidimensionnelle linéaire ancrée sur une ligne de base commune d’origine zéro.
Cette conformation permet à l’observateur de mobiliser la tâche d’estimation la plus performante de l’appareil perceptuel humain : la comparaison de positions relatives le long d’une échelle partagée. Des deltas infinitésimaux de l’ordre d’une fraction de pour cent deviennent instantanément identifiables d’un simple balayage oculaire horizontal ou vertical, sans qu’il soit impératif de surcharger la figure d’annotations chiffrées omniprésentes.
La supériorité opérationnelle du diagramme en barres s’avère éclatante dans deux configurations archétypales : le suivi longitudinal de séries temporelles — pour lesquelles la projection circulaire est structurellement incapable d’exprimer la flèche chronologique — et l’exploration de distributions comportant plus d’une demi-douzaine de modalités catégorielles. Le domaine de légitimité scientifique résiduel du graphique en secteurs se limite ainsi strictement aux visualisations macroscopiques destinées à des communications grand public où l’objectif unique réside dans l’illustration synoptique d’un clivage dichotomique ou tripartite majeur.
10.3 Rigueur méthodologique dans la communication des distributions empiriques
Le respect scrupuleux de l’intégrité déontologique dans la communication des données statistiques impose des barrières infranchissables lors de l’usage des diagrammes circulaires. La première de ces exigences réside dans le dogme de l’exhaustivité sommative absolue : un diagramme en secteurs ne saurait en aucun cas être tracé si la somme algébrique des pourcentages des composantes représentées ne totalise pas exactement cent pour cent (aux tolérances infinitésimales près inhérentes aux arrondis décimaux d’affichage).
La publication de graphiques sectoriels issus d’enquêtes à questions à choix multiples — au sein desquelles un même répondant est autorisé à sélectionner simultanément plusieurs modalités indépendantes — constitue l’une des infractions méthodologiques les plus destructrices pour la crédibilité d’un rapport de recherche. Dans une telle hypothèse, la somme cumulée des fractions relatives excède structurellement l’unité pour atteindre des totaux de cent cinquante ou deux cents pour cent, rendant la projection sur un disque géométrique de deux pi radians dépourvue de tout sens mathématique.
Enfin, la transparence méthodologique exige d’associer systématiquement aux visualisations en proportions la divulgation explicite de la taille globale de l’échantillon sous-jacent (la métrique scalaire N). Une part relative de cinquante pour cent n’emporte pas les mêmes implications épistémiques et décisionnelles selon qu’elle reflète l’avis de deux individus sur une cohorte de quatre sujets ou qu’elle scelle le consensus de cinquante mille citoyens au sein d’une enquête nationale représentative.
11. Sauvegarde haute résolution et intégration dans des publications académiques
L’aboutissement du cycle analytique réside dans l’exportation de l’artéfact graphique vers un format d’encodage pérenne, conforme aux exigences de résolution et de typographie imposées par les comités éditoriaux des revues scientifiques internationales.
11.1 Export vectoriel et matriciel via figure.savefig()
La chaîne de traitement graphique native de Pandas, adossée à Matplotlib, offre une flexibilité totale quant au formatage physique des fichiers d’exportation. Pour engager ce processus de sauvegarde sur le système de stockage persistant, l’analyste doit d’abord extraire l’objet Figure parent à partir de l’instance d’axes Matplotlib préalablement capturée lors de l’exécution de la méthode de tracé, puis invoquer sa méthode de sauvegarde dédiée.
Un arbitrage fondamental intervient dans le choix entre les formats matriciels non compressés ou compressés sans perte (tels que le format PNG) et les formats vectoriels d’encodage géométrique pur (tels que les formats SVG, PDF ou EPS). Pour une diffusion sur support numérique matriciel standard ou pour une incorporation rapide dans des diapositives de présentation, un export matriciel configuré avec un canal de transparence alpha activé confère une intégration esthétique parfaite en éliminant les cadres opaques discordants sur fond texturé.
Cependant, pour l’intégration formelle au sein d’un manuscrit soumis à un comité de lecture ou destiné à l’impression typographique offset haute définition, l’export sous format vectoriel s’avère non négociable. Les formats vectoriels encodent les secteurs géométriques, les courbes d’arcs et les polices typographiques sous la forme d’équations mathématiques scalaires autonomes. Cette architecture garantit une absence totale de pixellisation ou d’artefacts d’interpolation, conférant à la figure une netteté infinitésimale quel que soit le niveau de grossissement opéré par l’imprimeur ou le lecteur.
11.2 Paramétrage de la résolution spatiale et du cadrage géométrique
Lorsqu’un export matriciel de type PNG est décrété indispensable pour satisfaire aux contraintes d’une plateforme de publication web, l’analyste doit formellement court-circuiter la résolution par défaut du moteur de tracé — traditionnellement fixée à une valeur étriquée de cent points par pouce — pour lui substituer une densité d’échantillonnage conforme aux standards professionnels de l’édition scientifique, s’établissant minimalement à trois cents, voire six cents points par pouce pour les schémas linéaires complexes.
Parallèlement, la maîtrise de l’emprise spatiale du cadrage périphérique constitue une étape déterminante pour prévenir les troncatures textuelles intempestives. Par défaut, le moteur de sauvegarde Matplotlib applique une boîte de découpe statique alignée sur les dimensions physiques brutes de la figure. Si l’analyste a fait usage de labels extérieurs repoussés ou d’une boîte de légende déportée via des coordonnées d’ancrage décentrées, ces éléments graphiques périphériques se trouvent fréquemment tranchés net au ras du fichier exporté.
L’introduction méthodique du paramètre de découpage ajusté au sein de l’instruction d’exportation contraint le moteur de rendu à recalculer dynamiquement les frontières de la boîte englobante de l’ensemble des éléments vectoriels de la scène avant d’enregistrer le fichier. Ce mécanisme assure l’inclusion intégrale des annotations périphériques, tout en autorisant un calibrage millimétré des marges de composition par l’entremise du paramètre d’espacement de marge, garantissant une intégration sans friction dans les canevas d’édition typographique de type LaTeX.
11.3 Respect des normes de présentation éditoriale et conventions scientifiques
L’incorporation d’une figure sectorielle dans un corpus académique de haut rang implique une conformité stricte aux chartes graphiques et typographiques internationales, telles que les normes édictées par l’American Psychological Association (APA). Ces standards méthodologiques régissent non seulement la composition graphique en elle-même, mais également l’ordonnancement de son appareil critique d’accompagnement.
La règle d’or d’une présentation professionnelle réside dans l’harmonisation typographique complète entre le graphique et le corps du texte du manuscrit. La police de caractères employée pour les pourcentages, les catégories et la légende doit impérativement correspondre à la famille de fonte mobilisée dans le document textuel (qu’il s’agisse de polices avec ou sans empattement), tout en préservant une échelle de corps rigoureusement proportionnelle qui interdit la présence de caractères minuscules illisibles à la réduction d’impression.
Enfin, l’inscription d’une légende textuelle sous-jacente autonome conditionne l’acceptabilité de la publication. Cette note de figure, rédigée selon les normes de contextualisation scientifique en vigueur, doit expliciter méthodiquement la signification de chaque abréviation, rappeler formellement la source primaire des données empiriques, certifier le traitement opéré sur les catégories résiduelles et souligner d’éventuels intervalles de confiance associés aux estimations de proportions, assurant ainsi une parfaite reproductibilité de l’inférence statistique.
12. Études de cas appliquées et implémentations complètes pas à pas
Afin de synthétiser les concepts théoriques, algorithmiques et graphiques disséqués tout au long de cet ouvrage, cette dernière section déploie deux études de cas complètes issues de scénarios d’ingénierie réels, suivies d’une matrice méthodologique réutilisable pour la pratique analytique quotidienne.
12.1 Cas pratique 1 : Distribution des scores expérimentaux par cohorte
Considérons un protocole expérimental mené en neurosciences cognitives évaluant les performances d’un groupe d’individus stratifiés selon cinq cohortes distinctes réparties au sein d’une table d’observations longitudinales. Les données brutes recueillies se présentent sous la forme d’un tableau comportant l’identifiant du participant, son assignation de cohorte et un score métrique continu d’efficacité cognitive mesuré après application d’un stimulus.
Le pipeline analytique débute par l’ingestion tabulaire au sein d’un DataFrame Pandas, suivi d’un contrôle d’intégrité attestant l’absence de scores négatifs et la purge des valeurs non définies. L’analyste procède ensuite à un regroupement partitionné indexé sur la variable nominale de cohorte, en appliquant un opérateur de sommation scalaire sur la colonne des scores cognitifs pour mesurer la part respective de chaque groupe dans la performance globale accumulée par le système expérimental.
Pour la restitution graphique, l’analyste applique un tri décroissant sur la série résultante afin de garantir un ordonnancement spatial optimal. Le tracé est opéré en verrouillant un angle de rotation initiale vertical à quatre-vingt-dix degrés pour débuter par la cohorte dominante. Une palette qualitative issue des conventions perceptuelles de Seaborn est injectée via le paramètre de couleur. Les étiquettes relatives sont intégrées au moyen d’un formatage ne conservant qu’une seule décimale, tandis qu’une boîte de légende déportée sans bordure encombrante vient répertorier les noms formels des cohortes expérimentales sur le flanc droit de la figure, l’étiquette d’ordonnée résiduelle étant neutralisée.
12.2 Cas pratique 2 : Répartition temporelle de réponses comportementales
Ce second scénario mobilise un jeu de données transactionnelles volumineux issu de l’enregistrement en temps réel de réponses comportementales d’utilisateurs sur une interface numérique, classifiées selon une dizaine de catégories fonctionnelles. La problématique consiste à représenter la répartition fréquentielle des interactions, en gérant de manière rigoureuse la cardinalité élevée et en déployant un graphique en anneau enrichi d’un indicateur de volume central.
La première phase algorithmique consiste à dénombrer les fréquences unitaires de chaque modalité comportementale par l’application conjointe de l’agrégation catégorielle et de l’opérateur de comptage. Constatant la présence de multiples catégories n’agrégeant chacune que des fractions marginales inférieures à deux pour cent de la volumétrie globale, l’analyste applique une routine vectorisée de reclassement conditionnel sous l’étiquette unifiée « Autres », ramenant la cardinalité globale à cinq classes majeures et une classe résiduelle consolidée.
Le tracé du diagramme en secteur est ensuite orchestré sur un canevas symétrique. Pour isoler visuellement l’interaction primaire dont la dynamique fait l’objet de l’étude, l’analyste injecte un décalage radial modéré de cinq centièmes de rayon sur la première tranche. Un objet vectoriel de type patch circulaire blanc — présentant un rayon calibré à soixante-cinq pour cent du rayon nominal — est superposé au barycentre des axes, transformant le disque plein en couronne. Enfin, une fonction d’étiquetage textuel dépose au centre géométrique le volume absolu total des interactions enregistrées, offrant une synthèse analytique d’une limpidité absolue.
12.3 Synthèse des flux de travail réutilisables pour le chercheur
Pour assurer la pérennité et la standardisation de ces protocoles au sein des laboratoires ou des équipes d’ingénierie statistique, la consolidation du flux de travail sous la forme d’une fonction procédurale paramétrable constitue la démarche d’industrialisation logicielle recommandée. Cette routine d’abstraction prend en entrée un DataFrame brut, la désignation des colonnes nominale et quantitative, ainsi que des seuils de troncature automatique des catégories mineures, et retourne une figure entièrement formatée conforme aux standards éditoriaux.
Le tableau fonctionnel des paramètres cardinaux mobilisés dans l’interface de tracé sectoriel de Pandas s’établit comme suit :
- kind=’pie’ (ou df.plot.pie()) : Ordre impératif de projection géométrique en coordonnées polaires fermées pour la décomposition du tout unitaire.
- y : Spécification univoque de la variable numérique cible lors de l’application sur un conteneur DataFrame multivarié, levant toute ambiguïté dimensionnelle.
- autopct : Chaîne de formatage d’interpolation ou fonction algorithmique anonyme déterminant le calcul et l’affichage typographique des proportions chiffrées relatives.
- colors : Vecteur ordonné de descripteurs chromatiques hexadécimaux ou issus de palettes perceptuellement uniformes garantissant l’accessibilité sémiotique.
- startangle : Décalage trigonométrique d’amorce angulaire (recommandé à 90 degrés) alignant la première modalité statistique sur le sommet zénithal de la figure.
- explode : Séquence de coefficients radiaux décimaux orchestrant l’isolation spatiale d’une modalité d’intérêt analytique prioritaire.
- labels et legend : Mécanismes de dissociation entre l’étiquetage périmétrique direct et le déport contextuel des désignations taxonomiques vers un cartouche externe.
L’audit de conformité préalable à toute diffusion de données exige enfin une ultime validation humaine : s’assurer formellement de la pertinence irréductible de la partition circulaire par rapport à un tracé en barres linéaires, attester de l’exactitude de la somme cumulée à cent pour cent, et vérifier que la résolution d’exportation préserve la lisibilité totale des inscriptions chiffrées, garantissant ainsi le plein respect des règles déontologiques gouvernant la science des visualisations graphiques.
Références
Brewer, C. A. (2015). Designing better maps: A guide for GIS users (2nd ed.). Esri Press.
Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1922-00a
Playfair, W. (1801). The statistical breviary: Shewing, on a principle entirely new, the resources of every state and kingdom in Europe. T. Bensley.
Spence, I. (2005). No humble pie: The origins and usage of a statistical chart. Journal of Educational and Behavioral Statistics, 30(4), 353–368. https://doi.org/10.3102/10769986030004353
Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
Wickham, H. (2011). The split-apply-combine strategy for data analysis. Journal of Statistical Software, 40(1), 1–29. https://doi.org/10.18637/jss.v040.i01
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0