
Dans l’écosystème contemporain de l’économétrie appliquée et de l’ingénierie financière, la visualisation rigoureuse des données boursières constitue le point d’ancrage fondamental de toute démarche empirique. Les marchés financiers mondiaux, caractérisés par une stochasticité inhérente et une densité informationnelle colossale, génèrent des flux continus de transactions dont la synthèse visuelle conditionne la prise de décision, qu’elle soit humaine ou algorithmique. Parmi l’éventail des représentations géométriques conçues pour capturer la dynamique des cours, le graphique en chandeliers japonais — communément désigné sous l’anglicisme candlestick chart — s’est imposé comme le standard paradigmatique par excellence. Cette prééminence découle de sa remarquable capacité à compacter une multiplicité de dimensions cinématiques en une forme graphique unitaire, offrant une lisibilité immédiate des forces de confrontation entre l’offre et la demande sur un intervalle temporel discret.
Toutefois, la génération de ces artefacts visuels au sein d’environnements de recherche quantitative exige une flexibilité, une précision vectorielle et une reproductibilité scientifique que les logiciels de bureautique traditionnels ou les interfaces fermées ne sauraient garantir. C’est à ce croisement méthodologique précis que l’écosystème scientifique de Python, articulé autour de la bibliothèque matricielle NumPy, des structures tabulaires de Pandas et du moteur graphique de bas niveau de Matplotlib, déploie sa puissance architecturale. Matplotlib ne se cantonne pas à une simple couche de rendu générique ; il fournit une infrastructure graphique de précision permettant un contrôle atomique sur chaque entité géométrique, depuis l’épaisseur infinitésimale d’un segment de droite matérialisant une ombre jusqu’à la composition chromatique et spatiale d’un rectangle représentant le corps de la séance boursière.
Cet article propose une exploration exhaustive, didactique et théoriquement ancrée de la modélisation et du traçage programmatique des graphiques en chandeliers au moyen de Matplotlib. En décomposant les fondements sémiotiques des quatre grandeurs critiques du marché, en élucidant les défis algorithmiques posés par les discontinuités temporelles calendaires, et en disséquant l’implémentation vectorisée couche par couche, ce traité vise à doter les analystes quantitatifs, chercheurs en finance de marché et ingénieurs logiciels des compétences nécessaires pour bâtir des visualisations de qualité publication, exemptes de distorsions géométriques et conformes aux plus hauts standards de la science des données.
1. Introduction théorique aux graphiques en chandeliers japonais et à leur modélisation
1.1 Anatomie structurelle d’un chandelier financier
L’origine séculaire du chandelier japonais remonte aux travaux précurseurs de Munehisa Homma au XVIIIe siècle sur les marchés à terme de riz de Dojima à Osaka, travaux qui furent ultérieurement théorisés et introduits dans la finance occidentale moderne par Steve Nison. D’un point de vue purement topologique, un chandelier financier transcende la simple réduction scalaire d’un cours de clôture en agrégeant, pour chaque tranche de temps élémentaire spécifiée, un quadruplet de valeurs numériques délimitant le comportement de l’actif sous-jacent : le cours d’ouverture ($O$), le cours le plus haut ($H$), le cours le plus bas ($L$) et le cours de clôture ($C$). Cet ensemble ordonné, canoniquement désigné sous l’acronyme OHLC (Open, High, Low, Close), forme le squelette mathématique indispensable à la construction de la bougie.
La morphologie d’un chandelier se décompose géométriquement en deux composantes primordiales : le corps réel (real body) et les ombres ou mèches (shadows ou wicks). Le corps de la bougie est constitué par la zone polygonale — généralement un rectangle bidimensionnel — délimitée sur l’axe des ordonnées par le cours d’ouverture et le cours de clôture. L’amplitude verticale de ce corps, calculée par la valeur absolue de la différence entre la clôture et l’ouverture, $|C – O|$, reflète directement l’intensité de la pression directionnelle dominante durant l’intervalle d’observation. Un corps étiré témoigne d’un consensus unilatéral puissant et d’un déséquilibre marqué entre les flux acheteurs et vendeurs, tandis qu’un corps compressé ou inexistant (caractéristique d’un doji où $C \approx O$) traduit une phase de neutralité, d’indécision systémique ou de transition d’équilibre au sein du carnet d’ordres.
Les mèches, quant à elles, se matérialisent sous la forme de segments linéaires filiformes prolongeant le corps réel vers le haut et vers le bas le long de l’axe vertical des prix. L’ombre supérieure (upper shadow) s’étend depuis le sommet du corps réel, défini par $max(O, C)$, jusqu’au niveau du plus haut de la période ($H$). Symétriquement, l’ombre inférieure (lower shadow) relie la base du corps réel, définie par $min(O, C)$, au plus bas de la période ($L$). Ces extensions linéaires capturent la volatilité intra-période et quantifient les phénomènes de rejet de prix : une longue mèche supérieure révèle une tentative d’incursion haussière repoussée agressivement par des ordres vendeurs avant la clôture temporelle de l’intervalle. Les standards des bourses mondiales imposent une normalisation chromatique ou géométrique de cette disposition, permettant de distinguer instantanément les séances haussières ($C > O$, traditionnellement représentées par un corps vert, blanc ou vide) des séances baissières ($C < O$, représentées par un corps rouge ou plein).
1.2 Pertinence analytique dans l’évaluation des séries temporelles boursières
L’analyse des séries temporelles en micro-structure de marché met en lumière une asymétrie informationnelle fondamentale entre les différents modes de transcription graphique. Un graphique linéaire classique, restreint à la seule trajectoire continue des cours de clôture, souffre d’un biais d’effacement majeur : il occulte complètement l’amplitude des oscillations intradéterminées et comprime la variance locale en une simple trajectoire unidimensionnelle. À l’inverse, bien que les graphiques à barres traditionnels (barres OHLC occidentales) préservent l’intégralité des quatre grandeurs critiques, leur minceur géométrique uniforme sollicite un effort cognitif supérieur pour déchiffrer rapidement l’orientation relative de la séance, particulièrement lorsque des centaines d’occurrences sont juxtaposées sur un même écran.
Le chandelier japonais résout cette contrainte ergonomique en créant un contraste volumétrique marqué grâce à la surface plane de son corps réel. Cette condensation géométrique permet à l’observateur d’opérer une double analyse : une interprétation macroscopique de la tendance structurelle du sous-jacent à travers la succession des corps, et une auscultation microscopique des dynamiques de renversement potentielles matérialisées par des configurations spécifiques telles que les marteaux (hammers), les étoiles filantes (shooting stars) ou les avalements (engulfing patterns). Chaque bougie constitue ainsi un résumé statistique discret d’un processus stochastique sous-jacent modélisable, à l’échelle continue, par un mouvement brownien géométrique ou un processus à sauts de Poisson.
Néanmoins, la représentation en chandelier présente des limites structurelles intrinsèques qu’il convient de souligner d’un point de vue quantitatif. En discrétisant le flux continu des cotations en tranches temporelles arbitraires (par exemple, 1 minute, 1 heure, 1 jour), elle efface l’ordre séquentiel intra-période dans lequel le plus haut et le plus bas ont été atteints. Dès lors, deux séances présentant rigoureusement les mêmes métriques OHLC peuvent correspondre à des micro-trajectoires totalement divergentes au sein du carnet d’ordres, l’une illustrant une dépréciation brutale suivie d’une lente remontée, l’autre une montée linéaire précédant un effondrement soudain. Pour l’analyse à très haute fréquence (high-frequency trading), le chandelier doit donc être complété ou supplanté par des métriques continues directes (cotations tick-by-tick, profils de liquidité et cartographies du carnet de commandes).
1.3 Justification méthodologique de Python et Matplotlib dans la recherche quantitative
Dans l’écosystème scientifique international, Python s’est solidement établi comme le langage universel pour le prototypage rapide, la recherche quantitative et la mise en production de pipelines de calcul économique. Sa flexibilité syntaxique combinée à la vélocité d’implémentation de bibliothèques écrites en extensions C/C++ en fait un véhicule idéal pour manipuler d’immenses vecteurs de séries temporelles financières. Dans cette architecture, Matplotlib assume le rôle de moteur de rendu fondamental. Conçu à l’origine par John D. Hunter pour reproduire la logique matricielle de MATLAB au sein d’un environnement libre, Matplotlib fournit une infrastructure bas niveau d’une robustesse exceptionnelle, garantissant un contrôle déterministe sur chaque primitive de dessin.
Contrairement aux bibliothèques de haut niveau orientées vers le web ou l’exploration commerciale rapide, qui reposent fréquemment sur des moteurs JavaScript encapsulés et imposent des contraintes rigides sur l’agencement spatial, Matplotlib traite le graphique comme une véritable composition cartésienne programmable. Chaque élément — axe, graduation majeure, graduation mineure, étiquette textuelle, boîte de délimitation ou segment géométrique — est instancié sous la forme d’un objet Python manipulable directement en mémoire. Cette précision géométrique est vitale pour la recherche quantitative : elle autorise l’exact alignement des chandeliers avec des matrices d’ordres, des histogrammes de volume dérivés de micro-structures complexes ou des sous-panneaux d’indicateurs probabilistes.
De surcroît, l’interopérabilité sans couture entre Matplotlib, NumPy et Pandas assure que les flux de calcul matriciel ne subissent aucune déperdition de performance lors de la phase de conversion graphique. La manipulation d’objets `Series` et `DataFrame` munis d’un `DatetimeIndex` natif s’effectue avec une fluidité conceptuelle totale. Enfin, la dimension impérative de la recherche scientifique exige une reproductibilité absolue des visualisations : un script Python utilisant Matplotlib garantit qu’une figure boursière complexe générée pour une thèse ou une revue académique à comité de lecture demeurera strictement identique, au pixel près et à l’épaisseur de ligne près, quel que soit le système d’exploitation ou le serveur distant sans interface graphique (headless server) exécutant le traitement.
2. Environnement de développement et prérequis techniques
2.1 Installation et compatibilité des bibliothèques fondamentales
L’édification d’un pipeline robuste de rendu graphique financier nécessite la mise en place d’un environnement d’exécution isolé afin d’éviter toute interférence de dépendances logicielles. L’utilisation d’outils de gestion d’environnements virtuels, tels que l’utilitaire standard `venv` fourni avec la distribution standard de Python ou le gestionnaire de paquets binaire `conda`, constitue une bonne pratique incontournable. L’analyste doit s’assurer de déployer une version moderne de l’interpréteur Python (de préférence Python 3.9 ou une mouture supérieure) garantissant une prise en charge complète des spécifications typologiques récentes et des optimisations de performances matricielles apportées aux bibliothèques de bas niveau.
Les dépendances fondamentales de notre pile technique se structurent autour de trois axes : le calcul matriciel avec NumPy (version $ge$ 1.20), la manipulation de données tabulaires chronologiques avec Pandas (version $ge$ 1.3), et la génération visuelle avec Matplotlib (version minimale recommandée $ge$ 3.4 afin de bénéficier des améliorations notables apportées à la gestion des conteneurs de barres et aux localisateurs de dates). L’installation via le gestionnaire officiel de paquets de Python s’exécute typiquement par l’instruction de terminal suivante :
pip install numpy pandas matplotlib
Il est crucial de valider la compatibilité réciproque de ces bibliothèques, particulièrement en ce qui concerne la gestion interne des types d’horodatage. Matplotlib dispose de son propre sous-module de gestion chronologique (`matplotlib.dates`), qui convertit les dates et heures sous la forme d’un flottant représentant le nombre de jours écoulés depuis une époque canonique définie (l’époque standard étant le 1er janvier 1970 avec l’ajustement du calendrier grégorien proleptique). Une synchronisation rigoureuse entre les types `datetime64[ns]` de NumPy, les instances `Timestamp` de Pandas et les formats flottants requis par Matplotlib évite les exceptions d’incompatibilité de type au moment du passage des arguments aux primitives de dessin vectoriel.
2.2 Architecture logicielle et paradigmes de visualisation
L’une des sources majeures de confusion chez les développeurs abordant Matplotlib réside dans la coexistence historique de deux paradigmes d’interface distincts : l’interface fonctionnelle procédurale (`matplotlib.pyplot`, calquée sur l’héritage historique de MATLAB) et l’interface orientée objet (OO). L’approche procédurale s’appuie sur une machine à états sous-jacente implicite, où les commandes telles que `plt.plot()` ou `plt.title()` opèrent systématiquement sur la figure ou l’axe « courant » actif en mémoire. Bien que séduisante pour des manipulations fugaces dans un carnet interactif, cette approche révèle rapidement ses limites dès lors qu’il s’agit de concevoir des architectures graphiques complexes et modulaires, telles que des tableaux de bord boursiers intégrant plusieurs axes synchronisés.
Dans le cadre d’une modélisation financière avancée, l’adoption stricte et systématique du paradigme orienté objet s’impose impérativement. Cette architecture repose sur la dissociation fondamentale entre l’objet `Figure` et l’objet `Axes`. La `Figure` représente la surface totale du canevas, l’espace mémoire global englobant l’ensemble des éléments visuels, y compris les bordures extérieures, les titres généraux et les légendes transversales. L’objet `Axes`, quant à lui, incarne la région mathématique réelle de projection des données : il encapsule le système de coordonnées cartésiennes, les échelles, les limites numériques, les lignes de grille et l’intégralité des primitives graphiques (lignes, polygones, collections géométriques). En manipulant explicitement les références vers les objets `Axes`, l’analyste conserve la maîtrise absolue de chaque sous-composant de la scène.
Par ailleurs, la sélection du moteur de rendu (backend) de Matplotlib revêt une dimension stratégique selon le contexte de destination. Pour un affichage interactif dans un carnet Jupyter Notebook ou une session de débogage locale, des moteurs comme le module interactif `widget` ou les interfaces graphiques natives (Qt, Tk) sont sollicités. En revanche, pour la recherche académique ou les chaînes de traitement automatisées s’exécutant sur des serveurs distants de calcul, la configuration d’un moteur vectoriel passif (non-interactif) comme `Agg` (pour les formats matriciels matriciels PNG haute résolution) ou `pdf` / `svg` (pour la publication vectorielle sans crénelage) s’avère indispensable. Enfin, la libération déterministe des ressources mémoires via l’invocation formelle de `plt.close(fig)` constitue une exigence stricte pour éviter les fuites de mémoire (memory leaks) lors de la génération automatisée de plusieurs milliers de graphiques de backtesting.
3. Structure et préparation rigoureuse des données avec Pandas
3.1 Modélisation du DataFrame boursier canonique
L’ingénierie financière computationnelle repose sur la manipulation d’entités tabulaires standardisées. Dans l’écosystème Python, le `DataFrame` de Pandas constitue le standard universel pour héberger des séries temporelles boursières. Pour qu’une structure de données puisse être projetée sous forme de chandeliers sans ambiguïté algorithmique, elle doit obligatoirement présenter une organisation matricielle canonique constituée d’au moins quatre colonnes numériques continues : l’ouverture (`open`), le plus-haut (`high`), le plus-bas (`low`) et la clôture (`close`), complétées très fréquemment par la colonne de volume d’échange transactionnel (`volume`).
Une attention méticuleuse doit être accordée au typage sous-jacent de ces vecteurs. Les valeurs de prix doivent impérativement être transtypées en flottants de précision double (flottants 64 bits, soit le type standard `float64` dans NumPy et Pandas), conformément à la norme IEEE 754. L’utilisation inadéquate d’entiers ou de chaînes de caractères résiduelles issues de l’importation de fichiers CSV ou d’appels à des interfaces applicatives (API) corromprait instantanément les calculs géométriques de différentiels d’amplitude verticale et fausserait le positionnement spatial des boîtes.
Parallèlement, la dimension temporelle doit être rigoureusement structurée. L’index du DataFrame ne doit pas consister en une banale séquence d’entiers arbitraires, mais doit être formellement converti en un conteneur d’horodatage optimisé de type `pd.DatetimeIndex`. Lors de la création de séries simulées ou de la reconstruction de données historiques, l’analyste s’appuie avantageusement sur la fonction `pd.date_range()`, en spécifiant explicitement la fréquence de discrétisation (par exemple `’B’` pour les jours ouvrés bancaires, ou `’D’` pour les jours calendaires stricts). Cette configuration permet d’exploiter la puissance des méthodes de rééchantillonnage temporel et d’alignement chronologique intrinsèques à Pandas avant toute tentative de projection graphique.
3.2 Validation de la cohérence mathématique des séries de prix
Avant d’engager le moindre calcul de rendu graphique, une phase de validation défensive de l’intégrité axiomatique des données s’avère indispensable. En vertu des principes élémentaires régissant la formation des prix au sein d’une enceinte boursière, chaque enregistrement OHLC doit impérativement satisfaire un ensemble d’inégalités strictes traduisant la réalité physique des transactions :
- Le niveau le plus haut de la séance doit nécessairement dominer ou égaler toutes les autres grandeurs de l’intervalle : $H ge max(O, C)$ ;
- Le niveau le plus bas de la séance doit nécessairement être inférieur ou égal à toutes les autres grandeurs : $L le min(O, C)$ ;
- L’amplitude globale de l’intervalle doit être positive ou nulle : $H – L ge 0$ ;
- Toutes les grandeurs de prix doivent être strictement positives pour les actifs conventionnels : $min(O, H, L, C) > 0$.
Dans les jeux de données réels, il n’est pas rare de constater des corruptions introduites par des anomalies de transmission de paquets, des pannes de serveurs de flux ou des erreurs de saisie manuelle au niveau des bourses locales. Des incohérences géométriques fondamentales — telles qu’un cours le plus bas enregistré supérieur au cours de clôture ($L > C$) — produiraient des artefacts graphiques aberrants, matérialisés par des mèches négatives ou des inversions spatiales des polygones sur l’axe des ordonnées. Une étape d’assainissement systématique (data sanitation) doit être déployée dans le script Python afin d’identifier ces violations au moyen de masques booléens et de décider formellement de leur correction par interpolation ou de leur éviction pure et simple.
De surcroît, la problématique des valeurs manquantes (`NaN` pour Not a Number) et des ajustements historiques requiert une vigilance technique absolue. La présence d’une seule valeur non numérique au sein du quadruplet OHLC paralyse le tracé de la bougie correspondante ou provoque un décrochage inesthétique des courbes environnantes. De même, lorsqu’on analyse des séries couvrant plusieurs années, l’impact des divisions d’actions (stock splits) et des détachements de dividendes altère la continuité des cours. Il convient de s’assurer si les données fournies correspondent aux cours bruts ou aux cours ajustés (adjusted prices) ; l’utilisation de cours ajustés garantit la cohérence mathématique de la dynamique tendancielle, bien qu’elle puisse modifier les niveaux de prix nominaux historiques absolus.
3.3 Gestion des discontinuités temporelles de marché
L’un des écueils majeurs rencontrés lors du traçage de chandeliers boursiers réside dans la divergence structurelle existant entre le temps calendaire universel et le temps d’échange effectif. Les marchés financiers traditionnels ne fonctionnent pas de manière ininterrompue : ils ferment leurs portes durant les nuits, les fins de semaine et lors des jours fériés légaux propres à chaque juridiction financière. En conséquence, les séries chronologiques de cours d’actions réelles ne constituent pas des signaux continus, mais des séquences discontinues d’intervalles d’activité.
Lorsque ces séries temporelles sont injectées directement dans un système de projection graphique cartésien traditionnel qui traite l’axe horizontal selon une métrique temporelle continue stricte, le moteur graphique interpole géométriquement les périodes d’inactivité. Matplotlib réserve alors un espacement physique sur l’axe des abscisses pour le samedi et le dimanche, créant ainsi des « trous » ou des vides temporels artificiels tous les cinq jours ouvrés. Ce phénomène est décuplé lors de l’analyse de données intradéterminées (par exemple, des barres de 5 minutes), où chaque nuitée se traduit par un hiatus temporel béant de seize heures consécutives sans la moindre bougie.
Ces espaces vides détériorent gravement l’ergonomie analytique : ils distendent inutilement le tracé, rompent la continuité visuelle des configurations techniques de chandeliers, faussent l’appréciation des pentes des droites de tendance et gaspillent une proportion substantielle de la résolution horizontale disponible sur le canevas. La résolution mathématique de ce problème réside dans l’abandon de l’échelle temporelle continue absolue au profit d’une échelle ordinale discrète. En renumérotant séquentiellement chaque séance boursière sous forme d’un indice entier dense ($0, 1, 2, dots, N-1$), on élimine structurellement tout vide spatial entre les bougies, tout en conservant la possibilité de remapper secondairement des étiquettes de dates lisibles sur l’axe horizontal.
4. Principes géométriques du traçage natif avec Matplotlib
4.1 Décomposition mathématique du chandelier en éléments primitifs
Pour implémenter un graphique en chandeliers à l’état pur avec Matplotlib sans recourir à des surcouches opaques, il est nécessaire de déconstruire géométriquement la bougie en ses éléments graphiques primitifs les plus simples. Dans l’espace affine bidimensionnel défini par le plan du graphique, où l’axe horizontal représente la dimension ordinale séquentielle ou temporelle ($x$) et l’axe vertical capture l’amplitude des prix ($y$), un chandelier individuel d’indice $i$ se compose exactement de deux structures géométriques distinctes :
- Le segment linéaire vertical (la mèche) : Un segment unidimensionnel orthogonal reliant l’extrémité inférieure du domaine de prix ($L_i$) à son extrémité supérieure ($H_i$). En coordonnées cartésiennes, ce segment est le lieu des points $(x_i, y)$ tels que $y in [L_i, H_i]$. Dans Matplotlib, cette structure se trace nativement au moyen de la méthode vectorisée `ax.vlines()`, qui instancie une collection de segments droits parfaitement verticaux.
- Le polygone rectangulaire (le corps réel) : Un rectangle bidimensionnel centré horizontalement sur la coordonnée $x_i$, dont la largeur est calibrée par un paramètre fixe $w$, et dont l’extension verticale s’étend entre les cours d’ouverture et de clôture. Mathématiquement, ce rectangle occupe l’espace cartésien $[x_i – \frac{w}{2}, x_i + \frac{w}{2}] \times [\min(O_i, C_i), \max(O_i, C_i)]$. Dans l’arsenal de Matplotlib, la méthode `ax.bar()` permet de matérialiser ce polygone avec une précision optimale en fournissant l’abscisse de référence, la hauteur scalaire du rectangle et le décalage inférieur (`bottom`).
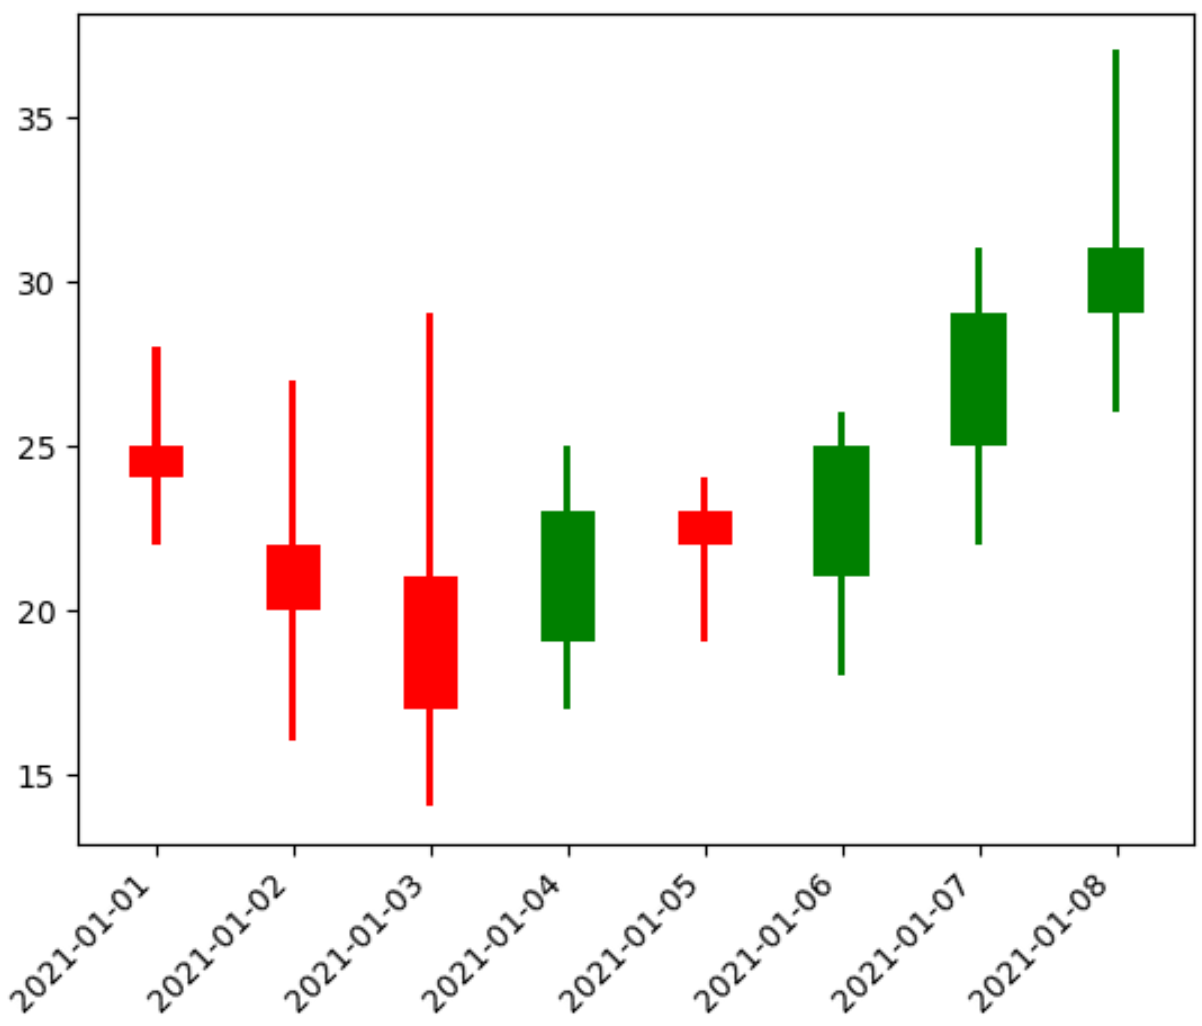
La superposition ordonnée de ces deux primitives requiert la gestion rigoureuse de ce que l’on nomme l’ordre d’empilement en profondeur, ou z-order. Par défaut, Matplotlib assigne des priorités de rendu différentes aux lignes et aux surfaces de barres. Si l’on ne spécifie pas explicitement cet empilement, le corps opaque de la barre risque d’écraser la mèche centrale ou, inversement, une mèche trop épaisse pourrait masquer le liseré du rectangle lors de séances de très faible amplitude. Pour garantir une restitution visuelle immaculée, il est d’usage d’assigner un `zorder=2` pour les mèches linéaires et un `zorder=3` pour les rectangles de corps, assurant ainsi que le corps de la bougie s’assoit net sur le segment vertical en masquant la portion de droite inutile comprise entre l’ouverture et la clôture.
4.2 Calibrage proportionnel des largeurs relatives
Le réglage de la largeur horizontale ($w$) du corps du chandelier conditionne l’élégance et la lisibilité du graphique boursier final. Dans un repère où la distance indiciaire entre deux bougies consécutives est normalisée à l’unité ($\Delta x = x_{i+1} – x_i = 1$), une largeur théorique $w = 1.0$ entraînerait un accolement physique strict des rectangles adjacents, annihilant tout espace de respiration visuelle entre les séances et rendant le graphique totalement illisible. À l’opposé, une valeur excessivement faible ($w le 0.2$) amincirait les corps au point de les faire ressembler à de banals segments de barres, détruisant l’impact perceptif du chandelier.
L’expérience empirique et les conventions de design financier préconisent un ratio de largeur compris entre $0.6$ et $0.8$ fois l’espacement unitaire entre les centres des bougies. Une valeur standard de $w = 0.6$ ou $w = 0.8$ offre un équilibre géométrique idéal : elle confère une surface de projection suffisante aux couleurs contrastées pour identifier la tendance instantanée tout en réservant une gouttière d’espacement latéral de $0.2$ à $0.4$ unité, assurant que deux bougies contiguës aux cours extrêmes similaires ne se confondent pas dans le plan de dessin.
Ce calibrage de largeur doit également être mis en adéquation harmonique avec l’épaisseur de trait (`linewidth`) de la mèche centrale et des bordures du rectangle. Si l’on applique une largeur de corps de $0.8$ et une épaisseur de mèche de $1.0$ point, le contraste sera harmonieux pour un ensemble contenant entre 50 et 100 bougies projetées sur une figure de largeur standard (10 à 12 pouces). En revanche, lors de l’affichage de séries massives excédant 500 unités temporelles sur un même canevas, les rectangles commencent à se chevaucher visuellement en raison de la limitation de résolution en pixels de l’écran ou de la cible de rastérisation. Dans ce contexte, l’épaisseur de la mèche et la largeur du corps doivent faire l’objet d’un ajustement algorithmique dynamique décroissant afin de préserver l’acuité géométrique de la figure.
5. Implémentation complète pas à pas d’un chandelier personnalisé
5.1 Initialisation du canvas et du conteneur graphique
L’amorce de la construction d’un graphique en chandeliers personnalisé exige une instanciation méthodique de l’environnement visuel. En application stricte du paradigme orienté objet préconisé précédemment, nous rejetons l’utilisation implicite des méthodes directes de Pyplot pour mobiliser la fabrique de sous-graphiques `plt.subplots()`. Cette démarche permet de réserver explicitement les descripteurs de la figure globale et de l’axe de traçage, tout en spécifiant les dimensions physiques du canevas en pouces via le paramètre `figsize` :
fig, ax = plt.subplots(figsize=(14, 7), dpi=100)
Ce calibrage géométrique initial (14 pouces de largeur pour 7 pouces de hauteur avec une résolution de base de 100 points par pouce) procure un ratio d’aspect rectangulaire 2:1, particulièrement adapté à la morphologie longitudinale des séries temporelles boursières. Immédiatement après cette instanciation, il convient de définir la gestion des marges de sécurité spatiale. Par défaut, Matplotlib applique une extension automatique de 5 % sur les frontières des données (`margins(0.05)`). Dans le cadre d’un graphique boursier, une marge horizontale trop lâche disperse l’attention, tandis qu’une absence de marge verticale entraîne un contact brutal entre les mèches extrêmes de la série et les liserés supérieur et inférieur de l’encadrement.
L’analyste configure dès lors précisément les délimitations spatiales au moyen des méthodes `ax.set_xlim()` et `ax.set_ylim()`. Pour l’axe horizontal, si l’on projette une série de $N$ observations indexées de $0$ à $N-1$, les bornes optimales s’établiront entre $-0.5$ et $N – 0.5$, garantissant ainsi que la première et la dernière bougie bénéficient d’un demi-intervalle de dégagement esthétique vis-à-vis des épines de l’axe. Sur l’axe vertical, l’amplitude minimale et maximale sera ajustée pour englober le plus bas absolu et le plus haut absolu de la série, majorés et minorés d’une marge tampon proportionnelle (typiquement 2 % de la volatilité globale de l’échantillon).
5.2 Séparation logique des séances haussières et baissières
D’un point de vue algorithmique et afin de garantir des performances d’exécution maximales sans recourir à des boucles conditionnelles explicites hautement inefficaces en Python pur, la construction du chandelier repose sur la technique de la vectorisation booléenne offerte par NumPy et Pandas. La première opération logique consiste à discriminer la série temporelle en deux sous-ensembles mutuellement exclusifs sur la base du différentiel entre le cours de clôture et le cours d’ouverture :
- Le sous-ensemble des séances haussières (ou neutres), formalisé par le masque booléen :
masque_hausse = df['close'] >= df['open'] - Le sous-ensemble des séances baissières, formalisé par le masque booléen réciproque :
masque_baisse = df['close'] < df['open']
Cette dichotomie logique permet de scinder le traitement des coordonnées géométriques du corps rectangulaire. Rappelons que la primitive `ax.bar()` de Matplotlib prend en arguments obligatoires : l’abscisse de la barre ($x$), la hauteur absolue du rectangle ($h$), et l’ordonnée de départ de la base du rectangle (`bottom`). Or, la fonction `ax.bar()` n’admet pas de hauteur géométrique négative sans introduire des anomalies potentielles dans le calcul automatique des limites du tracé.
Dès lors, pour le sous-ensemble haussier, la base du rectangle correspond strictement au cours d’ouverture (`bottom = df.loc[masque_hausse, ‘open’]`), tandis que la hauteur scalaire s’exprime par la différence positive simple `df.loc[masque_hausse, ‘close’] – df.loc[masque_hausse, ‘open’]`. Symétriquement, pour le sous-ensemble baissier, la base du rectangle doit être ancrée au niveau du cours de clôture (`bottom = df.loc[masque_baisse, ‘close’]`), et la hauteur scalaire est calculée par le différentiel `df.loc[masque_baisse, ‘open’] – df.loc[masque_baisse, ‘close’]`. Cette formulation analytique rigoureuse élimine d’emblée toute valeur d’amplitude négative et préserve l’alignement géométrique strict des corps.
5.3 Exécution vectorisée des tracés graphiques
Une fois les coordonnées géométriques et les filtres booléens articulés, le tracé vectorisé peut être exécuté sur l’objet `Axes` sans aucune itération `for` manuelle. L’élimination des boucles au profit des opérations vectorisées en C sous-jacentes à NumPy et Matplotlib permet de réduire le temps de traitement de plusieurs ordres de grandeur, un impératif absolu lorsque des centaines de graphiques doivent être compilés de manière automatisée.
Le tracé des mèches est exécuté en premier lieu. Plutôt que de tracer chaque mèche individuellement, nous invoquons la méthode `ax.vlines()` en lui transmettant l’intégralité du vecteur d’abscisses, le vecteur des cours les plus bas (`low`), et le vecteur des cours les plus hauts (`high`). Si l’on opte pour une colorimétrie bicolore unifiée où la mèche adopte la couleur dominante du corps auquel elle est rattachée, nous effectuons deux appels distincts à `ax.vlines()` : l’un pour la sous-population haussière (en injectant les sous-vecteurs filtrés par `masque_hausse`), l’autre pour la sous-population baissière (filtrée par `masque_baisse`).
Dans un second temps, les corps sont matérialisés via deux appels à la méthode `ax.bar()`. Le premier appel prend les abscisses haussières, les hauteurs haussières correspondantes, le paramètre `bottom` ajusté sur l’ouverture, la largeur paramétrique `width=0.6`, la couleur de remplissage haussière, et une couleur de liseré identique. Le second appel réplique l’opération pour la composante baissière avec les vecteurs de baisse et la couleur d’invalidation associée.
Un cas particulier fondamental doit être traité à cet instant : la configuration du doji, où le cours de clôture est rigoureusement identique au cours d’ouverture ($C = O$). Dans cette conjoncture, la hauteur géométrique calculée est exactement nulle ($h = 0$). Dans certaines versions de moteurs graphiques, une barre de hauteur nulle devient totalement invisible, privant l’observateur d’un signal technique majeur de retournement. Pour pallier cette anomalie, l’algorithme doit forcer une hauteur minimale infinitésimale de compensation (par exemple, une fraction millimétrique proportionnelle à la résolution verticale, ou l’ajout d’une fine ligne horizontale distincte via `ax.hlines()`) afin que la séance d’indécision soit visible sous la forme d’une croix nette au centre de la mèche.
6. Gestion avancée de la colorimétrie et conventions sémiotiques
6.1 Typologie des palettes graphiques boursières
La transmission sémiotique de l’information financière repose lourdement sur la perception chromatique instantanée. Toutefois, les conventions de couleurs appliquées aux chandeliers japonais sont loin d’être universelles et varient substantiellement selon les ères géographiques et les cultures de marché. Dans la finance occidentale contemporaine (Wall Street, places financières européennes), le consensus dominant associe la couleur verte (code hexadécimal standard `#26a69a` ou `#2ca02c`) à l’appréciation des cours ($C ge O$) et la couleur rouge (code `#ef5350` ou `#d62728`) à la dépréciation des cours ($C < O$). Cette convention puise ses racines dans la sémiologie universelle de la signalisation routière et industrielle occidentale, où le vert évoque la validation ou la progression et le rouge l'alerte ou la perte.
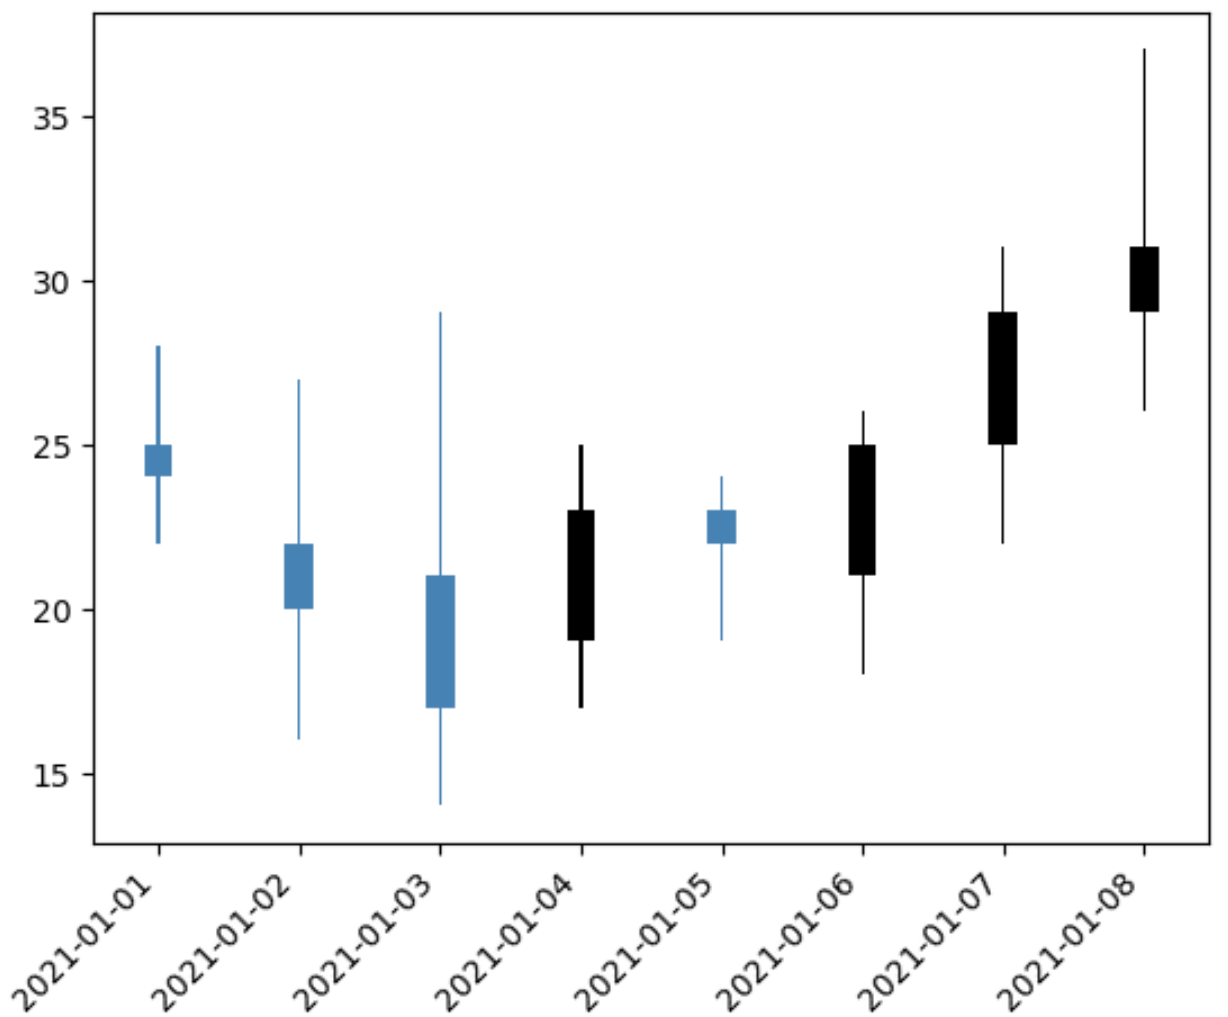
À l’inverse, sur les marchés financiers d’Asie orientale — notamment en Chine continentale (bourses de Shanghai et Shenzhen), à Taïwan et historiquement au Japon — la sémiotique chromatique est rigoureusement inversée. Le rouge, symbole culturel de prospérité, de chance et d’élévation sociale, y matérialise les hausses de cours, tandis que le vert ou le bleu sombre caractérise les phases de baisse. Par ailleurs, dans la littérature scientifique académique imprimée et dans les traités financiers historiques, la convention noir et blanc (monochrome) demeure le standard de référence : la bougie haussière est représentée par un corps vide (blanc, translucide) cerclé de noir, tandis que la bougie baissière est incarnée par un corps plein et opaque de couleur noire.
D’un point de vue de l’ingénierie logicielle et du design d’interface, le choix des valeurs hexadécimales ne doit jamais être laissé aux couleurs saturées primaires par défaut (`green` et `red` purs sous Matplotlib). Ces teintes fluorescentes brutes engendrent une fatigue cognitive et oculaire rapide lors de sessions d’analyse prolongées. L’analyste averti calibrera des nuances spectrales atténuées, offrant un contraste suffisant tout en limitant l’agressivité visuelle. L’harmonisation chromatique stricte entre l’ombre linéaire et le corps associé constitue également une exigence de premier ordre pour éviter les discordances stylistiques au sein de la composition.
6.2 Normes d’accessibilité et perception universelle
Une lacune prévalente dans la conception de visualisations financières réside dans l’omission des impératifs d’accessibilité visuelle, particulièrement vis-à-vis des troubles de la vision des couleurs qui affectent statistiquement environ 8 % de la population masculine mondiale (notamment le daltonisme sous ses formes deutéranope et protanope). Pour ces individus, la distinction classique entre un vert moyen et un rouge moyen est extrêmement ardue, voire totalement impossible, ces deux longueurs d’onde étant perçues comme des tonalités jaunâtres ou brunâtres indiscernables.
Pour concevoir des représentations universellement accessibles et conformes aux directives internationales de publication scientifique, il est impératif d’intégrer des palettes alternatives sécurisées (colorblind-friendly). La substitution de la palette vert/rouge par une combinaison bleu cyan (`#1f77b4` ou `#00aaff`) pour les séances ascendantes et orange ambré (`#ff7f0e` ou `#ff5500`) pour les séances descendantes résout intégralement ce déficit perceptif. Ces deux teintes occupent des régions du spectre lumineux qui demeurent distinctement différentiables pour la quasi-totalité des personnes atteintes d’anomalies de vision des couleurs.
Pour les publications académiques destinées à des revues à comité de lecture imposant une reproduction strictement monochrome en niveaux de gris, une autre stratégie géométrique doit être déployée dans Matplotlib. Elle consiste à jouer sur le paramètre de transparence `alpha` et sur l’attribut de remplissage `fill`. En configurant les séances haussières avec un fond blanc translucide (`facecolor=’white’`, `edgecolor=’black’`, `linewidth=1`) et les séances baissières avec un remplissage noir opaque (`facecolor=’black’`, `edgecolor=’black’`), on rétablit la lisibilité absolue du signal boursier sans aucune dépendance à la chromaticité, garantissant une transmission immaculée de l’information lors de l’impression physique sur papier.
7. Résolution des problèmes d’affichage sur l’axe temporel
7.1 Le défi des espacements non ouvrés
L’introduction d’objets `Timestamp` directs de Pandas sur l’axe horizontal de Matplotlib déclenche le convertisseur chronologique automatique de la bibliothèque. Ce module convertit les dates en une échelle continue où chaque unité entière correspond exactement à un jour calendaire grégorien. Si cette continuité physique est irréprochable pour la modélisation de phénomènes climatiques ou physiques continus, elle se heurte violemment à la structure opérationnelle des marchés d’actions.
Considérons une série temporelle journalière s’étalant sur trois semaines consécutives. Les cours s’échangent du lundi au vendredi, s’interrompent le vendredi soir, et reprennent le lundi matin. Sur une échelle temporelle continue, l’intervalle entre le vendredi à la clôture et le lundi à l’ouverture apparaît d’une largeur spatiale équivalente à deux journées entières de transactions. Visuellement, le graphique génère une clairière stérile tous les cinq chandeliers, fractionnant artificiellement l’évolution des cours.
Ce morcellement géométrique nuit profondément à l’analyse quantitative. D’une part, il altère la perception des figures chartistes : un saut de cotation (gap) survenant entre le vendredi et le lundi se trouve visuellement étiré sur un large espace vide, alors que dans le temps d’échange effectif du carnet d’ordres, la bougie du lundi succède immédiatement à celle du vendredi. D’autre part, ce phénomène perturbe dramatiquement le calcul visuel des angles d’inclinaison des canaux de régression linéaire ou des moyennes mobiles, introduisant une distorsion anamorphique dans l’évaluation de la cinématique des cours.
7.2 Technique de renumérotation indiciaire
La parade algorithmique la plus robuste pour neutraliser ces artefacts calendaires sans dénaturer l’architecture de données consiste à implémenter une technique de renumérotation indiciaire ordinale. Le principe opérationnel repose sur le découplage fonctionnel strict entre la coordonnée spatiale de dessin sur l’axe cartésien et la métadonnée temporelle descriptive rattachée à cette coordonnée.
Concrètement, l’ensemble des chandeliers de la série historique est projeté sur l’axe des abscisses non pas en fonction de leur valeur d’horodatage absolue, mais en utilisant une séquence numérique d’entiers contigus :
abscisses_indices = np.arange(len(df))
Chaque bougie $i$ est ainsi positionnée au point cartésien horizontal $x = i$. Dès lors, le vendredi prend la coordonnée $k$ et le lundi ouvré suivant reçoit la coordonnée $k+1$. Par cette substitution géométrique, la distance spatiale séparant la séance du vendredi de celle du lundi devient rigoureusement identique à celle séparant le mardi du mercredi ($\Delta x = 1$). Les jours chômés, fermetures exceptionnelles et week-ends sont mathématiquement éradiqués de l’axe des abscisses, rétablissant une continuité topologique parfaite du flux des échanges.
Toutefois, cette manœuvre déconnecte temporairement l’axe horizontal du référentiel temporel humain : si l’on n’intervient pas davantage, les graduations inférieures du graphique afficheront de vulgaires indices numériques ($0, 20, 40, 60dots$) dépourvus de sens financier. Il devient donc nécessaire d’intercepter la mécanique de rendu des étiquettes d’axes pour réinjecter dynamiquement les chaînes textuelles de dates correspondant à chaque indice numérique positionnel.
7.3 Formatage des graduations et étiquettes d’abscisses
La réconciliation entre l’échelle indiciaire dense et la lisibilité chronologique s’accomplit par l’orchestration concertée des localisateurs (`Locators`) et des formateurs (`Formatters`) de graduations disponibles dans le sous-module spécialisé `matplotlib.ticker`. Pour éviter une surcharge visuelle où les dates de chaque bougie se chevaucheraient en un bandeau textuel illisible au bas du graphique, une sélection discrète d’intervalles de graduation majeurs doit être effectuée.
L’approche programmatique standard consiste à définir une fréquence d’échantillonnage des graduations en fonction de la taille totale de l’échantillon. Pour une série de 100 séances, nous pouvons décider de disposer une marque textuelle tous les 10 ou 15 jours de cotation. Nous instancions un localisateur d’indices fixes à l’aide de `ticker.FixedLocator`, auquel nous passons le sous-ensemble de positions entières sélectionnées. Parallèlement, nous construisons un tableau de chaînes textuelles de dates formatées (par exemple au standard ISO `YYYY-MM-DD` ou `DD/MM/YYYY`) extraites directement du `DatetimeIndex` de notre DataFrame Pandas aux indices correspondants.
Ces chaînes textuelles sont ensuite appliquées sur l’axe horizontal par l’intermédiaire de `ticker.FixedFormatter`. Pour parfaire l’ergonomie visuelle et empêcher tout contact entre deux mentions de dates voisines lors d’éventuels redimensionnements interactifs de la fenêtre graphique, nous appliquons une rotation angulaire de 45 degrés à l’aide de l’instruction `plt.setp(ax.get_xticklabels(), rotation=45, ha=’right’)`. L’argument d’alignement horizontal `ha=’right’` (pour horizontal alignment right) garantit que l’extrémité supérieure droite du texte de la date pointe avec une exactitude typographique irréprochable sous la graduation cartésienne associée.
8. Superposition d’indicateurs quantitatifs sur le graphique
8.1 Intégration de moyennes mobiles tendancielles
L’analyse technique quantitative ne s’arrête que rarement à l’examen isolé des chandeliers ; elle requiert la confrontation de la dynamique brute des prix à des descripteurs statistiques lissés permettant de filtrer le bruit stochastique à haute fréquence. Parmi ces indicateurs, la moyenne mobile simple (Simple Moving Average ou SMA) et la moyenne mobile exponentielle (Exponential Moving Average ou EMA) constituent les fondations universelles du suivi de tendance.
Le calcul de ces grandeurs s’exécute avec une remarquable concision vectorielle grâce aux méthodes de fenêtrage glissant intégrées nativement à Pandas. Pour une série de clôtures $C$, la moyenne mobile simple d’ordre $k$ est définie par la moyenne arithmétique des $k$ dernières observations :
df['sma_50'] = df['close'].rolling(window=50).mean()
Tandis que la moyenne mobile exponentielle, accordant un poids décroissant exponentiellement aux observations passées via un facteur de lissage $\alpha = \frac{2}{k+1}$, s’obtient par l’invocation :
df['ema_20'] = df['close'].ewm(span=20, adjust=False).mean()
L’intégration de ces courbes sur le graphique en chandeliers s’opère sur le même objet `Axes` en invoquant la méthode classique `ax.plot()`. Il est crucial de veiller à ce que l’abscisse transmise à `ax.plot()` corresponde rigoureusement au même repère indiciaire ($0$ à $N-1$) que celui utilisé pour positionner les chandeliers. Sur le plan esthétique, l’épaisseur de trait (`linewidth`) des moyennes mobiles doit être subtilement inférieure ou égale à $1.5$ point, et leurs teintes doivent être choisies pour contraster nettement avec le rouge et le vert des corps de bougies (par exemple en utilisant des nuances distinctives de pourpre, d’or ambré ou de cyan), sans quoi la hiérarchie visuelle dominante des chandeliers serait altérée.
Un enjeu technique récurrent concerne la gestion des valeurs nulles initiales (`NaN`). Pour une moyenne mobile à 50 périodes, les 49 premiers enregistrements de la série résultante sont mathématiquement indéfinis. Matplotlib gère ces valeurs avec élégance en interrompant simplement le tracé linéaire sans générer d’exception logicielle ; toutefois, lors du réglage des limites verticales automatiques de l’axe, il convient de s’assurer que ces plages indéfinies ne viennent pas fausser l’évaluation automatique de l’échelle d’amplitude des prix.
8.2 Modélisation des bandes de volatilité de Bollinger
Développées par John Bollinger au début des années 1980, les bandes de volatilité de Bollinger fournissent une enveloppe stochastique dynamique autour du cours boursier. Elles modélisent l’écartement des prix par rapport à une tendance centrale en intégrant directement l’écart-type mobile des cours, capturant ainsi les phénomènes d’expansion et de contraction de volatilité (volatility clustering).
Mathématiquement, l’indicateur se compose de trois trajectoires calculées sur une fenêtre temporelle donnée (généralement $k = 20$ périodes) : une bande médiane ($B_M$) équivalente à la moyenne mobile simple à 20 jours, une bande supérieure ($B_S = B_M + d \times \sigma$) et une bande inférieure ($B_I = B_M – d \times \sigma$), où $\sigma$ représente l’écart-type glissant de la clôture sur la même fenêtre et $d$ le multiplicateur d’échelle (fixé canoniquement à $2$). Dans Pandas, l’implémentation vectorisée s’écrit :
sigma = df['close'].rolling(window=20).std()
df['bollinger_up'] = df['sma_20'] + 2 * sigma
df['bollinger_down'] = df['sma_20'] - 2 * sigma
Le traçage géométrique de cette enveloppe sous Matplotlib requiert une technique avancée pour matérialiser le canal de volatilité. Au-delà du simple tracé linéaire discontinu (`linestyle=’–‘`) des frontières supérieure et inférieure, la méthode `ax.fill_between()` permet d’ombrer l’espace interstitiel délimité par $B_S$ et $B_I$. L’enjeu critique réside ici dans la gestion de l’opacité : un indice alpha excessif saturerait la zone de dessin et masquerait les chandeliers situés à l’intérieur du canal. L’assignation d’une opacité très faible (`alpha=0.08` à `alpha=0.12`) avec une tonalité neutre (comme un bleu acier ou un gris perle) et d’un ordre de profondeur en retrait (`zorder=1`) assure un rendu d’une grande distinction graphique, sur lequel les bougies se détachent avec un relief immaculé.
8.3 Règles d’ergonomie pour les affichages multi-couches
L’accumulation effrénée d’indicateurs quantitatifs sur un canevas boursier constitue le piège classique dans lequel basculent de nombreux développeurs, aboutissant au phénomène délétère de saturation cognitive (ou surcharge graphique). Lorsqu’un graphique empile simultanément trois moyennes mobiles, deux canaux de régression, des nuages Ichimoku et des bandes de volatilité, la clarté sémiotique s’effondre totalement, anéantissant l’objectif initial de visualisation.
Pour concevoir des visualisations multi-couches efficaces répondant aux canons du design scientifique, plusieurs règles directrices doivent être rigoureusement appliquées :
- Règle de dominance perceptuelle : Le chandelier OHLC représente la variable maîtresse ; il doit toujours occuper le niveau de contraste le plus élevé et le plan de profondeur visuelle le plus immédiat. Tout indicateur subsidiaire doit adopter un trait plus fin ou une teinte désaturée.
- Consolidation des légendes : L’accumulation d’appels dispersés à `ax.legend()` génère des encarts multiples qui amputent la surface de dessin utile. Il convient d’unifier l’ensemble des descripteurs d’indicateurs au sein d’une boîte de légende unique, positionnée stratégiquement dans une zone d’inactivité graphique (typiquement le coin supérieur gauche, paramétré par `loc=’upper left’`), encadrée d’une bordure semi-transparente (`framealpha=0.6`).
- Intégrité de l’échelle d’ordonnées : L’ajout d’indicateurs aux valeurs aberrantes ou aux dérives extrêmes peut entraîner un élargissement automatique démesuré de l’axe vertical, compressant les chandeliers au point de les réduire à une bande horizontale minuscule et indéchiffrable. Il est indispensable de contraindre dynamiquement les bornes de `set_ylim()` sur les extrêmes réels des bougies visibles, en contraignant les indicateurs périphériques à se calquer sur cette plage.
9. Architecture multi-panneaux : Intégration des volumes boursiers
9.1 Construction d’une disposition en grille verticale
Le volume des transactions représente la seconde variable fondamentale de la microstructure des marchés. L’adage boursier classique énonçant que le volume valide le prix rappelle que la signification cinématique d’un chandelier est intimement corrélée à la masse de liquidité qui a soutenu sa formation. Cependant, le volume étant une grandeur volumétrique exprimée en nombre de titres ou de contrats échangés (absolument incommensurable avec l’unité monétaire de l’axe des prix), il ne saurait être projeté directement sur le même axe d’ordonnées que les cours sans provoquer un écrasement mathématique immédiat.
La solution architecturale consiste à concevoir une figure scindée en plusieurs sous-panneaux étagés verticalement. Pour orchestrer cette géométrie complexe avec une précision d’orfèvre, Matplotlib propose la classe de disposition `GridSpec` issue du sous-module `matplotlib.gridspec`. Cette approche supplante avantageusement la commande basique `plt.subplots()` en permettant d’affecter des ratios de hauteur différentiels aux différentes sections du graphique :
from matplotlib.gridspec import GridSpec
fig = plt.figure(figsize=(14, 9), dpi=100)
gs = GridSpec(nrows=2, ncols=1, height_ratios=[3, 1], hspace=0.0)
ax_prix = fig.add_subplot(gs[0, 0])
ax_vol = fig.add_subplot(gs[1, 0], sharex=ax_prix)
Dans cette configuration paradigmatique, le panneau supérieur dédié aux chandeliers (`ax_prix`) accapare 75 % de l’espace vertical disponible (`height_ratios=[3, 1]`), tandis que le sous-panneau inférieur (`ax_vol`) est réservé à l’histogramme des volumes sur les 25 % résiduels. L’argument capital `sharex=ax_prix` synchronise de manière indissociable l’axe des abscisses du sous-panneau avec celui du graphique principal, garantissant que toute manipulation d’échelle ou tout défilement temporel appliqué au panneau supérieur se répercutera instantanément sur le panneau de volume.
Par ailleurs, l’assignation du paramètre de séparation verticale `hspace=0.0` élimine l’espace interstitiel entre les deux boîtes cartésiennes. Pour parfaire la transition visuelle, les graduations et étiquettes textuelles horizontales du panneau supérieur sont rendues invisibles via `plt.setp(ax_prix.get_xticklabels(), visible=False)`, déléguant l’affichage des repères chronologiques exclusivement à la frange inférieure du panneau de volume. Ce procédé confère à l’ensemble un aspect monobloc d’une rigueur professionnelle remarquable, identique aux terminaux financiers de référence.
9.2 Tracé conditionnel du sous-panneau de volume
L’affichage du volume transactionnel sous forme d’histogramme vertical s’opère par le déploiement de la méthode `ax_vol.bar()`. À l’instar de la construction géométrique du corps des chandeliers, la restitution graphique du volume gagne une valeur analytique considérable lorsqu’elle adopte une coloration conditionnelle synchronisée avec la direction de la séance boursière.
En exploitant les masques booléens de hausse et de baisse définis précédemment (`masque_hausse` et `masque_baisse`), nous traçons l’histogramme en deux opérations vectorisées distinctes. Les barres de volume associées à des séances de progression ($C ge O$) sont teintées avec la nuance chromatique haussière (vert émeraude ou bleu ciel), tandis que les barres reflétant des séances de dépréciation ($C < O$) reçoivent la livrée baissière (rouge corail ou orange vif). Cette synchronisation chromatique immédiate permet à l'analyste d'évaluer d'un simple coup d'œil si les pics de liquidité soutiennent les impulsions ascendantes ou s'ils sanctionnent des vagues de capitulation vendeuse.
Sur le plan de l’échelle d’ordonnées du panneau de volume, deux raffinements techniques s’imposent :
- L’ancrage obligatoire de la limite inférieure à zéro (`ax_vol.set_ylim(bottom=0)`) afin de respecter la métrique absolue du volume et d’éviter tout flottement géométrique au-dessus de la ligne d’axe.
- Le plafonnement de la limite supérieure à environ 1.25 fois le volume maximal enregistré sur la période (`top = df[‘volume’].max() * 1.25`). Ce dégagement zénithal de 25 % évite que les plus hautes barres de volume ne viennent heurter la ligne de démarcation du graphique des prix, préservant une zone de respiration visuelle pour l’affichage éventuel d’une moyenne mobile de volume (calculée classiquement sur 20 périodes).
Enfin, la notation numérique sur l’axe vertical du volume doit être formellement épurée. Les volumes sur les marchés d’actions s’exprimant couramment en centaines de milliers ou millions de titres échangés, un affichage brut en notation décimale standard saturerait l’espace latéral gauche avec des suites de chiffres indigestes (`15000000`). L’adjonction d’un formateur numérique personnalisé (`ticker.FuncFormatter`) convertissant ces grandeurs en unités synthétiques abrégées (`15M`, `250K`) garantit une lisibilité irréprochable et libère une précieuse surface de traçage utile.
9.3 Synchronisation dynamique des curseurs et survols
Dans un contexte d’analyse quantitative interactive ou lors du déploiement de scripts au sein d’environnements applicatifs interactifs, la coordination spatiale entre les différents axes verticaux superposés exige des mécanismes de liaison logicielle continus. Lorsqu’un utilisateur déplace son pointeur sur le panneau supérieur des prix, un repère visuel orthogonal doit pouvoir traverser la frontière de séparation pour pointer avec une coïncidence géométrique absolue sur la barre de volume correspondante située en contrebas.
Ce résultat s’obtient sous Matplotlib par l’implémentation de la classe `MultiCursor` issue du module d’interaction `matplotlib.widgets`. Cet outil enregistre un écouteur d’événements de mouvement de souris (`motion_notify_event`) sur la figure globale et projette une ligne de visée transversale synchronisée sur l’ensemble des objets `Axes` spécifiés lors de son instanciation :
from matplotlib.widgets import MultiCursor
cursor = MultiCursor(fig.canvas, (ax_prix, ax_vol), color='gray', lw=0.8, ls='--', useblit=True)
L’utilisation de l’argument `useblit=True` active le mécanisme de rastérisation rapide par transfert de blocs de pixels (blitting). Cette technique d’optimisation bas niveau évite de redessiner l’intégralité du canevas vectoriel lors de chaque micro-mouvement de la souris ; seul le masque de pixels survolé par les lignes de curseur est invalidé et repeint à la volée. Ce réglage confère une fluidité cinématique de 60 images par seconde à l’interface, éliminant tout phénomène de latence logicielle, même face à des séries boursières denses composées de plusieurs milliers de bougies et de barres de volume interconnectées.
10. Étude comparative : Matplotlib natif versus bibliothèque mplfinance
10.1 Évolution historique de matplotlib.finance à mplfinance
L’histoire de la visualisation financière au sein de l’écosystème Python est marquée par une profonde mutation architecturale. Aux débuts du framework, le sous-module interne `matplotlib.finance` proposait des fonctions de tracé historiques basiques, telles que `candlestick_ohlc()`. Toutefois, ce module pionnier souffrait de nombreuses lacunes conceptuelles : il imposait une mise en forme fastidieuse des données d’entrée sous forme de tuples ordonnés, ne gérait pas nativement les structures `DataFrame` de Pandas, imposait une conversion manuelle contraignante des dates en flottants via `date2num`, et s’avérait totalement incapable d’élider automatiquement les ruptures calendaires des week-ends sans un code de contournement laborieux.
Face au développement massif de la science des données et pour assainir le cœur de bibliothèque de Matplotlib, les mainteneurs officiels ont pris la décision salutaire de déprécier puis d’extraire totalement ces utilitaires financiers de la branche maîtresse. Cette transition a donné naissance à une bibliothèque indépendante entièrement repensée, hébergée sous l’égide de l’organisation officielle : mplfinance.
Réécrite de fond en comble pour s’interfacer nativement avec l’infrastructure de Pandas, `mplfinance` encapsule l’intégralité de la plomberie géométrique bas niveau que nous avons disséquée dans les sections précédentes. Elle assure de manière transparente l’éviction des jours non ouvrés, l’empilement automatique des panneaux de volume, le calcul des moyennes mobiles glissantes et la stylisation chromatique sophistiquée par le biais d’appels déclaratifs synthétiques, allégeant considérablement la charge cognitive du développeur pour les tâches exploratoires standard.
10.2 Syntaxe et mise en œuvre immédiate avec mplfinance
La puissance d’abstraction offerte par `mplfinance` se mesure à la compacité phénoménale du code requis pour générer un graphique boursier complet conforme aux standards de l’industrie. Dès lors qu’un DataFrame Pandas respecte la nomenclature canonique de colonnes (`Open`, `High`, `Low`, `Close`, `Volume`) indexée par un `DatetimeIndex` valide, la construction d’une scène financière complète s’exécute en une instruction unique :
import mplfinance as mpf
mpf.plot(df, type='candle', style='charles', volume=True, mav=(20, 50), figsize=(14, 8))
En un seul appel de haut niveau, la fonction `mpf.plot()` prend en charge l’instanciation de la figure, l’allocation des ratios de sous-panneaux verticaux, la synchronisation rigoureuse de l’axe temporel sans discontinuité de week-end, le calcul vectorisé des moyennes mobiles simples à 20 et 50 jours (`mav=(20, 50)`), l’assignation de la palette de styles boursiers professionnels (`charles`, `yahoo` ou `binance`) et la mise en forme condensée des étiquettes numériques de volumes et de cours.
Pour intégrer des indicateurs propriétaires complexes ou des signaux d’exécution d’ordres algorithmiques (achats/ventes matérialisés par des marqueurs géométriques fléchés), la bibliothèque met à disposition la fonction `mpf.make_addplot()`. Cette méthode permet d’instancier des couches géométriques auxiliaires (lignes d’indicateurs personnalisés, bandes stochastiques, nuages de dispersion de points d’exécution) qui sont injectées directement dans le paramètre `addplot` de la fonction principale, garantissant un alignement spatial sans faille sur les chandeliers de référence.
10.3 Critères de décision pour le choix architectural
Le choix méthodologique entre l’implémentation sur mesure en Matplotlib natif (telle qu’exposée aux chapitres 4 et 5) et l’utilisation de l’enveloppe de haut niveau `mplfinance` dépend intimement de la nature du projet et des contraintes du cahier des charges technique. Le tableau comparatif suivant synthétise les arbitrages opérationnels fondamentaux :
- mplfinance — L’efficacité de la recherche exploratoire : S’avère le choix indiscutable pour le prototypage rapide, les carnets de recherche interactifs, les analyses d’opportunité d’investissement au jour le jour, ou lorsqu’il s’agit de générer des visualisations standards sans consacrer des centaines de lignes de code à la maintenance de primitives graphiques. Sa fiabilité sur la gestion des calendriers d’échanges est inégalée.
- Matplotlib natif — La souveraineté géométrique absolue : Demeure incontournable dès lors que le projet implique des architectures visuelles hétérodoxes. Si vous devez concevoir des interfaces graphiques complexes embarquées dans des applications desktop (via des canevas PyQt, PySide ou Tkinter), superposer des cartographies bidimensionnelles de densité de carnet d’ordres (heatmaps de liquidité), synchroniser des visualisations de microstructure en temps réel alimentées par des flux de données continus (websockets de streaming de cotations), ou respecter une charte éditoriale stricte imposant un agencement géométrique millimétré, le contrôle atomique offert par Matplotlib natif est irremplaçable.
En somme, le chercheur quantitatif moderne doit posséder la maîtrise des deux paradigmes : la vélocité déclarative de `mplfinance` pour l’investigation empirique quotidienne, et l’expertise programmatique bas niveau de Matplotlib natif pour bâtir des instruments graphiques scientifiques sur mesure.
11. Personnalisation esthétique et standardisation pour publication scientifique
11.1 Typographie et calibrage des métadonnées
La transformation d’un graphique financier générique en un document visuel de niveau académique digne de figurer dans une revue à comité de lecture internationale exige une attention maniaque portée à la typographie et à la hiérarchie de l’information textuelle. Par défaut, Matplotlib exploite des polices de caractères sans empattement universelles (famille DejaVu Sans) qui, bien que fonctionnelles, manquent de distinction éditoriale.
Dans un protocole de publication scientifique, il est fortement conseillé de synchroniser la typographie de la figure avec la police du document hôte, fréquemment rédigé sous LaTeX. Matplotlib intègre un moteur de rendu typographique LaTeX complet, activable via la directive de configuration globale `plt.rcParams[‘text.usetex’] = True`. Cette activation autorise l’injection d’expressions mathématiques formalisées dans les titres et les annotations, rendant compte de grandeurs quantitatives avec leur formalisme académique exact (par exemple, $\mathbb{E}[R_t]$ ou $\sigma_{\text{daily}}$).
La hiérarchie des corps de texte doit être rigoureusement échelonnée afin de structurer la lecture du document :
- Titre principal (`fontsize=14`, poids `bold`) : Doit exposer formellement l’actif sous-jacent, l’horizon temporel et la périodicité de discrétisation (ex: Dynamique des cours journaliers d’Air Liquide (AI.PA) et bandes de Bollinger [2022-2023]).
- Titres des axes (`fontsize=11`, poids `medium`) : Doivent préciser sans ambiguïté les unités de mesure physiques et monétaires (ex: Niveau de valorisation (EUR) sur l’axe vertical des prix, Volume échangé (milliers de titres) sur le panneau de volume).
- Étiquettes de graduations (`fontsize=9`) : Doivent adopter une taille réduite et un contraste modéré pour servir de repères fonctionnels sans distraire le regard.
- Annotations ponctuelles (`fontsize=8.5`) : Lorsqu’un événement exceptionnel (annonce de résultats financiers, choc exogène macroéconomique) doit être mis en exergue, l’utilisation de `ax.annotate()` avec une flèche de ciblage élégante (`arrowprops=dict(facecolor=’black’, arrowstyle=’->’, lw=0.7)`) permet de guider l’interprétation du lecteur avec une rigueur analytique irréprochable.
11.2 Optimisation des bordures, grilles et repères visuels
L’esthétique moderne de la visualisation scientifique préconise la réduction impitoyable de ce que l’éminent théoricien de l’information Edward Tufte désigne sous le concept d’encre non-informative (non-data ink). Tout élément graphique qui ne sert pas directement la transmission ou la contextualisation mathématique de la donnée doit être purgé ou drastiquement allégé.
Dans l’architecture native de Matplotlib, chaque objet `Axes` est cerné par quatre bordures structurelles appelées épines (spines : `top`, `bottom`, `left`, `right`). Dans la majorité des visualisations financières, l’épine supérieure et l’épine droite n’apportent aucune valeur informative et forment une cage visuelle oppressante autour des cours. Il est d’usage d’en ordonner la disparition logicielle au moyen des instructions ciblées :
ax.spines['top'].set_visible(False)
ax.spines['right'].set_visible(False)
Les épines inférieure et gauche restantes doivent être affinées (`set_linewidth(0.8)`) et adopter une teinte gris neutre plutôt qu’un noir pur agressif. Parallèlement, le réglage des marques de graduation (ticks) doit privilégier un positionnement sortant (`ax.tick_params(direction=’out’, length=4, width=0.8, colors=’#333333′)`) afin de ne pas interférer avec le tracé des chandeliers les plus proches des bordures.
La grille cartésienne d’arrière-plan (`ax.grid()`) exige un traitement subtil : si son absence totale pénalise l’évaluation visuelle des niveaux de prix horizontaux, sa présence trop marquée pollue l’identification des mèches fines. La configuration optimale associe un style de trait pointillé ou discontinu (`linestyle=’:’`), une épaisseur ultra-fine (`linewidth=0.5`), une couleur d’estompage claire (`color=’#d0d0d0’`) et une assignation formelle au plan d’arrière-plan le plus reculé (`zorder=0`). Ainsi configurée, la grille guide discrètement l’œil de l’analyste vers les axes sans jamais entrer en collision avec le premier plan des données géométriques.
12. Bonnes pratiques logicielles, performance et exportation haute fidélité
12.1 Encapsulation fonctionnelle et réutilisabilité du code
L’amateurisme dans l’écriture de scripts graphiques se caractérise par la dispersion d’instructions de tracé impératives dans le corps principal du programme, rendant toute maintenance ultérieure cauchemardesque. À l’inverse, l’ingénierie logicielle appliquée à la finance exige une modularisation stricte sous la forme de fonctions réutilisables, paramétriques, documentées et défensives vis-à-vis des données qui leur sont soumises.
Une fonction de tracé de chandeliers industrielle doit encapsuler l’ensemble des étapes méthodologiques décrites précédemment au sein d’une signature d’appel propre et standardisée :
def tracer_graphique_chandeliers(df: pd.DataFrame, titre: str = "Analyse OHLC", volume: bool = True, sma: list = [20, 50], theme: str = "classique") -> tuple:
Cette signature fonctionnelle s’accompagne obligatoirement d’une chaîne de documentation technique formalisée (PEP 257 / standard numpydoc) détaillant les préconditions requises pour le DataFrame en entrée (présence immuable des colonnes canoniques en minuscules, index de type `DatetimeIndex`), les types des arguments optionnels et la structure des objets retournés (le tuple contenant la `Figure` et la liste des `Axes`).
De plus, la fonction doit intégrer une batterie de tests d’assertion défensifs en amorce de routine : vérification du non-vide du tableau, contrôle de conformité des types de données, validation de l’ordonnancement chronologique strictement croissant de l’index temporel, et levée d’exceptions explicites (`ValueError`, `KeyError`) assorties de messages informatifs en cas de violation des règles structurelles. Cette encapsulation permet d’intégrer sans risque la brique graphique au sein de suites logicielles automatisées, de bibliothèques internes de backtesting ou de serveurs d’édition de rapports d’arbitrage.
12.2 Optimisation des performances sur de larges volumes de données
L’un des goulots d’étranglement les plus sévères de Matplotlib réside dans son comportement computationnel face à des séries temporelles à haute fréquence temporelle ou couvrant de longues décennies. Lorsque le nombre de bougies à tracer franchit le seuil des dizaines de milliers d’unités, l’instanciation individuelle de milliers d’objets `Rectangle` (via `ax.bar()`) sature dramatiquement la mémoire vive et effondre la vitesse de rendu en raison de la complexité algorithmique de gestion de la liste des artistes graphiques.
Pour démultiplier les performances de traçage sur des jeux de données massifs, deux techniques algorithmiques fondamentales doivent être mobilisées :
- L’agrégation vectorielle via `LineCollection` et `PolyCollection` : Au lieu d’injecter des milliers de primitives polygonales distinctes dans le moteur de dessin, le développeur avancé assemble l’ensemble des segments de mèches au sein d’un conteneur graphique unique de type `matplotlib.collections.LineCollection`, et l’intégralité des rectangles de corps dans une `matplotlib.collections.PolyCollection`. En transmettant ces collections unifiées au moteur en un seul bloc matriciel, le coût d’overhead lié à la gestion des objets Python individuels est intégralement annihilé, propulsant le framerate de dessin à des cadences dix à cinquante fois plus rapides.
- Le rééchantillonnage dynamique préventif : Si l’affichage physique d’un écran standard 4K ne compte horizontalement qu’environ 3840 pixels, tenter de projeter 100 000 chandeliers sur cette même largeur d’écran relève de l’hérésie numérique : les bougies se chevaucheraient au point de former un bloc de pixels indiscernable. Il convient d’adjoindre en amont de la fonction graphique une logique de rééchantillonnage adaptatif (`df.resample()`) qui calibre automatiquement la granularité temporelle (passage de la seconde à la minute, ou de l’heure au jour) en fonction de l’amplitude de la fenêtre temporelle active, préservant ainsi la réactivité de la machine et l’intelligence de la visualisation.
Enfin, lors de l’exécution de processus de calcul intensifs générant séquentiellement des milliers de figures sur un serveur (par exemple pour compiler les fiches visuelles d’un univers de 5 000 actions après chaque clôture de marché), l’oubli de la libération mémoire détruit rapidement les ressources de la machine hôte. Il est impératif d’intégrer dans la boucle de traitement l’instruction systématique `plt.close(fig)` conjuguée occasionnellement à des appels explicites au ramasse-miettes (`import gc; gc.collect()`) pour forcer l’assainissement de l’empreinte mémoire vive du système.
12.3 Exportation multi-formats haute résolution
La finalité ultime de la création d’un graphique en chandeliers sous Matplotlib réside dans son exportation immuable vers des supports de diffusion extérieurs : articles de recherche économique, mémoires universitaires, plateformes web institutionnelles ou présentations de comités d’investissement. L’opération d’exportation s’orchestre par la méthode `fig.savefig()`, dont les paramètres conditionnent directement la fidélité de restitution géométrique.
Le choix de l’extension de fichier commande la sélection interne du pilote de sortie :
- Formats vectoriels sans perte (`.pdf`, `.svg`, `.eps`) : Constituent le standard absolu et exclusif pour toute intégration documentaire académique (notamment via LaTeX). Contrairement aux formats matriciels, un fichier PDF ou SVG conserve la nature mathématique pure des primitives graphiques : quelle que soit l’intensité du zoom appliqué sur le document, les segments de mèches, les contours de chandeliers et les polices de caractères demeurent d’une netteté absolue, sans la moindre pixellisation ou artefact de compression.
- Formats matriciels haute définition (`.png`) : Sont réservés aux affichages écrans, aux applications web ou aux rapports bureautiques classiques. Dans ce cas de figure, l’omission du paramètre de résolution conduit à une image floue inutilisable. L’analyste doit impérativement forcer le paramètre `dpi=300` (voire `dpi=600` pour l’édition papier de prestige), garantissant une densité de pixels par pouce garantissant un piqué visuel parfait.
Par ailleurs, deux paramètres techniques complémentaires méritent d’être systématiquement activés lors de l’invocation de `savefig()` :
fig.savefig('analyse_chandeliers_hd.pdf', dpi=300, bbox_inches='tight', transparent=False)
L’argument `bbox_inches=’tight’` commande à Matplotlib d’effectuer un calcul de découpe dynamique au plus près des éléments graphiques externes réels, éliminant ainsi les marges blanches périphériques superflues qui altèrent l’alignement lors de l’insertion dans un manuscrit. Enfin, l’assignation explicite de `transparent=False` assortie d’une couleur d’arrière-plan uniforme (`facecolor=’white’`) protège le document des mauvaises surprises de restitution sur des logiciels tiers dotés d’un mode sombre forcé, assurant que la création graphique traversera les plateformes et les époques avec une intégrité visuelle irréprochable.
Références
Bollinger, J. (2002). Bollinger on Bollinger Bands. McGraw-Hill Education.
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
McKinney, W. (2010). Data structures for statistical computing in Python. Proceedings of the 9th Python in Science Conference, 445, 51–56. https://doi.org/10.25080/Majora-92bf1921-00a
Nison, S. (1991). Japanese Candlestick Charting Techniques: A Contemporary Guide to the Ancient Investment Techniques of the Far East. New York Institute of Finance.
Tufte, E. R. (2001). The Visual Display of Quantitative Information (2e éd.). Graphics Press.
Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2