
L’évaluation de la concordance entre deux instruments de mesure constitue une problématique fondamentale en métrologie biomédicale, en psychométrie et dans l’ensemble des sciences empiriques. Lorsqu’un clinicien ou un chercheur souhaite substituer un nouveau dispositif médical à une méthode de référence souvent plus invasive ou plus onéreuse, la simple observation d’une association statistique étroite ne suffit pas à garantir l’interchangeabilité des outils. Durant plusieurs décennies, la recherche appliquée a pourtant souffert d’un contresens méthodologique majeur consistant à utiliser le coefficient de corrélation linéaire comme critère d’équivalence, confondant ainsi la force d’une liaison mathématique avec l’identité parfaite des valeurs mesurées.
Pour remédier à cette faille conceptuelle, les statisticiens britanniques John Martin Bland et Douglas G. Altman ont formalisé au milieu des années 1980 une approche graphique et analytique désormais universelle. Le graphique de Bland-Altman, également dénommé diagramme de Tukey des différences moyennes, repose sur un principe d’une grande élégance : projeter la différence individuelle entre deux mesures appariées en fonction de leur moyenne arithmétique. Cette modélisation permet d’isoler visuellement et statistiquement le biais systématique global, de quantifier la variabilité des écarts par l’intermédiaire des limites d’agrément à 95 %, et d’identifier immédiatement les anomalies structurales telles que l’hétéroscédasticité ou le biais proportionnel.
À l’ère de la science des données et de la recherche reproductible, la mise en œuvre computationnelle de cette méthode exige des environnements logiciels flexibles, rigoureux et standardisés. Le langage de programmation Python, soutenu par son écosystème scientifique comprenant NumPy, Pandas, Matplotlib et Statsmodels, offre un cadre idéal pour automatiser cette analyse, depuis le diagnostic de distribution jusqu’à la publication de visualisations conformes aux exigences académiques les plus strictes. Cet article propose une exploration exhaustive des fondements théoriques, des démonstrations mathématiques et des architectures logicielles nécessaires à la maîtrise complète de l’analyse de Bland-Altman en Python.
1. Fondements théoriques et épistémologiques du graphique de Bland-Altman
1.1 Genèse et raison d’être de la méthode de Bland et Altman
L’histoire de la métrologie clinique a longtemps été marquée par l’utilisation inappropriée du coefficient de corrélation de Pearson pour comparer deux techniques d’évaluation. Lorsque deux instruments mesurent la même grandeur physique, physiologique ou psychologique sur un échantillon hétérogène, les valeurs observées varient naturellement sur une large étendue d’un sujet à l’autre. Cette dispersion interindividuelle produit mécaniquement un coefficient de corrélation linéaire extrêmement élevé, souvent supérieur à 0,95, qui masque totalement des écarts absolus inacceptables en pratique clinique. Le coefficient de Pearson ne quantifie en réalité que la rectitude de l’alignement des points le long d’une droite de régression quelconque, sans imposer que cette droite corresponde à la ligne d’identité absolue où chaque observation égalerait exactement son homologue.
Cette confusion historique entre corrélation et concordance a généré d’importantes erreurs d’interprétation dans l’évaluation de dispositifs médicaux tels que les tensiomètres, les spiromètres ou les analyseurs biochimiques. Un instrument mesurant systématiquement une valeur double de celle rapportée par l’instrument étalon afficherait un coefficient de corrélation parfait de 1,00, bien que son utilisation directe conduirait à des diagnostics erronés et potentiellement délétères. La publication princeps de Bland et Altman en 1986 dans The Lancet a constitué une véritable rupture épistémologique, devenant l’un des articles scientifiques les plus cités de l’histoire biomédicale en réorientant l’évaluation métrologique vers l’analyse directe de l’erreur de mesure individuelle.
Dans le domaine contemporain des sciences comportementales, de la psychométrie et des neurosciences cognitives, cette distinction demeure cruciale. Les chercheurs comparent fréquemment des biomarqueurs numériques issus de capteurs passifs embarqués avec des questionnaires psychométriques étalonnés ou des mesures d’imagerie par résonance magnétique fonctionnelle. L’évaluation de l’interchangeabilité de ces méthodes d’acquisition requiert une rigueur identique afin de garantir que les scores obtenus ne dérivent pas selon des dynamiques instrumentales non contrôlées.
1.2 Différence fondamentale entre concordance, corrélation et cohérence interne
La caractérisation psychométrique et métrologique d’un outil d’évaluation repose sur plusieurs concepts statistiques qui, bien qu’apparentés, répondent à des questions scientifiques distinctes. La corrélation évalue l’intensité et le sens d’une liaison linéaire entre deux variables sans considération d’échelle ou de décalage. En revanche, la cohérence interne, traditionnellement mesurée par l’alpha de Cronbach dans les échelles psychologiques, quantifie le degré d’homogénéité avec lequel plusieurs items mesurent un même construit latent sous-jacent. Aucun de ces deux indicateurs ne permet d’établir si deux instruments fournissent des valeurs numériques interchangeables en valeur absolue.
Le coefficient de corrélation intraclasse (ICC), particulièrement dans ses formulations à effets mixtes à accord absolu (comme l’ICC bipoint), tente de combler cette lacune en pénalisant les écarts de moyenne entre les évaluateurs ou les appareils. Toutefois, l’ICC agrège l’ensemble de l’information en un unique scalaire compris entre 0 et 1, fortement sensible à la variance inter-sujets de la population testée. Si la variabilité interindividuelle de l’échantillon est massive, l’ICC peut demeurer artificiellement élevé en dépit d’une imprécision instrumentale inacceptable pour des décisions individuelles. L’approche de Bland-Altman s’en distingue par son caractère désagrégé et graphique, projetant les erreurs de mesure dans l’unité physique réelle de la variable observée.
La présence d’un biais systématique constant illustre parfaitement cette dichotomie. Si un moniteur d’activité physique sous-estime constamment la dépense énergétique journalière de 300 kilocalories chez l’ensemble des participants, le coefficient de corrélation de Pearson reste strictement inchangé par rapport à une situation d’accord parfait. La cohérence interne n’en est pas altérée et l’ICC peut afficher une fiabilité relative jugée excellente selon les conventions usuelles. En revanche, la méthode de Bland-Altman isole immédiatement cette translation systématique de 300 kilocalories sur son axe d’ordonnée, permettant aux cliniciens de juger souverainement de l’impact opérationnel d’un tel écart.
1.3 Principe de représentation : moyenne contre différence
Le choix géométrique des axes dans le graphique de Bland-Altman découle d’une nécessité statistique fondamentale. Lorsqu’on souhaite comparer deux instruments dont aucun ne peut être considéré a priori comme l’étalon-or absolu exempt de toute imperfection métrologique, la véritable valeur sous-jacente de la grandeur biologique mesurée demeure inconnue. La meilleure approximation sans biais de cette valeur théorique inconnue est constituée par la moyenne arithmétique des deux mesures obtenues chez un sujet donné. Porter la différence entre les deux mesures en fonction de la mesure issue d’un seul appareil introduirait une corrélation spurieuse, l’erreur de mesure de cet appareil particulier étant mathématiquement présente dans les deux coordonnées du graphique.
L’axe des abscisses représente ainsi la grandeur estimée du phénomène physiologique ou psychologique observé, tandis que l’axe des ordonnées affiche la différence brute entre la mesure du premier outil et celle du second. Cette rotation à 45 degrés par rapport au tracé conventionnel de régression linéaire isole entièrement l’erreur de mesure sur l’axe vertical, permettant à l’observateur d’analyser la structure résiduelle sans être influencé par la dispersion globale des niveaux de base des sujets. Chaque point du nuage représente un individu unique pour lequel la direction et la magnitude de la divergence instrumentale sont immédiatement perceptibles.
Cette disposition spatiale facilite l’identification immédiate des anomalies structurelles du système de mesure. L’hétéroscédasticité, définie par une augmentation ou une diminution de la dispersion des différences à mesure que la moyenne s’élève, apparaît sous la forme d’un entonnoir ou d’un cône caractéristique. De même, un biais d’échelle ou biais proportionnel se manifeste par une trajectoire oblique du nuage de points, trahissant le fait que l’un des instruments surévalue les valeurs basses tout en sous-évaluant les valeurs hautes par rapport à l’autre. Le diagramme fournit ainsi une évaluation qualitative et quantitative d’une clarté incomparable.
2. Cadre mathématique et modélisation statistique sous-jacente
2.1 Calcul du biais moyen et de son écart-type
La formalisation statistique de la méthode de Bland-Altman débute par la modélisation des différences individuelles observées au sein d’un échantillon apparié de taille $n$. Pour chaque participant $i$ (avec $i in {1, dots, n}$), soient $X_{1,i}$ et $X_{2,i}$ les mesures concomitantes obtenues respectivement par le premier et le second instrument. La différence individuelle $d_i$ est définie par l’équation linéaire :
$$d_i = X_{1,i} – X_{2,i}$$
Le biais systématique global, noté $\bar{d}$, représente la moyenne arithmétique de ces différences individuelles. Il caractérise le décalage moyen permanent existant entre les deux modalités d’évaluation et se formule ainsi :
$$\bar{d} = \frac{1}{n} \sum_{i=1}^{n} d_i$$
Lorsque $\bar{d}$ est significativement différent de zéro, l’une des méthodes produit de façon consistante des valeurs supérieures à l’autre. Pour apprécier la variabilité stochastique résiduelle autour de cette tendance centrale, l’écart-type de l’échantillon des différences, noté $s_d$, est calculé selon l’estimateur sans biais habituel :
$$s_d = \sqrt{\frac{1}{n – 1} \sum_{i=1}^{n} (d_i – \bar{d})^2}$$
Cette modélisation postule explicitement que les différences $d_i$ suivent une distribution gaussienne de moyenne $\delta$ et de variance $\sigma_d^2$. Il importe de souligner avec la plus grande rigueur méthodologique que cette hypothèse de normalité porte exclusivement sur la série des différences $d_i$, et nullement sur la distribution univariée des mesures brutes $X_{1,i}$ ou $X_{2,i}$, lesquelles peuvent tout à fait adopter une allure multimodale, tronquée ou asymétrique sans compromettre la validité mathématique du modèle.
2.2 Définition formelle des limites d’agrément à 95 %
Sous l’hypothèse d’une distribution gaussienne des écarts, les propriétés théoriques de la loi normale standard établissent qu’approximativement 95 % des observations se situent dans un intervalle centré sur l’espérance mathématique, délimité par plus ou moins 1,96 écart-type. Bland et Altman ont ainsi défini les limites d’agrément à 95 % (communément désignées sous l’acronyme anglophone LoA pour Limits of Agreement) comme les bornes numériques entre lesquelles s’inscrivent la quasi-totalité des divergences futures observées entre les deux instruments :
$$\text{Borne Supérieure (ULoA)} = \bar{d} + 1{,}96 \cdot s_d$$
$$\text{Borne Inférieure (LLoA)} = \bar{d} – 1{,}96 \cdot s_d$$
L’interprétation probabiliste de cet intervalle est fondamentale pour la décision clinique. Elle stipule que pour un sujet donné issu de la même population métrologique, il existe une probabilité de 0,95 pour que la différence entre les deux mesures se situe entre la limite inférieure et la limite supérieure calculées. Si cet intervalle est suffisamment étroit pour demeurer sans conséquence sur le diagnostic, la posologie thérapeutique ou la classification d’un profil comportemental, les deux méthodes peuvent être légitimement considérées comme interchangeables dans la pratique courante.
L’arrondi conventionnel du coefficient z à la valeur 1,96 suppose une taille d’échantillon suffisamment vaste pour que la distribution t de Student converge vers la normale. Lorsque les effectifs sont plus modestes, certains statisticiens recommandent l’usage du quantile exact de la loi de Student $t_{0{,}975; n-1}$, bien que la formulation originale de Bland et Altman conserve préférentiellement la constante 1,96 pour fixer les limites empiriques de concordance attendues dans la population générale.
2.3 Intervalles de confiance des limites d’agrément
Les paramètres $\bar{d}$ et $s_d$ constituent des estimations ponctuelles obtenues à partir d’un échantillon fini de sujets et sont par conséquent assujettis à l’aléa d’échantillonnage. Pour évaluer la précision métrologique de ces estimations, il est indispensable de construire les intervalles de confiance (IC) à 95 % entourant le biais moyen ainsi que chacune des limites d’agrément. L’erreur-type du biais moyen dépend directement de la taille d’échantillon $n$ et s’exprime sous la forme classique :
$$\text{SE}(\bar{d}) = \frac{s_d}{\sqrt{n}}$$
L’intervalle de confiance à 95 % du biais systématique se calcule alors en mobilisant la distribution de Student à $n – 1$ degrés de liberté :
$$\text{IC}_{95%}(\bar{d}) = \bar{d} \pm t_{0{,}975; n-1} \cdot \text{SE}(\bar{d})$$
La dérivation de l’erreur-type des limites d’agrément supérieures et inférieures est plus complexe, car elle combine l’incertitude liée à l’estimation de la moyenne et celle inhérente à l’estimation de la variance. Bland et Altman ont proposé une approximation robuste et universellement adoptée dans laquelle la variance d’échantillonnage de la limite s’élève approximativement à trois fois la variance de la moyenne :
$$\text{SE}(\text{LoA}) = \sqrt{\frac{1}{n} + \frac{1{,}96^2}{2(n – 1)}} \cdot s_d \approx \sqrt{\frac{3 \cdot s_d^2}{n}} = s_d \cdot \sqrt{\frac{3}{n}}$$
L’intervalle de confiance à 95 % pour la limite supérieure d’agrément s’établit dès lors comme suit :
$$\text{IC}_{95%}(\text{ULoA}) = (\bar{d} + 1{,}96 \cdot s_d) \pm t_{0{,}975; n-1} \cdot \text{SE}(\text{LoA})$$
De façon strictement symétrique, l’intervalle de confiance pour la limite inférieure s’énonce :
$$\text{IC}_{95%}(\text{LLoA}) = (\bar{d} – 1{,}96 \cdot s_d) \pm t_{0{,}975; n-1} \cdot \text{SE}(\text{LoA})$$
Cette formulation démontre mathématiquement le rôle capital de la puissance statistique. Dans une cohorte réduite de 15 à 20 sujets, les intervalles de confiance encadrant les limites d’agrément sont excessivement larges, révélant une incertitude métrologique qui empêche toute conclusion définitive quant à l’équivalence des outils, même si les estimations ponctuelles paraissent favorables.
3. Configuration de l’environnement Python et gestion des dépendances
3.1 Sélection des bibliothèques d’analyse et de visualisation
L’implémentation algorithmique d’une analyse de Bland-Altman complète repose sur un ensemble de bibliothèques canoniques de l’écosystème scientifique de Python. La bibliothèque Pandas constitue la colonne vertébrale du dispositif pour la structuration tubulaire des observations. Elle offre des structures de données en séries et en DataFrames particulièrement performantes pour aligner rigoureusement les paires de mesures, vérifier la cohérence des index de sujets et appliquer des opérations d’imputation ou de filtrage conditionnel sans distorsion des données.
La librairie NumPy assure l’efficacité computationnelle indispensable au traitement vectorisé des calculs statistiques. Grâce à ses structures de tableaux homogènes (ndarrays) écrites en langage C, NumPy permet de déterminer instantanément les sommes pondérées, les différences résiduelles, les écarts-types sans biais et les quantiles théoriques sans recourir à des boucles itératives interprétées par Python, lesquelles dégraderaient les performances lors du traitement de volumétries importantes issues de capteurs biomédicaux à haute fréquence.
La composante de visualisation s’appuie sur le moteur graphique de Matplotlib, et plus spécifiquement sur son interface orientée objet accessible via matplotlib.pyplot. Contrairement aux surcouches déclaratives haut niveau qui masquent les primitives de dessin, Matplotlib accorde un contrôle absolu sur chaque élément géométrique du canevas : superposition de plans transparents, manipulation des transformations de coordonnées pour les annotations textuelles dynamiques, et configuration vectorielle fine des axes d’échelles. Enfin, la bibliothèque Statsmodels apporte des modules spécialisés d’estimation économétrique et biométrique, incluant des routines prédéfinies d’accord de mesure et des architectures de régression linéaire indispensables aux étapes diagnostiques.
3.2 Bonnes pratiques d’installation et environnements virtuels
La reproductibilité computationnelle est un impératif méthodologique fondamental en recherche académique. L’exécution d’analyses statistiques au sein d’un environnement global partagé par le système d’exploitation expose l’expérimentateur à des ruptures de compatibilité ascendante et à des divergences algorithmiques induites par des montées de version inopinées des paquets sous-jacents. Il est donc indispensable d’isoler l’espace de travail du projet via un environnement virtuel dédié, généré soit au moyen de l’utilitaire natif venv, soit via le gestionnaire de paquets d’entreprise conda.
Dans un terminal système, la création et l’activation d’un environnement hermétique reposent sur l’orchestration séquentielle de commandes d’isolation et d’installation contrôlée. L’ancrage précis des versions majeures et mineures dans un fichier de configuration déclaratif (tel qu’un fichier d’exigences pip standardisé) garantit que les calculs statistiques et les rendus typographiques demeureront rigoureusement identiques quel que soit le système d’exploitation hôte sur lequel l’analyse sera ultérieurement répliquée :
- Isolation de l’interpréteur Python dans un dossier d’environnement dédié au projet expérimental.
- Mise à niveau systématique du gestionnaire de dépendances pip pour prévenir les erreurs de compilation binaire.
- Installation déterministe des versions stables de
numpy,pandas,matplotlib,scipyetstatsmodels. - Génération automatisée d’un fichier de verrouillage détaillant la signature exacte de l’arbre complet des sous-dépendances logicielles.
Dès l’initialisation de la session analytique Python, il est hautement recommandé de paramétrer les variables globales de rendu graphique via le dictionnaire matplotlib.rcParams. La définition a priori d’une résolution minimale fixée à 300 points par pouce (DPI), le choix d’un jeu de polices typographiques conformes aux normes des périodiques scientifiques (comme Helvetica ou Computer Modern), et l’activation du moteur de formatage mathématique garantissent une uniformité visuelle sans faille lors de l’exportation des figures vers les manuscrits définitifs.
4. Préparation, validation et structuration du jeu de données
4.1 Ingestion et vérification structurelle des paires de mesures
La viabilité métrologique d’une analyse de Bland-Altman est conditionnée par l’intégrité structurelle du jeu de données source. Les observations doivent obligatoirement se conformer à un schéma bidimensionnel apparié au sein duquel chaque ligne représente un sujet ou une unité expérimentale unique, et chaque colonne contient les évaluations quantitatives rapportées par un instrument particulier. Avant toute modélisation, une inspection approfondie de l’homogénéité des échelles de mesure s’impose : comparer un appareil exprimant une glycémie en millimoles par litre (mmol/L) avec un lecteur calibré en milligrammes par décilitre (mg/dL) produirait un biais gigantesque purement artificiel résultant d’une négligence dimensionnelle.
Le traitement des données manquantes constitue une autre étape critique du nettoyage préalable. Si un sujet ne présente une valeur que pour l’une des deux modalités instrumentales, l’appariement est rompu. La règle méthodologique stricte impose l’exclusion complète de ce sujet pour le tracé principal de concordance, toute tentative d’imputation univariée arbitraire risquant de distordre la corrélation d’erreur et d’altérer artificiellement les limites d’agrément. L’utilisation des routines de filtrage de Pandas permet d’éliminer élégamment les paires incomplètes tout en conservant une trace quantitative du nombre d’enregistrements rejetés pour la rédaction du rapport d’étude.
Enfin, l’identification des valeurs aberrantes ou physiologiquement impossibles requiert un discernement clinique rigoureux. Un point discordant ne doit pas être supprimé par simple convenance statistique dans le dessein d’optimiser artificiellement la concordance apparente des outils. Seules les anomalies résultant d’une défaillance technique manifeste, d’un artefact d’enregistrement documenté ou d’une erreur de saisie typographique justifient un nettoyage pré-analytique, lequel doit être consigné de manière transparente et reproductible dans le cahier d’observation numérique.
4.2 Simulation d’un jeu de données expérimental pour l’analyse
Afin d’illustrer de manière concrète et didactique les protocoles computationnels détaillés dans ce guide, construisons un jeu de données biomédical synthétique simulant la comparaison de deux tensiomètres mesurant la pression artérielle systolique (exprimée en millimètres de mercure, mmHg) chez une cohorte de 20 patients adultes. Ce scénario d’émulation permet de contrôler précisément les paramètres métrologiques sous-jacents, notamment l’injection intentionnelle d’un biais systématique connu et l’ajout d’une composante de bruit stochastique représentative de l’aléa biologique.
Considérons que la méthode de référence (Instrument A, le sphygmomanomètre à colonne de mercure étalonné) enregistre des valeurs vraies réparties sur une plage physiologique réaliste comprise entre 110 mmHg et 160 mmHg. Le nouvel instrument à évaluer (Instrument B, un capteur oscillométrique digital portable) est paramétré algorithmiquement pour présenter un biais systématique positif de +2,5 mmHg (l’appareil B ayant tendance à surestimer la pression artérielle globale) conjugué à une erreur aléatoire distribuée selon une loi gaussienne de moyenne nulle et d’écart-type égal à 3,0 mmHg.
La génération programmatique de ce jeu de données sous Pandas s’opère en mobilisant le générateur de nombres pseudo-aléatoires de NumPy, préalablement initialisé avec une graine de reproductibilité fixe (seed). Cette configuration permet d’obtenir un tableau comprenant l’identifiant individuel du patient, la valeur issue de l’Instrument A, la valeur fournie par l’Instrument B, ainsi que les premières statistiques descriptives univariées. L’inspection préalable de la distribution de chaque colonne confirme que les deux dispositifs explorent une étendue clinique similaire, ouvrant la voie à l’analyse différentielle fine.
5. Implémentation automatisée via le module Statsmodels
5.1 Utilisation de la fonction mean_diff_plot
Le module statsmodels.graphics.agreement propose une solution directe et standardisée pour produire un tracé de Bland-Altman à travers la fonction dédiée mean_diff_plot. Cette routine d’automatisation a été conçue pour offrir un accès immédiat au tracé sans exiger de l’analyste le codage manuel des équations de dispersion. Son invocation requiert simplement le passage en arguments des deux séries numériques appariées extraites du DataFrame.
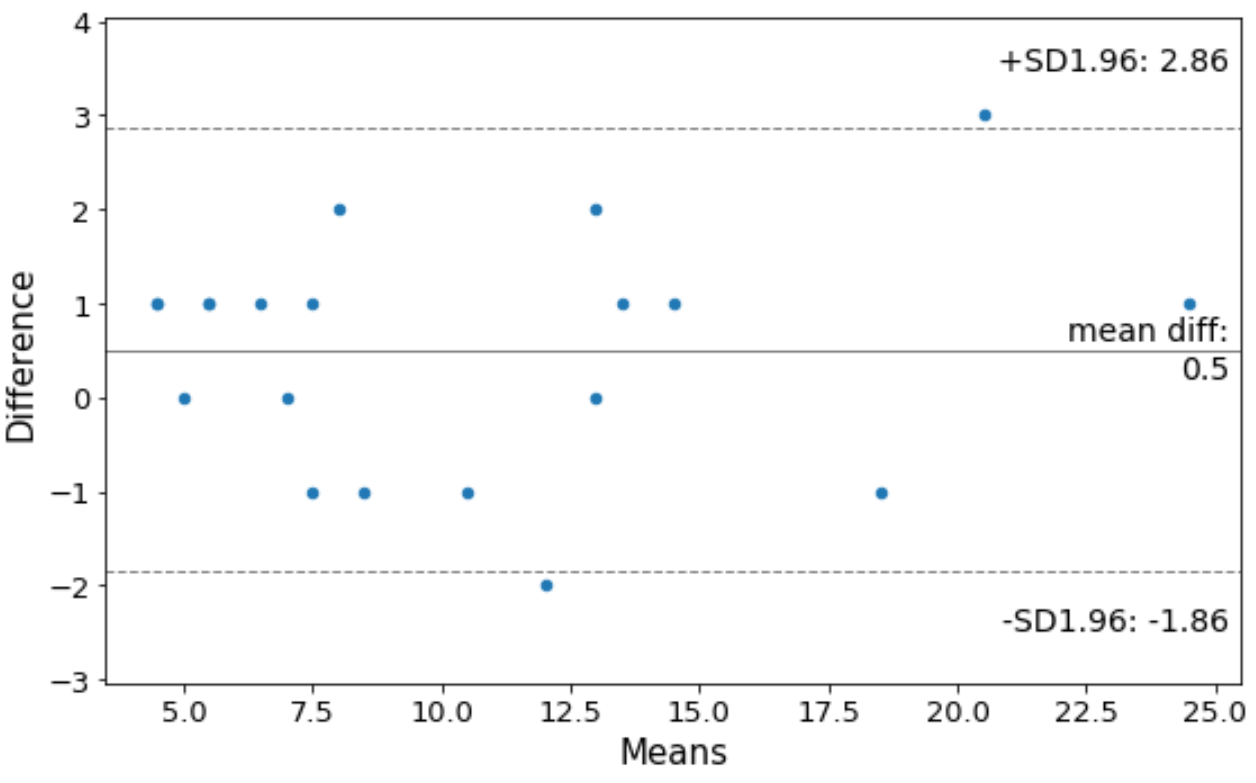
D’un point de vue algorithmique, la fonction mean_diff_plot extrait les vecteurs d’entrée, calcule automatiquement la moyenne de chaque paire ainsi que la différence arithmétique orientée (généralement premier argument moins second argument), puis dérive en interne le biais moyen et les limites d’agrément fixées par défaut au seuil classique de 1,96 écart-type. L’appel de cette fonction instancie directement un canevas graphique Matplotlib et retourne les références vers les objets Figure et Axes correspondants, offrant un point d’ancrage programmatique pour d’éventuelles retouches ultérieures.
Cette approche standardisée garantit la conformité algorithmique immédiate du tracé avec les préceptes théoriques de base formulés par Bland et Altman. Elle dispense l’utilisateur des risques d’erreurs d’implémentation manuelle dans le calcul du diviseur des degrés de liberté ou dans l’orientation vectorielle des différences, constituant ainsi un outil d’exploration exploratoire de premier ordre lors des phases préliminaires d’un projet de recherche.
5.2 Personnalisation élémentaire de l’objet graphique généré
Bien que la fonction mean_diff_plot génère un tracé fonctionnel en une seule ligne de code, le rendu brut obtenu ne répond pas toujours aux exigences esthétiques et éditoriales des revues académiques internationales. L’extraction de l’objet Axes renvoyé par la fonction permet d’intervenir chirurgicalement sur les attributs visuels du graphique afin d’en optimiser l’intelligibilité et la rigueur informative.
Il est notamment possible de redimensionner le cadre géométrique de la figure pour éviter toute distorsion visuelle, de reformuler les libellés des axes en mentionnant explicitement la grandeur mesurée et son unité physique normalisée, et d’ajuster la typographie générale. De surcroît, les lignes horizontales matérialisant le biais central et les limites d’agrément peuvent être reconfigurées en modifiant leur couleur, leur épaisseur de trait et leur motif de pointillés (par exemple en assignant une ligne pleine rouge pour le biais nul théorique et des tirets denses pour les limites d’agrément à 95 %).
Une fois ces ajustements appliqués via les méthodes conventionnelles de Matplotlib, le graphique peut être exporté dans des formats haute fidélité. La sauvegarde au format matriciel PNG avec une résolution de 300 à 600 DPI, ou préférentiellement en format vectoriel non pixellisé tel que le PDF ou l’EPS, garantit que la figure conservera une netteté absolue quelle que soit la réduction d’échelle imposée par la mise en page d’un article scientifique.
5.3 Forces et contraintes de l’approche intégrée de Statsmodels
L’utilisation de la routine native de Statsmodels présente des avantages indéniables, au premier rang desquels figurent la rapidité d’exécution et la concision syntaxique. Pour un biostatisticien souhaitant réaliser un contrôle qualité instantané sur un ensemble de capteurs ou évaluer rapidement la convergence de deux biomarqueurs lors d’une phase de criblage expérimental, cette solution s’avère particulièrement efficace et limite drastiquement le risque de coquilles algorithmiques.
Toutefois, cette fonction montre de sévères limitations dès lors que l’étude requiert une méthodologie métrologique avancée. Le principal écueil réside dans l’absence d’évaluation automatisée des intervalles de confiance encadrant le biais moyen et les limites d’agrément, omission dommageable au vu des exigences modernes de publication qui réclament la matérialisation explicite de l’incertitude d’échantillonnage. En outre, la fonction n’intègre aucun mécanisme natif pour traiter les biais proportionnels, n’offre aucune flexibilité pour basculer vers des percentiles non paramétriques, et impose un formatage visuel rigide dont la modification en profondeur requiert des manipulations laborieuses des collections internes de Matplotlib.
Face à ces contraintes fonctionnelles, la conception d’un pipeline d’analyse entièrement personnalisé, reposant sur le calcul direct via NumPy et une orchestration graphique millimétrée avec Matplotlib, apparaît comme la solution d’excellence pour tout chercheur aspirant à une maîtrise totale de ses figures et de ses inférences statistiques.
6. Construction algorithmique personnalisée avec NumPy et Matplotlib
6.1 Calcul vectoriel des métriques de concordance
La construction autonome d’un graphique de Bland-Altman débute par la transcription vectorielle des estimateurs fondamentaux au moyen de NumPy. Cette approche garantit une vitesse de calcul optimale et permet d’extraire des variables scalaires réutilisables pour les annotations dynamiques. À partir de deux vecteurs unidimensionnels représentant les mesures synchronisées des deux instruments, la première étape calcule la série des moyennes locales point par point :
La moyenne arithmétique vectorisée s’obtient par la simple addition des deux vecteurs divisée par la constante scalaire 2. De façon synchronisée, le vecteur des différences d’échantillonnage est déterminé en soustrayant le vecteur de l’instrument de référence du vecteur de l’instrument évalué. Cette opération vectorielle préserve rigoureusement l’alignement indiciaire de chaque patient.
À partir du vecteur des différences, le biais moyen est extrait via la fonction de moyenne arithmétique de NumPy. L’écart-type résiduel est calculé en spécifiant explicitement un degré de liberté égal à 1 (paramètre ddof=1), condition sine qua non pour appliquer la correction de Bessel et obtenir un estimateur non biaisé de la variance de la population. Enfin, les limites d’agrément supérieure et inférieure sont dérivées par simple translation du biais moyen par le produit de 1,96 et de cet écart-type corrigé.
6.2 Traçage détaillé et contrôle absolu du canevas
Une fois les grandeurs scalaires déterminées, l’orchestration graphique dans Matplotlib s’effectue au sein d’une structure à axe unique gérée de manière orientée objet. Le nuage de points est disposé à l’aide de la méthode de dispersion (scatter). Afin de prévenir les phénomènes d’occlusion visuelle et de surimpression qui surviennent fréquemment lorsque plusieurs patients présentent des coordonnées très proches, l’analyste applique un paramètre de transparence alpha modéré (par exemple entre 0,6 et 0,8) combiné à un liseré contrasté autour des marqueurs circulaires.
La structure de référence repose sur l’adjonction de quatre lignes horizontales stratégiques réparties sur l’axe des ordonnées :
- Une ligne d’identité absolue tracée à la coordonnée $y = 0$, figurant l’absence totale de divergence instrumentale théorique.
- Une ligne centrale représentant le biais systématique observé $\bar{d}$, souvent matérialisée par un trait plein ou discontinu distinctif.
- Une ligne supérieure marquant la limite d’agrément à +1,96 écart-type.
- Une ligne inférieure marquant la limite d’agrément à -1,96 écart-type.
L’attribution de codes couleur différenciés (par exemple une tonalité neutre pour le zéro, un bleu profond pour le biais central et un rouge brique ou gris anthracite pour les limites extérieures) assure une hiérarchisation perceptive immédiate pour le lecteur, tout en préservant la sobriété requise par les publications scientifiques internationales.
6.3 Automatisation des annotations textuelles informatives
Un graphique de Bland-Altman ne saurait être complet sans l’inscription explicite des valeurs chiffrées associées aux limites statistiques tracées. Plutôt que de contraindre le lecteur à interpoler approximativement les niveaux sur l’axe des ordonnées, l’inscription dynamique de labels textuels à l’extrémité droite du canevas décuple la valeur informative de la figure.
L’implémentation de ces annotations recourt à la fonction text de Matplotlib, en associant une transformation de coordonnées adaptée. L’utilisation du système de coordonnées mixtes (où l’abscisse est définie en coordonnées relatives à l’axe, par exemple à 1,02 pour dépasser légèrement de la bordure droite, tandis que l’ordonnée demeure verrouillée sur l’échelle des données réelles) garantit que les mentions textuelles resteront parfaitement alignées avec leurs droites respectives, indépendamment de l’échelle ou du zoom appliqué ultérieurement.
Les chaînes de caractères inscrites sont systématiquement formatées avec un contrôle rigoureux du nombre de décimales significatives, en cohérence avec la précision métrologique réelle des appareils évalués. L’adjonction d’un cartouche récapitulatif élégant dans l’un des angles du graphique, précisant la taille d’échantillon $n$, la valeur exacte de l’écart-type résiduel et l’intervalle de dispersion global, parachève l’automatisation informative du tracé.
7. Visualisation avancée, intervalles de confiance et mise en forme esthétique
7.1 Calcul et matérialisation des zones de confiance à 95 %
L’intégration des intervalles de confiance encadrant le biais systématique et les limites d’agrément constitue l’une des marques distinctives d’une analyse métrologique de rang académique. La simple projection de lignes fines suggère une certitude absolue quant à la position des bornes d’agrément, occultant l’imprécision statistique intrinsèque liée à l’échantillonnage d’une cohorte finie de patients.
Pour calculer rigoureusement ces zones d’incertitude sous Python, l’expérimentateur utilise le quantile approprié de la loi de Student extrait du module scipy.stats.t, calibré sur $n – 1$ degrés de liberté au seuil de confiance bilatéral de 95 %. L’erreur-type du biais et celle des limites d’agrément sont ensuite multipliées par ce coefficient critique pour obtenir les demi-largeurs des intervalles de confiance correspondants.
La matérialisation visuelle de ces incertitudes s’opère élégamment via la méthode axhspan de Matplotlib. Cette commande permet de déployer des bandes horizontales ombrées translucides s’étendant d’une borne de l’intervalle de confiance à l’autre. L’assignation d’un coefficient d’opacité modéré (alpha compris entre 0,15 et 0,25) assure que ces plages d’incertitude demeurent parfaitement visibles sans surcharger le dessin ni masquer les points de dispersion sous-jacents.
7.2 Raffinement graphique selon les standards des revues scientifiques
La lisibilité d’une figure scientifique conditionne sa capacité à transmettre une information sans équivoque. Trop souvent, les graphiques générés par défaut souffrent d’une saturation d’éléments graphiques superflus qui altèrent le ratio données-encre théorisé par Edward Tufte. Un nettoyage méticuleux s’impose pour débarrasser le canevas de toute fioriture distrayante.
Ce raffinement graphique s’articule autour de préceptes rigoureux :
- Suppression des bordures supérieure et droite du cadre graphique (spines) pour aérer la composition spatiale.
- Allègement de la grille de fond par l’emploi de traits fins, discontinus et grisés afin de faciliter le repérage sans rivaliser avec les données.
- Adoption d’une palette chromatique respectueuse des règles d’accessibilité universelle, en évitant les contrastes rouge-vert incompatibles avec le daltonisme et en favorisant des contrastes de luminance élevés.
- Recours à la typographie LaTeX pour le rendu impeccable des symboles mathématiques et des lettres grecques sur les étiquettes d’axes.
Le dimensionnement géométrique de la figure doit également être anticipé pour coïncider avec les gabarits standardisés des maisons d’édition biomédicales, qui privilégient généralement des largeurs de colonne simple (environ 85 millimètres) ou double colonne (environ 175 millimètres). L’exportation finale à très haute résolution (typiquement 600 DPI pour les schémas au trait) garantit une reproduction irréprochable au stade de la composition prépresse.
7.3 Conception d’une fonction Python modulaire et réutilisable
Afin de capitaliser sur ces développements et de favoriser une démarche d’ingénierie logicielle pérenne, il convient d’encapsuler l’ensemble de ces routines mathématiques et graphiques au sein d’une fonction Python paramétrable et modulaire. Cette architecture logicielle favorise la réutilisation du code à travers de multiples protocoles expérimentaux tout en prévenant les dérives de copie-collage.
Une fonction robuste doit accepter en entrée deux structures de données compatibles (tableaux NumPy ou séries Pandas) accompagnées d’arguments optionnels permettant de personnaliser le titre de la figure, les étiquettes textuelles des instruments comparés, le niveau de confiance souhaité, ainsi que l’activation conditionnelle de l’ombrage des intervalles de confiance. La signature de la fonction doit être documentée par des docstrings détaillées spécifiant le format des arguments, les hypothèses statistiques sous-jacentes et la nature des objets retournés.
Plutôt que de se limiter à l’affichage du dessin, cette fonction professionnelle retourne systématiquement un dictionnaire exhaustif contenant l’ensemble des métriques quantitatives dérivées : biais moyen, écart-type des différences, bornes des limites d’agrément, erreurs-types et intervalles de confiance numériques associés. Cette double restitution, à la fois graphique et tabulaire, permet à l’utilisateur d’alimenter directement les tableaux récapitulatifs de ses publications tout en préservant une traçabilité totale des calculs.
8. Diagnostic statistique rigoureux des postulats d’application
8.1 Test de la normalité de la distribution des différences
La validité des limites d’agrément à 95 % formulées par Bland et Altman repose structurellement sur le postulat d’une distribution gaussienne des différences individuelles $d_i$. Si cette hypothèse n’est pas vérifiée, la constante d’élargissement 1,96 perd sa signification probabiliste, et l’intervalle calculé échoue à capturer fidèlement les 95 % attendus de la population sous-jacente. Il est par conséquent impératif de soumettre la série résiduelle à un diagnostic de normalité exhaustif avant toute validation définitive.
Ce contrôle statistique mobilise traditionnellement le test formel de Shapiro-Wilk, disponible dans le module scipy.stats.shapiro, réputé pour sa puissance élevée sur les cohortes de taille modeste à intermédiaire. Une p-valeur supérieure au seuil conventionnel de 0,05 conduit à ne pas rejeter l’hypothèse nulle de normalité. Néanmoins, les tests d’hypothèse formels souffrent d’une double vulnérabilité : un manque de puissance statistique sur les échantillons très réduits (qui ne détectent pas des déviations majeures) et une hypersensibilité sur les cohortes volumineuses (qui rejettent la normalité pour des écarts infinitésimaux sans portée clinique).
C’est pourquoi le diagnostic formel doit impérativement être doublé d’une inspection graphique à l’aide d’un diagramme quantile-quantile (Q-Q plot) normal, facilement tracé via statsmodels.graphics.gofplots.qqplot. L’alignement rigoureux des points empiriques le long de la bissectrice théorique confirme l’adéquation gaussienne, tandis que l’incurvation des extrémités trahit la présence de queues de distribution épaisses, d’asymétries marquées ou de valeurs aberrantes nécessitant un traitement méthodologique spécifique.
8.2 Évaluation de l’homoscédasticité et détection du biais proportionnel
Le second postulat fondamental de l’analyse classique de Bland-Altman impose l’homoscédasticité des résidus, c’est-à-dire l’invariance de la dispersion des différences sur l’ensemble de l’étendue de mesure. De surcroît, le biais systématique doit demeurer constant quel que soit le niveau moyen de la variable. La violation de ces conditions se manifeste par l’apparition d’un biais proportionnel ou d’un élargissement continu de l’erreur métrologique à mesure que les valeurs augmentent.
Pour diagnostiquer objectivement la présence d’un biais proportionnel, l’expérimentateur modélise la régression linéaire simple de la différence $d_i$ en fonction de la moyenne appariée $m_i = (X_{1,i} + X_{2,i}) / 2$. L’estimation des moindres carrés ordinaires, réalisée au moyen de la classe OLS de Statsmodels, fournit l’estimation de la pente de régression accompagnée de son intervalle de confiance et de son test de nullité de Student :
Si la p-valeur associée au coefficient de pente s’avère inférieure au seuil critique de 0,05, l’hypothèse d’un biais constant est réfutée. Cette pente statistiquement significative démontre que la discordance entre les instruments dépend de la magnitude de la grandeur mesurée. Dans les situations où la relation entre l’erreur et la moyenne s’avère monotone mais non strictement linéaire, le calcul du coefficient de corrélation de rang de Spearman entre les différences absolues $|d_i|$ et les moyennes $m_i$ offre un diagnostic non paramétrique robuste de l’hétéroscédasticité.
L’observation visuelle d’un nuage de points adoptant une conformation d’entonnoir caractéristique confirme l’existence d’une hétéroscédasticité marquée, invalidant le tracé de limites d’agrément rectilignes et parallèles à l’axe horizontal.
9. Stratégies méthodologiques face au biais proportionnel et à l’hétéroscédasticité
9.1 Transformation logarithmique des données brutes
Lorsque la variabilité des différences et le biais s’élargissent proportionnellement à la magnitude de la grandeur mesurée, l’erreur de mesure ne présente plus un caractère additif, mais multiplicatif. Dans cette configuration fréquente en biochimie, en pharmacocinétique et en physiologie de l’effort, la stratégie d’ajustement la plus rigoureuse et la plus élégante consiste à opérer une transformation logarithmique népérienne préalable sur les séries brutes des deux instruments avant toute dérivation différentielle.
D’un point de vue mathématique, la différence entre deux logarithmes équivaut rigoureusement au logarithme du quotient des grandeurs initiales :
$$\ln(X_{1,i}) – \ln(X_{2,i}) = \ln\left(\frac{X_{1,i}}{X_{2,i}}\right)$$
En effectuant l’analyse de Bland-Altman standard sur ces séries transformées, l’analyste obtient un biais moyen logarithmique $\bar{d}_{\ln}$ et un écart-type associé $s_{d,\ln}$. La rétro-transformation exponentielle de ces scalaires permet de s’affranchir de l’échelle logarithmique abstraite pour exprimer les résultats sous la forme intuitive d’un ratio géométrique entre les deux instruments :
$$\text{Ratio Moyen} = \exp(\bar{d}_{\ln})$$
$$\text{Limites d’agrément relatives} = [\exp(\bar{d}_{\ln} – 1{,}96 \cdot s_{d,\ln}) ;;; \exp(\bar{d}_{\ln} + 1{,}96 \cdot s_{d,\ln})]$$
Un ratio moyen de 1,03 signifie que le premier instrument fournit des valeurs systématiquement supérieures de 3 % à celles du second. De même, des limites d’agrément relatives comprises entre 0,92 et 1,15 indiquent avec un niveau de certitude de 95 % que les mesures du nouvel appareil fluctuent entre une sous-estimation maximale de 8 % et une surestimation maximale de 15 % par rapport à la méthode de comparaison. Cette formulation en pourcentage résout élégamment la problématique de l’hétéroscédasticité tout en offrant une interprétation clinique limpide.
9.2 Régression linéaire directe pour limites d’agrément dynamiques
Dans les cas de figure où l’erreur métrologique présente une dérive proportionnelle mais que la transformation logarithmique ne parvient pas à stabiliser la variance ou se heurte à la présence de valeurs négatives ou nulles, Bland et Altman ont formalisé une approche par modélisation dynamique des limites d’agrément fondée sur la régression linéaire.
Le protocole s’articule en deux régressions successives. La première consiste à modéliser la différence brute $d$ en fonction de la moyenne $m$ par une droite des moindres carrés classiques : $\hat{d} = \beta_0 + \beta_1 \cdot m$. Cette droite remplace la ligne horizontale du biais moyen constant et matérialise le biais dépendant de l’échelle. Dans un second temps, les résidus absolus issus de cette première régression, notés $r_i = |d_i – \hat{d}_i|$, sont eux-mêmes régressés sur la moyenne $m$ afin de capturer l’évolution de la dispersion : $\hat{r} = \gamma_0 + \gamma_1 \cdot m$.
Sous l’hypothèse de résidus semi-gaussiens, la relation liant la moyenne des valeurs absolues des résidus à leur écart-type théorique est établie par la constante mathématique $\sqrt{\pi / 2} \approx 1{,}2533$. L’écart-type dynamique estimé s’exprime donc par $s(m) = 1{,}2533 \cdot (\gamma_0 + \gamma_1 \cdot m)$. Les limites d’agrément dynamiques supérieures et inférieures se déploient dès lors non plus comme des droites horizontales, mais sous la forme de lignes obliques ou courbes encadrant le nuage de points :
$$\text{Limites Dynamiques}(m) = (\beta_0 + \beta_1 \cdot m) \pm 1{,}96 \cdot 1{,}2533 \cdot (\gamma_0 + \gamma_1 \cdot m)$$
L’implémentation sous Python fait appel aux fonctions de régression linéaire de Statsmodels ou de Scipy pour estimer les coefficients $\beta$ et $\gamma$, permettant de tracer ces enveloppes dynamiques personnalisées sur le canevas Matplotlib avec une exactitude métrologique sans faille.
9.3 Approches non paramétriques basées sur les centiles
Lorsque la distribution des différences résiduelles dévie radicalement de la loi normale (présence d’asymétries sévères, d’un aplatissement excessif ou de distributions multimodales) et qu’aucune transformation mathématique d’échelle ne permet de restaurer la symétrie gaussienne, le recours aux limites d’agrément paramétriques devient méthodologiquement fallacieux. L’analyste doit alors s’orienter vers une approche non paramétrique fondée sur les centiles empiriques.
Dans cette formulation robuste, le biais systématique n’est plus estimé par la moyenne arithmétique (excessivement sensible aux valeurs extrêmes), mais par la médiane de la série des différences :
$$\tilde{d} = \text{Médiane}(d_i)$$
De même, les limites d’agrément ne sont plus calculées par l’adjonction d’un multiple de l’écart-type, mais sont directement définies par les 2,5ème et 97,5ème centiles de la distribution empirique des différences, déterminés au moyen de la méthode vectorisée numpy.percentile :
$$\text{LLoA}_{\text{non-param}} = \text{Centile}_{2{,}5%}(d)$$
$$\text{ULoA}_{\text{non-param}} = \text{Centile}_{97{,}5%}(d)$$
Cette approche présente l’avantage majeur d’une neutralité distributionnelle totale, s’adaptant à n’importe quelle morphologie empirique sans contraindre la réalité des données. Toutefois, elle impose une exigence fondamentale en matière de puissance : l’estimation précise des centiles extrêmes d’une distribution exige des tailles d’échantillons nettement plus substantielles que l’estimation de la moyenne et de la variance. Alors qu’une analyse paramétrique peut fournir des estimations raisonnables avec une quarantaine de patients, une approche non paramétrique par centiles nécessite fréquemment un minimum de 100 à 200 observations appariées pour stabiliser les bornes et éviter une variabilité d’échantillonnage délétère.
10. Adaptations pour protocoles expérimentaux complexes et mesures répétées
10.1 Problématique de la violation de l’indépendance des observations
Dans de nombreux contextes d’évaluation clinique et ergonomique, le protocole expérimental ne se limite pas à une mesure unique par patient, mais procède à des enregistrements séquentiels répétés sur chaque individu sous diverses conditions physiologiques ou à des instants temporels successifs. L’agrégation naïve de l’ensemble de ces points au sein d’un tracé de Bland-Altman conventionnel constitue l’une des erreurs méthodologiques les plus destructrices en statistique médicale.
Cette concaténation globale viole le postulat fondamental d’indépendance des observations. Les mesures répétées issues d’un même sujet partagent une variance commune et sont intrinsèquement corrélées entre elles. Traiter $k$ mesures acquises chez $n$ patients comme un échantillon global de taille $N = n \times k$ observations indépendantes produit une sous-estimation dramatique de la variance réelle des erreurs, conduisant à des limites d’agrément artificiellement resserrées et à un taux d’erreur de première espèce incontrôlé quant à la substituabilité des appareils.
Dans leurs travaux méthodologiques complémentaires de 1999 et 2007, Bland et Altman ont explicitement formalisé les solutions mathématiques adaptées à cette structure hiérarchique, distinguant soigneusement les protocoles où la grandeur physiologique sous-jacente demeure stationnaire durant les répétitions de ceux où la grandeur varie dynamiquement au cours du protocole expérimental.
10.2 Modélisation linéaire mixte avec Statsmodels pour décomposer la variance
La résolution rigoureuse de la problématique des mesures répétées en Python repose sur le déploiement d’un modèle linéaire à effets mixtes (Mixed Linear Model). Cette architecture statistique permet de décomposer la variance totale des différences individuelles en deux composantes stochastiques orthogonales : la variance inter-sujets (reflétant la variabilité du biais individuel d’un patient à l’autre) et la variance intra-sujet (caractérisant l’erreur instrumentale résiduelle répétée au sein d’un même individu).
Cette décomposition s’opère en mobilisant la classe MixedLM du module statsmodels.formula.api. Le modèle régresse la différence brute sur une constante globale (estimant le biais systématique moyen fixe $\bar{d}$), en déclarant l’identifiant du patient comme variable de regroupement aléatoire pour intercepter la variance individuelle :
L’estimation par le maximum de vraisemblance restreint (REML) permet d’extraire la variance résiduelle intra-sujet $\sigma_w^2$ ainsi que la variance de l’intercept aléatoire inter-sujets $\sigma_b^2$. La variance totale combinée, qui capture l’intégralité de l’incertitude métrologique à laquelle sera confronté un praticien mesurant un patient futur quelconque, s’obtient par la sommation de ces deux composantes :
$$\sigma_{\text{totale}}^2 = \sigma_b^2 + \sigma_w^2$$
Les limites d’agrément corrigées pour mesures répétées sont alors calculées en appliquant la racine carrée de cette variance globale agrégée :
$$\text{LoA}_{\text{corrigées}} = \bar{d} \pm 1{,}96 \cdot \sqrt{\sigma_b^2 + \sigma_w^2}$$
Cette approche hiérarchique rétablit la validité probabiliste de l’inférence en évitant toute inflation artificielle des degrés de liberté, garantissant que les limites projetées reflètent fidèlement la concordance opérationnelle dans des conditions de variabilité écologique.
10.3 Agrégation préalable versus analyse multi-niveaux
Face à la complexité des modèles mixtes, certains praticiens ont recours à une stratégie simplificatrice consistant à calculer préalablement la moyenne des mesures répétées pour chaque sujet avant de tracer un graphique de Bland-Altman conventionnel sur ces valeurs agrégées. Si cette méthode élimine effectivement le problème de la dépendance sérielle des observations, elle induit une distorsion métrologique majeure qu’il convient de comprendre parfaitement.
L’agrégation par la moyenne lisse les fluctuations aléatoires intra-individuelles et compresse artificiellement la variance résiduelle. L’écart-type des différences entre moyennes de $k$ mesures est systématiquement inférieur à l’écart-type des différences entre mesures individuelles uniques, car il est divisé par un facteur proportionnel à $\sqrt{k}$. Les limites d’agrément obtenues par cette procédure ne quantifient que la concordance entre des protocoles moyens répétés, et sous-estiment l’erreur réelle qui se manifestera lorsqu’un praticien prendra une mesure isolée en consultation courante.
Le choix méthodologique dépend donc de l’usage futur prévu de l’instrument évalué :
- Si l’indication clinique finale impose d’effectuer systématiquement une moyenne de trois mesures consécutives (pratique fréquente dans le monitoring de la pression artérielle ambulatoire), l’analyse agrégée sur les moyennes individuelles est conceptuellement valide et directement transposable à la pratique future.
- Si l’instrument est destiné à être utilisé par une mesure ponctuelle unique en situation d’urgence ou de dépistage ambulatoire, seule l’approche par modèle linéaire mixte décomposant la variance globale permet d’estimer sans biais les limites d’agrément applicables à cette prise de décision unitaire.
11. Interprétation décisionnelle et validation clinique des instruments
11.1 Définition a priori du seuil d’équivalence clinique acceptable
L’une des dérives les plus pernicieuses dans l’évaluation de la concordance instrumentale consiste à laisser les résultats statistiques dicter a posteriori le jugement clinique. La méthode de Bland-Altman est un instrument purement descriptif et estimatif ; elle ne produit aucun verdict automatique binaire de validité ou d’équivalence métrologique. C’est à l’équipe clinique et métrologique qu’incombe la responsabilité imprescriptible de définir, a priori et en amont de tout recueil de données, la différence maximale cliniquement tolérable, notée $\Delta$.
Ce seuil d’équivalence clinique correspond à la divergence maximale entre deux instruments qui demeure sans incidence sur l’orientation diagnostique, la décision thérapeutique ou la sécurité du patient. Dans le domaine de la surveillance glycémique, par exemple, les consensus internationaux fixent des seuils d’erreur maximale stricts (souvent 10 % ou 15 mg/dL) pour éviter tout risque de surdosage d’insuline susceptible d’engendrer un coma hypoglycémique mortel. En psychométrie, ce seuil est calibré sur la différence minimale cliniquement importante (MCID) des échelles d’évaluation.
La règle décisionnelle formelle exige que l’intégralité de l’intervalle de confiance des limites d’agrément s’inscrive à l’intérieur de cet intervalle de tolérance prédéfini $[-\Delta, +\Delta]$. Si la limite d’agrément supérieure empirique (ou son intervalle de confiance à 95 %) franchit le seuil $+\Delta$, ou si la limite inférieure franchit $-\Delta$, l’interchangeabilité des instruments doit être catégoriquement rejetée, même si le coefficient de corrélation frôle la perfection ou si la p-valeur du biais moyen est jugée non significative.
11.2 Analyse critique des cas aberrants et diagnostic ciblé
Par définition statistique pure, environ 5 % des points d’un graphique de Bland-Altman valide ont vocation à se situer à l’extérieur des limites d’agrément à 95 %, sans que cela ne constitue une anomalie méthodologique. Néanmoins, l’analyste se doit d’examiner avec une vigilance chirurgicale chacun de ces points excentrés pour identifier d’éventuels schémas récurrents ou des dysfonctionnements instrumentaux localisés.
L’exploration programmatique sous Python s’appuie sur le filtrage booléen des lignes du DataFrame dont les différences excèdent les limites calculées. Pour chaque patient identifié comme discordant, il convient d’investiguer l’historique expérimental :
- Présence d’un artefact physiologique transitoire au moment de l’enregistrement (mouvement corporel, arythmie cardiaque subite, impédance cutanée anormale).
- Défaillance matérielle ponctuelle du capteur (chute de tension de la batterie, dérive thermique, saturation de conversion analogique-numérique).
- Caractéristiques physiopathologiques atypiques du sujet (obésité majeure, rigidité artérielle sévère, interférence pharmacologique biochimique).
Afin d’évaluer la robustesse de l’évaluation globale, une analyse de sensibilité systématique est fortement recommandée. Cette procédure consiste à recalculer l’ensemble des métriques de concordance après exclusion motivée des observations hautement discordantes, et à consigner conjointement les deux analyses dans le rapport final. Cette transparence épistémologique prévient tout soupçon d’embellissement artificiel des données tout en éclairant les limites opérationnelles des dispositifs évalués.
12. Bonnes pratiques de publication, reproductibilité et intégration logicielle
12.1 Conformité avec les directives internationales de reporting
La publication d’études de concordance instrumentale dans les revues biomédicales à fort facteur d’impact est régie par des standards de transparence méthodologique stricts, au premier rang desquels s’impose la déclaration GRRAS (Guidelines for Reporting Reliability and Agreement Studies). Le respect scrupuleux de ces recommandations garantit la complétude de l’information transmise à la communauté scientifique internationale.
Pour être jugé pleinement conforme aux standards GRRAS, tout manuscrit intégrant un graphique de Bland-Altman doit obligatoirement expliciter les éléments contextuels et numériques suivants dans son corps de texte et ses légendes :
- La formulation explicite de la définition a priori de la différence maximale cliniquement acceptable ($\Delta$).
- La mention numérique exacte du biais moyen constaté, de l’écart-type des différences et des bornes numériques des limites d’agrément.
- La publication systématique des intervalles de confiance à 95 % encadrant tant le biais que chacune des deux limites d’agrément.
- L’indication précise de l’orientation arithmétique de la soustraction (en spécifiant sans ambiguïté quel instrument est soustrait de l’autre).
- Le compte-rendu exhaustif des vérifications de normalité et des tests d’homoscédasticité, accompagné de la description des éventuelles transformations d’échelles mobilisées.
Les légendes de figures doivent être rédigées de façon totalement autonome, permettant au lecteur d’appréhender l’intégralité du dispositif expérimental, de la métrique observée et du verdict décisionnel sans avoir à chercher les définitions dans le corps de l’article.
12.2 Création d’un pipeline complet et reproductible en Python
L’aboutissement opérationnel d’une démarche d’évaluation métrologique rigoureuse réside dans l’intégration de ces standards au sein d’un pipeline d’analyse entièrement automatisé et reproductible. Ce pipeline, structuré sous forme de module Python autonome ou de carnet de recherche numérique (Jupyter Notebook), orchestre l’ingestion des données brutes, la validation des postulats, la dérivation mathématique des métriques et la génération simultanée de la figure haute résolution et du tableau de synthèse normalisé.
Pour assurer la pérennité et l’auditabilité de ce traitement, l’architecture logicielle doit respecter les canons de l’ingénierie moderne de données :
- Séparation stricte entre les données brutes immutables, les scripts de transformation intermédiaire et les artefacts de sortie finaux.
- Consignation des versions logicielles de l’environnement au moyen de fichiers d’environnement reproductibles (requirements.txt ou environment.yml) adossés à des conteneurs légers (Docker).
- Structuration modulaire des fonctions de calcul et de visualisation, dotées de tests unitaires vérifiant leur comportement sur des cas limites ou des jeux de données de référence certifiés.
- Enregistrement synchronisé des métriques calculées au format tabulaire CSV ou JSON afin de faciliter leur intégration dans des méta-analyses futures ou des dossiers d’homologation réglementaire (FDA, marquage CE médical).
En adoptant ces pratiques rigoureuses d’ingénierie et de biostatistique, le chercheur ou l’ingénieur métrologue transforme le tracé d’un graphique de Bland-Altman en un levier décisionnel de haute précision, garantissant la fiabilité métrologique et la sécurité clinique des technologies de mesure de demain.
Références
Altman, D. G., & Bland, J. M. (1983). Measurement in medicine: The analysis of method comparison studies. The Statistician, 32(3), 307–317. https://doi.org/10.2307/2987937
Bland, J. M., & Altman, D. G. (1986). Statistical methods for assessing agreement between two methods of clinical measurement. The Lancet, 327(8476), 307–310. https://doi.org/10.1016/S0140-6736(86)90837-8
Bland, J. M., & Altman, D. G. (1999). Measuring agreement in method comparison studies. Statistical Methods in Medical Research, 8(2), 135–160. https://doi.org/10.1177/096228029900800204
Bland, J. M., & Altman, D. G. (2007). Agreement between methods of measurement with multiple observations per individual. Journal of Biopharmaceutical Statistics, 17(4), 571–582. https://doi.org/10.1080/10543400701329422
Kottner, J., Audigé, L., Brorson, S., Donner, A., Gajewski, B. J., Hróbjartsson, A., Roberts, C., Shoukri, M., & Streiner, D. L. (2011). Guidelines for Reporting Reliability and Agreement Studies (GRRAS) were proposed. Journal of Clinical Epidemiology, 64(1), 96–106. https://doi.org/10.1016/j.jclinepi.2011.01.004
Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. Proceedings of the 9th Python in Science Conference, 92–96. https://doi.org/10.25080/Majora-92bf1922-011
Tufte, E. R. (2001). The Visual Display of Quantitative Information (2e éd.). Graphics Press.
Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2