
La visualisation graphique des données quantitatives constitue l’un des piliers fondamentaux de la démarche scientifique contemporaine, permettant de transformer des matrices numériques complexes en représentations perceptuelles immédiatement appréhendables par l’esprit humain. Parmi l’arsenal méthodologique à la disposition des statisticiens, des chercheurs et des analystes de données, le diagramme à barres empilées occupe une position singulière. Cette géométrie visuelle permet de capturer simultanément deux dimensions analytiques cruciales : l’amplitude globale d’un phénomène agrégé à travers différentes modalités catégorielles et la décomposition structurelle de ce même phénomène en sous-composantes additives. L’accès à une telle double lecture confère à ce graphique une pertinence exceptionnelle dans l’examen de séries chronologiques discrètes, d’études démographiques ou de bilans comparatifs sectoriels.
Toutefois, la concrétisation informatique d’un diagramme à barres empilées au sein de l’écosystème Python a longtemps suscité des interrogations conceptuelles et pratiques. Alors que la bibliothèque Seaborn s’est imposée comme la référence incontournable en matière d’esthétique statistique de haut niveau grâce à son intégration élégante avec les structures de données de Pandas, son interface de programmation applicative a historiquement privilégié les diagrammes à barres groupées ou juxtaposées au détriment d’une fonction d’empilement direct universelle. Ce choix d’ingénierie logicielle, loin de constituer une entrave insurmontable, a favorisé l’émergence de plusieurs méthodologies complémentaires, allant de l’hybridation vertueuse entre Seaborn et Matplotlib jusqu’à l’exploitation moderne des fonctions de distribution avancées.
Ce guide exhaustif a pour vocation d’exposer de manière rigoureuse, méthodique et progressive l’ensemble des techniques permettant de concevoir, personnaliser et perfectionner des diagrammes à barres empilées de calibre académique en Python. En explorant successivement la théorie de la sémiologie graphique, la préparation matricielle des jeux de données, les différentes stratégies de rendu algorithmique, l’annotation barycentrique des segments et la normalisation en pourcentages relatifs, ce document offre aux praticiens les outils d’ingénierie visuelle nécessaires pour produire des visualisations irréprochables, tant sur le plan de l’exactitude mathématique que sur celui de l’accessibilité cognitive et de la rigueur éditoriale.
1. Introduction aux diagrammes à barres empilées et pertinence en analyse de données
1.1 Définition et fondements méthodologiques des barres empilées
Le diagramme à barres empilées, ou histogramme à strates cumulées selon les terminologies francophones historiques de la sémiologie graphique, représente une transposition géométrique bidimensionnelle où chaque barre rectangulaire est subdivisée en sous-segments contigus proportionnels à la contribution respective de variables secondaires. Contrairement à une barre simple qui n’associe qu’une seule mesure scalaire à une modalité discrète, la barre segmentée projette une structure multivariée au sein d’un même repère cartésien. La caractéristique essentielle de cette géométrie réside dans l’alignement orthogonal et l’addition physique des segments : la coordonnée terminale d’un sous-rectangle inférieur constitue la ligne de base d’ancrage du sous-rectangle immédiatement supérieur. Cette conception permet de formaliser visuellement le postulat additif selon lequel la somme des parties recompose l’intégralité du système étudié.
La distinction fonctionnelle entre le diagramme à barres groupées et le diagramme à barres empilées mérite une clarification théorique approfondie. Dans un diagramme à barres groupées, les sous-entités de chaque catégorie sont placées les unes à côté des autres, partageant toutes une origine commune alignée sur l’axe des abscisses. Cette configuration optimise la comparaison locale et précise de l’amplitude absolue de chaque sous-groupe, mais rend ardue l’évaluation instantanée du volume total agrégé. Inversement, le diagramme à barres empilées sacrifie l’alignement commun des strates supérieures afin de privilégier la lecture immédiate du grand total cumulé, tout en conservant une appréciation globale des proportions relatives internes. Le choix entre ces deux paradigmes repose donc sur la question analytique centrale : cherche-t-on à comparer des composantes individuelles isolées ou à évaluer l’évolution conjointe d’un ensemble et de sa constitution interne ?
La puissance du diagramme à barres empilées repose sur cette capacité unique d’articulation entre l’échelle macroscopique et l’échelle microscopique des distributions de fréquences. En conservant l’intégrité de la hauteur globale, le lecteur saisit d’un coup d’œil l’ampleur absolue du phénomène étudié, tout en discernant les variations de prévalence de chaque sous-population. Cette double encodation visuelle optimise l’espace graphique disponible et réduit la dispersion cognitive inhérente à la multiplication de figures disjointes, garantissant ainsi une synthèse d’une remarquable densité sémantique.
1.2 Applications empiriques dans l’étude des distributions de fréquences
Dans le champ de la recherche appliquée et de l’ingénierie des données, le recours aux représentations empilées s’avère particulièrement fécond pour documenter des séries temporelles à pas discrets. L’analyse des variations comportementales journalières, hebdomadaires ou saisonnières constitue un cas d’école : observer l’évolution de la fréquentation d’une infrastructure selon les tranches horaires au cours des jours ouvrés permet de détecter à la fois les jours de surcharge globale et les variations internes dans la répartition des usagers. L’observateur peut ainsi identifier si une hausse de la demande globale résulte d’une augmentation homogène sur l’ensemble de la journée ou d’une saturation spécifique concentrée sur une période restreinte.
L’évaluation de la composition sous-jacente des cohortes et des flux d’individus représente un autre domaine d’application privilégié. En épidémiologie, en sociologie quantitative ou en économétrie comportementale, les chercheurs mobilisent fréquemment ce dispositif pour représenter la décomposition d’une population selon des critères démographiques, des classes socio-économiques ou des statuts cliniques au sein de différents groupes expérimentaux. La visualisation permet d’apprécier immédiatement les transferts de charges, les phénomènes de substitution et les asymétries de répartition qui échapperaient à une simple analyse univariée ou à un tableau de contingence brut.
Sur le plan pédagogique et de la communication scientifique, le diagramme à barres empilées s’impose comme un médiateur visuel particulièrement performant. Il permet de vulgariser des analyses quantitatives denses sans en altérer la substance statistique, offrant aux décideurs et aux pairs un vecteur de compréhension immédiat. La lisibilité inhérente à la juxtaposition ordonnée des strates chromatiques facilite l’émergence d’intuitions analytiques fortes, guidant l’audience vers les conclusions empiriques les plus déterminantes tout en préservant l’accès aux valeurs de second niveau.
1.3 Positionnement technique de Seaborn et Matplotlib dans l’écosystème Python
L’environnement informatique Python dédié à la science des données repose sur une architecture modulaire hautement spécialisée. Au sommet de cette hiérarchie pour la visualisation statistique trône Seaborn, conçu par Michael Waskom comme une surcouche d’abstraction sophistiquée au-dessus de Matplotlib. Seaborn a été spécifiquement développé pour s’interfacer de manière transparente avec les structures de données tabulaires de Pandas, automatisant des opérations complexes telles que l’agrégation statistique, l’estimation des intervalles de confiance et l’application de palettes chromatiques perceptuellement uniformes. Cette orientation vers l’analyse statistique exploratoire confère à Seaborn une élégance et une concision syntaxique particulièrement appréciées dans les milieux académiques.
Cependant, la gestion de l’empilement géométrique direct a longtemps constitué une singularité historique au sein de Seaborn. Alors que les diagrammes à barres groupées bénéficient d’un paramétrage direct via l’argument sémantique hue dans la fonction de barre standard, la fonction dédiée n’a pas intégré de commutateur d’empilement direct équivalent pendant plusieurs cycles de versions majeures. Les concepteurs ont initialement soutenu que la lecture visuelle des barres empilées présentait des limites perceptuelles sévères pour la comparaison fine des segments intérieurs, incitant ainsi la communauté à privilégier d’autres formes de restitution géométrique comme les diagrammes en facettes multiples ou les barres dégroupées.
Face aux besoins concrets des praticiens confrontés à des impératifs d’agrégation globale, l’écosystème a développé une complémentarité pragmatique. D’une part, l’exploitation du moteur de tracé sous-jacent de Matplotlib, piloté directement depuis les objets DataFrame de Pandas mais sublimé par les paramètres esthétiques et les contextes de Seaborn, offre une voie robuste et éprouvée. D’autre part, les récentes évolutions de l’API de Seaborn, notamment à travers les fonctions d’analyse distributionnelle comme histplot, ont formalisé un support natif du cumul vertical pour des données correctement ordonnées. Comprendre cette dualité technique et architecturale est indispensable pour choisir la démarche algorithmique la plus pérenne en fonction de la structure des données matricielles disponibles.
2. Préparation de l’environnement de travail et gestion des dépendances
2.1 Installation rigoureuse des modules analytiques
La mise en œuvre d’un flux de travail reproductible et robuste nécessite la configuration préalable d’un environnement d’exécution garantissant la compatibilité des bibliothèques logicielles. L’orchestration conjointe de Pandas, Matplotlib et Seaborn requiert des versions synchronisées afin d’éviter tout conflit d’interface de programmation ou la dépréciation soudaine d’arguments graphiques. L’installation de ces modules analytiques s’effectue couramment via le gestionnaire de paquets officiel de Python, en s’assurant que l’interpréteur de commandes pointe vers l’environnement approprié.
L’isolation logicielle au sein d’un environnement virtuel constitue une règle d’or en recherche reproductible. Que l’on emploie le module natif venv ou des solutions de gestion d’environnements scientifiques telles que Conda, l’isolement permet de figer les versions fonctionnelles des bibliothèques dans un fichier de spécification textuel. Cela garantit que les scripts générant les visualisations statistiques pourront être réexécutés des années plus tard sans altération du rendu typographique ou de la logique d’empilement. La commande d’installation standardise le déploiement en téléchargeant simultanément Seaborn, Matplotlib, Pandas ainsi que les dépendances mathématiques fondamentales comme NumPy et SciPy, garantissant ainsi l’intégrité de la pile d’exécution.
Il est recommandé de vérifier rigoureusement les versions installées dès l’initialisation de l’espace de calcul. Les versions de Seaborn supérieures ou égales à 0.11 ou 0.12 introduisent des refontes substantielles dans la gestion des tracés d’histogrammes et des interfaces de données orientées objets, autorisant des approches modernes d’empilement qui n’étaient pas envisageables sur les versions historiques de la décennie précédente. Une vérification explicite des numéros de version garantit la compatibilité du script avec les instructions algorithmiques détaillées dans les sections ultérieures.
2.2 Importation conventionnelle et configuration initiale du script
L’amorce de tout script d’analyse en langage Python répond à des conventions typographiques et communautaires strictes. L’importation standardisée associe des alias universels aux trois modules fondamentaux : matplotlib.pyplot est systématiquement assigné à l’alias plt, seaborn est condensé sous l’alias sns, et pandas est instancié sous la dénomination pd. L’adhésion scrupuleuse à ces abréviations canoniques garantit l’immédiate lisibilité du code source pour tout relecteur extérieur et préserve l’alignement avec la documentation institutionnelle de référence.
Dans le cadre d’un développement au sein d’environnements interactifs tels que Jupyter Notebook ou JupyterLab, l’initialisation requiert parfois des instructions de contrôle du moteur de rendu graphique. L’utilisation historique de directives magiques permettait d’ancrer les tracés directement sous les cellules d’exécution, bien que les versions récentes des environnements de développement interactifs intègrent désormais ce comportement de manière native. Il demeure essentiel de paramétrer la résolution graphique d’arrière-plan afin d’éviter que les figures générées à l’écran n’apparaissent pixellisées ou disproportionnées lors des premières phases d’exploration des données.
Enfin, la maîtrise du cycle de vie des conteneurs de figures exige une gestion consciente du ramasse-miettes graphique de Matplotlib. Lorsque des analyses impliquent la génération séquentielle de multiples diagrammes au sein d’une même boucle itérative, l’omission de la fermeture explicite des figures via les commandes de libération mémoire peut conduire à des surcharges de calcul substantielles ou à des phénomènes de superposition fantôme non désirés. La discipline logicielle impose de structurer chaque étape de visualisation en un bloc hermétique comprenant l’initialisation du canevas, l’application du tracé, l’ajustement contextuel et l’affichage ou la sérialisation finale.
3. Étape 1 : Conception et structuration du jeu de données expérimental
3.1 Modélisation matricielle sous forme de DataFrame Pandas
La construction d’un diagramme à barres empilées exige une attention méticuleuse portée à la disposition des tenseurs et des tableaux d’observation. Pour illustrer concrètement la démarche, considérons un cadre d’étude centré sur l’analyse de la fréquentation d’une plateforme universitaire ou d’un centre de recherche au fil d’une semaine d’activité standard. La variable indépendante principale est une variable catégorielle ordonnée représentant les jours ouvrés, s’étendant du lundi au vendredi. Les grandeurs quantitatives mesurées décrivent le volume d’usagers recensés sur deux plages temporelles disjointes : la tranche matinale et la tranche vespérale.
La transcription numérique de cette expérience s’opère par l’instanciation d’un dictionnaire de données dans lequel chaque clé correspond au libellé explicite d’un vecteur de mesures, les valeurs étant assemblées au sein de listes Python homogènes. Ce dictionnaire est immédiatement converti en une structure de tableau bidimensionnel via le constructeur DataFrame de Pandas. Les données brutes s’articulent ainsi autour de trois séries synchronisées : la série textuelle désignant les journées, la série numérique continue associée aux comptages du matin, et la série homologue relative aux comptages du soir.
Cette démarche de conception matricielle synthétique permet d’isoler parfaitement les mécanismes de traçage sans introduire de parasites exogènes liés à des données incomplètes ou asynchrones. La distribution des effectifs est volontairement calibrée pour présenter des variations de volume absolu combinées à des fluctuations structurelles de la proportion de chaque tranche horaire, fournissant ainsi une base empirique idéale pour mettre à l’épreuve la clarté sémiologique du futur diagramme à barres empilées.
3.2 Inspection dimensionnelle et validation structurelle
Avant d’engager le moindre processus de mise en forme graphique, une validation structurelle du tableau d’observations s’impose comme une étape incontournable de la méthodologie statistique. L’inspection formelle de la structure brute via l’affichage des premières lignes du DataFrame permet d’attester de la conformité du type des données : les jours de la semaine doivent être identifiés sous un format d’objet textuel ou de catégorie ordonnée, tandis que les métriques de fréquentation doivent être encodées sous forme d’entiers ou de nombres à virgule flottante standardisés.
L’absence d’éléments lacunaires ou de valeurs manquantes doit faire l’objet d’un contrôle rigoureux. Dans le contexte géométrique d’un diagramme à barres empilées, la présence d’une valeur nulle ou non définie au sein d’une sous-composante peut altérer la continuité de l’empilement, générer un trou spatial inattendu ou provoquer un décalage imprévisible de la ligne de flottaison des segments supérieurs selon le moteur de rendu utilisé. Il convient de vérifier explicitement que chaque couple de modalités temporelles possède une valeur numérique valide, comprise dans des intervalles réalistes.
Cette étape permet également de formaliser la nature du format matriciel courant. Le tableau tel qu’initialement défini adopte une structure dite au format large, caractérisée par le fait que chaque variable quantitative mesurée dispose de sa propre colonne dédiée le long d’une seule ligne d’observation par unité catégorielle. Cette organisation large s’avère particulièrement adaptée à certains mécanismes d’empilement natifs de Pandas, mais demandera une restructuration ultérieure lorsqu’il s’agira d’exploiter les paradigmes modernes de la grammaire des graphiques sous Seaborn.
3.3 Gestion de l’indexation comme clé catégorielle
L’un des fondements du couplage entre Pandas et les moteurs graphiques de l’écosystème Python réside dans l’utilisation sémantique de l’index du DataFrame. Par défaut, lors de la création d’un tableau de données, Pandas assigne un index entier séquentiel démarrant à zéro. Si cet index numérique est conservé tel quel lors du tracé, l’axe des abscisses héritera de ces identifiants abstraits au lieu d’afficher directement les étiquettes signifiantes correspondant aux jours de la semaine, exigeant des opérations ultérieures de renommage manuel fastidieuses et propices aux erreurs d’attribution.
La stratégie optimale consiste à promouvoir la colonne catégorielle au rang d’index formel du DataFrame en appliquant la méthode dédiée de sélection d’index. En assignant explicitement la variable textuelle temporelle comme clé d’indexation principale, la table bidimensionnelle ne conserve plus dans son corps de données que les colonnes strictement numériques destinées à composer l’empilement vertical. Cette opération structurelle modifie fondamentalement la manière dont les méthodes d’affichage interprètent la table : l’axe des index devient l’ordonnateur naturel de l’axe catégoriel du graphique, chaque ligne représentant un emplacement géographique distinct sur l’axe des abscisses.
Cette standardisation de l’index prévient l’apparition d’artefacts de projection visuelle fréquemment rencontrés par les débutants, tels que le tracé accidentel du libellé textuel comme une modalité numérique ou le décalage chromatique des séries. Une fois le tableau indexé par ses modalités catégorielles, la matrice numérique est mathématiquement prête à subir l’opération d’addition cumulative sous-jacente au rendu graphique du diagramme à barres empilées.
4. Étape 2 : Configuration du style esthétique avec Seaborn
4.1 Principes directeurs de la sémiologie graphique sous Seaborn
L’intégration de la bibliothèque Seaborn dans le processus d’élaboration graphique répond avant tout à une exigence d’harmonisation sémiologique et d’optimisation du ratio encre-données cher aux théoriciens de la visualisation tels qu’Edward Tufte. Matplotlib, dans sa configuration d’origine élémentaire, impose des choix de rendu par défaut souvent jugés rigides, caractérisés par des bordures épaisses, des quadrillages intrusifs et des palettes primaires agressives. L’activation des thèmes globaux de Seaborn permet de transformer instantanément l’apparence visuelle globale sans alourdir la syntaxe d’assemblage du tracé.
L’appel aux fonctions de paramétrage thématique de Seaborn réinitialise les variables de contrôle de bas niveau de Matplotlib pour instaurer une scénographie épurée. Les thèmes graphiques fondés sur un arrière-plan blanc uni ou assorti de repères tick discrets sont particulièrement privilégiés dans les publications académiques et les manuscrits scientifiques. Ce choix permet d’éliminer le bruit de fond visuel superflu constitué par les teintes grises massives, orientant immédiatement l’attention cognitive du relecteur vers la morphologie différentielle des barres et des segments colorés.
La suppression programmatique des bordures supérieure et droite du repère cartésien, couramment désignée sous le terme de dépouillement des axes, parachève cette purification visuelle. En ne conservant que l’axe horizontal inférieur délimitant la ligne de zéro et l’axe vertical gauche portant l’échelle des valeurs, on garantit une lisibilité maximale, évitant tout encadrement superflu qui pourrait donner une sensation d’enfermement spatial aux grandeurs statistiques projetées.
4.2 Paramétrage fin du contexte et de la typographie
Au-delà de la tonalité globale de l’arrière-plan, la rigueur d’une figure de recherche repose sur le calibrage précis de son facteur d’échelle graphique, une dimension gérée avec souplesse par la notion de contexte au sein de Seaborn. Les paramètres de contexte ajustent dynamiquement les tailles relatives des polices de caractères, l’épaisseur des traits de repère et le débordement des marques sur les axes pour s’adapter à la destination finale de la figure, qu’il s’agisse d’une diffusion sous forme d’article imprimé, de communication affichée ou de présentation projetée sur grand écran.
L’alignement typographique nécessite une cohérence absolue entre les différents niveaux d’information textuelle. L’usage de typographies sans empattement, d’une grande sobriété géométrique, assure une lisibilité irréprochable y compris à des résolutions réduites ou lors de réductions d’échelle imposées par les maquettes de revues scientifiques. Le paramétrage contextuel veille à ce que les libellés des axes, les graduations numériques et les textes de légende conservent des rapports de proportionnalité harmonieux, interdisant toute prédominance accidentelle d’une légende hypertrophiée sur le corps principal des données.
L’épaisseur des lignes d’axes et des marqueurs secondaires doit également être calibrée pour afficher une finesse élégante mais perceptible. Un trait trop lourd détourne l’œil de la segmentation des barres, tandis qu’un trait excessivement ténu peut disparaître lors de la pixellisation ou de l’impression sur papier standard. En mobilisant les réglages contextuels de Seaborn, le chercheur s’assure d’une uniformité stylistique conforme aux standards éditoriaux internationaux les plus rigoureux.
5. Étape 3 : Création du graphique à barres empilées via Pandas et l’esthétique Seaborn
5.1 Mise en œuvre syntaxique de l’argument de cumul
La stratégie la plus directe et la plus largement éprouvée pour générer un graphique à barres empilées consiste à exploiter la méthode d’affichage intégrée aux objets DataFrame de Pandas, tout en laissant l’écosystème Seaborn gouverner l’esthétique globale de l’environnement d’exécution. Cette approche tire parti de la structure au format large préalablement établie, dans laquelle l’index catégoriel fournit les ancrages horizontaux et les colonnes numériques définissent les strates d’élévation verticale.
L’exécution s’effectue en invoquant la méthode de traçage du tableau de données, en spécifiant formellement l’indicateur géométrique correspondant aux barres et en activant le paramètre booléen de cumul vertical. L’activation de cet argument d’empilement modifie fondamentalement le moteur de placement géométrique : au lieu de fractionner la largeur de la bande catégorielle pour disposer des barres étroites juxtaposées, l’algorithme alloue la pleine largeur disponible à chaque catégorie temporelle et calcule la base de chaque sous-rectangle à partir de la hauteur cumulée des segments le précédant immédiatement dans l’ordre des colonnes.
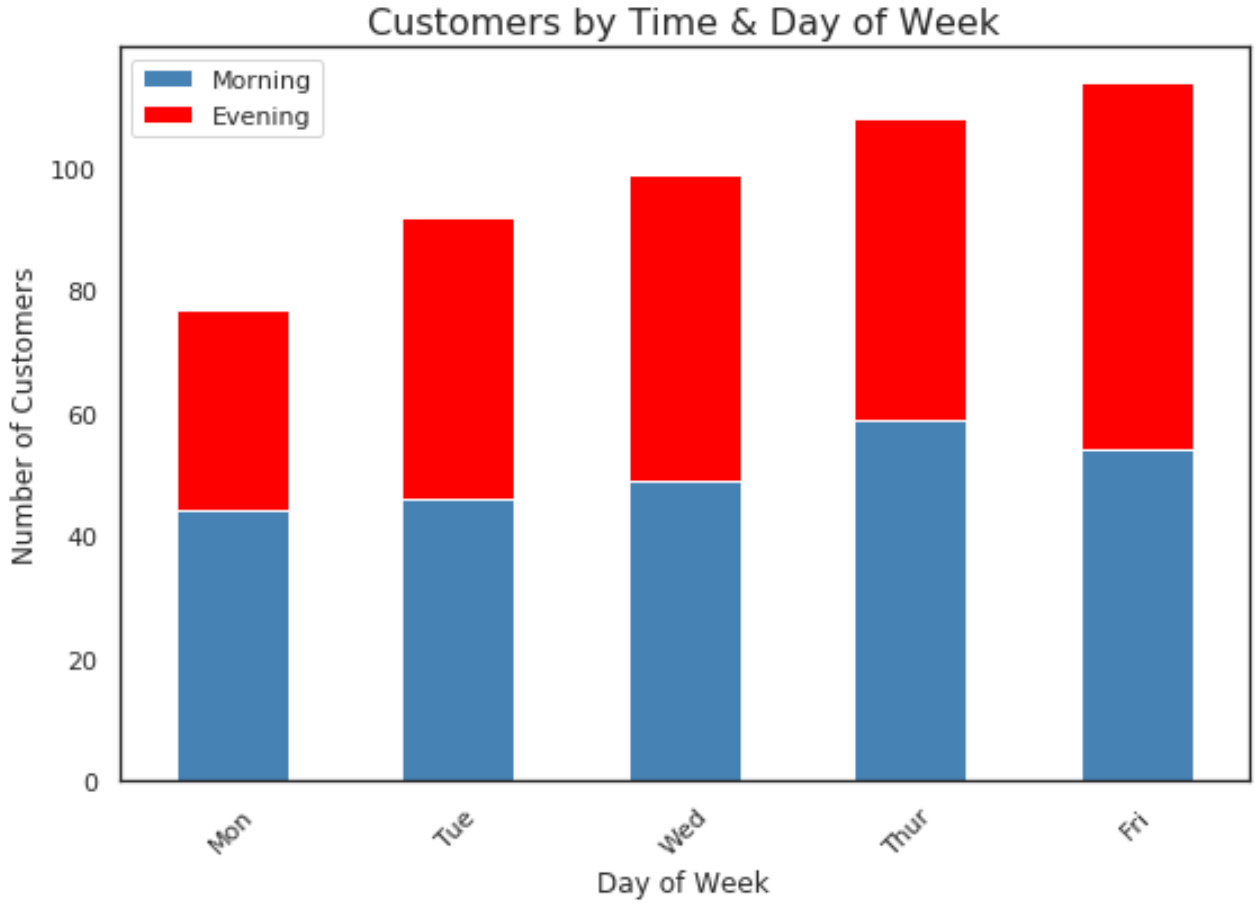
Cette collaboration technique entre l’abstraction logique de Pandas et le socle graphique de Matplotlib opère en harmonie avec les styles préalablement imposés par Seaborn. La fonction retourne un objet d’axe cartésien standard, qui encapsule l’intégralité des primitives géométriques dessinées, offrant ainsi un point d’ancrage programmable pour toutes les personnalisations avancées ultérieures. Cette méthode présente l’immense avantage de la compacité syntaxique, ne requérant qu’une seule ligne d’instruction pour opérer l’agrégation, le calcul spatial et le rendu initial du diagramme empilé.
5.2 Attribution et contrôle de la palette chromatique
La sélection chromatique dans un diagramme à barres empilées ne répond pas uniquement à des considérations esthétiques ; elle remplit une fonction sémiotique critique de discrimination perceptuelle. Lorsque l’on recourt à la méthode d’affichage de Pandas adossée au style Seaborn, il est possible de spécifier explicitement un nuancier de couleurs sous la forme d’une liste de codes hexadécimaux ou de désignations chromatiques formelles, garantissant un contraste adapté entre les strates successives.
L’emploi d’une palette harmonisée issue des travaux de colorimétrie statistique permet d’éviter les contrastes trop vifs qui induisent une fatigue oculaire ou des illusions d’optique sur les contours de partage. Par exemple, l’association d’un bleu acier tempéré pour désigner la strate matinale et d’une nuance corail ou pourpre sourde pour la strate vespérale procure une dissociation visuelle nette, tout en maintenant une perception d’équivalence d’importance entre les deux périodes d’activité. La luminance et la saturation des teintes choisies doivent être équilibrées afin qu’aucune strate ne semble artificiellement mise en exergue par rapport à l’autre au simple détriment de la précision statistique.
Il est également possible de puiser directement dans les palettes nommées de Seaborn en extrayant les listes de couleurs associées via les fonctions utilitaires dédiées, avant de les injecter comme argument de coloration dans la méthode de tracé du DataFrame. Cette passerelle garantit que la palette employée respecte les principes fondamentaux de continuité perceptuelle et d’uniformité de gradient qui font la renommée scientifique de la bibliothèque de Michael Waskom.
5.3 Affichage et clôture du conteneur de tracé
Une fois l’instruction de dessin exécutée et les paramètres chromatiques assignés, la figure graphique réside dans la mémoire vive de l’environnement d’exécution sous la forme d’un arbre d’objets graphiques interconnectés. Pour matérialiser visuellement le résultat à l’écran dans le cadre d’un script Python standard autonome, l’appel à la fonction d’affichage global du module pyplot est impératif. Cette commande déclenche le cycle de rastérisation ou de rendu vectoriel final au sein du système de fenêtrage configuré.
L’interprétation initiale de la morphologie du tracé obtenu permet de valider instantanément deux niveaux de lecture statistique. Au premier regard, l’observateur évalue le profil global formé par le sommet des colonnes, discernant sans effort le jour d’activité maximale et le jour de fréquentation la plus basse de la semaine. Simultanément, la ligne de partition intérieure reliant visuellement les frontières entre les deux sous-segments autorise une analyse fine de l’évolution structurelle : on peut ainsi noter si le surcroît de fréquentation observé en milieu de semaine découle d’une affluence matinale exceptionnelle ou d’un tassement des activités en fin de journée.
La vérification formelle de l’alignement horizontal des jours de la semaine sur l’axe des abscisses permet de s’assurer que la clé catégorielle n’a subi aucune déformation ou inversion d’ordre séquentiel lors de la translation matricielle. La clôture propre du processus d’affichage parachève cette première approche constructive, posant les bases méthodologiques sur lesquelles vont pouvoir se greffer des techniques de manipulation plus poussées.
6. Méthode alternative : Construction native avec Seaborn par superposition contrôlée
6.1 Principe de la superposition géométrique via la fonction de barre standard
Bien que l’interaction entre Pandas et Matplotlib sous style Seaborn réponde avec efficacité aux besoins usuels, il existe une méthode de construction purement interne à Seaborn reposant sur l’usage réitéré de sa fonction de barre générique. L’absence historique d’un commutateur d’empilement direct au sein de cette fonction peut être élégamment contournée en recourant au paradigme de la superposition géométrique ordonnée dans l’espace euclidien à deux dimensions.
Cette technique repose sur un principe optique élémentaire : tracer en premier lieu une barre englobante représentant la somme totale de l’ensemble des strates cumulées, puis tracer par-dessus, sur le même axe géométrique, une seconde barre plus courte représentant uniquement la composante inférieure. Par un effet de recouvrement spatial délibéré, la portion supérieure de la grande barre demeure visible au-dessus du sommet de la petite barre, simulant avec une exactitude mathématique rigoureuse l’apparence et les proportions d’un segment supérieur empilé.
La maîtrise de l’ordre d’affichage, conceptuellement assimilable à l’ordre d’empilement sur l’axe de profondeur (z-order), s’avère ici capitale. Si la petite barre était matérialisée avant la grande barre, cette dernière recouvrirait intégralement la première, masquant définitivement l’information sous-jacente. L’algorithme d’exécution doit donc obligatoirement séquencer le tracé de la strate totale en premier lieu, suivi du tracé de la strate de base, chaque couche graphique venant s’ancrer précisément sur la ligne de zéro de l’axe des ordonnées.
6.2 Transformation algorithmique préalable des données cumulées
La mise en œuvre de cette stratégie de superposition exige une manipulation matricielle préalable afin d’enrichir le jeu de données d’une variable composite synthétique. À partir du tableau d’observations d’origine, il est nécessaire de calculer vectoriellement la somme ligne à ligne des composantes matinale et vespérale, instanciant ainsi une nouvelle dimension représentant le grand total journalier consolidé.
L’exécution graphique procède alors en deux appels successifs à la fonction de diagramme en barres de Seaborn, en pointant explicitement vers le même conteneur d’axe cartésien. Le premier appel lie la variable catégorielle temporelle à la nouvelle variable quantitative de total, en lui attribuant la teinte chromatique réservée à la strate supérieure (par exemple le créneau vespéral). Immédiatement après, le second appel relie la même variable catégorielle temporelle à la seule mesure matinale, en lui appliquant la couleur représentative de la strate inférieure.
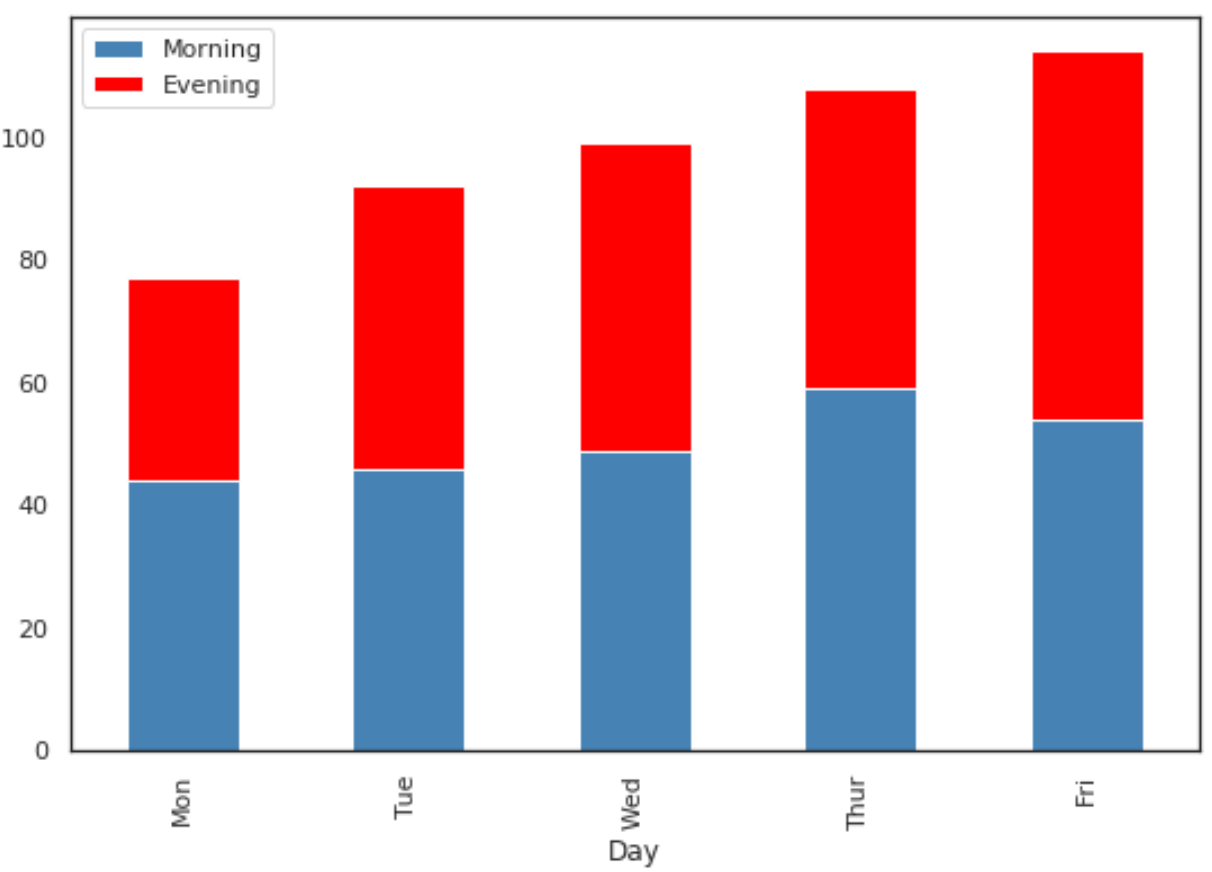
Il est également possible de moduler les propriétés de transparence ou les bordures de contour de ces rectangles superposés afin d’assurer une transition visuelle parfaite. Comme les deux tracés partagent scrupuleusement la même largeur de barre par défaut au sein du moteur Seaborn, l’illusion d’une barre segmentée unique en deux compartiments étanches est totale, démontrant la puissance de la composition déclarative en visualisation de données.
6.3 Évaluation comparative des deux approches
L’arbitrage méthodologique entre l’approche native par superposition Seaborn et l’approche matricielle directe via Pandas repose sur un compromis entre flexibilité esthétique et coût de maintenance programmatique. L’approche par superposition Seaborn présente l’avantage notable de conserver l’accès direct à l’ensemble des arguments avancés de la bibliothèque, tels que l’ajustement dynamique de l’incertitude statistique, le contrôle automatique des espaces inter-barres ou l’intégration native dans des grilles de facettes complexes pilotées par FacetGrid.
Néanmoins, cette méthode révèle une limite intrinsèque majeure dès lors que le nombre de sous-catégories à empiler s’accroît. Alors qu’elle demeure triviale et très lisible pour deux composantes disjointes, l’approche par superposition devient algorithmiquement lourde pour trois, quatre ou cinq strates. Il devient en effet nécessaire de calculer l’ensemble des sommes cumulées partielles de manière séquentielle et de multiplier les appels d’affichage successifs dans un ordre strictement descendant, ce qui accroît le risque d’erreurs logiques et complique la mise à jour dynamique des scripts.
En conséquence, la méthode de superposition native sous Seaborn sera particulièrement recommandée pour les analyses statistiques simples à deux composantes où l’on souhaite tirer pleinement parti des fonctionnalités sémantiques de Seaborn, tandis que l’approche matricielle de Pandas sera privilégiée pour les décompositions polytomiques riches comportant de nombreuses strates additives.
7. Méthode moderne : Exploitation de Seaborn histplot avec données au format long
7.1 Restructuration des données au format long (Tidy Data)
L’évolution récente de l’ingénierie logicielle au sein de Seaborn a vu l’émergence d’une prise en charge native de l’empilement à travers les fonctions d’analyse distributionnelle, sous réserve d’alimenter l’algorithme avec des données conformes au paradigme des données ordonnées (Tidy Data) théorisé par Hadley Wickham. Dans cette architecture conceptuelle, chaque ligne du tableau doit représenter une observation unitaire unique, et chaque colonne doit représenter une variable descriptive distincte.
Pour transposer notre tableau d’origine au format large vers cette structure au format long, on applique la méthode de fonte matricielle disponible dans Pandas. Cette transformation vectorielle réorganise le jeu de données : la colonne des jours de la semaine est conservée comme variable identifiante immuable, tandis que les colonnes ‘Morning’ et ‘Evening’ sont dépivotées pour former deux nouvelles séries. La première, de nature catégorielle, recueille le nom de la plage horaire sous forme de modalité descriptive, et la seconde rassemble la valeur numérique associée au comptage de fréquentation.
Cette démultiplication des lignes, doublant le volume du tableau tout en réduisant son nombre de colonnes d’amplitude, aligne parfaitement la structure informationnelle sur la philosophie de la grammaire des graphiques. Le tableau résultant dissocie rigoureusement la variable d’ancrage spatial horizontal, la variable sémantique de regroupement chromatique et la variable d’intensité quantitative, offrant un canevas idéal pour l’interprétation automatisée par les moteurs graphiques modernes.
7.2 Paramétrage de l’empilement avec la fonction de distribution
Une fois la matrice ordonnée selon ce formalisme rigoureux, la création d’un diagramme à barres empilées s’opère de façon native et sans artifice de superposition grâce à la fonction de distribution empirique histplot de Seaborn. Bien que traditionnellement dévolue à l’analyse de fréquence d’échantillons continus, cette fonction se révèle d’une polyvalence remarquable pour tracer des agrégations catégorielles discrètes.
Le paramétrage algorithmique s’articule autour de quatre dimensions fondamentales : la variable temporelle est assignée à l’axe des abscisses en tant que variable indépendante ; la variable qualitative de période de la journée est allouée au paramètre sémantique hue, dictant la décomposition chromatique ; la variable quantitative de comptage est injectée au sein du paramètre des poids (weights), transformant l’histogramme de comptage unitaire en un histogramme pondéré par les effectifs observés ; enfin, l’argument critique de multiplicité est formellement configuré sur la valeur ‘stack’.
À la réception de cette séquence d’instructions, le moteur de Seaborn effectue de manière autonome la sommation des poids par cellule catégorielle et empile verticalement les segments colorés correspondant aux différentes modalités de regroupement. Aucun calcul de somme intermédiaire n’est requis de la part de l’utilisateur, et l’ordre d’élévation est automatiquement géré par la logique interne du compilateur graphique, garantissant un rendu rigoureux, robuste et parfaitement aligné sur les canons statistiques actuels.
7.3 Avantages de la robustesse analytique du format long
L’adoption de cette méthode moderne adossée aux données au format long présente des avantages conceptuels et opérationnels considérables pour la recherche quantitative. Le premier atout réside dans son extensibilité immédiate : si l’étude venait à intégrer de nouvelles tranches horaires — comme la période nocturne ou les créneaux médians de mi-journée —, aucune modification de la syntaxe graphique ne serait requise. Le désempilement de nouvelles modalités s’effectuerait de manière transparente, l’algorithme allouant dynamiquement les strates supplémentaires au sein de la barre sans intervention manuelle sur les équations de cumul.
Le second bénéfice fondamental concerne l’automatisation intégrale de la légende descriptive. Contrairement à la méthode par superposition géométrique qui impose de reconstruire manuellement les éléments de légende pour éviter les confusions de couches, la fonction histplot inspecte directement les modalités distinctes de la variable de regroupement sémantique et génère un cartouche explicatif exhaustif, fidèlement apparié aux teintes de la palette sélectionnée.
Enfin, la conformité avec les postulats du modèle Tidy confère au code une grande fluidité pour transiter vers d’autres types d’analyses exploratoires. Une même matrice au format long peut être instantanément réorientée vers des graphiques en facettes multiples, des tracés de densité conditionnelle ou des modèles de régression catégorielle sans nécessiter de refonte structurelle préalable, optimisant ainsi substantiellement le cycle de vie du code d’analyse au sein d’un laboratoire de recherche.
8. Personnalisation académique avancée : Axes, titres et légende
8.1 Standardisation formelle des libellés et du titre
L’élévation d’une simple ébauche graphique au rang de figure publiable dans une revue internationale à comité de lecture repose sur la précision et l’austérité de ses métadonnées textuelles. Un graphique dépourvu d’étiquettes d’axes rigoureusement calibrées ou affichant un titre imprécis perd immédiatement sa portée probatoire. L’ensemble des libellés doit être rédigé dans une langue scientifique limpide, en explicitant systématiquement les unités de mesure sous-jacentes.
Le titre principal de la figure doit formuler de manière concise le phénomène mesuré ainsi que le périmètre spatio-temporel de l’observation. Au lieu d’une formule générique, on privilégiera une formulation synthétique décrivant l’interaction entre les facteurs catégoriels et la variable de résultat. La taille de la typographie du titre doit marquer une hiérarchie nette, généralement supérieure de deux à quatre points typographiques par rapport à celle des étiquettes d’axes, tout en conservant une graisse équilibrée qui évite la saturation visuelle du sommet de la figure.
La gestion des étiquettes sur l’axe des abscisses requiert une vigilance particulière quant aux phénomènes d’encombrement spatial. Lorsque les libellés textuels des modalités catégorielles présentent une certaine longueur lexicale, leur disposition horizontale standard peut conduire à des chevauchements disgracieux ou illisibles. L’application d’un angle de rotation contrôlé (typiquement de l’ordre de 30 à 45 degrés), couplée à un point d’ancrage orienté vers l’extrémité droite du texte, permet de concilier une compacité maximale avec une lisibilité sans faille pour le relecteur.
8.2 Affinement sémantique et ergonomique de la légende
Le cartouche de légende constitue la clef de décodage analytique d’un diagramme à barres empilées, puisqu’il permet de rétablir la correspondance biunivoque entre chaque nuance chromatique et la nature de la sous-composante qu’elle incarne. Par défaut, les générateurs automatisés reproduisent textuellement les noms de variables informatiques dans la légende, laissant subsister des abréviations de code qui contreviennent aux standards éditoriaux les plus stricts.
La personnalisation de la légende implique de renommer explicitement les étiquettes descriptives afin d’adopter une terminologie naturelle et exhaustive, affranchie de tout jargon informatique. Le titre interne du cartouche de légende peut être clarifié ou purement supprimé s’il génère une redondance évidente avec le titre principal ou la note explicative accompagnant la figure. L’objectif est d’offrir une association cognitive immédiate entre la strate géométrique et la réalité empirique qu’elle figure.
Le positionnement spatial de ce cartouche constitue un enjeu ergonomique majeur. Laissé à la discrétion de l’algorithme de placement automatique, il risque de masquer partiellement l’une des barres de données ou de créer une asymétrie de composition regrettable. Dans les publications académiques, il est fréquent de contraindre l’ancrage de la légende soit dans une zone neutre garantie sans données à l’intérieur du repère cartésien, soit en déportation complète à l’extérieur des bordures du graphique (par exemple sur le flanc droit supérieur ou centrée horizontalement en partie basse), préservant ainsi l’intégrité absolue de la surface d’encodage géométrique.
8.3 Gestion des échelles et des graduations secondaires
L’intégrité de la restitution statistique repose de manière inconditionnelle sur la fixation de l’origine de l’axe des grandeurs cumulées. Dans un diagramme à barres empilées, la troncature de l’axe vertical constitue une faute déontologique sévère : décaler la borne inférieure vers une valeur arbitraire non nulle détruit instantanément la proportionnalité physique entre la surface des rectangles et les quantités réelles, introduisant un biais cognitif majeur de grossissement artificiel des variations. L’origine de l’axe des ordonnées doit donc être irrévocablement verrouillée à zéro.
L’intervalle séparant les graduations majeures de l’axe des ordonnées doit être étalonné de sorte à proposer des valeurs repères intuitives et rondes. La prolifération désordonnée de graduations surcharge inutilement l’espace graphique, tandis qu’une échelle trop clairsemée empêche l’estimation quantitative des hauteurs de barres. Un échelonnement régulier, fondé sur des incréments arithmétiques constants, offre un juste équilibre cognitif.
L’incorporation facultative d’un quadrillage d’arrière-plan peut apporter une assistance précieuse à la lecture des valeurs élevées situées au sommet des colonnes les plus distantes de l’axe de référence. Toutefois, ce quadrillage doit demeurer d’une discrétion absolue : on lui appliquera une teinte grise très évanescente, une épaisseur de trait minimale et éventuellement un motif en pointillés fins, en veillant scrupuleusement à ce qu’il soit relégué à un plan spatial sous-jacent aux barres de données afin de ne jamais hacher la continuité des surfaces colorées.
9. Calcul et affichage des étiquettes numériques au cœur des barres
9.1 Algorithme de calcul des coordonnées spatiales des segments
Bien que la sémiologie graphique vise l’appréhension synthétique des données, la restitution des valeurs scalaires exactes au sein même de la figure graphique enrichit considérablement le document, épargnant au lecteur le besoin d’effectuer des interpolations approximatives le long de l’axe des ordonnées. L’insertion d’annotations textuelles au centre des segments d’une barre empilée requiert cependant la mise en œuvre d’un algorithme de calcul géométrique rigoureux pour déterminer avec précision le barycentre spatial de chaque sous-rectangle.
Lorsqu’une figure est matérialisée par le moteur sous-jacent de Matplotlib, les barres physiques sont converties en une collection d’objets géométriques élémentaires accessibles via des conteneurs d’objets correcteurs (désignés sous le terme de patches). Chaque rectangle individuel dispose de fonctions d’interrogation spatiales permettant d’extraire ses attributs métriques fondamentaux : son abscisse de référence, sa largeur géométrique, son altitude de base (qui correspond au sommet de la strate inférieure précédente) et sa hauteur propre.
Le calcul barycentrique dérive de ces paramètres structurels : la coordonnée horizontale médiane correspond à l’abscisse du bord gauche majorée de la moitié exacte de la largeur de la barre, tandis que la coordonnée verticale médiane s’obtient en additionnant à l’élévation de base la moitié de la hauteur spécifique du segment considéré. En itérant programmatiquement sur l’ensemble de ces conteneurs géométriques ordonnés, le statisticien peut projeter une étiquette textuelle exactement au centre de masse de chaque cellule graphique.
9.2 Formatage typographique et affichage des valeurs
L’intégration textuelle au sein de zones colorées soulève des contraintes d’ergonomie et de lisibilité perceptuelle spécifiques. Le premier défi réside dans le maintien d’un contraste suffisant entre la police de caractères et la teinte d’arrière-plan du rectangle. Si une typographie blanche immaculée ressort parfaitement sur un segment bleu profond ou violacé, elle devient quasi invisible sur une strate à haute luminance comme un jaune pâle ou un pastel léger. Une logique de conditionnement chromatique peut être introduite pour basculer automatiquement la couleur du texte vers le noir ou le blanc selon la clarté de la strate d’accueil.
Un second impératif découle de l’encombrement physique des étiquettes face à des segments d’épaisseur infinitésimale. Lorsque la valeur numérique d’une sous-composante est très faible par rapport au reste de la distribution, la hauteur du sous-rectangle peut s’avérer inférieure à la hauteur de corps de la police typographique. Tenter d’y insérer une valeur textuelle provoque un débordement disgracieux sur les segments adjacents. L’algorithme d’annotation doit donc intégrer une condition de seuil d’affichage, n’imprimant le texte que si la dimension verticale du segment excède une tolérance géométrique préétablie.
Enfin, pour parachever la double lecture analytique, il est particulièrement judicieux d’adjoindre au sommet de chaque colonne le chiffre attestant du total consolidé. En appliquant une logique d’annotation similaire ciblant cette fois la hauteur cumulée intégrale de la barre, majorée d’un léger décalage vers le haut pour éviter tout contact physique avec la tranche supérieure, on offre au relecteur un accès immédiat à la fois au décompte détaillé de chaque segment intérieur et au bilan agrégé de la catégorie temporelle observée.
10. Normalisation des données : Construction d’un graphique à barres empilées à 100 %
10.1 Transformation mathématique en proportions relatives
Si le diagramme à barres empilées absolu excelle dans la démonstration de l’amplitude globale et de ses apports internes, il présente une limite analytique structurelle dès lors que les totaux par catégorie varient de manière spectaculaire : la disparité des hauteurs totales empêche alors de comparer avec finesse les fluctuations de la part relative occupée par chaque sous-groupe. Dans de nombreuses configurations expérimentales, la question posée ne relève pas de la quantité volumétrique brute mais de la composition proportionnelle interne.
Pour neutraliser l’effet d’amplitude globale et ramener l’ensemble des observations à une base comparative strictement unitaire, on opère une transformation mathématique de normalisation marginale. Cette opération s’effectue directement sur les données tabulaires en exploitant les capacités de calcul vectorisé de Pandas : on calcule la somme arithmétique de chaque ligne d’observation, puis on divise chaque terme de cette ligne par le total ainsi obtenu.
Cette opération matricielle engendre un tableau où la somme des composantes de chaque modalité catégorielle équivaut exactement à l’unité (soit 1,0 dans une modélisation fractionnaire ou 100 dans une projection en pourcentages entiers). L’indexation temporelle initiale est scrupuleusement conservée durant l’opération, garantissant que l’identité de chaque catégorie temporelle demeure associée à son nouveau profil de distribution relative. Les données ainsi transfigurées sont prêtes pour un traçage à sommation normalisée.
10.2 Tracé et configuration de l’échelle unitaire
La génération graphique d’un diagramme à barres empilées à 100 % mobilise des syntaxes analogues aux méthodes précédemment établies, mais opère sur la matrice des proportions relatives. L’impact visuel est immédiat et saisissant : toutes les barres du graphique présentent désormais une hauteur strictement identique et uniforme, formant un alignement d’horizon continu au sommet du repère cartésien.
Pour que la figure réponde aux exigences académiques, la configuration de l’axe des ordonnées doit refléter fidèlement la nature probabiliste ou proportionnelle des données projetées. L’emploi du formateur de pourcentage issu du sous-module ticker de Matplotlib permet de convertir automatiquement les valeurs décimales comprises entre 0 et 1 en indications explicites s’étendant de 0 % à 100 %, évitant ainsi toute ambiguïté sur la nature relative des grandeurs représentées.
Dans cette configuration à hauteur constante, l’œil de l’analyste n’est plus distrait par les variations de taille globale de la cohorte ; il peut se concentrer exclusivement sur la dynamique des partages internes. Les mouvements d’ascension ou de repli de la frontière de séparation entre les strates acquièrent une netteté remarquable, révélant avec une grande acuité les transferts de composition relative qui pouvaient être masqués par les contractions ou dilatations volumétriques globales au sein du graphique en valeurs brutes.
10.3 Applications méthodologiques et compromis d’interprétation
Bien que le diagramme à barres empilées à 100 % constitue un outil d’une remarquable élégance pour cartographier les parts de marché, les compositions démographiques ou les mix énergétiques, son utilisation exige une conscience aiguë des compromis sémiologiques qu’il impose. En égalisant artificiellement la taille de l’ensemble des barres, cette représentation opère une oblitération totale de l’information volumétrique absolue. Une catégorie temporelle ne rassemblant qu’une poignée d’individus et une autre brassant des milliers d’observations apparaissent avec une présence visuelle strictement équivalente.
Cette perte d’information quant au volume d’échantillonnage peut induire des erreurs d’interprétation critiques chez un lecteur non averti, qui pourrait accorder une portée stratégique majeure à une variation de composition observée sur un effectif marginal. Il s’avère donc souvent indispensable, dans le cadre d’un manuscrit scientifique, de stipuler explicitement l’effectif total absolu de chaque colonne, soit en l’inscrivant textuellement au-dessus du sommet de la barre de 100 %, soit en documentant les effectifs globaux au sein de la légende explicative de la figure.
Une pratique méthodologique hautement vertueuse consiste à associer conjointement les deux graphiques au sein d’une même planche composée en facettes : le premier panneau expose les barres empilées en valeurs absolues pour établir la réalité dimensionnelle du phénomène, tandis que le second panneau présente les barres normalisées à 100 % pour autoriser une analyse chirurgicale des parts de composition. Cette gémellité visuelle offre l’exhaustivité analytique maximale sans compromettre la rigueur d’interprétation.
11. Diagnostic des erreurs fréquentes et accessibilité graphique
11.1 Résolution des écueils de manipulation de données sous Pandas
La conception de diagrammes à barres empilées expose fréquemment le praticien à des anomalies de rendu ou à des interruptions d’exécution découlant d’une préparation imparfaite de la matrice de données en amont du tracé. L’un des écueils les plus récurrents réside dans l’oubli de la reconfiguration de l’index avant l’appel à la méthode de tracé cumulé de Pandas. Lorsque la variable catégorielle demeure cantonnée au statut de colonne ordinaire, le moteur tente de tracer l’identifiant textuel comme s’il s’agissait d’une variable quantitative, provoquant des erreurs de typage ou l’apparition d’une strate absurde au sein de l’empilement.
La présence inattendue de valeurs manquantes (valeurs non définies ou nulles) au sein des séries numériques constitue une autre source majeure de dysfonctionnement géométrique. Contrairement aux diagrammes à barres groupées qui tolèrent l’absence d’une barre en laissant un intervalle vide au sein du groupe catégoriel, le calcul cumulatif de l’empilement peut être rompu par une valeur non numérique. Selon la version du moteur graphique employé, cela peut conduire à l’éviction totale de la colonne, à un décalage erratique des strates supérieures ou à un plantage de l’interpréteur. L’application préventive de méthodes de remplissage ou de substitution de ces valeurs par le chiffre zéro neutralise rigoureusement cette vulnérabilité.
Enfin, il convient de veiller scrupuleusement à l’alignement dimensionnel lors des opérations de pivotement ou d’empilement. Une confusion fréquente consiste à intervertir accidentellement les axes lors de l’appel à la fonction de fonte ou de restructuration matricielle, aboutissant à regrouper les données selon les variables continues plutôt que selon les modalités catégorielles cibles. L’exécution systématique d’une instruction d’affichage du format matriciel et d’un contrôle d’en-tête permet d’intercepter ces anomalies de structuration avant l’engagement des phases de rendu graphique.
11.2 Biais cognitifs et limites perceptuelles des barres empilées
Sur le plan de la théorie de la perception visuelle, popularisée par les travaux fondamentaux de William Cleveland et Robert McGill dans les années 1980, le diagramme à barres empilées présente des limites cognitives intrinsèques qu’il convient de connaître et d’anticiper. L’esprit humain évalue les longueurs avec une précision maximale lorsque les segments partagent une ligne de référence commune, comme c’est le cas pour la strate inférieure ancrée sur l’axe des abscisses.
Dès lors que l’on observe la seconde, la troisième ou la quatrième strate d’une barre empilée, ces segments intérieurs ne reposent plus sur une ligne de base constante mais sur une frontière ondulante déterminée par les variations combinées des segments qui les précèdent. En conséquence, l’observateur éprouve des difficultés neuro-cognitives substantielles à comparer l’amplitude relative des strates intermédiaires d’une colonne à l’autre, son jugement étant parasité par les mouvements d’élévation ou de translation verticale de la base de sustentation.
Cette dissymétrie perceptuelle confère un avantage cognitif disproportionné à la strate de fond, qui bénéficie d’une lisibilité comparable à celle d’une barre simple isolée. Le chercheur doit donc ordonner intentionnellement ses couches : la variable dont l’évolution comparative constitue l’argument scientifique cardinal doit impérativement être assignée à la strate inférieure de fondation. Si l’ensemble des sous-variables requiert une précision d’estimation individuelle rigoureuse, il conviendra d’abandonner l’empilement au profit d’un diagramme à barres juxtaposées ou d’une déclinaison en facettes parallèles autonomes.
11.3 Principes d’accessibilité visuelle et choix de palettes inclusives
La diffusion éthique et universelle des résultats de la recherche impose d’intégrer les principes d’accessibilité visuelle dès le choix des encodages chromatiques. Une fraction non négligeable de la population masculine et féminine présente des formes variées d’anomalies de la vision des couleurs (daltonisme, deutéranopie, protanopie). L’usage des associations primaires rouge-vert ou d’échelles arc-en-ciel désuètes comme la palette jet aboutit à fusionner les strates adjacentes en des nuances de gris indiscernables pour ces lecteurs.
L’écosystème Seaborn intègre nativement des palettes colorimétriques scientifiquement conçues pour contourner ces déficits perceptuels, telles que les nuances viridis, cividis ou la palette spécifiquement calibrée colorblind. Ces gammes de teintes garantissent que la différentiation visuelle ne repose pas uniquement sur la chrominance pure, mais également sur une progression linéaire et monotone de la luminance. Ainsi, même convertie en niveaux de gris stricts ou perçue par un individu présentant une altération de la vision chromatique, la figure préserve l’intégrité de ses frontières géométriques.
Pour accroître encore le niveau d’accessibilité sans saturer l’espace visuel, il est vivement conseillé de coupler la distinction colorimétrique à des encodages texturés via l’usage de hachures géométriques différentielles (motifs obliques, croisillons, pointillés). Matplotlib permet d’assigner des motifs texturés distincts à chaque conteneur de segment, offrant ainsi un second canal d’identification visuelle totalement indépendant de la couleur, répondant ainsi aux plus hautes exigences d’inclusivité graphique internationales.
12. Exportation scientifique, reproductibilité et intégration dans un manuscrit
12.1 Sauvegarde dans des formats graphiques standardisés
L’aboutissement de la démarche d’ingénierie visuelle réside dans la sérialisation informatique du graphique en vue de son intégration dans un manuscrit édité, une thèse de doctorat ou un rapport d’expertise. Le choix du format d’encodage numérique détermine la pérennité de la restitution visuelle. Deux grandes catégories de formats se disputent l’usage : les formats matriciels composés de pixels et les formats vectoriels fondés sur des primitives géométriques mathématiques.
Pour la confection d’articles scientifiques rédigés sous des environnements de composition typographique tels que LaTeX, l’exportation vers des formats vectoriels (comme le Portable Document Format ou le Scalable Vector Graphics) s’impose comme le standard d’excellence absolue. Ces formats n’enregistrent pas une image figée en pixels, mais stockent les instructions mathématiques traçant les rectangles, les segments et les polices de caractères. Il en résulte que la figure conserve une netteté infinitésimale quel que soit le niveau de grossissement appliqué par le lecteur, éliminant tout risque d’aliasing ou de flou visuel lors de l’impression professionnelle.
Lorsque les spécifications éditoriales exigent la transmission de fichiers matriciels (généralement au format PNG non compressé), il est impératif de configurer manuellement la résolution de projection par point à une valeur minimale de 300 points par pouce (DPI), voire 600 points par pouce pour les schémas fins. De surcroît, le paramétrage strict du cadre de découpage délimité via l’argument d’ajustement serré des boîtes englobantes garantit que l’algorithme d’exportation éliminera les marges blanches inutiles tout en interdisant toute troncature intempestive des textes de légende ou des étiquettes d’axes positionnés en périphérie du canevas.
12.2 Bonnes pratiques de documentation de code et de science ouverte
L’inscription de la pratique analytique dans le mouvement contemporain de la science ouverte exige que la création d’une visualisation de données ne soit pas un événement isolé mais un maillon transparent et parfaitement documenté d’une chaîne de traitement informatique reproductible. Chaque bloc de code ayant concouru à l’assemblage d’un diagramme à barres empilées doit être rigoureusement commenté, en explicitant non seulement la syntaxe employée, mais surtout les justifications méthodologiques ayant motivé les choix de transformation de données ou les filtrages d’échantillons.
La sauvegarde conjointe du code source d’affichage et de la matrice de données brutes, au sein de dépôts institutionnels pérennes dotés d’identifiants d’objets numériques pérennes (DOI), assure la pérennité de l’expérimentation. Tout chercheur indépendant doit être en mesure de réexécuter l’arborescence des scripts et de régénérer à l’identique, au pixel près, la figure présentée dans la publication, garantissant ainsi l’intégrité déontologique de la recherche publiée face aux risques d’altération graphique non documentée.
Enfin, l’intégration de la figure au sein du corps du texte académique exige la rédaction d’une légende textuelle (caption) descriptive autonome et substantielle. Les standards éditoriaux stipulent qu’une figure scientifique doit pouvoir être comprise de manière indépendante de la lecture linéaire de l’article. La légende textuelle doit donc décliner de façon limpide : le rappel du sujet d’étude, la définition précise des variables affectées aux axes cartésiens, la description explicite de la signification des couleurs associées à chaque sous-composante de l’empilement, la taille de l’échantillon global consolidé et, le cas échéant, le rappel des tests statistiques attestant de la significativité des variations de composition observées.
Références
- Cleveland, W. S., & McGill, R. (1984). Graphical Perception: Theory, Experimentation, and Application to the Development of Graphical Methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Hunter, J. D. (2007). Matplotlib: A 2D Graphics Environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56-61). https://doi.org/10.25080/Majora-92bf1924-003
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wilke, C. O. (2019). Fundamentals of Data Visualization: A Primer on Making Informative and Compelling Figures. O’Reilly Media.