
Dans le champ contemporain de l’analyse quantitative et des sciences comportementales, la communication visuelle des données constitue une articulation épistémologique cruciale entre le recueil empirique et la déduction théorique. L’avènement des tableurs infonuagiques, au premier rang desquels figure Google Sheets, a démocratisé l’accès à des instruments de modélisation graphique autrefois réservés à des environnements statistiques spécialisés comme R, SAS ou SPSS. Parmi cet arsenal visuel, le graphique à barres empilées s’impose comme un vecteur sémiotique de premier ordre lorsqu’il s’agit de restituer la structure sous-jacente de variables catégorielles agrégées, d’illustrer la composition interne de cohortes ou d’exposer les distributions fréquentielles issues de protocoles psychométriques complexes.
Toutefois, la manipulation de telles figures géométriques ne relève pas d’une simple exécution technique au sein d’une interface logicielle ; elle engage une compréhension rigoureuse des mécanismes de perception visuelle et de sémiologie graphique. Représenter la part relative ou absolue de multiples sous-groupes au sein d’une macro-catégorie exige un calibrage méthodique de la matrice de données, une sélection avisée des modes d’empilement (absolu ou proportionnel à 100 %), ainsi qu’une maîtrise pointue des principes d’encodage perceptif théorisés par les pères de la visualisation scientifique tels que Jacques Bertin et Edward Tufte. Un graphique mal configuré génère inévitablement des distorsions herméneutiques, accentue la charge cognitive de l’observateur et compromet l’intégrité de la restitution scientifique.
Le présent traité propose une analyse exhaustive, méthodique et opérationnelle de la création, du paramétrage avancé et de l’interprétation critique des diagrammes à barres empilées au sein de Google Sheets. Conçu selon les exigences de rigueur de la recherche académique et des applications organisationnelles de haut niveau, ce guide explore l’ensemble du cycle de vie de la donnée : de son architecture matricielle dans les cellules du tableur jusqu’à son exportation sous les standards typographiques stricts de l’American Psychological Association (normes APA), en passant par la gestion algorithmique des séries statistiques et la correction des biais perceptifs inhérents à l’absence de ligne de base commune.
1. Fondements conceptuels du graphique à barres empilées dans Google Sheets
1.1 Définition sémiotique et taxonomie des visualisations empilées
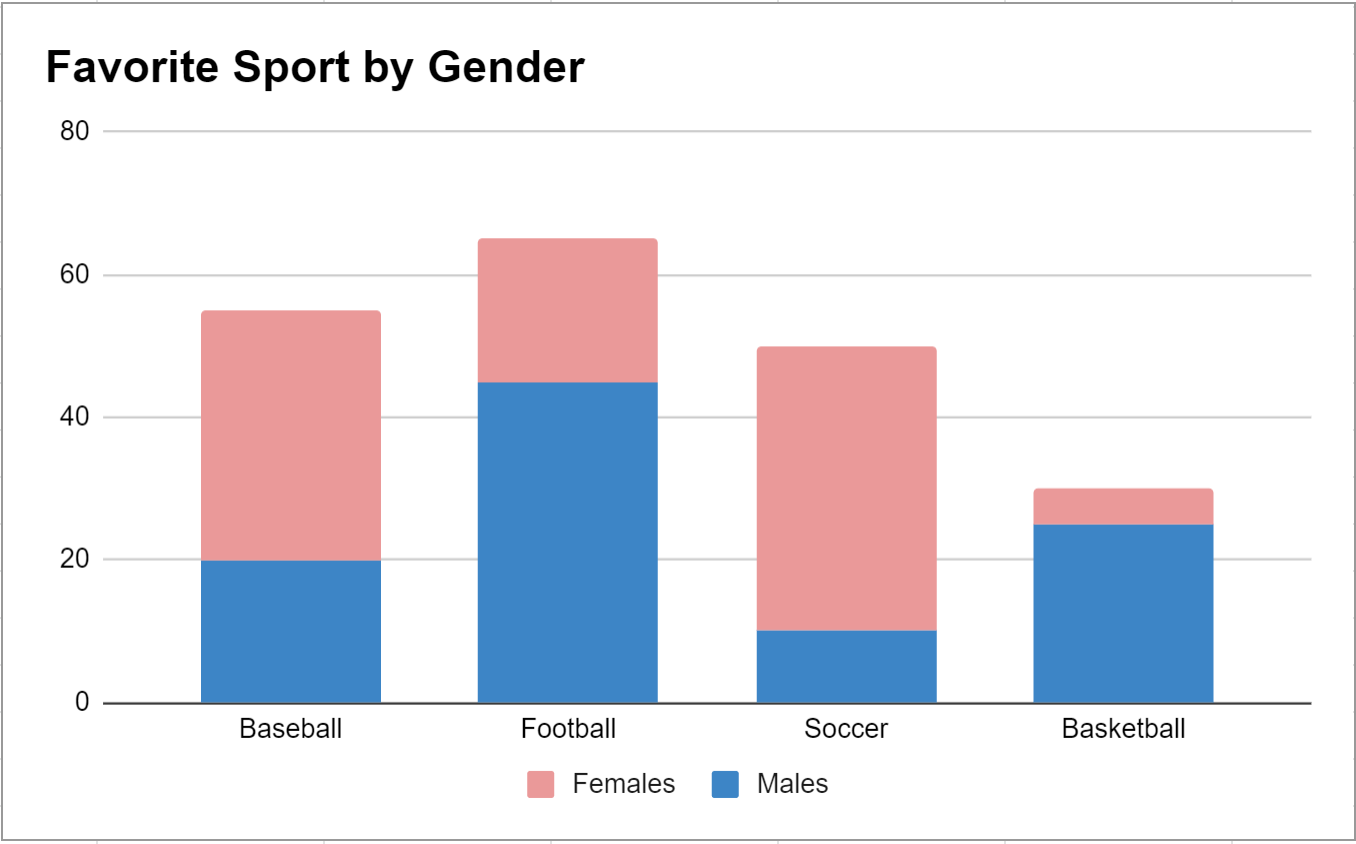
Sur le plan de la sémiologie graphique, le diagramme en barres segmentées se définit comme une structure bidimensionnelle au sein de laquelle un rectangle unique, matérialisant une catégorie discrète sur un axe nominal, se trouve partitionné en sous-segments géométriques continus. Chaque segment adopte une longueur (dans le cas des barres horizontales) ou une hauteur (dans le cas des colonnes verticales) strictement proportionnelle à la magnitude de la sous-variable qu’il incarne. Contrairement aux diagrammes en barres juxtaposées où chaque modalité dispose de sa propre assise spatiale le long de l’axe directeur, le diagramme empilé superpose les composantes scalaires, générant une lecture gigogne où la somme arithmétique des parties détermine le contour extérieur de l’entité observée.
Cette différenciation fondamentale entre disposition juxtaposée et disposition cumulative induit des conséquences cognitives majeures. La juxtaposition privilégie la comparaison discrète et univoque des grandeurs individuelles le long d’une ligne de référence partagée, facilitant le jugement d’amplitude entre sous-ensembles. En revanche, le graphique empilé remplit une fonction heuristique synthétique : il communique simultanément le volume global de l’agrégat et l’anatomie interne de sa composition. L’analyste observe d’un seul tenant la macro-structure du phénomène étudié tout en conservant la traçabilité des sous-populations qui le constituent.
Les avantages cognitifs de cette décomposition sont particulièrement manifestes lors de l’examen de systèmes multifactoriels. L’encodage par segmentation permet à l’appareil visuel humain de mobiliser les lois de l’organisation perceptive, notamment la relation figure-fond et le principe d’inclusion. L’esprit synthétise d’abord la silhouette générale conférée par la sommation des barres, avant de focaliser son attention sur les micro-variations chromatiques internes. Cette double échelle de lecture optimise l’économie cognitive du lecteur, pourvu que le nombre de strates demeure contenu dans les limites de la mémoire de travail visuo-spatiale.
1.2 Pertinence épistémologique pour l’analyse des données psychologiques
Dans l’écosystème de la psychologie différentielle, sociale et cognitive, la collecte de données repose de façon prépondérante sur des instruments standardisés générant des distributions ordinales et catégorielles. Les protocoles empiriques exploitent massivement des échelles d’évaluation subjective de type Likert, destinées à sonder des attitudes, des états affectifs ou des représentations cognitives. Le recours aux barres empilées constitue l’approche canonique pour modéliser les fréquences croisées issues de ces enquêtes comportementales, car il préserve le caractère discret des réponses tout en traduisant l’équilibre global des opinions au sein de la cohorte d’étude.
L’évaluation de la variance interindividuelle à travers divers sous-groupes démographiques – stratifiés selon le genre, la tranche d’âge, le niveau socio-éducatif ou le statut clinique – bénéficie directement de cette sémiotique cumulative. En déployant chaque sous-groupe le long d’une coordonnée catégorielle unique et en segmentant ses réactions selon l’intensité des réponses observées, le chercheur s’affranchit de la prolifération anarchique de figures isolées. La mise en regard de profils d’attitudes hétérogènes au sein d’un même cadre géométrique révèle immédiatement d’éventuelles polarisations ou homologies comportementales.
Par ailleurs, cette méthodologie graphique contribue à réduire drastiquement la charge cognitive lors de la comparaison de sous-groupes expérimentaux soumis à des conditions différentielles. Face à une matrice de corrélation ou à un tableau de contingence brut comprenant des dizaines de coefficients de fréquence, l’observateur humain éprouve des difficultés à extraire des tendances invariantes. Le diagramme empilé matérialise l’information sous la forme d’un continuum morphologique, transformant le calcul mental abstrait en une inspection visuelle directe des proportions et des asymétries distributionnelles.
1.3 Critères de sélection du graphique à barres empilées dans Google Sheets
L’adoption du graphique à barres empilées ne saurait constituer un choix par défaut dicté par de simples impératifs esthétiques ; elle doit résulter d’un arbitrage méthodologique rigoureux fondé sur la typologie des données. La condition de validité primordiale réside dans la restriction du nombre de catégories empilées. Si la variable de stratification interne excède cinq à six modalités, la lisibilité globale s’effondre de manière exponentielle. L’œil humain peine à discriminer les variations de longueur des segments situés au centre de la colonne, privé qu’il est d’une ligne de référence stable pour ces composants médians.
Lorsque la structure factorielle devient excessivement dense, la prolifération des frontières colorimétriques engendre un bruit visuel délétère, fréquemment qualifié de « fouillis graphique ». Dans une telle configuration, l’analyste se doit de renoncer à l’empilement pour privilégier un réseau de micro-graphiques en petits multiples (small multiples) ou revenir à un diagramme en barres groupées conventionnel, quitte à dissocier la macro-analyse de la micro-analyse des parts relatives.
Enfin, le choix géométrique entre barres horizontales et colonnes verticales dépend substantiellement des contraintes lexicales de l’étude. Lorsque les libellés de la variable nominale primaire sont formulés au moyen d’expressions textuelles étendues – telles que des énoncés complets d’items d’enquête, des désignations cliniques complexes ou des dénominations de départements institutionnels –, les barres horizontales s’imposent impérativement. Elles offrent un espace typographique linéaire préservant la lecture naturelle de gauche à droite, évitant l’angulation acrobatique ou la troncature dommageable des étiquettes inhérente aux colonnes verticales étriquées.
2. Préparation et structuration rigoureuse de la matrice de données
2.1 Architecture matricielle requise par le moteur de Google Sheets
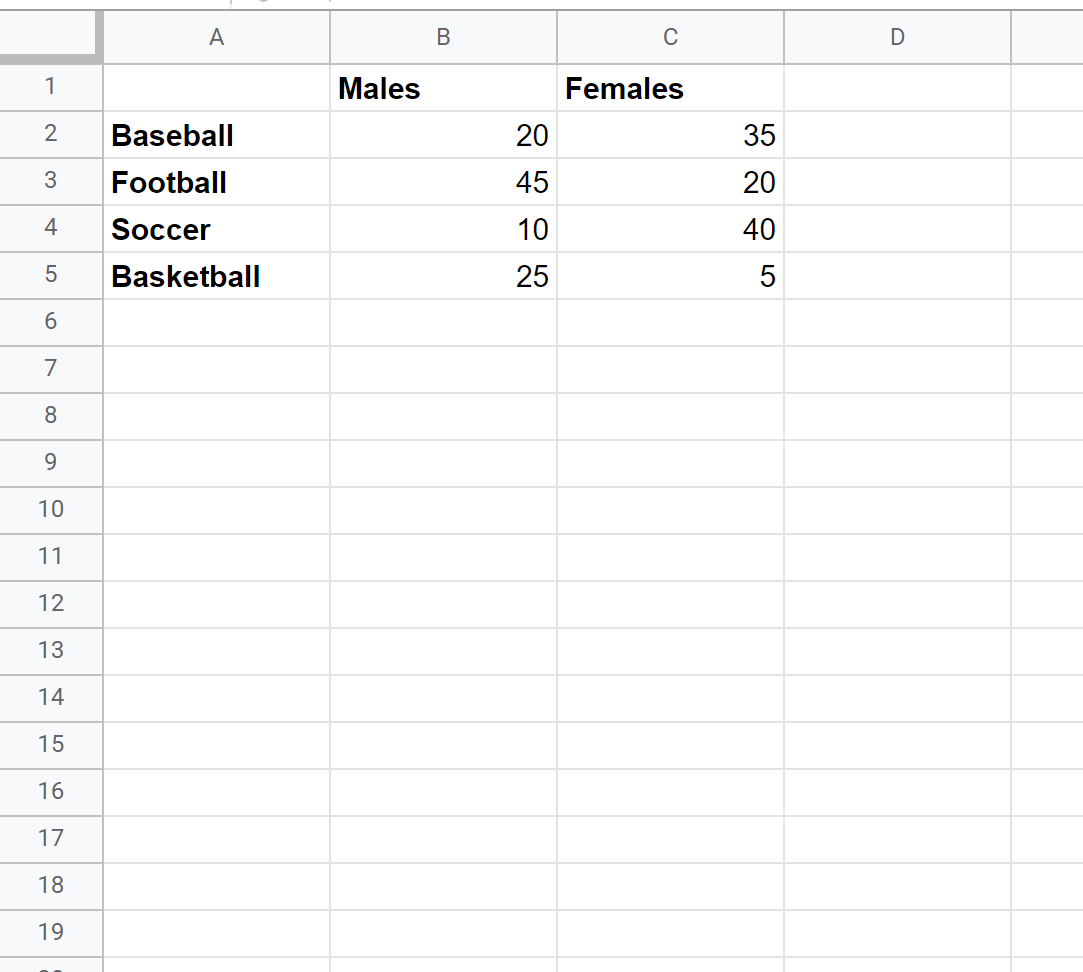
Le moteur de rendu graphique de Google Sheets fonctionne sur la base d’inférences déterministes qui conditionnent directement le succès de la visualisation. Pour qu’un graphique empilé soit généré sans distorsion ni inversion axiomatique, le jeu de données doit respecter scrupuleusement le paradigme de la table pivotée ou matrice d’adjacence bidimensionnelle. Cette organisation canonique stipule que la première colonne (colonne A) doit impérativement héberger la variable indépendante principale, c’est-à-dire les catégories discrètes qui définiront l’axe structurel du diagramme (les abscisses dans une orientation verticale, les ordonnées dans une orientation horizontale).
Les en-têtes horizontaux, répartis sur la première ligne à partir de la deuxième colonne (cellules B1, C1, D1, etc.), doivent consigner exclusivement les modalités de la seconde variable catégorielle, qui formeront les séries empilées distinctes. Les intersections matricielles (les cellules de la plage B2:Zn) doivent contenir impérativement des grandeurs scalaires continues : effectifs observés, pourcentages calculés ou moyennes d’échelles standardisées. Tout écart par rapport à cette topologie perturbe l’algorithme d’interprétation contextuelle de Google Sheets, contraignant l’analyste à des rectifications manuelles fastidieuses dans la configuration des plages.
La distinction typologique des cellules requiert une rigueur absolue. L’injection inopinée de caractères textuels au sein de plages numériques – comme des mentions d’absence de données codées sous la forme de lettres ou d’espaces insécables – transforme le format de la cellule en chaîne de texte, ce qui neutralise la capacité de sommation du moteur graphique. Les valeurs sont alors interprétées comme nulles ou exclues arbitrairement de l’axe métrique, introduisant des ruptures de continuité intolérables au sein des segments empilés.
2.2 Modélisation empirique : intégration de l’échantillon d’enquête
Afin d’illustrer la démarche de façon concrète, considérons une investigation empirique portant sur l’impact de l’activité physique sur le stress perçu, menée auprès d’un échantillon stratifié de 1 200 individus. La variable de stratification primaire correspond aux cohortes de genre et de statut démographique (ex. « Femmes actives », « Hommes actifs », « Étudiantes », « Étudiants »), tandis que la variable secondaire correspond à la typologie de l’activité sportive dominante pratiquée (« Sports collectifs », « Endurance individuelle », « Activités douces / Yoga », « Sédentaires / Sans activité »).
La transcription de ce protocole dans le tableur Google Sheets impose de créer une grille structurée sans lignes intercalaires vides ni fusions de cellules prématurées :
- Cellule A1 : Libellé de la variable d’ancrage, par exemple Cohorte.
- Cellules B1 à E1 : Noms respectifs des modalités comportementales : Sports collectifs, Endurance individuelle, Activités douces, Sédentaire.
- Lignes 2 à 5 (Colonne A) : Désignation des sous-groupes démographiques.
- Plage B2:E5 : Effectifs bruts réels issus du dépouillement statistique ou calculés via des fonctions d’agrégation conditionnelle telles que
NB.SI.ENS.
Avant d’engager le module de visualisation, une validation rigoureuse des sommes marginales est indispensable. L’analyste insère temporairement des fonctions de vérification (SOMME) sur chaque ligne pour s’assurer que le total arithmétique de chaque cohorte correspond rigoureusement à l’effectif total consigné dans le cahier d’observation, éliminant en amont tout biais de double comptage ou d’omission d’individus.
2.3 Gestion des données manquantes et contrôle de validité
Dans tout recueil empirique sur le terrain, l’apparition de données incomplètes constitue un écueil inévitable. La confrontation de Google Sheets à des cellules vides au sein d’une matrice destinée à l’empilement peut engendrer des représentations incohérentes, le logiciel oscillant entre l’attribution d’une valeur zéro et l’interruption spatiale du tracé de la barre. Sur le plan méthodologique, une cellule vide ne doit jamais être assimilée par inadvertance à une magnitude nulle sans une justification statistique explicite.
Lorsque l’absence de donnée relève d’une modalité non observée dans un groupe restreint, il convient d’assigner formellement la valeur arithmétique 0 dans la cellule concernée. Si la donnée est véritablement manquante au sens de la théorie de Rubin (Missing Completely at Random – MCAR ou Missing at Random – MAR), le chercheur doit procéder à une imputation méthodique préalable ou renormaliser les effectifs sur la base des cas complets avant de structurer la matrice finale du graphique. Les tableurs ne disposent pas d’algorithmes d’imputation stochastique intégrés ; la correction doit impérativement précéder l’étape graphique.
La normalisation syntaxique des étiquettes nominales exige une attention équivalente. L’inclusion involontaire d’espaces typographiques en queue de chaîne (ex. « Femmes » et « Femmes ») conduit Google Sheets à scinder artificiellement une catégorie unique en deux entités disjointes le long de l’axe nominal. Pour parer à cette défaillance humaine, l’application préalable de la fonction de nettoyage textuel SUPPRESPACE sur l’ensemble des libellés catégoriels garantit l’intégrité topologique et prévient l’effondrement structural du futur diagramme.
3. Procédure pas à pas d’insertion du graphique de base
3.1 Sélection de la plage et invocation du module de visualisation
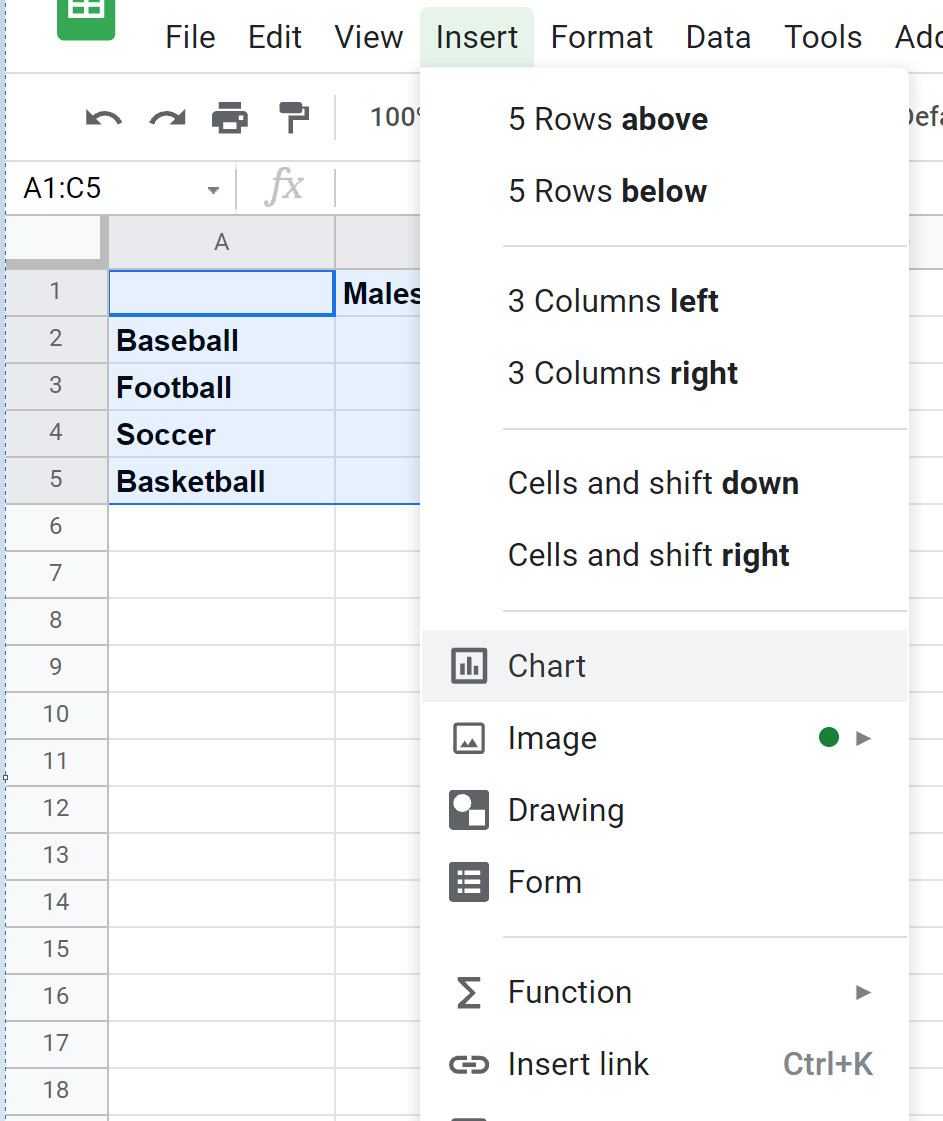
L’initialisation de l’objet graphique exige une sélection opératoire exhaustive et rigoureuse de la zone matricielle. L’opérateur positionne le curseur en cellule A1, englobant activement les en-têtes catégoriels de colonnes et les libellés de lignes, jusqu’à la dernière cellule contenant une métrique numérique (par exemple, la plage continue A1:E5). Il convient de proscrire absolument l’inclusion des lignes ou colonnes réservées aux totaux généraux arithmétiques. Si les totaux étaient intégrés dans la sélection, le moteur graphique les traiterait comme une série statistique indépendante, doublant artificiellement les hauteurs d’empilement et ruinant la cohérence de l’échelle métrique.
La plage étant convenablement surlignée, l’invocation du générateur s’effectue soit par le biais de la barre de menu supérieure via le cheminement Insertion > Graphique, soit par l’activation du glyphe idoine situé dans la barre d’outils contextuelle. Instantanément, le moteur d’intelligence heuristique de Google Sheets procède à une inférence algorithmique sur la typologie des données : il évalue le ratio entre variables textuelles et numériques afin d’extrapoler le rendu géométrique qu’il juge le plus congruent avec la structure décelée.
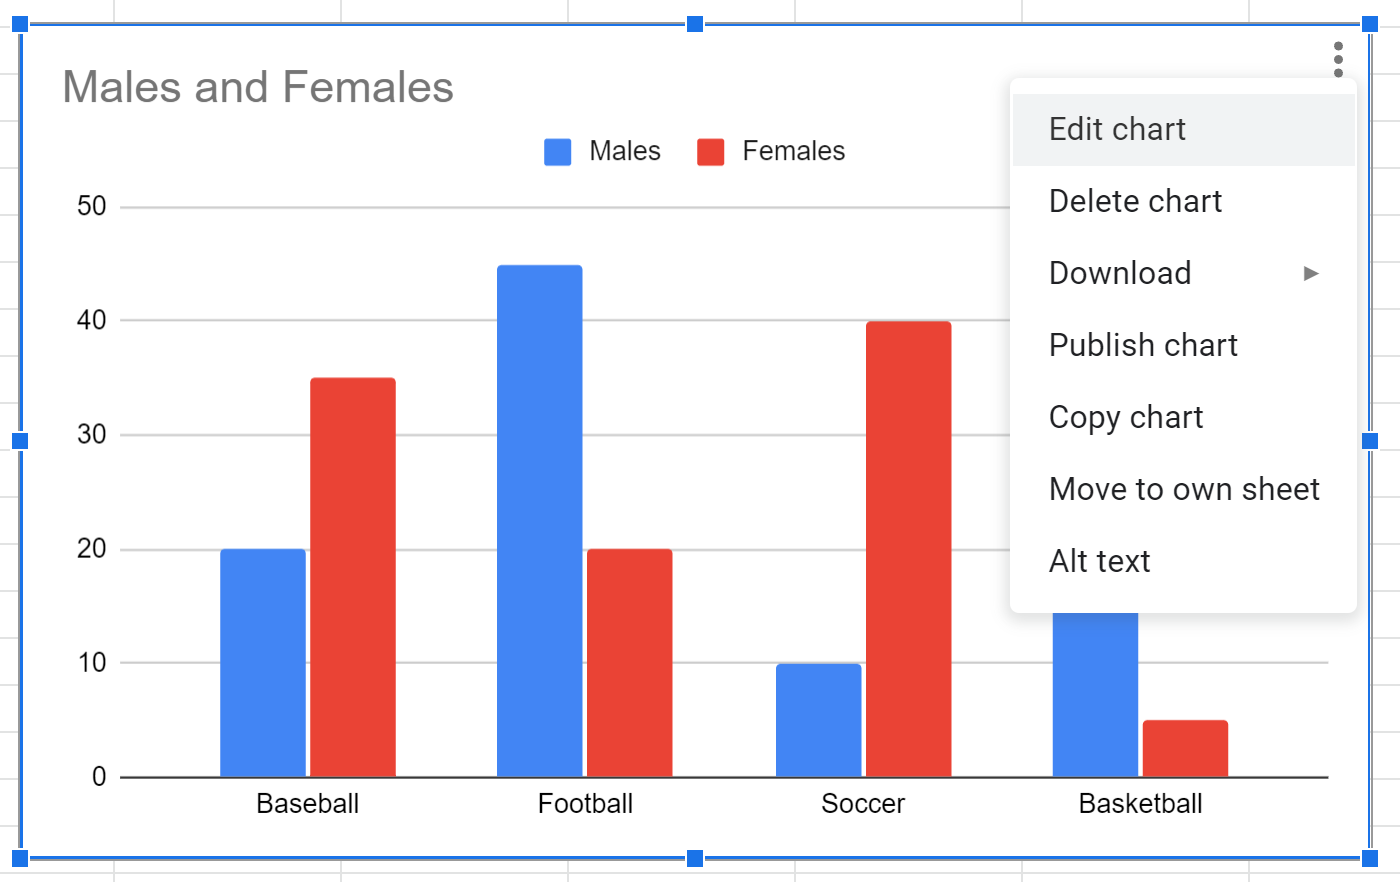
Dans la grande majorité des cas, ce processus automatisé engendre par défaut un graphique à colonnes standard juxtaposées. L’analyste ne doit point s’alarmer de cette configuration initiale disjointe : elle ne représente que l’ébauche structurelle brute. La transformation en un modèle cumulatif exige l’accès dirigé au panneau de contrôle analytique, où les paramètres d’agrégation spatiale devront être formellement reconfigurés.
3.2 Configuration du panneau de l’Éditeur de graphiques
Dès l’insertion du diagramme primitif, l’interface de Google Sheets déploie sur le flanc droit de l’espace de travail un volet latéral d’ingénierie intitulé Éditeur de graphiques. Ce panneau constitue la tour de contrôle névralgique de la visualisation ; il se structure en deux onglets opérationnels distincts : Configuration et Personnaliser. La phase présente requiert de se consacrer exclusivement à l’onglet Configuration, garant de l’intégrité architecturale de la restitution visuelle.
Le premier paramètre critique réside dans le champ Type de graphique. L’ouverture de ce menu déroulant présente un vaste répertoire taxonomique. L’analyste localise la section dédiée aux barres ou colonnes et opère son choix initial. Si l’axe d’orientation retenu est vertical, il sélectionne l’icône intitulée Graphique à colonnes empilées. Si une lecture horizontale est commandée par l’allongement des libellés textuels, son choix se porte sur le Graphique à barres empilées.
Dans le sous-espace inférieur de ce même volet, il est impératif de vérifier l’adéquation de l’affectation des axes. Le champ Axe X (ou axe des ordonnées en configuration horizontale) doit référencer strictement la colonne A. La section Séries doit énumérer individuellement chacune des colonnes quantitatives (Sports collectifs, Endurance, etc.). Deux cases à cocher méthodologiques réclament une vigilance particulière : « Utiliser la ligne 1 comme en-têtes » et « Utiliser la colonne A comme libellés ». Ces deux assertions doivent être formellement validées afin de garantir que les étiquettes ne soient pas confondues avec des données scalaires.
4. Transformation et paramétrage de l’empilement dans Google Sheets
4.1 Activation du mode d’empilement standard
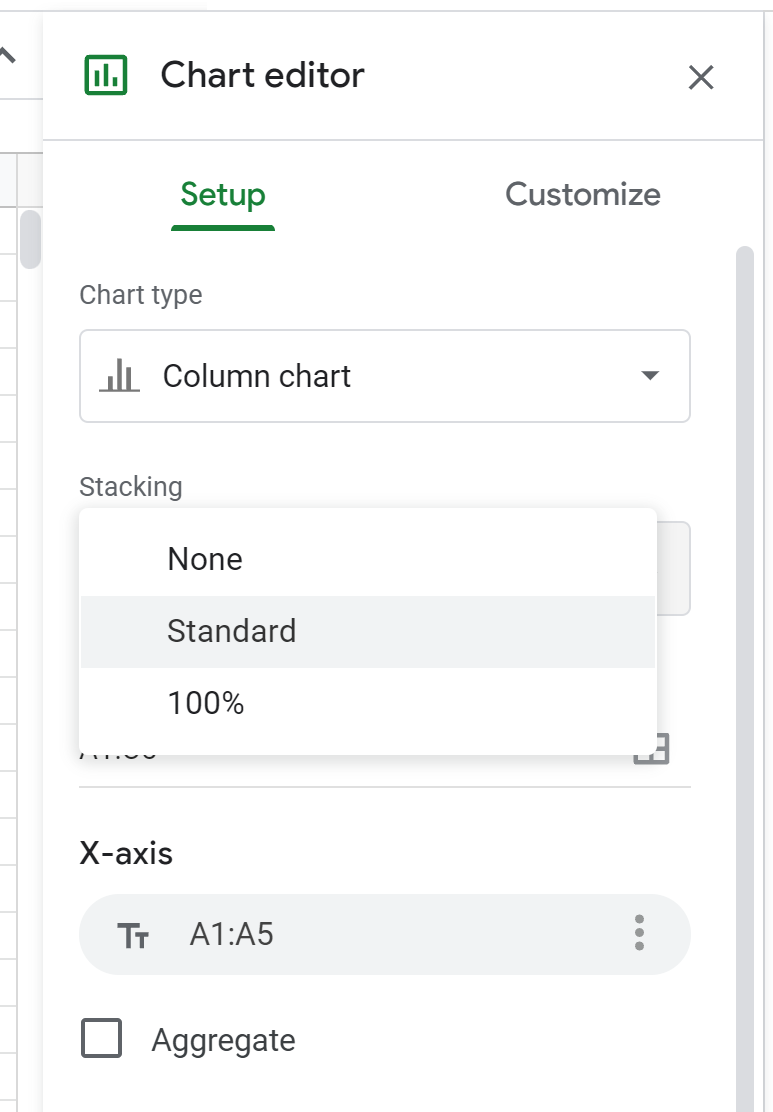
Dans l’éventualité où l’analyste n’a pas sélectionné directement le gabarit préconfiguré dans la galerie des modèles, ou s’il souhaite modifier un graphique existant, l’activation de l’empilement s’opère par l’ajustement du paramètre dédié dans l’onglet Configuration. Sous la sélection du type de graphique générique (colonnes ou barres standards), le menu déroulant Empilement offre trois états logiques : Aucun, Standard et 100 %. Le choix de l’état Standard déclenche une réorganisation géométrique immédiate des primitives vectorielles.
D’un point de vue algorithmique, le logiciel recalcule instantanément les coordonnées spatiales de chaque sommet de polygone. Au lieu d’ancrer le pied de chaque rectangle sur la ligne d’ordonnée zéro (comme dans le modèle groupé), le moteur assigne pour base du premier segment la coordonnée zéro, puis utilise le sommet de ce segment comme base de référence pour le segment consécutif, et ainsi de suite de manière récursive. L’axe continu voit son amplitude maximale s’étendre automatiquement pour absorber la somme cumulative maximale de la cohorte la plus volumineuse.
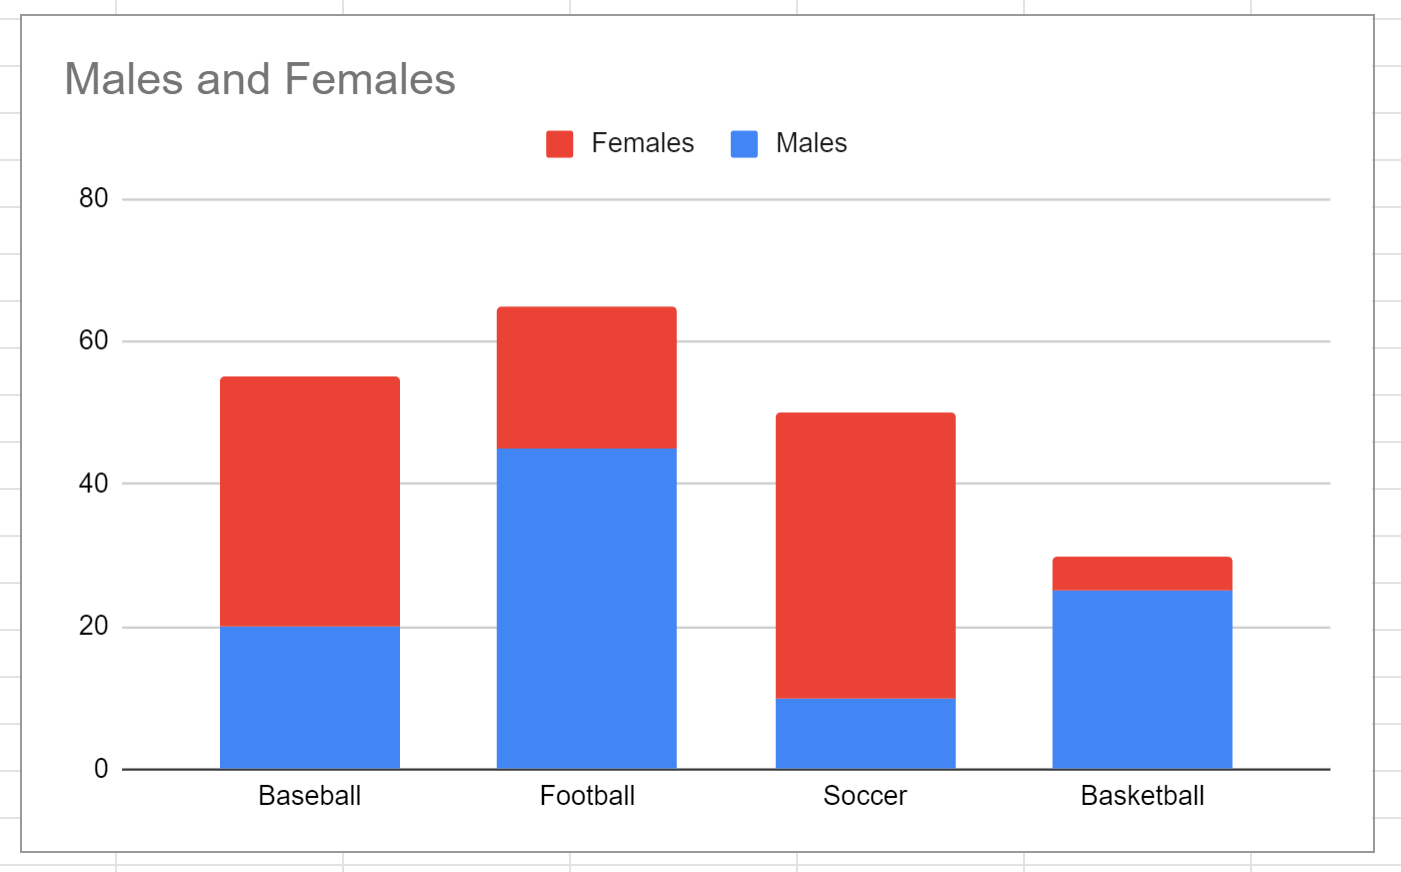
Cette transition vectorielle métamorphose la dynamique de lecture. L’observateur n’évalue plus une séquence de valeurs déconnectées, mais perçoit directement l’ampleur volumétrique globale de chaque groupe démographique. La hauteur totale de chaque barre matérialise l’effectif cumulé réel, tandis que la modulation interne des couleurs traduit l’équilibre des forces au sein de chaque strate d’échantillonnage.
4.2 Vérification des correspondances algébriques de la sommation
L’automatisation logicielle ne dispense jamais le chercheur d’un audit de conformité arithmétique. Une anomalie fréquente réside dans la désynchronisation involontaire des unités de mesure ou dans une mauvaise interprétation des polarités numériques. Il convient d’opérer un contrôle visuel direct : le sommet de la barre cumulée doit coïncider avec une précision absolue avec l’addition mathématique manuelle des valeurs inscrites dans les cellules sources correspondantes.
Un autre point névralgique de validation concerne l’ancrage inviolable de l’axe métrique sur la valeur zéro. Dans certaines circonstances, notamment lors de manipulations antérieures des paramètres de zoom, le moteur de Google Sheets peut être tenté de tronquer l’origine de l’échelle pour amplifier de faibles écarts perceptibles. Dans un diagramme empilé, une telle troncature de la ligne de base constituerait une faute méthodologique majeure : elle fausserait irrémédiablement le ratio dimensionnel du segment basal, conférant à la première série une magnitude visuelle disproportionnée par rapport à la réalité empirique.
Enfin, la cohérence entre la légende catégorielle et la stratification séquentielle physique des barres requiert un contrôle minutieux. Par défaut, Google Sheets ordonne l’empilement du bas vers le haut en suivant la progression séquentielle des colonnes de gauche à droite dans la feuille de calcul. L’analyste s’assure que cette hiérarchie vectorielle ne subit pas d’inversion intempestive susceptible de troubler l’intelligibilité de la progression logique des variables observées.
5. Dichotomie analytique : Empilement standard versus Empilement à 100 %
5.1 Fondements de l’empilement à 100 % dans les études quantitatives
L’alternative majeure à l’empilement additif standard réside dans l’activation du mode Empilement à 100 %, sélectionnable dans le même menu contextuel de configuration. Cette modalité graphique substitue aux valeurs absolues brutes une transformation proportionnelle instantanée : le tableur normalise la hauteur de chaque colonne à une valeur constante unitaire (100 %), et recalcule la fraction occupée par chaque segment sous la forme d’un pourcentage relatif du total spécifique de la catégorie considérée.
Sur le plan épistémologique, cette métamorphose vectorielle présente une utilité cardinale lorsqu’il s’agit de comparer des sous-échantillons d’amplitudes numériques hautement hétérogènes. Si, au sein de l’enquête susmentionnée, le groupe des « Femmes actives » comprend 600 répondants tandis que celui des « Étudiantes » n’en rassemble que 80, l’empilement standard produirait des barres de dimensions si disparates que la comparaison directe de la distribution interne des préférences sportives entre ces deux populations s’avérerait visuellement compromise. L’œil serait capté par la différence massive de masse globale au détriment de l’architecture distributionnelle interne.
Le diagramme empilé à 100 % rétablit une stricte égalité dimensionnelle : toutes les barres partagent une hauteur rigoureusement identique. Dès lors, le focus perceptif glisse exclusivement vers les profils distributionnels relatifs. L’analyste isole et compare avec une netteté remarquable les disparités d’orientation comportementale sans que celles-ci ne soient occultées ou déformées par les déséquilibres d’effectifs inhérents au plan d’échantillonnage de terrain.
5.2 Critères décisionnels entre valeurs absolues et relatives
Le choix entre l’empilement en valeurs brutes et l’empilement normalisé à 100 % découle directement de la question de recherche et de l’hypothèse soumise à l’épreuve des faits. Si l’enjeu principal réside dans la quantification des flux réels, le dimensionnement des capacités ou la compréhension du poids macroéconomique de différents segments (par exemple, estimer le nombre exact d’adhérents à accueillir dans une infrastructure sportive), l’empilement standard s’avère irremplaçable, car il ancre l’analyse dans le concret des volumétries opérationnelles.
En revanche, dès lors que la recherche interroge la structure psychologique des attitudes, la prévalence relative de symptômes cliniques ou l’équivalence de profils cognitifs entre des populations distinctes, l’empilement à 100 % devient l’instrument de prédilection. Il permet de neutraliser la variance dimensionnelle pour n’analyser que la dynamique interne des fréquences relatives conditionnelles.
Néanmoins, l’analyste doit demeurer conscient du péril interprétatif inhérent à l’empilement proportionnel : l’occultation totale du volume effectif global (le N méthodologique). Un segment représentant 25 % d’une population de 20 individus produit un impact visuel rigoureusement identique à un segment représentant 25 % d’une cohorte de 2 000 sujets. Cette équivalence géométrique superficielle peut conduire un observateur non averti à attribuer un niveau de confiance et une robustesse inférentielle équivalents à des estimations dont les erreurs-types et les intervalles de confiance diffèrent pourtant d’un ordre de grandeur. Il sera donc impératif de stipuler explicitement les effectifs nominaux dans les légendes ou les annotations textuelles annexes.
6. Personnalisation technique des axes et de l’échelle métrique
6.1 Calibrage de l’axe vertical dans Google Sheets
Une fois l’architecture générale stabilisée, la phase de raffinement s’amorce au sein de l’onglet Personnaliser de l’Éditeur de graphiques. Le volet consacré à l’Axe vertical constitue le théâtre d’opérations prioritaires pour garantir l’orthodoxie métrique de la visualisation. L’une des interventions les plus salutaires consiste à verrouiller manuellement les bornes inférieure et supérieure (valeurs minimale et maximale de l’échelle) au lieu d’abandonner cette décision à l’heuristique de lissage automatique du logiciel.
Dans le cas d’un empilement à 100 %, l’assignation explicite d’un minimum à 0 et d’un maximum à 1 (ou 100 selon le formatage numérique matriciel) empêche le tableur d’étirer l’axe jusqu’à 105 ou 110 %, artéfact récurrent qui génère un espace mort dommageable au sommet de la composition. Pour un empilement additif en valeurs brutes, l’analyste arrondit judicieusement la borne maximale au multiple supérieur significatif le plus proche afin de préserver une marge de respiration visuelle sans écraser la dynamique des barres.
Le contrôle du pas de graduation (les lignes de quadrillage principales et secondaires) réclame une rigueur mathématique proportionnée à l’écart-type de la série. Un maillage trop dense engendre une saturation graphique inutile, alors qu’un maillage trop lâche prive le lecteur de repères d’interpolation quantitatifs. Google Sheets autorise, via le sous-menu Quadrillage et graduations, la fixation formelle du pas de pas d’incrément, garantissant un étalonnage régulier et congruent avec les conventions de lecture décimale ou centésimale.
6.2 Optimisation typographique et orientation des étiquettes horizontales
La typographie employée sur les axes participe activement à la hiérarchie visuelle et à la lisibilité universelle du document scientifique. Dans le panneau Axe horizontal, l’analyste veille à sélectionner des polices de caractères sans empattement hautement lisibles à basse résolution (telles qu’Arial, Roboto ou Helvetica), en proscrivant les fontes fantaisistes. Le corps de police doit être calibré pour résister aux réductions dimensionnelles ultérieures lors de l’intégration dans des manuscrits ou des présentations académiques.
L’angulation des étiquettes de catégories horizontales représente un défi récurrent en matière d’ergonomie cognitive. Par défaut, face à des intitulés volumineux, Google Sheets applique une rotation inclinée à 45 ou 90 degrés. Or, les recherches en psychophysique de la lecture attestent sans équivoque que le temps de décodage et le taux d’erreur augmentent dès lors que le texte subit une rotation angulaire par rapport à l’horizontale naturelle. L’analyste consciencieux s’efforce de maintenir une inclinaison nulle (0 degré).
Pour parvenir à cet alignement horizontal sans provoquer la troncature ou la disparition pure et simple d’une étiquette sur deux par manque de place, plusieurs stratégies éditoriales s’offrent au concepteur : scinder les libellés au sein de la matrice initiale au moyen de retours à la ligne programmés (en utilisant le raccourci clavier Ctrl+Entrée ou Cmd+Entrée au sein de la cellule de Google Sheets), réduire modérément le corps typographique, ou opter résolument pour un graphique à barres horizontales, structurellement insensible aux contraintes de largeur d’étiquettes.
7. Sémiologie graphique et harmonisation de la palette chromatique
7.1 Application des principes de contraste et de gestaltisme perceptif
La couleur ne saurait être appréhendée comme un simple artifice cosmétique ; elle opère comme le vecteur syntaxique fondamental permettant de discriminer instantanément les variables représentées. L’application des théories de la Gestalt – et plus particulièrement des principes de similarité, de clôture et de continuité – conditionne l’efficacité avec laquelle l’esprit humain regroupe ou dissocie les strates empilées. Si les teintes sélectionnées partagent une luminance ou une saturation trop proches, le cerveau peine à isoler la silhouette respective de chaque sous-composant.
Dans un contexte d’évaluation scientifique ou d’enquête psychologique, le choix de la palette doit refléter la nature intrinsèque de l’échelle sous-jacente. Pour une variable nominale pure (ex. sports collectifs versus sports individuels), des teintes qualitatives différenciées sur le spectre chromatique (par exemple un bleu ardoise, un ambre chaleureux, un vert sauge) s’imposent. En revanche, pour des variables ordinales ou des échelles d’intensité (faible, modéré, élevé), le recours à un dégradé séquentiel monochrome ou bichrome – modulant progressivement la luminance du plus clair au plus sombre – est impératif afin de préserver l’analogie visuelle naturelle avec l’amplification quantitative.
L’accessibilité universelle représente désormais un impératif éthique et légal de toute publication académique moderne. Une fraction significative de la population masculine présentant des déficiences de la vision chromatique (deutéranopie, protanopie), les antagonismes conventionnels vert/rouge doivent être rigoureusement bannis. L’analyste privilégie des combinaisons éprouvées et perceptuellement uniformes – telles que les palettes inspirées de Viridis ou des travaux de Cynthia Brewer (ColorBrewer) –, garantissant une restitution contrastée et exempte d’ambiguïté, y compris lors d’une impression en niveaux de gris.
7.2 Attribution manuelle des nuances par série statistique
L’interface par défaut de Google Sheets assigne automatiquement une palette chromatique générique aux contrastes parfois criards et peu compatibles avec l’austérité éditoriale d’une revue scientifique. La personnalisation fine de ces teintes s’opère dans l’onglet Personnaliser, sous la rubrique spécifique Séries. L’analyste sélectionne successivement chacune des séries dans le menu déroulant contextuel pour lui attribuer une signature chromatique spécifique.
Au lieu de se limiter aux pastilles primaires prédéfinies, il est hautement recommandé d’utiliser l’option de couleur personnalisée permettant de consigner des codes hexadécimaux stricts (par exemple #2B5C8F pour un bleu institutionnel profond ou #D97736 pour une teinte ocre contrastante). Cette traçabilité hexadécimale assure une reproductibilité graphique absolue d’un projet à l’autre et garantit l’alignement formel avec les chartes graphiques de l’université ou de l’organisme de publication.
Outre la couleur de remplissage, l’analyste dispose de réglages sur l’opacité et les bordures de segments. L’application d’un léger contour contrastant (par exemple un liseré d’une teinte subtilement plus sombre que le fond ou un blanc pur en cas de couleurs denses) offre un avantage ergonomique indéniable : elle délimite chirurgicalement la transition entre deux segments adjacents de tonalités voisines. Cet artifice visuel élimine les effets d’irradiation lumineuse et préserve la netteté structurelle de l’empilement.
8. Intégration d’annotations, d’étiquettes de données et de légendes
8.1 Affichage et positionnement précis des valeurs numériques
Si la géométrie spatiale informe avec efficacité sur les tendances globales, la précision analytique exige fréquemment l’adjonction de valeurs numériques directes au cœur de la figure. Google Sheets intègre cette fonctionnalité au sein de la sous-section Séries sous la forme de l’activation des Étiquettes de données. Une fois cochée, cette option projette la valeur quantitative issue de la cellule sur le segment graphique correspondant.
L’arbitrage géométrique du positionnement de ces étiquettes constitue une décision critique. Le menu propose plusieurs modes : Centre, Extrémité intérieure, Base intérieure ou Extrémité extérieure (cette dernière étant généralement désactivée dans les configurations empilées pour des raisons évidentes d’alignement). Le positionnement au Centre offre la solution la plus stable sur le plan gestaltiste, ancrant le symbole numérique au foyer géométrique de la surface colorée correspondante.
Toutefois, un écueil morphologique majeur surgit dès lors qu’un segment présente une magnitude particulièrement réduite : l’étiquette textuelle excède la superficie du polygone qui l’héberge, générant des débordements disgracieux ou des télescopages de chiffres illisibles. Dans Google Sheets, l’analyste peut remédier à cette congestion en calibrant la taille de la police des étiquettes (en optant par exemple pour un corps de 9 ou 10 points) ou en choisissant délibérément de n’activer les étiquettes que sur les séries majeures de l’étude, déchargeant ainsi la zone de traçage des détails numériques non cardinaux.
8.2 Affinement de la légende explicative et repères de lecture
La légende constitue la clef de décodage sémantique sans laquelle la figure demeure un rébus abstrait. Accessible sous la section Légende de l’Éditeur de graphiques, sa disposition spatiale gouverne la chorégraphie du regard. Les positions périphériques standards incluent : Haut, Bas, Gauche, Droite ou Aucune. Pour un diagramme à barres empilées, la position Supérieure ou Inférieure s’avère généralement supérieure sur le plan ergonomique par rapport au flanc droit, car elle préserve une plus grande largeur horizontale utile pour la zone de traçage des barres elles-mêmes.
Un principe fondamental de psychophysique visuelle impose que l’ordre des éléments au sein de la légende reflète strictement l’ordre d’empilement physique des segments au sein des colonnes. Une discordance entre la séquence textuelle de la légende et la stratification géométrique verticale impose à l’esprit une gymnastique cognitive inutile, l’observateur devant constamment recalibrer ses repères d’orientation. Si nécessaire, l’analyste réorganise physiquement l’ordre des colonnes dans sa matrice source sous Google Sheets pour aligner parfaitement la lecture de gauche à droite de la légende avec l’empilement du bas vers le haut du diagramme.
Enfin, lorsque le diagramme formalise des résultats soumis à des seuils de significativité inférentielle (ex. p < .05), la légende textuelle peut être enrichie d’une annotation méthodologique. Quoique Google Sheets ne dispose pas d’un système d’astérisques dynamiques superposées aux segments, le chercheur compense cette limite logicielle en insérant une zone de texte narrative directement sous le graphique, déclarant les conditions d’échantillonnage, la taille totale du panel ainsi que les éventuelles conventions typographiques de significativité.
9. Visualisation de métriques psychométriques et variables multiniveaux
9.1 Restitution des résultats issus d’échelles de Likert divergentes
La transcription graphique d’échelles de Likert (mesurant par exemple l’accord de « Pas du tout d’accord » à « Tout à fait d’accord ») pose un défi théorique particulier au sein d’un diagramme empilé classique. Dans un empilement cumulatif traditionnel à 100 %, l’ensemble des réponses positives et négatives s’empilent dans une même direction unidirectionnelle, ce qui rend délicate l’appréciation immédiate du point de bascule neutre ou de la polarisation de l’opinion collective.
Pour transcender cette limite sans quitter l’écosystème de Google Sheets, la technique du graphique à barres divergentes s’impose comme une méthodologie d’élite. Cette méthode requiert une manipulation algébrique ingénieuse au sein de la matrice source : les fréquences relatives associées aux réponses négatives sont converties en valeurs mathématiques négatives (multipliées par -1), tandis que les réponses positives demeurent strictement positives. La catégorie médiane « Neutre » est scindée arithmétiquement en deux fractions égales (ex. 50 % reportés du côté négatif et 50 % du côté positif).
En traçant ensuite un graphique à barres empilées horizontales à partir de cette matrice recalculée, l’axe vertical zéro devient le point pivot central naturel. Les strates négatives s’étendent vers la gauche de l’axe, tandis que les strates positives se déploient vers la droite. Cette géométrie symétrique fournit une lecture immédiate et saisissante du climat d’opinion : le regard isole instantanément le centre de gravité de chaque item et discerne avec une clarté remarquable le différentiel d’approbation entre les dimensions psychométriques explorées.
9.2 Croisement multidimensionnel et sous-groupes factoriels
L’investigation scientifique contemporaine se caractérise fréquemment par l’analyse simultanée de multiples prédicteurs factoriels (par exemple : Co-occurrence de la tranche d’âge, du genre biologique et du niveau d’anxiété pathologique). L’intégration de ces strates imbriquées au sein d’un modèle graphique unique met à rude épreuve les capacités structurelles d’un tableur conventionnel.
Dans Google Sheets, l’analyste résout ce problème d’empilement multidimensionnel en exploitant la technique des en-têtes hiérarchiques à double entrée sur l’axe primaire. En configurant les colonnes A et B de la feuille de calcul comme deux niveaux d’étiquetage nominal conjoints (la colonne A hébergeant la variable macro-démographique « Âge » sous forme de cellules fusionnées par plage, et la colonne B détaillant le « Genre » pour chaque sous-ensemble), le moteur graphique génère un axe horizontal étagé à deux degrés de lecture.
Toutefois, un seuil d’intelligibilité strict doit être respecté. La modélisation empirique démontre que l’insertion de plus de trois facteurs concurrents (deux sur l’axe des catégories et un au sein des strates empilées) entraîne un effondrement irréversible de la clarté visuelle. Au-delà de ce volume d’interaction, la charge de décodage computationnelle excède les gains heuristiques de la synthèse graphique. Il convient dès lors de fragmenter l’analyse en matrices de graphiques distincts ou d’abandonner l’empilement au profit de modélisations en équations structurelles ou de surfaces de régression multivariées.
10. Biais cognitifs et écueils d’interprétation des barres empilées
10.1 Le biais de l’absence de ligne de base commune
L’écueil sémiotique le plus redoutable et le mieux documenté inhérent aux graphiques à barres empilées réside dans ce que la psychophysique de la vision nomme l’absence d’alignement sur une ligne de base commune. Dans toute figure empilée, seul le segment positionné à la base même du graphique (ancré sur l’axe zéro) et la hauteur globale cumulée de la colonne bénéficient d’un point d’ancrage fixe facilitant une comparaison spatiale directe de longueur.
Pour l’ensemble des segments intermédiaires nichés au cœur de la colonne, leur point de départ inférieur varie dynamiquement en fonction de la magnitude des segments qui les précèdent. Par conséquent, l’observateur qui tente d’évaluer l’évolution ou la différence de taille d’un segment intermédiaire entre plusieurs cohortes doit se livrer à un jugement perceptif complexe de longueur relative flottante dans l’espace. Les études fondamentales conduites par Cleveland et McGill (1984) ont rigoureusement démontré que le jugement d’une longueur non alignée génère un taux d’erreur systématique et une variance d’estimation significativement plus élevés que le jugement d’une position sur une échelle commune.
Ce biais cognitif inconscient pousse fréquemment les lecteurs à surévaluer ou sous-évaluer les variations des composantes médianes. La parade méthodologique prioritaire consiste à positionner systématiquement la sous-variable la plus cruciale pour l’argumentation scientifique au premier niveau de l’empilement (directement sur la ligne de base zéro). Pour les segments intermédiaires indispensables à l’analyse, l’insertion explicite d’étiquettes de données textuelles chiffrées constitue l’unique garde-fou permettant de neutraliser l’illusion optique par une corroboration symbolique immédiate.
10.2 Effets de contexte et distorsions optiques d’échelle
La disposition spatiale des données exerce une influence insidieuse sur l’attribution subjective d’importance par l’esprit humain. Un phénomène d’ancrage perceptif tend à valoriser inconsciemment la première série visible (la base) ainsi que la série sommitale qui sculpte la ligne de crête du graphique, au détriment des éléments intercalaires. L’ordre des séries dans la matrice de Google Sheets ne doit donc jamais être abandonné au hasard de la saisie ; il doit découler d’un plan d’exposition logique : de la modalité la plus positive à la plus négative, ou de la composante la plus stable à la plus volatile.
Un autre écueil redoutable procède des distorsions d’échelles induites par des variations contextuelles mal maîtrisées. L’omission délibérée ou accidentelle du chiffre zéro sur l’axe continu dans le but d’exagérer des micro-fluctuations entre groupes relève de la manipulation visuelle (chartjunk au sens de Tufte). De même, l’adoption d’un rapport de forme (aspect ratio) démesurément étiré en hauteur ou en largeur altère la perception des pentes et des angles formés par les transitions d’un groupe à l’autre.
Enfin, le concepteur doit se prémunir contre les illusions de contraste simultané induites par la contiguïté de blocs colorimétriques aux intensités dissemblables. Une nuance de gris moyen paraîtra plus sombre si elle est prise en étau entre deux segments clairs, et substantiellement plus claire si elle jouxte des segments foncés. L’uniformisation rigoureuse des séparateurs géométriques (liserés de délimitation blancs ou neutres) concourt à immuniser l’appareil perceptif contre ces perturbations optiques physiologiques.
11. Automatisation, dynamisation et interconnexion dans Google Sheets
11.1 Liaison directe avec Google Forms pour l’actualisation en temps réel
La puissance intrinsèque de Google Sheets s’affirme de manière spectaculaire lors de son intégration au sein d’un écosystème automatisé de collecte de données de recherche, notamment via la passerelle dynamique native avec Google Forms. Dans le cadre de protocoles longitudinaux ou d’enquêtes psychologiques à large échelle, les réponses brutes des participants s’incrémentent en continu, ligne par ligne, dans une feuille d’ingestion primaire sans intervention humaine requise.
Pour alimenter le graphique à barres empilées de manière vivante sans saturer la matrice de calcul, l’analyste déploie une feuille intermédiaire dédiée à l’agrégation, pilotée par des formules matricielles hautement résilientes. L’emploi de la fonction QUERY, combinée au langage quasi-SQL interne du tableur, permet d’extraire, filtrer et pivoter dynamiquement les flux d’entrées brutes :
=QUERY(Reponses_Formulaire!A1:Z; "SELECT B, COUNT(A) WHERE B IS NOT NULL GROUP BY B PIVOT C")
Cette directive syntaxique agrège instantanément les effectifs catégoriels croisés (la variable B constituant l’axe nominal primaire, et la variable C générant les colonnes de pivot représentatives des séries empilées). Dès lors qu’un nouveau sujet valide le questionnaire en ligne, l’équation recalcule instantanément la matrice d’adjacence, et le graphique à barres empilées interconnecté actualise ses coordonnées vectorielles en temps réel. La chaîne de transmission entre le stimulus expérimental et la restitution synthétique s’opère ainsi avec une fluidité cybernétique totale.
11.2 Utilisation des segments et filtres interactifs pour l’exploration de données
Au-delà de la restitution statique destinée au support papier, Google Sheets autorise le déploiement d’interfaces analytiques interactives permettant l’exploration visuelle de sous-hypothèses de recherche sans requérir la multiplication désordonnée de figures distinctes. L’insertion d’un Segment (accessible via le ruban supérieur Données > Ajouter un segment) adjoint à la feuille de calcul un module de contrôle dynamique particulièrement performant.
L’analyste configure le segment en le reliant à une variable d’intérêt modératrice ou modélisatrice présente dans la base de données, telle que la strate socio-professionnelle, la zone géographique ou la condition expérimentale spécifique. En manipulant les curseurs déroulants directement sur l’interface, l’expérimentateur applique des filtres sélectifs instantanés sur l’échantillon global. Le diagramme empilé réagit dynamiquement en recalculant les hauteurs absolues et proportions relatives des séries pour le sous-ensemble isolé.
Cette approche ergonomique émancipe l’investigateur de l’obligation de concevoir laborieusement des dizaines de graphiques dérivés. Elle favorise un examen itératif et exploratoire des patterns empiriques (Exploratory Data Analysis – EDA), permettant de débusquer en amont d’éventuelles interactions insoupçonnées entre variables ou des anomalies distributionnelles locales avant la formalisation définitive des modèles de régression multivariée.
12. Conformité académique, normes APA et exportation des visualisations
12.1 Adaptation aux directives formelles de publication scientifique
L’intégration d’une figure au sein d’un manuscrit soumis aux exigences de publication scientifique – particulièrement dans les revues affiliées aux sciences psychologiques et sociales régies par la 7e édition du manuel de style de l’APA – requiert une purge rigoureuse des fioritures visuelles superflues. Le dogme épistémologique défendu par Edward Tufte quant à la maximisation du ratio données-encre (Data-Ink Ratio) trouve ici sa pleine application normative.
Concrètement, l’adaptation d’un graphique Google Sheets aux standards APA impose les réglages de personnalisation suivants :
- Suppression intégrale du quadrillage d’arrière-plan : Les lignes de grille horizontales et verticales doivent être formellement désactivées dans le panneau Quadrillage et graduations, de même que la bordure extérieure encadrant la zone de traçage, conférant à la composition une pureté minimale.
- Typographie normalisée : Les polices doivent correspondre rigoureusement à celle du corps de texte du manuscrit (ex. Times New Roman, Calibri ou Arial), en calibrant la hiérarchie de taille entre 8 et 14 points selon la nature de l’élément textuel.
- Bannissement du titre intégré à la zone graphique : Dans la nomenclature APA, le titre de la figure ne doit jamais être inclus à l’intérieur du canevas graphique généré par le logiciel. Il doit figurer à l’extérieur, en tête du document textuel d’accueil.
La formulation extérieure normalisée se déploie selon une architecture séquentielle bipartite immuable :
Figure 1 (en gras, sur sa propre ligne)
Distribution des préférences comportementales sportives selon la cohorte démographique (en italique, sur la ligne suivante)
Sous la figure géométrique, l’analyste insère une note méthodologique (introduite par le vocable Note. en italique), précisant les paramètres contextuels : Note. Données recueillies par protocole standardisé (N = 1 200). Les pourcentages au sein des segments sont arrondis à l’unité la plus proche. Les seuils de significativité des tests d’indépendance du khi-carré sont stipulés le cas échéant.
12.2 Procédures d’exportation vectorielle et insertion documentaire
L’ultime écueil technique se situe au stade du transfert de l’artefact visuel depuis l’environnement infonuagique du tableur vers le processeur de texte ou le moteur de mise en page éditoriale. Une erreur dévastatrice, hélas fréquente, consiste à opérer une banale capture d’écran de l’affichage pixelisé du navigateur web. Cette pratique délétère aboutit à une pixellisation destructive, un flou typographique rédhibitoire à l’impression physique et une violation caractérisée des exigences de résolution minimale (fixées à 300 voire 600 DPI par les éditeurs scientifiques).
Google Sheets offre deux voies professionnelles pérennes pour exporter les visualisations dans le respect de l’intégrité vectorielle. La première consiste à cliquer sur le menu contextuel à trois points verticaux situé dans l’angle supérieur droit du cadre du graphique, puis à emprunter la commande Télécharger > Document PDF (.pdf) ou Télécharger > Graphique vectoriel évolutif (.svg). Ces formats vectoriels préservent les équations mathématiques décrivant chaque courbe et polygone, autorisant un agrandissement ou une réduction dimensionnelle à l’infini sans la moindre dégradation de netteté sur presse d’imprimerie.
La seconde méthodologie s’applique lors de la rédaction sous Google Docs. En procédant par le menu Insertion > Graphique > À partir de Sheets, l’auteur incorpore la figure sous la forme d’un objet lié dynamiquement (Linked Object). Cette interconnexion logicielle permet, en cas de révision post-arbitrage des données statistiques dans le tableur source, d’actualiser instantanément le rendu graphique au sein du manuscrit d’un simple clic sur le bouton interactif de mise à jour, éliminant tout risque d’asynchronie documentaire au fil des révisions du projet académique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions Gauthier-Villars.
- Brewer, C. A. (2003). ColorBrewer in print: A catalog of color schemes for maps. Cartography and Geographic Information Science. https://colorbrewer2.org/
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Google Workspace Support. (2023). Ajouter et modifier un graphique dans Google Sheets. Google Docs Editors Help. https://support.google.com/docs/answer/190718
- Koffka, K. (1935). Principles of Gestalt psychology. Harcourt, Brace and Company.
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press. https://www.edwardtufte.com/tufte/
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098