
La visualisation des données quantitatives constitue un pilier fondamental de la démarche scientifique moderne, assurant l’interface critique entre le traitement algorithmique brut et la cognition humaine. Au sein de l’écosystème scientifique du langage Python, les représentations graphiques ne se contentent plus de résumer sommairement des distributions statistiques ; elles incarnent de véritables instruments de découverte, de validation d’hypothèses et de dissémination du savoir. Parmi l’éventail des sémiotiques visuelles disponibles, le graphique en aires, ou diagramme à surfaces superposées, occupe une place prépondérante dès lors qu’il s’agit d’illustrer l’évolution conjointe de plusieurs grandeurs cumulatives à travers le temps.
Cependant, l’utilisateur confronté à l’environnement de visualisation Python découvre rapidement une singularité architecturale : la bibliothèque Seaborn, reconnue mondialement pour son élégance déclarative et sa puissance statistique, ne dispose pas d’une commande native explicitement nommée pour tracer des graphiques en aires empilées déterministes standards. Cette absence apparente d’abstraction dédiée ne constitue nullement une carence fonctionnelle, mais reflète la philosophie modulaire de Python, au sein de laquelle Seaborn agit comme un orchestrateur esthétique et statistique directement greffé sur le moteur de bas niveau Matplotlib. La construction d’un graphique en aires rigoureux repose ainsi sur une synergie méthodique entre la manipulation de structures tabulaires sous Pandas, l’application des thèmes chromatiques de Seaborn et l’invocation ciblée des primitives de tracé de Matplotlib.
Le présent traité expose de manière exhaustive l’ensemble des fondements théoriques, des protocoles de structuration de données et des étapes d’implémentation programmatique nécessaires à l’élaboration de graphiques en aires d’un niveau professionnel et académique. En parcourant les nuances séparant les aires simples, empilées et normalisées, en disséquant les mécanismes d’empilement cumulatif et en abordant les écueils perceptifs documentés par la sémiologie graphique contemporaine, ce guide fournit aux chercheurs, analystes et ingénieurs de données les compétences requises pour transformer des flux de données complexes en visualisations analytiques irréprochables.
1. Fondements théoriques et conceptuels du graphique en aires avec Seaborn
1.1 Définition et taxonomie des graphiques en aires
D’un point de vue morphologique, le graphique en aires peut être appréhendé comme une extension bidimensionnelle directe du graphique linéaire conventionnel. Alors que la simple courbe cartésienne matérialise une trajectoire discrète ou continue en reliant des coordonnées ponctuelles par des segments infinitésimaux, l’aire remplit intégralement l’espace sous-jacent délimité par cette courbe et un axe de référence horizontal, généralement fixé à une valeur nulle. Cette matérialisation physique de la surface confère au tracé une charge sémiologique distincte : le regard n’interprète plus uniquement la pente ou la vitesse de variation d’un phénomène, mais intègre intuitivement le volume, la masse ou la magnitude globale de la grandeur mesurée.
La taxonomie de ces visualisations se décline traditionnellement en trois structures fondamentales. En premier lieu, le graphique en aires simples illustre l’évolution d’une unique variable quantitative continue en projetant sa surface sur l’axe des abscisses, renforçant l’impression d’accumulation d’une métrique isolée au fil du temps. En second lieu, le graphique en aires empilées superpose verticalement plusieurs séries temporelles : chaque strate successive s’appuie non pas sur l’axe zéro absolu, mais sur la frontière supérieure de la série qui la précède immédiatement. Cette architecture permet de lire simultanément la dynamique globale issue de la somme des strates et la contribution relative de chaque sous-composante. Enfin, le graphique en aires normalisées à 100 % contraint la somme cumulative de toutes les catégories à occuper une hauteur constante sur l’axe vertical, transformant l’affichage absolu en une distribution purement proportionnelle des parts relatives à chaque pas d’échantillonnage.
Sur le plan de l’ingénierie cognitive et de la perception humaine, conceptualisées notamment dans les travaux pionniers de William S. Cleveland et Robert McGill sur la hiérarchie des tâches graphiques élémentaires, l’évaluation des surfaces impose des contraintes de décodage spécifiques. Si l’œil humain excelle dans l’évaluation des positions relatives le long d’une échelle commune alignée — ce qui rend la lecture de la strate basale extrêmement précise —, il éprouve des difficultés systématiques à quantifier précisément l’évolution d’une strate médiane dont la ligne de base oscille au gré des variations des couches inférieures. La compréhension de ces biais perceptifs est impérative pour tout scientifique souhaitant employer l’aire empilée sans altérer la neutralité épistémique de ses données.
1.2 Synergie architecturale entre Seaborn et Matplotlib
Pour appréhender la mécanique d’implémentation sous Python, il est indispensable de comprendre la relation symbiotique qui unit Matplotlib et Seaborn. Développé initialement par John D. Hunter, Matplotlib constitue l’infrastructure graphique sous-jacente fondamentale du langage ; il s’agit d’un moteur de bas niveau conçu pour reproduire l’environnement matriciel de MATLAB, accordant un contrôle absolu mais verbeux sur chaque élément atomique du canevas, de la gestion des artistes polygonaux au positionnement des graduations. Seaborn, initié ultérieurement par Michael Waskom, a été pensé comme une surcouche de haut niveau visant à simplifier l’analyse exploratoire des données en intégrant des structures de données Pandas et en automatisant des opérations statistiques avancées telles que l’estimation de densité ou l’ajustement de régressions linéaires.
Dans ce paysage technique, la création d’un graphique en aires met en lumière cette complémentarité opérationnelle. Seaborn ne propose délibérément pas de fonction générique autonome pour les aires déterministes cumulatives, considérant que la primitive historique sous-jacente de Matplotlib satisfait pleinement les exigences mathématiques de projection géométrique. Le rôle de Seaborn consiste dès lors à transformer la restitution visuelle austère du moteur primaire grâce à son moteur thématique, ses palettes perceptuellement uniformes et sa gestion fine des grilles et contextes typographiques. L’analyste convoque ainsi les fonctions de tracé de surfaces vectorielles tout en baignant l’environnement d’exécution dans la configuration esthétique et sémantique de Seaborn.
Cette approche hybride garantit une flexibilité incomparable dans les flux de travail de la science des données. Elle permet à l’utilisateur de s’affranchir du code fastidieux de configuration des marges, des fontes et des contrastes chromatiques grâce aux fonctions de haut niveau de Seaborn, tout en conservant la liberté chirurgicale de manipulation offerte par les objets graphiques fondamentaux de Matplotlib. La maîtrise conjointe de ces deux bibliothèques permet d’éviter les abstractions restrictives et d’adapter précisément chaque composant du graphique aux exigences des comités de lecture académiques ou des tableaux de bord industriels.
1.3 Critères d’adéquation méthodologique du graphique en aires
L’application non discriminée du graphique en aires peut conduire à de graves distorsions d’interprétation ; son déploiement doit donc répondre à des critères méthodologiques stricts. Le prérequis fondamental réside dans la nature des variables mobilisées : l’axe horizontal doit impérativement représenter une variable d’intervalle ou d’échelle continue, le cas paradigmatique étant le temps physique séquencé en unités régulières (secondes, jours, trimestres, décennies). Les données discrètes ou catégorielles dépourvues d’ordre intrinsèque sont absolument proscrites sur cet axe, car la surface continue suggère une transition fluide et une interpolation fonctionnelle entre deux points successifs qui n’auraient aucun sens logique dans le cas de modalités qualitatives disjointes.
Un autre impératif réside dans la propriété d’additivité des grandeurs représentées. Pour qu’un empilement d’aires soit valide sur le plan sémiotique, il est nécessaire que la somme arithmétique des différentes séries possède une signification physique ou économique concrète. On peut légitimement empiler des volumes de production d’énergie exprimés en mégawatts-heures par filière technologique, car la surface cumulée représente la production énergétique totale d’un territoire. En revanche, empiler des taux d’intérêt, des moyennes de température ou des ratios d’efficacité relève de l’hérésie méthodologique, la somme de ces variables intensives n’ayant aucune consistance mathématique. De surcroît, les valeurs représentées doivent obligatoirement être positives ou nulles ; l’apparition de grandeurs négatives briserait la géométrie euclidienne de l’empilement ascendant, engendrant des chevauchements contradictoires et illisibles.
Enfin, le choix entre un graphique en aires empilées et un diagramme en barres empilées repose sur l’évaluation de la granularité temporelle. Lorsque le nombre de points d’échantillonnage le long de l’axe temporel est restreint (par exemple, trois années fiscales isolées), le diagramme en barres s’avère supérieur en préservant la discrétisation des périodes sans extrapolation abusive. À l’inverse, dès lors que la série chronologique s’étire sur des dizaines ou des centaines d’observations continues révélant une tendance macroscopique fluide, le graphique en aires s’impose comme le format optimal, supprimant la surcharge cognitive visuelle causée par la juxtaposition d’innombrables colonnes verticales disjointes.
2. Configuration de l’environnement Python et initialisation des modules
2.1 Installation et vérification des dépendances logicielles
La reproductibilité computationnelle d’une chaîne de visualisation statistique exige un contrôle rigoureux de l’écosystème logiciel. Le déploiement d’un environnement de travail adéquat pour la construction de visualisations fondées sur Seaborn nécessite l’installation conjointe de trois bibliothèques interdépendantes : Pandas pour l’ingestion, le nettoyage et la manipulation matricielle des données ; Matplotlib pour la gestion de l’infrastructure graphique vectorielle ; et Seaborn pour la gouvernance stylistique et statistique. L’installation de ces modules s’effectue usuellement via les gestionnaires de paquets standardisés de Python, tels que l’installateur pip ou la distribution scientifique Conda.
Il est fortement recommandé d’isoler ces composants au sein d’un environnement virtuel dédié, prévenant ainsi les conflits d’arborescence entre les versions des bibliothèques logicielles. L’évolution récente de Seaborn, notamment le passage à la version 0.12 et ultérieure, a profondément restructuré son API sous-jacente en intégrant une interface déclarative orientée objets tout en maintenant la rétrocompatibilité avec les scripts historiques. Il convient dès lors de s’assurer de la compatibilité des versions installées, en particulier vis-à-vis des versions de NumPy qui sous-tendent l’intégralité des calculs vectoriels d’interpolation polygonale.
Dans l’en-tête de tout script d’analyse, l’importation de ces outils obéit à des conventions communautaires universellement reconnues. On importe Matplotlib sous son sous-module pyplot en lui attribuant l’alias conventionnel plt, la bibliothèque Pandas sous l’alias pd, et Seaborn sous le diminutif historique sns — un hommage subtil au personnage de fiction Samuel Norman Seaborn de la série télévisée The West Wing. L’observance stricte de ces alias normalisés garantit la lisibilité immédiate du code source par l’ensemble de la communauté scientifique internationale.
2.2 Application des styles et contextes visuels Seaborn
La supériorité immédiate de Seaborn sur les tracés natifs de Matplotlib réside dans son architecture de contrôle global de l’apparence des figures. Par défaut, Matplotlib applique des choix graphiques hérités des standards informatiques du début des années 2000, caractérisés par des bordures épaisses, des fonds d’écran uniformément blancs dépourvus de repères et des contrastes typographiques peu harmonieux. Seaborn pallie cette lacune par l’intermédiaire de fonctions d’initialisation thématique globale, au premier rang desquelles figure la méthode fondamentale de configuration du thème de l’environnement.
L’exécution de cette fonction maîtresse permet d’instancier un ensemble cohérent de paramètres régissant l’espacement des lignes de repère, la nuance des bordures et la typographie. Seaborn décline son univers en plusieurs styles canoniques : le style whitegrid, particulièrement plébiscité dans les publications académiques pour la discrétion de ses lignes grises facilitant la lecture des coordonnées sans alourdir le support ; le style darkgrid, idéal pour l’exploration interactive sur écran numérique ; ainsi que les styles minimalistes ticks, white et dark, adaptés aux figures nécessitant une sobriété absolue. L’appel à la fonction permet en outre de basculer l’ensemble des graphiques ultérieurs sur ces normes typographiques sans nécessiter de redéfinition manuelle récurrente.
Conjointement au style de fond, Seaborn introduit la notion de contexte visuel d’affichage, paramétrable via une fonction dédiée d’échelle contextuelle. Cette fonctionnalité recalibre proportionnellement la taille des étiquettes d’axes, l’épaisseur des traits de graduation, la taille des points et la graisse des titres selon le médium de destination. Les contextes prédéfinis incluent le format paper pour les manuscrits scientifiques imprimés, le format notebook pour la recherche interactive sur calepin électronique, le format talk pour les projections lors de colloques et le format poster pour les affichages grand format. En manipulant ces contextes, le chercheur s’assure que son graphique en aires conserve une lisibilité optimale indépendamment de sa résolution ou de son échelle finale de diffusion.
2.3 Gestion des conteneurs graphiques Matplotlib
Bien que Seaborn pilote l’environnement stylistique, l’instanciation de la surface de tracé géométrique demeure l’apanage des objets conteneurs de Matplotlib. Une pratique de programmation rigoureuse impose de rompre avec l’interface d’état implicite de pyplot au profit de l’approche orientée objet, qui dissocie explicitement l’objet Figure — matérialisant l’ensemble de la fenêtre, de la toile ou du fichier de sortie — et l’objet Axes, incarnant la zone rectangulaire délimitée par les échelles où les données sont concrètement projetées.
L’instanciation de ces conteneurs s’effectue canoniquement par l’intermédiaire de la méthode de création de sous-figures, laquelle retourne simultanément le tuple constitué de la figure globale et de l’axe (ou de la matrice d’axes) d’affichage. Dès cette phase inaugurale, deux paramètres déterminants doivent être scrupuleusement calibrés : les dimensions physiques de la figure, classiquement stipulées en pouces par un tuple de largeur et de hauteur, et la résolution spatiale intrinsèque mesurée en points par pouce (dots per inch ou DPI). Pour un travail exploratoire régulier sur moniteur haute densité, une résolution modérée de cent points par pouce s’avère fluide et économique en mémoire vive, tandis qu’une publication finale exigera une densité supérieure.
Cette structuration orientée objet offre un contrôle granulaire sur l’empilement des couches. L’attribution explicite de l’axe de tracé comme cible de toutes les opérations ultérieures évite les effets de bord fréquents lors de la génération séquentielle de plusieurs dizaines de figures au sein d’un même pipeline d’ingénierie de données. Elle garantit que chaque méthode de dessin viendra s’ancrer précisément sur l’espace vectoriel désigné sans interférer avec les états antérieurs du moteur de rendu.
3. Préparation et structuration rigoureuse des données sous Pandas
3.1 Structure en format large (Wide Format) requise
La phase d’ingestion et de prétraitement des données sous Pandas est sans conteste l’étape la plus critique du flux d’ingénierie, conditionnant directement la faisabilité algorithmique du graphique en aires. Contrairement à de nombreuses fonctions statistiques de Seaborn qui attendent des collections au format long (également désigné sous l’appellation de format Tidy Data selon les préceptes formulés par Hadley Wickham dans le Journal of Statistical Software), les fonctions d’empilement cumulatif vectoriel requièrent structurellement un format large (Wide Format) pour leur calcul géométrique d’accumulation verticale.
Dans un arrangement au format large, la matrice de données est organisée de telle sorte que chaque colonne individuelle représente une variable ou une sous-composante catégorielle distincte du phénomène observé, tandis que les lignes successives traduisent le déroulement temporel ou séquentiel de l’axe des abscisses. Ainsi, si l’on souhaite modéliser la consommation énergétique par filière (solaire, éolien, nucléaire, hydraulique) sur une période de dix années échantillonnée mensuellement, la structure de données idéale doit comporter une colonne d’indexation chronologique associée à quatre colonnes numériques distinctes hébergeant les valeurs absolues respectives de chaque technologie.
Cette topologie matricielle permet de traiter les séries non pas comme un flux d’observations isolées accompagnées d’étiquettes qualitatives, mais comme un ensemble de vecteurs unidimensionnels synchronisés sur une même base d’abscisses. Chaque série temporelle devient une tranche de coordonnées verticales directes pouvant être projetée séquentiellement par les algorithmes de remplissage de polygones. L’alignement dimensionnel strict de ces vecteurs constitue la condition préalable indispensable pour prévenir tout décalage d’échantillonnage lors du calcul de la somme cumulative des hauteurs sur l’axe des ordonnées.
3.2 Transformation de données depuis un format long avec pivot_table
Dans la pratique analytique contemporaine, les bases de données relationnelles, les fichiers transactionnels et les architectures d’entrepôts de données délivrent quasi systématiquement des enregistrements sous forme normalisée longue. Chaque ligne de table représente alors un tuple unitaire consignant un identifiant temporel, une étiquette de groupe catégorielle et une mesure numérique. Pour rendre ces données exploitables par un algorithme d’empilement d’aires, une étape de reconfiguration morphologique s’impose au moyen de la méthode de pivotement de tables de Pandas.
L’opération de pivotement consiste à redistribuer les modalités de la colonne catégorielle pour les transposer en autant d’en-têtes de colonnes indépendantes, tout en indexant la table résultante sur la variable temporelle continue. Durant cette transformation, une fonction d’agrégation mathématique doit être explicitement définie afin de gérer les éventuels doublons temporels pour une même modalité ; par défaut, la moyenne arithmétique ou la somme intégrale est appliquée. Si plusieurs mesures ont été enregistrées pour une même sous-catégorie à un instant donné, l’agrégation garantit l’unicité de la valeur résultante pour chaque intersection de ligne et de colonne.
Un aspect méthodologique fondamental lors de cette transposition réside dans la gestion de la continuité de l’index chronologique. L’opération de pivotement peut révéler des lacunes temporelles intrinsèques aux données brutes, se matérialisant par des pas d’échantillonnage asymétriques. L’analyste doit veiller à réindexer la série sur un intervalle temporel continu, en s’assurant que chaque date ou période possède une ligne dédiée. Cette rigueur structurelle évite les discontinuités de pente artificielles lors du raccordement des coordonnées polygonales par le moteur graphique.
3.3 Contrôle de la qualité et intégrité numérique des données
L’intégrité sémiotique d’un graphique en aires dépend directement de l’homogénéité et de la propreté arithmétique des séries injectées. La première vérification à opérer concerne la détection et le traitement des valeurs nulles, manquantes ou non définies (les valeurs Not a Number sous l’acronyme standard NaN). Dans un graphique linéaire standard, une valeur manquante se traduit simplement par une interruption locale de la ligne continue ; en revanche, dans un algorithme de calcul cumulatif d’aires empilées, la présence d’une seule valeur manquante à l’instant t engendre une indétermination mathématique qui contamine l’ensemble des strates supérieures, provoquant l’effondrement visuel brutal de toute la colonne de pixels correspondante.
La deuxième exigence de conformité numérique porte sur la stricte positivité des grandeurs enregistrées. La sémantique de l’aire empilée postule géométriquement que la frontière supérieure de la strate k est égale à la somme des valeurs des strates 1 à k. L’introduction impromptue d’une valeur négative entraîne une inversion locale du vecteur d’accumulation : la frontière supérieure redescend en dessous de la strate précédente, créant un phénomène d’auto-intersection polygonale et de superposition visuelle incohérente que le moteur de rendu ne peut résoudre sans introduire de graves artefacts de masquage.
Enfin, le contrôle de qualité impose une vérification rigoureuse des types de données sous-jacents au sein des structures Pandas. Les colonnes destinées à l’empilement doivent être impérativement converties en types numériques à virgule flottante ou entiers stricts (float64 ou int64), éliminant toute chaîne de caractères dissimulée qui bloquerait la vectorisation mathématique. L’axe des abscisses, quant à lui, doit faire l’objet d’un tri séquentiel strictement monotone et croissant. Une série temporelle non ordonnée chronologiquement provoquerait des retours en arrière géométriques dans le tracé des segments, transformant le graphique en un entrelacs chaotique de surfaces polygonales inintelligibles.
4. Syntaxe fondamentale et implémentation du premier graphique en aires
4.1 Analyse détaillée de la fonction plt.stackplot
Le cœur de l’implémentation algorithmique d’un graphique en aires en environnement Python repose sur l’appel à la fonction d’empilement vectoriel fournie par l’interface pyplot de Matplotlib, désignée sous l’appellation générique stackplot. Cette fonction a été spécifiquement conçue pour automatiser le calcul itératif des sommes cumulatives et générer les polygones fermés correspondants en une seule passe d’exécution, déchargeant ainsi l’analyste de l’implémentation manuelle d’algorithmes géométriques de remplissage entre courbes.
La signature de la méthode requiert en tout premier lieu un argument désignant les coordonnées de l’axe horizontal x, qui peut se matérialiser sous la forme d’un tableau unidimensionnel, d’une série Pandas ou d’un index temporel monotone. Les arguments subséquents représentent les séries de données numériques y constitutives de l’empilement vertical. Ces séries peuvent être transmises de deux manières alternatives : soit sous la forme d’une énumération de vecteurs positionnels distincts de même longueur que x, soit sous la forme d’une matrice bidimensionnelle ou d’un tableau structuré dont chaque ligne ou colonne correspond à une strate élémentaire.
Sur le plan mécanique interne, la fonction exécute une somme cumulative discrète. Si l’on désigne par y_k(x) la valeur de la k-ième série au point d’abscisse x, la bordure inférieure de la première strate coïncide avec la droite d’équation y=0, et sa bordure supérieure est délimitée par la courbe d’équation y=y_1(x). Pour la deuxième strate, la base d’appui est constituée par la courbe y=y_1(x), tandis que son plafond s’établit à y=y_1(x) + y_2(x). De proche en proche, la k-ième strate occupe l’espace géométrique compris entre la somme cumulée des k-1 premières strates et la somme cumulée des k premières strates. L’algorithme instancie ensuite des objets de type PolyCollection qui sont intégrés à l’axe de coordonnées pour le rendu matriciel.
4.2 Étude pas à pas de l’exemple initial d’évolution d’équipes
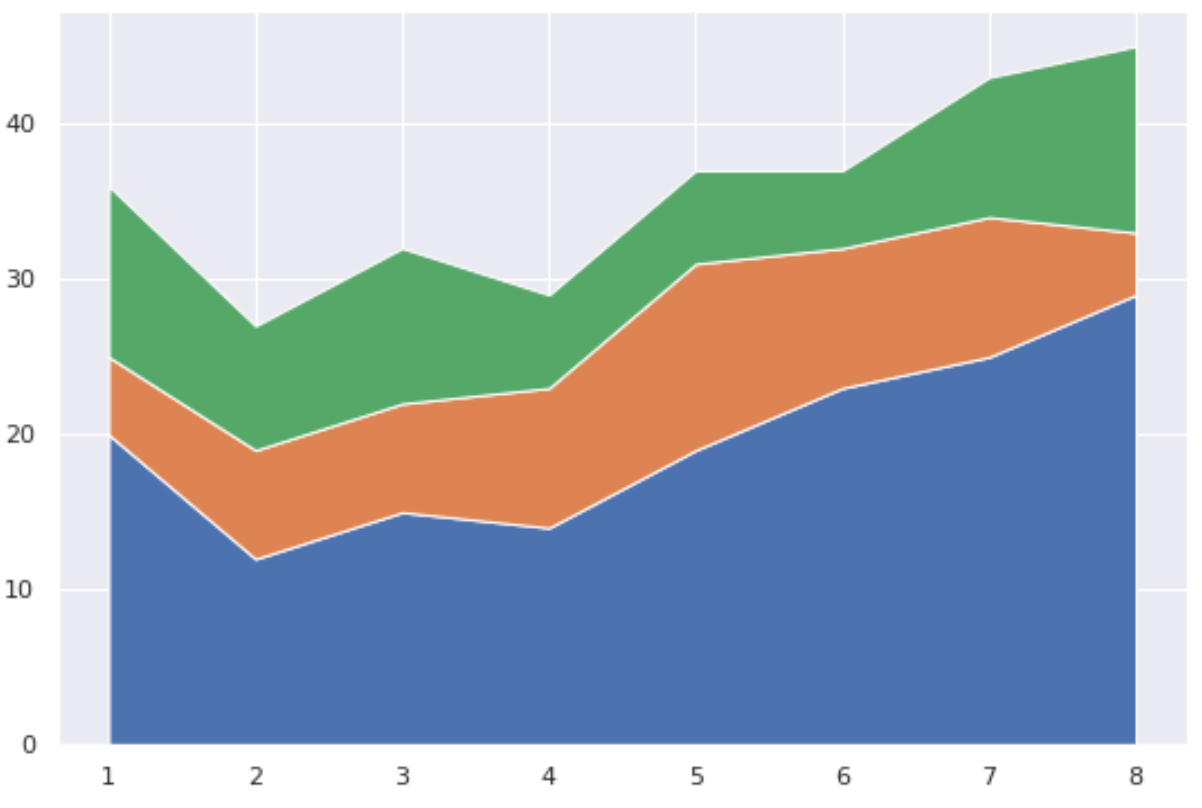
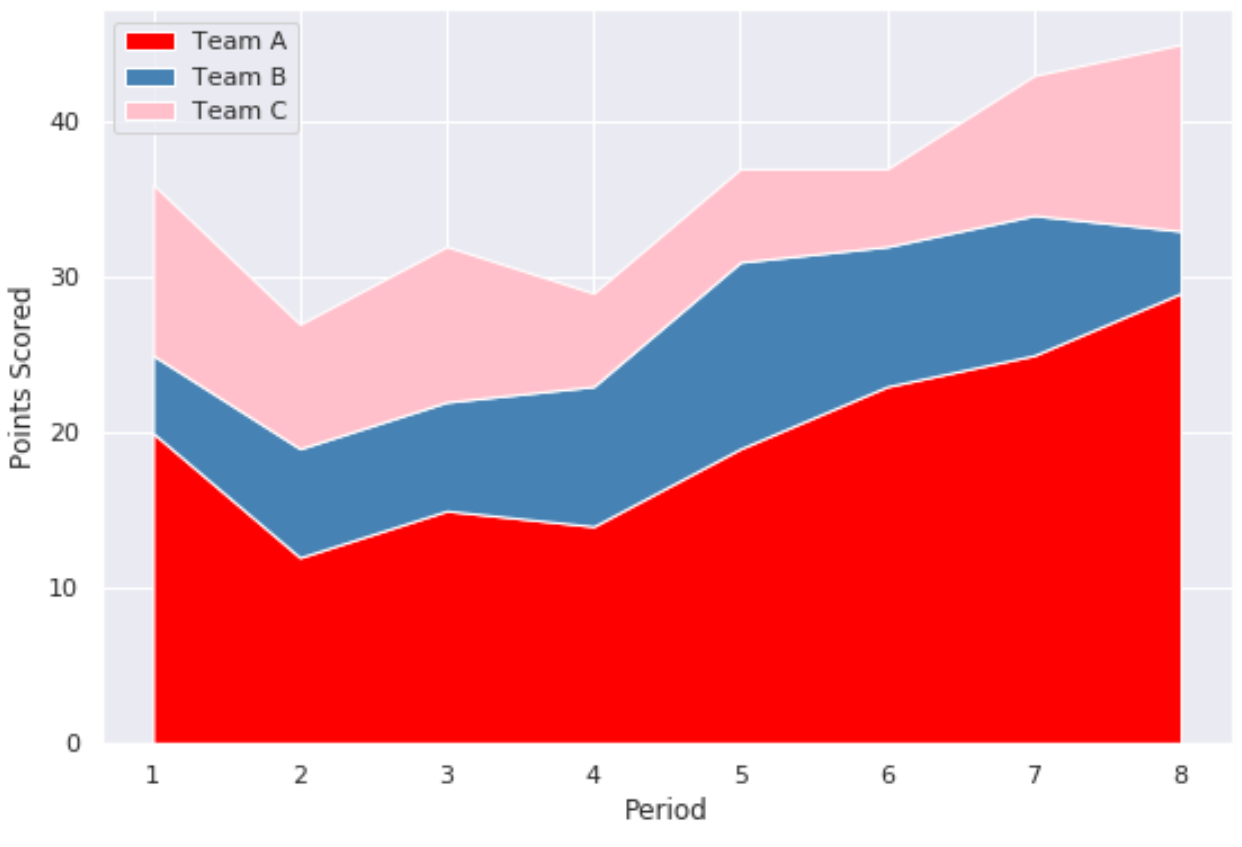
Afin de concrétiser cette mécanique dans un scénario expérimental tangible, considérons un protocole d’observation mesurant les performances ou les scores cumulatifs de trois équipes distinctes — conventionnellement dénommées Équipe Alpha, Équipe Bêta et Équipe Gamma — suivies à travers huit périodes d’évaluation successives. Les données sont agrégées dans une structure Pandas au format large, où la première colonne recense les identifiants séquentiels des périodes temporelles, flanquée de trois colonnes numériques abritant les scores positifs respectifs de chaque collectif.
Le déroulement opératoire du script débute par l’invocation de la fonction d’application du style Seaborn afin de configurer l’arrière-plan avec une grille claire et discrète. L’opérateur initialise ensuite formellement l’objet Figure et l’objet Axes via la méthode de sous-figures en spécifiant une dimension standardisée, par exemple dix pouces de largeur par six pouces de hauteur. Cette phase préparatoire garantit un canevas vectoriel parfaitement calibré avant toute projection géométrique.
Le tracé proprement dit s’opère en fournissant à la méthode d’empilement l’axe chronologique de la table pour le paramètre horizontal, suivi successivement des séries de scores de chaque équipe extraites de l’objet tabulaire sous forme de vecteurs. L’exécution de cette instruction génère instantanément la superposition des trois strates polygonales. L’instruction finale de restitution visuelle permet d’afficher la scène sur le moniteur interactif ou d’en libérer l’allocation mémoire dans le cadre d’un script exécuté en ligne de commande batch.
4.3 Évaluation du rendu visuel par défaut
L’observation critique du graphique brut obtenu à l’issue de cette première exécution sans personnalisation additionnelle révèle immédiatement les limites fonctionnelles d’une démarche purement mécanique et met en exergue les défis de la communication scientifique. Bien que la géométrie générale des surfaces cumulées soit rigoureusement exacte sur le plan calculatoire, la figure souffre d’un déficit d’expressivité sémantique qui en interdit l’usage direct dans un rapport d’expertise ou un article soumis à révision par les pairs.
En premier lieu, la distribution chromatique par défaut s’appuie sur le cycle de nuances standard de la bibliothèque graphique sous-jacente. Si ces couleurs primaires présentent un contraste suffisant sur un écran calibré, elles manquent souvent d’harmonie tonale, peuvent saturer l’attention visuelle et ne sont généralement pas optimisées pour les lecteurs atteints de déficiences de la vision des couleurs. De surcroît, les strates sont tracées sous forme d’aplats uniformes avec une opacité totale de 100 %, sans aucune ligne de démarcation supérieure contrastée, ce qui rend difficile l’appréciation des micro-variations de pente le long des frontières de contact entre les équipes superposées.
En second lieu, le graphique élémentaire brille par son absence totale de métadonnées descriptives : l’axe des ordonnées n’indique aucune unité de mesure physique ou comptable, l’axe horizontal se contente d’afficher des index numériques anonymes sans ancrage temporel explicite, et aucune légende ne permet d’associer une surface polygonale à une équipe donnée. Cette configuration brute illustre parfaitement le fossé qui sépare la simple génération d’une forme géométrique par un interpréteur informatique de l’élaboration d’une figure de visualisation scientifique dotée d’une réelle portée cognitive et heuristique.
5. Personnalisation esthétique : Palettes chromatiques et transparence
5.1 Sélection et injection des palettes de couleurs Seaborn
L’apport qualitatif déterminant de Seaborn dans le processus d’élaboration d’un graphique en aires réside dans la sophistication de son système de gestion des couleurs. La bibliothèque met à disposition un catalogue étendu de palettes colorimétriques conçues selon des critères de régularité perceptuelle, garantissant que la distance euclidienne perçue entre deux nuances correspond fidèlement à l’écart statistique entre les données qu’elles représentent. Pour assigner ces tonalités à un empilement géométrique, la démarche consiste à extraire un échantillon discret de codes hexadécimaux ou de tuples RVB au moyen de la méthode d’extraction de palette de Seaborn.
Le choix de la palette doit être rigoureusement subordonné à la nature taxonomique des données représentées. Dans le cadre de sous-composantes nominales sans hiérarchie intrinsèque — comme différentes équipes de recherche, pays ou gammes de produits —, l’analyste privilégiera des palettes qualitatives réputées pour leur équilibre, à l’instar des jeux de teintes tab10, Set2 ou husl. Si les strates traduisent une gradation ordinale ou une intensité progressive (par exemple des tranches de gravité clinique ou des segments d’âge consécutifs), l’usage d’une palette séquentielle monotone telle que Blues, viridis ou rocket s’impose pour guider intuitivement l’interprétation de la hiérarchie structurelle.
Une fois la liste chromatique générée pour un nombre de teintes strictement identique au nombre de strates empilées, cette structure itérable est directement injectée dans l’appel à la fonction d’empilement via son paramètre d’attribution des couleurs. Dès cet instant, l’austérité géométrique originelle cède la place à un dégradé spatial contrôlé, aligné sur les canons esthétiques de l’édition scientifique internationale et assurant une différenciation visuelle immédiate des surfaces en contact.
5.2 Ajustement de l’opacité et séparation des strates
La lisibilité d’une superposition d’aires peut être considérablement dégradée par l’effet de saturation provoqué par des aplats de couleurs opaques juxtaposés. Pour aérer la composition visuelle et faciliter l’intégration de la grille d’arrière-plan dans le champ de vision de l’observateur, l’application d’un coefficient de transparence alpha représente un levier d’optimisation ergonomique précieux. Configuré sur une valeur décimale comprise entre 0.7 et 0.85, ce paramètre atténue la lourdeur des pigments tout en maintenant un contraste suffisant pour distinguer les transitions sans affadir les teintes maîtresses.
Cependant, l’introduction de transparence peut estomper la netteté de la frontière supérieure de chaque strate, en particulier lorsque deux nuances adjacentes présentent des luminosités relatives similaires. Pour pallier cet inconvénient sans restaurer l’opacité totale, une technique avancée consiste à tracer délibérément une fine ligne de contour au sommet de chaque couche. Cette opération est réalisée en surimposant, immédiatement après l’empilement, une série de tracés linéaires continus à l’aide de la méthode plot de Matplotlib, en utilisant pour chaque ligne la somme cumulative correspondante.
Ces bordures structurales, tracées avec une épaisseur infinitésimale de l’ordre de 0.8 à 1.5 point et parées d’une nuance légèrement plus sombre ou d’un blanc pur éclatant, délimitent impeccablement les surfaces polygonales. Elles confèrent à la visualisation un aspect architectural haut de gamme, permettant à l’œil d’isoler instantanément le profil cinématique propre à chaque sous-composante tout en appréciant la masse volumique de la strate sous-jacente.
5.3 Configuration des grilles et du cadrage spatial
Le traitement des marges et du cadrage spatial conditionne la rigueur géométrique ressentie lors de la lecture d’une figure. Par conception intrinsèque, un graphique en aires illustre une quantité mesurable reposant sur une base d’origine ; il est par conséquent inadmissible d’observer un espace vide flottant entre l’axe horizontal inférieur et la strate basale. L’analyste doit impérativement verrouiller les limites de l’axe vertical pour faire coïncider son origine strictement avec le zéro absolu au moyen de la méthode de limitation d’échelle verticale.
De même, sur l’axe horizontal, les fonctions de tracé de base ont tendance à introduire un rembourrage marginal artificiel de part et d’autre des points d’échantillonnage extrêmes. Pour obtenir un rendu professionnel où l’aire s’étend harmonieusement d’un bord à l’autre du cadre graphique, il convient de forcer les limites horizontales en leur assignant très précisément les valeurs minimale et maximale de l’index temporel observé. Cette suppression du gaspillage spatial amplifie la portée dynamique de la série chronologique.
Enfin, l’épuration des bordures périphériques participe au désencombrement cognitif de la figure. Seaborn propose une méthode élégante d’élagage des bordures — la fonction despine — qui permet d’éradiquer d’un seul appel les segments rectangulaires supérieur et droit de la boîte de coordonnées, conservant uniquement les axes porteurs d’information fonctionnelle à gauche et en bas. La grille d’arrière-plan, calibrée avec une intensité lumineuse subtile et des lignes pointillées discontinues, offre des points d’ancrage visuels pour l’estimation mentale des ordonnées sans jamais rivaliser avec la primauté perceptive des surfaces polygonales au premier plan.
6. Intégration de légendes explicites et étiquetage scientifique
6.1 Attribution sémantique des labels de données
Un tracé géométrique dépourvu d’identification textuelle explicite constitue une énigme sémiotique sans valeur démonstrative. Dans la fonction d’empilement vectoriel, l’association entre les surfaces polygonales et leur dénomination sémantique s’effectue au moyen de l’argument d’étiquetage labels. Ce paramètre attend une collection ordonnée de chaînes de caractères dont la longueur et la disposition séquentielle doivent correspondre exactement à l’ordre des séries injectées dans l’opération d’empilement.
Dans le cadre d’un flux de travail rigoureux articulé autour de Pandas, ces libellés sont avantageusement extraits de manière programmatique à partir des en-têtes de colonnes du DataFrame source. Cette extraction dynamique élimine tout risque d’erreur humaine de transcription manuelle et garantit la mise à jour automatique des textes en cas de modification de la structure de données amont. Il est primordial de s’assurer que l’ordre des intitulés transmis à la fonction reflète fidèlement la disposition verticale de bas en haut des strates physiques tracées sur le canevas.
Cette rigueur d’affectation constitue la condition préalable indispensable pour que le moteur graphique puisse générer les métadonnées internes qui seront ultérieurement interceptées par le constructeur de légende. Sans la transmission formelle de cette liste de labels au moment exact de l’instanciation des polygones, les appels ultérieurs aux fonctions de génération de légendes resteront infructueux ou afficheront des avertissements de conteneurs vides dans le terminal d’exécution.
6.2 Positionnement et stylisation de la légende
La disposition spatiale de la légende soulève des arbitrages ergonomiques déterminants dans les graphiques en aires. Dans les graphiques linéaires classiques, la boîte de légende est fréquemment logée à l’intérieur de l’espace de tracé, exploitant une zone de vide géométrique laissée vacante par les courbes. En revanche, un graphique en aires cumulées présente par nature une occupation de surface dense et ascendante qui rend le positionnement interne de la légende particulièrement périlleux : celle-ci risque immanquablement de masquer une inflexion critique ou de chevaucher une frontière de strate.
La bonne pratique académique impose d’ancrer la légende à l’extérieur de la surface active de projection des données. Matplotlib offre pour cela l’argument de boîte d’ancrage délimitée (bbox_to_anchor), combiné avec le paramètre de localisation spatiale. En définissant des coordonnées normalisées excédant l’unité (par exemple une position horizontale de 1.02 couplée à un alignement vertical sommital), la légende est déportée avec précision dans la marge latérale droite du graphique, préservant ainsi l’intégralité du champ de lecture de la zone polygonale.
Pour parfaire l’esthétique de cet élément d’orientation cognitive, plusieurs paramètres complémentaires méritent d’être minutieusement ajustés. L’opérateur peut structurer la légende sur une ou plusieurs colonnes via le paramètre de distribution colonnaire, supprimer les bordures opaques encombrantes au profit d’un cadre allégé ou inexistant, et uniformiser la police typographique sur le standard formel du manuscrit en cours de rédaction. De surcroît, il est vivement recommandé d’inverser l’ordre des éléments au sein de la légende pour faire correspondre visuellement le premier label de la liste avec la strate sommitale de l’empilement graphique, rétablissant ainsi une parfaite congruence directionnelle de haut en bas entre le texte et l’image.
6.3 Documentation rigoureuse des axes et du titre
L’appareil documentaire textuel ceinturant le graphique en aires assoit sa validité scientifique en contextualisant rigoureusement les métriques visualisées. L’intitulé de la figure ne doit pas se réduire à une mention lapidaire ou triviale, mais formuler explicitement la nature de la relation représentée, la population d’étude considérée ainsi que la couverture spatio-temporelle de l’échantillon. L’usage d’une hiérarchie typographique distinguant un titre principal mis en exergue et un sous-titre descriptif plus discret constitue une norme stylistique hautement recommandable.
La labellisation des axes orthogonaux répond à des impératifs d’exactitude mathématique stricts. L’axe des ordonnées doit impérativement comporter le nom complet de la variable d’accumulation accompagné de son unité de mesure physique, dimensionnelle ou financière standardisée, conventionnellement formalisée entre crochets ou parenthèses (par exemple : Débit volumique cumulé [m³/s] ou Consommation électrique consolidée [GWh]). L’omission de cette indication dimensionnelle expose l’auteur à des contresens majeurs de la part des relecteurs.
Quant à l’axe des abscisses, son étiquetage doit lever toute ambiguïté sur l’échelle temporelle mobilisée, en précisant le format calendaire appliqué (mois calendaires, trimestres fiscaux ou années écoulées depuis le début d’une phase de test unitaire). L’insertion éventuelle d’une note de bas de figure méthodologique, ancrée discrètement en bas à droite de la composition générale via la commande d’annotation textuelle globale de la figure, offre l’espace nécessaire pour consigner les sources primaires des données ainsi que les protocoles de redressement statistique mis en œuvre lors du traitement préalable.
7. Création d’un graphique en aires normalisé à 100 %
7.1 Fondement mathématique de la normalisation relative
Tandis que le graphique en aires empilées classique se focalise sur l’accumulation de volumes absolus, des situations d’analyse quantitative fréquentes exigent de s’abstraire des variations de magnitude globale pour étudier exclusivement la dynamique structurelle des parts relatives au sein d’un tout. Cette nécessité épistémologique donne naissance au graphique en aires normalisé à 100 %, dont la bordure supérieure forme une ligne d’horizon invariante, rectiligne et parfaitement horizontale, étalonnée sur la totalité intégrale de 100 % (ou 1.0 en échelle unitaire).
Sur le plan mathématique formel, la normalisation implique une transformation matricielle élémentaire mais rigoureuse exécutée sur l’ensemble de l’espace de données. Soit une matrice de mesures dont l’élément x_(i,j) caractérise la grandeur observée pour la j-ième sous-composante temporelle à l’instant séquentiel i. La première étape algorithmique consiste à calculer le vecteur des sommes transversales par ligne, où chaque composante S_i est définie par la somme arithmétique de toutes les valeurs j répertoriées pour cet instant i.
La seconde phase consiste à générer la matrice des proportions relatives p_(i,j) en divisant chaque cellule d’origine par le terme sommatoire de sa ligne respective. Cette opération de projection assure que, pour chaque ligne temporelle i, la somme des composantes relatives p_(i,j) est rigoureusement et invariablement égale à 1. La multiplication scalaire de cette matrice résultante par la constante 100 permet ensuite de convertir directement ces fractions unitaires en pourcentages statistiques explicites prêts à être ingérés par le moteur de tracé géométrique.
7.2 Implémentation sous Python avec Pandas et Seaborn
L’implémentation algorithmique de cette transformation mathématique sous Python est remarquablement concise et performante grâce aux capacités de diffusion matricielle (broadcasting) nativement supportées par la structure de données DataFrame de Pandas. Supposons un jeu de données au format large hébergeant des séries chronologiques d’allocation budgétaire par département ministériel, indexé par les millésimes de dépenses.
L’analyste extrait en premier lieu le sous-ensemble de colonnes purement numériques et applique la méthode de sommation le long de l’axe transversal horizontal (axis=1) pour générer la série des totaux périodiques. La division normalisatrice est ensuite exécutée via la méthode arithmétique vectorisée divide de l’objet tabulaire, en lui transmettant le vecteur des sommes transversales et en assignant formellement l’axe de projection vertical (axis=0). Une multiplication scalaire par cent parachève la transformation en assignant à chaque cellule sa part relative en pourcentage.
La matrice résultante est alors immédiatement transmise à la primitive d’empilement vectoriel de Matplotlib, accompagnée des étiquettes et des palettes chromatiques harmonieuses issues de Seaborn. Le tracé généré se distingue par une horizontalité absolue de sa démarcation supérieure, offrant une lisibilité immédiate des phénomènes de substitution, de cannibalisation de parts de marché ou de transition de mix énergétique, affranchis de l’influence perturbatrice de l’expansion ou de la contraction du volume total.
7.3 Formatage professionnel de l’axe des pourcentages
Pour conférer à la visualisation normalisée un niveau d’excellence digne des revues scientifiques les plus exigeantes, le traitement de l’axe des ordonnées requiert une attention particulière. Par défaut, l’axe vertical affiche de simples entiers arithmétiques échelonnés de zéro à cent. Il incombe à l’analyste de formater ces repères pour signaler sans ambiguïté la nature fractionnaire de la mesure, au moyen du module de formatage d’axes spécialisé de Matplotlib (matplotlib.ticker).
L’importation de la classe de formatage de pourcentages permet d’instancier un opérateur de chaîne qui adjoint automatiquement le symbole typographique du pourcentage à chaque graduation majeure de l’axe. En configurant cet opérateur pour travailler sur une base d’échelle centésimale, les graduations se parent d’étiquettes formelles et élégantes sans nécessiter de conversion textuelle manuelle préalable qui dénaturerait les propriétés d’interpolation de l’axe.
Parallèlement, les bornes de l’échelle d’affichage verticale doivent être impérativement verrouillées sur l’intervalle fermé [0, 100] via la méthode de bornage d’axe vertical. Tout flottement visuel laissant apparaître une marge résiduelle en dessous de zéro ou au-dessus de cent briserait la convention cognitive fondamentale selon laquelle la boîte de tracé circonscrit l’intégralité absolue du système physique étudié. Le positionnement maîtrisé d’intervalles de graduation réguliers (par exemple tous les vingt pour cent) garantit un calibrage visuel équilibré de l’espace graphique.
8. Application empirique : Visualisation de données longitudinales et comportementales
8.1 Conception d’un jeu de données expérimental complexe
Afin de mettre à l’épreuve l’ensemble des concepts théoriques et architecturaux exposés dans un cadre empirique réaliste, nous concevons un scénario de recherche simulant une étude longitudinale en psychologie cognitive et en ergonomie du travail. L’expérimentation vise à quantifier la dynamique de la charge mentale et de l’allocation des ressources attentionnelles chez un groupe de sujets soumis à un protocole de résolution de crises complexes au sein d’un simulateur opérationnel pendant une session continue de cent vingt minutes, échantillonnée minute par minute.
L’architecture cognitive modélisée postule l’existence de quatre composantes concurrentes dont la somme représente l’effort mental total déployé : le traitement perceptif des signaux visuels, l’analyse stratégique et la prise de décision, la communication et coordination verbale avec l’équipe, ainsi que la charge parasite liée au stress et à la fatigue cumulative. Ce scénario produit des séries temporelles fortement corrélées mais soumises à des ruptures de régime franches (induites par l’apparition soudaine d’incidents critiques dans le simulateur), idéales pour évaluer la réactivité graphique de l’empilement d’aires.
La synthèse des données sous Pandas s’appuie sur la génération d’un vecteur chronologique unitaire articulé autour d’une indexation temporelle minute par minute, couplé à des fonctions mathématiques combinant des oscillations harmoniques représentatives des cycles de travail, des sauts de marche traduisant l’impact des pannes injectées et une dérive tendancielle ascendante incarnant l’épuisement cognitif. Le DataFrame structuré en format large qui en résulte constitue un support d’une grande rigueur méthodologique pour un déploiement de visualisation analytique avancée.
8.2 Exécution d’un script complet de visualisation avancée
La concrétisation de cette étude expérimentale se matérialise par l’exécution d’un script de visualisation complet mobilisant l’ensemble de la chaîne méthodologique consolidée. L’environnement graphique est initialisé en sélectionnant le style de fond blanc tramé de Seaborn, assorti d’une échelle contextuelle calibrée pour un manuscrit académique standard. L’analyste convoque une palette chromatique perceptuellement ordonnée et exempte de distorsion visuelle, à l’instar de la palette mako ou viridis, afin de refléter la parenté structurelle des composantes cognitives mesurées.
Le script pilote le tracé vectoriel des surfaces par le biais de la fonction d’empilement cumulatif en alimentant les arguments avec l’axe temporel continu et les quatre séries de charge attentionnelle. Une transparence subtile est appliquée aux polygones, instantanément soulignée par des lignes de crête blanches tracées chirurgicalement sur chaque frontière d’accumulation afin de mettre en valeur les micro-dérivées temporelles de chaque modalité. L’axe des abscisses est restreint aux limites exactes de la session d’évaluation, bannissant toute vacuité marginale.
Pour parachever l’impact démonstratif de la figure, le script procède à l’insertion d’annotations textuelles ponctuelles au moyen de la méthode spécialisée d’annotation vectorielle de Matplotlib. Une flèche directionnelle élégante et effilée vient désigner avec exactitude le point de rupture temporelle correspondant à la soixantième minute, explicitant le basculement soudain de la charge vers la composante communicative lors du déclenchement de l’avarie simulée. Une légende harmonieuse, déportée sur le flanc extérieur droit et réordonnée de haut en bas selon la topologie des strates, confère à l’ensemble une lisibilité et une puissance d’argumentation scientifique exemplaires.
8.3 Interprétation analytique et risques d’illusions visuelles
L’observation analytique du graphique en aires cumulées ainsi finalisé exige une grande lucidité épistémologique quant aux biais d’interprétation inhérents à ce mode de représentation. Le phénomène cognitif majeur documenté par la sémiologie graphique contemporaine réside dans l’effet perturbateur de la ligne de base flottante pour l’ensemble des strates situées au-dessus du premier niveau d’empilement basal. Alors que la strate inférieure relative au traitement perceptif repose sur la droite d’équation y=0 — permettant une estimation exacte et directe des amplitudes de variation via la hauteur absolue —, la deuxième strate relative à l’analyse stratégique subit intégralement les ondulations de la couche sous-jacente.
Cette oscillation de la base engendre une illusion visuelle fréquente : l’observateur non averti a tendance à évaluer l’épaisseur d’une strate en mesurant la distance la plus courte entre ses deux courbes frontières (la distance orthogonale à la pente locale) plutôt que la distance verticale stricte le long de l’axe des ordonnées. Lorsque la pente générale de l’empilement s’accentue brutalement, la distance orthogonale rétrécit visuellement, conduisant le cerveau humain à sous-estimer dramatiquement la magnitude réelle de la grandeur étudiée à cet instant précis.
Pour atténuer l’impact de cette distorsion géométrique dans les restitutions académiques, deux règles prudentielles doivent être scrupuleusement observées. D’une part, il convient de toujours positionner sur la base du graphique (au premier niveau d’empilement) la catégorie présentant l’évolution la plus stable et la plus critique pour l’analyse, afin de maximiser la précision de lecture sur cette composante maîtresse. D’autre part, si l’objectif principal de la recherche réside dans la comparaison minutieuse des profils cinématiques internes de chaque sous-composante plutôt que dans l’appréciation du volume cumulatif global, l’analyste doit avoir l’honnêteté méthodologique de doubler le graphique en aires d’un panneau de graphiques linéaires multiples juxtaposés (small multiples), où chaque série est tracée indépendamment sur une échelle alignée.
9. Gestion des séries temporelles avancées et valeurs manquantes
9.1 Traitement des index de dates avec Pandas DatetimeIndex
Dans la recherche empirique appliquée, les abscisses chronologiques ne se présentent que rarement sous la forme d’indices entiers artificiels simples ; elles s’incarnent préférentiellement dans des séries d’horodatages réels complexes comportant des fuseaux horaires, des années bissextiles et des variations de calendrier. L’exploitation robuste de ces temporalités sous Python exige la conversion préalable des chaînes textuelles en objets d’horodatage standardisés grâce à la fonction de conversion chronologique de Pandas (pd.to_datetime), établissant un index temporel dédié (DatetimeIndex).
La présence d’un tel index temporel débloque des fonctionnalités d’ingénierie statistique avancées indispensables avant tout tracé d’aires. Si l’enregistrement des mesures sur le terrain s’est opéré à des fréquences d’échantillonnage asymétriques ou erratiques, l’utilisation de la méthode de rééchantillonnage temporel de Pandas (resample) permet d’harmoniser mathématiquement l’axe des abscisses sur une fréquence fixe et régulière (par exemple journalière, hebdomadaire ou mensuelle), en appliquant les fonctions d’agrégation adaptées à la physique du phénomène observé.
Sur le plan du rendu graphique, l’injection d’objets temporels réels dans la primitive d’empilement requiert l’activation des formateurs de dates spécialisés de Matplotlib (matplotlib.dates). L’usage de localisateurs majeurs couplés à des formateurs d’horodatage personnalisés permet de calibrer avec précision la typographie des mentions chronologiques sur l’axe horizontal, en affichant par exemple uniquement le millésime annuel ou l’abréviation textuelle des mois. Une légère rotation angulaire appliquée à ces étiquettes textuelles au moyen de la méthode d’auto-formatage de dates de la figure élimine tout risque de chevauchement typographique disgracieux, préservant une lisibilité exemplaire sur les séries chronologiques de longue durée.
9.2 Stratégies d’imputation et correction des discontinuités
L’occurrence de lacunes dans les relevés longitudinaux — qu’elles découlent d’une défaillance instrumentale de capteur ou d’un refus de réponse dans une enquête sociale — pose un défi mathématique redoutable pour la génération de graphiques en aires. Comme souligné précédemment, la présence d’une valeur indéterminée interrompt le calcul cumulatif de l’intégrale discrète sous-jacente. L’analyste doit donc arbitrer entre plusieurs stratégies d’imputation numérique avant d’engager le rendu graphique.
La stratégie la plus rigoureuse sur le plan de la physique mathématique consiste à opérer une interpolation linéaire des données manquantes via la méthode spécialisée de Pandas. Cette opération remplace les valeurs absentes en calculant le segment de droite joignant la dernière observation valide connue à la première observation postérieure disponible. Pour des dynamiques fluides, l’interpolation préserve la géométrie continue des surfaces polygonales sans induire de déformation violente de l’empilement vertical. Dans d’autres contextes caractérisés par une inertie prononcée, une imputation par maintien de la dernière valeur observée (forward fill) sera méthodologiquement plus défendable.
Une distinction fondamentale doit impérativement être opérée entre une valeur manquante non collectée et un zéro numérique réel traduisant l’absence physique d’une sous-composante à un instant t. La valeur zéro doit être explicitement codée sous forme numérique et maintenue dans la table de données : elle conduira géométriquement la strate correspondante à s’écraser localement sur une épaisseur nulle, ses frontières supérieure et inférieure fusionnant temporairement avant de diverger à nouveau dès la réapparition du phénomène. La maîtrise de ces mécanismes d’imputation conditionne directement l’authenticité scientifique et la continuité graphique du tracé.
9.3 Filtrage et lissage pour réduire le bruit visuel
Les séries chronologiques issues de dispositifs de captation haute fréquence ou de flux de transactions financières présentent fréquemment un bruit stochastique à haute fréquence qui dégrade considérablement la lisibilité du graphique en aires. Les oscillations permanentes et saccadées des données brutes hérissent les frontières de strates d’une multitude d’aspérités géométriques parasitaires, saturant la perception visuelle de l’observateur et masquant les tendances macroscopiques lourdes d’évolution sous-jacente.
Pour purifier la restitution graphique tout en préservant l’intégrité analytique des données, l’application d’un lissage par moyenne mobile s’avère hautement bénéfique. Ce traitement s’exécute sous Pandas par le chaînage de la méthode d’échantillonnage glissant (rolling) sur une fenêtre temporelle judicieusement dimensionnée, suivie du calcul de la moyenne arithmétique locale. La taille de la fenêtre de glissement doit être rigoureusement proportionnée à la fréquence d’échantillonnage pour filtrer les artefacts aléatoires sans atténuer excessivement l’amplitude des inflexions macroscopiques réelles.
Sur le plan mathématique, l’opération de convolution associée à la moyenne mobile jouit d’une propriété remarquable de linéarité : la somme des moyennes mobiles de plusieurs séries est rigoureusement identique à la moyenne mobile de la somme de ces mêmes séries. Cette concordance garantit que le lissage n’introduit aucune distorsion d’empilement ; la surface totale calculée sur les données lissées reflète scrupuleusement la tendance de l’intégrale des données brutes d’origine, offrant une visualisation harmonieuse et apaisée des dynamiques de moyen et long terme.
10. Techniques alternatives dans Seaborn : sns.kdeplot et fill_between
10.1 Graphiques d’aire probabilistes avec sns.kdeplot(fill=True)
Bien que le propos central de ce traité concerne les graphiques en aires appliqués à des séries chronologiques déterministes, il est indispensable d’aborder une technique alternative majeure nativement embarquée au cœur de Seaborn : la représentation de densités de probabilités continues au moyen de la méthode d’estimation de densité par noyau (Kernel Density Estimation ou KDE).
Contrairement aux fonctions d’empilement vectoriel basées sur des relevés chronologiques discrets, la fonction de tracé de densité de Seaborn modélise la distribution statistique d’une variable aléatoire continue. Lorsque le paramètre de remplissage surfacique (fill=True) est activé, l’espace situé sous la courbe de probabilité est intégralement teinté, créant visuellement un graphique en aires probabiliste. Seaborn enrichit cette fonctionnalité en autorisant la stratification conditionnelle selon une variable catégorielle de regroupement, et en proposant un paramètre d’empilement multiple qui calcule l’accumulation verticale des densités partielles de chaque groupe.
Cette approche s’avère particulièrement puissante en analyse exploratoire multivariée, par exemple pour visualiser la répartition des salaires ou des scores biométriques selon différentes cohortes démographiques. L’avantage fondamental réside ici dans l’automatisation complète de la chaîne d’estimation mathématique : Seaborn gère intrinsèquement le calcul du noyau gaussien, le dimensionnement de la largeur de bande passante et l’affectation des nuances de la palette sans exiger de restructuration tabulaire manuelle de la part du chercheur.
10.2 Utilisation sélective de plt.fill_between pour aires simples
Lorsqu’un protocole de recherche n’exige pas l’empilement vertical de strates multiples concurrentes, mais se concentre sur l’illustration de la dynamique volumique d’une seule variable maîtresse ou sur la matérialisation d’un couloir de dispersion stochastique, la fonction de remplissage interstitiel de Matplotlib (fill_between) constitue un outil d’une flexibilité chirurgicale incomparable.
Cette méthode vectorielle opère en recevant un vecteur horizontal d’abscisses x et deux vecteurs verticaux délimitant respectivement la frontière inférieure et la frontière supérieure du polygone fermé à générer. Pour créer un graphique en aires simple d’une grande sobriété, il suffit de configurer la frontière inférieure sur un scalaire nul constant (y1=0) et la frontière supérieure sur la série chronologique d’intérêt (y2=f(x)). L’association de cette primitive avec la méthode de tracé de lignes de Seaborn garantit un contrôle indépendant parfait de l’épaisseur du trait de crête et de la transparence du remplissage basal sous-jacent.
Au-delà du simple tracé d’aire isolé, cette fonction représente l’instrument canonique par excellence pour matérialiser les intervalles de confiance statistiques, les écarts-types interquartiles ou les marges d’erreur autour d’une courbe de régression ou d’une moyenne empirique. En projetant une nappe légèrement teintée entre les bornes supérieure et inférieure de l’intervalle estimé par rééchantillonnage bootstrap, l’analyste enrichit le graphique d’une indication explicite de l’incertitude épistémique inhérente à toute mesure expérimentale.
10.3 Matrice décisionnelle : Choisir la fonction adéquate
Face à la diversité des primitives disponibles dans l’écosystème Python combiné, le statisticien doit opérer des choix programmatiques rationnels alignés sur la typologie de son jeu de données et la visée heuristique de sa recherche. Le tableau mental qui guide cette décision s’articule autour de trois variables fondamentales : la nature déterministe ou probabiliste du phénomène, le nombre de strates concurrentes et le format d’ingénierie tabulaire disponible.
Pour représenter des séries chronologiques déterministes comportant au minimum deux sous-composantes additives dont on souhaite suivre simultanément le total consolidé et les parts contributives, la primitive d’empilement vectoriel demeure le choix incontournable. Elle exige certes un prétraitement matriciel au format large sous Pandas, mais offre une exécution vectorielle instantanée et une robustesse géométrique absolue face aux larges volumes d’échantillons continus.
À l’inverse, si l’objectif consiste à visualiser des distributions de fréquences empiriques à partir de microdonnées individuelles brutes au format long sans agrégation préalable, l’appel aux fonctions d’estimation de densité de Seaborn avec empilement volumique s’impose naturellement, déléguant au compilateur les calculs d’ajustement statistique. Enfin, dès lors que l’analyste souhaite isoler une aire sous une courbe unique, marquer des seuils critiques asymétriques ou projeter des cônes de variabilité stochastique autour d’une trajectoire centrale, la méthode de remplissage interstitiel offre le degré de granularité géométrique le plus élevé, permettant d’adresser les problématiques de communication scientifique les plus complexes.
11. Erreurs courantes, diagnostics et bonnes pratiques méthodologiques
11.1 Résolution des bogues fréquents d’exécution
La mise en œuvre des graphiques en aires confronte régulièrement les développeurs et scientifiques à une série d’erreurs d’exécution récurrentes au niveau de l’interpréteur Python. L’incident technique le plus fréquent se manifeste par une exception d’incompatibilité de forme dimensionnelle (ValueError: shapes mismatch). Cette interruption brutale survient lorsque la dimension du vecteur de l’axe des abscisses diverge du nombre d’éléments hébergés dans les séries verticales empilées. Ce dysfonctionnement trouve systématiquement son origine dans un mauvais alignement des index lors du filtrage préalable sous Pandas, et se résout par une réindexation stricte garantissant une cardinalité identique sur l’ensemble des vecteurs de données.
Un autre écueil méthodologique subtil concerne le passage accidentel de colonnes contenant des chaînes de caractères masquées ou des objets non vectorisables à la fonction d’empilement. Dans de telles circonstances, Matplotlib tente d’interpréter ces entités comme des données catégorielles, ce qui engendre un tracé dégénéré où les ordonnées perdent leur métrique continue pour adopter un espacement arbitraire discret. L’exécution systématique d’une vérification des types de données au sein du DataFrame Pandas avant toute projection graphique permet de déjouer ce piège silencieux.
Enfin, l’apparition d’aberrations visuelles géométriques — telles que des croisements polygonaux chaotiques ou des strates qui semblent s’annuler mutuellement — résulte quasi invariablement de l’introduction intempestive de valeurs numériques négatives dans le jeu de données empilé. Le moteur d’accumulation n’étant conceptuellement pas modélisé pour soustraire des surfaces au sein d’une pile ascendante unilatérale, l’analyste doit impérativement auditer son fichier source au moyen d’assertions numériques logiques afin de certifier que chaque valeur injectée est strictement supérieure ou égale à zéro.
11.2 Accessibilité visuelle et conformité chromatique
La responsabilité éthique et déontologique de l’auteur d’une visualisation scientifique inclut l’accessibilité universelle de ses figures à l’ensemble de la communauté, y compris les personnes atteintes de déficiences de perception des couleurs telles que la deutéranopie, la protanopie ou la tritanopie, qui affectent une fraction significative de la population masculine et féminine mondiale. L’emploi non critique de palettes historiques opposant le rouge et le vert sans nuance de saturation constitue un manquement majeur aux règles élémentaires de la diffusion scientifique.
Pour assurer une conformité chromatique rigoureuse, Seaborn propose des palettes spécifiquement étalonnées pour maintenir des contrastes de luminance perceptibles indépendamment des altérations de vision des teintes, à l’image de la palette viridis, plasma ou de la palette qualitative conçue pour le daltonisme accessible sous l’identifiant colorblind. Il est vivement conseillé de soumettre les figures finalisées à des simulateurs de vision daltonienne avant soumission pour s’assurer que les strates contiguës conservent un contraste de luminosité suffisant pour être dissociées sans hésitation.
De surcroît, une attention particulière doit être portée à la reproduction des manuscrits sur support papier en niveaux de gris monochromes. L’application exclusive de couleurs présentant une intensité lumineuse médiane identique résultera en un aplat grisâtre indifférencié lors d’une impression noir et blanc standard. L’analyste averti articulera sa palette sur un gradient monotone de clarté ou combinera les nuances chromatiques avec des motifs de texture hachurés différenciés appliqués sur les polygones, assurant ainsi une pérennité sémiotique absolue du document quel que soit le médium physique de diffusion finale.
11.3 Principes de minimalisme et de charge cognitive
La conception d’une figure de haut niveau obéit aux préceptes de l’esthétique fonctionnaliste théorisés par Edward Tufte sous la notion de ratio encre-données (Data-Ink Ratio). Selon ce principe directeur, chaque goutte d’encre virtuelle déposée sur la surface graphique doit avoir pour raison d’être exclusive la transmission d’une parcelle d’information analytique fondamentale. Tout ornement décoratif gratuit, bordure surchargée, fond d’écran lourdement teinté ou effet d’ombrage tridimensionnel artificiel doit être banni comme une pollution cognitive parasite (le fameux chartjunk).
Dans le cas spécifique des graphiques en aires empilées, ce devoir de sobriété se traduit par une limitation volontaire du nombre de composantes superposées. La littérature en perception visuelle recommande de ne jamais excéder un seuil critique de quatre à six strates simultanées sur une même figure. Au-delà de ce volume, l’accumulation de frontières ondulantes désoriente irrémédiablement l’attention de l’observateur, rend l’évaluation des surfaces médianes totalement impossible et transforme un instrument de synthèse rigoureux en un amas bariolé indéchiffrable.
Si la structure d’étude impose la documentation d’un nombre supérieur de sous-catégories, la bonne pratique méthodologique commande de regrouper les séries les plus marginales au sein d’une catégorie agrégée unique conventionnellement étiquetée « Autres », positionnée immédiatement sous la strate sommitale. L’analyste préserve ainsi la clarté d’interprétation des déterminants majeurs du phénomène tout en respectant scrupuleusement l’exactitude comptable de la somme cumulative intégrale.
12. Exportation haute résolution et intégration pour publications académiques
12.1 Paramétrage de la résolution d’exportation avec plt.savefig
L’ultime maillon de la chaîne d’ingénierie visuelle réside dans l’exportation du canevas graphique depuis l’interpréteur Python vers un fichier de stockage physique destiné à l’insertion dans un manuscrit typographique ou un système de gestion de contenu scientifique. Cette sérialisation s’exécute par l’intermédiaire de la méthode de sauvegarde graphique de Matplotlib (plt.savefig), dont le paramétrage conditionne directement la fidélité de restitution optique.
Pour satisfaire aux exigences drastiques des comités d’édition des revues scientifiques internationales, le paramètre de résolution spatiale intrinsèque (dpi) doit être expressément fixé à une valeur minimale de trois cents points par pouce, et idéalement à six cents points par pouce pour les figures combinant des trames polygonales fines et des caractères typographiques denses. Une résolution inférieure engendre des phénomènes d’antialiasing disgracieux et de pixellisation qui dégradent instantanément le professionnalisme perçu du travail de recherche.
Un autre paramètre indispensable à la pérennité de l’exportation est l’ajustement automatique de la boîte de délimitation (bbox_inches=’tight’). Lors de l’ancrage d’une légende à l’extérieur du canevas de coordonnées ou lors de l’extension de labels temporels obliques, l’enregistrement brut par défaut a tendance à tronquer net ces éléments périphériques qui dépassent de la surface d’origine de la figure. L’activation de cette option force le moteur de rendu à recalculer l’emprise englobante réelle de l’ensemble des artistes graphiques présents, garantissant une intégration intégrale et harmonieuse de tous les éléments textuels au sein du fichier exporté.
12.2 Sélection des formats vectoriels et matriciels
Le choix de l’extension de fichier lors de l’exportation ne relève pas d’une simple préférence technique anodine ; il engage des paradigmes informatiques profondément divergents qui dictent la qualité de restitution finale de l’aire graphique. Les formats graphiques se scindent fondamentalement en deux catégories : les formats vectoriels d’une part, et les formats matriciels ou raster d’autre part.
Les formats vectoriels, au premier rang desquels figurent le PDF (Portable Document Format) et le SVG (Scalable Vector Graphics), doivent être systématiquement privilégiés pour les publications académiques et les compositions imprimées de haute facture. Dans ces formats, les polygones constituant le graphique en aires ne sont pas encodés sous forme d’une grille de pixels figée, mais sous forme d’instructions géométriques et d’équations mathématiques décrivant des sommets, des segments et des aplats colorimétriques. Il en résulte une invariance totale à l’échelle : la figure peut être agrandie indéfiniment sans jamais perdre sa netteté chirurgicale, et les polices typographiques demeurent parfaitement éditables dans les logiciels de mise en page professionnels.
Les formats matriciels, tels que le PNG (Portable Network Graphics) avec compression sans perte, conservent néanmoins une pertinence reconnue pour la diffusion interactive sur le web, l’intégration dans des présentations multimédias ou l’évaluation rapide sur des plateformes collaboratives légères. En revanche, l’utilisation de formats matriciels destructifs appliquant des algorithmes de compression à perte (comme le JPEG) est formellement proscrite pour les graphiques en aires : les artefacts de compression thermique qui apparaissent le long des contours contrastés et des séparations de strates dénaturent la propreté des frontières polygonales et confèrent au rendu final une apparence brouillonne inacceptable.
12.3 Standardisation du script final pour la reproductibilité scientifique
La reproductibilité computationnelle constitue l’idéal régulateur de la science moderne. Pour garantir qu’un graphique en aires élaboré à un instant donné puisse être régénéré à l’identique par d’autres chercheurs ou intégré de manière fluide au sein d’un pipeline d’intégration continue de données, l’analyste doit encapsuler l’ensemble de la logique algorithmique au sein d’une fonction Python modulaire, documentée et robuste.
Cette fonction normalisée doit accepter en entrée des arguments typés explicites — le DataFrame Pandas source, l’identifiant de la colonne temporelle, la liste ordonnée des colonnes d’accumulation, la désignation textuelle de la palette Seaborn ainsi que les métadonnées de titre et d’unités d’axes — et intégrer des assertions défensives vérifiant préalablement la stricte positivité des grandeurs et l’absence de valeurs indéterminées. La fonction prend en charge l’instanciation de la figure, l’empilement géométrique, la pose des lignes de démarcation, le positionnement extérieur de la légende inversée et l’exportation haute résolution vers un répertoire désigné.
En adoptant cette discipline d’ingénierie logicielle, l’analyste dépasse le stade du bricolage expérimental interactif pour ériger un standard de visualisation pérenne, fiable et vérifiable. Le graphique en aires cesse d’être une simple illustration cosmétique pour devenir un véritable composant d’infrastructure analytique, capable de synthétiser avec une fidélité absolue et une clarté cognitive totale la complexité dynamique des séries de données massives qui caractérisent la recherche contemporaine.
Références
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. Proceedings of the 9th Python in Science Conference, 51-56. https://doi.org/10.25080/Majora-92bf1920-00a
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wilke, C. O. (2019). Fundamentals of Data Visualization: A Primer on Making Informative and Compelling Figures. O’Reilly Media.