
Dans le champ contemporain de la recherche en psychologie, en neurosciences cognitives et en sciences sociales, l’intelligibilité des distributions empiriques constitue le socle fondamental sur lequel reposent la validité interne et la reproductibilité des inférences scientifiques. Trop souvent, l’analyse descriptive initiale se trouve indûment réduite à deux paramètres gaussiens élémentaires : la moyenne arithmétique et l’écart-type. Or, dans les investigations comportementales, cliniques ou psychométriques, les données recueillies s’écartent fréquemment de la distribution normale théorique. Les latences de réponse motrice, les scores d’inventaires psychopathologiques ou les indices de performance sous contrainte temporelle exhibent régulièrement des asymétries prononcées, des distributions multimodales et des observations périphériques aberrantes. Dans ce contexte épistémologique, la boîte à moustaches — désignée sous l’appellation anglo-saxonne de box plot ou box-and-whisker plot — s’impose comme un instrument d’exploration visuelle irremplaçable, conjuguant concision sémiotique et robustesse mathématique.
Historiquement formalisée pour libérer le chercheur des postulats distributionnels restrictifs, la boîte à moustaches permet d’appréhender d’un coup d’œil synthétique la dispersion centrale, l’étendue globale, le degré d’asymétrie ainsi que la présence éventuelle d’artéfacts de mesure au sein d’un échantillon. Alors que les logiciels d’analyse statistique spécialisés tels que R, SPSS ou Jamovi ont longtemps détenu le monopole de sa génération rigoureuse, l’intégration native de ce moteur graphique au sein de la suite logicielle Microsoft Excel offre désormais une accessibilité méthodologique sans précédent. Toutefois, la production et l’interprétation de ces diagrammes au sein d’un tableur grand public ne sauraient s’opérer de manière empirique ou naïve. Elles exigent une maîtrise rigoureuse des mécanismes de calcul sous-jacents, des options d’agencement matriciel, des règles de détection d’anomalies et des normes de publication scientifique en vigueur, notamment les directives de l’American Psychological Association (APA).
Le présent traité propose une déconstruction exhaustive, théorique et opérationnelle, de la boîte à moustaches dans l’environnement Microsoft Excel. Conçu à l’intention des chercheurs, des doctorants, des neuropsychologues et des analystes de données quantitatives, ce guide détaille chaque étape du protocole : depuis les fondements historiques de l’analyse exploratoire des données jusqu’au paramétrage méticuleux des étiquettes et des clôtures statistiques, en passant par le traitement des données manquantes, le diagnostic de normalité visuelle et la formalisation d’une étude de cas complète consacrée à un paradigme d’interférence cognitive de type Stroop. Par cette approche systématique, le praticien sera en mesure d’exploiter la pleine puissance analytique d’Excel afin de produire des représentations visuelles conformes aux standards académiques les plus exigeants.
1. Fondements épistémologiques et utilité de la boîte à moustaches en psychologie
1.1 Origine historique et conceptuelle selon John Tukey
L’émergence de la boîte à moustaches s’inscrit au cœur d’une révolution méthodologique majeure amorcée au début des années 1970 sous l’impulsion du statisticien américain John Wilder Tukey. Confronté à la dépendance excessive de la statistique inférentielle envers les distributions paramétriques et les tests d’hypothèses rigides, Tukey a formalisé le cadre conceptuel de l’analyse exploratoire des données (Exploratory Data Analysis ou EDA) dans son ouvrage séminal de 1977. Son postulat fondamental reposait sur l’impératif de « laisser parler les données » avant d’imposer des modèles probabilistes préconçus. Dans cette perspective épistémologique, la boîte à moustaches a été conçue comme une alternative graphique d’une sobriété radicale, capable de résumer les propriétés morphologiques fondamentales d’un échantillon sans recourir aux postulats de la loi normale.
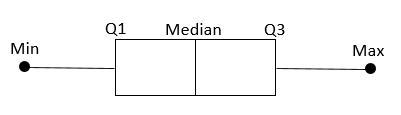
Contrairement aux représentations conventionnelles fondées sur la moyenne et l’écart-type — grandeurs hautement vulnérables à la moindre contamination par des valeurs extrêmes —, le diagramme de Tukey mobilise des estimateurs d’ordre : la médiane et les quartiles. Cette rupture algorithmique confère à la boîte à moustaches une résistance statistique exceptionnelle. En condensant l’information issue de plusieurs centaines ou milliers d’observations en un rectangle central flanqué de deux segments linéaires, l’outil permet de préserver l’intégrité de la structure distributionnelle sous-jacente tout en isolant visuellement les singularités empiriques. Pour les sciences du comportement, cette avancée a marqué le passage d’une vision normative de la variabilité à une exploration granulaire de la diversité des réponses individuelles.
1.2 Pertinence méthodologique pour les données psychométriques et comportementales
Dans l’investigation empirique des processus mentaux et des construits psychologiques, la linéarité et la symétrie constituent l’exception plutôt que la règle. Les données psychométriques issues d’échelles de Likert cumulées, d’inventaires d’anxiété ou de questionnaires d’évaluation de la dépression présentent structurellement des phénomènes d’asymétrie positive ou négative. Par exemple, au sein d’une population non clinique soumise à une échelle de détresse psychologique, une proportion écrasante de participants obtiendra des scores regroupés à proximité du plancher de l’instrument, générant une traîne distributionnelle étirée vers les valeurs hautes. La boîte à moustaches révèle instantanément cette dissymétrie par l’excentrement de la ligne médiane au sein du rectangle interquartile et par l’étirement différentiel des moustaches.
Par ailleurs, la neuropsychologie et la psychologie différentielle s’intéressent précisément aux profils atypiques qui se démarquent de la tendance centrale. Qu’il s’agisse de mesurer la détérioration cognitive consécutive à une lésion cérébrale ou de repérer des capacités intellectuelles hautement supérieures, l’identification non invasive et immédiate des valeurs aberrantes ou extrêmes s’avère critique. En dissociant explicitement la dispersion ordinaire — circonscrite à l’intérieur des limites théoriques du diagramme — des performances périphériques isolées au-delà des clôtures, la boîte à moustaches offre au clinicien et à l’expérimentateur un outil de criblage diagnostique immédiat, préservant la fidélité de l’observation sans altérer la sensibilité de la comparaison intergroupe.
1.3 Avantages comparatifs face aux histogrammes et diagrammes en barres
L’utilisation récurrente dans les publications scientifiques de diagrammes en barres (bar charts) surmontés d’une simple barre d’erreur standard — pratique parfois qualifiée de « graphiques dynamite » — a été vivement dénoncée par la communauté méthodologique contemporaine. Ces représentations dissimulent la variabilité interne réelle des données, induisent une illusion cognitive quant à l’importance de l’aire sous la barre et ne permettent aucunement de déceler si une condition expérimentale est tirée par deux individus atypiques ou si l’ensemble du groupe présente une augmentation homogène de son niveau de performance. L’histogramme, s’il offre une vision détaillée de la densité de distribution, présente l’inconvénient majeur de requérir un espace visuel considérable et dépend excessivement du découpage en classes (binning), rendant ardues les comparaisons directes entre de multiples facteurs.
La boîte à moustaches surmonte ces écueils grâce à une remarquable économie sémiotique. Sa morphologie standardisée et compacte autorise la juxtaposition latérale sans surcharge cognitive de dizaines de conditions expérimentales sur un même axe métrique ordonné. Les paramètres affichés — médiane et intervalle interquartile — sont totalement insensibles aux effets de bord qui déforment si profondément les moyennes arithmétiques. De surcroît, le diagramme prévient l’artefact bien connu du masquage de la variance : deux groupes affichant une moyenne et un écart-type rigoureusement identiques peuvent présenter des boîtes à moustaches radicalement discordantes en termes d’asymétrie et de regroupement central, guidant ainsi l’analyste vers le choix adéquat d’un modèle statistique explicatif.
2. Anatomie théorique du diagramme : Le résumé à cinq nombres
2.1 La médiane comme mesure robuste de tendance centrale
L’élément d’ancrage fondamental de la boîte à moustaches repose sur la médiane de l’échantillon, traditionnellement désignée comme le second quartile ou $Q_2$. Mathématiquement, la médiane est la valeur qui scinde la série statistique ordonnée en deux segments d’effectifs rigoureusement identiques : exactement 50 % des observations se situent en deçà de cette grandeur, et 50 % au-delà. Cette métrique d’ordre jouit d’une propriété de robustesse de 50 %, ce qui signifie qu’il faudrait corrompre la moitié exacte des observations d’un échantillon pour déplacer arbitrairement la médiane vers l’infini, alors qu’une unique valeur erronée suffit à biaiser substantiellement la moyenne arithmétique.
Dans le recueil des latences de réponse en chronométrie mentale, cette stabilité conceptuelle est déterminante. Les temps de réaction intègrent inévitablement des bruits périphériques : un relâchement attentionnel transitoire de la part du sujet expérimental peut engendrer une latence de 4 500 millisecondes sur un essai isolé, alors que la médiane de sa distribution se stabilise autour de 480 millisecondes. Là où la moyenne arithmétique intégrerait cette anomalie motrice en produisant un résultat artificiellement gonflé et non représentatif du traitement cognitif sous-jacent, la médiane demeure imperturbable. Elle figure au sein de la boîte sous la forme d’un trait horizontal transversale, matérialisant le point d’équilibre intrinsèque de la performance.
2.2 Les charnières : Premier et troisième quartiles
Le rectangle central de la boîte à moustaches, communément désigné sous le terme de corps de la boîte, est strictement délimité par deux bornes structurales qualifiées historiquement de « charnières » (hinges) par Tukey, correspondant au premier quartile ($Q_1$ ou 25e centile) et au troisième quartile ($Q_3$ ou 75e centile). Le premier quartile représente la valeur seuil sous laquelle se trouvent 25 % des observations les plus basses de la distribution ordonnée. Corrélativement, le troisième quartile constitue la frontière supérieure sous laquelle se situent 75 % des valeurs, laissant ainsi les 25 % des scores les plus élevés au-dessus de lui.
La distance mathématique séparant ces deux charnières définit l’écart interquartile (EIQ, ou Interquartile Range, IQR), formulé selon la relation :
$$\text{EIQ} = Q_3 – Q_1$$
Cet écart interquartile matérialise l’enveloppe contenant les 50 % centraux des données de l’échantillon. Il constitue un indice non paramétrique de dispersion de référence, insensible aux fluctuations des queues de distribution. La hauteur verticale du rectangle offre une appréciation immédiate de l’homogénéité du comportement étudié : une boîte étirée verticalement signale une hétérogénéité marquée de la population centrale, tandis qu’une boîte tassée témoigne d’un regroupement robuste et consensuel des réponses autour de la tendance médiane.
2.3 Les moustaches et les limites extrêmes non aberrantes
S’étendant verticalement de part et d’autre du rectangle central, les moustaches (whiskers) matérialisent la dispersion des données situées dans les zones périphériques non exceptionnelles de la série statistique. Selon la formalisation canonique établie par Tukey, les moustaches ne rejoignent pas systématiquement la valeur minimale et la valeur maximale absolues de l’échantillon, car ces dernières peuvent constituer des anomalies de mesure. Elles se déploient plutôt jusqu’aux valeurs adjacentes les plus éloignées qui demeurent à l’intérieur d’un intervalle de sécurité algorithmique borné par les clôtures intérieures (inner fences).
La moustache inférieure relie le bord bas de la boîte ($Q_1$) à la plus petite observation de l’échantillon qui soit supérieure ou égale à la clôture inférieure ($Q_1 – 1,5 \times \text{EIQ}$). De manière symétrique, la moustache supérieure s’étend du bord haut ($Q_3$) jusqu’à la plus grande observation qui soit inférieure ou égale à la clôture supérieure ($Q_3 + 1,5 \times \text{EIQ}$). Les moustaches délimitent ainsi ce qui relève de la variabilité normale attendue dans le cadre d’un échantillonnage empirique. Toute valeur se situant au-delà des extrémités de ces segments n’est pas connectée au corps du graphique : elle est rejetée dans l’espace des données exceptionnelles et représentée par un symbole géométrique distinct.
3. Structuration et nettoyage préalable des données dans Excel
3.1 Organisation tabulaire adaptée au moteur graphique d’Excel
Le moteur de rendu statistique de Microsoft Excel, profondément remanié à partir de la version 2016, obéit à des contraintes matricielles strictes pour l’interprétation automatique des séries de données. Pour une variable dépendante univariée isolée — par exemple, les scores d’anxiété d’une cohorte homogène —, l’agencement le plus rigoureux consiste à disposer l’ensemble des observations au sein d’une unique colonne verticale, précédée d’un en-tête explicite logé en ligne 1 (ex. Score_STAI_Y1). Cette organisation séquentielle en vecteur colonne prévient toute confusion algorithmique lors de la reconnaissance automatique de la dimension d’échantillonnage par le tableur.
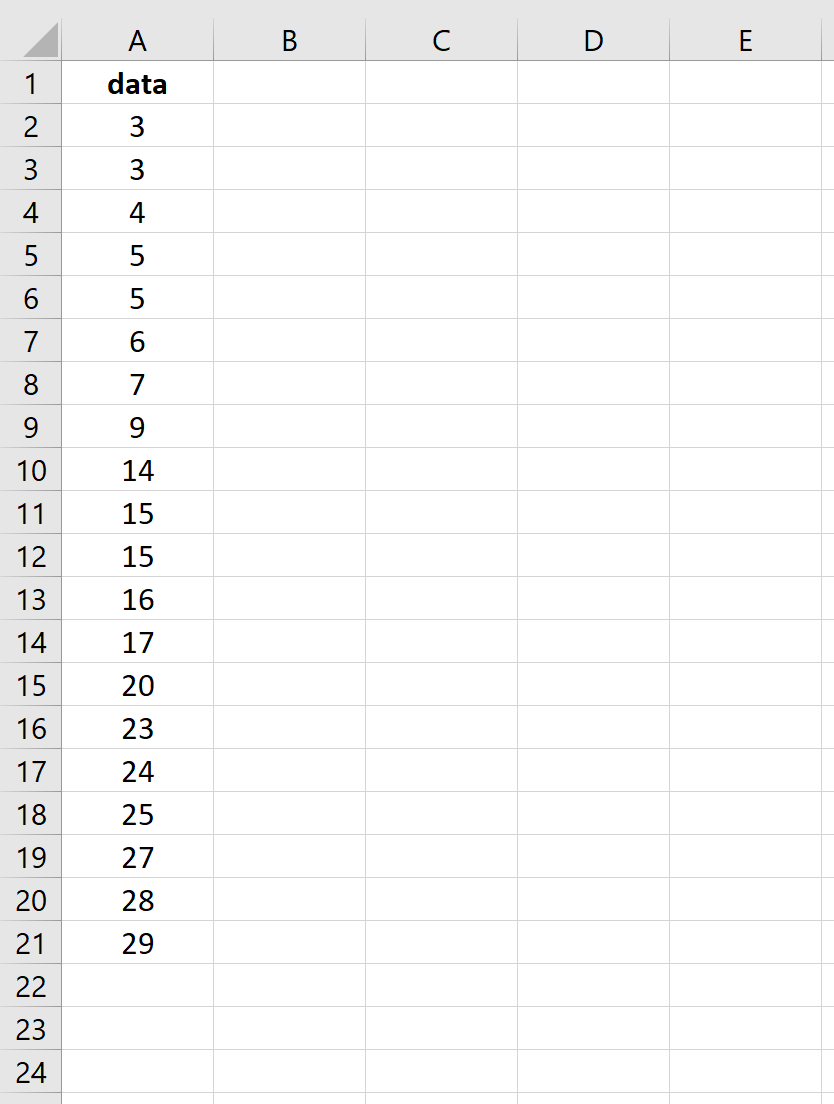
Dans le cas d’un plan factoriel ou d’une comparaison de groupes indépendants (ex. Groupe Contrôle, Groupe Thérapie Cognitive, Groupe Médication), la structuration peut adopter deux configurations tabulaires distinctes. La première, dite « format large », alloue une colonne distincte à chaque niveau de la variable indépendante, chaque colonne contenant la liste brute des scores associés. La seconde, dite « format long » ou relationnel, emploie une colonne de classification catégorielle (ex. Condition) couplée à une colonne numérique (ex. Latence_ms). Bien qu’Excel puisse traiter les deux formats sous certaines conditions via les tableaux croisés dynamiques, le format large en colonnes juxtaposées demeure la structure la plus directe et la plus stable pour générer nativement des boîtes à moustaches comparatives sans recourir à des étapes intermédiaires de modélisation.
3.2 Traitement des valeurs manquantes et incohérences de saisie
L’intégrité du rendu visuel de la boîte à moustaches dépend impérativement d’un nettoyage préalable du tableau de recueil. Dans la pratique expérimentale, il est fréquent que des cellules demeurent non renseignées en raison de défections de sujets ou de défaillances techniques. Dans Excel, une cellule laissée totalement vide est automatiquement ignorée par le moteur de tracé du box plot. En revanche, l’insertion accidentelle d’un zéro numérique (0) au lieu d’une valeur manquante altère dramatiquement la distribution : le zéro sera interprété comme une mesure valide de plancher, déplaçant artificiellement $Q_1$, comprimant l’écart interquartile et générant de potentielles fausses valeurs aberrantes.
De même, une erreur courante réside dans l’encodage textuel inadvertant de grandeurs quantitatives, par exemple l’usage d’une virgule au lieu d’un point décimal selon les paramètres régionaux du système d’exploitation, ou l’adjonction d’un espace insécable lors de l’importation de fichiers CSV. Une valeur numérique encodée sous forme de chaîne textuelle est purement exclue du calcul statistique sans notification d’erreur explicite, réduisant d’autant la taille apparente de l’échantillon $N$. L’application préalable de filtres automatiques combinée à des règles de mise en forme conditionnelle (repérant les formats non numériques via la formule =ESTTEXTE(cellule)) constitue un prérequis méthodologique non négociable avant d’activer le générateur de graphiques.
3.3 Vérification des postulats d’échelle de mesure
L’emploi légitime de la boîte à moustaches requiert que les données soient issues d’une échelle de mesure adaptée. En psychométrie, selon la classification canonique de Stanley Smith Stevens, les grandeurs se distribuent entre échelles nominales, ordinales, d’intervalles et de rapports. La boîte à moustaches n’a aucune pertinence sur des variables strictement nominales ou catégorielles. Elle acquiert sa pleine validité épistémique à partir des échelles ordinales rigoureuses comportant un nombre substantiel de modalités ordonnées, et trouve son terrain d’excellence sur les échelles d’intervalles (ex. échelles de quotients intellectuels, scores standardisés $T$, scores $Z$) et de rapports (ex. temps de réponse, taux de cortisol salivaire, seuils de discrimination sensorielle).
Une vigilance méthodologique accrue doit être observée lorsque le chercheur manipule des données fortement discrétisées issues d’un item de Likert unique à 4 ou 5 points. Bien que techniquement exécutable sous Excel, le tracé d’un diagramme en boîte sur un item isolé à très faible cardinalité de réponses engendre des écrasements sémiotiques sévères : les quartiles et la médiane se superposent fréquemment sur les mêmes entiers, annihilant la lisibilité de la dispersion et produisant des moustaches artificiellement dégénérées. Dans de telles circonstances, l’analyste privilégiera le score total composite sommé de l’échelle ou se tournera vers des diagrammes en barres de fréquences cumulées.
4. Protocole pas à pas : Création du graphique dans Excel
4.1 Sélection des séries de données brutes
L’initialisation de la procédure graphique requiert une délimitation spatiale rigoureuse de la matrice source au sein de la feuille de calcul. Le chercheur doit sélectionner l’intégralité de la plage de cellules hébergeant les valeurs quantitatives, en veillant scrupuleusement à intégrer la première ligne dévolue aux intitulés de colonnes. L’inclusion des en-têtes permet au moteur graphique d’associer automatiquement les libellés expérimentaux aux catégories d’axe horizontal, éliminant tout risque de permutation ultérieure des séries lors de remaniements du document.
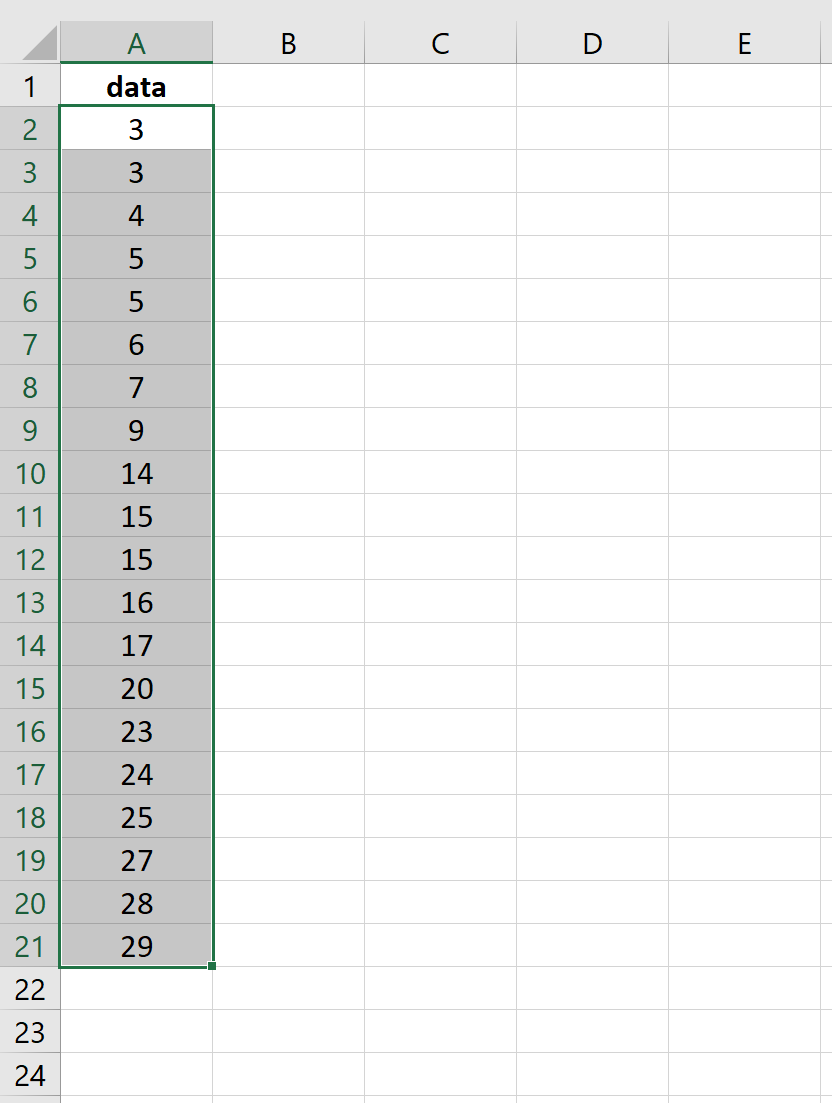
Pour manipuler des volumétries d’échantillons substantielles sans risquer une troncature accidentelle consécutive à un glissement de curseur manuel, il est vivement recommandé d’utiliser les raccourcis clavier standards de productivité. Le positionnement sur la cellule supérieure gauche de la plage suivi de l’exécution séquentielle de la combinaison Ctrl + Shift + Flèche Basse (ou Cmd + Shift + Flèche Basse sur macOS) permet d’étendre la sélection active jusqu’à la dernière cellule non vide du vecteur. Si plusieurs groupes expérimentaux sont disposés en colonnes contiguës, l’extension latérale s’opère instantanément via Ctrl + Shift + Flèche Droite. L’analyste s’assurera visuellement qu’aucune cellule résiduelle extérieure n’a été indûment capturée dans la zone active.
4.2 Navigation et sélection du type de graphique statistique
La sélection matricielle étant active, le protocole se déplace vers le ruban supérieur d’Excel. L’accès aux fonctionnalités d’ingénierie visuelle s’effectue par l’activation de l’onglet Insertion. Au sein du groupe d’outils labellisé Graphiques, Excel regroupe ses moteurs de rendu selon différentes topologies sémiotiques. Les boîtes à moustaches ne se situent pas dans les menus conventionnels d’histogrammes ou de courbes, mais relèvent de la catégorie dédiée à la modélisation statistique.
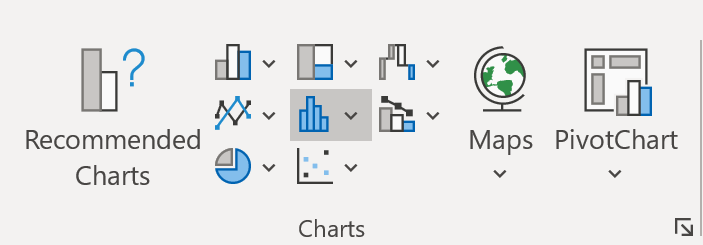
Le chercheur cliquera sur l’icône intitulée Insérer un graphique statistique, représentée visuellement par une série de barres bleues stylisées évoquant un histogramme de densité. Dans le menu contextuel déroulant qui se déploie alors sous la désignation générique « Graphiques statistiques », deux sous-familles apparaissent : « Histogramme » et « Zone et valeurs ». C’est sous cette dernière appellation, ou directement sous le libellé Boîte et moustaches (Box and Whisker selon la nomenclature de la version linguistique du logiciel), que se trouve l’algorithme dédié. Un clic gauche sur cette option ordonne l’instanciation immédiate de l’objet graphique au sein de la feuille active.
4.3 Génération initiale et positionnement sur la feuille de calcul
Dès la validation de l’insertion, le moteur d’Excel calcule en arrière-plan les quantiles requis pour chaque colonne sélectionnée et projette un canevas graphique vectoriel par défaut au centre de l’espace de travail. À ce stade primaire, le tracé généré présente une configuration standardisée intégrant un titre générique, un axe des ordonnées calibré automatiquement et un corps de boîte aux couleurs de la charte graphique par défaut du tableur.
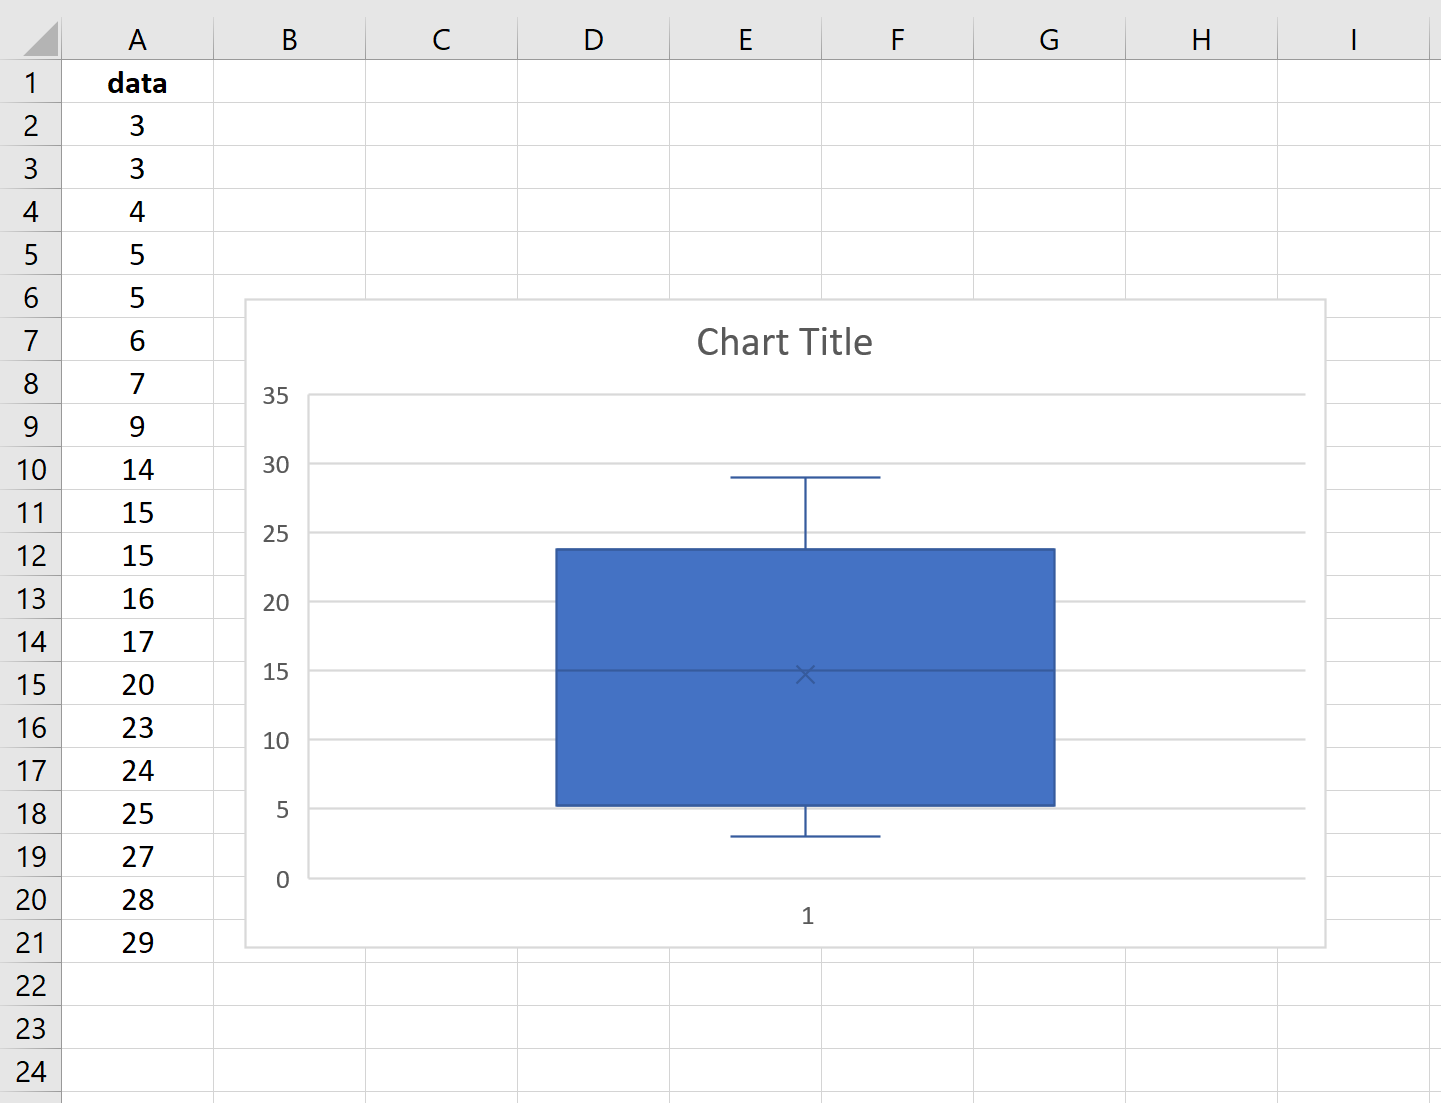
Ce rendu préliminaire souffre fréquemment d’une compression visuelle préjudiciable à l’analyse fine des distributions. Il incombe au chercheur de redimensionner proportionnellement l’objet graphique en saisissant les poignées d’ancrage situées sur ses bordures périphériques. Pour une exploitation documentaire ergonomique, notamment lors de la préparation de manuscrits destinés à l’expertise par les pairs, il est souvent préférable de détacher le graphique de la grille de données brutes. Un clic droit sur le canevas permet de sélectionner l’option Déplacer le graphique, offrant l’alternative de l’ancrer sous la forme d’un objet flottant dans une feuille dédiée ou de l’isoler sur une nouvelle feuille de graphique exclusive (Feuille Graphique), optimisant ainsi la résolution spatiale globale.
5. Paramétrage technique et affichage précis des étiquettes numériques
5.1 Activation de l’interface des éléments de graphique
L’exploration visuelle brute gagne immensément en rigueur lorsque les métriques fondamentales du résumé à cinq nombres sont explicitement superposées au dessin vectoriel. L’accès à la configuration modulaire s’effectue en sélectionnant le graphique, ce qui déclenche l’apparition d’un bouton contextuel flottant matérialisé par une croix verte (dans les versions Windows) en marge supérieure droite de l’objet, ou via l’onglet contextuel Création de graphique dans le ruban supérieur.
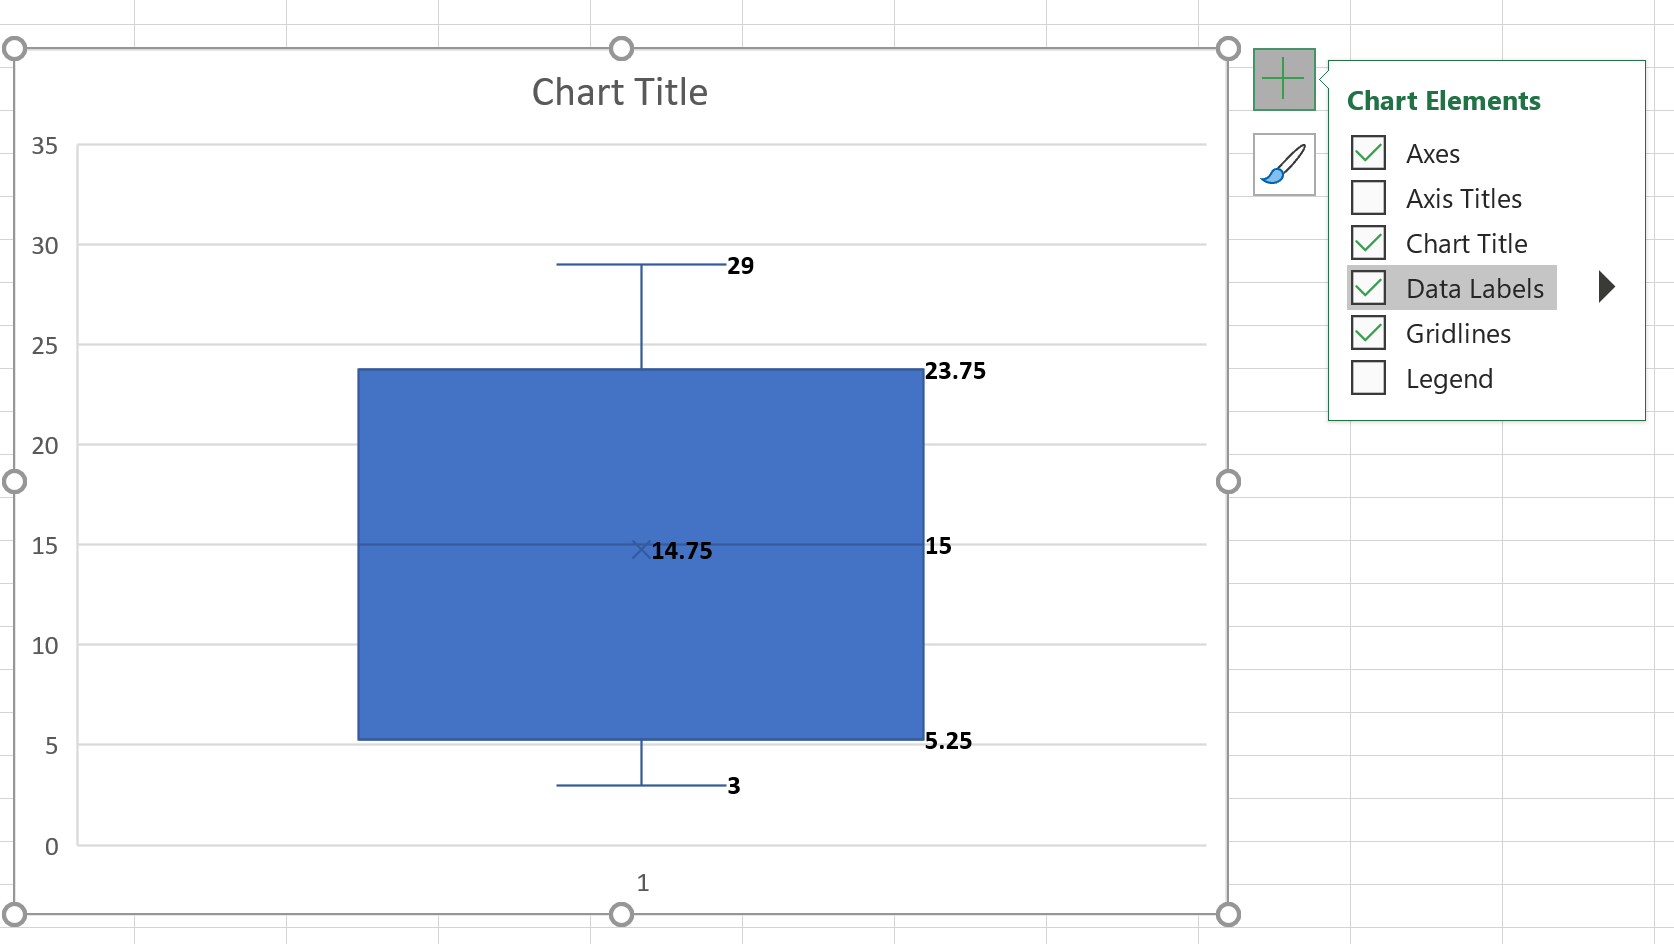
En déployant ce menu des éléments de graphique, le chercheur doit cocher l’option Étiquettes de données. Immédiatement, Excel affiche une série de grandeurs numériques le long de la structure de chaque boîte. Dans sa configuration par défaut, le système appose les six valeurs calculées : le minimum non aberrant, le premier quartile ($Q_1$), la médiane ($Q_2$), la moyenne arithmétique (symbolisée par une croix), le troisième quartile ($Q_3$) et le maximum non aberrant. En cas de proximité métrique serrée entre deux paramètres — par exemple, lorsque la médiane et la moyenne sont quasi superposées —, des collisions typographiques peuvent survenir. L’analyste interviendra manuellement en double-cliquant sur les étiquettes incriminées pour les décaler latéralement, garantissant une lisibilité absolue.
5.2 Configuration des options de la série de données
La personnalisation mathématique et structurelle profonde du diagramme requiert l’ouverture du panneau latéral de configuration. Un double-clic précis sur l’une des boîtes à moustaches ou un clic droit suivi de la commande Mise en forme des séries de données fait émerger à droite de l’écran un volet d’outils exhaustif. Sous l’onglet symbolisé par un icône de tracé en colonnes (Options de série), se trouvent les commutateurs algorithmiques régissant le comportement du modèle.
Parmi ces leviers figure l’option Afficher les points intérieurs. Lorsqu’elle est activée, Excel projette l’intégralité des observations empiriques réelles sous la forme de points dispersés latéralement (selon un principe de jittering pour réduire les recouvrements) à l’intérieur même du corps de la boîte et le long des moustaches. Cette fonctionnalité s’avère hautement vertueuse sur le plan épistémologique : elle restitue la granularité de l’échantillon sous-jacent, révélant d’éventuelles zones de vacuité distributionnelle ou des sous-agrégats invisibles au travers du seul résumé par quartiles. Corrélativement, le chercheur peut choisir d’activer ou d’inhiber le Marqueur de moyenne, qui superpose une croix arithmétique ($\times$) au sein du rectangle, facilitant l’évaluation visuelle immédiate du décalage entre moyenne et médiane.
5.3 Gestion de la ligne médiane et des segments de liaison
Toujours au sein du panneau de configuration des séries, une option stratégique intitulée Afficher la ligne de moyenne ou Lignes de liaison permet de tracer un segment continu reliant les moyennes ou les médianes respectives des différents groupes expérimentaux disposés côte à côte. Dans les protocoles longitudinaux ou les plans à mesures répétées (ex. Pré-test, Post-test immédiat, Rétention à long terme), ces segments de liaison soulignent graphiquement la trajectoire temporelle de la cohorte, offrant un pont sémiotique intuitif entre l’analyse descriptive transversale et les tests d’effets principaux issus de l’analyse de variance.
Il importe également de veiller à la différenciation chromatique et au contraste typographique de la barre médiane. Par défaut, Excel applique parfois une teinte identique pour le contour de la boîte et la ligne médiane transversale, ce qui peut nuire à l’identification instantanée de $Q_2$ lors de l’impression en niveaux de gris. En accédant aux propriétés de Remplissage et trait du volet latéral, le chercheur veillera à assigner un contour net et une épaisseur suffisante (au minimum 1,25 point) pour que la médiane s’impose visuellement comme l’axe pivot du diagramme.
6. Décodage analytique des cinq valeurs clés générées par Excel
6.1 Interprétation du minimum non aberrant
La limite inférieure matérialisée par la terminaison de la moustache basse représente le minimum non aberrant de la série empirique. Il est crucial d’insister sur la qualification de « non aberrant » : cette borne ne correspond pas nécessairement à la valeur minimale théorique accessible sur l’instrument d’évaluation, ni même systématiquement à la plus petite valeur enregistrée dans le fichier de données. Elle matérialise l’observation la plus basse qui n’a pas été disqualifiée par la clôture de Tukey, c’est-à-dire le point réel le plus bas vérifiant la condition $ge Q_1 – 1,5 \times \text{EIQ}$.
Sur le plan de l’interprétation psychologique, cette borne inférieure éclaire la présence potentielle d’un « effet plancher » au sein de la tâche cognitive ou de l’échelle d’évaluation. Si le minimum non aberrant coïncide rigoureusement avec le score zéro d’un inventaire d’anxiété ou avec la latence minimale physiologique d’un temps de réaction motrice (ex. 150 à 200 ms pour l’inhibition saccadique), cela confirme que le protocole capture fidèlement la limite basale de réactivité du système nerveux central, sans qu’aucun sujet n’ait produit d’anticipation motrice prématurée.
6.2 Lecture approfondie du bloc central (Q1, Médiane, Q3)
Le bloc central, formé par la réunion du premier quartile, de la médiane et du troisième quartile, concentre l’essence de l’information structurelle. Le premier quartile ($Q_1$) établit la ligne de démarcation sous laquelle s’enfoncent les 25 % des sujets les plus lents, les moins performants ou les moins symptomatiques de l’échantillon. À l’opposé, le troisième quartile ($Q_3$) consacre le seuil d’accès aux 25 % des scores supérieurs, marquant la frontière vers les performances exceptionnelles ou les degrés élevés de sévérité clinique.
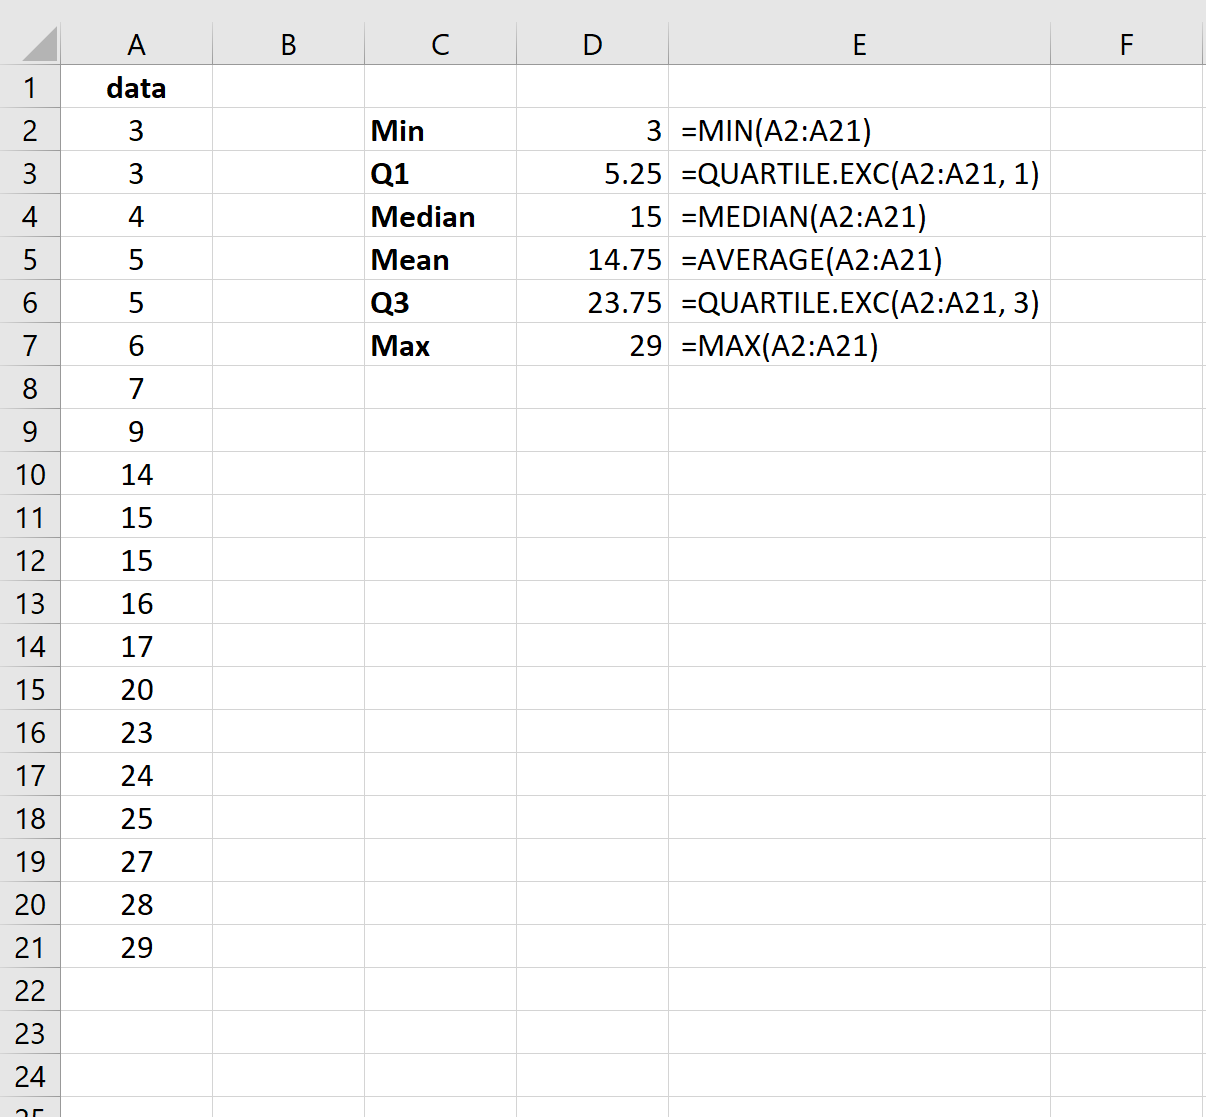
La distance métrique séparant la médiane de $Q_1$ et de $Q_3$ fournit un diagnostic immédiat quant à la morphologie de la dispersion interne. Si la médiane est rigoureusement équidistante des deux bordures du rectangle, la moitié centrale des données s’avère parfaitement symétrique. En revanche, si la médiane se tasse contre le bord inférieur $Q_1$, cela atteste que les scores situés entre le 25e et le 50e centile sont extrêmement concentrés et resserrés, tandis que les scores oscillant entre le 50e et le 75e centile s’étirent de manière beaucoup plus lâche vers les valeurs hautes. Cette asymétrie interne du corps central reflète fidèlement la dynamique de réponse propre aux populations examinées.
6.3 Interprétation du maximum non aberrant
À l’extrémité supérieure du diagramme, la terminaison de la moustache haute incarne le maximum non aberrant. Tout comme son pendant inférieur, cette marque identifie l’observation empirique la plus élevée qui s’inscrit encore en deçà de la clôture supérieure définie par $Q_3 + 1,5 \times \text{EIQ}$. Cette valeur constitue un indicateur de premier ordre pour évaluer l’étendue normale de la variabilité humaine dans la condition examinée.
Dans l’évaluation des compétences psychométriques, la confrontation entre ce maximum observé et la limite physique ou technique imposée par le paradigme expérimental (ex. le score maximal théorique à un test d’aptitude mathématique ou le délai d’expiration temporelle [time-out] fixé sur un logiciel de chronométrie) permet de déceler l’existence d’un « effet plafond ». Si le maximum non aberrant s’agglutine contre la borne supérieure autorisée par le test, le chercheur doit en déduire que l’instrument n’a pas permis de discriminer adéquatement les sujets aux capacités cognitives les plus avancées, orientant ainsi la révision méthodologique future de l’épreuve.
7. Traitement algorithmique des valeurs aberrantes (outliers) sous Excel
7.1 La formule de détection automatique des seuils de Tukey
L’un des apports majeurs de l’intégration native de la boîte à moustaches au sein de Microsoft Excel réside dans l’automatisation rigoureuse du criblage des anomalies distributionnelles selon les règles canoniques de Tukey. L’architecture computationnelle du tableur calcule dynamiquement les clôtures intérieures (inner fences) à partir des centiles de l’échantillon sans exiger de saisie manuelle de macros complexes. Les formules régissant cette démarcation s’énoncent formellement :
$$\text{Clôture Inférieure} = Q_1 – (1,5 \times \text{EIQ})$$
$$\text{Clôture Supérieure} = Q_3 + (1,5 \times \text{EIQ})$$
Tout score empirique individuel $x_i$ satisfaisant à la condition d’exclusion $x_i \text{Clôture Supérieure}$ est immédiatement extrait de la série continue reliant les moustaches. Le coefficient $1,5$ appliqué à l’écart interquartile n’est pas arbitraire : dans le cas d’une distribution parfaitement gaussienne, cette distance correspond approximativement à un intervalle couvrant $\pm 2,7$ écarts-types autour de la moyenne, ce qui signifie qu’environ 99,3 % des données d’une population normale théorique sont attendues à l’intérieur des moustaches, ne laissant émerger en dehors que 0,7 % d’observations statistiquement improbables.
7.2 Représentation graphique spécifique des points atypiques
Lorsqu’une observation franchit ces clôtures de Tukey, Excel neutralise l’extension de la moustache correspondante et matérialise l’anomalie sous la forme d’un point géométrique totalement désolidarisé du reste de l’édifice structural. Dans les options de série, la case à cocher Afficher les points hors limites (activée par défaut) régit ce comportement sémiotique. Si cette option venait à être désactivée par l’analyste, Excel forcerait artificiellement les moustaches à s’étirer jusqu’aux valeurs absolues minimales et maximales, masquant ainsi l’existence même des singularités empiriques, une pratique vivement déconseillée sur le plan de la déontologie scientifique.
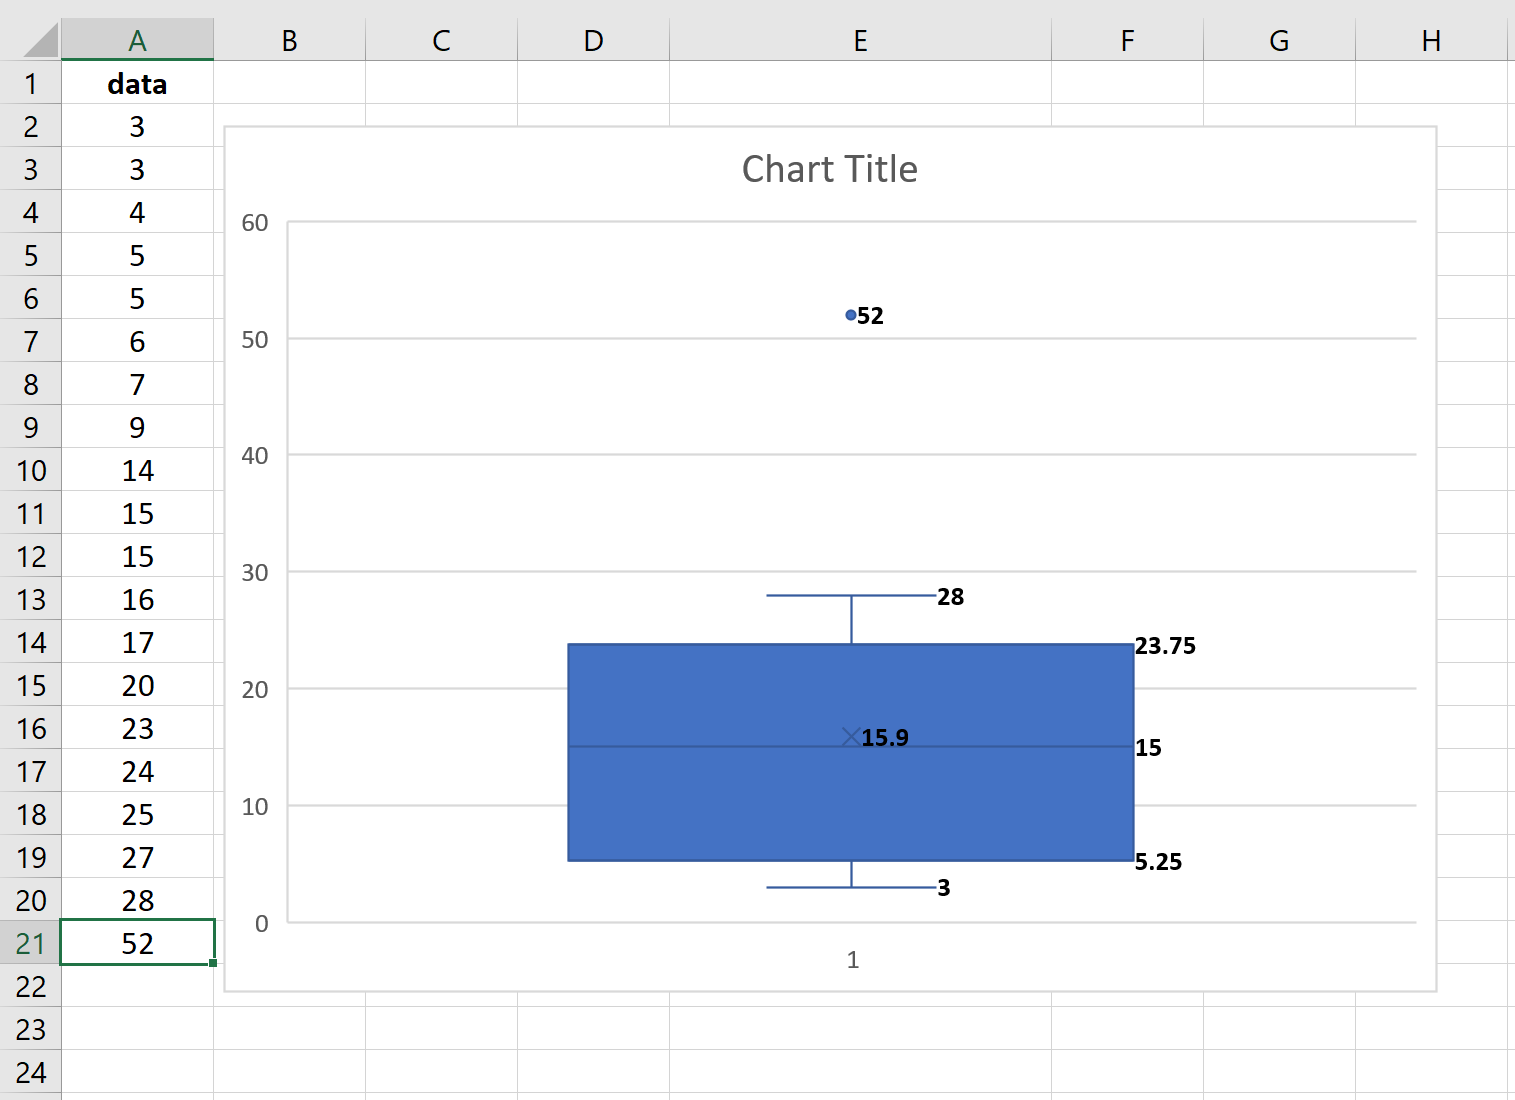
Il importe de souligner une nuance théorique majeure que l’interface native d’Excel simplifie parfois à l’excès. Dans la littérature statistique classique, Tukey distinguait les valeurs atypiques modérées (situées entre $1,5 \times \text{EIQ}$ et $3,0 \times \text{EIQ}$ au-delà des quartiles) des valeurs atypiques sévères ou extrêmes (dépassant $3,0 \times \text{EIQ}$). Alors que des progiciels comme SPSS ou R adoptent des symboles différenciés (par exemple des cercles pour les anomalies modérées et des astérisques pour les valeurs extrêmes), le moteur de rendu d’Excel projette un marqueur uniforme pour l’ensemble des points isolés. Il incombe donc à l’analyste de procéder à un examen tabulaire complémentaire pour quantifier la sévérité de l’écartement de chaque valeur hors limites.
7.3 Prise de décision clinique et méthodologique face aux valeurs isolées
L’émergence d’un point atypique sur un diagramme en boîte ne doit en aucun cas déclencher une réaction réflexe de suppression mécanique. Face à une observation périphérique isolée, le chercheur doit opérer une triple démarche décisionnelle. En premier lieu, il convient de traquer une éventuelle erreur matérielle de saisie ou d’encodage (par exemple, la saisie d’un temps de réaction de 50 000 ms résultant d’une frappe accidentelle sur un chiffre surnuméraire). Dans ce cas précis, la correction ou l’invalidation de la donnée procède d’un impératif d’assainissement évident.
En second lieu, si la donnée se révèle techniquement valide, l’analyste doit déterminer si elle procède d’un manquement protocolaire avéré (somnolence constatée du sujet, incompréhension des consignes verbales validée lors du débriefing). Enfin, dans les situations où la mesure traduit une réponse authentique mais hautement singulière émanant d’un sujet clinique (ex. un participant présentant une symptomatologie obsessionnelle-compulsive majeure au sein d’une cohorte tout-venant), la valeur aberrante constitue souvent l’information scientifique la plus substantielle du recueil. L’éradiquer reviendrait à appauvrir délibérément la réalité écologique du phénomène psychologique. La recommandation éthique contemporaine consiste à documenter rigoureusement toute anomalie, à publier le graphique intégrant les points isolés, et le cas échéant, à mener une analyse de sensibilité comparant les modèles statistiques avec et sans l’inclusion des cas extrêmes.
8. Analyse de la forme de la distribution psychologique : Asymétrie et variabilité
8.1 Diagnostic visuel de l’asymétrie positive et négative
La boîte à moustaches constitue un sismographe visuel d’une sensibilité remarquable pour apprécier l’asymétrie (skewness) d’une série statistique sans exiger dans l’immédiat le calcul formel des coefficients de Fisher ou de Pearson. Le diagnostic visuel repose sur la confrontation simultanée de trois indicateurs géométriques internes : la position de la barre médiane au sein du rectangle, la longueur relative des deux moustaches, et la position du marqueur de moyenne arithmétique par rapport à la médiane.
Une distribution est dite affectée d’une asymétrie positive (ou étalée à droite) lorsque les valeurs faibles sont très fortement concentrées et que les valeurs élevées s’étirent de manière diffuse. Graphiquement, cette configuration se traduit par :
- Une ligne médiane fortement rapprochée du premier quartile $Q_1$, laissant une vaste chambre supérieure dans le rectangle entre la médiane et $Q_3$ ;
- Une moustache supérieure considérablement plus longue que la moustache inférieure ;
- Un marqueur de moyenne arithmétique ($\times$) positionné nettement au-dessus de la ligne médiane, tiré vers le haut par les quelques scores très élevés de la queue de distribution.
À l’inverse, une asymétrie négative (ou étalée à gauche) exhibera une médiane collée à $Q_3$, une moustache inférieure démesurément étirée vers le bas et une moyenne située en dessous de la médiane. Cette situation est typique des épreuves d’évaluation cognitive trop faciles où la majorité des participants atteint des scores approchant la perfection.
8.2 Identification de l’aplatissement (kurtosis) et dispersion relative
Au-delà de l’asymétrie directionnelle, la morphologie du diagramme informe le chercheur sur l’aplatissement (kurtosis) et le degré relatif de dispersion des observations. La hauteur absolue du rectangle interquartile matérialise la compacité de la distribution : une boîte extrêmement étroite encadrée de moustaches très courtes traduit une distribution leptokurtique, caractérisée par une hyper-concentration des observations autour du centre et une vacuité relative des zones intermédiaires. Inversement, une boîte haute occupant une large proportion de l’axe métrique global signale une distribution platykurtique, révélant une dispersion uniforme et hétérogène des comportements individuels.
L’observation attentive des points intérieurs ou de configurations géométriques étranges peut également alerter l’analyste sur la présence d’une distribution bimodale, un phénomène qu’aucun calcul aveugle de moyenne ne permettrait de suspecter. Si l’activation des points intérieurs révèle deux nuages distincts de données agglutinés respectivement à proximité de $Q_1$ et de $Q_3$, séparés par un vide presque total autour de la médiane, la boîte à moustaches trahit l’existence sous-jacente de deux sous-populations distinctes au sein de l’échantillon (par exemple, des participants ayant utilisé spontanément deux stratégies cognitives diamétralement opposées pour résoudre une énigme neuropsychologique).
8.3 Confrontation graphique avec les postulats de normalité
La quasi-totalité des modèles statistiques inférentiels classiques de la famille paramétrique (test $t$ de Student pour échantillons indépendants, analyse de variance factorielle univariée ou multivariée, régressions linéaires) postule la normalité de la distribution des résidus au sein de la population parente. L’examen attentif de la boîte à moustaches constitue une première ligne de validation de ce postulat théorique. Pour qu’une distribution empirique apparaisse compatible avec l’hypothèse d’une loi normale de Gauss-Laplace, son diagramme doit satisfaire à des critères géométriques d’harmonie stricts :
- La médiane doit diviser le rectangle central en deux sous-espaces de hauteurs approximativement équivalentes ;
- La croix matérialisant la moyenne arithmétique doit être visuellement confondue avec le trait de la médiane ou s’en trouver extraordinairement proche ;
- Les moustaches inférieure et supérieure doivent déployer des longueurs quasi identiques de part et d’autre du corps ;
- Les points atypiques isolés doivent être totalement absents ou se manifester de manière rigoureusement symétrique aux deux extrémités.
Ce diagnostic visuel ne se substitue pas aux tests d’adéquation formels tels que le test de Shapiro-Wilk ou de Kolmogorov-Smirnov avec correction de Lilliefors. Toutefois, dans les grands échantillons où les tests statistiques de normalité deviennent hypersensibles au point de rejeter la normalité pour des déviations infinitésimales et sans conséquence pratique, l’inspection de la boîte à moustaches sous Excel permet de juger si la déviation constatée présente une gravité suffisante pour compromettre la robustesse des tests paramétriques, ou s’il s’avère impératif de basculer vers des alternatives non paramétriques (test de Wilcoxon-Mann-Whitney ou de Kruskal-Wallis).
9. Comparaison multi-groupes : Analyse factorielle et plans expérimentaux
9.1 Mise en place de structures comparatives multivariées
L’un des avantages les plus décisifs de la boîte à moustaches réside dans son aptitude à soutenir la comparaison simultanée de multiples groupes expérimentaux ou de conditions intra-sujets. Dans les protocoles de psychologie expérimentale confrontant un groupe contrôle à plusieurs modalités d’intervention (ex. Contrôle sans traitement, Thérapie cognitive informatisée, Thérapie métacognitive individualisée), l’analyste organise ses données au sein de la feuille Excel en réservant une colonne dédiée à chaque modalité factorielle.
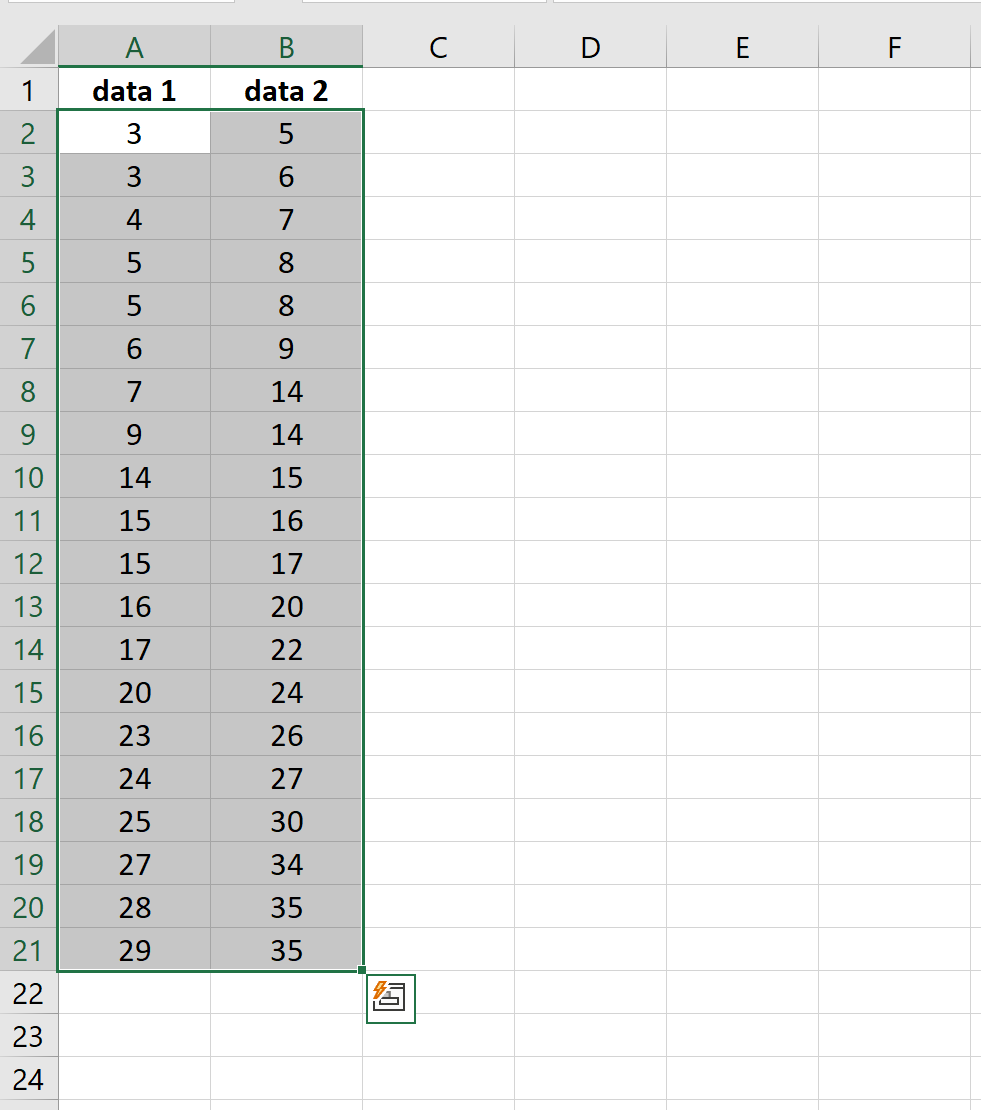
En sélectionnant l’ensemble de ces colonnes contiguës avant de solliciter l’insertion du diagramme statistique, Excel procède à l’alignement automatique des boîtes correspondantes sur une échelle ordonnée strictement commune. Cette projection sur un repère unique est méthodologiquement irremplaçable : elle élimine instantanément les biais cognitifs d’illusion d’échelle qui polluent régulièrement l’examen visuel lorsque les graphiques sont générés séparément avec des bornes d’axes disparates.
La juxtaposition latérale permet d’appréhender d’un coup d’œil synoptique non seulement le glissement de la tendance centrale d’une condition à l’autre, mais également la modulation concomitante de la variabilité interne. Le chercheur s’assurera que l’ordre des colonnes au sein du tableau Excel reflète fidèlement la progression logique de l’expérience (ex. du groupe témoin vers le traitement le plus intensif) afin que la succession horizontale des boîtes sur le canevas graphique serve immédiatement l’argumentation scientifique.
9.2 Évaluation du chevauchement interquartile entre conditions
L’interprétation conjointe de boîtes à moustaches parallèles repose sur une règle heuristique fondamentale en statistique descriptive : l’analyse du chevauchement des rectangles interquartiles. Lorsque deux boîtes juxtaposées présentent un non-recouvrement vertical total de leurs rectangles centraux — c’est-à-dire lorsque le bord inférieur ($Q_1$) du Groupe Traitement se situe au-dessus du bord supérieur ($Q_3$) du Groupe Contrôle —, le chercheur dispose d’un indice empirique puissant suggérant que plus de 75 % des participants du groupe traité obtiennent une performance supérieure à 75 % des sujets témoins.
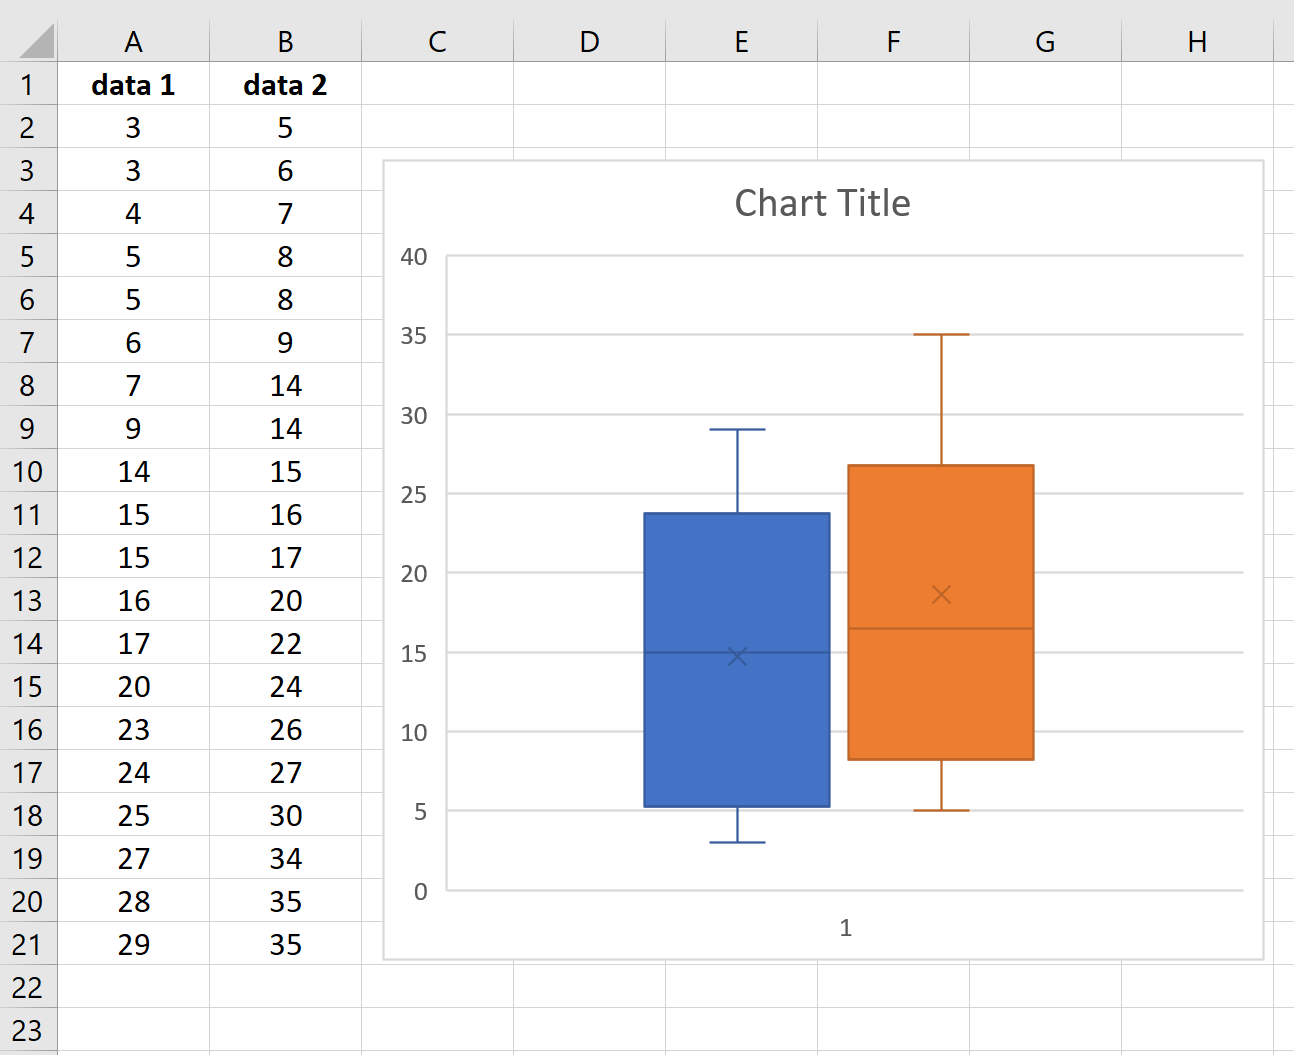
Une telle dissociation visuelle anticipe presque systématiquement une différence statistiquement significative lors du test inférentiel ultérieur, assortie d’une taille d’effet substantielle (ex. un $d$ de Cohen excédant 0,80). À l’inverse, si la médiane de l’une des conditions s’inscrit profondément à l’intérieur de l’espace interquartile de la condition adjacente, l’effet expérimental s’avère manifestement modeste ou marginal. La boîte à moustaches préserve également l’observateur du piège des tailles d’échantillons inégales ($n$ déséquilibrés) : les quartiles conservant leur définition proportionnelle indépendamment de l’effectif total du groupe, la morphologie des boîtes demeure directement comparable d’une modalité à l’autre.
9.3 Visualisation des plans pré-test / post-test
Dans les devis longitudinaux évaluant l’efficacité d’une remédiation neuropsychologique au moyen de mesures répétées chez les mêmes individus, la boîte à moustaches offre une mise en perspective éloquente des dynamiques d’apprentissage. En positionnant côte à côte la boîte représentative de la performance basale (Pré-test) et celle consécutive au protocole thérapeutique (Post-test), l’analyste peut simultanément observer deux dimensions transformatrices :
- L’amplitude du gain cognitif moyen, matérialisée par l’élévation ou la chute de la ligne médiane sur l’axe des ordonnées ;
- L’homogénéisation des compétences au sein de la cohorte, objectivée par un rétrécissement drastique de la hauteur de la boîte interquartile en Post-test par rapport à l’hétérogénéité initiale.
De surcroît, cette mise en parallèle longitudinale met en lumière le sort clinique réservé aux « non-répondeurs ». La persistance d’observations atypiques isolées sous la forme de points hors limites en phase post-test, alors même que l’ensemble du rectangle central a progressé de manière compacte vers les scores cibles, attire immédiatement l’attention du clinicien sur les profils individuels résistants au traitement standardisé, posant les jalons d’investigations étiologiques ciblées.
10. Personnalisation esthétique avancée selon les normes académiques (APA)
10.1 Épuration graphique et respect des standards scientifiques
Le gabarit graphique généré nativement par Microsoft Excel intègre des attributs cosmétiques — trames colorées saturées, contours bleutés, quadrillages de fond denses — qui contreviennent frontalement aux exigences de sobriété imposées par les périodiques scientifiques internationaux à comité de lecture, singulièrement ceux souscrivant aux normes du manuel de style de l’APA (7e édition). Une mise en conformité rigoureuse s’impose afin de transformer un graphique bureautique en une figure académique publiable.
Le protocole d’épuration esthétique implique les actions systématiques suivantes :
- Suppression intégrale du quadrillage d’arrière-plan : Les lignes de grille horizontales grises créent un encombrement visuel inutile. Il convient de les sélectionner et de les supprimer pour conférer à la zone de traçage un fond blanc pur (aucun remplissage) ;
- Abolition de la bordure du canevas : Le contour extérieur du cadre graphique doit être configuré sur « Aucun trait » afin d’éviter tout encadrement artificiel lors de l’insertion dans un logiciel de traitement de texte ;
- Uniformisation de la palette chromatique : Les boîtes doivent adopter des nuances de gris sobres, des hachures différenciées ou des aplats noirs et blancs garantissant une lisibilité sans faille tant à l’écran qu’à la reproduction xérographique monochrome ;
- Normalisation typographique : L’intégralité des textes du graphique (titres d’axes, étiquettes numériques, libellés de modalités) doit être harmonisée au moyen d’une police institutionnelle sans empattement telle qu’Arial ou Calibri, ou avec empattement comme Times New Roman, avec un calibrage typographique oscillant rigoureusement entre 9 et 11 points.
10.2 Formatage méticuleux des axes et de l’échelle métrique
L’axe vertical ordonné constitue le pivot métrologique du diagramme. Son calibrage par défaut sous Excel laisse souvent à désirer en instanciant des marges basales excessives ou en générant des incréments aux granularités peu intuitives. En sélectionnant l’axe des ordonnées et en déployant le panneau Format de l’axe, le chercheur doit en verrouiller explicitement les bornes minimale et maximale.
Il est impératif de configurer l’axe de manière à refléter fidèlement l’espace d’expression réel de la variable psychologique. Si une échelle clinique est bornée théoriquement entre 0 et 80 points, fixer arbitrairement le minimum à 20 sous prétexte qu’aucun sujet n’a obtenu moins déforme la perception de la gravité globale de l’échantillon. L’axe doit idéalement débuter à 0 pour ancrer la perspective basale, sauf contrainte spécifique liée à des temps de réaction physiologiques. Les graduations principales doivent adopter des incréments décimaux ou cardinaux cohérents (ex. par pas de 10 ou 50 unités). Enfin, l’axe vertical doit obligatoirement être affublé d’un titre formel mentionnant expressément la variable dépendante ainsi que son unité métrique précise (ex. « Temps de réponse moyen (en millisecondes) » ou « Score total d’inhibition cognitive »).
10.3 Gestion de la largeur de l’intervalle et de l’épaisseur du tracé
L’équilibre sémiotique d’une figure réside également dans le rapport spatial entre les surfaces occupées par les boîtes et les intervalles de vide qui les séparent. Dans le panneau latéral des options de séries, le paramètre Largeur de l’intervalle (Gap Width) régit cette proportion géométrique. Par défaut, Excel applique fréquemment une largeur d’intervalle approchant 100 %, conférant aux boîtes une allure effilée et grêle.
Pour conférer à la figure une assise académique robuste, il est recommandé d’ajuster la largeur de l’intervalle à une valeur comprise entre 50 % et 75 %. Cette modification épaissit harmonieusement le corps des boîtes, rendant la visibilité des lignes médianes et des croix arithmétiques infiniment plus accessible lors de la réduction à l’échelle d’une colonne de revue scientifique. Les contours des boîtes et des moustaches doivent être réglés sur une teinte noire unie d’une épaisseur minimale de 1 point. Lors de la phase terminale d’exportation, le graphique devra être extrait sous forme vectorielle ou copié en tant qu’image vectorielle améliorée (EMF/PDF) ou matricielle haute définition à 300 DPI minimum, garantissant une absence totale de pixellisation à l’impression.
11. Subtilités computationnelles d’Excel : Quartile.INC vs Quartile.EXC
11.1 La divergence algorithmique interne du moteur Excel
L’un des écueils méthodologiques les plus insidieux guettant l’analyste sous Microsoft Excel réside dans la coexistence de deux modes algorithmiques distincts pour le calcul des centiles. Historiquement, Excel a utilisé une formule d’interpolation continue dite « inclusive », formalisée par la fonction contemporaine QUARTILE.INCLURE (ou QUARTILE.INC). Cependant, depuis la version 2010, Microsoft a introduit une seconde syntaxe basée sur la logique probabiliste dite « exclusive », modélisée par la fonction QUARTILE.EXCLURE (ou QUARTILE.EXC).
La divergence entre ces deux formules réside dans le positionnement théorique du rang percentil :
QUARTILE.INCLUREcalcule le rang $k$ selon la relation $k = 1 + (n – 1) \times p$, où $n$ est l’effectif total et $p$ la proportion du quantile souhaité (ex. 0,25 pour $Q_1$). Cette formule intègre les bornes de l’échantillon comme des probabilités accessibles de 0 et 1 ;QUARTILE.EXCLUREmodélise le rang selon la relation $k = p \times (n + 1)$, partant du postulat que les valeurs de l’échantillon ne peuvent atteindre rigoureusement les probabilités cumulées extrêmes de la population sous-jacente.
Au sein d’un échantillon restreint ($n < 30$), ces deux algorithmes génèrent des estimations sensiblement différentes de $Q_1$ et $Q_3$. Par défaut, le moteur graphique natif des versions récentes d'Excel s'aligne préférentiellement sur l'algorithme exclusif, ce qui a pour conséquence mécanique d’élargir légèrement l’écart interquartile calculé par rapport à la méthode classique inclusive traditionnellement enseignée dans les manuels élémentaires.
11.2 Comparaison avec les progiciels statistiques dédiés (R, SPSS, Jamovi)
Cette particularité computationnelle explique pourquoi un chercheur transférant un même fichier de données brutes d’Excel vers des logiciels spécialisés comme SPSS ou le langage R constate fréquemment des écarts légers mais déroutants dans l’emplacement exact des charnières de ses boîtes à moustaches. Dans le langage R, par exemple, la fonction native quantile() met à disposition pas moins de neuf types d’algorithmes différents, le type 7 étant configuré par défaut (correspondant au QUARTILE.INC d’Excel), tandis que la fonction génératrice du graphique boxplot() mobilise historiquement les « charnières de Tukey » pures, qui reposent sur des calculs de médianes séquentielles de sous-groupes.
Sous SPSS, l’estimation des quantiles dans la procédure EXAMINE s’effectue par défaut selon la méthode de Tukey ou l’estimation par moyenne pondérée, lesquelles ne coïncident pas nécessairement avec le rendu d’Excel. En conséquence, la rigueur épistémique exige qu’un article de recherche ou un rapport clinique spécifie explicitement dans la section méthodologique la méthode computationnelle mobilisée. Il est impératif pour le chercheur de procéder à une validation croisée en calculant manuellement les valeurs au moyen des fonctions statistiques dans le tableur pour s’assurer que le graphique projeté par le moteur visuel concorde scrupuleusement avec les tableaux numériques annexés au rapport.
11.3 Formules manuelles alternatives pour un contrôle expérimental absolu
Lorsque des exigences éditoriales strictes imposent un modèle de boîte à moustaches dont les clôtures s’écartent du standard natif d’Excel (par exemple, si la revue requiert que les extrémités des moustaches figurent impérativement le 5e et le 95e centile, ou la moyenne $\pm 1,96$ erreur standard), le générateur natif d’Excel se trouve structurellement limité car ses paramètres de clôtures sont rigoureusement verrouillés en dur par les développeurs de Microsoft. Dans ces circonstances exceptionnelles, l’analyste expérimenté contournera cette limitation en bâtissant sa propre boîte à moustaches « sur mesure » via les graphiques combinés ou boursiers.
Cette approche experte repose sur le déploiement d’une table de synthèse matricielle alimentée par les fonctions statistiques suivantes :
=MIN.SI.CONDITIONS(...)ou=PETITE.VALEUR(...)pour les minima personnalisés ;=QUARTILE.INCLURE(plage; 1)pour le premier quartile maîtrisé ;=MEDIANE(plage)pour la tendance centrale robuste ;=MOYENNE(plage)pour le paramètre arithmétique complémentaire ;=QUARTILE.INCLURE(plage; 3)pour le troisième quartile ;=CENTILE.INCLURE(plage; 0,95)pour une borne supérieure sur mesure.
À partir de cette table condensée, l’analyste recourt à un graphique à barres empilées dont il rend certains segments invisibles (remplissage nul), ou à un Graphique boursier (spécifiquement le sous-type Max-Min-Clôture), en détournant ses composants pour figurer le corps et les barres d’erreur de Tukey. Cette méthode avancée restitue à l’expérimentateur un contrôle géométrique absolu sur l’affichage de chaque pixel de sa figure.
12. Étude de cas empirique : Analyse de temps de réaction en psychologie cognitive
12.1 Présentation du jeu de données et contexte expérimental
Afin de cristalliser l’ensemble de ces préceptes conceptuels et opératoires au sein d’une démonstration pratique, nous mobilisons un paradigme expérimental classique de psychologie cognitive : la tâche d’interférence verbale de type Stroop informatisée. Dans cette tâche, les participants sont placés face à un écran et doivent identifier le plus rapidement possible la couleur de l’encre dans laquelle un mot est imprimé, en inhibant la lecture automatique du mot sémantique lui-même.
Le protocole a été administré à un échantillon homogène de 60 étudiants universitaires ($N = 60$). Chaque participant a été soumis à deux conditions expérimentales distinctes au sein d’un plan à mesures répétées contrebalancé :
- Condition Congruente : Le mot sémantique coïncide avec la teinte de l’encre (ex. le mot « VERT » imprimé en vert) ;
- Condition Incongruente : Le mot sémantique entre en conflit frontal avec la teinte d’affichage (ex. le mot « ROUGE » imprimé en bleu), sollicitant un coût d’inhibition cognitive majeur sous peine d’erreur motrice.
La variable dépendante analysée réside dans la latence de réponse correcte, enregistrée numériquement avec une précision millimétrique en millisecondes (ms). Dans ce type de paradigme chronométrique, les données sont notoirement polluées par des temps de réponse ultra-courts accidentels (déclenchements moteurs anticipatoires n’ayant pas traité le stimulus) et par des latences démesurément longues consécutives à des micro-décrochages attentionnels transitoires. La boîte à moustaches constitue précisément l’outil idoine pour assainir et analyser cette cinématique mentale.
12.2 Exécution intégrale du traitement graphique sous Excel
Les données brutes issues du logiciel d’expérimentation sont importées dans Microsoft Excel et structurées sous forme de deux colonnes contiguës : la colonne A labellisée Stroop_Congruent (cellules A2 à A61) et la colonne B labellisée Stroop_Incongruent (cellules B2 à B61). L’application immédiate de la fonction de tri et de filtres conditionnels confirme l’absence de cellules textuelles corrompues ou de zéros accidentels.
Le protocole opératoire est déroulé avec rigueur :
- L’analyste sélectionne la plage globale
A1:B61en intégrant les libellés de la première ligne ; - Dans le ruban supérieur, clic sur l’onglet Insertion, puis sur l’icône Insérer un graphique statistique, et sélection définitive de l’option Boîte et moustaches ;
- Le graphique généré est redimensionné à des proportions canoniques de 12 cm de hauteur sur 10 cm de largeur pour éviter tout tassement optique ;
- Accès aux Éléments de graphique pour cocher Étiquettes de données et Titres des axes, tout en décochant le quadrillage d’arrière-plan ;
- Ouverture du volet latéral Mise en forme des séries de données : réglage de la Largeur de l’intervalle à 60 %, vérification que l’option Afficher les points hors limites est bien cochée, et sélection de l’affichage du Marqueur de moyenne.
Le dépouillement des paramètres statistiques affichés par Excel livre les résultats empiriques suivants pour les deux conditions chronométriques :
- Condition Congruente : Minimum non aberrant = 412 ms ; $Q_1$ = 478 ms ; Médiane = 525 ms ; Moyenne = 534 ms ; $Q_3$ = 582 ms ; Maximum non aberrant = 715 ms. Deux points hors limites isolés sont automatiquement projetés par le logiciel à 760 ms et 795 ms ;
- Condition Incongruente : Minimum non aberrant = 530 ms ; $Q_1$ = 645 ms ; Médiane = 730 ms ; Moyenne = 748 ms ; $Q_3$ = 840 ms ; Maximum non aberrant = 1 095 ms. Un point aberrant sévère est détecté à 1 180 ms.
12.3 Rédaction de l’interprétation scientifique pour un rapport de recherche
La transcription des constats graphiques au sein de la section « Résultats » d’un manuscrit soumis à publication scientifique obéit à une rhétorique rigoureuse, articulant les dimensions descriptives, les constats morphologiques et les conclusions méthodologiques. Le texte rédigé selon les standards académiques s’énonce comme suit :
« L’examen comparatif des distributions chronométriques au moyen de boîtes à moustaches révèle un effet d’interférence cognitive classique entre les deux modalités de la tâche de Stroop informatisée (voir Figure 1). En condition congruente, les participants exhibent une latence de réponse médiane de 525 millisecondes, adossée à un écart interquartile relativement restreint de 104 ms ($Q_1 = 478\text{ ms}$, $Q_3 = 582\text{ ms}$), témoignant d’une exécution motrice hautement homogène et automatisée. La quasi-concordance de la médiane et de la moyenne arithmétique ($M = 534\text{ ms}$), conjuguée à une symétrie presque parfaite des moustaches (minimum non aberrant à 412 ms, maximum non aberrant à 715 ms), atteste d’une distribution remarquablement stable, à l’exception de deux latences périphériques isolées au-delà de la clôture supérieure de Tukey à 760 ms et 795 ms. »
« En condition conflictuelle incongruente, l’édifice distributionnel subit un décalage massif vers les latences élevées, matérialisé par une médiane s’élevant à 730 millisecondes, confirmant un coût d’inhibition attentionnelle substantiel par rapport à la modalité neutre. Parallèlement à cette élévation de la tendance centrale, la boîte à moustaches met en évidence une explosion de la variabilité interindividuelle : l’écart interquartile s’élargit substantiellement pour atteindre 195 ms ($Q_1 = 645\text{ ms}$, $Q_3 = 840\text{ ms}$), signifiant un doublement de l’hétérogénéité des temps de réponse sous contrainte cognitive. Le non-recouvrement quasi total des rectangles interquartiles — le bord inférieur $Q_1$ de la condition incongruente (645 ms) excédant nettement le bord supérieur $Q_3$ de la condition congruente (582 ms) — fournit une indication empirique irréfutable de la puissance de l’effet d’interférence. La moustache supérieure étirée jusqu’à 1 095 ms ainsi que la présence d’une valeur atypique à 1 180 ms illustrent la présence d’une asymétrie positive marquée, symptomatique de la survenue ponctuelle d’échecs de filtrage exécutif chez certains participants, justifiant pleinement l’application conjointe de procédures statistiques robustes pour l’analyse inférentielle. »
Par cette synthèse textuelle, le chercheur valorise l’intégralité du pouvoir expressif de la figure générée sous Excel. Loin d’être un simple artifice d’illustration, la boîte à moustaches s’affirme comme un levier heuristique de premier plan, capable d’articuler avec une редoutable économie de moyens l’architecture de la variabilité humaine, l’intégrité du protocole empirique et la validité des conclusions scientifiques.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Frigge, M., Hoaglin, D. C., & Iglewicz, B. (1989). Some implementations of the boxplot. The American Statistician, 43(1), 50–54. https://doi.org/10.1080/00031305.1989.10475612
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- MacLeod, C. M. (1991). Half a century of research on the Stroop effect: An integrative review. Psychological Bulletin, 109(2), 163–203. https://doi.org/10.1037/0033-2909.109.2.163
- McGill, R., Tukey, J. W., & Larsen, W. A. (1978). Variations of box plots. The American Statistician, 32(1), 12–16. https://doi.org/10.1080/00031305.1978.10479236
- Rousselet, G. A., Pernet, C. R., & Wilcox, R. R. (2017). Beyond differences in means: Robust graphical methods to compare two groups in neuroscience and experimental psychology. European Journal of Neuroscience, 46(2), 1738–1748. https://doi.org/10.1111/ejn.13610
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H., & Stryjewski, L. (2011). 40 years of boxplots. Technical Report, Amstat. https://vita.had.co.nz/papers/boxplots.pdf
- Wilcox, R. R. (2012). Introduction to robust estimation and hypothesis testing (3rd ed.). Academic Press. https://doi.org/10.1016/C2010-0-67044-1