
Dans le champ de la statistique descriptive contemporaine, la synthèse d’ensembles volumineux de données constitue l’une des étapes fondamentales de l’exploration analytique. Qu’il s’agisse d’évaluer les résultats d’essais cliniques, de sonder les dynamiques comportementales de consommateurs ou de calibrer des instruments psychométriques, la manipulation des effectifs bruts présente des limites heuristiques majeures dès lors que la taille des échantillons varie ou que la complexité des distributions s’accroît. Pour transcender ces contraintes, les chercheurs et les analystes recourent à la distribution de fréquences en pourcentage, un instrument mathématique qui standardise le dénombrement des observations sur une base centésimale commune.
L’environnement logiciel Microsoft Excel s’impose comme une référence incontournable pour modéliser, transformer et restituer ces structures distributionnelles. Loin de se limiter à de simples opérations arithmétiques élémentaires, le tableur intègre désormais des moteurs de calcul matriciel dynamique, des fonctions statistiques de pointe et des architectures tabulaires relationnelles permettant d’automatiser entièrement la chaîne de traitement, depuis les données brutes jusqu’aux visualisations graphiques conformes aux standards académiques les plus stricts.
Ce guide exhaustif a pour vocation d’exposer avec une rigueur méthodologique absolue les fondements théoriques, les mécanismes de calcul algorithmique et les protocoles de validation nécessaires à l’élaboration d’une distribution de fréquences en pourcentage dans Excel. En explorant tant les approches formulaires traditionnelles que les innovations matricielles récentes (fonctions dynamiques, lambda-expressions et tableaux croisés dynamiques), ce document offre une référence analytique complète destinée aux chercheurs, ingénieurs et spécialistes du traitement quantitatif de l’information.
1. Fondements théoriques de la distribution de fréquences en pourcentage en analyse quantitative
1.1 Définition et distinction entre fréquence absolue, relative et en pourcentage
La caractérisation systématique d’une série statistique commence invariablement par la quantification des occurrences de chaque événement ou valeur observée. La fréquence absolue, communément notée ni, représente le dénombrement brut d’unités statistiques associées à une modalité spécifique xi au sein d’un échantillon fini de taille N. Bien que cette métrique reflète fidèlement l’amplitude empirique d’un phénomène dans un contexte donné, elle demeure intrinsèquement tributaire du volume global des données récoltées. L’effectif brut ne permet pas, à lui seul, d’extrapoler des comparaisons pertinentes avec d’autres séries expérimentales dont les effectifs totaux diffèrent.
Pour contourner cet écueil dimensionnel, l’analyste fait appel au concept de fréquence relative, notée formellement fi. Algébriquement, celle-ci correspond au rapport de la fréquence absolue observée sur l’effectif total de la population ou de l’échantillon, soit l’équation fi = ni / N. Par construction axiomatique, la fréquence relative constitue une proportion mathématique strictement bornée dans l’intervalle fermé [0, 1]. Cette métrique possède une propriété de clôture remarquable : la somme de l’ensemble des fréquences relatives associées aux k modalités mutuellement exclusives et exhaustivement observables d’une variable aléatoire discrète est rigoureusement égale à l’unité (Σ fi = 1 pour i variant de 1 à k).
La fréquence en pourcentage (ou fréquence centésimale), conventionnellement désignée par pi, ne constitue qu’un redimensionnement homothétique de la fréquence relative appliqué à une base de cent. Définie par la relation pi = fi × 100, elle exprime la part que prendrait chaque catégorie si l’échantillon d’origine était exactement ramené à un effectif théorique de cent unités. Les propriétés algébriques fondamentales demeurent préservées : les valeurs individuelles sont confinées à l’intervalle [0 %, 100 %] et leur sommation intégrale converge infailliblement vers 100 %. Cette normalisation constitue le pivot sémiotique facilitant l’appréhension intuitive des proportions relatives sans altérer l’intégrité probabiliste de la distribution d’origine.
1.2 Importance épistémologique dans la réduction des données expérimentales
Dans la démarche scientifique, l’agrégation de données ne vise pas simplement à condenser l’information, mais à révéler les structures sous-jacentes du phénomène étudié tout en filtrant le bruit stochastique. L’adoption des distributions de fréquences en pourcentage remplit une fonction épistémologique centrale : la standardisation des métriques. En s’affranchissant du volume absolu de l’échantillon, le chercheur élimine les biais d’échelle qui polluent l’évaluation comparative entre sous-groupes dissemblables, par exemple lors de la confrontation d’une cohorte clinique de 45 patients avec une cohorte épidémiologique de 12 000 individus.
Cette standardisation s’avère particulièrement critique dans l’analyse préliminaire des distributions d’échantillonnage. En statistique inférentielle, l’examen visuel et quantitatif de la dispersion centésimale permet d’identifier précocement des déséquilibres structurels tels que la surreprésentation d’une modalité, la présence de queues de distribution asymétriques ou la bimodalité d’un corpus. En neutralisant l’effet de taille, l’analyste peut superposer des profils de réponse, estimer des taux de prévalence standardisés et détecter d’éventuels artéfacts de mesure avec une acuité visuelle et mathématique accrue.
Enfin, sur le plan de la communication cognitive, l’esprit humain traite avec une efficience nettement supérieure des grandeurs normalisées par rapport à des séries d’entiers naturels discontinus. Réduire un tableau multidimensionnel hétérogène de plusieurs milliers de lignes à un vecteur ordonné de pourcentages permet de minimiser la charge cognitive de l’observateur. Cette transformation prépare le terrain à une restitution synthétique conforme aux standards de diffusion scientifique, consolidant ainsi la robustesse interprétative des résultats préliminaires.
1.3 Champs d’application : de la psychométrie à la modélisation statistique
L’utilisation des distributions de fréquences relatives centésimales traverse l’ensemble des disciplines quantitatives. En psychométrie, cette approche est systématiquement mobilisée pour étalonner les instruments de mesure tels que les inventaires de personnalité, les échelles de dépistage clinique ou les tests d’aptitude cognitive. L’analyse des fréquences en pourcentage permet de vérifier si les différents échelons d’une échelle de Likert (par exemple de 1 à 7) discriminent efficacement les sujets ou si certains seuils de réponse souffrent d’un effet de plancher ou d’un effet de plafond indésirable.
Dans le domaine de l’économétrie et de la modélisation prédictive, l’examen de la distribution de fréquences constitue le jalon obligatoire préalable au déploiement de régressions logistiques, de modèles de survie ou d’arbres de classification. Il permet de mesurer le degré d’asymétrie empirique (skewness) et la kurtose de variables cibles catégorielles. Face à une distribution montrant qu’un événement binaire ne survient que dans 2 % des cas observés, le statisticien saura immédiatement qu’il fait face à un problème de classes déséquilibrées (imbalanced dataset), requérant des techniques d’échantillonnage adaptées comme le sur-échantillonnage (SMOTE) ou l’ajustement des fonctions de coût.
Enfin, dans le cadre de la théorie des probabilités appliquées, la table des fréquences centésimales sert de passerelle empirique vers la construction de tables de probabilités discrètes. En vertu de la loi forte des grands nombres, lorsque la taille de l’échantillon N tend vers l’infini, la fréquence relative observée d’un événement converge presque sûrement vers sa probabilité théorique intrinsèque. Ainsi, la distribution empirique en pourcentage devient une approximation robuste de la fonction de masse de probabilité régissant le système physique, biologique ou social analysé.
2. Préparation et structuration rigoureuse des données brutes dans Excel
2.1 Typologie des variables : catégorielles, discrètes et continues discrétisées
Avant d’initier toute formule de comptage au sein d’Excel, une classification taxonomique scrupuleuse des variables s’impose, car le traitement algorithmique diffère fondamentalement selon la nature de l’espace d’états de la variable étudiée. Les variables qualitatives nominales (telles que le groupe sanguin, le statut marital ou le pays de résidence) et les variables qualitatives ordinales (comme le niveau d’instruction ou l’adhésion à une proposition graduée) possèdent un ensemble fini de modalités textuelles ou alphanumériques directement dénombrables sans modification mathématique préalable.
Les variables quantitatives discrètes, issues d’un processus de comptage et ne prenant que des valeurs entières (par exemple, le nombre d’admissions journalières dans un service d’urgence ou le nombre d’anomalies sur une chaîne de fabrication), se prêtent également à une extraction directe des modalités, à la condition expresse que leur étendue globale demeure modérée. Si le spectre des valeurs discrètes s’étend sur plusieurs milliers d’entiers distincts, le traitement analytique devra s’aligner sur celui des variables continues.
Enfin, les variables quantitatives continues (telles que la pression artérielle, le salaire, le temps d’attente ou la concentration molaire) ont pour support formel l’ensemble des réels ℝ. Pour ces variables, la probabilité théorique qu’une valeur se répète à l’identique est nulle si la précision de mesure est infinie. Il est par conséquent impératif de procéder à une opération de discrétisation préalable (binning), consistant à découper le continuum en un ensemble partitionné de classes d’intervalles mutuellement disjointes avant de pouvoir calculer la moindre distribution de fréquences intelligible.
2.2 Nettoyage et vérification de l’intégrité du jeu de données source
La qualité d’une analyse statistique dépend directement de la propreté du jeu de données primaire. Excel interprète les chaînes textuelles avec une sensibilité stricte aux espaces et aux variations de caractères invisibles. L’un des écueils les plus fréquents réside dans la présence d’espaces résiduels initiaux, terminaux ou multiples au sein des chaînes textuelles. L’utilisation systématique de la fonction SUPPRESPACE (ou TRIM dans les environnements anglophones) combinée à EPURAGE (CLEAN) garantit l’éradication des espaces superflus et des caractères non imprimables hérités de l’exportation depuis des bases de données SQL ou des fichiers CSV.
L’harmonisation de la casse textuelle représente un second impératif méthodologique. Bien que certaines fonctions de recherche d’Excel ne soient pas sensibles à la casse par défaut, l’intégrité visuelle et la manipulation matricielle requièrent une standardisation uniforme. L’emploi de la fonction MAJUSCULE, MINUSCULE ou NOMPROPRE sur le vecteur source prévient l’émergence de faux doublons lors de l’application d’outils de déduplication stricts.
Le traitement des données manquantes, classiquement étiquetées NA, N/A, None ou simplement matérialisées par des cellules vides, doit obéir à une stratégie préétablie. Laisser des cellules vides non qualifiées peut fausser le dénominateur lors de la sommation de l’échantillon effectif. Il convient d’appliquer une imputation formalisée ou d’isoler explicitement ces observations sous une modalité générique « Non déclaré » ou « Donnée manquante », évitant ainsi que le comptage global ne sous-estime l’assiette totale de collecte.
2.3 Organisation tabulaire optimale pour l’automatisation du calcul
L’architecture spatiale du classeur Excel détermine la pérennité et la fluidité des calculs statistiques. Il est impératif d’adopter les préceptes de la structure de données relationnelle plate (tidy data). Selon cette approche, chaque ligne doit impérativement représenter une unité observationnelle unique (un individu, une transaction, un échantillon biologique), et chaque colonne doit correspondre à une variable mesurée spécifique, sans aucune cellule fusionnée au sein de la matrice opérationnelle.
La ligne sommitale de cette matrice doit accueillir des en-têtes explicites, rédigés sans espaces complexes ni caractères diacritiques non standard, afin de faciliter leur référencement dans les syntaxes de formules avancées. Les données brutes doivent être sanctuarisées dans une feuille de calcul dédiée ou converties formellement en Tableau structuré Excel (via la commande Ctrl + L ou le ruban Accueil > Mettre sous forme de tableau). Ce dispositif confère un nommage global à la matrice et active les références structurées dynamiques.
Il est vivement déconseillé, d’un point de vue ergonomique et algorithmique, d’implanter la table de distribution analytique sur la même feuille de calcul immédiatement en dessous des données brutes. Une séparation stricte par onglets (un onglet « Source_Données » et un onglet « Analyse_Distribution ») isole l’espace de calcul de l’espace de stockage. Cette disposition évite les risques d’écrasement de données lors de filtres manuels et permet au tableur d’optimiser l’allocation de mémoire lors du recalcul automatique du classeur.
3. Extraction des modalités uniques : utilisation avancée de la fonction UNIQUE
3.1 Fonctionnement et syntaxe de la formule UNIQUE dans les versions modernes d’Excel
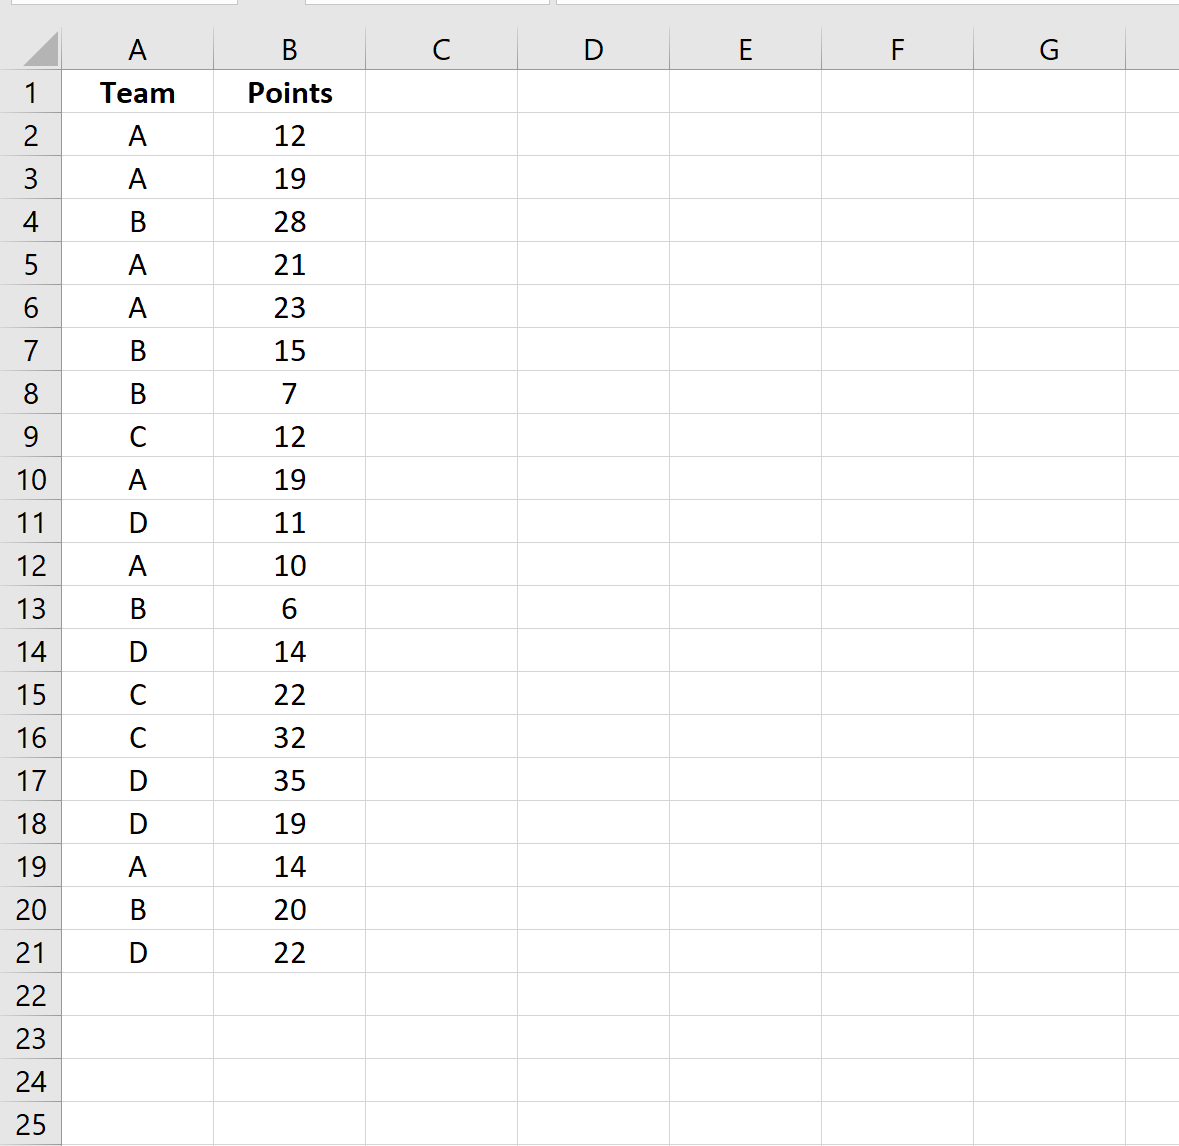
L’avènement du moteur de calcul dynamique dans Microsoft 365 et Excel 2021 a révolutionné l’extraction des catégories distinctes grâce à l’introduction de la fonction matricielle native UNIQUE. Auparavant tributaire de macros complexes ou de formules matricielles lourdes, l’identification de l’univers des modalités s’opère désormais au travers d’une syntaxe concise et élégante : =UNIQUE(tableau; [par_colonne]; [exactement_une_fois]).
L’argument principal tableau spécifie la plage de cellules ou la référence structurée contenant le vecteur de données brutes. Les deux arguments facultatifs, booléens, affinent le comportement de l’extraction : par_colonne détermine si l’analyse s’effectue ligne par ligne (valeur FAUX ou omis) ou colonne par colonne (valeur VRAI). L’argument exactement_une_fois, lorsqu’il est positionné sur FAUX (comportement standard), extrait chaque modalité distincte présente dans la source ; s’il est fixé à VRAI, il filtre strictement les éléments qui n’apparaissent qu’une seule et unique fois dans l’échantillon, éliminant tout élément ayant fait l’objet de répétitions.
Le principal atout de la fonction UNIQUE réside dans sa capacité de déversement (spill range). Dès lors que la formule est validée dans une cellule racine, le moteur d’Excel alloue dynamiquement une plage verticale contiguë capable d’accueillir l’ensemble des modalités uniques identifiées. Si de nouvelles lignes sont adjointes ultérieurement au tableau de données sources, la fonction réévalue son résultat et agrandit automatiquement le vecteur déversé sans aucune intervention humaine manuelle.
3.2 Gestion du débordement matriciel et résolution des erreurs potentielles
Bien que d’une efficacité redoutable, le mécanisme de propagation matricielle peut générer des anomalies opérationnelles, au premier rang desquelles figure l’erreur de blocage #PROPAGATION! (ou #SPILL!). Cette rupture algorithmique se produit lorsqu’au moins une cellule située dans la zone d’extension théorique de la matrice déversée contient une valeur résiduelle, un texte masqué, un formatage interférant ou une formule préexistante. La résolution exige l’identification et la libération intégrale de l’espace physique requis par la matrice.
Pour exploiter pleinement la dynamicité de cette extraction dans les étapes ultérieures du calcul, Excel met à disposition l’opérateur de plage déversée, matérialisé par le symbole dièse (#). Si la formule =UNIQUE(TableauSource[Categorie]) est implantée en cellule D2, la référence syntaxique D2# permet de cibler instantanément l’intégralité du vecteur des modalités uniques, quelle que soit sa longueur future. Cette notation élimine les risques d’oublis de bornage inhérents aux coordonnées statiques classiques de type D2:D15.
Dans une perspective de clarté analytique, il est généralement requis d’ordonner alphabétiquement ou numériquement les modalités uniques ainsi extraites. L’imbrication de la fonction TRIER autour de la fonction UNIQUE constitue la norme méthodologique d’excellence. La formule synthétique s’écrit alors : =TRIER(UNIQUE(TableauSource[Categorie])). Cette composition assure une présentation logique immédiate des catégories dans la table de distribution de fréquences finale.
3.3 Techniques alternatives pour les versions antérieures d’Excel
Dans les contextes d’infrastructure legacy ou de compatibilité avec des versions d’Excel antérieures à 2021 (telles qu’Excel 2016, 2013 ou 2010), l’absence du moteur de matrices dynamiques impose le recours à des méthodologies alternatives éprouvées. La technique native la plus directe consiste à utiliser l’outil d’élimination des doublons accessible via le ruban Données > Supprimer les doublons. Cependant, cette méthode présente l’inconvénient destructif d’être statique : toute modification ultérieure du jeu de données impose une réexécution manuelle du protocole de déduplication.
Pour obtenir un équivalent dynamique sur les versions historiques, les analystes chevronnés déploient une formule matricielle associant les fonctions INDEX, EQUIV et NB.SI. Implantée dans la première cellule de sortie et validée traditionnellement par la combinaison de touches Ctrl + Maj + Entrée, la structure algorithmique type se présente sous la forme suivante :
=SIERREUR(INDEX($A$2:$A$100; EQUIV(0; NB.SI($D$1:D1; $A$2:$A$100); 0)); "")
Dans cette formulation rigoureuse, $A$2:$A$100 représente le vecteur source des observations brutes, tandis que $D$1:D1 désigne la plage cumulative située immédiatement au-dessus de la cellule réceptrice. Le segment NB.SI($D$1:D1; $A$2:$A$100) renvoie un vecteur de zéros et de uns identifiant les occurrences déjà listées. La fonction EQUIV localise ensuite la position du premier zéro (représentant le premier élément non encore affiché), permettant à INDEX d’extraire la modalité correspondante. Bien que fonctionnelle, cette construction souffre d’une complexité algorithmique quadratique O(n²), induisant de lourdes latences de calcul sur de grands volumes de données.
4. Calcul des fréquences absolues à l’aide de la fonction NB.SI
4.1 Syntaxe formelle et paramétrage de la fonction NB.SI
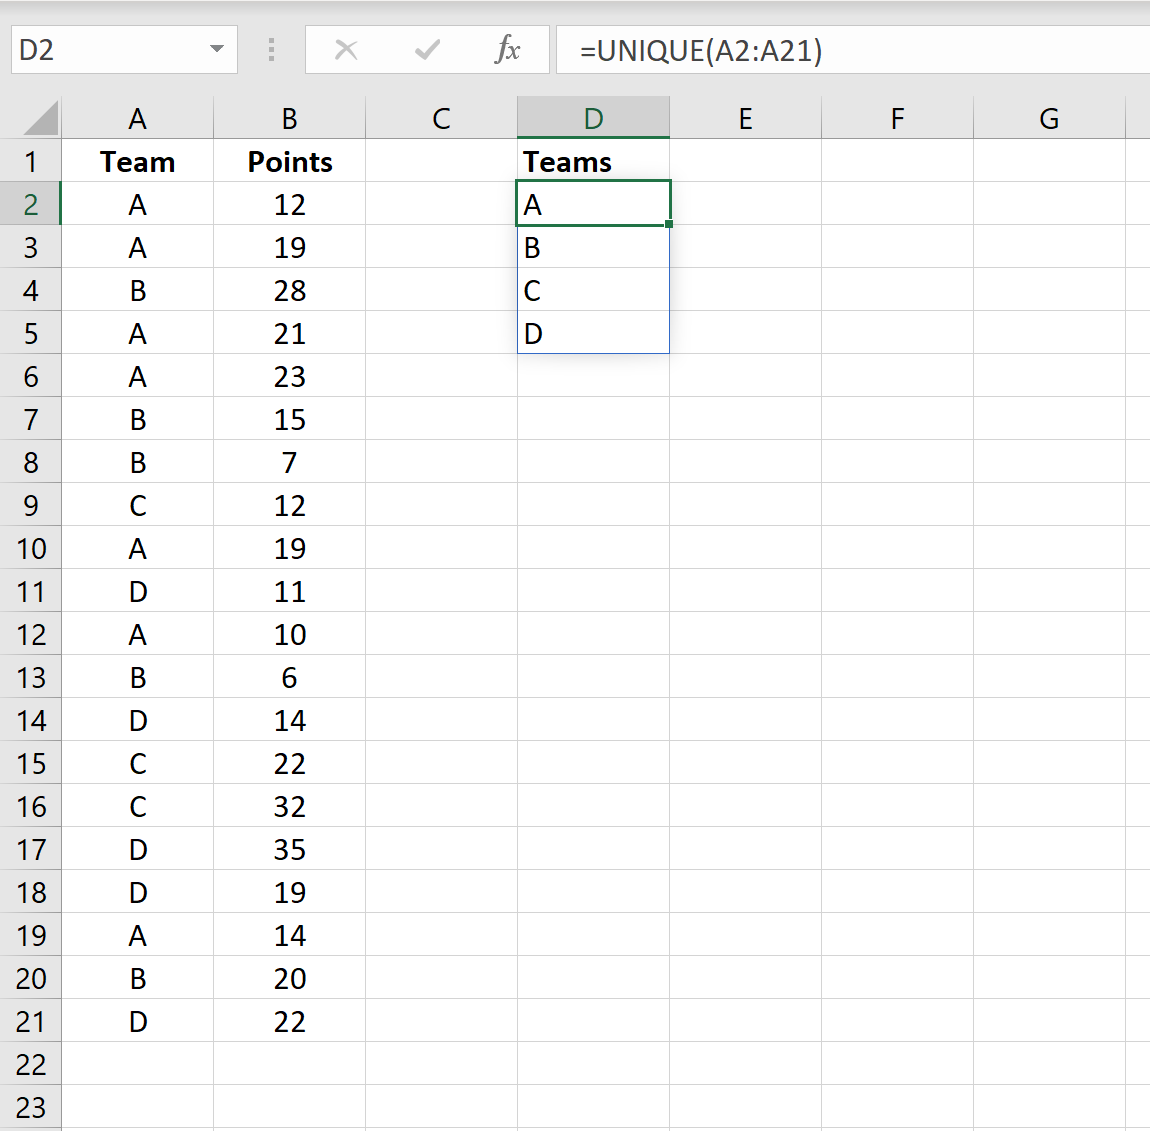
Une fois le répertoire des modalités uniques établi, la phase consécutive réside dans le dénombrement effectif des occurrences de chaque catégorie au moyen de la fonction native NB.SI (ou COUNTIF). Cette fonction statistique évalue le nombre de cellules au sein d’une plage donnée qui satisfont rigoureusement un critère prédéterminé. Son expression syntaxique universelle est définie par : =NB.SI(plage; critère).
Le paramètre plage circonscrit le domaine spatial des observations brutes à auditer, tandis que l’argument critère spécifie la condition logique ou la modalité exacte à comptabiliser. Dans le cadre de l’automatisation analytique, le critère ne doit jamais être saisi en chaîne textuelle figée (comme "Catégorie A"), mais doit impérativement faire référence à la cellule dynamique contenant la modalité unique extraite lors de l’étape précédente (par exemple, la cellule D2).
Il est fondamental de noter que la fonction NB.SI adopte un comportement agnostique face au typage textuel : elle ne discrimine pas les majuscules des minuscules, ce qui assure une certaine tolérance aux disparités mineures de casse. En revanche, lorsqu’elle est confrontée à des chaînes numériques volumineuses excédant 15 chiffres (tels que des codes-barres ou des numéros d’identification de cartes bancaires), NB.SI tronque la comparaison en raison des limites de précision en virgule flottante d’Excel régies par la norme IEEE 754, contraignant l’analyste à ajouter une apostrophe textuelle ou à recourir à la fonction SOMMEPROD pour éviter des comptages fallacieux.
4.2 Gestion du verrouillage des plages avec les références absolues
L’implémentation pérenne de la formule NB.SI requiert une maîtrise absolue des mécanismes d’adressage au sein de la grille de calcul. Par défaut, Excel applique un adressage relatif (par exemple A2:A100). Si l’analyste étire la formule verticalement vers le bas pour dénombrer les modalités subsidiaires, la plage de recherche glisse corrélativement (devenant A3:A101, puis A4:A102), ce qui altère de manière catastrophique la fenêtre temporelle de collecte et exclut arbitrairement les premières observations du comptage.
Pour sanctuariser l’intégrité de la zone de calcul, l’usage des références absolues est impératif. L’insertion du symbole dollar devant l’indice de colonne et le numéro de ligne permet d’ancrer définitivement la plage : $A$2:$A$100. La formule inscrite en E2 pour compter la modalité présente en D2 prend alors la forme canonique : =NB.SI($A$2:$A$100; D2). Lors de la recopie incrémentale vers le bas, la référence au critère (D2) évoluera librement vers D3, D4, etc., tandis que le domaine d’interrogation demeurera rigoureusement stationnaire.
L’emploi de tableaux structurés offre une alternative architecturale encore plus robuste. En substituant aux coordonnées spatiales l’adressage relationnel, la formule se transpose en =NB.SI(TableauSource[Categorie]; D2). Cette formalisation s’auto-verrouille nativement sans nécessiter l’adjonction explicite de symboles dollars et présente l’immense avantage d’ajuster automatiquement sa zone d’écoute chaque fois qu’une nouvelle observation est insérée dans la source.
4.3 Extension aux critères multiples avec la fonction NB.SI.ENS
Dans de nombreuses applications scientifiques ou managériales, la caractérisation d’une distribution ne se limite pas à un seul vecteur unidimensionnel. Il est fréquemment nécessaire de dresser une distribution conditionnelle croisant plusieurs facteurs indépendants, comme la répartition des profils psychopathologiques croisée avec les tranches d’âge et le genre biologique des sujets. Pour modéliser cette complexité, la fonction NB.SI.ENS (ou COUNTIFS) déploie une logique booléenne cumulative de type ET logique.
La syntaxe canonique de NB.SI.ENS requiert l’alternance ordonnée des plages de recherche et de leurs critères correspondants : =NB.SI.ENS(plage_critères1; critère1; [plage_critères2; critère2]; ...). Pour comptabiliser, par exemple, le nombre d’occurrences d’une modalité D2 sous la condition restrictive qu’un indicateur qualitatif secondaire situé en colonne B réponde au critère « Actif », la formulation mathématique s’établit comme suit :
=NB.SI.ENS($A$2:$A$100; D2; $B$2:$B$100; "Actif")
Cette approche permet de générer des matrices de contingence multidimensionnelles. Chaque cellule de résultat représente l’intersection ensembliste de plusieurs événements simultanés. La distribution résultante offre une base empirique pour calculer ultérieurement des distributions conjointes et conditionnelles en pourcentage, étendant l’analyse descriptive vers l’étude des dépendances et corrélations non paramétriques.
5. Conversion mathématique des fréquences absolues en pourcentages
5.1 Formule de base : rapport de la fréquence observée sur l’effectif total
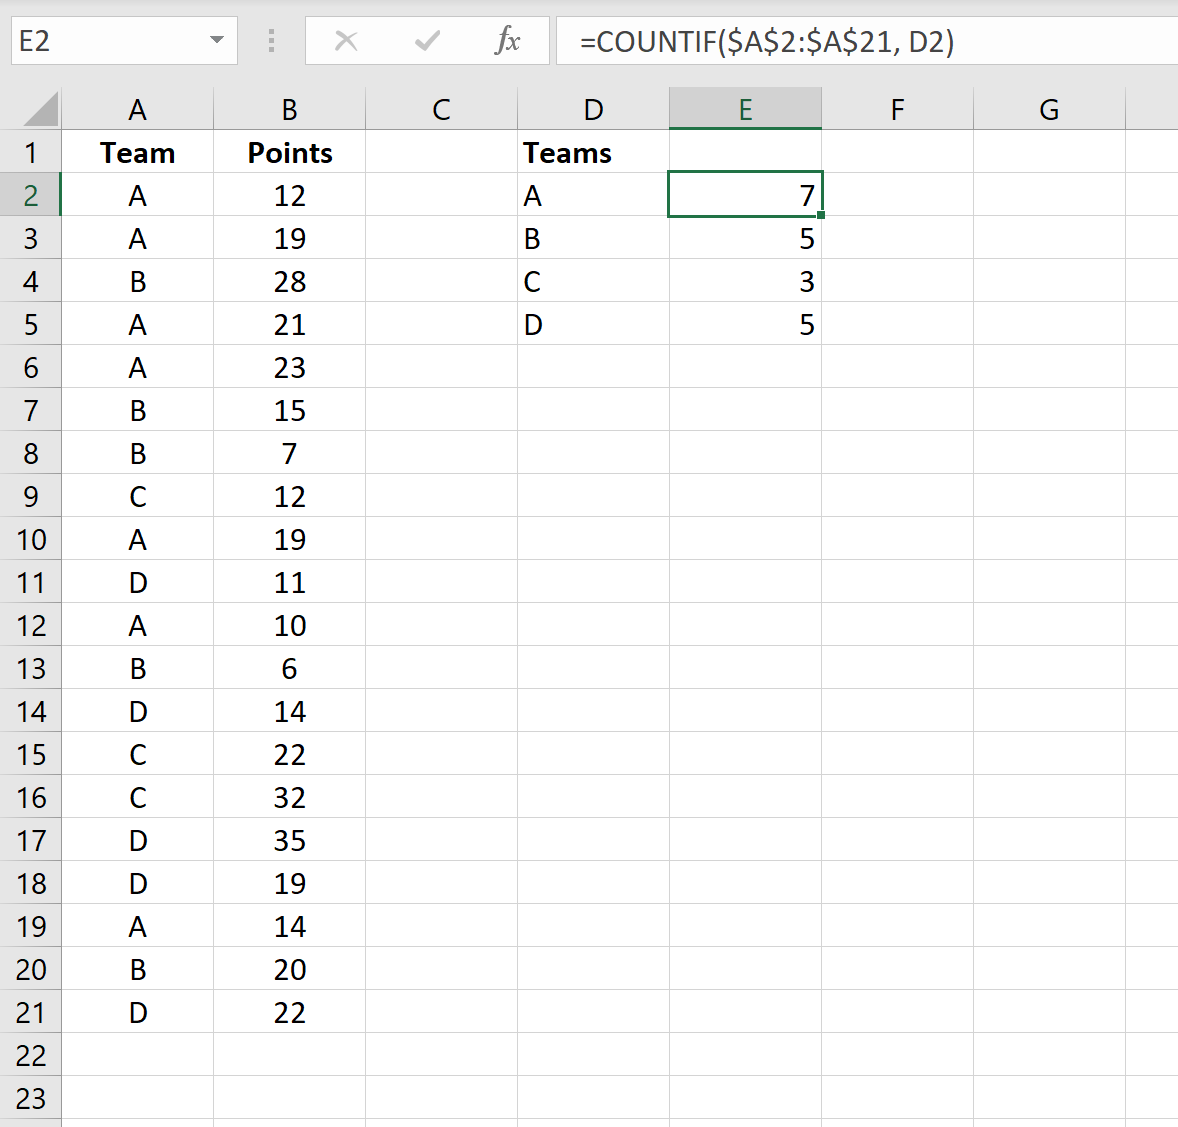
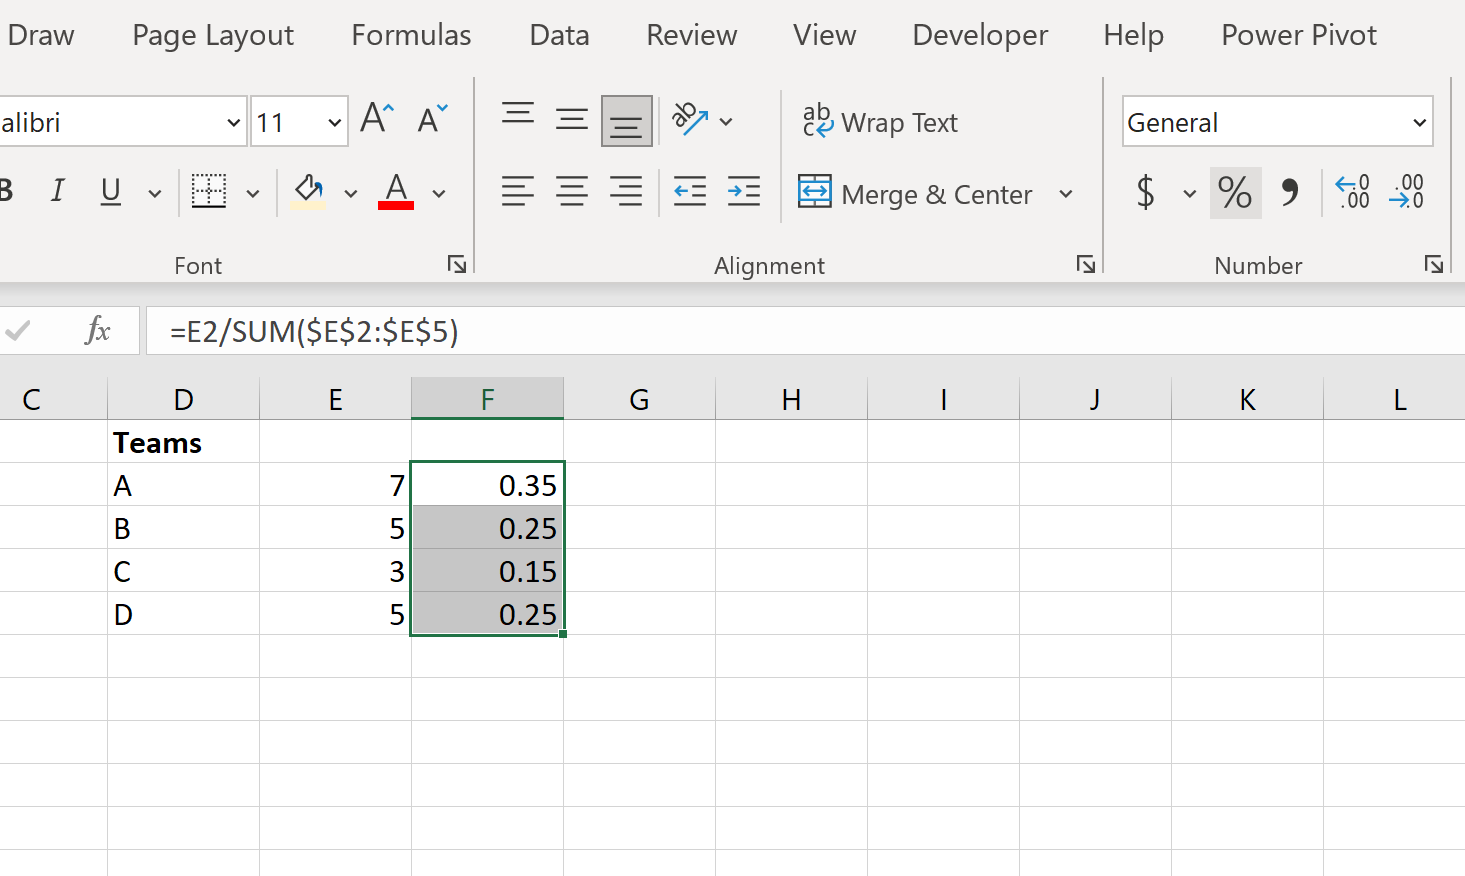
La transmutation d’un dénombrement empirique brut en une grandeur proportionnelle standardisée s’appuie sur la mise en œuvre de la définition mathématique universelle de la fréquence relative : fi = ni / N. Au sein du tableur Excel, cette opération se traduit par une division arithmétique directe entre la cellule renfermant l’effectif catégoriel et celle hébergeant la somme globale des observations de l’échantillon.
Considérons une configuration où les fréquences absolues sont disposées verticalement dans la colonne E, depuis la cellule E2 jusqu’à E6. Pour calculer la proportion relative associée à la première catégorie en F2, l’analyste formule l’instruction : =E2/$E$7, sous réserve que la cellule E7 contienne préalablement le total consolidé des effectifs. L’introduction de l’opérateur de division arithmétique (/) retourne une valeur décimale brute comprise entre zéro et un (par exemple 0,245), prête à faire l’objet d’une conversion scalaire vers l’échelle de pourcentage.
Il est primordial de maintenir une stricte cohérence dimensionnelle entre le numérateur et le dénominateur de cette équation. Le dénominateur ne doit sous aucun prétexte exclure arbitrairement des sous-catégories ou des occurrences singulières sans justification théorique explicite, sous peine de biaiser l’estimation des poids relatifs et d’invalider la représentativité statistique globale de l’échantillon analysé.
5.2 Utilisation de la fonction SOMME pour le dénominateur dynamique
Pour prévenir toute distorsion analytique résultant de l’omission d’une cellule sommative dédiée, il est fréquemment plus sécurisant d’intégrer directement la fonction SOMME au sein du dénominateur de chaque formule individuelle de pourcentage. Cette méthode évite la dépendance structurelle vis-à-vis d’une ligne de totalisation externe qui pourrait être accidentellement déplacée ou écrasée lors de tris de colonnes intempestifs.
La formulation algébrique combinée s’exprime alors par : =E2/SOMME($E$2:$E$6). Par ce procédé, chaque itération verticale calcule dynamiquement la somme de la plage complète d’effectifs pour l’affecter comme dénominateur normalisateur. Une variante élégante, calculant l’effectif total directement à partir du vecteur source de données qualitatives brutes situé en colonne A, fait appel à la fonction de comptage des valeurs non vides :
=E2/NBVAL($A$2:$A$100)
Cette seconde approche consolide le lien logique avec le jeu de données primaire. Elle assure que toute augmentation ou réduction du nombre d’enregistrements sources se répercute instantanément sur le diviseur de référence, sans exiger l’actualisation intermédiaire d’un sous-total dans la zone de distribution de fréquences absolues.
5.3 Implémentation de formules matricielles dynamiques pour un calcul global
L’introduction des matrices dynamiques dans Excel a profondément transformé la mécanique d’évaluation des distributions de fréquences, reléguant au second plan la pratique historique de la recopie incrémentale manuelle vers le bas. Désormais, une seule formule implantée dans la cellule sommitale de la colonne cible suffit à générer l’intégralité du vecteur de pourcentages par projection matricielle instantanée.
En couplant la référence déversée des fréquences absolues (par exemple E2#) à la somme totale de cette même projection scalaire, l’analyste peut implémenter la formule unitaire suivante :
=E2# / SOMME(E2#)
Lors de l’évaluation, le moteur de calcul d’Excel procède à une division terme à terme (opération vectorielle de broadcasting). Chaque élément individuel de la matrice E2# est divisé séquentiellement par le scalaire immuable retourné par SOMME(E2#). Le résultat se déverse instantanément sur la hauteur exacte requise par le tableau analytique. Cette approche optimise drastiquement le temps de calcul du microprocesseur, élimine toute possibilité de dérive accidentelle d’une formule isolée au milieu du tableau et garantit une maintenance logicielle irréprochable de l’outil statistique.
6. Formatage et typographie numérique des pourcentages dans Excel
6.1 Application des formats de pourcentage via le ruban et les raccourcis
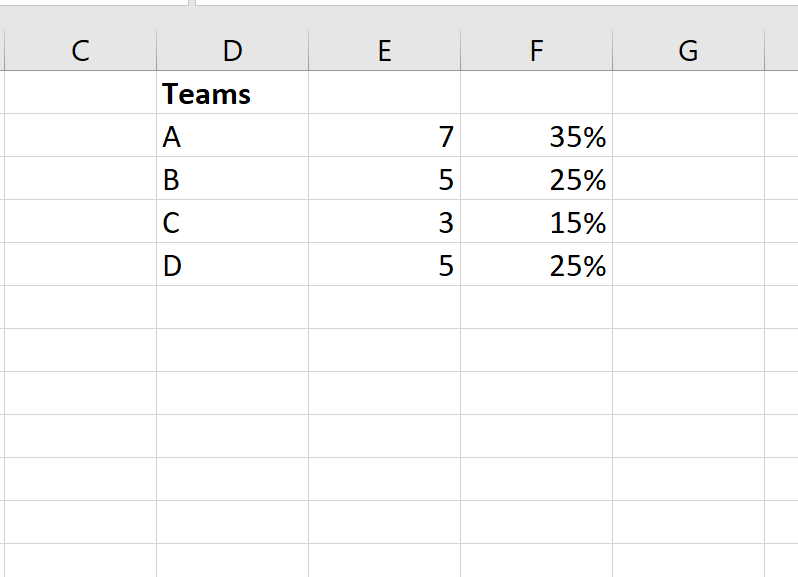
Dans l’architecture de données interne d’Excel, un pourcentage ne constitue en aucun cas un type de donnée autonome distinct des nombres réels standards. Le tableur stocke invariablement le résultat sous la forme d’un nombre décimal pur à virgule flottante compris entre 0 et 1 (par exemple 0,1542 pour une proportion de 15,42 %). Le pourcentage est uniquement une surcouche de représentation visuelle, conçue pour multiplier automatiquement la valeur sous-jacente par 100 à des fins d’affichage tout en lui adjoignant le symbole typographique centésimal (%).
L’application de ce masque de formatage s’effectue usuellement via l’interface graphique du ruban Accueil, dans le bloc fonctionnel Nombre, en cliquant sur l’icône de pourcentage. Les utilisateurs avancés privilégient l’usage du raccourci clavier universel Ctrl + Maj + % (ou Ctrl + Shift + 5 selon les configurations régionales de claviers AZERTY ou QWERTY). Ce raccourci applique instantanément le format centésimal sans exiger de navigation chronophage dans les menus contextuels.
Il est capital de distinguer rigoureusement une valeur numérique explicitement multipliée par 100 via une formule arithmétique (par exemple =(E2/N)*100) d’un formatage visuel de pourcentage standard. Si l’analyste applique le format pourcentage d’Excel sur un résultat ayant déjà fait l’objet d’une multiplication par 100, la grille affichera un résultat aberrante cent fois trop élevé (par exemple 1542 % au lieu de 15,42 %). La bonne pratique dicte de toujours conserver la valeur brute décimale dans l’équation et de déléguer l’affichage du ratio à la couche de mise en forme numérique du logiciel.
6.2 Ajustement de la précision décimale et seuils d’arrondi
Le calibrage de la précision décimale dans l’affichage des fréquences en pourcentage ne doit pas découler d’un choix esthétique arbitraire, mais d’une décision méthodologique rigoureuse corrélée à la taille effective de l’échantillon étudié (N). Afficher deux décimales (par exemple 24,35 %) sur un échantillon modeste de 20 observations constitue une aberration scientifique majeure appelée précision fallacieuse (spurious precision), puisqu’une seule variation d’unité statistique induit mécaniquement un saut proportionnel de 5 points de pourcentage entiers (1/20 = 0,05).
Pour ajuster cette précision, le ruban Accueil met à disposition les commandes « Ajouter une décimale » et « Réduire les décimales ». Les conventions statistiques internationales (notamment préconisées par l’Insee et l’ISO) recommandent généralement la règle empirique suivante :
- Pour des échantillons de taille inférieure à 100 unités (N < 100), les pourcentages doivent être restitués sous forme d’entiers arrondis (zéro décimale).
- Pour des échantillons compris entre 100 et 1 000 unités, une seule décimale (ex.
12,3 %) garantit un équilibre optimal entre granularité et significativité. - L’usage de deux décimales (ex.
12,34 %) ne se justifie épistémologiquement que pour des échantillons massifs excédant 10 000 observations ou dans des contextes financiers et métrologiques de haute précision.
Il convient d’opérer une distinction formelle entre l’arrondi d’affichage généré par les masques de formatage visuels et l’arrondi arithmétique opéré par la fonction ARRONDI(nombre; décimales). Le premier préserve la valeur exacte non tronquée dans le moteur de calcul pour les opérations sous-jacentes, tandis que le second modifie irrémédiablement la précision numérique interne stockée dans la cellule, ce qui peut influencer la sommation totale des pourcentages.
6.3 Formats personnalisés pour l’alignement avec les normes académiques
Pour satisfaire les exigences éditoriales strictes de revues scientifiques internationales (notamment le style de l’American Psychological Association – APA), les formats génériques proposés par le ruban peuvent s’avérer insuffisants. Excel permet de concevoir des formats de nombres personnalisés via la boîte de dialogue contextuelle (accessible par Ctrl + 1 > onglet Nombre > catégorie Personnalisée).
Le langage de formatage d’Excel repose sur une structure quadruple séparée par des points-virgules définissant successivement le comportement pour les valeurs positives, négatives, nulles et textuelles : Format_Positif; Format_Négatif; Format_Nul; Format_Texte. Pour afficher une distribution de fréquences conforme avec une décimale systématique, tout en neutralisant l’affichage des catégories sans occurrence par un tiret académique discret, l’analyste peut implémenter le masque suivant :
0,0 %;-0,0 %;"-" ;@
Ce masque garantit l’alignement décimal vertical des données chiffrées, force l’apparition d’un zéro initial pour les valeurs infinitésimales inférieures à 1 % (évitant l’affichage défectueux de ,5 % sans zéro devant la virgule, proscrit en typographie francophone), et remplace visuellement les fréquences nulles par un tiret cadratin ou demi-cadratin sans corrompre le statut numérique sous-jacent de la cellule. Cette rigueur typographique confère aux tableaux de résultats un niveau de finition immédiatement publiable au sein d’articles ou de rapports institutionnels.
7. Méthode alternative : Tableaux croisés dynamiques pour la distribution en pourcentage
7.1 Conception du tableau croisé dynamique à partir des données brutes
Outre l’approche algorithmique fondée sur des formules, Excel propose un outil de modélisation multidimensionnelle d’une remarquable puissance : le Tableau croisé dynamique (TCD). Cette fonctionnalité permet de synthétiser des distributions de fréquences complexes en quelques manipulations sans nécessiter la rédaction explicite de fonctions imbriquées.
Pour construire cette architecture, l’analyste positionne son curseur à l’intérieur de la plage source ou du tableau structuré, puis active le ruban Insertion > Tableau croisé dynamique. Dans la boîte de configuration, il est fortement recommandé de sélectionner un emplacement sur une nouvelle feuille de calcul afin d’éviter tout chevauchement spatial ultérieur avec d’autres objets opérationnels.
Dans le volet latéral des champs de tableau croisé dynamique, l’agencement logique s’établit avec simplicité : la variable d’intérêt catégorielle est glissée dans la zone Lignes, ce qui génère automatiquement l’extraction de l’univers exhaustif des modalités uniques sans aucun risque d’omission. Simultanément, cette même variable (ou un identifiant observationnel non vide) est glissée dans la zone Valeurs. Par défaut, face à une variable textuelle, le moteur du TCD applique l’opération d’agrégation Nombre, produisant immédiatement le vecteur des fréquences absolues brutes.
7.2 Configuration du champ de valeur pour afficher le pourcentage du total
La métamorphose des fréquences absolues brutes en fréquences centésimales s’opère au sein des paramètres de calcul internes du composant dynamique. Par un clic droit sur n’importe quelle cellule chiffrée de la colonne des valeurs agrégées, l’analyste accède au menu contextuel et sélectionne l’option Afficher les valeurs > % du total général.
Cette commande instruit le moteur analytique de recalculer instantanément chaque valeur de ligne comme le ratio précis entre le dénombrement catégoriel local et le dénombrement global consolidé sur la ligne du total général. Le résultat est automatiquement formaté avec le symbole centésimal sans requérir d’intervention de mise en forme manuelle supplémentaire.
Une configuration experte particulièrement élégante consiste à insérer la variable source deux fois consécutives dans la zone Valeurs du tableau croisé dynamique. Le premier champ conserve son paramétrage de comptage absolu standardisé (renommé par exemple « Effectif (n) »), tandis que le second champ est configuré pour afficher le pourcentage du total général (renommé « Fréquence relative (%) »). Ce protocole d’ingénierie statistique permet de produire une table de contingence bivariée complète et rigoureuse répondant simultanément aux impératifs d’audit des effectifs et d’analyse des proportions relatives.
7.3 Comparaison ergonomique et analytique entre formules directes et TCD
Le choix entre l’implémentation par formules explicites (UNIQUE, NB.SI, matricielles) et le déploiement de Tableaux croisés dynamiques dépend étroitement des objectifs opérationnels assignés au classeur. Les TCD offrent une vélocité de prototypage incomparable, une gestion native de la hiérarchisation multidimensionnelle (agrégation par sous-groupes, filtres de rapport, segments visuels) et une résilience totale face aux risques d’erreurs de syntaxe manuelle.
En contrepartie, le Tableau croisé dynamique présente une rigidité structurelle majeure : il ne recalcule pas ses résultats de manière synchrone en temps réel lors de la modification des données sources. Il nécessite impérativement un déclenchement explicite d’actualisation (via Alt + F5, le ruban Données, ou une routine VBA événementielle). Cette caractéristique peut s’avérer pénalisante dans les architectures de tableaux de bord automatisés en flux continu.
Inversement, les approches matricielles modernes basées sur des formules déversées se recalculent en temps réel et s’intègrent avec une flexibilité supérieure au sein de chaînes algorithmiques personnalisées complexes (incluant des conditions logiques non prises en charge par les TCD standard). La synthèse comparative suivante résume les arbitrages techniques majeurs :
- Vitesse de mise en place : Supériorité nette du Tableau croisé dynamique pour les explorations exploratoires ponctuelles.
- Synchronisation temps réel : Supériorité absolue des formules dynamiques, s’actualisant sans délai lors de toute altération de la grille.
- Personnalisation géométrique : Les formules permettent d’intercaler des lignes de calcul sur mesure, des notes méthodologiques ou des indices personnalisés, ce que proscrit la grille rigide d’un TCD.
- Impact sur les ressources : Les TCD consomment moins de mémoire vive sur des corpus dépassant plusieurs centaines de milliers d’enregistrements en comparaison avec de lourdes formules formulaires itératives.
8. Traitement des données continues : discrétisation en classes d’intervalles
8.1 Définition théorique des intervalles selon les règles de Sturges et de Scott
L’établissement d’une distribution de fréquences pour une variable quantitative continue requiert une phase méthodologique critique préalable : la partition de l’espace de mesure en classes d’intervalles contiguës, mutuellement exclusives et collectivement exhaustives. Un découpage arbitraire fondé sur la seule intuition subjective de l’opérateur introduit un biais majeur, risquant soit de lisser artificiellement des structures informatives essentielles (sous-ajustement), soit d’amplifier le bruit stochastique sous forme de variations erratiques (sur-ajustement).
Pour fonder scientifiquement ce partitionnement, la théorie statistique met à disposition plusieurs règles empiriques canoniques. La formulation de Sturges s’avère parfaitement adaptée aux distributions empiriques approximativement symétriques et de taille modérée (N < 200). Elle détermine le nombre optimal de classes k selon l’équation :
k = 1 + 3,322 × log10(N)
L’amplitude théorique de chaque classe, notée h, se déduit ensuite en divisant l’étendue globale de l’échantillon (valeur maximale observée moins valeur minimale) par le nombre de classes préconisé : h = (Xmax – Xmin) / k.
Lorsque la taille de l’échantillon devient substantielle ou que la distribution présente une forte asymétrie ou des queues épaisses, la règle de Scott offre une robustesse bien supérieure en s’appuyant sur la dispersion paramétrique. Elle définit la largeur idéale d’intervalle h par l’équation : h = (3,49 × s) / N1/3, où s désigne l’écart-type de l’échantillon. Pour une insensibilité totale aux valeurs aberrantes, la formulation de Freedman-Diaconis substitue à l’écart-type l’écart interquartile (IQR) : h = 2 × IQR × N-1/3. L’intégration de ces équations dans Excel permet de borner rigoureusement les limites inférieures et supérieures de chaque segment de regroupement.
8.2 Utilisation de la fonction FREQUENCE sous forme matricielle
Une fois les bornes supérieures de chaque classe d’intervalle définies et consignées dans un vecteur ordonné (le tableau des limites), Excel met à disposition une fonction statistique native spécifiquement dédiée au dénombrement continu : la fonction FREQUENCE (ou FREQUENCY). Sa syntaxe requiert deux arguments : =FREQUENCE(tableau_données; tableau_intervalles).
Le fonctionnement interne de la fonction FREQUENCE obéit à une convention mathématique rigoureuse : elle modélise des intervalles semi-ouverts à gauche et fermés à droite, conventionnellement notés ]a ; b]. Cela implique qu’une observation est comptabilisée dans une classe si elle est strictement supérieure à la borne de la classe précédente et inférieure ou égale à la borne supérieure de la classe courante. De surcroît, la fonction renvoie systématiquement une valeur supplémentaire à la fin de la matrice de sortie, quantifiant les observations excédant strictement la borne terminale du tableau d’intervalles (le cas résiduel supérieur).
Dans les versions contemporaines d’Excel bénéficiant des matrices dynamiques, l’utilisateur implémente la formule en validant simplement par la touche Entrée dans la première cellule réceptrice ; la matrice se déverse verticalement le long du tableau d’intervalles. Dans les environnements historiques, il est impératif de présélectionner l’intégralité de la plage de sortie verticale (ayant une dimension égale au nombre d’intervalles plus un) avant de saisir la formule et de la valider conjointement par l’instruction matricielle historique Ctrl + Maj + Entrée.
8.3 Normalisation des fréquences de classes en pourcentages relatifs et cumulés
Après obtention du vecteur d’effectifs bruts de chaque intervalle par la fonction FREQUENCE, la normalisation centésimale s’effectue en divisant le vecteur résultant par l’effectif global de l’échantillon. Si le résultat matriciel de FREQUENCE débute en G2, la formule de fréquence centésimale s’écrit de façon concise : =G2# / SOMME(G2#).
Au-delà de la distribution simple, l’analyse des données continues exige presque systématiquement la détermination des pourcentages cumulés croissants. Cette mesure cumulative répond à la question critique : « Quelle proportion de l’échantillon présente une valeur inférieure ou égale à la borne de la classe considérée ? ». Le calcul s’articule via la sommation progressive des pourcentages individuels. Pour une série débutant en H2, la formule implantée en I2 et étirée verticalement se formule comme suit :
=SOMME($H$2:H2)
Par l’effet d’ancrage absolu de la borne initiale $H$2 conjugué à la dérive relative de la borne finale H2, l’équation cumule les strates proportionnelles au fil de la progression séquentielle. La dernière classe atteint rigoureusement 100 %, fournissant une assise directe pour l’estimation empirique des quantiles, des percentiles et de la fonction de répartition empirique (ECDF) du système analysé.
9. Visualisation graphique de la distribution de fréquences en pourcentage
9.1 Construction d’un histogramme standardisé en pourcentages
La transcription visuelle d’une distribution statistique ne doit pas être appréhendée comme un simple artifice d’illustration, mais comme un instrument d’inférence géométrique. Pour une variable continue discrétisée en classes d’amplitudes égales, la représentation canonique est l’histogramme. Dans ce graphique, l’aire de chaque colonne représente la fréquence de la classe correspondante.
Pour construire un histogramme conforme dans Excel à partir de classes discrétisées, l’analyste sélectionne la distribution centésimale calculée et insère un graphique en colonnes 2D groupées standard. Une correction géométrique impérative s’impose immédiatement : par défaut, Excel insère un intervalle d’espacement substantiel entre les rectangles verticaux. Or, en statistique mathématique, l’absence d’espace entre les colonnes traduit graphiquement la continuité sous-jacente de la variable réelle mesurée.
Par un clic droit sur les séries de données du graphique, l’utilisateur active le panneau Mettre en forme une série de données et réduit la valeur du curseur Largeur du coup d’œil (ou Largeur de l’intervalle) à exactement 0 %. L’adjonction d’une bordure contrastée fine (de couleur sombre) autour de chaque barre individualise visuellement les rectangles tout en préservant le continuum graphique structurel.
L’axe vertical des ordonnées doit être étalonné de manière standardisée avec des graduations en pourcentages explicites (ex. 0 %, 5 %, 10 %, 15 %, etc.), tandis que l’axe horizontal des abscisses doit afficher rigoureusement les étiquettes des intervalles bornés (ex. [10 - 20[, [20 - 30[). Les visualisations statistiques soignées évitent toute surcharge décorative (effets 3D, ombrages dégradés) pour se concentrer exclusivement sur l’intégrité de la morphologie distributionnelle.
9.2 Élaboration de diagrammes en barres et graphiques sectoriels : bonnes pratiques
Pour les variables catégorielles nominales ou ordinales pures, l’histogramme n’a pas de fondement théorique puisque les catégories ne partagent pas un continuum dimensionnel. Le standard visuel réside alors dans le diagramme en barres (ou en colonnes discontinues), au sein duquel un espacement délibéré (classiquement fixé entre 50 % et 100 % de la largeur d’une barre) matérialise l’indépendance discrète des modalités.
Si les étiquettes textuelles des catégories présentent une longueur typographique importante, il est méthodologiquement recommandé d’opter pour un diagramme en barres horizontales plutôt que verticales. Cette orientation évite l’inclinaison diagonale disgracieuse ou le chevauchement illisible des textes le long de l’axe, fluidifiant ainsi la lecture visuelle linéaire de gauche à droite.
Le diagramme sectoriel (ou graphique en camembert), bien que populaire dans la communication d’entreprise grand public, fait l’objet de réserves unanimes au sein de la communauté scientifique et de l’ingénierie visuelle des données (notamment théorisées par Edward Tufte). L’appareil perceptif humain éprouve de lourdes difficultés cognitives à évaluer précisément des angles géométriques et des aires curvilignes en comparaison avec des longueurs linéaires droites alignées sur un axe commun. Si le diagramme sectoriel est néanmoins retenu, il doit impérativement respecter trois contraintes drastiques :
- Être restreint à un nombre maximal de 4 à 5 modalités pour éviter l’illisibilité des segments infinitésimaux.
- Intégrer directement les étiquettes de données pourcentages et les libellés de catégories sur les parts elles-mêmes, en éliminant les légendes détachées qui imposent une gymnastique oculaire fatigante.
- Bannir formellement tout éclatement artificiel des secteurs ou perspective pseudo-tridimensionnelle, générateurs d’anamorphoses et d’illusions d’optique sur les proportions réelles.
9.3 Création d’une courbe d’ogive des pourcentages cumulés
L’ogive de Galton représente la projection graphique privilégiée pour analyser la progression de la fonction de répartition cumulative d’une variable continue. Construite en portant en abscisse les limites supérieures de chaque classe d’intervalle et en ordonnée les pourcentages cumulés croissants (de 0 % à 100 %), elle trace une courbe sigmoïde continue décrivant la vélocité d’accumulation des unités statistiques.
Dans Excel, cette visualisation se concrétise par l’insertion d’un graphique en nuage de points avec lignes directes reliées ou d’un graphique en courbes 2D fondé sur la colonne des pourcentages cumulés. L’intérêt analytique de l’ogive réside dans sa capacité à opérer des interpolations géométriques directes sans recourir à des calculs matriciels complexes :
Le tracé d’une droite horizontale fictive à l’ordonnée de 50 % intercepte la sigmoïde en un point dont la projection orthogonale sur l’axe des abscisses livre une estimation géométrique immédiate de la médiane empirique de l’échantillon. De même, les projections depuis les seuils de 25 % et 75 % isolent respectivement le premier quartile (Q1) et le troisième quartile (Q3). La pente locale de la courbe traduit instantanément la densité de probabilité : une ascension verticale abrupte indique une forte concentration de données sur l’intervalle considéré, tandis qu’un plateau horizontal révèle une raréfaction des observations.
10. Validation méthodologique, contrôle de cohérence et gestion des erreurs
10.1 Vérification de la somme unitaire et résolution du problème des arrondis
Tout protocole rigoureux de traitement de données quantitatives doit s’achever par une phase de contrôle d’intégrité algorithmique. Pour une distribution de fréquences en pourcentage, le postulat axiomatique fondamental impose que la sommation intégrale des composantes relatives soit égale à 100 % :
Σ pi = 100,0 %
Au sein du tableur, l’implantation d’une cellule de contrôle booléen est fortement recommandée. Utilisant la fonction SOMME encapsulée dans un test logique, la formule de vérification peut s’écrire : =SI(ARRONDI(SOMME(F2:F10); 4) = 1; "Validation conforme"; "Erreur d'intégrité"). Notons l’application d’un arrondi à la quatrième décimale dans le test : en raison de la représentation des nombres décimaux en virgule flottante binaire selon la norme IEEE 754, des résidus infinitésimaux (de l’ordre de 1 × 10-16) peuvent corrompre l’égalité logique stricte dans le processeur, rendant le test d’équivalence brute SOMME(...) = 1 inopinément faux.
Un phénomène classique fréquemment rencontré dans les rapports d’études réside dans le « problème des arrondis d’affichage », où la sommation visuelle des pourcentages affichés avec zéro décimale produit un total apparent de 99 % ou de 101 % (par exemple, trois catégories valant chacune 33,33 % s’afficheront sous la forme 33 % + 33 % + 33 % = 99 %). Pour éviter de déconcerter le lectorat sans pour autant manipuler les données fondamentales, les conventions internationales imposent soit d’ajouter une note méthodologique infrapaginale précisant que « Les totaux peuvent différer légèrement de 100 % en raison des arrondis », soit de recourir à l’algorithme d’optimisation des plus forts restes (méthode de Hare-Niemeyer) pour réconcilier les unités sans altérer la représentativité distributionnelle.
10.2 Détection et traitement des cellules vides ou des données non conformes
L’incohérence d’une distribution de fréquences résulte fréquemment de pollutions insidieuses nichées dans la matrice brute. Des cellules paraissant visuellement vides mais contenant en réalité une chaîne vide renvoyée par une formule antérieure ("") ou une espace simple (" ") perturbent l’évaluation de la fonction NB.SI et altèrent le décompte global réalisé par NBVAL.
Pour auditer visuellement et assainir ces anomalies de saisie, l’analyste averti déploie des règles de Mise en forme conditionnelle ciblées. La création d’une règle fondée sur la formule logique =ET(ESTTEXTE(A2); SUPPRESPACE(A2)="") permet de surligner instantanément en chromatisme d’alerte toute cellule facticement vide hébergeant des caractères invisibles parasites.
De même, pour les données quantitatives continues, l’occurrence accidentelle d’une valeur textuelle (par exemple la mention « Absc » pour une absence de mesure) au milieu d’un vecteur de valeurs réelles empêche la fonction FREQUENCE de classifier convenablement la ligne concernée. L’application préventive de la fonction ESTNUM ou l’usage de filtres automatiques sur les données permet de tracer et d’extraire systématiquement ces corps étrangers avant de valider la table de distribution définitive.
10.3 Gestion des divisions par zéro via les fonctions de protection logique
Dans les environnements analytiques dynamiques où les jeux de données sont régulièrement filtrés, segmentés ou réinitialisés, l’apparition de l’erreur fatale #DIV/0! représente un écueil classique. Cette interruption de calcul survient lorsque le dénominateur de la fraction centésimale — c’est-à-dire l’effectif total N calculé par la fonction SOMME ou NBVAL — s’effondre à zéro lors de l’application d’un filtre sur un sous-échantillon ne comportant aucune observation valide.
Pour immuniser l’architecture du classeur contre cette défaillance, il est impératif d’encapsuler les équations de division au sein de fonctions de protection logique défensive, principalement la fonction SIERREUR :
=SIERREUR(E2 / SOMME($E$2:$E$6); 0)
Cette syntaxe préventive neutralise la levée de l’erreur système : si le dénominateur est nul, la formule intercepte l’anomalie et retourne élégamment la valeur numérique zéro (ou une chaîne vide "" selon l’objectif ergonomique recherché). Cette précaution assure que les tableaux de synthèse demeurent intègres, évitant la propagation en cascade de codes d’erreur au sein des graphiques associés ou des modules d’exportation de données vers des progiciels tiers (tels que R, Python ou SPSS).
11. Automatisation et dynamisation avancée des distributions dans Excel
11.1 Utilisation des tableaux structurés Excel pour l’actualisation dynamique
La pérennisation des modèles quantitatifs exige que toute adjonction de nouvelles données s’accompagne d’une extension automatique sans faille des calculs de distribution de fréquences. L’implémentation de Tableaux structurés Excel (anciennement connus sous la désignation de listes de données) constitue la clé de voûte de cette architecture d’ingénierie logicielle.
La conversion d’une matrice brute s’opère instantanément via le raccourci clavier Ctrl + L (ou Ctrl + T). Dès cette étape, la plage de coordonnées statiques (A1:C500) est promue en une entité relationnelle baptisée par exemple T_Observations. Les colonnes acquièrent le statut de champs de métadonnées interrogés au travers de références structurées typées : T_Observations[Diagnostique].
Cette architecture transforme radicalement la résilience des formules de distribution. L’instruction formulée en amont : =NB.SI(T_Observations[Diagnostique]; D2) ne requiert aucun ajustement d’indices lorsque 500 nouvelles lignes d’observations sont intégrées au bas de la base. Le tableau structuré redimensionne automatiquement son empreinte spatiale interne, répercutant instantanément les nouveaux effectifs et actualisant l’ensemble de la distribution de fréquences en pourcentage sans manipulation manuelle de recopie.
11.2 Combinaisons avancées avec les fonctions matricielles modernes LET et LAMBDA
Les fonctionnalités récentes du tableur permettent désormais de s’affranchir complètement des colonnes de calculs intermédiaires grâce à la fusion des fonctions LET et LAMBDA. La fonction LET permet d’optimiser les performances en assignant des variables locales temporaires aux calculs répétitifs, évitant à Excel d’évaluer plusieurs fois la même instruction matricielle au cours du cycle de rafraîchissement.
Il devient ainsi possible de générer l’intégralité d’une table de distribution en pourcentage (modalités uniques, fréquences absolues et pourcentages) au moyen d’une unique formule matricielle monumentale auto-contenue :
=LET(

  source; T_Observations[Categorie];

  mods; TRIER(UNIQUE(source));

  comptes; NB.SI(source; mods);

  total; SOMME(comptes);

  pourcents; comptes / total;

  ASSEMB.H(mods; comptes; pourcents)

)
Cette formulation matricielle élégante isole la colonne source, en extrait les modalités uniques triées, calcule le vecteur de fréquences absolues ainsi que la somme globale, procède à la normalisation centésimale vectorielle, puis assemble horizontalement le tout au sein d’une seule matrice déversée grâce à la fonction ASSEMB.H (ou HSTACK). Le tableau analytique complet se déploie instantanément à partir d’une seule cellule d’ancrage.
Poussant l’abstraction algorithmique à son apogée, l’analyste peut encapsuler cette structure au sein du gestionnaire de noms via une fonction LAMBDA personnalisée réutilisable, baptisée par exemple DISTRIB_POURCENT(plage). Les utilisateurs finaux du classeur peuvent dès lors produire des distributions de fréquences sophistiquées par un simple appel fonctionnel =DISTRIB_POURCENT(A2:A1000), démocratisant l’analyse statistique de pointe sans exposer les mécanismes sous-jacents de la formule.
11.3 Conception de modèles paramétrables pour les études répétées
Dans les laboratoires de recherche, les observatoires sectoriels ou les services de contrôle qualité, le traitement statistique s’applique de manière récurrente à des flux périodiques de données (rapports hebdomadaires, cohortes d’essais annuelles). Pour rationaliser ce processus, la création de modèles paramétrables standardisés (fichiers au format modèle .xltx) garantit un gain d’efficience substantiel et une reproductibilité sans faille.
La conception d’un tel modèle repose sur une sectorisation stricte du classeur en trois zones étanches :
- Zone d’injection (Input) : Une feuille dédiée, vierge de tout calcul, destinée à recevoir par collage brut ou par requête Power Query les nouveaux jeux de données sans déstructurer les formules aval.
- Zone motrice (Processing) : Une feuille hébergeant les paramètres configurables (choix du nombre de classes, règles d’arrondi, critères de segmentation) et les équations matricielles dynamiques.
- Zone de restitution (Dashboard) : Un tableau de bord verrouillé contre les écritures intempestives, agrégeant les tableaux finaux formatés aux normes académiques et les visualisations graphiques synchronisées.
Pour assurer la pérennité du modèle dans le temps et faciliter son exploitation par des équipes pluridisciplinaires, chaque formule clé doit être accompagnée d’une documentation interne précise matérialisée par des métadonnées de cellule (commentaires et notes explicatives). Le verrouillage des cellules de calcul via le protocole de protection des feuilles d’Excel empêche l’altération involontaire de la logique matricielle tout en laissant les zones de paramétrage accessibles aux collaborateurs.
12. Interprétation statistique et rédaction des résultats dans les rapports scientifiques
12.1 Dérivation d’inférences descriptives rigoureuses à partir des pourcentages
L’obtention d’une distribution de fréquences en pourcentage ne constitue pas la finalité de la recherche, mais le point de départ de l’interprétation statistique. L’analyste doit traduire les grandeurs chiffrées en constats phénoménologiques robustes, en se gardant scrupuleusement de commettre des contresens épistémiques fréquents.
Le premier impératif réside dans la distinction fondamentale entre la distribution empirique observée sur un échantillon donné et la distribution de probabilité théorique de la population parente. Affirmer qu’une modalité regroupe 40 % des réponses au sein d’un échantillon de 50 sujets ne signifie nullement que la probabilité d’occurrence sous-jacente dans la population globale est strictement égale à 0,40. L’inférence descriptive doit s’accompagner, dès que possible, du calcul d’un intervalle de confiance binomial pour la proportion observée (par exemple selon la méthode de Wilson ou de Clopper-Pearson).
Par ailleurs, l’analyse descriptive doit identifier clairement le mode (la modalité recueillant la plus forte proportion relative) et caractériser le degré d’hétérogénéité de la dispersion. Une distribution répartie de manière quasi uniforme entre les modalités traduit une incertitude maximale, tandis qu’une polarisation marquée sur une modalité prépondérante souligne un consensus ou une attraction structurelle forte.
Enfin, une mise en garde méthodologique absolue s’impose quant à l’interprétation des variations relatives sur de très faibles effectifs : une augmentation apparente de « 100 % » d’un événement passant de 1 observation à 2 observations sur un échantillon de 10 personnes ne traduit qu’un aléa d’échantillonnage infinitésimal et ne saurait être assimilée à une dynamique de croissance substantielle.
12.2 Normes de présentation tabulaire et textuelle conforme aux standards académiques
La restitution éditoriale des résultats quantitatifs au sein d’articles scientifiques ou de thèses universitaires répond à des directives typographiques rigides, dont les plus universellement reconnues sont dictées par le manuel de publication de l’American Psychological Association (style APA, 7e édition).
Sur le plan tabulaire, un tableau de fréquences conforme aux normes APA doit proscrire rigoureusement tout quadrillage vertical interne. Seules trois lignes horizontales principales doivent structurer la présentation : une première délimitant le haut du tableau, une seconde séparant la rangée des en-têtes de colonnes du corps des données chiffrées, et une troisième fermant le bas du tableau immédiatement avant les éventuelles notes de bas de page. De plus, il est formellement obligatoire d’indiquer de façon explicite la taille globale de l’échantillon (N) dans le titre du tableau ou dans l’en-tête de la colonne des effectifs bruts.
Sur le plan textuel, la rédaction académique d’un résultat ne doit jamais consigner un pourcentage de manière isolée sans rappeler simultanément l’effectif brut sous-jacent. La syntaxe canonique d’intégration narrative s’articule traditionnellement de la façon suivante :
« L’analyse de la cohorte révèle que la majorité des participants s’identifie à la modalité intermédiaire (n = 45; 37,5 %), tandis qu’une minorité résiduelle sélectionne le niveau d’adhésion supérieur (n = 6; 5,0 %). L’ensemble de la distribution catégorielle est consigné dans la Table 1. »
Cette discipline de restitution assure au relecteur et à la communauté scientifique une translucidité absolue sur les données fondamentales ayant servi de support aux calculs proportionnels.
12.3 Limites inhérentes à l’usage exclusif des fréquences en pourcentage
Si la distribution de fréquences en pourcentage représente un outil de réduction synthétique d’une redoutable efficacité, elle comporte des limites méthodologiques intrinsèques qu’un analyste rigoureux ne doit jamais occulter. La principale faiblesse réside dans le masquage de l’échelle d’échantillonnage. Un tableau affichant qu’une procédure thérapeutique présente un taux de succès de 80 % dissimule une vulnérabilité scientifique critique si ce résultat émane en réalité d’un essai portant sur seulement 5 patients (4 succès sur 5), comparativement à un essai portant sur 500 individus (400 succès sur 500).
En second lieu, pour les variables quantitatives continues discrétisées en classes d’intervalles, le découpage proportionnel induit une perte d’information irréversible relative à la variance interne de chaque intervalle. Une fois les mesures agrégées au sein d’une classe, il devient impossible de déterminer si les observations se massaient au voisinage immédiat de la borne inférieure ou si elles se dispersaient de manière homogène le long de la tranche d’amplitude.
Enfin, l’examen isolé des fréquences relatives centésimales ne permet pas de caractériser exhaustivement une distribution quantitative sans l’adjonction des indices de tendance centrale (médiane, moyenne arithmétique épurée) et des métriques de dispersion paramétriques et non paramétriques (écart-type, écart interquartile). Par conséquent, la distribution de fréquences en pourcentage ne doit jamais être mobilisée comme un substitut unilatéral à l’exploration descriptive, mais plutôt comme la charpente de référence sur laquelle viennent se greffer les modélisations inférentielles plus avancées.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Institut national de la statistique et des études économiques (Insee). (2021). Méthodes statistiques pour l’analyse des distributions catégorielles et continues. Insee Méthodes. https://www.insee.fr
- Microsoft Corporation. (2024). Fonction FREQUENCE dans Excel. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/fonction-frequence-44e3be2b-de50-4036-851e-e425279c09d6
- Microsoft Corporation. (2024). Fonction UNIQUE dans Excel. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/fonction-unique-c5ab87fd-30a3-4ce9-9d1a-40204fb85e1e
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10