
L’exploration des données quantitatives constitue le socle fondamental sur lequel repose l’édifice de l’inférence statistique contemporaine. Bien avant l’avènement des modèles prédictifs complexes et des algorithmes d’apprentissage automatique supervisé, le chercheur se trouve confronté à l’impérieuse nécessité d’interroger la structure morphologique brute de ses observations. Dans ce cadre épistémologique précis, l’analyse exploratoire des données, conceptualisée par John Tukey à la fin des années 1970, a introduit une rupture méthodologique majeure en réhabilitant la primauté du contact direct avec la donnée empirique, à l’écart des postulats paramétriques restrictifs de la statistique inférentielle classique.
Au cœur de cette panoplie d’outils heuristiques figure le diagramme tige et feuilles, désigné en anglais sous le terme de stem-and-leaf plot. Véritable hybride entre la table de distribution numérique et la représentation graphique semi-spatiale, cet instrument conserve une pertinence scientifique singulière à l’ère du traitement computationnel intensif. Alors que les techniques modernes de visualisation tendent fréquemment à abstraire, agréger et masquer la granularité intrinsèque des mesures au profit d’enveloppes lissées de densité, le diagramme tige et feuilles opère selon un principe inverse : il assure une synthèse visuelle de la forme distributionnelle tout en garantissant la traçabilité intégrale de chaque point de données individuel.
Ce guide exhaustif a pour vocation d’exposer en profondeur les fondements théoriques, les mécanismes computationnels et les protocoles d’implémentation du diagramme tige et feuilles au sein de l’écosystème open source Python. À travers une analyse rigoureuse des structures arithmétiques sous-jacentes, l’étude comparative de bibliothèques spécialisées comme stemgraphic, et le développement d’algorithmes natifs optimisés pour l’inspection de distributions psychométriques, cet article fournit aux analystes de données, psychomètres et biostatisticiens une référence technique et conceptuelle complète pour maîtriser cette représentation essentielle de l’analyse exploratoire.
1. Introduction théorique et épistémologique au diagramme tige et feuilles
1.1 Genèse et rôle dans l’analyse exploratoire des données (EDA)
L’histoire de la statistique appliquée au vingtième siècle a longtemps été dominée par une approche confirmatoire, caractérisée par une dépendance stricte aux tests d’hypothèses formels formulés par Ronald Fisher, Jerzy Neyman et Egon Pearson. Dans ce paradigme traditionnel, la visualisation n’était trop souvent perçue que comme un adjuvant ornemental postérieur aux calculs paramétriques. En 1977, la publication de l’ouvrage fondateur de John Wilder Tukey, intitulé Exploratory Data Analysis, est venue bouleverser cet ordre établi en conférant au diagnostic visuel préliminaire le statut d’étape épistémologique indispensable. Tukey défendait la thèse selon laquelle le statisticien doit se comporter comme un détective à la recherche d’indices avant de prétendre endosser la toge du juge évaluant les preuves.
C’est au sein de ce renouveau théorique que le diagramme tige et feuilles a trouvé sa pleine formulation conceptuelle. Tukey a conçu cet outil dans le but explicite de surmonter la dichotomie contraignante entre la précision numérique du tableau de contingence et l’intuitivité géométrique de l’histogramme. Alors qu’un histogramme discrétise la variable continue en intervalles de classe arbitraires et résume la masse de données sous forme de rectangles proportionnels aux effectifs, il aliène irréversiblement l’identité numérique des observations. Dès lors qu’un point est absorbé par une barre d’histogramme, il devient impossible pour le chercheur de savoir si les mesures au sein de cette classe se concentrent sur ses bornes, se dispersent uniformément ou exhibent un motif récurrent.
Le diagramme tige et feuilles résout ce dilemme avec une élégance structurelle remarquable : il utilise les chiffres constitutifs de la valeur observée pour ériger la barre de fréquence elle-même. Dès lors, le tracé remplit une double vocation indissociable. D’une part, il génère une silhouette géométrique dont le profil extérieur reflète directement la fonction de masse empirique ou la densité de probabilité sous-jacente. D’autre part, il conserve la totalité de l’information arithmétique d’origine, permettant une rétro-conversion immédiate du graphique vers l’échantillon brut sans aucune perte de précision.
Dans les disciplines vouées à l’observation du comportement humain et des processus cognitifs, telles que la psychologie différentielle, la neuropsychologie et les sciences de l’éducation, cette propriété offre une valeur méthodologique inestimable. Lors des phases de calibration d’un test standardisé ou de l’évaluation préliminaire de temps de réaction sensorimoteurs, le chercheur travaille fréquemment sur des cohortes d’échantillons cliniques restreints. Dans ces contextes, agréger prématurément les scores dans une boîte à moustaches ou un histogramme revient à occulter des discontinuités qualitatives, des regroupements spécifiques à un sous-type nosologique ou des anomalies d’enregistrement susceptibles de modifier radicalement les conclusions de l’investigation.
1.2 Propriétés distributionnelles et intégrité des données
L’un des attributs les plus puissants du diagramme tige et feuilles réside dans sa capacité à préserver l’ordonnancement séquentiel intrinsèque des données tout en maintenant leur intégrité métrique. Contrairement aux méthodes d’estimation non paramétrique contemporaines, à l’instar de l’estimation de densité par noyau qui introduit un lissage fondé sur un paramètre de bande passante subjectif et génère parfois des artefacts géométriques sur les frontières du domaine de définition, le tracé tige et feuilles ne falsifie jamais la distribution empirique. Il constitue une transcription discrète exacte, ordonnée de façon strictement croissante.
Sur le plan analytique, cette disposition permet au statisticien de déceler d’un simple coup d’œil les caractéristiques distributionnelles de premier et de second ordre. L’asymétrie de la distribution devient immédiatement visible à travers l’étirement unilatéral des rangées de tiges vers les valeurs positives ou négatives, traduisant graphiquement un coefficient de dissymétrie de Pearson non nul. De même, l’aplatissement ou le caractère leptokurtique d’une distribution se manifeste par une concentration excessive de feuilles sur un nombre très réduit de tiges centrales, flanquée d’une raréfaction abrupte le long des tiges distales, révélant sans ambiguïté la lourdeur des queues de distribution.
En outre, l’identification des points atypiques ou des observations discordantes bénéficie d’une transparence absolue. Dans une représentation par boîte à moustaches conventionnelle, un point considéré comme aberrant est isolé au-delà de l’intervalle d’un point cinq fois l’écart interquartile, mais sa relation avec les éléments voisins demeure masquée. Le diagramme tige et feuilles montre la distance métrique exacte séparant le point aberrant de la masse principale du nuage de données. Il permet de discerner si une valeur extrême constitue un événement isolé ou si elle amorce un second pôle de densité, annonciateur d’une distribution multimodale passée inaperçue.
D’un point de vue sémiotique, le diagramme tige et feuilles élimine la distance cognitive qui sépare traditionnellement la matrice de chiffres et la forme graphique. En psychométrie, où la signification d’un résultat dépend intimement de la position relative d’un sujet par rapport à des seuils étalonnés, cette superposition du symbole textuel et de la coordonnée spatiale confère au chercheur une posture épistémologique robuste : la structure macroscopique de l’échantillon émerge organiquement de la juxtaposition ordonnée de ses éléments microscopiques.
2. Anatomie structurelle et principes mathématiques de la représentation
2.1 Décomposition en tiges et feuilles
L’architecture mathématique fondamentale du diagramme repose sur une partition arithmétique modulaire de l’ensemble des observations. Soit un vecteur unidimensionnel de données réelles noté X comportant n éléments ordonnés de telle sorte que x indice un soit inférieur ou égal à x indice deux, lui-même inférieur ou égal à x indice n. La construction de la représentation nécessite la définition formelle d’une fonction de projection qui divise chaque mesure x indice i en deux composantes complémentaires : une composante structurelle appelée tige et une composante résiduelle appelée feuille.
Pour un ensemble d’observations discrètes composées d’entiers naturels, la tige correspond au quotient obtenu par la division euclidienne de la valeur par une puissance déterminée de dix, qualifiée d’unité de tige. Si l’on désigne par L la base de troncature, la valeur de la tige T associée à l’observation x indice i est formellement définie par la partie entière de x indice i divisé par dix élevé à la puissance L. Corrélativement, la feuille F correspond au résidu issu de cette division, modulé par l’unité de troncature immédiatement inférieure. Dans le cas le plus élémentaire où l’unité de feuille équivaut à l’unité arithmétique simple, la feuille F indice i s’exprime par le reste de la division euclidienne de x indice i par dix.
Le choix du facteur d’échelle est le paramètre gouvernant de la granularité du tracé. Si l’échelle sélectionnée est excessivement large, l’ensemble des observations viendra s’accumuler sur une ou deux tiges, transformant le diagramme en un bloc monolithique dénué de pouvoir séparateur. Inversement, si le facteur d’échelle est exagérément resserré, chaque tige ne contiendra qu’une quantité infime d’observations clairsemées, dissolvant la silhouette globale de la distribution dans un bruit visuel excessif. Ce problème d’optimisation est mathématiquement analogue à la sélection de la largeur optimale des classes dans la règle de Sturges ou la formule de Freedman-Diaconis appliquée aux histogrammes.
Lorsque le vecteur de données comporte des grandeurs fractionnaires ou des nombres décimaux continus, le protocole impose une normalisation exponentielle préalable. Chaque observation x indice i est multipliée par une puissance de dix adéquate, de telle façon que la précision décimale d’intérêt soit translatée dans le domaine des entiers positifs avant d’exécuter la troncature. Cette opération garantit une symétrie de traitement rigoureuse, permettant aux chiffres situés après la virgule de servir légitimement de feuilles sans distorsion d’arrondi.
2.2 Calcul et lecture des fréquences cumulées
Un diagramme tige et feuilles conforme aux standards méthodologiques établis par Tukey ne se limite pas à un alignement horizontal de chiffres adossés à une tige verticale ; il incorpore à sa gauche une colonne d’agrégation numérique fournissant la profondeur cumulée des observations. Cette métrique algorithmique vise à faciliter l’inférence immédiate des rangs percentiles et des quantiles distributionnels majeurs sans requérir de comptage individuel fastidieux.
Le calcul de cette colonne de fréquences cumulées s’opère selon une cinématique bidirectionnelle convergente. L’algorithme initie une sommation incrémentale à partir de la tige correspondant aux valeurs minimales en progressant vers l’intérieur de la distribution. Parallèlement, une sommation identique est engagée depuis la tige hébergeant les valeurs maximales en descendant vers le centre. La progression de ces deux sommes s’interrompt à la ligne critique qui contient la médiane statistique de l’échantillon.
Sur cette ligne médiane particulière, l’algorithme n’affiche pas la somme cumulée, mais plutôt l’effectif brut absolu des feuilles présentes sur la tige, conventionnellement encadré entre parenthèses dans la typographie de Tukey. Cette notation permet de vérifier instantanément la cardinalité centrale de l’échantillon. Soit n l’effectif total ; si n est impair, la médiane correspond précisément à la valeur occupant le rang défini par n plus un divisé par deux. Si n est pair, la médiane se situe entre les rangs n sur deux et n sur deux plus un.
La validation formelle de la cohérence de l’échantillon découle de cette arithmétique marginale. En additionnant la profondeur cumulée immédiatement supérieure à la classe médiane, la profondeur cumulée immédiatement inférieure, et l’effectif propre logé à l’intérieur des parenthèses de la classe médiane, la sommation doit restituer avec une exactitude arithmétique absolue la taille n du vecteur initial. La parité de l’échantillon modifie ainsi la lecture sémiotique : elle indique immédiatement à l’analyste si la médiane est ancrée sur une observation réelle ou si elle résultera d’une interpolation barycentrique entre deux observations contiguës.
3. Configuration de l’environnement de développement Python
3.1 Installation et gestion des dépendances
Le langage de programmation Python s’est imposé comme l’environnement computationnel de référence pour la science des données en raison de la richesse de son écosystème modulaire. Toutefois, l’environnement de base fourni par la distribution Python standard ne propose aucune primitive dédiée à la génération sophistiquée de diagrammes tige et feuilles. Pour combler cette lacune technique, la communauté statistique s’appuie principalement sur la bibliothèque spécialisée stemgraphic, développée par François Dion. Cette bibliothèque étend l’infrastructure visuelle de Matplotlib en introduisant des fonctions hautement paramétrables adaptées aux standards de Tukey.
L’installation rigoureuse de cet environnement requiert l’utilisation du gestionnaire de paquets officiel pip ou du gestionnaire d’environnements Conda. Dans un terminal de commande standard, l’instruction impérative s’exprime comme suit :
L’utilisateur saisit dans son invite de commande l’instruction d’installation standard pip install stemgraphic. Cette directive télécharge non seulement le module central mais procède également à l’évaluation des dépendances sous-jacentes indispensables à son bon fonctionnement, au premier rang desquelles figurent numpy pour le calcul vectoriel vectorisé, pandas pour la manipulation des structures tabulaires bidimensionnelles, et matplotlib pour le moteur de rendu graphique matriciel et vectoriel.
Dans un contexte de recherche académique ou de production industrielle, la reproductibilité computationnelle constitue une exigence déontologique impérieuse. Il est donc vivement recommandé de confiner cette installation à l’intérieur d’un environnement virtuel isolé, via l’outil venv ou au moyen d’un environnement virtuel Conda dédié. Cette précaution neutralise tout risque de collision de versions, notamment entre les versions récentes de Matplotlib dont les modifications d’interfaces de programmation internes peuvent occasionnellement induire des ruptures de compatibilité avec les routines de disposition textuelle de bibliothèques tierces.
3.2 Importation des modules et vérification de version
Une fois le déploiement technique des bibliothèques finalisé au sein du système, l’initialisation du pipeline d’analyse dans un script Python autonome ou dans un carnet interactif Jupyter requiert l’importation ordonnée des modules scientifiques. La convention canonique consiste à importer stemgraphic conjointement avec pandas, numpy et le sous-module pyplot de Matplotlib. Cette structuration garantit un accès fluide aux fonctions d’orchestration graphique de bas niveau tout en exploitant les couches d’abstraction de haut niveau fournies par stemgraphic.
Il est scientifiquement judicieux d’implémenter au début de chaque script une routine de vérification programmatique des versions des dépendances majeures. Cette vérification s’effectue en interrogeant l’attribut __version__ présent au sein de chaque espace de noms importé. Une telle démarche assure une traçabilité rigoureuse lors de la compilation des rapports de recherche, facilitant l’identification d’éventuelles divergences comportementales causées par des mises à jour intermédiaires des bibliothèques.
Dans les environnements interactifs tels que les carnets Jupyter, le choix du moteur de rendu graphique, ou backend, conditionne la fidélité visuelle de l’affichage. L’activation de la directive magique matplotlib inline ou, de manière encore plus robuste pour les sorties destinées à l’impression, l’instruction de configuration du format de rendu vectoriel par la commande plt.rcParams configurée pour produire du SVG, permet d’éviter toute pixellisation des textes minuscules qui forment les tiges et les feuilles. La précision typographique est ici capitale, car la lisibilité intrinsèque du diagramme repose sur l’alignement millimétrique et la netteté des glyphes numériques.
4. Implémentation élémentaire avec la bibliothèque stemgraphic
4.1 Déclaration du jeu de données et syntaxe fondamentale
L’exécution pratique d’un tracé tige et feuilles avec stemgraphic se distingue par sa concision syntaxique et sa capacité à s’adapter dynamiquement à des vecteurs de données non structurés. À titre d’illustration opérationnelle fondamentale, considérons la création d’un vecteur de mesures issu d’une observation chronométrique ou psychologique élémentaire. Ce vecteur peut être instancié sous la forme d’une simple liste d’entiers en Python ou d’un tableau unidimensionnel instancié via la bibliothèque numpy.
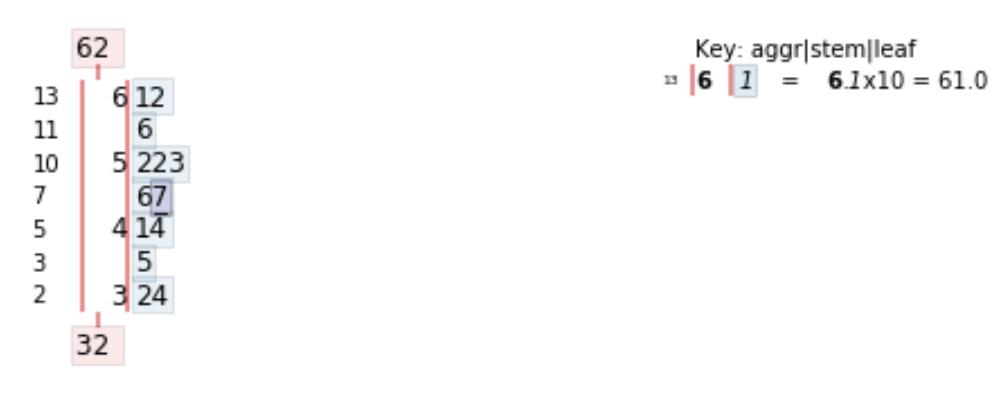
L’appel à la fonction cardinale de la bibliothèque, stemgraphic.stem_graphic, s’effectue en passant le vecteur de données comme argument primaire positionnel. Dès son invocation, la fonction déclenche une analyse descriptive automatisée de la distribution. Contrairement aux approches procédurales archaïques qui exigent de l’opérateur une spécification explicite des bornes d’intervalles, stemgraphic évalue la dispersion empirique de l’échantillon, calcule l’étendue globale, et détermine la troncature la plus harmonieuse pour garantir une projection visuelle équilibrée.
La fonction retourne systématiquement un tuple composé de deux instances fondamentales de l’écosystème Matplotlib : un objet Figure, qui encapsule l’ensemble du canevas graphique et gère les propriétés globales de dimensions et de résolution, et un objet Axes, qui contient les éléments géométriques, textuels et les délimiteurs cartésiens du tracé. La maîtrise de ces deux objets retournés confère au programmeur la possibilité d’intervenir a posteriori sur le diagramme pour y superposer des titres académiques personnalisés, modifier les marges ou ordonner l’exportation du graphique au moyen de la méthode standard savefig vers un stockage persistant, en format matriciel PNG haute résolution ou vectoriel PDF.
4.2 Paramètres d’appel de base et options par défaut
Le comportement de base de la fonction stem_graphic repose sur des algorithmes heuristiques sophistiqués destinés à optimiser la lisibilité sans intervention manuelle excessive de l’analyste. L’un des piliers de ce fonctionnement autonome est l’argument de mise à l’échelle, désigné par le paramètre scale. Lorsqu’il est laissé à sa valeur par défaut, l’algorithme calcule le logarithme en base dix de l’étendue des données afin d’isoler la puissance de dix qui produira un nombre de tiges conforme aux critères psychophysiques de la lisibilité visuelle, se situant traditionnellement entre cinq et vingt tiges.
Un autre composant fondamental de l’agencement graphique automatisé concerne la mise en place des lignes de démarcation verticales et horizontales. stemgraphic déploie des séparateurs visuels qui isolent nettement la colonne des profondeurs cumulées de la colonne des tiges, et cette dernière du réceptacle des feuilles. Cette sectorisation structurelle évite toute confusion optique lors de la lecture rapide des rangées numériques denses.
L’ordonnancement séquentiel des données s’avère totalement transparent pour l’utilisateur. Le pipeline computationnel interne de stemgraphic procède de manière implicite à un tri ascendant rigoureux du vecteur d’entrée au moyen d’un algorithme de tri performant à complexité quasi-linéaire. Enfin, la bibliothèque assure une modulation automatisée de la taille de police typographique. Si le jeu de données comporte un volume substantiel d’observations se traduisant par des dizaines de feuilles étalées sur une même rangée horizontale, la fonction stem_graphic contracte proportionnellement la taille des caractères pour juguler tout risque de chevauchement textuel sur les bordures du canevas.
5. Décodage sémiotique et interprétation approfondie de la sortie graphique
5.1 Balises d’encadrement des valeurs extrêmes
L’une des innovations ergonomiques les plus remarquables introduites par la bibliothèque stemgraphic par rapport aux représentations textuelles traditionnelles de Tukey réside dans l’utilisation de cartouches d’encadrement chromatiques spécifiquement dédiés à l’identification des points singuliers. Lors de la génération d’un tracé graphique complet, l’œil de l’analyste est immédiatement attiré par la présence de boîtes rectangulaires teintées de nuances rougeâtres positionnées aux deux extrémités cardinales du diagramme : la balise inférieure et la balise supérieure.
La boîte située à la base extrême inférieure du tracé isole de manière explicite la valeur minimale observée au sein de l’échantillon, tandis que l’encart positionné à l’extrémité supérieure circonscrit la valeur maximale. Ces balises ne constituent pas de simples artifices décoratifs. Dans le cadre d’un protocole d’évaluation psychométrique ou d’un essai clinique médical, ces scores seuils cristallisent fréquemment les enjeux diagnostiques cruciaux, tels que la détection d’un plancher de performance cognitive ou d’un seuil pathologique critique.
Sur le plan interprétatif, ces encarts imposent une distinction méthodologique fondamentale entre ce que l’on qualifie d’extrêmes distributionnels attendus et de valeurs aberrantes réelles ou discordantes. Un extrême distributionnel s’inscrit dans la continuité géométrique de l’étirement des tiges, manifestant simplement la variabilité naturelle des queues de distribution. À l’inverse, si un décalage métrique colossal sépare le contenu textuel de la boîte rouge de la première tige hébergeant des feuilles régulières, l’analyste est averti sans ambiguïté d’une rupture de continuité statistique nécessitant une investigation approfondie relative à la validité de la mesure ou à la présence d’une erreur d’enregistrement instrumental.
5.2 Lecture de la colonne d’agrégation et du corps textuel
L’anatomie d’un diagramme produit par stemgraphic obéit à une sémiologie rigoureuse qu’il convient de déchiffrer avec méthode pour en extraire toute la substance informationnelle. Le regard de l’évaluateur doit s’organiser de la périphérie gauche vers le cœur du tracé. La première colonne verticale rencontrée matérialise les fréquences cumulées évoquées dans les fondements mathématiques. Chaque nombre inscrit dans cette colonne informe instantanément sur le nombre total d’observations regroupées depuis la bordure la plus proche jusqu’à la tige considérée incluse.
Au point de convergence des sommations ascendante et descendante se dessine la ligne pivot de la distribution. Dans le rendu de stemgraphic, cette ligne hébergeant la médiane est immédiatement identifiable : le chiffre de gauche est conventionnellement substitué ou enrichi par l’affichage de l’effectif propre à cette classe, matérialisant l’acmé de la densité ou le barycentre des rangs. L’analyste observe ensuite la tige centrale, qui indique la modalité d’ordre supérieur partagée par ces observations médianes, avant de scruter les feuilles qui s’étirent horizontalement vers la droite.
La lecture du corps textuel horizontal informe directement sur l’hétérogénéité locale des données. La répétition séquentielle de chiffres identiques au sein d’une même feuille signale sans équivoque la présence de modes distributionnels discrets ou de nœuds de répétition expérimentaux, caractéristiques fréquentes des échelles d’évaluation de type Likert en sciences sociales. En outre, la comparaison de la longueur physique des rangées situées de part et d’autre de la tige médiane permet d’apprécier intuitivement l’étendue de l’intervalle interquartile : une distribution symétrique présentera une décroissance progressive et harmonieuse de la largeur des rangées au fur et à mesure que l’on s’écarte de la tige centrale vers les extrêmes.
6. Paramétrage avancé et personnalisation de la visualisation
6.1 Modulation de l’échelle et de la granularité
Bien que les routines heuristiques intégrées dans stemgraphic proposent une configuration généralement satisfaisante pour les échantillons conventionnels, l’exploration scientifique de distributions atypiques requiert impérativement une maîtrise experte des paramètres de granularité. Le levier de contrôle fondamental réside dans la manipulation conjointe des arguments scale et unit au sein de la signature de la fonction stem_graphic.
L’argument scale permet d’appliquer un coefficient multiplicateur ou diviseur sur la longueur d’intervalle allouée à chaque tige. Dans certaines situations empiriques caractérisées par une variance extrêmement faible au sein d’un échantillon par ailleurs vaste, l’algorithme standard risque de regrouper l’intégralité des observations sur une tige unique flanquée d’une rangée de feuilles interminable et illisible. En forçant la valeur de scale à un facteur fractionnaire approprié, l’analyste contraint la bibliothèque à scinder les tiges. Une tige décimale conventionnelle peut ainsi être fragmentée en deux sous-tiges (hébergeant respectivement les feuilles de zéro à quatre et de cinq à neuf) ou en cinq tiges distinctes couvrant des micro-intervalles de deux unités.
Cette technique de fractionnement des tiges exige toutefois une vigilance méthodologique aiguë. L’introduction d’un sur-fractionnement artificiel induit un risque statistique majeur : l’atomisation artificielle de la distribution. Si l’analyste déploie un nombre disproportionné de tiges face à un effectif restreint, la continuité géométrique s’effondre au profit d’un alignement anarchique de tiges désertes entrecoupées de feuilles orphelines, annihilant toute possibilité d’inférer la forme réelle de la densité sous-jacente.
L’argument unit, quant à lui, redéfinit la signification métrologique de la feuille. En spécifiant de manière explicite l’amplitude de l’unité représentée par chaque caractère individuel (par exemple en assignant unit=0.1 ou unit=10), le chercheur prévient toute ambiguïté interprétative lors de l’intégration du graphique au sein d’un manuscrit scientifique. Le diagramme ajuste automatiquement sa légende textuelle intégrée pour stipuler de façon formelle la clé de lecture mathématique liant la tige et la feuille.
6.2 Ajustement esthétique et intégration Matplotlib
L’insertion d’un diagramme tige et feuilles au sein d’une publication scientifique soumise à des normes éditoriales strictes, à l’image des directives de l’American Psychological Association, impose de transcender les choix esthétiques par défaut pour harmoniser la composition visuelle. Dans la mesure où stemgraphic repose intégralement sur les fondations de Matplotlib, la fonction stem_graphic expose une multitude de paramètres d’ajustement cosmétique et structurel de bas niveau.
Le paramètre figsize constitue le premier vecteur de calibrage dimensionnel. En transmettant un tuple définissant la largeur et la hauteur en pouces de la surface de dessin, l’analyste garantit que les proportions spatiales entre la colonne d’agrégation et le déploiement horizontal des feuilles demeurent parfaitement équilibrées. Pour des distributions comportant un grand nombre de tiges, l’accroissement délibéré de la hauteur de figure évite l’écrasement vertical des rangées et préserve un espacement interligne optimal pour la lecture oculaire.
La personnalisation chromatique s’effectue via les arguments dédiés à la palette visuelle. Il est tout à fait envisageable de redéfinir la coloration des cartouches d’extrémités pour substituer aux tons rougeâtres par défaut des nuances de gris neutres conformes aux exigences d’impression en noir et blanc des revues académiques traditionnelles. De même, les polices typographiques, les couleurs des filets séparateurs et la visibilité des statistiques marginales peuvent être modulées avec précision.
L’intégration fluide dans le pipeline graphique se concrétise lors de l’étape finale d’exportation. En manipulant directement l’objet Figure retourné par la fonction, le chercheur exécute l’enregistrement sous forme vectorielle pure via le format Scalable Vector Graphics (SVG) ou Portable Document Format (PDF). Contrairement aux sorties matricielles (PNG, JPEG) sujettes aux phénomènes de pixellisation et de flou de compression lors de redimensionnements ultérieurs, le format vectoriel conserve une netteté absolue des glyphes numériques, quelle que soit l’échelle d’agrandissement typographique adoptée par l’éditeur.
7. Algorithme de construction textuelle en Python pur sans dépendance
7.1 Conception d’une fonction Python native
L’étude approfondie d’un outil statistique ne saurait être complète sans l’exploration de ses mécanismes algorithmiques internes. Concevoir une fonction autonome de diagramme tige et feuilles en Python pur, sans solliciter aucune dépendance tierce telle que stemgraphic, numpy ou pandas, présente un intérêt heuristique et opérationnel majeur. Cette démarche permet d’exécuter des analyses exploratoires rapides au sein d’environnements d’exécution hautement contraints, de micro-serveurs ou de terminaux dépourvus de gestionnaires de fenêtrage et de moteurs graphiques compilés.
Le cœur algorithmique d’une telle implémentation repose sur l’exploitation judicieuse de l’arithmétique entière de Python et de structures de données natives optimisées. En premier lieu, la collection d’observations doit être soumise à une opération de tri préalable ascendante au moyen de la méthode native sort(), qui implémente le puissant algorithme hybride Timsort doté d’une complexité temporelle garantie en O(N log N) dans le pire des cas.
Une fois le vecteur rigoureusement ordonné, la segmentation morphologique de chaque entier s’opère par l’application conjointe de l’opérateur de division entière, symbolisé en Python par le double barre oblique, et de l’opérateur modulo, désigné par le symbole de pourcentage. Pour chaque observation individuelle, la tige est isolée par la division entière par dix, tandis que la feuille correspond strictement au reste de cette division. L’agrégation structurelle de ces composantes s’effectue avec une efficacité optimale en recourant à la structure defaultdict(list) issue du module standard collections, qui permet de regrouper instantanément chaque feuille dans une liste dynamique indexée par sa tige correspondante sous forme de clé associative.
La complétude mathématique du processus impose de traiter adéquatement la continuité des tiges. Même si certaines classes intermédiaires ne comportent aucune observation dans l’échantillon empirique, l’intégrité sémiotique du tracé exige que ces tiges vides soient matérialisées dans l’affichage console afin de rendre compte fidèlement de la dispersion spatiale réelle et d’éviter un télescopage artificiel des valeurs distantes.
7.2 Formatage et affichage console standard
La matérialisation visuelle du diagramme dans le flux textuel de sortie console repose sur une rigueur absolue d’alignement typographique, sans laquelle l’illusion géométrique d’un pseudo-histogramme s’évanouit immédiatement. Cette contrainte est résolue par le calcul dynamique préalable de la largeur d’affichage maximale des tiges. L’algorithme doit identifier la longueur maximale en caractères de la tige la plus volumineuse afin de calibrer le décalage horizontal des rangées au moyen des spécificateurs d’alignement intégrés dans les f-strings de Python.
Chaque ligne textuelle générée se compose de trois segments rigides distincts. À gauche, la tige est insérée en alignement justifié à droite, assurant que les unités, dizaines et centaines soient verticalement superposées avec une régularité géométrique parfaite. Au centre, un caractère délimiteur invariant, conventionnellement une barre verticale, sépare le pôle des tiges du réceptacle des feuilles. À droite, les éléments de la liste des feuilles associées sont concaténés sans espacement au moyen de la méthode de chaîne join(), érigeant une barre horizontale continue dont la longueur physique devient rigoureusement proportionnelle à l’effectif statistique de la classe.
Pour parachever l’instrument de mesure textuel, l’algorithme doit imprimer une légende formelle en en-tête ou au pied du tracé. Cette mention standardisée précise de manière univoque la clé de décodage sous la forme conventionnelle stipulant par exemple que la notation un suivi d’une barre puis d’un cinq équivaut arithmétiquement à la valeur quinze, avec une unité de feuille fixée à l’unité. En matière d’efficacité computationnelle, cet algorithme natif présente une complexité spatiale linéaire en O(N), ce qui lui permet de traiter des séries de données volumineuses en une fraction infime de seconde sur n’importe quel interpréteur Python standard.
8. Génération textuelle avancée avec le sous-module stemgraphic.stem_text
8.1 Exécution de stem_text en environnement sans interface graphique
Bien que le tracé vectoriel offert par stem_graphic constitue l’option privilégiée pour l’élaboration de documents académiques finaux, la réalité pratique de l’ingénierie des données et de l’analyse exploratoire décentralisée impose fréquemment de travailler sur des serveurs distants via des connexions terminal sécurisées (SSH). Dans ces architectures dénuées de serveur d’affichage X11 ou de moteur Wayland, le déclenchement de routines Matplotlib nécessite des configurations lourdes de backends non interactifs tels que Agg.
Pour répondre à cette contrainte opérationnelle avec une élégance maximale, la bibliothèque stemgraphic propose un sous-module spécialisé de très haut niveau : stemgraphic.stem_text. Cette fonction se dispense intégralement de l’infrastructure graphique matricielle de Matplotlib pour générer un flux purement textuel au format ASCII enrichi directement calibré pour le flux de sortie standard stdout de l’interpréteur.
L’utilisation de stem_text offre des avantages majeurs en matière de vélocité d’exécution et de légèreté computationnelle. Elle ne crée aucune structure d’objets graphiques volumineuse en mémoire vive, ce qui la rend parfaitement adaptée à l’inspection rapide de séries temporelles ou de métriques systèmes au sein de scripts de maintenance automatisés. De surcroît, le flux textuel produit peut être intercepté de manière fluide et redirigé vers des fichiers de journalisation plats (logs) ou archivé au sein de bases de données textuelles pour constituer une trace d’audit analytique immuable et immédiatement lisible par l’œil humain.
8.2 Paramétrage typographique du rendu textuel
Loin d’être une déclinaison rudimentaire de la fonction graphique, stem_text intègre une sophistication de paramétrage typographique tout à fait remarquable. L’une de ses prérogatives majeures concerne le contrôle strict de la largeur maximale des colonnes de sortie, administré par l’argument column_width. Lors du traitement de vecteurs volumineux présentant des concentrations massives de feuilles sur des tiges spécifiques, un terminal textuel standard risque d’introduire des retours à la ligne intempestifs qui désagrègent complètement l’alignement spatial et rendent la silhouette méconnaissable.
Grâce au paramètre de largeur maximale, stem_text met en œuvre une stratégie intelligente de troncature sélective. Lorsque le nombre de feuilles dépasse la capacité spatiale allouée au terminal, la fonction condense l’affichage en insérant un symbole d’ellipse textuelle explicite et en stipulant entre crochets le décompte exact des feuilles résiduelles omises. Cette disposition garantit que la géométrie globale du diagramme conserve sa rectitude visuelle sur n’importe quel écran ou support de terminal.
De plus, stem_text permet à l’utilisateur de moduler la présence des métriques récapitulatives textuelles. Il est possible d’activer ou d’inhiber l’affichage des valeurs minimales, maximales, des quantiles et de la médiane sous forme de pavé récapitulatif adossé au tracé. Dans les chaînes d’intégration continue de modélisation statistique, cette fonctionnalité autorise des contrôles d’intégrité automatisés où la sortie textuelle est scannée par des expressions régulières pour valider que la distribution des erreurs de prédiction ne présente pas d’anomalies de symétrie avant le déploiement d’un modèle en production.
9. Application empirique aux jeux de données psychométriques avec pandas
9.1 Ingestion et nettoyage d’un DataFrame de variables comportementales
L’application concrète des diagrammes tige et feuilles trouve un terrain d’élection privilégié dans l’analyse des données psychométriques et comportementales. Dans ces disciplines, les protocoles expérimentaux génèrent des tables de données hétérogènes regroupant des inventaires d’auto-évaluation de la personnalité, des échelles d’anxiété clinique standardisées et des latences de réponses motrices acquises au millième de seconde. La bibliothèque pandas constitue l’instrument canonique pour l’ingestion, le nettoyage et la structuration de ces matrices d’observations.
Le traitement liminaire impose une rigueur méthodologique absolue. L’ingestion initiale d’un fichier tabulaire, qu’il s’agisse d’un format délimité par des virgules (CSV) ou d’un classeur de données de recherche, s’opère via la fonction read_csv de pandas. Immédiatement après cette étape de chargement, l’analyste doit isoler la série univariée d’intérêt et déployer un protocole d’assainissement méticuleux destiné à éliminer les valeurs manquantes ou non renseignées, conventionnellement codées sous la forme de constantes NaN.
La présence d’une seule valeur non numérique au sein d’un vecteur de calcul suffit à corrompre les algorithmes de tri et les opérations arithmétiques de division entière sous-jacentes. L’application de la méthode dropna() sur la série pandas ciblée permet d’élaguer sans ambiguïté les observations incomplètes. Par la suite, une vérification explicite du typage s’avère impérative via la méthode astype() pour convertir impérativement la variable en un format numérique à virgule flottante ou entier strict.
Enfin, l’examen préalable des statistiques d’amplitude constitue une étape de contrôle incontournable. L’interrogation conjointe des méthodes min(), max(), et de l’étendue globale via describe() permet à l’analyste de valider la conformité de l’intervalle empirique avec les bornes théoriques de l’instrument d’évaluation psychologique utilisé, évitant ainsi d’injecter des artefacts de saisie aberrants au sein du pipeline de visualisation.
9.2 Visualisation de distributions psychométriques réelles
L’interopérabilité conceptuelle et technique entre la bibliothèque pandas et le module stemgraphic est conçue pour être directe et transparente. La fonction stem_graphic accepte sans aucune restriction une instance de l’objet pandas.Series comme argument d’entrée. Cette intégration native permet au moteur d’extraire automatiquement le nom de la variable contenu dans les métadonnées de la série pour enrichir l’habillage contextuel du graphique généré.
Dans le contexte clinique de l’évaluation cognitive, le recours au diagramme tige et feuilles permet de diagnostiquer avec une acuité inégalée des phénomènes distributionnels fondamentaux tels que les effets de plafond ou les effets de plancher. Un effet de plafond se manifeste visuellement par une accumulation massive et asymétrique de feuilles sur la tige correspondant au score maximal admissible par l’instrument de mesure, traduisant l’incapacité du test à discriminer les aptitudes supérieures des sujets les plus performants. L’observation immédiate de cette butée mécanique sur le tracé avertit le psychomètre de la non-pertinence des postulats de normalité gaussienne pour cette sous-population.
De même, l’évaluation de la normalité empirique d’un score comportemental s’opère d’une manière infiniment plus informative qu’à travers un simple test d’hypothèse formel comme le test de Shapiro-Wilk ou de Kolmogorov-Smirnov. Alors que ces tests inférentiels se bornent à délivrer une valeur p globale souvent excessivement sensible à la seule taille de l’échantillon, le diagramme tige et feuilles expose la morphologie exacte de la déviance : il montre si le rejet de la normalité est imputable à une bimodalité latente suggérant l’existence de deux sous-groupes cliniques non diagnostiqués, ou à une dissymétrie modérée compatible avec l’usage de statistiques non paramétriques robustes.
La documentation de ces observations morphologiques au sein d’un carnet de recherche numérique (Jupyter Notebook) offre un support d’audit scientifique exceptionnel. Les commentaires cliniques peuvent être adossés directement à la figure haute résolution générée, instaurant une traçabilité indéfectible entre l’échantillon brut, son nettoyage statistique et l’interprétation théorique finale.
10. Traitement des distributions complexes : décimaux et valeurs négatives
10.1 Gestion algorithmique des nombres décimaux continus
L’un des défis les plus redoutables lors de la construction algorithmique d’un diagramme tige et feuilles en informatique réside dans la gestion des grandeurs numériques continues représentées sous forme de nombres à virgule flottante. En raison des spécificités inhérentes à la norme matérielle standardisée IEEE 754 régissant l’arithmétique en virgule flottante dans les processeurs modernes, les opérations sur les décimaux sont sujettes à des imprécisions infinitésimales de troncature binaire. Par exemple, la valeur zéro virgule un ne possède pas de représentation binaire exacte finie, ce qui peut induire des erreurs d’arrondi perverses lors de l’exécution successive d’opérations de division entière et d’opérateurs modulo.
Pour immuniser le tracé contre ces artefacts numériques déstabilisants, le pipeline computationnel doit adopter une stratégie de normalisation déterministe préalable. La technique privilégiée consiste à identifier le nombre maximal de décimales significatives requises par l’analyse, puis à multiplier l’ensemble du vecteur empirique par la puissance de dix correspondante avant toute partition arithmétique. Cette opération projette l’ensemble des mesures dans l’espace sécurisé des entiers relatifs, où les calculs de division modulaire s’exécutent avec une exactitude mathématique rigoureuse.
Dans l’analyse des chronométries ultrarapides, telles que les temps d’inspection sensorielle mesurés en millisecondes ou en fractions de seconde, cette modulation d’échelle doit être explicitée avec une clarté totale. La configuration manuelle de l’argument unit au sein de la fonction stemgraphic devient alors impérative. Si les valeurs initiales oscillent par exemple entre 0.12 et 0.89 seconde, l’unité de tige sera positionnée au dixième de seconde (0.1), et l’unité de feuille au centième de seconde (0.01).
L’analyste et le lecteur doivent alors appréhender la lecture du diagramme à travers une grille de décodage proportionnelle : chaque chiffre individuel composant la feuille ne représente plus une unité entière, mais une fraction décimale de la mesure. Cette gymnastique sémiotique rétablit la totale continuité de l’analyse exploratoire pour les grandeurs physiques continues, sans céder aux facilités trompeuses de l’arrondi grossier qui appauvrirait la finesse de la mesure expérimentale.
10.2 Représentation et symétrie des valeurs numériques négatives
Le traitement des séries statistiques hébergeant des valeurs négatives soulève des paradoxes arithmétiques et visuels complexes, dont le plus célèbre est incontestablement l’ambiguïté du zéro négatif. Dans le domaine mathématique conventionnel, le zéro ne possède pas de signe distinctif. Cependant, dans le cadre d’un diagramme tige et feuilles où la tige représente la troncature d’ordre supérieur, une observation valant moins cinq (-5) et une observation valant plus cinq (+5) partageraient théoriquement la même tige entière nulle égale à zéro si l’on procédait à une division entière naïve par dix.
Cette confusion détruirait instantanément la symétrie axiale du diagramme. Pour résoudre cette aporie structurelle, la modélisation statistique avancée introduite par Tukey et fidèlement répliquée dans stemgraphic crée deux tiges distinctes pour la valeur nulle : une tige annotée moins zéro (-0) et une tige annotée plus zéro (+0). La tige négative accueille exclusivement les valeurs fractionnaires négatives comprises entre moins zéro virgule neuf et moins zéro virgule un, préservant ainsi la séparation stricte de part et d’autre de l’origine.
Ce protocole technique prend toute son importance lors de l’étude de variables standardisées, universellement répandues en psychométrie sous forme de scores centrés réduits, couramment qualifiés de scores Z. Par construction mathématique, ces variables présentent une moyenne théorique fixée à zéro et un écart-type égal à un. L’échantillon se compose donc intrinsèquement d’une proportion substantielle de valeurs négatives équilibrant les valeurs positives.
L’algorithme de stemgraphic administre cette structure en ordonnant les tiges de manière strictement continue, des valeurs les plus négatives en bas vers les valeurs les plus positives en haut, ou inversement selon l’axe de projection sélectionné. Le statisticien doit vérifier avec soin la bonne concordance directionnelle des feuilles le long des tiges négatives. En effet, sur une tige négative, l’éloignement par rapport au point zéro central implique que des feuilles de valeur absolue plus élevée correspondent à des grandeurs algébriquement plus petites, imposant une lecture symétrique inversée par rapport au quadrant positif pour respecter l’ordonnancement croissant continu de la droite des réels.
11. Comparaison de groupes par diagrammes tige et feuilles dos-à-dos
11.1 Principes des représentations dos-à-dos (Back-to-Back)
L’exploration univariée d’un échantillon unique ne constitue souvent que la première phase d’un protocole de recherche scientifique, rapidement relayée par des questions comparatives complexes visant à contraster deux populations distinctes. Dans ce dessein méthodologique, John Tukey a imaginé une déclinaison architecturale remarquablement efficace : le diagramme tige et feuilles dos-à-dos, connu dans la littérature anglo-saxonne sous la désignation de back-to-back stem-and-leaf plot.
Le principe spatial de cette représentation repose sur la mutualisation d’une colonne centrale unique hébergeant l’ensemble des tiges communes aux deux distributions. De part et d’autre de cette armature centrale rigide, les feuilles des deux sous-échantillons se déploient dans des directions opposées : conventionnellement, les feuilles du groupe expérimental ou pathologique s’étirent horizontalement vers la gauche du diagramme, tandis que les feuilles du groupe témoin ou de contrôle s’étirent vers la droite.
Cette disposition géométrique offre une puissance d’inférence qualitative immédiate pour la comparaison de cohortes appariées ou indépendantes. Elle permet de visualiser de manière instantanée si l’administration d’un traitement pharmacologique ou d’une intervention psychologique induit une translation générale de la tendance centrale de la distribution vers le haut ou le bas des tiges. De surcroît, les divergences d’hétérogénéité ou d’homogénéité de variance (homoscédasticité) se manifestent avec une clarté saisissante par le contraste entre l’étalement vertical étiré des feuilles d’un groupe face à la condensation compacte de l’autre.
L’avantage sémiotique sur des représentations concurrentes telles que la double boîte à moustaches est considérable. Alors que les boîtes à moustaches peuvent sembler similaires en présence de moyennes et d’écarts interquartiles équivalents, le tracé dos-à-dos révèle immédiatement si cette apparente équivalence masque en réalité des distributions asymétriques divergentes, l’une étirée vers les valeurs hautes et l’autre affectée par une forte concentration basse.
11.2 Mise en œuvre technique sous Python
Sur le plan de l’outillage logiciel sous Python, la génération d’un tracé dos-à-dos requiert une démarche technique avertie. Bien que la bibliothèque stemgraphic possède des primitives pour aborder les comparaisons de séries, la flexibilité maximale s’obtient fréquemment par l’élaboration d’un script personnalisé combinant la puissance de structuration des dictionnaires Python et le formatage textuel standard ou vectoriel.
Le défi algorithmique fondamental réside dans la gestion de la direction de lecture des feuilles du panneau latéral gauche. Pour respecter scrupuleusement la cohérence cognitive de l’observateur, l’ordonnancement des feuilles associées au groupe positionné à gauche des tiges doit impérativement être inversé lors de l’affichage. Cela signifie que les feuilles les plus petites doivent être disposées au plus près de la tige centrale, les feuilles croissant en valeur absolue au fur et à mesure que le regard s’éloigne vers l’extrême gauche.
Cette inversion impose une cinématique computationnelle rigoureuse : après avoir segmenté les observations du premier groupe en tiges et feuilles, la liste de feuilles de chaque tige doit être triée de manière descendante avant sa concaténation textuelle, alors que celle du groupe de droite demeure triée de manière ascendante conventionnelle. Le calibrage de la largeur d’alignement du panneau gauche exige une justification textuelle à droite pour assurer que toutes les feuilles viennent s’aboucher rigoureusement contre le séparateur vertical central sans laisser d’interstice irrégulier.
L’application de ce protocole technique à l’analyse différentielle de scores de performance cognitive entre un échantillon de sujets neurotypiques et un échantillon de patients présentant un déficit de l’attention offre une illustration éclatante de l’intérêt de la méthode. L’analyste observe en direct l’élargissement de la dispersion des temps de réponse chez les patients cliniques, tout en conservant la capacité de repérer le score exact de chaque individu, favorisant ainsi le dialogue entre la clinique individuelle et la quantification collective.
12. Évaluation critique, limites méthodologiques et comparaison avec les outils modernes
12.1 Limites de scalabilité face aux mégadonnées (Big Data)
En dépit de son élégance mathématique et de son incontestable pertinence épistémologique dans l’exploration fine d’échantillons qualifiés, le diagramme tige et feuilles se heurte à une limitation structurelle infranchissable dès lors qu’il est confronté aux écosystèmes massifs de données contemporains, désignés sous le vocable de Big Data. Cette vulnérabilité intrinsèque découle directement de son principe fondateur le plus noble : la préservation intégrale de l’individualité de chaque point d’observation.
Lorsque la cardinalité de l’échantillon franchit le seuil critique de quelques centaines d’observations pour atteindre des dizaines ou des centaines de milliers de mesures, le mécanisme de transcription textuelle s’effondre sous le poids de la saturation visuelle. L’accumulation de dizaines de milliers de chiffres formant les feuilles génère des blocs massifs et opaques qui annihilent toute lisibilité locale et transforment l’espace graphique en un amas informe. Sur le plan computationnel, les algorithmes d’allocation de texte et de rendu vectoriel subissent un ralentissement drastique, la disposition de milliers d’objets textuels distincts saturant rapidement les mémoires tampons de rendu de Matplotlib.
Dans ce contexte d’inflation volumétrique, le statisticien méthodologiste doit impérativement acter la transition vers des paradigmes de modélisation continue fondés sur l’agrégation statistique. L’emploi de l’estimation de densité par noyau (KDE), la mise en œuvre de tracés hexagonaux de densité bidimensionnelle (hexbin plots) ou l’usage d’histogrammes pondérés deviennent alors les seules approches méthodologiquement soutenables pour extraire la tendance distributionnelle globale sans saturer la cognition visuelle.
Il est donc essentiel de circonscrire le domaine d’application électif du diagramme tige et feuilles : cet instrument n’a jamais été conçu pour le traitement de mégadonnées industrielles, mais s’affirme comme l’outil diagnostique roi pour l’exploration en profondeur de petits et moyens échantillons, typiques des protocoles d’investigation en psychologie expérimentale, en biologie clinique et dans les phases de contrôle qualité de haute précision.
12.2 Positionnement comparatif face aux représentations graphiques contemporaines
Pour apprécier la juste valeur heuristique du diagramme tige et feuilles dans la boîte à outils contemporaine de l’analyste de données sous Python, il convient d’opérer une mise en perspective comparative rigoureuse avec les visualisations concurrentes les plus répandues au sein des bibliothèques scientifiques comme Seaborn et Plotly.
Confronté à l’histogramme conventionnel à intervalles réguliers ou variables, le diagramme tige et feuilles conserve l’avantage décisif de la traçabilité sans perte. Un histogramme dissimule l’hétérogénéité interne des classes et s’avère particulièrement vulnérable au choix de l’origine et de la largeur des intervalles, des variations minimes de ces paramètres pouvant modifier radicalement la silhouette perçue. Le tracé tige et feuilles expose crûment la distribution réelle, interdisant tout maquillage involontaire des données.
Face au diagramme en boîte (box plot), l’outil de Tukey apporte un complément d’information vital. Si la boîte à moustaches excelle dans le résumé synthétique des quantiles et la détection d’observations distales, elle est par nature aveugle aux bimodalités. Une distribution parfaitement bimodale symétrique produit rigoureusement la même boîte à moustaches qu’une distribution unimodale normale de variance équivalente. Le diagramme tige et feuilles dissipe instantanément cette illusion géométrique en révélant le creux médian entre les deux modes.
Le diagramme en violon (violin plot), qui associe une boîte à moustaches à une enveloppe bilatérale d’estimation de densité par noyau, constitue sans doute l’alternative moderne la plus séduisante pour résumer des densités multimodales complexes. Néanmoins, pour des échantillons modestes n n’excédant pas cinquante observations, l’enveloppe lissée du violon tend à sur-ajuster le profil statistique et à suggérer une régularité continue fallacieuse là où n’existent que quelques mesures discrètes disjointes. Le diagramme tige et feuilles ne succombe jamais à ce biais de continuité artificielle.
Sur le plan pédagogique, enfin, le diagramme tige et feuilles demeure un instrument didactique d’une efficacité inégalée dans l’enseignement supérieur des statistiques quantitatives appliquées aux sciences humaines. Il offre aux étudiants et aux jeunes chercheurs une passerelle intuitive entre la matière brute du nombre et l’abstraction de la courbe de densité, ancrant durablement la compréhension des concepts de variance, de dissymétrie et d’aplatissement dans une expérience visuelle tangible et directe.
Références
- Dion, F. (2016). Stemgraphic: A comprehensive stem-and-leaf plotting library for Python. GitHub. https://github.com/fdion/stemgraphic
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. Proceedings of the 9th Python in Science Conference, 445, 51–56. https://doi.org/10.25080/Majora-92bf1924-003
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley Publishing Company.
- Velleman, P. F., & Hoaglin, D. C. (1981). Applications, basics, and computing of exploratory data analysis. Duxbury Press.
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0