
Dans le champ de l’économétrie appliquée, de la biométrie et de l’analyse empirique des données en sciences sociales, la modélisation des relations quantitatives repose massivement sur l’estimation de paramètres au sein de structures linéaires. Les praticiens sont continuellement confrontés à la nécessité d’incorporer des informations de nature qualitative, telles que le statut socio-économique, l’appartenance géographique, le niveau de diplôme ou le protocole de traitement clinique, au sein de modèles mathématiques conçus à l’origine pour traiter des grandeurs purement numériques et continues. L’incompatibilité fondamentale entre les attributs catégoriels et les algorithmes d’estimation linéaire requiert un cadre de transformation formel, connu sous le nom de codage disjonctif ou d’instanciation de variables indicatrices, communément appelées variables muettes (ou dummy variables).
Le tableur Microsoft Excel demeure l’un des environnements computationnels les plus largement déployés dans les organisations académiques, financières et de recherche institutionnelle pour la manipulation préliminaire et l’analyse statistique exploratoire. Si des logiciels dédiés tels que R, Python, Stata ou SPSS intègrent des mécanismes d’abstraction procédurale masquant la conversion des facteurs sous-jacents, l’exécution de ces opérations dans Excel impose à l’analyste une compréhension intime et rigoureuse de la structure matricielle des données. La création manuelle ou semi-automatisée de variables binaires dans Excel constitue un exercice méthodologique exemplaire, révélant la mécanique intime des équations de régression, la gestion des degrés de liberté et les dangers omniprésents de la redondance vectorielle.
Le présent traité propose une immersion exhaustive, théorique et opérationnelle dans l’art et la science de la génération de variables muettes au sein de Microsoft Excel. De la clarification des fondements de la mesure jusqu’à la mise en œuvre de régressions linéaires multiples complexes intégrant des termes d’interaction, chaque étape est disséquée avec une rigueur académique sans compromis. L’objectif est d’armer l’analyste, le chercheur ou le décideur des compétences nécessaires pour structurer des jeux de données d’une propreté irréprochable, déjouer les pièges algorithmiques de la multicolinéarité et interpréter les coefficients estimés avec une absolue précision statistique.
1. Fondements conceptuels des variables muettes en analyse statistique quantitative
1.1 Définition et nature mathématique des variables catégorielles et binaires
L’analyse statistique repose sur une typologie stricte des niveaux de mesure formalisée initialement par Stanley Smith Stevens. On distingue classiquement les échelles nominales, caractérisées par l’absence d’ordre intrinsèque entre les classes (par exemple, la nationalité ou le groupe sanguin), les échelles ordinales, qui établissent une hiérarchie sans préjuger de l’équidistance des intervalles (comme le niveau d’adhésion à une proposition ou le stade clinique d’une affection), et les échelles métriques d’intervalles ou de rapports, qui autorisent les opérations arithmétiques fondamentales d’addition, de soustraction et de calcul de moyennes. Dès lors qu’une variable se présente sous une forme nominale ou ordinale, son intégration brute dans un système d’équations linéaires constitue une transgression épistémologique majeure, car attribuer un chiffre arbitraire (tel que 1 pour Paris, 2 pour Lyon, et 3 pour Marseille) reviendrait à postuler fallacieusement que Lyon est le double de Paris et que la différence entre Marseille et Lyon équivaut à celle entre Lyon et Paris.
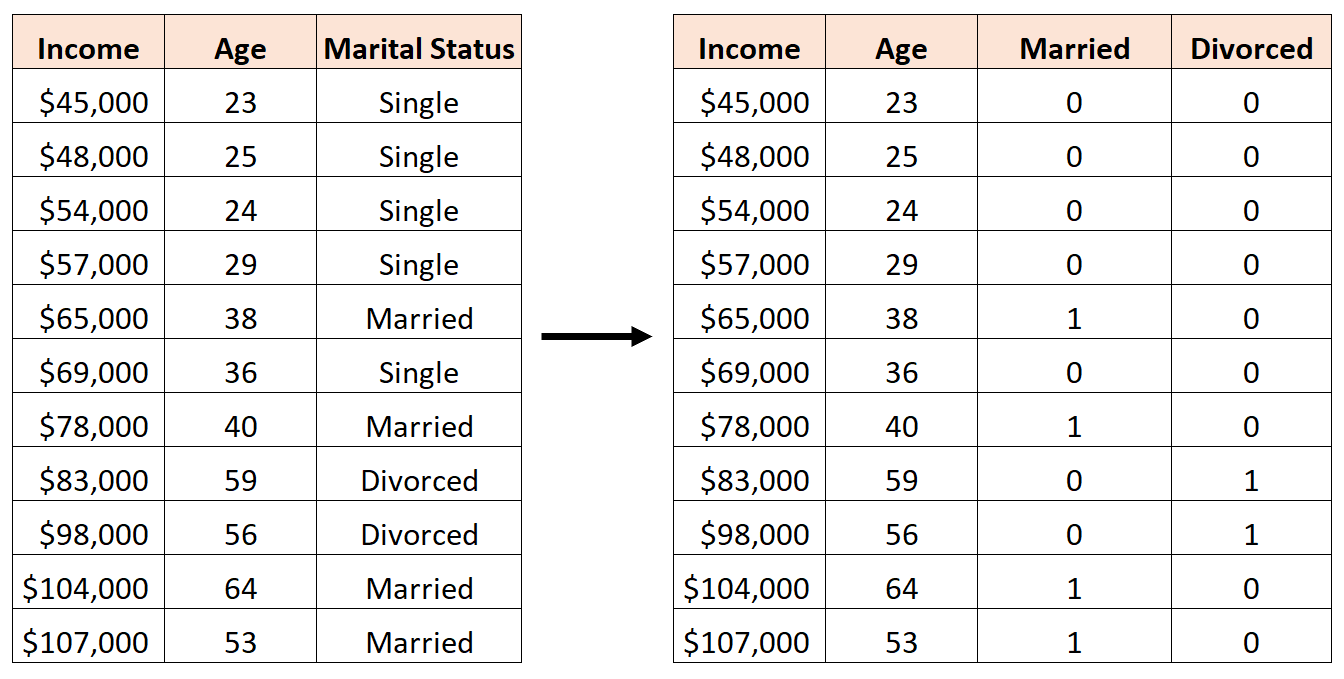
Pour remédier à cette aporie sans occulter la richesse informative des attributs qualitatifs, la théorie statistique recourt à la transformation disjonctive complète. Cette procédure convertit une information qualitative discrète comportant plusieurs modalités exclusives en un ensemble d’indicateurs vectoriels restreints au support binaire compact {0, 1}. Une variable binaire, ou indicatrice, assume la valeur 1 lorsque l’unité statistique observée possède l’attribut catégoriel considéré, et 0 dans l’éventualité contraire. Sur le plan des propriétés mathématiques fondamentales, l’élévation à la puissance d’une variable binaire ne modifie pas sa valeur (propriété d’idempotence arithmétique : $0^p = 0$ et $1^p = 1$ pour tout $p > 0$), et son espérance mathématique correspond très exactement à la proportion empirique d’observations présentant la modalité étudiée dans la population d’échantillonnage.
Dans le domaine des sciences du comportement, de la sociologie quantitative et de l’épidémiologie, la quantification rigoureuse des données qualitatives garantit que les distances entre individus sont modélisées de manière purement probabiliste et structurelle. Elle écarte toute assignation numérique subjective tout en permettant de formaliser les hypothèses de rupture ou de saut de palier d’une population à l’autre. Le passage par les variables muettes constitue ainsi la passerelle analytique indispensable entre les réalités qualitatives observables et les exigences formelles des représentations matricielles modernes.
1.2 Le rôle indispensable des variables muettes dans les modèles de régression
Les algorithmes d’estimation linéaire, au premier rang desquels figurent les estimateurs des moindres carrés ordinaires (MCO), reposent sur l’algèbre matricielle pour identifier le vecteur de paramètres qui minimise la somme des carrés des écarts entre les valeurs observées et les projections théoriques. Les matrices de calcul ne peuvent en aucun cas traiter des chaînes de caractères typographiques ni des représentations sémantiques non numériques. L’insertion d’une variable textuelle au sein d’un moteur de calcul d’inversion matricielle aboutit immanquablement à une erreur de type fatale. Dès lors, la première finalité opérationnelle des variables muettes est d’opérer cette numérisation formelle sans altérer l’essence de l’information catégorielle sous-jacente.
Au-delà de cette nécessité computationnelle, les variables indicatrices jouent un rôle structural déterminant : elles permettent de linéariser les écarts d’effets entre sous-populations statistiques au sein d’une seule et même équation de régression. Dans un modèle de régression univariée reliant le niveau de salaire à l’ancienneté professionnelle, l’adjonction d’une variable muette traduisant le genre ou l’obtention d’un diplôme spécifique autorise un décalage vertical et parallèle de la droite d’estimation. Ce décalage représente l’effet propre de la modalité, purgé de la covariance liée aux autres régresseurs continus. Cette capacité à segmenter l’espace échantillonnal sans scinder l’échantillon en sous-groupes indépendants optimise drastiquement la puissance statistique en mobilisant l’intégralité des degrés de liberté résiduels.
En intégrant des attributs qualitatifs comme prédicteurs exogènes au sein de l’équation linéaire générale, l’analyste préserve l’homogénéité de la variance structurelle. Contrairement à une échelle arbitraire qui introduirait une courbure factice ou des distorsions métriques injustifiables, le codage binaire 0/1 agit comme un interrupteur logique au niveau de chaque observation. Il garantit que la dispersion naturelle intra-groupe et la variance inter-groupe sont décomposées conformément aux postulats du théorème de Gauss-Markov, condition indispensable à l’obtention d’estimateurs linéaires sans biais et de variance minimale (BLUE).
1.3 La règle méthodologique des k-1 variables et le choix du groupe de référence
L’une des contraintes les plus fondamentales de l’économétrie linéaire stipule que pour une variable qualitative dénombrant un nombre fini $k$ de modalités mutuellement exclusives et exhaustivement observables, il est impératif d’intégrer exactement $k – 1$ variables muettes au sein de la matrice de régression lorsque celle-ci comprend un terme constant (ordonnée à l’origine). La démonstration mathématique de ce principe relève de l’indépendance linéaire des vecteurs d’entrée. Si un chercheur venait à générer et injecter la totalité des $k$ variables indicatrices en sus du vecteur colonne de constantes (qui est par convention une colonne de uns), la somme vectorielle de ces $k$ colonnes d’indicatrices équivaudrait ligne par ligne au vecteur constant unitaire. Cette égalité crée une relation de dépendance linéaire parfaite, rendant la matrice des produits croisés $X’X$ non inversible, un phénomène pathologique connu sous le nom de singularité matricielle.
La modalité délibérément écartée du codage disjonctif dans le système d’équations est formellement désignée comme le groupe de référence, la catégorie de base, ou le niveau témoin. Dans le cadre de l’estimation des moindres carrés, la constante mathématique du modèle (l’ordonnée à l’origine) n’exprime plus une moyenne indifférenciée, mais correspond très précisément à l’espérance conditionnelle de la variable dépendante pour ce groupe de référence omis, lorsque l’ensemble des autres variables explicatives continues est fixé à zéro. Choisir judicieusement ce niveau témoin revêt une importance académique capitale pour la lisibilité et l’interprétation des résultats statistiques subséquents.
Les critères de sélection académiques pour désigner le groupe de référence recommandent généralement d’opter soit pour la modalité la plus fréquente de l’échantillon (la catégorie modale), soit pour un groupe témoin au sens expérimental strict (comme les patients recevant un placebo). Retenir la catégorie la plus stable et la plus peuplée offre l’avantage de minimiser l’erreur-type associée à la constante et garantit que les coefficients de régression associés aux $k – 1$ variables muettes restantes mesurent avec une précision statistique optimale l’écart relatif (la différence d’espérance) entre chaque modalité spécifique et cette base de référence. Une catégorie résiduelle, hétérogène ou extrêmement minoritaire doit être systématiquement évitée en guise de référence, sous peine d’induire des variances d’échantillonnage disproportionnées sur l’ensemble des estimateurs différentiels.
2. Préparation de l’environnement de travail et structuration du classeur Excel
2.1 Organisation tabulaire et hygiène des données selon les standards empiriques
L’intégrité de toute modélisation quantitative dépend étroitement de la rigueur apportée à la phase de structuration tabulaire en amont de toute manipulation mathématique. Selon les principes du tidy data énoncés par Hadley Wickham, une matrice de données opérationnelle doit respecter une règle topologique immuable : chaque ligne doit correspondre à une et une seule unité d’observation statistique (un individu, une entreprise, une transaction), tandis que chaque colonne doit être dédiée exclusivement à une variable mesurée précise. Les structures de feuilles de calcul comprenant des totaux intermédiaires, des lignes vides insérées à des fins de lisibilité visuelle ou des fusions de cellules horizontales ou verticales violent directement cette architecture relationnelle et provoquent des erreurs de calcul en chaîne lors des traitements vectoriels.
Avant d’engager la création d’indicatrices binaires, une procédure d’hygiène textuelle s’avère indispensable pour neutraliser les bruits typographiques susceptibles de fausser les correspondances logiques d’Excel. Des chaînes de caractères en apparence identiques telles que « Cadre » (comportant une espace insécable finale) et « Cadre » seront traitées par les algorithmes de comparaison logique comme deux catégories distinctes, ce qui multiplierait artificiellement les modalités qualitatives. L’application systématique de la fonction combinée =SUPPRESPACE(MAJUSCULE(Cellule)) permet d’éliminer les espacements parasites au début et à la fin des chaînes de texte tout en unifiant la casse des caractères. Cette harmonisation préalable assainit les colonnes d’attributs avant toute segmentation analytique.
Enfin, la gestion des données manquantes (souvent encodées par des libellés hétéroclites comme « N/A », « Non renseigné » ou des cellules vides) doit être formalisée avec une absolue limpidité. En économétrie empirique, une cellule vide ne saurait être assimilée par défaut à la valeur numérique zéro, car l’absence d’information diffère fondamentalement de la constatation d’un état négatif. Le verrouillage structurel de la feuille de travail originale, par duplication des données brutes au sein d’un onglet immuable d’archivage, garantit la reproductibilité intégrale de l’expérience et permet de prémunir l’analyste contre toute modification accidentelle du corpus expérimental.
2.2 Activation et vérification de l’Utilitaire d’analyse de données d’Excel
Microsoft Excel dispose nativement d’une bibliothèque statistique puissante, l’Analysis ToolPak (ou Utilitaire d’analyse en langue française), qui intègre les moteurs de calcul matriciel pour la régression multiple, l’analyse de la variance (ANOVA), le filtrage des séries temporelles et les matrices de covariance. Néanmoins, pour des raisons d’allocation des ressources mémoire au démarrage de l’application, ce complément n’est pas activé par défaut lors de l’installation standard de la suite Microsoft Office. Il incombe donc à l’utilisateur de procéder à son initialisation formelle au sein des paramètres du tableur.
La procédure d’activation sous l’environnement Windows requiert de naviguer vers le menu Fichier, de sélectionner l’onglet Options en bas de l’arborescence, puis de cliquer sur la catégorie Compléments. Dans la zone inférieure de cette boîte de dialogue, le menu déroulant « Gérer » doit être positionné sur « Compléments Excel », avant de valider par le bouton « Atteindre… ». Une fenêtre modale affiche alors la liste des modules d’extension natifs disponibles : il convient de cocher la case relative à l’Utilitaire d’analyse (l’extension VBA de l’Utilitaire d’analyse peut également être sélectionnée si des automatisations par macros sont envisagées), puis de cliquer sur « OK ». Sur macOS, l’arborescence est accessible directement via le menu système Outils, suivi de la sélection de « Compléments Excel ».
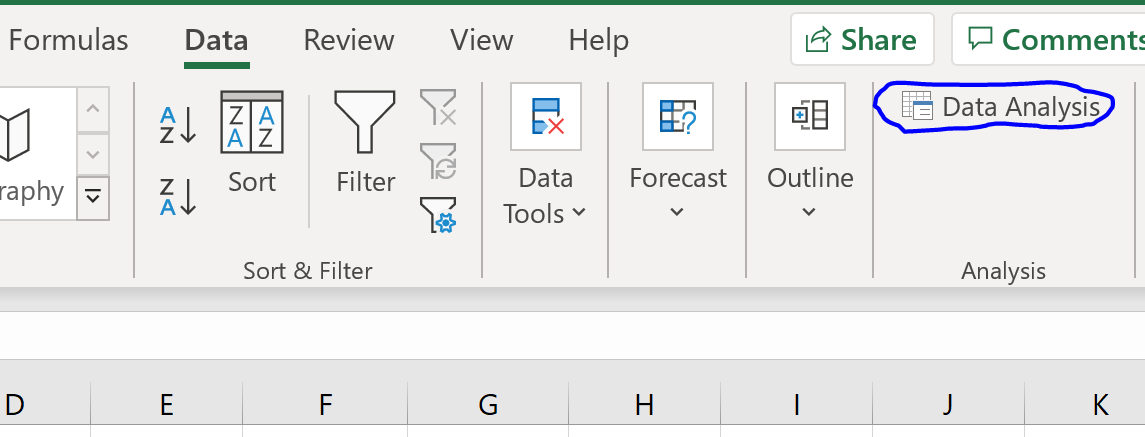
Une fois cette validation entérinée, un nouveau segment intitulé « Analyse » se matérialise à l’extrémité droite de l’onglet Données du ruban supérieur d’Excel, arborant le bouton de commande Utilitaire d’analyse. Il est impératif de vérifier la présence effective de ce module avant d’entamer le traitement, car les versions allégées d’Excel basées sur le Web (Excel Online) n’offrent pas une prise en charge complète de ces extensions algorithmiques compilées en local. L’utilisation de ces outils natifs certifiés par les équipes d’ingénierie de Microsoft offre des garanties d’invariance et de robustesse algorithmique incomparablement supérieures aux scripts d’origine tierce ou aux macros non auditées téléchargeables sur les forums techniques.
2.3 Documentation du livre de codes et nomenclature des variables créées
La transposition d’une variable nominale unique en une série de colonnes binaires engendre mécaniquement une augmentation sensible de la dimensionnalité de la table de données, ce qui induit un risque élevé de confusion sémantique lors de la lecture des résultats par des pairs ou des auditeurs indépendants. Il est par conséquent indispensable d’adopter une convention de nommage rigoureuse et standardisée pour chaque colonne muette générée. Une convention académique éprouvée consiste à concaténer le nom de la variable originelle avec le nom de la modalité spécifique codée, en employant le tiret bas comme séparateur et en évitant formellement les caractères accentués, les signes diacritiques et les espacements qui pourraient corrompre l’interopérabilité avec d’autres environnements de calcul (par exemple : Statut_Celibataire, Statut_Marie, Statut_Divorce).
Parallèlement à cette nomenclature en en-tête de colonnes, la rédaction d’une feuille de métadonnées dédiée, ou codebook (livre de codes), fait partie intégrante des bonnes pratiques scientifiques internationales imposées par les comités de lecture académiques. Ce document doit consigner formellement :
- Le nom exhaustif et la description opérationnelle de la variable mère d’origine.
- Le libellé précis et la signification de chaque modalité binarisée.
- La formule exacte ou le script de transformation utilisé pour générer la colonne muette.
- L’identification univoque de la modalité délibérément exclue du système pour servir de groupe de référence lors de l’estimation économétrique.
- Le traitement appliqué aux valeurs marginales, aberrantes ou manquantes.
Cette rigueur documentaire garantit une transparence méthodologique absolue et prévient toute interprétation fallacieuse lors de l’analyse ultérieure des tableaux de contingence ou des tables de régression. Un analyste tiers reprenant le classeur d’analyse est ainsi en mesure de reconstruire immédiatement l’architecture logique du protocole sans risquer d’attribuer par méprise le coefficient d’une modalité à une autre sous-population.
3. Méthode 1 : Création de variables indicatrices via la fonction conditionnelle SI
3.1 Syntaxe de base et implémentation univariée de la fonction conditionnelle
La méthode la plus intuitive et pédagogiquement limpide pour construire une variable indicatrice dans l’interface tabulaire d’Excel consiste à recourir à la fonction de branchement logique conditionnel SI. La structure formelle de cette fonction requiert trois arguments positionnels : SI(test_logique; valeur_si_vrai; valeur_si_faux). Le premier argument héberge une proposition logique susceptible d’être évaluée univoquement par le processeur de calcul comme VRAIE ou FAUSSE. Les deuxième et troisième arguments spécifient respectivement les valeurs que doit renvoyer la cellule selon l’issue booléenne de l’évaluation.
Dans le cas d’espèce du recodage disjonctif d’une colonne de données textuelles située par exemple en colonne C, pour isoler la modalité « Salarié », le test logique est formulé sous la forme d’une assertion d’égalité textuelle stricte : C2="Salarié". Il est impératif d’encadrer la chaîne de caractères discriminante par des guillemets typographiques doubles droits pour indiquer au compilateur d’Excel qu’il s’agit d’une constante littérale et non d’une référence à une plage nommée de la feuille de calcul. Lorsque l’évaluation confirme l’identité textuelle, la cellule doit renvoyer le chiffre 1 ; dans le cas contraire, elle doit restituer le chiffre 0.
La formule s’écrit formellement comme suit : =SI(C2="Salarié"; 1; 0). Une attention méticuleuse doit être portée à l’écriture des retours numériques : les entiers 1 et 0 ne doivent sous aucun prétexte être encapsulés dans des guillemets (l’écriture "1" et "0" constituerait une erreur méthodologique sévère). L’insertion de guillemets forcerait le stockage de la valeur sous le type de données textuelles (chaîne de caractères alphanumériques), ce qui neutraliserait immédiatement les capacités de l’Utilitaire d’analyse à reconnaître ces cellules comme des prédicteurs quantitatifs continus ou discrets dans une régression linéaire. Un contrôle d’alignement visuel constitue un premier diagnostic immédiat : par défaut dans Excel, les valeurs numériques s’alignent automatiquement à droite de la cellule, tandis que les valeurs textuelles demeurent alignées à gauche.
3.2 Utilisation des références relatives et absolues pour faciliter l’étirement
Dès lors que le jeu d’observations empiriques comprend des centaines ou des milliers de lignes et que la variable qualitative mère dénombre plusieurs modalités nécessitant la création concomitante de plusieurs colonnes muettes contiguës, l’efficience computationnelle impose d’optimiser l’adressage des cellules au sein de la formule. La manipulation non réfléchie du curseur de recopie incrémentale (étirement vers la droite ou vers le bas) risque d’altérer les références aux colonnes sources si le système de verrouillage par coordonnées absolues ou mixtes n’est pas maîtrisé.
L’utilisation judicieuse du métacaractère dollar ($) permet de geler dynamiquement l’axe de référence. Considérons une colonne source $C$ contenant les catégories à binariser, et une rangée d’en-têtes horizontaux située sur la première ligne (par exemple en cellules $D1$, $E1$ et $F1$) portant le nom exact des modalités recherchées (« Salarié », « Indépendant », « Retraité »). En formulant en cellule $D2$ l’instruction logique : =SI($C2=D$1; 1; 0), l’analyste crée un mécanisme d’une flexibilité absolue. Le symbole $ placé devant la lettre $C$ assure que la colonne source demeure invariante lors d’une recopie horizontale vers les colonnes $E$ et $F$, tandis que le symbole $ placé devant le chiffre 1 garantit que le comparateur demeure ancré sur la ligne des libellés lors de l’extension verticale vers le bas de la table.
Ce protocole réduit drastiquement le risque d’erreur humaine inhérent à la saisie répétitive de formules manuelles pour chaque colonne et chaque observation. Après avoir positionné cette formule mixte en cellule $D2$, un simple double-clic sur la poignée de recopie inférieure droite propage instantanément le test logique le long de la matrice de données. L’intégrité de la structure dimensionnelle est ainsi préservée tout au long de l’échantillon, assurant une parfaite adéquation entre le volume des données fuentes et la table d’indicatrices résultante.
3.3 Imbrication de conditions pour les variables catégorielles à modalités multiples
Bien que la génération de variables muettes pour une régression linéaire implique généralement la création de colonnes distinctes isolant chacune un état binaire 0/1, certaines architectures analytiques ou représentations intermédiaires requièrent l’attribution d’un indice numérique discret ordonné ou pondéré au sein d’une seule et même colonne synthétique. Cette démarche nécessite alors l’imbrication séquentielle de plusieurs instructions conditionnelles SI les unes au sein des autres.
La logique d’imbrication procède d’un raisonnement en cascade arborescente : =SI(C2="Faible"; 1; SI(C2="Moyen"; 2; SI(C2="Élevé"; 3; 0))). Dans ce schéma, le processeur évalue la première assertion ; si celle-ci s’avère fausse, il évalue immédiatement la clause alternative suivante, et ainsi de suite jusqu’à atteindre la condition de fermeture finale. Cette dernière clause, dénommée clause de sécurité, est fondamentale : elle permet d’attribuer une valeur sentinelle prédéterminée (le chiffre 0, ou une chaîne explicite telle que « Inconnu ») à toute observation présentant une valeur non répertoriée, une faute d’orthographe ou une omission de saisie au sein de la cellule source.
Il importe toutefois de souligner les limites computationnelles inhérentes aux imbrications profondes sur les versions antérieures d’Excel, qui plafonnaient la profondeur de la pile à 64 niveaux d’imbrication tout en devenant particulièrement opaques à auditer et excessivement vulnérables aux fautes de parenthésage. Sur les versions modernes de Microsoft 365 et d’Excel 2019 ou ultérieures, il est vivement recommandé d’abandonner l’empilement complexe de fonctions SI au profit de la fonction moderne SI.CONDITIONS (ou IFS en anglais). Cette fonction permet une linéarisation élégante de la syntaxe par couples logiques : =SI.CONDITIONS(C2="Faible"; 1; C2="Moyen"; 2; C2="Élevé"; 3; VRAI; 0), où la dernière condition fixée à l’état booléen VRAI capture de manière systématique tous les résidus non conformes.
4. Méthode 2 : Codage binaire direct par évaluation logique et double négation
4.1 Principe de l’évaluation logique pure renvoyant VRAI ou FAUX
Une approche alternative d’une élégance mathématique remarquable repose sur l’évaluation directe de propositions logiques au sein du moteur natif de calcul d’Excel, sans solliciter l’intermédiation de la fonction conditionnelle SI. L’architecture interne des tableurs évalue toute assertion comparative (telle que l’égalité, la supériorité ou l’infériorité) comme un état booléen primaire formalisé par les constantes système VRAI ou FAUX. Dès lors qu’un analyste inscrit dans une cellule la simple formulation relationnelle : =(C2="Salarié"), le logiciel compare le contenu de la cellule $C2$ à la chaîne spécifiée et renvoie immédiatement l’un de ces deux états logiques fondamentaux.
Cette formulation minimale présente un avantage computationnel considérable sur de grands volumes de données. La fonction SI requiert une interprétation syntaxique et un routage d’exécution de branches conditionnelles qui consomment des cycles de calcul additionnels au sein du processeur, tandis que l’évaluation logique pure opère au plus près du langage binaire de bas niveau de la machine. Sur des jeux de données d’envergure comportant des dizaines de milliers d’enregistrements et de multiples colonnes indicatrices, l’économie de temps de calcul devient particulièrement substantielle.
Toutefois, la restitution brute de valeurs booléennes pose un défi opératoire lors des étapes subséquentes de modélisation économétrique. Si le moteur d’Excel affiche lisiblement les mentions VRAI et FAUX, l’Utilitaire d’analyse statistique ne reconnaît pas systématiquement ces états logiques comme des variables indépendantes numériques valides au sein de ses algorithmes d’inversion matricielle. Il est donc indispensable d’appliquer une technique de coercition de type afin de contraindre ces grandeurs booléennes à se convertir en entiers stricts {0, 1}.
4.2 Conversion coercitive des booléens en entiers au moyen de l’opérateur double unaire
L’opérateur double unaire, formalisé par l’adjonction de deux signes négatifs consécutifs (--) devant une proposition logique ou une référence cellulaire, constitue la méthode de coercition de type la plus efficiente et académiquement reconnue dans l’écosystème d’Excel. Son mécanisme s’articule en deux micro-opérations arithmétiques successives. Le premier opérateur unaire (le premier signe moins) force le tableur à appliquer une opération arithmétique de négation sur la variable ; or, pour effectuer une négation sur un booléen, Excel doit impérativement le convertir en son équivalent numérique sous-jacent : VRAI devient -1, et FAUX devient 0 (car -0 équivaut arithmétiquement à 0). Le second opérateur unaire inverse à son tour le signe mathématique de cette grandeur intermédiaire, transformant -1 en +1 et laissant 0 invariant.
La syntaxe canonique de cette instruction se résume ainsi : =--(C2="Salarié"). L’utilisation des parenthèses encadrant le test logique est indispensable afin de contraindre l’ordre de priorité des opérateurs, le processeur devant d’abord résoudre la comparaison d’égalité textuelle avant d’appliquer la transformation arithmétique de double négation.
Il existe certes des variantes arithmétiques alternatives conduisant à un résultat strictement superposable, telles que la multiplication de la proposition logique par l’élément neutre de la multiplication (=(C2="Salarié")*1) ou l’addition de l’élément neutre de l’addition (=(C2="Salarié")+0). Néanmoins, dans la littérature consacrée à l’optimisation des modèles de calcul sous Excel, l’opérateur double négation (--) est universellement privilégié par les modélisateurs chevronnés en raison de sa compacité visuelle, de son absence de surcharge mémoire et de sa vitesse d’exécution supérieure, le compilateur reconnaissant immédiatement cette instruction comme une opération de transtypage univarié direct.
4.3 Gestion de la sensibilité à la casse avec l’intégration de la fonction EXACT
Un angle mort technique majeur de l’opérateur d’égalité conventionnel (=) réside dans son insensibilité totale à la casse typographique (c’est-à-dire l’indifférenciation absolue entre lettres minuscules et majuscules). Dans la syntaxe standard d’Excel, l’évaluation de l’assertion =("PARIS"="paris") renvoie immanquablement l’état logique VRAI. Dans la majorité des scénarios de gestion de bases de données, cette tolérance est avantageuse ; cependant, dans des contextes de recherche scientifique spécialisée, de génomique, de linguistique informatique ou de contrôle fiscal rigoureux, les variations de casse peuvent dénoter des états expérimentaux ou des classifications administratives fondamentalement distincts.
Afin de garantir une sélection binaire rigoureusement discriminante qui tienne compte de la casse typographique exacte, l’analyste doit substituer au comparateur basique la fonction native EXACT. Cette dernière prend exactement deux chaînes textuelles en paramètres et ne renvoie VRAI que si et seulement si l’ensemble des caractères alphabétiques, des signes de ponctuation et la casse sont rigoureusement identiques au niveau binaire. En combinant la fonction EXACT avec l’opérateur double unaire explicité précédemment, la formule acquiert une précision sans faille : =--(EXACT(C2; "Salarié")).
Sous cette spécification, si la cellule $C2$ contient le libellé « salarié » avec une minuscule initiale ou « SALARIÉ » en capitales intégrales, la fonction EXACT renverra immédiatement FAUX, et l’opérateur de double négation contraindra la cellule résultante à la valeur 0. Cette méthode immunise l’architecture de données contre l’apparition de faux positifs accidentels résultant d’une agrégation non désirée de modalités linguistiques distinctes, assurant ainsi un partitionnement disjonctif d’une rigueur absolue.
5. Méthode 3 : Automatisation avancée du recodage disjonctif via Power Query
5.1 Importation et préparation de la table dans l’éditeur Power Query
Lorsque les corpus de données atteignent des dimensions considérables (plusieurs centaines de milliers de lignes) ou s’inscrivent dans des protocoles de recherche longitudinaux alimentés périodiquement par de nouvelles vagues d’enquêtes, l’utilisation de formules de feuille de calcul classiques devient source de vulnérabilité, de lenteur d’affichage et de dégradation des performances logicielles. L’environnement Power Query, moteur d’extraction, de transformation et de chargement (ETL) intégré nativement dans les versions récentes de Microsoft Excel, constitue le paradigme moderne par excellence pour automatiser le recodage disjonctif complet sans altérer la table source originale.
La première phase opérationnelle consiste à convertir la plage de données brutes en un Tableau structuré Excel au moyen du raccourci clavier standardisé Ctrl + L ou Ctrl + T. Une fois le tableau nommé de manière explicite (par exemple Table_Observations), l’analyste se positionne sur l’onglet Données du ruban principal, puis active la commande À partir d’un tableau/d’une plage au sein du groupe « Récupérer et transformer des données ». Cette action déclenche l’ouverture de l’interface indépendante de l’Éditeur Power Query, isolant les données dans un conteneur mémoire sécurisé.
Dans l’éditeur, une vérification immédiate du typage des données s’impose. En inspectant l’icône positionnée à gauche de l’en-tête de la colonne catégorielle d’intérêt, l’utilisateur doit s’assurer que le type est explicitement configuré sur « Texte » (représenté par le glyphe ABC). Ce typage préventif empêche toute interprétation numérique prématurée d’éventuels codes catégoriels chiffrés et prépare la structure relationnelle aux transformations vectorielles ultérieures. L’avantage souverain de ce flux réside dans sa totale non-destructivité : aucune modification appliquée dans l’environnement Power Query n’écrase ni ne corrompt le classeur source tant que les opérations ne sont pas formellement validées et exportées.
5.2 Utilisation de la commande de pivotement et de colonnes conditionnelles
Pour matérialiser le codage disjonctif complet d’une variable qualitative dans Power Query, deux stratégies fonctionnelles d’une efficacité redoutable s’offrent à l’analyste : la création itérative de colonnes conditionnelles ou le pivotement direct sans fonction d’agrégation numérique.
La première technique fait appel au bouton de commande Colonne conditionnelle, accessible depuis l’onglet Ajouter une colonne de l’éditeur. L’interface graphique permet de configurer visuellement les règles de dérivation sans requérir l’écriture manuelle de code. Pour chaque modalité observée au sein de la variable catégorielle, l’analyste paramètre une clause stipulant : « Si [Colonne_Statut] est égal à ‘Marié’ alors 1 sinon 0 ». Cette opération est répétée pour $k – 1$ modalités afin de respecter la contrainte d’identification économétrique. L’interface traduit automatiquement ces instructions graphiques dans le langage fonctionnel sous-jacent Power Query M.
La seconde technique, particulièrement plébiscitée pour sa puissance d’automatisation lorsque la variable comporte un nombre élevé de catégories, repose sur la commande Pivoter la colonne de l’onglet Transformer. Pour mettre en œuvre cette méthode avancée, l’analyste crée préalablement une colonne auxiliaire temporaire assignée uniformément à la valeur constante 1. En sélectionnant la colonne catégorielle originelle et en déclenchant l’outil de pivotement avec pour colonne de valeurs cette variable auxiliaire unitaire, et en spécifiant sous les options avancées « Ne pas agréger », Power Query déploie instantanément l’ensemble des modalités uniques sous la forme d’en-têtes de colonnes horizontales distinctes. Les croisements non observés sont initialement peuplés de valeurs d’absence (null). Un clic droit sur les nouvelles colonnes suivi de la sélection de Remplacer les valeurs permet de convertir l’ensemble des occurrences null en la valeur entière 0. Le script M résultant encapsule ainsi une transformation complète, reproductible et instantanée.
5.3 Chargement des données encodées et stratégie de mise à jour dynamique
L’achèvement du pipeline de transformation dans Power Query implique le transfert de la structure matricielle binarisée vers le classeur de calcul principal. En cliquant sur le bouton déroulant Fermer et charger situé à l’extrémité gauche de l’onglet Accueil, l’analyste sélectionne la commande Fermer et charger dans…. Cette précaution permet d’éviter l’écrasement de la feuille active en choisissant spécifiquement d’importer la table de résultats sous la forme d’une nouvelle feuille de calcul dédiée, judicieusement nommée (par exemple Donnees_Modelisation).
Le bénéfice architectural majeur de cette approche réside dans sa dynamique transactionnelle entièrement réactive. Dans l’éventualité où de nouvelles observations statistiques viendraient enrichir la table brute d’origine, ou si des corrections d’erreurs de saisie étaient opérées sur les catégories qualitatives, aucune manipulation manuelle des formules d’indicatrices n’est requise. Un simple clic sur le bouton Actualiser tout de l’onglet Données (ou le raccourci Ctrl + Alt + F5) relance l’ensemble de la séquence des transformations M en arrière-plan : les nouvelles lignes sont scannées, filtrées, typées, pivotées et binarisées en quelques fractions de seconde.
Sur le plan de l’optimisation des performances informatiques, Power Query surpasse structurellement les formules de calcul matricielles volatiles d’Excel. En matérialisant une table de données statique optimisée pour l’analyse mais instantanément rafraîchissable à la demande, le logiciel libère la mémoire vive de l’ordinateur des recalculs continus qui ralentissent invariablement les classeurs complexes lors de l’extension de formules conditionnelles sur des millions de cellules.
6. Le piège de la variable muette et la prévention de la multicolinéarité parfaite
6.1 Compréhension théorique de la singularité matricielle en régression
La formulation algébrique canonique du modèle de régression linéaire multiple s’écrit sous la notation matricielle condensée $Y = X\beta + \varepsilon$, où $Y$ désigne le vecteur colonne des $n$ observations de la variable dépendante, $X$ représente la matrice de dessein (ou matrice d’expérience) de dimensions $n \times (p + 1)$ regroupant l’ensemble des prédicteurs exogènes précédés d’une colonne unitaire assignée à l’ordonnée à l’origine, $\beta$ est le vecteur des $p + 1$ paramètres à estimer, et $varepsilon$ le vecteur des perturbations stochastiques résiduelles. L’estimateur analytique fondamental des moindres carrés ordinaires est déterminé par l’équation normale bien connue : $\hat{\beta} = (X’X)^{-1}X’Y$.
Pour que cette solution unique existe au sens mathématique strict, une condition sine qua non doit impérativement être satisfaite : la matrice carrée des produits croisés $X’X$ doit être formellement inversible. Cette inversibilité requiert que la matrice $X$ soit de rang plein colonne, ce qui signifie qu’aucune colonne de la matrice ne doit pouvoir s’exprimer sous la forme d’une combinaison linéaire exacte d’une ou plusieurs autres colonnes. Si un chercheur intègre imprudemment dans la matrice $X$ la totalité des $k$ variables muettes associées aux $k$ modalités d’une caractéristique qualitative en conservant simultanément le vecteur colonne de la constante (composé uniquement du chiffre 1), la relation d’interdépendance linéaire devient absolue :
$$\sum_{j=1}^{k} D_{ij} = 1 = \text{Constante}_i \quad \forall i in {1, dots, n}$$
Cette redondance vectorielle parfaite conduit à un déterminant matriciel strictement égal à zéro : $det(X’X) = 0$. La matrice d’information devient singulière, rendant son inversion rigoureusement impossible. Ce phénomène mathématique constitue la définition formelle du piège de la variable muette (ou Dummy Variable Trap). D’un point de vue algorithmique, l’Utilitaire d’analyse de données d’Excel confronté à une telle matrice singulière échoue à trouver une solution matricielle unique ; selon les versions du logiciel, le module d’estimation soit rejette brutalement l’opération en renvoyant un message d’erreur d’inversion, soit neutralise arbitrairement l’une des colonnes en lui assignant un coefficient nul ou des valeurs résiduelles non exploitables (#NOMBRE! ou 0 avec une erreur-type absente).
6.2 Identification et sélection stratégique de la catégorie omise
Pour désamorcer mathématiquement le piège de la variable muette, la solution universelle consiste à briser la combinaison linéaire parfaite en omettant délibérément l’une des indicatrices du bloc d’estimation. La colonne retranchée assume dès lors le statut méthodologique de catégorie omise ou de base de comparaison. La matrice d’expérience $X$ retrouve ainsi son rang plein colonne, autorisant l’inversion fluide de la matrice $(X’X)$ et assurant l’identification univoque du vecteur des estimateurs $\hat{\beta}$.
Le choix de la modalité devant faire l’objet de cette exclusion volontaire ne relève pas d’un hasard arbitraire, mais doit procéder d’une réflexion épistémologique dictée par la nature des hypothèses scientifiques formulées. Les recommandations méthodologiques privilégient trois approches majeures :
- La sélection du groupe de contrôle : Dans les protocoles quasi-expérimentaux ou d’évaluation des politiques publiques, la modalité correspondant à l’état de référence « Témoin », « Sans traitement » ou « Statut préexistant » s’impose naturellement comme la catégorie omise. Les coefficients des variables muettes restantes mesurent alors sans ambiguïté l’effet de traitement marginal imputable à chaque modalité d’intervention active.
- La sélection de la modalité modale (la plus fréquente) : En l’absence de statut témoin évident (par exemple, pour la variable région d’implantation ou type de contrat de travail), il est statistiquement judicieux de désigner comme catégorie de référence la classe dénombrant le plus grand effectif au sein de l’échantillon. Cette démarche assure que la constante du modèle est estimée sur la base empirique la plus dense, réduisant son erreur-type et conférant aux tests de Student bilatéraux sur les écarts relatifs une puissance statistique maximale.
- La sélection d’une modalité pivot conceptuelle : Dans les échelles de satisfaction ou de gravité clinique, choisir la catégorie intermédiaire neutre permet d’interpréter symétriquement les déviations positives et négatives par rapport au point médian de la distribution.
Une méprise fondamentale fréquemment observée chez les analystes novices consiste à oublier quelle catégorie a été omise lors de la phase de transformation. Une telle omission conduit inévitablement à des contresens sémantiques lors de la restitution des conclusions, l’analyste risquant d’imputer l’écart observé à la mauvaise sous-population de référence.
6.3 Diagnostic pré-analytique de la multicolinéarité dans le tableur
Bien que le piège de la variable muette stricte relève d’une collinéarité parfaite ($R^2 = 1$ entre prédicteurs), la multicolinéarité quasi-parfaite représente un péril tout aussi redoutable pour la stabilité des estimations économétriques. Ce risque survient fréquemment lorsque plusieurs variables qualitatives partageant des proximités structurelles fortes sont simultanément introduites sous forme de variables indicatrices, ou lorsqu’une sous-catégorie ne comporte qu’un nombre infime d’observations au sein de l’échantillon.
Avant de lancer l’estimation d’un modèle de régression multiple sous Excel, il est impératif d’auditer les corrélations croisées entre l’ensemble des prédicteurs retenus. Pour ce faire, l’analyste fait appel à l’outil Corrélation de l’Utilitaire d’analyse. Cet outil génère une matrice symétrique de corrélations bivariées de Pearson. L’inspection méticuleuse de cette matrice permet d’identifier d’éventuels coefficients de corrélation affichant des valeurs extrêmes supérieures à 0,80 ou 0,90 en valeur absolue. La détection d’un coefficient égal à 1 ou -1 entre deux indicatrices signale une redondance fonctionnelle absolue, révélant qu’une des deux modalités doit être immédiatement purgée du jeu de variables indépendantes.
Au-delà de la corrélation bivariée, l’évaluation de la multicolinéarité s’appuie formellement sur le calcul du Facteur d’inflation de la variance (abrégé en VIF pour Variance Inflation Factor). Pour une variable indicatrice $D_j$, le VIF est déterminé par l’expression mathématique :
$$\text{VIF}_j = \frac{1}{1 – R_j^2}$$
où $R_j^2$ représente le coefficient de détermination obtenu en régressant la variable muette $D_j$ sur l’ensemble des autres variables indépendantes du modèle. Bien qu’Excel n’intègre pas de commande automatisée dédiée au calcul du VIF au sein de son module de régression standard, l’analyste rigoureux peut l’obtenir en régressant successivement chaque variable explicative sur toutes les autres. Une règle empirique conventionnelle stipule qu’un seuil de VIF excédant la valeur 5 (ou 10 selon les disciplines les plus conservatrices) met en évidence une multicolinéarité sévère, susceptible de gonfler artificiellement les erreurs-types des coefficients et d’annihiler la significativité statistique des tests d’hypothèses de Student.
7. Tutoriel pratique pas à pas : Modélisation du revenu par l’âge et le statut matrimonial
7.1 Étape 1 : Saisie, inspection et mise en page du jeu de données expérimental
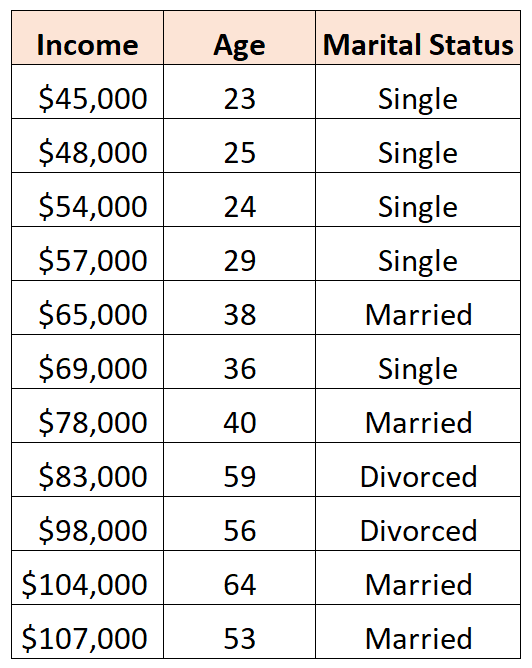
Pour illustrer de manière concrète et didactique l’intégralité du protocole de modélisation avec variables muettes dans Excel, nous étudions un cas pratique classique d’économie du travail : la prédiction du revenu annuel brut (exprimé en milliers d’euros) à partir de l’âge biologique du travailleur (variable quantitative continue) et de son statut matrimonial légal (variable qualitative nominale à trois modalités exclusives). Le corpus empirique d’illustration comprend un échantillon représentatif de salariés du secteur tertiaire.
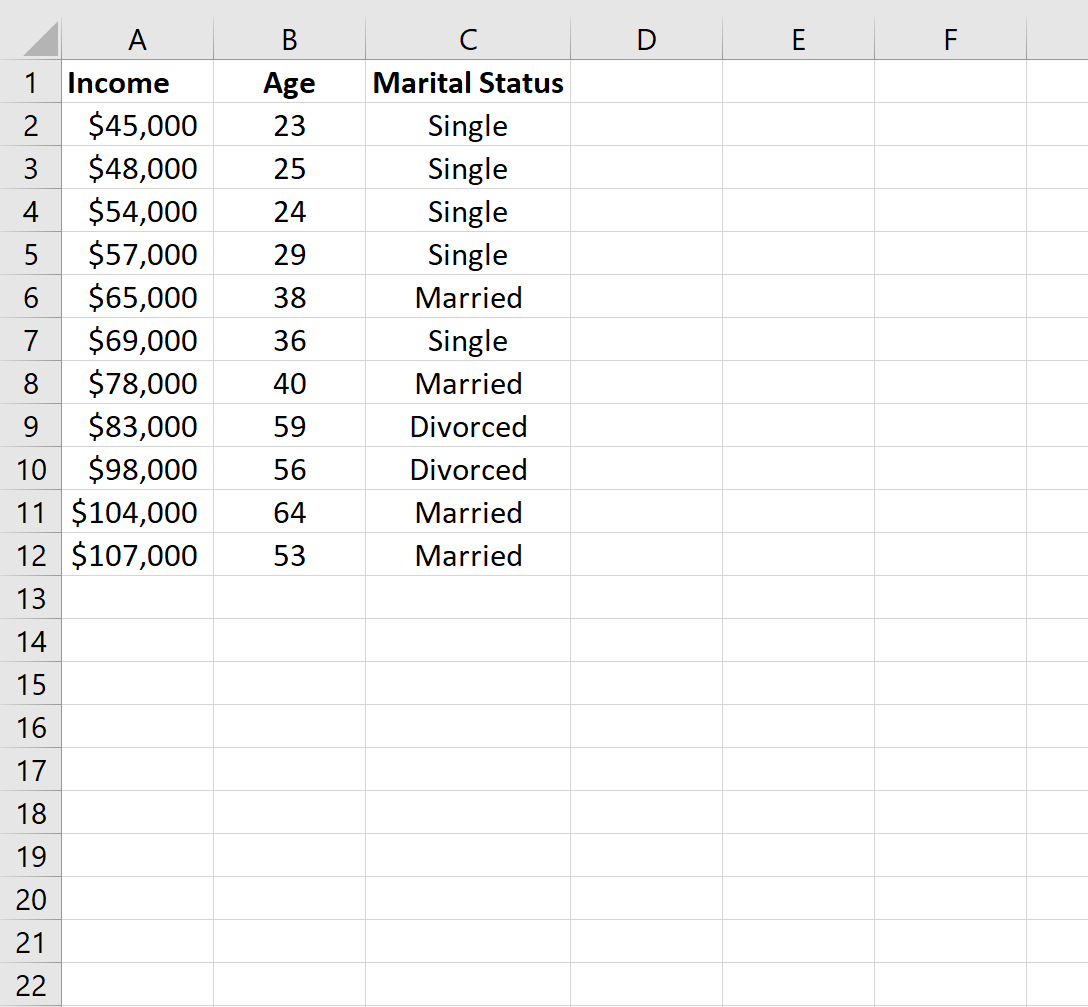
La première phase opératoire consiste à organiser scrupuleusement la feuille de calcul principale. La colonne $A$ héberge la variable dépendante continue, étiquetée Revenu_Annuel (exprimée par exemple de 24.5 à 85.2). La colonne $B$ accueille la variable explicative quantitative continue, intitulée Age (variant de 22 à 64 ans). Enfin, la colonne $C$ recueille l’attribut catégoriel brut sous l’en-tête Statut_Matrimonial, dont les enregistrements textuels se distribuent exclusivement sous trois libellés stricts : « Célibataire », « Marié » et « Divorcé ».
L’inspection visuelle et le contrôle des distributions s’effectuent immédiatement au moyen de l’outil Tableau croisé dynamique d’Excel. L’analyste dépose la variable Statut_Matrimonial dans la zone des lignes et dans la zone des valeurs (en sélectionnant l’agrégation par « Nombre »). Cette manipulation permet de vérifier qu’aucune modalité parasite n’a été introduite par inadvertance (telle qu’une faute de frappe « marie » sans accent ou une espace superflue) et d’évaluer les effectifs absolus et relatifs associés à chaque modalité. Pour que le modèle économétrique soit robuste, chaque classe catégorielle doit comporter un volume d’observations suffisant pour autoriser une inférence statistique valide.
7.2 Étape 2 : Détermination mathématique des k-1 indicatrices requises
Face à une variable qualitative dénombrant un effectif de modalités distinctes égal à $k = 3$ (« Célibataire », « Marié », « Divorcé »), l’application rigoureuse du postulat d’indépendance linéaire impose de dériver mathématiquement exactement :
$$k – 1 = 3 – 1 = 2 \text{ variables muettes}$$
L’inclusion d’une troisième variable indicatrice violerait immédiatement la condition de rang plein de la matrice des régresseurs, déclenchant irrémédiablement le piège de la multicolinéarité parfaite théorisé à la section précédente. L’analyste doit donc procéder à la désignation rationnelle de la catégorie de référence. Dans le cadre de cette étude, la modalité « Célibataire » est sélectionnée comme catégorie de base (baseline conceptuelle). Ce choix méthodologique se justifie par le fait qu’en sociologie économique de l’emploi, l’entrée sur le marché du travail s’effectue généralement sous le statut de célibataire ; l’évaluation des statuts d’union ou de dissolution matrimoniale subséquents permettra ainsi de mesurer directement la prime salariale ou l’écart d’espérance associés aux modifications du statut civil par rapport à cet état initial.
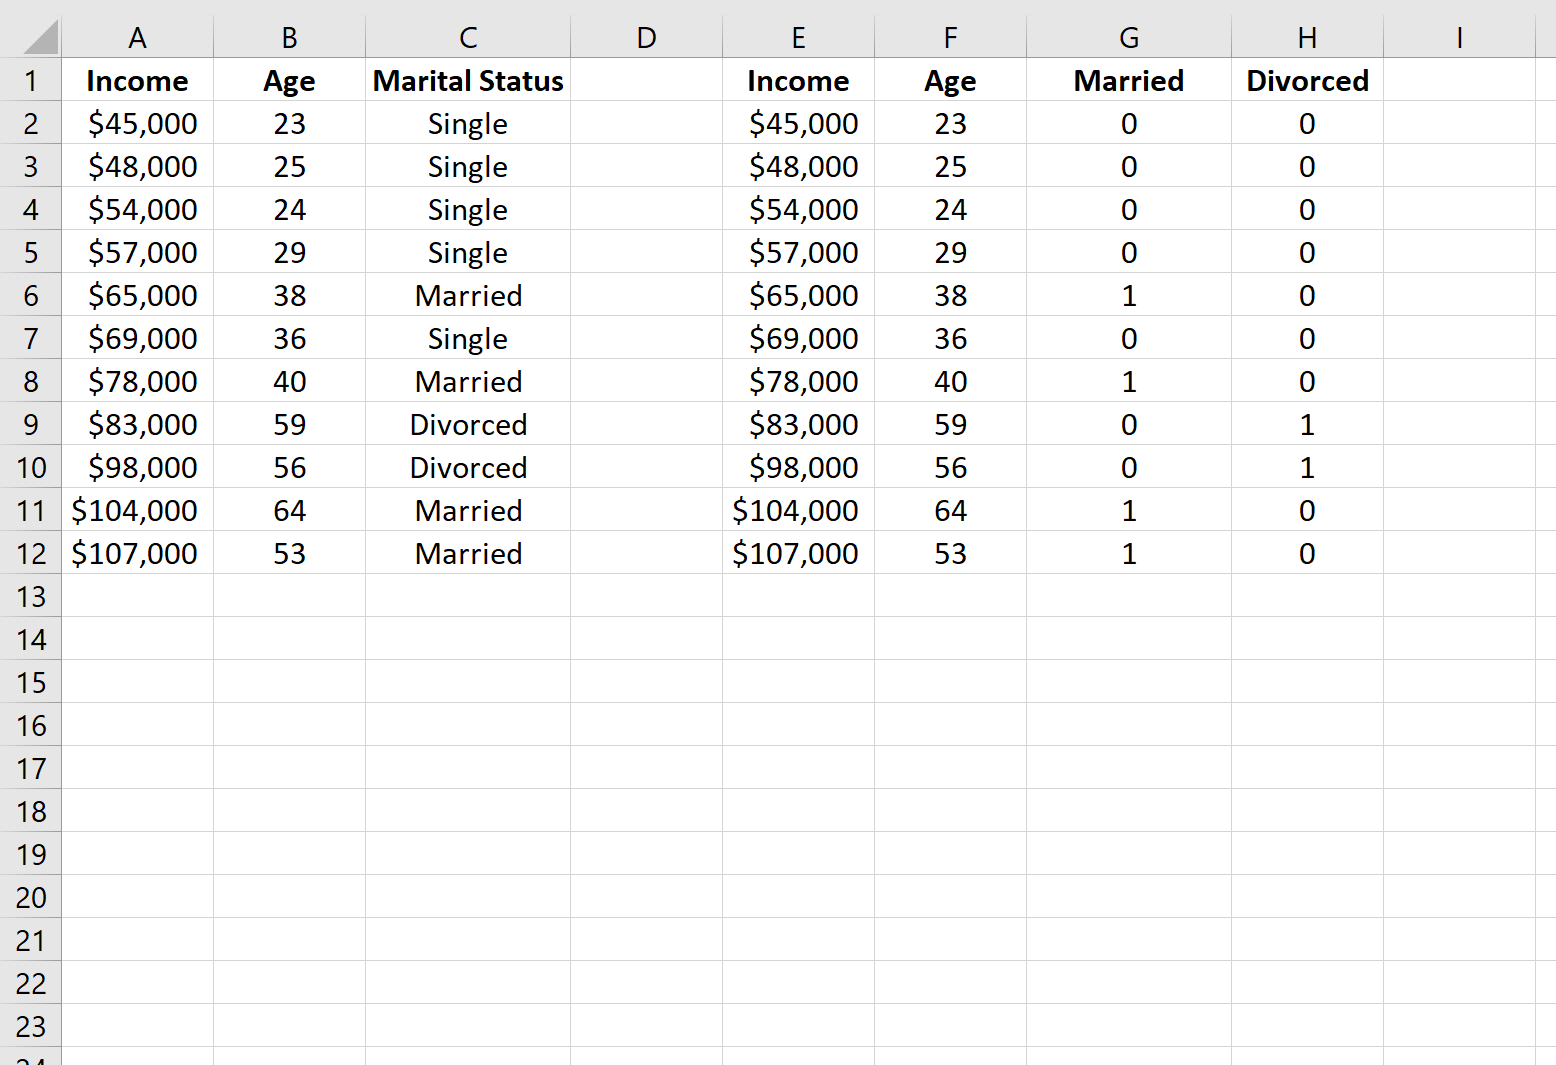
En conséquence directe de cette décision méthodologique, l’analyste insère deux nouvelles colonnes immédiatement contiguës aux données existantes, en colonnes $D$ et $E$. Les en-têtes de ces colonnes doivent être documentés avec une nomenclature explicite : la colonne $D$ est baptisée Statut_Marie et la colonne $E$ reçoit l’intitulé Statut_Divorce. La modalité « Célibataire » ne dispose volontairement d’aucune colonne dédiée, son influence structurelle étant intégralement absorbée par le terme constant (l’ordonnée à l’origine) lors de la régression.
7.3 Étape 3 : Implémentation pratique des formules et vérification des résultats
L’implémentation algorithmique des formules logiques s’effectue au niveau de la première ligne d’observation empirique (la ligne 2 du tableau, la ligne 1 étant réservée aux en-têtes de colonnes). En cellule $D2$, dédiée à l’isolation de la modalité « Marié », l’analyste saisit la formule conditionnelle suivante :
=SI(C2="Marié"; 1; 0)
De manière symétrique, en cellule $E2$, assignée à la capture de la modalité « Divorcé », la formule s’écrit formellement :
=SI(C2="Divorcé"; 1; 0)
Après avoir validé ces écritures, l’analyste sélectionne conjointement le bloc de cellules $D2:E2$ et double-clique sur la poignée de recopie incrémentale située à l’angle inférieur droit de la cellule $E2$. Les formules se propagent instantanément jusqu’à la dernière observation active de la table de données.
Une étape d’audit et de contrôle de conformité vectorielle est alors indispensable. Pour s’assurer de l’absence totale de défaillance algorithmique, l’analyste insère temporairement en colonne $F$ une formule de sommation horizontale de contrôle : =D2+E2. En vertu du principe d’exclusivité mutuelle des modalités matrimoniales, deux conditions logiques strictes doivent être observées sur l’intégralité des lignes de l’échantillon :
- Pour tout individu dont le statut est « Marié », la somme en colonne $F$ doit être exactement égale à 1 (avec $D_i = 1$ et $E_i = 0$).
- Pour tout individu dont le statut est « Divorcé », la somme en colonne $F$ doit être rigoureusement égale à 1 (avec $D_i = 0$ et $E_i = 1$).
- Pour tout individu dont le statut est « Célibataire » (le groupe de référence), la somme en colonne $F$ doit être impérativement égale à 0 (avec $D_i = 0$ et $E_i = 0$).
L’existence d’une seule ligne affichant une valeur supérieure ou égale à 2 signalerait une violation des postulats d’exclusivité ou une erreur d’écriture logique. Une fois ce diagnostic de validité confirmé au moyen d’un filtre textuel ou de la fonction =MAX(F2:Fn) (qui doit impérativement renvoyer la valeur 1), la colonne de vérification temporaire $F$ peut être supprimée.
8. Exécution de la régression linéaire multiple avec variables muettes dans Excel
8.1 Configuration précise de l’outil Régression dans l’Utilitaire d’analyse
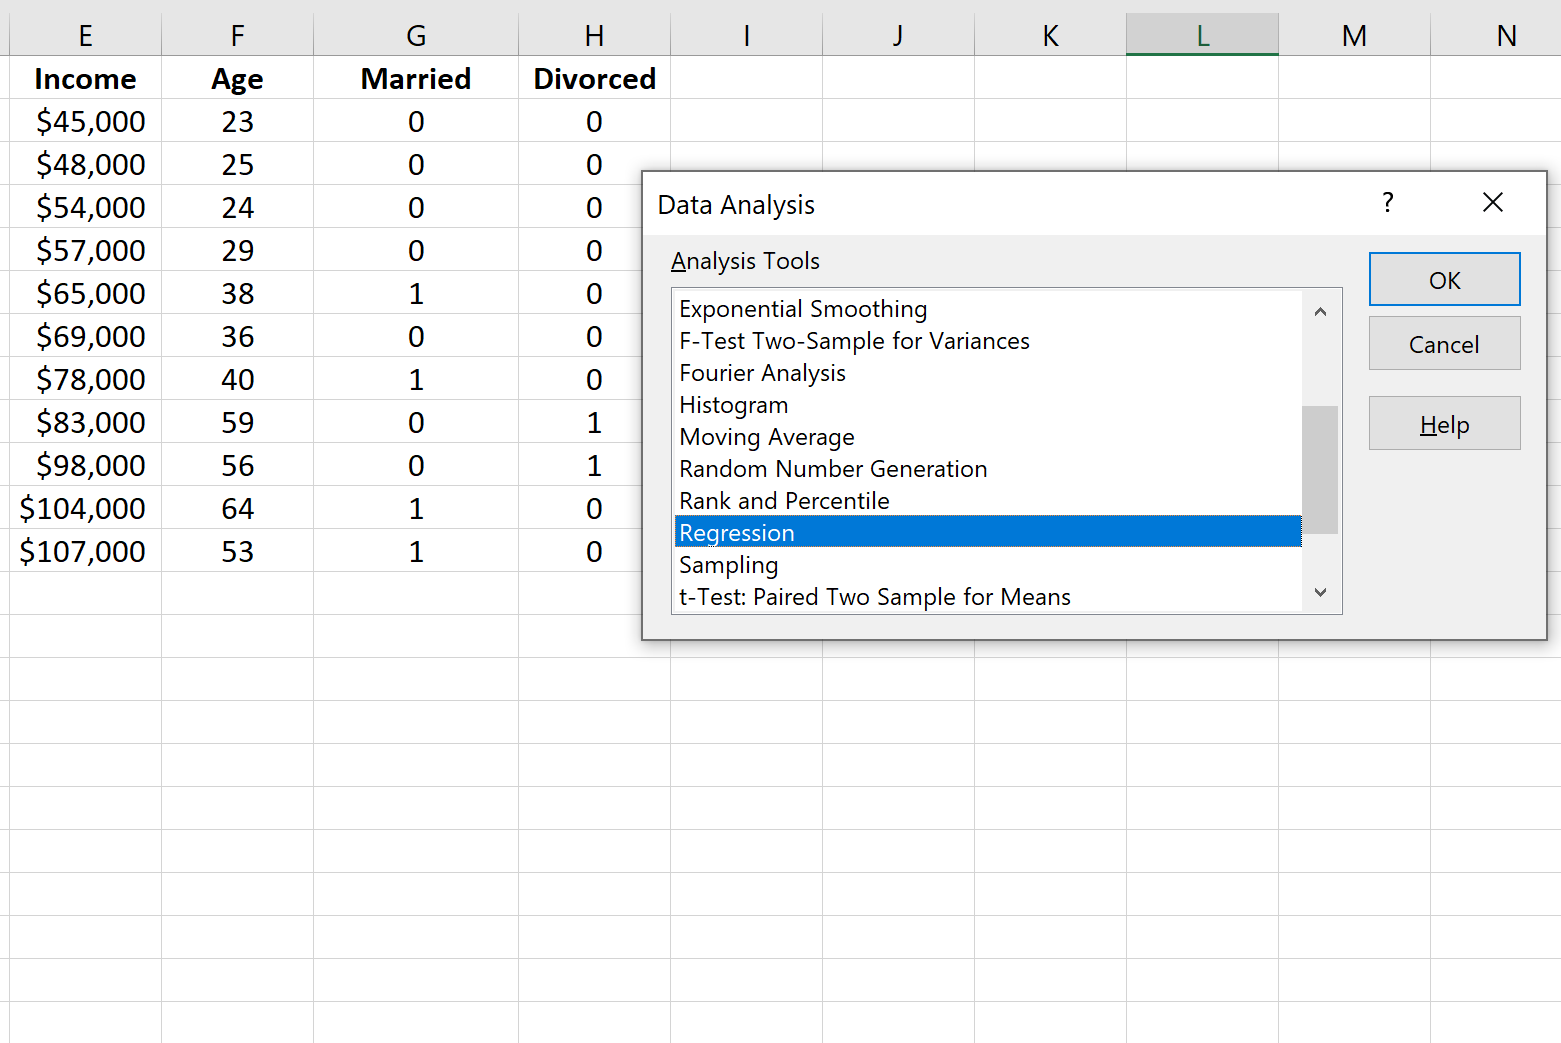
Dès lors que la structure matricielle des données est parfaitement assainie et que les variables indicatrices sont matérialisées sous un format purement numérique, l’analyste peut procéder à l’estimation économétrique des moindres carrés ordinaires. Depuis l’onglet Données du ruban d’Excel, un clic sur le bouton Utilitaire d’analyse déploie la liste des modules statistiques. Il convient de faire défiler la sélection jusqu’à mettre en surbrillance l’item Régression, puis de valider en cliquant sur le bouton « OK ».
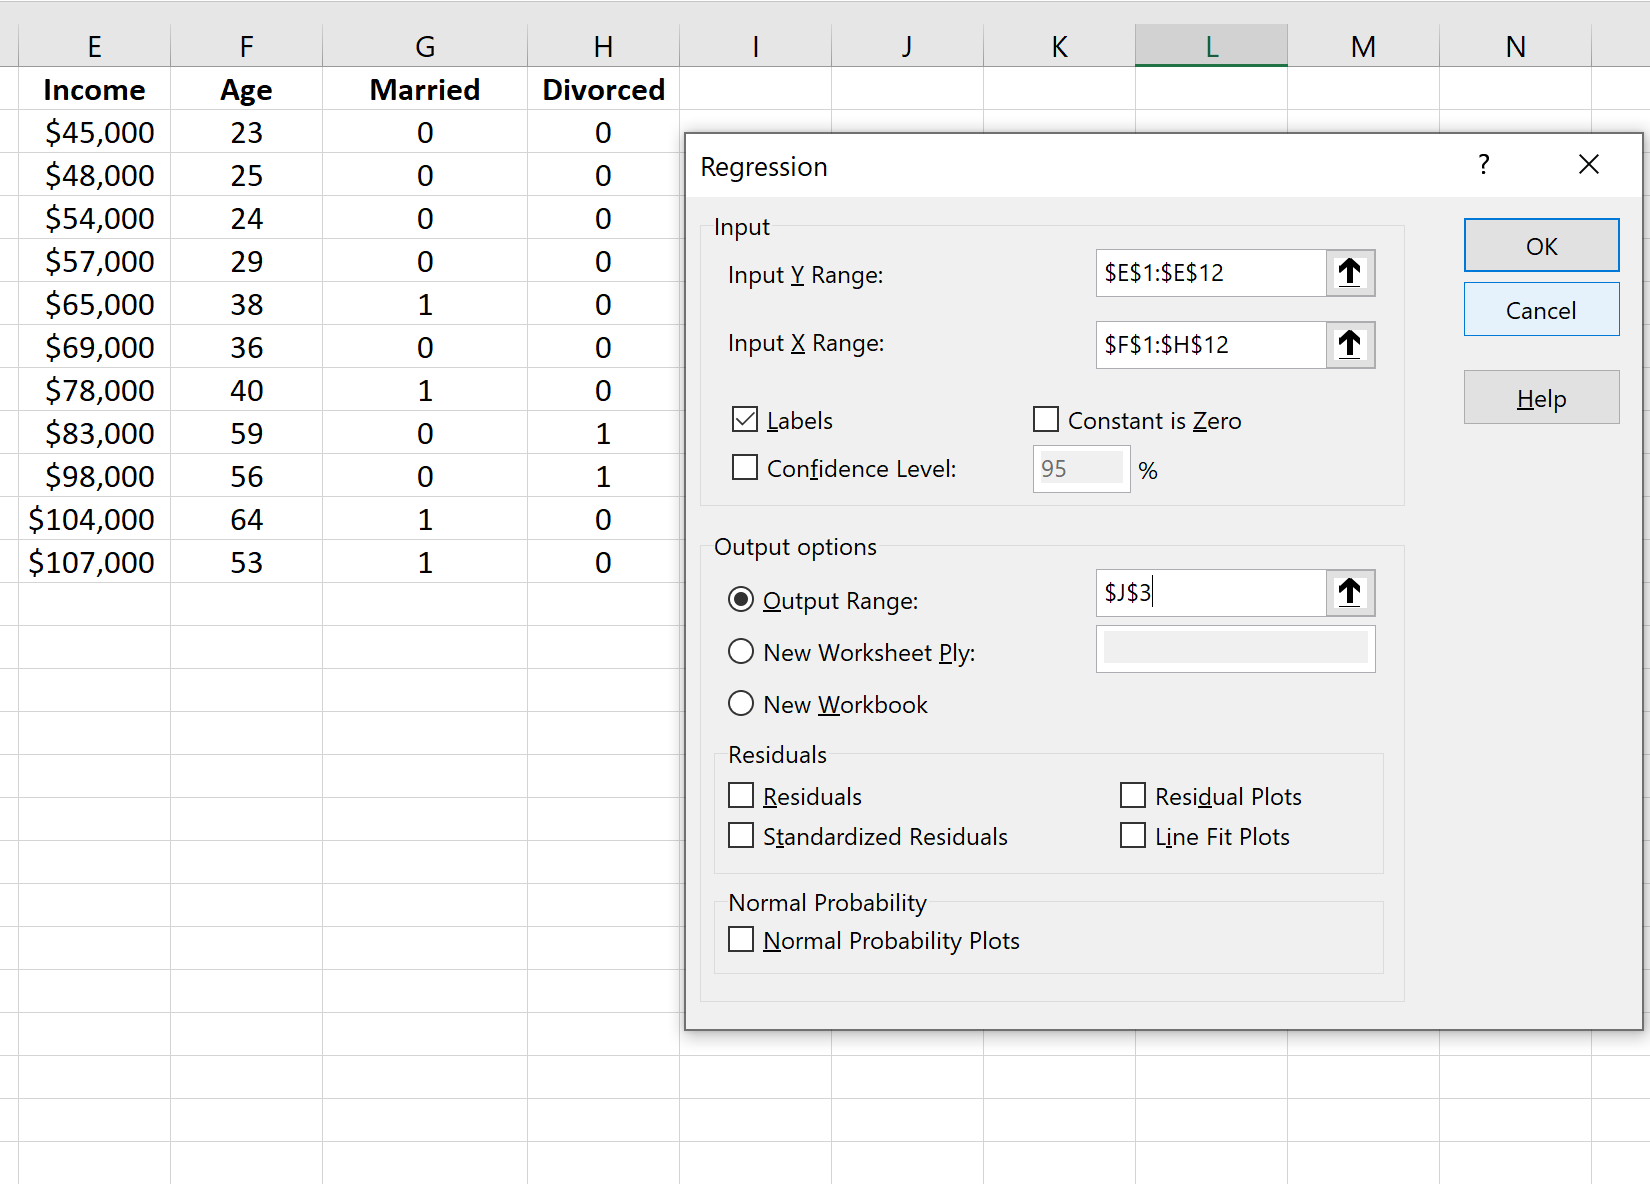
La boîte de dialogue de configuration de la régression s’affiche alors à l’écran. L’ergonomie du module impose de renseigner deux zones d’adresses cellulaires fondamentales :
- Plage d’entrée Y : Cette zone correspond à la variable dépendante (le vecteur à expliquer). L’analyste clique sur l’icône de sélection et surligne l’intégralité de la colonne du revenu, y compris la cellule d’en-tête, soit la plage
$A$1:$A$101pour un échantillon de cent observations. - Plage d’entrée X : Cette zone regroupe l’ensemble des variables explicatives indépendantes (les régresseurs exogènes). Il convient ici de surligner conjointement et simultanément la variable continue
Ageet les deux variables indicatrices créées, soit la plage matricielle contiguë$B$1:$E$101.
Une contrainte architecturale majeure de l’Utilitaire d’analyse de données de Microsoft Excel doit être vigoureusement soulignée : le compilateur sous-jacent n’autorise pas la sélection de plages non contiguës au sein de la zone « Plage d’entrée X ». Si la variable Age était positionnée en colonne $B$ et que les variables muettes avaient été reléguées en colonnes $Z$ et $AA$, l’outil refuserait catégoriquement d’opérer le calcul ou générerait un message d’erreur d’incompatibilité de plage. Les variables indépendantes destinées à être intégrées dans l’équation linéaire doivent être rigoureusement juxtaposées au sein de colonnes adjacentes dans la feuille de travail avant le lancement du module de régression.
8.2 Paramétrage des options de sortie, étiquettes et niveaux de confiance
Le paramétrage des options avancées au sein de la boîte de dialogue de régression conditionne directement la lisibilité et l’exploitabilité académique des résultats statistiques. La première précaution méthodologique indispensable consiste à cocher impérativement la case Intitulés (ou Étiquettes selon les versions linguistiques du tableur). Cette instruction explicite signale à l’algorithme que la première ligne des plages d’entrée sélectionnées ($A1$ et $B1:E1$) contient les libellés alphanumériques des variables et non des observations numériques. L’omission de cette coche lorsque des étiquettes sont présentes entraîne l’interruption immédiate de l’analyse avec le message d’erreur « La plage d’entrée contient des données non numériques ».
La case relative au Niveau de confiance doit être activée. Par défaut, Excel paramètre cet intervalle au seuil conventionnel de 95 % (correspondant à un risque de première espèce $\alpha = 0,05$). Si le cadre expérimental impose des contraintes de significativité plus draconiennes (par exemple en toxicologie clinique ou en ingénierie de précision financière), l’utilisateur peut forcer la valeur à 99 % afin d’obtenir le calcul des bornes de confiance élargies correspondantes.
Concernant les options de sortie, il est formellement déconseillé d’écraser la feuille de calcul courante. L’analyste cochera préférentiellement l’option Nouvelle feuille de calcul et lui assignera une dénomination descriptive (par exemple Resultats_Regression_Revenu). Enfin, pour permettre les diagnostics résiduels indispensables à la validation des hypothèses de modélisation, il convient de cocher les options relatives aux Résidus, aux Résidus standardisés et aux Graphiques des résidus. Ces éléments matérialiseront automatiquement les vecteurs d’erreurs d’estimation indispensables aux audits de robustesse.
8.3 Résolution des messages d’erreur fréquents lors du lancement de l’outil
Lors de la validation de la boîte de dialogue par le bouton « OK », l’Utilitaire d’analyse peut être interrompu par différents messages d’erreur système. Le plus omniprésent demeure l’alerte textuelle : « Régression – Les données d’entrée doivent être numériques ». Ce dysfonctionnement trouve systématiquement son origine dans l’une des trois anomalies suivantes :
- L’analyste a inclus la ligne d’en-tête dans les plages d’entrée $X$ ou $Y$ mais a omis de cocher la case Intitulés.
- La formule de génération des variables indicatrices a été rédigée avec des guillemets encadrant les chiffres (
"1"et"0"au lieu de1et0), forçant le tableur à traiter les sorties comme des chaînes de texte. - Des cellules vides, des espaces insécables ou des mentions textuelles d’erreur (telles que
#VALEUR!ouN/A) sont résiduelles au sein des colonnes de données.
Un autre message d’erreur classique concerne la disparité dimensionnelle : « Les plages d’entrée X et Y doivent comporter le même nombre de lignes ». Ce message survient lorsque la sélection du vecteur dépendant et celle de la matrice des régresseurs ne possèdent pas exactement les mêmes limites vectorielles (par exemple si la plage $Y$ s’étend jusqu’à la ligne 101 tandis que la plage $X$ s’arrête prématurément à la ligne 99). L’analyste doit contrôler l’égalité absolue du nombre d’enregistrements soumis à l’évaluation.
Enfin, si l’Utilitaire d’analyse génère une table de régression mais affiche des coefficients accompagnés de la mention d’erreur #NOMBRE! ou si l’une des colonnes muettes est tout simplement absente du rapport de sortie final, cela indique de manière irréfutable que l’analyste a succombé au piège de la variable muette en omettant de retrancher la modalité de référence, provoquant la singularité matricielle explicité précédemment. Dès que ces contrôles de conformité sont validés, le module déploie la table normalisée d’analyse de variance et d’estimation des coefficients des moindres carrés ordinaires.
9. Interprétation statistique et biométrique rigoureuse des résultats obtenus
9.1 Décodage de l’ordonnée à l’origine (Intercept) et du groupe de référence
L’exploitation académique de la table de sortie générée par l’Utilitaire d’analyse d’Excel exige une rigueur sémantique absolue, particulièrement en ce qui concerne la première ligne de coefficients, étiquetée Constante (ou Intercept en terminologie anglo-saxonne). Dans un modèle de régression linéaire simple ne comportant que des prédicteurs continus, la constante représente l’espérance mathématique de la variable dépendante $Y$ lorsque l’ensemble des prédicteurs $X$ est rigoureusement égal à zéro. Cependant, dès lors que des variables indicatrices intègrent l’équation, la signification structurelle de cette constante est profondément modifiée.
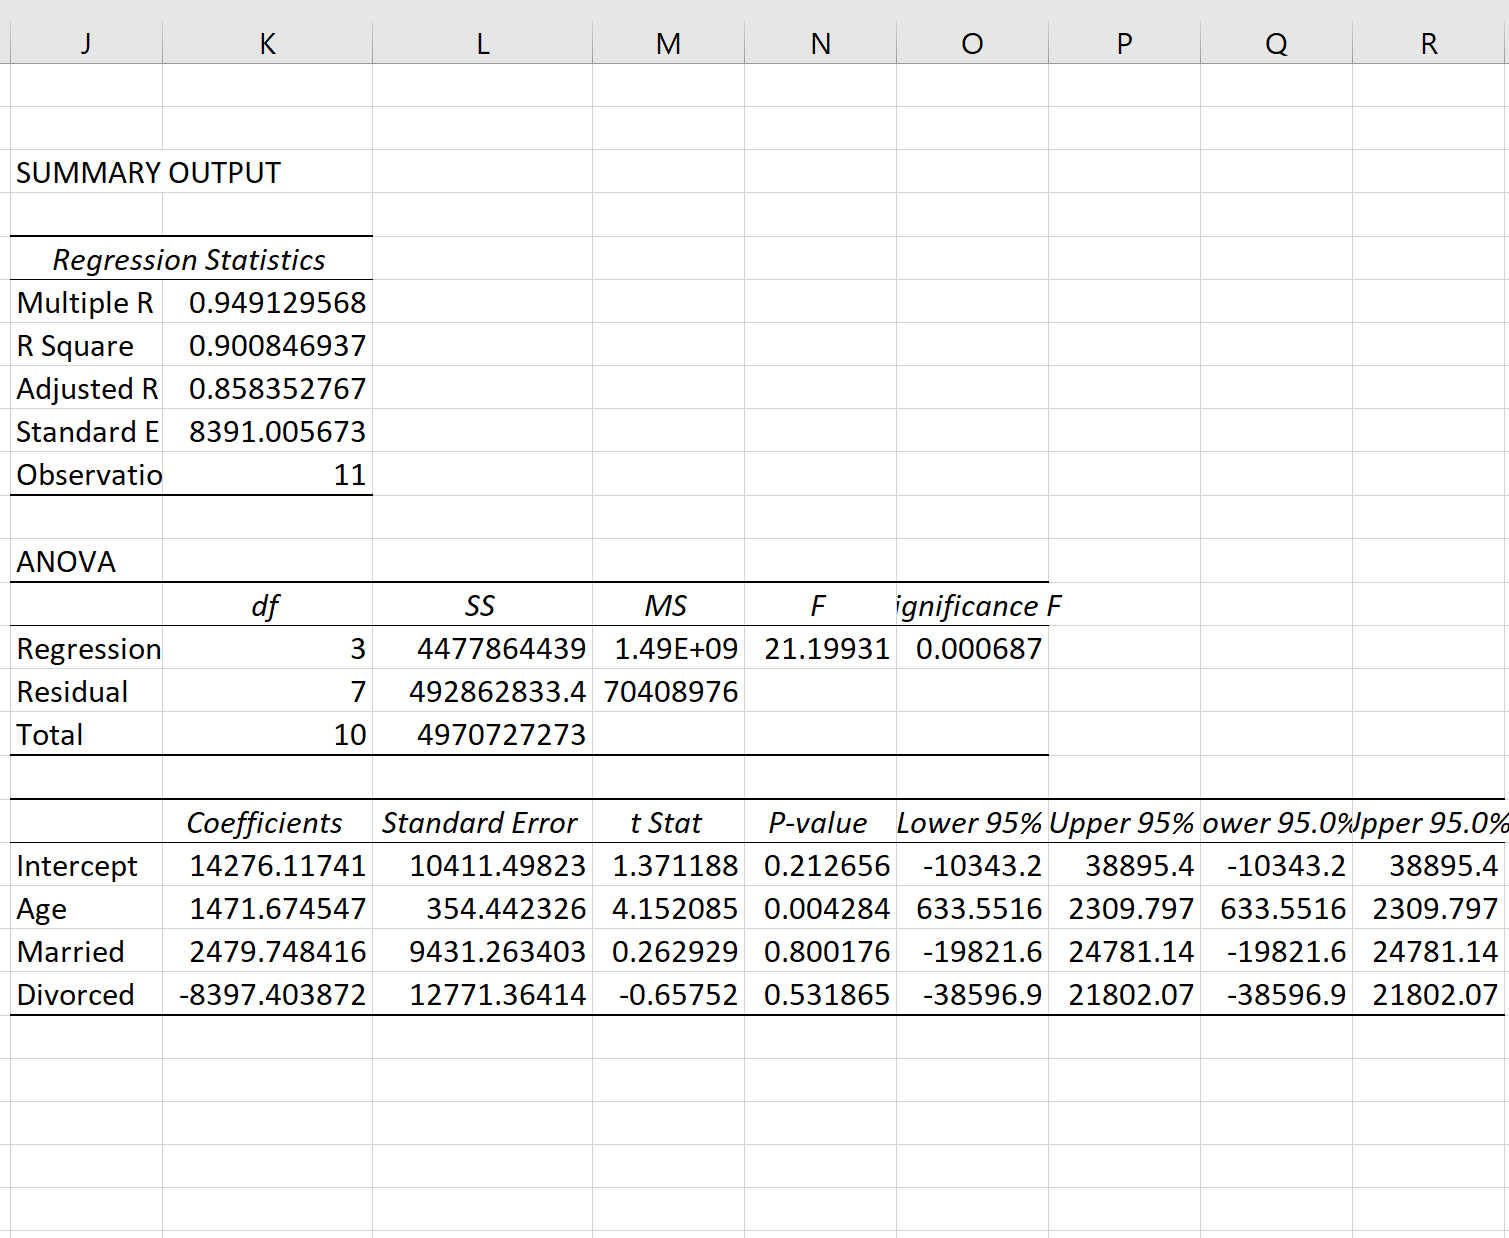
Dans notre cas d’étude, où la modalité « Célibataire » a été omise pour constituer le groupe de référence, la constante modélise conjointement l’effet du groupe témoin et l’origine de l’échelle continue. Formellement, la valeur numérique de la constante correspond au revenu annuel moyen prédit pour un individu qui cumule simultanément les conditions suivantes : être âgé de zéro an ($Age = 0$) ET appartenir à la catégorie de référence omise ($Statut_Marie = 0$ et $Statut_Divorce = 0$, ce qui désigne par définition un travailleur Célibataire).
D’un point de vue biométrique ou économique, prédire le revenu d’un individu à l’âge de zéro an constitue une extrapolation mathématique dépourvue de validité empirique directe (puisqu’aucun nourrisson n’évolue sur le marché du travail). Pour restituer à cette constante une interprétation physique réaliste, il est d’usage en économétrie appliquée de procéder au centrage préalable de la variable continue autour de sa moyenne échantillonnale ($\text{Age_Centre}_i = \text{Age}_i – \overline{\text{Age}}$). Si cette transformation est opérée, la constante du modèle devient directement égale au revenu annuel moyen prédit pour un individu Célibataire ayant l’âge moyen de l’échantillon d’étude. L’analyste doit impérativement expliciter ce point dans ses rapports afin d’éviter que des tiers non avertis ne rejettent le modèle au motif que l’ordonnée à l’origine semble contre-intuitive ou déconnectée des réalités observables.
9.2 Interprétation sémantique et différentielle des coefficients des variables muettes
Contrairement au coefficient associé à la variable continue Age (qui mesure la pente de la droite, soit l’accroissement marginal moyen du revenu annuel pour chaque année biologique supplémentaire), les coefficients attribués aux variables indicatrices binaires ne traduisent pas des pentes d’inclinaison, mais des écarts de niveau moyens différentiels (des déplacements verticaux parallèles de la droite d’estimation) strictement mesurés par rapport à la catégorie de référence omise.
Supposons que la table de sortie d’Excel fournisse les estimations numériques suivantes :
- $\text{Constante} = 18{,}45$
- $\text{Coefficient de l’Âge} = 0{,}85$
- $\text{Coefficient de Statut_Marié} = 6{,}20$
- $\text{Coefficient de Statut_Divorcé} = -1{,}50$
La formalisation rigoureuse de la lecture sémantique du coefficient $\beta_2 = 6{,}20$ (associé à la variable muette Statut_Marie) s’énonce comme suit : « Toutes choses étant égales par ailleurs (clause ceteris paribus), les individus mariés perçoivent en moyenne un revenu annuel supérieur de 6 200 euros par rapport aux individus célibataires (groupe de référence). » Le maintien de l’âge constant dans cette formulation est fondamental : ce coefficient isole l’effet propre du statut matrimonial, garantissant que l’écart de salaire constaté n’est pas un artéfact lié au fait que les travailleurs mariés sont potentiellement plus âgés que les célibataires dans l’échantillon.
Symétriquement, le coefficient $\beta_3 = -1{,}50$ indique que les individus divorcés perçoivent en moyenne 1 500 euros de moins par an que les célibataires, à âge rigoureusement identique. Une erreur conceptuelle majeure consisterait à comparer directement entre eux les coefficients de deux variables muettes distinctes sans précaution. La différence entre le revenu d’un individu marié et celui d’un individu divorcé n’est pas testée directement par rapport à zéro par les tests de Student affichés dans cette table ; cet écart inter-muettes ($6{,}20 – (-1{,}50) = 7{,}70$ milliers d’euros) requiert un test de combinaison linéaire de paramètres (test d’hypothèse générale $H_0: \beta_2 – \beta_3 = 0$) que l’Utilitaire d’analyse de base d’Excel ne calcule pas spontanément sans passer par la manipulation de la matrice de variance-covariance des estimateurs.
9.3 Évaluation de la significativité statistique globale et locale des estimateurs
L’évaluation de la pertinence empirique du modèle calibré s’organise selon une hiérarchie séquentielle stricte, allant de l’adéquation globale de l’ajustement jusqu’aux inférences locales sur chaque estimateur individuel :
- Le coefficient de détermination ajusté ($R^2$ ajusté) : Situé dans le tableau « Statistiques de la régression », le $R^2$ ajusté mesure la proportion de la variance totale du revenu expliquée par l’ensemble des prédicteurs (l’âge et les deux indicatrices de statut), tout en pénalisant mathématiquement l’adjonction de variables explicatives surnuméraires. Un $R^2$ ajusté de 0,65 indique que 65 % des variations du salaire au sein de l’échantillon sont fidèlement captées par la spécification linéaire retenue.
- Le test F de Fisher-Snedecor (Analyse de variance) : Le second tableau d’Excel présente le tableau de l’ANOVA. La valeur de la statistique $F$ observée et sa significativité critique associée (la p-value globale étiquetée « Signification F ») testent l’hypothèse nulle conjointe selon laquelle l’ensemble des coefficients du modèle (à l’exception de la constante) sont simultanément nuls ($H_0: \beta_1 = \beta_2 = \beta_3 = 0$). Une valeur de « Signification F » inférieure au seuil critique de 0,05 (par exemple $1{,}2 \times 10^{-8}$) permet de rejeter catégoriquement cette hypothèse nulle et d’attester de la validité statistique globale de l’équation prédictive.
- Les tests de Student individuels et les p-values : Dans le tableau inférieur des coefficients, chaque variable dispose d’une erreur-type (l’écart-type de sa distribution d’échantillonnage), d’une statistique $t$ de Student ($t = \hat{\beta} / \text{erreur-type}$) et d’une p-value (colonne « Probabilité »). Si la p-value associée au coefficient de
Statut_Marieest de 0,002 (donc largement inférieure au seuil conventionnel de 0,05), l’analyste conclut avec un niveau de confiance de 95 % que la prime salariale observée par rapport aux célibataires est statistiquement significative et ne peut être imputée aux seules fluctuations d’échantillonnage. En revanche, si la p-value deStatut_Divorces’établit à 0,38, l’analyste ne peut pas rejeter l’hypothèse d’égalité des revenus moyens entre divorcés et célibataires au seuil de 5 %. - Les intervalles de confiance : Les colonnes finales définissent les bornes inférieure et supérieure de l’estimation à 95 %. Si l’intervalle de confiance d’un coefficient encadre la valeur zéro (c’est-à-dire que la borne inférieure est strictement négative et la borne supérieure strictement positive), cela confirme visuellement la non-significativité statistique de l’effet marginal mesuré au seuil de confiance considéré.
10. Extensions méthodologiques : Modélisation des termes d’interaction avec variables muettes
10.1 Concepts fondamentaux des effets modérateurs et d’interaction
L’architecture linéaire additive explorée jusqu’à présent repose sur un postulat mathématique restrictif : l’impact marginal d’une variable quantitative continue (la pente de l’âge sur le revenu) est supposé rigoureusement invariant quel que soit le statut matrimonial de l’individu, tandis que l’effet du statut matrimonial est supposé strictement uniforme quel que soit l’âge de l’observé. Graphiquement, cette hypothèse se matérialise par un faisceau de droites d’estimation strictement parallèles les unes aux autres, ne différant que par leur point de départ sur l’axe des ordonnées (l’ordonnée à l’origine conditionnelle).
Or, la théorie économique et la psychologie organisationnelle suggèrent fréquemment l’existence d’effets modérateurs (ou termes d’interaction). Il est éminemment plausible de poser comme hypothèse de recherche que le rythme d’accumulation de revenu au fil des années (la trajectoire de progression salariale) ne s’effectue pas à la même vitesse pour un individu célibataire que pour un individu marié. L’insertion d’un terme d’interaction permet de relâcher l’hypothèse de parallélisme en autorisant à la fois un décalage de l’ordonnée à l’origine (effet principal de niveau) et une modification de la pente de la variable continue (effet de divergence angulaire).
Sur le plan formel, le terme multiplicatif d’interaction entre une variable continue $X$ et une variable muette $D$ s’exprime comme le produit algébrique direct de leurs valeurs respectives : $X \times D$. Si l’individu appartient au groupe de référence ($D = 0$), le produit s’annule identiquement, et l’équation se replie sur la pente de base. En revanche, si l’individu présente la caractéristique codée ($D = 1$), le terme d’interaction prend la valeur $X \times 1 = X$, et son coefficient vient s’additionner algébriquement à la pente de référence. Cette flexibilisation structurelle permet de tester des théories complexes sans recourir à des fractionnements d’échantillons préjudiciables à la puissance de l’analyse.
10.2 Calcul opérationnel des produits croisés au sein de la feuille Excel
L’implémentation opérationnelle de termes d’interaction dans Excel exige la matérialisation de nouvelles colonnes calculées au sein du classeur avant d’exécuter l’Utilitaire d’analyse. Compte tenu de la contrainte impérative de contiguïté spatiale des colonnes explicatives imposée par le module de régression d’Excel, l’agencement tabulaire doit être méticuleusement planifié.
Dans notre feuille de travail, nous disposons déjà en colonnes $B$, $D$ et $E$ respectivement des variables Age, Statut_Marie et Statut_Divorce. L’analyste insère deux colonnes supplémentaires contiguës, en colonnes $F$ et $G$, qui accueilleront les produits croisés. Les étiquettes d’en-tête de ces colonnes doivent documenter sans équivoque la nature du couplage : Age_X_Marie en cellule $F1$ et Age_X_Divorce en cellule $G1$.
En cellule $F2$, la formule mathématique de calcul se formule par une simple multiplication arithmétique :
=B2*D2
De façon symétrique, la cellule $G2$ accueille le produit :
=B2*E2
Ces formules sont ensuite propagées vers le bas sur l’ensemble des observations au moyen du curseur de recopie incrémentale. Une observation minutieuse des grandeurs ainsi calculées confirme le comportement dynamique du terme d’interaction : pour un individu dont le statut est « Célibataire », $D_i = 0$ et $E_i = 0$, ce qui implique que les cellules $F_i$ et $G_i$ affichent impérativement la valeur 0. Pour un individu âgé de 40 ans dont le statut est « Marié », la cellule $F_i$ prendra la valeur exacte $40 \times 1 = 40$, tandis que la cellule $G_i$ restera fixée à 0. L’ensemble matriciel contigu regroupant les colonnes $B$ à $G$ (soit cinq variables indépendantes au total : une continue, deux muettes principales, et deux termes d’interaction croisés) est désormais prêt à être sélectionné comme plage d’entrée $X$ dans le module d’estimation.
10.3 Interprétation des pentes conditionnelles et visualisation graphique
L’introduction des termes croisés redéfinit en profondeur la structure de l’équation d’estimation estimée par les moindres carrés ordinaires sous Excel :
$$\hat{Y} = \beta_0 + \beta_1 \text{Age} + \beta_2 \text{Statut_Marie} + \beta_3 \text{Statut_Divorce} + \beta_4 (\text{Age} \times \text{Statut_Marie}) + \beta_5 (\text{Age} \times \text{Statut_Divorce})$$
À partir de cette spécification générale, l’analyste peut dériver analytiquement l’équation de régression conditionnelle spécifique à chaque sous-population d’intérêt :
- Pour le groupe de référence (Célibataires) : En annulant les indicatrices ($\text{Statut_Marie} = 0$ et $\text{Statut_Divorce} = 0$), l’ensemble des termes dérivés disparaît, ce qui livre l’équation linéaire : $\hat{Y} = \beta_0 + \beta_1 \text{Age}$. La constante $\beta_0$ représente l’ordonnée à l’origine des célibataires, et $\beta_1$ est leur pente d’avancement d’âge exclusive.
- Pour les individus Mariés : En fixant $\text{Statut_Marie} = 1$ et $\text{Statut_Divorce} = 0$, l’équation devient après regroupement des termes : $\hat{Y} = (\beta_0 + \beta_2) + (\beta_1 + \beta_4)\text{Age}$. Ici, $(\beta_0 + \beta_2)$ représente l’ordonnée à l’origine propre aux travailleurs mariés, tandis que leur pente salariale spécifique par année d’âge équivaut rigoureusement à la somme algébrique $(\beta_1 + \beta_4)$.
- Pour les individus Divorcés : De même, en fixant $\text{Statut_Divorce} = 1$ et $\text{Statut_Marie} = 0$, l’équation s’écrit : $\hat{Y} = (\beta_0 + \beta_3) + (\beta_1 + \beta_5)\text{Age}$.
Si le coefficient estimé $\beta_4$ ressort avec une valeur positive (par exemple $+0{,}35$) assortie d’une p-value inférieure à 0,05, cela démontre l’existence d’une interaction modératrice statistiquement significative : le revenu annuel des individus mariés progresse plus rapidement avec l’âge (de 350 euros par an supplémentaires) que celui des célibataires. Pour restituer visuellement ces dynamiques divergentes, l’analyste peut générer sous Excel un Graphique de dispersion en nuage de points en y adjoignant trois séries de données filtrées distinctes, puis en activant l’affichage de la courbe de tendance linéaire pour chacune d’entre elles. Les droites qui se croisent ou s’écartent matérialisent de manière visuelle la géométrie non parallèle des effets modérateurs.
11. Audits méthodologiques et contrôle des hypothèses de régression sous Excel
11.1 Analyse de la normalité et de l’homoscédasticité des résidus de l’estimation
L’attribution du statut d’estimateurs linéaires sans biais et efficients (postulat de Gauss-Markov) repose sur un ensemble d’hypothèses relatives au comportement des résidus stochastiques du modèle : ces perturbations doivent afficher une espérance nulle, une variance constante en tout point de l’espace des variables explicatives (homoscédasticité), une absence d’autocorrélation mutuelle et suivre idéalement une loi normale. L’introduction de variables muettes rend les modèles particulièrement susceptibles aux violations d’homoscédasticité, la dispersion interne de la variable dépendante pouvant diverger substantiellement d’un sous-groupe qualitatif à un autre.
Pour auditer cette hypothèse dans l’environnement Excel, l’analyste inspecte les colonnes de résidus et de résidus standardisés générées lors de l’exécution de la régression. La démarche diagnostique fondamentale consiste à construire un graphique de dispersion croisant les Valeurs prédites sur l’axe des abscisses et les Résidus de régression sur l’axe des ordonnées. En présence d’homoscédasticité parfaite, le nuage de points doit former une bande horizontale d’épaisseur homogène et aléatoire, distribuée symétriquement de part et d’autre de la ligne zéro. À l’inverse, si le nuage prend une configuration triangulaire en entonnoir (l’éventail de dispersion s’évasant pour les valeurs prédites élevées) ou révèle des grappes de points à dispersions hautement inégales entre les segments catégoriels, l’hypothèse de variance constante est réfutée.
Le contrôle de la distribution normale des résidus s’opère par la construction d’un histogramme des résidus à l’aide de l’outil Histogramme de l’Utilitaire d’analyse. En évaluant visuellement l’asymétrie de la cloche de Gauss et en calculant les coefficients d’asymétrie (=SKEW(...) ou =COEFFICIENT.ASYMETRIE(...)) et d’aplatissement de Pearson (=KURT(...) ou =KURTOSIS(...)), l’analyste valide si les résidus ne dévient pas excessivement d’une distribution normale standardisée. Bien que le théorème central limite garantisse une robustesse asymptotique des estimateurs sur des échantillons étendus ($n > 100$), des déviations extrêmes de normalité sur de petites cohortes fragilisent considérablement la validité des seuils de décision des tests de Student et de Fisher.
11.2 Détection des points atypiques et des observations influentes au sein des groupes
L’estimation par la méthode des moindres carrés ordinaires possède une sensibilité mathématique exacerbée aux valeurs aberrantes (outliers) et aux observations disposant d’un fort effet de levier sur la matrice de régression. Dans les modèles incorporant des variables muettes, ce péril s’amplifie particulièrement lorsqu’une catégorie qualitative ne comprend qu’un sous-effectif marginal d’individus : un unique point aberrant situé dans une catégorie minoritaire peut dévier substantiellement la constante différentielle ou fausser l’inclinaison d’un terme d’interaction.
La recherche de points atypiques s’effectue rigoureusement en examinant la colonne des Résidus standardisés produite par l’Utilitaire d’analyse d’Excel. En vertu des propriétés de la loi normale centrée réduite, environ 95 % des résidus standardisés doivent se situer à l’intérieur de l’intervalle $[-1{,}96 ; +1{,}96]$, et plus de 99 % au sein de l’intervalle $[-2{,}58 ; +2{,}58]$. Tout point d’observation statistique dont le résidu standardisé dépasse en valeur absolue le seuil critique de 3 doit être formellement catégorisé comme un point extrême et faire l’objet d’un examen minutieux.
Il est impératif d’isoler si ces points extrêmes ne sont pas la conséquence d’une coquille matérielle de saisie dans le classeur Excel (telle qu’un salaire renseigné à 600 000 euros au lieu de 60 000 euros). Si la valeur s’avère authentique sur le plan expérimental, l’analyste ne doit jamais l’éliminer de façon discrétionnaire sans justification théorique documentée. La bonne pratique académique impose d’exécuter une analyse de sensibilité par ré-estimation comparative : le chercheur calibre le modèle sur l’échantillon complet, puis réitère l’estimation en excluant temporairement les observations influentes afin de consigner dans le rapport final la stabilité des coefficients et des seuils de significativité face à ces variations échantillonnales.
11.3 Contrôle de robustesse par ré-échantillonnage ou permutation du groupe de référence
Un exercice de validation méthodologique fondamental pour tout chercheur utilisant des variables muettes dans Excel consiste à procéder à un audit de permutation du groupe de référence. Cette procédure d’invariance démontre de façon mathématique et empirique que le choix de la modalité exclue n’exerce aucune influence sur les statistiques fondamentales du modèle d’ensemble, mais modifie exclusivement le référentiel de lecture des coefficients individuels.
Pour mettre en œuvre cet audit, l’analyste duplique son classeur d’analyse et reconstruit un jeu d’indicatrices alternatif. En lieu et place d’omettre la modalité « Célibataire », il omet cette fois-ci la modalité « Marié », en injectant dans la boîte de dialogue de régression les variables indicatrices Statut_Celibataire et Statut_Divorce aux côtés de l’Age. Lors de l’examen comparatif des deux tables de régression ainsi obtenues, l’analyste doit constater une équivalence mathématique absolue sur les paramètres d’ajustement structurels :
- Le coefficient de détermination $R^2$ et le $R^2$ ajusté sont rigoureusement identiques jusqu’à la dernière décimale.
- La somme des carrés des résidus (SSR) et des carrés totaux (SST) dans le tableau ANOVA demeure strictement inchangée.
- La statistique $F$ globale de Fisher et sa valeur critique (« Signification F ») sont rigoureusement invariantes.
- Le coefficient associé à la variable continue
Agereste parfaitement identique en valeur numérique, en erreur-type et en p-value.
Seuls l’ordonnée à l’origine (la constante) et les coefficients des variables muettes voient leurs grandeurs arithmétiques se réajuster. La nouvelle constante capture désormais le salaire moyen attendu pour un individu Marié à l’âge zéro, et le coefficient de Statut_Celibataire prend exactement l’opposé mathématique de l’ancien coefficient de Statut_Marie. Réaliser cette démonstration sous Excel consolide la maîtrise analytique du praticien et immunise son travail contre tout soupçon de distorsion arbitraire lié au choix du point d’ancrage de la régression.
12. Bonnes pratiques académiques, limites de l’outil et transition logicielle
12.1 Guide des meilleures pratiques pour la documentation et la reproductibilité
L’utilisation de tableurs comme Microsoft Excel au sein de travaux à visée décisionnelle ou de publication scientifique s’accompagne d’une exigence de rigueur documentaire, en raison de la propension historique des environnements non programmatiques aux erreurs humaines d’inattention ou de manipulation de cellules. Afin d’établir une chaîne d’audit irréprochable répondant aux critères modernes de la science ouverte et de la reproductibilité empirique, plusieurs directives incontournables doivent être respectées :
Premièrement, la règle de la séparation étanche des couches applicatives doit être appliquée. Un classeur d’analyse professionnelle ne doit jamais amalgamer sur la même grille de calcul les données brutes, les colonnes dérivées calculées et les résultats d’estimation économétrique. Il convient de consacrer un premier onglet immuable (verrouillé en écriture) au stockage des données initiales non altérées, un second onglet dédié au pipeline d’assainissement et de génération des variables muettes, et des onglets séparés pour chaque rapport statistique produit par l’Utilitaire d’analyse.
Deuxièmement, la documentation des cellules calculées doit être explicitée au moyen de commentaires de cellules ou de notes documentaires ancrées dans les en-têtes de colonnes, stipulant la formule sous-jacente, la date de compilation et l’hypothèse de codage retenue. L’ensemble des métadonnées du dictionnaire de variables doit être consigné dans une feuille dédiée, conformément aux recommandations de l’American Psychological Association (normes APA) ou des standards d’archivage des comités de données en recherche économique et sociale.
Enfin, l’exportation des corpus de travail définitifs doit privilégier des formats pérennes et ouverts, tels que le fichier texte délimité par des virgules (CSV) ou l’archive textuelle balisée, afin d’assurer l’interopérabilité à long terme et de permettre l’audit externe du code sans dépendre d’une version propriétaire spécifique du tableur.
12.2 Frontières fonctionnelles de Microsoft Excel pour la modélisation statistique avancée
Si Microsoft Excel s’avère un vecteur d’initiation et un outil d’exploration immédiate de premier ordre, l’économétrie moderne se heurte rapidement à des limites logicielles structurelles dès que les modèles gagnent en complexité théorique. L’une des lacunes les plus sévères de l’Utilitaire d’analyse réside dans son incapacité native à corriger l’hétéroscédasticité des erreurs. Contrairement aux environnements statistiques spécialisés, Excel ne permet pas de basculer en un clic sur le calcul des erreurs-types robustes de White (ou estimateurs « sandwich » HC0, HC1, HC2, HC3). En présence de variance inégale entre les groupes muets, les inférences produites par Excel peuvent donc s’avérer fallacieusement optimistes et conclure à tort à la significativité de certains paramètres.
Une seconde contrainte majeure concerne la gestion des attributs polytomiques à très forte cardinalité. Si une variable qualitative dénombre 50 départements ou 100 codes d’activités industrielles, la création manuelle ou semi-manuelle de 49 ou 99 colonnes indicatrices dans la feuille de calcul devient une source majeure de saturation cognitive et de risque de corruption de plages. De plus, l’outil de régression ne propose aucun test d’hypothèse linéaire générale automatisé (test de Wald post-estimation) permettant de comparer simultanément deux variables indicatrices entre elles sans avoir à reformuler l’intégralité du modèle et permuter manuellement les catégories de base.
Enfin, le traitement des structures de données hiérarchiques, des modèles de panel à effets fixes longitudinaux ou des régressions logistiques binaires/multinomiales (nécessaires dès lors que la variable dépendante elle-même devient dichotomique) dépasse le cadre fonctionnel de l’Utilitaire d’analyse standard. L’analyste parvenu à ce niveau d’investigation doit nécessairement appréhender la transition vers des écosystèmes de programmation statistique dédiés.
12.3 Passerelle conceptuelle vers les environnements spécialisés (R, SPSS, Python)
La compréhension intime des variables indicatrices acquise par la pratique méthodique sous Excel constitue un socle cognitif exceptionnellement valorisant pour appréhender les environnements d’analyse avancés que sont le langage R, le progiciel IBM SPSS Statistics ou l’écosystème Python orienté data science. Dans ces langages de haut niveau, la mécanique de binarisation disjonctive des données qualitatives est généralement masquée derrière des abstractions procédurales automatisées.
Dans l’environnement de programmation statistique R, le typage explicite d’une colonne en tant que facteur au moyen de la commande as.factor(vecteur) ou factor() délègue intégralement la gestion du recodage disjonctif à l’interpréteur. Lors de l’invocation de la fonction d’estimation linéaire lm(Revenu ~ Age + Statut, data = df), le moteur d’évaluation de R génère automatiquement les variables muettes $k – 1$ en arrière-plan, désignant par défaut la modalité alphabétiquement première comme catégorie de référence. Les contrastes de traitement peuvent ensuite être ajustés programmatiquement au moyen de l’instruction relevel().
Sous IBM SPSS Statistics, la procédure de régression linéaire standard traite de façon comparable les prédicteurs catégoriels via sa clause de sous-commande /CONTRAST, permettant à l’analyste de spécifier explicitement dans une interface graphique si la première ou la dernière catégorie observée doit être désignée comme témoin d’ancrage méthodologique.
Enfin, dans l’écosystème Python adossé aux bibliothèques Pandas et Scikit-Learn, la transition s’effectue via deux commandes paradigmatiques. La fonction pd.get_dummies(df, columns=['Statut'], drop_first=True) réplique exactement le processus disséqué dans ce guide : l’argument drop_first=True constitue l’instruction impérative chargée d’omettre la première variable indicatrice pour déjouer le piège de la multicolinéarité matricielle. Pour les pipelines d’apprentissage automatique destinés à la production, la classe OneHotEncoder(drop='first') de Scikit-Learn standardise cette transformation sous forme d’un transformateur mathématique sérialisable. Grâce à l’apprentissage concret mené cellule par cellule sur Excel, l’analyste sait désormais avec une absolue certitude ce que ces fonctions exécutent sous le capot, maîtrisant ainsi la modélisation statistique de ses prémisses matricielles jusqu’à ses interprétations théoriques les plus abouties.
Références
- Brooks, C. (2019). Introductory Econometrics for Finance (4th ed.). Cambridge University Press. https://doi.org/10.1017/9781108522229
- Greene, W. H. (2018). Econometric Analysis (8th ed.). Pearson.
- Gujarati, D. N., & Porter, D. C. (2009). Basic Econometrics (5th ed.). McGraw-Hill Education.
- Microsoft Corporation. (2023). Charger et transformer des données avec Power Query dans Excel. Support Microsoft Learn. https://support.microsoft.com/fr-fr/office/obtenir-et-transformer-des-donn%C3%A9es-dans-excel-885679d8-b074-47c6-b4ac-b5e76e8195ac
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wooldridge, J. M. (2020). Introductory Econometrics: A Modern Approach (7th ed.). Cengage Learning.