
L’exploration visuelle des données matricielles complexes représente l’un des piliers méthodologiques de l’ingénierie contemporaine des données, de la bio-informatique et de la recherche en sciences computationnelles. Face à l’accroissement vertigineux des volumes d’information collectés, la capacité de condenser des relations multivariées en représentations immédiatement intelligibles conditionne la vitesse et la pertinence des déductions analytiques. Au cœur de cette sémiotique graphique moderne, la carte thermique — communément désignée sous l’anglicisme heatmap — s’impose comme un instrument d’analyse incontournable pour appréhender les topologies multidimensionnelles, quantifier les corrélations croisées et isoler instantanément les discontinuités ou singularités au sein de grands agrégats tabulaires.
Dans l’écosystème scientifique articulé autour du langage Python, la bibliothèque Seaborn a redéfini les standards de production graphique en offrant une interface de haut niveau adossée aux mécanismes fondamentaux de Matplotlib. Loin de constituer une simple alternative stylistique, Seaborn intègre directement les abstractions conceptuelles de la statistique inférentielle et de la théorie de la perception visuelle. En associant nativement la flexibilité structurelle des DataFrames de la bibliothèque Pandas à des algorithmes automatisés d’étalonnage chromatique, elle permet aux analystes et chercheurs de concevoir des représentations d’une rigueur éditoriale irréprochable sans exiger une surcharge fastidieuse de code d’infrastructure.
Le présent traité propose une immersion exhaustive dans les méthodologies d’élaboration, de paramétrage fin et d’interprétation critique des cartes thermiques avec Seaborn. De la formalisation de la perception psycho-visuelle des gradients colorimétriques jusqu’aux techniques avancées de classification non supervisée par clustermap, en passant par le calibrage dynamique des dynamiques de saturation et l’optimisation des annotations typographiques, ce guide procure l’armature technique indispensable pour métamorphoser des tableaux de nombres bruts en synthèses graphiques de rang académique.
1. Introduction conceptuelle aux cartes thermiques et à la bibliothèque Seaborn
1.1 Définition et principes fondamentaux de la carte thermique
La carte thermique constitue une modalité de représentation graphique bidimensionnelle où les valeurs numériques scalaires composant une matrice sont transcrites de manière univoque selon un continuum de couleurs. Dans une approche cartésienne canonique, les rangées et les colonnes de la matrice correspondent respectivement aux modalités discrètes de deux variables catégorielles distinctes, ou à la discrétisation ordonnée d’un plan d’observation temporel et spatial. L’intersection d’une rangée $i$ et d’une colonne $j$ forme une cellule unitaire dont la couleur intrinsèque est définie par une fonction de transfert associant l’espace des réels à un espace chromatique prédéfini.
Cette transposition sémiologique trouve ses origines historiques dans les travaux de statisticiens et de cartographes de la fin du dix-neuvième siècle, à l’image des matrices ombrées employées par Toussaint Loua en 1873 pour caractériser les variations socio-économiques des arrondissements parisiens. Sur le plan cognitif, la carte thermique exploite le canal préattentif du système visuel humain. Alors que la lecture séquentielle d’un tableau composé de centaines de valeurs numériques impose une charge cognitive prohibitive, le cerveau traite de manière massivement parallèle les variations de luminance et de chromaticité. Ce basculement perceptif permet de détecter instantanément des regroupements de valeurs similaires (clusters), des gradients évolutifs, ainsi que des points aberrants (outliers) isolés au sein de structures massives.
En analyse exploratoire des données (EDA), la carte thermique n’agit pas comme une simple illustration statique, mais comme une sonde analytique active. Elle autorise une réduction drastique de la dimensionalité perçue sans recourir immédiatement à des transformations mathématiques destructrices d’information telles que l’analyse en composantes principales (ACP). En préservant la disposition relationnelle de chaque observation dans sa matrice d’origine, le chercheur conserve l’accès simultané à la vue macroscopique du système et au détail microscopique de chaque cellule élémentaire.
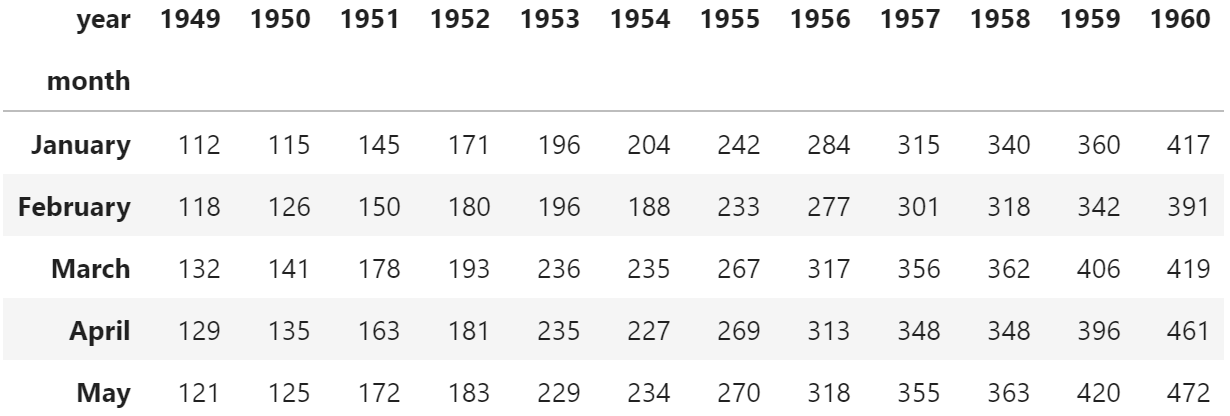
1.2 Le rôle de Seaborn dans l’écosystème scientifique Python
Au sein de la pile scientifique Python, l’émergence de Seaborn a comblé une fracture méthodologique persistante entre la manipulation de structures tabulaires et la formalisation graphique. Développée originellement par Michael Waskom, Seaborn s’érige comme une couche d’abstraction sophistiquée reposant sur l’infrastructure de Matplotlib. Alors que Matplotlib exige de l’utilisateur qu’il décrive minutieusement chaque primitive géométrique — de la position absolue des polygones à la spécification individuelle des barres d’échelle —, Seaborn encapsule ces mécanismes impératifs dans une grammaire déclarative orientée vers la sémantique des données.
L’atout majeur de Seaborn réside dans son interopérabilité directe et organique avec les structures de données DataFrame et Series de Pandas. Les métadonnées inhérentes aux tableaux — notamment les index de lignes, les intitulés de colonnes et les types catégoriels sous-jacents — sont automatiquement reconnues, interprétées et projetées sur les axes graphiques sans qu’il soit nécessaire d’extraire manuellement des matrices unidimensionnelles de valeurs brutes. Cette synergie conceptuelle minimise les risques d’inversion d’axes ou de désalignement d’étiquettes qui polluent fréquemment les développements conduits en pur Matplotlib.
Par ailleurs, Seaborn automatise les décisions ergonomiques complexes qui incombent d’ordinaire à l’analyste. L’attribution automatique d’une échelle colorimétrique équilibrée, le calcul dynamique des contrastes entre le texte d’annotation et le fond de la cellule, ainsi que la synchronisation d’une barre de référence latérale (colorbar) dotée de graduations cohérentes sont gérés par des heuristiques computationnelles éprouvées. Cette architecture préserve la fluidité du cycle de prototypage tout en générant nativement des représentations dont la finition esthétique respecte les critères typographiques des revues internationales les plus exigeantes.
1.3 Champs d’application scientifique et analytique
La polyvalence structurelle de la carte thermique confère à cette modalité visuelle un spectre d’utilisation transdisciplinaire particulièrement étendu. En analyse statistique multivariée, l’usage prééminent demeure sans conteste la restitution visuelle des matrices de corrélation. Qu’il s’agisse des coefficients paramétriques de Pearson, ou des métriques non paramétriques de Spearman et Kendall, la cartographie thermique permet d’évaluer d’un coup d’œil l’intensité et le sens des liaisons linéaires ou monotoniques unissant des dizaines de variables covariantes, orientant ainsi les stratégies de sélection d’attributs avant la phase de modélisation prédictive.
Dans l’étude des séries temporelles longitudinales et des chronogrammes d’activité, la carte thermique opère une restructuration cyclique des données chronologiques. En distribuant les heures du jour sur l’axe des ordonnées et les jours consécutifs de l’année sur l’axe des abscisses, l’observateur révèle des périodicités infracellulaires, des signatures d’utilisation énergétique ou des ruptures de charge au sein d’infrastructures cloud qu’un graphique en lignes traditionnel masquerait sous une superposition chaotique de tracés enchevêtrés.
Enfin, le domaine de l’apprentissage automatique et des sciences de la décision mobilise continuellement les cartes thermiques pour l’évaluation diagnostique de la performance des classificateurs. La matrice de confusion, instrument d’analyse confrontant les classes théoriques aux prédictions effectives de l’algorithme, trouve dans la projection thermique une lisibilité immédiate. Les cellules diagonales quantifient instantanément les vrais positifs et négatifs, tandis que les cellules extradiagonales mettent en relief les biais d’attribution systématiques ou les confusions préférentielles du modèle, accélérant par là même l’optimisation des hyperparamètres et la correction des déséquilibres d’échantillonnage.
2. Fondements méthodologiques et perception visuelle des représentations matricielles
2.1 Théorie de la perception visuelle et encodage colorimétrique
La transcription d’une grandeur numérique en une valeur chromatique ne constitue pas un acte purement esthétique ; elle relève d’une modélisation rigoureuse régie par les lois de la psychophysique et de la sémiologie graphique. Dès 1967, Jacques Bertin établissait dans sa Sémiologie Graphique une hiérarchie fondamentale des variables rétiniennes, démontrant que la valeur (luminance) possède une propriété ordonnée et quantitative, alors que la teinte (longueur d’onde) n’est dotée que d’une propriété qualitative et associative. Il en résulte que pour communiquer fidèlement une métrique continue, la modulation de la luminance doit impérativement obéir à la dynamique de la variable sous-jacente.
Le système visuel humain est intrinsèquement non linéaire dans sa perception des intensités lumineuses. Confronté à des transitions de teintes brutes, le cerveau perçoit des frontières artificielles là où le gradient mathématique est pourtant strictement constant. Ce phénomène, exacerbé par des échelles saturées historiquement populaires mais scientifiquement erronées comme la palette arc-en-ciel (jet ou rainbow), altère profondément la neutralité de l’observation empirique. Une transition soudaine entre le cyan et le jaune peut être interprétée comme un seuil critique ou une rupture de gradient, alors qu’elle ne correspond qu’à une non-uniformité de la perception humaine de la luminance à travers le spectre visible.
De surcroît, la conception d’une carte thermique impose une stricte prise en compte des disparités d’acuité visuelle au sein de la population cible. Les déficiences de la vision des couleurs, à l’instar de la deutéranopie, de la protanopie ou de la tritanopie, affectent approximativement huit pour cent de la population masculine mondiale. L’emploi exclusif d’un axe d’opposition rouge-vert sans modulation conjointe de la luminance condamne les figures produites à une ambiguïté complète pour ces observateurs. Les normes scientifiques contemporaines exigent l’emploi d’espaces colorimétriques uniformes au sens perceptuel — tels que CIELAB ou CAM02-UCS —, garantissant qu’une variation d’une unité mathématique induit une variation perceptive rigoureusement identique sur l’intégralité du continuum.
2.2 Typologie des schémas de données adaptés aux heatmaps
Pour qu’une représentation thermique conserve son efficacité cognitive, les données matricielles brutes doivent être répertoriées selon leur structure intrinsèque et leur distribution statistique. Le premier archétype regroupe les données séquentielles strictement positives et monotones, telles que les densités de trafic, les taux de prévalence épidémiologique ou les flux financiers. Pour ces grandeurs, le zéro absolu ou la borne minimale de l’échantillon constitue un ancrage perceptif naturel, exigeant un encodage progressif unilatéral s’étirant d’une teinte claire et désaturée vers une teinte profonde et fortement saturée.
Le second schéma structural relève des données divergentes, caractérisées par l’existence d’une valeur pivot médiane signifiante. Ce cas de figure est typique des matrices de corrélation (où zéro marque l’absence d’association, encadré par des bornes théoriques de moins un et de plus un), des indices d’anomalies de température ou des scores normalisés (z-scores). L’encodage impose ici une structure symétrique bipolaire : une couleur neutre et peu saturée fixe le centre mathématique, tandis que deux teintes chromatiquement opposées et de luminance équivalente s’éloignent symétriquement vers les pôles positif et négatif.
Enfin, les distributions de probabilités conjointes et les matrices de co-occurrence issues du traitement automatique du langage ou de l’analyse comportementale requièrent un prétraitement géométrique et statistique spécifique. Ces matrices présentent fréquemment une asymétrie marquée ou une dispersion à queue lourde, où une infime fraction de cellules monopolise la quasi-totalité de la masse statistique. L’application directe d’un encodage linéaire aboutit alors à une visualisation uniforme et atone, neutralisant la variance des zones de plus faible amplitude. L’introduction d’une transformation logarithmique préalable ou d’un échelonnement quantile s’avère dans ce contexte indispensable pour restaurer la discriminabilité visuelle sans altérer l’intégrité ordinale des observations.
3. Configuration de l’environnement de travail et gestion des dépendances
3.1 Installation et compatibilité des bibliothèques nécessaires
L’implémentation robuste d’un pipeline de visualisation matricielle requiert la configuration méthodique d’un environnement d’exécution isolé. L’évolution rapide des dépendances logicielles et les ruptures d’API entre les versions majeures imposent de figer les versions des composants applicatifs à l’aide d’outils de gestion tels que Conda, l’utilitaire natif venv ou des orchestrateurs déterministes à l’instar de Poetry. Cette isolation prévient les conflits de binaires compilés, particulièrement fréquents lors de l’intégration de bibliothèques sous-jacentes d’algèbre linéaire comme OpenBLAS ou LAPACK.
L’infrastructure logicielle minimale repose sur le quadrilatère classique : NumPy pour le calcul matriciel vectorisé, Pandas pour la manipulation des structures tabulaires relationnelles, Matplotlib pour le moteur de rendu vectoriel et matriciel bas niveau, et Seaborn comme interface de synthèse statistique. L’installation standardisée s’opère usuellement via le gestionnaire de paquets officiel de Python, en veillant à interroger les dépôts de métadonnées pour certifier la compatibilité inter-bibliothèques. Une attention particulière doit être portée aux versions de Seaborn supérieures ou égales à 0.12.0, qui ont introduit une refonte substantielle de l’API avec le nouveau système d’objets tout en consolidant les interfaces fonctionnelles traditionnelles.
La commande d’installation via l’interface en ligne de commande s’articule généralement ainsi :
pip install numpy pandas matplotlib seaborn
Dans un contexte scientifique soumis à des protocoles de reproductibilité stricts, l’analyste vérifiera systématiquement les versions logicielles au moment de l’initialisation de l’interpréteur. Cette précaution garantit que les arguments d’API dépréciés ne génèrent pas d’avertissements intempestifs et que les algorithmes de rendu graphique conservent un comportement strictement uniforme d’une machine de calcul à une autre.
3.2 Initialisation du calepin de développement et conventions de codage
L’initialisation d’une session d’analyse dans un calepin interactif (Jupyter Notebook ou Google Colab) obéit à des conventions communautaires strictes. L’importation des modules fondamentaux s’effectue traditionnellement sous des alias standardisés devenus quasi-universels dans la littérature technique : sns pour Seaborn, plt pour le sous-module pyplot de Matplotlib, pd pour Pandas et np pour NumPy. Ces conventions facilitent l’interopérabilité et la relecture collégiale des scripts de recherche.
Dès le préambule de la session, l’invocation de la fonction sns.set_theme() permet d’harmoniser le contexte graphique global. Seaborn applique automatiquement des choix typographiques raffinés, supprime les fioritures inutiles et ajuste les paramètres d’affichage de Matplotlib (les fameux rcParamètres). Il est fortement recommandé d’opter pour un style visuel sobre — tel que le thème white ou ticks —, qui évite de polluer l’arrière-plan avec des grilles grises susceptibles de parasiter la perception des contrastes de couleur intrinsèques aux cartes thermiques.
Pour anticiper une publication dans des revues académiques exigeant un haut niveau de netteté graphique, la résolution d’affichage des graphiques vectoriels et matriciels doit être calibrée dès l’en-tête du calepin. L’ajustement du paramètre figure.dpi à une valeur minimale de 300 points par pouce assure un rendu net des polices de caractères et des délimitations de cellules, éradiquant les effets de pixellisation disgracieux lors des phases d’exportation préliminaires ou des revues de pairs.
4. Structuration et prétraitement matriciel des données avec Pandas
4.1 Chargement et inspection des jeux de données d’apprentissage
La réussite de l’élaboration d’une carte thermique dépend presque exclusivement de la conformité topologique des données transmises à la fonction de rendu. À la différence d’un nuage de points ou d’un tracé linéaire qui accepte aisément des données tabulaires plates dites « longues » (où chaque variable constitue une colonne et chaque mesure une ligne), la carte thermique exige conceptuellement un format « large », c’est-à-dire une structure matricielle bidimensionnelle pure où les lignes et les colonnes délimitent conjointement un réseau réticulaire de valeurs scalaires.
Pour illustrer ce paradigme, le jeu de données didactique flights, intégré nativement à Seaborn, offre un cas d’école optimal. Ce corpus retrace l’évolution mensuelle du nombre total de passagers du transport aérien international civil entre les années 1949 et 1960. Son chargement s’effectue directement via la méthode interne sns.load_dataset('flights'), renvoyant un DataFrame Pandas classique constitué de trois vecteurs sériels : l’année (year), le mois calendaire (month) et le volume quantitatif de passagers (passengers).
L’inspection analytique initiale à l’aide des méthodes descriptives élémentaires (head(), info(), dtypes) révèle la nature orthogonale de ces variables. La colonne temporelle annuelle se présente sous la forme d’un entier quantitatif discret, le mois comme une variable catégorielle ordonnée dotée d’une périodicité stricte, et le nombre de passagers comme une mesure quantitative continue strictement positive. En l’état, ce tableau ne peut être injecté directement dans la fonction de cartographie thermique sans subir une métamorphose relationnelle complète.
4.2 Transformation en structure matricielle via le pivotage
L’opération fondamentale requise pour transposer ce tableau relationnel longitudinal en un tenseur d’ordre deux exploitable s’effectue au moyen de la méthode pivot() de Pandas. Cette transformation matricielle réalloue les dimensions vectorielles du DataFrame en spécifiant trois paramètres cardinaux : l’index de ligne (index), l’attribut de colonne (columns) et la variable quantitative scalaire destinée à saturer le corps du tableau (values).
En assignant index='month', columns='year' et values='passengers', Pandas restructure instantanément le jeu de données en une matrice de dimension douze par douze. Chaque intersection spatiale correspond désormais sans équivoque au flux volumétrique de passagers associé à un mois et une année donnés. L’intégrité de la projection suppose qu’il n’existe aucun doublon pour un couple (mois, année) spécifique ; en présence d’agrégations multiples, le praticien substituera à pivot() la méthode pivot_table(), laquelle intègre une fonction d’agrégation statistique explicite (telle que la moyenne, la médiane ou la somme sommatoire).
Au cours de ce processus de structuration, une attention rigoureuse doit être allouée au traitement des cellules vacantes (valeurs NaN). Une carte thermique intégrant des valeurs manquantes affichera des perforations blanches ou grises qui brisent la continuité du balayage visuel. Selon les postulats méthodologiques de l’étude, ces données absentes doivent être documentées, isolées, ou traitées via des procédures d’imputation matricielle rigoureuses (interpolation linéaire, imputation par les k-plus proches voisins ou modèles gaussiens latents) avant toute finalisation du tracé graphique.
5. Conception d’une carte thermique élémentaire avec sns.heatmap()
5.1 Syntaxe de base et rendu graphique par défaut
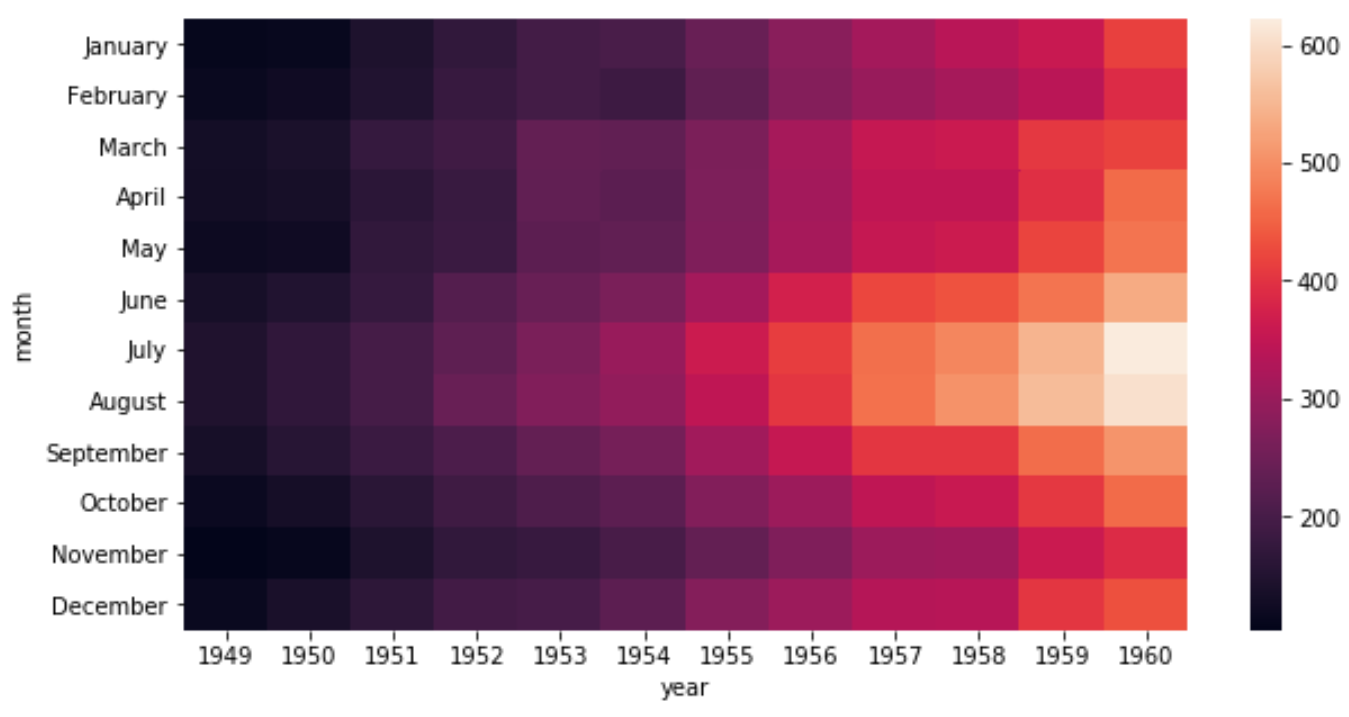
L’accès à la représentation matricielle s’effectue dans Seaborn via l’invocation de la fonction d’ordre supérieur sns.heatmap(). Cette fonction constitue le point d’entrée universel du module pour la cartographie thermique. En lui transmettant simplement la matrice bidimensionnelle préalablement articulée via le pivotage de Pandas, Seaborn mobilise ses heuristiques internes pour automatiser l’intégralité du pipeline de construction visuelle, sans solliciter de configuration complémentaire obligatoire de la part de l’utilisateur.
L’instruction minimale prend la forme canonique suivante :
sns.heatmap(data=vols_matrice)
Dès cette exécution élémentaire, Seaborn procède à une analyse introspective des dimensions du DataFrame. Les étiquettes de l’index de ligne (les douze mois de l’année) sont automatiquement projetées sur l’axe vertical des ordonnées, tandis que les identifiants de colonnes (les années de 1949 à 1960) viennent habiller l’axe horizontal des abscisses. Les valeurs d’échelle numérique minimale et maximale sont immédiatement calculées à partir de la distribution globale du tableau, déterminant ainsi les bornes du gradient colorimétrique appliqué.
Sur le flanc droit de la zone d’affichage principale, la fonction génère de manière congruente une barre d’échelle colorée verticale (colorbar). Cet élément périphérique indispensable établit la relation métrique explicite entre le continuum des nuances spectrales affichées dans les cellules et les unités de mesure physiques sous-jacentes. L’instruction finale de restitution, traditionnellement orchestrée par plt.show(), valide le dessin graphique et purge les tampons mémoires graphiques alloués par le moteur Matplotlib.
5.2 Déconstruction anatomique de la figure générée
L’appréhension fine de la manipulation des heatmaps requiert une déconstruction systématique de l’architecture sous-jacente générée par Seaborn. Lorsque la fonction sns.heatmap() est invoquée, elle ne crée pas un objet graphique hermétique et isolé ; elle opère directement au sein d’une instance de la classe matplotlib.axes.Axes. Si aucun axe préexistant n’est explicitement spécifié dans l’appel, Seaborn interroge la machine d’état de Matplotlib pour solliciter l’axe courant (plt.gca()) ou en instancier un nouveau au sein de la figure active.
L’aire de traçage principale est structurée sous la forme d’une collection d’éléments polygonaux bidimensionnels (une instance de matplotlib.collections.QuadMesh). Cette approche computationnelle s’avère infiniment plus économe en ressources mémoire que l’assemblage individuel de centaines d’objets rectangles distincts. Chaque vertex de ce maillage est indexé selon un système de coordonnées discrètes démarrant conventionnellement à l’origine $(0, 0)$ située à l’angle supérieur gauche de la matrice dans la convention de lecture tabulaire habituelle, rompant ainsi avec la tradition cartésienne classique où l’origine se positionne à l’angle inférieur gauche.
Cette particularité géométrique induit un comportement singulier sur l’orientation de l’axe vertical. Alors que les visualisations mathématiques standards projettent les valeurs croissantes de bas en haut, la carte thermique inverse cette dynamique pour préserver la séquence de lecture naturelle du tableau source : le premier élément de l’index de ligne figure au sommet de la figure, garantissant une parfaite isomorphie entre la représentation visuelle et la topologie du DataFrame originel. Les graduations et étiquettes textuelles (tick labels) sont alors positionnées au centre barycentrique de chaque colonne et de chaque rangée.
6. Contrôle géométrique, échelle et dimensionnement de la figure
6.1 Ajustement de la surface d’affichage avec Matplotlib
L’un des écueils les plus récurrents rencontrés lors de l’élaboration de cartes thermiques réside dans l’inadéquation spatiale entre le volume des données à projeter et la résolution géométrique de la surface d’affichage allouée par défaut. Lorsque le nombre de variables dépasse la vingtaine, les paramètres dimensionnels standards de Matplotlib aboutissent inévitablement à un écrasement mutuel des cellules, à une troncature des étiquettes textuelles périphériques ou à une illisibilité complète des descripteurs catégoriels.
Pour juguler cette compression anormale, l’instanciation délibérée de la figure via la commande plt.figure(figsize=(largeur, hauteur)) doit impérativement précéder l’appel à la fonction Seaborn. Les dimensions, conventionnellement exprimées en pouces dans l’écosystème Matplotlib, doivent être calibrées en proportion directe du ratio d’aspect de la matrice de données. Une matrice présentant un déséquilibre structurel majeur — par exemple, cinquante descripteurs génomiques évalués sur seulement cinq cohortes d’échantillons cliniques — réclamera une surface d’affichage fortement allongée verticalement pour éviter l’atrophie spatiale de l’axe le plus dense.
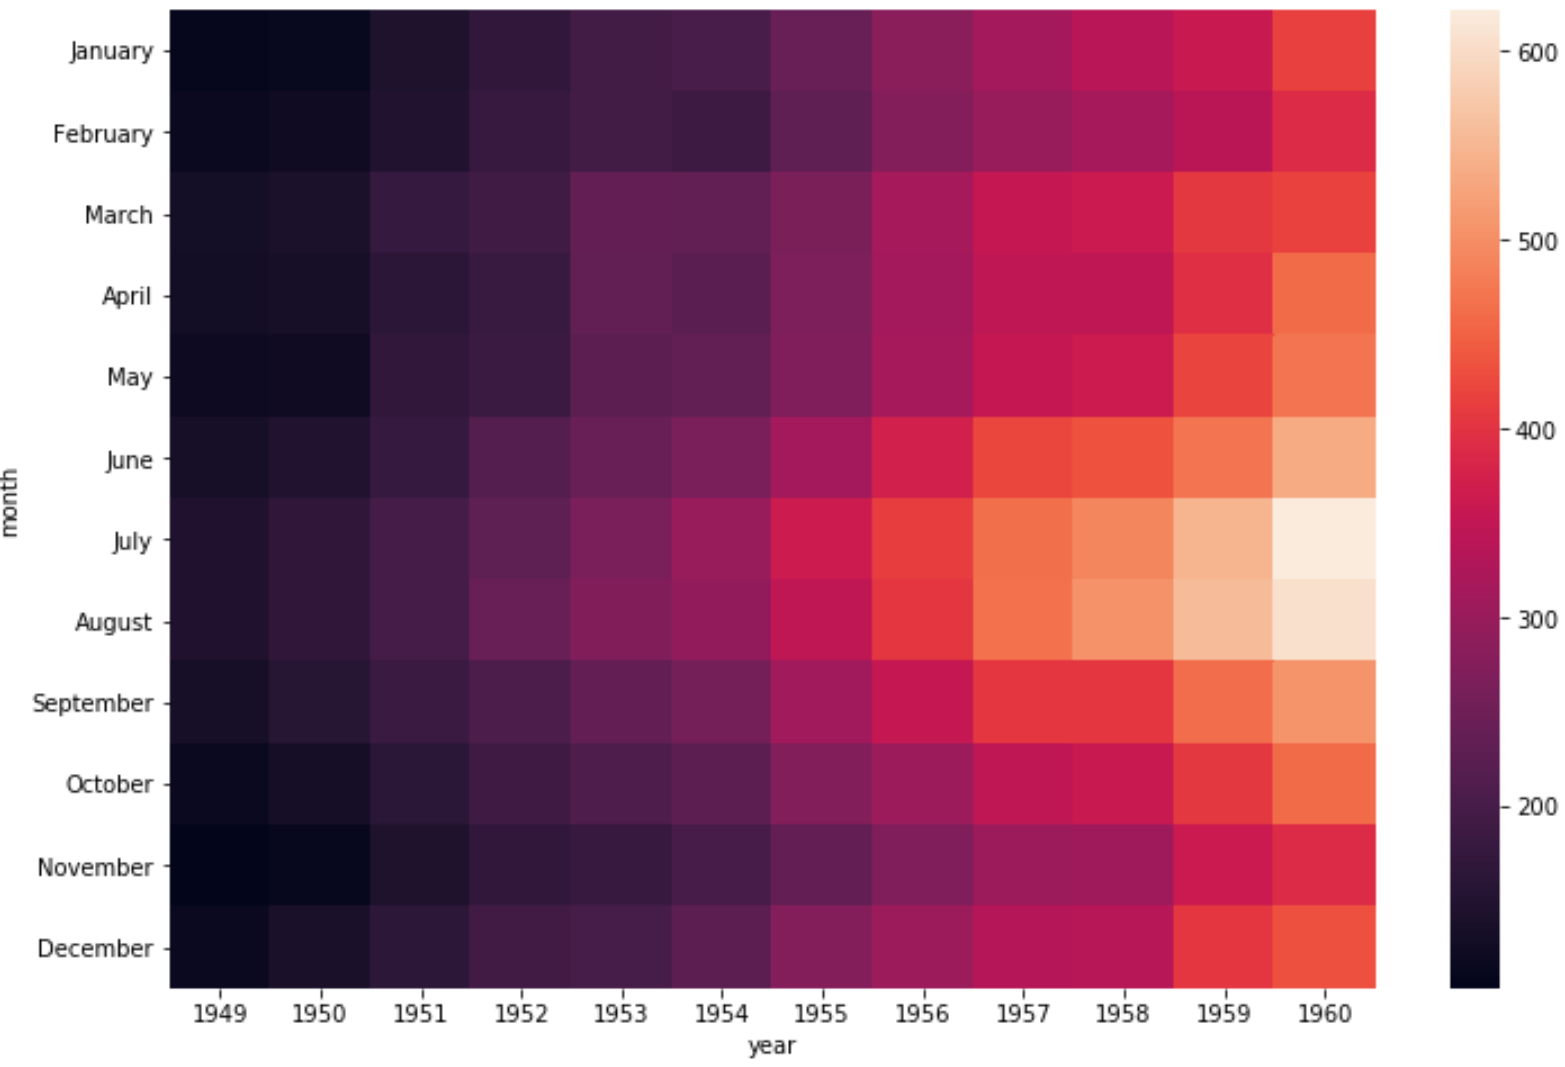
Le contrôle de la typographie des axes intervient également à cette étape de raffinement spatial. L’utilisation conjointe de plt.xticks(rotation=45, ha='right') permet d’incliner diagonalement les étiquettes de l’axe horizontal, éliminant les collisions textuelles frontales tout en guidant le regard vers l’ancrage exact de chaque colonne. Enfin, la sollicitation de l’utilitaire plt.tight_layout() en clôture de script recalibre automatiquement les marges externes de la figure, assurant que les étiquettes nominales les plus longues ne soient pas exclues de la zone de cadrage lors de l’exportation sur disque.
6.2 Gestion de la résolution spatiale et proportionnalité des cellules
Au-delà du dimensionnement global du canevas, la morphologie individuelle de chaque cellule gouverne l’équilibre esthétique et la neutralité perceptive du document graphique. Par défaut, Seaborn étend de manière élastique les mailles du quadrillage pour occuper l’intégralité du rectangle d’affichage alloué aux axes de coordonnées. Cette distorsion élastique produit fréquemment des cellules rectangulaires allongées qui peuvent induire involontairement un sentiment d’asymétrie ou orienter le regard préférentiellement dans le sens horizontal ou vertical.
Pour contraindre les cellules à préserver une géométrie rigoureusement isométrique, Seaborn met à disposition le paramètre booléen square. En affectant la valeur True à cet argument (sns.heatmap(data, square=True)), l’analyste force le moteur de rendu à verrouiller le rapport d’aspect de chaque cellule unitaire sur un ratio de un pour un. Cette contrainte transforme chaque composante en un carré parfait, contraignant l’axe global à s’ajuster uniformément, indépendamment de la disparité entre le nombre de lignes et de colonnes.
Cette normalisation carrée s’avère particulièrement préconisée dans le cadre des publications scientifiques à double colonne (comme celles répondant aux formats IEEE ou Nature Portfolio). Elle évite que des cellules rectangulaires disproportionnées ne suggèrent de fausses corrélations directionnelles ou n’altèrent la perception des distances topologiques lors de l’inspection de matrices d’adjacence en théorie des graphes. La surface graphique se trouve rationalisée, favorisant une concentration immédiate sur les dynamiques de distribution scalaire.
7. Harmonisation chromatique : Maîtrise des palettes de couleurs (cmap)
7.1 Typologie scientifique des palettes : Séquentielles, divergentes et qualitatives
L’attribution de la palette de couleurs — désignée sous l’acronyme technique colormap ou l’argument cmap — représente le choix méthodologique le plus déterminant de la construction d’une carte thermique. Une discordance entre la nature statistique des données et la structure chromatique de la palette engendre instantanément des distorsions herméneutiques majeures, susceptibles de ruiner la valeur démonstrative de la publication scientifique.
La taxonomie moderne des échelles colorimétriques se scinde en trois familles distinctes :
- Les palettes séquentielles : Destinées aux données continues unidirectionnelles dont l’amplitude s’étend d’une valeur basse à une valeur haute. Elles exploitent une progression monotone de la luminance, conjuguée à une variation contrôlée de la saturation et de la teinte. Les standards scientifiques majeurs incluent Viridis, Cividis, Crest ou les gradients monochromes tels que Blues ou Rocket. Leur uniformité perceptuelle garantit une fidélité d’interprétation mathématique absolue, y compris en cas de reproduction monochrome sur support papier imprimé.
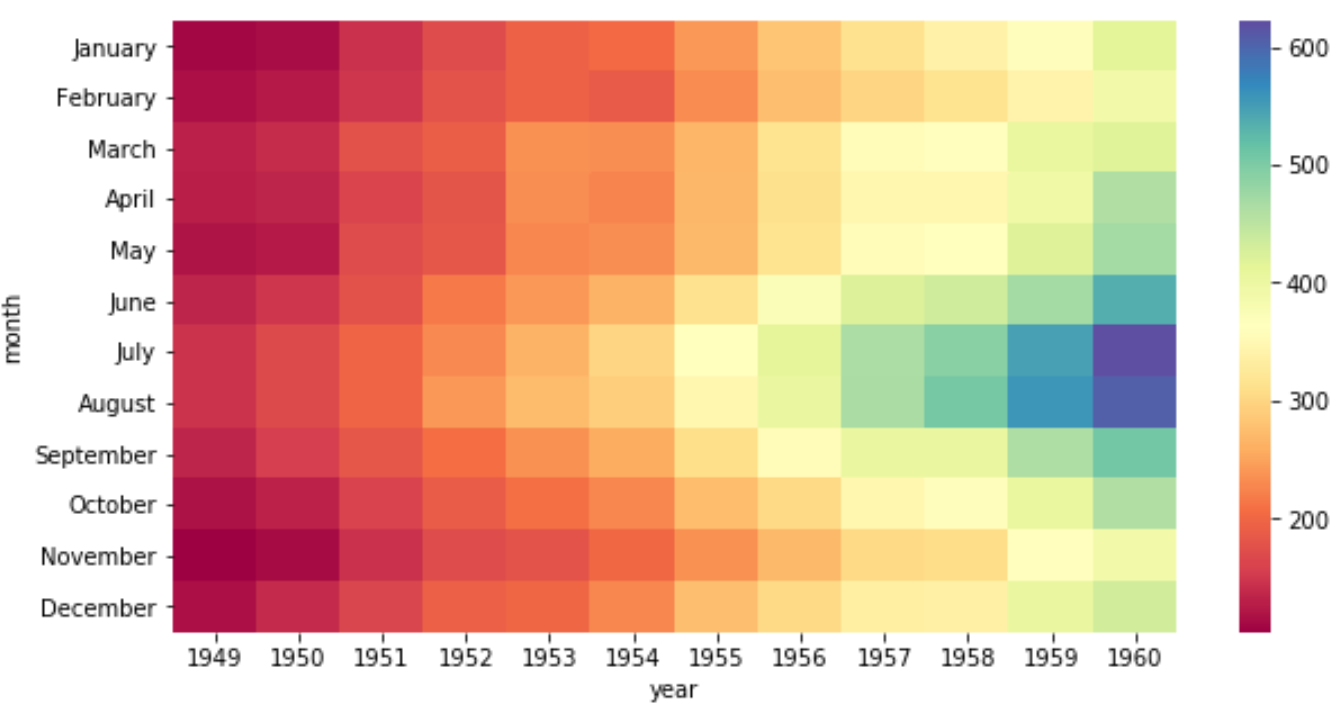
- Les palettes divergentes : Conçues pour les données ordonnées possédant une valeur médiane ou un seuil critique préétabli (zéro, moyenne, température d’équilibre). Elles associent deux dégradés séquentiels distincts convergeant vers un centre déchromatisé commun (blanc, gris neutre ou crème). Les palettes coolwarm, vlag, Spectral ou RdBu en constituent les déclinaisons canoniques. Elles permettent de dissocier immédiatement les régimes de sur-performance et de sous-performance par rapport à l’indice de référence.
- Les palettes qualitatives : Adaptées exclusivement aux variables nominales discrètes dépourvues de hiérarchie intrinsèque (appartenance à des grappes non ordonnées, partitions géographiques). Les teintes y sont différenciées par leur chromaticité tout en maintenant une luminance globale similaire pour ne conférer aucun poids psychologique artificiel à une catégorie particulière. Leur usage au sein d’une carte thermique demeure toutefois marginal, cette dernière étant intrinsèquement orientée vers l’expression d’intensités continues.
Il convient de proscrire solennellement l’utilisation de palettes historiques telles que jet ou hsv. En raison de leurs variations erratiques de luminance locale, elles génèrent des gradients trompeurs en induisant l’illusion de discontinuités topologiques prononcées là où la distribution sous-jacente est parfaitement homogène.
7.2 Implémentation pratique du paramètre cmap
L’assignation de la palette s’effectue au moyen de l’argument cmap transmis à sns.heatmap(). Seaborn reconnaît nativement les chaînes de caractères désignant les palettes standardisées issues des catalogues de Matplotlib, les palettes spécifiques intégrées à Seaborn lui-même, ainsi que les constructions chromatiques dérivées de la bibliothèque externe Colorcet.
La syntaxe opératoire s’illustre de manière directe :
sns.heatmap(data=vols_matrice, cmap='viridis')
Une fonctionnalité d’inversion dynamique du sens de lecture chromatique est accessible de façon universelle par l’adjonction du suffixe _r à la désignation de la palette (par exemple, cmap='rocket_r' ou cmap='coolwarm_r'). Ce mécanisme permet d’ajuster instantanément la correspondance symbolique des teintes en fonction du paradigme sémantique étudié (par exemple, assigner des couleurs sombres ou chaudes aux valeurs statistiquement préoccupantes, comme des taux d’erreur ou des concentrations de polluants toxiques).
Pour satisfaire aux chartes graphiques rigides imposées par certaines institutions ou périodiques, l’utilisateur a la possibilité de concevoir des colormaps hautement personnalisées. En mobilisant les classes LinearSegmentedColormap ou ListedColormap du sous-module matplotlib.colors, il est aisé d’interpoler un continuum mathématique continu à partir d’un échantillonnage restreint de codes hexadécimaux précis. L’objet colorimétrique ainsi instancié est ensuite directement injecté comme argument de la fonction de cartographie thermique, assurant une parfaite adéquation stylistique sans sacrifier l’ordonnancement de la luminance.
8. Calibration quantitative : Normalisation, centrage et saturation des valeurs
8.1 Fixation délibérée des bornes extrêmes (vmin et vmax)
Par défaut, l’algorithme d’encodage de Seaborn analyse la matrice de manière empirique et assigne la borne minimale de l’échelle de couleur à la valeur la plus basse observée dans l’échantillon ($min(X)$), tandis que la borne maximale est verrouillée sur la valeur la plus élevée ($max(X)$). Si cette approche automatisée garantit l’exploitation intégrale de l’amplitude spectrale pour une figure isolée, elle s’avère particulièrement préjudiciable et trompeuse dès lors qu’il s’agit d’effectuer des comparaisons inter-graphiques au sein d’une même étude.
En fixant manuellement les bornes extrêmes à l’aide des paramètres quantitatifs vmin et vmax, l’analyste impose une échelle absolue universelle. Par exemple, lors de la restitution d’une matrice de corrélations de Pearson, il est méthodologiquement impératif de déclarer explicitement vmin=-1.0 et vmax=1.0, quand bien même la liaison observée la plus extrême dans l’échantillon ne dépasserait pas $0.65$. À défaut, le lecteur percevrait visuellement un coefficient modéré de $0.65$ avec la saturation chromatique maximale théoriquement réservée à une corrélation parfaite de $1.0$, induisant un biais de surévaluation cognitif majeur.
La fixation des bornes remplit une fonction diagnostique supplémentaire : la maîtrise de la saturation intentionnelle. Face à des distributions asymétriques polluées par des valeurs extrêmes sporadiques, le calibrage standard comprime l’ensemble des données ordinaires dans une bande spectrale étroite et indiscernable. L’abaissement concerté de la borne vmax (par exemple au 95e percentile de la distribution) écrête délibérément les valeurs aberrantes en les fusionnant dans la teinte saturée terminale, révélant ainsi les micro-variations critiques au sein du corps principal des observations.
8.2 Centrage sérique avec le paramètre center
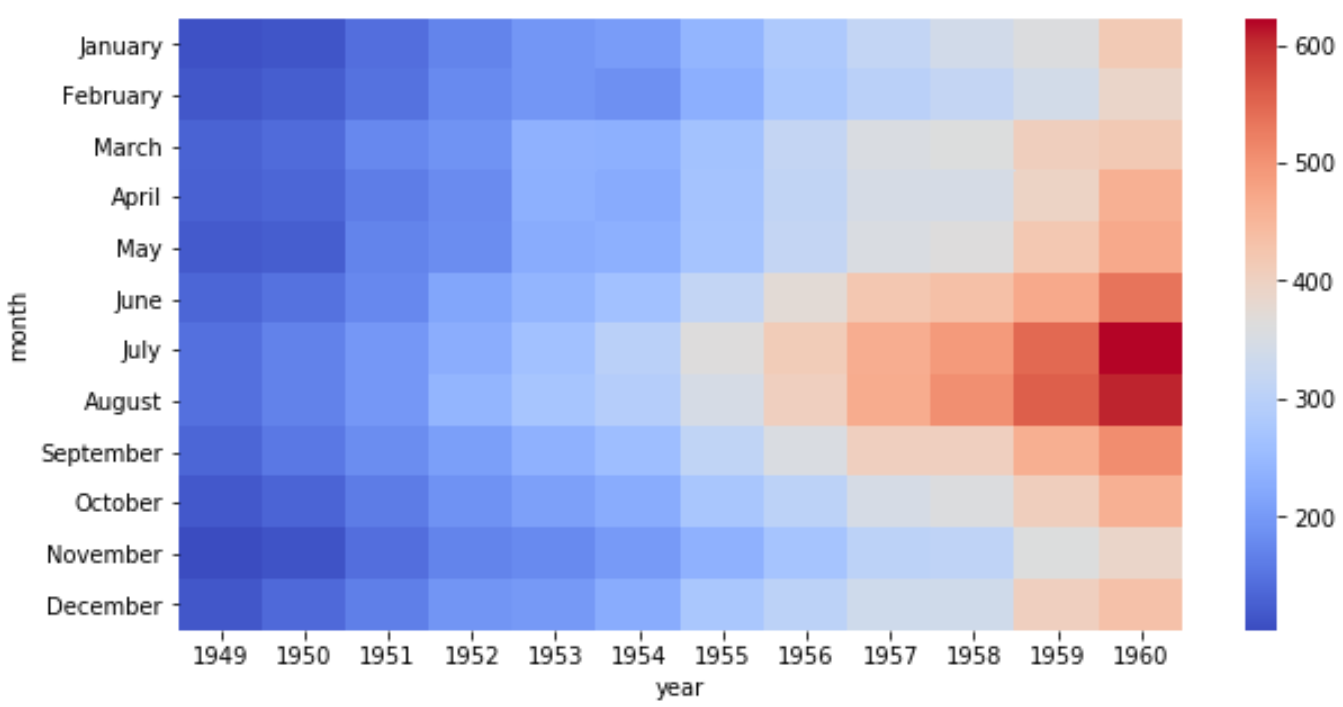
Dans l’exploitation des palettes divergentes, l’alignement précis de la valeur charnière sur le point d’inflexion neutre constitue une condition absolue de validité scientifique. L’argument center permet de désigner explicitement la valeur quantitative exacte à laquelle doit correspondre la couleur médiane et désaturée de la palette chromatique sélectionnée.
L’omission du paramètre center sur des données distribuées de façon asymétrique conduit à des erreurs d’interprétation pernicieuses. Si une métrique varie entre $-20$ et $+80$, une colormap divergente standard distribuera le centre chromatique de manière strictement géométrique à mi-chemin des extrêmes, soit à $+30$. Dès lors, des valeurs strictement positives comprises entre $0$ et $+30$ arboreront la couleur associée au pôle négatif, faussant radicalement la compréhension de l’état physique observé.
En formulant sns.heatmap(data, cmap='coolwarm', center=0.0), Seaborn garantit que le zéro scalaire correspond sans ambiguïté à la tonalité neutre (le blanc ou le gris clair). Les écarts positifs basculent exclusivement dans le registre chaud, tandis que les anomalies négatives sont cantonnées au registre froid, préservant la symétrie conceptuelle indépendamment des dissymétries d’amplitude observées dans les ailes de la distribution. Cette technique s’avère particulièrement puissante lors de la visualisation de scores $Z$ ou de différentiels d’expression génique (log fold-change).
9. Annotation textuelle et sémiotique numérique intra-cellulaire
9.1 Activation et configuration élémentaire des annotations
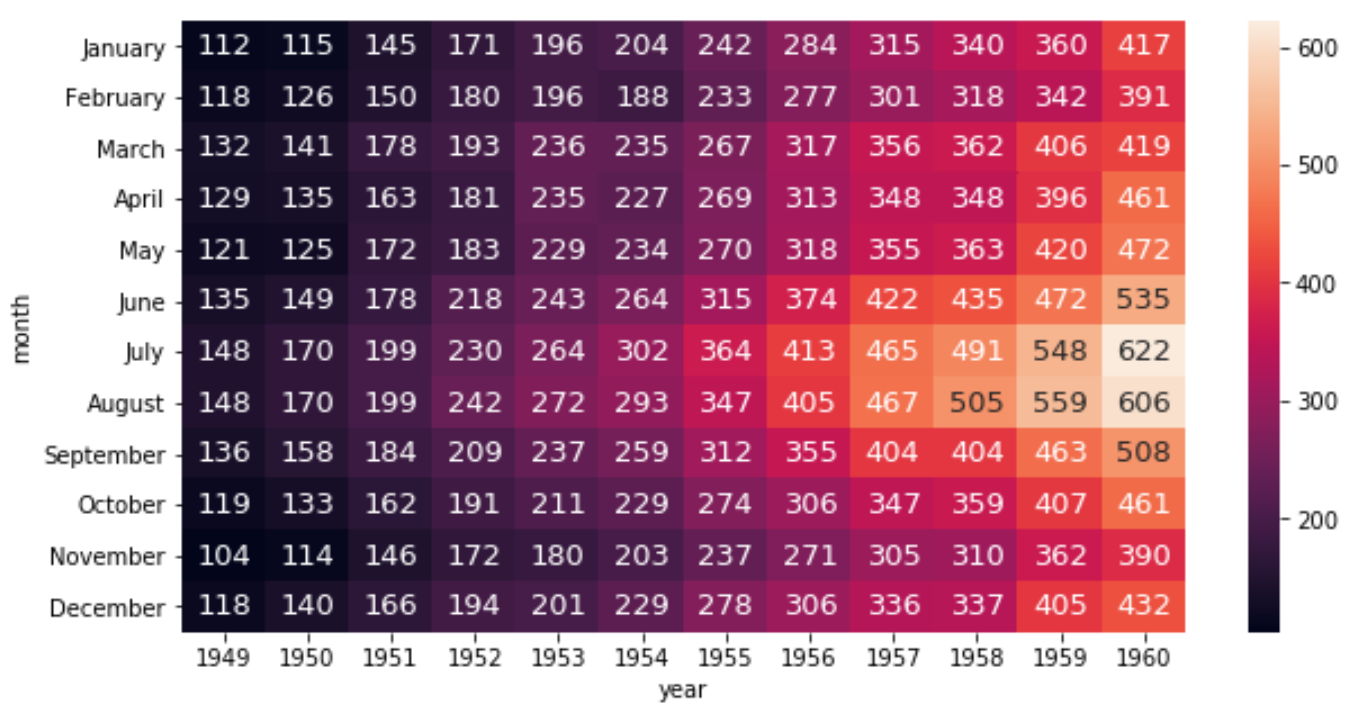
Si l’encodage par le gradient de couleur offre une perception holistique inégalable de la structure globale des données, il ne permet pas d’extraire instantanément une valeur numérique avec une précision décimale rigoureuse. Pour concilier la macro-lecture spatiale et la micro-lecture exacte, Seaborn autorise l’incrustation directe de descripteurs textuels au sein de chaque cellule individuelle au moyen du paramètre booléen annot.
L’initialisation élémentaire sns.heatmap(data, annot=True) déclenche l’écriture de la valeur scalaire correspondante au centre géométrique de chaque polygone. L’intérêt majeur de cette implémentation réside dans la gestion adaptative des contrastes automatisée par Seaborn : l’algorithme sous-jacent évalue la luminance de la couleur de fond de chaque maille et commute dynamiquement la teinte de la typographie entre le noir et le blanc afin de préserver une lisibilité maximale selon les critères d’accessibilité chromatique standardisés.
Il importe toutefois de souligner que l’activation systématique des annotations devient contre-productive dès lors que les dimensions de la matrice augmentent significativement. Au-delà d’une vingtaine de colonnes ou de lignes, l’encombrement graphique généré par la superposition de centaines de chaînes textuelles surcharge inutilement la figure et détruit l’avantage préattentif du canal colorimétrique. L’annotation textuelle doit donc être réservée à des matrices synthétiques d’échelle modérée ou à des extractions ciblées.
9.2 Formatage typographique et chaînes de spécification (fmt)
L’intégration brute des valeurs numériques sans formatage préalable aboutit fréquemment à des incohérences visuelles majeures, notamment lorsque des réels en virgule flottante comportant six à huit décimales viennent déborder hors des limites physiques de leurs cellules respectives. Pour contrôler cette restitution avec précision, Seaborn expose le paramètre de formatage fmt, lequel interprète les chaînes de formatage standardisées de Python basées sur la spécification du mini-langage Format String Syntax.
Le contrôle de l’affichage typographique répond à des règles rigoureuses :
fmt='.1f'oufmt='.2f': Tronque et arrondit les valeurs réelles à une ou deux décimales après la virgule, standard optimal pour les pourcentages ou les métriques expérimentales standardisées.fmt='d': Force l’affichage en nombres entiers décimaux stricts, indispensable lors de la restitution de dénombrements bruts, de volumes d’individus ou de matrices de confusion où les décimales sont dépourvues de réalité physique.fmt='.1e': Bascule l’affichage en notation scientifique exponentielle, configuration préconisée lors du traitement de données issues de la physique théorique, de la génomique ou d’évaluations de $p$-valeurs statistiques infinitésimales.
En outre, l’argument annot ne se limite pas à la transmission d’un simple booléen : il accepte directement une matrice ou un DataFrame de chaînes de caractères textuelles aux dimensions rigoureusement identiques à la matrice source. Cette flexibilité avancée permet aux analystes de concevoir des représentations sophistiquées où les cellules affichent simultanément la valeur estimée et des symboles de significativité statistique conventionnels (à l’exemple des astérisques marquant les seuils $p < 0.05$, $p < 0.01$ ou $p < 0.001$), condensant ainsi deux niveaux d’inférence en une seule unité spatiale.
9.3 Contrôle typographique fin avec annot_kws
Pour parfaire l’intégration éditoriale des données écrites, le paramètre annot_kws (dictionnaire de mots-clés d’annotation) offre un pont direct vers les propriétés de bas niveau de l’objet matplotlib.text.Text. Grâce à cette interface, le concepteur du graphique s’affranchit des styles par défaut pour moduler précisément l’ergonomie visuelle des annotations.
Le dictionnaire d’arguments permet de modifier substantiellement le rendu :
annot_kws={'size': 10, 'weight': 'bold', 'family': 'sans-serif', 'ha': 'center', 'va': 'center'}
L’ajustement dynamique de la taille de police (size ou fontsize) s’avère indispensable pour adapter la typographie à l’espace disponible lorsque la matrice croît en dimension. De même, l’altération du poids typographique (weight='bold') améliore drastiquement la lisibilité sur les écrans à basse résolution ou lors de projections dans le cadre de colloques internationaux. L’ajustement explicite de l’alignement horizontal et vertical garantit une assise parfaite du texte au barycentre spatial de la cellule, éliminant les micro-dérives perceptives qui pénalisent la finition professionnelle d’un tracé graphique.
10. Raffinement structurel : Grilles de séparation, barres d’échelle et masquage
10.1 Délimitation cellulaire via linewidths et linecolor
Dans sa configuration initiale, la fonction sns.heatmap() juxtapose les cellules sans aucune solution de continuité spatiale. Bien que cette approche maximise la compacité graphique, elle présente l’inconvénient d’estomper la distinction géométrique entre des cellules adjacentes arborant des teintes extrêmement proches, favorisant l’apparition de blocs indistincts qui gênent la lecture discrète des unités expérimentales.
L’introduction de bordures séparatrices nettes s’opère par l’activation conjointe des arguments linewidths et linecolor. Le paramètre linewidths reçoit une valeur flottante quantifiant l’épaisseur de la marge séparatrice exprimée en points typographiques, tandis que linecolor spécifie la tonalité chromatique du tracé de délimitation (souvent fixée sur le blanc immaculé 'white' ou sur un gris neutre discret tel que '#e0e0e0').
L’adjonction de ces séparateurs crée une grille réticulaire propre qui structure les matrices denses. Elle améliore significativement la discrimination visuelle périphérique en guidant le regard le long des travées orthogonales, empêchant que l’intensité chromatique d’une cellule dominante ne déborde perceptivement sur l’évaluation des cellules immédiatement limitrophes (atténuation de l’effet d’assimilation optique).
10.2 Personnalisation complète de la barre de couleur (cbar_kws)
La barre d’échelle colorée (colorbar) est le garant de la dimension quantitative de la carte thermique. Loin d’être un simple ornement périphérique, elle établit la correspondance univoque entre l’intensité lumineuse perçue et l’amplitude statistique des réels observés. Seaborn offre un contrôle exhaustif sur cette composante via l’argument cbar_kws, qui accepte un dictionnaire de paramètres transmis en profondeur à la classe matplotlib.colorbar.Colorbar.
Les possibilités de raffinement incluent la modification radicale de l’orientation spatiale de la légende :
cbar_kws={'orientation': 'horizontal', 'label': 'Indice de saturation (%)', 'pad': 0.15, 'shrink': 0.8}
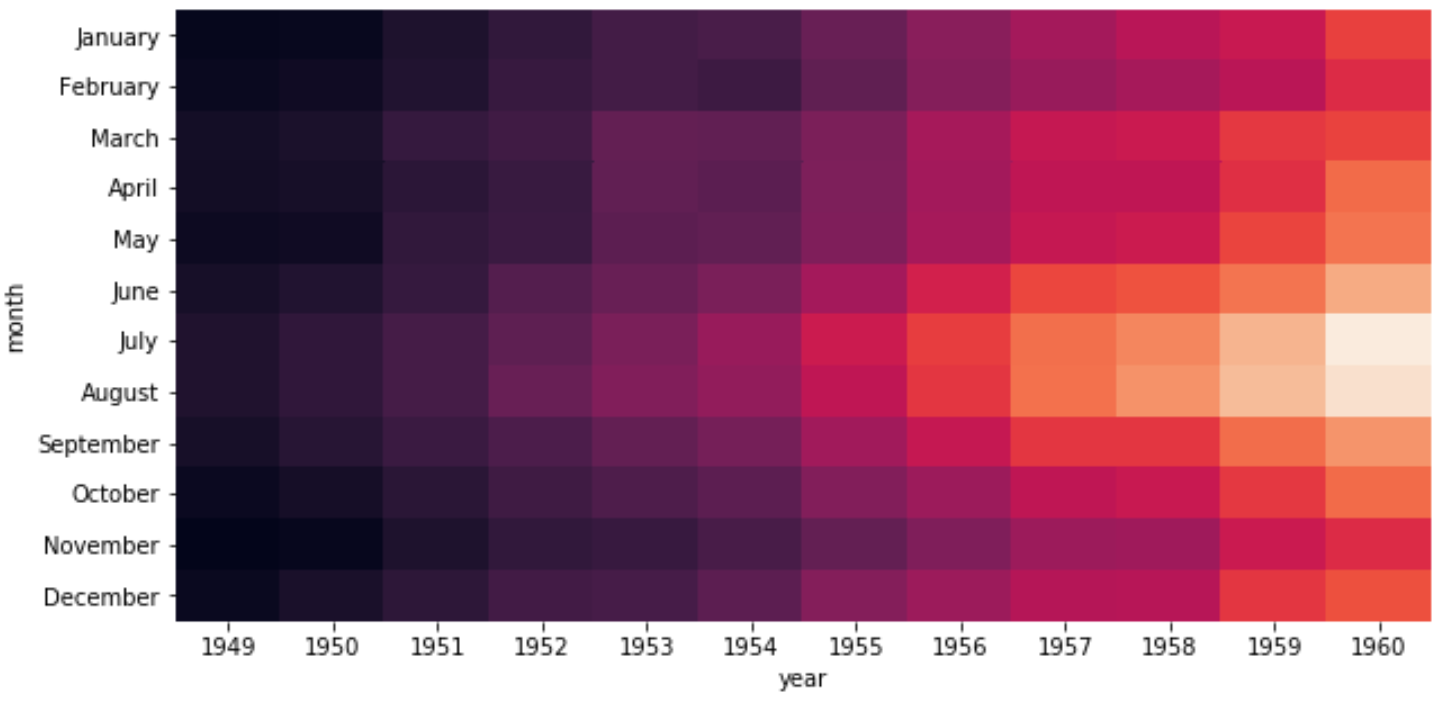
Le paramètre orientation='horizontal' transplante la barre d’échelle au bas de la figure, une disposition fréquemment privilégiée dans les rapports à format paysage ou les infographies à colonnage unique. L’adjonction d’un intitulé formel via la clé label permet de nommer explicitement la grandeur mesurée ainsi que ses unités physiques, répondant ainsi à une exigence incontournable de la communication scientifique. Le paramètre pad calibre la distance d’écartement entre l’axe thermique principal et la légende latérale, évitant tout empiétement sur les étiquettes de graduation, tandis que shrink module le ratio de longueur globale de la barre pour préserver un équilibre proportionnel harmonieux.
Dans certaines architectures graphiques complexes — par exemple lors de l’assemblage de panneaux multipfigures (small multiples) régis par une échelle globale partagée —, il devient méthodologiquement impératif de supprimer les redondances visuelles. La simple déclaration cbar=False désactive intégralement la production de la barre d’échelle sur les sous-graphiques secondaires, libérant un espace visuel précieux au profit de la lisibilité des cellules matricielles.
10.3 Technique de masquage sélectif avec le paramètre mask
L’analyse des matrices de corrélation ou des réseaux de connectivité symétriques révèle une inefficience sémiotique structurelle : la duplication parfaite de l’information de part et d’autre de la diagonale principale ($M_{ij} = M_{ji}$). Présenter simultanément le triangle supérieur et le triangle inférieur d’une telle matrice double inutilement la charge cognitive imposée à l’observateur sans apporter la moindre plus-value analytique, tout en consacrant la diagonale ($M_{ii} = 1$) à une répétition monotone de valeurs triviales.
Pour éliminer cette redondance, Seaborn intègre le paramètre de masquage mask, lequel accepte une matrice de valeurs booléennes aux dimensions identiques à celles du jeu de données. Dès lors qu’une cellule est associée à l’état booléen True au sein du masque, elle est purement et simplement exclue du processus de restitution graphique, demeurant transparente et laissant transparaître le fond neutre du canevas.
L’élaboration élégante de ce filtre matriciel s’effectue en couplant Seaborn aux primitives d’algèbre triangulaire de NumPy. La combinaison de np.triu() (extraction du triangle supérieur) ou de np.tril() (extraction du triangle inférieur) avec la matrice des corrélations génère en une ligne de code le masque booléen d’exclusion optimal :
masque = np.triu(np.ones_like(matrice_corr, dtype=bool))
En transmettant ce masque à l’appel sns.heatmap(matrice_corr, mask=masque, ...), l’analyste épure instantanément la visualisation en ne conservant que le triangle inférieur non redondant. Au-delà de la simplification des matrices symétriques, cette technique s’avère particulièrement précieuse pour occulter sélectivement les cellules dont la significativité statistique n’est pas avérée (par exemple en masquant systématiquement toute cellule dont la $p$-valeur associée est supérieure au seuil critique de $\alpha = 0.05$).
11. Extensions avancées : Classification hiérarchique avec sns.clustermap()
11.1 Principes du regroupement non supervisé appliqué aux cartes thermiques
Lorsque les dimensions d’une matrice deviennent substantielles, l’ordonnancement arbitraire des lignes et des colonnes (par exemple, par ordre alphabétique des noms de gènes ou ordre chronologique de collecte) tend à diluer les corrélations latentes et à masquer les structures relationnelles d’intérêt. La classification ascendante hiérarchique (CAH) adossée à la représentation thermique propose de réorganiser dynamiquement la séquence spatiale des vecteurs d’observation en fonction de leur proximité mathématique au sein de l’espace multidimensionnel.
Cette approche est encapsulée de manière unifiée dans la fonction sns.clustermap(). Contrairement à sns.heatmap() qui n’opère qu’un simple tracé de surface statique sur un objet Axes préétabli, clustermap() déploie une architecture computationnelle complète de classe ClusterGrid. Ce pipeline exécute une batterie d’algorithmes statistiques non supervisés en deux phases successives : d’abord le calcul d’une matrice de dissimilarité pairwise à l’aide d’une métrique géométrique (distance euclidienne, distance de Manhattan, corrélation de Pearson), puis l’agglomération itérative des vecteurs via un critère de liaison spécifique (méthode de Ward, saut moyen, saut complet).
Les rangées et les colonnes de la matrice d’origine font ainsi l’objet d’une permutation spatiale rigoureuse visant à juxtaposer les entités présentant les profils statistiques les plus homologues. Ce réordonnancement fait instantanément émerger à l’œil nu des macro-blocs homogènes (biclusters), révélant des synexpressions géniques en biologie moléculaire, des typologies de consommateurs cohérentes en analyse marketing ou des sous-groupes nosologiques homogènes en recherche épidémiologique.
11.2 Intégration et lecture des dendrogrammes
La manifestation visuelle la plus manifeste de la classification ascendante réside dans l’adjonction de dendrogrammes arborescents le long des bordures externes de la carte matricielle. Ces arbres phylogénétiques ou taxinomiques schématisent fidèlement la trajectoire des fusions successives opérées par l’algorithme d’agglomération. La longueur axiale de chaque embranchement (ou branchement) quantifie avec précision la distance mathématique séparant deux grappes au moment de leur réunion : une branche longue signale une hétérogénéité prononcée, tandis que des embranchements resserrés traduisent une similarité fonctionnelle étroite.
L’exploitation rigoureuse de sns.clustermap() exige fréquemment la normalisation préalable des signaux statistiques afin d’éviter qu’une variable pourvue d’une variance intrinsèque colossale ne domine unilatéralement le calcul des distances spatiales. La fonction met à disposition deux arguments de pré-calibrage d’une efficience remarquable : standard_scale (qui rééchelonne les variables sur un intervalle unitaire $[0, 1]$ le long de l’axe désigné) et z_score (qui soustrait la moyenne et divise par l’écart-type le long des lignes ou des colonnes). L’activation de z_score=0 standardise par exemple chaque ligne de manière autonome, permettant de comparer directement les profils de régulation de variables dont les échelles absolues diffèrent de plusieurs ordres de grandeur.
Pour enrichir la sémiotique du graphique, des métadonnées qualitatives supplémentaires peuvent être injectées sous la forme de barres de coloration latérale via les arguments row_colors et col_colors. Cette technique consiste à adosser aux marges du dendrogramme des rubans chromatiques discrets codant pour des facteurs expérimentaux indépendants (par exemple, le phénotype tumoral, le laboratoire d’origine de l’échantillon ou le groupe de traitement). L’observateur peut ainsi confronter d’un regard la classification non supervisée purement géométrique issue de l’arbre dendrogrammique avec la distribution réelle des étiquettes cliniques répertoriées.
11.3 Optimisation des performances sur les grands ensembles de données
L’emploi de la classification hiérarchique impose un coût computationnel exponentiel qui ne doit pas être négligé lors du traitement de volumétries massives. L’algorithme standard d’agglomération présente une complexité spatiale et temporelle asymptotique en $\mathcal{O}(n^2)$ voire $\mathcal{O}(n^3)$, où $n$ désigne le nombre de vecteurs à comparer. Confrontée à des matrices comprenant plusieurs dizaines de milliers de lignes et de colonnes, l’exécution aveugle de sns.clustermap() engendre une consommation de mémoire vive saturante et peut bloquer l’interpréteur Python lors de la résolution du graphe de liaison.
Pour contenir cette surcharge algorithmique, plusieurs démarches d’optimisation s’imposent :
- Le filtrage préalable par variance : Éliminer en amont les variables ou entités dont la variance globale est proche de zéro. Ces caractéristiques plates n’apportent aucun pouvoir séparateur à la classification mais grèvent lourdement les matrices de covariance.
- Le pré-calcul externalisé via SciPy : Réaliser le calcul de liaison matricielle de manière anticipée à l’aide des routines compilées en C et Fortran de
scipy.cluster.hierarchy.linkage(), puis transmettre les matrices de liaison résultantes directement aux paramètresrow_linkageetcol_linkagede Seaborn. - La désactivation sélective des dendrogrammes : Lorsque l’analyse ne nécessite qu’un regroupement unidirectionnel, désactiver la classification sur l’axe orthogonal via l’affectation
col_cluster=Falseourow_cluster=Falsepour diviser par deux le coût de résolution des arbres.
Dans les configurations extrêmes relevant du Big Data, le recours à des algorithmes de partitionnement linéaire non hiérarchiques (à l’instar des k-moyennes ou de MiniBatchKMeans) pour réduire au préalable les données à des centroïdes archétypaux constitue la stratégie la plus pérenne avant toute tentative de restitution graphique matricielle.
12. Études de cas empiriques, diagnostics d’erreurs et bonnes pratiques de publication
12.1 Cas pratique complet : Analyse matricielle d’un jeu de données psychométriques
Pour consolider l’ensemble des concepts théoriques et syntaxiques disséqués jusqu’ici, concevons de bout en bout un pipeline de restitution graphique répondant aux plus stricts critères éditoriaux d’une revue académique à comité de lecture. Considérons un jeu de données psychométriques empirique dans lequel une cohorte d’individus a été évaluée sur dix indicateurs standardisés de la personnalité (modèle du Big Five étendu : Extraversion, Névrosisme, Agréabilité, Conscienciosité, Ouverture, etc.).
Le script débute par l’importation déterministe des modules requis, la simulation contrôlée du jeu d’échantillons avec initialisation d’une graine aléatoire, et la conversion du tableau en matrice de corrélations de Spearman (indispensable face à d’éventuelles liaisons ordinales non strictement linéaires) :
Dans cette séquence, la matrice des coefficients est calculée via la commande interne df.corr(method='spearman') de Pandas. Pour préserver l’intégrité de la figure, un masque triangulaire supérieur strict est généré au moyen de l’instruction np.triu(np.ones_like(corr, dtype=bool)). La figure de base est dimensionnée rigoureusement à des proportions de dix par huit pouces, garantissant un espacement aéré des cellules polygonales.
L’appel à Seaborn est configuré avec un niveau d’exigence éditoriale maximal :
- L’argument
cmap='vlag'injecte une palette divergente perceptuellement uniforme dont les propriétés de luminance sont rigoureusement symétriques. - Les bornes
vmin=-1.0etvmax=1.0, couplées àcenter=0.0, établissent un calibrage mathématique absolu des corrélations. - Le masquage
mask=masqueélimine toute redondance au-dessus de la diagonale principale. - L’argument
square=Trueverrouille la morphologie des cellules en carrés parfaits. - Les séparateurs
linewidths=1.2etlinecolor='white'découpent la matrice avec une netteté cristalline. - Les annotations
annot=True, formatées avecfmt='.2f'et gouvernées parannot_kws={'size': 9, 'weight': 'medium'}, incrustent les valeurs numériques sans agressivité visuelle.
L’enrichissement typographique final est opéré directement via l’objet Axes retourné : adjonction d’un titre scientifique explicite spécifiant la méthode inférentielle employée (Spearman $rho$), rotation des étiquettes d’axes pour fluidifier la lecture séquentielle, et élimination des graduations parasites. La sauvegarde s’opère enfin à l’aide de la commande plt.savefig('matrice_psychometrique.pdf', dpi=300, bbox_inches='tight'), générant un document vectoriel haute définition au standard PDF/X prêt pour l’intégration typographique sous LaTeX.
12.2 Diagnostic et résolution des erreurs d’implémentation fréquentes
La mise en œuvre quotidienne des heatmaps Seaborn se heurte fréquemment à une série d’anomalies d’exécution récurrentes dont l’origine découle d’une mécompréhension des liaisons structurelles unissant Pandas, NumPy et Matplotlib. L’analyste averti doit savoir diagnostiquer promptement ces dysfonctionnements.
L’erreur la plus emblématique se matérialise par l’exception bloquante :
ValueError: could not convert string to float: 'valeur'
Cette interruption critique survient invariablement lorsqu’une matrice brute transmise à sns.heatmap() contient une ou plusieurs colonnes dont le type de données (dtype) interne sous Pandas est object ou string. Seaborn exige que chaque cellule soit coercible en un scalaire flottant pour pouvoir en déduire son affectation chromatique. La résolution impose de purger les descripteurs nominaux superflus, d’isoler les identifiants catégoriels dans l’index de ligne via df.set_index('identifiant'), ou de contraindre le transtypage des colonnes quantitatives à l’aide de pd.to_numeric().
Une seconde anomalie visuelle, historiquement célèbre dans les versions de Matplotlib 3.1.1, réside dans le phénomène de troncature marginale des cellules extrêmes : la première et la dernière rangée de la carte thermique se trouvent tronquées à mi-hauteur, leurs étiquettes d’axes apparaissant à demi avalées par le cadre du canevas. Ce dysfonctionnement trouve sa source dans un calcul erroné des limites spatiales (ylim) de l’axe par Matplotlib. La remédiation logicielle s’opère en réinitialisant manuellement les bornes de projection à l’aide de l’instruction corrective :
plt.ylim(len(matrice), 0)
Enfin, le conflit récurrent de recouvrement de texte entre les graduations d’axes contiguës provient généralement d’une densité excessive de labels nominaux. Lorsque l’axe temporel comprend des centaines de pas discrets (par exemple des relevés journaliers sur plusieurs décennies), vouloir afficher chaque étiquette constitue un non-sens graphique. L’utilisation du paramètre xticklabels=10 dans l’appel Seaborn force le moteur à n’imprimer qu’une graduation toutes les dix unités, aérant drastiquement le cadre spatial tout en préservant l’intégralité du continuum de données au sein du corps du maillage thermique.
12.3 Recommandations éthiques et éditoriales pour les publications scientifiques
L’élaboration d’une visualisation matricielle engage directement la responsabilité déontologique de l’analyste de données. La puissance évocatrice des cartes thermiques en fait un instrument particulièrement vulnérable aux manipulations rhétoriques et aux distorsions interprétatives involontaires. Le respect de directives éthiques et éditoriales strictes conditionne la reproductibilité et la probité des conclusions soumises à la communauté scientifique.
En premier lieu, la sélection de la palette de couleurs ne doit jamais être dictée par des impératifs décoratifs ou des préférences subjectives. L’usage de gradients non uniformes ou tronqués dans le but délibéré d’exagérer des contrastes locaux marginaux relève de la fraude sémiotique. La légende colorimétrique doit impérativement afficher l’intégralité de la fonction de correspondance sans rupture de pente artificielle. Lorsqu’une normalisation mathématique préalable (telle qu’une transformation logarithmique, un centrage-réduction ou un écrêtage de percentiles) est appliquée à l’échantillon brut, cette intervention méthodologique doit être mentionnée sans équivoque tant dans le corps du texte que dans la légende accompagnant formellement la figure.
En second lieu, la reproductibilité de la figure doit être garantie par la mise à disposition conjointe du code source d’orchestration graphique et de la matrice matricielle tabulée finale. Une carte thermique isolée de ses valeurs numériques sous-jacentes demeure invérifiable. L’adjonction systématique d’une graine déterministe (random seed) lors de tout tirage d’échantillonnage, la documentation formelle des versions logicielles de Seaborn et Matplotlib exploitées, et l’archivage pérenne des scripts d’analyse sur des dépôts ouverts certifiés constituent les piliers d’une communication graphique scientifique intègre et pérenne.
Références
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (pp. 56-61). https://doi.org/10.25080/Majora-92bf1924-00a
- Moreland, K. (2009). Diverging color maps for scientific visualization. In Advances in Visual Computing (pp. 92-103). Springer, Berlin, Heidelberg. https://doi.org/10.1007/978-3-642-10520-3_9
- Nuñez, J. R., Anderton, C. R., & Renslow, R. S. (2018). Optimizing colormaps with recognition of color vision deficiency to improve scientific communication. PLOS ONE, 13(7), e0199239. https://doi.org/10.1371/journal.pone.0199239
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- van der Walt, S., Colbert, S. C., & Varoquaux, G. (2011). The NumPy array: A structure for efficient numerical computation. Computing in Science & Engineering, 13(2), 22-30. https://doi.org/10.1109/MCSE.2011.37
- Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wilkinson, L., & Friendly, M. (2009). The history of the cluster heat map. The American Statistician, 63(2), 179-184. https://doi.org/10.1198/tas.2009.0033