
La sémiologie graphique contemporaine et l’analyse exploratoire de données occupent une position névralgique dans l’édifice de la démarche scientifique moderne. Au sein de cet écosystème où la prolifération des données massives impose des exigences d’intelligibilité toujours plus rigoureuses, le diagramme en barres demeure l’une des constructions visuelles les plus universellement déployées. Pourtant, sous une apparente simplicité géométrique se dissimulent des enjeux méthodologiques fondamentaux touchant à la réduction dimensionnelle, à l’estimation statistique de la tendance centrale et à la communication de l’incertitude. La conversion d’un agrégat de mesures empiriques en un ensemble discret de hauteurs ou de longueurs vectorielles requiert une vigilance épistémologique constante, sous peine d’induire des distorsions cognitives majeures auprès des pairs ou des décideurs.
L’émergence d’environnements computationnels de haut niveau a profondément métamorphosé cette pratique graphique. Dans l’écosystème du langage Python, la bibliothèque Seaborn, conçue par Michael Waskom, s’est imposée comme la référence paradigmatique pour la visualisation statistique descriptive et inférentielle. Érigée sur les fondations programmatiques de Matplotlib et intimement articulée autour de la structure tabulaire de Pandas, Seaborn ne se limite pas à un simple rôle d’ornementation esthétique. La bibliothèque matérialise une couche d’abstraction supérieure qui unifie l’analyse statistique et l’encodage visuel, automatisant des calculs d’agrégation et des estimations d’intervalles de confiance par rééchantillonnage que le chercheur devait autrefois implémenter manuellement.
Cet ouvrage didactique et monographique a pour dessein d’explorer de manière exhaustive l’ingénierie et l’interprétation des diagrammes en barres au moyen de Seaborn. Depuis les fondements de la perception visuelle théorisés par Jacques Bertin et William Cleveland jusqu’aux subtilités d’implémentation de la fonction maîtresse *sns.barplot()*, chaque section se propose de déconstruire les mécanismes sous-jacents aux représentations catégorielles. À travers une analyse théorique, mathématique et programmatique approfondie, ce guide fournira aux statisticiens, chercheurs en sciences comportementales et praticiens de la science des données les clés nécessaires pour concevoir des visualisations conformes aux normes académiques internationales les plus strictes.
1. Fondements théoriques des diagrammes en barres dans l’analyse de données
1.1 Définition et rôle sémiotique du barplot
Le diagramme en barres, communément désigné sous l’anglicisme barplot, constitue une représentation graphique bidimensionnelle assignant des grandeurs quantitatives à des modalités qualitatives discrètes. D’un point de vue sémiotique, tel que défini originellement par Jacques Bertin dans sa Sémiologie Graphique, ce type de figure exploite la variable visuelle de longueur ou de position le long d’une échelle commune non alignée pour transmettre l’information relative à une grandeur statistique. Il est méthodologiquement impératif de distinguer rigoureusement le diagramme en barres de l’histogramme. Alors que l’histogramme partitionne une variable quantitative continue en intervalles de classes contigus pour approcher une densité de probabilité sous-jacente, le barplot opère sur des catégories nominales ou ordinales intrinsèquement disjointes, séparées par des espaces vides traduisant l’absence de continuité topologique.
La fonction première du barplot réside dans l’agrégation de sous-populations. Contrairement à un nuage de points qui maintient l’intégrité granulaire de chaque unité statistique élémentaire, le barplot condense l’information en associant à chaque niveau d’un facteur une mesure synthétique, le plus souvent une moyenne arithmétique ou une médiane, augmentée d’un indice de dispersion. Cette abstraction visuelle facilite la comparaison instantanée des contrastes expérimentaux en minimisant la charge cognitive de l’observateur. Dans la hiérarchie des tâches perceptives graphiques formalisée par William S. Cleveland et Robert McGill, le jugement de position sur une échelle commune figure au sommet de la précision cognitive, conférant au barplot une efficacité communicative substantiellement supérieure aux diagrammes circulaires ou aux cartographies thermiques pour la discrimination des amplitudes moyennes.
1.2 L’écosystème Seaborn au sein de Python
Dans l’architecture computationnelle de la science des données en langage Python, Seaborn occupe une position charnière, agissant comme une interface d’intermédiation conceptuelle entre la bibliothèque d’infrastructure graphique élémentaire Matplotlib et la structure d’analyse matricielle et tabulaire fournie par Pandas. Alors que Matplotlib impose à l’utilisateur de spécifier impérativement chaque primitive géométrique — des coordonnées cartésiennes des polygones rectangulaires jusqu’à la boucle explicite d’itération sur les groupes —, Seaborn propose une approche déclarative orientée vers l’analyse statistique exploratoire. L’analyste ne déclare plus comment dessiner un rectangle, mais spécifie quelle relation variable-à-variable doit être matérialisée à l’écran.
L’apport décisif de Seaborn réside dans l’intégration native des processus d’inférence au cœur même du pipeline de rendu visuel. Lorsque l’instruction graphique est invoquée, la bibliothèque exécute en coulisses le partitionnement des données selon les facteurs désignés, procède à l’évaluation numérique de la fonction d’agrégation requise, calcule les distributions d’incertitude par des méthodes asymptotiques ou non paramétriques, et applique des harmonies colorimétriques scientifiquement étalonnées. Ce paradigme réduit drastiquement les risques d’incohérences computationnelles entre le calcul de l’estimateur et son inscription spatiale, tout en offrant une passerelle transparente vers les objets de bas niveau de Matplotlib pour d’éventuelles retouches typographiques ou structurelles ultérieures.
1.3 Pertinence méthodologique en sciences quantitatives et comportementales
Au sein des sciences quantitatives, incluant la psychologie expérimentale, l’épidémiologie, la biométrie et l’économétrie appliquée, le barplot demeure la figure prédominante pour illustrer les résultats issus de plans factoriels et d’analyses de variance (ANOVA). Il permet de juxtaposer de manière hautement lisible les performances d’un groupe contrôle face à diverses conditions de traitement, rendant immédiatement perceptibles les contrastes d’hypothèses principales ainsi que les éventuelles interactions d’ordre supérieur. Cette ubiquité s’explique par sa capacité à condenser en un espace graphique restreint l’espérance mathématique conditionnelle d’une variable réponse dépendante liée à des facteurs contrôlés.
Néanmoins, cette concision représentative impose de sérieuses limites méthodologiques que la communauté scientifique contemporaine a largement mises en lumière. En occultant la forme exacte de la distribution empirique — qu’elle soit symétrique, bimodale, uniformément étalée ou polluée par des valeurs aberrantes —, le barplot peut masquer des réalités distributionnelles totalement divergentes sous une hauteur de barre identique. Deux groupes présentant rigoureusement la même moyenne empirique et le même intervalle de confiance peuvent découler, dans un cas, d’une distribution gaussienne homogène et, dans l’autre, d’une distribution polarisée avec des sous-groupes latents. Dès lors, l’emploi du diagramme en barres doit s’accompagner d’une rigueur d’estimation irréprochable et, dans la mesure du possible, de techniques de superposition de données brutes pour garantir l’honnêteté intellectuelle de la communication scientifique.
2. Configuration de l’environnement de développement et préparation des données
2.1 Installation et importation des bibliothèques nécessaires
L’implémentation rigoureuse d’un protocole de visualisation sous Python requiert la mise en place d’un environnement d’exécution reproductible. L’installation des bibliothèques s’effectue traditionnellement par le gestionnaire de paquets officiel pip ou au sein d’environnements isolés gérés par conda. Les dépendances cardinales pour la génération de diagrammes statistiques comprennent la bibliothèque Seaborn, le module pyplot de Matplotlib pour le pilotage de la figure et des axes, Pandas pour l’ingénierie des données tabulaires, ainsi que NumPy pour le calcul vectoriel et matriciel sous-jacent. Il est recommandé de consigner explicitement les versions logicielles dans un fichier de dépendances afin de prémunir les scripts contre d’éventuelles dépréciations fonctionnelles.
Une fois l’interpréteur Python initialisé, l’importation de ces modules s’articule autour des conventions de nommage canoniques de la communauté scientifique, à savoir l’assignation des alias standardisés sns pour Seaborn, plt pour Matplotlib Pyplot, pd pour Pandas et np pour NumPy. Immédiatement consécutivement aux déclarations d’importation, la configuration globale de l’environnement graphique via la commande sns.set_theme() permet d’homogénéiser la typographie, la taille relative des polices, le contraste des lignes d’axes et la colorimétrie générale de la session. Cette initialisation programmatique évite les disparités stylistiques au sein des rapports de recherche et garantit que chaque figure générée partagera une charte esthétique cohérente et conforme aux exigences éditoriales modernes.
2.2 Chargement et inspection structurelle du jeu de données
Pour illustrer de manière reproductible l’ensemble des concepts déployés dans cette étude, le jeu de données internationalement reconnu tips sera privilégié comme banc d’essai empirique. Accessible directement via la fonction de chargement intégrée sns.load_dataset(‘tips’), ce jeu de données consigne les pourboires perçus par un serveur dans un établissement de restauration américain au cours de plusieurs dizaines de services consécutifs. Il présente une structure multidimensionnelle particulièrement adaptée à l’apprentissage statistique, combinant des variables numériques continues, telles que le montant total de l’addition et la valeur absolue du pourboire, à des variables qualitatives nominales et ordinales, telles que le sexe du payeur, son statut de fumeur, le jour de la semaine, le créneau de service et la taille de la tablée.
Dès l’ingestion de la structure de données dans un objet de type DataFrame Pandas, une phase d’audit structural et d’analyse exploratoire élémentaire est indispensable. L’application des méthodes d’inspection comme info() et describe() permet de s’assurer de l’absence de valeurs manquantes (valeurs nulles ou non assignées), de valider le typage catégoriel formel des variables de partitionnement et d’évaluer la dispersion marginale des variables dépendantes. La détection préalable d’éventuelles anomalies d’encodage évite toute distorsion algorithmique lors de l’exécution des fonctions d’estimation automatique de Seaborn, assurant ainsi la parfaite validité interne des tracés graphiques subséquents.
2.3 Principes des données au format long (Tidy Data)
L’architecture interne de Seaborn a été spécifiquement conceptualisée pour interagir de façon symbiotique avec le paradigme des données bien rangées, ou Tidy Data, formalisé par le statisticien Hadley Wickham. Dans ce standard organisationnel rigoureux, trois règles fondamentales prévalent : chaque variable observée doit résider dans sa propre colonne dédiée, chaque observation individuelle ou unité expérimentale doit occuper une ligne unique, et chaque type d’unité d’observation doit former une table distincte. Cette conformation s’oppose formellement au format large, dans lequel différentes colonnes représentent en réalité de multiples occurrences temporelles ou expérimentales de la même variable dépendante.
Lorsque les données sources se présentent sous une forme matricielle non normalisée, l’utilisation préalable des opérateurs de restructuration de Pandas, et singulièrement de la fonction melt(), s’avère incontournable. Cette méthode permet de dépivoter les colonnes superflues afin de regrouper les identifiants de facteurs dans une colonne de modalité unique et les scores correspondants dans une colonne de valeurs homogènes. La syntaxe native de Seaborn repose intégralement sur ce découplage fonctionnel : assigner des noms de colonnes textuels aux arguments cartésiens d’abscisse et d’ordonnée présuppose que chaque colonne constitue une série univoque. Cette harmonisation structurelle simplifie considérablement la maintenance du code et permet l’adjonction ultérieure de facteurs de nuance sans nécessiter de réécriture complexe du script de transformation.
3. Construction d’un barplot univarié élémentaire avec Seaborn
3.1 Syntaxe canonique de la fonction sns.barplot()
La génération d’un diagramme en barres élémentaire via Seaborn repose sur l’appel à la fonction sns.barplot(). Dans son implémentation canonique contemporaine, cette fonction requiert la spécification explicite de trois composantes structurelles majeures : le paramètre data, qui reçoit la référence vers le DataFrame Pandas sous-jacent, le paramètre x, qui désigne la variable catégorielle indépendante destinée à structurer les abscisses, et le paramètre y, qui définit la variable quantitative continue dont on souhaite quantifier l’amplitude sur l’axe vertical des ordonnées.
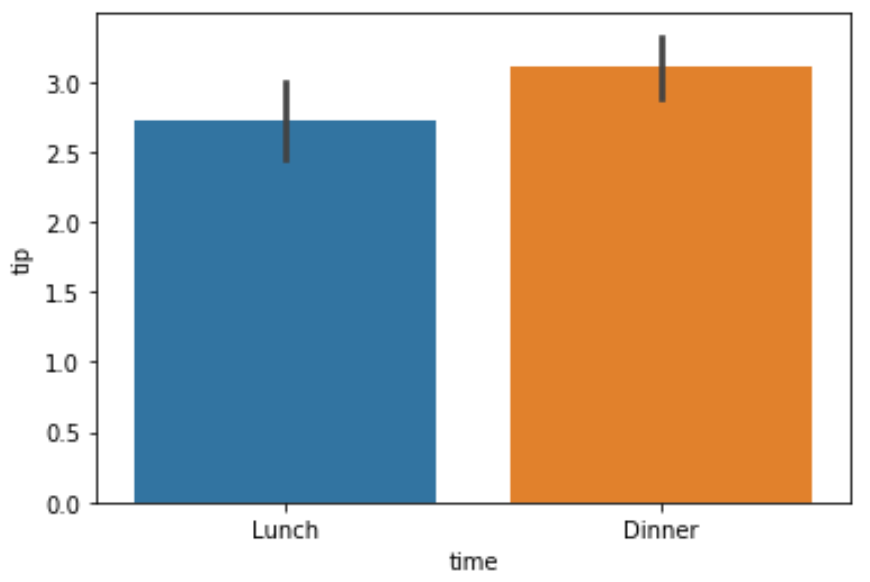
À titre d’illustration méthodologique, la confrontation entre le moment de la journée, matérialisé par la variable catégorielle binaire time comprenant les modalités du déjeuner et du dîner, et la variable métrique du pourboire, dénommée tip, s’exécute par une instruction programmatique compacte. Par défaut, Seaborn intercepte la variable continue, partitionne l’échantillon global en deux sous-ensembles conditionnés par les modalités du créneau horaire, applique de manière autonome l’estimateur de la moyenne arithmétique sur chaque strate, et transcrit graphiquement cette valeur sous forme de deux barres verticales dont la base est ancrée à l’ordonnée zéro.
3.2 Interprétation statistique du tracé graphique par défaut
La lecture analytique de la figure ainsi générée doit s’effectuer à la lumière des mécanismes computationnels mobilisés de façon transparente par l’algorithme. La hauteur terminale de chaque rectangle plein n’est nullement une somme cumulative ou une simple valeur brute issue d’un enregistrement unique ; elle constitue un estimateur ponctuel paramétrique de la tendance centrale de la population sous-jacente, précisément la moyenne de l’échantillon pour chaque groupe observé. En observant la différence de niveau vertical entre la barre assignée au déjeuner et celle dédiée au dîner, l’observateur évalue visuellement la grandeur d’effet non standardisée séparant ces deux contextes temporels.
Simultanément, le sommet de chaque barre est surmonté d’un segment vertical sombre, souvent qualifié de moustache d’erreur. Dans les spécifications par défaut de Seaborn, ce segment n’illustre ni la variance d’échantillonnage simple ni l’écart-type descriptif des observations individuelles. Il s’agit d’un intervalle de confiance à 95 % obtenu par une procédure d’inférence non paramétrique de rééchantillonnage bootstrap. Ce segment communique visuellement la zone de plausibilité statistique dans laquelle l’espérance mathématique de la population a de fortes chances de résider, signalant immédiatement à l’analyste si la disparité observée entre les moyennes empiriques pourrait découler du simple aléa d’échantillonnage ou d’une véritable hétérogénéité structurelle.
3.3 Affichage et gestion de l’objet graphique Matplotlib
L’exécution d’une fonction de haut niveau dans Seaborn ne constitue pas une fin hermétique en soi, mais s’inscrit dans un continuum d’ingénierie logicielle géré par Matplotlib. La fonction sns.barplot() retourne systématiquement un objet de classe matplotlib.axes.Axes. Cet objet graphique contient l’intégralité des primitives vectorielles composant le système cartésien : les conteneurs de rectangles matérialisant les barres, les lignes de projection des barres d’erreur, les graduations majeures et mineures (les ticks) ainsi que les étiquettes textuelles des axes. L’affectation du résultat du tracé à une variable contextuelle, classiquement désignée par l’identifiant ax, confère un contrôle programmatique absolu sur l’ensemble de ces sous-éléments géométriques.
Dans un script d’exécution autonome en environnement terminal ou lors du déploiement d’un pipeline de production, la matérialisation de l’interface visuelle impose l’appel conclusif à la commande plt.show(), laquelle boucle le cycle de traitement de la boucle d’événements de l’interface graphique. Pour les impératifs de la publication académique, l’exportation de la figure vers un fichier externe s’effectue au moyen de la méthode plt.savefig(). Cette dernière autorise la spécification de formats vectoriels sans perte, tels que le format PDF ou SVG, ou de formats matriciels compressés à très haute densité de points par pouce, prévenant toute pixellisation lors de l’intégration dans des manuscrits scientifiques rédigés sous LaTeX.
4. Gestion rigoureuse des barres d’erreur et incertitude statistique
4.1 Évolution syntaxique : du paramètre ci au paramètre moderne errorbar
L’histoire du développement logiciel de Seaborn a été marquée par une révision architecturale majeure lors du passage de la branche v0.11 à la version moderne v0.12. Antérieurement à cette transition, le contrôle des barres d’erreur reposait sur le paramètre polymorphique ci, acronyme de confidence interval. Ce paramètre acceptait indifféremment des scalaires numériques définissant le niveau de couverture statistique souhaité — typiquement 95 pour désigner l’intervalle canonique —, la chaîne de caractères ‘sd’ pour basculer vers l’écart-type, ou la valeur booléenne None pour oblitérer totalement la représentation de l’incertitude. Cette surcharge sémantique générait des ambiguïtés méthodologiques et limitait l’expressivité de l’inférence graphique.
L’avènement de la version v0.12 a introduit une formalisation rigoureuse matérialisée par le nouveau paramètre unifié errorbar. Ce dernier adopte une grammaire paramétrique typée et modulaire, scindant clairement la nature de la métrique d’incertitude de son calibrage quantitatif. Les analystes opérant sur des bases de code modernes doivent impérativement abandonner l’usage du paramètre ci, désormais formellement déprécié, au profit des arguments structurés de errorbar. Cette standardisation garantit la pérennité des scripts d’analyse, prévient les avertissements d’exécution lors de l’intégration continue et offre une souplesse méthodologique sans précédent pour adapter l’affichage de l’incertitude aux conventions spécifiques de chaque discipline scientifique.
4.2 Estimation par rééchantillonnage bootstrap versus erreur standard
La compréhension intime des algorithmes d’estimation de l’incertitude constitue le socle d’une communication statistique éthique. Par défaut, la configuration errorbar=(‘ci’, 95) déploie un algorithme non paramétrique de rééchantillonnage avec remise, le bootstrap de Bradley Efron. L’algorithme tire itérativement des milliers de répliques synthétiques de l’échantillon d’origine, calcule l’estimateur de tendance centrale pour chaque réplique, et extrait les percentiles 2,5 % et 97,5 % de la distribution empirique ainsi construite. Cette méthodologie présente l’avantage majeur de ne postuler aucune hypothèse a priori quant à la normalité de la distribution de la population mère, capturant d’éventuelles asymétries dans la largeur relative des moustaches supérieure et inférieure.
À l’inverse, l’assignation de la directive errorbar=’se’ ordonne le calcul paramétrique de l’erreur standard de la moyenne arithmétique. Cette grandeur statistique, mathématiquement définie par le ratio de l’écart-type de l’échantillon sur la racine carrée de l’effectif total d’observations, modélise la dispersion théorique de la moyenne d’échantillonnage sous l’empire du théorème central limite. Enfin, l’instruction errorbar=’sd’ reporte directement l’écart-type de l’échantillon, cessant dès lors d’illustrer la précision de l’estimation de la moyenne pour informer le lecteur sur la variabilité intrinsèque des individus au sein du groupe considéré. Il incombe au chercheur de spécifier sans ambiguïté dans la légende textuelle de sa figure la nature exacte de la métrique reportée, ces grandeurs véhiculant des significations épistémologiques profondément divergentes.
4.3 Suppression et personnalisation visuelle des moustaches
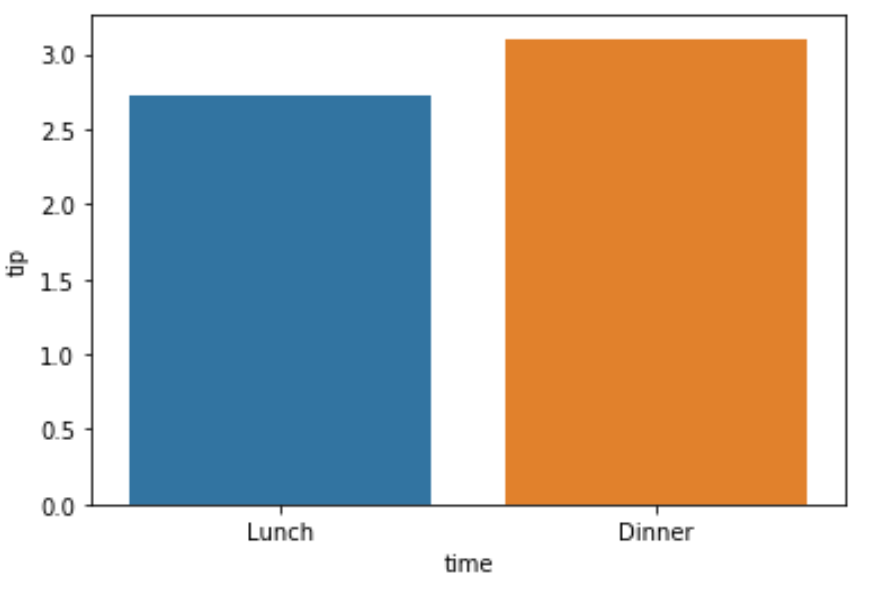
Dans certaines configurations spécifiques de présentation, notamment lorsque les effectifs d’échantillonnage sont tellement massifs que les intervalles d’incertitude deviennent indiscernables de la ligne supérieure de la barre, ou lorsque le barplot est purement employé à des fins comptables ou descriptives déterministes, il est souhaitable de supprimer les moustaches d’erreur. Cette épuration s’opère simplement en assignant la valeur nulle None au paramètre errorbar, aboutissant à une géométrie rectangulaire épurée sans appendices linéaires.
À l’opposé, lorsque le maintien des moustaches d’erreur est requis, leur stylisation géométrique peut être affinée afin d’en optimiser la lisibilité. L’introduction du paramètre capsize, prenant pour argument un nombre flottant désignant la largeur relative des terminaisons horizontales, ajoute des barres d’arrêt orthogonales au sommet et à la base de l’intervalle. Bien que parfois jugées superflues par les tenants du minimalisme graphique d’Edward Tufte, ces terminaisons s’avèrent précieuses pour lever toute ambiguïté sur les limites exactes de l’intervalle lors de superpositions chromatiques complexes. De surcroît, le dictionnaire d’arguments err_kws permet de moduler directement l’épaisseur du trait, la couleur d’encrage de l’incertitude ainsi que sa transparence optique, adaptant la sémiologie graphique aux normes de publication les plus pointues.
5. Ordonnancement méthodique et structuration des catégories
5.1 Hiérarchisation explicite des barres via l’argument order
Par défaut, Seaborn détermine la séquence séquentielle d’apparition des catégories le long de l’axe cartésien en se conformant scrupuleusement à l’ordre chronologique de leur première instanciation au sein du DataFrame Pandas fourni. Ce comportement empirique peut engendrer un agencement arbitraire et dénué de pertinence heuristique, nuisant à l’efficacité du transfert d’information vers le récepteur humain. Afin de maîtriser rigoureusement l’organisation de l’axe catégoriel, la fonction met à disposition l’argument formel order.
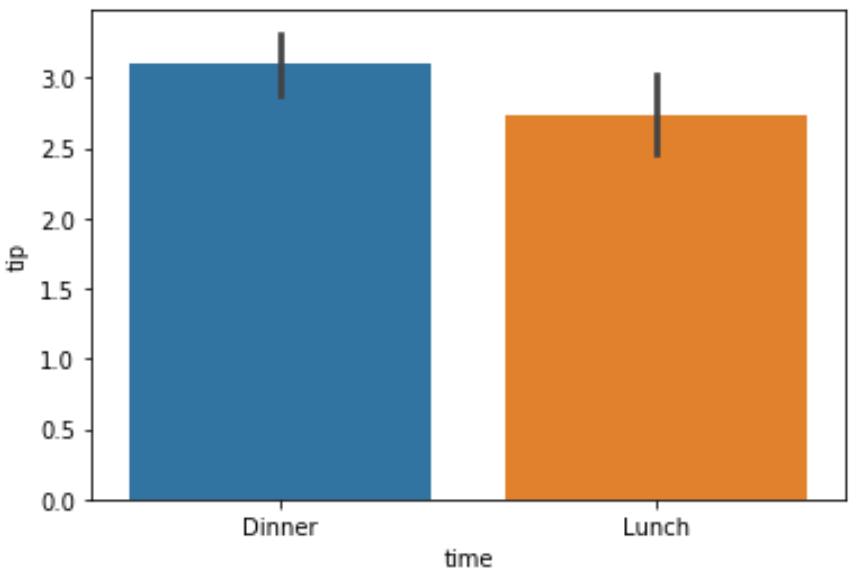
Le paramètre order reçoit une structure itérable de chaînes de caractères, typiquement une liste ordonnée contenant l’exacte graphie des modalités à tracer. À travers cette spécification, le praticien peut imposer une logique ordinale naturelle — par exemple en ordonnant les jours de la semaine du lundi au dimanche, ou les créneaux horaires selon la succession diurne —, garantissant que la lecture cognitive de gauche à droite s’harmonise avec les représentations chronologiques ou logiques implicites de l’observateur. Cette explicitation de l’ordre d’affichage immunise également les figures automatisées contre les variations accidentelles de disposition dues à un réarrangement fortuit des lignes dans les bases de données sources.
5.2 Tri dynamique fondé sur les grandeurs statistiques
Lorsque la variable de partitionnement relève d’une échelle nominale pure — telle qu’une nomenclature de spécialités professionnelles, de régions géographiques ou de catégories de produits —, il n’existe aucun ordre naturel intrinsèque pour guider la séquence des barres. Dans ce contexte, maintenir un affichage désordonné contraint l’œil de l’analyste à un balayage erratique pour repérer les catégories dominantes ou récessives. La bonne pratique méthodologique commande d’aligner dynamiquement l’ordre spatial des barres sur l’amplitude même de l’estimateur statistique tracé.
Cette orchestration s’accomplit par l’entremise des opérateurs d’agrégation tabulaire de Pandas. En appliquant consécutivement la méthode groupby() sur la variable catégorielle, en sélectionnant la variable dépendante continue, en extrayant sa moyenne arithmétique empirique, puis en chaînant la méthode sort_values(ascending=False), on isole la liste formelle des modalités rangées par ordre décroissant de performance. En injectant l’attribut d’index de cette série résultante directement au sein du paramètre order de Seaborn, le diagramme résultant présente une décroissance monotone des hauteurs de barres. Cet agencement transforme une figure descriptive basique en un puissant outil d’analyse parétienne, permettant d’identifier immédiatement la hiérarchie des grandeurs d’effet sans requérir d’effort cognitif d’ordonnancement mental.
5.3 Filtrage et sélection ciblée de sous-ensembles catégoriels
Une propriété particulièrement élégante du paramètre order réside dans sa capacité sous-jacente de filtrage opératoire. Si la liste passée en argument omet volontairement une ou plusieurs modalités présentes dans le jeu de données sous-jacent, Seaborn procède à l’exclusion silencieuse et sélective de ces catégories lors de la matérialisation graphique, sans qu’il soit nécessaire d’altérer la structure du DataFrame maître par des requêtes de sous-échantillonnage préalables.
Néanmoins, l’analyste doit appréhender avec discernement les implications statistiques de ce filtrage ciblé. L’éviction purement visuelle de certains groupes ne modifie en rien la distribution des groupes restants au sein d’un modèle d’analyse globale, mais elle redéfinit le cadre inférentiel offert au lecteur de la figure. D’autre part, si une modalité renseignée dans la liste order ne possède aucun enregistrement empirique dans les données filtrées, Seaborn allouera un espace vide sur l’axe cartésien sans générer d’erreur d’exécution, signalant visuellement l’absence totale d’observation dans cette condition spécifique d’expérience, ce qui s’avère précieux pour mettre en évidence des plans de collecte incomplets.
6. Analyse multivariée : Conception de barplots groupés avec hue
6.1 Introduction d’un deuxième facteur catégoriel via l’argument hue
L’investigation empirique dans les sciences contemporaines dépasse rarement le cadre univarié élémentaire pour se concentrer sur l’exploration de systèmes complexes régis par de multiples facteurs interactifs. L’architecture de Seaborn excelle dans cette transition multivariée grâce à l’incorporation de l’argument hue, littéralement la nuance chromatique. L’assignation d’une seconde variable catégorielle à ce paramètre modifie en profondeur la typologie du diagramme, opérant une partition croisée bidirectionnelle des observations.
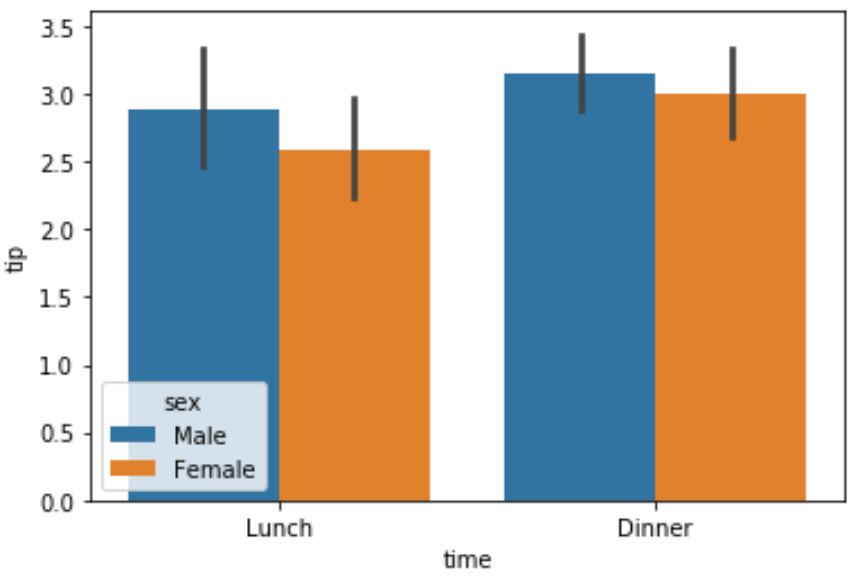
Dès lors que le paramètre hue est instancié, Seaborn segmente chaque modalité de l’axe principal en autant de sous-catégories qu’en contient le facteur de nuance. Graphiquement, cette décomposition se traduit par la juxtaposition étroite de barres adjacentes, différenciées par un encodage chromatique distinct. Cette disposition côte à côte permet d’évaluer simultanément l’effet principal du facteur d’axe, l’effet principal du facteur de couleur, et de détecter instantanément les effets d’interaction statistique : si l’écart entre les barres de couleur varie substantiellement d’une modalité d’abscisse à l’autre, l’analyste est en présence d’une non-parallélisme traduisant une interaction factorielle significative.
6.2 Contrôle de l’ordre et des catégories de la variable de nuance
À l’instar du contrôle exercé par l’argument order sur la disposition spatiale primaire, le paramètre hue_order confère une maîtrise absolue sur l’agencement séquentiel des sous-groupes chromatiques. Cet agencement est doublement déterminant : il régit la position géométrique relative des barres au sein de chaque cluster d’abscisse — par exemple en plaçant systématiquement la modalité féminine à gauche de la modalité masculine — et il fixe la séquence hiérarchique de présentation des éléments explicatifs au sein de la légende graphique.
Le contrôle rigide de hue_order est un impératif méthodologique lors de la conception de rapports multi-figures. En l’absence de spécification délibérée, une figure représentant une sous-population spécifique pourrait inverser involontairement l’ordre des couleurs si l’une des modalités est manquante au premier enregistrement, provoquant une dissonnance cognitive aiguë lors de la lecture comparée des planches graphiques. Par ailleurs, la fonction intègre l’argument booléen dodge. Calibré par défaut à True pour scinder spatialement les barres, le passage de dodge à False engendre la superposition directe des rectangles sur une abscisse partagée, une géométrie toutefois déconseillée dans le cas du barplot car les rectangles antérieurs peuvent totalement occulter les rectangles postérieurs d’amplitude moindre.
6.3 Personnalisation et positionnement de la légende statistique
L’introduction d’un facteur de nuance provoque l’apparition automatique d’une légende contextuelle, générée par Seaborn pour décoder l’association entre les teintes chromatiques et les modalités conceptuelles. Cependant, l’implantation par défaut de cette légende est fréquemment susceptible d’empiéter sur les surfaces encrées de données statistiques, occultant des barres d’erreur critiques ou comprimant excessivement l’espace utile du canevas cartésien.
Pour remédier à cette contrainte ergonomique, l’analyste doit mobiliser l’interface de contrôle des légendes de Matplotlib via la fonction plt.legend() ou la méthode ax.legend(). L’utilisation du paramètre bbox_to_anchor autorise l’expulsion maîtrisée de la boîte de légende en dehors des limites strictes de la boîte d’axes cartésienne, déplaçant par exemple les descripteurs vers la marge latérale droite du document. Conjointement, cette fonction permet de requalifier les étiquettes textuelles pour éliminer les abréviations cryptiques des bases de données brutes, d’épurer le titre de la légende pour lui substituer une nomenclature intelligible, ou de supprimer purement et simplement la légende lorsque l’encodage visuel est rendu trivial par le contexte éditorial.
7. Orientation spatiale et barplots horizontaux
7.1 Inversion des axes pour les diagrammes horizontaux
L’orientation orthogonale conventionnelle, érigeant les barres verticalement depuis l’axe des abscisses, ne constitue qu’une des déclinaisons projectives possibles du diagramme en barres. Seaborn permet une inversion bidirectionnelle immédiate par la simple permutation fonctionnelle de ses arguments de liaison cartésienne. Pour opérer le basculement d’un diagramme vertical classique vers une géométrie horizontale, il suffit d’assigner la variable continue métrique au paramètre x et la variable catégorielle factorielle au paramètre y.
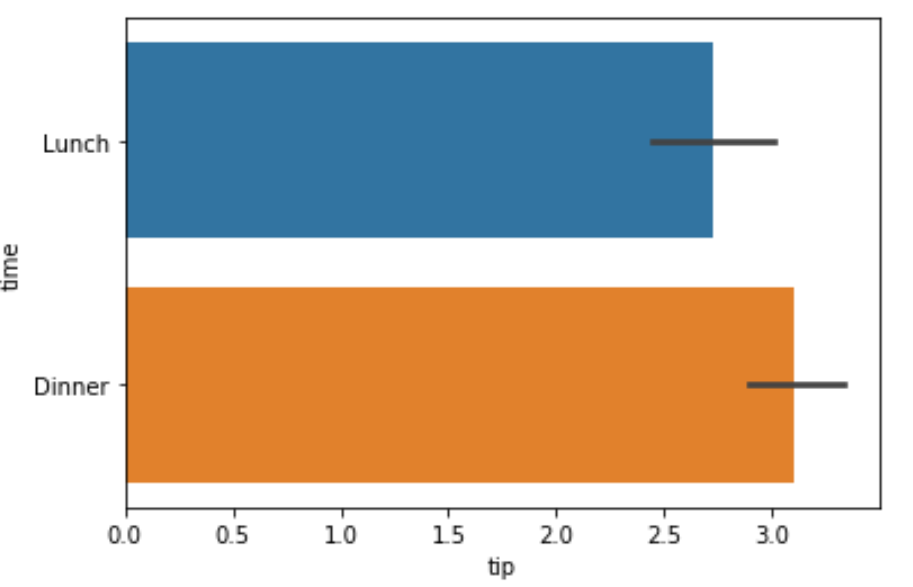
Le moteur d’inférence de Seaborn analyse dynamiquement les types de données transmis à chaque axe. Lorsqu’il identifie que l’axe vertical accueille une variable de type chaîne de caractères ou de type catégoriel Pandas, tandis que l’axe horizontal reçoit une distribution de nombres réels continus, il recalibre instantanément le tracé des primitives géométriques : les rectangles émergent désormais de l’axe vertical d’ordonnée zéro pour s’étirer horizontalement vers la droite, et les moustaches d’incertitude statistique basculent d’une orientation verticale à une projection purement horizontale.
7.2 Justifications ergonomiques pour les libellés catégoriels longs
Ce basculement d’orientation ne relève pas d’une simple fantaisie esthétique, mais s’enracine dans des impératifs d’ergonomie cognitive de la perception écrite. Dans un diagramme à barres verticales traditionnel, la présence de libellés catégoriels verbeux — fréquents dans les enquêtes d’opinion, les ontologies biomédicales ou les descriptions d’items psychométriques — engendre inévitablement des collisions spatiales entre les étiquettes adjacentes le long de l’axe horizontal. Les analystes tentent trop souvent de pallier cet écueil par une rotation angulaire des textes à quarante-cinq ou quatre-vingt-dix degrés, une pratique hautement délétère qui contraint le lecteur à une gymnastique posturale et ralentit considérablement la vitesse de déchiffrage cognitif.
L’adoption du barplot horizontal résout structurellement ce problème. En déportant les libellés textuels sur l’axe vertical gauche, le graphique s’aligne parfaitement sur le sens naturel de lecture de l’écriture occidentale, permettant l’intégration de longues phrases descriptives sans aucune inclinaison ni tronquage typographique. Le lecteur appréhende les désignations de facteurs de manière fluide avant de déplacer son regard vers la droite pour évaluer la magnitude respective des barres, optimisant ainsi la transmission de l’information statistique sans dégrader la densité textuelle requise pour une compréhension sans ambiguïté des modalités examinées.
7.3 Ajustement des proportions et des marges graphiques
L’exploitation de barplots horizontaux, en particulier lorsqu’ils intègrent un nombre substantiel de niveaux catégoriels — excédant couramment la quinzaine de modalités —, impose une gestion rigoureuse de la dimensionnalité globale du canevas graphique. La conservation des proportions par défaut de Matplotlib engendre inévitablement un écrasement vertical des barres, qui se transforment en minces bandelettes difficiles à discriminer visuellement, les moustaches d’erreur finissant par se chevaucher de façon anarchique.
L’instanciation préalable de la figure via la commande plt.subplots(figsize=(largeur, hauteur)) constitue la solution programmatique cardinale. Pour un barplot horizontal dense, il est hautement pertinent d’allouer une dimension verticale substantielle tout en contenant la largeur cartésienne, conférant à chaque rectangle une épaisseur physique adéquate pour supporter l’encodage chromatique et les annotations d’incertitude. Par ailleurs, l’analyste doit ajuster les paramètres de marge externe — notamment par la commande plt.tight_layout() ou par le paramétrage explicite de subplots_adjust() — afin d’éviter que les longues chaînes textuelles des étiquettes d’abscisse verticale ne soient tronquées lors de l’exportation finale de la composition graphique.
8. Fonctions d’agrégation personnalisées avec l’argument estimator
8.1 Remplacement de la moyenne par des estimateurs robustes
Le recours systématique et aveugle à la moyenne arithmétique comme fonction de réduction statistique constitue l’une des failles méthodologiques majeures de l’analyse exploratoire contemporaine. En tant qu’estimateur linéaire dépendant de l’ensemble des valeurs observées, la moyenne présente un point de rupture égal à zéro : la présence d’une unique observation hautement aberrante, consécutive par exemple à une erreur de transcription instrumentale ou à une dynamique distributionnelle à queue lourde, suffit à translater arbitrairement l’estimateur hors de la zone de densité centrale de l’échantillon.
Pour immuniser la représentation graphique contre ces distorsions dévastatrices, Seaborn met à disposition le paramètre formel estimator. En assignant à cet argument la fonction np.median issue du package NumPy, l’analyste substitue l’espérance arithmétique par la médiane de l’échantillon. Présentant un point de rupture de 50 %, la médiane offre une résistance remarquable aux valeurs extrêmes et capture la véritable tendance centrale des distributions asymétriques, telles que les distributions de revenus, de temps de survie cellulaire ou de montants de transactions financières, garantissant une intégrité descriptive nettement supérieure.
8.2 Implémentation d’estimateurs statistiques personnalisés
La puissance d’abstraction de Seaborn se déploie pleinement à travers la compatibilité universelle de son argument estimator avec n’importe quelle fonction vectorielle exécutable au sein de l’environnement Python. L’analyste n’est nullement restreint aux seules fonctions de réduction élémentaires intégrées dans la bibliothèque standard, mais peut injecter des fonctions sur mesure, des expressions anonymes de type lambda, ou des fonctions statistiques hautement élaborées issues du sous-module scipy.stats.
Parmi ces alternatives méthodologiques avancées, la moyenne tronquée (ou trimmed mean) occupe une place privilégiée. Cette métrique élimine systématiquement un pourcentage préétabli des quantiles extrêmes supérieurs et inférieurs de la distribution avant d’évaluer la moyenne de la masse centrale restante, réalisant une synthèse élégante entre la sensibilité statistique de la moyenne et l’invariance protectrice de la médiane. D’autres configurations autorisent l’utilisation d’estimateurs probabilistes plus complexes, comme l’évaluation de pourcentages d’atteinte de seuil ou de ratios de cotes, Seaborn se chargeant d’exécuter la fonction déclarée sur chaque sous-segment factoriel avec une parfaite rigueur computationnelle.
8.3 Cohérence entre estimateur ponctuel et calcul d’incertitude
L’altération de l’estimateur de tendance centrale au sein d’un diagramme en barres impose impérativement une reconsidération complète de la modélisation des barres d’erreur associées. Une incohérence méthodologique fréquemment relevée dans la littérature scientifique consiste à coupler un estimateur robuste non linéaire, tel que la médiane, avec une métrique d’incertitude paramétrique stricte présupposant une distribution gaussienne, comme l’erreur standard de la moyenne arithmétique.
Lorsque l’argument estimator est dérivé vers la médiane ou une moyenne robuste, la configuration par défaut du paramètre errorbar — déployant le bootstrap non paramétrique centré sur cet estimateur spécifique — démontre toute sa supériorité. Le rééchantillonnage algorithmique va calculer les quantiles de la distribution d’échantillonnage de la médiane elle-même, produisant un intervalle de confiance empirique rigoureusement harmonisé avec l’estimateur ponctuel tracé. Le chercheur doit faire preuve d’une vigilance intellectuelle intransigeante : coupler graphiquement une médiane à un écart-type paramétrique génère un artefact méthodologique trompeur, dépourvu de toute validité mathématique sous-jacente.
9. Esthétique visuelle, palettes chromatiques et conformité académique
9.1 Application de palettes de couleurs adaptées et accessibles
Le choix des teintes au sein d’une figure statistique transcende largement la dimension décorative pour s’inscrire dans une démarche rigoureuse d’accessibilité universelle et de fidélité cognitive. L’utilisation de contrastes chromatiques inappropriés ou de progressions lumineuses non uniformes peut biaiser l’appréciation quantitative du lecteur, voire exclure totalement les individus affectés de déficiences de la vision des couleurs, telles que le daltonisme sous ses formes deutéranope ou protanope.
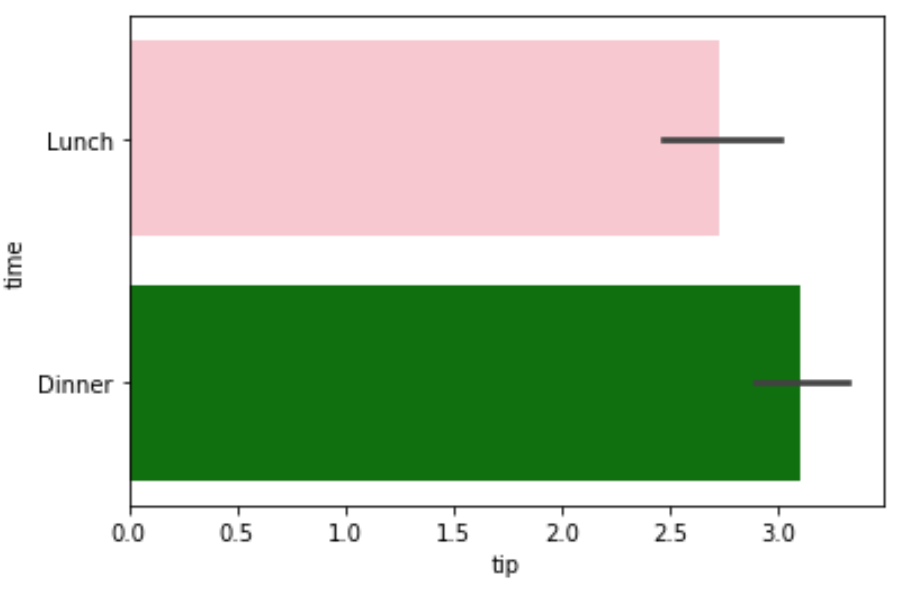
Seaborn propose une gestion sophistiquée des harmonies colorimétriques par l’intermédiaire du paramètre palette. Pour les ventilations purement catégorielles nominales, les palettes qualitatives universellement reconnues comme ‘deep’, ‘muted’ ou ‘colorblind’ garantissent une séparation perceptuelle équilibrée sans saturer excessivement l’espace visuel. Pour des contextes d’édition imprimée en noir et blanc, imposés par certaines revues internationales prestigieuses, l’application de dégradés séquentiels perceptuellement uniformes — à l’instar des échelles ‘viridis’, ‘mako’ ou d’une gamme de gris calibrée — s’impose pour préserver une discrimination parfaite des barres lors de la conversion photographique monochrome.
9.2 Gestion des contours, de la transparence et de la texture
L’optimisation du contraste entre les zones encrées et l’arrière-plan cartésien requiert un paramétrage minutieux de la géométrie de surface des barres. Le paramètre alpha, qui prend pour valeur un scalaire compris entre zéro et un, permet de réguler l’opacité des aplats de couleur. Une opacité légèrement atténuée, calibrée par exemple aux alentours de 0,85, s’avère particulièrement judicieuse pour adoucir les compositions massives tout en autorisant la perception d’éléments d’arrière-plan contextuels ou de trames de grille sous-jacentes.
Conjointement, l’adjonction de contours périphériques nets délimite rigoureusement l’enveloppe spatiale de chaque modalité. L’instanciation des paramètres edgecolor (définissant la couleur du contour) et linewidth (régissant l’épaisseur du trait vectoriel) permet de ceinturer les barres d’un liséré sombre et précis. Cette séparation linéaire empêche la fusion optique de barres adjacentes partageant des valeurs de luminance proches, un atout précieux lors des présentations magistrales sur écran de projection ou sur des supports d’affichage de type poster de congrès où la résolution optique peut être dégradée par l’environnement d’observation.
9.3 Stylisation de l’arrière-plan et de la grille contextuelle
Le conditionnement visuel de l’environnement spatial dans lequel s’insèrent les barres conditionne directement l’aisance avec laquelle l’observateur projette mentalement la hauteur des rectangles vers les graduations numériques de l’axe quantitatif. La bibliothèque Seaborn met à disposition une série de styles d’arrière-plan prédéfinis, activables via la fonction sns.set_style(). Les environnements ‘whitegrid’ et ‘ticks’ incarnent les standards recommandés pour la littérature scientifique : le premier déploie un réseau discret de lignes horizontales d’appui facilitant l’estimation visuelle sans surcharger la composition, tandis que le second restitue la rigueur minimaliste des diagrammes d’instrumentation classique.
Enfin, l’application de la fonction sns.despine() immédiatement après l’instruction de tracé permet d’éradiquer systématiquement les segments de bordure superflus, classiquement les montants supérieur et droit du cadre cartésien. Cette élimination du bruit graphique, théorisée par Edward Tufte sous le concept d’accroissement du ratio données-encre (data-ink ratio), canalise l’attention cognitive de l’observateur exclusivement sur les éléments porteurs d’information discriminante, conférant à la figure finale une élégance formelle et une conformité irréprochable avec les normes éditoriales académiques internationales.
10. Annotation numérique précise et enrichissement informatif
10.1 Utilisation de la méthode native ax.bar_label()
Si la sémiologie graphique excelle dans la communication immédiate des tendances relatives et des contrastes directionnels, elle présente des limites inhérentes dès lors que le lecteur recherche une lecture numérique d’une précision absolue. Dans un diagramme conventionnel, l’observateur est contraint de projeter visuellement le sommet de la barre vers l’axe cartésien gradué, une translation approximative source d’erreurs d’arrondi. L’adjonction d’annotations quantitatives directes au sommet de chaque rectangle compense cette déficience.
Historiquement, l’insertion programmatique de ces annotations nécessitait l’implémentation de boucles itératives fastidieuses au sein des sous-éléments de l’objet graphique, extrayant manuellement les coordonnées cartésiennes de chaque boîte pour formater des chaînes textuelles via la commande ax.annotate(). La modernisation de l’API de Matplotlib a heureusement introduit la méthode hautement optimisée ax.bar_label(). En transmettant simplement à cette fonction le conteneur de barres généré par Seaborn, accessible via ax.containers[0], le moteur procède à l’extraction algorithmique autonome des grandeurs agrégées et positionne sans faille les libellés textuels le long des segments de sommet, garantissant un enrichissement informatif instantané sans surcharge de script.
10.2 Positionnement et stylisation des annotations de données
L’inscription d’étiquettes numériques requiert une harmonisation spatiale millimétrée afin d’éviter les télescopages visuels désastreux avec les moustaches d’incertitude statistique. La méthode ax.bar_label() offre une flexibilité typographique intégrale via une série d’arguments contextuels. Le paramètre label_type autorise le choix entre une disposition déportée sur le bord externe du rectangle (‘edge’) ou une implantation intégrée au centre de la surface géométrique colorée (‘center’).
Lorsque le déploiement externe est privilégié, l’ajustement du paramètre padding permet d’espacer délicatement l’annotation de la limite physique de la barre ou de la borne supérieure de l’intervalle de confiance, évitant toute superposition d’encrage. Parallèlement, l’argument fmt permet d’appliquer des directives de formatage de chaînes rigoureuses — telles que l’arrondi décimal strict à deux chiffres significatifs ou l’incorporation d’unités de mesure comme des pourcentages ou des devises monétaires —, conférant à la transcription de la valeur statistique un niveau de finition et de professionnalisme conforme aux meilleures revues d’économie ou de sociologie quantitative.
10.3 Ajout de repères théoriques et de lignes de seuil
La contextualisation de l’information graphique gagne fréquemment à être confrontée à des repères exogènes, qu’il s’agisse d’un seuil réglementaire, d’une valeur de performance critique, ou de la moyenne marginale globale de l’ensemble de l’échantillon. L’interopérabilité fluide entre Seaborn et Matplotlib facilite grandement cette hybridation narrative à travers les instructions de traçage de lignes de référence telles que ax.axhline() pour une coupe horizontale ou ax.axvline() pour un repère vertical.
L’adjonction d’une droite de référence pointillée, stylisée avec discrétion par des paramètres de texture de ligne et d’opacité modulés, permet au lecteur d’évaluer instantanément si les sous-groupes examinés se situent en deçà ou au-delà d’une norme établie. Ce repère peut être enrichi d’une annotation textuelle sémantique ciblée via ax.text(), clarifiant le sens théorique du seuil (par exemple, un seuil de significativité clinique ou un équilibre budgétaire théorique). Cette stratification des niveaux de lecture transforme un graphique purement descriptif en un véritable dispositif d’aide à la décision et d’argumentation statistique probatoire.
11. Approfondissement architectural : sns.catplot() et grilles de facettes
11.1 Différenciation conceptuelle entre Axes-level et Figure-level
Pour dominer l’écosystème Seaborn dans sa dimension la plus architecturale, il est indispensable d’assimiler la distinction conceptuelle et programmatique fondamentale qui sépare les fonctions opérant au niveau des axes (Axes-level) de celles gouvernant l’intégralité de la figure (Figure-level). La commande sns.barplot() relève formellement de la catégorie des fonctions Axes-level : elle est conçue pour matérialiser son tracé au sein d’une instance unique et autonome de matplotlib.axes.Axes, ce qui la rend éminemment malléable pour être imbriquée au sein de mises en page composites complexes programmées manuellement via Matplotlib.
À l’inverse, la macro-fonction sns.catplot() incarne l’interface de haut niveau dite Figure-level dédiée à l’ensemble des représentations catégorielles. En spécifiant l’argument kind=’bar’ au sein de sns.catplot(), le statisticien sollicite le même moteur géométrique sous-jacent que celui de sns.barplot(), mais délègue simultanément à Seaborn le contrôle architectural absolu de la figure à travers l’instanciation automatique d’un objet gestionnaire de structure facettée dénommé FacetGrid. Ce changement de paradigme modifie en profondeur la syntaxe de paramétrage typographique tout en décuplant les capacités de mise en résonance multivariée des sous-populations observées.
11.2 Création de matrices de graphiques en barres par facettage
L’intérêt transcendantal de sns.catplot() réside dans sa faculté de décomposer un problème analytique multidimensionnel selon le principe des petits multiples théorisé par Bertin et popularisé par Tufte. En présence d’un plan d’investigation associant jusqu’à quatre variables catégorielles simultanées — par exemple une variable de réponse continue évaluée selon un facteur d’abscisse principal, un facteur de sous-groupement par couleur de nuance, un facteur de découpage en colonnes spatiales et un facteur de stratification par lignes horizontales —, la représentation sur un axe unique conduirait à un enchevêtrement illisible de barres entrelacées.
En assignant simplement des variables explicatives disjointes aux paramètres col et row de sns.catplot(), Seaborn segmente le jeu de données en une matrice ordonnée de sous-graphiques cartésiens synchronisés. Chaque facette individuelle présente le barplot associé à une combinaison factorielle spécifique, tout en partageant rigoureusement la même échelle d’ordonnées et les mêmes incréments de mesure que ses voisines. Cette harmonisation d’échelle automatisée prévient tout risque de manipulation d’interprétation visuelle et autorise une comparaison analytique croisée d’une rigueur expérimentale incomparable, isolant visuellement d’éventuelles interactions triples ou quadruples impossibles à discerner sur des diagrammes conventionnels isolés.
11.3 Personnalisation fine des objets FacetGrid générés
La manipulation d’une composition architecturée sous sns.catplot() exige l’abandon des méthodes d’ajustement classiques opérant sur l’objet Axes au profit de l’API déclarative propre à la classe FacetGrid. Toute tentative d’invoquer directement des commandes comme ax.set_title() sur l’objet retourné générera une exception logicielle, car la variable encapsule désormais une collection de sous-axes coordonnés et non plus une entité cartésienne unitaire.
La personnalisation de ces matrices multi-facettes s’articule autour de méthodes en chaîne conçues pour propager les modifications typographiques sur l’ensemble de la grille sans nécessiter de boucles itératives explicites. La méthode set_titles() permet d’injecter des modèles textuels dynamiques pour reformater les en-têtes de colonnes et de lignes en exploitant des variables contextuelles d’interpolation. La méthode set_axis_labels() redéfinit simultanément les désignations lexicales des grandeurs cartésiennes pour l’ensemble des panneaux. Enfin, le calibrage de l’emprise physique de la grille ne s’effectue pas via figsize, mais par le couplage des arguments scalaires height (qui dicte la hauteur absolue en pouces de chaque facette unitaire) et aspect (qui détermine le ratio géométrique entre la largeur et la hauteur de chaque panneau), conférant à l’analyste un contrôle proportionnel absolu sur l’esthétique finale de la planche de recherche.
12. Bonnes pratiques de communication statistique et écueils à éviter
12.1 L’impératif de l’origine à zéro et risques de troncature trompeuse
S’il existe un impératif déontologique et méthodologique inviolable dans la construction sémiotique des diagrammes en barres, c’est l’obligation catégorique d’ancrer l’origine de l’axe quantitatif à la valeur numérique zéro. Cette exigence fondamentale découle directement de la façon dont le système cognitif humain décode les propriétés physiques du stimulus graphique : dans un barplot, la grandeur représentée n’est pas uniquement encodée par la position absolue du segment terminal dans l’espace cartésien, mais par la surface encrée totale et la hauteur physique du polygone rectangulaire déployé depuis la ligne de base.
La troncature artificielle de l’axe vertical — consistant par exemple à démarrer l’échelle d’ordonnées à une valeur substantiellement supérieure à zéro afin d’exagérer visuellement des disparités intergroupes d’amplitudes minimes — constitue l’un des mécanismes les plus pernicieux de manipulation visuelle, formellement condamné par Darrell Huff dans son ouvrage classique How to Lie with Statistics. En tronquant l’ordonnée d’origine, le ratio spatial proportionnel séparant la hauteur relative de deux barres cesse d’être congru au ratio mathématique réel séparant leurs espérances statistiques sous-jacentes. Si l’amplitude des variations relatives est tellement congrue qu’elle demeure imperceptible sur une échelle partant de zéro, la déontologie scientifique impose d’abandonner formellement le diagramme en barres pour se tourner vers des représentations orientées vers la quantification ponctuelle des contrastes, telles que le graphique de Cleveland (Cleveland dot plot) ou les visualisations de grandeurs d’effet standardisées.
12.2 Le problème du graphique dynamite (dynamite plot) et ses solutions
Le diagramme en barres conventionnel surmonté d’une moustache d’erreur unidirectionnelle — péjorativement qualifié par la communauté biomédicale et méthodologique internationale de dynamite plot en raison de sa ressemblance évocatrice avec un bâton d’explosif relié à son détonateur — a fait l’objet d’une contestation scientifique véhémente au cours de la dernière décennie. La critique épistémologique centrale adressée à cette construction graphique réside dans sa propension dévastatrice à oblitérer la distribution microscopique des observations individuelles au profit d’un résumé paramétrique réducteur.
Un barplot est incapable de discriminer une distribution gaussienne unitaire d’une distribution bimodale révélant deux sous-populations distinctes, d’une distribution uniformément étalée, ou d’une situation où la moyenne est totalement faussée par un agrégat de valeurs aberrantes extrêmes. Pour pallier cette cécité distributionnelle sans renoncer à la clarté synthétique de la tendance centrale, la bonne pratique contemporaine préconise l’hybridation des représentations. L’analyste peut superposer avec une parfaite élégance visuelle un tracé de points individuels dispersés de manière non couvrante via sns.stripplot() ou sns.swarmplot() par-dessus la structure de barres de sns.barplot(). En appliquant une transparence optique délicate et une chromaticité neutre aux points de données brutes, cette approche duale restitue l’intégrité de la dispersion empirique réelle tout en fournissant au lecteur le point d’ancrage statistique de la moyenne agrégée.
12.3 Synthèse procédurale et aide au choix de représentation
Au terme de cette exploration systématique, il convient d’ancrer le diagramme en barres dans une taxonomie décisionnelle raisonnée régissant l’ingénierie des visualisations en science des données. Le barplot n’est pas une réponse universelle ; il constitue un outil spécifique optimisé pour la communication claire de mesures de tendance centrale comparées au sein de facteurs discrets clairement identifiés, dans des contextes où l’effectif d’observations est suffisamment documenté et où l’ancrage à zéro conserve une cohérence théorique absolue.
Le chercheur confronté à un arbitrage de représentation doit s’orienter selon une arborescence méthodique stricte. Si la priorité de l’investigation réside dans la modélisation exhaustive de la dispersion, de la forme des queues de distribution et de la détection des valeurs aberrantes, les diagrammes en boîte à moustaches (sns.boxplot()) ou les diagrammes en violon (sns.violinplot()) doivent impérativement supplanter le barplot. Si l’échantillon est d’une taille modeste (typiquement inférieur à une trentaine d’individus par condition expérimentale), la présentation intégrale des données brutes via un nuage de points enrichi de barres transversales d’intervalles est méthodologiquement supérieure. Enfin, avant toute diffusion publique ou soumission éditoriale d’un diagramme en barres finalisé sous Seaborn, la validation systématique d’une check-list de contrôle — confirmant l’inclusion formelle de l’origine zéro, l’explicitation typographique univoque de la nature exacte de la barre d’erreur, la vérification de l’uniformité perceptuelle des palettes et l’absence d’encombrement textuel — constitue l’ultime garantie d’une communication scientifique éthique, reproductible et exempte de tout biais d’illusion perceptive.
Références
Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions Gauthier-Villars.
Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experiment, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
Efron, B., & Tibshirani, R. J. (1994). An introduction to the bootstrap. CRC Press.
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press.
Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: time for a new data presentation paradigm. PLOS Biology, 13(4), e1002128. https://doi.org/10.1371/journal.pbio.1002128
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
Wilke, C. O. (2019). Fundamentals of data visualization: A primer on making informative and compelling figures. O’Reilly Media.