
L’évaluation de la performance des modèles prédictifs constitue l’une des pierres angulaires de la science des données moderne et de l’apprentissage automatique appliqué. Dans de nombreux contextes réels, tels que le diagnostic médical assisté par ordinateur, la détection de transactions frauduleuses, la maintenance prédictive industrielle ou l’analyse psychométrique computationnelle, les praticiens sont confrontés à des distributions de classes profondément déséquilibrées. Dans ces scénarios où les événements d’intérêt représentent une infime fraction du corpus d’apprentissage, les métriques globales traditionnelles échouent de manière critique à rendre compte de l’efficacité opérationnelle des algorithmes.
Face à ces limites conceptuelles, la courbe précision-rappel (Precision-Recall Curve ou courbe PR) s’est imposée au sein de la communauté scientifique comme un outil analytique indispensable et rigoureux. Contrairement aux approches fondées sur un seuil de décision binaire arbitraire fixé par défaut à cinquante pour cent, la courbe précision-rappel explore de façon exhaustive l’ensemble du continuum des valeurs de coupure possibles. Elle met en lumière les arbitrages fondamentaux auxquels tout modèle statistique est inévitablement soumis lorsqu’il doit départager la certitude diagnostique et la couverture globale des observations positives.
Ce guide exhaustif a pour vocation d’examiner en profondeur les fondements théoriques, la formulation mathématique et la mise en œuvre computationnelle de la courbe précision-rappel en utilisant l’écosystème scientifique du langage Python, articulé autour de scikit-learn, Matplotlib et NumPy. De la décomposition fine des matrices de confusion à la quantification scalaire via l’Average Precision, en passant par le traitement du déséquilibre de classe aigu et la sélection optimale du point de fonctionnement opérationnel, chaque composante fait l’objet d’une analyse systématique conçue pour répondre aux plus hauts standards méthodologiques et académiques.
1. 1. Fondements conceptuels des métriques d’évaluation en apprentissage automatique
1.1 1.1 Le rôle de la classification binaire dans la modélisation prédictive
La classification binaire représente l’une des formulations les plus fondamentales et omniprésentes de l’apprentissage statistique supervisé. Formellement, elle consiste à mapper un vecteur de variables explicatives continues ou catégorielles, noté X appartenant à un espace d’entrée de dimension d, vers une variable cible discrète y n’admettant que deux états distincts, traditionnellement étiquetés par les scalaires zéro et un, ou désignés sous les qualificatifs de classe négative et classe positive. Dans la quasi-totalité des architectures contemporaines, qu’il s’agisse de modèles linéaires généralisés, de forêts aléatoires ou de réseaux de neurones profonds, l’inférence ne produit pas directement une attribution catégorielle déterministe. Au contraire, le modèle calcule une valeur continue, souvent interprétable comme une probabilité a posteriori conditionnelle, représentant la vraisemblance que l’instance sous-jacente appartienne à la classe cible positive étant donné le profil d’attributs observé.
L’évaluation rigoureuse de ces attributions probabilistes constitue un défi majeur en sciences computationnelles. La pratique historiquement répandue consistant à convertir immédiatement ces probabilités continues en décisions binaires en appliquant un seuil invariant de zéro virgule cinq masque la structure probabiliste sous-jacente et empêche toute analyse approfondie de la calibration du classifieur. De surcroît, l’exactitude globale, communément appelée accuracy et définie comme la proportion de prédictions correctes sur l’ensemble de l’échantillon, révèle des défaillances dramatiques dès lors que la distribution marginale des classes s’écarte de la parfaite symétrie. Dans un scénario clinique où une affection pathologique rare ne touche qu’un individu sur mille au sein de la population générale, un algorithme trivial prédisant systématiquement la négativité pour chaque sujet obtiendrait une exactitude de quatre-vingt-dix-neuf virgule neuf pour cent. Malgré ce score flatteur, ce système serait totalement inopérant et dangereux sur le plan pragmatique, car il échouerait à identifier le moindre cas positif réel.
1.2 1.2 Décomposition de la matrice de confusion
Pour dépasser l’illusion d’efficacité générée par l’exactitude brute, l’analyse descriptive doit reposer sur la matrice de confusion, tableau de contingence croisant les étiquettes réelles observées et les assignations décrétées par l’algorithme sous un seuil opérationnel donné. Cette structure isole quatre états cardinaux fondamentaux qui gouvernent la totalité des métriques dérivées. Les Vrais Positifs (VP) quantifient les occurrences pour lesquelles le modèle a judicieusement diagnostiqué la présence de la condition cible chez une entité effectivement positive. À l’opposé, les Faux Positifs (FP), également désignés sous le terme d’erreurs de type I dans le cadre du test d’hypothèse neyman-pearsonien, caractérisent les situations où l’algorithme déclenche une alerte erronée, classifiant positivement une instance qui s’avère négative dans la réalité du terrain.
Symétriquement, les Vrais Négatifs (VN) dénombrent les entités négatives rejetées à juste titre par le mécanisme décisionnel, tandis que les Faux Négatifs (FN), ou erreurs de type II, représentent l’échec critique du modèle à intercepter une instance positive, étiquetée à tort comme indemne ou non concernée. L’impact de la prévalence et des distributions asymétriques sur ces grandeurs est massif. Lorsque la masse des données est écrasée par la classe négative, le cardinal des Vrais Négatifs peut atteindre des ordres de grandeur démesurés, masquant les variations absolues des Faux Positifs et rendant caduques les métriques intégrant ce compartiment sans normalisation adaptée. Dans le domaine de la décision clinique ou de la cybersécurité, les répercussions d’une fausse attribution divergent radicalement. Un Faux Positif dans un système de détection d’intrusion réseau engendre une charge d’audit supplémentaire pour les équipes d’investigation, alors qu’un Faux Négatif équivaut à une brèche de sécurité non détectée susceptible de compromettre l’intégrité de l’ensemble de l’infrastructure logicielle.
1.3 1.3 La tension inhérente entre sensibilité et spécificité
L’analyse historique des systèmes d’alerte et de transmission du signal a conduit à l’émergence d’un couple classique de métriques opérationnelles : la sensibilité, correspondant au taux de vrais positifs, et la spécificité, mesurant la capacité du système à exclure la classe négative en rapportant les vrais négatifs à l’ensemble des négatifs réels. Ces deux dimensions se trouvent dans un état de divergence structurelle perpétuelle induit par le comportement des frontières de décision dans les espaces vectoriels multidimensionnels. Lorsqu’un modèle ajuste son hyperplan séparateur pour envelopper de manière plus permissive les vecteurs d’apprentissage suspects, il augmente mécaniquement le nombre de vrais positifs capturés au détriment de l’admission d’intrusions négatives, ce qui dégrade instantanément la spécificité.
Dans un espace où les densités de probabilité conditionnelles des deux classes se chevauchent de manière inexorable le long d’une variété différentiable, aucun seuil invariant ne peut maximiser simultanément ces deux objectifs antinomiques. L’abaissement du seuil décisionnel privilégie la sensibilité en tendant vers l’interception intégrale des anomalies, mais expose l’opérateur à un déluge de faux positifs. À l’inverse, l’élévation de ce seuil aseptise les prédictions positives en garantissant une spécificité absolue, mais au prix prohibitif d’une prolifération de faux négatifs. Cette réalité mathématique impose l’abandon des évaluations ponctuelles figées et exige l’adoption d’outils d’exploration graphique continue capables de cartographier la frontière de Pareto des performances d’un classifieur sur l’intégralité de son spectre paramétrique.
2. 2. Définitions mathématiques et théoriques de la précision et du rappel
2.1 2.1 Formalisation mathématique de la précision
La précision, souvent dénommée valeur prédictive positive (VPP) dans la littérature biomédicale et épidémiologique, quantifie la pureté des alertes générées par le modèle statistique. Sur le plan formel, elle se définit comme le ratio arithmétique unissant le nombre de vrais positifs à la somme totale des instances classifiées comme positives par le modèle sous un seuil donné :
Précision = VP / (VP + FP)
Sous une perspective probabiliste bayésienne, la précision correspond à l’estimation empirique de la probabilité a posteriori conditionnelle qu’une instance appartienne réellement à la classe positive sachant que le système prédictif l’a étiquetée comme telle, soit P(y = 1 | y_pred = 1). Cette métrique renseigne directement l’utilisateur final sur la fiabilité de l’information délivrée par l’algorithme lorsque celui-ci déclenche un signal positif. Si la précision est faible, une part substantielle des alertes s’avère non fondée, ce qui peut saturer les mécanismes décisionnels humains et provoquer une désensibilisation cognitive face aux avertissements de la machine.
Le coût fonctionnel induit par un niveau élevé de faux positifs varie en fonction des applications mais demeure souvent considérable. Dans le contexte de l’attribution de prêts bancaires ou de l’audit financier automatisé, un modèle doté d’une faible précision alloue des ressources d’enquête précieuses à des transactions légitimes, pénalisant l’expérience utilisateur et générant des coûts opérationnels excessifs. En imagerie médicale diagnostique, une faible précision expose les patients à des biopsies invasives inutiles, à des examens radiologiques complémentaires anxiogènes et à un surcoût économique majeur pour les régimes d’assurance maladie, soulignant l’importance d’une estimation mathématiquement rigoureuse de cette grandeur.
2.2 2.2 Formalisation mathématique du rappel (sensibilité)
Le rappel, rigoureusement équivalent à la sensibilité statistique et au taux de vrais positifs (True Positive Rate ou TPR), capture l’exhaustivité de la détection opérée par le classifieur au sein de la population cible. Son expression mathématique met en relation le volume de vrais positifs interceptés avec l’ensemble des éléments qui appartiennent de facto à la classe positive :
Rappel = VP / (VP + FN)
D’un point de vue de théorie de la mesure de l’information, le rappel quantifie le taux de couverture de la classe d’intérêt. Il s’interprète sous l’angle probabiliste comme la probabilité conditionnelle P(y_pred = 1 | y = 1), traduisant la propension intrinsèque de l’algorithme à réagir positivement en présence effective du phénomène modélisé. Un rappel unitaire, égal à un, indique qu’aucune instance de la classe cible n’a échappé à la sagacité du modèle, le dénominateur étant totalement absorbé par les vrais positifs, reléguant le décompte des faux négatifs à zéro.
La gravité statistique et opérationnelle de l’omission de cas positifs confère souvent au rappel une priorité absolue lors de la conception de systèmes critiques. En épidémiologie d’urgence ou en oncologie précoce, l’occurrence d’un faux négatif signifie qu’un patient porteur d’une pathologie létale quitte le parcours de soins sans prise en charge thérapeutique adaptée, entraînant des conséquences fonctionnelles potentiellement irréversibles, voire fatales. Dans l’ingénierie aérospatiale, ignorer une microfissure structurelle lors d’une inspection ultrasonore automatisée compromet l’intégrité de l’aéronef en phase de vol opérationnel. Par conséquent, l’optimisation mathématique du rappel répond à un impératif catégorique d’exhaustivité sélective.
2.3 2.3 La dynamique d’arbitrage (trade-off) précision-rappel
La mécanique décisionnelle d’un classifieur probabiliste repose sur la modulation d’un paramètre scalaire, le seuil de coupure thêta, appartenant à l’intervalle fermé [0, 1]. Toute modification infinitésimale de ce seuil induit une translation réciproque et contradictoire entre la précision et le rappel. Si l’on contraint thêta à approcher la borne supérieure unitaire, seules les observations associées aux probabilités prédictives les plus extrêmes sont admises au sein de la classe positive. Cette stratégie élimine quasi totalement les faux positifs, hissant la précision vers son asymptote maximale, mais précipite une chute drastique du rappel en générant une multitude de faux négatifs issus des observations à certitude modérée.
À l’inverse, abaisser le seuil thêta vers zéro étend la surface de capture décisionnelle jusqu’à englober la quasi-totalité de l’espace vectoriel d’entrée. Le rappel culmine alors vers sa valeur idéale unitaire au prix d’une contamination généralisée de la prédiction par des instances négatives, entraînant une dégradation sévère de la précision. Cet antagonisme est particulièrement marqué au sein de distributions conditionnelles présentant des queues de densité à chevauchement gaussien substantiel. Afin de synthétiser cet arbitrage en un indice scalaire unique pour un seuil donné, la littérature scientifique privilégie le score F1, défini comme la moyenne harmonique de la précision et du rappel :
Score F1 = 2 * (Précision * Rappel) / (Précision + Rappel)
La formulation harmonique du score F1 pénalise de manière draconienne les configurations asymétriques où l’une des deux composantes s’effondre, interdisant qu’une précision dérisoire soit compensée arithmétiquement par un rappel élevé. Dans les contextes industriels requérant une asymétrie délibérée dans l’allocation des priorités, on recourt à la famille généralisée des métriques F-bêta, intégrant un paramètre de pondération réel positif bêta. Celui-ci calibre l’importance relative allouée au rappel vis-à-vis de la précision, offrant un cadre formel pour modéliser des préférences opérationnelles hautement spécialisées.
3. 3. Analyse comparative : Courbe Précision-Rappel versus Courbe ROC
3.1 3.1 Mécanismes de la courbe Receiver Operating Characteristic (ROC)
La courbe ROC (Receiver Operating Characteristic), initialement développée dans le cadre de la théorie de la détection du signal radar durant la Seconde Guerre mondiale, cartographie graphiquement le taux de vrais positifs (sensibilité) sur l’axe des ordonnées en fonction du taux de faux positifs (FPR = FP / (FP + VN) = 1 – spécificité) sur l’axe des abscisses, pour chaque seuil de discrimination envisageable. Cette construction jouit d’une popularité considérable dans les sciences expérimentales en raison de sa structure géométrique canonique, s’étendant invariablement du point d’origine (0, 0) jusqu’au sommet unitaire (1, 1), la diagonale identité incarnant la ligne de référence d’un classifieur purement aléatoire.
Le rôle pivot joué par le volume de vrais négatifs (VN) au dénominateur du taux de faux positifs confère à la courbe ROC une propriété fondamentale de stabilité apparente. Chaque point opérationnel met en rapport la proportion des positifs correctement récupérés avec la proportion des négatifs erronément transgressés. En vertu de cette formulation mathématique, la trajectoire fonctionnelle de la courbe ROC présente l’invariance analytique remarquable par rapport à la prévalence relative des classes au sein de la population analysée. Si l’on multiplie artificiellement la masse des instances négatives sans modifier leurs distributions conditionnelles internes, les ratios TPR et FPR demeurent inchangés, préservant l’allure de la trajectoire ROC et l’aire sous-jacente (ROC AUC).
3.2 3.2 Le biais d’optimisme de la courbe ROC en présence de déséquilibre
L’invariance de la courbe ROC par rapport à la prévalence, souvent célébrée comme un atout conceptuel, se transforme en un piège méthodologique majeur dès lors que le classifieur opère sous un déséquilibre de classe massif. Dans les situations où la classe négative outrepasse la classe positive par plusieurs ordres de grandeur, le terme VN au dénominateur du FPR atteint une magnitude immense. Par conséquent, même si le modèle produit un nombre absolu catastrophique de faux positifs (par exemple dix mille erreurs d’attribution), ce cardinal se trouve dilué par les millions de vrais négatifs composant l’arrière-plan statistique. Le taux de faux positifs demeure alors microscopique, maintenant artificiellement la trajectoire ROC tout près de l’axe vertical gauche idéal.
Ce phénomène génère un biais d’optimisme délétère lors de l’évaluation du modèle. Le statisticien observant une aire sous la courbe ROC de zéro virgule quatre-vingt-quinze conclura indûment à l’excellence discriminative de son architecture. Pourtant, confrontée aux réalités de la production, cette même architecture produira potentiellement cent alertes fallacieuses pour un unique cas positif détecté. C’est précisément pour lever cette distorsion cognitive que la courbe précision-rappel s’impose avec une sensibilité analytique décuplée. En substituant le FPR par la précision, la courbe PR remplace les vrais négatifs par les faux positifs au dénominateur de l’ordonnée. Tout afflux d’erreurs de type I dégrade instantanément la précision, provoquant un effondrement vertical spectaculaire de la courbe PR et exposant immédiatement la vulnérabilité intrinsèque du modèle face au déséquilibre sous-jacent.
3.3 3.3 Critères méthodologiques de sélection du type de courbe
L’arbitrage méthodologique régissant la sélection entre une modélisation par courbe ROC ou par courbe précision-rappel repose sur une analyse conjointe de la distribution marginale de la variable dépendante et des objectifs décisionnels assignés à l’algorithme. Les lignes directrices publiées dans la littérature méthodologique de pointe établissent des critères formels d’orientation analytique :
- Règle du ratio de prévalence : Lorsque la classe d’intérêt positive représente moins de dix à quinze pour cent de la masse globale des données empiriques, l’utilisation de la courbe précision-rappel doit être déclarée obligatoire afin d’éviter tout diagnostic de performance fallacieux induit par la dilution des faux négatifs au sein du vaste réservoir des vrais négatifs.
- Asymétrie des coûts opérationnels : Lorsque le coût de l’investigation d’un faux positif est substantiel et que l’attention opérationnelle est focalisée exclusivement sur la détection des occurrences positives critiques, la courbe précision-rappel offre une adéquation écologique supérieure en matérialisant directement le taux d’exactitude des alarmes.
- Évaluation de la séparabilité intrinsèque non contextualisée : Lorsque l’analyste cherche à qualifier l’aptitude générique d’un extracteur de caractéristiques indépendamment des variations épidémiologiques futures de la prévalence dans divers environnements de déploiement, la courbe ROC conserve une validité théorique pour apprécier la divergence distributionnelle brute entre deux populations.
De nombreux consortiums de recherche en apprentissage automatique biomédical et en intelligence artificielle appliquée au diagnostic clinique préconisent désormais d’intégrer systématiquement les deux représentations graphiques dans les protocoles de publication académique, tout en accordant la primauté interprétative à la courbe précision-rappel dès lors que le corpus expérimental présente une asymétrie distributionnelle notable.
4. 4. Configuration de l’environnement Python et spécifications logicielles
4.1 4.1 Écosystème scientifique Python et bibliothèques requises
L’écosystème open-source du langage de programmation Python constitue l’environnement préférentiel pour l’implémentation, l’évaluation et l’optimisation des architectures de classification binaire. Au cœur de cette infrastructure se trouve la bibliothèque scikit-learn, reconnue internationalement pour la rigueur algorithmique de ses estimateurs, l’uniformité de ses interfaces de programmation et la robustesse mathématique de son sous-module sklearn.metrics. Cette bibliothèque standardise l’extraction des coordonnées continues de la courbe précision-rappel et intègre des structures de visualisation intégrées de haut niveau.
La restitution visuelle et la manipulation matricielle reposent sur le couplage synergique de Matplotlib et NumPy. Matplotlib fournit une machinerie de rendu graphique vectoriel autorisant un contrôle micrométrique sur l’ensemble des primitives graphiques, depuis l’ajustement de la typographie typique des presses universitaires jusqu’au positionnement des axes et légendes multiparamétriques. NumPy assure quant à lui l’accélération vectorielle indispensable au calcul d’opérations d’algèbre linéaire hautement performantes sur des tableaux multidimensionnels d’observations. Pour la gestion structurée des métadonnées expérimentales, l’adjonction de Pandas et de Seaborn garantit une flexibilité accrue dans le prétraitement tabulaire et l’application de chartes chromatiques harmonisées aux contraintes de publication.
4.2 4.2 Importation des modules spécifiques
L’initialisation rigoureuse d’un script de modélisation statistique requiert une sélection explicite des composants nécessaires, évitant les importations indifférenciées susceptibles de polluer l’espace de noms global. Dans le cadre de l’évaluation précision-rappel, les dépendances critiques se structurent autour de plusieurs axes fonctionnels au sein de l’environnement scikit-learn et de l’infrastructure de visualisation graphique :
- Génération et partitionnement :
from sklearn.datasets import make_classificationpour la synthèse contrôlée de données, etfrom sklearn.model_selection import train_test_splitpour la scission probabiliste des corpus. - Algorithmique prédictive :
from sklearn.linear_model import LogisticRegressionpour l’instanciation de classifieurs probabilistes régularisés, accompagnée defrom sklearn.preprocessing import StandardScalerpour la transformation d’échelle. - Extraction de métriques spécialisées :
from sklearn.metrics import precision_recall_curve, auc, average_precision_score, PrecisionRecallDisplaypour le calcul des coordonnées cartésiennes et des indices d’intégration scalaire. - Rendu graphique :
import matplotlib.pyplot as pltcomplété par la manipulation directe du dictionnaire de configurationplt.rcParamsafin de calibrer la résolution (dots-per-inch), les fontes typographiques et les épaisseurs des tracés vectoriels aux standards académiques.
4.3 4.3 Reproductibilité computationnelle et contrôle de l’aléa
La reproductibilité scientifique constitue l’un des piliers méthodologiques régissant les sciences computationnelles. Dans les chaînes de traitement d’apprentissage automatique, de multiples étapes s’appuient sur des générateurs de nombres pseudo-aléatoires, notamment la génération stochastique de bruit au sein des données synthétiques, l’initialisation des poids des algorithmes d’optimisation et la fragmentation aléatoire des ensembles d’apprentissage et d’évaluation. L’absence de fixation stricte des graines d’aléa empêche toute réplication exacte des trajectoires de courbes précision-rappel obtenues et invalide la comparaison rigoureuse entre architectures rivales.
L’ancrage du contrôle stochastique s’effectue en Python via la standardisation explicite de l’argument random_state à l’ensemble des méthodes logicielles mobilisées. L’utilisation systématique d’une constante entière immuable, telle que quarante-deux, transmise de façon transparente aux fonctions de partitionnement et d’entraînement, garantit que chaque itération computationnelle reproduira rigoureusement le même agencement matriciel. De surcroît, la consignation formelle des métadonnées d’environnement logiciel, englobant les numéros de version précis de l’interpréteur Python, de NumPy et de scikit-learn via des mécanismes de figeage de dépendances, parachève le protocole assurant la pérennité et la transférabilité des découvertes empiriques.
5. 5. Synthèse et préparation des données expérimentales
5.1 5.1 Génération contrôlée avec make_classification
L’utilisation de jeux de données réels présente parfois des biais d’échantillonnage incontrôlés ou une corrélation structurelle complexe entre covariables, rendant l’analyse pédagogique et fondamentale difficilement isolable. Pour étudier avec exactitude le comportement de la courbe précision-rappel face à des pathologies distributionnelles connues, l’utilisation de la fonction make_classification s’impose comme une méthodologie d’étalonnage de référence. Cet utilitaire de scikit-learn permet de façonner synthétiquement un espace vectoriel dont chaque paramètre de génération est asservi à la volonté du chercheur.
Le paramétrage débute par la spécification du volume global d’observations via n_samples (par exemple dix mille instances) et de la dimensionnalité de l’espace vectoriel via n_features. Le niveau de difficulté intrinsèque est modulé en configurant le nombre de variables informatives portant le signal discriminant (n_informative), le nombre de variables redondantes issues de combinaisons linéaires des premières (n_redundant), et la quantité de bruit aléatoire constitué par des variables résiduelles dénuées de pertinence prédictive. De surcroît, le déséquilibre de classe aigu est orchestré via l’argument weights, par exemple paramétré à quatre-vingt-dix-sept pour cent pour la classe majoritaire et trois pour cent pour la classe minoritaire, reproduisant fidèlement les pathologies observées lors de la surveillance épidémiologique de maladies orphelines.
5.2 5.2 Stratification et partitionnement du jeu de données
Une fois la matrice synthétique générée, le protocole expérimental requiert la division du corpus en sous-ensembles mutuellement exclusifs dédiés respectivement à l’entraînement algorithmique et à la validation indépendante des performances. L’outil pivot de cette scission est la méthode train_test_split. Dans le cadre de cohortes soumises à une asymétrie de classe critique, une division aléatoire naïve expose le modélisateur à un risque méthodologique majeur : la distorsion d’échantillonnage, par laquelle la fraction minoritaire se trouverait fortuitement sous-représentée, voire totalement absente, du jeu de test réservé à l’évaluation.
Pour immuniser le protocole contre ce biais expérimental, l’argument stratify=y doit être formellement activé. Cette instruction enjoint l’algorithme de partitionnement de calculer la distribution de prévalence empirique de la variable dépendante y au sein du réservoir matriciel complet et de répliquer rigoureusement ce ratio de positivité dans chacun des sous-ensembles résultants. La proportion accordée au jeu de test, gouvernée par le paramètre test_size et fréquemment fixée entre vingt et trente pour cent du volume total, doit concilier une masse critique suffisante pour assurer la robustesse statistique de l’estimation du rappel avec la préservation d’un échantillon d’apprentissage suffisamment dense pour garantir la convergence des estimateurs paramétriques.
5.3 5.3 Normalisation et standardisation des variables prédictives
Les variables prédictives composant l’espace vectoriel d’entrée présentent fréquemment des échelles de mesure hétérogènes et des amplitudes de variance divergentes. Pour la plupart des algorithmes d’optimisation numérique basés sur la descente de gradient ou assujettis à des contraintes de régularisation analytique, la présence d’attributs non standardisés biaise l’estimation des coefficients en pénalisant de façon disproportionnée les variables à large dispersion scalaire. Une mise à l’échelle uniforme s’avère donc méthodologiquement indispensable préalablement à toute phase d’inférence.
La classe StandardScaler procède à une transformation affine consistant à centrer les distributions sur leur moyenne empirique et à normaliser leur variance à l’unité. Toutefois, la séquence d’application de cette transformation obéit à un impératif épistémologique absolu : la prévention absolue des fuites d’information d’apprentissage, concept désigné sous le terme de data leakage. L’estimateur StandardScaler doit être calibré via sa méthode fit exclusivement sur la fraction matricielle allouée à l’entraînement, pour dériver la moyenne et l’écart-type de référence. Cette calibration est ensuite appliquée pour transformer les données d’entraînement puis réutilisée sans recalcul sur le jeu d’évaluation. Toute estimation conjointe des scalaires de normalisation sur l’intégralité du corpus contaminerait le protocole expérimental en transférant des connaissances statistiques du futur vers le passé, invalidant la rigueur des conclusions méthodologiques.
6. 6. Modélisation statistique : Ajustement de la régression logistique
6.1 6.1 Fondements théoriques de la régression logistique
La régression logistique constitue le modèle d’étalonnage par excellence dans le spectre des classifieurs probabilistes paramétriques. Son formalisme repose sur l’hypothèse que le logit, défini comme le logarithme naturel du rapport de cotes (log-odds) de la probabilité a posteriori de positivité, constitue une combinaison linéaire déterministe des variables prédictives augmentée d’un terme résiduel d’interception. La transformation mathématique liant le score linéaire continu z à l’intervalle de probabilité borné [0, 1] est orchestrée par la fonction sigmoïde canonique :
sigma(z) = 1 / (1 + exp(-z))
L’estimation des coefficients optimaux du modèle ne relève pas de la minimisation de la somme des carrés des résidus comme dans la régression linéaire ordinaire, mais fait appel au principe de maximisation de la vraisemblance (Maximum Likelihood Estimation ou MLE). La fonction de coût optimisée, formellement équivalente à l’entropie croisée binaire (log-loss), quantifie la divergence distributionnelle entre les étiquettes binaires empiriques et les attributions probabilistes déduites par l’estimateur. Afin de juguler les risques d’instabilité numérique consécutifs à la quasi-séparabilité des données et d’atténuer le surapprentissage au sein d’espaces à forte dimensionalité, des pénalités de régularisation, qu’elles relèvent de la norme L2 de Tikhonov (Ridge) ou de la norme L1 induisant la parcimonie (Lasso), sont adjointes à l’objectif d’optimisation.
6.2 6.2 Instanciation et calibration du modèle en Python
L’instanciation logicielle du modèle au sein de l’environnement scikit-learn s’opère via la classe LogisticRegression. Le praticien dispose d’un vaste éventail d’arguments de configuration permettant d’ajuster l’algorithme d’optimisation sous-jacent. Parmi les solveurs numériques disponibles, l’algorithme L-BFGS (Limited-memory Broyden-Fletcher-Goldfarb-Shanno) représente le standard privilégié pour les problèmes convexes non contraints de taille moyenne, tandis que le solveur saga offre une accélération substantielle face à des corpus massifs soumis à des contraintes de pénalité L1 ou de type ElasticNet.
L’ajustement formel s’exécute par l’invocation de la méthode .fit() appliquée rigoureusement sur le sous-ensemble de covariables standardisées de l’échantillon d’entraînement et sur les vecteurs d’étiquettes correspondants. Lors de cette étape computationnelle, l’algorithme itère à travers les gradients de la surface de perte jusqu’à satisfaire les critères de tolérance numérique préétablis. Les diagnostics post-entraînement incluent la vérification explicite du nombre d’itérations consommées vis-à-vis du plafond alloué (max_iter), garantissant que la trajectoire d’optimisation a atteint un minimum global stable sans avortement prématuré dû à des gradients dégénérés ou des anomalies de conditionnement matriciel.
6.3 6.3 Extraction des probabilités prédictives continues
La dérivation opérationnelle de la courbe précision-rappel exige l’accès direct au gradient de scores continus générés par le modèle, avant toute opération de quantification binaire. Dans l’API scikit-learn, il existe une divergence fondamentale entre la méthode classique .predict() et sa variante .predict_proba(). La première applique par défaut une fonction indicatrice rigide articulée autour du seuil de coupure invariant de cinquante pour cent, renvoyant un tableau d’entiers binaires inutilisables pour apprécier le comportement continu du classifieur sur l’ensemble de son spectre de fonctionnement.
À l’opposé, l’appel à la méthode .predict_proba() retourne une matrice bidimensionnelle de dimensions (n_échantillons, 2). La première colonne consigne la probabilité estimée d’appartenance à la classe négative P(y = 0 | X), tandis que la seconde matérialise la grandeur cible : la probabilité conditionnelle a posteriori d’appartenance à la classe positive critique P(y = 1 | X). L’extraction sélective de cette seconde colonne par indexation matricielle ([:, 1]) fournit le vecteur unidimensionnel de scores continus requis pour alimenter les algorithmes d’extraction de seuils et construire de manière mathématiquement rigoureuse la courbe précision-rappel.
7. 7. Algorithme d’extraction des métriques avec precision_recall_curve
7.1 7.1 Implémentation fonctionnelle de scikit-learn
La fonction precision_recall_curve, hébergée au sein du sous-module sklearn.metrics, encapsule la logique algorithmique permettant de convertir la confrontation entre la vérité terrain et les scores prédictifs continus en une série d’états cartésiens précis. L’invocation canonique de cette fonction respecte une signature immuable prenant en arguments le vecteur d’étiquettes réelles observées sur l’échantillon de test et le vecteur des probabilités continues associées à la classe positive, comme formalisé ci-après :
precision, recall, thresholds = precision_recall_curve(y_true, y_scores)
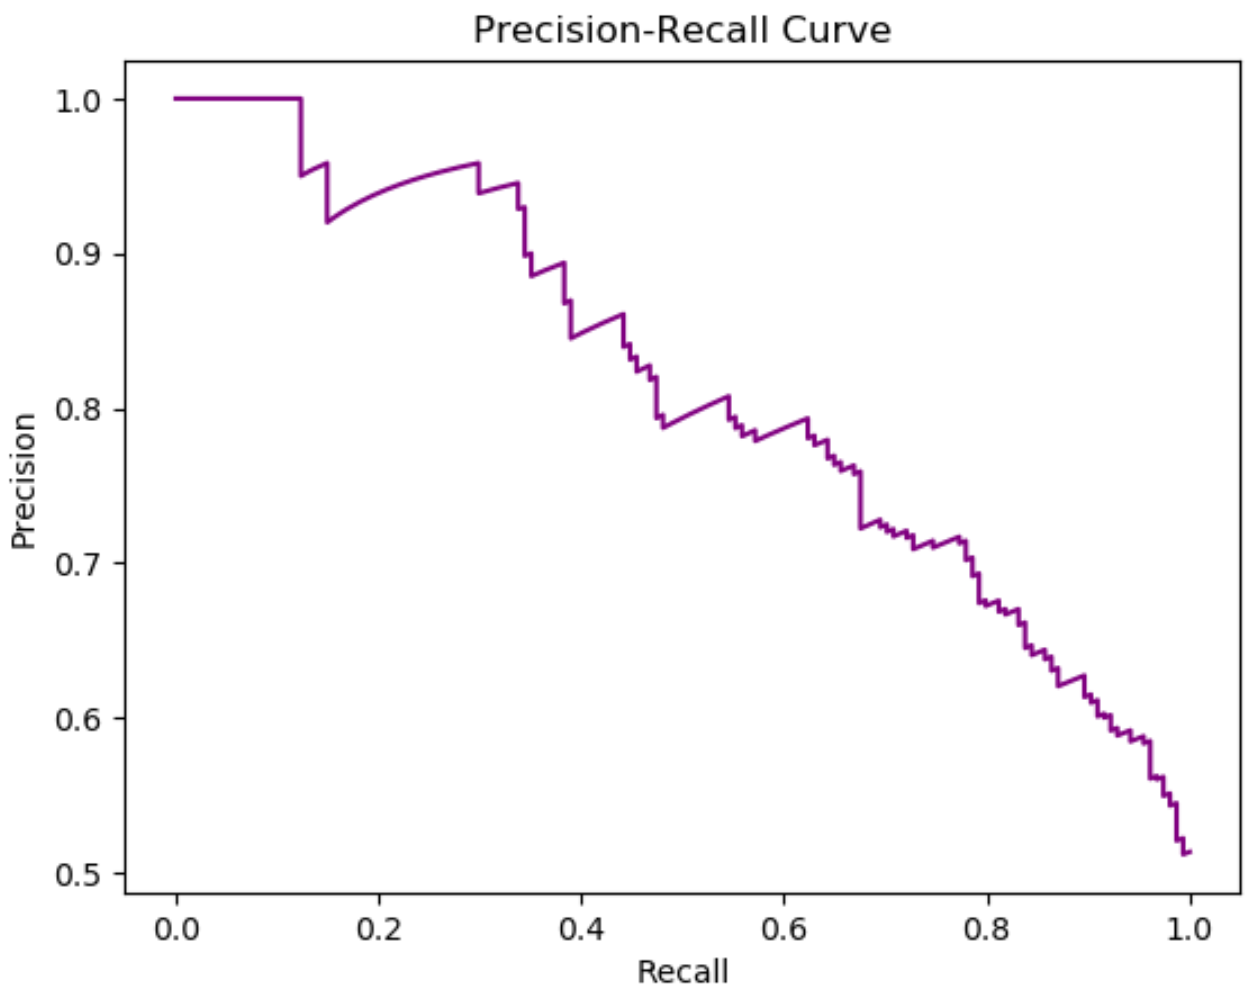
L’exécution de cette routine computationnelle génère en sortie trois tableaux unidimensionnels NumPy présentant une asymétrie dimensionnelle structurelle méritant une attention soutenue. Si l’on désigne par k le nombre de seuils décisionnels distincts identifiés par l’algorithme, le vecteur thresholds possède exactement une longueur k. En revanche, les vecteurs precision et recall possèdent systématiquement une dimension égale à k + 1. Cette configuration délibérée découle de l’adjonction conventionnelle d’un point terminal à la frontière de l’espace, où le rappel est fixé arbitrairement à zéro et la précision à un, garantissant ainsi que la courbe débute mathématiquement sur l’axe vertical des ordonnées à l’extrémité droite de l’éventail des seuils.
7.2 7.2 Mécanisme algorithmique sous-jacent de variation des seuils
Le fonctionnement interne de la routine precision_recall_curve déploie une mécanique algorithmique optimisée évitant la recalculation exhaustive et coûteuse d’une matrice de confusion complète pour chaque seuil arbitraire. L’algorithme débute par le tri des probabilités prédictives dans un ordre strictement décroissant. Ce tri induit une permutation ordonnée correspondante sur le vecteur des étiquettes cibles réelles. L’analyse ne s’effectue pas sur une grille régulière de décimales figées, mais exploite exclusivement les valeurs de scores uniques générées par le modèle, réduisant considérablement la combinatoire d’évaluation.
En parcourant séquentiellement cette liste ordonnée, l’algorithme incrémente les Vrais Positifs dès qu’une étiquette positive unitaire est franchie et accumule les Faux Positifs dans le cas contraire. L’utilisation d’opérations de sommes cumulatives vectorisées (np.cumsum) sur l’architecture bas niveau de NumPy confère à cet algorithme une complexité temporelle dominée exclusivement par l’étape initiale de tri, soit un coût en O(N log N), où N représente le volume d’échantillons au sein du jeu d’évaluation. Cette vectorisation permet de traiter des millions d’observations en quelques fractions de seconde, éliminant tout goulot d’étranglement computationnel lors de la phase d’audit du modèle.
7.3 7.3 Inspection analytique des matrices de résultats
L’analyse descriptive fine des vecteurs issus de l’algorithme permet de mettre en relief les singularités mathématiques régissant la transition entre les seuils d’attribution. Aux bornes extrêmes de l’évaluation, le comportement des métriques reflète fidèlement la théorie des probabilités. Pour la valeur de seuil minimale, la totalité des instances de test est assignée à la classe positive ; le rappel culmine dès lors à sa valeur théorique idéale de un, tandis que la précision s’effondre pour coïncider exactement avec la prévalence naturelle de la classe cible au sein de l’échantillon d’évaluation.
Une observation critique, fréquemment source d’interrogations chez les analystes juniors, réside dans la non-monotonie locale de la trajectoire de précision. Alors que le vecteur du rappel est mathématiquement garanti d’être strictement monotone et décroissant à mesure que le seuil de décision s’élève, la courbe de précision présente une dynamique en dents de scie ou en escalier irrégulier. Ce phénomène provient de la structure du ratio VP / (VP + FP). Lors du passage d’un seuil au suivant, si l’instance nouvellement rejetée de la zone positive s’avère être un vrai positif, le numérateur et le dénominateur diminuent conjointement, ce qui peut mécaniquement induire une baisse locale ponctuelle de la précision, soulignant le caractère non lisse de cette fonction sur des échantillons discrets de petite taille.
8. 8. Construction graphique pas à pas de la courbe avec Matplotlib
8.1 8.1 Tracé basique et configuration des axes orthogonaux
La matérialisation visuelle de la relation précision-rappel nécessite une mise en page graphique obéissant à des conventions cartographiques rigoureuses et standardisées dans la communauté scientifique internationale. Conformément à la norme admise, le rappel est systématiquement assigné à l’axe orthogonal des abscisses (X), représentant la variable de couverture indépendante, tandis que la précision est projetée le long de l’axe des ordonnées (Y), matérialisant la pureté de la prédiction résultante.
La commande fondamentale plt.plot(recall, precision) permet de tracer la ligne polygonale reliant les coordonnées calculées. Cependant, la configuration des limites dimensionnelles exige une attention particulière : les axes doivent impérativement être bornés à l’intervalle canonique fermé via plt.xlim([0.0, 1.0]) et plt.ylim([0.0, 1.05]). L’extension minimale de l’axe vertical jusqu’à un virgule zéro cinq permet d’éviter que le tracé horizontal supérieur, souvent proche de l’unité, ne vienne se confondre ou s’écraser visuellement contre la bordure structurelle du cadre de la figure, préservant ainsi la clarté de lecture pour les évaluateurs.
8.2 8.2 Intégration de la ligne de base aléatoire (Baseline)
L’interprétation de la performance d’un modèle sur une courbe précision-rappel exige la présence d’une référence comparative explicite. Dans le cas de la courbe ROC, cette référence est universelle et matérialisée par la diagonale identité joignant l’origine au sommet supérieur droit, correspondant à une aire de zéro virgule cinq. Sur une courbe précision-rappel, la ligne de base aléatoire d’un classifieur dénué d’information (le dummy classifier émettant des prédictions purement aléatoires ou constantes) n’est pas diagonale, mais strictement horizontale.
Cette ligne de base horizontale intercepte l’axe des ordonnées à une altitude rigoureusement égale à la prévalence marginale de la classe positive au sein du jeu de test, formellement exprimée par le ratio P / (P + N). Sur le plan graphique, cette référence s’intègre au moyen de l’instruction plt.axhline(y=prevalence, color='navy', linestyle='--'). L’espace géométrique compris entre cette ligne de base horizontale discontinue et la trajectoire de la courbe calculée matérialise directement le gain informationnel réel apporté par l’architecture prédictive au-delà du hasard. Dans des contextes de déséquilibre extrême où la prévalence n’excède pas un pour cent, cette matérialisation met en évidence l’abîme séparant un modèle performant d’un modèle aléatoire, même si la trajectoire semble visuellement basse par rapport au plafond unitaire.
8.3 8.3 Enrichissement sémantique et typographique de la figure
Une figure scientifique destinée à l’archivage académique ou à la diffusion décisionnelle doit être immédiatement intelligible sans recours obligatoire au corps du texte narratif. Ce niveau d’exigence implique un enrichissement typographique rigoureux. Les axes doivent être dotés de libellés formels explicites générés via plt.xlabel('Rappel (Sensibilité)', fontsize=12) et plt.ylabel('Précision (Valeur Prédictive Positive)', fontsize=12), assortis d’une grille de fond orthogonale semi-transparente (plt.grid(True, linestyle=':', alpha=0.6)) facilitant la rétro-ingénierie visuelle des valeurs scalaires.
L’intégration d’une légende explicative exhaustive, positionnée dans une zone exempte de chevauchement géométrique (typiquement le coin inférieur gauche via loc='lower left'), doit préciser la nature de l’architecture algorithmique évaluée ainsi que la quantification synthétique de son aire sous-jacente. Enfin, l’exportation du graphique doit impérativement s’affranchir des formats compressés dégradés au profit de fichiers vectoriels pérennes ou d’images matricielles à très haute définition, orchestrée via l’instruction plt.savefig('precision_recall_curve.png', dpi=300, bbox_inches='tight'), garantissant une netteté absolue des tracés lors de l’impression physique ou de l’inclusion dans des documents de recherche.
9. 9. Quantification globale des performances : L’aire sous la courbe (PR AUC) et l’Average Precision
9.1 9.1 Formalisation de l’aire sous la courbe précision-rappel (PR AUC)
Si la visualisation graphique complète offre un panorama qualitatif indispensable des compromis décisionnels, les protocoles d’étalonnage exigent fréquemment la condensation de cette information bidimensionnelle en une métrique scalaire unique, permettant le classement univoque de modèles concurrents. L’approche intuitive historique réside dans le calcul de l’intégrale définie de la précision par rapport au rappel sur l’intervalle d’évaluation, grandeur formellement désignée sous l’acronyme de PR AUC (Precision-Recall Area Under the Curve) :
PR AUC = Intégrale de 0 à 1 de P(R) dR
En pratique logicielle, cette intégration continue est approximée sur des vecteurs discrets via la règle trapézoïdale composite, accessible dans scikit-learn via la fonction auc(recall, precision). Cependant, la littérature statistique a démontré que l’approximation trapézoïdale linéaire génère une surestimation systématique et biaisée de la surface réelle lorsque les points cartésiens sont disjoints ou distants. En raison de la concavité locale et de la non-linéarité inhérente à la précision entre deux paliers de seuil successifs, la connexion rectiligne de segments de trapèze majore artificiellement la surface sous-jacente, incitant la communauté mathématique à privilégier des estimateurs d’intégration plus conservateurs et rigoureux.
9.2 9.2 L’estimateur Average Precision (AP)
Pour pallier les insuffisances structurelles de la règle des trapèzes, la métrique de l’Average Precision (AP) s’est imposée comme le standard de référence pour résumer l’efficacité d’un système de classification probabiliste. L’AP reformule l’intégration en une somme pondérée discrète, évaluant la précision obtenue au seuil k multipliée par la variation marginale du rappel induite par le passage au palier précédent, comme formalisé par l’équation suivante :
AP = Somme pour k de 1 à n de (R_k – R_{k-1}) * P_k
Au sein de la bibliothèque scikit-learn, cette formulation est rigoureusement implémentée sous la fonction average_precision_score(y_true, y_scores). L’avantage fondamental de l’Average Precision réside dans son traitement en escalier : la fonction de précision n’est pas indûment interpolée de façon continue le long d’une hypothétique ligne droite entre les variations de rappel, mais demeure figée au palier opératoire effectif jusqu’à la découverte du prochain événement positif. Cette formulation interdit toute distorsion géométrique optimiste et confère à l’estimateur AP une supériorité méthodologique incontestée, faisant de lui l’indice privilégié dans les compétitions internationales d’extraction d’information et de vision par ordinateur.
9.3 9.3 Intégration de l’indice scalaire dans la légende du graphique
L’association conjointe du tracé de la courbe et de son résumé scalaire dans la légende de la figure constitue une pratique d’excellence scientifique. L’insertion s’effectue dynamiquement en Python en utilisant les fonctionnalités de formatage de chaînes de caractères (f-strings), permettant d’injecter la valeur de l’AP avec un degré de précision d’au moins trois ou quatre décimales significatives :
ap_score = average_precision_score(y_test, y_scores)
plt.plot(recall, precision, label=f'Régression Logistique (AP = {ap_score:.3f})')
Cette synthèse visuo-numérique permet une comparaison instantanée et hautement discriminative entre différentes variantes d’un même algorithme ou entre familles de modèles divergentes (par exemple, confronter un modèle linéaire régularisé à un algorithme d’amplification de gradient comme XGBoost). Dans les contextes de déséquilibre extrême où les aires ROC AUC ont tendance à stagner indifféremment entre zéro virgule quatre-vingt-seize et zéro virgule quatre-vingt-dix-huit pour tous les compétiteurs, l’indice Average Precision discrimine avec netteté les modèles, révélant par exemple des écarts substantiels entre un AP médiocre de zéro virgule trente-cinq et un AP performant de zéro virgule soixante-douze, clarifiant sans ambiguïté le choix de déploiement pour l’ingénieur système.
10. 10. Identification et sélection du seuil de décision optimal
10.1 10.1 Maximisation du score F1 et compromis fonctionnels
Si la courbe précision-rappel cartographie avec exhaustivité le continuum fonctionnel du classifieur, l’application concrète en milieu opérationnel requiert l’isolement d’une valeur de coupure scalaire unique (le seuil thêta optimal) pour commander les actions automatiques de production. Le critère objectif le plus couramment employé dans la littérature consiste à identifier le point maximisant le score F1 global sur l’échantillon d’évaluation. Ce point d’équilibre représente le compromis harmonique idéal où la performance n’est sacrifiée unilatéralement ni sur l’autel de la pureté ni sur celui de l’exhaustivité.
Sur le plan computationnel, l’opération s’exécute de manière vectorisée avec NumPy. On calcule d’abord le vecteur des scores F1 pour chaque palier de la courbe, en prenant soin d’exclure le point terminal artificiel de dimension k + 1 afin d’aligner les longueurs vectorielles avec le tableau thresholds :
f1_scores = (2 * precision[:-1] * recall[:-1]) / (precision[:-1] + recall[:-1] + 1e-10)
best_idx = np.argmax(f1_scores)
best_threshold = thresholds[best_idx]
L’adjonction d’un terme infinitésimal résiduel (1e-10) au dénominateur neutralise toute instabilité consécutive à une division par zéro accidentelle aux franges extrêmes de la distribution. Une fois le point d’indice best_idx extrait, il devient possible de projeter ce point remarquable directement sur la courbe tracée sous forme d’un marqueur circulaire proéminent (plt.scatter), offrant au regard une localisation immédiate du seuil de compromis standard.
10.2 10.2 Personnalisation basée sur une matrice de coûts asymétriques
L’optimisation mathématique centrée sur le score F1 repose sur l’hypothèse implicite que l’occurrence d’un Faux Positif et celle d’un Faux Négatif engendrent des nuisances économiques ou opérationnelles strictement d’égale intensité. Dans le monde réel, cette égalité est quasi systématiquement caduque. L’analyse décisionnelle moderne impose d’adosser le choix du seuil à une fonction de coût formalisée, paramétrant des pondérations financières ou cliniques différentielles :
Perte Totale = C_FP * FP(thêta) + C_FN * FN(thêta)
Dans ce formalisme, C_FP symbolise le coût unitaire marginal associé au déclenchement d’une alerte erronée, tandis que C_FN représente la pénalité allouée à la non-interception d’une instance positive critique. Dans le secteur bancaire anti-fraude, la non-détection d’un virement illégal massif (FN) coûte le montant intégralement spolié, alors que l’envoi d’une notification de confirmation de sécurité sur le terminal d’un client légitime (FP) n’induit qu’une fraction de centime en coût d’infrastructure réseau. En faisant varier le seuil thêta sur son ensemble de définition, l’algorithme calcule pour chaque coordonnée les cardinaux absolus de FP et FN dérivés de la précision et du rappel, puis sélectionne la valeur minimisant la fonction de risque empirique globale, ancrant l’intelligence artificielle dans une rationalité économique explicite.
10.3 10.3 Visualisation simultanée des métriques en fonction des seuils
Bien que la courbe cartésienne classique précision versus rappel soit hautement informative pour les modélisateurs chevronnés, elle occulte la variable fondamentale régissant le système : la valeur physique du seuil décisionnel thêta lui-même. Pour restituer cette dimension essentielle aux décideurs, comités d’audit ou cliniciens, une visualisation complémentaire hautement pédagogique consiste à projeter simultanément l’évolution de la précision et celle du rappel sur l’axe vertical en fonction de l’échelle scalaire des seuils déployée sur l’axe horizontal.
Ce graphique à deux courbes distinctes met immédiatement en scène le croisement structurel des métriques. À mesure que l’axe du seuil progresse de zéro vers un, la courbe de rappel s’affaisse tandis que celle de précision amorce sa trajectoire ascendante. Le point géométrique exact d’intersection de ces deux trajectoires, repérable instantanément, fournit une indication visuelle intuitive du palier d’équivalence opérationnelle. Cette interface graphique offre un levier de négociation transparent lors des arbitrages multidisciplinaires, permettant aux directions métiers de visualiser immédiatement quel volume d’exhaustivité sera consenti ou sacrifié si l’on déplace le curseur réglementaire pour durcir la tolérance aux fausses alertes.
11. 11. Modularité et extensions avancées avec les classes Display de scikit-learn
11.1 11.1 Utilisation de PrecisionRecallDisplay.from_estimator
Dans le but de rationaliser les développements et d’éradiquer le code redondant (boilerplate), les versions modernes de la suite logicielle scikit-learn ont introduit des interfaces orientées objet de haut niveau baptisées Displays. La méthode d’usine PrecisionRecallDisplay.from_estimator encapsule l’intégralité du pipeline opérationnel décrit précédemment en un appel programmatique unique et condensé, minimisant drastiquement le risque d’erreurs d’implémentation manuelle.
Cette fonction requiert simplement la fourniture de l’estimateur statistique préalablement entraîné, de la matrice de test et des étiquettes cibles de validation :
disp = PrecisionRecallDisplay.from_estimator(model, X_test, y_test, name='Modèle Logistique', ax=ax)
En coulisses, la méthode prend automatiquement en charge l’extraction des scores continus via predict_proba, l’inférence vectorielle des coordonnées cartésiennes, le calcul déterministe de l’Average Precision et l’agencement graphique des tracés sur un objet d’axe Matplotlib (ax). Cette encapsulation offre une robustesse logicielle remarquable tout en préservant la configurabilité esthétique du rendu final par la transmission directe d’arguments de style typographique et colorimétrique.
11.2 11.2 Utilisation de PrecisionRecallDisplay.from_predictions
Si la méthode from_estimator brille par sa concision au sein de l’écosystème natif de scikit-learn, les flux industriels contemporains mobilisent fréquemment des architectures prédictives externes hautement spécialisées, à l’instar des bibliothèques d’arbres décisionnels boostés (XGBoost, LightGBM, CatBoost) ou des moteurs d’apprentissage profond reposant sur des graphes de tenseurs différentiables (PyTorch, TensorFlow). Ces systèmes hétérogènes ne partagent pas nécessairement l’API complète des estimateurs de scikit-learn, mais génèrent invariablement des vecteurs de probabilités prédictives.
Pour répondre à cette hétérogénéité d’ingénierie, la classe PrecisionRecallDisplay.from_predictions dissocie formellement la phase de génération prédictive de la logique d’analyse métrique. Cette approche prend en paramètres directs le vecteur de référence vérité-terrain et le tenseur de probabilités prédictives sérialisé au format NumPy natif :
disp = PrecisionRecallDisplay.from_predictions(y_true, y_pred_external, name='Réseau Neurones Profond')
Cette modularité architecturale standardise l’ensemble des protocoles de diagnostic métrologique au sein d’une organisation scientifique, garantissant que des modèles de natures mathématiques profondément disparates sont évalués rigoureusement selon les mêmes formules de calcul et visualisés au sein d’une charte graphique d’évaluation parfaitement cohérente.
11.3 11.3 Superposition multimodèle et validation croisée
L’évaluation rigoureuse d’algorithmes concurrents requiert la superposition simultanée de leurs trajectoires respectives au sein d’un repère cartésien partagé, permettant une appréciation visuelle instantanée des zones de dominance de Pareto. En transmettant le même objet d’axe (ax=ax) lors d’appels successifs aux afficheurs de scikit-learn, le modélisateur juxtapose les tracés, comparant graphiquement par exemple une forêt aléatoire, une régression logistique et une machine à vecteurs de support.
Au-delà de la comparaison statique, la robustesse statistique face aux aléas d’échantillonnage s’apprécie par l’intégration d’un protocole de validation croisée k-fold stratifiée (Stratified K-Fold). Plutôt que de consigner une courbe unique issue d’un partitionnement arbitraire, le chercheur évalue le classifieur sur chaque pli de validation, interpolant les trajectoires de rappel sur une grille uniforme d’abscisses. Cette méthodologie permet d’extraire la courbe de précision moyenne (Mean PR Curve) tout en matérialisant visuellement un intervalle de confiance empirique à plus ou moins un écart-type à l’aide de rubans ombrés semi-transparents via ax.fill_between. Ce déploiement illustre la variance des performances de l’algorithme, discriminant avec acuité les architectures stables de celles sujettes à une trop forte variabilité d’estimation.
12. 12. Rigueur méthodologique, pièges d’interprétation et applications spécialisées
12.1 12.1 Écueils fréquents lors du calcul et du tracé
La pratique quotidienne de la modélisation prédictive est jalonnée de subtilités techniques dont l’inattention peut conduire à des conclusions scientifiques lourdement erronées. Parmi les écueils récurrents recensés dans les laboratoires de recherche computationnelle figure l’inversion d’arguments positionnels au sein des fonctions de l’API logicielle. Les signatures de scikit-learn imposent systématiquement l’ordre canonique (y_true, y_score). Intervertir ces paramètres génère un calcul incohérent qui, bien que ne provoquant pas nécessairement de plantage logiciel immédiat en raison de la similitude des dimensions vectorielles, retourne des coordonnées aberrantes et invalide l’audit.
Un deuxième travers fondamental réside dans le biais d’évaluation consécutif au calcul des métriques sur le jeu de données ayant servi à l’entraînement du modèle plutôt que sur un jeu de test hermétique. Face à des algorithmes à forte capacité mémorielle (comme les arbres non élagués), la précision et le rappel sur la cohorte d’entraînement culmineront artificiellement vers l’unité parfaite, masquant un surapprentissage dévastateur. Enfin, l’absence de mise en perspective de la courbe vis-à-vis de la ligne de base horizontale proportionnelle à la prévalence conduit fréquemment à des contresens majeurs : célébrer une courbe de précision oscillant autour de vingt pour cent comme un échec dans un corpus clinique où la prévalence est de zéro virgule un pour cent constitue une méprise grave, car cette performance traduit en réalité un facteur d’amplification informationnelle de deux cents fois par rapport au hasard.
12.2 12.2 Applications en psychométrie computationnelle et diagnostic clinique
Les sciences biomédicales, la neuro-imagerie et la psychométrie computationnelle constituent des terrains d’application électifs où la courbe précision-rappel exerce une fonction diagnostique prépondérante. Lors du développement de modèles prédictifs fondés sur l’apprentissage automatique pour le dépistage précoce de phénotypes psychiatriques rares, d’idéations suicidaires ou de troubles cognitifs naissants au sein de cohortes épidémiologiques générales, la rareté des cas confirmés place d’emblée l’analyste sous l’égide du déséquilibre de classe aigu.
Dans ces disciplines, la régulation du seuil de décision touche immédiatement à l’éthique médicale. Fixer une exigence de rappel quasi absolu pour intercepter le moindre patient à risque suicidaire peut entraîner une multiplication incontrôlée de faux positifs. Cet étiquetage diagnostique erroné expose des individus psychologiquement stables à des thérapeutiques lourdes, à une anxiété iatrogène majeure et à la stigmatisation sociale inhérente aux dossiers médicaux partagés. À l’inverse, une politique de sur-sélection axée exclusivement sur une précision sans compromis abandonne des sujets en détresse critique sans prise en charge institutionnelle. L’exploration cartésienne de la courbe précision-rappel offre ainsi une interface délibérative indispensable aux comités d’éthique pour calibrer les seuils en toute lucidité sur les compromis sociétaux sous-jacents.
12.3 12.3 Synthèse opératoire et recommandations pour les publications scientifiques
Afin d’assurer la transparence épistémologique et la reproductibilité des résultats lors de la soumission de manuscrits au sein de revues scientifiques à comité de lecture, il est impératif d’adopter une checklist méthodologique formalisée. Cette grille d’assurance qualité prescrit la divulgation systématique des items opératoires suivants :
- Rapportage univoque des métriques scalaires : Publication systématique de l’indice Average Precision (AP) assorti de la méthode exacte d’estimation mathématique mobilisée, en évitant toute confusion lexicale ambiguë entre l’aire intégrée par trapèzes (PR AUC) et la sommation pondérée.
- Explicitation de la prévalence d’arrière-plan : Mention formelle du taux de prévalence brute au sein des cohortes globales, d’entraînement et de validation, systématiquement matérialisé sous la forme d’une ligne de référence horizontale discontinue sur l’ensemble des figures soumises.
- Divulgation transparente des points de fonctionnement : En sus des tracés continus, consignation tabulaire exhaustive des valeurs réelles de précision, de rappel et de spécificité associées aux seuils décisionnels spécifiquement retenus pour les déploiements pratiques, accompagnée des matrices de coûts sous-jacentes ayant motivé ces sélections.
- Ouverture du code source et gestion des dépendances : Partage public des scripts d’évaluation au sein de dépôts pérennes, stipulant explicitement les paramètres de fixation stochastique (random_state) et l’environnement logiciel complet pour autoriser la réplication par les pairs.
Enfin, lorsque la recherche s’étend au-delà du cadre binaire vers des classifications multiclasses déséquilibrées, les mêmes principes méthodologiques commandent l’extension vectorielle selon la stratégie Un-contre-Tous (One-vs-Rest ou OvR). Dans ce scénario étendu, chaque modalité fait l’objet de sa propre courbe précision-rappel dédiée, complétée par des calculs de moyennes macro-pondérées ou micro-agrégées, assurant une fidélité d’évaluation optimale quel que soit le niveau de complexité de l’ontologie d’étiquetage investiguée.
Références
- Davis, J., & Goadrich, M. (2006). The relationship between Precision-Recall and ROC curves. In Proceedings of the 23rd international conference on Machine learning (pp. 233-240). Association for Computing Machinery. https://doi.org/10.1145/1143844.1143874
- Fawcett, T. (2006). An introduction to ROC analysis. Pattern Recognition Letters, 27(8), 861-874. https://doi.org/10.1016/j.patrec.2005.10.010
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Murphy, K. P. (2022). Probabilistic Machine Learning: An Introduction. MIT Press. https://probml.github.io/pml-book/book1.html
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, E. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825-2830. https://jmlr.csail.mit.edu/papers/v12/pedregosa11a.html
- Saito, T., & Rehmsmeier, M. (2015). The precision-recall plot is more informative than the ROC plot when evaluating imbalanced datasets. PLOS ONE, 10(3), e0118432. https://doi.org/10.1371/journal.pone.0118432