
L’analyse exploratoire des données quantitatives constitue le socle fondamental sur lequel repose toute démarche inférentielle rigoureuse. Dans le cadre des plans expérimentaux contemporains, notamment au sein des disciplines comportementales, psychométriques, agronomiques et biomédicales, les chercheurs sont invariablement confrontés à des structures factorielles croisées exigeant la comparaison simultanée de plusieurs sous-populations. Face à de tels agencements de données, les représentations graphiques simplistes, à l’instar des diagrammes en barres flanqués d’écarts-types, échouent de manière dramatique à restituer l’intégralité du profil distributionnel des variables mesurées. L’obscurcissement de l’hétéroscédasticité, la dissimulation de la bimodalité sous-jacente et l’invisibilisation des observations atypiques représentent des menaces directes pour la reproductibilité scientifique et la validité interne des conclusions empiriques.
Pour pallier ces écueils méthodologiques, le diagramme en boîte à moustaches, conceptualisé par le statisticien John Tukey dans le cadre de l’analyse exploratoire des données, s’est imposé comme un standard de rigueur incontournable. Lorsqu’il est décliné sous sa forme groupée, le boxplot permet de projeter sur un même espace bidimensionnel les effets conjugués d’un facteur d’assignation principal et d’un facteur de stratification secondaire sur une variable métrique continue. Cette double partitionnement factoriel offre une vision synoptique immédiate des effets principaux, des asymétries de distribution au sein de chaque strate et des interactions potentielles entre covariables, tout en préservant l’intégrité de la dispersion empirique via des estimateurs robustes non paramétriques.
L’environnement informatique et statistique open-source R, soutenu par l’écosystème conceptuel du Tidyverse et l’implémentation magistrale de la grammaire des graphiques via la bibliothèque ggplot2 conçue par Hadley Wickham, fournit le cadre computationnel le plus abouti pour l’élaboration de ces représentations graphiques sophistiquées. L’objet de cet article est de disséquer de manière exhaustive la théorie statistique, l’architecture informatique et les protocoles de personnalisation esthétique régissant la production d’un boxplot groupé dans R avec ggplot2. À travers un parcours technique structuré, allant de la décomposition mathématique des quantiles aux exigences typographiques des normes APA pour les manuscrits scientifiques, ce guide offre aux analystes et chercheurs un cadre opératoire complet pour transformer des données brutes en visualisations diagnostiques d’une précision irréprochable.
1. Introduction aux boîtes à moustaches groupées dans R et ggplot2
1.1 Définition et rôle statistique du boxplot
Le diagramme en boîte à moustaches, universellement désigné sous l’anglicisme boxplot, constitue une projection graphique standardisée permettant de synthétiser la structure distributionnelle d’une variable métrique univariée continue. Mis au point par le statisticien John Tukey en 1977 au sein de son ouvrage fondateur intitulé Exploratory Data Analysis, ce schéma repose intégralement sur le résumé à cinq nombres. Contrairement aux approches paramétriques classiques qui s’appuient exclusivement sur le calcul de la moyenne arithmétique et de l’écart-type, le boxplot privilégie des métriques d’ordre insensibles aux anomalies numériques extrêmes, offrant ainsi une description robuste de la tendance centrale et de la variabilité.
La morphologie d’une boîte à moustaches articule de manière géométrique cinq jalons fondamentaux de la distribution des données : le minimum non aberrant, le premier quartile (correspondant au 25e centile), la médiane ou second quartile (50e centile), le troisième quartile (75e centile) et le maximum non aberrant. Le corps central de la boîte matérialise l’étendue interquartile, zone délimitée par les premier et troisième quartiles où se concentrent précisément cinquante pour cent des observations centrales. Une ligne transversale rigoureuse coupe la boîte au niveau exact de la médiane, permettant au lecteur d’appréhender instantanément la symétrie ou l’asymétrie de la dispersion interne.
D’un point de vue analytique, la supériorité du boxplot sur les diagrammes à barres conventionnels — péjorativement qualifiés dans la littérature de dynamite plots — est absolue. Les graphiques en barres superposant une hauteur de moyenne et une antenne d’écart-type dissimulent la réalité sous-jacente des données : ils ne révèlent ni la présence éventuelle de poches de bimodalité, ni l’asymétrie positive ou négative de la densité empirique, ni l’existence de valeurs isolées exerçant un levier statistique démesuré. Le boxplot préserve la topologie de l’échantillon, prévenant les déductions erronées et favorisant un diagnostic préliminaire préalable à toute modélisation linéaire ou non linéaire.
1.2 Principe et intérêt du regroupement factoriel
Dans la recherche expérimentale et observationnelle, les phénomènes étudiés sont rarement réductibles à l’action isolée d’un déterminant unilatéral. Le principe du regroupement factoriel au sein d’un diagramme en boîte à moustaches consiste à segmenter la variable réponse continue en fonction du croisement systématique de deux variables catégorielles distinctes. La variable de groupement primaire est généralement projetée le long de l’axe des abscisses, tandis que la variable de groupement secondaire assure une subdivision intra-catégorielle, chaque sous-ensemble étant différencié visuellement par une tonalité chromatique ou un motif spécifique juxtaposé dans la même cellule spatiale.
Cette approche permet d’observer simultanément les variations inter-groupes et intra-groupes à une échelle d’analyse granulaire. Sur le plan méthodologique, le regroupement factoriel permet d’examiner visuellement la présence d’effets d’interaction entre les facteurs expérimentaux. Une interaction se manifeste graphiquement lorsque l’écart de distribution entre les niveaux du second facteur change d’amplitude, d’orientation ou de morphologie selon le niveau considéré du facteur primaire. L’identification visuelle d’un tel mécanisme est cruciale avant d’engager une analyse de variance factorielle (ANOVA) ou un modèle linéaire à effets mixtes.
Cette instrumentation graphique s’avère particulièrement déterminante au sein des protocoles en sciences comportementales et en psychométrie. Par exemple, lors de l’évaluation de scores d’anxiété ou de temps de réaction cognitive, la stratification simultanée selon le groupe clinique (contrôle versus pathologie) et selon le paradigme expérimental (condition neutre versus stressante) dévoile immédiatement si la réactivité au stress est modulée par le terrain clinique sous-jacent. Le boxplot groupé condense ainsi une complexité multivariée substantielle sans nécessiter la multiplication confuse de panneaux graphiques distincts.
1.3 L’architecture graphique de ggplot2
L’implémentation des boîtes à moustaches groupées dans l’environnement statistique R trouve son apogée technique au travers de la bibliothèque ggplot2. Cette extension révolutionnaire repose sur les concepts théoriques exposés par Leland Wilkinson dans son ouvrage canonique The Grammar of Graphics. Plutôt que de traiter le graphique comme une image figée composée de primitives de dessin indépendantes, la grammaire des graphiques postule qu’une visualisation de données s’édifie par la combinaison harmonieuse de composantes structurelles indépendantes et empilables.
L’architecture de ggplot2 repose sur un principe d’empilement de couches successives (dénommées layers). À la base se trouvent les données brutes, qui doivent impérativement être formatées selon un paradigme rectangulaire rigoureux. Sur ces données vient s’appliquer la couche de correspondance esthétique, matérialisée par la fonction aes(). Cette dernière cartographie les variables du jeu de données vers des attributs visuels perceptibles, tels que la position spatiale horizontale ou verticale, la teinte de remplissage, la couleur des bordures ou la transparence. Viennent ensuite les couches géométriques, à l’instar de geom_boxplot(), qui déterminent la forme visuelle concrète assignée aux correspondances esthétiques.
La supériorité technique de ggplot2 face au système graphique de base de R (représenté par les fonctions boxplot() ou plot()) réside dans sa gestion automatisée et dynamique de la complexité. Alors que les fonctions graphiques historiques exigent une orchestration manuelle laborieuse des espacements latéraux, de la création des légendes et de la synchronisation des palettes de couleurs pour chaque sous-groupe, ggplot2 calcule automatiquement les décalages de positionnement spatial, ajuste les échelles cartésiennes et génère des légendes cohérentes et adaptatives, assurant un gain de productivité considérable et une reproductibilité sans faille.
2. Fondements statistiques : Le résumé à cinq nombres et la détection d’anomalies
2.1 Calcul et décomposition des quartiles
L’assise formelle de la boîte à moustaches repose sur le partitionnement ordonné de l’échantillon d’observations en quatre sous-ensembles équiprobables via le calcul des quartiles. Soit un vecteur de valeurs réelles ordonnées de manière croissante. Le premier quartile, couramment noté Q1, correspond à la valeur au-dessous de laquelle se trouvent vingt-cinq pour cent des observations les plus basses de l’échantillon. Le second quartile, universellement désigné comme la médiane empirique (Q2), sépare la distribution en deux moitiés parfaitement égales, garantissant que cinquante pour cent des valeurs lui soient inférieures et cinquante pour cent supérieures. Le troisième quartile, noté Q3, correspond au seuil en dessous duquel se positionnent soixante-quinze pour cent des données enregistrées.
La distance métrique séparant le premier quartile du troisième quartile constitue l’intervalle interquartile (IQR = Q3 – Q1). Contrairement à l’écart-type ou à la variance, qui incorporent les carrés des écarts à la moyenne et subissent de ce fait une instabilité dramatique face aux perturbations extrêmes, l’intervalle interquartile offre une mesure de dispersion non paramétrique caractérisée par un point de rupture élevé de vingt-cinq pour cent. L’écartement physique de la boîte centrale d’un boxplot matérialise directement cet IQR, offrant un indice visuel immédiat de l’hétérogénéité des données au sein du cœur de la distribution.
L’évaluation comparative de l’emplacement de la médiane au regard des charnières que représentent Q1 et Q3 livre des indications directes sur la forme de la loi distributionnelle. Lorsque la médiane est positionnée à égale distance de Q1 et de Q3, et que les longueurs relatives de part et d’autre sont équivalentes, la distribution témoigne d’une parfaite symétrie. À l’inverse, si la médiane se contracte vers le bas, à proximité immédiate de Q1, tout en laissant un vaste espace en direction de Q3, la distribution accuse une asymétrie positive (étalement vers la droite). Une médiane accotée à Q3 dénote quant à elle une asymétrie négative (étalement vers la gauche).
2.2 Délimitation des moustaches et critères de Tukey
Au-delà de la délimitation de la boîte centrale, le tracé des antennes — ou moustaches — obéit à un algorithme mathématique strict défini par Tukey afin de discriminer objectivement les variations aléatoires ordinaires des fluctuations résiduelles atypiques. Le calcul initie la projection d’intervalles de tolérance théoriques, traditionnellement appelés barrières intérieures. La limite inférieure théorique se définit par la soustraction d’une fois et demie l’écart interquartile au premier quartile (Q1 – 1,5 × IQR). Symétriquement, la limite supérieure théorique est établie en additionnant une fois et demie l’écart interquartile au troisième quartile (Q3 + 1,5 × IQR).
Cependant, une méconception courante consiste à croire que les moustaches se prolongent systématiquement jusqu’à ces barrières théoriques. Dans la rigueur de l’algorithme standard de Tukey appliqué par ggplot2, l’extrémité de la moustache supérieure s’arrête très exactement à la valeur observée la plus élevée qui demeure inférieure ou égale à la barrière supérieure (Q3 + 1,5 × IQR). Réciproquement, l’extrémité de la moustache inférieure s’arrête à la valeur empirique la plus basse qui reste supérieure ou égale à la barrière inférieure (Q1 – 1,5 × IQR). Les moustaches sont donc intrinsèquement calées sur des données effectives de l’échantillon.
Toute donnée dont la valeur excède strictement ces barrières intérieures est formellement catégorisée comme une valeur aberrante ou atypique (désignée par le terme outlier). Dans le rendu graphique du boxplot, ces observations ne sont pas incorporées dans l’allongement des moustaches : elles sont isolées et projetées sous la forme de points géométriques disjoints. Cette ségrégation visuelle prévient la contamination de la perception de l’amplitude globale et alerte sans ambiguïté le statisticien quant à l’existence de cas extrêmes méritant une investigation clinique ou expérimentale ciblée.
2.3 Sensibilité distributionnelle et tests de robustesse
Bien que le boxplot constitue un instrument d’analyse exploratoire remarquablement polyvalent, le statisticien averti doit en appréhender les frontières de validité et la sensibilité distributionnelle. Le principal angle mort du boxplot réside dans son incapacité structurelle à diagnostiquer les phénomènes de multimodalité. Une distribution parfaitement unimodale et symétrique peut présenter un résumé à cinq nombres strictement identique à celui d’une distribution hautement biconcave ou bimodalement scindée en deux populations distinctes. Dans une telle situation, la boîte centrale agrège indistinctement les deux sommets sous un intervalle interquartile trompeusement homogène.
Pour cette raison, le boxplot gagne à être systématiquement articulé avec des indicateurs complémentaires de forme, notamment le coefficient d’aplatissement (kurtosis) et le coefficient d’asymétrie (skewness). Le diagnostic d’un aplatissement excessif permet d’anticiper la présence de queues de distribution lourdes, lesquelles se traduisent visuellement par une multiplication inhabituelle de points aberrants au-delà des moustaches. L’asymétrie documentée par les moments statistiques corrobore empiriquement le décalage observé de la ligne médiane au sein de la boîte centrale.
La robustesse des estimations issues du boxplot face à celles découlant des paramètres gaussiens conventionnels s’apprécie particulièrement en présence de contaminations lourdes. Alors qu’une unique valeur aberrante peut accroître démesurément la variance empirique et dévier la moyenne arithmétique de plusieurs unités d’écart-type, le résumé de Tukey préserve l’intégrité des conclusions descriptives. La boîte à moustaches garantit ainsi un filtre épistémologique indispensable contre les distorsions analytiques induites par des artefacts instrumentaux ou des erreurs de saisie.
3. Préparation de l’environnement R et configuration des données
3.1 Installation et chargement des packages requis
Pour garantir une exécution fluide et reproductible de nos procédures graphiques, l’infrastructure logicielle doit être rigoureusement configurée. Le travail dans l’environnement R nécessite l’installation et le chargement préalable de la bibliothèque ggplot2, idéalement complétée par la panoplie d’outils de manipulation du package dplyr. Ces modules sont tous deux intégrés au méta-package Tidyverse, mais peuvent être acquis de façon autonome depuis le réseau officiel du CRAN (Comprehensive R Archive Network).
L’installation s’opère par l’appel de la commande install.packages(« ggplot2 ») et install.packages(« dplyr ») au sein de la console R. Une fois le déploiement sur le disque dur accompli, les bibliothèques doivent être rendues disponibles pour la session de travail active à l’aide des instructions library(ggplot2) et library(dplyr). Ce chargement séquentiel initialise les fonctions d’agencement visuel et les opérateurs de transformation de pipelines, autorisant une interaction directe entre le nettoyage structurel des données et leur transcription graphique immédiate.
Il est impératif de contrôler régulièrement la compatibilité des versions de R et des dépendances logicielles. L’utilisation d’une version de R supérieure ou égale à 4.1.0 est hautement recommandée afin de bénéficier des améliorations natives de gestion des palettes graphiques et du nouvel opérateur de tuyau fonctionnel. La consultation régulière de sessionInfo() permet d’archiver la traçabilité computationnelle exacte des packages sollicités, condition fondamentale pour répondre aux exigences modernes de reproductibilité imposées par les comités éditoriaux scientifiques.
3.2 Structuration des variables au format long (Tidy Data)
L’une des causes les plus récurrentes d’échec ou de dysfonctionnement lors de la tentative de création d’un boxplot groupé dans ggplot2 découle d’une mauvaise architecture dimensionnelle du jeu de données. La grammaire de ggplot2 exige inconditionnellement que les collections de données adoptent le paradigme dit du format long (ou tidy data). Selon les axiomes formalisés par Hadley Wickham, ce format impose trois contraintes structurelles indissociables : chaque variable observée doit posséder sa colonne exclusive, chaque unité expérimentale ou observation doit occuper une ligne unique, et chaque cellule doit renfermer une seule et unique valeur scalaire.
Dans un contexte d’analyse factorielle, il est fréquent que les expérimentateurs conservent leurs mesures sous un format large, où les différents traitements ou niveaux de sous-groupes sont éclatés à travers de multiples colonnes distinctes. Une telle disposition empêche ggplot2 d’assigner une esthétique unique de groupement. La conversion préalable du format large vers le format long s’effectue aisément à l’aide des fonctions de restructuration du package tidyr, telles que pivot_longer(), qui permettent de rabattre les colonnes de mesures multiples vers une unique colonne de variable métrique couplée à une colonne indicatrice du facteur.
Au-delà de la forme rectangulaire du tableau, le typage strict des variables constitue un impératif technique non négociable. Les colonnes destinées à piloter l’axe des abscisses et le fractionnement chromatique doivent impérativement être explicitées en tant que facteurs catégoriels dans R via l’instruction as.factor(). Si une variable expérimentale numérique (par exemple codée 1 pour le groupe témoin et 2 pour le groupe traité) est conservée sous le type numérique de base (integer ou double), ggplot2 l’interprétera comme un continuum scalaire. Cette erreur de typage anéantit le mécanisme de regroupement discret et produit un diagramme confus dépourvu de décalage spatial entre les catégories.
3.3 Création d’un jeu de données empirique reproductible
Afin de concrétiser les manipulations techniques exposées tout au long de cette étude, nous élaborons un jeu de données empirique entièrement reproductible. Pour ce faire, nous fixons préalablement la graine du générateur de nombres pseudo-aléatoires au moyen de l’instruction set.seed(123), garantissant que chaque lecteur exécutant le protocole obtienne des distributions numériques strictement identiques à celles documentées dans nos développements.
Imaginons un protocole d’évaluation neuropsychologique à grande échelle portant sur trois cohortes cliniques distinctes (Groupe Contrôle, Trouble Anxieux Généralisé, Épisode Dépressif Majeur) soumises à deux paradigmes d’administration d’un traitement cognitif (Condition Placebo versus Entraînement Cognitif Actif). La variable continue d’intérêt correspond au temps de réponse exécutif exprimé en millisecondes. En utilisant les fonctions rep() pour répliquer méthodiquement les niveaux des facteurs et rnorm() pour simuler des gaussiennes aux moyennes et variances modulées par l’appartenance aux sous-groupes, nous formons un tableau de données exhaustif comptant trois cents observations.
L’inspection analytique de ce tableau s’opère au moyen de la fonction str(), qui permet de s’assurer de la correcte conversion des prédicteurs catégoriels en facteurs ordonnés ou nominaux, et de la nature numérique flottante de la mesure d’intérêt. La commande complémentaire head() vérifie la rectitude de l’alignement des colonnes. Cet échantillon factice mais réaliste intègre volontairement des décalages de moyennes, des amplifications d’hétéroscédasticité et des asymétries distributionnelles calibrées pour éprouver les facultés diagnostiques de nos futures boîtes à moustaches groupées.
4. Construction syntaxique du boxplot groupé de base
4.1 Initialisation du canevas avec ggplot()
La matérialisation d’un graphique sous ggplot2 débute par l’invocation de la fonction homonyme ggplot(), qui a pour fonction exclusive d’instancier l’objet graphique et d’établir le contrat de liaison entre la structure de données sous-jacente et les variables cartographiques. L’argument fondamental data accueille le data frame préparé selon les canons du format long. La commande ggplot(data = donnees_experimentales) crée un canevas vierge, une toile de fond neutre dénuée de tout élément pictural, mais désormais informée du contexte référentiel de l’échantillon.
Dans cette même impulsion syntaxique, la fonction aes(), abrégée pour aesthetics, est encapsulée au sein de ggplot() afin d’assigner les coordonnées primaires du système cartésien bidimensionnel. Nous spécifions l’argument x en lui assignant la variable catégorielle principale (notre facteur clinique à trois niveaux) et l’argument y en lui attribuant la variable quantitative métrique (le temps de réponse exécutif). Cette déclaration informe l’interpréteur de ggplot2 de la nature des axes : l’axe horizontal sera subdivisé en trois paliers discrets fixes, tandis que l’axe vertical sera calibré sur une échelle linéaire métrique continue.
À ce stade préparatoire, aucun objet géométrique n’est encore généré. L’exécution de cette seule instruction produit une zone graphique structurée, graduée et étiquetée avec les noms des colonnes déclarées, mais totalement dépourvue de données visibles. Ce cloisonnement délibéré entre l’assignation des axes et la projection de formes matérielles incarne la puissance de la grammaire des graphiques : la scène est géométriquement verrouillée avant que les objets de synthèse distributionnelle ne viennent y prendre place.
4.2 Dédoublement factoriel avec l’esthétique fill
L’opération centrale qui transforme un simple boxplot univarié en une boîte à moustaches groupée réside dans l’introduction d’un second facteur de stratification au sein de la fonction esthétique aes(). Pour concrétiser cette décomposition factorielle, deux arguments distincts sont envisageables : colour et fill. Il importe de maîtriser la frontière fonctionnelle entre ces deux attributs. L’argument colour régit exclusivement la teinte des contours linéaires, des segments de bordure et des points aberrants. En revanche, l’argument fill dicte la tonalité de remplissage intérieur de l’aire géométrique polygonale formant le cœur de la boîte.
Dans la conception standardisée d’un boxplot groupé, l’argument fill constitue le vecteur préférentiel de regroupement. En intégrant la directive fill = Condition_Traitement à l’intérieur de aes(), l’analyste ordonne à ggplot2 de scinder chaque cellule spatiale de l’axe x en autant de sous-entités visuelles qu’il existe de niveaux dans la variable de traitement. ggplot2 prend alors en charge la totalité de la mécanique combinatoire : il génère un partitionnement automatique, sélectionne des couleurs différentielles par défaut et projette instantanément une légende explicative sur le flanc latéral de l’espace graphique.
Cette approche évite tout risque de confusion visuelle. Si l’on commettait l’erreur d’utiliser colour à la place de fill, les boîtes présenteraient des bordures colorées mais un fond uniformément transparent, ce qui réduirait drastiquement la lisibilité des contrastes chromatiques en cas de superposition ou d’impression papier. L’arbitrage judicieux en faveur de fill garantit que l’œil humain perçoive immédiatement l’entité surfacique de chaque sous-groupe comme un bloc distinct, facilitant l’intégration cognitive des disparités distributionnelles.
4.3 Application de la couche géométrique geom_boxplot()
La matérialisation physique effective du graphique s’opère par la jonction de la couche géométrique geom_boxplot(), rattachée au canevas principal par l’opérateur arithmétique d’addition (+). L’adjonction de cette fonction déclenche l’exécution des algorithmes statistiques de Tukey sur chaque sous-échantillon croisé. ggplot2 segmente les données en cellules correspondant aux couples formés par chaque niveau de x et chaque niveau de fill, calcule de façon totalement autonome les cinq nombres de Tukey pour chacune de ces sous-populations, et dessine les boîtes et leurs moustaches associées.
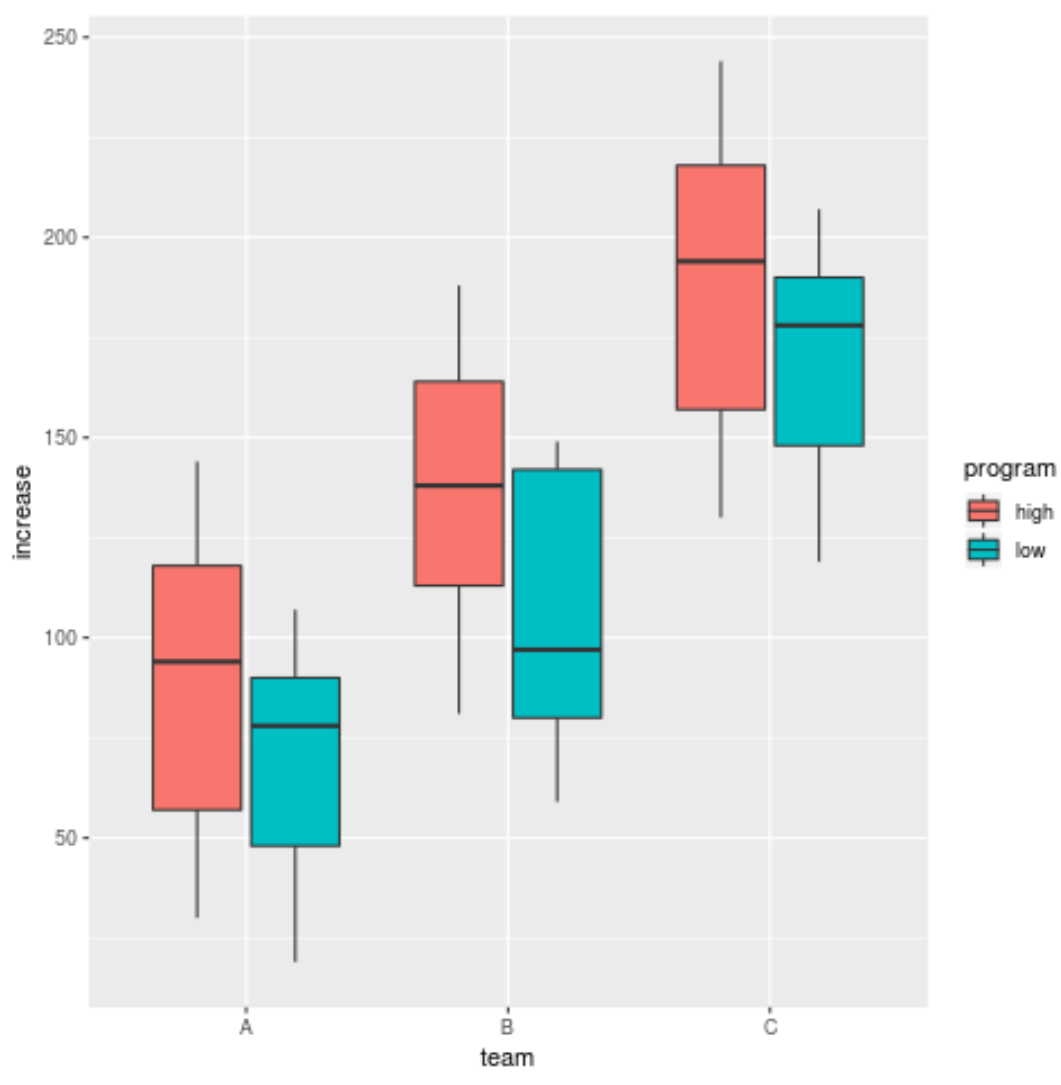
Le comportement fondamental de geom_boxplot() lorsqu’une variable de remplissage (fill) est déclarée repose sur le paramètre de positionnement latéral nommé dodge. Par défaut, la fonction assigne l’argument position = « dodge », ce qui force les boîtes à moustaches associées à une même modalité de l’axe x à se décaler horizontalement les unes à côté des autres de manière parfaitement symétrique, au lieu de se chevaucher ou de s’empiler. Ce décalage préserve la visibilité intégrale de chaque polygone tout en conservant leur affiliation évidente à la catégorie primaire de l’axe horizontal.
Dès l’affichage du premier tracé, une vérification visuelle rigoureuse s’impose à l’analyste. Il convient de contrôler que chaque modalité de l’axe x présente bien le nombre attendu de boîtes jumelées, que les décalages spatiaux n’induisent aucun débordement en dehors de la grille de mesure, et que les moustaches traduisent avec cohérence la variabilité empirique documentée dans le tableau de données. Ce premier jet synthétique offre d’emblée une vue panoramique des distributions croisées, constituant la pierre angulaire des futurs enrichissements graphiques.
5. Inversion stratégique des variables et interprétation cognitive
5.1 Permutation des axes et des facteurs de regroupement
Dans la construction d’un diagramme factoriel à deux voies, le statisticien dispose d’un degré de liberté fondamental : le choix de l’assignation respective des facteurs entre l’axe des abscisses (x) et l’esthétique de remplissage (fill). Ce choix est loin d’être anodin et ne doit pas résulter d’une décision arbitraire. La structure visuelle du graphique conditionne directement la nature des comparaisons cognitives que le cerveau humain effectuera avec le plus d’acuité et de rapidité.
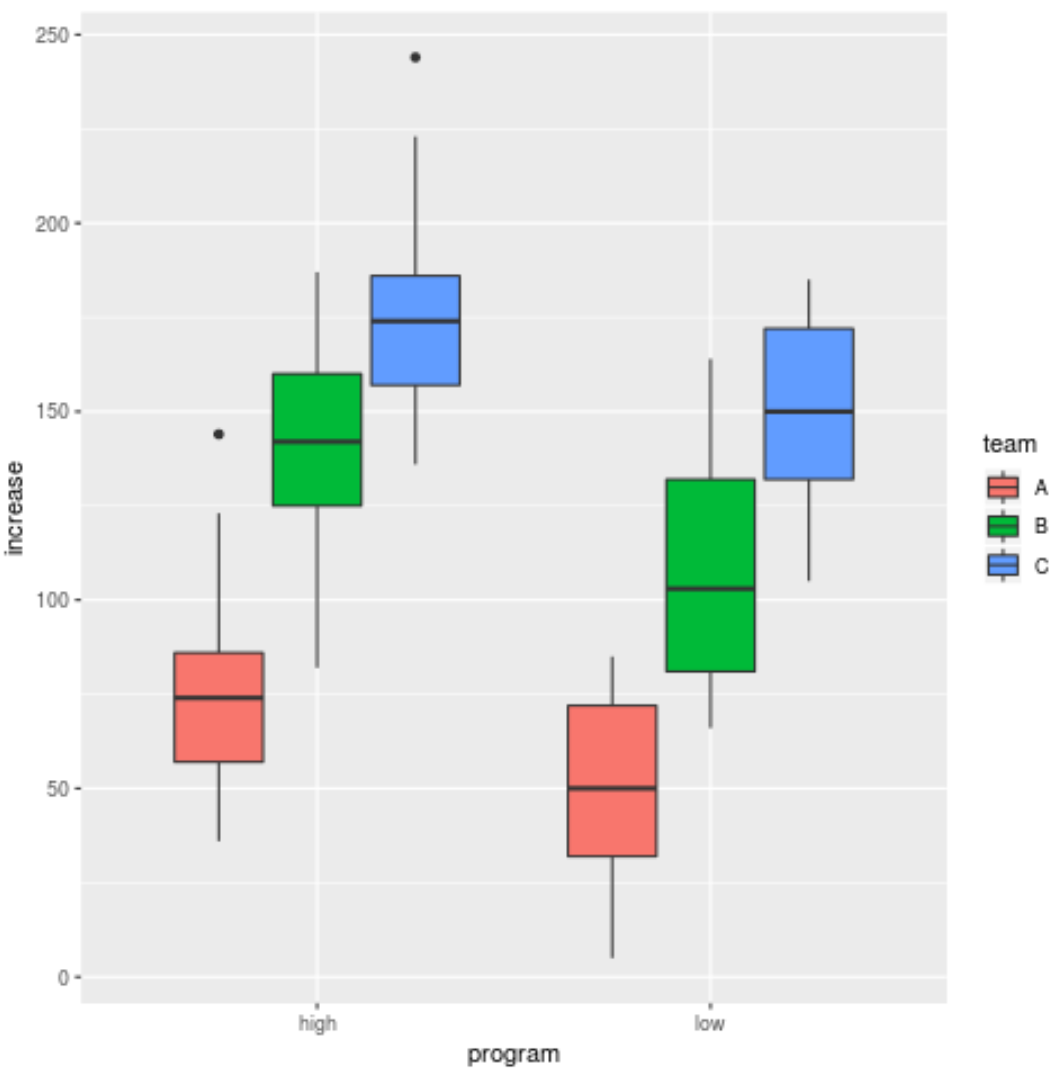
Lorsque la cohorte clinique est assignée à l’axe x et le traitement à l’argument fill, le lecteur est visuellement incité à prioriser les comparaisons intra-groupes : il jauge avec une facilité déconcertante l’efficacité du traitement au sein de chaque pathologie prise isolément, car les deux boîtes à moustaches associées sont immédiatement contiguës. À l’inverse, si l’on inverse cette configuration en affectant le traitement à l’axe x et les cohortes cliniques au remplissage fill, l’attention analytique pivote vers des comparaisons inter-pathologies au sein d’une même modalité thérapeutique.
La sélection de l’architecture d’affichage optimale doit impérativement s’aligner sur les hypothèses de recherche préenregistrées dans le protocole expérimental. Si l’interrogation scientifique porte principalement sur la modulation différentielle d’un traitement spécifique en fonction du diagnostic psychiatrique, la première option doit être retenue. Cette réflexivité critique quant au rôle assigné à chaque variable optimise la saillance de l’information statistique et prévient les erreurs d’interprétation chez les évaluateurs et les pairs lors de la communication des résultats.
5.2 Orientation horizontale des boîtes à moustaches
La disposition cartésienne standard positionne invariablement la variable métrique sur l’ordonnée verticale et les catégories qualitatives sur l’abscisse horizontale. Bien que cette convention soit solidement ancrée dans les habitudes de publication, elle engendre des contraintes graphiques majeures dès lors que les libellés textuels des modalités catégorielles présentent une longueur typographique significative. Les intitulés se chevauchent alors inévitablement, obligeant l’analyste à des contorsions esthétiques malvenues telles que la rotation diagonale ou le tronquage des étiquettes.
Pour résoudre élégamment cette impasse typographique, le basculement horizontal de l’ensemble du système d’axes s’avère particulièrement judicieux. Historiquement, cette transformation s’obtenait par l’adjonction de la fonction coord_flip() à la fin de la chaîne d’instructions ggplot2. Depuis les versions récentes du moteur graphique, il est également possible de permuter directement les déclarations au sein de aes(), en affectant la variable quantitative à l’argument x et la variable catégorielle primaire à l’argument y, tout en conservant fill pour le découpage factoriel secondaire.
Cette orientation horizontale présente l’avantage ergonomique d’aligner les étiquettes textuelles parallèlement au sens naturel de lecture de l’œil occidental. Les dénominations cliniques complexes, les descriptions anatomiques ou les formulations psychométriques détaillées peuvent ainsi se déployer dans toute leur extension sans jamais perturber la trajectoire des boîtes à moustaches. En outre, ce format permet souvent une comparaison plus intuitive de l’asymétrie distributionnelle le long d’une échelle horizontale rappelant la ligne naturelle des nombres réels.
5.3 Évaluation de la charge cognitive lors de la lecture des graphiques
L’efficacité de la communication scientifique par l’image repose sur des principes psychophysiques rigoureux issus de la psychologie de la forme, communément désignée sous le nom de théorie de la Gestalt. Le cerveau humain décode les scènes visuelles en appliquant inconsciemment des lois de proximité spatiale, de similarité chromatique et de continuité de contour. Dans un boxplot groupé, deux boîtes partageant la même teinte de remplissage sont instantanément perçues comme appartenant à une classe commune (loi de similarité), tandis que deux boîtes spatialement contiguës sont agrégées au sein d’une même entité expérimentale (loi de proximité).
La détection d’une interaction factorielle requiert une gymnastique visuelle exigeante : l’observateur doit comparer la pente imaginaire ou le décalage relatif reliant les centres des boîtes sous une condition avec le décalage observé sous une autre modalité. Si la distance séparant les boîtes d’un même groupe est disproportionnée ou si l’agencement chromatique est chaotique, la charge cognitive extrinsèque s’accroît considérablement, au détriment de l’assimilation du signal biologique ou comportemental d’intérêt.
Pour concevoir des visualisations destinées à des revues scientifiques de premier rang, l’auteur doit minimiser tout ce qu’Edward Tufte qualifie de chartjunk — c’est-à-dire le bruit graphique superflu. L’équilibre entre l’espacement intra-groupe et l’espacement inter-groupes doit être soigneusement dosé afin de maximiser le rapport signal/bruit. Une boîte à moustaches groupée réussie doit autoriser un décodage pré-attentionnel quasi instantané : en moins de cinq secondes d’examen, le lecteur doit avoir isolé l’effet de groupe, la tendance générale du traitement et l’éventuelle inversion de polarité traduisant une interaction statistique majeure.
6. Personnalisation esthétique : Palettes chromatiques et contours
6.1 Gestion des palettes de couleurs scientifiques
Les palettes de couleurs appliquées par défaut par ggplot2, fondées sur une distribution équidistante des teintes autour du cercle chromatique HSL, souffrent de faiblesses perceptuelles rédhibitoires pour l’édition scientifique. Leurs niveaux de luminance ne sont pas calibrés de manière homogène, ce qui tend à conférer artificiellement un poids visuel supérieur à certaines catégories au détriment d’autres. La mise en place de palettes chromatiques scientifiquement validées constitue donc un prérequis méthodologique fondamental.
L’analyste dispose de plusieurs leviers au sein de l’environnement R. L’assignation manuelle et déterministe des codes hexadécimaux s’opère au moyen de la fonction scale_fill_manual(), au sein de laquelle on injecte un vecteur nommé associant précisément chaque modalité factorielle à une nuance chromatique spécifique (values = c(« Placebo » = « #2b5c8f », « Traitement » = « #d95f02 »)). Cette approche garantit une stabilité graphique absolue lors de la génération séquentielle de multiples figures destinées à un même manuscrit de recherche.
Une alternative élégante réside dans l’exploitation des échelles issues de la bibliothèque RColorBrewer via scale_fill_brewer(palette = « Set2 ») ou, plus robuste encore, dans l’intégration des échelles perceptuellement uniformes du package viridis avec scale_fill_viridis_d(). Conçues spécifiquement pour la visualisation de données complexes, les palettes de viridis assurent une progression linéaire et continue de la luminance, éliminant tout artéfact cognitif et conférant au boxplot groupé une sobriété esthétique en parfaite résonance avec les canons contemporains de l’édition scientifique.
6.2 Ajustement de la transparence et de l’épaisseur des traits
L’impact visuel d’une boîte à moustaches ne dépend pas exclusivement de la teinte de son aplat intérieur ; il procède également d’une articulation subtile entre la texture du remplissage et la fermeté des contours géométriques. L’opacité des boîtes se module via l’argument alpha inséré directement dans geom_boxplot(). En fixant une valeur fractionnaire (par exemple alpha = 0.75), on atténue la saturation de la couleur de remplissage, ce qui adoucit le rendu global et prépare le terrain visuel pour l’éventuelle superposition ultérieure de nuages de points de dispersion individuels.
Parallèlement, la définition structurelle des bordures polygonales et des segments de moustaches exige un calibrage rigoureux. Le paramètre size ou linewidth (selon la version de ggplot2) contrôle l’épaisseur des traits de dessin. Une valeur de trait trop fine engendre un phénomène de flou optique lors de l’impression sur support physique ou de la réduction à l’échelle d’une colonne de journal, tandis qu’un trait excessivement épais alourdit le graphique et oblitère la position fine de la médiane.
L’harmonisation des contours s’accomplit en jouant sur l’argument colour au sein de geom_boxplot(). En substituant au noir pur (#000000) une nuance plus feutrée de gris ardoise foncé (telle que #2b2b2b ou « gray20 »), l’analyste supprime le contraste excessif et agressif entre l’intérieur de la boîte et son cerclage extérieur. Cette régulation méticuleuse de la géométrie linéaire valorise la perception globale de la distribution tout en préservant la distinction chirurgicale des quantiles empiriques.
6.3 Accessibilité visuelle et critères d’impression
La dissémination universelle du savoir scientifique requiert impérativement la prise en compte de l’accessibilité visuelle dès l’étape de conception des figures. Une proportion significative de la population masculine (environ huit pour cent) présente des déficits congénitaux de la vision des couleurs, principalement regroupés sous les formes de deutéranopie et de protanopie (confusion du rouge et du vert). L’usage de palettes chromatiques juxtaposant des nuances rouges et vertes sans variation drastique de luminance rend le boxplot groupé strictement illisible pour cette communauté de lecteurs.
L’adoption systématique d’échelles chromatiques insensibles au daltonisme, telles que les palettes Viridis, Magma, Cividis ou Color Universal Design (CUD), s’impose comme une norme éthique et technique. Ces palettes garantissent que les sous-groupes factoriels demeurent instantanément différenciables, non seulement par la teinte, mais surtout par des contrastes de luminosité rigoureusement différenciés que l’œil perçoit sans altération même sous une vision monochromatique.
Enfin, il demeure impératif d’anticiper les contraintes de reproduction physique en noir et blanc appliquées par certaines presses universitaires traditionnelles. Un boxplot groupé optimisé doit pouvoir être converti en niveaux de gris purs sans qu’aucune confusion n’émerge entre les niveaux du facteur secondaire. L’analyste averti testera virtuellement son tracé sous une matrice de désaturation complète pour s’assurer que les nuances de gris respectives conservent une pente de contraste suffisante pour identifier sans ambiguïté les catégories associées à chaque polygone.
7. Contrôle rigoureux et mise en forme des valeurs aberrantes
7.1 Modification des attributs des points aberrants
Dans la géométrie d’une boîte à moustaches, les observations excédant les barrières de Tukey constituent des signaux statistiques de première importance qui ne doivent en aucun cas être noyés dans la masse picturale. Par défaut, ggplot2 représente ces valeurs atypiques sous forme de disques pleins de couleur noire uniforme. Cependant, geom_boxplot() renferme une collection dédiée de paramètres de contrôle permettant d’ajuster finement l’apparence de ces valeurs extrêmes afin d’en moduler la saillance diagnostique.
L’attribut outlier.colour permet d’assigner une teinte individualisée à l’ensemble des points aberrants, indépendamment de la couleur de bordure des boîtes. Par exemple, l’application d’un rouge carmin ou d’un bordeaux sombre permet d’attirer immédiatement le regard de l’évaluateur sur les anomalies distributionnelles. Conjointement, l’argument outlier.shape autorise la substitution du disque standard par des formes géométriques alternatives issues du codage standard de R (telles que des losanges évidés, des croix ou des triangles), renforçant la signalétique de l’anomalie.
Le dimensionnement métrique des points d’anomalies s’ajuste quant à lui via l’argument outlier.size. Dans des configurations expérimentales impliquant de vastes cohortes de données (plusieurs milliers d’unités d’échantillonnage), les outliers ont tendance à s’agglomérer massivement au-delà des moustaches, générant des zones de saturation graphique indésirables. Une réduction proportionnelle de la taille des points (par exemple outlier.size = 1.2), couplée à un assouplissement de leur transparence (outlier.alpha = 0.5), restaure la granularité de l’affichage et permet de dénombrer visuellement les foyers de données divergentes.
7.2 Masquage technique des outliers sans altération statistique
Une des situations techniques les plus délicates survient lorsque l’expérimentateur décide de superposer un nuage de points individuels (jitter) sur son boxplot groupé afin de dévoiler l’intégralité des données empiriques. Si aucune précaution syntaxique n’est prise, un artéfact méthodologique majeur se produit immanquablement : les valeurs aberrantes sont représentées deux fois sur la figure ! Une première fois par la couche geom_boxplot() en tant qu’outlier calculé, et une seconde fois par la couche d’échantillonnage des points individuels, créant une superposition décalée préjudiciable à la précision de la lecture.
Face à cet écueil, une erreur catastrophique consisterait à filtrer le tableau de données en amont pour éliminer les observations extrêmes avant de soumettre les données à ggplot2. Une telle manipulation altérerait gravement le calcul sous-jacent des quartiles, de la médiane et de l’écart interquartile, aboutissant à une boîte à moustaches biaisée ne reflétant plus la réalité mathématique de l’échantillon initial. La doctrine statistique impose de préserver l’intégrité de la série complète lors du calcul des résumés d’ordre.
La solution technique rigoureuse consiste à masquer le tracé des points aberrants au sein même de la géométrie de boîte, sans en affecter le modèle de calcul sous-jacent. Cet effacement ciblé s’opère en spécifiant l’instruction outlier.shape = NA (ou outlier.colour = NA) directement dans les paramètres de geom_boxplot(). De cette façon, ggplot2 calcule scrupuleusement la position des moustaches sur la base de la totalité des données incluant les valeurs extrêmes, mais renonce à matérialiser les points résiduels isolés, laissant à la couche géométrique subséquente le soin de dessiner ces observations de manière fluide et unifiée.
7.3 Analyse empirique des cas extrêmes en psychométrie
Au-delà de la virtuosité technique requise pour leur mise en forme dans R, la présence de valeurs aberrantes au sein d’un boxplot groupé soulève des interrogations théoriques de premier plan, singulièrement dans le périmètre des sciences psychométriques et comportementales. Face à un point d’observation rejeté au-delà des moustaches de Tukey, l’analyste doit impérativement conduire une autopsie diagnostique rigoureuse afin d’élucider l’étiologie statistique de ce décrochage.
Deux sources radicalement distinctes président à la genèse de ces valeurs atypiques. D’une part, elles peuvent résulter d’erreurs instrumentales patentes, d’artéfacts d’encodage numérique (par exemple une inversion involontaire de chiffres lors de la frappe) ou de comportements parasites du participant (déficit motivationnel manifeste, non-respect avéré de la consigne d’un chronomètre psychologique). D’autre part, ces points extrêmes peuvent incarner l’expression authentique d’une variabilité phénotypique ou biologique réelle, traduisant l’existence d’une sous-population clinique non diagnostiquée ou de mécanismes d’hyper-réactivité physiologique rares mais parfaitement valides.
L’élimination arbitraire et non documentée de ces cas atypiques dans le seul dessein de normaliser la distribution constitue une infraction épistémologique sévère, susceptible de gonfler artificiellement le taux d’erreur de première espèce dans les tests inférentiels ultérieurs. La boîte à moustaches groupée joue ici le rôle de lanceur d’alerte : elle impose à l’expérimentateur d’expliciter, au sein de la section méthodologique de ses publications, le protocole post-hoc appliqué (analyses de sensibilité, recours à des modèles linéaires robustes ou transformations logarithmiques stabilisatrices) pour traiter ces singularités empiriques.
8. Enrichissement graphique : Superposition de points et densités
8.1 Ajout des données brutes avec geom_jitter()
Si la boîte à moustaches excelle dans la synthèse compacte des quantiles fondamentaux, elle opère par essence une condensation massive qui prive le lecteur de la connaissance fine de la distribution des effectifs sous-jacents. L’adjonction des points d’observations bruts directement sur les polygones de boîtes constitue une pratique d’excellence de plus en plus plébiscitée par les comités de lecture internationaux, car elle apporte une transparence empirique absolue sur la masse réelle de données compilées.
Toutefois, la projection directe des coordonnées exactes génère un chevauchement spatial massif (overplotting) rendant impossible l’évaluation de la densité locale. Pour contourner ce problème, on recourt à la fonction geom_point() couplée à une dispersion aléatoire via geom_jitter(), ou plus rigoureusement à l’objet de positionnement position_jitterdodge(). Il s’agit ici d’une condition technique impérative : dans un boxplot groupé, un simple geom_jitter() disperserait les points de manière homogène sur toute la largeur de l’axe x sans respecter la partition chromatique du facteur de remplissage, provoquant un brouillage visuel absolu.
L’instruction exacte exige donc d’appliquer position = position_jitterdodge(jitter.width = 0.15, dodge.width = 0.75). Ce paramétrage sophistiqué force l’algorithme à synchroniser la dispersion horizontale résiduelle des points avec le décalage spatial précis des boîtes jumelées. En assignant aux points une taille discrète, une transparence affirmée (alpha = 0.4) et une bordure différenciée, on produit une visualisation d’une richesse descriptive incomparable, où la structure des observations réelles vient corroborer la géométrie théorique de la boîte de Tukey.
8.2 Combinaison avec les graphiques en violon (geom_violin)
Dans de nombreuses configurations empiriques, le résumé à cinq nombres échoue à dépeindre des singularités structurelles majeures telles que la présence de vallées distributionnelles ou de bosses asymétriques secondaires. Pour pallier cette lacune sans sacrifier la précision métrique des quartiles, la fusion hybride d’un diagramme en violon avec une boîte à moustaches groupée représente une solution d’une remarquable puissance expressive. Le tracé en violon, matérialisé par geom_violin(), projette une estimation non paramétrique de la densité de probabilité par la méthode du noyau (kernel density estimation).
Pour réussir cette articulation au sein d’un plan factoriel double, la hiérarchie d’empilement des couches de ggplot2 s’avère déterminante. L’analyste doit d’abord déclarer la couche de violon au moyen de geom_violin(position = position_dodge(0.8), alpha = 0.5), créant une enveloppe surfacique continue qui révèle les renflements et les amincissements de la distribution pour chaque sous-groupe. Par-dessus cette silhouette volumétrique, on vient superposer une boîte à moustaches amincie à l’aide de geom_boxplot(width = 0.15, position = position_dodge(0.8), color = « black », alpha = 0.9).
L’amincissement de la largeur de la boîte centrale permet de l’enchâsser au cœur même du violon sans en masquer les contours extérieurs. Cette combinaison synergique livre le meilleur des deux mondes statistiques : le violon informe le regard sur la morphologie continue de la fonction de densité, tandis que le boxplot intérieur fournit l’ancrage chiffré rigoureux de la médiane et de l’intervalle interquartile, écartant tout soupçon d’illusion perceptive liée au lissage par noyau.
8.3 Apport des représentations de type « Raincloud Plot »
Poussant la logique de transparence distributionnelle jusqu’à son paroxysme conceptuel, la communauté statistique a récemment développé un paradigme visuel unifié baptisé Raincloud Plot (graphique en nuage de pluie). Formalisée initialement par Allen et ses collaborateurs en 2019, cette approche hybride décompose la visualisation d’une condition expérimentale en trois composantes spatialement coordonnées : un demi-violon horizontal figurant la densité probabiliste (le nuage), une boîte à moustaches minimaliste synthétisant les quartiles de Tukey (l’éclair), et un nuage de points individuels décalés représentant les unités échantillonnées (les gouttes de pluie).
L’implémentation d’un Raincloud Plot groupé dans R ne peut être prise en charge directement par les primitives de base de ggplot2 ; elle requiert l’adjonction de bibliothèques spécialisées telles que gghalves ou ggdist. Ces extensions fournissent des géométries orientables asymétriques, notamment stat_halfeye() ou geom_half_violin(), qui permettent de dessiner la densité sur une seule moitié de l’axe tout en réservant l’autre flanc spatial à la projection linéaire des observations individuelles et du boxplot amenuisé.
Dans le contexte des devis expérimentaux factoriels, le Raincloud Plot groupé constitue l’étalon-or contemporain de la rigueur méthodologique. Il supprime intégralement les biais d’agrégation, prévient les manipulations interprétatives et permet à l’évaluateur de vérifier d’un seul coup d’œil si la distribution sous-jacente est compromise par des sous-populations cachées ou des discontinuités de mesure, établissant un niveau de probité scientifique infiniment supérieur aux anciennes pratiques graphiques condensées.
9. Superposition de paramètres statistiques descriptifs
9.1 Intégration de la moyenne arithmétique
Par construction mathématique formelle, la ligne centrale d’une boîte à moustaches transcrit exclusivement la médiane de la distribution. Toutefois, au sein des paradigmes quantitatifs conventionnels, les modèles inférentiels linéaires appliqués en aval (tels que l’analyse de régression linéaire standard ou les tests t de Student) testent des hypothèses relatives aux espérances mathématiques, c’est-à-dire aux moyennes arithmétiques. La confrontation visuelle directe entre la médiane et la moyenne au sein de chaque boîte offre un intérêt diagnostique majeur pour jauger instantanément du degré d’asymétrie de la population observée.
L’injection de la moyenne s’effectue avec une remarquable concision syntaxique via l’application de la fonction stat_summary(). Cette commande avancée de ggplot2 délègue le calcul d’une fonction de synthèse statistique directement au moteur de rendu graphique, sans nécessiter la création manuelle préalable d’un tableau de données agrégées. L’appel s’articule ainsi : stat_summary(fun = « mean », geom = « point », shape = 23, size = 3, fill = « white », color = « black », position = position_dodge(0.75)).
L’arbitrage géométrique en faveur d’un losange plein (shape = 23) blanc cerclé de noir assure une démarcation visuelle irréprochable avec les disques ordinaires d’échantillonnage et la ligne médiane sombre de la boîte. Lorsque ce losange coïncide parfaitement avec la barre de médiane, le chercheur recueille la confirmation graphique d’une symétrie distributionnelle exemplaire compatible avec les postulats de normalité. À l’opposé, une translation verticale marquée du losange au-dessus ou au-dessous de la médiane matérialise sans ambiguïté l’attraction exercée par une queue de distribution étirée, orientant le statisticien vers des approches inférentielles non paramétriques ou robustes.
9.2 Tracé d’intervalles de confiance et barres d’erreur
Bien que le boxplot expose la dispersion empirique de l’échantillon par l’intervalle interquartile, il demeure silencieux quant à la précision de l’estimation de la vraie moyenne populationnelle. Pour enrichir la portée inférentielle de la figure, il est fréquent d’adjoindre des barres d’erreur matérialisant des intervalles de confiance paramétriques (typiquement à 95 %) ou des écarts-types calibrés autour de la moyenne. Cette opération s’accomplit en mobilisant de nouveau la machinerie fonctionnelle de stat_summary().
En invoquant la fonction stat_summary(fun.data = « mean_cl_normal », geom = « errorbar », width = 0.2, position = position_dodge(0.75), color = « black », linewidth = 0.8), ggplot2 calcule dynamiquement les limites inférieure et supérieure de l’intervalle de Student pour chaque sous-cellule factorielle. La rigueur technique exige de veiller scrupuleusement à ce que l’argument position_dodge() appliqué aux barres d’erreur concorde mathématiquement avec la largeur de décalage assignée aux boîtes à moustaches, sous peine de voir les antennes d’erreur flotter de façon discordante à côté de leurs boîtes respectives.
Une distinction pédagogique fondamentale doit être rappelée ici à destination du lecteur scientifique. L’amplitude délimitée par la boîte (l’IQR) reflète la dispersion naturelle invariante des observations de l’échantillon : elle ne se rétrécit pas mécaniquement avec l’augmentation de la taille d’échantillon. En revanche, l’intervalle de confiance projeté par stat_summary() est inversement proportionnel à la racine carrée de l’effectif n : il capture l’incertitude métrologique et converge vers zéro à mesure que la cohorte s’accroît. La coexistence de ces deux indices au sein d’un même graphique dote le chercheur d’un instrument d’une exceptionnelle puissance argumentative.
9.3 Ajout d’effectifs d’échantillon par sous-groupe
L’interprétation de la robustesse visuelle d’une boîte à moustaches est intimement conditionnée par la taille d’échantillon sur laquelle elle s’édifie. Une boîte représentant cinquante observations possède une assise distributionnelle infiniment plus fiable qu’une boîte calée sur six données erratiques, bien que leurs morphologies géométriques puissent apparaître strictement identiques à l’écran. L’indication transparente des effectifs réels (notés conventionnellement n) au sein de chaque strate factorielle relève ainsi des meilleures pratiques éditoriales contemporaines.
ggplot2 permet d’automatiser cette annotation descriptive sans avoir à coder manuellement des chaînes de texte fixes au-dessus de chaque boîte. L’opération s’exécute en concevant une fonction auxiliaire personnalisée ou en combinant stat_summary() avec un appel géométrique de type text. L’instruction utilise une fonction de calcul d’effectif qui retourne la valeur scalaire de longueur du vecteur pour chaque sous-groupe, positionnée stratégiquement au ras du sommet des moustaches ou le long de la marge supérieure de la zone de traçage.
En formulant la clause stat_summary(fun.data = fonction_effectif, geom = « text », position = position_dodge(0.75), vjust = -0.5, size = 3.5, fontface = « italic »), chaque boîte à moustaches se voit surmontée d’une étiquette dynamique affichant avec élégance la dimension de sa cohorte (par exemple n = 48). Ce contrôle visuel immédiat permet au relecteur d’évaluer sur-le-champ le degré d’équilibre du plan factoriel, de repérer les attritions expérimentales différentielles et de modérer ses conclusions face à des sous-groupes sous-dimensionnés.
10. Décomposition multidimensionnelle par facettage
10.1 Compartimentation factorielle avec facet_wrap()
Lorsque le protocole expérimental complexifie son architecture en intégrant un troisième facteur qualitatif de stratification (par exemple, le sexe biologique des participants ou le centre hospitalier d’inclusion), la tentative d’incorporer ce paramètre supplémentaire au sein d’un graphique unifié via une multiplication des décalages latéraux ou des bordures de couleurs conduit inéluctablement à une saturation perceptive ingérable. La solution canonique fournie par la grammaire des graphiques repose sur le concept de facettage (faceting), qui décompose la scène visuelle globale en une matrice de sous-graphiques cohérents.
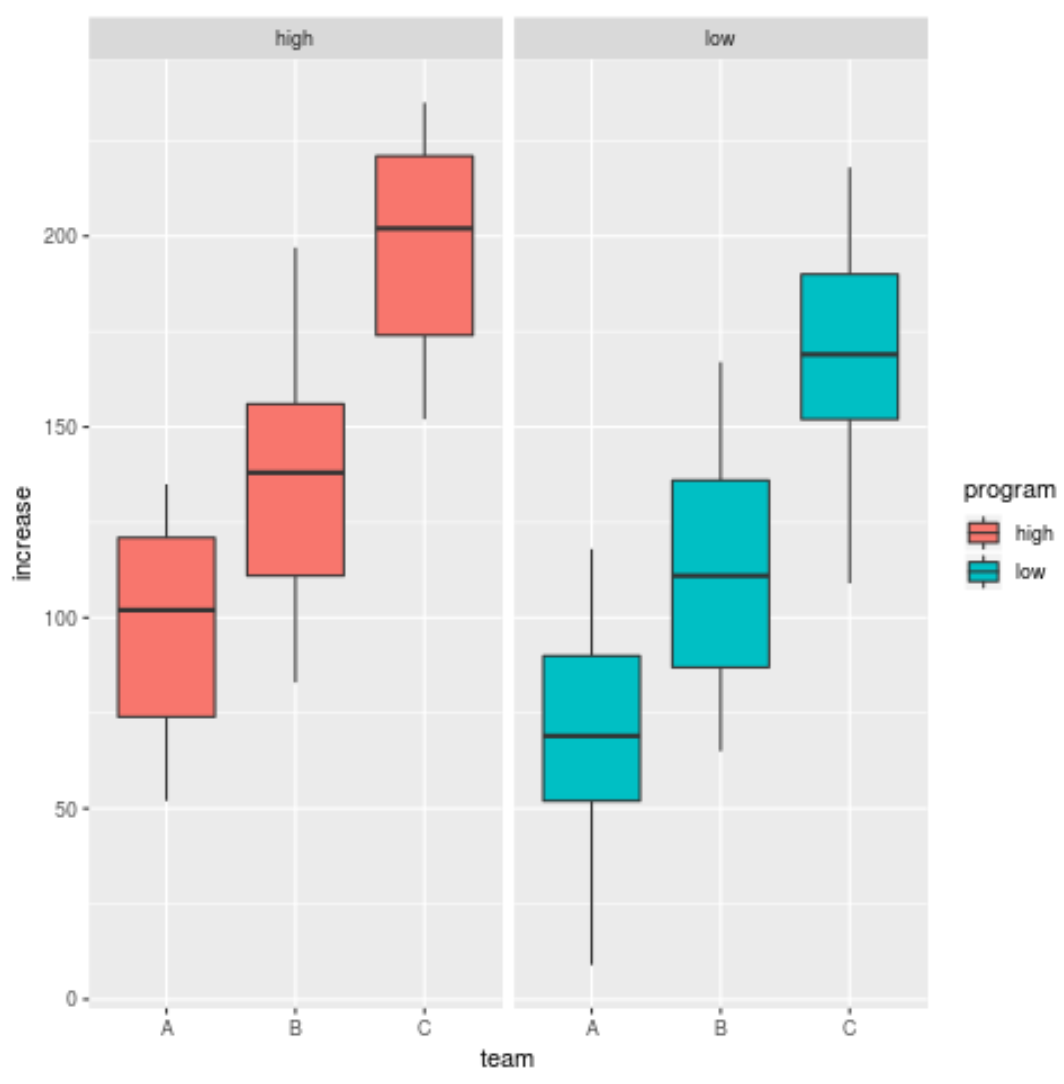
La commande facet_wrap() matérialise cette partition en créant une séquence de panneaux rectangulaires distincts, chacun dédié à un niveau exclusif de la troisième variable catégorielle. La syntaxe repose sur l’opérateur tilde : facet_wrap(~ Facteur_Tertiaire, ncol = 2). ggplot2 découpe alors instantanément le jeu de données matriciel et réplique le boxplot groupé de base au sein de chaque panneau, tout en garantissant une homogénéité absolue des coordonnées cartésiennes et des correspondances chromatiques d’un panneau à l’autre.
Le contrôle rigoureux du nombre de colonnes (ncol) et de lignes (nrow) permet d’optimiser l’encombrement spatial de la figure en fonction du format de mise en page requis par la revue cible. L’alignement standardisé des panneaux autorise une lecture transversale immédiate, permettant de vérifier si la structure d’interaction précédemment documentée entre le traitement et la pathologie se conserve invariablement à travers les différentes strates du facteur tertiaire ou si elle fait l’objet d’une modulation d’ordre supérieur.
10.2 Structuration en matrice croisée avec facet_grid()
Pour les plans factoriels équilibrés de haute dimension impliquant jusqu’à quatre variables catégorielles distinctes, l’utilisation de facet_grid() surpasse les capacités de facet_wrap(). Contrairement à ce dernier qui enroule une suite linéaire de panneaux sur plusieurs lignes, facet_grid() matérialise une table de contingence géométrique stricte à deux dimensions, croisant explicitement une variable de facettage en ligne avec une autre variable de facettage en colonne.
La formulation syntaxique facet_grid(Facteur_Ligne ~ Facteur_Colonne) engendre un réseau cartésien parfaitement orthogonal. Dans cette matrice, chaque case présente le boxplot groupé correspondant au croisement exclusif des facteurs intérieurs (x et fill) sous les contraintes spécifiques des deux facteurs extérieurs de découpage. Les étiquettes de facettes sont projetées sur les bordures supérieure et latérale droite sous forme de bandeaux informatifs (strips) d’une extrême limpidité organisationnelle.
L’immense valeur ajoutée de facet_grid() réside dans la conservation stricte de l’alignement géométrique des axes de mesure. Les repères verticaux et horizontaux étant partagés sans discontinuité à travers l’ensemble des cellules matricielles, l’œil de l’observateur peut réaliser des balayages visuels horizontaux ou verticaux sans subir le moindre décalage d’échelle, rendant possible l’appréhension synoptique d’agencements expérimentaux d’une remarquable complexité sans générer d’artéfacts de parallaxe cognitive.
10.3 Paramétrage des échelles : Libres versus Fixes
L’un des choix de paramétrage les plus lourds de conséquences lors de l’application du facettage concerne l’arbitrage entre échelles partagées fixes et échelles d’axes libérées, gouverné par l’argument scales au sein de facet_wrap() ou facet_grid(). Par défaut, ggplot2 applique rigoureusement scales = « fixed », imposant des limites cartésiennes minimales et maximales strictement identiques sur l’intégralité des panneaux graphiques de la figure.
Il est techniquement possible de déverrouiller ce comportement en stipulant scales = « free_y » (pour libérer l’axe vertical), scales = « free_x » (pour l’axe horizontal), ou scales = « free » (pour les deux dimensions). Si la libération de l’axe y présente l’avantage apparent de maximiser l’amplitude visuelle des boîtes au sein de chaque panneau en occupant l’intégralité de l’espace disponible, elle constitue une pratique méthodologiquement périlleuse qui doit être prohibée dans la vaste majorité des cas de comparaison inter-groupes.
En libérant l’échelle verticale, on détruit la comparabilité directe des niveaux de médiane et des étendues de dispersion entre les facettes : une variation métrique de dix millisecondes dans un panneau peut paraître visuellement équivalente à un écart de deux cents millisecondes dans le panneau adjacent, induisant en erreur le lecteur non averti. L’analyste rigoureux réservera exclusivement l’argument scales = « free_y » aux cas particuliers où les variables projetées dans les différentes facettes reposent sur des unités physiques fondamentalement distinctes et incommensurables.
11. Normalisation graphique et conformité aux standards de publication
11.1 Application de thèmes épurés (Normes APA)
L’apparence visuelle générée par défaut par ggplot2, caractérisée par un fond de canevas gris soutenu sillonné d’un quadrillage blanc dense, présente des qualités ergonomiques indéniables pour le travail exploratoire sur écran, mais contrevient frontalement aux directives de publication des revues internationales de premier rang, à l’instar des normes édictées par l’American Psychological Association (APA). Ces standards académiques proscrivent tout remplissage de fond ombré et exigent la suppression intégrale des grilles superflues.
Pour hisser le boxplot groupé au niveau d’exigence des presses universitaires, l’application de thèmes de base épurés constitue la première étape incontournable. L’adjonction de theme_classic() ou theme_minimal(base_size = 12, base_family = « sans ») élimine instantanément le fond gris pour lui substituer une surface blanche immaculée, purge les lignes de quadrillage parasites et installe des axes noirs discrets mais nets. Le paramètre base_size permet de calibrer de façon proportionnelle l’ensemble des éléments typographiques de la scène.
Cette mise en conformité se parfait par une personnalisation chirurgicale des primitives au moyen de la fonction theme(). Il est recommandé de raffermir le tracé des axes au moyen de axis.line = element_line(colour = « black », linewidth = 0.6), de calibrer l’orientation des repères gradués avec axis.ticks = element_line(colour = « black »), et de supprimer les bordures superflues encadrant la légende. Cette rigueur stylistique dégage le tracé de tout encombrement décoratif, focalisant l’attention de l’évaluateur sur la pureté du signal empirique dépeint par les boîtes.
11.2 Édition typographique des étiquettes et des légendes
Un graphique destiné à une diffusion scientifique doit posséder une autonomie informative absolue : il doit être pleinement intelligible sans que le lecteur ne soit contraint de se plonger dans le corps textuel de l’article pour déchiffrer des acronymes obscurs ou des variables encodées sous forme brute. La standardisation typographique des éléments textuels s’opère par l’intermédiaire de la fonction englobante labs().
L’instruction permet de spécifier un titre d’axe d’abscisse précis (x = « Cohorte Clinique Diagnostiquée »), un titre d’ordonnée rigoureux flanqué de l’unité physique de mesure (y = « Temps de Réponse Exécutif (ms) »), ainsi qu’un titre de légende intelligible et descriptif (fill = « Protocole Expérimental »). Si la revue accepte les titres directement intégrés à l’image, on enrichit la figure d’un titre formel (title = « Modulation des performances exécutives par le traitement cognitif ») et d’un sous-titre contextualisant (subtitle = « Échantillon randomisé en double aveugle, N = 300 »).
La gestion fine de la légende s’ajuste ensuite via les arguments dédiés de theme(). Pour les figures destinées à s’insérer sur la largeur standard d’une colonne de texte, le positionnement latéral de la légende consomme une surface horizontale précieuse, réduisant la taille effective des boîtes. L’application de theme(legend.position = « top », legend.direction = « horizontal ») rapatrie élégamment la légende au-dessus du tracé graphique, libérant toute la portée latérale pour le déploiement spatial des données et optimisant le ratio d’occupation de la planche d’impression.
11.3 Exportation vectorielle haute définition
L’aboutissement de la démarche graphique réside dans la phase d’exportation vers un support de stockage externe. Une erreur méthodologique funeste, malheureusement trop répandue, consiste à réaliser une capture d’écran de la fenêtre graphique de RStudio ou à exporter la figure dans un format matriciel compressé de basse résolution (JPEG standard). Cette pratique engendre un phénomène irréversible de pixellisation lors de l’agrandissement et détériore dramatiquement la lisibilité des textes et des moustaches.
La bibliothèque ggplot2 intègre une fonction d’archivage haute performance nommée ggsave(). L’analyste doit privilégier de manière systématique les formats vectoriels d’encodage, tels que le PDF ou le SVG : ggsave(« figure_1_boxplot_groupe.pdf », width = 180, height = 120, units = « mm », device = cairo_pdf). Les formats vectoriels ne stockent pas des pixels mais des équations mathématiques de primitives géométriques ; ils autorisent une mise à l’échelle infinie sans aucune dégradation de netteté, garantissant un rendu d’une pureté chirurgicale sur les presses d’imprimerie professionnelle.
Lorsque les exigences éditoriales d’une revue imposent formellement la fourniture d’un fichier matriciel (généralement au format TIFF sans compression), il convient de verrouiller impérativement la résolution optique à une densité minimale de 300 points par pouce (DPI), voire 600 DPI pour les schémas linéaires complexes : ggsave(« figure_1.tiff », width = 7, height = 5, dpi = 600, compression = « lzw »). Cette discipline technique finale assure que la virtuosité déployée dans R lors du tracé se traduira fidèlement sur les épreuves définitives du manuscrit.
12. Résolution des anomalies courantes et synthèse interprétative
12.1 Diagnostic des erreurs syntaxiques et de rendu fréquentes
Dans la pratique courante de la programmation sous R avec ggplot2, les analystes se heurtent fréquemment à des anomalies de rendu récurrentes dont l’origine réside généralement dans des méprises syntaxiques subtiles. L’un des écueils les plus classiques réside dans l’apparition d’une figure où les boîtes de sous-groupes ne sont pas décalées côte à côte, mais empilées ou confondues en une seule boîte hybride informe. Ce symptôme découle presque invariablement de l’omission de l’argument fill dans la fonction aes(), ou de l’assignation d’une variable qui n’a pas été préalablement convertie en facteur catégoriel.
Un second conflit courant procède de la collision spatiale lors de l’adjonction de géométries multiples (boîtes et points individuels). Si les paramètres de positionnement dodge ne partagent pas scrupuleusement la même valeur numérique scalaire (par exemple width = 0.8 dans geom_boxplot et dodge.width = 0.8 dans position_jitterdodge()), les points se retrouveront projetés en dehors de l’axe central des boîtes correspondantes. L’harmonisation absolue de ces coefficients de largeur constitue le seul remède à ce défaut d’alignement.
Enfin, la présence de valeurs manquantes (notées NA) dans le tableau de données déclenche l’émission d’avertissements (warnings) récurrents lors du tracé, tout en créant parfois une catégorie de boîte fantôme non désirée dans la légende. L’assainissement préalable du tableau de données via les pipelines de dplyr, au moyen de filter(!is.na(Variable_Mesure)), permet de purger silencieusement ces cellules lacunaires avant l’injection dans ggplot(), garantissant une exécution sans scorie technique.
12.2 Artéfacts d’asymétrie et détection d’effets de plancher/plafond
L’observation attentive de la morphologie finale d’un boxplot groupé constitue un outil de diagnostic clinique et psychométrique d’une redoutable perspicacité pour repérer les limites instrumentales des échelles d’évaluation. L’un des phénomènes les plus cruciaux à diagnostiquer est l’effet de plancher (floor effect) ou l’effet de plafond (ceiling effect). Un effet de plancher se manifeste graphiquement par l’écrasement complet de la moustache inférieure, du premier quartile et de la médiane directement sur la ligne de base du score minimal théorique de l’instrument de mesure.
Dans cette configuration morphologique, la boîte centrale semble amputée de sa moitié inférieure : la médiane se confond avec la bordure basse de la boîte et une cohorte massive d’observations s’agglutine sur la valeur plancher, tandis que la moustache supérieure s’étire démesurément vers le haut. Ce tableau visuel alerte immédiatement le chercheur sur le fait que l’épreuve expérimentale administrée est excessivement ardue pour la cohorte évaluée, ou que l’instrument psychométrique manque dramatiquement de sensibilité pour discriminer les variations subtiles dans les bas niveaux de compétence.
Réciproquement, un écrasement de la boîte contre la borne supérieure du tracé signe un effet de plafond patent, indiquant que l’outil de mesure sature précocement. Face à de tels signaux d’alerte distributionnelle documentés par le boxplot, l’analyste doit impérativement renoncer à l’application de tests paramétriques standards qui reposent sur des postulats d’homoscedasticité et de résidus gaussiens symétriques. La boîte à moustaches impose ici une réorientation méthodologique salutaire vers des modèles linéaires généralisés (famille Poisson ou binomiale négative) ou des modèles de régression ordinale censurée de type Tobit.
12.3 Protocole de rédaction des résultats empiriques
L’insertion d’une figure de boxplot groupé au sein d’un manuscrit scientifique ne dispense en aucun cas l’auteur d’une articulation rédactionnelle rigoureuse au sein du corps de texte. Une illustration ne se substitue pas aux statistiques inférentielles : elle en constitue le complément cognitif indispensable. Le protocole de rédaction académique exige que la présentation de la figure s’intègre de façon harmonieuse avec les résultats des tests d’hypothèses et les mesures d’amplitude d’effet.
Le commentaire rédigé doit guider le lecteur à travers les niveaux de lecture du graphique, en explicitant successivement l’effet principal du facteur d’abscisse, l’effet du facteur de remplissage, et la présence éventuelle d’une interaction visuelle que le test inférentiel viendra valider ou réfuter. Les médianes et intervalles interquartiles de chaque cellule doivent être explicitement chiffrés entre parenthèses, complétés par les statistiques de test formelles (valeur du F de Fisher ou du Chi-deux de Kruskal-Wallis, degrés de liberté, valeur p exacte et indice d’effet de type d de Cohen ou êta-carré partiel).
À titre d’exemple paradigmatique, un paragraphe de résultats intégrant notre figure s’énoncera ainsi dans un manuscrit rédigé selon les standards APA : « L’examen de la distribution des temps de réponse exécutifs au moyen de boîtes à moustaches groupées (voir Figure 1) révèle une réduction substantielle de la latence de traitement au sein du groupe soumis à l’entraînement cognitif actif comparativement à la condition placebo. Cet effet thérapeutique s’avère particulièrement prononcé chez les participants présentant un trouble anxieux généralisé (médiane = 412 ms, IQR = 48 ms sous entraînement vs médiane = 538 ms, IQR = 62 ms sous placebo) par rapport à la cohorte témoin. Une analyse de variance factorielle à deux voies confirme statistiquement cette observation visuelle en révélant une interaction significative entre la condition de traitement et la catégorie diagnostique, F(2, 294) = 14.82, p < .001, η²p = .092. Le diagnostic de la Figure 1 démontre par ailleurs l’absence d’effets d’asymétrie sévères ou de saturation d’échelle, validant la conformité des données avec les postulats du modèle linéaire. »
Références
Allen, M., Poggiali, D., Whitaker, K., Marshall, T. R., & Kievit, R. A. (2019). Raincloud plots: a multi-platform tool for robust data visualization. Wellcome Open Research, 4, 63. https://doi.org/10.12688/wellcomeopenres.15191.1
American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Kassambara, A. (2020). ggpubr: ‘ggplot2’ Based Publication Ready Plots (R package version 0.4.0). CRAN. https://CRAN.R-project.org/package=ggpubr
R Core Team. (2023). R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer Science+Business Media. https://doi.org/10.1007/0-387-28695-0