
L’analyse exploratoire des données et la restitution visuelle constituent des piliers indissociables de la pratique contemporaine de la science des données. Dans l’écosystème open source de Python, la bibliothèque Pandas s’est imposée comme le standard incontournable pour la manipulation, la structuration et la préparation des données tabulaires. Grâce à une abstraction intuitive bâtie au-dessus des structures de calcul matriciel de NumPy, elle permet aux chercheurs, analystes et ingénieurs de formuler des requêtes analytiques complexes avec une concision remarquable. Néanmoins, cette apparente simplicité syntaxique dissimule une tuyauterie logicielle sophistiquée, régie par des règles d’évaluation strictes et des contraintes de typage binaire qui ne tolèrent aucune ambiguïté.
L’interfaçage fluide entre la manipulation tabulaire et la visualisation graphique repose sur une intégration étroite entre Pandas et le moteur de rendu de la bibliothèque Matplotlib. En invoquant simplement la méthode de traçage intégrée sur un tableau de données, l’analyste s’attend légitimement à voir émerger une représentation graphique immédiate de ses distributions et de ses séries chronologiques. Cependant, cette chaîne de traitement algorithmique est fréquemment interrompue par l’émergence d’exceptions explicites, parmi lesquelles l’erreur désignée sous la formule textuelle indiquant l’absence de données numériques à tracer occupe une place prépondérante. Ce message d’erreur, loin de constituer une simple anomalie passagère, signale une fracture fondamentale entre la représentation mentale que l’utilisateur se fait de son jeu de données et la réalité computationnelle de son stockage en mémoire vive.
La survenue de cette anomalie reflète la fragilité des mécanismes d’ingestion et d’inférence de types dans les environnements distribués ou hétérogènes. Face à des données textuelles, des valeurs manquantes mal encodées, des artefacts de numérisation ou des divergences dans les conventions typographiques internationales, les colonnes que l’on présumait quantitatives se retrouvent silencieusement rétrogradées au statut d’objets génériques. Cet article propose une dissection exhaustive, tant théorique que pratique, des fondements logiciels régissant cette exception. Nous examinerons avec rigueur l’architecture interne des structures de données sous-jacentes, les protocoles d’inspection méticuleux permettant de poser un diagnostic irréfutable, les stratégies algorithmiques de remédiation, ainsi que les paradigmes d’ingénierie préventive garantissant la pérennité et la reproductibilité des chaînes de traitement quantitatives.
1. Introduction et cadre théorique de l’exception TypeError dans Pandas
1.1 Définition formelle de l’exception no numeric data to plot
L’exception identifiée sous l’intitulé formel signalant l’absence de données numériques exploitables pour le traçage graphique est émise de manière synchrone lors de l’appel à la méthode de tracé sur un objet de type DataFrame ou Series. Dans l’architecture interne de Pandas, cette exception procède d’un mécanisme d’assertion défensive déployé au sein des modules de liaison graphique. Lorsque l’utilisateur instruit l’interpréteur de tracer un jeu de données, la méthode examine le typage de l’ensemble des colonnes candidates. Dès lors qu’aucune variable ne satisfait aux critères d’éligibilité arithmétique élémentaire, le sous-système de calcul refuse de déléguer l’opération à la couche d’affichage et interrompt immédiatement l’exécution du script en levant une exception de type d’erreur.
Le mécanisme sous-jacent révèle une dichotomie frappante entre la perception empirique de l’analyste et la structure binaire intrinsèque de la matrice de données. Pour un observateur humain inspectant un tableau à l’écran, une suite de caractères représentant des chiffres évoque instantanément une quantité mesurable, ordonnée et continue. En revanche, pour la machine virtuelle, la valeur symbolique d’un chiffre encapsulé sous forme de chaîne de caractères ne possède aucune propriété arithmétique. La méthode de traçage ne tente pas d’interpréter magiquement les caractères non structurés ; elle exige un contrat d’interface formel où chaque valeur doit être convertible en coordonnées cartésiennes continues.
Sur le plan de l’ingénierie logicielle et de la recherche quantitative, l’émergence de cette anomalie constitue un point de rupture critique. Elle signale l’échec silencieux des étapes préliminaires d’ingestion des données et hypothèque gravement la reproductibilité des analyses. Si un pipeline de données laisse transiter des vecteurs textuels en lieu et place de grandeurs scalaires, l’ensemble des dérivations statistiques ultérieures, telles que les moyennes, les variances ou les régressions économétriques, s’avère vicié. L’exception levée par le moteur graphique n’est donc pas la cause première d’un dysfonctionnement, mais le symptôme visible et salutaire d’une corruption de l’intégrité typologique du jeu de données.
1.2 Le rôle du typage strict dans l’architecture de Pandas
Pour appréhender la genèse de cette exception, il est indispensable d’examiner les fondations architecturales de Pandas, qui reposent historiquement sur le moteur matriciel de NumPy. Contrairement au langage Python standard, où chaque variable constitue une référence vers un objet dynamique complet avec un surcoût mémoire notable, NumPy et Pandas exploitent des tableaux homogènes de bas niveau alloués de manière contiguë en mémoire vive. Cette contiguïté mémoire permet d’exécuter des opérations vectorisées hautement optimisées grâce à des instructions matérielles spécialisées. Dans ce modèle, une colonne de données ne peut posséder qu’un seul type de données machine, rigoureusement défini en amont.
Le gestionnaire d’inférence de Pandas opère une distinction fondamentale entre les types natifs hautement optimisés, tels que les entiers signés ou non signés et les réels en virgule flottante sur soixante-quatre bits, et le type générique dit d’objet. Le type objet constitue un mécanisme de repli : lorsqu’une colonne héberge des données disparates ou des chaînes de caractères, Pandas renonce à l’allocation contiguë de scalaires numériques et stocke à la place un tableau de pointeurs pointant vers des objets Python individuels. Cette bascule entraîne une dégradation drastique des performances de calcul et déchoit la colonne de ses privilèges arithmétiques.
Le processus d’évaluation et de détection automatique des types lors de l’instanciation d’un tableau de données accentue cette problématique. Pandas utilise une heuristique probabiliste pour déduire le type le plus adapté à partir des premiers blocs de données d’un fichier source. Si un unique élément non conforme s’immisce dans une séquence de plusieurs millions de nombres, l’analyseur syntaxique, privilégiant la non-perte d’information à la rigueur de typage, convertit l’intégralité du vecteur sous le type générique d’objet. Cette politique de tolérance immédiate crée une dette technique masquée qui explose ultérieurement lors de l’appel aux modules d’analyse ou de visualisation.
1.3 Biais cognitifs et erreurs d’interprétation des données tabulaires
L’apparition récurrente de cette exception s’explique également par des facteurs d’ordre cognitif inhérents à l’interaction entre l’analyste et ses environnements de développement interactifs, tels que les carnets de notes Jupyter. Lorsqu’un tableau de données est affiché dans une interface graphique ou un terminal, la sortie textuelle est dépourvue d’indications typographiques explicites quant à la nature binaire sous-jacente des champs. Un nombre réel et une chaîne de caractères contenant la représentation textuelle de ce même nombre sont rendus de manière strictement identique aux yeux de l’observateur, créant une puissante illusion visuelle de conformité mathématique.
Cette illusion d’intégrité conduit fréquemment les praticiens à contourner ou à abréger la phase préliminaire d’audit structurel. Dans l’urgence de produire des visualisations exploratoires, la tentation est grande de charger un fichier plat et d’enchaîner immédiatement sur l’invocation d’un tracé linéaire ou d’un nuage de points. Cette omission délibérée de l’inspection formelle méconnaît le principe fondamental selon lequel une visualisation n’est pas un simple acte de dessin, mais une opération mathématique consistant à projeter un sous-espace vectoriel multidimensionnel sur un plan géométrique à deux dimensions.
Il existe ainsi une fracture conceptuelle profonde entre la modélisation abstraite d’une variable dans l’esprit du chercheur et sa matérialisation informatique dans la structure tabulaire. Alors que le modélisateur raisonne en termes de salaire, de température, de pression atmosphérique ou de cours boursier — des concepts purement continus et mesurables —, la machine n’interagit qu’avec des octets ordonnés selon des conventions d’encodage strictes. Dès lors que cette correspondance symbolique est rompue par une discordance technique, la tentative de traçage échoue inévitablement, rappelant avec sévérité la primauté de la structure informatique sur l’intuition sémantique.
2. Anatomie technique de l’erreur : interaction entre Pandas et Matplotlib
2.1 La passerelle de rendu graphique entre Pandas et Matplotlib
Pour déconstruire avec précision les conditions menant à l’émission de cette exception, il convient d’analyser les mécanismes internes de la couche d’abstraction graphique de Pandas. Loin de réimplémenter un moteur de rendu vectoriel indépendant, Pandas encapsule les fonctionnalités avancées de la bibliothèque Matplotlib à travers une interface unifiée. Lorsqu’un utilisateur exécute la méthode de traçage sur une instance de tableau de données, l’appel est acheminé vers un sous-système spécialisé qui assure la traduction des structures tabulaires en primitives géométriques compréhensibles par les axes de Matplotlib.
Au cours de cette phase d’intermédiation, la couche de traçage effectue un travail critique d’extraction et de validation vectorielle. Le tableau de données d’origine est scanné afin d’isoler les séries de données susceptibles d’alimenter les coordonnées des axes des abscisses et des ordonnées. Cette étape intermédiaire ne transmet pas aveuglément la totalité des colonnes au sous-système de tracé. Au contraire, un filtre préalable est appliqué pour discriminer les données représentables des attributs purement descriptifs, tels que les identifiants textuels ou les étiquettes catégorielles non ordonnées.
Cette architecture en couches présente l’avantage indéniable de masquer la verbosité de Matplotlib pour les opérations courantes. Cependant, elle introduit un niveau d’opacité qui peut désorienter l’utilisateur lorsque les conditions d’exécution nominales ne sont pas réunies. Si l’extraction préparatoire ne parvient pas à identifier un seul vecteur répondant aux critères mathématiques d’un espace euclidien, la chaîne de transmission s’arrête net. La couche de liaison refuse d’émettre des commandes d’affichage absurdes vers le canevas graphique et déclenche une interception logicielle préventive.
2.2 Critères d’exclusion des colonnes non numériques
La sélection des colonnes admises sur le canevas de traçage repose sur un filtrage algorithmique rigoureux adossé aux types de données gérés par NumPy et l’infrastructure typologique de Pandas. Pour qu’une colonne soit qualifiée pour un traçage conventionnel sur l’axe des ordonnées dans un graphique linéaire ou un histogramme, son type de données doit appartenir à la famille des types numériques primitifs. Cela englobe l’ensemble des représentations en virgule flottante, les entiers signés et non signés de toutes largeurs d’octets, ainsi que les types temporels convertibles en valeurs continues.
Inversement, le sous-système de traçage applique une exclusion catégorique dès qu’une série est typée en tant qu’objet générique, en tant que chaîne de caractères stricte ou sous certaines formes de catégories textuelles non converties. Dans le scénario où un tableau de données ne comporte que des colonnes classées sous ces types inéligibles, la liste interne des variables exploitables se retrouve totalement vide à l’issue de la phase de filtrage sélectif. La classe responsable de la génération du graphique se trouve alors confrontée à une absence totale de matière première géométrique.
C’est précisément à cet instant de l’arborescence décisionnelle qu’intervient une instruction de garde programmée au sein de la fonction de tracé interne. Constatant que la sous-matrice destinée à être projetée ne contient aucune dimension numérique résiduelle, le code exécute délibérément une instruction levant l’exception d’incompatibilité de type. L’interpréteur interrompt immédiatement le calcul, empêchant la génération d’une figure vierge d’axes ou le déclenchement ultérieur d’erreurs en cascade beaucoup plus sibyllines au tréfonds du moteur de rendu matriciel.
3. Reproduction méthodique de l’anomalie : protocole expérimental
3.1 Construction d’un DataFrame synthétique défaillant
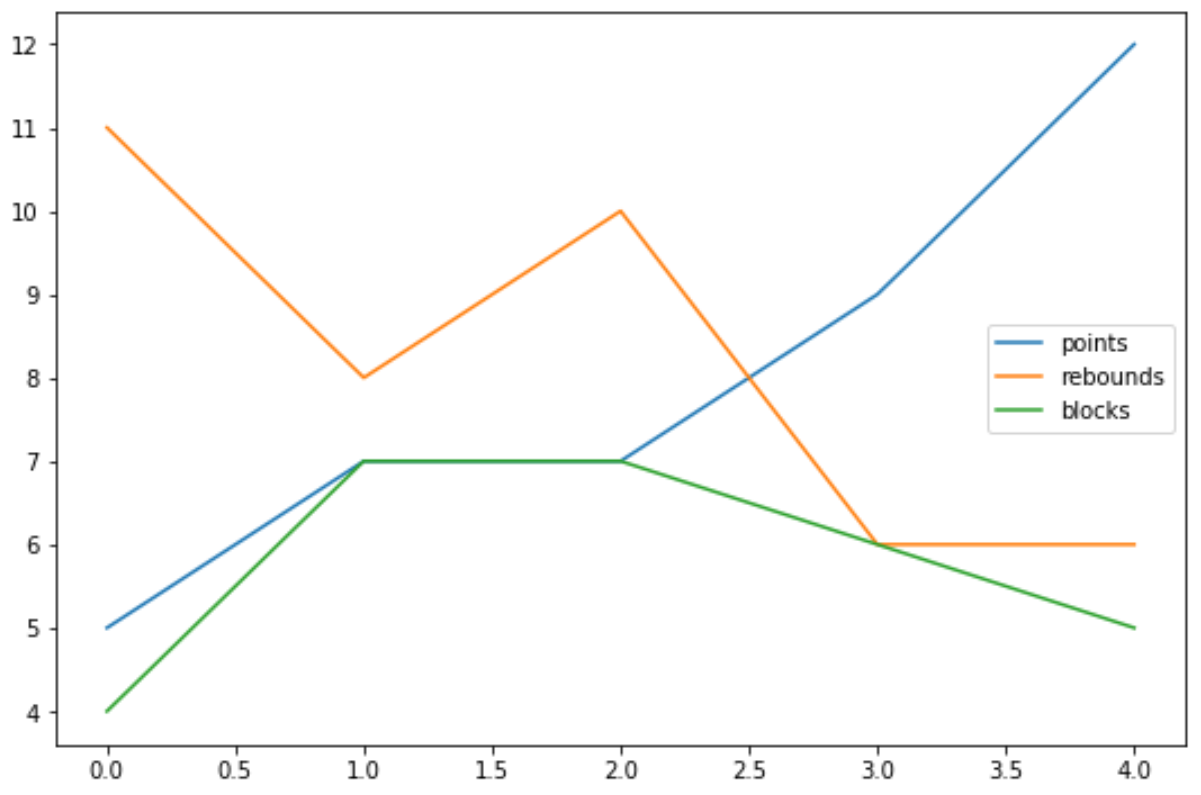
Afin d’étudier le phénomène avec toute la rigueur d’une démarche scientifique, il est impératif d’établir un protocole expérimental permettant de reproduire l’anomalie de manière déterministe et contrôlée. Considérons la modélisation des performances sportives de joueurs de basket-ball au sein d’une structure tabulaire. Nous instancions délibérément un tableau de données composé de trois variables quantitatives par essence : le nombre de points marqués, le volume de rebonds captés et la quantité de contres réalisés au cours d’une série de rencontres sportives successives.
Dans le cadre de cette expérience, lors de la création de la structure de données à partir de vecteurs séquentiels, nous encapsulons intentionnellement l’ensemble des valeurs numériques entre des guillemets simples ou doubles. Cette manipulation typographique force l’analyseur interne de Python à instancier des chaînes de caractères littérales en lieu et place de scalaires numériques. De plus, pour refléter la réalité des bases de données de production imparfaites, nous intégrons dans l’une des séries un enregistrement contenant une valeur manquante notée sous la forme d’une chaîne textuelle arbitraire, telle qu’une abréviation conventionnelle de non-disponibilité.
Lorsque le tableau de données synthétique ainsi constitué est affiché dans l’interpréteur interactif, le résultat visuel est remarquablement trompeur. Les colonnes s’alignent avec une élégance parfaite sous leurs en-têtes respectifs ; les chiffres s’affichent avec une netteté absolue et aucune anomalie apparente ne saute aux yeux du praticien non averti. La matrice semble prête pour l’analyse comparative et la modélisation statistique la plus sophistiquée, alors même qu’au niveau binaire, elle ne contient qu’une collection désordonnée de pointeurs vers des représentations textuelles.
3.2 Exécution de la commande graphique et interception de l’erreur
L’illusion d’intégrité se dissipe brutalement dès l’instant où l’analyste cherche à matérialiser les tendances évolutives de ses données en sollicitant la méthode de visualisation par défaut du tableau de données. En exécutant une instruction demandant le tracé direct des séries de points et de rebonds en fonction des index chronologiques, le flux d’exécution normal est violemment interrompu. L’environnement d’exécution n’affiche aucune courbe sinueuse ni aucun repère cartésien, mais déploie instantanément une pile d’appels détaillée signalant l’échec structurel de l’opération.
L’analyse minutieuse de la trajectoire de la pile d’exécution permet de tracer avec exactitude le cheminement de l’exception à travers les couches logicielles successives. L’appel initial formulé au niveau de l’espace utilisateur traverse l’interface de haut niveau du module graphique de Pandas. Il descend ensuite dans les fonctions de cadrage du sous-système de tracé interne, franchit les routines d’évaluation des arguments dimensionnels, pour venir finalement butter contre le test logique qui certifie la présence d’au moins une série numérique valide dans la sélection transmise.
À cet endroit précis de la chaîne d’exécution, la condition de validation échoue de manière irrévocable. L’interpréteur génère alors le message signalant expressément qu’aucune donnée numérique n’a été localisée pour accomplir le traçage requis. La lecture attentive de ce rapport de rupture démontre sans équivoque que la défaillance ne provient pas d’un bogue sous-jacent au moteur graphique, ni d’une défaillance matérielle des bibliothèques graphiques de bas niveau, mais de l’incompatibilité absolue entre les données fournies et le contrat fonctionnel de l’algorithme d’affichage.
3.3 Variations syntaxiques de l’erreur selon les versions
Il est capital pour l’ingénieur de données de reconnaître que la signature formelle de cette exception a connu des évolutions au fil des révisions successives de la bibliothèque Pandas. Dans les versions historiques appartenant à la branche 1.x, l’exception levée était quasi systématiquement un type d’erreur formel (TypeError) explicitant textuellement l’absence de données numériques à tracer, ou notifiant l’impossibilité d’effectuer un calcul de coordonnées cartésiennes sur des vecteurs de type objet.
Avec l’avènement des architectures majeures de la branche Pandas 2.x, qui intègrent une refonte profonde de la gestion des types via l’introduction facultative des moteurs de stockage d’Apache Arrow et une application plus stricte du principe de non-conversion implicite, certaines déclinaisons de cette exception ont été remaniées. Dans des contextes spécifiques où un tableau de données totalement vide ou dépourvu de dimensions valides est soumis au tracé, l’infrastructure logicielle peut désormais émettre une erreur de valeur (ValueError), indiquant qu’aucun objet traçable n’a pu être extrait du conteneur fourni.
En dépit de ces fluctuations lexicographiques et de la typologie exacte de l’exception levée au sommet de la pile d’appels, le phénomène déterministe sous-jacent demeure invariant. Qu’elle soit classifiée sous le label d’une incompatibilité de type ou sous celui d’une anomalie de valeur dimensionnelle, la cause racine demeure invariablement la même : l’incapacité absolue du moteur de rendu à dériver une représentation géométrique continue à partir de données encapsulées sous une forme binaire non arithmétique.
4. Diagnostic rigoureux : protocoles d’inspection des dtypes
4.1 Utilisation de l’attribut dtypes pour un audit exhaustif
Face à l’irruption de cette anomalie bloquante, le premier réflexe méthodologique de l’analyste quantitatif ne doit pas consister à appliquer des corrections empiriques hasardeuses, mais à engager un protocole de diagnostic systématique. L’instrument d’investigation le plus direct et le plus concis réside dans l’interrogation de l’attribut spécial exposant les types de données de l’ensemble des colonnes de la structure tabulaire. Cet attribut renvoie une série synthétique qui associe formellement à chaque étiquette de colonne la signature de son type machine effectif.
L’exécution de cet audit de premier niveau met immédiatement en lumière la véritable nature du stockage mémoire. Dans le cas d’un tableau corrompu générant l’erreur de tracé, la consultation de cet attribut révélera invariablement que les colonnes incriminées portent la mention formelle du type objet, en lieu et place des dénominations attendues certifiant un encodage d’entiers ou de nombres réels sur soixante-quatre bits. Cette simple constatation apporte la preuve matérielle que la machine traite les valeurs numériques présumées comme de simples chaînes scalaires arbitraires.
L’intégration de cette vérification typologique dès les premières lignes de tout script analytique constitue une bonne pratique d’ingénierie logicielle élémentaire. Plutôt que de supposer la conformité d’un jeu de données sur la base de visualisations partielles dans la console, l’analyste rigoureux insère une assertion programmatique validant formellement l’appartenance des colonnes d’intérêt au groupe des types numériques. Tout écart de conformité est ainsi détecté en amont, avant que la chaîne de traitement n’atteigne le stade critique de la modélisation statistique ou du rendu graphique.
4.2 Exploitation de la méthode info() pour un état des lieux structurel
Si l’attribut d’identification des types fournit une synthèse bienvenue, la méthode d’information structurelle intégrée à Pandas procure un état des lieux considérablement plus riche et opérationnel. Lorsqu’elle est invoquée sur une structure tabulaire, cette méthode effectue un balayage exhaustif qui compile non seulement la distribution exacte des types de données colonne par colonne, mais également le dénombrement précis des valeurs non nulles présentes au sein de chaque dimension, tout en quantifiant l’empreinte mémoire globale mobilisée par l’objet.
Cette approche diagnostique intégrée présente un intérêt majeur pour déceler les incohérences structurelles subtiles. En confrontant le nombre total de lignes de la structure tabulaire au nombre de valeurs formellement certifiées non nulles dans une colonne typée en tant qu’objet, le praticien peut immédiatement repérer si la dégradation du typage résulte de l’introduction intempestive de marqueurs d’absence hétérogènes. Un différentiel entre le décompte attendu et les enregistrements effectifs constitue souvent le premier indice d’une contamination par des chaînes textuelles atypiques.
De surcroît, l’examen de l’empreinte mémoire rapportée par cette méthode fournit un avertissement sans appel quant à l’inefficacité computationnelle du jeu de données sous sa forme dégradée. Une colonne numérique indûment contrainte sous le type objet requiert une quantité de mémoire vive dramatiquement supérieure à celle mobilisée par un tableau binaire contigu, en raison de l’allocation individuelle de chaque descripteur d’objet Python. La résolution du problème de typage ne répond donc pas uniquement à une exigence graphique, mais participe directement à l’optimisation des performances de calcul.
4.3 Inspection granulaire des éléments individuels
Dans certaines situations particulièrement pernicieuses, l’évaluation globale d’une colonne sous le type objet ne permet pas d’identifier immédiatement la nature exacte de la pollution sous-jacente. Il devient alors indispensable de descendre au niveau de granularité le plus fin en examinant la distribution des types d’objets Python réels qui cohabitent au sein de la même série. Pour ce faire, l’application fonctionnelle de la fonction d’identification de type native sur chaque élément de la colonne constitue une démarche d’investigation d’une redoutable efficacité.
L’exécution de cette analyse granulaire permet d’agréger et de dénombrer la fréquence respective des différents types coexistant dans un même vecteur. Il n’est pas rare de découvrir qu’une même série abrite simultanément une majorité de nombres réels authentiques, une minorité d’entiers naturels, mais également une poignée de chaînes de caractères isolées, voire des objets booléens ou des structures personnalisées. Cette hétérogénéité structurelle empêche irrémédiablement Pandas de consolider la colonne au sein d’un bloc numérique NumPy uniforme.
Cette inspection élément par élément s’avère particulièrement précieuse pour débusquer les artefacts typographiques imperceptibles à l’œil nu. Elle permet de localiser avec une précision chirurgicale la présence d’espaces insécables, de retours à la ligne résiduels, de séquences d’échappement invisibles ou de caractères d’espacement standard qui enrobent des valeurs numériques autrement valides. L’identification de ces micro-pollutions textuelles constitue le préalable indispensable à la formulation d’une stratégie d’assainissement ciblée.
5. Étiologie des données non numériques : origines de la corruption de type
5.1 Ingestion déficiente depuis des sources externes
L’origine première de la corruption typologique conduisant à l’erreur de tracé réside dans la phase d’ingestion initiale des flux de données depuis des fichiers plats de type valeurs séparées par des virgules ou tabulations. Par nature, le format texte ne comporte aucune métadonnée explicite définissant la sémantique ou le schéma binaire des colonnes qu’il héberge. Le moteur d’analyse de Pandas est contraint de procéder à une inférence rétrospective, qui repose sur l’hypothèse simplificatrice d’une stricte conformité anglo-saxonne des représentations numériques.
Dans l’espace francophone et dans de nombreuses économies d’Europe continentale, la convention typographique universelle prescrit l’utilisation de la virgule comme séparateur décimal, réservant le point ou l’espace à la délimitation des milliers. Lorsque l’analyseur standard de Pandas traite un fichier encodé selon cette convention sans instruction spécifique, il interprète systématiquement la virgule comme un caractère alphabétique ordinaire. Incapable de convertir une expression comportant une virgule en nombre réel conforme aux standards internationaux de virgule flottante, le processeur rétrograde l’ensemble de la colonne au rang de chaîne textuelle.
Une pathologie analogue se manifeste lors de la manipulation de données financières ou statistiques issues de rapports bureautiques, où les grandeurs scalaires sont fréquemment enrobées de symboles de devises monétaires, de signes de pourcentages ou de séparateurs de milliers typographiés sous forme d’espaces standards ou insécables. Dès lors qu’une suite de chiffres est contiguë à un symbole typographique quelconque, l’analyseur syntaxique conclut formellement à l’absence de nature numérique pure et verrouille la colonne dans une représentation textuelle opaque.
5.2 Artefacts de saisie et valeurs sentinelles
Au-delà des conventions de notation régionales, l’introduction de valeurs sentinelles au sein des jeux de données d’origine représente une cause majeure d’altération typologique. Dans de nombreux systèmes de gestion de bases de données patrimoniaux ou au sein de fichiers de saisie manuelle conçus par des opérateurs humains, les données manquantes ou non applicables ne sont pas laissées vides, mais sont consignées au moyen d’abréviations textuelles arbitraires telles qu’un point d’interrogation, une suite de tirets ou des formules littérales indiquant l’absence d’enregistrement.
Lors de la phase de chargement, si ces marqueurs empiriques ne correspondent pas exactement à la liste restrictive des représentations de nullité reconnues nativement par le moteur d’ingestion, Pandas les traite comme des chaînes de caractères parfaitement légitimes. La présence d’une seule de ces sentinelles textuelles au milieu d’une série de dix millions de mesures physiques contraint l’interpréteur à considérer que la colonne héberge des données polymorphes, provoquant instantanément la conversion de la totalité de la structure sous le type d’objet générique.
Le problème est encore accentué lors du recours à des techniques d’extraction automatisée de données web, couramment désignées sous le vocable de moissonnage web. Les tableaux extraits du code source de pages Internet incorporent fréquemment des résidus de mise en page invisibles, des balises de formatage non nettoyées, des espaces d’espacement typographique spécifiques ou des commentaires éditoriaux insérés directement au sein des cellules numériques. Ces scories textuelles parasitent l’ingestion et interdisent toute conversion arithmétique spontanée lors de l’instanciation de la structure tabulaire.
5.3 Effets de bord des transformations antérieures
La pollution typologique ne procède pas exclusivement de sources de données externes viciées ; elle peut également résulter d’effets de bord délétères induits par des opérations de manipulation interne mal maîtrisées par l’analyste lui-même. L’application intempestive de certaines fonctions de nettoyage textuel ou de normalisation scalaire via des mécanismes de délégation itérative peut altérer silencieusement la signature binaire d’une colonne initialement saine.
Un cas d’école réside dans l’opération de concaténation de plusieurs tableaux de données initialement distincts. Si l’un des segments présente une colonne typée numériquement tandis que le second segment comporte pour la même colonne une seule occurrence de type textuel, l’algorithme d’unification de Pandas résout le conflit en alignant l’ensemble sur le plus petit dénominateur commun typologique, à savoir le type objet. L’analyste se retrouve alors avec un tableau unifié dont les colonnes ont perdu leur statut numérique à son insu, préparant le terrain pour l’exception graphique ultérieure.
De même, l’emploi imprudent de méthodes de substitution visant à combler les valeurs manquantes par des chaînes textuelles explicites produit des ravages considérables. Remplacer une valeur nulle formelle au sein d’une série de nombres réels par un terme littéral signifiant son indisponibilité transforme instantanément la colonne en une structure mixte non vectorisable. Ce type de pratique trahit une incompréhension de la différence fondamentale entre la gestion computationnelle des valeurs nulles et leur présentation cosmétique destinée à des tiers.
6. Résolution canonique : conversion dynamique via pd.to_numeric()
6.1 Mécanique opérationnelle de pd.to_numeric()
Pour remédier de manière chirurgicale et performante à l’anomalie de typage, la boîte à outils de Pandas propose une fonction dédiée de très haut niveau : la fonction de conversion numérique vectorisée. Contrairement aux approches artisanales fondées sur des boucles itératives ou des compréhensions de listes écrites en langage Python pur, cette routine s’appuie sur des liaisons compilées en langage C, capables de balayer les vecteurs de données avec une vitesse d’exécution optimale et une gestion fine de la mémoire.
Le fonctionnement de cette procédure repose sur une tentative de désérialisation systématique de chaque élément de la série cible vers la représentation arithmétique la plus compacte et la plus fidèle possible. Si une colonne d’objets ne contient que des représentations textuelles de nombres entiers, la routine infère spontanément le passage vers un type d’entier machine approprié. Si elle détecte des composants fractionnaires, elle bascule automatiquement vers une représentation en virgule flottante sur soixante-quatre bits, restaurant immédiatement les prérogatives mathématiques de la dimension analysée.
La syntaxe de mise en œuvre canonique impose de réaffecter explicitement le résultat produit par la fonction à la colonne d’origine ou à une nouvelle variable d’analyse. En raison du paradigme de non-mutation par défaut privilégié par les concepteurs de Pandas, l’invocation de la conversion ne modifie pas l’état interne de la structure existante sur place, mais génère une nouvelle série binaire saine. L’omission de cette étape de réassignation constitue une étourderie fréquente qui laisse le tableau de données dans son état corrompu d’origine.
6.2 Gestion des valeurs aberrantes grâce au paramètre errors
La véritable puissance de la fonction de conversion numérique réside dans son paramétrage sophistiqué de la gestion des exceptions lors de la rencontre d’éléments textuels impossibles à désérialiser. Par défaut, le paramètre contrôlant les erreurs est configuré sur une modalité d’interruption stricte : dès que la procédure rencontre un caractère réfractaire à la transformation arithmétique, elle interrompt le traitement et lève une exception circonstanciée décrivant l’élément fautif et sa localisation.
Cependant, dans le contexte du traitement de données du monde réel, la modalité la plus stratégique consiste à positionner ce paramètre sur l’option de coercition forcée. Sous ce régime opérationnel, la fonction adopte une attitude hautement résiliente : chaque fois qu’un élément ne peut être converti de manière déterministe en nombre valide — qu’il s’agisse d’une chaîne textuelle arbitraire, d’un point d’interrogation ou d’un symbole mal nettoyé —, le moteur logiciel le neutralise silencieusement en lui substituant la valeur spéciale représentant l’absence d’information numérique selon la norme internationale de virgule flottante.
Il importe toutefois d’analyser avec lucidité les conséquences épistémologiques et statistiques de cette coercition forcée. Si cette option permet de débloquer instantanément la chaîne de traitement et de satisfaire aux exigences du moteur graphique, elle implique l’effacement définitif de la nature originelle du contenu non convertible. L’analyste doit impérativement auditer la proportion d’enregistrements ainsi transformés en données manquantes, sous peine d’induire des biais d’échantillonnage sévères susceptibles de fausser l’interprétation des représentations visuelles qui en découleront.
6.3 Application multi-colonnes par vectorisation et apply()
Dans les jeux de données complexes comportant plusieurs dizaines ou centaines de dimensions quantitatives corrompues, procéder à la conversion manuelle colonne par colonne représente une approche fastidieuse et propice aux erreurs de saisie. Il est nettement plus judicieux de déployer des stratégies de traitement par lots tirant parti de la méthode d’application fonctionnelle vectorisée offerte par les structures tabulaires de Pandas.
L’approche recommandée consiste à isoler au préalable la liste nominative des colonnes devant faire l’objet de l’assainissement typologique, puis à leur appliquer globalement la routine de conversion numérique configurée avec l’option de coercition. Cette opération s’exécute en une ligne d’instruction concise, assurant le traitement séquentiel rapide de l’ensemble du sous-ensemble sélectionné sans altérer les colonnes descriptives ou identifiantes qui doivent légitimement conserver un typage textuel.
Sur le plan de l’architecture logicielle, le recours à la méthode d’application combinée à la conversion numérique surpasse structurellement toute forme de boucle itérative explicite rédigée en langage Python. Même si cette méthode implique en interne une traversée des séries composant la matrice, la conversion de chaque vecteur individuel demeure entièrement déléguée aux bibliothèques d’analyse numérique de bas niveau. L’empreinte temporelle de la phase de nettoyage s’en trouve drastiquement réduite, garantissant le passage à l’échelle sur des volumes de données substantiels.
7. Résolution alternative : conversion explicite via astype() et ses limites
7.1 Application de la méthode astype() pour les données nettoyées
Une alternative fréquemment rencontrée dans la littérature technique et les référentiels de code consiste à utiliser la méthode de conversion explicite de type native des tableaux NumPy et des séries Pandas. Cette méthode opère une réaffectation directe et contraignante du format d’encodage binaire d’une colonne en lui imposant un type cible rigoureusement défini, qu’il s’agisse d’un type d’entier standard, d’un format en virgule flottante ou d’un type textuel spécialisé.
La syntaxe de cette commande offre une élégance formelle indéniable, permettant d’adresser une transformation unitaire sur une série isolée ou de piloter une reconfiguration globale du schéma d’un tableau de données par l’injection d’un dictionnaire d’associations. Ce dictionnaire établit pour chaque nom de variable le type machine précis attendu par le concepteur du pipeline, assurant une déclaration explicite et centralisée des contrats de typage au sein du code applicatif.
Dans un contexte expérimental parfaitement maîtrisé, où le praticien dispose d’une garantie formelle absolue quant à l’absence totale de données corrompues ou de résidus textuels au sein de ses vecteurs d’entrée, cette méthode procure une efficience syntaxique optimale. Elle effectue la mutation des descripteurs de mémoire sans introduire la surcharge logique associée aux analyses syntaxiques conditionnelles déployées par les routines de désérialisation dynamique plus sophistiquées.
7.2 Vulnérabilités critiques de la méthode astype()
En dépit de son attrait syntaxique, la méthode de conversion directe de type souffre de vulnérabilités conceptuelles majeures qui en restreignent considérablement la fiabilité en environnement de production incertain. La faille la plus critique réside dans son intransigeance absolue face aux anomalies d’encodage : si la méthode se heurte à une unique cellule renfermant une chaîne textuelle non immédiatement traduisible en valeur binaire conforme, l’algorithme capitule instantanément et soulève une exception fatale.
Contrairement aux fonctions de conversion dynamiques spécialisées, cette méthode ne propose aucun mécanisme interne d’atténuation d’erreur analogue à l’option de coercition silencieuse. Face à un fichier contaminé par des abréviations de données manquantes non standards ou des résidus d’espaces typographiques, l’instruction s’effondre sans offrir de solution de contournement gracieuse, contraignant l’analyste à implémenter manuellement des passes de filtrage préalables complexes pour assainir le vecteur en amont.
Une seconde limitation structurelle concerne la manipulation historique des valeurs manquantes dans les colonnes d’entiers. Pendant longtemps, l’implémentation originelle de NumPy interdisait formellement l’existence de valeurs de virgule flottante représentant l’absence au sein d’un tableau d’entiers primitifs. La conversion forcée vers un type entier provoquait une rupture d’exécution immédiate dès qu’une cellule s’avérait non renseignée, imposant de convertir la série vers des nombres réels à virgule flottante pour préserver la vacuité de certaines entrées, au détriment de l’intégrité sémantique originelle de la variable.
7.3 Comparatif décisionnel : to_numeric() versus astype()
L’arbitrage entre le recours à la procédure de conversion dynamique et l’usage de la conversion directe de type doit être adossé à une évaluation méthodique de l’état de maturité et de propreté du jeu de données analysé. Là où la fonction dynamique privilégie la résilience, la détection des anomalies et le traitement adaptatif des scories textuelles, la conversion directe privilégie la vitesse brute et la validation stricte d’un état supposé exempt de tout défaut de saisie.
Dans une optique de programmation défensive et de recherche empirique sur des données brutes issues de processus ouverts, l’utilisation de la fonction dynamique s’impose comme le choix méthodologique par excellence. Elle prémunit le chercheur contre les arrêts inopinés de ses scripts lors de l’intégration de nouveaux flux d’enregistrements et fournit des leviers élégants pour quantifier et isoler la fraction d’enregistrements non convertibles. Son coût d’exécution légèrement supérieur est largement compensé par sa robustesse opérationnelle.
À l’inverse, l’emploi de la méthode de conversion directe doit être réservé aux étapes avales du pipeline de données, lorsque les phases d’ingestion, d’assainissement et de filtrage ont d’ores et déjà été exécutées avec succès et que les variables ont été certifiées exemptes d’artefacts. Dans ce cadre post-nettoyage, elle permet de verrouiller définitivement l’empreinte mémoire du tableau en assignant des largeurs de bits minimales et rigoureuses, préparant le jeu de données pour des modélisations mathématiques intensives.
8. Prévention en amont : maîtrise du chargement des données
8.1 Optimisation des paramètres de pd.read_csv()
La stratégie la plus rationnelle pour neutraliser l’exception relative au manque de données numériques ne consiste pas à réparer un tableau de données a posteriori, mais à empêcher formellement sa corruption dès l’étape fondamentale de l’ingestion sur disque. La fonction de lecture de fichiers plats de Pandas dispose d’un ensemble exceptionnel de paramètres configurables qui permettent de guider étroitement le moteur d’analyse syntaxique et de prévenir toute dérive typologique lors de la construction initiale de la matrice.
Le levier préventif le plus puissant réside dans la spécification explicite du dictionnaire de typage dès l’invocation de la fonction d’ingestion. En déclarant en amont la signature binaire impérative de chaque colonne, l’analyste interdit au moteur d’inférence de basculer de manière opportuniste vers le type objet. Si une incompatibilité fondamentale survient lors de la lecture d’une ligne spécifique, le processus se signale immédiatement, contraignant l’utilisateur à investiguer la source plutôt que de laisser s’installer une corruption silencieuse.
Par ailleurs, la neutralisation des divergences de conventions internationales s’opère aisément via la configuration du paramètre de définition du séparateur décimal. En assignant la virgule à cette option, l’analyseur intègre d’emblée la spécificité des notations continentales et transforme les représentations chiffrées francophones en nombres réels authentiques dès la lecture physique du flux d’octets. De manière symétrique, le renseignement exhaustif des marqueurs de nullité attendus au sein d’une liste dédiée permet d’intercepter les chaînes sentinelles atypiques et de les transcrire immédiatement en valeurs manquantes formelles lors du parsing.
8.2 Parsing des fichiers complexes et semi-structurés
Les difficultés d’ingestion atteignent leur paroxysme lors de la confrontation avec des fichiers semi-structurés, caractérisés par des séparateurs de champs instables, des délimitations de chaînes imparfaitement closes ou la présence de lignes de commentaires erratiques insérées au cœur de la trame de données. Dans ces configurations hostiles, le choix du moteur d’exécution interne de la fonction d’ingestion joue un rôle déterminant sur la qualité du typage résultant.
Pandas offre la possibilité de basculer entre un moteur optimisé rédigé en langage C et un moteur alternatif codé en Python standard. Si le moteur C excelle par sa vélocité fulgurante sur des structures parfaitement normées, il fait preuve d’une rigidité marquée face aux irrégularités syntaxiques. Le moteur Python, bien que pénalisé par des temps d’exécution sensiblement plus longs, présente une flexibilité supérieure et permet de mobiliser des expressions régulières sophistiquées comme délimiteurs, garantissant une séparation nette des colonnes numériques même au sein d’environnements tabulaires dégradés.
Lorsque les volumes de données atteignent des proportions telles que l’audit manuel devient impraticable, la stratégie du chargement par blocs successifs s’avère particulièrement judicieuse. En fragmentant la lecture du fichier source en segments dimensionnés, le script peut opérer une validation typologique précoce sur les premières itérations. Cette approche permet de détecter la dérive d’une colonne vers le type objet dès l’apparition du premier bloc corrompu, évitant l’allocation inutile de ressources informatiques colossales pour charger un jeu de données qui sera ultimement rejeté par les routines graphiques.
8.3 Validation de schéma à l’ingestion
Pour conférer une rigueur industrielle aux chaînes d’analyse quantitative, il est impératif de dépasser la simple configuration heuristique des paramètres de lecture et d’instaurer des mécanismes d’assertion formelle dès la frontière d’entrée des données. Cette démarche s’inspire directement des architectures logicielles dirigées par les contrats de données, où aucune entité logicielle n’est autorisée à consommer une matrice dont la structure et le typage ne satisfont pas à des spécifications préalablement actées.
L’implémentation de cette barrière d’admission repose sur la définition d’un protocole de vérification exécuté immédiatement après la matérialisation en mémoire du tableau de données. Ce module d’audit compare la liste des types effectifs du tableau entrant à une matrice de conformité théorique. Toute divergence critique, telle que la requalification inopinée d’un indice boursier ou d’une coordonnée géographique sous le statut de variable textuelle, déclenche l’avortement immédiat de la procédure et le refoulement du fichier source vers une file d’attente d’anomalies.
L’automatisation de ce contrôle qualité à l’entrée des environnements de recherche ou des pipelines opérationnels transforme radicalement la gestion des erreurs. Au lieu de subir une interruption tardive et déroutante au moment de produire une visualisation graphique en bout de chaîne, l’équipe d’ingénierie identifie la régression au point précis où elle a été introduite. Cette séparation stricte entre les responsabilités d’ingestion et les modules de visualisation constitue l’un des piliers de l’architecture logicielle moderne appliquée à la science des données.
9. Traitement avancé des résidus : valeurs manquantes et caractères parasites
9.1 Assainissement des chaînes via les accesseurs .str
Lorsque l’ingestion a produit des colonnes typées en objet en raison de la présence d’artefacts d’encodage non triviaux, le recours immédiat à la conversion arithmétique globale s’avère voué à l’échec ou destructeur d’information. Il convient alors de déployer une phase intermédiaire de nettoyage chirurgical exploitant les accesseurs de chaînes vectorisés intégrés à Pandas. Ces accesseurs permettent d’appliquer des transformations textuelles hautement optimisées sur l’intégralité d’une série sans recourir à l’écriture de boucles explicites lentes et inélégantes.
L’assainissement typique débute par la neutralisation des symboles monétaires, des annotations d’unités physiques et des séparateurs de milliers résiduels au moyen d’expressions régulières compilées. En substituant ces caractères perturbateurs par des séquences vides, la chaîne de caractères retrouve une morphologie strictement conforme aux normes de désérialisation numérique. L’opération se poursuit par l’invocation systématique des méthodes d’élagage des blancs typographiques afin d’éradiquer les espaces en début et fin de chaîne qui échappent souvent à la perception de l’observateur.
Une attention méticuleuse doit également être portée à la normalisation de l’encodage des caractères Unicode. Dans de multiples scénarios de traitement de données internationales, des caractères apparemment anodins tels que des espaces insécables, des tirets cadratins ou des caractères de contrôle invisibles parasitent la représentation textuelle des nombres. L’application d’une standardisation de forme normale permet d’aplanir ces divergences microscopiques et d’assurer que chaque symbole graphique corresponde strictement au point de code standardisé attendu par l’analyseur arithmétique.
9.2 Gestion des valeurs NaN consécutives à la conversion
L’exécution de la conversion numérique vectorisée avec l’option de coercition forcée conduit inéluctablement à la genèse de valeurs manquantes formelles aux emplacements où résidaient des scories textuelles réfractaires. Cette substitution, bien que salutaire pour débloquer le typage machine de la colonne, transfère la problématique vers le domaine du traitement de la vacuité informationnelle. Le moteur graphique de Matplotlib, orchestré par Pandas, réagit de façon très spécifique face à la présence de ces discontinuités mathématiques.
L’analyste dispose de deux voies méthodologiques pour arbitrer la présence de ces valeurs manquantes avant d’ordonner le traçage définitif. La première option réside dans l’élagage contrôlé des lignes incomplètes au moyen de la méthode de suppression dédiée. Si la perte d’enregistrements demeure marginale au regard de la volumétrie globale du jeu de données, cette approche garantit un tracé graphique d’une netteté absolue, exempt d’interpolations hasardeuses ou d’artefacts visuels déroutants.
La seconde alternative repose sur le déploiement de stratégies d’imputation numérique adaptées à la distribution empirique observée. Remplacer les valeurs manquantes par des mesures de tendance centrale, telles que la moyenne arithmétique ou la médiane de la variable, permet de maintenir intacte la structure dimensionnelle du tableau de données. Toutefois, le praticien doit rester conscient que toute imputation numérique altère la variance naturelle de l’échantillon et peut projeter sur le graphique des plateaux artificiels qui n’ont aucune contrepartie dans le phénomène physique ou économique sous-jacent.
9.3 Préservation de l’intégrité scientifique des séries temporelles
La problématique du traitement des valeurs manquantes induites par la conversion typologique revêt une acuité critique lors de l’analyse et du traçage de séries temporelles régulières. Dans ce cadre précis, la simple suppression aveugle des enregistrements défaillants s’avère proscrite, car elle détruit la régularité du maillage chronologique et fausse la perception visuelle des dynamiques d’évolution en condensant artificiellement des périodes temporelles disjointes.
Pour préserver la fidélité de la trajectoire historique sans heurter le moteur de visualisation, il convient d’appliquer des algorithmes d’interpolation mathématique formels. Selon la nature du processus dynamique sous-jacent, l’analyste arbitrera entre une interpolation linéaire élémentaire, un raccordement polynomial d’ordre supérieur ou une propagation de la dernière observation valide vers l’avant. Ces techniques permettent de combler élégamment les lacunes informationnelles en garantissant une continuité graphique fluide le long de l’axe des abscisses.
Enfin, il est impératif d’opérer une distinction conceptuelle rigoureuse entre une absence avérée de signal de mesure et une valeur nulle réelle représentant un état physique neutre. Confondre une valeur manquante avec le chiffre zéro sous prétexte de faciliter l’affichage d’un graphique constitue une faute d’analyse statistique lourde de conséquences. L’analyste rigoureux documente scrupuleusement la proportion de points interpolés sur ses figures afin de préserver l’intégrité scientifique et la transparence de ses représentations visuelles.
10. Validation empirique et réalisation du tracé graphique
10.1 Contrôle qualité post-conversion
Avant de solliciter à nouveau le sous-système de visualisation graphique à l’issue des opérations d’assainissement typologique, la méthodologie scientifique impose de soumettre la matrice tabulaire à une phase d’audit de validation post-opératoire. Cette étape vise à certifier de manière irréfutable que les transformations algorithmiques ont produit les effets escomptés et que l’infrastructure de données répond désormais en tout point aux exigences du moteur de tracé.
L’instrument de contrôle privilégié consiste à interroger la méthode de sélection sélective par types de données intégrée à Pandas, en restreignant explicitement le périmètre d’extraction aux membres de la famille des nombres réels et entiers de NumPy. En confrontant le nombre de colonnes ainsi sélectionnées à la liste des grandeurs que l’on envisageait de projeter graphiquement, l’analyste s’assure qu’aucune variable d’intérêt n’a été égarée ou dégradée en cours de route.
Ce contrôle structurel est avantageusement complété par le calcul des métriques statistiques descriptives préliminaires au moyen de la méthode de description globale. La production réussie d’une synthèse quantifiant les effectifs non nuls, les moyennes, les écarts-types, ainsi que les bornes d’intervalles quartiles sur l’ensemble des colonnes assainies apporte la confirmation éclatante que la structure de données est pleinement réintégrée au sein de l’espace computationnel arithmétique. Le feu vert est ainsi formellement accordé pour l’étape de rendu graphique.
10.2 Exécution réussie du graphique
Fort d’un tableau de données dont l’intégrité binaire a été rigoureusement restaurée, l’appel à la méthode de visualisation graphique peut être formulé en toute confiance. L’interpréteur n’émet plus la moindre exception de typage ; la couche d’abstraction de Pandas dialogue harmonieusement avec le moteur de rendu de Matplotlib, transmettant les vecteurs numériques compilés pour instancier les coordonnées géométriques correspondantes sur le canevas d’affichage.
L’exécution nominale permet désormais de déployer toute la richesse paramétrique offerte par l’API graphique. L’analyste peut personnaliser sans entrave les éléments fondamentaux de la mise en scène visuelle : ajustement des échelles cartésiennes, incorporation de titres explicatifs, paramétrage de grilles de lecture secondaires et génération automatisée d’une légende discriminante associant chaque courbe stylisée à son étiquette de colonne d’origine. La structure tabulaire s’efface au profit d’un discours visuel fluide et informatif.
L’aboutissement de ce processus se matérialise par l’exportation haute fidélité du résultat graphique vers des formats matriciels ou vectoriels adaptés à la communication scientifique ou à la publication académique. Grâce à la résolution intégrale des anomalies de typage sous-jacentes, la figure produite s’appuie sur des calculs d’axes mathématiquement irréprochables, garantissant que les proportions relatives, les pentes de régression visuelle et les intervalles de dispersion reflètent avec une exactitude absolue la réalité empirique consignée dans les données brutes d’origine.
10.3 Exploration des méthodes de visualisation alternatives
La restauration de la pleine conformité numérique des données tabulaires débloque l’accès à un vaste horizon de techniques visuelles complémentaires qui étaient structurellement interdites tant que les colonnes demeuraient confinées sous le statut d’objets génériques. L’analyste ne se limite plus au traçage de lignes continues élémentaires ; il est désormais en mesure de mobiliser l’ensemble de l’arsenal méthodologique de l’analyse exploratoire des données.
L’inspection des distributions univariées devient immédiatement opérationnelle grâce à la génération d’histogrammes à découpage adaptatif ou de diagrammes de dispersion en boîtes à moustaches. Ces représentations permettent de révéler d’un coup d’œil l’asymétrie éventuelle des distributions, l’existence de bimodalisations structurales ou la présence de valeurs extrêmes nécessitant un traitement statistique particulier. Ces diagnostics visuels avancés n’auraient jamais pu être formalisés au sein d’un tableau corrompu sans lever une nouvelle variante d’exception typologique.
Par ailleurs, la consolidation des types numériques permet d’intégrer avec une fluidité remarquable d’autres bibliothèques de l’écosystème Python de visualisation scientifique, à l’instar de Seaborn pour les visualisations statistiques riches ou de bibliothèques orientées web pour la génération de graphiques interactifs en trois dimensions. Ces outils, encore plus exigeants que Pandas quant à la rigueur des schémas d’entrée, exploitent sans friction les matrices assainies, ouvrant la voie à des tableaux de bord analytiques sophistiqués.
11. Automatisation et conception de pipelines de données résilients
11.1 Encapsulation fonctionnelle des routines de nettoyage
La maîtrise intellectuelle de la résolution ponctuelle d’une exception de typage ne saurait suffire dans un contexte de développement d’ingénierie moderne. La répétition manuelle de séquences d’assainissement au sein de scripts fragmentés représente une source intarissable d’erreurs humaines et de divergence technique. La réponse organisationnelle réside dans la formalisation et l’encapsulation de ces routines au sein de modules fonctionnels purs, dotés d’interfaces clairement documentées et réutilisables à l’échelle d’une organisation.
Cette démarche d’architecture logicielle implique la création de transformateurs spécialisés, conçus selon les principes de la programmation modulaire. Une fonction d’assainissement exemplaire reçoit en entrée un tableau de données potentiellement vicié, une cartographie déclarative des schémas de typage requis et un jeu de paramètres régissant la sévérité du traitement des erreurs. Elle applique séquentiellement les phases de normalisation de chaînes, de conversion dynamique vectorisée et de gestion contrôlée des valeurs manquantes, pour restituer une structure certifiée conforme aux consommateurs avals.
L’encapsulation offre également l’opportunité d’implanter un mécanisme unifié de capture et de journalisation des exceptions. Au lieu de laisser une erreur de type interrompre brutalement l’exécution globale d’une chaîne de traitement nocturne de plusieurs téraoctets, le composant intercepte la défaillance, consigne un diagnostic détaillé dans les registres d’audit du système, extrait le sous-ensemble de lignes corrompues pour inspection humaine ultérieure, et poursuit le traitement des segments sains avec une résilience optimale.
11.2 Utilisation d’outils de typage et de validation de schéma
Pour élever le niveau d’assurance qualité des flux d’ingestion à des standards industriels, la communauté de la science des données s’appuie désormais sur des bibliothèques de validation de schéma dédiées, au premier rang desquelles figurent des cadriciels spécialisés tels que Pandera ou les initiatives de contrats déclaratifs de données. Ces outils permettent de définir formellement la spécification structurelle attendue pour un tableau de données, à la manière des schémas de validation régissant les bases relationnelles SQL.
À travers une syntaxe déclarative élégante, l’ingénieur spécifie pour chaque dimension non seulement son type machine impératif, mais également un éventail d’assertions statistiques et physiques incontournables : appartenance à un intervalle continu défini, interdiction de valeurs manquantes, respect de formats de dates particuliers ou unicité des identifiants. Dès son franchissement de la couche d’ingestion, le tableau de données est soumis à ce crible contractuel rigide.
Cette approche transforme radicalement la détection des corruptions typologiques. Au lieu de découvrir de manière accidentelle l’absence de données numériques lors d’une tentative de traçage graphique à l’extrême bout du cycle analytique, le contrat de données échoue immédiatement dès la réception du fichier fautif avec un rapport d’audit exhaustif pointant l’exacte colonne déviante. Le schéma de données devient ainsi la documentation vivante et exécutoire du pipeline, garantissant une communication sans ambiguïté entre les producteurs de données et les chercheurs analystes.
11.3 Intégration continue et tests unitaires de non-régression
L’édification d’un pipeline de données robuste et pérenne ne saurait être complète sans l’établissement d’une suite de tests automatisés intégrée aux mécanismes de livraison continue du logiciel. L’objectif fondamental de ces tests unitaires consiste à prouver mathématiquement l’invariance et l’immunité de l’algorithme d’assainissement face à des variations ou des dégradations imprévues des formats de données en entrée.
La méthodologie prescrit d’élaborer des jeux d’essais synthétiques reproduisant scrupuleusement l’ensemble des pathologies typologiques documentées dans cet article : présence de séparateurs décimaux francophones, intégration de symboles monétaires exotiques, insertion de sentinelles textuelles multiples, injection d’espaces invisibles et présence de valeurs manquantes hétérogènes. La chaîne d’intégration continue exécute périodiquement la routine d’assainissement sur ces structures délibérément viciées et valide que le tableau de données produit en sortie conserve imperturbablement son statut numérique valide.
De surcroît, le déploiement de techniques de test aléatoire ou d’injection de données dégradées permet d’éprouver les limites opérationnelles des routines d’ingestion face à des entrées imprévues générées de façon probabiliste. Cette pratique de génie logiciel assure que même confrontée à des flux de données extrêmes ou corrompus par des défaillances matérielles amont, l’infrastructure tabulaire ne s’effondrera jamais silencieusement et maintiendra en toute circonstance la conformité de ses structures de données vis-à-vis des composants de visualisation et de calcul.
12. Synthèse épistémologique et recommandations pour l’analyse quantitative
12.1 La typologie des données comme fondement de la validité scientifique
L’analyse approfondie de l’exception technique étudiée tout au long de cet ouvrage met en exergue une réalité épistémologique trop souvent occultée par les praticiens : dans les disciplines quantitatives modernes, la validité scientifique des conclusions est indissociable de la rigueur de l’architecture logicielle sous-jacente. Une erreur de typage n’est jamais un simple désagrément cosmétique ; elle constitue une violation de la sémantique de l’information qui menace directement la chaîne de preuve empirique.
À cet égard, les erreurs explicites du système d’exécution doivent être considérées non comme des obstacles malvenus, mais comme des garde-fous salutaires. Une exception qui interrompt net l’exécution d’un script de visualisation graphique protège le chercheur contre un péril infiniment plus redoutable : l’erreur silencieuse. Un algorithme permissif qui tenterait d’extrapoler ou de masquer magiquement des types corrompus produirait des figures mathématiquement faussées, induisant des interprétations scientifiques erronées et conduisant ultimement à la publication de résultats irréproductibles.
L’adoption systématique d’une démarche de programmation défensive chez le chercheur en sciences sociales, l’économiste ou le biostatisticien s’impose ainsi comme un impératif éthique et professionnel. Respecter la stricte typologie des représentations en machine vive, auditer méthodiquement l’alignement entre le modèle conceptuel et le substrat binaire, et proscrire toute complaisance face aux ambiguïtés d’ingestion constituent les gestes fondamentaux garantissant l’intégrité de la démarche empirique à l’ère du traitement massif des données.
12.2 Guide récapitulatif des commandes de remédiation
Pour clore cet exposé exhaustif par une synthèse opérationnelle directement exploitable dans la pratique quotidienne, il convient d’ordonnancer les protocoles de remédiation sous la forme d’un arbre de décision logique et d’un mémento syntaxique rigoureux. Confronté à l’émergence soudaine du message indiquant l’absence de données numériques à tracer, l’analyste est invité à dérouler la séquence ordonnée d’interventions formalisée ci-après.
La première phase implique impérativement l’exécution d’un diagnostic d’invariance via la consultation de l’attribut des types de colonnes ou l’appel à la méthode d’information synthétique de la structure tabulaire. Cette vérification immédiate permet de confirmer sans équivoque le statut d’objet générique de la colonne incriminée et d’évaluer le volume d’enregistrements affectés. Dès cet instant, tout appel supplémentaire au moteur graphique doit être formellement suspendu jusqu’à la résolution complète du diagnostic sous-jacent.
La seconde phase consiste à appliquer le protocole de conversion adapté au degré d’assainissement requis :
- Si la colonne ne comporte que des représentations textuelles de nombres altérées par des marqueurs sentinelles ou des valeurs manquantes informelles, mobiliser immédiatement la fonction de conversion numérique vectorisée configurée impérativement avec l’argument de coercition des erreurs, en veillant à réassigner explicitement le vecteur résultant à la colonne du tableau de données.
- Si la colonne héberge des scories typographiques récurrentes telles que des virgules décimales, des symboles de devises ou des séparateurs de milliers, procéder préalablement à un nettoyage vectorisé au moyen des expressions régulières via les accesseurs de chaînes, avant de déclencher la procédure de conversion numérique.
- Si l’ensemble du tableau de données présente des colonnes numériques polluées, systématiser la transformation par l’application de la conversion dynamique sur le sous-ensemble vectoriel complet via la méthode d’application fonctionnelle.
- Si et seulement si le jeu de données est certifié intègre et strictement nettoyé en amont, utiliser la méthode de conversion explicite de type pour assigner un format machine strict et optimiser l’empreinte mémoire globale.
Enfin, la troisième phase de clôture impose de vérifier l’absence d’effets de bord par la réévaluation des métriques descriptives à l’aide de la méthode de description statistique, et d’arbitrer le traitement des éventuelles valeurs manquantes générées par suppression ou interpolation contrôlée. Une fois ce protocole scrupuleusement exécuté, la commande de visualisation graphique originelle peut être invoquée avec l’assurance absolue d’obtenir une restitution cartésienne fidèle, pérenne et scientifiquement irréprochable.
Références
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56-61). https://doi.org/10.25080/Majora-92bf1924-00a
- McKinney, W. (2022). Python for data analysis: Data wrangling with pandas, NumPy, and Jupyter (3rd ed.). O’Reilly Media.
- The pandas development team. (2024). pandas-dev/pandas: Pandas (Version 2.2.0). Zenodo. https://doi.org/10.5281/zenodo.3509134
- Van der Walt, S., Colbert, S. C., & Varoquaux, G. (2011). The NumPy array: A structure for efficient numerical computation. Computing in Science & Engineering, 13(2), 22-30. https://doi.org/10.1109/MCSE.2011.37
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021