
Dans le domaine de l’analyse statistique contemporaine et de la science des données, le langage R s’est imposé comme l’un des piliers méthodologiques les plus robustes, principalement grâce à la puissance expressive de son écosystème de visualisation graphique. Au cœur de cet écosystème, la bibliothèque ggplot2 incarne une véritable révolution paradigmatique en traduisant les concepts théoriques de la sémiologie graphique en une syntaxe programmatique cohérente et modulaire. Cependant, la rigueur structurelle imposée par ce système engendre fréquemment des frictions chez les analystes, qu’ils soient débutants ou chercheurs chevronnés. L’interruption brutale d’un pipeline de traitement par un message d’erreur du compilateur graphique constitue une expérience universelle qui, loin d’être un simple dysfonctionnement technique, révèle souvent une incompréhension profonde des mécanismes de liaison entre les structures de données sous-jacentes et les primitives visuelles qui les représentent.
Parmi la typologie des exceptions générées par le moteur d’exécution de ggplot2, l’alerte formulée sous l’expression aesthetics must be either length 1 or the same as the data représente l’un des écueils les plus récurrents et les plus formateurs. Ce message d’erreur signale une dissonance fondamentale entre la dimensionnalité d’un paramètre visuel injecté dans le graphique et le nombre effectif d’observations contenues dans le tableau de données traité par la couche géométrique. Loin d’être une limitation arbitraire imposée par les concepteurs du paquet, cette contrainte dimensionnelle stricte découle directement de l’algèbre relationnelle qui gouverne l’attribution des propriétés graphiques aux entités statistiques. Comprendre les fondements mathématiques et informatiques de ce verrouillage est indispensable pour quiconque aspire à produire des visualisations scientifiques rigoureuses, reproductibles et exemptes de biais d’interprétation.
Le présent traité propose une déconstruction exhaustive de cette anomalie de programmation. En explorant les principes de la grammaire des graphiques, les subtilités de l’évaluation non standard propre à R, ainsi que les divergences architecturales entre assignation scalaire et mappage vectoriel, cet article offre une grille de lecture complète pour diagnostiquer, comprendre et résoudre définitivement ce conflit d’arités. À travers des protocoles expérimentaux reproductibles, des scénarios réels issus de la recherche comportementale et une taxonomie détaillée des solutions techniques, ce guide permettra aux analystes de transformer une erreur syntaxique déroutante en une opportunité d’optimisation structurelle de leur flux de travail analytique.
1. Introduction à la grammaire des graphiques et genèse de l’erreur dans ggplot2
1.1 Fondements conceptuels de ggplot2 et logique vectorielle de R
Pour appréhender l’origine précise de l’erreur dimensionnelle dans ggplot2, il est impératif de remonter aux sources théoriques qui ont présidé à sa conception. L’architecture de la bibliothèque repose sur les travaux fondateurs du statisticien et informaticien Leland Wilkinson, formalisés dans son ouvrage séminal The Grammar of Graphics. Wilkinson a postulé qu’un graphique statistique ne doit pas être appréhendé comme une simple juxtaposition de pixels ou un dessin figé, mais plutôt comme une composition formelle et hiérarchisée de couches indépendantes. Ces strates comprennent invariablement un ensemble de données brutes, un système de coordonnées spatiales, des transformations statistiques potentielles, des objets géométriques appelés geoms, et une fonction de mappage esthétique reliant les variables du jeu de données aux attributs perceptifs des géométries.
Dans l’implémentation logicielle réalisée par Hadley Wickham au sein de l’environnement R, cette abstraction théorique est strictement couplée à la nature vectorielle intrinsèque du langage. R traite nativement les collections d’éléments sous forme de vecteurs atomiques homogènes. Chaque colonne d’un tableau de données rectangulaire standardisé, tel qu’un data.frame ou un tibble, constitue un vecteur doté d’une longueur rigoureusement identique à celle de ses pairs, garantissant ainsi l’intégrité de la dimensionnalité tabulaire. Lorsque l’opérateur graphique entreprend de rendre une figure, le compilateur procède à une opération de jointure structurelle interne : chaque ligne du tableau de données doit être projetée de manière univoque sur un élément géométrique donné, lequel hérite des propriétés visuelles correspondantes.
L’interruption du pipeline d’affichage par le compilateur graphique intervient dès lors que cette correspondance bijective est rompue. Si l’interpréteur se voit fournir un vecteur d’attributs visuels dont la cardinalité ne correspond ni à l’élément neutre de diffusion scalaire (la longueur unitaire), ni à la dimension intrinsèque de la table de données d’entrée (la longueur $N$), l’opération de projection devient indéterminée. Face à cette ambiguïté sémantique, le moteur d’évaluation refuse d’extrapoler ou de deviner l’intention de l’analyste, interrompant formellement l’exécution pour prévenir toute distorsion visuelle non contrôlée du corpus empirique.
1.2 Importance de la rigueur de codage en analyse de données quantitatives
L’exigence de conformité stricte imposée par les bibliothèques d’analyse modernes n’est pas une simple coquetterie de développeur de logiciels, mais une nécessité épistémologique liée à l’intégrité de la recherche quantitative contemporaine. Dans un contexte scientifique marqué par la crise de la reproductibilité, la précision des visualisations de données joue un rôle tout aussi déterminant que le calcul des estimateurs statistiques paramétriques ou non paramétriques. Une représentation visuelle inexacte, issue d’un alignement erratique entre les observations et leurs descripteurs chromatiques ou morphologiques, peut altérer drastiquement la perception des tendances, masquer des structures de variance critiques ou introduire des artéfacts d’analyse fallacieux.
Dans de nombreux environnements de programmation graphique permissifs ou historiques, des mécanismes d’adaptation automatique, tels que le recyclage silencieux et partiel de vecteurs disparates, permettent au script de s’exécuter sans émettre d’avertissement explicite. Toutefois, cette apparente flexibilité constitue un danger méthodologique majeur : lorsqu’un vecteur de dix couleurs est appliqué silencieusement à un échantillon de quinze observations selon une règle de découpage arbitraire, l’analyste court le risque d’interpréter une alternance de teintes comme une propriété systématique de son phénomène d’étude, alors qu’il ne s’agit que d’un résidu accidentel de mémoire tampon. La rigueur syntaxique imposée par ggplot2 participe ainsi directement à la sécurité intellectuelle du chercheur en rendant explicites les dysfonctionnements dimensionnels dès leur apparition.
L’alignement rigoureux entre les variables indépendantes modélisées et les paramètres visuels garantit que chaque variation chromatique, spatiale ou géométrique observée sur le panneau final correspond à une variation mesurée dans le monde réel ou issue du protocole expérimental. La maîtrise de ces mécanismes d’interception d’erreurs devient alors un jalon indispensable de la formation méthodologique, assurant que les supports visuels destinés à la publication scientifique respectent scrupuleusement les exigences de traçabilité, de transparence et d’exactitude numérique indispensables au progrès scientifique.
2. Anatomie structurelle de l’erreur : décryptage du message d’alerte
2.1 Exégèse de l’énoncé d’erreur du compilateur R
Le message émis par l’interpréteur R lors du déclenchement de cette exception mérite une dissection terminologique rigoureuse. L’énoncé complet prend généralement la forme suivante dans la console d’exécution :
Error: Aesthetics must be either length 1 or the same as the data
Cette proposition logique disjonctive énonce deux conditions d’admissibilité mutuellement exclusives qui gouvernent l’attribution de tout paramètre esthétique au sein d’une couche géométrique. La première branche de l’alternative, désignée par length 1, stipule qu’une valeur graphique peut être un scalaire au sens computationnel du terme, c’est-à-dire une entité unitaire unique. Lorsqu’un paramètre, par exemple une couleur de contour ou une épaisseur de trait, possède une longueur égale à un, le moteur de rendu procède à une extension universelle : cette valeur invariable est appliquée de manière uniforme et indifférenciée à la totalité des primitives géométriques générées par la couche considérée.
La seconde branche de l’alternative, formulée par the same as the data, renvoie à la condition de conformité vectorielle complète. Si la propriété visuelle n’est pas constante pour l’ensemble du calque, elle doit impérativement posséder un cardinal mathématique exactement égal au nombre total d’enregistrements présents dans le tableau de données associé à cette géométrie spécifique, noté formellement $N = \mathrm{nrow}(\mathrm{data})$. Dans ce cas de figure, il s’établit une relation d’isomorphisme strict : le premier élément du vecteur visuel module le premier point d’observation, le second élément module la deuxième ligne, et ainsi de suite jusqu’à l’épuisement simultané des données et des propriétés visuelles.
L’erreur se manifeste précisément lorsque l’argument incriminé, qu’il s’agisse de l’attribut de remplissage (fill), de teinte (color ou colour), de transparence (alpha), de morphologie (shape) ou de dimensionnement (size), se voit attribuer un vecteur dont la longueur $k$ vérifie l’inéquation stricte $1 < k N$. Pour le compilateur graphique, un tel vecteur représente une anomalie insoluble : le système ne dispose d’aucune règle déterministe valide pour associer $k$ éléments esthétiques à $N$ observations sans violer l’un des principes fondamentaux de la grammaire visuelle.
2.2 Mécanisme d’évaluation non standard et portée des variables
Pour comprendre comment un analyste peut introduire par inadvertance un vecteur de dimension discordante, il convient d’examiner le mécanisme d’évaluation non standard (NSE, pour Non-Standard Evaluation) qui constitue le cœur fonctionnel de la bibliothèque ggplot2. Au sein de la fonction d’encapsulation esthétique aes(), R ne résout pas les identifiants selon les règles d’évaluation lexicale standard. Au lieu de rechercher immédiatement une variable dans l’environnement global d’exécution (le .GlobalEnv), l’expression est d’abord interceptée sous forme de citation de code, puis évaluée à l’intérieur du contexte délimité par les colonnes du tableau de données fourni à la fonction ggplot() ou à la couche géométrique active.
Ce comportement d’évaluation paresseuse et contextuelle crée une dichotomie fondamentale entre deux environnements d’exécution :
- Le contexte interne du tableau de données : Dans cet espace, toute colonne référencée possède naturellement et mécaniquement la longueur $N$, garantissant l’alignement dimensionnel avec le jeu de données sous-jacent.
- Le contexte externe de l’espace de travail global : Dans cet espace résident les vecteurs arbitraires, les variables de calcul temporaires et les paramètres de session définis par l’utilisateur, dont les dimensions peuvent être totalement décorrelées de la structure du tableau étudié.
Les conflits de portée émergent fréquemment lorsqu’un utilisateur transmet à un argument esthétique un objet vectoriel résidant dans l’espace de travail global au lieu de faire référence à une variable interne au jeu de données, ou lorsqu’il tente d’effectuer une assignation manuelle sans maîtriser la délimitation syntaxique des parenthèses de la fonction aes(). L’interpréteur tente alors de concilier la cardinalité de cet objet externe indépendant avec le volume des lignes de données internes, déclenchant l’exception dès lors que la divergence de longueur est constatée par l’algorithme d’inspection dimensionnelle.
3. Reproduction méthodique de l’anomalie avec des jeux de données de référence
3.1 Protocole expérimental à partir du jeu de données standard airquality
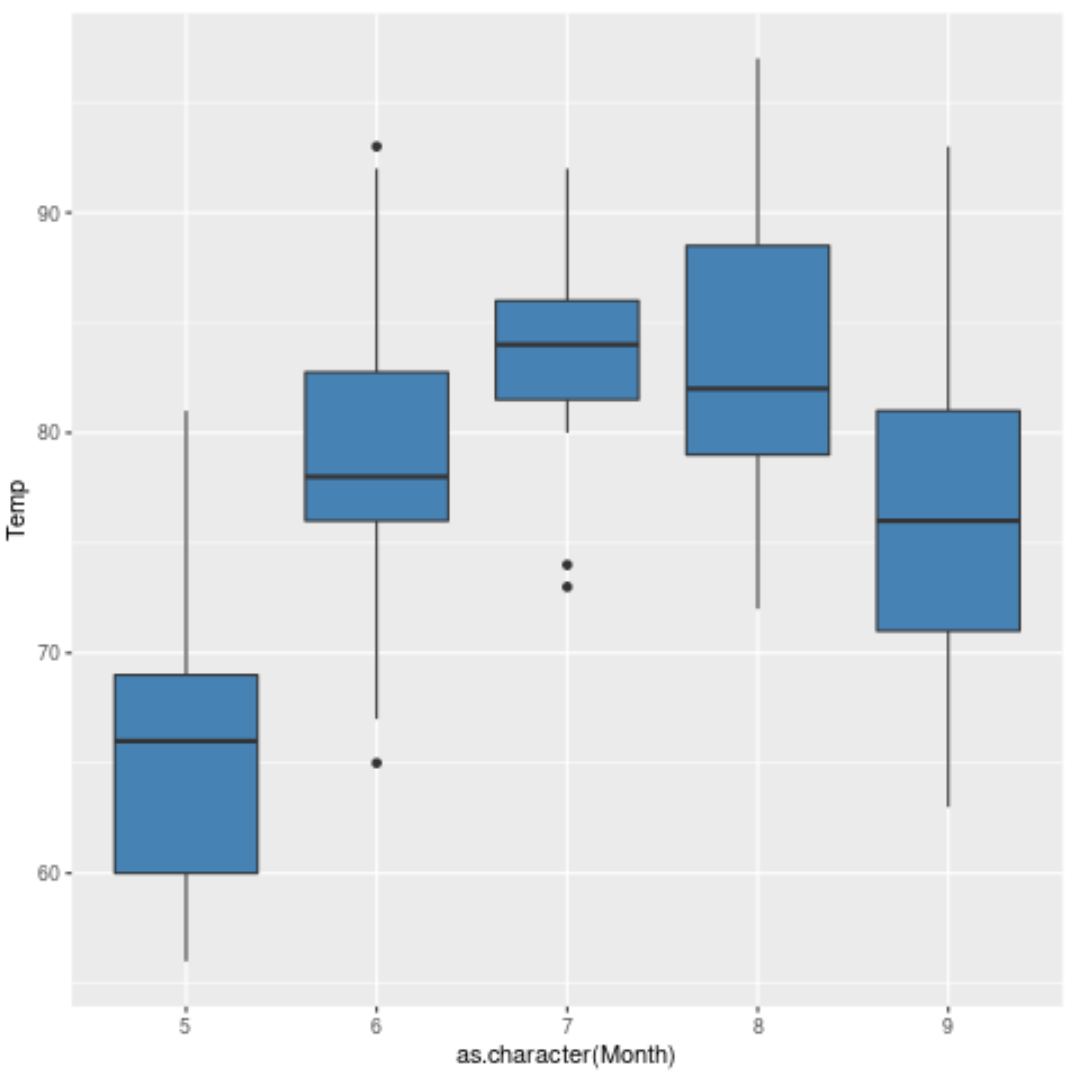
Afin de disséquer le comportement du compilateur de manière empirique et reproductible, nous pouvons mobiliser l’un des jeux de données de référence les plus couramment exploités dans l’écosystème R : la table airquality, incluse nativement dans le paquetage de base de données du langage. Ce jeu de données consigne 153 observations météorologiques quotidiennes mesurées à New York sur une période s’étendant de mai à septembre 1973. Les variables mesurées incluent des indicateurs continus tels que la concentration d’ozone, le rayonnement solaire, la vitesse du vent et la température, ainsi que des marqueurs temporels discrets désignant le mois et le jour de la mesure.
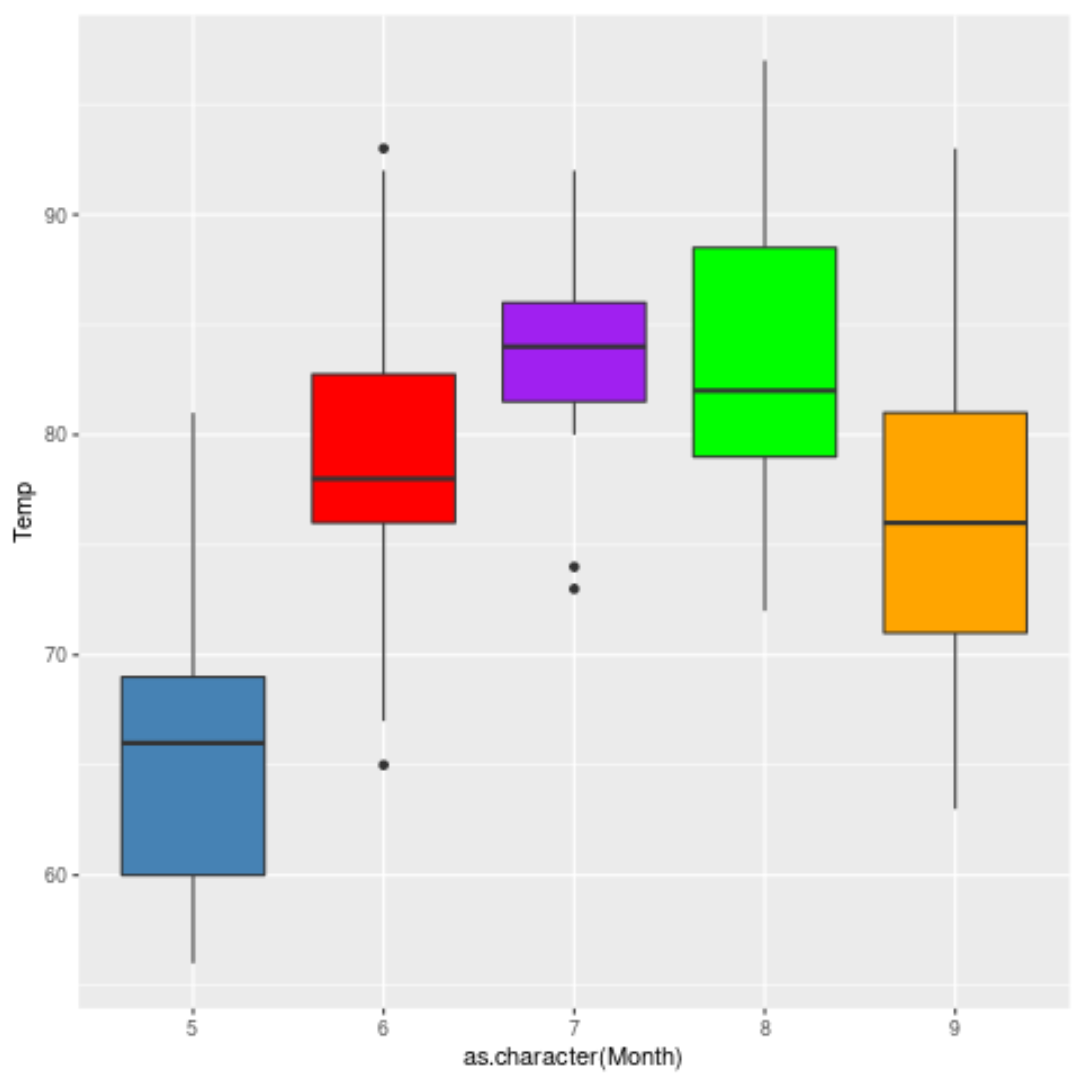
Imaginons un protocole d’analyse dans lequel un chercheur souhaite générer une série de boîtes à moustaches stratifiées représentant la distribution des niveaux de température pour chacun des cinq mois documentés dans l’échantillon. Le chercheur prépare un vecteur chromatique composé de cinq nuances distinctes, avec l’intention louable d’attribuer une coloration propre à chacune des cinq boîtes à moustaches mensuelles. Le piège syntaxique se referme lorsque ce vecteur de longueur cinq est injecté directement en tant qu’argument dans la couche geom_boxplot() en dehors de tout cadre de transformation approprié.
Le raisonnement intuitif erroné de l’analyste repose sur l’hypothèse que la couche géométrique va automatiquement détecter qu’il existe cinq sous-groupes graphiques sur l’axe des abscisses, et qu’elle va par conséquent appliquer le vecteur de taille cinq de manière séquentielle sur ces cinq représentations agrégées. Or, pour ggplot2, la couche geom_boxplot() opère formellement sur les 153 observations unitaires initiales avant d’effectuer les calculs de réduction statistique (médianes, quartiles et moustaches). En recevant un vecteur de couleur de longueur 5 alors que le tableau sous-jacent comprend 153 lignes, le système identifie une incompatibilité arithmétique flagrante : 5 n’étant ni égal à 1, ni égal à 153, l’évaluation s’interrompt instantanément en émettant le signal d’erreur caractéristique.
3.2 Simulation d’échec sur données continues et graphiques de dispersion
L’occurrence de cette anomalie ne se cantonne pas aux représentations stratifiées par facteurs discrets ; elle s’observe avec une fréquence similaire lors de la génération de graphiques de dispersion univariés ou bivariés mobilisant la primitive geom_point(). Considérons l’analyse relationnelle liant la concentration d’ozone à la vitesse du vent dans ce même échantillon environnemental. Supposons que l’analyste dispose par ailleurs, dans son espace de travail global, d’un vecteur numérique issu d’un traitement préalable, par exemple un vecteur d’indices d’importance ou de classification préliminaire ne contenant que 50 valeurs.
Si l’opérateur tente d’assigner ce vecteur externe de cinquante éléments au paramètre morphologique de taille des points en rédigeant une instruction associant geom_point(size = mon_vecteur_de_50) ou geom_point(aes(size = mon_vecteur_de_50)), la divergence dimensionnelle frappe de nouveau. Le sous-jacent computationnel exige impérativement la fourniture de 153 dimensions de points, soit une valeur par coordonnée spatiale $(x, y)$. En constatant que le vecteur externe ne présente que cinquante entrées, le moteur de validation interrompt la construction du graphe de scène.
L’analyse de la trace d’appels (communément désignée sous le terme de traceback) permet de situer précisément le lieu de la défaillance. L’inspection logicielle montre que l’erreur n’est pas émise au moment de la déclaration formelle de la commande ggplot(), mais lors de la phase de matérialisation et d’impression de l’objet graphique, orchestrée par la fonction générique print.ggplot() ou plot(). C’est en effet au cours de cette phase d’évaluation finale que le compilateur exécute la fonction interne ggplot_build(), laquelle audite la cohérence dimensionnelle des calques et déclenche l’exception dès la détection d’une disparité entre le vecteur d’attributs visuels et la matrice d’observations.
4. La distinction fondamentale entre assignation statique et mappage esthétique
4.1 Le rôle précis de l’environnement fonctionnel aes()
La pierre angulaire de la maîtrise de ggplot2 réside dans la compréhension indéfectible de la frontière conceptuelle qui sépare le mappage esthétique dynamique de l’assignation de paramètres statiques. La fonction constructrice aes() a pour mission exclusive de réaliser un mappage (ou appariement formel). Au sens de la théorie de la communication graphique théorisée par Jacques Bertin et affinée par William S. Cleveland, un mappage consiste à faire correspondre les variations d’une échelle de données empiriques aux modulations d’un canal perceptif humain, tel que la position le long d’un axe, l’intensité lumineuse, la chromaticité, ou la forme géométrique.
Lorsque des variables sont déclarées à l’intérieur de l’instruction aes(), le système déploie un ensemble d’automatisations complexes :
- Il inspecte le domaine de définition de la variable (ses valeurs minimales et maximales si elle est continue, ou l’ensemble de ses modalités exhaustives si elle est catégorielle).
- Il instancie une échelle statistique correspondante (continue, discrète ou temporelle).
- Il calcule les intervalles de transformation mathématique pour projeter ces valeurs sur l’espace d’affichage numérique.
- Il génère une légende ou un axe gradué cohérent pour permettre au lecteur d’effectuer le décodage cognitif inverse des données visuelles vers les données numériques.
L’une des erreurs conceptuelles les plus fréquemment observées chez les praticiens consiste à encapsuler une constante typographique ou chromatique au sein de la fonction aes(), par exemple en écrivant aes(color = "forestgreen"). L’analyste s’attend intuitivement à ce que les points adoptent une teinte verte forestière. Cependant, le compilateur interprète la chaîne de caractères "forestgreen" non pas comme une directive de couleur littérale, mais comme une nouvelle variable catégorielle nominale ne comportant qu’une unique modalité. Par conséquent, ggplot2 crée une échelle chromatique artificielle, attribue à cette modalité unique la première couleur de sa palette par défaut (généralement une teinte rosâtre ou rouge saumon), et appose une légende superflue étiquetée avec le terme textuel injecté.
4.2 L’assignation de paramètres constants en dehors de aes()
À l’opposé du mappage dynamique, l’assignation de paramètres graphiques statiques intervient systématiquement en dehors de l’encapsulation aes(), directement dans le corps de la fonction géométrique considérée (telle que geom_point(), geom_line() ou geom_bar()). Dans ce mode opératoire, l’attribut visuel n’est plus assujetti aux variations d’une quelconque variable empirique : il devient une directive stylistique absolue qui s’applique uniformément à la totalité des primitives rendues par cette couche spécifique.
La règle d’or qui gouverne l’assignation statique externe est l’obligation de scalairité. L’argument transmis doit impérativement être un vecteur unitaire de longueur égale à 1. Si l’on souhaite colorer l’ensemble des observations en bleu cobalt, on écrira rigoureusement geom_point(color = "steelblue"). La chaîne "steelblue" est un vecteur de caractères de longueur 1 ; le moteur graphique l’applique sans ambiguïté à chaque point tracé.
L’erreur structurelle aesthetics must be either length 1 or the same as the data survient dès lors qu’un analyste tente d’utiliser l’assignation externe pour réaliser subreptice d’un mappage multiple, en passant par exemple un vecteur de plusieurs couleurs en dehors de aes(), sous la forme erronée geom_point(color = c("blue", "red", "green")). Le récepteur d’arguments constate alors que la valeur fournie n’est pas un scalaire unique (sa longueur étant de 3), tout en constatant qu’elle ne peut pas être mise en correspondance avec le jeu de données puisque l’évaluation se fait hors du contexte de mappage relationnel structuré. Devant cette transgression des règles de typage dimensionnel, le système interrompt immédiatement l’exécution.
5. Diagnostic approfondi : vérification de la longueur et de la dimensionalité des vecteurs
5.1 Audit dimensionnel préalable du jeu de données
Lorsqu’un script de visualisation est interrompu par l’exception dimensionnelle de ggplot2, la démarche rationnelle de débogage ne consiste pas à modifier aléatoirement la syntaxe, mais à entreprendre un audit structurel rigoureux des objets informatiques impliqués. L’objectif premier est d’identifier les longueurs exactes de tous les vecteurs concurrents afin de localiser la disparité arithmétique. Le langage R propose à cet égard une batterie de fonctions d’inspection primitives permettant d’établir un diagnostic immédiat.
L’investigation doit débuter par l’interrogation formelle de la matrice de données au moyen des primitives suivantes :
nrow(data): Renvoie la cardinalité exacte $N$ des observations de la table de référence.dim(data): Explicite le nombre de lignes et de colonnes, confirmant que l’objet n’a pas subi une troncature inattendue lors d’une étape de filtrage préalable.length(vecteur_externe): Évalue la taille intrinsèque de tout objet résidant dans l’espace global que l’analyste tente d’injecter dans la géométrie.unique(data$variable)ounlevels(data$facteur): Détermine le nombre précis de modalités distinctes contenues dans la variable de groupement, une métrique capitale pour le paramétrage ultérieur des échelles manuelles.
Dans un flux d’analyse rigoureux, ces vérifications permettent de déceler des incohérences invisibles à l’œil nu. Par exemple, si une table nettoyée contient 98 observations par suite de la suppression de valeurs aberrantes, alors qu’un vecteur de labels d’annotations préparé manuellement en conserve 100, la fonction stopifnot(nrow(df) == length(annotations)) permettra d’intercepter la discordance avant même d’invoquer le compilateur graphique, sécurisant ainsi l’ensemble de la chaîne de calcul.
5.2 Identification des effets pervers du recyclage partiel
Pour apprécier la pertinence du refus de compilation opposé par ggplot2, il est éclairant de situer cette décision architecturale dans l’histoire plus large du langage R. Dans les fonctions graphiques historiques issues du paquetage graphics (telles que plot(), points() ou lines()), R applique de manière extensive le mécanisme dit de recyclage vectoriel. Selon cette règle héritée du langage S, lorsqu’une fonction opère sur deux vecteurs de tailles inégales, le vecteur le plus court est répété cycliquement jusqu’à ce que sa longueur coïncide avec celle du vecteur le plus long.
Si ce recyclage fonctionne de manière mathématiquement cohérente lorsque la longueur du grand vecteur est un multiple exact de celle du petit vecteur, il engendre des distorsions catastrophiques dans le cas contraire. Dans un graphique généré avec le système de base, assigner un vecteur de trois couleurs à un ensemble de dix points conduit à une répartition chromatique $(1, 2, 3, 1, 2, 3, 1, 2, 3, 1)$ où le dernier groupe ne comporte qu’une seule occurrence, créant un artefact visuel dépourvu de toute réalité scientifique.
Les concepteurs de ggplot2 ont délibérément proscrit le recyclage implicite non multiple, érigeant la non-ambiguïté en principe méthodologique inviolable. Le tableau ci-dessous synthétise la divergence de comportement entre le moteur de base et ggplot2 face à des anomalies de dimensionnalité vectorielle :
| Scénario dimensionnel | Système graphique de base (base R) | Moteur ggplot2 | Conséquence épistémologique |
|---|---|---|---|
| Longueur scalaire ($k = 1$) | Application uniforme sans recyclage. | Autorisé : assignation unitaire homogène. | Représentation neutre et contrôlée. |
| Longueur identique ($k = N$) | Appariement bijectif régulier index par index. | Autorisé : mappage vectoriel conforme. | Correspondance empirique exacte. |
| Longueur multiple partiel ($1 < k < N$) avec $N pmod k = 0$ | Recyclage silencieux répété du vecteur court. | Rejet catégorique : interruption par erreur. | ggplot2 prévient la génération de motifs périodiques artificiels. |
| Longueur discordante ($1 < k < N$) avec $N pmod k \neq 0$ | Recyclage avec avertissement de non-concordance. | Rejet catégorique : interruption par erreur. | Évite le biais d’un échantillonnage tronqué en fin de distribution. |
| Longueur excédentaire ($k > N$) | Troncature silencieuse des $k – N$ derniers éléments. | Rejet catégorique : interruption par erreur. | Alerte sur la divergence structurelle entre métadonnées et données. |
Ce tableau démontre avec netteté que l’interruption du compilateur ggplot2 n’est pas un dysfonctionnement, mais une mesure de protection de la validité interne des inférences visuelles tirées par le chercheur à partir de ses représentations graphiques.
6. Solution 1 : Utilisation adéquate des échelles manuelles
6.1 Implémentation rigoureuse de scale_fill_manual et scale_color_manual
La solution paradigmatique par excellence pour colorer différemment des sous-groupes statistiques consiste à respecter l’intégralité de la chaîne grammaticale prévue par ggplot2 : lier d’abord la variable de groupement au sein de la fonction aes(), puis paramétrer la projection chromatique au moyen des couches d’échelles dédiées, à savoir scale_fill_manual() pour les remplissages surfaciques et scale_color_manual() pour les éléments linéaires et ponctuels.
Dans ce modèle, l’affectation se décompose en deux temps logiques rigoureusement coordonnés :
- Le mappage de la variable discrète : Au sein de la couche géométrique ou dans l’appel initial, on définit la relation d’appartenance catégorielle, par exemple
aes(fill = factor(Month))dans le cas du jeu de données météorologiques. À cette étape, le système sait que l’esthétiquefilldoit varier en fonction des modalités du facteur mois. - La déclaration explicite de la palette : On adjoint au graphique une couche
scale_fill_manual(values = mon_vecteur_chromatique). L’argumentvaluesreçoit ici le vecteur de teintes personnalisé.
L’aspect critique de cette implémentation réside dans la validation préalable de l’égalité formelle entre le nombre de couleurs contenues dans le vecteur d’échelle et le nombre effectif de modalités prises par la variable catégorielle. Si la variable factorielle comprend cinq modalités distinctes, le vecteur values doit comporter exactement cinq spécifications de couleurs valides (sous forme de noms textuels reconnus par R ou de codes hexadécimaux conformes).
Pour éliminer tout risque d’inversion ou de décalage silencieux lors de variations d’ordre dans les facteurs, la pratique recommandée au niveau académique consiste à utiliser des vecteurs nommés. Dans un vecteur nommé, chaque couleur est explicitement associée au label textuel de la modalité correspondante. De la sorte, même si les données sont réordonnées ou si certaines modalités sont absentes d’un sous-ensemble, le compilateur garantit que la teinte assignée à une modalité reste inaltérable, scellant ainsi l’intégrité de la signalétique visuelle à travers l’ensemble des figures d’un manuscrit scientifique.
6.2 Gestion des palettes prédéfinies et modulaires
Bien que la définition manuelle des vecteurs de couleurs offre un contrôle granulaire total, elle expose le chercheur à des erreurs humaines d’estimation de dimensionnalité, particulièrement lorsque les jeux de données sous-jacents subissent des mises à jour dynamiques ou des extensions d’échantillonnage. Pour s’affranchir de cette vulnérabilité, il est hautement préférable de déléguer la sélection chromatique à des bibliothèques de palettes algorithmiques et perceptuellement uniformes.
Parmi ces solutions logicielles, la suite de palettes viridis, intégrée nativement dans ggplot2 via les fonctions scale_fill_viridis_d() et scale_color_viridis_d() (le suffixe d désignant une échelle discrète), représente l’étalon-or pour la visualisation quantitative. Les palettes Viridis sont mathématiquement conçues pour maintenir une linéarité perceptuelle stricte à travers l’espace colorimétrique, garantissant une lisibilité optimale lors de l’impression en niveaux de gris et éliminant tout biais interprétatif chez les individus présentant des déficiences de la vision des couleurs (telles que la protanopie ou la deutéranopie).
De manière similaire, l’intégration des travaux de Cynthia Brewer via les fonctions scale_fill_brewer() et scale_color_brewer() permet de sélectionner des palettes qualitatives, séquentielles ou divergentes pré-étalonnées (comme les palettes Set2, Dark2 ou Spectral). Le bénéfice méthodologique fondamental de ces échelles réside dans leur capacité d’adaptation automatique : le moteur calcule en interne le nombre de modalités présentes dans le facteur cible et extrait dynamiquement le nombre exact d’échantillons chromatiques nécessaires, prévenant mathématiquement toute survenue de l’erreur dimensionnelle length 1 or the same as the data.
7. Solution 2 : Assignation d’une valeur scalaire unique
7.1 Uniformisation de l’attribut graphique pour l’ensemble des données
Dans de nombreuses situations d’analyse exploratoire, le chercheur ne cherche aucunement à stratifier ses données selon une variable catégorielle, mais souhaite simplement modifier l’apparence générique d’une géométrie pour en améliorer la lisibilité, le contraste ou l’élégance éditoriale. L’apparition de l’erreur de longueur esthétique traduit alors, dans la grande majorité des cas, une erreur d’encapsulation : l’analyste a inséré une directive scalaire à l’intérieur de la fonction aes() au lieu de la laisser reposer dans l’espace des arguments directs de la géométrie.
Pour assigner une propriété invariante à l’ensemble des observations d’un calque graphique, il convient de respecter la règle de la valeur scalaire unique positionnée en dehors de aes(). Si l’objectif est de tracer un histogramme de la distribution des températures dont toutes les barres arborent une teinte uniforme bleu acier avec une bordure blanche, la formulation syntaxique correcte exige :
geom_histogram(fill = "steelblue", color = "white", bins = 30)
Dans cette structure, les arguments fill et color reçoivent chacun un vecteur de mode caractère dont la longueur est rigoureusement égale à un. Le compilateur graphique traite ces scalaires comme des paramètres de configuration matérielle du calque. Aucune échelle n’est instanciée dans l’arbre syntaxique du graphique, aucune légende superflue n’est attachée au panneau de visualisation, et le test de validation dimensionnelle est validé avec succès puisque la longueur unitaire remplit parfaitement la première condition d’admissibilité énoncée dans la proposition logique de l’erreur.
Cette rigueur s’applique uniformément à toutes les primitives géométriques : les nuages de points (geom_point), les tracés de lignes chronologiques (geom_line), les polygones de densité (geom_density) et les représentations de surfaces (geom_polygon). Tout paramètre visuel devant demeurer invariant au sein d’un calque géométrique donné doit obligatoirement être un scalaire assigné en dehors de l’enceinte fonctionnelle de aes().
7.2 Combinaison multicouche et superposition de géométries
La puissance expressive de la grammaire des graphiques se manifeste dans la possibilité de superposer des couches hétérogènes répondant à des logiques dimensionnelles divergentes au sein d’une même figure. Un graphique scientifique de haute qualité combine fréquemment un calque principal piloté par un mappage vectoriel complexe issu des données et des calques secondaires à vocation contextuelle gouvernés par des assignations scalaires unitaires.
Considérons le cas où l’on souhaite représenter des observations individuelles stratifiées par condition clinique, tout en superposant une ligne de référence horizontale signalant le seuil pathologique standardisé. La structure modulaire du script séparera nettement ces deux logiques :
- La couche principale (données empiriques) : Elle exploite le mappage dynamique au moyen de
geom_point(aes(x = Temps, y = Score, color = Groupe)), où les attributs visuels varient selon les colonnes du tableau empirique. - La couche secondaire (repère normatif) : Elle mobilise une géométrie indépendante via
geom_hline(yintercept = 50, linetype = "dashed", color = "firebrick", linewidth = 1).
Dans ce calque secondaire, l’ensemble des paramètres (l’ordonnée à l’origine yintercept, la morphologie discontinue du trait linetype, la couleur color et l’épaisseur linewidth) sont des scalaires stricts de longueur 1. L’indépendance de ces calques prévient tout télescopage dimensionnel : chaque primitive géométrique résout son propre environnement de liaison sans interférer avec les dimensions matricielles des couches sous-jacentes, illustrant la supériorité opérationnelle d’un code modulaire et sémantiquement étanche.
8. Solution 3 : Harmonisation et restructuration des données avec tidyr
8.1 Transition du format large vers le format long
L’une des causes les plus profondes et les plus insidieuses déclenchant l’erreur d’incompatibilité de longueur esthétique réside dans la non-conformité structurelle de la matrice de données avec le paradigme des données ordonnées (ou tidy data), théorisé par Hadley Wickham. Dans une structure ordonnée idéale :
- Chaque variable mesurée correspond à une colonne unique.
- Chaque observation distincte correspond à une ligne unique.
- Chaque type d’unité observationnelle forme une table distincte.
Dans la pratique expérimentale, les données sont très souvent consignées dans un format dit large (wide format), où plusieurs colonnes adjacentes représentent en réalité la même variable mesurée à des moments temporels successifs (par exemple, des colonnes distinctes nommées Semaine_1, Semaine_2, Semaine_3). Face à une telle table, un analyste non averti tentera d’injecter manuellement des vecteurs d’attributs pour différencier ces colonnes temporelles lors de la création d’un graphique de profil moyen, provoquant inéluctablement l’interruption dimensionnelle de ggplot2.
La résolution définitive de cette impasse requiert la transition préalable vers le format long (long format) au moyen de la fonction pivot_longer() du paquetage tidyr. En transformant les multiples colonnes temporelles en une unique variable explicative catégorielle (qui reçoit les labels des semaines) et une unique variable quantitative de réponse (qui consigne les scores correspondants), le tableau de données se réorganise mécaniquement de telle sorte que chaque observation élémentaire occupe une ligne dédiée. Dès lors, le mappage esthétique via aes(color = Semaine) devient naturel, le vecteur des semaines possédant exactement la même longueur que le tableau étendu résultant de l’opération de pivotement.
8.2 Jointure préalable des annotations et vecteurs d’attributs
Une seconde défaillance structurelle classique découle de la manipulation de vecteurs d’annotations orphelins, conservés dans l’espace de travail global en marge du tableau d’analyse principal. Ce scénario s’observe fréquemment lorsque des métadonnées contextuelles (telles que le statut expérimental d’un sujet, des coordonnées géographiques de stations de mesure, ou des seuils statistiques calculés a posteriori) sont calculées dans des vecteurs séparés sans être formellement fusionnées dans la table de données centrale.
L’injection directe de ces vecteurs flottants au sein d’un calque graphique via une syntaxe de type geom_text(aes(label = vecteur_annotations_global)) génère presque systématiquement l’erreur de divergence de longueur, particulièrement si le tableau principal a subi des tris, des suppressions de valeurs manquantes ou des filtrages statistiques que le vecteur flottant n’a pas répercutés.
La correction méthodologique impérative consiste à intégrer l’ensemble des descripteurs d’annotations directement dans le tableau d’analyse en amont de toute invocation graphique, en utilisant les opérateurs de jointure relationnelle du paquetage dplyr, tels que left_join() ou inner_join(). En fusionnant la table des annotations sur la base d’une clé d’identification unique (telle que l’identifiant du sujet ou le code de la station de mesure), le compilateur R garantit la complétion et la conformité dimensionnelle stricte de la colonne résultante. L’appel graphique n’a plus alors à interroger des structures externes incertaines, éliminant à la racine la vulnérabilité d’une asymétrie de cardinalité.
9. Application concrète aux données de recherche en psychologie et sciences comportementales
9.1 Visualisation des scores psychométriques à travers des groupes cliniques
Pour illustrer la mise en pratique de ces principes de correction dans un contexte empirique exigeant, considérons un protocole de recherche en psychologie clinique conçu pour comparer l’efficacité de trois interventions psychothérapeutiques sur des scores d’anxiété standardisés (évalués via l’inventaire de Beck). Le protocole mobilise trois cohortes indépendantes : un groupe soumis à une thérapie cognitivo-comportementale (TCC), un groupe suivant une approche basée sur la pleine conscience (Mindfulness), et un groupe témoin placé sur liste d’attente (Contrôle).
Un jeu de données simulant cette architecture expérimentale peut être généré formellement dans l’environnement R. L’analyste se propose de concevoir une figure articulée superposant des diagrammes en violon (illustrant la densité de probabilité des scores) et des boîtes à moustaches internes (figurant les paramètres d’emplacement central et de dispersion interquartile). L’écueil classique se matérialise lorsque l’analyste décide d’appliquer une palette spécifique de trois couleurs pastel en écrivant par mégarde geom_violin(fill = c("#A6CEE3", "#1F78B4", "#B2DF8A")).
L’application rigoureuse des solutions exposées précédemment permet de structurer le pipeline graphique selon les règles de l’art :
- Le tableau de données clinique consolide pour chaque participant son identifiant, son appartenance au groupe factoriel et son score d’anxiété continue.
- Le mappage esthétique universel est déclaré au sein de l’instruction maîtresse
ggplot(data_clinique, aes(x = Groupe, y = Score_Anxiete, fill = Groupe)). - Les violons sont instanciés avec un niveau de transparence unitaire via
geom_violin(alpha = 0.7, trim = FALSE). - Les boîtes à moustaches sont imbriquées avec une assignation scalaire de couleur neutre pour éviter la surcharge visuelle, via
geom_boxplot(width = 0.2, fill = "white", color = "black", outlier.shape = NA). - L’assignation chromatique des groupes est déléguée à
scale_fill_manual(values = c("Contrôle" = "#E41A1C", "TCC" = "#377EB8", "Mindfulness" = "#4DAF4A")).
Ce protocole assure un rendu graphique impeccable, exempt de toute rupture d’exécution, et garantit que chaque condition expérimentale se voit attribuer la nuance chromatique théoriquement planifiée, autorisant une comparaison visuelle immédiate et scientifiquement irréprochable.
9.2 Représentation de designs factoriels et mesures répétées
Les difficultés dimensionnelles s’intensifient lorsque le design expérimental intègre des mesures répétées dans le temps, introduisant une imbrication de facteurs inter-sujets et intra-sujets. Dans une étude longitudinale évaluant la réactivité au stress, des participants répartis en deux sous-groupes (vulnérabilité élevée vs faible vulnérabilité) sont évalués à quatre étapes protocolaires : phase de repos basal, phase d’exposition à un stresseur aigu, phase de récupération immédiate et phase de suivi tardif.
Une maladresse fréquente consiste à tenter de tracer simultanément les trajectoires individuelles des sujets et les trajectoires moyennes de groupe en liant de manière discordante les vecteurs de liaison géométrique dans la primitive geom_line(). Si un vecteur de groupement résidant dans l’environnement global ne reflète pas l’appariement longitudinal exact des données, l’évaluation de la ligne s’interrompt avec le message aesthetics must be either length 1 or the same as the data.
Pour immuniser le flux de production graphique face à cette instabilité, il est impératif de déclarer explicitement la structure d’appariement au moyen du paramètre de regroupement esthétique : aes(group = Subject_ID) pour le traçage des trajectoires individuelles en traits semi-transparents fins (geom_line(alpha = 0.2, linewidth = 0.5)), superposé à un second calcul statistique représentant la trajectoire moyenne de chaque groupe via la fonction de calcul intégrée stat_summary(aes(group = Groupe, color = Groupe), fun = mean, geom = "line", linewidth = 1.2). Cette dissociation claire entre les niveaux de regroupement individuels et agrégés garantit la stricte concordance dimensionnelle à chaque étape du pipeline de rendu analytique.
10. Pièges courants liés aux facteurs, aux données manquantes et aux sous-groupes
10.1 Impact des niveaux de facteurs non observés ou résiduels
L’une des sources les plus déroutantes d’erreurs dimensionnelles découle du comportement interne des vecteurs de type factor dans le langage R. Un facteur est un vecteur d’entiers pointant vers une table de chaînes de caractères représentant ses modalités (ou levels). Une caractéristique cruciale de ces objets est que la suppression physique d’enregistrements au sein d’un tableau de données n’entraîne pas automatiquement la disparition des modalités correspondantes dans la table d’attributs du facteur.
Supposons qu’une recherche clinique collecte des données sur quatre sites hospitaliers distincts (Site A, Site B, Site C, Site D). Si, lors d’une étape de pré-traitement, l’analyste décide de restreindre l’étude aux seuls sites A et B à l’aide d’une opération de filtrage telle que filter(Site %in% c("A", "B")), les lignes physiques relatives aux sites C et D sont bien éliminées. Toutefois, l’attribut levels(data_filtree$Site) conserve en mémoire la présence formelle des quatre sites originels. Ces modalités orphelines, bien que vidées de toute observation réelle, demeurent actives dans la mémoire de l’objet factoriel.
Si l’analyste instancie ultérieurement une échelle manuelle en ne transmettant que deux couleurs au motif qu’il n’y a plus que deux sites réels dans son échantillon (scale_color_manual(values = c("navy", "darkred"))), ggplot2 va auditer les modalités déclarées du facteur et identifier une discordance arithmétique : le facteur déclare quatre niveaux théoriques alors que la palette manuelle n’en fournit que deux. Selon les versions et les géométries mobilisées, cela peut déclencher soit l’attribution silencieuse de valeurs NA dégradant la figure, soit l’interruption formelle du compilateur. La mesure préventive absolue consiste à purger systématiquement les modalités résiduelles via l’invocation explicite de la fonction droplevels() sur le tableau de données filtré avant d’engager la chaîne d’instructions graphiques.
10.2 Filtrage dynamique et suppression silencieuse des valeurs manquantes
L’interaction entre la gestion des données manquantes (codées sous la forme de valeurs non disponibles NA) et la validation dimensionnelle des couches géométriques constitue un autre piège algorithmique majeur. Lorsqu’un tableau de données comporte des données incomplètes sur l’une des variables projetées sur les axes spatiaux ou les canaux esthétiques, le moteur de rendu de ggplot2 procède par défaut à une suppression par omission (listwise deletion) des lignes concernées, signalant cette opération par un avertissement informatif : Removed X rows containing missing values (geom_point).
Ce mécanisme automatique modifie subrepticement la dimension effective $N$ de la matrice de travail interne de la couche géométrique. Si l’échantillon initial comportait 100 observations mais que 12 enregistrements présentent une valeur NA sur la variable d’abscisse, la couche géométrique n’opère plus que sur un effectif réel de $N’ = 88$ points.
Si, en parallèle, l’utilisateur a transmis un vecteur esthétique externe pré-calibré sur la taille de l’échantillon nominal de départ ($k = 100$), le compilateur confronte alors un vecteur esthétique externe de longueur 100 avec une matrice interne réduite à 88 lignes. L’incompatibilité dimensionnelle est immédiate et génère l’interruption formelle du traçage. Pour pallier cette asymétrie, il est fondamental :
- Soit d’épurer préalablement le tableau de données de ses valeurs manquantes au moyen d’un filtrage explicite via
tidyr::drop_na()avant tout engagement dans le flux de tracé. - Soit de veiller à ce que l’ensemble des descripteurs soient strictement encapsulés sous forme de colonnes dans la matrice de données, de manière à ce que l’omission des
NAs’applique simultanément et harmonieusement aux variables dépendantes et aux attributs esthétiques associés.
11. Bonnes pratiques de programmation défensive et débogage avancé dans l’écosystème tidyverse
11.1 Outils d’inspection dynamique et d’arrêt sur anomalie
Dans un cadre de production logicielle ou de traitement analytique à haut débit (tel que le déploiement de tableaux de bord interactifs ou la génération automatisée de rapports épidémiologiques), les scripts de visualisation doivent adopter les préceptes de la programmation défensive. Cette approche méthodologique consiste à anticiper activement les défaillances potentielles en insérant des points de contrôle formels avant que les fonctions d’affichage graphique ne soient sollicitées.
L’exploitation de la fonction primitive de R traceback() immédiatement après l’interruption par l’erreur aesthetics must be either length 1 or the same as the data permet de remonter l’arborescence des appels fonctionnels jusqu’à la sous-routine précise ayant validé l’inégalité de dimensions. Dans les versions modernes de l’écosystème tidyverse, l’instruction rlang::last_error() et son extension rlang::last_trace() fournissent une cartographie encore plus détaillée des environnements de liaison et des couches géométriques défaillantes.
Par ailleurs, l’insertion d’assertions préventives au moyen du paquetage assertthat ou de l’instruction de base stopifnot() permet d’intercepter les discordances en amont du pipeline. Un analyste rigoureux vérifiera par exemple l’adéquation dimensionnelle entre un vecteur d’annotations catégorielles et une matrice empirique par des expressions explicites :
assertthat::assert_that(length(palette_couleurs) == length(unique(data$Condition)), msg = "Le nombre de couleurs spécifiées ne correspond pas au nombre de modalités observées.")
Ce niveau de contrôle préventif immunise les architectures computationnelles complexes contre les défaillances silencieuses et fournit des messages d’erreur contextualisés et intelligibles aux utilisateurs finaux ou aux collaborateurs d’une équipe de recherche.
11.2 Encapsulation dans des fonctions graphiques personnalisées
L’industrialisation des procédures d’analyse de données exige fréquemment l’encapsulation de séquences d’instructions ggplot2 au sein de fonctions d’analyse personnalisées et réutilisables. Ce travail d’abstraction nécessite une maîtrise approfondie du mécanisme de tidy evaluation (évaluation ordonnée), orchestré par le paquetage rlang et intégré dans la syntaxe moderne de R au moyen de l’opérateur d’injection d’expressions {{ }} (couramment désigné sous le terme de double accolade ou embrace operator).
Lorsqu’un chercheur conçoit une fonction générique pour standardiser les graphiques de son laboratoire, l’injection dynamique de noms de colonnes pour les axes ou les groupements doit impérativement utiliser cette syntaxe d’évaluation protégée :
tracer_distribution_clinique <- function(data, variable_x, variable_groupe, palette_chromatique) {

  ggplot(data, aes(x = {{ variable_x }}, fill = {{ variable_groupe }})) +

    geom_density(alpha = 0.6) +

    scale_fill_manual(values = palette_chromatique)

}
Dans ce canevas fonctionnel robuste, l’argument palette_chromatique est passé comme un vecteur standard, tandis que les identifiants de colonnes variable_x et variable_groupe sont correctement contextualisés au sein de l’environnement de données de la table passée en premier argument. L’embrace operator assure que les noms de colonnes sont évalués paresseusement dans le cadre de la table data, prévenant toute tentative de résolution indue dans l’espace de travail global et éliminant tout risque de conflit de longueur entre les colonnes sélectionnées et les dimensions effectives du tableau de bord.
12. Synthèse méthodologique et guide de référence rapide pour les chercheurs
12.1 Arbre décisionnel face à l’erreur de longueur esthétique
Face au surgissement inopiné de l’exception aesthetics must be either length 1 or the same as the data au sein d’une session de travail, le chercheur ou l’analyste peut déployer un protocole d’intervention méthodique structuré sous la forme d’un arbre décisionnel séquentiel en quatre phases :
Étape 1 : Clarification de la finalité perceptive de l’attribut visuel
L’analyste doit formuler explicitement la question suivante : la propriété visuelle incriminée (couleur, taille, forme, transparence) doit-elle refléter les variations d’une variable de données empiriques (mappage dynamique), ou doit-elle conférer une apparence uniforme et invariable à l’ensemble du calque géométrique (assignation statique) ?
Étape 2 : Positionnement architectural de l’instruction
Si la propriété est invariable : l’argument doit obligatoirement être extrait de l’appel fonctionnel aes() et positionné comme un argument direct de la géométrie (ex. : geom_point(color = "black")). On s’assurera alors rigoureusement que la valeur transmise est un scalaire de longueur strictement égale à un.
Si la propriété est variable : elle doit impérativement être encapsulée à l’intérieur de aes() (ex. : aes(color = Facteur_Groupe)) et faire référence à une colonne physique validée de la table de données.
Étape 3 : Audit dimensionnel de l’échelle personnalisée
Si l’analyste souhaite spécifier manuellement les valeurs de cette propriété dynamique via une couche d’échelle (telle que scale_color_manual()) : il convient d’exécuter immédiatement dans la console l’instruction length(unique(data$Facteur_Groupe)) afin de dénombrer formellement les modalités actives. Le vecteur fourni à l’argument values de l’échelle manuelle doit comporter un nombre d’éléments exactement identique à ce cardinal, idéalement sous forme de vecteur nommé.
Étape 4 : Vérification de l’intégrité de la table de données sous-jacente
Si l’anomalie persiste, l’analyste doit contrôler l’absence de modalités de facteurs orphelines (via l’appel droplevels()) et s’assurer que des opérations d’omission de valeurs manquantes (na.omit) ou de filtrage dynamique n’ont pas altéré silencieusement le nombre effectif de lignes exploitées par la géométrie incriminée.
12.2 Tableau récapitulatif des erreurs courantes et de leurs corrections
Afin d’offrir une référence pratique immédiatement exploitable dans l’activité quotidienne de recherche, le tableau ci-dessous recense les configurations syntaxiques défaillantes les plus communément observées ainsi que les architectures de correction conformes aux standards de l’écosystème R contemporain :
| Structure fautive observée | Mécanisme de défaillance sous-jacent | Syntaxe de correction recommandée |
|---|---|---|
geom_point(color = c("red", "blue")) |
Assignation externe d’un vecteur non scalaire ($k = 2$) en dehors de l’environnement esthétique aes(). |
geom_point(aes(color = Groupe)) + |
geom_point(aes(color = "blue")) |
Encapsulation erronée d’une constante scalaire dans aes(), créant une variable catégorielle artificielle. |
geom_point(color = "blue") |
geom_boxplot(aes(fill = Mois))(avec un vecteur externe couleurs_mois de taille 5 alors que le jeu de données compte 150 lignes) |
Tentative d’injecter directement un vecteur de palettes au niveau de l’esthétique générale de la géométrie. | geom_boxplot(aes(fill = factor(Mois))) + |
geom_line(aes(y = Val1)) +(tentative de tracer deux colonnes en format large) |
Non-respect du format ordonné (tidy data) générant des décalages d’indices lors de l’annotation des séries. | df %>% pivot_longer(cols = c(Val1, Val2)) %>% |
geom_text(aes(label = labels_externes))(où labels_externes réside dans le .GlobalEnv avec une longueur divergente) |
Désynchronisation entre la taille de la table filtrée et un vecteur de texte flottant dans l’espace de travail. | df <- df %>% left_join(table_annotations, by = "ID") |
scale_color_manual(values = c("red", "blue"))(sur un facteur possédant 3 modalités effectives) |
Sous-dimensionnement du vecteur de l’échelle manuelle par rapport au nombre de niveaux du facteur. | scale_color_manual(values = c("A" = "red", "B" = "blue", "C" = "darkgreen")) |
La compréhension approfondie de ces mécanismes garantit non seulement l’élimination des interruptions d’exécution lors du rendu des graphiques statistiques, mais élève également la rigueur conceptuelle de l’analyste dans sa gestion des flux de données quantitatives, assurant une conformité exemplaire entre la théorie de la modélisation statistique et sa matérialisation visuelle.
Références
- Bertin, J. (1983). Semiology of Graphics: Diagrams, Networks, Maps. University of Wisconsin Press.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3-28. https://doi.org/10.1198/jcgs.2009.07098
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wickham, H., Çetinkaya-Rundel, M., & Grolemund, G. (2023). R for Data Science: Import, Tidy, Transform, Visualize, and Model Data (2nd ed.). O’Reilly Media. https://r4ds.hadley.nz/
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0