
Dans le domaine du traitement analytique de données, la quantification précise des distributions empiriques constitue l’opération fondamentale sur laquelle reposent l’inférence statistique, la modélisation prédictive et la prise de décision éclairée. Qu’il s’agisse d’évaluer la représentativité d’un échantillon expérimental en psychologie cognitive, d’auditer des cohortes cliniques en épidémiologie ou d’analyser des flux transactionnels au sein d’infrastructures commerciales modernes, la capacité à dénombrer avec exactitude la fréquence d’apparition d’événements discrets est une compétence méthodologique indispensable. L’application en ligne Google Sheets s’est progressivement imposée comme un environnement de choix pour les chercheurs, analystes et ingénieurs grâce à son accessibilité ubiquitaire, ses fonctions de calcul vectoriel avancées et ses capacités collaboratives natives.
Néanmoins, la transition d’une masse brute de données textuelles ou numériques hétérogènes vers une table de distribution ordonnée exige une compréhension rigoureuse des mécanismes sous-jacents aux feuilles de calcul modernes. Dénombrer des occurrences ne se réduit pas à l’application mécanique d’une formule arithmétique élémentaire ; cette opération implique une série de choix paradigmatiques cruciaux. La gestion fine de la sensibilité à la casse, le traitement des chaînes de caractères invisibles, la manipulation des plages matricielles dynamiques, ainsi que l’arbitrage entre requêtes relationnelles et formules natives conditionnent directement l’intégrité des résultats obtenus. Une erreur d’évaluation logique ou une mauvaise gestion des espaces typographiques peut biaiser substantiellement les fréquences observées et invalider des analyses subséquentes.
Ce traité exhaustif a pour vocation d’exposer en profondeur l’ensemble des concepts, fonctions et protocoles algorithmiques requis pour compter le nombre d’occurrences dans Google Sheets avec une rigueur académique irréprochable. En explorant successivement les fonctions scalaires traditionnelles, les extensions vectorielles dynamiques, les requêtes semi-structurées et les mécanismes réguliers de détection lexicale, cet ouvrage fournit un cadre opérationnel complet destiné aux praticiens de la donnée exigeants. Chaque dimension technique y est examinée sous l’angle de la robustesse computationnelle et de la fiabilité statistique, garantissant une reproductibilité optimale de vos flux de travail quantitatifs.
1. Introduction à l’analyse quantitative de fréquence dans Google Sheets
1.1 Fondements de l’analyse distributionnelle et importance de la récurrence
L’analyse distributionnelle représente la pierre angulaire de toute démarche scientifique fondée sur l’observation empirique. Dans les jeux de données observationnels et expérimentaux, une occurrence désigne la manifestation concrète d’une unité d’observation ou d’un état spécifique au sein d’une variable déterminée. Qu’il s’agisse de relever l’apparition d’un biomarqueur particulier, le choix d’un consommateur face à un panier d’options ou la réponse apportée à une tâche de discrimination cognitive, la récurrence mesure l’intensité probabiliste avec laquelle un phénomène s’actualise dans la réalité observée.
Le rôle du dénombrement fréquentiel réside principalement dans la réduction dimensionnelle des variables catégorielles. Face à une succession linéaire de milliers d’enregistrements individualisés, l’esprit humain comme les modèles mathématiques complexes se trouvent dans l’incapacité d’appréhender directement les tendances structurales sans un processus préalable d’agrégation. En quantifiant le nombre d’apparitions de chaque modalité, le chercheur condense une masse indistincte en un vecteur de fréquences absolues, condition préalable à l’estimation des densités de probabilité empiriques et au calcul des moments statistiques fondamentaux.
Cette transition de la donnée brute vers des distributions discrètes exploitables constitue une phase d’abstraction formelle. Elle permet d’ordonner le désordre inhérent à la collecte sur le terrain en structures mathématiques manipulables. Google Sheets offre à cet égard un cadre computationnel remarquable pour le traitement collaboratif de données empiriques. Sa nature d’application infonuagique permet à des équipes géographiquement dispersées d’agréger, d’harmoniser et d’auditer simultanément des tables volumineuses, éliminant les asynchronies de versionnage et garantissant une transparence analytique en temps réel.
1.2 Typologie des données soumises au dénombrement fréquentiel
L’application d’un protocole de comptage fréquentiel nécessite au préalable une classification épistémologique stricte de la nature des variables mesurées. Les variables qualitatives se subdivisent classiquement en échelles nominales et ordinales. Les variables nominales désignent des catégories mutuellement exclusives dépourvues de toute relation d’ordre hiérarchique intrinsèque, à l’instar du groupe sanguin, de la nationalité ou du statut matrimonial. Le dénombrement fréquentiel y vise uniquement à établir la prévalence absolue et relative de chaque modalité indépendante.
À l’inverse, les échelles ordinales introduisent une relation d’ordre monotone entre les modalités observées, bien que la distance numérique entre deux échelons successifs demeure incommensurable. L’archétype de ce type de données réside dans les échelles de Likert et les questionnaires psychométriques couramment exploités en sciences sociales. Le dénombrement fréquentiel des réponses sur de telles échelles permet non seulement de calculer les effectifs par modalité, mais aussi de modéliser des fonctions de répartition cumulée indispensables pour juger de la dispersion des jugements ou des attitudes.
Un défi analytique majeur émerge lors du traitement de données textuelles non standardisées, d’identifiants comportementaux générés par des interfaces logicielles ou de verbatims cliniques transcrits manuellement. Ces données présentent une forte propension à la variabilité typographique, à la synonymie et à l’irrégularité morphologique. Enfin, la volumétrie globale du jeu de données influe lourdement sur le comportement des moteurs de calcul : le coût computationnel d’un balayage complet de colonnes par des fonctions matricielles croît de manière polynomiale si la structure algorithmique de la feuille de calcul n’est pas scrupuleusement optimisée.
1.3 Aperçu des paradigmes de calcul disponibles dans le tableur
Google Sheets propose une diversité remarquable de paradigmes analytiques pour quantifier la récurrence des événements, chacun répondant à des exigences ergonomiques et computationnelles distinctes. Le premier paradigme repose sur l’approche unitaire par formules conditionnelles traditionnelles, incarnée de façon prééminente par la fonction NB.SI et sa déclinaison multivariée NB.SI.ENS. Cette méthode offre une accessibilité immédiate et une lisibilité algorithmique directe, idéale pour les modèles déterministes à structure tabulaire fixe.
Le second paradigme s’articule autour de l’approche matricielle et vectorielle. En mobilisant des constructions avancées telles que la fonction ARRAYFORMULA ou les fonctions d’itération modernes de la famille LAMBDA (notamment BYROW et MAP), l’analyste programme l’exécution dynamique du comptage sur l’ensemble d’un vecteur vertical sans avoir à étirer physiquement les formules cellule par cellule. Ce mode opératoire assure une maintenance centralisée du code et s’adapte de manière transparente à l’afflux continu de nouvelles observations.
Enfin, le troisième paradigme relève de l’agrégation relationnelle via le moteur de requêtes internes, formalisé par la fonction QUERY. Cette approche emprunte la syntaxe déclarative du langage SQL et exécute simultanément le filtrage, l’extraction des modalités distinctes et leur dénombrement au sein d’une seule formule compacte. Le choix de l’un de ces trois paradigmes doit impérativement découler d’un arbitrage réfléchi entre le volume d’enregistrements à traiter, la dynamique d’actualisation de la source et le degré de complexité des critères logiques envisagés.
2. Préparation rigoureuse des données empiriques et protocoles de nettoyage
2.1 Normalisation typographique et suppression des artefacts textuels
Avant d’engager la moindre opération de dénombrement automatisé, l’assainissement systématique de la base brute constitue une obligation méthodologique incontournable. L’écueil le plus fréquent lors de l’analyse textuelle dans Google Sheets découle de la présence insidieuse d’espaces superflus insérés par inadvertance en début ou en fin de chaîne. L’interpréteur de la feuille de calcul évaluant les chaînes au caractère près, une modalité comportant une espace terminale sera inexorablement scindée de sa forme nominale canonique, fragmentant artificiellement la distribution de fréquence.
Pour immuniser l’analyse contre ces altérations invisibles, la fonction SUPPRESPACE doit être systématiquement déployée sur les colonnes cibles. Elle purge la chaîne de toute espace initiale ou terminale tout en normalisant les espaces internes consécutives en une espace unique. Parallèlement, l’homogénéisation de la casse logicielle prévient les dysfonctionnements dans les requêtes sensibles aux variations typographiques. Bien que certaines fonctions comme NB.SI soient par défaut insensibles à la casse, d’autres architectures de recherche ou de comparaison relationnelle distinguent rigoureusement les majuscules des minuscules. Le recours aux fonctions MAJUSCULE, MINUSCULE ou NOMPROPRE permet de formater univoquement les entrées textuelles.
Un danger additionnel réside dans l’importation de caractères de contrôle non imprimables et d’espaces insécables (dont le code Unicode est souvent U+00A0), fréquemment générés par des formulaires en ligne ou des extractions de bases de données relationnelles. La fonction EPURAGE permet d’éliminer les caractères de contrôle ASCII, tandis qu’une substitution explicite via la fonction SUBSTITUE s’avère indispensable pour éradiquer les espaces insécables avant d’amorcer le calcul des occurrences.
2.2 Traitement des valeurs manquantes et cellules vides
La distinction conceptuelle et informatique entre une absence d’observation et une donnée manquante est cruciale pour préserver la validité interne d’une distribution statistique. Dans Google Sheets, il existe une frontière subtile mais déterminante entre une cellule structurellement vide (valeur équivalente à l’absence totale d’allocation de mémoire, ou état nul) et une cellule hébergeant une chaîne de caractères de longueur nulle (souvent générée par l’instruction conditionnelle « »). La négligence de cette nuance engendre fréquemment des anomalies d’agrégation lors de l’application de filtres ou de critères stricts.
L’omission d’une réponse dans un protocole d’enquête ne doit jamais être assimilée par défaut à une occurrence de valeur nulle. Méthodologiquement, le chercheur doit arbitrer entre l’exclusion délibérée des non-réponses pour calculer des fréquences relatives rapportées aux seuls répondants valides, ou leur quantification formelle sous forme de modalité dédiée afin de mesurer précisément le taux d’attrition de l’instrument d’évaluation. L’audit d’intégrité préliminaire s’opère rigoureusement à l’aide des fonctions ESTVIDE et NB.VIDE, qui quantifient l’incomplétude du jeu de données.
Dans l’hypothèse où les données manquantes doivent faire l’objet d’une imputation statistique ou d’un recodage déterministe (par exemple, assigner l’étiquette sémantique « Non renseigné » à toute vacuité structurelle), ce traitement doit s’effectuer en amont de toute formule de dénombrement. Cela prévient la contamination des plages d’analyse et évite que des fonctions comme NB.SI n’interprètent de façon erronée des opérateurs relationnels sur des cellules dépourvues de contenu substantiel.
2.3 Structuration spatiale de la feuille de calcul
L’architecture spatiale d’un classeur analytique doit se conformer rigoureusement aux principes du format de données ordonné, formalisé sous le vocable international de Tidy Data par Hadley Wickham. Ce standard prescrit que chaque variable doit être isolée au sein de sa propre colonne univoque, chaque observation individuelle doit occuper une ligne distincte, et chaque tableau doit se consacrer exclusivement à une unité d’analyse homogène. Le non-respect de ce formalisme compromet immédiatement la transposabilité des formules matricielles de Google Sheets.
Une règle ergonomique et scientifique cardinale consiste à opérer une séparation matérielle absolue entre la zone de saisie des données brutes et la zone de synthèse analytique dédiée au comptage fréquentiel. Les données sources doivent idéalement résider sur un onglet dédié, protégé en écriture contre toute altération accidentelle, tandis que les tables récapitulatives et les distributions marginales doivent être hébergées sur une feuille de calcul distincte. Cette dissociation évite la pollution des vecteurs de données par des cellules de totaux intermédiaires ou des annotations périphériques non standardisées.
Enfin, la robustesse des calculs univariés ou multivariés dépend du verrouillage systématique des plages de référence par l’usage rigoureux du symbole dollar ($). L’ancrage absolu des coordonnées géométriques (par exemple, $A$2:$A$1000) empêche tout glissement intempestif du champ d’observation lors de la réplication verticale des formules vers les lignes adjacentes, neutralisant ainsi l’une des sources d’erreurs logiques les plus pernicieuses du travail sur tableur.
3. La fonction NB.SI : Fondements théoriques et syntaxe univariée
3.1 Décomposition de la syntaxe et mécanique d’évaluation
La fonction NB.SI (équivalent français de l’instruction anglophone COUNTIF) constitue le mécanisme primitif d’évaluation conditionnelle univariée dans Google Sheets. Conçue pour dénombrer les cellules qui satisfont à un prédicat logique spécifique, sa signature syntaxique canonique se déploie selon la structure biparamétrique : =NB.SI(plage; critère). Le premier argument définit l’espace vectoriel bidimensionnel ou unidimensionnel soumis à l’évaluation, tandis que le second argument formalise la condition logique régissant l’incrémentation du compteur scalaire interne.
L’interpréteur de Google Sheets applique un mécanisme de typage dynamique particulièrement sophistiqué lors de l’évaluation de l’argument de critère. Par conception native, la fonction NB.SI est strictement insensible à la casse lorsqu’elle évalue des chaînes de caractères littérales : les entrées « Traitement », « TRAITEMENT » et « traitement » sont reconnues comme rigoureusement équivalentes. Cette tolérance intrinsèque simplifie considérablement les analyses préliminaires, bien qu’elle interdise de distinguer des acronymes différenciés uniquement par leur casse typographique.
Cependant, le comportement de la fonction diverge profondément selon que le critère renvoie à une valeur textuelle ou à une quantité numérique. Alors que le texte exige généralement un encadrement par des guillemets typographiques pour être parsé en tant que constante littérale, les valeurs numériques directes peuvent être spécifiées sans artifices syntaxiques. Lorsqu’un opérateur de comparaison relationnel est convoqué pour scruter une grandeur quantitative, la syntaxe exige une fusion textuelle qui mérite une analyse d’ingénierie logicielle méticuleuse.
3.2 Mise en œuvre concrète sur des critères statiques
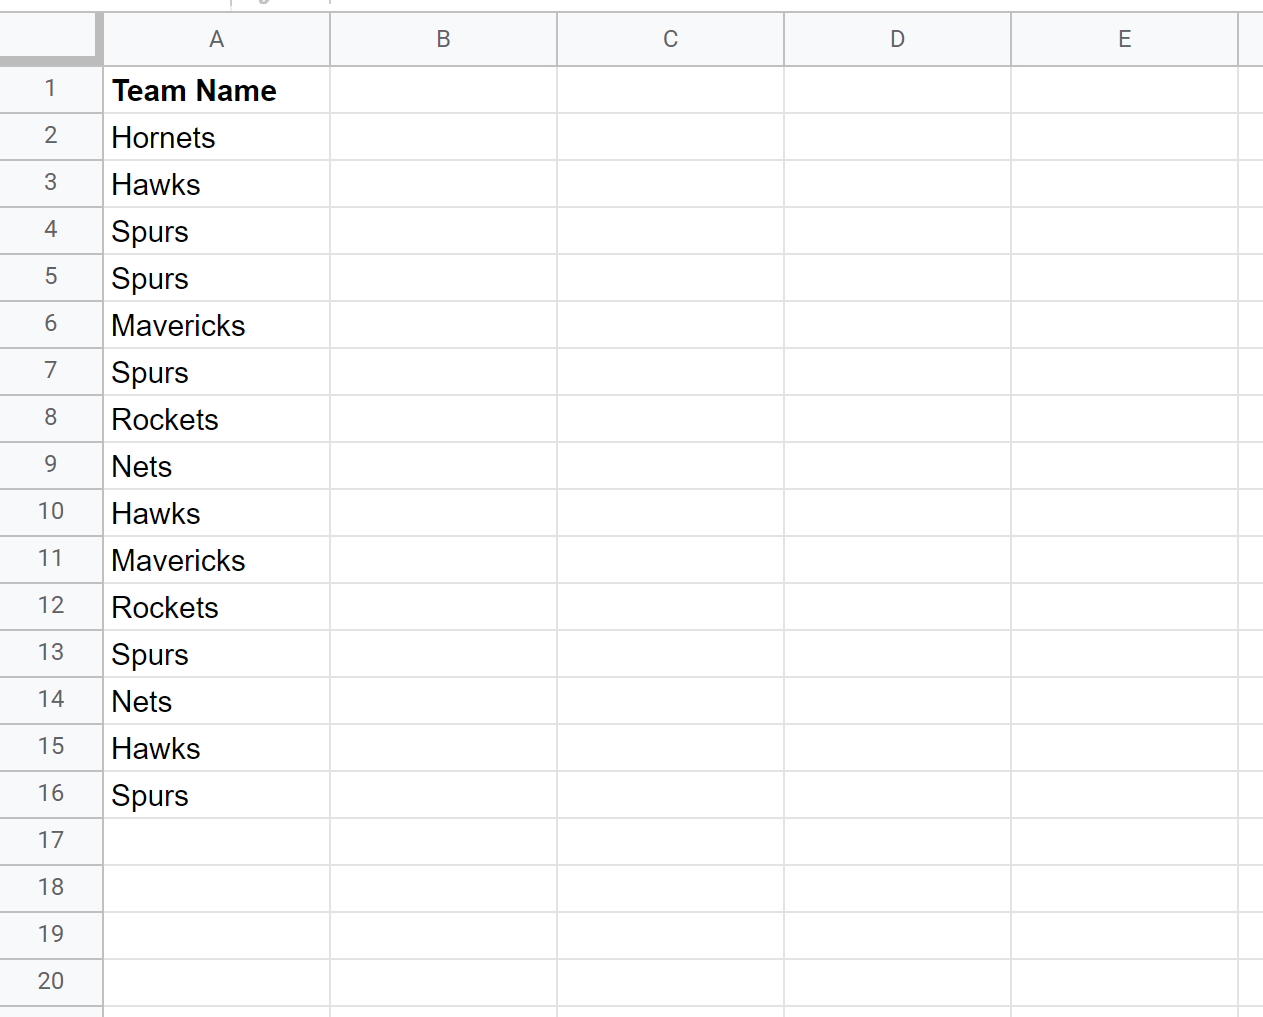
Le cas d’usage le plus élémentaire de la fonction NB.SI consiste à quantifier des étiquettes textuelles fermées saisies de façon immuable dans le corps de la formule. Par exemple, au sein d’une cohorte clinique mesurant l’efficacité d’une molécule thérapeutique, l’analyste peut implémenter la commande =NB.SI($B$2:$B$500; « Placebo ») pour extraire instantanément le nombre d’individus assignés au groupe témoin. Cette syntaxe statique assure une lisibilité immédiate pour une vérification ponctuelle et rapide du protocole.
Sur le versant numérique, le comptage des occurrences de valeurs entières ou décimales s’exécute avec une grande sobriété : l’expression =NB.SI($C$2:$C$500; 100) recensera l’ensemble des observations dont la mesure quantitative est strictement égale à cent. Toutefois, la véritable puissance de NB.SI s’exprime dans sa capacité à intégrer des opérateurs arithmétiques de comparaison (supérieur, inférieur, supérieur ou égal, différent) pour délimiter des seuils d’analyse distributionnelle, comme dans l’expression =NB.SI($D$2:$D$500; « >=50 »).
Néanmoins, l’encodage statique de critères en dur au sein du code de la formule présente des limites méthodologiques majeures. Cette pratique, qualifiée de « hard-coding », rend la maintenance du classeur extrêmement laborieuse et hautement vulnérable aux erreurs humaines. Si le libellé d’une modalité subit une révision lexicale ou si l’analyste souhaite étendre son modèle à des dizaines d’étiquettes distinctes, chaque formule individuelle doit être rectifiée manuellement, ce qui viole frontalement les principes de robustesse logicielle.
3.3 Dynamisation du critère par références cellulaires relatives
Pour conférer à la fonction NB.SI une adaptabilité optimale, la bonne pratique d’ingénierie documentaire consiste à lier systématiquement l’argument de critère à une cellule cible extérieure. En positionnant le libellé de la modalité d’intérêt dans une colonne de synthèse distincte (par exemple en F2), la formule de dénombrement s’écrit sous la forme fluide et hautement maintenable : =NB.SI($A$2:$A$1000; F2). L’évaluation s’actualise alors immédiatement dès lors que le contenu sémantique de la cellule cible est modifié.
Cette architecture paramétrique facilite considérablement l’étirement vertical de la formule sur l’intégralité de la colonne de synthèse. Grâce à la préservation des dollars sur la plage source (référence absolue) et à l’absence délibérée de dollars sur la référence du critère (référence relative), l’interpréteur ajuste dynamiquement la cible d’évaluation pour chaque ligne successive : F3, F4, F5, etc. Cette méthode neutralise radicalement le risque d’inadvertance humaine lors de la duplication des expressions logiques.
Lorsque la dynamisation implique des opérateurs de comparaison arithmétique associés à une valeur numérique variable, la concaténation de chaînes devient indispensable. Si le seuil quantitatif de décision est consigné dans la cellule G1, la formulation canonique doit conjuguer l’opérateur textuel et la référence dynamique par le biais de l’esperluette : =NB.SI($C$2:$C$1000; « >= » & G1). Du point de vue des performances de calcul, la référence cellulaire dynamique présente une empreinte computationnelle rigoureusement équivalente à l’argument statique tout en garantissant une scalabilité analytique incomparable.
4. Extraction des modalités distinctes à l’aide de la fonction UNIQUE
4.1 Propriétés algorithmiques de la fonction UNIQUE
L’une des innovations majeures de Google Sheets par rapport aux tableurs historiques réside dans l’intégration native du calcul matriciel expansif, dont la fonction UNIQUE est l’illustration par excellence. Contrairement aux approches procédurales qui requièrent des algorithmes complexes d’élimination de doublons ou des macros scriptées, la fonction UNIQUE applique un filtre algorithmique déterministe qui balaie une plage source et renvoie instantanément un vecteur ou une matrice comprenant l’ensemble des valeurs mutuellement exclusives sans la moindre redondance.
Le comportement séquentiel de la fonction UNIQUE préserve scrupuleusement l’ordre chronologique d’apparition des données : la première modalité rencontrée lors du parcours vertical de haut en bas est positionnée en première ligne du tableau dérivé, suivie de la deuxième modalité distincte non encore répertoriée, et ainsi de suite. Cette propriété algorithmique garantit une restitution fidèle et prévisible de l’ordre d’échantillonnage originel.
Il importe de souligner l’interaction de la fonction UNIQUE avec les espaces vides. Si la plage source inspectée contient une ou plusieurs cellules vides, l’algorithme identifiera l’état vide comme une modalité distincte unique et allouera une cellule vierge au sein de la matrice résultante. Cette caractéristique impose une vigilance particulière lors de l’intégration ultérieure de cette liste dans des calculs fréquentielles, sous peine de voir apparaître une ligne récapitulative dépourvue de désignation explicite.
4.2 Déploiement pratique sur une colonne empirique
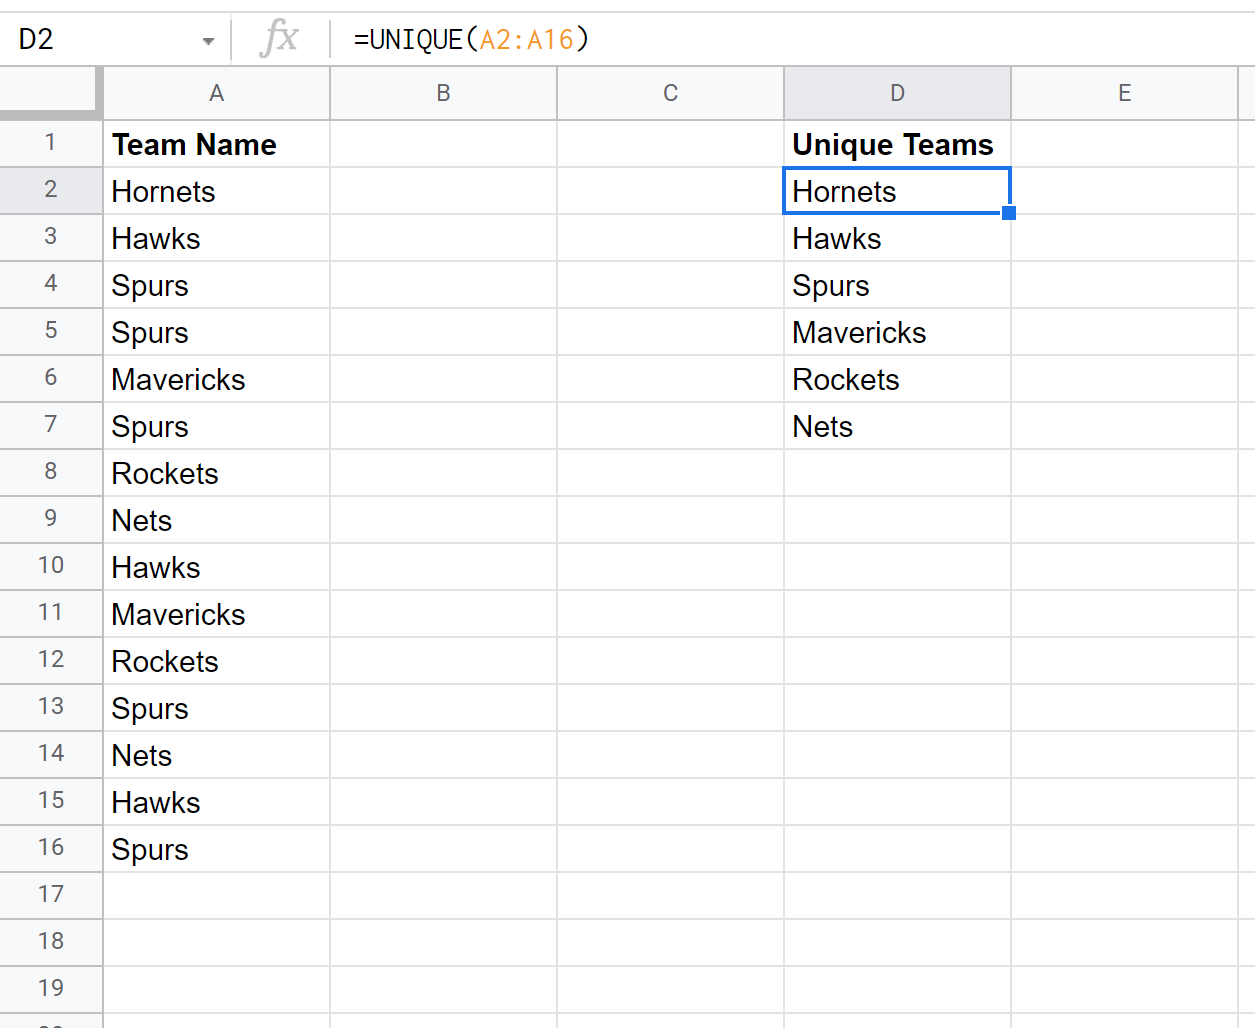
L’implémentation opérationnelle de la fonction répond à une syntaxe minimale d’une remarquable concision : =UNIQUE(plage). En insérant l’instruction =UNIQUE(A2:A) dans la première cellule d’une colonne de synthèse (par exemple en E2), Google Sheets déploie automatiquement l’ensemble des modalités uniques vers le bas, occupant exactement le nombre de lignes physiques requis par la cardinalité de l’ensemble d’observations.
Cette expansion dynamique impose impérativement le respect de l’espace de débordement sous-jacent. Si un utilisateur saisit manuellement du texte ou une valeur numérique dans une cellule située sur la trajectoire d’expansion de la matrice générée, le moteur de calcul interrompt immédiatement l’affichage et retourne une erreur bloquante de référence (l’infâme code #REF!), signalant qu’il est impossible de détruire les données existantes pour étendre la formule matricielle. La zone située sous la cellule racine doit demeurer strictement libre de toute saisie.
Pour optimiser la lisibilité humaine et structurer logiquement les catégories identifiées, il est hautement recommandé d’imbriquer la fonction UNIQUE au sein d’une fonction de tri alphabétique ou numérique. L’expression combinée =TRI(UNIQUE(A2:A)) génère une liste ordonnée ascendante des modalités uniques, standardisant ainsi la présentation du futur tableau de distribution sans nécessiter la moindre intervention manuelle de réorganisation spatiale.
4.3 Considérations méthodologiques sur la dynamicité des listes uniques
La dynamicité en temps réel constitue à la fois la plus grande force et une source potentielle d’instabilité structurelle de la fonction UNIQUE. Chaque modification, ajout ou suppression d’une observation au sein de la plage source entraîne un recalcul immédiat de l’arbre matriciel. Si un opérateur injecte par inadvertance une nouvelle catégorie ou une coquille orthographique dans les données brutes, la liste des modalités uniques se redimensionne instantanément, intégrant ce nouvel élément au tableau de synthèse sans validation humaine préalable.
Ce comportement dynamique soulève un risque méthodologique majeur lorsque des calculs manuels adjacents non vectorisés sont positionnés parallèlement à la matrice expansive. Si l’ordre interne des modalités vient à permuter sous l’effet de l’adjonction d’une observation précoce, les annotations ou formules adjacentes non liées dynamiquement risquent de se retrouver décalées par rapport à leur objet d’évaluation initial, provoquant une asynchronie catastrophique des attributions analytiques.
Pour la publication scientifique définitive ou la transmission de rapports institutionnels figés, il est par conséquent souvent judicieux de figer temporairement les résultats issus de UNIQUE. Cette opération s’effectue par un copier-coller des valeurs seules (raccourci Ctrl+Maj+V ou commande dédiée du menu Édition). Par ailleurs, le contrôle d’exhaustivité méthodologique impose de comparer systématiquement le nombre de modalités isolées par UNIQUE au dictionnaire de données théorique établi lors de l’élaboration du protocole de recherche.
5. Combinaison méthodologique des fonctions UNIQUE et NB.SI
5.1 Architecture en deux étapes du tableau de fréquences
La construction d’un tableau de distribution fréquentielle rigoureux, transparent et évolutif repose traditionnellement sur une architecture logicielle bipolaire associant l’extraction dynamique d’une part, et l’agrégation conditionnelle d’autre part. Cette articulation s’exécute selon une logique géométrique stricte : la première colonne est dédiée à l’inventaire automatique des catégories distinctes, tandis que la seconde colonne héberge les compteurs quantitatifs associés à chaque modalité répertoriée.
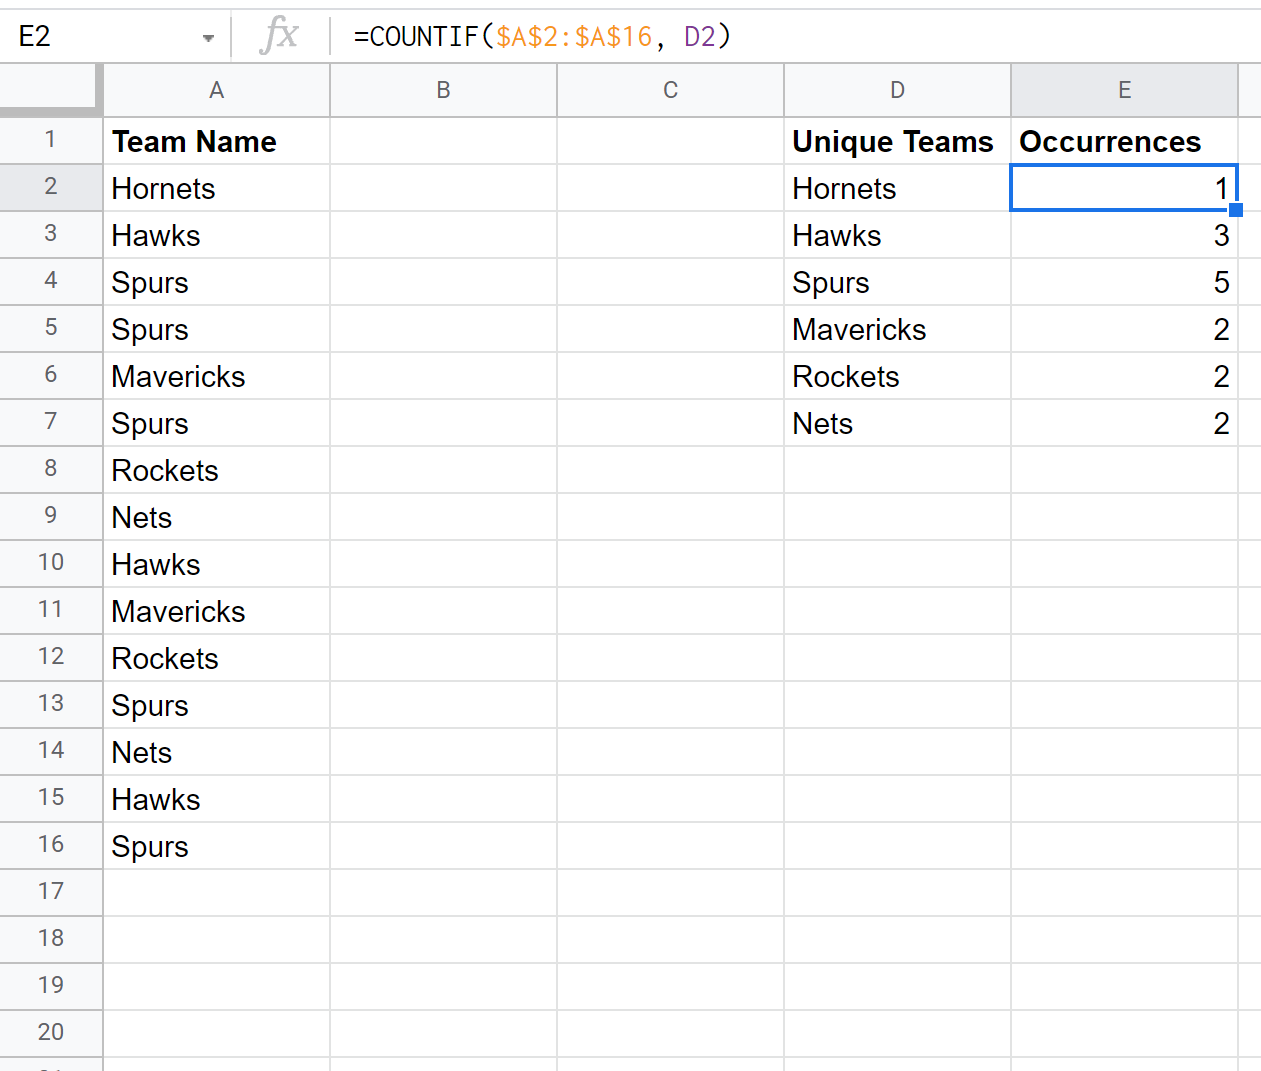
Dans la cellule d’amorce de la colonne de synthèse (admettons E2), l’analyste implante la formule d’extraction vectorielle ordonnée =TRI(UNIQUE(A2:A1000)). Immédiatement, le spectre exhaustif des modalités sans redondance s’affiche sur l’axe vertical. Dans la cellule immédiatement contiguë (F2), l’analyste implémente la formule d’évaluation univariée en ancrant rigidement la base d’observation tout en ciblant de façon relative la modalité fraîchement extraite : =NB.SI($A$2:$A$1000; E2).
Une fois cette formule étirée le long du vecteur des modalités uniques, le chercheur doit impérativement instaurer un protocole arithmétique de validation d’intégrité. Au bas de la colonne des fréquences calculées, une cellule de sommation totale =SOMME(F2:F) doit être mise en place. La conformité absolue entre cette somme marginale et le nombre total d’enregistrements valides audités dans la base source (obtenu par =NBVAL($A$2:$A$1000)) certifie que l’intégralité des données a été captée par l’algorithme sans omission ni déperdition d’unités d’observation.
5.2 Application concrète à un protocole de données comportementales
Afin d’illustrer la pertinence empirique de cette modélisation, considérons un protocole de psychologie expérimentale évaluant les performances mnésiques sous l’influence de divers inducteurs environnementaux. Le jeu de données consigne dans une colonne A l’assignation expérimentale de plusieurs centaines de participants selon quatre modalités distinctes : « Contrôle », « Bruit Blanc », « Stimulation Musicale » et « Privation Sensorielle ». L’objectif immédiat de l’expérimentateur consiste à vérifier l’homogénéité de la puissance statistique en vérifiant l’équilibrage des effectifs par condition.
La mise en œuvre de la combinaison UNIQUE et NB.SI permet d’extraire instantanément la structure d’allocation. La fonction UNIQUE(A2:A) isole les quatre conditions expérimentales sans risque d’omettre un groupe minoritaire. En étirant la formule NB.SI($A$2:$A; E2) face à ces quatre étiquettes, le tableau révèle avec netteté les effectifs observés (par exemple : 124 pour Contrôle, 122 pour Bruit Blanc, 125 pour Stimulation Musicale et 89 pour Privation Sensorielle), mettant immédiatement en lumière un déficit structurel de recrutement sur le dernier groupe.
Pour enrichir cette distribution brute d’indicateurs normalisés immédiatement exploitables dans la section descriptive d’une communication académique, une troisième colonne dédiée aux fréquences relatives est adjointe. En consignant dans la cellule G2 la formule normalisatrice =F2/SOMME($F$2:$F$5) et en appliquant un formatage de pourcentage à deux décimales, l’analyste accède directement au profil probabiliste de son échantillonnage, documentant les probabilités a priori nécessaires aux analyses inférentielles subséquentes.
5.3 Diagnostic et résolution des anomalies de correspondance
Lors de l’appariement entre les modalités extraites par UNIQUE et les résultats quantifiés par NB.SI, des discordances logiques déconcertantes peuvent émerger sous l’effet d’artefacts structurels. L’anomalie la plus pernicieuse se manifeste sous la forme de doublons apparents au sein de la colonne issue de UNIQUE : deux lignes semblent afficher rigoureusement la même chaîne de caractères, mais la fonction NB.SI renvoie pour chacune d’elles un effectif fractionné qui ne reflète pas la réalité du concept théorique mesuré.
Ce phénomène pathologique trouve presque invariablement son origine dans des micro-divergences typographiques invisibles à l’œil nu. L’existence d’une espace insécable (code 160) au lieu d’une espace standard (code 32), ou la présence d’espaces typographiques résiduelles en fin de chaîne, contraint l’algorithme de UNIQUE à individualiser deux entrées qu’un être humain perçoit comme sémantiquement identiques. Le recours immédiat à un protocole de diagnostic par inspection de longueur avec la fonction NBCAR permet d’objectiver instantanément l’écart de caractères entre les deux modalités discordantes.
Pour immuniser le flux de travail contre ces anomalies sans altérer irréversiblement la colonne source, il convient d’intercaler une étape de transformation au sein même de la formule d’extraction. En reformulant la commande sous la forme =TRI(UNIQUE(SUPPRESPACE(A2:A))), les artefacts d’espacement sont neutralisés avant même que l’inventaire des catégories ne soit dressé, assurant une congruence parfaite entre le décompte univarié et la réalité distributionnelle du corpus empirique.
6. Dénombrement sous conditions multiples avec la fonction NB.SI.ENS
6.1 Syntaxe multidimensionnelle et conjonction logique (ET)
Dès lors que l’investigation empirique s’émancipe de la simple description univariée pour explorer les interactions entre plusieurs dimensions d’analyse, la fonction NB.SI.ENS (homologue francophone de COUNTIFS) devient l’outil central de quantification. Cette fonction est spécifiquement paramétrée pour déterminer le nombre d’occurrences au sein d’un échantillon qui satisfont simultanément à une pluralité de conditions logiques, modélisant ainsi une conjonction d’événements booléens de type ET.
La signature syntaxique de NB.SI.ENS procède par paires alternées et indéfiniment extensibles : =NB.SI.ENS(plage_critère1; critère1; plage_critère2; critère2; …). Cette structure impose une contrainte algorithmique absolue : la congruence dimensionnelle. Toutes les plages d’évaluation mobilisées au sein de la formule doivent obligatoirement posséder une géométrie rigoureusement identique (même nombre de lignes et même orientation vectorielle). Le moindre décalage dimensionnel génère immédiatement une erreur structurelle de valeur (#VALUE!).
Le moteur d’évaluation de Google Sheets procède par intersection ensembliste séquentielle. Il inspecte la première observation sur l’axe vectoriel, vérifie si elle satisfait au critère 1, puis interroge la valeur de la même ligne dans la seconde plage pour vérifier la conformité au critère 2. Ce n’est que lorsque l’ensemble des prédicats logiques sont simultanément validés que l’accumulateur interne s’incrémente d’une unité. Pour maximiser la rapidité d’exécution sur de très grands jeux de données, il est méthodologiquement recommandé de placer en première position le critère le plus discriminant, afin d’optimiser l’élagage logique interne.
6.2 Croisement de variables catégorielles sociodémographiques ou cliniques
Le cas d’application canonique de la fonction NB.SI.ENS se situe dans l’intersection de facteurs sociodémographiques et de classifications cliniques ou expérimentales. Considérons un échantillon d’évaluation psychiatrique où la colonne B consigne le sexe biologique des sujets (« Masculin » versus « Féminin »), la colonne C le diagnostic nosologique primaire (« Dépression Majeure », « Trouble Panique », « Trouble Obsessionnel »), et la colonne D l’âge chronologique des participants.
Si l’analyste souhaite isoler précisément le sous-groupe des femmes âgées de plus de 40 ans présentant un diagnostic formel de dépression majeure, l’expression formelle s’articulera selon une conjonction tripartite : =NB.SI.ENS($B$2:$B$1000; « Féminin »; $C$2:$C$1000; « Dépression Majeure »; $D$2:$D$1000; « >40 »). Cette formulation compacte s’affranchit du recours à des filtres manuels successifs et confère une stabilité totale aux statistiques descriptives face à toute extension de la cohorte.
Cette approche permet en outre d’échafauder manuellement des matrices bidirectionnelles de fréquences, couramment désignées sous le terme de tables de contingence. En disposant les modalités du facteur d’exposition sur l’axe vertical et les catégories de réponse sur l’axe horizontal, l’implémentation de la fonction NB.SI.ENS combinant des références cellulaires mixtes (bloquant la colonne pour l’une et la ligne pour l’autre, par exemple $E2 et F$1) permet d’alimenter l’intégralité du tableau croisé par simple réplication bidimensionnelle.
6.3 Modélisation de critères disjonctifs (OU logique)
Une limitation architecturale majeure de la fonction NB.SI.ENS réside dans son incapacité structurelle à interpréter nativement l’opérateur disjonctif OU. Par conception, la juxtaposition d’arguments au sein de cette fonction est exclusivement additive dans son exigence de conformité, traduisant rigoureusement une intersection (ET). Si un analyste cherche à dénombrer les observations qui remplissent soit la modalité « A », soit la modalité « B » au sein d’une même variable catégorielle, une simple formule NB.SI.ENS ne saurait être paramétrée directement de façon unitaire.
La première stratégie de contournement, élégante et parfaitement transparente pour les modalités mutuellement exclusives, repose sur la sommation arithmétique simple de deux fonctions NB.SI indépendantes. Puisqu’un individu ne peut simultanément appartenir au groupe « Traitement A » et au groupe « Traitement B » au sein d’une variable univoque, la disjonction se formalise par l’addition scalaire élémentaire : =NB.SI(A2:A; « Traitement A ») + NB.SI(A2:A; « Traitement B »).
Une seconde approche, particulièrement prisée pour sa concision lorsqu’une multitude de conditions disjonctives doivent être agrégées, mobilise une constante matricielle encapsulée au sein d’une fonction sommatoire : =SOMME(NB.SI(A2:A; {« Modalité A »; « Modalité B »; « Modalité C »})). Dans cette syntaxe avancée, la fonction NB.SI renvoie un vecteur de résultats pour chaque élément de la matrice de critères, que la fonction SOMME englobante agrège immédiatement en un effectif global consolidé, sans risque de redondance computationnelle.
7. Automatisation dynamique vectorielle via ARRAYFORMULA
7.1 Principes du calcul vectoriel unifié dans Google Sheets
L’extension matricielle via la fonction ARRAYFORMULA incarne le changement de paradigme le plus profond entre la manipulation conventionnelle d’un tableur et l’ingénierie logicielle avancée de données. Dans un modèle standard, le dénombrement sur une série de lignes requiert de copier manuellement une formule descendante, créant autant d’instances distinctes de code qu’il existe d’observations. Ce modèle traditionnel présente une fragilité systémique : si un utilisateur modifie accidentellement la formule d’une ligne intermédiaire, l’homogénéité du modèle analytique est irrémédiablement rompue.
Le calcul vectoriel unifié résout cette vulnérabilité en appliquant le principe de la cellule maîtresse unique. Une seule formule matricielle saisie au sommet d’une colonne projette instantanément ses calculs sur l’intégralité d’un vecteur sous-jacent. Les cellules réceptrices affichent les valeurs calculées de manière automatique, mais leur contenu demeure sous la dépendance exclusive de la cellule souche. Il devient matériellement impossible de corrompre une ligne isolée sans intervenir délibérément sur l’instruction d’origine.
Outre cette robustesse structurelle, le calcul matriciel garantit une scalabilité automatique face à la croissance des bases de données empiriques. Lorsque de nouvelles lignes d’observations sont importées ou saisies en continu à la fin d’une table d’expérimentation, ARRAYFORMULA intègre instantanément ces nouveaux enregistrements dans le flux analytique sans nécessiter la moindre intervention de redimensionnement manuel, réalisant ainsi une automatisation intégrale de l’enrichissement documentaire.
7.2 Combinaison de UNIQUE et NB.SI sous ARRAYFORMULA
L’ambition suprême de l’analyste sous Google Sheets consiste à formaliser un tableau de distribution de fréquences entièrement autonome qui s’auto-génère et s’auto-actualise sans aucune recopie de cellules. Pour ce faire, il est théoriquement possible de combiner les fonctions UNIQUE et NB.SI au sein d’une enveloppe vectorielle. Cependant, l’intégration directe de NB.SI au sein d’une syntaxe matricielle classique présente des frictions algorithmiques notoires, car NB.SI est par essence une fonction d’agrégation qui tend à réduire les vecteurs plutôt qu’à s’étendre naturellement.
Pour surmonter cette contrainte et créer une colonne de dénombrement entièrement automatisée face à une liste de modalités extraites dynamiquement par UNIQUE (située par exemple en E2:E), la stratégie vectorielle moderne s’articule autour de l’encapsulation suivante : =ARRAYFORMULA(SI(E2:E= » »; « »; NB.SI(A2:A; E2:E))). Dans cette architecture formelle, la clause conditionnelle SI(E2:E= » »; « ») est indispensable : elle évalue préalablement si la cellule de référence contient une modalité valide et neutralise l’évaluation pour l’infinité de lignes vides résiduelles situées en bas de page.
Cette formulation canonique offre une élégance computationnelle remarquable. Une seule saisie en F2 suffit à piloter la totalité des comptages d’occurrences pour toutes les modalités présentes et à venir. Dès lors qu’une nouvelle modalité émerge dans la colonne d’observation A, la fonction UNIQUE en E2 l’intègre automatiquement, et l’instruction vectorielle en F2 projette instantanément son effectif correspondant sans que l’analyste n’ait à effleurer la souris ou le clavier.
7.3 Limites algorithmiques de l’expansion matricielle
Bien que d’une puissance incontestable, le calcul matriciel via ARRAYFORMULA se heurte à des incompatibilités structurelles avec un sous-ensemble de fonctions indigènes de Google Sheets. Notamment, les fonctions qui effectuent par définition une contraction scalaire globale d’une plage — à l’image de SOMME, MOYENNE, ou ET logique — ne peuvent être distribuées ligne par ligne au sein d’une simple enveloppe ARRAYFORMULA sans perdre leur comportement individualisé.
Pour contourner ces limitations historiques, les ingénieurs de Google ont intégré l’environnement fonctionnel des expressions LAMBDA, ouvrant la voie à des fonctions d’itération vectorielle de haut niveau telles que BYROW ou MAP. Au lieu de contraindre des fonctions rétives dans ARRAYFORMULA, l’analyste moderne peut désormais formuler un comptage fréquentiel ultra-robuste en écrivant : =BYROW(UNIQUE(FILTRE(A2:A; A2:A » »)); LAMBDA(modalite; NB.SI(A2:A; modalite))).
Cette construction algorithmique itère rigoureusement la variable temporaire « modalite » sur chaque ligne de l’ensemble filtré des valeurs uniques, exécutant l’évaluation univariée avec une isolation mémoire parfaite pour chaque itération. Cette méthodologie élimine définitivement les erreurs d’expansion matricielle inattendues et offre une alternative supérieure à ARRAYFORMULA lorsque les jeux de données complexes impliquent des traitements conditionnels imbriqués ou des vérifications logiques multidimensionnelles.
8. Utilisation de la fonction QUERY pour une analyse agrégée avancée
8.1 Introduction au langage de requête Google Visualization API
La fonction QUERY constitue sans conteste l’outil d’agrégation et de transformation le plus puissant, le plus polyvalent et le plus expressif disponible nativement au sein de Google Sheets. Conçue comme une passerelle d’accès direct au moteur Google Visualization API Query Language, cette instruction transcende le paradigme classique du tableur pour introduire la logique déclarative des bases de données relationnelles, calquée directement sur la grammaire standard du Structured Query Language (SQL).
Au lieu de chaîner laborieusement de multiples fonctions dépendantes (telles que UNIQUE, NB.SI, TRI et FILTRE), la fonction QUERY condense l’intégralité de la chaîne de traitement analytique au sein d’une chaîne textuelle unifiée et rigoureusement paramétrée. L’analyste y formule son intention de manière déclarative en spécifiant quelles variables doivent être sélectionnées, selon quelles conditions d’exclusion, et sous quel format d’agrégation mathématique elles doivent être regroupées.
Il est fondamental de souligner que le langage interne de QUERY est doté d’une rigueur formelle stricte. Contrairement aux fonctions arithmétiques habituelles du tableur, les clauses de commande du langage de requête — à l’instar de SELECT, WHERE, GROUP BY, ORDER BY ou LABEL — sont strictement sensibles à la casse et doivent être rédigées exclusivement en lettres majuscules sous peine de provoquer une erreur de syntaxe immédiate lors du parsing par le compilateur interne.
8.2 Formulation de requêtes de comptage avec SELECT, COUNT et GROUP BY
Pour dénombrer la fréquence de toutes les occurrences d’une colonne d’observations et dresser un tableau récapitulatif complet d’une seule traite, la syntaxe de base de la fonction QUERY s’articule autour de la clause d’agrégation COUNT couplée à l’instruction de partitionnement GROUP BY. Considérons une colonne A abritant des données qualitatives non ordonnées ; l’instruction fondamentale s’énonce ainsi : =QUERY(A2:A; « SELECT A, COUNT(A) WHERE A IS NOT NULL GROUP BY A »).
L’élégance de cette expression réside dans son exhaustivité procédurale. En une seule instruction élémentaire, le moteur écarte les lignes dépourvues d’information (WHERE A IS NOT NULL), extrait l’ensemble des modalités uniques existantes (effet implicite du GROUP BY A), et incrémente le compteur arithmétique pour chaque catégorie observée (COUNT(A)). Le résultat est immédiatement déversé sous la forme d’un tableau à deux colonnes parfaitement agencé.
L’expression peut être immédiatement magnifiée pour répondre aux plus hautes exigences de publication grâce aux clauses d’ordonnancement et d’habillage sémantique. En adjoignant l’instruction ORDER BY COUNT(A) DESC, les modalités sont instantanément hiérarchisées de la plus fréquente à la plus rare. Enfin, l’utilisation de la clause LABEL COUNT(A) ‘Effectif’ permet de substituer dynamiquement un en-tête professionnel et explicite à la formulation brute générée par le système, produisant un rapport analytique achevé en une seule formule souveraine.
8.3 Comparaison critique des performances : QUERY versus NB.SI
Bien que la fonction QUERY séduise par sa concision syntaxique magistrale et son potentiel déclaratif, l’analyste rigoureux se doit d’évaluer ses performances computationnelles à la lumière de ses compromis structurels face au modèle traditionnel NB.SI. Le premier écueil méthodologique de QUERY réside dans son exigence absolue d’homogénéité des types de données au sein d’une même colonne. Le moteur de visualisation détermine le type dominant (numérique ou textuel) sur les premières lignes d’une plage ; si des valeurs d’un type minoritaire subsistent plus bas, elles sont tout simplement interprétées comme nulles et exclues du décompte, générant des biais d’omission invisibles.
Sur le plan des performances pures face à la volumétrie massive (jeux de données excédant plusieurs dizaines ou centaines de milliers d’enregistrements), la fonction QUERY tend à présenter une vitesse d’exécution supérieure à une multitude de formules NB.SI indépendantes, car elle opère un balayage vectoriel unique optimisé en mémoire vive plutôt que de répéter autant de lectures séquentielles de la colonne qu’il y a de modalités à évaluer.
En revanche, la fragilité structurelle de QUERY face aux modifications de colonnes constitue un point de vigilance fondamental. Dans une instruction standard, les colonnes sont identifiées par des identifiants littéraux rigides (A, B, C). Si un collaborateur insère une nouvelle colonne au cœur de la feuille d’origine, le champ de données se décale sans que la requête textuelle ne s’adapte automatiquement, brisant instantanément le modèle analytique. L’utilisation de NB.SI avec des références cellulaires traditionnelles demeure donc préférable dans des classeurs instables soumis à des réorganisations manuelles fréquentes.
9. Tableaux croisés dynamiques pour la quantification fréquentielle
9.1 Création et configuration de l’espace de tableau croisé
En marge des architectures fondées sur des formulations mathématiques codées en dur, les tableaux croisés dynamiques (communément désignés sous le vocable international de Pivot Tables) représentent un instrument d’exploration interactive indispensable pour la quantification rapide des fréquences empiriques. Cet outil visuel permet d’interroger la structure sous-jacente des données sans exiger la maîtrise préalable d’une syntaxe programmatique complexe.
La mise en œuvre s’initie par la sélection intégrale de la matrice tabulaire originelle, suivie de l’insertion de l’espace dynamique via le menu Données > Tableau croisé dynamique. L’analyste se voit alors présenter un éditeur latéral de configuration contextuelle. Pour formaliser la distribution univariée de la variable cible, celle-ci doit être glissée-déposée au sein du quadrant des Lignes, ce qui déclenche instantanément l’extraction et l’affichage ordonné de toutes ses modalités distinctes.
L’étape de quantification s’opère en assignant cette même variable au quadrant des Valeurs, en veillant scrupuleusement à paramétrer le moteur de réduction sur la fonction de comptage adéquate : COUNTA (NBVAL) pour les données textuelles qualitatives, ou COUNT (NB) pour les mesures exclusivement numériques. L’ergonomie du tableau croisé autorise en outre une personnalisation immédiate de l’affichage, permettant de convertir en un clic la métrique d’effectifs absolus en pourcentages relatifs rapportés au total de la colonne.
9.2 Segmentation croisée multidimensionnelle
La valeur ajoutée d’un tableau croisé dynamique culmine lors de la construction instantanée de tables de contingence multidimensionnelles complexes, tâche qui exigerait de nombreuses heures de programmation via des formules NB.SI.ENS imbriquées. En projetant une seconde variable catégorielle au sein de l’espace des Colonnes, le tableau croisé engendre automatiquement une matrice bidirectionnelle croisant chaque modalité du facteur d’exposition avec chaque catégorie de la variable de réponse.
Cette modélisation croisée s’accompagne de l’activation systématique des totaux généraux horizontaux et verticaux. Ces marges de sommation constituent un dispositif d’audit essentiel permettant au statisticien de valider d’un coup d’œil l’équilibre des distributions marginales. Parallèlement, l’interface intègre des filtres contextuels sophistiqués, offrant la faculté d’exclure dynamiquement des cohortes spécifiques ou de masquer les données aberrantes sans détruire l’intégrité de la source sous-jacente.
Un atout cognitif majeur réside dans la fonctionnalité d’inspection granulaire directe (le « drill-down » analytique). Par un simple double-clic sur une cellule de fréquence agrégée au sein de la matrice résultante, Google Sheets génère instantanément un nouvel onglet temporaire isolant scrupuleusement l’ensemble des enregistrements empiriques individuels qui constituent cet effectif spécifique, facilitant ainsi les vérifications d’anomalies cliniques ou méthodologiques.
9.3 Péréquation entre tableaux dynamiques et solutions par formules
L’arbitrage méthodologique entre l’adoption d’un tableau croisé dynamique ou le déploiement d’une armature de calcul par formules constitue une décision structurelle importante dans la conception d’un système de traitement d’information. Les tableaux croisés dynamiques offrent une plasticité exploratoire sans égale pour l’analyste en phase de découverte d’un jeu de données inconnu, permettant de restructurer les dimensions d’analyse et de tester des hypothèses de distribution en quelques fractions de seconde.
Néanmoins, cette souplesse ergonomique s’accompagne d’inconvénients notables dans le cadre de flux de travail totalement automatisés. Bien que Google Sheets actualise désormais ses tableaux croisés avec une réactivité bien supérieure à celle de ses homologues traditionnels sur poste de travail, leur incorporation au sein de chaînes de calcul automatisées en aval s’avère souvent délicate. Les tableaux croisés sont des structures spatiales fluctuantes qui peuvent écraser des cellules adjacentes lors d’une expansion inattendue de modalités.
À l’opposé, les solutions fondées sur des architectures de formules unifiées (combinant UNIQUE, NB.SI, QUERY ou BYROW) offrent une rigidité protectrice supérieure, une intégration fluide avec les fonctions de traçage graphique vectoriel, et une reproductibilité scriptée absolue indispensable aux standards de la recherche scientifique. Il est donc hautement recommandé de réserver les tableaux croisés aux phases d’exploration préliminaire, et de stabiliser l’analyse finale au sein de formulations explicites avant toute publication ou diffusion institutionnelle.
10. Traitement des occurrences textuelles partielles et expressions régulières
10.1 Utilisation des caractères génériques avec la fonction NB.SI
Dans de nombreuses disciplines empiriques — telles que la linguistique computationnelle, l’analyse d’entretiens qualitatifs en sociologie ou l’exploration de bases d’incidents techniques —, l’analyste est confronté à des corpus où le concept d’intérêt n’apparaît pas sous une étiquette catégorielle isolée, mais se trouve enkysté au sein de segments textuels plus vastes ou de verbatims ouverts. Dans cette configuration, un test d’égalité stricte s’avère totalement inopérant.
Pour résoudre cette difficulté sans quitter la simplicité de la fonction NB.SI, Google Sheets intègre la prise en charge native de caractères génériques (communément désignés sous le terme de « wildcards »). Le premier de ces opérateurs est l’astérisque (*), qui formalise une séquence de zéro, un ou plusieurs caractères alphanumériques indéterminés. Ainsi, pour dénombrer l’ensemble des cellules consignant une observation où le radical lexical « anxi » est présent (couvrant des occurrences telles que « anxieux », « anxiété », « anxieuse », ou « état sub-anxieux »), la syntaxe s’énonce élégamment sous la forme : =NB.SI(A2:A; « *anxi* »).
Le second caractère générique est le point d’interrogation (?), qui se substitue rigoureusement à un caractère unique et obligatoire. Cette commande se révèle précieuse pour repérer des variantes morphologiques à longueur fixe ou des identifiants normalisés sujets à des variations mineures. Enfin, dans l’éventualité où l’analyste chercherait à dénombrer la présence explicite d’un symbole astérisque ou point d’interrogation littéral au sein du texte, il est impératif d’échapper le caractère en le faisant précéder d’un tilde (~), comme dans l’expression =NB.SI(A2:A; « *~?* ») qui comptabilise les cellules contenant un point d’interrogation formel.
10.2 Dénombrement avancé basé sur REGEXMATCH et SOMMEPROD
Lorsque la structure lexicale des occurrences recherchées dépasse la combinatoire élémentaire des caractères génériques simples — par exemple pour identifier des formats d’adresses électroniques institutionnelles, des numéros d’inclusion clinique obéissant à des masques complexes, ou des combinaisons syntaxiques disjonctives au sein d’un même verbatim —, l’analyste doit convoquer la puissance des expressions régulières (Regex).
Google Sheets dispose de fonctions dédiées à l’évaluation par expressions régulières, au premier rang desquelles figure REGEXMATCH. Toutefois, cette fonction est conçue pour renvoyer une valeur booléenne unitaire (VRAI ou FAUX) face à une entrée scalaire. Pour la transformer en un puissant instrument de dénombrement vectoriel opérant sur une colonne entière, il convient de l’associer à la fonction SOMMEPROD. La syntaxe canonique se structure alors comme suit : =SOMMEPROD(N(REGEXMATCH(A2:A1000; « (?i)b(symptôme|manifestation|signe)b »))).
Dans ce modèle d’ingénierie avancée, le modificateur (?i) neutralise la sensibilité à la casse, les balises b délimitent les frontières de mots stricts pour prévenir la capture intempestive de sous-chaînes non ciblées, et le symbole barre verticale (|) applique l’opérateur disjonctif OU au niveau intralexical. La fonction unaire N() (ou l’emploi d’un double opérateur unaire négatif —) contraint la matrice des booléens résultants à se convertir en un vecteur arithmétique binaire composé de 1 et de 0, que la fonction SOMMEPROD accumule immédiatement pour délivrer le décompte exact d’occurrences textuelles complexes.
10.3 Comptage des occurrences multiples d’un même mot au sein d’une seule cellule
Une distinction épistémologique et méthodologique fondamentale doit être opérée entre la fréquence de cellules positives et l’intensité lexicale globale d’une observation. Toutes les formules présentées jusqu’ici (qu’il s’agisse de NB.SI avec astérisques ou de REGEXMATCH) évaluent la conformité d’une unité cellulaire : si un mot clé spécifique apparaît quatre fois au sein du verbatim recueilli auprès d’un unique participant, ces fonctions incrémenteront le compteur général d’une seule unité, mesurant la prévalence du phénomène au niveau inter-sujet mais occultant totalement son intensité intra-sujet.
Pour mesurer la fréquence totale absolue de répétition d’un terme au sein d’une cellule donnée (ou d’une colonne agrégée), il est nécessaire de déployer un algorithme mathématique ingénieux fondé sur le différentiel de longueur de chaînes textuelles. En mesurant la longueur totale de la chaîne initiale à l’aide de NBCAR, puis en soustrayant la longueur de cette même chaîne après avoir intégralement purgé le mot cible via la fonction SUBSTITUE, l’analyste obtient le nombre exact de caractères consommés par les apparitions du terme. Il suffit alors de diviser ce reliquat par la longueur intrinsèque du terme recherché.
La formule univariée pour une observation logée en A2 se formalise de la sorte : =(NBCAR(A2) – NBCAR(SUBSTITUE(A2; « terme »; « »))) / NBCAR(« terme »). Afin d’étendre ce dénombrement à l’intégralité d’un corpus de plusieurs milliers de lignes textuelles, cette logique de soustraction de longueurs vectorielles est avantageusement encapsulée au sein d’une commande sommatoire matricielle : =SOMMEPROD((NBCAR(A2:A1000) – NBCAR(SUBSTITUE(A2:A1000; « terme »; « »))) / NBCAR(« terme »)), livrant une quantification exhaustive de l’intensité discursive globale de l’échantillon.
11. Gestion des biais méthodologiques, erreurs fréquentes et valeurs manquantes
11.1 Diagnostic des erreurs typiques de dénombrement
L’exploitation de feuilles de calcul pour des travaux scientifiques de haute précision est fréquemment compromise par des défaillances insidieuses qui ne déclenchent aucune interruption formelle du moteur de calcul. L’illusion d’exactitude créée par l’affichage péremptoire d’un chiffre arithmétique constitue le danger le plus redoutable pour l’analyste. Le premier piège réside dans le pseudo-formatage des nombres stockés en tant que chaînes de caractères littérales, anomalie survenant couramment lors de l’importation de fichiers au format CSV générés par des plateformes d’enquêtes en ligne.
Si une colonne contient des valeurs numériques dont certaines sont préfixées d’une apostrophe ou formatées en texte, les fonctions d’évaluation arithmétique et les comparaisons de seuils peuvent se comporter de manière totalement incohérente. Ainsi, une condition de comparaison telle que « >50 » exclura arbitrairement des observations numériques stockées sous forme de texte, faussant silencieusement le décompte final. L’application préalable de la fonction CNUM ou la réapplication explicite du format numérique via le menu Format s’avère indispensable pour assainir ces discordances de typage.
Une autre anomalie hautement pernicieuse découle des références circulaires involontaires induites lors de l’implantation des tables de synthèse. Si la plage vectorielle couverte par une formule de dénombrement (par exemple A:A) vient à englober la cellule même qui héberge le calcul de synthèse ou son sous-total, une boucle d’itération instable est amorcée, risquant de geler les ressources computationnelles du navigateur ou d’afficher des résultats totalement aberrants. Le confinement rigoureux des plages au moyen d’indices d’intervalles précis (comme A2:A500) élimine radicalement ce danger systémique.
11.2 Biais d’échantillonnage et intégrité de la distribution
Sur le plan de l’épistémologie de la mesure, le dénombrement brut d’occurrences ne saurait s’exonérer d’une réflexion critique sur l’intégrité de la distribution sous-jacente. L’erreur la plus commune chez les analystes débutants consiste à assimiler aveuglément l’absence réelle d’un événement (qui correspond rigoureusement à une fréquence empirique de zéro) avec l’état de donnée manquante ou non renseignée (qui relève de l’incertitude épistémique absolue, traditionnellement notée NA). Confondre ces deux statuts au sein d’une feuille de calcul détruit la validité de l’inférence statistique ultérieure.
Un phénomène corollaire concerne le traitement des modalités à très faible fréquence, également désigné sous le terme de problème des cellules rares ou éparses. Dans les distributions empiriques hautement asymétriques (obéissant fréquemment à des lois de puissance ou lois de Pareto), une multitude de modalités ne comptabilisent qu’une seule occurrence isolée (les « hapax » lexicaux ou cliniques). L’inclusion brute de ces événements sporadiques au sein de tables d’analyse peut déstabiliser lourdement les tests statistiques confirmatoires (notamment les tests de contingence asymptotiques).
Face à ce constat, le chercheur doit se garder de procéder à des regroupements arbitraires a posteriori pour gonfler artificiellement les effectifs de certaines cases. Toute décision d’amendement taxonomique — telle que la fusion de modalités secondaires sous l’étiquette générique « Autre » — doit impérativement s’adosser à une justification théorique prédéfinie dans le protocole de recherche pré-enregistré, et ne doit en aucun cas être guidée par la simple opportunité statistique découverte à la volée sur la feuille de calcul.
11.3 Mise en place de tests de validation automatisés
Pour immuniser les chaînes de traitement quantitatif contre les dérives computationnelles et garantir une reproductibilité conforme aux standards de la science ouverte, l’ingénierie des classeurs analytiques doit intégrer des systèmes d’assertions logiques et de tests unitaires automatisés. Le dispositif de sécurité le plus élémentaire mais le plus efficace consiste à implanter une cellule de contrôle d’intégrité marginale adjacente au tableau de distribution des fréquences.
Cette cellule de vérification doit confronter en temps réel la somme de l’ensemble des fréquences calculées par les fonctions NB.SI au nombre effectif d’enregistrements validés au sein de la base d’origine. L’implémentation d’une assertion logique explicite se structure comme suit : =SI(SOMME(F2:F) = NBVAL(A2:A); « CONFORME »; « ALERTE : DISCORDANCE D’EFFECTIFS »). Si un écart arithmétique quelconque survient — qu’il s’agisse de la présence d’espaces non normalisés ou de critères mal configurés —, la cellule passe instantanément en état d’alerte sémantique.
Ce dispositif de surveillance logique est avantageusement couplé à une règle de formatage conditionnel dynamique. En configurant la cellule d’audit pour qu’elle vire au rouge vif dès lors que la condition d’égalité n’est pas rigoureusement vérifiée, l’analyste se dote d’un tableau de bord visuel inviolable. Aucun résultat ne doit être communiqué, visualisé ou soumis à publication académique tant que l’ensemble des assertions logiques du classeur n’avertit pas d’une congruence parfaite de tous les décomptes d’occurrences.
12. Visualisation et interprétation psychométrique des distributions d’occurrences
12.1 Traduction graphique des décomptes fréquentiels
L’agrégation numérique des occurrences au sein d’une table de contingence ne constitue qu’une étape intermédiaire du traitement analytique ; la transmission des savoirs empiriques exige leur restitution sous une forme visuelle rigoureuse, fidèle et directement décodable par les pairs. Dans le cadre de variables qualitatives discrètes, le choix de la sémiologie graphique s’avère hautement critique pour éviter toute distorsion projective de l’ampleur des phénomènes mesurés.
Pour représenter des modalités catégorielles disjointes, le diagramme en barres verticales ou horizontales demeure la norme de référence incontestée des publications scientifiques. Contrairement à une croyance répandue, un diagramme en barres pour variables catégorielles ne doit pas être confondu avec un histogramme continu, ce dernier étant formellement réservé à la distribution de variables quantitatives continues préalablement découpées en classes d’amplitudes égales. Les barres doivent être nettement espacées pour matérialiser graphiquement la discontinuité logique des états nominaux.
Une règle de probité scientifique cardinale — trop souvent bafouée dans les représentations hâtives — impose d’ancrer systématiquement l’axe quantitatif des ordonnées au point d’origine arithmétique zéro. L’interruption artificielle de l’axe de référence dans le but d’amplifier visuellement de modestes écarts d’effectifs entre catégories constitue un biais de communication caractérisé. Par ailleurs, l’usage des diagrammes à secteurs (communément appelés camemberts) doit être rigoureusement proscrit dès que le nombre de modalités dépasse trois : le système visuel humain peinant lourdement à estimer avec précision des différences d’aires et d’angles, ce format dégrade l’interprétation comparative des effectifs réels.
12.2 Transition des effectifs vers les probabilités et analyses inférentielles
Dès lors que le dénombrement fréquentiel est certifié exempt de toute scorie méthodologique, la distribution des effectifs bruts s’émancipe de son statut purement descriptif pour devenir le socle des démarches inférentielles. La première phase de cette transition mathématique s’incarne dans la dérivation des fréquences relatives (notées fi), obtenues en divisant l’effectif observé de chaque catégorie par la taille totale de l’échantillon (N). Ces fréquences relatives constituent des estimateurs convergents non biaisés des probabilités réelles sous-jacentes du phénomène au sein de la population parente.
Ces vecteurs et matrices d’occurrences préparés dans Google Sheets sont spécifiquement dimensionnés pour alimenter les tests d’hypothèses confirmatoires classiques. Le plus emblématique d’entre eux est incontestablement le test d’indépendance ou d’adéquation du Chi-carré de Pearson. En confrontant les effectifs empiriquement dénombrés par nos fonctions aux effectifs théoriques attendus sous l’hypothèse nulle d’équiprobabilité ou d’indépendance stochastique, le statisticien quantifie le degré de divergence entre observation et modèle.
Pour assurer la fluidité de ces démarches confirmatoires avancées, Google Sheets sert souvent de plateforme intermédiaire de nettoyage et de prétraitement avant exportation vers des environnements spécialisés tels que R, JASP ou SPSS. La structuration ordonnée des tables d’occurrences permet une conversion fluide au format CSV ou une aspiration directe via des scripts d’API sans nécessiter la moindre réorganisation de syntaxe au sein du progiciel statistique de destination.
12.3 Synthèse procédurale et guide de bonnes pratiques
Au terme de cette exploration multidimensionnelle des mécanismes de comptage fréquentiel dans Google Sheets, il convient de cristalliser ces prescriptions techniques sous la forme d’un arbre décisionnel d’ingénierie des données. Face à une problématique de dénombrement concrète, l’analyste doit articuler son choix algorithmique selon un protocole clair et éprouvé :
- Critère univarié ponctuel dans un tableau stable : Mobiliser la fonction NB.SI en associant obligatoirement l’argument à une référence cellulaire dynamique extérieure pour éviter le hard-coding.
- Génération automatique d’un tableau exhaustif à deux colonnes : Déployer la combinaison TRI(UNIQUE(plage)) pour les libellés, puis implanter l’instruction vectorielle BYROW ou ARRAYFORMULA avec neutralisation des vides pour les effectifs.
- Segmentation croisée multivariée complexe (ET logique) : Recourir à la fonction congruente NB.SI.ENS sur des plages vectorielles rigoureusement dimensionnées à l’identique.
- Rapport récapitulatif consolidé avec tri et filtrage immédiat : Exécuter une requête déclarative unique via la fonction QUERY en combinant les clauses SELECT, COUNT, GROUP BY et LABEL.
- Exploration phénoménologique préliminaire non finalisée : Exploiter l’interactivité d’un Tableau croisé dynamique avec calcul des pourcentages marginaux.
- Recherche sémantique partielle au sein de verbatims ouverts : Mobiliser les caractères génériques avec NB.SI ou déployer l’architecture combinée SOMMEPROD et REGEXMATCH.
Enfin, la gouvernance analytique prescrit d’ériger la documentation formelle en impératif déontologique. Chaque classeur d’importance scientifique ou professionnelle doit intégrer un onglet de métadonnées détaillant sans ambiguïté la définition opérationnelle de chaque variable observée, la signification exacte des étiquettes de codage, la justification des protocoles de nettoyage typographique adoptés, ainsi que la date de la dernière certification d’intégrité marginale des effectifs. Ce n’est qu’au prix de cette rigueur méthodologique sans faille que l’analyse des occurrences dans Google Sheets acquiert les vertus cardinales de fiabilité, de transparence et de pérennité inhérentes à toute recherche d’excellence.
Références
- Google. (2024). Utiliser la fonction NB.SI dans Google Sheets. Centre d’aide Google Docs. https://support.google.com/docs/answer/3093480?hl=fr
- Google Developers. (2023). Google Visualization API Query Language Version 0.7. Google Developers Reference Guide. https://developers.google.com/chart/interactive/docs/querylanguage
- Institut National de la Statistique et des Études Économiques (INSEE). (2021). Les fondamentaux de la statistique descriptive : Mesures de distribution et fréquences. Manuels méthodologiques de l’INSEE. https://www.insee.fr
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. Philosophical Magazine Series 5, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0