
Dans le paysage contemporain de l’ingénierie des données et de l’analyse décisionnelle, le tableur Microsoft Excel demeure omniprésent, agissant simultanément comme une interface de saisie universelle, un support de stockage transitoire et un outil de rapportage opérationnel. Cette ubiquité engendre fréquemment des architectures documentaires complexes au sein desquelles l’information se trouve dispersée à travers de multiples feuilles de calcul, subdivisées selon des critères temporels, géographiques ou organisationnels. Or, si ce cloisonnement visuel et conceptuel répond aux exigences de consultation humaine immédiate, il constitue une entrave méthodologique majeure dès lors qu’il s’agit d’appliquer des méthodes quantitatives rigoureuses, des modélisations économétriques ou des algorithmes d’apprentissage automatique nécessitant une structure de données unifiée et cohérente.
Pour dépasser ces limitations inhérentes aux formats bureautiques, l’écosystème scientifique Python, structuré autour de la bibliothèque fondamentale Pandas, offre des abstractions informatiques performantes permettant de réconcilier, d’agréger et de transformer ces flux disparates. La consolidation de multiples onglets Excel au sein d’une structure matricielle bidimensionnelle unique — le DataFrame — ne relève pas d’une simple manipulation syntaxique triviale. Elle mobilise des concepts fondamentaux d’algèbre relationnelle, de gestion de l’occupation mémoire, de typage statique et dynamique, ainsi que de validation d’intégrité structurelle. Une telle entreprise exige une compréhension exhaustive des mécanismes sous-jacents aux moteurs de lecture, des stratégies d’optimisation entrées-sorties et de la traçabilité des métadonnées contextuelles.
Ce traité exhaustif a pour vocation d’exposer, de manière méthodique et académique, l’ensemble des protocoles théoriques et programmatiques nécessaires à l’ingestion, à l’harmonisation et à la concaténation de jeux de données distribués sur plusieurs feuilles au sein d’un même classeur Excel. À travers l’analyse systématique des architectures de fichiers, des signatures fonctionnelles avancées et des arbitrages de performance, cette étude fournit aux ingénieurs et chercheurs les compétences indispensables à la mise en œuvre de pipelines de données industriels, robustes, déterministes et hautement reproductibles.
1. Fondements théoriques de l’ingestion de données tabulaires multi-onglets
1.1 Structure matricielle des classeurs Excel et limites de la fragmentation
L’architecture fondamentale d’un classeur Excel repose sur une collection ordonnée de grilles bidimensionnelles discrètes, désignées communément sous le terme de feuilles de calcul ou onglets. D’un point de vue de la théorie de l’information, chaque feuille constitue une matrice clairsemée indexée par un système de coordonnées cartésiennes bilatérales, associant des identifiants de lignes entiers et des colonnes alphabétiques. Cette organisation spatiale découle historiquement du paradigme comptable physique, où la séparation physique des registres permettait d’isoler des périodes comptables distinctes, des centres de coûts spécifiques ou des entités juridiques indépendantes. Cependant, cette fragmentation impose un partitionnement logique artificiel qui segmente le continuum informationnel.
Sur le plan cognitif, la compartimentation par onglets introduit une rupture dans la perception globale des distributions statistiques. L’analyste se trouve contraint de naviguer de manière itérative entre différentes vues partielles, ce qui augmente substantiellement la charge mentale et le risque d’erreur humaine lors des synthèses manuelles. Les liaisons transversales par formules inter-feuilles s’avèrent fragiles, opaques à l’audit algorithmique et sujettes à des corruptions silencieuses lors du déplacement ou du renommage inopiné d’un onglet source. En outre, la séparation physique des enregistrements masque les dérives structurelles, telles que les modifications progressives de typologie de colonnes ou les omissions d’attributs au fil des itérations temporelles.
D’un point de vue analytique multidimensionnel, la segmentation entrave directement l’application des postulats fondamentaux de la modélisation statistique. Les opérations canoniques telles que les régressions multivariées, les décompositions en composantes principales ou les regroupements non supervisés exigent l’accès à une matrice d’observations complète où chaque ligne représente une unité statistique indépendante et identiquement distribuée, et chaque colonne une variable aléatoire observée. La transition de la feuille de calcul vers la structure relationnelle standardisée formalisée par le DataFrame de Pandas requiert donc l’abandon du positionnement spatial au profit d’un schéma tabulaire strict, régi par la première forme normale de l’algèbre de Codd.
1.2 L’écosystème Pandas face aux flux de travail analytiques complexes
La bibliothèque Pandas s’est affirmée comme la clé de voûte du calcul tabulaire en Python grâce à l’implémentation de structures de données en mémoire hautement optimisées, reposant sur les fondations mathématiques de NumPy. Au cœur de cette architecture, les objets de type Series et DataFrame encapsulent des tableaux homogènes contigus en mémoire, déléguant les opérations computationnelles intensives à des routines compilées en langage C ou Fortran. Cette conception technique tranche radicalement avec l’exécution interprétée cellule par cellule propre aux moteurs de calcul des tableurs traditionnels, dont la complexité algorithmique s’accroît de manière quadratique dès lors que les volumes de données s’étendent au-delà des échelles bureautiques élémentaires.
La supériorité opérationnelle de Pandas réside dans le concept de vectorisation. Contrairement aux approches manuelles ou aux macros procédurales écrites en Visual Basic for Applications (VBA), qui parcourent séquentiellement les lignes et les colonnes au moyen de boucles conditionnelles coûteuses, la vectorisation permet d’appliquer des transformations unaires ou binaires simultanément à des blocs entiers de mémoire via des instructions matérielles spécialisées de type SIMD (Single Instruction, Multiple Data). Par conséquent, l’agrégation, le filtrage et l’alignement de multiples feuilles de calcul voient leur temps d’exécution réduit de plusieurs ordres de grandeur, transformant un processus chronophage de plusieurs heures en une opération quasi instantanée.
Au-delà du gain d’efficience computationnelle, l’adoption de Pandas répond à un impératif épistémologique de reproductibilité scientifique. Tout protocole d’extraction, de nettoyage et d’unification exécuté au sein d’un script Python constitue un artefact logiciel versionnable, déterministe et entièrement auditable. Chaque étape de transformation est explicite, éliminant l’aléa lié aux interactions gestuelles dans une interface graphique. Cette formalisation algorithmique garantit que le pipeline de consolidation produit des résultats rigoureusement identiques, indépendamment de la machine hôte ou de l’opérateur, assurant ainsi la robustesse requise par les standards contemporains de la recherche académique et de la gouvernance des systèmes d’information.
1.3 Typologie des structures de données réparties au sein d’un même classeur
L’hétérogénéité structurelle des classeurs Excel représente un défi d’ingénierie majeur qui conditionne la stratégie d’ingestion programmatique. Il est possible d’établir une taxonomie rigoureuse des configurations rencontrées en pratique, classées selon leur degré de cohérence géométrique et sémantique. La typologie la plus favorable correspond aux schémas strictement homogènes : chaque onglet partage une nomenclature d’attributs parfaitement superposable, des types de données identiques et un ordre séquentiel de colonnes invariant. Cette configuration est typique des découpages purement administratifs ou temporels standardisés, à l’instar d’enregistrements mensuels générés par des progiciels de gestion intégrés (ERP).
À l’opposé de cette régularité idéale se trouvent les schémas évolutifs ou dégradés, caractérisés par des asymétries informationnelles entre les différentes feuilles. Au fil du temps, de nouvelles variables sont introduites par les opérateurs, d’anciennes sont dépréciées, ou des libellés sémantiquement équivalents subissent des altérations typographiques imprévisibles. De surcroît, la présence de structures imbriquées, de tableaux juxtaposés au sein d’un même onglet, ou de sous-totaux intercalés de manière non normalisée engendre une divergence structurelle qui interdit toute concaténation aveugle sans un travail préalable de standardisation et de projection matricielle.
Sur le plan formel, la consolidation de ces sous-ensembles matriciels s’exprime au travers de deux opérations fondamentales de l’algèbre linéaire et relationnelle. L’union verticale, modélisée par l’opération d’empilement matriciel, requiert que l’espace vectoriel d’arrivée partage la dimensionnalité des colonnes de départ, complétant les attributs non partagés par des éléments neutres d’indétermination statistique, les valeurs nulles. L’union horizontale, quant à elle, s’apparente à une juxtaposition matricielle conditionnée par l’alignement strict d’un ensemble d’identifiants ou d’index temporels sous-jacents, formalisée par des produits cartésiens restreints :
- Union verticale : Concaténation de matrices d’observations le long de l’axe des ordonnées, unifiant les instances tout en alignant les attributs homologues.
- Union horizontale : Alignement de matrices de variables le long de l’axe des abscisses, associant les attributs selon une clé de correspondance primaire invariante.
- Transformation tensorielle : Déploiement longitudinal de séries temporelles éclatées sur plusieurs axes géométriques afin de reconstruire une dimension temporelle continue.
2. Configuration de l’environnement technique et des dépendances sous-jacentes
2.1 Rôles respectifs des moteurs de traitement xlrd et openpyxl
L’interaction entre l’interpréteur Python et les structures de fichiers propriétaires ou normalisées d’Excel nécessite une couche logicielle d’abstraction intermédiaire, désignée sous le concept de moteur de lecture (engine). Historiquement, la bibliothèque xlrd a constitué la référence incontournable pour le traitement des formats binaires propriétaires de Microsoft, en particulier les spécifications fermées BIFF8 correspondant aux extensions de fichiers .xls. Ces formats sérialisaient l’information sous la forme de flux binaires denses et complexes, exigeant des algorithmes de bas niveau pour décoder les pointeurs de cellules, les polices vectorielles et les tables de chaînes partagées.
Cependant, avec la démocratisation de la norme ISO/IEC 29500 définissant le format OpenXML — matérialisé par l’extension universelle .xlsx —, l’architecture physique des fichiers a fondamentalement muté vers une archive compressée au format ZIP encapsulant une arborescence de documents structurés en XML (Extensible Markup Language). Face aux failles de sécurité potentielles et à l’obsolescence des architectures binaires, les responsables de xlrd ont pris la décision critique de déprécier totalement la prise en charge de tout format autre que le format historique .xls depuis la version 2.0. De nos jours, l’analyse des fichiers .xlsx est majoritairement dévolue au moteur openpyxl, capable de décompresser et de parser dynamiquement les arbres d’objets XML.
Pour les scénarios impliquant des volumes de données industriels de grande ampleur conditionnés sous forme de classeurs binaires modernes, identifiés par le suffixe .xlsb, une troisième dépendance spécifique s’avère nécessaire : la bibliothèque pyxlsb. Cette dernière lit directement les flux binaires encapsulés dans le conteneur ZIP, court-circuitant ainsi l’overhead significatif induit par la désérialisation textuelle des structures XML d’openpyxl. Le choix du moteur d’exécution, explicité via l’argument dédié dans l’interface de programmation de Pandas, détermine donc directement l’empreinte mémoire, la consommation CPU et la compatibilité structurelle du flux d’ingestion.
2.2 Installation, gestion des versions et compatibilité des bibliothèques
L’orchestration rigoureuse des dépendances logicielles conditionne la stabilité et la reproductibilité des environnements de calcul scientifique. Les conflits de versions entre la couche d’orchestration Pandas et les moteurs d’analyse syntaxique sous-jacents constituent l’une des sources d’erreurs les plus prégnantes lors du déploiement en production. Il est donc impératif d’isoler l’environnement d’exécution au moyen de conteneurs légers ou d’environnements virtuels isolés, gérés par des outils déterministes tels que venv, pipenv ou les gestionnaires d’environnements multi-plateformes comme conda.
La démarche standardisée consiste à consigner l’intégralité du graphe de dépendances au sein d’un fichier de spécifications formel, fixant non seulement les numéros de version majeurs, mais également les révisions mineures des bibliothèques critiques. Une incohérence fréquente réside dans la tentative d’ingestion d’un classeur .xlsx sans la présence explicite d’openpyxl, générant une exception à l’exécution de type ImportError. De même, les versions anciennes de Pandas peuvent présenter des divergences comportementales dans la gestion des arguments de compatibilité ou dans l’inférence des types d’indexation par défaut.
Pour prévenir l’apparition de régressions ou de comportements non documentés, il est vivement préconisé d’exécuter, préalablement à tout traitement de masse, une vérification programmatique de l’intégrité de l’environnement. Cette étape implique l’inspection des modules chargés en mémoire, la validation de la conformité des protocoles d’appels entre Pandas et le moteur C d’encapsulation, ainsi que l’interdiction de versions incompatibles au moyen de vérifications de préconditions. L’alignement rigoureux des couches logicielles garantit que les optimisations de bas niveau restent actives sans provoquer de failles d’interopérabilité silencieuses.
2.3 Diagnostic des anomalies d’encodage et de corruption de fichiers
Préalablement à toute analyse syntaxique par le moteur tabulaire, le fichier source doit faire l’objet d’un audit de conformité binaire destiné à prévenir les échecs catastrophiques lors du traitement par lots. L’une des problématiques les plus pernicieuses concerne la discordance des jeux de caractères et des encodages textuels. Si le format OpenXML moderne standardise nativement ses flux textuels en UTF-8 via sa couche de sérialisation XML, les anciens classeurs ou ceux générés par des progiciels tiers obsolètes intègrent fréquemment des chaînes de caractères encodées selon des normes régionales spécifiques telles que Windows-1252, ISO-8859-1 ou des formats spécifiques à certains systèmes industriels.
Une altération physique du conteneur de compression ZIP sous-tendant les classeurs modernes constitue une autre source fréquente d’interruption. Une transmission réseau tronquée ou un processus d’écriture asynchrone non finalisé engendre une corruption de l’en-tête central de l’archive ou des segments de données défléchis. La tentative de lecture d’un tel fichier au moyen de fonctions de haut niveau sans vérification liminaire déclenche des erreurs de type BadZipFile émanant des bibliothèques de bas niveau du système d’exploitation, interrompant brutalement l’ensemble de la chaîne analytique.
L’ingénierie logicielle défensive impose donc l’implémentation de tests de validation préliminaires. Ces procédures doivent vérifier systématiquement l’existence matérielle de la ressource, la validité des permissions d’accès au système de fichiers, l’intégrité de l’en-tête de l’archive binaire et, dans la mesure du possible, sonder la conformité des tables de relations internes du classeur. Ce diagnostic préventif garantit qu’aucun flux corrompu ou mal formé ne parvienne aux étages supérieurs de transformation matricielle, assurant une tolérance aux pannes optimale.
3. Analyse approfondie de la fonction pd.read_excel avec l’argument sheet_name
3.1 Mécanisme interne de l’argument sheet_name=None
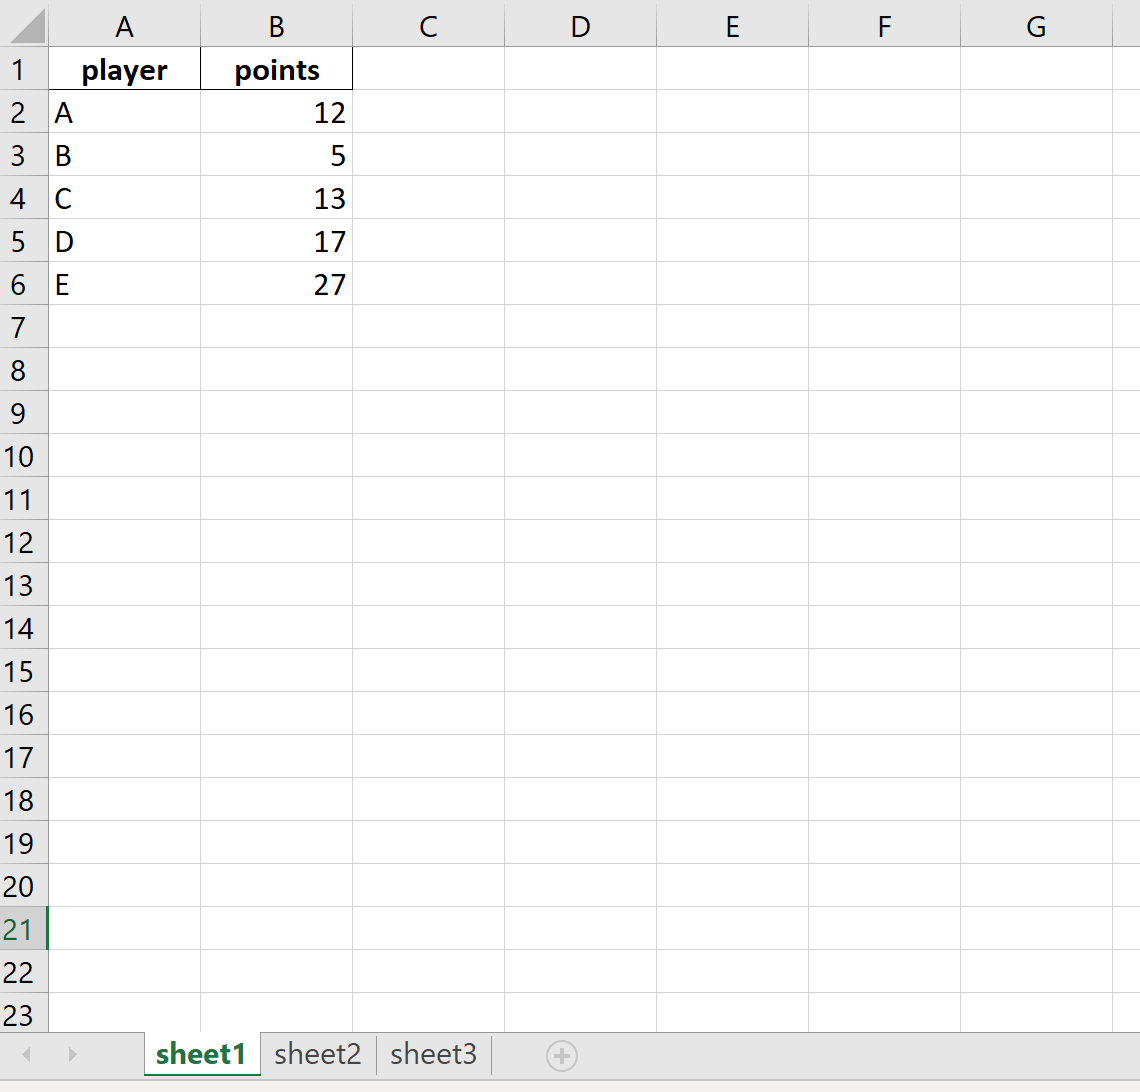
L’interface fondamentale pour l’extraction de données tabulaires depuis un support Excel réside dans la fonction pd.read_excel. Cette routine de haut niveau masque une complexité opérationnelle considérable grâce à son comportement polymorphique, modulé principalement par la configuration assignée au paramètre sheet_name. Par défaut, la fonction opère de manière scalaire, extrayant exclusivement la première feuille de calcul rencontrée selon l’ordre physique du classeur, retournant ainsi une unique instance de DataFrame.
Toutefois, l’assignation de la valeur spéciale None au paramètre sheet_name altère substantiellement la dynamique d’exécution du composant. Dans cette configuration, le moteur de lecture procède à une inspection exhaustive de la table des matières du classeur et engage une boucle d’ingestion séquentielle sur la totalité des onglets déclarés comme valides. Au lieu d’une matrice isolée, la fonction retourne un conteneur associatif ordonné — un dictionnaire Python standard ou une structure de type OrderedDict — dont les clés s’avèrent être les chaînes de caractères désignant les noms stricts des onglets, et les valeurs associées correspondent aux DataFrames respectifs générés à partir du contenu de chaque feuille.
Ce mécanisme, bien que d’une remarquable simplicité syntaxique pour le développeur, engendre des répercussions significatives en matière de gestion des ressources informatiques. L’évaluation de l’expression charge de manière synchrone l’intégralité du contenu tabulaire du classeur au sein de l’espace d’adressage de la mémoire vive (RAM). Pour des classeurs contenant des dizaines d’onglets hautement dimensionnels ou des tables enrichies de millions de cellules, cette approche peut saturer la mémoire disponible et déclencher des mécanismes d’éviction du système d’exploitation, justifiant une analyse attentive des besoins analytiques avant son déploiement systématique.
3.2 Lecture sélective : listes, indices entiers et expressions textuelles
Afin de tempérer la voracité mémorielle de l’ingestion universelle et de répondre à des exigences de ciblage chirurgical, le paramètre sheet_name accepte une typologie variée d’arguments d’entrée. L’analyste a la faculté de spécifier une collection ordonnée d’identifiants, combinant des chaînes de caractères alphabétiques, pour cibler des onglets nominatifs, ou des entiers scalaires représentant la position ordinale relative des feuilles au sein du conteneur, l’indexation débutant à l’entier zéro selon les conventions canoniques de l’informatique moderne.
L’utilisation d’indices entiers s’avère particulièrement pertinente dans le cadre de protocoles d’automatisation où la dénomination des onglets varie au gré des localisations linguistiques ou des périodes temporelles, mais où l’ordonnancement topologique demeure rigoureusement invariant d’une extraction à l’autre. Inversement, l’assignation d’une liste explicite d’identifiants nominatifs permet de restreindre l’ingestion à un sous-ensemble strict d’entités fonctionnelles, écartant de facto les feuilles périphériques non normalisées. Dans les deux cas de figure, l’objet résultant préserve la typologie du dictionnaire ordonné, indexé conformément aux critères de sélection fournis.
Bien que la signature de la fonction n’accepte pas directement un objet d’expression régulière compilé en lieu et place du paramètre sheet_name, cette limitation fonctionnelle se contourne élégamment par la mise en œuvre d’une inspection préliminaire des métadonnées du fichier. En isolant la liste exhaustive des intitulés via une instanciation légère de l’objet d’accès au classeur, il devient aisé de projeter un masque booléen basé sur un motif textuel (regex) pour dériver dynamiquement la liste d’onglets admissibles. Cette approche hybride optimise les temps de cycles d’entrées-sorties en évitant le décodage inutile de feuilles non pertinentes.
3.3 Contrôle granulaire du processus d’importation
L’alignement de multiples feuilles de calcul exige fréquemment une normalisation préalable des paramètres d’ingestion propres à chaque bloc tabulaire, les fichiers bureautiques s’écartant presque invariablement des canons du formalisme des bases de données relationnelles. La fonction read_excel déploie un ensemble étendu de paramètres permettant de configurer finement la délimitation géométrique de la matrice d’extraction. Le paramètre header joue un rôle éminent dans ce dispositif, autorisant la spécification de l’indice de ligne contenant la nomenclature des colonnes, ou l’attribution d’une liste d’entiers dans l’éventualité d’en-têtes hiérarchiques à plusieurs niveaux.
Il est extrêmement courant que les producteurs de classeurs Excel intercalent des métadonnées non tabulaires — telles que des titres organisationnels, des dates d’extraction de rapports ou des mentions de confidentialité — au sein des premières rangées physiques de la feuille. Les arguments skiprows et nrows fournissent le levier programmatique nécessaire pour contourner ce bruit informationnel. skiprows permet d’ignorer un nombre déterministe de lignes initiales ou d’exécuter une fonction d’évaluation dynamique pour filtrer les lignes non conformes, tandis que nrows borne supérieurement l’ingestion, évitant la lecture de blocs de commentaires ou de signatures positionnés en bas de page.
De surcroît, le contrôle d’accès géométrique s’étend aux dimensions longitudinales grâce au paramètre usecols. Ce dernier permet de restreindre l’ingestion à un sous-ensemble déterminé de colonnes, spécifié soit sous forme de lettres conventionnelles d’Excel, soit via une liste d’entiers ordonnés, soit par une fonction de rappel évaluant la dénomination textuelle de l’attribut. Cette sélection précoce réduit drastiquement la charge de désérialisation XML imposée au moteur d’analyse syntaxique et restreint immédiatement l’empreinte mémoire volumétrique en évinçant les attributs accessoires dès la phase de lecture physique.
4. Concaténation vectorisée et principes d’assemblage avec pd.concat
4.1 L’algèbre relationnelle sous-tendant la fonction pd.concat
Une fois les structures tabulaires extraites de manière atomique sous la forme d’un dictionnaire ou d’une collection d’instances de DataFrames, l’étape logique subséquente réside dans leur unification au sein d’une entité matricielle unique. Cette tâche incombe au composant pd.concat de Pandas, dont l’implémentation opérationnalise les principes fondamentaux de l’algèbre relationnelle et de la théorie ensembliste appliquée aux matrices de données. La fonction concatène des tenseurs le long d’un axe géométrique spécifique, gouverné par le paramètre dimensionnel axis.
Dans l’immense majorité des processus d’ingestion de feuilles multiples représentant des cohortes distinctes, la concaténation s’opère selon l’axe vertical (correspondant formellement à axis=0 ou axis=’index’). Cette manœuvre équivaut mathématiquement à une union ensembliste des lignes d’observations, où les colonnes homologues subissent un alignement vectorisé basé sur leurs étiquettes d’indexation respectives. À l’inverse, une concaténation le long de l’axe horizontal (axis=1 ou axis=’columns’) traduirait une juxtaposition dimensionnelle, semblable à une opération de jointure externe où la cohérence repose entièrement sur la superposition exacte des index de lignes.
L’algorithme sous-jacent à pd.concat orchestre une gestion rigoureuse des intersections et des unions d’attributs au moyen du paramètre join. Par défaut, la méthode applique une logique d’union ensembliste totale (join=’outer’) : si un attribut est présent dans une feuille spécifique mais absent d’une autre, il est conservé au sein de la matrice consolidée finale, et les observations déficitaires se voient assigner une valeur sentinelle d’absence. Si l’analyste contraint l’opération à l’intersection stricte (join=’inner’), seules les variables partagées unanimement par l’ensemble des feuilles sources sont préservées, élaguant impitoyablement toute divergence dimensionnelle au détriment potentiel d’une perte d’information contextuelle.
4.2 Traitement critique de l’argument ignore_index
L’un des écueils structurels les plus insidieux lors de la concaténation verticale de plusieurs sous-ensembles tabulaires émane de la préservation non intentionnelle des index de lignes d’origine. Chaque feuille de calcul Excel, lorsqu’elle est ingérée isolément sans indexation explicite sur une colonne métier, hérite par défaut d’une séquence d’entiers monotones générée par un objet RangeIndex, débutant à zéro et culminant à N-1 (où N désigne l’effectif total de lignes de la feuille considérée).
Par conséquent, l’assemblage vertical naïf de ces structures conduit inévitablement à la juxtaposition d’index dupliqués. La matrice résultante présente une cardinalité d’index non univoque : l’indice zéro correspondra simultanément à la première observation de la première feuille, à la première observation de la seconde, et ainsi de suite. Cette duplication viole le principe fondamental de l’unicité référentielle au sein du DataFrame et fragilise l’ensemble des opérations ultérieures de filtrage positionnel ou d’accès par étiquette, induisant des comportements erratiques lors des manipulations menées au moyen des accesseurs vectoriels loc ou iloc.
Pour prévenir cette dérive structurelle, l’argument booléen ignore_index doit être mobilisé avec discernement. Lorsqu’il est configuré sur la valeur True, l’algorithme d’assemblage procède à la dissociation complète des index primitifs associés aux matrices contributrices. En lieu et place, il alloue un nouvel espace de stockage contigu au sein duquel un unique RangeIndex continu est synthétisé, courant de manière strictement croissante depuis zéro jusqu’à la somme totale des observations agrégées. Cette réinitialisation garantit l’intégrité topologique du DataFrame assemblé tout en minimisant la fragmentation mémoire liée à la persistance d’index redondants.
4.3 Syntaxe concise d’assemblage direct en une seule expression
L’expressivité du langage Python, combinée aux abstractions de haut niveau de Pandas, autorise la formulation d’expressions particulièrement condensées pour réaliser l’ingestion et l’assemblage de classeurs entiers. L’idiome paradigmatique le plus célèbre consiste à imbriquer l’appel de concaténation directement autour de l’instruction de lecture globale, exploitant la méthode d’accès aux valeurs du dictionnaire sous-jacent :
Cette construction algorithmique synthétise en une seule ligne d’instruction logique l’intégralité du cycle de vie élémentaire de l’ingestion : l’appel à read_excel avec sheet_name=None matérialise le conteneur associatif, dont la méthode intrinsèque extrayant les valeurs fournit la collection de DataFrames requise par le premier argument positionnel de pd.concat. L’ajout du paramètre ignore_index=True parachève la normalisation structurelle en garantissant la contiguïté de l’indexation matricielle résultante.
Néanmoins, si cette compacité syntaxique présente un attrait stylistique certain pour des analyses exploratoires rapides sur des environnements de prototypage tels que Jupyter Notebook, elle soulève d’importantes réserves sur le plan du génie logiciel. Cette formulation monolithe occulte toute traçabilité immédiate de la provenance des enregistrements : l’étiquette sémantique portée par le nom de l’onglet source est irrémédiablement perdue lors de l’extraction brute des valeurs du dictionnaire. En outre, elle interdit toute injection de logique conditionnelle ou de validation unitaire intermédiaire, exposant le pipeline à des ruptures brutales en cas d’anomalie sur une feuille isolée.
5. Traçabilité et conservation des métadonnées d’origine des feuilles
5.1 Création d’index hiérarchiques multi-niveaux (MultiIndex)
Dans un contexte d’analyse statistique rigoureuse, la provenance d’une observation ne constitue pas un artefact documentaire négligeable mais représente une variable catégorielle à part entière, indispensable à la modélisation des effets de groupe ou à la stratification temporelle. L’un des dispositifs les plus élégants déployés par Pandas pour préserver cette filiation sans altérer la géométrie intrinsèque des données tabulaires repose sur la construction d’un MultiIndex, ou index hiérarchique.
Ce mécanisme s’active de manière transparente lors de l’appel à pd.concat en fournissant directement le dictionnaire ordonné résultant de read_excel, ou en mobilisant conjointement une liste de DataFrames et le paramètre dédié keys. L’algorithme d’assemblage génère alors un index de lignes à deux dimensions : le niveau supérieur (level 0) est constitué par la clé contextuelle correspondant au libellé de l’onglet source, tandis que le niveau inférieur (level 1) hérite de l’index individuel d’origine propre à chaque ligne au sein de sa feuille d’extraction.
Cette représentation multidimensionnelle aplatie offre une flexibilité analytique remarquable. Elle permet d’appliquer des filtres transversaux sur l’ensemble de la structure via l’opérateur de découpage xs (cross-section), autorisant l’interrogation comparative d’un sous-ensemble spécifique d’observations à travers toutes les strates d’onglets simultanément. Si une forme tabulaire classique bidimensionnelle est requise pour des traitements avals, la méthode reset_index permet de transposer instantanément le niveau hiérarchique supérieur en une colonne explicite standard, réintégrant l’information contextuelle au sein de l’espace régulier des variables observables.
5.2 Injection dynamique du nom de l’onglet dans le jeu de données
Une alternative procédurale à la création d’index hiérarchiques consiste en l’adjonction déterministe d’une variable structurelle explicite au sein de chaque sous-matrice préalablement à son empilement vertical. Cette approche repose sur la décomposition séquentielle du conteneur associatif produit par l’ingestion exhaustive du classeur. En itérant explicitement sur les paires clé-valeur constituées par le couple unissant le nom de l’onglet et le DataFrame associé, l’ingénieur dispose de la liberté d’altérer l’état interne de chaque sous-ensemble de données de manière isolée.
Au cours de cette phase d’itération préalable, l’opération canonique consiste à allouer une nouvelle colonne vectorielle au sein du DataFrame courant, assignant de manière scalaire la chaîne de caractères représentant l’intitulé de la feuille à chaque enregistrement. Cette opération vectorielle est optimisée au niveau de l’allocateur de mémoire de Pandas, qui réplique une référence à la métadonnée textuelle sans duplication inutile des chaînes sous-jacentes :
- Itération déterministe sur les paires de données et de métadonnées du dictionnaire source.
- Création explicite d’une colonne de contextualisation au moyen d’un identifiant normalisé.
- Conversion systématique de cette nouvelle variable vers un type catégoriel afin de minimiser la surcharge mémorielle.
- Agrégation subséquente des sous-matrices enrichies via un appel standardisé à la fonction de concaténation.
L’avantage cardinal de cette méthodologie réside dans sa résilience fonctionnelle. La variable d’origine se trouve immédiatement intégrée dans le schéma relationnel de la table combinée, accessible sans manipulation d’index complexes. Elle permet d’engager sans délai des segmentations causales, des regroupements au moyen de la méthode groupby, ou d’alimenter directement des frameworks d’apprentissage automatique dont les interfaces d’ingestion exigent des structures plates dépourvues d’indexations imbriquées.
5.3 Standardisation des identifiants contextuels pour les séries comparatives
L’exploitation des noms d’onglets en tant que variables analytiques met en exergue une problématique récurrente dans l’écosystème bureautique : la variabilité typographique des dénominations manuelles. Les intitulés de feuilles de calcul souffrent fréquemment d’incohérences de saisie, incluant des espacements superflus en début ou en fin de chaîne, des alternances désordonnées entre majuscules et minuscules, des variations d’accents orthographiques, ou l’utilisation confuse de séparateurs visuels tels que des tirets, des traits de soulignement ou des barres obliques.
La transformation de ces descripteurs textuels en identifiants statistiques fiables exige donc une phase de standardisation canonique par le biais d’opérations de traitement du langage naturel de base. Cette normalisation syntaxique implique le recours à des algorithmes de nettoyage éliminant les espaces insécables, harmonisant la casse typographique vers une notation minuscule unifiée, et remplaçant les caractères spéciaux par des marqueurs normalisés. Dans l’éventualité où l’intitulé de la feuille encode de l’information structurée — à l’instar d’une date d’arrêté comptable ou d’un trigramme de filiale —, des expressions régulières strictes doivent être compilées pour extraire et segmenter ces signaux discrets au sein de multiples colonnes discriminantes.
Cette standardisation garantit l’unicité et la stabilité des modalités catégorielles résultantes. Sans ce traitement préalable, une chaîne telle que « Janvier_2024 » serait traitée par les algorithmes de regroupement comme une catégorie conceptuellement totalement distincte de « janvier 2024 » ou de « JANVIER-2024 ». La rigueur de cette étape conditionne directement la validité des agrégations temporelles et longitudinales ultérieures, prévenant l’introduction de bruit statistique artificiel au sein des pipelines de modélisation prédictive.
6. Gestion des incohérences structurelles et des schémas asymétriques
6.1 Alignement de colonnes aux nomenclatures hétérogènes
Le défi majeur de l’ingestion multi-onglets réside dans la variabilité lexicale employée pour désigner des attributs sémantiquement superposables. Dans un classeur distribué entre différents services décentralisés, il est courant de constater que la variable désignant le chiffre d’affaires soit successivement libellée « Chiffre d’Affaires », « CA_HT », « Revenu_Global » ou « Total_Ventes ». Face à une telle dispersion nominale, l’algorithme de concaténation de Pandas, agissant sur la stricte équivalence textuelle des étiquettes de colonnes, segmente l’information au lieu de l’unifier, générant une multiplicité de colonnes disjointes peuplées de valeurs manquantes.
La résolution systématique de cette asymétrie implique l’établissement d’une matrice de passage lexicographique, matérialisée sous la forme d’un dictionnaire d’homologation. Cette structure fait correspondre à chaque variante syntaxique connue un identifiant cible standardisé. Avant de procéder à l’agrégation verticale, chaque sous-ensemble matriciel est soumis à la méthode rename, projetant l’ensemble de ses colonnes vers le schéma terminologique canonique :
Dans des configurations hautement dégradées où les variantes ne peuvent être anticipées de manière déterministe, des techniques d’analyse de similarité de chaînes de caractères — à l’instar de la distance de Levenshtein ou de l’indice de Jaccard calculé sur des n-grammes — peuvent être mobilisées. Ces heuristiques calculent la proximité sémantique entre les en-têtes découverts et la nomenclature cible, automatisant la réconciliation tout en consignant dans des journaux d’audit les décisions d’alignement prises en dessous d’un seuil de confiance paramétrable.
6.2 Variations d’ordre et omissions de variables entre onglets
L’un des atouts déterminants de l’architecture de concaténation de Pandas réside dans son indépendance intrinsèque vis-à-vis de l’ordonnancement géométrique des colonnes. Contrairement à des environnements bas niveau où les opérations d’assemblage matriciel reposent sur la juxtaposition aveugle de vecteurs mémoires ordonnés par position ordinale — exposant le traitement à des corruptions massives en cas de décalage spatial —, pd.concat utilise une approche nominative relationnelle. Les colonnes partageant une même dénomination sont automatiquement alignées, indépendamment de leur disposition relative sur la feuille d’origine.
Cette résilience mécanique face aux permutations physiques ne résout toutefois pas l’intégralité du problème lorsque des omissions structurelles surviennent. Si un onglet spécifique omet d’enregistrer une variable critique pour des raisons temporelles ou opérationnelles, l’union externe par défaut intègre l’ensemble du spectre dimensionnel tout en injectant des marqueurs de non-disponibilité (NaN) sur l’ensemble des observations émanant de la feuille déficitaire. Ce comportement préserve l’intégrité de l’échantillon mais requiert des choix méthodologiques tranchés quant au traitement de l’incomplétude.
Pour assurer la conformité absolue de l’ensemble assemblé vis-à-vis d’un contrat de données cible, il est recommandé de mettre en place une assertion structurelle. Cette opération consiste à valider chaque matrice individuelle par rapport à un gabarit idéal de colonnes attendues. Les variables excédentaires non répertoriées peuvent faire l’objet d’un élagage systématique, tandis que les attributs obligatoires absents peuvent être formellement instanciés et initialisés selon des politiques d’imputation contrôlées avant que ne soit initiée l’opération de fusion globale.
6.3 Homogénéisation structurelle par transformations fonctionnelles
L’assainissement de classeurs asymétriques requiert une approche d’ingénierie logicielle modulaire, préconisant l’utilisation de transformations fonctionnelles pures appliquées systématiquement à chaque sous-DataFrame. Au lieu d’écrire des scripts de nettoyage séquentiels itératifs complexes et sujets aux effets de bord, la stratégie optimale consiste à encapsuler l’ensemble des règles de normalisation au sein d’un opérateur unitaire réutilisable, matérialisé par une fonction de transformation.
Cette fonction d’homogénéisation prend en entrée une matrice brute issue d’un onglet quelconque et lui applique une succession d’opérations élémentaires déterministes : élimination des lignes entièrement vacantes via dropna, élagage des artefacts typographiques par des méthodes de manipulation textuelle vectorisées sur l’index des colonnes, filtrage des colonnes non documentées et réalignement sur le schéma directeur. Cette séquence peut être aisément déployée sur l’ensemble du dictionnaire intermédiaire en utilisant une syntaxe d’évaluation fonctionnelle par compréhension de collection.
En complément, cette étape fonctionnelle s’avère déterminante pour traiter le phénomène fréquent des données non tabulaires intercalées. Il est fréquent que des opérateurs humains intègrent des totaux partiels, des notes de bas de page ou des cellules isolées de synthèse statistique directement sous les blocs de données. La fonction d’homogénéisation doit alors inspecter dynamiquement la continuité des types le long des colonnes ou détecter les ruptures d’index afin d’amputer ces excroissances cosmétiques avant qu’elles ne polluent les séries de données numériques pures par des chaînes de caractères imprévues.
7. Typage strict, coercion et gestion des valeurs manquantes
7.1 Inférences de types conflictuelles lors de l’assemblage
Le moteur d’inférence de types de données de Pandas (dtype inference engine) analyse les données colonnaires de manière heuristique lorsqu’aucun schéma formel ne lui est imposé à l’importation. Cette analyse se heurte à un problème d’incohérence fondamentale lors de l’ingestion multi-onglets : un attribut donné peut présenter une distribution exclusivement numérique au sein d’une première feuille, incitant le moteur à allouer un conteneur d’entiers optimisé (tel que int64), tandis que la même colonne dans une feuille ultérieure intègre des mentions textuelles sporadiques (comme « Non Renseigné » ou des codes d’erreur bureautiques).
Lors de la phase de concaténation de ces deux structures hétérogènes, Pandas applique une règle de compatibilité ascendante, qualifiée de conversion de type coercitive ou upcasting. L’algorithme se trouve contraint de dégrader la précision de la colonne unifiée vers le dénominateur commun le plus permissif, à savoir le type générique object. Ce type stocke des pointeurs vers des structures Python brutes sur le tas (heap), annihilant instantanément les bénéfices computationnels de la vectorisation NumPy, multipliant par trois ou quatre l’empreinte mémoire de la colonne et bloquant l’accès aux méthodes analytiques optimisées pour le calcul numérique.
Pour prévenir cette dérive préjudiciable, il est impératif d’adopter une stratégie de typage déclaratif strict en amont de toute concaténation. La fonction read_excel offre à cet effet le paramètre dtype, capable de recevoir une cartographie exhaustive liant chaque attribut cible à son type NumPy ou Pandas canonique. Dans l’éventualité où des anomalies d’encodage interdiraient une instanciation directe, le recours à la fonction pd.to_numeric avec le paramètre de contrainte errors=’coerce’ permet de convertir de manière déterministe toute valeur aberrante en valeur nulle, préservant ainsi l’intégrité de la structure numérique contiguë.
7.2 Traitement systématique des données manquantes et sentinelles Excel
La gestion de la vacuité informationnelle constitue une source perpétuelle de distorsions méthodologiques lors de l’interaction avec des classeurs bureautiques. Excel matérialise l’absence de données au travers d’une multiplicité de représentations symboliques discordantes : cellules totalement vides, chaînes textuelles vides issues de formules conditionnelles, valeurs sentinelles formelles telles que « #N/A », « #VALEUR! », « #REF! », ou conventions métier subjectives comme l’usage des caractères « -« , « ND » (Non Disponible) ou de valeurs numériques arbitraires telles que 9999 ou -1.
Par défaut, Pandas intègre un ensemble d’heuristiques identifiant une liste prédéfinie de chaînes standards comme des valeurs nulles équivalentes à np.nan. Toutefois, face aux conventions informelles, ces heuristiques demeurent aveugles, interprétant un tiret typographique comme une chaîne de caractères valide et provoquant la corruption de type évoquée précédemment. Il convient donc de surcharger ce comportement en définissant explicitement une collection enrichie de motifs d’indétermination via le paramètre na_values lors de l’appel d’extraction.
Une fois le classeur consolidé et l’ensemble des représentations manquantes aligné sur le standard unifié NaN (ou l’objet moderne de Pandas pd.NA garantissant la propagation d’indétermination typée), une politique de traitement doit être rigoureusement arrêtée. Selon les postulats sous-jacents aux futures analyses statistiques, l’ingénieur choisira d’élaguer les observations incomplètes de manière systématique par le biais de la méthode dropna, ou d’appliquer des stratégies de substitution statistique au moyen de fillna, mobilisant des métriques de tendance centrale (médiane, moyenne) ou des techniques d’interpolation spatio-temporelle.
7.3 Harmonisation des formats temporels et des formats de devises
Les variables temporelles et monétaires constituent deux catégories particulièrement vulnérables aux dérives d’interprétation lors de l’assemblage de feuilles multiples. Sur le plan chronologique, Excel utilise un système interne d’horodatage sériel représentant les dates sous la forme d’un nombre flottant décomptant les jours écoulés depuis une date pivot (le 1er janvier 1900 ou 1904 selon les systèmes d’exploitation d’origine). Une altération de la métadonnée d’affichage dans une feuille donnée peut amener Pandas à ingérer cette colonne comme un nombre décimal brut au lieu d’instancier un objet chronologique normalisé de type datetime64[ns].
La résolution de ce différentiel chronologique impose une coercition systématique au moyen de l’opérateur pd.to_datetime. Cet opérateur doit être configuré avec des spécifications de formats stricts afin de lever toute ambiguïté sur l’ordonnancement du jour et du mois au sein de notations internationales divergentes (telles que le format anglo-saxon MM/DD/YYYY opposé au standard européen DD/MM/YYYY), dont la confusion silencieuse engendrerait des aberrations temporelles majeures au sein des séries chronologiques combinées.
De manière analogue, les champs monétaires et comptables intègrent fréquemment des artefacts de mise en page graphique : symboles de devises (€, $, £), séparateurs de milliers sous forme d’espaces insécables ou de points, et parenthèses encadrant les valeurs négatives selon la tradition comptable anglo-saxonne. Ces colonnes sont invariablement ingérées en tant que chaînes textuelles. Un protocole de nettoyage rigoureux doit donc être exécuté par des expressions régulières vectorisées sur la méthode str.replace, éliminant tout symbole non numérique et harmonisant le séparateur décimal vers le point conventionnel avant d’exécuter la conversion finale vers un type flottant :
- Élimination systématique des symboles de devises et des caractères d’espacement typographiques.
- Substitution des parenthèses comptables par des signes négatifs formels via des motifs réguliers.
- Harmonisation des séparateurs décimaux par transformation du caractère virgule en point décimal.
- Conversion explicite vers un format numérique à virgule flottante contigu via un appel vectorisé à astype.
8. Paradigmes procéduraux alternatifs : itérateurs, boucles et dictionnaires
8.1 L’approche procédurale classique par boucle for et liste accumulatrice
Bien que l’idiome déclaratif en une ligne analysé précédemment séduise par son économie textuelle, le paradigme procédural classique — articulé autour d’une itération séquentielle explicite via une boucle for et d’une structure de liste accumulatrice — demeure le standard d’ingénierie le plus robuste pour les pipelines complexes en environnement de production. Ce modèle dissocie nettement l’étape d’acquisition unitaire, l’étape de transformation locale et l’étape d’assemblage matriciel final.
L’architecture de ce modèle repose sur l’instanciation liminaire d’une liste Python vide. Au cours de l’itération à travers la collection de feuilles ciblées, chaque sous-matrice est extraite de manière autonome, soumise immédiatement à des protocoles de validation unitaire et de nettoyage structurel, puis adjointe à la liste accumulatrice via la méthode primitive append. Une fois la boucle close, l’unique appel à pd.concat intervient en aval, prenant la liste d’accumulateurs comme argument d’entrée vectoriel :
Sur le plan de l’analyse algorithmique et de la gestion de l’empreinte mémoire, cette approche présente une supériorité structurelle indiscutable. Elle évite l’écueil catastrophique consistant à concaténer itérativement un DataFrame au sein d’une boucle (motif anti-performant désigné sous le terme de « concaténation quadratique »), qui force le système à réallouer un bloc contigu de mémoire et à recopier l’intégralité des données préexistantes à chaque itération élémentaire. En différant l’allocation globale au terme du cycle, la complexité temporelle de l’opération demeure strictement linéaire vis-à-vis du volume cumulé des données.
8.2 Utilisation de la classe ExcelFile pour les lectures différées
L’exécution itérative d’appels multiples et indépendants à la fonction pd.read_excel au sein d’une boucle procédurale engendre une inefficience majeure en matière d’opérations d’entrées-sorties. En effet, chaque invocation de read_excel sur un chemin de fichier force le système d’exploitation à ouvrir le fichier physique, à instancier le moteur d’analyse, à décompresser l’archive OpenXML dans son intégralité et à localiser les tables de relations internes, pour ne lire qu’une unique feuille avant de libérer brutalement le descripteur de fichier et recommencer au cycle suivant.
Pour éliminer ce goulot d’étranglement matériel, Pandas met à disposition une abstraction de plus bas niveau : la classe pd.ExcelFile. Cette structure s’instancie une seule fois en lui passant le chemin du classeur ou un flux binaire en mémoire. Dès son initialisation, pd.ExcelFile procède à la décompression du conteneur et maintient une référence persistante vers les flux de travail décompactés, évitant ainsi des décompressions redondantes et coûteuses en ressources processeur.
De surcroît, l’objet ainsi instancié expose instantanément un attribut essentiel : la liste sheet_names. Cette propriété offre un accès direct et sans latence à la métadonnée d’inventaire du classeur, permettant d’inspecter, de filtrer ou de trier les dénominations des feuilles préalablement à toute opération d’ingestion lourde. En transmettant ensuite l’instance même de ExcelFile comme premier argument des fonctions parse ou read_excel, les lectures successives s’effectuent par des accès mémoire directs et optimisés, réduisant de manière spectaculaire le temps d’exécution global du pipeline d’ingestion.
8.3 Paradigme fonctionnel : utilisation de map, filter et générateurs
Les adeptes du génie logiciel contemporain et du paradigme fonctionnel peuvent structurer l’ingestion multi-onglets au moyen d’abstractions élégantes excluant les états mutables partagés et favorisant l’évaluation paresseuse (lazy evaluation). Ce paradigme mobilise des fonctions de premier ordre, telles que map et filter, ou s’appuie sur la syntaxe des expressions génératrices pour construire des pipelines de données hautement modulaires et composables.
Dans ce modèle d’architecture, la fonction de lecture et de normalisation unitaire est traitée comme un opérateur pur, prenant en argument un identifiant d’onglet et retournant une matrice standardisée. Une expression génératrice permet alors de projeter cet opérateur sur la séquence filtrée des feuilles du classeur. L’évaluation de l’ingestion ne s’amorce qu’au moment précis où la fonction d’agrégation terminale pd.concat sollicite les éléments du générateur pour allouer la matrice combinée finale, évitant la persistance intermédiaire de structures redondantes :
- Encapsulation de la chaîne de lecture et d’assainissement au sein d’une fonction d’extraction unitaire pure.
- Définition d’un générateur procédant à l’évaluation paresseuse des flux d’onglets de manière séquentielle.
- Consommation directe du flux itératif par l’opérateur de concaténation vectorisée sans allocation de listes statiques.
Cette approche apporte des garanties formelles en matière de testabilité unitaire : l’opérateur d’ingestion unitaire peut faire l’objet de tests automatisés isolés au moyen de jeux de données fictifs (mocks), garantissant la non-régression du pipeline sans nécessiter l’exécution de cycles d’entrées-sorties complets sur des fichiers réels volumineux. La maintenabilité du code source s’en trouve significativement renforcée au sein de systèmes décisionnels critiques.
9. Filtrage conditionnel préalable et sélection dynamique des feuilles
9.1 Exclusion programmatique des onglets non pertinents
La pratique bureautique courante conduit fréquemment à l’accumulation, au sein d’un même classeur, d’onglets périphériques dont la vocation est purement documentaire ou ornementale : pages de garde, feuilles de paramètres de configuration, onglets de documentation méthodologique, synthèses dynamiques sous forme de tableaux croisés ou graphiques vectoriels natifs. L’inclusion accidentelle de ces segments dans le pipeline d’unification corrompt inévitablement la structure matricielle globale en introduisant des dimensions parasites ou des lignes d’artefacts.
Il est donc nécessaire de formaliser des règles de gouvernance strictes matérialisées par des listes de filtrage d’admissibilité. La première approche repose sur le concept de liste noire (blacklist), consistant à déclarer une collection immuable d’intitulés formellement exclus du périmètre d’ingestion (par exemple, des dénominations telles que « Sommaire », « Paramètres », « Notes », « Recap »). Tout onglet dont le libellé coïncide avec cette liste est immédiatement écarté de l’arbre d’exécution lors de la phase préliminaire d’inspection des métadonnées.
À l’inverse, l’approche par liste blanche (whitelist) adopte une posture d’ingénierie défensive supérieure, consistant à n’autoriser l’accès au pipeline qu’aux feuilles dont l’intitulé figure explicitement au sein d’un référentiel validé. De plus, une attention technique doit être portée à l’état de visibilité de l’onglet : les moteurs d’analyse modernes permettent d’interroger la propriété d’affichage des feuilles afin d’exclure systématiquement les onglets masqués par l’utilisateur (hidden sheets), qui abritent souvent des versions de calcul dépréciées ou des tables de travail transitoires non validées.
9.2 Règles de sélection par analyse sémantique des intitulés
Dans des configurations où la volumétrie des feuilles s’avère dynamique et sujette à une expansion continue au gré de l’exercice opérationnel — par exemple, l’adjonction périodique d’onglets mensuels ou régionaux non formalisés a priori —, la sélection ne peut reposer sur des listes statiques exhaustives. Il devient impératif d’intégrer des règles d’évaluation sémantique dynamique en mobilisant la puissance formelle des expressions régulières (regex).
L’ingénieur élabore un motif d’expression régulière compilé modélisant fidèlement la grammaire des onglets admissibles. Par exemple, une expression telle que ^20d{2}_(Q1|Q2|Q3|Q4)$ ciblera exclusivement les feuilles d’arrêtés trimestriels débutant par un millésime du XXIe siècle, écartant tout libellé s’écartant de cette syntaxe canonique. Cette sélection dynamique s’opère par une compréhension de liste filtrant la collection fournie par ExcelFile.sheet_names avant tout déclenchement d’opérations d’entrées-sorties lourdes.
Parallèlement à cette sélection lexicale, le code doit implémenter une gestion robuste des exceptions structurelles. Dans l’éventualité où le processus de filtrage s’achèverait sur une sélection vide — traduisant l’absence de feuilles conformes suite à une modification non annoncée de la convention de nommage par les producteurs du fichier —, le pipeline doit lever une exception explicite et contextuelle de type ValueError, interdisant à la fonction de concaténation d’échouer de manière opaque sur une collection vide.
9.3 Validation dynamique du contenu avant décision de concaténation
L’inspection des métadonnées lexicales des intitulés de feuilles, bien qu’indispensable, s’avère parfois insuffisante pour garantir la viabilité d’un onglet. Il n’est pas rare de rencontrer des feuilles portant un nom parfaitement conforme mais dont le corps de données est totalement vierge suite à une initialisation prématurée, ou dont la géométrie interne a été profondément dégradée par des manipulations locales non autorisées.
La mise en œuvre d’un protocole d’échantillonnage dynamique léger permet de lever cette indétermination sans pénaliser significativement les performances globales. Ce protocole consiste à exécuter une lecture minimale restreinte aux toutes premières lignes de l’onglet — en exploitant conjointement les paramètres nrows et usecols — afin de valider la présence effective d’enregistrements et la conformité des signatures de colonnes par rapport aux spécifications attendues :
| Étape de validation | Indicateur technique | Action programmatique corrective |
|---|---|---|
| Détection de vacuité | Matrice de dimension nulle (df.empty == True) | Exclusion immédiate de la feuille et consignation dans les journaux d’audit. |
| Conformité d’en-tête | Intersection des colonnes inférieure au seuil critique | Déclenchement d’une alerte de divergence de schéma ou rejet conditionnel. |
| Continuité des types | Présence de valeurs textuelles dans des colonnes strictement numériques | Coercition forcée, imputation unitaire ou isolement de la ligne aberrante. |
Ce filtre dynamique agit comme un pare-feu au sein du pipeline d’ingestion. Chaque décision de rejet ou d’admission est consignée de manière déterministe dans un journal d’événements (logging), associant à chaque décision le motif précis de non-conformité. Cette traçabilité élimine l’apparition d’effets de bord silencieux et fournit aux équipes opérationnelles un diagnostic immédiat pour corriger les anomalies à la source chez les producteurs de données.
10. Optimisation des performances et gestion de l’empreinte mémoire
10.1 Limites inhérentes à l’architecture Excel lors de charges massives
L’ingestion de volumétries massives réparties sur des dizaines d’onglets révèle les limites intrinsèques de l’architecture des formats bureautiques. Le format .xlsx, bien que normalisé, impose un surcoût computationnel substantiel induit par la désérialisation XML. Chaque cellule, attribut ou métadonnée textuelle est représentée sous forme de balises verbeuses au sein de l’arborescence compressée. Lors de l’ingestion, le moteur Python doit parser ces flux textuels, instancier des millions d’objets intermédiaires pour représenter l’arbre DOM ou les événements SAX, avant de pouvoir enfin transcrire ces valeurs sous la forme de tableaux de bas niveau NumPy.
Ce processus de conversion génère une consommation exponentielle de mémoire vive. Il est fréquemment observé que la désérialisation d’un classeur Excel de quelques dizaines de mégaoctets peut mobiliser plusieurs gigaoctets de mémoire volatile au cours de son traitement par les moteurs d’analyse. Si la machine hôte dispose de ressources restreintes, cette amplification mémorielle déclenche des opérations de pagination sur disque (swapping), dégradant dramatiquement la vitesse d’exécution, voire conduisant au plantage pur et simple du processus par épuisement des ressources système (Out Of Memory).
L’ingénierie de haute performance impose donc une surveillance continue de l’occupation mémoire. L’utilisation d’outils d’analyse structurelle tels que la méthode info(memory_usage=’deep’) sur les DataFrames permet d’auditer avec une précision chirurgicale l’espace réel alloué, en incluant l’occupation indirecte induite par les pointeurs d’objets sur le tas. L’évaluation continue de ce profil mémoire permet d’anticiper les seuils de saturation et de dimensionner adéquatement les infrastructures d’exécution, qu’il s’agisse de conteneurs d’orchestration ou d’environnements infonuagiques élastiques.
10.2 Optimisation des types primitifs par les catégories et entiers optimisés
Par défaut, l’allocateur de Pandas adopte une posture de sécurité conservatrice en assignant les types numériques les plus étendus (tels que float64 ou int64) et en affectant le type générique object à toute série de données textuelles. Pour un ensemble tabulaire consolidé issu de multiples feuilles de calcul, cette allocation par défaut s’avère particulièrement dispendieuse et inefficace en termes d’empreinte mémoire.
Une optimisation déterminante réside dans la conversion méthodique des variables textuelles présentant une faible cardinalité — c’est-à-dire un ratio faible entre le nombre de modalités uniques et le nombre total d’enregistrements — vers le type d’extension Categorical. Sous cette représentation, Pandas stocke un dictionnaire entier unique des modalités textuelles et encode la série d’observations sous la forme d’un tableau compact de petits entiers pointant vers ce registre. Cette simple transformation permet de réduire l’empreinte mémoire d’une colonne textuelle de plus de 80 à 90 %, tout en accélérant les opérations de comparaison et de tri vectorisé.
De même, pour les attributs quantitatifs, l’application d’une réduction d’échelle déterministe (downcasting) s’avère particulièrement profitable. Un attribut modélisant un millésime, un identifiant de mois ou un comptage d’effectifs discrets ne requiert aucunement l’allocation d’un entier signé sur 64 bits. L’abaissement contrôlé de cette précision vers des types primitifs plus compacts — tels que int16, int8 ou float32 — au moyen de la méthode vectorisée astype ou de fonctions de coercion dédiées permet de diviser par deux ou quatre la charge mémorielle brute de chaque tenseur, optimisant par la même occasion l’exploitation des lignes de cache du processeur central (L1/L2/L3).
10.3 Traitement par flux et stratégies d’externalisation hors-mémoire
Lorsque le volume agrégé des feuilles d’un classeur dépasse les capacités d’allocation physique de la machine locale, l’empilement simultané de l’ensemble des DataFrames au sein d’une unique variable en mémoire vive devient techniquement irréalisable. L’architecture logicielle doit alors opérer une rupture paradigmatique en adoptant une stratégie de traitement par flux (streaming architecture) et de sérialisation intermédiaire persistante.
Cette stratégie consiste à traiter chaque feuille de manière strictement atomique au sein d’une boucle procédurale sans jamais accumuler les structures en mémoire. Dès lors qu’un onglet est ingéré, validé et normalisé, il est immédiatement sérialisé sur un support de stockage persistant sous la forme d’une partition d’un format de données colonnaire moderne, tel que Apache Parquet. Ce format hautement compressé préserve scrupuleusement le typage des variables, intègre des dictionnaires statistiques par bloc et élimine tout overhead de désérialisation textuelle ultérieure :
Une fois le cycle d’ingestion et de sérialisation complété pour l’ensemble des onglets, le jeu de données unifié n’a plus besoin d’être rechargé d’un bloc en mémoire vive classique. L’ingénieur peut alors s’appuyer sur des moteurs d’exécution analytiques hors-mémoire ou massivement distribués, tels que DuckDB, Apache Arrow, Dask ou Polars. Ces architectures sont capables d’exécuter des filtres, des agrégations complexes et des jointures directement sur le répertoire de fichiers Parquet partitionnés en utilisant des techniques avancées de balayage paresseux et de parallélisation multi-cœurs, surmontant définitivement les limitations imposées par le format Excel d’origine.
11. Validation statistique et vérification de l’intégrité post-combinaison
11.1 Contrôle arithmétique de la conservation volumétrique
L’assemblage matriciel de sous-ensembles tabulaires ne peut être validé sans la mise en œuvre de protocoles de vérification arithmétique formels garantissant l’intégrité volumétrique du processus. Au sein d’un pipeline de production, l’ingénieur ne saurait présumer du succès d’une opération au seul motif qu’aucune exception logicielle n’a été levée lors de l’exécution de l’algorithme. Des corruptions silencieuses peuvent subvenir, notamment l’éviction par inadvertance de segments de données suite à des opérations de déduplication aveugles ou l’omission d’onglets liée à des erreurs d’indexation.
L’assertion primordiale consiste à valider la stricte conservation du cardinal des lignes d’observations. L’équation formelle impose que la somme arithmétique exacte des effectifs de lignes propres à chaque DataFrame individuel — décomptés immédiatement après application des filtres de nettoyage unitaire — soit rigoureusement égale à la dimensionnalité longitudinale du DataFrame consolidé final. Cette vérification s’implémente au travers d’instructions de contrôle assertives intégrées dans le code, interrompant immédiatement l’exécution si une divergence est constatée :
Parallèlement, une surveillance attentive doit être accordée à la détection de lignes parasites introduites par les artefacts d’Excel. Il est fréquent que des lignes de totalisation générale ou de sous-totaux intermédiaires, présentes en bas des feuilles sources, se trouvent amalgamées au sein des observations régulières lors de l’empilement. Le protocole de validation doit donc inspecter la présence éventuelle de ces enregistrements aberrants en vérifiant l’absence de chaînes de caractères réservées dans les colonnes d’identifiants et en s’assurant que la cardinalité des clés primaires métier ne présente aucun doublon accidentel non maîtrisé.
11.2 Tests de cohérence distributionnelle des variables quantitatives
La consolidation de séries de données éclatées soulève le risque d’introduire des anomalies d’échelle distributionnelle. Ces distorsions proviennent fréquemment de modifications des unités de mesure adoptées d’un onglet à l’autre — par exemple, une feuille consignant des montants financiers en euros bruts tandis qu’une autre applique une convention en milliers d’euros —, ou d’une altération locale du système métrique due à des configurations régionales de séparateurs décimaux mal interprétées.
Pour auditer la validité statistique des distributions combinées, le recours à la méthode describe fournit un premier panorama des indicateurs de tendance centrale et de dispersion (moyenne, écart-type, médiane, quartiles, minimum et maximum). Toutefois, dans un cadre automatisé, cette inspection empirique doit être suppléée par des tests d’hypothèses statistiques programmés :
- Vérification de la continuité des plages de valeurs au moyen de calculs de scores Z (Z-scores) pour détecter l’émergence d’anomalies extrêmes artificielles.
- Application de tests de rupture structurelle sur les séries chronologiques combinées afin de vérifier l’absence de discontinuités brutales aux frontières d’onglets.
- Évaluation de l’homogénéité des variances entre les sous-populations d’onglets via des tests d’homosパdasticité standardisés.
Toute détection d’une translation anormale de la distribution d’une variable quantitative à l’instant précis de transition entre deux feuilles de calcul doit déclencher un protocole d’investigation. Ce diagnostic prévient la propagation de données biaisées vers des modèles d’inférence statistique où des ruptures d’échelle locales compromettraient l’estimation des paramètres économétriques ou des poids d’un réseau de neurones.
11.3 Protocoles d’assertion automatisés dans un pipeline de données
Pour conférer aux pipelines d’ingestion Pandas le degré de fiabilité requis par les architectures de données d’entreprise critiques, l’intégration de frameworks spécialisés dans la validation de schéma et de contrats de données s’avère indispensable. Des bibliothèques open source telles que Pandera ou Great Expectations permettent de substituer à de simples instructions impératives éparses une couche déclarative rigoureuse régissant l’ensemble des contraintes d’intégrité du DataFrame consolidé.
Au moyen de ces outils, l’ingénieur définit un modèle de schéma formel spécifiant pour chaque attribut les types de données attendus, l’interdiction ou l’autorisation de valeurs nulles, les domaines de validité numérique (par exemple, la contrainte stricte qu’un prix unitaire soit strictement positif), ainsi que des modèles d’expression régulière stricts pour les chaînes de caractères d’identifiants. Dès l’achèvement de l’opération de concaténation, la matrice unifiée est soumise à ce censeur algorithmique :
Si une seule ligne d’observation contrevient aux clauses contractuelles définies dans le schéma, le validateur génère un rapport d’anomalies exhaustif isolant l’indice précis de la ligne fautive, le nom de l’onglet d’origine encodé dans la métadonnée contextuelle, et la nature exacte de la déviation constatée. Ce mécanisme permet d’isoler immédiatement les données non conformes et d’interrompre le pipeline en toute sécurité avant que les tables de données dégradées ne soient déversées dans l’entrepôt de données de l’organisation.
12. Synthèse opérationnelle, pièges récurrents et directives d’ingénierie
12.1 Inventaire critique des erreurs fréquentes et résolutions
L’exploitation industrielle de données stockées dans des classeurs bureautiques confronte régulièrement les développeurs à une typologie d’anomalies récurrentes, dont la compréhension des causes profondes permet une remédiation rapide et méthodique :
- L’exception FileNotFoundError et la résolution de chemins : L’utilisation de chemins d’accès relatifs dépend directement du répertoire de travail courant (current working directory) du processus Python hôte, variant fréquemment selon l’environnement de lancement. L’ingénierie moderne prescrit l’utilisation exclusive du module standard pathlib, résolvant les chemins canoniques absolus à partir de l’emplacement déterministe du script d’exécution ou de variables d’environnement explicites.
- La corruption induite par les cellules fusionnées (merged cells) : Excel gère les fusions de cellules en stockant la valeur uniquement dans la cellule supérieure gauche de la plage fusionnée, tout en assignant des valeurs vides à l’ensemble des cellules adjacentes couvertes par la fusion visuelle. Lors de l’ingestion par Pandas, ces cellules apparaissent comme des valeurs NaN orphelines. La résolution exige l’application ciblée d’opérations de propagation avant (ffill pour forward fill) sur les axes géométriques concernés pour restaurer la continuité matricielle.
- Les formules de calcul non évaluées ou en cache obsolète : Dans des classeurs volumineux, Excel peut différer l’évaluation de formules complexes ou omettre de sérialiser le cache des valeurs calculées dans les structures XML. Le moteur d’analyse Python ingère alors des chaînes représentant la syntaxe brute de la formule (par exemple « =SOMME(A1:A10) ») ou des valeurs nulles au lieu des résultats numériques escomptés. La remédiation nécessite soit une phase d’automatisation via l’interface COM de l’application hôte pour forcer le recalcul complet, soit l’interdiction formelle des cellules calculées dynamiquement dans les classeurs sources.
12.2 Modèle de conception pour un module d’ingestion robuste et réutilisable
Afin de capitaliser sur l’ensemble des principes méthodologiques développés au cours de ce traité, il convient de synthétiser la logique d’ingestion au sein d’une structure logicielle pérenne et réutilisable, matérialisée par une classe dédiée ou un module fonctionnel structuré selon les patrons de conception (design patterns) reconnus du génie logiciel.
Cette structure doit encapsuler l’intégralité du cycle de vie du traitement : validation de l’existence matérielle du fichier source, instanciation optimisée de ExcelFile, filtrage dynamique des feuilles au moyen d’expressions régulières compilées, ingestion unitaire protégée par des assertions de schéma, enrichissement par injection de métadonnées de contextualisation, normalisation des types et concaténation finale vectorisée :
Ce module d’ingestion doit faire l’objet d’une instrumentation complète au moyen du module standard logging de Python. Au lieu d’instructions d’affichage temporaires par la fonction print, les différents états de progression opérationnelle, les avertissements structurels et les volumes d’enregistrements traités sont acheminés vers des flux de journaux standardisés (fichiers de log tournants ou collecteurs d’événements centralisés). Cette rigueur garantit que les opérations d’ingestion s’intègrent de manière transparente au sein d’architectures d’orchestration d’entreprise telles qu’Apache Airflow, Prefect ou Dagster.
12.3 Recommandations architecturales pour la gouvernance des données tabulaires
Bien que la bibliothèque Pandas offre des instruments computationnels puissants pour pallier la dispersion et l’hétérogénéité des feuilles de calcul, la manipulation de classeurs Excel pour stocker et structurer des bases de données d’entreprise demeure une hérésie architecturale à long terme. L’absence d’un moteur transactionnel garantissant les propriétés ACID (Atomicité, Cohérence, Isolation, Durabilité), l’inexistence de contraintes d’intégrité référentielle formelles et la vulnérabilité intrinsèque aux altérations manuelles non tracées disqualifient le tableur en tant que système de persistance fiable pour des données d’importance critique.
Les organisations parvenues à maturité analytique doivent donc concevoir les pipelines d’ingestion Pandas décrits dans cet ouvrage comme des vecteurs de transition transitoires, destinés à rapatrier les flux de travail historiques vers des architectures de persistance modernes. Ces cibles privilégieront des bases de données relationnelles conformes aux standards SQL (PostgreSQL), des moteurs de bases de données intégrés analytiques (DuckDB) ou des couches de stockage colonnaire de type Data Lakehouse (Delta Lake, Apache Iceberg) garantissant l’auditabilité et le partitionnement optimisé.
Dans l’attente d’une telle migration structurelle, la mise en place de contrats de données stricts (data contracts) entre les métiers producteurs de fichiers Excel et les ingénieurs chargés de l’exploitation analytique s’avère indispensable. Ces contrats doivent proscrire l’introduction de variantes syntaxiques arbitraires, imposer des modèles de nommage normalisés pour les onglets, interdire l’usage de cellules fusionnées et formaliser des cycles de gel de structures. Ce n’est qu’à ce prix, alliant discipline méthodologique et rigueur algorithmique, que la consolidation de multiples feuilles Excel dans Pandas révélera son plein potentiel d’efficience et de reproductibilité pour la science des données.
Références
- Augspurger, T., et al. (2024). pandas-dev/pandas: Pandas (Version 2.2.0) [Logiciel]. Zenodo. https://doi.org/10.5281/zenodo.3509134
- Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377-387. https://doi.org/10.1145/362384.362685
- Gazoni, E., & Clark, C. (2023). openpyxl – A Python library to read/write Excel 2010 xlsx/xlsm files (Version 3.1.2) [Logiciel]. Python Software Foundation. https://openpyxl.readthedocs.io/
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
- ISO/IEC. (2016). Information technology — Document description and processing languages — Office Open XML File Formats — Part 1: Fundamentals and Markup Language Reference (ISO/IEC standard n° 29500-1:2016). Organisation internationale de normalisation. https://www.iso.org/standard/71691.html
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51-56). SciPy. https://doi.org/10.25080/Majora-92bf1924-00a
- McKinney, W. (2022). Python for data analysis: Data wrangling with Pandas, NumPy, and Jupyter (3e éd.). O’Reilly Media.
- Peng, R. D. (2011). Reproducible research in computational science. Science, 334(6060), 1226-1227. https://doi.org/10.1126/science.1213847
- VanderPlas, J. (2016). Python data science handbook: Essential tools for working with data. O’Reilly Media.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10