
Dans le domaine de la visualisation scientifique et de l’ingénierie des données, la fidélité de la transmission d’une information dépend tout autant de la justesse mathématique des coordonnées tracées que de l’ergonomie visuelle des éléments paratextuels qui l’accompagnent. La légende d’un graphique ne constitue pas un simple accessoire cosmétique relégué à la périphérie du plan cartésien ; elle forme l’interface sémiotique indispensable par laquelle le lecteur décode, associe et hiérarchise les différentes strates d’informations encodées sous forme de couleurs, de motifs de ligne et de marqueurs. Dans l’écosystème Matplotlib, bibliothèque fondamentale de l’écosystème scientifique Python, la génération de ces légendes obéit par défaut à une logique séquentielle purement mécanique, régie par l’ordre temporel d’exécution des commandes de tracé dans le script. Cette approche, bien que pratique lors des phases exploratoires, engendre systématiquement des dissonances cognitives majeures dès lors que la complexité des données exige une organisation logique, chronologique, décroissante ou thématique distincte.
Le décalage récurrent entre l’ordonnancement visuel des séries sur le canevas — par exemple, l’élévation relative des courbes à l’extrémité droite d’un graphique temporel — et la séquence textuelle des entrées de la légende contraint l’œil de l’observateur à des allers-retours saccadés et incessants. Ce phénomène d’interférence perceptuelle, amplement documenté dans les travaux de psychologie cognitive appliquée à l’analyse graphique, surcharge la mémoire de travail du lecteur et dégrade l’efficacité de la communication scientifique. Maîtriser l’ordonnancement programmatique des éléments de légende au sein de Matplotlib représente par conséquent une compétence critique pour quiconque aspire à produire des visualisations de niveau publication, conformes aux exigences des revues à comité de lecture et des rapports d’aide à la décision stratégique.
Le présent traité propose une déconstruction exhaustive des mécanismes sous-jacents qui régissent la manipulation des descripteurs graphiques (handles) et de leurs étiquettes lexicales associées (labels). En transcendant les recettes empiriques superficielles, cet article expose l’architecture orientée objet de Matplotlib, détaille les méthodes canoniques d’extraction et de réindexation par vectorisation d’indices, explore les algorithmes de tri dynamique fondés sur les propriétés intrinsèques des séries, et aborde les cas complexes posés par les figures composites, les axes jumeaux et les conteneurs hétérogènes. À travers une démarche méthodologique rigoureuse, nous examinerons comment restaurer une parfaite cohérence sémantique et spatiale entre le modèle sous-jacent et sa représentation graphique.
1. Introduction théorique et principes de la disposition visuelle des légendes dans Matplotlib
1.1 Le rôle perceptif de la légende dans la communication des données
La légende graphique opère comme un dictionnaire bilingue visuel-sémantique. Dans le paradigme sémiotique défini par Jacques Bertin dans sa Sémiologie Graphique, l’œil de l’analyste décompose une image selon des variables rétiniennes élémentaires : la position spatiale, la forme, la couleur, la valeur et l’orientation. Lorsque ces variables sont exploitées pour différencier des catégories expérimentales, des cohortes cliniques ou des variables macroéconomiques, le cerveau humain ne peut opérer la synthèse cognitive sans une table de correspondance stable et immédiatement accessible. La légende remplit précisément cette fonction d’ancrage en fournissant la clef de déchiffrement qui transforme une géométrie abstraite en information signifiante.
Le parcours oculaire d’un lecteur explorant un graphique n’est pas aléatoire ; il est soumis à des lois physiologiques d’exploration séquentielle. Lorsqu’une divergence survient entre la position spatiale relative des courbes sur l’axe vertical d’un graphique et la disposition textuelle de leurs désignations dans la boîte de légende, l’observateur est victime d’un coût de commutation attentionnelle. Chaque vérification d’étiquette requiert un mouvement oculaire de recherche, une mémorisation temporaire de la couleur ou du style, puis une comparaison avec la trace physique sur le plan d’affichage. Si l’ordre de la légende reproduit fidèlement la hiérarchie visuelle naturelle des données — par exemple l’agencement vertical des courbes au dernier point temporel observé —, le temps de fixation cognitive est drastiquement comprimé, favorisant une compréhension pré-attentive fluide et exempte d’ambiguïté.
Il est donc impératif de considérer la séquence des catégories au sein de la légende comme une dimension sémantique active du graphique. Un agencement mal orchestré ne dégrade pas uniquement l’esthétique générale de la figure ; il affaiblit la portée argumentative du discours scientifique en forçant l’interlocuteur à démêler un enchevêtrement artificiel d’indices avant d’accéder au sens profond des résultats.
1.2 Le comportement par défaut de Matplotlib lors de l’instanciation de la légende
Pour appréhender la nécessité d’une reconfiguration explicite, il convient d’analyser les mécanismes internes de la bibliothèque Matplotlib lors de la génération automatique d’une légende. Lorsqu’un praticien invoque une méthode de tracé sur un objet d’axe, telle que la fonction de dessin linéaire ou de dispersion, l’interpréteur instancie un descripteur graphique — désigné dans la terminologie interne par le terme générique d’Artist — et l’ajoute à la liste séquentielle interne des éléments graphiques de l’axe. Si le paramètre textuel identificateur a été spécifié lors de cet appel, l’objet graphique est simultanément étiqueté comme éligible à figurer au sein de la légende.
Lors de l’appel subséquent de la méthode de construction de légende, le moteur graphique procède à une inspection chronologique passive de tous les artistes enregistrés dans le conteneur de l’axe. Il extrait sans modification la liste ordonnée des objets graphiques dotés d’une chaîne descriptive valide, associant chaque élément géométrique au texte fourni lors de sa création. L’ordre d’apparition final des entrées dans la légende est donc strictement isomorphe à l’ordre chronologique d’exécution des lignes de code dans l’interpréteur Python. Ce fonctionnement en boîte noire présente un écueil fondamental : la séquence optimale pour l’exécution d’un script logiciel (chargement séquentiel de tables de données, boucles conditionnelles sur des dictionnaires ou ajouts itératifs de calques) coïncide rarement avec la séquence logique, conceptuelle ou visuelle que requiert l’observateur humain.
Cette passivité architecturale place l’entière responsabilité de l’ordonnancement sur le développeur. Sans une intervention programmatique délibérée, toute variation accidentelle dans la structure d’itération des données source se répercute instantanément sur la légende, introduisant des inconsistances arbitraires susceptibles de varier d’une exécution à l’autre lorsque les structures sous-jacentes ne garantissent pas un ordre déterministe strict.
1.3 Les limites de l’ordre d’insertion séquentiel par défaut
L’asservissement de l’ordre de la légende à la chronologie d’exécution logicielle produit des dysfonctionnements majeurs dès lors que l’on manipule des visualisations multicouches ou multivariées. Le premier de ces désagréments réside dans la friction cognitive engendrée par les croisements de références. Si une courbe représentée en haut du graphique est déclarée en premier dans le script, tandis qu’une seconde courbe située immédiatement en dessous est déclarée en dernier à la suite d’un traitement algorithmique spécifique, la légende présentera une inversion qui contredira l’intuition perceptive élémentaire du lecteur.
Un second problème critique émerge des exigences contradictoires relatives à l’axe Z, c’est-à-dire l’ordre de superposition visuelle des tracés sur la surface du graphique. Dans Matplotlib, le paramètre de profondeur contrôle quel élément géométrique recouvre les autres en cas d’intersection spatiale. Souvent, pour des motifs de clarté visuelle évidents, un chercheur choisira de tracer une courbe de référence volumineuse ou une bande d’incertitude ombrée en premier afin qu’elle se positionne en arrière-plan, puis superposera par-dessus des séries temporelles fines ou des nuages de points denses. Si l’on s’en remet à l’instanciation automatique de la légende, la courbe d’arrière-plan figurera inexorablement en tête de liste dans le bloc textuel, reléguant les séries principales au second plan cognitif.
Enfin, cette rigidité séquentielle empêche l’application systématique de taxonomies métier ou scientifiques préétablies. Qu’il s’agisse de respecter un protocole expérimental imposant de mentionner systématiquement le groupe témoin avant les variantes traitées, d’ordonner des tranches d’âge de manière strictement monotone, ou d’organiser des catégories socio-professionnelles selon une nomenclature standardisée, le tri séquentiel passif impose des contorsions structurelles inacceptables dans le code source s’il n’est pas corrigé par une méthode d’extraction et de réordonnancement explicite.
2. Anatomie technique d’une légende Matplotlib : Handles et Labels
2.1 Définition et rôle fondamental des descripteurs graphiques (handles)
Pour manipuler programmatiquement l’ordonnancement d’une légende, il est indispensable de disséquer ses constituants fondamentaux au niveau de l’architecture objet. Dans le lexique de Matplotlib, le terme handle (souvent traduit par descripteur ou poignée graphique) désigne une instance concrète de la classe abstraite Artist, ou plus spécifiquement de ses spécialisations géométriques telles que les segments de ligne, les polygones fermés ou les collections de marqueurs. Le handle n’est pas une simple réplique iconique passive ; il s’agit d’un proxy graphique qui encapsule l’intégralité des propriétés chromatiques, scalaires et stylistiques de la série qu’il représente.
Lorsqu’une courbe linéaire est tracée, le handle généré conserve les attributs d’épaisseur de trait, de couleur de contour, de transparence et de style de tiretement assignés à la série parente. Cette encapsulation garantit une stricte correspondance entre l’entité représentée sur le plan cartésien et son échantillon miniaturisé dans la boîte de légende. Le handle opère une abstraction essentielle : il permet au moteur de rendu de dupliquer la signature visuelle de la donnée sans devoir recalculer ni restituer l’intégralité des milliers de coordonnées numériques formant le tracé original. Cette séparation étanche entre la topologie géométrique massive de la courbe et son descripteur stylistique compact constitue l’une des forces de conception les plus élégantes de la bibliothèque.
Comprendre que le handle est un objet Python manipulable en tant que référence en mémoire permet de saisir la mécanique de réordonnancement : déplacer une entrée de légende ne requiert nullement de retracer la courbe ou de modifier les données source, mais consiste simplement à intervertir des pointeurs d’objets au sein d’une structure de liste avant de soumettre cette dernière au compilateur visuel de la légende.
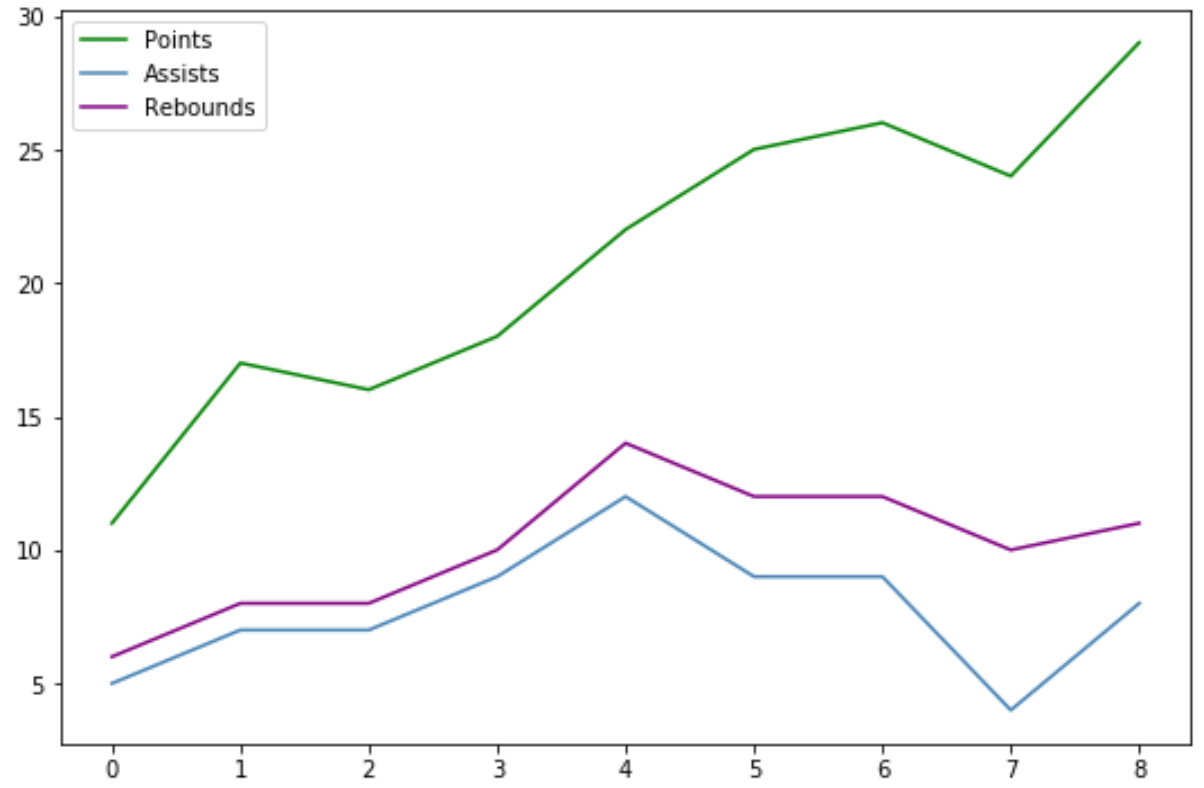
2.2 Rôle et extraction des étiquettes textuelles (labels)
Le second pilier de la structure d’une légende est constitué par le vecteur des labels, c’est-à-dire les chaînes de caractères littérales destinées à expliciter la sémantique de chaque descripteur graphique. Ces étiquettes sont originellement transmises sous forme d’arguments textuels lors des appels aux méthodes de tracé. Sur le plan architectural, Matplotlib applique une règle de filtrage implicite déterminante : toute chaîne de caractères dont le premier caractère est un tiret de soulignement (underscore) est automatiquement considérée comme privée et se voit exclue du recensement automatique pour la composition de la légende.
Cette convention de nommage interne explique pourquoi de nombreux éléments graphiques auxiliaires — tels que les lignes de grille secondaires, les repères de moyenne ou les tracés de remplissage d’arrière-plan — ne polluent pas spontanément l’espace de la légende lorsqu’ils sont créés sans spécification explicite d’étiquette, leur identifiant par défaut débutant par cette marque d’exclusion. En revanche, pour tous les éléments déclarés avec un libellé textuel formel, Matplotlib maintient une relation d’association directe avec le handle correspondant au sein de son registre interne.
Dans l’environnement d’exécution, ces étiquettes sont stockées sous la forme d’une liste séquentielle standard de chaînes de caractères Python. Cette structure linéaire standardisée offre une flexibilité totale : elle peut être parcourue, filtrée, tronquée, complétée ou réorganisée par les mécanismes algorithmiques usuels du langage, à la condition absolue de maintenir un appariement bijectif rigoureux avec la liste des descripteurs graphiques correspondants afin d’éviter toute inversion fatale d’attributions.
2.3 L’interaction entre l’objet Axes et le constructeur de légende
L’orchestration des handles et des labels repose sur une relation hiérarchique stricte au sein de l’arborescence des conteneurs de Matplotlib. L’objet Axes — qui représente la région du canevas délimitée par les axes de coordonnées où s’opère le tracé — agit comme le réceptacle primaire de tous les artistes créés. C’est en son sein que sont accumulées les références géométriques et que s’articule la communication avec la classe spécialisée représentant la légende.
Lorsque la méthode de construction de légende est invoquée sur une instance d’axe, celle-ci délègue la tâche à un constructeur dédié qui initialise un conteneur graphique composite. Cette nouvelle structure calcule l’encombrement spatial requis, positionne le cadre d’arrière-plan (l’élément de bordure), dispose les descripteurs miniatures selon une grille régulière et aligne les chaînes textuelles à leur droite immédiate. Ce conteneur de légende vient ensuite s’imbriquer dans l’arborescence des enfants de l’axe, prenant place au sommet de la hiérarchie de rendu afin d’éviter d’être occulté par les éléments de données sous-jacents.
Il est fondamental de noter que l’objet de légende ainsi créé ne conserve aucun lien dynamique direct de synchronisation automatique avec la structure des données d’origine : il s’agit d’un instantané (snapshot) statique généré à partir des paramètres transmis au moment exact de l’instanciation. Toute altération ultérieure de l’ordre d’affichage nécessite impérativement soit une reconfiguration intégrale de l’objet de légende existant, soit la substitution de ce dernier par une nouvelle instance construite avec les vecteurs réordonnés.
3. La méthode canonique : Extraction via get_legend_handles_labels()
3.1 Analyse syntaxique de plt.gca().get_legend_handles_labels()
La porte d’entrée universelle pour accéder aux entrailles de la légende réside dans la méthode fondamentale d’inspection intitulée get_legend_handles_labels(). Accessible soit de manière impérative via le gestionnaire de contexte d’axe courant, soit de manière explicite sur une instance d’axe identifiée, cette méthode effectue un parcours exhaustif des registres de l’axe afin de compiler et de retourner les deux composantes sous forme d’un tuple standard à deux éléments.
L’évaluation syntaxique de cette opération se formalise par une affectation simultanée :
Le premier terme extrait recueille la collection ordonnée des descripteurs graphiques éligibles, tandis que le second agrège les chaînes textuelles associées. Il est crucial d’observer que cette méthode garantit de manière déterministe un isomorphisme parfait entre les deux listes : pour chaque indice donné, le handle situé à cet emplacement correspond sans équivoque au label occupant la position indiciaire équivalente dans la liste textuelle. Cette bijection structurelle constitue le fondement sécuritaire sur lequel reposent toutes les stratégies ultérieures de permutation algorithmique.
Bien que l’accès via le sélecteur procédural de l’axe courant soit fréquemment rencontré dans la littérature technique rapide, son usage en contexte de calcul intensif ou d’architectures applicatives complexes est fortement déconseillé en raison des risques inhérents d’ambiguïté contextuelle, au profit d’une invocation directe sur l’objet d’axe ciblé.
3.2 Structure des objets retournés (tuples, listes et proxys d’artistes)
Une analyse approfondie du type des objets renvoyés par la méthode d’inspection éclaire la flexibilité du dispositif. Le conteneur primaire est un tuple immuable de longueur deux, dont la décomposition immédiate produit deux listes Python hautement mutables. La première liste contient des références directes vers des instances spécialisées de la hiérarchie d’artistes graphiques : des segments de ligne pour les tracés continus, des ensembles de polygones pour les diagrammes à barres, ou des collections de chemins vectoriels pour les nuages de points.
Chacun de ces artistes conserve ses méthodes intrinsèques d’inspection et de mutation, ce qui signifie qu’au-delà d’un simple réordonnancement spatial, le développeur dispose de la faculté d’interroger dynamiquement les caractéristiques de chaque élément (par exemple, extraire la couleur de contour hexadécimale via les accesseurs dédiés de l’objet) afin de fonder ses critères de tri sur des considérations visuelles objectives. La seconde liste rassemble quant à elle des chaînes textuelles standard, totalement découplées de leur support graphique d’origine.
Cette dissociation matérielle entre l’enveloppe géométrique et son étiquette textuelle offre une liberté d’ingénierie considérable : il devient possible de manipuler ces deux séquences en mémoire vive comme n’importe quel tableau de données unidimensionnel, d’appliquer des filtres de sélection, des suppressions ciblées ou des inversions géométriques complètes, avant de réinjecter ces vecteurs restructurés dans la mécanique de rendu final.
3.3 Bonnes pratiques de capture dans l’environnement programmatique orienté objet
Dans les pipelines d’analyse de données modernes, la rigueur logicielle impose de proscrire l’utilisation des commandes procédurales globales au profit d’une instanciation orientée objet rigoureuse. L’obtention de la référence d’axe doit s’opérer en amont, lors de la création de la figure, garantissant que chaque opération s’exécute dans un espace de noms graphique scellé et totalement isolé des processus d’affichage parallèles.
L’extraction canonique doit ainsi systématiquement s’écrire sous la forme d’un appel direct à la méthode attachée à l’instance locale d’axe :
Cette démarche prévient tout risque de collision d’état, notamment lors de la manipulation de figures complexes subdivisées en grilles de sous-graphiques multiples, ou dans le cadre d’exécutions asynchrones au sein de serveurs d’arrière-plan où l’axe courant global peut être subrepticement altéré par un fil d’exécution concurrent.
De surcroît, cette approche garantit une gestion prévisible du cycle de vie des objets : les descripteurs capturés demeurent fermement ancrés dans le contexte matériel de leur axe d’origine, évitant les erreurs de rendu silencieuses où un descripteur orphelin d’un axe distinct est injecté par inadvertance dans la légende d’un autre, corrompant la cohérence topologique du document final.
4. Réorganisation explicite par indexation et compréhension de listes
4.1 Définition du vecteur d’indices de permutation
La technique la plus directe et la plus transparente pour réordonner les éléments d’une légende consiste à définir un vecteur explicite d’indices de permutation. Cette approche mathématique repose sur la construction d’une liste d’entiers naturels dont la valeur de chaque élément spécifie l’emplacement originel de l’élément à positionner dans le nouvel agencement séquentiel.
Considérons, à titre d’illustration formelle, une configuration initiale dans laquelle quatre séries expérimentales ont été tracées dans l’ordre chronologique d’acquisition, générant les listes de descripteurs et d’étiquettes correspondantes associées aux indices séquentiels zéro, un, deux et trois. Si des considérations ergonomiques ou hiérarchiques imposent de faire apparaître le troisième élément en première position, suivi du premier, puis du quatrième et enfin du second, le vecteur d’indices de réordonnancement se définira rigoureusement comme une liste ordonnée contenant la suite des entiers : deux, zéro, trois et un.
Cette formulation matricielle du problème présente l’immense avantage de la clarté algorithmique et du déterminisme absolu. Toutefois, sa validité repose sur une contrainte structurelle inviolable : le vecteur de permutation doit constituer une bijection parfaite sur l’ensemble des indices initiaux. Toute omission d’un indice conduira à l’exclusion pure et simple de la série correspondante dans la boîte de légende finale, tandis que la répétition accidentelle d’un même entier provoquera une duplication indésirable de l’entrée concernée.
4.2 Application de la compréhension de liste pour réorganiser les handles et labels
Une fois le vecteur de projection indiciaire formellement défini, le langage Python offre un idiome d’une efficacité et d’une concision remarquables pour appliquer cette permutation simultanément aux structures de descripteurs et d’étiquettes : la compréhension de liste. Ce mécanisme permet de régénérer de nouvelles collections ordonnées en itérant séquentiellement sur les indices spécifiés par le vecteur directeur.
Le schéma d’implémentation canonique s’articule autour de deux compréhensions parallèles rigoureusement synchronisées. La première réordonne la collection des descripteurs graphiques en sélectionnant pour chaque indice cible l’objet géométrique correspondant, tandis que la seconde opère l’exacte même sélection parmi les chaînes de caractères de la liste des libellés. La simultanéité de cette opération garantit mathématiquement la préservation de la concordance bijective entre l’élément visuel et son signifiant textuel.
D’un point de vue de l’ingénierie logicielle, cette technique évite le recours à des structures intermédiaires complexes ou à des opérations de tri destructives en place. Elle préserve l’intégrité des listes originelles tout en générant, pour un coût computationnel négligeable à l’échelle des microsecondes, deux nouvelles séquences prêtes à être ingérées par le constructeur graphique.
4.3 Transmission des listes réordonnées au constructeur de légende
L’étape conclusive de la manœuvre réside dans la restitution des descripteurs et des étiquettes permutés au sous-système de composition graphique. Cette réinjection s’effectue en fournissant les deux collections réindexées en tant qu’arguments positionnels primaires à la méthode de légende de l’axe concerné.
L’appel formel s’énonce selon une signature précise où le premier argument reçoit la liste ordonnée des handles et le second argument accueille la liste alignée des labels. Il est fondamental de comprendre qu’en passant explicitement ces deux structures vectorielles, on court-circuite intégralement le mécanisme d’inspection automatique par défaut de Matplotlib : le moteur graphique renonce à son parcours chronologique des artistes enregistrés et se conforme strictement à la double séquence imposée par le développeur.
Cette substitution délibérée ne dégrade en rien l’accessibilité des autres options de paramétrage géométrique et cosmétique. L’ensemble des arguments nommés habituels — régissant l’ancrage spatial, la présence et l’opacité du cadre, la typographie, la taille de police, la couleur de fond ou la répartition en colonnes multiples — conservent leur entière opérabilité et doivent être stipulés conjointement au sein du même appel d’instanciation.
5. Cas pratique pas à pas : Réorganisation d’un tracé de séries temporelles
5.1 Établissement du jeu de données et tracé initial non ordonné
Afin de matérialiser ces concepts théoriques au sein d’un cas d’usage représentatif des défis quotidiens de l’analyse de données, examinons le comportement d’un modèle économique comparant les trajectoires de croissance de plusieurs zones géographiques sur une période décennale. Supposons une simulation numérique modélisant l’évolution temporelle de quatre régions distinctes, générées sous la forme de séries séquentielles enregistrées dans un tableau structuré à deux dimensions.
Dans un script d’analyse classique non optimisé, ces séries sont fréquemment tracées au gré de leur apparition dans la structure tabulaire source, par exemple : le contingent européen en premier lieu, suivi du marché asiatique, puis du secteur nord-américain, et enfin de la zone émergente d’Amérique latine. Supposons qu’au terme de la fenêtre temporelle d’observation, les dynamiques structurelles aient radicalement redistribué les magnitudes relatives : le marché asiatique culmine au sommet de l’échelle des ordonnées, suivi immédiatement par l’Amérique du Nord, tandis que l’Europe s’établit en troisième position et l’Amérique latine en queue de peloton.
Dans le rendu brut généré par le moteur par défaut de Matplotlib, la boîte de légende affichera les catégories dans l’ordre historique de déclaration du code source : Europe, Asie, Amérique du Nord, Amérique latine. L’observateur fait alors face à une discordance perceptive immédiate : son regard identifie la trajectoire supérieure du graphique comme étant l’Asie, mais la première entrée textuelle de la légende qui attire spontanément son attention annonce l’Europe. Cette friction altère l’intelligibilité globale de l’artefact visuel.
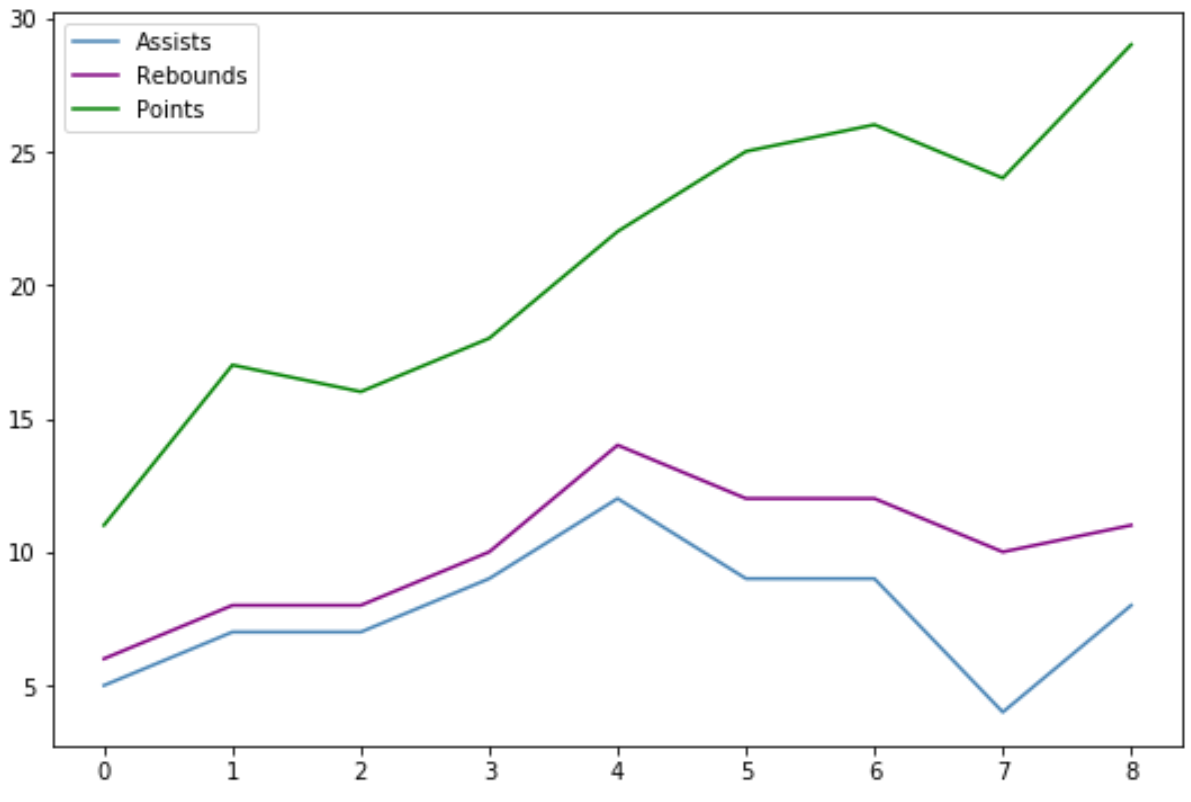
5.2 Implémentation pas à pas de la permutation manuelle
Pour restaurer une harmonie cognitive totale, nous déployons la méthodologie d’inversion programmatique méthodique. La première phase consiste à extraire les structures natives via la méthode d’inspection sur l’axe après l’achèvement de toutes les opérations de tracé élémentaires. À ce stade, la liste des descripteurs contient les quatre objets de ligne continue et la liste des étiquettes rassemble les quatre désignations géographiques dans leur ordre non optimal.
La seconde phase implique l’établissement cartographique du vecteur de correspondance. L’analyste identifie les positions initiales : l’Europe occupe l’indice zéro, l’Asie l’indice un, l’Amérique du Nord l’indice deux, et l’Amérique latine l’indice trois. Pour refléter l’ordre décroissant d’altitude finale sur l’axe des ordonnées — Asie en premier, Amérique du Nord en deuxième, Europe en troisième, Amérique latine en quatrième —, le vecteur d’indexation optimal s’établit formellement comme la suite : un, deux, zéro, trois.
La troisième phase exécute la réorganisation concrète au moyen des compréhensions vectorielles parallèles évoquées précédemment, générant deux listes de taille identique parfaitement ordonnées. Enfin, la quatrième phase convoque la méthode de génération de légende en lui injectant ces deux vecteurs remaniés, assortis des consignes de disposition esthétique souhaitées, par exemple un ancrage sur le coin supérieur gauche du tracé avec un arrière-plan semi-transparent.
5.3 Analyse comparative du rendu avant et après réordonnancement
L’évaluation rigoureuse du document graphique post-intervention confirme l’élimination absolue de la dissonance cognitive. Lorsque l’œil du réviseur scientifique parcourt l’extrémité droite de la figure pour analyser l’aboutissement des trajectoires dynamiques, il lit de haut en bas les courbes représentant respectivement l’Asie, l’Amérique du Nord, l’Europe et l’Amérique latine. S’il déplace immédiatement son foyer attentionnel vers la boîte de légende, il découvre une séquence textuelle parfaitement identique, alignée sur le même axe vertical de lecture.
Cette symétrie visuelle et conceptuelle supprime le besoin de confirmation itérative par décodage de couleur : la correspondance devient intuitive et quasi instantanée, opérant selon le principe sémiotique d’analogie de structure. Par ailleurs, les propriétés géométriques des descripteurs graphiques — telles que la couleur spécifique, le calibre du trait et les tirets distinctifs — sont demeurées intactes, attestant de la totale innocuité de la permutation d’indices vis-à-vis de l’intégrité intrinsèque des objets graphiques.
Pour les comités de lecture des revues scientifiques de premier rang, ce niveau de finition typographique et fonctionnelle distingue immédiatement une simple esquisse de travail préliminaire d’une figure de synthèse destinée à la dissémination académique rigoureuse.
6. Techniques de tri algorithmique et dynamique des éléments de légende
6.1 Tri alphabétique direct basé sur les chaînes de caractères
Bien que la permutation par vecteurs d’indices manuels convienne parfaitement aux figures statiques dotées d’un nombre restreint de variables, elle s’avère fragile et peu maintenable dans le cadre de chaînes de traitement automatisées où le nombre et la nature des séries tracées fluctuent de manière dynamique. Dans de telles configurations industrielles, le recours à des algorithmes de tri formels devient une nécessité architecturale.
Le cas d’usage le plus élémentaire concerne la standardisation lexicographique, particulièrement requise dans les inventaires taxonomiques, les nomenclatures génétiques ou les classifications géographiques exhaustives. Pour ordonner alphabétiquement une légende sans intervention humaine, la méthode la plus élégante en Python combine l’encapsulation par agrégation de tuples et le mécanisme de tri standard. En liant temporairement chaque étiquette textuelle à son descripteur graphique au sein de couples indivisibles, on garantit la préservation de leur relation bijective tout au long du processus de réarrangement.
L’opération s’articule autour de l’invocation de la fonction d’ordonnancement native de Python appliquée aux paires étiquette-descripteur, en stipulant que la clef d’évaluation doit porter exclusivement sur la composante textuelle du premier élément. Une fois l’ordonnancement complété, une étape de décompression vectorielle — couramment exécutée au moyen de l’opérateur d’étoilement syntaxique couplé à la fonction de fermeture — sépare à nouveau les éléments en deux séquences distinctes, parfaitement ordonnées selon l’alphabet, prêtes à être immédiatement acheminées vers le constructeur de légende.
6.2 Tri numérique fondé sur les valeurs des métriques sous-jacentes
Une sophistication analytique nettement supérieure consiste à automatiser l’alignement de la légende sur les métriques effectives issues des données quantitatives elles-mêmes. L’objectif consiste ici à éliminer toute détermination manuelle des indices d’élévation finale en confiant à l’algorithme la tâche d’extraire la coordonnée verticale terminale de chaque courbe pour dicter l’ordre de présentation.
Chaque descripteur de tracé linéaire détient, au sein de son interface de programmation interne, des accesseurs permettant de consulter les tableaux de données géométriques qui lui ont été injectés lors de sa genèse. Il est ainsi possible d’extraire par programmation la séquence des ordonnées associées à un descripteur spécifique, d’en isoler la valeur finale correspondant à la borne temporelle la plus avancée, et d’associer cette grandeur scalaire comme score de tri pour l’entrée de légende correspondante.
Cette approche dynamique peut être généralisée à n’importe quelle autre métrique statistique synthétique : l’aire sous la courbe intégrée numériquement, la moyenne empirique de la série, la variance des résidus ou le taux de croissance instantané. En couplant l’extraction des descripteurs avec un dictionnaire de valeurs agrégées préalablement calculé sur le jeu de données d’origine, le système réorganise la légende selon une logique analytique d’une précision irréprochable, qui s’ajustera automatiquement en cas de rafraîchissement ou de mutation de la base de données amont sans requérir la moindre modification du code de visualisation.
6.3 Utilisation de la fonction sorted() avec expressions lambda personnalisées
Pour orchestrer ces transformations avec une souplesse maximale, l’emploi de fonctions anonymes (expressions lambda) transmises au paramètre de sélection de clef de la fonction d’ordonnancement constitue le paradigme fonctionnel le plus robuste de l’écosystème Python. Cette méthode permet d’injecter des heuristiques de tri arbitrairement complexes au sein d’une unique ligne d’instruction hautement expressive.
Considérons un scénario analytique exigeant que l’ensemble des séries associées à des conditions de contrôle expérimental figure systématiquement en tête de légende par ordre alphabétique, tandis que l’ensemble des variantes mutantes ou traitées doit être relégué dans une seconde section ordonnée selon leur amplitude de réponse. Une expression anonyme peut évaluer séquentiellement la nature lexicale de chaque étiquette : elle renverra un tuple composite dont le premier terme agira comme discriminant binaire catégoriel (zéro pour les contrôles, un pour les traitements) et dont le second terme fournira la valeur scalaire de tri spécifique à chaque sous-ensemble.
L’adjonction du paramètre booléen d’inversion permet de basculer instantanément d’une logique ascendante à un agencement strictement descendant. De surcroît, le moteur d’ordonnancement interne de Python reposant sur l’algorithme Timsort, cette approche garantit une stabilité rigoureuse : lorsque deux séries obtiennent un score d’évaluation strictement équivalent selon la clef spécifiée, leur ordre chronologique d’insertion initial est scrupuleusement préservé, écartant tout aléa dans le rendu final du document.
7. Gestion avancée des légendes multi-axes et figures complexes
7.1 Fusion et ordonnancement des handles issus de plusieurs sous-graphiques
Dans les publications scientifiques contemporaines, l’information est rarement condensée au sein d’un tracé unitaire isolé ; elle s’exprime préférentiellement à travers des figures composites articulant plusieurs sous-graphiques disposés en grille régulière. Dans une telle architecture, l’écueil le plus fréquent consiste en la prolifération de légendes redondantes disséminées dans chaque sous-panneau, ce qui encombre inutilement l’espace graphique et contraint la surface utile dédiée à l’exposition des données.
La solution ergonomique optimale réside dans l’extraction transverse de l’ensemble des descripteurs répartis sur les différents axes pour les consolider au sein d’une légende centralisée unique, positionnée au niveau de l’objet global de figure. Ce patron de conception exige d’itérer méthodiquement sur la collection des axes composant la grille, d’interroger chaque conteneur via la méthode d’inspection canonique, et d’agréger les descripteurs et libellés au sein de deux listes de fusion transversales.
Une fois cette collecte intégrale accomplie, l’analyste applique les algorithmes d’ordonnancement et de hiérarchisation sur ce corpus unifié. La légende consolidée est alors instanciée non plus à l’échelle d’un axe individuel, mais directement sur l’instance maîtresse de la figure, en ajustant précisément ses coordonnées de référence pour qu’elle vienne coiffer harmonieusement la grille de sous-graphiques ou s’aligner sur une marge latérale dédiée sans entrer en collision avec les titres et étiquettes d’échelles locales.
7.2 Cas critique des axes jumeaux (twinx et twiny)
L’un des défis techniques les plus notoires de la bibliothèque Matplotlib survient lors de l’emploi d’axes jumeaux, couramment mobilisés pour représenter simultanément des grandeurs physiques aux échelles dimensionnelles incompatibles sur un même intervalle horizontal d’abscisses. La méthode standard génère une seconde instance d’axe totalement superposée au plan d’origine, possédant son propre repère d’ordonnées à droite de la figure.
Si l’analyste invoque successivement la méthode de légende sur l’axe primaire puis sur l’axe secondaire, Matplotlib composera deux boîtes distinctes qui, selon les configurations d’ancrage automatique, risquent de se superposer physiquement ou de masquer des fragments de tracés essentiels. Pire encore, si l’on invoque la légende sur l’axe primaire seul, tous les tracés hébergés sur l’axe secondaire demeureront totalement invisibles à l’inspection automatique et seront exclus de la table explicative.
La résolution de cette anomalie architecturale requiert une capture bilatérale délibérée. Le praticien doit extraire explicitement le tuple descripteurs-étiquettes de l’axe primaire, accomplir l’opération identique sur l’axe secondaire jumeau, puis concaténer algébriquement les deux listes de descripteurs et les deux listes de libellés. Cette consolidation bipolaire permet ensuite d’opérer un ordonnancement global — par exemple en alternant systématiquement une série primaire et sa dérivée secondaire — avant de soumettre la collection fusionnée au constructeur de légende de l’axe primaire uniquement, neutralisant ainsi toute instanciation parasite sur le second axe.
7.3 Déduplication des entrées répétées tout en garantissant un ordre strict
Lors de la production de tracés itératifs — tels que des courbes de régression tracées par sous-groupes expérimentaux ou des trajectoires individuelles issues d’analyses de cohortes longitudinales —, il est fréquent que de multiples segments partagent une même classe sémantique et se voient par conséquent attribuer une chaîne de désignation strictement identique lors de l’exécution de boucles de traitement.
Si aucune mesure d’assainissement n’est adoptée, l’interrogation de l’axe retournera une prolifération de doublons lexicaux au sein de la liste des étiquettes, assortis chacun de leur descripteur individuel. Instancier la légende en l’état conduirait à une répétition fastidieuse de lignes identiques, dégradant gravement l’esthétique et la crédibilité de la figure. Il est donc indispensable d’élaguer ces occurrences redondantes tout en préservant scrupuleusement l’ordre d’apparition désiré ou la logique séquentielle préétablie.
Le recours traditionnel aux ensembles non ordonnés est formellement proscrit dans ce contexte, car la nature fondamentale des tables de hachage standard détruit l’ordre des éléments, introduisant un aléa inacceptable dans l’agencement graphique. La stratégie logicielle recommandée en Python moderne consiste à exploiter la propriété d’ordre d’insertion des dictionnaires natifs : en insérant chaque étiquette comme clef d’une table associative et son descripteur initial comme valeur associée, les doublons subséquents sont silencieusement écrasés ou ignorés selon la condition de présence. Il suffit ensuite d’extraire les clefs et les valeurs de cette structure pour obtenir deux listes parfaitement purgées de tout doublon, prêtes pour un ordonnancement déterministe final.
8. Réorganisation d’éléments hétérogènes : Barres, Nuages de points et Surfaces
8.1 Gestion des conteneurs de barres (BarContainer) et collections de polygones
L’ordonnancement d’une légende devient considérablement plus complexe dès lors que le graphique s’éloigne de la pure représentation linéaire pour embrasser des typologies géométriques composites. Lorsque l’on invoque une méthode de tracé de diagramme à barres, l’entité enregistrée dans le registre de l’axe n’est pas une simple instance de ligne continue, mais un objet complexe désigné sous le terme de BarContainer, lequel regroupe sous sa gouvernance l’ensemble des rectangles géométriques individuels formant chaque colonne du tracé.
La méthode d’inspection canonique est heureusement conçue pour convertir ce conteneur composite en un unique descripteur représentatif — généralement un objet de type polygone — préservant fidèlement la teinte de remplissage, la texture des bordures et les motifs de hachures appliqués aux barres correspondantes. Cependant, lors des opérations de réordonnancement par permutation ou filtrage algorithmique, l’analyste doit veiller à traiter ce descripteur composite comme une unité atomique indivisible.
Si la figure associe des séries temporelles linéaires et des histogrammes catégoriels en arrière-plan, l’ordonnancement par défaut place généralement les conteneurs de barres en queue de liste si ceux-ci ont été tracés postérieurement pour des contraintes d’échelle. Pour rétablir une lecture logique — où, par exemple, la variable structurelle représentée par les barres doit introduire la légende avant les indicateurs dynamiques représentés par les lignes —, l’extraction et la réindexation par listes permettent de repositionner ces polygones volumétriques en tête de la séquence textuelle avec une aisance absolue.
8.2 Harmonisation entre tracés continus et nuages de points (PathCollection)
Une situation récurrente dans les sciences empiriques réside dans la superposition d’un modèle d’ajustement théorique continu sur un nuage de points expérimentaux discrets. Dans l’architecture interne de Matplotlib, les nuages de dispersion issus de la fonction dédiée ne sont pas encapsulés sous forme d’artistes de ligne, mais sous l’entité structurelle d’une collection vectorielle de chemins.
Cette distinction typologique induit des comportements particuliers au sein du mécanisme de légende. Le proxy généré pour représenter un nuage de dispersion adopte par défaut l’échelle et la morphologie du marqueur graphique configuré lors de l’appel. Lorsque l’on réordonne conjointement des lignes continues et des collections de marqueurs expérimentaux, il apparaît fréquemment des déséquilibres visuels au sein de la boîte de légende : les marqueurs ponctuels miniatures peuvent sembler microscopiques ou disproportionnés face aux segments linéaires continus qui les jouxtent.
Pour parfaire l’ordonnancement de ces éléments hétérogènes, il est hautement avantageux d’intercepter les objets de collection lors de la phase de réindexation afin d’ajuster dynamiquement leurs propriétés d’affichage au sein de la légende. Sans modifier l’échelle réelle des points de données sur le plan d’observation principal, il est possible d’harmoniser la signature stylistique des descripteurs réordonnés, assurant ainsi une cohérence chromatique et morphologique optimale entre les traces continues théoriques et les observations discrètes.
8.3 Gestion des surfaces remplies et intervalles de confiance (fill_between)
L’incorporation explicite des mesures d’incertitude statistique — qu’il s’agisse d’écarts-types empiriques, d’intervalles de confiance calculés par rééchantillonnage ou d’étendues interquartiles — s’effectue quasi universellement par le biais de zones d’ombrage surfacique générées par des fonctions de remplissage continu entre courbes. Ces opérations engendrent des artistes de type collection de polygones fermés.
Si l’auteur d’une étude attribue un libellé textuel formel à cette nappe d’incertitude lors de sa déclaration, celle-ci est immédiatement intégrée dans le recensement des entrées de légende. Or, le tri séquentiel passif a tendance à séparer visuellement la courbe maîtresse représentant la valeur centrale attendue de sa zone d’incertitude sous-jacente, en particulier lorsque plusieurs modèles prédictifs concurrents sont comparés sur la même surface de tracé.
Dans une légende scientifique rigoureuse, la zone d’incertitude ombrée doit impérativement figurer soit immédiatement en dessous de la courbe moyenne correspondante avec une indentation conceptuelle, soit faire l’objet d’un descripteur composite unifié. En appliquant la méthodologie de permutation vectorielle, l’analyste peut coupler de manière indissociable chaque trajectoire continue avec sa région probabiliste associée, en garantissant que le couple d’indicateurs d’un modèle A soit entièrement explicité avant d’entamer la description des propriétés du modèle B, ce qui prévient tout malentendu d’attribution des bandes de confiance.
9. Approche orientée objet versus approche procédurale de l’ordonnancement
9.1 Réordonnancement explicite via ax.legend() et ax.get_legend_handles_labels()
L’histoire du développement de la bibliothèque Matplotlib a laissé coexister deux philosophies d’interaction logicielle distinctes : le paradigme procédural hérité de la syntaxe MATLAB — structuré autour de l’interface globale de la machine à états — et le paradigme orienté objet moderne centré sur l’instanciation délibérée des structures de figure et d’axe. Bien que le paradigme procédural soit souvent plébiscité dans les tutoriels élémentaires pour sa brièveté superficielle, son emploi pour des manipulations fines d’ordonnancement présente des risques systémiques.
L’approche procédurale repose sur la notion implicite de cible courante : chaque commande opère sur le dernier axe rendu actif dans l’espace global du système. Cette architecture d’état partagé devient hautement vulnérable aux effets de bord dès lors que le pipeline de calcul implique des boucles d’itération imbriquées, des générations asynchrones de rapports ou des appels de fonctions modulaires répartis dans différents modules logiciels. Une inversion d’ordre d’appel peut subrepticement faire basculer le pointeur d’axe courant et appliquer la réorganisation de légende sur un panneau cartésien inapproprié.
À l’inverse, l’architecture orientée objet impose d’invoquer les méthodes d’extraction et de régénération exclusivement sur les références d’axe explicites. Ce formalisme garantit une parfaite étanchéité des états graphiques : les descripteurs manipulés sont rigoureusement attachés à leur conteneur physique légitime, assurant une robustesse absolue au code informatique, indispensable pour les déploiements de logiciels d’analyse en production et la reproductibilité des résultats scientifiques.
9.2 Encapsulation du réordonnancement dans des fonctions génériques
Afin de maximiser la modularité logicielle et de respecter le principe fondamental de non-répétition du code informatique, il est particulièrement vertueux d’encapsuler la logique de réorganisation de légende au sein d’une fonction d’assistance réutilisable. Une telle fonction doit être conçue pour accepter en entrée la référence d’axe ciblée ainsi qu’une spécification déclarative de l’ordre désiré, qui peut prendre la forme soit d’une liste ordonnée d’indices numériques, soit d’une liste explicite d’étiquettes textuelles cibles.
Une implémentation défensive de cette fonction doit intégrer des vérifications préventives systématiques. Si l’utilisateur fournit une liste de chaînes textuelles pour dicter l’ordonnancement, la fonction doit interroger l’axe pour compiler les descripteurs présents, confronter la liste souhaitée avec les étiquettes effectivement déclarées, intercepter les discordances éventuelles et lever des avertissements documentés si une série attendue fait défaut sur le tracé courant. Cette approche prévient les pannes silencieuses d’exécution qui altèrent la cohérence des graphiques sans interrompre le script.
En intégrant ce module utilitaire au sein de la boîte à outils logicielle d’une équipe de recherche, on standardise instantanément le traitement esthétique et ergonomique de l’ensemble des figures du laboratoire, garantissant une uniformité de présentation remarquable à travers les différents chapitres d’un rapport ou les articles d’une série de publications.
9.3 Contrôle programmatique du placement spatial et de la mise en page
La réorganisation de la séquence interne des descripteurs graphiques ne constitue que la moitié du travail d’agencement ergonomique : elle doit s’articuler harmonieusement avec le dimensionnement géométrique et la disposition spatiale de la boîte de légende sur le canevas d’ensemble. Le constructeur de légende fournit une collection d’arguments paramétriques avancés dont la maîtrise conjointe décuple la clarté du résultat final.
Le paramètre de répartition en colonnes multiples revêt une importance cruciale lorsque la légende rassemble un nombre conséquent de séries ou lorsqu’elle est positionnée horizontalement au sommet ou au pied de la figure. L’analyste doit alors garder à l’esprit une spécificité structurelle essentielle de Matplotlib : le flux de remplissage multi-colonnes s’opère par défaut de haut en bas puis de gauche à droite (remplissage en colonne majeure). Si l’on ne maîtrise pas l’ordre des éléments sous-jacents, une permutation pensée pour une lecture linéaire horizontale apparaîtra totalement désorganisée si elle est distribuée sur plusieurs colonnes verticales.
Par ailleurs, l’ancrage spatial de précision au moyen de boîtes englobantes de référence permet d’expulser la légende hors de la surface utile de données lorsque la densité des tracés interdit toute incrustation interne sans masquage critique. La combinaison d’un vecteur de réordonnancement logique et d’un ancrage externe rigoureusement calibré produit des figures aérées, lisibles et conformes aux standards graphiques les plus exigeants.
10. Ergonomie cognitive et perception visuelle appliquées aux légendes de données
10.1 La loi de proximité de la Gestalt appliquée à la disposition des séries
L’agencement des éléments d’une légende graphique ne relève pas d’une simple convenance stylistique arbitraire ; il trouve sa justification théorique la plus profonde dans les lois fondamentales de l’organisation perceptive formulées par la psychologie de la forme (Gestalt-théorie). Parmi ces principes régissant la vision humaine, la loi de proximité stipule que les éléments spatiaux les plus proches les uns des autres sont spontanément regroupés par le système visuel pré-attentif pour constituer une unité signifiante cohérente.
Appliquée à la conception graphique de données scientifiques, cette loi impose de minimiser à la fois la distance géométrique et la distance topologique entre une série tracée et son étiquette nominale. Lorsque l’observateur observe la terminaison d’une série temporelle à l’extrême droite du plan cartésien, son œil recherche immédiatement le libellé textuel correspondant. Si l’ordre séquentiel vertical de la boîte de légende reproduit à l’identique l’altitude relative des courbes à ce point d’impact visuel, la distance cognitive est quasi nulle : le regard glisse horizontalement de la ligne à son texte sans rupture de trajectoire.
À l’inverse, si l’ordre est inversé ou désordonné, le lecteur subit un croisement attentionnel. Les trajectoires de mise en relation visuelle se chevauchent, créant une interférence spatiale qui contraint le cerveau à inhiber temporairement la loi de proximité naturelle pour engager un processus d’analyse analytique séquentiel lent et coûteux en énergie cognitive.
10.2 Hiérarchie de l’attention visuelle et ordonnancement sémantique
L’attention visuelle humaine est sélective et obéit à des schémas d’exploration hiérarchisés. Dans les cultures de lecture occidentales, le balayage oculaire d’un bloc textuel s’effectue invariablement du sommet vers la base et de la gauche vers la droite. Les entrées positionnées aux premiers rangs d’une liste bénéficient ainsi d’une primauté attentionnelle indiscutable, captant l’intérêt du réviseur avant que celui-ci ne parcoure les lignes inférieures.
Cette réalité psychophysique dicte une stratégie rigoureuse d’ordonnancement sémantique des catégories dans la légende. La série incarnant la condition expérimentale de référence — par exemple le groupe témoin ou la valeur théorique de base — doit impérativement figurer en tête de la séquence explicative. Les variantes expérimentales, les traitements pharmacologiques ou les alternatives de politique publique doivent ensuite s’échelonner logiquement, soit par degré croissant d’écart au témoin, soit selon une chronologie d’application protocolaire cohérente.
Placer un groupe témoin au milieu d’une légende désorganisée par le simple hasard de l’ordre d’importation d’un fichier CSV constitue une faute méthodologique majeure : cela oblige le lecteur à reconstruire mentalement l’espace des différences relatives sans disposer de l’étalon de mesure visuel à son point naturel d’initiation cognitive. L’ordonnancement n’est donc pas neutre ; il guide subtilement mais puissamment l’interprétation rationnelle des faits scientifiques sans altérer en rien la factualité brute des coordonnées tracées.
10.3 Réduction de la charge cognitive extrinsèque
Dans la théorie de la charge cognitive développée par John Sweller, la capacité de traitement de la mémoire de travail humaine est sévèrement contrainte face à de nouvelles informations. Cette théorie segmente la charge mentale globale en trois composantes : la charge intrinsèque (associée à la difficulté conceptuelle propre du sujet étudié), la charge essentielle (consacrée à la construction de schémas de compréhension durables) et la charge extrinsèque, engendrée par la manière dont l’information est présentée à l’apprenant.
Une légende désorganisée, dont la séquence défie l’intuition visuelle et impose des va-et-vient incessants pour associer une teinte de couleur à sa signification, surcharge inutilement et lourdement la composante cognitive extrinsèque de l’observateur. Au lieu de consacrer la totalité de ses facultés analytiques à interpréter les implications théoriques d’une divergence de trajectoire entre deux modèles, l’esprit du lecteur épuise ses précieuses ressources de mémoire de travail à résoudre l’énigme superficielle de la table de correspondance graphique.
En harmonisant rigoureusement l’ordre des descripteurs graphiques et de leurs étiquettes avec la disposition logique des données, le chercheur purge son document de cette friction attentionnelle parasitaire. L’acte de lecture graphique devient fluide, presque inconscient, permettant au lecteur d’investir l’intégralité de son potentiel intellectuel dans la saisie immédiate des insights profonds portés par les données.
11. Diagnostics, pièges fréquents et résolution des erreurs d’indexation
11.1 Erreur d’inadéquation de dimension entre listes permutées
La manipulation directe de listes d’indices et de compréhensions vectorielles expose l’ingénieur à des erreurs logicielles classiques mais potentiellement pernicieuses si elles ne sont pas anticipées dès la conception du code. L’anomalie la plus explicite se manifeste sous la forme d’une exception de débordement indiciaire, déclenchée lorsqu’un nombre spécifié dans le vecteur de permutation dépasse la taille effective de la liste des descripteurs collectés sur l’axe.
Ce dysfonctionnement survient classiquement lorsque le code graphique est réutilisé sur un sous-ensemble filtré de données ne contenant qu’une portion des séries attendues. Si le vecteur d’indices a été configuré de manière statique pour quatre éléments alors que le jeu de données épuré n’en fournit que trois, l’interpréteur interrompra brutalement le tracé lors de l’appel indiciaire. La réponse défensive face à ce risque consiste à systématiser l’emploi d’assertions préalables vérifiant que la longueur maximale du vecteur de permutation ne surpasse jamais la dimension des tableaux retournés par la méthode d’inspection.
Un danger plus insidieux encore concerne la troncature accidentelle de la légende. Si le vecteur de réordonnancement omet involontairement un indice — par exemple en ne spécifiant que trois entiers alors que l’axe héberge quatre séries distinctes —, Python n’émettra aucune alerte : il construira docilement une légende à trois éléments, amputant silencieusement la figure de l’un de ses indicateurs essentiels. Une vérification d’égalité stricte entre la taille des listes source et celle des listes réordonnées doit être systématiquement instaurée avant la régénération du composant graphique.
11.2 Désynchronisation entre la géométrie des handles et le texte des labels
De toutes les erreurs susceptibles d’entacher une visualisation de données scientifiques, la désynchronisation croisée entre les descripteurs graphiques et les libellés textuels constitue incontestablement la plus catastrophique sur le plan déontologique et analytique. Si un développeur réordonne la liste des chaînes de caractères au moyen d’un algorithme de tri alphabétique mais omet d’appliquer l’exacte même séquence de permutation à la collection des descripteurs géométriques, la légende générée associera des couleurs, des marqueurs et des styles parfaitement erronés aux concepts décrits.
Cette faute produit un phénomène de faux étiquetage silencieux : le graphique demeure syntaxiquement valide, le moteur de rendu ne soulève aucune erreur d’exécution, et la figure présente un aspect visuel irréprochable. Pourtant, une courbe affichant une mortalité clinique alarmante pourra se voir attribuée l’étiquette du groupe placebo, et inversement, induisant les réviseurs scientifiques et les décideurs politiques en erreur absolue.
Pour immuniser définitivement son pipeline analytique contre ce fléau, il est impératif de proscrire tout traitement isolé de l’une ou l’autre des deux listes. L’agrégation systématique sous forme de couples insécables (via la primitive native de fermeture de listes) avant toute opération de tri ou de permutation, suivie d’une décompression scellée au moment exact de l’affectation, garantit mathématiquement que chaque descripteur demeure indissolublement rivé à son signifiant nominal d’origine.
11.3 Comportement erratique lors de tracés itératifs ou d’animations
L’orchestration des légendes révèle des comportements particulièrement instables dans les environnements de calcul itératifs, tels que les carnets de notes interactifs ou les scripts générant des animations temporelles image par image. Lorsqu’un même axe fait l’objet de tracés successifs au sein d’une boucle logicielle sans réinitialisation complète de son état graphique, les artistes précédemment déclarés continuent d’exister dans la mémoire interne du conteneur.
Si la méthode de construction de légende est invoquée à chaque cycle itératif en s’appuyant sur l’inspection automatique, la méthode compilerait une liste sans cesse croissante de descripteurs fantômes — incluant les traces des itérations antérieures —, aboutissant à une boîte de légende hypertrophiée, saturée de doublons orphelins et de références obsolètes. L’application d’un vecteur d’ordonnancement statique sur cette collection en prolifération incontrôlée produira alors des décalages imprévisibles.
Pour assainir les contextes itératifs, l’analyste doit impérativement exécuter une purge délibérée de l’état de l’axe ou détruire l’ancienne instance de légende avant de recompiler la nouvelle. L’accès à la propriété de légende existante permet d’appeler explicitement sa méthode de suppression matérielle, assurant que l’axe retrouve une virginité structurelle avant que la nouvelle vague de données ne soit tracée, capturée, réordonnée et restituée.
12. Synthèse pratique et modèles de code réutilisables pour la recherche
12.1 Modèle universel pour tri personnalisé basé sur une liste de références
Afin de concrétiser l’ensemble des préceptes théoriques et méthodologiques développés tout au long de cet ouvrage au sein d’une solution directement exploitable, formalisons un patron de conception universel destiné à réordonner n’importe quelle légende Matplotlib selon une hiérarchie sémantique prédéfinie.
Ce modèle repose sur une fonction d’assistance architecturée selon les meilleures pratiques de programmation défensive. La fonction reçoit en paramètre formel l’objet d’axe cible ainsi qu’une liste de chaînes de caractères établissant la hiérarchie nominale exacte souhaitée pour la légende finale. Dans son corps d’exécution, elle interroge l’axe pour compiler les couples descripteurs-étiquettes effectivement présents sur le canevas graphique. Elle bâtit ensuite une table de correspondance associative univoque liant chaque libellé à son descripteur matériel.
La reconstitution des listes ordonnées s’opère alors en itérant sur la liste de référence : chaque étiquette sollicitée est extraite du dictionnaire avec son descripteur associé. Si l’axe contient des éléments tracés qui n’étaient pas explicitement mentionnés dans la nomenclature de référence, la fonction les capture dans un second temps et les adjoint élégamment en queue de liste, évitant toute perte involontaire d’information visuelle. Enfin, la légende de l’axe est reconfigurée avec ces vecteurs harmonisés, garantissant une conformité parfaite avec les exigences éditoriales.
12.2 Intégration transparente avec Seaborn et les visualisations à facettes
Dans l’écosystème contemporain de la science des données, de nombreuses visualisations de haut niveau sont générées via la surcouche logicielle Seaborn, réputée pour ses abstractions statistiques sophistiquées et son intégration native avec les structures tabulaires pandas. Toutefois, lorsqu’il s’agit de restructurer finement l’ordre des entrées de légende d’une grille de facettes ou d’une matrice de dispersions croisées, l’utilisateur se heurte fréquemment aux limitations des paramètres déclaratifs de haut niveau.
Seaborn délègue l’intégralité de son rendu d’infrastructure aux objets fondamentaux de Matplotlib. Les objets de grille générés par la bibliothèque encapsulent en leur sein une référence directe vers l’instance de figure parente ainsi qu’une matrice de sous-axes. Pour réordonner la légende autonome positionnée par Seaborn en dehors de la grille de sous-graphiques, la méthode canonique consiste à intercepter directement cette légende de figure, à extraire ses artistes constitutifs, puis à appliquer les algorithmes de réindexation vectorielle développés précédemment.
Il est essentiel de noter qu’après avoir instancié la nouvelle légende réordonnée sur la figure Seaborn, il convient de désactiver ou de purger explicitement la légende interne originelle générée automatiquement par la méthode de facettage, sous peine de voir coexister deux blocs de légende concurrents sur le document vectoriel final. Cette synergie entre l’expressivité analytique de Seaborn et la précision chirurgicale de l’API bas niveau de Matplotlib confère au chercheur un contrôle plastique et typographique absolu sur ses figures de synthèse.
12.3 Recommandations finales pour les manuscrits et rapports de haute précision
Au terme de cette analyse approfondie des dynamiques d’ordonnancement de légende, nous formulons une grille d’audit qualité opérationnelle destinée à valider chaque figure avant son incorporation définitive dans un manuscrit académique ou un rapport stratégique à fort impact :
- Critère d’alignement spatial et cognitif : Vérifier systématiquement que la séquence verticale des entrées de la légende reproduit sans distorsion l’altitude terminale relative des courbes sur l’axe des ordonnées, ou qu’elle reflète une taxonomie logique évidente (par exemple, le témoin expérimental trônant invariablement en tête de liste).
- Vérification d’intégrité sémiotique : Échantillonner minutieusement chaque couleur, style de tiretement et morphologie de marqueur au sein de la boîte de légende pour garantir qu’aucune désynchronisation structurelle n’a interverti l’attribution des identités lors de la phase de réindexation programmatique.
- Gestion raisonnée de l’encombrement géométrique : S’assurer que la boîte de légende ne masque aucun point de données critique ni aucune étiquette d’échelle. En cas de forte densité informative sur le plan d’affichage, déporter la légende à l’extérieur de la surface cartésienne au moyen des ancrages englobants ou ventiler les catégories sur plusieurs colonnes régulières.
- Exclusion des éléments graphiques parasites : Confirmer que tous les calques d’arrière-plan, lignes de moyenne auxiliaires ou repères d’incertitude non pertinents pour la légende portent bien un identifiant textuel débutant par un tiret de soulignement, interdisant leur prolifération involontaire dans l’espace paratextuel.
- Pérennité de l’exportation vectorielle : Lors de l’enregistrement final de la figure au format vectoriel haute résolution (tel que le format PDF ou SVG requis par les presses académiques), vérifier que la structure des calques de texte et des descripteurs graphiques n’a subi aucune pixellisation destructrice, préservant la netteté typographique et la finesse géométrique à n’importe quelle échelle d’impression physique.
La rigueur investie dans l’ordonnancement chirurgical d’une légende graphique reflète la rigueur même du protocole expérimental et de l’analyse computationnelle sous-jacents. En maîtrisant les subtilités architecturales de Matplotlib exposées dans ce traité, l’analyste transmue une simple image de données en un puissant instrument de démonstration scientifique, où chaque composant perceptif converge harmonieusement vers une transmission cristalline de la vérité empirique.
Références
Bertin, J. (1967). Sémiologie Graphique: Les diagrammes, les réseaux, les cartes. Éditions Gauthier-Villars.
Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
Koffka, K. (1935). Principles of Gestalt Psychology. Harcourt, Brace and Company.
Matplotlib Development Team. (2024). Legend guide: Controlling the legend order and layout in Matplotlib. Matplotlib Documentation. https://matplotlib.org/stable/tutorials/intermediate/legend_guide.html
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
Tufte, E. R. (2001). The Visual Display of Quantitative Information (2e éd.). Graphics Press.
Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021