
Dans le domaine de l’analyse quantitative et de la communication scientifique, la restitution graphique des données constitue le vecteur fondamental de transmission des résultats empiriques. L’écosystème statistique du logiciel R, et tout particulièrement l’extension ggplot2 conçue par Hadley Wickham, s’est imposé comme le paradigme de référence pour la production de représentations visuelles rigoureuses et reproductibles. Fondé sur les principes théoriques de l’ouvrage fondateur de Leland Wilkinson, The Grammar of Graphics, ggplot2 envisage chaque tracé non comme une simple illustration statique, mais comme une composition stratifiée associant un modèle de données sous-jacent, des transformations statistiques, des coordonnées spatiales et des correspondances esthétiques explicites.
Cependant, la traduction automatisée d’un tableau de données en une figure intelligible soulève des défis sémiotiques considérables, dont le principal réside dans la gestion des guides et des légendes associées aux variables discrètes. Par défaut, le moteur de rendu applique des règles d’ordonnancement algorithmiques neutres, le plus souvent calquées sur l’ordre alphabétique ou l’indexation interne des facteurs. Cette disposition machinale entre fréquemment en conflit direct avec la logique conceptuelle de la recherche scientifique. Qu’il s’agisse de respecter la hiérarchie d’un protocole clinique, la progression séquentielle d’une échelle psychométrique ordinale ou l’étalonnage chronologique d’un devis expérimental, l’ordonnancement précis des éléments dans la légende graphique représente une exigence méthodologique majeure.
Le présent article propose une analyse approfondie des mécanismes régissant la génération, la configuration et le tri des légendes au sein de ggplot2. À travers l’examen détaillé des structures de données en amont, des fonctions d’échelle discrètes, du paramétrage fin des guides graphiques et des impératifs éditoriaux issus notamment des normes internationales de l’American Psychological Association (APA), cette étude constitue un guide exhaustif destiné aux chercheurs, biostatisticiens et analystes désireux de maîtriser pleinement la rhétorique visuelle de leurs figures.
1. Introduction aux mécanismes de génération des légendes dans ggplot2
1.1 Architecture fondamentale de la grammaire des graphiques
L’architecture interne de ggplot2 repose sur une formalisation rigoureuse de la visualisation de données, dans laquelle chaque composant visuel émerge de l’application de fonctions d’association univoques appelées correspondances esthétiques (aesthetic mappings). Lorsqu’une variable issue du jeu de données est assignée à un canal perceptif discret — qu’il s’agisse de la chromaticité de remplissage (fill), de la teinte des contours (color), de la géométrie des symboles (shape) ou du motif de trait (linetype) —, le moteur graphique ne se contente pas de dessiner des formes géométriques. Il instancie simultanément une échelle de mesure (scale) chargée de convertir les modalités abstraites de la variable en valeurs physiques perceptibles dans l’espace du canevas.
Ce processus de transformation s’accompagne obligatoirement de la construction d’une table de correspondance inverse, matérialisée par le guide ou la légende. Le rôle structurel de cette table est de permettre au lecteur d’effectuer le décodage sémiotique : retrouver la modalité expérimentale d’origine à partir du stimulus visuel observé sur la figure. Il existe ainsi une dissociation théorique essentielle entre l’objet géométrique (la couche geom_*) qui matérialise les données dans le repère cartésien et l’échelle (la fonction scale_*) qui gouverne la codification et l’étiquetage des attributs. Comprendre cette dichotomie s’avère indispensable pour appréhender les leviers d’action permettant de modifier l’ordre d’affichage des éléments sans altérer l’intégrité de la géométrie sous-jacente.
La cohérence visuelle dans l’interprétation des données scientifiques découle directement de la fidélité de cette table de correspondance. Si l’échelle de mesure subit une distorsion non maîtrisée ou si l’ordre des catégories affichées diverge de l’ordre conceptuel de lecture, la validité interne de la transmission des connaissances est directement compromise. Les guides générés par ggplot2 ne sont donc pas de simples ornements périphériques, mais des composants structurels du modèle statistique visuel, assurant la transition entre la syntaxe formelle du code R et la perception cognitive humaine.
1.2 Fonction sémiotique de la légende en sciences quantitatives
En sciences quantitatives, la légende assume une fonction sémiotique fondamentale qui dépasse la simple identification lexicale des groupes d’observation. Elle agit comme un filtre cognitif dont l’agencement séquentiel conditionne l’accès au sens et dicte la trajectoire oculaire de l’observateur. Selon la théorie de la charge cognitive appliquée à la communication graphique, la distance mentale nécessaire pour faire correspondre un point d’intérêt graphique à sa signification textuelle doit être réduite au strict minimum. Un ordonnancement anarchique ou contre-intuitif oblige l’intellect à des allers-retours oculaires fréquents, saturant la mémoire de travail au détriment de l’analyse critique des contrastes statistiques.
L’impact de la hiérarchisation séquentielle des éléments se manifeste avec une acuité particulière lors de la comparaison de conditions expérimentales. Lorsqu’un chercheur présente un groupe contrôle face à diverses gradations thérapeutiques, le cerveau s’attend naturellement à ce que la condition de référence apparaisse en tête de liste, suivie par les doses croissantes ou les paliers temporels successifs. Une inversion ou un désordre alphabétique brise cette continuité séquentielle et introduit un biais d’interprétation, voire une méprise quant à la direction de l’effet mesuré.
Les exigences normatives des revues à comité de lecture imposent désormais une rigueur éditoriale stricte concernant l’alignement des conditions expérimentales. Dans de nombreuses disciplines, les évaluateurs sanctionnent les représentations graphiques où l’ordre des légendes ne reflète pas scrupuleusement le protocole décrit dans la section méthodologique. Les problématiques récurrentes de tri non contrôlé — telles que l’insertion involontaire de la modalité « Placebo » entre deux traitements actifs par simple coïncidence orthographique — constituent l’une des causes majeures de non-conformité lors des processus de révision par les pairs.
1.3 Vue d’ensemble des approches méthodologiques disponibles
Afin de résoudre cette discordance entre le tri automatique et la hiérarchie empirique, l’environnement de développement R offre trois grandes approches méthodologiques, chacune intervenant à un niveau distinct du pipeline de traitement des données. La première stratégie, qualifiée de structurelle, s’opère en amont de la construction graphique, directement au sein du tableau de données (data frame ou tibble). Elle consiste à convertir explicitement les vecteurs textuels en variables de type facteur (factor) et à fixer de manière immuable l’attribut vectoriel de leurs niveaux (levels). Cette méthode garantit une propagation systématique de l’ordre désiré à l’ensemble des figures, analyses de variance ou régressions linéaires subséquentes.
La seconde approche relève de l’ajustement contextuel au sein même de l’expression graphique. Elle mobilise les fonctions d’échelle discrètes natives de ggplot2, notamment à travers les familles scale_color_discrete(), scale_fill_discrete() ou leurs variantes manuelles scale_*_manual(). En exploitant judicieusement les paramètres formels breaks et limits, l’analyste peut remodeler ponctuellement l’ordre d’affichage de la légende pour un tracé spécifique, sans altérer la définition globale de la variable dans la structure de données maîtresse. Cette flexibilité est particulièrement recherchée dans les flux d’exploration interactive.
La troisième approche concerne le paramétrage direct des spécifications du guide par l’intermédiaire de la fonction guides() et de son constructeur guide_legend(). Cette technique de post-traitement cosmétique permet d’inverser globalement l’ordre de présentation ou de réagencer spatialement les entrées sous forme matricielle sans toucher aux échelles sous-jacentes. Le tableau comparatif suivant synthétise les caractéristiques opérationnelles de ces trois stratégies :
- Approche structurelle (Facteurs) : Intervention en amont dans le pipeline de données ; portée globale affectant les graphiques et modèles statistiques ; reproductibilité maximale ; maintenance simplifiée dans les grands projets.
- Approche par les échelles (
scale_*) : Intervention locale dans le code ggplot2 ; isolation des modifications sans effet de bord sur le jeu de données ; idéale pour des présentations ad hoc ou des variations visuelles ponctuelles. - Approche par les guides (
guides(reverse=...)) : Intervention purement cosmétique ; idéale pour synchroniser instantanément l’ordre vertical d’une légende avec des barres empilées sans modifier la palette de couleurs.
2. Comprendre le comportement par défaut de tri dans ggplot2
2.1 L’ordonnancement lexicographique des vecteurs textuels
Lorsqu’un utilisateur transmet à une fonction graphique de ggplot2 un tableau de données contenant des vecteurs de chaînes de caractères (type character), le système effectue une conversion de type implicite et silencieuse. En effet, les algorithmes de spatialisation et de correspondance chromatique ne peuvent opérer sur un continuum indifférencié de textes bruts : ils requièrent l’identification d’un ensemble fini de modalités discontinues. Dès lors, la fonction sous-jacente transforme à la volée le vecteur textuel en un facteur temporaire, assignant à chaque chaîne distincte une position ordinale.
Par défaut, cette conversion applique rigoureusement un tri lexicographique, c’est-à-dire l’ordre alphabétique standard propre aux paramètres régionaux (locale) configurés sur le système d’exploitation de la machine hôte. Cette dépendance environnementale implique d’ailleurs un risque subtil mais réel de non-reproductibilité : le même script exécuté sur un serveur configuré sous un environnement linguistique anglo-saxon ou scandinave peut théoriquement générer un ordonnancement différent si des caractères diacritiques ou des ligatures spécifiques sont présents dans les modalités de la variable catégorielle.
Ce tri lexicographique s’avère dans l’immense majorité des cas totalement inadapté à la logique conceptuelle de la recherche. Si l’on considère une variable décrivant l’intensité d’un phénomène selon les trois modalités « Faible », « Moyen » et « Élevé », l’ordre alphabétique automatique produira la séquence « Élevé », « Faible », « Moyen ». L’observateur se trouve alors confronté à une inversion flagrante de la dynamique naturelle du phénomène étudié. Cette distorsion visuelle brise les attentes mnésiques et contraint l’esprit à corriger intellectuellement la trajectoire visuelle imposée par le graphique, illustrant l’inadéquation structurelle du tri par défaut pour les variables ordinales.
2.2 L’influence structurelle des variables de type facteur
Pour dépasser les limites inhérentes aux vecteurs textuels, le langage R dispose d’une classe d’objets spécifique et incontournable : le facteur (factor). Sur le plan de son architecture mémoire interne, un facteur n’est pas une simple chaîne de caractères, mais un vecteur d’entiers pointant vers une table de recherche interne matérialisée par l’attribut levels. Cet attribut est lui-même un vecteur de chaînes de caractères ordonné de manière rigide, où chaque niveau correspond à un entier précis, débutant conventionnellement par 1 pour la première modalité déclarée.
Le moteur de ggplot2 accorde une priorité absolue et inconditionnelle à l’attribut levels des facteurs lors de l’exécution de la méthode d’échelle. Quelle que soit la manière dont les observations sont disposées au sein des lignes du tableau de données, l’ordre d’attribution des couleurs, des formes et des entrées de la légende suivra scrupuleusement la séquence définie dans ce vecteur de niveaux. Il existe toutefois une distinction conceptuelle fondamentale entre les niveaux internes (levels) et les étiquettes de surface (labels) : les premiers constituent la clé d’identification structurelle de la modalité, tandis que les seconds ne représentent que son habillage typographique destiné à l’affichage humain.
Un phénomène classique mais souvent source de confusion réside dans la persistance des niveaux inutilisés (empty levels). Lorsqu’un chercheur filtre un tableau de données pour n’analyser qu’un sous-ensemble expérimental — par exemple en éliminant une condition aberrante —, les modalités correspondantes disparaissent des données observées mais demeurent inscrites dans l’attribut levels du facteur sous-jacent. En l’absence de purge explicite, ggplot2 conservera ces catégories fantômes au sein de la légende graphique, générant des entrées vides dépourvues de toute géométrie associée, ce qui dégrade considérablement la lisibilité globale de l’œuvre scientifique.
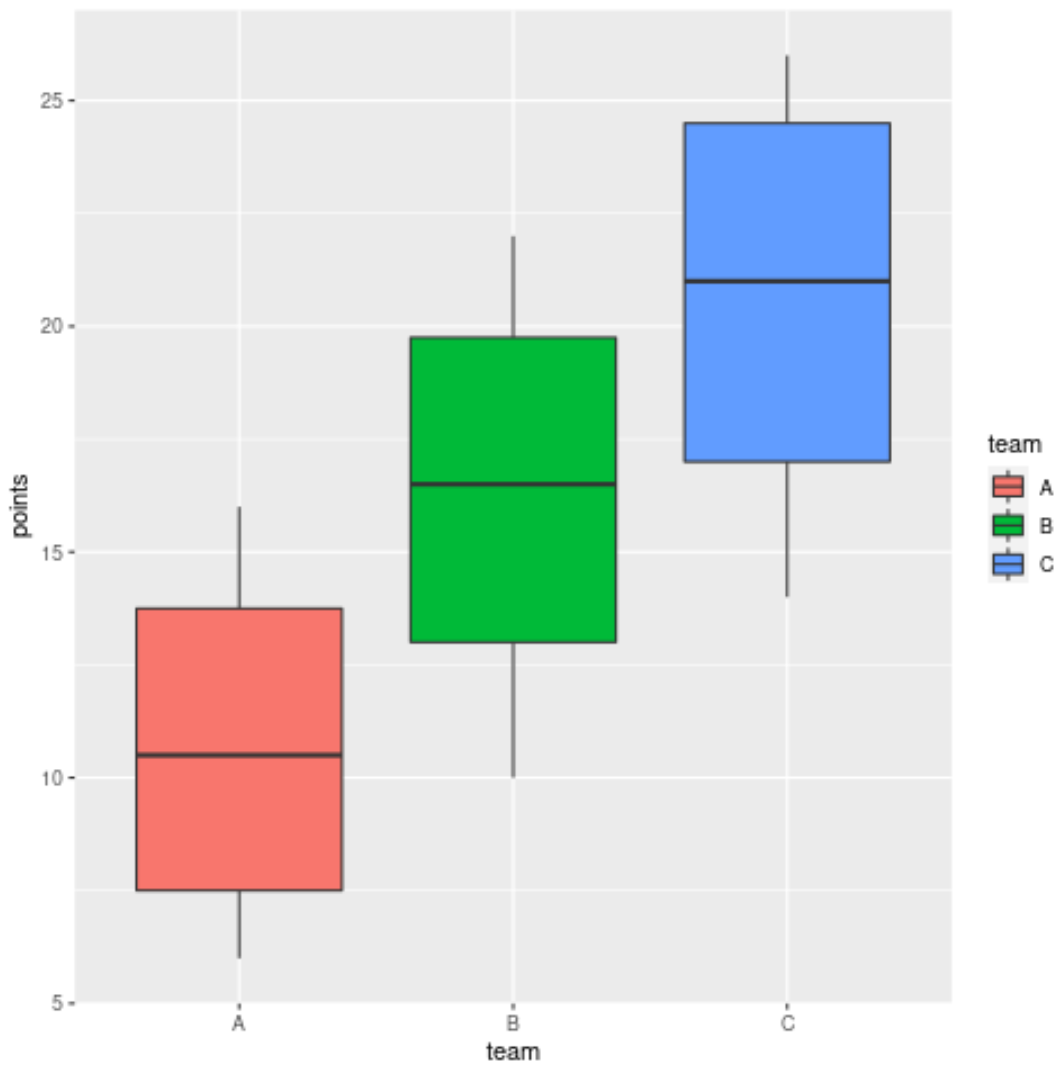
2.3 Interactions entre axes géométriques et légendes associées
Dans la grammaire des graphiques, les axes géométriques (l’abscisse x et l’ordonnée y) partagent le même socle mathématique formel que les canaux esthétiques chromatiques ou volumétriques : il s’agit d’échelles de projection. De ce fait, lorsqu’une même variable catégorielle est projetée simultanément sur un axe de coordonnées spatiales (par exemple l’axe horizontal d’un diagramme en barres ou d’un diagramme en boîte) et sur une esthétique de remplissage (fill), ggplot2 applique un couplage automatique et synchronise leur tri sur la base des niveaux du facteur correspondant.
Cette synchronisation native peut toutefois être rompue lors d’interventions partielles ou asymétriques au sein du script. Si un analyste tente de forcer l’ordre de la légende par un mécanisme cosmétique local tout en omettant de réaligner l’échelle de l’axe discret spatial, il s’expose à une désynchronisation cognitive sévère : la progression spatiale de gauche à droite sur l’axe des abscisses ne correspondra plus à l’ordre séquentiel de haut en bas de la boîte de légende. Cette rupture d’harmonie visuelle viole l’un des principes cardinaux de l’ergonomie graphique.
Ces interactions atteignent un degré de complexité supérieur lors de l’usage des techniques de multi-panneaux, couramment désignées sous le vocable de facettage (faceting via facet_wrap() ou facet_grid()). Dans ces configurations multifactorielles, la légende centrale doit rester cohérente vis-à-vis de l’ensemble des sous-graphiques générés. Une mauvaise gestion de l’ordonnancement de la variable de facettage ou de la variable d’esthétique partagée induit un éclatement de la cohérence visuelle d’un panneau à l’autre, rendant impérative une harmonisation globale du flux de traitement des variables en amont de toute tentative de mise en page graphique.
3. Méthode structurale : Réordonner en amont via les facteurs R
3.1 Utilisation de la fonction factor() de base
L’approche la plus robuste, la plus pérenne et la plus respectueuse de l’architecture logicielle de R consiste à intervenir directement sur l’objet de données avant tout appel à la fonction ggplot(). La méthode canonique repose sur l’utilisation explicite du constructeur factor() issu du paquet de base du langage. Cette fonction permet de convertir une variable catégorielle tout en précisant rigoureusement la séquence des modalités attendues via l’argument formel levels.
Sur le plan computationnel, l’opération consiste à redéfinir la colonne d’intérêt au sein du tableau de données en lui fournissant un vecteur de chaînes de caractères représentant l’intégralité des modalités dans leur ordre logique souhaité. Par exemple, pour une variable désignant des cohortes expérimentales, l’expression data$groupe <- factor(data$groupe, levels = c("Controle", "Dose_Faible", "Dose_Forte")) réécrit l’attribut structurel sans modifier la valeur intrinsèque d’aucune observation. Chaque individu statistique conserve son assignation expérimentale, mais le système lui attribue désormais un code numérique interne garantissant que « Controle » portera l’indice 1, « Dose_Faible » l’indice 2 et « Dose_Forte » l’indice 3.
Cette manipulation requiert une vigilance absolue quant à l’exactitude typographique des valeurs déclarées dans l’argument levels. Toute omission involontaire ou faute de frappe entraîne la transformation immédiate et irréversible de la modalité non reconnue en valeur manquante (NA), altérant l’intégrité du jeu de données expérimental. Il convient donc de toujours valider au préalable l’exhaustivité des niveaux à l’aide de la commande unique() ou table() avant d’exécuter la réaffectation vectorielle.
3.2 Exploitation du package forcats pour manipulations complexes
Bien que les fonctions de base de R suffisent pour des permutations manuelles simples, la manipulation de variables catégorielles complexes bénéficie grandement de l’apport de l’écosystème forcats, un composant central du méta-package tidyverse spécifiquement conçu pour l’ingénierie des facteurs. Ce paquet propose une collection de fonctions utilitaires intuitives débutant par le préfixe unifié fct_, apportant une lisibilité et une puissance expressive incomparables au sein des pipelines de données modernes fondés sur l’opérateur de tuyauterie (pipe).
Parmi ces outils, la fonction fct_relevel() s’impose comme l’alternative la plus élégante pour repositionner manuellement une ou plusieurs modalités cibles sans devoir spécifier l’intégralité du vecteur. Si un chercheur souhaite simplement extraire la condition « Temoin » pour la placer en première position tout en conservant le classement naturel des autres modalités, l’instruction fct_relevel(donnees$groupe, "Temoin") accomplit cette opération en une fraction de seconde, éliminant tout risque d’erreur de saisie sur le reste de la liste.
Pour les scénarios où l’ordonnancement doit découler des propriétés statistiques de l’échantillon plutôt que d’une décision a priori, forcats déploie des algorithmes d’ordonnancement empirique hautement performants. La fonction fct_reorder() permet de réordonner les niveaux d’un facteur selon les valeurs prises par une seconde variable continue, sous l’égide d’une fonction de synthèse telle que la médiane ou la moyenne arithmétique. Cette approche s’avère fondamentale lors de la création de diagrammes d’importance où les facteurs doivent être hiérarchisés selon leur amplitude d’effet. Par ailleurs, fct_rev() permet l’inversion pure et simple de l’ordre existant, tandis que fct_other() et fct_lump() facilitent le regroupement conditionnel des modalités résiduelles ou peu fréquentes sous un label synthétique d’agrégation.
3.3 Avantages de la méthode amont sur la maintenabilité du code
Le choix de restructurer les facteurs en amont de la modélisation visuelle procure des avantages architecturaux considérables pour la maintenabilité et l’évolutivité des projets de science des données volumineux. En appliquant le principe fondamental d’ingénierie logicielle dit de « séparation des préoccupations » (separation of concerns), l’analyste isole hermétiquement l’étape de préparation et d’assainissement des données de l’étape de rendu graphique. Le code responsable de la figure demeure ainsi épuré, compact et focalisé uniquement sur les questions de mise en scène spatiale.
Cette rigueur structurelle déploie ses effets les plus bénéfiques lors de la production de rapports scientifiques exhaustifs, d’articles académiques ou de thèses universitaires nécessitant la génération de multiples figures interconnectées accompagnées de tableaux statistiques de synthèse. Dès lors que l’attribut levels est fixé au niveau du tableau de bord central des données, l’ensemble des figures générées par ggplot2, mais également les sorties tabulaires produites par des outils tels que knitr::kable ou gt, adopteront spontanément et uniformément la même hiérarchie séquentielle sans la moindre ligne de code supplémentaire.
En outre, cette cohérence structurelle s’avère déterminante pour la phase de modélisation statistique formelle. Dans le cadre de l’estimation d’un modèle linéaire généralisé (comme un modèle ANOVA ou une régression logistique), le logiciel R retient conventionnellement le premier niveau du facteur comme groupe de référence pour le calcul des contrastes statistiques et des coefficients de régression. Structurer rigoureusement ses facteurs en amont permet ainsi d’aligner parfaitement les résultats numériques des modèles statistiques avec les représentations graphiques qui les illustrent, évitant les erreurs de concordance intellectuelle qui surviennent inévitablement lorsqu’un chercheur utilise un groupe de référence pour le calcul et un autre pour l’affichage visuel.
4. Réordonnancement direct par les fonctions d’échelle scale_*_discrete()
4.1 Syntaxe fondamentale et mécanisme de l’argument breaks
Bien que la méthode d’intervention en amont soit recommandée pour les chaînes de traitement standardisées, il se présente régulièrement des situations expérimentales où l’analyste doit modifier l’affichage de la légende au sein même de l’appel graphique sans altérer la définition globale de la variable dans le data frame. C’est précisément le rôle dévolu aux fonctions de la famille scale_*_discrete(), qui constituent le point d’entrée programmatique direct pour contrôler le comportement des échelles catégorielles dans ggplot2.
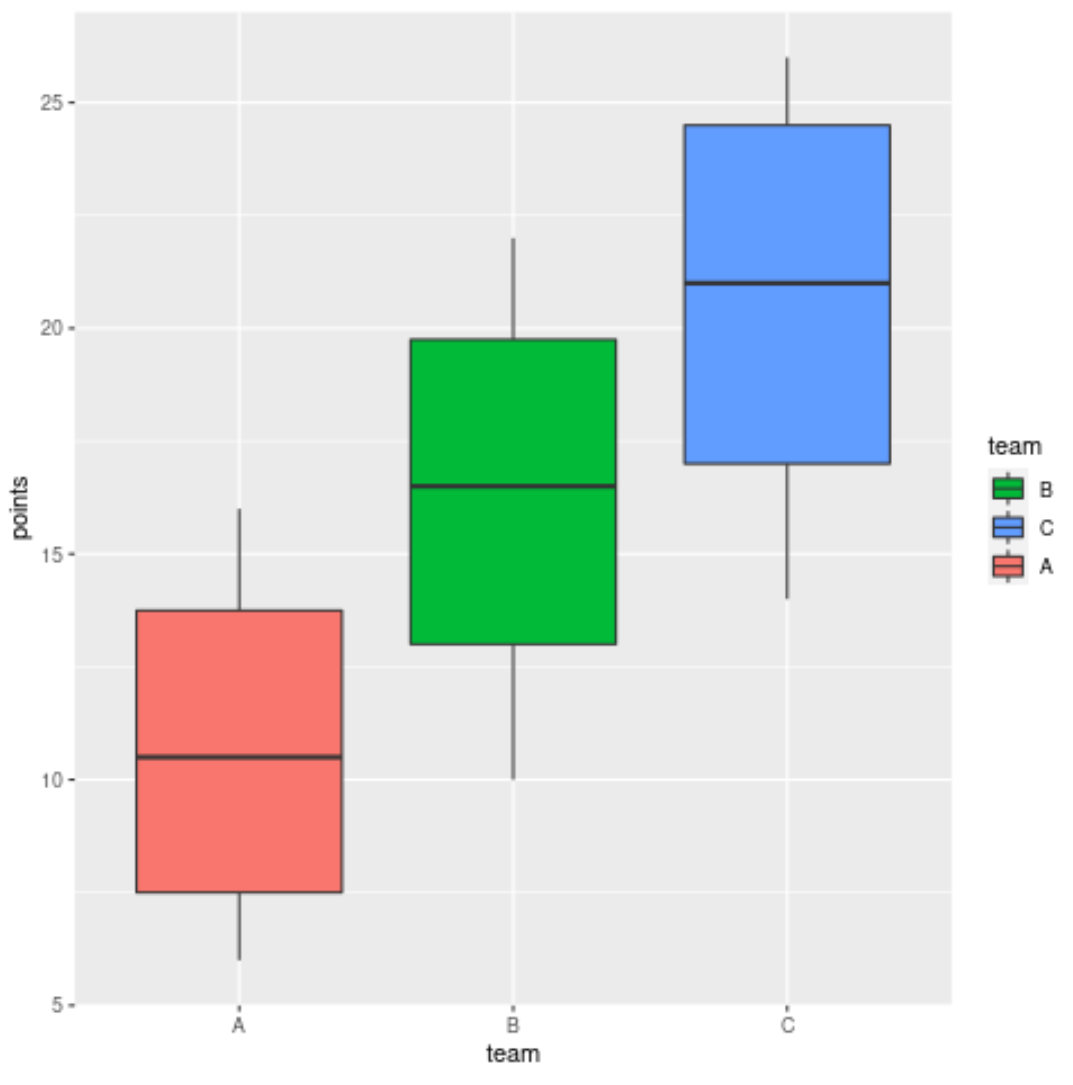
Au cœur de ces fonctions se trouve l’argument formel breaks. D’un point de vue fonctionnel, breaks agit comme un filtre sélecteur et un ordonnanceur pour le guide graphique. En assignant à ce paramètre un vecteur de chaînes de caractères explicitant la séquence des modalités désirées, l’utilisateur ordonne au sous-système de rendu de formater la légende selon cette séquence exacte, de haut en bas ou de gauche à droite, selon l’orientation spatiale du conteneur. Si la variable esthétique concernée est le remplissage coloré, la fonction scale_fill_discrete(breaks = c("C", "A", "B")) positionnera la modalité « C » au sommet de la légende, suivie de « A », puis de « B ».
L’un des bénéfices majeurs de l’usage de breaks réside dans sa capacité à découpler l’ordre de la légende de l’ordre d’affichage sur les axes physiques. Si une variable est mappée sur l’axe des abscisses et qu’une esthétique identique lui est adjointe pour différencier les boîtes à moustaches par une palette chromatique, l’ajustement du vecteur breaks dans l’échelle de remplissage modifie exclusivement l’ordonnancement séquentiel au sein du guide latéral. La géométrie spatiale du tracé demeure parfaitement intacte sur l’axe des coordonnées, conférant à l’analyste un contrôle cartographique d’une précision chirurgicale.
4.2 Distinction cruciale entre breaks, limits et labels
L’une des sources d’erreurs les plus pernicieuses lors de la configuration manuelle des graphiques réside dans l’incompréhension des rôles hautement distincts dévolus aux trois arguments fondamentaux des échelles ggplot2 : breaks, limits et labels. Ces paramètres, bien qu’étroitement interconnectés dans l’évaluation de l’échelle, opèrent à des niveaux conceptuels radicalement différents du moteur géométrique.
L’argument limits définit le domaine de définition exhaustif de l’échelle. Pour une variable discrète, il détermine la liste exacte des modalités autorisées à figurer sur le graphique. L’omission accidentelle d’une modalité dans le vecteur fourni à limits n’a pas pour effet de simplement la masquer de la légende : elle la supprime purement et simplement du processus de tracé géométrique. Toute observation correspondant à un niveau exclu de limits sera traitée comme une valeur en dehors du domaine (out of bounds) et convertie en NA, entraînant la disparition totale de la barre, du point ou de la boîte correspondante sur la figure finale, souvent accompagnée d’un avertissement en console de type Removed rows containing missing values.
À l’opposé, l’argument breaks n’affecte en aucune manière la présence physique des géométries sur le canevas : il gouverne exclusivement la sélection et l’ordonnancement des repères visuels tracés dans le guide ou le long de l’axe. Enfin, l’argument labels n’exerce qu’une fonction cosmétique et typographique : il fournit les chaînes de caractères destinées à remplacer visuellement les noms originaux des modalités. Une contrainte stricte pèse sur l’argument labels : il doit impérativement comporter une longueur vectorielle rigoureusement égale à celle du vecteur passé à breaks, sous peine de déclencher une discordance d’attribution ou une erreur d’exécution bloquante.
4.3 Exemples comparatifs de code étape par étape
Pour illustrer la mise en œuvre pratique de ces concepts, considérons un scénario expérimental représenté sous la forme d’un graphique de dispersion catégoriel. Supposons un jeu de données simulant l’évaluation de trois protocoles pédagogiques : « Standard », « Innovant » et « Hybride ». Dans la configuration initiale non contrôlée, la syntaxe de base s’écrit classiquement en déclarant la couche d’initialisation ggplot(data, aes(x = Score_Test, y = Temps_Reponse, color = Methode)) + geom_point(size = 3). Par défaut, la légende générée classe les modalités selon l’ordre alphabétique strict : Hybride, Innovant, Standard.
Pour réorganiser cette légende de manière à positionner la méthode de référence « Standard » en premier lieu, suivie de la méthode « Innovant », puis de la méthode « Hybride », l’adjonction de l’échelle discrète s’exécute par l’ajout de l’instruction + scale_color_discrete(breaks = c("Standard", "Innovant", "Hybride")). Dès l’exécution, le moteur graphique conserve la palette chromatique par défaut mais réarrange immédiatement les entrées de la boîte de légende pour satisfaire la séquence prescrite par le vecteur d’ordonnancement.
L’analyse des écueils typographiques révèle qu’une erreur fréquente consiste à vouloir simultanément traduire ou renommer les modalités via l’argument labels sans respecter l’ordre interne. Si l’on écrit scale_color_discrete(breaks = c("Standard", "Innovant", "Hybride"), labels = c("Groupe Témoin", "Pédagogie Active", "Modalité Mixte")), l’association s’opère terme à terme selon l’indice de position : « Standard » prendra pour étiquette « Groupe Témoin » et « Innovant » deviendra « Pédagogie Active ». Toute interversion accidentelle au sein du vecteur labels provoque un décalage sémantique catastrophique, associant un nom de modalité erroné à une couleur de données, altérant irrémédiablement la validité des conclusions exposées au lecteur.
5. Adaptation aux différentes esthétiques graphiques
5.1 Contrôle de l’esthétique de contour avec scale_color_discrete()
Dans l’écosystème conceptuel de ggplot2, une différenciation fondamentale et rigide sépare l’attribut de remplissage surfacique (fill) de l’attribut de tracé des contours et de linéarité (color ou colour). Alors que fill régit la coloration interne des polygones, des aires et des histogrammes, color administre exclusivement la teinte des nuages de points, des segments, des encadrements polygonaux et, surtout, des courbes représentant des trajectoires continues. La maîtrise de l’échelle scale_color_discrete() s’avère donc essentielle pour l’ensemble des modélisations longitudinales.
Lors de l’analyse de profils longitudinaux ou de courbes d’évolution temporelle — par exemple dans l’étude de la dynamique d’acquisition d’une compétence cognitive au fil de sessions hebdomadaires —, chaque trajectoire moyenne est matérialisée par un objet géométrique de type geom_line() couplé à une correspondance esthétique catégorielle sur la couleur. Si l’on souhaite que la légende hiérarchise les courbes non pas selon l’orthographe de leur dénomination, mais selon leur niveau de performance finale à la dernière session d’observation, la syntaxe requiert l’injection explicite de ce vecteur de performance ordonné dans le paramètre breaks de scale_color_discrete().
Cette réorganisation de la légende des couleurs impose une harmonisation chromatique vigilante. En modifiant l’ordre des repères sans définir manuellement les valeurs spectrales, l’utilisateur confie à ggplot2 le soin de segmenter l’espace colorimétrique standard HCL de manière équidistante le long de la nouvelle séquence définie. Il importe de vérifier que la permutation de l’ordre d’affichage préserve un contraste perceptif suffisant entre les trajectoires adjacentes, particulièrement lorsque les courbes se croisent à de multiples reprises le long de la série temporelle.
5.2 Gestion des attributs de forme avec scale_shape_discrete()
L’utilisation de symboles typographiques géométriques via l’esthétique shape représente un recours méthodologique classique en sciences comportementales et en psychologie différentielle, tout particulièrement lorsqu’un document est destiné à une reproduction imprimée monochrome ou lorsque l’analyste cherche à combiner plusieurs facteurs expérimentaux au sein d’un même repère cartésien. La fonction scale_shape_discrete() gouverne la projection de ces variables discrètes sur le jeu de symboles natifs de la bibliothèque graphique de R (cercles pleins, triangles, croix, losanges, carrés).
La perception des formes géométriques est soumise à des contraintes cognitives nettement plus sévères que celle des couleurs. L’œil humain discrimine aisément des teintes contrastées, mais distingue difficilement des glyphes géométriques complexes lorsque la densité de points devient substantielle. Dans ce contexte, l’ordonnancement au sein de scale_shape_discrete(breaks = ...) doit impérativement être mis au service de la saillance perceptuelle : les symboles les plus compacts, nets et immédiatement reconnaissables (généralement le point plein de code 16 ou le carré plein de code 15) doivent être assignés aux conditions expérimentales prioritaires ou aux groupes de référence.
Lorsque le chercheur combine la réorganisation des éléments avec une sélection sur mesure des glyphes via la fonction dérivée scale_shape_manual(), l’alignement entre le vecteur des symboles attribués (values) et l’ordre des libellés (breaks) doit faire l’objet d’un paramétrage rigoureux. Le code doit expliciter sans équivoque quel symbole correspond à quelle condition pour éviter qu’une forme géométrique ne soit intervertie lors de la redéfinition des niveaux de lecture de la légende.
5.3 Contrôle des types de traits avec scale_linetype_discrete()
L’esthétique de motif de ligne (linetype) régit la morphologie des tracés continus en découpant le trait selon des séquences mathématiques de pleins et de vides (trait continu, tireté, pointillé, alternance tiret-point). Cette dimension graphique constitue le médium par excellence pour formaliser une divergence méthodologique ou conceptuelle majeure au sein d’une même figure, comme la distinction fondamentale entre des trajectoires observées empiriquement et des prédictions issues d’un modèle mathématique ou théorique.
Dans un rapport académique soumis à des contraintes strictes d’impression en noir et blanc sans dégradé de gris, scale_linetype_discrete() s’avère être la seule passerelle permettant de différencier des cohortes concurrentes. L’organisation du guide associé doit alors respecter une convention de lisibilité éprouvée : le trait plein (solid), doté de la masse visuelle la plus robuste, doit impérativement figurer au sommet de la légende et caractériser l’hypothèse principale ou la population de référence, tandis que les motifs de plus en plus discontinus (dashed, puis dotted) occupent les rangs inférieurs de la hiérarchie.
Le paramétrage explicite de l’argument breaks au sein de scale_linetype_discrete(breaks = c("Reference_Theorique", "Groupe_Actif", "Groupe_Placebo")) permet de garantir cette hiérarchisation sémiotique. L’observateur décode ainsi de manière intuitive la solidité épistémologique des courbes : le continu pour la norme ou le modèle validé, le discontinu pour les conditions exploratoires, instaurant un ordre logique parfait entre l’étalonnage conceptuel de l’expérience et son expression géométrique imprimée.
6. Utilisation conjointe des échelles manuelles : scale_*_manual()
6.1 Définition explicite des palettes personnalisées
Dans le cadre de publications scientifiques d’envergure, l’usage des échelles génériques automatiques cède quasi systématiquement le pas à l’implémentation d’échelles manuelles via la famille scale_*_manual() (notamment scale_color_manual() et scale_fill_manual()). Ces fonctions spécialisées offrent le niveau de contrôle le plus absolu, en permettant au chercheur de conjuguer au sein d’un appel syntaxique unique l’affectation précise des valeurs physiques (nuances hexadécimales, glyphes ou styles de ligne), la sélection des repères affichés et la rédaction de leurs étiquettes éditoriales.
Pour éliminer définitivement tout risque de permutation accidentelle ou d’aléa lié à l’ordre des lignes dans le jeu de données, la méthode experte consiste à utiliser rigoureusement des vecteurs nommés pour alimenter le paramètre values. Un vecteur nommé associe expressément chaque modalité textuelle brute de la variable à un code couleur spécifique (par exemple : c("Placebo" = "#7F7F7F", "Dose_Faible" = "#4A90E2", "Dose_Forte" = "#D0021B")). Une fois cette fondation chromatique sécurisée, l’adjonction de l’argument breaks = c("Placebo", "Dose_Faible", "Dose_Forte") assure la régulation stricte de la disposition verticale ou horizontale de ces éléments dans la légende.
L’intégration de palettes de couleurs répondant aux standards modernes de l’accessibilité visuelle — notamment les spectres certifiés universels tels que les échelles ColorBrewer ou Viridis — s’effectue avec une remarquable élégance via cette formulation manuelle. L’analyste s’assure ainsi que le public atteint de déficiences de la vision chromatique (daltonisme de type deutéranopie ou protanopie) perçoit les contrastes entre modalités ordonnées sans la moindre ambiguïté, les valeurs hexadécimales sélectionnées garantissant un gradient de luminosité monotone le long de la séquence ordonnée.
6.2 Prévention des discordances entre esthétiques manuelles
Le recours aux échelles manuelles accroît considérablement la responsabilité du développeur statistique vis-à-vis de l’intégrité de son code. Une erreur particulièrement fréquente et insidieuse survient lorsque l’on modifie le vecteur d’ordonnancement breaks sans adapter corrélativement le vecteur non nommé d’attribution de couleurs values. Si values est fourni sous forme d’un vecteur positionnel anonyme, l’inversion des breaks n’intervertit pas les couleurs correspondantes sur les objets géométriques mais altère la table de transcription, provoquant une distorsion majeure de l’interprétation des résultats statistiques.
Pour immuniser le flux de traitement contre ces anomalies, le paramètre na.value doit être impérativement configuré. Lorsque l’argument breaks ou limits exclut intentionnellement ou par mégarde une modalité présente dans l’échantillon, ggplot2 sollicite la couleur réservée aux valeurs manquantes pour peindre la géométrie résiduelle. Si na.value est positionné par défaut sur un gris neutre indiscernable des autres catégories de contrôle, l’erreur de conception peut échapper à la relecture initiale et se propager insidieusement jusqu’à l’étape d’impression éditoriale.
La robustesse des scripts graphiques repose sur des protocoles de vérification systématiques de la structure interne des objets de tracé. L’écriture de tests unitaires vérifiant que la longueur du vecteur des breaks coïncide rigoureusement avec le nombre de modalités effectives et que chaque nom de niveau correspond sans ambiguïté aux étiquettes déclarées constitue une pratique exemplaire en science ouverte. Elle garantit la stabilité et la reproductibilité du rendu graphique à travers les versions successives des jeux de données expérimentaux.
6.3 Modularisation du style visuel pour publications
Dans un laboratoire ou une équipe de recherche collaborative, l’écriture répétitive d’instructions manuelles volumineuses au sein de chaque figure engendre une redondance de code néfaste pour la maintenabilité globale des analyses. L’approche recommandée par l’ingénierie logicielle moderne consiste à encapsuler l’ensemble des définitions d’échelles au sein de fonctions d’habillage graphique personnalisées, assurant une gouvernance standardisée de la charte visuelle institutionnelle.
L’utilisateur peut concevoir une fonction modulaire — telle que appliquer_echelle_labo() — encapsulant un appel complet à scale_color_manual(), configuré avec un jeu prédéfini de teintes institutionnelles, un ordre de niveaux figé correspondant à l’organigramme méthodologique du projet, et une nomenclature typographique unifiée. Il suffit ensuite d’agréger cette brique logicielle à n’importe quel objet de type ggplot par une simple opération d’addition (+ appliquer_echelle_labo()) pour formater l’intégralité des représentations selon les mêmes normes de rigueur.
Cette modularisation optimise de manière spectaculaire le flux de production des monographies scientifiques, thèses de doctorat et manuscrits destinés aux revues académiques. Toute décision de révision ultérieure formulée par les pairs ou le comité de rédaction — comme le déplacement du groupe contrôle de la dernière à la première position de la légende — ne nécessite qu’une modification unique dans le corps de la fonction génératrice pour se propager instantanément à l’ensemble des dizaines de figures composant l’ouvrage final.
7. Ordonnancement fin via la fonction guides() et guide_legend()
7.1 Inversion globale de l’ordre avec le paramètre reverse
Au-delà de la redéfinition des échelles de mesure, ggplot2 offre une passerelle de contrôle dédiée à la mise en page physique des guides : la fonction guides() couplée au constructeur spécialisé guide_legend(). Ce sous-système intervient en aval du calcul mathématique des échelles, au niveau de la génération finale des éléments d’habillage graphique (grobs sous l’égide de la bibliothèque grid). Il permet d’opérer des ajustements typographiques et géométriques d’une grande finesse sans recalculer les tables d’affectation statistique.
L’une des options les plus remarquables de guide_legend() réside dans l’argument booléen reverse. L’instruction explicite guides(fill = guide_legend(reverse = TRUE)) commande au système de retourner intégralement l’ordre de présentation des symboles et des libellés dans la boîte de légende. Cette fonctionnalité résout de manière immédiate l’un des casse-têtes les plus récurrents de la visualisation de données : la synchronisation des diagrammes en barres empilées (stacked bar charts).
Par construction géométrique native, ggplot2 empile les segments d’un diagramme en barres de bas en haut en suivant l’ordre croissant des niveaux de la variable. Cependant, la légende standard affiche ces mêmes modalités de haut en bas, créant un effet d’inversion visuelle inconfortable où la catégorie située en haut du graphique correspond à l’entrée située en bas de la légende. L’utilisation de reverse = TRUE inverse l’affichage du guide sans modifier la structure des données, restaurant un parallélisme parfait entre l’espace cartésien et la légende périphérique sans introduire la moindre altération dans la matrice des facteurs.
7.2 Configuration géométrique de la boîte de légende
La spatialisation de la légende ne se limite pas à un simple empilement unidimensionnel. Dans les publications scientifiques où l’espace disponible au sein de la page est compté — par exemple lors de l’insertion d’une figure sur toute la largeur d’une double colonne —, la configuration géométrique de la boîte de légende nécessite une adaptation matricielle rigoureuse. La fonction guide_legend() permet de contraindre précisément cette morphologie spatiale par l’intermédiaire des arguments nrow et ncol.
En fixant, par exemple, ncol = 1, l’analyste contraint l’ensemble des entrées à s’aligner sur une colonne unique verticale, ce qui s’avère idéal pour une position latérale à droite du graphique. Inversement, lors d’un positionnement sous le panneau cartésien (via theme(legend.position = "bottom")), la spécification de nrow = 1 aligne horizontalement l’intégralité des modalités en une seule rangée compacte, évitant ainsi d’amputer la figure de son amplitude verticale utile.
L’agencement matriciel soulève immédiatement la question du parcours visuel d’exploration des catégories, déterminé par l’argument logique byrow. Si byrow = FALSE (comportement par défaut), le remplissage de la matrice s’effectue colonne par colonne, de haut en bas puis de gauche à droite. L’assignation byrow = TRUE inverse cette logique d’itération et distribue les éléments ligne par ligne, de gauche à droite. Cette modulation structurelle conditionne directement la vitesse de balayage oculaire du lecteur et doit impérativement respecter les habitudes culturelles de lecture occidentale pour maintenir une accessibilité cognitive optimale.
7.3 Ajustement des repères visuels internes (keywidth, keyheight)
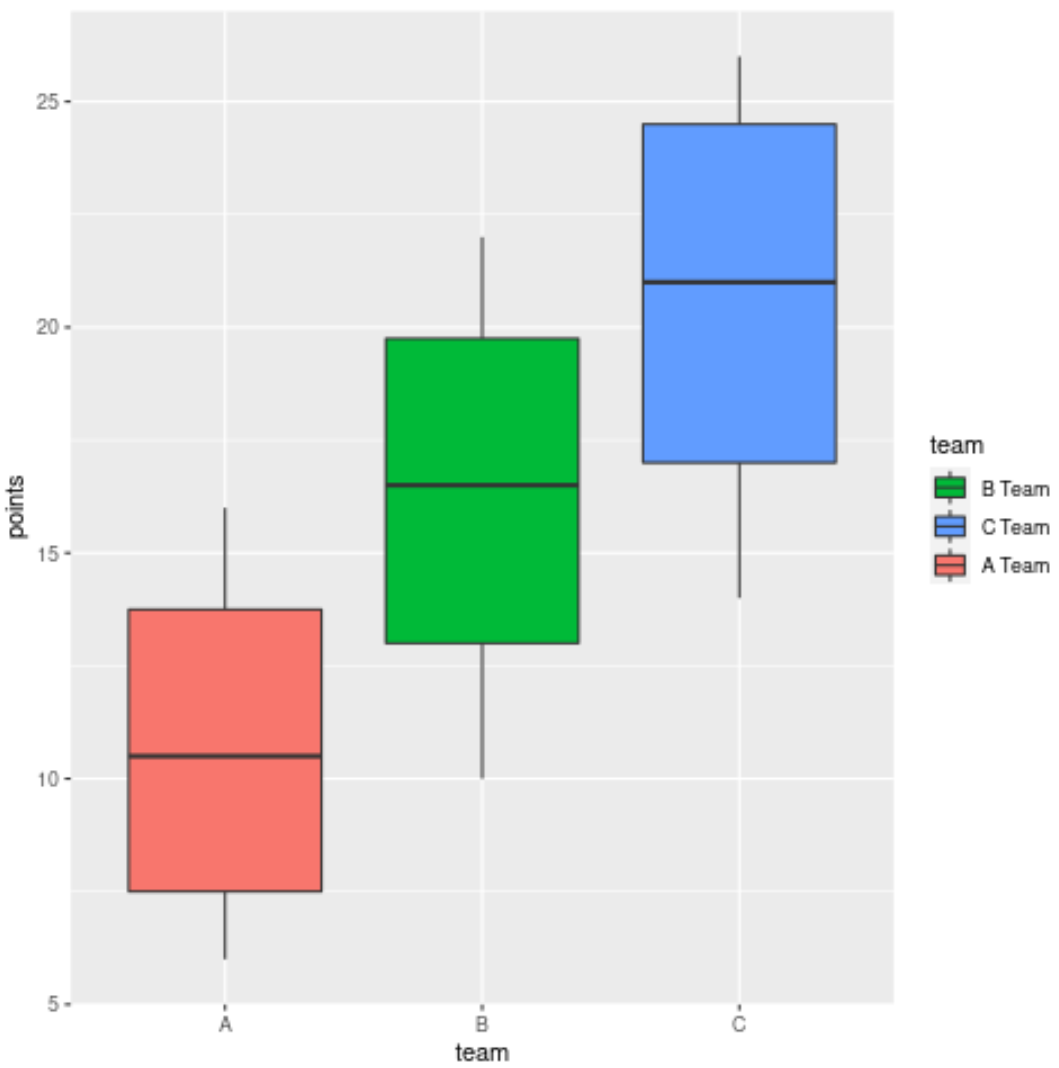
Pour parfaire l’ordonnancement de la légende et garantir une hiérarchisation sans ambiguïté, le calibrage des dimensions physiques des repères visuels (les boîtes d’échantillons ou legend keys) constitue une étape déterminante. La fonction guide_legend() autorise la manipulation microscopique de ces paramètres à l’aide des arguments keywidth et keyheight, alimentés par des unités dimensionnelles strictes issues du package grid (comme unit(0.8, "cm")).
Un dimensionnement inadéquat des boîtes de repère visuel peut gravement entraver la reconnaissance de l’ordre d’affichage. Dans le cas de motifs de lignes pointillés ou tiretés (linetype), une boîte d’échantillon trop étroite (valeur de keywidth insuffisante) ne permet pas au motif périodique de se déployer complètement. Le lecteur ne perçoit alors qu’un fragment indistinct de ligne droite, annulant la différenciation entre une ligne continue et un tireté long. Augmenter substantiellement la largeur de clé pour ces échelles spécifiques restaure la clarté sémiotique du symbole.
Parallèlement, le contrôle de keyheight permet de moduler l’espacement vertical entre les modalités ordonnées. Dans les contextes où la légende présente des descripteurs textuels longs nécessitant des renvois à la ligne, un accroissement de la hauteur des clés empêche le chevauchement visuel des étiquettes adjacentes. L’architecture graphique gagne ainsi en aération typographique, soulignant avec élégance les frontières catégorielles définies par l’ordre d’affichage des conditions d’étude.
8. Gestion des légendes combinées et des mappages multiples
8.1 Fusion harmonieuse de multiples attributs esthétiques
Une démarche avancée d’ingénierie visuelle consiste à assigner une même variable catégorielle à plusieurs canaux esthétiques simultanés — par exemple, en associant conjointement la couleur (color) et la forme (shape) aux différents groupes expérimentaux. Cette technique de codage redondant améliore l’accessibilité perceptive des graphiques, permettant une lecture sans perte d’information tant sur écran couleur que sur un tirage noir et blanc.
Toutefois, le mécanisme interne de coalescence de ggplot2 est d’une intransigeance mathématique absolue. Pour que les deux canaux esthétiques fusionnent spontanément en un guide unifié, il est impératif que les échelles respectives partagent rigoureusement et sans la moindre divergence trois propriétés : le titre textuel exact du guide, l’étendue de leur domaine (limits), et la séquence complète de leurs repères (breaks).
Si un analyste applique une redéfinition de l’ordre sur l’échelle de couleur via scale_color_discrete(breaks = c("A", "B", "C")) mais omet de reproduire identiquement ce vecteur dans l’échelle de forme scale_shape_discrete(), le moteur ggplot2 interprète les deux spécifications comme des objets inconciliables. Il scinde immédiatement l’habillage périphérique en deux légendes isolées et concurrentes : une première légende pour la couleur et une seconde pour la forme. Cette fragmentation visuelle encombre le canevas, désoriente le lecteur et détruit le bénéfice de la redondance perceptive.
8.2 Dissociation volontaire et hiérarchisation d’échelles concurrentes
À l’opposé de la fusion, des plans d’expérience multifactoriels complexes requièrent la présence simultanée de plusieurs variables catégorielle distinctes, projetées sur des esthétiques séparées. Par exemple, la couleur peut matérialiser un facteur inter-sujets (tel que le type de pathologie clinique), tandis que le motif de ligne traduit un facteur intra-sujets (comme la phase d’évaluation temporelle). Dans un tel dispositif, les légendes doivent impérativement coexister sans interférer, chacune conservant son autonomie séquentielle.
La hiérarchisation de l’affichage vertical de ces blocs de légende multiples s’opère par l’intermédiaire du paramètre order intégré dans le constructeur guide_legend(). En assignant des indices entiers explicites à chaque échelle — par exemple guides(color = guide_legend(order = 1), linetype = guide_legend(order = 2)) —, le chercheur détermine de manière déterministe la préséance visuelle des guides le long de la marge du tracé, plaçant la variable centrale de l’étude au sommet de l’attention cognitive.
En outre, lorsque l’assemblage de multiples panneaux graphiques est orchestré par des bibliothèques avancées telles que patchwork ou cowplot, la prolifération de légendes redondantes menace l’équilibre esthétique de la planche finale. L’instruction ciblée guides(fill = "none") ou l’usage de directives de rassemblement global (comme plot_layout(guides = "collect")) permettent de neutraliser les doublons inutiles tout en sanctuarisant un guide unifié dont l’ordonnancement interne synthétise harmonieusement l’ensemble des conditions expérimentales disséminées.
8.3 Étude de cas complexe : graphiques factoriels croisés
Pour saisir toute l’étendue méthodologique de cette gestion, analysons un modèle factoriel croisé d’ordre supérieur, fréquent dans les neurosciences comportementales, combinant un Traitement (deux modalités : Contrôle vs Molécule Active), un Profil Génétique (trois modalités : Sauvage, Hétérozygote, Mutant) et un Temps de mesure (trois répétitions chronologiques). La représentation intégrée de ce dispositif au sein d’un graphique unique pousse les capacités de ggplot2 dans leurs retranchements ultimes.
Pour préserver l’intelligibilité de cette imbrication, la stratégie optimale consiste à hiérarchiser les échelles selon le modèle causal sous-jacent. Le facteur spatial principal (l’axe horizontal) reçoit l’axe chronologique, tandis que le Traitement régit la couleur et le Profil Génétique gouverne la forme géométrique. Dans cette configuration, l’ordre des entrées au sein de la légende de couleur doit impérativement respecter la polarité clinique : la modalité « Contrôle » placée en tête pour asseoir la base de référence visuelle, suivie de la « Molécule Active ».
Simultanément, la légende des formes doit être strictement ordonnée selon le degré d’altération génétique (Sauvage, puis Hétérozygote, puis Mutant). Les deux légendes superposées fournissent alors une grille de décodage cognitive matricielle instantanée : le lecteur balaie d’abord la hiérarchie thérapeutique, puis vérifie la déclinaison génotypique correspondante. L’absence d’un contrôle rigoureux de ces ordres de légende conduirait à un enchevêtrement chaotique de formes et de nuances, neutralisant totalement la portée démonstrative d’un protocole scientifique lourd et coûteux.
9. Cas d’application en psychologie et sciences du comportement
9.1 Échelles de Likert et construits psychométriques ordinaux
L’administration de questionnaires psychométriques fondés sur des échelles de réponse graduées (échelles de type Likert) constitue le fondement empirique d’une part prépondérante des recherches en psychologie sociale, organisationnelle et cognitive. Ces construits ordinaux se caractérisent par une valence psychologique intrinsèque continue, s’étendant sans rupture depuis le rejet total d’une proposition jusqu’à son adhésion inconditionnelle (par exemple : « Pas du tout d’accord », « Modérément en désaccord », « Neutre », « Modérément d’accord », « Tout à fait d’accord »).
La restitution de ces distributions d’attitudes via des graphiques en barres divergentes constitue une pratique méthodologique standardisée. Cependant, si l’on abandonne le traitement des modalités au tri lexicographique par défaut, l’ordre alphabétique pulvérise l’axe psychométrique sous-jacent. La modalité « Modérément d’accord » se retrouvera positionnée avant « Neutre », rompant la continuité phénoménologique de la mesure. Le rétablissement méticuleux de l’ordre d’origine via les niveaux d’un facteur ou par la spécification d’un vecteur de breaks rigoureux s’impose dès lors comme une obligation épistémologique absolue.
De surcroît, la disposition de la modalité centrale ou d’indifférence (« Neutre ») réclame un traitement perceptif particulier au sein de la légende. Dans une démarche éditoriale rigoureuse, cette modalité médiane est fréquemment positionnée au centre géométrique du guide ou mise en exergue par une teinte achromatique (tel qu’un gris moyen) encadrée par des teintes polarisées divergentes (bleu pour l’accord, rouge pour le désaccord), matérialisant visuellement la symétrie conceptuelle du construit mesuré.
9.2 Groupes expérimentaux et protocoles cliniques
Dans le domaine des essais cliniques randomisés et des protocoles de psychopharmacologie expérimentale, l’ordonnancement des conditions d’étude dans la légende n’est pas un choix esthétique libre, mais un reflet direct de l’architecture déontologique et méthodologique du protocole. L’universalité des conventions scientifiques exige que le groupe témoin (qu’il s’agisse d’un contrôle non traité, d’un groupe sous placebo ou d’une procédure simulée de type sham) apparaisse en première position de toute nomenclature visuelle.
Après le positionnement hiérarchique de ce niveau de référence, la séquence ordinale doit suivre le gradient de l’exposition thérapeutique : concentrations croissantes d’une molécule d’intérêt, intensité progressive d’une stimulation cognitive ou durées cumulées d’un accompagnement psychologique. Inverser cette disposition — par exemple en plaçant la plus haute dose thérapeutique au sommet de la légende suivie du placebo — trouble l’évaluation spontanée de la relation dose-réponse et impose une gymnastique intellectuelle superflue aux évaluateurs médicaux.
L’uniformisation de cet ordre doit être maintenue avec une fidélité absolue à travers l’ensemble des figures, panneaux de facettes et planches composites d’un même article de recherche. Une divergence fortuite entre la Figure 1 (où le contrôle apparaît en tête) et la Figure 2 (où le contrôle glisse en queue de peloton à la suite d’un reclassement non maîtrisé) mine la confiance des réviseurs dans la méticulosité du traitement des données et altère la crédibilité globale de la publication scientifique.
9.3 Séries temporelles et études longitudinales d’évaluation
Les protocoles longitudinaux de suivi thérapeutique — évaluant la rémission de troubles anxieux ou dépressifs à travers des jalons temporels rigides (évaluation pré-test, post-test immédiat, puis suivis de relance à six mois, un an et trois ans) — obéissent à la flèche irréversible du temps physique. La légende graphique associée à ces séries d’observations doit refléter fidèlement cette chronologie séquentielle.
Le traitement des cohortes expérimentales au cours du temps se heurte fréquemment au phénomène d’attrition statistique (perte de sujets entre les différentes vagues d’évaluation). Lors du traitement de ces données par des modèles mixtes, les vagues tardives comportent un effectif restreint d’observations. Si l’ordre de la légende était calculé automatiquement sur la base de la fréquence décroissante des effectifs (via des fonctions empiriques aveugles comme fct_infreq()), les jalons chronologiques seraient totalement désorganisés, le suivi tardif étant relégué arbitrairement en bas de liste.
Une mise en scène graphique experte assure la pérennité de l’axe temporel dans la légende et peut même, dans des tracés longitudinaux épurés (spaghetti plots ou courbes d’évolution moyennes), opérer un alignement dynamique parfait entre l’extrémité terminale des séries de données sur le bord droit du canevas et la hauteur spatiale des entrées du guide. Cette stratégie d’alignement direct supprime toute dissociation spatiale et permet une identification immédiate de la trajectoire clinique de chaque cohorte.
10. Diagnostic et résolution des erreurs courantes
10.1 L’apparition inattendue de valeurs ‘NA’ dans la légende
L’une des anomalies les plus couramment signalées par les utilisateurs de ggplot2 réside dans l’apparition intempestive et inesthétique d’une entrée supplémentaire labellisée NA dans la boîte de légende, souvent associée à un symbole grisâtre ou transparent. Cette défaillance trouve presque systématiquement son origine dans une rupture de concordance stricte entre les modalités effectives de la variable et le vecteur fourni à l’argument breaks ou limits.
Le moteur d’échelle de ggplot2 est excessivement sensible à la précision orthographique, à la casse typographique (majuscules/minuscules) et à la présence de caractères d’espacement invisibles. Si votre vecteur de données contient la modalité "Placebo " (comportant un espace résiduel en fin de chaîne) alors que votre instruction d’échelle déclare breaks = c("Placebo", "Traitement"), l’algorithme ne reconnaît pas la modalité, la classe hors des bornes d’ordonnancement prévues et lui assigne la valeur manquante NA, qui se retrouve alors projetée dans la légende.
Pour éradiquer ce problème, la première étape consiste à assainir rigoureusement les chaînes de caractères en amont via l’utilisation systématique de fonctions d’élagage comme stringr::str_trim(), garantissant l’éradication de tout espace invisible résiduel. Si toutefois des valeurs réellement manquantes existent légitimement dans le jeu de données mais que l’analyste souhaite délibérément les occulter de la légende sans filtrer les observations géométriques, l’argument spécialisé na.translate = FALSE intégré dans les fonctions d’échelle discrètes assure la suppression définitive de cette mention indésirable.
10.2 Duplication involontaire des guides de légende
Un autre désagrément visuel majeur survient lorsqu’un graphique affiche deux légendes d’apparence identique côte à côte ou l’une en dessous de l’autre, répétant inutilement les mêmes modalités catégorielles. Ce dysfonctionnement résulte invariablement d’un conflit de déclarations sur deux couches esthétiques qui auraient dû fusionner, mais dont les spécifications typographiques divergent imperceptiblement.
Considérons le cas typique où un diagramme de dispersion combine une esthétique de couleur et une esthétique de forme sur la même variable. Si l’analyste attribue un titre explicite à l’échelle chromatique via scale_color_discrete(name = "Groupe d'étude") mais oublie de redéfinir le titre de l’échelle géométrique (qui conserve par défaut le nom technique de la colonne du tableau de données, par exemple "groupe_exp"), ggplot2 constate une divergence sémantique et génère immédiatement deux guides séparés. Le même problème survient de manière plus pernicieuse si l’argument breaks est réordonné dans l’échelle de couleur mais omis dans l’échelle de forme.
La résolution de cette duplication passe par un protocole d’harmonisation rigoureux : l’unification des titres soit au sein de chaque fonction scale_*(), soit de manière centralisée et préférable via la fonction générique labs() (par exemple : labs(color = "Groupe d'étude", shape = "Groupe d'étude")), couplée à la duplication rigoureusement identique des vecteurs passés à breaks sur l’ensemble des esthétiques mobilisées.
10.3 Désynchronisation entre les éléments du graphique et de la légende
La défaillance la plus pernicieuse — car potentiellement invisible lors d’une relecture hâtive, mais dévastatrice pour la validité scientifique — est la désynchronisation entre les géométries représentées sur le tracé et les étiquettes correspondantes dans la légende. Ce phénomène se produit généralement lorsqu’un utilisateur manipule conjointement les arguments breaks et labels de manière positionnelle anonyme.
Si la variable sous-jacente est un facteur dont les niveaux internes sont ordonnés selon la séquence (A, B, C), et que l’utilisateur déclare l’instruction téméraire suivante : scale_fill_discrete(breaks = c("C", "B", "A"), labels = c("Contrôle", "Dose 1", "Dose 2")), l’affectation s’opère dans l’ordre séquentiel du vecteur labels : l’étiquette « Contrôle » est attachée au break « C », « Dose 1 » à « B », et « Dose 2 » à « A ». Si la réalité expérimentale voulait que « A » soit le contrôle, le graphique présente désormais des données totalement interverties : les mesures du groupe traité portent l’étiquette de la référence, inversant textuellement la conclusion statistique.
Pour conjurer tout risque d’une telle catastrophe analytique, la règle d’or consiste à bannir les vecteurs anonymes pour les arguments cosmétiques et à recourir systématiquement à des vecteurs nommés. Dans un vecteur nommé, l’étiquette est explicitement adossée à sa clé interne : labels = c("A" = "Contrôle", "B" = "Dose 1", "C" = "Dose 2"). Quelle que soit la réorganisation ultérieure imposée à breaks ou le tri appliqué aux données brutes, l’association clé-valeur demeure indestructible, garantissant l’exactitude pérenne de la restitution graphique.
11. Automatisation et programmation fonctionnelle dans R
11.1 Paramétrage dynamique de l’ordre basé sur des métriques descriptives
Dans un contexte de traitement massif de données ou d’analyses statistiques exploratoires portant sur des dizaines de variables simultanées, il est inenvisageable de coder manuellement à la main chaque séquence de breaks pour chaque figure générée. L’automatisation du tri des légendes s’impose comme une nécessité computationnelle, exploitant la programmation fonctionnelle pour dériver dynamiquement l’ordre optimal à partir des métriques descriptives calculées sur l’échantillon.
En couplant les verbes de transformation du package dplyr avec la grammaire de ggplot2, il devient aisé d’ordonnancer une légende en fonction de n’importe quel estimateur statistique robuste. À titre d’exemple, l’analyste peut calculer dynamiquement le vecteur ordonné des médianes d’un biomarqueur pour chaque groupe, extraire la nomenclature de ces groupes dans l’ordre décroissant de leur médiane, et transmettre immédiatement ce vecteur résultat à l’argument breaks de l’échelle d’affichage.
Cette approche dynamique garantit la robustesse absolue des scripts face à l’adjonction de nouvelles données expérimentales au sein des pipelines d’intégration continue ou de rapports reproductibles automatisés sous Quarto ou R Markdown. Si une mise à jour du jeu de données expérimentales modifie la hiérarchie des performances de groupe, le pipeline graphique recalcule l’ordre à la volée et restitue une figure impeccablement triée sans nécessiter la moindre intervention manuelle dans le code source.
11.2 Écriture de fonctions d’habillage graphique personnalisées
Pour opérationnaliser cette automatisation au sein d’un laboratoire de recherche collaborative, la création d’extensions logicielles internes ou de fonctions d’habillage sur mesure (wrappers) représente la démarche d’ingénierie la plus aboutie. Il s’agit de rédiger des fonctions R spécialisées qui acceptent en entrée un objet de tracé ggplot2 brut et lui appliquent un ensemble standardisé de directives de mise en forme des échelles et des légendes.
Une fonction avancée peut, par exemple, encapsuler la logique d’inspection de l’objet graphique, extraire les variables assignées aux esthétiques discrètes, interroger les niveaux des facteurs correspondants et appliquer dynamiquement un template d’échelle enrichi d’un ordonnancement préférentiel. En utilisant l’opérateur d’adjonction %+% ou en s’appuyant sur le mécanisme des arguments variables (...), ces fonctions transmettent de manière sécurisée les paramètres additionnels aux primitives sous-jacentes de ggplot2.
Cette pratique élève la qualité globale de la production scientifique du collectif de recherche. Elle évite la dispersion des styles visuels, homogénéise la présentation des protocoles expérimentaux entre les différents chercheurs de l’institution et réduit drastiquement le temps consacré par chaque analyste aux tâches ingrates de réglages typographiques périphériques.
11.3 Exportation haute résolution et conformité vectorielle
La finalisation d’une figure rigoureusement ordonnée culmine avec son exportation sous forme de fichier graphique haute résolution répondant aux spécifications techniques intransigeantes des éditeurs scientifiques internationaux (tels que Elsevier, Springer Nature ou Wiley). Cette étape critique est administrée par la fonction ggsave(), dont l’utilisation requiert une compréhension fine de la rasterisation et de la vectorisation.
Une altération fréquente de l’ordonnancement de la légende survient lors de l’exportation vers des formats bitmap contraints lorsque les dimensions spatiales absolues (spécifiées par width et height) sont sous-évaluées par rapport à la taille de la police typographique. Dans ces circonstances de compression spatiale, le moteur de rendu peut être contraint de tronquer les libellés de la légende ou de rejeter certaines clés en dehors du canevas visible, créant un sentiment trompeur de perte de catégories ordonnées.
Pour prévenir ces écueils, le recours aux formats vectoriels purs tels que le format PDF (avec incorporation intégrale des polices vectorielles) ou le format EPS garantit une préservation mathématique inviolable des coordonnées de chaque texte et de chaque repère visuel, quelle que soit la mise à l’échelle ultérieure imposée par le maquettiste éditorial. Lorsque le format matriciel haute résolution TIFF ou PNG est requis, la fixation d’une résolution spatiale minimale de 300 à 600 DPI (dots per inch) combinée à un dimensionnement géométrique généreux assure la netteté absolue de chaque composant du guide graphique.
12. Bonnes pratiques de conception graphique et normes éditoriales APA
12.1 Recommandations du manuel de style de l’APA (7e édition)
La diffusion des savoirs quantitatifs en sciences humaines, sociales, comportementales et médicales est profondément structurée par les directives normatives édictées par l’American Psychological Association, dont la 7e édition du Publication Manual fixe des critères éditoriaux d’une grande rigueur pour la confection des figures scientifiques. Le respect de ces directives conditionne directement la recevabilité académique d’un manuscrit soumis pour publication.
Sur le plan de l’ordonnancement des légendes, les normes APA préconisent une sobriété typographique totale et proscrivent formellement les ornements visuels superflus (dénoncés par Edward Tufte sous le vocable de chartjunk). Les encadrements massifs autour de la boîte de légende, les fonds grisés ou colorés et les effets d’ombrage doivent être scrupuleusement éliminés via la commande theme(legend.background = element_blank(), legend.box.background = element_blank()).
Concernant l’emplacement des légendes, le style APA privilégie deux configurations spatiales distinctes selon la morphologie du tracé : soit une intégration à l’intérieur même du cadre de tracé dans une zone libre de toute donnée (si l’espace le permet sans interférer avec les géométries), soit une disposition ordonnée en dessous de l’axe horizontal. Les titres de légendes doivent être formulés de manière concise, dans une casse de type phrase ou titre sobre, et toute abréviation ou convention d’ordonnancement méthodologique complexe doit faire l’objet d’une note de figure explicative exhaustive rédigée immédiatement sous l’illustration.
12.2 Accessibilité visuelle et théorie de la perception
L’éthique scientifique moderne impose que la restitution visuelle des données quantitatives soit universellement accessible à l’ensemble des membres de la communauté, y compris les personnes présentant des altérations de la perception visuelle. Cette exigence s’appuie à la fois sur les théories fondamentales de la perception visuelle (notamment les lois de la Gestalt sur la similarité et la proximité) et sur les directives d’accessibilité numérique internationales telles que les Web Content Accessibility Guidelines (WCAG).
L’application de la loi de la proximité à la conception graphique commande que l’ordre des éléments dans la boîte de légende reflète de manière isomorphique la disposition spatiale des données sur le tracé. Si les courbes d’un graphique longitudinal se terminent sur la marge droite de la figure selon une hiérarchie verticale précise (Courbe A au sommet, Courbe B au centre, Courbe C à la base), la légende positionnée à droite doit impérativement reproduire scrupuleusement la séquence (A, puis B, puis C). Forcer l’observateur à croiser mentalement les lignes de correspondance entre le tracé et le guide s’apparente à une faute d’ergonomie cognitive majeure.
Sur le plan colorimétrique, l’utilisation de palettes universellement perceptibles s’avère non négociable. Les palettes à arc-en-ciel traditionnelles (comme la palette jet) sont définitivement proscrites au profit d’échelles perceptuellement uniformes issues des recherches de Viridis ou ColorBrewer. En outre, la théorie de la redondance perceptive stipule qu’une modalité expérimentale ordonnée ne devrait jamais être encodée par la seule variation de teinte : la conjonction délibérée de la couleur, du symbole géométrique (forme) et du motif de trait garantit une transmissibilité absolue de l’ordonnancement, y compris sous des conditions de visualisation dégradées ou lors de photocopies monochromes répétées.
12.3 Check-list finale pour la validation pré-publication
Avant d’engager formellement le dépôt d’un article scientifique auprès du portail de soumission d’une revue à comité de lecture, il est impératif d’exécuter une revue systématique de validation graphique en s’appuyant sur une grille de contrôle standardisée. Cette check-list méthodologique permet d’intercepter les anomalies résiduelles d’ordonnancement qui échappent fréquemment à la lecture globale du texte :
- Adéquation protocolaire : L’ordre d’apparition des catégories dans la légende coïncide-t-il exactement avec l’ordre chronologique ou hiérarchique exposé dans la section « Méthodologie » du manuscrit (ex. Groupe Témoin / Contrôle placé rigoureusement au premier rang) ?
- Intégrité géométrie-légende : Chaque modalité affichée dans la légende possède-t-elle une projection physique effective sur le canevas (absence de niveaux fantômes ou de données résiduelles non filtrées) ?
- Exclusion des résidus NA : La boîte de légende est-elle exempte de toute mention
NAparasite issue d’une discordance typographique ou d’un caractère d’espacement involontaire dans l’assignation desbreaks? - Sécurisation par vecteurs nommés : Toutes les affectations manuelles de couleurs, formes ou étiquettes reposent-elles sur des vecteurs nommés explicites interdisant toute permutation silencieuse en cas de réorganisation de l’échantillon ?
- Synchronisation multidimensionnelle : Dans le cas d’esthétiques combinées (ex. couleur et forme), les échelles partagent-elles strictement le même titre, les mêmes limites et la même séquence de découpage pour garantir une coalescence parfaite du guide ?
- Conformité aux formats vectoriels : L’exportation finale a-t-elle été exécutée sous un format vectoriel (PDF/EPS) ou sous une résolution bitmap minimale de 300 DPI sans troncature des étiquettes périphériques ?
- Reproductibilité computationnelle : Le script R générant la figure s’exécute-t-il intégralement de manière déterministe depuis un environnement vierge, attestant de l’archivage pérenne du pipeline d’analyse ?
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
Sweller, J. (2011). Cognitive load theory. In J. P. Mestre & B. H. Ross (Eds.), The psychology of learning and motivation: Cognition in education (Vol. 55, pp. 37-76). Academic Press. https://doi.org/10.1016/B978-0-12-387693-5.00002-8
Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3-28. https://doi.org/10.1198/jcgs.2009.07098
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
Wickham, H., Çetinkaya-Rundel, M., & Grolemund, G. (2023). R for data science (2nd ed.). O’Reilly Media. https://r4ds.hadley.nz/
Wilke, C. O. (2019). Fundamentals of data visualization: A primer on making informative and compelling figures. O’Reilly Media. https://clauswilke.com/dataviz/
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0