
Dans le domaine de l’ingénierie des données et de la recherche computationnelle, la restitution visuelle ne constitue pas un simple artifice cosmétique, mais un vecteur fondamental d’intelligibilité scientifique. La bibliothèque Seaborn, érigée au-dessus de l’infrastructure matricielle de Matplotlib, s’est imposée comme le standard de facto pour la modélisation statistique exploratoire et confirmatoire en langage Python. Par ses abstractions sémantiques raffinées, elle permet de projeter des tenseurs multidimensionnels sur des plans géométriques bidimensionnels d’une remarquable expressivité. Néanmoins, cette automatisation poussée engendre fréquemment une friction ergonomique déterminante : le positionnement arbitraire ou sub-optimal des métadonnées contextuelles, au premier rang desquelles figure la légende.
La légende représente la clef de voûte sémiotique d’une figure ; elle matérialise l’équivalence univoque entre les canaux perceptifs primaires (variations chromatiques, gradients de saturation, modulations typologiques de glyphes ou calibrages dimensionnels) et les variables sous-jacentes du schéma relationnel. Lorsqu’une légende vient occulter des densités de points empiriques, masquer des bifurcations de trajectoires régressives ou scinder arbitrairement l’attention focale du lecteur, l’intégrité du transfert d’information s’en trouve dégradée. Maîtriser le positionnement, l’ancrage spatial et la reconfiguration topologique de cet élément d’interface constitue dès lors un impératif méthodologique incontournable pour tout chercheur ou praticien de la donnée soucieux de rigueur éditoriale.
Ce traité exhaustif se propose d’élucider, sous un prisme théorique, mathématique et programmatique, l’intégralité des dynamiques régissant la manipulation spatiale de la légende dans l’écosystème Seaborn. De la déconstruction des coordonnées de boîtes englobantes à l’orchestration avancée des canevas multi-facettes, en passant par l’optimisation des flux d’attention cognitive et la résolution des conflits de superposition, ce parcours fournit les clés de contrôle absolu sur la composition graphique. L’objectif ultime consiste à affranchir l’analyste des contingences par défaut de l’interpréteur pour instaurer une pratique visuelle conforme aux normes les plus exigeantes de la publication scientifique internationale.
1. Fondements théoriques et pertinence du positionnement de la légende sous Seaborn
1.1 Le rôle sémiotique de la légende dans la communication visuelle de données
Dans le paradigme sémiologique formalisé initialement par Jacques Bertin dans sa Sémiologie Graphique, la visualisation de données opère une transcription rigoureuse entre un univers de concepts abstraits et un réseau de variables visuelles perceptibles. Au sein de cette architecture, la légende remplit une fonction d’ancrage sémantique irremplaçable. Elle établit une correspondance bidirectionnelle continue entre le signifiant graphique (une teinte spécifique de la palette chromatique, un motif d’hachure discontinu, l’épaisseur calibrée d’une courbe vectorielle) et le signifié conceptuel (un niveau de traitement pharmacologique, une covariable démographique ou une classe taxonomique discrète). Sans cet ancrage textuel et symbolique, la représentation graphique demeure une forme géométrique silencieuse, incapable de transmettre un énoncé scientifique falsifiable.
L’emplacement exact de cet encart conditionne directement la charge cognitive imposée au système perceptif humain. Lorsque la légende est judicieusement intégrée, le trajet oculaire nécessaire pour vérifier la nature d’un agrégat statistique est minimisé, ce qui permet au récepteur de mobiliser ses ressources cérébrales sur l’analyse comparative des motifs chứ que sur le décodage laborieux des identifiants visuels. En sciences expérimentales, une légende mal positionnée qui chevauche des valeurs extrêmes ou introduit une asymétrie spatiale peut susciter des biais d’interprétation critiques, allant jusqu’à fausser la lecture des variances ou l’identification de ruptures de pente dans un nuage de points multidimensionnel.
Il convient par ailleurs d’opérer une distinction méthodologique claire entre l’exploration statistique interne et la diffusion auprès de la communauté académique. Lors de la phase de prototypage rapide, le scientifique tolère des collisions visuelles mineures au profit de la célérité d’itération numérique. En revanche, le passage à la communication externe exige une rigueur géométrique absolue. Dans un manuscrit destiné à une revue à fort facteur d’impact ou un rapport institutionnel d’aide à la décision, l’agencement spatial des métadonnées participe de la validité interne du propos : une figure irréprochable inspire confiance dans la rigueur du pipeline computationnel qui l’a engendrée.
1.2 L’articulation structurelle entre Seaborn et Matplotlib
Pour manipuler avec autorité les coordonnées d’une légende, il est indispensable de disséquer la relation de dépendance structurelle qui lie Seaborn à la bibliothèque fondamentale Matplotlib. Seaborn ne constitue pas un moteur de rendu autonome indépendant ; il s’agit d’une couche d’abstraction déclarative de haut niveau qui délègue l’intégralité de la rasterisation géométrique, du tracé vectoriel et de la gestion spatiale au noyau sous-jacent de Matplotlib. Lorsque Seaborn traite un bloc d’instructions de haut niveau, il transfigure les données tabulaires issues d’un conteneur en primitives élémentaires gérées par le moteur graphique de bas niveau.
Cette architecture en couches implique que toute composante visuelle instanciée par une directive Seaborn, qu’il s’agisse d’un tracé de dispersion ou d’une estimation de densité par noyau, vient s’inscrire dans la hiérarchie standard des objets Matplotlib. Au sommet de cette topologie réside l’instance Figure, qui matérialise l’espace global du canevas, laquelle encapsule une ou plusieurs instances d’Axes, qui représentent les sous-graphiques opérationnels dotés de leurs propres systèmes de coordonnées cartésiennes. La légende, matérialisée par la classe matplotlib.legend.Legend, n’est donc pas un module propriétaire inaccessible de Seaborn, mais un conteneur standardisé de glyphes et de textes greffé soit sur un objet Axes individuel, soit directement sur la Figure globale.
La manipulation spatiale de ce conteneur requiert une appréhension précise de la frontière entre l’interface orientée objet de Matplotlib et l’API fonctionnelle pyplot. Alors que Seaborn autorise des appels concis masquant la complexité sous-jacente, l’ajustement millimétré du positionnement légendaire contraint fréquemment le développeur à redescendre d’un niveau d’abstraction. Il lui faut alors intercepter l’objet Axes retourné par la fonction génératrice pour appliquer des méthodes de reconfiguration directe, contournant ainsi les limitations inhérentes aux arguments déclaratifs simplifiés de la surface de l’API Seaborn.
1.3 La surcharge cognitive induite par les configurations par défaut
L’algorithme par défaut présidant à l’insertion des légendes au sein de Seaborn adopte une heuristique conventionnelle qui s’avère rapidement déficiente dès lors que la complexité des données excède les cas d’école élémentaires. Dans sa configuration de base, Seaborn tente de loger l’encart explicatif à l’intérieur du cadre des axes, souvent dans le cadran supérieur droit ou via une routine automatisée d’évitement. Face à des ensembles de données massifs caractérisés par une variance spatiale élevée ou une forte dispersion des observations périphériques, cette approche produit inévitablement des interférences visuelles dommageables, matérialisant ce que les ergonomes qualifient de parasitage informationnel.
Le conflit spatial surgit lorsque l’encadré de métadonnées est dessiné par-dessus des points de données réels, des barres d’erreur expérimentales ou des trajectoires d’interpolation non linéaires. Cette superposition crée une occlusion locale qui détruit la continuité du signal visuel. Le lecteur se trouve dans l’incapacité de discerner si une raréfaction locale d’observations procède d’une réalité statistique intrinsèque ou de la dissimulation mécanique orchestrée par la boîte de légende. De surcroît, le fond opaque ou semi-transparent classiquement employé pour garantir la lisibilité textuelle de l’encart altère la perception des densités relatives dans les approches de type nuage de points dense.
Face à ces écueils, l’abandon passif des figures aux algorithmes automatiques de placement constitue une faiblesse méthodologique. Le contrôle manuel et paramétrique des coordonnées de la légende s’impose donc comme une nécessité programmatique systématique. Ce contrôle ne vise pas seulement l’élégance stylistique ; il répond au besoin impérieux de garantir la fidélité de la représentation, d’éliminer toute ambiguïté interprétative et de restituer aux structures de données leur visibilité intégrale sur l’ensemble de l’étendue des axes de mesure.
2. L’accès programmatique à l’objet légende : axes et figures
2.1 Différenciation fondamentale entre fonctions Axes-level et Figure-level
Une source prépondérante de confusion lors de l’apprentissage approfondi de Seaborn réside dans la dichotomie fondamentale entre les fonctions opérant au niveau de l’axe (Axes-level) et celles opérant au niveau de la figure globale (Figure-level). Les fonctions dites Axes-level, à l’instar de sns.scatterplot, sns.lineplot, sns.histplot ou sns.boxplot, tracent leurs primitives directement sur un objet matplotlib.axes.Axes fourni explicitement ou emprunté à l’état courant de pyplot. Dans cette modalité, la légende est rattachée intrinsèquement au conteneur local des axes, ce qui permet une manipulation immédiate par les méthodes usuelles de l’axe hôte.
À l’inverse, les fonctions dites Figure-level, telles que sns.relplot, sns.catplot, sns.displot ou sns.lmplot, adoptent une architecture en façade supervisant la création d’une structure composite gérée par l’objet FacetGrid. Ces méthodes ne renvoient pas un objet Axes isolé, mais une instance englobante capable de générer dynamiquement une matrice de sous-tracés interconnectés. Par conséquent, la légende n’appartient plus nécessairement à un axe cartésien particulier ; elle est déportée et consolidée au niveau de la Figure entière pour représenter de manière synthétique l’ensemble des panneaux de la grille graphique.
Comprendre cette distinction est indispensable pour identifier le réceptacle légendaire adéquat sur lequel appliquer les fonctions de déplacement spatial. Appliquer une méthode conçue pour un objet Axes sur un retour de fonction Figure-level déclenche immédiatement une erreur d’attribut de l’interpréteur Python, tout comme tenter de manipuler la légende d’un FacetGrid comme s’il s’agissait d’un tracé élémentaire conduit fréquemment à l’échec de la mutation géométrique ou à la génération intempestive de légendes dupliquées et incohérentes.
2.2 Récupération explicite de l’instance de légende via ax.get_legend()
Dès lors que l’on travaille dans le périmètre d’une fonction Axes-level, l’accès à l’objet matériel de la légende s’effectue au moyen de la méthode ax.get_legend(). Cette méthode renvoie l’instance active de la classe matplotlib.legend.Legend actuellement associée au système d’axes cartésiens désigné par la variable ax. Si la légende a été générée par Seaborn lors de l’exécution de la commande de tracé, cet appel extrait l’entité vivante de la mémoire, autorisant ainsi l’inspection de ses variables d’état internes et la modification rétrospective de sa disposition sans nécessiter une reconstruction complète du graphique.
L’interrogation de cette instance permet de sonder des propriétés géométriques et typographiques avancées. Il devient envisageable de mesurer la boîte englobante actuelle de l’encart, d’analyser la liste ordonnée des glyphes qu’elle encapsule ou encore d’extraire la chaîne de caractères formant son titre catégoriel. Par cette introspection, l’ingénieur peut vérifier par programmation si la légende interfère avec des seuils critiques ou si ses dimensions physiques excèdent un ratio prédéfini de la surface globale du graphique.
Néanmoins, la manipulation directe de cette instance existante présente des limites intrinsèques. Certains attributs de positionnement spatial sont figés lors de l’instanciation initiale au sein du moteur Matplotlib et ne disposent pas de mutateurs publics idempotents pour altérer leur ancrage a posteriori. Si la modification des propriétés de surface (comme l’opacité ou la bordure) demeure triviale via des méthodes telles que set_frame_on(), le déplacement fondamental d’un cadran vers un autre impose fréquemment de supprimer l’instance primaire ou de la réécraser de façon méthodique.
2.3 Extraction et réinjection des gestionnaires graphiques (handles et labels)
La technique universelle et la plus robuste pour reconfigurer intégralement une légende consiste à extraire les primitives graphiques fondamentales afin de réinstancier un nouvel objet Legend sous un contrôle géométrique total. Cette opération repose sur l’appel à ax.get_legend_handles_labels(). Cette méthode extrait simultanément deux listes distinctes : la collection des gestionnaires de tracé (handles), qui sont les objets géométriques réels (lignes, rectangles, collections de points vectoriels) insérés dans le canevas, et la collection des étiquettes textuelles (labels) correspondantes, extraites des métadonnées du jeu de données.
Une fois ces primitives isolées dans l’environnement d’exécution, le développeur bénéficie d’une liberté de reconfiguration sans restriction. Il est possible de filtrer les éléments d’annotation redondants générés de manière excessive par Seaborn lors du croisement de plusieurs variables catégorielles, d’inverser l’ordre des éléments pour refléter une hiérarchie statistique descendante, ou de purger les descripteurs de taille pour ne conserver que les indicateurs de tonalité chromatique. Cette séparation entre contenu sémiotique et forme spatiale permet de reconstruire l’élément de légende exactement selon le devis d’implantation souhaité.
La réinjection spatiale s’opère subséquemment en invoquant de manière explicite ax.legend() ou plt.legend(), en transmettant les listes épurées d’arguments handles et labels assorties des nouveaux paramètres d’implantation géométrique. Cette approche garantit une stabilité structurelle absolue : le tracé statistique primitif n’est nullement altéré, mais la structure de décodage visuel est totalement reconstruite selon les coordonnées et contraintes topologiques rigoureusement stipulées par l’analyste.
3. Déplacement intra-graphique via le paramètre loc
3.1 La nomenclature normalisée des emplacements prédéfinis
Le mécanisme primaire de navigation de la légende à l’intérieur du périmètre fonctionnel d’un axe s’articule autour de l’argument loc, abréviation canonique de location. Dans le modèle de conception de Matplotlib dont hérite Seaborn, cet argument accepte une nomenclature standardisée de chaînes de caractères qui cartographient la boîte de délimitation de la légende sur les points cardinaux et les zones d’ancrage remarquables de l’espace graphique bidimensionnel. Les valeurs reconnues comprennent : ‘upper right’, ‘upper left’, ‘lower left’, ‘lower right’, ‘center’, ‘center left’, ‘center right’, ‘lower center’, et ‘upper center’.
Pour des raisons d’interopérabilité historique et d’optimisation computationnelle dans les boucles de traitement intensif, le moteur graphique admet également une notation par équivalences numériques scalaires. Dans ce registre d’encodage formel, l’entier 1 correspond strictement à ‘upper right’, 2 à ‘upper left’, 3 à ‘lower left’, 4 à ‘lower right’, tandis que 10 désigne ‘center’. Bien que l’utilisation de ces entiers offre une concision syntaxique appréciable dans le code source de bas niveau, l’emploi explicite des chaînes de caractères descriptives demeure vivement recommandé dans le cadre d’un développement scientifique rigoureux pour maximiser la lisibilité du code et la pérennité de maintenance logicielle.
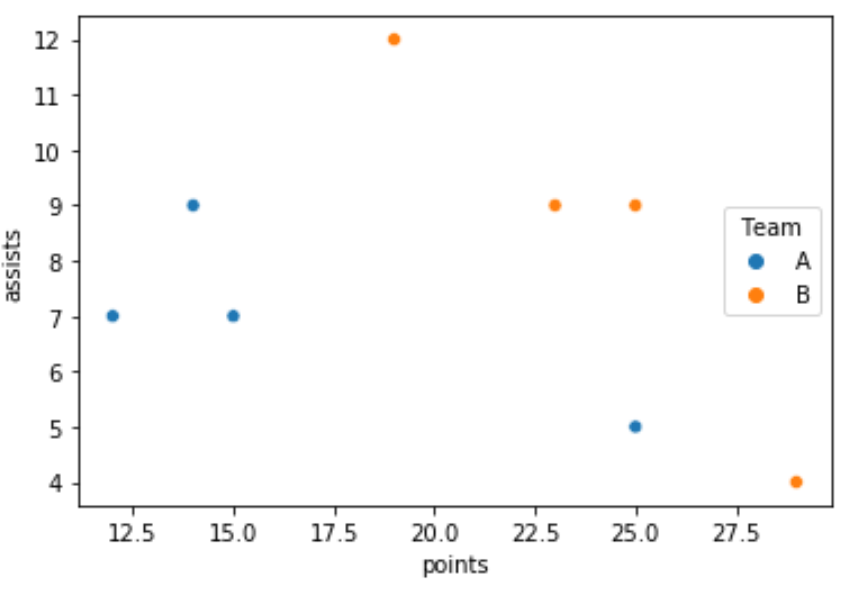
Chacune de ces appellations définit un point d’ancrage géométrique rigoureusement fixé contre le bord interne de l’axe considéré. Ainsi, la désignation ‘upper left’ force le coin supérieur gauche du rectangle englobant de la légende à s’aligner mathématiquement sur le coin supérieur gauche de la boîte de délimitation de l’axe, en ménageant simplement une marge d’espacement standard déterminée par les paramètres typographiques de l’environnement global.
3.2 Implémentation technique du paramètre loc sur un tracé de type Axes
L’intégration concrète du paramètre loc dans un flux d’instructions Seaborn nécessite une synchronisation rigoureuse entre la commande de traçage statistique et l’appel de reconfiguration spatiale. Lorsque l’on emploie une fonction Axes-level élémentaire, l’invocation de la fonction de tracé Seaborn engendre une légende par défaut qu’il convient de remodeler immédiatement au moyen d’un appel subsidiaire à plt.legend() ou, de préférence dans un paradigme purement orienté objet, par ax.legend().
Lors de cet appel consécutif, l’argument loc est spécifié pour contraindre le conteneur à migrer vers le quadrant ciblé. Il est capital d’observer que si la commande ax.legend(loc=’lower left’) est invoquée sans spécifier les gestionnaires graphiques préexistants, certaines versions historiques ou configurations de l’interpréteur peuvent accidentellement réinitialiser ou altérer les métadonnées de titrage de la légende. Pour contourner cette vulnérabilité, il est recommandé de capturer les éléments primitifs avant de forcer le déplacement, assurant ainsi la parfaite préservation de la sémantique textuelle et des symboles graphiques.
Un autre écueil technique récurrent lors de cette manœuvre réside dans la duplication fortuite de la légende. Si l’environnement de tracé est mal instancié ou si plusieurs appels de haut niveau se chevauchent dans le même bloc de script sans réinitialisation explicite du canevas, l’ancienne instance de légende peut demeurer active sous la nouvelle, générant des artefacts visuels indésirables. Une gestion programmatique propre implique donc l’écrasement délibéré de l’instance antérieure ou sa désactivation préventive lors de l’appel initial à Seaborn.
3.3 Analyse comparative des quatre quadrants principaux
L’attribution spatiale d’une légende parmi les quatre quadrants fondamentaux d’un graphique cartésien (supérieur droit, supérieur gauche, inférieur gauche, inférieur droit) ne relève pas d’une préférence graphique arbitraire, mais d’une analyse probabiliste de la distribution des données sous-jacentes. Chaque quadrant présente une prédisposition contextuelle spécifique qu’il convient d’aligner sur la topologie du phénomène statistique représenté afin d’optimiser l’équilibre global de la composition.
Dans les études de corrélations positives univariées ou bivariées, le flux des observations trace généralement une diagonale ascendante partant du quadrant inférieur gauche pour converger vers le quadrant supérieur droit. En pareille circonstance, les quadrants supérieur gauche et inférieur droit constituent des zones d’ombre statistique naturelles, caractérisées par une densité d’observations quasi nulle. Ce sont précisément ces zones visuellement neutres qui doivent accueillir prioritairement la boîte de légende pour éliminer tout risque d’occultation des tendances critiques ou des groupements centraux de points.
À l’opposé, forcer une légende dans le quadrant supérieur droit d’un tracé de corrélation linéaire directe constitue une faute méthodologique évidente, car ce cadran accueille traditionnellement les points d’intensité maximale, les asymptotes de saturation ou les barycentres des classes les plus discriminées. De surcroît, le quadrant inférieur gauche est fréquemment encombré par le croisement des zéros d’axes ou par des agrégats d’observations à l’état de repos dans les mesures physiques ou économiques. La cartographie des quadrants doit ainsi être corrélée à l’analyse exploratoire préalable des moments statistiques de la distribution observée.
4. Analyse critique et limites de l’algorithme d’optimisation loc=’best’
4.1 Modélisation computationnelle du placement automatique
Pour décharger l’analyste de l’assignation explicite des coordonnées, Matplotlib et Seaborn intègrent une option heuristique automatisée accessible via l’instruction loc=’best’ (ou son équivalent numérique scalaire 0). Cet algorithme sophistiqué tente de résoudre de manière autonome le problème d’empaquetage bidimensionnel en recherchant la zone rectangulaire de la surface graphique présentant la plus faible intersection spatiale avec l’ensemble des éléments visuels déjà projetés sur l’axe.
Sur le plan computationnel, l’algorithme opère par discrétisation du plan cartésien en une grille matricielle de résolution finie. Il procède ensuite à un balayage combinatoire en évaluant un score de recouvrement pour chaque cellule candidate en fonction du nombre de sommets de lignes, de marqueurs de dispersion ou de limites de polygones qui la traversent. L’emplacement retenu in fine correspond théoriquement au minimiseur de la fonction de coût de collision informationnelle, permettant d’insérer la légende dans la cavité spatiale la plus préservée d’artefacts graphiques.
Toutefois, cette sophistication algorithmique s’accompagne d’un coût computationnel non négligeable. Lors du rendu de graphiques massifs comportant des centaines de milliers de marqueurs vectoriels ou des maillages de courbes haute densité, l’évaluation combinatoire des intersections géométriques ralentit substantiellement la boucle de tracé. Dans les environnements d’analyse en temps réel, de tableaux de bord interactifs ou de génération automatisée de volumes considérables de planches scientifiques, le recours systématique à loc=’best’ grève l’efficience globale du pipeline de calcul.
4.2 Scénarios d’échec de la détection d’espace vierge
En dépit de son élégance conceptuelle, la routine loc=’best’ manifeste une fragilité structurelle dès lors qu’elle est confrontée à des distributions statistiques non conventionnelles ou hautement continues. L’un des scénarios d’échec les plus documentés survient lors de l’intégration d’estimations de densité par noyau (KDE) continues générées par sns.kdeplot. Les contours de gradient de densité et les surfaces semi-remplies perturbent fréquemment l’algorithme d’évitement, qui ne parvient pas à apprécier la translucidité des couches et positionne la légende directement sur les isocontours de plus forte probabilité.
Une seconde défaillance critique concerne la gestion des valeurs aberrantes ou extrêmes (outliers) isolées en périphérie du nuage de points principal. L’algorithme de minimisation de collisions privilégie souvent une vaste zone marginale apparemment dégagée, sans percevoir qu’un point de dispersion isolé s’y trouve localisé. La légende est alors plaquée sur cette observation extrême, masquant précisément l’élément d’anomalie que l’investigateur cherche à mettre en exergue dans le cadre d’un protocole de détection de signaux faibles ou d’hétérogénéités marginales.
Enfin, l’automatisation dynamique introduit une instabilité majeure au sein des protocoles itératifs. Lors de la génération séquentielle de sous-graphiques alimentés par des fenêtres temporelles glissantes ou des sous-échantillons d’apprentissage, la position de la légende peut sauter de manière erratique d’un quadrant à l’autre d’une image à la suivante. Cette instabilité topologique brise la cohérence cognitive de la série chronologique et complique l’inspection visuelle comparative pour l’examinateur humain.
4.3 Critères empiriques pour abandonner l’option automatique
La dépendance aveugle envers loc=’best’ doit être proscrite dès lors que l’on aborde la formalisation finale de documents destinés à l’examen par les pairs ou à l’édition technique institutionnelle. Le premier critère dictant son abandon formel est l’exigence de standardisation géométrique d’un manuscrit. Lorsque plusieurs figures d’un même article traitent de cohortes expérimentales comparables, la légende doit demeurer ancrée à une position invariable afin d’instaurer une grille de lecture synoptique immuable pour le cerveau du lecteur.
Le deuxième critère réside dans la complexité topologique des données empiriques représentées. Dès lors qu’un graphique mobilise simultanément un tracé de dispersion, un ajustement polynomial d’ordre supérieur et des intervalles de confiance bootstrappés, la probabilité d’une collision spatiale indétectée par l’algorithme simpliste de Matplotlib croît de manière exponentielle. Dans ces conditions de charge informationnelle dense, l’abandon du mode automatique au profit d’une allocation spatiale rigoureusement supervisée et vérifiée manuellement devient la seule garantie contre les erreurs d’occlusion.
Enfin, la reproductibilité graphique absolue exige de bannir les heuristiques non déterministes ou sensibles aux micro-variations de calibrage des polices d’écriture locales. Selon l’environnement d’exécution (système d’exploitation, serveur sans tête graphique, résolutions d’écrans disparates), les métriques de rendu des glyphes typographiques peuvent osciller légèrement, conduisant loc=’best’ à basculer la boîte d’un coin à un autre d’une machine de calcul à une autre. Seule une assignation paramétrique explicite garantit une invariance morphologique stricte à travers toutes les plateformes de compilation.
5. Déportation externe de la légende avec bbox_to_anchor
5.1 Théorie du système de coordonnées de la boîte englobante (Bounding Box)
Lorsque la densité des données à l’intérieur de la zone de traçage est telle qu’aucun quadrant ne peut être sacrifié sans dissimuler des observations pertinentes, la solution d’excellence consiste à déporter intégralement la boîte de légende en dehors du cadre des axes cartésiens. Cette opération d’extériorisation spatiale repose théoriquement sur l’utilisation du paramètre bbox_to_anchor (abréviation de bounding box to anchor). Pour manipuler ce vecteur avec pertinence, il est impératif d’assimiler la nature du repère de coordonnées auquel il se réfère.
Par défaut, l’argument bbox_to_anchor opère dans le système de coordonnées normalisé de l’objet Axes (Axes Coordinate System). Dans ce repère canonique affine, l’origine cartésienne (0.0, 0.0) correspond rigoureusement au sommet inférieur gauche de la zone de délimitation intérieure de l’axe, tandis que la coordonnée (1.0, 1.0) désigne le sommet supérieur droit de cette même zone. Tout point dont les valeurs d’abscisse ou d’ordonnée sont strictement inférieures à 0 ou supérieures à 1 se situe physiquement à l’extérieur de la surface de tracé, dans les marges de la figure globale.
L’argument accepte préférentiellement un tuple de deux valeurs scalaires (x, y) spécifiant la localisation vectorielle du point d’ancrage absolu. De manière alternative et pour un calibrage chirurgical, il peut accepter un tuple de quatre dimensions formellement défini comme (x, y, largeur, hauteur). Dans cette notation quadri-dimensionnelle élargie, l’utilisateur dicte non seulement la coordonnée spatiale du point d’attache, mais impose également une contrainte dimensionnelle ferme sur la boîte englobante virtuelle dans laquelle la légende est sommée de se formater et d’ajuster ses retours de ligne textuels.
5.2 Synergie entre bbox_to_anchor et le paramètre loc
L’erreur la plus fréquente chez les utilisateurs intermédiaires de Seaborn consiste à considérer l’argument bbox_to_anchor comme une entité isolée se substituant à loc. En réalité, ces deux paramètres agissent dans une synergie mathématique et vectorielle indissociable. Le point spatial (x, y) défini par bbox_to_anchor détermine l’emplacement de l’épingle d’ancrage sur le canevas, tandis que l’argument loc précise quel point remarquable de la boîte de légende vient s’accrocher sur cette épingle.
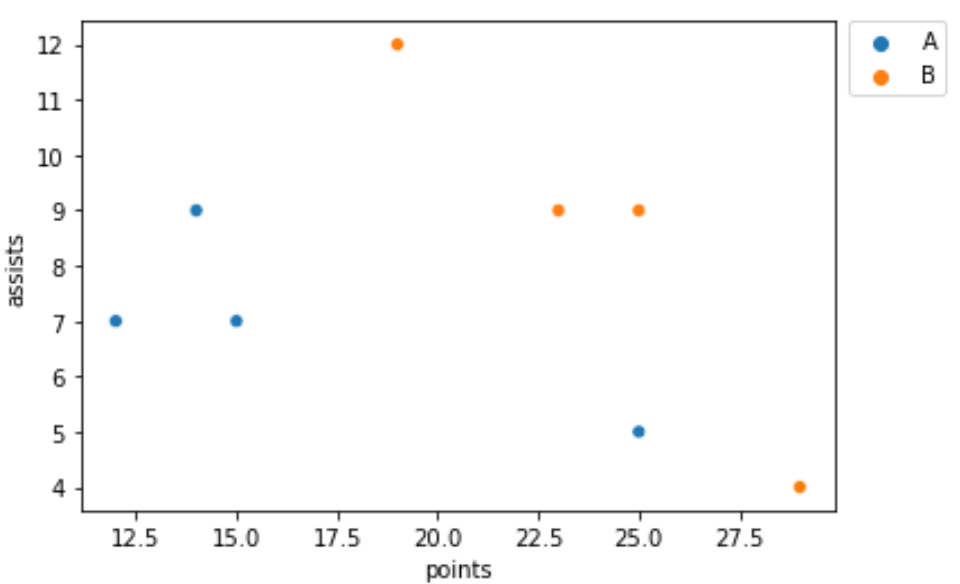
Pour illustrer cette interaction, considérons la formulation canonique bbox_to_anchor=(1.05, 1.0), combinée avec loc=’upper left’. Dans ce schéma géométrique précis, le point d’ancrage est établi à 1.05 unités sur l’axe horizontal (soit légèrement au-delà de la bordure droite du graphique) et à 1.0 unité sur l’axe vertical (rigoureusement aligné sur la crête supérieure de la zone de tracé). En assignant loc=’upper left’, on informe le moteur graphique que c’est le coin supérieur gauche du conteneur de la légende qui doit fusionner avec ce repère extérieur. La légende se déploie ainsi naturellement vers le bas et vers la droite, sans empiéter d’un seul pixel sur le tracé de données.
Si, pour ce même point d’ancrage (1.05, 1.0), le praticien spécifiait par inadvertance loc=’upper right’, c’est l’extrémité supérieure droite de la légende qui viendrait s’amarrer au point extérieur, forçant la quasi-totalité de l’encart à refluer vers la gauche et à envahir massivement le champ intérieur de visualisation des données. La maîtrise conjointe du couple (bbox_to_anchor, loc) offre ainsi une précision de disposition chirurgicale, permettant de suspendre la boîte explicative à n’importe quelle latitude ou longitude relative du plan de composition.
5.3 Positionnement sur le flanc droit et la marge supérieure
Dans la pratique de la visualisation scientifique, deux configurations de déportation externe prédominent largement : le positionnement sur le flanc droit latéral et le déploiement horizontal sur la marge supérieure. L’ancrage latéral droit est la configuration privilégiée pour les graphiques présentant un ratio hauteur/largeur conventionnel (proche du format 4:3 ou du format carré), car il préserve la continuité visuelle naturelle de gauche à droite propre à la lecture occidentale sans tronquer la progression temporelle ou linéaire de l’axe des abscisses.
Pour matérialiser cet amarrage latéral droit d’une manière visuellement harmonieuse, on configure usuellement ax.legend(bbox_to_anchor=(1.02, 0.5), loc=’center left’), ce qui a pour effet de centrer verticalement l’encart explicatif par rapport à la médiane du panneau de données. Cette disposition évite les déséquilibres de masse visuelle souvent induits par un ancrage systématique au sommet. Si la légende comporte un très grand nombre de modalités factorielles, ce centrage médian distribue la hauteur totale de la liste de manière équilibrée de part et d’autre de l’horizon du graphique.
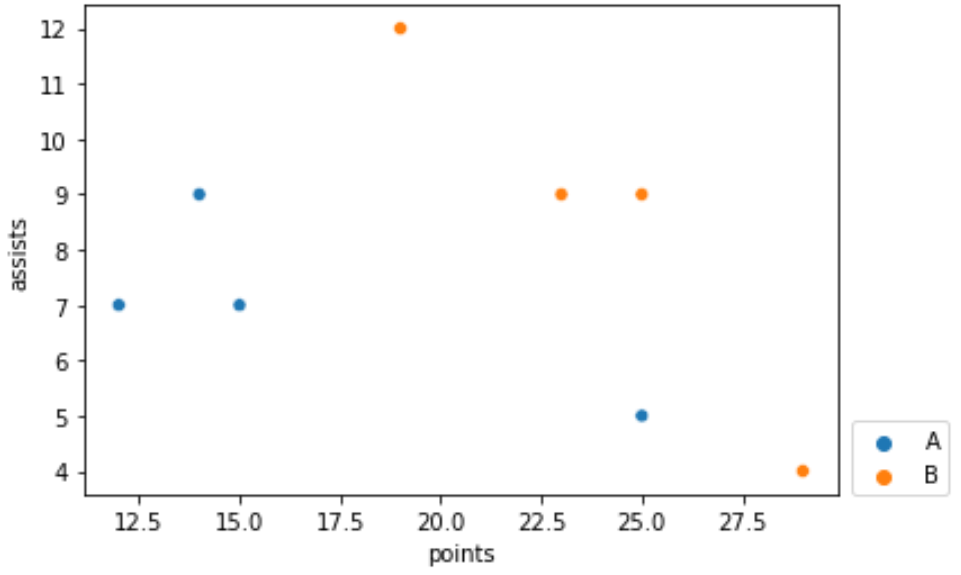
Pour les représentations caractérisées par un format panoramique très allongé ou lorsque le flanc latéral droit est déjà mobilisé par un axe d’ordonnées secondaire (axe y jumeau), l’ancrage sur la marge supérieure représente l’alternative d’excellence. On implémente alors typiquement une combinaison telle que ax.legend(bbox_to_anchor=(0.5, 1.15), loc=’lower center’, ncol=n), où le conteneur est hissé verticalement au-dessus de la ligne supérieure de l’axe et centré horizontalement. Cette disposition requiert impérativement de réorganiser les éléments de la légende sur une ou plusieurs lignes horizontales pour éviter toute protrusion verticale excessive dans le titre général de l’œuvre visuelle.
6. Contrôle des espacements millimétrés et gestion des marges périphériques
6.1 Utilisation du paramètre borderaxespad pour affiner la distance
Au-delà de la définition brute des coordonnées vectorielles par les systèmes d’ancrage, le moteur de Matplotlib et Seaborn intègre des variables de compensation fine destinées à moduler les espacements micro-métriques entre les bordures physiques de l’axe et le périmètre externe de la boîte de légende. Le paramètre pivot gouvernant cette respiration spatiale est borderaxespad. Cette variable quantifie l’intervalle de décalage séparant le cadre délimitant l’axe cartésien et la bordure de la légende, mesuré de manière relative en fraction de la taille de police courante (fontsize).
Par défaut, borderaxespad adopte une valeur conservative de 0.5, ce qui insère une distance incompressible d’un demi-cadratin entre l’ancrage et la bordure. Dans les contextes où l’on déporte explicitement une légende vers l’extérieur avec des coordonnées au centième près via bbox_to_anchor, cette marge par défaut peut venir perturber les calculs millimétrés de l’analyste en introduisant un écart visuel disproportionné. L’assignation délibérée borderaxespad=0 permet de neutraliser totalement ce décalage implicite, garantissant que les coordonnées saisies dans la boîte englobante correspondent rigoureusement à la position géométrique réelle des éléments graphiques.
À l’inverse, lorsque la légende est cantonnée à l’intérieur du tracé via les directives canoniques de loc, augmenter borderaxespad à des valeurs telles que 1.0 ou 1.5 permet de détacher visiblement la boîte des arêtes extérieures des axes. Cela crée un îlot de lecture clairement isolé de la graduation numérique des graduations (ticks), évitant la sensation d’étouffement visuel qui pénalise souvent les compositions graphiques denses ou mal aérées.
6.2 Correction des coupures visuelles via plt.tight_layout() et subplots_adjust
L’extériorisation spatiale d’une légende au moyen de bbox_to_anchor engendre invariablement un phénomène de troncature sévère si les paramètres d’emballage de la figure globale ne sont pas réajustés de manière appropriée. Par défaut, le moteur de rendu alloue un canevas dont les limites périphériques circonscrivent étroitement les axes principaux et leurs étiquettes scalaires. En déportant un conteneur au-delà de l’abscisse 1.0, celui-ci est projeté dans un néant géométrique virtuel et se retrouve brutalement cisaillé lors de la conversion matricielle ou de l’affichage à l’écran.
Pour pallier ce désagrément universel, l’analyste peut invoquer l’instruction plt.tight_layout(). Cette routine automatique recalcule dynamiquement les marges périphériques de la figure pour y inclure l’ensemble des éléments textuels environnants. Néanmoins, l’algorithme tight_layout ne prend pas toujours en compte avec une précision absolue les boîtes de légendes déportées par des coordonnées bbox_to_anchor arbitraires, car ces dernières sont fréquemment traitées comme des entités flottantes hors des flux structurels standards des sous-tracés.
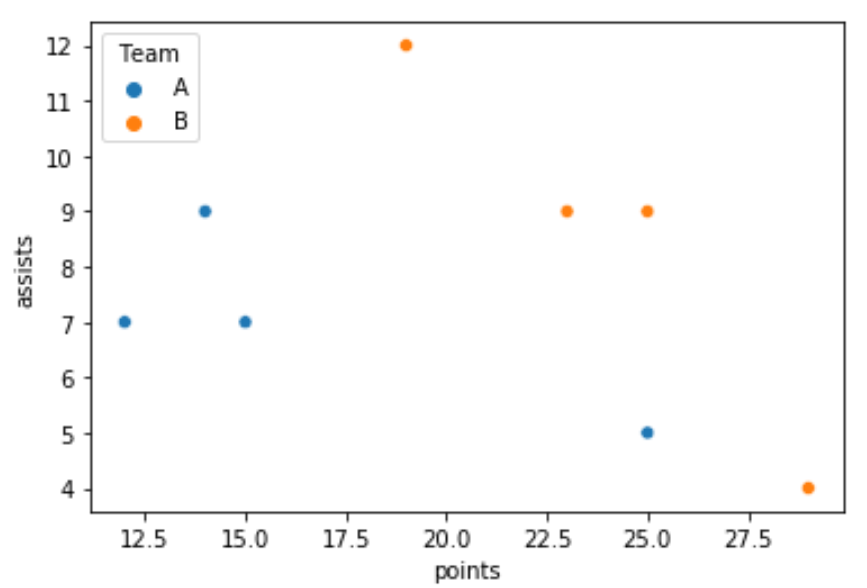
La méthode d’ajustement la plus infaillible et déterministe consiste dès lors à recourir à l’instruction fig.subplots_adjust() (ou son équivalent pyplot plt.subplots_adjust()). Cette fonction autorise un contrôle paramétrique direct sur les coordonnées normalisées des bordures de l’espace de sous-tracés au sein de la Figure. Par exemple, en déclarant plt.subplots_adjust(right=0.75), le chercheur réduit délibérément la largeur de la zone de tracé principale à 75 % de l’espace horizontal total de la fenêtre, réservant de manière inconditionnelle les 25 % restants sur la droite pour accueillir sereinement la boîte de légende déportée sans risque d’amputation visuelle.
6.3 Sécurisation de l’export vectoriel avec bbox_inches=’tight’
La phase ultime de production d’une figure scientifique consiste en son exportation vectorielle vers des formats pérennes haute fidélité tels que le PDF (Portable Document Format) ou le SVG (Scalable Vector Graphics). C’est précisément à cette étape que se manifestent les disparitions inopinées de légendes externes si la routine de sérialisation n’est pas convenablement paramétrée. La fonction plt.savefig() obéit par défaut aux dimensions théoriques de la Figure définies lors de son instanciation, ignorant royalement les objets flottants qui prolifèrent en marge de ces frontières conventionnelles.
Pour sécuriser l’exportation et contraindre le moteur d’enregistrement à englober tous les éléments graphiques sans exception, il est formellement requis de stipuler l’argument bbox_inches=’tight’ au sein de l’appel savefig(). Sous cette directive, Matplotlib suspend la restitution rigide aux dimensions prédéfinies et procède au calcul géométrique de l’enveloppe convexe englobant la totalité des artistes (artists) instanciés sur le canevas, y compris les textes de légende déportés et les graduations extérieures. La dimension physique du fichier produit est alors automatiquement agrandie pour enchâsser la composition dans son intégrité spatiale.
On peut raffiner cette opération en injectant concomitamment l’argument pad_inches, qui définit l’épaisseur de la marge blanche de sécurité résiduelle ceinturant la composition finale. Fixer savefig(‘figure.pdf’, bbox_inches=’tight’, pad_inches=0.05) constitue le standard industriel pour générer des figures d’une compacité optimale, exemptes de coupures de texte accidentelles et directement assimilables par les compilateurs de traitement de texte scientifique comme LaTeX sans nécessiter de recadrages bitmap destructeurs sous des logiciels tiers.
7. Gestion des légendes sur les objets multi-facettes (FacetGrid, relplot, catplot)
7.1 Spécificités architecturales des structures Figure-level de Seaborn
L’architecture interne des fonctions Figure-level de Seaborn, représentées par le paradigme structurel de la classe FacetGrid, obéit à un modèle d’ingénierie logicielle substantiellement différent des tracés simples sur un seul axe. Lorsqu’un jeu de données complexe est scindé selon des variables de conditionnement catégorielles via des arguments tels que col ou row, Seaborn instancie une matrice de plusieurs sous-axes cartésiens indépendants. Au lieu de surcharger chaque sous-axe d’une légende répétitive et redondante, la bibliothèque extrait cette responsabilité et rattache une légende consolidée unique à l’objet Figure d’ordre supérieur.
Cette abstraction sophistiquée engendre un défi programmatique direct pour l’utilisateur habitué aux commandes pyplot conventionnelles. L’appel standard plt.legend() ou ax.legend() sur un objet retourné par sns.relplot ou sns.catplot échoue inévitablement à manipuler la légende consolidée de la grille. Au mieux, il fait apparaître une seconde légende parasite au sein du dernier sous-axe parcouru lors de l’exécution interne de la boucle de tracé ; au pire, il laisse l’encart global totalement indifférent aux ordres de déplacement, car celui-ci est maintenu hors d’atteinte dans les attributs d’encapsulation de la structure composite.
Pour intervenir sur la topologie spatiale d’un tel ensemble, il est impératif de cibler directement l’instance de FacetGrid résultant de l’opération de tracé. Cette instance expose des méthodes spécialisées et des attributs structurels conçus spécifiquement pour propager les modifications à l’échelle de la composition complète, garantissant ainsi que l’alignement des facettes demeure symétrique tandis que l’élément sémantique explicatif est déporté de façon harmonieuse sur la périphérie de l’échiquier visuel.
7.2 Emploi de la méthode moderne seaborn.move_legend()
Conscient des difficultés historiques éprouvées par la communauté pour reconfigurer sans friction la légende des structures Figure-level et Axes-level complexes, Seaborn a introduit à partir de ses itérations logicielles récentes une fonction dédiée de très haut niveau : sns.move_legend(). Cette routine standardise et unifie la syntaxe de déplacement en éliminant le besoin de démonter laborieusement les gestionnaires de tracé ou de manipuler les structures protégées des objets graphiques.
La fonction sns.move_legend() accepte en tant que premier argument soit un objet Axes standard, soit directement une instance composite de type FacetGrid ou PairGrid. Les paramètres subséquents permettent de redéfinir instantanément son positionnement spatial via l’argument new_loc (qui admet la nomenclature standardisée telle que ‘upper right’ ou ‘center left’), tout en intégrant nativement la redirection de coordonnées vectorielles par bbox_to_anchor. L’instruction s’illustre par une syntaxe limpide : sns.move_legend(g, « center right », bbox_to_anchor=(1.02, 0.5), frameon=True).
L’atout méthodologique majeur de cette fonction réside dans la préservation scrupuleuse de l’ensemble des attributs sémantiques et stylistiques hérités de Seaborn. Contrairement à une recréation manuelle par plt.legend(), move_legend transfère intégralement le titre originel de la légende, la typologie dimensionnelle des glyphes, les palettes chromatiques discrètes et les espacements de texte sans nécessiter de redéclaration fastidieuse. La routine recalculera également en interne les ajustements géométriques requis pour assurer la viabilité de la nouvelle disposition spatiale.
7.3 Manipulation manuelle de la propriété g._legend
Avant la démocratisation de move_legend() ou dans le cadre de déploiements au sein d’environnements d’exécution contraints exploitant des versions historiques de Seaborn, l’accès direct aux entrailles du FacetGrid demeure une compétence indispensable. Dans cette structure de programmation, la légende consolidée est stockée sous l’attribut d’instance interne g._legend. Cet objet, bien que préfixé d’un tiret bas suggérant son statut d’attribut privé dans les conventions Python, constitue la poignée réelle gouvernant la géométrie de la légende globale.
Pour orchestrer un déplacement manuel sous ce paradigme, une approche éprouvée consiste à altérer directement les attributs géométriques du conteneur ou à procéder à sa désassignation complète suivie d’une reconstruction ciblée. La suppression radicale s’opère par l’invocation explicite de g._legend.remove(), ce qui a pour effet immédiat de purger le canevas de toute trace visuelle de l’encart global. Une fois cette étape accomplie, le chercheur dispose du champ libre pour invoquer la méthode g.add_legend() en lui injectant les coordonnées fines d’ancrage souhaitées.
Il est également envisageable d’extraire les descripteurs sous-jacents via les dictionnaires internes de l’objet FacetGrid, notamment g._legend_data, qui conserve la table de hachage associant chaque intitulé catégoriel à son gestionnaire de glyphe graphique respectif. Par cette porte dérobée, on peut extraire sélectivement ces données pour instancier manuellement une nouvelle légende sur un sous-axe spécifique ou la suspendre au canevas global via des méthodes Matplotlib directes, contournant ainsi avec maestria les rigidités conceptuelles imposées par le canevas multi-facettes de haut niveau.
8. Ajustement typographique, dimensionnel et structurel selon l’emplacement
8.1 Réorganisation multi-colonnes avec le paramètre ncol
Le choix de l’emplacement spatial d’une légende impose une reconfiguration directe de sa structure morphologique interne. Une légende cantonnée le long d’un flanc vertical tolère parfaitement une liste linéaire unicolonne descendante, mais ce format devient désastreux lorsque la boîte est translatée sur la marge supérieure ou sous l’axe des abscisses. Dans cette disposition horizontale, une liste unicolonne induit une occupation d’espace vertical totalement disproportionnée qui comprime indûment la surface allouée aux données scientifiques.
Le paramètre déterminant pour gouverner cette métamorphose dimensionnelle est ncol (ou ncols dans les versions récentes de Matplotlib), qui dicte le nombre de colonnes d’alignement au sein de la boîte de légende. En fixant délibérément ncol=3 ou ncol=4 lors de la réassignation de la légende, la collection d’étiquettes est immédiatement redistribuée selon une matrice horizontale compacte. Cette métrique permet de concevoir un élégant bandeau d’en-tête ou de pied de page, parfaitement adapté aux écrans larges et aux maquettes de publications académiques composées sur plusieurs colonnes de texte.
L’ajustement du nombre de colonnes doit toutefois faire l’objet d’un calcul rigoureux indexé sur la parité et le volume total des modalités catégorielles. Si l’on applique ncol=3 à une variable factorielle découpée en sept classes, la disposition générera une ligne finale asymétrique orpheline d’un seul élément, ce qui altère l’harmonie géométrique de la planche. Il est dès lors primordial de calibrer ce paramètre en parfaite adéquation avec la combinatoire du schéma de données sous-jacent.
8.2 Échelle des marqueurs et hiérarchie textuelle (fontsize, markerscale)
La modification de la localisation d’une légende modifie invariablement sa distance relative par rapport au foyer attentionnel du lecteur. Si la légende est déportée à la périphérie du tracé, ses éléments textuels et ses repères géométriques doivent subir une correction typographique et scalaire pour maintenir leur lisibilité intrinsèque à un niveau équivalent à celui du corps du graphique. À cet égard, deux leviers fondamentaux doivent être mobilisés de concert : fontsize et markerscale.
L’argument fontsize gouverne l’échelle des étiquettes descriptives et peut recevoir soit une valeur numérique absolue exprimée en points typographiques standard (par exemple fontsize=9), soit des qualificatifs d’échelle relative tels que ‘small’, ‘medium’ ou ‘large’. Pour les notes marginales condensées, réduire légèrement la taille de la police s’avère indispensable pour comprimer l’encombrement global de la boîte. Néanmoins, cette réduction textuelle ne doit pas compromettre l’identification des formes géométriques minuscules qui constituent le référentiel des classes.
C’est ici qu’intervient le paramètre markerscale. Lorsque les données tracées sur le plan cartésien recourent à des micro-points de dispersion pour atténuer le sur-traçage (overplotting), ces glyphes deviennent quasiment imperceptibles lorsqu’ils sont reproduits à l’échelle 1:1 dans la boîte de légende. En spécifiant markerscale=1.5 ou markerscale=2.0, l’analyste contraint le moteur de rendu à doubler la superficie des marqueurs à l’intérieur exclusif de la légende, sans altérer la finesse des points au sein de la matrice de données, garantissant ainsi une discrimination immédiate des formes et des teintes sans effort d’accommodation visuelle.
8.3 Contrôle de l’opacité et de la texture du cadre (framealpha, facecolor)
Lorsque des contraintes spatiales insolubles forcent l’analyste à maintenir la boîte de légende à l’intérieur même du champ cartésien des données, la manipulation des textures et de la transparence du cadre constitue la dernière ligne de défense pour conjurer la rupture d’intelligibilité. Par défaut, Matplotlib et Seaborn ceignent la légende d’un rectangle à fond opaque dont la blancheur brute occulte impitoyablement toute trace statistique sous-jacente.
L’argument framealpha permet de réguler avec une extrême précision l’opacité du fond (face) de la boîte de délimitation sur une échelle continue oscillant entre 0.0 (translucidité absolue) et 1.0 (opacité totale). En calibrant cette variable aux alentours de framealpha=0.6 ou 0.7, le chercheur crée un effet de verre dépoli élégant : le texte et les glyphes de la légende demeurent parfaitement contrastés et lisibles au premier plan, tout en laissant transparaître les masses globales et les trajectoires des données qui cheminent au second plan de l’espace géométrique.
Dans une démarche minimaliste inspirée des préceptes d’épuration graphique d’Edward Tufte, il est souvent préférable de neutraliser intégralement la matérialité de cette boîte en déclarant frameon=False. Privée de son cadre rigide et de son aplat de couleur, la légende se transmue en une constellation d’annotations flottantes pures, éliminant tout bruit graphique non informationnel. Si toutefois le cadre doit être conservé pour harmoniser la composition avec une charte éditoriale précise, les arguments facecolor et edgecolor permettent de moduler les teintes du fond et du liseré périphérique pour les intégrer visuellement à la palette générale du document de recherche.
9. Résolution des anomalies fréquentes : duplications, écrasements et disparitions
9.1 Élimination des légendes parasites créées automatiquement par Seaborn
L’un des comportements les plus frustrants lors de l’orchestration avancée de figures sous Seaborn réside dans l’apparition intempestive de légendes doubles ou concurrentes au sein d’une composition graphique unique. Cette pathologie visuelle survient typiquement lorsqu’un utilisateur applique une fonction de tracé Seaborn (qui instancie automatiquement sa propre légende interne par défaut), puis invoque consécutivement la méthode standard plt.legend() ou ax.legend() pour en dicter les nouvelles coordonnées spatiales sans purger l’entité préexistante.
Le moteur graphique, interprétant ces deux directives comme des déclarations indépendantes plutôt que comme une mutation d’état, superpose le nouveau conteneur directement sur le tracé tout en maintenant l’ancien en sommeil ou en l’affichant en filigrane décalé. Pour éradiquer ce parasitage à la racine, la méthode la plus élégante consiste à désactiver préventivement la création automatique de la légende native lors de l’appel initial à Seaborn. L’injection explicite de l’argument legend=False au sein de fonctions telles que sns.scatterplot ou sns.lineplot informe la bibliothèque qu’elle doit se cantonner au tracé des données pures, abandonnant l’émission de métadonnées spatiales.
Si la désactivation amont n’est plus envisageable dans le flux d’exécution, l’éradication a posteriori s’impose par voie de programmation orientée objet. Il suffit d’intercepter la légende fautive via ax.get_legend() puis d’ordonner sa destruction explicite au moyen de la méthode ax.get_legend().remove(). Le champ spatial se trouve ainsi totalement assaini, autorisant l’instanciation ultérieure d’une légende reconstructrice unique, purgée de tout conflit de calque visuel.
9.2 Conservation du titre de la légende lors d’une réassignation spatiale
Une anomalie pernicieuse récurrente lors de l’utilisation de l’instruction ax.legend() pour modifier la localisation d’un tracé Seaborn est la disparition subite et involontaire du titre catégoriel de la légende. Par défaut, Seaborn inspecte les métadonnées de la colonne tabulaire assignée aux paramètres sémantiques (tels que hue, style ou size) et forge automatiquement un titre explicatif au-dessus des symboles graphiques. Or, dès lors que l’on invoque une commande de redéfinition spatiale naïve telle que ax.legend(loc=’lower right’), Matplotlib réinitialise le conteneur en appliquant ses valeurs par défaut internes, lesquelles n’incluent aucun titre textuel.
Pour conjurer cette perte d’information sémantique, il est impératif d’extraire la chaîne textuelle du titre originel avant toute opération d’écrasement ou de la déclarer de manière explicite lors de la réassignation. L’extraction programmatique s’opère élégamment au moyen de l’inspection de l’instance courante via ax.get_legend().get_title().get_text(). Cette chaîne de caractères peut alors être immédiatement réinjectée dans le nouvel appel via l’argument dédié : ax.legend(loc=’lower right’, title=ancien_titre).
Cette discipline d’extraction et de réinjection textuelle s’avère particulièrement cruciale lorsque les variables du jeu de données portent des intitulés formels issus de bases de données relationnelles (souvent des acronymes techniques peu amènes tels que var_exp_grp_1). La réassignation offre l’opportunité idéale d’injecter un titre typographiquement impeccable et doté d’une sémantique humaine enrichie, intégrant le cas échéant des symboles mathématiques interprétés par le moteur LaTeX de Matplotlib (par exemple title=r’$\beta_{\text{traitement}}$‘).
9.3 Gestion des conflits d’ordre d’affichage (zorder)
Dans l’environnement de rendu bidimensionnel de Matplotlib, la visibilité respective des éléments graphiques concurrents ne dépend pas exclusivement de leur ordonnancement chronologique dans le code source Python, mais de leur altitude relative sur l’axe virtuel de profondeur, quantifiée par la variable scalaire zorder. Tout élément d’un canevas se voit attribuer une valeur de zorder entière ou décimale : les éléments possédant un zorder inférieur sont restitués en premier et forment les couches d’arrière-plan, tandis que ceux caractérisés par un zorder élevé viennent recouvrir les couches sous-jacentes.
Des anomalies spectaculaires se produisent lorsque la boîte de légende hérite accidentellement d’une priorité de zorder inférieure ou égale à celle de primitives graphiques denses, telles que des barres d’histogramme, des nuages de dispersion massifs ou des lignes de grille cartésienne. La légende apparaît alors perforée ou partiellement dissimulée sous les éléments statistiques, produisant un rendu brouillon inacceptable selon les critères éditoriaux modernes. Les lignes de grille majeures et mineures, en particulier, traversent parfois de part en part les boîtes dont l’opacité d’arrière-plan est incomplète.
Pour sanctuariser la position de la légende au sommet absolu de la pyramide d’affichage, il est vivement préconisé d’assigner formellement un zorder élevé lors de sa reconstruction, ou d’intervenir sur l’objet Legend existant par l’instruction leg.set_zorder(100). En conférant une altitude arbitrairement dominante (la plupart des primitives de données standard évoluant entre les valeurs de zorder 1 et 5), on acquiert la certitude mathématique que la légende et son arrière-plan protecteur planeront souverainement au-dessus de la totalité des flux de données et des guides structurels de l’axe.
10. Cas d’usage spécialisés : graphiques de régression, corrélations et distributions
10.1 Positionnement sur les tracés de régression univariée (sns.lmplot)
Le tracé de modèles de régression linéaire au moyen de sns.lmplot constitue un cas d’école particulièrement complexe quant à la manipulation des métadonnées explicatives. À l’instar des commandes Figure-level analysées précédemment, lmplot orchestre la génération d’un objet FacetGrid qui intègre nativement non seulement les nuages de dispersion empiriques, mais également les vecteurs de régression calculés et les enveloppes d’incertitude associées matérialisées par des bandes d’intervalles de confiance bootstrappées semi-transparentes.
La présence de ces zones d’intervalles de confiance étendues restreint drastiquement l’espace libre à l’intérieur du cadre de coordonnées. Si la légende par défaut est maintenue à l’intérieur de la boîte, elle entrera presque inévitablement en collision avec la trajectoire asymptotique du modèle ou avec la marge d’erreur supérieure du corridor de prédiction. Il est dès lors structurellement requis de déporter la légende sur le flanc externe droit via sns.move_legend() ou en exploitant les arguments globaux de la grille.
Dans l’éventualité où l’analyste souhaite ancrer la légende dans le quadrant supérieur gauche (généralement épargné lors d’une corrélation négative prononcée), il convient de porter une attention méticuleuse à l’argument scatter_kws et line_kws. En contraignant l’épaisseur des tracés de régression et en modulant précisément les espacements via borderaxespad, on assure une cohabitation harmonieuse où le modèle prédictif et sa boîte d’identification se côtoient sans jamais violer leurs périmètres respectifs.
10.2 Interaction avec les barres de couleur (Colorbars) dans sns.heatmap
La restitution graphique de matrices de corrélation ou de surfaces de chaleur via la fonction sns.heatmap introduit un mécanisme de signalement sémiotique distinct de la boîte de légende discrète usuelle : la barre d’échelle chromatique continue, communément appelée colorbar. Bien que remplissant une fonction sémiotique analogue de décodage des valeurs scalaires, la colorbar s’apparente techniquement à un objet Axes autonome greffé sur le flanc de la matrice principale, entrant directement en compétition spatiale avec toute velléité d’implantation d’une légende factorielle additionnelle.
Lorsque l’on doit superposer ou juxtaposer une légende catégorielle et une barre de couleur continue sur un même panneau graphique, une orchestration rigoureuse de la disposition géométrique est requise. Le contrôle de l’axe de la barre d’échelle s’effectue via l’argument dictionnaire cbar_kws passé à l’instruction Seaborn. Par ce canal, il est possible d’infléchir son orientation (par exemple cbar_kws={‘orientation’: ‘horizontal’}), de contraindre sa fraction de taille ou de la déporter vers la marge inférieure du graphique, libérant ainsi l’intégralité du flanc droit pour le déploiement d’une légende vectorielle conventionnelle.
Si la colorbar est maintenue sur le flanc droit, toute tentative de positionner une légende externe via bbox_to_anchor doit impérativement intégrer l’épaisseur physique de cette barre dans le calcul de son décalage horizontal. Assigner une coordonnée d’abscisse naïve telle que bbox_to_anchor=(1.05, 1.0) conduirait la légende à venir se plaquer directement sur les graduations de la barre de couleur. L’abscisse devra être majorée à des valeurs de l’ordre de 1.25 ou 1.30 pour enjamber proprement l’axe chromatique et s’établir dans une zone marginale sécurisée.
10.3 Défis d’intégration spatiale sur un JointGrid (sns.jointplot)
La fonction sns.jointplot offre une structure de visualisation bivariée particulièrement dense, orchestrée autour de la classe JointGrid. Cette architecture tripartite associe un axe central majeur dédié à la modélisation bidimensionnelle des covariations à deux axes marginaux étroits alignés respectivement au sommet et sur la droite du panneau principal, dévolus à l’affichage des distributions univariées individuelles sous forme d’histogrammes ou de courbes de densité.
Cette géométrie intriquée complique singulièrement l’intégration spatiale d’une légende de regroupement catégoriel (hue). Si la légende est assignée de manière standard, elle risque d’apparaître compressée dans l’axe marginal supérieur ou de venir oblitérer les barres de distribution marginales droites. Pour garantir une lisibilité optimale, deux stratégies spatiales divergentes s’offrent à l’analyste.
La première stratégie consiste à forcer le confinement strict de la boîte de légende à l’intérieur exclusif de l’axe central (ax_joint), dans un cadran rigoureusement choisi pour sa vacuité statistique. On y parvient en ciblant explicitement la propriété g.ax_joint.legend(loc=’upper left’). La seconde stratégie, plus ambitieuse, consiste à déporter la légende totalement hors de la composition globale en la rattachant à l’objet Figure souverain (g.fig.legend()), en calculant des coordonnées d’ancrage absolues qui la positionnent dans le coin supérieur droit du canevas, juste au-dessus du tracé marginal horizontal, instaurant ainsi un équilibre parfait entre les trois panneaux de données et les métadonnées de décodage.
11. Principes de psychologie cognitive et ergonomie de la visualisation graphique
11.1 Théorie de la charge cognitive appliquée à l’exploration visuelle
L’efficacité d’une représentation graphique ne s’évalue pas à l’aune de critères purement esthétiques, mais selon sa conformité aux lois de l’ergonomie cognitive qui régissent le traitement de l’information par le néocortex humain. Au cœur de cette discipline trône la théorie de la charge cognitive formalisée par John Sweller, et plus particulièrement la modélisation de l’effet d’attention partagée (Split-Attention Effect). Ce phénomène délétère se manifeste avec acuité lorsque le lecteur est contraint de scinder continuellement son foyer attentionnel entre deux sources d’information spatialement disjointes qui doivent être intégrées mentalement pour être comprises.
Lorsqu’une légende est déportée loin du phénomène empirique qu’elle explicite, le système visuel de l’analyste est soumis à des mouvements oculaires saccadiques incessants. L’observateur doit fixer un groupe de points sur le canevas, mémoriser temporairement sa nuance chromatique dans sa mémoire de travail à court terme, translater son regard vers la périphérie pour consulter l’étiquette textuelle correspondante dans la boîte de légende, puis opérer le trajet inverse pour valider son hypothèse. Cette gymnastique oculaire permanente consomme de précieuses ressources cognitives au détriment direct de l’analyse en profondeur des corrélations, des ruptures de symétrie et des modélisations causales.
L’optimisation spatiale de la légende vise précisément à réduire à sa plus simple expression cette charge cognitive extrinsèque. En rapprochant géométriquement l’élément explicatif de l’élément expliqué ou en concevant des ancrages spatiaux qui minimisent l’amplitude angulaire des saccades oculaires, le chercheur fluidifie le transfert d’information et autorise une assimilation intuitive et immédiate des structures multivariées les plus complexes.
11.2 Les lois de la Gestalt dans l’organisation de l’espace graphique
Les principes fondamentaux de la psychologie de la forme, ou lois de la Gestalt, fournissent une grille d’analyse rigoureuse pour concevoir des visualisations dont l’agencement spatial résonne naturellement avec les mécanismes innés de perception humaine. La loi de proximité, en particulier, stipule que les éléments géométriques les plus proches les uns des autres sont spontanément regroupés et traités comme une unité fonctionnelle unique par le système perceptif.
L’application de ce principe au positionnement de la légende est immédiate : si la légende est située à proximité immédiate d’un agrégat de points prédominant, le cerveau aura tendance à associer inconsciemment l’ensemble de la boîte explicative à ce seul sous-groupe, introduisant une distorsion d’interprétation contextuelle. D’où la nécessité de maintenir un équilibre spatial neutre ou d’isoler explicitement le conteneur par une frontière géométrique distincte. C’est ici qu’intervient la loi de clôture, selon laquelle une ligne de contour fermée isole visuellement son contenu du fond ambiant ; l’utilisation mesurée d’un cadre (frameon=True) permet d’ériger une barrière cognitive étanche garantissant que les étiquettes de métadonnées ne seront pas confondues avec les données brutes.
Enfin, la loi de continuité dicte que les éléments alignés sur un même axe vectoriel sont perçus comme appartenant à une trajectoire commune. Aligner chirurgicalement le bord de la boîte de légende sur l’arête externe d’un axe cartésien (par exemple via bbox_to_anchor=(1.0, 1.0) et loc=’upper left’) conforte cette attente de continuité structurelle. Le graphique et sa légende cessent d’apparaître comme des composants disparates assemblés par accident pour former un ensemble architectural cohérent, équilibré et fonctionnellement unifié.
11.3 L’alternative de l’étiquetage direct (Direct Labeling)
Face aux limitations cognitives inhérentes au concept même de légende encadrée, les théoriciens de la visualisation de données préconisent de plus en plus le recours à une alternative radicale mais hautement vertueuse : l’étiquetage direct (direct labeling). Cette approche consiste à supprimer purement et simplement la boîte de légende traditionnelle au profit d’annotations textuelles typographiques projetées directement à l’intérieur du champ de données, au contact immédiat des primitives graphiques qu’elles désignent.
Dans un graphique temporel linéaire multi-séries tracé via sns.lineplot, l’étiquetage direct consiste à ancrer le nom textuel de chaque catégorie à l’extrémité terminale de la courbe correspondante, en exploitant les coordonnées réelles du dernier point d’observation via ax.annotate() ou ax.text(). Cette disposition supprime instantanément l’effet d’attention partagée théorisé par Sweller : l’œil identifie la courbe et son étiquette nominale dans une seule et même fixation fovéale, éliminant tout besoin de navette oculaire vers un encart déporté.
Bien que Seaborn ne dispose pas d’un argument déclaratif unifié pour automatiser l’étiquetage direct de manière universelle, l’implémentation de cette technique au moyen de courtes routines Python itérant sur les coordonnées des séries statistiques surpasse qualitativement les meilleurs placements de légendes externes. Cette pratique est particulièrement recommandée pour les visualisations grand public, les résumés graphiques d’articles de premier plan (graphical abstracts) et les présentations scientifiques orales où la vitesse d’assimilation cognitive de l’auditoire représente une contrainte opérationnelle décisive.
12. Guide décisionnel, protocoles de validation et patrons de conception réutilisables
12.1 Arbre de décision pour la sélection de la méthode de positionnement
Afin de rationaliser le choix de la méthode d’implantation spatiale de la légende au sein de vos pipelines analytiques, il est précieux d’adopter un protocole décisionnel formel structuré selon les caractéristiques topologiques des données et la nature architecturale de l’appel graphique. Le logigramme conceptuel suivant résume les arbitrages optimaux à opérer :
- Cas d’un tracé de type Axes (ex. scatterplot, lineplot) :
- Densité spatiale modérée présentant un quadrant intérieur vacant : Appliquer un positionnement intra-graphique ciblé via
ax.legend(loc='zone_vacante')en évitant le mode automatique non déterministe. - Données saturées occupant l’intégralité du champ cartésien : Déporter la légende sur le flanc externe via
ax.legend(bbox_to_anchor=(1.02, 1.0), loc='upper left')combiné impérativement àplt.subplots_adjust(right=0.8)oubbox_inches='tight'. - Séries chronologiques ou courbes continues distinctes : Proscrire la légende classique et implémenter l’étiquetage direct (Direct Labeling) en bout de ligne via des annotations vectorielles ciblées.
- Densité spatiale modérée présentant un quadrant intérieur vacant : Appliquer un positionnement intra-graphique ciblé via
- Cas d’un tracé de type Figure-level (ex. relplot, catplot, lmplot) :
- Usage des versions contemporaines de Seaborn (v0.11.2+) : Employer universellement la directive unifiée
sns.move_legend(g, new_loc='flanc_choisi', bbox_to_anchor=...)pour garantir l’intégrité des styles et du titre factoriel. - Environnements contraints ou scripts patrimoniaux : Neutraliser la légende globale primitive par
g._legend.remove()puis réinstancier l’encart consolidé via l’API interne ou un amarrage explicite sur la figure maîtresse.
- Usage des versions contemporaines de Seaborn (v0.11.2+) : Employer universellement la directive unifiée
Ce formalisme décisionnel permet d’éliminer les tâtonnements empiriques et d’aligner systématiquement la technique de programmation graphique sur les contraintes géométriques spécifiques de la structure matricielle à modéliser.
12.2 Liste de contrôle pour la validation esthétique et technique pré-publication
Avant de valider l’insertion d’une figure dans un corpus éditorial final, l’analyste rigoureux se doit de passer la composition graphique au crible d’une liste de contrôle qualité exhaustive. Cette grille de vérification méthodique prévient les erreurs de rendu latentes qui échappent fréquemment à l’inspection hâtive sur les affichages interactifs des carnets de calcul (notebooks) :
- Intégrité géométrique : Vérifier à l’échelle 100 % qu’aucun point de dispersion critique, barre d’erreur, corridor de confiance ou étiquette d’axe n’est masqué, même partiellement, par la boîte englobante de la légende ou par son ombre portée.
- Imperméabilité aux duplications : Contrôler l’absence de toute légende fantôme résiduelle superposée en arrière-plan d’une boîte réinstanciée suite à un double appel de fonctions d’affichage.
- Cohérence typographique et textuelle : S’assurer que le titre sémantique de la légende a survécu à la translation spatiale, qu’il est rédigé dans une casse homogène et qu’il inclut les unités de mesure physiques afférentes aux données.
- Pérennité scalaire à l’export : Compiler le graphique au format vectoriel (PDF ou SVG) en forçant
bbox_inches='tight'et s’assurer que les bords extrêmes de la légende ne subissent aucune coupure le long du périmètre physique du document. - Accessibilité visuelle universelle : Simuler la lecture du graphique sous des filtres de daltonisme (deutéranopie, protanopie) pour confirmer que les symboles graphiques différenciés par la légende demeurent séparables indépendamment du canal de perception chromatique.
Le respect scrupuleux de ce protocole garantit une transition sans heurt de l’espace exploratoire interactif vers les exigences les plus rigoureuses de l’édition scientifique internationale.
12.3 Patron de conception Python modulaire pour graphiques standardisés
Pour pérenniser ces exigences méthodologiques au sein d’une équipe de recherche ou d’un projet d’ingénierie logicielle, la meilleure pratique consiste à encapsuler la logique d’ajustement spatial au sein d’un patron de conception modulaire réutilisable. Plutôt que de disperser des appels fragmentés à pyplot à travers des dizaines de scripts d’analyse, l’implémentation d’une fonction utilitaire unifiée garantit une standardisation esthétique absolue de toutes les figures produites.
L’architecture d’un tel composant logiciel doit accepter un objet graphique polymorphique (prenant en charge aussi bien un objet Axes standard qu’un conteneur de type FacetGrid), intercepter et épurer les descripteurs sémiotiques, appliquer les transformations géométriques vectorielles via un amarrage déporté standardisé, et recalculer automatiquement les marges périphériques de la figure pour immuniser le rendu contre tout risque de cisaillement.
En consignant cette rigueur spatiale au sein de briques fonctionnelles paramétrables, l’ingénieur de données s’assure que le positionnement de la légende cesse d’être une source de friction technique itérative pour devenir une composante fluide, automatisée et irréprochable de son protocole d’investigation statistique. La visualisation de données s’élève alors au rang de langage formel pur, où chaque métadonnée réside à sa place géométrique exacte au service de la transmission limpide du savoir scientifique.
Références
Bertin, J. (1967). Sémiologie Graphique: Les diagrammes, les réseaux, les cartes. Gauthier-Villars. https://monoskop.org/images/0/05/Bertin_Jacques_Semiologie_graphique.pdf
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
Tufte, E. R. (2001). The Visual Display of Quantitative Information (2e éd.). Graphics Press.
Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3-28. https://doi.org/10.1198/jcgs.2009.07098