
Dans le domaine de l’analyse exploratoire des données et de la communication scientifique, la restitution graphique constitue la passerelle fondamentale entre la modélisation statistique abstraite et l’interprétation humaine. Au sein de l’écosystème du calcul scientifique en langage Python, la bibliothèque Seaborn s’est imposée comme une référence incontournable grâce à son intégration étroite avec les structures de données tabulaires de Pandas et sa capacité à concevoir des visualisations statistiques sophistiquées en un nombre restreint d’instructions. Toutefois, la puissance d’abstraction de Seaborn repose sur un compromis sous-jacent : en automatisant la génération des éléments visuels à partir des métadonnées du tableau source, elle attribue par défaut les noms bruts des colonnes aux axes cartésiens, ce qui produit fréquemment des visualisations impropres à la publication académique ou aux rapports institutionnels.
Le titrage rigoureux des axes ne constitue nullement une coquetterie cosmétique, mais un impératif méthodologique de premier ordre. Une étiquette d’axe déficiente, tronquée ou employant des identifiants programmatiques hermétiques compromet la validité écologique d’une étude, induit une surcharge cognitive évitable et peut altérer la fidélité de l’interprétation des inférences statistiques par les pairs. Maîtriser avec précision les mécanismes d’altération et de mise en forme des libellés d’abscisses et d’ordonnées constitue dès lors une compétence cardinale pour tout chercheur, biostatisticien ou praticien de la science des données soucieux de rigueur et d’intelligibilité.
Ce guide exhaustif a pour vocation d’analyser en profondeur les mécanismes typographiques, syntaxiques et structurels permettant de modifier, styliser et perfectionner les étiquettes des axes au sein de graphiques produits par Seaborn. En explorant conjointement le paradigme orienté objet hérité de Matplotlib, les fonctions de commodité procédurales et les architectures complexes à facettes multiples, ce document offre une analyse technique et empirique complète pour transformer des représentations de données brutes en visualisations conformes aux plus hauts standards de la publication internationale.
1. Introduction aux étiquettes d’axes dans Seaborn et importance dans la communication scientifique
1.1 Rôle épistémologique de la précision graphique en recherche quantitative
Dans l’épistémologie de la recherche quantitative, la visualisation des données remplit une fonction probatoire essentielle. Loin d’être de simples illustrations décoratives, les graphiques statistiques sont des instruments d’inférence visuelle qui traduisent des distributions probabilistes, des estimations paramétriques et des structures relationnelles multidimensionnelles. La transmission sans ambiguïté des variables mesurées et de leurs dimensions physiques ou conceptuelles dépend intrinsèquement de l’exactitude de leurs descripteurs textuels. Un axe d’abscisse ou d’ordonnée dépourvu d’étiquette explicite ou affichant un acronyme réservé au schéma de base de données oblige le lecteur à reconstruire mentalement le protocole d’échantillonnage, rompant ainsi l’immédiateté perceptive nécessaire à l’analyse critique.
La théorie de la charge cognitive, largement adoptée dans l’étude des interfaces visuelles et de la communication pédagogique, postule que la mémoire de travail humaine dispose d’une capacité de traitement limitée. Lorsqu’un lecteur est confronté à un graphique statistique, il alloue une part substantielle de ses ressources attentionnelles à l’intégration des signaux visuels et des métadonnées linguistiques. La présence d’étiquettes d’axes rigoureuses, incluant la dénomination complète du construit mesuré ainsi que ses unités dimensionnelles, réduit considérablement la charge cognitive extrinsèque. Cette économie de ressources cognitives permet au scientifique de se concentrer pleinement sur la charge cognitive intrinsèque, c’est-à-dire l’évaluation des tendances, la dispersion empirique, la présence de valeurs aberrantes et l’adéquation du modèle mathématique sous-jacent.
En outre, la standardisation des rapports statistiques selon les normes académiques internationales, à l’instar des directives stipulées par l’American Psychological Association ou les comités éditoriaux médicaux, impose des règles typographiques et sémantiques inflexibles. Ces standards requièrent que chaque graphique soit autosuffisant, ce qui implique qu’un lecteur doit être capable d’en comprendre l’intégralité du contenu sans avoir à se référer immédiatement au corps du manuscrit. L’omission des unités de mesure, une notation mathématique approximative ou l’absence d’indication claire sur les transformations mathématiques appliquées (telles que les échelles logarithmiques ou standardisées) altèrent directement la portée des inférences statistiques déduites par la communauté scientifique, réduisant par là même la reproductibilité des résultats présentés.
1.2 Architecture sous-jacente : l’interaction structurelle entre Seaborn et Matplotlib
Pour appréhender rationnellement la manipulation des étiquettes d’axes dans Seaborn, il est indispensable de disséquer l’architecture logicielle sous-jacente qui lie cette bibliothèque à Matplotlib. Seaborn ne constitue pas un moteur de rendu graphique autonome fondé sur un pipeline de bas niveau; elle agit plutôt comme une surcouche d’abstraction déclarative à haut niveau construite directement sur les fondations de Matplotlib. Lorsque Seaborn exécute une fonction de traçage, elle interagit avec l’arborescence des objets graphiques de Matplotlib, traduisant les instructions statistiques et les tables de données en primitives graphiques élémentaires telles que des polygones, des lignes, des collections de points et des conteneurs de texte.
Cette symbiose architecturale implique une génération conjointe, implicite ou explicite, d’objets fondamentaux que sont la Figure et l’instance d’Axes. Dans la terminologie de Matplotlib, la Figure représente la surface globale de dessin, le conteneur englobant l’intégralité des éléments de composition graphique, tandis que l’Axes correspond à la région cartésienne spécifique dans laquelle les données sont projetées, pourvue de son propre système de coordonnées, de graduations et de délimitations spatiales. Seaborn encapsule ces mécanismes complexes en créant automatiquement ces instances si l’utilisateur ne les fournit pas explicitement, garantissant une ergonomie optimale pour l’analyse exploratoire de surface.
Cependant, cette conception à double niveau entraîne une conséquence primordiale sur le cycle de vie du rendu graphique. Bien que Seaborn prenne l’initiative de nommer automatiquement les axes en extrayant les en-têtes du DataFrame Pandas fourni, ces libellés sont instanciés sous forme d’objets texte rattachés directement à l’Axes Matplotlib sous-jacent. Dès lors, le chercheur dispose d’une compatibilité ascendante totale : il lui est possible d’initier une représentation statistique via l’expressivité de Seaborn, puis d’intervenir chirurgicalement sur les objets géométriques et typographiques par l’intermédiaire du modèle d’objet de Matplotlib. Cette dualité entre le paradigme déclaratif centré sur les données et le paradigme impératif orienté objet constitue la pierre angulaire de toute personnalisation graphique avancée en Python.
1.3 Aperçu des stratégies algorithmiques pour modifier les libellés
Face à la nécessité de modifier les libellés d’axes, le praticien dispose de trois grandes stratégies algorithmiques, chacune répondant à des contraintes structurelles distinctes. La première stratégie repose sur l’approche par mutateur d’état global, incarnée par l’interface procédurale issue du module pyplot de Matplotlib. Cette méthode s’appuie sur une machine à états implicite qui mémorise la dernière figure et le dernier système de coordonnées instanciés dans le thread d’exécution. Les fonctions scalaires permettent alors d’altérer les libellés en modifiant directement le contexte actif. Bien que d’une extrême simplicité syntaxique lors de sessions interactives sur des calepins numériques, cette technique souffre d’un manque de déterminisme structurel dès que le canevas intègre des sous-graphiques multiples.
La deuxième stratégie procède du paradigme orienté objet strict. Dans cette approche, l’utilisateur capture la référence explicite de l’objet Axes retourné par la fonction Seaborn et interagit directement avec ses méthodes d’encapsulation dédiées, telles que set_xlabel et set_ylabel. Cette démarche garantit une isolation parfaite des modifications, éliminant tout risque d’effet de bord sur d’autres régions du canevas. Elle offre en outre un accès exhaustif à l’ensemble des paramètres de bas niveau gérant la disposition spatiale, l’ancrage typographique et la géométrie des boîtes englobantes des textes, s’affirmant comme la méthode de prédilection au sein des architectures logicielles pérennes et des pipelines de production de figures scientifiques.
Enfin, la troisième stratégie correspond à l’approche déclarative unifiée offerte par la méthode set de l’instance d’Axes. Cette fonction regroupe au sein d’un appel unique la configuration combinée des étiquettes d’abscisse et d’ordonnée, du titre principal de la vue cartésienne ainsi que des bornes limites des échelles de mesure. Le choix entre ces différentes alternatives algorithmiques ne dépend pas uniquement de considérations de style de programmation, mais de la topologie de la figure à construire : un graphique univarié isolé s’accommodera aisément de la concision de l’approche déclarative unifiée, tandis qu’une grille complexe de facettes statistiques exigera l’application rigoureuse de méthodes itératives orientées objet ou de fonctions dédiées aux structures distribuées.
2. Fondements théoriques : l’architecture hybride Seaborn-Matplotlib
2.1 Compréhension de la hiérarchie des objets Axes et Figure
Pour opérer des transformations fiables sur la présentation visuelle des données, il convient de formaliser avec exactitude la hiérarchie structurelle des objets graphiques qui composent une scène sous Matplotlib et Seaborn. Au sommet de cette arborescence trône la classe Figure. Cet objet matriciel constitue le canevas physique ou virtuel de destination, définissant des propriétés globales telles que la résolution matricielle exprimée en points par pouce, les dimensions spatiales totales exprimées en pouces ou en millimètres, la couleur d’arrière-plan du support, ainsi que le gestionnaire d’événements interactifs le cas échéant. La Figure n’a pas vocation à interpréter directement des coordonnées statistiques relatives aux données; elle héberge un ou plusieurs conteneurs géométriques subordonnés.
Ces conteneurs spécialisés sont modélisés par la classe Axes. L’Axes est le véritable réceptacle statistique de la figure : il définit un repère de coordonnées bi- ou tridimensionnel à l’intérieur duquel les valeurs numériques sont traduites en coordonnées spatiales d’affichage via des matrices de projection affines. Chaque instance d’Axes possède son propre système d’axes gradués, matérialisé par des objets distincts de type XAxis et YAxis. Ces sous-composants gèrent l’affichage des lignes d’axes, l’espacement et la valeur des graduations majeures et mineures, ainsi que l’ancrage du libellé textuel correspondant. La hiérarchie est donc strictement descendante : la Figure contient des Axes, lesquels contiennent des objets XAxis et YAxis, qui à leur tour instancient des objets Text pour représenter les étiquettes.
Lorsque Seaborn reçoit une collection de données tabulaires encapsulée dans un DataFrame de Pandas, elle procède à une analyse introspective des colonnes transmises via les arguments d’abscisse et d’ordonnée. Par conception, Seaborn interroge les attributs d’en-tête de ces séries de données et procède à une assignation automatique des chaînes de caractères ainsi collectées aux objets Text rattachés aux axes respectifs. Ce comportement par défaut, bien que facilitant la lecture rapide lors de la phase exploratoire initiale, conserve intrinsèquement les imperfections des désignations de bases de données, telles que les soulignés bas, la casse inadéquate ou l’omission totale des systèmes d’unités de mesure métriques ou statistiques.
2.2 Différenciation entre fonctions au niveau des axes et au niveau des figures
L’une des particularités majeures de Seaborn réside dans la séparation fondamentale de son interface applicative en deux familles distinctes de fonctions de traçage : les fonctions opérant au niveau des axes et celles opérant au niveau des figures complètes. Ignorer cette dichotomie structurelle représente la source la plus fréquente d’anomalies de compilation et de comportements inattendus lors de la manipulation des étiquettes graphiques. Les fonctions dites au niveau des axes, telles que barplot, scatterplot, lineplot, boxplot ou histplot, sont conçues pour dessiner directement sur un objet Axes préexistant ou sur l’axe couramment actif, et renvoient systématiquement en valeur de retour l’instance précise de cet Axes.
À l’inverse, les fonctions dites au niveau des figures, incarnées principalement par catplot, relplot, displot ou lmplot, constituent des métamoteurs de visualisation. Ces fonctions ne dessinent pas sur un simple axe mais créent, configurent et gèrent une architecture complète de sous-graphiques structurés en facettes, encapsulée au sein d’un objet gestionnaire de type FacetGrid. Par conséquent, la valeur de retour de ces fonctions n’est point un objet Axes classique de Matplotlib, mais une instance de la classe FacetGrid. Tenter d’invoquer directement des méthodes d’Axes sur l’objet retourné par l’une de ces fonctions provoque inévitablement une exception de type AttributeError.
Cette divergence structurelle dicte la stratégie d’accès aux étiquettes des axes. Lorsqu’un praticien travaille avec une fonction au niveau des axes, il peut assigner le résultat à une variable conventionnellement nommée ax et appliquer immédiatement l’ensemble des mutateurs de Matplotlib. Lorsqu’il emploie une fonction au niveau de la figure, il doit appréhender l’objet FacetGrid retourné comme une entité composite, disposant de ses propres méthodes de propagation globale ou imposant l’itération explicite sur le tableau matriciel d’Axes sous-jacent. La distinction entre ces deux niveaux d’abstraction conditionne l’ensemble des protocoles de configuration des métadonnées visuelles.
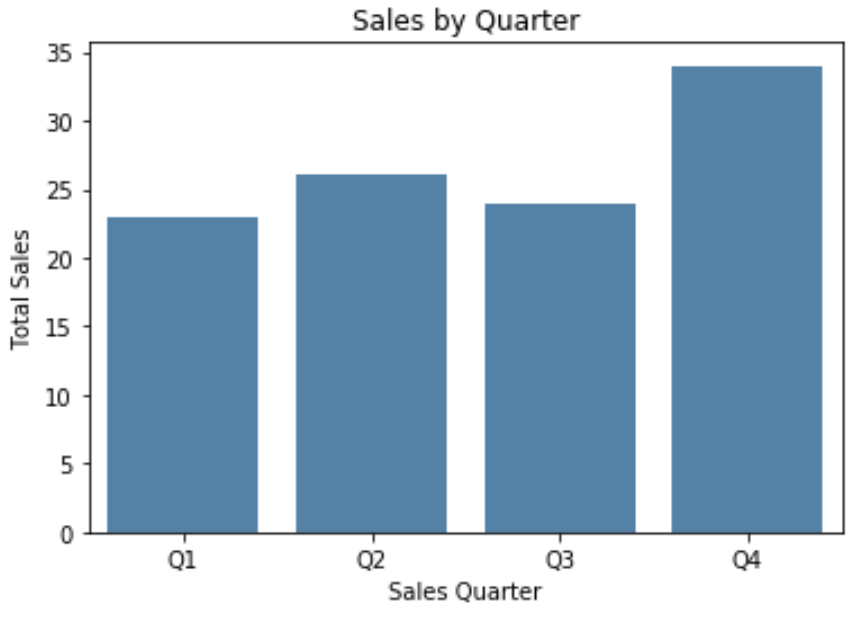
3. Méthode 1 : Utilisation de la méthode ax.set() pour configurer les étiquettes
3.1 Syntaxe fondamentale et sémantique des arguments
La méthode set, rattachée à l’instance de la classe Axes de Matplotlib, représente l’un des mécanismes les plus élégants et efficaces pour modifier de manière coordonnée les propriétés graphiques d’un système de coordonnées généré par Seaborn. Cette méthode fonctionne comme une interface d’agrégation haut niveau : au lieu de contraindre le développeur à formuler de multiples appels séquentiels pour ajuster les étiquettes, le titre et les échelles, elle centralise ces mutations au sein d’une signature d’appel unifiée. En recevant des arguments nommés standardisés, elle procède en interne à une distribution ordonnée des paramètres vers les sous-méthodes spécialisées respectives.
La signature canonique de cette instruction prend la forme ax.set(xlabel=’Libellé Abscisse’, ylabel=’Libellé Ordonnée’), où ax constitue la référence directe vers l’Axes instancié par la fonction Seaborn. La sémantique des arguments xlabel et ylabel stipule la transmission de chaînes de caractères brutes, supportant l’encodage universel UTF-8 ainsi que les directives de formatage mathématique. En outre, la méthode set accepte simultanément des paramètres tels que title pour le titrage sommital, ainsi que xlim et ylim pour la délimitation des frontières d’affichage des axes numériques, offrant ainsi une compacité syntaxique remarquable qui améliore considérablement la maintenabilité et la lisibilité du code source.
Sur le plan de l’architecture d’exécution, la méthode set renvoie une liste contenant les références vers les objets graphiques sous-jacents qui ont été modifiés par l’opération. Cette particularité permet, dans les environnements de programmation fonctionnelle, d’envisager des chaînages d’opérations fluides. L’utilisation de cette interface unifiée protège également le script contre les désynchronisations accidentelles d’état qui surviennent fréquemment lorsque des fonctions éparses de l’API procédurale sont mélangées de façon désordonnée au sein d’une même cellule de calcul scientifique.
3.2 Exemple pratique : Diagramme en barres avec ax.set()
Pour illustrer la mise en œuvre pratique de cette approche, considérons un scénario de recherche où l’on évalue l’efficacité de plusieurs protocoles d’optimisation algorithmique sur la réduction de latence computationnelle. Dans ce cadre empirique, les données sont préalablement regroupées au sein d’un DataFrame de Pandas contenant les catégories d’algorithmes et leurs temps d’exécution respectifs exprimés en millisecondes. L’objectif consiste à générer un diagramme en barres représentant la moyenne et les intervalles de confiance associés, tout en substituant aux noms de variables informatiques des libellés rigoureusement formulés.
L’exécution débute par l’appel de la fonction barplot de Seaborn, en spécifiant les variables d’abscisse et d’ordonnée. Il est impératif d’assigner formellement le résultat de cet appel à une variable réceptrice nommée ax. Dès cet instant, la variable ax détient la référence directe sur l’Axes nouvellement instancié et configuré par Seaborn. Immédiatement après cette étape de traçage statistique, le chercheur invoque la méthode ax.set en lui transmettant explicitement les paramètres xlabel et ylabel dotés de descriptions académiques exhaustives, incluant systématiquement la nature de la métrique et son unité physique standardisée, ainsi qu’un titre de figure formel via l’argument title.
La finalisation du pipeline visuel est ensuite scellée par l’invocation de la fonction d’affichage de Matplotlib via l’interface pyplot. L’examen du rendu graphique produit met en lumière la substitution totale et sans bavure des intitulés bruts du tableau de données par les nouvelles chaînes d’information. Les espacements typographiques, le centrage par rapport à la longueur des axes et l’échelle globale de la figure s’ajustent harmonieusement, validant la pertinence de la méthode ax.set pour les déploiements rapides ne nécessitant pas de modifications microscopiques de la géométrie vectorielle des glyphes.
3.3 Paramétrage avancé via le dictionnaire de propriétés dans ax.set()
Au-delà de la transmission directe de chaînes scalaires simples, la méthode set dispose de capacités avancées de configuration via l’injection de dictionnaires de propriétés typographiques. Bien que les arguments xlabel et ylabel acceptent prioritairement des chaînes textuelles, le système sous-jacent de Matplotlib permet d’associer des métadonnées de style en exploitant des arguments spécifiques ou en combinant les directives globales de l’instance d’Axes. Cela s’avère particulièrement utile lorsque la figure doit s’insérer dans une charte graphique éditoriale stricte imposant des dimensions de police et des graisses normalisées.
Un enjeu technique récurrent lors de l’application de libellés via ax.set réside dans le contrôle de l’espacement physique séparant le texte de l’axe des graduations numériques ou textuelles de la règle de coordonnées. Lorsque les graduations numériques comportent des valeurs volumineuses ou des notations scientifiques étendues, un chevauchement spatial entre les chiffres et le libellé de l’axe peut survenir. Bien que la méthode unifiée set ne présente pas toujours une granularité d’accès immédiate à l’ensemble des microparamètres de marge pour chaque axe individuel, elle permet d’agir de concert avec les dictionnaires d’environnement graphique pour prévenir les collisions perceptives.
De plus, l’utilisation de variables de dictionnaire Python pour stocker préalablement les configurations d’axes permet d’assurer une parfaite cohérence stylistique à travers des dizaines de figures générées au sein d’un même projet de recherche. En construisant une structure de données contenant les clés standardisées des libellés et en la déballant au sein de l’appel ax.set via l’opérateur de déballage d’arguments nommés, le développeur garantit l’homogénéité absolue de ses visualisations empiriques tout en réduisant substantiellement la duplication de code dans ses scripts d’analyse.
4. Méthode 2 : Utilisation des fonctions d’état Matplotlib (plt.xlabel et plt.ylabel)
4.1 Paradigme procédural de l’interface pyplot
L’interface pyplot de Matplotlib implémente historiquement un modèle de programmation procédural inspiré directement des environnements matriciels de calcul numérique tels que MATLAB. Ce paradigme repose entièrement sur le concept d’une machine à états finis implicite opérant au niveau du thread d’exécution global de Python. Dans cette architecture, l’environnement maintient en permanence une référence vers la Figure active courante et vers l’Axes actif courant, désigné couramment sous l’acronyme de gca pour l’expression anglaise get current axes. Toutes les opérations de modification visuelle déclenchées via les fonctions issues du module pyplot ciblent par défaut cette instance sous-jacente sans nécessiter de passage explicite de variable.
Les fonctions scalaires plt.xlabel et plt.ylabel procèdent directement de ce mécanisme à état implicite. Lorsque l’utilisateur invoque l’une de ces instructions en lui passant une chaîne textuelle en paramètre, le moteur d’exécution interroge le contexte global, identifie l’Axes qui a fait l’objet de la dernière opération de rendu, et délègue la mutation du libellé à l’objet XAxis ou YAxis associé. La syntaxe qui en résulte est extrêmement concise, ne réclamant aucune capture préalable de référence d’objet lors de l’appel initial de la fonction de tracé statistique Seaborn.
Néanmoins, la puissance apparente de cette approche masque d’importantes limites conceptuelles. Dès lors qu’une composition graphique dépasse le cadre élémentaire du graphique unique et fait intervenir une multiplicité de sous-graphiques, l’état implicite devient une source majeure de fragilité. Le développeur doit impérativement s’assurer que le focus d’exécution réside sur le bon système de coordonnées au moment précis de l’invocation du libellé. Une rupture dans la séquence chronologique des instructions ou une imbrication de boucles de tracé mal maîtrisée aboutit inévitablement à la modification d’un axe inapproprié, rendant le débogage complexe et aléatoire.
4.2 Exemple pratique : Graphique de dispersion avec plt.xlabel et plt.ylabel
Afin de mettre en exergue le fonctionnement de ce paradigme procédural dans un contexte typique, prenons l’exemple de la modélisation d’une distribution bivariée représentant la relation entre la concentration sérique d’un biomarqueur et l’âge chronologique d’une cohorte de patients. Dans cette configuration, le chercheur s’appuie sur la fonction scatterplot de Seaborn pour projeter le nuage de points et examiner la dispersion empirique des observations sans instancier explicitement de gestionnaire d’axes.
Le script s’exécute de manière séquentielle : la fonction de tracé Seaborn est appelée directement avec la spécification du jeu de données et des variables assignées aux coordonnées cartésiennes. Immédiatement à la suite de cette instruction, sans capture intermédiaire de variable de retour, les fonctions plt.xlabel et plt.ylabel sont appelées consécutivement. La machine à états de pyplot identifie que le tracé de dispersion vient de solliciter l’axe courant et applique instantanément les nouvelles dénominations textuelles spécifiées par l’opérateur, venant recouvrir les noms des colonnes initiales du tableau.
Comparée à l’approche orientée objet, cette structure de code présente une allure linéaire très familière pour les profils formés aux langages de scripts scientifiques traditionnels. Toutefois, une analyse critique de cette écriture révèle qu’elle masque les flux de dépendances logicielles. Si une fonction annexe venait à intercaler un tracé secondaire ou un ajustement d’échelle entre l’appel de Seaborn et les instructions de titrage des axes, l’intégrité de la figure serait immédiatement compromise par la réorientation invisible de l’état actif, illustrant la précarité de cette méthodologie au sein de bases de code complexes.
4.3 Effets de bord et écueils de l’état global
L’exploitation de l’état global dans un environnement d’analyse de données expose le chercheur à des effets de bord insidieux dont les répercussions peuvent fausser l’interprétation des résultats statistiques. Le principal écueil réside dans la modification accidentelle d’un sous-graphique non ciblé lors de la génération de figures composites. Par exemple, lorsqu’un script configure une grille de tracés via la fonction plt.subplot de Matplotlib avant d’appeler des fonctions Seaborn au niveau des axes, l’appel subséquent de plt.xlabel applique l’étiquette exclusivement sur la dernière case de la grille ayant reçu une opération de dessin, laissant les autres axes inchangés ou altérant un panneau erroné.
Un autre risque structurel majeur concerne la non-reproductibilité temporelle du script lors de l’exécution asynchrone ou non linéaire, une situation extrêmement courante lors de l’utilisation de calepins électroniques de type Jupyter. Si l’utilisateur réexécute une cellule contenant uniquement l’instruction plt.xlabel après avoir exécuté d’autres cellules de visualisation en amont, la modification textuelle s’appliquera sur la figure restée active en mémoire tampon, conduisant à des superpositions typographiques désastreuses ou à des incohérences de métadonnées invisibles au premier regard.
C’est pourquoi les règles contemporaines d’ingénierie logicielle appliquée à la science des données recommandent formellement de restreindre l’usage de plt.xlabel et plt.ylabel aux seuls scripts d’exploration préliminaire éphémères et aux démonstrations pédagogiques minimales. Dès lors que le code est destiné à intégrer un pipeline de traitement reproductible, une bibliothèque de fonctions analytiques ou la chaîne de production d’un manuscrit scientifique destiné à l’évaluation par les pairs, l’abandon définitif de la machine à états au profit d’un adressage orienté objet explicite devient une exigence incontournable.
5. Méthode 3 : Manipulation orientée objet avec ax.set_xlabel() et ax.set_ylabel()
5.1 Précision chirurgicale des setters explicites
La manipulation orientée objet fondée sur l’utilisation des méthodes ax.set_xlabel et ax.set_ylabel représente l’étalon d’or de la programmation graphique au sein de l’écosystème Python scientifique. Contrairement à la méthode agrégée set, ces deux mutateurs spécialisés ont été expressément conçus pour offrir une granularité de contrôle maximale sur chacun des axes indépendamment. Ils traduisent une adhésion stricte aux principes de la programmation orientée objet, où chaque composant visuel de la scène constitue une instance autonome disposant d’un espace d’état hermétique et de méthodes d’action univoques.
La signature technique complète de ax.set_xlabel et ax.set_ylabel révèle une richesse paramétrique considérable. Au-delà de l’argument positionnel principal recevant la chaîne de caractères du libellé, ces méthodes acceptent une constellation d’arguments nommés destinés à gouverner avec une précision chirurgicale l’ensemble des propriétés typographiques et géométriques du rendu. Parmi ceux-ci figurent le contrôle de l’angle d’inclinaison du texte, les modes d’ancrage d’alignement horizontal et vertical, l’interstice métrique séparant le texte de la frontière physique du système de coordonnées, ainsi que l’ensemble des variables scalaires relatives aux familles de polices de caractères et aux palettes chromatiques.
Cette rigueur fonctionnelle confère aux setters explicites une stabilité parfaite dans les environnements de calcul distribué ou multithread. L’état du tracé ne dépend plus d’une variable globale fluctuante gérée par un interpréteur invisible, mais découle strictement des propriétés de l’instance d’Axes explicitement référencée en mémoire vive. Cette architecture favorise également l’écriture de tests unitaires sur les figures graphiques, la réutilisation de gabarits de mise en page formels et la collaboration au sein de larges consortiums scientifiques où la cohérence du code source constitue un critère absolu d’évaluation de la qualité logicielle.
5.2 Exemple pratique : Tracé linéaire longitudinal
Pour matérialiser la supériorité opérationnelle de cette approche, analysons la formalisation d’une trajectoire longitudinale issue d’une étude d’intervention clinique. Dans ce protocole, un groupe de sujets soumis à un protocole pharmacologique fait l’objet de mesures itératives d’une variable métabolique à différents temps d’observation post-administration. Le tableau de données de départ associe à chaque point temporel une valeur continue représentative, ainsi que des marqueurs de variabilité interindividuelle.
Le protocole de visualisation débute par la génération explicite d’un conteneur graphique via l’appel de la fonction subplots de Matplotlib, permettant de définir précisément les dimensions de la figure dès son instanciation. Cet appel produit simultanément la Figure maîtresse et l’instance unique d’Axes, assignée à la variable ax. Ensuite, la fonction lineplot de Seaborn est appelée en lui transmettant explicitement cet objet via son paramètre ax=ax. Seaborn délègue ainsi son rendu directement au repère cartésien préalablement alloué, consolidant un couplage parfait entre l’outil de calcul statistique et le support visuel.
Le chercheur intervient alors sur les métadonnées de l’axe temporel en invoquant ax.set_xlabel, en définissant non seulement un libellé rigoureux mentionnant la durée et l’unité horaire, mais en lui appliquant une taille de police majorée et un espacement personnalisé par rapport aux graduations de l’axe. Dans la foulée, ax.set_ylabel est mobilisée pour spécifier avec exactitude le dosage métabolique, l’échelle logarithmique employée et la dimension physique unitaire. Le résultat final présente une netteté visuelle et une rigueur géométrique irréprochables, illustrant comment le contrôle direct des setters d’Axes permet de satisfaire instantanément aux exigences de rigueur des plus grandes revues scientifiques.
6. Gestion des graphiques complexes à facettes : FacetGrid, PairGrid et JointGrid
6.1 Personnalisation des étiquettes sur FacetGrid et catplot/relplot
L’une des fonctionnalités les plus puissantes de Seaborn réside dans sa capacité à partitionner un jeu de données complexe selon plusieurs dimensions catégorielles pour produire des matrices de graphiques coordonnées, communément qualifiées de facettes ou de petits multiples statistiques selon la terminologie d’Edward Tufte. Des fonctions d’ordonnancement de haut niveau telles que catplot et relplot orchestrent cette décomposition matricielle en instanciant un conteneur évolué de la classe FacetGrid. Ce conteneur ne se comporte pas comme un axe élémentaire mais encapsule une matrice multidimensionnelle d’instances d’Axes Matplotlib coordonnées entre elles.
Pour interagir avec l’ensemble des libellés d’une telle composition sans altérer la cohérence d’ensemble, la classe FacetGrid expose une méthode dédiée de très haut niveau intitulée set_axis_labels. Cette fonction accepte deux arguments positionnels principaux représentant respectivement l’étiquette globale de l’abscisse et l’étiquette globale de l’ordonnée. Son exécution déclenche une boucle de mise à jour optimisée qui applique les dénominations textuelles sur les sous-graphiques périphériques de la matrice tout en désactivant automatiquement les étiquettes sur les facettes internes pour éviter les redondances visuelles qui pollueraient inutilement la lecture des données transversales.
Dans des configurations expérimentales plus exigeantes, il apparaît indispensable d’assigner des libellés distincts et conditionnels à chaque ligne ou colonne de la matrice de facettes, par exemple lorsque chaque sous-panneau représente une variable physiologique dotée d’une unité de mesure propre. Dans ce cas de figure, l’opérateur doit s’abstraire de la mise à jour globale et parcourir explicitement l’attribut axes du conteneur FacetGrid. Cet attribut expose la matrice bidimensionnelle des objets Axes sous-jacents sous la forme d’un tableau NumPy. En itérant par double boucle sur les indices de lignes et de colonnes de cette structure matricielle, le programmeur peut adresser individuellement chaque sous-axe via les méthodes ax.set_xlabel et ax.set_ylabel, accomplissant une personnalisation différentielle sur mesure de chaque panneau de la figure.
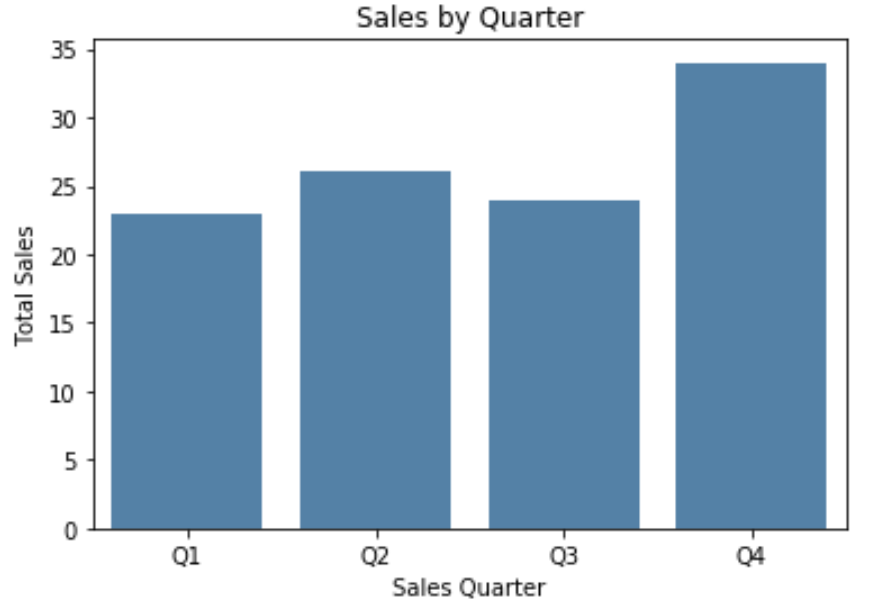
6.2 Manipulation des matrices de corrélation et PairGrid
La classe PairGrid constitue une autre spécialisation majeure de Seaborn destinée à l’exploration exhaustive des interactions multivariées au sein d’une distribution de données. Contrairement aux visualisations univariées classiques, la fonction pairplot génère une matrice symétrique où chaque variable numérique du tableau est croisée avec l’ensemble des autres variables, combinant des tracés de distribution univariée sur la diagonale principale et des tracés de dispersion ou de densité bivariée sur les triangles matriciels supérieur et inférieur. L’architecture qui en résulte engendre une densité textuelle considérable si chaque sous-axe tente d’afficher ses propres libellés de coordonnées.
La gestion rationnelle des étiquettes au sein d’une PairGrid impose une politique stricte d’épuration visuelle. Par défaut, Seaborn positionne les libellés uniquement sur la bordure extérieure gauche pour l’ordonnée et sur la bordure inférieure pour l’abscisse, supprimant judicieusement les annotations sur les panneaux intérieurs. Toutefois, lorsque les dénominations originelles des variables s’avèrent trop verbeuses ou nécessitent l’adjonction de notations mathématiques complexes, le praticien doit intervenir programmatiquement sur les marges périphériques pour harmoniser l’affichage.
Cette optimisation s’opère en capturant l’instance de PairGrid retournée par la fonction de traçage et en modifiant les attributs textuels des bordures externes. Le parcours ciblé de la dernière ligne d’Axes permet de redéfinir uniformément les libellés d’abscisses, tandis que l’itération exclusive sur la première colonne d’Axes assure la mise à niveau des étiquettes d’ordonnées. Il convient durant cette opération de préserver scrupuleusement l’alignement typographique et la taille des caractères afin d’éviter tout déséquilibre visuel qui briserait la lecture matricielle synoptique indispensable à la comparaison simultanée des coefficients de corrélation empiriques.
6.3 Cas spécifique des objets JointGrid et de leurs axes marginaux
L’objet JointGrid, mobilisé en coulisses par la fonction jointplot de Seaborn, présente une configuration topologique singulière au sein du paysage de la visualisation scientifique. Il combine, au sein d’une surface d’affichage unifiée, une région cartésienne centrale bidimensionnelle destinée à exprimer la distribution conjointe de deux variables (via un nuage de points, une estimation par noyau ou un tracé hexagonal) et deux régions cartésiennes secondaires marginales, positionnées respectivement au sommet et sur le flanc droit du panneau principal, vouées à l’expression des densités marginales univariées.
Cette ségrégation spatiale complexe soulève un défi particulier pour la modification des étiquettes. Tenter d’invoquer une méthode d’état globale de Matplotlib ou appliquer un mutateur mal ciblé sur l’objet JointGrid conduit fréquemment à titrer de manière erronée l’un des histogrammes marginaux plutôt que l’espace cartésien central des données. Pour prévenir toute ambiguïté structurelle, l’architecture de la classe JointGrid fournit un accès explicite et direct à son panneau central par l’intermédiaire de son attribut public ax_joint.
Le protocole technique optimal exige donc de cibler exclusivement cet attribut ax_joint pour toutes les opérations de labellisation : l’application de ax_joint.set_xlabel et de ax_joint.set_ylabel permet de fixer avec une autorité absolue les libellés des axes de la distribution conjointe. Seaborn prend alors automatiquement la charge de masquer les graduations et étiquettes redondantes sur les axes marginaux, garantissant que les distributions univariées sommitale et latérale conservent une pureté visuelle absolue, exempte de toute surcharge textuelle parasitique qui nuirait à l’appréciation des densités marginales.
7. Personnalisation typographique et stylistique avancée des étiquettes d’axes
7.1 Contrôle de la police, de la graisse et du corps de texte
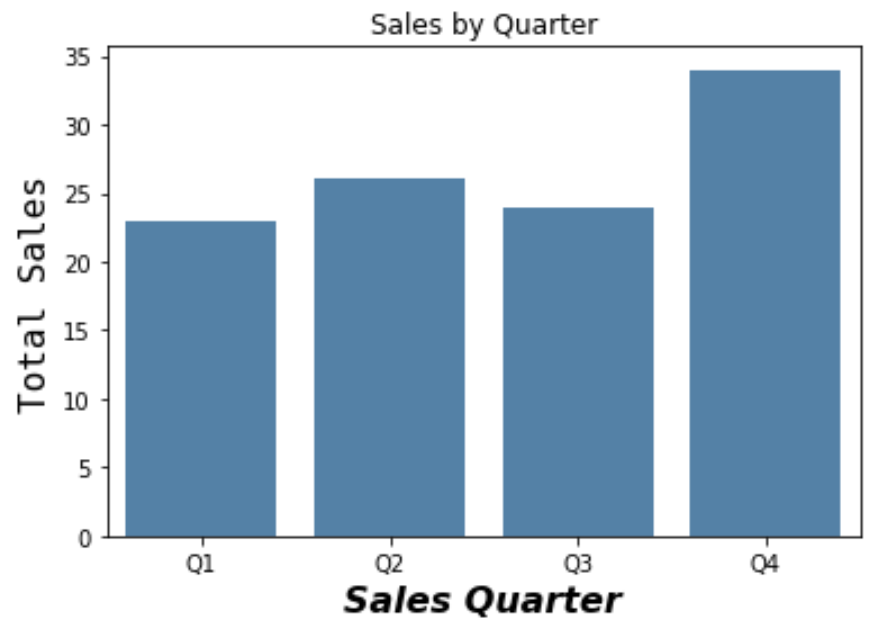
L’intégration d’un graphique au sein d’une publication savante exige une adéquation typographique totale avec le corps de texte du manuscrit environnant. Les éditeurs académiques imposent fréquemment des chartes graphiques drastiques quant aux familles de glyphes autorisées, interdisant le recours aux polices génériques par défaut des bibliothèques de calcul. Dans le cadre de Matplotlib et Seaborn, le contrôle microscopique de la police s’effectue soit de manière ponctuelle au niveau de l’appel des setters d’axes, soit de manière universelle par la reconfiguration de la table des paramètres de configuration du système, désignée sous le terme technique de rcParams.
Lors d’une modification ponctuelle, les méthodes ax.set_xlabel et ax.set_ylabel reçoivent des arguments spécifiques dédiés à l’anatomie typographique. Le paramètre fontsize permet de déterminer avec exactitude le corps de texte en points typographiques ou par le biais d’échelles lexicales relatives. L’argument fontweight contrôle l’épaisseur ou la graisse du dessin de la lettre, autorisant des gradations allant du tracé fin jusqu’à la graisse ultra-épaisse, ce qui permet de hiérarchiser visuellement l’importance relative d’un axe par rapport à un autre. Enfin, l’argument fontfamily autorise la sélection formelle de familles de polices avec empattement, de polices linéaires sans empattement, ou de polices à espacement fixe selon les contraintes de lisibilité du document final.
Pour les projets d’envergure englobant des dizaines de figures distribuées à travers un manuscrit de thèse ou un rapport institutionnel, il est hautement préférable de centraliser ces directives au sein du dictionnaire rcParams avant d’exécuter les fonctions de tracé. En modifiant globalement les clés associant les tailles et les familles de polices aux libellés d’axes, le chercheur s’assure d’une reproductibilité typographique parfaite sans devoir alourdir chaque bloc de code par une cascade d’arguments identiques. Cette pratique standardise les productions graphiques selon les canons de l’artisanat éditorial et élimine les disparités visuelles susceptibles d’altérer la perception de professionnalisme d’une étude expérimentale.
7.2 Colorimétrie et harmonisation avec la palette de données
L’utilisation rationnelle de la couleur sur les étiquettes d’axes constitue un levier d’encodage visuel d’une puissance sous-estimée. Dans la majorité des visualisations conventionnelles, les libellés sont maintenus dans des tons noirs ou gris neutres afin de ne point rivaliser avec l’encodage chromatique des données elles-mêmes. Cependant, dans des configurations graphiques spécifiques, telles que les représentations à double échelle d’ordonnées ou les figures d’analyse différentielle, la couleur du texte devient un vecteur sémiotique fondamental pour relier cognitivement un axe cartésien à la courbe statistique correspondante.
Le paramètre color, disponible au sein des méthodes de configuration des étiquettes, accepte une diversité étendue de spécifications chromatiques : identifiants scalaires standardisés, codes hexadécimaux conformes au standard RVB, coordonnées normalisées au sein de l’espace colorimétrique, ou encore références directes aux palettes de couleurs perceptuellement uniformes développées au sein de Seaborn. L’attribution d’une couleur spécifique au libellé d’axe doit néanmoins se conformer scrupuleusement aux directives internationales d’accessibilité visuelle, à l’instar des normes édictées par la Web Accessibility Initiative. Un contraste de luminance insuffisant entre le texte du libellé et la surface de fond du canevas dégrade dramatiquement la lisibilité pour les lecteurs malvoyants ou lors de l’impression monochrome sur support papier.
Dans le cas d’études statistiques complexes impliquant des seuils de significativité clinique prédéfinis, il est également possible de synchroniser la couleur de l’étiquette d’axe avec le résultat d’un test d’hypothèse sous-jacent, conférant au titre de l’axe une fonction d’alerte métasémantique. Dans des contextes visuels très encombrés où des nuages de points denses s’étendent jusqu’aux limites extrêmes du système de coordonnées, l’incorporation d’une boîte d’arrière-plan opaque autour du libellé textuel au moyen de l’argument bbox permet de maintenir une isolation optique parfaite entre le texte explicatif et les éléments géométriques de dispersion de données.
7.3 Gestion de l’espacement et du décalage (padding)
L’un des défauts de composition les plus dégradants dans une figure statistique destinée à la publication réside dans la collision géométrique entre le texte du libellé de l’axe et les graduations chiffrées de l’échelle. Par défaut, Matplotlib alloue une marge d’espacement standard qui s’avère satisfaisante pour des nombres entiers courts. Cependant, dès lors que les graduations comportent des décimales étendues, des annotations d’intervalles ou des puissances de dix accompagnées de leur base arithmétique, le contour géométrique des chiffres vient fréquemment chevaucher la boîte de délimitation du libellé de l’axe, provoquant une confusion de lecture intolérable.
Pour résoudre chirurgicalement cette difficulté d’agencement spatial, les méthodes ax.set_xlabel et ax.set_ylabel intègrent un argument dédié nommé labelpad. Ce paramètre quantifie, en points typographiques d’affichage, la distance physique stricte maintenue entre la bordure externe des graduations de l’axe et le point d’ancrage le plus proche de la chaîne de texte du libellé. En majorant délibérément la valeur de labelpad, le programmeur repousse l’étiquette vers l’extérieur du système cartésien, créant une respiration spatiale qui restaure instantanément la netteté et l’élégance de la composition d’ensemble.
L’utilisation de décalages spatiaux sur les étiquettes doit toutefois s’opérer de concert avec les algorithmes de recalcul automatique des marges extérieures de la figure. L’invocation conjointe de la fonction tight_layout ou du moteur de mise en page contrainte de Matplotlib garantit que l’augmentation de la marge typographique d’un axe ne repoussera pas le texte en dehors du canevas de rendu visible de la Figure maîtresse. L’interaction harmonieuse entre le labelpad manuel et le dimensionnement automatique global assure l’obtention de fichiers vectoriels parfaitement proportionnés, prêts pour le processus de gravure typographique éditoriale.
8. Positionnement, rotation et alignement spatial des étiquettes
8.1 Orientation angulaire des libellés d’axes
L’orientation angulaire des éléments textuels représente une variable ergonomique critique dans la conception des visualisations empiriques. Par convention immuable dans l’édition cartésienne, le libellé de l’axe des abscisses est disposé horizontalement, parallèlement au flux de lecture textuel standard, tandis que le libellé de l’axe des ordonnées est orienté verticalement avec un angle de rotation de quatre-vingt-dix degrés dirigé vers le haut, afin d’épouser le vecteur dimensionnel vertical tout en préservant la compacité latérale de la composition graphique.
Toutefois, dans certains scénarios d’analyse impliquant des dénominations de variables qualitatives particulièrement longues sur l’abscisse, ou lorsque l’ergonomie visuelle impose une lecture horizontale immédiate pour l’ordonnée afin d’éviter au lecteur d’incliner la tête, la modification de l’angle d’affichage devient indispensable. L’argument rotation, accepté par les setters d’Axes, permet d’imposer n’importe quelle orientation angulaire exprimée en degrés trigonométriques. En positionnant l’argument rotation sur zéro au sein de ax.set_ylabel, le chercheur bascule le libellé vertical en une lecture horizontale conventionnelle au sommet de la règle de coordonnées.
Cependant, toute modification angulaire d’un conteneur textuel brise son centre de gravité typographique initial. Pour éviter que le texte ainsi pivoté n’entre en collision avec la ligne physique de l’axe ou ne dérive de façon incontrôlée dans l’espace vierge de la figure, il est impératif d’ajuster simultanément les points d’ancrage spatiaux. Cet équilibrage s’accomplit par l’intermédiaire des paramètres d’alignement horizontal, stipulés par horizontalalignment ou son alias ha, et d’alignement vertical, paramétrés via verticalalignment ou son alias va. La manipulation coordonnée de la rotation angulaire et des ancrages géométriques garantit un positionnement millimétrique irréprochable des étiquettes les plus complexes.
8.2 Translation et ancrage aux extrémités des axes
Bien que le centrage géométrique parfait par rapport à la longueur de l’axe cartésien constitue le comportement par défaut de l’ensemble des bibliothèques de tracé sous Python, certaines traditions scientifiques, notamment en physique théorique et en économétrie appliquée, privilégient un ancrage des libellés aux extrémités directionnelles des axes. Ce choix de mise en page vise à transformer métaphoriquement l’axe en un vecteur vectoriel continu, dont le nom de la dimension mesurée vient couronner la flèche terminale pour indiquer la trajectoire d’expansion des grandeurs réelles ou théoriques.
Matplotlib et Seaborn autorisent cette disposition stylistique par le truchement du paramètre positionnel loc au sein des méthodes spécialisées. Pour l’axe des abscisses gouverné par ax.set_xlabel, le développeur peut assigner à l’argument loc les chaînes de positionnement désignant la droite, la gauche ou le centre. Pour l’axe des ordonnées via ax.set_ylabel, les positions admises correspondent au sommet, à la base ou au centre géométrique du système cartésien. Positionner le libellé d’ordonnée au sommet avec un alignement horizontal adéquat transforme l’esthétique du graphique en conférant une clarté instantanée à l’orientation de l’échelle de mesure.
Pour des exigences de mise en page encore plus singulières, telles que la conception de graphiques cartésiens centrés sur l’origine avec des axes se croisant au point de coordonnées nulles, les transformations affines de Matplotlib permettent d’ancrer le libellé textuel directement dans l’espace de coordonnées des données plutôt que dans l’espace relatif de l’axe. En exploitant les systèmes de transformation de coordonnées, le praticien peut lier l’affichage de l’étiquette à une valeur numérique précise du tableau de données, assurant que les métadonnées textuelles se déplacent de manière dynamique et solidaire lors des phases d’actualisation séquentielle des bases d’échantillonnage.
8.3 Traitement des textes longs et retours à la ligne programmatiques
Un dilemme ergonomique majeur survient fréquemment lors de l’évaluation de construits psychométriques, d’items de sondages d’opinion publique ou d’indicateurs composites dont la dénomination exhaustive s’étend sur une ou plusieurs phrases complètes. Tenter d’injecter une telle chaîne linéaire au sein du paramètre de libellé d’un axe produit une dilatation disproportionnée de la boîte de délimitation du tracé, comprimant la surface d’expression utile des données ou provoquant une coupure brutale du texte au-delà des marges physiques de l’image matricielle exportée.
La technique la plus directe pour remédier à cette dispersion horizontale consiste à insérer intentionnellement des caractères d’échappement de saut de ligne au sein de la chaîne de caractères transmise à l’axe. En fragmentant judicieusement le texte aux frontières syntagmatiques naturelles, le développeur transforme une chaîne linéaire démesurée en un paragraphe typographique compact et harmonieux. L’espacement interligne de ce bloc textuel peut ensuite être modulé finement pour éviter que les lignes successives ne se chevauchent ou ne s’écartent excessivement.
Dans le cadre de pipelines de calcul entièrement automatisés où les noms de variables proviennent de bases de données dynamiques sans intervention humaine possible, l’insertion manuelle de sauts de ligne s’avère irréalisable. Il convient alors de mobiliser les fonctions de traitement de chaînes de la bibliothèque standard de Python, à l’instar du module textwrap. En encapsulant le libellé d’entrée dans une routine d’enroulement textuel paramétrée avec une largeur limite de caractères prédéfinie, l’algorithme génère de façon dynamique une chaîne enrichie de retours à la ligne parfaitement calibrés. Cette approche garantit que, quelle que soit la verbosité des descripteurs de variables transmis, la visualisation conservera des proportions géométriques rigoureusement conformes aux critères de publication.
9. Intégration de symboles mathématiques et notation LaTeX dans les libellés
9.1 Syntaxe mathématique standard Mathtext sans installation externe
Dans la communication des résultats de la recherche quantitative, les grandeurs mesurées s’expriment très fréquemment par le truchement de symboles mathématiques formalisés : lettres de l’alphabet grec figurant des paramètres de population, indices de strates factorielles, exposants de puissances physiques, ou opérateurs différentiels. Intégrer ces formulations au sein des libellés d’axes Seaborn est rendu possible de façon native grâce au sous-système intégré d’analyse mathématique de Matplotlib, universellement désigné sous l’appellation de moteur Mathtext.
Le moteur Mathtext permet de composer des équations et des symboles de haute tenue typographique sans dépendre de l’installation externe d’une distribution logicielle complexe de composition de documents. La syntaxe repose sur l’encadrement des expressions mathématiques par des symboles de dollar, calquant directement la grammaire classique du langage typographique de Donald Knuth. Lors de la rédaction du script Python, il est formellement impératif de préfixer la chaîne de caractères par la lettre r afin de signifier à l’interpréteur qu’il s’agit d’une chaîne brute (raw string). Cette précaution capitale empêche Python d’interpréter les barres obliques inverses requises par les commandes mathématiques comme des séquences d’échappement conventionnelles du langage.
Grâce à cette infrastructure, l’opérateur peut enrichir ses étiquettes d’abscisse et d’ordonnée de notations hautement rigoureuses. Il devient trivial de spécifier des coefficients de détermination quadratique, des métriques d’erreur standard de la moyenne intégrant des racines carrées, des indices de corrélation de rangs ou des notations d’intégrales définies pour des fonctions de densité cumulée. Le moteur Mathtext intègre une police vectorielle spécialisée qui s’harmonise avec les glyphes alphabétiques environnants, assurant une lecture limpide et rigoureuse des dimensions statistiques fondamentales du tracé sans aucune surcharge d’infrastructure logicielle.
9.2 Rendu complet via le moteur de composition LaTeX externe
Lorsque le manuscrit scientifique dans son ensemble est rédigé et composé sous le moteur typographique de haute précision qu’est le système de composition de documents TeX ou LaTeX, une exigence de fidélité visuelle absolue peut pousser le chercheur à déléguer le rendu intégral des textes du graphique au compilateur LaTeX de son système d’exploitation. Cette intégration de haut niveau garantit que les polices de caractères, les césures, les graisses et les moteurs d’espacement des étiquettes du graphique soient mathématiquement identiques à ceux qui régissent les paragraphes du texte imprimé, atteignant une symbiose esthétique parfaite.
Pour activer ce mécanisme de composition externe, il est nécessaire d’altérer la configuration de Matplotlib en assignant la valeur de vérité booléenne True à la clé text.usetex au sein du dictionnaire rcParams. Dès cet instant, chaque chaîne de caractères attribuée aux libellés d’axes n’est plus analysée par le moteur interne de Python, mais est exportée sous forme de fragment source vers la distribution LaTeX installée sur la machine hôte. Le système compile silencieusement le fragment en un fichier vectoriel temporaire contenant les polices Computer Modern ou toute autre fonte vectorielle configurée par l’utilisateur, puis réintègre les glyphes résultants à l’emplacement géométrique exact de l’axe.
Ce niveau ultime de raffinement stylistique comporte néanmoins des contraintes techniques substantielles. D’une part, il requiert la présence vérifiée d’une distribution TeX opérationnelle ainsi que des paquets typographiques associés sur l’environnement d’exécution du code, ce qui exclut son déploiement au sein de microservices ou de conteneurs légers dépourvus de ces dépendances lourdes. D’autre part, la chaîne de caractères transmise aux méthodes ax.set_xlabel et ax.set_ylabel doit respecter scrupuleusement les contraintes de syntaxe du compilateur : la présence accidentelle de caractères réservés non protégés par une barre d’échappement déclenche instantanément une erreur de compilation système fatale. Utilisée avec discernement, cette méthode produit néanmoins des résultats d’une qualité esthétique inégalable pour les publications au sein des plus grandes revues internationales.
10. Cas pratiques appliqués aux données comportementales et psychométriques
10.1 Cas 1 : Graphique d’évaluation d’échelles de Likert et scores composites
Dans le champ des sciences du comportement, de la psychologie cognitive et de la recherche en santé publique, la modélisation de construits latents non observables directement repose fréquemment sur l’utilisation d’échelles de réponse psychométriques de type Likert ou sur l’agrégation de scores composites multidimensionnels. L’analyse graphique de ces distributions par l’intermédiaire de diagrammes en boîtes avec Seaborn impose une labellisation d’une méticulosité absolue afin d’expliciter sans ambiguïté les bornes d’ancrage sémantique et la métrique opérationnelle employée pour quantifier le phénomène d’intérêt.
Considérons une étude clinique comparant le niveau d’anxiété état mesuré par un inventaire standardisé entre un groupe de contrôle et plusieurs cohortes soumises à différentes modalités de remédiation cognitive. Les données brutes stockées au sein du DataFrame Pandas associent à chaque participant un identifiant expérimental, la modalité d’intervention et un score composite continu résultant de la sommation d’items catégoriels. Lors de l’instanciation du tracé statistique au moyen de la fonction boxplot de Seaborn, le passage par défaut des noms de colonnes produirait des intitulés sommaires totalement dépourvus de validité écologique pour un lecteur extérieur.
Le chercheur intervient alors sur l’instance d’Axes capturée en déployant la méthode unifiée ax.set. L’axe des abscisses est configuré pour afficher non seulement la dénomination explicite du facteur d’exposition, mais également l’effectif total d’échantillonnage associé à chaque condition expérimentale. Sur l’axe des ordonnées, le libellé détaille avec précision le nom officiel de l’instrument d’évaluation, la nature de l’indice composite ainsi que l’intervalle théorique de l’échelle entre parenthèses. Cette mise en contexte immédiate permet à l’évaluateur ou au clinicien d’apprécier la signification diagnostique des médianes et des dispersions interquartiles sans avoir à sonder les sections méthodologiques du document.
10.2 Cas 2 : Visualisation de temps de réaction lors de paradigmes expérimentaux
Les paradigmes de chronométrie mentale en neurosciences cognitives mesurent usuellement les temps de réaction des participants face à des stimuli sensoriels ciblés. Ces chronométries présentent systématiquement une asymétrie distributionnelle prononcée vers la droite, marquée par des queues de distribution épaisses induites par des réponses tardives accidentelles. La visualisation de telles variables via la fonction violinplot de Seaborn combine une représentation par boîte à moustaches avec une estimation par noyau de la densité de probabilité, offrant un panorama exhaustif de la structure sous-jacente des latences motrices.
Face à de telles asymétries, la rigueur méthodologique commande fréquemment d’appliquer des transformations mathématiques stabilisatrices de variance, à l’instar des transformations logarithmiques népériennes ou des inversions réciproques en vitesses de traitement. La présence d’une telle altération mathématique doit impérativement être documentée dans le corps même de l’étiquette d’ordonnée. Omettre de stipuler la nature de l’échelle logarithmique sur l’axe des ordonnées fausserait dramatiquement la perception de la distance relative entre les groupes expérimentaux en laissant présumer une relation linéaire classique.
Dans ce scénario empirique, la manipulation orientée objet prend toute sa valeur. Par le truchement de la méthode ax.set_ylabel, le chercheur intègre au libellé la formulation mathématique explicite de la transformation opérée en mobilisant la syntaxe Mathtext pour formater le logarithme et les parenthèses de dimensionnement. Parallèlement, l’axe temporel des abscisses détaille avec minutie les conditions de compatibilité stimulus-réponse manipulées expérimentalement. Ce titrage rigoureux préserve la conformité méthodologique du travail de recherche et renforce la crédibilité des inférences de temps de calcul mental soumises à la révision critique des pairs.
10.3 Cas 3 : Matrice factorielle multivariée avec FacetGrid
Les plans d’expérience factoriels complexes, croisant simultanément des facteurs intra-sujets et inter-sujets à travers des cohortes multiples, réclament une décomposition visuelle matricielle orchestrée par l’objet FacetGrid de Seaborn. Imaginons une expérience d’apprentissage supervisé évaluant les performances mnésiques de sujets jeunes et âgés face à différentes charges d’interférence cognitive, mesurées à intervalles de rétention différés. La fonction catplot permet de projeter cette architecture factorielle en articulant les données en une matrice de sous-graphiques catégorisés par tranche d’âge en ligne et par niveau de charge cognitive en colonne.
Dans une structure matricielle aussi dense, le titrage naïf de chaque sous-axe engendrerait une cacophonie typographique paralysante, saturant le canevas de rappels textuels répétés à l’identique d’un panneau à l’autre. La gestion optimale des étiquettes impose dès lors une différenciation structurelle rigoureuse. L’opérateur utilise d’abord la méthode g.set_axis_labels pour imposer les dénominations fondamentales aux frontières extérieures de la matrice d’ensemble, garantissant la lisibilité des dimensions métriques sans encombrer les séparations internes.
Dans un second temps, le scientifique parcourt par itération les axes sommitaux et latéraux pour injecter des libellés de facettes hautement contextualisés via ax.set_title, tout en garantissant un alignement horizontal parfait entre les panneaux contigus. Cette synchronisation millimétrique des échelles et de leurs descripteurs linguistiques assure que la comparaison visuelle des pentes de régression ou des amplitudes de distribution s’effectue sans biais perceptif. Le graphique ainsi façonné transcende la simple présentation brute des données pour devenir un instrument analytique de haute volée, apte à soutenir les argumentations théoriques les plus exigeantes.
11. Diagnostic et résolution des erreurs courantes lors de la modification des axes
11.1 L’erreur AttributeError: ‘FacetGrid’ object has no attribute ‘set_xlabel’
L’une des anomalies les plus couramment rencontrées par les chercheurs migrant d’un code exploratoire élémentaire vers des architectures de visualisation modulaires sous Seaborn réside dans le déclenchement de l’exception de type AttributeError stipulant que l’objet FacetGrid ne dispose d’aucun attribut nommé set_xlabel. Ce message d’erreur, souvent accueilli avec incompréhension par les programmeurs novices, découle directement de la rupture d’isomorphisme entre les fonctions opérant au niveau des axes et celles opérant au niveau des figures complètes, telle que détaillée précédemment dans nos fondements théoriques.
Lorsque le chercheur utilise une fonction génératrice de facettes matricielles telle que catplot, relplot ou lmplot, l’objet retourné n’est pas une instance terminale de la classe Axes de Matplotlib, mais une instance englobante de la classe FacetGrid. Tenter d’exécuter directement g.set_xlabel(‘Libellé’) sur cette entité composite constitue une erreur d’adressage fonctionnel : la classe FacetGrid n’expose pas de mutateur unitaire axé sur un seul bord spatial, car elle gère potentiellement un agrégat de dizaines de sous-axes simultanés.
La résolution de cette anomalie obéit à deux protocoles bien établis selon l’objectif visé. Si l’utilisateur souhaite appliquer uniformément un libellé à l’ensemble des axes situés aux bordures de sa grille, il doit substituer à l’appel défaillant l’instruction g.set_axis_labels(‘Libellé X’, ‘Libellé Y’), qui constitue la méthode officielle et documentée de mise à jour globale pour la classe FacetGrid. Si, en revanche, la figure ne comporte qu’une facette unique ou que l’opérateur souhaite modifier exclusivement le panneau cartésien principal, il doit pénétrer l’encapsulation de l’objet en adressant son attribut ax, ou en indexant son tableau matriciel axes pour invoquer en toute légitimité la méthode set_xlabel sur l’instance d’Axes véritablement hébergée à cet emplacement.
11.2 Écrasement involontaire des étiquettes lors du réordonnancement du tracé
Une seconde catégorie de dysfonctionnements particulièrement frustrante survient lorsque des étiquettes d’axes méticuleusement configurées par le développeur sont inopinément écrasées ou réinitialisées à leurs valeurs brutes d’origine lors de l’exécution d’instructions ultérieures au sein de la même cellule de script. Ce phénomène d’amnésie graphique découle de l’ordre d’exécution séquentiel et des mécanismes internes de mise à jour automatique dont sont pourvues certaines fonctions de Seaborn et de Matplotlib.
Par conception logicielle, chaque fois qu’une fonction de tracé statistique de haut niveau Seaborn est invoquée en ciblant un système d’axes préexistant, elle procède à une analyse des nouvelles données injectées et réassigne automatiquement les métadonnées de colonnes aux objets Text des axes XAxis et YAxis correspondants. Par conséquent, si un chercheur configure rigoureusement ses libellés par l’intermédiaire de la méthode ax.set_xlabel au début de son bloc de calcul, puis invoque subséquemment une fonction de superposition graphique pour ajouter une courbe de tendance ou une estimation de densité sans paramétrage protecteur, Seaborn écrase silencieusement le travail de titrage antérieur au profit du nom brut de la dernière variable tracée.
Pour immuniser ses visualisations contre cet écrasement accidentel, le praticien doit adopter une discipline d’ingénierie stricte dans la structuration de ses pipelines graphiques. La règle d’or consiste à reléguer l’intégralité des instructions de mise en forme, de titrage, d’ajustement des marges et de personnalisation des étiquettes d’axes à la fin absolue de la séquence d’instructions, immédiatement avant l’appel d’enregistrement du fichier ou d’affichage sur le canevas. En consolidant cette phase de stylisation terminale en aval des opérations statistiques de projection de données, la persistance des propriétés typographiques est garantie de manière déterministe.
11.3 Problèmes de rognage des textes à l’exportation
Un défaut technique majeur, survenant fréquemment lors de la phase d’exportation matricielle ou vectorielle des figures destinées à l’impression, concerne le rognage physique des étiquettes d’axes. Le graphique apparaît parfaitement proportionné au sein de l’environnement interactif du calepin numérique, mais dès lors que l’instruction d’enregistrement sur disque plt.savefig est sollicitée, le fichier graphique généré présente des libellés d’abscisse ou d’ordonnée tronqués sur leur bordure externe, voire complètement évincés de la boîte englobante de l’image finale.
L’origine de cette coupure matérielle réside dans l’incapacité de l’algorithme d’exportation standard de Matplotlib à anticiper la dilatation spatiale provoquée par des étiquettes d’axes pourvues de corps de police agrandis ou de décalages majeurs induits par l’argument labelpad. Le moteur calcule par défaut la boîte englobante de la Figure selon des paramètres fixes d’espacement des marges, ignorant les extensions typographiques qui débordent du canevas primitif alloué.
La remédiation pérenne à cette pathologie d’exportation repose sur l’adjonction systématique de l’argument nommé bbox_inches=’tight’ au sein de l’appel de la méthode plt.savefig. Cette directive impose au moteur de rendu d’exécuter, préalablement à la rasterisation ou à la vectorisation des tracés, une passe de calcul géométrique recalculant la boîte englobante minimale absolue qui englobe l’intégralité des artistes graphiques de la scène, y compris les textes les plus excentrés. Alternativement, le contrôle direct des marges périphériques via la méthode fig.subplots_adjust permet d’allouer manuellement un espace d’accueil confortable pour les étiquettes complexes, garantissant la préservation intégrale de la figure lors des processus de photogravure éditoriale.
12. Bonnes pratiques de conception graphique et accessibilité des visualisations de données
12.1 Règles stylistiques et déontologie de la présentation quantitative
La formalisation des étiquettes d’axes ne saurait s’abstraire d’une réflexion éthique et déontologique sur la présentation des faits scientifiques quantitatifs. Les visualisations de données constituent des arguments visuels dotés d’une grande force rhétorique; à ce titre, elles doivent se conformer à des exigences d’honnêteté intellectuelle et de clarté absolue afin d’interdire toute distorsion d’interprétation. La première règle stylistique fondamentale consiste à proscrire impérativement le jargon abréviatif propre aux bases de données, les acronymes cryptiques de colonnes de calcul et les désignations tronquées au profit d’une dénomination textuelle explicite et exhaustive de la variable représentée.
La deuxième prescription déontologique concerne la mention obligatoire et rigoureuse des unités de mesure. Représenter une grandeur physique, biologique ou psychologique sans indiquer expressément entre crochets ou entre parenthèses son unité dimensionnelle constitue une faute méthodologique majeure susceptible d’invalider la portée des comparaisons d’effets statistiques. Le lecteur ne doit à aucun moment avoir à conjecturer si un intervalle temporel s’exprime en millisecondes ou en secondes, ou si une concentration s’évalue en nanomoles ou en milligrammes par litre de fluide corporel.
Enfin, la sobriété architecturale commande d’éradiquer impitoyablement toute redondance textuelle parasite entre le titre sommital de la figure et les étiquettes de ses axes cartésiens. Répéter dans le titre principal l’exacte combinaison des noms de variables déjà stipulés sur l’abscisse et l’ordonnée surcharge inutilement la composition visuelle selon les principes fondamentaux de minimisation du ratio encre-données théorisés par Edward Tufte. Le titre d’une visualisation scientifique doit prioritairement synthétiser l’inférence théorique majeure ou la question de recherche explorée, laissant aux étiquettes d’axes la charge de documenter avec une précision comptable irréprochable l’espace des données observables.
12.2 Principes d’accessibilité et conception universelle
La conception universelle des visualisations statistiques impose de garantir l’accès intégral aux données pour l’ensemble des membres de la communauté scientifique, sans discrimination fondée sur des déficiences visuelles telles que la baisse d’acuité visuelle liée à l’âge ou les différentes formes de dyschromatopsie. L’accessibilité visuelle des étiquettes d’axes commence par l’application stricte de ratios de contraste chromatique suffisants entre la couleur du texte et l’arrière-plan de la figure, conformément aux recommandations émises par les standards internationaux du World Wide Web Consortium. L’utilisation d’un texte gris clair sur un fond blanc pur doit être formellement bannie au profit d’un contraste élevé garantissant une lisibilité optimale sous tous les angles d’éclairage.
De surcroît, le choix de la taille des corps de texte ne doit pas être subordonné à des impératifs d’économie spatiale malavisés. Une étiquette d’axe dont la taille typographique est inférieure à huit points devient quasiment indéchiffrable lors de la miniaturisation imposée par la mise en page en double colonne des revues académiques contemporaines. Il est de la responsabilité du concepteur d’anticiper le coefficient de réduction homothétique que subira sa figure lors de son insertion finale dans la publication et de calibrer les tailles de police initiales de telle sorte que le texte conserve une hauteur physique minimale absolue garantissant un déchiffrement sans effort optique.
Enfin, dans l’ère numérique actuelle où les publications scientifiques sont disséminées via des plateformes web interactives et des documents électroniques consultés par des lecteurs d’écran d’assistance, les métadonnées linguistiques contenues dans les libellés d’axes jouent un rôle capital dans la génération des textes alternatifs descriptifs. Un graphique pourvu d’axes rigoureusement décrits permet l’extraction automatisée d’annotations sémantiques précises qui seront vocalisées à destination des chercheurs aveugles ou malvoyants. La rigueur apportée à la configuration textuelle d’un axe Seaborn transcende ainsi la simple esthétique pour devenir le garant d’une science véritablement inclusive, démocratique et universellement accessible.
Références
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press. https://www.edwardtufte.com/tufte/books_vdqi
Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
World Wide Web Consortium. (2018). Web content accessibility guidelines (WCAG) 2.1. W3C Recommendation. https://www.w3.org/TR/WCAG21/