
Dans le champ des sciences humaines et de la psychologie contemporaine, l’administration de protocoles expérimentaux et de questionnaires standardisés engendre des masses considérables de données numériques. Avant de pouvoir tester des hypothèses de recherche complexes par le biais de modélisations structurales, de régressions multiples ou d’analyses de variance, le chercheur doit impérativement se confronter à l’étape fondatrice que constitue l’exploration statistique descriptive. L’analyse descriptive ne se résume pas à une simple formalité technique préalable ; elle incarne le premier dialogue épistémologique entre le chercheur et la réalité empirique recueillie sur le terrain, permettant de déceler la structure intime des mesures, d’identifier d’éventuelles anomalies d’échantillonnage et de vérifier les postulats nécessaires aux inférences ultérieures.
Le logiciel IBM SPSS Statistics s’est imposé depuis plusieurs décennies comme l’environnement computationnel de référence pour les chercheurs, enseignants et étudiants en psychologie et en sciences sociales. Conçu pour allier une interface graphique conviviale à un moteur de traitement par syntaxe d’une grande rigueur, SPSS offre une panoplie d’outils analytiques permettant de résumer, d’explorer et de visualiser les distributions de scores psychométriques. Néanmoins, la maîtrise de cet outil exige une compréhension fine des fondements mathématiques sous-jacents et une grande lucidité quant au niveau de mesure des variables étudiées. Une manipulation mécanique des menus déroulants, dénuée de réflexion méthodologique, expose l’analyste à des contresens majeurs, tels que le calcul d’indices non pertinents ou l’interprétation biaisée de scores déformés par des valeurs aberrantes.
Ce guide exhaustif a pour ambition d’accompagner les chercheurs et les praticiens dans l’apprentissage et le perfectionnement des techniques de calcul des statistiques descriptives au sein de l’environnement SPSS. En adoptant une perspective résolument ancrée dans les exigences méthodologiques de la recherche quantitative en psychologie, ce manuel explore l’ensemble du cycle de traitement : du paramétrage initial de la matrice de données jusqu’à la mise en forme des résultats finaux selon les normes strictes de l’American Psychological Association (APA). À travers l’examen des commandes fondamentales, la détection des anomalies distributionnelles et l’automatisation par syntaxe, vous développerez les compétences analytiques requises pour valoriser pleinement vos données empiriques avec la plus haute précision scientifique.
1. Introduction aux statistiques descriptives dans la recherche en psychologie sous SPSS
1.1 Rôle fondamental des statistiques descriptives dans l’analyse quantitative
L’acte de mesure en psychologie, qu’il concerne des temps de réaction milliseconde par milliseconde, des scores d’anxiété évalués sur une échelle psychométrique ou des indicateurs psychophysiologiques, aboutit inévitablement à une accumulation de données brutes difficilement déchiffrables à l’œil nu. Le rôle premier de la statistique descriptive réside dans la réduction ordonnée des données. Cette réduction statistique permet de condenser un ensemble vaste et complexe d’observations individuelles en un nombre restreint d’indicateurs synthétiques intelligibles, sans pour autant sacrifier l’essence de l’information structurelle contenue dans l’échantillon. En condensant l’information, le chercheur extrait le signal pertinent du bruit de mesure inhérent à toute investigation empirique en sciences humaines.
Sur le plan épistémologique, il convient d’établir une frontière rigoureuse entre l’analyse descriptive exploratoire et la statistique inférentielle. Alors que la première vise à décrire, organiser et résumer les caractéristiques observées d’un échantillon spécifique sans prétendre généraliser au-delà de celui-ci, la seconde s’appuie sur la théorie des probabilités pour tester des hypothèses formelles et extrapoler les régularités observées à l’ensemble de la population parente. Cependant, toute démarche inférentielle valide repose sur une statistique descriptive irréprochable. Tenter d’estimer des paramètres populationnels sans avoir préalablement ausculté la distribution empirique des données s’avère méthodologiquement hasardeux et peut conduire à des erreurs de type I ou de type II dans les tests d’hypothèse.
L’exploration descriptive constitue également l’unique moyen d’identifier les structures distributionnelles sous-jacentes et les patrons de réponse atypiques au sein de la cohorte d’étude. Elle met en lumière les phénomènes d’agrégation, les planchers ou plafonds psychométriques dans les questionnaires d’auto-évaluation, ainsi que la présence d’hétérogénéités inattendues dans les groupes expérimentaux. Dans le cadre des standards méthodologiques régissant les revues savantes à comité de lecture, la documentation rigoureuse des caractéristiques descriptives des participants représente un gage de transparence scientifique et une condition sine qua non pour la réplication des études et l’intégration ultérieure des données dans des méta-analyses quantitatives internationales.
1.2 Les trois piliers descriptifs : synthèses numériques, tableaux et graphiques
Pour appréhender exhaustivement la géométrie d’une variable quantitative ou qualitative, l’analyste chevronné s’appuie sur trois piliers méthodologiques complémentaires : les synthèses numériques, les représentations tabulaires et les visualisations graphiques. Les indicateurs numériques synthétiques condensent l’information d’une variable en une métrique unique hautement informative. Ces métriques se divisent traditionnellement entre mesures de tendance centrale (qui désignent la valeur typique ou centrale autour de laquelle gravitent les observations) et mesures de variabilité ou de dispersion (qui chiffrent l’écartement ou la dispersion des scores individuels par rapport à ce centre). L’isolation d’un nombre unique facilite les comparaisons directes, mais elle masque inévitablement les singularités locales de la distribution.
Les tableaux de distribution et de fréquences constituent le second pilier analytique, offrant une cartographie détaillée de la répartition des scores. En énumérant chaque modalité ou classe d’intervalles avec son effectif absolu, sa proportion relative et ses pourcentages cumulés, le tableau permet de saisir l’organisation spatiale des données sur l’ensemble du continuum de mesure. Cette approche s’avère particulièrement éclairante pour diagnostiquer la présence de sous-groupes dissimulés ou pour vérifier si certaines catégories de réponse ont été délaissées ou, à l’inverse, sur-sélectionnées par les participants lors de la passation de batteries de tests.
Enfin, les représentations graphiques forment le troisième volet indispensable d’un screening approfondi des variables d’étude. L’esprit humain traitant plus rapidement les signaux visuels que les tableaux denses de chiffres, les histogrammes, boîtes à moustaches et diagrammes de densité permettent une évaluation intuitive et immédiate de la forme générale des données. La visualisation révèle instantanément la bimodalité, l’asymétrie prononcée ou l’existence d’observations isolées se détachant manifestement du corpus principal. C’est précisément l’interaction synergique entre l’indicateur numérique précis, le détail chiffré du tableau de fréquences et la perception spatiale du graphique qui garantit un examen descriptif holistique et rigoureux.
1.3 Présentation de l’environnement de travail IBM SPSS Statistics
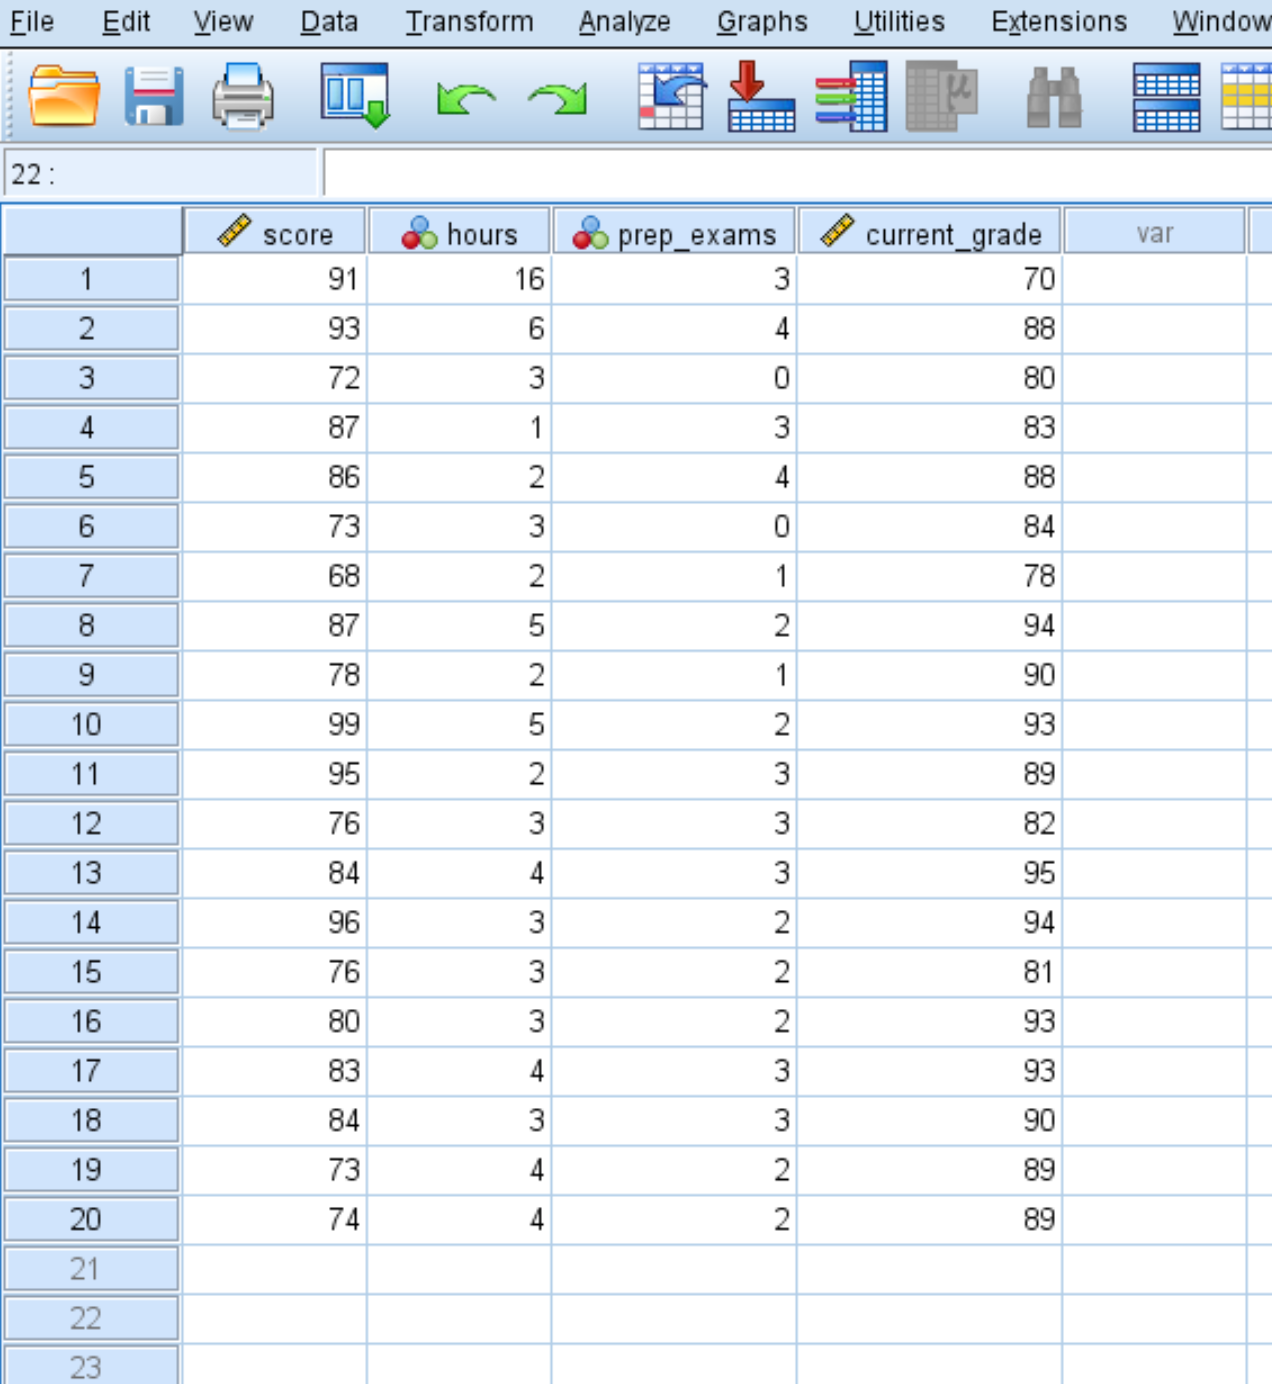
L’utilisation judicieuse d’IBM SPSS Statistics nécessite une familiarisation approfondie avec son architecture modulaire articulée autour de trois fenêtres principales interconnectées. Au cœur de la saisie et de la manipulation se trouve la matrice de données, qui propose deux affichages complémentaires : la Vue des données (Data View) et la Vue des variables (Variable View). La Vue des données adopte une disposition matricielle rectangulaire standardisée où chaque ligne correspond impérativement à une unité d’observation unique (généralement un participant en psychologie) et chaque colonne représente une variable mesurée ou calculée. À l’inverse, la Vue des variables adopte une perspective structurelle où chaque ligne définit les attributs métrologiques d’une variable spécifique (nom, étiquette, type de stockage, niveau de mesure, valeurs manquantes).
Lorsqu’une procédure analytique est sollicitée, SPSS bascule vers ou génère une fenêtre distincte nommée le Visualiseur de résultats (Output Viewer). Cette interface hiérarchique accueille l’ensemble des sorties textuelles, des tableaux croisés et des graphiques générés par les calculs statistiques. L’arborescence latérale gauche du visualiseur permet une navigation rapide entre les différents blocs de résultats, facilitant ainsi l’inspection détaillée, l’édition des tableaux dynamiques (Pivot Tables) et l’exportation des éléments pertinents vers des traitements de texte ou des logiciels de mise en page scientifique. La préservation méthodique de ces fichiers de sortie (portant l’extension .spv) assure une traçabilité fondamentale des analyses intermédiaires.
Cependant, le pilier le plus critique pour la rigueur scientifique demeure l’éditeur de syntaxe SPSS (fichiers d’extension .sps). Bien que l’interface par menus déroulants et boîtes de dialogue offre une prise en main intuitive, elle s’avère insuffisante pour garantir la reproductibilité scientifique préconisée par les standards contemporains de la science ouverte. L’utilisation du bouton Coller (Paste) présent dans presque toutes les boîtes de dialogue permet de transférer les instructions de commande sous forme de code textuel dans l’éditeur de syntaxe. Ce script documente de manière immuable l’intégralité des transformations de variables, des sélections de sous-groupes et des paramètres de calcul, autorisant une réplication exacte et instantanée de l’analyse, indispensable lors des révisions d’articles académiques.
2. Typologie des variables et configuration préalable dans SPSS
2.1 Classification des échelles de mesure en psychologie
La validité scientifique de toute démarche descriptive dépend de la concordance stricte entre l’opération mathématique exécutée et la nature de l’échelle de mesure sous-jacente. Selon la typologie fondamentale introduite par le psychologue et métrologue Stanley Smith Stevens en 1946, les variables se divisent en quatre niveaux d’abstraction quantitative croissante : nominal, ordinal, d’intervalle et de rapport. Dans SPSS, ces quatre catégories sont synthétisées en trois modalités opérationnelles : Nominal, Ordinal et Échelle (Scale), cette dernière regroupant sans distinction algorithmique les échelles d’intervalles et de rapports.
Les variables nominales représentent le niveau le plus élémentaire de la mesure : elles assignent des étiquettes ou des catégories mutuellement exclusives sans aucun ordre hiérarchique intrinsèque sous-jacent. En recherche psychologique, il s’agit par exemple du genre biologique, de l’état civil, du groupe d’assignation expérimentale (condition contrôle vs condition expérimentale) ou de la présence/absence d’un diagnostic clinique selon le DSM-5. Pour de telles variables, les calculs de moyenne arithmétique ou d’écart-type sont formellement dénués de sens mathématique. Seuls les dénombrements d’effectifs, les pourcentages, les proportions et le mode constituent des descripteurs valides.
Les variables ordinales introduisent une relation d’ordre ou de rang hiérarchique entre les catégories, mais sans que l’on puisse postuler l’égalité des intervalles séparant les échelons successifs. C’est le cas typique des échelles de Likert couramment employées dans les questionnaires de personnalité ou d’attitudes (ex. : « pas du tout d’accord », « modérément d’accord », « tout à fait d’accord »), des niveaux de diplôme ou des rangs de naissance au sein d’une fratrie. Enfin, les variables d’échelle (intervalles et ratios) comportent des intervalles égaux et standardisés entre chaque unité consécutive, autorisant toutes les opérations arithmétiques. Les temps de réaction en millisecondes mesurés dans une tâche d’attention soutenue, le score total à un inventaire standardisé comme le Beck Depression Inventory ou l’âge chronologique relèvent de cette catégorie, ouvrant l’accès à la panoplie complète des métriques paramétriques.
2.2 Paramétrage adéquat dans la Vue des variables
L’exactitude des calculs descriptifs dépend du soin apporté à la configuration de chaque colonne dans la Vue des variables d’IBM SPSS Statistics. Trop de praticiens débutants négligent cette étape et se heurtent ultérieurement à des résultats inexploitables ou à des tableaux illisibles. La première exigence concerne l’attribution de noms de variables concis (colonne Nom) respectant les contraintes syntaxiques du logiciel, couplée systématiquement à une étiquette de variable explicite (colonne Étiquette). L’étiquette permet de consigner l’intitulé complet de la question ou la description précise de la mesure psychométrique, garantissant que les tableaux et graphiques générés dans le visualiseur de résultats soient immédiatement compréhensibles sans recours permanent au cahier d’expérimentation.
Pour les variables qualitatives et catégorielles, la définition rigoureuse de la colonne Valeurs (Value Labels) s’avère impérative. Bien que SPSS encode généralement ces modalités sous forme d’entiers numériques (par exemple : 1 pour « Groupe Témoin », 2 pour « Groupe Thérapie Cognitive », 3 pour « Groupe Pleine Conscience »), le logiciel doit savoir à quelle signification sémantique correspond chaque code numérique. L’omission de cette étape transforme la lecture des tableaux de fréquences en un exercice d’équilibriste propice aux erreurs d’attribution, en particulier lorsque le chercheur manipule des bases de données complexes comprenant des dizaines d’items codés de façon binaire ou polytomique.
Parallèlement, la colonne Mesure doit être scrupuleusement ajustée en sélectionnant Nominal, Ordinal ou Échelle selon la nature de la variable. Bien que les procédures de base comme DESCRIPTIVES exécutent les calculs demandés quel que soit le statut de la colonne Mesure, des procédures plus récentes ou les modules de visualisation graphique ajustent automatiquement leurs algorithmes en fonction de cette spécification. Enfin, la gestion explicite des Valeurs manquantes définies par l’utilisateur (User-defined missing) permet d’attribuer des codes numériques réservés (tels que 99, 999 ou -1) à des motifs d’absence précis (refus de répondre, question non applicable, abandon de tâche), évitant que ces valeurs aberrantes ne soient traitées par mégarde comme des scores authentiques dans le calcul des moyennes.
2.3 Nettoyage préliminaire et validation de l’intégrité du jeu de données
L’application précipitée de commandes descriptives sur une base de données brute expose l’analyste au risque universel de l’informatique : « Garbage in, garbage out » (des données viciées en entrée produisent des conclusions erronées en sortie). Avant toute entreprise statistique, une phase d’audit et d’assainissement systématique des données doit être déployée. Cette validation débute par le contrôle des erreurs de saisie numérique et des dépassements de bornes théoriques. Si un inventaire psychologique valide comporte des items scorés de 1 à 5, la présence d’une valeur 6 ou 15 dans la base témoigne d’une faute de frappe humaine ou d’un artefact d’importation qui fausserait gravement l’estimation des moments statistiques.
Le contrôle de la cohérence interne entre variables interconnectées constitue le second volet de cet audit préliminaire. Par exemple, si une participante est codée comme ayant un statut d’étudiante de premier cycle, mais que son âge indique 8 ans, ou si un score global calculé ne correspond pas à la sommation arithmétique de ses sous-composantes, une incohérence logique doit être levée en consultant le protocole source sur papier ou le registre électronique d’origine. De telles discordances, si elles demeurent non corrigées, altèrent silencieusement les estimations de dispersion et faussent la structure de corrélation de l’échantillon.
Enfin, l’audit technique des formats de stockage prévient les blocages algorithmiques récurrents sous SPSS. Il arrive fréquemment que des colonnes numériques soient importées par mégarde sous le format de chaîne de caractères (String), par exemple à la suite de la présence accidentelle d’une lettre, d’une espace ou d’un caractère typographique non reconnu dans une cellule. Les commandes quantitatives d’SPSS ignorent tout simplement ces variables ou refusent de s’exécuter tant que le type de variable n’a pas été reconfiguré en Numérique et que les anomalies textuelles n’ont pas été rectifiées ou recodées en valeurs manquantes conformes.
3. Calcul des statistiques descriptives via la commande Descriptives
3.1 Navigation et sélection des variables continues
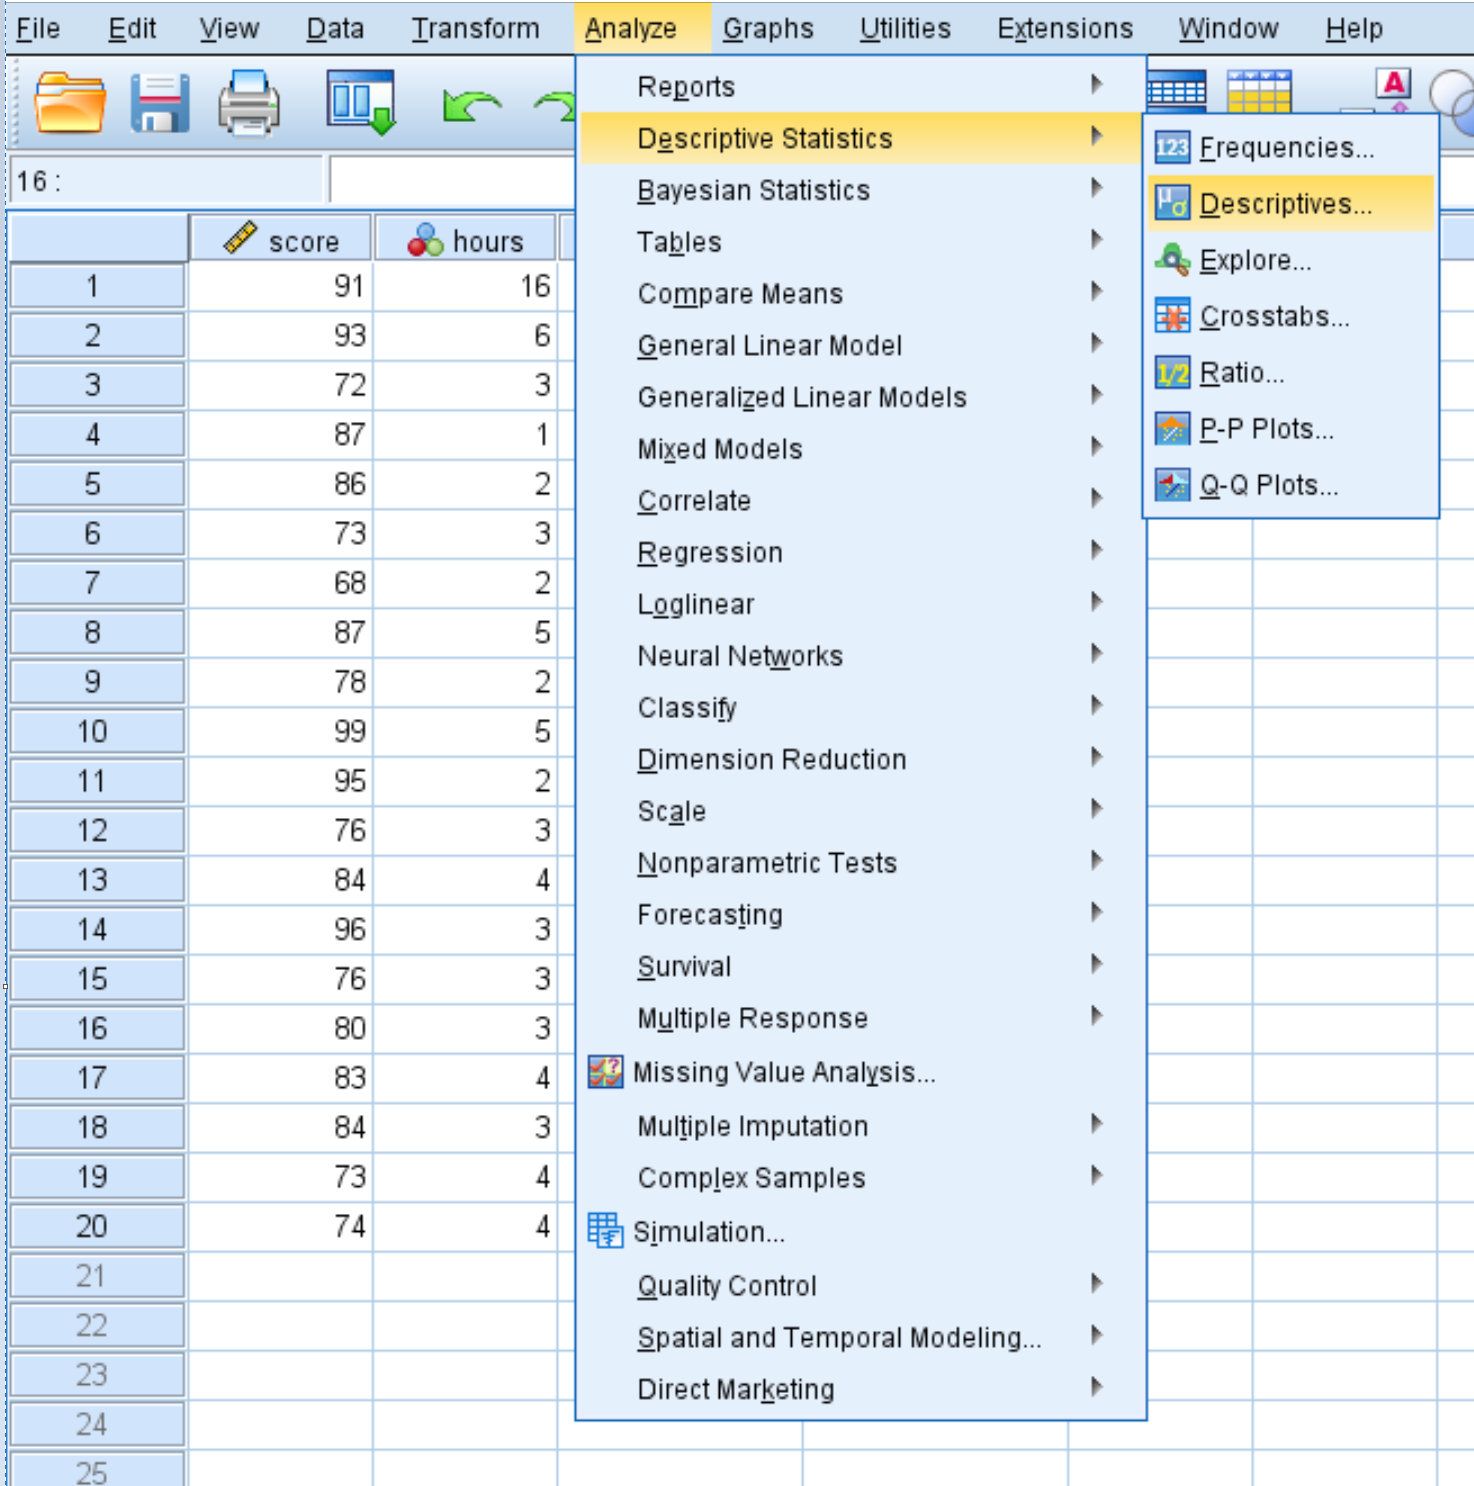
La commande DESCRIPTIVES d’IBM SPSS Statistics constitue l’outil de prédilection pour l’extraction rapide, ciblée et synthétique des paramètres de tendance centrale et de variabilité applicables aux variables quantitatives continues. Pour initier cette procédure via l’interface interactive, l’utilisateur navigue à travers la barre de menus supérieure en suivant le cheminement classique : Analyse > Statistiques descriptives > Descriptifs…. Cette action déploie une boîte de dialogue standardisée présentant sur le panneau de gauche la liste exhaustive de l’ensemble des variables enregistrées dans le fichier de données actif.
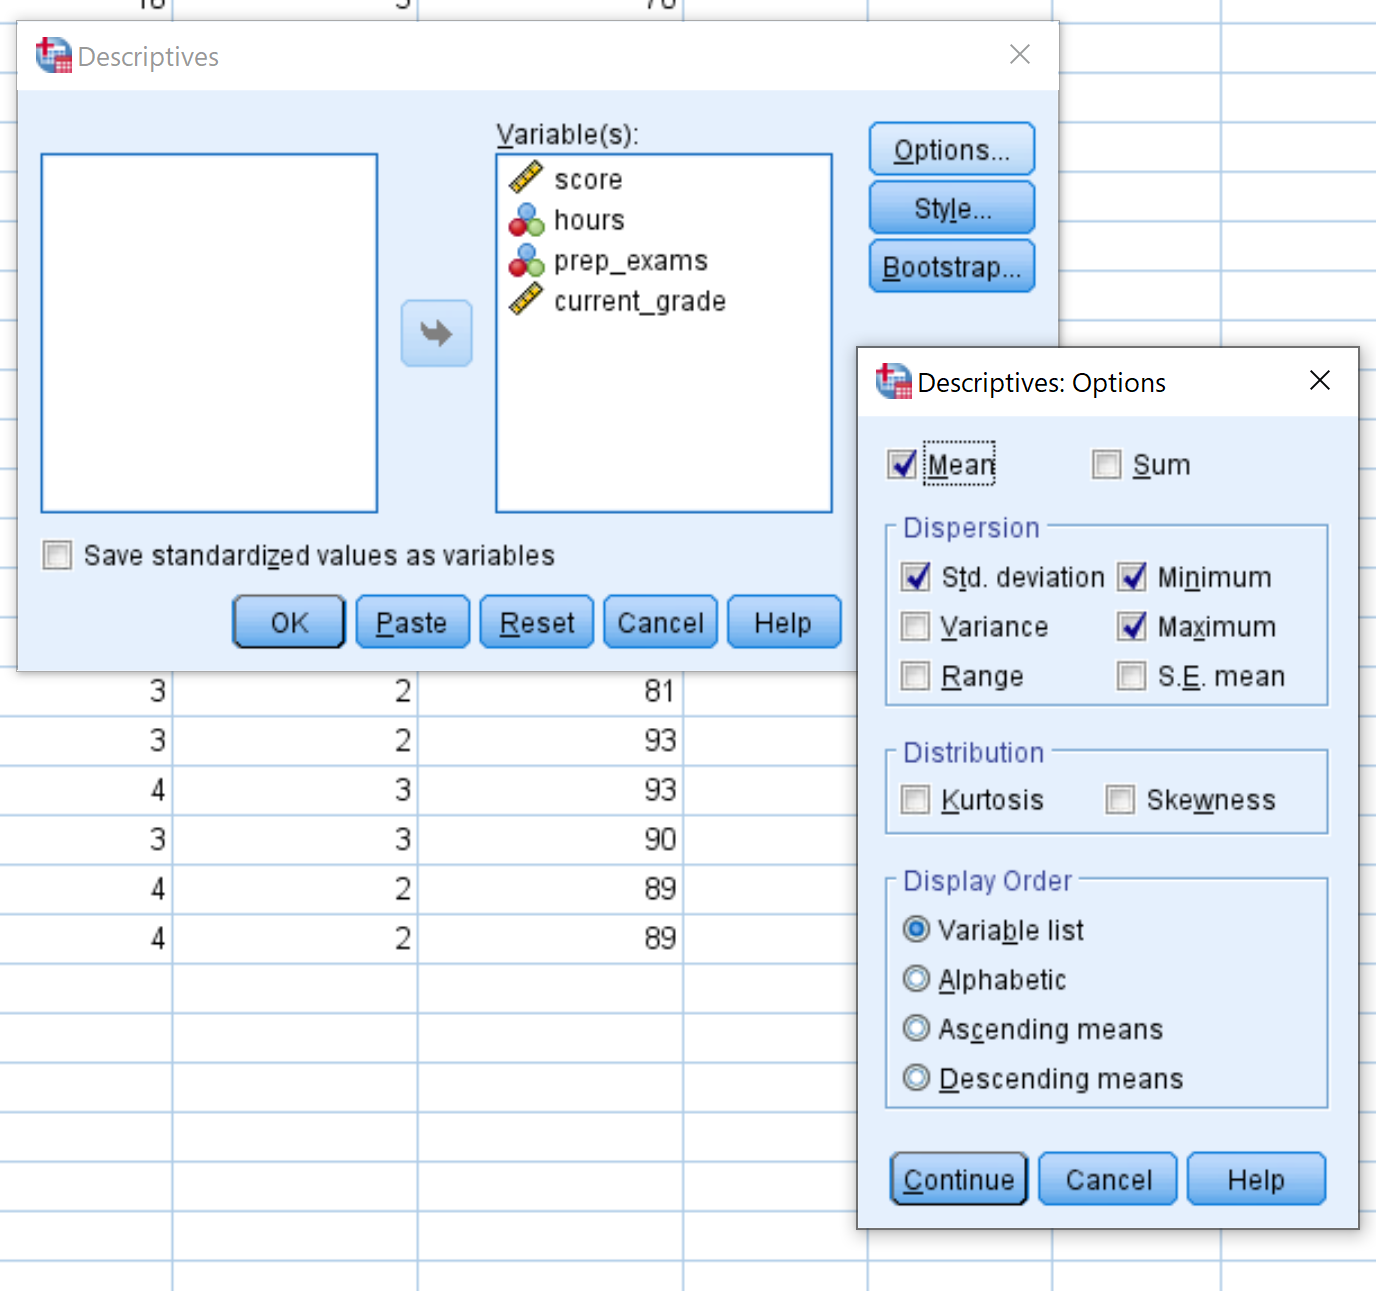
Le transfert des variables d’intérêt vers le champ de droite intitulé Variable(s) : s’opère par simple glisser-déposer ou en sélectionnant les variables cibles puis en cliquant sur la flèche directionnelle centrale. À cette étape, une rigueur méthodologique absolue s’impose : seules les variables continues mesurées à un niveau d’intervalle ou de rapport doivent être intégrées dans cette boîte de dialogue. Transférer des variables qualitatives nominales (telles que la filière d’étude ou le groupe expérimental) dans la commande DESCRIPTIVES constitue une erreur d’analyse cardinale, car SPSS calculera sans sourciller une moyenne mathématiquement absurde sur des codes de désignation arbitraires.
Dans la boîte de dialogue, il est souvent judicieux d’utiliser le bouton contextuel droit de la souris sur la liste des variables pour basculer entre l’affichage des étiquettes descriptives et l’affichage des noms de variables réels, ou pour trier la liste par ordre alphabétique plutôt que par ordre de création dans le fichier. Cette ergonomie s’avère particulièrement précieuse lors du traitement de jeux de données massifs comprenant des centaines d’items. Par ailleurs, si une session d’analyse précédente a laissé des sélections résiduelles, l’activation du bouton Réinitialiser (Reset) permet de purger instantanément la configuration en cours, garantissant qu’aucun artefact de sélection antérieure ne vienne polluer l’extraction des nouvelles statistiques descriptives.
3.2 Configuration des options de dispersion et de tendance centrale
Une fois les variables quantitatives transférées dans le panneau de calcul, l’activation du bouton Options… situé dans le coin supérieur droit de la boîte de dialogue ouvre une sous-fenêtre dédiée au paramétrage spécifique des estimateurs à extraire. Par défaut, SPSS pré-coche la moyenne arithmétique (Moyenne), l’écart-type (Écart type), ainsi que les valeurs minimales (Minimum) et maximales (Maximum). Bien que ces quatre indicateurs fournissent un aperçu élémentaire, une analyse psychométrique digne de ce nom nécessite généralement l’activation d’indicateurs de variabilité additionnels pour mieux caractériser le comportement de la distribution.
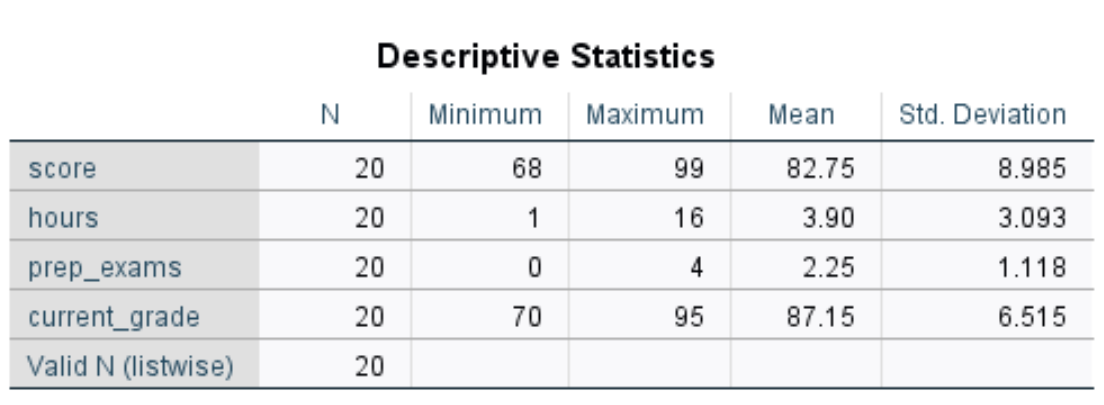
L’activation conjointe de la Variance (le carré de l’écart-type) et de l’Étendue (Range, mesurant la différence absolue entre le score maximal et le score minimal) affine considérablement la compréhension de l’étalement des données. L’écart-type quantifie la distance moyenne (euclidienne) des observations par rapport au centre de gravité de la cohorte, tandis que l’étendue informe sur l’espace global occupé par les participants sur le continuum expérimental. Il convient également de cocher l’Erreur standard (S.E. moyenne), qui mesure la fluctuation d’échantillonnage théorique de la moyenne et permet d’évaluer la précision avec laquelle l’échantillon empirique estime le paramètre central de la population d’origine.
Dans la partie inférieure de cette même fenêtre d’options, SPSS propose de spécifier l’Ordre d’affichage des variables au sein de la table récapitulative finale. L’utilisateur peut opter pour l’ordre de la liste de variables (par défaut), l’ordre alphabétique des intitulés, ou encore un tri ascendant ou descendant basé sur les moyennes empiriques obtenues. Cette dernière option offre une plus-value appréciable lorsqu’il s’agit de hiérarchiser rapidement une batterie de questions d’attitude ou de mesurer la sévérité relative de symptômes cliniques au sein d’une cohorte psychiatrique, en ordonnant instantanément les moyennes observées de la plus faible à la plus élevée.
3.3 Standardisation automatique des scores (Scores Z)
L’un des avantages les plus substantiels de la commande DESCRIPTIVES réside dans sa capacité intégrée à calculer et enregistrer directement les scores standardisés (scores z) au sein du fichier de données courant. Pour déclencher cette opération, il suffit de cocher la case intitulée Enregistrer les valeurs normalisées dans des variables située au bas de la boîte de dialogue principale. Lors de l’exécution, SPSS ne se contente pas de produire le tableau récapitulatif dans le visualiseur de résultats ; il crée automatiquement de nouvelles colonnes dans la Vue des données, en préfixant le nom original de chaque variable par la lettre « Z » (par exemple, la variable Anxiete génère la nouvelle variable ZAnxiete).
La transformation en score standardisé repose sur l’équation fondamentale :
z = (X – M) / SD
où X représente la valeur observée pour un participant donné, M la moyenne arithmétique de l’échantillon, et SD l’écart-type de ce même échantillon. Cette opération mathématique a pour effet d’annuler les unités de mesure d’origine pour projeter les scores sur une métrique universelle dont la moyenne arithmétique est rigoureusement égale à zéro et l’écart-type égal à un. Dans les recherches impliquant des échelles hétérogènes (par exemple, comparer un test de mémoire de travail scoré sur 30 points avec une mesure de potentiel évoqué cognitif en microvolts), la conversion en scores z permet des comparaisons directes et l’agrégation d’indices composites non biaisés.
Au-delà de la standardisation psychométrique, les variables de scores z nouvellement générées constituent un instrument d’une remarquable efficacité pour la détection des valeurs aberrantes univariées. Selon la théorie distributionnelle de la loi normale, environ 99,7 % des observations doivent se situer dans un intervalle compris entre -3 et +3 écarts-types autour de la moyenne. Dans la littérature méthodologique en psychologie, un seuil critique conventionnel est couramment fixé à |z| > 3,29 (correspondant à une probabilité d’occurrence inférieure à p = 0,001 pour une distribution normale). L’inspection rapide de la colonne standardisée permet ainsi d’isoler immédiatement les participants présentant des performances extraordinairement déviantes, justifiant une vérification approfondie de leur protocole de passation.
4. Analyse distributionnelle détaillée via la commande Fréquences
4.1 Procédure d’exécution et choix des indicateurs
Si la commande DESCRIPTIVES excelle dans la synthèse de variables d’échelle homogènes, la procédure FREQUENCIES s’impose comme l’outil le plus polyvalent, le plus exhaustif et le plus souple d’IBM SPSS Statistics pour l’examen distributionnel. Pour mobiliser cette commande, l’analyste chemine via Analyse > Statistiques descriptives > Fréquences…. Contrairement à sa consœur restreinte aux variables d’échelle, la commande Fréquences est universellement adaptable : elle traite avec une égale précision les variables qualitatives nominales, les ordonnancements ordinaux et les données quantitatives continues discrètes ou denses.
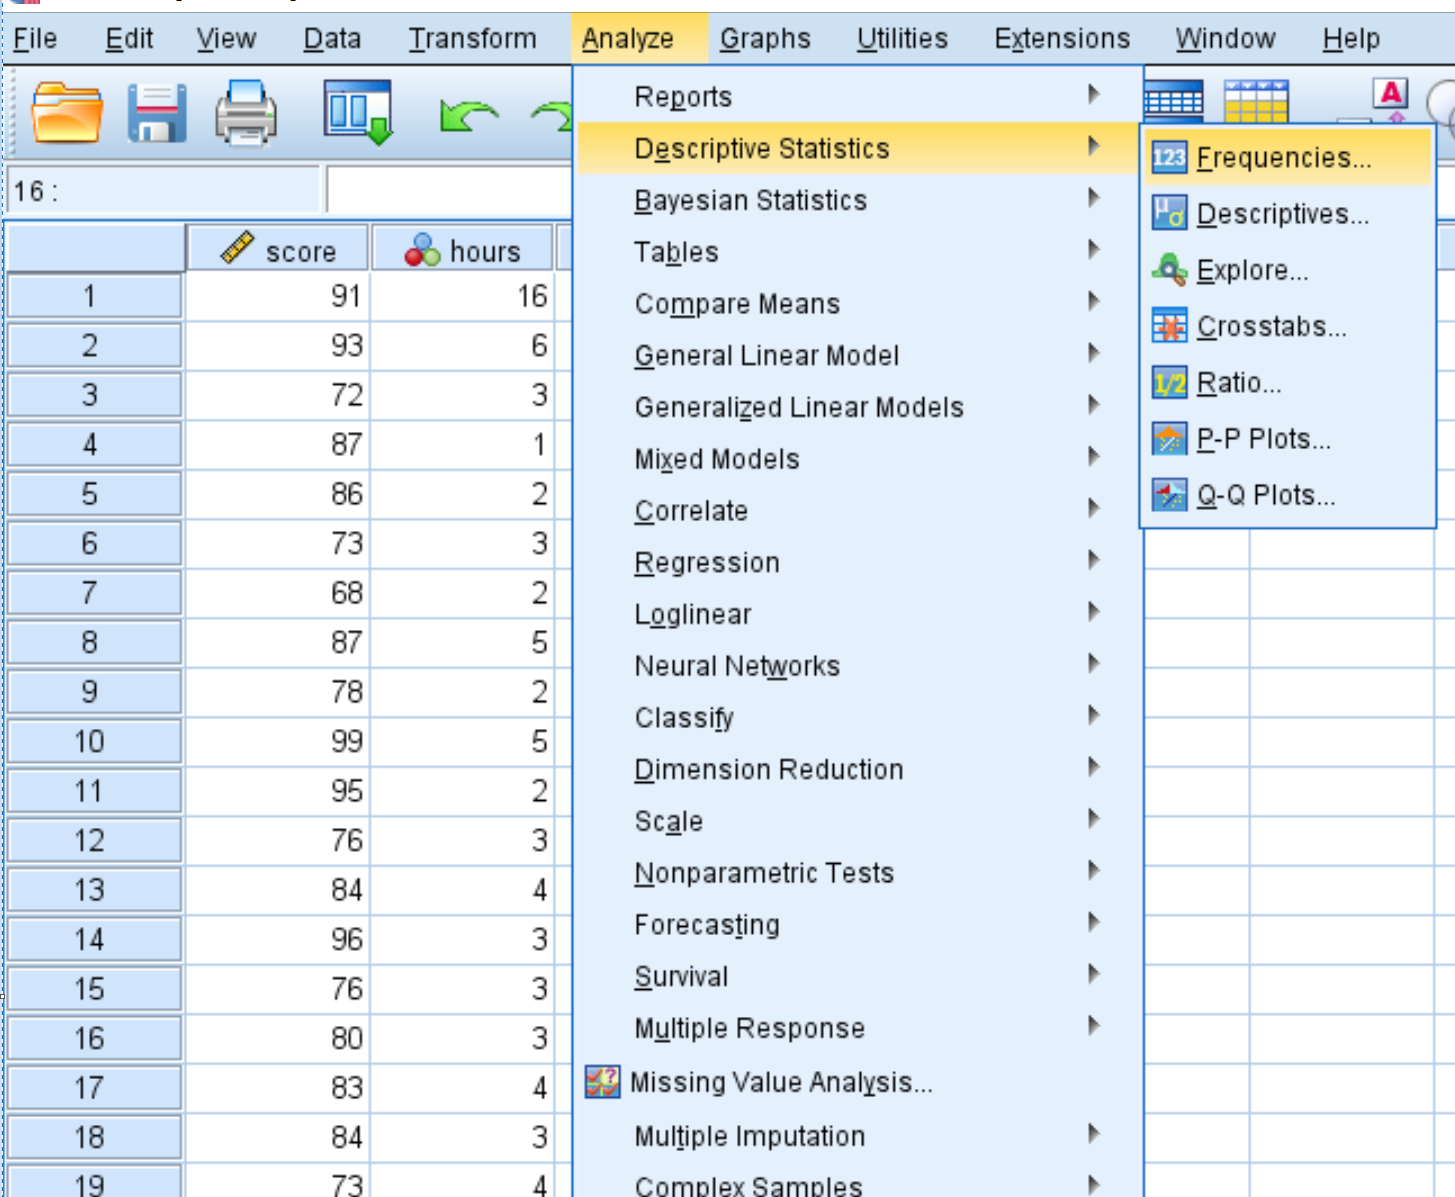
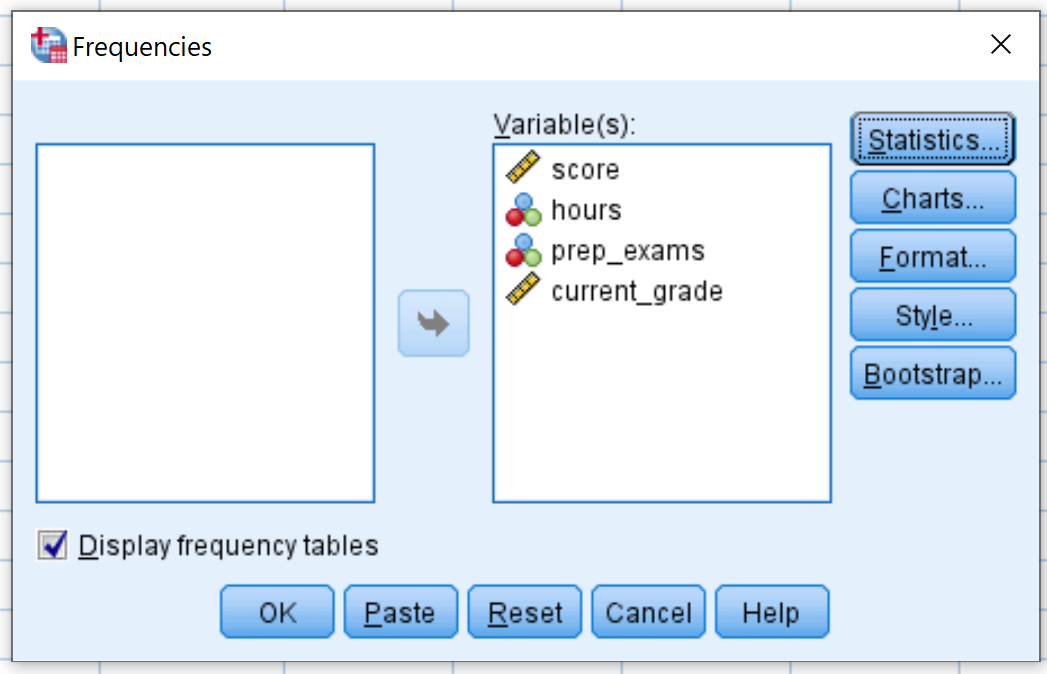
En cliquant sur le bouton Statistiques… de la boîte de dialogue des Fréquences, l’utilisateur accède à un ensemble d’indicateurs bien plus étendu que celui offert par la commande Descriptives. Aux côtés de la moyenne arithmétique classique, il est possible de solliciter la Médiane (le score qui scinde l’échantillon ordonné en deux moitiés exactement égales de 50 %) et le Mode (la valeur la plus fréquemment observée dans l’échantillon). La confrontation simultanée de ces trois indicateurs de tendance centrale permet de diagnostiquer d’emblée la présence d’une asymétrie distributionnelle : lorsque moyenne, médiane et mode coïncident parfaitement, la distribution est rigoureusement symétrique ; lorsqu’elles divergent notablement, la médiane offre un ancrage central bien plus robuste que la moyenne.
La sous-fenêtre permet également de requérir la Somme arithmétique cumulative de tous les scores, ainsi que l’affichage précis des bornes extrêmes via le Minimum et le Maximum. Les mesures de dispersion incluent également l’Écart type, la Variance, l’Étendue et l’Erreur standard de la moyenne. La possibilité d’ordonner ces calculs et de les coupler à des indicateurs de forme géométrique fait de cette boîte de dialogue le carrefour névralgique de toute exploration univariée méticuleuse dans le domaine des sciences du comportement.
4.2 Partitionnement de la distribution par percentiles et quartiles
L’analyse non-paramétrique et la psychométrie appliquée reposent abondamment sur le partitionnement ordinal de la distribution des participants, une fonctionnalité où la commande Fréquences démontre toute sa puissance opérationnelle. En cochant la case Quartiles dans la section des valeurs de centiles, SPSS fractionne automatiquement l’échantillon en quatre tranches proportionnellement équivalentes contenant chacune 25 % des observations. Le premier quartile (Q1 ou 25e centile), le deuxième quartile (Q2 ou 50e centile, correspondant à la médiane) et le troisième quartile (Q3 ou 75e centile) sont alors systématiquement isolés et intégrés au tableau de sortie.
Cette approche permet notamment le calcul immédiat de l’intervalle interquartile (IQR = Q3 – Q1), qui quantifie l’espace au sein duquel se concentrent les 50 % centraux de la population étudiée. Contrairement à l’écart-type, dont la valeur est mécaniquement tirée vers le haut par les scores extrêmes en raison de l’élévation des écarts au carré, l’intervalle interquartile est un indicateur de variabilité éminemment résistant aux valeurs aberrantes. Il constitue la métrique de dispersion privilégiée dès lors que les données psychométriques dévient de la gaussianité ou présentent des distorsions ordinales significatives.
Au-delà des quartiles, la commande offre la flexibilité de spécifier des Points de coupure pour n groupes égaux (par exemple, fractionner en déciles pour 10 groupes ou en quintiles pour 5 groupes), ou d’indiquer manuellement des Centiles singuliers (par exemple, le 5e et le 95e centile). Cette fonctionnalité s’avère indispensable pour l’étalonnage normatif des instruments psychologiques (tels que les échelles de QI de Wechsler ou les inventaires de personnalité NEO-PI), permettant aux cliniciens de situer la performance d’un patient individuel par rapport à des seuils normatifs rigoureusement standardisés sur de vastes cohortes de référence.
4.3 Génération et interprétation des tableaux de fréquences
Le produit d’analyse le plus distinctif de cette procédure réside dans la table de fréquences détaillée générée dans le visualiseur de résultats. Pour chaque valeur distincte présente dans le jeu de données, cette table ventile méthodiquement quatre colonnes fondamentales : l’Effectif (fréquence absolue brute), le Pourcentage (proportion relative calculée sur l’ensemble de l’échantillon, y compris les données manquantes), le Pourcentage valide (proportion recalculée strictement sur la base des participants ayant effectivement répondu à l’item) et le Pourcentage cumulé.
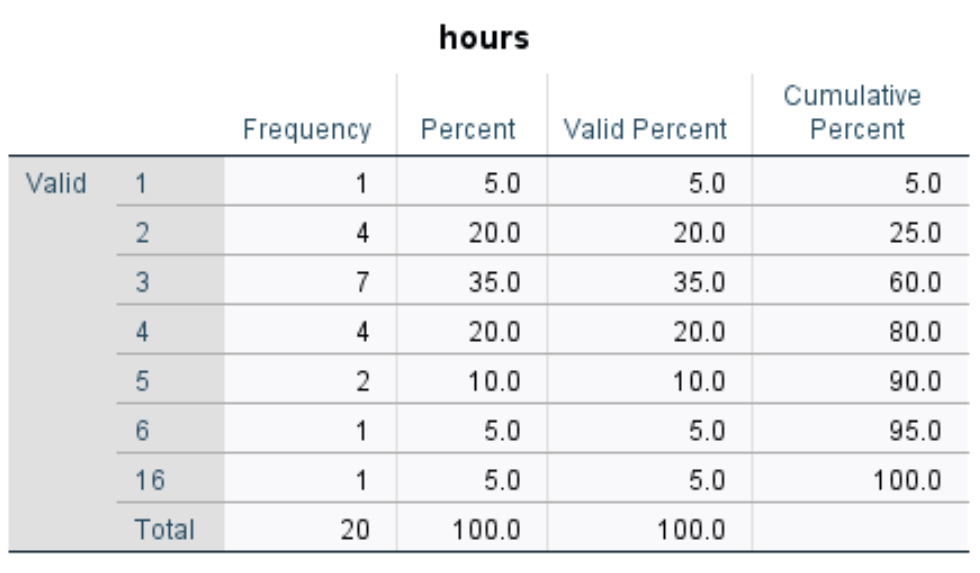
L’examen critique de la distinction entre « Pourcentage » et « Pourcentage valide » est d’une grande importance méthodologique. Lorsqu’un questionnaire présente un taux de non-réponse notable (par exemple, 15 % de données manquantes sur une question intime relative à l’idéation suicidaire), le pourcentage brut minore artificiellement le poids réel de chaque modalité parmi les répondants effectifs. L’analyste doit impérativement rapporter le pourcentage valide dans ses manuscrits pour refléter fidèlement l’état des réponses collectées, tout en documentant parallèlement le volume global d’attrition de l’item.
Le Pourcentage cumulé, quant à lui, s’avère particulièrement éclairant pour les échelles ordinales d’attitude. Il permet de répondre instantanément à des interrogations cliniques ou psychosociologiques concrètes, telles que : « Quelle proportion globale des participants se situe au niveau ou en dessous du seuil d’accord modéré ? ». Cependant, une mise en garde s’impose : si la variable analysée est une mesure d’échelle continue dense comportant une multitude de décimales (comme des temps de réaction continus ou des concentrations hormonales de cortisol salivaire), la génération de la table de fréquences produit un tableau démesuré et illisible listant chaque milliseconde observée. Dans ce cas spécifique, il convient impérativement de décocher l’option Afficher les tables de fréquences au sein de la boîte de dialogue principale pour ne conserver que les indicateurs numériques de synthèse.
5. Exploration approfondie des données via la commande Explorer
5.1 Mise en place de la procédure Explorer
La commande EXAMINE, matérialisée dans l’interface graphique sous l’appellation Explorer, constitue sans conteste la procédure univariée et bivariée la plus avancée d’IBM SPSS Statistics pour l’analyse descriptive approfondie et le criblage méthodologique rigoureux. Son accès s’opère via le chemin : Analyse > Statistiques descriptives > Explorer…. Conçue à l’origine dans l’esprit de l’analyse exploratoire des données (EDA) théorisée par le statisticien de Princeton John W. Tukey, cette procédure fusionne simultanément l’estimation robuste de paramètres, l’identification visuelle des distributions et la recherche systématique d’anomalies structurelles.
La boîte de dialogue Explorer se distingue par sa structure à compartiments multiples. Le champ supérieur, intitulé Liste des variables dépendantes :, accueille la ou les variables quantitatives continues dont on désire dresser la radiographie complète. Juste en dessous, le champ Liste des facteurs : autorise l’intégration de variables qualitatives catégorielles (par exemple, le sexe, la pathologie ou la modalité de traitement). Si un ou plusieurs facteurs sont assignés à ce compartiment, SPSS n’exécute pas une analyse globale indistincte, mais décompose instantanément l’intégralité des calculs descriptifs et des graphiques pour chaque cellule ou sous-groupe expérimental constitué par le croisement des niveaux de facteurs.
Dans la zone inférieure intitulée Affichage, le chercheur sélectionne l’étendue des sorties requises : Statistiques, Graphiques ou l’option par défaut Les deux. Le fait de sélectionner « Les deux » offre un tableau de bord analytique complet, reliant directement chaque estimation numérique à sa représentation spatiale dans le visualiseur. Enfin, le champ Étiqueter les observations par : permet d’insérer une variable d’identification unique (telle que le numéro d’anonymat du participant ID_Participant), ce qui garantit que toute valeur aberrante repérée ultérieurement sur les graphiques sera désignée par son véritable identifiant plutôt que par son simple rang de saisie dans le fichier.
5.2 Indicateurs robustes et estimateurs M
L’un des apports majeurs de la procédure Explorer réside dans la restitution systématique d’estimateurs robustes conçus pour pallier la vulnérabilité intrinsèque de la moyenne arithmétique et de l’écart-type face aux distributions asymétriques ou contaminées. Le tableau descriptif principal généré par Explorer fournit systématiquement la Moyenne tronquée à 5 % (5% Trimmed Mean). Pour obtenir cet indice, l’algorithme d’SPSS commence par éliminer les 5 % d’observations les plus basses et les 5 % d’observations les plus hautes de la distribution ordonnée, puis recalcule la moyenne sur les 90 % restants. Une divergence marquée entre la moyenne globale et cette moyenne tronquée signale immédiatement que la moyenne standard est sous l’influence disproportionnée d’une poignée de scores extrêmes situés dans les queues de distribution.
Le tableau rapporte également l’Intervalle de confiance à 95 % bordant la moyenne observée, délimitant les bornes inférieure et supérieure entre lesquelles le véritable paramètre populationnel a 95 % de chances de se trouver sous l’hypothèse de répétition de l’échantillonnage. En complément, l’utilisateur a la possibilité d’activer, via le bouton Statistiques…, le module des Estimateurs M (M-estimators). Ces algorithmes itératifs sophistiqués, développés notamment par Peter Huber, John Tukey, Frank Hampel et Andrew Andrews, attribuent des coefficients de pondération décroissants aux observations au fur et à mesure qu’elles s’éloignent du centre de la distribution.
Contrairement à une troncature abrupte qui exclut aveuglément un pourcentage fixe d’observations licites, les estimateurs M réduisent graduellement le poids des données distantes sans les censurer totalement. Si le jeu de données est strictement conforme à une loi de Gauss parfaite, la moyenne arithmétique ordinaire, la moyenne tronquée à 5 % et l’estimateur bipoïdique de Tukey (Tukey’s Biweight) afficheront des valeurs pratiquement indiscernables. En revanche, dans le cadre de recherches psychologiques appliquées portant sur des populations cliniques où la variabilité comportementale est élevée, l’utilisation et le signalement comparatif des estimateurs M garantissent une estimation centrale d’une remarquable stabilité mathématique.
5.3 Détection systématique des valeurs aberrantes univariées
La contamination des données par des valeurs aberrantes (outliers) constitue l’une des menaces les plus insidieuses pesant sur la validité statistique des conclusions scientifiques. Une valeur aberrante non détectée peut créer une fausse corrélation significative, faire basculer un résultat d’analyse de variance du côté de la fausse significativité (erreur de type I) ou, à l’inverse, gonfler artificiellement la variance résiduelle au point de masquer un effet expérimental réel (erreur de type II). La commande Explorer répond à cet impératif d’audit en intégrant une recherche systématique et automatisée des déviations univariées.
En cochant l’option Valeurs extrêmes dans la sous-fenêtre des statistiques d’Explorer, le logiciel produit une table dédiée dressant l’inventaire minutieux des cinq observations les plus élevées et des cinq observations les plus basses pour la variable sous examen. Pour chacune de ces dix données périphériques, le tableau consigne le numéro d’ordre de la ligne de données correspondante (ou l’étiquette d’identification spécifiée par l’utilisateur) ainsi que la valeur exacte observée. Cette désignation nominative permet au chercheur de remonter immédiatement à la source documentaire pour déterminer la nature de l’anomalie.
Il importe de rappeler qu’une observation extrême ne doit jamais être supprimée d’un simple clic par convenance sans examen raisonné. La typologie méthodologique distingue les valeurs aberrantes procédurales (fautes de saisie, mauvaise manipulation des appareils de mesure, tricherie délibérée d’un sujet, non-respect avéré des consignes d’inclusion) et les valeurs aberrantes authentiques issues de la variabilité biologique ou psychologique normale de l’espèce humaine. Si la première catégorie justifie une correction immédiate ou une suppression documentée, la seconde recèle souvent des informations cliniques déterminantes sur la vulnérabilité ou l’exceptionnalité de certains profils psychologiques.
6. Évaluation de la normalité et de la forme de la distribution
6.1 Mesures d’asymétrie (Skewness) et d’aplatissement (Kurtosis)
L’application de la quasi-totalité des modèles statistiques paramétriques classiques (tests t de Student, ANOVA univariée et multivariée, corrélations de Pearson, régressions linéaires) repose sur le postulat théorique de la distribution normale des erreurs ou des variables continues. L’évaluation de cette normalité débute par l’analyse géométrique des moments d’ordre 3 et 4 : le coefficient d’asymétrie (Skewness) et le coefficient d’aplatissement (Kurtosis), tous deux calculables via les commandes Fréquences, Descriptives ou Explorer.
L’asymétrie quantifie le degré d’écart par rapport à la symétrie spéculaire bilatérale d’une courbe en cloche idéale. Une asymétrie positive (positive skew, supérieure à zéro) caractérise une distribution dont la queue s’étire de façon prononcée vers la droite, indiquant une forte concentration de scores faibles et quelques valeurs extraordinairement élevées (comme c’est fréquemment le cas pour les revenus, les temps de réaction ou les scores de consommation de drogues). À l’inverse, une asymétrie négative (negative skew, inférieure à zéro) reflète une queue étalée vers la gauche avec une majorité de scores agglutinés au sommet supérieur (effet de plafond psychométrique).
L’aplatissement (kurtosis) caractérise l’épaisseur des queues de distribution et la proéminence du sommet comparativement à la loi normale standard. SPSS rapporte le kurtosis d’excès, centré sur zéro. Une distribution leptokurtique (kurtosis positif supérieur à zéro) présente un pic central très aigu et des queues épaisses chargées en valeurs atypiques, ce qui accroît la vulnérabilité aux erreurs d’inférence. Une distribution platykurtique (kurtosis négatif inférieur à zéro) exhibe un profil écrasé et aplati avec des queues très minces. Dans la pratique, on évalue la significativité de ces déviations en calculant le score z d’asymétrie (ou ratio critique) :
zskew = Skewness / S.E.skew
Bien qu’un seuil statistique strict rejette la normalité dès que |z| > 1,96 (au seuil alpha de 0,05), les spécialistes de la modélisation psychométrique comme Rex B. Kline recommandent des seuils pratiques plus tolérants pour les données psychologiques écologiques : des valeurs absolues d’asymétrie inférieures à 2 et d’aplatissement inférieures à 7 demeurent acceptables pour la robustesse des estimateurs paramétriques dans les échantillons de taille raisonnable.
6.2 Tests d’hypothèse formels de normalité dans SPSS
Pour soumettre l’ajustement distributionnel à une validation statistique formelle, le chercheur active l’option Graphiques de normalité avec tests accessible via le bouton Graphiques… de la procédure Explorer. Lors de l’exécution, SPSS calcule deux tests statistiques d’adéquation universellement reconnus : le test de Kolmogorov-Smirnov (équipé de la correction de Lilliefors pour le cas où les paramètres de moyenne et de variance sont estimés à partir de l’échantillon) et le test de Shapiro-Wilk.
Le principe général de ces tests d’hypothèse repose sur la formulation suivante : l’hypothèse nulle (H0) postule que la distribution empirique observée ne diffère pas significativement d’une distribution normale théorique de même moyenne et de même variance. Dès lors, le chercheur espère un résultat non significatif (c’est-à-dire une valeur p supérieure au seuil conventionnel de 0,05). Si la valeur de significativité affichée dans la colonne Sig. est inférieure à 0,05, l’hypothèse nulle de normalité est formellement rejetée, signifiant que les données s’écartent statistiquement du modèle gaussien.
Le test de Shapiro-Wilk s’impose dans la littérature méthodologique comme le test le plus puissant et le plus fiable, particulièrement adapté aux échantillons de taille modérée ou réduite (typiquement N < 50). Toutefois, une réserve méthodologique d’envergure doit être formulée quant à la dépendance de ces tests à la taille de l’échantillon. Dans les très grands échantillons (N > 300 ou 500), même une distorsion microscopique et totalement triviale par rapport à la courbe de Gauss déclenchera inévitablement un rejet formel (p < 0,001) de la normalité. À l’opposé, dans les très petits échantillons (N < 20), la puissance statistique est souvent insuffisante pour détecter des déviations majeures. Il est donc imprudent de fonder son diagnostic exclusivement sur ces tests d’hypothèse sans les corroborer par une inspection visuelle minutieuse.
6.3 Outils diagnostiques visuels de la normalité
Face aux limites inhérentes aux tests d’hypothèse dépendants de la puissance de l’échantillon, l’examen des graphiques diagnostiques constitue l’étalon-or pour porter un jugement éclairé sur la distribution d’une variable continue. La procédure Explorer génère deux visualisations graphiques de référence : le diagramme quantile-quantile normal (Normal Q-Q Plot) et le diagramme sans tendance (Detrended Normal Q-Q Plot).
Le graphique Q-Q plot projette sur l’axe des abscisses les quantiles théoriques attendus sous l’hypothèse d’une loi normale parfaite, et sur l’axe des ordonnées les quantiles empiriques réellement observés dans le jeu de données. La référence idéale prend la forme d’une ligne droite diagonale continue. Si les données de l’échantillon sont parfaitement conformes à la normalité, l’ensemble des points d’observation vient se superposer étroitement à cette diagonale théorique. Tout comportement déviant se traduit par des configurations géométriques identifiables : des points qui s’incurvent de manière convexe ou concave révèlent une asymétrie marquée, tandis qu’une courbure en forme de « S » aux extrémités trahit un phénomène d’aplatissement (leptokurtose ou platykurtose) avec des queues anormalement épaisses ou tronquées.
Le diagramme sans tendance (Detrended Normal Q-Q Plot) propose une perspective complémentaire en représentant la différence arithmétique nette entre le quantile observé et le quantile théorique pour chaque niveau de score. La ligne de référence horizontale est ici fixée à zéro. Dans une distribution saine, les observations oscillent de manière purement aléatoire et homogène de part et d’autre de cette ligne zéro, sans structure apparente. L’apparition de motifs sinusoïdaux structurés ou d’entonnoirs d’hétérogénéité confirme que les distorsions ne sont pas de simples fluctuations aléatoires d’échantillonnage, guidant ainsi le chercheur vers l’adoption de méthodes non paramétriques ou vers des transformations mathématiques correctrices appropriées (telles que les transformations logarithmiques ou racine carrée).
7. Calcul de statistiques descriptives conditionnelles et par sous-groupes
7.1 Segmentation de la population avec l’instruction Scinder le fichier
Dans la conduite de protocoles de recherche en psychologie, il est rare que l’on s’intéresse uniquement au comportement global de l’échantillon agrégé ; l’objectif consiste le plus souvent à disséquer le profil de sous-cohortes définies par des statuts cliniques, des tranches d’âge ou des conditions expérimentales. L’instruction la plus puissante d’SPSS pour opérer cette désagrégation systématique est la commande Scinder le fichier (Split File), localisée dans le menu supérieur sous : Données > Scinder le fichier….
Une fois la boîte de dialogue ouverte, l’utilisateur a le choix entre deux modes de fonctionnement fondamentaux après avoir coché l’option d’activation : Comparer les groupes (qui regroupe les sorties des différents sous-groupes au sein des mêmes tableaux pour faciliter la confrontation directe) ou Organiser les résultats par groupes (qui génère des blocs de tableaux totalement séparés et consécutifs pour chaque modalité). Le chercheur sélectionne ensuite la ou les variables de stratification (par exemple, Groupe_Clinique) et les transfère dans la case Groupes basés sur :.
Dès que cette instruction est exécutée, SPSS applique un filtre de partitionnement interne invisible : toutes les procédures statistiques sollicitées ultérieurement (qu’il s’agisse de DESCRIPTIVES, FREQUENCIES, d’histogrammes ou de tests de normalité) seront automatiquement scindées selon les modalités de la variable de découpage. Cependant, un piège récurrent guette l’utilisateur distrait : ce scindement demeure actif de façon permanente jusqu’à sa désactivation explicite. Il est donc impératif, une fois les calculs conditionnels achevés, de retourner immédiatement dans la boîte de dialogue Scinder le fichier et de réenclencher l’option Analyser toutes les observations, ne pas créer de groupes, sous peine de voir toutes les analyses futures segmentées de façon inappropriée.
7.2 Utilisation de la commande Moyennes pour les comparaisons directes
Pour les chercheurs désireux d’obtenir une synthèse comparative rapide de scores quantitatifs en fonction de variables indépendantes catégorielles sans devoir scinder l’ensemble de l’environnement de données, la commande Moyennes offre une ergonomie remarquable. Elle est accessible en naviguant à travers le menu : Analyse > Comparer les moyennes > Moyennes… (ou Moyennes et ANOVA à 1 facteur selon les versions de SPSS).
Dans cette interface, la variable quantitative continue d’intérêt est placée dans le champ Variables dépendantes :, tandis que les facteurs explicatifs catégoriels sont assignés au champ Variables indépendantes :. La commande autorise un emboîtement hiérarchique complexe en exploitant le bouton Suivant (Next), ce qui permet de croiser simultanément plusieurs facteurs (par exemple, analyser les scores d’anxiété en fonction du sexe biologique au niveau 1, croisé avec le niveau de sévérité du trouble au niveau 2). L’architecture génère un tableau matriciel élégant et synthétique présentant chaque cellule d’intersection avec une grande clarté.
En cliquant sur le bouton Options… de la commande Moyennes, le statisticien peut enrichir considérablement le contenu informationnel de chaque cellule. Au-delà des moyennes, effectifs et écarts-types fournis par défaut, il est possible d’adjoindre la médiane, la moyenne géométrique, la moyenne harmonique, les pourcentages d’effectifs, ainsi que des mesures de dispersion robustes. Cette procédure constitue le moyen le plus direct et le plus économique pour vérifier l’homogénéité préliminaire des groupes d’étude avant de lancer formellement des analyses de variance factorielles complexes.
7.3 Agrégation de données pour l’analyse au niveau du groupe
Dans les champs de la psychologie sociale, de la psychologie organisationnelle et des sciences de l’éducation, les devis de recherche impliquent souvent des structures de données hiérarchiques ou imbriquées (des élèves nichés au sein de classes scolaires, des patients suivis au sein de différentes cliniques, ou des employés appartenant à des équipes de travail distinctes). Pour analyser des propriétés contextuelles émergentes, il est souvent nécessaire de calculer la statistique descriptive d’un groupe (par exemple, le niveau moyen de cohésion de l’équipe) et de réassigner cette valeur synthétique à chaque individu membre de ce collectif.
Cette opération s’effectue avec rigueur grâce à la commande : Données > Agréger… (Aggregate Data). Dans l’interface d’agrégation, la variable définissant l’appartenance collective (ex. : ID_Classe) est transférée dans la section Variables de rupture : (Break Variables), tandis que la variable individuelle à résumer (ex. : Score_Motivation) est placée dans la section Agréger les variables :. L’utilisateur clique ensuite sur Fonction… pour choisir l’indicateur d’agrégation requis (moyenne, médiane, écart-type, pourcentage au-dessus d’un seuil, etc.).
SPSS offre alors trois options de destination pour les données agrégées : créer un nouveau jeu de données distinct, enregistrer un fichier de données externe sur le disque, ou sélectionner l’option particulièrement féconde : Ajouter les variables d’agrégation au jeu de données actif. Dans ce dernier cas, SPSS ne compresse pas le fichier : il crée une nouvelle colonne dans la matrice courante, attribuant à chaque participant individuel la valeur synthétique globale de son groupe d’appartenance. Cette opération ouvre la voie aux analyses multiniveaux et permet d’utiliser des statistiques descriptives collectives comme prédicteurs au niveau micro-individuel.
8. Représentation graphique des statistiques descriptives sous SPSS
8.1 Histogrammes et courbes de Gauss superposées
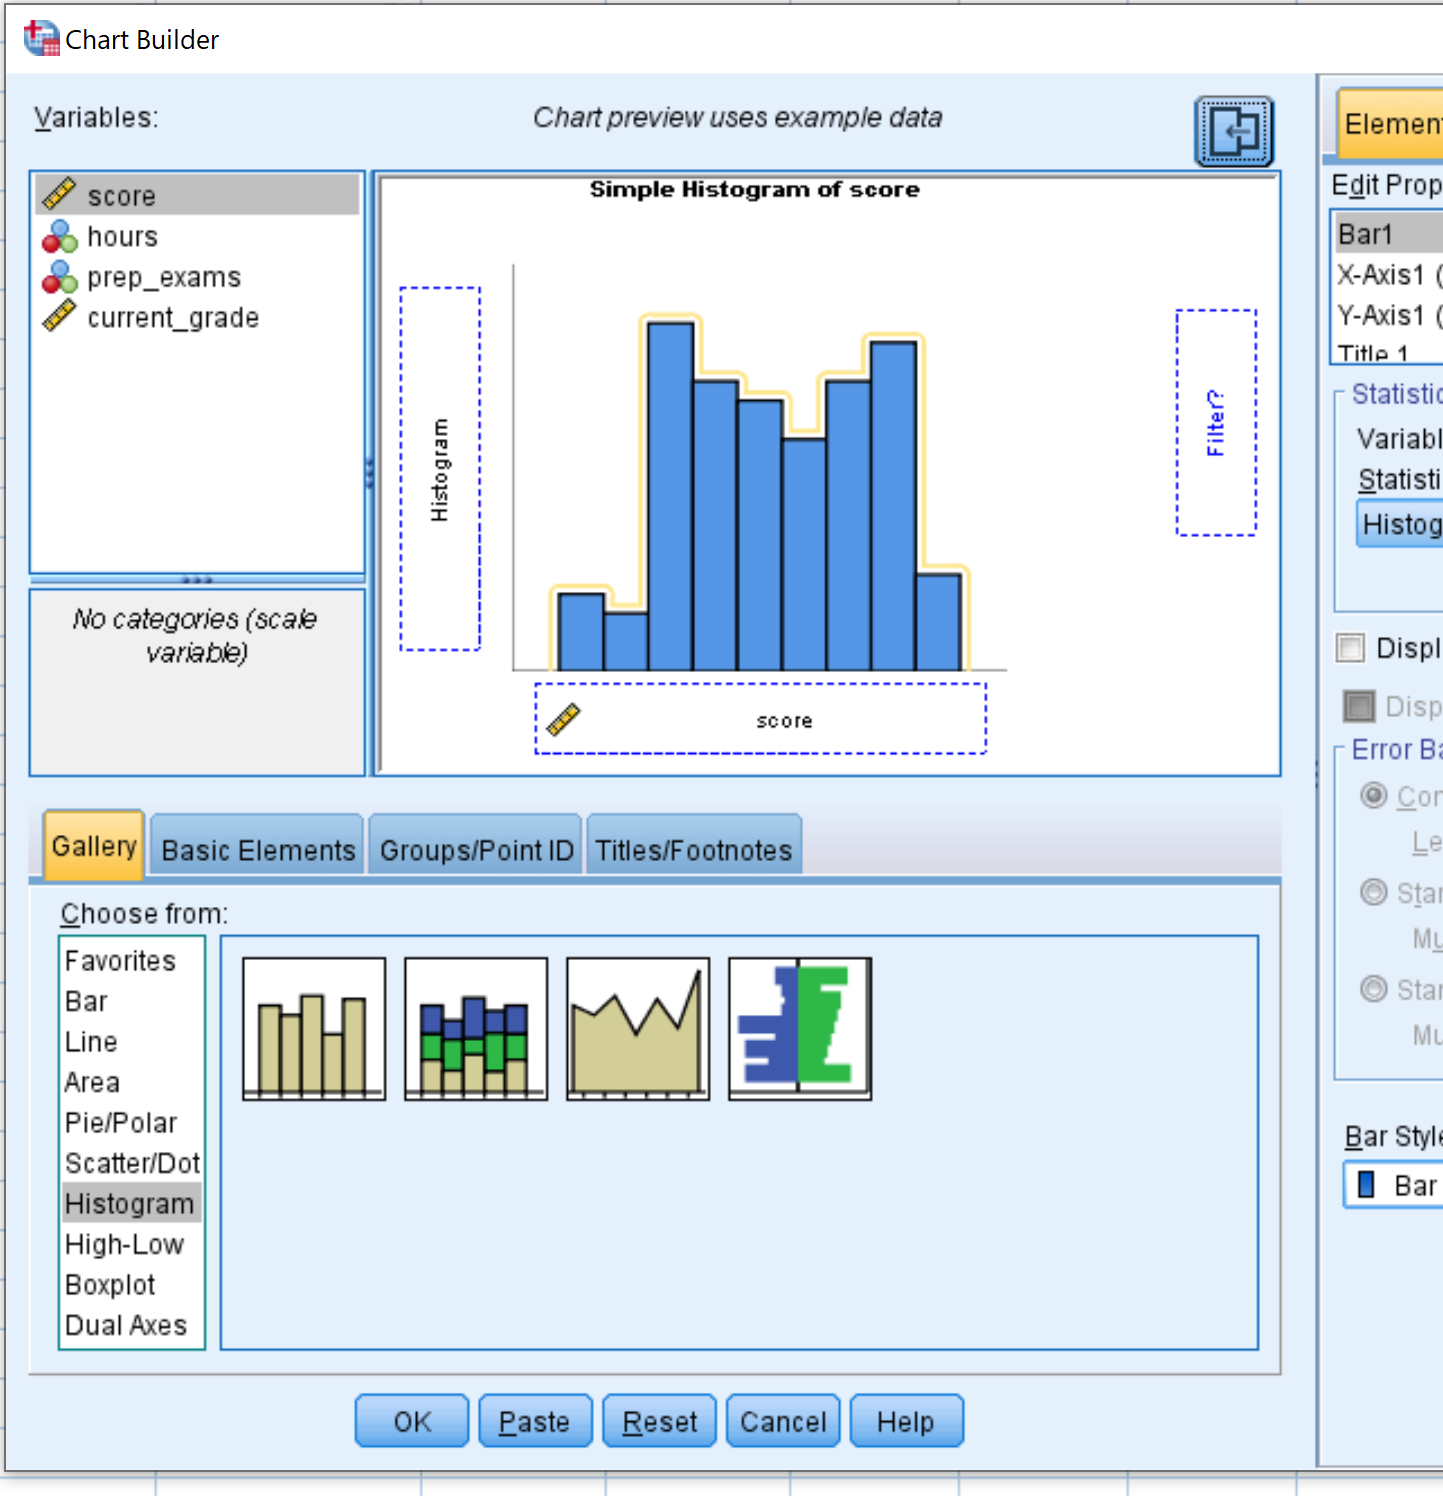
L’inspection graphique constitue le prolongement visuel indispensable de toute synthèse numérique des distributions. L’histogramme demeure la représentation fondamentale pour visualiser la densité empirique d’une variable quantitative continue. Sous SPSS, la construction d’un histogramme rigoureux peut s’effectuer directement via le sous-menu Graphiques… de la commande Fréquences, ou de façon plus hautement personnalisable via le Générateur de graphiques (Chart Builder) accessible sous : Graphiques > Générateur de graphiques….
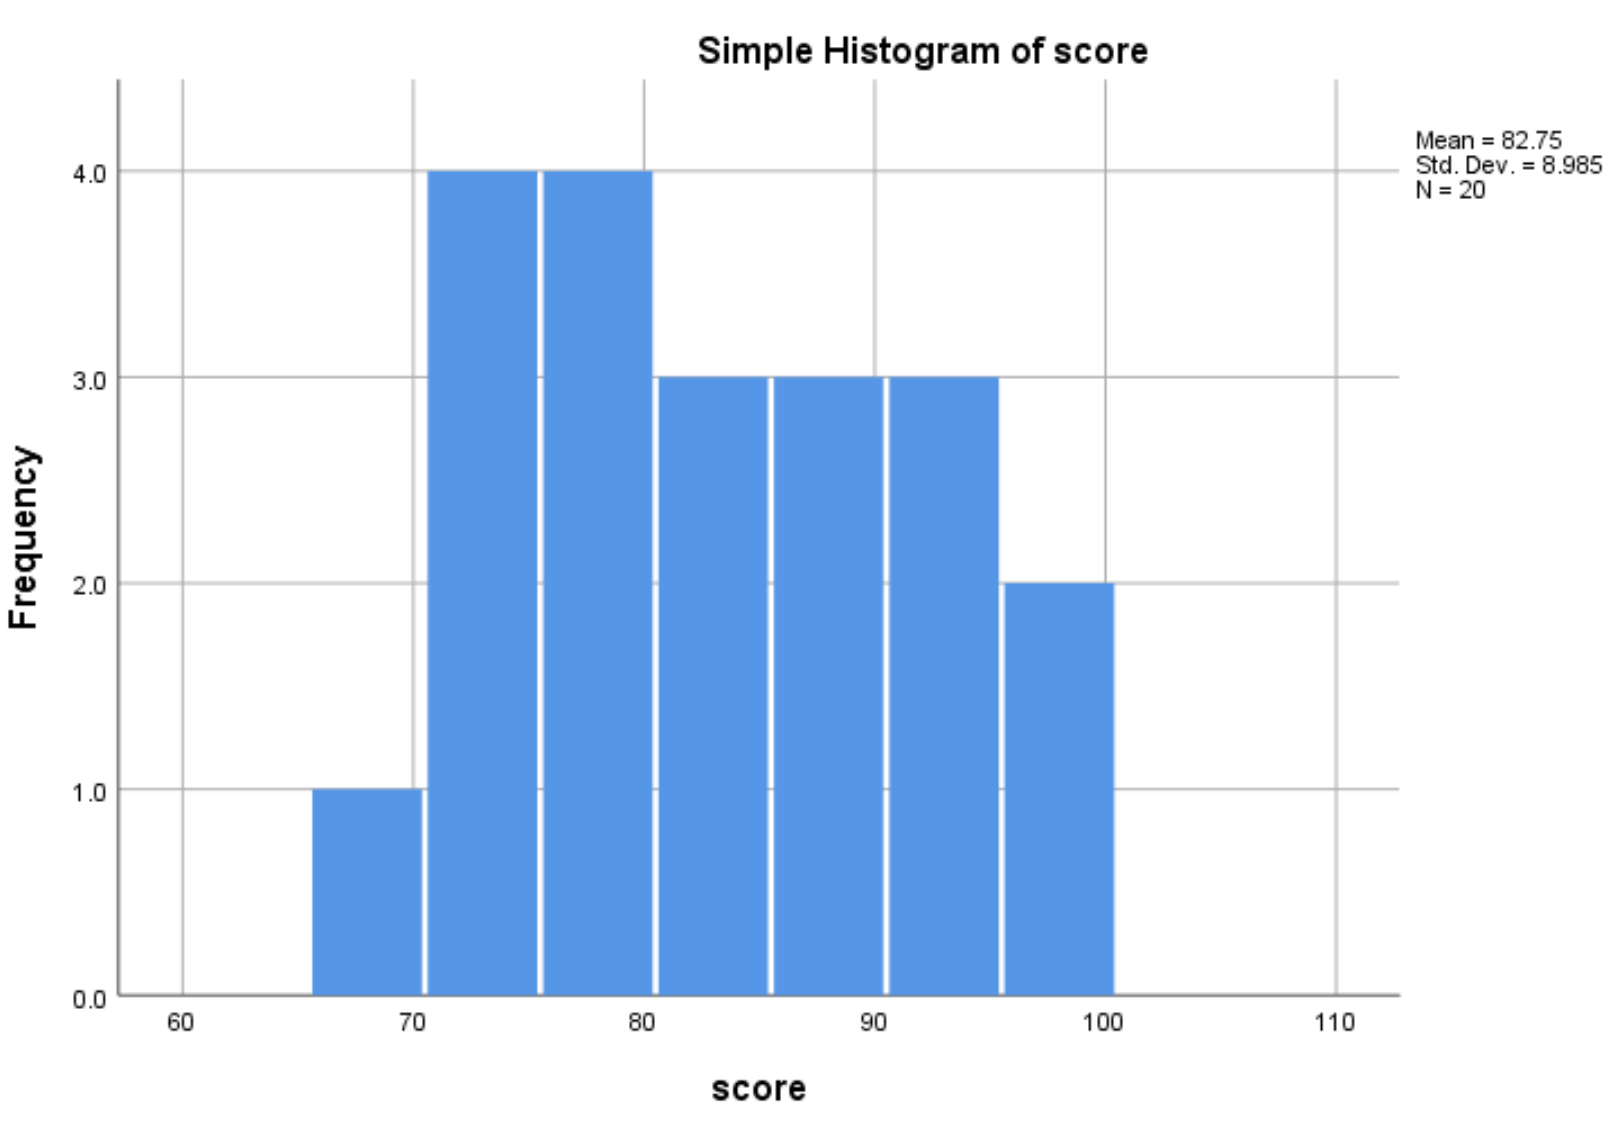
L’un des atouts diagnostiques majeurs de l’histogramme sous SPSS réside dans la possibilité de superposer instantanément une courbe normale théorique de référence calibrée sur les paramètres empiriques de moyenne et d’écart-type de la variable mesurée. Pour ce faire, dans la boîte de dialogue Fréquences, il suffit de cocher Histogrammes puis d’activer l’option secondaire Afficher la courbe normale sur l’histogramme. Dans le visualiseur de résultats, la cloche théorique gaussienne vient se draper sur les barres rectangulaires des effectifs observés, permettant d’identifier immédiatement à l’œil nu les déficits ou excès de fréquences sur l’ensemble de l’étendue.
Un aspect critique de la manipulation des histogrammes réside dans le calibrage de la largeur des intervalles de classe (bins). Par défaut, SPSS applique un algorithme de découpage automatique qui peut parfois lisser excessivement la distribution ou, à l’inverse, générer un fractionnement artificiellement haché. En double-cliquant sur le graphique dans le visualiseur, le chercheur accède à l’Éditeur de graphiques, où il peut ajuster manuellement le nombre d’intervalles ou leur largeur absolue. Ce réglage précis est indispensable pour distinguer une distribution unimodale asymétrique d’une distribution véritablement bimodalement structurée, révélatrice de la coexistence de deux sous-populations distinctes au sein du même échantillon.
8.2 Diagrammes en boîte (Boxplots) pour l’examen de la dispersion
Initié par John Tukey, le diagramme en boîte (ou boîte à moustaches / Boxplot) figure parmi les outils graphiques les plus denses et les plus informatifs de la statistique moderne. Il synthétise en une figure géométrique unique les cinq indicateurs clés de la distribution non-paramétrique : la médiane, le premier quartile, le troisième quartile, ainsi que les bornes minimales et maximales non aberrantes. Sous SPSS, les boxplots peuvent être générés via la procédure Explorer, la commande Boîtes à moustaches… du menu Graphiques, ou via le Générateur de graphiques.
L’anatomie d’un boxplot SPSS mérite une lecture experte : le rectangle central (la boîte) délimite l’intervalle interquartile (IQR), s’étendant du 25e centile (charnière inférieure) au 75e centile (charnière supérieure). La ligne épaisse traversant le corps de la boîte figure la médiane empirique. La hauteur totale de la boîte reflète ainsi directement le degré de variabilité ou de dispersion des 50 % centraux de l’échantillon. Les segments verticaux émergeant de part et d’autre (les moustaches) s’étirent jusqu’à la valeur observée la plus éloignée ne dépassant pas 1,5 fois l’intervalle interquartile au-delà des charnières respectives.
Toute donnée se situant au-delà de ces moustaches est explicitement identifiée comme une anomalie distributionnelle par SPSS, qui applique un codage typographique rigoureux. Les valeurs situées entre 1,5 et 3 fois l’IQR au-delà de la charnière sont signalées par un petit cercle (identifiant une valeur aberrante modérée ou outlier), tandis que les données franchissant le seuil critique de 3 fois l’IQR sont marquées d’une étoile (désignant une valeur extrême sévère). À côté de chaque symbole, SPSS affiche systématiquement le numéro d’observation ou l’identifiant du sujet, facilitant le diagnostic clinique immédiat. Enfin, la comparaison visuelle de boxplots juxtaposés pour plusieurs sous-groupes permet d’évaluer de manière qualitative le respect du postulat d’homogénéité des variances (homoscédasticité).
8.3 Diagrammes en bâtons et diagrammes circulaires
Pour la restitution graphique des variables qualitatives nominales et ordinales, le recours aux histogrammes continus est proscrit. L’analyste se tourne alors vers les diagrammes en bâtons (Bar charts) ou les diagrammes circulaires (Pie charts), disponibles au sein de la commande Fréquences ou du Générateur de graphiques. Contrairement aux histogrammes où les rectangles sont contigus pour illustrer la continuité métrique, le diagramme en bâtons impose un espacement physique net entre chaque barre, matérialisant visuellement la discontinuité ontologique séparant des catégories indépendantes.
Dans l’environnement de configuration d’SPSS, l’utilisateur a toute liberté pour paramétrer la métrique portée par l’axe des ordonnées. Il est généralement préférable, dans les rapports de recherche empirique, de sélectionner l’affichage des Pourcentages plutôt que des Effectifs bruts, afin de faciliter la contextualisation mentale des proportions relatives au sein de la cohorte. L’éditeur de graphiques permet en outre d’ajouter des étiquettes de données directement au sommet de chaque bâton, mentionnant la valeur chiffrée exacte pour une lisibilité optimale sans encombrer la mise en page générale.
Les diagrammes circulaires (ou « camemberts ») sont également largement utilisés, mais ils requièrent une réserve méthodologique stricte en psychologie expérimentale. L’œil humain éprouve une difficulté cognitive documentée à évaluer et comparer avec précision des angles et des surfaces curvilignes. Par conséquent, l’usage des diagrammes circulaires sous SPSS doit être strictement restreint aux variables nominales ne comportant qu’un très petit nombre de modalités (trois au maximum). Dès que la variable comporte quatre catégories ou davantage, le diagramme circulaire devient visuellement encombré et confus ; le diagramme en bâtons horizontaux ou verticaux s’impose alors impérativement pour garantir une communication scientifique non ambiguë.
9. Gestion des données manquantes dans les calculs descriptifs
9.1 Typologie des données manquantes en psychologie
Dans l’investigation empirique humaine, la survenue de données manquantes (missing data) est une fatalité méthodologique : fatigue d’un sujet en fin de protocole, panne d’un capteur électrodermal, refus pudique de divulguer un traumatisme d’enfance ou abandon pur et simple lors d’une étude longitudinale (attrition expérimentale). L’analyste ne peut se contenter d’ignorer passivement ces trous dans la matrice ; il doit en comprendre la nature probabiliste selon le modèle séminal formalisé par Donald Rubin en 1976.
Rubin postule trois mécanismes distincts générant l’absence de mesure. Le mécanisme où les données manquent complètement au hasard (Missing Completely At Random, MCAR) suppose que la probabilité d’absence d’une observation est totalement indépendante tant de la variable observée elle-même que de toutes les autres variables du protocole (par exemple, une feuille de réponse accidentellement égarée par l’expérimentateur). Le mécanisme où les données manquent au hasard (Missing At Random, MAR) se produit lorsque la probabilité d’absence est corrélée à une autre variable observée dans le fichier, mais pas à la valeur manquante elle-même (par exemple, les hommes refusent plus fréquemment de répondre à une échelle d’anxiété que les femmes, mais au sein des hommes, le refus n’est pas lié au niveau d’anxiété sous-jacent).
Enfin, le mécanisme où le manque est non aléatoire (Missing Not At Random, MNAR) constitue la menace la plus grave : la cause de l’absence est directement couplée à la valeur théorique non mesurée (par exemple, les individus souffrant d’une dépression clinique majeure omettent de remplir l’item portant sur le désespoir précisément en raison de leur état psychique sévère). Ignorer le statut MNAR fausse gravement l’estimation descriptive, car la moyenne calculée sur les seuls cas observables sous-estimera dramatiquement la véritable moyenne de la population. Dans SPSS, il importe également de distinguer techniquement les données manquantes système (System-missing, matérialisées par un simple point . dans les cellules vides) des données manquantes définies par l’utilisateur (User-defined missing), explicitement attribuées à des codes spécifiques.
9.2 Options de traitement dans les boîtes de dialogue SPSS
Face à la présence inévitable de cellules vides, les procédures d’analyse descriptive d’SPSS offrent différentes modalités de gestion de l’exclusion, accessibles généralement sous le bouton Options… : l’exclusion cas par cas (Pairwise deletion / « Exclure les observations cas par cas ») et l’exclusion de la liste complète (Listwise deletion / « Exclure toutes les observations incomplètes »).
Le choix entre ces deux stratégies entraîne des conséquences méthodologiques profondes sur la stabilité des indicateurs calculés :
- Exclusion de la liste complète (Listwise) : Cette modalité élimine purement et simplement de toutes les analyses descriptives tout participant présentant ne serait-ce qu’une seule valeur manquante sur l’ensemble de la liste des variables sélectionnées. Bien que cette approche garantisse que tous les indicateurs soient estimés sur une base d’individus strictement identique, elle peut réduire drastiquement la taille effective de l’échantillon (la puissance statistique s’effondrant si 30 % de la cohorte est purgée en raison de réponses éparses non complétées).
- Exclusion observationnelle pas à pas (Pairwise) : Cette méthode n’exclut une observation que pour le calcul spécifique de la variable sur laquelle la donnée est manquante. Pour toute autre variable renseignée, le participant demeure pleinement intégré au calcul de la moyenne et de la variance. La taille d’échantillon globale est ainsi préservée au maximum.
L’analyste doit impérativement faire preuve d’une rigueur documentaire irréprochable en consultant systématiquement la ligne N valide (liste) ou la colonne N dans les tableaux générés par SPSS. Présenter une matrice de résultats sans expliciter si le dénominateur varie d’un indicateur à l’autre constitue une faute de rigueur méthodologique. En présence d’attrition substantielle, la documentation explicite de la taille réelle de l’échantillon (N valide) pour chaque paramètre calculé est formellement exigée par les comités de lecture des revues scientifiques.
9.3 Analyse descriptive préliminaire du patron des valeurs manquantes
Avant d’engager des calculs descriptifs définitifs, il est fortement recommandé de mener un diagnostic systématique de la morphologie des données absentes. Si l’établissement de recherche dispose de la licence intégrant le module optionnel spécialisé Analyse des valeurs manquantes d’IBM SPSS (accessible via Analyse > Analyse des valeurs manquantes…), le chercheur bénéficie d’un panel d’outils statistiques de pointe.
Ce module permet de générer des tableaux de profils identifiant les variables les plus atteintes par la non-réponse, de cartographier les configurations de données manquantes (par exemple, vérifier si l’absence d’une mesure à un temps T2 prédit systématiquement l’absence au temps T3), et surtout de tester formellement l’hypothèse d’absence complète au hasard grâce au célèbre Test de Little pour MCAR. Un résultat de test de Little non significatif (p > 0,05) apporte l’assurance méthodologique que les trous dans la matrice sont distribués de façon purement stochastique, ce qui autorise sereinement l’usage de méthodes d’imputation ou d’exclusions observationnelles classiques.
Si ce module dédié n’est pas disponible, une investigation artisanale mais efficace reste possible via la commande standard Fréquences : en intégrant l’ensemble des variables et en observant attentivement la ligne récapitulative des données manquantes dans les tableaux de sortie, le chercheur calcule le taux de défaillance relatif pour chaque item. Si un item psychométrique présente un taux de non-réponse excédant 10 à 15 %, une alerte méthodologique doit être levée quant à la formulation même de la question (ambiguïté, caractère intrusif ou formulation trop complexe), et des précautions majeures doivent être prises avant d’envisager une imputation simple ou multiple par équations chaînées.
10. Automatisation des statistiques descriptives via la syntaxe SPSS
10.1 Avantages méthodologiques et reproductibilité de la recherche
Si la manipulation par pointage et clics de l’interface graphique d’SPSS facilite l’apprentissage initial des étudiants de premier cycle, elle ne saurait satisfaire aux exigences contemporaines de la recherche empirique professionnelle. Le recours à l’interface graphique souffre d’une faille majeure : il est amnésique, chronophage lors d’analyses répétitives, et hautement vulnérable aux erreurs humaines involontaires (glissement accidentel d’une mauvaise variable dans un champ, oubli d’une case d’option cochée lors d’une analyse ultérieure).
L’automatisation via l’éditeur de syntaxe SPSS (fichiers .sps) représente la clé de voûte de la reproductibilité scientifique et de la science ouverte (Open Science). Un fichier de syntaxe constitue une archive textuelle pérenne documentant mot pour mot la trajectoire exacte suivie pour transformer les variables et générer les sorties statistiques. Il peut être relu par des pairs, archivé sur des plateformes ouvertes comme l’Open Science Framework (OSF), et réexécuté des années plus tard sur de nouvelles vagues de données pour reproduire à l’identique l’ensemble des analyses en une fraction de seconde.
En outre, l’adoption de la syntaxe induit un gain d’efficience opérationnelle spectaculaire pour les laboratoires de recherche. Le traitement récurrent de cohortes expérimentales standardisées, le nettoyage automatisé de questionnaires administrés périodiquement et le recalcul instantané de scores globaux après détection d’une erreur de codage s’effectuent par simple exécution d’un script préalablement validé, libérant le chercheur des tâches de saisie répétitives pour lui permettre de se concentrer sur l’interprétation théorique de ses résultats.
10.2 Commandes syntaxiques fondamentales pour le calcul descriptif
Le langage de commande sous-jacent d’IBM SPSS Statistics est particulièrement sobre et structuré. La quasi-totalité des calculs descriptifs explorés dans ce guide se condense en trois instructions canoniques majeures : DESCRIPTIVES, FREQUENCIES et EXAMINE. La commande DESCRIPTIVES s’articule autour de la désignation des variables et de la sous-commande /STATISTICS :
DESCRIPTIVES VARIABLES=Score_Anxiete Tempons_Reaction

  /STATISTICS=MEAN STDDEV VARIANCE RANGE SEMEAN SKEWNESS KURTOSIS

  /SAVE.
Dans cette commande, le mot-clé /SAVE instruit directement SPSS de calculer et d’enregistrer les scores standardisés (scores z) dans le fichier de travail actif, sans aucune manipulation graphique supplémentaire. Pour obtenir des distributions de fréquences détaillées enrichies de quartiles, l’instruction FREQUENCIES est rédigée comme suit :
FREQUENCIES VARIABLES=Item_1 Item_2 Echelle_Likert

  /PERCENTILES=25.0 50.0 75.0

  /STATISTICS=STDDEV MEAN MEDIAN MODE

  /ORDER=ANALYSIS.
Enfin, pour mobiliser la puissance exhaustive de l’exploration de Tukey incluant l’évaluation formelle de la normalité et la génération des boîtes à moustaches comparatives, l’instruction EXAMINE s’impose :
EXAMINE VARIABLES=Score_Memoire BY Condition_Experimentale

  /PLOT=BOXPLOT NPPLOT

  /STATISTICS=DESCRIPTIVES EXTREME(5)

  /MESTIMATORS=HUBER TUKEY

  /CINTERVAL 95.
Dans ce script, la clause BY spécifie la stratification par facteur, le paramètre NPPLOT requiert les tracés de normalité et les tests formels (Kolmogorov-Smirnov et Shapiro-Wilk), tandis qu’EXTREME(5) extrait nominativement les cinq cas les plus périphériques. L’exécution s’opère en surlignant les lignes de code requises dans l’éditeur de syntaxe et en cliquant sur le triangle vert (« Exécuter la sélection ») ou en utilisant le raccourci clavier universel Ctrl + R.
10.3 Personnalisation avancée de la syntaxe
Pour les devis quantitatifs massifs caractérisés par l’administration de dizaines de batteries psychologiques, la programmation SPSS offre des structures de contrôle avancées pour traiter les variables par blocs cohérents. L’utilisation de mots-clés de raccourci comme TO permet d’exécuter des analyses descriptives sur des centaines d’items consécutifs sans devoir taper laborieusement leurs noms individuels :
DESCRIPTIVES VARIABLES=Item_01 TO Item_60

  /STATISTICS=MEAN STDDEV.
De plus, l’analyste chevronné peut implémenter des instructions conditionnelles directes telles que TEMPORARY couplée à SELECT IF pour calculer des statistiques descriptives sur un sous-ensemble très ciblé de données (par exemple, uniquement les sujets âgés de plus de 65 ans et présentant un diagnostic validé) sans altérer de manière irréversible le fichier de données principal :
TEMPORARY.

SELECT IF (Age > 65 AND Statut_Clinique = 1).

DESCRIPTIVES VARIABLES=Score_Cognitif

  /STATISTICS=MEAN STDDEV.
L’intégration de commentaires textuels au sein du script, introduits par un astérisque (*) et obligatoirement clôturés par un point final (.), assure la documentation pédagogique et méthodologique de chaque étape pour les collaborateurs d’un même laboratoire. Ces fichiers .sps, légers et universellement lisibles par n’importe quel éditeur de texte brut, constituent le patrimoine méthodologique fondamental d’un projet de recherche quantitative bien mené.
11. Formatage et présentation des résultats selon les normes APA (7e édition)
11.1 Règles typographiques et abréviations statistiques officielles
L’effort analytique déployé sous SPSS ne trouve son aboutissement académique que si les indicateurs descriptifs sont retranscrits en conformité rigoureuse avec les règles typographiques prescrites par l’American Psychological Association (APA, 7e édition). Les normes APA établissent une distinction stricte quant à la mise en forme typographique des symboles statistiques mathématiques, exigeant que toutes les lettres latines utilisées pour désigner des statistiques d’échantillon soient composées en italique.
Les symboles les plus couramment employés en statistique descriptive doivent être formatés comme suit :
- M : désigne la moyenne arithmétique de l’échantillon (ne jamais utiliser la notation « Moyenne » ou le symbole « X̄ » dans le corps du texte ou les tableaux).
- SD : désigne l’écart-type de l’échantillon (Standard Deviation ; l’usage de la notation francophone « ÉT » est généralement proscrit dans les revues internationales et fortement découragé dans les revues francophones affiliées aux standards APA).
- Mdn : désigne la médiane.
- N : désigne la taille totale de l’échantillon global de l’étude.
- n : désigne la taille d’un sous-échantillon ou d’un sous-groupe spécifique.
- SE : désigne l’erreur standard de la moyenne (Standard Error).
- IQR : désigne l’intervalle interquartile (Interquartile Range).
Concernant les règles d’arrondi numérique, les normes APA stipulent une précision standardisée à deux décimales pour la grande majorité des indicateurs descriptifs univariés (moyennes, écarts-types, médianes, etc.), par exemple : M = 24,35, SD = 4,12. En revanche, une règle typographique impérative dicte la suppression du zéro initial (leading zero) pour toute statistique bornée par construction entre zéro et un (comme les probabilités p, les coefficients de corrélation r ou les proportions relatives) : on écrira ainsi p = ,024 et non pas p = 0,024. Pour les statistiques descriptives non bornées par l’unité, le zéro initial doit être scrupuleusement conservé (ex. : M = 0,85 g).
11.2 Construction de tableaux descriptifs normalisés
Les tableaux descriptifs générés par le visualiseur de résultats d’SPSS (Pivot Tables) ne doivent jamais être exportés et copiés-collés tels quels dans un mémoire académique, une thèse ou un article soumis pour publication. Le style typographique propriétaire d’SPSS, avec ses bordures intérieures épaisses et ses cellules grisées, contrevient frontalement aux standards d’austérité graphique imposés par la 7e édition du manuel de publication de l’APA.
La morphologie canonique d’un tableau descriptif APA obéit à des règles immuables :
- Absence totale de lignes verticales : Aucune ligne verticale ne doit figurer dans le tableau.
- Trois lignes horizontales majeures : Une ligne horizontale supérieure délimitant le haut de la table, une ligne horizontale séparant l’en-tête de colonnes du corps des données numériques, et une ligne horizontale de fermeture délimitant le bas du tableau avant les notes éventuelles.
- Disposition structurelle : Les variables psychologiques sous examen sont généralement disposées en lignes ordonnées, tandis que les différents indicateurs statistiques synthétiques (n, M, SD, ou Intervalle de confiance à 95 %) occupent les colonnes successives.
Les notes de bas de tableau constituent un élément indispensable pour garantir l’autonomie conceptuelle du tableau : tout lecteur doit être en mesure de comprendre le contenu de la table sans avoir à se plonger dans le texte principal de l’article. Une note générale (introduite par le mot Note. en italique suivi d’un point) sert à définir les abréviations non standardisées, à spécifier la métrique des échelles ou à documenter le traitement des valeurs manquantes. La méthode recommandée consiste à exporter les tableaux SPSS vers Microsoft Word sous forme de texte modifiable, puis à appliquer les styles de bordures spécifiques et à réaligner les colonnes numériques sur le point décimal.
11.3 Intégration narrative des statistiques dans le corps du texte
L’intégration narrative des statistiques descriptives dans le corps du texte de la section Résultats obéit à des principes d’économie stylistique et de clarté syntaxique. Une règle d’or domine la rédaction scientifique : toute mesure de tendance centrale doit être obligatoirement couplée à sa mesure de dispersion associée. Rapporter une moyenne arithmétique isolée sans son écart-type correspondant constitue un manquement méthodologique rédhibitoire, car cela prive le lecteur de toute indication sur l’hétérogénéité des participants sous-jacents.
Voici un modèle canonique de formulation narrative respectant scrupuleusement les exigences de l’APA :
« Les scores moyens d’anxiété pré-expérimentale observés chez les étudiants de la cohorte (M = 42,30, SD = 6,85) témoignent d’une détresse psychologique globalement modérée. Cependant, l’examen comparatif par sous-groupes révèle que les participants assignés à la condition de stress induit ont rapporté des niveaux de tension significativement plus élevés (n = 45, M = 48,15, SD = 5,20) que ceux placés en condition de relaxation passive (n = 48, M = 36,80, SD = 4,95). »
Dans les cas où les distributions s’écartent notablement de la gaussianité justifiant l’abandon des métriques paramétriques, l’analyste formate son texte autour de la médiane et de l’intervalle interquartile : « Le temps de latence médian avant la première réponse motrice s’établissait à 245,00 ms (IQR = 65,00 ms, Mdn = 245,00). » Enfin, le ton employé dans la rédaction de ces constats doit rester strictement neutre, objectif et dénué d’adjectifs emphatiques ou de conjectures spéculatives, ces dernières devant être impérativement réservées à la section Discussion du travail de recherche.
12. Guide pratique : exemple pas à pas sur un jeu de données psychométriques
12.1 Présentation du cas d’étude : mesure de l’anxiété et performance académique
Afin de concrétiser l’ensemble des préceptes théoriques et des procédures techniques développés au fil de ce guide, examinons une étude empirique menée en psychologie cognitive et de l’éducation. Un chercheur souhaite investiguer la relation univariée liant le niveau d’anxiété aux examens et les résultats académiques obtenus lors d’une épreuve certificative universitaire finale. Pour ce projet pilote, une cohorte de N = 20 étudiants de première année de licence de psychologie a été suivie méthodiquement.
Le jeu de données comprend quatre variables quantitatives continues et catégorielles méticuleusement configurées dans SPSS :
ID_Participant: identifiant d’anonymat du participant (de 1 à 20), configuré comme variable nominale textuelle ou numérique.Anxiete_Pre: score total obtenu à un inventaire standardisé d’anxiété aux examens, administré 20 minutes avant le début de l’épreuve. L’échelle est théoriquement bornée entre 20 (absence totale d’anxiété) et 100 (panique aiguë invalidante) ; configurée en Échelle.Heures_Revision: nombre total d’heures déclarées par l’étudiant consacrées à la révision de la matière durant les sept jours précédant l’examen ; configurée en Échelle.Note_Finale: score final réel obtenu à l’examen académique, noté sur une échelle continue de 0 à 100 points ; configurée en Échelle.
L’objectif analytique immédiat de cette étape ne consiste pas à inférer un modèle prédictif par régression, mais à réaliser le profilage descriptif complet de cette cohorte d’étudiants. Il s’agit de quantifier la tendance centrale et la dispersion de chaque variable, de traquer d’éventuelles valeurs aberrantes d’origine procédurale ou clinique, et de tester formellement si la distribution des scores d’anxiété et de performance académique autorisera ultérieurement l’utilisation légitime d’analyses statistiques paramétriques univariées.
12.2 Exécution séquentielle et interprétation pas à pas des outputs SPSS
Pour engager le profilage descriptif complet de la variable Anxiete_Pre, l’analyste mobilise la procédure Explorer en programmant la commande syntaxique suivante dans son éditeur :
EXAMINE VARIABLES=Anxiete_Pre Note_Finale

  /PLOT=BOXPLOT NPPLOT HISTOGRAM

  /STATISTICS=DESCRIPTIVES EXTREME(5)

  /CINTERVAL 95.
L’exécution de cette commande produit instantanément une cascade de tableaux structurés dans le visualiseur de résultats. Le premier tableau, intitulé Récapitulatif de traitement des observations, confirme que les 20 observations sont valides (taux de complétude de 100 %, aucune donnée manquante). L’analyste se focalise ensuite sur le tableau majeur Descriptifs pour la variable Anxiete_Pre, qui affiche les valeurs empiriques suivantes :
- Moyenne arithmétique : M = 78,50 (SE = 3,42 ; Intervalle de confiance à 95 % : [71,34 ; 85,66]).
- Moyenne tronquée à 5 % : 78,11. La grande proximité entre la moyenne brute (78,50) et la moyenne tronquée (78,11) confirme d’emblée que le centre de gravité des données n’est pas distordu par des valeurs périphériques démesurées.
- Médiane : Mdn = 79,00. L’alignement remarquable entre la moyenne (78,50) et la médiane (79,00) constitue un indice majeur de symétrie distributionnelle.
- Variance et Écart-type : s2 = 233,95 ; SD = 15,29. L’écart-type témoigne d’une variabilité interindividuelle substantielle dans le niveau de stress pré-examen ressenti au sein de la promotion.
- Bornes empiriques : Minimum = 48,00 ; Maximum = 99,00 ; Étendue = 51,00 ; Intervalle interquartile = 21,50 (Q1 = 68,25 ; Q3 = 89,75).
- Forme géométrique : Asymétrie (Skewness) = -0,422 (SE = 0,512) ; Aplatissement (Kurtosis) = -0,615 (SE = 0,992).
Le calcul du ratio critique d’asymétrie (zskew = -0,422 / 0,512 = -0,82) se situe bien en deçà du seuil critique de ±1,96. De même, le ratio critique d’aplatissement (zkurt = -0,615 / 0,992 = -0,62) confirme l’absence de toute déformation significative de la courbure. L’examen du tableau Tests de normalité conforte ce diagnostic : le test de Shapiro-Wilk affiche une statistique de W(20) = 0,962 avec une significativité de p = ,585. La valeur de p étant très largement supérieure au seuil alpha conventionnel de 0,05, nous échouons à rejeter l’hypothèse nulle d’adéquation gaussienne. La distribution empirique de l’anxiété pré-examen peut être tenue pour rigoureusement normale.
L’examen des sorties graphiques achève de valider cette conclusion : sur le diagramme Q-Q plot normal, l’ensemble des 20 points de données vient s’agréger de manière presque fusionnelle le long de la ligne diagonale de référence, sans courbure systématique. L’inspection du boxplot confirme qu’aucun point isolé (cercle ou étoile) n’apparaît au-delà des moustaches, attestant de l’absence de toute valeur aberrante univariée. Le chercheur peut ainsi certifier que sa variable Anxiete_Pre remplit de manière exemplaire l’ensemble des critères de validité pour être ultérieurement introduite dans des analyses inférentielles paramétriques de type corrélation de Pearson ou modèles de régression linéaire.
12.3 Synthèse des pièges fréquents et recommandations pour les chercheurs
L’expérience accumulée dans l’encadrement méthodologique des recherches quantitatives permet d’identifier une série d’erreurs récurrentes commises lors du calcul et du rapportage des statistiques descriptives sous SPSS. La vigilance de l’analyste doit s’exercer en priorité sur les aspects critiques suivants :
- Ne pas confondre écart-type et erreur standard : Il s’agit sans conteste de l’erreur la plus ubiquitaire dans la littérature étudiante et débutante. L’écart-type (SD) quantifie la dispersion et la variabilité intrinsèque des observations au sein de l’échantillon empirique mesuré. L’erreur standard de la moyenne (SE) quantifie la variabilité probabiliste de la moyenne d’échantillonnage théorique à travers une infinité de réplications. Rapporter l’erreur standard à la place de l’écart-type sous prétexte que son chiffre est plus petit (donnant l’illusion fallacieuse d’une plus grande précision des scores) constitue une dénaturation de l’information descriptive fondamentale.
- Calculer la moyenne sur des variables nominales : SPSS ne possède pas de conscience méthodologique autonome ; si vous demandez la moyenne d’une variable nominale codant l’orientation religieuse ou la spécialité universitaire, le logiciel exécutera la commande et renverra un chiffre mathématiquement absurde (ex. : « Filière moyenne = 2,42 »). Il incombe au chercheur de restreindre formellement le calcul des moyennes aux seules variables quantitatives continues ou d’intervalles valides.
- Ignorer l’impact destructeur des valeurs extrêmes : Une moyenne arithmétique ne doit jamais être analysée de façon isolée sans vérifier préalablement les indices d’asymétrie et la concordance avec la médiane et la moyenne tronquée à 5 %. Une seule valeur extrême non traitée (par exemple, un participant ayant répondu 99 heures de révision par inadvertance au lieu de 9) peut à elle seule décaler la moyenne de l’échantillon et tripler la variance, ruinant la puissance des analyses futures.
- Recourir passivement au « Tout-Listwise » : Laisser SPSS purger automatiquement l’ensemble des lignes dès qu’une cellule est vide (exclusion de la liste) peut décimer la taille de votre échantillon sans que vous en ayez conscience. Surveillez en permanence le N effectif dans les tableaux pour mesurer le coût réel des données manquantes sur votre effectif final.
Avant d’apposer son approbation finale sur un rapport d’analyse descriptive destiné à la diffusion scientifique ou académique, tout chercheur rigoureux gagnera à confronter son travail à la liste de contrôle méthodologique suivante :
- Toutes les variables sont-elles explicitement nommées, étiquetées et correctement configurées dans la Vue des variables (statut Mesure exact) ?
- Les valeurs aberrantes potentielles ont-elles été traquées visuellement (boxplots) et numériquement (|z| > 3,29 ou tableau des valeurs extrêmes) ?
- Les conditions de forme (asymétrie, aplatissement, tests de Shapiro-Wilk et Q-Q plots) ont-elles été systématiquement documentées avant de valider la métrique de moyenne ?
- Chaque moyenne est-elle rigoureusement accompagnée de son écart-type (SD) et de la taille d’échantillon valide correspondante ?
- Les abréviations, arrondis et mises en page tabulaires sont-ils rigoureusement calibrés sur les standards de publication APA (7e édition) ?
- L’intégralité du cheminement de calcul a-t-elle été consignée et sauvegardée dans un script de syntaxe SPSS (
.sps) dûment commenté et reproductible ?
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Field, A. (2018). Discovering statistics using IBM SPSS Statistics (5th ed.). SAGE Publications.
Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
IBM Corporation. (2021). IBM SPSS Statistics 28 Brief Guide. IBM Corp. https://www.ibm.com/docs/en/spss-statistics
Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). Guilford Press.
Little, R. J. A., & Rubin, D. B. (2019). Statistical analysis with missing data (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119482581
Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–590. https://doi.org/10.1093/biomet/63.3.581
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.