
L’investigation empirique dans les sciences du comportement, en psychologie cognitive, en neuropsychologie et en sciences sociales repose fondamentalement sur la transformation méthodique d’observations brutes en synthèses intelligibles et reproductibles. Dans l’écosystème contemporain des laboratoires universitaires, des structures cliniques et des centres d’expérimentation, les chercheurs sont confrontés à des volumes considérables de données psychométriques, allant des latences de réponse mesurées en millisecondes aux scores d’échelles composites évaluant l’anxiété, la dépression ou la mémoire de travail. Avant même d’envisager la modélisation prédictive ou le déploiement de modèles linéaires généralisés, l’analyste se doit de procéder à une description méticuleuse et exhaustive de la structure distributionnelle de son échantillon.
Le recours à des environnements infonuagiques partagés, au premier rang desquels figure le tableur Google Sheets, a profondément redéfini l’ingénierie des flux de traitement statistique. Longtemps cantonnés aux progiciels propriétaires lourds, les calculs de réduction d’information et les analyses exploratoires s’exécutent désormais au sein d’environnements collaboratifs en temps réel, garantissant une accessibilité ubiquitaire, une traçabilité rigoureuse des transformations analytiques et une auditabilité complète des cohortes de participants. Cette démocratisation logicielle ne saurait toutefois dispenser le chercheur d’une maîtrise théorique absolue des estimateurs mathématiques mobilisés, des postulats sous-jacents aux métriques de tendance centrale et de dispersion, ainsi que de leurs vulnérabilités intrinsèques face aux biais d’échantillonnage.
Ce guide exhaustif a pour vocation d’exposer de manière systématique l’ensemble des procédures algorithmiques, des formulations analytiques et des principes méthodologiques requis pour calculer, interpréter et communiquer des statistiques descriptives dans Google Sheets, dans le respect scrupuleux des normes internationales de la recherche psychologique et des canons de publication de l’American Psychological Association (APA, 7e édition). De la structuration initiale de la matrice de données à l’évaluation fine de la skewness et du kurtosis, ce traité offre une trajectoire opérationnelle complète pour asseoir la robustesse et la reproductibilité des analyses quantitatives.
1. Fondements des statistiques descriptives dans la recherche en psychologie
1.1 Définition et rôle épistémologique des paramètres descriptifs
Dans l’architecture de la recherche expérimentale et observationnelle en psychologie, la statistique descriptive constitue le socle épistémologique fondamental sur lequel repose l’ensemble de l’édifice analytique. Sa mission principale réside dans l’organisation, le résumé et la caractérisation quantitative des observations empiriques, sans formuler a priori de généralisations probabilistes vers une population hypothétique plus large, rôle dévolu à la statistique inférentielle. Alors que l’inférence vise à tester des hypothèses de recherche par l’intermédiaire de valeurs d’indécision statistique (p-values) ou d’intervalles de confiance pour déterminer si un effet observé dépasse les fluctuations aléatoires d’échantillonnage, la statistique descriptive s’attache à dépeindre fidèlement la réalité de l’échantillon effectivement recueilli.
La synthèse quantitative des variables psychologiques et des comportements observés s’avère indispensable pour réduire l’entropie inhérente aux mesures humaines. Qu’il s’agisse du relevé continu des variations du diamètre pupillaire au cours d’une tâche d’attention soutenue, du comptage des erreurs d’intrusion dans une épreuve de rappel libre ou de l’auto-évaluation d’un état affectif via une échelle visuelle analogique, la masse des données brutes se révèle opaque à l’esprit humain. La réduction méthodique des données permet d’extraire des indicateurs d’équilibre et de variabilité synthétiques, indispensables à l’interprétation clinique et cognitive, permettant d’objectiver des profils psychopathologiques ou des dissociations fonctionnelles.
Enfin, sur le plan métrologique, l’analyse descriptive constitue l’étape d’évaluation préliminaire incontournable de tout protocole expérimental. Avant de déployer des modèles statistiques paramétriques complexes tels que l’analyse de variance factorielle (ANOVA) ou la régression linéaire multivariée, le chercheur doit impérativement cartographier les propriétés structurelles de ses métriques. Cette étape diagnostique permet d’identifier précocement d’éventuelles anomalies d’acquisition, d’évaluer la faisabilité pratique du protocole et de vérifier si les données empiriques s’accordent avec les présupposés théoriques du modèle d’évaluation psychologique retenu.
1.2 Pertinence de Google Sheets pour l’analyse des données de recherche
L’utilisation de Google Sheets dans l’analyse de données en sciences comportementales représente une évolution majeure vers la science ouverte et la reproductibilité computationnelle. Dans les contextes de recherche universitaire contemporains, les protocoles expérimentaux impliquent fréquemment des équipes multisites, des laboratoires collaborateurs dispersés sur plusieurs fuseaux horaires ou des collectes distribuées au sein de structures hospitalières distinctes. Google Sheets élimine les barrières de licence logicielle propriétaire et offre une synchronisation continue des données, permettant à plusieurs chercheurs de travailler simultanément sur un même corpus sans risque de divergence de versions.
L’intégrité des données psychométriques est renforcée par l’historique exhaustif des versions offert nativement par l’infrastructure cloud. Chaque saisie, modification ou implémentation de formule est horodatée et attribuée à un utilisateur identifié, ce qui confère une traçabilité totale au traitement des données. Cette fonctionnalité permet de restaurer un état antérieur en cas d’altération accidentelle et d’auditer avec précision le processus de nettoyage analytique. De surcroît, le contrôle granulaire des droits d’accès garantit une conformité optimale avec les cadres réglementaires éthiques, en limitant l’accès aux variables d’identification sensibles uniquement aux chercheurs dument accrédités par le comité d’éthique institutionnel.
Sur le plan de l’écosystème logiciel, Google Sheets présente une interopérabilité remarquable avec les formats standards d’échange de données scientifiques. Les flux bruts issus de logiciels d’expérimentation cognitive (tels que PsychoPy, OpenSesame ou Qualtrics) peuvent être injectés sans friction via des fichiers CSV, TSV ou XLSX. Réciproquement, une fois les étapes préliminaires d’apurement et de calcul descriptif achevées, la base de données peut être immédiatement exportée pour des analyses bayésiennes ou multivariées poussées vers des environnements spécialisés comme R, Python ou JASP, constituant ainsi un pivot idéal du pipeline méthodologique moderne.
1.3 Typologie des échelles de mesure psychologiques
Le choix et la légitimité mathématique des paramètres descriptifs dépendent impérativement de la nature des échelles de mesure mobilisées, selon la taxonomie fondatrice formalisée par Stanley Smith Stevens. La maîtrise de ces distinctions métrologiques évite l’écueil d’appliquer des calculs algébriques dépourvus de validité sur des variables dont la granularité ne s’y prête pas. En premier lieu, les échelles nominales caractérisent des variables qualitatives au sein desquelles les valeurs numériques constituent de simples étiquettes typologiques arbitraires, telles que le groupe diagnostique (par exemple : schizophrénie, trouble bipolaire, groupe témoin) ou le genre des participants. Pour ces échelles, les opérations arithmétiques sont proscrites ; seules les fréquences absolues, relatives et le mode possèdent une signification descriptive.
Les échelles ordinales, largement omniprésentes en psychométrie à travers les questionnaires de type Likert (mesurant des degrés d’adhésion de « Pas du tout d’accord » à « Tout à fait d’accord ») et les classements hiérarchiques, introduisent une relation d’ordre mathématique stricte sans pour autant garantir l’équidistance des intervalles séparant les échelons successifs. La distance psychologique perçue entre un score de 1 et 2 n’est pas nécessairement isomorphe à celle séparant un score de 4 et 5. Dès lors, l’application aveugle de moyennes ou d’écarts-types sur de telles données est théoriquement contestable, la médiane et les quantiles constituant les indices de référence pour capturer l’ordonnancement de ces variables comportementales.
Enfin, les échelles d’intervalles et de rapports quantifient les dimensions psychologiques continues où l’écart entre chaque valeur est mathématiquement constant et mesurable. Les scores standardisés issus de tests d’efficience intellectuelle (comme le QI de Wechsler) illustrent les échelles d’intervalles, caractérisées par l’absence de zéro absolu naturel. À l’inverse, les temps de réaction chronométriques mesurés lors de paradigmes attentionnels relèvent d’échelles de rapports, dans la mesure où un temps de zéro milliseconde traduit l’absence absolue de délai de réponse. Ce n’est que sur ces deux derniers niveaux d’échelle que l’éventail complet des statistiques descriptives paramétriques — incluant la moyenne arithmétique, la variance, l’écart-type et les indices de dissymétrie — acquiert une légitimité théorique et computationnelle absolue.
2. Structuration et nettoyage des données psychométriques dans Google Sheets
2.1 Organisation tabulaire selon les standards scientifiques
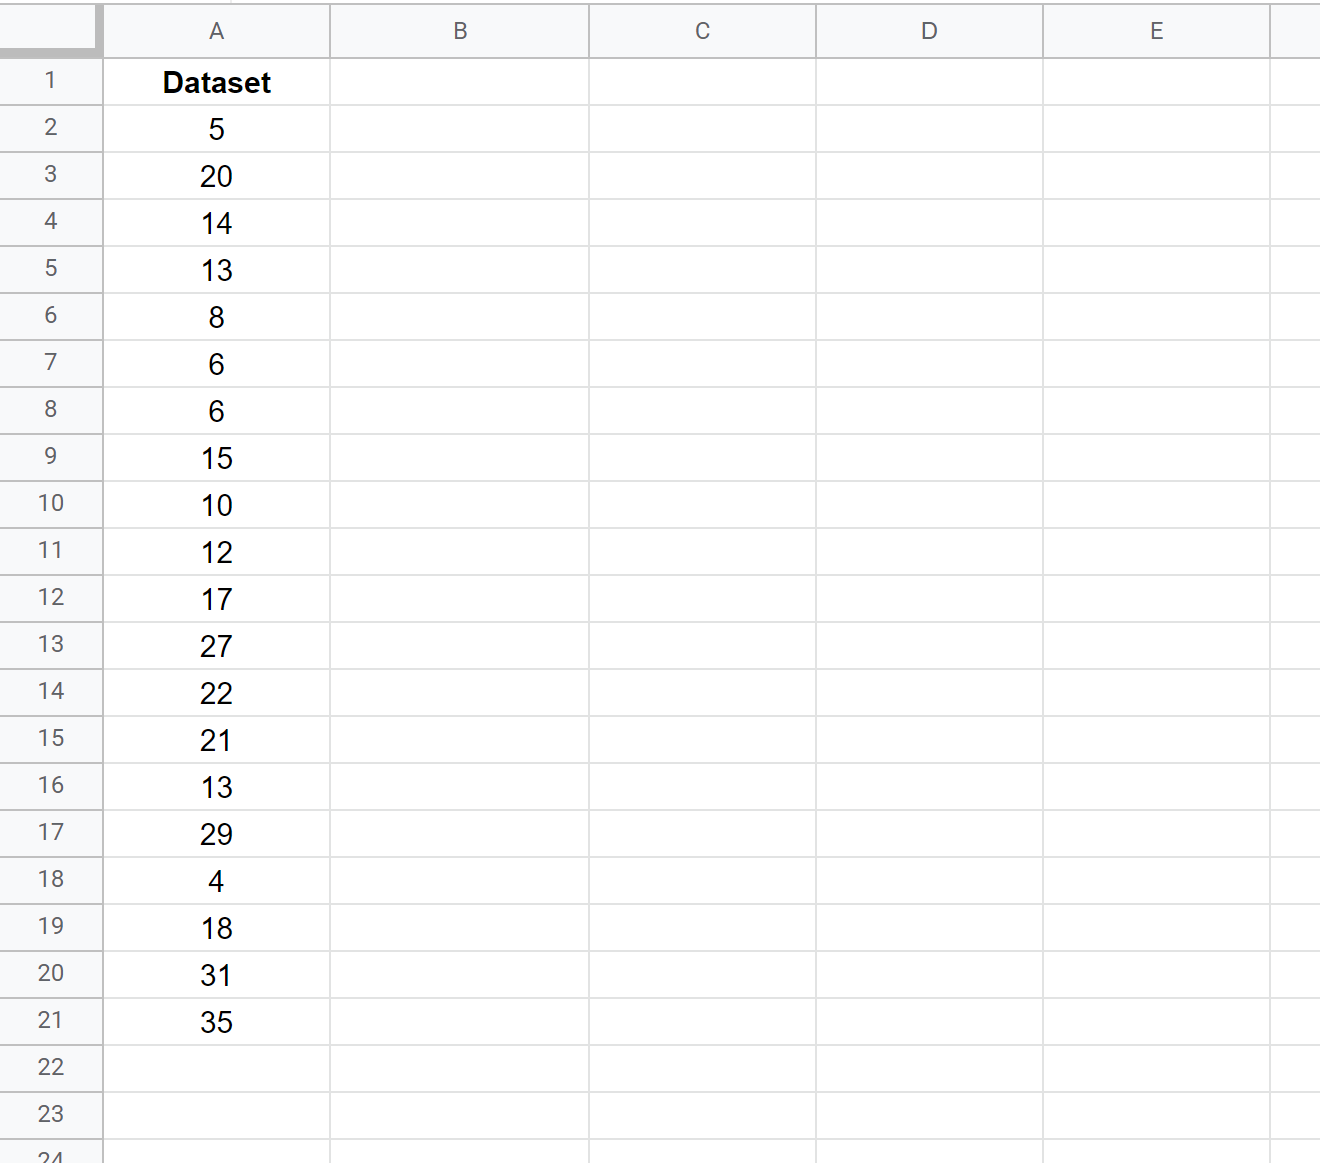
La crédibilité et l’efficience de tout traitement statistique sous Google Sheets dépendent de la conformité de la feuille de calcul avec les standards de la structuration des données en forme ordonnée (souvent formalisée sous le concept de tidy data). Selon ce paradigme, chaque ligne doit représenter une unité d’observation individuelle unique — dans la majorité des protocoles psychologiques, un participant unique ou un essai expérimental spécifique —, tandis que chaque colonne doit correspondre rigoureusement à une variable distincte, qu’elle soit indépendante, dépendante ou confondante. Cette orthogonalité géométrique garantit que les plages de données demeurent continues, cohérentes et directement exploitables par les moteurs de calcul intégrés.
Dans le respect des cadres déontologiques et réglementaires encadrant la recherche biomédicale et comportementale, la première colonne de la matrice doit être impérativement réservée à un identifiant anonymisé (tel que P001, P002, ou SUBJ_101), excluant toute mention nominale directe, numéro d’identification médicale ou adresse électronique. Cette démarche de pseudonymisation protège la vie privée des sujets tout en assurant l’unicité du référencement matriciel pour les suivis longitudinaux ou les analyses appariées. Toute information sociodémographique annexe (âge, scolarité, latéralité) doit être isolée dans des colonnes adjacentes prédéfinies.
Les étiquettes d’en-tête, positionnées systématiquement sur la première ligne de la feuille de travail, obéissent à des contraintes syntaxiques strictes : elles doivent être courtes, univoques, rédigées sans espaces, sans caractères diacritiques complexes ni symboles mathématiques susceptibles de perturber les analyseurs syntaxiques des formules avancées. Des conventions telles que le camelCase (ex: tempsReactionMs) ou l’usage du tiret bas (ex: score_anxiete_pre) doivent être appliquées uniformément. Il est impératif de verrouiller cette ligne d’en-tête via la fonctionnalité d’affichage et de figeage de Google Sheets pour conserver la lisibilité contextuelle lors du défilement de volumineux tableaux.
2.2 Détection et gestion rigoureuse des données manquantes
L’incomplétude des observations constitue une problématique chronique dans la recherche expérimentale, qu’elle résulte d’une fatigue cognitive du sujet, d’une défaillance instrumentale lors de la saisie numérique ou de l’omission volontaire de réponses à des items sensibles. L’identification systématique des lacunes tabulaires est une étape de pré-traitement obligatoire. Google Sheets fournit des opérateurs logiques performants à cet effet : l’application de la fonction =ESTVIDE(cellule) ou le recours à la mise en forme conditionnelle appliquant une surbrillance colorée aux cellules vides permet une cartographie visuelle instantanée des manques au sein de l’échantillon brut.
D’un point de vue méthodologique, l’analyste doit impérativement discriminer la typologie sous-jacente des données manquantes selon les concepts formalisés par Donald Rubin : données manquantes complètement au hasard (MCAR), manquantes au hasard (MAR) ou non aléatoires (MNAR). Si des omissions d’items dans une échelle de dépression dépendent directement du niveau de sévérité du trouble (cas MNAR), l’élimination brute des lignes concernées introduit un biais de sélection dramatique qui déforme l’estimation des paramètres de tendance centrale et sous-estime la variance de la population clinique cible.
Le choix entre l’exclusion ponctuelle (listwise ou pairwise deletion) et les approches d’imputation doit être argumenté avec rigueur. Dans les petites cohortes de laboratoire, l’exclusion d’un participant complet dès lors qu’une variable secondaire est manquante réduit considérablement la puissance statistique de l’échantillon. À l’inverse, l’imputation par la moyenne globale — bien que simple à implémenter via des formules conditionnelles — doit être fermement évitée car elle compresse artificiellement la variance résiduelle et accroît fallacieusement la précision apparente des mesures, faussant les étapes inférentielles ultérieures.
2.3 Validation des formats et cohérence des valeurs
L’exactitude des calculs statistiques est tributaire de l’homogénéité du typage des données contenues dans chaque colonne. Une cause majeure d’erreur dans Google Sheets provient de l’intégration involontaire de chaînes de caractères au sein de plages numériques, causée par l’utilisation erronée d’un point au lieu d’une virgule comme séparateur décimal (ou inversement, selon la localisation linguistique définie dans les paramètres du tableur). Pour prévenir ces distorsions, il est préconisé d’appliquer un formatage numérique explicite via le menu Format, en sélectionnant l’option Nombre avec une précision décimale normalisée, garantissant que les algorithmes n’interpréteront pas des scores quantitatifs comme des chaînes de texte inertes.
L’implémentation de règles de validation des données constitue un rempart préventif fondamental contre les fautes de saisie manuelle et les incohérences physiologiques ou psychométriques. Par le biais du menu Données > Validation des données, le chercheur peut borner strictement les plages de réponses admissibles. Par exemple, pour un questionnaire d’évaluation émotionnelle dont l’ancrage est compris entre 1 et 7, la règle de validation rejettera systématiquement toute entrée inférieure à 1 ou supérieure à 7, ainsi que les valeurs décimales non conformes. Pour les temps de réaction, une borne d’exclusion automatique peut rejeter les latences inférieures à 150 millisecondes, physiologiquement incompatibles avec le temps de conduction nerveuse et révélatrices d’anticipations motrices.
Enfin, l’activation des filtres contextuels et le recours aux règles de mise en forme conditionnelle basées sur des formules booléennes permettent de repérer les anomalies distributionnelles manifestes, telles que des doublons parfaits d’identifiants participants ou des inversions de colonnes lors de la compilation des données. Cette hygiène opératoire assure que les calculs statistiques subséquents porteront exclusivement sur une matière empirique assainie, stable et exempte de corruptions logicielles invisibles.
3. Détermination de la taille de l’échantillon et des fréquences d’observation
3.1 Comptabilisation de l’échantillon valide avec les fonctions NB et NBVAL
La quantification de la taille effective de l’échantillon constitue la première exigence méthodologique préalable à tout calcul descriptif. En psychologie empirique, il est fondamental de distinguer la taille théorique de la cohorte recrutée du nombre d’observations valides effectivement recueillies pour chaque variable psychométrique. Google Sheets propose deux fonctions centrales dont le comportement logique répond à des impératifs métrologiques distincts : la fonction NB et la fonction NBVAL, dont l’utilisation adéquate conditionne la validité du dénominateur d’échantillonnage N.
La fonction =NB(plage) a pour propriété exclusive de comptabiliser les cellules hébergeant des données strictement numériques. Si la plage sélectionnée (par exemple B2:B150) contient des valeurs textuelles, des symboles d’absence de réponse de type « NA », des espaces blancs résiduels ou des codes d’erreur, ceux-ci sont automatiquement ignorés par la fonction. Elle est donc l’outil de référence pour déterminer l’effectif valide n sur une variable quantitative continue, telle qu’une latence d’inhibition ou un score sommé à une épreuve neuropsychologique. Sa formulation mathématique directe fournit le dénominateur fondamental nécessaire à tous les calculs de moments statistiques.
À l’opposé, la fonction =NBVAL(plage) dénombre l’ensemble des cellules non vides, englobant sans discrimination les valeurs numériques, les chaînes de texte, les expressions booléennes et les caractères d’échappement invisibles. Son usage est recommandé pour quantifier le nombre total d’inscriptions au protocole ou pour dénombrer des réponses sur des variables qualitatives nominales codées textuellement (par exemple : « Contrôle », « Pathologique »). L’évaluation conjointe de la différence entre =NBVAL(plage) et =NB(plage) offre une procédure automatisée élégante pour détecter la présence parasite d’encodages corrompus au sein d’une variable théoriquement numérique, confirmant l’adéquation de l’effectif final avec le protocole initial déposé lors de l’enregistrement préalable de l’étude (preregistration).
3.2 Quantification des fréquences par sous-groupes avec NB.SI et NB.SI.ENS
L’analyse des profils démographiques et des répartitions typologiques impose la décomposition de l’échantillon global en sous-groupes discrets. L’estimation des fréquences absolues d’observation s’opère au moyen de la fonction =NB.SI(plage; critère). Cette formulation permet d’isoler le volume de participants répondant à une condition univariée stricte. Par exemple, pour déterminer l’effectif de participants féminins dans une cohorte codée dans la plage C2:C200, la syntaxe =NB.SI(C2:C200; « Féminin ») renvoie instantanément la fréquence brute d’occurrence, servant de base au calcul de la prévalence d’un statut au sein de l’échantillon.
Lorsque le plan expérimental croise plusieurs facteurs de stratification — situation omniprésente dans les paradigmes quasi-expérimentaux évaluant des interactions entre le genre, la classe d’âge et le diagnostic —, la fonction =NB.SI.ENS(plage_critères1; critères1; plage_critères2; critères2; …) étend les capacités de dénombrement à une multiplicité de conditions logiques simultanées (conjonction ET). Ainsi, la formule =NB.SI.ENS(C2:C200; « Féminin »; D2:D200; « >=65 »; E2:E200; « Dépression_Majeure ») quantifie avec une précision chirurgicale l’effectif de femmes âgées de 65 ans et plus diagnostiquées avec un épisode dépressif majeur, sans altérer la disposition tabulaire des données.
Pour convertir ces décomptes bruts en fréquences relatives immédiatement exploitables pour les bilans statistiques, il convient de rapporter la fréquence d’observation à l’effectif global valide. L’imbrication syntaxique =(NB.SI(C2:C200; « Féminin »)/NBVAL(C2:C200))*100 génère dynamiquement le pourcentage d’occurrence relatif. L’application du format Pourcentage dans l’interface de Google Sheets évite d’effectuer manuellement la multiplication par 100 et maintient la précision interne du calcul sous-jacent, tout en assurant une présentation visuelle conforme aux exigences des publications scientifiques.
4. Mesures de tendance centrale : Calcul et interprétation de la moyenne
4.1 Calcul de la moyenne arithmétique via la formule MOYENNE
La moyenne arithmétique constitue la mesure de tendance centrale la plus universellement déployée pour les variables quantitatives continues répondant à des lois de distribution approximativement symétriques. D’un point de vue conceptuel, la moyenne représente le barycentre d’une distribution de scores : elle correspond au point d’équilibre physique où la somme des écarts algébriques de chaque observation par rapport à cette valeur est rigoureusement égale à zéro. Dans les modèles psychométriques classiques, elle est considérée comme le meilleur estimateur sans biais de l’espérance mathématique d’une dimension latente sous-jacente.
Dans Google Sheets, l’implémentation opérationnelle de cette métrique s’exécute via la formule standardisée =MOYENNE(plage), par exemple =MOYENNE(F2:F150) pour calculer le score moyen d’anxiété-état mesuré par l’inventaire STAI. Sur le plan computationnel, l’algorithme sous-jacent de Google Sheets effectue la sommation des valeurs numériques présentes dans l’intervalle et divise automatiquement ce total par le nombre d’entrées numériques valides (=NB(plage)), en ignorant passivement les cellules vides ou les valeurs textuelles non convertibles, évitant ainsi d’altérer artificiellement le dénominateur.
Malgré ses remarquables propriétés algébriques — notamment sa capacité à être combinée linéairement dans des scores composites et son intégration naturelle dans l’estimation de la variance —, la moyenne arithmétique présente une vulnérabilité majeure : une sensibilité extrême aux valeurs atypiques ou extrêmes (outliers). Dans des échantillons de taille modeste, couramment rencontrés en neuro-imagerie fonctionnelle ou en psychologie clinique (N compris entre 15 et 30), la présence d’une unique observation déviante — par exemple un participant ayant suspendu sa tâche cognitive durant plusieurs secondes, affichant une latence de 4 500 ms contre une moyenne de groupe à 600 ms — déplace substantiellement la moyenne arithmétique vers la queue de distribution, rendant cet estimateur non représentatif de la performance typique du groupe.
4.2 Calcul de la moyenne tronquée pour atténuer les biais extrêmes
Face à la fragilité de la moyenne arithmétique conventionnelle en présence de queues de distribution lourdes ou de scores sporadiquement contaminés, la statistique robuste préconise le calcul de moyennes élaguées ou tronquées. Le principe directeur de la moyenne tronquée consiste à éliminer une proportion prédéterminée des valeurs les plus basses et les plus hautes de la série ordonnée avant de calculer la moyenne des observations centrales résiduelles. Ce paramètre conserve la manipulabilité algébrique de la moyenne tout en neutralisant l’influence disproportionnée des valeurs extrêmes.
Dans Google Sheets, cette opération est directement exécutée par la fonction =MOYENNE.REDUITE(données; pourcentage). Le second argument spécifie la fraction totale des points de données à retrancher de l’analyse, répartie de manière équilibrée entre les deux extrémités de la distribution. Par exemple, la syntaxe =MOYENNE.REDUITE(F2:F150; 0,10) applique une troncature bilatérale de 10 % au total, signifiant concrètement que les 5 % des valeurs les plus faibles et les 5 % des valeurs les plus élevées de l’échantillon seront écartées du calcul, la moyenne étant alors dérivée sur les 90 % restants des observations intermédiaires.
Sur le plan méthodologique, le recours à la moyenne tronquée (typiquement fixée à 5 % ou 10 % d’élagage selon les préconisations de Rand Wilcox) offre une résistance accrue aux artefacts techniques fréquents dans les enregistrements psychophysiologiques ou chronométriques (bruits de clignement oculaire, déconnexions électrophysiologiques momentanées). La comparaison systématique entre la valeur issue de =MOYENNE(plage) et celle obtenue via =MOYENNE.REDUITE(plage; 0,20) fournit au chercheur un diagnostic informel rapide : un écart prononcé entre ces deux estimateurs signale irréfutablement que la moyenne standard est indûment tirée par des observations périphériques aberrantes.
4.3 Moyenne pondérée pour les épreuves composites
Dans de multiples paradigmes psychométriques, les variables globales résultent de l’intégration de plusieurs sous-épreuves dont la contribution à l’indice factoriel général ne saurait être considérée comme équivalente. Qu’il s’agisse de refléter l’inégale fidélité des sous-tests, leur saturation factorielle issue d’une analyse en composantes principales, ou la durée relative d’exposition à différentes conditions cognitives, le chercheur doit calculer une moyenne pondérée afin de restituer le poids fonctionnel réel de chaque composante.
Google Sheets ne dispose pas d’une fonction atomique native intitulée spécifiquement « MOYENNE.POUNDEREE », mais permet son calcul par la combinaison conjointe des fonctions =SOMMEPROD et =SOMME. Si les scores obtenus par un sujet aux différentes épreuves cognitives figurent dans la plage horizontale B2:G2 et que les coefficients de pondération psychométrique respectifs sont fixés dans la plage B$1:G$1, la formulation analytique s’écrit rigoureusement : =SOMMEPROD(B2:G2; B$1:G$1)/SOMME(B$1:G$1). Le numérateur calcule la somme des produits élémentaires de chaque score par son poids respectif, tandis que le dénominateur normalise le résultat en le divisant par la somme totale des coefficients attribués.
Cette approche est particulièrement déterminante dans l’élaboration de profils d’évaluation neuropsychologique multidimensionnels, tels que les indices de mémoire de travail ou de vitesse de traitement de l’échelle de mémoire de Wechsler. Elle garantit que les sous-tests affichant une plus haute validité théorique et une consistance interne supérieure exercent une traction proportionnellement calibrée sur l’estimation du fonctionnement cognitif global de l’individu, évitant ainsi les distorsions induites par des sommations univoques non pondérées.
5. Mesures de tendance centrale : Détermination de la médiane
5.1 Calcul du cinquantième centile avec la fonction MEDIANE
La médiane, définie mathématiquement comme le 50e centile ou le deuxième quartile d’une série statistique, constitue le paramètre d’emplacement robuste par excellence. Elle correspond à la valeur qui scinde la distribution ordonnée des observations en deux sous-ensembles d’effectifs strictement égaux, de telle sorte qu’exactement la moitié des participants présente un score inférieur ou égal à ce seuil, et l’autre moitié un score supérieur ou égal. Contrairement à la moyenne, sa détermination repose uniquement sur le rang des valeurs et non sur leur magnitude relative.
Au sein de Google Sheets, l’extraction de cet indicateur s’effectue avec une remarquable simplicité syntaxique via la fonction =MEDIANE(plage), par exemple =MEDIANE(H2:H250). L’algorithme interne du tableur procède de manière autonome à l’ordonnancement séquentiel des scores. Lorsque la taille de l’échantillon N est impaire, la fonction isole la valeur centrale exacte occupant le rang (N + 1) / 2. Lorsque N est pair, la fonction calcule automatiquement la demi-somme arithmétique des deux valeurs occupant les rangs centraux N / 2 et (N / 2) + 1, garantissant une résolution mathématique sans discontinuité.
La médiane s’avère particulièrement adaptée pour décrire les distributions hautement asymétriques, phénomène structurel en psychologie expérimentale lors de la mesure des temps de latence ou des durées de fixation oculaire. Dans ces protocoles, les distributions présentent systématiquement un étirement marqué vers la droite (asymétrie positive), causé par des réponses tardives sporadiques. La médiane demeure insensible à l’amplitude de ces latences extrêmes : qu’un temps de réaction très lent soit de 1 200 ms ou de 15 000 ms, son impact sur le rang médian est strictement identique, ce qui fait de la médiane le résumé descriptif le plus fidèle du comportement typique du participant.
5.2 Confrontation critique entre moyenne et médiane
La confrontation systématique entre la moyenne et la médiane constitue l’un des diagnostics exploratoires les plus révélateurs de la morphologie d’une distribution psychologique. Dans une distribution théorique parfaitement symétrique et unimodale (telle qu’une loi normale idéale), la moyenne et la médiane coïncident rigoureusement. Dès lors que l’échantillon empirique s’écarte de cette symétrie parfaite, un décalage s’instaure entre ces deux métriques, dont la direction et l’amplitude traduisent l’ampleur du biais distributionnel.
D’un point de vue clinique et méthodologique, lorsque la moyenne arithmétique est substantiellement supérieure à la médiane (Moyenne > Médiane), la distribution est caractérisée par une asymétrie positive (skewness à droite). Cette configuration est typique des échelles mesurant des conduites addictives, des comportements agressifs ou des affects dépressifs au sein de populations non cliniques : la grande majorité des participants cumule des scores minimaux proches du plancher, tandis qu’une minorité clinique génère des scores très élevés qui attirent mécaniquement la moyenne vers le haut. Inversement, une moyenne inférieure à la médiane (Moyenne < Médiane) dénote une asymétrie négative (skewness à gauche), fréquente lors d'épreuves cognitives trop faciles générant un effet plafond massif.
En présence d’échelles de mesure ordinales ou de scores continus s’écartant notablement de la normalité, le chercheur doit privilégier la médiane comme indicateur prédominant de tendance centrale dans ses synthèses narratives. Remplacer la moyenne par la médiane dans le rapport des résultats évite de diffuser une perception fallacieuse du comportement modal des sujets testés. Il est fortement conseillé de rapporter conjointement les deux paramètres dans les tableaux descriptifs afin d’offrir au lecteur une appréciation immédiate de l’asymétrie intrinsèque des mesures recueillies.
6. Mesures de tendance centrale : Identification du mode
6.1 Calcul univarié avec la fonction MODE.SIMPLE
Le mode représente la valeur d’une distribution qui recueille la plus forte fréquence d’occurrence au sein de l’échantillon observé. Sur le plan de la théorie du mesurage, il constitue l’unique mesure de tendance centrale universellement applicable à tous les niveaux d’échelles, incluant spécifiquement les variables qualitatives nominales pour lesquelles le calcul d’une moyenne ou d’une médiane est dénué de tout fondement mathématique. Il indique le comportement, la réponse ou la typologie clinique la plus probable au sein du groupe étudié.
Dans Google Sheets, l’identification du mode pour une variable univariée s’opère par l’appel de la fonction =MODE.SIMPLE(plage), par exemple =MODE.SIMPLE(D2:D150). Lorsque cette fonction est exécutée sur une colonne de données numériques discrètes, l’interpréteur scanne l’ensemble des valeurs et renvoie l’élément dont l’effectif est maximal. Il importe toutefois de noter que si les cellules contiennent du texte brut (comme « Groupe_A »), la fonction =MODE.SIMPLE génère une erreur technique ; elle requiert impérativement un encodage numérique sous-jacent (par exemple 1 pour Groupe_A, 2 pour Groupe_B) ou le recours à une formule matricielle combinant =INDEX et =EQUIV pour extraire la modalité textuelle modale.
L’application de =MODE.SIMPLE sur des variables strictement continues (comme des potentiels évoqués cognitifs ou des durées de réponse enregistrées à la microseconde) révèle rapidement ses limites fonctionnelles. Dans de telles séries de données où la précision métrologique entraîne une dispersion quasi-infinie des valeurs, il est fréquent qu’aucune observation ne se répète rigoureusement à l’identique. Dans cette situation, la fonction renvoie l’erreur #N/A, signifiant qu’aucun doublon n’a été détecté. Le chercheur doit alors au préalable procéder à un regroupement des scores par intervalles de classes (binning) pour que la notion de modalité reprenne son sens opérationnel.
6.2 Traitement des distributions multimodales avec MODE.MULTIPLE
Dans de nombreuses investigations psychologiques et psychiatriques, les distributions observées ne convergent pas vers un pic unique, mais révèlent au contraire une plurimodalité sous-jacente. L’apparition d’une distribution bimodale signale fréquemment que l’échantillon n’est pas homogène, mais est en réalité constitué de deux sous-populations distinctes masquées sous un label unique — par exemple, des sujets mobilisant deux stratégies cognitives diamétralement opposées lors de la résolution d’une tâche spatiale, ou une cohorte mélangeant des répondeurs et des non-répondeurs à une intervention psychothérapeutique.
Pour faire face à cette complexité distributionnelle, Google Sheets propose la fonction matricielle =MODE.MULTIPLE(plage). Contrairement à =MODE.SIMPLE qui se borne à restituer arbitrairement la première valeur modale rencontrée en cas d’ex æquo, =MODE.MULTIPLE extrait l’ensemble des valeurs qui partagent la fréquence maximale d’apparition. Son déploiement nécessite d’allouer une plage verticale de cellules réceptrices et de valider la formule via l’environnement matriciel dynamique, de sorte que chaque pic de fréquence vienne peupler une cellule distincte de la colonne de sortie.
L’interprétation cognitive de la coexistence de plusieurs modes décisionnels apporte un éclairage substantiel que la moyenne arithmétique occulte totalement. Si une échelle d’évaluation de la douleur post-opératoire présente un mode primaire à 2 et un mode secondaire à 8, une moyenne arithmétique globale établie à 5 serait un contresens clinique complet : elle décrirait un niveau d’inconfort modéré qu’aucun des patients ne ressent réellement, la réalité empirique étant scindée entre soulagement quasi-complet et détresse algique sévère. La détection de la multimodalité via Google Sheets constitue ainsi un garde-fou fondamental contre les généralisations abusives.
6.3 Application spécifique aux items de Likert
L’application élective du mode se manifeste avec une acuité particulière lors du dépouillement psychométrique d’inventaires d’attitudes, de questionnaires de personnalité (comme le NEO-PI-R ou le Big Five) et d’échelles de satisfaction construits sur des formats de réponse de Likert gradués en 4, 5 ou 7 points. Dans ces contextes métrologiques, l’attribution d’une valeur moyenne décimale (par exemple, 3,42 sur une échelle d’ancrage en 5 points) s’avère souvent déroutante pour le praticien, dans la mesure où cette modalité fractionnaire ne correspond à aucun choix opérationnel offert aux répondants lors de la passation.
L’extraction du mode univarié pour chaque item permet de qualifier sans ambiguïté le comportement modal ou l’attitude prédominante de la cohorte face à une proposition spécifique. En associant la formule =MODE.SIMPLE(plage) à l’analyse visuelle des fréquences par item, le chercheur repère instantanément les phénomènes de consensus fort (mode univoque concentrant plus de 70 % des suffrages) ou, à l’inverse, des dynamiques de polarisation idéologique ou émotionnelle (bimodalité marquée aux ancrages extrêmes 1 et 5 avec effondrement de la catégorie centrale neutre 3).
Néanmoins, pour préserver la rigueur de l’interprétation, le mode ne doit jamais être analysé isolément des effectifs cumulés. Un mode peut en effet être minoritaire en valeur absolue s’il ne rassemble, par exemple, que 25 % des observations dans une échelle à sept niveaux où les autres choix recueillent des fractions légèrement inférieures. Il est donc indispensable d’accompagner systématiquement la mention du mode de la fréquence relative exacte de son occurrence, afin d’attester de la représentativité réelle de la valeur modale identifiée.
7. Mesures de dispersion : Calcul de l’étendue et analyse interquartile
7.1 Calcul de l’étendue par les fonctions MAX et MIN
La compréhension d’une série quantitative exige impérativement de coupler l’évaluation de sa tendance centrale à la mesure de sa dispersion. Deux échantillons de participants peuvent afficher une moyenne rigoureusement identique de 100 à une tâche cognitive, tout en présentant des profils d’homogénéité radicalement divergents : l’un peut être ultra-concentré entre les scores 95 et 105, tandis que l’autre rassemble des performances éclatées entre 40 et 160. L’indicateur de variabilité le plus rudimentaire est l’étendue (ou range), qui quantifie l’écart total séparant les deux observations les plus extrêmes du continuum.
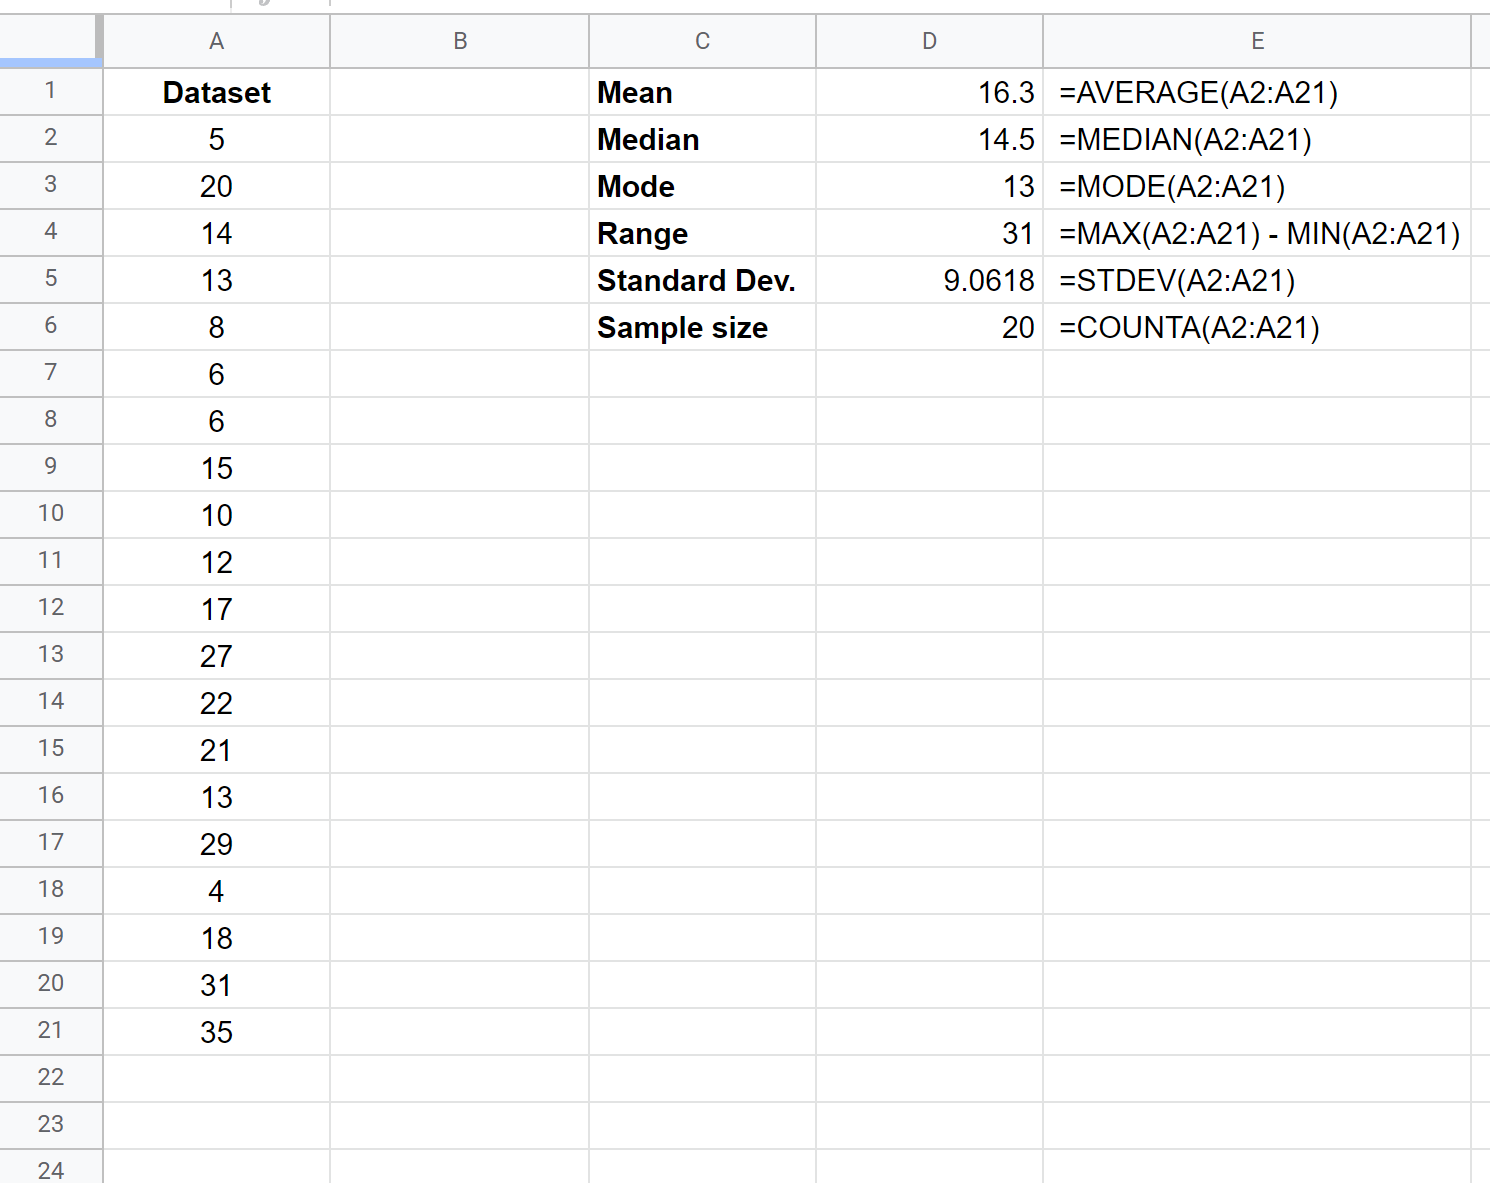
Dans Google Sheets, l’étendue ne bénéficie pas d’une fonction dédiée autonome, mais s’obtient instantanément par l’association algébrique élémentaire des fonctions d’extrêmes : =MAX(plage)-MIN(plage). En appliquant la formule =MAX(E2:E180)-MIN(E2:E180), l’analyste soustrait la borne empirique inférieure de la borne empirique supérieure de la variable étudiée, obtenant ainsi la largeur brute du spectre des comportements manifestés au cours de l’expérimentation.
En dépit de son intuitivité pédagogique, l’étendue brute souffre d’une instabilité statistique notoire qui restreint son usage dans les inférences formelles. Étant exclusivement conditionnée par les deux valeurs les plus périphériques de l’échantillon, elle est totalement dépendante de la taille N (les échantillons massifs ayant une probabilité mécanique plus élevée d’incorporer des valeurs très éloignées) et se révèle hypersensible aux erreurs de mesure expérimentales, aux aberrations de saisie ou aux décrochages attentionnels atypiques des sujets. L’étendue ne renseigne en rien sur la structure de variabilité des données situées entre ces deux bornes, ce qui impose le recours à des estimateurs de dispersion plus sophistiqués.
7.2 Détermination des quartiles via les fonctions QUARTILE.INC et QUARTILE.EXC
Afin de s’affranchir de la vulnérabilité de l’étendue brute face aux scores limites, la démarche statistique privilégie la segmentation fractile de la distribution en découpant l’échantillon ordonné en quatre segments équiprobables comprenant chacun 25 % des observations. Ces points de coupure sont les quartiles : le premier quartile (Q1 ou 25e centile), le deuxième quartile (Q2 ou médiane, 50e centile) et le troisième quartile (Q3 ou 75e centile). Google Sheets propose deux algorithmes de calcul distincts, formalisés sous les fonctions =QUARTILE.INC et =QUARTILE.EXC, dont les postulats mathématiques sous-jacents méritent une clarification rigoureuse.
La fonction =QUARTILE.INC(plage; quartile) adopte la méthode inclusive, dans laquelle le rang du quartile est calculé selon la relation k(N – 1) + 1, où k représente la fraction quartilaire souhaitée (0,25 pour Q1 ; 0,75 pour Q3). Cette formule inclut formellement les percentiles 0 (minimum) et 4 (maximum). La syntaxe =QUARTILE.INC(G2:G120; 1) extrait ainsi le premier quartile de manière cohérente avec la majorité des logiciels généralistes, en appliquant une interpolation linéaire entre les rangs lorsque le résultat n’est pas un entier naturel.
À l’inverse, la fonction =QUARTILE.EXC(plage; quartile) repose sur la méthode exclusive, paramétrant les rangs selon la formule k(N + 1). Dans ce paradigme, les bornes extrêmes de l’échantillon sont exclues de l’espace d’interpolation, ce qui interdit de solliciter les quartiles 0 et 4. Cette formulation est privilégiée par certains statisticiens théoriciens pour modéliser des populations infinies continues à partir de petits échantillons. Dans la pratique courante de la recherche psychologique, la fonction inclusive =QUARTILE.INC s’impose comme le standard consensuel d’ingénierie statistique, garantissant une parfaite comparabilité avec les routines descriptives de bases de données publiées.
7.3 Calcul de l’écart interquartile (EIQ) et identification des valeurs aberrantes
L’écart interquartile (EIQ ou IQR pour Interquartile Range) représente la distance mathématique séparant le troisième quartile du premier quartile. Il quantifie l’étendue du domaine numérique au sein duquel se concentrent les 50 % centraux de la cohorte observée. Formulé dans Google Sheets par l’expression =QUARTILE.INC(plage; 3) – QUARTILE.INC(plage; 1), l’EIQ s’érige comme le paramètre de dispersion robuste homologue de la médiane : il est totalement affranchi de l’influence des valeurs aberrantes nichées dans les 25 % supérieurs ou les 25 % inférieurs de la distribution.
Au-delà de son rôle descriptif d’homogénéité centrale, l’EIQ constitue la pierre angulaire de l’algorithme d’identification objective des valeurs aberrantes développé par John Tukey. Selon la règle heuristique des clôtures de Tukey (Tukey’s fences), une observation est formellement catégorisée comme une valeur atypique (outlier) modérée si elle franchit un seuil de 1,5 fois l’EIQ au-delà des quartiles, et comme un outlier extrême si elle franchit une barrière de 3 fois l’EIQ. L’implémentation de ces seuils critiques dans Google Sheets s’exécute aisément à l’aide de formules conditionnelles configurées comme suit :
- Limite inférieure de Tukey : =QUARTILE.INC(plage; 1) – (1,5 * (QUARTILE.INC(plage; 3) – QUARTILE.INC(plage; 1)))
- Limite supérieure de Tukey : =QUARTILE.INC(plage; 3) + (1,5 * (QUARTILE.INC(plage; 3) – QUARTILE.INC(plage; 1)))
L’identification algorithmique de ces scores seuils permet au chercheur d’établir des règles de décision méthodologiques transparentes et reproductibles concernant l’éviction ou le maintien de participants périphériques. Plutôt que de recourir à des exclusions arbitraires susceptibles d’introduire des biais de confirmation, l’utilisation de tests basés sur l’EIQ confère une rigueur métrologique inattaquable au tri des données psychométriques brutes préalablement aux phases d’inférence statistique.
8. Mesures de dispersion : Calcul de la variance et de l’écart-type
8.1 Distinction cruciale entre variance échantillonnale et populationnelle
La variance constitue la mesure de dispersion de référence au sein de la théorie classique des tests et des modèles linéaires. Elle évalue la moyenne des carrés des écarts de l’ensemble des scores individuels par rapport à leur moyenne arithmétique globale. L’élévation au carré de ces écarts remplit une double fonction mathématique : elle neutralise le signe négatif des observations inférieures à la moyenne, empêchant ainsi l’auto-annulation des déviations algébriques, et pénalise de manière géométrique les écarts de grande magnitude.
Une distinction statistique d’une importance capitale doit être opérée entre la variance populationnelle et la variance échantillonnale. Lorsque l’analyste dispose de l’intégralité absolue de la population d’intérêt (cas rarissime en psychologie, limité par exemple à l’étude exhaustive des scores de l’ensemble des élèves d’un établissement d’enseignement fermé), la somme des carrés des écarts est divisée par l’effectif total N. Dans Google Sheets, cette métrique exacte s’obtient via la fonction =VAR.P(plage). Toutefois, dans 99 % des protocoles expérimentaux, le chercheur travaille sur un échantillon probabiliste restreint extrait d’une population cible infinie.
Lorsque l’on calcule la variance d’un échantillon en divisant simplement par N, cet estimateur se révèle structurellement biaisé : il a tendance à sous-estimer systématiquement la véritable dispersion régnant dans la population globale parente. Pour corriger cette distorsion asymptotique, l’incontournable correction de Bessel substitue au dénominateur N le terme (N – 1), représentant les degrés de liberté résiduels après estimation de la moyenne d’échantillon. Google Sheets intègre rigoureusement ce redressement à travers la fonction =VAR.S(plage) (ou =VAR.STANDARD). L’utilisation indue de VAR.P à la place de VAR.S dans un rapport de recherche empirique conduit à une minoration fautive de l’erreur d’échantillonnage, faussant potentiellement l’estimation de la puissance statistique des tests ultérieurs.
8.2 Calcul opérationnel de l’écart-type avec ECARTYPE.STANDARD
Bien que la variance possède des propriétés mathématiques élégantes indispensables aux décompositions de sommes de carrés propres aux modèles ANOVA, son interprétation descriptive directe est malaisée car elle s’exprime dans le carré de l’unité de mesure originale (par exemple, des millisecondes au carré ou des points d’anxiété au carré). L’écart-type (ou déviation standard) remédie à cette abstraction en extrayant la racine carrée arithmétique de la variance, ramenant ainsi l’estimation de la variabilité dans l’unité métrologique naturelle de la variable comportementale investiguée.
Dans Google Sheets, l’analyste calcule l’écart-type échantillonnal corrigé au moyen de la formule canonique =ECARTYPE.STANDARD(plage) (ou l’expression synonyme internationale =STDEV.S(plage)). En appliquant =ECARTYPE.STANDARD(K2:K160), le logiciel traite l’ensemble des scores valides, applique la correction de Bessel et renvoie l’indice exact de dispersion attendu par les revues scientifiques à comité de lecture. Pour les très rares cas où la cohorte représente la population intégrale fermée, la fonction homologue est =ECARTYPE.P(plage).
L’écart-type constitue la clé de voûte de l’interprétation des distributions se conformant de manière acceptable à la loi normale (loi de Gauss-Laplace). Dans ce cadre théorique, la règle empirique universelle (ou règle empirique 68-95-99,7) stipule qu’approximativement 68,2 % des observations se situent dans un intervalle borné par la moyenne plus ou moins un écart-type [M – SD, M + SD], que 95,4 % des scores sont confinés dans un rayon de deux écarts-types [M – 2 SD, M + 2 SD], et que plus de 99,7 % de la cohorte s’inscrit dans un périmètre de trois écarts-types. L’écart-type fournit donc une estimation instantanée du degré d’homogénéité cognitive ou comportementale des participants inclus dans l’expérimentation.
8.3 Calcul du coefficient de variation pour la comparaison inter-variables
L’interprétation de l’écart-type brut atteint une limite infranchissable dès lors que le chercheur ambitionne de comparer le degré relatif de variabilité manifesté sur deux variables psychologiques mesurées sur des métriques d’amplitudes divergentes ou d’unités hétérogènes. Par exemple, comment déterminer si la dispersion d’une latence d’inhibition motrice (M = 450 ms, SD = 90 ms) est plus ou moins substantielle que celle observée sur une échelle de propension à la prise de risque (M = 18 points, SD = 6 points) ? Les échelles étant incommensurables, la comparaison directe des écarts-types (90 vs 6) est rigoureusement non avenue.
Le coefficient de variation (CV) neutralise ces dissemblances d’échelle en normalisant la dispersion par rapport au niveau global de tendance centrale de la mesure. Défini mathématiquement comme le ratio de l’écart-type sur la moyenne arithmétique, il exprime la dispersion relative sous la forme d’une métrique adimensionnelle, couramment traduite en pourcentage. Google Sheets n’incorporant pas de macro-fonction CV native, sa modélisation repose sur l’assemblage algébrique des fonctions de base :
=(ECARTYPE.STANDARD(plage)/MOYENNE(plage))*100
Pour le premier exemple moteur, le CV s’établit à (90 / 450) * 100 = 20 %, tandis que pour l’échelle de prise de risque, le CV atteint (6 / 18) * 100 = 33,3 %. Cette normalisation met instantanément en lumière que le comportement des participants face au risque manifeste une dispersion intrinsèque relative nettement plus marquée que leur réactivité chronométrique motrice. Le coefficient de variation est par conséquent un outil psychométrique de choix pour évaluer la sensibilité différentielle et la stabilité de protocoles expérimentaux concurrents.
9. Évaluation de la forme de la distribution : Asymétrie et aplatissement
9.1 Calcul du coefficient d’asymétrie avec COEFFICIENT.ASYMETRIE
La caractérisation exhaustive d’une variable quantitative ne saurait se borner à la description de ses deux premiers moments statistiques (tendance centrale et dispersion) ; elle requiert impérativement l’analyse de son troisième moment centré, matérialisé par le coefficient d’asymétrie (ou skewness). L’asymétrie documente la direction et l’amplitude de la déviation d’une distribution empirique par rapport à la symétrie spéculaire théorique d’une courbe en cloche gaussienne, signalant un déséquilibre dans le positionnement des observations autour de la moyenne.
Google Sheets implémente l’estimation non biaisée du coefficient d’asymétrie d’échantillon par la fonction =COEFFICIENT.ASYMETRIE(plage) (ou =SKEW(plage)). Le signe algébrique généré par cette formule dicte l’orientation de la dissymétrie :
- Asymétrie positive (skewness > 0) : Indique que la queue de distribution s’étire substantiellement vers les valeurs positives élevées, la majorité de la masse de l’échantillon étant concentrée sur les scores faibles (configuration typique des échelles psychopathologiques en cohorte saine ou des temps de réaction).
- Symétrie parfaite (skewness ≈ 0) : Les données se distribuent de façon parfaitement équilibrée de part et d’autre du centre d’inertie.
- Asymétrie négative (skewness < 0) : Indique un étirement de la queue de distribution vers les valeurs basses, résultant d’une saturation de l’échantillon dans les tranches de scores élevées (effet plafond sur des tests de performance cognitive simples).
Sur le plan des seuils critiques admis dans la littérature méthodologique (notamment les recommandations de Kline et de George & Mallery), un coefficient d’asymétrie compris strictement entre -1,0 et +1,0 est couramment considéré comme compatible avec l’hypothèse d’une normalité distributionnelle acceptable pour le déploiement de tests paramétriques. Si la valeur absolue du coefficient outrepasse 2,0, la sévérité du biais distributionnel compromet la validité des modèles linéaires standards, imposant des transformations mathématiques correctrices (logarithmiques, inverses ou racines carrées) ou le basculement vers des modélisations non paramétriques.
9.2 Mesure de l’aplatissement à l’aide de la fonction KURTOSIS
Complémentaire direct du skewness, le quatrième moment statistique centré est le coefficient d’aplatissement, universellement désigné sous le terme de kurtosis (ou voussure). Le kurtosis caractérise la morphologie générale des extrémités (les queues de distribution) et le degré de concentration des scores au voisinage immédiat du sommet par rapport à la distribution normale de référence. Il quantifie la propension de la variable comportementale à générer des événements statistiques extrêmes ou des observations déviantes concentrées.
L’implémentation opérationnelle de cette métrique s’effectue dans Google Sheets au travers de la fonction =KURTOSIS(plage) (ou =KURT(plage)). L’algorithme de Google Sheets calcule par défaut l’excès de kurtosis (excess kurtosis), dans lequel la valeur théorique d’une loi normale parfaite (qui présente un kurtosis brut de 3) est soustraite pour ramener le point de référence central à zéro :
- Distribution mésocurtique (kurtosis ≈ 0) : Les queues de distribution et la voussure centrale présentent des épaisseurs conformes à la loi normale gaussienne standard.
- Distribution leptocurtique (kurtosis > 0) : La distribution exhibe un pic central très effilé et proéminent, associé à des queues de distribution épaisses et chargées (« fat tails »). Cela dénote une concentration extrême d’individus autour de la valeur centrale couplée à une fréquence anomalement élevée d’observations périphériques très distantes.
- Distribution platicurtique (kurtosis < 0) : Le sommet est aplati, évoquant un plateau, tandis que les queues de distribution sont fines et pauvres en événements extrêmes, traduisant une dispersion relativement homogène et étale des participants sur l’ensemble de l’étendue.
L’examen du kurtosis s’avère capital pour anticiper le comportement des résidus d’estimation dans les modèles d’analyse multivariée. Des valeurs excessives de kurtosis (généralement admises au-delà de l’intervalle [-2; +2] ou [-3; +3] selon la tolérance des protocoles) révèlent la présence récurrente de scores idiosyncrasiques qui menacent l’homoscédasticité et fragilisent les estimations de variance empirique.
9.3 Vérification des postulats préliminaires aux tests paramétriques
L’articulation raisonnée du coefficient d’asymétrie et du coefficient d’aplatissement procure à l’analyste un arsenal diagnostique indispensable pour trancher la décision méthodologique cardinale de la recherche quantitative : l’arbitrage entre l’emploi de tests statistiques paramétriques (tels que le test t de Student, les modèles ANOVA ou les corrélations de Pearson) et le recours aux approches non paramétriques (telles que le test U de Mann-Whitney, le test de Kruskal-Wallis ou le tau de Kendall).
Bien que des tests formels d’adéquation à la normalité existent (tels que le test de Shapiro-Wilk ou de Kolmogorov-Smirnov), ils présentent des défauts bien connus dans la pratique de recherche : ils se révèlent inutilement hypersensibles aux déviations insignifiantes dans les grands échantillons (N > 200), rejetant systématiquement la normalité, tout en manquant cruellement de puissance statistique dans les petits échantillons (N < 30). L'évaluation empirique pragmatique repose donc préférentiellement sur le calcul des ratios d'asymétrie et d'aplatissement standardisés, obtenus en divisant l'indice estimé par son erreur-type respective :
- Ratio d’asymétrie : =COEFFICIENT.ASYMETRIE(plage) / SQRT(6 / NB(plage))
- Ratio de kurtosis : =KURTOSIS(plage) / SQRT(24 / NB(plage))
Si ces ratios se situent à l’intérieur de l’intervalle critique délimité par [-1,96; +1,96] (au seuil alpha conventionnel de 5 %), l’hypothèse de déviation significative par rapport à la normalité peut être raisonnablement écartée. La compilation rigoureuse de ces indicateurs dans Google Sheets fournit la justification documentaire préalable requise par les évaluateurs scientifiques lors de la phase de soumission du manuscrit, garantissant la légitimité des modélisations inférentielles déployées ultérieurement.
10. Automatisation et construction d’une matrice descriptive récapitulative
10.1 Conception d’un tableau de bord de statistiques univariées
Afin d’éviter la démultiplication anarchique de calculs isolés et de prévenir les erreurs manuelles de manipulation, l’analyste rigoureux conçoit, au sein d’un onglet distinct de sa feuille Google Sheets, une matrice descriptive univariée structurée et automatisée. Cet agencement récapitule l’ensemble des métriques fondamentales pour chaque variable psychométrique mesurée au cours de l’expérimentation. Une telle matrice adopte une structure en double entrée où les colonnes correspondent aux différentes dimensions évaluées et les lignes successives hébergent les estimateurs statistiques cardinaux.
L’automatisation efficiente repose sur l’exploitation scrupuleuse du référencement absolu et relatif des plages tabulaires. En utilisant judicieusement le symbole dollar ($) pour bloquer les coordonnées de lignes lors de l’extension latérale des cellules, le chercheur formule ses algorithmes une unique fois avant de les étendre horizontalement par glisser-déposer sur des dizaines de colonnes de variables. L’architecture type d’une telle matrice descriptive s’articule autour du schéma computationnel suivant, où la colonne A spécifie les intitulés métrologiques et la colonne B cible la première variable brute (par exemple, la plage ‘Donnees_Brutes’!B$2:B$150) :
- Effectif valide (n) : =NB(‘Donnees_Brutes’!B$2:B$150)
- Moyenne arithmétique (M) : =MOYENNE(‘Donnees_Brutes’!B$2:B$150)
- Écart-type échantillonnal (SD) : =ECARTYPE.STANDARD(‘Donnees_Brutes’!B$2:B$150)
- Médiane (Mdn) : =MEDIANE(‘Donnees_Brutes’!B$2:B$150)
- Premier quartile (Q1) : =QUARTILE.INC(‘Donnees_Brutes’!B$2:B$150; 1)
- Troisième quartile (Q3) : =QUARTILE.INC(‘Donnees_Brutes’!B$2:B$150; 3)
- Écart interquartile (EIQ) : =QUARTILE.INC(‘Donnees_Brutes’!B$2:B$150; 3) – QUARTILE.INC(‘Donnees_Brutes’!B$2:B$150; 1)
- Minimum empirique (Min) : =MIN(‘Donnees_Brutes’!B$2:B$150)
- Maximum empirique (Max) : =MAX(‘Donnees_Brutes’!B$2:B$150)
- Coefficient d’asymétrie : =COEFFICIENT.ASYMETRIE(‘Donnees_Brutes’!B$2:B$150)
- Excès d’aplatissement (Kurtosis) : =KURTOSIS(‘Donnees_Brutes’!B$2:B$150)
Pour enrichir ce tableau de bord, des règles de mise en forme conditionnelle dynamiques peuvent être associées aux cellules du skewness et du kurtosis : toute cellule dont la valeur outrepasse le seuil absolu de 1,5 peut s’illuminer d’un aplat orangé, avertissant visuellement le chercheur que la variable correspondante dévie notablement du standard de normalité.
10.2 Exploitation de la fonction QUERY et des tableaux croisés dynamiques
Lorsque le protocole de recherche intègre un plan factoriel croisant plusieurs conditions expérimentales ou comparant différents groupes cliniques, la production manuelle de matrices récapitulatives par sous-groupes devient fastidieuse et propice aux télescopages de formules. Google Sheets offre deux environnements computationnels avancés de haut niveau pour automatiser cette ségrégation analytique : les tableaux croisés dynamiques et le moteur SQL natif articulé autour de la fonction =QUERY.
Les tableaux croisés dynamiques (accessibles via Insertion > Tableau croisé dynamique) permettent une décomposition descriptive immédiate de l’échantillon sans requérir l’écriture de formules complexes. En assignant la variable de classification indépendante (ex: Groupe_Clinique) en Lignes, et les variables dépendantes psychométriques en Valeurs, le chercheur sélectionne les synthèses algorithmiques souhaitées : AVERAGE (Moyenne), STDEV (Écart-type) et COUNT (Effectif). Cette interface dynamique répercute instantanément tout ajout ou correction ultérieure intervenant dans la matrice source des données brutes, constituant un outil d’exploration interactif particulièrement puissant.
Pour les utilisateurs exigeant une reproductibilité programmatique intégrale et un contrôle total sur l’affichage, la fonction =QUERY s’avère sans égal. En mobilisant le pseudo-langage d’interrogation SQL de Google, une unique ligne de code permet d’extraire la taille de groupe, la moyenne et l’écart-type conditionnels. Considérons une matrice source étendue sur les colonnes A à D (où A représente le code participant, B le genre, C le groupe diagnostique et D le temps de réaction) ; la syntaxe déclarative s’écrit avec une remarquable élégance mathématique :
=QUERY(A1:D150; « SELECT C, COUNT(D), AVG(D) WHERE D IS NOT NULL GROUP BY C »)
Cette commande génère de manière autonome une table ordonnée présentant pour chaque pathologie (colonne C) l’effectif valide et le temps de réaction moyen correspondant, éliminant tout risque d’erreur humaine inhérente au copier-coller de sous-ensembles matriciels manuels.
10.3 Vérification dynamique des données via des formules combinées
Un tableau de bord descriptif ne se limite pas à la simple agrégation passive d’indices récapitulatifs ; il doit constituer un système dynamique de surveillance de la validité interne des calculs. L’automatisation du contrôle de cohérence passe par l’implémentation de formules conditionnelles combinées combinant les opérateurs =SI, =ESTNUM et les routines d’arrondi décimal =ARRONDI.
Une problématique récurrente dans l’assemblage de tableaux de publication réside dans la disparité de précision décimale induite par les divisions arithmétiques. L’enrobage systématique des fonctions descriptives dans l’opérateur d’arrondi garantit une normalisation métrologique stricte. Ainsi, l’expression =ARRONDI(MOYENNE(plage); 2) assure que le résultat numérique produit ne propagera pas d’artefacts d’affichage à dix décimales, tout en limitant la charge mémoire des calculs imbriqués.
De surcroît, la construction d’intervalles descriptifs dynamiques fondés sur l’erreur type de la moyenne (SEM, Standard Error of the Mean) peut être intégrée en une formule synthétique unique. L’erreur type, reflétant la précision avec laquelle la moyenne d’échantillon estime la moyenne de population, se calcule algébriquement par le ratio de l’écart-type sur la racine carrée de la taille de l’échantillon (SD / √N). Dans Google Sheets, la formulation intégrée s’écrit :
=ARRONDI(ECARTYPE.STANDARD(plage) / RACINE(NB(plage)); 2)
En associant cette métrique à la moyenne arithmétique via l’opérateur de concaténation (&), l’analyste peut générer automatiquement une cellule de synthèse textuelle répondant au format canonique des rapports descriptifs de laboratoire : =ARRONDI(MOYENNE(plage); 2) & » ± » & ARRONDI(ECARTYPE.STANDARD(plage)/RACINE(NB(plage)); 2). Cette standardisation procédurale fiabilise considérablement la transition vers les phases de rédaction scientifique.
11. Visualisation graphique des statistiques descriptives dans Google Sheets
11.1 Construction d’histogrammes de fréquence
L’inspection visuelle directe de la forme distributionnelle constitue un impératif épistémologique absolu qui doit systématiquement corroborer les calculs numériques du skewness et du kurtosis. Le célèbre paradoxe du quartette d’Anscombe illustre avec force que des séries quantitatives aux paramètres descriptifs numériques strictement identiques (mêmes moyennes, mêmes variances) peuvent dissimuler des configurations structurales et morphologiques radicalement divergentes. L’histogramme de fréquence est l’outil graphique privilégié pour appréhender l’allure d’une variable continue.
Dans Google Sheets, l’élaboration d’un histogramme s’effectue en sélectionnant l’intégralité de la plage de données univariée, puis en activant la commande Insertion > Graphique, avant de sélectionner le type Histogramme au sein du panneau de configuration latéral. L’algorithme graphique agrège de manière autonome les observations continues en classes d’intervalles contiguës (bins) et élève au-dessus de chaque classe une barre dont la surface est strictement proportionnelle au nombre de sujets s’inscrivant dans cet intervalle.
La validité diagnostique de l’histogramme dépend étroitement du paramétrage de la largeur de classe (taille du bin), accessible dans le sous-menu Personnaliser > Histogramme. Par défaut, le moteur heuristique de Google Sheets tente d’estimer un découpage adapté, mais il est fréquemment indispensable que le chercheur impose manuellement une largeur d’intervalle théoriquement signifiante (par exemple, des tranches de 50 ms pour des temps de réaction ou des paliers de 5 points pour un inventaire de personnalité). Un découpage excessivement large occulte les creux et masque une éventuelle bimodalité, tandis qu’un découpage excessivement fin pulvérise la série en barres disjointes illisibles. L’histogramme permet d’apprécier d’un coup d’œil l’alignement empirique des données sur la cloche de Gauss et de repérer les asymétries saillantes.
11.2 Génération de diagrammes en boîte à moustaches
Le diagramme en boîte à moustaches (ou boxplot), théorisé par John Tukey, constitue sans conteste la représentation graphique descriptive la plus riche et la plus dense de l’analyse exploratoire des données. Il condense simultanément au sein d’une géométrie unifiée cinq paramètres cardinaux : la médiane (Q2), le premier quartile (Q1), le troisième quartile (Q3), les valeurs limites de dispersion non aberrantes (les moustaches) et les observations déviantes ponctuelles isolées.
Google Sheets supporte nativement la construction de graphiques en boîte à moustaches (identifiés sous la dénomination Graphique en chandeliers ou Boîte à moustaches selon les versions linguistiques). Pour concevoir un boxplot comparatif rigoureux entre plusieurs sous-groupes expérimentaux (par exemple, comparer la distribution de l’impulsivité entre un groupe témoin et un groupe avec trouble de l’usage de substances), il convient d’agencer préalablement les données de telle sorte que chaque groupe occupe une colonne distincte, ou de renseigner la colonne catégorielle comme axe de segmentation dans l’éditeur de graphiques.
L’inspection du diagramme offre une lecture immédiate de multiples propriétés statistiques complexes :
- La hauteur de la boîte centrale (la distance séparant le bas et le haut du rectangle) matérialise visuellement l’écart interquartile (EIQ), illustrant immédiatement le degré d’homogénéité des 50 % centraux de l’échantillon.
- La ligne horizontale interne scindant la boîte visualise la médiane. Si cette ligne ne coupe pas le rectangle en deux moitiés symétriques mais se trouve plaquée vers le bas ou vers le haut, cela trahit une asymétrie interne marquée.
- La longueur relative des moustaches supérieure et inférieure documente l’étendue des résidus non extrêmes, tandis que les points flottant au-delà des segments signalent visuellement les outliers selon la règle de Tukey, permettant une comparaison comparative instantanée entre groupe contrôle et groupe expérimental.
11.3 Élaboration de graphiques en barres avec barres d’erreur
En dépit des qualités indéniables du diagramme en boîte à moustaches, le graphique en barres représentant la moyenne arithmétique demeure le format de restitution visuelle le plus largement attendu et codifié au sein des revues scientifiques de psychologie expérimentale et de neurosciences. Toutefois, la publication d’une moyenne nue, dépourvue de l’indication explicite de la variabilité d’échantillon qui l’entoure, constitue une infraction méthodologique majeure aux recommandations éditoriales modernes.
Pour concevoir un graphique conforme aux canons académiques dans Google Sheets, le chercheur érige un diagramme en colonnes basé sur le tableau récapitulatif des moyennes de groupe, puis déploie l’option Barres d’erreur dans l’onglet Personnaliser > Série. Google Sheets permet de paramétrer ces barres d’erreur selon trois modalités statistiques distinctes :
- Écart-type (Constant ou Facteur) : Configure la barre pour qu’elle s’étende à ± 1 écart-type (SD) autour de la moyenne, illustrant l’hétérogénéité brute interindividuelle de l’échantillon.
- Pourcentage : Option purement descriptive commerciale, à proscrire fermement dans les communications scientifiques.
- Plage personnalisée : L’option méthodologique royale, permettant de pointer vers une colonne externe précalculée hébergeant rigoureusement l’erreur-type de la moyenne (SEM) ou les limites bilatérales d’un intervalle de confiance à 95 % (IC 95 %).
Le respect absolu des standards de communication visuelle exige que la légende du graphique ou sa note explicative inférieure mentionne explicitement la nature métrologique de la barre d’erreur représentée (par exemple : « Les barres d’erreur indiquent ± 1 erreur type de la moyenne » ou « Les barres d’erreur représentent l’intervalle de confiance à 95 % »). Cette rigueur documentaire évite toute méprise interprétative quant à la portée inférentielle de la dispersion visualisée.
12. Rapportage académique des statistiques descriptives selon les normes APA
12.1 Directives de la 7e édition de l’APA pour les indicateurs descriptifs
La formalisation textuelle et typographique des résultats descriptifs au sein d’un manuscrit scientifique est strictement gouvernée par les prescriptions du Publication Manual de l’American Psychological Association (7e édition). L’APA impose un ensemble de règles conventionnelles destinées à garantir l’uniformité, la lisibilité et l’exactitude de la communication savante internationale. La première exigence concerne l’usage immuable de l’italique pour désigner les symboles statistiques alphabétiques latins, tandis que les lettres grecques (comme le coefficient bêta β ou l’indice khi-carré χ²) demeurent en typographie romaine droite.
Les abréviations conventionnelles normalisées doivent être scrupuleusement respectées dans le corps du texte :
- M (en italique majuscule) : Désigne la moyenne arithmétique de l’échantillon.
- Mdn (en italique) : Représente la médiane.
- SD (en italique majuscule) : Qualifie l’écart-type de l’échantillon (Standard Deviation).
- N (en italique majuscule) : Spécifie la taille totale de l’échantillon global recruté.
- n (en italique minuscule) : Désigne la taille effective d’un sous-groupe ou d’un segment d’échantillon.
Concernant les directives d’arrondi décimal, la 7e édition de l’APA prescrit une sobriété calculée : les paramètres de tendance centrale (moyennes, médianes) ainsi que les indices de dispersion (écarts-types, intervalles interquartiles) doivent être arrondis de manière uniforme à deux décimales après la virgule (ou après le point dans les soumissions en langue anglaise), par exemple : M = 24,35, SD = 4,12. Il convient d’éviter l’étalage de décimales surnuméraires issues directement des calculs bruts de Google Sheets, lesquelles confèrent une illusion trompeuse d’hyper-précision métrologique sans rapport avec la fidélité réelle des instruments psychologiques.
L’intégration narrative des résultats descriptifs dans la section Résultats d’un article obéit à une concision rigoureuse. L’énoncé textuel articule organiquement les indicateurs sans redondance syntaxique : « Les participants du groupe d’entraînement cognitif ont présenté des temps de réponse significativement plus courts (M = 412,50 ms ; SD = 35,20 ms) comparativement aux sujets assignés à la condition témoin (M = 485,12 ms ; SD = 42,80 ms). » Cette structure canonique délivre au lecteur l’exhaustivité des paramètres requis pour apprécier l’amplitude de l’effet descriptif.
12.2 Conception de tables descriptives conformes aux exigences éditoriales
Lorsque le plan d’expérience embrasse un nombre conséquent de variables quantitatives ou procède à de multiples segmentations factorielles, la présentation des données sous forme de tables synthétiques s’impose pour désencombrer le corps textuel. La 7e édition des normes APA édicte des contraintes architecturales extrêmement rigoureuses quant à la mise en page des tableaux statistiques, prescriptions que le chercheur peut préparer dès l’interface de Google Sheets avant l’exportation finale vers un traitement de texte académique.
La règle éditoriale la plus emblématique proscrit de manière absolue l’usage de lignes de quadrillage verticales. Une table APA canonique ne tolère que des délimitations horizontales strictes :
- Une ligne horizontale supérieure délimitant le haut de la table.
- Une ligne horizontale séparant la rangée d’en-tête descriptive des lignes de données empiriques.
- Une ligne horizontale inférieure marquant la clôture de la table, positionnée immédiatement au-dessus des notes de bas de tableau.
L’agencement des colonnes doit obéir à une hiérarchie logique immuable : la première colonne, alignée à gauche, énumère les libellés des variables ou les sous-groupes expérimentaux. Les colonnes subséquentes, dont les données numériques doivent être impérativement alignées sur la virgule décimale (ou centrées), présentent séquentiellement l’effectif valide (n), la moyenne arithmétique (M), l’écart-type (SD) et, le cas échéant, l’intervalle de confiance à 95 % [IC 95 %] borné entre crochets.
Le tableau doit systématiquement comporter un titre numéroté en gras (ex: Tableau 1) suivi d’une description cursive en italique explicitant le contenu (ex: Statistiques descriptives des performances mnésiques selon le groupe expérimental). Il se conclut obligatoirement par une section de notes (alignée à gauche, débutant par le mot Note. en italique) explicitant l’ensemble des acronymes utilisés, précisant la méthode d’imputation ou d’exclusion éventuelle des participants, et documentant la nature exacte des transformations statistiques préalablement opérées.
12.3 Pièges fréquents et bonnes pratiques lors de la transition inférentielle
L’achèvement des calculs descriptifs marque le passage délicat vers la modélisation inférentielle. Cette phase de transition est fréquemment le théâtre de glissements conceptuels insidieux qui polluent la littérature publiée. Le piège le plus universel réside dans la confusion pernicieuse entre l’écart-type de l’échantillon (SD) et l’erreur type de la moyenne (SEM). Alors que l’écart-type est un indicateur purement descriptif quantifiant la dispersion réelle des individus autour de leur moyenne au sein de l’échantillon observé, l’erreur type est un paramètre inférentiel modélisant la variabilité théorique de la moyenne elle-même à travers des réplications hypothétiques d’échantillonnage.
Cette distinction métrologique est illustrée dans la comparaison suivante :
- L’écart-type (SD) demeure stable lorsque la taille de l’échantillon N augmente, convergeant vers la vraie dispersion de la population.
- L’erreur type (SEM) diminue mécaniquement au fur et à mesure que N croît (car divisée par √N), tendant asymptotiquement vers zéro.
Rapporter l’erreur type à la place de l’écart-type dans une table purement descriptive constitue une mauvaise pratique méthodologique fréquente, dont le travers inavoué est souvent de masquer visuellement une forte hétérogénéité empirique sous des barres d’erreur artificiellement réduites. L’APA impose de réserver rigoureusement le SD pour la description univariée brute des scores.
Un second écueil réside dans la surinterprétation unilatérale de la moyenne arithmétique en présence de distributions fortement asymétriques ou contaminées par des effets de seuil (plancher ou plafond). Conclure à une différence cliniquement substantielle entre deux cohortes sur la seule base d’un décalage de moyennes arithmétiques, alors que les médianes sont strictement identiques et que l’écart est entièrement tiré par deux valeurs déviantes extrêmes, relève d’une erreur d’inférence directe. Le chercheur aguerri valide toujours la convergence des estimateurs robustes (médiane, moyenne tronquée) avant de statuer sur la réalité matérielle d’un phénomène expérimental.
Enfin, la bonne pratique contemporaine exige l’archivage pérenne et transparent de la feuille Google Sheets au sein d’un dépôt public de données de recherche (tel que l’Open Science Framework). L’analyste veille à préserver une séparation stricte entre l’onglet de données sources immuables (brutes) et les onglets de transformation analytique automatisée. En fournissant à la communauté des pairs une feuille de calcul documentée, où chaque cellule de synthèse renvoie dynamiquement à des formules auditables, le psychologue garantit l’intégrité de sa démarche scientifique et participe activement à l’effort collectif de reproductibilité computationnelle des sciences du comportement.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.2307/2682899
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- George, D., & Mallery, P. (2020). IBM SPSS statistics 26 step by step: A simple guide and reference (16th ed.). Routledge. https://doi.org/10.4324/9780429056765
- Kline, R. B. (2016). Principles and practice of structural equation modeling (4th ed.). Guilford Press.
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02228-0