
Dans l’arsenal des méthodes quantitatives appliquées aux sciences humaines, à l’évaluation psychologique et à l’analyse de données expérimentales, la standardisation des mesures constitue une étape méthodologique fondamentale. Qu’il s’agisse d’évaluer le quotient intellectuel, de mesurer des traits de personnalité via des inventaires multidimensionnels ou d’agréger des indices comportementaux hétérogènes, le praticien et le chercheur sont constamment confrontés au défi de la comparabilité des données brutes. Une performance brute, isolée de son contexte distributionnel, demeure intrinsèquement muette : obtenir un score de soixante-quinze à une épreuve mnésique n’a de signification clinique ou théorique que si l’on connaît la moyenne des scores obtenus par la population de référence ainsi que la dispersion des résultats autour de cette tendance centrale.
Le score Z, également désigné sous le vocable de note standardisée ou de cote centrée-réduite, apporte une réponse d’une élégance mathématique absolue à cette problématique. En convertissant une mesure brute en une unité d’écart à la moyenne exprimée en fractions d’écart-type, le score Z affranchit la métrique de son échelle de mesure d’origine pour la transposer dans un espace vectoriel universellement interprétable. Cette transformation linéaire stabilise la moyenne à zéro et fixe la variance à l’unité, permettant ainsi la juxtaposition et la corrélation immédiates de dimensions autrefois incommensurables. Pour approfondir les concepts sous-jacents aux distributions statistiques, on consultera avec profit les travaux fondateurs sur l’analyse de la distribution normale en statistique inférentielle.
À l’ère du travail collaboratif et de la reproductibilité scientifique, l’utilisation de plateformes accessibles en ligne s’impose progressivement dans les laboratoires et les structures appliquées. Google Sheets représente aujourd’hui un environnement de choix pour l’implémentation de tels calculs statistiques. Alliant la flexibilité d’un tableur basé sur l’informatique en nuage à la puissance de fonctions algorithmiques avancées, il autorise un traitement fluide, automatisé et auditable des jeux de données psychométriques. Ce guide exhaustif explore l’ensemble du spectre théorique et opérationnel du calcul des scores Z dans Google Sheets, allant des postulats mathématiques matriciels aux modélisations graphiques complexes, tout en offrant les clés méthodologiques indispensables à une interprétation clinique et expérimentale rigoureuse.
1. Introduction théorique au score Z et son rôle en psychométrie
1.1 Définition conceptuelle de la note standardisée
La note standardisée, ou score Z, se définit fondamentalement comme une mesure statistique adimensionnelle qui exprime la distance exacte séparant une observation empirique donnée de la moyenne de sa distribution, cette distance étant quantifiée en unités d’écart-type. Sur le plan formel, transformer une distribution brute en une distribution standardisée revient à lui appliquer une translation vectorielle consistant à soustraire la valeur centrale, suivie d’une homothétie d’échelle consistant à diviser ce résultat par l’indicateur de dispersion canonique. Cette opération a pour effet mécanique de déchoir la donnée de son unité de mesure physique originelle — qu’il s’agisse de millisecondes lors d’un temps de réaction, de points cumulés sur une échelle de Likert, ou de réponses correctes à un test d’efficience cognitive — au profit d’un étalon universel.
L’origine historique de cette démarche s’ancre dans les balbutiements de la psychologie différentielle et de la biométrie à la fin du dix-neuvième siècle, notamment sous l’impulsion de pionniers tels que Sir Francis Galton et Karl Pearson. Ces derniers cherchaient à quantifier les variations interindividuelles au sein de populations biologiques et humaines en s’affranchissant des artefacts métrologiques. La transformation linéaire en score Z permet ainsi de résoudre la discontinuité fondamentale entre les scores bruts idiosyncrasiques, dépendants du nombre d’items ou de l’arbitraire du barème retenu, et les métriques standardisées nécessaires aux comparaisons intergroupes. Les principes fondamentaux de la Société Américaine de Psychologie soulignent l’importance de ces métriques standardisées pour l’harmonisation des mesures comportementales.
Sur le plan mathématique, les propriétés invariantes d’une distribution ainsi réduite constituent la pierre angulaire de la théorie classique des tests. Toute distribution brute transformée en scores Z acquiert obligatoirement, quelles que soient les caractéristiques initiales de ses paramètres d’origine, une moyenne strictement égale à zéro et une variance rigoureusement unitaire. Ce principe fondamental d’invariance permet d’établir une norme de référence stable : un score Z positif indique sans équivoque une performance se situant au-dessus du centre de gravité de l’échantillon, tandis qu’un score Z négatif témoigne d’un résultat inférieur à cette valeur centrale. La métrique obtenue confère à chaque observation un statut relatif direct au sein de l’architecture distributionnelle globale.
1.2 Utilité méthodologique en recherche psychologique
Dans le domaine de la recherche psychologique et des neurosciences comportementales, l’hétérogénéité des protocoles expérimentaux génère couramment des matrices de données composées de dimensions incommensurables. Un chercheur évaluant le déclin cognitif chez des patients âgés recueille fréquemment des données temporelles (latences d’inhibition motrice mesurées en fractions de seconde), des données discrètes (nombre d’erreurs commises lors d’une tâche de mémoire de travail) et des scores d’auto-évaluation continue (niveaux d’anxiété sur une échelle analogique visuelle de cent millimètres). Il est méthodologiquement erroné d’effectuer une somme brute ou un profilage direct à partir de ces métriques discordantes, sous peine de pondérer artificiellement les variables dotées de la plus forte variance brute.
L’étalonnage des tests psychométriques et des inventaires de personnalité repose entièrement sur la conversion en notes standardisées. Lors de la conception d’un outil d’évaluation de la personnalité comme le modèle des Big Five, les sous-échelles comportent rarement un nombre identique d’items, et leurs distributions brutes peuvent présenter des moyennes divergentes en raison de formulations asymétriques favorisant l’assentiment. La standardisation en scores Z annule ces biais d’échelle et permet de construire des profils psychologiques individuels où l’ensemble des dimensions — névrosisme, extraversion, ouverture, agréabilité et conscience — sont visualisées sur un continuum métrologique partagé. L’examinateur peut dès lors repérer d’un simple coup d’œil les forces et fragilités relatives d’un individu par rapport à une population de référence équivalente en termes d’âge et de caractéristiques sociodémographiques.
De surcroît, l’harmonisation de batteries d’évaluations cognitives multifactorielles s’avère indispensable lors des analyses statistiques de second ordre, telles que les analyses factorielles exploratoires ou confirmatoires, et les régressions linéaires multiples. La présence de variables prédictives possédant des variances extrêmement disparates peut engendrer des instabilités d’estimation des coefficients de régression et compliquer l’évaluation de l’importance relative de chaque prédicteur. En convertissant préalablement toutes les variables sous forme de scores Z, les coefficients de régression non standardisés deviennent directement équivalents aux coefficients standardisés bêta, ce qui facilite grandement l’interprétation théorique de la contribution unique de chaque fonction cognitive au modèle explicatif global.
1.3 Conditions d’application et postulats distributionnels
L’application rigoureuse du score Z exige une compréhension profonde de ses postulats sous-jacents, sous peine de tirer des conclusions analytiques totalement infondées. L’un des postulats implicites les plus fréquemment méconnus réside dans l’hypothèse de normalité univariée de la distribution empirique. Si la transformation linéaire en note Z peut techniquement s’appliquer à n’importe quel ensemble de données numériques — la soustraction de la moyenne et la division par l’écart-type étant toujours réalisables du moment que ce dernier est non nul —, l’interprétation probabiliste du score Z est quant à elle subordonnée au respect de la loi normale, souvent garantie par le théorème central limite lorsque les échantillons sont de taille substantielle.
Lorsque la distribution sous-jacente s’écarte notablement du modèle gaussien, l’asymétrie statistique (skewness) et l’aplatissement excessif (kurtosis) perturbent gravement la validité inférentielle du score Z. Dans une distribution fortement asymétrique à droite — situation typique observée lors de l’enregistrement de temps de réaction où une longue traîne de réponses lentes étire la distribution —, un score Z de +2,00 ne correspondra absolument pas au quatre-vingt-dix-septième centile théorique attendu sous la courbe normale. De même, une distribution leptokurtique, caractérisée par des queues épaisses, augmentera considérablement la proportion réelle d’observations situées au-delà de deux écarts-types comparativement aux cinq pour cent théoriques d’une loi normale unitaire. L’application mécanique du score Z sans contrôle préalable de ces moments statistiques induit donc des erreurs diagnostiques majeures.
Enfin, il convient de souligner les limites épistémologiques inhérentes à la standardisation menée sur des échantillons de dimension restreinte. Dans les études pilotes ou les situations de neuropsychologie clinique où l’échantillon normatif ne regroupe que quinze à vingt sujets, la moyenne empirique et l’écart-type d’échantillon constituent des estimateurs particulièrement fragiles et bruités des véritables paramètres populationnels. La standardisation effectuée sur une cohorte réduite incorpore une erreur d’échantillonnage considérable, rendant les scores Z extrêmement instables. Dans ces contextes méthodologiques contraints, le recours à des distributions t de Student ou à des méthodes non paramétriques basées sur les rangs s’avère bien souvent supérieur à l’utilisation simpliste de la cote Z standardisée.
2. Fondements mathématiques et équations de normalisation
2.1 L’équation standard du score Z pour une population
La formulation mathématique théorique du score Z s’exprime avec une limpidité universelle dans le cadre d’une population globale exhaustif. Lorsque l’ensemble des individus constitutifs de la population d’intérêt a été mesuré, ou lorsque l’on dispose de données normatives massives permettant de considérer les paramètres distributionnels comme connus et certains, l’équation s’énonce ainsi :
z = (X – μ) / σ
Dans cette formulation canonique, chaque paramètre joue un rôle structural déterminant. La variable notée X représente la valeur brute observée, c’est-à-dire la donnée primaire issue directement de l’instrument d’évaluation psychométrique ou du dispositif de mesure sensorimoteur. Cette valeur brute est soumise au différentiel de translation par rapport au paramètre μ (mu), qui désigne l’espérance mathématique ou la moyenne arithmétique globale de la population parente. Ce différentiel (X – μ) constitue l’écart brut à la moyenne, une grandeur absolue qui renseigne déjà sur le sens de la déviation mais demeure tributaire de l’unité de départ.
Le dénominateur de cette équation est constitué par le paramètre σ (sigma), représentant l’écart-type de la population parente, c’est-à-dire la racine carrée de la variance populationnelle. En divisant l’écart brut par cette métrique d’hétérogénéité structurelle, le score z devient un coefficient adimensionnel qui exprime le nombre d’unités de variance standard qui séparent la mesure individuelle du centre de gravité théorique de l’ensemble de la population considérée.
2.2 Adaptation de la formule pour des données d’échantillon
Dans l’immense majorité des travaux empiriques conduits en psychologie expérimentale et en neurosciences cognitives, l’accès à l’exhaustivité de la population demeure une abstraction théorique inatteignable. Le chercheur travaille systématiquement sur des échantillons finis prélevés au sein de cette population cible. Dès lors, les paramètres populationnels vrais mais inconnus doivent être suppléés par des estimateurs statistiques calculés sur l’échantillon disponible. La formulation pratique du score Z prend alors la forme d’une équation d’échantillonnage :
z = (X – x̄) / s
Dans cette adaptation pragmatique, la moyenne d’échantillon x̄ (x-barre) se substitue à l’espérance mathématique μ, tandis que l’écart-type de l’échantillon s remplace le sigma populationnel. Cette transition impose une attention statistique scrupuleuse quant au mode de calcul de l’écart-type s. En vertu de la théorie de l’estimation, la dispersion au sein d’un échantillon sous-estime tendanciellement la variabilité réelle de la population sous-jacente. Afin de corriger ce biais d’échantillonnage structurel, il est impératif d’intégrer la célèbre correction de Bessel dans l’équation de la variance d’échantillon.
La correction de Bessel stipule que la somme des carrés des écarts à la moyenne empirique ne doit pas être divisée par la taille absolue de l’échantillon N, mais par ses degrés de liberté résiduels, soit (N – 1). Cette modification permet d’obtenir un estimateur sans biais de la variance populationnelle. Les conséquences méthodologiques de cette estimation conjointe de la moyenne et de la variance sur le même jeu de données sont notables : la variabilité supplémentaire introduite par l’erreur d’estimation des paramètres signifie que pour de très petits échantillons, les scores calculés s’ajustent théoriquement à une statistique de Student plutôt qu’à une variable normale pure, un détail d’importance lors des extrapolations inférentielles de précision.
2.3 Transformation inverse : de la note Z au score brut
L’une des propriétés formelles les plus précieuses du score Z réside dans sa réversibilité algébrique absolue. Étant le fruit d’une transformation purement linéaire du premier degré, l’équation fondamentale peut être inversée sans aucune perte d’information statistique, permettant de recalculer le score brut théorique à partir de n’importe quelle valeur standardisée selon la formule réciproque :
X = μ + (z * σ)
Cette réciproque trouve une utilité majeure lors de la reconstitution de données normatives ou dans le domaine de la simulation statistique de Monte-Carlo. Par exemple, si un psychologue clinicien dispose du score Z d’un patient issu d’une méta-analyse ou d’un rapport de diagnostic dématérialisé, et qu’il connaît la moyenne et l’écart-type des étalonnages spécifiques d’une version révisée d’un test mnésique, il peut instantanément reconstituer la performance brute théorique que ce sujet aurait obtenue sur ce test particulier.
Cette transformation inverse constitue également le mécanisme mathématique élémentaire permettant de migrer d’un score Z vers une infinité d’autres métriques dérivées couramment utilisées en psychométrie clinique. Dans la mesure où les scores Z manipulent des nombres négatifs et des valeurs décimales parfois anxiogènes ou peu commodes lors de la restitution de bilans aux patients, on applique couramment une seconde transformation linéaire de type métrique composite. Ainsi, la conversion vers le score T de McCall s’opère selon l’équation T = 50 + (z * 10), garantissant une moyenne fixée à 50 et un écart-type à 10. De façon similaire, les échelles d’efficience intellectuelle de David Wechsler reposent sur la transformation standardisée QI = 100 + (z * 15), convertissant instantanément une coordonnée Z en une note de quotient intellectuel universellement appréhendée.
3. Préparation et structuration des données dans Google Sheets
3.1 Organisation tabulaire conforme aux principes de données ordonnées
L’exécution fluide et l’intégrité analytique d’un calcul de score Z dans l’environnement Google Sheets dépendent directement de la discipline adoptée lors de la structuration initiale du classeur. Il est hautement recommandé de respecter scrupuleusement le paradigme des données ordonnées (communément désigné sous l’anglicisme de « tidy data »), théorisé par Hadley Wickham. Dans cette optique, la matrice tabulaire doit être construite selon une architecture stricte : chaque ligne horizontale doit correspondre de manière univoque à une seule unité expérimentale ou à un sujet observé, tandis que chaque colonne verticale doit incarner une et une seule variable spécifique d’évaluation.
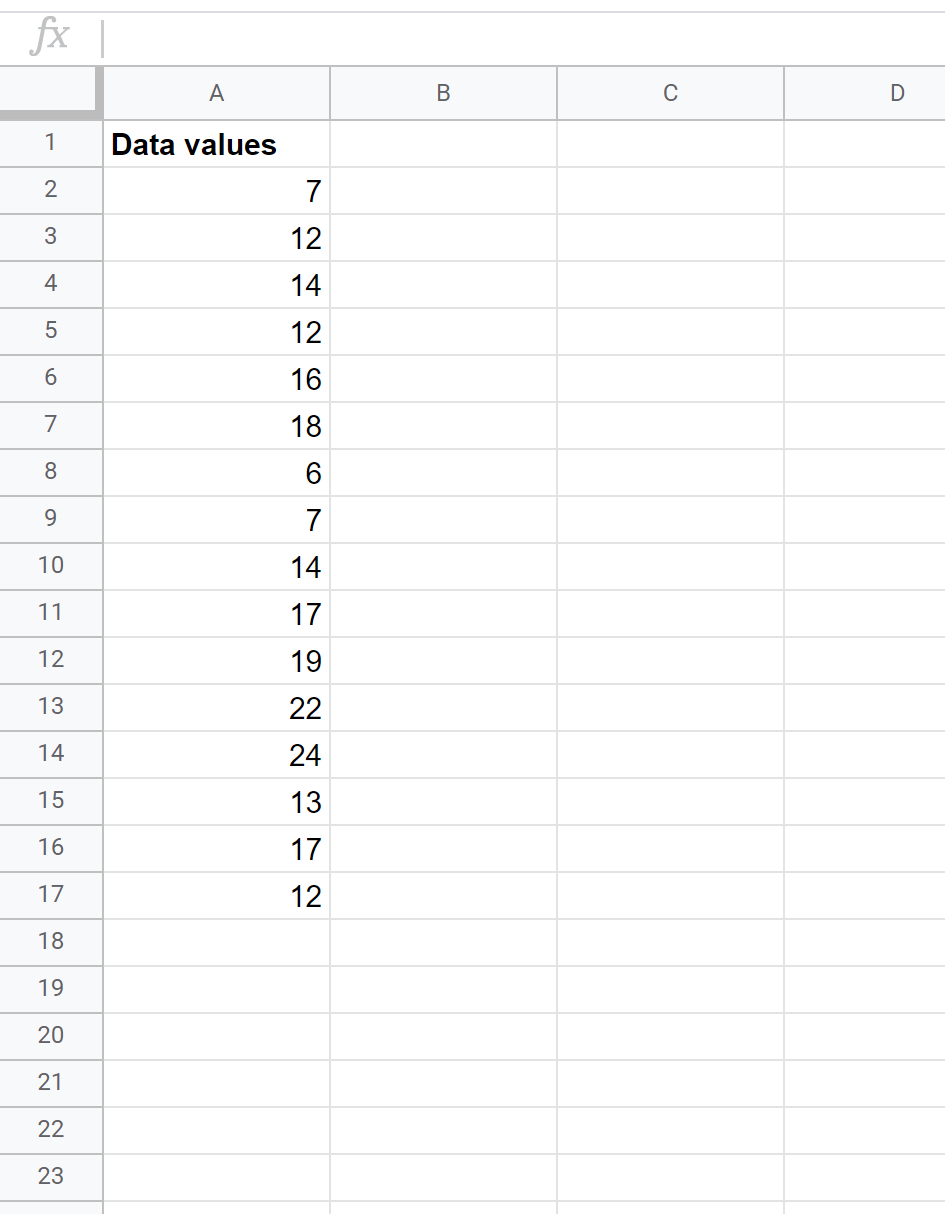
Dans le cadre d’une recherche psychométrique ou clinique, il est impératif de réserver la première colonne (colonne A) à un identifiant unique, anonymisé et immutable pour chaque participant (par exemple : SUJET_001, SUJET_002, etc.). Cette disposition prévient tout risque de confusion ou de désalignement lors de tris ultérieurs ou de filtres dynamiques appliqués à la feuille de calcul. Les colonnes consécutives (B, C, D) accueilleront les différentes mesures expérimentales brutes collectées, en isolant méthodiquement les épreuves distinctes ou les temps de mesure successifs (pré-test versus post-test).
La première ligne du tableur doit être exclusivement consacrée aux étiquettes d’en-tête. Ces libellés doivent être concis, explicites et exempts de caractères spéciaux, de sauts de ligne intempestifs ou d’espaces superflus qui risqueraient de corrompre l’écriture des formules de requêtes futures. Une codification rigoureuse consistera par exemple à nommer les colonnes de manière normalisée : ID_Participant, Score_Memoire_Brut, Temps_Reaction_MS, Anxiete_STAI_Brut. Cette rigueur sémantique évite les ambiguïtés de syntaxe lorsque Google Sheets référence des plages matricielles entières au sein de fonctions statistiques avancées.
3.2 Nettoyage préliminaire et vérification de la cohérence
Avant d’engager le moindre calcul de normalisation statistique, une étape indispensable d’épuration et d’assainissement du jeu de données doit être conduite au sein du tableur. La présence d’irrégularités invisibles constitue la cause prépondérante d’échec des fonctions mathématiques dans Google Sheets. L’analyste doit tout d’abord procéder à l’identification des données manquantes, fréquentes lors des passations de batteries de tests prolongées. Il convient de décider en amont si une cellule vide sera imputée par une méthode statistique valide (comme la moyenne conditionnelle ou l’algorithme des k plus proches voisins) ou si le sujet doit être écarté de l’analyse via un filtrage rigoureux.
Il est ensuite crucial de vérifier la pureté typologique des valeurs encodées. Il arrive fréquemment, lors de l’importation de fichiers CSV ou de formulaires web, que certains nombres soient malencontreusement interprétés comme des chaînes de caractères textuelles par le moteur de Google Sheets, notamment en raison de confusions d’alignement ou de l’inclusion accidentelle d’espaces insécables. Une formule arithmétique ou une fonction de dispersion renverra invariablement un résultat biaisé ou une erreur si elle tente d’agréger des chaînes de texte. L’utilisation des fonctionnalités natives de validation des données de Google Sheets (accessibles via le menu Données > Validation des données) permet de verrouiller les cellules pour n’autoriser strictement que des valeurs numériques réelles.
Enfin, la cohérence substantielle des observations doit être vérifiée à l’aune des plages de validité théorique des instruments psychométriques mobilisés. Si une échelle psychométrique est étalonnée sur une étendue bornée de zéro à cinquante points, la présence d’une valeur de cinquante-deux dans le tableau trahit indubitablement une faute de frappe lors de la saisie manuelle. L’implémentation de filtres conditionnels ou de règles de coloration instantanée permet d’intercepter immédiatement ces valeurs aberrantes de saisie, évitant ainsi d’altérer la moyenne et l’écart-type d’échantillon qui serviront de base à l’ensemble du calcul des scores Z.
3.3 Gestion des plages de données et nommage
Pour conférer à la feuille de calcul une lisibilité optimale, limiter les erreurs humaines de retranscription et professionnaliser l’architecture du projet, le recours aux plages nommées représente une bonne pratique méthodologique incontournable. Dans Google Sheets, cette fonctionnalité permet d’attribuer une désignation textuelle claire et signifiante à un intervalle continu ou discontinu de cellules, remplaçant ainsi les coordonnées matricielles cryptiques du type A2:A150 par un libellé compréhensible tel que Scores_Bruts_Memoire.
L’affectation de ces noms s’effectue aisément via le menu Données > Plages nommées. Une fois la plage correctement définie, toute formule analytique gagne considérablement en clarté sémantique. L’opérateur peut alors rédiger ses fonctions d’agrégation sous la forme intuitive =MOYENNE(Scores_Bruts_Memoire) ou =ECARTYPE.STANDARD(Scores_Bruts_Memoire). Ce procédé garantit également une maintenance aisée : si la dimension de la cohorte expérimentale évolue à la hausse avec l’adjonction de nouveaux participants, il suffit de modifier la borne terminale dans la définition de la plage nommée pour que l’ensemble des calculs dépendants soient réajustés instantanément sans nécessiter de réécriture complexe.
Dans cette même perspective de gouvernance des données, une séparation spatiale scrupuleuse doit être opérée entre les zones de collecte de données primaires et les espaces d’analyse computationnelle. L’approche la plus robuste consiste à dédier un premier onglet de la feuille Google Sheets à l’enregistrement intangible des données brutes issues de l’expérimentation, tandis qu’un second onglet — souvent nommé Analyses_Normalisation — héberge les formules de calcul des scores Z, les tables de constantes descriptives et les représentations graphiques afférentes. Cette ségrégation fonctionnelle protège les observations originales de toute manipulation accidentelle ou écrasement involontaire.
4. Calcul des statistiques descriptives préalables dans Google Sheets
4.1 Calcul de la moyenne empirique via la fonction MOYENNE
Le calcul préalable du centre de gravité de la distribution constitue le premier jalon obligatoire de la chaîne de standardisation. Dans Google Sheets, la fonction standard destinée à déterminer l’espérance arithmétique d’une série numérique s’écrit sous la désignation française MOYENNE (correspondant à l’équivalent anglophone classique AVERAGE). La syntaxe de cette commande élémentaire s’établit selon la structure :
=MOYENNE(plage)
Lorsque cette fonction est appelée sur une étendue de cellules, comme par exemple =MOYENNE(B2:B101), l’algorithme du tableur additionne automatiquement l’ensemble des grandeurs numériques présentes dans la plage désignée et effectue la division de ce total cumulé par le décompte strict des cellules contenant des valeurs de type numérique. Les cellules entièrement vides ainsi que les entrées contenant des chaînes de caractères textuelles sont implicitement neutralisées et exclues du dénominateur, évitant ainsi de biaiser l’estimation vers le bas, contrairement à ce qui surviendrait si le tableur substituait un zéro arbitraire aux cellules vacantes.
Sur le plan interprétatif, cette valeur moyenne empirique représente le barycentre précis de la cohorte d’étude. Elle constitue le point d’équilibre dynamique où la somme algébrique de tous les écarts individuels positifs compense rigoureusement la somme des écarts négatifs. En psychométrie, cette moyenne fait office de niveau d’efficience moyen ou de réponse comportementale modale typique pour la population sous-jacente au moment précis du recueil expérimental.
4.2 Calcul de la dispersion : choix entre ECARTYPE.STANDARD et ECARTYPE.P
L’estimation de la variabilité constitue l’étape la plus critique du paramétrage, car le tableur Google Sheets propose deux fonctions distinctes d’écart-type dont la confusion engendre des distorsions méthodologiques directes sur les scores Z finaux : ECARTYPE.STANDARD (anciennement STDEV ou ECARTYPE) et ECARTYPE.P (ou STDEVP). Le choix entre ces deux opérateurs n’est pas d’ordre esthétique ou arbitraire, mais répond à des justifications épistémologiques et mathématiques profondes.
La fonction =ECARTYPE.P(plage) calcule l’écart-type d’une population intégrale en divisant la somme des carrés des écarts par N. Cet algorithme ne doit être employé que dans le cas très restrictif où les données encodées dans Google Sheets recensent sans exception la totalité absolue de la population d’intérêt — par exemple, l’ensemble des élèves d’un établissement d’enseignement fermé sans aucune visée de généralisation statistique externe. En revanche, dès lors que l’on manipule un échantillon représentatif ou probabiliste destiné à inférer des propriétés sur un groupe plus vaste, la formule d’échantillon s’impose catégoriquement :
=ECARTYPE.STANDARD(plage)
Cette commande implémente explicitement la correction de Bessel en utilisant le dénominateur (N – 1), fournissant de ce fait un estimateur sans biais de la dispersion parente. Si l’analyste souhaite expliciter les étapes intermédiaires de son raisonnement au sein du tableur, il peut également quantifier la variance d’échantillon sous-jacente au moyen de la fonction =VAR.S(plage) avant d’en extraire la racine carrée par l’opérateur arithmétique =RACINE(cellule_variance). L’omission de cette distinction et l’usage fautif de la dispersion de population sur un échantillon modeste aboutissent à sous-estimer systématiquement l’écart-type réel, gonflant de manière artificielle les valeurs absolues des scores Z calculés consécutivement.
4.3 Localisation spatiale optimale des paramètres d’agrégation
Une architecture de tableur efficace proscrit formellement la dispersion anarchique des statistiques descriptives à l’intérieur de la grille de calcul. Afin d’assurer une traçabilité sans faille des transformations appliquées et de faciliter la maintenance des modèles d’évaluation, les paramètres de tendance centrale et de dispersion doivent impérativement être isolés au sein d’une zone dédiée et parfaitement bornée.
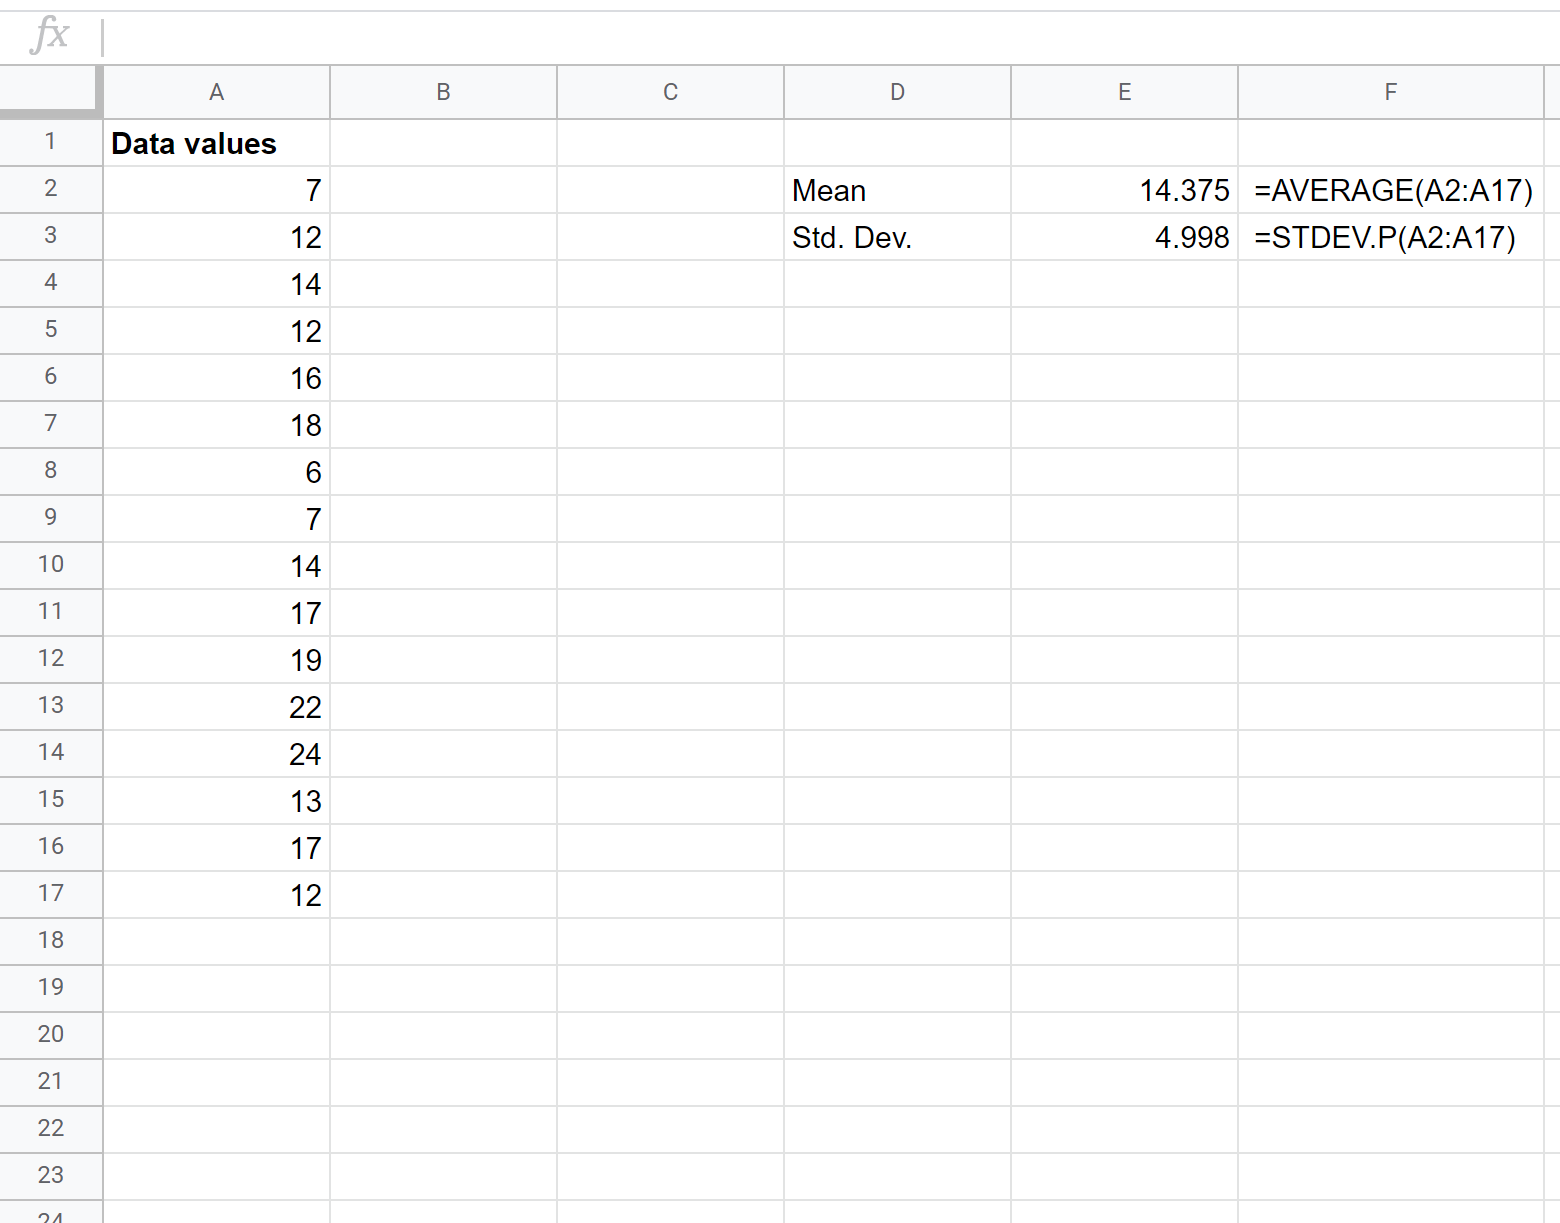
Deux méthodologies ergonomiques se distinguent couramment dans la pratique professionnelle. La première consiste à aménager une section récapitulative statique en tête de colonne, par exemple dans les lignes supérieures gelées de la feuille (lignes 1 à 4), les séries d’observations démarrant strictement à la ligne 6. Cette disposition offre l’immense avantage de maintenir en permanence la visibilité sur la moyenne et l’écart-type lors du défilement vertical du jeu de données. La seconde méthode, plus académique, préconise l’aménagement d’une table de paramètres autonome positionnée à droite des séries brutes (par exemple dans le bloc de cellules E2:F3), ou au sein d’une feuille indépendante réservée aux agrégats statistiques globaux.
Dans cette table de paramètres, il convient de renseigner explicitement les libellés descriptifs en vis-à-vis des valeurs numériques calculées. On disposera par exemple en cellule E2 la mention Moyenne Échantillon associée à la formule =MOYENNE(B2:B101) en F2, puis en cellule E3 le libellé Écart-type Échantillon couplé à =ECARTYPE.STANDARD(B2:B101) en F3. Cet agencement ordonné garantit que les coordonnées cibles devant faire l’objet d’un adressage absolu lors du calcul du score Z seront clairement identifiables par l’analyste, éliminant tout risque de sélection erronée lors de la réplication mécanique des formules.
5. Calcul manuel du score Z par la formule arithmétique standard
5.1 Implémentation de l’expression mathématique de base
L’approche la plus intuitive et pédagogiquement instructive pour calculer un score Z dans Google Sheets consiste à traduire fidèlement l’équation arithmétique théorique à l’aide des opérateurs mathématiques conventionnels du tableur. Cette méthode permet à l’analyste de conserver une compréhension intime de la mécanique calculatoire à chaque étape de l’analyse, en exposant sans artifice la dynamique du centrage et de la réduction.
Pour un sujet expérimental dont la mesure brute est localisée dans la cellule A2, avec une moyenne d’échantillon positionnée dans une cellule auxiliaire (nommons-la arbitrairement E2) et un écart-type hébergé dans une cellule contiguë (E3), la traduction informatique de la formule s’opère selon une syntaxe algébrique directe. L’attention de l’opérateur doit se porter prioritairement sur l’agencement scrupuleux des parenthèses arithmétiques, indispensables pour contraindre le moteur de calcul de Google Sheets à respecter les règles élémentaires de priorité opératoire :
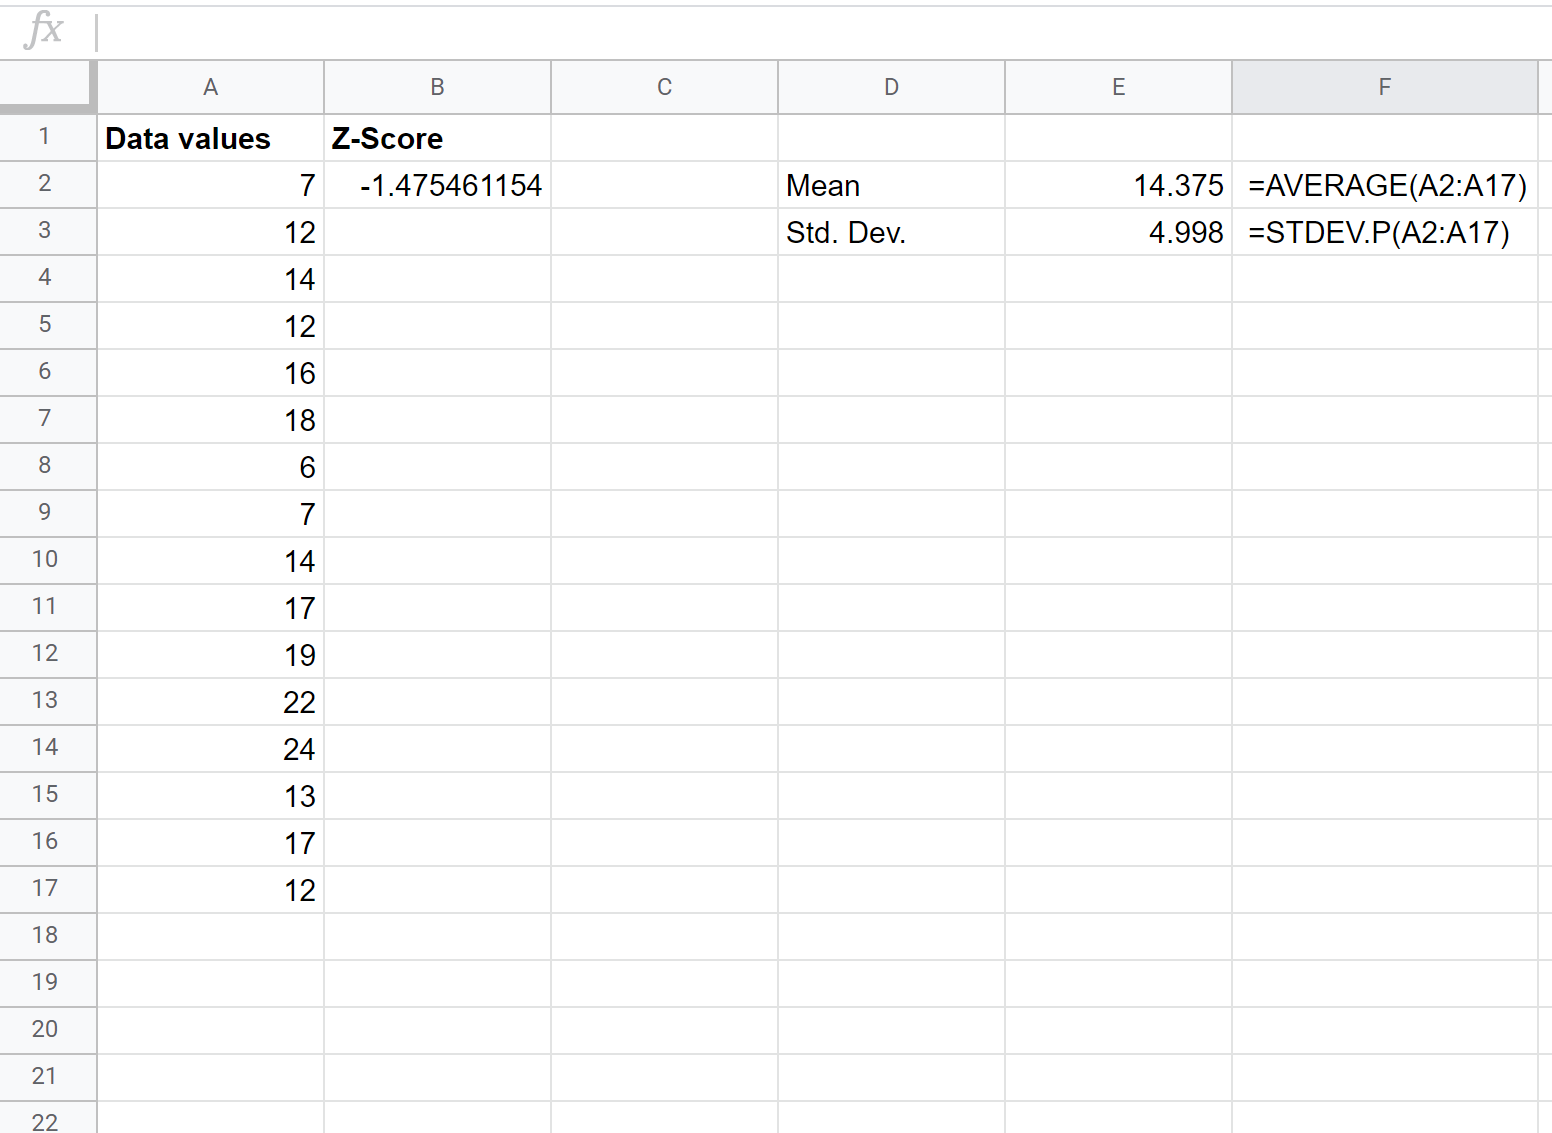
=(A2 – E2) / E3
L’omission accidentelle des parenthèses englobant le numérateur constituerait une erreur dramatique : l’expression mathématique s’exécuterait alors sous la forme erronée =A2 – (E2 / E3) en vertu de la primauté standard de la division sur la soustraction, aboutissant à une valeur aberrante dénuée de tout fondement psychométrique. En observant le résultat retourné pour cette première ligne, on réalise immédiatement le décodage théorique : si le score brut de la cellule A2 surpasse la valeur de la moyenne stockée en E2, le numérateur produit un résultat arithmétique strictement positif, qui une fois divisé par la dispersion positive de E3, génère un score Z positif attestant d’une performance située dans l’hémisphère supérieur de la distribution.
5.2 Maîtrise indispensable de l’adressage absolu ($)
La transition entre le calcul isolé sur une seule ligne et la généralisation de la métrique à l’ensemble des centaines ou des milliers de participants composant la matrice de données nécessite la maîtrise impérative d’un concept fondamental de l’ingénierie des tableurs : l’adressage absolu des coordonnées cellulaires via l’emploi du symbole dollar ($).
Par défaut, toute référence à une cellule dans Google Sheets est de nature purement relative. Cela signifie que lorsque l’on recopie une formule de la ligne 2 vers la ligne 3, les coordonnées matricielles s’incrémentent automatiquement d’un cran : A2 devient A3, E2 se transmute en E3, et E3 devient E4. Si cette incrémentation automatique est précisément recherchée pour la colonne des scores individuels bruts (afin que chaque sujet voie sa propre performance traitée), elle s’avère absolument désastreuse pour les paramètres de centralité et de dispersion qui occupent des cellules géographiquement fixes sur la grille. Si l’on ne verrouille pas les références E2 et E3, la formule en ligne 3 tentera de soustraire la valeur d’une cellule E3 pour ensuite la diviser par une cellule E4 potentiellement vide ou textuelle, générant instantanément des corruptions de calculs et de multiples erreurs de division par zéro.
Pour immuniser la formule contre ce déplacement relatif lors de l’incrémentation verticale, il est strictement impératif de figer la position de la ligne et de la colonne en plaçant le symbole dollar devant chaque composante des coordonnées fixes. La formulation canonique irréprochable s’écrit par conséquent sous la syntaxe :
=(A2 – $E$2) / $E$3
Dans cette architecture robuste, la cellule A2 demeure une référence relative libre d’évoluer de ligne en ligne lors de la propagation du calcul, tandis que les paramètres $E$2 et $E$3 demeurent inébranlablement ancrés sur leurs positions respectives de référence, garantissant une cohérence arithmétique totale d’un bout à l’autre du jeu de données.
5.3 Propagation matricielle et remplissage automatique
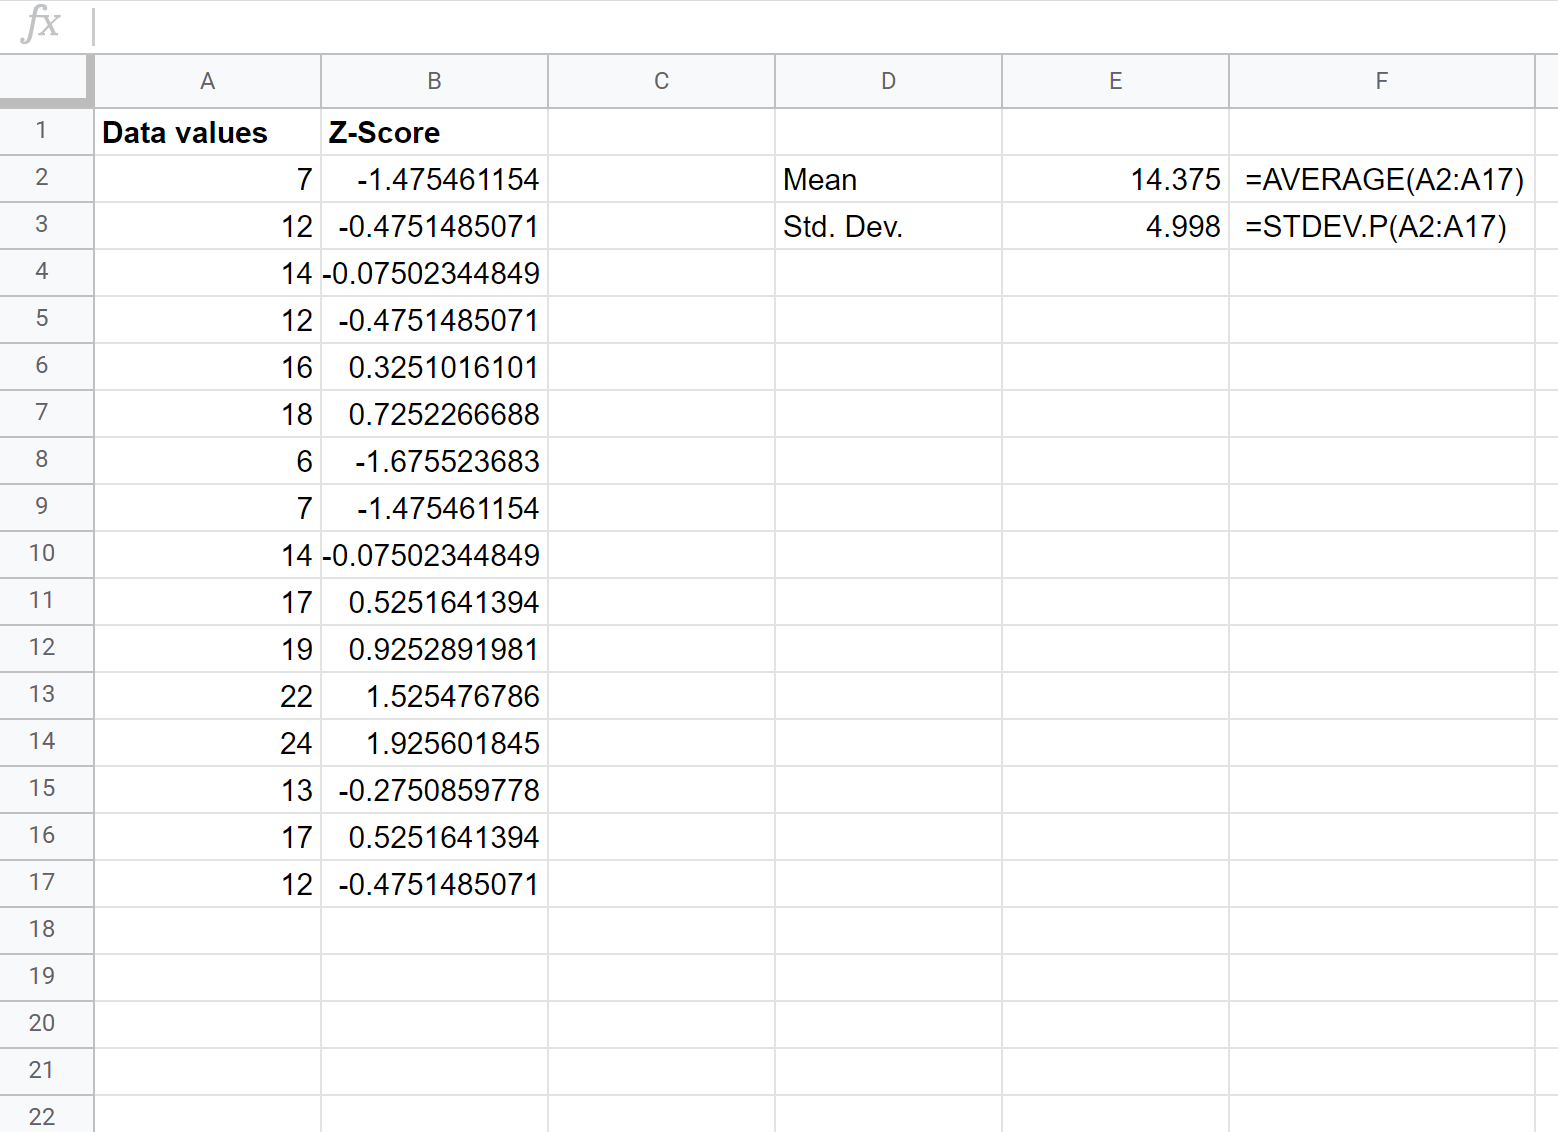
Une fois la formule élémentaire rigoureusement paramétrée sur la première ligne d’observation au sein de la colonne réservée aux cotes Z (par exemple en cellule C2), l’analyste dispose de plusieurs protocoles opérationnels dans l’interface de Google Sheets pour répliquer le calcul sur l’intégralité de la série expérimentale sans avoir à ressaisir manuellement la syntaxe.
La première modalité, visuelle et manuelle, repose sur l’usage de la poignée de recopie incrémentale. L’utilisateur positionne le curseur de sa souris sur le coin inférieur droit de la cellule active C2 jusqu’à ce que le pointeur se métamorphose en une fine croix noire, puis procède à un cliquer-glisser descendant jusqu’à la dernière ligne garnie du tableau. De façon plus expéditive, un simple double-clic gauche appliqué sur cette même poignée de recopie ordonne à Google Sheets de scanner automatiquement la continuité des données présentes dans la colonne adjacente gauche et d’étendre la formule jusqu’à l’exacte ligne de terminaison de la cohorte.
Pour les cohortes massives regroupant des dizaines de milliers de lignes où le défilement manuel s’avère fastidieux, les raccourcis clavier fournissent une efficacité supérieure. Il suffit de sélectionner la cellule source C2, de combiner les touches Ctrl + Maj + Flèche Bas (ou Cmd + Maj + Flèche Bas sous macOS) afin d’englober la totalité de la plage cible à renseigner, puis d’exécuter la combinaison de commande Ctrl + D (pour « Fill Down »). Cette instruction remplit instantanément l’intégralité de la sélection avec la formule d’origine. Avant de clore l’opération, une inspection attentive de la dernière ligne du tableau constitue une saine discipline de contrôle qualité pour certifier que les références relatives pointent sans dérive sur les données du dernier participant tandis que les paramètres descriptifs demeurent parfaitement verrouillés.
6. Calcul optimisé avec la fonction intégrée CENTREE.REDUIRE
6.1 Présentation et syntaxe de la fonction CENTREE.REDUIRE
Si la méthode arithmétique manuelle séduit par sa limpidité conceptuelle, Google Sheets propose une fonction native entièrement dédiée à cette opération mathématique, issue directement de l’arsenal des tableurs professionnels : la fonction CENTREE.REDUIRE. Cette commande logicielle, rigoureusement équivalente à la fonction anglo-saxonne STANDARDIZE, a été spécialement modélisée pour décharger l’utilisateur de la gestion explicite des parenthèses et rationaliser le temps d’exécution des algorithmes de calcul statistique en mémoire.
La structure syntaxique de cette fonction intégrée répond à un ordre paramétrique formel immuable, décliné sous trois arguments obligatoires séparés par des points-virgules dans la configuration régionale francophone du tableur :
=CENTREE.REDUIRE(valeur; moyenne; écart_type)
Le premier argument, valeur, renvoie à la donnée brute observée relative au sujet en cours d’analyse (par exemple la coordonnée matricielle A2). Le deuxième argument, moyenne, attend le point central de la distribution empirique ou théorique, tandis que le troisième paramètre, écart_type, requiert l’indicateur de dispersion standard de cette même distribution. L’un des atouts computationnels majeurs de cette commande réside dans sa gestion interne optimisée des calculs en virgule flottante au sein des serveurs de Google Cloud, ce qui atténue significativement les risques d’erreurs d’arrondi infinitésimales susceptibles d’apparaître sur de très volumineuses matrices numériques lors de divisions successives manuelles.
6.2 Intégration dynamique des calculs au sein d’une seule formule
L’un des raffinements les plus puissants offerts par l’écosystème de Google Sheets réside dans la capacité à imbriquer fonctionnellement plusieurs instructions complexes au sein d’une seule et même formulation synthétique. Au lieu d’assujettir le calcul du score Z à l’existence préalable de cellules auxiliaires externes hébergeant la moyenne et l’écart-type, il est parfaitement possible de condenser l’intégralité du processus mathématique au cœur même de l’appel à la fonction CENTREE.REDUIRE :
=CENTREE.REDUIRE(A2; MOYENNE($A$2:$A$101); ECARTYPE.STANDARD($A$2:$A$101))
Cette approche dynamique présente des avantages substantiels en ingénierie de données tabulaires. Elle confère une compacité absolue à la feuille de calcul en éliminant le recours à des plages périphériques secondaires, limitant ainsi les risques de suppression accidentelle d’une cellule de paramètre par un tiers. L’intégrité du modèle analytique est directement contenue dans chaque cellule calculée. Il convient néanmoins de souligner que les étendues soumises aux fonctions internes MOYENNE et ECARTYPE.STANDARD doivent impérativement faire l’objet d’un verrouillage absolu par le symbole dollar afin d’éviter que la fenêtre temporelle ou d’échantillonnage ne glisse progressivement vers le bas lors de l’étirement vertical de la formule.
Toutefois, sur le plan des ressources computationnelles, il importe d’avertir l’analyste manipulant des jeux de données d’une ampleur considérable : la réplication à l’identique de cette formule dynamique imbriquée sur cinquante mille lignes contraint Google Sheets à recalculer cinquante mille fois consécutives la moyenne et l’écart-type de la série complète. Ce phénomène de recalcul redondant peut entraîner une dégradation sensible de la fluidité d’affichage du classeur en ligne. Dans les contextes de méga-données (Big Data), l’ancrage des paramètres préalablement stabilisés dans deux cellules fixes distinctes demeure par conséquent la recommandation technique préférentielle.
6.3 Comparaison méthodologique des deux approches
Le choix entre l’expression arithmétique manuelle élémentaire (X – Moyenne) / EcartType et l’instruction intégrée CENTREE.REDUIRE doit s’opérer en fonction du public cible de la feuille de calcul, du niveau d’expertise technique de l’équipe d’analystes et des impératifs d’auditabilité scientifique du protocole de recherche. Aucune des deux modalités ne peut être décrétée universellement supérieure ; elles répondent à des objectifs ergonomiques distincts.
L’approche arithmétique manuelle brille par sa vertueuse simplicité didactique. Pour des étudiants débutant dans l’analyse de données quantitatives ou pour des évaluateurs externes appelés à contrôler une expertise médico-légale, voir apparaître ostensiblement la structure de la fraction avec son numérateur différentiel et son dénominateur réducteur désamorce l’effet « boîte noire » que peuvent induire certaines fonctions propriétaires. Tout lecteur disposant d’un bagage algébrique élémentaire peut immédiatement attester de la loyauté des calculs appliqués sans avoir à investiguer l’aide documentaire du tableur.
Inversement, la fonction CENTREE.REDUIRE apporte une robustesse syntaxique indéniable dans les projets professionnels collaboratifs à grande échelle. Son intitulé fonctionnel explicite protège la cellule contre les altérations accidentelles que des utilisateurs tiers pourraient provoquer en modifiant malencontreusement un opérateur arithmétique ou une parenthèse au sein d’une longue formule complexe. De plus, elle s’aligne formellement sur les standards syntaxiques préconisés par les organismes internationaux de normalisation logicielle, facilitant l’interopérabilité lors d’éventuelles exportations ou migrations de la base de données vers des progiciels statistiques avancés tels que R, Python ou SAS.
7. Automatisation avancée avec les formules matricielles ARRAYFORMULA
7.1 Principes de fonctionnement de la fonction ARRAYFORMULA
L’un des avantages compétitifs majeurs de Google Sheets face aux tableurs bureautiques traditionnels réside dans son moteur natif d’évaluation vectorielle, orchestré principalement par la fonction ARRAYFORMULA. Dans un tableur classique, l’application d’un calcul à une série de mille observations contraint traditionnellement l’utilisateur à créer mille instances distinctes d’une même formule, répliquées ligne par ligne. Cette approche dite cellulaire présente une fragilité structurelle notoire : si un collaborateur supprime involontairement la formule d’une ligne intermédiaire, ou si de nouvelles lignes de données sont injectées ultérieurement au bas de la cohorte, la continuité de la chaîne analytique se trouve rompue.
La commande ARRAYFORMULA transcende cette contrainte en instaurant une logique de programmation matricielle : une unique formule, saisie dans la toute première cellule de la colonne de restitution, prend en charge l’évaluation de la totalité du vecteur de données sur toute la hauteur de la feuille. Le processeur du tableur prend en compte l’ensemble du tableau en un seul passage de calcul vectoriel, générant de facto une cascade descendante de résultats instantanés sans qu’aucune formule n’ait besoin d’être inscrite dans les cellules sous-jacentes. Cette approche procure un gain d’efficacité inestimable, garantissant que tout nouvel enregistrement arrivant au sein du classeur (par exemple via une connexion directe avec un questionnaire Google Forms) sera immédiatement et automatiquement transformé en score Z sans nécessiter la moindre intervention manuelle.
7.2 Syntaxe de vectorisation pour les scores Z
L’implémentation pratique de la vectorisation pour le calcul des scores Z requiert l’adaptation du référencement matriciel dans la syntaxe élémentaire. Au lieu de désigner une cellule unique représentative de la première ligne (comme A2), l’opérateur doit stipuler formellement l’étendue continue de la colonne entière à traiter sous la notation indicielle A2:A. En omettant délibérément le numéro de ligne finale, on ordonne au tableur de considérer toutes les lignes existantes et futures jusqu’à la limite inférieure de la feuille.
En combinant la méthode arithmétique aux capacités de vectorisation, la formule matricielle s’articule de la manière suivante en cellule C2 :
=ARRAYFORMULA((A2:A – $E$2) / $E$3)
Sous cette instruction, Google Sheets applique quasi instantanément la soustraction de la moyenne $E$2 et la division par l’écart-type $E$3 à chaque composante scalaire du vecteur A2:A. Il importe cependant d’alerter sur une restriction fonctionnelle d’importance : certaines commandes haut niveau intégrées, telles que CENTREE.REDUIRE, ne tolèrent pas nativement l’expansion vectorielle au sein de l’environnement ARRAYFORMULA standard de Google Sheets. Pour exploiter pleinement la puissance des formules matricielles globales sans générer de blocages d’évaluation de tableaux, la formulation arithmétique fractionnaire standardisée demeure la modalité technique la plus fiable et la plus compatible pour la vectorisation automatique.
7.3 Conditionnement logique pour les lignes vierges
Une mise en œuvre naïve de la commande ARRAYFORMULA vectorisée sur une étendue illimitée du type A2:A révèle immédiatement un écueil esthétique et analytique majeur : le tableur traite les cellules vides situées au bas de la colonne comme des zéros arithmétiques. En conséquence, la formule soustrait la moyenne à ces zéros fictifs et divise le tout par l’écart-type, remplissant des centaines de lignes vierges avec des scores Z artificiels hautement négatifs (égaux précisément à -Moyenne / EcartType). Ce phénomène dégrade la clarté visuelle du rapport et risque de corrompre de futures représentations graphiques ou calculs d’agrégation subséquents.
Pour parer à ce désagrément de manière élégante et professionnelle, il est fondamental de subordonner l’exécution de la transformation mathématique à une structure de contrôle logique conditionnelle. La fonction SI (IF), combinée au prédicat ESTVIDE (ISBLANK), s’intègre parfaitement à l’intérieur du bloc matriciel :
=ARRAYFORMULA(SI(ESTVIDE(A2:A); « »; (A2:A – $E$2) / $E$3))
Grâce à cette imbrication conditionnelle, le moteur algorithmique inspecte chaque ligne de l’étendue vectorielle avant d’opérer la normalisation. Si la cellule correspondante de la colonne d’entrée A s’avère vide, le tableur renvoie une chaîne de caractères strictement vide symbolisée par les guillemets fermés (« »), laissant la ligne correspondante parfaitement immaculée. Ce n’est que dans l’éventualité où une donnée numérique tangible est constatée que la transformation en score Z s’exécute. La colonne des scores standardisés conserve ainsi une netteté visuelle absolue et s’ajuste dynamiquement en temps réel au fur et à mesure de la saisie incrémentale de nouveaux participants dans l’étude.
8. Interprétation statistique et psychométrique des scores Z obtenus
8.1 Lecture analytique de la magnitude et du signe
L’obtention d’une colonne de scores Z au sein de Google Sheets ne représente qu’un jalon technique préliminaire ; l’enjeu prépondérant réside dans l’art de l’interprétation diagnostique et théorique des coefficients produits. Chaque score Z condense simultanément deux vecteurs d’information analytique d’une richesse remarquable : une polarité directionnelle définie par son signe algébrique, et une magnitude quantitative régie par sa valeur absolue.
Sur le plan sémiologique, un score Z rigoureusement égal à 0,00 indique avec une exactitude absolue que l’individu testé s’aligne mathématiquement sur le point d’équilibre central de sa population de référence. La polarité du signe affine immédiatement le positionnement différentiel : une cote pourvue d’un signe positif (+z) atteste sans équivoque d’une performance ou d’un niveau d’expression du trait supérieur à la tendance centrale, tandis qu’un signe négatif (-z) matérialise un positionnement dans la moitié inférieure de la cohorte.
La magnitude du score, c’est-à-dire sa distance cardinale par rapport à l’origine zéro, calibre la rareté et l’intensité clinique du phénomène observé selon des jalons méthodologiques universels :
- Zone de moyenne typique (|Z| < 1,00) : L’observation se situe à l’intérieur d’un couloir de fluctuation normale englobant approximativement 68,2 % des effectifs au sein d’une distribution normale classique. Aucun écart fonctionnel notable n’est constaté.
- Zone d’écart significatif (1,00 ≤ |Z| < 2,00) : Le sujet commence à s’isoler notablement de la médiane commune. Dans un contexte psychologique, ce niveau d’écart caractérise des zones de fragilité modérée ou d’efficience marquée qui méritent une attention clinique spécifique sans pour autant constituer une atypie pathologique avérée.
- Zone de déviation atypique ou pathologique (|Z| ≥ 2,00) : L’observation se situe à deux écarts-types ou plus du centre, ce qui ne concerne théoriquement que moins de 5 % de la population générale. En neuropsychologie, le franchissement du seuil Z = -1,65 ou Z = -2,00 constitue souvent le critère diagnostique d’alerte pour caractériser un déficit cognitif avéré (par exemple un trouble amnésique substantiel justifiant une prise en charge ciblée).
- Zone d’exceptionnalité extrême (|Z| ≥ 3,00) : Présente chez moins de 0,3 % des individus, une telle déviation dénote un profil hautement singulier, soulevant la question d’un potentiel exceptionnel, d’une rupture pathologique sévère ou d’un artéfact expérimental.
8.2 Correspondance avec la distribution normale unitaire
L’immense force épistémologique du score Z s’épanouit pleinement lorsqu’on le connecte à la fonction de répartition cumulative de la loi normale centrée réduite, matérialisée par la célèbre courbe en cloche de Gauss-Laplace. Dans cette perspective probabiliste, chaque valeur de score Z correspond de façon univoque à un rang centile déterminé, renseignant avec une précision chirurgicale sur le pourcentage cumulé de la population dont la performance est inférieure ou égale à celle de l’individu examiné.
Google Sheets offre une fonction statistique dédiée permettant d’opérer cette conversion probabiliste de manière instantanée et dynamique : la fonction LOI.NORMALE.STANDARD.N (ou NORMSDIST). En inscrivant en vis-à-vis d’une cellule de score Z (par exemple C2) la commande suivante :
=LOI.NORMALE.STANDARD.N(C2)
Le tableur renvoie une valeur décimale comprise entre 0 et 1, qu’il suffit de formater en pourcentage via l’interface logicielle pour obtenir le rang centile. À titre d’illustration, l’application de cette fonction à un score Z de +1,00 renvoie une probabilité cumulative de 0,8413, signifiant que le sujet dépasse précisément 84,1 % de la cohorte d’étalonnage. De façon symétrique, une note Z de -1,96 correspond exactement au seuil centile critique de 0,025 (soit 2,5 % de la population dans la queue de distribution inférieure). Cette équivalence mathématique directe permet aux professionnels de santé d’expliquer les résultats d’un bilan avec une limpidité parfaite aux patients et aux familles, substituant l’abstraction d’une formule algébrique par une représentation concrète en rang de centiles.
8.3 Étalonnages dérivés en sciences psychologiques
Bien que le score Z s’impose comme le pivot analytique universel du statisticien, il est rarement restitué tel quel aux évaluateurs finaux dans les rapports cliniques ou les bilans de compétences. Sa manipulation implique en effet des cotes négatives et des valeurs décimales souvent mal interprétées par un public non initié, qui tend à percevoir une cote négative comme un résultat « nul » ou un échec sanctionnant. C’est pourquoi la psychométrie contemporaine recourt abondamment à des échelles de transformation dérivées, construites par translation et dilatation d’échelle à partir de la matrice fondamentale des scores Z calculés dans Google Sheets.
La transformation vers les scores T de McCall est particulièrement privilégiée dans les inventaires cliniques de la personnalité (tels que le MMPI). En déployant la formule =(C2 * 10) + 50 dans une nouvelle colonne du tableur, l’analyste transpose la distribution sur une échelle conventionnelle dont la moyenne est calée à 50 et l’écart-type à 10. Ainsi, un score Z de -2,00 se traduit par un score T de 30, tandis qu’un score Z de +1,50 culmine à un score T de 65, écartant définitivement l’apparition de polarités négatives tout en préservant scrupuleusement les proportions de dispersion originelles.
Dans la sphère de l’évaluation de l’intelligence générale et des aptitudes cognitives multifactorielles (batteries d’échelles de Wechsler telles que le WAIS ou le WISC), la métrique reine s’incarne dans le QI standardisé. Sa génération sous Google Sheets dérive directement du score Z via la formule =(C2 * 15) + 100. L’échelle ainsi matérialisée attribue une note de 100 à la moyenne populationnelle exacte, avec des paliers d’écart-type fixés à 15 points. Le seuil paradigmatique de la douance intellectuelle ou des hauts potentiels cognitifs, traditionnellement fixé à deux écarts-types au-dessus de la moyenne (Z ≥ +2,00), se traduit immédiatement par l’atteinte d’un QI égal ou supérieur à 130 points, tandis que le seuil de déficience intellectuelle (Z ≤ -2,00) correspond symétriquement à un score inférieur ou égal à 70.
9. Détection et traitement rigoureux des valeurs aberrantes
9.1 Critères statistiques d’identification des outliers
Dans tout dispositif expérimental ou protocole d’évaluation psychologique de grande ampleur, le jeu de données recueilli est inévitablement pollué par des valeurs aberrantes ou atypiques, couramment désignées sous le vocable anglais d’outliers. La présence de ces données exogènes peut biaiser dramatiquement les estimations inférentielles subséquentes, en augmentant artificiellement la variance et en gauchissant la moyenne d’échantillon. Grâce à sa métrique adimensionnelle standardisée, le score Z s’affirme comme un outil diagnostique de premier plan pour débusquer méthodiquement ces anomalies distributionnelles.
La littérature méthodologique internationale en psychologie quantitative préconise deux seuils statistiques conventionnels majeurs pour statuer sur la nature aberrante d’un enregistrement :
- Le critère de détection exploratoire (|Z| > 2,58) : Ce jalon mathématique correspond au niveau de significativité bilatérale alpha de 0,01. Dans l’hypothèse gaussienne unitaire, la probabilité d’observer par pur hasard une valeur s’éloignant à plus de 2,58 écarts-types de la moyenne n’est que de 1 sur 100. Tout score excédant cette borne doit être impérativement marqué d’un pavillon d’audit statistique au sein du tableur.
- Le critère d’exclusion conservatrice (|Z| > 3,29) : Aligné sur le seuil critique d’extrême rareté de p < 0,001, ce niveau de troncature stipule qu’une telle valeur ne devrait survenir spontanément que trois fois sur mille observations. Sur des cohortes expérimentales de tailles modérées (N compris entre 50 et 300 sujets), une observation affichant |Z| > 3,29 trahit quasi invariablement un problème de fidélité métrologique ou un comportement expérimental déviant.
Il importe toutefois pour l’analyste de maintenir une distinction épistémologique scrupuleuse entre deux catégories d’outliers : l’erreur expérimentale factice (provoquée par une double frappe de touche, un décrochage capteur lors d’un enregistrement EEG, ou une incompréhension totale des consignes par le sujet) et la variabilité biologique authentique. Une observation extrêmement déviante n’est pas nécessairement erronée ; elle peut refléter l’expression clinique légitime d’une pathologie rare ou d’un profil cognitif atypique mais parfaitement valide, que l’on aurait tort d’évincer hâtivement du jeu de données.
9.2 Mise en forme conditionnelle pour signalement visuel
L’exploitation de l’interface graphique de Google Sheets permet d’automatiser le repérage visuel des observations critiques au moyen des règles dynamiques de mise en forme conditionnelle. Cette fonctionnalité offre à l’évaluateur un tableau de bord analytique interactif, où les déviations statistiques majeures émergent instantanément à l’œil nu dès l’ouverture du classeur collaboratif.
Pour orchestrer ce balisage visuel au sein de la colonne des scores Z (admettons la plage C2:C101), la procédure opérationnelle se déploie à travers le menu Format > Mise en forme conditionnelle. Dans le panneau de configuration latéral, l’analyste sélectionne la modalité de règle par « Formule personnalisée » afin de s’affranchir des contraintes des filtres préprogrammés. Pour marquer en surbrillance rouge vif toute observation suspecte violant le seuil bilatéral des 2,58 écarts-types, l’instruction logique s’énonce avec élégance en mobilisant la fonction de valeur absolue :
=ABS(C2) > 2,58
Cette simple condition commande au tableur d’inspecter dynamiquement chaque cellule de la plage ; dès lors que la valeur absolue du score Z franchit le paramètre critique, la cellule se colore immédiatement dans la teinte sélectionnée. Il est tout aussi pertinent de déployer une mise en forme sous la forme d’une échelle de dégradé thermique bicolore ou tricolore (allant du bleu froid pour les scores très faibles, vers le blanc pour les scores médians, pour culminer au rouge incandescent pour les scores très élevés). Ce dispositif visuel continu permet d’apprécier d’un simple balayage du regard l’équilibre global de la dispersion empirique de l’étude.
9.3 Décisions méthodologiques face aux scores extrêmes
Une fois les scores Z aberrants rigoureusement isolés et cartographiés dans l’environnement Google Sheets, l’analyste ne peut se contenter d’une posture passive ; il doit arrêter une décision méthodologique transparente et documentée quant au sort réservé à ces données marginales. L’époque des suppressions discrétionnaires et silencieuses d’observations discordantes est révolue ; les standards de la science ouverte imposent une traçabilité totale des choix d’épuration.
La première orientation, radicale mais justifiée en cas de dysfonctionnement technique flagrant avéré, réside dans l’élision pure et simple de l’enregistrement incriminé. Cette suppression ne doit cependant intervenir que si elle est adossée à un protocole de pré-enregistrement d’analyse ou justifiée par un compte-rendu d’incident expérimental documenté au moment de la passation. Si l’on choisit cette voie sous Google Sheets, la bonne pratique commande de ne pas supprimer physiquement la ligne du classeur originel, mais de créer une colonne d’exclusion binaire (avec des marqueurs 0 ou 1) et d’utiliser la fonction FILTER pour édifier la table d’analyse finale épurée sur un onglet distinct.
Une alternative méthodologique plus robuste et élégante consiste à recourir à la technique de winsorisation (ou écrêtement des queues distributionnelles). Cette approche statistique conserve l’ensemble des unités d’observation mais rabat les valeurs extrêmes situées au-delà des bornes critiques sur l’exacte valeur plafond autorisée (par exemple, tout score brut correspondant à un score Z supérieur à +3,00 est systématiquement réassigné à la valeur brute théorique calibrée précisément à Z = +3,00). Enfin, la conduite d’une analyse de sensibilité constitue la stratégie scientifique la plus irréprochable : l’analyste exécute l’ensemble des modélisations statistiques sur les données brutes intégrales, puis réitère les mêmes équations sur les données sans les outliers repérés par les scores Z, en consignant minutieusement dans son rapport de recherche si l’exclusion de ces données modifie ou non les conclusions substantielles de l’étude.
10. Visualisation graphique des scores Z dans Google Sheets
10.1 Construction d’un histogramme de distribution standardisée
La modélisation graphique des données transformées constitue le corollaire indispensable de l’analyse tabulaire. L’histogramme de distribution représente l’outil visuel par excellence pour attester empiriquement du bon déroulement de la standardisation et apprécier la morphologie globale de la série des scores Z générés au sein de Google Sheets.
Pour élaborer cette figure, l’opérateur commence par sélectionner l’intégralité de la colonne hébergeant les scores Z calculés, puis actionne la commande du ruban supérieur Insertion > Graphique. Au sein du panneau d’édition latéral qui se déploie sur la droite de l’interface, il convient de modifier le type d’affichage par défaut en sélectionnant l’icône spécifique « Histogramme » dans la sous-section descriptive. Le moteur graphique de Google Sheets procède alors spontanément au regroupement des données continues au sein d’intervalles de classes adjacents.
Une intervention manuelle experte s’avère toutefois nécessaire pour conférer à cet histogramme une pertinence psychométrique indiscutable. Dans l’onglet « Personnaliser » du configurateur de graphique, au sein de la rubrique dédiée « Histogramme », l’analyste doit modifier la largeur des classes (le compartimentage ou « bucket size ») pour lui attribuer une valeur unitaire fixe de 0,5 ou de 1,0. Ce paramétrage force le tableur à caler ses barres verticales sur les jalons théoriques de dispersion canonique : de -3 à -2, de -2 à -1, de -1 à 0, et ainsi de suite. L’histogramme ainsi calibré permet d’examiner instantanément la symétrie de la distribution expérimentale et de vérifier visuellement si le sommet modal coïncide fidèlement avec le point de centrage zéro attendu.
10.2 Superposition de la courbe gaussienne théorique
L’un des accomplissements visuels les plus valorisants dans un rapport de recherche ou une présentation clinique consiste à superposer, au-dessus des barres de l’histogramme expérimental, la trajectoire idéale de la courbe gaussienne théorique (la fonction de densité de probabilité normale). Cette confrontation visuelle offre une démonstration directe de l’adéquation ou de la dérive de l’échantillon par rapport au modèle d’échantillonnage universel.
Bien que Google Sheets ne dispose pas d’un bouton automatisé de superposition de densité théorique dans son module d’histogramme standard, il est tout à fait possible d’édifier ce double affichage par le biais d’un montage graphique combiné (graphique combiné colonnes / lignes). Pour orchestrer cette mise en scène, l’analyste génère sur une plage contiguë une série de valeurs Z théoriques régulières s’étendant de -4,00 à +4,00 par incréments constants de 0,10 point. Dans la colonne voisine, on calcule la densité de probabilité normale théorique associée à chaque pas au moyen de la fonction mathématique intégrée :
=LOI.NORMALE.N(valeur_Z; 0; 1; FAUX)
Le paramètre logique « FAUX » ordonne rigoureusement au tableur de renvoyer la hauteur de la densité de probabilité ponctuelle et non l’intégrale cumulative. Il ne reste plus ensuite qu’à fusionner la distribution des fréquences relatives empiriques de l’échantillon et cette trajectoire mathématique continue au sein d’un graphique composite combinant barres d’histogramme et tracé curvilinéaire lisse. La convergence ou la divergence des deux couches graphiques permet d’évaluer d’un simple coup d’œil l’ampleur des phénomènes d’asymétrie ou d’aplatissement affectant le jeu de données.
10.3 Diagrammes de dispersion et profils individuels
Au-delà de la vision macroscopique offerte par les histogrammes de fréquences, le chercheur ou le psychologue clinicien a fréquemment besoin d’examiner la distribution des scores Z à l’échelle mésoscopique ou individuelle. Le diagramme de dispersion (ou nuage de points) s’avère dans cette optique un instrument d’une remarquable puissance sémiologique.
Dans un contexte d’analyse d’échantillon globale, configurer un graphique de dispersion représentant les scores Z sur l’axe des ordonnées (axe Y) en fonction de l’identifiant séquentiel des participants sur l’axe des abscisses (axe X) permet d’obtenir une cartographie exhaustive de la cohorte. L’intérêt méthodologique majeur de ce diagramme réside dans l’insertion manuelle de lignes horizontales d’annotation de référence, positionnées à Y = +2,00 et Y = -2,00. Ces démarcations visuelles scindent instantanément l’espace graphique en un couloir de normativité centrale et deux corridors d’atypie marginale supérieure et inférieure, rendant l’extraction des profils singuliers d’une simplicité enfantine.
Dans le domaine du bilan neuropsychologique individuel, cette modalité graphique se réinvente sous la forme d’un profil psychométrique multidimensionnel pour un sujet unique. En plaçant sur l’axe horizontal les différents sous-tests administrés (Mémoire épisodique, Fonctions exécutives, Vitesse de traitement, Flexibilité mentale) et sur l’axe vertical les scores Z respectifs obtenus par le patient, le clinicien trace une véritable « ligne de flottaison » cognitive. Ce profilage vectoriel, exportable sous forme d’image vectorielle ou de document PDF directement intégrable dans un manuscrit académique, met en exergue de façon saisissante les contrastes inter-domaines et les dissociations cognitives propres au patient.
11. Erreurs courantes, écueils méthodologiques et dépannage
11.1 Résolution des erreurs techniques de syntaxe
L’implémentation de calculs statistiques au sein d’un tableur basé sur le Web n’est pas exempte d’incidents techniques d’encodage. Une compréhension lucide des codes d’erreur retournés par Google Sheets s’avère indispensable pour dépanner promptement une feuille de travail compromise.
Le message d’alerte #DIV/0! s’impose comme l’incident le plus fréquemment rencontré lors du calcul d’un score Z. Cette erreur de division par zéro trahit inéluctablement une défaillance au niveau du dénominateur de la formule, c’est-à-dire l’écart-type. Deux causes majeures engendrent ce symptôme : soit la plage de calcul de la dispersion pointe vers un intervalle de cellules entièrement vierges ou textuelles, soit l’échantillon mesuré présente une variance nulle absolue (situation où tous les participants ont retourné rigoureusement le même score brut, rendant la dispersion égale à zéro et la réduction mathématiquement impossible). Dans ce dernier cas, la métrique Z ne peut tout simplement pas être calculée en l’absence de toute variation interindividuelle.
L’apparition de l’erreur #VALEUR! signale quant à elle une anomalie de typage des données. Ce problème émerge quasi systématiquement lorsqu’un caractère typographique parasite (tel qu’un espace insécable, un point au lieu d’une virgule, ou une lettre égarée) est présent dans la cellule contenant le score brut ou dans les paramètres d’agrégation. Il convient de souligner que les divergences de configuration régionale au sein des paramètres du classeur Google Sheets (accessibles sous Fichier > Paramètres) constituent une source récurrente de friction technique : sous une localisation francophone, le séparateur décimal officiel est impérativement la virgule et le séparateur d’arguments de fonction le point-virgule, tandis qu’un profil anglo-saxon exige le point décimal et la virgule de séparation d’arguments. Une discordance à ce niveau paralyse instantanément l’exécution des équations.
11.2 Biais d’échantillonnage et instabilité des paramètres
Au-delà des accrocs purement informatiques, les écueils les plus pernicieux qui menacent l’analyste sont d’ordre conceptuel et méthodologique. Le plus redoutable réside dans la sous-estimation dramatique de la volatilité des estimateurs descriptifs lorsque la standardisation est conduite sur des cohortes d’échantillonnage étriquées. Calculer des scores Z sur un groupe de douze sujets expérimentaux en traitant la moyenne et l’écart-type empiriques comme des vérités métrologiques intangibles relève de l’illusion statistique : l’erreur standard de la moyenne et l’intervalle de confiance de la variance sont alors tellement démesurés que la cote Z attribuée à un individu fluctuerait de façon spectaculaire avec l’adjonction de seulement deux sujets supplémentaires.
Un autre écueil méthodologique récurrent réside dans la comparaison erronée de scores Z issus de sous-échantillons distincts ou d’étalonnages temporels disjoints. Il est scientifiquement proscrit de comparer directement le score Z d’un sujet issu d’un groupe expérimental A avec le score Z d’un autre sujet calculé sur les paramètres d’un groupe témoin B, sans les avoir au préalable rattachés à un référentiel de standardisation commun et unifié. Dans la mesure où chaque score Z est intrinsèquement tributaire de la moyenne et de la variance spécifiques du groupe qui l’a engendré, une cote Z de +1,50 au sein d’une cohorte clinique sévèrement altérée peut matériellement correspondre à une performance brute inférieure à celle caractérisée par un score Z de -0,50 au sein d’une population de contrôle de haut niveau.
Enfin, la problématique de la troncature de variance doit alerter le psychométricien intervenant en milieux spécialisés. Lors de l’évaluation d’une population hypersélectionnée (par exemple des candidats à un concours de très haute sélectivité ou des patients atteints d’un stade terminal d’une pathologie neurodégénérative), la variance des scores bruts se trouve drastiquement compressée comparativement à la population générale. Si l’on calcule les scores Z sur cet échantillon homogénéisé, le dénominateur s’en trouvera artificiellement réduit, provoquant une dilatation disproportionnée des cotes Z au moindre écart brut marginal. L’analyste doit impérativement documenter ces phénomènes de sélection sous peine d’émettre des inférences cliniques totalement fallacieuses.
11.3 Procédures de vérification et d’audit des formules
Pour parachever l’élaboration d’un modèle d’analyse quantitatif au sein de Google Sheets et garantir une reproductibilité exempte de tout soupçon méthodologique, la mise en place d’une routine de validation croisée et d’audit interne des calculs s’avère indispensable. Le chercheur dispose d’une série de contrôles d’intégrité déterministes reposant directement sur les propriétés mathématiques invariantes de la distribution réduite canonique.
La première règle de cohérence stipule que la moyenne arithmétique globale de l’ensemble des scores Z générés au sein d’une colonne doit obligatoirement converger vers zéro. En insérant au bas de la colonne standardisée une formule de vérification telle que =MOYENNE(C2:C101), le résultat retourné doit être égal à 0,00 (ou osciller à des puissances résiduelles infinitésimales de l’ordre de 10⁻¹⁵ résultant de l’approximation de calcul du microprocesseur). De façon strictement analogue, la mesure de la dispersion calculée sur cette même série au moyen de la fonction =ECARTYPE.P(C2:C101) doit s’établir avec une inflexibilité totale à 1,00.
Il est extrêmement judicieux de synthétiser ces postulats au sein d’une cellule sentinelle de validation logique dédiée à l’audit. En positionnant dans un encart de vérification une formule d’assertion conditionnelle booléenne telle que :
=SI(ET(ABS(MOYENNE(C2:C101)) < 0,0001; ARRONDI(ECARTYPE.P(C2:C101); 4) = 1); « INTÉGRITÉ CONFORME »; « ERREUR DE STANDARDISATION »)
L’analyste dispose d’un témoin de sécurité permanent au sein de sa feuille de calcul. Toute modification accidentelle d’une formule matricielle, toute introduction malencontreuse de texte dans les colonnes ou tout décalage d’adressage absolu déclenche immédiatement le basculement du voyant d’alerte, protégeant ainsi l’ensemble de la chaîne inférentielle contre les erreurs d’inattention avant toute publication académique ou exploitation médicale des résultats.
12. Applications pratiques avancées : Standardisation d’échelles psychologiques
12.1 Harmonisation d’échelles de Likert hétérogènes
L’une des manifestations les plus éclatantes de la puissance des scores Z dans Google Sheets concerne l’unification d’inventaires d’attitudes ou de questionnaires psychologiques composés de structures d’échelles de Likert hétérogènes. Dans les grandes enquêtes épidémiologiques ou organisationnelles, les chercheurs sont fréquemment conduits à administrer simultanément des instruments conçus par des équipes de recherche distinctes : un questionnaire d’épuisement professionnel articulé sur une échelle en cinq points (allant de 1 « Jamais » à 5 « Quotidiennement ») et un inventaire de soutien social mesuré sur une échelle en sept points (de 1 « En total désaccord » à 7 « En total accord »).
Tenter de fusionner ou d’agréger les scores bruts issus de ces deux métriques discordantes au sein d’un score composite global constitue une faute statistique grossière, car l’échelle à sept points pèserait mécaniquement d’un poids disproportionné dans la variance totale du construit combiné. La standardisation préalable de chacune des échelles en scores Z respectifs au sein de colonnes parallèles de Google Sheets résout définitivement ce biais d’échelle. En convertissant chaque sous-dimension sous forme d’unités de variance relatives, les variables acquièrent une métrique commune strictement commensurable.
Dès lors, l’analyste peut élaborer un score composite agrégé d’une loyauté métrologique absolue, en calculant la moyenne ou la somme pondérée des scores Z des deux colonnes au sein d’une troisième division du tableur. De surcroît, cette approche ouvre la voie à la correction des biais de désirabilité sociale ou de style de réponse par la méthode du centrage intra-individuel (ipsatisation) : en calculant le score Z d’un individu non pas par rapport à la moyenne de l’échantillon, mais par rapport à la propre moyenne de l’ensemble de ses réponses au questionnaire, on neutralise efficacement les tendances idiosyncrasiques à acquiescer systématiquement ou à fuir vers les réponses modales extrêmes.
12.2 Comparaison de profils cognitifs multidimensionnels
L’évaluation des profils d’efficience intellectuelle et cognitive en neuropsychologie clinique constitue le sanctuaire d’application par excellence du score Z sous Google Sheets. Lors de l’investigation approfondie des troubles des apprentissages chez l’enfant ou du déclin amnésique chez l’adulte, l’objectif fondamental n’est pas uniquement de quantifier une performance globale, mais d’objectiver des contrastes cliniques internes en cartographiant les forces et les faiblesses relatives au sein de l’architecture cognitive du sujet.
En structurant une feuille d’évaluation où chaque ligne représente un sous-test d’aptitude spécifique (par exemple : empan mnésique verbal, rétention visuo-spatiale, dénomination lexicale rapide, raisonnement fluide perceptif, et vitesse d’inhibition motrice), l’analyste consigne les performances brutes du patient en colonne B. En colonnes C et D sont inscrites les données normatives correspondantes (moyennes et écarts-types étalonnés par tranche d’âge, issus des manuels psychométriques validés). La colonne E automatise alors le calcul immédiat des scores Z de chaque domaine par la fonction arithmétique verrouillée :
=(B2 – C2) / D2
Cette disposition permet l’implémentation algorithmique de calculs d’indices de dispersion intra-individuelle au moyen de formules avancées sous Google Sheets. En calculant l’amplitude différentielle maximale (la distance entre le score Z le plus élevé et le score Z le plus bas via la formule =MAX(E2:E6) – MIN(E2:E6)), le tableur alerte immédiatement le clinicien sur l’hétérogénéité significative du profil. Si cette dispersion outrepasse les seuils de variabilité normale prévus par les modèles psychométriques, cela interdit formellement l’agrégation des scores en une note globale unique de quotient intellectuel et oriente vers des hypothèses diagnostiques spécifiques (telles qu’une dissociation fronto-sous-corticale ou un trouble spécifique du développement), dont les conclusions interprétatives peuvent être formulées automatiquement à l’aide de chaînes conditionnelles imbriquées.
12.3 Archivage et partage de feuilles d’analyse reproductibles
Le point d’orgue de toute recherche quantitative réside dans la préservation pérenne de la traçabilité des analyses et l’ouverture des procédures computationnelles à la communauté scientifique internationale, conformément aux principes FAIR (Faciles à trouver, Accessibles, Interopérables et Réutilisables). L’architecture nativement infonuagique de Google Sheets en fait une plateforme de choix pour la standardisation ouverte, à condition d’observer une discipline stricte de sécurisation et de documentation du classeur.
La première mesure de gouvernance consiste à verrouiller l’inviolabilité des formules de calcul contre toute manipulation accidentelle lors de consultations partagées. L’administrateur de la feuille doit naviguer vers le menu Données > Feuilles et plages protégées, afin de restreindre les autorisations d’édition : les plages hébergeant les formules matricielles des scores Z ainsi que les tables d’étalonnages normatifs doivent être paramétrées en mode « Lecture seule » pour les utilisateurs invités, seules les cellules dédiées à la saisie de nouvelles données brutes demeurant ouvertes à l’encodage collaboratif.
Enfin, pour hisser le classeur aux standards d’excellence de la recherche reproductible, l’ensemble des choix méthodologiques sous-jacents doit faire l’objet d’une documentation méticuleuse directement ancrée dans l’interface. L’utilisation systématique des Notes ou des Commentaires de cellule (accessibles par clic droit sur les en-têtes de colonnes) permet d’expliciter le rationnel scientifique : description de l’instrument de mesure, référence bibliographique de l’étalonnage normatif employé, indication de la formule de dispersion retenue (correction de Bessel), et justification du seuil d’exclusion des outliers. Une fois documentée, la feuille d’analyse Google Sheets transcende son statut de simple grille utilitaire pour s’ériger en un protocole computationnel transparent, auditable et parfaitement publiable au sein d’entrepôts de données scientifiques ouverts tels qu’Open Science Framework (OSF) ou Zenodo.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anastasi, A., & Urbina, S. (1997). Psychological testing (7th ed.). Prentice Hall.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Google. (2023). Centre d’aide Google Sheets : Liste des fonctions de feuille de calcul. Google Support. https://support.google.com/docs/table/25273
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Kline, P. (2015). A handbook of test construction: Introduction to psychometric design. Routledge. https://doi.org/10.4324/9781315694856
- McCall, W. A. (1922). How to measure in education. Macmillan.
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10