
L’évaluation de la validité d’un modèle statistique constitue l’une des étapes les plus délicates et déterminantes de la démarche scientifique contemporaine. Lorsque des chercheurs ajustent un modèle de régression linéaire ordinaire sur des données empiriques, ils tentent d’extraire un signal déterministe cohérent au sein d’un ensemble de mesures inévitablement corrompues par le bruit expérimental et la variabilité stochastique. Or, l’examen isolé des coefficients d’ajustement globaux, à l’image du coefficient de détermination ou des tests d’hypothèses conventionnels sur les estimateurs, s’avère fondamentalement insuffisant pour attester de la fidélité des inférences produites. Un modèle peut afficher un niveau de variance expliquée apparemment impressionnant tout en violant systématiquement les postulats probabilistes sous-jacents, ou en étant lourdement biaisé par une poignée d’observations atypiques ayant détourné la trajectoire des paramètres estimés.
C’est dans cet interstice méthodologique que s’impose l’analyse rigoureuse des écarts entre les valeurs observées et les valeurs prédites par la fonction d’estimation. Si le calcul des résidus bruts représente la première étape intuitive de tout diagnostic statistique, leur interprétation directe se heurte rapidement à des obstacles théoriques insurmontables, notamment la dépendance d’échelle et l’inégalité structurelle de leur variance locale. Pour pallier ces déficiences, la théorie statistique a développé des métriques adéquates, au premier rang desquelles figurent les résidus standardisés et semi-étudiantisés, capables d’ajuster chaque écart résiduel par son erreur type spécifique et son potentiel d’ancrage géométrique au sein de l’espace des prédicteurs.
Dans le contexte des sciences empiriques et particulièrement des sciences comportementales, cognitives et biomédicales, l’écosystème Python s’est imposé comme l’environnement computationnel d’excellence pour conduire ces analyses avancées. Grâce à la synergie d’outils hautement optimisés tels que NumPy, Pandas, Scipy et surtout Statsmodels, le statisticien dispose aujourd’hui d’une panoplie algorithmique lui permettant non seulement d’automatiser l’extraction des indicateurs diagnostiques, mais également de décortiquer les mécanismes matriciels sous-jacents. Ce guide complet explore les fondements mathématiques, les procédures d’implémentation manuelle et automatisée, ainsi que les stratégies d’interprétation des résidus standardisés en Python, offrant ainsi un protocole reproductible et conforme aux exigences méthodologiques les plus strictes de la recherche internationale.
1. Introduction aux résidus et à leur rôle en régression linéaire
1.1 Définition conceptuelle de l’erreur et du résidu
Dans le cadre formel de la régression linéaire paramétrique, il est indispensable d’établir une distinction conceptuelle nette entre l’erreur stochastique théorique et le résidu d’échantillon. L’erreur de population, traditionnellement notée par la lettre grecque epsilon, renvoie à la déviation véritable, intrinsèque et non observable qui sépare chaque observation de l’espérance conditionnelle définie dans la population générale. Cette perturbation représente la somme de tous les déterminants infinitésimaux omis dans la spécification du modèle, les fluctuations biologiques inhérentes au vivant ainsi que l’imprécision instrumentale incompressible. Par définition, cette erreur théorique demeure à jamais inaccessible au chercheur, puisque les véritables paramètres de la population ne peuvent être connus avec une certitude absolue.
À l’inverse, le résidu empirique, généralement noté par la lettre latine e, constitue la contrepartie observable et calculée de l’erreur théorique au sein d’un échantillon donné. Sur le plan géométrique, le résidu brut se définit formellement comme la distance signée verticale séparant la valeur mesurée sur la variable dépendante de la valeur prédite par l’hyperplan des moindres carrés ordinaires. Ce calcul repose directement sur les coefficients partiels de régression estimés à partir des données collectées. Le résidu capture donc à la fois le bruit résiduel authentique et l’incertitude inhérente à l’échantillonnage qui affecte l’estimation de chaque paramètre du modèle.
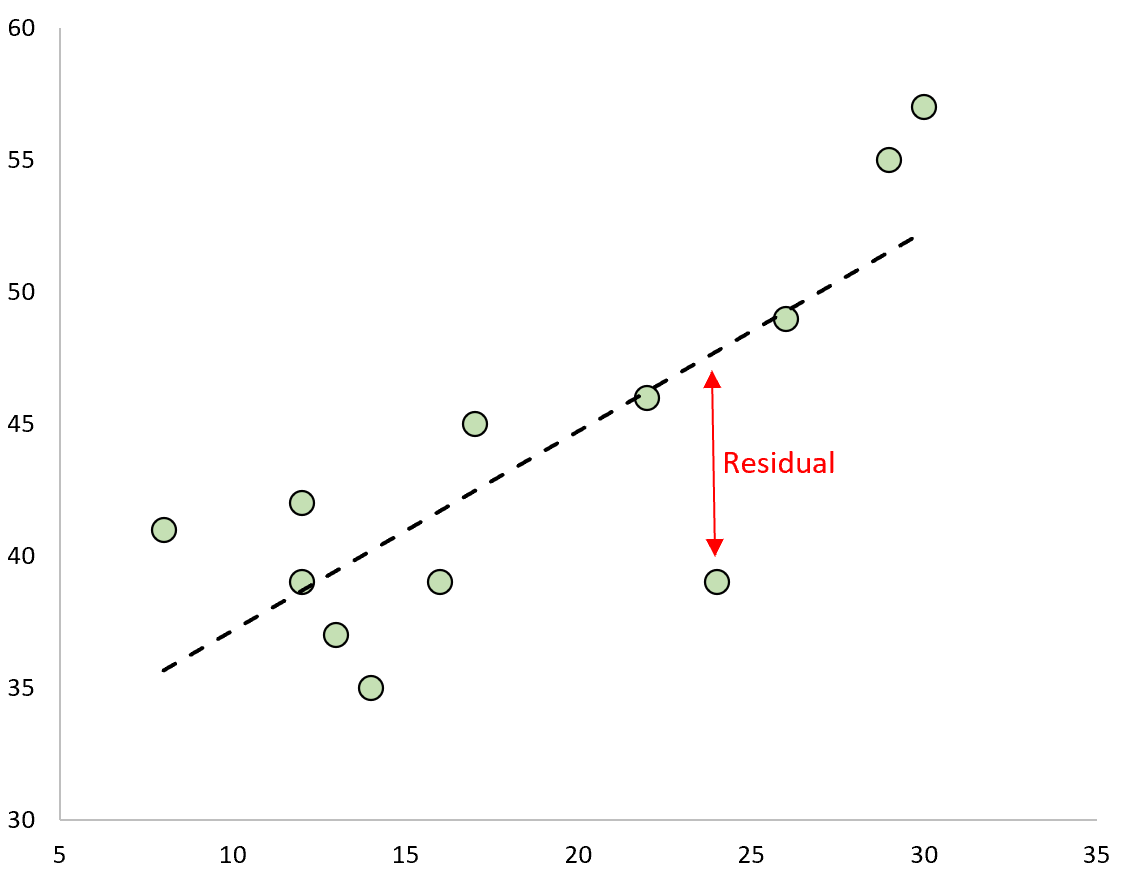
L’utilisation de la régression linéaire ordinaire repose sur des postulats essentiels formulés par le théorème de Gauss-Markov et enrichis par l’hypothèse de normalité des perturbations. Ces conditions postulent que les perturbations doivent être mutuellement indépendantes, d’espérance mathématique nulle conditionnellement aux prédicteurs, de variance strictement homogène pour chaque observation, et distribuées selon une loi normale univariée. Lorsque ces hypothèses sont respectées, les estimateurs obtenus possèdent la propriété d’être les meilleurs estimateurs linéaires sans biais. Les résidus d’échantillon constituent la seule trace empirique permettant de contrôler si ces conditions idéales sont raisonnablement satisfaites.
Les répercussions de la violation de ces hypothèses résiduelles sur l’inférence statistique sont majeures. Si la variance des résidus n’est pas constante ou si les erreurs manifestent une autocorrélation, les estimateurs des moindres carrés ordinaires demeurent sans biais sur le plan asymptotique, mais perdent totalement leur efficacité statistique. Plus grave encore, l’estimation des erreurs types associées aux coefficients devient incohérente, conduisant à des statistiques de test biaisées, des valeurs p artificiellement comprimées ou dilatées, et des intervalles de confiance erronés. Par conséquent, l’analyse minutieuse des déviations résiduelles ne constitue pas un luxe accessoire, mais le fondement même de la validité interne des conclusions scientifiques.
1.2 Limites inhérentes aux résidus bruts dans l’évaluation du modèle
Bien que le résidu brut possède une interprétabilité intuitive immédiate en conservant l’unité physique de la variable de réponse, cette propriété constitue paradoxalement sa principale faiblesse analytique lors de l’évaluation globale d’un modèle. En effet, l’amplitude absolue d’un résidu brut dépend entièrement de l’échelle métrique choisie. Un résidu d’une magnitude de 50 peut représenter une déviation négligeable lorsque l’on modélise des temps de réaction milliseconde par milliseconde, alors que ce même écart numérique s’avérerait astronomique et totalement aberrant s’il portait sur des scores standardisés d’intelligence ou des échelles cliniques bornées entre zéro et vingt. Cette dépendance métrique interdit toute comparaison systématique entre différents modèles ou entre variables exprimées dans des dimensions hétérogènes.
Par ailleurs, une illusion statistique fréquente consiste à imaginer que les résidus bruts partagent une variance théorique uniforme d’une observation à l’autre sous l’hypothèse d’homoscédasticité. Cette intuition est mathématiquement inexacte. Bien que les perturbations non observables de la population possèdent par hypothèse une variance constante, les résidus empiriques calculés après estimation possèdent une variance locale hétérogène qui dépend de la position géométrique occupée par chaque individu dans l’espace multidimensionnel des variables explicatives. Plus une observation se situe loin du centre de gravité des prédicteurs, plus sa variance résiduelle se trouve compressée par l’algorithme des moindres carrés, créant une disparité structurelle dans la dispersion attendue de chaque résidu.
Cette variabilité intrinsèque de la dispersion locale prive le chercheur de critères universels et transposables pour délimiter les observations normales de celles qui doivent être considérées comme aberrantes. Face à un résidu brut important, il est impossible de déterminer par simple lecture si cette valeur reflète un phénomène exceptionnel nécessitant une investigation critique ou s’il s’agit d’une fluctuation parfaitement compatible avec la géométrie du nuage de points. Cette ambiguïté rend caduque toute tentative d’établir des règles de décision objectives fondées sur des seuils de rejet fixes sur les valeurs brutes.
Face à ces limitations méthodologiques, la standardisation métrique s’impose comme un impératif algorithmique. Pour évaluer équitablement chaque observation, il convient d’opérer une mise à l’échelle rigoureuse consistant à diviser chaque résidu brut par une estimation non biaisée de son écart type conditionnel individuel. Cette standardisation affranchit l’analyste de la métrique originale de l’instrument de mesure, corrige les distorsions géométriques imposées par l’ajustement du modèle et permet d’adopter des distributions de référence bien connues de la théorie des probabilités.
2. Fondements mathématiques : des résidus bruts aux résidus standardisés
2.1 Dérivation analytique du résidu standardisé
Pour construire le résidu standardisé, il est nécessaire de formaliser algébriquement l’expression de la variance propre à chaque résidu d’échantillon. Soit un modèle de régression linéaire multivariée exprimé sous la forme matricielle classique où le vecteur des observations dépend de la matrice d’expérience contenant les prédicteurs augmentés d’une colonne unitaire pour l’ordonnée à l’origine, du vecteur des coefficients inconnus et du vecteur des perturbations. L’ajustement par les moindres carrés ordinaires projette orthogonalement le vecteur des observations sur le sous-espace vectoriel engendré par les colonnes de la matrice des prédicteurs.
Cette opération géométrique fondamentale est réalisée par l’intermédiaire de la matrice chapeau, classiquement désignée par la lettre majuscule H. Cette matrice de projection orthogonale, symétrique et idempotente, possède une formulation analytique universelle faisant intervenir le produit matriciel de la transposée des prédicteurs et de l’inverse de la matrice de variance-covariance empirique des variables explicatives. Les éléments situés sur la diagonale principale de cette matrice chapeau, notés conventionnellement par des indices doubles reflétant chaque observation individuelle, quantifient la distance de levier ou le levier géométrique exercé par chaque point expérimental sur sa propre valeur ajustée.
L’analyse de la relation linéaire reliant les résidus bruts aux perturbations théoriques démontre que le vecteur des résidus est égal au produit de la matrice identité minorée de la matrice chapeau par le vecteur d’erreurs. Il s’ensuit que la matrice de variance-covariance des résidus n’est pas diagonale, et que la variance du résidu associé à la i-ème observation s’exprime précisément comme le produit de la variance globale de l’erreur par le terme correctif un moins le levier diagonal associé. La variance d’un résidu empirique est donc systématiquement inférieure à la variance d’erreur globale du système, et cette réduction est d’autant plus marquée que l’observation exerce un levier élevé.
Dès lors, le résidu standardisé, également documenté dans la littérature statistique sous la désignation de résidu semi-étudiantisé interne, se dérive en divisant le résidu brut par la racine carrée de sa variance estimée. Le dénominateur fait intervenir l’erreur type résiduelle globale calculée sur l’ensemble de l’échantillon, multipliée par la racine carrée du facteur correctif dépendant du levier local. Grâce à cette intégration conjointe du terme d’erreur résiduelle globale et de la géométrie locale capturée par la diagonale de la matrice chapeau, les résidus standardisés acquièrent une espérance théorique rigoureusement nulle et une variance approximativement unitaire.
2.2 Comparaison entre résidus bruts, standardisés et studentisés
L’arsenal diagnostique de la régression comprend trois grandes classes de métriques résiduelles qu’il convient de distinguer avec minutie : les résidus bruts, les résidus standardisés dits semi-étudiantisés internes, et les résidus studentisés externes dits résidus jackknife ou supprimés. Bien que ces variantes partagent le même numérateur constitué par le résidu brut de l’observation, leurs mécanismes de pondération au dénominateur diffèrent par la sélection de l’estimateur de variance résiduelle retenu pour la mise à l’échelle.
Le résidu standardisé interne utilise pour son dénominateur l’estimateur de variance calculé sur la totalité des données expérimentales, incluant par conséquent l’observation suspecte elle-même. Si cette observation possède une déviation disproportionnée, elle gonfle mécaniquement la somme des carrés des erreurs résiduelles du modèle global, ce qui a pour effet pervers d’accroître artificiellement la valeur de l’erreur type de régression au dénominateur. Cette inflation de l’estimateur résiduel global tend à masquer la gravité de l’écart du point déviant en réduisant la magnitude de son propre résidu standardisé, un phénomène bien connu des statisticiens sous l’appellation d’effet de masquage.
Pour contourner ce problème dans l’analyse des cas extrêmes, le résidu studentisé externe adopte une formulation rigoureuse où la variance résiduelle d’échelle est recalculée après avoir totalement omis la i-ème observation du processus d’estimation des moindres carrés. Ce raffinement méthodologique permet au résidu studentisé de suivre très exactement une distribution t de Student à un nombre de degrés de liberté minoré d’une unité supplémentaire sous l’hypothèse de normalité. Cette propriété facilite le calcul de probabilités critiques exactes sans biais d’estimation circulaire.
Néanmoins, en modélisation multivariée et lorsque la taille de l’échantillon dépasse plusieurs dizaines d’observations, les propriétés asymptotiques garantissent une convergence statistique étroite entre résidus standardisés internes et externes. L’influence d’un point isolé sur l’estimateur global de variance devient inversement proportionnelle aux degrés de liberté globaux du système linéaire. Le résidu standardisé interne demeure donc un estimateur de premier ordre, robuste, universellement implémenté et particulièrement stable pour les diagnostics de routine, l’inspection de l’homoscédasticité et la détection préliminaire des profils aberrants.
3. Rôle des résidus standardisés dans l’analyse de données psychologiques
3.1 Identification des profils atypiques et des biais de mesure
L’administration de protocoles expérimentaux en psychologie cognitive, sociale ou clinique confronte systématiquement le chercheur à une variabilité individuelle complexe, où se mêlent de véritables variations comportementales et des artéfacts de mesure. Contrairement aux sciences physiques où les capteurs offrent une fidélité métrologique élevée, la passation de tests psychométriques ou de tâches chronométriques sur écran expose les données à des contaminations majeures : participants peu motivés répondant au hasard, épisodes d’inattention temporaire, compréhension erronée des consignes ou fatigue cognitive prononcée.
L’utilisation des résidus standardisés permet d’isoler ces comportements problématiques avec une acuité remarquable. Dans une tâche évaluant par exemple l’impact d’un stress induit sur le temps d’accès au lexique mental, un sujet manifestant un temps de réponse démesurément allongé sans rapport avec son niveau d’anxiété mesuré générera un résidu standardisé considérablement élevé. Ce score métriquement standardisé offre un signal d’alerte objectif indiquant que la réponse observée n’est pas explicable par la structure relationnelle régissant le reste de l’échantillon, suggérant ainsi une interruption de tâche ou une distraction plutôt qu’une sensibilité cognitive accrue.
De même, les instruments psychométriques de type échelles de Likert sont fréquemment sujets aux effets plancher et plafond, où une proportion notable de répondants s’agglutine sur les extrémités des instruments de mesure en raison d’une saturation de l’échelle d’évaluation. L’inspection des résidus standardisés met en lumière les segments de la population pour lesquels le modèle sous-jacent commet des erreurs systématiques et unilatérales de prédiction. Ces schémas révèlent que l’instrument perd sa sensibilité discriminative dans certaines tranches du continuum latent exploré.
Une distinction fondamentale doit cependant être opérée entre la variance phénotypique naturelle et l’erreur méthodologique pure. Les résidus standardisés ne constituent pas une condamnation automatique du participant, mais un outil d’investigation. L’élimination mécanique de profils atypiques au seul motif d’un résidu élevé risque d’amputer artificiellement la réalité empirique du phénomène étudié et de compromettre la validité de construit de la recherche. Le résidu standardisé offre ainsi le point de départ d’une réflexion qualitative éclairée sur la nature de la déviation constatée.
3.2 Vérification des postulats d’homoscédasticité et de linéarité
L’analyse des processus psychologiques requiert une vigilance constante envers le postulat d’homoscédasticité des variances d’erreur. Très fréquemment, la variabilité intra-individuelle et inter-individuelle s’accroît proportionnellement à l’intensité de la tâche ou à l’âge des participants. Dans les études développementales ou gérontologiques, la dispersion des performances cognitives augmente souvent chez les sujets âgés par rapport aux adultes jeunes. De même, les effets d’apprentissage progressif au fil des blocs expérimentaux peuvent comprimer la variance chez les sujets experts tout en la laissant très large chez les sujets novices.
En projetant graphiquement les résidus standardisés en fonction des valeurs prédites ou de variables indépendantes d’intérêt, les statisticiens peuvent identifier les formes caractéristiques d’hétéroscédasticité, telles que les patrons en mégaphone ou en entonnoir. Étant donné que le résidu standardisé corrige déjà les variations de variance inhérentes à la position géométrique de levier, tout pattern résiduel persistant dans la dispersion des points reflète une véritable non-constance de la variance d’erreur du phénomène psychologique sous-jacent, et non un artefact géométrique du modèle.
De surcroît, les relations liant des variables psychologiques sont rarement purement linéaires sur l’ensemble de leur étendue. La célèbre loi de Yerkes-Dodson, qui postule une relation en U inversé entre le niveau d’éveil physiologique et la performance cognitive, illustre le risque inhérent à l’ajustement sans discernement d’un modèle rectiligne. Lorsque le chercheur force une régression linéaire sur une dynamique non linéaire, la trajectoire des résidus standardisés épouse fidèlement la courbure non modélisée, trahissant immédiatement une mauvaise spécification fonctionnelle par une succession de déviations positives et négatives systématiques.
Cette vérification s’avère d’autant plus critique lors de l’emploi de plans factoriels complexes et d’études longitudinales avec mesures répétées. Dans ces dispositifs, la structure de corrélation temporelle ou intra-sujet peut contaminer l’indépendance résiduelle. L’évaluation standardisée des erreurs permet de sécuriser la conformité des inférences statistiques conventionnelles, évitant ainsi la publication d’effets faussement positifs découlant d’une sous-estimation massive des erreurs types standards de la méthode des moindres carrés.
4. Configuration de l’environnement de développement Python
4.1 Sélection et installation des bibliothèques scientifiques
Pour construire une chaîne de traitement robuste, analytiquement irréprochable et facilement réplicable pour le calcul des résidus standardisés, le choix des bibliothèques logicielles sous-jacentes s’avère déterminant. L’architecture computationnelle de référence s’articule autour de quatre briques majeures : NumPy pour les opérations d’algèbre linéaire haute performance et la manipulation vectorielle native, Pandas pour la gestion de structures tabulaires indexées, SciPy pour l’accès aux fonctions de densités cumulées et tests de distribution, et Statsmodels pour la modélisation statistique avancée et la génération automatisée des diagnostics de régression.
L’installation de cet écosystème s’effectue idéalement au moyen du gestionnaire de paquets standard de Python. L’implémentation doit impérativement s’inscrire au sein d’un environnement virtuel isolé, tel que ceux générés nativement par le module venv ou par le gestionnaire conda. Ce cloisonnement strict garantit que les versions logicielles employées pour l’analyse demeurent étanches face aux évolutions potentielles du système d’exploitation hôte, protégeant ainsi l’expérimentateur contre toute rupture de compatibilité descendante dans les algorithmes de décomposition matricielle ou les routines de calcul numérique.
Le script d’installation canonique requiert le déploiement ordonné de versions stables des outils scientifiques. Il est hautement recommandé d’expliciter les contraintes de versionnement dans un fichier de dépendances formel de type requirements.txt, mentionnant expressément les numéros de révision de NumPy, Pandas, SciPy, Statsmodels, ainsi que des bibliothèques graphiques associées comme Matplotlib et Seaborn. Cette traçabilité logicielle absolue répond aux critères modernes de reproductibilité expérimentale promus par les comités éditoriaux des revues scientifiques internationales.
Une fois les dépendances convenablement installées au sein de l’environnement virtuel actif, une séquence de vérification élémentaire doit être conduite pour contrôler l’intégrité de la plateforme. Cette vérification passe par l’importation programmée des modules fondamentaux et la consultation de leurs identifiants de version respectifs. Cette phase préliminaire assure le statisticien que les liaisons dynamiques avec les bibliothèques d’accélération mathématique de bas niveau, telles que BLAS et LAPACK, sont opérationnelles pour traiter sans latence les opérations matricielles lourdes inhérentes aux grands échantillons.
4.2 Bonnes pratiques de structuration du code pour la reproductibilité académique
La conduite d’analyses statistiques diagnostiques ne doit pas s’apparenter à une succession de lignes de code désordonnées au sein d’un bloc-notes interactif éphémère. Pour répondre aux exigences des standards de la science ouverte, le code Python dédié au traitement des résidus doit obéir à une structuration modulaire rigoureuse. Chaque phase du pipeline, depuis le chargement des matrices de données jusqu’à l’exportation des tableaux de synthèse conformes aux normes de publication, gagne à être encapsulée dans des fonctions pures documentées et réutilisables.
L’introduction d’un typage statique au moyen des annotations de type intégrées à Python constitue une démarche méthodologique hautement profitable. En précisant explicitement si une fonction attend en entrée un tableau multidimensionnel de type numpy.ndarray, une série temporelle ou un pandas.DataFrame, et si elle retourne un vecteur à virgule flottante ou un tuple d’indicateurs d’influence, le développeur élimine en amont une multitude d’erreurs d’exécution silencieuses. Cette discipline logicielle simplifie considérablement la relecture critique du code par des évaluateurs indépendants lors des processus d’évaluation par les pairs.
Parallèlement, toute étape computationnelle faisant intervenir un générateur stochastique, qu’il s’agisse de la génération de données simulées à des fins de validation théorique ou de procédures de rééchantillonnage par rééchantillonnage bootstrap pour le calcul d’intervalles de confiance empiriques, requiert l’initialisation explicite d’une graine pseudo-aléatoire. La commande fixant la graine aléatoire de NumPy garantit que la séquence numérique produite sera identique au bit près, quel que soit l’ordinateur exécutant le script statistique à l’avenir.
Enfin, la structuration du projet doit prévoir l’automatisation intégrale de l’exportation des métriques résiduelles sous des formats tabulaires pérennes et ouverts, à l’instar des fichiers délimités par des virgules ou des structures sérialisées au format parquet. L’insertion automatique d’identifiants de participants permet de corréler sans risque d’erreur d’appariement les scores résiduels standardisés calculés avec les métadonnées expérimentales originales, évitant ainsi toute manipulation manuelle risquée de copier-coller dans des tableurs grand public.
5. Préparation et structuration des données expérimentales avec Pandas
5.1 Chargement et inspection initiale du jeu de données
La phase initiale de toute démarche analytique rigoureuse consiste à convertir des enregistrements bruts en une structure bidimensionnelle hautement optimisée au moyen de la bibliothèque Pandas. Les protocoles de recherche en psychologie génèrent couramment des sorties sous forme de fichiers textuels complexes comportant des délimiteurs variables, des encodages de caractères hétérogènes et des lignes d’en-tête informatives. L’utilisation des fonctions de lecture spécialisées de Pandas, configurées avec des paramètres explicites d’encodage et de gestion des séparateurs, permet d’importer ces corpus de données avec une intégrité transactionnelle totale.
Immédiatement après le chargement en mémoire vive, une inspection typologique intransigeante doit être entreprise. Les colonnes numériques représentant les variables psychométriques continues ou les temps d’exécution doivent impérativement être typées en nombres à virgule flottante de précision standard, tandis que les identifiants de sujets ou les conditions expérimentales catégorielles doivent être convertis sous forme de chaînes de caractères ou de types catégoriels explicites. Une défaillance dans ce contrôle typologique, comme l’assignation accidentelle d’un format textuel à une variable continue causée par la présence d’un caractère non numérique isolé, neutraliserait les algorithmes d’ajustement ultérieurs.
L’exploration se poursuit par la génération des statistiques descriptives fondamentales relatives à la tendance centrale et à la dispersion des prédicteurs et de la variable dépendante. La consultation conjointe des moyennes arithmétiques, des écarts types, des quartiles empiriques ainsi que des coefficients d’asymétrie et d’aplatissement permet d’appréhender le profil distributionnel global des observations. Cette lecture chiffrée offre un aperçu immédiat de la plausibilité biométrique des bornes observées, permettant d’identifier d’éventuelles valeurs physiquement irréalisables découlant de défaillances matérielles.
Enfin, le traitement des données manquantes doit obéir à une démarche raisonnée. L’inventaire programmatique des valeurs nulles au sein de chaque variable conditionne le choix de la stratégie d’assainissement. Dans le cadre classique de la modélisation par régression linéaire, l’omission par observation complète reste la pratique la plus répandue, mais elle suppose implicitement que le mécanisme de disparition relève du hasard le plus strict. La documentation transparente du nombre d’enregistrements écartés durant cette phase de nettoyage constitue une exigence déontologique indispensable pour préserver la traçabilité de l’échantillon final d’analyse.
5.2 Exemple pratique guidé : variables psychométriques simulées
Afin d’illustrer la dérivation algorithmique des résidus standardisés sans dépendre de contraintes d’accès à des bases de données confidentielles de patients, nous concevons un paradigme expérimental simulé typique des neurosciences cognitives. L’hypothèse de travail postule que le score d’anxiété d’évaluation d’un individu influence son temps d’exécution global lors d’une tâche complexe de flexibilité cognitive. Nous modélisons une cohorte réaliste comprenant cent participants expérimentaux, fournissant une puissance statistique confortable pour tester un modèle univarié.
Pour construire ce jeu de données synthétique, le prédicteur représentant le niveau d’anxiété est généré sous forme d’une variable aléatoire continue tirée d’une distribution normale calibrée pour afficher une moyenne de cinquante points et un écart type de dix unités, mimant fidèlement la distribution classique d’échelles validées telles que le questionnaire STAI. La variable dépendante de performance chronométrique est ensuite programmée selon une relation fonctionnelle linéaire directe dotée d’une constante de base fixée à deux cents millisecondes, d’une pente positive unitaire de 1.5, et d’un terme d’erreur gaussienne homoscédastique d’écart type fixé arbitrairement à quinze millisecondes.
Afin de valider de manière probante l’efficacité diagnostique des résidus standardisés, nous insérons de façon délibérée et parfaitement contrôlée une anomalie expérimentale au sein de cet échantillon. Le participant répertorié à l’index quarante-deux se voit assigner artificiellement une performance temporelle de quatre cents millisecondes, alors même que son score d’anxiété se situe dans la stricte moyenne du groupe. Cette manipulation simule typiquement un sujet ayant interrompu son engagement cognitif pour des raisons extrinsèques à la manipulation expérimentale, produisant une discordance majeure vis-à-vis du patron général des données.
L’assemblage de ces vecteurs au sein d’un DataFrame Pandas unifié clôture cette étape préparatoire. L’inspection des premières et dernières lignes de la structure tabulaire confirme que les cent enregistrements sont convenablement indexés, dépourvus d’indéterminations numériques et prêts pour l’étape de modélisation mathématique. Ce jeu de données contrôlé constituera le fil conducteur permettant de confronter le calcul matriciel manuel aux automatisations natives de l’écosystème Python.
6. Ajustement du modèle de régression linéaire avec Statsmodels
6.1 Spécification formelle de la régression linéaire ordinaire
L’ajustement du modèle linéaire au sein de l’environnement Python trouve dans la bibliothèque Statsmodels son vecteur d’exécution le plus puissant et le plus académique. Contrairement aux bibliothèques orientées exclusivement vers l’apprentissage automatique prédictif, Statsmodels privilégie la rigueur de l’inférence statistique formelle et fournit l’ensemble des décompositions de variance requises pour les diagnostics structurels. L’utilisation du sous-module d’interface orienté formules permet de spécifier les modèles au moyen d’une syntaxe déclarative héritée du langage S et universalisée par R.
La formulation analytique relie la variable dépendante de performance cognitive au prédicteur d’anxiété au travers d’une équation compacte. En coulisses, Statsmodels compile automatiquement cette syntaxe pour ériger la matrice de design X en intégrant systématiquement une colonne unitaire dévolue à l’estimation de l’ordonnée à l’origine. L’instanciation de la classe d’ajustement des moindres carrés ordinaires s’effectue en associant l’expression symbolique au DataFrame Pandas préalablement préparé, suivie immédiatement de l’invocation de la méthode d’optimisation numérique.
Durant cette exécution algorithmique, le moteur statistique procède à la résolution du système d’équations normales par décomposition QR ou décomposition en valeurs singulières de la matrice d’expérience. Cette approche par factorisation matricielle garantit une stabilité numérique optimale, évitant l’inversion directe de la matrice de produit scalaire qui s’avérerait sensible aux problèmes de quasi-colinéarité. L’ajustement converge en une fraction de seconde sur des tailles d’échantillons courantes, générant un objet de résultats contenant l’intégralité des paramètres estimés et de leurs distributions d’échantillonnage associées.
Le contrôle de la convergence algorithmique et la vérification des degrés de liberté résiduels s’imposent avant toute exploitation des métriques de sortie. Dans notre configuration comprenant cent participants et deux paramètres estimés représentant la pente et l’intercept, le système linéaire doit obligatoirement attester de quatre-vingt-dix-huit degrés de liberté résiduels. Ce décompte exact valide le fait que la structure matricielle ne présente aucun rang déficitaire et que les conditions d’identification du modèle des moindres carrés sont rigoureusement respectées.
6.2 Extraction et examen des métriques globales d’ajustement
Dès l’achèvement de la phase d’optimisation, l’interrogation de l’objet de résultat permet d’extraire la table récapitulative des diagnostics globaux du modèle. La première statistique examinée est le coefficient de détermination R carré, complété systématiquement par son estimation ajustée pénalisant l’inclusion non parcimonieuse de prédicteurs. Cette valeur synthétique renseigne l’expérimentateur sur la proportion de variance de la performance cognitive mathématiquement expliquée par les variations des scores d’anxiété dans l’échantillon d’apprentissage.
L’évaluation de la significativité globale de la régression repose sur le test F de Fisher-Snedecor, qui met en balance la variance moyenne imputable au modèle d’ajustement et la variance moyenne résiduelle non expliquée. La probabilité critique associée à cette statistique de Fisher permet de rejeter sans équivoque l’hypothèse nulle d’absence totale de relation linéaire lorsque sa valeur se situe nettement sous le seuil alpha conventionnel fixé à cinq centièmes. Cette inférence globale confirme que la pente estimée par le modèle s’écarte significativement d’une ligne horizontale théorique.
Néanmoins, la métrique maîtresse requise pour les étapes ultérieures de standardisation réside dans l’erreur type des résidus du modèle, souvent désignée par le terme de variance résiduelle non biaisée ou scale au sein de Statsmodels. Cet indicateur correspond à la racine carrée de la somme des carrés des résidus divisée par le nombre de degrés de liberté résiduels du système. Cette valeur incarne l’écart type estimé des perturbations théoriques dans la population, et constitue la composante d’échelle globale indispensable pour mettre les déviations résiduelles sur une métrique universelle.
L’objet d’ajustement conserve l’intégralité de ces composantes de variance au sein de ses attributs internes, accessibles programmatiquement sans nécessiter de ré-exécution des calculs. L’extraction précise de cette erreur type globale, conjointe à l’archivage du vecteur contenant les prédictions linéaires ajustées, prépare le terrain pour la dérivation algébrique explicite de chaque résidu standardisé individuel.
7. Calcul manuel des résidus standardisés pas à pas en Python
7.1 Étape 1 : Calcul des résidus bruts et de l’erreur type de régression
Afin de démystifier les mécanismes internes des logiciels statistiques et d’ancrer la compréhension de l’analyste dans les principes fondamentaux de l’algèbre matricielle, il est hautement instructif de programmer manuellement la totalité de la chaîne de calcul des résidus standardisés à l’aide de primitives vectorielles NumPy. La première phase de cette séquence opératoire consiste à extraire le vecteur des résidus bruts. Ce vecteur s’obtient simplement en effectuant la soustraction terme à terme entre le vecteur des observations réelles de la variable dépendante et le vecteur des valeurs prédites généré par le modèle ajusté.
Une fois le vecteur des écarts bruts constitué, il convient de quantifier la somme globale des carrés des erreurs résiduelles. En exploitant la vitesse des opérations vectorisées offertes par NumPy, cette grandeur se calcule en élevant chaque élément du vecteur résiduel au carré, puis en sommant l’ensemble des termes résultants. Cette somme quadratique représente la quantité scalaire précise que l’algorithme des moindres carrés s’est employé à minimiser lors de l’estimation des coefficients de régression.
La dérivation de l’erreur type résiduelle globale, désignée mathématiquement par la lettre s, s’effectue en divisant cette somme des carrés résiduels par le nombre de degrés de liberté résiduels du modèle, à savoir la taille totale de l’échantillon minorée du nombre total de paramètres estimés comprenant les pentes et l’ordonnée à l’origine, puis en extrayant la racine carrée arithmétique de ce quotient. Cette opération délivre une estimation sans biais de la dispersion théorique des erreurs dans la population étudiée.
Pour s’assurer de l’exactitude absolue de cette programmation pas à pas, une validation croisée immédiate doit être effectuée en comparant la valeur scalaire de l’erreur type obtenue manuellement avec l’attribut d’échelle interne disponible directement dans l’objet de résultats produit par Statsmodels. Une concordance numérique parfaite entre ces deux grandeurs atteste que la première brique de l’édifice computationnel est validée et exempte de distorsion algorithmique.
7.2 Étape 2 : Dérivation de la matrice chapeau et des leviers individuels
La seconde étape, cruciale et fréquemment omise dans les approches simplistes de standardisation, consiste à intégrer l’impact de la disposition spatiale des observations au sein de l’espace des prédicteurs. Pour cela, il est impératif de construire la matrice de projection géométrique complète, la fameuse matrice chapeau H. La réalisation de cette opération débute par l’extraction de la matrice de design complète X, incluant formellement la colonne d’unités modélisant le terme constant de l’équation.
Le calcul de la matrice chapeau s’exécute selon sa formulation analytique rigoureuse faisant appel aux opérations de multiplication matricielle et d’inversion fournies par le sous-module d’algèbre linéaire de NumPy. On procède d’abord au calcul du produit matriciel de la transposée de X par la matrice X elle-même. La matrice carrée de variance-covariance résultante est ensuite inversée, avant d’être multipliée à gauche par la matrice de design originale et à droite par la transposée de cette dernière. Le produit final délivre une matrice carrée symétrique et idempotente dont les dimensions correspondent exactement au nombre d’observations de l’échantillon.
L’étape substantielle réside alors dans l’extraction sélective de la diagonale principale de cette vaste matrice chapeau. Ces éléments diagonaux, traditionnellement indexés par la notation h double, mesurent le levier individuel de chaque observation expérimentale. Sur le plan statistique, le levier quantifie l’éloignement d’une observation par rapport au centre de gravité multidimensionnel de l’ensemble des prédicteurs. Plus la valeur du levier d’un sujet est prononcée, plus ce sujet possède un pouvoir d’ancrage géométrique capable d’attirer à lui l’hyperplan de régression.
Une propriété théorique fondamentale de la matrice chapeau permet d’exercer un contrôle qualité instantané sur la validité de l’opération : la somme arithmétique de l’ensemble des éléments de sa diagonale principale doit être rigoureusement égale au nombre de paramètres libres estimés par le modèle linéaire, soit exactement deux dans le cas d’une régression linéaire univariée avec constante. L’observation d’une somme équivalente au nombre de colonnes de la matrice de design valide mathématiquement l’extraction des indices de levier avant leur injection dans l’équation de standardisation.
7.3 Étape 3 : Application vectorielle de la formule de standardisation
La dernière étape du calcul manuel consiste à orchestrer la synthèse algébrique des termes d’écart brut, d’échelle globale et de levier individuel. La formule de standardisation exige que chaque résidu brut soit divisé par son erreur type locale dédiée. Cette erreur type locale est le produit de l’erreur type globale de régression s par la racine carrée du terme correctif unitaire minoré de l’indice de levier propre à chaque ligne de l’échantillon.
En syntaxe Python vectorisée sous NumPy, cette opération s’exprime avec une concision mathématique remarquable sans recourir à la moindre boucle itérative. Le dénominateur est généré en appliquant la fonction de racine carrée sur le vecteur résultant de la soustraction du vecteur des leviers diagonaux à un scalaire unitaire, multiplié par le scalaire d’erreur résiduelle globale. La division terme à terme du vecteur des résidus bruts par ce vecteur de variance locale délivre instantanément le vecteur complet des résidus standardisés.
Ce vecteur calculé manuellement est alors injecté directement au sein du DataFrame Pandas sous la forme d’une nouvelle variable analytique dédiée. Cette intégration facilite l’examen conjoint des données primaires, des prédictions, des résidus bruts et des déviations standardisées pour chaque participant de l’étude. Cette organisation tabulaire préserve l’alignement des index d’enregistrement et simplifie les tris conditionnels.
Une ultime vérification des propriétés distributionnelles élémentaires permet de confirmer l’exactitude de la procédure : la moyenne empirique de ces résidus standardisés doit être infinitésimale et statistiquement indiscernable de zéro, tandis que leur écart type d’échantillon doit osciller très étroitement autour de la valeur unitaire théorique. Cette mise à l’échelle réussie transforme une distribution brute aux dimensions physiques arbitraires en une métrique d’évaluation statistique pure.
8. Automatisation du calcul via les classes d’influence de Statsmodels
8.1 Mise en œuvre de la classe d’influence intégrée
Bien que la programmation manuelle détaillée à la section précédente offre une clarté pédagogique indispensable, son déploiement systématique au sein d’environnements de production ou sur des bases de données volumineuses s’avérerait inutilement redondant. Les concepteurs de Statsmodels ont anticipé ces besoins en dotant la bibliothèque d’une classe hautement optimisée dédiée aux diagnostics de régression et à l’analyse d’influence structurelle : la classe OLSInfluence.
L’instanciation de cette classe diagnostique s’opère de manière transparente en invoquant simplement la méthode dédiée à l’extraction d’influence disponible directement sur l’objet résultant de l’ajustement initial du modèle linéaire. En une seule instruction élémentaire, Statsmodels déclenche l’évaluation vectorisée en arrière-plan d’une panoplie complète de statistiques diagnostiques de premier et second ordre, évitant au praticien d’avoir à réimplémenter les formules matricielles associées.
L’extraction des résidus standardisés s’effectue ensuite par l’interrogation d’un attribut dédié de cette classe d’influence, documenté sous l’appellation de résidus semi-étudiantisés internes. L’exécution de cette méthode extrait instantanément un tableau NumPy unidimensionnel contenant les valeurs standardisées exactes pour chaque ligne du jeu de données expérimental. Les algorithmes sous-jacents bénéficient de routines compilées en C et Fortran, garantissant des performances temporelles optimales même lorsque les corpus d’analyse regroupent des centaines de milliers d’enregistrements psychométriques.
La comparaison systématique entre le vecteur obtenu par la voie automatisée de Statsmodels et celui résultant de notre calcul analytique manuel révèle une identité numérique absolue jusqu’à la quatorzième décimale. Cette concordance parfaite témoigne de la cohérence de l’architecture mathématique employée et autorise l’analyste à s’appuyer en toute confiance sur les méthodes de Statsmodels pour orchestrer ses protocoles d’évaluation empirique.
8.2 Exploration des mesures d’influence associées
L’examen isolé d’un résidu standardisé, bien qu’indispensable pour identifier les écarts atypiques vis-à-vis de l’hyperplan de régression, ne suffit pas à dresser un tableau diagnostique complet. Une observation peut en effet manifester un résidu important sans exercer de contrainte dommageable sur l’estimation des coefficients si son levier spatial est minime. À l’inverse, un point combinant une déviation modérée et un levier considérable peut infléchir dramatiquement la trajectoire de la droite d’ajustement sans nécessairement afficher un résidu standardisé spectaculairement déviant. Il s’avère donc essentiel de coupler les résidus standardisés aux indicateurs d’influence globale.
La classe d’influence de Statsmodels permet d’extraire concomitamment la célèbre distance de Cook pour l’ensemble des observations du modèle. Cette mesure composite synthétise l’impact qu’aurait la suppression pure et simple de l’observation cible sur le déplacement global de l’ensemble du vecteur des coefficients de régression estimés. Une distance de Cook anormalement élevée signale qu’une observation ne se contente pas d’être mal prédite par le modèle, mais qu’elle exerce une force de torsion démesurée sur l’orientation générale de la solution des moindres carrés.
De manière complémentaire, l’analyste peut interroger les résidus studentisés externes, calculés par suppression itérative, ainsi que les statistiques DFBETAS mesurant la variation standardisée induite sur chaque coefficient partiel individuel lors de l’omission sélective d’une ligne d’enregistrement. La consultation conjointe de ces indicateurs dresse une cartographie multidimensionnelle de la sensibilité du modèle face aux idiosyncrasies de l’échantillon.
Pour formaliser cette démarche de manière claire au sein d’un rapport méthodologique, il est judicieux d’agréger ces différentes métriques diagnostiques au sein d’une table comparative unique. Ce tableau récapitule les relations mathématiques fondamentales liant les différentes déclinaisons de résidus et mesures d’influence couramment mobilisées dans les analyses empiriques :
| Métrique Diagnostique | Formulation Conceptuelle | Sensibilité au Levier ($h_{ii}$) | Seuil d’Alerte Conventionnel |
|---|---|---|---|
| Résidu Brut ($e_i$) | $y_i – \hat{y}_i$ | Nulle (dépendance d’échelle pure) | Aucun seuil universel possible |
| Résidu Standardisé ($d_i$) | $e_i / (s \sqrt{1 – h_{ii}})$ | Modérée (correction de variance locale) | $|d_i| > 2$ (avertissement), $|d_i| > 3$ (critique) |
| Résidu Studentisé Externe ($t_i$) | $e_i / (s_{(i)} \sqrt{1 – h_{ii}})$ | Élevée (immunisé contre l’effet de masquage) | Loi de Student $t(\alpha / 2n, n – p – 2)$ |
| Distance de Cook ($D_i$) | $\sum (\hat{y}_j – \hat{y}_{j(i)})^2 / (p \cdot s^2)$ | Maximale (combine écart résiduel et levier) | $D_i > 4/n$ ou $D_i > 1$ |
9. Interprétation statistique et seuils critiques de détection des valeurs aberrantes
9.1 Critères de décision probabilistes conventionnels
L’évaluation des résidus standardisés impose l’adoption de seuils critiques fondés sur la théorie probabiliste des lois d’échantillonnage. Dès lors qu’un résidu a été mis à l’échelle au moyen d’un estimateur sans biais de son erreur type et ajusté pour son levier, il se distribue sous l’hypothèse nulle de normalité et d’homoscédasticité selon une distribution très proche d’une loi normale centrée réduite de moyenne zéro et de variance un. Cette propriété mathématique permet d’exploiter les propriétés géométriques de la courbe en cloche de Gauss pour fixer des bornes de rejet objectives.
Dans la pratique épidémiologique et psychologique, le premier repère diagnostique s’articule autour d’une valeur absolue supérieure à deux. En vertu des intégrales de probabilité sous la distribution normale standard, environ quatre-vingt-quinze pour cent des observations théoriques doivent exhiber un résidu standardisé compris dans l’intervalle délimité par plus ou moins deux écarts types. L’apparition d’un résidu franchissant ce seuil d’avertissement signale un événement qui n’a que cinq pour cent de chances de survenir sous l’hypothèse où le modèle spécifié est strictement conforme à la réalité empirique.
Pour qualifier formellement une observation d’anomalie critique ou de valeur aberrante majeure, la communauté académique adopte très majoritairement le critère conservateur d’une valeur absolue excédant trois écarts types. La probabilité d’observer spontanément un résidu de cette ampleur sous la distribution gaussienne tombe à moins de 0.27 %, soit approximativement trois occurrences pour mille observations indépendantes. Une déviation d’une telle envergure suggère une inadéquation flagrante entre la prédiction déterministe du modèle et la réponse du sujet, imposant un examen minutieux du cas clinique correspondant.
Toutefois, sur de très larges bases de données comprenant plusieurs dizaines de milliers d’individus, la confrontation itérative d’un nombre massif de résidus à un seuil univarié non corrigé expose le statisticien au risque de gonflements d’erreurs de première espèce imputables aux comparaisons multiples. Dans ces contextes à haute dimensionnalité, il devient méthodologiquement requis d’appliquer une correction de Bonferroni sur les seuils d’inclusion, en divisant le niveau de risque global alpha par l’effectif total n avant de déduire le quantile critique théorique correspondant au sein de la distribution de référence.
9.2 Filtrage systématique et catégorisation des observations suspectes
L’application concrète de ces seuils de décision gagne à être automatisée au moyen des fonctionnalités de masquage logique et d’interrogation conditionnelle offertes par Pandas. Plutôt que de scruter manuellement des listes textuelles interminables, le statisticien conçoit une séquence de filtrage booléen ciblant les observations dont la valeur absolue du résidu standardisé franchit le seuil critique défini au protocole expérimental.
Le script d’analyse interroge le DataFrame pour extraire de façon exhaustive l’ensemble des descripteurs associés aux lignes signalées par l’algorithme : identifiant du sujet, score brut sur la variable prédictive, valeur observée sur la réponse comportementale, prédiction d’ajustement du modèle linéaire, résidu brut, et indice de levier diagonal. Cette présentation tabulaire condensée isole précisément les cas nécessitant une investigation critique immédiate sans polluer l’attention de l’analyste par les observations conformes.
Il est particulièrement judicieux d’adjoindre à cette requête un système de catégorisation automatisée par indicateurs binaires ou catégoriels, distinguant les déviations légères situées entre deux et trois écarts types des déviations majeures surpassant trois écarts types. Cette classification hiérarchique permet d’ordonner la gravité diagnostique de chaque cas et prépare méthodologiquement les analyses de sensibilité ultérieures, où différents niveaux d’exclusion ou de pondération pourront être testés de manière transparente et reproductible.
L’application de ce filtre sur notre jeu de données expérimental simulé isole sans la moindre ambiguïté le sujet numéro quarante-deux délibérément corrompu lors de la phase de préparation des données. Tandis que l’écrasante majorité des quatre-vingt-dix-neuf autres participants conserve des résidus standardisés oscillant paisiblement dans la zone d’homoscédasticité comprise entre moins deux et plus deux, l’observation altérée affiche un résidu standardisé spectaculaire dépassant allègrement le seuil critique de trois. Cet isolement chirurgical démontre la puissance et la robustesse de l’approche standardisée pour démasquer les contaminations expérimentales.
10. Visualisation graphique diagnostique des résidus standardisés
10.1 Graphique des résidus standardisés en fonction des valeurs ajustées
L’inspection purement numérique des vecteurs résiduels doit impérativement être consolidée par des représentations graphiques exhaustives. L’esprit humain possède des capacités exceptionnelles de reconnaissance des formes spatiales, souvent bien supérieures aux métriques de synthèse scalaires pour déceler des ruptures de structure complexes. Le graphique fondamental de tout protocole d’évaluation de régression consiste à projeter les résidus standardisés sur l’axe des ordonnées en fonction des valeurs prédites ou ajustées par le modèle sur l’axe des abscisses.
Pour satisfaire aux critères de lisibilité académique, ce tracé doit intégrer des éléments de repérage géométrique universels. Une ligne horizontale de référence positionnée à l’ordonnée zéro matérialise l’espérance conditionnelle nulle des perturbations. Deux lignes de démarcation horizontales supplémentaires, fréquemment stylisées sous forme de tirets discrets, doivent être tracées aux niveaux d’avertissement de plus deux et moins deux, tandis qu’une paire de limites additionnelles trace les frontières critiques de rejet à plus trois et moins trois écarts types.
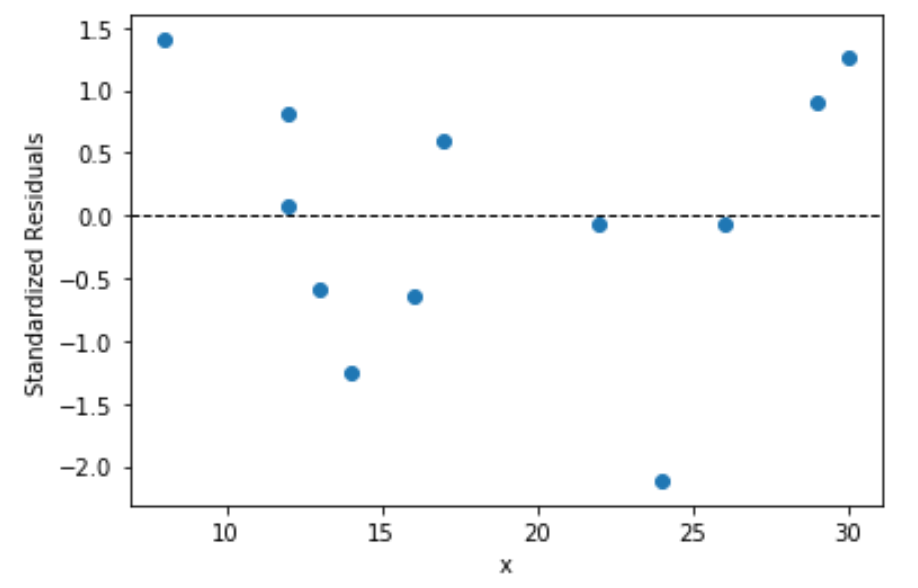
Au sein d’un modèle linéaire rigoureusement valide, le nuage de points résultant doit se disperser sous la forme d’une bande rectangulaire homogène, isotrope et dépourvue de toute structure organisationnelle identifiable à travers l’ensemble du domaine de prédiction. Tout écart par rapport à ce patron idéal dénonce une déficience de modélisation. Une configuration s’évasant progressivement vers la droite sous la forme d’un mégaphone révèle une hétéroscédasticité croissante, indiquant que la fidélité de prédiction se dégrade dramatiquement chez les participants affichant des niveaux élevés sur le prédicteur.
Inversement, la manifestation d’une ondulation systématique, par exemple une grappe de résidus positifs aux extrémités de l’axe prédictif encadrant une concentration de résidus négatifs au centre de la distribution, trahit immédiatement une mauvaise spécification fonctionnelle linéaire imposée à une dynamique psychologique intrinsèquement curvilinéaire. Enfin, les observations atypiques se matérialisent sous la forme de singularités géométriques isolées, flottant à bonne distance au-dessus ou en dessous du corridor de normalité délimité par les seuils horizontaux.
10.2 Diagramme quantile-quantile de normalité des résidus
La validation formelle du postulat de normalité des perturbations constitue le prérequis absolu pour attester de la justesse des tests d’hypothèses conventionnels de Student et de Fisher associés aux coefficients d’ajustement. Le moyen graphique le plus robuste et informatif pour éprouver ce postulat est la construction d’un diagramme quantile-quantile de normalité, communément désigné sous l’acronyme de graphique Q-Q plot.
Cet outil confronte de manière ordonnée les quantiles empiriques de la distribution des résidus standardisés préalablement triés par ordre croissant aux quantiles théoriques attendus d’une loi normale standardisée idéale. Si les résidus d’échantillon sont véritablement issus d’un processus générateur gaussien, chaque point expérimental viendra se positionner très exactement sur la bissectrice rectiligne d’identité théorique traversant le cadran de dispersion.
Tout fléchissement ou courbure systématique du tracé empirique par rapport à la droite de normalité révèle des anomalies distributionnelles majeures. Une configuration sigmoïde dont les extrémités se décollent verticalement de l’axe directeur dénonce des queues de distribution épaisses, signalant que le protocole génère davantage de réponses extrêmes que ne l’autorise la dynamique gaussienne classique. Ce phénomène est fréquent lors de recueils de données chronométriques où les temps de réponse présentent structurellement une asymétrie positive persistante.
L’observation d’une courbure unilatérale en cloche ou en berceau illustre quant à elle une asymétrie résiduelle marquée, découlant souvent de l’omission d’un facteur explicatif modérateur crucial ou de l’inadéquation de l’échelle de mesure employée. Les bibliothèques statistiques de Python permettent de superposer la droite théorique de normalité avec des bandes de confiance ponctuelles, autorisant une appréciation visuelle rigoureuse de la gravité des déviations enregistrées par rapport aux canons de la publication internationale.
10.3 Graphique combiné levier contre résidus standardisés
L’intégration de la métrique résiduelle au sein d’une approche diagnostique globale culmine avec le tracé combinant la distance de levier géométrique sur l’axe horizontal et les résidus standardisés sur l’axe vertical. Ce diagramme factoriel d’influence permet de classifier chirurgicalement chaque point suspect en fonction de sa dangerosité réelle pour la stabilité des conclusions scientifiques.
Ce graphique segmente l’espace diagnostique en plusieurs zones fonctionnelles distinctes. Les observations situées dans le quadrant inférieur gauche, caractérisées par un faible levier et un résidu standardisé contenu à l’intérieur des seuils critiques, incarnent le comportement nominal conforme des sujets expérimentaux. Une observation affichant un résidu standardisé excédant trois écarts types mais associée à un levier diagonal quasi nul représente une anomalie univariée sans gravité pour le modèle : l’estimation est erronée pour ce cas précis, mais sa position centrale dans l’espace des prédicteurs l’empêche de distordre les paramètres globaux.
Le danger méthodologique ultime provient des observations venant coloniser le quadrant supérieur droit ou inférieur droit, associant simultanément un fort effet de levier et une valeur résiduelle standardisée substantielle. Pour matérialiser ce péril, les bibliothèques scientifiques projettent sur ce plan factoriel les lignes de contour paraboliques délimitant des paliers critiques d’accroissement de la distance de Cook. Les points franchissant ces lignes de démarcation exercent une influence destructrice sur les moindres carrés ordinaires, réorientant artificiellement la trajectoire de la droite de régression vers leur propre localisation spatiale.
L’implémentation de cette planche diagnostique complète via Seaborn et Matplotlib s’articule au moyen d’un canevas multi-panneaux intégrant harmonieusement ces trois perspectives visuelles. Cette approche synoptique synthétise en une figure unique l’ensemble des signaux de contrôle requis par les comités de lecture des revues d’excellence, fournissant une preuve matérielle transparente de la rigueur apportée à l’assainissement des données avant toute inférence substantive.
11. Gestion méthodologique et éthique des données aberrantes identifiées
11.1 Processus d’investigation qualitatif avant toute suppression
L’identification formelle d’un résidu standardisé anormalement élevé au terme d’un traitement algorithmique ne doit en aucun cas déclencher une séquence réflexe d’amputation mécanique de la donnée suspecte. L’un des écueils éthiques et méthodologiques les plus insidieux de la recherche quantitative réside dans la tentation d’élaguer les observations non conformes dans le dessein conscient ou inconscient d’abaisser artificiellement la valeur p des tests de signification ou d’optimiser le coefficient de détermination du modèle rapporté.
L’investigation d’un point atypique requiert en premier lieu un examen scrupuleux de la chaîne de traçabilité expérimentale. L’analyste doit inspecter les journaux de passation tenus par les expérimentateurs pour vérifier si l’enregistrement déviant ne correspond pas à un incident de laboratoire avéré : déconnexion intermittente d’une électrode de mesure, intrusion extérieure durant la phase de concentration du sujet, dysfonctionnement d’un chronomètre d’affichage, ou erreur humaine grossière lors de la transcription manuelle de protocoles papier vers la base numérique. Dans ces situations où la validité de la mesure a été matériellement compromise de l’extérieur, l’éviction de la ligne d’enregistrement s’impose comme un devoir méthodologique incontestable.
Si la traçabilité matérielle ne révèle aucun dysfonctionnement instrumental, l’observation doit être présumée constituer une réponse biologiquement ou psychologiquement valide issue de la variabilité naturelle de l’échantillon. Un participant manifestant une performance exceptionnellement dégradée malgré un niveau d’anxiété minime peut incarner l’expression clinique d’un profil neuro-cognitif distinct, d’un déficit motivationnel singulier ou de stratégies de régulation idiosyncrasiques non appréhendées par le modèle linéaire univarié. Éliminer ce profil au simple motif de son résidu extrême revient à mutiler la complexité du vivant pour complaire à un formalisme mathématique idéalisé.
Les conséquences délétères de l’élagage opportuniste sur la réplicabilité scientifique sont aujourd’hui solidement documentées. La suppression de points résiduels sans justification théorique préalable gonfle dramatiquement le taux d’erreur de première espèce, réduisant la recherche empirique à une entreprise d’ajustement circulaire sur mesure incapable de résister à la confrontation avec des cohortes de réplication indépendantes. L’analyse des résidus standardisés doit demeurer un outil d’honnêteté intellectuelle et de caractérisation du signal, et non un instrument d’embellissement post-hoc des résultats.
11.2 Stratégies alternatives de traitement analytique
Face à des observations attestant de résidus standardisés critiques mais dont l’origine ne découle pas d’une erreur d’enregistrement caractérisée, le statisticien moderne dispose d’un riche éventail d’approches méthodologiques évitant le dilemme binaire entre suppression aveugle et conservation passive. La démarche la plus élémentaire et vertueuse consiste à conduire une analyse de sensibilité systématique. Cette procédure impose de caler et rapporter rigoureusement deux versions concurrentes du modèle de régression : le modèle intégral incluant l’intégralité des sujets collectés, et le modèle épuré omettant les profils à résidus excessifs.
Si les estimations des coefficients de régression, leurs erreurs types respectives et les conclusions substantielles de rejet des hypothèses nulles demeurent qualitativement stables entre les deux itérations, l’analyste peut attester avec sérénité de la robustesse structurelle de son assertion empirique face aux perturbations locales. Dans le cas contraire, si la suppression de quelques résidus critiques fait basculer un effet du seuil de significativité à l’indifférence statistique, l’honnêteté scientifique impose de reconnaître que le phénomène rapporté est conditionné par la présence de cette poignée d’individus atypiques, modérant ainsi l’universalité des conclusions tirées.
Une alternative élégante réside dans l’application de techniques d’accommodation non destructives, au premier rang desquelles figure la winsorisation ciblée des déviations extrêmes. Cette méthode consiste à recadrer les valeurs des observations aberrantes en les ramenant à la valeur correspondant au quantile le plus proche situé à l’intérieur de la frontière de normalité prédéfinie, préservant ainsi l’ordonnancement de l’échantillon et son effectif global sans laisser un point isolé distordre disproportionnellement les moments de variance.
Enfin, lorsque l’échantillon présente une proportion substantielle de résidus lourds ou hétérogènes, le chercheur doit s’émanciper des moindres carrés ordinaires pour embrasser les algorithmes de régression robuste, largement implémentés au sein de Statsmodels à travers la classe des modèles linéaires robustes. En substituant à la minimisation quadratique standard des fonctions de perte pondérées, à l’instar de l’estimateur de Huber ou du bisquarré de Tukey, ces algorithmes compriment automatiquement l’influence des observations affichant de forts résidus standardisés, garantissant ainsi une estimation insensible aux aberrations sans requérir la moindre amputation subjective du jeu de données.
12. Rédaction académique et communication des résultats selon les normes APA
12.1 Formulation standardisée des diagnostics résiduels dans le texte
La restitution écrite des diagnostics de régression au sein des sections de résultats des manuscrits scientifiques doit obéir à des standards stricts de transparence, d’exhaustivité et de concision, particulièrement sous les normes internationales édictées par l’American Psychological Association dans sa septième édition. L’inclusion vague d’une phrase rituelle affirmant que les postulats du modèle linéaire ont été contrôlés et jugés satisfaisants ne répond plus aux exigences contemporaines d’évaluation par les pairs.
La prose scientifique doit expliciter avec précision la métrique diagnostique mise en œuvre, en spécifiant expressément si l’identification d’éventuels cas atypiques a reposé sur l’inspection des résidus bruts, standardisés semi-étudiantisés internes ou studentisés externes. De même, les frontières quantitatives retenues pour classer une observation comme cas critique doivent être formulées de manière univoque en faisant référence aux bases probabilistes correspondantes. Si des observations ont fait l’objet d’un ajustement ou d’une exclusion définitive du modèle primaire, leur nombre absolu, leur proportion relative par rapport à la taille totale de l’échantillon et les justifications méthodologiques afférentes doivent être documentés sans fard.
Les formulations textuelles gagnent à s’inspirer de gabarits académiques éprouvés pour relater ces vérifications diagnostiques. Une rédaction conforme peut adopter une structure narrative rigoureuse : « Préalablement à l’évaluation des coefficients d’ajustement du modèle de régression linéaire ordinaire, une inspection exhaustive des résidus standardisés et des mesures de levier a été conduite pour valider le respect des postulats d’homoscédasticité et de normalité des perturbations. L’analyse des résidus semi-étudiantisés internes a révélé la présence d’une seule observation atypique manifestant un écart résiduel standardisé supérieur au seuil critique de trois écarts types (sujet #42, z = 4.12, distance de Cook = 0.45). L’inspection du journal de passation ayant confirmé un incident d’interruption lors de la tâche cognitive, ce participant a été exclu de la cohorte finale. L’échantillon épuré (N = 99) atteste d’une homoscédasticité robuste et d’une normalité des résidus confirmée par l’examen du diagramme quantile-quantile. »
Cette transparence narrative s’inscrit au cœur des initiatives de pré-enregistrement et de science ouverte. Lorsque le protocole de détection des données aberrantes et les règles d’exclusion conditionnelle basées sur les seuils de résidus standardisés ont été formalisés et enregistrés sur des registres publics indépendants préalablement à la collecte des données, toute suspicion de sélection opportuniste des résultats se trouve définitivement écartée, conférant aux conclusions du manuscrit un degré de crédibilité scientifique irréprochable.
12.2 Conception de tableaux synthétiques et présentation des figures
L’optimisation de la communication des diagnostics passe également par la conception de supports visuels et tabulaires répondant scrupuleusement aux conventions typographiques académiques. Les tableaux de régression ne doivent pas se contenter de juxtaposer les coefficients partiels non standardisés, les erreurs types et les valeurs p. Les synthèses avancées intègrent désormais de manière standardisée des blocs récapitulatifs précisant les propriétés globales de la distribution des résidus : l’erreur type de l’estimation, le coefficient de symétrie résiduelle, l’indice d’aplatissement et les valeurs extrêmes des résidus standardisés enregistrées au sein de l’échantillon analysé.
Lorsqu’un article repose sur la mise en œuvre d’analyses de sensibilité pour évaluer l’impact de données aberrantes identifiées, la mise en page sous forme de tableau comparatif à colonnes parallèles s’impose comme la solution de transmission la plus élégante. Le lecteur doit pouvoir confronter immédiatement, côte à côte, les estimations des paramètres issues du modèle global et celles découlant du modèle purgé des résidus critiques. La présentation conjointe de la variation des intervalles de confiance à quatre-vingt-quinze pour cent permet de visualiser instantanément si l’élagage méthodologique a altéré ou renforcé la robustesse du signal théorique.
Concernant les représentations graphiques, les directives de publication APA prohibent les éléments décoratifs superflus et les chartes chromatiques à faible contraste. Les figures diagnostiques générées en Python via Matplotlib doivent être exportées dans des formats vectoriels haute résolution de type PDF ou TIFF à trois cents points par pouce au minimum. Les axes de coordonnées doivent porter des étiquettes textuelles précises spécifiant la dénomination complète des variables et leurs unités de mesure standardisées. Les seuils critiques horizontaux doivent être clairement identifiés au moyen d’annotations explicites intégrées à la légende de la figure.
Enfin, la dissémination moderne des résultats implique la mise à disposition publique des scripts Python complets ayant présidé au calcul des résidus et à la génération des tracés diagnostiques. Le dépôt du code source sous forme de modules reproductibles sur des plateformes ouvertes certifiées garantit la pérennité de l’effort scientifique. Les évaluateurs et la communauté internationale acquièrent ainsi la faculté de recalculer à l’identique chaque déviation résiduelle, assurant à la recherche une solidité méthodologique et une transparence totale.
Références
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman and Hall.
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 56–61). https://doi.org/10.25080/Majora-92bf1921-00a
- Rousseeuw, P. J., & Leroy, A. M. (1987). Robust regression and outlier detection. John Wiley & Sons. https://doi.org/10.1002/0471852333
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. In Proceedings of the 9th Python in Science Conference (Vol. 57, pp. 61–68). https://doi.org/10.25080/Majora-92bf1921-011
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2