
L’analyse quantitative des données en psychologie, en neurosciences cognitives et dans l’ensemble des sciences comportementales se heurte de manière quasi systématique à un défi méthodologique fondamental : l’écart béant entre les postulats théoriques des modèles statistiques classiques et la réalité empirique des distributions observées. Depuis les travaux fondateurs de Ronald Fisher et de Karl Pearson, la communauté scientifique s’est largement reposée sur la moyenne arithmétique comme mesure universelle de tendance centrale. Cependant, cette prédominance historique découle d’une hypothèse de normalité idéale qui ne se vérifie presque jamais sur le terrain empirique. Les temps de réaction, les scores d’échelles d’anxiété ou les indices psychophysiologiques présentent continuellement des queues de distribution épaisses, des asymétries prononcées et des valeurs aberrantes inhérentes à la complexité de l’appareil psychique humain.
Face à ces distributions contaminées, l’application aveugle de la moyenne classique entraîne des distorsions préjudiciables : un seul score extrême provoqué par un décrochage attentionnel passager, une erreur de saisie ou une stratégie de réponse atypique peut déplacer substantiellement l’estimation du centre de gravité des données, gonfler artificiellement la variance et affaiblir drastiquement la puissance statistique des tests d’hypothèses inférentiels. Pour pallier cette vulnérabilité structurelle, la statistique robuste s’est développée tout au long de la seconde moitié du vingtième siècle, proposant des estimateurs capables de préserver leur efficacité et leur validité même en présence de déviations sévères par rapport au modèle gaussien.
Au cœur de cet arsenal méthodologique figure la moyenne tronquée (ou trimmed mean). Cet estimateur allie la simplicité conceptuelle de la moyenne arithmétique à la résistance empirique des méthodes d’ordre. En écartant de façon contrôlée, symétrique et transparente une fraction prédéfinie des valeurs situées aux extrémités d’une distribution ordonnée, le chercheur neutralise l’influence délétère des artefacts de mesure sans basculer dans l’arbitraire de la suppression manuelle de données au cas par cas. Ce guide détaillé offre un parcours exhaustif, théorique et opérationnel pour maîtriser, calculer pas à pas, interpréter et communiquer rigoureusement la moyenne tronquée dans les travaux de recherche empirique.
1. Introduction conceptuelle à la moyenne tronquée en recherche psychologique
1.1 Définition théorique et fondements mathématiques
La moyenne tronquée se définit formellement comme un estimateur robuste de tendance centrale de la famille des L-estimateurs, c’est-à-dire des combinaisons linéaires de statistiques d’ordre. Contrairement à la moyenne arithmétique simple qui attribue un poids uniforme de 1/n à chaque observation brute, la moyenne tronquée opère une modification déterministe de la fonction de pondération appliquée aux données préalablement ordonnées. Le principe directeur consiste à éliminer une proportion précise notée alpha ($\alpha$) des observations les plus faibles et une proportion identique des observations les plus élevées, avant de calculer la moyenne arithmétique conventionnelle sur les données restantes situées au cœur de la distribution.
Sur le plan mathématique, pour un échantillon de taille $n$ ordonné de telle sorte que $X_{(1)} le X_{(2)} le dots le X_{(n)}$, et pour une proportion de rognage symétrique $\alpha in [0, 0.5[$, le nombre d’observations exclues à chaque extrémité correspond à un entier $k$. La moyenne tronquée s’exprime alors rigoureusement par la formule de sommation normalisée appliquée au sous-ensemble des rangs conservés. Cette formulation garantit que l’estimateur demeure invariant par translation et équivariant par changement d’échelle, deux propriétés algébriques fondamentales pour la métrologie psychologique.
Il est impératif d’établir une différenciation conceptuelle stricte entre le rognage symétrique standardisé et le filtrage discrétionnaire ou opportuniste des données. Le rognage statistique ne dépend pas de l’amplitude absolue des écarts numériques observés, ni d’un jugement subjectif de l’expérimentateur sur ce qui constituerait une valeur acceptable ou anormale. Il s’agit d’une règle algorithmique systématique, définie de manière purement structurelle sur la base des rangs, ce qui immunise le protocole expérimental contre le risque de manipulation des seuils d’exclusion et garantit l’objectivité computationnelle de la recherche.
1.2 Vulnérabilité de la moyenne arithmétique standard face aux valeurs extrêmes
La vulnérabilité de la moyenne arithmétique classique découle directement de son point de rupture empirique, qui est égal à $1/n$, ce qui tend asymptotiquement vers 0 % lorsque la taille de l’échantillon augmente. En d’autres termes, il suffit d’une unique observation arbitrairement extrême, qu’elle soit infinitésimale ou gigantesque, pour déstabiliser totalement la moyenne arithmétique et la déplacer hors de toute zone biologiquement ou psychologiquement plausible. Dans les contextes expérimentaux, les artefacts de mesure tels que les doubles frappes sur un clavier, les déconnexions transitoires d’électrodes en électroencéphalographie ou les distractions massives d’un participant induisent des données qui corrompent de façon dévastatrice l’estimateur moyen conventionnel.
Cette fragilité a des conséquences directes sur l’erreur quadratique moyenne de l’estimateur. Lorsque la distribution sous-jacente des variables mesurées présente des queues plus lourdes que celles d’une distribution normale théorique — un phénomène presque omniprésent en psychologie expérimentale —, la variance d’échantillonnage de la moyenne classique explose. Contrairement à une croyance répandue, le théorème central limite ne résout pas magiquement ce problème pour des tailles d’échantillon modérées : si les données proviennent d’une distribution contaminée par des lois à queues épaisses, la vitesse de convergence vers la normalité est extrêmement lente, ce qui compromet la validité des intervalles de confiance standard.
Le modèle gaussien strict repose sur l’hypothèse que les déviations par rapport au centre sont symétriques et exponentiellement rares au-delà de deux à trois écarts-types. Or, en psychométrie et en neurosciences, les distributions empiriques sont presque continuellement asymétriques et leptokurtiques. L’adhésion dogmatique à la moyenne arithmétique standard dans ces conditions expose le chercheur à des erreurs d’interprétation substantielles, en confondant l’asymétrie de la queue de distribution ou la présence d’artefacts sporadiques avec le fonctionnement cognitif moyen de la population cible étudiée.
1.3 Rôle des estimateurs robustes dans les sciences du comportement
L’intégration des estimateurs robustes, conceptualisée notamment par les travaux séminaux de Peter J. Huber et John Tukey, répond à une nécessité méthodologique absolue : préserver la représentativité des paramètres descriptifs et inférentiels extraits des échantillons psychométriques. Dans les sciences du comportement, la variabilité humaine n’est pas une simple erreur de mesure aléatoire, mais le reflet de processus cognitifs complexes, d’oscillations motivationnelles et de réponses physiologiques fluctuantes. Un protocole rigoureux doit parvenir à caractériser le comportement typique de l’échantillon sans être pris en otage par des événements périphériques déconnectés du processus étudié.
La stabilisation des estimations face aux comportements atypiques des participants — comme le phénomène de non-conformité délibérée, le désengagement passager ou la panique face à une tâche chronométrée — est précisément rendue possible par l’usage d’estimateurs robustes. En neutralisant l’influence disproportionnée des valeurs d’ancrage marginales, la moyenne tronquée offre une estimation centrale hautement stable qui reflète véritablement le point d’équilibre de la majorité des participants. Elle garantit que les conclusions scientifiques ne reposent pas sur une poignée de cas périphériques non généralisables.
De surcroît, le recours systématique aux estimateurs robustes participe directement à la résolution de la crise de la reproductibilité qui secoue la psychologie contemporaine. Les tests statistiques paramétriques classiques construits sur la moyenne ordinaire voient leur puissance chuter de manière spectaculaire dès que la normalité est violée, provoquant une prolifération de faux négatifs (erreurs de type II) ou, à l’inverse, des fluctuations d’échantillonnage induisant des faux positifs (erreurs de type I). En stabilisant les estimations centrales, la moyenne tronquée accroît la réplicabilité des tailles d’effet à travers des laboratoires et des échantillons distincts.
2. Fondements méthodologiques : pourquoi et quand tronquer une distribution
2.1 Le cas critique des temps de réaction en chronométrie mentale
L’étude des temps de réaction (TR) en chronométrie mentale fournit le paradigme le plus éloquent justifiant l’application d’un rognage systématique. Les distributions temporelles des réponses cognitives suivent typiquement des lois asymétriques positives, modélisables par des distributions ex-gaussiennes, log-normales ou de Wald. Dans ces contextes, deux types d’anomalies comportementales se superposent inévitablement au signal cognitif d’intérêt : d’une part, les réponses anticipatoires ultracourtes (par exemple inférieures à 150 millisecondes), causées par des déclenchements moteurs involontaires avant l’intégration du stimulus sensoriel, et d’autre part, les latences démesurées (dépassant parfois plusieurs secondes) engendrées par des micro-sommeils, des clignements d’yeux ou des pertes complètes d’attention sélective.
Pendant longtemps, les chercheurs ont géré ces anomalies en appliquant des seuils de coupure fixes (par exemple, rejeter arbitrairement tout TR inférieur à 200 ms ou supérieur à 2000 ms) ou des seuils basés sur un certain nombre d’écarts-types par rapport à la moyenne globale de l’échantillon (souvent plus ou moins 2,5 ou 3 écarts-types). Cette dernière approche est notoirement circulaire et mathématiquement viciée : la présence même des scores aberrants gonfle la moyenne et l’écart-type, déplaçant les critères de coupure et masquant des valeurs anormales par un effet bien documenté de masquage statistique (masking effect).
La moyenne tronquée apporte une solution élégante et mécaniquement supérieure à ce dilemme. Plutôt que d’éliminer des essais entiers sur la base de seuils absolus arbitraires variant d’une étude à l’autre, le rognage symétrique élimine une proportion constante des extrémités de la distribution au sein de chaque condition ou pour chaque participant. Cette standardisation élimine l’arbitraire du filtrage, prévient les biais induits par les réponses anticipées non contrôlées et les latences aberrantes, tout en garantissant un traitement parfaitement symétrique et réplicable des données chronométriques.
2.2 Atténuation des biais de réponse dans les inventaires psychologiques
Dans le domaine de l’évaluation psychométrique et des questionnaires de personnalité utilisant des échelles de Likert ou des échelles visuelles analogiques, les distributions de réponses souffrent fréquemment de styles de réponse idiosyncrasiques. Parmi ceux-ci, le style de réponse extrême (Extreme Response Style, ERS) conduit certains participants à mobiliser quasi systématiquement les ancres extrêmes de l’échelle (telles que 1 ou 7 sur une échelle en 7 points), indépendamment de la sémantique de l’item. À l’opposé, d’autres individus manifestent des biais d’acquiescement ou des comportements de réponse aléatoire causés par la fatigue cognitive lors de protocoles d’évaluation volumineux.
Lorsque le chercheur procède à l’agrégation de multiples items pour calculer des scores factoriels ou des scores composites d’échelles, l’existence de ces profils de réponse aberrants produit des distorsions notables. Si la distribution d’une sous-population clinique ou organisationnelle est synthétisée par une moyenne classique, la présence de quelques individus adoptant une stratégie d’opposition délibérée ou de simulation pathologique peut déplacer l’indicateur d’ajustement global du groupe de manière fallacieuse.
Le recours à la moyenne tronquée lors de l’analyse transversale de groupes ou de l’analyse d’items au sein de batteries de tests permet d’atténuer puissamment l’impact de ces comportements de non-conformité. En neutralisant les observations marginales issues des profils ERS ou des négligences d’encodage, le score moyen tronqué fournit une métrique composite stabilisée qui ne déforme pas artificiellement la variance réelle du construit sous-jacent, assurant ainsi une évaluation fidèle des dimensions psychologiques analysées.
2.3 Arbitrage méthodologique : moyenne arithmétique, médiane et moyenne tronquée
L’arbitrage méthodologique entre les différentes métriques de tendance centrale repose traditionnellement sur la comparaison de deux paramètres théoriques fondamentaux : le point de rupture empirique et l’efficacité asymptotique relative. Le point de rupture désigne la fraction minimale d’observations contaminées qu’un échantillon peut contenir avant que l’estimateur ne puisse produire un résultat arbitrairement aberrant. Comme le résume le tableau synthétique ci-dessous, ces estimateurs présentent des propriétés structurellement contrastées :
- Moyenne arithmétique standard : Point de rupture nul de 0 % ($1/n$). Efficacité optimale de 100 % sous normalité gaussienne parfaite, mais effondrement catastrophique de la puissance dès l’introduction de légères contaminations aux queues de distribution.
- Médiane empirique : Point de rupture maximal de 50 %. Résistance absolue aux valeurs extrêmes, mais efficacité relative considérablement dégradée en situation de normalité pure (chute d’efficacité à environ 64 %), entraînant une perte substantielle d’information métrique quantitative au profit d’un simple classement ordinal.
- Moyenne tronquée (au taux alpha) : Point de rupture exactement égal à la proportion de rognage $\alpha$ (par exemple 20 %). Efficacité remarquable (généralement supérieure à 85-95 %) sur des distributions normales comme sur des distributions contaminées, préservant la granularité métrique des scores centraux tout en éliminant l’instabilité des queues.
Dans son célèbre modèle de la distribution normale contaminée, John Tukey a démontré qu’il suffit d’une contamination de seulement 1 % de l’échantillon par des observations issues d’une distribution normale de même moyenne mais de variance neuf fois supérieure pour que la variance de la moyenne arithmétique devienne supérieure à celle de la médiane ou d’une moyenne tronquée. La moyenne tronquée représente ainsi un compromis optimal : elle refuse la vulnérabilité absolue de la moyenne classique sans accepter la perte drastique d’information quantitative imposée par la médiane, qui ignore l’intégralité des distances métriques en dehors de l’élément central.
3. Paramètres clés du rognage statistique : choisir la proportion adéquate
3.1 Détermination du pourcentage de rognage optimal
Le choix de la proportion de rognage $\alpha$ constitue le paramètre central du protocole d’analyse robuste. Dans la littérature méthodologique spécialisée, les taux de rognage usuels oscillent historiquement entre 5 %, 10 % et 20 % à chaque extrémité de la distribution ordonnée. Une troncature à 5 % (soit un élagage total de 10 % des données de l’échantillon) constitue un réglage conservateur conçu pour éliminer uniquement les anomalies les plus grossières sans modifier substantiellement les propriétés inférentielles du modèle classique lorsque la distribution d’origine est très proche d’une gaussienne.
Cependant, les recherches approfondies menées par le statisticien et psychométricien Rand Wilcox, figure de proue des statistiques robustes en psychologie, démontrent avec force qu’un taux de rognage de 20 % ($\alpha = 0.20$) offre un équilibre remarquable entre le biais potentiel et la variance de l’estimateur dans la grande majorité des applications comportementales. Une troncature à 20 % (qui retire les 20 % les plus bas et les 20 % les plus hauts pour conserver les 60 % centraux) garantit une protection robuste contre des formes sévères de non-normalité, de kurtosis excessif et d’hétéroscédasticité, tout en maintenant une puissance statistique particulièrement élevée lors des tests d’hypothèses ultérieurs.
Il importe toutefois de souligner les risques inhérents à un rognage excessif. Lorsque la proportion $\alpha$ augmente au-delà de 25 % pour approcher la limite théorique de 50 % (qui correspond fonctionnellement à la médiane), l’estimateur commence à souffrir d’une perte d’efficacité statistique non négligeable si les données sous-jacentes étaient en réalité modérément régulières. De plus, une amputation trop large de l’échantillon réduit artificiellement la représentativité de la dispersion naturelle du phénomène étudié, risquant de masquer des hétérogénéités fonctionnelles légitimes au sein des populations évaluées.
3.2 Rognage symétrique versus rognage asymétrique
La règle canonique en inférence statistique robuste impose un rognage strictement symétrique, consistant à élaguer exactement la même proportion $\alpha$ ou le même nombre $k$ d’observations aux deux queues de la distribution. Cette symétrie structurelle préserve les propriétés asymptotiques de l’estimateur et évite de déplacer artificiellement la tendance centrale vers l’un des pôles lorsque la distribution génératrice est par essence symétrique. Sous l’hypothèse d’une loi de probabilité sous-jacente symétrique, la moyenne tronquée symétrique demeure un estimateur strictement sans biais de la moyenne de la population.
Néanmoins, des circonstances expérimentales exceptionnelles et motivées théoriquement peuvent inciter certains praticiens à envisager un rognage directionnel asymétrique (ou unilatéral). Ce cas de figure se rencontre principalement en chronométrie mentale lorsqu’un effet plancher physiologique indépassable (par exemple, le temps incompressible de transduction sensorielle et de conduction nerveuse motrice, fixé à environ 120 ms) prévient tout risque d’artéfact sur la queue inférieure, tandis que la queue supérieure subit des contaminations massives dues aux divagations attentionnelles. Dans une telle situation, élaguer uniquement la queue supérieure semblerait intuitivement attrayant.
Toutefois, la prudence méthodologique la plus stricte doit être observée : le rognage asymétrique modifie fondamentalement la cible de l’estimation. Si l’on tronque davantage une extrémité que l’autre sur une distribution continue, l’estimateur obtenu ne converge plus vers l’espérance mathématique de la distribution d’origine, mais introduit un biais systématique orienté. Sauf dans des protocoles psychométriques très spécifiques disposant d’un modèle formel de distribution asymétrique validé a priori, le rognage asymétrique est vivement déconseillé en recherche inférentielle en raison des biais arbitraires qu’il injecte directement dans les comparaisons inter-groupes.
3.3 Gestion des contraintes liées à la taille d’échantillon
L’implémentation opérationnelle du rognage dépend intimement de la taille d’échantillon disponible ($n$). En pratique, l’application d’une moyenne tronquée exige un effectif minimal pour que l’opération conserve un sens mathématique et méthodologique. Si l’on travaille sur un échantillon minuscule de $n = 5$ participants, un taux de rognage usuel de 20 % correspond à éliminer une observation de part et d’autre ($k = 1$), laissant seulement trois observations pour estimer la tendance centrale. Si $n$ tombe en dessous de 4 ou 5 unités, le rognage symétrique devient virtuellement impraticable ou équivaut stricto sensu à la médiane.
En neuropsychologie clinique ou dans les études portant sur des pathologies rares où les effectifs oscillent fréquemment entre 8 et 15 sujets, la problématique du rognage se pose avec acuité. L’exclusion de données réduit mécaniquement l’effectif résiduel effectif ($n – 2k$), ce qui influence directement le calcul des degrés de liberté lors des procédures inférentielles associées (telles que le test de Yuen). Il convient dès lors de ne pas adopter des taux de troncature disproportionnés sur des petits échantillons, sous peine d’éroder dramatiquement la puissance statistique des analyses comparatives.
De plus, lorsque la multiplication de la taille d’échantillon par la proportion de rognage ($n \times \alpha$) ne produit pas un nombre entier strict, des conventions computationnelles d’arrondi formel doivent être instaurées. La manière de résoudre ce résultat fractionnaire détermine avec précision les limites d’inclusion et d’exclusion des rangs dans l’échantillon fini, un enjeu opérationnel capital que nous allons détailler dans les sections computationnelles suivantes.
4. Étape 1 : Ordonnancement systématique de la série de données
4.1 Procédure de tri séquentiel des observations quantitatives
La première étape algorithmique du calcul d’une moyenne tronquée réside dans l’ordonnancement rigoureux et systématique de l’ensemble de la série de données univariée. Soit une série brute de mesures empiriques collectées auprès de $n$ participants, notée $X = {x_1, x_2, dots, x_n}$. Cette série brute non ordonnée doit être transformée par une bijection de tri croissant afin d’engendrer le vecteur des statistiques d’ordre :
$$X_{(1)} le X_{(2)} le X_{(3)} le dots le X_{(n)}$$
Dans cette notation standardisée, $X_{(1)}$ représente impérativement la valeur minimale absolue observée dans l’échantillon, tandis que $X_{(n)}$ correspond à la valeur maximale absolue observée. Cette phase de tri séquentiel constitue le socle indispensable à l’identification univoque des positions relatives des scores sur l’axe continu de mesure. Avant d’exécuter cette opération, l’analyste doit impérativement auditer l’intégrité de la structure numérique du jeu de données, en vérifiant l’absence d’incohérences de codage (telles que des valeurs négatives sur des échelles strictement positives ou des encodages de valeurs manquantes mal formatés sous forme de 999).
Il est également crucial, pour la traçabilité déontologique de la recherche, de préserver l’indexation initiale reliant chaque score $x_i$ à l’identifiant unique du participant correspondant. Bien que la moyenne tronquée travaille sur des statistiques d’ordre anonymisées dans leur classement, la conservation de la table d’association entre rangs ordonnés et identifiants expérimentaux permet de documenter ultérieurement quels participants spécifiques ont vu leurs données marginalisées par le rognage, assurant une parfaite transparence méthodologique lors de l’audit des données brutes.
4.2 Traitement rigoureux des scores ex æquo lors du tri
Dans les jeux de données issus des sciences du comportement, l’apparition de scores ex æquo (valeurs strictement identiques partagées par plusieurs participants) est extrêmement fréquente, particulièrement sur les échelles psychométriques discrètes comportant un nombre fini d’échelons (échelles de Likert en 5 ou 7 points, scores de précision discrets sur 20 items). La présence d’égalités multiples impose une clarification rigoureuse des règles de tri afin d’éviter toute ambiguïté sur les limites du rognage.
En présence d’observations ex æquo, la convention standard des statistiques d’ordre consiste à attribuer des rangs consécutifs arbitraires aux valeurs identiques, sans modifier la valeur quantitative elle-même. Si deux participants obtiennent un score de 42, l’un occupera par exemple le rang ordonné $X_{(4)}$ et le second le rang $X_{(5)}$, l’ordre précis entre ces deux valeurs identiques n’ayant strictement aucun impact sur le calcul final tant que ces scores se situent à l’intérieur du segment central conservé.
Cependant, une complexité théorique émerge lorsqu’une égalité survient précisément au seuil critique de démarcation du rognage, c’est-à-dire au rang $k$ ou au rang $k+1$. Si la valeur au rang $k$ (qui doit être éliminée) est numériquement identique à la valeur au rang $k+1$ (qui doit être conservée), l’application stricte de l’algorithme retire l’une des instances et conserve l’autre. Cette situation, parfaitement gérée par les environnements informatiques standardisés via l’indexation matricielle déterministe, doit être documentée avec précision si un calcul manuel ou semi-automatisé est entrepris, garantissant que l’objectivité de l’analyste ne soit jamais mise en défaut.
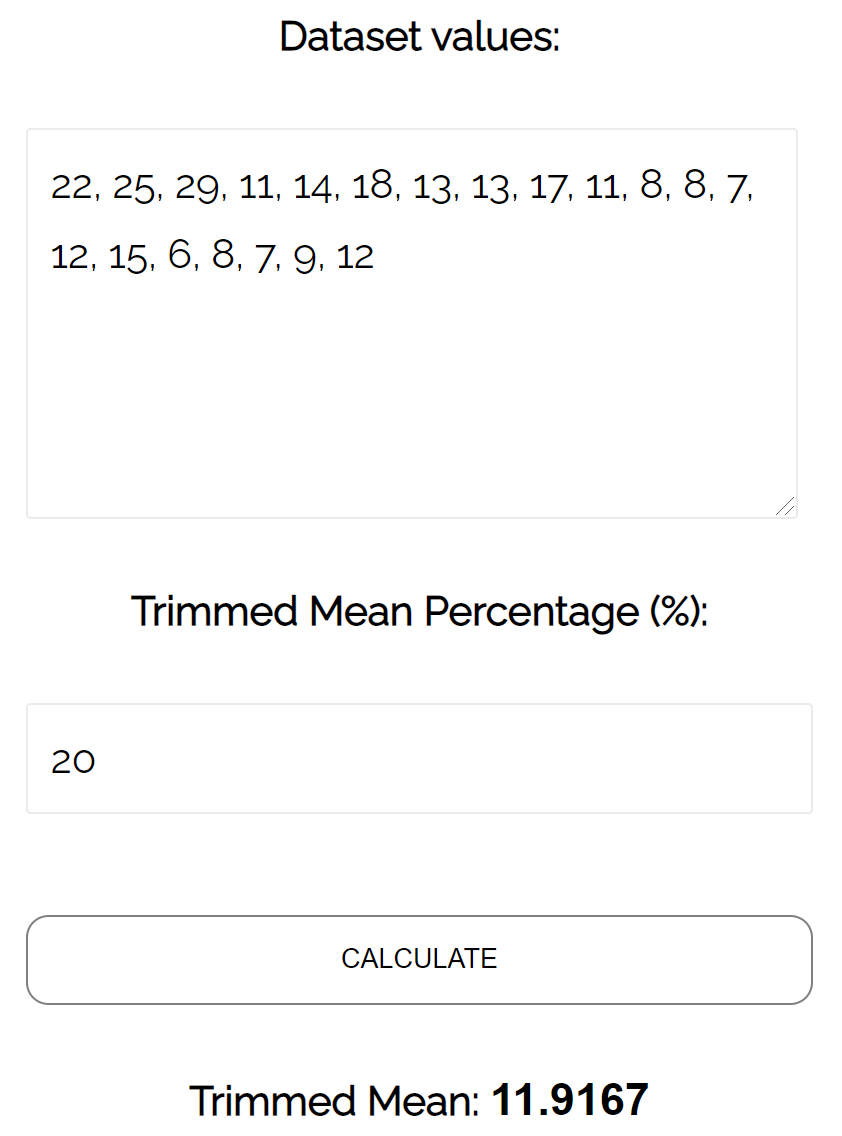
4.3 Diagnostic exploratoire visuel préalable
Avant d’engager mécaniquement le calcul mathématique de la troncature, il est hautement recommandé d’effectuer un diagnostic exploratoire visuel de la distribution des données ordonnées. L’exploration graphique permet de confirmer empiriquement la présence effective de queues de distribution épaisses, de valeurs isolées atypiques ou d’asymétries structurelles qui légitiment le recours à un estimateur robuste plutôt qu’à la moyenne arithmétique ordinaire.
Deux outils graphiques se révèlent particulièrement précieux pour cette analyse préliminaire :
- Le diagramme en boîte (Boxplot) de Tukey : Il met immédiatement en exergue les valeurs situées au-delà des clôtures intérieure ($1,5 \times \text{IQR}$) et extérieure ($3 \times \text{IQR}$), offrant un repérage visuel instantané des scores aberrants potentiels qui se trouveront sous le coup de l’élagage.
- Le diagramme quantile-quantile (Q-Q plot ou droite de Henry) : En confrontant les quantiles observés de l’échantillon aux quantiles théoriques d’une loi normale, il met en évidence les déviations en forme de « S » caractéristiques des distributions leptokurtiques ou les courbures révélatrices d’une asymétrie marquée.
Cette étape exploratoire permet également de détecter la présence éventuelle d’une multimodalité sévère dans l’échantillon. Si la distribution se compose de deux sous-populations distinctes formant deux bosses clairement séparées (distribution bimodalement stratifiée), le recours à une moyenne — qu’elle soit classique ou tronquée — perd largement de sa pertinence conceptuelle, car une seule valeur centrale ne saurait résumer fidèlement deux régimes comportementaux concurrents. Le diagnostic visuel préalable protège ainsi l’expérimentateur contre une utilisation aveugle et inappropriée des outils de réduction statistique.
5. Étape 2 : Détermination du nombre exact d’observations à exclure
5.1 Application de l’équation standard du nombre d’exclusions
Une fois les données rigoureusement classées par ordre croissant, la deuxième étape consiste à formaliser le volume précis d’observations à soustraire de chaque extrémité de la distribution. Le calcul du nombre d’unités à exclure, désigné conventionnellement par la lettre $k$, dépend de deux facteurs : la taille totale de l’échantillon ($n$) et la proportion de rognage prédéterminée ($\alpha$, exprimée sous forme décimale, par exemple 0.10 pour 10 % ou 0.20 pour 20 %).
L’équation fondamentale définissant le nombre théorique d’exclusions unilatérales s’énonce simplement comme le produit de la taille d’échantillon par la proportion de troncature choisie :
$$k = n \times \alpha$$
La valeur de $k$ représente exclusivement le nombre d’observations à éliminer sur la queue inférieure ET le nombre d’observations à éliminer sur la queue supérieure. Par conséquent, le volume total de données éliminées de l’échantillon global s’élève systématiquement à $2k$. La taille effective du sous-ensemble résiduel sur lequel portera le calcul arithmétique final est donc rigoureusement déterminée par la relation :
$$n_{\text{résiduel}} = n – 2k$$
À titre d’illustration immédiate, si un chercheur dispose d’une cohorte expérimentale de $n = 40$ participants et décide d’appliquer un rognage classique à 10 % ($\alpha = 0.10$), le calcul produit $k = 40 \times 0.10 = 4$. Il conviendra alors d’exclure les 4 plus petites valeurs et les 4 plus grandes valeurs de l’échantillon ordonné, laissant un sous-ensemble central intact comprenant $40 – (2 \times 4) = 32$ observations.
5.2 Gestion des résultats fractionnaires et règles d’arrondi
Dans la pratique de la recherche empirique, la taille d’échantillon $n$ n’est que rarement un multiple parfait de la proportion de troncature choisie. Par exemple, si l’on applique un taux de rognage de 20 % ($\alpha = 0.20$) sur un groupe de $n = 23$ participants, le produit direct donne $k = 23 \times 0.20 = 4.6$. Puisqu’il est impossible dans un protocole discret d’éliminer physiquement 4,6 participants, des règles computationnelles standardisées doivent être appliquées pour résoudre cette valeur fractionnaire.
Trois approches distinctes existent dans la littérature statistique :
- La fonction partie entière (troncature / floor) : Notée $k = \lfloor n \times \alpha \rfloor$. Cette convention, la plus largement implémentée dans les progiciels statistiques universitaires (notamment dans la syntaxe de base de R ou de SAS), arrondit systématiquement le résultat à l’entier immédiatement inférieur. Pour $k = 4.6$, on retiendra donc strictement $k = 4$. C’est une approche conservatrice qui garantit que la proportion réelle d’élagage ne dépasse jamais la proportion théorique $\alpha$.
- L’arrondi à l’entier le plus proche (nearest integer) : Le résultat est arrondi à l’entier arithmétiquement le plus proche (pour 4.6, on retient $k = 5$). Bien qu’intuitive, cette méthode peut conduire à éliminer une fraction de données légèrement supérieure au taux annoncé.
- La moyenne tronquée avec pondération partielle (fractional trimming) : Formulée initialement par Stephen Stigler, cette méthode avancée conserve l’entier inférieur $k = \lfloor n \times \alpha \rfloor$, mais pondère la $(k+1)$-ième observation par la fraction décimale résiduelle (dans notre exemple, $1 – 0.6 = 0.4$) afin que la contribution effective corresponde exactement au ratio mathématique continu $\alpha$.
Dans le cadre de ce guide didactique et pour assurer une compatibilité optimale avec la majorité des implémentations logicielles en recherche comportementale, nous retiendrons la convention dominante : la fonction partie entière par défaut ($k = \lfloor n \times \alpha \rfloor$).
5.3 Formalisation des seuils de démarcation
L’attribution exacte de l’entier $k$ permet d’établir formellement les seuils de démarcation qui séparent le sous-ensemble central conservé des segments extrêmes rejetés. Dans le vecteur des statistiques d’ordre $X_{(1)}, X_{(2)}, dots, X_{(n)}$, la ligne de partition s’établit sans aucune ambiguïté spatiale :
La zone d’exclusion inférieure est constituée par les $k$ premières statistiques d’ordre de la série :
$$\text{Zone inférieure rejetée} = { X_{(1)}, X_{(2)}, dots, X_{(k)} }$$
Symétriquement, la zone d’exclusion supérieure est formée par les $k$ dernières statistiques d’ordre, ce qui correspond aux rangs ordonnés partant de $(n – k + 1)$ jusqu’à $n$ inclus :
$$\text{Zone supérieure rejetée} = { X_{(n – k + 1)}, X_{(n – k + 2)}, dots, X_{(n)} }$$
Une condition mathématique impérative de validité doit systématiquement être validée lors de cette étape : la non-intersection des zones de coupure. Il est impératif que l’inégalité stricte suivante soit respectée :
$$2k < n \quad iff \quad k < \frac{n}{2}$$
Si cette condition n’était pas remplie, les zones de troncature inférieure et supérieure se chevaucheraient, annihilant l’ensemble de l’échantillon. La validation de cette borne assure que le sous-ensemble central contient toujours au minimum une observation (et en pratique, toujours une fraction substantielle de l’échantillon, idéalement supérieure ou égale à 50 % ou 60 % de l’effectif total).
6. Étape 3 : Élagage effectif et isolement du sous-ensemble central
6.1 Suppression formelle des scores extrêmes inférieurs et supérieurs
L’étape d’élagage effectif consiste à concrétiser l’exclusion algorithmique déterminée à l’étape précédente. Ayant identifié les $k$ rangs inférieurs et les $k$ rangs supérieurs dans la série ordonnée, le chercheur extrait délibérément ces observations marginales pour isoler le cœur de la distribution. Cette opération ne constitue en aucun cas une falsification de données, mais un filtrage mathématique contrôlé visant à assainir l’estimateur de tendance centrale.
Le sous-ensemble des données conservées, que l’on qualifiera de sous-échantillon central épuré et que l’on notera $X_{\text{central}}$, est alors constitué exclusivement des observations s’étendant du rang ordinal $(k + 1)$ au rang ordinal $(n – k)$ :
$$X_{\text{central}} = { X_{(k+1)}, X_{(k+2)}, dots, X_{(n-k-1)}, X_{(n-k)} }$$
Toutes les observations contenues dans ce sous-ensemble bénéficient dès lors d’un statut d’inclusion parfait, conservant leur valeur métrique brute originelle sans aucune modification ni rétrécissement d’échelle. À ce stade, le profil de distribution résiduel se trouve mécaniquement débarrassé des scores les plus atypiques qui auraient pu exercer un bras de levier disproportionné sur l’agrégation statistique.
6.2 Vérification post-élagage de la structure de l’échantillon
Avant d’engager le calcul arithmétique de synthèse, une vérification d’assurance qualité s’impose. L’analyste doit contrôler que la cardinalité du sous-ensemble épuré correspond rigoureusement à la prédiction théorique. Si l’on dénombre les éléments de $X_{\text{central}}$, la quantité exacte d’observations résiduelles doit impérativement satisfaire l’égalité :
$$\text{Effectif conservé} = (n – k) – (k + 1) + 1 = n – 2k$$
Toute discordance numérique à ce stade signale une erreur d’indexation d’indice ou une mauvaise interprétation des bornes d’inclusion lors du tri manuel. Par ailleurs, cette étape post-élagage offre l’opportunité de réévaluer brièvement les propriétés descriptives du vecteur $X_{\text{central}}$. On observe typiquement un effondrement spectaculaire de l’asymétrie empirique (skewness) et un retour de l’aplatissement (kurtosis) vers des valeurs beaucoup plus raisonnables, démontrant concrètement l’action régulatrice du rognage sur la morphologie distributionnelle.
Cette vérification prévient également le risque d’un biais de troncature accidentelle asymétrique, qui surviendrait si un opérateur omettait d’extraire le même nombre d’éléments à gauche et à droite. L’équilibrage strict du retrait garantit la préservation des garanties théoriques de l’estimateur robuste.
6.3 Documentation méthodologique des données écartées
Conformément aux standards modernes de la science ouverte (Open Science) et aux principes de l’American Psychological Association, l’élagage de données ne doit jamais s’opérer dans l’opacité. Bien que les valeurs situées au-delà des rangs seuils soient exclues du calcul de la moyenne tronquée, elles ne doivent en aucun cas être purement et simplement effacées du fichier de données d’origine.
L’expérimentateur doit consigner formellement dans son cahier de laboratoire numérique ou dans son script de programmation :
- Les identifiants individuels des participants ou des essais dont les valeurs ont été soustraites du calcul central.
- La valeur numérique exacte de chacun des scores écartés, aux bornes inférieures comme aux bornes supérieures.
- La justification statistique a priori ayant guidé le choix du pourcentage de troncature $\alpha$.
Cette rigueur documentaire répond à une exigence déontologique et méthodologique : elle permet à tout auditeur scientifique, évaluateur par les pairs ou chercheur indépendant souhaitant répliquer l’étude d’avoir un accès immédiat à l’intégralité du jeu de données non transformé. La moyenne tronquée se distingue fondamentalement des pratiques contestables de recherche (Questionable Research Practices) précisément parce qu’elle repose sur un protocole algorithmique transparent, prédictible et entièrement documentable.
7. Étape 4 : Calcul arithmétique de la moyenne sur le sous-ensemble épuré
7.1 Sommation des données quantitatives résiduelles
La quatrième étape opérationnelle consiste à réaliser l’agrégation arithmétique conventionnelle sur le sous-ensemble central préalablement isolé. La première composante de cette agrégation est la sommation rigoureuse de l’ensemble des valeurs quantitatives appartenant au vecteur résiduel $X_{\text{central}}$.
Mathématiquement, cette somme cumulée s’exprime par l’opérateur sigma appliqué entre les indices de rang ordinal $(k+1)$ et $(n-k)$ :
$$S_{\text{tronquée}} = \sum_{i = k + 1}^{n – k} X_{(i)}$$
Lors d’un calcul manuel ou semi-automatisé, une vigilance scrupuleuse doit être accordée à la propagation des erreurs d’arrondi intermédiaires, particulièrement si les mesures brutes comportent plusieurs décimales (comme des latences physiologiques exprimées en fractions de millisecondes ou des pourcentages de précision cognitive). Il convient de conserver l’ensemble des décimales natives de l’instrument de mesure durant la sommation cumulée afin de ne pas injecter de biais de troncature arithmétique dans le total partiel obtenu.
Un contrôle élémentaire de cohérence consiste à s’assurer que la valeur de la somme $S_{\text{tronquée}}$ se situe dans un intervalle strictement prévisible : elle doit obligatoirement être supérieure ou égale à $(n – 2k) \times X_{(k+1)}$ et inférieure ou égale à $(n – 2k) \times X_{(n-k)}$. Cette simple validation par encadrement protège contre les erreurs grossières de calculatrice.
7.2 Normalisation par l’effectif résiduel effectif
L’obtention de la moyenne tronquée finale requiert la normalisation de la somme partielle obtenue par le nombre effectif d’observations ayant contribué à cette somme. Une erreur conceptuelle fréquente consiste à diviser par inadvertance la somme résiduelle par la taille d’échantillon d’origine $n$. Cette confusion conduirait à un écrasement artificiel et totalement faux de la métrique centrale.
La division doit s’effectuer exclusivement par l’effectif résiduel corrigé, c’est-à-dire $(n – 2k)$. L’expression formelle exhaustive de l’estimateur de la moyenne tronquée au taux $\alpha$, conventionnellement notée $\bar{X}_{t\alpha}$, s’écrit dès lors sous sa forme canonique :
$$\bar{X}_{t\alpha} = \frac{1}{n – 2k} \sum_{i = k + 1}^{n – k} X_{(i)}$$
Le résultat final doit être arrondi en respectant la précision métrologique de la variable initiale. En psychométrie et en chronométrie comportementale, la norme académique préconise généralement de rapporter la moyenne avec une décimale supplémentaire par rapport à la précision du recueil de données brut (par exemple, rapporter au dixième de milliseconde près pour des temps de réaction initialement enregistrés à la milliseconde entière).
7.3 Interprétation substantive du résultat final
L’aboutissement du calcul mathématique ne marque pas la fin du travail du chercheur : s’ouvre alors la phase d’interprétation substantive du résultat obtenu. La moyenne tronquée représente le centre de gravité corrigé du comportement typique du groupe étudié, débarrassé de l’influence déformante des cas extrêmes. Pour évaluer la portée pratique de cette correction robuste, il est indispensable de confronter directement la moyenne tronquée $\bar{X}_{t\alpha}$ à la moyenne arithmétique ordinaire $\bar{X}_{\text{classique}}$.
Trois configurations comparatives majeures peuvent émerger de cette confrontation :
- Concordance étroite ($\bar{X}_{t\alpha} \approx \bar{X}_{\text{classique}}$) : Si les deux valeurs sont quasi identiques, cela confirme que l’échantillon d’origine ne souffre d’aucun score marginal influent et que la distribution empirique est remarquablement symétrique au centre comme aux extrémités. Dans cette situation, la moyenne classique était acceptable, mais la moyenne tronquée confirme empiriquement sa représentativité.
- Décrochement vers le bas ($\bar{X}_{t\alpha} ll \bar{X}_{\text{classique}}$) : Cette configuration, très courante dans les tâches cognitives chronométrées, indique que quelques valeurs extrêmes positives géantes tiraient artificiellement la moyenne vers le haut. La moyenne tronquée restitue la réalité de la performance typique des sujets en éliminant cet effet d’entraînement trompeur.
- Décrochement vers le haut ($\bar{X}_{t\alpha} gg \bar{X}_{\text{classique}}$) : À l’inverse, si la moyenne tronquée est nettement plus élevée que la moyenne classique, cela traduit la présence de scores aberrants extrêmement bas (par exemple des abandons ou des scores nuls dans une épreuve de mémoire) ayant effondré indûment la moyenne ordinaire.
L’écart absolu et relatif entre ces deux indicateurs fournit une mesure empirique directe de l’intensité de la contamination par les valeurs atypiques au sein du protocole expérimental.
8. Application guidée 1 : Calcul manuel d’une moyenne tronquée à 10 %
8.1 Présentation du jeu de données expérimentales
Afin d’ancrer ces concepts dans une pratique opérationnelle limpide, déployons une application didactique complète portant sur une tâche de chronométrie cognitive élémentaire (tâche de détection visuelle simple avec temps de réaction). Un échantillon de $n = 10$ participants consécutifs a été soumis au protocole expérimental. Les temps de latence de réponse, mesurés initialement en millisecondes puis convertis en secondes pour faciliter la lecture didactique, sont présentés dans leur ordre brut de collecte ci-dessous :
$$X_{\text{brut}} = { 0.45, ; 0.38, ; 1.82, ; 0.41, ; 0.39, ; 0.44, ; 0.12, ; 0.42, ; 0.40, ; 0.47 }$$
L’inspection substantielle de ces dix valeurs révèle immédiatement deux anomalies manifestes imputables aux aléas de la passation humaine :
- Le score de 0.12 seconde (120 ms) suggère fortement une réponse anticipée motrice non contrôlée, le sujet ayant appuyé sur le poussoir avant que le traitement perceptif conscient du stimulus n’ait pu s’achever.
- Le score de 1.82 seconde (1820 ms) traduit de toute évidence un épisode de distraction sévère ou un décrochage attentionnel passager, déconnecté de la vitesse réelle de traitement neuronal du participant.
Le chercheur décide d’appliquer a priori une moyenne tronquée à 10 % ($\alpha = 0.10$) pour neutraliser ces artefacts sans supprimer arbitrairement des essais après coup.
8.2 Exécution chronologique des calculs pas à pas
Suivons méthodiquement les étapes formalisées dans les sections précédentes :
Étape 1 : Ordonnancement systématique de la série
On réorganise les 10 observations par ordre croissant strict :
$$X_{(1)} = 0.12, ; X_{(2)} = 0.38, ; X_{(3)} = 0.39, ; X_{(4)} = 0.40, ; X_{(5)} = 0.41,$$
$$X_{(6)} = 0.42, ; X_{(7)} = 0.44, ; X_{(8)} = 0.45, ; X_{(9)} = 0.47, ; X_{(10)} = 1.82$$
Étape 2 : Détermination du nombre d’exclusions $k$
La taille d’échantillon est $n = 10$, et la proportion de rognage est $\alpha = 0.10$. On applique l’équation standard :
$$k = n \times \alpha = 10 \times 0.10 = 1$$
Le calcul aboutit à un nombre entier strict : $k = 1$. L’expérimentateur doit donc soustraire exactement 1 observation à la queue inférieure ($X_{(1)}$) et 1 observation à la queue supérieure ($X_{(10)}$).
Étape 3 : Élagage effectif et isolement du sous-ensemble central
On retire formellement :
- La valeur minimale : $X_{(1)} = 0.12$
- La valeur maximale : $X_{(10)} = 1.82$
Le sous-échantillon résiduel épuré $X_{\text{central}}$ s’étend du rang $X_{(2)}$ au rang $X_{(9)}$ et comporte $10 – (2 \times 1) = 8$ observations :
$$X_{\text{central}} = { 0.38, ; 0.39, ; 0.40, ; 0.41, ; 0.42, ; 0.44, ; 0.45, ; 0.47 }$$
Étape 4 : Calcul de la somme et normalisation
Calculons la somme arithmétique des 8 données résiduelles :
$$S_{\text{tronquée}} = 0.38 + 0.39 + 0.40 + 0.41 + 0.42 + 0.44 + 0.45 + 0.47 = 3.36$$
Normalisons cette somme par l’effectif résiduel effectif ($n_{\text{résiduel}} = 8$) :
$$\bar{X}_{t(0.10)} = \frac{3.36}{8} = 0.42 \text{ seconde}$$
La moyenne tronquée à 10 % de cet échantillon s’établit avec exactitude à 0.42 seconde (soit 420 ms).
8.3 Analyse critique des écarts observés
Procédons à présent à la mise en contraste critique des indicateurs descriptifs sur ce jeu de données démonstratif. Calculons d’abord la moyenne arithmétique conventionnelle sur les 10 données brutes non modifiées :
$$S_{\text{brute}} = 0.45 + 0.38 + 1.82 + 0.41 + 0.39 + 0.44 + 0.12 + 0.42 + 0.40 + 0.47 = 4.90$$
$$\bar{X}_{\text{classique}} = \frac{4.90}{10} = 0.49 \text{ seconde}$$
La comparaison numérique directe révèle un écart massif :
- Moyenne arithmétique standard : 0.49 s (490 ms)
- Moyenne tronquée à 10 % : 0.42 s (420 ms)
- Différence absolue : +0.07 s (+70 ms, soit une distorsion haussière de 16.7 % de la moyenne classique)
Cette divergence substantielle illustre parfaitement le mécanisme d’amplification causé par les données asymétriques. L’observation extrême supérieure de 1.82 s tire puissamment la moyenne classique vers le haut, faisant croire faussement que la latence cognitive typique du groupe avoisine un demi-seconde. En réalité, une lecture attentive des données ordonnées montre que 80 % des participants se regroupent de manière remarquablement homogène entre 0.38 s et 0.47 s. La moyenne tronquée neutralise simultanément l’anticipation motrice (0.12 s) et la distraction (1.82 s), fournissant une synthèse fidèle qui capture avec précision la vitesse réelle de traitement de l’information cognitive du groupe.
9. Application guidée 2 : Calcul avec seuil de 20 % et gestion des arrondis
9.1 Scénario psychométrique : inventaire d’anxiété sur échantillon étendu
Pour illustrer un cas de figure méthodologique plus complexe impliquant un seuil de rognage élevé et la problématique des effectifs non modulaires, examinons un scénario psychométrique en psychologie clinique. Un protocole d’évaluation administre un inventaire d’anxiété validé (mesuré sur une échelle continue standardisée de 0 à 100 points) auprès d’une cohorte clinique de $n = 15$ patients consécutifs admis en consultation d’évaluation du stress post-traumatique.
Les scores bruts non ordonnés collectés auprès de ces quinze patients s’énoncent comme suit :
$$X_{\text{brut}} = { 24, ; 31, ; 28, ; 89, ; 26, ; 35, ; 30, ; 27, ; 33, ; 95, ; 29, ; 32, ; 12, ; 34, ; 22 }$$
L’examen clinique immédiat révèle une dissymétrie positive marquée, caractérisée par un groupe compact de scores modérés d’anxiété (se situant majoritairement entre 25 et 35 points), mais sévèrement contaminé par deux scores extrêmement élevés (89 et 95 points, correspondant à des crises d’angoisse paroxystiques aiguës lors de la passation) et un score très bas atypique (12 points, lié à un état de sidération émotionnelle avec émoussement affectif complet). Compte tenu de cette forte hétérogénéité et conformément aux recommandations de Rand Wilcox, l’équipe clinique opte formellement pour un rognage robuste à 20 % ($\alpha = 0.20$).
9.2 Résolution mathématique du calcul non entier
Procédons chronologiquement à la résolution mathématique sur l’échantillon de $n = 15$ participants :
Tri croissant des scores bruts :
$$X_{(1)}=12, ; X_{(2)}=22, ; X_{(3)}=24, ; X_{(4)}=26, ; X_{(5)}=27,$$
$$X_{(6)}=28, ; X_{(7)}=29, ; X_{(8)}=30, ; X_{(9)}=31, ; X_{(10)}=32,$$
$$X_{(11)}=33, ; X_{(12)}=34, ; X_{(13)}=35, ; X_{(14)}=89, ; X_{(15)}=95$$
Calcul du nombre d’exclusions pour $n = 15$ :
Le produit donne :
$$k = n \times \alpha = 15 \times 0.20 = 3$$
Ici, $k$ est un entier parfait. On exclut les 3 plus petites valeurs ($12, 22, 24$) et les 3 plus grandes valeurs ($35, 89, 95$). L’effectif résiduel conservé compte $15 – (2 \times 3) = 9$ observations allant du rang 4 au rang 12 inclus :
$$X_{\text{central}} = { 26, 27, 28, 29, 30, 31, 32, 33, 34 }$$
$$S_{\text{tronquée}} = 26 + 27 + 28 + 29 + 30 + 31 + 32 + 33 + 34 = 270$$
$$\bar{X}_{t(0.20)} = \frac{270}{9} = 30.00 \text{ points}$$
Variante didactique avec calcul non entier ($n = 14$) :
Supposons maintenant, à titre de démonstration computationnelle, que l’étude n’ait comporté que les 14 premiers participants (en retirant le score 95). L’échantillon compte alors $n = 14$ observations. Calculons $k$ pour un seuil de 20 % :
$$k_{\text{théorique}} = 14 \times 0.20 = 2.8$$
Le produit aboutit à une valeur fractionnaire non entière. En appliquant la convention méthodologique dominante de la fonction partie entière par défaut ($lfloor 2.8 rfloor$) :
$$k = \lfloor 2.8 \rfloor = 2$$
L’expérimentateur retire alors rigoureusement les 2 plus petites observations ($X_{(1)}=12, X_{(2)}=22$) et les 2 plus grandes ($X_{(13)}=35, X_{(14)}=89$). L’échantillon résiduel comptera $14 – (2 \times 2) = 10$ observations (du rang 3 au rang 12). La proportion effective réelle de troncature appliquée s’établit dès lors à :
$$\alpha_{\text{réel}} = \frac{2}{14} \approx 14.29 % \text{ à chaque extrémité}$$
Cette approche évite de sur-élaguer les données tout en garantissant un algorithme d’exclusion parfaitement reproductible d’un laboratoire à l’autre.
9.3 Évaluation comparative de la robustesse
Pour mesurer la progression de la stabilisation en fonction de l’intensité de l’effort de troncature, dressons une comparaison exhaustive des métriques calculées sur notre échantillon initial de $n = 15$ patients :
- Moyenne arithmétique standard (0 % de rognage) :
Somme brute = 547. Moyenne = $547 / 15 = \mathbf{36.47 \text{ points}}$. - Moyenne tronquée à 10 % ($\alpha = 0.10$) :
$k = \lfloor 15 \times 0.10 \rfloor = \lfloor 1.5 \rfloor = 1$. On élimine 1 valeur à chaque extrémité ($12$ et $95$).
Somme résiduelle (13 scores) = $547 – 12 – 95 = 440$.
Moyenne tronquée à 10 % = $440 / 13 = \mathbf{33.85 \text{ points}}$. - Moyenne tronquée à 20 % ($\alpha = 0.20$) :
$k = 3$. On élimine 3 valeurs à chaque extrémité.
Moyenne tronquée à 20 % = $\mathbf{30.00 \text{ points}}$. - Médiane empirique (50 % de rognage théorique) :
Valeur au rang 8 (milieu strict de 15 valeurs ordonnées) = $\mathbf{30.00 \text{ points}}$.
Cette trajectoire comparative est particulièrement révélatrice : la moyenne standard (36.47) classe le groupe dans un niveau d’anxiété sévère, alors même que treize des quinze patients affichent des scores inférieurs ou égaux à 35. La troncature à 10 % corrige une partie de l’artefact (33.85), mais reste perturbée par le score atypique de 89. Seule la moyenne tronquée à 20 % réussit à converger parfaitement vers le centre de gravité authentique de la pathologie (30.00), coïncidant ici avec la médiane tout en préservant l’information paramétrique métrique pour les analyses inférentielles subséquentes.
10. Mise en œuvre computationnelle : automatisation sous R, Python et SPSS
10.1 Programmation statistique sous le langage R
Dans l’écosystème de recherche contemporain, le langage open source R constitue la référence mondiale incontournable pour l’analyse de données robuste. Calculer une moyenne tronquée sous R est extrêmement aisé grâce à la fonction générique native mean(), qui intègre un argument dédié intitulé trim. Cet argument attend une valeur numérique décimale comprise entre 0 et 0.5, représentant la proportion unilatérale de rognage $\alpha$ désirée.
L’exécution de la commande standard s’effectue par exemple sous la forme syntaxique suivante :
scores <- c(24, 31, 28, 89, 26, 35, 30, 27, 33, 95, 29, 32, 12, 34, 22)
moyenne_tronquee_20 <- mean(scores, trim = 0.20)
Sous le capot, R applique rigoureusement la fonction partie entière par défaut ($k = \lfloor n \times \text{trim} \rfloor$). Pour aller bien au-delà de la simple statistique descriptive et exécuter des inférences avancées (tests d’hypothèses, corrélations robustes, ANOVA sur moyennes tronquées), l’installation du paquet spécialisé WRS2 développé par Rand Wilcox et Patrick Mair est chaudement recommandée. Le paquet WRS2 offre un ensemble exhaustif de routines robustes fondées directement sur les moyennes tronquées à 20 %, garantissant une intégration sans faille dans les flux de travail reproductibles sous RMarkdown ou Quarto.
10.2 Implémentation scientifique en Python
Au sein de l’environnement Python pour la science des données, l’écosystème scientifique reposant sur SciPy, NumPy et Pandas fournit tous les outils nécessaires à l’automatisation computationnelle du rognage statistique. Le module scipy.stats propose une routine hautement optimisée dédiée spécifiquement à cette opération : la fonction trim_mean().
Pour mobiliser cette fonction au sein d’un pipeline de traitement de données, la structure programmatique s’articule comme suit :
from scipy import stats
import numpy as np
donnees = np.array([24, 31, 28, 89, 26, 35, 30, 27, 33, 95, 29, 32, 12, 34, 22])
tm_result = stats.trim_mean(donnees, proportiontocut=0.20)
Le paramètre proportiontocut attend la proportion à soustraire à chaque extrémité (ici 0.20 pour un rognage bilatéral total de 40 %). Si l’analyste manipule de volumineux tableaux matriciels structurés sous forme de DataFrames Pandas, il est parfaitement envisageable de combiner scipy.stats.trim_mean avec les méthodes apply() ou transform() afin de calculer les moyennes tronquées par condition expérimentale ou par groupe de participants de manière vectorisée et rapide.
10.3 Configuration sous IBM SPSS Statistics
Pour les praticiens de la recherche exploitant l’environnement graphique d’IBM SPSS Statistics, le calcul de la moyenne tronquée est nativement intégré dans le module des statistiques descriptives exploratoires, bien qu’il souffre d’une rigidité paramétrique par défaut. Pour y accéder via l’interface graphique utilisateur (GUI) :
- Naviguer dans les menus déroulants : Analyser (Analyze) > Statistiques descriptives (Descriptive Statistics) > Explorer (Explore).
- Transférer la variable continue d’intérêt dans le volet Liste des variables dépendantes (Dependent List).
- Dans le bouton Statistiques, s’assurer que l’option Descriptifs (Descriptives) est cochée, puis valider l’analyse.
Dans le tableau récapitulatif généré par SPSS, le logiciel affiche systématiquement une métrique intitulée Moyenne tronquée à 5 % (5% Trimmed Mean). Il est fondamental de noter que SPSS applique un seuil fixe universel de 5 % unilatéral (soit 10 % de données éliminées au total) et ne propose aucun curseur direct dans son interface graphique pour modifier ce pourcentage vers 10 % ou 20 %.
Si l’analyste sous SPSS requiert un pourcentage de rognage plus agressif et scientifiquement recommandé, tel qu’un rognage à 20 %, il devient nécessaire de recourir au langage de syntaxe de commande SPSS (fichiers .sps) en combinant les commandes de classement RANK, de filtrage conditionnel FILTER BY sur les percentiles ou de programmation de macros personnalisées, ou encore de mobiliser le module d’intégration Python pour SPSS afin d’exécuter la routine scipy.stats.trim_mean directement au sein de la session SPSS.
11. Inférence statistique et tests d’hypothèses basés sur les moyennes tronquées
11.1 Estimation de l’erreur type et variance de Winsor
L’un des pièges statistiques les plus critiques lors de la transition de la statistique descriptive vers la statistique inférentielle réside dans l’estimation de l’erreur-type de la moyenne tronquée. Une intuition mathématiquement naïve consisterait à calculer simplement la variance classique de l’échantillon résiduel conservé $X_{\text{central}}$ et à la diviser par la racine carrée de l’effectif résiduel. Cette procédure intuitive est théoriquement fausse et méthodologiquement invalide.
En effet, en élaguant déterministement les extrémités d’une distribution, on tronque artificiellement la dispersion naturelle de l’échantillon : la variance directe du sous-ensemble résiduel sous-estime massivement la variance d’échantillonnage réelle de la moyenne tronquée. Pour obtenir une estimation correcte et asymptotiquement non biaisée de l’erreur-type d’une moyenne tronquée, les travaux fondateurs de la statistique robuste imposent de recourir obligatoirement à la variance winsorisée ($s_w^2$).
La winsorisation (du nom du biostatisticien Charles P. Winsor) consiste, non pas à éliminer les $k$ observations extrêmes, mais à remplacer leur valeur par la valeur conservée la plus proche. Ainsi, les $k$ plus petites observations sont remplacées par $X_{(k+1)}$ et les $k$ plus grandes par $X_{(n-k)}$. La variance winsorisée $s_w^2$ est ensuite calculée sur cet échantillon transformé de taille $n$. L’erreur-type formelle de la moyenne tronquée à la proportion $\alpha$ est alors rigoureusement formulée par :
$$SE(\bar{X}_{t\alpha}) = \frac{s_w}{(1 – 2\alpha) \sqrt{n}}$$
Cette formulation remarquable réajuste avec exactitude la variance pour compenser la troncature des queues et fournit le dénominateur fondamental nécessaire à tous les tests de significativité statistique.
11.2 Le test t de Yuen pour deux échantillons indépendants
Lorsque l’objectif du chercheur est de comparer les moyennes tronquées de deux groupes indépendants (par exemple un groupe expérimental sous intervention cognitive versus un groupe témoin sous placebo), le test classique $t$ de Student se révèle inadapté sous non-normalité ou hétérogénéité des variances. L’alternative robuste exacte et canonique est le test $t$ de Yuen, développé par Karen Yuen.
Le test de Yuen applique une logique analogue au test $t$ de Welch, mais opère intégralement sur les moyennes tronquées et les variances winsorisées de chaque sous-groupe. Soient deux groupes de tailles $n_1$ et $n_2$, avec des nombres d’élagage respectifs $k_1 = \lfloor n_1 \alpha \rfloor$ et $k_2 = \lfloor n_2 \alpha \rfloor$, et des effectifs résiduels $h_1 = n_1 – 2k_1$ et $h_2 = n_2 – 2k_2$. La statistique de test robuste $T_y$ s’exprime formellement par le rapport :
$$T_y = \frac{\bar{X}_{t1} – \bar{X}_{t2}}{\sqrt{\frac{(n_1 – 1) s_{w1}^2}{h_1 (h_1 – 1)} + \frac{(n_2 – 1) s_{w2}^2}{h_2 (h_2 – 1)}}}$$
Cette statistique suit approximativement une distribution de Student dont les degrés de liberté sont ajustés par une équation spécifique tenant compte des effectifs effectifs $h_1$ et $h_2$. Le test de Yuen présente des propriétés de robustesse exceptionnelles : il maintient de façon quasi parfaite le taux d’erreur de première espèce (le risque alpha nominal, usuellement 5 %) même en présence de distributions fortement asymétriques, leptokurtiques ou d’hétéroscédasticité sévère, des situations où le test $t$ conventionnel de Student s’effondre.
11.3 Génération d’intervalles de confiance par rééchantillonnage
En complément des approches inférentielles paramétriques de Yuen, la statistique robuste contemporaine s’appuie massivement sur les techniques computationnelles de rééchantillonnage non paramétrique (bootstrapping) pour générer des intervalles de confiance extrêmement fiables autour de la moyenne tronquée. La méthode du bootstrap percentile ou du bootstrap accéléré et corrigé pour le biais (BCa) se dispense totalement de l’hypothèse de normalité de la distribution d’échantillonnage.
L’algorithme de bootstrap pour moyenne tronquée se déroule selon la séquence computationnelle suivante :
- Générer un nombre massif $B$ de pseudo-échantillons (par exemple $B = 2,000$ ou $B = 10,000$) de taille $n$, par tirage avec remise à partir de l’échantillon empirique initial.
- Pour chaque pseudo-échantillon bootstrap $b in {1, dots, B}$, calculer avec exactitude la moyenne tronquée $\bar{X}_{t\alpha}^{*b}$ selon la méthode d’ordonnancement et d’élagage standard.
- Compiler l’ensemble des $B$ estimations dans une distribution empirique d’échantillonnage.
- Extraire les percentiles d’intérêt : pour un intervalle de confiance bilatéral à 95 %, identifier le 2.5-ième percentile ($P_{2.5}$) pour la borne inférieure et le 97.5-ième percentile ($P_{97.5}$) pour la borne supérieure.
L’intervalle de confiance empirique ainsi obtenu présente l’immense avantage de pouvoir être asymétrique autour de la moyenne tronquée ponctuelle, épousant fidèlement l’éventuelle asymétrie réelle de la distribution sous-jacente. Cette méthodologie computationnelle représente le standard d’excellence méthodologique moderne préconisé dans les revues internationales de premier rang en psychologie quantitative.
12. Recommandations méthodologiques et rédaction scientifique aux normes APA
12.1 Justification méthodologique préalable et pré-enregistrement
L’adoption d’estimateurs robustes, bien que scientifiquement vertueuse, ne doit jamais servir de prétexte à une exploration discrétionnaire opportuniste des données dans le but de forcer un résultat statistiquement significatif (pratique délétère connue sous le vocable de p-hacking). Si un chercheur calcule successivement la moyenne classique, la moyenne tronquée à 5 %, à 10 %, puis à 20 %, pour ne retenir et ne rapporter dans son article que celle qui franchit le seuil fatidique de $p < .05$, il gonfle artificiellement le taux de faux positifs de la littérature scientifique.
Pour immuniser la recherche contre cet écueil méthodologique majeur, le standard contemporain de rigueur exige le pré-enregistrement systématique du plan d’analyse statistique sur des plateformes reconnues telles que l’Open Science Framework (OSF) ou AsPredicted. L’analyste doit y stipuler a priori :
- La métrique de tendance centrale retenue comme critère d’évaluation primaire (par exemple : moyenne tronquée à 20 %).
- Le pourcentage unilatéral précis de rognage appliqué ($\alpha = 0.20$).
- La procédure de résolution mathématique des résultats fractionnaires (par exemple, utilisation stricte de la fonction partie entière par défaut).
- Le modèle d’inférence statistique associé (par exemple : test de Yuen bilatéral avec seuil de décision nominal fixé à 5 %).
Si la décision de recourir à une moyenne tronquée est prise a posteriori lors de l’analyse exploratoire de distributions anormales non anticipées, l’honnêteté déontologique impose de qualifier explicitement l’analyse d’exploratoire et de présenter une analyse de sensibilité exhaustive comparant systématiquement les résultats de la statistique classique et ceux de la méthode robuste.
12.2 Modalités de communication des résultats selon le style APA 7
La restitution écrite des moyennes tronquées dans les sections méthodologiques et de résultats doit se conformer rigoureusement aux normes formelles de la 7e édition du manuel de publication de l’American Psychological Association (APA 7). Le style APA privilégie une clarté absolue, la description sans équivoque de l’estimateur et la fourniture conjointe des indicateurs de dispersion adaptés.
Voici un modèle canonique de rédaction textuelle pour rapporter la comparaison de deux groupes via un test de Yuen sur moyennes tronquées à 20 % :
« Afin de contrôler la présence de valeurs extrêmes et l’asymétrie marquée des latences de réponse, les hypothèses ont été testées au moyen de moyennes tronquées à 20 % et de variances winsorisées, conformément aux préconisations de Wilcox (2012). Le temps de réaction moyen tronqué du groupe expérimental ($M_{\text{tronquée 20%}} = 421.3 \text{ ms}$, $SE = 14.2 \text{ ms}$) est significativement inférieur à celui observé au sein du groupe témoin ($M_{\text{tronquée 20%}} = 488.7 \text{ ms}$, $SE = 16.8 \text{ ms}$), $T_y(23.4) = 3.06$, $p = .005$, $\hat{\xi} = 0.54$, IC 95 % $[-112.4, -22.4]$. »
Dans ce modèle textuel standardisé, plusieurs éléments indispensables sont scrupuleusement renseignés : la mention explicite du pourcentage d’élagage (20 %), l’utilisation du symbole $M_{\text{tronquée 20%}}$, l’erreur-type dérivée de la variance winsorisée, la statistique $T_y$ de Yuen avec ses degrés de liberté ajustés non entiers ($23.4$), la valeur $p$ exacte, la taille d’effet robuste adaptée (notée ici $\hat{\xi}$) et l’intervalle de confiance à 95 % associé à la différence des moyennes épurées.
12.3 Erreurs fréquentes et pièges d’interprétation à éviter
Pour parachever ce guide exhaustif, dressons l’inventaire des confusions méthodologiques et computationnelles récurrentes qu’il convient impérativement de neutraliser lors de la rédaction de manuscrits scientifiques :
- Confusion conceptuelle entre rognage et winsorisation : Nombre d’auteurs utilisent indistinctement les deux termes. Rappelons avec insistance que la moyenne tronquée supprime purement et simplement les $2k$ observations du calcul arithmétique de la tendance centrale, tandis que la moyenne winsorisée remplace les scores extrêmes par les bornes adjacentes tout en conservant un effectif de calcul strictement égal à $n$. Confondre ces deux estimateurs introduit une discordance majeure dans les équations rapportées.
- Rapporter l’écart-type classique de la série tronquée : Comme nous l’avons théoriquement démontré à la section 11.1, rapporter l’écart-type arithmétique ordinaire calculé sur les $(n – 2k)$ données conservées pour accompagner une moyenne tronquée est une faute méthodologique caractérisée. Cet écart-type tronqué artificiellement est biaisé vers le bas et donne une illusion de précision fallacieuse. La mesure de dispersion légitime d’une moyenne tronquée est l’erreur-type dérivée de la variance winsorisée ou les quantiles de dispersion bootstrap.
- Élimination aveugle de cas à forte valeur clinique : La moyenne tronquée est un outil d’estimation de la tendance centrale typique, elle ne doit pas devenir un instrument d’invisibilisation des trajectoires humaines atypiques. En neuropsychologie, en psychiatrie ou en ergonomie, les valeurs situées aux extrêmes d’une distribution sont parfois porteuses de la signification clinique ou fonctionnelle la plus cruciale de l’étude (e.g., les patients en rupture cognitive aiguë ou en décompensation). L’analyste doit systématiquement mener une exploration descriptive conjointe de ces cas écartés, garantissant que la quête de robustesse statistique ne se fasse jamais au détriment de la profondeur clinique et substantielle de la recherche.
Références
- Erceg-Hurn, D. M., & Mirosevich, V. M. (2008). Modern robust statistical methods: An easy way to maximize the accuracy and power of your research. American Psychologist, 63(7), 591–601. https://doi.org/10.1037/0003-066X.63.7.591
- Huber, P. J. (1981). Robust Statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
- Keselman, H. J., Kowalchuk, R. K., Algina, J., Lix, L. M., & Wilcox, R. R. (2008). Testing treatment effects in repeated measures designs: Trimmed means and bootstrapping. British Journal of Mathematical and Statistical Psychology, 61(1), 135–153. https://doi.org/10.1348/000711006X160358
- Rousseeuw, P. J., & Leroy, A. M. (1987). Robust Regression and Outlier Detection. John Wiley & Sons. https://doi.org/10.1002/0471725382
- Stigler, S. M. (1977). Do robust estimators work with real data? The Annals of Statistics, 5(6), 1055–1098. https://doi.org/10.1214/aos/1176343997
- Tukey, J. W. (1960). A survey of sampling from contaminated distributions. In I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow, & H. B. Mann (Eds.), Contributions to Probability and Statistics: Essays in Honor of Harold Hotelling (pp. 448–485). Stanford University Press.
- Wilcox, R. R. (2012). Introduction to Robust Estimation and Hypothesis Testing (3rd ed.). Academic Press. https://doi.org/10.1016/C2010-0-67044-1
- Wilcox, R. R., & Keselman, H. J. (2003). Modern robust data analysis methods for tests of differences between group means. Psychological Methods, 8(3), 254–274. https://doi.org/10.1037/1082-989X.8.3.254
- Yuen, K. K. (1974). The two-sample trimmed t for unequal population variances. Biometrika, 61(1), 165–170. https://doi.org/10.1093/biomet/61.1.165