
L’analyse des séries temporelles constitue l’un des piliers fondamentaux de la science des données moderne, irrigant des disciplines aussi variées que l’économétrie quantitative, le traitement du signal, la prévision météorologique et la psychométrie computationnelle. Au cœur de cette démarche réside la nécessité impérieuse d’extraire des composantes déterministes et signifiantes à partir d’observations empiriques continuellement corrompues par des bruits stochastiques d’amplitudes variables. Face à la volatilité intrinsèque des flux de données séquentiels, les praticiens et chercheurs mobilisent depuis plusieurs décennies des techniques de lissage statistique destinées à révéler les trajectoires latentes sous-jacentes sans introduire de distorsions méthodologiques majeures.
Parmi l’arsenal des filtres linéaires invariants dans le temps, la moyenne mobile exponentielle, communément désignée par son acronyme anglophone EMA (Exponential Moving Average), occupe une place prépondérante. Contrairement à la moyenne arithmétique glissante traditionnelle qui alloue un poids identique à chaque observation au sein d’un intervalle discret arbitraire avant de l’évacuer brutalement, l’approche exponentielle attribue une pondération décroissant de manière géométrique avec le recul temporel. Ce raffinement conceptuel résout élégamment le problème de la latence de phase tout en garantissant une réactivité accrue aux variations structurelles récentes de la série considérée.
La mise en œuvre contemporaine de ces formalisations analytiques exige des bibliothèques de calcul vectorisé alliant rigueur mathématique, flexibilité paramétrique et performance computationnelle de premier ordre. Dans l’écosystème Python dédié au calcul scientifique, la bibliothèque Pandas s’impose comme le standard de référence pour la manipulation et l’analyse de structures de données tabulaires indexées temporellement. À travers son interface dédiée matérialisée par l’opérateur DataFrame.ewm(), Pandas offre un cadre d’une granularité exceptionnelle pour modéliser, ajuster et exploiter les moyennes pondérées exponentielles. Ce guide exhaustif a pour vocation d’explorer en profondeur la mécanique théorique, les déclinaisons algorithmiques et les protocoles d’implémentation pratique de l’EMA au moyen de Pandas, offrant ainsi aux chercheurs et analystes une maîtrise complète de cet outil incontournable.
1. Introduction théorique aux séries temporelles et aux moyennes mobiles
1.1 Définition et structure fondamentale d’une série temporelle
Une série temporelle se définit formellement comme une suite ordonnée d’observations quantitatives associées à des instants temporels discrets, généralement notée sous la forme mathématique d’une famille indicée de variables aléatoires. D’un point de vue probabiliste, chaque point d’observation constitue la réalisation empirique d’un processus stochastique sous-jacent. L’ordonnancement chronologique strict confère à ces données une structure d’interdépendance sérielle singulière, interdisant de facto l’application aveugle des hypothèses d’indépendance et d’identique distribution qui régissent la statistique inférentielle classique. La prise en compte de l’autocorrélation temporelle devient dès lors le paramètre pivot de toute analyse rigoureuse.
Dans le cadre de l’approche classique de décomposition analytique popularisée par les travaux fondateurs de l’économétrie, une série temporelle brute peut être décomposée en trois composantes structurales fondamentales : la tendance séculaire, qui traduit l’orientation directionnelle à long terme du phénomène ; la composante saisonnière ou cyclique, caractérisée par des oscillations périodiques régulières induites par des rythmes astronomiques, institutionnels ou sociétaux ; et le bruit résiduel, souvent assimilé à un bruit blanc stochastique non corrélé représentant les fluctuations erratiques inhérentes aux aléas microscopiques. La formulation de cette décomposition peut revêtir un caractère additif lorsque l’amplitude des variations saisonnières demeure indépendante de la tendance générale, ou multiplicatif lorsque la dispersion s’accroît proportionnellement au niveau moyen de la variable observée.
La distinction entre séries stationnaires et non stationnaires conditionne également les démarches de modélisation mathématique. Une série est dite strictement stationnaire si sa loi conjointe de probabilité demeure invariante par translation temporelle, ce qui implique en particulier la constance de son espérance mathématique et de sa variance au cours du temps, ainsi qu’une fonction d’autocovariance ne dépendant exclusivement que du décalage temporel entre deux observations. Les séries réelles issues des sciences expérimentales et économiques exhibent quasi systématiquement des propriétés non stationnaires, qu’il s’agisse de dérives tendancielles déterministes ou de racines unitaires stochastiques, imposant le recours à des opérations préalables de différenciation ou de lissage statistique adaptées afin d’extraire les signaux informationnels pertinents.
1.2 Le rôle du lissage statistique dans l’analyse prédictive
Le lissage statistique répond à un objectif fondamental : filtrer les fluctuations à haute fréquence associées au bruit aléatoire pour isoler les composantes à basse fréquence représentatives des dynamiques macroscopiques et des tendances lourdes du système étudié. En réduisant drastiquement la variance locale d’un échantillon séquentiel sans en altérer la géométrie directionnelle globale, le lissage permet d’améliorer la lisibilité des indicateurs dérivés et de consolider la robustesse des modèles prédictifs subséquents. Sans cette étape préparatoire, les estimateurs statistiques courent le risque permanent de surajuster le bruit microscopique, dégradant considérablement leur capacité de généralisation sur des horizons temporels futurs.
D’un point de vue emprunté au traitement du signal numérique, les estimateurs de lissage fonctionnent intrinsèquement comme des filtres passe-bas. Leur fonction de transfert atténue de manière préférentielle les composantes spectrales situées au-delà d’une fréquence de coupure prédéterminée, tout en conservant l’intégrité des ondes dont la période excède la largeur effective de la fenêtre d’observation. Cette analogie fréquentielle met en lumière le défi épistémologique inhérent à la discipline : déterminer une fréquence de coupure qui élimine suffisamment le bruit résiduel sans éroder la morphologie des points d’inflexion critiques ou déformer l’amplitude des cycles intermédiaires porteurs d’information analytique.
Ce processus d’atténuation se heurte inéluctablement à un compromis méthodologique d’une importance capitale, formalisé sous la forme de l’arbitrage entre fidélité au signal historique et réactivité aux changements de régime contemporains. Un filtre trop agressif éliminera l’intégralité du bruit parasite mais introduira une inertie temporelle substantielle, se traduisant par un retard de phase délétère lors des retournements de tendance. À l’inverse, un lissage minimaliste garantira une réactivité quasi instantanée face aux sursauts de l’actualité immédiate, au prix toutefois d’une exposition démesurée aux faux signaux engendrés par des chocs stochastiques transitoires. L’étalonnage précis des paramètres de lissage constitue par conséquent l’un des exercices les plus délicats de l’analyse sérielle.
1.3 Évolution conceptuelle : de la moyenne arithmétique simple aux moyennes pondérées
Historiquement, la première tentative d’estimation de la tendance locale s’est incarnée dans le calcul de la moyenne arithmétique globale, agrégeant l’ensemble des données collectées depuis l’origine de l’enregistrement temporel. Cette méthode sommaire montre cependant très rapidement ses limites dès lors que le processus générateur n’est pas rigoureusement stationnaire. Une moyenne arithmétique stationnaire sur un historique infini attribue à des événements séculaires obsolètes le même poids qu’aux dynamiques contemporaines, conduisant à une fossilisation de l’estimateur incapable de capturer les bifurcations macroéconomiques ou environnementales récentes.
Pour contourner cet écueil, les statisticiens ont conçu le formalisme de la moyenne mobile simple, usuellement abrégée sous l’acronyme SMA pour Simple Moving Average. Ce modèle circonscrit l’opération de sommation à une fenêtre temporelle glissante d’étendue temporelle fixe, rejetant purement et simplement les données antérieures au seuil défini. Bien que ce dispositif restitue une capacité dynamique à l’indicateur en lui permettant d’accompagner les mouvements de fond, il engendre une pathologie mathématique notoire désignée sous le nom d’effet de palier ou effet d’écho. Lorsqu’une observation atypique extrême quitte la fenêtre d’échantillonnage, la moyenne arithmétique subit une variation discontinue brutale sans qu’aucune perturbation nouvelle ne soit pourtant intervenue dans la série observée au moment présent.
L’émergence des moyennes pondérées non uniformes découle directement de la nécessité de surmonter cette instabilité structurelle. En modulant l’influence de chaque observation par un coefficient dépendant de son ancienneté relative, ces approches assurent une transition continue de l’information statistique. Les premières formulations linéaires ont progressivement cédé le pas à des fonctions de pondération convexes décroissantes, culminant avec l’adoption généralisée des lois géométriques et exponentielles. Cette transition paradigmatique marque l’acte de naissance de la moyenne mobile exponentielle, qui combine une mémoire virtuellement infinie avec une décroissance continue et élégante du poids des données historiques.
2. Fondements mathématiques de la moyenne mobile exponentielle (EMA)
2.1 Formulation analytique et mécanisme récursif
La formulation théorique de la moyenne mobile exponentielle repose sur une relation de récurrence du premier ordre, qui exprime l’estimation contemporaine comme une combinaison linéaire convexe entre l’observation instantanée courante et l’estimation de la moyenne mobile obtenue à l’étape immédiatement précédente. Soit une série temporelle scalaire discrète notée $Y_t$ pour des indices temporels entiers $t$. L’état lissé de la série au temps $t$, conventionnellement désigné par $S_t$ ou $EMA_t$, obéit à l’équation récursive fondamentale suivante :
$$S_t = \alpha Y_t + (1 – \alpha) S_{t-1}$$
Dans cette expression analytique, le coefficient $\alpha$ représente le facteur de lissage, strictement contraint à résider dans l’intervalle semi-ouvert $]0, 1]$. Ce facteur scalaire quantifie la vitesse d’incorporation de la nouveauté empirique au sein du modèle statistique. Lorsque $\alpha$ se rapproche de l’unité, le filtre attribue une prépondérance quasi absolue à la mesure instantanée $Y_t$, réduisant le lissage à une quasi-identité où l’information passée est instantanément oblitérée. Inversement, lorsque $\alpha$ converge vers zéro, le poids attribué à la nouvelle mesure devient infinitésimal, conférant à la trajectoire lissée une inertie extrême dictée par la persistance de l’état antérieur $S_{t-1}$.
Pour appréhender la structure profonde de cette formulation récursive, il convient d’exécuter un développement par récurrence descendante en substituant itérativement les états antérieurs $S_{t-1}, S_{t-2}, dots, S_0$. Ce déploiement géométrique infini révèle la nature continue de la distribution de pondération :
$$S_t = \alpha Y_t + \alpha(1-\alpha)Y_{t-1} + \alpha(1-\alpha)^2 Y_{t-2} + dots + \alpha(1-\alpha)^k Y_{t-k} + (1-\alpha)^t S_0$$
Cette sommation met en évidence la décroissance strictement exponentielle des coefficients associés aux observations rétrospectives. Le poids associé à une observation située à $k$ périodes en arrière s’établit exactement à $w_k = \alpha(1 – \alpha)^k$. La somme théorique de cette série géométrique de raison $(1-\alpha)$ converge rigoureusement vers l’unité lorsque le nombre de termes tend vers l’infini, validant la condition mathématique de non-biais d’une moyenne pondérée normalisée. Toutefois, dans toute mise en œuvre computationnelle finie, le terme résiduel $(1-\alpha)^t S_0$ demeure dépendant de la condition initiale d’amorce $S_0$, dont l’impact numérique ne s’estompe que de façon asymptotique au fur et à mesure que le temps $t$ progresse.
2.2 Propriétés asymptotiques et décroissance de l’information
L’analyse du comportement asymptotique de l’EMA met en lumière son statut de filtre à réponse impulsionnelle infinie, communément désigné dans la théorie spectrale sous l’acronyme IIR pour Infinite Impulse Response. Contrairement à la moyenne mobile simple qui s’apparente à un filtre à réponse impulsionnelle finie (FIR) dont les coefficients s’annulent de façon strictement binaire au-delà de la longueur de la fenêtre, l’EMA conserve théoriquement la mémoire de chaque observation historique jusqu’à l’origine des temps. L’intensité de cette rétention mémorielle décroît selon une loi de puissance régie par la base $(1 – \alpha)$, instaurant un régime d’oubli progressif et déterministe.
Ce mécanisme d’atténuation graduelle confère à la moyenne exponentielle une stabilité remarquable face aux régimes transitoires et aux chocs exogènes discontinus. Lorsqu’une série temporelle subit une rupture de moyenne unitaire sous la forme d’un saut échelon de Heaviside, la trajectoire de l’EMA converge vers le nouveau palier d’équilibre selon une courbe de réponse exponentielle continue, exempte des ruptures de dérivabilité locale qui caractérisent les filtres rectangulaires. L’erreur d’ajustement résiduelle après $k$ périodes post-choc décroît rigoureusement proportionnellement à $(1 – \alpha)^k$. Cette propriété garantit une différentiabilité d’ordre supérieur du signal lissé, ce qui s’avère particulièrement précieux lorsque les séries traitées doivent ensuite faire l’objet d’opérations d’estimation de dérivées, de gradients d’accélération ou d’optimisation numérique.
3. Comparaison approfondie : SMA versus EMA dans l’analyse de données
3.1 Différences algorithmiques et structurelles
L’examen comparatif des algorithmes de calcul met en relief des divergences structurelles substantielles entre la moyenne mobile arithmétique simple et son homologue exponentielle. La moyenne mobile simple sur une fenêtre d’étendue $k$ procède par convolution discrète d’une fonction porte rectangulaire normalisée avec le signal d’entrée. Dans ce schéma, chaque point inclus dans l’intervalle temporel $[t – k + 1, t]$ reçoit une pondération uniforme égale à $1/k$, tandis que toute observation située en amont de cet horizon strict se voit assigner un poids rigoureusement nul. Cette troncature abrupte matérialise une discontinuité spatiale dans la distribution des poids d’échantillonnage.
Cette géométrie rectangulaire est à l’origine directe de l’effet d’écho évoqué précédemment. Si un événement exceptionnel se traduit par une valeur aberrante transitoire à l’instant $t_0$, cette dernière impactera uniformément la SMA pendant exactement $k$ périodes. Cependant, à l’instant $t_0 + k$, lorsque la donnée aberrante franchit la frontière de la fenêtre glissante, la SMA subit une chute ou une hausse artificielle symétrique, indépendamment de toute actualité informationnelle sur le phénomène observé. L’EMA résout intégralement ce dysfonctionnement : l’observation extrême exerce son impact maximal lors de son occurrence immédiate, puis sa contribution décroît continûment et de manière strictement monotone au cours des itérations suivantes, prévenant toute résurgence fantôme ultérieure.
En termes de continuité mathématique, la trajectoire temporelle générée par l’EMA offre une régularité supérieure. En assimilant la série temporelle à un signal continu sur un continuum réel, l’application de l’EMA s’apparente à une régularisation de type Sobolev, adoucissant les variations à forte courbure sans créer de discontinuités dans le gradient directionnel. Cette cohérence morphologique simplifie grandement l’interprétation sémantique des courbes de tendance pour les analystes de données.
3.2 Analyse du déphasage temporel et de la latence
Tout opérateur de lissage linéaire introduit inévitablement un déphasage temporel, communément appelé latence ou retard de groupe, mesurant le délai avec lequel l’indicateur enregistre et répercute une inflexion directionnelle effective de la série d’origine. Dans le cas d’une moyenne mobile simple calculée sur une période discrète de taille $k$, le retard temporel moyen correspond rigoureusement au barycentre de sa fonction de pondération rectangulaire. Étant donné l’uniformité des coefficients sur l’intervalle, ce centre de gravité se situe au point médian temporel, induisant une latence théorique moyenne de :
$$\tau_{SMA} = \frac{k – 1}{2}$$
Pour une SMA paramétrée sur une fenêtre de 21 périodes, le déphasage systématique s’établit par conséquent à exactement 10 périodes temporelles, ce qui constitue une inertie considérable préjudiciable à la réactivité décisionnelle. En revanche, le barycentre de la distribution géométrique des poids de l’EMA se calcule en sommant les moments temporels pondérés. Pour un coefficient de lissage $\alpha$, le retard moyen théorique s’obtient via la dérivée de la fonction génératrice des moments, fournissant la relation élégante suivante :
$$\tau_{EMA} = \frac{1 – \alpha}{\alpha}$$
Lorsque l’on convertit une fenêtre de taille équivalente $k$ selon la relation conventionnelle usuelle $\alpha = 2 / (k + 1)$, le déphasage temporel effectif de l’EMA se réduit à :
$$\tau_{EMA} = \frac{1 – \frac{2}{k+1}}{\frac{2}{k+1}} = \frac{k – 1}{2}$$
Bien que le décalage temporel moyen d’une EMA équivalente possède le même ordre de grandeur asymptotique que celui de la SMA, la distribution asymétrique de ses poids confère à l’EMA une sensibilité exponentiellement accrue aux variations immédiates. En concentrant la majeure partie de son intégrale de masse sur les observations les plus récentes, l’EMA détecte les ruptures structurelles et les inversions de dérivée première bien plus précocement que la SMA, réduisant empiriquement de façon substantielle les retards de réaction lors des points d’inflexion critiques.
3.3 Critères méthodologiques de sélection selon le type de série
Le choix méthodologique entre une moyenne mobile simple et une moyenne mobile exponentielle ne saurait relever d’une simple préférence esthétique ou d’une routine logicielle ; il requiert une qualification rigoureuse des propriétés spectrales et stochastiques du signal à traiter ainsi que des objectifs analytiques visés. La SMA conserve une pertinence incontestable dans les domaines où l’analyste cherche à évaluer des grandeurs agrégées sur des cycles périodiques fixes prédéterminés. Par exemple, l’élimination parfaite d’une saisonnalité hebdomadaire sur des données quotidiennes s’effectue idéalement via une SMA de période 7, car celle-ci annule rigoureusement la fréquence fondamentale du cycle hebdomadaire par intégration rectangulaire complète, ce qu’un filtre à décroissance exponentielle ne peut réaliser qu’imparfaitement.
À l’inverse, l’EMA s’impose de façon incontournable dans les contextes dynamiques caractérisés par des séries à forte volatilité stochastique, des flux asynchrones haute fréquence et des comportements adaptatifs rapides. Dans l’analyse quantitative des marchés d’actifs, le suivi de données télémétriques de capteurs industriels de l’Internet des objets (IoT) ou la modélisation de trajectoires psychométriques longitudinales, l’hypothèse d’une importance équivalente accordée au présent et au passé lointain s’avère manifestement intenable. L’EMA permet d’amortir le bruit blanc microscopique tout en épousant avec souplesse les modifications soudaines d’équilibre dynamique.
Il importe toutefois de souligner que cette réactivité accrue expose structurellement l’EMA à une vulnérabilité supérieure vis-à-vis du bruit à très haute fréquence comparativement à une SMA de très large envergure. Lorsque le rapport signal sur bruit d’une série devient dramatiquement faible, la sensibilité locale de l’EMA peut induire des oscillations parasites trompeuses autour de la tendance centrale. L’analyste doit par conséquent évaluer le niveau d’entropie du processus avant d’opter pour un coefficient d’atténuation $\alpha$ approprié.
4. L’écosystème Pandas et la méthode pandas.DataFrame.ewm()
4.1 Architecture objet de l’opérateur Exponentially Weighted Moving
Au sein de la bibliothèque logicielle Pandas, le traitement des séries temporelles repose sur une conception orientée objet rigoureusement hiérarchisée, articulée autour de paradigmes d’exécution vectorisée hérités du moteur NumPy. Afin de manipuler les opérations de pondération exponentielle, Pandas n’intègre pas une fonction scalaire isolée, mais expose un constructeur d’abstraction désigné sous le nom de classe ExponentialMovingWindow. Cet objet intermédiaire joue un rôle structurellement analogue aux objets générés par les méthodes d’agrégation partitionnée DataFrame.groupby() ou de fenêtrage rectangulaire DataFrame.rolling().
L’invocation de la méthode ewm() sur une structure de type Series ou DataFrame ne calcule pas immédiatement les valeurs statistiques finales. Elle procède plutôt à une instanciation différée, encapsulant les métadonnées de configuration temporelle, les facteurs de pondération géométrique et les directives de gestion des anomalies au sein d’une instance dédiée. Ce mécanisme de séparation fonctionnelle entre la définition de la fenêtre dynamique et l’opération d’agrégation mathématique subséquente confère une expressivité exceptionnelle au code source.
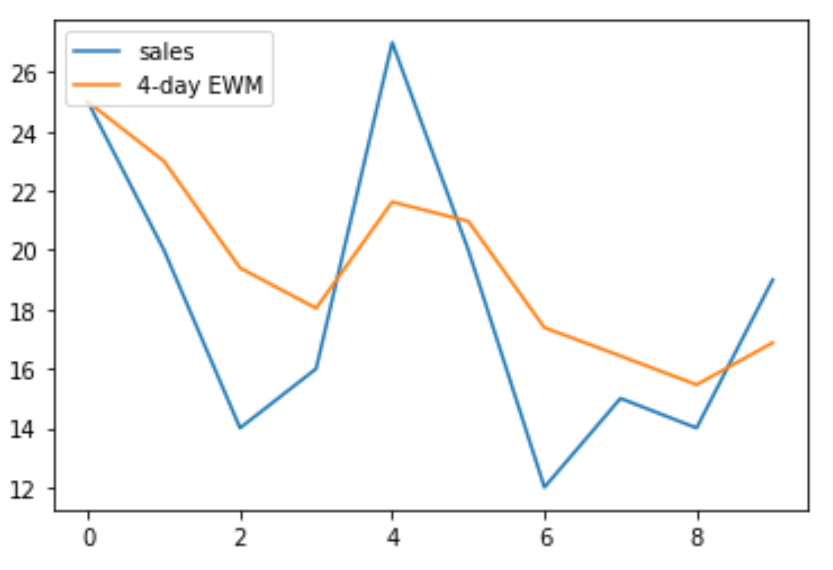
Une fois l’objet ExponentialMovingWindow matérialisé, il devient possible de lui adjoindre par chaînage fonctionnel une vaste gamme d’opérateurs statistiques de réduction. Bien que l’opérateur de moyenne pondérée .mean() constitue l’usage prédominant dans la pratique analytique, l’API native de Pandas supporte nativement des transformations statistiques plus complexes d’ordre supérieur, telles que la variance pondérée .var(), l’écart-type exponentiel .std(), ainsi que des estimateurs de dynamique conjointe comme la covariance .cov() et la corrélation bivariée .corr(). Ce chaînage vectorisé garantit une exécution algorithmique à haute vitesse optimisée en langage C sous-jacent.
4.2 Signature complète et arguments de la fonction
L’interface de programmation de la méthode pandas.DataFrame.ewm() présente une signature paramétrique sophistiquée, conçue pour répondre à l’ensemble des cas d’usage industriels et académiques. La signature canonique s’agence selon les paramètres fondamentaux suivants :
DataFrame.ewm(com=None, span=None, halflife=None, alpha=None, min_periods=0, adjust=True, ignore_na=False, axis=0, times=None)
La règle d’or architecturale régissant l’initialisation de cette fonction stipule que les quatre paramètres temporels directeurs — com (centre de masse), span (envergure temporelle), halflife (demi-vie) et alpha (coefficient direct de lissage) — présentent une relation d’exclusion mutuelle stricte. L’analyste est impérativement tenu de spécifier l’un et un seul de ces quatre arguments mathématiques. La fourniture simultanée de deux paramètres contradictoires ou l’absence totale de définition temporelle déclenche une levée d’exception immédiate de type ValueError par l’interpréteur.
Au-delà de la métrique temporelle directrice, l’argument min_periods (initialisé par défaut à 0) gouverne le seuil de tolérance quant au nombre minimal d’observations valides requises avant qu’une estimation numérique ne soit émise en sortie de chaîne ; tant que ce quorum n’est pas atteint, la méthode renvoie des valeurs manquantes normalisées de type np.nan. Le paramètre booléen adjust pilote l’arbitrage fondamental entre l’estimation avec normalisation des poids cumulés finis ou le formalisme récursif strict. L’option ignore_na conditionne l’évolution des poids exponentiels lors du franchissement de cases d’observation absentes, tandis que axis (par défaut positionné sur l’axe vectoriel 0) détermine la dimension d’itération le long de la matrice de données. Enfin, le paramètre times permet l’intégration d’horodatages discontinus explicites pour le traitement de signaux non équidistants.
5. Paramétrage mathématique de ewm() : alpha, com, span et halflife
5.1 Le coefficient de lissage direct (alpha)
L’argument scalaire alpha matérialise l’accès direct et sans intermédiaire au facteur de lissage originel apparaissant dans la formule récursive canonique de l’EMA. Il exprime formellement le ratio d’actualisation instantané accordé à l’observation contemporaine $Y_t$ par rapport au stock de mémoire accumulée $S_{t-1}$. Sur le plan des bornes analytiques, la documentation et l’architecture algorithmique de Pandas imposent la contrainte rigoureuse $0 < \alpha le 1$. La fixation directe d’un coefficient $\alpha$ prédéterminé s’avère particulièrement indiquée dans les modèles statistiques formalisés au sein desquels ce paramètre a été préalablement estimé via une procédure de maximisation de la vraisemblance conditionnelle ou un étalonnage économétrique d’optimisation numérique sous contrainte.
L’examen des comportements limites d’alpha permet de vérifier la validité structurelle du filtre numérique. Si l’on assigne la valeur limite $\alpha = 1$, la formulation analytique s’effondre sur l’identité pure : chaque valeur lissée correspond rigoureusement à l’observation brute contemporaine, éliminant totalement l’effet de mémoire historique. Inversement, lorsque $\alpha$ décroît vers des grandeurs infinitésimales (par exemple $\alpha = 0.001$), l’inertie du système devient gigantesque : le signal généré se transforme en une courbe asymptotique quasi constante, réfractaire aux fluctuations locales et ne réagissant qu’à des mouvements cumulatifs massifs et prolongés de la série d’entrée.
5.2 La métrique de portée temporelle (span)
Dans la grande majorité des applications de modélisation financière, d’économétrie et de suivi de performance opérationnelle, les praticiens éprouvent de sérieuses difficultés à conceptualiser un facteur de décroissance abstrait exprimé directement en termes de probabilité ou de taux $\alpha$. Ils lui préfèrent quasi universellement le concept d’envergure temporelle ou portée, désigné sous le terme de span dans la nomenclature de Pandas. L’argument span correspond conceptuellement au nombre de périodes d’une fenêtre de moyenne mobile simple équivalente, facilitant ainsi les comparaisons méthodologiques.
La conversion mathématique opérée sous le capot par le moteur de calcul de Pandas entre le paramètre span et le coefficient direct alpha obéit à la relation biunivoque fondamentale :
$$\alpha = \frac{2}{\text{span} + 1} \quad Long\leftrightarrow \quad \text{span} = \frac{2}{\alpha} – 1$$
Cette égalité découle d’une équivalence statistique formulée à l’origine par les analystes quantitatifs : elle assure que le déphasage temporel moyen (centre de gravité temporel) de l’EMA converge vers le centre de gravité temporel d’une SMA calculée sur $N$ observations, soit $(N-1)/2$. De ce fait, lorsque l’analyste spécifie la commande span=10, Pandas calcule instantanément en interne $\alpha = 2 / (10 + 1) = 2/11 \approx 0.1818$. De même, pour les standards industriels universellement consacrés dans l’analyse de signaux temporels — à l’instar des fenêtres de 50, 100 ou 200 périodes —, la saisie directe de span=50 permet de configurer le filtre exponentiel de façon intuitive sans avoir à manipuler des fractions décimales récurrentes imprécises.
5.3 Le centre de masse (com) et la demi-vie (halflife)
Le paramètre com, abréviation usuelle de l’expression anglaise center of mass, ancre la modélisation de l’EMA au cœur des théories physiques du signal continu. Dans cette analogie mécanique, les observations chronologiques successives sont modélisées comme des poids discrets positionnés le long d’un levier temporel. Le centre de masse représente le point d’équilibre spatial moyen de cette distribution de poids pondérés exponentiellement. La relation algébrique stricte liant le centre de masse $C$ au facteur de lissage $\alpha$ s’établit par l’équation :
$$C = \frac{1 – \alpha}{\alpha} \quad Long\leftrightarrow \quad \alpha = \frac{1}{1 + C}$$
On constate immédiatement que le centre de masse coïncide rigoureusement avec le déphasage temporel moyen ou retard de groupe $\tau_{EMA}$ explicité au sein de la section théorique précédente. Spécifier com=9 équivaut par conséquent à assigner un retard temporel barycentrique d’exactement 9 périodes dans l’intégration du signal, ce qui aboutit algébriquement à $\alpha = 1 / (1 + 9) = 0.10$.
Enfin, l’argument halflife matérialise le concept de demi-vie temporelle, largement emprunté à la cinétique chimique et à la physique nucléaire de la désintégration radioactive. La demi-vie quantifie la durée ou le nombre discret de pas temporels $h$ strictement nécessaires pour que l’importance relative ou le poids accordé à une observation donnée s’effondre exactement de moitié ($50,%$ de son amplitude inaugurale). L’expression analytique régissant la conversion exacte de la demi-vie en facteur de lissage $\alpha$ s’articule comme suit :
$$(1 – \alpha)^h = 0.5 \quad Long\leftrightarrow \quad \alpha = 1 – \exp\left(\frac{\ln(0.5)}{h}\right) = 1 – 2^{-1/h}$$
Cette approche par demi-vie s’avère exceptionnellement puissante et naturelle dès lors que l’on traite de processus de dégradation mémorielle, de dissipation thermique, de rémanence de traces d’apprentissage en psychologie cognitive ou encore de modèles de volatilité conditionnelle où la mémoire des chocs s’évapore selon une périodicité naturelle intuitive.
6. Le paramètre adjust : Différences fondamentales entre True et False
6.1 Mécanisme théorique du paramètre adjust=True
L’un des aspects les plus singuliers et les plus fréquemment mal compris de l’implémentation de la classe ewm() dans Pandas réside dans le fonctionnement de l’argument booléen adjust, qui est assigné par défaut à la valeur True. Lorsque adjust=True est activé, l’algorithme sous-jacent renonce temporairement à l’application aveugle de la formule de récurrence pure au profit d’une normalisation formelle par la somme cumulée finie des poids géométriques effectivement alloués à chaque point depuis le début de la série observée.
Sous ce régime de calcul normalisé, la valeur lissée contemporaine $y_t$ pour une série observée $x_0, x_1, dots, x_t$ est calculée selon l’équation sommatoire explicite suivante :
$$y_t = \frac{\sum_{i=0}^t (1 – \alpha)^i x_{t-i}}{\sum_{i=0}^t (1 – \alpha)^i}$$
Cette méthode a été spécifiquement conçue par les ingénieurs concepteurs de Pandas pour résoudre l’épineuse question du biais d’amorce au démarrage d’une série temporelle finie. Dans une formulation purement récursive, l’état initial $y_0$ nécessiterait théoriquement la connaissance de l’état asymptotique antérieur $y_{-1}$. Si l’on démarre arbitrairement à $t=0$ en posant $y_0 = x_0$, la formule de récurrence brute va, dès la deuxième observation $t=1$, appliquer un facteur $(1-\alpha)$ à cette première valeur, ce qui sous-pondère artificiellement l’historique disponible et engendre une distorsion notable. En divisant la somme pondérée par la somme effective des poids géométriques disponibles $\sum_{i=0}^t (1-\alpha)^i$, l’option adjust=True garantit que le résultat demeure rigoureusement une moyenne pondérée convexe sans perte d’échelle, fournissant ainsi des estimations statistiques impeccables dès les toutes premières observations temporelles.
6.2 Mécanisme récursif strict avec adjust=False
À l’opposé de cette normalisation intégrale, l’activation explicite du paramètre adjust=False contraint Pandas à opérer selon le formalisme de récurrence stricte d’ordre 1, tel qu’il est conventionnellement documenté dans la littérature canonique du traitement du signal et les moteurs d’exécution des plateformes financières en temps réel. Sous ce mode opératoire, l’algorithme applique sans aucune modification de normalisation la relation dynamique directe :
$$y_0 = x_0$$
$$y_t = (1 – \alpha) y_{t-1} + \alpha x_t \quad \text{pour tout } t > 0$$
Cette approche récursive présente l’avantage considérable de la pureté algorithmique et de l’équivalence unitaire avec les structures de calcul séquentiel streaming où l’on ne conserve en mémoire physique que la dernière valeur d’état $y_{t-1}$ sans avoir à recalculer de séries partielles cumulatives. Néanmoins, elle porte en elle une inertie structurelle directe héritée de l’initialisation $y_0 = x_0$. La première valeur observée acquiert une influence disproportionnée durant les phases initiales de la séquence temporelle, car le mécanisme suppose implicitement que le système se trouvait déjà stabilisé au niveau de cette première mesure singulière.
6.3 Analyse comparative des sorties numériques
L’écart numérique entre les trajectoires générées par adjust=True et adjust=False peut être mis en évidence de façon éclatante au moyen d’un exemple analytique simple. Considérons une séquence discrète stationnaire élémentaire où les observations successives sont constantes et valent $x = [10.0, 20.0, 30.0, 40.0]$ avec un coefficient de lissage direct fixé à $\alpha = 0.5$.
Sous la configuration canonique adjust=False :
- À $t=0$ : $y_0 = 10.0$
- À $t=1$ : $y_1 = 0.5 \times 20.0 + (1 – 0.5) \times 10.0 = 10.0 + 5.0 = 15.0$
- À $t=2$ : $y_2 = 0.5 \times 30.0 + (1 – 0.5) \times 15.0 = 15.0 + 7.5 = 22.5$
- À $t=3$ : $y_3 = 0.5 \times 40.0 + (1 – 0.5) \times 22.5 = 20.0 + 11.25 = 31.25$
Analysons à présent la même séquence sous la configuration par défaut adjust=True :
- À $t=0$ : le poids est $w_0 = 1.0$, le dénominateur vaut $1.0$, d’où $y_0 = 10.0 / 1.0 = 10.0$
- À $t=1$ : les poids respectifs pour $x_1=20$ et $x_0=10$ sont $w_0=1.0$ et $w_1=(1-0.5)=0.5$. Le numérateur est $(1.0 \times 20) + (0.5 \times 10) = 25.0$. La somme cumulée des poids s’établit à $1.0 + 0.5 = 1.5$. La moyenne s’obtient par le ratio : $y_1 = 25.0 / 1.5 \approx 16.6667$
- À $t=2$ : les poids sont $1.0$, $0.5$ et $0.25$. Le numérateur s’élève à $(1.0 \times 30) + (0.5 \times 20) + (0.25 \times 10) = 42.5$. La somme des poids vaut $1.0 + 0.5 + 0.25 = 1.75$. On obtient $y_2 = 42.5 / 1.75 \approx 24.2857$
On constate une divergence marquée sur les premières itérations : à $t=1$, la valeur passe de $15.0$ en mode récursif pur à $16.67$ en mode ajusté. Toutefois, au fur et à mesure que $t$ grandit vers l’infini, la somme de la série géométrique $\sum_{i=0}^t (1-\alpha)^i$ converge de manière déterministe vers sa limite asymptotique $1/\alpha$. En factorisant par $\alpha$, on démontre formellement que l’impact de la normalisation s’éteint et que les deux formulations convergent asymptotiquement vers des trajectoires rigoureusement indiscernables. Pour des séries courtes ou tronquées, adjust=True offre une supériorité statistique indiscutable en éradiquant le biais d’initialisation, tandis que adjust=False doit être réservé aux environnements exigeant une stricte compatibilité récursive avec les outils temps réel traditionnels.
7. Guide pratique pas à pas : Implémentation de base d’une EMA avec Pandas
7.1 Préparation de l’environnement et structuration du DataFrame
L’implémentation opérationnelle d’une moyenne mobile exponentielle requiert la mise en place d’un environnement Python rigoureusement configuré autour des bibliothèques fondamentales de la data science. L’étape inaugurale consiste à importer les modules Pandas et NumPy, tout en s’assurant que les structures de données temporelles reposent sur une indexation chronologique stricte de type DatetimeIndex, indispensable à la prévention des inversions de flux séquentiel.
Considérons la création d’un jeu de données expérimental structuré représentant une série temporelle continue s’étendant sur une période de plusieurs mois. Il convient d’initialiser une plage temporelle par l’intermédiaire de la fonction pd.date_range(), en fixant une fréquence d’échantillonnage régulière, par exemple quotidienne (fréquence ‘D’). La génération d’une trajectoire synthétique associant une composante tendancielle linéaire, des oscillations harmoniques sinusoïdales et un bruit gaussien aléatoire permet de reproduire fidèlement les conditions réelles des séries quantitatives empiriques.
L’intégrité de la structure tabulaire impose de vérifier explicitement deux conditions préalables impératives : d’une part, l’absence d’inversions chronologiques au sein de l’index temporel — validée via l’attribut logique df.index.is_monotonic_increasing —, et d’autre part, la cohérence du typage des données numériques, qui doivent être castées sous un format flottant standard à virgule flottante double précision de type np.float64 afin de prévenir les erreurs de troncature lors des calculs de pondération géométrique.
7.2 Calcul vectorisé d’une colonne EMA simple
Dès lors que le DataFrame est structuré et validé, l’exécution du calcul de l’EMA s’effectue au moyen d’une instruction vectorisée d’une concision et d’une efficience remarquables. En invoquant la méthode ewm() directement sur la colonne d’intérêt et en chaînant l’opérateur d’agrégation .mean(), Pandas délègue l’ensemble des opérations arithmétiques séquentielles à ses routines internes optimisées en C.
L’assignation de la série lissée au sein du DataFrame s’opère par l’instruction syntaxique :
df['EMA_20'] = df['Valeur_Brute'].ewm(span=20, adjust=False).mean()
Dans cette configuration, nous spécifions une envergure temporelle de 20 périodes couplée à l’option récursive stricte adjust=False. L’inspection immédiate des premiers enregistrements du DataFrame permet d’attester la validité du comportement algorithmique : la première observation lissée s’aligne fidèlement sur l’observation brute initiale, avant d’amorcer sa trajectoire de filtrage géométrique au fur et à mesure de l’arrivée des données subséquentes. La rapidité d’exécution de cette syntaxe vectorisée élimine tout recours à des boucles itératives manuelles lentes et inefficaces, garantissant une intégration fluide dans les pipelines de production industrielle.
7.3 Calcul simultané de multiples horizons temporels d’EMA
Dans les applications d’analyse technique, de modélisation financière multivariée ou d’apprentissage automatique prédictif, l’extraction de signaux directionnels ne se limite presque jamais à un horizon temporel unique. Les analystes recourent traditionnellement à un ensemble composite d’horizons scalaires couvrant le court terme, le moyen terme et le long terme. Ce faisceau de filtres permet de capturer simultanément la dynamique immédiate du système et sa tendance de fond séculaire.
Pour générer élégamment cette matrice de variables lissées sans redondance syntaxique, une itération programmée au travers d’une liste de périodes prédéterminées constitue la démarche méthodologique la plus robuste. Il est ainsi classique d’instancier un tableau de fenêtres telles que 9, 21, 50 et 200 périodes. En itérant sur cette liste au sein d’une boucle génératrice, on assigne dynamiquement de nouvelles colonnes au DataFrame :
for fenetre in [9, 21, 50, 200]:
    df[f'EMA_{fenetre}'] = df['Valeur_Brute'].ewm(span=fenetre, adjust=True).mean()
L’intégration conjointe de ces différents horizons au sein de la même matrice de données autorise l’analyse algorithmique des croisements de courbes, phénomène hautement documenté dans l’analyse de séries temporelles. Lorsque l’EMA à court terme (par exemple 9 périodes) franchit de bas en haut l’EMA à plus long terme (par exemple 50 périodes), le système enregistre une accélération positive nette de son gradient, signalant une rupture potentielle de régime au sein de la dynamique sous-jacente.
8. Gestion des valeurs manquantes (NaN) et des données non équidistantes
8.1 Comportement de l’argument ignore_na dans la chaîne de calcul
Dans les séries empiriques collectées sur des systèmes réels, la présence de valeurs manquantes, encodées sous forme d’objets np.nan (Not a Number), constitue une occurrence inévitable induite par des dysfonctionnements matériels de capteurs, des interruptions de réseau ou des fermetures calendaires de marchés. La bibliothèque Pandas offre une gestion exceptionnellement rigoureuse de ces lacunes informationnelles à travers l’argument booléen ignore_na au sein de l’opérateur ewm().
L’arbitrage entre ignore_na=False (valeur par défaut) et ignore_na=True gouverne directement la façon dont le décompte du recul temporel est traité face au vide informationnel. Lorsque le paramètre est laissé à ignore_na=False, Pandas considère que le temps physique continue de s’écouler inexorablement malgré l’absence de mesure valide. Par conséquent, lors du franchissement d’une observation nulle, le poids géométrique attribué aux données antérieures continue de décroître d’un facteur $(1 – \alpha)$ supplémentaire à chaque pas d’échantillonnage vacant. La structure temporelle absolue est rigoureusement préservée, évitant d’attribuer une proximité temporelle artificielle à deux points séparés par un large fossé de mesures manquantes.
À l’opposé, si l’analyste spécifie explicitement ignore_na=True, l’algorithme fait abstraction des cellules vides en écrasant les pas temporels correspondants. Les poids exponentiels ne sont décrémentés que lorsque des valeurs réelles non nulles sont rencontrées. Cela revient fonctionnellement à renuméroter artificiellement la chronologie de la série pour coller les fragments de données observées les uns aux autres. Cette configuration peut se révéler méthodologiquement dangereuse dans les séries hautement dynamiques, car elle fausse l’échelle de mémoire relative du filtre en assignant une influence disproportionnée à des données séparées par des interruptions massives d’enregistrement.
8.2 Application sur des séries temporelles irrégulièrement espacées
L’hypothèse d’équidistance temporelle parfaite sous-tendant les modélisations discrètes standard s’effondre systématiquement dans une multitude d’applications contemporaines, à l’image des flux de transactions financières de haute fréquence ou des relevés d’examens médicaux hospitaliers intermittents. Dans de tels cas de figure, l’indexation par simples entiers positionnels est conceptuellement erronée : un intervalle séparant deux observations consécutives peut fluctuer entre quelques millisecondes et plusieurs jours.
Pour surmonter cette hétérogénéité structurelle sans contraindre l’utilisateur à un rééchantillonnage arbitraire par interpolation, Pandas intègre une syntaxe avancée capable de traiter nativement les signaux continus asynchrones. Cette fonctionnalité s’articule autour de la conjonction du paramètre times et de l’argument halflife exprimé sous forme d’une chaîne temporelle de type pd.Timedelta. La signature prend alors la forme opérationnelle :
df.ewm(halflife='2 days', times=df['timestamp']).mean()
Dans ce cadre continu, le facteur d’atténuation appliqué entre deux observations $x_i$ et $x_j$ situées respectivement aux horodatages réels $t_i$ et $t_j$ n’est plus une constante discrète arbitraire $(1-\alpha)^{i-j}$, mais une fonction exponentielle continue de la durée physique exacte écoulée :
$$w(t_i, t_j) = \exp\left(-\frac{\ln(2)}{\Delta t_{\text{halflife}}} \cdot (t_i – t_j)\right)$$
Cette élégante formalisation garantit que l’atténuation de l’information statistique est gouvernée par le temps physique réel et non par la fréquence stochastique d’échantillonnage de l’appareil de mesure, assurant une modélisation invariante face aux irrégularités de capture des flux de données complexes.
9. Calculs avancés : EMA multidimensionnelle, groupée et fenêtres glissantes
9.1 Application de l’EMA au sein d’un regroupement groupby()
Les infrastructures de mégadonnées tabulaires manipulent couramment des volumes massifs de séries temporelles longitudinales partitionnées selon des identifiants catégoriels, qu’il s’agisse de cohortes de patients suivis cliniquement, de catalogues de capteurs industriels d’usines réparties géographiquement ou de portefeuilles d’actifs boursiers hétérogènes. L’application directe d’un opérateur de lissage global sur l’ensemble d’une telle table entraînerait une aberration statistique fatale désignée sous le nom de contamination croisée ou fuite d’information inter-entités, les données finales du premier sujet venant écraser ou amorcer artificiellement le lissage du second sujet.
Pour garantir une étanchéité méthodologique absolue, la bibliothèque Pandas permet d’imbriquer fonctionnellement l’opérateur exponentiel à l’intérieur d’un pipeline de segmentation préalablement instancié par la méthode groupby(). La syntaxe canonique s’exprime selon le schéma :
df['EMA_Groupee'] = df.groupby('Identifiant_Entite')['Valeur_Mesuree'].transform(lambda x: x.ewm(span=14, adjust=True).mean())
L’emploi de la méthode vectorisée transform() assure que les calculs géométriques sont exécutés de façon strictement isolée et indépendante pour chaque sous-groupe catégoriel tout en garantissant un réalignement dimensionnel parfait avec l’index matriciel originel du DataFrame. Cette approche élimine radicalement tout risque de contagion sérielle entre cohortes distinctes, permettant un traitement en masse hautement fiable des séries multivariées complexes.
9.2 Agrégations statistiques complémentaires au-delà de la moyenne
Si la moyenne lissée constitue l’application la plus fréquente de la méthode ewm(), l’architecture de la classe ExponentialMovingWindow recèle un potentiel analytique bien supérieur grâce à l’intégration native d’agrégateurs statistiques d’ordre supérieur indispensables à la quantification de la volatilité et des corrélations dynamiques.
L’estimation de la dispersion locale d’une série temporelle s’effectue vectoriellement via les méthodes .var() et .std(). Contrairement aux estimateurs classiques d’écart-type calculés sur fenêtres rectangulaires, l’écart-type exponentiel pondère quadratiquement les écarts à la moyenne exponentielle contemporaine en conférant une importance prépondérante aux écarts les plus récents :
df['Volatilite_EMA'] = df['Valeur_Mesuree'].ewm(span=30).std()
Cet estimateur constitue une mesure d’une réactivité exceptionnelle pour le suivi en continu de la volatilité stochastique d’un système. De manière analogue, pour deux colonnes de données quantitatives indexées de concert au sein du même DataFrame, l’analyse conjointe par l’opérateur de corrélation mobile exponentielle .corr() permet d’évaluer la trajectoire d’alignement ou de désynchronisation directionnelle en temps réel, fournissant un outil quantitatif indispensable à la détection précoce des ruptures de couplage structurel dans les réseaux de capteurs ou les modèles d’allocation d’actifs.
9.3 Combinaison avec des transformations analytiques
La moyenne mobile exponentielle déploie toute sa puissance mathématique lorsqu’elle est combinée avec des opérations de normalisation analytique avancée ou intégrée comme brique fondamentale d’indicateurs composites. L’un des exemples les plus emblématiques de cette synergie s’incarne dans la création d’oscillateurs statistiques centrés réduits dynamiques, où une série est normalisée en continu par soustraction de son EMA et division par son écart-type exponentiel ewm().std(), produisant une variable transformée sans dimension représentative des anomalies relatives locales.
Une autre application fondamentale réside dans l’élaboration du célèbre indicateur de convergence et de divergence de moyennes mobiles, universellement désigné par l’acronyme MACD (Moving Average Convergence Divergence) conçu originellement par Gerald Appel. La mécanique algorithmique du MACD repose sur l’interaction dynamique de trois composantes temporelles lissées distinctes :
- La ligne principale du MACD, obtenue par la soustraction vectorielle d’une EMA à longue portée (conventionnellement paramétrée avec un
span=26) à une EMA à portée plus courte (généralementspan=12) :df['MACD'] = df['Prix'].ewm(span=12).mean() - df['Prix'].ewm(span=26).mean() - La ligne de signal, générée en appliquant une troisième EMA de lissage interne (généralement
span=9) directement sur la colonne différentielle du MACD ainsi obtenue :df['MACD_Signal'] = df['MACD'].ewm(span=9).mean() - L’histogramme différentiel d’accélération, matérialisant l’écart arithmétique pur entre la ligne du MACD et son signal d’inertie :
df['MACD_Hist'] = df['MACD'] - df['MACD_Signal']
Ce formalisme double exponentiel permet d’éliminer les dérives tendancielles d’ordre supérieur et de transformer une série non stationnaire en un indicateur stationnaire oscillant autour de zéro, illustrant la polyvalence des opérateurs ewm() dans les chaînes de traitement statistique avancées.
10. Visualisation graphique des EMA avec Matplotlib et Seaborn
10.1 Construction d’un graphique comparatif clair
La communication scientifique et l’interprétation des résultats issus du lissage de séries temporelles requièrent une restitution visuelle d’une clarté irréprochable. L’intégration harmonieuse de Pandas avec les bibliothèques graphiques de l’écosystème Python, au premier rang desquelles Matplotlib et Seaborn, permet de bâtir des représentations visuelles hautement informatives et esthétiquement rigoureuses.
Un protocole de visualisation standardisé exige de superposer sur un même repère cartésien la série brute observée et les trajectoires lissées par les différents horizons d’EMA. La convention graphique recommandée consiste à tracer la série empirique initiale avec un trait fin, une nuance chromatique neutre et une légère transparence alpha (par exemple une courbe grise semi-transparente), de façon à conserver la lisibilité du nuage de points sans saturer le champ visuel. En contraste marqué, les courbes d’EMA à court, moyen et long terme doivent être dessinées avec des épaisseurs de trait supérieures et des couleurs contrastées issues de palettes chromatiques perceptuellement uniformes telles que viridis ou plasma.
De surcroît, l’incorporation de corridors d’incertitude dynamique fondés sur l’écart-type exponentiel constitue une bonne pratique méthodologique majeure. En traçant l’intervalle d’oscillation délimité par l’expression $EMA_t \pm k \cdot \sigma_t^{\text{EMA}}$ (où $k$ représente un facteur scalaire d’élargissement typiquement fixé à 2 pour approcher un intervalle de confiance empirique à $95,%$ sous hypothèse de quasi-normalité locale), l’analyste fait immédiatement ressortir les zones d’hyper-volatilité et les valeurs statistiques aberrantes méritant une inspection approfondie.
10.2 Mise en évidence visuelle des zones de convergence et divergence
Au-delà du tracé linéaire simple, la mise en exergue des déphasages et des zones de croisement entre deux horizons d’EMA constitue un apport visuel décisif pour l’analyse diagnostique. La fonction matplotlib.pyplot.fill_between() fournit un cadre technique idéal pour implémenter cette visualisation dynamique.
En transmettant à fill_between() l’index temporel commun et les deux séries vectorielles correspondantes à l’EMA rapide et à l’EMA lente, il devient trivial de colorer dynamiquement l’aire différentielle séparant ces deux horizons temporels. L’introduction d’un argument conditionnel booléen (paramètre where) autorise une segmentation chromatique bipartite : l’aire peut être automatiquement teintée d’une nuance verte lorsque l’EMA rapide évolue au-dessus de l’EMA lente — matérialisant une dynamique ascendante vigoureuse —, et basculer instantanément dans une teinte rouge lorsque la tendance s’inverse et que l’EMA rapide plonge sous la trajectoire séculaire de fond.
Cette sémiologie graphique transforme une simple figure temporelle statique en un tableau de bord analytique intuitif, où les points de strict croisement (zéro de la fonction différentielle) marquent sans ambiguïté les instabilités et retournements directionnels du processus générateur.
11. Optimisation algorithmique et performance sur de volumineuses séries temporelles
11.1 Profilage de la mémoire et temps d’exécution sous Pandas
Le traitement contemporain de volumes de données massifs — qu’il s’agisse de téraoctets d’enregistrements énergétiques issus de compteurs intelligents ou de carnets d’ordres financiers haute fréquence — impose une vigilance extrême quant à la complexité algorithmique et à la consommation d’empreinte mémoire vive des opérations analytiques. Sur le plan de la complexité computationnelle théorique, l’implémentation de la méthode ewm() dans Pandas s’exécute selon une complexité temporelle linéaire optimale en $\mathcal{O}(N)$, où $N$ matérialise le nombre total d’observations chronologiques séquentielles. Cette linéarité découle directement de la récursivité du formalisme, chaque nouvelle valeur ne nécessitant qu’un nombre fini et constant d’opérations arithmétiques scalaires indépendant de la longueur de la fenêtre passée.
Néanmoins, les performances d’exécution réelles peuvent être sévèrement dégradées si l’utilisateur ne maîtrise pas les particularités de l’allocation mémoire de Pandas. L’application de transformations ewm() sur des DataFrames entiers comportant des centaines de colonnes hétérogènes génère des duplications temporaires de matrices susceptibles de provoquer une saturation brutale de la RAM. Un profilage rigoureux réalisé au moyen du module memory_profiler ou des méthodes internes df.memory_usage(deep=True) met régulièrement en évidence l’intérêt déterminant d’optimiser le typage des données numériques d’entrée. Convertir préalablement des colonnes de données continues du format float64 (8 octets par élément) vers le format float32 (4 octets par élément) permet de diviser instantanément par deux la bande passante mémoire requise, tout en accélérant significativement les calculs vectoriels exécutés par les registres d’instructions vectorielles du processeur (instructions SIMD).
11.2 Alternatives d’accélération numérique pour le Big Data
Lorsque la volumétrie des séries temporelles excède les capacités d’un thread unique sous Pandas ou que les opérations de lissage doivent être réitérées des millions de fois au sein de simulations de Monte-Carlo hautement distribuées, l’analyste de données doit envisager des architectures computationnelles alternatives complémentaires.
Une première voie d’accélération d’une efficacité redoutable consiste à compiler à la volée des fonctions récursives sur mesure à l’aide de la bibliothèque Numba. Grâce à son décorateur @jit(nopython=True), Numba contourne intégralement l’interpréteur Python classique et la surcharge interne des objets Pandas en compilant l’algorithme de récurrence pure de l’EMA sous la forme de code machine natif ultra-optimisé exécuté directement par le microprocesseur. Cette technique permet couramment d’atteindre des gains de vélocité temporelle d’un facteur 5 à 15 par rapport aux routines natives de Pandas, tout en s’affranchissant totalement des pénalités d’initialisation mémoire.
Pour des échelles de traitement distribuées ou nécessitant des architectures de calcul massivement parallèle sur processeurs graphiques (GPU), l’écosystème propose désormais des moteurs modernes de nouvelle génération tels que Polars ou CuPy. Polars, architecturé intégralement en langage de bas niveau Rust et fondé sur le standard de mémoire colonnaire Apache Arrow, intègre des opérateurs de moyenne mobile exponentielle nativement multi-threadés capables d’exploiter la totalité des cœurs de calcul physiques disponibles sur la machine sans blocage lié au verrou global de l’interpréteur Python (GIL). Ces alternatives offrent des perspectives de montée en charge indispensables pour les pipelines modernes d’ingénierie de données Big Data.
12. Applications concrètes et études de cas en modélisation comportementale et financière
12.1 Étude de cas 1 : Suivi des scores psychométriques et de l’humeur longitudinale
L’application des moyennes mobiles exponentielles ne se cantonne pas aux sciences économiques ; elle connaît un essor particulièrement fécond en recherche psychologique computationnelle et en psychiatrie quantitative dans le cadre de la méthode d’évaluation écologique momentanée, universellement désignée par le sigle EMA (Ecological Momentary Assessment) — une troublante coïncidence d’acronymes avec l’Exponential Moving Average. Dans ces protocoles cliniques modernes, des patients atteints de troubles affectifs bipolaires ou de dépression majeure renseignent quotidiennement sur leur smartphone des scores psychométriques ordinaux évaluant la valence de leur état d’humeur, leur niveau d’anxiété ou leur sentiment d’épuisement émotionnel.
Ces données longitudinales empiriques se caractérisent par un bruit de mesure stochastique particulièrement prononcé, induit par des biais d’auto-évaluation momentanés, des événements anecdotiques journaliers sans portée clinique et des lacunes d’échantillonnage fréquentes durant les week-ends. L’application d’un filtre EMA paramétré par demi-vie temporelle, via l’instruction df['Humeur'].ewm(halflife='4 days', times=df['Date']).mean(), permet de modéliser avec une grande finesse l’inertie émotionnelle théorique des sujets. En éliminant les micro-fluctuations d’auto-évaluation quotidiennes, le filtre exponentiel isole la dérive lente de l’état thymique fondamental du patient.
Sur le plan du diagnostic clinique quantitatif, la surveillance en temps réel de l’écart arithmétique entre le score instantané observé et la ligne de base lissée par l’EMA fournit une métrique dynamique de labilité émotionnelle. Si cet écart dépasse de façon répétée un seuil critique calibré sur l’écart-type exponentiel local ewm().std(), l’algorithme médical peut déclencher une alerte préventive signalant l’imminence d’une bifurcation d’état pathologique ou d’un virage maniaque bien avant que l’état du patient ne se détériore de manière irréversible.
12.2 Étude de cas 2 : Modélisation des volumes de transactions et indicateurs de marché
Dans l’ingénierie financière quantitative, l’analyse conjointe des cours boursiers et des volumes d’activité transactionnelle constitue le fondement de la microstructure des marchés. Les séries de volumes bruts échangés sur des marchés électroniques exhibent des profils de distribution hautement leptokurtiques, caractérisés par des queues de distribution épaisses et des pointes d’hyper-activité intermittentes déclenchées par la publication d’annonces macroéconomiques ou de résultats d’entreprises.
Afin de transformer cette série bruitée en un signal exploitable, les analystes recourent à une normalisation du volume au moyen d’un ratio de volume lissé par EMA. En calculant simultanément une moyenne exponentielle rapide des volumes échangés (span=10) et une moyenne exponentielle de référence à plus long terme (span=50), le quotient de ces deux grandeurs génère un indicateur d’anomalie de liquidité instantanée exempt d’effet d’écho :
df['Ratio_Volume'] = df['Volume'].ewm(span=10).mean() / df['Volume'].ewm(span=50).mean()
Parallèlement, la mise en œuvre d’une stratégie de suivi de tendance algorithmique systématique par double croisement d’EMA sur les prix de clôture constitue un cas d’école emblématique. En modélisant un croisement entre une trajectoire à 12 périodes et une trajectoire à 26 périodes, l’analyste quantitative élimine les composantes haute fréquence du cours pour ne capturer que le gradient sous-jacent. Toutefois, la méthodologie scientifique impose d’encadrer ces simulations avec la plus grande rigueur : la sélection a posteriori des paramètres optimaux de lissage doit impérativement faire l’objet de protocoles stricts de validation croisée temporelle marchante (walk-forward validation) afin d’éviter le piège récurrent du surajustement statistique (overfitting), où des coefficients d’atténuation sont calibrés de façon artificielle sur le passé sans posséder la moindre valeur prédictive sur les régimes futurs du marché.
12.3 Synthèse critique et recommandations méthodologiques
Pour parachever cette étude exhaustive, il convient de récapituler les règles d’arbitrage paramétrique gouvernant l’opérateur ewm() de Pandas et de formuler une série de recommandations méthodologiques indispensables à l’exercice d’une analyse quantitative rigoureuse.
Le choix des paramètres de configuration doit être guidé par une analyse préalable des propriétés de la série d’entrée et des finalités analytiques de l’étude, comme le synthétise la grille de décision suivante :
- Choix du mode temporel : Privilégier
spanpour les analogies avec les fenêtres mobiles conventionnelles (SMA) ; utiliserhalflifepour les processus physiques, cognitifs ou biologiques de décroissance continue ; réserveralphaaux modèles stochastiques pré-calibrés mathématiquement ; mobilisercompour les études d’inertie barycentrique et de réponse de phase. - Arbitrage sur adjust : Conserver rigoureusement
adjust=Truesur les séries courtes ou tronquées pour neutraliser mathématiquement le biais d’initialisation inaugurale ; basculer suradjust=Falseexclusivement si l’objectif implique une réplication stricte de formules récursives déterministes temps réel. - Gestion des données manquantes : Maintenir
ignore_na=Falsesi le temps calendaire physique absolu conditionne l’oubli de l’information ; n’activerignore_na=Trueque dans l’éventualité où l’absence de mesure fige totalement la dynamique du système étudié.
Sur le plan des pièges cognitifs et méthodologiques, deux écueils majeurs guettent perpétuellement le praticien. Le premier est le biais d’anticipation ou fuite temporelle d’information (désigné en anglais sous le vocable de lookahead bias). Bien que la formule récursive de l’EMA soit intrinsèquement causale (elle ne dépend que des points contemporains et passés), ce biais est fréquemment introduit involontairement par l’analyste lors des phases de préparation de données — par exemple en procédant à un centrage-réduction global du jeu de données ou à une imputation de valeurs manquantes par interpolation bilatérale en amont du calcul de l’EMA. Le second écueil réside dans l’illusion de certitude directionnelle : une moyenne mobile exponentielle demeure par essence un filtre rétrospectif qui accuse invariablement un retard de phase par rapport à la trajectoire réelle du signal. Confondre une extrapolation de courbe lissée avec une prédiction de causalité ontologique constitue une erreur épistémologique fondamentale qu’aucun raffinement algorithmique ne saurait absoudre.
Références
Appel, G. (2005). Technical Analysis: Power Tools for Active Investors. Financial Times Prentice Hall.
Box, G. E., Jenkins, G. M., Reinsel, G. C., & Ljung, G. M. (2015). Time Series Analysis: Forecasting and Control (5th ed.). John Wiley & Sons. https://doi.org/10.1002/9781118619193
Brown, R. G. (1959). Statistical Forecasting for Inventory Control. McGraw-Hill.
Holt, C. C. (2004). Forecasting seasonals and trends by exponentially weighted moving averages. International Journal of Forecasting, 20(1), 5-10. https://doi.org/10.1016/j.ijforecast.2003.09.015
Hunter, J. S. (1986). The exponentially weighted moving average. Journal of Quality Technology, 18(4), 203-210. https://doi.org/10.1080/00224065.1986.11979014
Lucas, J. M., & Saccucci, M. S. (1990). Exponentially weighted moving average control schemes: Properties and enhancements. Technometrics, 32(1), 1-12. https://doi.org/10.1080/00401706.1990.10484583
McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56-61). https://doi.org/10.25080/Majora-92bf1922-00a
McKinney, W. (2022). Python for Data Analysis: Data Wrangling with pandas, NumPy, and Jupyter (3rd ed.). O’Reilly Media.
Pandas Development Team. (2024). pandas.DataFrame.ewm — pandas documentation. PyData. https://pandas.pydata.org/docs/reference/api/pandas.DataFrame.ewm.html
Shumway, R. H., & Stoffer, D. S. (2017). Time Series Analysis and Its Applications: With R Examples (4th ed.). Springer. https://doi.org/10.1007/978-3-319-52452-8
Winters, P. R. (1960). Forecasting sales by exponentially weighted moving averages. Management Science, 6(3), 324-342. https://doi.org/10.1287/mnsc.6.3.324