
L’analyse statistique descriptive constitue la pierre angulaire de toute démarche de recherche empirique en sciences humaines, sociales et biomédicales. Lorsque le chercheur ou le praticien est confronté à un ensemble volumineux de données brutes issues de protocoles expérimentaux, d’évaluations psychométriques ou d’enquêtes épidémiologiques, la réduction méthodique de cette information s’avère indispensable pour dégager des tendances compréhensibles et scientifiquement exploitables. Au cœur de ce processus d’agrégation réside la distinction fondamentale entre les valeurs brutes observées et leur importance relative au sein du collectif étudié. La transformation des décomptes bruts en fréquences relatives permet d’affranchir l’analyse des contraintes strictement liées à la taille de l’échantillon, autorisant ainsi des comparaisons rigoureuses entre groupes, cohortes ou périodes temporelles distinctes.
Le logiciel Microsoft Excel s’impose historiquement comme l’environnement computationnel le plus universellement déployé au sein des laboratoires universitaires, des départements de ressources humaines et des instituts de sondage pour réaliser ces opérations de statistique descriptive. Bien que des progiciels spécialisés tels que SPSS, R ou SAS offrent des fonctionnalités avancées pour la modélisation inférentielle, la polyvalence d’Excel, sa transparence algorithmique et son accessibilité immédiate en font l’outil privilégié pour la structuration initiale, le nettoyage et le traitement tabulaire des données. Toutefois, l’obtention d’indicateurs fiables exige une maîtrise pointue de la syntaxe de calcul, de la gestion des références cellulaires et de la logique matricielle sous-jacente au tableur, sous peine d’introduire des erreurs systématiques susceptibles de corrompre l’interprétation diagnostique ou expérimentale.
Cet article propose une exploration exhaustive et méthodologiquement rigoureuse des procédures permettant de calculer, formater, exploiter et représenter graphiquement la fréquence relative au sein de Microsoft Excel. En articulant les fondements théoriques de la statistique mathématique avec des applications concrètes issues de la psychométrie et des sciences comportementales, ce guide détaille l’ensemble des approches opérationnelles disponibles : de la division arithmétique élémentaire avec ancrage absolu aux fonctions matricielles dynamiques, en passant par la puissance analytique des tableaux croisés dynamiques. Chaque étape est minutieusement documentée pour assurer la reproductibilité intégrale des calculs, la validité des conclusions cliniques et la parfaite conformité des résultats avec les standards académiques internationaux.
1. Fondements théoriques : Définition et distinction entre fréquence absolue et fréquence relative
1.1 Définition mathématique de la fréquence absolue
La fréquence absolue, traditionnellement désignée par le terme d’effectif et notée conventionnellement ni dans le formalisme statistique, représente le décompte brut et direct du nombre de fois où une modalité spécifique d’une variable ou une valeur appartenant à un intervalle prédéfini se manifeste au sein d’un ensemble d’observations. D’un point de vue ensembliste, si l’on considère une population ou un échantillon composé de N individus statistiques chez lesquels on mesure une variable aléatoire discrète ou continue discrétisée, la fréquence absolue correspond au cardinal du sous-ensemble des observations satisfaisant exactement la condition d’appartenance à la classe considérée. Ce décompte élémentaire constitue le niveau primaire de la quantification descriptive, indispensable à toute tentative ultérieure de modélisation mathématique.
Dans le cadre formel d’une distribution statistique partitionnée en k classes disjointes, l’effectif associé à la i-ème classe, noté ni (où i varie de 1 à k), est soumis à une contrainte arithmétique fondamentale : la somme de tous les effectifs de classe doit être rigoureusement égale à la taille globale de l’échantillon analysé, notée N. Mathématiquement, cette propriété s’exprime par la relation de fermeture :
$$\sum_{i=1}^{k} n_i = N$$
Cette sommation garantit qu’aucune observation n’a été omise ni comptabilisée de manière redondante. En recherche comportementale, cette notation formelle s’applique typiquement à la catégorisation des sujets selon des typologies cliniques mutuellement exclusives, ou à la distribution des temps de réponse segmentés en tranches temporelles de durée constante.
Les applications concrètes de la fréquence absolue sont particulièrement manifestes lors du dépouillement d’instruments psychométriques standardisés. Considérons, par exemple, l’administration d’un questionnaire d’évaluation de la symptomatologie dépressive auprès d’une cohorte clinique de 250 patients. Le dénombrement direct des individus ayant sélectionné la modalité « Sévère » à l’item explorant l’anhédonie fournit un effectif brut absolu. Ce nombre entier naturel fournit une information logistique et opérationnelle immédiate pour le clinicien ou le gestionnaire de santé : il quantifie précisément la charge de morbidité au sein de la structure de soins étudiée. Toutefois, cette valeur brute demeure fondamentalement dépendante de l’effectif total N, ce qui limite drastiquement sa portée dès lors qu’il s’agit de confronter ces observations à celles issues d’autres cohortes de dimensions divergentes.
1.2 Concept et formulation de la fréquence relative
La fréquence relative, universellement notée fi, transcende les limitations inhérentes à l’effectif brut en établissant un rapport de proportionnalité invariant entre la fréquence observée ni pour une classe donnée et la taille totale N de l’échantillon ou de la population sous examen. Mathématiquement, elle s’énonce selon le quotient élémentaire suivant :
$$f_i = \frac{n_i}{N}$$
Ce ratio adimensionnel quantifie le poids proportionnel ou la contribution relative de chaque modalité à l’ensemble du système observé. Par définition théorique, la fréquence relative est strictement bornée au sein de l’intervalle fermé [0, 1]. Une fréquence relative de 0 traduit l’absence absolue de la modalité dans l’échantillon, tandis qu’une valeur de 1 indique que l’intégralité des observations se concentre de façon unanime dans cette classe unique.
L’expression de la fréquence relative peut adopter plusieurs déclinaisons numériques selon les exigences du protocole de communication scientifique. Elle s’énonce nativement sous la forme d’une fraction irréductible, particulièrement prisée en statistique théorique pour préserver l’exactitude des calculs probabilistes. Dans les contextes appliqués, elle est préférentiellement traduite en notation décimale, généralement bornée à trois ou quatre chiffres après la virgule selon le niveau de précision requis. Enfin, par une simple multiplication par une constante d’échelle égale à 100, la fréquence relative se transmute en un pourcentage normalisé :
$$P_i = f_i \times 100 = \left(\frac{n_i}{N}\right) \times 100$$
Cette normalisation procentuelle permet d’exprimer la distribution sur une base unitaire uniforme de 100 éléments, facilitant ainsi l’appréhension intuitive des grandeurs mesurées par l’esprit humain.
L’intérêt comparatif prééminent de la fréquence relative réside dans sa capacité à neutraliser les distorsions d’échelle inhérentes aux comparaisons inter-groupes. Si une étude longitudinale cherche à évaluer l’efficacité d’une thérapie cognitivo-comportementale en comparant un groupe expérimental de 45 patients à un groupe témoin recruté sur liste d’attente comprenant 180 individus, l’observation d’un effectif absolu de 15 rémissions dans les deux groupes n’a absolument pas la même signification clinique. L’analyse des fréquences relatives révèle que la proportion de rémission atteint 33,33 % (15/45) dans la cohorte expérimentale, contre seulement 8,33 % (15/180) dans le groupe contrôle. La fréquence relative constitue donc l’unique métrique descriptive permettant d’attester de la disparité thérapeutique réelle entre des cohortes d’amplitudes inégales.
1.3 Rôle de la fréquence relative en psychométrie et sciences comportementales
Dans le domaine spécialisé de la psychométrie, la fréquence relative joue un rôle fondamental dans les processus de standardisation et d’étalonnage des tests comportementaux. Lors de l’administration d’une échelle d’évaluation utilisant des items de type Likert ordonnés selon plusieurs degrés d’approbation (par exemple : « Jamais », « Parfois », « Souvent », « Toujours »), les scores bruts collectés ne possèdent aucune signification intrinsèque absolue. Pour conférer une valeur diagnostique à un score brut, le psychométricien doit établir la distribution des fréquences relatives de l’ensemble des réponses au sein d’un échantillon normatif représentatif de la population générale. Cette normalisation permet de situer la performance ou le profil d’un individu par rapport aux tendances centrales et dispersives de sa population de référence.
En outre, l’élaboration des tables de conversion pour profils psychologiques et diagnostics nosographiques repose entièrement sur l’exploitation des distributions de fréquences relatives. Ces tables permettent de transposer des scores composites bruts en échelles standardisées, telles que les notes z, les stens (standard ten), les stanines ou les rangs percentiles. Sans une appréciation rigoureuse de la part relative occupée par chaque tranche de score au sein de la courbe empirique, il serait impossible d’isoler avec précision les frontières séparant un comportement réputé typique d’une manifestation clinique déviante se situant dans les extrémités de la distribution (typiquement au-delà de deux écarts-types de la moyenne, correspondant aux 2,5 % supérieurs ou inférieurs).
Enfin, la fréquence relative constitue le pont méthodologique indispensable reliant la statistique descriptive à l’inférence statistique et à la théorie des probabilités. Selon la loi faible des grands nombres formalisée par Jacques Bernoulli, lorsque la taille N de l’échantillon tend vers l’infini, la fréquence relative observée fi d’un événement converge en probabilité vers la probabilité théorique P(A) de cet événement :
$$\lim_{N to \infty} P(|f_i – P(A)| > \varepsilon) = 0$$
Dans les paradigmes neurocognitifs ou psychophysiologiques denses (tels que l’analyse des temps de réaction milliseconde par milliseconde ou l’enregistrement des potentiels évoqués), les distributions de fréquences relatives empiriques servent d’estimateurs directs des densités de probabilité sous-jacentes. Elles permettent ainsi de tester l’ajustement des données réelles à des lois théoriques canoniques, à l’instar de la loi normale de Laplace-Gauss ou de la loi ex-gaussienne.
2. Préparation et structuration des données expérimentales dans Microsoft Excel
2.1 Organisation tabulaire conforme aux normes méthodologiques
L’intégrité de toute computation statistique réalisée sous Microsoft Excel dépend de la rigueur architecturale de la matrice de données sources. Une feuille de calcul destinée au traitement de données expérimentales ne doit jamais être organisée selon des critères purement esthétiques, mais doit se conformer strictement au modèle relationnel standardisé connu sous le vocable de « tidy data ». Selon ce principe fondamental théorisé en science des données, chaque ligne horizontale doit impérativement représenter une unité observationnelle unique et indivisible (un participant, un essai clinique, une session de mesure), tandis que chaque colonne verticale doit encapsuler une variable d’intérêt spécifique, exhaustivement qualifiée par un intitulé univoque positionné sur la toute première rangée du tableau.
Une distinction opérationnelle rigoureuse doit être maintenue entre les variables indépendantes (telles que le groupe de traitement, le sexe biologique ou la tranche d’âge) et les variables dépendantes (telles que le temps de réaction, le score d’anxiété ou le nombre d’erreurs commises). Pour garantir un traitement computationnel optimal par les moteurs d’inférence d’Excel, le chercheur doit spécifier le typage exact de chaque colonne. Les variables quantitatives continues doivent être formatées au format numérique standard sans symboles parasites, tandis que les variables catégorielles nominales et ordinales doivent faire l’objet d’un codage alphanumérique strictement standardisé afin d’éviter toute ambiguïté lexicale lors de l’exécution des formules conditionnelles.
Le nettoyage méticuleux des données constitue une étape préalable non négociable. La présence de cellules vides, d’espaces insécables résiduels ou de valeurs aberrantes résultant d’erreurs de saisie manuelle est susceptible de compromettre radicalement le calcul de la taille totale N de l’échantillon, générant par ricochet une distorsion systématique de toutes les fréquences relatives associées. Il convient d’adopter des règles de gestion strictes pour l’imputation ou l’exclusion des valeurs manquantes (notées classiquement NA pour « Non Applicable » ou laissées rigoureusement nulles selon le protocole retenu), en s’assurant que ces codes textuels ne soient pas interprétés par mégarde comme des chaînes de caractères valides lors des opérations de comptage automatique.
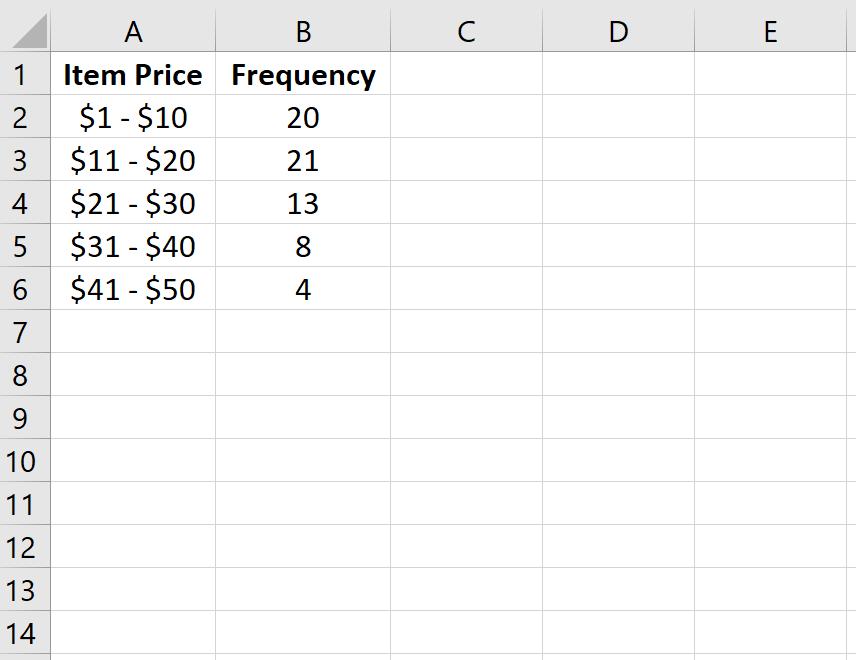
2.2 Création des classes ou intervalles de regroupement (bins)
Lorsque la variable empirique sous investigation présente une nature quantitative continue (à l’instar de la conductance cutanée, des temps de latence cognitive ou de l’âge chronologique des participants), le calcul direct des fréquences relatives sur les valeurs discrètes isolées perd toute pertinence statistique. En effet, la probabilité théorique qu’une variable continue prenne une valeur exacte infiniment précise est nulle, ce qui conduirait à l’émergence d’une multitude d’effectifs unitaires égaux à 1. Il devient dès lors impératif de partitionner le continuum de mesure en un ensemble fini d’intervalles contigus et disjoints, désignés sous le terme technique de classes ou de « bins ».
Pour déterminer le nombre optimal de classes sans introduire d’arbitraire subjectif, il est recommandé de s’appuyer sur des fondements biométriques éprouvés, au premier rang desquels figure la célèbre règle de Sturges. Formulée pour des distributions approximativement symétriques et de taille modérée (N < 200), cette heuristique stipule que le nombre de classes k doit être déterminé par la relation logarithmique :
$$k = 1 + \log_2(N) \approx 1 + 3,322 \times \log_{10}(N)$$
Dans les contextes d’échantillons plus volumineux ou asymétriques, l’équation de Scott ou la règle de Freedman-Diaconis basée sur l’intervalle interquartile peut être substituée à celle de Sturges pour préserver la structure fine de la distribution sous-jacente sans lisser artificiellement les singularités locales.
Une fois le nombre k arrêté, l’amplitude ou la largeur de chaque classe h est calculée en divisant l’étendue totale des données (la différence arithmétique entre la valeur maximale et la valeur minimale observées) par k. Il est impératif d’édicter des conventions de bornage univoques pour garantir l’exclusion mutuelle des intervalles. Sur le plan méthodologique, la structure standard adopte la forme d’intervalles semi-ouverts à gauche et fermés à droite, notés ]a ; b], ou semi-ouverts à droite et fermés à gauche, notés [a ; b[. Dans Excel, la structuration des limites supérieures de classe doit être rigoureusement planifiée dans une colonne dédiée pour piloter ultérieurement les algorithmes d’agrégation matricielle.
2.3 Vérification de l’intégrité de la base de données
Avant d’engager le moindre calcul algorithmique de fréquence, une série de protocoles de validation croisée doit être exécutée au sein de la feuille de calcul afin de certifier l’absence de corruptions structurelles. L’activation des filtres automatiques natifs d’Excel sur l’ensemble de la plage tabulaire constitue un moyen immédiat d’inspecter visuellement les valeurs extrêmes et d’identifier d’éventuelles coquilles typographiques au sein des variables qualitatives (par exemple, la coexistence erronée des chaînes « F », « f » et « Femme » pour désigner une modalité de genre identique).
Pour prévenir les dérives d’encodage lors de la saisie continue, l’opérateur averti déploiera l’outil de « Validation des données » accessible via le ruban d’Excel. En configurant des critères de restriction stricts sur les plages de saisie (par exemple, en n’autorisant que des nombres entiers compris entre 1 et 5 pour un item de Likert, ou des valeurs décimales positives inférieures à 3000 pour des temps de réaction exprimés en millisecondes), on immunise la base contre l’introduction accidentelle d’artefacts computationnels. Cette politique de blindage structurel garantit la conformité de chaque cellule avec le schéma conceptuel de l’étude comportementale.
Enfin, l’audit de l’échantillon effectif exploitable est formalisé au moyen de la fonction native NB pour les colonnes numériques, ou de la fonction NBVAL pour les attributs alphanumériques. En comparant le résultat renvoyé par la formule =NB(Plage_Mesures) avec le registre physique des sujets ayant effectivement participé à l’expérimentation, le chercheur quantifie avec une certitude absolue le volume N effectif qui servira de dénominateur universel dans l’ensemble des formules de fréquence relative. Toute divergence numérique entre ces décomptes doit obligatoirement être résolue avant de procéder à l’étape suivante du pipeline analytique.
3. Calcul de la fréquence absolue : Détermination des effectifs par classe
3.1 Utilisation de la fonction NB.SI pour variables discrètes
La détermination automatisée des effectifs absolus pour des variables qualitatives ou discrètes ne nécessitant pas de découpage par intervalles s’opère canoniquement par l’intermédiaire de la fonction native NB.SI. Cette fonction exécute un balayage séquentiel d’une plage de données désignée et incrémente un compteur unitaire chaque fois que le contenu d’une cellule remplit un critère logique ou lexical explicitement articulé par l’utilisateur. Sa syntaxe générale s’articule autour de deux arguments obligatoires :
=NB.SI(plage; critère)
Le premier argument spécifie l’étendue du vecteur de données sources à auditer, tandis que le second définit la condition d’évaluation.
Dans le contexte d’une évaluation psychologique où l’on souhaite recenser le nombre de sujets manifestant un style d’attachement spécifique parmi quatre modalités prédéterminées (« Sécure », « Anxieux », « Évitant », « Désorganisé »), la variable catégorielle se trouve consignée dans la plage verticale $A$2:$A$101. Pour calculer la fréquence absolue de la modalité « Sécure », la formule s’énoncera sous la forme :
=NB.SI($A$2:$A$101; "Sécure")
Il est toutefois hautement préférable, sur le plan des bonnes pratiques méthodologiques, de substituer à la chaîne de texte littérale une référence relative pointant vers une cellule adjacente contenant l’étiquette de la classe (par exemple, D2), ce qui permet de dupliquer la formule verticalement sans réécriture manuelle :
=NB.SI($A$2:$A$101; D2)
Toutefois, la fonction NB.SI présente des limitations intrinsèques insurmontables dès lors que l’analyste est confronté à des distributions quantitatives continues partitionnées en classes. Incapable de traiter simultanément plusieurs conditions d’inégalité imbriquées sur un même vecteur de valeurs sans recourir à des soustractions arithmétiques complexes et sources d’erreurs (comme soustraire deux NB.SI consécutifs), elle doit être délaissée au profit de structures syntaxiques plus avancées dès lors que la définition d’une classe requiert la conjonction d’une borne inférieure et d’une borne supérieure.
3.2 Mise en œuvre de la fonction NB.SI.ENS pour intervalles continus
Pour surmonter les restrictions dimensionnelles de sa variante unaire, Microsoft Excel propose la fonction NB.SI.ENS, conçue pour évaluer un nombre arbitraire de critères logiques conjoints appliqués à une ou plusieurs plages de données. Son utilisation s’avère particulièrement adaptée à la quantification des fréquences absolues au sein d’intervalles continus fermés ou semi-ouverts. La structure syntaxique fondamentale de cette fonction se déploie selon la séquence de paramètres suivante :
=NB.SI.ENS(plage_critères1; critères1; [plage_critères2; critères2]; ...)
Tous les critères stipulés doivent être simultanément vrais pour qu’une observation soit intégrée au décompte final.
Considérons un protocole expérimental en neuropsychologie mesurant les latences d’attention sélective au cours d’une tâche de Stroop, où les temps de réponse s’échelonnent entre 300 et 1200 millisecondes au sein de la plage $B$2:$B$501. Si l’on souhaite quantifier le nombre exact d’observations appartenant à la classe définie par l’intervalle semi-ouvert ]450 ; 600] millisecondes, la borne inférieure de 450 étant consignée dans la cellule D2 et la borne supérieure de 600 dans la cellule E2, la formule conjonctive s’écrira en exploitant l’opérateur de concaténation typographique & :
=NB.SI.ENS($B$2:$B$501; ">" & D2; $B$2:$B$501; "<=" & E2)
Cette écriture paramétrique confère une adaptabilité totale à la feuille de calcul : toute modification apportée aux bornes D2 ou E2 recalculera instantanément l’effectif associé sans nécessiter l’édition de la formule sous-jacente.
La rigueur méthodologique impose de veiller à la stricte cohérence logique des opérateurs de comparaison d’une classe à l’autre pour empêcher formellement le risque de double comptage ou d’omission aux frontières d’intervalles. Si la classe 1 est bornée par ">=" & D2 et "<=" & E2, et que la classe consécutive 2 utilise ">=" & D3 avec D3 = E2, toute observation tombant exactement sur la valeur charnière E2 sera artificiellement comptabilisée au sein des deux classes à la fois. L’adoption scrupuleuse de bornes strictement unilatérales (par exemple, ">" pour la borne basse et "<=" pour la borne haute) garantit l’étanchéité statistique absolue de chaque case d’analyse.
3.3 Agrégation de la somme totale de référence avec SOMME
L’étape conclusive de l’élaboration de la table d’effectifs absolus consiste à agréger l’ensemble des fréquences dénombrées pour dériver formellement la taille totale de référence N. Cette opération d’addition est assignée à la fonction fondamentale SOMME, positionnée sous la colonne des effectifs calculés. Si les effectifs des k classes sont disposés dans la plage verticale allant de F2 à F11, la formule de clôture s’énonce sans ambiguïté :
=SOMME(F2:F11)
Cette sommation ne constitue pas une simple formalité comptable : elle assume une fonction critique de validation de la cohérence interne du protocole descriptif.
Le résultat généré par la formule =SOMME(F2:F11) doit être rigoureusement identique au résultat obtenu par la fonction d’audit indépendant =NB($B$2:$B$501) appliquée directement au vecteur originel des données brutes. Toute divergence, fût-elle d’une seule unité statistique, signale impérieusement la présence d’une anomalie structurelle dans le modèle : un recouvrement involontaire d’intervalles provoquant un surcomptage, ou au contraire une lacune dans le maillage des bornes de classes ayant laissé échapper certaines observations périphériques en deçà du minimum ou au-delà du maximum empirique.
Le positionnement de cette cellule récapitulative au sein du canevas tabulaire doit faire l’objet d’une réflexion ergonomique préalable. Bien que la tradition typographique suggère de placer le total directement en dessous de la dernière modalité d’analyse, l’insertion future de nouvelles classes peut induire des altérations accidentelles des plages de référence lors de l’extension de la table. Pour prémunir le modèle contre ces ruptures de liaison, il est fréquent, au sein des feuilles de calcul professionnelles, de loger la cellule récapitulative dans un encadré méthodologique en en-tête de page (par exemple en F1 ou dans une cellule dédiée hors du flux de données), gelant ainsi son statut d’ancrage absolu pour tous les calculs subséquents.
4. La formule fondamentale pour calculer la fréquence relative dans Excel
4.1 Écriture de la formule de division élémentaire
Le calcul de la fréquence relative au sein d’une table statistique informatisée sous Excel s’articule autour d’une équation arithmétique élémentaire traduisant le ratio mathématique fi = ni / N. Dans la structure canonique d’une feuille de calcul, la colonne réservée aux fréquences relatives est immédiatement juxtaposée à la colonne des effectifs absolus préalablement établis. L’expression de la formule impose d’interfacer deux opérandes cellulaires distincts : le numérateur, qui correspond à la cellule d’effectif propre à la ligne considérée, et le dénominateur, qui renvoie exclusivement à la cellule récapitulative hébergeant la somme totale N.
Si l’on postule que la première classe de données possède son effectif absolu n1 consigné dans la cellule F2, et que le volume global de l’échantillon N est archivé de manière pérenne dans la cellule F$12, la formule canonique régissant l’évaluation de la fréquence relative de cette première modalité s’inscrit au sein de la cellule G2 sous la forme textuelle suivante :
=F2/F$12
La validation de cette saisie au moyen de la touche Entrée déclenche l’exécution immédiate du moteur arithmétique d’Excel, qui divise le contenu numérique de la cellule source par le total général.
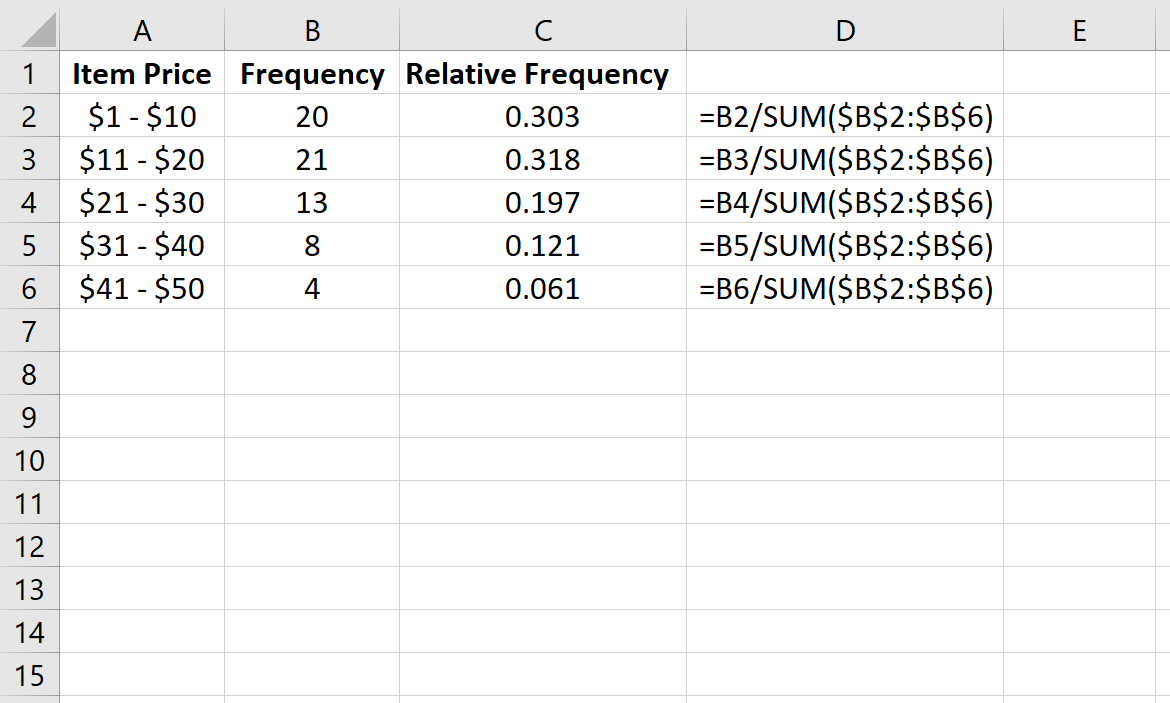
Le résultat primaire généré par l’interpréteur de calcul d’Excel adopte instantanément une typologie décimale brute non formatée, oscillant typiquement entre 0 et 1 (par exemple, 0,2375). Cette valeur reflète la fraction continue exacte de la représentativité de la classe F2 au sein du groupe. À ce stade du traitement, le tableur préserve la précision computationnelle maximale du processeur (représentation en virgule flottante double précision à 64 bits conforme à la norme IEEE 754), stockant jusqu’à 15 chiffres significatifs dans la mémoire vive, indépendamment de l’apparence visuelle tronquée que peut provisoirement afficher la cellule à l’écran en fonction de sa largeur physique.
4.2 Gestion des arrondis et précision numérique
Une confusion méthodologique pernicieuse doit être impérativement dissipée quant à la nature des valeurs manipulées : il existe une divergence conceptuelle fondamentale entre un arrondi d’affichage, purement cosmétique, et un arrondi de calcul sous-jacent, qui tronque de manière irréversible la valeur mathématique résidant dans la cellule. La modification du nombre de décimales apparentes via l’interface ruban d’Excel modifie simplement le masque typographique de la cellule, mais laisse intacte la fraction infinie stockée en mémoire. Lorsque ces cellules sont ultérieurement mobilisées dans d’autres chaînes d’opérations, le processeur continue d’utiliser la valeur brute non arrondie.
Pour assurer la reproductibilité parfaite de rapports de recherche clinique et se conformer aux directives éditoriales d’organismes scientifiques tels que l’American Psychological Association, il est parfois méthodologiquement requis d’imposer un arrondi structurel explicite en encapsulant l’opération de division au sein de la fonction native ARRONDI. La syntaxe canonique stabilisant le ratio à trois décimales s’exprime selon le schéma :
=ARRONDI(F2/F$12; 3)
Le second argument spécifie le nombre de chiffres conservés après la virgule, le moteur appliquant rigoureusement les règles d’arrondi symétrique au plus proche (la valeur 5 étant arrondie au chiffre supérieur).
Il importe toutefois de souligner l’impact indésirable potentiel de ces approximations discrètes successives sur la somme cumulative finale des fréquences relatives. Lorsque chaque fréquence relative individuelle est tronquée ou arrondie de façon autonome, la sommation arithmétique de ces valeurs arrondies peut fréquemment produire un total global s’écartant légèrement de l’unité théorique, oscillant typiquement entre 0,999 et 1,001 (ou entre 99,9 % et 100,1 % en notation de pourcentage). Bien que cet écart d’arrondi soit mathématiquement bénin, il suscite fréquemment des interrogations chez les évaluateurs non avertis. Dès lors, si l’intégrité de la fermeture stochastique est primordiale, il demeure préférable de conserver les valeurs décimales brutes en mémoire computationnelle et de n’appliquer le filtrage de précision qu’au niveau du format de présentation visuelle.
4.3 Interprétation quantitative du ratio obtenu
Sur le plan de l’inférence descriptive, le ratio numérique issu de la division élémentaire transcende son statut d’artefact tabulaire pour devenir un descripteur comportemental d’une haute teneur informative. Dans le cadre de la théorie probabiliste fréquentiste, la fréquence relative fi obtenue représente l’estimateur sans biais au maximum de vraisemblance de la probabilité ponctuelle qu’un événement relevant de la modalité i se produise au sein de la population cible sous des conditions expérimentales rigoureusement identiques. Une valeur de 0,342 implique que toute observation extraite au hasard a 34,2 % de chances objectives de se situer dans la classe considérée.
Dans un paradigme clinique ou psychopathologique, l’analyse comparative des profils de fréquences relatives permet d’objectiver immédiatement des anomalies de distribution symptomatique. L’identification d’une fréquence relative anormalement élevée (par exemple, supérieure à 0,45) au sein d’une classe mesurant les perturbations du sommeil chez des sujets exposés à un stress post-traumatique, comparativement à une valeur de référence populationnelle de 0,12, documente une concentration morbide majeure nécessitant une intervention ciblée. Ce ratio relatif traduit directement la prévalence relative du trouble indépendamment des variations des effectifs totaux de recrutement.
Enfin, la standardisation offerte par la fréquence relative confère une comparabilité universelle aux profils psychologiques individuels ou groupaux. Qu’un laboratoire collige 80 observations dans une étude pilote ou que 12 000 participants soient inclus dans un essai multicentrique international, les vecteurs de fréquences relatives résultants sont strictement superposables et immédiatement commensurables. Ils permettent d’évaluer la stabilité des architectures factorielles ou comportementales à travers des contextes écologiques profondément hétérogènes.
5. Maîtrise des références absolues ($) pour l’automatisation du calcul
5.1 Principe théorique des références relatives versus absolues
La puissance d’automatisation des tableurs repose sur la mécanique computationnelle des références cellulaires relatives. Par défaut, lorsqu’un utilisateur écrit une formule faisant appel à une cellule voisine (par exemple, en G2 tapant =F2/F12), Excel n’enregistre pas une coordonnée statique, mais encode une trajectoire relative, c’est-à-dire un déplacement vectoriel dans la grille (en l’occurrence : « divise la valeur située une colonne à gauche sur la même ligne par la valeur située une colonne à gauche et dix lignes plus bas »). Lorsque cette formule est copiée ou étirée verticalement vers la cellule G3, ce même déplacement spatial est appliqué mécaniquement : la formule mute spontanément en =F3/F13.
Si ce glissement automatique s’avère parfaitement adapté pour le numérateur, qui doit obligatoirement progresser ligne par ligne pour interroger chaque classe consécutive (passant successivement de F2 à F3, puis F4), il engendre une catastrophe computationnelle majeure pour le dénominateur. En glissant vers le bas, la référence à la cellule de somme totale se décale vers des cellules vides sous le tableau (F13, F14…). Or, dans le modèle logique d’Excel, une cellule vide intervenant dans une division est interprétée comme équivalente à la valeur numérique zéro. L’interpréteur de calcul interrompt immédiatement l’exécution et renvoie l’erreur fatale #DIV/0!, rendant la table inexploitable.
Pour neutraliser ce déplacement cinématique et figer une coordonnée spatiale immuable, le langage de programmation d’Excel recourt au caractère conventionnel du dollar ($). Ce préfixe agit comme un opérateur d’ancrage syntaxique absolu. Il permet de discriminer trois modes d’indexation cellulaire :
- L’ancrage total (
$F$12), où la colonne et la ligne sont simultanément verrouillées de manière inviolable ; - L’ancrage semi-absolu de ligne (
F$12), où la ligne est pérennisée tandis que la colonne demeure mobile en cas de décalage latéral ; - L’ancrage semi-absolu de colonne (
$F12), où la colonne demeure stationnaire tandis que l’index de ligne conserve sa translation verticale.
5.2 Implémentation pratique du signe dollar ($)
L’implémentation opérationnelle du verrouillage de référence au sein de la feuille de calcul s’exécute de manière optimale via l’usage de raccourcis matériels lors de la phase de saisie de la formule. Lorsque l’analyste rédige la formule au sein de la barre d’édition de la première cellule de résultat (G2), après avoir saisi le signe de division et cliqué sur la cellule contenant la somme totale de référence (F12), il suffit de presser consécutivement la touche de fonction clavier F4 (ou la combinaison Fn + F4 sur certains terminaux portables). Cette action cyclique commute instantanément le mode d’adressage, convertissant la saisie brute F12 en sa forme strictement ancrée $F$12.
Une fois la syntaxe canonique =F2/$F$12 dûment validée, le déploiement vertical s’effectue sans aucun risque d’altération géométrique. L’opérateur positionne le curseur de la souris sur le coin inférieur droit de la cellule active jusqu’à ce que le pointeur se métamorphose en une fine croix noire connue sous le vocable de « poignée de recopie ». Un double-clic vigoureux ou une opération de glisser-déposer vers le bas propage instantanément la formule mathématique sur l’ensemble de la plage verticale jusqu’au niveau de la dernière modalité d’analyse.
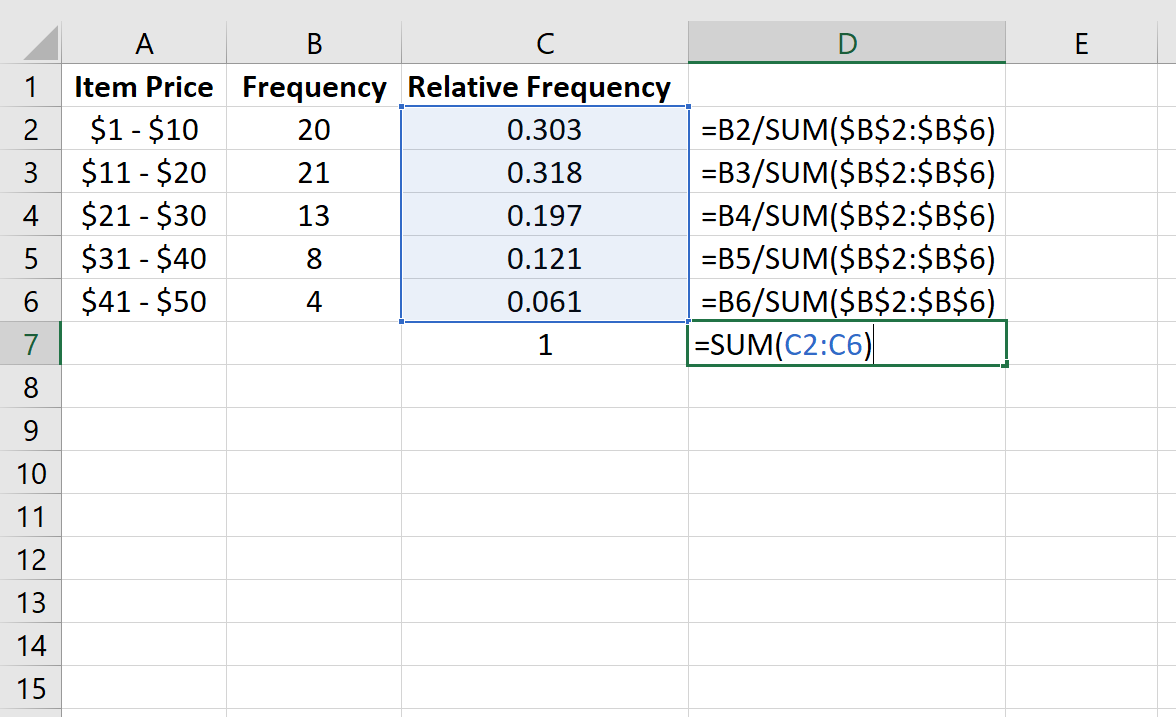
Il est impératif d’exécuter un contrôle d’intégrité visuel immédiatement consécutif à la recopie. En sélectionnant la dernière cellule de la colonne générée (par exemple G11) et en activant le mode d’audit des formules (au moyen de la touche clavier F2), l’analyste peut visualiser en surbrillance colorée les plages dépendantes actives. Si le protocole d’ancrage a été rigoureusement respecté, le cadre de numérateur s’est déplacé harmonieusement sur la dernière classe d’effectif (F11), tandis que le cadre du dénominateur demeure fermement enclavé sur la cellule totalisatrice immuable ($F$12), confirmant l’absence totale de dérive computationnelle.
5.3 Recours aux plages nommées comme alternative sémantique
Bien que l’usage du caractère dollar constitue la méthode d’ancrage la plus répandue, la rigueur méthodologique propre à la recherche expérimentale et aux audits cliniques recommande l’adoption d’une approche d’abstraction sémantique supérieure : la création de plages nommées. Dans Excel, toute cellule ou ensemble de cellules peut être associé à un identifiant textuel univoque qui remplace avantageusement les coordonnées alphanumériques brutes dans l’écriture des équations statistiques.
Pour opérationnaliser cette technique, l’analyste sélectionne la cellule totalisatrice hébergeant la somme totale (F12), puis accède à la « Zone Nom » située à l’extrême gauche de la barre de formule d’Excel. Il y inscrit un descripteur méthodologique sans équivoque, par exemple Total_Echantillon_N, et valide par la touche Entrée. Dès cet instant, le tableur assigne de manière intrinsèque un ancrage absolu permanent à cet identifiant au sein de la table des symboles du classeur. La formule de calcul de la fréquence relative s’énonce alors avec une pureté syntaxique remarquable :
=F2/Total_Echantillon_N
Cette méthodologie d’adressage textuel transforme radicalement la lisibilité des feuilles de calcul. Tout chercheur tiers, évaluateur académique ou auditeur clinique inspectant le classeur comprend immédiatement la signification scientifique de l’opération en cours d’exécution, sans devoir identifier laborieusement l’origine spatiale d’une cellule isolée telle que $F$12. Cette pratique élimine structurellement les erreurs de recopie de formule et s’inscrit de plain-pied dans les préconisations actuelles visant à garantir la traçabilité et la transparence des traitements informatisés en sciences comportementales.
6. Calcul avancé de la fréquence relative avec les Tableaux Croisés Dynamiques (TCD)
6.1 Configuration initiale du Tableau Croisé Dynamique
Les Tableaux Croisés Dynamiques (TCD) représentent l’une des technologies de traitement OLAP (Online Analytical Processing) les plus robustes intégrées nativement dans l’environnement Microsoft Excel. Conçus pour opérer des synthèses multidimensionnelles sans exiger la moindre rédaction manuelle de formules, ils permettent de compiler et d’agréger d’immenses registres de données comportementales en quelques opérations d’interfaçage. Le déploiement d’un TCD constitue la méthode industrielle par excellence pour extraire instantanément des distributions de fréquences, tant absolues que relatives.
L’initialisation de ce dispositif computationnel exige la sélection préalable d’une cellule quelconque au sein de la matrice rectangulaire contenant les données expérimentales brutes préalablement assainies. Par le ruban « Insertion », l’utilisateur active la commande « Tableau croisé dynamique » et confirme l’implantation du moteur d’analyse sur une nouvelle feuille de calcul afin d’éviter tout chevauchement avec les données sources. Cette action déploie instantanément l’interface de paramétrage composée de la zone de rapport vierge et du volet latéral des champs de tableau croisé dynamique répertoriant l’ensemble des variables d’étude.
La structuration du rapport s’exécute par glisser-déposer vectoriel. La variable indépendante ou dépendante dont on désire établir la distribution (par exemple, la catégorie de diagnostic psychologique ou le groupe clinique) est assignée à la zone intitulée « Lignes ». Cette opération a pour effet d’extraire de manière instantanée toutes les modalités uniques et de les lister verticalement sans doublon. Ensuite, pour initier le calcul d’occurrence, ce même champ de variable est glissé deux fois consécutives au sein de la zone opérationnelle « Valeurs » : la première occurrence sera dédiée au décompte des effectifs absolus, tandis que la seconde sera configurée pour générer les fréquences relatives.
6.2 Paramétrage de l’affichage en pourcentage du total
Dès lors que deux occurrences de la variable cible coexistent dans la zone « Valeurs », le moteur du TCD applique généralement par défaut une fonction de dénombrement intitulée « Nombre de [Variable] ». Pour transformer la seconde instance en indicateur de proportion relative normalisée, il convient de modifier la logique de restitution mathématique sous-jacente sans altérer les données sources. L’analyste effectue un clic droit sur n’importe quelle cellule appartenant à cette seconde colonne de valeur dans le rapport en cours d’élaboration, et navigue au sein du menu contextuel vers l’option « Afficher les valeurs ».
Un sous-menu exhaustif révèle les multiples modes de normalisation pris en charge par le moteur OLAP d’Excel. L’option méthodologiquement requise dans ce contexte d’analyse univariée s’intitule « % du total général » ou « % du total de la colonne ». Dès la sélection de cet item, le tableau croisé dynamique recalcule instantanément chaque cellule en divisant dynamiquement son effectif absolu par la somme globale des occurrences de la colonne, convertissant le ratio résultant en une valeur de pourcentage explicite.
Cette approche par TCD offre un avantage déterminant sur le calcul manuel par formule : l’immunité structurelle contre les erreurs de décalage spatial. Si la matrice des données brutes se trouve modifiée par l’adjonction de nouveaux participants ou l’exclusion rétrospective de sujets ayant transgressé les critères d’inclusion expérimentaux, un simple clic sur le bouton « Actualiser » dans l’onglet d’analyse du TCD synchronise instantanément les décomptes et recalcule l’intégralité des pourcentages. Les formules manuelles dépendantes de plages fixes, quant à elles, nécessiteraient un réajustement manuel chronophage et potentiellement vulnérable aux bévues de sélection.
6.3 Regroupement automatique des variables quantitatives continues
La puissance d’analyse du Tableau Croisé Dynamique se déploie avec une efficacité accrue lors du traitement de variables empiriques quantitatives continues (à l’instar d’un score d’échelle psychométrique variant continûment de 0 à 100, ou de niveaux d’anxiété mesurés sur un spectre large). Traditionnellement, l’analyste devait concevoir des colonnes auxiliaires complexes intégrant des fonctions logiques imbriquées SI ou des matrices NB.SI.ENS pour allouer chaque mesure à son intervalle de regroupement. Le TCD élimine intégralement cette phase laborieuse grâce à sa fonctionnalité native de « Groupement ».
Pour activer cette segmentation instantanée, la variable quantitative continue est insérée telle quelle dans la zone « Lignes » du TCD, générant provisoirement une table étirée affichant chaque score brut individuel. En réalisant un clic droit sur n’importe quelle valeur numérique de cette colonne axiale et en sélectionnant la commande « Grouper », l’analyste accède à une boîte de dialogue de discrétisation paramétrique. Cette interface sollicite trois paramètres statistiques cardinaux :
- Le point de départ (« Début »), qui fixe la limite inférieure absolue de la première classe ;
- Le point d’arrivée (« Fin »), qui verrouille le plafond supérieur d’observation ;
- Le pas d’incrémentation (« Par »), qui définit l’amplitude constante de classe h.
En renseignant, par exemple, une valeur de début à 0, une fin à 100 et un pas d’intervalle fixé à 10, le TCD restructure instantanément le rapport en classes disjointes parfaites (0-9, 10-19, 20-29…). Les colonnes de valeurs calculent de façon concomitante les effectifs bruts et les fréquences relatives associées à chaque décile du spectre de mesure. Cette souplesse permet d’explorer de multiples scénarios de partitionnement en quelques clics, facilitant l’identification de seuils diagnostiques optimaux sans introduire de modifications irréversibles dans la base de données maîtresse.
7. Emploi de la fonction matricielle FREQUENCE pour distributions quantitatives
7.1 Fonctionnement matriciel de la fonction FREQUENCE
Pour les méthodologues qui privilégient les architectures de formules transparentes plutôt que les interfaces opaques des tableaux croisés, la fonction FREQUENCE constitue l’instrument algorithmique de prédilection. Appartenant à la catégorie des fonctions statistiques matricielles, elle a été spécifiquement codée pour dénombrer en une passe unique la distribution d’une variable continue à travers un ensemble prédéfini d’intervalles contigus. Sa syntaxe requiert impérativement deux arguments vectoriels :
=FREQUENCE(tableau_données; matrice_intervalles)
Le premier paramètre désigne le vecteur colonne rassemblant l’ensemble des mesures brutes observées, tandis que le second pointe vers le vecteur contenant les bornes supérieures de chaque classe d’analyse préalablement délimitée.
La singularité architecturale de la fonction FREQUENCE réside dans sa nature nativement matricielle. Dans les versions historiques d’Excel antérieures à la révision d’architecture de calcul dynamique intervenue avec Microsoft 365, l’insertion de cette fonction exigeait une procédure manuelle contraignante : l’utilisateur devait pré-sélectionner l’exacte plage verticale réceptrice, formuler l’instruction mathématique, puis procéder à la validation matricielle tripartite conjointe via les touches clavier Ctrl + Maj + Entrée. Le tableur encapsulait alors la formule entre des accolades formelles ({...}), matérialisant son statut de formule matricielle héritée.
Dans l’écosystème contemporain d’Excel exploitant le moteur de « Tableaux Dynamiques », la fonction FREQUENCE bénéficie du mécanisme de « propagation automatique » (spill). Il suffit désormais d’écrire la fonction dans une unique cellule de départ et de valider ordinairement par la touche Entrée. Le moteur calcule instantanément l’ensemble des classes et propage le vecteur des effectifs vers le bas sur une plage bordée d’un liseré bleu fin. Cette supériorité computationnelle en fait la solution optimale pour ingérer d’immenses registres de données psychophysiologiques denses (par exemple, des séries temporelles d’électroencéphalographie ou des flux d’oculométrie totalisant des dizaines de milliers de lignes) où les fonctions de comptage conditionnel traditionnelles s’effondrent sous le poids de la complexité algorithmique.
7.2 Conversion directe des résultats matriciels en fréquences relatives
Bien que la fonction FREQUENCE génère nativement des décomptes d’effectifs absolus ni, sa structure syntaxique autorise une vectorisation directe pour produire d’un seul jet le vecteur complet des fréquences relatives normalisées, sans requérir de colonnes intermédiaires ni de manipulations manuelles répétitives. Cette conversion directe s’opère par l’emboîtement de la fonction de dénombrement matriciel divisée scalairement par le résultat renvoyé par la fonction de décompte universel NB appliquée au même tableau de mesures.
Considérons un tableau de mesures brutes stocké dans la plage $A$2:$A$1000 et une matrice d’intervalles de bornes supérieures consécutivement définie en $C$2:$C$8. La formule combinée, insérée au sommet de la colonne réceptrice des fréquences relatives en D2, s’énonce selon l’instruction suivante :
=FREQUENCE($A$2:$A$1000; $C$2:$C$8) / NB($A$2:$A$1000)
Le moteur d’évaluation procède d’abord au calcul vectoriel de la distribution des effectifs bruts, puis divise chaque élément de ce vecteur résultant par le scalaire unique représentant N, déversant une colonne continue et parfaitement normalisée de valeurs décimales au sein de la plage D2:D9.
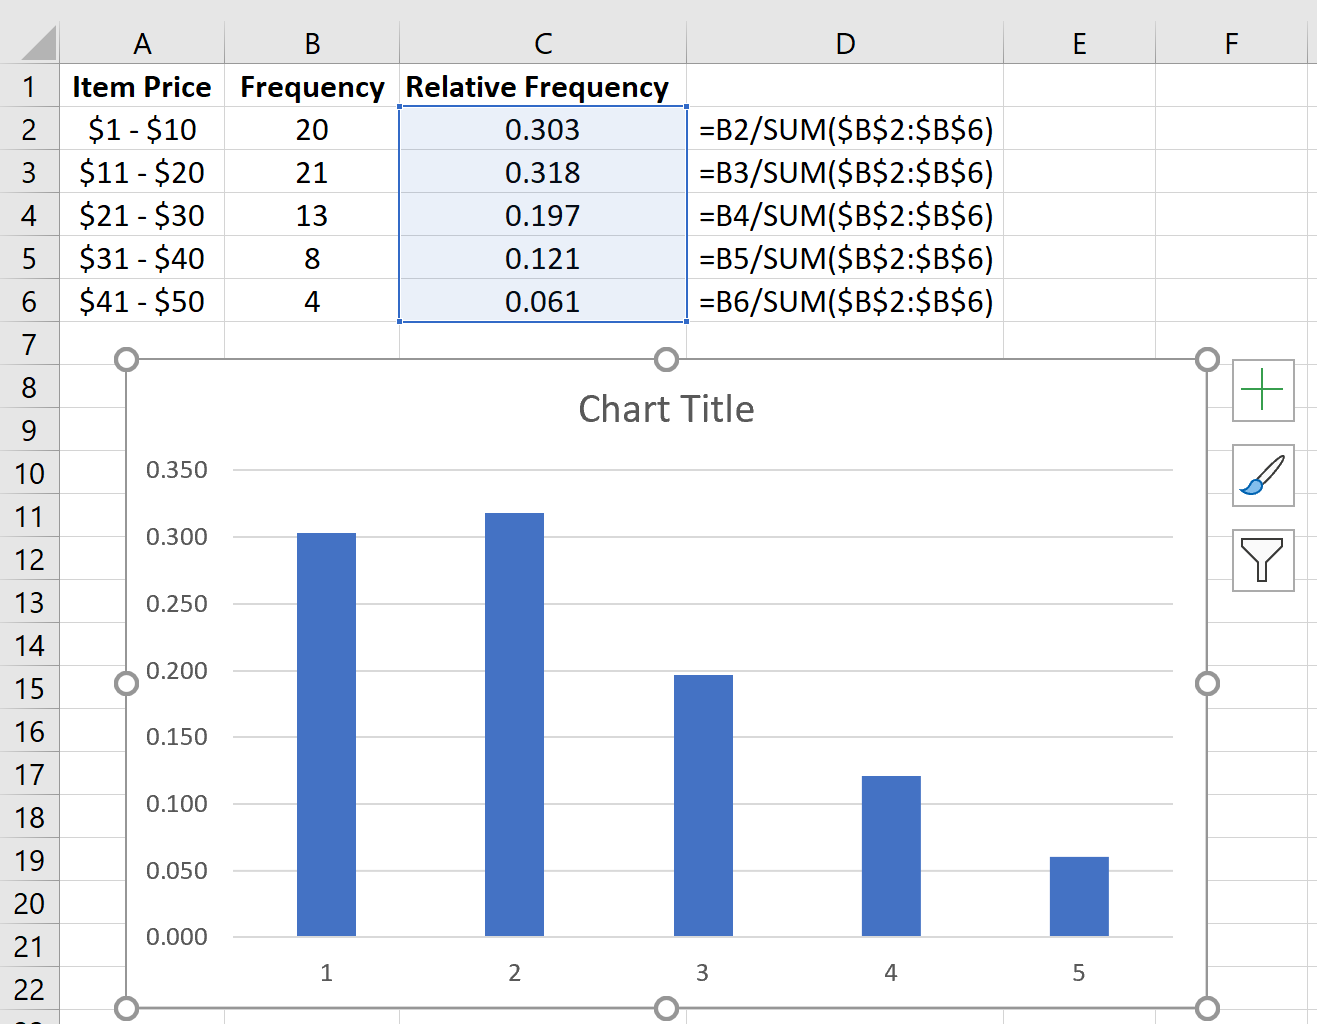
Une particularité algorithmique critique de la fonction FREQUENCE doit impérativement être maîtrisée par l’analyste statistique : cette fonction renvoie systématiquement un vecteur dont la dimension excède d’une unité la taille de la matrice des intervalles spécifiée. Si votre matrice de seuils $C$2:$C$8 comporte 7 valeurs délimitant 7 classes standards, la formule générera invariablement 8 lignes de résultats. La huitième cellule, terminale, capture de manière automatique l’ensemble des observations résiduelles qui excèdent rigoureusement la borne supérieure la plus élevée déclarée dans le filtre. Cette classe résiduelle d’échappement garantit l’exhaustivité de la partition statistique : aucune valeur atypique ou extrême supérieure ne peut être exclue de l’espace d’échantillonnage, certifiant que la somme des proportions relatives issues de la matrice soit rigoureusement égale à 1.
7.3 Comparaison de performance entre FREQUENCE et NB.SI.ENS
L’arbitrage méthodologique entre l’emploi de la fonction matricielle FREQUENCE et le recours aux formules itératives NB.SI.ENS repose sur des considérations de performance computationnelle et de flexibilité structurelle. Sur le plan algorithmique brut, FREQUENCE surclasse de façon exponentielle les architectures basées sur NB.SI.ENS. En effet, FREQUENCE opère en triant initialement le vecteur des données en mémoire vive avant de le parcourir en une seule passe séquentielle de complexité temporelle O(N log N). En revanche, l’utilisation de k fonctions NB.SI.ENS consécutives contraint Excel à scanner l’intégralité des N lignes pour chaque classe individuelle, déployant une complexité de calcul linéaire cumulée de l’ordre de O(k × N), ce qui paralyse l’environnement dès lors que N franchit le seuil des centaines de milliers d’enregistrements.
Néanmoins, la fonction NB.SI.ENS conserve une flexibilité supérieure quant à la granularité de définition des critères d’inclusion. Alors que FREQUENCE est irrévocablement verrouillée par son code source sur des intervalles fermés à droite et stricts à gauche (valeurs strictement supérieures à la borne inférieure et inférieures ou égales à la borne supérieure), NB.SI.ENS offre une liberté absolue quant au paramétrage des inégalités mathématiques. L’analyste peut ainsi concevoir à sa discrétion des classes ouvertes à droite et fermées à gauche, ou intégrer des conditions qualitatives exogènes croisées (comme segmenter simultanément par tranche de score et par modalité de sexe), ce qui est strictement impossible au sein de la structure vectorielle unaire de FREQUENCE.
Le tableau comparatif suivant synthétise les critères de sélection méthodologique entre ces deux technologies pour le traitement des variables comportementales :
- Volume de données massif (N > 50 000) : Préférer formellement
FREQUENCEpour préserver les ressources CPU et éliminer la latence de recalcul. - Intervalles rigoureusement constants et continus : Préférer
FREQUENCE, dont la matrice de sortie intègre nativement la gestion des résidus d’extrémités. - Critères multifactoriels et variables transversales : Préférer
NB.SI.ENS, capable de gérer des conjonctions logiques complexes impliquant des colonnes hétérogènes. - Architecture dynamique sans redimensionnement manuel : Préférer
FREQUENCEcouplée aux tableaux dynamiques de Microsoft 365 pour son comportement d’extension automatique.
8. Calcul des fréquences relatives pour les variables catégorielles et ordinales
8.1 Traitement spécifique des échelles de Likert
Les échelles de mesure ordinale constituent le véhicule d’investigation privilégié en psychométrie, en sociologie quantitative et en recherche marketing, cristallisées principalement par les protocoles à ancrage de type Likert. Ces instruments soumettent aux répondants une assertion psychologique face à laquelle ils expriment leur degré de concordance à travers un continuum ordinal discret, usuellement décliné en cinq ou sept modalités étiquetées (par exemple, de « 1 = Pas du tout d’accord » à « 5 = Tout à fait d’accord »). Le calcul des fréquences relatives sur ces données ne requiert aucune discrétisation par classe continue, mais commande une analyse des proportions respectives accordées à chaque modalité discrète.
Le traitement rigoureux de ces items sous Excel s’organise en concevant une table récapitulative où chaque rangée encapsule l’une des valeurs discrètes possibles de l’échelle ordinale (de 1 à 5). La fréquence absolue est extraite par la formule =NB.SI(Plage_Reponses; Modalite_Active), puis convertie en fréquence relative par la division canonique par l’effectif total N. Cette normalisation proportionnelle est indispensable lors du calibrage d’échelles psychologiques composées de multiples items : elle permet de tracer le « profil de réponse » de chaque proposition et de détecter d’éventuels biais de désirabilité sociale ou d’acquiescement se traduisant par une concentration asymétrique des fréquences relatives sur les options d’assentiment maximal.
De surcroît, la fréquence relative standardisée autorise la comparaison immédiate entre des instruments d’évaluation divergents. Si un laboratoire confronte une ancienne version d’un inventaire de personnalité articulée sur une échelle en 4 points à un instrument révisé reposant sur une échelle en 6 points, les scores bruts sont totalement incommensurables. En revanche, l’évaluation des proportions relatives cumulées sur les pôles d’accord versus de désaccord fournit un indice d’équivalence de mesure robuste, permettant d’attester que le nouveau paradigme conserve la même sensibilité métrologique que son prédécesseur sans distorsion de la distribution sous-jacente.
8.2 Traitement des variables nominales et sociodémographiques
L’analyse des distributions de fréquences relatives au sein des variables qualitatives nominales (telles que le statut marital, la catégorie socioprofessionnelle, l’appartenance ethnoculturelle ou la filière d’orientation universitaire) répond à l’exigence méthodologique de vérifier la représentativité sociodémographique d’un échantillon expérimental par rapport à la population générale parente. Les décomptes bruts s’avèrent impropres à cette validation : seule la confrontation directe des fréquences relatives observées avec les données de recensement institutionnel permet de certifier l’absence de biais de sélection critique.
Lorsque l’analyse requiert le calcul de fréquences relatives conjointes ou bivariées (par exemple, déterminer la proportion d’individus présentant simultanément la modalité « Sexe = Féminin » et « Statut clinique = Rémis »), l’utilisation combinée de la fonction native SOMMEPROD constitue une alternative matricielle élégante aux tables croisées. Sa syntaxe s’affranchit des contraintes de plages conditionnelles ordinaires en multipliant directement des matrices booléennes :
=SOMMEPROD(($A$2:$A$200="Féminin") * ($B$2:$B$200="Rémis")) / NBVAL($A$2:$A$200)
Chaque condition logique génère un vecteur interne de valeurs VRAI (1) et FAUX (0). Le produit arithmétique de ces vecteurs n’isole que les observations satisfaisant simultanément les deux critères, avant que le résultat scalaire ne soit divisé par l’effectif global pour extraire la fréquence relative croisée.
Dans les contextes d’échantillonnage stratifié ou non probabiliste où certains groupes sociodémographiques se trouvent sous-représentés, la fréquence relative observée doit faire l’objet d’une pondération statistique corrective (redressement d’échantillon). Dans Excel, cette opération s’exécute en associant à chaque ligne d’observation un coefficient multiplicateur de pondération wi, calculé en divisant la fréquence relative théorique de la strate dans la population par sa fréquence relative observée dans l’échantillon. La fréquence relative redressée de chaque modalité s’obtient alors en calculant la somme des poids des individus de la classe divisée par la somme totale de l’ensemble des poids de la cohorte.
8.3 Standardisation des distributions ordinales
L’ultime finalité du calcul des fréquences relatives appliquées à des séries quantitatives ou qualitatives ordinales réside dans la dérivation des rangs centiles et des scores étalonnés standardisés. En psychométrie différentielle, le score brut d’un individu à un test d’aptitude cognitive n’a de sens que par la part proportionnelle de l’échantillon normatif dont la performance se situe strictement en deçà de son propre résultat. Ce rang centile n’est rien d’autre que l’expression formelle de la fréquence relative cumulée ascendante associée au score considéré.
Cette conversion des fréquences relatives en indices de position relative s’inscrit dans le cadre d’analyses statistiques non paramétriques. Contrairement aux approches paramétriques qui imposent l’hypothèse contraignante d’une distribution normale des erreurs et nécessitent le calcul de moyennes et d’écarts-types, l’étalonnage dérivé des fréquences relatives respecte scrupuleusement la nature ordinale des données. Il protège le diagnostic clinique contre les dérives interprétatives causées par l’asymétrie marquée des distributions ou par la présence d’observations extrêmes au sein de l’échantillon normatif.
Enfin, ce protocole de standardisation impose une vigilance constante quant à la neutralisation de l’illusion métrologique d’équidistance. Deux échelons successifs sur une échelle ordinale (par exemple, l’intervalle séparant un score de 12 d’un score de 13 sur une échelle d’évaluation comportementale) ne correspondent presque jamais à une quantité psychologique sous-jacente équivalente à celle séparant un score de 18 d’un score de 19. L’analyse détaillée de la distribution des fréquences relatives met précisément en lumière cette discontinuité : une faible variation de score brut localisée dans une zone de très forte concentration de fréquence relative induit un saut substantiel en termes de rang centile, tandis qu’une variation identique située dans les queues de distribution clairsemées ne modifie que marginalement la position relative du sujet.
9. Formatage, présentation et mise en forme conditionnelle des résultats
9.1 Paramétrage des formats numériques standard
La précision brute générée par les algorithmes de calcul d’Excel, bien qu’essentielle au maintien de l’exactitude computationnelle, génère un encombrement visuel néfaste dès lors qu’il s’agit de restituer les résultats dans des tableaux de synthèse méthodologique. Une colonne affichant des séries décimales hétérogènes telles que 0,0833333333333333 altère considérablement l’intelligibilité du document et contrevient aux directives de publication scientifique internationales. Il est par conséquent indispensable d’appliquer un masque de formatage numérique rigoureux qui harmonise l’affichage sans modifier la valeur stockée en mémoire.
La conversion de la notation décimale en format de pourcentage s’opère par la sélection de la plage de fréquences relatives, suivie de l’activation du bouton « Pourcentage » (%) situé dans le groupe « Nombre » du ruban Accueil d’Excel, ou par l’instruction raccourcie clavier Ctrl + Maj + 5. Par défaut, cette manipulation multiplie optiquement la valeur par 100 et y accole le symbole typographique du pourcentage. Pour répondre aux normes typographiques académiques, l’analyste doit impérativement calibrer le nombre de décimales apparentes à un ou deux chiffres après la virgule au moyen des commandes « Augmenter/Réduire les décimales ».
Une distinction stylistique majeure doit être opérée selon le support de diffusion des analyses. Dans le cadre de mémoires universitaires, d’articles soumis à des comités de lecture sous obédience APA ou de rapports cliniques formels, les conventions privilégient souvent l’affichage des fréquences relatives sous forme de proportions décimales strictes (comprises entre 0,000 et 1,000) avec trois décimales contrôlées. À l’inverse, dans les restitutions opérationnelles destinées à des praticiens ou à des gestionnaires de santé, l’expression sous la forme de pourcentages explicites arrondis à une seule décimale (par exemple, 24,8 %) demeure la norme consensuelle pour optimiser la transmission cognitive de l’information statistique.
9.2 Visualisation par mise en forme conditionnelle
Au-delà de la présentation typographique statique, Microsoft Excel dispose d’un moteur de mise en forme conditionnelle sophistiqué permettant d’intégrer des repères visuels intuitifs directement au sein de la matrice de données textuelle. L’intégration de « Barres de données » horizontales au cœur des cellules de fréquences relatives représente une technique ergonomique hautement performante. En appliquant cette règle via le menu « Mise en forme conditionnelle > Barres de données », chaque cellule se voit dotée d’une barre proportionnelle à sa grandeur relative, transformant la table numérique en un micro-histogramme dynamique intégré.
L’exploitation des « Nuances de couleurs » (ou cartes thermiques / heatmaps) offre une lecture analytique complémentaire pour l’identification immédiate des structures de distribution. L’application d’un dégradé bicolore ou tricolore (par exemple, une échelle chromatique variant du blanc neutre au bleu profond) applique automatiquement une teinte dont la saturation est directement indexée sur l’amplitude de la fréquence relative. Cette visualisation spatiale met instantanément en exergue la modalité modale d’un inventaire comportemental, tout en révélant les zones d’attrition ou de creux statistique sans nécessiter la scrutation fastidieuse de chaque valeur numérique individuelle.
Enfin, l’analyste rigoureux concevra des règles d’alerte automatisées fondées sur des seuils diagnostiques critiques. Par exemple, la mise en place d’une règle de surbrillance spécifique colorant en rouge toute cellule de fréquence relative inférieure à 0,05 (5 %) permet d’isoler en un clin d’œil les classes pathologiquement rares ou sous-représentées au sein d’un protocole expérimental. Cette détection précoce est cruciale pour avertir le chercheur que certaines cellules d’un futur plan d’analyse inférentiel (tel qu’un test d’indépendance du Chi-deux) ne disposeront pas des effectifs théoriques minimaux requis pour valider les conditions d’application asymptotiques de Cochran.
9.3 Validation formelle de l’unité (Somme égale à 100 %)
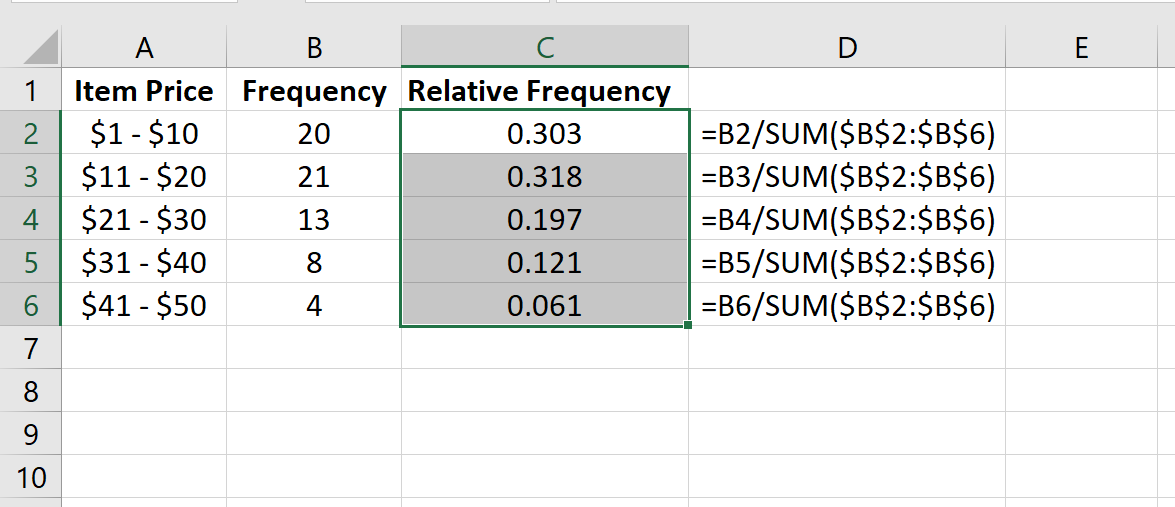
Toute présentation professionnelle d’une table de fréquences relatives doit rigoureusement comporter, en pied de colonne, une cellule de sommation de contrôle méthodologique. En insérant l’instruction =SOMME(G2:G10) sous la colonne des proportions relatives, le statisticien matérialise le respect de la règle d’exhaustivité stochastique formalisée par Kolmogorov. Lorsque les cellules sont formatées en notation décimale, cette cellule de clôture doit afficher invariablement la valeur 1,000 ; lorsqu’elles sont présentées en masque de pourcentage, elle doit afficher sans équivoque 100,0 %.
Il arrive fréquemment qu’une divergence minime apparaisse au niveau de la dernière décimale de la cellule de totalisation lorsque l’analyste a fait un usage inconsidéré de la fonction ARRONDI au sein des cellules élémentaires sous-jacentes, affichant par exemple 99,9 % ou 100,1 %. Face à cette situation, il est rigoureusement proscrit d’altérer manuellement l’une des fréquences relatives observées pour « forcer » l’ajustement arithmétique. La méthode académique standard consiste à préserver les calculs exacts non tronqués dans la feuille de calcul et à assortir le tableau, dans les notes méthodologiques de bas de page, d’une mention standardisée stipulant : « En raison des effets d’arrondi numérique indépendant sur chaque modalité, la somme des pourcentages présentés peut diverger très légèrement de 100 % ».
Pour immuniser les feuilles de calcul complexes contre toute altération accidentelle qui fausserait cette unité fondamentale, il est recommandé d’implémenter une formule de vérification logique automatique dans une cellule témoin adjacente. En inscrivant une expression conditionnelle du type :
=SI(ARRONDI(SOMME(G2:G10); 4) = 1; "COHÉRENT"; "ERREUR DE FERMETURE")
Le chercheur dispose d’une sentinelle computationnelle permanente qui valide l’intégrité globale de sa distribution de fréquences avant toute exportation des données vers des logiciels de rédaction ou d’analyse avancée.
10. Calcul de la fréquence relative cumulée dans les analyses psychométriques
10.1 Définition théorique de la fréquence cumulée ascendante
La fréquence relative cumulée, universellement désignée sous l’acronyme Fi dans le formalisme de la statistique mathématique, représente l’intégration séquentielle progressive des proportions relatives associées à l’ensemble des classes ou modalités dont le rang est inférieur ou égal à un échelon donné de la variable. Si une série de données est ordonnée de façon strictement croissante en k classes mutuellement exclusives, la fréquence relative cumulée correspondant à la i-ème classe se définit formellement par la sommation partielle :
$$F_i = \sum_{j=1}^{i} f_j = f_1 + f_2 + dots + f_i$$
Par construction théorique, la suite des fréquences relatives cumulées constitue une fonction strictement monotone non décroissante, dont la valeur initiale F1 est rigoureusement égale à la fréquence relative élémentaire de la première classe f1, et dont la valeur terminale Fk est obligatoirement égale à l’unité (ou 100 %).
D’un point de vue fonctionnel, la fréquence relative cumulée constitue la transcription empirique directe de la fonction de répartition F(x) d’une variable aléatoire, définie dans la théorie des probabilités par la relation :
$$F(x) = P(X le x)$$
En recherche comportementale et en psychométrie, cette mesure fournit une clé de lecture indispensable : elle quantifie la proportion exacte d’individus dont la caractéristique mesurée (temps de traitement cognitif, sévérité anxieuse, acuité perceptive) ne dépasse pas un plafond déterminé, fournissant une vue synthétique de l’occupation progressive de l’espace d’état psychologique.
L’interprétation diagnostique de la fréquence cumulée s’avère particulièrement éclairante lors de l’évaluation de cohortes cliniques au moyen d’échelles de gravité nosographique. Indiquer qu’une classe médiane de dépression présente une fréquence relative ponctuelle de 15 % ne renseigne aucunement sur le volume global de la population vulnérable. En revanche, constater que la fréquence relative cumulée à ce niveau de score atteint 85 % démontre avec une clarté limpide que 85 % de l’échantillon manifeste un niveau de souffrance inférieur ou égal à ce pallier, et que corollairement, seuls 15 % des sujets se situent au-delà, dans les zones de criticité psychopathologique aiguë justifiant une prise en charge d’urgence.
10.2 Syntaxe de calcul séquentiel dans Excel
L’implémentation algorithmique de la fréquence relative cumulée au sein d’une table statistique informatisée sous Excel peut s’effectuer selon deux paradigmes syntaxiques distincts, chacun présentant des avantages structurels propres en matière d’élégance et de robustesse computationnelle.
La première méthodologie repose sur une logique itérative récursive à deux temps, universellement déployée en raison de sa simplicité conceptuelle. Si la série des fréquences relatives élémentaires est logée dans la plage verticale allant de G2 à G10, et que la colonne adjacente H est assignée aux fréquences cumulées :
- Dans la première cellule réceptrice
H2, l’analyste inscrit une égalité directe pointant vers la première fréquence relative :=G2; - Dans la cellule immédiatement consécutive
H3, l’analyste formule l’itération arithmétique combinant le cumul précédent et la nouvelle fréquence ponctuelle :=H2 + G3; - Cette formule est ensuite étirée verticalement jusqu’au terme du tableau via la poignée de recopie.
Bien que hautement intuitive, cette méthode séquentielle présente une fragilité structurelle : la suppression ou l’interversion accidentelle d’une ligne intermédiaire brise la chaîne des pointeurs récursifs et corrompt l’ensemble des cumuls subséquents en générant une cascade d’erreurs de référence #REF!.
Pour s’affranchir de cette vulnérabilité, la méthodologie avancée privilégie l’emploi de la fonction SOMME exploitant une plage de calcul asymétrique semi-bloquée par ancrage absolu partiel. Dès la première cellule H2, la formule s’énonce sous la forme :
=SOMME($G$2:G2)
Remarquons avec une précision méthodologique scrupuleuse le rôle du caractère dollar : le point d’origine supérieur de la plage ($G$2) est strictement verrouillé de façon absolue, tandis que le point de terminaison inférieur (G2) demeure une référence purement relative. Lors de la recopie verticale de cette formule vers le bas, la borne haute demeure inébranlablement ancrée au sommet de la colonne, tandis que la borne basse s’étire dynamiquement pour inclure la classe courante (devenant successivement =SOMME($G$2:G3), puis =SOMME($G$2:G4), et ainsi de suite). Cette syntaxe est structurellement invulnérable aux suppressions ou insertions de lignes au sein du tableau et garantit une stabilité computationnelle absolue.
10.3 Exploitation pour le calibrage de seuils diagnostiques
L’exploitation fondamentale de la table des fréquences relatives cumulées dans l’analyse de données expérimentales réside dans l’extraction directe des métriques de position ordinale : la médiane empirique, les quartiles, les déciles et l’intégralité du treillis des percentiles. Par définition, le premier quartile (Q1) correspond au score associé au franchissement du seuil cumulé de 0,25 (25 %) ; la médiane (Q2) coïncide rigoureusement avec le pivot de 0,50 (50 %) ; et le troisième quartile (Q3) signale le point de bascule des 0,75 (75 %). L’inspection ordonnée de la colonne H permet ainsi d’isoler les intervalles de score abritant ces frontières statistiques sans nécessiter le recours à des approximations paramétriques souvent fallacieuses sur des données asymétriques.
Dans les contextes de neuropsychologie clinique et de diagnostic différentiel, ce repérage cumulé permet de délimiter les zones de criticité pathologique. Selon les standards cliniques internationaux, un score cognitif individuel est réputé significativement détérioré lorsqu’il s’enracine en deçà du 5-ème percentile de la distribution des sujets témoins normatifs. En consultant la table de distribution cumulée d’une épreuve d’efficience mnésique, le clinicien repère immédiatement la borne supérieure de score brut associée à une fréquence cumulée inférieure ou égale à 0,05. Tout patient dont le score s’inscrit en dessous de cette démarcation se trouve objectivé dans la zone d’alerte clinique avec un risque d’erreur d’inférence parfaitement contrôlé.
Enfin, la confrontation visuelle et numérique de la courbe des fréquences relatives cumulées empiriques avec les tables théoriques issues de la loi normale univariée permet d’exécuter des tests d’adéquation non paramétriques empiriques, à l’image de la logique déployée par le célèbre test de Kolmogorov-Smirnov. Ce dernier fonde son critère d’indépendance sur la mesure de la distance verticale maximale D séparant la fonction de répartition empirique Fn(x) de la fonction de répartition théorique postulée F0(x) :
$$D = \sup_{x} |F_n(x) – F_0(x)|$$
L’existence d’un écart substantiel entre le cumul observé dans Excel et la prédiction normale constitue l’indice probant d’une asymétrie marquée ou d’une présence critique de valeurs aberrantes, orientant impérieusement le chercheur vers des modélisations statistiques robustes ou non paramétriques.
11. Représentation graphique de la distribution des fréquences relatives
11.1 Construction d’un histogramme de fréquences relatives
La restitution tabulaire des données, quelle que soit sa complétude numérique, n’offre jamais la lisibilité intuitive procurée par une sémiologie graphique conforme aux canons de la communication scientifique. L’histogramme constitue la modalité canonique de représentation visuelle d’une distribution de fréquences relatives associées à une variable quantitative continue ou discrétisée par classes. Contrairement à un simple diagramme en barres catégoriel, l’histogramme véhicule l’information statistique par la surface relative de ses colonnes rectangulaires, dont l’aire totale est rigoureusement normalisée à 1 ou à 100 %.
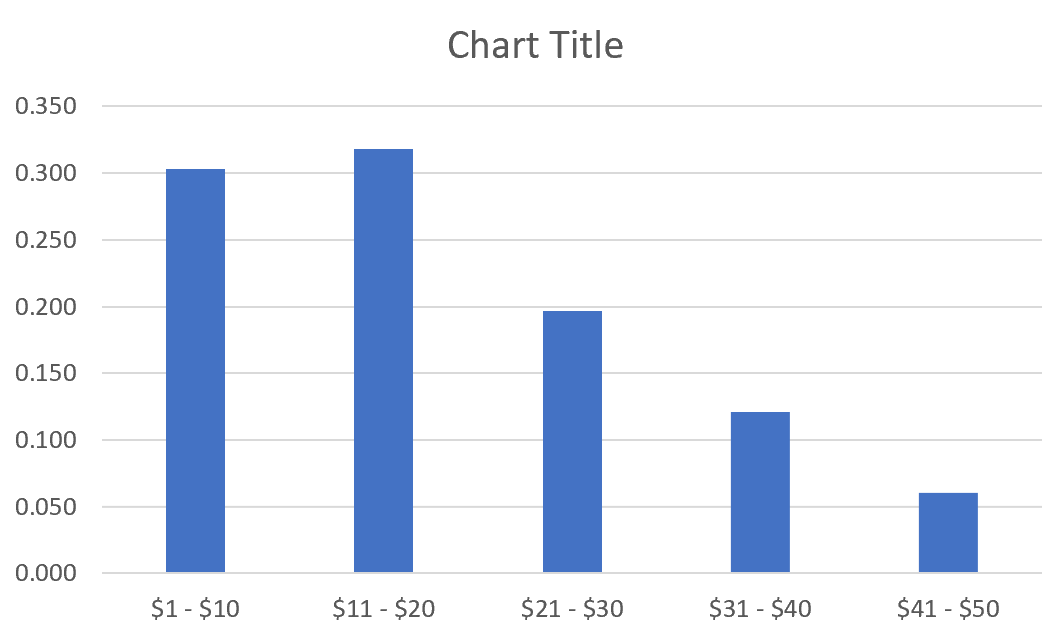
Pour ériger un histogramme de fréquences relatives dans Microsoft Excel, l’analyste sélectionne la plage des proportions calculées, puis active via l’onglet « Insertion » le bouton des graphiques statistiques pour opter pour un « Graphique à colonnes groupées 2D ». Une fois le squelette inséré, une modification de formatage structurel non négociable doit être exécutée pour respecter l’orthodoxie méthodologique : par défaut, Excel introduit des espaces blancs substantiels entre chaque barre verticale, suggérant erronément une discontinuité entre les classes. L’analyste effectue un clic droit sur l’une des séries de données graphiques, ouvre le volet « Format de la série de données », et réduit la jauge « Largeur de l’intervalle » à une valeur de 0 %. Cette manipulation joint immédiatement les rectangles, matérialisant graphiquement la nature continue et indivisible du spectre de mesure sous-jacent.
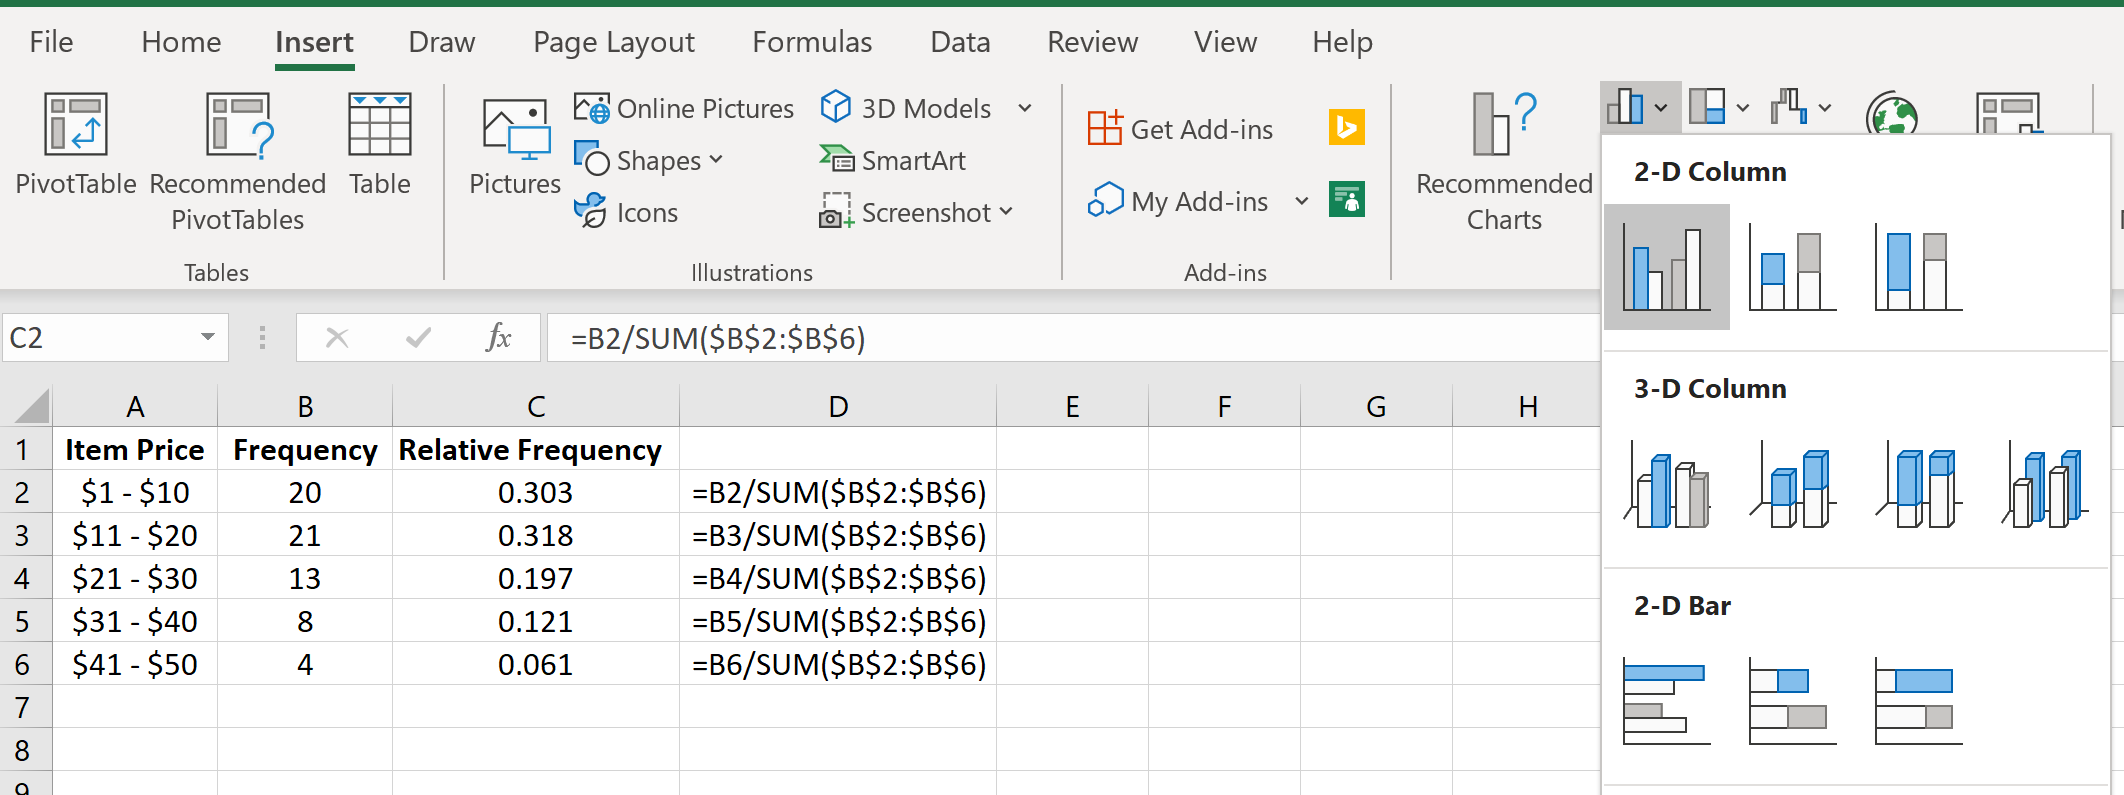
La finalisation de l’objet graphique exige un calibrage rigoureux des axes conformément aux directives de l’American Psychological Association (normes APA 7). L’axe horizontal des abscisses doit être formellement configuré pour arborer les étiquettes précises des bornes d’intervalles de regroupement via l’outil « Sélectionner des données > Modifier les étiquettes de l’axe horizontal », interdisant toute numérotation automatique arbitraire (1, 2, 3…). L’axe vertical des ordonnées doit être étiqueté « Fréquence relative (%) » avec une échelle graduée de façon arithmétique et bornée harmonieusement pour englober la classe modale sans laisser un vide disproportionné au sommet de la figure.
11.2 Tracé du polygone de fréquences et de l’ogive de Galton
Bien que l’histogramme excelle dans la représentation univariée isolée, il devient visuellement confus dès lors qu’il s’agit de superposer les distributions de plusieurs cohortes expérimentales indépendantes sur un canevas partagé. Dans cette optique comparative, le polygone de fréquences relatives s’impose comme une alternative graphique supérieure. Cette représentation s’obtient en reliant par des segments de droite discrets les sommets des centres de classe de chaque colonne d’histogramme. Dans Excel, son exécution s’opère en sélectionnant le type de graphique « Ligne 2D avec marques », positionnant les points nodaux au niveau exact des ratios relatifs calculés.
Le tracé de l’ogive de Galton (ou courbe des fréquences relatives cumulées) constitue le corollaire graphique indispensable pour visualiser l’ascension de la fonction de répartition empirique. En sélectionnant la colonne des cumuls ascendants Fi préalablement établie et en insérant une courbe lissée avec marqueurs, le statisticien fait émerger une trajectoire sigmoïdale caractéristique en forme de « S ». L’inclinaison locale de la pente de l’ogive renseigne immédiatement sur la densité probabiliste : une pente presque verticale traduit une concentration massive d’observations au sein d’une plage restreinte de scores, tandis qu’un profil aplati horizontalement signale un étalement des effectifs au sein des queues de distribution.
L’inspection combinée de ces figures géométriques autorise une appréciation visuelle immédiate des moments d’ordre supérieur de la distribution statistique, singulièrement l’asymétrie (skewness) et l’aplatissement (kurtosis). Une distribution manifestant une asymétrie positive (étalement vers la droite) se traduira par un polygone de fréquence doté d’une longue traîne dextre et une ogive de Galton amorçant son ascension abrupte dès les premiers déciles de score. Inversement, une distribution asymétrique négative décalera le sommet modal vers la droite et retardera l’inflexion de l’ogive vers la fin du continuum de mesure, fournissant des indications morphologiques précieuses avant tout calcul d’indices formels de Pearson.
11.3 Conception de graphiques combinés effectifs bruts et pourcentages
Dans la pratique de restitution de rapports scientifiques ou cliniques denses, il est fréquemment requis de faire coexister au sein d’une figure unique les volumes réels de recrutement (effectifs absolus) et la structure proportionnelle sous-jacente (fréquences relatives). Cette synthèse informationnelle est rendue possible grâce à la technologie des graphiques combinés dotés d’un axe vertical secondaire d’évaluation.
Pour ériger cette figure hybride, l’analyste sélectionne simultanément la colonne des étiquettes de classes, la série des effectifs absolus ni et la série des fréquences relatives fi. Dans le catalogue d’insertion de graphiques, il active l’option « Graphique combiné > Colonne groupée – Ligne sur axe secondaire ». Le moteur graphique d’Excel configure alors instantanément les effectifs bruts sous forme d’un histogramme vertical assujetti à l’axe vertical principal gauche, tandis que les fréquences relatives s’incarnent sous forme d’une ligne brisée superposée gouvernée par l’axe vertical secondaire déployé à droite de la figure.
Une rigueur esthétique et méthodologique exemplaire s’impose dans l’équilibrage de ce dispositif visuel. L’opérateur doit scrupuleusement synchroniser les limites maximales des deux axes verticaux de façon à respecter le rapport d’échelle unitaire fondamental ni / N = fi. Si l’effectif global N est de 500 individus et que la classe modale culmine à 150 sujets (soit une fréquence relative de 30 %), l’axe principal gauche doit être gradué jusqu’à un plafond de 200, tandis que l’axe droit doit afficher son maximum correspondant à exactement 40 % (0,40). Toute discordance dans cette mise en miroir géométrique brise l’harmonie des courbes et engendre une illusion perceptive susceptible d’induire le lecteur en erreur sur la magnitude proportionnelle des classes représentées.
12. Audit méthodologique, erreurs fréquentes et recommandations cliniques
12.1 Identification et résolution des erreurs de calcul classiques
L’audit de conformité d’une feuille de calcul statistique constitue une phase obligatoire préalablement à toute validation de conclusions cliniques ou soumission académique. L’environnement computationnel d’Excel, bien que d’une robustesse éprouvée, masque fréquemment des erreurs de logique syntaxique qui ne déclenchent pas nécessairement d’interruptions visibles d’exécution, mais faussent silencieusement les estimations relatives.
La première pathologie computationnelle réside dans l’apparition sporadique du code d’erreur #DIV/0! consécutivement au filtrage intempestif de données. Si le dénominateur de la formule de fréquence relative pointe vers une fonction SOUS.TOTAL ou AGREGAT qui s’annule lorsque certains filtres contextuels sont activés sur la feuille, la division devient arithmétiquement impossible. La parade méthodologique impose de sanctuariser la cellule de totalisation N au moyen d’un calcul statique indépendant non affecté par les opérations de filtrage visuel de la table maîtresse.
Une seconde bévue récurrente réside dans l’inclusion involontaire de la ligne récapitulative de somme totale dans le champ opératoire d’une formule matricielle ou d’un calcul de pourcentage. Si un utilisateur étire une formule de fréquence relative en intégrant la cellule de total au sein de la série des effectifs, le total global devient artificiellement doublé (égal à 2N), compressant indûment de moitié l’intégralité des fréquences relatives calculées. L’inspection méticuleuse des bornes de sélection via l’outil d’audit des formules (« Repérer les antécédents ») garantit que seules les classes d’analyse effectives sont interconnectées au dénominateur.
Le tableau d’audit synthétique ci-dessous récapitule les anomalies les plus prévalentes rencontrées lors de l’établissement de fréquences relatives dans Excel et fournit leurs protocoles de résolution immédiate :
- Symptôme : Code d’erreur
#DIV/0!récurrent | Étiologie : Omission du signe dollar ($) au dénominateur entraînant le glissement de la formule vers des cellules vides sous le tableau | Prescription : Réinsérer le verrouillage absolu$F$12ou déclarer une plage nommée pérenne. - Symptôme : Somme des pourcentages égale à 50 % ou 200 % | Étiologie : Erreur de délimitation intégrant la ligne de somme totale dans le calcul du diviseur | Prescription : Restreindre le numérateur strictement aux lignes de données expérimentales actives.
- Symptôme : Affichage textuel d’une formule au lieu du ratio | Étiologie : Formatage accidentel préalable de la cellule en mode « Texte » avant la saisie | Prescription : Rebasculer le format de cellule en « Standard », puis valider à nouveau l’équation par la touche Entrée.
- Symptôme : Somme globale des fréquences divergente de 1,000 | Étiologie : Utilisation excessive de la fonction
ARRONDIsur les ratios élémentaires intermédiaires | Prescription : Supprimer les troncatures fonctionnelles et confier le contrôle décimal au seul masque de formatage typographique.
12.2 Biais d’interprétation liés à la taille de l’échantillon
L’utilisation décontextualisée des fréquences relatives expose l’analyste et le praticien à des biais cognitifs et diagnostiques majeurs, singulièrement lorsque la cohorte empirique présente un faible effectif global N. En statistique descriptive, la fréquence relative opère une réduction d’échelle qui masque totalement la volumétrie sous-jacente des observations réelles. Déclarer solennellement dans un rapport clinique qu’un traitement expérimental a produit « 66,7 % d’événements indésirables sévères » engendre une perception de péril alarmante, alors même que cette proportion dérive de l’observation brute de seulement 2 cas néfastes documentés au sein d’une micro-cohorte pilote de 3 participants.
Ce phénomène s’enracine dans la variance d’échantillonnage inhérente aux lois de proportion. L’erreur-type d’une proportion f estimée à partir d’un échantillon de dimension N est inversement proportionnelle à la racine carrée de la taille de l’échantillon, selon la relation mathématique canonique :
$$\sigma_f = \sqrt{\frac{f(1-f)}{N}}$$
Il en découle mécaniquement que pour des échantillons réduits (par exemple, N < 30), l’intervalle de confiance à 95 % entourant la fréquence relative estimée présente une amplitude démesurée, rendant toute extrapolation décisionnelle caduque ou hasardeuse.
La déontologie méthodologique la plus stricte prescrit par conséquent d’interdire formellement la publication isolée de fréquences relatives ou de pourcentages sans mention explicite conjointe de la taille de l’échantillon total N et de l’effectif absolu ni de chaque classe. La formulation canonique internationale impose la notation standardisée f % (n / N), matérialisée par exemple par l’énoncé textuel : « Le groupe expérimental a enregistré une rémission chez 33,3 % des sujets (n = 15/45) ». Cette transparence descriptive permet immédiatement à la communauté scientifique d’évaluer la précision stochastique réelle de l’estimation sans céder aux illusions de grandeur induites par la normalisation procentuelle.
12.3 Bonnes pratiques de documentation et de reproductibilité
Dans le sillage du mouvement contemporain en faveur de la science ouverte (Open Science) et de la lutte contre la crise de la reproductibilité des résultats en psychologie et en biomédecine, la conception de feuilles de calcul sous Excel doit s’élever au rang de véritable protocole d’ingénierie logicielle documentaire. Une feuille de calcul ne doit jamais être configurée comme un bloc monolithique indéchiffrable, mais doit adopter une architecture modulaire segmentée séparant de façon hermétique les couches de données brutes, les couches d’assainissement computationnel et les couches finales de restitution synthétique.
Il est impératif de sanctuariser la matrice des données brutes au moyen des mécanismes natifs de protection d’Excel. En verrouillant en lecture seule la feuille source via l’outil « Protéger la feuille », l’analyste prévient toute altération accidentelle des valeurs primaires par inadvertance de saisie ou écrasement de cellule lors de manipulations ultérieures. Les calculs statistiques de fréquences relatives doivent être systématiquement cantonnés sur une feuille distincte et dédiée, interfacée dynamiquement avec la source via des formules de requêtage robustes (telles que les fonctions matricielles de filtrage ou l’interrogation via Power Query).
Enfin, la reproductibilité pérenne du protocole exige une documentation méticuleuse des algorithmes mis en œuvre. Chaque colonne de calcul doit comporter, au sein de sa cellule d’en-tête, un commentaire ou une note descriptive documentant explicitement la justification théorique de la règle de partitionnement retenue (par exemple : « Classes construites selon la règle de Sturges pour N = 180 »), l’équation mathématique sous-jacente et les conditions d’inclusion. Le classeur statistique final doit être archivé au format de standard ouvert standardisé (.xlsx ou complété par un export des matrices agrégées en .csv) et documenté selon les principes FAIR (Findable, Accessible, Interoperable, Reusable), garantissant que tout confrère indépendant ou organisme de régulation puisse auditer, répliquer et certifier l’exactitude absolue des fréquences relatives établies.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bernoulli, J. (1713). Ars Conjectandi, Opus Posthumum. Thurneysen Brothers.
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Howell, D. C. (2016). Méthodes statistiques en sciences humaines (M. Rogier, Trad. ; 3e éd.). De Boeck Supérieur.
- Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 1–55.
- Microsoft Corporation. (2023). Documentation sur les fonctions statistiques dans Excel. Microsoft Support. https://support.microsoft.com/fr-fr/excel
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10