
La pratique contemporaine de l’analyse quantitative en sciences du comportement, en médecine et dans les disciplines empiriques traverse une mutation paradigmatique majeure. Longtemps dominée par le culte quasi exclusif de la valeur p et les tests de signification de l’hypothèse nulle (NHST), l’inférence statistique s’oriente désormais résolument vers les méthodes d’estimation métrologique. Dans cette perspective rénovée, l’intervalle de confiance s’impose non pas comme un simple artifice calculatoire subsidiaire, mais bien comme la pierre angulaire de l’interprétation des données expérimentales et observationnelles. Il conjugue l’estimation ponctuelle d’un effet et l’explicitation sans fard de l’incertitude inhérente à tout échantillonnage aléatoire.
Pourtant, la mise en œuvre technique de ces concepts se heurte fréquemment aux environnements logiciels utilisés par les praticiens et les chercheurs. Si des langages spécialisés comme R ou Python offrent des fonctions modulaires d’une grande abstraction, Microsoft Excel demeure le vecteur d’ingénierie et de manipulation tabulaire le plus universellement déployé dans les laboratoires de recherche, les milieux hospitaliers et les organisations d’évaluation psychologique. La versatilité apparente d’Excel masque toutefois une complexité sous-jacente : les disparités de fonctions selon les versions, la rigueur requise dans la modélisation mathématique des erreurs types et les pièges de syntaxe exigent une maîtrise conceptuelle et algorithmique irréprochable pour éviter des conclusions fallacieuses.
Ce guide exhaustif a pour vocation d’articuler avec une absolue rigueur les fondements théoriques des intervalles de confiance et leur implémentation opératoire intégrale au sein du tableur Excel. De l’élucidation épistémologique du paradigme fréquentiste jusqu’aux protocoles complexes de correction d’hétéroscédasticité, en passant par les estimations binomiales de Wilson et la sémiologie graphique des diagrammes en forêt, ce traité fournit aux chercheurs, psychomètres et analystes de données une méthodologie pas à pas, exempte d’approximations, rigoureusement alignée sur les exigences académiques internationales contemporaines.
1. Fondements théoriques de l’intervalle de confiance en psychométrie et statistiques
1.1 Définition conceptuelle et statut épistémologique du paramètre
L’inférence statistique repose fondamentalement sur une scission ontologique entre deux univers distincts : l’univers de la population, caractérisé par des paramètres constants mais inconnaissables dans leur essence absolue (tels que la moyenne populationnelle notée μ ou l’écart-type σ), et l’univers de l’échantillon, caractérisé par des statistiques descriptives calculées sur un sous-ensemble fini d’observations (comme la moyenne empirique notée x̄ ou l’écart-type échantillonnal s). Le paramètre populationnel constitue une vérité latente vers laquelle tend l’investigation empirique, tandis que l’estimateur ponctuel n’est qu’une réalisation singulière, contingente et transitoire, assujettie aux aléas stochastiques du tirage au sort.
Cette contingence s’exprime mathématiquement par la notion de variabilité d’échantillonnage. Si un chercheur venait à répliquer une même étude psychométrique un nombre infini de fois, en extrayant à chaque itération un échantillon indépendant de taille identique au sein de la même population parente, les estimations ponctuelles obtenues oscilleraient de manière continue. L’ensemble théorique de ces estimations ponctuelles engendre ce que la théorie des probabilités nomme la distribution d’échantillonnage de la statistique. L’erreur fondamentale de l’analyste naïf consiste à réifier l’estimation ponctuelle unique, en lui attribuant la valeur de vérité du paramètre sous-jacent.
Pour dépasser cette aporie, l’approche fréquentiste formalisée par Jerzy Neyman en 1937 propose non pas de rechercher une valeur exacte illusoire, mais de construire une procédure algorithmique capable de borner le paramètre inconnu avec un taux de réussite garanti sur le long terme. L’intervalle de confiance se définit ainsi formellement comme un intervalle aléatoire délimité par deux statistiques d’échantillonnage, la borne inférieure et la borne supérieure, calculées de telle sorte que la probabilité a priori que cet intervalle contienne le paramètre fixe inconnu soit égale à une valeur prédéterminée, appelée niveau de confiance. Dès lors que l’échantillon particulier est extrait et que les bornes numériques sont calculées, l’intervalle devient déterministe et sa couverture relève d’une propriété globale de la procédure de mesure, évitant ainsi le piège de la certitude infondée.
1.2 Niveau de confiance et seuil de signification probabiliste
La mécanique probabiliste de l’intervalle de confiance s’articule autour d’une relation de complémentarité stricte entre le niveau de confiance, désigné par la quantité (1 – α), et le seuil de risque d’erreur, noté α. Ce coefficient α matérialise la proportion théorique d’intervalles qui, sur une infinité d’expériences identiques, échoueront à capturer le paramètre populationnel μ. En sciences comportementales et biomédicales, les conventions épistémologiques consacrent des valeurs nominales standardisées pour α : 0,10, 0,05 ou 0,01, générant respectivement des niveaux de confiance de 90 %, 95 % et 99 %.
Il importe de clarifier avec rigueur le sens exact de cette couverture fréquentiste afin d’éviter tout écueil sémantique. Affirmer qu’un intervalle de confiance est calculé à un niveau de 95 % ne signifie aucunement qu’il existe 95 % de chances que le paramètre populationnel se situe entre les deux bornes calculées. En logique fréquentiste, le paramètre μ n’est pas une variable aléatoire, mais une constante immuable : il est soit entièrement inclus, soit totalement exclu de l’intervalle calculé. La probabilité de 95 % caractérise la méthode de capture elle-même : si l’on répétait l’expérimentation 10 000 fois dans des conditions parfaitement identiques, générant ainsi 10 000 intervalles distincts, environ 9 500 d’entre eux encadreraient effectivement le paramètre μ, tandis que 500 le manqueraient.
Cette réalité mathématique impose une négociation constante entre la précision de l’estimation et la certitude épistémique du chercheur. À taille d’échantillon constante, accroître le niveau de confiance de 95 % à 99 % requiert mécaniquement d’élargir la distance séparant les bornes de l’intervalle, augmentant ainsi ce que l’on qualifie d’imprécision métrologique. Inversement, resserrer l’intervalle pour obtenir une estimation fine exige d’accepter une élévation substantielle du risque d’erreur α. L’intervalle de confiance quantifie et matérialise sans ambiguïté ce compromis fondamental, contraignant l’expérimentateur à évaluer le coût scientifique de l’incertitude.
1.3 Rôle des intervalles de confiance dans la crise de réplication en psychologie
Depuis le début des années 2010, la psychologie scientifique et les neurosciences cognitives traversent une profonde crise de réplication, mise en lumière par des initiatives collectives à grande échelle démontrant l’incapacité de reproduire une proportion substantielle d’effets expérimentaux publiés dans les revues les plus prestigieuses. L’une des causes méthodologiques majeures de cette crise réside dans la dépendance pathologique aux tests de signification de l’hypothèse nulle (NHST) et à la valeur dichotomique p < 0,05. Cette focalisation a encouragé des dérives méthodologiques telles que le p-hacking, la collecte sélective de données et l’omission des résultats non significatifs dans les tiroirs des laboratoires.
Face à ce constat, les comités méthodologiques de référence, et en premier lieu le Task Force on Statistical Inference de l’American Psychological Association (APA), ont édicté des directives formelles enjoignant les chercheurs à substituer ou adjoindre systématiquement les intervalles de confiance aux valeurs de p. Contrairement au test d’hypothèse binaire qui réduit l’investigation scientifique à une décision artificielle de type rejet/non-rejet, l’intervalle de confiance renseigne simultanément sur la direction de l’effet, l’amplitude estimée du phénomène (taille de l’effet) et le degré d’imprécision métrologique résiduelle lié à la taille de l’échantillon.
En psychométrie appliquée, l’emploi systématique des intervalles de confiance permet d’évaluer la stabilité des scores composites obtenus aux échelles cliniques ou aux inventaires de personnalité en incorporant l’erreur type de mesure. Deux études ayant obtenu une valeur de p similaire de 0,04 peuvent en réalité masquer des situations épistémiques radicalement divergentes : l’une disposant d’un intervalle extrêmement étroit confirmant un effet minuscule mais précis, l’autre affichant un intervalle béant allant du quasi-néant à des effets d’une magnitude irréaliste, révélant une instabilité expérimentale extrême. L’intervalle de confiance s’affirme ainsi comme l’outil par excellence de la transparence empirique et de la réplicabilité scientifique.
2. Anatomie mathématique générale de l’intervalle de confiance
2.1 Architecture tripartite de la formule fondamentale
En dépit de la diversité apparente des modèles d’estimation, l’intervalle de confiance pour un paramètre linéaire θ répond universellement à une architecture tripartite immuable. Cette structure symétrique classique s’articule autour de l’estimateur ponctuel, auquel on retranche et on additionne un terme additif global désigné sous le vocable de marge d’erreur. L’intervalle se formalise ainsi : Borne Inférieure = Estimateur – Marge d’erreur, et Borne Supérieure = Estimateur + Marge d’erreur.
Cette marge d’erreur est elle-même le produit arithmétique de deux composantes structurelles indépendantes :
- La valeur critique : issue de la distribution probabiliste théorique appropriée (loi normale ou loi de Student), cette valeur tabulée sans dimension dépend exclusivement du niveau de confiance désiré (1 – α) et de la nature bilatérale ou unilatérale du cadre inférentiel.
- L’erreur type (Standard Error) : quantificateur de la dispersion de l’estimateur autour du paramètre, l’erreur type reflète la variabilité stochastique de la statistique. Dans le cas de la moyenne d’un échantillon, elle est égale à l’écart-type de la variable divisé par la racine carrée de la taille de l’échantillon.
Le tableau ci-dessous explicite les éléments constitutifs de cette mécanique pour l’estimation d’une moyenne :
| Composante | Symbole mathématique | Fonction conceptuelle | Équivalent syntaxique Excel |
|---|---|---|---|
| Estimateur ponctuel | x̄ | Centre de symétrie de l’intervalle | MOYENNE(plage) |
| Valeur critique | Z1-α/2 ou t1-α/2, df | Multiplicateur de couverture probabiliste | LOI.NORMALE.STANDARD.INVERSE.N(…) ou LOI.STUDENT.INVERSE.N.B(…) |
| Erreur type | SE = s / √n | Dispersion d’échantillonnage de la moyenne | ECARTYPE.STANDARD(plage) / RACINE(NB(plage)) |
| Marge d’erreur | E = Valeur critique × SE | Demi-largeur totale de l’intervalle | INTERVALLE.CONFIANCE.NORMALE(…) ou INTERVALLE.CONFIANCE.STUDENT(…) |
2.2 Distinction distributionnelle : loi normale Z versus loi de Student t
L’une des décisions méthodologiques fondamentales lors de la modélisation de l’intervalle de confiance concerne la sélection de la distribution théorique régissant la valeur critique. Deux lois de probabilités concurrentes prévalent : la loi normale centrée réduite Z et la loi de Student t. Le critère discriminant théorique ne réside pas initialement dans la taille de l’échantillon, mais dans la connaissance ou l’ignorance de la variance de la population parente σ².
Lorsque la variance populationnelle σ² est rigoureusement connue — une situation extrêmement rare en pratique, parfois rencontrée dans des protocoles de contrôle industriel standardisés ou lors de l’utilisation d’échelles psychométriques nationales étalonnées sur des millions d’individus — la moyenne standardisée suit exactement une loi normale centrée réduite Z, quelle que soit la taille de l’échantillon, pourvu que la variable parente soit normalement distribuée. La valeur critique Z demeure fixe : par exemple, 1,95996 (couramment arrondie à 1,96) pour un niveau de confiance bilatéral de 95 %.
En revanche, dans l’immense majorité des recherches empiriques, σ² est inconnu et doit être estimé à partir de l’échantillon via la variance corrigée s². Cette double estimation (celle de la moyenne et celle de l’écart-type à partir du même jeu de données) introduit une incertitude supplémentaire. Le ratio ne suit plus une loi normale, mais la loi t de William Sealy Gosset (publiée sous le pseudonyme de Student en 1908). Cette distribution présente des queues de distribution plus épaisses et un sommet plus écrasé (leptokurtique), ce qui engendre des valeurs critiques supérieures à 1,96 pour compenser l’instabilité de l’estimation de s. Les degrés de liberté, définis par dl = n – 1, contrôlent directement cette forme : plus n est restreint, plus les queues sont massives, et plus l’intervalle calculé sera large et protecteur.
En vertu du théorème central limite, à mesure que la taille d’échantillon croît vers l’infini, la distribution t converge asymptotiquement vers la distribution Z. Dès que n dépasse 100 à 120 observations, les écarts entre les valeurs critiques t et Z deviennent négligeables aux arrondis près (par exemple, t = 1,984 pour dl = 100 contre Z = 1,960). Cependant, l’usage moderne et les standards méthodologiques imposent le recours systématique à la distribution de Student dès lors que σ est estimé, garantissant une parfaite exactitude formelle sans compromis arbitraire.
2.3 Déterminants de l’amplitude de l’intervalle
L’amplitude totale de l’intervalle de confiance (la différence entre la borne supérieure et la borne inférieure, soit deux fois la marge d’erreur 2 × E) mesure la précision métrologique de l’étude. Cette amplitude est gouvernée par trois variables interdépendantes :
- La dispersion intrinsèque du phénomène (s) : L’hétérogénéité des données dans la population, reflétée par l’écart-type de l’échantillon, exerce une relation linéaire proportionnelle directe sur l’amplitude. Plus les scores des participants à une échelle d’évaluation sont dispersés, plus l’intervalle de confiance sera large, traduisant le bruit expérimental élevé.
- La taille de l’échantillon (n) : L’erreur type diminue de façon inversement proportionnelle à la racine carrée de l’effectif (√n). Il s’agit d’une règle mathématique cruciale : la précision d’un intervalle est soumise à la loi des rendements décroissants. Pour diviser par deux la largeur d’un intervalle de confiance, il est impératif de quadrupler l’effectif de l’échantillon (car √4 = 2). Pour la diviser par trois, il faut multiplier l’effectif par neuf.
- Le niveau de confiance nominal (1 – α) : Le choix d’une certitude accrue implique le recours à un percentile plus éloigné dans la distribution théorique, augmentant directement la valeur critique. Réduire le risque d’erreur de 5 % à 1 % accroît mécaniquement la valeur critique de 1,96 à 2,576 en modèle normal, élargissant d’autant l’enveloppe de sécurité statistique.
La compréhension analytique de ces trois déterminants est au cœur de la planification d’expériences (calcul de puissance statistique a priori). Elle permet au chercheur de calibrer son échantillon afin de garantir que l’intervalle final n’excède pas une largeur maximale admissible au regard des enjeux théoriques et cliniques de sa discipline.
3. Préparation des données et fonctions statistiques fondamentales sous Excel
3.1 Structuration et contrôle de la qualité des données tabulaires
L’exactitude des calculs inférentiels sous Microsoft Excel dépend en amont d’une structuration rigoureuse de la base de données selon les principes du paradigme tidy data formalisé par Hadley Wickham. Chaque colonne doit représenter une variable statistique univoque (ex. Identifiant_Participant, Condition_Experimentale, Score_Anxiete), et chaque ligne doit correspondre à une unité d’observation individuelle unique. L’inclusion de cellules de synthèse (totaux, moyennes intermédiaires, annotations textuelles) à l’intérieur des plages de données primaires constitue une source d’erreurs majeures dans l’évaluation des arguments des fonctions matricielles d’Excel.
Le contrôle de la qualité requiert l’identification et la neutralisation systématique des valeurs manquantes et aberrantes. Dans les feuilles de calcul, une cellule vide n’est pas traitée de la même manière qu’un zéro : la fonction MOYENNE ignore par défaut les cellules vides textuelles, mais comptabilise les cellules contenant un zéro numérique, ce qui peut fausser radicalement le calcul de l’estimateur. Pour dénombrer les observations valides au sein d’une plage donnée (par exemple A2:A150), l’emploi de la formule =NB(A2:A150) est obligatoire, car elle exclut automatiquement les cellules non numériques et les chaînes de texte vides.
Par ailleurs, la détection des valeurs extrêmes (outliers) est impérative, dans la mesure où la moyenne et l’écart-type standard présentent un effondrement de robustesse face aux asymétries prononcées. Un individu ayant saisi un score hors échelle par erreur typographique (ex. 99 au lieu de 9 sur une échelle de Likert à 10 points) déformera considérablement l’écart-type échantillonnal, induisant un gonflement artificiel de l’erreur type et un élargissement démesuré de l’intervalle de confiance. Enfin, il convient de veiller au formatage des cellules numériques en conservant une précision de virgule flottante complète dans les calculs sous-jacents, l’arrondi visuel ne devant intervenir qu’à des fins d’affichage final.
3.2 Fonctions d’estimation ponctuelle et de dispersion
L’estimation des composantes de base d’un intervalle de confiance sous Excel implique de mobiliser les fonctions descriptives appropriées en respectant scrupuleusement la distinction entre métriques populationnelles et métriques échantillonnales. Pour une variable quantitative continue stockée dans la plage A2:A101 :
- L’estimation de la moyenne empirique x̄ s’obtient au moyen de la fonction =MOYENNE(A2:A101). Cette formule exécute la somme arithmétique des valeurs divisée par le nombre effectif de cellules numériques.
- L’estimation de la dispersion échantillonnale impose de recourir à =ECARTYPE.STANDARD(A2:A101) (ou son équivalent anglais STDEV.S). Cette fonction applique la correction de Bessel au dénominateur (division par n – 1) afin d’assurer un estimateur sans biais de la variance de la population. L’utilisation erronée de la fonction ECARTYPE.PEARSON (ou STDEV.P), qui divise par n, est strictement proscrite dans le cadre inférentiel, car elle sous-estime systématiquement la variance inconnue de la population.
- La variance d’échantillon corrigée s² s’obtient de manière analogue par la syntaxe =VAR.S(A2:A101), tandis que le dénominateur de taille n est systématiquement extrait via =NB(A2:A101).
La formulation de l’erreur type de la moyenne (SE) ne fait l’objet d’aucune fonction préprogrammée unitaire sous les versions classiques d’Excel. Elle s’obtient par la combinaison analytique : =ECARTYPE.STANDARD(A2:A101)/RACINE(NB(A2:A101)). Cette cellule intermédiaire matérialise la dispersion théorique de la moyenne et servira de brique fondamentale dans la construction des formules personnalisées.
3.3 Fonctions de distributions inverses dans le tableur
Pour déterminer avec une précision infinitésimale les valeurs critiques nécessaires au calcul des intervalles, Excel met à disposition des fonctions de distribution cumulative inverse. Depuis la refonte majeure du moteur statistique dans Excel 2010, la nomenclature des fonctions statistiques a été rationalisée pour se conformer aux standards internationaux, introduisant des séparateurs par points et une désignation explicite de la nature des queues de distribution.
Pour la distribution normale centrée réduite Z, le chercheur utilisera la fonction LOI.NORMALE.STANDARD.INVERSE.N(probabilité). Étant donné que cette fonction renvoie l’inverse de la distribution cumulative unilatérale à gauche (définit la valeur Z telle que P(X ≤ Z) = probabilité), l’obtention de la valeur critique pour un intervalle bilatéral au niveau de confiance (1 – α) requiert d’évaluer la fonction au quantile (1 – α/2). Par exemple, pour un risque α = 0,05, la formule =LOI.NORMALE.STANDARD.INVERSE.N(0,975) ou de manière paramétrée =LOI.NORMALE.STANDARD.INVERSE.N(1 – 0,05/2) restituera avec exactitude la valeur 1,959963985.
Pour la distribution de Student, Excel dispose de deux fonctions inverses aux comportements sémantiques divergents :
- LOI.STUDENT.INVERSE.N.B(probabilité; degres_liberte) : Cette fonction est spécifiquement programmée pour les tests bilatéraux (le suffixe « N.B » signifiant « Nouvelle Bilatérale », équivalent à T.INV.2T en anglais). L’argument de probabilité attendu correspond directement au seuil de risque bilatéral total α. Ainsi, pour α = 0,05 et 29 degrés de liberté, la formule =LOI.STUDENT.INVERSE.N.B(0,05; 29) retourne immédiatement la valeur critique 2,045229642.
- LOI.STUDENT.INVERSE.N(probabilité; degres_liberte) : Cette fonction correspond à l’inverse unilatérale gauche standard (T.INV en anglais). Pour obtenir la valeur critique bilatérale positive avec cette syntaxe, il est indispensable de renseigner le quantile supérieur, soit =LOI.STUDENT.INVERSE.N(1 – 0,05/2; 29).
La maîtrise absolue de ces syntaxes prévient les erreurs de paramétrage les plus courantes, où une confusion entre probabilité unilatérale et probabilité bilatérale conduit à calculer par mégarde un intervalle de confiance à 90 % au lieu de 95 %.
4. Calcul de l’intervalle de confiance pour une moyenne avec grand échantillon (Modèle Z)
4.1 Hypothèses et conditions de validité du test Z
L’application du modèle Z pour l’estimation de l’intervalle de confiance d’une moyenne repose sur des critères méthodologiques bien délimités. Formellement, le modèle Z exige la satisfaction de l’une des deux conditions suivantes : soit la distribution parente dans la population est strictement normale et l’écart-type populationnel σ est connu de manière déterministe (indépendamment des données recueillies) ; soit la taille de l’échantillon n est suffisamment importante pour invoquer le théorème central limite, permettant de considérer que l’estimation empirique de s constitue une approximation asymptotiquement exacte de σ.
Dans la littérature statistique classique, le seuil conventionnel d’effectif autorisant l’approximation normale est souvent fixé arbitrairement à n ≥ 30 ou n ≥ 50. Il convient toutefois de souligner qu’en sciences psychologiques et comportementales, cette règle empirique doit être nuancée selon le degré d’asymétrie de la population. Face à une distribution fortement asymétrique ou multimodale, un effectif de 30 reste notoirement insuffisant pour assurer la convergence de la loi d’échantillonnage vers la normalité. De surcroît, le postulat d’indépendance statistique des observations demeure inaliénable : le tirage des individus doit être aléatoire simple, exempt de dépendance intra-classe ou d’appariement non contrôlé.
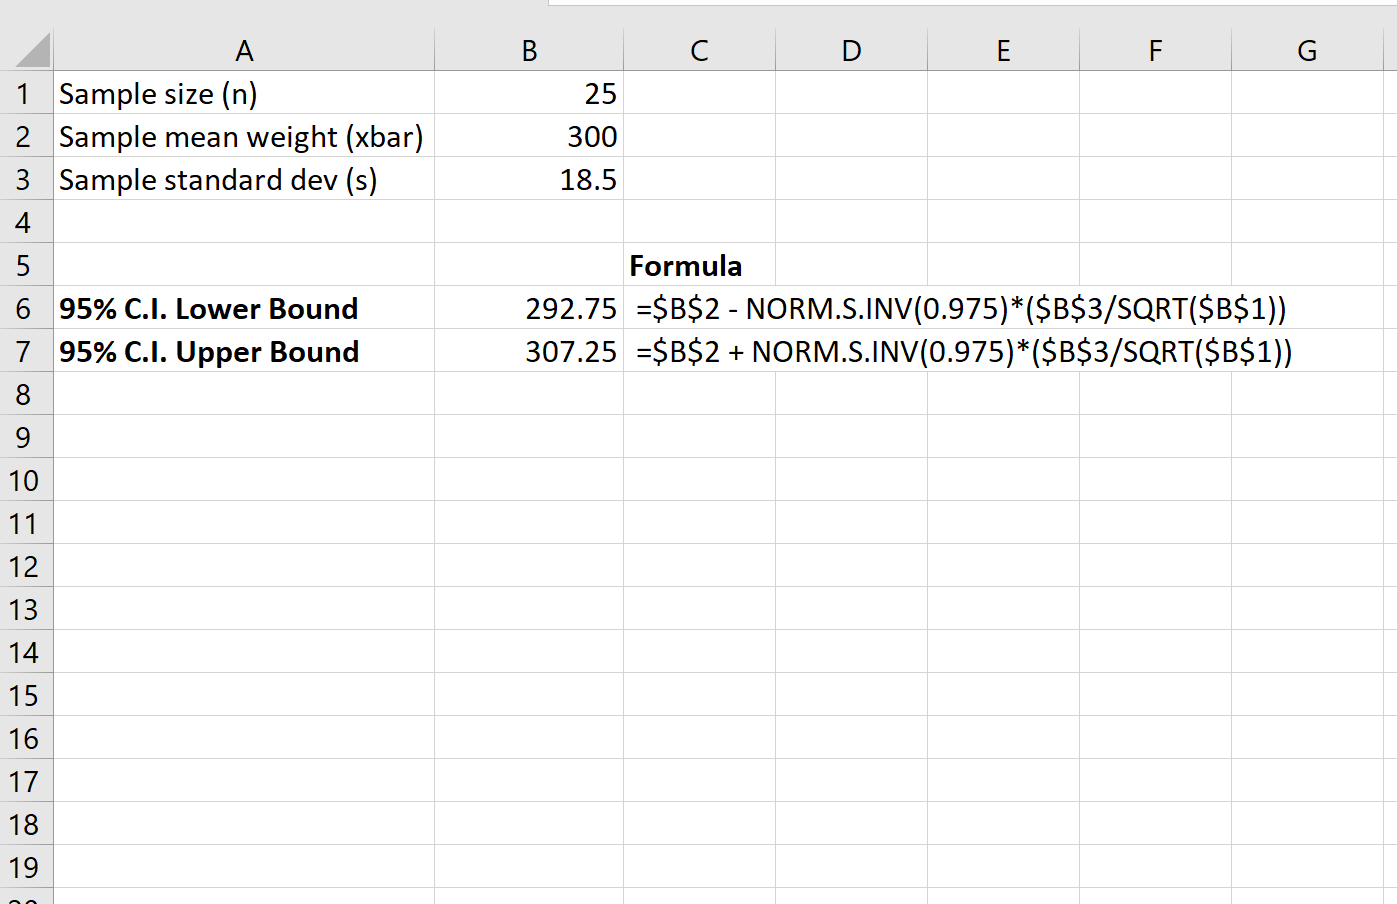
4.2 Exploitation de la fonction dédiée INTERVALLE.CONFIANCE.NORMALE
Pour automatiser le calcul de la marge d’erreur sous le paradigme normal, Excel intègre une fonction spécialisée dont la dénomination contemporaine est INTERVALLE.CONFIANCE.NORMALE (retranscrite CONFIDENCE.NORM dans les environnements anglophones). Cette fonction calcule de façon directe la marge d’erreur E, et non les bornes finales de l’intervalle.
La syntaxe canonique requiert trois arguments ordonnés :
=INTERVALLE.CONFIANCE.NORMALE(alpha; ecart_type; taille)
- alpha : le niveau de risque d’erreur consenti, exprimé sous forme décimale (ex. 0,05 pour un intervalle à 95 % de confiance).
- ecart_type : la valeur de l’écart-type de la population σ (ou l’écart-type de l’échantillon s si n est très élevé).
- taille : l’effectif numérique valide de l’échantillon n.
Sous le capot logiciel, la fonction exécute rigoureusement l’algorithme suivant : elle extrait la valeur critique Z correspondant au quantile (1 – α/2) via l’inverse de la loi normale standard, puis multiplie ce coefficient par le quotient de l’écart-type divisé par la racine carrée de la taille. Si un utilisateur saisit un argument α ≤ 0 ou ≥ 1, ou une taille d’échantillon < 1, Excel générera immédiatement une erreur #NOMBRE!. De même, toute référence pointant vers une cellule contenant une chaîne alphanumérique non convertible se traduira par le code d’erreur #VALEUR!.
4.3 Exemple pratique : scores à une échelle d’évaluation de l’anxiété
Considérons une étude clinique menée auprès d’une cohorte de N = 120 patients adultes souffrant de troubles de l’adaptation, évalués au moyen de l’inventaire d’anxiété état-trait de Spielberger (STAI-Y). Les scores bruts d’anxiété-trait sont compilés dans la feuille de calcul au sein de la plage B2:B121. L’écart-type théorique documenté dans les manuels d’étalonnage psychométrique nationaux pour cette population de référence est supposé connu et établi à σ = 10,5 points.
La mise en place de la feuille de calcul dynamique s’organise selon la topologie cellulaire suivante :
- Cellule E2 (Taille de l’échantillon n) : =NB(B2:B121) → affiche 120
- Cellule E3 (Moyenne observée x̄) : =MOYENNE(B2:B121) → admettons une valeur résultante de 48,60
- Cellule E4 (Écart-type populationnel σ) : 10,5 (saisie constante)
- Cellule E5 (Niveau de risque α) : 0,05 (pour un intervalle à 95 %)
- Cellule E6 (Marge d’erreur E) : =INTERVALLE.CONFIANCE.NORMALE(E5; E4; E2)
L’évaluation de la cellule E6 par le tableur génère : 1,95996 × (10,5 / √120) = 1,95996 × 0,958514 = 1,8786 points. Les bornes métrologiques sont ensuite établies dans les cellules adjacentes :
- Cellule E7 (Borne inférieure) : =E3 – E6 → affiche 46,72 points
- Cellule E8 (Borne supérieure) : =E3 + E6 → affiche 50,48 points
Sur le plan de l’interprétation clinique, si le seuil pathologique conventionnel de détresse sévère fixé par la littérature est établi à 50 points, nous observons que la borne supérieure de l’intervalle de confiance à 95 % (50,48) englobe cette valeur critique. Dès lors, bien que l’estimation ponctuelle (48,60) se situe en deçà du seuil clinique d’alerte, le chercheur ne peut affirmer avec un degré de confiance suffisant que la moyenne de la cohorte est strictement non pathologique, l’incertitude d’échantillonnage n’excluant pas des scores moyens populationnels atteignant 50,48.
5. Calcul de l’intervalle de confiance pour une moyenne avec petit échantillon (Loi de Student t)
5.1 Nécessité méthodologique du recours à la loi de Student
Lorsque la taille de l’échantillon est restreinte (typiquement n < 30 ou n < 50) et que l’écart-type populationnel σ demeure inconnu — ce qui constitue la règle quasi universelle en recherche fondamentale en psychologie expérimentale — le recours au modèle normal Z introduit un biais de libéralisme statistique inacceptable. En utilisant l’écart-type échantillonnal s à la place de σ au sein d’une fonction normale, on postule implicitement que s est exempt de toute fluctuation d’échantillonnage, ce qui conduit à sous-estimer systématiquement la largeur de la marge d’erreur et donc à produire des intervalles dont la couverture réelle est inférieure au niveau nominal promis (par exemple 89 % de couverture empirique réelle pour un intervalle annoncé à 95 %).
La loi de Student pallie précisément ce déficit épistémique en incorporant formellement l’aléa lié à l’estimation de s. Cependant, la validité de l’intervalle de Student repose sur une hypothèse distributionnelle fondamentale : la variable parente dans la population doit être approximativement normale. Si les données présentent une asymétrie majeure ou une leptocurtose sévère sur un échantillon restreint, l’intervalle calculé peut être trompeur. Il est donc méthodologiquement indispensable de procéder à un examen exploratoire de la distribution sous Excel au préalable.
Cet examen préliminaire se concrétise par le calcul des coefficients de forme : le coefficient d’asymétrie (skewness) via la formule =COEFFICIENT.ASYMETRIE(plage) et le coefficient d’aplatissement (kurtosis) via =KURTOSIS(plage). Des valeurs comprises dans l’intervalle [-1 ; +1] témoignent d’une concordance raisonnable avec la normalité, autorisant le déploiement serein de la procédure de Student sans risque d’altération substantielle des taux de couverture probabiliste.
5.2 Mise en œuvre de la fonction INTERVALLE.CONFIANCE.STUDENT
Pour opérer le calcul automatisé de la marge d’erreur sous distribution de Student, Excel dispose de la fonction INTERVALLE.CONFIANCE.STUDENT (dénommée CONFIDENCE.T dans les versions internationales). À l’instar de son homologue normal, cette fonction isole et résout exclusivement la marge d’erreur E.
Sa signature syntaxique est structurée comme suit :
=INTERVALLE.CONFIANCE.STUDENT(alpha; ecart_type; taille)
- alpha : le seuil de risque bilatéral d’erreur statistique (ex. 0,05).
- ecart_type : l’écart-type corrigé calculé sur l’échantillon via la fonction ECARTYPE.STANDARD.
- taille : le nombre effectif de participants n constituant l’échantillon.
Il est fondamental de noter qu’Excel dérive automatiquement les degrés de liberté en soustrayant 1 de l’argument de taille renseigné : dl = taille – 1. L’analyste ne doit donc en aucun cas retrancher manuellement 1 dans le paramètre taille, sous peine de fausser l’indexation de la loi t. Le tableau suivant met en relief la divergence conservatrice entre les marges d’erreur obtenues sous le modèle normal et le modèle de Student pour un même écart-type empirique (s = 15) et un risque α = 0,05, en fonction de variations d’effectif :
| Taille d’échantillon (n) | Degrés de liberté (dl) | Valeur critique Z | Valeur critique t | Marge d’erreur Normale | Marge d’erreur Student | Différence de largeur (%) |
|---|---|---|---|---|---|---|
| 8 | 7 | 1,960 | 2,365 | 10,39 | 12,54 | +20,7 % |
| 15 | 14 | 1,960 | 2,145 | 7,59 | 8,31 | +9,5 % |
| 30 | 29 | 1,960 | 2,045 | 5,37 | 5,60 | +4,3 % |
| 100 | 99 | 1,960 | 1,984 | 2,94 | 2,98 | +1,4 % |
Cette simulation démontre avec netteté que sur de petits effectifs (n = 8), le recours inapproprié à la loi normale génère une sous-estimation de la marge d’erreur de plus de 20 %, produisant une illusion de précision méthodologiquement intenable.
5.3 Protocole complet décomposé étape par étape
Afin de garantir une traçabilité totale et de permettre l’audit des calculs, il est vivement recommandé en milieu académique de décomposer explicitement la mécanique inférentielle plutôt que de se fier aveuglément à des formules boîtes noires. Considérons une étude de neurobiologie comportementale mesurant le temps de réaction moteur (en millisecondes) chez n = 16 volontaires soumis à un protocole de privation totale de sommeil durant 24 heures. Les données brutes occupent les cellules A2:A17.
Le protocole algorithmique s’exécute selon l’enchaînement de calculs élémentaires suivant :
- Étape 1 : Calcul de la taille de l’échantillon (n)
En cellule D2 : =NB(A2:A17) → Résultat : 16 - Étape 2 : Calcul des degrés de liberté (dl)
En cellule D3 : =D2 – 1 → Résultat : 15 - Étape 3 : Calcul de la moyenne empirique (x̄)
En cellule D4 : =MOYENNE(A2:A17) → Admettons 412,50 ms - Étape 4 : Calcul de l’écart-type de l’échantillon (s)
En cellule D5 : =ECARTYPE.STANDARD(A2:A17) → Admettons 38,20 ms - Étape 5 : Calcul de l’erreur type de la moyenne (SE)
En cellule D6 : =D5 / RACINE(D2) → Évaluation : 38,20 / 4 = 9,55 ms - Étape 6 : Extraction de la valeur critique t bilatérale
En cellule D7 (pour α = 0,05) : =LOI.STUDENT.INVERSE.N.B(0,05; D3) → Résultat : 2,13145 - Étape 7 : Calcul de la marge d’erreur (E)
En cellule D8 : =D7 * D6 → Résultat : 2,13145 × 9,55 = 20,36 ms
Vérification directe : la formule imbriquée alternative =INTERVALLE.CONFIANCE.STUDENT(0,05; D5; D2) aboutit exactement au même résultat de 20,36 ms. - Étape 8 : Détermination des bornes d’incertitude
En cellule D9 (Borne inférieure) : =D4 – D8 → 412,50 – 20,36 = 392,14 ms
En cellule D10 (Borne supérieure) : =D4 + D8 → 412,50 + 20,36 = 432,86 ms
Le chercheur conclut ainsi formellement, selon les normes de rédaction scientifique : le temps moyen de réaction moteur suite à 24 heures de privation de sommeil est estimé à 412,50 ms, avec un intervalle de confiance à 95 % de [392,14 ms, 432,86 ms]. L’épaisseur de l’intervalle reflète avec rigueur le niveau d’indétermination lié à la modicité de l’échantillon.
6. Intervalle de confiance pour la différence entre deux moyennes indépendantes
6.1 Cadre inférentiel du devis expérimental inter-sujets
En recherche expérimentale, le devis inter-sujets (échantillons indépendants) représente le modèle canonique par excellence. Il consiste à comparer les scores d’un groupe expérimental exposé à une intervention (thérapeutique, pédagogique ou pharmacologique) aux scores d’un groupe témoin recevant un placebo ou un traitement de référence. L’objet central de l’inférence n’est plus la moyenne isolée d’un groupe, mais la différence brute entre les deux moyennes populationnelles : Δ = μ1 – μ2.
L’estimateur sans biais de cette quantité est la différence observée entre les moyennes échantillonnales : D = x̄1 – x̄2. La construction de l’intervalle de confiance autour de cette différence requiert la détermination rigoureuse de l’erreur type de la différence intergroupes (SEdiff). La formulation de cette erreur type dépend d’une hypothèse distributionnelle décisive : l’homogénéité des variances populationnelles, ou homoscédasticité (σ1² = σ2²).
Si les variances des deux groupes sont statistiquement comparables, on applique le modèle combiné (pooled variance), développé par Gosset et Fisher. Si les variances sont hétérogènes (hétéroscédasticité), l’utilisation du modèle combiné biaise lourdement les taux d’erreur, imposant l’emploi de la solution de Welch-Satterthwaite, qui ajuste simultanément l’erreur type et les degrés de liberté. Pour discriminer ces deux régimes d’analyse sous Excel, le chercheur doit préalablement tester l’égalité des variances à l’aide de la fonction de test de Fisher : =TEST.F(plage_groupe1; plage_groupe2). Si la p-valeur résultante est inférieure à 0,05, l’hétéroscédasticité est avérée et le modèle ajusté de Welch s’impose impérativement.
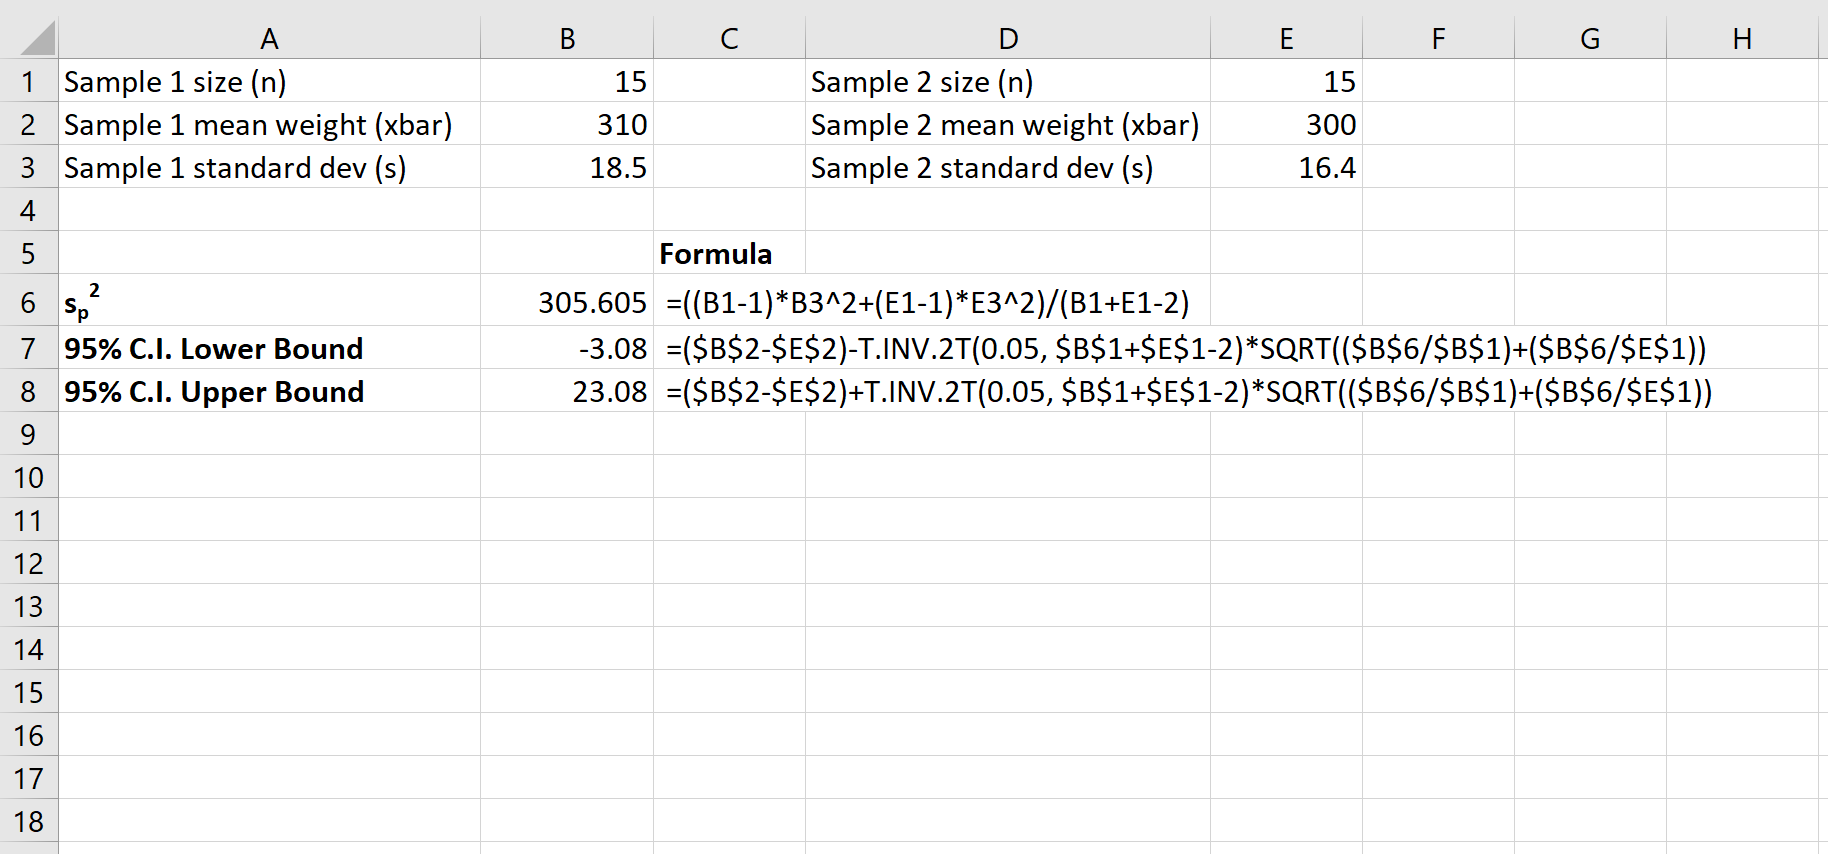
6.2 Calcul sous hypothèse d’homogénéité des variances
Lorsque l’homoscédasticité est respectée, l’information de dispersion issue des deux groupes est combinée pour calculer une estimation globale de la variance commune, appelée variance combinée ou pondérée (sp²). La formule théorique s’écrit :
sp² = [ (n1 – 1) × s1² + (n2 – 1) × s2² ] / (n1 + n2 – 2)
L’erreur type de la différence entre les deux moyennes se déduit ensuite par :
SEdiff = √ [ sp² × ( (1 / n1) + (1 / n2) ) ]
Pour matérialiser ce calcul dans Excel, imaginons que les statistiques descriptives préalablement extraites occupent les cellules suivantes :
- Groupe 1 (Expérimental) : n1 en C2 (25) ; x̄1 en C3 (78,4) ; s1 en C4 (12,2)
- Groupe 2 (Témoin) : n2 en D2 (28) ; x̄2 en D3 (69,1) ; s2 en D4 (11,8)
Le cheminement algorithmique sous Excel s’organise alors ainsi :
- Différence des moyennes (x̄1 – x̄2) en F2 : =C3 – D3 → affiche 9,30 points
- Degrés de liberté totaux (dltotal) en F3 : =C2 + D2 – 2 → 25 + 28 – 2 = 51
- Variance combinée (sp²) en F4 : =((C2 – 1)*C4^2 + (D2 – 1)*D4^2) / F3 → affiche 143,84
- Erreur type de la différence (SEdiff) en F5 : =RACINE(F4 * ((1/C2) + (1/D2))) → affiche 3,303 points
- Valeur critique t (bilatérale à 95 %) en F6 : =LOI.STUDENT.INVERSE.N.B(0,05; F3) → affiche 2,00758
- Marge d’erreur globale (E) en F7 : =F6 * F5 → affiche 6,63 points
- Borne inférieure en F8 : =F2 – F7 → 9,30 – 6,63 = 2,67 points
- Borne supérieure en F9 : =F2 + F7 → 9,30 + 6,63 = 15,93 points
L’intervalle de confiance à 95 % pour la différence intergroupes s’établit à [2,67 ; 15,93]. Dans la mesure où cet intervalle exclut strictement la valeur zéro (qui matérialise l’hypothèse nulle d’égalité des effets), le chercheur est fondé à conclure à une supériorité statistiquement significative du protocole expérimental à un seuil bilatéral α = 0,05.
6.3 Calcul sous hétéroscédasticité : correction de Welch-Satterthwaite
Lorsque les variances des deux groupes diffèrent substantiellement, l’hypothèse d’une variance commune s’effondre. Le modèle d’erreur type non combiné doit être mobilisé :
SEwelch = √ [ (s1² / n1) + (s2² / n2) ]
Cependant, la difficulté mathématique réside dans l’ajustement des degrés de liberté de la statistique t. L’équation de Welch-Satterthwaite produit des degrés de liberté corrigés, non entiers, selon l’expression :
dlwelch = [ (s1² / n1) + (s2² / n2) ]² / [ ( (s1² / n1)² / (n1 – 1) ) + ( (s2² / n2)² / (n2 – 1) ) ]
La transcription de cette équation complexe dans une feuille Excel nécessite une structuration intermédiaire claire pour éviter les erreurs de parenthèses. Reprenons des données où le groupe 1 présente une dispersion nettement plus large : n1 = 20, s1 = 18,4, x̄1 = 105,2 ; et le groupe 2 : n2 = 22, s2 = 7,6, x̄2 = 94,8.
- Variance d’échantillonnage 1 (V1 = s1² / n1) en E2 : =18,4^2 / 20 → 16,928
- Variance d’échantillonnage 2 (V2 = s2² / n2) en E3 : =7,6^2 / 22 → 2,625
- Erreur type de Welch en E4 : =RACINE(E2 + E3) → 4,422
- Degrés de liberté de Welch en E5 : =((E2 + E3)^2) / ((E2^2 / (20 – 1)) + (E3^2 / (22 – 1))) → affiche 24,96 (Excel gère nativement les degrés de liberté décimaux dans ses lois inverses)
- Valeur critique t ajustée en E6 : =LOI.STUDENT.INVERSE.N.B(0,05; E5) → affiche 2,0596
- Marge d’erreur en E7 : =E6 * E4 → 2,0596 × 4,422 = 9,11
- Différence moyenne : 105,2 – 94,8 = 10,40
- Bornes résultantes : [10,40 – 9,11 ; 10,40 + 9,11] = [1,29 ; 19,51]
L’implémentation de cette correction préserve rigoureusement le taux nominal d’erreur de première espèce, fournissant un intervalle robuste face aux violations de l’homoscédasticité.
7. Intervalle de confiance pour des mesures répétées ou échantillons appariés
7.1 Spécificités des protocoles intra-sujets pré-test / post-test
Les devis de recherche intra-sujets (mesures répétées ou échantillons appariés) présentent un avantage méthodologique et statistique majeur par rapport aux plans inter-sujets : ils éliminent la variance interindividuelle résiduelle. Dans un protocole pré-test / post-test évaluant l’efficacité d’une psychothérapie cognitive, les mêmes sujets sont mesurés avant (Temps 1) et après (Temps 2) l’intervention. L’erreur fondamentale consisterait à traiter ces deux séries temporelles comme deux échantillons indépendants en appliquant les procédures de la section 6.
Cette indépendance est théoriquement impossible du fait de la corrélation intra-classe substantielle existant entre les performances répétées d’un même individu. La présence d’une covariance positive entre pré-test et post-test réduit drastiquement l’erreur type de la différence intra-individuelle. L’artifice mathématique standard pour résoudre ce modèle bivarié consiste à opérer une réduction univariée : on transforme le couple d’observations de chaque individu en un score de différence unique : Di = Xpost,i – Xpre,i.
Dès lors que la variable de différence D est calculée pour chaque participant, le problème analytique se ramène strictement au cas univarié traité dans la section 5 : il s’agit d’estimer la moyenne populationnelle de la différence μD, sous l’hypothèse nulle μD = 0. La condition distributionnelle requise ne porte plus sur les scores bruts originaux, mais exclusivement sur la normalité de la distribution des différences calculées D.
7.2 Procédure algorithmique sur tableur
L’implémentation algorithmique de l’intervalle de confiance pour mesures appariées sous Excel est remarquablement sobre et élégante. Supposons une cohorte de n = 18 participants dont les scores à une échelle de dépression sont documentés en colonne B (Pré-intervention, cellules B2:B19) et en colonne C (Post-intervention, cellules C2:C19).
La séquence analytique pas à pas s’opère comme suit :
- Étape 1 : Création de la colonne de différence individuelle
En cellule D2, insérer la formule algébrique : =C2 – B2
Copier cette formule vers le bas jusqu’à la cellule D19. Chaque ligne contient désormais le changement net observé chez le patient i. - Étape 2 : Calcul de la moyenne des changements observés (D̄)
En cellule G2 : =MOYENNE(D2:D19) → Admettons une baisse moyenne observée de -8,44 points. - Étape 3 : Calcul de l’écart-type de la distribution différentielle (sD)
En cellule G3 : =ECARTYPE.STANDARD(D2:D19) → Admettons 4,12 points. - Étape 4 : Détermination de la taille d’échantillon (n)
En cellule G4 : =NB(D2:D19) → 18. - Étape 5 : Calcul direct de la marge d’erreur sous Student
En cellule G5 : =INTERVALLE.CONFIANCE.STUDENT(0,05; G3; G4)
Sous-jacent : Excel calcule LOI.STUDENT.INVERSE.N.B(0,05; 17) × (4,12 / √18) = 2,1098 × 0,9711 = 2,049 points. - Étape 6 : Établissement des bornes de l’intervalle
Borne inférieure (cellule G6) : =G2 – G5 → -8,44 – 2,05 = -10,49 points
Borne supérieure (cellule G7) : =G2 + G5 → -8,44 + 2,05 = -6,39 points
Cette approche par formule directe peut être recoupée à l’identique en activant l’outil d’analyse automatisé d’Excel (Test t pour deux échantillons appariés), lequel restituera la même moyenne de différence et les mêmes degrés de liberté, validant ainsi la chaîne de traitement matricielle.
7.3 Interprétation substantive et taille d’effet associée
L’intervalle de confiance calculé [-10,49 ; -6,39] renseigne immédiatement l’analyste sur la portée clinique du traitement évalué. Étant donné que la totalité de l’intervalle est située dans le domaine négatif et exclut formellement le chiffre 0, le chercheur peut réfuter l’hypothèse nulle d’absence d’effet et affirmer, avec un risque d’erreur consenti de 5 %, que la thérapie génère une réduction des scores de dépression comprise au minimum entre 6,39 et 10,49 points.
Cependant, conformément aux préconisations contemporaines de l’APA, une estimation par intervalle de confiance gagne à être complétée par la quantification de la taille de l’effet standardisée, matérialisée dans ce contexte par le d de Cohen pour mesures appariées (souvent noté dz). Cette mesure s’obtient sous Excel en divisant la moyenne des différences par l’écart-type des différences :
En cellule G8 : =ABS(G2) / G3 → |-8,44| / 4,12 = 2,05.
Une valeur de d supérieure à 0,80 signalant conventionnellement un effet de grande amplitude, un coefficient de 2,05 traduit un impact thérapeutique substantiel, corroborant la signification de l’intervalle de confiance et renforçant la validité écologique des conclusions tirées par le clinicien.
8. Calcul de l’intervalle de confiance pour une proportion binomiale
8.1 Fondements de la loi binomiale et approximation normale
Dans un grand nombre d’investigations psychométriques, médicales ou sociologiques, les variables recueillies ne sont pas quantitatives continues, mais qualitatives dichotomiques binaires (succès/échec, rémission/rechute, adhésion/refus, présence/absence d’un symptôme clinique). La variable sous-jacente suit alors une distribution binomiale théorique de paramètres n (nombre d’essais indépendants) et p (probabilité de succès dans la population). L’estimateur sans biais de cette proportion populationnelle est la fréquence observée : p̂ = k / n, où k représente le décompte des succès.
L’approche computationnelle historiquement classique repose sur l’approximation normale de la loi binomiale par le théorème de De Moivre-Laplace. Lorsque l’échantillon est de taille adéquate, la distribution d’échantillonnage de p̂ s’assimile à une loi normale de moyenne p et d’erreur type théorique :
SEprop = √ [ (p̂ × (1 – p̂)) / n ]
Cependant, l’approximation normale — désignée sous le nom d’intervalle de Wald — requiert la satisfaction expresse de critères de validité opérationnelle. Les standards statistiques exigent conjointement que n × p̂ ≥ 5 (voire 10 selon les auteurs les plus conservateurs) et n × (1 – p̂) ≥ 5. Lorsque ces conditions asymptotiques ne sont pas respectées, ou lorsque la proportion observée est proche des bornes extrêmes 0 ou 1, la méthode de Wald subit une dégradation catastrophique de ses propriétés métrologiques, générant des taux de couverture empiriques désastreux et produisant fréquemment des bornes absurdes excédant l’intervalle de probabilité logique [0 ; 1].
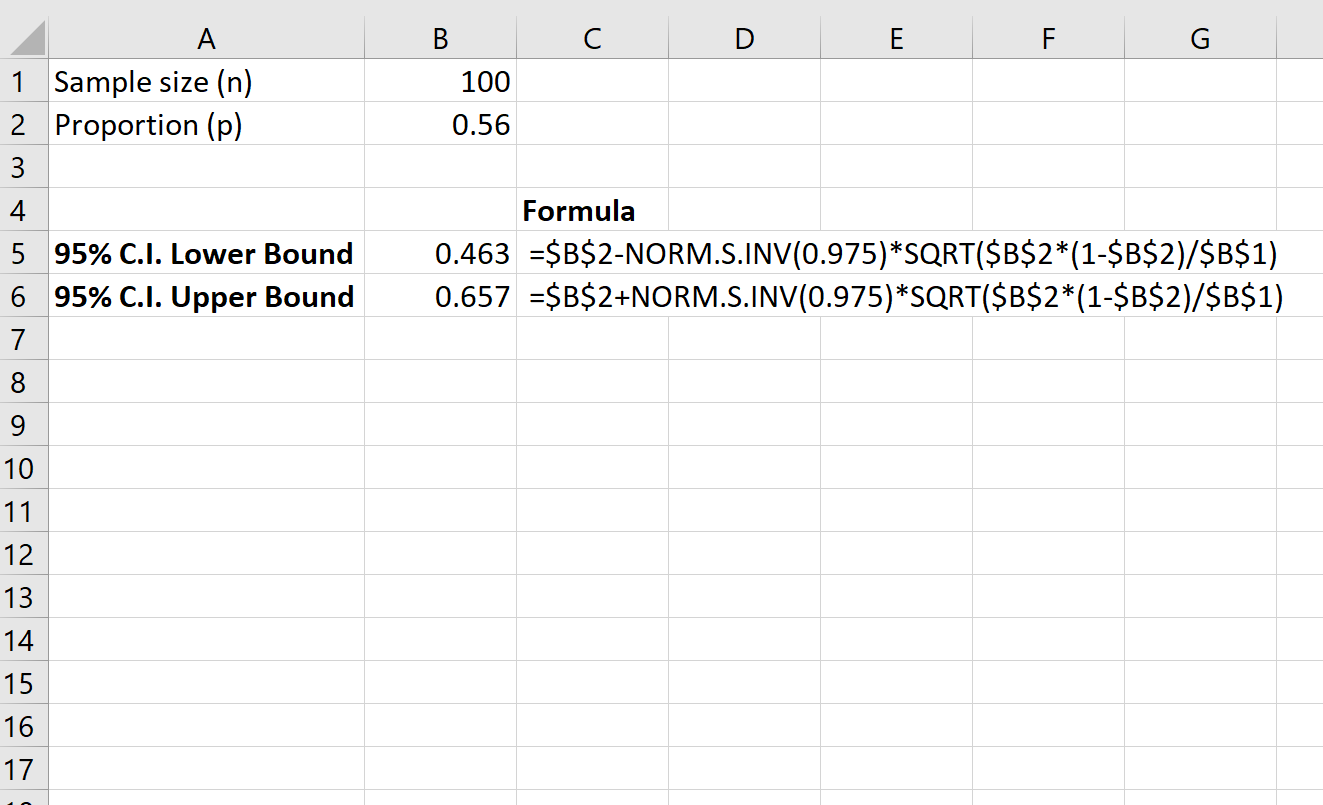
8.2 Mise en œuvre pratique de l’intervalle de Wald sous Excel
Bien que mathématiquement imparfaite aux limites, la méthode de Wald demeure abondamment utilisée pour les grands échantillons médians du fait de sa simplicité computationnelle. Imaginons une cohorte épidémiologique portant sur l’observance d’un traitement psychiatrique chez n = 240 patients schizophrènes, au sein de laquelle k = 168 individus démontrent une observance pharmacologique rigoureuse. Les données d’effectif sont stockées en B1 (succès = 168) et B2 (taille totale = 240).
La construction de l’intervalle de confiance asymptotique de Wald se déroule comme suit :
- Proportion observée p̂ en B3 : =B1 / B2 → affiche 0,70 (70 %)
- Complément (1 – p̂) en B4 : =1 – B3 → affiche 0,30 (30 %)
- Vérification des critères de validité :
n × p̂ = 240 × 0,70 = 168 ≥ 10 (Validé)
n × (1 – p̂) = 240 × 0,30 = 72 ≥ 10 (Validé) - Erreur type de la proportion en B5 : =RACINE((B3 * B4) / B2) → √((0,70 × 0,30)/240) = 0,02958
- Valeur critique Z bilatérale à 95 % en B6 : =LOI.NORMALE.STANDARD.INVERSE.N(0,975) → 1,95996
- Marge d’erreur en B7 : =B6 * B5 → 1,95996 × 0,02958 = 0,05798 (environ 5,8 %)
- Borne inférieure brute en B8 : =B3 – B7 → 0,70 – 0,05798 = 0,6420 (64,2 %)
- Borne supérieure brute en B9 : =B3 + B7 → 0,70 + 0,05798 = 0,7580 (75,8 %)
Pour prévenir rigoureusement tout dépassement des frontières logiques lors de modélisations semi-automatisées, il est impératif d’encapsuler les bornes dans des fonctions de troncature :
Borne inférieure sécurisée : =MAX(0; B3 – B7)
Borne supérieure sécurisée : =MIN(1; B3 + B7)
8.3 Alternatives robustes : l’intervalle du score de Wilson
En réponse aux défaillances structurelles de l’intervalle de Wald, Edwin Bidwell Wilson a formulé en 1927 un estimateur fondé sur l’inversion directe du test de score statistique. L’intervalle de score de Wilson ne centre pas son estimation sur la proportion empirique simple p̂, mais sur une moyenne pondérée entre p̂ et la valeur médiane 0,5, tout en intégrant la courbure de la variance sous-jacente. Il garantit une couverture empirique rigoureusement fidèle au niveau nominal de 95 %, y compris pour de petits effectifs (n < 30) ou des proportions asymétriques extrêmes (ex. p̂ = 0,02).
L’expression algébrique fermée des bornes de l’intervalle de Wilson est la suivante :
Bornes = [ p̂ + (Z² / (2n)) ± Z × √( (p̂(1 – p̂) / n) + (Z² / (4n²)) ) ] / [ 1 + (Z² / n) ]
Bien que son architecture algébrique paraisse intimidante au premier abord, son implémentation dans Excel sans aucune ligne de code VBA s’avère particulièrement fluide dès lors que l’on factorise les termes intermédiaires :
- Paramètres d’entrée : n en C2 (ex. 15), succès k en C3 (ex. 2 → p̂ = 0,1333), Z en C4 (=LOI.NORMALE.STANDARD.INVERSE.N(0,975) → 1,95996)
- Terme central ajusté (Centre) en C5 : =(C3/C2) + (C4^2 / (2*C2))
- Composante sous le radical en C6 : =(( (C3/C2)*(1 – (C3/C2)) ) / C2) + (C4^2 / (4 * C2^2))
- Dénominateur de normalisation en C7 : =1 + (C4^2 / C2)
- Marge d’ajustement en C8 : =(C4 * RACINE(C6))
- Borne inférieure de Wilson en C9 : =(C5 – C8) / C7 → affiche 0,0371 (3,71 %)
- Borne supérieure de Wilson en C10 : =(C5 + C8) / C7 → affiche 0,3789 (37,89 %)
Si l’analyste avait utilisé la formule de Wald sur ces mêmes données (n = 15, k = 2), la borne inférieure calculée aurait été négative (-0,038), illustrant l’aberration de la méthode classique et consacrant la supériorité métrologique de l’algorithme de Wilson dans l’ingénierie tabulaire contemporaine.
9. Intervalle de confiance pour la différence entre deux proportions indépendantes
9.1 Cadre théorique des comparaisons de taux en recherche expérimentale
La comparaison de deux taux ou pourcentages observés dans des groupes indépendants constitue l’épine dorsale des essais contrôlés randomisés en psychologie de la santé, en psychiatrie et dans les sciences du comportement. Qu’il s’agisse de mesurer la supériorité d’une prise en charge sur le taux de rémission clinique ou l’impact d’un dispositif pédagogique sur la réussite à un examen, l’estimateur fondamental est la différence des risques (Risk Difference) : Δ = p1 – p2.
L’estimateur ponctuel de cette divergence est dp = p̂1 – p̂2. Sous l’hypothèse de non-appariement et d’indépendance statistique des deux groupes d’échantillonnage de tailles n1 et n2, la variance de la différence est égale à la somme des variances d’échantillonnage de chaque groupe individuel. L’erreur type de la différence de proportions s’écrit formellement :
SE(p̂1 – p̂2) = √ [ ( (p̂1(1 – p̂1)) / n1 ) + ( (p̂2(1 – p̂2)) / n2 ) ]
Il importe de distinguer rigoureusement ce cadre inférentiel d’estimation de celui du test d’hypothèse d’homogénéité du chi-deux (χ²). Dans un test de chi-deux d’indépendance, l’erreur type est calculée sous l’hypothèse nulle d’égalité absolue des proportions en combinant les effectifs (pooled proportion). À l’inverse, lors de la construction d’un intervalle de confiance pour la différence, l’erreur type ne postule aucunement l’hypothèse nulle et utilise exclusivement les variances spécifiques non combinées de chaque cohorte, garantissant une estimation non conditionnée par l’hypothèse d’invariance.
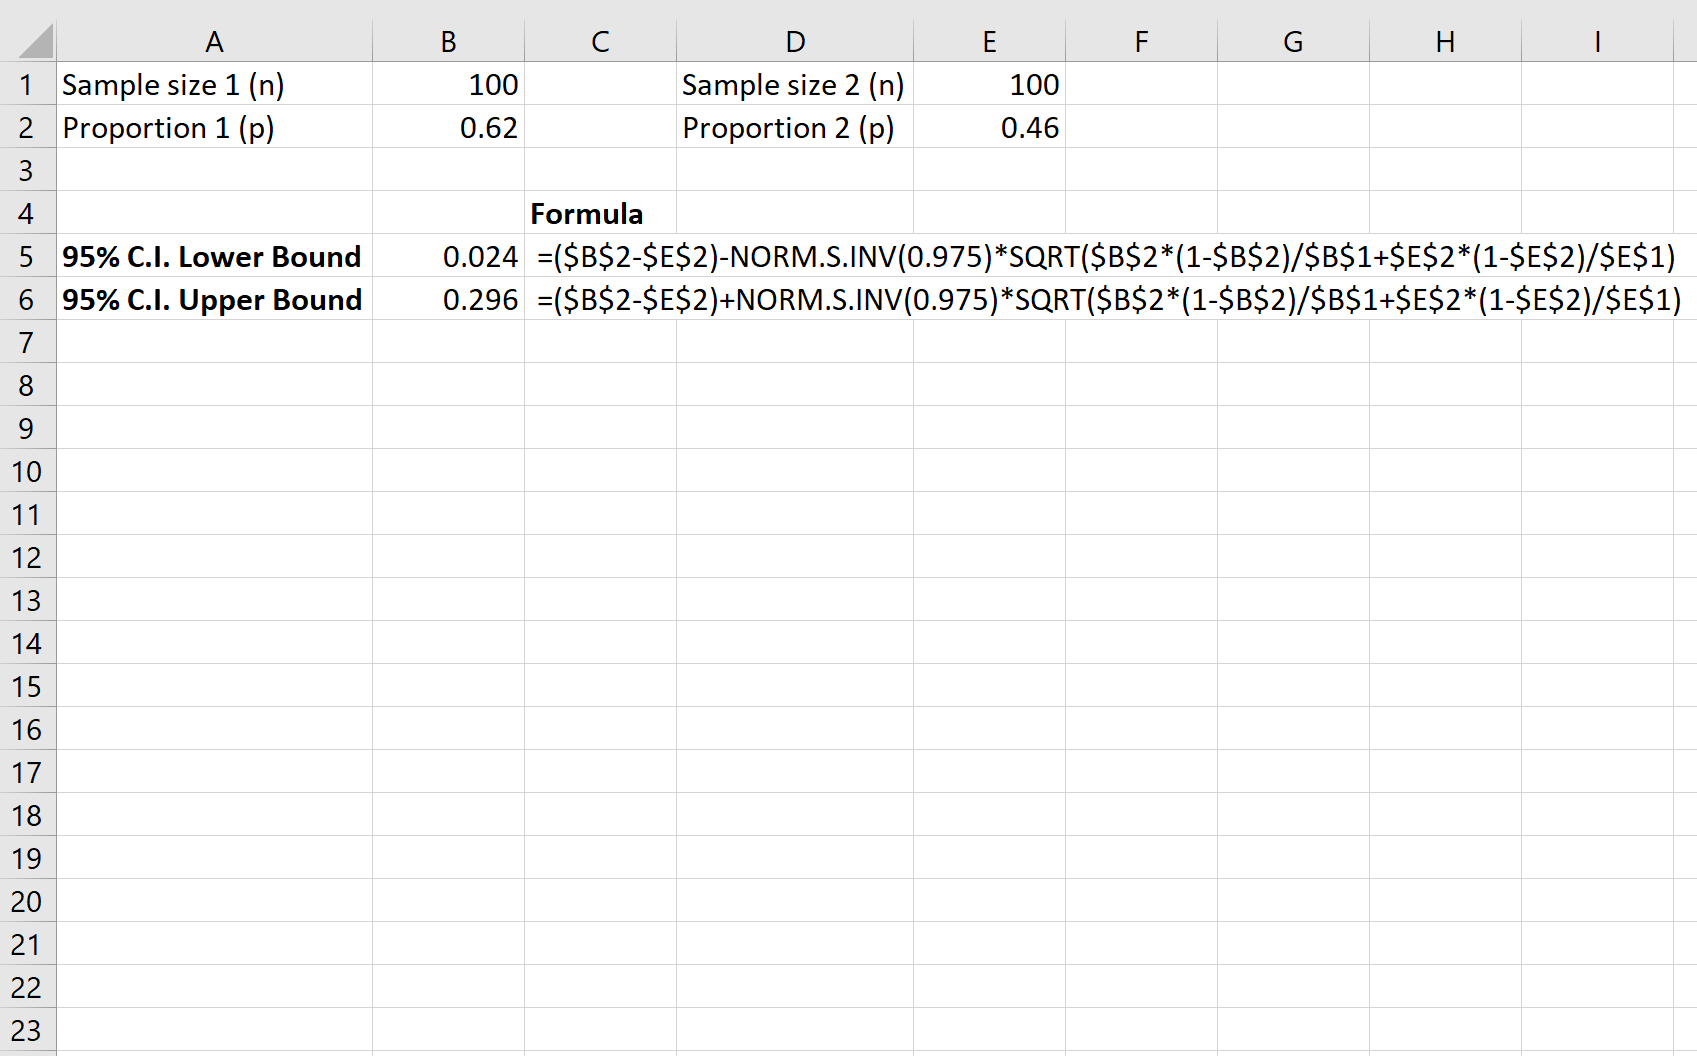
9.2 Programmation des formules de calcul sous Excel
Considérons une étude comparative randomisée évaluant le taux d’abandon prématuré de la thérapie (attrition) entre un protocole de télémédecine numérique (Groupe 1) et une thérapie conventionnelle en face-à-face (Groupe 2). Les données expérimentales brutes sont colligées comme suit :
- Groupe 1 : n1 = 140 participants, k1 = 21 abandons observés (p̂1 = 21/140 = 0,15, soit 15,0 %)
- Groupe 2 : n2 = 150 participants, k2 = 48 abandons observés (p̂2 = 48/150 = 0,32, soit 32,0 %)
L’organisation matricielle du modèle de calcul dynamique dans Excel s’opère selon les assignations cellulaires suivantes :
| Cellule | Libellé métrologique | Syntaxe de la formule Excel | Valeur affichée |
|---|---|---|---|
| B1 et C1 | Effectifs totaux (n1, n2) | Valeurs brutes saisies | 140 et 150 |
| B2 et C2 | Événements observés (k1, k2) | Valeurs brutes saisies | 21 et 48 |
| B3 et C3 | Proportions de succès (p̂1, p̂2) | =B2/B1 et =C2/C1 | 0,1500 et 0,3200 |
| D4 | Différence ponctuelle (p̂1 – p̂2) | =B3 – C3 | -0,1700 (-17,0 %) |
| D5 | Variance d’échantillonnage G1 | =(B3*(1-B3))/B1 | 0,0009107 |
| D6 | Variance d’échantillonnage G2 | =(C3*(1-C3))/C1 | 0,0014507 |
| D7 | Erreur type de la différence | =RACINE(D5 + D6) | 0,04859 |
| D8 | Valeur critique Z (α = 0,05) | =LOI.NORMALE.STANDARD.INVERSE.N(0,975) | 1,95996 |
| D9 | Marge d’erreur (E) | =D8 * D7 | 0,09524 (9,52 %) |
| D10 | Borne inférieure à 95 % | =D4 – D9 | -0,2652 (-26,52 %) |
| D11 | Borne supérieure à 95 % | =D4 + D9 | -0,0748 (-7,48 %) |
9.3 Interprétation épidémiologique et comportementale
L’intervalle de confiance à 95 % calculé s’étend de -26,52 % à -7,48 %. Le zéro se trouvant rigoureusement exclu de cette enveloppe de confiance, la différence observée est statistiquement significative au seuil classique de 5 %. L’analyste peut déduire avec assurance que la télémédecine numérique diminue le risque d’abandon thérapeutique d’au moins 7,48 points de pourcentage, la réduction pouvant atteindre jusqu’à 26,52 points de pourcentage en population générale.
Cette estimation par intervalle permet en outre de dériver un indicateur clinique de premier ordre : le Nombre de Sujets à Traiter (NNT — Number Needed to Treat). Le NNT représente le nombre de patients qu’il convient d’orienter vers la nouvelle modalité thérapeutique pour éviter exactement un abandon prématuré par rapport à la thérapie standard. Il est défini mathématiquement comme l’inverse absolu de la réduction absolue du risque : NNT = 1 / |p̂1 – p̂2|.
Sous Excel, l’incorporation de l’intervalle de confiance permet de borner le NNT :
- NNT ponctuel : =1 / ABS(D4) → 1 / 0,17 = 5,88 (soit environ 6 patients)
- NNT borne pessimiste : =1 / ABS(D11) → 1 / 0,0748 = 13,37 (14 patients)
- NNT borne optimiste : =1 / ABS(D10) → 1 / 0,2652 = 3,77 (4 patients)
Le clinicien dispose d’une conclusion d’une grande valeur décisionnelle : dans le scénario le plus défavorable compatible avec les données d’échantillonnage (borne à 95 %), orienter 14 patients vers la thérapie numérique suffit à préserver un suivi thérapeutique complet.
10. Visualisation graphique rigoureuse des intervalles de confiance dans Excel
10.1 Conception de diagrammes en barres avec barres d’erreur personnalisées
La transcription visuelle de l’incertitude statistique représente un impératif éthique et méthodologique fondamental dans la communication scientifique contemporaine. La publication de graphiques en barres dénués d’intervalles d’erreur — péjorativement désignés dans la littérature sous le sobriquet de dynamite plots — fait l’objet de condamnations répétées par les comités éditoriaux. Excel propose une infrastructure graphique complète pour intégrer des barres d’erreur personnalisées, mais le processus requiert une vigilance absolue pour éviter les pièges algorithmiques par défaut du logiciel.
Le protocole opératoire méthodique pour générer des barres d’erreur rigoureuses sous Excel s’organise selon les étapes séquentielles suivantes :
- Élaborer au préalable une table statistique de synthèse dans la feuille de calcul comprenant impérativement les libellés de modalités (ex. Contrôle, Traitement A, Traitement B), les moyennes respectives de chaque condition et la marge d’erreur E spécifiquement calculée pour chacune d’elles dans une colonne dédiée.
- Sélectionner les cellules de catégories et de moyennes, puis insérer un graphique standard sous le ruban Insertion → Graphiques → Histogramme groupé 2D.
- Sélectionner la série graphique dans l’espace visuel, cliquer sur le bouton + (Éléments de graphique) situé à l’angle supérieur droit, puis cocher la case Barres d’erreur.
- Cliquer sur la flèche contextuelle adjacente à Barres d’erreur et sélectionner obligatoirement Autres options…. Un volet d’ingénierie latéral apparaît.
- Attention au piège critique d’Excel : Excel propose par défaut des options automatiques réductrices intitulées « Écart-type » (qui calcule l’écart-type des moyennes affichées et non des données individuelles d’origine) ou « Marge d’erreur » (qui applique un pourcentage fixe fantaisiste de 5 %). Ces options par défaut sont erronées et ne doivent en aucun cas être sélectionnées.
- Dans la rubrique Marge d’erreur tout en bas du volet latéral, cocher impérativement le bouton radio Personnalisée, puis cliquer sur le bouton interactif Spécifier une valeur.
- Dans la boîte de dialogue contextuelle, pour le champ Valeur d’erreur positive, pointer la souris et sélectionner la plage exacte contenant les marges d’erreur E préalablement calculées. Répéter rigoureusement la même sélection pour le champ Valeur d’erreur négative. Valider par OK.
Les barres verticales résultantes délimitent désormais la marge d’erreur réelle autour de chaque estimateur ponctuel, matérialisant l’intervalle de confiance avec une conformité métrologique parfaite.
10.2 Graphiques de dispersion et profils d’évolution longitudinale
Dans le cadre d’études longitudinales avec suivi temporel (ex. Évaluation à Pré-test, Post-test, Suivi à 3 mois, Suivi à 6 mois), le diagramme en barres doit être avantageusement remplacé par un graphique de dispersion de type Nuage de points avec lignes droites et marqueurs. Ce format met visuellement en exergue la cinétique temporelle continue du changement tout en matérialisant l’évolution conjointe de l’incertitude.
Le chercheur procède de manière analogue pour l’assignation des barres d’erreur personnalisées sur l’axe des ordonnées (Y). Afin d’obtenir un rendu visuel conforme aux exigences des publications internationales de haut rang, il convient d’appliquer des règles strictes de mise en page académique :
- Supprimer intégralement le quadrillage horizontal en arrière-plan, souvent générateur de surcharge cognitive inutile.
- Formater les lignes de repère des barres d’erreur en appliquant un style de terminaison plat (avec empattement) et une épaisseur de trait calibrée entre 1 et 1,25 point, dans une teinte neutre (noir ou gris sombre).
- Régler l’échelle de l’axe vertical (ordonnées) afin de centrer la dynamique visuelle sur la zone de variance substantielle sans pour autant tronquer artificiellement la lecture naturelle des scores.
- Pour les designs asymétriques (notamment les intervalles issus du score de Wilson pour des proportions), renseigner distinctement dans la boîte de dialogue de valeur d’erreur personnalisée la plage des écarts supérieurs pour l’erreur positive et celle des écarts inférieurs pour l’erreur négative.
Cette distinction assure une représentation graphique asymétrique fidèle, illustrant les propriétés non gaussiennes des distributions d’échantillonnage tronquées.
10.3 Élaboration d’un graphique en forêt (Forest Plot) sous Excel
Le graphique en forêt — ou Forest Plot — constitue le standard de visualisation par excellence dans les méta-analyses, les revues systématiques et la cartographie simultanée de multiples sous-échelles d’un profil psychométrique. Il figure sur un axe horizontal commun l’ensemble des estimations ponctuelles accompagnées de leurs segments horizontaux d’intervalles de confiance, recoupés par une ligne verticale de référence matérialisant la valeur nulle d’absence d’effet (la valeur zéro pour les différences de moyennes ou de proportions, ou la valeur un pour les Odds Ratios).
Bien qu’Excel ne dispose pas d’un modèle prédéfini de Forest Plot, il est possible d’en concevoir un de niveau professionnel par l’utilisation astucieuse d’un graphique à barres horizontales flottantes ou d’un nuage de points XY combiné :
- Structurer la feuille avec les colonnes : Libellé de l’étude (ou de la sous-échelle), Rang ordinal vertical (valeurs entières 1, 2, 3… servant d’axe Y artificiel), Taille d’effet ponctuelle (axe X), Marge d’erreur inférieure, Marge d’erreur supérieure.
- Générer un Graphique en nuage de points XY (points uniquement) en affectant la Taille d’effet sur l’axe horizontal X et le Rang ordinal sur l’axe vertical Y. Les points se disposent verticalement les uns au-dessus des autres.
- Ajouter des barres d’erreur horizontales (sur l’axe X) via les options d’éléments graphiques, puis supprimer les barres d’erreur verticales automatiques non pertinentes.
- Assigner aux barres d’erreur horizontales les valeurs personnalisées calculées pour chaque étude.
- Insérer une forme de ligne verticale tracée rigoureusement à l’intersection X = 0 (ou insérer une série de données fictive avec deux points de coordonnées (0; 0) et (0; N+1) connectés par une ligne continue noire).
- Inverser l’axe vertical Y pour ordonner les études de haut en bas conformément à l’ordre chronologique de lecture, puis masquer les étiquettes numériques de l’axe Y pour les remplacer par les libellés nominatifs textuels des études associées.
Le résultat obtenu égale la qualité typographique des logiciels d’analyse méta-analytique spécialisés, tout en conservant une réactivité dynamique totale aux modifications des données sources saisies dans le tableur.
11. Automatisation, fonctions avancées et Utilitaire d’analyse d’Excel
11.1 Exploitation du module Utilitaire d’analyse statistique
Microsoft Excel intègre nativement un moteur de calcul statistique avancé regroupé sous le nom de complément Utilitaire d’analyse (Analysis ToolPak). Bien qu’il soit présent dans toutes les versions bureautiques d’Excel, ce module est inactif par défaut et doit faire l’objet d’une initialisation explicite par l’utilisateur.
L’activation s’effectue via le menu Fichier → Options → Compléments. Dans le menu déroulant inférieur Gérer, sélectionner Compléments Excel, puis cliquer sur Atteindre…. Dans la boîte de dialogue, cocher la case Utilitaire d’analyse et valider par OK. Un nouveau groupe intitulé Analyse apparaît désormais à l’extrémité droite du ruban Données, hébergeant le bouton de commande Utilitaire d’analyse.
Pour générer instantanément l’intervalle de confiance d’une variable quantitative sans rédiger de formules :
- Cliquer sur Utilitaire d’analyse, sélectionner dans la liste proposée l’élément Statistiques descriptives, puis valider par OK.
- Dans le champ Plage d’entrée, désigner la plage de données continues (ex. $A$1:$A$100). Si la première ligne contient un en-tête alphabétique, cocher la case Intitulés en première ligne.
- Dans les options de sortie, désigner une cellule réceptrice vierge pour la table résultante.
- Dans le groupe inférieur d’options statistiques, cocher obligatoirement la case Rapport statistique, ainsi que la case Niveau de confiance pour la moyenne en saisissant la valeur nominale souhaitée (par défaut 95 %).
Excel édite instantanément une table complète comprenant la moyenne, l’erreur type, la médiane, le mode, l’écart-type, la variance, la kurtosis, la skewness et une ligne finale explicitement nommée Niveau de confiance(95,0%). Cette valeur numérique finale correspond rigoureusement à la marge d’erreur E issue de la loi de Student : E = t0,05; n-1 × SE.
Limitation méthodologique majeure : Contrairement aux fonctions directes intégrées dans la feuille de calcul, les sorties générées par l’Utilitaire d’analyse sont des valeurs statiques fixes (non dynamiques). Tout ajout, suppression ou rectification d’une valeur dans la série primaire de données n’actualise pas la table d’analyse. Cette caractéristique impose de réserver cet outil à des audits exploratoires ponctuels et d’exclure son emploi au sein de tableaux de bord ou de pipelines de recherche itératifs nécessitant une réactivité dynamique continue.
11.2 Formules matricielles dynamiques modernes et fonctions LAMBDA
Avec le déploiement des moteurs de calcul matriciel dynamique moderne dans Microsoft 365, l’ingénierie des intervalles de confiance franchit un cap décisif d’abstraction et d’efficience opérationnelle. L’utilisation conjointe des fonctions LET et LAMBDA autorise la création de micro-programmes statistiques internes réutilisables, éliminant définitivement la prolifération de cellules intermédiaires éparses et réduisant le risque d’altération de formules.
La fonction LET permet d’attribuer des noms à des variables de calcul intermédiaires au sein d’une unique formule hermétique. Supposons une série brute située dans la plage A2:A50. L’estimation intégrale de l’intervalle de Student à 95 % peut être compilée dans une cellule unique renvoyant simultanément la borne inférieure et la borne supérieure grâce à la formule matricielle suivante :
=LET(
donnees; A2:A50;
n; NB(donnees);
m; MOYENNE(donnees);
s; ECARTYPE.STANDARD(donnees);
critique; LOI.STUDENT.INVERSE.N.B(0,05; n – 1);
marge; critique * (s / RACINE(n));
CHOOSE({12}; m – marge; m + marge)
)
Cette syntaxe dynamique calcule en mémoire vive l’ensemble des métriques d’échantillonnage et déverse (spill) automatiquement les deux bornes dans deux cellules horizontales contiguës.
Pour aller plus loin dans la rationalisation scientifique, le chercheur peut encapsuler cette architecture dans le Gestionnaire de noms sous forme d’une fonction personnalisée sans VBA nommée INTERVALLE_T, exploitant la fonction LAMBDA :
=LAMBDA(plage; alpha;
LET(
n; NB(plage);
m; MOYENNE(plage);
s; ECARTYPE.STANDARD(plage);
marge; LOI.STUDENT.INVERSE.N.B(alpha; n – 1) * (s / RACINE(n));
FRACTIONNEMENT.TEXTE(m – marge & « ; » & m + marge; « ; »)
)
)
Une fois cette fonction enregistrée dans le classeur, l’obtention des bornes d’un intervalle de confiance pour n’importe quelle colonne devient aussi triviale et immédiate que la saisie de : =INTERVALLE_T(A2:A50; 0,05). Couplée à des tableaux structurés (ListObjects), cette méthode garantit que toute insertion de nouveaux participants dans la base recalcule instantanément l’intervalle d’incertitude sur l’ensemble du classeur.
11.3 Sensibilité et modélisation stochastique par simulation
L’environnement tabulaire d’Excel se prête remarquablement à l’évaluation de la robustesse des intervalles de confiance face aux violations de leurs postulats mathématiques théoriques au moyen de simulations stochastiques de Monte-Carlo. Cette approche pédagogique et analytique permet de visualiser concrètement ce que recouvre le concept abstrait de couverture fréquentiste à long terme.
Pour concevoir une simulation empirique vérifiant la capture d’une moyenne connue (ex. μ = 100, σ = 15) :
- Générer une matrice de données synthétiques de 1 000 lignes représentant 1 000 réplications d’expériences indépendantes de taille n = 20. Dans les colonnes B à U (20 colonnes), insérer le générateur aléatoire gaussien de Box-Muller ou la formule inverse : =LOI.NORMALE.INVERSE(ALEA(); 100; 15).
- En colonne V, calculer la moyenne empirique de chaque échantillon simulé : =MOYENNE(B2:U2).
- En colonne W, calculer la marge d’erreur individuelle sous Student à 95 % : =INTERVALLE.CONFIANCE.STUDENT(0,05; ECARTYPE.STANDARD(B2:U2); 20).
- En colonne X, évaluer logiquement si l’intervalle spécifique généré englobe la valeur paramétrique réelle μ = 100 via la formule booléenne : =SI(ET(100 >= V2 – W2; 100 <= V2 + W2); 1; 0).
- En cellule Z1, calculer la proportion empirique de capture sur les 1 000 expériences virtuelles : =MOYENNE(X2:X1001).
Le résultat converge systématiquement vers une valeur comprise entre 0,945 et 0,955, démontrant empiriquement aux étudiants et analystes la véracité de la promesse de capture fréquentiste. De la même façon, en remplaçant la distribution normale sous-jacente par une distribution exponentielle ou log-normale fortement asymétrique, le chercheur peut quantifier avec une précision chirurgicale l’effondrement du taux de couverture réel de la procédure de Student en situation de petit échantillon non régulier.
12. Erreurs courantes, interprétations erronées et normes de publication APA
12.1 Biais d’interprétation conceptuels et sophisme bayésien
L’intervalle de confiance est sans doute l’un des objets statistiques les plus mal compris de la littérature scientifique, y compris par des chercheurs chevronnés et des enseignants-chercheurs. L’erreur conceptuelle la plus ubiquitaire consiste à énoncer : « Il y a 95 % de chances (ou de probabilité) que la véritable moyenne populationnelle se situe à l’intérieur de l’intervalle calculé [10,2 ; 15,8] ». Cette affirmation relève d’un contresens épistémologique absolu, désigné sous le terme de sophisme de transposition conditionnelle ou sophisme bayésien.
Dans l’édifice mathématique fréquentiste sur lequel repose le calcul des intervalles de confiance d’Excel, les probabilités ne s’appliquent qu’à des événements stochastiques futurs ou à des variables aléatoires. Or, le paramètre populationnel μ est une constante mathématique fixe : il ne possède pas de distribution de probabilité. Dès que l’échantillon est extrait et que les bornes numériques sont calculées, il n’y a plus aucune contingence : l’intervalle [10,2 ; 15,8] contient ou ne contient pas la moyenne. La probabilité postérieure est soit de 1, soit de 0, mais elle est définitivement inconnue. L’énoncé correct exige de situer la probabilité dans la procédure générale : « Si l’on réitérait cette procédure d’échantillonnage un nombre indéfini de fois, 95 % des intervalles de confiance calculés contiendraient la véritable moyenne de la population ».
Une seconde confusion majeure consiste à assimiler l’intervalle de confiance à un intervalle de prédiction ou à un intervalle de référence/tolérance :
- L’intervalle de confiance quantifie l’incertitude sur la localisation d’un paramètre central populationnel (la moyenne μ). Son amplitude tend vers zéro à mesure que l’effectif n croît vers l’infini.
- L’intervalle de prédiction vise à déterminer la plage dans laquelle se situera l’observation d’un prochain individu unique prélevé dans la population. Il intègre obligatoirement la variance résiduelle individuelle (σ²) en plus de l’erreur type, et son amplitude demeure très large même si n est infini.
- L’intervalle de tolérance circonscrit une proportion définie de la distribution individuelle globale des scores avec un degré de confiance assigné.
Confondre ces concepts conduit couramment des praticiens en psychométrie à déclarer qu’un score individuel est anormal s’il tombe hors de l’intervalle de confiance de la moyenne, commettant ainsi une erreur d’échelle métrologique élémentaire.
12.2 Erreurs techniques récurrentes commises sous Excel
L’exécution de routines statistiques sous Microsoft Excel présente une vulnérabilité singulière aux fautes d’inattention syntaxiques. L’analyse des classeurs d’expérimentation met en lumière quatre erreurs techniques hautement récurrentes :
- Confusion d’écart-type dans l’erreur type : Utiliser la fonction ECARTYPE.PEARSON au lieu de ECARTYPE.STANDARD. Sur un effectif modeste de n = 10, cette confusion biaise la dispersion de plus de 5 %, induisant un rétrécissement fallacieux de la marge d’erreur.
- Erreur de paramétrage de l’argument Alpha : Confondre le niveau de confiance nominal (95) et le risque statistique α (0,05). Saisir le chiffre entier 95 ou 0,95 au sein des fonctions INTERVALLE.CONFIANCE.NORMALE ou INTERVALLE.CONFIANCE.STUDENT aboutit soit à des codes d’erreur #NOMBRE!, soit à des marges d’erreur aberrantes correspondant à un risque d’erreur de 95 % (soit un niveau de confiance résiduel de 5 %).
- Confusion entre fonctions unilatérales et bilatérales : Utiliser LOI.STUDENT.INVERSE.N en lui passant directement la valeur 0,05 pour un intervalle bilatéral à 95 %. Cette fonction unilatérale gauche renverra un quantile négatif correspondant à un niveau unilatéral, faussant les calculs de marge d’erreur si la valeur absolue n’est pas appliquée ou si le seuil α n’est pas divisé par deux. Il convient d’utiliser impérativement LOI.STUDENT.INVERSE.N.B(0,05; dl).
- Assignation incorrecte des barres d’erreur graphiques : Ne renseigner que le champ d’erreur positive dans la boîte de dialogue d’Excel en laissant le champ d’erreur négative vide ou fixé à zéro, produisant des graphiques asymétriques tronqués où les barres ne s’étendent que vers le haut.
12.3 Directives de rédaction scientifique selon l’APA (7e édition)
La publication de résultats statistiques dans les revues académiques internationales requiert une adhésion scrupuleuse aux normes typographiques et formelles de l’American Psychological Association (APA, 7e édition, 2020). L’APA proscrit formellement les notations ambiguës du type « 45,2 ± 2,3 », qui ne permettent pas d’identifier si le terme additif matérialise un écart-type, une erreur type ou une marge d’erreur au seuil de 95 %.
Les règles canoniques de rédaction imposent les formats suivants :
- L’acronyme anglais officiel CI (Confidence Interval) ou son équivalent français IC (Intervalle de Confiance) doit être explicitement assorti du niveau de confiance en pourcentage nominal : 95% CI ou IC à 95 %.
- Les bornes inférieure et supérieure doivent impérativement être encadrées par des crochets droits, séparées par une virgule (ou un point-virgule en français pour éviter la confusion avec la virgule décimale) : [LL, UL] (pour Lower Limit et Upper Limit).
- Le niveau de précision décimale doit refléter la résolution de l’instrument de mesure d’origine, en s’alignant généralement sur deux décimales significatives.
Voici des modèles contextuels de formulation académique irréprochable intégrant les sorties calculées sous Excel :
Exemple univarié pour une moyenne :
« Le score moyen d’anxiété évalué après le protocole de relaxation s’établit à M = 48,60 points, s = 10,50, IC à 95 % [46,72 ; 50,48]. »
Exemple inter-sujets (test t de Student indépendant) :
« La différence entre le groupe expérimental et le groupe témoin est statistiquement significative, t(51) = 2,82, p = 0,007, avec un gain moyen de 9,30 points en faveur de l’intervention, IC à 95 % [2,67 ; 15,93], d de Cohen = 0,78. »
Exemple binaire pour une différence de proportions :
« Le taux de persistance symptomatique était significativement inférieur dans le groupe télémédecine par rapport au groupe standard (15,0 % contre 32,0 %), soit une réduction absolue du risque de 17,0 points de pourcentage, IC à 95 % [-26,52 % ; -7,48 %], z = -3,50, p < 0,001. »
Cette rigueur de communication garantit l’intégrité métrologique des données et offre à la communauté scientifique une base reproductible, exempte de toute ambiguïté inférentielle.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7-29. https://doi.org/10.1177/0956797613504966
- Gosset, W. S. [Student]. (1908). The probable error of a mean. Biometrika, 6(1), 1-25. https://doi.org/10.1093/biomet/6.1.1
- Neyman, J. (1937). Outline of a theory of statistical estimation based on the classical theory of probability. Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences, 236(767), 333-380. https://doi.org/10.1098/rsta.1937.0005
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129-133. https://doi.org/10.1080/00031305.2016.1154108
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28-35. https://doi.org/10.2307/2332510
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wilkinson, L., & Task Force on Statistical Inference. (1999). Statistical methods in psychology journals: Guidelines and explanations. American Psychologist, 54(8), 594-604. https://doi.org/10.1037/0003-066X.54.8.594
- Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209-212. https://doi.org/10.1080/01621459.1927.10502953