
Dans le champ des sciences humaines, de la biométrie et de la métrologie appliquée, la modélisation rigoureuse de la dispersion individuelle constitue un impératif méthodologique souvent négligé au profit de la seule estimation tendancielle. Les chercheurs et praticiens concentrent fréquemment leur attention sur l’estimation de la moyenne populationnelle au détriment de la dynamique des trajectoires individuelles. Si l’évaluation des paramètres centraux offre un aperçu précieux des tendances globales, elle demeure intrinsèquement incapable de circonscrire l’espace au sein duquel se distribuent concrètement les observations singulières d’une cohorte. Cette lacune épistémologique s’avère particulièrement préjudiciable lors de l’étalonnage d’épreuves psychométriques standardisées, de l’établissement d’intervalles de référence biologiques ou du contrôle qualité de dispositifs médicaux où la décision clinique s’applique à un sujet unique et non à une abstraction moyenne.
L’intervalle de tolérance statistique comble précisément ce vide analytique en associant deux composantes d’incertitude indissociables : la couverture d’une proportion définie de la population cible et le niveau de confiance associé à l’estimation échantillonnale de cette couverture. Contrairement aux approches intuitives mais erronées qui superposent artificiellement écarts-types et moyennes sans considération de l’erreur d’échantillonnage, le calcul d’un intervalle de tolérance répond à une axiomatique probabiliste stricte. Il permet de formuler une assertion d’une portée clinique ou normative décisive : garantir, avec un degré de certitude mathématique spécifié (par exemple 95 %), qu’au moins une proportion prédéterminée d’individus (par exemple 99 %) présentera des valeurs bornées par des limites quantifiables.
Bien que les logiciels spécialisés en biostatistique intègrent des routines propriétaires dédiées à ce type d’inférence, le tableur Microsoft Excel demeure l’environnement de modélisation le plus omniprésent dans les structures hospitalières, les laboratoires de psychologie expérimentale et les départements d’évaluation clinique. L’absence d’une commande native élémentaire dédiée aux intervalles de tolérance au sein d’Excel ne constitue aucunement une impasse technique, mais représente au contraire une opportunité remarquable de formaliser et de contrôler les étapes algébriques du modèle. Ce guide exhaustif expose la dérivation mathématique, la justification théorique et l’implémentation algorithmique pas-à-pas des intervalles de tolérance bilatéraux sous Excel, offrant ainsi aux praticiens une méthodologie reproductible, transparente et conforme aux standards de publication scientifique les plus exigeants.
1. Introduction théorique à l’intervalle de tolérance en psychométrie et statistiques appliquées
1.1 Définition fondamentale de l’intervalle de tolérance
L’intervalle de tolérance statistique se définit comme une étendue numérique délimitée par deux bornes, calculée à partir d’un échantillon aléatoire, et conçue pour englober une proportion prédéterminée, notée p, d’une population sous-jacente avec un niveau de confiance spécifié, noté 1 – α. Contrairement aux statistiques descriptives élémentaires qui se bornent à résumer les caractéristiques observées au sein d’une cohorte d’étude fermée, l’intervalle de tolérance relève pleinement de la statistique inférentielle. Il ne prétend pas simplement mesurer ce qui s’est produit dans un échantillon donné, mais projette une frontière probabiliste sur l’ensemble de la population dont cet échantillon est issu.
Cette approche se singularise par son double niveau d’aléa, ou double stochasticité. D’une part, la variable d’intérêt au sein de la population présente une dispersion naturelle, intrinsèque aux variations biologiques, cognitives ou comportementales des sujets. D’autre part, les paramètres régissant cette distribution (la moyenne et la variance) demeurent inconnus et doivent être estimés à partir des données empiriques. Cette estimation introduit une seconde source d’incertitude liée à l’erreur d’échantillonnage. L’intervalle de tolérance intègre simultanément ces deux aléas : il garantit que les fluctuations d’échantillonnage n’empêcheront pas l’intervalle d’englober la fraction p requise, et ce dans une proportion 1 – α de réplications expérimentales potentielles.
Dans la recherche sur les comportements et les fonctions cognitives, ce concept s’avère indispensable pour appréhender la variabilité interindividuelle. Alors que l’usage exclusif de la moyenne tend à homogénéiser conceptuellement des populations hétérogènes, l’intervalle de tolérance restitue la réalité empirique de l’écart à la norme. Il permet aux chercheurs d’isoler les performances individuelles authentiquement atypiques des fluctuations inhérentes à la variabilité physiologique normale, offrant ainsi un ancrage mathématique robuste aux diagnostics différentiels et aux décisions thérapeutiques.
1.2 Distinction épistémologique : tolérance, confiance et prédiction
L’une des confusions les plus dommageables en statistique appliquée réside dans l’interchangeabilité erronée des intervalles de confiance, de prédiction et de tolérance. Chacun de ces outils répond à une interrogation scientifique fondamentalement distincte, et l’usage inapproprié de l’un pour l’autre engendre des erreurs d’interprétation critiques, tant sur le plan théorique que pratique. Il convient donc de clarifier minutieusement leurs assises épistémologiques respectives.
L’intervalle de confiance classique se focalise exclusivement sur un paramètre populationnel fixe mais inconnu, le plus souvent la moyenne μ. Son amplitude reflète uniquement l’incertitude liée à l’échantillonnage de ce paramètre central. Lorsque la taille de l’échantillon n croît indéfiniment, la variance de la moyenne d’échantillonnage converge vers zéro, et l’intervalle de confiance se contracte jusqu’à devenir un point unique. Il ne fournit par conséquent aucune information directe sur la distribution des individus au sein de la population. À l’inverse, l’intervalle de prédiction vise à borner la valeur d’une seule observation future issue de la même population avec un degré de confiance fixé. Bien qu’il intègre la variance individuelle, il est intrinsèquement calibré pour une occurrence unique (N = 1) et ne garantit en rien la couverture globale d’un sous-ensemble défini de la population.
L’intervalle de tolérance répond quant à lui à l’exigence d’englober une proportion substantielle de la population générale, par exemple 95 % ou 99 % des individus, tout en maintenant un contrôle strict sur le risque d’échantillonnage via le seuil α. Le tableau synthétique suivant met en exergue ces divergences fondamentales :
| Type d’intervalle | Cible de l’inférence | Comportement asymptotique (quand n tend vers l’infini) | Usage clinique ou expérimental privilégié |
|---|---|---|---|
| Intervalle de confiance | Paramètre populationnel unique (μ, σ ou proportion) | Converge vers une largeur nulle centrée sur le paramètre | Estimation de l’effet moyen d’un traitement ou d’une intervention |
| Intervalle de prédiction | Une seule observation future individuelle (Xn+1) | Converge vers les quantiles théoriques de la population [μ ± z · σ] | Pronostic immédiat pour le prochain patient admis |
| Intervalle de tolérance | Une proportion définie (p) de la population générale | Converge vers l’intervalle englobant exactement la fraction p | Standardisation normative, seuils diagnostiques, étalonnage de tests |
1.3 Pertinence méthodologique dans l’évaluation psychologique et normative
La psychométrie moderne repose sur l’étalonnage rigoureux d’outils standardisés visant à positionner le score d’un individu par rapport à une population de référence. Qu’il s’agisse de mesurer l’efficience cognitive générale, des traits de personnalité ou des indices neuropsychologiques spécifiques, l’établissement de tables normatives constitue l’armature de la validité clinique. Dans cette perspective, le recours aux intervalles de tolérance permet de dépasser les écueils inhérents aux méthodes de normalisation naïves qui postulent implicitement une connaissance parfaite des paramètres de la population.
Traditionnellement, les étalonnages s’appuient sur des scores dérivés tels que les scores z, les quotients intellectuels ou les percentiles empiriques. Néanmoins, lorsque ces normes sont calculées sur des échantillons de standardisation de taille modeste, l’incertitude liée à l’erreur d’échantillonnage est souvent occultée. Un score se situant à deux écarts-types de la moyenne observée dans un échantillon de cinquante sujets ne possède pas la même significativité diagnostique que le même score évalué au sein d’un échantillon de dix mille individus. L’intervalle de tolérance incorpore formellement cette incertitude : il ajuste l’amplitude des seuils critiques en fonction de la taille de l’échantillon normatif, garantissant que les décisions de catégorisation clinique (par exemple, identification d’un déficit cognitif ou d’un haut potentiel) respectent scrupuleusement la proportion de couverture postulée.
Dans le diagnostic médical et psychiatrique, la gestion de l’incertitude d’échantillonnage s’avère vitale pour prévenir les erreurs de classification, notamment les faux positifs et les faux négatifs. En fixant des bornes normatives fondées sur des intervalles de tolérance bilatéraux à 95 % de couverture et 95 % de confiance, le praticien s’assure que les frontières entre la normalité statistique et la pathologie suspectée reposent sur une méthodologie mathématiquement conservatrice et reproductible.
2. Fondements mathématiques de l’intervalle de tolérance bilatéral
2.1 Formulation mathématique standard de l’intervalle bilatéral
La dérivation formelle d’un intervalle de tolérance bilatéral s’articule autour de la statistique d’échantillonnage classique composée de la moyenne arithmétique empirique et de l’écart-type corrigé. Sous l’hypothèse de normalité, l’intervalle de tolérance bilatéral prend l’expression générale suivante :
IT = [x̄ – k · s ; x̄ + k · s]
Dans cette formalisation, la variable x̄ désigne la moyenne de l’échantillon observée, calculée comme la somme des observations divisée par la taille de l’échantillon n. La lettre s symbolise l’écart-type échantillonnal non biaisé, calculé en divisant la somme des carrés des écarts à la moyenne par n – 1 degrés de liberté. La composante déterminante de cette équation réside dans le facteur multiplicatif k, couramment qualifié de facteur de tolérance statistique.
Le facteur k ne se réduit nullement à un simple quantile de la loi normale centrée réduite, tel que z = 1,96 pour une couverture théorique de 95 %. Il s’agit d’une fonction complexe dépendant simultanément de la proportion de population ciblée p, du niveau de confiance requis 1 – α et du nombre de degrés de liberté ν = n – 1. Ce facteur est calibré de manière à ce que la probabilité que l’intervalle stochastique contienne au moins une proportion p des valeurs de la variable aléatoire normale soit exactement égale à 1 – α :
P( P( x̄ – k · s ≤ X ≤ x̄ + k · s | x̄, s ) ≥ p ) = 1 – α
La présence du paramètre n – 1 reflète la pondération nécessaire face à l’imprécision inhérente à l’estimation de la variance populationnelle σ² par la variance d’échantillon s². Plus la taille de l’échantillon est restreinte, plus la distribution d’échantillonnage de la variance s’évase, exigeant un facteur k substantiellement supérieur afin de compenser les déviations statistiques potentielles.
2.2 Rôle de la distribution normale et hypothèse sous-jacente
L’exactitude mathématique de l’intervalle de tolérance paramétrique bilatéral repose sur le postulat strict selon lequel la variable mesurée suit une distribution normale (loi de Gauss-Laplace) de paramètres inconnus μ et σ². Ce postulat distributionnel constitue le fondement sur lequel repose l’indépendance stochastique entre la moyenne empirique x̄ et la variance empirique s², un théorème fondamental formalisé par Ronald Fisher.
Cette indépendance conditionne la modélisation mathématique du facteur k. En effet, la moyenne de l’échantillon se distribue selon une loi normale centrée sur μ de variance σ²/n, tandis que la somme des carrés des écarts normalisée suit une distribution du Khi-deux (χ²) à n – 1 degrés de liberté. Toute déviation par rapport à cette hypothèse de normalité affecte la validité des bornes calculées. L’intervalle de tolérance se révèle nettement plus vulnérable aux violations de la normalité que l’intervalle de confiance standard de la moyenne.
En vertu du théorème central limite, l’intervalle de confiance de la moyenne bénéficie d’une robustesse asymptotique remarquable : même si les données brutes s’écartent modérément de la symétrie gaussienne, la distribution des moyennes d’échantillons de taille suffisante converge rapidement vers une loi normale. Il n’en va absolument pas de même pour l’intervalle de tolérance, dont l’objet d’inférence concerne les queues de la distribution des données individuelles. Si la distribution réelle présente une asymétrie marquée (coefficient de dissymétrie prononcé) ou un aplatissement lourd (leptocurticité avec queues épaisses), l’intervalle de tolérance calculé selon le modèle gaussien standard sous-estimera systématiquement l’étendue nécessaire pour capturer la proportion p des sujets extrêmes, faussant radicalement l’évaluation normative.
2.3 Dérivation du facteur k de tolérance statistique
La résolution analytique exacte du facteur k bilatéral requiert des développements mathématiques complexes impliquant des intégrales sur des distributions non centrales de Student et des lois de Bessel. Historiquement, les statisticiens recouraient à des tables précalculées élaborées par Weissberg, Beatty ou Howe. Néanmoins, pour une implémentation logicielle fluide et computationnellement efficace, notamment au sein de feuilles de calcul Excel, des approximations analytiques de haute précision ont été développées.
L’approximation la plus largement reconnue et appliquée en métrologie industrielle et en statistique clinique est celle formalisée par W. G. Howe (1969), adoptée par les normes internationales de standardisation (notamment l’ISO 16269-6). Cette formule de dérivation exprime le facteur k en associant la valeur critique standard de la loi normale avec une correction quadratique issue du quantile de la distribution du Khi-deux :
k ≈ z_{(1+p)/2} · √( (n – 1) · (1 + 1/n) / χ²_{α, n-1} )
Dans cette structure algébrique, le terme z_{(1+p)/2} désigne le quantile bilatéral de la distribution normale standard correspondant à la couverture souhaitée p. Par exemple, pour une proportion de 95 %, l’argument cumulé s’établit à (1 + 0,95) / 2 = 0,975, délivrant la valeur conventionnelle de 1,960. Le terme multiplicateur sous la racine intègre le facteur d’ajustement (1 + 1/n), qui compense l’incertitude liée à l’estimation de la moyenne μ par x̄, et le dénominateur χ²_{α, n-1}, qui représente le quantile inférieur à l’ordre α de la loi du Khi-deux à n – 1 degrés de liberté.
Il importe de noter que certaines formulations équivalentes inversent la queue du Khi-deux selon que la fonction logicielle prend en entrée la probabilité cumulée à gauche ou à droite. Dans tous les cas, l’insertion de ce terme du Khi-deux pénalise de manière rigoureuse les petits échantillons : lorsque n est restreint, la valeur critique du Khi-deux au dénominateur est comparativement faible, ce qui accroît substantiellement la valeur de la racine, et propulse par conséquent le facteur k bien au-delà du simple quantile gaussien.
3. Les paramètres critiques : Proportion de population (p) et Niveau de confiance (1-α)
3.1 Sélection empirique de la couverture de population (p)
Le choix de la proportion de population p représente une décision méthodologique majeure qui conditionne la portée clinique ou industrielle de l’étalonnage. Fixer p revient à délimiter la fraction théorique de la population qui doit impérativement être contenue à l’intérieur des frontières de l’intervalle de tolérance. Les standards internationaux et la pratique psychométrique privilégient classiquement trois paliers conventionnels : 90 %, 95 % ou 99 %.
Le choix de ce paramètre repose sur l’arbitrage entre le risque d’exclusion prématurée et l’exigence de sensibilité diagnostique. Si un chercheur opte pour une couverture p = 0,90, il postule implicitement que 10 % de la population globale se situe hors de l’intervalle de référence normal (5 % dans chaque queue de la distribution pour un modèle bilatéral symétrique). Une telle décision augmente mécaniquement le nombre d’individus qualifiés d’atypiques, ce qui peut générer un taux inacceptable de faux positifs lors du dépistage de pathologies rares. À l’opposé, sélectionner p = 0,99 circonscrit l’atypisme à 1 % seulement des occurrences les plus extrêmes, limitant les faux positifs au détriment d’une réduction substantielle de la puissance d’identification des déviances subtiles.
Dans le domaine de l’évaluation neuropsychologique d’enfants d’âge scolaire, l’adoption de p = 0,95 constitue un compromis fréquent, aligné sur la référence des deux déviations-standards de la courbe de Gauss. Néanmoins, lorsque des décisions d’orientation hautement restrictives dépendent des scores observés, il est impératif d’évaluer formellement les implications socio-éducatives ou médicales d’une mauvaise classification en calibrant méticuleusement la valeur de p.
3.2 Fixation du seuil de confiance statistique (1-α)
Alors que la proportion p décrit le domaine physique de la population générale, le niveau de confiance 1 – α quantifie la certitude métrologique accordée au protocole statistique d’estimation. Le paramètre α représente le risque consenti que le protocole échoue à capturer la fraction p souhaitée en raison des aléas d’échantillonnage.
Une confusion récurrente consiste à assimiler le niveau de confiance 1 – α à la proportion de couverture elle-même. Il est impératif de dissocier conceptuellement ces deux grandeurs. L’affirmation selon laquelle un intervalle de tolérance est calculé à un seuil de confiance de 95 % (α = 0,05) pour une couverture de 99 % (p = 0,99) signifie concrètement que si l’expérimentateur répétait indéfiniment la collecte de son échantillon de taille n et recalculait les bornes à chaque itération, 95 % des intervalles ainsi générés contiendraient au moins 99 % des individus de la population globale. Les 5 % restants constitueraient des intervalles sous-couvrants, contenant une fraction inférieure à 99 %.
Le choix du niveau de confiance s’articule généralement autour de 1 – α = 0,95 dans les contextes de standardisation clinique usuelle, et peut être élevé à 1 – α = 0,99 dans les environnements biomédicaux hautement réglementés (validation de bioessais, certification d’instruments de mesure). Augmenter le niveau de confiance impose un surcoût statistique : les limites s’écartent pour parer à la possibilité d’avoir sélectionné un échantillon anormalement peu dispersé.
3.3 Interaction et compromis entre étendue et précision
L’interaction conjointe des paramètres p, 1 – α et de la taille d’échantillon n régit la dynamique géométrique de l’intervalle de tolérance. Toute tentative de maximiser simultanément la couverture de la population et la confiance statistique sans modifier la taille de la cohorte engendre une dilatation exponentielle de la largeur de l’intervalle.
L’écartement des bornes résulte directement de la modélisation mathématique du facteur k. L’accroissement de p élève la valeur du quantile normal z, tandis que l’élévation du niveau de confiance (diminution de α) diminue le quantile du Khi-deux figurant au dénominateur de la fraction, augmentant mécaniquement le quotient final. Ce phénomène traduit l’incertitude épistémique du statisticien : prétendre certifier avec une confiance presque totale (par exemple 99,9 %) le comportement d’une proportion quasi intégrale de la population (p = 0,999) sur la foi d’un échantillon modeste conduit à un intervalle démesurément large, dénué de toute utilité opérationnelle.
Le seul levier méthodologique permettant de resserrer l’amplitude de l’intervalle tout en maintenant des exigences élevées sur p et 1 – α consiste à accroître l’effectif n. Au fur et à mesure que n augmente, l’erreur d’échantillonnage s’amenuise, le terme (1 + 1/n) se rapproche de l’unité, et le ratio Khi-deux se stabilise. Les chercheurs planifiant des études normatives doivent donc conduire des calculs de dimensionnement a priori pour optimiser le compromis entre l’investissement logistique lié au recrutement des sujets et le bénéfice en termes de précision des bornes normatives.
4. Prérequis et vérification des hypothèses distributionnelles dans Excel
4.1 Évaluation de la normalité de la distribution des données
Avant d’initier la moindre étape de calcul d’un intervalle de tolérance paramétrique bilatéral dans une feuille Excel, la validation empirique de l’hypothèse de normalité constitue une exigence déontologique et méthodologique incontournable. Dans l’écosystème Excel, cette vérification s’opère par le croisement d’indicateurs d’asymétrie, d’aplatissement et d’inspections graphiques dédiées.
La première étape consiste à évaluer le coefficient d’asymétrie (skewness) au moyen de la fonction native COEFFICIENT.ASYMETRIE(), applicable à la plage de scores d’intérêt. Une distribution normale théorique présente une asymétrie nulle. En pratique expérimentale, une distribution est généralement considérée comme compatible avec la normalité univariée lorsque ce coefficient demeure confiné dans l’intervalle [-0,5 ; +0,5]. Simultanément, le coefficient d’aplatissement (kurtosis) doit être mesuré via la fonction KURT(). Excel calcule le kurtosis d’excès par rapport à la loi normale : une valeur proche de zéro signale une mesocurticité satisfaisante, tandis qu’une valeur substantiellement supérieure à 1 indique des queues lourdes qui menacent l’intégrité des bornes de tolérance.
L’évaluation numérique gagne impérativement à être complétée par la construction d’un diagramme quantile-quantile (Q-Q plot). Dans Excel, cette représentation s’élabore en ordonnant les données empiriques par ordre croissant, en leur associant des rangs standardisés, puis en calculant les quantiles théoriques correspondants via la fonction LOI.NORMALE.STANDARD.INVERSE(). L’insertion d’un graphique de type « Nuage de points » confrontant les valeurs observées aux quantiles théoriques permet de vérifier visuellement l’alignement des points sur la première bissectrice. Toute déviation systématique en forme de « S » ou de banane signale une non-conformité distributionnelle invalidant le recours aux formules paramétriques standard.
4.2 Détection et traitement des données aberrantes
La présence de valeurs aberrantes (ou outliers) au sein d’une série de données exerce un impact déstabilisateur massif sur le calcul des intervalles de tolérance. L’écart-type s, figurant comme multiplicateur direct dans l’expression de l’intervalle, est une statistique non robuste qui réagit de manière quadratique à l’éloignement d’une observation marginale. L’introduction accidentelle d’une donnée extrême entraîne une inflation artificielle de la dispersion et, corrélativement, un étirement excessif des bornes normatives calculées.
Pour diagnostiquer rigoureusement la présence d’aberrations numériques sans introduire d’arbitraire subjectif, il convient d’appliquer la règle classique de John Tukey, entièrement programmable sous Excel. Cette approche s’appuie sur le calcul de l’écart interquartile (EIQ), déduit de la différence entre le troisième quartile et le premier quartile obtenus respectivement par les formules QUARTILE.EXCLURE(plage; 3) et QUARTILE.EXCLURE(plage; 1). Les limites de détection des aberrations se structurent alors de la façon suivante :
- Seuil interne inférieur : Q1 – 1,5 · EIQ
- Seuil interne supérieur : Q3 + 1,5 · EIQ
- Seuil extrême externe : Q1 – 3 · EIQ ou Q3 + 3 · EIQ
En présence d’observations franchissant ces frontières, le chercheur doit mener une enquête métrologique : s’agit-il d’une erreur d’encodage évidente, d’un dysfonctionnement d’appareillage, ou d’une observation clinique authentique mais atypique ? Dans les deux premiers cas, la rectification ou l’exclusion formelle est requise. Dans le troisième cas, l’exclusion arbitraire est proscrite ; il conviendra alors d’envisager une transformation mathématique des données (logarithmique, Box-Cox) ou de recourir à des procédures de tolérance non paramétriques basées sur les statistiques d’ordre.
4.3 Considérations sur la taille minimale d’échantillon
Bien que l’approximation de Howe intègre formellement la taille d’échantillon n à travers les degrés de liberté du Khi-deux, l’application de la méthode sur des cohortes d’effectif très réduit pose des limites structurelles majeures quant à la stabilité des conclusions scientifiques. Lorsque n < 15, la distribution d’échantillonnage de la variance présente une instabilité considérable, ce qui se traduit par des valeurs critiques de k extrêmement élevées.
À titre d’exemple, pour une couverture de 95 % avec une confiance de 95 %, le facteur k excède 3,5 pour un échantillon de 10 individus, alors qu’il se stabilise autour de 2,2 pour une cohorte de 100 sujets. Cette disparité illustre le lourd tribut statistique imposé par l’incertitude d’échantillonnage sur les petits effectifs. Sur le plan pratique, un intervalle calculé sur un échantillon excessivement modeste risque de déborder des limites physiques ou physiologiques concevables du phénomène mesuré, vidant la démarche de toute applicabilité normative.
Du point de vue de la puissance d’estimation, il est formellement recommandé, pour tout étalonnage psychométrique ou biométrique destiné à un usage professionnel ou publié, de viser une taille d’échantillon minimale de n = 30 à n = 50 pour des exigences standards (p = 0,90 ou 0,95), et de porter cette exigence à plusieurs centaines d’individus lorsque p = 0,99 est sollicité. Lorsque la taille d’échantillon tend vers l’infini, le facteur k converge asymptotiquement vers la valeur idéale z_{(1+p)/2}, matérialisant l’élimination définitive du bruit d’échantillonnage au profit de la seule variabilité populationnelle.
5. Organisation et structuration de la feuille de calcul sous Excel
5.1 Architecture optimale du classeur d’analyse
La mise en œuvre opérationnelle de protocoles statistiques complexes au sein d’un tableur requiert une organisation spatiale et structurelle stricte. L’improvisation dans la disposition des formules favorise les erreurs d’adressage, complique l’audit scientifique et altère la reproductibilité des résultats. Une feuille de calcul destinée au calcul des intervalles de tolérance doit obéir au principe fondamental de compartimentation modulaire.
Il est recommandé de structurer la feuille en trois zones fonctionnelles distinctes, idéalement réparties par blocs horizontaux ou verticaux assortis d’un code visuel standardisé :
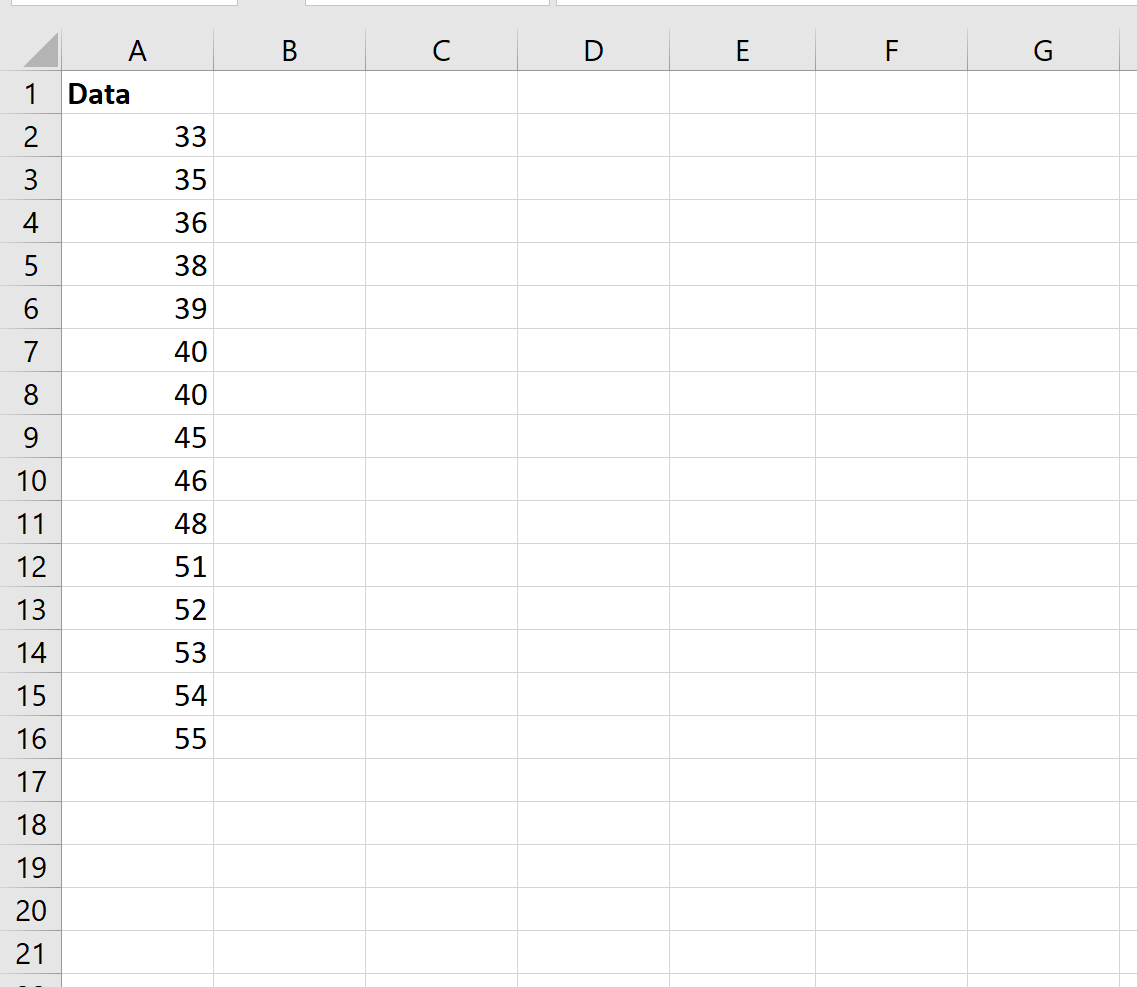
- Zone 1 : Matrice des données brutes. Située généralement dans les premières colonnes (par exemple colonnes A à C), cette section accueille les identifiants des participants, les variables de stratification (âge, sexe) et la colonne dédiée aux scores mesurés. Aucune opération de synthèse statistique ne doit être insérée dans cette zone afin de préserver l’intégrité de la série numérique.
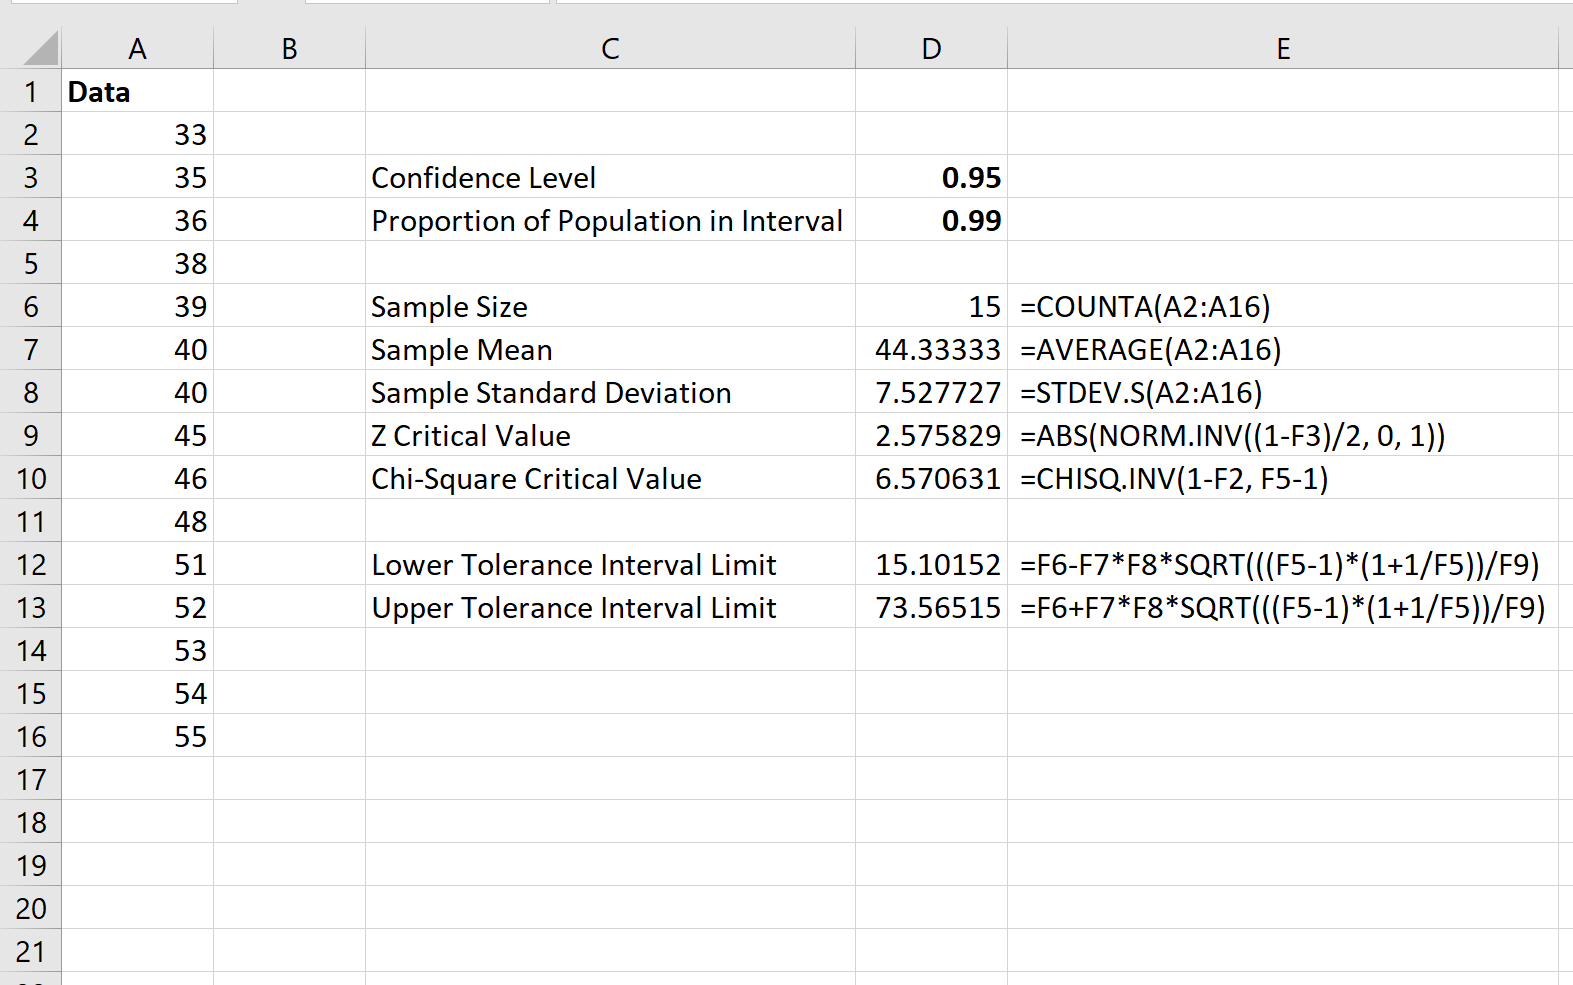
- Zone 2 : Panneau de contrôle des paramètres d’entrée. Positionnée dans un encart distinct (par exemple colonnes E et F, lignes 2 à 8), cette zone regroupe les choix théoriques de l’utilisateur : la proportion de population ciblée p et le niveau de confiance 1 – α.
- Zone 3 : Moteur de calcul et d’affichage des résultats. Ce bloc regroupe l’ensemble des statistiques descriptives calculées (taille, moyenne, écart-type, degrés de liberté), l’extraction des quantiles mathématiques intermédiaires, le facteur k, et enfin les bornes inférieure et supérieure de tolérance clairement isolées.
Pour assurer la pérennité de l’outil, il est judicieux de verrouiller les cellules contenant des formules critiques via la fonction de protection des feuilles d’Excel, tout en laissant les cellules de paramètres accessibles pour permettre une exploration dynamique immédiate.
5.2 Paramétrage des cellules d’entrée pour l’automatisation
L’automatisation robuste du modèle implique que l’utilisateur puisse faire varier instantanément les exigences inférentielles sans devoir modifier la structure interne des équations. À cette fin, les cellules d’entrée doivent être formellement documentées et sécurisées contre les erreurs de saisie numérique involontaires.
Désignons, par exemple, la cellule F2 comme l’espace dévolu à la saisie de la proportion de population p et la cellule F3 comme le réceptacle du niveau de confiance 1 – α. Afin d’éviter l’introduction de valeurs aberrantes (telles que des pourcentages négatifs, des entiers supérieurs à 1 ou des zéros mathématiques), il est vivement conseillé d’implémenter l’outil de « Validation des données » accessible via l’onglet Données du ruban Excel.
Dans la boîte de dialogue de validation, sélectionnez le critère « Décimal », avec pour condition « Compris entre », en spécifiant une borne minimale de 0,5000 et une borne maximale de 0,9999. Cette restriction garantit que le modèle opérera toujours dans des conditions théoriquement admissibles. De surcroît, le formatage des cellules d’entrée en « Pourcentage » avec une ou deux décimales (affichant par exemple 95,0 % pour une saisie de 0,95) accroît la lisibilité visuelle et élimine les ambiguïtés d’échelle lors de l’exploitation du classeur par des tiers.
5.3 Gestion du référencement et nommage des plages
L’utilisation de références de cellules brutes (telles que A2:A101 ou $F$2) au sein d’équations imbriquées complexes présente le désavantage majeur d’opacifier la lecture analytique et d’augmenter le risque de décalage accidentel lors de copies de formules. Pour hisser le classeur de calcul aux normes de clarté professionnelle, il convient de systématiser le recours aux plages nommées.
En utilisant le « Gestionnaire de noms » d’Excel (onglet Formules), le praticien peut assigner des étiquettes sémantiques univoques aux espaces clés de la feuille :
Scores: pour désigner la colonne contenant les valeurs quantitatives des sujets, par exemple=$A$2:$A$101.Prop_p: pour désigner la cellule contenant la proportion de couverture ciblée, par exemple=$F$2.Niv_Confiance: pour désigner la cellule hébergeant le degré de confiance, par exemple=$F$3.Facteur_k: pour identifier le résultat du calcul intermédiaire du facteur de tolérance.
L’emploi de ces plages nommées transforme des formules complexes et absconses en propositions quasi littérales, faciles à auditer. Par ailleurs, lors de l’extension de la cohorte d’étude, il suffit de redéfinir la plage Scores (ou d’utiliser un tableau structuré au format Tableau1[Scores] dont l’expansion est automatique lors de l’ajout de lignes) pour que l’intégralité du modèle recalcule instantanément les intervalles de tolérance sans la moindre manipulation d’équations.
6. Calcul des statistiques descriptives fondamentales dans Excel
6.1 Détermination de la taille de l’échantillon (n)
Le point de départ algorithmique de l’estimation de tolérance réside dans le dénombrement rigoureux du volume d’observations valides constituant l’échantillon de travail. Bien que cette tâche paraisse triviale, elle nécessite une vigilance méthodologique relative au traitement des valeurs manquantes ou des cellules accidentellement polluées par des caractères textuels.
Pour dénombrer exclusivement les données numériques exploitables au sein de la série, la fonction d’agrégation standard NB() doit être préférée à la fonction NBVAL(), cette dernière comptabilisant sans distinction les chaînes de caractères, les espaces invisibles ou les marqueurs de texte. La formule s’écrit de la manière suivante :
=NB(Scores)
Cette commande renvoie l’entier n correspondant aux observations strictement numériques. Dès cette valeur établie, la cellule adjacente dévolue au calcul des degrés de liberté, paramètre incontournable de la loi du Khi-deux, se formulera trivialement par :
=n - 1 (ou concrètement =NB(Scores)-1)
Cette distinction élémentaire prévient toute surestimation des degrés de liberté qui surviendrait si des cellules vides ou textuelles étaient intégrées par erreur dans le dénominateur de l’échantillon.
6.2 Calcul de la moyenne empirique (x̄)
La moyenne d’échantillon constitue le centre de gravité autour duquel vont s’articuler de manière symétrique les bornes bilatérales de l’intervalle de tolérance. Sur le plan théorique, la moyenne empirique x̄ est un estimateur sans biais, convergent et de variance minimale de l’espérance mathématique μ au sein des populations normalement distribuées.
Dans l’environnement Excel, le calcul s’effectue via la fonction native :
=MOYENNE(Scores)
D’un point de vue métrologique, bien qu’Excel réalise ses calculs internes en arithmétique flottante à double précision (garantissant environ 15 chiffres significatifs conformément à la norme IEEE 754), il est judicieux de maintenir un affichage cohérent sur le plan scientifique. L’utilisateur prendra soin de formater la cellule d’affichage de la moyenne avec un nombre de décimales en harmonie avec la précision intrinsèque de l’instrument de mesure employé (généralement une décimale supplémentaire par rapport aux données brutes), tout en laissant les formules ultérieures s’alimenter de la valeur interne exacte non arrondie afin d’éviter la propagation d’erreurs d’arrondi dans les étapes non linéaires du modèle.
6.3 Calcul de l’écart-type échantillonnal (s)
Le paramètre de dispersion s joue un rôle critique dans la largeur définitive de l’intervalle de tolérance. À ce niveau de la mise en œuvre, une attention extrême doit être portée au choix de la fonction d’écart-type au sein de la bibliothèque d’Excel, un écueil historique subsistant encore chez de nombreux utilisateurs.
Excel propose deux fonctions distinctes d’évaluation de la dispersion standard :
ECARTYPE.STANDARD()(ou historiquementECARTYPE()) : qui intègre au dénominateur la correction de Bessel n – 1.ECARTYPE.PE()(ouECARTYPEP()) : qui divise la somme des carrés des écarts par la taille d’échantillon brute n, postulant que les données constituent l’intégralité absolue de la population.
L’utilisation de ECARTYPE.PE() dans un calcul d’intervalle de tolérance constitue une faute mathématique majeure. En omettant la correction de Bessel, cette fonction introduit un biais d’estimation négatif systématique, sous-estimant la variance réelle de la population et conduisant à des intervalles artificiellement étroits qui violent les engagements de couverture statistique. La seule fonction valide est par conséquent :
=ECARTYPE.STANDARD(Scores)
Cet estimateur non biaisé garantit la conformité avec la distribution théorique du Khi-deux exploitée dans la modélisation du facteur k.
7. Calcul des valeurs critiques sous Excel : Normale et Khi-deux
7.1 Extraction de la valeur critique z pour la proportion p
Le calcul du facteur multiplicatif k s’amorce par l’extraction du quantile de la loi normale centrée réduite correspondant à la proportion bilatérale p stipulée dans le panneau de contrôle. Comme l’intervalle est symétrique, la proportion exclue, équivalente à 1 – p, doit être équitablement scindée en deux queues de probabilité égale : (1 – p) / 2 pour la queue inférieure et (1 – p) / 2 pour la queue supérieure.
Pour déterminer le point d’abscisse z englobant l’aire cumulée centrale p, il convient d’interroger la fonction quantile d’Excel avec la probabilité cumulée allant de l’extrême gauche jusqu’à la limite supérieure de la zone centrale. Cette probabilité cumulée totale s’exprime par la relation algébrique :
Probabilité cumulée = 1 – (1 – p) / 2 = (1 + p) / 2
Dans Excel, la fonction adéquate est LOI.NORMALE.STANDARD.INVERSE(). La formule dynamique à inscrire dans la cellule dédiée à la valeur critique z s’énonce donc :
=LOI.NORMALE.STANDARD.INVERSE((1 + Prop_p) / 2)
À titre d’étalonnage pour le vérificateur, si Prop_p est fixé à 0,95, la formule calcule l’antécédent de 0,975 et renvoie exactement la valeur théorique universelle 1,95996.... Si Prop_p est configuré à 0,99, la formule évalue le quantile pour 0,995 et renvoie 2,57582.... Cette dynamique garantit l’adaptation instantanée de la valeur z à toute modification de la cible de couverture.
7.2 Détermination du quantile de la loi du Khi-deux
L’incorporation de l’incertitude sur la variance exige le calcul du quantile pertinent de la loi de distribution du Khi-deux. Dans l’approximation standard de Howe adoptée pour les intervalles de tolérance bilatéraux, le terme d’ancrage fait intervenir le quantile inférieur associé au seuil de signification α avec n – 1 degrés de liberté.
Le traitement des distributions du Khi-deux dans Excel nécessite une rigueur d’implémentation absolue en raison de la coexistence de plusieurs fonctions dont le sens de cumul des probabilités diffère :
LOI.KHIDEUX.INVERSE(probabilité; degrés_liberté): calcule l’inverse de la fonction de répartition unilatérale à gauche (probabilité cumulée de 0 à x).LOI.KHIDEUX.INVERSE.DROITE(probabilité; degrés_liberté): calcule l’inverse de la queue unilatérale droite (probabilité que la variable aléatoire excède le seuil).
Le seuil de signification α représente le risque consenti, défini algébriquement par 1 – Niv_Confiance. Dans la formulation standard de Howe, le terme requis au dénominateur sous le radical est la valeur critique χ² telle que la probabilité d’obtenir une valeur inférieure soit égale à α. Si l’on recourt à la fonction standard à gauche, la formulation s’établit impérativement comme suit :
=LOI.KHIDEUX.INVERSE(1 - Niv_Confiance; n - 1)
Si la confiance est configurée à 95 % (Niv_Confiance = 0,95), l’argument de probabilité transmis à la fonction est 0,05. Il s’agit d’une source d’erreur fréquente chez les modélisateurs qui transmettent parfois par inadvertance la valeur de confiance 0,95 au lieu du risque résiduel α, aboutissant à une division par un quantile majeur qui effondre artificiellement le facteur k au lieu de le pénaliser conservativement.
7.3 Synthèse mathématique du facteur multiplicateur k
Dès lors que les composantes élémentaires — la taille n, les degrés de liberté n – 1, le quantile normal z et le quantile du Khi-deux χ² — sont adéquatement résolues dans la feuille de calcul, la synthèse algorithmique du facteur de tolérance k selon Howe peut être déployée.
Rappelons l’expression analytique de l’approximation :
k = z · √[ ((n – 1) · (1 + 1/n)) / χ²_{α, n-1} ]
La transcription littérale de cette architecture sous forme d’équation de feuille de calcul dans la cellule nommée Facteur_k prend la configuration suivante :
=Val_z * RACINE( (Degres_Lib * (1 + 1/Taille_n)) / Quant_Khi2 )
En remplaçant les alias nommés par leurs expressions logiques directes pour une formule autonome, l’expression globale équivaut à :
=LOI.NORMALE.STANDARD.INVERSE((1+Prop_p)/2) * RACINE(((NB(Scores)-1)*(1+1/NB(Scores))) / LOI.KHIDEUX.INVERSE(1-Niv_Confiance; NB(Scores)-1))
Cette cellule intermédiaire dédiée au facteur k remplit un rôle méthodologique fondamental de diagnostic. Elle permet à l’analyste de contrôler à tout moment la plausibilité statistique du multiplicateur. Le facteur k doit impérativement être supérieur au quantile z correspondant pour toute taille d’échantillon finie, et doit se rapprocher asymptotiquement de z lorsque n croît vers plusieurs centaines de points de mesure. Tout résultat où k ≤ z révèle une interversion de paramètres dans les quantiles ou une anomalie de codage de queue probabiliste.
8. Formulation pas-à-pas des bornes de tolérance dans Excel
8.1 Calcul de la marge d’erreur globale de tolérance
L’étape succédant à la détermination du facteur de tolérance k consiste à traduire cette métrique adimensionnelle dans l’échelle d’évaluation originelle de la variable étudiée (qu’il s’agisse de points de score à une batterie de mémoire, de milligrammes par décilitre dans un dosage sérique, ou de temps de réaction en millisecondes).
Cette opération s’effectue en multipliant le facteur k par l’écart-type échantillonnal non biaisé s. Le résultat de ce produit définit la marge d’erreur globale de tolérance, notée MEtol :
MEtol = k · s
Dans la feuille de calcul, la formule s’énonce simplement :
=Facteur_k * EcartType_s
L’analyse dimensionnelle confirme que cette marge d’erreur partage exactement l’unité de mesure de la variable analysée. En raison de la symétrie de la distribution normale sous-jacente, cette marge s’applique de façon équivalente de part et d’autre de la moyenne empirique, constituant le rayon statistique d’acceptabilité clinique ou métrologique.
8.2 Calcul de la limite inférieure de tolérance (LIT)
La limite inférieure de tolérance (LIT) représente le plancher quantitatif en deçà duquel seule une fraction théorique strictement contrôlée de la population est susceptible de se trouver. Sur le plan de la formulation arithmétique, elle s’obtient en retranchant la marge d’erreur de tolérance de la moyenne empirique de l’échantillon :
LIT = x̄ – MEtol = x̄ – k · s
La cellule dédiée au sein de la matrice de résultats sous Excel recevra la commande :
=Moyenne_x - ME_tol
En pratique clinique ou psychométrique, les analystes doivent confronter le résultat calculé aux propriétés intrinsèques de l’échelle d’évaluation. Il existe fréquemment des valeurs planchers théoriques absolues (par exemple, un test psychométrique dont le score ne peut être inférieur à 0). Si le calcul mathématique délivre une LIT négative en raison d’une forte dispersion ou d’une taille d’échantillon restreinte, cette situation révèle soit une asymétrie non décelée de la distribution empirique (incompatibilité avec l’hypothèse gaussienne), soit la nécessité d’imposer un ajustement logique via une structure conditionnelle du type :
=MAX(0; Moyenne_x - ME_tol)
Une telle borne doit néanmoins être formellement documentée dans le rapport méthodologique car elle marque la frontière entre l’espace probabiliste pur et la réalité opératoire de l’instrument.
8.3 Calcul de la limite supérieure de tolérance (LST)
Symétriquement, la limite supérieure de tolérance (LST) délimite le plafond quantitatif au-delà duquel les observations individuelles de la population générale ne peuvent survenir que dans une proportion infinitésimale et statistiquement encadrée. Elle est formalisée par l’addition de la marge d’erreur à la moyenne empirique :
LST = x̄ + MEtol = x̄ + k · s
L’instruction Excel s’écrit de manière analogue :
=Moyenne_x + ME_tol
À l’instar des bornes inférieures, les instruments d’évaluation psychologique présentent régulièrement des plafonds de mesure stricts (par exemple, un score maximal théorique de 80 ou 100 points à une épreuve cognitive). L’obtention d’une LST mathématique excédant la borne physique du protocole traduit souvent un effet de plafond dans l’échantillon normatif d’origine, susceptible de violer l’hypothèse de normalité et d’imposer une prudence d’interprétation diagnostique.
La paire ordonnée [LIT ; LST] délimite l’espace d’inclusion normatif. Tout sujet dont l’évaluation future s’insère à l’intérieur de cet intervalle fermé est scientifiquement qualifié d’appartenant à la variabilité normative de la population de référence avec le degré de confiance 1 – α garanti.
8.4 Intégration en une formule unifiée et modélisation dynamique
Bien que la décomposition analytique pas-à-pas en sous-cellules de calcul soit infiniment supérieure pour la traçabilité des opérations et l’auditabilité statistique, certaines applications d’ingénierie logicielle ou de métrologie industrielle requièrent l’implémentation directe d’une formule unifiée monolithique.
En rassemblant l’intégralité des dérivations algébriques précédemment établies au sein d’une unique expression, la borne inférieure de tolérance (LIT) peut être synthétisée dans Excel sans aucune cellule intermédiaire par la formule suivante :
=MOYENNE(Scores) - (LOI.NORMALE.STANDARD.INVERSE((1+Prop_p)/2) * RACINE(((NB(Scores)-1)*(1+1/NB(Scores))) / LOI.KHIDEUX.INVERSE(1-Niv_Confiance; NB(Scores)-1))) * ECARTYPE.STANDARD(Scores)
De manière rigoureusement équivalente, la borne supérieure de tolérance (LST) s’obtient en convertissant le premier opérateur de soustraction en addition :
=MOYENNE(Scores) + (LOI.NORMALE.STANDARD.INVERSE((1+Prop_p)/2) * RACINE(((NB(Scores)-1)*(1+1/NB(Scores))) / LOI.KHIDEUX.INVERSE(1-Niv_Confiance; NB(Scores)-1))) * ECARTYPE.STANDARD(Scores)
Pour parachever l’ergonomie de restitution visuelle au sein d’un tableau de bord ou d’une fiche clinique de synthèse, il est particulièrement pertinent de formater une chaîne de caractères textuelle dynamique qui assemble l’intervalle complet avec ses métadonnées associées au moyen des fonctions modernes de chaînage :
="Intervalle de Tolérance à " & TEXTE(Prop_p; "0,0%") & " (Confiance: " & TEXTE(Niv_Confiance; "0,0%") & ") = [ " & TEXTE(LIT; "0,000") & " ; " & TEXTE(LST; "0,000") & " ]"
Cette approche dynamique met à jour automatiquement la chaîne descriptive dès qu’un nouvel enregistrement est incrémenté dans la colonne des scores ou dès que l’opérateur altère les cellules de couverture.
9. Exemple pratique guidé : Application numérique sur un échantillon empirique
9.1 Description du jeu de données et paramétrage de l’étude
Pour matérialiser sans ambiguïté l’ensemble des instructions précédentes, considérons une étude empirique d’évaluation psychologique portant sur un échantillon normatif d’étalonnage. Une cohorte de n = 30 participants représentatifs d’une classe d’âge scolaire a été soumise à une épreuve standardisée de raisonnement perceptif mesurant une compétence d’assemblage logique.
Les paramètres d’entrée prescrits par le comité méthodologique de standardisation sont les suivants :
- Proportion de population ciblée : p = 0,99 (on exige d’englober 99 % de la distribution de la population générale).
- Niveau de confiance métrologique : 1 – α = 0,95 (on tolère un risque d’erreur d’échantillonnage résiduel α de 5 %).
La série brute des scores obtenus s’insère au sein des cellules A2:A31 de la feuille Excel. L’application préalable des tests d’adéquation univariés a confirmé une distribution symétrique sans dissymétrie marquée (skewness = +0,12) ni aplatissement anormal (kurtosis = -0,24), confirmant l’acceptabilité de l’hypothèse de normalité.
9.2 Exécution séquentielle des calculs numériques
Procédons au déroulement séquentiel des calculs arithmétiques tels qu’exécutés par le moteur de formules d’Excel :
Étape 1 : Calcul des statistiques élémentaires d’échantillon
- Taille de l’échantillon :
n = NB(A2:A31) = 30 - Degrés de liberté :
ν = 30 - 1 = 29 - Moyenne observée :
x̄ = MOYENNE(A2:A31) = 44,3335 - Écart-type corrigé de Bessel :
s = ECARTYPE.STANDARD(A2:A31) = 9,6775
Étape 2 : Extraction des quantiles probabilistes
- Quantile normal bilatéral pour p = 0,99 :
z = LOI.NORMALE.STANDARD.INVERSE((1 + 0,99) / 2) = LOI.NORMALE.STANDARD.INVERSE(0,995) = 2,57583 - Quantile unilatéral du Khi-deux pour α = 0,05 avec 29 degrés de liberté :
χ² = LOI.KHIDEUX.INVERSE(0,05 ; 29) = 17,7084
Étape 3 : Calcul du facteur multiplicateur k de Howe
L’évaluation du terme correctif s’opère selon l’équation :
Facteur de variance = (29 · (1 + 1/30)) / 17,7084 = (29 · 1,03333) / 17,7084 = 29,9667 / 17,7084 = 1,69223
En extrayant la racine carrée : √1,69223 = 1,30086
Le facteur k final s’établit donc à :
k = 2,57583 · 1,30086 = 3,04439
Étape 4 : Calcul de la marge d’erreur et des bornes
La marge d’erreur globale de tolérance est le produit de k et de l’écart-type s :
ME_tol = 3,04439 · 9,6775 = 29,2315
Nous pouvons dès lors en déduire directement les bornes bilatérales du modèle :
- Limite Inférieure de Tolérance (LIT) :
44,3335 - 29,2315 = 15,102 - Limite Supérieure de Tolérance (LST) :
44,3335 + 29,2315 = 73,565
9.3 Interprétation statistique et psychométrique du résultat [15,102 ; 73,565]
L’intervalle bilatéral obtenu se formalise rigoureusement par les limites [15,102 ; 73,565]. Sur le plan de l’inférence clinique et méthodologique, la portée de cet énoncé numérique s’énonce ainsi :
« Avec un niveau de confiance statistique de 95 %, nous pouvons affirmer qu’au moins 99 % de l’ensemble de la population de référence présentera un score à cette épreuve de raisonnement perceptif compris entre 15,102 et 73,565 points. »
Pour appréhender la singularité de ce résultat, il est particulièrement instructif de le confronter à ce qu’aurait produit un simple intervalle de confiance à 95 % de la moyenne empirique. L’erreur standard de la moyenne s’élevant à s / √n = 9,6775 / √30 = 1,767, l’intervalle de confiance de la moyenne de Student se délimiterait entre 40,719 et 47,948. Un praticien qui utiliserait par erreur cet intervalle de confiance pour apprécier la normalité d’un patient individuel conclurait qu’un score de 35 est pathologiquement déficitaire, alors que l’intervalle de tolérance démontre sans équivoque qu’un score de 35 s’inscrit pleinement dans le profil de distribution des 99 % d’individus normatifs de la population.
Dans l’arsenal du psychologue clinicien ou du médecin expert, les bornes [15,102 ; 73,565] constituent désormais la grille d’étalonnage absolue. Tout score individuel s’effondrant sous le seuil de 15,102 ne pourra plus être interprété comme une banale fluctuation d’échantillonnage, mais représentera une atypicité statistique formellement démontrée au seuil de 99 % de couverture de référence.
10. Analyse de sensibilité et simulation de scénarios sous Excel
10.1 Construction d’une table de données à double entrée
L’une des forces majeures de l’implémentation sous Excel réside dans sa capacité à générer des analyses de sensibilité exhaustives sans programmation complexe grâce à l’outil natif « Table de données » de la boîte à outils d’analyse de scénarios. Cet outil permet de modéliser instantanément l’élargissement ou le resserrement des bornes de tolérance lorsque l’on fait varier conjointement la couverture p et la confiance 1 – α.
Pour mettre en place cette simulation bidimensionnelle :
- Sur une nouvelle zone de la feuille, définissez un tableau matriciel. Disposez horizontalement sur la ligne d’en-tête (par exemple
H1:J1) différents niveaux de couverture :90%,95%,99%. - Disposez verticalement sur la première colonne (par exemple
G2:G4) les paliers de confiance souhaités :90%,95%,99%. - Dans la cellule située à l’intersection supérieure gauche de la matrice (cellule
G1), insérez la formule faisant référence à la marge de tolérance ou à la largeur totale de l’intervalle :=2 * Facteur_k * EcartType_s. - Sélectionnez l’intégralité de la plage matricielle
G1:J4, rendez-vous dans l’onglet Données, groupe Prévision, menu Analyse de scénarios, et activez la commande « Table de données ». - Dans l’invite de dialogue, assignez la « Cellule d’entrée en ligne » à la cellule contenant le paramètre
Prop_p, et la « Cellule d’entrée en colonne » à la cellule hébergeantNiv_Confiance. Validez l’opération.
Excel génère instantanément une table dynamique affichant la variabilité de la marge d’erreur. Cette matrice offre au chercheur une vision panoramique de l’impact des contraintes statistiques imposées, permettant d’identifier immédiatement le coût d’une exigence excessive de confiance sur la précision des étalonnages normatifs.
10.2 Évaluation de l’effet de la taille de l’échantillon (n)
La simulation paramétrique sous Excel met en lumière un enseignement fondamental de la statistique inférentielle : la loi des rendements marginaux décroissants relative à l’accroissement de la taille d’échantillon n.
En construisant une table évaluant l’amplitude du facteur k (pour p = 0,95 et 1 – α = 0,95) pour des échantillons successifs de taille n = 15, 30, 50, 100, 500, 1000 et 5000, l’analyste observe une décroissance rapide et spectaculaire du facteur de correction sur le segment n = 15 à n = 100, où k chute de plus de 2,75 à environ 2,23. En revanche, le passage de n = 500 (k ≈ 2,05) à n = 5000 (k ≈ 1,98) n’engendre qu’un gain marginal d’optimisation de l’intervalle, la valeur convergeant vers le plancher asymptotique gaussien de 1,960.
Cette modélisation revêt une valeur économique et éthique déterminante lors de la conception de protocoles de recherche biomédicale ou de campagnes de standardisation psychométrique. Elle permet de démontrer qu’au-delà d’un effectif de quelques centaines de participants bien échantillonnés, l’investissement consenti pour collecter des données supplémentaires n’apporte qu’un bénéfice négligeable en termes de resserrement des bornes de tolérance, fournissant un argument décisif pour arbitrer les budgets d’investigation de terrain.
10.3 Représentation graphique dynamique de l’intervalle de tolérance
La communication scientifique et clinique des résultats d’un étalonnage exige une restitution visuelle claire et didactique. Excel permet d’élaborer des graphiques de distribution enrichis matérialisant simultanément la densité de probabilité gaussienne et les limites de tolérance calculées.
Pour construire ce rendu visuel dynamique :
- Générez une colonne d’abscisses comprenant une cinquantaine de valeurs fictives régulièrement espacées, couvrant le domaine [x̄ – 4s ; x̄ + 4s].
- Dans la colonne adjacente, calculez la densité de probabilité correspondante en utilisant la fonction native
LOI.NORMALE.N(x ; Moyenne_x ; EcartType_s ; FAUX). - Tracez cette distribution sous forme d’un graphique de type « Ligne » ou « Nuage de points avec lignes lissées » pour obtenir la fameuse courbe en cloche de Gauss.
- Ajoutez ensuite deux séries de données secondaires consistant en deux segments verticaux : l’un positionné à l’abscisse exacte
LITmontant de l’axe zéro jusqu’à la hauteur de la cloche, l’autre situé à l’abscisseLST.
Une alternative graphique tout aussi percutante pour comparer plusieurs sous-groupes cliniques consiste à recourir à un graphique à barres d’erreurs bidirectionnelles personnalisées. En spécifiant la cellule de marge d’erreur ME_tol dans les champs de valeurs d’erreur positives et négatives d’Excel, l’utilisateur affiche un diagramme où chaque groupe clinique est doté de ses ailes de tolérance personnalisées, visualisant instantanément les recouvrements de population et les zones diagnostiques univoques.
11. Limites de l’approximation, cas non normaux et alternatives computationnelles
11.1 Limites de l’approximation analytique usuelle
Bien que l’approximation de Howe s’avère remarquable d’efficacité et présente une erreur relative inférieure à 1 % par rapport aux tables exactes pour la quasi-totalité des configurations expérimentales courantes (n ≥ 20), elle n’en demeure pas moins une approximation de second ordre de la distribution exacte de Wald-Wolfowitz. Dans des contextes de très faibles effectifs (n < 10) associés à des exigences de couverture extrêmes (p = 0,999), la méthode présente un biais résiduel d’estimation qui tend à sous-estimer très légèrement l’amplitude réelle de la marge d’erreur.
La formulation exacte rigoureuse requiert la résolution d’une intégrale double imbriquant les fonctions hypergéométriques confluentes et des distributions non centrales de Student. Pour la grande majorité des recherches appliquées en sciences sociales et cliniques, ce biais résiduel à partir de n = 30 devient infiniment inférieur aux imprécisions liées aux instruments de mesure psychométriques eux-mêmes.
Le risque majeur d’inférence ne provient donc pas de la dérivation analytique de Howe, mais bien de la violation de l’hypothèse de normalité univariée. Lorsque les données empiriques proviennent d’une loi exponentielle, log-normale, ou de distributions bimodales fréquentes en psychiatrie (présence d’un sous-groupe sain et d’un sous-groupe pathologique masqué), le calcul d’un intervalle de tolérance paramétrique bilatéral symétrique produit des aberrations manifestes, telles que des exclusions disproportionnées d’un côté de la distribution et une sous-couverture systémique de l’autre.
11.2 Intervalles de tolérance non paramétriques
Lorsque la vérification des prérequis distributionnels conclut à l’impossibilité de postuler la normalité des données, le chercheur doit renoncer au formalisme de Howe sous peine de biaiser ses conclusions normatives. Il convient alors de migrer vers les intervalles de tolérance non paramétriques, ou libres de distribution, initialement formalisés par Samuel Wilks en 1941.
L’approche de Wilks s’appuie sur la statistique des rangs et les statistiques d’ordre d’un échantillon. Elle stipule que les valeurs extrêmes observées au sein d’une série triée — à savoir la valeur minimale X(1) et la valeur maximale X(n) — forment un intervalle de tolérance dont la couverture de population p et le niveau de confiance 1 – α sont mathématiquement reliés par la relation polynomiale exacte :
1 – pn – n · (1 – p) · pn-1 ≥ 1 – α
Cette méthodologie affranchit intégralement le praticien de toute hypothèse sur la forme géométrique de la distribution. Néanmoins, elle impose une contrainte logistique sévère sur l’effectif minimal requis. Pour satisfaire, par exemple, une couverture de 95 % (p = 0,95) avec une confiance de 95 % (α = 0,05) en utilisant simplement les valeurs extrêmes comme bornes, l’inéquation de Wilks exige un échantillon minimal impératif de n = 93 individus. Pour p = 0,99 avec la même confiance, l’effectif minimal bondit à n = 473.
Dans Excel, l’extraction de ces bornes d’ordre s’opère instantanément une fois l’effectif requis validé en utilisant les fonctions :
- Borne inférieure non paramétrique :
=PETITE.VALEUR(Scores; 1)(ouMIN(Scores)) - Borne supérieure non paramétrique :
=GRANDE.VALEUR(Scores; 1)(ouMAX(Scores))
Si la taille d’échantillon est supérieure au seuil minimal de Wilks, des statistiques d’ordre plus internes (telles que le deuxième minimum et le deuxième maximum) peuvent être exploitées pour réduire la sensibilité aux artéfacts de mesure.
11.3 Automatisation avancée via VBA ou fonctions personnalisées (LAMBDA)
Avec l’avènement des fonctionnalités de calcul matriciel dynamique dans les versions modernes de Microsoft 365 et d’Excel, les utilisateurs ne sont plus contraints d’encombrer leurs classeurs de calculs intermédiaires ni d’écrire de complexes macros en Visual Basic for Applications (VBA) pour exécuter des algorithmes avancés. La fonction LAMBDA() permet désormais de créer une véritable fonction native personnalisée, encapsulée et réutilisable dans l’ensemble du classeur.
Pour concevoir la macro-fonction personnalisée TOLERANCE.BILATERALE(), il suffit d’ouvrir le Gestionnaire de noms d’Excel, de créer une nouvelle étiquette intitulée TOLERANCE.BILATERALE et d’insérer dans le champ « Fait référence à » la déclaration algorithmique suivante :
=LAMBDA(Plage_Scores; Couverture_p; Confiance_1_alpha; LET( n; NB(Plage_Scores); df; n - 1; xbar; MOYENNE(Plage_Scores); s; ECARTYPE.STANDARD(Plage_Scores); z; LOI.NORMALE.STANDARD.INVERSE((1 + Couverture_p) / 2); chi; LOI.KHIDEUX.INVERSE(1 - Confiance_1_alpha; df); k; z * RACINE((df * (1 + 1 / n)) / chi); me; k * s; CHOOSE({1;2}; xbar - me; xbar + me) ))
L’utilisation de la fonction LET() au sein de la fonction LAMBDA() autorise l’instanciation de variables locales éphémères, évitant ainsi le recalcul redondant des statistiques descriptives et garantissant des performances computationnelles optimales. Dès cette définition enregistrée, l’utilisateur peut appeler directement dans n’importe quelle cellule de son classeur la formule simplifiée :
=TOLERANCE.BILATERALE(A2:A100; 0,95; 0,95)
Le moteur matriciel d’Excel déverse instantanément les deux résultats (la borne inférieure et la borne supérieure) dans deux cellules contiguës adjacentes. Cette approche encapsulée immunise totalement l’analyste contre les corruptions accidentelles de formules tout en assurant une standardisation parfaite du protocole de calcul à l’échelle d’un laboratoire ou d’un service d’évaluation.
12. Guide de synthèse méthodologique, reporting scientifique et bonnes pratiques
12.1 Récapitulatif des formules Excel essentielles
Pour faciliter la conception, la maintenance et l’audit des feuilles de calcul dédiées à la standardisation normative, le tableau de synthèse ci-après récapitule l’ensemble des instructions logiques et des formules natives requises pour le calcul complet de l’intervalle de tolérance bilatéral paramétrique sous Excel :
| Statistique / Paramètre cible | Formulation algébrique standard | Syntaxe officielle Microsoft Excel (Version FR) |
|---|---|---|
| Taille valide de l’échantillon (n) | n = ∑ 1 | =NB(Scores) |
| Degrés de liberté (ν) | ν = n – 1 | =NB(Scores) - 1 |
| Moyenne empirique (x̄) | x̄ = (1/n) · ∑ xi | =MOYENNE(Scores) |
| Écart-type corrigé de Bessel (s) | s = √[ 1/(n-1) · ∑ (xi – x̄)² ] | =ECARTYPE.STANDARD(Scores) |
| Quantile gaussien bilatéral (z) | z_{(1+p)/2} | =LOI.NORMALE.STANDARD.INVERSE((1 + Prop_p) / 2) |
| Quantile du Khi-deux inférieur (χ²) | χ²_{α, n-1} | =LOI.KHIDEUX.INVERSE(1 - Niv_Confiance; n - 1) |
| Facteur multiplicateur de Howe (k) | z · √[ (n-1)(1 + 1/n) / χ² ] | =z * RACINE((df * (1 + 1/n)) / chi2) |
| Marge d’erreur globale de tolérance | MEtol = k · s | =Facteur_k * EcartType_s |
| Limite Inférieure de Tolérance (LIT) | LIT = x̄ – k · s | =Moyenne_x - ME_tol |
| Limite Supérieure de Tolérance (LST) | LST = x̄ + k · s | =Moyenne_x + ME_tol |
Le respect scrupuleux de cet enchaînement fonctionnel prémunit l’analyste contre toute rupture de logique stochastique lors du traitement de ses séries de données quantitatives.
12.2 Normes de rédaction et de communication scientifique (APA)
La publication de résultats d’intervalles de tolérance dans des revues savantes régies par les normes de l’American Psychological Association (APA, 7e édition) ou au sein de monographies médicales obéit à des conventions rédactionnelles strictes. Mentionner un intervalle de tolérance sans expliciter rigoureusement et conjointement le niveau de couverture et le niveau de confiance constitue un manquement épistémologique qui invalide la recevabilité de l’article.
Dans la section « Méthode » ou « Analyses statistiques », le protocole de calcul doit être décrit avec exactitude, en spécifiant l’approximation utilisée et l’évaluation des hypothèses préalables. Voici un modèle de paragraphe méthodologique standard conforme aux critères d’évaluation des pairs :
« L’étalonnage normatif des scores composites a été réalisé par la détermination d’intervalles de tolérance statistiques bilatéraux paramétriques fondés sur l’approximation de Howe (1969). La normalité univariée de la distribution a été préalablement confirmée par l’inspection des indices de symétrie (skewness = 0,12) et d’aplatissement (kurtosis = -0,24), ainsi que par l’ajustement linéaire d’un diagramme quantile-quantile. L’intervalle bilatéral a été paramétré pour capturer au moins 99 % de la population générale de référence (p = 0,99) avec un niveau de confiance statistique de 95 % (1 – α = 0,95). »
Dans la section « Résultats », la formulation numérique doit combiner la description des statistiques d’échantillon fondamentales et l’énoncé sans équivoque des bornes de tolérance :
« Pour l’épreuve de raisonnement perceptif (N = 30 ; M = 44,33 ; SD = 9,68), le facteur de tolérance calculé s’élève à k = 3,044. L’intervalle de tolérance bilatéral à 99 % de couverture avec 95 % de confiance s’établit formellement à [15,10 ; 73,57]. Ces limites définissent les frontières de l’étalonnage normatif pour cette classe d’âge. »
12.3 Erreurs méthodologiques fréquentes et comment les éviter
La pratique statistique courante sur tableur révèle la récurrence de plusieurs dérives méthodologiques majeures lors du calcul des intervalles de tolérance. Dresser l’inventaire de ces écueils permet aux praticiens de consolider leurs procédures de contrôle qualité :
- La confusion entre intervalle de tolérance et intervalle de confiance : Il s’agit de la défaillance la plus répandue. Elle consiste à présenter l’intervalle d’estimation de la moyenne x̄ ± t · (s / √n) comme s’il s’agissait des limites de dispersion de la population générale. Cette bévue conduit à proclamer des seuils d’atypisme clinique considérablement trop étroits, catégorisant à tort comme déficitaires ou pathologiques une proportion massive d’individus parfaitement sains.
- L’omission de la correction de Bessel sur l’écart-type : L’utilisation par mégarde de la fonction
ECARTYPE.PE()au lieu deECARTYPE.STANDARD()retire artificiellement un degré de liberté à la variance empirique. Cette sous-estimation de la dispersion entraîne un rétrécissement systématique non documenté de l’intervalle final, altérant le respect du taux de couverture nominal p. - L’interversion des queues de probabilité de la loi du Khi-deux : L’affectation directe de la valeur de confiance (par exemple 0,95) au sein de la fonction d’inversion cumulée à gauche d’Excel à la place du risque alpha résiduel (0,05) constitue une erreur classique de signe statistique. Le dénominateur sous le radical s’en trouve massivement gonflé, réduisant indûment le facteur k en dessous de sa valeur théorique nécessaire.
- L’application aveugle sans diagnostic de normalité : Calculer un intervalle de tolérance paramétrique bilatéral sur des scores fortement asymétriques ou tronqués (par exemple des scores de douleur analogiques fortement regroupés à zéro) sans tester la distribution ni procéder à une transformation préalable vicie totalement les inférences produites. Face à de telles distributions, l’application stricte des méthodes non paramétriques de Wilks s’impose impérativement.
L’observation rigoureuse des directives exposées dans ce traité méthodologique assure aux chercheurs et praticiens un cadre opératoire optimal pour concevoir des normes fiables, scientifiquement irréprochables et immédiatement transposables au sein de l’environnement Microsoft Excel.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
Howe, W. G. (1969). Two-sided tolerance limits for normal populations: Some approximations. Journal of the American Statistical Association, 64(326), 610–623. https://doi.org/10.1080/01621459.1969.10500999
International Organization for Standardization. (2014). Statistical interpretation of data — Part 6: Determination of statistical tolerance intervals (ISO Standard No. 16269-6:2014). https://www.iso.org/standard/55251.html
Krishnamoorthy, K., & Mathew, T. (2009). Statistical tolerance regions: Theory, applications, and computation. John Wiley & Sons. https://doi.org/10.1002/9780470473900
Meeker, W. Q., Hahn, G. J., & Escobar, L. A. (2017). Statistical intervals: A guide for practitioners and researchers (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118594841
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
Wald, A., & Wolfowitz, J. (1946). Tolerance limits for a normal distribution. The Annals of Mathematical Statistics, 17(2), 208–215. https://doi.org/10.1214/aoms/1177730955
Weissberg, A., & Beatty, G. H. (1960). Tables of tolerance-limit factors for normal distributions. Technometrics, 2(4), 483–500. https://doi.org/10.1080/00401706.1960.10489913
Wilks, S. S. (1941). Determination of sample sizes for setting tolerance limits. The Annals of Mathematical Statistics, 12(1), 91–96. https://doi.org/10.1214/aoms/1177731788