
Le traitement des données quantitatives repose fondamentalement sur la capacité du chercheur et de l’analyste à synthétiser des distributions complexes d’observations en indicateurs intelligibles et exploitables. Qu’il s’agisse de mesurer la dispersion de scores psychométriques, d’évaluer le temps de réaction de sujets dans le cadre de protocoles en neurosciences cognitives, ou d’analyser les indicateurs de performance au sein d’une organisation, la réduction des données brutes en distributions ordonnées constitue une étape méthodologique incontournable. Parmi ces instruments de statistique descriptive, la fréquence cumulée occupe une place privilégiée, reliant directement l’analyse exploratoire à la modélisation probabiliste par l’intermédiaire de la fonction de répartition empirique.
Le tableur Microsoft Excel demeure l’un des environnements computationnels les plus largement déployés pour concevoir, structurer et automatiser ces opérations de réduction distributionnelle. Bien que des environnements programmatiques dédiés tels que le projet R pour le calcul statistique ou des bibliothèques Python spécialisées offrent des solutions d’analyse avancée, la polyvalence, la transparence matricielle et l’immédiateté visuelle d’Excel en font un vecteur privilégié de modélisation statistique, tant dans les laboratoires académiques que dans les cabinets d’études cliniques et industriels. La mise en œuvre rigoureuse du calcul de la fréquence cumulée requiert néanmoins une maîtrise formelle des mécanismes d’adressage, de l’algèbre des fonctions natives et de la dynamique des structures tabulaires afin d’éviter tout écueil d’incohérence arithmétique.
Le présent traité méthodologique propose une exploration exhaustive des techniques de calcul, d’interprétation et de visualisation des fréquences cumulées dans Microsoft Excel. En articulant les fondements mathématiques de la statistique descriptive avec les subtilités algorithmiques du logiciel, nous examinerons successivement les méthodes itératives traditionnelles, les approches matricielles expansives par références mixtes, l’exploitation native des Tableaux Croisés Dynamiques, ainsi que les avancées récentes introduites par les moteurs de calcul dynamique à base d’itérateurs vectoriels comme les fonctions LAMBDA et SCAN. Ce cadre opératoire permettra d’aborder des applications avancées, notamment l’étalonnage normatif de tests psychologiques et la détection d’asymétries structurelles au sein d’échantillons complexes.
1. Introduction aux distributions statistiques et aux fréquences cumulées
1.1 Définition théorique de la fréquence absolue et relative
Dans l’architecture de la statistique descriptive, l’observation brute constitue l’unité fondamentale recueillie sur une unité expérimentale donnée. Lorsque ces observations sont compilées, elles se présentent initialement sous la forme d’un vecteur non structuré de mesures quantitatives ou de modalités qualitatives. La fréquence absolue, communément désignée sous le vocable d’effectif simple et notée mathématiquement ni, représente le dénombrement direct et exhaustif des occurrences associées à une modalité spécifique ou à un intervalle de valeurs désigné au sein d’un échantillon de taille N. Cette grandeur discrète quantifie l’intensité d’apparition d’un événement au sein de la série, sans considération immédiate de l’amplitude globale de l’échantillon analysé.
À l’inverse, la fréquence relative, couramment symbolisée par fi, opère une normalisation proportionnelle en rapportant chaque fréquence absolue à la cardinalité globale de l’ensemble d’observations, selon la relation fondamentale fi = ni / N. Cette opération confère à la fréquence relative des propriétés mathématiques strictes : la valeur obtenue est obligatoirement confinée dans l’intervalle réel fermé [0, 1], et la somme des fréquences relatives sur l’ensemble des k modalités mutuellement exclusives et exhaustivement répertoriées est rigoureusement égale à l’unité. En substituant le rapport de proportion au comptage brut, la fréquence relative neutralise l’effet d’échelle inhérent à la taille de l’échantillon, permettant des comparaisons directes entre sous-populations distinctes.
Dans le domaine de l’inférence statistique et de l’analyse quantitative appliquée aux sciences du comportement, cette distinction revêt une importance conceptuelle majeure. Les fréquences absolues sont indispensables pour apprécier la puissance statistique, estimer la variance d’échantillonnage et alimenter les tests d’adéquation paramétriques ou non paramétriques comme le test d’indépendance du khi-deux de Pearson. Parallèlement, les fréquences relatives fournissent les estimations empiriques des probabilités discrètes associées à chaque état de la variable. Lors de la description d’échantillons en psychométrie, la fréquence relative permet d’établir la prévalence d’un trait ou la distribution relative des patterns comportementaux indépendamment du nombre de participants inclus dans le protocole d’évaluation clinique.
1.2 Le concept mathématique de fréquence cumulée
L’agrégation cumulative des observations représente un saut qualitatif dans l’analyse distributionnelle, car elle postule implicitement ou explicitement l’existence d’une relation d’ordre sur l’ensemble des modalités évaluées. L’effectif cumulé croissant, noté formellement Ni ou parfois ECCi, se définit comme la sommation progressive et séquentielle des effectifs simples associés à l’ensemble des classes ou modalités dont le rang est inférieur ou égal au rang courant i. Mathématiquement, cette accumulation s’exprime par la relation sommative Ni = ∑ nj pour j variant de 1 à i. Cette formulation récursive permet de condenser dans une valeur unique le nombre total d’unités statistiques affichant un score inférieur ou égal à une borne supérieure spécifiée.
Il convient d’établir une distinction épistémologique et fonctionnelle fondamentale entre l’effectif cumulé croissant et l’effectif cumulé décroissant. Tandis que l’accumulation croissante renseigne sur le sous-ensemble des observations inférieures ou égales au seuil désigné, l’accumulation décroissante comptabilise les occurrences situées au-dessus de ce même seuil. Ce second paradigme s’avère particulièrement pertinent dans les études de survie, les analyses de fiabilité industrielle ou les protocoles psychologiques évaluant des critères de persévérance et de seuil de tolérance. Sur le plan arithmétique, la fréquence cumulée décroissante se déduit directement de la taille globale de l’échantillon par complémentarité avec l’effectif cumulé croissant de la classe précédente.
L’une des propriétés formelles les plus robustes de la série des fréquences cumulées réside dans son comportement asymptotique au sein de l’espace d’échantillonnage. En vertu de la positivité inhérente aux effectifs simples, la séquence des fréquences cumulées est une fonction monotone non décroissante. À mesure que l’index de parcours progresse le long de l’axe ordonné des modalités pour atteindre la dernière modalité k, la valeur cumulée converge avec une exactitude arithmétique stricte vers la taille totale de l’échantillon N dans le cas des effectifs absolus, ou vers la valeur unitaire 1 (respectivement 100 %) dans le cadre des fréquences relatives. Toute déviation terminale par rapport à cette égalité constitue un marqueur irréfutable d’incohérence algorithmique ou de troncature de données.
1.3 Utilité dans l’analyse de données comportementales et quantitatives
Dans le périmètre de la psychométrie appliquée et de l’analyse expérimentale du comportement, les fréquences cumulées constituent l’armature technique indispensable à l’évaluation fine de la dispersion des scores. Les distributions de temps de réaction dans des tâches d’inhibition cognitive ou d’attention sélective manifestent quasi systématiquement une asymétrie positive prononcée, incompatible avec les hypothèses de normalité gaussienne. Dans ce contexte, l’analyse cumulative offre une représentation empirique robuste de l’étalement des latences de réponse, permettant d’identifier la dynamique temporelle sans subir la distorsion induite par des valeurs extrêmes sur la moyenne arithmétique.
L’intérêt central de la fréquence relative cumulée réside en outre dans son équivalence fonctionnelle directe avec le rang percentile, outil cardinal de l’étalonnage des instruments d’évaluation standardisés. L’association d’un score brut à une fréquence relative cumulée permet de déterminer instantanément le pourcentage de la population normative ayant obtenu une note égale ou inférieure à cette valeur. Cette propriété opérationnelle est au cœur de l’élaboration des grilles d’étalonnage pour les échelles d’intelligence de Wechsler ou les inventaires de personnalité multidimensionnels, transformant des métriques brutes hétérogènes en indices standardisés directement interprétables par les praticiens.
Enfin, l’examen de la progression différentielle des fréquences cumulées permet la détection précoce des seuils de rupture et des singularités structurelles au sein des cohortes étudiées. Une augmentation abrupte de la pente de la courbe cumulative signale une zone de forte densité d’observations, délimitant des bassins d’attraction comportementaux ou des effets de plancher et de plafond inhérents aux épreuves administrées. À l’inverse, un aplatissement prolongé de la courbe met en lumière des zones de raréfaction statistique, guidant le chercheur dans l’identification d’éventuelles bimodalités qui pourraient traduire la présence de sous-populations cliniquement différenciées au sein de l’échantillon global.
2. Structuration et préparation rigoureuse des données dans Excel
2.1 Organisation matricielle des variables de recherche
L’obtention de calculs statistiques fiables dans l’environnement Microsoft Excel repose impérativement sur l’application des principes fondamentaux de la structure de données relationnelle, souvent formalisée sous le concept de données ordonnées ou données tabulaires strictes. Chaque ligne de la feuille de calcul doit correspondre univoquement à une observation ou unité expérimentale distincte, identifiée par un index ou un identifiant invariant, tandis que chaque colonne doit représenter une variable spécifique, définie sans ambiguïté sémantique. Les mélanges de structures horizontales et verticales au sein d’un même tableau constituent la source première d’échec lors du déploiement des formules cumulatives automatisées.
La standardisation typologique des cellules numériques représente un prérequis technique absolu. Dans les jeux de données complexes, il est fréquent que des nombres soient importés sous forme de chaînes textuelles en raison de dysfonctionnements lors de l’exportation CSV ou de discordances dans les paramètres régionaux du système d’exploitation. Une cellule contenant une valeur textuelle numérique ne déclenchera pas nécessairement d’erreur visible immédiate, mais elle sera silencieusement ignorée par la quasi-totalité des fonctions d’agrégation arithmétique natives comme SOMME ou FREQUENCE, faussant irrémédiablement le résultat cumulé sans générer d’alerte explicite.
Il est crucial de maintenir une traçabilité rigoureuse et une séparation stricte entre les données brutes initiales et les tableaux d’agrégation statistique. Toute intervention directe sur le jeu de données primaire sans conservation d’une copie immuable contrevient aux principes de reproductibilité scientifique. La structuration recommandée consiste à réserver un premier feuillet de calcul exclusivement au stockage des données sources nettoyées, puis à projeter les résultats d’interrogation, les classes de distribution et les colonnes de cumul sur un ou plusieurs feuillets d’analyse distincts, préservant ainsi l’intégrité référentielle du protocole expérimental.
2.2 Nettoyage et vérification de la cohérence des séries
Le prétraitement des séries quantitatives exige une approche systématique face aux valeurs manquantes et aux observations aberrantes. Dans Microsoft Excel, l’absence de saisie peut se matérialiser par une cellule vide, un code textuel standardisé ou une valeur sentinelle arbitraire. Si les cellules vides sont par défaut exclues des opérations de comptage par certaines fonctions conditionnelles, la présence de codes textuels non reconnus ou de valeurs sentinelles négatives contamine immédiatement la distribution des bornes. Il incombe à l’analyste de décider, selon la théorie sous-jacente du recueil de données, si ces enregistrements doivent être supprimés par filtrage ou imputés via des algorithmes appropriés avant toute compilation cumulative.
L’intégrité référentielle d’une série numérique dépend également de l’éradication des pollutions typographiques discrètes, au premier rang desquelles figurent les espaces insécables et les caractères non imprimables fréquemment injectés lors des requêtes d’extraction de bases de données relationnelles ou d’enquêtes en ligne. L’application combinée des fonctions de nettoyage textuel permet de normaliser les chaînes avant leur éventuelle conversion numérique. La validation visuelle ne suffisant pas, l’analyste déploiera des tests logiques automatisés pour attester que l’intégralité du vecteur d’analyse présente un comportement strictement numérique vérifié par le système de typage interne du tableur.
L’instauration préventive de règles de validation de données via l’interface native d’Excel constitue un rempart particulièrement robuste contre les dérives ultérieures de saisie. En limitant les entrées à une plage de valeurs réelles autorisées par le protocole expérimental (par exemple, des scores bornés entre 0 et 100 sur une échelle d’évaluation comportementale), l’analyste empêche l’apparition de distorsions accidentelles. L’association de messages d’alerte stricts garantit qu’aucune valeur discordante ne viendra étendre artificiellement la limite supérieure des intervalles cumulatifs lors des actualisations incrémentales du modèle de données.
2.3 Définition des classes d’intervalles pour variables continues
Lorsque la variable investiguée présente une nature continue ou un nombre discret particulièrement élevé de modalités, l’agrégation en classes d’intervalles devient indispensable pour conférer une lisibilité statistique à la distribution. Le découpage arbitraire de l’espace des valeurs entraîne des distorsions préjudiciables : un sur-découpage pulvérise l’information en effectifs unitaires erratiques, tandis qu’un sous-découpage oblitère les variations locales de la densité. Pour objectiver cette discrétisation, il convient de s’appuyer sur des fondements mathématiques standardisés tels que la règle empirique de Sturges, formulée sous la relation k = 1 + log2(N), préconisée pour des distributions unimodales approximativement symétriques.
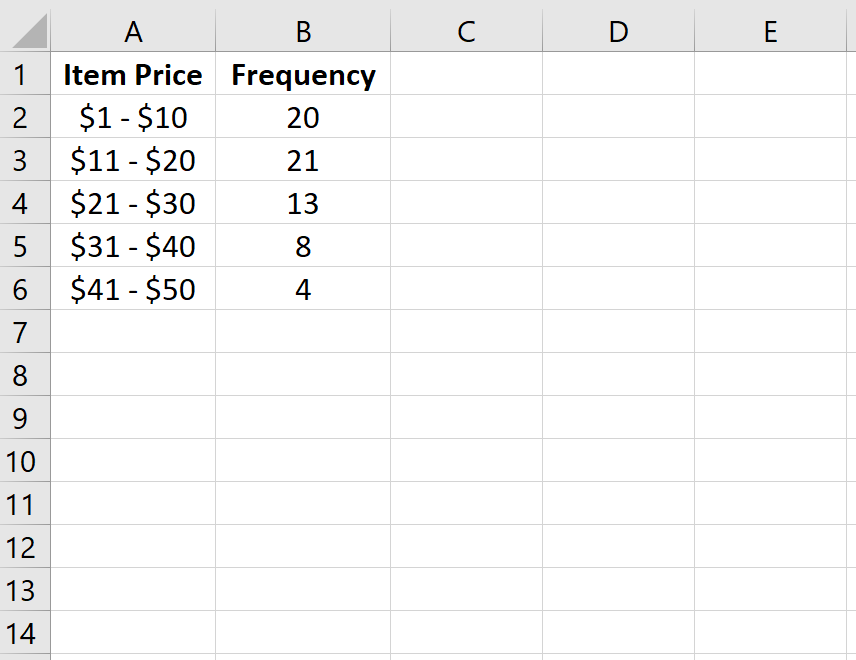
Pour des jeux de données plus volumineux ou marqués par des asymétries significatives, la règle de Scott, fondée sur l’écart-type de la série et la racine cubique de l’effectif total, ou encore la règle de Freedman-Diaconis basée sur l’écart interquartile, offrent une résilience supérieure face aux fluctuations distributionnelles. Ces formulations déterminent la largeur optimale de chaque classe d’intervalle, minimisant l’erreur quadratique moyenne intégrée entre l’histogramme empirique et la véritable densité théorique de probabilité sous-jacente. L’analyste psychomètre assure ainsi une transition fluide et rigoureuse entre la variable continue observée et sa représentation partitionnée discrète.
La délimitation opératoire des bornes d’intervalles dans Excel requiert une vigilance technique quant à l’inclusion des frontières. Dans la quasi-totalité des mécanismes algorithmiques natifs d’Excel, notamment au sein de la fonction matricielle d’agrégation, les intervalles sont traités selon la convention séquentielle d’inclusion à droite, où chaque classe comprend l’ensemble des valeurs strictement supérieures à la borne précédente et inférieures ou égales à la borne supérieure courante. Il est donc impératif de calibrer la borne inférieure de la toute première classe pour englober la valeur minimale absolue du jeu de données, évitant ainsi le rejet silencieux de l’observation minimale hors de la matrice des fréquences cumulées.
3. Calcul préalable des fréquences simples dans Excel
3.1 Utilisation de la fonction NB.SI pour variables discrètes
Pour des variables quantitatives discrètes comportant un ensemble restreint de scores entiers récurrents, l’emploi de la fonction statistique de comptage conditionnel NB.SI constitue l’approche fondamentale d’estimation des effectifs simples. La syntaxe canonique de cette instruction se décompose en deux arguments opérationnels : la plage des observations brutes et le critère spécifique d’appariement. Dans une implémentation rigoureuse, la plage source fait l’objet d’un verrouillage par adressage absolu tandis que le critère pointe vers la cellule contenant la modalité unique de la ligne courante du tableau de synthèse.
L’automatisation et la propagation verticale de cette formule sur l’axe des modalités nécessitent une gestion infaillible des ancrages référentiels. L’écriture conventionnelle NB.SI($A$2:$A$500; D2), où la colonne A héberge les observations brutes et la cellule D2 spécifie la modalité en cours de dénombrement, garantit que la zone de prospection demeure parfaitement stationnaire lorsque l’utilisateur recopie la formule vers le bas. Tout manquement au verrouillage absolu de la matrice source induirait un glissement progressif de la plage d’évaluation, tronquant systématiquement les données situées en tête de colonne pour les modalités ultérieures.
Néanmoins, la fonction NB.SI présente des limitations computationnelles notables lorsqu’elle est sollicitée sur des jeux de données volumineux comprenant plusieurs dizaines de milliers d’enregistrements combinés à un grand nombre de modalités. Chaque cellule hébergeant cette fonction déclenche un parcours linéaire complet de la plage d’origine, générant une complexité algorithmique globale proportionnelle au produit du nombre d’observations par le nombre de modalités. Pour des bases de grande envergure, cette réplication de parcours engendre une charge de traitement substantielle lors des phases de recalcul automatique du classeur.
3.2 Exploitation de la fonction matricielle FREQUENCE
Pour surmonter les contraintes de performance des fonctions conditionnelles itérées et pour traiter avec une rigueur absolue la segmentation en classes des variables continues, la fonction matricielle native FREQUENCE représente la solution computationnelle la plus robuste du tableur. Cette fonction exige deux vecteurs d’entrée obligatoires : la matrice des données représentant l’ensemble des observations brutes à caractériser, et la matrice des intervalles spécifiant les limites supérieures strictes de chaque classe de regroupement prédéfinie par le protocole statistique.
Le comportement de restitution de la fonction FREQUENCE obéit à des mécanismes précis qui varient selon la version de Microsoft Excel mise en œuvre. Dans les éditions traditionnelles du logiciel (Excel 2019 et versions antérieures), l’utilisateur devait préalablement sélectionner l’intégralité de la plage de sortie verticale, injecter la formule dans la barre d’édition, puis valider impérativement l’expression par la combinaison de touches Ctrl + Maj + Entrée, assignant ainsi la nature matricielle au bloc de cellules. Dans Microsoft 365, grâce au moteur de calcul dynamique vectoriel, la fonction génère spontanément une matrice propagée à partir d’une saisie unique dans la cellule sommitale.
Un avantage déterminant de la fonction FREQUENCE réside dans sa vitesse d’exécution optimale, fondée sur un algorithme interne de tri et d’indexation dichotomique exécuté en langage compilé au cœur du moteur du tableur. De surcroît, la fonction alloue automatiquement un élément matriciel supplémentaire à la fin de sa plage de sortie, dédié au recueil de toutes les observations excédant la borne supérieure maximale spécifiée dans le vecteur de calibrage. Cette disposition algorithmique prévient tout risque de troncature accidentelle des scores atypiques situés à l’extrémité supérieure de la distribution.
3.3 Agrégation automatique par Tableau Croisé Dynamique
L’exploitation du moteur de Tableau Croisé Dynamique (TCD) offre une alternative déclarative particulièrement efficiente à l’écriture directe de formules statistiques pour l’agrégation des fréquences simples. En intégrant la variable quantitative cible simultanément dans la zone des lignes de la structure relationnelle et dans la zone des valeurs d’agrégation, le tableur configure instantanément l’inventaire complet des modalités observées. Il suffit alors de basculer l’opération d’agrégation du mode standard de sommation vers le mode de dénombrement pour que les fréquences absolues simples apparaissent de façon consolidée.
Pour les variables quantitatives continues ou semi-continues, le moteur de Tableau Croisé Dynamique dispose d’un outil de discrétisation automatisé accessible via la commande de groupement numérique. L’analyste peut y spécifier la borne d’initiation du partitionnement, la limite terminale d’évaluation et le pas arithmétique de progression entre deux classes successives. Le moteur recompose instantanément les intervalles sous forme de chaînes textuelles normatives, calculant les effectifs associés à chaque sous-espace sans qu’aucune programmation de bornes annexes ne soit requise au sein de la feuille de calcul.
La comparaison entre l’efficacité du moteur de Tableau Croisé Dynamique et le déploiement de formules matricielles fait ressortir des compromis opérationnels distincts. Si le Tableau Croisé Dynamique excelle par son ergonomie, sa tolérance aux anomalies structurelles et son exceptionnelle rapidité de traitement sur de vastes volumes d’informations, il impose une réactualisation manuelle ou événementielle lors de la modification des données sources. À l’inverse, les formules dynamiques et matricielles garantissent un recalcul synchrone immédiat à chaque altération d’une cellule d’entrée, bien qu’au prix d’une vulnérabilité supérieure aux manipulations accidentelles de la structure tabulaire.
4. Méthode fondamentale : Calcul de la fréquence cumulée par formule itérative
4.1 Initialisation de la série dans la cellule de départ
La construction algorithmique d’une chaîne de fréquences cumulées repose sur un principe de récurrence arithmétique qui nécessite impérativement une condition d’ancrage initial rigoureuse. Sur le plan formel, la première fréquence cumulée croissante, associée à la borne ou modalité minimale de la distribution, est obligatoirement et strictement égale à la première fréquence simple de la série. Tout calcul d’accumulation qui ignorerait cette règle de parité initiale violerait la structure inductive du modèle descriptif, introduisant un biais additif systématique sur l’intégralité de la séquence descendante.
Dans la feuille de calcul Excel, cette initialisation s’opérationnalise par une affectation directe simple au sein de la première cellule de la colonne dédiée au cumul, généralement située sur la même ligne horizontale que la première modalité inventoriée. Si la série des fréquences absolues simples débute à la cellule C2, la cellule réservée au cumul D2 doit recevoir l’instruction formelle =C2. Il convient de proscrire absolument l’usage d’une formule d’addition complexe ou l’injection manuelle d’une valeur numérique statique à ce niveau de la structure, la liaison dynamique étant indispensable pour préserver la réactivité du modèle en cas de modification des données primaires.
Cette distinction opérationnelle entre la cellule de départ et les cellules itératives ultérieures est également primordiale pour immuniser le classeur contre les erreurs de dépendance circulaire. Si l’analyste tentait d’appliquer uniformément une formule de sommation cumulative dès la première rangée sans isoler son statut de borne initiale, le système de calcul d’Excel chercherait à référencer l’en-tête textuel de la colonne ou une cellule non définie située au-dessus, risquant de déclencher des erreurs de typage numérique. L’ancrage unitaire en D2 formalise ainsi de manière indiscutable le socle de départ de l’accumulation statistique.
4.2 Construction de la formule itérative d’addition récursive
Une fois la condition d’initialisation établie, le déploiement de la suite cumulative s’effectue par l’implémentation de la relation de récurrence canonique reliant chaque terme au résultat accumulé immédiatement antérieur. Mathématiquement, pour tout rang i supérieur ou égal à 2, la fréquence cumulée s’obtient par l’addition de l’effectif cumulé de rang i-1 et de la fréquence simple de rang i, soit Ni = Ni-1 + ni. Cette écriture récursive permet de minimiser le nombre d’opérations élémentaires exécutées à chaque étape du parcours séquentiel.
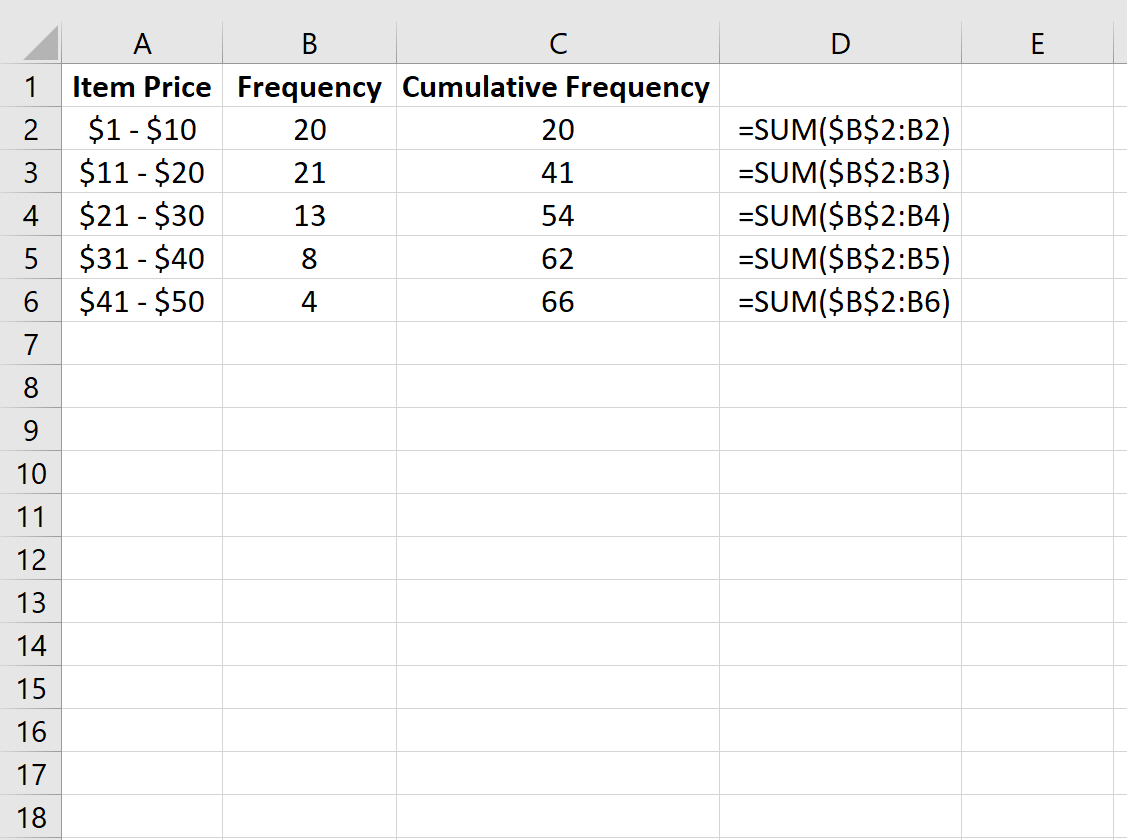
Transposée dans la syntaxe opérationnelle d’Excel, l’instruction introduite dans la cellule D3 prendra la forme universelle =D2+C3, où la référence relative D2 désigne la valeur cumulée précédemment arrêtée et C3 capture la nouvelle contribution d’effectif issue de la distribution simple. L’usage exclusif de références de position relatives à ce niveau est strictement intentionnel : il permet à la relation d’addition d’opérer un décalage synchronisé de ses deux opérandes lors de sa duplication verticale le long des lignes subséquentes de la table descriptive.
Cette méthodologie d’addition récursive présente une stabilité remarquable face aux cycles de recalcul automatique du classeur. Dans la mesure où chaque cellule n’interroge que deux adresses mémoire directes (la cellule supérieure immédiate et la cellule adjacente gauche), la charge de calcul allouée à l’arbre des dépendances internes demeure élémentaire et s’exécute avec une vitesse d’horloge quasi instantanée. Ce comportement linéaire garantit une excellente fluidité de l’interface logicielle, même lorsque l’analyse porte sur des taxonomies comportementales subdivisées en plusieurs centaines de sous-classes fines.
4.3 Propagation verticale et contrôle de cohérence finale
La diffusion de la logique récursive le long de la série s’effectue par les techniques de recopie incrémentale standards d’Excel. L’utilisateur positionne le curseur sur le coin inférieur droit de la cellule D3 jusqu’à l’apparition du pointeur de recopie, puis procède à un glissement descendant ou exécute un double-clic gauche d’entraînement automatique le long de la colonne contiguë déjà peuplée. Cette manipulation assure la duplication instantanée de l’algorithme jusqu’au niveau de la dernière modalité répertoriée, chaque cellule ajustant spontanément ses coordonnées relatives selon la translation verticale opérée.
L’étape de validation statistique impose un contrôle de cohérence arithmétique terminal strict. La valeur figurant dans la dernière cellule de la colonne des fréquences cumulées doit obligatoirement coïncider au millième près avec la taille globale de l’échantillon N, grandeur qui peut être vérifiée par l’évaluation sommative isolée =SOMME(C2:Ck) ou par le décompte global des observations =NB(A2:AN). L’obtention d’une identité parfaite entre ces deux entités numériques atteste formellement que chaque observation individuelle a été comptabilisée une et une seule fois au sein de la séquence cumulative ordonnée.
Dans l’éventualité d’une discordance numérique entre la valeur cumulée finale et le total d’échantillon constaté, l’analyste statistique doit immédiatement engager un audit de son protocole. Les étiologies les plus fréquentes de cet écart résident dans la présence d’une formule brisée lors de l’extension de colonne, l’omission involontaire d’une modalité lors de la saisie des bornes d’analyse, ou l’existence de valeurs observées se situant au-delà du seuil supérieur de la dernière classe d’intervalle. L’identification et la résolution de ces anomalies sont indispensables avant toute tentative d’exploitation clinique ou de modélisation mathématique subséquente.
5. Méthode experte : Utilisation de la fonction SOMME avec références mixtes
5.1 Principes des références relatives, absolues et mixtes
La maîtrise avancée de l’environnement de modélisation Excel repose sur l’assimilation des principes d’adressage cellulaire, caractérisés par l’articulation des modes d’adressage relatifs, absolus et mixtes. Dans le paradigme d’adressage relatif conventionnel (par exemple C2), les coordonnées d’une cellule s’interprètent sous la forme d’un vecteur de déplacement d’un certain nombre de lignes et de colonnes par rapport à la position de la formule active. Lors du déplacement de la formule, la cellule ciblée est décalée de manière proportionnelle à ce mouvement relatif.
L’introduction du métacaractère dollar $ modifie substantiellement ce comportement en neutralisant la dynamique de translation logicielle. L’incorporation du dollar devant le marqueur de colonne et le numéro de ligne (par exemple $C$2) génère une référence absolue intégrale, dont la position géographique est irrémédiablement verrouillée, quel que soit le lieu de réplication de la commande. Les références mixtes, quant à elles, appliquent une contrainte asymétrique sélective : l’expression $C2 fige exclusivement l’ordonnée de la colonne tout en autorisant la translation verticale des lignes, tandis que l’expression C$2 bloque l’abscisse de la ligne tout en laissant la colonne glisser librement sur le plan transversal.
Cette propriété de décomposition asymétrique constitue la pierre angulaire des calculs statistiques expansifs. En appliquant sélectivement le verrouillage absolu à la borne d’origine d’un intervalle tout en abandonnant la borne finale au dynamisme relatif du déplacement, le modélisateur engendre un phénomène d’étirement matriciel dirigé. Cette technique permet de redéfinir continuellement la surface d’exploration des fonctions standards du tableur au fil de la progression de la lecture tabulaire, offrant un haut niveau d’abstraction algorithmique.
5.2 Formulation syntaxique de la plage expansive
La formulation experte de la fréquence cumulée au moyen d’une plage expansive mobilise la fonction sommative universelle appliquée à un intervalle auto-incrémental. Dans la cellule D2, correspondant à la première modalité de la distribution, la formule s’écrit formellement sous la syntaxe =SOMME($C$2:C2). L’architecture de cette expression révèle une dualité conceptuelle élégante : l’extrémité supérieure de l’intervalle est rigidement ancrée sur la cellule de départ $C$2 par le truchement des marqueurs absolus, tandis que son extrémité inférieure C2 demeure totalement libre de ses mouvements relatifs.
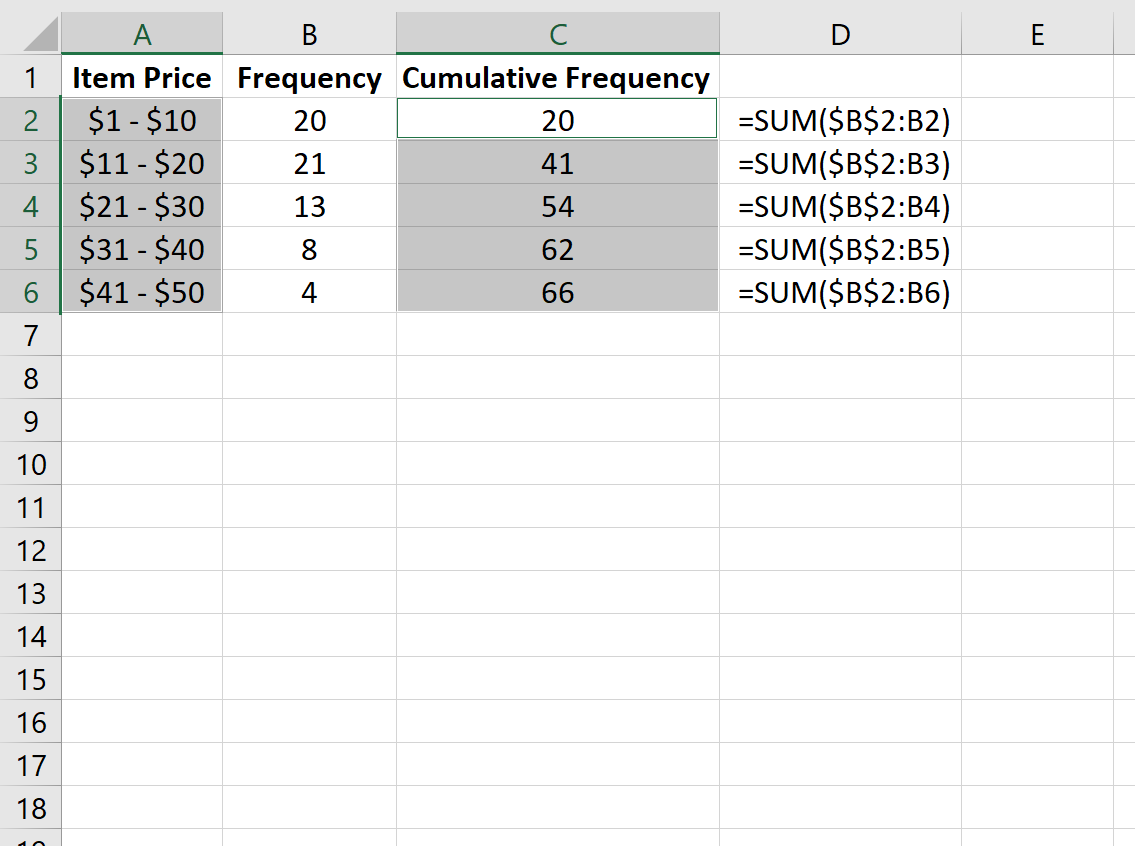
Lorsque cette syntaxe est étirée verticalement vers les rangées sous-jacentes du tableau, l’ancrage absolu refuse tout déplacement de l’origine, alors que la seconde référence s’incrémente de manière continue au fur et à mesure du franchissement des lignes. Ainsi, en cellule D3, l’expression se transmute automatiquement en =SOMME($C$2:C3), en cellule D4 en =SOMME($C$2:C4), et poursuit ainsi son déploiement jusqu’à la dernière ligne k où elle évaluera l’intégralité du champ =SOMME($C$2:Ck). L’accumulation n’est donc plus dépendante de l’état calculé de la cellule précédente, mais découle directement de la sommation exhaustive de la tranche correspondante du vecteur primaire des effectifs.
L’autonomie computationnelle de chaque cellule constitue le premier avantage structurel de cette méthode expansive. Contrairement à la technique itérative récursive qui dépend étroitement de la chaîne ininterrompue des cellules amont, chaque cellule instrumentée par une plage expansive est capable de recalculer son cumul de façon indépendante en interrogeant directement la source originelle des effectifs simples. Cette étanchéité prévient les phénomènes de cascade d’erreurs où la défaillance accidentelle d’un maillon unique compromet la totalité de la distribution descendante.
5.3 Comparaison de robustesse entre méthode itérative et plage expansive
L’analyse comparative de la robustesse opérationnelle des deux approches met en lumière des divergences fondamentales lors des phases de maintenance et d’altération de la structure des données. Dans le modèle itératif classique =D2+C3, l’insertion accidentelle d’une ligne intercalaire non renseignée ou la suppression physique d’une ligne intermédiaire au sein du tableau engendre instantanément une rupture de dépendance, matérialisée par la redoutée erreur de référence non résolue #REF! sur l’ensemble de la série descendante. L’intégrité du protocole d’analyse s’en trouve compromise et impose une réintervention manuelle pour reconstruire la chaîne de récurrence brisée.
À l’opposé, la méthodologie de la plage expansive =SOMME($C$2:C2) démontre une résilience remarquable face aux modifications structurelles. Si une ligne est supprimée ou intercalée au sein de la matrice, le moteur de gestion des références internes d’Excel adapte dynamiquement les délimitations spatiales des formules sous-jacentes sans corrompre les bornes fonctionnelles. L’intégrité de la série cumulative demeure ainsi totalement préservée, ce qui confère à cette formulation experte le statut de standard recommandé au sein des protocoles de recherche soumis à des exigences rigoureuses de traçabilité et d’auditabilité statistique.
Il importe toutefois de mentionner l’impact computationnel sous-jacent lié au déploiement des plages expansives sur de gigantesques volumes de données. Dans la méthode expansive, le calcul de chaque ligne de rang i exige l’exécution de i-1 additions. À l’échelle de la colonne complète comportant k modalités, le nombre total d’opérations élémentaires croît selon une complexité quadratique d’ordre asymptotique O(k2), alors que la méthode itérative simple conserve une complexité strictement linéaire d’ordre O(k). Pour des matrices de synthèse clinique comportant quelques dizaines ou centaines d’intervalles de classes, cet écart computationnel demeure imperceptible en temps machine; toutefois, dans le cadre de mégadonnées excédant plusieurs centaines de milliers de lignes de cumul, la méthode itérative ou les solutions vectorielles modernes reprennent l’avantage de la rapidité.
6. Calcul des fréquences relatives cumulées et des pourcentages
6.1 Normalisation des effectifs cumulés en proportions relatives
Pour dépasser le cadre strict de l’échantillon d’observation et accéder à des interprétations normalisées, la transformation des effectifs cumulés absolus en fréquences relatives cumulées est une opération fondamentale. Ce processus arithmétique consiste à diviser formellement chaque effectif cumulé d’étape Ni par la constante scalaire représentant la taille totale de la population étudiée N. L’indice résultant, traditionnellement noté Fi, exprime la proportion mathématique consolidée des unités d’échantillonnage dont le résultat se situe sous le seuil d’évaluation considéré.
Dans la feuille de calcul Excel, cette standardisation s’implémente en associant la cellule de fréquence cumulée à une référence absolue pointant vers la somme générale des effectifs simples. Si la colonne D héberge les effectifs cumulés croissants et que la taille totale de l’échantillon a été préalablement calculée et consignée dans la cellule C15 au moyen d’une instruction sommative, la formule régissant la première fréquence relative cumulée en cellule E2 s’articulera sous la forme =D2/$C$15. Le verrouillage absolu du dénominateur au moyen des dollars assure la permanence de l’élément diviseur lors de la réplication verticale de la formule jusqu’au terme de la distribution.
Le contrôle de conformité analytique de cette série repose sur l’observation de ses bornes scalaires strictes. La première valeur F1 doit être mathématiquement égale à la fréquence relative simple de la classe d’initiation. De manière corrélative et non négociable, la dernière valeur de la série, correspondant à la modalité finale de l’inventaire Fk, doit impérativement converger vers la valeur scalaire exacte de 1,0000. L’observation d’une valeur finale divergente trahit invariablement une anomalie dans le calcul du total d’échantillon au dénominateur ou l’application d’un verrouillage référentiel erroné au sein de la matrice logicielle.
6.2 Formulation directe des pourcentages cumulés
L’expression des fréquences cumulées relatives sous la forme de pourcentages constitue le mode de restitution privilégié dans les rapports de recherche comportementale et les bilans d’évaluation psychologique, en raison de son accessibilité cognitive immédiate pour les praticiens non statisticiens. L’analyste peut procéder à une formulation directe évitant les colonnes de décomposition intermédiaire en imbriquant la fonction d’expansion sommative dans un ratio dont le diviseur intègre la sommation globale du vecteur des effectifs simples, selon la syntaxe compacte =SOMME($C$2:C2)/SOMME($C$2:$C$14).
L’affichage formel de ce résultat nécessite l’application du format de cellule Pourcentage natif d’Excel. Ce formatage opère une translation visuelle sans corrompre la précision arithmétique sous-jacente du nombre réel conservé en mémoire binaire : la valeur scalaire 0,4528 est automatiquement projetée à l’écran sous la forme 45,28 % lorsque deux décimales sont requises. Il convient d’appliquer rigoureusement les préconisations internationales d’édition scientifique, telles que les normes éditoriales de l’American Psychological Association, qui recommandent en règle générale la publication de pourcentages bornés à une ou deux décimales significatives selon le degré de précision intrinsèque des instruments de mesure.
Une vigilance technique doit être portée sur la gestion de l’affichage décimal afin de prévenir l’illusion visuelle de discordances d’arrondi. Lorsque les pourcentages individuels et cumulés font l’objet d’un affichage tronqué à l’entier le plus proche par l’interface utilisateur, la somme visuelle des pourcentages simples peut occasionnellement suggérer un total de 99 % ou 101 %, en raison des effets d’arrondi arithmétique symétrique. L’explicitation formelle du mode de calcul cumulatif par une note méthodologique garantit au lecteur académique que les fluctuations observées relèvent exclusivement de conventions d’affichage et n’altèrent en rien la rigueur mathématique des intégrations sommatoires.
6.3 Interprétation probabiliste de la fonction de répartition empirique
Sur le plan de l’épistémologie mathématique, la série ordonnée des fréquences relatives cumulées représente l’exacte traduction discrète de la fonction de répartition empirique, traditionnellement dénotée Fn(x) dans le corpus du calcul des probabilités. Pour toute valeur seuil x donnée appartenant au spectre de la variable observée, la fonction de répartition empirique calcule la proportion des observations d’échantillonnage strictement inférieures ou égales à cette borne, formalisant de manière opératoire la probabilité statistique P(X ≤ x) au sein de la distribution échantillonnale considérée.
Cette passerelle probabiliste confère aux pourcentages cumulés une valeur opérationnelle inestimable pour l’inférence statistique et le contrôle d’hypothèses de conformité distributionnelle. La fonction de répartition empirique ainsi construite dans le tableur constitue le fondement direct des tests non paramétriques d’adéquation les plus rigoureux, au premier rang desquels s’illustre le test d’ajustement de Kolmogorov-Smirnov. Ce dernier mesure l’écart vertical suprémum entre la fonction de répartition empirique dérivée des données recueillies et la fonction de répartition théorique d’une loi de probabilité idéalisée (par exemple la loi normale ou la loi de Laplace-Gauss), fournissant un critère objectif de rejet de l’hypothèse nulle d’isomorphisme de distribution.
De surcroît, la normalisation des fréquences cumulées en pourcentages offre un moyen universel de comparer directement des séries statistiques prélevées sur des cohortes d’effectifs inégaux. Si une équipe clinique évalue un même indicateur psychométrique sur un groupe expérimental de 45 patients et un groupe témoin comprenant 350 individus, l’analyse comparative directe des effectifs bruts est rigoureusement stérile. La superposition des profils de pourcentages cumulés neutralise l’asymétrie de taille d’échantillon, permettant d’identifier immédiatement tout décalage d’abscisse entre les distributions, révélateur de l’effet d’une manipulation expérimentale ou d’un traitement thérapeutique ciblé.
7. Génération des fréquences cumulées via les Tableaux Croisés Dynamiques
7.1 Configuration des paramètres de champ de valeurs
L’interface analytique des Tableaux Croisés Dynamiques de Microsoft Excel héberge un puissant moteur de calcul statistique intégré qui s’affranchit totalement de la saisie manuelle de formules sommatoires pour l’évaluation des distributions cumulatives. Lorsque le tableau croisé est déployé et que la variable quantitative d’intérêt est positionnée en ligne et en zone de valeurs, le calcul par défaut se borne à agréger la somme ou le nombre d’occurrences simples. Pour accéder aux fonctionnalités de calcul séquentiel, l’analyste statistique doit activer le menu contextuel du champ de valeur ciblé et ouvrir la boîte de dialogue dédiée aux Paramètres de champ de valeurs.
Au sein de cette interface de configuration, la bascule opérationnelle s’effectue sous l’onglet intitulé Afficher les valeurs, conçu pour appliquer des transformations relationnelles instantanées aux mesures brutes calculées. En déroulant la sélection des calculs personnalisés, l’analyste sélectionne la directive d’agrégation intitulée Résultat cumulé par (ou Résultat cumulé en % par pour l’obtention directe d’une trajectoire relative). Cette option ordonne explicitement au moteur OLAP interne d’Excel de transformer les comptages discrets en une séquence d’accumulations progressives selon un champ spatial d’orientation prédéterminé.
La dernière étape de ce paramétrage réside dans la désignation non équivoque du Champ de base sur lequel s’appliquera le calcul cumulatif. L’utilisateur doit impérativement sélectionner l’en-tête de la variable ordonnée qui structure les lignes du tableau croisé dynamique. L’omission ou la mauvaise sélection de cette variable de référence empêcherait le moteur d’identifier l’axe d’accumulation séquentiel, provoquant l’affichage d’erreurs d’évaluation contextuelle ou la génération d’un bloc uniforme de valeurs statiques dénué de toute dynamique cumulative.
7.2 Affichage simultané des fréquences simples et cumulées
L’un des atouts d’ergonomie les plus remarquables du Tableau Croisé Dynamique réside dans sa capacité à juxtaposer simultanément plusieurs facettes statistiques complémentaires d’une même série d’observations sans surcharger la mémoire opérationnelle du classeur. Pour élaborer une table descriptive exhaustive de standard académique, l’analyste procède à une double ou triple instanciation de la même variable source dans la zone d’agrégation des Valeurs de l’arborescence du tableau croisé.
Cette réplication autorise un calibrage individualisé pour chaque occurrence de la variable au sein du rapport de synthèse tabulaire. La première itération du champ de valeur sera paramétrée sous le mode de synthèse standard par Nombre d’occurrences simples, affichant la distribution des effectifs discrets ni. La seconde itération recevra l’attribut de calcul personnalisé Résultat cumulé par, matérialisant la séquence des effectifs cumulés croissants Ni. Enfin, une troisième instance du même champ sera configurée avec l’option Résultat cumulé en % par, délivrant l’estimation continue de la fonction de répartition empirique en pourcentages Fi.
Cette disposition tabulaire multipolaire confère une lisibilité immédiate aux rapports d’investigation psychométrique ou aux bilans épidémiologiques. Sur une unique ligne horizontale du tableau, le clinicien ou l’expérimentateur dispose instantanément du décompte brut des sujets localisés dans la tranche de score considérée, du volume total consolidé des individus ayant obtenu un score inférieur ou égal à ce niveau, et du rang centile empirique associé au seuil d’évaluation. L’exhaustivité de l’information statistique est ainsi concentrée au sein d’une structure synthétique élégante, immédiatement exploitable à des fins d’interprétation diagnostique ou de publication scientifique.
7.3 Avantages de réactivité et gestion dynamique des mises à jour
Le principal avantage comparatif de l’utilisation des Tableaux Croisés Dynamiques pour le traitement des fréquences cumulées réside dans leur capacité exceptionnelle de réactivité face à l’enrichissement structurel ou temporel des jeux de données d’origine. Lorsque l’analyse est fondée sur des formules manuelles ancrées dans des grilles statiques, l’insertion de nouvelles unités expérimentales au sein de la base brute impose souvent d’ajuster manuellement les bornes de référence des plages ou d’étirer de nouvelles lignes de calcul. Au sein d’un environnement alimenté par un tableau croisé dynamique connecté à une plage structurée, une simple exécution de la commande Actualiser recalcule l’intégralité du réseau distributif sans exiger la moindre intervention de réécriture formelle.
Par ailleurs, la flexibilité avec laquelle le moteur gère le regroupement des classes d’intervalles élimine les lourdes contraintes inhérentes à la refonte manuelle des formules statistiques. Si le protocole expérimental requiert l’expérimentation de plusieurs largeurs d’intervalles de classes pour évaluer la sensibilité de la distribution (par exemple, tester des regroupements par tranches de 5 points, de 10 points ou de 20 points sur une échelle de dépression standardisée), l’analyste peut modifier les paramètres de l’intervalle au sein de l’interface de groupement numérique : le tableau réarticule instantanément la distribution, régénérant les effectifs cumulés sans qu’aucune ligne de code matriciel n’ait été altérée.
Enfin, les Tableaux Croisés Dynamiques démontrent une robustesse remarquable lors de l’application de filtres complexes et de segments interactifs (slicers). L’expérimentateur peut instantanément isoler un sous-échantillon démographique spécifique (par exemple, segmenter par classes d’âge ou par sous-groupes cliniques) en cliquant sur une interface de filtrage visuel : le tableau croisé réinitialise sur-le-champ le calcul des fréquences simples et de l’accumulation séquentielle sur la seule sous-population active. Cette interactivité fluide facilite l’exploration multidimensionnelle des données comportementales tout en protégeant les résultats contre les corruptions syntaxiques inhérentes à la manipulation directe de feuilles de calcul traditionnelles.
8. Utilisation des fonctions modernes et matricielles dynamiques (Excel 365)
8.1 Calcul vectoriel autonome avec la fonction SCAN
L’introduction récente du moteur de calcul matriciel dynamique au sein de Microsoft 365 a profondément redéfini l’écriture des algorithmes statistiques dans Excel en intégrant des concepts issus de la programmation fonctionnelle de haut niveau. Parmi ces innovations fondamentales, la fonction matricielle moderne SCAN se distingue comme l’outil algorithmique d’accumulation vectorielle le plus élégant pour modéliser des séries cumulatives sans faire appel à des formules étendues manuellement ou à des structures de boucle impératives.
La structure syntaxique formelle de la fonction SCAN s’articule autour de trois paramètres canoniques : la valeur initiale du registre d’accumulation (généralement initialisée à zéro pour un dénombrement additif), le tableau vectoriel d’entrée contenant les fréquences simples à additionner séquentiellement, et une fonction personnalisée encapsulée dans l’opérateur LAMBDA. Cet opérateur fonctionnel définit le mécanisme d’agrégation pas à pas en reliant le registre accumulateur d’étape à l’élément courant extrait du tableau d’entrée, selon la syntaxe formelle d’appel LAMBDA(accumulateur; valeur; accumulateur + valeur).
Pour générer l’intégralité du vecteur de fréquences cumulées à partir d’une colonne d’effectifs simples localisée dans la plage C2:C15, l’analyste inscrit dans une cellule unique la formule consolidée =SCAN(0; C2:C15; LAMBDA(a; v; a + v)). Lors de la validation, le moteur de calcul dynamique procède au balayage vectoriel interne, alloue la mémoire nécessaire et propage spontanément l’ensemble de la série de résultats le long de la colonne sans qu’aucun glissement de poignée de recopie ne soit nécessaire. Cette formule unitaire garantit l’inviolabilité de l’algorithme sous-jacent en prévenant les altérations locales par saisie accidentelle au sein de la plage de restitution.
8.2 Gestion des tableaux à propagation dynamique
L’exploitation des fonctions vectorielles modernes repose sur la mécanique de propagation dynamique (spill feature), dont l’analyste doit parfaitement comprendre le mode d’opérationnement pour éviter des blocages d’exécution. Lorsqu’une formule générant une matrice propagée est introduite dans une cellule, le moteur du tableur circonscrit une zone périmétrique dynamique correspondant exactement aux dimensions du vecteur de sortie. L’ensemble de ce périmètre est marqué d’une bordure bleutée temporaire, indiquant que le calcul réside exclusivement dans la cellule sommitale originelle et que les cellules inférieures ne sont que la projection visuelle passive du calcul dynamique.
Cette architecture implique une règle de gestion spatiale absolue : l’espace de propagation doit impérativement être vierge de tout contenu préexistant. Si une cellule textuelle, une formule indépendante ou un résidu de donnée quelconque se situe sur la trajectoire d’expansion de la fonction SCAN, le moteur interrompt immédiatement la restitution vectorielle et génère l’erreur explicite #PROPAGATION! (ou #SPILL! dans la nomenclature anglophone). La libération intégrale des cellules encombrant le périmètre de déploiement permet à la formule de se propager instantanément jusqu’au terme de sa trajectoire d’évaluation.
La puissance d’intégration des plages propagées atteint son plein potentiel lorsqu’elle est combinée avec les autres fonctions modernes de manipulation matricielle, telles que TRIER ou CHOISIRCOLS. L’analyste peut ainsi concevoir des chaînes de calcul entièrement réactives : une première fonction isole et ordonne dynamiquement les observations brutes, une seconde fonction compile les fréquences simples au vol, et la fonction SCAN finalise le cumul vectoriel. L’optimisation algorithmique inhérente au moteur dynamique minimise l’empreinte mémoire vive du classeur et accélère les opérations de recalcul, conférant aux classeurs d’analyse quantitative une efficacité computationnelle jadis réservée aux langages de programmation compilés.
8.3 Création de fonctions personnalisées de cumul avec LAMBDA
Le perfectionnement ultime de la modélisation statistique moderne sous Excel réside dans l’abstraction fonctionnelle permise par la combinaison des fonctions matricielles et du Gestionnaire de noms du tableur. Par le truchement de la fonction native LAMBDA, l’expérimentateur a désormais la faculté de formaliser ses propres fonctions statistiques personnalisées sans écrire la moindre ligne de code en Visual Basic for Applications (VBA), garantissant une compatibilité totale entre les plateformes de calcul de bureau et les environnements infonuagiques.
Pour standardiser le calcul des fréquences cumulées au sein d’un laboratoire ou d’une unité de recherche clinique, l’analyste peut créer une fonction nommée intitulée par exemple FREQ.CUMULEE. Dans l’interface du Gestionnaire de noms d’Excel, l’expression de référence de cette variable sera configurée selon la syntaxe déclarative formelle =LAMBDA(vecteur_frequences; SCAN(0; vecteur_frequences; LAMBDA(a; v; a + v))). Cette abstraction technique encapsule la complexité matricielle sous-jacente au sein d’un opérateur modulaire transparent et documenté, accessible par n’importe quel collaborateur de la structure de recherche.
Une fois enregistrée au niveau de la feuille de calcul ou du modèle de classeur maître, l’invocation de cette fonction s’effectue avec la même fluidité opérationnelle qu’une fonction native d’Excel, au moyen de l’appel élémentaire =FREQ.CUMULEE(C2:C15). Cette démarche d’industrialisation du calcul statistique présente des avantages considérables : elle prévient radicalement les erreurs de frappe syntaxique lors de l’application répétée des protocoles descriptifs, unifie les pratiques d’analyse au sein des équipes de recherche et simplifie considérablement la maintenance du code de modélisation dans le temps, tout changement apporté à la définition centrale du LAMBDA se répercutant instantanément sur l’ensemble des requêtes du classeur.
9. Représentation graphique des fréquences cumulées : L’ogive de Galton
9.1 Sélection et paramétrage du type de graphique dans Excel
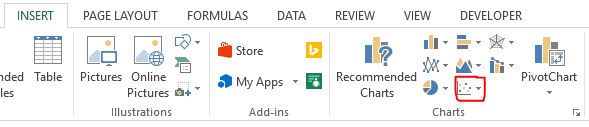
La restitution visuelle des distributions cumulatives trouve sa forme canonique dans l’ogive de Galton, également désignée sous l’appellation de courbe des fréquences cumulées ou polygone d’accumulation. Le choix du moteur graphique dans Microsoft Excel revêt une importance déterminante pour garantir la rectitude géométrique de cette figure. L’analyste doit impérativement privilégier le type Nuage de points avec lignes droites et marqueurs (Scatter Plot with Straight Lines) au détriment du classique graphique en courbes. En effet, le graphique en courbes traite l’axe horizontal sous forme d’étiquettes de catégories discrètes équidistantes, ce qui déforme gravement la perspective métrique lorsque les intervalles de scores sont inégaux.
Le paramétrage rigoureux de l’ogive exige que les points de transition de la courbe soient strictement positionnés au niveau des limites supérieures exactes de chaque classe d’intervalles, et non au centre ou à la limite inférieure de celles-ci. Puisqu’une fréquence cumulée comptabilise l’intégralité des observations inférieures ou égales au seuil défini, l’accumulation ne peut être mathématiquement atteinte et validée qu’à l’instant précis où la borne supérieure de l’intervalle est atteinte. Positionner un point de cumul sur le centre de classe constituerait une erreur de modélisation graphique, suggérant que l’accumulation est accomplie avant même que l’ensemble des données de la classe n’ait été parcouru.
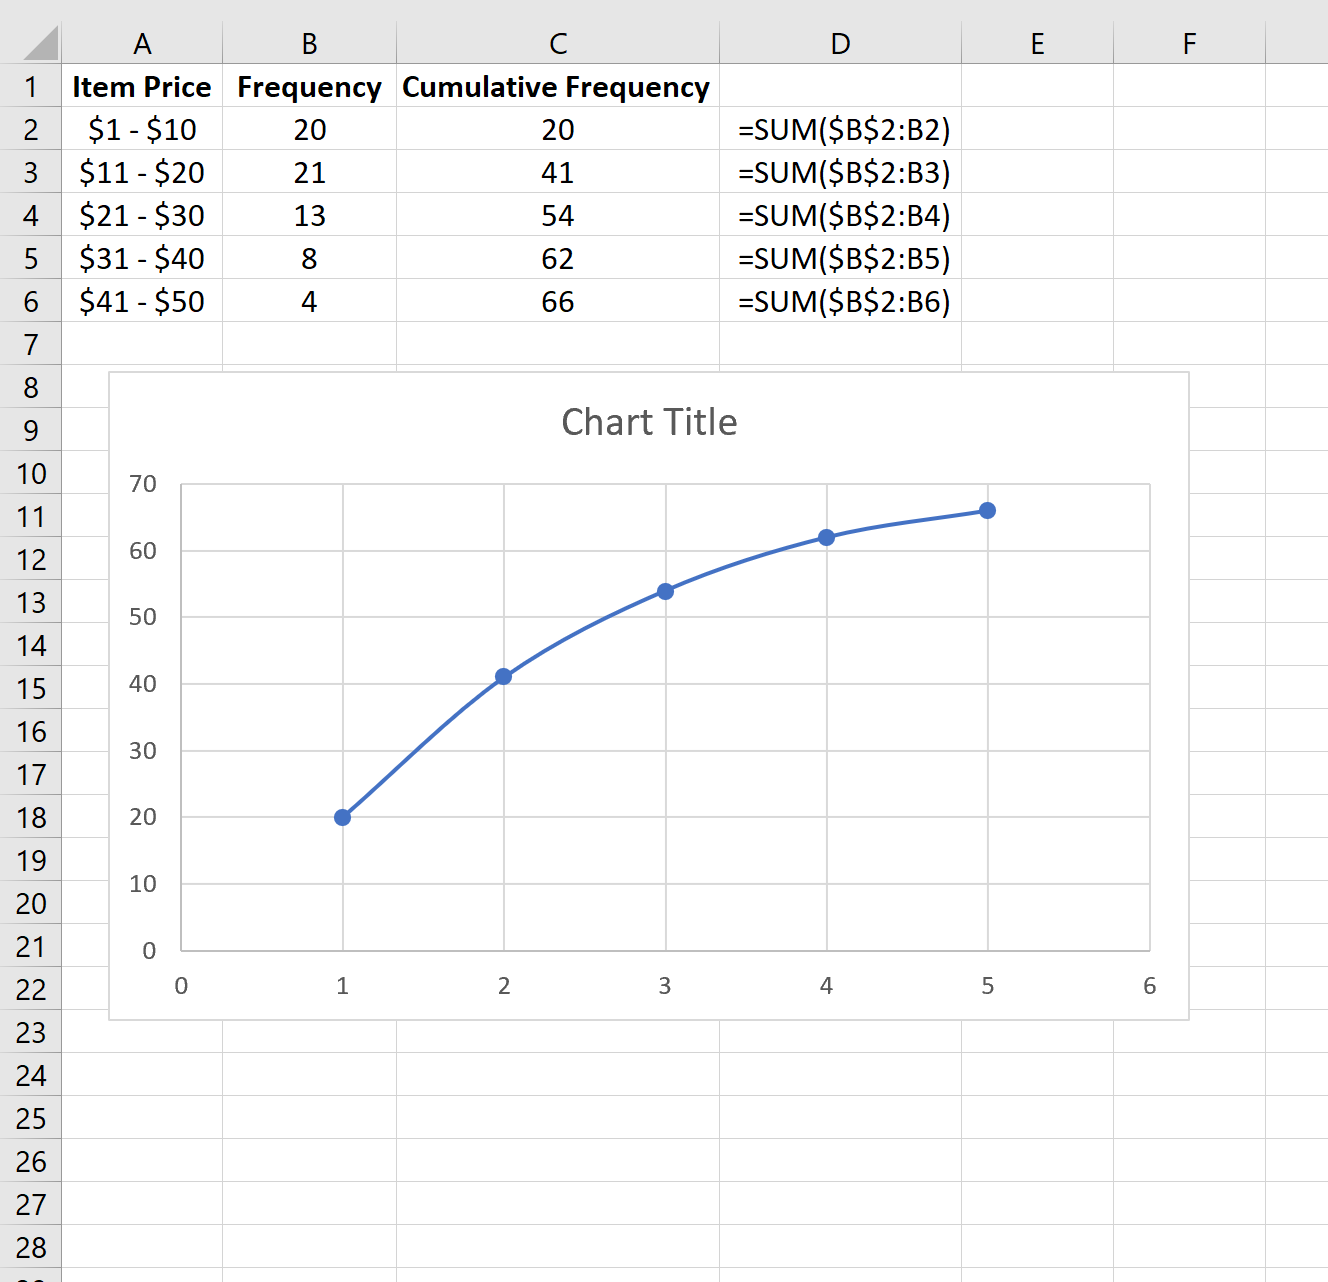
L’ancrage initial de la courbe constitue un autre impératif géométrique fréquemment omis dans les visualisations courantes. Pour que l’ogive respecte scrupuleusement la topologie d’une fonction de répartition empirique, le tracé doit s’amorcer à une fréquence strictement nulle (0 ou 0 %) au niveau de la borne inférieure de la toute première classe de la distribution. L’analyste doit donc délibérément insérer une ligne de calibrage liminaire au sommet de sa table de données graphiques, spécifiant la valeur minimale admissible du score assortie d’un effectif cumulé de zéro, assurant ainsi que le tracé graphique débute rigoureusement sur l’axe des abscisses.
9.2 Mise en forme académique des axes et graduations
L’agencement des paramètres d’axes de l’ogive de Galton doit répondre aux canons de rigueur imposés par les standards de publication scientifique et psychométrique. L’axe vertical des ordonnées, représentant les pourcentages cumulés ou les proportions relatives, doit être rigidement borné entre la valeur minimale de 0,0 (0 %) et la valeur maximale de 1,0 (100 %). Les ajustements automatiques d’Excel, qui étendent fréquemment la graduation supérieure jusqu’à 110 % ou 120 % pour ménager une marge d’affichage visuel, doivent être neutralisés manuellement pour ancrer le tracé dans son cadre de probabilité strict.
La configuration des graduations d’ordonnées doit idéalement refléter les seuils critiques de lecture de la distribution. En programmant un intervalle d’unité principale fixé à 0,10 (10 %) ou à 0,25 (25 %), l’expérimentateur projette directement sur le graphique les repères universels associés aux déciles et aux quartiles de la série statistique. L’adjonction d’un quadrillage horizontal discret permet au lecteur d’effectuer des interpolations graphiques rapides afin d’estimer mentalement le rang percentile ou la proportion cumulée correspondant à n’importe quel score brut positionné sur l’axe horizontal.
Le calibrage de l’axe des abscisses impose quant à lui une étiquette descriptive explicite comportant l’intitulé formel de la variable mesurée assorti de son unité physique ou psychométrique d’expression (par exemple, Temps de réponse en millisecondes ou Score standardisé à l’échelle d’anxiété de Spielberger). Conformément aux règles typographiques des revues internationales de psychologie et de sciences du comportement, les bordures inutiles, les effets de relief en trois dimensions et les palettes chromatiques disparates doivent être impérativement éliminés au profit d’un tracé épuré en niveaux de gris ou en teintes contrastées à haute lisibilité.
9.3 Interprétation visuelle de la forme de la distribution
L’interprétation analytique de l’ogive de Galton permet d’apprécier la structure distributionnelle d’un échantillon avec une acuité visuelle souvent supérieure à celle permise par l’histogramme classique. Dans une distribution gaussienne conventionnelle obéissant à la loi normale, l’ogive adopte une allure caractéristique en courbe sigmoïde ou en forme de S allongé. La courbure s’initie par une pente modérée dans les scores faibles, connaît une accélération marquée dans la zone centrale de la distribution, puis décélère progressivement pour aborder asymptotiquement le seuil des 100 % au niveau des valeurs extrêmes supérieures.
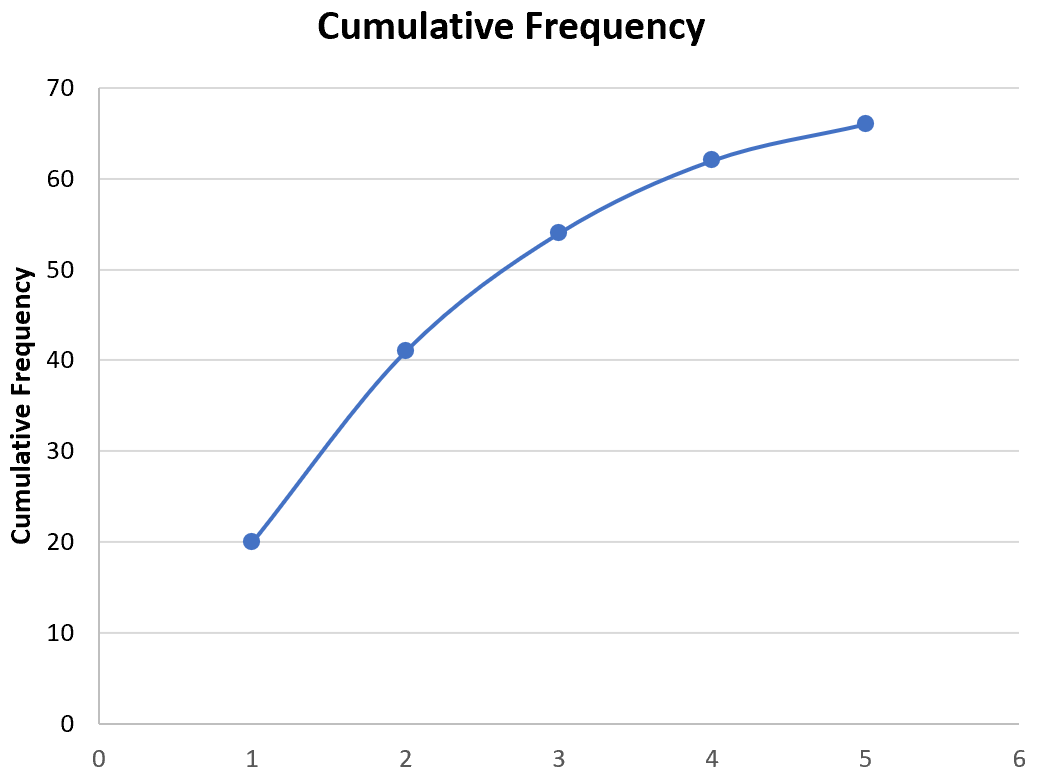
Le point d’inflexion topologique de cette courbe sigmoïde revêt une importance capitale : il correspond précisément au point géométrique où la concavité de la courbe s’inverse, marquant la valeur de la médiane statistique au niveau du cinquantième centile (50 %). Si la distribution présente une forte asymétrie positive (étalement vers les scores élevés), le point d’inflexion et la zone de plus forte pente se trouvent déportés vers la gauche du graphique, le plateau supérieur s’étirant longuement vers la droite. À l’inverse, une asymétrie négative se matérialise par un point d’inflexion tardif décalé vers l’extrémité droite de l’axe des abscisses.
La superposition de plusieurs ogives de Galton sur une même surface graphique constitue un instrument diagnostique d’une rare efficacité pour comparer des groupes expérimentaux distincts. Si la courbe associée à un groupe expérimental se situe systématiquement à droite de celle d’un groupe témoin sur l’ensemble du spectre de mesure, l’expérimentateur peut conclure visuellement à une dominance stochastique du traitement, indiquant qu’à tout seuil d’évaluation fixé, le groupe expérimental présente une probabilité systématiquement supérieure d’atteindre un score élevé, constatation qui préfigure et consolide les analyses inférentielles de comparaisons de moyennes ou de rangs.
10. Applications psychométriques : Rangs centiles et étalonnage
10.1 Calcul rigoureux des rangs centiles à partir des fréquences
En psychométrie expérimentale et clinique, la transposition d’un score brut en rang centile constitue l’opération d’évaluation normative par excellence. Le rang centile d’un score particulier ne se confond pas strictement avec la fréquence relative cumulée brute de la classe correspondante : il se définit comme le pourcentage de la cohorte d’étalonnage dont la performance se situe strictement en dessous de ce score, majoré de la moitié du pourcentage des observations obtenant exactement cette valeur numérique, selon la convention d’interpolation à mi-intervalle préconisée par les traités classiques de mesure psychologique.
La formulation rigoureuse du rang centile PR s’exprime mathématiquement par la relation formelle PR = [Ninf + (0,5 × ni)] / N × 100, où Ninf désigne l’effectif cumulé des observations situées sous la classe considérée, ni l’effectif propre de ladite classe, et N la cardinalité globale de l’échantillon. Cette convention d’arrondi centrée prévient la distorsion inhérente à l’usage direct de la borne cumulative supérieure, qui aboutirait artificiellement à assigner le rang centile 100 au score maximal de l’échantillon, violant le principe probabiliste selon lequel un individu ne peut dépasser 100 % de sa population de référence incluant son propre enregistrement.
Dans l’environnement Microsoft Excel, cette opération peut être menée soit manuellement à partir des colonnes de dénombrement par des formules algébriques intégrant les décalages de lignes nécessaires, soit de manière automatisée en sollicitant les fonctions statistiques dédiées de rang percentile. Les fonctions natives RANG.POURCENTAGE.INCLURE et RANG.POURCENTAGE.EXCLURE fournissent des estimateurs puissants fondés sur des algorithmes d’interpolation linéaire continue entre les scores observés, l’analyste devant explicitement consigner dans ses protocoles la variante algorithmique mise en œuvre afin d’assurer la reproductibilité exacte des diagnostics psychologiques.
10.2 Étalonnage de tests psychologiques et échelles comportementales
La construction des tables d’étalonnage psychométrique représente l’aboutissement applicatif de l’analyse des fréquences cumulées. Ces tables normatives permettent de normaliser des scores bruts hétérogènes prélevés sur des instruments composites en échelles de notes standards facilitant la comparaison intra-individuelle et inter-individuelle. À partir des fréquences cumulées relatives transformées en centiles empiriques, l’analyste procède à une conversion vers des métriques conventionnelles unifiées telles que les stanines (standard nines, échelle en neuf classes d’intervalles), les stens (échelles en dix classes) ou les notes T de McCall caractérisées par une moyenne de 50 et un écart-type de 10.
Ce processus de transformation non linéaire préserve le rang d’ordonnancement de l’échantillon tout en imposant à la distribution une forme standardisée généralement normale. Pour convertir un score brut en note normalisée T via Excel, l’analyste associe la fréquence relative cumulée à la fonction de distribution normale inverse LOI.NORMALE.INVERSE. En injectant la probabilité empirique issue de la fréquence cumulée au sein de l’instruction =LOI.NORMALE.INVERSE(Fi; 50; 10), le tableur génère instantanément la note standard normalisée correspondante, neutralisant les asymétries et anomalies d’aplatissement de l’instrument de mesure initial.
L’établissement d’une table d’étalonnage clinique sous Excel se matérialise par la constitution d’un tableau de référence à double entrée où chaque score brut observable est mis en correspondance univoque avec son rang centile, sa note T normalisée et sa classe d’étalonnage standardisée. La validation de ces grilles normatives requiert une documentation méthodologique exhaustive portant sur la taille de l’échantillon de référence, ses caractéristiques sociodémographiques et les indices de dispersion cumulée, critères obligatoires pour autoriser l’usage diagnostique de l’outil lors de bilans neuropsychologiques ou de recrutements organisationnels.
10.3 Identification des scores seuils et points de coupure
L’identification empirique de scores seuils (cut-off scores) constitue une autre application décisive des distributions cumulatives dans les protocoles de dépistage épidémiologique et de diagnostic clinique. Dans la validation d’échelles d’anxiété, de dépression ou de déclin cognitif, il est indispensable de formaliser des seuils de démarcation statistique au-delà desquels la performance d’un sujet est déclarée significativement atypique ou indicatrice d’une pathologie suspectée, par référence à la fréquence d’apparition du score au sein d’une population générale réputée saine.
Par convention diagnostique en psychopathologie quantitative, les seuils de déviation sont fréquemment fixés aux jalons percentiles critiques du 90e, 95e ou 99e centile pour des comportements pathologiques déficitaires, ou inversement sous les seuils du 5e ou du 1er centile pour des épreuves de performance intellectuelle ou de mémoire. Grâce à la colonne de pourcentage cumulé calculée sous Excel, l’expérimentateur localise instantanément le score brut minimal pour lequel la fréquence cumulée franchit ces seuils probabilistes prédéterminés, isolant le seuil de basculement statistique de manière objective et transparente.
Pour automatiser la détection algorithmique de ces scores seuils au sein de vastes bases de calibrage, l’analyste peut déployer les fonctions de recherche matricielle modernes combinées à des tests conditionnels. L’association imbriquée des fonctions INDEX, EQUIV ou de la fonction moderne RECHERCHEX permet d’extraire de manière dynamique le score critique associé à une probabilité de cumul spécifiée, évitant les erreurs d’interpolation visuelle manuelle et sécurisant l’application des critères de décision clinique dans les protocoles de recherche multicentriques.
11. Diagnostic, audit et résolution des erreurs de calcul
11.1 Résolution des erreurs de format et valeurs non numériques
La présence d’anomalies typologiques au sein des séries quantitatives constitue la cause la plus récurrente de dysfonctionnement des algorithmes cumulatifs dans Microsoft Excel. L’apparition de la notification d’erreur #VALEUR! lors de l’exécution d’une formule d’addition itérative simple comme =D2+C3 signale presque invariablement que l’un des deux termes référencés héberge une chaîne de texte non coercible, un espace résiduel ou un caractère invisible incompatible avec les opérateurs arithmétiques binaires.
Pour neutraliser ce risque et assainir la matrice des données, l’analyste statistique doit procéder à une conversion systématique des valeurs suspectes en nombres réels stricts. La mobilisation de la fonction native CNUM permet de contraindre une chaîne textuelle à structure numérique à adopter le statut de valeur scalaire binaire. Dans les architectures de données plus instables, l’opération matricielle consistant à multiplier l’ensemble du vecteur source par l’unité scalaire 1 (par exemple au moyen de la commande de collage spécial avec opération Multiplication) force le moteur du tableur à recalculer le typage interne de chaque cellule sans en modifier l’amplitude numérique.
Une vigilance technique spécifique doit être accordée aux paramètres linguistiques et régionaux régissant les séparateurs décimaux. Lorsqu’une base de données est transférée entre des environnements configurés selon les standards anglo-saxons (point décimal) et francophones (virgule décimale), les valeurs numériques importées sont fréquemment interprétées comme des chaînes de texte statiques non exploitables. L’analyste corrigera ces incohérences par le truchement de la fonctionnalité de substitution globale de caractères (Remplacer le point par la virgule) ou en modifiant temporairement les séparateurs d’environnement système dans les options de calcul avancées d’Excel.
11.2 Gestion des lignes masquées ou filtrées avec SOUS.TOTAL
L’utilisation de la fonction sommative standard SOMME au sein de séries cumulatives présente une limitation fonctionnelle majeure dès lors que l’analyste recourt à des filtres automatiques pour explorer dynamiquement des sous-ensembles d’échantillon. Par construction native, la fonction SOMME calcule la somme de l’ensemble des cellules physiques circonscrites dans la plage géométrique d’entrée, sans tenir compte du fait que certaines rangées ont été temporairement masquées par l’application d’un critère de filtrage textuel ou numérique.
Pour conférer à la fréquence cumulée un comportement adaptatif respectant scrupuleusement la visibilité réelle des enregistrements à l’écran, il est indispensable de substituer à l’addition standard la fonction statistique polymorphe SOUS.TOTAL. Cette fonction intègre un premier argument de configuration numérique qui spécifie la nature de l’opération statistique à exécuter ainsi que sa politique de traitement des lignes masquées. L’attribution du code d’instruction 109 programme l’exécution d’une sommation arithmétique qui exclut explicitement de son évaluation toutes les cellules dissimulées consécutivement à un filtrage ou à un masquage manuel de lignes.
La transcription expansive de cette approche adaptative prend la forme syntaxique =SOUS.TOTAL(109; $C$2:C2). Lorsque cette formule est déployée sur la colonne de cumul, l’application d’un filtre conditionnel sur une variable secondaire (par exemple, restreindre l’affichage au sous-groupe des participants masculins) déclenche un recalcul dynamique instantané de l’accumulation sur les seules données actives. Les effectifs cumulés se réinitialisent visuellement pour converger avec exactitude vers le total effectif du sous-échantillon affiché, assurant la cohérence constante de l’analyse exploratoire interactive.
11.3 Audit structurel et validation de l’arbre de dépendance
La validation formelle d’une matrice de calcul cumulatif impose un audit approfondi des flux de propagation des données avant toute exploitation décisionnelle des résultats statistiques. Microsoft Excel intègre dans son ruban Formules une suite d’outils d’audit graphique particulièrement performants. La commande Repérer les antécédents permet de matérialiser par des flèches directionnelles bleues l’ensemble des cellules sources qui alimentent directement le calcul d’une cellule de fréquence cumulée désignée, facilitant la détection visuelle des ruptures de progression expansive le long de la table.
L’analyste doit parallèlement vérifier l’absence totale de références circulaires non résolues au sein du classeur. Une référence circulaire survient lorsqu’une cellule de cumul tente d’incorporer son propre résultat au sein de sa chaîne d’évaluation récursive, neutralisant le moteur de calcul itératif d’Excel et figeant les valeurs numériques dans un état indéterminé. Le menu d’audit des erreurs permet d’isoler immédiatement les coordonnées spatiales de toute boucle d’autoréférencement accidentelle afin d’en corriger la syntaxe algébrique.
Enfin, la fiabilisation du classeur de recherche bénéficie grandement de l’adjonction de cellules de validation logique basées sur la fonction conditionnelle SI. L’implantation d’une cellule sentinelle comparant l’effectif cumulé terminal à la taille théorique de l’échantillon au moyen d’un test d’égalité stricte =SI(Dk=N; "COHÉRENCE VALIDÉE"; "ALERTE : DISCORDANCE ARITHMÉTIQUE") installe une alerte permanente et immédiate à destination de l’analyste, signalant instantanément toute corruption de l’intégrité de la série cumulative lors de futures manipulations de données.
12. Bonnes pratiques, automatisation et reproductibilité des classeurs
12.1 Conversion des plages en Tableaux Structurés Excel
Dans l’architecture moderne de modélisation sous Microsoft Excel, la conversion formelle des plages de données statiques en Tableaux Structurés (activable par le raccourci Ctrl + L ou via le menu Insérer > Tableau) représente la pratique de standardisation la plus fondamentale pour garantir la pérennité algorithmique des analyses quantitatives. L’attribution du statut de tableau structuré dote la matrice d’une identité relationnelle propre et remplace le système de coordonnées matricielles alphanumériques classiques par une syntaxe déclarative de références structurées particulièrement intelligible.
Le principal avantage d’un tableau structuré dans le contexte du calcul des fréquences réside dans sa capacité intrinsèque d’expansion dynamique automatique. Lorsque de nouvelles observations individuelles sont injectées à la suite immédiate de la liste, ou que de nouvelles classes d’intervalles sont adjointes au tableau de synthèse, la matrice structurée s’étend spontanément vers le bas, incorporant ces nouveaux éléments dans son périmètre sans exiger la redéfinition des formules sous-jacentes. La formule de calcul présente dans la colonne de cumul s’autoréplique instantanément sur les nouvelles lignes créées.
La formulation syntaxique de la fréquence cumulée au sein d’un tableau structuré requiert une écriture spécifique pour préserver la logique expansive le long de ses enregistrements. En exploitant les en-têtes nommés de la structure, la formule d’addition expansive prendra typiquement la forme =SOMME(TableauSynthese[[#En-têtes];[EffectifSimple]]:[@EffectifSimple]), syntaxe qui fige l’origine sur la borne supérieure de la colonne pour s’étendre progressivement jusqu’à la ligne active désignée par le métacaractère @. Cette écriture neutralise les risques d’altération accidentelle des adresses lors des tris et réorganisations transversales du tableau.
12.2 Conception de matrices de calcul réutilisables
La conception de classeurs d’analyse quantitative à vocation académique ou clinique doit impérativement respecter les principes de modularité et d’étanchéité fonctionnelle inspirés du génie logiciel. Une matrice de calcul statistique réutilisable doit être rigoureusement scindée en trois couches opérationnelles distinctes réparties sur des feuillets de calcul dédiés : un feuillet de saisie exclusivement réservé au recueil des données brutes immuables, un feuillet de traitement hébergeant les algorithmes d’agrégation et les distributions cumulées, et un feuillet de restitution consacré aux visualisations graphiques et aux synthèses normatives.
Pour prévenir la corruption involontaire de la logique de calcul lors de l’exploitation routinière du classeur par des tiers, il est impératif d’appliquer des protocoles de protection structurelle. Après avoir déverrouillé sélectivement les seules cellules destinées à recevoir les entrées de données primaires, l’analyste verrouille la feuille de traitement et active la protection globale du classeur via l’onglet Révision. Cette mesure technique empêche la modification fortuite ou la suppression involontaire des formules matricielles et des dépendances cumulatives tout en préservant l’interactivité des saisies.
Il est en outre hautement recommandé d’adosser à chaque matrice de traitement un tableau de contrôle de cohérence générale regroupant des indicateurs d’intégrité globale. Ce bloc récapitulatif vérifie en continu l’absence d’observations orphelines, la non-vacuité des cellules critiques, la parité stricte entre les sommes simples et cumulées, et la validité de la fermeture à 100 % des proportions relatives. Tout dysfonctionnement détecté par ce tableau de bord d’intégrité alerte immédiatement le modélisateur avant que des résultats tronqués ne soient exportés vers les rapports finaux.
12.3 Documentation méthodologique et standards de science ouverte
À l’ère de la reproductibilité scientifique et des standards de science ouverte, la documentation interne des algorithmes déployés au sein des tableurs constitue un impératif déontologique incontournable pour tout chercheur en psychologie et sciences comportementales. La transparence méthodologique exige que chaque formule statistique complexe ou non triviale soit accompagnée d’un commentaire contextuel explicite précisant la nature mathématique de l’opération menée, la signification des bornes d’intervalles appliquées et les justifications théoriques du choix de la méthode d’accumulation.
L’archivage des versions successives du protocole d’analyse statistique doit être rigoureusement orchestré afin d’assurer une traçabilité intégrale de la genèse des résultats quantitatifs. L’analyste prendra soin de consigner dans un feuillet de métadonnées dédié l’historique complet des versions du classeur, la date des modifications structurelles, l’identité des modélisateurs et la référence aux éventuels logiciels tiers ou scripts de collecte ayant alimenté le jeu de données primaires, écartant tout phénomène d’opacité analytique souvent reproché à l’usage non documenté des tableurs.
Enfin, la pérennité d’un protocole de recherche repose sur l’interopérabilité des structures de calcul avec les environnements d’analyse statistique avancés tels que les langages R, Python ou les progiciels dédiés comme SPSS. La structuration rigoureuse des données selon des formats tabulaires stricts et la normalisation des en-têtes garantissent que les matrices de fréquences simples et cumulées élaborées sous Excel pourront être instantanément exportées sous forme de fichiers ouverts (tels que des fichiers texte délimités CSV conformes à la norme UTF-8) et réanalysées par des scripts programmatiques indépendants, parachevant ainsi la validation et la robustesse scientifique de l’ensemble de la chaîne de traitement statistique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anastasi, A., & Urbina, S. (1997). Psychological testing (7th ed.). Prentice Hall.
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Galton, F. (1889). Natural inheritance. Macmillan. https://doi.org/10.1037/11690-000
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
- Microsoft Support. (2023). Fonction FREQUENCE. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/fréquence-fonction-44e91760-9192-49e0-a829-f9ba604f052a
- Microsoft Support. (2023). Fonction SCAN. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/fonction-scan-d58dfd16-08a6-4444-8451-9e79391ab102
- Microsoft Support. (2023). Basculer entre les références relatives, absolues et mixtes. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/basculer-entre-les-références-relatives-absolues-et-mixtes-dfec08cd-22fd-4ec2-8266-943e146e66f0
- Microsoft Support. (2023). Calculer les valeurs dans un tableau croisé dynamique. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/calculer-les-valeurs-dans-un-tableau-croisé-dynamique-11f41417-da80-435c-a5c6-b0185e59da77
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10