
L’analyse des distributions quantitatives constitue le socle fondamental de l’inférence statistique moderne, de la psychométrie expérimentale et de la modélisation des sciences du comportement. Lorsqu’un chercheur est confronté à un échantillon empirique ou à un modèle stochastique théorique, la tentation première consiste fréquemment à condenser la réalité observée sous la forme d’un histogramme de fréquences ou d’une estimation de densité par noyau. Pourtant, ces représentations courantes souffrent d’imperfections méthodologiques intrinsèques : la sensibilité arbitraire au découpage en intervalles de classes pour le premier, et la dépendance critique au choix d’une fenêtre de lissage pour la seconde. Face à ces limites, la fonction de répartition cumulative, universellement désignée par le sigle anglophone CDF pour Cumulative Distribution Function, s’impose comme l’outil analytique le plus robuste, le plus élégant et le plus rigoureux sur le plan mathématique.
Dans l’écosystème du logiciel statistique R, véritable référence pour le calcul scientifique international, la fonction de répartition bénéficie d’une implémentation matricielle et fonctionnelle native d’une rare puissance. Qu’il s’agisse de formaliser le comportement théorique de lois de probabilité continues et discrètes, ou de quantifier pas à pas les rangs percentiles au sein d’une cohorte expérimentale grâce à la fonction de répartition empirique (eCDF), R propose une dialectique complète alliant calcul analytique, calcul numérique et rendu graphique vectoriel haute résolution. La maîtrise de ces mécanismes ouvre des perspectives considérables pour l’évaluation diagnostique, l’étalonnage d’échelles de mesure psychologiques et la validation formelle d’hypothèses distributionnelles via des tests d’adéquation non paramétriques.
Ce traité exhaustif a pour vocation d’explorer l’ensemble des dimensions conceptuelles, mathématiques, computationnelles et appliquées entourant le calcul et la visualisation des fonctions de répartition dans R. Depuis les axiomes probabilistes fondateurs de Kolmogorov jusqu’aux personnalisations graphiques avancées sous l’environnement ggplot2, en passant par le traitement des ex æquo, l’estimation des bandes de confiance non paramétriques de Dvoretzky-Kiefer-Wolfowitz et la comparaison factorielle de protocoles cliniques, ce guide fournit aux chercheurs et analystes de données un cadre opératoire complet, reproductible et fondé sur les standards méthodologiques les plus exigeants de la recherche contemporaine.
1. Introduction fondamentale à la fonction de répartition (CDF) en statistique
1.1 Définition mathématique et propriétés axiomatiques de la CDF
Sur le plan formel de la théorie de la mesure et des probabilités, la fonction de répartition d’une variable aléatoire réelle (X), notée classiquement (F(x)) ou (F_X(x)), est définie sur l’ensemble des nombres réels (mathbb{R}) à valeurs dans l’intervalle unité fermé ([0, 1]). Elle exprime rigoureusement la probabilité que la variable aléatoire prenne une valeur inférieure ou égale à un seuil réel déterminé (x), ce qui s’écrit mathématiquement sous la forme : (F(x) = mathbb{P}(X le x)). Cette définition est universelle et s’applique avec une égale rigueur conceptuelle aux variables discrètes, continues ou mixtes, conférant à la fonction de répartition une universalité que ne possède pas la fonction de densité.
Pour être qualifiée de fonction de répartition au sens des axiomes probabilistes formalisés par le mathématicien Andreï Kolmogorov, toute fonction (F) doit impérativement satisfaire trois propriétés fondamentales. Premièrement, (F) est une fonction monotone croissante au sens large, ce qui implique que pour tout couple de réels ((x_1, x_2)) tel que (x_1 < x_2), nous avons obligatoirement (F(x_1) le F(x_2)). Deuxièmement, la fonction est continue à droite en tout point de son domaine de définition, signifiant que la limite de (F(x + epsilon)) lorsque (epsilon) tend vers zéro par valeurs positives est rigoureusement égale à (F(x)). Troisièmement, la fonction obéit à des limites asymptotiques strictes à l'infini : la limite de (F(x)) lorsque (x) tend vers moins l'infini est égale à zéro, tandis que sa limite lorsque (x) tend vers plus l'infini est égale à un.
Dans le cadre d’une variable aléatoire continue admettant une fonction de densité de probabilité (f(x)), la fonction de répartition correspond à l’intégrale de cette densité calculée depuis l’infini négatif jusqu’au point d’évaluation : (F(x) = int_{-infty}^{x} f(t) , mathrm{d}t). Inversement, lorsque la variable étudiée est discrète, la fonction de répartition prend la forme d’une fonction en escalier obtenue par la sommation des probabilités ponctuelles : (F(x) = sum_{x_i le x} mathbb{P}(X = x_i)). Cette formulation garantit une traçabilité intégrale de la masse de probabilité accumulée à travers l’ensemble du domaine de support.
1.2 Importance de la CDF dans l’analyse quantitative et psychométrique
Dans les sciences comportementales, la psychologie différentielle et la psychométrie contemporaine, la fonction de répartition joue un rôle structurel prépondérant dans l’étalonnage et la standardisation des instruments d’évaluation. L’interprétation d’un score brut issu d’une échelle d’anxiété, d’un test d’efficience intellectuelle ou d’un inventaire de personnalité est dénuée de sens clinique en l’absence de référentiel normatif. En convertissant directement un score continu ou discret en un rang percentile via l’expression (100 times F(x)), la fonction de répartition permet de situer instantanément un sujet au sein d’une population de référence, identifiant avec exactitude le pourcentage d’individus obtenant une performance inférieure ou égale à la sienne.
Au-delà de la simple conversion en percentiles ou en déciles, l’analyse de la morphologie de la fonction de répartition offre une lecture immédiate et globale des propriétés distributionnelles sans subir les déformations visuelles inhérentes aux découpages d’histogrammes. La pente locale de la courbe informe directement sur la dispersion et la concentration des observations : une pente abrupte signale une densité élevée d’observations autour d’une valeur centrale, tandis qu’un aplatissement prolongé trahit la présence de queues de distribution épaisses ou d’une forte variabilité interindividuelle. Cette caractéristique est cruciale pour évaluer l’asymétrie (skewness) et l’aplatissement (kurtosis) des profils de scores sans imposer a priori une hypothèse de normalité.
Dans le champ de la chronométrie mentale et de la psychologie cognitive, où l’on étudie les latences cognitives et les temps de réaction à des tâches d’attention soutenue ou de discrimination perceptive, les distributions présentent presque systématiquement une asymétrie positive marquée. La fonction de répartition empirique permet d’extraire fidèlement les quantiles critiques sans recourir à des transformations logarithmiques parfois trompeuses, facilitant l’évaluation précise des mécanismes sous-jacents de traitement de l’information et la détection d’altérations exécutives subtiles.
1.3 Présentation des outils disponibles dans l’écosystème R
L’environnement statistique R offre une architecture particulièrement riche et cohérente pour le traitement des fonctions de répartition, structurée autour du package de base stats ainsi que d’extensions graphiques modernes. Le moteur natif repose sur un préfixe conventionnel dédié : la lettre p (pour probability). Associée aux noms abrégés des lois théoriques, elle donne naissance à un ensemble standardisé d’outils analytiques tels que pnorm() pour la loi normale, pt() pour la distribution de Student, pchisq() pour le Chi-deux, ou encore pexp() et pgamma() pour les lois exponentielles et gamma. Ces fonctions calculent de manière instantanée et hautement optimisée la valeur exacte de (F(x)) pour n’importe quel vecteur de quantiles.
Pour le versant empirique, R intègre la puissante fonction d’ordre supérieur ecdf(), qui prend en argument un vecteur numérique de données brutes pour renvoyer un objet fonctionnel de première classe appartenant à la catégorie des stepfun (fonctions en escalier). Cet objet encapsule l’intégralité de la fonction de répartition empirique de l’échantillon et peut lui-même être interrogé comme n’importe quelle fonction R standard pour évaluer la probabilité cumulée associée à des valeurs arbitraires, qu’elles soient ou non présentes dans le jeu de données initial.
Sur le plan de la visualisation, l’utilisateur a le choix entre deux paradigmes complémentaires : le système graphique de base (base R), qui autorise des rendus rapides, légers et hautement paramétrables via la méthode plot.ecdf() et la fonction curve(), et la grammaire des graphiques déployée par le package ggplot2. Ce dernier propose la couche statistique dédiée stat_ecdf(), permettant une intégration fluide au sein de flux de manipulation de données complexes, avec une gestion native du facettage multi-groupes et une personnalisation esthétique conforme aux standards des publications scientifiques internationales.
2. Distinction mathématique et analytique entre PDF et CDF
2.1 Différences conceptuelles entre densité (PDF) et probabilité cumulée (CDF)
Pour comprendre pleinement la portée méthodologique de la fonction de répartition, il est impératif d’établir une distinction sans équivoque entre la fonction de densité de probabilité, désignée par le sigle PDF (Probability Density Function), et la fonction de répartition cumulative (CDF). Pour une variable continue, la densité (f(x)) représente le taux d’accumulation instantané de probabilité au voisinage immédiat du point (x). Sur le plan infinitésimal, la densité est définie comme la dérivée première de la fonction de répartition : (f(x) = frac{mathrm{d}F(x)}{mathrm{d}x}). Par conséquent, la valeur ponctuelle (f(x)) ne correspond en aucun cas à une probabilité directe, mais à une intensité de probabilité par unité de mesure, pouvant parfaitement dépasser la valeur 1 lorsque la variance du phénomène est très faible.
À l’inverse, l’ordonnée de la fonction de répartition (F(x)) représente une mesure probabiliste authentique, bornée sans exception entre 0 et 1. Géométriquement, alors que l’évaluation d’une densité requiert le calcul d’une surface sous la courbe entre deux bornes pour obtenir une probabilité exploitable, la fonction de répartition délivre immédiatement cette probabilité sous la forme d’une simple coordonnée verticale. Ainsi, la probabilité cumulée correspond à l’intégrale définie de la densité depuis l’origine du support jusqu’au point d’intérêt, transformant une opération de quadrature géométrique complexe en une simple lecture ponctuelle d’ordonnée.
Cette divergence conceptuelle se traduit par une supériorité technique notable de la CDF lorsqu’il s’agit d’analyser des données d’échantillonnage. L’estimation non paramétrique d’une densité par noyau (Kernel Density Estimation, accessible sous R via la fonction density()) nécessite de paramétrer arbitrairement une forme de noyau (gaussien, épanechnikov) et surtout une largeur de bande (bandwidth). Un sous-lissage engendre une courbe parasitée par de multiples artefacts locaux, tandis qu’un sur-lissage masque des bimodalités réelles. La fonction de répartition empirique s’affranchit totalement de cette subjectivité en conservant une objectivité numérique absolue.
2.2 Avantages méthodologiques de la CDF sur l’histogramme
Bien que l’histogramme demeure la méthode la plus populaire pour explorer visuellement une distribution univariée, il constitue l’un des estimateurs les plus fragiles et les plus trompeurs sur le plan statistique. Sa géométrie dépend intimement de deux paramètres arbitrairement fixés par l’utilisateur ou par les algorithmes par défaut du logiciel : la largeur des classes (le pas de découpage) et le positionnement précis de l’origine de la première classe. Une simple translation de la frontière des bacs de quelques unités peut radicalement métamorphoser l’allure générale de la distribution, créant des faux pics de fréquence ou dissimulant des asymétries cruciales.
La fonction de répartition empirique élimine intégralement cette source d’erreur méthodologique. Puisqu’elle ne procède à aucun regroupement artificiel en classes d’intervalles, elle préserve l’intégralité de l’information contenue dans le jeu de données initial, point par point. Chaque observation individuelle (x_i) est rigoureusement prise en compte sous la forme d’un saut de discontinuité d’amplitude (1/n), où (n) désigne la taille totale de l’échantillon. Aucune hypothèse d’agrégation n’est requise, ce qui garantit une neutralité analytique totale.
De surcroît, la robustesse statistique de la CDF s’avère nettement supérieure face aux échantillons de taille modeste ou hautement asymétriques. Alors qu’un histogramme appliqué à un effectif de 30 observations produit un tracé haché, erratique et difficilement interprétable, la fonction de répartition empirique génère une trajectoire monotone ordonnée, facilitant la comparaison visuelle avec des modèles théoriques et limitant les erreurs d’interprétation dues à la variance d’échantillonnage.
2.3 Passage analytique entre probabilité ponctuelle et cumulée
Le formalisme de la fonction de répartition offre un cadre de calcul analytique extrêmement direct pour déterminer les probabilités d’appartenance à n’importe quel intervalle de l’axe réel. En vertu des axiomes de finie additivité des probabilités, la probabilité qu’une observation se situe strictement au-dessus d’une borne inférieure (a) et en deçà ou au niveau d’une borne supérieure (b) est donnée par la différence exacte entre les valeurs prises par la fonction de répartition en ces deux bornes :
[mathbb{P}(a < X le b) = F(b) – F(a)]
Pour calculer la probabilité de survie, c’est-à-dire la probabilité que la variable dépasse un seuil critique (x), l’expression découle directement du principe de complémentarité : (mathbb{P}(X > x) = 1 – F(x)). Dans le langage R, ces opérations s’effectuent sans aucune dérivation complexe grâce aux arguments vectorisés des fonctions de répartition. Par exemple, l’évaluation de (mathbb{P}(-1.96 < X le 1.96)) pour une loi normale centrée réduite s'exécute nativement par la soustraction pnorm(1.96) - pnorm(-1.96), délivrant avec une extrême précision le résultat classique de 0.95 (soit 95 % de l’aire sous la courbe).
Un autre passage analytique primordial réside dans l’inversion de la fonction de répartition, couramment dénommée fonction quantile ou fonction de répartition inverse, notée (Q(p) = F^{-1}(p)) pour (p in ]0, 1[). Si la CDF prend en entrée une valeur métrique et renvoie une probabilité cumulée, la fonction quantile réalise le chemin inverse en associant à chaque niveau de probabilité la borne numérique exacte correspondante. Dans R, ces fonctions inverses sont préfixées par la lettre q, à l’image de qnorm() ou qchisq(), créant une bijection fonctionnelle indispensable pour l’inférence paramétrique et non paramétrique.
3. Préparation de l’environnement de travail et génération des données
3.1 Configuration de session R et gestion des dépendances
Pour garantir la reproductibilité totale des procédures analytiques et des rendus graphiques développés tout au long de cette étude, il est fondamental de structurer rigoureusement la session R dès son initialisation. Les bonnes pratiques imposent de s’assurer de la cohérence de l’environnement de travail, de documenter la version active du moteur R et de charger les bibliothèques logicielles spécialisées requises pour la manipulation des données et la visualisation avancée.
Trois packages principaux enrichissent l’écosystème de base de R pour notre propos : ggplot2 pour la construction modulaire de visualisations de haute tenue académique, scales pour le formatage précis des axes et des étiquettes probabilistes en pourcentages, et dplyr pour le filtrage et la restructuration matricielle des jeux de données d’observation. L’installation de ces modules s’effectue via les mécanismes standards du CRAN, et leur chargement en mémoire est encapsulé au début du script d’analyse. Par ailleurs, la gestion des générateurs de nombres pseudo-aléatoires constitue une exigence de premier ordre pour tout protocole computationnel impliquant des simulations stochastiques.
Le code d’initialisation suivant établit les fondations de l’espace de travail en fixant la graine aléatoire via l’instruction set.seed(42), garantissant que chaque tirage probabiliste sera rigoureusement identique sur n’importe quel ordinateur réexécutant le script :
# Configuration reproductible de la session R

options(scipen = 999, stringsAsFactors = FALSE)
# Chargement des bibliothèques scientifiques
if (!requireNamespace("ggplot2", quietly = TRUE)) install.packages("ggplot2")
if (!requireNamespace("scales", quietly = TRUE)) install.packages("scales")
if (!requireNamespace("dplyr", quietly = TRUE)) install.packages("dplyr")
library(ggplot2)
library(scales)
library(dplyr)
# Fixation de la graine pour reproductibilité absolue
set.seed(42)
3.2 Génération de jeux de données simulés selon des lois connues
Afin d’éprouver la validité des méthodes d’estimation empirique par rapport aux trajectoires théoriques exactes, la simulation numérique représente un paradigme d’une redoutable efficacité pédagogique et méthodologique. Nous allons générer trois vecteurs numériques distincts simulant des contextes expérimentaux fréquemment rencontrés en neurosciences cognitives et en psychométrie : une distribution symétrique gaussienne, une distribution asymétrique log-normale et une distribution exponentielle.
Le premier vecteur, baptisé scores_qi, simule les scores composites d’efficience intellectuelle d’une cohorte de 200 individus selon une loi normale d’espérance (mu = 100) et d’écart-type (sigma = 15). Le second vecteur, nommé latences_ms, modélise les temps de réaction (en millisecondes) de 300 participants soumis à une tâche d’inhibition attentionnelle, suivant une distribution log-normale définie par un paramètre moyen sur l’échelle log de (mu_{log} = 6.2) et une variabilité (sigma_{log} = 0.35). Le troisième vecteur, temps_attente, illustre les intervalles inter-réponses sous une loi exponentielle de paramètre de taux (lambda = 0.05).
L’implémentation sous R s’articule directement autour des fonctions de simulation préfixées par r (pour random) :
# Simulation d'échantillons selon des modèles distributionnels contrastés

taille_echantillon <- 250
# 1. Distribution Gaussienne symétrique (ex: Scores standardisés)
scores_qi <- rnorm(n = taille_echantillon, mean = 100, sd = 15)
# 2. Distribution Log-Normale asymétrique positive (ex: Latences cognitives)
latences_ms <- rlnorm(n = taille_echantillon, meanlog = 6.2, sdlog = 0.35)
# 3. Distribution Exponentielle décroissante (ex: Temps de survie / vigilance)
temps_attente <- rexp(n = taille_echantillon, rate = 0.05)
# Contrôle typologique de l'intégrité numérique des vecteurs générés
str(scores_qi)
summary(scores_qi)
3.3 Importation et nettoyage de données réelles d’observation
L’analyse de données réelles impose des précautions méthodologiques substantielles, en raison de la présence inévitable de valeurs manquantes (missing data, représentées par NA dans R), de doublons ou de scores aberrants résultant d’erreurs de saisie ou de dysfonctionnements de capteurs de mesure. Pour illustrer ce scénario de terrain, nous concevons un protocole d’importation et d’assainissement appliqué à des données tabulaires représentatives d’une enquête clinique en santé mentale.
Avant d’exécuter le calcul de la fonction de répartition empirique, le traitement des valeurs manquantes doit être conduit avec un discernement critique. La fonction ecdf() de base rejette par défaut les vecteurs corrompus par des valeurs non définies, rendant l’extraction impossible sans purge ou imputation préalable. Deux approches s’offrent alors au chercheur : une suppression par liste (pairwise/listwise deletion) via l’instruction na.omit() ou un filtrage explicite au sein d’une chaîne d’opérations vectorisées.
# Simulation d'un jeu de données brut avec artéfacts et valeurs manquantes

df_clinique_brut <- data.frame(

  id_patient = 1:120,

  score_depression = c(rnorm(115, mean = 24, sd = 6), rep(NA, 5)),

  groupe = rep(c("Temoin", "Therapie"), each = 60)

)
# Procédure de nettoyage rigoureux et d'exclusion des observations invalides
df_clinique_nettoye %
filter(!is.na(score_depression)) %>%
filter(score_depression >= 0 & score_depression <= 60) # Bornage métrique théorique
# Extraction du vecteur atomique épuré pour traitement statistique ultérieur
vecteur_scores <- df_clinique_nettoye$score_depression
cat("Nombre d'observations valides exploitables :", length(vecteur_scores), "n")
4. Calcul de la fonction de répartition empirique avec ecdf()
4.1 Fonctionnement interne et structure de l’objet ecdf
Au cœur du dispositif computationnel de R réside la fonction ecdf(), abréviation directe de Empirical Cumulative Distribution Function. L’algorithme exécuté par cette primitive statistique repose sur un ordonnancement initial strict du vecteur d’entrée (x). Soit un échantillon de (n) observations réelles ordonnées de manière croissante : (x_{(1)} le x_{(2)} le dots le x_{(n)}). La fonction de répartition empirique, conventionnellement notée (F_n(x)), assigne à chaque observation ordonnée un incrément probabiliste fixe égal à (1/n). Elle est formellement définie par l’expression mathématique suivante :
[F_n(x) = frac{1}{n} sum_{i=1}^{n} mathbb{I}_{(-infty, x]}(x_i)]
où (mathbb{I}_{A}) désigne la fonction indicatrice prenant la valeur 1 lorsque l’événement (x_i le x) est vérifié, et 0 dans le cas contraire.
Lorsque l’utilisateur exécute l’instruction fn <- ecdf(vecteur_scores), R ne produit pas un simple tableau de données statique, mais instancie un véritable objet fonctionnel doté d’attributs spécifiques. L’objet ainsi généré hérite simultanément de trois classes d’objets : ecdf, stepfun et function. Cette architecture permet à l’objet fn d’être invoqué directement avec la syntaxe standard d’une fonction R : en passant une valeur quelconque (t) en paramètre (par exemple fn(25)), le moteur exécute une recherche dichotomique ultrarapide sur le vecteur trié en mémoire et renvoie la proportion empirique d’observations inférieures ou égales à cette valeur.
# Instanciation de l'objet de répartition empirique

fonction_repartition_empirique <- ecdf(vecteur_scores)
# Examen de la nature structurelle et des classes de l'objet
class(fonction_repartition_empirique)
typeof(fonction_repartition_empirique)
# Évaluation dynamique pour une valeur seuil clinique arbitraire (ex: score de 20)
probabilite_score_20 <- fonction_repartition_empirique(20)
cat("Proportion cumulée observée sous le score 20 :", round(probabilite_score_20, 4), "n")
4.2 Extraction des caractéristiques mathématiques de l’objet
En tant que fonction en escalier dérivée de la classe stepfun, un objet ecdf encapsule des composantes mathématiques intrinsèques qu’il est possible d’extraire de manière programmatique à des fins d’inspection fine ou de modélisation mathématique. La caractéristique fondamentale réside dans l’ensemble des points de saut, désignés sous le terme de nœuds ou knots. La fonction R knots() permet d’extraire directement le vecteur trié des valeurs uniques observées qui provoquent une discontinuité sur la courbe cumulée.
En l’absence d’ex æquo au sein de l’échantillon, le nombre de nœuds correspond rigoureusement à la taille d’échantillon (n). En présence de valeurs identiques répétées, le nombre de nœuds se réduit au nombre de valeurs distinctes, chaque nœud concentrant une hauteur de marche proportionnelle à sa multiplicité. À chaque point de saut correspond une valeur de proportion cumulée. Les bornes extrêmes de l’objet obéissent strictement aux propriétés limites universelles : pour toute valeur strictement inférieure au minimum de l’échantillon (x_{(1)}), la fonction renvoie exactement 0 ; pour le minimum lui-même, elle prend la valeur (1/n) ; et pour toute valeur supérieure ou égale au maximum observé (x_{(n)}), la fonction se verrouille sur la valeur asymptotique absolue de 1.
# Extraction des points de discontinuité (nœuds de saut)

noeuds_saut <- knots(fonction_repartition_empirique)

cat("Nombre total de nœuds identifiés :", length(noeuds_saut), "n")
# Calcul des probabilités cumulées exactes associées à chaque nœud
proportions_cumulees <- fonction_repartition_empirique(noeuds_saut)
# Vérification computationnelle des conditions aux limites d'échantillonnage
valeur_min <- min(vecteur_scores)
valeur_max <- max(vecteur_scores)
cat("Fn(min - 1) =", fonction_repartition_empirique(valeur_min - 1), "n") # Doit renvoyer 0
cat("Fn(min) =", fonction_repartition_empirique(valeur_min), "n") # Doit renvoyer 1/n (ou k/n)
cat("Fn(max) =", fonction_repartition_empirique(valeur_max), "n") # Doit renvoyer 1.0
4.3 Interrogation probabiliste et calcul de percentiles empiriques
L’exploitation pratique de l’objet ecdf s’avère particulièrement puissante lors des démarches diagnostiques et d’interprétation normative. Dans un protocole clinique, l’analyste cherche continuellement à répondre à deux questions complémentaires : d’une part, quelle est la proportion de la population présentant un niveau de sévérité symptomatique inférieur ou égal à un score pivot donné ? D’autre part, quel est le score plancher correspondant aux 10 % ou aux 5 % des individus les plus sévèrement atteints ?
La première interrogation se résout par simple passage d’un scalaire ou d’un vecteur numérique à l’objet fonctionnel. La seconde interrogation mobilise l’opération inverse, à savoir la fonction quantile(). En R, la fonction quantile() accepte un vecteur de probabilités cibles compris entre 0 et 1 (argument probs) et applique par défaut l’un des neuf algorithmes d’interpolation quantile documentés par Hyndman et Fan (le type 7 étant le standard de base sous R). La combinaison synchronisée de ecdf() et de quantile() offre une boucle d’analyse complète, reliant sans friction l’espace métrique des scores au continuum probabiliste unitaire.
# 1. Évaluation probabiliste : Interrogation directe de scores pivots

scores_seuils <- c(15, 20, 25, 30)

pourcentages_cumules <- fonction_repartition_empirique(scores_seuils) * 100
resultats_eval <- data.frame(
Score_Brut = scores_seuils,
Rang_Percentile = round(pourcentages_cumules, 2)
)
print(resultats_eval)
# 2. Inversion quantile : Identification des seuils correspondant aux déciles cliniques
deciles_cibles <- seq(0.10, 0.90, by = 0.10)
valeurs_deciles <- quantile(vecteur_scores, probs = deciles_cibles)
print(valeurs_deciles)
5. Visualisation graphique de base de la CDF empirique avec plot()
5.1 Syntaxe fondamentale et rendu par défaut de plot.ecdf()
Le système graphique de base de R intègre une méthode polymorphique spécifiquement assignée à la classe ecdf : la fonction plot.ecdf(), invoquée automatiquement dès lors que la commande générique plot() reçoit en argument principal un objet issu de ecdf(). Cette méthode de tracé génère instantanément une représentation graphique vectorielle de la fonction de répartition empirique sans nécessiter l’écriture d’une seule ligne d’algorithme géométrique supplémentaire.
Par défaut, le tracé généré adopte fidèlement la morphologie en escalier prescrite par la théorie probabiliste. Des segments horizontaux traduisent la constance de la probabilité cumulée entre deux observations successives, tandis que de petits cercles ouverts ou pleins sont dessinés au niveau des nœuds pour expliciter la continuité à droite de l’opérateur mathématique. Le système configure automatiquement l’axe des ordonnées sur l’intervalle ([0, 1]), offrant un cadrage sans distorsion de l’ensemble de la masse d’échantillonnage.
# Tracé élémentaire par défaut sous le moteur graphique de base R

plot(fonction_repartition_empirique)
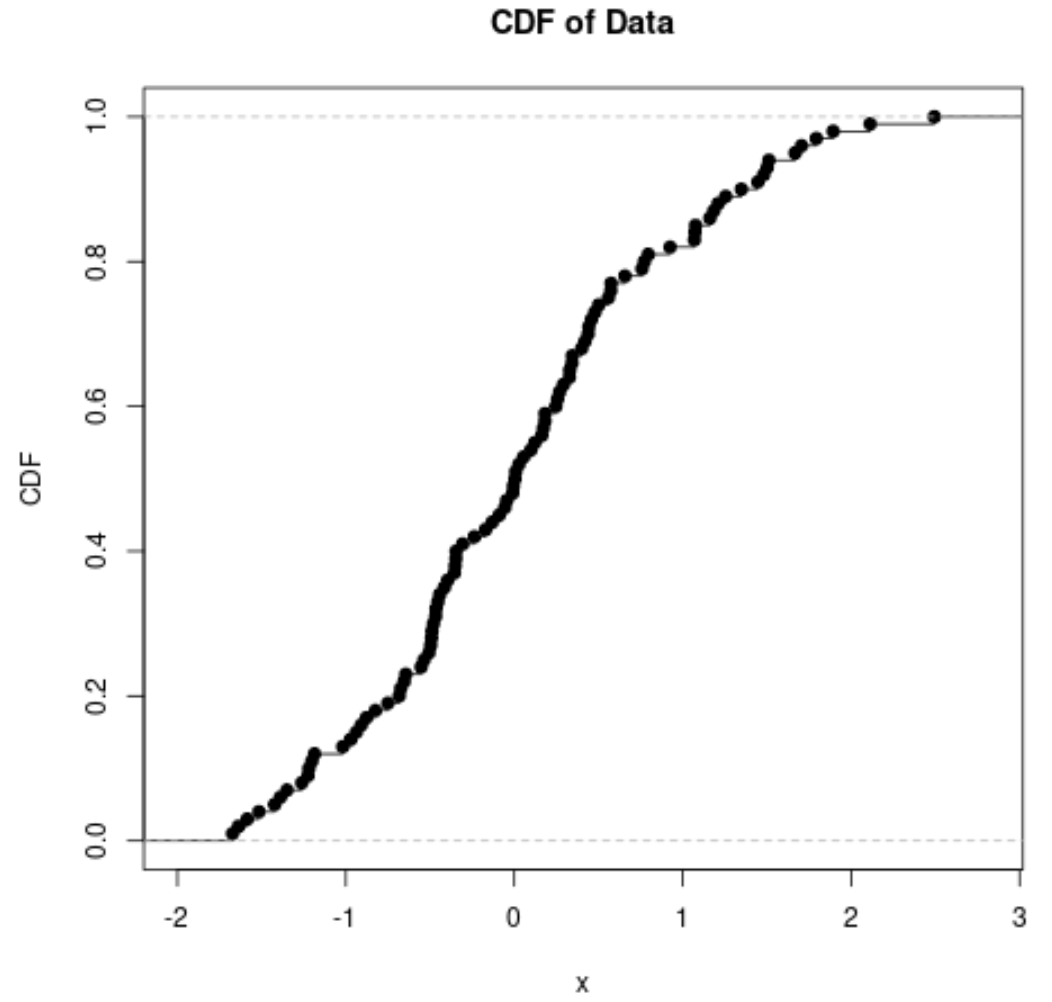
Bien que ce rendu brut soit d’une rigueur mathématique irréprochable, son esthétique initiale est volontairement épurée et s’avère insuffisante pour l’élaboration de documents de recherche formels. Les titres d’axes adoptent par défaut la syntaxe brute des variables R, le titre principal reprend le nom de l’objet d’appel, et l’épaisseur du trait peut paraître trop menue sur des écrans ou impressions haute densité. Une personnalisation minutieuse des arguments graphiques s’avère donc indispensable.
5.2 Personnalisation des paramètres graphiques de base
Pour hisser le tracé graphique aux standards des publications académiques, la méthode plot.ecdf() met à disposition un riche éventail d’arguments de contrôle esthétique et structurel. Les arguments fondamentaux d’habillage textuel comprennent xlab pour la légende métrique de l’axe horizontal, ylab pour l’ordonnée probabiliste, main pour le titre général de l’illustration et sub pour d’éventuelles notes méthodologiques de bas de page.
Un enjeu visuel majeur concerne le traitement des transitions de marche d’escalier. L’argument booléen verticals permet de décider si les lignes verticales reliant les paliers doivent être rendues visibles (verticals = TRUE) ou laissées invisibles (verticals = FALSE). Dans les travaux appliqués, l’activation des lignes verticales est largement plébiscitée car elle confère une lisibilité immédiate à la trajectoire globale de la courbe, en particulier lorsque la taille d’échantillon est conséquente. Par ailleurs, la présence des marqueurs circulaires aux nœuds de discontinuité peut être désactivée grâce à l’option do.points = FALSE, évitant ainsi la saturation visuelle générée par l’accumulation de dizaines de points noirs superposés.
# Personnalisation structurelle avancée du tracé de base

plot(

  fonction_repartition_empirique,

  verticals = TRUE,

  do.points = FALSE,

  main = "Fonction de Répartition Empirique (eCDF) des Scores Cliniques",

  xlab = "Score brut à l'inventaire d'évaluation",

  ylab = "Probabilité cumulée F_n(x)",

  col.01line = "gray70", # Couleur des asymptotes horizontales à 0 et 1

  lty.01line = 2         # Type de tiret pour les lignes asymptotiques

)
5.3 Ajustement du style de tracé, couleurs et axes
L’affinement final du tracé sous le système de base R implique la modification des propriétés stylistiques de la courbe, l’insertion de lignes de guidage orthogonales et le calibrage strict des limites d’échelles. L’épaisseur du trait de la fonction de répartition est calibrée via le paramètre numérique lwd (line width), la coloration de la courbe est ajustée via col, et la texture du tracé est modulée par lty (line type).
Pour faciliter le décodage quantitatif des percentiles fondamentaux, l’adjonction de repères horizontaux s’effectue aisément via la primitive abline(). Le positionnement de lignes pointillées aux ordonnées 0.25 (premier quartile), 0.50 (médiane) et 0.75 (troisième quartile) offre un système de repérage immédiat pour évaluer l’étalement interquartile du phénomène observé. De surcroît, le paramétrage explicite des arguments xlim et ylim garantit que la fenêtre graphique se concentre exclusivement sur l’étendue des données d’intérêt, éliminant tout espacement blanc périphérique superflu.
# Script complet de mise en forme esthétique de haut niveau sous base R

plot(

  fonction_repartition_empirique,

  verticals = TRUE,

  do.points = FALSE,

  col = "#1B4F72",       # Teinte bleu nuit académique

  lwd = 2.5,

  xlim = c(5, 45),

  ylim = c(0, 1),

  main = "Profil Distributionnel Cumulé des Performances",

  xlab = "Échelle métrique standardisée",

  ylab = "Fonction de répartition F_n(x)",

  panel.first = grid(col = "gray90", lty = 1) # Grille d'arrière-plan discrète

)
# Ajout des lignes de repère pour les quartiles d'échantillon
abline(h = c(0.25, 0.50, 0.75), col = "#C0392B", lty = c(3, 2, 3), lwd = 1.2)
abline(v = quantile(vecteur_scores, probs = c(0.25, 0.50, 0.75)),
col = "#C0392B", lty = c(3, 2, 3), lwd = 1.2)
# Insertion d'une légende explicative normalisée
legend(
"bottomright",
legend = c("eCDF empirique", "Quartiles (Q1, Médiane, Q3)"),
col = c("#1B4F72", "#C0392B"),
lty = c(1, 2),
lwd = c(2.5, 1.2),
bty = "o",
bg = "white"
)
6. Tracé de la CDF théorique pour des distributions paramétriques
6.1 Utilisation de curve() pour tracer la fonction pnorm
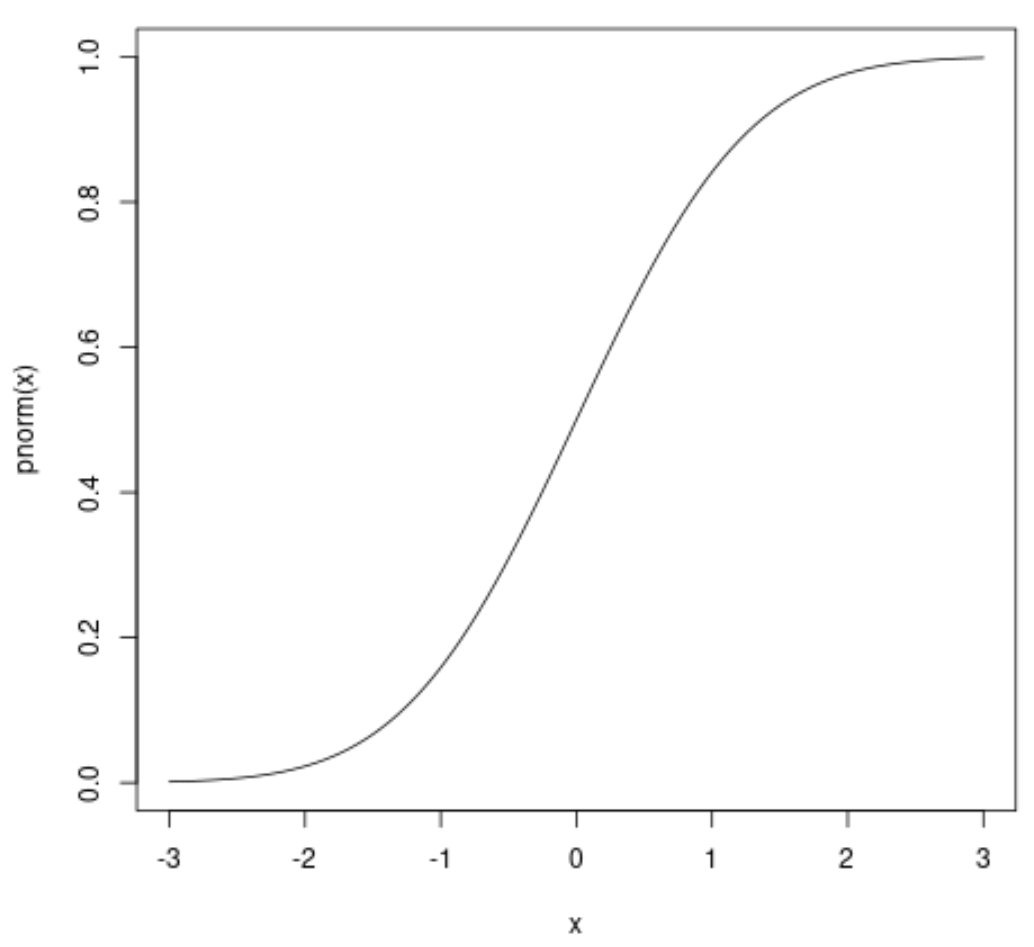
L’analyse distributionnelle ne prend tout son sens que lorsqu’elle confronte la réalité des données collectées à un modèle mathématique idéalisé. Pour évaluer la pertinence de l’hypothèse selon laquelle une variable découle d’un processus stochastique sous-jacent connu, le tracé de la CDF théorique constitue une étape incontournable. Dans le système graphique natif de R, l’outil par excellence pour représenter une fonction mathématique continue sur un intervalle donné est la primitive curve().
La fonction curve() prend en premier argument une expression vectorisée de la variable symbolique x ou directement le nom d’une fonction R préexistante prenant un vecteur numérique en entrée. Pour tracer la sigmoïde classique d’une loi normale centrée réduite (mathcal{N}(0, 1)), il suffit de spécifier curve(pnorm(x), from = -3.5, to = 3.5). La courbe obtenue adopte une allure caractéristique en S, présentant une stricte symétrie par rapport à son point d’inflexion situé exactement au point de coordonnées ((mu, 0.5)). Pour une distribution normale générale d’espérance (mu) et de variance (sigma^2), les paramètres de position et d’échelle sont passés sans difficulté à la fonction pnorm() via mean et sd.
# Tracé autonome d'une CDF théorique gaussienne paramétrée

mu_theorique <- 100

sigma_theorique <- 15
curve(
pnorm(x, mean = mu_theorique, sd = sigma_theorique),
from = 50,
to = 150,
lwd = 2,
col = "#27AE60",
main = "CDF Théorique d'une Loi Normale N(100, 15^2)",
xlab = "Quantiles théoriques",
ylab = "Probabilité cumulée P(X <= x)"
)
6.2 Superposition de la CDF théorique sur la CDF empirique
L’intérêt diagnostique majeur du tracé théorique réside dans sa superposition directe sur la courbe de répartition empirique calculée à partir des données de l’échantillon. Cette mise en regard visuelle permet de détecter instantanément d’éventuels écarts au modèle paramétrique postulé : un décalage horizontal signale une discordance de tendance centrale, une différence de pente trahit une sous-estimation ou sur-estimation de la variance, tandis que des écarts situés aux extrémités révèlent des anomalies d’aplatissement ou la présence d’asymétries non prises en charge par une distribution symétrique.
Pour superposer une courbe théorique sur un tracé de base préexistant généré par plot(ecdf(...)), la fonction curve() dispose de l’argument fondamental add = TRUE. Lorsqu’il est configuré sur le mode actif, cet argument neutralise la création d’un nouveau système de coordonnées et force le tracé à s’inscrire rigoureusement dans l’espace géométrique en cours d’utilisation, sous réserve d’harmoniser les intervalles d’abscisses.
# Estimation empirique des paramètres gaussiens sur l'échantillon de QI simulé

m_estime <- mean(scores_qi)

s_estime <- sd(scores_qi)
# Étape 1 : Tracé de la fonction empirique sous base R
plot(
ecdf(scores_qi),
verticals = TRUE,
do.points = FALSE,
col = "black",
lwd = 2,
xlim = c(55, 145),
main = "Ajustement de l'Échantillon à la Loi Normale Théorique",
xlab = "Score de quotient intellectuel",
ylab = "Probabilité cumulée"
)
# Étape 2 : Superposition directe de la CDF théorique ajustée
curve(
pnorm(x, mean = m_estime, sd = s_estime),
col = "#E74C3C",
lwd = 2.5,
lty = 2,
add = TRUE
)
# Légende explicative de l'adéquation
legend(
"topleft",
legend = c("eCDF empirique observée", "Modèle théorique N(m, s)"),
col = c("black", "#E74C3C"),
lty = c(1, 2),
lwd = c(2, 2.5),
bty = "n"
)
6.3 Tracé d’autres lois théoriques courantes (Student, Gamma, Log-Normale)
La boîte à outils probabiliste de R s’étend bien au-delà de la seule loi normale. Les données empiriques issues des neurosciences, de l’économie expérimentale ou de la psycholinguistique nécessitent fréquemment le recours à des distributions asymétriques à support strictement positif ou à des lois possédant des queues particulièrement lourdes. Les fonctions pt(), plnorm() et pgamma() permettent de modéliser avec précision ces comportements spécifiques.
Par exemple, la loi de Student est particulièrement précieuse pour modéliser des distributions sujettes à des observations extrêmes fréquentes, où les queues de distribution décroissent plus lentement que celles d’une gaussienne. La loi log-normale modélise idéalement les temps de traitement de l’information, caractérisés par une borne inférieure stricte (les limites physiologiques de transmission synaptique) et une queue étirée vers la droite reflétant des lapsus attentionnels. La comparaison multi-modèles sur un même système d’axes permet d’arbitrer visuellement entre plusieurs hypothèses d’ajustement avant d’engager des tests formels de sélection de modèle tels que le critère d’information d’Akaike (AIC).
# Comparaison visuelle multi-modèles sur une fenêtre graphique unifiée

curve(pnorm(x, mean = 0, sd = 1), from = -4, to = 4, lwd = 2, col = "black",

      main = "Comparaison de Lois Théoriques Symétriques et à Queues Lourdes",

      xlab = "Quantiles standardisés (z)", ylab = "Probabilité cumulée F(x)")
# Superposition de la loi de Student à 2 degrés de liberté (queues très épaisses)
curve(pt(x, df = 2), col = "#2980B9", lwd = 2, lty = 2, add = TRUE)
# Superposition de la loi de Student à 10 degrés de liberté (convergence vers la normale)
curve(pt(x, df = 10), col = "#E67E22", lwd = 2, lty = 3, add = TRUE)
legend("topleft", legend = c("Normale standard N(0,1)", "Student (df = 2)", "Student (df = 10)"),
col = c("black", "#2980B9", "#E67E22"), lty = c(1, 2, 3), lwd = 2)
7. Représentation avancée d’une CDF avec ggplot2
7.1 Tracé de la CDF empirique via stat_ecdf()
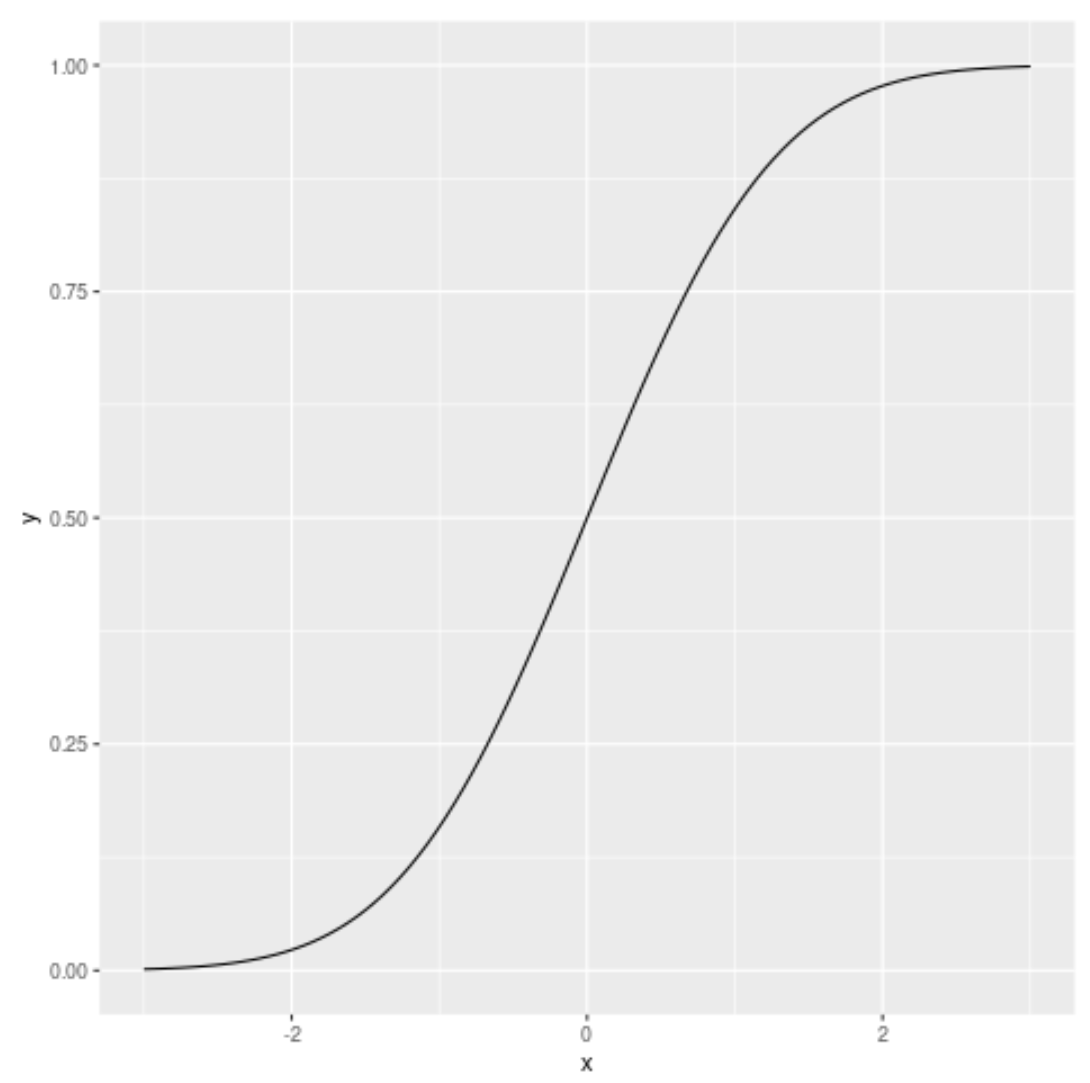
Dans le paradigme moderne de l’analyse de données sous R, le package ggplot2, fondé sur la théorie de la grammaire des graphiques formulée par Leland Wilkinson, constitue le standard incontesté pour la production de figures scientifiques. Plutôt que de calculer manuellement un objet ecdf au préalable, ggplot2 automatise intégralement cette opération grâce à sa couche de transformation statistique intégrée : stat_ecdf().
La syntaxe canonique requiert d’encapsuler les données dans un data frame, de déclarer la variable numérique d’intérêt au sein de la fonction d’esthétique globale aes(x = variable), puis d’adjoindre la couche stat_ecdf(). Par défaut, cette couche emploie une géométrie de type marche d’escalier (geom = "step"), calculant de manière transparente les proportions d’échantillon associées à chaque point d’observation. Alternativement, le chercheur peut forcer la géométrie en ligne continue (geom = "line"), bien que ce choix implique une interpolation lissée reliant directement les points sans respecter rigoureusement la discontinuité axiomatique en escalier.
# Construction d'un tracé de CDF empirique élémentaire sous ggplot2

df_simulation <- data.frame(Scores = scores_qi)
p_ecdf <- ggplot(df_simulation, aes(x = Scores)) +
stat_ecdf(geom = "step", color = "#2C3E50", linewidth = 1) +
labs(
title = "Fonction de Répartition Empirique sous ggplot2",
x = "Score standardisé",
y = "Probabilité cumulée F_n(x)"
) +
theme_minimal()
print(p_ecdf)
7.2 Représentation d’une CDF théorique continue via stat_function()
L’un des atouts majeurs de l’architecture de ggplot2 réside dans sa capacité à superposer sur un même graphique des données observées discrétisées et des fonctions mathématiques théoriques continues, grâce à la couche statistique stat_function(). Cette primitive s’avère particulièrement puissante pour formaliser un modèle théorique sans avoir à générer manuellement un vecteur dense de coordonnées artificielles.
Pour superposer une loi normale ajustée sur la fonction de répartition empirique, stat_function() reçoit en argument le pointeur vers la fonction distributionnelle (en l’occurrence fun = pnorm) et une liste de paramètres passés via args = list(mean = ..., sd = ...). Afin d’assurer une restitution visuelle parfaitement fluide de la courbe théorique, l’argument n peut être rehaussé (par exemple à 1000 points d’évaluation), empêchant l’apparition de facettes polygonales visibles sur des écrans haute résolution.
# Combinaison harmonieuse de stat_ecdf() et stat_function() sur un jeu de données

m_empirique <- mean(df_simulation$Scores)

s_empirique <- sd(df_simulation$Scores)
p_comparaison <- ggplot(df_simulation, aes(x = Scores)) +
# Couche 1 : Courbe empirique en escalier
stat_ecdf(aes(color = "Empirique (Observée)"), geom = "step", linewidth = 0.9) +
# Couche 2 : Courbe théorique paramétrée continue
stat_function(
fun = pnorm,
args = list(mean = m_empirique, sd = s_empirique),
aes(color = "Modèle Gaussien"),
linewidth = 1.1,
linetype = "dashed",
n = 1000
) +
scale_color_manual(
name = "Distribution :",
values = c("Empirique (Observée)" = "#2C3E50", "Modèle Gaussien" = "#E74C3C")
) +
labs(
title = "Confrontation Graphique de l'eCDF au Modèle Théorique Gaussien",
subtitle = "Paramètres estimés par maximum de vraisemblance sur l'échantillon",
x = "Score d'efficience cognitive",
y = "Probabilité cumulée F(x)"
) +
theme_minimal()
print(p_comparaison)
7.3 Habillage esthétique et thèmes de publication avec ggplot2
Pour destiner une figure à une publication scientifique répondant aux normes de l’American Psychological Association (APA) ou des revues de biométrie de premier rang, l’habillage esthétique doit se conformer à des principes de sobriété, de clarté typographique et de précision d’échelle. L’utilisation du package scales permet notamment de transformer les étiquettes de l’axe vertical en pourcentages stricts (par exemple 0 %, 25 %, 50 %, 75 %, 100 %), éliminant les ambiguïtés de lecture pour les cliniciens et praticiens.
Le choix d’un thème sans fioritures comme theme_classic() ou theme_bw() combiné à un contrôle explicite de la taille des polices de caractères, des marges intérieures et de l’épaisseur des axes garantit une lisibilité maximale lors des réductions de colonnes dans les maquettes d’édition. L’intégration de lignes de quadrillage majeures très pâles guide le regard sans surcharger la densité d’encre visuelle (respect du principe d’optimisation du ratio encre-donnée formulé par Edward Tufte).
# Finalisation esthétique selon les normes académiques internationales

p_academique <- ggplot(df_simulation, aes(x = Scores)) +

  stat_ecdf(geom = "step", color = "#1A5276", linewidth = 1) +

  scale_y_continuous(

    labels = scales::percent_format(accuracy = 1),

    breaks = seq(0, 1, by = 0.20),

    limits = c(0, 1),

    expand = expansion(mult = c(0, 0.02))

  ) +

  scale_x_continuous(

    breaks = seq(50, 150, by = 15),

    limits = c(50, 150)

  ) +

  labs(

    title = "Distribution Cumulative des Scores de Quotient Intellectuel",

    x = "Score standardisé (M = 100, SD = 15)",

    y = "Rang percentile cumulé"

  ) +

  theme_classic(base_size = 12, base_family = "sans") +

  theme(

    plot.title = element_text(face = "bold", size = 13, hjust = 0.5),

    axis.title = element_text(face = "bold"),

    axis.line = element_line(color = "black", linewidth = 0.6),

    panel.grid.major.y = element_line(color = "gray92", linetype = "dotted")

  )
print(p_academique)
8. Comparaison simultanée de plusieurs groupes et conditions expérimentales
8.1 Stratification par facteur dans ggplot2
L’un des apports majeurs de la fonction de répartition réside dans la comparaison directe de sous-populations ou de bras d’essais cliniques (par exemple : groupe contrôle versus groupe traitement, ou comparaison de sous-groupes diagnostiques). Contrairement aux histogrammes superposés, qui génèrent une illisibilité immédiate en raison de l’occultation mutuelle des barres, et aux boîtes à moustaches, qui réduisent l’information à de simples résumés à cinq nombres, les courbes cumulées superposées offrent une vision exhaustive et limpide des divergences distributionnelles.
Sous ggplot2, cette stratification s’opère de façon native en mappant une variable catégorielle (un facteur) sur l’argument esthétique color ou linetype au sein de l’instruction stat_ecdf(). Le moteur regroupe alors automatiquement les données par modalité et calcule indépendamment chaque fonction empirique avec son effectif propre (n_k). L’intégration de palettes de couleurs adaptées aux personnes daltoniennes (telles que viridis ou ColorBrewer) assure une accessibilité visuelle sans faille.
# Simulation d'un essai randomisé à trois bras expérimentaux

set.seed(101)

n_groupe <- 100
df_groupes <- data.frame(
Score = c(
rnorm(n_groupe, mean = 50, sd = 10), # Groupe Témoin / Placebo
rnorm(n_groupe, mean = 46, sd = 10), # Thérapie Standard
rnorm(n_groupe, mean = 38, sd = 9) # Nouvelle Thérapie Expérimentale
),
Condition = factor(rep(c("Placebo", "Standard", "Innovant"), each = n_groupe),
levels = c("Placebo", "Standard", "Innovant"))
)
# Visualisation comparative multigroupes avec palette Viridis
p_multigroupes <- ggplot(df_groupes, aes(x = Score, color = Condition)) +
stat_ecdf(geom = "step", linewidth = 1.1) +
scale_color_viridis_d(option = "plasma", end = 0.85) +
scale_y_continuous(labels = scales::percent_format()) +
labs(
title = "Comparaison de l'Efficacité Thérapeutique selon les Groupes",
subtitle = "Décalage vers la gauche traduisant une réduction significative des symptômes",
x = "Score de sévérité pathologique",
y = "Proportion cumulée de patients",
color = "Bras de l'essai :"
) +
theme_minimal() +
theme(legend.position = "bottom")
print(p_multigroupes)
8.2 Facettage multi-panneaux pour plans factoriels complexes
Lorsque le plan expérimental croise plusieurs facteurs de classification (par exemple le type d’intervention thérapeutique combiné à la tranche d’âge des sujets ou à leur statut biologique), la superposition de l’ensemble des courbes sur un unique système d’axes engendre un enchevêtrement difficilement déchiffrable. Le mécanisme de facettage (small multiples) déployé par ggplot2 apporte une réponse visuelle optimale en partitionnant la grille de tracé selon les combinaisons de facteurs.
Les fonctions facet_wrap() (pour une disposition unidimensionnelle flexible) et facet_grid() (pour une matrice factorielle stricte en lignes et colonnes) permettent d’isoler chaque sous-groupe dans son panneau dédié, tout en préservant une synchronisation parfaite des échelles horizontales et verticales. Cette harmonisation métrique rigoureuse permet à l’œil d’effectuer des comparaisons spatiales directes et fiables entre les panneaux sans subir de distorsions d’axes.
# Simulation d'un plan factoriel 2x2 : Traitement x Tranche d'Âge

df_factoriel %

  filter(Condition %in% c("Placebo", "Innovant")) %>%

  mutate(

    Age_Classe = rep(rep(c("Jeunes Adultes", "Seniors"), each = 50), 2)

  )
p_facettes <- ggplot(df_factoriel, aes(x = Score, color = Condition)) +
stat_ecdf(geom = "step", linewidth = 1) +
facet_wrap(~ Age_Classe) +
scale_color_manual(values = c("Placebo" = "#7F8C8D", "Innovant" = "#2980B9")) +
scale_y_continuous(labels = scales::percent_format()) +
labs(
title = "Évaluation Factorielle de la Réponse Thérapeutique selon l'Âge",
x = "Score symptomatique",
y = "Probabilité cumulée"
) +
theme_bw() +
theme(legend.position = "bottom", strip.background = element_rect(fill = "gray95"))
print(p_facettes)
8.3 Calcul et affichage des écarts maximaux intergroupes
L’analyse comparative de deux fonctions de répartition empiriques débouche directement sur le concept fondamental de dominance stochastique. Si la courbe de répartition d’une condition (A) se situe en tout point strictement au-dessus de celle d’une condition (B) (ce qui s’écrit (F_A(x) ge F_B(x)) pour tout (x)), on affirme que la condition (B) domine stochastiquement la condition (A) au premier ordre. Dans notre contexte clinique, une courbe située à gauche indique que les scores sont systématiquement plus faibles, ce qui traduit une supériorité d’un traitement visant la baisse des symptômes.
L’écart vertical maximal séparant deux fonctions de répartition empiriques constitue la statistique de test fondamentale de Kolmogorov-Smirnov à deux échantillons, notée (D) :
[D = sup_{x} |F_A(x) – F_B(x)|]
L’identification de la localisation exacte de cet écart critique sur l’axe des abscisses permet de cibler le niveau de score précis où la divergence d’action entre deux protocoles thérapeutiques est la plus prononcée sur le plan clinique.
# Calcul algorithmique de l'écart vertical maximal entre Placebo et Innovant

scores_placebo <- df_groupes$Score[df_groupes$Condition == "Placebo"]

scores_innovant <- df_groupes$Score[df_groupes$Condition == "Innovant"]
fn_placebo <- ecdf(scores_placebo)
fn_innovant <- ecdf(scores_innovant)
# Grille d'évaluation commune fine
grille_x <- sort(unique(c(scores_placebo, scores_innovant)))
differences_absolues <- abs(fn_placebo(grille_x) - fn_innovant(grille_x))
indice_max <- which.max(differences_absolues)
x_critique <- grille_x[indice_max]
y_placebo <- fn_placebo(x_critique)
y_innovant <- fn_innovant(x_critique)
valeur_d_max <- differences_absolues[indice_max]
cat("Statistique de divergence maximale D :", round(valeur_d_max, 4), "n")
cat("Localisation du score d'écart maximal :", round(x_critique, 2), "n")
9. Personnalisation technique avancée et annotations scientifiques
9.1 Ajout de segments et d’intervalles critiques
Pour conférer à une figure de publication une haute valeur explicative, il est recommandé d’incorporer directement sur la trajectoire de la courbe des segments de projection orthogonale matérialisant des valeurs charnières, telles que la médiane d’échantillon ou des seuils de significativité diagnostique. Ces segments permettent au lecteur d’appréhender d’un seul coup d’œil l’articulation entre l’espace des mesures brutes et l’échelle des probabilités cumulées.
Sous ggplot2, cette contextualisation graphique s’élabore grâce à la couche geom_segment(), combinée à des instructions textuelles via annotate("text", ...) ou annotate("label", ...). L’utilisation d’annotations intégrées permet de s’affranchir de légendes périphériques parfois déconnectées de la géométrie des données, améliorant l’efficience cognitive de la lecture de la figure.
# Construction d'un graphique annoté mettant en exergue la médiane empirique

mediane_score <- median(df_simulation$Scores)
p_annote <- ggplot(df_simulation, aes(x = Scores)) +
stat_ecdf(geom = "step", color = "#34495E", linewidth = 1) +
# Segment horizontal de l'axe y = 0.50 jusqu'à la médiane
geom_segment(
aes(x = 50, xend = mediane_score, y = 0.50, yend = 0.50),
color = "#E74C3C", linetype = "dashed", linewidth = 0.8
) +
# Segment vertical de la médiane jusqu'à l'axe x
geom_segment(
aes(x = mediane_score, xend = mediane_score, y = 0, yend = 0.50),
color = "#E74C3C", linetype = "dashed", linewidth = 0.8
) +
# Point marquant l'intersection exacte sur la courbe
annotate("point", x = mediane_score, y = 0.50, color = "#E74C3C", size = 3) +
# Étiquette descriptive
annotate(
"label", x = mediane_score + 8, y = 0.45,
label = paste("Médiane =", round(mediane_score, 1)),
color = "#E74C3C", fill = "white", fontface = "bold", size = 3.8
) +
scale_y_continuous(labels = scales::percent_format(), limits = c(0, 1)) +
labs(
title = "Mise en Évidence de la Médiane sur la Courbe de Répartition",
x = "Score d'efficience", y = "Probabilité cumulée"
) +
theme_classic()
9.2 Intégration d’intervalles de confiance de Dvoretzky-Kiefer-Wolfowitz (DKW)
L’un des défis les plus cruciaux de l’inférence non paramétrique concerne la quantification de l’incertitude d’échantillonnage entourant la fonction de répartition empirique. Si la loi forte des grands nombres et le théorème central limite garantissent la convergence ponctuelle de (F_n(x)) vers (F(x)), le théorème de Glivenko-Cantelli établit une convergence presque sûre uniforme sur l’ensemble de l’axe réel :
[lim_{n to infty} sup_{x in mathbb{R}} |F_n(x) – F(x)| = 0]
Pour construire une bande de confiance simultanée rigoureuse couvrant la véritable fonction de répartition inconnue (F(x)) sur l’ensemble de son domaine avec un niveau de confiance garanti (1 – alpha), l’inégalité de Dvoretzky-Kiefer-Wolfowitz (DKW), dont la constante optimale a été établie par Pascal Massart en 1990, fournit la relation exacte :
[mathbb{P}left(sup_{x in mathbb{R}} |F_n(x) – F(x)| > epsilonright) le 2e^{-2nepsilon^2}]
En fixant le risque d’erreur à (alpha) (par exemple 0.05 pour une bande de confiance à 95 %), la marge d’erreur uniforme (epsilon) s’obtient directement par inversion de l’inégalité :
[epsilon = sqrt{frac{ln(2 / alpha)}{2n}}]
La bande de confiance supérieure et inférieure s’en déduit immédiatement : (L(x) = max(F_n(x) – epsilon, 0)) et (U(x) = min(F_n(x) + epsilon, 1)). Sous ggplot2, cette enveloppe non paramétrique se matérialise avec une remarquable élégance géométrique via la couche geom_ribbon().
# Calcul de la bande de confiance non paramétrique de DKW (Massart, 1990)

alpha_dkw <- 0.05

n_obs <- length(scores_qi)

epsilon_dkw <- sqrt(log(2 / alpha_dkw) / (2 * n_obs))
# Construction du jeu de données pour l'enveloppe de confiance
df_dkw %
mutate(
Fn = ecdf(scores_qi)(Scores),
Borne_Inf = pmax(Fn - epsilon_dkw, 0),
Borne_Sup = pmin(Fn + epsilon_dkw, 1)
)
# Tracé sous ggplot2 intégrant le ruban de confiance DKW
p_dkw <- ggplot(df_dkw, aes(x = Scores)) +
geom_ribbon(aes(ymin = Borne_Inf, ymax = Borne_Sup), fill = "#BDC3C7", alpha = 0.4) +
geom_step(aes(y = Borne_Inf), color = "#7F8C8D", linetype = "dotted", linewidth = 0.7) +
geom_step(aes(y = Borne_Sup), color = "#7F8C8D", linetype = "dotted", linewidth = 0.7) +
geom_step(aes(y = Fn), color = "#2C3E50", linewidth = 1) +
scale_y_continuous(labels = scales::percent_format(), limits = c(0, 1)) +
labs(
title = "Fonction de Répartition Empirique et Bande de Confiance DKW à 95 %",
subtitle = "Garantie simultanée non paramétrique sur l'intégralité du domaine réel",
x = "Score standardisé", y = "Probabilité cumulée F(x)"
) +
theme_minimal()
print(p_dkw)
9.3 Exportation haute résolution pour manuscrits académiques
L’étape ultime du processus de visualisation consiste à exporter l’objet graphique produit vers des formats de fichiers conformes aux directives de soumission des maisons d’édition scientifiques (Springer, Elsevier, APA). La commande centrale de l’écosystème ggplot2 est ggsave(), qui prend en charge une gestion rigoureuse de la rastérisation, de la vectorisation, des dimensions physiques et de la résolution d’impression.
Deux familles de formats coexistent dans la pratique éditoriale : les formats vectoriels (PDF et SVG), à privilégier absolument dans la mesure où ils conservent la définition infinie des tracés et du texte sans aucune pixellisation lors des redimensionnements typographiques ; et les formats matriciels non compressés ou compressés sans perte (TIFF, PNG), qui doivent impérativement satisfaire à un standard minimal de 300 à 600 DPI (dots per inch). La maîtrise explicite des unités physiques (centimètres ou pouces) empêche toute déformation du ratio d’aspect.
# Exportation vectorielle haute définition pour manuscrit de recherche

ggsave(

  filename = "Figure_CDF_Cognitive_DKW.pdf",

  plot = p_dkw,

  device = "pdf",

  width = 18,

  height = 12,

  units = "cm",

  dpi = 600

)
# Exportation matricielle de contrôle au format PNG (300 DPI)
ggsave(
filename = "Figure_CDF_Cognitive_DKW.png",
plot = p_dkw,
device = "png",
width = 18,
height = 12,
units = "cm",
dpi = 300
)
10. Inférence statistique et tests d’adéquation basés sur la CDF
10.1 Le test de Kolmogorov-Smirnov à un échantillon (ks.test)
La mise en regard visuelle de la fonction de répartition empirique et d’un modèle théorique constitue une démarche exploratoire incontournable, mais elle doit être étayée par un test d’hypothèse formel d’adéquation (goodness-of-fit). Le test non paramétrique le plus célèbre fondé directement sur la CDF est le test de Kolmogorov-Smirnov à un échantillon. Il évalue l’hypothèse nulle (H_0 : F(x) = F_0(x)) contre l’hypothèse alternative selon laquelle la véritable distribution sous-jacente s’écarte de la loi postulée (F_0).
La statistique de test, notée (D), correspond à la distance suprémum (l’écart vertical absolu le plus grand) mesurée entre la fonction empirique d’échantillon (F_n(x)) et la CDF théorique spécifiée (F_0(x)) :
[D = sup_{x in mathbb{R}} |F_n(x) – F_0(x)|]
Dans R, ce test est exécuté via la fonction générique ks.test(). Cependant, une mise en garde méthodologique fondamentale s’impose : la théorie asymptotique standard du test de Kolmogorov-Smirnov exige que la distribution théorique (F_0) soit intégralement spécifiée a priori, de manière totalement indépendante de l’échantillon. Si les paramètres de la distribution cible (comme la moyenne et l’écart-type d’une gaussienne) sont directement estimés à partir de l’échantillon sous étude, le test standard devient excessivement conservateur (les p-valeurs sont artificiellement gonflées). Dans ce scénario de paramètres estimés, il est impératif d’utiliser la variante de Lilliefors, implémentée dans le package nortest via lillie.test().
# Exécution du test de Kolmogorov-Smirnov standard à un échantillon

# Hypothèse nulle : Les données de QI suivent exactement une loi N(100, 15^2)

resultat_ks_un <- ks.test(scores_qi, "pnorm", mean = 100, sd = 15)

print(resultat_ks_un)
# Démonstration du test de Lilliefors en cas de paramètres estimés sur l'échantillon
if (requireNamespace("nortest", quietly = TRUE)) {
resultat_lilliefors <- nortest::lillie.test(scores_qi)
print(resultat_lilliefors)
}
10.2 Le test de Kolmogorov-Smirnov à deux échantillons
Dans une perspective clinique ou expérimentale comparant deux groupes indépendants, le test de Kolmogorov-Smirnov à deux échantillons évalue l’hypothèse nulle selon laquelle deux ensembles d’observations continues sont issus d’une même population parente indéterminée, ce qui s’écrit formellement (H_0 : F_1(x) = F_2(x)) pour tout réel (x). La statistique de test repose sur l’écart suprémum absolu mesuré entre les deux fonctions de répartition empiriques (F_{n_1}(x)) et (F_{n_2}(x)) :
[D = sup_{x in mathbb{R}} |F_{n_1}(x) – F_{n_2}(x)|]
Il est critique de souligner la différence méthodologique fondamentale séparant le test de Kolmogorov-Smirnov du classique test des rangs de Wilcoxon-Mann-Whitney. Alors que le test de Wilcoxon est essentiellement sensible à un déplacement de la tendance centrale (différence de position ou de médiane sous hypothèse d’homoscédasticité), le test de Kolmogorov-Smirnov est un test de morphologie globale. Il réagit à n’importe quelle disparité distributionnelle : un décalage de moyenne, une altération de la variance, une dissymétrie locale ou encore une bimodalité latente.
# Comparaison non paramétrique globale des conditions Thérapeutique vs Témoin

resultat_ks_deux <- ks.test(scores_placebo, scores_innovant)

print(resultat_ks_deux)
# Interprétation de la statistique D et de la p-valeur associée
cat("Statistique D calculée :", resultat_ks_deux$statistic, "n")
cat("Degré de signification p-valeur :", resultat_ks_deux$p.value, "n")
10.3 Approches complémentaires : Cramer-von Mises et Anderson-Darling
Bien que le test de Kolmogorov-Smirnov soit d’une simplicité conceptuelle remarquable, il souffre d’une faiblesse méthodologique notoire largement documentée dans la littérature statistique : sa sensibilité décroît considérablement à mesure que l’on s’éloigne du centre de la distribution pour se rapprocher des queues extrêmes. En effet, la variance de la statistique empirique (F_n(x)) s’annule aux asymptotes 0 et 1, rendant le test KS relativement aveugle aux déviations structurelles intervenant sur les percentiles marginaux (les 5 % les plus bas ou les plus élevés).
Pour pallier ce déficit de puissance statistique, les tests de la famille quadratique apportent une solution de premier ordre. Le test de Cramér-von Mises intègre l’écart quadratique sur l’ensemble de la distribution. Quant au test d’Anderson-Darling, il introduit une fonction de pondération hyperbolique qui accorde un poids prépondérant aux queues de distribution :
[A^2 = n int_{-infty}^{+infty} frac{left(F_n(x) – F_0(x)right)^2}{F_0(x)(1 – F_0(x))} , mathrm{d}F_0(x)]
Ces tests spécialisés sont mis en œuvre sous R via les packages goftest et nortest, complétant de façon déterminante l’inférence distributionnelle.
# Mise en œuvre des tests d'adéquation quadratiques pondérés

if (requireNamespace("goftest", quietly = TRUE)) {

  # Test de Cramér-von Mises

  cvm_res <- goftest::cvm.test(scores_qi, "pnorm", mean = 100, sd = 15)

  cat("P-valeur Cramér-von Mises :", cvm_res$p.value, "n")


  # Test d'Anderson-Darling (forte sensibilité aux queues de distribution)

  ad_res <- goftest::ad.test(scores_qi, "pnorm", mean = 100, sd = 15)

  cat("P-valeur Anderson-Darling :", ad_res$p.value, "n")

}
11. Résolution des problèmes fréquents et optimisation computationnelle
11.1 Traitement des ex æquo (ties) et données discrètes
L’application rigoureuse de la théorie des fonctions de répartition présuppose conceptuellement que les variables observées soient issues de processus continus, où la probabilité théorique d’observer deux valeurs rigoureusement identiques est strictement nulle. Dans la réalité empirique des sciences humaines et de la biomédecine, cette assomption est quasi systématiquement violée : les instruments de mesure (échelles de Likert, scores de questionnaires, chronométrages arrondis au centième) génèrent une proportion importante de valeurs répétées, communément appelées ex æquo ou ties.
Sur le plan du calcul pur de la fonction ecdf(), la présence de valeurs identiques répétées n’induit aucun blocage algorithmique : le moteur R regroupe les occurrences identiques en un unique nœud, et la hauteur de la marche d’escalier associée est automatiquement multipliée par le nombre de doublons constatés (hauteur égale à (k/n) où (k) désigne la fréquence absolue de la valeur). En revanche, la présence d’ex æquo perturbe sévèrement les fondements théoriques des tests d’adéquation de type Kolmogorov-Smirnov. L’exécution de ks.test() sur un vecteur présentant des doublons génère un avertissement formel signalant que la p-valeur exacte ne peut être calculée et repose sur une approximation asymptotique potentiellement biaisée.
Pour surmonter cet obstacle lors des phases inférentielles, deux protocoles sont validés : l’adjonction d’un bruit infinitésimal continu (jittering via la fonction jitter() de R) afin de disjoindre artificiellement les valeurs sans altérer la topologie de la distribution, ou le recours à des tests de permutations exacts non conditionnels.
# Illustration de l'impact des ex æquo sur la fonction ecdf

scores_discrets <- c(12, 14, 14, 14, 18, 20, 20, 25)

fn_discrete <- ecdf(scores_discrets)
# La valeur 14 apparaît 3 fois sur 8 observations :
# Fn(14) passe instantanément de 1/8 à 4/8 (saut de 3/8)
knots(fn_discrete)
fn_discrete(14)
# Stratégie de contrôle par jittering pour tests non paramétriques sensibles
scores_sans_ties <- jitter(scores_discrets, amount = 0.001)
ks_ajuste <- suppressWarnings(ks.test(scores_sans_ties, "pnorm", mean = 17, sd = 4))
11.2 Gestion de jeux de données massifs (Big Data)
À l’ère des mégadonnées cognitives, de la génomique comportementale ou de l’analyse des traces numériques issues d’applications mobiles, les jeux de données peuvent atteindre des millions d’enregistrements. Dans un tel contexte, le calcul brut et le rendu graphique naïf d’une fonction de répartition empirique se heurtent à des limitations computationnelles majeures. Si l’évaluation de ecdf() sur un vecteur de 5 millions d’éléments s’exécute en quelques secondes grâce à la vélocité des algorithmes de tri sous R, le tracé graphique direct de 5 millions de marches d’escalier sous ggplot2 sature la mémoire vidéo, génère des fichiers vectoriels de plusieurs centaines de mégaoctets et fige les moteurs de rendu PDF.
Pour optimiser le rendu sans altérer d’un iota la fidélité de la courbe globale, la stratégie computationnelle standard consiste à évaluer l’objet ecdf() sur une grille régulière d’abscisses uniformément espacées comprenant entre 1 000 et 10 000 points. Sur un écran ou une planche d’impression standard, la résolution physique ne permet pas de discerner un pas géométrique inférieur à 1/1 000 de l’espace de coordonnées. Cette réduction de dimension produit un rendu vectoriel ultraléger, instantané et rigoureusement indiscernable du tracé exhaustif d’origine.
# Simulation d'une volumétrie massive (1 million d'observations)

grand_echantillon <- rnorm(1e6, mean = 50, sd = 10)
# Calcul instantané de l'objet fonctionnel complet
fn_massive <- ecdf(grand_echantillon)
# Optimisation : Sous-échantillonnage d'une grille de coordonnées à 2 000 points
grille_optimale <- seq(min(grand_echantillon), max(grand_echantillon), length.out = 2000)
df_optimise <- data.frame(
x = grille_optimale,
y = fn_massive(grille_optimale)
)
# Tracé haute performance via geom_line sur coordonnées condensées
p_optimise <- ggplot(df_optimise, aes(x = x, y = y)) +
geom_line(color = "#16A085", linewidth = 1) +
scale_y_continuous(labels = scales::percent_format()) +
labs(
title = "eCDF Haute Performance sur Échantillon Massif (N = 1 000 000)",
x = "Valeur observée", y = "Probabilité cumulée"
) +
theme_minimal()
print(p_optimise)
11.3 Erreurs de syntaxe communes et débogage
L’exploitation pratique des fonctions de répartition en langage R est régulièrement émaillée d’erreurs récurrentes, tant au niveau du typage des données d’entrée que du paramétrage des fonctions théoriques. L’erreur la plus banale concerne le format de l’objet transmis à ecdf(). Cette primitive exige impérativement un vecteur atomique numérique (numeric vector). Si l’utilisateur lui passe par inadvertance une colonne issue d’un tibble sans extraction vectorielle (par exemple df["score"] au lieu de df$score ou df[["score"]]), R lèvera une erreur d’incompatibilité de type.
Une seconde méprise classique réside dans la paramétrisation des lois asymétriques au sein des fonctions curve() ou stat_function(). Pour la loi exponentielle pexp(), le paramètre par défaut est le taux (rate), et non la moyenne (qui en constitue l’inverse mathématique (1/lambda)). Pour la loi gamma pgamma(), la confusion entre le paramètre d’échelle (scale) et son inverse le taux (rate) produit des courbes théoriques totalement aberrantes. Enfin, lors de l’usage conjoint de plot() et de curve(add = TRUE) sous le moteur graphique de base R, omettre de définir explicitement la borne d’abscisse from et to dans curve() peut contraindre la courbe théorique à adopter l’intervalle unitaire par défaut ([0, 1]), provoquant son écrasement hors du champ visuel des données réelles.
# Débogage exemplaire : Prévention des erreurs de typage et de paramétrisation

df_test <- data.frame(mesure = rgamma(100, shape = 2, scale = 5))
# ERREUR COMMUNE : passer un data frame d'une seule colonne
# fn_erreur <- ecdf(df_test["mesure"]) # Déclenche un dysfonctionnement
# SYNTAXE VALIDE : extraction sous forme de vecteur atomique pur
fn_correcte <- ecdf(df_test$mesure)
# CONTRÔLE DES PARAMÈTRES GAMMA : pgamma attend shape et rate par défaut
shape_estime <- 2
scale_estime <- 5
rate_equivalent <- 1 / scale_estime
curve(pgamma(x, shape = shape_estime, rate = rate_equivalent),
from = 0, to = 30, lwd = 1.5, lty = 2,
main = "Paramétrisation Rigoureuse d'une Loi Gamma")
12. Études de cas appliquées en psychologie et mise en perspective comparative
12.1 Étude de cas 1 : Étalonnage normatif d’un questionnaire d’évaluation cognitive
Pour concrétiser l’ensemble des concepts théoriques développés, nous déployons une première étude de cas portant sur l’étalonnage standardisé d’un instrument psychométrique d’évaluation des capacités de mémoire de travail (score brut sur une échelle de 0 à 50) administré à une cohorte normative de (N = 500) adultes sains. L’objectif méthodologique consiste à établir la table de conversion officielle permettant de transposer n’importe quel score brut en son rang percentile certifié, tout en identifiant les seuils d’alerte clinique (déficit cognitif léger fixé au percentile 10, et déficit sévère fixé au percentile 2.5).
Après importation et validation d’intégrité de l’échantillon, nous calculons la fonction de répartition empirique globale. Grâce à l’interpolation quantile, nous extrayons la grille complète des scores planchers associés à l’ensemble des déciles et percentiles cardinaux. La visualisation graphique intègre les zones de vigilance clinique sous forme d’ombrages contextuels discrets, fournissant aux praticiens un support de restitution diagnostique d’une clarté absolue.
# Simulation de la cohorte normative psychométrique (N = 500)

set.seed(777)

scores_memoire <- round(rnorm(500, mean = 28.5, sd = 6.2))

scores_memoire <- pmin(pmax(scores_memoire, 0), 50) # Bornage strict à l'échelle [0, 50]
# Instanciation fonctionnelle
fn_memoire <- ecdf(scores_memoire)
# Détermination des seuils pathologiques
seuil_deficit_severe <- quantile(scores_memoire, probs = 0.025)
seuil_deficit_leger <- quantile(scores_memoire, probs = 0.10)
cat("Seuil de déficit sévère (Percentile 2.5) : Score <=", seuil_deficit_severe, "n")
cat("Seuil de déficit léger (Percentile 10) : Score <=", seuil_deficit_leger, "n")
# Visualisation normée d'étalonnage clinique sous ggplot2
df_memoire <- data.frame(Score = scores_memoire)
p_etalonnage <- ggplot(df_memoire, aes(x = Score)) +
# Zone ombrée clinique : Déficit cognitif léger et sévère
annotate("rect", xmin = -Inf, xmax = seuil_deficit_leger, ymin = 0, ymax = 0.10,
fill = "#FADBD8", alpha = 0.5) +
stat_ecdf(geom = "step", color = "#1B4F72", linewidth = 1.1) +
geom_vline(xintercept = c(seuil_deficit_severe, seuil_deficit_leger),
color = "#C0392B", linetype = "dashed", linewidth = 0.8) +
scale_y_continuous(labels = scales::percent_format(), breaks = seq(0, 1, by = 0.10)) +
scale_x_continuous(breaks = seq(0, 50, by = 5)) +
labs(
title = "Étalonnage Normatif du Score de Mémoire de Travail (N = 500)",
subtitle = "Zone rouge délimitant les seuils cliniques conventionnels (P10 et P2.5)",
x = "Score brut à l'épreuve", y = "Rang percentile normatif"
) +
theme_classic()
print(p_etalonnage)
12.2 Étude de cas 2 : Modélisation des temps de réponse en psychologie expérimentale
La seconde étude de cas explore le domaine de la psychologie cognitive expérimentale à travers le paradigme célèbre de l’effet Stroop. Dans cette tâche, les participants sont soumis à deux conditions d’affichage : une condition congruente (où le mot « VERT » est calligraphié à l’encre verte) et une condition incongruente créant un conflit cognitif (le mot « ROUGE » est écrit à l’encre bleue). La variable dépendante continue enregistrée correspond au temps de réponse en millisecondes.
En chronométrie mentale, l’effet d’interférence ne se traduit pas uniquement par une augmentation du temps de réponse moyen, mais par une déformation profonde de l’asymétrie de la distribution. Alors que les moyennes masquent la dynamique temporelle, la superposition des fonctions de répartition empiriques met en évidence le ralentissement cognitif sur l’intégralité de la courbe, et tout particulièrement sur la queue de distribution supérieure reflétant les échecs transitoires du contrôle exécutif inhibiteur.
# Simulation d'une tâche de Stroop (N = 200 essais par condition)

set.seed(404)

n_essais <- 200
# Modélisation par loi Log-Normale réaliste (latences cognitives positives)
latences_congruentes <- rlnorm(n_essais, meanlog = 6.30, sdlog = 0.22) # Moyenne géométrique ~545 ms
latences_incongruentes <- rlnorm(n_essais, meanlog = 6.48, sdlog = 0.28) # Moyenne géométrique ~650 ms
df_stroop <- data.frame(
Temps_Reaction = c(latences_congruentes, latences_incongruentes),
Condition = factor(rep(c("Congruente", "Incongruente"), each = n_essais))
)
# Visualisation dynamique de l'effet d'interférence cognitive via stat_ecdf
p_stroop <- ggplot(df_stroop, aes(x = Temps_Reaction, color = Condition)) +
stat_ecdf(geom = "step", linewidth = 1.2) +
scale_color_manual(values = c("Congruente" = "#27AE60", "Incongruente" = "#8E44AD")) +
scale_x_continuous(limits = c(300, 1400), breaks = seq(300, 1400, by = 200)) +
scale_y_continuous(labels = scales::percent_format()) +
labs(
title = "Dynamique Distributionnelle de l'Effet Stroop",
subtitle = "L'écartement croissant vers la droite illustre le coût inhibiteur exécutif",
x = "Temps de réaction (millisecondes)",
y = "Probabilité cumulée d'initiation motrice",
color = "Condition cognitive :"
) +
theme_minimal() +
theme(legend.position = "bottom")
print(p_stroop)
12.3 Mise en perspective : R versus tableurs bureautiques (Excel)
L’analyse comparative des fonctionnalités logicielles souligne avec force la supériorité structurelle du langage R sur les tableurs bureautiques conventionnels de type Microsoft Excel lorsqu’il s’agit de modéliser des fonctions de répartition. Dans un tableur, il n’existe aucune primitive algorithmique équivalente à l’objet fonctionnel ecdf(). Pour construire une courbe cumulée sous Excel, l’utilisateur est contraint de trier physiquement ses colonnes de données, de concevoir manuellement une colonne de numérotation d’incréments, de diviser cette dernière par la taille de l’échantillon, puis de générer un graphique de dispersion de type nuage de points relié par des lignes droites polygonales.
Cette approche manuelle sous tableur présente de multiples vulnérabilités rédhibitoires pour la recherche scientifique : un risque colossal d’erreur humaine lors des manipulations manuelles de cellules, une absence totale de gestion algorithmique des ex æquo (qui exigent une formule de rang moyen ou maximum complexe), et l’incapacité d’automatiser le tracé face à de nouveaux flux de données sans redessiner manuellement la plage de cellules source. De surcroît, Excel ne dispose d’aucun mécanisme natif pour calculer les bandes de confiance simultanées de Dvoretzky-Kiefer-Wolfowitz ou pour exécuter des tests de Kolmogorov-Smirnov et d’Anderson-Darling.
À l’inverse, l’environnement R assure une reproductibilité scientifique intégrale : l’intégralité du pipeline — depuis le chargement des données brutes jusqu’à l’exportation vectorielle haute définition, en passant par l’interrogation fonctionnelle directe et les tests d’adéquation paramétrique — est encapsulée au sein d’un script textuel auditable, pérenne et réexécutable à l’identique. Cette rigueur computationnelle fait de R l’instrument indispensable pour tout chercheur ou analyste soucieux de valoriser ses données distributionnelles selon les standards méthodologiques les plus élevés de la science contemporaine.
Références
- Anderson, T. W., & Darling, D. A. (1952). Asymptotic theory of certain « goodness of fit » criteria based on stochastic processes. The Annals of Mathematical Statistics, 23(2), 193–212. https://doi.org/10.1214/aoms/1177729382
- Dvoretzky, A., Kiefer, J., & Wolfowitz, J. (1956). Asymptotic minimax character of the sample distribution function and of the classical multinomial estimator. The Annals of Mathematical Statistics, 27(3), 642–669. https://doi.org/10.1214/aoms/1177728174
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Julius Springer.
- Massart, P. (1990). The tight constant in the Dvoretzky-Kiefer-Wolfowitz inequality. The Annals of Probability, 18(3), 1269–1283. https://doi.org/10.1214/aop/1176990746
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag New York. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer Science+Business Media. https://doi.org/10.1007/0-387-28695-0