
Dans le domaine de la recherche quantitative, de la psychométrie et des sciences comportementales, l’évaluation rigoureuse de la précision des estimations constitue le fondement même de la démarche scientifique. Toute mesure empirique prélevée sur un échantillon d’individus est intrinsèquement soumise aux aléas de l’échantillonnage. Lorsque des chercheurs mesurent une variable dépendante continue, telle qu’une latence de réponse cognitive, un niveau de cortisol salivaire ou un score sur une échelle psychométrique standardisée, la moyenne observée ne représente qu’une approximation ponctuelle du paramètre fondamental de la population parente. Pour quantifier l’incertitude inhérente à cette estimation, les statisticiens s’appuient sur une métrique fondamentale : l’erreur type de la moyenne, couramment désignée par l’acronyme anglo-saxon SEM (Standard Error of the Mean). Comprendre, calculer et interpréter cet indicateur avec une exactitude irréprochable s’avère indispensable pour quiconque souhaite publier des résultats conformes aux exigences méthodologiques contemporaines.
Bien que des logiciels statistiques spécialisés tels que R, SPSS ou SAS soient traditionnellement employés pour l’inférence complexe, les environnements de tableurs en ligne, au premier rang desquels figure Google Sheets, se sont imposés comme des outils d’une polyvalence remarquable au sein des laboratoires de recherche académique. Grâce à ses fonctionnalités de travail collaboratif en temps réel, à sa flexibilité d’accès dans le cloud et à l’implémentation robuste de fonctions mathématiques avancées, Google Sheets permet de concevoir des chaînes de traitement de données transparentes et reproductibles. Toutefois, contrairement à d’autres indices descriptifs élémentaires, Google Sheets ne propose pas de fonction native unique dédiée au calcul direct de l’erreur type. Cette apparente lacune contraint les analystes à combiner stratégiquement plusieurs opérateurs fondamentaux pour édifier une formule mathématiquement exacte et adaptée à la structure de leurs devis expérimentaux.
Ce guide exhaustif a pour vocation d’articuler l’ensemble des fondements théoriques, des formulations mathématiques et des procédures pratiques nécessaires à la détermination de l’erreur type de la moyenne dans Google Sheets. De la dérivation conceptuelle issue du théorème central limite jusqu’à la programmation de scripts personnalisés et la visualisation graphique conforme aux directives de l’American Psychological Association, ce document détaille chaque étape avec la rigueur académique qui s’impose. Qu’il s’agisse de traiter des données simples issues d’un plan unifactoriel ou d’analyser des devis factoriels complexes à mesures répétées, l’ensemble des protocoles présentés garantit une fiabilité numérique absolue et une conformité stricte aux exigences de la science ouverte.
1. Fondements théoriques de l’erreur type de la moyenne en psychométrie
1.1 Définition conceptuelle de l’erreur type de la moyenne
L’erreur type de la moyenne ne mesure pas la dispersion des observations individuelles autour de la moyenne d’un échantillon, mais caractérise formellement la variabilité de la moyenne elle-même à travers une infinité théorique de réplications de l’expérience dans des conditions identiques. Dans le cadre de la théorie classique de l’échantillonnage, si un chercheur extrayait indéfiniment des échantillons aléatoires indépendants de taille identique au sein d’une même population parente, la moyenne calculée sur chacun de ces échantillons fluctuerait inévitablement en raison de l’erreur d’échantillonnage aléatoire. La distribution résultante de ces moyennes d’échantillons est qualifiée de distribution d’échantillonnage de la moyenne. L’erreur type n’est rien d’autre que l’écart-type théorique de cette distribution d’échantillonnage hypothétique.
Ce concept est indissociable du théorème central limite (TCL), l’un des piliers les plus puissants de la théorie des probabilités. Selon ce théorème, quelle que soit la forme de la distribution de la variable au sein de la population d’origine (qu’elle soit normale, bimodale, uniforme ou asymétrique), la distribution d’échantillonnage des moyennes converge asymptotiquement vers une distribution normale à mesure que la taille de l’échantillon s’accroît, pourvu que la variance de la population soit finie. Dès lors, le SEM fournit une métrique standardisée permettant de situer la moyenne observée au sein de cette distribution théorique normale et de déterminer avec quelle acuité cette moyenne empirique cerne l’espérance mathématique inconnue de la population.
Sur le plan épistémologique, il est impératif de distinguer la variabilité intra-échantillon, qui reflète la diversité phénotypique, comportementale ou cognitive intrinsèque aux individus observés, de la précision de l’estimation statistique, qui dépend conjointement de cette diversité biologique et de l’effort d’échantillonnage consenti. En psychologie cognitive et sociale, où les devis expérimentaux comparent fréquemment des moyennes de latence ou de précision entre différentes conditions expérimentales, l’erreur type de la moyenne constitue le thermomètre métrologique par excellence : elle indique aux pairs dans quelle mesure les effets observés sont susceptibles de fluctuer sous le simple effet du hasard lors d’une réplication ultérieure.
1.2 Formulation mathématique de la métrique
La dérivation formelle de l’erreur type de la moyenne s’enracine dans les propriétés fondamentales des variances de variables aléatoires indépendantes et identiquement distribuées. Soit un échantillon aléatoire simple constitué de n variables aléatoires indépendantes X₁, X₂, …, Xₙ prélevées dans une population caractérisée par une variance σ². La variance de la moyenne d’échantillon est égale à la somme des variances individuelles divisée par le carré de l’effectif total, ce qui conduit à l’expression Var(X̄) = σ² / n. Par conséquent, l’erreur type théorique de la moyenne, notée σ_X̄, correspond à la racine carrée de cette variance d’échantillonnage, soit le quotient de l’écart-type de la population par la racine carrée de l’effectif : σ_X̄ = σ / √n.
Dans la pratique de la recherche psychologique et empirique, la variance σ² de la population parente demeure presque universellement inconnue. Le statisticien est donc contraint d’estimer ce paramètre à partir des données recueillies au sein de son échantillon. L’estimateur sans biais de la variance de population est la variance échantillonnale corrigée, notée s², dont la racine carrée s représente l’écart-type de l’échantillon calculé avec la correction de Bessel au dénominateur (n – 1). L’erreur type de la moyenne estimée, conventionnellement notée SEM ou s_X̄, est donc formellement définie par l’équation standard :
SEM = s / √n
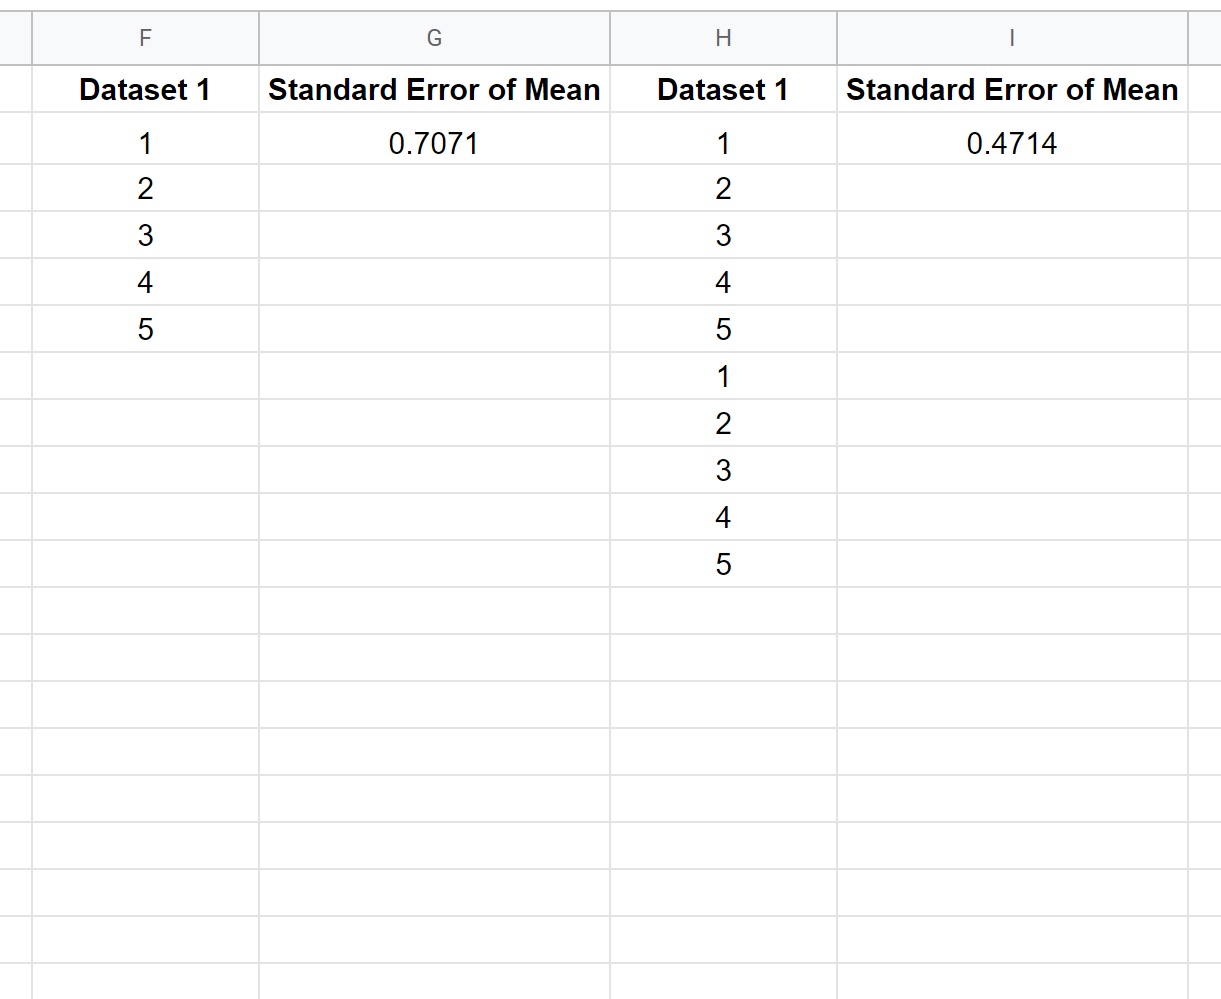
L’examen de cette formulation mathématique révèle immédiatement le comportement asymptotique de la métrique : lorsque n tend vers l’infini, le dénominateur croît indéfiniment tandis que le numérateur converge vers une constante stable (l’écart-type de la population), ce qui entraîne une décroissance de l’erreur type vers zéro. Toutefois, cette décroissance est proportionnelle à la racine carrée de n, ce qui implique que pour réduire de moitié l’erreur type d’une mesure, un laboratoire ne doit pas doubler mais quadrupler la taille de sa cohorte expérimentale. Enfin, dans le cas particulier où les prélèvements sont effectués sans remise au sein d’une population finie d’effectif N, il convient d’appliquer au SEM un facteur correctif de population finie, √((N – n) / (N – 1)), bien que cette situation soit exceptionnelle dans les protocoles de psychologie générale où la population cible est virtuellement infinie.
1.3 Rôle dans l’inférence statistique et la reproductibilité
L’erreur type de la moyenne joue un rôle d’intermédiaire technique et conceptuel fondamental dans l’édifice de l’inférence statistique fréquentiste. Elle constitue l’élément constitutif direct des intervalles de confiance paramétriques entourant la moyenne observée. En multipliant le SEM par un coefficient critique dérivé de la loi normale (valeur z) ou de la loi de Student (valeur t associée aux degrés de liberté correspondants), le chercheur génère une plage de valeurs qui, sous l’hypothèse d’une infinité de répétitions du protocole, contient le véritable paramètre populationnel selon un pourcentage nominal prédéterminé, classiquement 95 % ou 99 %.
De surcroît, le SEM constitue le dénominateur standardisé des statistiques de test dans le cadre du test d’hypothèse nulle (NHST, Null Hypothesis Significance Testing). Par exemple, dans un test t de Student pour échantillon unique visant à évaluer si la moyenne empirique diffère d’une valeur théorique μ₀, la statistique t est précisément le rapport entre l’écart brut (X̄ – μ₀) et le SEM. L’erreur type agit donc comme une unité de mesure du bruit de fond expérimental : elle permet de déterminer si le signal observé dans l’expérience émerge suffisamment au-delà des fluctuations d’échantillonnage pour justifier le rejet de l’hypothèse nulle.
Au cours des deux dernières décennies, la crise de reproductibilité qui a secoué les sciences comportementales et biomédicales a mis en lumière les ravages provoqués par des études sous-dimensionnées statistiquement. Des échantillons trop étroits génèrent des erreurs types considérables, ce qui gonfle artificiellement le risque de commettre une erreur de type II (non-détection d’un effet réel) ou, de manière encore plus insidieuse, conduit à l’inflation des tailles d’effet rapportées (la « malédiction du vainqueur ») lorsqu’un résultat franchit par hasard le seuil arbitraire de p < 0,05. La transparence dans le calcul, le compte-rendu rigoureux et l’inspection minutieuse de l’erreur type de la moyenne constituent dès lors une condition préalable incontournable pour assainir les pratiques d’inférence et renforcer la robustesse des données publiées.
2. Distinction cruciale entre écart-type et erreur type de la moyenne
2.1 Objectifs descriptifs vs objectifs inférentiels
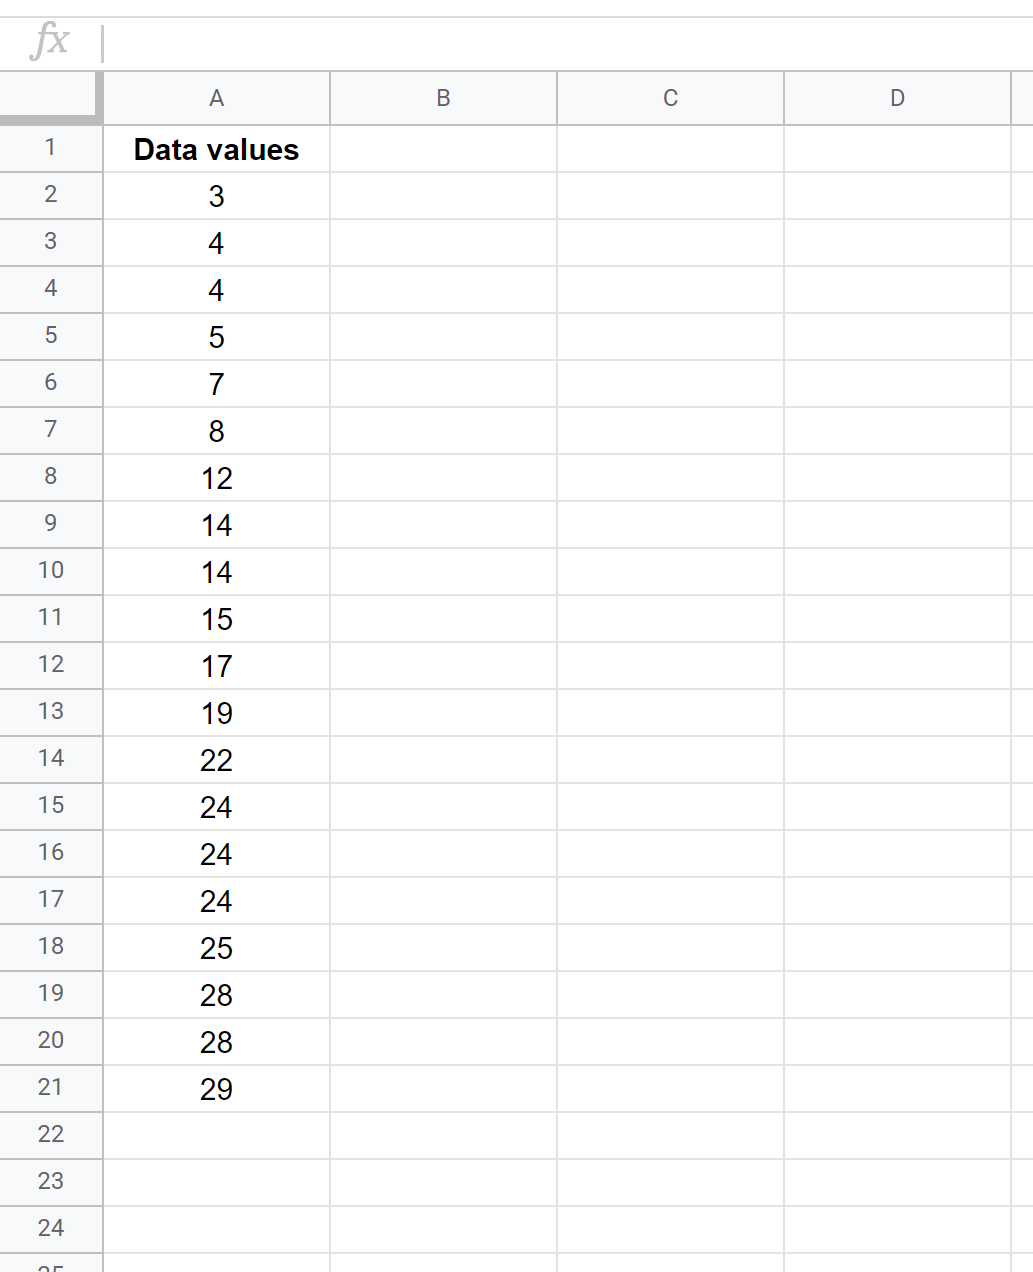
L’une des confusions conceptuelles les plus persistantes et documentées au sein de la littérature scientifique réside dans l’interchangeabilité erronée entre l’écart-type (noté s ou SD pour Standard Deviation) et l’erreur type de la moyenne (SEM). Bien que ces deux statistiques partagent les mêmes unités dimensionnelles de mesure que la variable d’origine, elles répondent à des finalités épistémologiques radicalement divergentes. L’écart-type est un indice exclusivement descriptif. Son objectif est de quantifier l’étendue de la variabilité biologique, comportementale ou psychologique existant entre les unités d’observation individuelles composant l’échantillon. Il décrit à quel point les participants diffèrent les uns des autres autour de la moyenne centrale du groupe.
À l’inverse, l’erreur type de la moyenne est un indice résolument inférentiel. Elle ne cherche aucunement à dépeindre la variabilité interindividuelle, mais vise à exprimer l’incertitude épistémique entourant l’estimation de la moyenne de la population. Présenter un SEM à la place d’un SD revient à dissimuler l’hétérogénéité réelle des réponses individuelles sous le voile de la précision de l’échantillonnage. Réciproquement, utiliser le SD pour inférer la localisation de la moyenne populationnelle ignore l’effet modérateur de la taille de l’échantillon. Dans les rapports de recherche, cette confusion conduit fréquemment à des erreurs substantielles d’appréciation : des auteurs peu scrupuleux ou mal formés rapportent parfois délibérément le SEM en lieu et place du SD dans leurs graphiques descriptifs pour donner l’illusion fallacieuse d’une dispersion minime de leurs mesures, ce qui constitue une distorsion grave de la réalité empirique.
2.2 Sensibilité respective à la taille d’échantillon
Pour appréhender pleinement l’abîme conceptuel qui sépare ces deux métriques, il convient d’analyser leur dynamique mathématique en fonction de l’augmentation de la taille d’échantillon n. L’écart-type de l’échantillon s est un estimateur convergent de l’écart-type de la population σ. Par conséquent, lorsque n passe de 20 à 2 000 participants, la valeur calculée de s ne diminue pas de manière systématique : elle fluctue simplement de moins en moins autour de la véritable valeur paramétrique σ de la population. Que l’on mesure la taille adulte humaine sur 50 ou 50 000 individus, l’écart-type de la population restera d’environ 7 centimètres, car la diversité génétique et environnementale de la population demeure inchangée.
L’erreur type de la moyenne, en revanche, présente une sensibilité absolue et mécanique à l’accroissement de n. Comme la formule du SEM divise s par la racine carrée de n, la valeur du SEM chute continuellement à mesure que l’effectif progresse. Si l’on reprend l’exemple de la taille humaine avec un écart-type de 7 cm, un échantillon de n = 49 individus générera un SEM de 7 / √49 = 1,00 cm, tandis qu’un échantillon épidémiologique de n = 490 000 individus produira un SEM infinitésimal de 7 / 700 = 0,01 cm. Cette démonstration mathématique illustre le fait fondamental suivant : un écart-type élevé associé à une taille d’échantillon massive peut engendrer une erreur type extrêmement faible. L’écart-type renseigne sur les sujets ; l’erreur type renseigne sur la moyenne.
2.3 Recommandations de la communauté scientifique
Face à la persistance de ces confusions dans les revues à comité de lecture, les grandes institutions scientifiques ont édicté des directives strictes. Le manuel de publication de l’American Psychological Association, qui régit la rédaction académique en psychologie et dans les disciplines connexes, exige une transparence méthodologique totale. Lorsque les statistiques descriptives d’un groupe sont exposées, l’écart-type doit impérativement accompagner la moyenne, typiquement sous la forme standardisée M = 45,21, SD = 8,34. L’erreur type de la moyenne ne doit pas être substituée subrepticement à l’écart-type dans les tableaux récapitulatifs des caractéristiques d’échantillon.
En médecine et en psychologie clinique, des consortiums internationaux tels que le groupe CONSORT (Consolidated Standards of Reporting Trials) préconisent la présentation conjointe des deux métriques ou, plus fréquemment, l’abandon du SEM isolé au profit des intervalles de confiance à 95 %, jugés plus directement informatifs sur le plan clinique. Une revue systématique d’articles biomédicaux a démontré que plus d’un tiers des articles publiés omettent d’expliciter si les barres d’erreur apposées sur les diagrammes figurent des écarts-types, des erreurs types ou des intervalles de confiance. Pour garantir l’intégrité de la communication scientifique, tout auteur exploitant Google Sheets pour colliger et analyser ses données doit veiller à définir explicitement la nature de chaque indicateur calculé et à ne jamais employer l’un au détriment de l’autre sans justification théorique explicite.
3. Préparation et structuration des données expérimentales dans Google Sheets
3.1 Organisation tabulaire conforme aux normes Tidy Data
L’exactitude des calculs statistiques dans un tableur dépend au premier chef de la qualité architecturale de la matrice de données. Trop souvent, les expérimentateurs organisent leurs feuilles de calcul de manière intuitive mais anarchique, en juxtaposant des tableaux disparates, en fusionnant des cellules ou en mêlant des données individuelles et des calculs agrégés au sein de la même plage spatiale. Pour éviter toute corruption d’analyse, il est essentiel d’adopter le paradigme des données structurées selon les principes du Tidy Data formulés par Hadley Wickham. Ce standard prescrit que chaque variable observée doit résider dans sa propre colonne dédiée, chaque unité observationnelle distincte (le participant ou le sujet) doit occuper une ligne unique, et chaque cellule individuelle doit contenir une et une seule valeur atomique.
Dans le cadre d’un plan d’échantillonnage inter-sujets (par exemple, un groupe expérimental recevant un placebo versus un groupe recevant un traitement pharmacologique), la première colonne du tableur Google Sheets doit comporter un identifiant unique non ambigu (tel que ID_Participant), la seconde doit codifier la variable indépendante catégorielle (Condition), et la troisième doit recueillir la variable dépendante continue d’intérêt (Score_Performance). Pour les devis expérimentaux intra-sujets à mesures répétées, deux formats sont envisageables : le format large (wide), où chaque répétition temporelle ou conditionnelle occupe une colonne distincte par participant, ou le format long (long), où les observations successives d’un même sujet s’empilent verticalement sur plusieurs lignes successives. Le respect scrupuleux de ces structures tabulaires linéaires constitue le préalable technique absolu pour que les fonctions d’agrégation conditionnelle de Google Sheets s’exécutent sans le moindre biais computationnel.
3.2 Vérification de l’intégrité et typage des données
Une des vulnérabilités critiques des tableurs réside dans la gestion implicite et parfois opaque du typage des données saisies ou importées. Lorsqu’un fichier CSV issu d’un logiciel de passation expérimentale (tel que PsychoPy, OpenSesame ou Qualtrics) est importé dans Google Sheets, des anomalies de délimitation peuvent survenir. Si le séparateur décimal du fichier d’origine est un point anglo-saxon (« . ») alors que les paramètres régionaux de la feuille Google Sheets sont configurés sur un standard francophone utilisant la virgule (« , »), les valeurs numériques importées ne sont plus reconnues comme des nombres réels, mais comme des chaînes de caractères textuelles.
Pour identifier immédiatement cette anomalie, l’opérateur doit observer l’alignement par défaut dans les cellules non formatées : par convention universelle dans Google Sheets, les nombres s’alignent automatiquement à droite, tandis que le texte est aligné à gauche. Des cellules numériques converties par inadvertance en texte seront invisibles pour les fonctions d’analyse statistique comme l’écart-type, ce qui faussera silencieusement le dénombrement de l’effectif et l’ensemble de la chaîne de calcul ultérieure. L’application des règles de Validation des données (accessible via le menu Données > Validation des données) permet de prémunir les matrices contre ce risque en interdisant la saisie de caractères non numériques et en bornant les plages de valeurs plausibles selon les caractéristiques physiques ou psychométriques de l’instrument de mesure.
3.3 Gestion préalable des valeurs manquantes et des aberrances
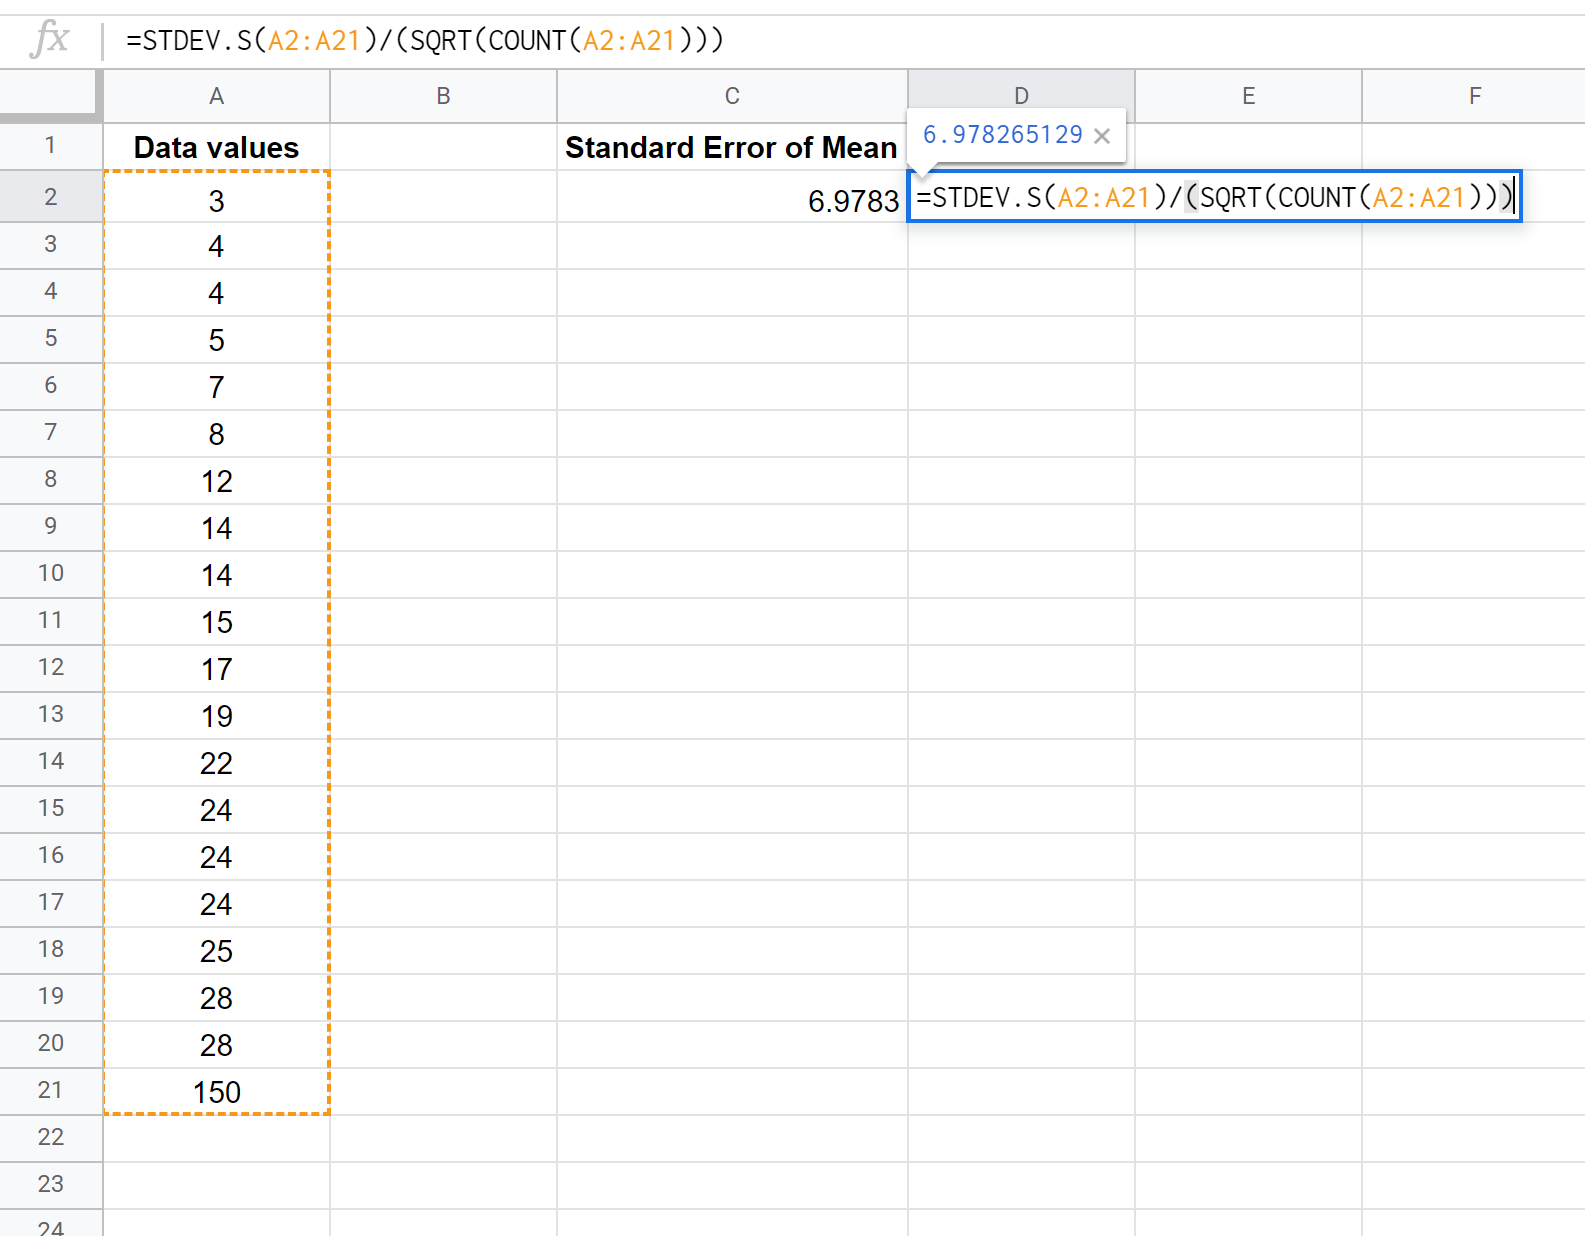
Avant de procéder à l’extraction de l’erreur type, le chercheur doit opérer un nettoyage méthodique de son jeu de données, documenté avec rigueur pour satisfaire aux standards de la recherche reproductible. La présence de cellules vides ou de non-réponses peut refléter des mécanismes d’attrition distincts : une omission accidentelle sur un item psychologique, une panne d’enregistrement d’un capteur de latence, ou l’abandon complet d’un participant au cours de l’expérimentation. Dans Google Sheets, il convient de ne jamais combler arbitrairement une cellule manquante par la valeur zéro, car le chiffre 0 serait traité comme une observation empirique valide, abaissant artificiellement la moyenne et gonflant indûment la variance de l’échantillon.
Parallèlement, la détection des valeurs aberrantes (outliers) s’impose pour préserver la fidélité de l’estimation. L’écart-type étant un estimateur non robuste hautement sensible aux valeurs extrêmes, une unique aberration dans une distribution peut décupler le SEM. Deux approches méthodologiques classiques peuvent être automatisées dans la feuille de calcul : le calcul des scores Z (où toute observation s’éloignant de plus de trois écarts-types de la moyenne est examinée avec suspicion) ou la méthode plus robuste de l’écart interquartile (IQR) formulée par John Tukey, qui isole les observations situées au-delà de 1,5 fois l’IQR des quartiles supérieur ou inférieur. Toute exclusion de données doit faire l’objet d’une traçabilité irréprochable dans les métadonnées de l’étude, stipulant explicitement la règle de décision appliquée et le volume de données tronqué.
4. La syntaxe canonique du calcul du SEM dans Google Sheets
4.1 Architecture de la formule unifiée
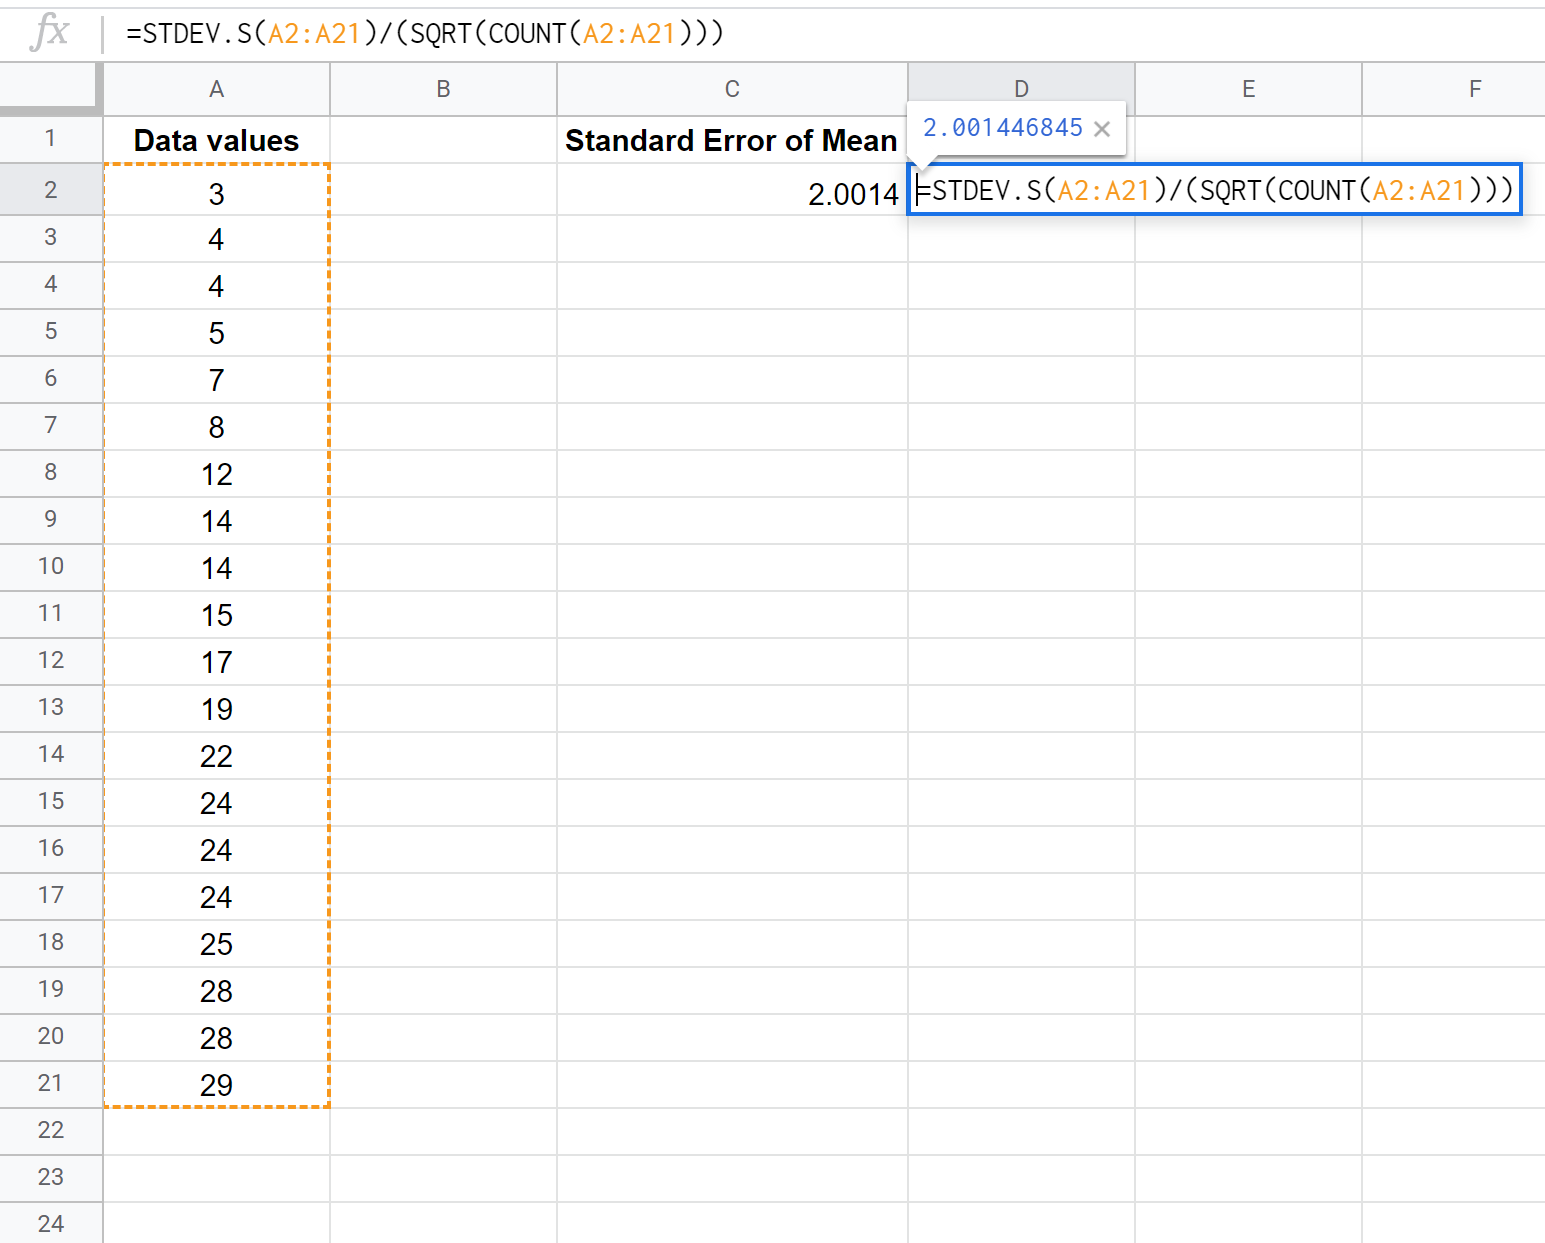
Puisque Google Sheets ne renferme aucune fonction autonome dédiée à l’erreur type de la moyenne sous un intitulé de type SEM() ou STANDARD_ERROR(), l’analyste doit assembler les fonctions mathématiques élémentaires disponibles pour traduire directement l’expression analytique SEM = s / √n. L’architecture de la formule canonique universellement acceptée et recommandée repose sur l’imbrication de trois fonctions natives distinctes au sein d’une seule et unique expression vectorielle :
=STDEV.S(plage) / SQRT(COUNT(plage))
Dans les versions francophones de l’interface Google Sheets, la syntaxe équivalente stricte s’écrit :
=ECARTYPE.STANDARD(plage) / RACINE(NB(plage))
L’opérateur de division centrale (la barre oblique /) orchestre l’interaction entre les deux composantes structurelles de la métrique. Au numérateur, la fonction d’écart-type échantillonnal extrait l’estimation sans biais de la dispersion dans la population. Au dénominateur, la fonction de racine carrée traite l’effectif réel obtenu par la fonction de dénombrement numérique. La rigueur impose de respecter scrupuleusement la syntaxe des arguments : la désignation de la plage (par exemple B2:B21) doit être rigoureusement identique dans les deux segments de l’équation afin de garantir que l’échantillon évalué pour l’effectif coïncide parfaitement avec l’ensemble des données mobilisées pour l’écart-type. Le moteur de calcul de Google Sheets n’est pas sensible à la casse (il accepte indifféremment minuscules ou majuscules), mais l’adoption systématique des majuscules demeure la convention de lisibilité académique universelle.
4.2 Sélection de la fonction d’écart-type appropriée
Le choix précis de la fonction d’écart-type constitue une zone de vulnérabilité méthodologique majeure dans les tableurs. Google Sheets propose historiquement plusieurs déclinaisons de cette fonction : STDEV.S (ou ECARTYPE.STANDARD), STDEV.P (ou ECARTYPE.PEST) ainsi que la fonction héritée STDEV (ou ECARTYPE). L’emploi de la fonction adéquate dépend intégralement du statut épistémologique des données collectées.
La fonction STDEV.P calcule l’écart-type d’une population exhaustive en utilisant le dénominateur complet n. Elle part du postulat mathématique selon lequel les données contenues dans la plage sélectionnée représentent l’ensemble de tous les individus existants dans l’univers étudié. Si un chercheur applique STDEV.P à des données échantillonnées pour calculer un SEM, il commet une erreur de sous-estimation systématique de la variance : la variance empirique d’un échantillon sous-évalue tendanciellement la variance de sa population d’origine en raison de la restriction d’échantillonnage.
Pour éliminer rigoureusement ce biais statistique, l’algorithme doit intégrer la correction de Bessel, qui substitue au dénominateur classique n le terme (n – 1), conférant ainsi à l’estimateur la propriété formelle d’être non biaisé. C’est précisément l’opération exécutée par la fonction moderne STDEV.S. Quant à la fonction historique STDEV, bien qu’elle intègre également la correction de Bessel dans Google Sheets, elle relève d’une nomenclature déclarée obsolète et conservée uniquement à des fins de rétrocompatibilité logicielle. Dans toute démarche de recherche formalisée, l’usage exclusif de STDEV.S est impératif afin de certifier l’intégrité de la correction mathématique au numérateur de l’erreur type.
4.3 Comptabilisation exacte du dénominateur via COUNT
Le dénominateur de l’erreur type de la moyenne requiert la détermination exacte de l’effectif n avant l’extraction de sa racine carrée. Le piège classique dans les tableurs consiste à encoder « en dur » une constante numérique (par exemple en tapant manuellement / SQRT(20)) ou à exploiter une fonction de comptage inappropriée. L’insertion d’une valeur fixe expose l’analyste à des erreurs dramatiques en cas de mise à jour ultérieure de la base de données, d’ajout de nouveaux participants ou de suppression de lignes aberrantes.
La fonction COUNT (ou NB en version française) possède une propriété algorithmique fondamentale : elle ne dénombre strictement que les cellules qui hébergent des valeurs numériques réelles au sein de la plage ciblée. Elle ignore superbement et automatiquement les cellules vides, les cellules textuelles, les caractères d’espacement et les balises d’erreur. À l’inverse, l’utilisation imprudente de la fonction COUNTA (ou NBVAL) doit être proscrite pour cette tâche précise. La commande COUNTA dénombre aveuglément toute cellule qui n’est pas rigoureusement vide, y compris des chaînes de caractères résiduelles, des apostrophes masquées ou des mentions qualitatives telles que « absent » ou « NA ». Si de telles entrées figurent dans la colonne de données, COUNTA surestimera artificiellement la taille de l’échantillon valide n, diminuant indûment le dénominateur de la racine carrée et produisant un SEM sous-estimé et mathématiquement faux. L’alliance harmonieuse entre STDEV.S et COUNT garantit que l’effectif mobilisé au dénominateur correspond trait pour trait aux scores numériques effectifs soumis à l’évaluation de la dispersion au numérateur.
5. Application pas à pas sur un jeu de données psychologiques
5.1 Contexte de l’exemple : Temps de réaction à une tâche de Stroop
Afin de matérialiser la mise en œuvre opérationnelle de cette méthodologie, considérons une étude expérimentale classique en psychologie cognitive examinant le contrôle inhibiteur et l’attention sélective au moyen de la célèbre tâche de Stroop. Dans cette tâche, les participants sont confrontés à des mots de couleur imprimés dans une encre non congruente (par exemple le mot « ROUGE » imprimé en bleu) et doivent dénommer la couleur physique de l’encre tout en inhibant la lecture automatique du signifiant textuel. La variable dépendante continue mesurée chez les participants est le temps de réaction moyen de latence, exprimé en millisecondes (ms).
Imaginons un groupe de vingt sujets adultes sains (n = 20) soumis à cette condition d’interférence cognitive. Les données brutes recueillies dans le laboratoire sont saisies directement dans la première feuille d’un classeur Google Sheets, sous la colonne B, s’étalant de la cellule B2 jusqu’à la cellule B21, la ligne 1 étant réservée à l’étiquette de colonne standard Temps_Reaction_ms. Les latences observées se distribuent comme suit :
645, 680, 712, 630, 755, 690, 722, 660, 685, 740, 695, 710, 675, 730, 650, 705, 688, 715, 662, 704
L’inspection préliminaire de ce vecteur de mesures montre des scores plausibles pour cette tâche expérimentale, sans rupture manifeste de l’échelle temporelle ni présence de valeurs physiquement impossibles (comme des temps négatifs ou des latences inférieures à 200 ms qui refléteraient une anticipation motrice). L’objectif est à présent de synthétiser la tendance centrale et d’estimer avec précision l’erreur type de cette moyenne observée.
5.2 Décomposition du calcul en étapes discrètes
Pour des finalités d’apprentissage méthodologique, de traçabilité pédagogique ou de vérification croisée au sein de l’équipe de recherche, il est vivement recommandé dans un premier temps de décomposer le calcul global en cellules intermédiaires ordonnées. Cette approche didactique permet de visualiser pas à pas l’architecture du modèle avant de condenser la formule. Nous réservons la colonne D pour les libellés conceptuels et la colonne E pour l’exécution des formules correspondantes :
- Étape 1 : Calcul de la moyenne empirique (X̄). Dans la cellule
E2, saisissez la commande=AVERAGE(B2:B21)(ou=MOYENNE(B2:B21)). Le moteur renvoie la valeur arithmétique de 692,60 ms. - Étape 2 : Extraction de l’écart-type échantillonnal (s). Dans la cellule
E3, introduisez=STDEV.S(B2:B21)(ou=ECARTYPE.STANDARD(B2:B21)). L’évaluation fournit un écart-type de 32,3230 ms, reflétant la dispersion interindividuelle des latences au sein de cette cohorte d’étudiants. - Étape 3 : Dénombrement de la taille d’échantillon valide (n). Dans la cellule
E4, tapez=COUNT(B2:B21)(ou=NB(B2:B21)). Le résultat confirme l’inclusion rigoureuse de 20 observations numériques valides. - Étape 4 : Calcul de la racine carrée de l’effectif (√n). Dans la cellule
E5, insérez=SQRT(E4)(ou=RACINE(E4)). La racine carrée de 20 produit le diviseur scalaire 4,4721. - Étape 5 : Synthèse du quotient pour obtenir le SEM. Enfin, dans la cellule
E6, déterminez le ratio final par la formule directe=E3 / E5. Le tableur renvoie avec exactitude la valeur de 7,2277 ms.
Cette décomposition analytique met en lumière la mécanique du processus : bien que la dispersion individuelle entre les participants s’élève à plus de 32 ms, l’incertitude quant à l’emplacement de la moyenne réelle de la population pour cette tâche expérimentale n’est que de 7,23 ms.
5.3 Calcul direct par cellule unique et validation croisée
Dès lors que le mécanisme théorique est maîtrisé et validé, il devient plus économique sur le plan de l’espace tabulaire et de la gestion de la mémoire d’implémenter l’estimation du SEM au sein d’une seule cellule synthétique, éliminant le recours aux étapes intermédiaires susceptibles de surcharger inutilement la matrice de travail. Dans une cellule dédiée (par exemple E8), saisissez la formule unifiée complète :
=STDEV.S(B2:B21) / SQRT(COUNT(B2:B21))
L’exécution instantanée de cette formule combinée produit rigoureusement le même résultat : 7,227702… ms. Pour une restitution académique standardisée, l’analyste utilise l’icône de réduction des décimales de la barre d’outils de Google Sheets (ou applique un formatage personnalisé via Format > Nombre > Format de nombre personnalisé) pour arrondir l’affichage à deux décimales, aboutissant à une valeur affichée de 7,23 ms. La comparaison entre la démarche fragmentée et la formule condensée démontre la parfaite cohérence interne de l’environnement : aucune perte de précision numérique par troncature n’intervient lors de l’imbrication des fonctions mathématiques, garantissant une estimation exempte de distorsion d’arrondi.
6. Traitement avancé des groupes et conditions expérimentales multiples
6.1 Calcul conditionnel avec FILTER pour plans inter-sujets
Dans la recherche contemporaine, les devis expérimentaux unifactoriels isolés sont rares ; les chercheurs comparent usuellement les performances de plusieurs sous-groupes ou conditions distinctes réparties le long d’une variable indépendante catégorielle. Supposons une extension de l’expérience précédente où la colonne A spécifie le groupe d’appartenance (« Contrôle » versus « Stress ») et la colonne B recueille les scores d’inhibition cognitive. Il serait archaïque et risqué de découper manuellement la matrice en plusieurs sous-colonnes pour calculer le SEM de chaque condition.
L’approche la plus robuste dans Google Sheets consiste à combiner dynamiquement la fonction de filtrage vectoriel FILTER avec les opérateurs canoniques du SEM. La fonction FILTER(plage_données, plage_critère = condition) isole en temps réel les enregistrements correspondant exclusivement au statut spécifié, sans altérer la disposition tabulaire globale. Dès lors, pour déterminer l’erreur type de la moyenne spécifique au groupe « Contrôle », la syntaxe s’établit avec élégance :
=STDEV.S(FILTER(B2:B100, A2:A100 = "Contrôle")) / SQRT(COUNT(FILTER(B2:B100, A2:A100 = "Contrôle")))
Cette construction s’avère particulièrement puissante pour les plans d’échantillonnage inter-sujets déséquilibrés, c’est-à-dire comportant des tailles de groupes inégales consécutives à des exclusions d’échantillons ou des abandons en cours d’expérimentation. Le dénominateur COUNT(FILTER(...)) recalculant dynamiquement le nombre effectif de sujets pour chaque modalité de manière indépendante, l’erreur type de chaque groupe demeure structurellement juste sans qu’aucune modification structurelle de la feuille de calcul ne soit requise.
6.2 Utilisation de tableaux croisés dynamiques pour extraire le SEM
Lorsque les jeux de données intègrent des volumes considérables d’observations ventilées sur plusieurs variables qualitatives, le recours aux tableaux croisés dynamiques (Pivot Tables) de Google Sheets offre un niveau d’exploration supérieur. En sélectionnant l’intégralité de la matrice de données et en activant le menu Insertion > Tableau croisé dynamique, l’utilisateur peut assigner la variable indépendante en « Lignes », puis glisser la variable dépendante dans la section « Valeurs » à deux reprises : la première configurée sur la fonction de synthèse AVERAGE (Moyenne) et la seconde configurée sur STDEV (Écart-type).
Néanmoins, une contrainte technique inhérente au moteur actuel de Google Sheets doit être soulignée : l’outil de tableau croisé dynamique ne propose pas nativement de champ calculé capable d’exécuter une racine carrée de l’effectif agrégé au sein même de la grille dynamique pour délivrer directement le SEM. Pour contourner cette limite d’ergonomie, la stratégie standard consiste à ajouter une troisième valeur agrégée configurée sur COUNT, puis à implanter immédiatement à l’extérieur de la table croisée dynamique une colonne périphérique de formules annexes référençant les cellules d’écart-type et d’effectif calculées par le tableau (par exemple : =C5 / SQRT(D5)). Cette configuration hybride conjugue la souplesse de restructuration instantanée des tableaux croisés dynamiques avec la rigueur mathématique du calcul de l’erreur type.
6.3 Organisation modulaire pour les devis factoriels à plusieurs variables indépendantes
Dans les devis factoriels orthogonaux croisant plusieurs variables indépendantes (par exemple un plan factoriel 2×2 croisant le Type d’amorçage linguistique [Congruent / Non congruent] et le Statut d’anxiété [Faible / Élevé]), la synthèse claire des données requiert l’édification d’une matrice récapitulative modulaire. Une feuille de calcul académique bien conçue comporte systématiquement un onglet de données brutes (« Données_Brutes ») et un onglet distinct dévolu aux statistiques synthétiques (« Statistiques_Descriptives »).
Dans cet onglet de synthèse, une grille croisée est déployée où chaque cellule d’intersection est interrogée au moyen de filtres à conditions multiples. La fonction FILTER admet une infinité d’arguments booléens consécutifs :
=STDEV.S(FILTER(Données_Brutes!C$2:C$200, (Données_Brutes!A$2:A$200 = $A3) * (Données_Brutes!B$2:B$200 = B$2))) / SQRT(COUNT(FILTER(Données_Brutes!C$2:C$200, (Données_Brutes!A$2:A$200 = $A3) * (Données_Brutes!B$2:B$200 = B$2))))
L’utilisation rigoureuse des ancrages absolus et relatifs par le symbole du dollar ($) permet d’étendre la formule par simple glissement bilatéral (horizontal et vertical) sur toute l’étendue de la matrice factorielle, sans risque de dérive des références de plages. Cette disposition garantit non seulement une organisation infaillible des moyennes et de leurs erreurs types respectives pour chaque cellule expérimentale, mais prépare idéalement l’exportation des métriques vers des scripts R ou des utilitaires de création graphique spécialisés.
7. Automatisation du calcul via des formules matricielles et personnalisées
7.1 Implémentation d’expressions matricielles avec ARRAYFORMULA et BYROW
Avec les évolutions récentes apportées au moteur de calcul de Google Sheets, la gestion des jeux de données denses n’exige plus de recopier manuellement les formules le long de centaines de rangées. L’introduction des fonctions fonctionnelles modernes de programmation matricielle, notamment BYROW conjuguée à la structure modulaire LAMBDA, permet de vectoriser l’extraction des erreurs types sur des ensembles multidimensionnels entiers.
Considérons un protocole psychophysiologique comportant plusieurs dizaines d’essais successifs organisés horizontalement en rangées pour chaque participant, où chaque ligne de la matrice B2:Z100 contient les réponses individuelles d’un sujet sur 25 essais consécutifs. Pour évaluer instantanément l’erreur type de chaque individu sans insérer 99 formules distinctes, la formule matricielle suivante peut être déployée dans la colonne de tête :
=BYROW(B2:Z100, LAMBDA(ligne, STDEV.S(ligne) / SQRT(COUNT(ligne))))
L’opérateur BYROW itère automatiquement à travers chaque vecteur horizontal de la matrice désignée, confie ce vecteur comme paramètre à la fonction LAMBDA, et calcule sans latence le SEM correspondant. Cette formule dynamique génère instantanément un vecteur colonne complet de résultats, qui se recalcule en temps réel dès qu’une valeur sous-jacente est modifiée dans la grille matricielle. Non seulement cette méthodologie élimine le risque d’omission lors de la duplication de formules manuelles, mais elle optimise grandement les performances mémoires du navigateur en réduisant la complexité du graphe d’interdépendance des cellules.
7.2 Développement d’une fonction SEM personnalisée en Google Apps Script
Pour les laboratoires de recherche accueillant de nombreux collaborateurs, assistants ou étudiants parfois peu rompus aux syntaxes complexes de tableur, la mise à disposition d’une fonction personnalisée dédiée intégrée au catalogue des fonctions de Google Sheets représente une optimisation ergonomique inestimable. Grâce à l’environnement Google Apps Script intégré à Google Workspace, tout utilisateur peut étendre les fonctionnalités logicielles en développant un module en langage JavaScript.
En accédant au menu Extensions > Apps Script, l’opérateur peut implémenter la routine statistique optimisée suivante :
/**

* Calcule l'erreur type de la moyenne (SEM) d'un échantillon de données.

* @param {range} input Plage de cellules ou vecteur numérique contenant les observations.

* @return {number} L'erreur type de la moyenne estimée.

* @customfunction

*/

function ERREUR_TYPE(input) {

  var values = [];

  if (Array.isArray(input)) {

    for (var i = 0; i < input.length; i++) {

      for (var j = 0; j < input[i].length; j++) {

        var val = input[i][j];

        if (typeof val === 'number' && !isNaN(val) && val !== '') {

          values.push(val);

        }

      }

    }

  } else if (typeof input === 'number') {

    return 0;

  }

  var n = values.length;

  if (n <= 1) return null;

  var mean = values.reduce(function(a, b) { return a + b; }, 0) / n;

  var sumSquares = values.reduce(function(a, b) { return a + Math.pow(b - mean, 2); }, 0);

  var variance = sumSquares / (n - 1);

  var stdDev = Math.sqrt(variance);

  return stdDev / Math.sqrt(n);

}
Après enregistrement du script sous l’éditeur de code, la fonction =ERREUR_TYPE(plage) devient immédiatement exploitable dans l’ensemble des feuilles du classeur avec l’autocomplétion native de Google Sheets. Ce module applicatif filtre scrupuleusement les entrées pour exclure les chaînes textuelles, applique la correction de Bessel au numérateur et intercepte les exceptions d’effectifs insuffisants (n ≤ 1), offrant aux membres d’une équipe de recherche une interface intuitive et uniforme qui élimine radicalement le risque d’erreurs de syntaxe manuelle.
7.3 Création d’un modèle réutilisable pour les laboratoires
Pour assurer la pérennité et la standardisation des protocoles d’analyse au sein d’un laboratoire universitaire, l’individualisation des feuilles de calcul doit s’effacer au profit de gabarits structurés et verrouillés. Un modèle Google Sheets optimisé doit comporter des règles strictes de protection des plages : les cellules accueillant les formules canoniques de moyenne, d’écart-type et d’erreur type doivent être formellement verrouillées en écriture (via le menu Données > Feuilles et plages protégées) afin d’éviter qu’une manipulation hâtive d’un stagiaire ou d’un co-chercheur n’écrase par mégarde une formule complexe sous une valeur numérique brute.
En outre, l’intégration d’un onglet de documentation (« Protocole_Metadonnees ») définissant exhaustivement chaque variable, l’unité de mesure, les valeurs autorisées et la syntaxe statistique employée permet de répondre aux exigences de traçabilité de la recherche moderne. Le cloud de Google facilitant le partage collaboratif en temps réel, l’administrateur du modèle doit régler les permissions de partage en mode « Consultation seule » pour le classeur racine, forçant ainsi les assistants de recherche à créer une copie indépendante du classeur pour chaque nouvelle cohorte de participants, tout en préservant intacte la matrice générique du laboratoire.
8. Visualisation graphique : Intégration des barres d’erreur dans Google Sheets
8.1 Création d’un graphique à barres représentatif
La restitution visuelle des résultats constitue le prolongement naturel du calcul quantitatif dans tout article de recherche empirique. Les graphiques à barres (bar charts) sont traditionnellement mis à contribution pour exposer la comparaison des moyennes entre différentes conditions expérimentales. Dans Google Sheets, la construction d’un tel graphique débute impérativement par la sélection d’une table synthétique comportant les étiquettes textuelles des conditions dans une première colonne et les moyennes associées dans la seconde (par exemple les cellules A1:B3).
En accédant au menu Insertion > Graphique, l’éditeur de graphiques de Google Sheets configure par défaut un rendu initial. L’expérimentateur doit veiller à respecter une sobriété visuelle rigoureusement alignée sur les standards de communication scientifique : suppression des lignes de quadrillage superflues qui alourdissent inutilement la figure, application d’une palette de couleurs accessible aux personnes daltoniennes (privilégiant les niveaux de gris ou les palettes divergentes standardisées), sélection d’une typographie sans empattement hautement lisible (telle qu’Arial ou Roboto) et ajustement rigoureux des échelles d’axes pour éviter toute troncature artificielle susceptible de distordre visuellement la magnitude perçue des effets observés.
8.2 Configuration des barres d’erreur de moyenne personnalisées
L’écueil majeur dans Google Sheets lors de l’adjonction de barres d’erreur réside dans le paramétrage par défaut de son éditeur graphique. Dans l’onglet Personnaliser > Série, l’activation de la case « Barres d’erreur » ouvre un menu déroulant comprenant trois modes préconfigurés : « Aucun », « Constante », « Pourcentage » et « Écart-type ». Il est impératif de souligner avec la plus grande fermeté que l’option « Écart-type » proposée automatiquement par l’interface graphique de Google Sheets est généralement inadaptée aux exigences scientifiques : cette option applique un écart-type global calculé sur la série des moyennes affichées elles-mêmes, et non pas l’écart-type ou l’erreur type de la distribution sous-jacente des observations de chaque condition !
Pour assigner avec une exactitude scientifique absolue les valeurs de SEM préalablement calculées, il convient de sélectionner le mode Constante si tous les groupes possèdent miraculeusement le même SEM, ou plus rigoureusement d’exploiter la fonctionnalité de Barres d’erreur personnalisées si la version logicielle le permet, en liant directement la plage contenant les valeurs calculées de l’erreur type. Si l’interface standard de Google Sheets limite l’attribution asymétrique ou vectorielle directe sur les graphiques à barres basiques, l’utilisation d’un graphique en nuage de points avec lignes de connexion ou la configuration fine via l’API Google Charts permet d’ancrer exactement chaque segment d’erreur à la valeur ±1 SEM calculée pour chaque groupe. Les segments doivent obligatoirement être symétriques et centrés sur le sommet de la barre figurant la moyenne empirique.
8.3 Interprétation visuelle des recouvrements d’intervalles
L’inspection visuelle des barres d’erreur type sur une figure scientifique induit fréquemment des erreurs d’interprétation chez les étudiants et les jeunes chercheurs. Il existe une croyance naïve mais tenace selon laquelle si les barres d’erreur de deux groupes se chevauchent visuellement, la différence entre les deux moyennes ne saurait être statistiquement significative. Inversement, l’absence de chevauchement visuel entre deux barres d’erreur représentant chacune ±1 SEM est souvent interprétée à tort comme la preuve indiscutable d’un écart significatif au seuil canonique de p < 0,05.
Sur le plan mathématique, cette déduction intuitive est erronée. Des modélisations probabilistes rigoureuses démontrent que lorsque deux échantillons indépendants de variances comparables présentent des barres d’erreur à ±1 SEM qui se frôlent sans se recouvrir (c’est-à-dire que l’extrémité supérieure de l’un coïncide avec l’extrémité inférieure de l’autre), la valeur p associée au test t de Student correspondant n’est pas de 0,05, mais se situe approximativement autour de p ≈ 0,16. Pour que la significativité bilatérale atteigne le seuil conventionnel de 0,05 par la simple inspection visuelle de deux moyennes indépendantes, l’écart spatial entre les extrémités des barres à 1 SEM doit représenter au minimum la moitié de la longueur d’un bras d’erreur type. Par conséquent, l’absence de recouvrement entre des barres de SEM constitue une condition nécessaire mais nullement suffisante pour inférer la significativité statistique, soulignant l’obligation de toujours coupler l’examen graphique à un calcul formel de la valeur de p ou à la visualisation d’intervalles de confiance à 95 %.
9. Gestion des pièges statistiques et techniques fréquents
9.1 Traitement des erreurs de division par zéro (#DIV/0!)
Dans les feuilles de calcul complexes intégrant des tableaux de bord dynamiques ou des filtres automatisés, l’affichage inopiné de codes d’erreur tels que #DIV/0! représente une défaillance fréquente qui dégrade la lisibilité et brise les chaînes de calcul dépendantes en aval. Dans la formule canonique =STDEV.S(plage) / SQRT(COUNT(plage)), cette erreur de division par zéro survient inévitablement dans deux cas précis : d’une part, si la plage ciblée ne contient rigoureusement aucune valeur numérique (l’effectif n retourné par COUNT est alors égal à zéro, conduisant à une division par zéro) ; d’autre part, si la plage ne contient qu’une seule observation isolée (n = 1), car dans ce cas la correction de Bessel opérée au sein de STDEV.S divise la somme des carrés des écarts par (n – 1) = 0, déclenchant l’exception computationnelle au sein même du numérateur.
Pour immuniser les formules contre cette vulnérabilité et concevoir des modèles analytiques résilients, l’analyste doit encapsuler l’expression mathématique au sein de la fonction structurelle IFERROR (ou SIERREUR). La formulation blindée s’écrit comme suit :
=IFERROR(STDEV.S(B2:B21) / SQRT(COUNT(B2:B21)), "")
Grâce à cette précaution syntaxique, si la cohorte d’observations est temporairement vide en attendant l’inclusion de futurs participants, ou si un sous-groupe expérimental ne dispose pas encore du quorum minimal de données (n ≥ 2), la cellule affiche une valeur nulle propre (une chaîne vide délimitée par des guillemets doubles) au lieu d’une alerte visuelle perturbatrice, permettant ainsi aux formules matricielles associées de poursuivre leur exécution sans interruption de flux.
9.2 Le piège de la formule standard appliquée aux mesures répétées
L’une des fautes méthodologiques les plus pernicieuses et malheureusement répandues dans la littérature scientifique consiste à appliquer la formule standard du SEM (conçue pour des échantillons indépendants) à des données issues d’un plan expérimental intra-sujets ou à mesures répétées. Dans un devis à mesures répétées, chaque participant est testé successivement dans l’ensemble des conditions expérimentales (par exemple Pré-test versus Post-test, ou Condition A versus Condition B). Dès lors, les scores recueillis dans les différentes conditions ne sont pas indépendants : ils présentent une forte corrélation positive intra-classe, issue du fait qu’un individu performant dans une condition tend à demeurer performant dans l’autre.
Si l’expérimentateur utilise la formule classique =STDEV.S(plage) / SQRT(COUNT(plage)) pour tracer les barres d’erreur de chaque condition séparément, le SEM ainsi calculé incorpore l’intégralité de la variance interindividuelle globale (les différences de niveau moyen entre les sujets). Or, dans un test t pour échantillons appariés ou une ANOVA à mesures répétées, cette variance interindividuelle est mathématiquement purgée de l’erreur expérimentale pour isoler l’interaction intra-sujet. Les barres d’erreur classiques s’avèrent alors disproportionnellement massives par rapport à la puissance réelle du test statistique. Pour pallier cette distorsion majeure, il est théoriquement impératif d’appliquer les corrections de normalisation intra-individuelle formalisées par Loftus et Masson (1994) ou la méthode de Cousineau-Morey (Morey, 2008). Cette procédure requiert de centrer préalablement les scores de chaque participant sur sa propre moyenne individuelle avant d’estimer l’écart-type et le SEM ajusté sur les données recentrées, une transformation qui peut être programmée dans Google Sheets par des colonnes de déviation intermédiaire.
9.3 Problématique de la non-normalité des distributions
L’utilisation de la moyenne arithmétique et, par extension, de l’erreur type classique repose sur le postulat fondamental de distributions symétriques et relativement bien conformées. Lorsque les données expérimentales présentent une asymétrie marquée (skewness prononcée), comme c’est typiquement le cas des temps de réaction qui suivent une distribution ex-gaussienne ou log-normale étirée vers les valeurs lentes, ou des données psychométriques victimes d’un effet de plafond ou de plancher, l’erreur type paramétrique classique perd sa pertinence métrologique.
Dans de telles configurations empiriques, le SEM estimé sous-évalue la marge d’incertitude dans la direction de la queue de distribution et la surestime de l’autre côté. Google Sheets intègre des fonctions de diagnostic distributionnel permettant d’objectiver ce phénomène : SKEW (ou COEFFICIENT.ASYMETRIE) pour l’asymétrie et KURT (ou KURTOSIS) pour l’aplatissement. Si les coefficients d’asymétrie excèdent des valeurs absolues de ±1 ou ±2, l’analyste doit renoncer à l’application aveugle du SEM brut. Deux alternatives s’imposent alors : appliquer une transformation mathématique préliminaire aux données brutes (telle qu’une transformation logarithmique =LN(score) ou racine carrée =SQRT(score) pour rétablir la normalité avant calcul du SEM), ou basculer vers des indicateurs non paramétriques de dispersion, tels que la médiane encadrée de son écart interquartile ou des intervalles de confiance obtenus par rééchantillonnage bootstrap.
10. Interprétation académique et communication des résultats du SEM
10.1 Analyse de la grandeur de l’erreur type
L’obtention d’une valeur numérique pour le SEM n’a de sens que si elle est mise en perspective avec la grandeur de la moyenne observée et les objectifs de la mesure. Pour évaluer de façon pragmatique la précision d’une expérimentation, il est souvent instructif d’examiner le ratio entre le SEM et la moyenne arithmétique X̄. Ce ratio, qui s’apparente à une déclinaison de l’erreur type relative, permet de déterminer immédiatement la proportion d’incertitude pesant sur l’estimation. Si un chercheur observe un temps moyen de latence de 500 ms avec un SEM de 5 ms, l’incertitude relative ne représente que 1 % de la métrique, signalant une estimation d’une exceptionnelle acuité. Si, en revanche, le SEM atteint 120 ms pour une moyenne de 300 ms, l’erreur type culmine à 40 % de la valeur estimée, indiquant un niveau de bruit statistique tel que l’inférence devient particulièrement hasardeuse.
L’amplitude du SEM exerce une répercussion directe sur la puissance statistique a posteriori du protocole d’étude. Un SEM excessif trahit deux écueils méthodologiques potentiels : soit une hétérogénéité intrinsèque massive au sein de la cohorte d’individus recrutés, révélant la présence de sous-populations non contrôlées ou de variables modératrices omises ; soit une imprécision instrumentale liée aux outils de mesure (latence logicielle, imprécision des consignes, perturbations environnementales lors de la passation). Le diagnostic d’un SEM surdimensionné doit alerter l’expérimentateur sur l’obligation d’accroître substantiellement son effectif d’échantillonnage n ou de raffiner drastiquement le protocole expérimental pour juguler le bruit de mesure lors de futures réplications.
10.2 Rédaction textuelle selon les normes formelles APA (7e édition)
La communication écrite des données quantitatives obéit à des conventions typographiques et structurelles extrêmement précises au sein de la littérature académique internationale. La 7e édition du manuel de publication de l’APA stipule les règles de mise en forme typographique des statistiques d’échantillonnage dans le corps du texte. Les symboles statistiques alphabétiques latins doivent impérativement être composés en italique, tandis que les indices numériques, les symboles grecs ou les parenthèses demeurent en typographie droite.
Lorsque des auteurs choisissent d’inclure le SEM dans leur rapport narratif, la formulation recommandée s’agence selon la structure suivante :
« Le temps de réaction moyen sous la condition d’interférence cognitive s’est élevé à 692,60 ms (SEM = 7,23 ms), contre une moyenne de 540,12 ms (SEM = 5,18 ms) observée lors de la condition de congruence neutre. »
Il convient de proscrire rigoureusement les formulations ambiguës recourant au symbole typographique plus ou moins sans contextualisation explicite, telles que « 692,60 ± 7,23 ms », car le lecteur ignore si la marge indiquée délimite un écart-type, une erreur type ou un intervalle de confiance à 95 %. En outre, le niveau de précision décimale doit refléter la sensibilité métrologique de l’instrument de mesure : en règle générale, arrondir la moyenne et le SEM à deux décimales après la virgule constitue la norme universelle, à moins que l’imprécision inhérente à la mesure ne justifie d’arrondir à l’entier le plus proche (comme pour des millisecondes entières sans fraction d’enregistrement).
10.3 Rédaction de la légende des figures scientifiques
Toute figure scientifique intégrant des barres d’erreur se doit d’être parfaitement intelligible de manière autonome, sans obliger le lecteur à parcourir l’intégralité du texte pour déchiffrer la nature de l’illustration graphique. La légende sous-jacente au graphique (figure caption) constitue l’élément contractuel d’explicitation méthodologique entre le chercheur et ses pairs. Omettre de définir la nature des barres d’erreur constitue l’un des motifs de révision éditoriale les plus systématiquement soulevés par les relecteurs des revues internationales de premier rang.
Une légende irréprochable doit systématiquement spécifier trois informations fondamentales : la statistique représentée par la hauteur centrale de la barre ou du point, la signification métrologique exacte des segments d’erreur, et l’effectif d’échantillonnage n par modalité. Une formulation type conforme aux critères éditoriaux s’énonce comme suit :
Figure 1. Temps de réaction moyen en millisecondes en fonction de la condition d’interférence cognitive. Les sommets des barres représentent les moyennes empiriques d’échantillon. Les barres d’erreur représentent ±1 erreur type de la moyenne (SEM). L’effectif par condition est de n = 20 participants. ** p < .01.
Si les tailles de groupes diffèrent, la légende doit explicitement ventiler les effectifs distincts (par exemple n₁ = 22, n₂ = 19). Cette précision textuelle lève définitivement toute équivoque entre l’erreur type et l’intervalle de confiance à 95 %, garantissant ainsi une transparence métrologique absolue lors de l’évaluation par les pairs.
11. Calculs avancés : Intervalles de confiance dérivés de l’erreur type
11.1 Transition mathématique du SEM vers l’intervalle de confiance
L’erreur type de la moyenne constitue le moteur fondamental à partir duquel se construisent les intervalles de confiance (IC). Alors que le SEM quantifie l’erreur moyenne attendue sur une échelle unitaire d’écart-type, un intervalle de confiance délimite explicitement un segment continu de valeurs plausibles pour le paramètre inconnu de la population à un seuil de confiance théorique choisi (universellement fixé à 95 % ou 99 % dans les sciences quantitatives). La transition mathématique reliant l’erreur type à l’intervalle de confiance s’articule par l’intermédiaire d’une multiplication vectorielle :
Marge d’erreur = Valeur critique × SEM
Pour des cohortes expérimentales extrêmement larges (n > 100 ou tendant vers l’infini), le théorème central limite permet de recourir aux fractiles de la distribution normale standardisée : le multiplicateur critique pour un intervalle bilatéral à 95 % est la célèbre constante asymptotique z = 1,960. Cependant, dès lors que l’analyste travaille sur des échantillons de recherche typiques en psychologie ou en biomédecine, dont les effectifs sont souvent restreints (n < 30 ou n < 50), l’estimation de l’écart-type σ par s introduit une incertitude stochastique supplémentaire. L’emploi de la distribution z sous-évalue alors l’épaisseur réelle des queues de distribution, générant des intervalles artificiellement trop étroits.
Pour corriger cette lacune, William Sealy Gosset a élaboré la distribution de Student (loi t). La valeur critique t dépend intimement du nombre de degrés de liberté de l’estimation, défini par df = n – 1. Pour un seuil bilatéral à 95 % et un échantillon modeste de n = 10 (df = 9), le multiplicateur t s’élève à 2,262, ce qui élargit considérablement l’intervalle par rapport au multiplicateur z = 1,96. Par conséquent, l’articulation mathématique rigoureuse de l’intervalle de confiance d’échantillons réels ne peut s’affranchir de la modélisation sous-jacente de la loi t de Student.
11.2 Implémentation de la fonction T.INV.2T dans Google Sheets
Google Sheets met à disposition des chercheurs une fonction avancée spécialement conçue pour extraire avec une exactitude décimale irréprochable la valeur critique bilatérale d’une distribution de Student : la fonction T.INV.2T (ou LOI.STUDENT.INVERSE.BILATERALE). La syntaxe de cette fonction requiert deux paramètres : la probabilité résiduelle alpha dans les deux queues (soit 0,05 pour un intervalle de confiance à 95 %) et les degrés de liberté associés (n – 1). L’extraction de la marge d’erreur pour notre plage de données B2:B21 s’effectue au moyen de la formule imbriquée suivante :
=T.INV.2T(0.05, COUNT(B2:B21) - 1) * (STDEV.S(B2:B21) / SQRT(COUNT(B2:B21)))
À partir de cette marge d’erreur, le calcul des bornes inférieure et supérieure de l’estimation de la moyenne psychométrique devient une opération d’une simplicité limpide :
- Borne inférieure de l’IC à 95 % :
=AVERAGE(B2:B21) - T.INV.2T(0.05, COUNT(B2:B21) - 1) * (STDEV.S(B2:B21) / SQRT(COUNT(B2:B21))) - Borne supérieure de l’IC à 95 % :
=AVERAGE(B2:B21) + T.INV.2T(0.05, COUNT(B2:B21) - 1) * (STDEV.S(B2:B21) / SQRT(COUNT(B2:B21)))
Sur notre jeu de données de 20 observations pour la tâche de Stroop, où n = 20 (donc df = 19), la fonction T.INV.2T(0.05, 19) extrait un multiplicateur critique t de 2,093024. En multipliant ce coefficient par notre SEM déjà obtenu de 7,23 ms, la marge d’erreur calculée s’établit à 15,13 ms. L’intervalle de confiance à 95 % s’étend donc de 677,47 ms à 707,73 ms. Ce résultat démontre que l’erreur type de la moyenne constitue le bloc modulaire indispensable sans lequel la dérivation des intervalles de confiance de Student serait tout simplement impossible.
11.3 Comparaison de l’utilité informative entre SEM et intervalles de confiance
Bien que le SEM et les intervalles de confiance partagent la même matrice algébrique sous-jacente, leur utilité informative n’est pas équivalente selon la finalité communicationnelle visée. L’avantage prépondérant de l’intervalle de confiance à 95 % réside dans son interprétabilité heuristique directe pour l’esprit humain : il borne visuellement une région de valeurs hautement plausibles pour la moyenne réelle, permettant de juger instantanément si une différence minimale cliniquement significative est compatible avec les données recueillies.
En revanche, dans une optique de méta-analyse et de synthèse cumulative des données scientifiques, le SEM demeure l’information brute privilégiée. Lorsqu’une équipe de méta-analystes extrait les statistiques publiées dans des dizaines d’articles pour synthétiser un effet à l’échelle mondiale à l’aide de modèles à effets fixes ou aléatoires, la variance inverse de chaque étude (utilisée comme coefficient de pondération du poids de l’étude) est calculée directement à partir du SEM au moyen de la relation W_i = 1 / (SEM_i)². Si les auteurs n’ont rapporté que des intervalles de confiance parfois dissymétriques ou tronqués, les méta-analystes doivent déployer des algorithmes de reconstruction approximatifs. Le consensus méthodologique actuel consacre ainsi une heureuse complémentarité : fournir systématiquement le SEM pour assurer la pérennité méta-analytique et l’exactitude de l’estimation brute, tout en visualisant les intervalles de confiance à 95 % pour guider l’interprétation inférentielle directe.
12. Synthèse pratique, protocole d’audit et recommandations méthodologiques
12.1 Grille de contrôle pour la validation des calculs dans Google Sheets
Pour prémunir les laboratoires contre les erreurs logicielles non intentionnelles susceptibles de compromettre la validité d’une publication, il est vivement recommandé d’instaurer une grille formelle d’audit des feuilles de calcul avant tout envoi d’un manuscrit pour évaluation par les pairs. Cette démarche d’assurance qualité s’articule autour de plusieurs points de vérification critiques :
- Contrôle de l’estimateur de variance : S’assurer formellement que la formule utilise sans exception la fonction
STDEV.S(avec correction de Bessel n – 1) et non pas la fonctionSTDEV.P. - Intégrité du dénominateur : Vérifier que la fonction de dénombrement est strictement
COUNTet nonCOUNTA, afin d’exclure toute cellule textuelle de l’évaluation de n. - Orthogonalité des plages d’arguments : Examiner les coordonnées de cellules pour certifier que la plage couverte par l’écart-type est rigoureusement isomorphe à celle couverte par la fonction de dénombrement (ex.
B2:B50au numérateur etB2:B50au dénominateur). - Absence de valeurs zéro par inadvertance : Scruter l’absence de cellules saisies accidentellement avec le chiffre « 0 » au lieu de rester vierges lors de sessions d’enregistrement manquées.
- Réplication indépendante : Faire auditer la feuille par un second chercheur du laboratoire, qui implémente le calcul sur une colonne parallèle sans consulter la cellule originale afin de valider la parfaite concordance des estimations.
12.2 Comparabilité des résultats entre Google Sheets, R, SPSS et JASP
Une préoccupation récurrente au sein de la communauté académique porte sur la comparabilité des résultats numériques délivrés par Google Sheets avec ceux produits par les progiciels statistiques spécialisés de référence tels que R, IBM SPSS ou JASP. Il convient de rassurer pleinement les analystes : sur le plan arithmétique strict, le moteur de calcul à virgule flottante double précision (conforme au standard IEEE 754) exploité par Google Sheets génère des estimations identiques jusqu’à la quatorzième décimale à celles obtenues via l’environnement R.
Dans le langage R, le calcul équivalent s’obtient typiquement par l’instruction sd(x) / sqrt(length(x)) (pour un vecteur sans données manquantes) ou via des packages dédiés comme plotrix::std.error(x). Dans le logiciel libre JASP, le SEM est affiché par défaut dans le panneau des statistiques descriptives élémentaires sous l’en-tête « Std. Error of Mean ». L’exactitude comparée sur des jeux de données d’étalonnage démontre une absence totale de divergence algorithmique. Le tableur Google Sheets constitue donc un environnement computationnel parfaitement légitime, fiable et auditable pour l’exécution d’analyses d’erreur type préliminaires ou définitives.
12.3 Principes de science ouverte appliqués aux feuilles de calcul
L’essor contemporain de la science ouverte (Open Science) redéfinit les exigences déontologiques pesant sur les chercheurs. Il ne suffit plus de présenter des moyennes et des erreurs types dans des tableaux statiques sur un PDF imprimé ; la communauté scientifique exige la mise à disposition publique et vérifiable des données brutes et des routines analytiques sous-jacentes. Pour satisfaire à ces exigences, les chercheurs utilisant Google Sheets disposent d’un vecteur de diffusion idéal.
Avant d’archiver un classeur Google Sheets sur des entrepôts de données certifiés tels que l’Open Science Framework (OSF) ou Zenodo, l’analyste doit procéder à une anonymisation méticuleuse des données (suppression définitive des adresses IP, des noms de participants ou des identifiants nominatifs). Les formules doivent être préservées in extenso au sein des cellules dynamiques plutôt que collées sous forme de valeurs figées, de façon à permettre aux auditeurs externes de vérifier la chaîne de dépendance mathématique. De surcroît, le créateur doit documenter chaque formule complexe au moyen de commentaires contextuels insérés dans les cellules (via Insertion > Commentaire). En rendant ses feuilles de calcul librement consultables sous licence ouverte (telle que Creative Commons CC-BY 4.0), le laboratoire concrétise l’idéal de transparence, favorise la réutilisation méthodologique de ses outils et garantit une reproductibilité expérimentale totale à ses pairs.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903
- Cumming, G., Fidler, F., & Vaux, D. L. (2007). Error bars in experimental biology. The Journal of Cell Biology, 177(1), 7–11. https://doi.org/10.1083/jcb.200702084
- Cousineau, D. (2005). Confidence intervals in within-subject designs: A simple alternative to Loftus and Masson’s approach. Tutorials in Quantitative Methods for Psychology, 1(1), 42–45. https://doi.org/10.20982/tqmp.01.1.p042
- Loftus, G. R., & Masson, M. E. (1994). Using confidence intervals in within-subject designs. Psychonomic Bulletin & Review, 1(4), 476–490. https://doi.org/10.3758/BF03210951
- Morey, R. D. (2008). Confidence intervals from normalized data: A correction to Cousineau (2005). Tutorials in Quantitative Methods for Psychology, 4(2), 61–64. https://doi.org/10.20982/tqmp.04.2.p061
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wilkinson, L., & the Task Force on Statistical Inference. (1999). Statistical methods in psychology journals: Guidelines and explanations. American Psychologist, 54(8), 594–604. https://doi.org/10.1037/0003-066X.54.8.594