
L’analyse des distributions statistiques et de la variabilité constitue le pivot central de la modélisation quantitative moderne, que ce soit en psychométrie, en économétrie appliquée, en biostatistique ou dans l’évaluation des risques financiers. Lorsque l’ensemble des observations d’un échantillon partage rigoureusement la même représentativité empirique et le même degré de précision métrologique, l’estimation des paramètres de dispersion repose sur des indicateurs classiques tels que la variance et l’écart-type non pondérés. Toutefois, dans les protocoles d’investigation réels, l’hypothèse d’équipondération est fréquemment invalidée : les données issues d’enquêtes par sondage stratifié, les méta-analyses intégrant des études de tailles hétérogènes, ou encore les instruments de mesure psychométriques requièrent une modulation explicite du poids accordé à chaque observation afin de préserver la validité de l’inférence.
Dans cet environnement méthodologique, l’écart-type pondéré s’impose comme l’estimateur de référence pour quantifier l’amplitude de dispersion des valeurs autour d’un barycentre préalablement ajusté. Contrairement à une croyance largement répandue chez les praticiens, le tableur Microsoft Excel ne dispose pas, au sein de sa bibliothèque native de fonctions statistiques, d’une commande directe dédiée à l’écart-type pondéré équivalente aux fonctions conventionnelles ECARTYPE.STANDARD ou ECARTYPE.PEARSON. Cette lacune apparente contraint l’analyste à maîtriser l’architecture matricielle du logiciel pour concevoir des algorithmes sur mesure, alliant rigueur algébrique et efficacité computationnelle.
Le présent guide a pour vocation de déconstruire exhaustivement les fondements mathématiques, les subtilités d’échantillonnage et les modalités de transcription algorithmique de l’écart-type pondéré dans Microsoft Excel. À travers un parcours pédagogique et technique approfondi, nous explorerons les justifications épistémologiques de la pondération, la dérivation des corrections de biais pour petits échantillons, la mise en œuvre pas à pas de formules matricielles via la fonction SOMMEPROD, l’usage des fonctionnalités modernes introduites par les fonctions dynamiques LET et LAMBDA, ainsi que l’automatisation via Visual Basic for Applications (VBA). Ce document offre aux chercheurs, analystes de données et biostatisticiens un référentiel méthodologique complet pour auditer, implémenter et interpréter la dispersion pondérée avec une précision scientifique irréprochable.
1. Fondements théoriques de l’écart-type pondéré en analyse statistique
1.1 Définition et pertinence de la pondération des données
D’un point de vue épistémologique, la mesure de la dispersion représente la quantification de l’incertitude et de l’hétérogénéité inhérente à tout phénomène quantifiable. Dans le cadre de la statistique descriptive classique de Gauss et de Pearson, chaque observation recueillie est implicitement postulée comme possédant une autorité informationnelle strictement équivalente à celle de ses pairs. Cette hypothèse d’homogénéité informationnelle s’avère particulièrement fragile dès lors que le processus générateur de données comporte des degrés de précision variables, des erreurs de mesure corrélées ou des structures d’échantillonnage non aléatoires simples. La pondération des observations intervient précisément comme un opérateur de rééquilibrage, conférant à chaque réalisation un coefficient multiplicatif proportionnel à sa représentativité réelle ou à sa fiabilité intrinsèque.
La nécessité de modéliser l’hétérogénéité de la précision est particulièrement tangible lorsque l’on analyse des estimateurs synthétiques agrégés. Par exemple, si l’on cherche à caractériser la distribution des scores d’anxiété au sein d’une population divisée en sous-groupes cliniques disparates, attribuer la même importance relative à une moyenne de sous-groupe établie sur cinq patients qu’à une moyenne issue d’une cohorte de cinq cents patients introduirait une distorsion majeure dans la caractérisation de la variabilité globale. Les observations issues d’échantillons massifs bénéficient d’une variance d’échantillonnage réduite selon le théorème central limite, ce qui justifie formellement l’attribution d’un poids statistique supérieur lors de la sommation globale.
En psychométrie appliquée, l’assignation de poids est indispensable dans le cadre de la théorie classique des tests et de la théorie de réponse aux items (TRI). La stratification des échantillons normatifs exige d’ajuster les poids a posteriori afin d’aligner les proportions empiriques sur les distributions démographiques du recensement général (âge, sexe, niveau d’éducation). De surcroît, la fidélité des items d’une échelle d’évaluation dépend de leur pouvoir discriminant ; négliger ces disparités conduit inévitablement à biaiser la variance observée du construit psychologique sous-jacent. L’omission délibérée des pondérations dans une telle configuration expose l’investigateur à un biais d’échantillonnage substantiel, déformant à la fois l’estimation de la moyenne centrale et l’estimation de l’amplitude de l’écart-type.
1.2 Propriétés métrologiques des poids statistiques
Sur le plan métrologique, il est primordial de distinguer conceptuellement deux grandes catégories de coefficients : les poids de fréquence et les poids de fiabilité, également qualifiés de poids de variance inverse ou poids de précision. Les poids de fréquence, couramment désignés sous le terme d’effectifs, correspondent à des nombres entiers représentant le dénombrement réel d’individus ou d’événements partageant des caractéristiques observationnelles identiques. Dans cette perspective, un poids entier équivaut à la réplication matérielle de la ligne de données correspondante, ce qui permet de comprimer un fichier volumineux en un tableau de contingence condensé sans altérer la nature stochastique de l’échantillon sous-jacent.
À l’inverse, les poids de fiabilité ou d’échantillonnage probabiliste (poids d’enquête, poids de calage ou poids d’atrition) sont fréquemment des nombres réels continus, parfois normalisés de sorte que leur somme équivaille à l’unité ou à l’effectif global de l’échantillon. En métrologie physique et en synthèse méta-analytique, les poids sont définis comme l’inverse de la variance de l’erreur de mesure associée à chaque point expérimental. Plus la variance de l’observation est restreinte, plus la précision métrologique est élevée, et plus le poids attribué à la valeur doit être prépondérant. Cette propriété confère au barycentre statistique une propriété d’optimalité au sens du théorème de Gauss-Markov, garantissant que l’estimateur résultant est l’estimateur sans biais de variance minimale.
La normalisation de la somme des poids constitue une étape critique dans le traitement des séries quantitatives. Si la moyenne pondérée demeure invariante par rapport à une transformation homothétique uniforme des poids, la détermination de l’écart-type pondéré est intimement tributaire de l’échelle absolue de ces coefficients lorsque l’on procède à la correction de degrés de liberté. De surcroît, la robustesse de l’écart-type pondéré est directement conditionnée par la morphologie de la distribution des poids : l’existence de poids fortement asymétriques ou de poids extrêmes confère à quelques observations isolées un effet de levier considérable, susceptible de masquer artificiellement la dispersion réelle ou, au contraire, d’induire une instabilité numérique majeure dans le calcul de la dispersion.
1.3 Comparaison entre dispersion arithmétique et dispersion pondérée
L’omission délibérée ou accidentelle des facteurs de pondération dans l’estimation de la dispersion entraîne des conséquences mathématiques rigoureusement démontrables. Lorsque les observations caractérisées par une déviation extrême par rapport à la moyenne bénéficient d’un poids statistique marginal, l’écart-type classique non pondéré aura tendance à surestimer de manière disproportionnée la variabilité de la population cible, attribuant une représentativité erronée à des valeurs atypiques. Réciproquement, si les observations atypiques sont porteuses de poids massifs – par exemple, un sous-groupe clinique minoritaire mais fortement surreprésenté par la pondération de calage –, l’écart-type conventionnel sous-estimera dramatiquement l’hétérogénéité réelle de la population.
Cette divergence entre dispersion arithmétique et dispersion pondérée engendre des répercussions directes sur l’ensemble de la chaîne de l’inférence statistique. Les erreurs-types des paramètres estimés, les valeurs des statistiques de test paramétriques (tels que le t de Student ou le F de Fisher-Snedecor) ainsi que les bornes des intervalles de confiance reposent intrinsèquement sur la précision de l’estimation de l’écart-type. Une sous-estimation de la dispersion conduit à des intervalles de confiance indûment étroits, gonflant le taux d’erreur de première espèce (rejet à tort de l’hypothèse nulle d’absence d’effet), tandis qu’une surestimation érode drastiquement la puissance statistique des protocoles expérimentaux, empêchant la détection d’effets cliniques ou économiques réels.
Le choix méthodologique d’adopter une formalisation pondérée en recherche empirique doit répondre à des critères précis et documentés dans le plan d’analyse statistique : présence d’un plan d’échantillonnage complexe à plusieurs degrés, existence de probabilités inégales de sélection des unités d’observation, disparité structurelle dans le rapport signal-sur-bruit des appareils de mesure, ou nécessité d’agréger des sources de données secondaires dotées de fiabilités contrastées. Dès lors que l’un de ces critères est formellement identifié, le recours exclusif à l’écart-type pondéré s’avère un impératif méthodologique incontournable pour garantir la validité écologique et interne des conclusions.
2. Formulation mathématique de l’écart-type pondéré
2.1 Décomposition algébrique de la formule de population
Pour aborder avec rigueur la modélisation de la dispersion pondérée, il convient d’expliciter en premier lieu la formule de population, laquelle suppose que la totalité des unités constitutives de l’univers statistique est observée. Soit un ensemble de N observations scalaires réelles notées xi (pour i = 1, 2, …, N), associées à un vecteur de poids strictement positifs notés wi. La moyenne pondérée de la population, qui représente le barycentre statistique exact de la distribution, est formellement définie par l’équation suivante :
$$\mu_w = \frac{\sum_{i=1}^{N} w_i x_i}{\sum_{i=1}^{N} w_i}$$
Dans cette formulation, le numérateur correspond au produit scalaire canonique entre le vecteur des réalisations et le vecteur des pondérations, tandis que le dénominateur agit comme un scalaire de normalisation traduisant la masse totale attribuée à la population d’intérêt. Une fois ce barycentre déterminé, la variance pondérée de population correspond à l’espérance mathématique des carrés des écarts à la moyenne pondérée, chaque terme quadratique étant modulé par son poids respectif. L’expression analytique de la variance pondérée de population s’énonce :
$$\sigma_w^2 = \frac{\sum_{i=1}^{N} w_i (x_i – \mu_w)^2}{\sum_{i=1}^{N} w_i}$$
L’écart-type pondéré de la population s’obtient alors immédiatement par l’extraction de la racine carrée positive de cette quantité scalaire. Les conditions de validité mathématique sous-jacentes à cette définition requièrent impérativement que tous les poids wi soient strictement positifs, ou à tout le moins positifs ou nuls avec une condition d’existence imposant que la somme globale des poids soit strictement supérieure à zéro afin d’interdire toute division par zéro.
2.2 Ajustement pour l’échantillonnage et correction de Bessel pondérée
En pratique empirique, l’analyste ne dispose presque jamais de l’intégralité de la population, mais seulement d’un échantillon fini constitué de n observations. Lorsque l’on remplace la véritable moyenne de population par la moyenne pondérée empirique de l’échantillon, un biais d’estimation mécanique est introduit : les déviations des observations sont calculées par rapport à un point d’équilibre qui minimise par définition la somme des carrés des écarts de l’échantillon lui-même, sous-estimant la variabilité réelle par rapport au barycentre de population inconnu. Dans le cadre de la statistique non pondérée, la correction de ce biais d’estimation est accomplie via la classique correction de Bessel, consistant à diviser la somme des carrés par n – 1 plutôt que par n.
Dans l’univers pondéré, la transposition de la correction de Bessel dépend fondamentalement de la typologie métrologique des poids manipulés. Dans le cas où les coefficients wi représentent des poids de fréquence stricts (chaque poids est un entier dénotant la réplication d’individus physiques identiques), la masse totale équivaut à l’effectif réel cumulé de l’échantillon. Par conséquent, le dénominateur non biaisé de l’échantillon s’exprime simplement par la somme des poids diminuée d’une unité :
$$s_w^2 = \frac{\sum_{i=1}^{n} w_i (x_i – \bar{x}_w)^2}{\left(\sum_{i=1}^{n} w_i\right) – 1}$$
En revanche, lorsque les poids sont des poids d’échantillonnage probabilistes, de calage ou de fiabilité analytique, la réduction d’une unité sur la somme des poids s’avère inadéquate et mathématiquement viciée, particulièrement si les poids ont été préalablement normalisés pour sommer à 1. Dans ce cas de figure complexe, il est impératif de faire appel à la formulation asymptotique de William G. Cochran ou à l’ajustement développé par Leslie Kish pour les plans d’échantillonnage complexes. L’estimateur non biaisé de la variance d’un échantillon pondéré par des poids de sondage continus prend la forme analytique suivante :
$$s_{w,\text{sondage}}^2 = \frac{\sum_{i=1}^{n} w_i (x_i – \bar{x}_w)^2}{\sum_{i=1}^{n} w_i – \frac{\sum_{i=1}^{n} w_i^2}{\sum_{i=1}^{n} w_i}}$$
Ce dénominateur ajusté intègre la somme des carrés des poids divisée par la masse totale, traduisant formellement la réduction du nombre de degrés de liberté effectifs induite par la variance interne des poids eux-mêmes. Il est important de souligner que la validité sans biais de ces estimateurs repose sur des hypothèses asymptotiques de régularité et que, sous des distributions asymétriques ou fortement non gaussiennes, des techniques de rééchantillonnage bootstrap pondéré peuvent être requises pour garantir une convergence inférentielle optimale.
2.3 Différenciation entre variance pondérée et écart-type pondéré
Bien que la variance pondérée et l’écart-type pondéré soient intimement liés par une relation de puissance univoque, leur manipulation et leur interprétation métrologique obéissent à des impératifs distincts. La variance pondérée correspond à un moment centré d’ordre deux exprimé dans le carré de l’unité de mesure initiale de la variable latente ou manifeste. Ainsi, si une variable psychométrique quantifie un temps de réaction en millisecondes, la variance résultante s’exprime en millisecondes au carré, ce qui prive le résultat d’une interprétabilité clinique directe et intuitive.
L’écart-type pondéré réhabilite l’homogénéité dimensionnelle en appliquant l’opérateur de racine carrée unilatérale. Ce passage dimensionnel préserve fidèlement les unités de mesure d’origine, permettant d’énoncer un intervalle de dispersion directement superposable à la moyenne pondérée de la variable étudiée. Sur le plan de la géométrie vectorielle hilbertienne, l’écart-type pondéré s’interprète élégamment comme la norme euclidienne pondérée du vecteur des écarts centrés projeté dans un espace métrique doté du produit scalaire défini par la matrice diagonale des poids. Cette conceptualisation met en exergue le fait que l’écart-type pondéré mesure la véritable distance géométrique moyenne séparant chaque point de données du barycentre du nuage d’observations dans un espace anisotrope.
3. Préparation et structuration de la feuille de calcul Excel
3.1 Organisation tabulaire optimale des variables d’étude
L’implémentation d’une analyse statistique avancée au sein de Microsoft Excel exige une rigueur architecturale absolue dès la conception de la grille de données. Toute ambiguïté dans la disposition des vecteurs de données est susceptible de corrompre l’intégrité des calculs matriciels ultérieurs ou de susciter des références circulaires involontaires. Une structuration tabulaire optimale repose sur le respect des standards de bases de données relationnelles élémentaires : une ligne d’en-tête explicite, une variable par colonne et une unité d’observation par ligne.
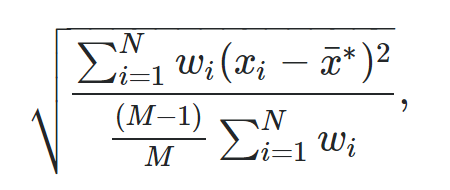
Pour mener à bien le calcul de l’écart-type pondéré, nous recommandons la mise en place systématique de trois colonnes fonctionnelles disjointes. La colonne A reçoit l’identifiant univoque de l’observation (numéro de sujet, code de participant, libellé de l’item ou référence expérimentale). La colonne B accueille la variable continue d’intérêt, notée conventionnellement x, qui correspond aux valeurs observées (scores psychométriques, rendements, mesures chronométriques). Enfin, la colonne C est réservée au vecteur des coefficients de pondération, noté w.
Pour maximiser la robustesse de l’environnement de calcul et prévenir les erreurs de débordement lors de l’ajout ultérieur d’observations, il est fortement préconisé de convertir immédiatement la plage de données conventionnelle en Tableau Structuré Excel (via le raccourci clavier standard Ctrl+L ou Ctrl+T). Les Tableaux Structurés offrent l’avantage déterminant d’attribuer des références structurées dynamiques (par exemple Tableau1[Score] et Tableau1[Poids]), éliminant de facto les risques d’omission de lignes lors de l’actualisation continue des bases de données de recherche.
3.2 Validation et nettoyage préalable des données
L’étape de validation et de nettoyage constitue un prérequis métrologique incontournable avant tout engagement algorithmique. Dans Excel, les cellules vides et les cellules contenant des espaces insécables ou des chaînes de caractères invisibles génèrent des dysfonctionnements subtils lors de l’évaluation des formules matricielles. Il convient de formaliser sans équivoque la distinction entre une valeur nulle réelle (zéro) et une valeur manquante. Alors qu’un score de zéro participe pleinement à l’estimation du barycentre et de la variance, une valeur manquante doit être exclue avec son poids associé sous peine de distordre massivement la somme des dénominateurs.
Le contrôle d’intégrité du vecteur des poids requiert une vigilance accrue. Tout coefficient de pondération présentant une valeur strictement négative doit être proscrit, car il violerait l’axiome fondamental de non-négativité de la métrique probabiliste, conduisant à des résultats absurdes où la somme des écarts pondérés pourrait s’avérer négative sous le radical. Les poids égaux à zéro doivent faire l’objet d’un arbitrage méthodologique : bien qu’ils n’induisent pas d’erreur de syntaxe dans les fonctions matricielles en annulant simplement la contribution de la ligne afférente, leur présence massive peut induire en erreur l’estimation des degrés de liberté de l’échantillon.
Enfin, il est impératif de contrôler l’homogénéité des formats numériques au sein des colonnes d’étude. Selon les paramètres régionaux du système d’exploitation et d’Excel (notamment entre les configurations francophones exploitant la virgule et les configurations anglo-saxonnes exploitant le point), des données numériques collées depuis des fichiers CSV externes peuvent être interprétées arbitrairement comme du texte brut. L’application d’un filtre ou d’une règle de validation des données exigeant le type décimal garantit l’alignement typologique strict indispensable au fonctionnement optimal des fonctions d’algèbre vectorielle d’Excel.
3.3 Paramétrage de l’environnement de calcul dans Excel
Avant d’initier la saisie des expressions matricielles complexes, l’optimisation des options de calcul globales du classeur doit être vérifiée. Dans le menu « Fichier », sous l’onglet « Options », puis « Formules », le mode de calcul d’Excel doit être configuré par défaut sur « Automatique ». Si le classeur est accidentellement basculé en mode « Manuel », les résultats matriciels intermédiaires ne s’actualiseront pas lors de la modification des coefficients de pondération, ce qui pourrait amener l’analyste à des interprétations biaisées.
Pour accroître la transparence du modèle et minimiser les risques de confusion dans la désignation des plages de cellules, l’usage des Noms Définis constitue une pratique d’excellence recommandée par les standards d’audit de feuilles de calcul. En désignant formellement la plage des observations sous l’identifiant mnémonique Scores_X et la plage correspondante des poids sous l’identifiant Poids_W, les formules subséquentes gagnent immensément en lisibilité, s’affranchissant des contraintes de référencement absolu via les symboles de dollar.
Il importe également de prendre en compte le moteur de calcul sous-jacent de la version d’Excel déployée. Depuis l’introduction du moteur de tableaux dynamiques dans Microsoft 365 et Office 2021, la gestion des matrices a subi une refonte structurelle majeure : les formules matricielles s’étendent désormais naturellement sans nécessiter la validation historique Ctrl+Maj+Entrée. Si l’environnement de travail repose sur des versions patrimoniales (Excel 2016, 2013 ou 2010), l’architecture des formules doit être pensée de manière à préserver une rétrocompatibilité descendante sans faille.
4. Étape 1 : Structuration de l’échantillon et affectation des poids
4.1 Création des séries de valeurs et assignation des coefficients
Afin de matérialiser concrètement la trajectoire algorithmique, établissons un échantillon empirique représentatif issu d’une étude d’évaluation psychométrique. Considérons une cohorte de dix sujets soumis à un test standardisé de performance cognitive, mesuré sur une échelle continue de scores de 10 à 50 points. Parallèlement, chaque sujet se voit attribuer un coefficient de pondération reflétant la fiabilité métrologique de la modalité d’évaluation (poids de précision continue) ou le poids de sondage démographique correspondant à son groupe d’appartenance.
Dans la feuille de calcul Excel, nous procédons à la saisie rigoureuse des données dans les cellules s’étendant de la ligne 2 à la ligne 11. La colonne A héberge les scores d’évaluation cognitive observés (xi), tandis que la colonne B accueille les coefficients de pondération respectifs (wi). La configuration empirique de notre échantillon d’investigation se structure rigoureusement comme suit :
- Sujet 1 : Cellule A2 = 24 ; Cellule B2 = 1,2
- Sujet 2 : Cellule A3 = 35 ; Cellule B3 = 2,5
- Sujet 3 : Cellule A4 = 18 ; Cellule B4 = 0,8
- Sujet 4 : Cellule A5 = 42 ; Cellule B5 = 3,1
- Sujet 5 : Cellule A6 = 29 ; Cellule B6 = 1,5
- Sujet 6 : Cellule A7 = 33 ; Cellule B7 = 2,0
- Sujet 7 : Cellule A8 = 47 ; Cellule B8 = 4,0
- Sujet 8 : Cellule A9 = 22 ; Cellule B9 = 1,1
- Sujet 9 : Cellule A10 = 15 ; Cellule B10 = 0,5
- Sujet 10 : Cellule A11 = 38 ; Cellule B11 = 2,8
Un contrôle de cohérence dimensionnelle élémentaire permet de s’assurer que le vecteur A2:A11 et le vecteur B2:B11 possèdent une cardinalité strictement identique de 10 éléments. L’asymétrie dans la longueur des vecteurs constitue l’une des causes prépondérantes de l’erreur #VALEUR! lors des opérations vectorielles avec les fonctions de cumul scalaire.
4.2 Calcul de la somme globale des poids
L’étape inaugurale de tout calcul statistique pondéré réside dans la détermination de la masse totale de l’échantillon, symbolisée par la sommation de l’ensemble des pondérations individuelles. Cette valeur joue un rôle cardinal, intervenant au dénominateur de la formule de la moyenne pondérée, puis dans le calcul des degrés de liberté de l’écart-type de l’échantillon. Dans une cellule réservée, par exemple la cellule E1, l’analyste implémente la formule standard suivante :
=SOMME(B2:B11)
L’exécution de cette fonction sur notre jeu de données expérimental produit une somme scalaire totale rigoureusement égale à 19,5. Il convient de s’interroger conceptuellement sur la signification de ce résultat en fonction de l’ancrage méthodologique de l’étude. Si nous manipulions des poids d’effectifs, ce chiffre signifierait que les dix lignes de notre tableau résument en réalité un échantillon d’observations démultipliées représentant 19,5 unités physiques (dans ce cas précis, les poids seraient des entiers et non des décimaux).
En revanche, dans notre cadre empirique de poids continus de fiabilité ou de représentativité probabiliste, la somme de 19,5 démontre que la masse d’information accumulée ne correspond pas à la taille nominale apparente de l’échantillon (qui est de n = 10). Cette discordance arithmétique fondamentale entre la somme des poids et le cardinal du vecteur des observations conditionne directement le choix du dénominateur d’ajustement qui sera appliqué lors de la finalisation de l’écart-type non biaisé.
5. Étape 2 : Détermination de la moyenne pondérée avec SOMMEPROD
5.1 Mécanique fonctionnelle de la formule SOMMEPROD
Le calcul manuel de la moyenne pondérée consisterait à multiplier laborieusement chaque observation de la colonne A par le coefficient adjacent de la colonne B dans une colonne tierce, avant de sommer verticalement l’ensemble des résultats intermédiaires. Cette méthodologie archaïque encombre inutilement la grille de données et démultiplie les risques d’altération accidentelle des formules de cellules. Pour court-circuiter ces colonnes auxiliaires redondantes, Microsoft Excel intègre une fonction d’algèbre linéaire hautement optimisée : la fonction SOMMEPROD.
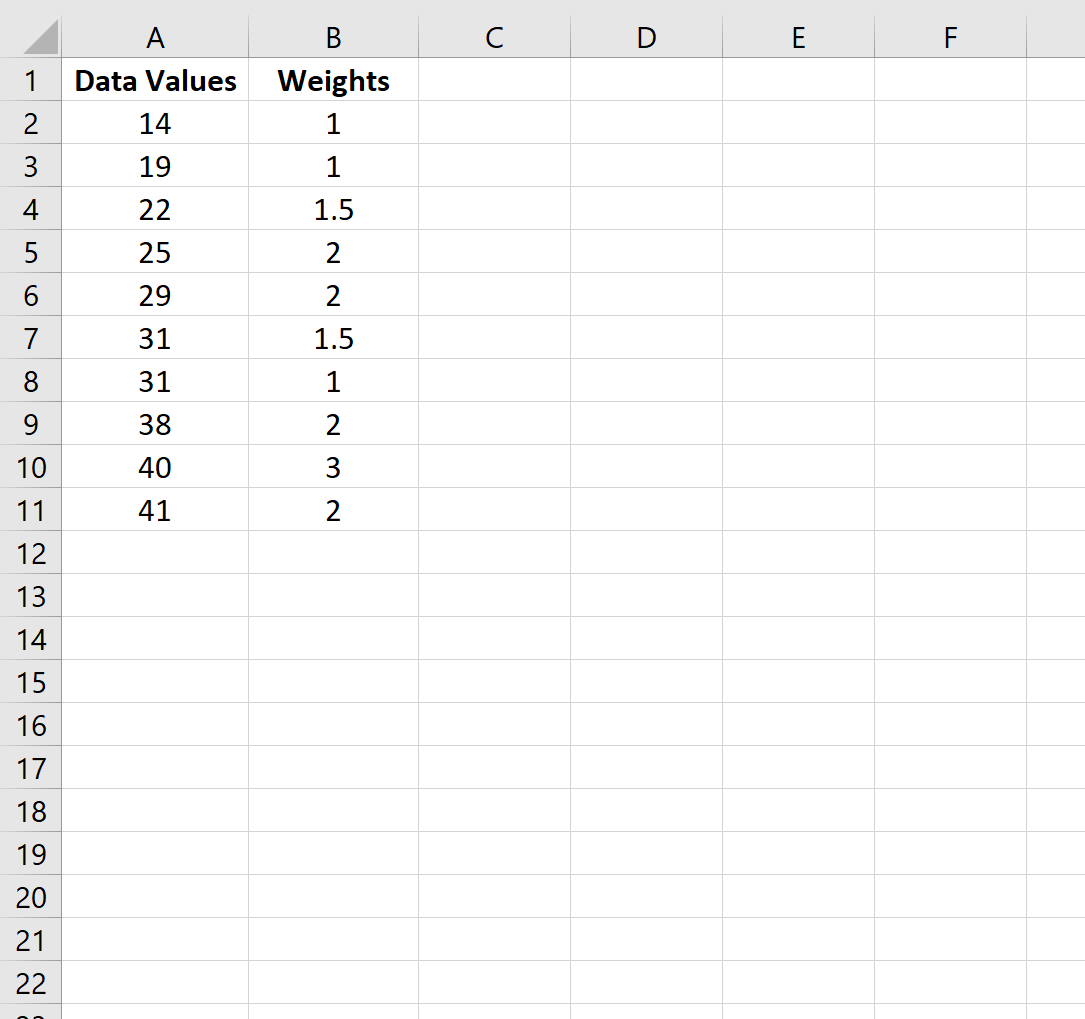
La fonction SOMMEPROD (désignée sous le vocable SUMPRODUCT dans les versions anglophones) effectue nativement le produit matriciel terme à terme de deux ou plusieurs tableaux de dimensions compatibles, avant de procéder à la sommation scalaire unitaire de l’ensemble des composantes obtenues. Sur le plan algorithmique, cette commande s’apparente à l’exécution d’une routine vectorielle en mémoire vive, offrant une vélocité computationnelle largement supérieure aux macro-commandes itératives et aux formules de tableau traditionnelles.
La syntaxe opératoire pour calculer le numérateur du barycentre s’énonce simplement :
=SOMMEPROD(A2:A11; B2:B11)
Lors de son exécution par le processeur d’Excel, l’instruction effectue l’opération vectorielle suivante : (24 × 1,2) + (35 × 2,5) + (18 × 0,8) + (42 × 3,1) + (29 × 1,5) + (33 × 2,0) + (47 × 4,0) + (22 × 1,1) + (15 × 0,5) + (38 × 2,8). Le produit scalaire agrégé génère un numérateur global de 607,37.
5.2 Normalisation par la somme des poids
L’obtention de la moyenne pondérée définitive requiert la normalisation du produit scalaire obtenu par la masse totale déterminée à l’étape précédente. L’analyste synthétise cette opération au sein d’une unique cellule de référence stratégique, désignée arbitrairement comme la cellule E2. La formule complète et autosuffisante s’écrit de la manière suivante :
=SOMMEPROD(A2:A11; B2:B11) / SOMME(B2:B11)
L’évaluation de cette expression au sein du modèle empirique produit le quotient suivant :
$$\bar{x}_w = \frac{607,37}{19,5} \approx 31,147179$$
En arrondissant à trois décimales significatives, nous établissons le barycentre statistique pivot à 31,147. Il est fascinant de comparer ce barycentre pondéré à la moyenne arithmétique élémentaire non pondérée des mêmes données, laquelle s’obtient par la formule =MOYENNE(A2:A11) et s’établit rigoureusement à 27,300.
Cette divergence remarquable de près de 3,85 points entre la moyenne simple (27,300) et la moyenne pondérée (31,147) illustre de manière spectaculaire l’impact métrologique du schéma de pondération : les observations dotées de scores élevés (notamment le Sujet 7 avec un score de 47 et un poids de 4,0, ou le Sujet 4 avec un score de 42 et un poids de 3,1) attirent gravitationnellement le barycentre vers les valeurs supérieures de l’échelle, neutralisant l’effet des scores modestes assortis de pondérations anecdotiques.
5.3 Diagnostic des anomalies de calcul de la moyenne
Lors de l’implémentation de formules basées sur SOMMEPROD, des anomalies d’exécution peuvent survenir en cas d’incohérence syntaxique ou métrologique. L’erreur la plus emblématique est l’affichage de l’exception arithmétique #DIV/0!. Cette condition d’erreur se manifeste inexorablement dès lors que le dénominateur s’annule, ce qui arrive si la plage de pondération B2:B11 est intégralement vide, si elle ne contient que des valeurs nulles, ou si la somme algébrique des coefficients aboutit à zéro en présence de poids négatifs malencontreusement intégrés.
Une seconde pathologie algorithmique fréquente prend la forme du code d’erreur #VALEUR!. Dans la quasi-totalité des occurrences, ce signalement découle d’un désalignement géométrique des arguments matriciels au sein de la fonction SOMMEPROD. Si la matrice des observations s’étend de A2 à A11 (10 lignes sur 1 colonne), tandis que la matrice des poids est spécifiée accidentellement de B2 à B12 (11 lignes sur 1 colonne), Excel se trouve dans l’incapacité d’effectuer les multiplications terme à terme et rejette l’opération.
Enfin, il convient de prémunir l’architecture de calcul contre les dégradations de précision induites par les arrondis intermédiaires. L’analyste ne doit en aucun cas remplacer l’expression dynamique de la cellule E2 par la constante tronquée 31,15 dans les étapes de calcul subséquentes. La conservation de la pleine précision en virgule flottante (conforme au standard IEEE 754 à double précision, soit environ 15 chiffres significatifs dans Excel) est un impératif technique pour éviter l’accumulation d’erreurs d’arrondi lors de l’élévation au carré des déviations pondérées.
6. Étape 3 : Calcul de la somme des écarts quadratiques pondérés
6.1 Calcul des déviations individuelles par rapport à la moyenne
La caractérisation de la dispersion exige d’estimer l’ampleur des écarts individuels séparant chaque observation du barycentre calculé. Pour expliciter le mécanisme de calcul et autoriser un audit visuel rigoureux des étapes computationnelles, il est hautement pédagogique d’instancier temporairement des colonnes intermédiaires avant de basculer vers une formule synthétique fermée. Dans la colonne D de notre feuille de calcul, nous allons matérialiser les déviations individuelles élémentaires.
Dans la cellule D2, la formule de déviation s’écrit formellement :
=(A2 - $E$2)
L’usage impératif des symboles de dollar ($E$2) assure le verrouillage absolu de la cellule hébergeant la moyenne pondérée pivot lors du processus d’incrémentation verticale par recopie vers le bas jusqu’à la cellule D11. L’évaluation de cette colonne pour notre première observation génère l’écart suivant : 24 – 31,147179 = -7,147179. Les écarts individuels présentent par nature des signes alternés, les valeurs inférieures au barycentre étant négatives et les valeurs supérieures étant positives.
Si l’on tentait de pondérer directement ces déviations linéaires simples pour en faire la somme, les contributions positives et négatives s’annuleraient mutuellement en vertu des propriétés géométriques fondamentales du barycentre statistique (la somme pondérée des déviations au barycentre étant rigoureusement nulle). Pour éliminer cette compensation de signe tout en pénalisant de manière exponentielle les déviations massives, l’opérateur d’élévation au carré s’impose logiquement.
6.2 Application de la pondération aux déviations quadratiques
L’opération suivante consiste à multiplier chaque déviation élevée au carré par le poids statistique spécifiquement attribué à l’observation correspondante. Cette déviation quadratique pondérée quantifie la contribution individuelle de chaque ligne à l’énergie de dispersion totale du système statistique. Dans la colonne E, à partir de la ligne 2, nous implémentons la formule combinée suivante :
=B2 * (A2 - $E$2)^2
L’analyse détaillée des premiers éléments de cette colonne intermédiaire met en lumière la mécanique de modulation opérée par le schéma de pondération :
- Sujet 1 (Cellule E2) : 1,2 × (24 – 31,147179)2 = 1,2 × (-7,147179)2 = 1,2 × 51,082173 ≈ 61,2986
- Sujet 2 (Cellule E3) : 2,5 × (35 – 31,147179)2 = 2,5 × (3,852821)2 = 2,5 × 14,844226 ≈ 37,1106
- Sujet 7 (Cellule E8) : 4,0 × (47 – 31,147179)2 = 4,0 × (15,852821)2 = 4,0 × 251,311930 ≈ 1005,2477
Ce dernier calcul illustre avec acuité la puissance multiplicatrice de la méthode : le Sujet 7 cumule à la fois une déviation substantielle par rapport à la moyenne (+15,85) et un poids institutionnel maximal de 4,0, générant une contribution quadratique pondérée excédant 1005 points. En procédant à la sommation verticale des dix cellules intermédiaires via la fonction =SOMME(E2:E11), nous obtenons la somme globale des écarts quadratiques pondérés, qui s’élève exactement à 1358,6907.
6.3 Synthèse directe au sein d’une unique formule matricielle
Bien que le recours à des colonnes auxiliaires favorise l’intelligibilité didactique, la pratique professionnelle des modèles quantitatifs sous Excel réprouve la multiplication des structures de calcul intermédiaires, sources fréquentes de corruption lors des tris de colonnes ou des manipulations de lignes. Il est infiniment plus élégant et performant de condenser l’ensemble de cette chaîne d’opérations dans une unique expression matricielle hermétique exploitant le potentiel intrinsèque de la fonction SOMMEPROD.
Pour calculer directement le numérateur global de la variance pondérée sans aucune colonne de transit, l’analyste rédige la formule suivante :
=SOMMEPROD((A2:A11 - E2)^2; B2:B11)
Au sein de cette syntaxe, le premier argument (A2:A11 - E2)^2 génère un vecteur virtuel temporaire en mémoire contenant les dix écarts quadratiques calculés par rapport à la moyenne pondérée hébergée en E2. Le second argument B2:B11 transmet le vecteur des poids. La fonction effectue instantanément le produit scalaire entre ces deux structures vectorielles, restituant d’un seul tenant la valeur scalaire globale de 1358,6907.
Sous le moteur d’évaluation moderne de Microsoft 365, cette opération vectorielle s’exécute avec une fluidité absolue. Sur les architectures Excel plus anciennes dépourvues du moteur de tableaux dynamiques natif, la fonction SOMMEPROD conserve la remarquable propriété de traiter intrinsèquement les opérations matricielles sur ses arguments sans exiger la validation par la combinaison matricielle historique Ctrl+Maj+Entrée, faisant de cette formule un modèle de portabilité et de robustesse algorithmique.
7. Étape 4 : Finalisation du calcul de l’écart-type pondéré
7.1 Intégration du dénominateur d’échantillon
Avec l’agrégation de la somme des écarts quadratiques pondérés (1358,6907), la construction de notre estimateur atteint sa phase décisive : l’intégration du dénominateur régissant la variance d’échantillon. Conformément aux arbitrages méthodologiques développés lors de notre décomposition théorique de la section 2, le choix de la constante de normalisation dépend de l’extrapolation inférentielle visée par l’analyste.
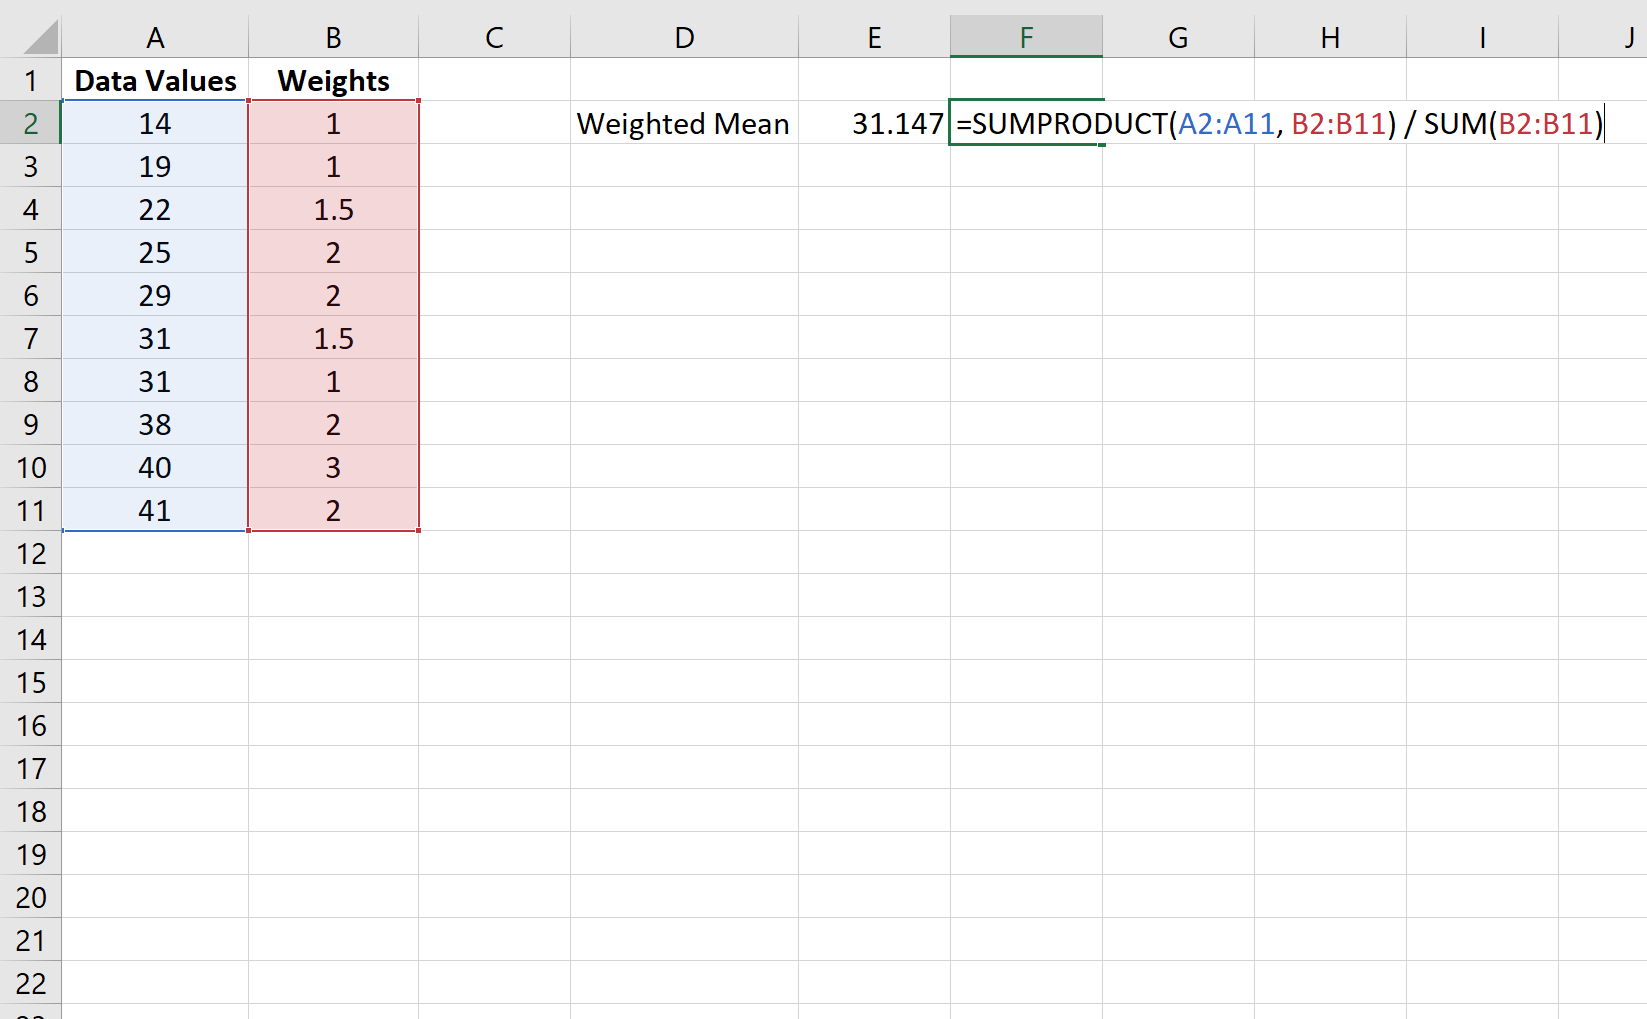
Si l’étude a pour dessein d’estimer sans biais la variance d’une population globale à partir d’un échantillon fini assujetti à des poids de fréquence stricts, la correction de Bessel exige de soustraire la valeur unitaire à la masse cumulée des pondérations. Le dénominateur d’échantillon s’exprime ainsi sous la forme algébrique SOMME(B2:B11) - 1, ce qui équivaut pour notre modèle empirique à :
$$D_{\text{échantillon}} = 19,5 – 1 = 18,5$$
À l’opposé, si les dix observations colligées constituent l’intégralité exhaustive de la population cible sous investigation (cas d’une étude métrologique fermée ou d’une modélisation de population complète), la correction de Bessel n’a pas lieu d’être appliquée. Le dénominateur de population pure conserve alors l’intégralité de la masse scalaire, soit SOMME(B2:B11) (19,5). Dans la perspective la plus universelle des sciences empiriques – où l’on cherche à généraliser les résultats au-delà du strict échantillon étudié –, nous retiendrons formellement le diviseur d’échantillon ajusté de 18,5.
7.2 Application de la fonction racine carrée RACINE
Pour parachever l’estimation et ramener la métrique de dispersion à la dimensionnalité originelle des scores psychométriques, il ne reste plus qu’à encapsuler le quotient de la variance au sein de la fonction unilatérale de racine carrée positive de Microsoft Excel, baptisée RACINE (ou SQRT dans les environnements anglophones). La formule globale assemblée, calculant l’écart-type pondéré d’échantillon en référençant la moyenne établie en E2, s’énonce magistralement ainsi :
=RACINE(SOMMEPROD((A2:A11 - E2)^2; B2:B11) / (SOMME(B2:B11) - 1))
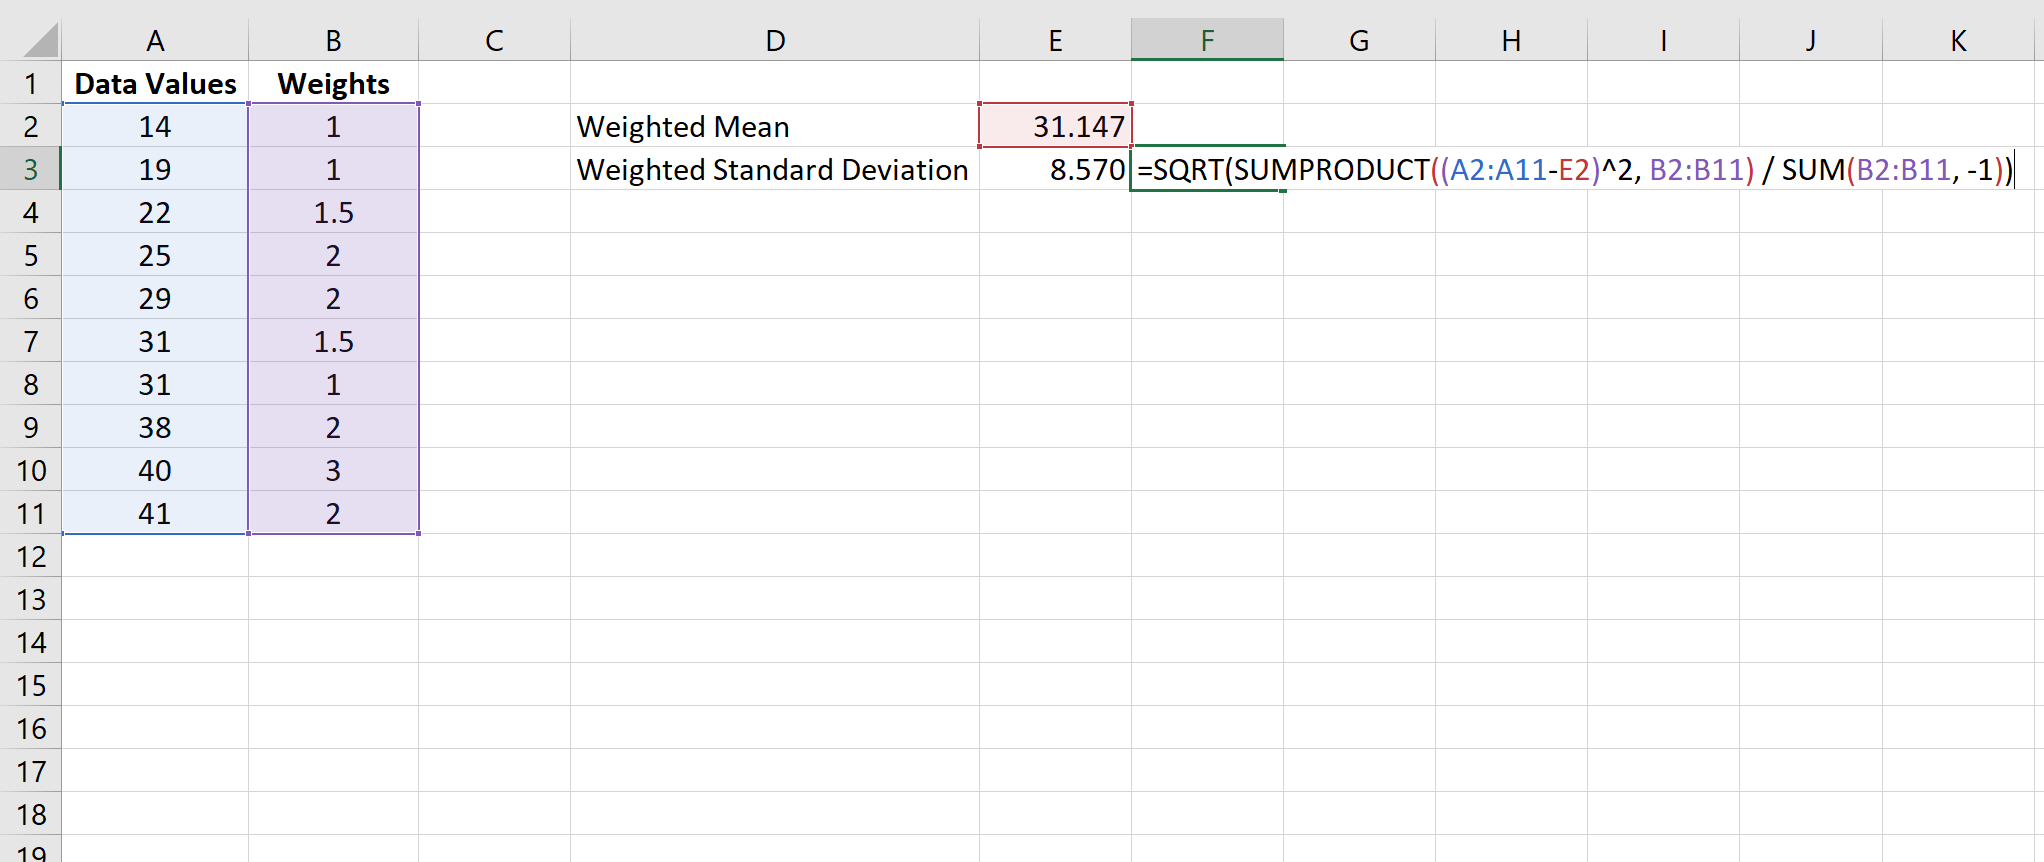
Décomposons méticuleusement l’exécution arithmétique sous-jacente menée par le moteur du tableur :
$$s_w^2 = \frac{1358,690718}{19,5 – 1} = \frac{1358,690718}{18,5} \approx 73,442741$$
$$s_w = \sqrt{73,442741} \approx 8,569874$$
L’exécution de la formule au sein de la cellule de synthèse assignée délivre la valeur finale standardisée de 8,570 (arrondie à trois décimales significatives). Sur le plan des vérifications arithmétiques internes, le terme situé sous le radical s’avère rigoureusement positif (73,4427), éliminant tout risque de génération de l’erreur #NOMBRE!, qui sanctionnerait l’extraction de la racine carrée d’un nombre négatif.
7.3 Interprétation contextuelle de la dispersion obtenue
L’aboutissement de cette procédure computationnelle conduit à l’énonciation d’un couple d’estimateurs statistiques fondamentaux caractérisant notre distribution cognitive pondérée : une moyenne centrale pivot de 31,147 points et un écart-type pondéré de 8,570 points. Dans l’hypothèse d’une distribution unimodale approximativement symétrique, cette métrique nous renseigne sur le fait qu’approximativement 68 % de la masse informationnelle de la population d’intérêt se concentre dans un intervalle compris entre 22,577 points ($31,147 – 8,570$) et 39,717 points ($31,147 + 8,570$).
Il s’avère particulièrement éclairant de confronter directement ce résultat à l’écart-type non pondéré calculé sur les mêmes scores bruts de la colonne A. L’application de la fonction standard d’Excel =ECARTYPE.STANDARD(A2:A11) produit une valeur scalaire de 10,510 points. La comparaison méthodique des deux approches met en relief un contraste statistique majeur :
- Moyenne non pondérée : 27,300 | Écart-type non pondéré : 10,510
- Moyenne pondérée : 31,147 | Écart-type pondéré : 8,570
Cette confrontation démontre sans ambiguïté que l’omission des poids fausse radicalement la perception de la réalité empirique. Dans notre échantillon, la prise en compte des coefficients de pondération a pour effet de translater la moyenne vers le haut tout en resserrant substantiellement l’estimation de la variabilité interindividuelle (l’écart-type chutant de 10,510 à 8,570, soit une réduction de dispersion de près de 18,5 %). Les observations extrêmes basses (telles que le Sujet 9 affichant un score de 15), qui tiraient artificiellement la dispersion vers le haut dans le modèle classique, se voient attribuer un poids modeste (0,5), atténuant drastiquement leur impact distorsif sur la variance globale du groupe.
8. Dérivation et interprétation de la variance pondérée
8.1 Calcul direct de la variance pondérée de l’échantillon
Bien que l’écart-type soit l’indicateur privilégié pour la restitution descriptive des résultats en raison de son homogénéité dimensionnelle avec la variable mesurée, la variance pondérée constitue la grandeur fondamentale requise pour la modélisation mathématique avancée. L’estimation directe de la variance pondérée s’obtient simplement en omettant l’opérateur de racine carrée dans la formule assemblée précédemment. Dans la cellule de résultat de variance, l’analyste formalise :
=SOMMEPROD((A2:A11 - E2)^2; B2:B11) / (SOMME(B2:B11) - 1)
L’évaluation délivre la variance d’échantillon non biaisée de 73,443 points au carré. La variance pondérée s’avère une statistique indispensable dès lors que l’on s’engage dans des analyses de décomposition structurelle, telles que l’analyse de variance pondérée (ANOVA pondérée) ou la régression linéaire par les moindres carrés pondérés (WLS – Weighted Least Squares). Dans ces cadres inférentiels, la variance présente des propriétés mathématiques de linéarité et d’additivité que ne possède pas l’écart-type, autorisant le partitionnement rigoureux des sommes de carrés entre différentes sources de variabilité systématique et résiduelle.
8.2 Propriétés d’additivité et décomposition des sources de variabilité
Sur le plan théorique, la variance pondérée d’une distribution partitionnée en plusieurs strates disjointes obéit rigoureusement au théorème de Huygens appliqué aux mesures discrètes. La variance pondérée globale se décompose de manière univoque en deux composantes additives mutuellement orthogonales : la moyenne pondérée des variances internes à chaque groupe (la variance intra-groupe ou within-group variance) et la variance pondérée des moyennes de chaque groupe par rapport au barycentre général (la variance inter-groupe ou between-group variance).
Cette propriété de décomposition de Huygens s’exprime analytiquement selon l’identité fondamentale :
$$\sigma_{w,\text{total}}^2 = \sigma_{w,\text{intra}}^2 + \sigma_{w,\text{inter}}^2$$
Dans l’ingénierie des échelles d’évaluation et la validation psychométrique des tests, cette formulation pondérée de la décomposition de la variance constitue le socle mathématique indispensable à l’estimation des coefficients de fidélité et de consistance interne, tels que le coefficient alpha de Cronbach généralisé ou l’oméga de McDonald pour scores composites pondérés. Si les items d’un test présentent des variances d’erreur dissemblables, seule la variance pondérée permet d’isoler avec exactitude la part de variance attribuable au trait latent pur par rapport au bruit de mesure aléatoire.
9. Approches alternatives et formules matricielles directes dans Excel
9.1 Formule condensée ‘en une seule cellule’ sans cellule de moyenne
Dans de nombreuses applications d’ingénierie financière ou lors de la compilation de tableaux de bord décisionnels denses, l’exigence d’autonomie des formules interdit le recours à des cellules auxiliaires comme la cellule E2 hébergeant le barycentre. L’analyste est alors amené à encapsuler l’intégralité du calcul – dérivation du barycentre, calcul des écarts quadratiques, pondération, ajustement des degrés de liberté et extraction de la racine carrée – au sein d’une formule matricielle unifiée occupant une cellule unique et isolée.
Cette condensation algorithmique s’opère par substitution textuelle directe de la référence E2 par l’expression de la moyenne pondérée. La formule autoportante résultante se déploie selon la syntaxe suivante :
=RACINE(SOMMEPROD((A2:A11 - (SOMMEPROD(A2:A11; B2:B11) / SOMME(B2:B11)))^2; B2:B11) / (SOMME(B2:B11) - 1))
Sur le plan computationnel, cette formule délivre un résultat rigoureusement identique de 8,570. Cependant, cette compacité présente un coût algorithmique sous-jacent : le sous-ensemble SOMMEPROD(A2:A11; B2:B11) / SOMME(B2:B11) est recalculé virtuellement pour chaque élément du vecteur dans les versions patrimoniales d’Excel si l’optimiseur de requêtes ne met pas en cache l’expression scalaire invariante. Bien que cet impact soit négligeable sur une matrice de 10 lignes, il peut dégrader sensiblement la latence de rafraîchissement d’un classeur manipulant des dizaines de milliers de lignes.
9.2 Utilisation des fonctions matricielles modernes (LET et LAMBDA)
Pour concilier l’autonomie d’une formule unique en cellule fermée et l’efficacité de calcul sans redondance, les versions modernes de Microsoft Excel (Microsoft 365 et Office 2021) introduisent un paradigme de programmation fonctionnelle révolutionnaire matérialisé par les fonctions LET et LAMBDA. La fonction LET permet d’assigner des noms intermédiaires à des calculs partiels ou à des plages de données directement au sein de la formule, évitant tout recalcul redondant tout en clarifiant considérablement l’architecture du code.
L’implémentation de l’écart-type pondéré via la fonction LET se structure selon l’architecture modulaire suivante :
=LET(

  x; A2:A11;

  w; B2:B11;

  sw; SOMME(w);

  moy_w; SOMMEPROD(x; w) / sw;

  ss_w; SOMMEPROD((x - moy_w)^2; w);

  RACINE(ss_w / (sw - 1))

)
Cette écriture apporte une lisibilité conceptuelle comparable à celle des langages de script scientifiques de haut niveau (Python ou R). Les variables x et w isolent les plages sources, la masse totale sw est évaluée une unique fois, le barycentre moy_w est instancié en mémoire vive, et la somme des déviations pondérées ss_w est normalisée avant application de la racine carrée finale.
Pour franchir un degré supplémentaire d’abstraction et mettre à disposition de tous les utilisateurs du classeur une fonction native réutilisable à volonté sur n’importe quelle plage, l’analyste peut recourir à la fonction LAMBDA. Dans le Gestionnaire de noms d’Excel (accessible via le ruban « Formules » > « Gestionnaire de noms »), on crée une nouvelle entité nommée ECARTYPE.PONDERE définie par l’expression suivante :
=LAMBDA(valeurs; poids; LET(x; valeurs; w; poids; sw; SOMME(w); moy_w; SOMMEPROD(x; w)/sw; ss_w; SOMMEPROD((x - moy_w)^2; w); RACINE(ss_w / (sw - 1))))
Une fois cette fonction personnalisée enregistrée dans le classeur hôte, son appel dans la grille de calcul devient d’une simplicité absolue, masquant totalement la complexité algorithmique sous-jacente :
=ECARTYPE.PONDERE(A2:A11; B2:B11)
9.3 Calculs matriciels historiques (Ctrl+Maj+Entrée)
Dans un contexte d’interopérabilité avec des infrastructures informatiques exploitant d’anciennes versions d’Excel (notamment Excel 2010, 2013 ou 2016 sans souscription cloud), l’usage de LET ou de LAMBDA provoque inévitablement l’erreur critique #NOM?. Sur ces systèmes patrimoniaux, l’analyste est contraint de mobiliser l’ancien moteur matriciel CSE (Control + Shift + Enter).
Au lieu de s’appuyer sur SOMMEPROD, il est possible d’exploiter la fonction élémentaire SOMME encapsulant des opérations algébriques matricielles directes. La syntaxe sous moteur hérité prend la forme suivante :
=RACINE(SOMME(B2:B11 * (A2:A11 - (SOMME(A2:A11 * B2:B11) / SOMME(B2:B11)))^2) / (SOMME(B2:B11) - 1))
Lors de la saisie de cette formule dans les versions antérieures à 2019, la validation par simple pression de la touche Entrée génère un résultat faux ou une erreur scalaire. L’opérateur doit impérativement valider l’expression en pressant simultanément les touches Ctrl + Maj + Entrée. Cette manipulation a pour effet visuel d’entourer la formule d’accolades graphiques automatiques {...} au sein de la barre de formule, signalant que le moteur exécute un balayage matriciel sur les vecteurs d’arguments.
Le talon d’Achille majeur de cette approche réside dans sa fragilité structurelle : toute modification accidentelle d’une cellule par un collaborateur validant par simple Entrée détruit les accolades matricielles, invalidant instantanément le calcul sans émettre nécessairement d’alerte visuelle flagrante. C’est précisément pour juguler ce risque opérationnel que la formulation fondée sur SOMMEPROD, auto-matricielle par conception, demeure la recommandation de référence pour garantir une compatibilité descendante totale sans le risque d’invalidation CSE.
10. Gestion des cas complexes et des pièges méthodologiques
10.1 Traitement rigoureux des poids non entiers et normalisés
L’un des pièges statistiques les plus dévastateurs et les plus répandus en analyse d’enquêtes concerne l’utilisation aveugle de la formule de Bessel (SOMME(w) - 1) sur des coefficients de pondération continus qui ont été préalablement normalisés. Considérons un cas clinique ou sociologique typique où des poids de sondage probabilistes ont été divisés par leur somme de sorte que la somme totale des poids soit rigoureusement égale à 1 (normalisation stochastique unitaire) :
$$\sum_{i=1}^{n} w_i = 1$$
Si l’analyste injecte ces poids normalisés dans la formule d’échantillon classique, le dénominateur devient :
$$D = \left(\sum_{i=1}^{n} w_i\right) – 1 = 1 – 1 = 0$$
L’algorithme tente d’exécuter une division par zéro, sanctionnée instantanément par l’erreur fatale #DIV/0! sous Excel. Plus subtilement, si les poids sont normalisés de façon à ce que leur somme soit égale à un nombre arbitrairement faible ou si des poids d’enquête continus somment à l’effectif réel n mais présentent une forte variance interne, la soustraction d’une unité induit une correction de Bessel excessive ou erratique, faussant radicalement l’inférence.
Pour traiter méthodologiquement ce scénario en présence de poids d’échantillonnage ou de calage, il est impératif d’intégrer le calcul de la taille effective d’échantillon de Kish (Kish’s effective sample size), notée neff. La formulation de Leslie Kish détermine le nombre réel d’observations non corrélées équivalentes que véhicule l’échantillon pondéré :
$$n_{eff} = \frac{\left(\sum_{i=1}^{n} w_i\right)^2}{\sum_{i=1}^{n} w_i^2}$$
Le facteur de correction sans biais correct à intégrer au diviseur de la variance pondérée s’exprime alors selon le ratio $(n_{eff} – 1) / n_{eff}$, multiplié par la somme des poids. Dans Excel, cette correction avancée s’implémente en remplaçant le diviseur naïf (SOMME(B2:B11) - 1) par l’expression vectorielle exacte suivante :
SOMME(B2:B11) - (SOMMEPROD(B2:B11; B2:B11) / SOMME(B2:B11))
Cette écriture garantit que, même si les poids sont multipliés par une constante scalaire quelconque ou normalisés pour sommer à 1, l’estimation de l’écart-type pondéré demeure mathématiquement invariante et parfaitement exacte au sens de la théorie de l’échantillonnage de Cochran et de Kish.
10.2 Présence de zéros, de valeurs négatives et de données aberrantes
L’intégrité des calculs statistiques sous Excel est hautement vulnérable aux pathologies de distribution des données sources. En ce qui concerne le vecteur des observations (colonne A), l’existence de valeurs négatives est parfaitement licite sur le plan mathématique, notamment dans le cadre d’échelles d’attitude psychométriques bipolaires centrées sur zéro (allant par exemple de -5 à +5) ou d’indices de performance différentiels. Le centrage par rapport au barycentre (A2 - E2) préserve rigoureusement la métrique des déviations, et l’élévation au carré garantit la positivité de la grandeur sous le radical.
En revanche, la présence de coefficients nuls dans la colonne des pondérations (colonne B) modifie la structure de l’échantillon. Une observation dont le poids est fixé à 0 est mécaniquement neutralisée : elle ne contribue ni au numérateur de la moyenne ni à la somme des carrés des écarts. Néanmoins, si l’on utilise un dénominateur naïf basé sur le comptage des lignes via la fonction NB(A2:A11) au lieu de la somme réelle des poids, les degrés de liberté seront artificiellement gonflés, conduisant à une sous-estimation de la variance. Tout poids nul doit être considéré comme une exclusion pure et simple de l’unité d’analyse.
Le défi le plus redoutable réside dans la gestion des données aberrantes (outliers) assorties d’un poids prépondérant. Dans une distribution pondérée, une valeur atypique située à plusieurs écarts-types de la moyenne combinée à un coefficient d’échantillonnage massif génère un effet de levier (high leverage point) susceptible de déstabiliser totalement les indicateurs. Pour assainir l’échantillon sans supprimer arbitrairement des observations, l’analyste peut mettre en œuvre une procédure de winsorisation pondérée.
La winsorisation consiste à remplacer les valeurs extrêmes situées au-delà d’un centile déterminé (par exemple le 5ème et le 95ème centile pondéré) par la valeur seuil correspondante. Bien que nativement complexe dans Excel, le repérage des observations à fort levier peut s’opérer en calculant pour chaque ligne la proportion de variance expliquée :
=E2 / SOMME($E$2:$E$11)
Toute observation concentrant à elle seule plus de 30 % à 40 % de la somme des écarts quadratiques globale doit faire l’objet d’un examen métrologique approfondi afin d’écarter une éventuelle erreur de saisie ou un artefact de mesure.
10.3 Audit et débogage des formules statistiques
L’évaluation rigoureuse d’un modèle statistique sous Excel implique la maîtrise des outils de diagnostic intégrés au tableur pour traquer et résoudre les anomalies computationnelles. L’instrument privilégié de cet audit est la fonctionnalité « Évaluer la formule », accessible sous l’onglet « Formules » du ruban principal. Cet outil d’inspection pas à pas permet de visualiser la résolution séquentielle de l’arbre syntaxique, visualisant le déploiement des vecteurs virtuels générés par SOMMEPROD en mémoire vive avant leur réduction scalaire.
L’apparition de codes d’erreur spécifiques doit orienter immédiatement le diagnostic vers la cause racine :
#VALEUR!: Signale un désalignement dimensionnel strict entre les plages de cellules (par exempleA2:A11combiné avecB2:B12), ou la présence accidentelle d’une chaîne textuelle au sein d’une plage censée n’héberger que des réels numériques.#NOMBRE!: Indique que le terme soumis à la fonctionRACINEest strictement négatif. Dans notre formulation, cet état ne peut théoriquement survenir que si des poids négatifs ont été intégrés ou si le dénominateurSOMME(w) - 1devient négatif (ce qui advient si la somme totale des poids est strictement inférieure à 1).#DIV/0!: Traduit l’annulation mathématique du dénominateur, causée par une somme de poids nulle ou par l’absence d’observations numériques dans la sélection.#REF!: Intervient suite à la suppression matérielle d’une colonne ou d’une cellule intermédiaire qui était explicitement référencée dans la structure algorithmique de la formule.
Pour parachever l’audit de conformité méthodologique, la procédure de validation croisée par équipondération constitue le test ultime : si l’on assigne artificiellement la valeur constante unitaire (1,00) à l’intégralité des cellules de pondération de la colonne B, l’écart-type pondéré obtenu doit converger au cent-millième près vers le résultat délivré par la fonction native non pondérée d’Excel =ECARTYPE.STANDARD(A2:A11). L’exactitude de cette égalité empirique atteste de la parfaite validité structurelle du modèle matriciel déployé.
11. Automatisation du calcul via VBA et les macros Excel
11.1 Création d’une fonction personnalisée UDF (User Defined Function)
Bien que les formules matricielles et la fonction moderne LAMBDA répondent à la majorité des exigences opérationnelles, l’intégration de fonctions statistiques au sein d’environnements d’entreprise complexes ou de classeurs distribués à des utilisateurs non experts justifie fréquemment le recours à Visual Basic for Applications (VBA). Le développement d’une fonction personnalisée (UDF – User Defined Function) permet d’encapsuler la logique de calcul au cœur du classeur, offrant une syntaxe d’appel native et masquant la complexité algorithmique.
Pour implémenter cette fonction statistique, l’analyste accède à l’éditeur VBE via la combinaison de touches Alt+F11, insère un module standard vierge (« Insertion » > « Module »), et transcrit rigoureusement le code VBA optimisé ci-après :
Function ECARTYPE_PONDERE_VBA(PlageValeurs As Range, PlagePoids As Range, Optional EstEchantillon As Boolean = True) As Variant

    Dim nVals As Long, nPoids As Long

    Dim i As Long

    Dim SommePoids As Double, SommeProdXY As Double

    Dim MoyennePonderee As Double

    Dim SommeCarresEcarts As Double

    Dim Denominateur As Double

    Dim arrVals() As Variant, arrPoids() As Variant


    nVals = PlageValeurs.Cells.Count

    nPoids = PlagePoids.Cells.Count


    If nVals <> nPoids Or nVals < 2 Then

        ECARTYPE_PONDERE_VBA = CVErr(xlErrValue)

        Exit Function

    End If


    arrVals = PlageValeurs.Value

    arrPoids = PlagePoids.Value


    SommePoids = 0#

    SommeProdXY = 0#


    For i = 1 To nVals

        If IsNumeric(arrVals(i, 1)) And IsNumeric(arrPoids(i, 1)) Then

            If arrPoids(i, 1) < 0 Then

                ECARTYPE_PONDERE_VBA = CVErr(xlErrNum)

                Exit Function

            End If

            SommePoids = SommePoids + CDbl(arrPoids(i, 1))

            SommeProdXY = SommeProdXY + (CDbl(arrVals(i, 1)) * CDbl(arrPoids(i, 1)))

        End If

    Next i


    If SommePoids <= 0# Then

        ECARTYPE_PONDERE_VBA = CVErr(xlErrDiv0)

        Exit Function

    End If


    MoyennePonderee = SommeProdXY / SommePoids

    SommeCarresEcarts = 0#


    For i = 1 To nVals

        If IsNumeric(arrVals(i, 1)) And IsNumeric(arrPoids(i, 1)) Then

            SommeCarresEcarts = SommeCarresEcarts + (CDbl(arrPoids(i, 1)) * ((CDbl(arrVals(i, 1)) - MoyennePonderee) ^ 2))

        End If

    Next i


    If EstEchantillon Then

        Denominateur = SommePoids - 1#

    Else

        Denominateur = SommePoids

    End If


    If Denominateur <= 0# Then

        ECARTYPE_PONDERE_VBA = CVErr(xlErrDiv0)

        Exit Function

    End If


    ECARTYPE_PONDERE_VBA = Sqr(SommeCarresEcarts / Denominateur)

End Function
Cette implémentation procède d’abord au transfert des plages Excel au sein de tableaux mémoires internes (arrays), une technique qui décuple la vitesse d’exécution en évitant des accès disques répétitifs à la feuille de calcul. Elle intègre un troisième paramètre optionnel boléen EstEchantillon, configuré par défaut sur VRAI, conférant à l’utilisateur la liberté de basculer instantanément sur l’écart-type pondéré de population en renseignant FAUX lors de l’appel.
11.2 Optimisation des performances et gestion des exceptions en VBA
L’algorithme VBA proposé intègre une gestion défensive intégrale des exceptions d’exécution. Les vérifications dimensionnelles préliminaires s’assurent que les deux plages soumises possèdent un nombre d’éléments rigoureusement congru ; dans l’éventualité d’une dissymétrie, la fonction renvoie l’erreur standard xlErrValue (se traduisant par #VALEUR! dans la cellule), interrompant immédiatement le traitement.
La boucle de calcul traite élégamment le cas des coefficients négatifs en renvoyant l’erreur d’incompatibilité de domaine xlErrNum (soit #NOMBRE!). De même, l’évaluation du dénominateur vérifie si la masse de pondération excède l’unité dans le cas d’un calcul d’échantillon ; si la condition n’est pas satisfaite, l’exception xlErrDiv0 est générée proprement, préservant l’intégrité globale du classeur hôte sans provoquer l’interruption brutale de l’environnement VBA.
Sur le plan des performances comparées, il importe toutefois de rappeler que le code VBA s’exécute dans un environnement interprété unithread. Par conséquent, pour des volumes d’observations massifs (dépassant 100 000 lignes), la fonction native compilée multithreadée SOMMEPROD demeure approximativement trois à quatre fois plus rapide que la boucle VBA équivalente. L’usage de l’UDF VBA est donc à réserver prioritairement aux architectures nécessitant une ergonomie d’utilisation simplifiée pour des utilisateurs tiers sur des volumes de données intermédiaires.
12. Extensions et analyses statistiques pondérées complémentaires
12.1 Calcul de l’erreur type de la moyenne pondérée
La dérivation de l’écart-type pondéré constitue le socle méthodologique nécessaire à l’évaluation de la précision d’échantillonnage du barycentre lui-même. Dans les protocoles d’investigation biomédicale ou psychométrique, l’estimateur ponctuel de la moyenne pondérée doit impérativement être escorté de son erreur-type (notée SEw pour Weighted Standard Error). Cette grandeur quantifie la fluctuation stochastique théorique de la moyenne pondérée d’un échantillon à un autre.
Dans un cadre de pondération probabiliste continu, l’erreur-type de la moyenne pondérée s’exprime comme le quotient entre l’écart-type pondéré d’échantillon et la racine carrée de la taille effective de l’échantillon au sens de Kish :
$$SE(\bar{x}_w) = \frac{s_w}{\sqrt{n_{eff}}} = \frac{s_w}{\sqrt{\frac{\left(\sum w_i\right)^2}{\sum w_i^2}}}$$
Dans notre modèle Excel, en supposant que l’écart-type pondéré d’échantillon (8,570) soit hébergé en E3, la formule transcrivant l’erreur-type s’implémente en associant SOMME et SOMMEPROD :
=E3 / RACINE((SOMME(B2:B11)^2) / SOMMEPROD(B2:B11; B2:B11))
L’obtention de cette erreur-type autorise la construction directe des intervalles de confiance à 95 % encadrant le barycentre de la population. En invoquant la distribution normale asymptotique (facteur critique de 1,96) ou la loi de Student via la fonction native LOI.STUDENT.INVERSE.N(0,05; DegresLiberte), l’analyste génère les bornes de confiance requises pour calibrer rigoureusement les barres d’erreur des représentations graphiques publiables sous Excel.
12.2 Calcul du coefficient de variation pondéré
Une limitation inhérente à l’écart-type pondéré réside dans sa dépendance absolue à l’échelle de mesure : un écart-type de 8,570 points sur une échelle cognitive bornée entre 0 et 50 n’a absolument pas la même portée métrologique qu’un écart-type de 8,570 milligrammes dans un dosage pharmacologique d’échelle millimolaire. Afin d’autoriser la comparaison de la dispersion relative entre des échelles psychométriques ou des instruments de métrologie hétérogènes, le recours au coefficient de variation pondéré (CVw) s’avère hautement judicieux.
Le coefficient de variation pondéré normalise la dispersion en rapportant l’écart-type pondéré directement à la moyenne pondérée de la variable étudiée, sous réserve que cette dernière soit strictement positive et mesurée sur une échelle de rapport :
$$CV_w = \frac{s_w}{\bar{x}_w}$$
Dans notre grille de modélisation, avec le barycentre (31,147) situé en E2 et l’écart-type pondéré (8,570) hébergé en E3, la syntaxe de détermination s’énonce avec une concision limpide :
=E3 / E2
Ce calcul délivre un ratio unitaire scalaire de 0,2751, qu’il convient de formater immédiatement en pourcentage via le format de cellule natif d’Excel pour afficher 27,51 %. Cette valeur standardisée indique que la dispersion intrinsèque des scores représente approximativement 27,5 % de la valeur moyenne du groupe. Ce ratio s’avère un indice fondamental pour diagnostiquer la fidélité comparative de plusieurs batteries d’évaluation psychologique concurrentes.
12.3 Indicateurs associés : MAPE pondéré et moyennes mobiles pondérées
L’exploitation des mécanismes vectoriels appliqués à la dispersion ouvre la voie à d’autres indicateurs avancés d’analyse prédictive. Dans la modélisation des séries temporelles et le contrôle prévisionnel, le calcul de la dispersion des erreurs de prévision recourt massivement au WMAPE (Weighted Mean Absolute Percentage Error). Contrairement au MAPE classique qui surpondère artificiellement les erreurs relatives commises sur des volumes anecdotiques, le WMAPE normalise la somme des erreurs absolues par le volume cumulé réel de la variable cible :
=SOMMEPROD(ABS(Reel - Prevision); Poids) / SOMMEPROD(Reel; Poids)
De même, l’analyse dynamique de séries longitudinales (telles que le suivi des scores d’anxiété d’une cohorte sur plusieurs mois) tire un profit substantiel des moyennes et variances mobiles pondérées. En substituant aux plages vectorielles fixes des références dynamiques décalées à l’aide de la fonction DECALER ou INDEX, l’analyste peut générer des fenêtres d’observation glissantes où les observations les plus récentes se voient attribuer des pondérations exponentiellement décroissantes (lissage exponentiel).
L’ensemble de ces méthodologies statistiques démontre avec force que la compréhension fine de la variance et de l’écart-type pondérés dépasse le strict cadre du calcul descriptif statique. En maîtrisant l’interaction subtile entre les propriétés mathématiques des estimateurs et la puissance matricielle de calcul de Microsoft Excel, l’analyste transforme un simple tableur bureautique en un laboratoire d’analyse statistique avancée capable de modéliser avec précision l’hétérogénéité et la complexité des données empiriques contemporaines.
Références
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Sampling+Techniques%2C+3rd+Edition-p-9780471162407
- Kish, L. (1965). Survey sampling. John Wiley & Sons. https://doi.org/10.1002/bimj.19680100122
- Microsoft Corporation. (2024). Fonction SOMMEPROD. Support Microsoft. https://support.microsoft.com/fr-fr/office/sommeprod-fonction-sommeprod-174fac74-ad89-45c0-a3cd-b1489413b7b9
- Microsoft Corporation. (2024). Fonction LET. Support Microsoft. https://support.microsoft.com/fr-fr/office/let-fonction-let-34842dd8-b92b-4d3f-b325-b44b99e89613
- Microsoft Corporation. (2024). Fonction LAMBDA. Support Microsoft. https://support.microsoft.com/fr-fr/office/lambda-fonction-lambda-bd212d27-1cd1-4321-a34a-ccbf254b8b67
- Pearson, K. (1895). Notes on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240-242. https://doi.org/10.1098/rspl.1895.0041
- Rao, J. N. K., & Scott, A. J. (1984). On chi-squared tests for multiway contingency tables with cell proportions estimated from survey data. The Annals of Statistics, 12(1), 46-60. https://doi.org/10.1214/aos/1176346391
- Särndal, C.-E., Swensson, B., & Wretman, J. (2003). Model assisted survey sampling. Springer Science & Business Media. https://doi.org/10.1007/978-1-4684-9289-7