
Le traitement informatique des séquences textuelles et symboliques constitue l’un des piliers fondamentaux de l’informatique moderne et de l’intelligence artificielle. Dès les prémices du calcul automatisé, la nécessité de quantifier le degré de divergence ou de similarité entre deux chaînes de caractères s’est imposée aux ingénieurs et aux mathématiciens. Qu’il s’agisse de corriger les erreurs de transmission sur des canaux de communication bruités, d’aligner des macromolécules biologiques ou de concevoir des interfaces capables de tolérer les fautes de frappe des utilisateurs, la question centrale demeure invariable : comment formaliser mathématiquement et calculer efficacement la divergence structurelle entre deux séquences discrètes ?
Parmi l’ensemble des métriques d’édition élaborées au cours du vingtième siècle, la distance de Levenshtein s’est érigée en référence absolue. Conçue à l’origine dans un cadre théorique lié à la théorie de l’information et aux codes correcteurs d’erreurs, cette mesure évalue le nombre minimal d’opérations élémentaires requises pour transformer une chaîne source en une chaîne cible. Sa simplicité conceptuelle dissimule une richesse combinatoire remarquable, dont la résolution naïve mène à une explosion exponentielle, mais dont l’optimisation par la programmation dynamique offre un exemple canonique d’élégance algorithmique. En linguistique computationnelle comme en science des données, elle constitue un composant fondamental des architectures de recherche floue, de déduplication d’entités et d’évaluation des systèmes de reconnaissance vocale.
Le langage Python, grâce à son écosystème scientifique étendu et à sa syntaxe expressive, représente l’environnement de prédilection pour explorer, implémenter et déployer cette métrique. Toutefois, le passage d’une compréhension théorique abstraite à une exploitation industrielle performante requiert une maîtrise approfondie des structures de données sous-jacentes, des mécanismes de compilation binaire et des arbitrages entre complexité temporelle et spatiale. Cet article propose une monographie exhaustive dédiée au calcul de la distance de Levenshtein en Python, guidant le lecteur des démonstrations mathématiques formelles jusqu’aux implémentations hautement optimisées en C et aux architectures d’indexation métrique à grande échelle.
1. Introduction théorique à la métrique de Levenshtein
1.1 Définition formelle de la distance d’édition
La distance d’édition trouve son ancrage historique fondamental dans les travaux pionniers du mathématicien soviétique Vladimir Levenshtein, qui publia en 1965 un article séminal consacré aux codes binaires capables de corriger des suppressions, des insertions et des inversions de symboles. Dans son acception contemporaine, la métrique de Levenshtein s’applique à tout alphabet fini et mesure le coût minimal pour métamorphoser une séquence de départ en une séquence d’arrivée par le biais d’une suite finie de transformations atomiques élémentaires.
La typologie standard de ces opérations repose sur trois transformations discrètes canoniques. Premièrement, l’insertion consiste à adjoindre un nouveau symbole en une position quelconque de la séquence. Deuxièmement, la suppression retranche un symbole existant, réduisant la longueur totale de la chaîne d’une unité. Troisièmement, la substitution remplace un caractère donné par un symbole distinct appartenant à l’alphabet de référence. Dans le modèle de Levenshtein classique, chacune de ces opérations est affectée d’un coût unitaire équivalent à un, bien que des généralisations autorisent des pondérations asymétriques ou spécifiques aux paires de caractères manipulées.
Formellement, si l’on considère un alphabet fini noté Sigma et deux mots finis u et v appartenant au monoïde libre généré par cet alphabet, la distance de Levenshtein entre u et v est définie comme la borne inférieure de la somme des coûts des opérations élémentaires composant une dérivation transformant u en v. Cette formulation distingue nettement la distance de Levenshtein d’autres métriques apparentées. Par exemple, la distance de Hamming n’admet que l’opération de substitution, ce qui restreint strictement son champ d’application aux chaînes de longueurs identiques. En revanche, l’indice de Jaro-Winkler privilégie les correspondances globales et les transpositions en accordant un poids déterminant aux préfixes communs, délaissant ainsi la rigueur combinatoire de la dérivation par opérations unitaires au profit d’une heuristique probabiliste adaptée aux noms de personnes.
1.2 Propriétés métriques de la distance de Levenshtein
Pour qu’une fonction de comparaison textuelle puisse prétendre au statut mathématique d’espace métrique au sens de Fréchet, elle doit impérativement satisfaire à quatre axiomes fondamentaux régissant la géométrie des ensembles abstraits. La fonction associant à tout couple de chaînes leur distance d’édition vérifie rigoureusement ces conditions, conférant à l’espace des chaînes de caractères une structure topologique robuste et exploitable pour l’indexation multidimensionnelle.
Le premier axiome est celui de la non-négativité : pour toute chaîne u et v, la distance est toujours supérieure ou égale à zéro, ce qui découle trivialement du fait que le coût de toute opération élémentaire est unitaire ou strictement positif. Le second axiome, l’identité des indiscernables, stipule que la distance entre u et v est rigoureusement nulle si et seulement si la chaîne u est strictement identique à la chaîne v. En effet, si les deux séquences sont identiques, la dérivation vide de coût zéro suffit ; à l’inverse, si elles diffèrent par au moins un caractère ou par leur longueur, aucune dérivation nulle ne peut combler cet écart sans exécuter au minimum une opération de coût positif.
Le troisième axiome est la symétrie, garantissant que la distance entre u et v équivaut à la distance entre v et u. Cette propriété découle du fait que chaque opération élémentaire possède une opération duale inverse de coût identique : toute insertion d’un caractère dans le sens direct correspond point par point à la suppression de ce même caractère dans le sens rétrograde, tandis que la substitution d’un caractère a par un caractère b s’inverse par la substitution de b par a. Enfin, l’inégalité triangulaire affirme que pour trois chaînes arbitraires u, v et w, la distance directe entre u et w ne peut excéder la somme de la distance entre u et v et de la distance entre v et w. La concaténation de la séquence minimale d’opérations menant de u à v avec celle reliant v à w constitue en elle-même un chemin valide reliant u à w, dont le coût global borne supérieurement le coût du chemin minimal optimal.
1.3 Domaines d’application en sciences computationnelles
L’universalité du formalisme séquentiel confère à la métrique de Levenshtein un spectre d’applications remarquablement vaste à travers l’ensemble des sciences computationnelles. En bio-informatique, l’alignement de séquences nucléotidiques d’acide désoxyribonucléique (ADN) et d’acides aminés au sein des protéines constitue une déclinaison directe de ce cadre théorique. Les mutations génétiques correspondent point par point aux opérations de Levenshtein : les insertions et délétions de bases azotées reflètent les variations structurales d’indels, tandis que les substitutions traduisent les mutations ponctuelles de type transition ou transversion. L’adaptation de cette métrique a donné naissance aux célèbres algorithmes de Needleman-Wunsch et de Smith-Waterman pour l’alignement global et local.
Dans le domaine du traitement automatique du langage naturel (TALN), la distance de Levenshtein demeure le noyau algorithmique central de la détection et de la correction des erreurs orthographiques, des moteurs d’autocomplétion prédictive et des systèmes de réconciliation d’entités nommées. Elle permet d’évaluer la proximité de surface entre une entrée utilisateur imparfaite et un lexique lemmatisé, résolvant avec aisance les coquilles typographiques générées par la saisie au clavier ou les artefacts issus de logiciels de reconnaissance optique de caractères (OCR).
Enfin, les systèmes modernes de reconnaissance automatique de la parole (ASR) et de synthèse vocale exploitent cette métrique sous la forme du taux d’erreur sur les mots (Word Error Rate ou WER). Dans ce paradigme, les symboles unitaires ne sont plus des caractères individuels mais des tokens lexicaux ou phonétiques complets. Calculer la distance d’édition entre la transcription générée par un modèle acoustique et la transcription humaine de référence permet de quantifier objectivement le taux de substitution, d’omission et d’insertion du réseau de neurones, fournissant un gradient d’évaluation standardisé pour l’industrie technologique.
2. Fondements mathématiques et programmation dynamique
2.1 La relation de récurrence de Wagner-Fischer
La résolution de la distance de Levenshtein repose sur le principe d’optimalité de Bellman, selon lequel une solution optimale à un problème global s’obtient par la composition de solutions optimales à ses sous-problèmes élémentaires. Robert Wagner et Michael Fischer ont formalisé en 1974 une relation de récurrence élégante permettant d’exprimer la distance entre deux préfixes de chaînes en fonction des distances calculées sur des sous-préfixes plus courts, établissant ainsi le pont mathématique vers la programmation dynamique.
Soient deux chaînes finies notées s de longueur m et t de longueur n. Désignons par D(i, j) la distance d’édition existant entre le préfixe de s formé par ses i premiers caractères et le préfixe de t constitué de ses j premiers caractères, où i varie de 0 à m et j varie de 0 à n. Les conditions aux limites s’imposent d’elles-mêmes : la transformation d’une chaîne vide en un préfixe de longueur j requiert exactement j opérations d’insertion, de sorte que D(0, j) = j pour tout j. Réciproquement, la réduction d’un préfixe de longueur i vers une chaîne vide nécessite i suppressions consécutives, imposant D(i, 0) = i pour tout i.
Pour des indices strictement positifs, le calcul de D(i, j) résulte d’un arbitrage entre trois transitions possibles issues des cellules adjacentes dans l’espace des préfixes. La première option correspond à la suppression du i-ième caractère de s, induisant un coût cumulé de D(i – 1, j) + 1. La deuxième correspond à l’insertion du j-ième caractère de t dans s, menant à une valeur de D(i, j – 1) + 1. La troisième option considère la mise en correspondance du i-ième caractère de s avec le j-ième caractère de t : si ces caractères sont identiques, aucun coût n’est encouru et la valeur est D(i – 1, j – 1) ; s’ils diffèrent, une opération de substitution de coût unitaire intervient, générant D(i – 1, j – 1) + 1. La relation générale se formalise donc par le minimum strict de ces trois alternatives.
2.2 Construction de la matrice d’alignement
L’opérationnalisation de la formule récursive s’effectue au moyen d’une grille matricielle bidimensionnelle de dimensions (m + 1) lignes par (n + 1) colonnes. L’indice de ligne i correspond à l’état d’avancement dans la chaîne source s, tandis que l’indice de colonne j reflète l’état de progression dans la chaîne cible t. La cellule initiale située en haut à gauche, d’indice (0, 0), reçoit la valeur 0, symbolisant deux chaînes vides congruentes.
Le remplissage de cette matrice s’exécute de manière déterministe, généralement ligne par ligne, de gauche à droite et de haut en bas. Chaque cellule (i, j) interroge ses trois voisines immédiates préalablement résolues : la cellule supérieure (i – 1, j), la cellule occidentale (i, j – 1) et la cellule diagonale nord-ouest (i – 1, j – 1). Ce mécanisme garantit que toutes les dépendances requises par l’équation de Bellman sont stabilisées avant d’évaluer le nœud courant. Une fois l’intégralité du tableau renseignée, la cellule inférieure droite, positionnée aux coordonnées (m, n), renferme la distance d’édition globale séparant la chaîne s de la chaîne t.
Au-delà de la simple obtention d’une valeur scalaire, cette matrice contient la mémoire complète de toutes les trajectoires de dérivation possibles. En initiant une procédure de rétro-ingénierie (backtracking) depuis la cellule (m, n) jusqu’à l’origine (0, 0), un algorithme peut reconstituer le chemin d’alignement optimal. Un déplacement horizontal vers la gauche traduit une insertion, une remontée verticale signale une suppression, et une translation diagonale reflète soit une conservation de caractère (si le coût marginal est nul), soit une substitution explicite. Lorsqu’il existe plusieurs chemins minimaux concurrents, cette exploration rétrospective met en lumière la multiplicité des scénarios d’édition équivalents.
2.3 Analyse de la complexité algorithmique
L’évaluation rigoureuse des performances théoriques de l’algorithme de Wagner-Fischer démontre une complexité temporelle asymptotique quadratique, notée en notation grand O sous la forme O(m * n), où m et n représentent les longueurs respectives des deux chaînes analysées. En effet, la matrice comporte exactement (m + 1) * (n + 1) cellules distinctes, et chaque étape de calcul n’exécute qu’un nombre fini et constant d’opérations arithmétiques et de comparaisons logiques (trois additions et une extraction de minimum parmi trois opérandes). Par conséquent, le temps de calcul croît proportionnellement au produit des longueurs des séquences.
Sur le plan spatial, l’allocation naïve d’une grille matricielle complète requiert la réservation d’un espace mémoire proportionnel à O(m * n) mots machine. Pour des chaînes courtes issues du langage naturel courant, telles que des lemmes comprenant de cinq à quinze caractères, cette empreinte mémoire demeure totalement insignifiante. Néanmoins, dès lors que l’on manipule des séquences génomiques comptant plusieurs dizaines de milliers de nucléotides ou des documents textuels volumineux, la saturation de la mémoire vive devient immédiate : une matrice de dimension 100 000 par 100 000 requiert l’instanciation de dix milliards d’entiers, représentant plusieurs dizaines de gigaoctets de mémoire tampon.
Ces contraintes structurelles fixent des limites théoriques et pratiques sévères lorsqu’il s’agit de traiter des corpus massifs ou de réaliser des comparaisons croisées à l’échelle du web. L’exécution de millions de comparaisons quadratiques impose soit une révision architecturale de l’empreinte spatiale de l’algorithme, soit l’application de techniques d’élagage heuristique ou de structures arborescentes spécialisées capables d’éviter le calcul exhaustif de paires manifestement divergentes.
3. Implémentation de l’algorithme en Python pur sans dépendance
3.1 Implémentation récursive naïve et ses limites
L’approche la plus directe pour traduire la relation de Wagner-Fischer en langage Python consiste à concevoir une fonction récursive reflétant scrupuleusement la définition mathématique formelle. Une telle fonction prend en arguments deux séquences ainsi que leurs longueurs respectives, traitant la chaîne vide comme cas de base terminal et appelant récursivement trois sous-instances correspondant à la suppression, à l’insertion et à la substitution.
Bien que cette implémentation brille par sa limpidité conceptuelle et sa conformité visuelle avec la récurrence théorique, elle s’avère catastrophique sur le plan computationnel. En l’absence de mécanisme de mémorisation des résultats intermédiaires, l’arbre des appels récursifs se déploie selon un facteur de branchement ternaire, engendrant une complexité temporelle exponentielle en O(3^(max(m, n))). Les mêmes préfixes sont recalculés un nombre incalculable de fois le long de branches d’appels distinctes mais redondantes.
Dès que la taille des mots dépasse une douzaine de caractères, le temps d’attente devient prohibitif pour un utilisateur humain, atteignant rapidement plusieurs secondes, voire plusieurs minutes. De surcroît, le moteur d’exécution standard CPython impose une profondeur maximale de récursion bornée par défaut à 1000 appels successifs via la configuration du système. L’évaluation de séquences longues déclenche inévitablement une levée d’exception fatale de type RecursionError, marquant l’inadéquation absolue de la récursion naïve pour tout usage pratique ou industriel.
3.2 Implémentation itérative avec programmation dynamique
Pour éliminer l’explosion combinatoire de la récursion naïve, l’implémentation standard en Python pur repose sur une structure matricielle itérative ascendante (bottom-up). On initialise une liste de listes en compréhension, où chaque élément matrice[i][j] stockera le coût minimal calculé pour les sous-chaînes correspondantes. La première ligne est peuplée par la séquence des entiers de 0 à n, et la première colonne par les entiers de 0 à m.
Le corps algorithmique s’articule autour de deux boucles itératives imbriquées. La boucle externe parcourt les indices i de 1 à m, tandis que la boucle interne fait progresser l’indice j de 1 à n. À chaque itération, un indicateur binaire de substitution évalue si le caractère courant de la première chaîne diffère de celui de la seconde. La valeur de la cellule est alors déterminée par l’appel à la fonction native d’extraction minimale sur les trois transformations possibles. Prenons l’exemple concret de la transformation du lemme « fête » vers le lemme « bête » :
- Initialisation : la grille de dimension 5 par 5 est configurée avec des bordures graduées de 0 à 4.
- Traitement de la première ligne active : la comparaison entre ‘f’ et ‘b’ engendre un coût de substitution de 1 en position (1, 1).
- Propagations subséquentes : les caractères suivants ‘ê’, ‘t’, ‘e’ étant rigoureusement identiques entre les deux mots, les cellules diagonales suivantes conservent ce coût unitaire sans lui ajouter de pénalité marginale.
- Résultat final : la cellule terminale (4, 4) contient la valeur 1, reflétant la substitution unique du ‘f’ initial par la lettre ‘b’.
Cette approche itérative stabilise la complexité temporelle à une échelle rigoureusement quadratique tout en exploitant les mécanismes d’itération rapide optimisés des listes Python.
3.3 Optimisation spatiale à deux lignes
L’observation attentive des dépendances matricielles révèle une propriété structurelle déterminante : pour évaluer les cellules d’une ligne i donnée, l’algorithme a uniquement besoin des valeurs appartenant à la ligne courante et de celles situées sur la ligne immédiatement précédente i – 1. Les lignes antérieures, situées au-delà de cet horizon direct, ne participent plus à aucune décision algorithmique ultérieure et constituent une charge mémoire superflue.
Il est donc parfaitement possible de réduire la consommation spatiale en remplaçant la matrice intégrale par deux vecteurs de taille n + 1. Le premier vecteur conserve l’état de la ligne précédente, tandis que le second agrège dynamiquement les calculs de la ligne courante. À l’issue de chaque itération de la boucle externe, le vecteur courant est copié ou réassigné pour devenir le vecteur précédent du cycle suivant. Cette refactorisation abaisse drastiquement l’empreinte spatiale d’un ordre O(m * n) vers un ordre linéaire O(n).
Pour optimiser encore davantage cette logique en Python, il convient d’identifier systématiquement la chaîne la plus courte entre les deux entrées et de la positionner en colonne. Ainsi, l’espace mémoire alloué dépend de la dimension O(min(m, n)). Cette amélioration permet d’exécuter des calculs de distance de Levenshtein sur des chaînes comptant des centaines de milliers de caractères sans risquer la moindre saturation de la mémoire vive de la machine hôte.
4. Installation et configuration de la bibliothèque python-Levenshtein
4.1 Architecture et compilation sous-jacente en C
Bien que l’implémentation en Python pur illustre parfaitement la mécanique conceptuelle de la programmation dynamique, les limitations intrinsèques de l’interpréteur CPython en matière d’exécution de boucles imbriquées se traduisent par une surcharge d’instructions non négligeable. Pour des applications de production nécessitant des millions de comparaisons par seconde, l’exploitation d’une bibliothèque compilée s’avère indispensable. Le paquet Levenshtein (anciennement python-Levenshtein) s’impose comme la référence historique de cet écosystème.
L’architecture interne de cette bibliothèque repose sur une extension écrite en langage C de bas niveau, interfacée directement avec les structures internes de l’API CPython. Les calculs matriciels s’effectuent sans aucune conversion intermédiaire d’objets Python lors des passages d’itérations, tirant parti de tableaux continus alloués directement sur la pile ou le tas du système d’exploitation. Cette proximité matérielle permet d’exploiter les registres vectoriels des processeurs contemporains et d’éliminer totalement le surcoût lié au typage dynamique et au comptage de références.
Au fil de son évolution technologique, le projet a été modernisé pour s’intégrer au moteur sous-jacent de RapidFuzz, bénéficiant d’optimisations matérielles exploitant les jeux d’instructions SIMD (Single Instruction, Multiple Data) tels que SSE4.2 et AVX2. Cette compilation avancée permet d’atteindre des débits de traitement plusieurs dizaines à plusieurs centaines de fois supérieurs à ceux du code interprété, tout en offrant une interface de programmation Python transparente et hautement ergonomique.
4.2 Procédure d’installation et résolution des dépendances
L’intégration du module au sein d’un environnement de développement Python s’effectue usuellement par l’intermédiaire du gestionnaire de paquets standard pip. Il est fortement recommandé d’opérer au sein d’un environnement virtuel isolé (créé via l’outil système standard venv) afin de prévenir tout conflit de versions entre les paquets de bas niveau de la machine hôte.
L’installation s’amorce par la commande standard ciblant le paquet moderne nommé Levenshtein. Sous les systèmes d’exploitation modernes, tels que Microsoft Windows, Apple macOS ou les distributions Linux courantes, l’installeur télécharge préférentiellement des archives binaires précompilées au format wheel. Ces distributions contiennent l’extension C déjà liée dynamiquement aux bibliothèques d’exécution de la plateforme, dispensant l’utilisateur final de posséder une chaîne d’outils de compilation sur son poste.
Dans l’éventualité où le système cible reposerait sur une architecture matérielle spécifique ou une distribution Linux minimale ne disposant pas de wheels précompilés, pip bascule automatiquement vers l’archive des sources. Cette étape requiert la présence préalable d’un compilateur C compatible (tel que GCC ou Clang sous Unix, ou Microsoft Visual C++ Build Tools sous Windows) et des en-têtes de développement Python (souvent distribués sous le paquet python3-dev). Une fois le processus achevé, l’intégrité de l’installation se valide immédiatement en exécutant une instruction d’importation dans l’interpréteur interactif afin de confirmer la disponibilité du module.
4.3 Interface de programmation et fonctions disponibles
L’interface de programmation fournie par la bibliothèque Levenshtein met à disposition un ensemble cohérent et spécialisé de métriques de comparaison séquentielle. La fonction cardinale du paquet est sans conteste la fonction de calcul direct de la distance brute, qui accepte deux chaînes textuelles en paramètres positionnels et renvoie un entier représentant le nombre minimal d’opérations d’édition nécessaires.
Parallèlement au calcul brut, le module intègre la fonction normalisée calculant un indice de similarité flottant compris entre zéro et un. Cette fonction pondère la distance brute par la somme des longueurs des deux opérandes, offrant un indicateur relatif insensible aux disparités d’échelles de taille entre chaînes hétérogènes. D’autres primitives algorithmiques spécialisées viennent enrichir la boîte à outils :
- La fonction calculant la distance de Hamming, dédiée aux séquences de longueur strictement équivalente, ignore les opérations d’insertion et de suppression pour ne considérer que les substitutions pures.
- La fonction d’indice de Jaro et son raffinement de Jaro-Winkler, particulièrement adaptée aux correspondances phonétiques et aux transpositions de lettres proches dans les noms propres.
- Des utilitaires d’extraction de séquences de modifications (opcodes), permettant de documenter précisément la liste ordonnée des suppressions, insertions et substitutions à opérer.
Cette exhaustivité fonctionnelle fait de la bibliothèque une solution polyvalente capable de s’adapter aux exigences variées des projets d’ingénierie linguistique.
5. Calcul de la distance entre deux chaînes simples
5.1 Exécution d’un cas nominal élémentaire
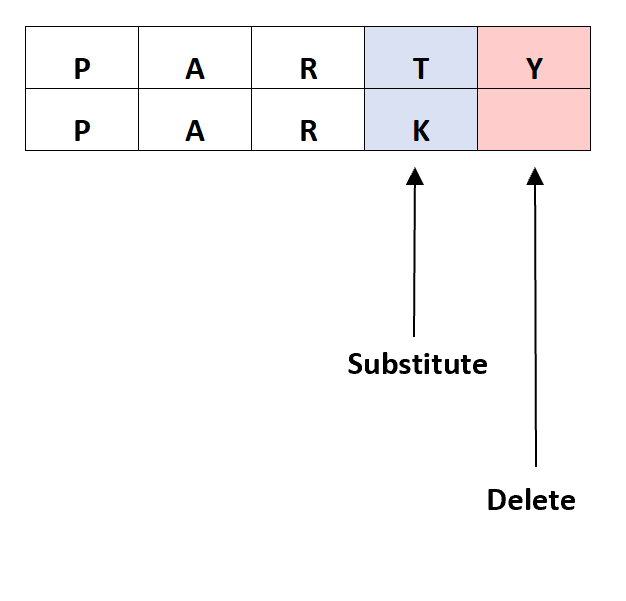
Pour illustrer la mise en œuvre pratique de la métrique, analysons le calcul de la distance d’édition séparant deux termes du lexique anglais présentant une proximité morphologique manifeste : la chaîne source « party » et la chaîne cible « park ». L’appel direct à la fonction de distance de la bibliothèque Levenshtein, ou à notre implémentation itérative personnalisée, renvoie une valeur entière égale à deux.
Cette valeur de deux ne relève pas d’une heuristique arbitraire mais découle rigoureusement de la décomposition minimale suivante :
- Les trois premiers caractères ‘p’, ‘a’, ‘r’ sont strictement identiques et ordonnés de manière congruente dans les deux mots, ce qui induit un coût de transformation cumulé nul sur ce préfixe initial.
- Le quatrième caractère de la chaîne source est la consonne ‘t’, tandis que la cible présente la consonne ‘k’. Une opération de substitution est ici déclenchée pour remplacer ‘t’ par ‘k’, portant le coût cumulé à un.
- Le cinquième et dernier caractère de la source est la lettre ‘y’, qui ne trouve aucun homologue dans la chaîne cible dont la taille est plus courte. Une opération de suppression de ce caractère terminal est donc requise, portant le total final à exactement deux opérations.
L’affichage de ce résultat en console permet aux praticiens de vérifier la justesse de leurs configurations logicielles et offre une illustration concrète de l’arbitrage opéré entre la modification interne d’un glyphe et l’ajustement structurel de la dimension de la séquence.
5.2 Traitement de la casse et des caractères spéciaux
Sur le plan computationnel strict, les algorithmes d’édition comparent des valeurs numériques correspondant aux points de code sous-jacents des symboles manipulés. Par conséquent, la métrique de Levenshtein est intrinsèquement sensible à la casse typographique. Si l’on confronte le terme « Python » avec son homologue en minuscules « python », l’algorithme ne perçoit aucune parenté sémantique : le caractère majuscule ‘P’ (point de code Unicode 80) est traité comme une entité radicalement dissemblable du caractère minuscule ‘p’ (point de code 112), générant une distance de un.
Pour la majorité des cas d’usage en traitement de texte ou en recherche documentaire, cette stricte différentiation typographique constitue un biais indésirable. La normalisation lexicale en amont du calcul s’avère donc impérative. L’application systématique de la méthode native de transformation en minuscules sur l’ensemble des entrées permet d’éliminer cette source d’erreur mécanique avant l’évaluation métrique.
Le traitement des signes de ponctuation, des tirets, des espaces insécables et des délimiteurs de mots obéit à la même rigueur. Dans un contexte de comparaison lexicale, la chaîne « arc-en-ciel » et sa variante sans tirets « arc en ciel » cumulent deux opérations de substitution dues à la discordance entre le tiret et l’espace. Selon les objectifs applicatifs poursuivis, il conviendra d’appliquer une phase de nettoyage par expressions régulières pour purger ou standardiser les séparateurs préalablement à l’évaluation d’édition.
5.3 Gestion des caractères accentués et codage Unicode
Le traitement des langues romanes, et tout particulièrement de la langue française, introduit une complexité supplémentaire majeure liée à la présence de caractères diacrités (accents aigus, graves, circonflexes, cédilles et trémas). En encodage standard Unicode UTF-8, un caractère accentué peut être représenté selon deux formes distinctes en mémoire : soit sous la forme d’un glyphe précomposé unique (forme canonique NFC), soit sous la forme d’une lettre de base combinée avec un point de code diacritique flottant autonome (forme décomposée NFD).
Si deux chaînes visuellement indiscernables à l’écran ont été instanciées selon des modes de normalisation Unicode divergents, l’algorithme de Levenshtein renverra une distance non nulle hautement perturbatrice. Pour immuniser le pipeline de calcul contre ces artefacts d’encodage, l’usage du module natif unicodedata est indispensable. La standardisation systématique des flux textuels sous la forme canonique NFC garantit l’homogénéité des représentations scalaires de chaque graphème.
Dans certaines applications spécifiques de recherche approximative, il est judicieux de neutraliser totalement l’impact des accents afin qu’une faute de frappe sur un « e » aigu ne pénalise pas excessivement le score de proximité. Une décomposition sous le format de normalisation NFKD suivie de l’extraction sélective des seuls caractères n’appartenant pas à la catégorie des marques diacritiques combinatoires permet de transformer « forêt » en « foret », ramenant le calcul à un alphabet latin fondamental sans altérer la cohérence interne du processus d’alignement.
6. Calcul de distances vectorisées et traitement de collections
6.1 Comparaison d’une chaîne cible à un vecteur lexical
Dans de multiples architectures logicielles, la problématique opérationnelle ne se limite pas à confronter deux termes isolés, mais consiste à identifier l’élément le plus proche d’une chaîne requête au sein d’un dictionnaire référentiel comprenant des dizaines ou des centaines de milliers de vocables. La technique de référence en Python pour amorcer ce traitement repose sur les compréhensions de listes ou les expressions génératrices optimisées.
En encapsulant l’appel de distance au sein d’une compréhension de liste, l’interpréteur exécute la boucle de comparaison à une vitesse supérieure à celle d’une boucle classique grâce aux optimisations de bas niveau de la machine virtuelle Python. Pour extraire le terme minimisant la métrique, on combine cette projection avec la fonction intégrée min en lui transmettant une fonction clé dédiée. Cette approche fonctionnelle évite la création de structures temporaires volumineuses et assure une syntaxe concise et lisible.
Cependant, lorsque le vecteur lexical atteint des proportions massives, comme le dictionnaire officiel d’une langue contenant plus de 300 000 entrées, la répétition linéaire séquentielle d’appels de distance d’édition induit une latence globale qui peut devenir perceptible. Il devient alors critique de mesurer rigoureusement les temps d’exécution à l’aide de chronomètres de précision et d’envisager des stratégies de filtrage liminaire par longueur de chaîne afin d’exclure instantanément les candidats dont la simple différence de longueur outrepasse déjà le seuil de tolérance visé.
6.2 Génération de matrices de distance inter-collections
Dans les travaux de linguistique computationnelle, de dialectométrie ou d’analyse typologique de corpus, il est fréquemment nécessaire d’évaluer la proximité globale existant entre deux ensembles distincts de mots. Cette opération prend la forme d’une matrice de distances croisées, où chaque cellule (p, q) contient la distance séparant le p-ième élément de la première collection du q-ième élément de la seconde.
Pour stocker et manipuler ces volumes d’informations de manière hautement efficiente, l’emploi de la bibliothèque scientifique NumPy est préconisé. L’allocation préalable d’un tableau bidimensionnel à base d’entiers non signés (par exemple de type uint16) optimise l’agencement contigu en mémoire vive et permet d’appliquer ultérieurement des opérations d’algèbre linéaire, des réductions statistiques ou des visualisations thermiques sans aucune réallocation.
Lorsque la collection est comparée à elle-même (matrice d’autodistance intra-collection), une propriété géométrique essentielle doit être exploitée : la symétrie de la métrique de Levenshtein. Sachant que la distance entre le mot u et le mot v est rigoureusement identique à celle entre v et u, et que la diagonale principale est exclusivement composée de zéros, il est inutile d’exécuter la totalité des N * N calculs. L’algorithme itère uniquement sur le triangle supérieur strict de la matrice, divisant ainsi par deux le nombre global d’opérations nécessaires avant de dupliquer les résultats symétriquement par transposition matricielle.
6.3 Intégration dans un flux de données pandas
L’ingénierie moderne des données repose massivement sur l’écosystème pandas pour nettoyer, structurer et réconcilier des ensembles tabulaires disparates. Le calcul de la distance de Levenshtein trouve naturellement sa place au sein de ces pipelines pour des tâches de déduplication d’enregistrements clients ou d’appariement flou d’adresses postales stockées dans des colonnes de DataFrame.
La méthode usuelle consiste à appliquer une fonction anonyme via la méthode apply sur les séries textuelles à confronter. Cette formulation vectorise logiquement l’exécution au niveau de l’interface utilisateur, bien que l’interpréteur continue en réalité de dérouler une boucle sous-jacente. Pour maximiser le débit, il est préférable d’invoquer directement les fonctions de l’extension C du module Levenshtein au travers d’une compréhension de liste zippée plutôt que de subir le surcoût d’encapsulation de la méthode apply de pandas.
Une fois les scores d’édition matérialisés dans une nouvelle colonne du tableau, des filtres de sélection booléens permettent de scinder instantanément les données en catégories étanches. On peut ainsi extraire automatiquement les doublons certains (distance nulle), isoler les variations orthographiques suspectes nécessitant une correction automatisée (distance de un ou deux), et rejeter les discordances structurelles profondes vers une file de validation humaine manuelle.
7. Normalisation de la métrique et calcul du ratio de similarité
7.1 Formule mathématique de normalisation
Bien que la distance absolue de Levenshtein fournisse un décompte rigoureux des opérations élémentaires requises, elle souffre d’un défaut interprétatif majeur : elle ne tient aucun compte de la taille globale des chaînes comparées. Une distance brute de 2 entre deux mots très courts de trois lettres (comme « car » et « bus ») signale une divergence structurelle quasi totale, tandis que cette même distance de 2 mesurée entre deux mots de quinze lettres (comme « anticonstitutionnel » et « anticonstitutionnels ») ne représente qu’une variation marginale négligeable.
Pour remédier à cette asymétrie d’échelle, il est nécessaire de transposer la distance absolue vers un indice de similarité relatif normalisé, confiné de manière déterministe au sein de l’intervalle réel fermé [0.0, 1.0]. La formulation standard adoptée dans la majorité des systèmes d’édition textuelle normalise la distance par la somme des longueurs des deux séquences. Soient s et t deux chaînes et d(s, t) leur distance d’édition, le ratio de similarité se définit classiquement par la formule mathématique :
Ratio(s, t) = (Longueur(s) + Longueur(t) – d(s, t)) / (Longueur(s) + Longueur(t))
Lorsque les deux chaînes sont strictement identiques, la distance est nulle et le ratio atteint sa valeur maximale théorique de 1.0, traduisant une congruence totale. À l’inverse, lorsque les deux séquences ne partagent aucun élément commun et nécessitent un remplacement intégral de leurs symboles, la distance équivaut à la longueur maximale et l’indice décroît vers zéro. Cette métrique relative s’interprète géométriquement comme le pourcentage d’alignement effectif préservé entre les deux séquences symboliques.
7.2 Usage pratique du ratio avec Levenshtein.ratio
L’utilisation pratique du ratio s’opère directement par l’appel à la fonction dédiée intégrée dans la bibliothèque Levenshtein. Cette routine optimise le calcul arithmétique sous-jacent au niveau du code C compilé, éliminant les erreurs d’arrondi à virgule flottante et délivrant des performances très élevées.
Analysons son comportement sur des exemples linguistiques contrastés :
- La comparaison des mots « maison » et « maisons » génère une distance absolue de 1 pour des longueurs de 6 et 7 caractères. Le ratio s’élève à (6 + 7 – 1) / (6 + 7) = 12 / 13, soit approximativement 0.923, reflétant une proximité morphologique très élevée.
- La comparaison des termes « chat » et « chien » induit une distance absolue de 3 pour des longueurs respectives de 4 et 5 lettres. Le ratio s’établit à (4 + 5 – 3) / (4 + 5) = 6 / 9 = 0.666, signalant une divergence bien plus prononcée.
Dans les applications de réconciliation d’entités textuelles ou d’épuration de bases de données, le choix du seuil de décision statistique (threshold) revêt une importance critique. L’expérience empirique démontre qu’un seuil fixé à 0.85 ou 0.90 permet de capturer la quasi-totalité des fautes de frappe d’inattention sans introduire de faux positifs perturbateurs entre mots de la même famille lexicale.
7.3 Évaluation comparative des indices dérivés
Le ratio standard de Levenshtein ne représente qu’une modalité de normalisation parmi un éventail plus large d’indices dérivés conçus pour répondre à des contraintes structurelles spécifiques. Il importe pour l’ingénieur en traitement du signal textuel de savoir discriminer ces différentes métriques selon la typologie des données manipulées.
L’indice de Jaro-Winkler, par exemple, introduit une modification substantielle de l’évaluation en appliquant un coefficient multiplicateur préférentiel lorsque les deux chaînes partagent un préfixe commun identique sur leurs quatre premiers caractères. Cette heuristique se justifie par le constat cognitif selon lequel les erreurs typographiques humaines surviennent très rarement sur l’amorce initiale des mots, mais se concentrent préférentiellement sur les terminaisons ou les suffixes. Dans le cadre de l’appariement de patronymes au sein de registres d’état civil, Jaro-Winkler s’avère souvent plus discriminant que le simple ratio de Levenshtein.
En contrepartie, si la distorsion résulte d’une inversion de mots au sein d’une chaîne complexe (comme « Jean Dupont » opposé à « Dupont Jean »), la distance de Levenshtein pure s’effondre et affiche un ratio de similarité médiocre, car elle ne dispose pas du concept de permutation de blocs. Dans un tel contexte documentaire, il convient de se tourner vers des variantes tokenisées, telles que le token sort ratio de RapidFuzz, qui segmente les chaînes en lexèmes individuels, les ordonne alphabétiquement, puis applique la distance de Levenshtein sur les représentations restructurées.
8. Applications en psycholinguistique et sciences cognitives
8.1 Modélisation de la densité de voisinage orthographique
En psycholinguistique expérimentale, l’étude de l’accès au lexique mental chez le locuteur humain mobilise intensément des métriques formelles d’édition. L’une des modélisations les plus influentes est celle du voisinage orthographique formalisée par Max Coltheart en 1977, usuellement désignée sous le symbole N. Par définition, le voisinage d’un mot au sens de Coltheart rassemble l’ensemble des lemmes d’un dictionnaire donné qui peuvent être formés en substituant une seule lettre à ce mot, tout en préservant strictement sa longueur globale.
Cette définition historique correspond rigoureusement à l’ensemble des termes situés à une distance de Hamming égale à un. Toutefois, la psycholinguistique cognitive contemporaine a largement étendu ce paradigme en adoptant la métrique de Levenshtein pour intégrer les voisins orthographiques dérivés non seulement par substitution, mais également par l’insertion ou la suppression d’un caractère unique (métrique de voisinage de Levenshtein, ou OLD20 pour Orthographic Levenshtein Distance sur les vingt plus proches voisins). Un lemme situé à une distance de Levenshtein de 1 partage une parenté perceptive immédiate avec la cible étudiée.
Sur le plan de l’architecture cognitive, les expériences chronométriques démontrent que la densité de ce voisinage exerce un effet inhibiteur ou facilitateur mesurable sur la vitesse de reconnaissance visuelle des mots. Un mot possédant une densité de voisinage extrêmement élevée (c’est-à-dire entouré d’une multitude de concurrents lexicaux situés à une distance d’édition de 1) déclenche une compétition lexicale plus intense au niveau des réseaux neuronaux corticaux, allongeant le temps nécessaire au sujet pour confirmer son identification lors des protocoles d’amorçage masqué.
8.2 Analyse computationnelle des erreurs de frappe (lapsus calami)
La production écrite sur des interfaces physiques ou tactiles contemporaines engendre des erreurs motrices systématiques connues sous la dénomination de lapsus calami ou fautes de saisie. Contrairement à des altérations purement aléatoires, la probabilité d’occurrence d’une substitution entre deux caractères n’est pas uniforme au sein de l’alphabet : elle est fonction directe de la proximité spatiale des touches sur l’agencement ergonomique du clavier utilisé (qu’il s’agisse d’un clavier AZERTY, QWERTY ou Dvorak).
L’implémentation de modèles computationnels cognitifs de la saisie textuelle exploite la métrique de Levenshtein en modifiant la matrice des coûts élémentaires de transformation. Au lieu d’assigner un coût forfaitaire invariable de 1 à toute substitution, l’algorithme pondère la pénalité par la distance euclidienne séparant les centres géométriques des touches cibles sur la disposition matérielle du clavier. Remplacer la lettre ‘a’ par la lettre ‘z’ sur une disposition AZERTY (touches contiguës) reçoit une pénalité marginale très faible, tandis que substituer ‘a’ par ‘p’ (situées aux extrémités opposées du clavier) se voit infliger une pénalité maximale.
Ce raffinement biomécanique permet de simuler fidèlement les défaillances de contrôle moteur et la cinématique dactylographique des utilisateurs. Dans les systèmes d’autocorrection pour terminaux mobiles, cette modélisation de Levenshtein pondérée spatialement améliore spectaculairement la précision des suggestions prédictives en recalibrant le coût d’édition sur la base des contraintes neuromotrices humaines.
8.3 Simulation expérimentale de tâches de décision lexicale
La tâche de décision lexicale représente un paradigme expérimental standard des neurosciences cognitives : elle consiste à présenter visuellement une chaîne de caractères à un participant humain, qui doit déterminer aussi rapidement et précisément que possible s’il s’agit d’un mot valide de sa langue maternelle ou d’un pseudo-mot dénué de signification (tel que « brateau »). La conception rigoureuse de ces protocoles exige la création de stimuli parfaitement étalonnés sur le plan structural.
L’algorithme de Levenshtein permet de concevoir des scripts d’extraction et de génération automatisées capables de forger des pseudo-mots contrôlés. Pour qu’un pseudo-mot soit expérimentalement valide, il doit mimer fidèlement la phonotaxe de la langue cible tout en se positionnant à une distance de Levenshtein strictement contrôlée du lexique authentique. En calibrant la distance d’édition minimale séparant le stimulus artificiel du mot légitime le plus proche à une valeur exacte de un ou deux, les chercheurs s’assurent que la difficulté perceptive demeure homogène à travers l’ensemble des essais expérimentaux.
En analysant conjointement les temps de réaction recueillis auprès des sujets humains et les distances de Levenshtein calculées vers l’ensemble du corpus lexical, les modèles de régression prédisent avec une acuité statistique remarquable les latences cognitives de décision. La métrique de Levenshtein s’affirme ainsi comme un instrument méthodologique central pour sonder l’organisation géométrique et la dynamique temporelle du lexique mental humain.
9. Systèmes de correction orthographique et recherche floue
9.1 Architecture d’un correcteur orthographique élémentaire
L’architecture fondamentale d’un correcteur orthographique contextuel repose historiquement sur le modèle probabiliste bayésien formalisé avec une remarquable clarté didactique par Peter Norvig. Ce dispositif combine deux composantes complémentaires : un modèle de langue a priori mesurant la probabilité d’apparition intrinsèque d’un mot donné dans le corpus textuel, et un modèle d’erreur acoustique ou graphique évaluant la plausibilité qu’un mot valide ait pu être déformé en la chaîne fautive observée.
Le calcul de la distance de Levenshtein intervient de manière centrale dans la phase de génération des hypothèses concurrentes. Face à un mot inconnu du lexique, le moteur procède à une exploration combinatoire pour instancier systématiquement l’ensemble des variantes orthographiques situées à une distance d’édition de 1 ou de 2 par rapport à la séquence erronée :
- Ensemble des suppressions possibles : exclusion séquentielle de chaque caractère composant l’entrée.
- Ensemble des transpositions possibles : inversion de chaque paire de lettres consécutives.
- Ensemble des substitutions possibles : permutation de chaque position avec chacune des lettres de l’alphabet.
- Ensemble des insertions possibles : intercalation de chaque symbole de l’alphabet à toutes les positions envisageables.
Ce vivier de candidats est ensuite filtré pour ne conserver que les formes attestées dans le vocabulaire de référence. La sélection du terme rectifié résulte alors de la maximisation de la probabilité a posteriori : l’algorithme privilégie le mot qui minimise la distance de Levenshtein tout en maximisant sa fréquence lexicale globale dans le corpus d’entraînement de la langue.
9.2 Algorithme d’appariement flou (Fuzzy String Matching)
L’appariement textuel flou transcende la simple correction ponctuelle pour résoudre la recherche de sous-chaînes approchées au sein de volumes documentaires non structurés. Lorsqu’un utilisateur formule une requête dans un moteur de recherche interne, les approximations typographiques, les variations de segmentation ou les fautes d’accord empêchent les algorithmes de recherche exacte (tels que Boyer-Moore ou Knuth-Morris-Pratt) de faire correspondre la requête avec le corpus.
Les bibliothèques contemporaines dédiées à l’appariement flou en Python, au premier rang desquelles figure RapidFuzz (héritière moderne et hautement optimisée du projet FuzzyWuzzy), intègrent la distance de Levenshtein au sein de modules de correspondance locale. L’algorithme glisse une fenêtre d’exploration le long du texte cible, calculant dynamiquement la distance d’édition entre la requête et les fragments contextuels afin de localiser la sous-séquence maximisant le score de similarité.
La puissance de ces mécanismes réside dans leur flexibilité d’évaluation : ils intègrent des modes partiels (partial ratio) qui permettent d’isoler une correspondance parfaite même si la chaîne requête est substantiellement plus courte que la chaîne documentaire englobante. Dans le cadre de l’ingénierie logicielle appliquée à la réconciliation de catalogues e-commerce, ces outils permettent de regrouper instantanément des descriptions d’articles rédigées selon des conventions divergentes avec un niveau de rappel statistique exceptionnel.
9.3 Intégration d’un arbre BK (Burkhard-Keller) en Python
L’obstacle majeur auquel se heurte l’usage intensif de la distance de Levenshtein sur des dictionnaires volumineux réside dans la complexité de l’exploration linéaire : confronter chaque requête à l’intégralité des N mots du lexique requiert O(N) calculs de distances coûteux. Pour briser ce verrou computationnel, Walter Burkhard et Robert Keller ont conçu en 1973 une structure de données arborescente révolutionnaire tirant parti direct des propriétés métriques : l’arbre BK (Burkhard-Keller tree).
L’arbre BK est un arbre métrique discret dont la construction exploite impérativement le respect de l’inégalité triangulaire par la distance de Levenshtein. Chaque nœud de l’arbre abrite un mot du dictionnaire, et ses branches descendantes sont étiquetées par les valeurs entières discrètes de distance le séparant de ses fils. Lors de l’insertion d’un nouveau mot dans la structure, on calcule sa distance avec la racine courante ; si une branche correspondant à cette valeur entière existe déjà, on descend récursivement le long de celle-ci, sinon on y greffe le nouveau mot comme feuille terminale.
L’intérêt spectaculaire de l’arbre BK se manifeste lors de la phase de requête : si l’on recherche tous les mots du dictionnaire distants d’au plus k opérations d’une chaîne requête q, et que la distance entre q et le nœud courant p vaut d, l’inégalité triangulaire démontre mathématiquement qu’aucun mot valide ne peut se trouver sur les sous-arbres dont les arêtes sont étiquetées par des valeurs extérieures à l’intervalle fermé [d – k, d + k]. Toutes les autres branches sont massivement élaguées sans nécessiter le moindre calcul d’édition. L’implémentation complète d’un arbre BK en Python permet ainsi d’accélérer les recherches de correction de plusieurs ordres de grandeur, transformant un balayage linéaire exhaustif en une descente sub-linéaire logarithmique hautement véloce.
10. Variantes algorithmiques : Damerau-Levenshtein et au-delà
10.1 La métrique de Damerau-Levenshtein et les transpositions
Bien que la distance de Levenshtein classique formalise avec élégance les trois opérations d’insertion, de suppression et de substitution, elle souffre d’un angle mort cognitif notable : elle ne possède pas d’opérateur élémentaire pour rendre compte de la transposition de deux caractères contigus. Dans le cadre de la frappe dactylographique, l’inversion involontaire de deux lettres adjacentes (par exemple écrire « chmeise » au lieu de « chemise ») représente pourtant l’une des erreurs motrices les plus récurrentes.
Sous la métrique de Levenshtein standard, la transformation de « ab » en « ba » exige deux opérations distinctes (la substitution de ‘a’ par ‘b’ suivie de la substitution de ‘b’ par ‘a’, ou alternativement une suppression suivie d’une insertion). En 1964, Frederick Damerau a postulé qu’une transposition de deux caractères adjacents devait être sanctionnée par un coût unitaire direct de un. La distance de Damerau-Levenshtein enrichit ainsi le paradigme de Wagner-Fischer en ajoutant une quatrième condition dans l’évaluation matricielle de la cellule (i, j) :
Si le caractère courant s[i] correspond au caractère précédent t[j – 1] et que le caractère précédent s[i – 1] correspond au caractère courant t[j], la valeur de la cellule peut être mise à jour par D(i – 2, j – 2) + 1. Cette transition fait intervenir une cellule située deux rangs en arrière sur la diagonale matricielle. Il convient de distinguer la variante restreinte (dite algorithme d’alignement optimal des chaînes, OSA) qui interdit d’appliquer plusieurs opérations sur une même sous-chaîne transposée, de la variante complète non restreinte dont la résolution algorithmique requiert la mémorisation des occurrences les plus récentes de chaque symbole de l’alphabet.
10.2 Calcul de l’alignement global via Needleman-Wunsch
Dans les sciences biologiques computationnelles, l’alignement global de macromolécules d’ADN ou de protéines s’appuie sur une formulation algorithmique conceptuellement jumelle de celle de Levenshtein, formalisée par Saul Needleman et Christian Wunsch en 1970. Cependant, alors que la distance de Levenshtein minimise une pénalité d’édition globale (distance de coût), l’algorithme de Needleman-Wunsch maximise un score global de similarité biologique.
La distinction opératoire majeure réside dans le traitement des insertions et des délétions, regroupées en bio-informatique sous le concept d’indels ou de pénalités de trou (gap penalties). Alors que Levenshtein pénalise chaque gap de manière strictement linéaire par une constante unitaire, les modèles biologiques adoptent des systèmes de pénalités de trous affines, où l’ouverture d’une brèche (gap opening) se voit infliger un coût initial substantiel, tandis que son extension successive (gap extension) n’encourt qu’une pénalité marginale modérée, traduisant le fait que les réarrangements génétiques surviennent souvent par blocs de nucléotides groupés.
De surcroît, le coût de substitution de Needleman-Wunsch ne repose pas sur une simple distinction binaire égal/différent, mais consulte des matrices empiriques de substitution physico-chimique complexes, telles que les matrices BLOSUM ou PAM. Ces matrices quantifient la vraisemblance évolutive qu’un acide aminé soit remplacé par un autre en fonction de leurs propriétés biochimiques (polarité, volume stérique, hydrophobicité). L’implémentation en Python d’un tel aligneur s’articule autour de la même dynamique matricielle que Levenshtein, mais oriente ses conditions de transition vers la maximisation du score biologique.
10.3 Distances avec matrices de coûts personnalisées
L’adaptation de la distance de Levenshtein à des environnements métiers hautement spécialisés passe fréquemment par l’abandon du modèle de coût unitaire au profit de matrices de coûts hétérogènes et personnalisées. Dans ce schéma, le coût unitaire C(op, a, b) est rendu fonction explicite de la nature de l’opération op et de l’identité des caractères a et b mis en jeu.
Une application remarquable concerne l’ingénierie acoustique et la phonétique computationnelle. En transcrivant préalablement les mots textuels en représentations de l’Alphabet Phonétique International (API), on peut associer au calcul de Levenshtein une matrice de confusion phonétique issue d’enregistrements audio en milieu bruité. La substitution de deux voyelles ouvertes ou de deux consonnes fricatives proches (comme /s/ et /z/) se voit attribuer un coût marginal infinitésimal, tandis que la substitution d’une plosive occlusive par une voyelle nasale encourt un coût maximal dissuasif.
La mise en œuvre d’une telle logique en Python s’effectue en adaptant le script de programmation dynamique matricielle. Au sein de la double boucle itérative, les termes constants d’incrémentation + 1 sont remplacés par des lectures d’indices au sein d’un dictionnaire bidimensionnel de coûts ou d’une matrice NumPy préindexée. Cette plasticité algorithmique démontre la flexibilité architecturale de la programmation dynamique face aux exigences de précision contextuelle.
11. Analyse comparative des performances et benchmarking
11.1 Protocole expérimental de banc d’essai
L’évaluation rigoureuse de l’efficience computationnelle des diverses implémentations de la métrique de Levenshtein requiert l’établissement d’un protocole expérimental formel, reproductible et méthodologiquement étanche. Il s’agit de neutraliser les interférences matérielles et logicielles pour isoler la vitesse d’exécution intrinsèque de chaque moteur algorithmique.
Le protocole de référence mobilise le module standard timeit de Python, conçu spécifiquement pour exécuter un bloc d’instructions un grand nombre de fois consécutives et en dériver la médiane statistique des temps CPU. Pour prévenir les biais d’optimisation liés aux mécanismes de prédiction de branchement des microprocesseurs modernes, le corpus de banc d’essai doit alterner des couples de chaînes générées aléatoirement présentant des distributions de longueurs graduées : séquences courtes de 5 à 15 caractères (représentatives du lexique naturel), séquences intermédiaires de 50 à 100 caractères (phrases et descriptions) et séquences longues de 500 à 2000 caractères (documents ou séquences d’acides nucléiques).
Un facteur technique déterminant réside dans la neutralisation des pauses induites par le ramasse-miettes (garbage collector) de CPython. Durant la phase de mesure chronométrée, la collecte automatique des objets cycliques doit être temporairement suspendue via l’interface gc.disable() afin qu’un cycle d’épuration mémoire inopiné ne vienne pas fausser artificiellement la latence d’une itération d’essai.
11.2 Comparaison quantitative : Pur Python, C-Extension et Numba
La confrontation empirique des différentes approches met en lumière des écarts de vélocité spectaculaires, confirmant l’impact critique du choix de la pile technologique pour le calcul intensif :
- L’implémentation naïve récursive en Python pur s’effondre instantanément : pour des séquences excédant 12 caractères, la latence dépasse la seconde, et l’explosion combinatoire rend tout banc d’essai sur séquences moyennes physiquement impossible à finaliser.
- L’implémentation itérative avec programmation dynamique en Python pur matriciel stabilise l’exécution : pour deux chaînes de 100 caractères, le calcul requiert de l’ordre de 1 à 2 millisecondes par paire, ce qui correspond à un débit d’environ 500 à 1000 opérations par seconde sur un cœur processeur standard.
- L’approche compilée à la volée (JIT) via la bibliothèque Numba transforme radicalement le comportement du code Python pur. En décorant la fonction matricielle par l’attribut @njit, les boucles Python sont traduites en instructions machine natives optimisées via LLVM, abaissant la latence sous les 50 microsecondes et offrant un gain d’accélération d’un facteur 20 à 40 par rapport au code interprété.
- L’extension C hautement optimisée de la bibliothèque Levenshtein (ou RapidFuzz) surpasse l’ensemble des solutions concurrentes : exploitant les instructions vectorielles SIMD des processeurs, elle traite le même couple de chaînes en une fraction de microseconde, atteignant des cadences industrielles de plusieurs centaines de milliers à plusieurs millions de comparaisons par seconde.
Cette hiérarchie quantitative souligne que l’arbitrage entre l’écriture d’un code Python sans dépendance et l’incorporation d’une bibliothèque compilée en C dépend directement de la volumétrie globale du projet envisagé.
11.3 Scalabilité et parallélisation sur de grands volumes
Lorsque le volume d’opérations d’édition à exécuter atteint des dizaines de millions de couples, l’exécution séquentielle sur un cœur de calcul unique atteint ses limites physiques, quelle que soit l’efficience de l’extension C employée. Le passage à l’échelle requiert une stratégie de parallélisation matérielle sur des architectures multiprocesseurs.
En Python standard, l’existence du verrou global de l’interpréteur (Global Interpreter Lock ou GIL) empêche les threads natifs d’exécuter du bytecode Python simultanément sur plusieurs cœurs de processeur. Heureusement, la plupart des extensions C modernes dédiées au calcul intensif, à l’instar de RapidFuzz, ont la capacité de libérer explicitement le GIL durant la phase de calcul d’édition pure, autorisant ainsi une véritable parallélisation multithread au niveau du processeur.
Pour distribuer le traitement de collections volumineuses de données sous forme de flux autonomes, l’emploi du module standard multiprocessing ou de bibliothèques distribuées telles que joblib ou Dask représente la norme architecturale. La collection globale de chaînes est scindée en fragments contigus homogènes (chunks), chaque bloc étant alloué à un processus ouvrier indépendant exécuté sur un cœur dédié. Cette distribution sans partage d’état (embarrassingly parallel) permet d’obtenir un facteur d’accélération quasi linéaire proportionnel au nombre de cœurs physiques disponibles sur la machine hôte.
12. Bonnes pratiques, gestion des erreurs et synthèse méthodologique
12.1 Nettoyage et validation rigoureuse des données d’entrée
La robustesse logicielle d’un pipeline de traitement textuel repose en premier lieu sur la rigueur de la phase d’assainissement et de validation des données transmises à l’algorithme d’édition. Dans des flux de données réels, les entrées comportent fréquemment des anomalies structurelles : valeurs nulles, scalaires non textuels (entiers, flottants), représentations manquantes (NaN dans les DataFrames pandas) ou chaînes totalement vides.
Une fonction de calcul de distance industrielle doit impérativement intercepter ces cas pathologiques en amont de toute exécution matricielle :
- Vérification du typage : s’assurer que les deux paramètres sont rigoureusement des instances de chaînes de caractères (type str en Python 3), ou déclencher une conversion explicite contrôlée.
- Traitement des valeurs nulles : rejeter formellement les objets None par des levées d’exceptions explicites (telles que TypeError ou ValueError) pour éviter des comportements indéterminés dans les couches inférieures compilées.
- Filtrage préalable par la différence de longueurs : si l’écart absolu entre les longueurs des deux chaînes outrepasse déjà un seuil maximal toléré, il est totalement inutile d’exécuter l’algorithme de Levenshtein, car la distance d’édition est mathématiquement minorée par cette différence de taille. Cette vérification immédiate en temps O(1) épargne des millions de cycles de calcul superflus.
- Pré-filtrage par n-grammes de caractères : pour des corpus d’envergure, l’exigence d’un partage minimal de sous-chaînes communes de taille 2 ou 3 (bi-grammes ou tri-grammes) permet d’élaguer drastiquement le pool de candidats avant toute confrontation métrique détaillée.
12.2 Conception d’une architecture modulaire et maintenable
Afin de garantir la pérennité et la maintenabilité des applications d’entreprise intégrant le calcul de distance de Levenshtein, il est fortement déconseillé de disperser des appels directs à des fonctions tierces au sein du code applicatif métier. Il convient d’encapsuler la logique de mesure au sein d’une couche d’abstraction logicielle dédiée, conçue selon les principes fondamentaux de l’ingénierie orientée objet.
L’implémentation d’une classe de service ou d’un composant appliquant le patron de conception Stratégie (Strategy Pattern) offre une flexibilité architecturale supérieure. Ce composant peut intégrer un mécanisme de repli transparent (fallback) : le système tente préférentiellement d’importer et d’exploiter le moteur compilé C de Levenshtein ou RapidFuzz pour maximiser le débit ; si cet environnement binaire n’est pas disponible sur la machine cible (par exemple dans un conteneur minimaliste dénué d’extensions compilées), le composant bascule de manière totalement invisible vers l’implémentation de secours itérative en Python pur optimisée à deux lignes.
De surcroît, le respect scrupuleux des normes de codage contemporaines formalisées par la PEP 484 impose l’adjonction systématique d’annotations de type (type hints) sur l’ensemble des interfaces de calcul. La documentation exhaustive des paramètres, des types retournés et des exceptions potentielles garantit une intégration harmonieuse avec les analyseurs statiques de code (tels que mypy) et fiabilise le déploiement au sein de systèmes d’intégration continue exigeants.
12.3 Synthèse comparative et recommandations pratiques
Pour conclure cette étude approfondie, il convient de synthétiser les critères décisionnels présidant au choix de la méthodologie de calcul de la distance de Levenshtein en Python selon la nature spécifique des projets envisagés :
- Pour les projets pédagogiques, académiques ou exploratoires visant à comprendre les mécanismes intimes de la programmation dynamique, l’implémentation itérative en Python pur à deux lignes représente le choix d’excellence, combinant élégance conceptuelle et totale indépendance vis-à-vis d’outils tiers.
- Pour les applications logicielles de production, les pipelines d’ingénierie de données sous pandas et les systèmes de recherche floue temps réel, l’adoption de bibliothèques binaires hautement optimisées en C comme Levenshtein ou RapidFuzz est une nécessité absolue pour des motifs d’efficience énergétique et de réduction de latence.
- Pour les corpus lexicaux massifs nécessitant des interrogations répétitives, la métrique brute doit impérativement être couplée à des structures d’indexation géométrique avancées, au premier rang desquelles trône l’arbre BK (Burkhard-Keller), sous peine de voir les temps de calcul dériver au-delà des tolérances acceptables.
Enfin, dans le paysage actuel de l’intelligence artificielle marqué par l’hégémonie des modèles de langage neuronaux et des représentations sémantiques denses (embeddings vectoriels calculés par Transformeurs), il importe de conserver une juste appréciation du rôle de la distance de Levenshtein. Si les modèles neuronaux excellent dans la capture des parentés de sens profondes et de la synonymie contextuelle, ils s’avèrent totalement inaptes et démesurément coûteux pour repérer une inversion de deux lettres ou une coquille dans un numéro de série. La distance de Levenshtein demeure, par sa rigueur déterministe, sa frugalité computationnelle et son socle mathématique inaltérable, l’une des armes les plus précieuses et indispensables de l’arsenal informatique moderne.
Références
- Burkhard, W. A., & Keller, R. M. (1973). Some approaches to best-match file searching. Communications of the ACM, 16(4), 230–236. https://doi.org/10.1145/362003.362025
- Coltheart, M., Davelaar, E., Jonasson, J. T., & Besner, D. (1977). Access to the internal lexicon. In S. Dornic (Ed.), Attention and Performance VI (pp. 535–555). Lawrence Erlbaum Associates.
- Damerau, F. J. (1964). A technique for computer detection and correction of spelling errors. Communications of the ACM, 7(3), 171–176. https://doi.org/10.1145/363958.363994
- Levenshtein, V. I. (1966). Binary codes capable of correcting deletions, insertions, and reversals. Soviet Physics Doklady, 10(8), 707–710.
- Needleman, S. B., & Wunsch, C. D. (1970). A general method applicable to the search for similarities in the amino acid sequence of two proteins. Journal of Molecular Biology, 48(3), 443–453. https://doi.org/10.1016/0022-2836(70)90057-4
- Norvig, P. (2007). How to Write a Spelling Corrector. https://norvig.com/spell-correct.html
- Wagner, R. A., & Fischer, M. J. (1974). The string-to-string correction problem. Journal of the ACM, 21(1), 168–173. https://doi.org/10.1145/321796.321811
- Yujian, L., & Bo, L. (2007). A normalized Levenshtein metric. IEEE Transactions on Pattern Analysis and Machine Intelligence, 29(6), 1091–1095. https://doi.org/10.1109/TPAMI.2007.1078