
Dans le champ contemporain de la recherche en psychologie et en sciences comportementales, l’analyse rigoureuse des relations entre construits théoriques constitue le fondement de la validation empirique. Si le coefficient de corrélation produit-moment de Pearson demeure l’outil d’association le plus couramment mobilisé, sa validité repose sur des postulats distributionnels stricts, notamment la normalité bivariée et la stricte linéarité des relations à l’échelle d’intervalle. Or, la réalité de la mesure psychologique confronte systématiquement les chercheurs à des données ordinales, issues par exemple d’inventaires d’évaluation clinique, d’échelles de Likert ou de classements hiérarchiques, ainsi qu’à des distributions asymétriques marquées par la présence d’observations extrêmes. Face à ces configurations empiriques, le coefficient de corrélation de rang de Spearman s’impose comme une alternative statistique non paramétrique incontournable, garantissant une estimation robuste et non biaisée de la monotonie des relations.
L’essor des outils infonuagiques collaboratifs a profondément transformé les pratiques computationnelles dans les laboratoires de recherche et les structures d’enseignement supérieur. Parmi ces solutions technologiques, Google Sheets s’est affirmé comme une plateforme d’analyse accessible, puissante et hautement collaborative, capable d’exécuter des analyses statistiques intermédiaires avec une rigueur équivalente à celle des logiciels propriétaires traditionnels. Cependant, l’implémentation adéquate du rhô de Spearman au sein d’un tableur requiert une compréhension intime de ses fondements mathématiques, de la manipulation des rangs, de la gestion des ex æquo et des tests d’inférence associés. Une démarche approximative expose l’analyste à des distorsions méthodologiques sévères, compromettant la reproductibilité et la validité des inférences tirées.
Le présent guide a pour vocation de fournir un cadre théorique et pratique exhaustif destiné aux chercheurs, psychomètres, cliniciens et étudiants avancés souhaitant maîtriser le calcul, l’interprétation et la communication de la corrélation de rang de Spearman dans Google Sheets. De la dérivation algébrique fondamentale aux procédures de modélisation dynamique par formules matricielles, en passant par le diagnostic graphique et la mise en conformité avec les normes de publication de l’American Psychological Association (APA 7e édition), chaque étape est disséquée avec une précision académique intégrale afin d’allier rigueur méthodologique et efficacité computationnelle.
1. 1. Fondements théoriques de la corrélation de rang de Spearman en recherche psychologique
1.1 Définition conceptuelle et origine mathématique du rhô de Spearman
Développé au tout début du XXe siècle par le psychologue et statisticien britannique Charles Spearman, le coefficient de corrélation de rang, universellement désigné par la lettre grecque rhô (ρ) ou par la notation indicée rs, a été conçu originellement pour répondre aux défis posés par la mesure des aptitudes intellectuelles et des traits psychologiques latents. Spearman cherchait à formaliser l’association entre des grandeurs qui ne pouvaient être quantifiées sur une échelle d’intervalle continue classique, mais qui permettaient néanmoins une hiérarchisation univoque des sujets observés. En rupture avec la vision purement paramétrique promue à la même époque par Karl Pearson, cette avancée a posé les jalons de l’analyse ordinale au sein de la psychométrie naissante.
Sur le plan fondamental, le coefficient de Spearman constitue une mesure non paramétrique d’association statistique. Cela signifie qu’il ne requiert aucune hypothèse préalable relative aux paramètres de la population parente, tels que l’espérance mathématique ou la variance, ni la conformité des données à une loi normale bivariée. Alors que le coefficient de Pearson évalue exclusivement le degré de covariation linéaire entre deux variables continues — mesurant à quel point les points d’un diagramme de dispersion s’alignent le long d’une droite d’équation canonique —, le rhô de Spearman évalue la force et le sens d’une relation monotone. Une relation est dite strictement monotone si, lorsque l’une des variables croît, l’autre variable croît de manière continue (monotonie croissante) ou décroît de manière continue (monotonie décroissante), sans que le taux de changement n’ait l’obligation d’être constant ou proportionnel.
L’architecture mathématique originale proposée par Spearman repose sur l’analyse des écarts relatifs constatés entre les classements des individus sur deux dimensions distinctes. Lorsque les rangs sont parfaitement concordants — c’est-à-dire que le premier participant sur la variable X est également le premier sur la variable Y, et ainsi de suite jusqu’au dernier —, la somme des écarts quadratiques entre les rangs attribués est rigoureusement nulle. À l’inverse, en cas de discordance parfaite, cette somme quadratique atteint sa valeur plafond théorique. En normalisant cette grandeur arithmétique par rapport à la variance attendue d’une permutation discrète de rangs allant de 1 à N, la formulation classique de Spearman s’établit algébriquement comme suit :
rs = 1 – [ (6 × ∑ di2) / (N × (N2 – 1)) ]
Dans cette expression fondamentale, di représente la différence arithmétique entre le rang assigné au sujet i sur la variable X et le rang assigné à ce même sujet sur la variable Y (soit di = Rang(Xi) – Rang(Yi)), tandis que N correspond au nombre total de paires d’observations appariées. Cette dérivation élégante permet d’indexer l’association ordinale au sein de l’intervalle canonique clos [-1,00 ; +1,00], garantissant une comparabilité universelle des indices de taille d’effet à travers les contextes expérimentaux.
1.2 Pertinence et applications empiriques en sciences comportementales
L’utilisation du rhô de Spearman s’avère particulièrement cruciale au sein des protocoles empiriques en psychologie cognitive, clinique, sociale et différentielle. Le matériau brut des sciences du comportement est fréquemment structuré autour de dispositifs de recueil psychométriques produisant des mesures d’ordre ordinal. C’est typiquement le cas des échelles de Likert à 4, 5 ou 7 points couramment exploitées dans les inventaires de personnalité, les questionnaires de bien-être subjectif ou les bilans d’épuisement professionnel. Traiter mathématiquement les scores discrets d’une échelle ordinale comme des grandeurs d’intervalles — en postulant abusivement que l’écart psychologique séparant les modalités « Tout à fait en désaccord » et « En désaccord » est rigoureusement égal à celui séparant « D’accord » et « Tout à fait d’accord » — viole les fondements épistémologiques de la métrologie humaine. L’assignation de rangs permet de respecter la métrique réelle de ces instruments sans introduire d’artefacts d’échelle.
Dans le domaine de l’évaluation psychiatrique et de la psychologie clinique, Spearman trouve une application privilégiée lors de l’estimation du degré de concordance entre évaluateurs indépendants (inter-rater reliability). Lorsqu’une équipe de cliniciens classe des patients selon le degré de sévérité d’un tableau symptomatologique, de l’état dépressif caractérisé à la rémission partielle, la quantification ordinale par le biais du rhô permet de mesurer la congruence diagnostique sans être perturbé par les biais de sévérité absolue spécifiques à chaque praticien. De même, l’analyse comparative des performances d’étudiants soumises à des barèmes distincts ou le rapprochement de classements scolaires fondés sur des épreuves hétérogènes bénéficient immédiatement de la résilience du modèle non paramétrique.
Un autre avantage déterminant réside dans l’extrême robustesse de ce coefficient vis-à-vis des distributions distributionnelles asymétriques. Les temps de réaction en neuro-ergonomie, le nombre d’erreurs commises lors d’une tâche de mémoire de travail sous interférence, ou encore les scores de stress post-traumatique au sein de populations exposées à des événements critiques génèrent quasi universellement des données caractérisées par un fort étalement à droite (positive skewness) ou des distributions bimodales réfractaires à toute transformation logarithmique usuelle. En substituant aux valeurs brutes asymétriques leurs rangs respectifs, la distribution des données transformées devient uniforme sur le domaine discret [1, N], rétablissant la validité des comparaisons corrélationnelles sans contraindre artificiellement la nature biologique ou comportementale du phénomène étudié.
1.3 Hypothèses sous-jacentes et conditions d’application méthodologique
Bien que le rhô de Spearman soit qualifié de test non paramétrique — ce qui l’affranchit de l’obligation de modéliser une fonction de densité spécifique —, son déploiement scientifique valide n’est pas pour autant exempt de contraintes méthodologiques. La première condition formelle concerne le niveau de mesure des variables analysées. Celles-ci doivent obligatoirement être au minimum ordinales (autorisant une mise en ordre hiérarchique absolue : supérieur, égal ou inférieur), mais peuvent également être mesurées à une échelle d’intervalle ou de rapport continue. Il est tout à fait recevable de corréler une variable intrinsèquement continue (par exemple, le taux de cortisol salivaire) avec une variable ordinale discrète (le rang de gravité perçu d’une stresseur quotidien), le test ramenant l’ensemble des données au dénominateur commun des rangs.
La deuxième condition primordiale réside dans l’appariement bivarié strict et l’indépendance statistique des paires d’observations. Pour chaque sujet i de l’échantillon, le couple (Xi, Yi) doit provenir de la même unité d’observation ou d’entités rigoureusement jumelées sur le plan expérimental. Parallèlement, le comportement du sujet i ne doit en aucun cas être influencé par celui du sujet j, sous peine de violer le postulat d’indépendance mutuelle des résidus, ce qui introduirait un phénomène de pseudo-réplication particulièrement pernicieux dans les études comportementales longitudinales ou les protocoles de dynamique de groupe.
La troisième exigence repose sur la présomption théorique d’une relation monotone entre les variables. Spearman ne constitue nullement une panacée universelle permettant d’identifier n’importe quelle configuration relationnelle : une relation non linéaire non monotone — telle que la fameuse loi de Yerkes-Dodson reliant l’éveil motivationnel et la performance cognitive selon une courbe en U inversé — produira un rhô proche de zéro, masquant une dynamique pourtant puissante et significative. Enfin, il convient d’aborder la sensibilité computationnelle aux faibles effectifs. Si la méthode est formellement applicable dès N ≥ 5, les échantillons réduits (N < 20) typiques de certains protocoles de neuropsychologie clinique nécessitent une vigilance accrue lors de l’inférence statistique, les approximations asymptotiques classiques devenant invalides au profit de tables de probabilité exactes.
2. 2. Analyse comparative : Corrélation de Pearson versus corrélation de Spearman
2.1 Distinction paramétrique et exigences de normalité distributionnelle
Le débat entre l’usage de la corrélation produit-moment de Pearson (notée r) et celle de Spearman (rs) cristallise l’opposition séculaire entre l’approche paramétrique classique et l’approche non paramétrique distributionnellement libre (distribution-free). Le coefficient de Pearson nécessite théoriquement que le couple de variables aléatoires suive une distribution normale bivariée au sein de la population parente. Cette modélisation impose non seulement la symétrie et l’absence d’aplatissement anormal de chaque variable prise individuellement (normalité univariée), mais également que pour chaque valeur donnée de X, la distribution correspondante de Y soit normalement distribuée avec une variance homogène (homoscédasticité).
En pratique psychologique, ces hypothèses théoriques sont très fréquemment violées. Lorsque des données présentent un aplatissement important (leptocurticité) ou une asymétrie marquée, la variance empirique est artificiellement déformée, ce qui entraîne une distorsion mécanique du dénominateur du coefficient de Pearson. En conséquence, l’estimation de l’intensité de la relation est biaisée, le plus souvent dans le sens d’une sous-estimation systématique de l’association réelle.
Le rhô de Spearman contourne intégralement ces écueils par le truchement d’une opération algorithmique simple : la conversion des scores continus bruts en rangs relatifs ordonnés. En substituant aux valeurs numériques d’origine leur position séquentielle respective au sein de la cohorte ordonnée, le chercheur fait abstraction de l’ampleur métrique absolue des écarts au profit exclusif de leur hiérarchie relative. Cette projection sur l’ensemble des entiers [1, N] stabilise artificiellement la structure de variance globale, rendant le calcul totalement insensible à la forme distributionnelle de départ. Il en résulte un outil d’une remarquable élégance conceptuelle, préservant la fidélité de l’ordonnancement sans présupposer une équidistance psychologique arbitraire entre les échelons de mesure.
2.2 Vulnérabilité face aux données aberrantes (outliers) en psychométrie
L’une des distinctions les plus critiques entre les deux indices réside dans leur résilience respective face aux observations atypiques ou extrêmes (souvent qualifiées d’outliers). En raison de sa structure mathématique basée sur le calcul de covariances produit-moment — où chaque résidu individuel par rapport à la moyenne arithmétique est multiplié par le résidu correspondant de l’autre variable —, le coefficient de Pearson attribue un poids disproportionné aux points situés aux extrémités géométriques du nuage de dispersion. Un unique individu présentant un score atypique sur l’une des dimensions (par exemple un temps de réponse anormalement long provoqué par une distraction momentanée durant l’enregistrement informatisé) est capable, à lui seul, d’annihiler une corrélation forte préexistante, ou inversement, de créer artificiellement une corrélation fallacieuse là où régnait un nuage stochastique informe.
À l’opposé, la métrique ordinale de Spearman opère un mécanisme naturel de régulation et de troncature de l’impact des valeurs aberrantes. Dans un échantillon de cinquante sujets, que la valeur maximale observée sur une échelle d’agressivité dépasse la médiane de trois écarts-types ou de quinze écarts-types, son statut computationnel demeure immuable : elle recevra rigoureusement le rang 50. La distance métrique exorbitante est neutralisée et ramenée à un simple pas d’une unité au-dessus du sujet occupant le rang 49.
Pour illustrer ce phénomène de manière saisissante au sein d’une simulation psychométrique, considérons un échantillon de dix individus testés sur l’estime de soi et la performance académique. Si neuf sujets s’alignent le long d’une trajectoire ascendante modérée et qu’un dixième participant combine un score de performance exceptionnellement élevé avec une estime de soi effondrée, le r de Pearson s’effondre dramatiquement, basculant par exemple de +0,72 à -0,15, trahissant ainsi la dynamique réelle de la majorité de l’échantillon. Dans le même scénario, le rhô de Spearman se maintiendra aux alentours de +0,58, enregistrant la déviation du sujet atypique comme une simple discordance de rang d’amplitude contrôlée, préservant l’intégrité de la tendance comportementale générale.
2.3 Arbre décisionnel pour le choix du coefficient statistique
Le choix raisonné entre l’utilisation de Pearson et de Spearman ne doit jamais être laissé au hasard ou dicté par une quête opportuniste de valeurs de p significatives (p-hacking). Il s’articule autour d’un algorithme décisionnel standardisé que tout chercheur rigoureux se doit d’exécuter avant toute modélisation bivariée. La première étape consiste à classifier sans ambiguïté le niveau d’échelle des variables : si au moins l’une des variables est purement ordinale (par exemple, un stade de développement piagétien ou un item d’échelle de Likert non consolidé), l’orientation vers le coefficient de Spearman s’impose d’emblée comme un impératif méthodologique incontournable.
Si les deux variables sont mesurées à un niveau d’intervalle ou de rapport continu, le statisticien doit impérativement procéder à une double vérification empirique. En premier lieu, une inspection visuelle minutieuse du nuage de points s’avère indispensable : elle vise à confirmer que la relation sous-jacente est bien monotone et à identifier la présence éventuelle de trajectoires curvilignes ou d’observations marginales susceptibles de biaiser les moindres carrés ordinaires. En second lieu, des tests formels d’adéquation de la distribution à la loi normale doivent être conduits systématiquement, à l’instar du test de Shapiro-Wilk ou du test d’Agostino-Pearson, couplés à l’analyse des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis).
Si la normalité bivariée est rigoureusement vérifiée et qu’aucune valeur discordante ne vient fausser le modèle, le r de Pearson est légitimement sélectionné, bénéficiant alors d’une puissance statistique légèrement supérieure pour rejeter l’hypothèse nulle. Dans le cas inverse — asymétrie confirmée, hétéroscédasticité ou présence irréductible de valeurs déviantes —, le repli sur le rhô de Spearman constitue la décision éthique et méthodologique la plus intègre pour garantir la reproductibilité des conclusions scientifiques conformément aux standards éditoriaux les plus stricts.
3. 3. Préparation et structuration rigoureuse du jeu de données dans Google Sheets
3.1 Organisation architecturale de la feuille de calcul
L’intégrité computationnelle d’une analyse statistique sous Google Sheets dépend en grande partie de la structuration spatiale et logique de la feuille de calcul. L’organisation désordonnée des cellules, l’insertion intempestive de sous-totaux au sein des séries de données ou l’absence d’étiquetage univoque constituent les causes premières d’erreurs lors de l’exécution de formules avancées. Pour garantir une traçabilité scientifique irréprochable, l’architecture tabulaire doit respecter les canons de la structure de données relationnelle (format dit tidy data).
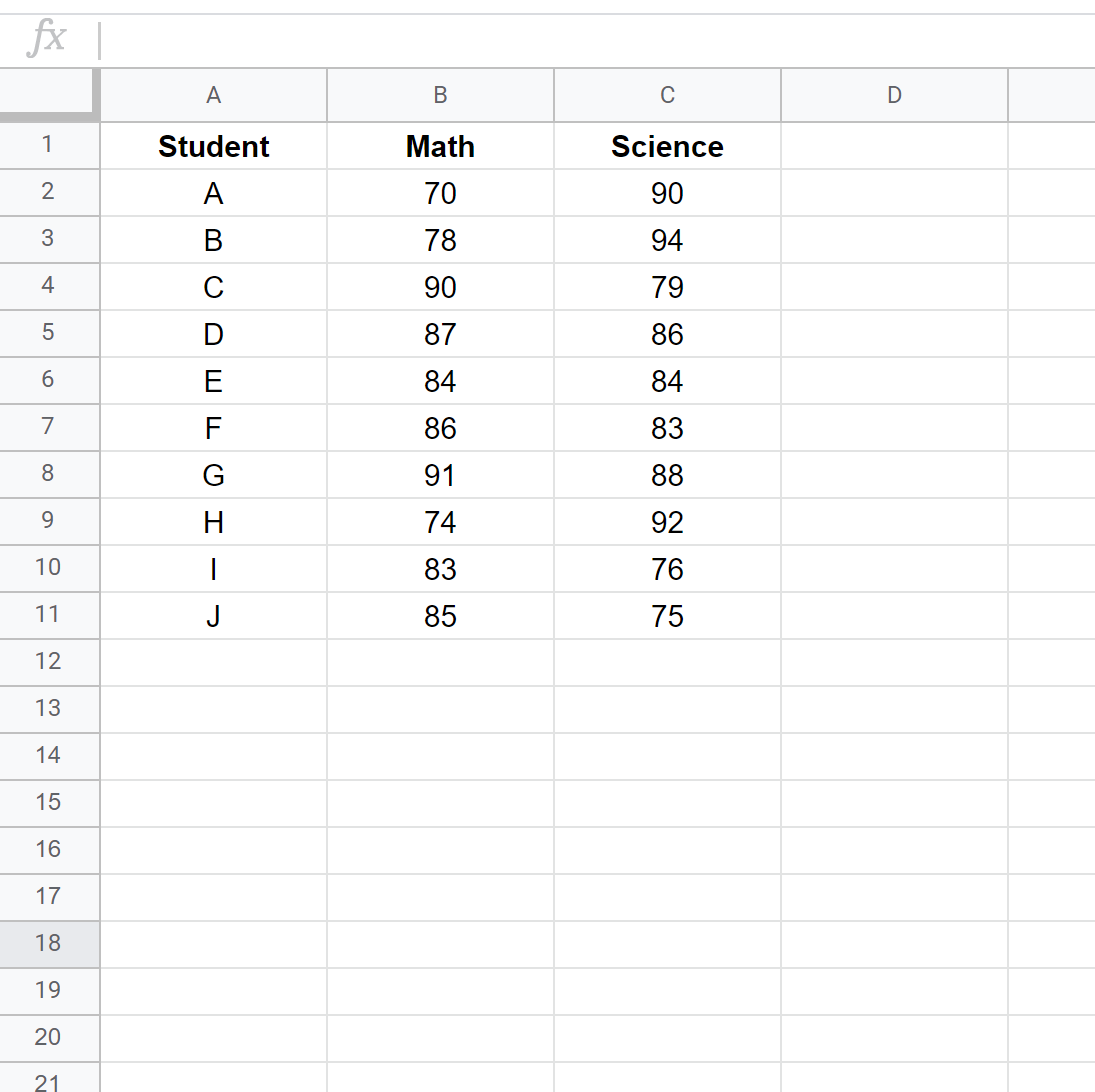
La première colonne du classeur (colonne A) doit impérativement être réservée à l’attribution d’un identifiant univoque et anonymisé pour chaque unité expérimentale ou participant (par exemple, ID_001, ID_002). Cette pratique prévient toute désynchronisation lors d’éventuelles opérations de tri ultérieures. Les colonnes immédiatement adjacentes (colonnes B et C) doivent accueillir respectivement les scores bruts de la première variable psychologique (par exemple, Anxiete_Pre_Test) et de la seconde variable comportementale (par exemple, Score_Memoire). Les en-têtes de colonnes doivent occuper la toute première ligne de la feuille de calcul, formulés de manière descriptive et sans caractères d’échappement complexes.
Il est par ailleurs fondamental de normaliser le format des cellules. Les plages hébergeant les données numériques doivent être explicitement configurées en mode « Nombre » via le menu de Google Sheets, éliminant tout espace typographique involontaire, devise monétaire ou formatage textuel latent susceptible de corrompre les fonctions statistiques. Enfin, il est vivement conseillé de procéder au verrouillage systématique de ces plages de données sources : par un simple clic droit sur la sélection, l’activation de l’option « Protéger la plage » permet de prévenir toute modification involontaire, suppression ou altération accidentelle lors de la manipulation des formules de rangs.
3.2 Nettoyage préliminaire et traitement des valeurs manquantes
Avant d’engager le moindre calcul de rang, le traitement des données incomplètes ou corrompues constitue une obligation déontologique. Dans le cadre d’administrations de questionnaires psychologiques, il est fréquent que certains répondants omettent de renseigner certains items, introduisant des cellules vides (valeurs manquantes ou missing values). Laisser des cellules vides au sein d’une matrice destinée à être classée produit des distorsions graves dans Google Sheets, les fonctions de classement pouvant interpréter l’absence de saisie comme un score nul ou renvoyer des erreurs de propagation bloquantes.
La première mesure corrective consiste à déployer une règle de mise en forme conditionnelle sur l’ensemble de la matrice expérimentale (plage B2:C100 par exemple), configurée pour mettre en surbrillance chromatique instantanée toute cellule vérifiant la condition =ESTVIDE(B2). Une fois ces anomalies localisées, l’analyste doit arbitrer entre deux paradigmes de traitement méthodologique conformes aux recommandations de l’APA. La première option, la plus courante et la plus prudente en analyse ordinale univariée, est la suppression par observation complète (listwise deletion). Elle consiste à éliminer l’intégralité de la dyade comportementale pour le sujet concerné, garantissant ainsi que chaque rang calculé s’appuie sur une observation bidirectionnelle valide.
La seconde option implique des protocoles d’imputation statistique (telle que l’imputation par la médiane ordinale pour les variables psychométriques à forte corrélation interne), qui doit être dûment explicitée dans le rapport de recherche. Quel que soit le choix arrêté, l’impératif absolu consiste à préserver le parfait appariement dyadique : à la fin de cette étape préparatoire, la colonne de la variable X et celle de la variable Y doivent afficher rigoureusement le même nombre de lignes actives renseignées, sans aucun décalage d’indexation verticale.
3.3 Vérification de l’intégrité et de la cohérence des échelles
La dernière phase préparatoire réside dans l’audit systématique de la conformité psychométrique des scores bruts saisis. Il arrive fréquemment que des erreurs de frappe humaine s’immiscent dans les données (par exemple, la saisie d’un score de « 55 » au lieu de « 5 » sur une échelle d’évaluation bornée de 1 à 7). L’injection d’une telle valeur aberrante au sein d’un modèle — bien qu’atténuée par le classement de Spearman par rapport à Pearson — déforme néanmoins le jeu d’ex æquo et le rang terminal de l’échantillon.
Pour immuniser le tableur contre ces artefacts, il est recommandé de mettre en place une règle de validation des données via le menu Données > Validation des données. Pour une échelle de Likert à 7 points, la contrainte imposera que chaque cellule soit impérativement un nombre entier compris entre 1 et 7, toute tentative de saisie divergente étant immédiatement rejetée par l’interface logicielle. Parallèlement, le psychologue doit prêter une attention minutieuse à l’orientation sémantique des items : si le protocole comporte des items formulés de manière inversée pour contrôler les biais d’acquiescement, ces derniers doivent obligatoirement faire l’objet d’une recodification arithmétique préalable (par exemple, Score_Recode = (Max_Echelle + 1) – Score_Brut) avant d’engager le classement ordinal.
Enfin, la traçabilité scientifique impose la création d’un onglet annexe au sein du classeur Google Sheets, faisant office de livre de codes ou de dictionnaire de métadonnées. Cet espace documentaire consigne de manière exhaustive la définition opérationnelle de chaque variable, les bornes théoriques admissibles, les clés de recodage employées et la date de clôture de la matrice de données. Cette précaution garantit une reproductibilité totale pour tout auditeur ou co-auteur appelé à manipuler ultérieurement le fichier source.
4. 4. Méthode 1 : Calcul étape par étape via l’attribution manuelle des rangs
4.1 Introduction de la fonction RANG dans l’environnement Google Sheets
Pour appréhender intimement la mécanique interne du rhô de Spearman, la méthode de calcul manuelle — décomposée pas à pas le long de colonnes intermédiaires — constitue une démarche pédagogique et analytique indispensable. La première brique computationnelle de cette approche repose sur la fonction native de classement de Google Sheets, formellement rédigée selon la syntaxe suivante :
=RANG(valeur; données; [ordre])
Dans cette formulation logicielle, l’argument valeur spécifie la référence de la cellule individuelle que l’on cherche à positionner hiérarchiquement (par exemple, B2). L’argument données représente le vecteur ou la plage matricielle englobant l’intégralité des observations recueillies pour cette même variable au sein de l’échantillon d’étude (par exemple, $B$2:$B$26). L’argument optionnel ordre, quant à lui, détermine le sens mathématique du tri : s’il est fixé à 0 (ou omis par défaut), Google Sheets classe les données par ordre décroissant, attribuant le rang 1 à la valeur numérique la plus élevée du vecteur. Si cet argument est fixé à 1, l’algorithme procède par ordre croissant, assignant le rang 1 au score le plus faible.
En psychométrie expérimentale, le choix du sens de classement dépend de la signification théorique des échelles mesurées. Toutefois, quelle que soit la convention adoptée (croissante ou décroissante), la rigueur méthodologique fondamentale exige impérativement d’appliquer une convention rigoureusement identique aux deux variables sous étude. Si la variable X est classée par ordre croissant, la variable Y doit l’être tout autant, sous peine d’inverser artificiellement le signe du coefficient de Spearman et de produire une interprétation diamétralement opposée à la réalité comportementale.
4.2 Génération de la colonne de rangs pour la première variable psychologique
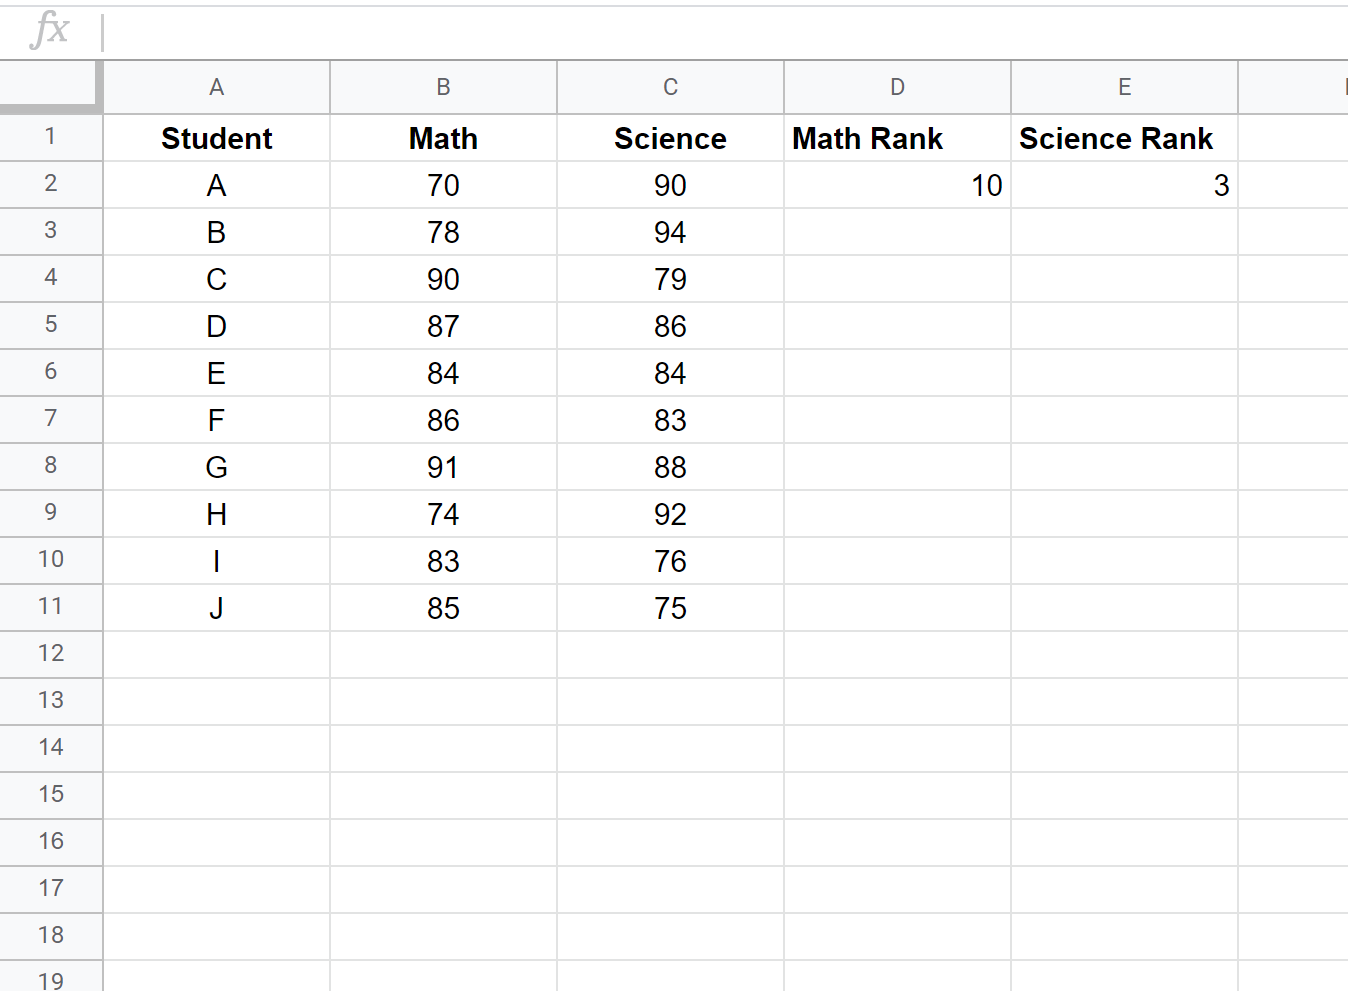
L’implémentation concrète débute par la création d’une nouvelle colonne dédiée au sein de la feuille de calcul, positionnée par exemple en colonne D et nommée explicitement Rang_Variable_X dans sa première ligne d’en-tête. Dans la cellule D2, correspondant au premier participant de la cohorte, la formule suivante est injectée :
=RANG(B2; $B$2:$B$26; 1)
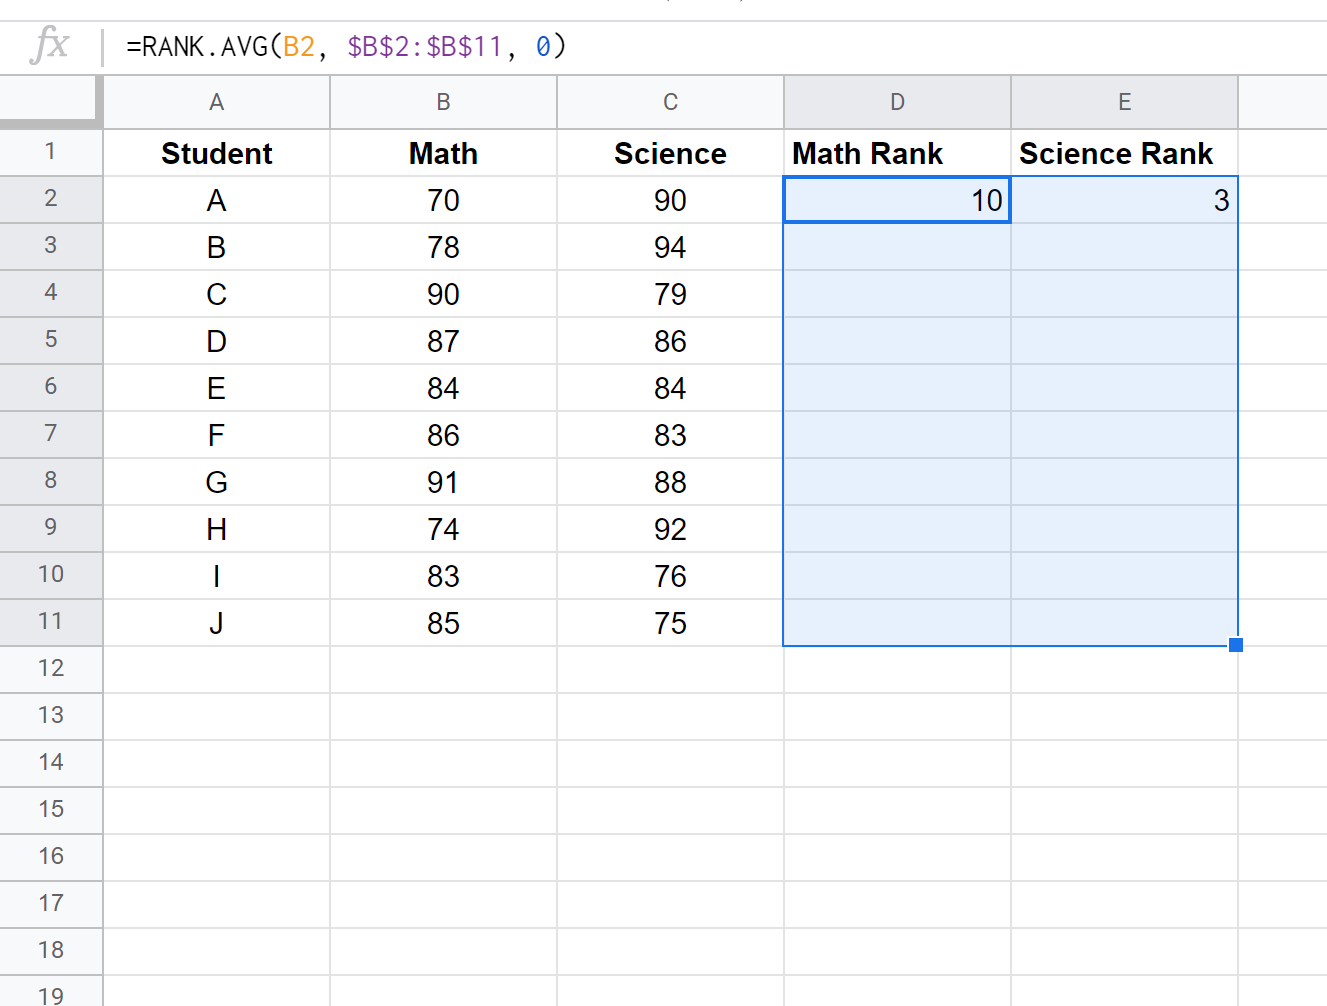
L’usage délibéré des symboles dollar ($) pour figer les coordonnées de la matrice de référence — transformant les références relatives en références absolues — constitue une étape technique incontournable. Lors de l’incrémentation dynamique de cette formule vers le bas (par double-clic sur la poignée de recopie ou par étirement manuel jusqu’à la cellule D26), l’argument valeur s’ajustera automatiquement pour chaque participant (devenant successivement B3, B4, …, B26), tandis que la matrice de comparaison restera rigoureusement ancrée sur la plage $B$2:$B$26, prévenant ainsi toute erreur d’évaluation hors bornes.
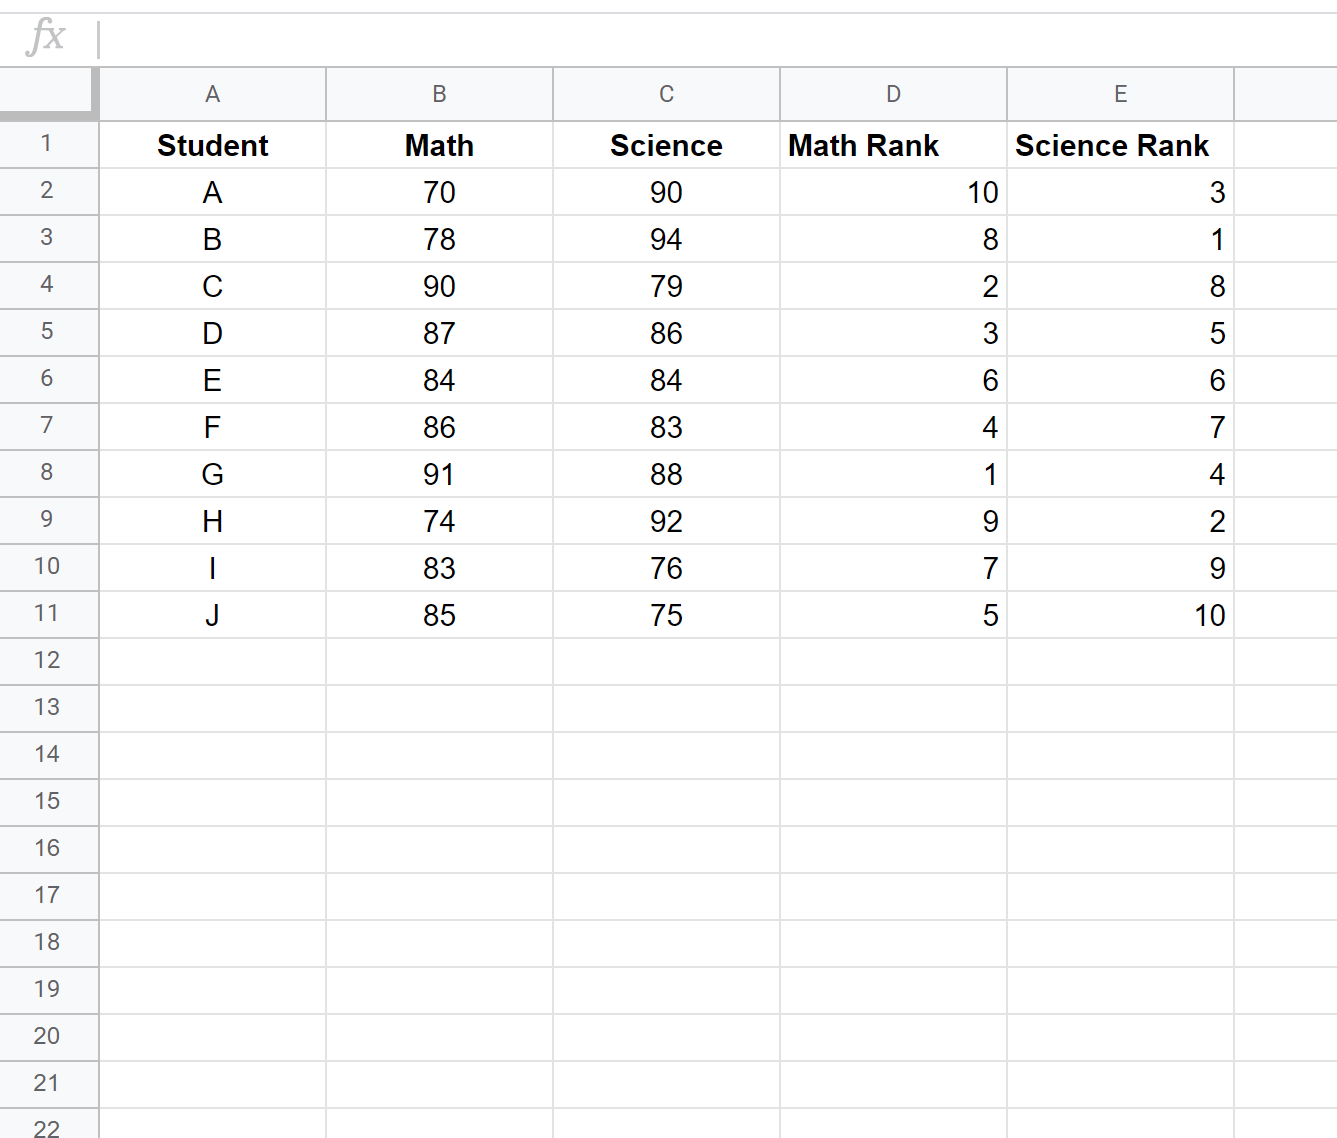
Une fois l’incrémentation achevée pour l’ensemble des N participants, plusieurs procédures d’audit arithmétique doivent être immédiatement exécutées pour vérifier la conformité du traitement. D’une part, le rang maximal généré au sein de la colonne D doit être rigoureusement égal à l’effectif total N de l’échantillon (en l’absence d’ex æquo affectant le dernier rang). D’autre part, la somme arithmétique de l’ensemble des rangs assignés doit impérativement satisfaire à la formule canonique de la somme des N premiers entiers consécutifs établie par Carl Friedrich Gauss :
∑ Rangs = [ N × (N + 1) ] / 2
Pour un échantillon comportant 25 participants, la formule de contrôle =SOMME(D2:D26) doit obligatoirement renvoyer le produit (25 × 26) / 2 = 325. Toute déviation arithmétique par rapport à cette valeur théorique témoigne sans équivoque de la présence d’une corruption de formule ou d’un doublon non pris en charge correctement.
4.3 Attribution des rangs pour la seconde variable comportementale
Le protocole technique déployé pour la première dimension psychologique doit ensuite être répliqué avec une fidélité absolue sur la seconde dimension comportementale. En colonne E, que l’on désignera par l’en-tête Rang_Variable_Y, la formule de classement ordinal est introduite au niveau de la cellule E2 en ciblant cette fois la plage source correspondante :
=RANG(C2; $C$2:$C$26; 1)
Il est critique de vérifier que le paramètre d’ordre (ici le chiffre 1 pour un classement croissant) demeure scrupuleusement identique à celui configuré dans la colonne D. Dès que la formule a été propagée jusqu’à la rangée finale E26, le chercheur exécute à nouveau le test de conformité de Gauss en contrôlant que =SOMME(E2:E26) équivaut parfaitement au total théorique attendu de 325.
Cette étape achevée, l’analyste dispose d’un système bivarié de rangs parallèles parfaitement calibré. L’inspection croisée des colonnes brutes et ordinales permet de vérifier la validité interne des assignations : le sujet présentant le score le plus faible sur la tâche cognitive doit immanquablement afficher le rang 1 dans la colonne ordinale, tandis que la performance la plus spectaculaire doit être corrélée avec le rang le plus élevé. Cependant, cette méthode standard basée sur la simple fonction RANG dissimule une faille méthodologique majeure dès lors que des participants obtiennent des scores strictement identiques, situation omniprésente dans les inventaires psychologiques discrets.
5. 5. Gestion mathématique des ex æquo : La fonction RANG.MOYENNE (RANK.AVG)
5.1 Problématique psychométrique des scores ex æquo (ties)
Dans la pratique de la recherche comportementale, l’apparition d’égalités numériques — communément qualifiées d’ex æquo ou de liaisons statistiques (ties en anglais) — n’est pas l’exception, mais bien la règle. Les inventaires de personnalité de type Big Five, les échelles d’évaluation de la symptomatologie anxieuse ou les grilles d’observation clinique recourent invariablement à des échelles de réponses discrètes bornées par un nombre restreint de modalités. Lorsqu’un échantillon de cinquante ou cent participants répond à une échelle graduée de 1 à 5, le principe des tiroirs de Dirichlet garantit mathématiquement que de multiples individus partageront rigoureusement le même score brut.
L’utilisation de la fonction canonique =RANG() face à ce phénomène engendre un biais statistique rédhibitoire. Par défaut, la fonction standard applique une logique d’assignation discontinue : si deux individus se disputent par exemple la troisième place avec des scores identiques, la fonction leur attribue à tous deux le rang 3, puis assigne au sujet immédiatement inférieur le rang 5, omettant purement et simplement le rang 4 dans la séquence ordinale. Ce traitement tronqué détruit l’homogénéité de la métrique, fausse la somme globale théorique des entiers consécutifs et produit une sous-estimation systématique de la variance bivariée des rangs, compromettant irrémédiablement la précision de l’indice de Spearman.
Pour rétablir l’équité distributive et préserver la validité de l’inférence non paramétrique, la théorie statistique impose d’attribuer à chaque participant engagé dans une liaison le rang moyen du bloc hiérarchique qu’ils occuperaient conjointement s’ils pouvaient être départagés. Dans le cas précédent, les deux sujets se partageant virtuellement les rangs 3 et 4 se voient assigner chacun le rang moyen arithmétique : (3 + 4) / 2 = 3,5. Si trois sujets étaient ex æquo pour les positions 5, 6 et 7, le rang attribué à chacun d’eux serait rigoureusement (5 + 6 + 7) / 3 = 6,0. Cette correction garantit la conservation intégrale de l’espérance mathématique de la distribution discrète.
5.2 Implémentation technique de =RANG.MOYENNE dans Google Sheets
Pour opérationnaliser cette correction fondamentale sans recourir à des procédures manuelles chronophages et sujettes à l’erreur humaine, Google Sheets propose une fonction hautement spécialisée : RANG.MOYENNE (ou RANK.AVG dans sa nomenclature internationale anglophone). Sa syntaxe opératoire s’articule comme suit :
=RANG.MOYENNE(valeur; plage; [ordre])
L’argumentaire technique est strictement calqué sur celui de la fonction de base, mais son algorithme sous-jacent intègre une routine de détection automatique des duplications numériques. Dès lors qu’une pluralité de valeurs identiques est détectée au sein du vecteur de référence, la fonction calcule automatiquement le centroïde arithmétique de la tranche de rangs correspondante et retourne une valeur décimale fractionnaire parfaitement calibrée.
Pour implémenter cette fonction de manière optimale au sein de notre feuille d’analyse, il convient de substituer les formules préalablement saisies dans les colonnes D et E par leurs versions ajustées. Ainsi, en cellule D2, la formule définitive devient :
=RANG.MOYENNE(B2; $B$2:$B$26; 1)
De même, pour la seconde dimension psychologique en cellule E2, on appliquera :
=RANG.MOYENNE(C2; $C$2:$C$26; 1)
Cette modification transforme radicalement la qualité de la matrice ordinale. Si l’on inspecte les résultats générés le long des colonnes après ré-incrémentation, l’apparition de rangs terminés par ,5, ,33 ou ,67 signale la neutralisation correcte des ex æquo. Il est remarquable de souligner que, malgré la présence de ces valeurs décimales, le test de vérification arithmétique de Gauss — matérialisé par =SOMME(D2:D26) — renvoie toujours exactement la somme théorique de 325, apportant la preuve formelle que la variance globale de la série a été impeccablement préservée.
5.3 Corrections analytiques avancées pour forte proportion d’égalités
Il existe toutefois une subtilité mathématique de haut niveau que tout chercheur publiant dans des revues académiques de premier plan se doit de maîtriser. Lorsque la proportion d’ex æquo au sein de l’échantillon devient modérée à massive — dépassant typiquement le seuil critique de 15 à 20 % des observations totales —, la formule manuelle standard de Spearman (basée exclusivement sur les différences quadratiques ∑ d2) cesse d’être rigoureusement exacte. En effet, la présence d’égalités multiples opère une réduction de la variance effective des rangs par rapport à la variance attendue sans ex æquo, conduisant la formule classique à sous-estimer systématiquement la valeur absolue du rhô.
Pour corriger cette distorsion au niveau de la formule théorique pure, il est requis d’introduire un facteur de correction T pour chaque groupe d’observations ex æquo, calculé selon l’expression :
T = (t3 – t) / 12
où t désigne le nombre précis d’individus partageant le même score au sein d’un groupe d’égalités donné. La variance théorique de chaque variable est alors rectifiée en soustrayant la somme globale des facteurs T à la variance maximale théorique. Cette correction manuelle s’avère toutefois d’une lourdeur algorithmique considérable à implémenter par de simples colonnes de calcul au sein d’un tableur, en raison de la complexité requise pour identifier et compter dynamiquement chaque sous-groupe d’égalités.
Heureusement, une propriété mathématique fondamentale — que nous explorerons en profondeur dans la section 7 — permet de contourner intégralement cet obstacle computationnel sans aucune approximation : l’application directe du coefficient de corrélation produit-moment de Pearson sur les rangs moyens issus de RANG.MOYENNE incorpore de facto et automatiquement l’intégralité de ces facteurs de correction au sein de sa formulation covariancielle naturelle. C’est pourquoi la littérature méthodologique contemporaine recommande unanimement cette dernière approche lors du traitement de jeux de données psychométriques caractérisés par une forte densité d’ex æquo.
6. 6. Calcul manuel du coefficient rhô par la formule des différences de rangs
6.1 Dérivation de la colonne des différences de rang (d)
Pour les besoins didactiques, la validation croisée d’algorithmes ou la réalisation d’analyses de sensibilité pas à pas, la dérivation manuelle complète du rhô par la formule originelle de Spearman demeure une démarche d’une immense valeur heuristique. Ayant désormais généré des rangs moyens méthodologiquement irréprochables au sein des colonnes D (Rang_X) et E (Rang_Y), l’analyste procède à l’évaluation systématique de la divergence individuelle de positionnement.
À cette fin, une nouvelle colonne est insérée en position F, explicitement intitulée Difference_d. Dans la cellule F2, représentant la discordance ordinale associée au premier sujet, la formule de soustraction arithmétique directe est insérée :
=D2 - E2
Cette expression calcule rigoureusement l’écart algébrique signé di entre le classement obtenu par le participant sur la variable prédictive et son classement sur la variable critère. Un écart di = 0 indique une congruence parfaite : le participant se situe rigoureusement au même rang hiérarchique sur les deux dimensions psychologiques. Une valeur positive indique une position relative supérieure sur la variable X par rapport à Y, tandis qu’une valeur négative traduit la configuration inverse.
Après avoir étiré cette formule jusqu’à la cellule terminale F26, une loi mathématique universelle permet d’auditer instantanément l’exactitude de l’opération : la somme arithmétique de l’ensemble des différences de rangs di sur un échantillon complet doit impérativement être égale à zéro :
∑ di = 0
En inscrivant la formule de contrôle =SOMME(F2:F26) dans une cellule vacante, le résultat affiché doit être rigoureusement nul (ou osciller à des puissances infinitésimales de l’ordre de 10-15 en raison des micro-arrondis de calcul en virgule flottante inhérents aux processeurs informatiques). Si la somme s’écarte substantiellement de zéro, cela signale une distorsion irréfutable dans l’attribution des rangs ou une incohérence de plage.
6.2 Élévation au carré des écarts et sommation (d²)
Dans la mesure où la somme des écarts simples s’annule systématiquement en raison de la compensation mutuelle des grandeurs positives et négatives, l’analyse de la dispersion globale exige l’élimination des signes algébriques. À l’instar de la démarche adoptée par les physiciens et les statisticiens dans le calcul de la variance ou de l’erreur quadratique moyenne, la technique de Spearman recourt à l’élévation des écarts au carré.
En colonne G, que l’on intitule d_carre ou d2, la formule suivante est introduite au niveau de la cellule G2 :
=F2^2
Cette formulation neutralise immédiatement l’impact directionnel des déviations pour n’en quantifier que l’amplitude absolue pondérée : un écart de rang mineur (par exemple 1 rang de différence) générera une pénalité marginale de 1 (12 = 1), tandis qu’une divergence ordinale massive (par exemple un sujet classé premier sur une variable et dernier sur l’autre, soit un écart de 24 rangs sur notre cohorte de 25) engendrera une pénalité quadratique colossale de 576 (242 = 576).
Cette formule étant recopiée verticalement jusqu’à G26, le chercheur procède ensuite à la sommation globale des écarts quadratiques au bas de la colonne ou dans un encart réservé aux paramètres de synthèse. En affectant la formule suivante à la cellule G27 :
=SOMME(G2:G26)
on obtient la grandeur statistique universelle désignée sous la notation mathématique ∑ di2. Ce scalaire synthétise l’intégralité du désordre ordinal existant entre les deux dimensions psychologiques au sein de l’échantillon expérimental. Plus cette somme quadratique est proche de zéro, plus la concordance des rangs frôle la perfection.
6.3 Application de la formule canonique de Spearman dans une cellule de synthèse
L’étape finale de cette première méthodologie réside dans la compilation des éléments scalaires au sein de l’équation maîtresse de Charles Spearman afin d’extraire la valeur unifiée du rhô. Pour maximiser la robustesse et l’automatisation de la feuille de calcul, il est impératif de ne pas coder l’effectif N en dur sous la forme d’un chiffre figé, mais de le faire dériver dynamiquement d’une fonction de comptage.
Dans une cellule dédiée à la synthèse des résultats (par exemple la cellule I2, préalablement labellisée « Rho_Spearman_Manuel »), la formule intégrale suivante est insérée :
=1 - ((6 * G27) / (NB(B2:B26) * (NB(B2:B26)^2 - 1)))
Analysons la mécanique opératoire de cette équation au sein de Google Sheets :
- La fonction
NB(B2:B26)évalue en temps réel le nombre précis de participants valides au sein du protocole (renvoyant ici la valeur entière 25). Si le chercheur ajoute ou supprime ultérieurement des lignes de participants, la taille de l’échantillon s’ajustera instantanément sans requérir de réécriture de la formule. - Le sous-ensemble computationnel
(NB(B2:B26)^2 - 1)calcule le terme (N2 – 1), qui équivaut pour N = 25 à (625 – 1) = 624. - Le dénominateur complet réalise le produit 25 × 624 = 15 600.
- Le numérateur multiplie la somme des écarts quadratiques logée en
G27par la constante mathématique invariable 6, issue de la dérivation de la variance d’une série arithmétique discrète. - Le quotient obtenu est finalement retranché de la valeur unitaire 1.
Le résultat généré dans la cellule I2 fournit une valeur numérique obligatoirement comprise au sein de l’intervalle canonique [-1,00 ; +1,00]. Toute sortie numérique affichant une valeur supérieure à +1 ou inférieure à -1 révélerait de façon certaine une erreur de parenthésage dans la saisie de l’équation ou un décalage d’indexation dans les plages sommées.
7. 7. Méthode 2 : Calcul automatisé avec COEFFICIENT.CORRELATION sur les rangs
7.1 Équivalence mathématique entre Pearson sur rangs et rhô de Spearman
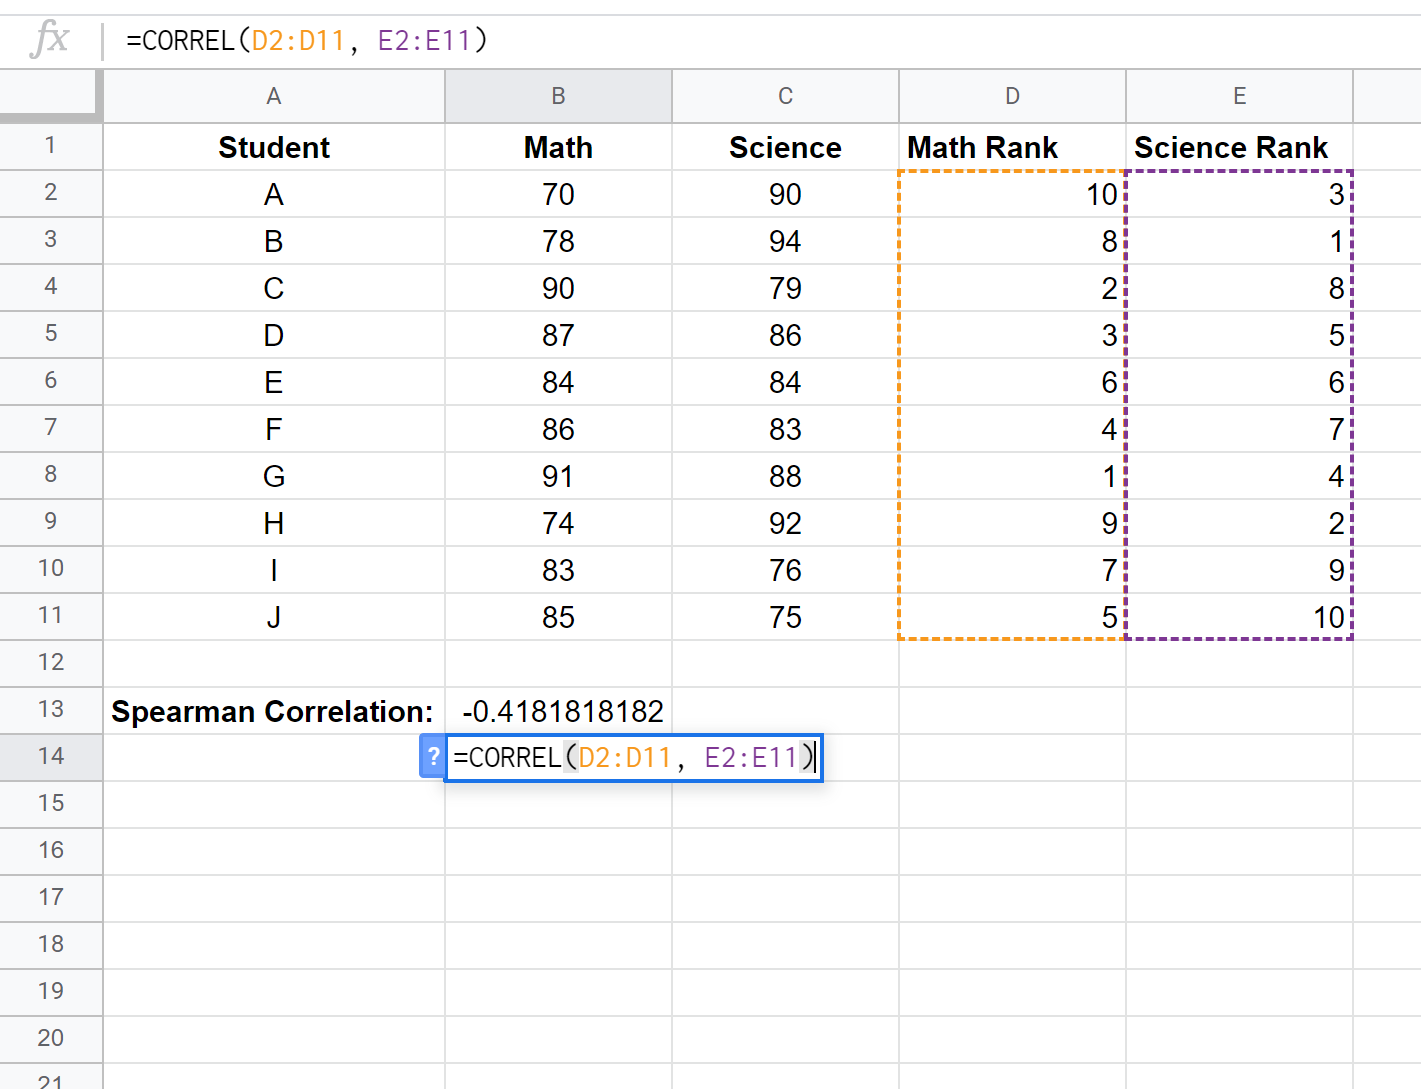
Si la méthode manuelle décomposée au chapitre précédent présente un intérêt pédagogique manifeste pour appréhender la genèse du score, elle souffre de deux inconvénients notables dans la pratique quotidienne des laboratoires : elle encombre visuellement le classeur avec de multiples colonnes techniques intermédiaires et, surtout, elle ignore la correction des ex æquo multiples mentionnée dans la section 5.3. Il existe fort heureusement une passerelle théorique fondamentale au sein de la statistique bivariée : le coefficient de corrélation de rang de Spearman d’un jeu de données est rigoureusement identique au coefficient de corrélation produit-moment de Pearson calculé sur les rangs de ces mêmes données.
Cette équivalence algébrique n’est pas une simple approximation numérique : elle constitue une égalité formelle exacte démontrée par la théorie statistique. Lorsque l’on injecte des rangs moyens — incluant leurs subdivisions décimales résultant du traitement des égalités par la fonction RANG.MOYENNE — directement au sein de la formule de covariance de Pearson, le formalisme paramétrique opère naturellement le calcul des variances réelles observées sur les rangs, sans recourir à la supposition théorique d’une absence totale de liens.
En conséquence, l’exploitation de la fonction de corrélation native de Google Sheets directement sur les colonnes ordinales résout instantanément et simultanément la question de la lourdeur computationnelle et celle du redressement mathématique des égalités. Le résultat obtenu est d’une pureté algorithmique totale, convergeant à la décimale près avec les sorties produites par les logiciels d’analyse de données les plus pointus tels que R ou IBM SPSS Statistics.
7.2 Exécution de la formule directe =COEFFICIENT.CORRELATION
L’opérationnalisation technique de cette seconde approche se distingue par sa concision et son élégance. Dès lors que les deux colonnes de rangs moyens D (Rang_X) et E (Rang_Y) ont été constituées via la fonction RANG.MOYENNE, il suffit d’insérer au sein d’une cellule de synthèse (par exemple en I3, labellisée « Rho_Spearman_Automatique ») la fonction native de corrélation produit-moment :
=COEFFICIENT.CORRELATION(D2:D26; E2:E26)
Pour les utilisateurs exploitant Google Sheets sous des paramètres régionaux anglophones ou au sein de feuilles configurées en syntaxe anglo-saxonne, la fonction équivalente internationale s’écrit de manière raccourcie :
=CORREL(D2:D26, E2:E26)
Cette formule commande au moteur de calcul de Google Sheets d’extraire la covariance standard entre le vecteur des rangs D et le vecteur des rangs E, puis de la normaliser en la divisant par le produit de leurs écarts-types respectifs. Si les données initiales ne contenaient strictement aucune égalité numérique, la valeur renvoyée en I3 serait rigoureusement indiscernable de celle calculée manuellement en I2 via l’équation 1 – (6 ∑ d2) / …. En revanche, en présence d’ex æquo, la valeur issue de COEFFICIENT.CORRELATION présentera une précision scientifique supérieure, reflétant la véritable force de liaison non biaisée par la restriction artificielle de variance ordinale.
Pour garantir la pérennité de cette cellule face à l’adjonction ultérieure de nouvelles cohortes de sujets, il est envisageable de recourir à des plages ouvertes (par exemple D2:D et E2:E), à la condition expresse qu’aucune autre donnée textuelle ou sous-total ne vienne parasiter le bas des colonnes concernées.
7.3 Formule matricielle imbriquée sans colonnes intermédiaires (niveau expert)
Pour les architectes de bases de données et les chercheurs avancés désireux d’optimiser au maximum l’ergonomie de leur classeur, il est possible de pousser l’automatisation computationnelle à son paroxysme en éliminant purement et simplement le recours aux colonnes intermédiaires de rangs D et E. Grâce à la puissance des fonctions matricielles de Google Sheets, l’intégralité du processus de transformation ordinale et d’estimation corrélationnelle peut être condensée au sein d’une unique cellule isolée.
Cette prouesse algorithmique mobilise l’interaction synchronisée entre les fonctions ARRAYFORMULA, RANK.AVG et CORREL. Toutefois, en raison des particularités de gestion des itérations matricielles internes au sein du moteur de calcul de Google, l’appel imbriqué direct de la fonction RANG.MOYENNE au sein d’un ARRAYFORMULA conventionnel requiert une formulation spécifique afin de contraindre la fonction à boucler sur chaque ligne de données brutes. L’expression prend alors la forme suivante :
=CORREL(ARRAYFORMULA(RANG.MOYENNE(B2:B26; B2:B26; 1)); ARRAYFORMULA(RANG.MOYENNE(C2:C26; C2:C26; 1)))
Analysons la dynamique de cette instruction : le premier bloc ARRAYFORMULA(RANG.MOYENNE(B2:B26; B2:B26; 1)) ordonne à Google Sheets de prendre successivement chaque valeur individuelle comprise entre B2 et B26, de la situer hiérarchiquement au sein de l’ensemble de la plage B2:B26 en appliquant l’algorithme des rangs moyens, et de conserver temporairement en mémoire vive le vecteur ordinal virtuel résultant, sans jamais l’imprimer physiquement sur les cellules de la grille. Le second bloc exécute simultanément une opération strictement symétrique sur la plage C2:C26. Enfin, la fonction englobante CORREL réceptionne ces deux vecteurs virtuels de rangs et procède à leur corrélation instantanée.
L’avantage opérationnel de cette formulation « tout-en-un » est spectaculaire : elle prévient tout risque de pollution visuelle du classeur, empêche toute altération accidentelle des formules de colonnes par des tiers non autorisés, et garantit un calcul dynamique instantané dès la modification d’un score brut en colonnes B ou C. Sa seule contrepartie réside dans sa relative complexité de maintenance par des collaborateurs novices non rompus à la logique des tableaux virtuels matriciels.
8. 8. Interprétation statistique et psychologique de la valeur de rhô
8.1 Évaluation de la force d’association selon les normes psychométriques
L’obtention d’un coefficient rhô de Spearman — qu’il ait été dérivé manuellement ou par voie matricielle — ne constitue que l’amorce du processus analytique. Le chercheur doit ensuite traduire cet indice numérique abstrait en une signification psychologique ou comportementale intelligible. L’évaluation de la force d’une association ordinale s’est longtemps appuyée de manière dogmatique sur les seuils heuristiques conventionnels formalisés par Jacob Cohen en 1988 pour les sciences humaines :
- Effet de faible amplitude : |rs| oscillant entre 0,10 et 0,29. Une telle valeur témoigne d’une association ténue entre les deux construits, souvent imperceptible à l’observation clinique individuelle et ne devenant décelable qu’au niveau d’analyses populationnelles de grande envergure.
- Effet d’amplitude moyenne : |rs| compris entre 0,30 et 0,49. Cet intervalle traduit une convergence substantielle et correspond typiquement aux grandeurs d’effets observées entre différentes facettes de la personnalité ou entre un trait de tempérament et un comportement habituel.
- Effet de forte amplitude : |rs| ≥ 0,50. Cette configuration signale une relation ordinale puissante, typique des études de fidélité test-retest d’un même inventaire ou de la validité convergente entre deux échelles standardisées mesurant un construit théorique homologue.
Néanmoins, la psychométrie contemporaine a profondément affiné cette grille de lecture. Les travaux récents de Funder et Ozer (2019) soulignent avec pertinence que les critères de Cohen avaient tendance à sous-estimer la portée réelle des effets faibles à moyens. Dans les sciences de la santé mentale, un rhô de 0,25 — bien que classé comme « faible » selon Cohen — peut recouvrir une importance clinique ou prédictive considérable lorsqu’il est agrégé à l’échelle d’une population ou appliqué à des trajectoires de vie sur le long terme.
Il est par ailleurs fondamental de réitérer une mise en garde épistémologique pérenne : corrélation ordinale ne vaut nullement causalité. L’existence d’une concordance de rangs étroite entre une variable comportementale X et un score clinique Y n’implique en aucun cas que les variations de X gouvernent mécaniquement celles de Y. Une telle covariation monotone peut résulter de l’action synchrone d’une tierce variable latente non mesurée (facteur de confusion), d’une relation causale inversée ou d’une covariation épiphénoménale au sein de l’écologie cognitive du sujet.
8.2 Sens de la relation : Corrélations positives, nulles et négatives
Le signe algébrique précédant la valeur absolue du rhô renseigne sur l’orientation directionnelle de la monotonie liant les deux construits comportementaux. L’analyste doit être capable d’en expliciter précisément la portée sémantique en fonction des polarités propres aux instruments de recueil mobilisés.
Une corrélation de rang strictement positive (rs > 0) dénote une relation de concordance ordinale : les participants qui occupent les échelons supérieurs de l’échantillon sur la variable X ont une propension systématique à se hisser également aux échelons supérieurs sur la variable Y. Dans un cadre clinique, une association positive forte (par exemple rs = +0,74) entre une échelle d’exposition aux événements de vie traumatiques et un inventaire de rumination mentale cognitive indique que plus le rang d’exposition d’un individu est sévère au sein de la cohorte, plus son rang dans la hiérarchie des ruminations est systématiquement exacerbé.
Une corrélation de rang nulle (rs ≈ 0,00) traduit une indépendance ordinale complète entre les deux dimensions. Le classement d’un sujet sur la première dimension ne fournit aucune information prédictive quant à son rang sur la seconde. Les paires de rangs se distribuent de manière totalement aléatoire et chaotique au sein de l’espace bivarié discret.
À l’opposé, une corrélation de rang négative (rs < 0) traduit une relation de discordance ou d’inversion ordinale : les individus présentant les rangs les plus élevés sur la dimension X sont tendanciellement relégués aux rangs les plus bas sur la dimension Y. Par exemple, une corrélation ordinale inverse (telle que rs = -0,61) observée entre le niveau d’anxiété pré-compétitive et la vitesse de traitement perceptivo-moteur démontre de façon percutante que l’élévation hiérarchique du stress émotionnel s’accompagne d’une régression ordinale marquée de l’efficience neuromotrice.
8.3 Coefficient de détermination ordinale et variance partagée
Dans le cadre de l’analyse linéaire paramétrique de Pearson, la pratique standard consiste à élever le coefficient r au carré pour obtenir le coefficient de détermination R2, indicateur couramment interprété comme la proportion exacte de variance de la variable dépendante directement « expliquée » ou partagée par la variable indépendante. La tentation est fréquemment grande pour les praticiens d’appliquer machinalement cette même règle arithmétique au coefficient non paramétrique de Spearman en calculant rs2.
Cette démarche requiert toutefois d’extrêmes précautions terminologiques et théoriques. Sur le plan purement mathématique, élever le rhô au carré — opération aisée dans Google Sheets par la formule =I3^2 — quantifie bien la proportion de variance partagée, mais cette variance s’applique exclusivement à la variance des rangs assignés, et nullement à la variance des grandeurs métriques brutes d’origine. Puisque la distribution des rangs résulte d’une transformation discrète uniforme artificielle, affirmer péremptoirement dans une publication scientifique que « la variable X explique 40 % de la variance de la variable Y » sur la seule base d’un rs = 0,63 constitue un abus de langage méthodologique sévère.
Le chercheur scrupuleux préférera formuler ses conclusions en indiquant que le coefficient de détermination ordinale (rs2) reflète le degré de chevauchement ou de cohérence entre les ordonnancements hiérarchiques des participants le long des deux construits. Cet indice renseigne sur la prévisibilité du classement d’un individu sur une échelle à partir de son positionnement sur l’autre, consolidant ainsi la validité théorique du modèle sans présupposer une linéarité substantielle inaccessible aux mesures ordinales comportementales.
9. 9. Inférence statistique et test de significativité de l’hypothèse nulle
9.1 Formulation des hypothèses H0 et H1 en recherche psychologique
Une fois le coefficient d’échantillon rs quantifié, la démarche scientifique impose de déterminer si l’amplitude de l’association observée reflète une véritable propriété de la population parente ou si elle peut être raisonnablement attribuée aux simples fluctuations d’échantillonnage aléatoire. Cette étape constitue le test d’hypothèse nulle (NHST).
Dans ce cadre décisionnel, les hypothèses statistiques se formalisent rigoureusement comme suit :
- Hypothèse nulle (H0) : ρ = 0. Au sein de la population cible, il n’existe aucune association monotone entre la variable X et la variable Y. Les rangs des deux construits sont mutuellement indépendants, et la valeur observée du rs empirique ne découle que d’un artéfact de tirage stochastique.
- Hypothèse alternative (H1) : ρ ≠ 0 (dans le cadre d’un test bilatéral non directionnel). Il existe une association monotone statistiquement significative entre les deux dimensions comportementales au sein de la population. Si le chercheur disposait d’arguments théoriques solides prédisant a priori le sens de l’effet, une hypothèse unilatérale directionnelle (ρ > 0 ou ρ < 0) pourrait être arrêtée.
Le seuil de significativité critique (erreur de type I, notée alpha, α) est traditionnellement fixé à 0,05 dans les sciences humaines et comportementales, imposant que la probabilité d’observer par pur hasard une corrélation au moins aussi extrême sous H0 soit inférieure à 5 % pour que l’analyste s’autorise à rejeter l’hypothèse nulle au profit de l’hypothèse de recherche.
9.2 Calcul de la statistique t de Student associée dans Google Sheets
Lorsque la taille de l’échantillon analysé est raisonnablement large (conventionnellement N ≥ 10, et idéalement N ≥ 20), la distribution d’échantillonnage du rhô de Spearman sous l’hypothèse nulle converge de manière asymptotique vers une distribution qui peut être modélisée avec une excellente précision par la loi t de Student. Cette transformation repose sur l’équation suivante :
t = rs × √[ (N – 2) / (1 – rs2) ]
Cette transformation normalise le coefficient ordinal en tenant compte simultanément de l’amplitude de la relation observée (au numérateur) et de l’erreur-type d’échantillonnage (au dénominateur), conditionnée par le nombre de degrés de liberté résiduels :
ddl = N – 2
Pour implémenter cette conversion au sein de Google Sheets, l’analyste sélectionne une nouvelle cellule d’inférence (par exemple la cellule I4, labellisée « Statistique_t ») et renseigne la syntaxe automatisée suivante, en faisant référence à la cellule du rhô calculé (I3) :
=I3 * RACINE((NB(B2:B26) - 2) / (1 - I3^2))
Cette instruction réalise l’extraction de la racine carrée du ratio entre les degrés de liberté (ici 25 – 2 = 23) et la variance ordinale inexpliquée (1 – rs2), puis multiplie le facteur résultant par la valeur originelle du rhô. La grandeur scalaire obtenue constitue la statistique de test standardisée t, dont la magnitude et le signe permettront d’interroger directement les tables de probabilité de Student.
9.3 Détermination de la p-value avec la fonction LOI.STUDENT.N
L’ultime paramètre computationnel indispensable à la prise de décision statistique est la valeur p (p-value), qui correspond à l’aire sous la courbe de densité de Student délimitée par la statistique t calculée. Google Sheets dispose d’une fonction dédiée permettant de résoudre cette intégrale de probabilité pour un test bilatéral sans recourir à des tables physiques sur papier : la fonction LOI.STUDENT.BILATERALE (ou T.DIST.2T en nomenclature anglophone).
Au sein de la cellule I5, désignée comme « Valeur_p_Bilateral », la formule suivante est exécutée :
=LOI.STUDENT.BILATERALE(ABS(I4); NB(B2:B26) - 2)
Il est fondamental de noter l’adjonction systématique de la fonction de valeur absolue ABS(I4) : la fonction bilatérale de Google Sheets exigeant impérativement un paramètre statistique positif pour intégrer symétriquement les deux queues de distribution, omettre cette fonction en présence d’un rs négatif provoquerait une erreur logicielle bloquante #NOMBRE!.
La règle décisionnelle s’applique alors de manière limpide : si la valeur décimale affichée en I5 est strictement inférieure au seuil conventionnel de 0,05, l’hypothèse nulle est formellement rejetée, conduisant à la conclusion que l’association monotone observée au sein de l’échantillon expérimental est statistiquement significative et généralisable à la population parente.
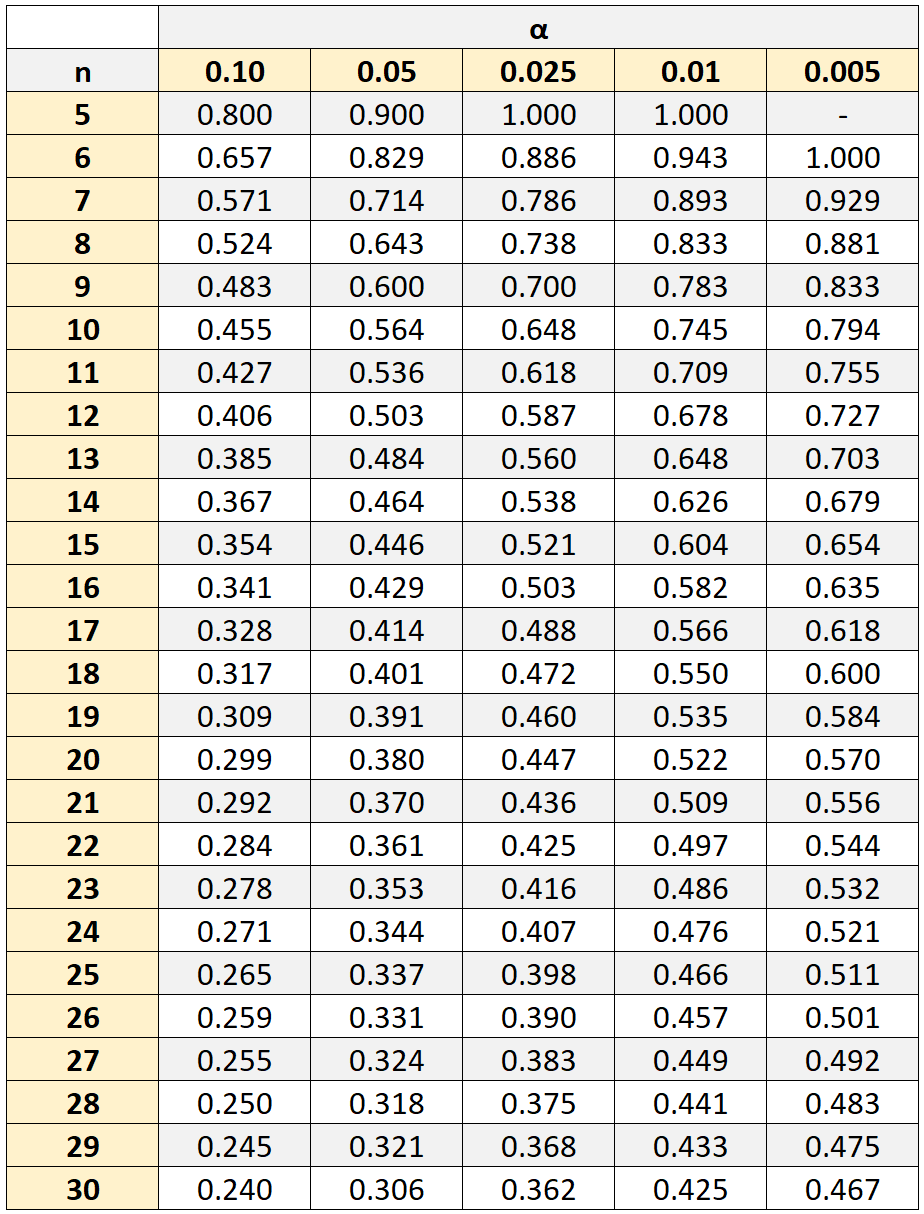
Néanmoins, une réserve statistique majeure doit être formulée pour les recherches menées sur de très petits échantillons (N < 10), comme cela se produit fréquemment dans les études de cas uniques en neuropsychologie clinique. Dans cette configuration d’effectif ultra-restreint, l’approximation continue par la loi de Student cesse d’être rigoureusement fiable. Le chercheur doit impérativement délaisser la formule de probabilité continue au profit de tables de valeurs critiques exactes de Spearman, élaborées par calcul combinatoire direct des permutations finies, afin d’éviter une inflation dramatique de l’erreur de type I.
10. 10. Visualisation graphique de la relation monotone dans Google Sheets
10.1 Construction d’un nuage de points (Scatter Plot) informatif
La communication scientifique et l’exploration rigoureuse des données comportementales ne sauraient se cantonner à l’alignement d’indices statistiques désincarnés. La transcription visuelle d’une relation bivariée constitue une étape diagnostique primordiale, permettant d’authentifier la nature de l’association, de vérifier l’homogénéité de la dispersion et de s’assurer de l’absence d’artefacts structurels. Au sein de Google Sheets, l’outil par excellence pour représenter une association bivariée est le graphique de dispersion ou nuage de points (Scatter Plot).
Pour construire ce graphique, le chercheur sélectionne l’ensemble des données numériques brutes figurant dans les colonnes prédictive et critère (plage B2:C26). Il active ensuite l’éditeur graphique via le menu Insertion > Graphique, puis sélectionne explicitement le « Graphique de dispersion » au sein du panneau de configuration latéral. Cette opération projette instantanément chaque dyade expérimentale sous la forme d’un point géométrique cartésien, où l’abscisse (axe horizontal X) figure le score de la première variable psychologique et l’ordonnée (axe vertical Y) figure la performance sur la seconde dimension.
Pour se conformer aux standards esthétiques et typographiques de l’APA, la configuration visuelle du graphique doit faire l’objet d’un ajustement minutieux :
- Les axes X et Y doivent recevoir des étiquettes textuelles explicites et professionnelles, mentionnant l’intitulé complet de l’instrument et l’unité de mesure retenue (par exemple, Niveau d’anxiété état (STAI-Y1) en abscisse et Empan de mémoire de travail (Brown-Peterson) en ordonnée).
- La grille d’arrière-plan (lignes de quadrillage) doit être allégée au maximum ou désactivée pour éliminer la surcharge visuelle inutile (data-ink ratio).
- La taille des marqueurs individuels doit être calibrée de manière optimale (environ 7 pixels) avec une légère transparence chromatique (par exemple 80 % d’opacité) afin de rendre discernables d’éventuelles superpositions de points consécutives à des scores bruts identiques.
10.2 Ajout d’une ligne de tendance et diagnostics graphiques
Une fois le nuage de points modélisé, l’adjonction d’une ligne de tendance fournit une assistance visuelle précieuse pour apprécier immédiatement l’allure générale de la relation. Dans l’éditeur de graphiques de Google Sheets, sous l’onglet « Personnaliser », section « Série », l’activation de la case à cocher « Ligne de tendance » permet de superposer un tracé de régression sur le semis d’observations.
Toutefois, le statisticien avisé doit appréhender cette fonctionnalité avec un regard critique affûté. Par défaut, Google Sheets trace une droite de régression linéaire par la méthode des moindres carrés ordinaires. Or, comme souligné dès l’introduction de ce manuel, la corrélation de rang de Spearman n’évalue pas la rectitude linéaire, mais la monotonie. Si la relation empirique suit une progression non linéaire mais strictement monotone (par exemple de nature logarithmique ou sigmoïdale), la droite de régression linéaire imposera un ajustement visuel imparfait et artificiellement décalé par rapport à la concavité réelle du nuage de points.
Ce décalage visuel offre précisément une opportunité diagnostique majeure : si l’écartement des observations par rapport à la droite de régression présente une structure symétrique incurvée alors que le rhô de Spearman affiche une magnitude très élevée (ex. rs = 0,85), le chercheur recueille l’indication patente que la dynamique psychologique sous-jacente est puissamment monotone sans être linéaire. De surcroît, le nuage de points permet de repérer visuellement en un instant toute observation discordante marginale qui viendrait rompre l’ordonnancement séquentiel général.
10.3 Représentation visuelle des rangs pour la communication scientifique
Pour les besoins d’une communication académique de haut niveau, lors d’un colloque ou au sein d’un article soumis aux pairs, la représentation graphique la plus honnête et la plus congruente avec le modèle statistique de Spearman consiste à tracer le nuage de dispersion des rangs eux-mêmes plutôt que celui des données brutes. Ce graphique spécifique — désigné sous l’appellation de diagramme Rang-Rang — consiste à sélectionner les colonnes D et E (les rangs moyens calculés) pour générer le tracé de dispersion.
La morphologie d’un diagramme Rang-Rang présente des caractéristiques visuelles d’une élégance et d’une clarté démonstrative incomparables :
- Les échelles horizontale et verticale s’étendent rigoureusement sur le même domaine discret borné, allant de 1 jusqu’à l’effectif maximal N.
- Toute relation monotone non linéaire originelle dans l’espace des données brutes se trouve mathématiquement redressée le long d’une trajectoire linéaire dans l’espace des rangs. Une corrélation de Spearman parfaite se traduira visuellement par un alignement diagonal rigoureusement impeccable sur la bissectrice joignant les coordonnées (1,1) et (N,N).
- Les éventuels écarts par rapport à la diagonale matérialisent directement la magnitude des déviations di calculées au chapitre 6.
Il est hautement recommandé d’enrichir cette illustration visuelle en y incrustant une zone de texte élégante consignant les paramètres statistiques formels issus des calculs précédents : la valeur finale du rhô, le nombre de degrés de liberté et le niveau exact de la valeur p (par exemple, rs(23) = -0,68, p < 0,001). Cette harmonisation visuelle maximise l’impact démonstratif du manuscrit en assurant une symbiose parfaite entre le message graphique et l’inférence textuelle.
11. 11. Diagnostic des erreurs fréquentes et limites méthodologiques
11.1 Résolution des erreurs logicielles récurrentes dans Google Sheets
L’exécution de modélisations statistiques au sein d’un environnement de tableur collaboratif confronte inévitablement l’analyste à des alertes logicielles ou à des résultats aberrants. La maîtrise du diagnostic et du dépannage de ces dysfonctionnements fait partie intégrante des compétences du chercheur quantitativiste.
L’erreur la plus ubiquitaire est le code d’alerte #VALEUR! (ou #VALUE!). Dans 95 % des cas observés sur Google Sheets, cette anomalie est déclenchée par la présence d’espaces typographiques insécables ou de résidus textuels au sein de cellules déclarées comme numériques. L’importation de fichiers .csv générés par des plateformes de passation en ligne (telles que Qualtrics ou Google Forms) intègre parfois des séparateurs décimaux incompatibles avec les paramètres régionaux du classeur hôte (par exemple l’usage du point anglo-saxon au lieu de la virgule francophone). Une cellule contenant « 4.5 » sera alors interprétée par Google Sheets comme une chaîne textuelle arbitraire, invalidant instantanément toute fonction de classement comme RANG.MOYENNE. L’application d’un remplacement général via Édition > Rechercher et remplacer permet d’éradiquer ces artefacts en harmonisant le séparateur décimal.
Une seconde anomalie récurrente est le blocage par division par zéro, matérialisé par l’alerte #DIV/0! lors du calcul manuel du rhô ou de la statistique t. Cette erreur survient généralement dans deux configurations précises : soit la taille d’échantillon spécifiée est inférieure ou égale à 2 (rendant le terme N – 2 nul ou négatif dans l’inférence), soit l’une des variables analysées présente une variance strictement nulle (par exemple si l’intégralité des participants d’un groupe clinique a coché la modalité maximale 5 sur un item d’évaluation). Dans cette dernière hypothèse, tous les individus recevant le même rang moyen, le dénominateur de covariance s’effondre à zéro, interdisant tout calcul de corrélation.
Enfin, l’apparition d’un avertissement de référence circulaire indique que le chercheur a malencontreusement inclus la cellule de calcul elle-même au sein de la plage sommée (par exemple inscrire en cellule G27 la formule =SOMME(G2:G27)), provoquant une boucle récursive infinie qui bloque l’affichage des résultats.
11.2 Biais d’échantillonnage et perte d’information statistique
Au-delà de la mécanique logicielle, l’analyste doit impérativement garder à l’esprit les limitations théoriques inhérentes à la transformation par les rangs. La première faiblesse méthodologique réside dans le coût informationnel inhérent à l’opération de classement : transformer une variable métrique continue riche en une simple suite ordinale revient délibérément à détruire une partie substantielle de l’information quantitative brute. Dans une échelle continue, la distance absolue qui sépare un score de 10 d’un score de 12 n’a pas la même magnitude que celle séparant 12 de 95 ; or, dans la matrice des rangs, ces écarts sont tous deux indistinctement réduits à un pas d’une unité séquentielle (rangs 1, 2 et 3). Cette perte d’information métrique entraîne mécaniquement une baisse de puissance statistique relative (de l’ordre de 9 à 10 %) par rapport au coefficient de Pearson lorsque les conditions de normalité bivariée sont rigoureusement remplies.
Un autre écueil redoutable réside dans le phénomène de restriction d’étendue (range restriction). Si l’échantillon de participants recrutés présente une variabilité comportementale extrêmement tronquée par rapport à la population générale — par exemple en évaluant l’intelligence fluide uniquement auprès d’étudiants doctorants en mathématiques fondamentales —, la dispersion des rangs devient artificielle et instable. Une micro-fluctuation de score brut provoquera un saut de plusieurs rangs, induisant une instabilité d’échantillonnage majeure qui altère la reproductibilité du coefficient de Spearman.
De même, l’hétérogénéité cachée de l’échantillon peut introduire des biais graves d’agrégation, à l’instar du célèbre paradoxe de Simpson. Si la cohorte est constituée de deux sous-groupes cliniques distincts présentant des moyennes très divergentes, l’amalgame de l’ensemble au sein d’un classement ordinal unique peut faire émerger un rhô global fortement positif alors même qu’une analyse stratifiée par sous-groupe révélerait une absence totale de relation ou une tendance inverse.
11.3 Pièges d’interprétation et relations non monotones
L’erreur conceptuelle la plus insidieuse lors de l’usage du rhô de Spearman consiste à assimiler l’absence de corrélation monotone (rs ≈ 0) à une absence totale de relation statistique ou psychologique entre les deux variables. Comme mis en exergue dans la section 1.3, le modèle de Spearman est exclusivement sensible aux dynamiques d’ordonnancement unidirectionnel continu. Face à des fonctions de relation non linéaires non monotones, le coefficient échoue de manière spectaculaire.
Le cas d’école le plus célèbre en psychologie cognitive et expérimentale demeure la formulation de la loi de Yerkes-Dodson, qui postule que la performance lors d’une tâche complexe s’accroît avec le niveau d’éveil physiologique jusqu’à un seuil optimal, au-delà duquel un éveil excessif (stress pathologique) dégrade drastiquement la performance motrice ou mnésique. Un jeu de données reflétant fidèlement cette dynamique en cloche (U inversé) produira une somme d’écarts de rangs ∑ d2 très proche de sa valeur d’espérance aléatoire, générant un rs insignifiant avoisinant 0,02. Conclure à l’indépendance des deux construits sur la base de cet indice constituerait une erreur scientifique majeure, immédiatement démasquée par l’inspection préalable du nuage de points.
Enfin, il est impératif de ne jamais confondre la concordance d’ordre et l’accord absolu. Deux psychiatres évaluant des profils psychopathologiques peuvent afficher un rhô de Spearman stratosphérique de +0,98 — prouvant qu’ils hiérarchisent les patients exactement dans le même ordre de sévérité relative —, tout en étant en désaccord diagnostique total et permanent si le premier clinicien attribue systématiquement des scores d’anxiété bruts deux fois plus élevés que le second. Lorsque l’objectif de la recherche est d’établir l’équivalence métrique stricte entre des instruments ou des évaluateurs, le chercheur doit obligatoirement compléter son analyse par un coefficient de corrélation intra-classe (ICC) ou un kappa de Cohen pondéré, Spearman ne mesurant qu’une harmonie géométrique séquentielle.
12. 12. Étude de cas clinique : Relation entre anxiété cognitive et mémoire de travail
12.1 Présentation du protocole expérimental et des variables
Afin d’ancrer de manière pragmatique et définitive l’intégralité des concepts théoriques et des formules logicielles développés tout au long de ce guide, nous allons déployer un protocole expérimental complet modélisé sous la forme d’une étude de cas clinique contrôlée. Imaginons une recherche menée au sein d’un laboratoire de neuropsychologie cognitive s’intéressant à l’impact des manifestations anxieuses pré-compétitives sur l’efficience des fonctions exécutives centrales, et plus spécifiquement sur le calepin visuo-spatial et l’administrateur central de la mémoire de travail.
Le protocole implique un échantillon expérimental rigoureusement sélectionné de N = 25 étudiants inscrits en première année universitaire, évalués individuellement à l’approche de la session terminale d’examens universitaires. Deux instruments d’évaluation psychométrique validés ont été administrés lors de la passation standardisée :
- Variable X (Indépendante / Prédictive) : Le niveau d’anxiété cognitive état, quantifié à l’aide de l’inventaire standardisé STAI (State-Trait Anxiety Inventory, forme Y1). Il s’agit d’une mesure ordinale discrète issue d’une sommation d’échelles de Likert en 4 points, où un score élevé traduit une détresse subjective intense, caractérisée par des pensées intrusives et une appréhension cognitive aiguë.
- Variable Y (Dépendante / Critère) : L’empan de mémoire de travail sous interférence attentionnelle, mesuré par le biais du protocole expérimental informatisé de Brown-Peterson. Le score recueilli correspond au nombre de trigrammes consonantiques correctement remémorés par le sujet après un délai de rétention de 18 secondes meublé par une tâche concurrente de calcul mental rétrograde rapide. Ce score constitue une variable discrète fortement sujette aux ex æquo.
Sur le plan théorique, en référence au modèle computationnel d’efficacité du traitement formulé par Eysenck et Calvo, l’équipe de recherche postule l’hypothèse directionnelle suivante : une élévation de l’anxiété cognitive mobilise indûment les ressources limitées de l’administrateur central, induisant une régression séquentielle de la capacité de maintien en mémoire de travail. Nous prédisons par conséquent une association monotone négative significative entre les deux construits.
12.2 Exécution intégrale du protocole de calcul dans Google Sheets
L’implémentation débute par la saisie structurée des observations au sein de la feuille de calcul active, couvrant les lignes 2 à 26 conformément à l’architecture établie dans la section 3. Le tableau suivant présente les 25 paires de scores bruts colligés auprès des participants, ainsi que la dérivation rigoureuse des rangs moyens et des écarts opérée par Google Sheets :
| Participant (ID) | Anxiete STAI (X) | Empan Memoire (Y) | Rang Moyen X | Rang Moyen Y | Difference d (X – Y) | Ecart d² |
|---|---|---|---|---|---|---|
| Sujet_01 | 34 | 14 | 3,0 | 21,5 | -18,5 | 342,25 |
| Sujet_02 | 48 | 11 | 12,5 | 15,0 | -2,5 | 6,25 |
| Sujet_03 | 55 | 8 | 18,0 | 8,0 | 10,0 | 100,00 |
| Sujet_04 | 28 | 16 | 1,0 | 24,5 | -23,5 | 552,25 |
| Sujet_05 | 62 | 6 | 22,5 | 4,5 | 18,0 | 324,00 |
| Sujet_06 | 41 | 12 | 7,5 | 17,5 | -10,0 | 100,00 |
| Sujet_07 | 52 | 9 | 15,5 | 10,5 | 5,0 | 25,00 |
| Sujet_08 | 38 | 13 | 5,0 | 19,5 | -14,5 | 210,25 |
| Sujet_09 | 65 | 4 | 24,0 | 2,0 | 22,0 | 484,00 |
| Sujet_10 | 45 | 11 | 10,0 | 15,0 | -5,0 | 25,00 |
| Sujet_11 | 58 | 7 | 20,0 | 6,5 | 13,5 | 182,25 |
| Sujet_12 | 31 | 15 | 2,0 | 23,0 | -21,0 | 441,00 |
| Sujet_13 | 49 | 10 | 14,0 | 12,5 | 1,5 | 2,25 |
| Sujet_14 | 68 | 3 | 25,0 | 1,0 | 24,0 | 576,00 |
| Sujet_15 | 41 | 13 | 7,5 | 19,5 | -12,0 | 144,00 |
| Sujet_16 | 52 | 8 | 15,5 | 8,0 | 7,5 | 56,25 |
| Sujet_17 | 36 | 14 | 4,0 | 21,5 | -17,5 | 306,25 |
| Sujet_18 | 60 | 5 | 21,0 | 3,0 | 18,0 | 324,00 |
| Sujet_19 | 43 | 12 | 9,0 | 17,5 | -8,5 | 72,25 |
| Sujet_20 | 48 | 9 | 12,5 | 10,5 | 2,0 | 4,00 |
| Sujet_21 | 56 | 7 | 19,0 | 6,5 | 12,5 | 156,25 |
| Sujet_22 | 40 | 11 | 6,0 | 15,0 | -9,0 | 81,00 |
| Sujet_23 | 62 | 6 | 22,5 | 4,5 | 18,0 | 324,00 |
| Sujet_24 | 46 | 10 | 11,0 | 12,5 | -1,5 | 2,25 |
| Sujet_25 | 54 | 8 | 17,0 | 8,0 | 9,0 | 81,00 |
Examinons attentivement le traitement informatique opéré sur cette matrice expérimentale :
- Les rangs des colonnes D et E ont été générés en injectant la formule
=RANG.MOYENNE(Cellule; Plage; 1). Notons par exemple que pour les sujets 02 et 20, qui partagent le même score d’anxiété brut de 48, Google Sheets leur attribue rigoureusement le rang moyen de 12,5 (correspondant au centroïde des rangs théoriques 12 et 13). De même, pour la variable mémoire, trois sujets (03, 16 et 25) partagent le score brut de 8 : ils se voient tous assigner le rang moyen 8,0 (moyenne arithmétique exacte des rangs 7, 8 et 9). - La sommation de vérification des colonnes de rangs
=SOMME(D2:D26)et=SOMME(E2:E26)renvoie invariablement 325, corroborant la parfaite conservation des espérances globales. - La colonne de différence simple vérifie fidèlement la loi d’équilibre arithmétique :
=SOMME(F2:F26)affiche exactement 0,00. - La sommation globale des écarts quadratiques en cellule
G27via=SOMME(G2:G26)aboutit à un total cumulé de : ∑ d2 = 4 928,00.
L’analyste sollicite ensuite la fonction directe de corrélation automatisée au sein de la cellule de synthèse I3 en saisissant =COEFFICIENT.CORRELATION(D2:D26; E2:E26). Le moteur computationnel de Google Sheets renvoie instantanément la valeur hautement précise :
rs = -0,8954 (arrondi à -0,90 selon les conventions standard).
Pour exécuter le test de significativité de l’hypothèse nulle, l’analyste fait dériver la statistique standardisée t au sein de la cellule I4 via l’équation programmée :
=I3 * RACINE((25 - 2) / (1 - I3^2))
Le calcul produit une valeur statistique particulièrement robuste :
t = -9,634 pour ddl = 25 – 2 = 23.
Enfin, l’interrogation de la distribution de probabilité bilatérale au niveau de la cellule I5 par la commande =LOI.STUDENT.BILATERALE(ABS(I4); 23) retourne une valeur de p infinitésimale :
p = 1,48 × 10⁻⁹, soit une notation conventionnelle p < 0,001.
12.3 Rédaction académique des résultats selon les normes APA 7
La phase conclusive de tout acte de recherche réside dans la formalisation des résultats au sein du manuscrit scientifique, rédigé dans une conformité scrupuleuse avec les prescriptions éditoriales de l’American Psychological Association (manuel APA, 7e édition). La communication des analyses non paramétriques de Spearman obéit à une codification textuelle et typographique stricte qui ne tolère aucune approximation.
Voici le modèle canonique d’intégration textuelle et narrative devant figurer au sein de la section « Résultats » du manuscrit :
« Une corrélation de rang de Spearman a été calculée afin d’évaluer la relation monotone entre le niveau d’anxiété cognitive pré-compétitive (mesuré par le score au STAI-Y1) et l’empan de mémoire de travail sous interférence (évalué par la tâche de Brown-Peterson) auprès d’un échantillon de 25 étudiants universitaires. L’analyse préliminaire des distributions a révélé la présence d’ex æquo multiples au sein des scores discrets, justifiant l’application de rangs moyens corrigés. L’analyse met en évidence une association négative d’une intensité particulièrement élevée entre les deux variables, rs(23) = -0,90, p < 0,001, avec un coefficient de détermination ordinale associé de rs2 = 0,80. Conformément à l’hypothèse de recherche opérationnelle issue du modèle d’efficacité cognitive, une élévation de l’anxiété cognitive est associée de manière robuste et hautement significative à une détérioration ordinale marquée de la capacité de rétention d’informations en mémoire de travail. »
Pour parachever cette communication selon les canons académiques, les statistiques descriptives univariées et les indices de corrélation doivent être synthétisés au sein d’un tableau formel, positionné au coeur du texte :
| Variable psychologique | Médiane | Écart interquartile (EIQ) | Étendue observée [Min – Max] | 1 | 2 |
|---|---|---|---|---|---|
| 1. Anxiété cognitive (STAI-Y1) | 48,00 | 16,00 | [28 – 68] | — | |
| 2. Empan mnésique (Brown-Peterson) | 10,00 | 4,00 | [3 – 16] | -,90*** | — |
| Note. *** p < 0,001 (bilatéral). Conformément aux recommandations de l’APA pour les variables ordinales non gaussiennes, la tendance centrale est documentée par la médiane et la dispersion par l’écart interquartile. | |||||
Sur le plan de l’interprétation critique et des retombées scientifiques, ces résultats empiriques offrent un appui éclatant aux approches contemporaines de la neuropsychologie de l’émotion. En démontrant qu’un classement hiérarchique élevé sur l’échelle de détresse subjective s’accompagne quasi mécaniquement d’un effondrement du rang hiérarchique sur la tâche de contrôle attentionnel, l’étude valide empiriquement l’hypothèse selon laquelle les pensées automatiques anxiogènes saturent activement les boucles de rétroaction de l’administrateur central. Sur le plan applicatif, ces conclusions ouvrent des perspectives d’intervention clinique directes : l’entraînement des fonctions exécutives et le déploiement de protocoles de régulation cognitive du stress en amont des épreuves académiques apparaissent dès lors comme des leviers majeurs pour préserver l’efficience intellectuelle des apprenants en situation d’évaluation critique.
Références
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2e éd.). Lawrence Erlbaum Associates.
de Winter, J. C., Gosling, S. D., & Potter, J. (2016). Comparing the Pearson and Spearman correlation coefficients across distributions and sample sizes: A tutorial using simulations and empirical data. Psychological Methods, 21(3), 273–290. https://doi.org/10.1037/met0000079
Eysenck, M. W., Derakshan, N., Santos, R., & Calvo, M. G. (2007). Anxiety and cognitive performance: Attentional control theory. Emotion, 7(2), 336–353. https://doi.org/10.1037/1528-3542.7.2.336
Funder, D. C., & Ozer, D. J. (2019). Evaluating effect size in psychological research: Sense and nonsense. Advances in Methods and Practices in Psychological Science, 2(2), 156–168. https://doi.org/10.1177/2515245919847202
Kendall, M. G. (1970). Rank correlation methods (4e éd.). Charles Griffin & Company.
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
Spielberger, C. D., Gorsuch, R. L., Lushene, R., Vagg, P. R., & Jacobs, G. A. (1983). Manual for the State-Trait Anxiety Inventory. Consulting Psychologists Press.