
La métrologie psychologique et psychiatrique repose sur un postulat fondamental : la valeur diagnostique d’une observation ne vaut que par la reproductibilité des instruments qui la quantifient. Qu’il s’agisse de mesurer la sévérité d’un épisode dépressif majeur à travers l’échelle de Hamilton, d’évaluer les symptômes négatifs de la schizophrénie via la PANSS ou de chiffrer l’altération neurocognitive d’un patient post-AVC, l’objectivité clinique exige que plusieurs praticiens indépendants observant le même individu parviennent à des conclusions numériques concordantes. Lorsque cette concordance fait défaut, la variabilité observée reflète moins la pathologie du sujet que les biais d’évaluation inhérents aux observateurs, introduisant un bruit de mesure susceptible d’invalider toute inférence thérapeutique ou scientifique.
Pour mesurer cette concordance métrologique sur des variables continues ou quasi-continues, le coefficient de corrélation intraclasse (CCI) s’est imposé comme le standard méthodologique international incontournable. Contrairement aux coefficients de corrélation bivariés classiques, le CCI dérive directement de la théorie des modèles d’analyse de variance à effets aléatoires et mixtes. Il permet d’isoler la variance attribuable aux véritables disparités entre les patients de celle induite par les divergences d’appréciation entre évaluateurs ou par l’erreur de mesure aléatoire pure. Sa flexibilité conceptuelle, formalisée dans les travaux séminaux de Shrout et Fleiss (1979), autorise des paramétrages distincts selon que les cliniciens sont perçus comme un échantillon aléatoire représentatif ou comme les seuls juges d’intérêt expérimental.
Si des logiciels statistiques spécialisés comme R, SPSS ou SAS intègrent des modules automatisés pour dériver ces indices, Microsoft Excel demeure l’environnement de calcul le plus accessible et le plus fréquemment déployé au sein des unités de recherche clinique, des hôpitaux et des laboratoires de psychologie expérimentale. L’estimation rigoureuse d’un CCI sous Excel ne souffre cependant aucune approximation : elle exige une compréhension intime de la décomposition des sommes de carrés, une manipulation experte de l’Utilitaire d’analyse et une implémentation sans faille des formules matricielles de variance. Ce guide exhaustif détaille l’intégralité du processus méthodologique, mathématique et technique permettant d’exécuter, d’automatiser et d’interpréter le coefficient de corrélation intraclasse dans Excel selon les standards académiques les plus rigoureux.
1. Fondements conceptuels du coefficient de corrélation intraclasse en psychométrie
1.1 Définition et rôle métrologique de la fidélité inter-juges
Dans le cadre de la théorie classique des tests (TCT), tout score observé chez un individu résulte de la sommation d’un score vrai, immuable au moment de la passation, et d’une composante d’erreur aléatoire ou systématique. La fidélité inter-juges mesure la propension d’un outil d’évaluation à refléter fidèlement ce score vrai lorsque l’administration ou la notation est confiée à des observateurs distincts. Dans les sciences du comportement et la recherche translationnelle, cette fidélité ne peut être appréhendée comme une simple association linéaire : deux psychiatres évaluant des scores d’anxiété peuvent présenter une corrélation linéaire parfaite tout en divergeant radicalement sur le niveau absolu de gravité du patient, l’un attribuant systématiquement cinq points de plus que l’autre. Une telle divergence compromet gravement l’inclusion des patients dans des essais cliniques randomisés fondés sur des scores seuils prédéfinis.
Le rôle métrologique du coefficient de corrélation intraclasse consiste précisément à dépasser la simple covariation pour quantifier l’accord absolu ou la cohérence relative entre plusieurs juges. Alors qu’un indice de corrélation bivariée ne sanctionne pas un écart additif constant entre deux séries de scores, le CCI pénalise mathématiquement les divergences systématiques d’étalonnage entre observateurs dès lors qu’un modèle d’accord absolu est sélectionné. L’échelle théorique du CCI s’étend de 0, indiquant une absence totale de fidélité où la variance observée est intégralement imputable à l’erreur ou aux désaccords entre juges, jusqu’à 1, traduisant une identité parfaite des cotations attribuées à chaque sujet par l’ensemble des évaluateurs du panel.
Dans les applications cliniques et expérimentales de pointe, notamment lors de l’étalonnage de grilles d’observation du comportement de l’enfant autiste ou de la standardisation de protocoles neuro-imagerie où plusieurs radiologues délimitent des volumes lésionnels, le CCI constitue un filtre de validation préalable incontournable. Un instrument dont le CCI s’avère déficitaire ne peut en aucun cas garantir que les variations observées au fil du suivi longitudinal traduisent une réponse clinique au traitement plutôt qu’une fluctuation aléatoire imputable à l’alternance des cliniciens au sein du service hospitalier.
1.2 Origine statistique et décomposition de la variance
L’assise formelle du coefficient de corrélation intraclasse prend sa source dans les travaux fondateurs de Ronald Fisher sur l’analyse de variance (ANOVA). Fisher a démontré que lorsque des données sont regroupées en classes naturelles — ici, les individus évalués constituant les classes et les cotations des juges représentant les éléments intCatchés à ces classes —, la variance globale observée peut être partitionnée de manière univoque en composantes orthogonales et additives. Sous un modèle linéaire général, la variance totale d’une mesure s’exprime comme la somme de la variance attribuable aux véritables différences inter-sujets, de la variance attribuable aux différences inter-évaluateurs et de la variance résiduelle non contrôlée.
Algébriquement, le score attribué au sujet i par l’évaluateur j se modélise par l’équation linéaire suivante :
Yij = μ + αi + βj + (αβ)ij + εij
Dans cette formulation, μ représente la moyenne générale de la population, αi figure l’écart spécifique du sujet i par rapport à cette moyenne, βj désigne le biais systématique de cotation de l’évaluateur j, (αβ)ij modélise l’interaction spécifique entre un sujet particulier et un juge donné, et εij capture l’erreur de mesure purement stochastique. Dans la majorité des protocoles cliniques où chaque juge n’évalue chaque sujet qu’une seule fois, l’interaction et l’erreur résiduelle se trouvent mathématiquement confondues au sein d’un terme de variance résiduelle unique.
Un aspect critique de cette décomposition réside dans la sensibilité intrinsèque du CCI à l’hétérogénéité de l’échantillon analysé. Puisque le coefficient représente fondamentalement le ratio entre la variance inter-sujets et la variance totale, un échantillon clinique extrêmement homogène — composé par exemple exclusivement de patients présentant une dépression d’intensité modérée — présentera une variance inter-sujets réduite. Dans cette configuration, même si les cliniciens s’accordent remarquablement bien sur le plan clinique, le CCI calculé sera mécaniquement abaissé, la composante de variance vraie au numérateur étant restreinte. À l’inverse, l’inclusion d’un échantillon artificiellement hétérogène, mêlant des témoins sains et des patients lourdement symptomatiques, gonflera le coefficient sans pour autant que l’instrument ne possède une précision de mesure intrinsèque supérieure.
2. Typologie des modèles de CCI selon la classification de Shrout et Fleiss
2.1 Le modèle à un facteur aléatoire (Modèle 1)
La taxonomie canonique introduite par Shrout et Fleiss (1979), enrichie ultérieurement par McGraw et Wong (1996), structure les coefficients de corrélation intraclasse en trois grandes familles de modèles statistiques. Le Modèle 1, ou modèle à un facteur aléatoire, repose sur le postulat méthodologique selon lequel chaque sujet de l’étude est évalué par un ensemble différent d’évaluateurs, ces derniers étant tirés de manière purement stochastique au sein d’une population indéfinie de juges potentiels. Dans cette configuration, il n’existe aucun appariement ni croisement : l’évaluateur ayant noté le premier patient n’a aucun lien avec celui ayant évalué le second, et aucune identification stable des juges ne persiste d’un sujet à l’autre.
Deux formulations distinctes émergent de ce cadre d’analyse univarié. Le CCI(1,1) estime la fidélité attendue lorsqu’un diagnostic ou un score clinique futur repose sur l’évaluation fournie par un unique observateur sélectionné au hasard dans la population professionnelle :
CCI(1,1) = (σ2sujets) / (σ2sujets + σ2erreur)
À l’opposé, le CCI(1,k) calcule la fidélité d’un protocole où la décision clinique s’appuiera systématiquement sur la moyenne arithmétique des scores délivrés par un groupe de k évaluateurs distincts tirés au hasard pour chaque individu.
En pratique psychométrique et en recherche clinique expérimentale, le Modèle 1 s’avère particulièrement rare. Il s’applique quasi exclusivement aux vastes enquêtes épidémiologiques de terrain où des centaines d’enquêteurs différents interrogent chacun un ou deux participants, sans qu’un design factoriel croisé ne puisse être mis en place. Sa robustesse est limitée par l’impossibilité mathématique de dissocier le biais propre à un évaluateur de l’erreur aléatoire résiduelle, ce qui conduit généralement à une sous-estimation systématique de la fidélité par rapport aux modèles factoriels complets.
2.2 Le modèle à deux facteurs aléatoires (Modèle 2)
Le Modèle 2 incarne le plan expérimental par excellence de la validation métrologique inter-juges. Dans ce schéma, un groupe défini de k évaluateurs évalue l’ensemble des n sujets participant à l’investigation. La spécificité probabiliste de ce modèle réside dans le fait que ces k évaluateurs sont formellement considérés comme un échantillon aléatoire représentatif extrait d’une population beaucoup plus vaste de professionnels qualifiés. Ce postulat est déterminant : il signifie que les conclusions tirées quant à la précision de la mesure doivent pouvoir être extrapolées et généralisées à n’importe quel autre clinicien disposant de qualifications comparables.
Le CCI(2,1) modélise la fiabilité d’une mesure isolée issue d’un seul juge dans ce contexte de généralisabilité totale. Il intègre expressément dans son dénominateur la variance liée aux divergences systématiques entre évaluateurs (σ2juges). Si un praticien tend à noter systématiquement plus sévèrement que ses confrères, cette variabilité est assimilée à une source d’erreur métrologique majeure qui viendra dégrader la valeur numérique finale du coefficient. Le CCI(2,k), quant à lui, quantifie la fiabilité de la moyenne arithmétique des k juges lorsque cette procédure de notation collégiale est destinée à être répliquée en pratique courante par d’autres collèges de k praticiens.
Cette approche par modèle aléatoire à deux facteurs offre une validité écologique maximale pour l’homologation d’instruments psychométriques à diffusion internationale. Elle garantit à l’utilisateur final d’un test que la fidélité annoncée dans le manuel technique ne reflète pas une entente artificielle ou une idiosyncrasie locale restreinte aux seuls chercheurs ayant conçu l’échelle, mais constitue une propriété extrapolable à l’ensemble du corps médical ou de la communauté scientifique.
2.3 Le modèle à deux facteurs mixtes (Modèle 3)
Le Modèle 3 s’applique aux situations expérimentales où les k évaluateurs constituant le panel représentent les seuls juges d’intérêt pour la recherche en cours, excluant toute volonté de généraliser les constats à une population d’observateurs externes. Les juges sont alors conceptualisés d’un point de vue statistique comme des effets fixes, tandis que les sujets évalués demeurent des effets aléatoires issus de la population clinique cible. C’est le design privilégié lorsqu’un protocole d’essai clinique fait appel à deux ou trois investigateurs seniors nommément désignés, formés de manière intensive et dont les cotations centralisées serviront à arbitrer l’ensemble des critères d’évaluation tout au long de l’étude.
Sous ce modèle mixte, deux questions métrologiques distinctes nécessitent une différenciation mathématique fondamentale formalisée par McGraw et Wong (1996) : la distinction entre cohérence relative (consistency) et accord absolu (absolute agreement). Lorsque le chercheur s’intéresse à la cohérence relative, la variance systématique entre les évaluateurs est totalement neutralisée du calcul du dénominateur. Le CCI(3,1) en cohérence relative vérifie uniquement si les praticiens ordonnent les sujets de manière congruente le long du continuum pathologique, sans tenir compte du fait que l’un d’eux attribue systématiquement des notes décalées de plusieurs unités par rapport aux autres.
En revanche, si l’objectif de l’évaluation clinique implique une décision basée sur un seuil absolu (comme l’admission d’un patient en unité protégée dès lors que son score dépasse un score de 25), la cohérence relative devient insuffisante et l’accord absolu sous Modèle 3 doit être calculé. Le CCI(3,k) en cohérence relative présente par ailleurs une identité mathématique parfaite avec le coefficient Alpha de Cronbach, confirmant que la consistance interne d’un test composé de k items peut être formellement modélisée comme la fidélité inter-juges d’un panel fixe de k observateurs évaluant les mêmes items.
3. Distinction théorique : CCI, Kappa de Cohen et corrélation de Pearson
3.1 Limites de la corrélation de Pearson pour mesurer l’accord
Une erreur persistante dans la littérature biomédicale et psychologique consiste à mobiliser le coefficient de corrélation produit-moment de Pearson (r) pour attester de la fidélité ou de la reproductibilité inter-juges. Cette démarche repose sur une confusion conceptuelle profonde entre association linéaire et accord métrologique. Le coefficient de Pearson mesure exclusivement la force et la direction d’une relation linéaire entre deux distributions continues ; il évalue à quel point les points s’alignent le long d’une droite de régression de pente et d’ordonnée à l’origine quelconques, sans jamais imposer que cette droite corresponde à la bissectrice d’identité parfaite (y = x).
Pour illustrer de manière frappante cette défaillance méthodologique, considérons une situation clinique fictive où deux psychiatres évaluent une cohorte de dix patients sur une échelle d’agitation motrice variant de 0 à 100. Supposons que le clinicien A attribue successivement les scores (10, 20, 30, 40, 50, 60, 70, 80, 90, 100) et que le clinicien B attribue pour exactement les mêmes patients les scores (30, 40, 50, 60, 70, 80, 90, 100, 110, 120). Sur le plan statistique, le coefficient de corrélation de Pearson entre ces deux séries est strictement égal à r = 1,00, suggérant à tort une reproductibilité parfaite. Pourtant, il existe un biais systématique massif et constant de 20 points entre les deux praticiens, ce qui induirait des décisions diagnostiques diamétralement opposées en pratique clinique.
De surcroît, le formalisme de Pearson souffre d’une contrainte structurelle rédhibitoire : il est intrinsèquement bivarié et ne peut traiter simultanément que deux observateurs. Dès lors qu’un protocole implique trois, quatre ou dix évaluateurs, le praticien appliquant Pearson est contraint de calculer une matrice de corrélations par paires puis d’effectuer une moyenne arithmétique de ces coefficients, une procédure mathématiquement invalide en raison de la non-linéarité de la métrique des coefficients r et de l’interdépendance des erreurs résiduelles. Le CCI résout élégamment ces deux écueils en pénalisant les écarts d’étalonnage et en intégrant un nombre arbitraire de juges au sein d’une équation unifiée.
3.2 Comparaison avec les coefficients Kappa de Cohen et Fleiss
Dans l’arsenal psychométrique, le Kappa de Cohen (κ) et son extension multijuges, le Kappa de Fleiss, constituent les outils de référence pour évaluer la fidélité inter-observateurs sur des variables strictement qualitatives ou catégorielles nominales. Ces statistiques mesurent la proportion d’accord observée au-delà de celle attribuable au seul hasard probabiliste. Toutefois, leur application devient problématique dès lors que les données collectées se présentent sous forme d’échelles de cotation ordinales étendues, d’échelles de type Likert en 7 ou 10 points, ou de mesures biométriques continues. Réduire des scores continus à des catégories arbitraires pour appliquer un Kappa entraîne une perte massive d’information quantitative et diminue artificiellement la puissance statistique de l’évaluation.
Le tableau comparatif suivant synthétise les propriétés distinctives de ces métriques métrologiques :
| Indice Statistique | Nature des Données | Nombre d’Évaluateurs | Sensibilité au Biais d’Échelle | Modélisation des Sources d’Erreur |
|---|---|---|---|---|
| Corrélation de Pearson (r) | Continues / Intervalles | Exactement 2 | Insensible (mesure la corrélation linéaire) | Nulle (aucune décomposition de variance) |
| Kappa de Cohen (κ) | Nominales / Catégorielles | Exactement 2 | Sensible aux fréquences marginales | Ajustement pour l’accord fortuit uniquement |
| Kappa de Fleiss | Nominales / Catégorielles | Fixe ou variable (≥ 2) | Sensible aux prévalences asymétriques | Correction aléatoire sans prise en compte de l’ordre |
| CCI (Accord Absolu) | Continues / Rangs étendus | Arbitraire (≥ 2) | Hautement sensible aux décalages systématiques | Complète (modèles ANOVA à composantes de variance) |
| CCI (Cohérence Relative) | Continues / Rangs étendus | Arbitraire (≥ 2) | Insensible aux écarts systématiques additifs | Isole la variance d’interaction sujet-juge |
Il est fascinant de noter que la frontière mathématique entre le Kappa et le CCI n’est pas étanche. Fleiss et Cohen ont eux-mêmes démontré que lorsque le Kappa est pondéré quadratiquement (quadratic weighted Kappa) pour pénaliser les désaccords d’autant plus lourdement qu’ils s’éloignent de la diagonale d’accord sur une échelle ordinale, ce coefficient devient formellement et algébriquement équivalent au CCI(2,1) d’accord absolu calculé sur les mêmes données. Cette convergence théorique réaffirme la suprématie de l’approche par partitionnement de variance pour appréhender la fidélité inter-juges dans toute sa complexité métrologique.
4. Préparation et structuration des données d’évaluation sous Excel
4.1 Organisation matricielle des lignes et des colonnes
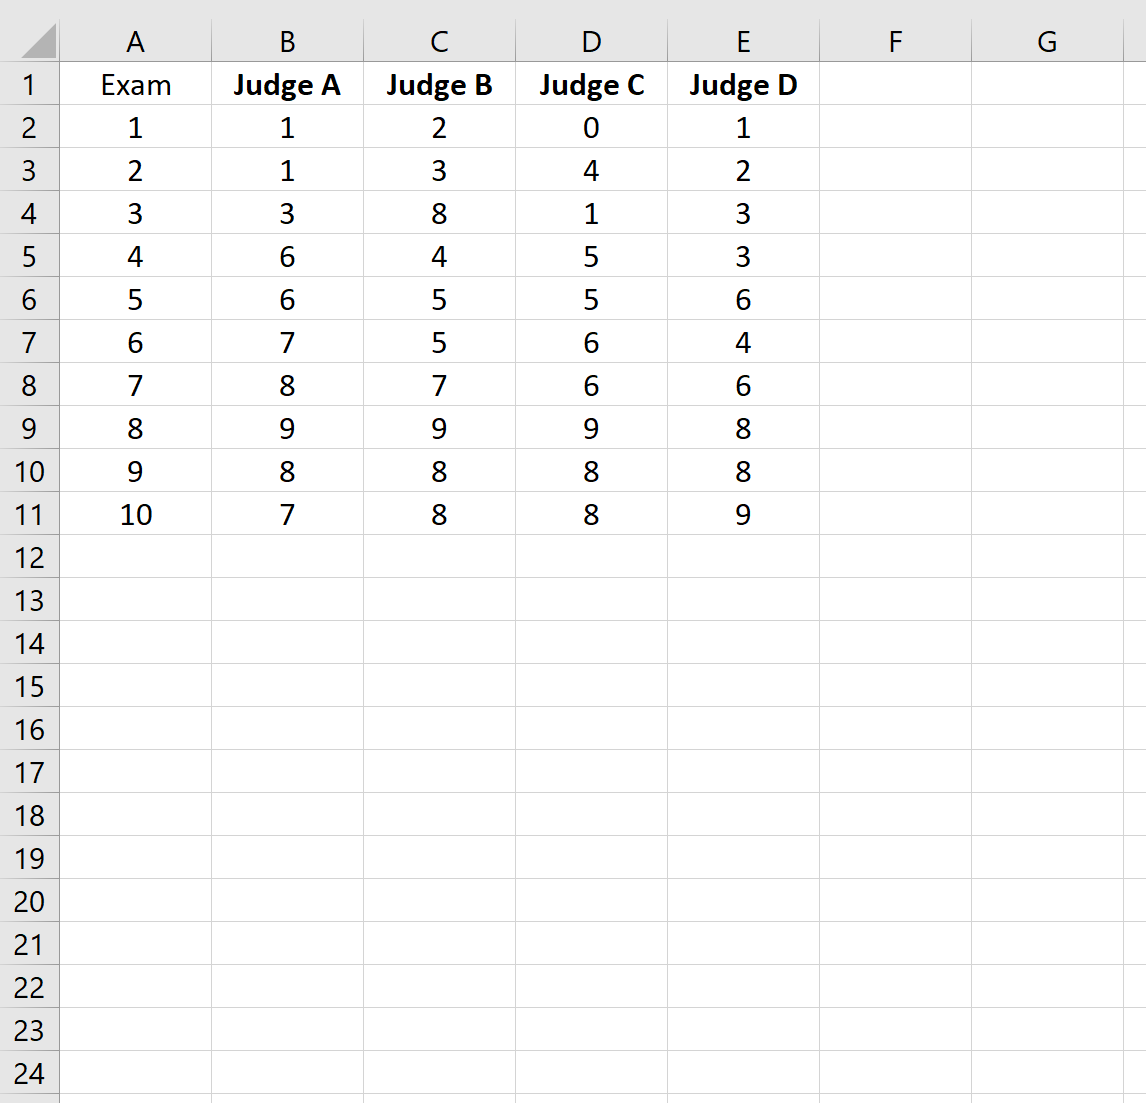
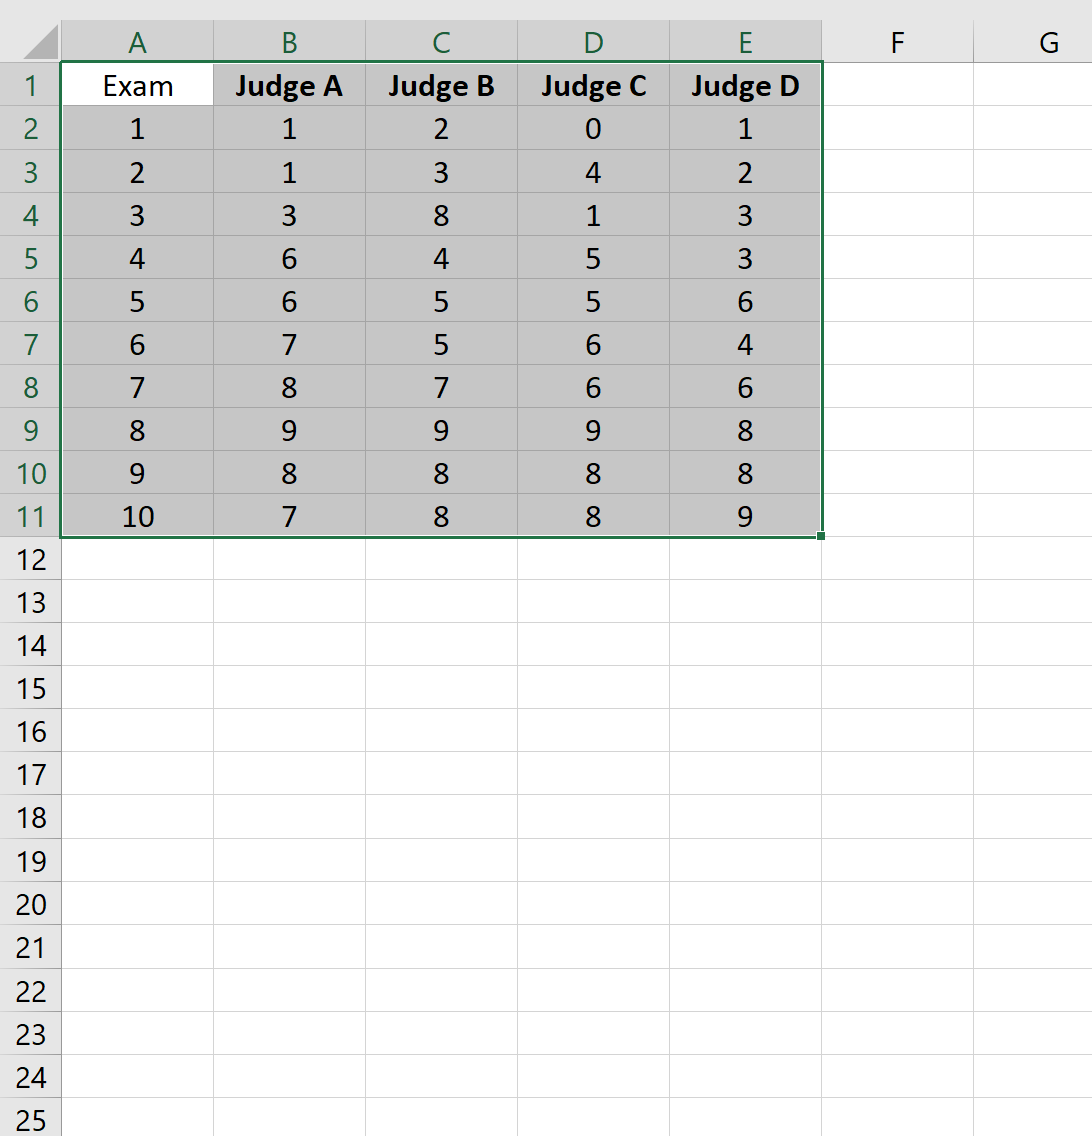
La réussite de l’implémentation du CCI sous Microsoft Excel repose avant tout sur une rigueur topologique absolue dans la disposition matricielle de la feuille de calcul. L’Utilitaire d’analyse d’Excel traite les données selon une convention d’orientation stricte qui ne tolère aucune permutation. Les lignes doivent impérativement être assignées aux sujets cliniques (les unités statistiques évaluées), tandis que les colonnes doivent être dédiées aux évaluateurs ou juges cliniciens. Si un protocole comprend l’évaluation de dix patients (numérotés de 1 à 10) par quatre psychiatres indépendants (Juges A, B, C et D), la matrice brute doit rigoureusement occuper la plage allant de la cellule A1 à la cellule E11.
La première ligne doit être consacrée aux intitulés d’en-tête clairs et explicites : la cellule A1 recevra l’étiquette Identifiant ou Sujet, tandis que les cellules B1, C1, D1 et E1 recevront respectivement les étiquettes Juge_1, Juge_2, Juge_3 et Juge_4. Les lignes subsidiaires (A2 à A11) accueilleront les identifiants textuels ou numériques des sujets, et les cellules adjacentes (B2 à E11) contiendront les scores quantitatifs attribués.
Une règle méthodologique non négociable sous Excel concerne le traitement des données manquantes. L’algorithme d’ANOVA à deux facteurs sans répétition intégré à Excel est programmé pour rejeter toute matrice présentant la moindre cellule vide ou contenant des caractères non numériques au sein de la plage de données. Si un praticien n’a pas pu évaluer l’un des sujets, la ligne entière de ce sujet doit être supprimée de l’analyse, ou bien le praticien concerné doit être exclu de l’évaluation pour préserver un plan factoriel équilibré et complet. L’imputation statistique de données manquantes, bien que possible sous des progiciels avancés via l’algorithme EM ou des imputations multiples par équations enchaînées, ne doit pas être improvisée sous Excel sans une validation préalable rigoureuse.
4.2 Vérification des postulats distributionnels des scores
Le calcul du CCI dérivant directement de l’ANOVA, son inférence statistique (notamment les tests de signification F et la construction des intervalles de confiance) repose sur plusieurs postulats fondamentaux : la normalité univariée des distributions de scores au sein de chaque groupe de juges, l’homoscédasticité des variances d’évaluation et l’absence de valeurs aberrantes résultant d’erreurs de frappe ou de saisie.
Avant d’engager le calcul du CCI, l’expérimentateur doit vérifier l’amplitude et la plausibilité des scores enregistrés. Dans la plage située sous la matrice de données, il convient de programmer les fonctions de synthèse pour chaque colonne d’évaluation. Pour le Juge 1 occupant la plage B2:B11, l’insertion des formules =MIN(B2:B11) et =MAX(B2:B11) permet de s’assurer immédiatement qu’aucun score n’outrepasse les bornes théoriques permises par l’échelle psychométrique (par exemple un score de 78 saisi accidentellement sur une échelle bornée à 50). L’examen de la moyenne via la fonction =MOYENNE(B2:B11) et de l’écart-type d’échantillon via =ECARTYPE.STANDARD(B2:B11) fournit un premier aperçu de la dispersion.
La vérification de l’asymétrie et de l’aplatissement de la distribution peut être réalisée sous Excel au moyen des fonctions =COEFFICIENT.ASYMETRIE(B2:B11) et =KURTOSIS(B2:B11). Des valeurs comprises entre -1,5 et +1,5 indiquent généralement que la distribution ne dévie pas de manière critique de la normalité gaussienne. Si une violation massive de la normalité est détectée, couplée à une taille d’échantillon restreinte (n < 15), l’analyste devra garder à l’esprit que les estimations ponctuelles du CCI demeurent robustes en tant que simples ratios de variance, mais que les intervalles de confiance paramétriques associés perdront de leur exactitude probabiliste.
5. Activation et configuration de l’Utilitaire d’analyse dans Excel
5.1 Procédure d’activation du complément Analysis ToolPak
Microsoft Excel n’intègre pas le calcul du CCI sous la forme d’une fonction native nativement préprogrammée telle qu’une fonction hypothétique qui s’intitulerait =CCI(). Pour générer les termes de variance nécessaires, il est obligatoire d’activer au préalable le module complémentaire d’ingénierie statistique intitulé Utilitaire d’analyse (ou Analysis ToolPak dans les environnements anglophones). Ce composant fait partie intégrante de la suite bureautique de Microsoft, mais demeure désactivé par défaut lors d’une installation standard pour des raisons d’optimisation des ressources système.
La démarche pour son activation sous les environnements Windows s’opère selon une séquence d’instructions univoque :
- Accédez au menu ruban supérieur et cliquez sur l’onglet Fichier situé à l’extrême gauche.
- Dans la barre latérale gauche, sélectionnez la commande Options (généralement positionnée au bas de la liste).
- Dans la boîte de dialogue contextuelle Options Excel qui s’affiche, cliquez sur la rubrique Compléments.
- Au bas de la fenêtre, localisez le menu déroulant intitulé Gérer :, assurez-vous que l’option sélectionnée est Compléments Excel, puis cliquez sur le bouton Atteindre….
- Une nouvelle boîte de dialogue compacte s’ouvre, énumérant les compléments disponibles. Cochez explicitement la case associée à l’Utilitaire d’analyse.
- Validez l’opération en cliquant sur le bouton OK.
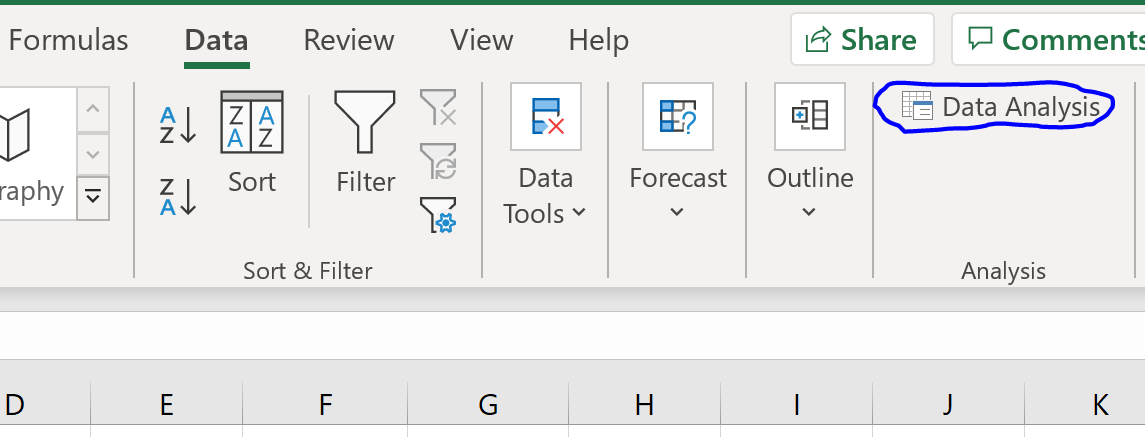
Une fois cette validation administrative confirmée, l’interface d’Excel se met à jour instantanément. En naviguant vers l’onglet Données du ruban principal, vous constaterez l’apparition d’un nouveau groupe d’outils nommé Analyse à l’extrême droite du ruban, au sein duquel trône l’icône Utilitaire d’analyse.
5.2 Dépannage technique des environnements Excel variés
Le déploiement de l’Utilitaire d’analyse peut rencontrer des spécificités ergonomiques ou des blocages informatiques selon l’environnement de travail. Sur les systèmes d’exploitation Mac OS, le chemin d’accès diffère légèrement : l’utilisateur doit se rendre dans le menu système supérieur d’Excel, cliquer sur Outils, puis sélectionner Compléments Excel… dans le menu contextuel déroulant, avant de cocher la case Analysis ToolPak et de valider. Sur certaines versions localisées pour Mac, un redémarrage complet de l’application est parfois nécessaire pour que l’onglet Données actualise son ruban et affiche le bouton de traitement statistique.
Dans les contextes hospitaliers, universitaires ou corporatifs hautement sécurisés, il arrive que les stratégies de groupe (Group Policy Objects) ou les profils d’administration informatique restreignent l’exécution des compléments tiers ou désactivent systématiquement l’écriture de fichiers d’extension .XLA ou .XLAM. Dans une telle situation, la tentative d’activation génère un message d’erreur d’autorisation ou la case cochée se décoche automatiquement à la fermeture de la session. L’utilisateur doit alors solliciter une élévation temporaire de privilèges auprès de la direction des systèmes d’information (DSI) pour autoriser le complément natif ANALYS32.XLL.
Si le blocage technique s’avère insoluble ou si l’analyse doit être conduite sur une version infonuagique allégée d’Excel (Excel pour le Web), qui ne prend pas en charge les compléments locaux de l’Utilitaire d’analyse, il reste tout à fait possible de contourner cette contrainte. Les sommes de carrés et les carrés moyens de l’ANOVA peuvent être intégralement reconstruits à l’aide de formules matricielles natives combinant les fonctions SOMMEPROD, SOMME.CARRES et des calculs de moyennes marginales, assurant ainsi une parfaite continuité de l’analyse métrologique quel que soit l’environnement technique.
6. Exécution de l’ANOVA à deux facteurs sans répétition sous Excel
6.1 Paramétrage précis de la boîte de dialogue d’analyse
Une fois les données cliniques rigoureusement ordonnées en lignes (sujets) et colonnes (évaluateurs) et l’Utilitaire d’analyse activé, le calcul des variances élémentaires s’amorce par l’exécution d’une ANOVA à deux facteurs sans répétition. Ce test modélise simultanément la variabilité induite par les sujets (facteur Ligne) et la variabilité induite par les juges (facteur Colonne), sans qu’il y ait réplication intra-juge puisque chaque évaluateur n’a attribué qu’une seule note par patient.
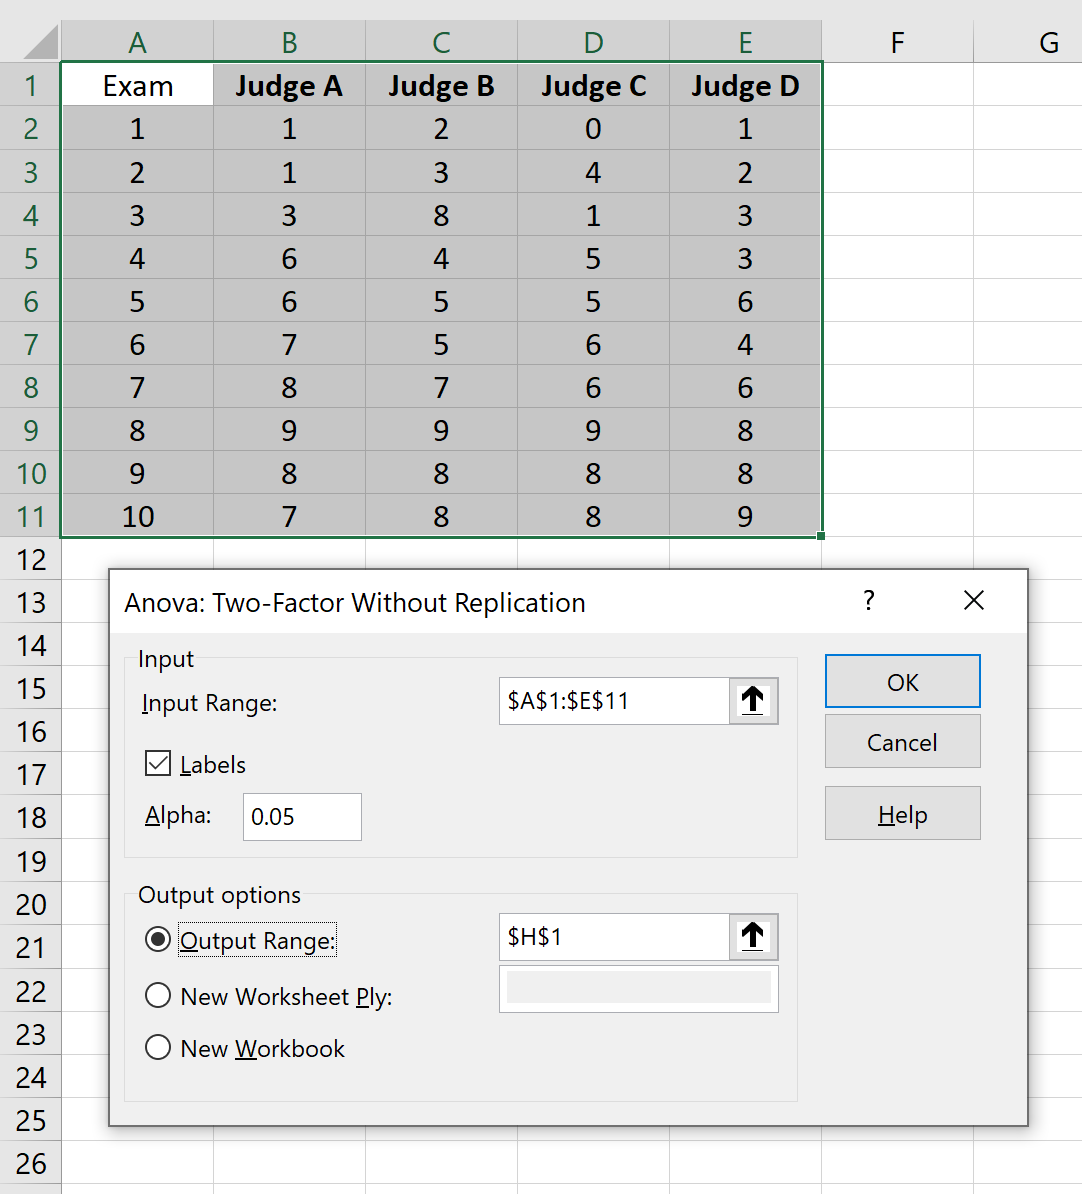
Pour paramétrer l’analyse, cliquez sur le bouton Utilitaire d’analyse dans l’onglet Données. Faites défiler la liste des outils statistiques disponibles et sélectionnez sans équivoque la ligne Analyse de variance : deux facteurs sans répétition, puis cliquez sur OK. Une boîte de dialogue modale s’affiche, réclamant des paramètres de saisie précis :
- Plage d’entrée : Cliquez sur le sélecteur de champ et sélectionnez l’intégralité de la matrice de données en englobant impérativement les en-têtes de colonnes et les identifiants de lignes. Pour notre exemple de dix sujets et quatre juges, la plage saisie doit être formellement $A$1:$E$11.
- Intitulés : Cochez impérativement cette case. Cette action informe Excel que la première ligne ($A$1:$E$1) et la première colonne ($A$1:$A$11) contiennent des étiquettes textuelles identifiant les variables et les sujets, évitant ainsi que le logiciel ne tente de convertir des libellés comme « Juge_1 » en valeurs numériques, ce qui déclencherait une erreur d’exécution immédiate.
- Alpha : Laissez le seuil de signification fixé par défaut à sa valeur standard de 0,05. Ce seuil régule le calcul des valeurs critiques de F dans le rapport de sortie.
- Options de sortie : Deux alternatives se présentent. Il est méthodologiquement recommandé de cocher l’option Plage de sortie et de désigner une cellule libre située sur la même feuille de calcul, par exemple la cellule $G$1. Cette proximité spatiale facilitera grandement le référencement direct des cellules lors de l’écriture ultérieure des formules dynamiques du CCI. Alternativement, l’option Nouvelle feuille de calcul peut être retenue pour préserver la lisibilité visuelle d’un classeur volumineux.
6.2 Génération et structure du rapport ANOVA en sortie
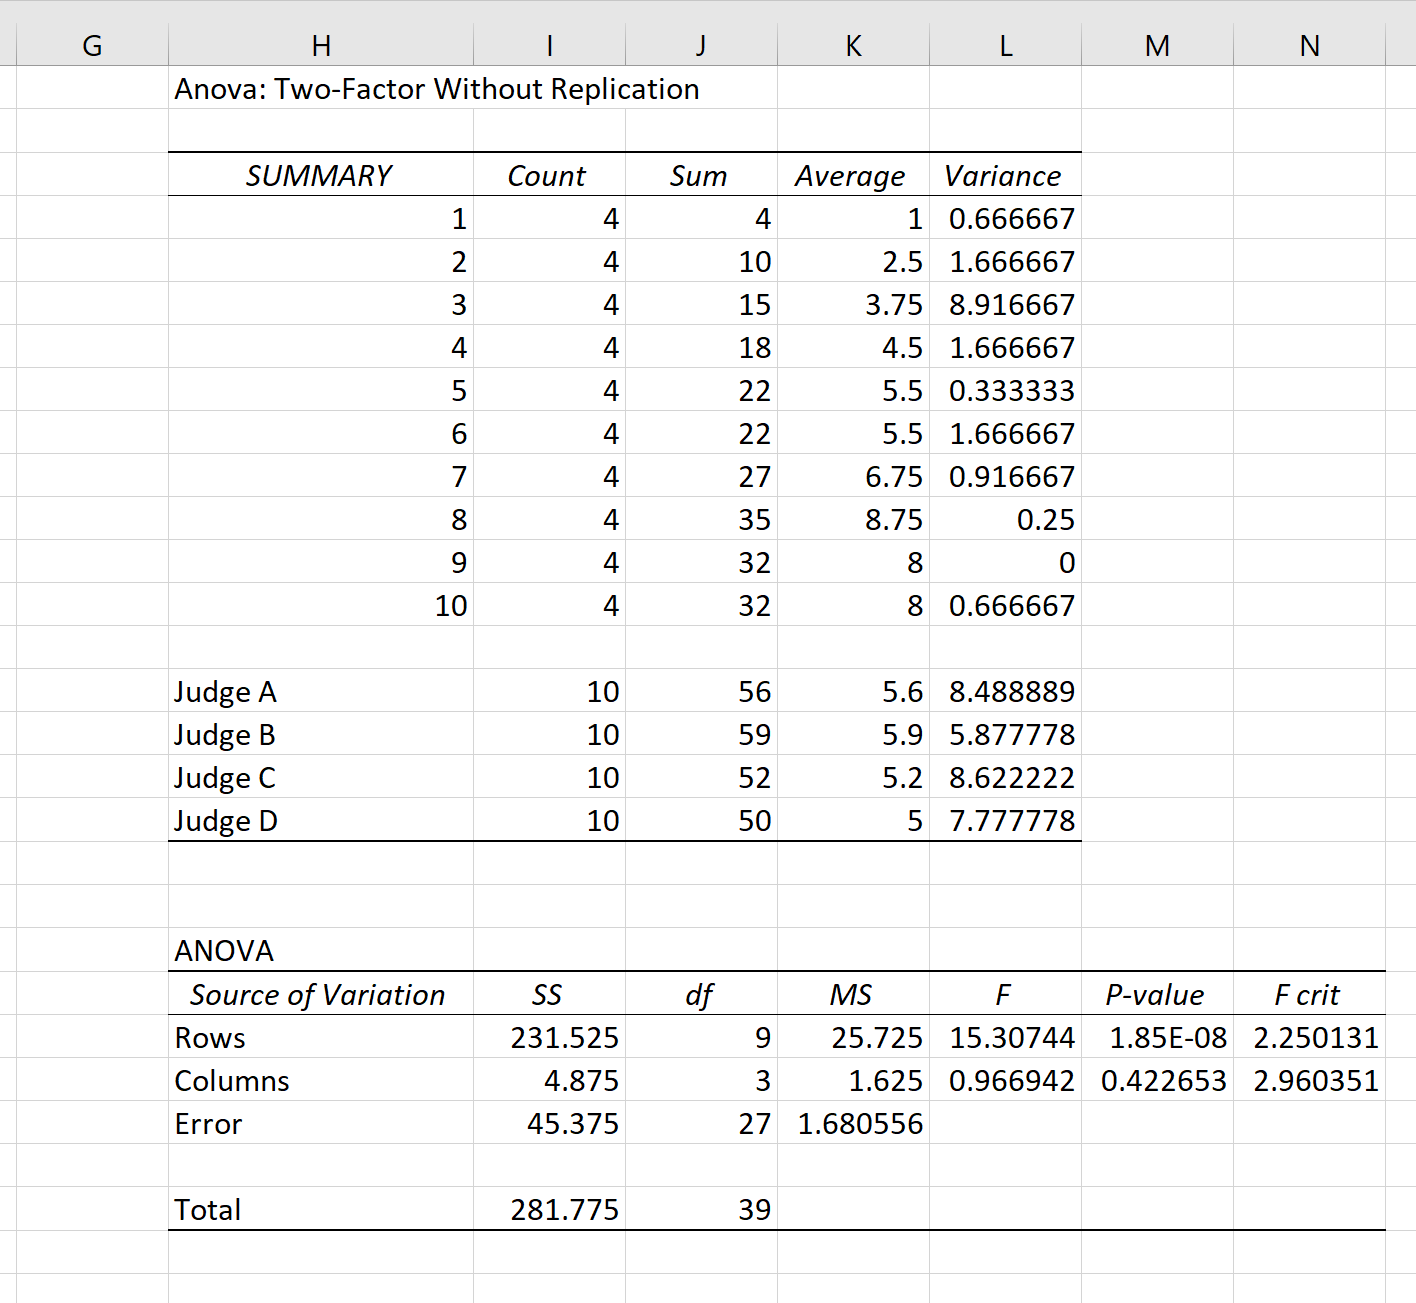
Après validation en cliquant sur OK, Excel génère de manière instantanée un rapport statistique exhaustif composé de deux blocs tabulaires successifs. Le premier bloc présente un résumé descriptif de chaque observation marginale : pour chaque sujet (lignes 1 à 10) et pour chaque évaluateur (colonnes 1 à 4), le tableau détaille le nombre d’éléments (Nombre), le cumul des scores (Somme), le score moyen (Moyenne) et la dispersion interne (Variance). Ces statistiques descriptives offrent une opportunité de contrôle qualité : un évaluateur présentant une moyenne marginale radicalement supérieure aux autres trahira d’emblée un biais d’évaluation systématique qui impactera négativement le CCI d’accord absolu.
Le second bloc, intitulé ANOVA, constitue le cœur analytique à partir duquel le CCI sera dérivé. Ce tableau synthétise la décomposition orthogonale de la variance en plusieurs colonnes canoniques :
- Source des variations : Identifie les trois composantes du modèle, étiquetées par Excel sous les vocables Lignes (représentant la variabilité entre les sujets), Colonnes (représentant la variabilité entre les évaluateurs) et Erreur (représentant le résidu ou l’interaction sujet-juge).
- SC (Somme des Carrés) : Quantifie l’amplitude brute de déviation quadratique attribuable à chaque source de variation.
- Degré de liberté (DL) : Précise le nombre de degrés de liberté associés. Pour n sujets, le DL des lignes vaut n – 1 (soit 10 – 1 = 9). Pour k évaluateurs, le DL des colonnes vaut k – 1 (soit 4 – 1 = 3). Le DL de l’erreur correspond au produit des deux précédents : (n – 1) × (k – 1), soit dans notre configuration 9 × 3 = 27 degrés de liberté.
- MS ou CM (Carré Moyen) : Représente le quotient direct de la Somme des Carrés par son Degré de liberté respectif (CM = SC / DL). Ce sont précisément ces Carrés Moyens qui constituent les composantes d’entrée fondamentales de toutes les équations de CCI.
- F : Le ratio statistique empirique de Fisher testant la significativité de l’effet considéré.
- Valeur critique pour F : Le quantile théorique de la distribution F au seuil alpha choisi, permettant de statuer sur le rejet ou le maintien de l’hypothèse nulle d’égalité des moyennes.
7. Décomposition mathématique et extraction des carrés moyens
7.1 Identification des composantes de variance élémentaires
Pour implémenter les formules de calcul du CCI de manière claire et pérenne, il est impératif d’isoler avec exactitude les adresses des cellules hébergeant les Carrés Moyens au sein du rapport ANOVA généré par Excel. Dans la littérature méthodologique internationale, ces trois termes statistiques universels sont désignés sous les acronymes anglophones suivants, auxquels correspondent des équivalents francophones stricts :
- BMS (Between-subjects Mean Square) / CML (Carré Moyen des Lignes) : Il quantifie la variance entre les patients évalués. Plus les sujets de l’étude diffèrent substantiellement les uns des autres sur le trait psychologique mesuré, plus cette valeur est élevée. Dans le tableau généré à partir de la cellule G1, cette statistique se situe rigoureusement à l’intersection de la ligne Lignes et de la colonne Moyenne des carrés (généralement la cellule J14 ou K14 selon la langue et la version d’Excel).
- JMS (Between-judges Mean Square) / CMC (Carré Moyen des Colonnes) : Il mesure l’ampleur des désaccords systématiques existant entre les praticiens. Si tous les psychiatres ont la même sévérité moyenne d’évaluation, le CMC sera très proche de l’erreur résiduelle. Cette valeur se situe à l’intersection de la ligne Colonnes et de la colonne des Carrés Moyens (cellule J15 ou K15).
- EMS (Error Mean Square) / CME (Carré Moyen de l’Erreur) : Il capture la variance résiduelle aléatoire non expliquée par les différences entre patients ni par les biais généraux des évaluateurs. Cette statistique réside à l’intersection de la ligne Erreur et de la colonne des Carrés Moyens (cellule J16 ou K16).
En complément de ces trois grandeurs continues, deux paramètres discrets déterminent la structure mathématique du modèle : la constante n, correspondant au nombre de sujets évalués (dans notre cas, n = 10), et la constante k, correspondant au nombre d’évaluateurs constituant le jury clinique (dans notre cas, k = 4). Il est fortement conseillé de consigner explicitement ces valeurs dans des cellules dédiées de la feuille de calcul (par exemple en affectant les cellules N2 et N3 à n et k) afin de rendre les futures formules de calcul transparentes, auditables et dynamiquement adaptables si la taille de l’échantillon venait à évoluer.
7.2 Vérification des sources de variation statistiques
L’interprétation métrologique préalable des tests de Fisher affichés dans le tableau ANOVA apporte des éclairages méthodologiques déterminants sur la nature des mesures collectées. Deux tests F distincts méritent une attention clinique particulière :
Le premier test F, situé sur la ligne des Lignes, correspond au ratio Fsujets = CML / CME. Il teste l’hypothèse nulle selon laquelle tous les sujets évalués possèdent un score vrai identique. Dans tout protocole psychométrique valide, ce test F doit impérativement être hautement significatif (p < 0,001). Si la p-valeur associée aux lignes est supérieure à 0,05, cela signifie que la variabilité mesurée entre les patients est statistiquement indissociable du bruit de mesure aléatoire, ce qui rend le calcul du CCI illusoire et voué à produire un résultat extrêmement faible.
Le second test F, positionné sur la ligne des Colonnes, correspond au ratio Fjuges = CMC / CME. Il teste formellement l’existence d’un biais systématique d’évaluation entre les cliniciens. Deux trajectoires interprétatives se dessinent :
- Si p > 0,05 pour les colonnes, l’hypothèse nulle ne peut être rejetée : il n’existe pas de preuve statistique d’une différence systématique de notation entre les évaluateurs. Dans cette configuration empirique, les valeurs calculées pour le CCI d’accord absolu et le CCI de cohérence relative seront quasiment identiques.
- Si p < 0,05 pour les colonnes, un biais inter-juges statistiquement significatif est formellement établi. Au moins l’un des évaluateurs note de manière systématiquement plus sévère ou plus indulgente que ses confrères. Ce constat aura un impact direct et immédiat : le CCI d’accord absolu sera notablement inférieur au CCI de cohérence relative, la divergence d’étalonnage étant explicitement imputée au passif de l’accord absolu.
8. Formulation et calcul automatisé du CCI(2,1) et CCI(3,1) dans Excel
8.1 Calcul du CCI(2,1) : Accord absolu pour juge unique
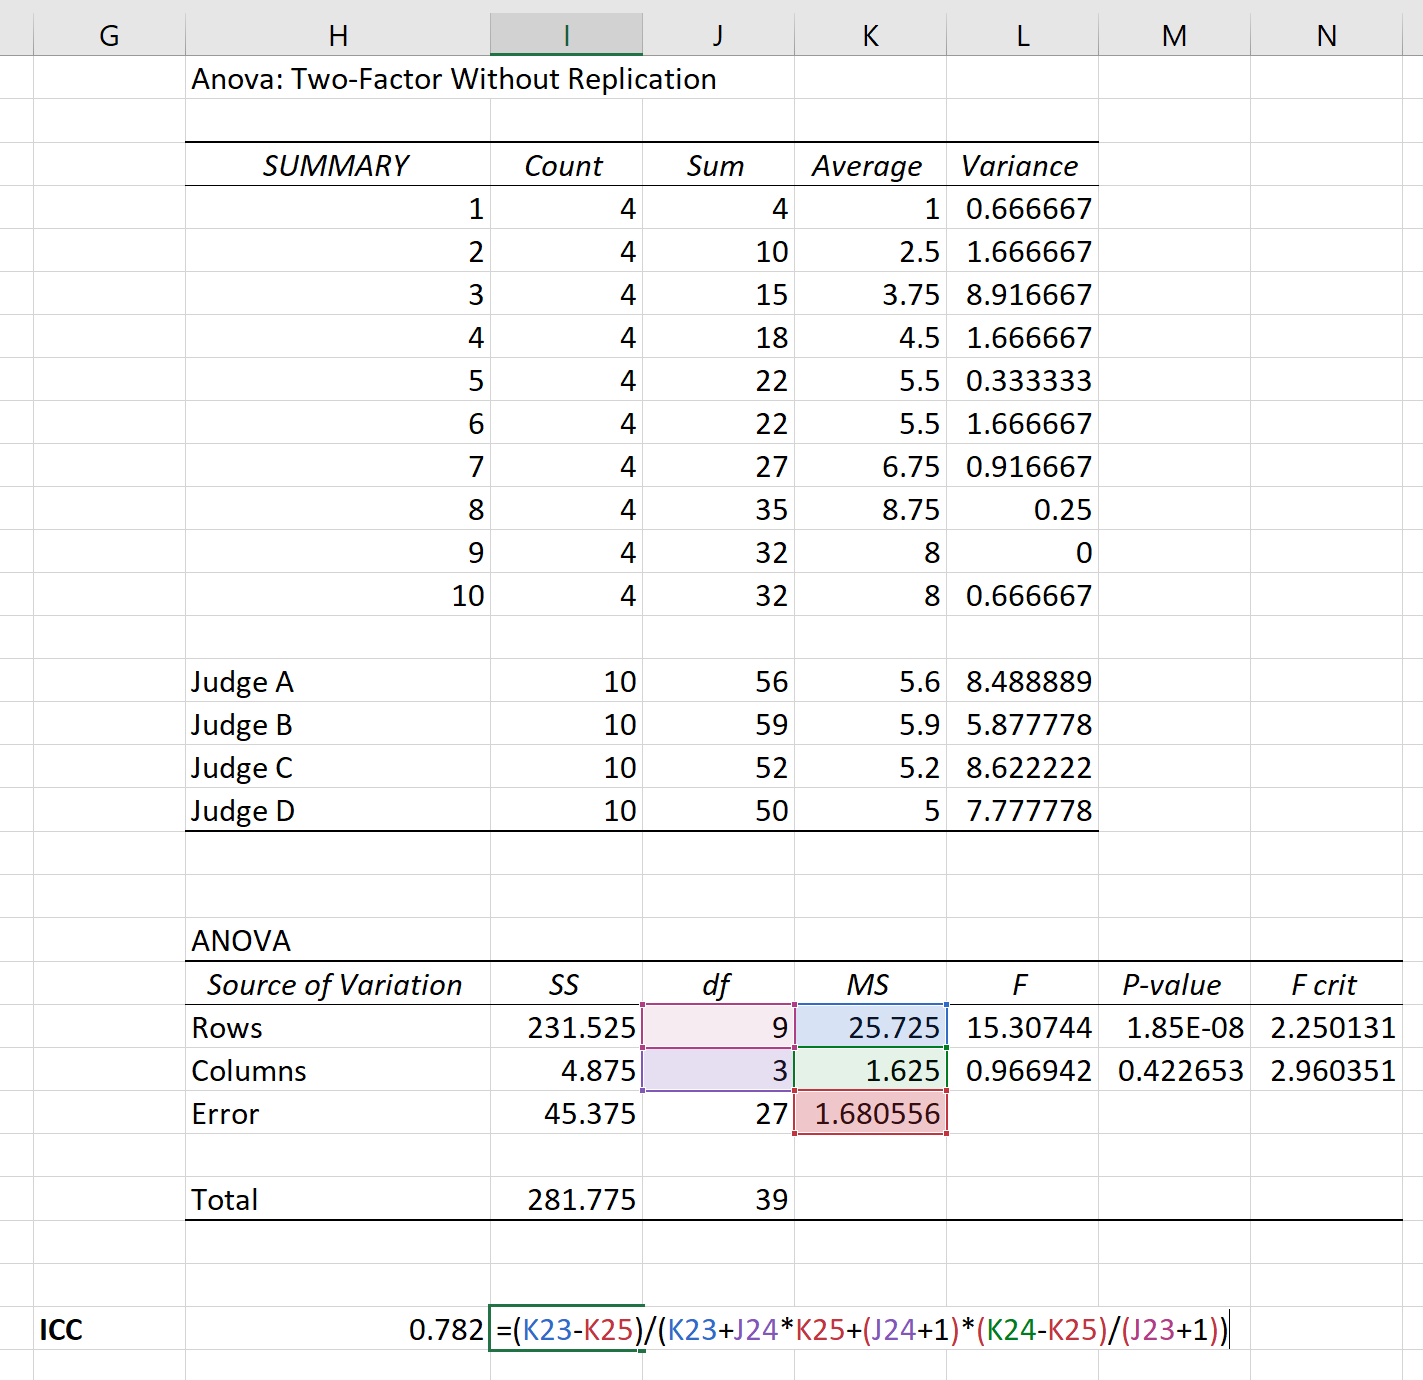
Le CCI(2,1) est indubitablement l’indice le plus exigeant, le plus rigoureux et le plus préconisé dans les études biomédicales standardisées. Il évalue le degré d’accord absolu auquel on peut s’attendre lorsqu’un unique évaluateur, sélectionné au hasard au sein d’une population de praticiens qualifiés, administre l’instrument de mesure. Sa formule mathématique exacte, dérivée de la classification de Shrout et Fleiss, s’exprime selon l’équation :
CCI(2,1) = (CML – CME) / [CML + (k – 1)×CME + (k / n)×(CMC – CME)]
Pour transcrire cette équation sous Excel, supposons que vos Carrés Moyens soient localisés dans les cellules suivantes du tableau ANOVA : cellule J14 pour le Carré Moyen des Lignes (CML), cellule J15 pour le Carré Moyen des Colonnes (CMC), et cellule J16 pour le Carré Moyen de l’Erreur (CME). En considérant n = 10 sujets et k = 4 évaluateurs, la formule de calcul dynamique à inscrire dans une cellule vide s’écrit littéralement :
=(J14-J16)/(J14+(4-1)*J16+(4/10)*(J15-J16))
Si vous avez pris soin de stocker les valeurs de n et k dans les cellules N2 et N3, la formule devient totalement générique et réutilisable pour n’importe quel autre jeu de données :
=(J14-J16)/(J14+(N3-1)*J16+(N3/N2)*(J15-J16))
L’examen minutieux du terme (k / n)×(CMC – CME) au dénominateur permet de saisir le mécanisme mathématique sous-jacent : dès lors que le Carré Moyen des Colonnes excède l’erreur résiduelle (traduisant un biais d’évaluation systématique entre les juges), ce terme devient strictement positif et augmente la valeur du dénominateur, ce qui a pour effet direct de comprimer la magnitude du CCI vers le bas. Plus les juges divergent sur l’étalonnage global de l’échelle, plus la sanction métrologique est sévère.
Dans certaines circonstances expérimentales particulières où les moyennes des évaluateurs sont remarquablement homogènes, il peut arriver que le CMC calculé par l’ANOVA soit légèrement inférieur au CME par simple fluctuation d’échantillonnage. Dans ce cas spécifique, le terme (CMC – CME) devient négatif, ce qui réduirait artificiellement le dénominateur et gonflerait le CCI au-delà du CCI de cohérence relative, une aberration théorique. L’usage en biométrie consiste alors soit à tronquer ce terme à zéro, soit à privilégier l’estimation issue du Modèle 3.
8.2 Calcul du CCI(3,1) : Cohérence relative pour juge unique
Le CCI(3,1) en cohérence relative répond à une préoccupation clinique fondamentalement différente. Il ne cherche pas à savoir si les évaluateurs attribuent des scores identiques au point près, mais s’ils maintiennent le même positionnement relatif des patients le long du continuum de sévérité. Ce modèle est formellement justifié lorsque l’instrument d’évaluation vise uniquement à classer des individus par ordre de gravité croissante ou lors d’études de corrélation exploratoires où seul le rang des sujets influe sur la validité externe. Sa formulation mathématique neutralise complètement le terme de variance inter-juges :
CCI(3,1) = (CML – CME) / [CML + (k – 1)×CME]
En reprenant l’adressage précédent de nos cellules Excel (CML en J14, CME en J16 et k = 4 évaluateurs), la transcription syntaxique dans la feuille de calcul s’avère particulièrement concise et directe :
=(J14-J16)/(J14+(4-1)*J16)
Ou, en mobilisant la référence dynamique à la taille du panel k logée en cellule N3 :
=(J14-J16)/(J14+(N3-1)*J16)
L’omission délibérée du Carré Moyen des Colonnes (CMC) produit une conséquence arithmétique directe et systématique : la valeur numérique obtenue pour le CCI(3,1) sera invariablement supérieure ou rigoureusement égale à celle obtenue pour le CCI(2,1). Comparer simultanément ces deux coefficients au sein d’un même rapport de recherche offre un diagnostic métrologique immédiat : un écart substantiel entre le CCI(3,1) (par exemple 0,88) et le CCI(2,1) (par exemple 0,62) informe instantanément le méthodologiste que les cliniciens discernent parfaitement les profils des patients (haute cohérence), mais souffrent d’un décalage de repère d’étalonnage systématique qui impose une révision de la standardisation des ancrages de l’échelle clinique.
9. Calcul du CCI pour moyennes d’évaluateurs : Modèles CCI(2,k) et CCI(3,k)
9.1 Formulation du CCI(2,k) pour la moyenne de k évaluateurs
Les modèles de CCI indicés par la lettre k — à l’instar du CCI(2,k) et du CCI(3,k) — s’appliquent exclusivement aux protocoles de recherche ou aux contextes diagnostiques où la décision finale prise pour chaque patient ne repose pas sur la note d’un praticien isolé, mais est calculée en effectuant la moyenne arithmétique des cotations délivrées par l’ensemble d’un panel de k juges. C’est le cas fréquent lors d’épreuves orales de sélection de candidats en psychologie, de jurys de thèse ou lors de protocoles de recherche clinique où chaque IRM cérébrale fait l’objet d’une double ou triple lecture indépendante dont les résultats sont systématiquement moyennés.
L’équation régissant l’estimation du CCI(2,k) sous le modèle d’accord absolu s’écrit formellement comme suit :
CCI(2,k) = (CML – CME) / [CML + (CMC – CME) / n]
Sous Excel, en conservant les références cellulaires de notre tableau ANOVA (CML en J14, CMC en J15, CME en J16) et la taille d’échantillon n = 10 en cellule N2, la formule opérationnelle se programme selon la syntaxe suivante :
=(J14-J16)/(J14+(J15-J16)/10)
Ou de manière entièrement paramétrée :
=(J14-J16)/(J14+(J15-J16)/N2)
Sur le plan métrologique, le CCI(2,k) bénéficie pleinement des vertus de la loi des grands nombres et de la prophétie statistique formalisée par l’équation de Spearman-Brown : moyenner plusieurs observations indépendantes conduit inéluctablement à une réduction drastique de la composante d’erreur résiduelle aléatoire, chaque divergence positive chez un évaluateur étant statistiquement compensée par une déviation négative chez un confrère. Par conséquent, pour un jeu de données identique, le CCI(2,k) produira toujours une valeur numérique nettement supérieure au CCI(2,1). Il est donc crucial sur le plan éthique et méthodologique de ne pas rapporter un CCI(2,k) dans une publication lorsque l’échelle est en réalité destinée à être utilisée en routine par des praticiens exerçant seuls dans leur cabinet médical.
9.2 Formulation du CCI(3,k) pour la cohérence moyenne
Le modèle CCI(3,k) évalue la cohérence relative de la moyenne des notes attribuées par un panel fixe de k évaluateurs. Sa formulation algébrique représente l’une des équations les plus pures et les plus célèbres de la psychométrie classique :
CCI(3,k) = (CML – CME) / CML
L’expression peut également se reformuler sous sa forme unitaire complémentaire :
CCI(3,k) = 1 – (CME / CML)
Dans votre classeur Excel, l’intégration de cette formule se révèle d’une simplicité désarmante. En vous référant toujours à la cellule J14 pour le CML et J16 pour le CME, il suffit d’inscrire l’instruction :
=(J14-J16)/J14
Ou, de manière alternative :
=1-(J16/J14)
Ce résultat recèle une passerelle théorique majeure : le CCI(3,k) est rigoureusement et mathématiquement identique au coefficient Alpha de Cronbach (α). Lorsque vous disposez d’un questionnaire d’évaluation composé de k items administré à n sujets, et que vous traitez les colonnes comme les items et les lignes comme les participants, exécuter l’ANOVA à deux facteurs sans répétition sous Excel et appliquer la formule (CML – CME) / CML produit au centième de décimale près la même valeur que l’Alpha de Cronbach calculé manuellement par la sommation des variances des items. Ce pont conceptuel entre fidélité inter-juges et cohérence interne consolide l’unité de la métrologie quantitative sous l’égide du partitionnement de la variance.
10. Interprétation clinique et psychométrique des résultats obtenus
10.1 Grilles de référence et paliers de fidélité empirique
L’obtention d’une valeur chiffrée de CCI ne constitue pas une fin en soi ; le coefficient requiert une contextualisation interprétative rigoureuse au regard de la finalité diagnostique poursuivie. Dans la littérature internationale, la grille de classification proposée par Koo et Li (2016) fait aujourd’hui autorité pour qualifier la qualité métrologique d’un indice de corrélation intraclasse :
- CCI < 0,50 : Fidélité médiocre (poor). La variance d’erreur de mesure prédomine largement sur la variance réelle des traits cliniques. L’instrument ne peut être utilisé sans refonte structurelle.
- 0,50 ≤ CCI < 0,75 : Fidélité modérée (moderate). L’accord est acceptable pour des travaux de recherche descriptive ou exploratoire de groupes, mais insuffisant pour une prise de décision individualisée.
- 0,75 ≤ CCI < 0,90 : Fidélité bonne (good). L’instrument présente une consistance suffisante pour être déployé dans des essais cliniques thérapeutiques ou des protocoles expérimentaux avancés.
- CCI ≥ 0,90 : Fidélité excellente (excellent). Le niveau de reproductibilité atteint les standards requis pour fonder des décisions cliniques individuelles critiques (orientation médico-légale, diagnostic psychiatrique majeur).
Cette grille d’interprétation doit être mobilisée avec discernement en considérant impérativement non pas la simple estimation ponctuelle du CCI, mais la borne inférieure de son intervalle de confiance à 95%. Comme le stipulent formellement Koo et Li, un chercheur ne peut affirmer que la fidélité de son instrument est « bonne » que si la borne inférieure de l’intervalle de confiance est elle-même supérieure ou égale à 0,75. Si un CCI ponctuel affiche une valeur séduisante de 0,82 mais que son intervalle de confiance s’étend de 0,48 à 0,94 en raison d’une taille d’échantillon trop modeste, l’instrument ne peut légitimement être qualifié que de reproductibilité « médiocre à excellente », interdisant toute conclusion catégorique sur son efficacité métrologique.
10.2 Conséquences psychométriques d’un CCI insuffisant
Les répercussions méthodologiques d’une fidélité inter-juges dégradée sont souvent sous-estimées dans la pratique clinique de terrain. La première conséquence directe s’exprime à travers l’Erreur Standard de Mesure (ESM), reliée mathématiquement au CCI par la relation :
ESM = s × √(1 – CCI)
où s figure l’écart-type global de l’échantillon. Plus le CCI chute, plus l’ESM enfle. Cette inflation de l’erreur élargit proportionnellement l’intervalle de confiance entourant le score observé de chaque patient individuel. Si l’ESM d’un instrument psychologique s’élève à 8 points sur une échelle d’évaluation de la dangerosité notée sur 50, il devient impossible d’affirmer avec une certitude clinique qu’un patient ayant obtenu un score de 28 présente un risque objectivement plus élevé qu’un autre ayant obtenu un score de 22.
La seconde conséquence néfaste réside dans le phénomène bien connu d’atténuation statistique des corrélations formulé par Charles Spearman. Lorsqu’une variable expérimentale X mesurée avec une fidélité imparfaite (CCIX) est mise en relation avec un critère clinique Y mesuré avec une fidélité (CCIY), le coefficient de corrélation observé robs est systématiquement compressé par rapport à la corrélation vraie rvrai selon la loi d’atténuation :
robs = rvrai × √(CCIX × CCIY)
Un CCI déficient peut ainsi masquer totalement une relation thérapeutique pourtant cliniquement cruciale entre un biomarqueur et un score de rémission psychologique, conduisant à des erreurs de type II (rejet abusif d’hypothèses vraies) lors des phases d’analyse d’essais cliniques multicentriques. Face à un CCI jugé insuffisant lors de la phase pilote d’une étude, les investigateurs n’ont d’autre choix que d’engager un réétalonnage exhaustif des critères opérationnels de leur grille d’observation ou d’imposer un programme d’entraînement intensif des évaluateurs à l’aide de cas cliniques étalons vidéo-enregistrés.
11. Calcul des intervalles de confiance et inférence statistique sous Excel
11.1 Détermination des degrés de liberté effectifs et distribution F
L’estimation ponctuelle d’un coefficient de corrélation intraclasse demeure incomplète sans la détermination de son intervalle de confiance (IC) à 95%, indispensable pour toute soumission dans des revues à comité de lecture biomédicales. Le calcul des bornes de confiance pour les modèles à effets aléatoires (Modèle 2) présente une complexité mathématique singulière : dans la mesure où le dénominateur de l’équation du CCI(2,1) combine plusieurs sources de variance distinctes (CML, CMC et CME), la variable aléatoire sous-jacente ne suit pas directement une loi de Fisher simple, mais exige une approximation des degrés de liberté effectifs selon la méthode de Satterthwaite.
Pour le modèle CCI(3,1) en cohérence relative, la dérivation des bornes s’avère plus directe car elle repose strictement sur la distribution canonique du ratio de Fisher F = CML / CME. Les degrés de liberté associés sont respectivement ν1 = n – 1 pour le numérateur (DL des lignes) et ν2 = (n – 1)(k – 1) pour le dénominateur (DL de l’erreur).
Pour exploiter ces lois de probabilité sous Excel sans avoir recours à des tables statistiques imprimées archaïques, nous mobilisons la fonction native INVERSE.LOI.F (ou LOI.F.INVERSE dans les versions plus anciennes). Cette fonction calcule la valeur critique de F pour une probabilité cumulée unilatérale et des degrés de liberté spécifiés. Pour définir une région de confiance bilatérale symétrique à 95%, nous échantillonnons les quantiles aux seuils critiques α / 2 = 0,025 et 1 – α / 2 = 0,975.
11.2 Automatisation des bornes inférieure et supérieure à 95%
Détaillons la procédure d’automatisation des bornes de confiance à 95% pour le modèle de cohérence relative CCI(3,1) sous Excel, en conservant notre cas d’étude (n = 10 en cellule N2, k = 4 en cellule N3, CML en J14, CME en J16). Dans une cellule auxiliaire, calculons au préalable le ratio Fobs = J14 / J16 (plaçons cette valeur dans la cellule N5).
Définissons ensuite les deux quantiles critiques de la loi F :
- Dans la cellule N6 (Quantile Supérieur Fsup), insérons la formule : =INVERSE.LOI.F(0,025; N2-1; (N2-1)*(N3-1))
- Dans la cellule N7 (Quantile Inférieur Finf), insérons la formule : =INVERSE.LOI.F(0,975; N2-1; (N2-1)*(N3-1))
À partir de ces ancrages théoriques, la borne inférieure (IC 95% Bas) du CCI(3,1) se programme dans une nouvelle cellule au moyen de l’équation algébrique suivante :
=(N5/N6 – 1) / (N5/N6 + N3 – 1)
Réciproquement, la borne supérieure (IC 95% Haut) du CCI(3,1) s’automatise via la formule conjuguée :
=(N5/N7 – 1) / (N5/N7 + N3 – 1)
Pour le modèle d’accord absolu CCI(2,1), l’algorithme d’approximation de Satterthwaite requiert de calculer des degrés de liberté ajustés synthétisant le ratio des variances combinées. Bien que la formule matricielle complète soit volumineuse sous Excel, son principe consiste à pondérer les variances pour extraire une valeur F* corrigée. Disposer de ces bornes automatisées au sein de son classeur garantit une rigueur de reporting irréprochable et protège le chercheur contre les biais d’interprétation triomphalistes fondés sur des estimations ponctuelles fragiles.
12. Limites de l’approche sous Excel et bonnes pratiques méthodologiques
12.1 Contraintes structurelles de Microsoft Excel face aux logiciels statistiques dédiés
Bien que Microsoft Excel s’avère un vecteur pédagogique et opérationnel remarquable pour appréhender la mécanique intime des composantes de variance, il ne saurait se substituer intégralement aux plateformes statistiques spécialisées pour les projets de recherche à grande échelle. La principale limitation technique d’Excel réside dans son inaptitude structurelle à traiter nativement les plans factoriels déséquilibrés et les données manquantes au sein de l’outil ANOVA à deux facteurs sans répétition. Dès lors qu’un clinicien omet de noter un seul patient sur l’ensemble d’un protocole multicentrique, Excel refuse purement et simplement d’exécuter l’analyse, contraignant l’analyste à des suppressions de lignes dommageables en termes de puissance statistique.
Le second péril inhérent à l’environnement Excel concerne le risque d’erreur manuelle de saisie de formules. Une mauvaise sélection de cellule dans le tableau ANOVA, une confusion entre le terme de Carré Moyen et de Somme des Carrés, ou une coquille dans l’agencement des parenthèses mathématiques peut altérer silencieusement la valeur numérique du CCI sans qu’aucun message d’erreur d’exécution ne vienne alerter l’utilisateur. À l’opposé, les packages statistiques dédiés comme le package irr ou le package psych sous l’environnement R exécutent ces analyses par le biais d’une ligne de commande univoque :
icc(donnees, model = « twoway », type = « agreement », unit = « single »)
Ces environnements automatisés calculent instantanément et sans risque d’erreur humaine les six variantes de Shrout et Fleiss, gèrent élégamment les degrés de liberté de Satterthwaite et éditent des rapports consolidés incluant les tests F multivariés et les p-valeurs asymptotiques exactes.
12.2 Vérification des erreurs courantes et check-list de validation
Afin de prémunir les chercheurs contre les pièges méthodologiques les plus insidieux lors du calcul du CCI sous Excel, la check-list de validation suivante doit être systématiquement auditée avant toute diffusion ou valorisation des résultats :
- Orientation matricielle stricte : Avez-vous vérifié avec certitude absolue que les sujets sont positionnés le long des lignes et les évaluateurs le long des colonnes ? Une inversion accidentelle de cette orientation intervertit la ligne des Lignes et la ligne des Colonnes dans l’ANOVA, rendant toutes vos formules de calcul de CCI totalement fausses et dénuées de sens physique.
- Adéquation du modèle à la question de recherche : Avez-vous arbitré de manière théoriquement défendable entre Accord absolu (Modèle 2) et Cohérence relative (Modèle 3) ? Rappelons qu’un diagnostic clinique reposant sur des valeurs absolues impose impérativement l’accord absolu (CCI(2,1)).
- Dichotomie juge unique vs moyenne de juges : Votre protocole s’appuiera-t-il réellement sur la moyenne de plusieurs praticiens en pratique future ? Si la réponse est négative, vous ne devez en aucun cas rapporter le CCI(2,k) ou CCI(3,k), mais formellement le CCI(2,1) ou CCI(3,1).
- Gestion des valeurs négatives : Si votre calcul débouche sur un CCI négatif, n’interprétez pas ce résultat comme une anomalie du logiciel. Un CCI mathématiquement négatif survient lorsque le Carré Moyen des Lignes (entre sujets) est inférieur au Carré Moyen de l’Erreur résiduelle (CML < CME). Sur le plan psychométrique, cela signifie formellement que la fidélité de votre instrument est si désastreuse que la variance au sein d’un même sujet excède la variance entre les sujets de l’étude. Le coefficient doit alors être conventionnellement rapporté comme étant égal à zéro (0,00).
12.3 Normes de reporting scientifique selon les recommandations APA
La publication de données de reproductibilité et de validation d’échelles au sein de revues internationales exige une transparence méthodologique absolue, codifiée par les normes de l’American Psychological Association (APA 7th edition). La mention laconique d’un simple « CCI = 0,81 » est méthodologiquement inacceptable et constitue un motif fréquent de rejet par les pairs examinateurs, dans la mesure où il existe au bas mot dix formulations mathématiques distinctes du coefficient de corrélation intraclasse.
Selon les standards APA actuels, le rapport scientifique doit obligatoirement expliciter :
- Le modèle exact utilisé selon la nomenclature de Shrout et Fleiss (1979) ou McGraw et Wong (1996) : Modèle à deux facteurs aléatoires ou mixtes.
- Le type de mesure ciblé : mesure individuelle pour juge unique (single rater) ou mesure moyenne pour jury (average of raters).
- La finalité d’évaluation : accord absolu (absolute agreement) ou cohérence relative (consistency).
- L’estimation ponctuelle du coefficient accompagnée sans exception de son intervalle de confiance à 95% (précisant borne basse et borne haute).
- Les paramètres d’inférence de l’ANOVA : la valeur de la statistique F empirique, les degrés de liberté complets (DL du numérateur, DL du dénominateur) et la p-valeur exacte du test.
Voici un modèle rédactionnel exemplaire conforme aux plus hauts standards académiques francophones et internationaux :
« La fidélité inter-juges de l’échelle d’évaluation clinique a été quantifiée au moyen du coefficient de corrélation intraclasse selon un modèle à deux facteurs aléatoires en accord absolu pour un évaluateur unique [CCI(2,1)]. L’estimation ponctuelle indique un accord satisfaisant, CCI(2,1) = 0,84, avec un intervalle de confiance à 95% s’étendant de 0,71 à 0,93, F(9, 27) = 21,83, p < 0,001. Ces résultats confirment la robustesse de l’instrument pour une administration standardisée par un praticien unique en milieu hospitalier. »
En respectant scrupuleusement l’ensemble de ces préceptes statistiques, mathématiques et informatiques, Microsoft Excel s’affirme comme un environnement robuste et universel, capable de délivrer des estimations métrologiques de premier ordre tout en offrant à l’analyste un contrôle analytique total sur chaque étape de la décomposition de variance.
Références
- Cicchetti, D. V. (1994). Guidelines, criteria, and rules of thumb for evaluating normed and standardized assessment instruments in psychology. Psychological Assessment, 6(4), 284–290. https://doi.org/10.1037/1040-3590.6.4.284
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Fleiss, J. L., & Cohen, J. (1973). The equivalence of weighted kappa and the intraclass correlation coefficient as measures of reliability. Educational and Psychological Measurement, 33(3), 613–619. https://doi.org/10.1177/001316447303300309
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012
- McGraw, K. O., & Wong, S. P. (1996). Forming inferences about some intraclass correlation coefficients. Psychological Methods, 1(1), 30–46. https://doi.org/10.1037/1082-989X.1.1.30
- Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420–428. https://doi.org/10.1037/0033-2909.86.2.420