
L’analyse des séries temporelles constitue un pilier fondamental de la science des données contemporaine, de la modélisation économétrique et de l’ingénierie du traitement du signal. Au cœur de cette discipline réside un principe fondamental : les observations successives recueillies le long d’un continuum temporel ne sont presque jamais mutuellement indépendantes. Contrairement aux postulats classiques de l’échantillonnage aléatoire simple où les variables sont présumées indépendantes et identiquement distribuées, les dynamiques temporelles réelles portent l’empreinte indélébile de leur passé immédiat ou lointain. L’autocorrélation représente précisément l’outil mathématique et computationnel permettant de quantifier, de décomposer et d’interpréter cette mémoire sérielle inhérente aux processus stochastiques.
Comprendre et mesurer l’autocorrélation s’avère indispensable pour quiconque souhaite explorer des phénomènes complexes, qu’il s’agisse de fluctuations boursières, de variations climatiques, de signaux biomédicaux ou de dynamiques comportementales en psychologie quantitative. Une mauvaise prise en compte de la dépendance sérielle expose le chercheur ou le praticien à des biais statistiques majeurs, tels que la sous-estimation systématique des erreurs-types dans les modèles de régression, conduisant à des inférences erronées et à la détection d’effets illusoires. Maîtriser le calcul de l’autocorrélation constitue donc un prérequis méthodologique absolu pour valider les hypothèses sous-jacentes à la modélisation prédictive et garantir la robustesse des conclusions tirées des données empiriques.
Dans le paysage computationnel moderne, le langage de programmation Python s’est imposé comme le standard de référence pour l’analyse scientifique, grâce à un écosystème mature articulé autour de bibliothèques hautement optimisées telles que NumPy, Pandas, SciPy et Statsmodels. Ce guide encyclopédique se propose d’explorer en profondeur la théorie, l’algorithmique et la mise en œuvre pratique de l’autocorrélation en Python. Des fondements probabilistes aux architectures de calcul distribué pour le traitement de flux massifs, chaque étape sera disséquée avec une rigueur mathématique et technique absolue, offrant ainsi un cadre de référence exhaustif pour l’analyste, le chercheur et l’ingénieur soucieux d’excellence méthodologique.
1. Fondements théoriques et mathématiques de l’autocorrélation
1.1 Définition conceptuelle et notion de dépendance sérielle
L’autocorrélation désigne la corrélation mutuelle qui lie les différentes réalisations d’un même processus stochastique à des instants temporels distincts. Alors que la corrélation de Pearson bivariée classique évalue l’intensité de l’association linéaire entre deux variables aléatoires distinctes mesurées simultanément au sein d’une même population, l’autocorrélation opère de manière univariée le long de la dimension chronologique. Elle mesure le degré auquel la valeur présente d’un signal porte l’empreinte statistique de ses états antérieurs. Cette propriété fondamentale, souvent qualifiée de dépendance sérielle ou d’inertie temporelle, reflète la persistance des chocs et la vitesse à laquelle un système dynamique dissipe ou amplifie les perturbations qui l’affectent.
D’un point de vue épistémologique, la notion de mémoire sérielle remet en cause le paradigme d’indépendance statistique. Dans les processus physiques, biologiques ou sociétaux, l’état d’un système à l’instant t est conditionné par sa trajectoire historique. Une température ambiante élevée à midi implique une probabilité accrue d’observer une température similaire à midi cinq minutes. Cette continuité structurelle n’est pas un artefact de mesure, mais l’expression directe des lois de conservation et des constantes de temps régissant le phénomène sous-jacent. L’analyse de l’autocorrélation permet ainsi de sonder l’architecture dynamique des systèmes complexes, qu’ils soient décrits en temps continu via des équations différentielles stochastiques ou échantillonnés sous la forme de séquences discrètes équidistantes.
1.2 Formulation mathématique de la fonction d’autocovariance et d’autocorrélation
Considérons un processus stochastique à temps discret noté X indexé par l’entier t. La fonction d’autocovariance théorique au décalage k, traditionnellement notée gamma indice k, est définie formellement comme l’espérance mathématique du produit des écarts à la moyenne temporelle mesurés à deux dates séparées par k unités de temps. Mathématiquement, cette grandeur s’exprime par la formule : gamma indice k est égal à l’espérance de l’expression le produit de X à l’instant t moins son espérance par X à l’instant t plus k moins son espérance. Lorsque k est nul, l’autocovariance gamma indice zéro coïncide rigoureusement avec la variance non conditionnelle du processus stochastique étudié.
La fonction d’autocorrélation, désignée par la lettre grecque rho indice k, correspond à la normalisation de la fonction d’autocovariance par la variance globale du processus. Elle s’obtient en divisant gamma indice k par gamma indice zéro. Par construction, le coefficient d’autocorrélation est une quantité adimensionnelle bornée de manière canonique sur le segment fermé [-1, 1], où la valeur 1 traduit une dépendance linéaire positive parfaite, -1 une dépendance linéaire négative parfaite (alternance stricte de signe), et 0 une absence totale de corrélation linéaire au décalage k. En vertu de la stationnarité, la fonction d’autocorrélation bénéficie d’une symétrie paire fondamentale : rho indice k est strictement égal à rho indice moins k. L’estimateur empirique standard calculé à partir d’un échantillon fini de taille N remplace l’espérance théorique par la moyenne arithmétique des produits croisés centrés, fournissant une approximation asymptotiquement convergente de la métrique sous-jacente.
1.3 Hypothèse de stationnarité au sens faible et impact méthodologique
L’évaluation rigoureuse de l’autocorrélation repose impérativement sur l’hypothèse de stationnarité au sens faible, ou stationnarité de second ordre. Un processus stochastique satisfait à cette condition si et seulement si deux postulats fondamentaux sont vérifiés : premièrement, son espérance mathématique doit être constante et invariante dans le temps ; deuxièmement, son autocovariance entre deux instants quelconques ne doit dépendre exclusivement que de l’écart temporel k qui les sépare, et non du repère temporel absolu t. Sans cette hypothèse d’invariance par translation temporelle, la notion même d’autocorrélation au retard k perdrait son sens univoque, puisqu’elle varierait selon le moment précis de l’observation.
La présence de composantes déterministes non stationnaires, telles que des tendances linéaires ou polynomiales ainsi que des périodicités saisonnières marquées, induit des distorsions sévères dans le calcul de l’autocorrélation. Une tendance macroscopique haussière génère artificiellement une corrélation positive très élevée sur des retards considérables, masquant la véritable structure stochastique du phénomène. Par conséquent, une démarche méthodologique rigoureuse impose la mise en œuvre de procédures de prétraitement systématiques, incluant la différenciation sérielle (application de l’opérateur retard de premier ordre) ou l’ajustement par régression pour éliminer la tendance et la saisonnalité, avant d’engager toute quantification de la dépendance sérielle.
2. Configuration de l’environnement Python et écosystème scientifique
2.1 Sélection et déploiement des bibliothèques fondamentales
L’écosystème open-source de Python offre une panoplie d’outils hautement spécialisés pour le traitement des séries chronologiques. Au niveau le plus fondamental, la bibliothèque NumPy fournit les structures de données matricielles multidimensionnelles (ndarray) et les primitives de calcul vectorisé en mémoire contiguë, garantissant une rapidité d’exécution proche du code C natif. Pandas vient enrichir ce socle en intégrant des structures de données évoluées telles que les Series et les DataFrames, dotées d’un système d’indexation temporelle élaboré capable de gérer nativement les fréquences régulières, les fuseaux horaires et les alignements de séquences asynchrones.
Pour l’analyse statistique et économétrique formelle, la bibliothèque Statsmodels constitue la référence académique incontournable. Elle encapsule des algorithmes rigoureux pour l’estimation de l’autocorrélation, l’ajustement de modèles ARMA/ARIMA et l’exécution de batteries de tests de diagnostic résiduel. Enfin, la restitution visuelle des trajectoires temporelles et de leurs structures de corrélation s’appuie traditionnellement sur le couple Matplotlib et Seaborn, qui permettent la génération de graphiques vectoriels de qualité publication, indispensables à la communication scientifique rigoureuse.
2.2 Gestion des environnements virtuels et reproductibilité computationnelle
Dans un contexte scientifique ou de production industrielle, la reproductibilité absolue des résultats numériques exige une isolation méticuleuse de l’environnement d’exécution. L’utilisation d’outils d’isolation tels que venv ou les environnements Conda prévient les conflits d’arborescence de dépendances entre différentes versions de bibliothèques critiques. Les évolutions d’API entre les versions majeures de Statsmodels et de SciPy peuvent en effet altérer la valeur par défaut de certains estimateurs, notamment le mode de correction de biais ou l’algorithme sous-jacent d’optimisation numérique.
Au-delà de la fixation des numéros de version via un fichier de verrouillage de configuration logicielle, la reproductibilité des simulations stochastiques impose la fixation déterministe des graines des générateurs de nombres pseudo-aléatoires (via les modules natifs de Python ou le nouveau générateur de bits de NumPy). Sur le plan matériel, la compilation optimisée des extensions C et Fortran sous-jacentes via les bibliothèques d’algèbre linéaire accélérées (OpenBLAS, Intel MKL ou Apple Accelerate) doit être vérifiée, car elle conditionne non seulement la vitesse de calcul des produits tensoriels, mais également la précision de l’arithmétique en virgule flottante sur de très grandes séquences.
2.3 Structuration et typage des objets temporels avec Pandas
L’intégrité du calcul de l’autocorrélation dépend intrinsèquement de la précision avec laquelle la série temporelle est modélisée au sein de l’environnement logiciel. L’ingestion de données brutes doit impérativement aboutir à la création d’un objet Pandas Series ou DataFrame pourvu d’un DateTimeIndex valide. Il convient de vérifier explicitement que l’attribut de fréquence de cet index est défini sans ambiguïté (par exemple une fréquence journalière, horaire ou à la milliseconde), faute de quoi les retards temporels ne correspondraient pas à des intervalles physiques équidistants mais à des positions ordinales arbitraires.
Le typage des données numériques doit être vérifié avec la plus grande circonspection. L’utilisation systématique du type flottant 64 bits (float64) est impérative afin de minimiser l’accumulation des erreurs d’arrondi lors du calcul des sommes de carrés et des produits croisés cumulés. De plus, une vérification programmatique de la monotonie croissante de l’index chronologique doit être effectuée au préalable, car tout désordre temporel ou tout doublon d’horodatage vicie fondamentalement l’interprétation des opérateurs de décalage temporel nécessaires à l’analyse de dépendance sérielle.
3. Calcul algorithmique manuel de l’autocorrélation avec NumPy et Pandas
3.1 Implémentation pas-à-pas via les opérateurs de décalage temporel
Pour assimiler intimement la mécanique sous-jacente à la dépendance temporelle, il est pédagogiquement précieux de concevoir un algorithme naïf exploitant les fonctionnalités de manipulation d’indices offertes par Pandas. La méthode de décalage temporel intégrée aux séries Pandas permet de translater l’ensemble des observations d’un retard entier k donné vers le futur. Cette opération crée mécaniquement un alignement temporel direct entre la valeur observée à l’instant t et son ancêtre observé à l’instant t moins k.
Ce décalage présente toutefois une conséquence immédiate : l’apparition inévitable de valeurs manquantes (NaN) sur les k premières positions de la série translatée. Pour calculer la covariance de Pearson entre la série originelle et sa version retardée, deux alternatives méthodologiques s’affrontent. La première consiste à tronquer la série originale pour ne conserver que le sous-ensemble apparié, puis à calculer le coefficient de corrélation linéaire standard sur ces N moins k observations conjointes. Bien que conceptuellement intuitive, cette approche souffre d’un défaut théorique majeur : la moyenne et la variance d’échantillonnage changent pour chaque valeur de k, empêchant l’obtention d’une fonction de corrélation mathématiquement unifiée et stable sur les grands retards.
3.2 Vectorisation du calcul matriciel avec NumPy
Pour pallier les inefficiences algorithmiques des structures de données de haut niveau et éliminer le coût des boucles interprétées en Python pur, l’implémentation vectorisée native avec NumPy s’impose comme la solution privilégiée pour le calcul manuel. Le premier jalon algorithmique consiste à centrer rigoureusement l’ensemble de la série temporelle en soustrayant la moyenne empirique calculée sur la totalité de l’échantillon d’observation. Ce centrage global unifié est indispensable pour respecter les propriétés mathématiques des processus stationnaires de second ordre.
Une fois le vecteur centré obtenu, le calcul du numérateur de l’autocovariance pour un ensemble de décalages peut être formalisé comme une série de produits scalaires vectoriels. Pour un décalage k donné, le produit scalaire entre le vecteur tronqué de l’indice zéro jusqu’à N moins k et le vecteur décalé de l’indice k jusqu’à N fournit directement la somme brute des produits croisés. La normalisation de cette somme par la somme totale des carrés du vecteur centré complet permet d’obtenir le coefficient d’autocorrélation empirique exact. L’assemblage de cette logique matricielle au sein d’une fonction Python pure sans boucle externe lente garantit des performances computationnelles remarquables tout en préservant une transparence mathématique absolue.
3.3 Comparaison critique entre les estimateurs avec et sans biais
Dans la littérature statistique relative aux séries chronologiques, une controverse historique concerne le choix du dénominateur utilisé pour normaliser la somme des produits croisés au décalage k. Deux estimateurs de l’autocovariance coexistent : l’estimateur dit sans biais, qui divise la somme des produits croisés par le nombre effectif de paires observées (N moins k), et l’estimateur conventionnel avec biais, qui maintient une division constante par la taille totale de l’échantillon N, indépendamment de la magnitude du retard temporel exploré.
Bien que l’estimateur divisant par N moins k soit asymptotiquement non biaisé au sens strict de la théorie de l’estimation, les théoriciens des processus stochastiques recommandent presque unanimement l’usage de l’estimateur divisant par N. La raison sous-jacente est d’une importance capitale en modélisation mathématique : l’estimateur normalisé par N garantit de façon inconditionnelle que la matrice d’autocovariance de Toeplitz résultante demeure strictement semi-définie positive. Cette propriété géométrique est indispensable pour s’assurer que les variances de prédiction calculées ultérieurement ne prennent jamais de valeurs négatives aberrantes et que les algorithmes d’inversion matricielle convergent sans instabilité numérique.
4. Implémentation standard avec statsmodels.tsa.stattools.acf
4.1 Syntaxe générale et paramètres essentiels de la fonction acf
Dans un cadre de développement professionnel et de recherche appliquée, l’écriture d’algorithmes manuels cède le pas aux implémentations industrielles rigoureusement optimisées et testées de la bibliothèque Statsmodels. Le module d’outils statistiques pour séries chronologiques fournit à cet effet la fonction acf, accessible directement via l’arborescence des outils de séries temporelles. Cette fonction prend en entrée une structure de données unidimensionnelle (tableau NumPy ou série Pandas) et renvoie un vecteur ordonné contenant la suite séquentielle des coefficients d’autocorrélation estimés.
Le paramétrage fin de cette routine statistique conditionne directement la validité des conclusions analytiques. L’argument nlags permet de borner explicitement l’horizon temporel de l’exploration en définissant le nombre maximal de décalages à calculer. Par défaut ou via l’argument adjusted, l’utilisateur peut contraindre l’algorithme à adopter l’estimateur avec ou sans la correction par la taille effective de sous-échantillon. Enfin, la gestion des éventuelles valeurs manquantes est arbitrée par le paramètre missing, qui autorise soit la levée immédiate d’une exception en cas d’anomalie, soit l’application d’un masque de filtration interne assurant la robustesse du flux d’exécution.
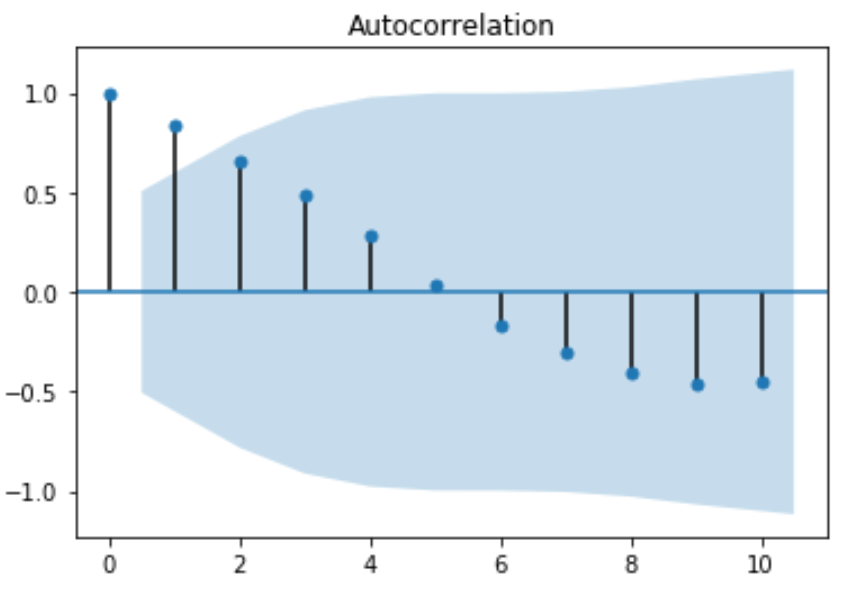
4.2 Interprétation quantitative du vecteur d’autocorrélation résultant
L’exécution de la fonction acf génère un vecteur unidimensionnel de nombres flottants dont la première composante, située à l’indice zéro, correspond invariablement à la valeur 1.0. Cette caractéristique découle trivialement de la définition même de la corrélation d’une variable avec elle-même sans décalage temporel. L’intérêt analytique se concentre dès lors sur les composantes subséquentes, associées aux retards progressifs de 1 jusqu’à la limite spécifiée.
L’analyse fine de la décroissance sérielle permet de dégager des diagnostics structurels cruciaux. Une décroissance géométrique exponentielle et continue des coefficients vers zéro est la marque caractéristique des processus autorégressifs d’ordre 1 stables. À l’inverse, une décroissance très lente, quasi linéaire et persistante sur plusieurs dizaines de retards révèle une mémoire à long terme ou la persistance d’une composante non stationnaire non purgée. De surcroît, la présence d’alternances régulières de signe entre valeurs positives et négatives trahit l’existence d’une périodicité sous-jacente ou d’une dynamique de surcompensation oscillatoire dans le système étudié.
4.3 Paramétrisation avancée : transformée de Fourier et options d’estimation
L’un des atouts déterminants de l’implémentation offerte par Statsmodels réside dans l’intégration native du paramètre fft, acceptant une valeur booléenne. Lorsque cette option est activée, l’algorithme délaisse le calcul direct dans le domaine temporel au profit d’un calcul dans le domaine fréquentiel, en s’appuyant sur la transformée de Fourier rapide (FFT) appliquée au signal convenablement rembourré de zéros (zero-padding). Ce mécanisme exploite les propriétés algébriques du produit de convolution discret pour accélérer de manière spectaculaire l’évaluation numérique.
Sur le plan de la complexité computationnelle, le calcul direct classique exige un nombre d’opérations proportionnel au carré de la taille du vecteur d’échantillon ou au produit de la taille par le nombre de retards demandés. L’approche fréquentielle réduit cette complexité à un ordre proportionnel à N multiplié par le logarithme de N. Pour des séries massives comprenant des centaines de milliers d’enregistrements à haute fréquence, l’activation de la FFT permet de diviser les temps de traitement par des facteurs considérables, sans introduire de distorsion arithmétique sensible au-delà des tolérances classiques de la virgule flottante double précision.
5. Visualisation graphique et corrélogramme avec plot_acf
5.1 Génération et configuration du corrélogramme de Statsmodels
La simple inspection tabulaire d’un vecteur de coefficients d’autocorrélation s’avère rapidement fastidieuse dès lors que l’horizon d’analyse dépasse quelques unités. Pour permettre une appréhension globale et intuitive de la dynamique sérielle, la visualisation graphique via un corrélogramme constitue le standard universel de l’analyse exploratoire des séries chronologiques. La fonction spécialisée plot_acf, localisée dans le module graphique de Statsmodels, automatise intégralement cette représentation en projetant les coefficients sous forme de bâtonnets verticaux discrets disposés le long de l’axe horizontal des retards.
Cette routine graphique a été pensée pour s’intégrer harmonieusement dans le flux de travail de Matplotlib. En lui transmettant un objet d’axes préexistant via le paramètre ax, l’analyste peut inscrire le corrélogramme au sein d’une figure composite multi-panneaux, juxtaposant par exemple la trajectoire temporelle brute, sa distribution marginale et sa fonction d’autocorrélation. La configuration du paramètre lags permet de moduler la densité d’information affichée, évitant la surcharge cognitive et concentrant le regard critique sur les échelles temporelles structurellement pertinentes pour la problématique investiguée.
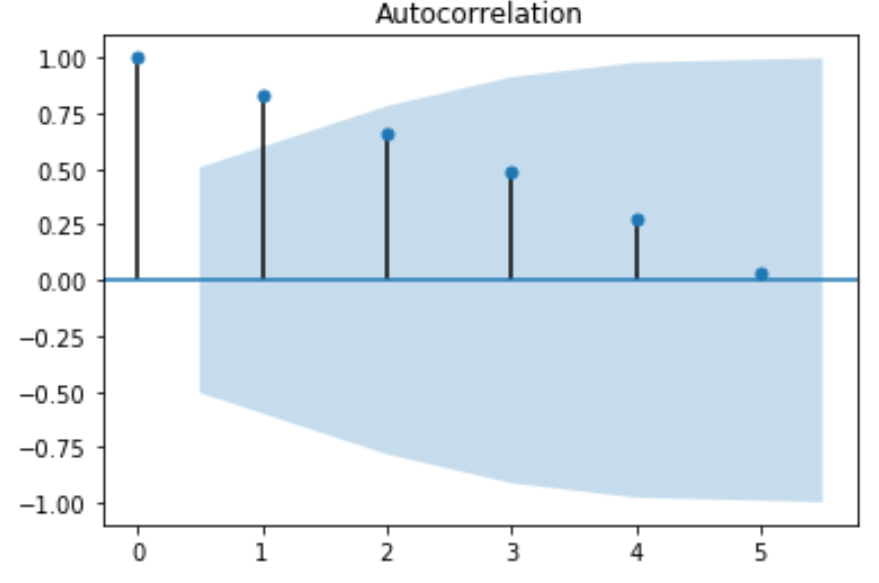
5.2 Calcul et signification statistique des bandes de confiance
L’élément distinctif majeur d’un corrélogramme rigoureux réside dans la présence systématique d’une bande de confiance ombrée encadrant l’axe d’amplitude zéro. Par défaut, cette zone de tolérance représente l’intervalle de confiance statistique bilatéral au seuil de signification de 95 % (correspondant à un risque de première espèce alpha fixé à 0.05). Ce calcul repose sur la formulation asymptotique établie par le statisticien Maurice Bartlett pour les processus stochastiques sous l’hypothèse nulle que la série temporelle est générée par un bruit blanc gaussien sans dépendance sérielle.
Sous cette hypothèse nulle, les estimateurs empiriques de l’autocorrélation suivent approximativement une loi normale centrée dont la variance est égale à l’inverse de la taille de l’échantillon. Les frontières de la bande d’indifférence statistique sont donc matérialisées par des bornes valant plus ou moins 1.96 divisé par la racine carrée de la taille d’échantillon N. Tout bâtonnet de corrélation dont l’extrémité émerge de cette zone ombrée est considéré comme statistiquement significatif au seuil choisi, traduisant une dépendance temporelle réelle qui ne peut être raisonnablement attribuée aux simples fluctuations de l’échantillonnage aléatoire. Il convient toutefois de garder à l’esprit le problème des tests d’hypothèses multiples : sur un grand nombre de retards inspectés simultanément, quelques dépassements marginaux peuvent survenir par pur hasard statistique.
5.3 Personnalisation esthétique et rigueur académique du rendu graphique
La production de figures destinées à des manuscrits universitaires ou à des rapports de recherche de haut niveau exige une personnalisation avancée des propriétés visuelles du corrélogramme. L’objet figure renvoyé par plot_acf expose l’intégralité des primitives graphiques de Matplotlib, autorisant la modification fine de la couleur des marqueurs, de l’épaisseur des segments verticaux, de la transparence de l’intervalle ombré et de la typographie des labels d’axes. L’activation du moteur de rendu mathématique LaTeX permet l’intégration formelle de notations telles que rho indice k sur l’axe des ordonnées.
Pour garantir une netteté absolue dans les documents imprimés ou les formats électroniques haute résolution, l’exportation graphique doit être réalisée dans des formats vectoriels non destructifs tels que le PDF ou le SVG, ou en format matriciel PNG avec une résolution minimale de 300 points par pouce (DPI). Enfin, un détail syntaxique crucial dans l’environnement interactif Jupyter Notebook consiste à faire suivre l’appel à la fonction graphique d’un point-virgule ou d’assigner son résultat à une variable muette, afin de supprimer l’affichage redondant et disgracieux du pointeur de l’objet figure dans la cellule de sortie.
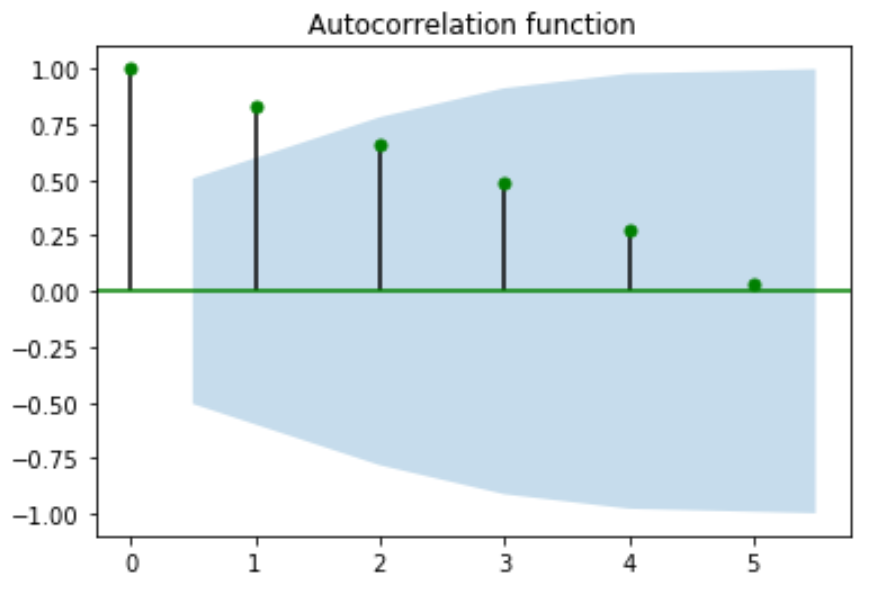
6. Analyse comparative : Fonction d’autocorrélation simple (ACF) et partielle (PACF)
6.1 Fondements mathématiques de l’autocorrélation partielle
Tandis que la fonction d’autocorrélation simple (ACF) mesure la dépendance globale entre deux points temporels distants de k pas, cette mesure agrège sans distinction l’effet linéaire direct entre ces deux instants et la cascade d’influences indirectes transitant par l’ensemble des observations intermédiaires situées entre t et t plus k. À titre d’exemple, dans un processus où l’observation à l’instant t est fortement corrélée à celle à l’instant t plus 1, et où cette dernière est elle-même corrélée à t plus 2, l’ACF révélera inévitablement une corrélation positive substantielle au retard 2, même si aucun lien causal ou structurel direct n’unit t à t plus 2.
La fonction d’autocorrélation partielle (PACF), formellement désignée par la notation phi indice k k, résout ce problème fondamental de confusion statistique. Elle quantifie exclusivement la corrélation résiduelle entre X à l’instant t et X à l’instant t plus k, une fois éliminée par projection orthogonale (au sens de l’espérance conditionnelle linéaire) l’influence combinée de toutes les variables intermédiaires comprises entre t plus 1 et t plus k moins 1. Mathématiquement, le coefficient d’autocorrélation partielle d’ordre k correspond exactement au dernier coefficient estimé dans une régression linéaire multiple projetant la variable temporelle sur ses k retards successifs. La résolution de ce problème d’estimation repose classiquement sur le système matriciel des célèbres équations de Yule-Walker, impliquant l’inversion de la matrice d’autocovariance de Toeplitz.
6.2 Calcul opérationnel de la PACF avec statsmodels.tsa.stattools.pacf
L’estimation numérique de la PACF sous Python s’effectue avec la même fluidité que celle de l’ACF grâce à la fonction pacf et son homologue graphique plot_pacf. Cette fonction implémente plusieurs variantes algorithmiques majeures, sélectionnables via le paramètre de méthode. Parmi les options disponibles figurent l’algorithme récursif de Levinson-Durbin (méthode yw), l’ajustement séquentiel par moindres carrés ordinaires non biaisés (méthode ols), et les approximations de Yule-Walker ajustées pour petits échantillons.
Le choix méthodologique de l’algorithme conditionne la robustesse des estimations en situation de données limitées. La méthode des moindres carrés ordinaires tend à fournir des estimateurs moins contraints par la structure théorique mais plus sensibles à la colinéarité lorsque le nombre de retards exploré s’approche de la taille totale de l’échantillon. L’algorithme de Levinson-Durbin, en tirant parti de la structure symétrique et constante sur les diagonales de la matrice de corrélation de Toeplitz, assure une stabilité computationnelle remarquable et garantit que les racines du polynôme autorégressif associé demeurent dans le cercle unité complexe, condition sine qua non de la stationnarité.
6.3 Identification conjointe des signatures de processus stochastiques
La mise en regard comparative des profils de l’ACF et de la PACF constitue le cœur de la méthodologie classique de Box-Jenkins pour l’identification de l’ordre structurel des modèles de séries temporelles ARMA. Chaque classe de processus stochastique fondamental imprime en effet une signature mathématique duale et parfaitement distincte sur ces deux fonctions de corrélation.
Pour un processus autorégressif pur d’ordre p noté AR(p), la fonction d’autocorrélation simple décline de façon asymptotique et continue vers zéro selon un profil exponentiel décroissant ou sous forme d’oscillations sinusoïdales amorties. En revanche, la fonction d’autocorrélation partielle subit une rupture structurelle nette : elle affiche des coefficients significatifs jusqu’au retard p, puis s’annule brusquement et tombe rigoureusement dans la bande d’indifférence statistique au-delà de ce seuil. Inversement, pour un processus moyenne mobile pur d’ordre q noté MA(q), c’est l’ACF qui s’annule abruptement après le décalage q, tandis que la PACF s’éteint de manière exponentielle ou oscillatoire. Dans le cas de processus mixtes ARMA(p, q), les deux fonctions présentent des déclins progressifs, exigeant des critères d’information pénalisés pour discriminer les ordres optimaux.
7. Prétraitement et gestion des irrégularités dans les séries temporelles
7.1 Diagnostic et impact des données manquantes sur l’autocorrélation
Les séries temporelles issues du monde réel sont fréquemment altérées par des discontinuités de collecte, des pannes d’instrumentation ou des artéfacts de transmission, matérialisés dans les jeux de données par des valeurs manquantes. L’impact de ces cellules vides sur l’évaluation de l’autocorrélation est dévastateur sur le plan algorithmique. En effet, l’opérateur de décalage temporel propage mécaniquement la présence d’une seule valeur manquante à l’ensemble des paires de calcul qui l’englobent, amplifiant artificiellement la perte d’information statistique.
Sur le plan méthodologique, la suppression aveugle des enregistrements contenant des valeurs manquantes (listwise deletion) altère irrémédiablement la trame chronologique sous-jacente. Deux observations séparées historiquement par une journée peuvent se retrouver artificiellement accolées après suppression d’un intervalle manquant, faussant radicalement le calcul des retards d’autocorrélation. Il est donc indispensable d’analyser la nature probabiliste du mécanisme de manque (manque complètement au hasard, manque au hasard ou manque non aléatoire) afin de sélectionner une stratégie de traitement qui préserve l’équidistance des observations temporelles.
7.2 Techniques d’imputation adaptées aux dépendances temporelles
Pour restaurer l’intégrité séquentielle d’une série sans corrompre son profil spectral, des algorithmes d’imputation spécifiquement conçus pour les dynamiques temporelles doivent être mobilisés. Les méthodes naïves consistant à remplacer les valeurs manquantes par la moyenne globale de la série sont formellement proscrites : cette pratique réduit artificiellement la variance empirique et tire brutalement les coefficients d’autocorrélation vers zéro, introduisant un biais conservateur sévère.
La technique de report de la dernière observation valide (LOCF), bien que très populaire dans les essais cliniques, engendre quant à elle un effet pervers inverse : en répétant artificiellement un niveau constant sur plusieurs pas de temps, elle injecte une fausse persistance locale qui gonfle indûment l’autocorrélation aux premiers retards. Les approches recommandées reposent sur l’interpolation par splines cubiques régularisées ou sur des modèles d’espace d’état utilisant le filtre et le lisseur de Kalman appliqués à une modélisation structurelle sous-jacente. L’interpolation doit impérativement faire l’objet d’un contrôle post-hoc en vérifiant que le corrélogramme de la série imputée ne présente pas de discontinuités spectrales aberrantes par rapport aux segments continus observés.
7.3 Détection et traitement des observations aberrantes (outliers)
L’estimateur canonique de l’autocorrélation repose sur la somme des produits croisés des écarts à la moyenne, une formulation algébrique qui confère une sensibilité extrême aux valeurs aberrantes isolées. Un choc exogène de grande magnitude, même limité à un instant isolé t, pollue simultanément le produit croisé au décalage k avec l’observation t moins k et avec l’observation t plus k, déformant l’ensemble de la fonction de dépendance sérielle et pouvant générer des corrélations fallacieuses.
Pour immuniser l’analyse contre ces distorsions, il convient de déployer des protocoles de diagnostic robustes basés sur des estimateurs de dispersion résistants, tels que la médiane des écarts absolus (MAD) ou l’écart interquartile calculé sur des fenêtres glissantes adaptatives. Face à des anomalies avérées, la winsorisation temporelle – consistant à rabattre les valeurs extrêmes sur les percentiles autorisés les plus proches – permet de préserver la dynamique ordinale du signal sans laisser les amplitudes excessives détruire l’estimation de la covariance. Alternativement, le recours à des estimateurs d’autocorrélation non paramétriques basés sur les rangs (corrélation de Spearman sérielle) procure une robustesse totale face aux queues de distribution lourdes.
8. Tests statistiques formels de significativité de l’autocorrélation
8.1 Test de Durbin-Watson pour la corrélation d’ordre 1
Si l’inspection visuelle du corrélogramme permet d’orienter le diagnostic initial, la confirmation rigoureuse de la dépendance sérielle exige l’application de tests d’hypothèses statistiques formels. Le test le plus célèbre et le plus anciennement documenté dans le cadre de l’analyse de régression linéaire est sans conteste le test de Durbin-Watson. Développé initialement pour évaluer l’indépendance sérielle des termes d’erreur d’un modèle de régression ordinaire, ce test sonde spécifiquement l’existence d’une autocorrélation résiduelle de premier ordre (AR(1)).
La statistique de test, notée d, est construite en calculant la somme des carrés des différences entre résidus successifs divisée par la somme globale des carrés résiduels. Sur le plan asymptotique, la valeur de d est étroitement liée au coefficient d’autocorrélation empirique d’ordre un par la relation d approximativement égal à 2 facteur de 1 moins rho indice un. La statistique oscille rigoureusement au sein de l’intervalle [0, 4]. Une valeur proche de 2 valide l’hypothèse d’absence d’autocorrélation d’ordre 1. Une valeur tendant vers 0 révèle une autocorrélation sérielle positive prononcée, tandis qu’une valeur se rapprochant de 4 indique une autocorrélation négative intense. L’exécution programmatique de ce test sous Python s’opère instantanément via la fonction durbin_watson accessible dans le sous-module d’outils statistiques de Statsmodels.
8.2 Test portemanteau de Ljung-Box et test de Box-Pierce
L’inconvénient intrinsèque du test de Durbin-Watson réside dans sa stricte limitation au seul retard temporel immédiat (ordre 1). Pour tester conjointement l’absence d’autocorrélation sur une fenêtre temporelle élargie comprenant plusieurs retards successifs, les statisticiens ont développé des procédures dites « portemanteau ». Le test historique de Box-Pierce agrégeait simplement la somme des carrés des coefficients d’autocorrélation empiriques jusqu’au décalage m spécifié, pondérée par la taille de l’échantillon, la quantité résultante convergeant asymptotiquement vers une loi du Chi-deux à m degrés de liberté sous l’hypothèse nulle de bruit blanc.
Conscients de la faible puissance statistique du test de Box-Pierce sur les échantillons de taille finie ou modérée, Greta Ljung et George Box ont proposé une modification cruciale en introduisant une pondération différentielle des coefficients selon leur décalage. La statistique Q de Ljung-Box surpondère systématiquement les corrélations associées aux retards courts, compensant l’inflation de variance induite par la réduction du nombre effectif de paires de données. La fonction acorr_ljungbox de Statsmodels exécute ce test de manière vectorisée sur une grille de retards prédéfinie, fournissant la statistique Q et la p-valeur associée pour chaque échelle de temps, facilitant ainsi un diagnostic global d’indépendance stochastique.
8.3 Diagnostic des résidus dans les modèles statistiques
L’application fondamentale des tests d’autocorrélation se manifeste dans la validation rigoureuse des modèles statistiques et économétriques. Le théorème classique de Gauss-Markov stipule en effet que l’estimateur des moindres carrés ordinaires n’est le meilleur estimateur linéaire non biaisé (BLUE) que si les perturbations stochastiques sous-jacentes sont mutuellement indépendantes et dépourvues d’autocorrélation sérielle.
Lorsque les résidus d’une modélisation prédictive présentent une autocorrélation significative non prise en compte, les conséquences théoriques sont dommageables : bien que les coefficients estimés demeurent convergents, les erreurs-types calculées sur ces coefficients sont massivement sous-estimées. Cette distorsion artificielle gonfle exagérément les statistiques de test de Student, conduisant l’analyste à conclure à la significativité de variables explicatives totalement inopérantes. Lorsqu’un corrélogramme résiduel signale la présence d’une structure persistante, il convient soit de reformuler la dynamique du modèle en intégrant des composantes autorégressives, soit de recourir à des matrices de covariance robuste pour l’inférence, à l’instar de l’estimateur de Newey-West garantissant la cohérence sous hétéroscédasticité et autocorrélation sérielle (HAC).
9. Application à l’analyse de données comportementales et chronopsychologiques
9.1 Quantification de l’inertie émotionnelle et affective
Au-delà de la finance et de la météorologie, l’analyse de l’autocorrélation a connu une expansion remarquable au sein des neurosciences computationnelles et de la psychologie quantitative. Dans le cadre des protocoles de recueil écologique momentané (Experience Sampling Methodology ou EMA), les participants rapportent leur état affectif ou psychologique plusieurs fois par jour via des applications mobiles. L’autocorrélation d’ordre 1 (lag-1) calculée sur ces séries temporelles intra-individuelles mesure ce que la littérature clinique nomme l’« inertie émotionnelle ».
Une inertie émotionnelle statistiquement élevée traduit la difficulté d’un individu à réguler ses états affectifs et à s’adapter avec souplesse aux sollicitations de son environnement. Des scores d’autocorrélation lag-1 très élevés pour des affects négatifs comme l’anxiété ou la tristesse constituent des marqueurs cliniques validés de vulnérabilité dépressive et de rigidité psychologique. L’analyse sous Python de telles trajectoires requiert une étape préalable de désagrégation de la variance : la tendance centrale propre à chaque sujet doit être soustraite afin d’isoler la pure dynamique intra-individuelle de la variabilité interindividuelle avant l’estimation de l’autocorrélation empirique.
9.2 Analyse de la dépendance sérielle dans les temps de réaction cognitive
Dans les paradigmes expérimentaux de psychologie cognitive explorant l’attention soutenue, les sujets exécutent de façon répétée des tâches de discrimination perceptive sur des centaines ou des milliers d’essais consécutifs. La séquence temporelle des temps de réaction enregistrés essai par essai (trial-by-trial) présente presque universellement une structure de dépendance sérielle caractéristique, connue sous la dénomination de dynamique de bruit 1/f ou bruit rose.
Cette propriété de dépendance à long terme, révélée par une fonction d’autocorrélation qui décroît selon une loi de puissance plutôt que selon une loi exponentielle, reflète l’organisation multi-échelle des réseaux neuronaux sous-tendant la vigilance cognitive. Pour isoler fidèlement cette mémoire sérielle en Python, il est crucial d’appliquer des filtres de dé-tendance adaptés afin d’éliminer les dérives macroscopiques générées par l’apprentissage moteur précoce ou la fatigue neuromusculaire tardive, garantissant que l’autocorrélation résiduelle mesure exclusivement la dynamique intrinsèque du contrôle exécutif.
9.3 Étude des signaux physiologiques et rythmes biologiques
La physiologie computationnelle exploite massivement l’autocorrélation pour sonder la périodicité des biorythmes. L’analyse des séries temporelles d’intervalles R-R extraites des électrocardiogrammes (variabilité de la fréquence cardiaque) permet de cartographier l’équilibre homéostatique entre les branches sympathique et parasympathique du système nerveux autonome. L’amplitude des oscillations d’autocorrélation reflète directement l’arythmie sinusale respiratoire.
De même, dans les études actimétriques continues du sommeil s’étendant sur plusieurs semaines, l’autocorrélation appliquée aux séries d’accélérométrie permet d’extraire automatiquement l’harmonique circadienne dominante (approximativement située à un retard de 24 heures) ainsi que les oscillations ultradiennes secondaires associées aux cycles de repos et d’activité. La détection de l’abaissement du premier pic d’autocorrélation à 24 heures constitue un indicateur objectif précoce de désynchronisation circadienne, souvent corrélé à des troubles de l’humeur ou à des pathologies métaboliques.
10. Optimisation algorithmique pour flux continus et volumétries massives
10.1 Calcul de l’autocorrélation via le théorème de Wiener-Khintchine
Lorsque le volume d’échantillonnage atteint des millions de points – une situation courante dans l’analyse de données de capteurs industriels (IoT) ou le traitement de flux financiers à haute fréquence – les implémentations canoniques basées sur des boucles ou des matrices de décalage deviennent prohibitives en temps de calcul. La solution élégante apportée par la théorie du traitement du signal réside dans l’exploitation du théorème de Wiener-Khintchine, qui établit une équivalence mathématique rigoureuse entre la fonction d’autocorrélation d’un signal stationnaire et la transformée de Fourier inverse de sa densité spectrale de puissance.
En pratique sous Python, cette approche se concrétise via l’utilisation de la fonction correlate de la bibliothèque SciPy, configurée avec le paramètre de méthode réglé sur ‘fft’. L’algorithme transforme le signal centré dans l’espace des fréquences via une FFT, calcule le module au carré des coefficients spectraux, puis projette ce produit scalaire vers le domaine temporel par transformée de Fourier rapide inverse (IFFT). Le gain d’échelle computationnel est phénoménal : pour un signal de un million de points, le calcul fréquentiel s’exécute en une fraction de seconde, là où une approche naïve nécessiterait plusieurs heures de calcul matriciel standard.
10.2 Autocorrélation en fenêtre glissante (Rolling Autocorrelation)
L’hypothèse globale de stationnarité stricte est fréquemment violée sur les longues séquences temporelles réelles, les systèmes subissant des transitions de phase graduelles ou des dérives de régime dynamique. Pour capturer ces évolutions temporelles locales sans présumer de la constance des paramètres sur l’ensemble de l’horizon, les praticiens recourent à l’autocorrélation en fenêtre glissante (rolling autocorrelation).
Cette méthodologie consiste à faire coulisser une sous-fenêtre d’échantillonnage de largeur temporelle fixe le long de la série chronologique et à évaluer localement le coefficient d’autocorrélation pour chaque position successive. Une élévation continue de l’autocorrélation locale lag-1 est reconnue dans la théorie des systèmes dynamiques complexes comme un signal précurseur universel d’une bifurcation critique imminente ou d’un effondrement systémique (phénomène de ralentissement critique). L’implémentation de ce calcul via les primitives standard de Pandas peut néanmoins s’avérer lente, justifiant la compilation à la volée du noyau arithmétique grâce à la bibliothèque Numba (décorateur @jit), permettant d’atteindre des vitesses de traitement comparables aux boucles optimisées en langage C.
10.3 Traitement distribué pour données volumineuses avec Dask et Polars
Lorsque la taille des séries chronologiques excède la capacité de la mémoire vive (RAM) de la station de travail, l’écosystème Python propose des alternatives de nouvelle génération basées sur le traitement distribué ou les architectures matricielles multithreadées modernes. Dask offre des structures de données (Dask Series) partitionnées sur disque ou sur une grappe de calcul, capables d’évaluer paresseusement des fonctions d’autocovariance globales via des réductions distribuées map-reduce sans saturer la mémoire.
Parallèlement, la bibliothèque Polars, développée en langage Rust et optimisée pour l’exploitation massive des jeux d’instructions vectorielles des processeurs récents (SIMD), transforme radicalement le calcul des décalages temporels. Grâce à son moteur d’exécution paresseux (LazyFrame) et à sa gestion de la mémoire sans copie (via le format Apache Arrow), Polars surpasse les performances de Pandas de plusieurs ordres de grandeur lors de l’alignement de séries massives et du calcul des sommes croisées, éliminant les goulets d’étranglement computationnels dans les pipelines de traitement de mégadonnées.
11. Pièges méthodologiques et écueils d’interprétation
11.1 Confusion entre autocorrélation réelle et tendance macroscopique
L’erreur la plus répandue et la plus pernicieuse dans l’analyse empirique des séries temporelles réside dans la confusion intellectuelle entre une dépendance stochastique réelle et l’effet mécanique induit par une composante tendancielle déterministe sous-jacente. Si une série chronologique présente une dérive monotone positive sur la durée totale de son enregistrement, deux valeurs chronologiquement proches auront une probabilité mathématique quasi certaine d’afficher des niveaux comparables par rapport à la moyenne globale de l’échantillon.
Cette configuration produit immanquablement un corrélogramme exhibant des coefficients d’autocorrélation extrêmement élevés sur des dizaines, voire des centaines de retards, créant l’illusion trompeuse d’un processus doté d’une mémoire stochastique infinie. De même, la survenue de ruptures structurelles non modélisées – telles qu’un saut soudain de la moyenne du système suite à un choc exogène – contamine massivement la fonction d’autocovariance globale. La validation impérative de la stationnarité via des tests de racine unitaire formels, à l’image du test augmenté de Dickey-Fuller (ADF) ou du test KPSS, doit précéder toute tentative d’interprétation théorique du profil de corrélation.
11.2 Sur-interprétation des coefficients aux retards élevés
Un autre écueil méthodologique classique guette l’analyste lors de l’examen des décalages temporels élevés sur un corrélogramme. Par construction mathématique, l’évaluation du produit croisé au décalage k ne peut mobiliser que le nombre d’observations restantes, à savoir précisément N moins k couples de points. Au fur et à mesure que le retard temporel s’accroît et s’approche de la taille globale de l’échantillon N, le volume de données étayant l’estimation s’effondre de manière drastique.
Cet appauvrissement de l’échantillon effectif entraîne une envolée exponentielle de la variance d’échantillonnage de l’estimateur. Les coefficients situés aux retards lointains affichent alors des amplitudes bruitées et hautement instables, augmentant dramatiquement le risque d’erreur statistique de type I (rejet à tort de l’hypothèse d’absence d’autocorrélation). La règle empirique canonique formulée par George Box et Gwilym Jenkins préconise de borner formellement l’exploration de l’autocorrélation à un décalage maximal n’excédant jamais le quart ou le tiers de la taille totale de l’échantillon (N divisé par 4).
11.3 Erreurs d’échantillonnage et intervalles temporels non équidistants
L’ensemble de l’édifice mathématique de la fonction d’autocorrélation à temps discret repose sur le postulat tacite d’une grille temporelle strictement régulière, au sein de laquelle le pas temporel delta t séparant deux indices contigus consécutifs demeure rigoureusement invariant sur l’ensemble de la trajectoire observée. Dans la pratique expérimentale, cette régularité géométrique est souvent compromise par des latences de communication réseau, des irrégularités de cadencement matériel ou des plannings d’observation fluctuants.
L’application aveugle des algorithmes standards de calcul d’autocorrélation sur une séquence ordinale issue d’intervalles physiques hétérogènes génère une distorsion mathématique majeure : le retard k n’a plus de signification métrique stable, agrégeant des durées réelles totalement disparates. Dans de telles circonstances, l’analyste doit impérativement renoncer aux estimateurs conventionnels et mobiliser des formulations adaptées aux données asynchrones, telles que le périodogramme de Lomb-Scargle, les fonctions d’autocorrélation à temps continu (CTACF) ou procéder à un rééchantillonnage temporel préliminaire par interpolation régularisée sur une grille temporelle artificielle unifiée.
12. Intégration de l’autocorrélation dans la modélisation prédictive et le Machine Learning
12.1 Sélection des hyperparamètres p et q des modèles ARIMA/SARIMA
Dans le domaine classique de la prévision statistique, la fonction d’autocorrélation simple et son homologue partielle constituent les instruments décisionnels directeurs de l’étape de diagnostic d’identification des modèles autorégressifs intégrés de moyennes mobiles (ARIMA). La lecture concertée de leurs structures de coupure et de décroissance oriente directement l’analyste vers le choix des ordres autorégressifs p et de moyenne mobile q.
Bien que des algorithmes automatisés d’exploration d’espace de paramètres – à l’instar de la bibliothèque pmdarima en Python – permettent d’optimiser ces hyperparamètres par minimisation de critères d’information pénalisés (critère d’information d’Akaike AIC ou critère bayésien BIC), l’expertise humaine appuyée sur le corrélogramme demeure incontournable pour éviter le surparamétrage. La présence de coefficients significatifs périodiques aux retards multiples d’un cycle (par exemple aux retards 12, 24, 36 pour des fréquences mensuelles) dicte en outre l’introduction obligatoire de composantes saisonnières spécifiques (modèles SARIMA), assurant l’extinction complète de l’autocorrélation dans la trajectoire prédictive résiduelle.
12.2 Ingénierie des caractéristiques temporelles (Feature Engineering) pour le Machine Learning
La transition de la modélisation économétrique vers les architectures contemporaines de Machine Learning (telles que les algorithmes de Gradient Boosting comme XGBoost ou LightGBM) n’amoindrit en rien la centralité de l’autocorrélation ; elle en décuple au contraire la portée opérationnelle. Ces modèles supervisés n’intègrent pas nativement la notion de temporalité séquentielle : ils exigent que l’analyste convertisse explicitement la mémoire stochastique du signal en variables descriptives tabulaires (features).
L’inspection préalable du corrélogramme permet d’effectuer un ciblage hautement rationnel de ces variables retardées (lag features). Plutôt que d’injecter aveuglément les cinquante derniers retards au risque de saturer l’espace dimensionnel et de déclencher une multicolinéarité paralysante, l’ingénieur sélectionne spécifiquement les retards affichant des pics d’autocorrélation statistiquement significatifs. De plus, la vitesse de décroissance de l’autocorrélation dicte la largeur optimale des fenêtres statistiques glissantes (moyennes mobiles, écarts-types mobiles), alignant précisément l’horizon de mémoire des descripteurs algorithmiques sur la dynamique physique intrinsèque du processus étudié.
12.3 Validation croisée temporelle tenant compte de la dépendance sérielle
L’erreur la plus fatale lors du déploiement d’un modèle d’apprentissage automatique supervisé sur des séries chronologiques réside dans l’application naïve des protocoles standards de validation croisée aléatoire (K-Fold cross-validation). En assignant aléatoirement des observations successives entre le jeu d’entraînement et le jeu de test, cette méthode pulvérise la structure temporelle et provoque un phénomène massif de fuite d’information statistique (data leakage) médiée par l’autocorrélation sérielle.
En présence d’une forte dépendance temporelle, l’état d’un système à l’instant t d’entraînement contient une quantité colossale d’information sur son état à l’instant t plus un assigné artificiellement au jeu de test. Le modèle réalise ainsi une simple interpolation mémorielle, affichant des métriques d’évaluation extraordinairement optimistes qui s’effondrent lamentablement lors du déploiement en conditions réelles. Pour pallier cette faille méthodologique, il est impératif d’utiliser des schémas de validation croisée respectant scrupuleusement la flèche du temps, tels que le TimeSeriesSplit de scikit-learn. Dans les cas de très forte dépendance sérielle, il convient d’intercaler une zone tampon temporelle (purge et embargo) entre l’échantillon d’apprentissage et l’échantillon de test, neutralisant toute transmission d’information par le canal de l’autocorrélation résiduelle.
Références
- Bartlett, M. S. (1946). On the theoretical specification and sampling properties of autocorrelated time-series. Supplement to the Journal of the Royal Statistical Society, 8(1), 27-41. https://doi.org/10.2307/2983611
- Box, G. E., Jenkins, G. M., Reinsel, G. C., & Ljung, G. M. (2015). Time series analysis: forecasting and control (5th ed.). John Wiley & Sons. https://www.wiley.com
- Brockwell, P. J., & Davis, R. A. (2016). Introduction to time series and forecasting (3rd ed.). Springer. https://doi.org/10.1007/978-3-319-29854-2
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression: I. Biometrika, 37(3/4), 409-428. https://doi.org/10.2307/2332388
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
- Ljung, G. M., & Box, G. E. (1978). On a measure of lack of fit in time series models. Biometrika, 65(2), 297-303. https://doi.org/10.1093/biomet/65.2.297
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51-56). https://doi.org/10.25080/Majora-92bf1924-003
- Newey, W. K., & West, K. D. (1987). A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix. Econometrica, 55(3), 703-708. https://doi.org/10.2307/1913610
- Prado, R., Ferreira, M. A., & West, M. (2021). Time series: modeling, computation, and inference (2nd ed.). CRC Press. https://doi.org/10.1201/9781351111676
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. In Proceedings of the 9th Python in Science Conference (Vol. 57, pp. 92-96). https://doi.org/10.25080/Majora-92bf1924-011
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2
- Wiener, N. (1949). Extrapolation, interpolation, and smoothing of stationary time series. MIT Press. https://mitpress.mit.edu