
L’évaluation de la fidélité des instruments de mesure constitue l’un des piliers fondamentaux des sciences humaines, sociales, médicales et comportementales. Lorsqu’un chercheur ou un praticien conçoit une échelle d’évaluation psychologique, un questionnaire de satisfaction ou une batterie de tests diagnostiques, la question primordiale de la cohérence des items se pose inévitablement : les différents énoncés mesurent-ils fidèlement et uniformément le même construit théorique sous-jacent ? Parmi l’ensemble des métriques développées pour répondre à cette exigence méthodologique, le coefficient alpha de Cronbach demeure, depuis plus de sept décennies, l’indice de cohérence interne le plus largement calculé et rapporté dans la littérature scientifique internationale.
Si des progiciels statistiques spécialisés tels que SPSS, R, Stata ou SAS permettent d’estimer ce paramètre en quelques lignes de commande, le recours au tableur Microsoft Excel offre une valeur pédagogique, heuristique et opérationnelle incomparable. En décomposant les étapes algorithmiques au sein d’une feuille de calcul, l’analyste s’émancipe de l’effet « boîte noire » des logiciels dédiés, accédant à une compréhension intime de la mécanique matricielle, des variances d’items et des décompositions de sommes de carrés. Cette maîtrise technique permet non seulement d’identifier d’éventuelles anomalies métriques dans les jeux de données, mais garantit également une flexibilité absolue dans l’automatisation de tableaux de bord psychométriques réutilisables.
Ce guide encyclopédique a pour vocation de détailler, avec une rigueur statistique et académique irréprochable, l’ensemble des fondements théoriques, des formulations algébriques et des méthodologies appliquées nécessaires au calcul de l’alpha de Cronbach dans Microsoft Excel. À travers trois approches distinctes — l’analyse de variance à deux facteurs, les fonctions statistiques directes de variance et l’algèbre matricielle de covariance —, vous explorerez pas à pas chaque phase computationnelle, du prétraitement des données brutes à la rédaction des résultats selon les normes éditoriales de l’American Psychological Association (APA).
1. Introduction théorique à la cohérence interne et à l’alpha de Cronbach
1.1 Définition psychométrique de la fidélité et de la cohérence interne
Dans le paradigme de la théorie classique des tests (TCT), tout score observé à un instrument de mesure psychologique est modélisé comme la sommation linéaire d’un score vrai inobservable et d’une composante d’erreur de mesure aléatoire non corrélée. La fidélité (ou reliability dans la tradition anglo-saxonne) désigne formellement la proportion de la variance totale du score observé attribuable à la variance du score vrai. Sur le plan épistémologique, elle quantifie le degré de reproductibilité, de stabilité et de précision d’une mesure à travers différentes conditions d’observation.
Il convient de distinguer rigoureusement la cohérence interne des autres formes classiques d’estimation de la fidélité. La fidélité test-retest évalue la stabilité temporelle d’un score en administrant le même instrument aux mêmes individus à deux moments distincts, ce qui l’expose aux effets de rémanence, d’apprentissage et de maturation des participants. La fidélité par formes parallèles, quant à elle, requiert l’élaboration de deux versions équivalentes d’un même test administrées de manière concomitante ou différée, une démarche particulièrement coûteuse et méthodologiquement complexe. À l’opposé de ces protocoles diachroniques, l’évaluation de la cohérence interne ne sollicite qu’une seule et unique passation d’un ensemble d’items à un échantillon donné, examinant l’homogénéité avec laquelle les items constitutifs d’une échelle convergent vers la mesure d’un construit commun.
Au cœur de cette approche synchronique, l’alpha de Cronbach intervient non pas comme une mesure directe et parfaite de la fidélité, mais comme l’estimation mathématique de la borne inférieure de la fidélité d’une échelle composée, pour autant que les postulats métriques sous-jacents soient raisonnablement satisfaits. Sa popularité universelle trouve son ancrage dans sa capacité à traiter aussi bien des épreuves de performance maximale que des inventaires de personnalité, des tests d’aptitude cognitive ou, plus fréquemment encore, des échelles d’attitude reposant sur des items ordinaux de type Likert.
1.2 Origine historique et publication séminale de Lee Cronbach (1951)
L’acte de naissance officiel du coefficient alpha remonte à l’année 1951, lorsque le psychologue et statisticien américain Lee Joseph Cronbach publia son article fondateur intitulé « Coefficient alpha and the internal structure of tests » dans les colonnes de la prestigieuse revue Psychometrika. Cependant, la genèse de ce coefficient s’inscrit dans un continuum historique de réflexions amorcées plusieurs décennies auparavant au sujet de la fidélité par division en deux moitiés (split-half reliability) et des équations de Spearman-Brown.
Avant la formalisation de Cronbach, les psychomètres étaient confrontés aux limites drastiques des formules KR-20 et KR-21 élaborées en 1937 par G. Frederic Kuder et Marion Richardson. Bien que remarquables, ces formules demeuraient strictement restreintes aux items dichotomiques, codés de manière binaire sous la forme de réussite (1) ou d’échec (0). L’innovation conceptuelle et mathématique majeure apportée par Lee Cronbach résida dans la généralisation de l’approche de Kuder-Richardson aux items polytomiques, qu’ils soient continus, semi-continus ou ordinaux à catégories multiples, à l’image des échelles graduées en cinq ou sept points de Likert.
Cronbach démontra avec brio que son coefficient alpha représente en réalité la moyenne arithmétique exacte de tous les coefficients de fidélité obtenus par l’ensemble des découpages possibles d’un test en deux sous-ensembles équilibrés. Cette publication magistrale a profondément redéfini les standards méthodologiques internationaux de la psychométrie, devenant l’un des articles les plus cités de toute l’histoire des sciences comportementales et un passage obligé pour tout processus de validation d’instruments de mesure.
1.3 Importance de l’automatisation du calcul dans Microsoft Excel
Bien que des environnements de programmation tels que R ou des suites intégrées comme IBM SPSS Statistics exécutent l’alpha de Cronbach de manière quasi instantanée, l’usage de Microsoft Excel s’impose comme une alternative hautement pédagogique, transparente et universellement accessible. Contrairement aux interfaces opaques qui masquent les équations sous-jacentes, un tableur contraint le praticien ou l’étudiant à décomposer explicitement chaque vecteur, chaque variance marginale et chaque terme de covariance, renforçant de facto la compréhension conceptuelle des données.
Sur le plan organisationnel, Excel dispose d’une disponibilité quasi universelle au sein des universités, des laboratoires de recherche, des cabinets de conseil et des départements de ressources humaines. Il élimine les barrières financières associées aux licences logicielles propriétaires onéreuses ainsi que les courbes d’apprentissage abruptes inhérentes aux langages de scripts statistiques. De plus, la richesse de son écosystème de fonctions natives combinée à l’Utilitaire d’analyse permet de construire des gabarits automatisés où la simple actualisation des données sources met immédiatement à jour les indices psychométriques.
Enfin, la modélisation sous Excel garantit une reproductibilité intégrale des protocoles de calcul. En archivant les formules directement au sein du classeur, les chercheurs s’assurent que leurs collègues ou relecteurs académiques pourront auditer méticuleusement chaque transition numérique, depuis le traitement initial des énoncés inversés jusqu’au résultat final, écartant ainsi les erreurs silencieuses d’exécution qui surviennent fréquemment lors de manipulations de données non contrôlées.
2. Fondements mathématiques et formulation statistique du coefficient alpha
2.1 La formule classique basée sur les variances des items et du score total
L’expression algébrique canonique de l’alpha de Cronbach est formulée à partir du rapport entre la somme des variances individuelles de chaque item et la variance du score composite total généré par l’ensemble de l’échelle. Pour un instrument d’évaluation constitué de $k$ items, l’équation s’énonce formellement comme suit :
$$\alpha = \frac{k}{k – 1} \left( 1 – \frac{\sum_{i=1}^{k} \sigma_{y_i}^2}{\sigma_x^2} \right)$$
Dans cette formulation mathématique, la variable $k$ représente le nombre total d’items composant l’instrument ou la sous-échelle sous examen. Le facteur multiplicatif initial, $k / (k – 1)$, constitue un terme de correction d’échelle indispensable : sans lui, l’indice serait structurellement biaisé à la baisse pour les instruments comportant un nombre modeste de questions. Ce ratio compense la sous-estimation inhérente à l’agrégation finie des items. Le symbole $\sigma_{y_i}^2$ désigne la variance statistique de l’item individuel $i$, calculée sur l’ensemble de l’échantillon des participants observés. Le terme $\sigma_x^2$ correspond quant à lui à la variance globale du score total $X$, où le score total de chaque participant est défini par la sommation linéaire des réponses attribuées aux $k$ items constitutifs ($X = y_1 + y_2 + dots + y_k$).
L’analyse structurelle du terme entre parenthèses révèle le cœur conceptuel de la formule : le quotient $\frac{\sum \sigma_{y_i}^2}{\sigma_x^2}$. Si tous les items d’une échelle étaient totalement indépendants les uns des autres (c’est-à-dire si leurs covariances mutuelles étaient rigoureusement nulles), la variance de la somme d’items serait alors strictement égale à la somme des variances individuelles. Par conséquent, le rapport équivaudrait exactement à 1, conduisant à un terme entre parenthèses égal à zéro ($1 – 1 = 0$), et donc à un coefficient alpha nul. À l’inverse, dès lors que les items covarient positivement et partagent une source commune de variance vraie, la variance du score total $\sigma_x^2$ augmente considérablement et surpasse largement la simple somme des variances isolées. Le rapport tend alors vers zéro, et le terme entre parenthèses converge vers 1, maximisant la valeur finale de l’alpha.
2.2 L’approche par la matrice des covariances et corrélations
Pour appréhender l’alpha de Cronbach dans toute sa profondeur algébrique, il est fondamental d’examiner la structure de la matrice de variance-covariance inter-items, notée $boldsymbol{\Sigma}$, de dimension $k \times k$. Dans cette configuration matricielle, les éléments situés sur la diagonale principale représentent les variances propres de chaque item ($\sigma_{y_i}^2$), tandis que les éléments hors diagonale représentent les covariances bivariées unilatérales et symétriques ($\sigma_{y_i y_j}$) entre chaque paire d’items distincts.
La variance du score composite total $\sigma_x^2$ n’est rien d’autre que la somme de l’ensemble des cellules composant cette matrice carrée. Dès lors, nous pouvons décomposer la variance totale comme la somme des variances diagonales additionnée à la somme de l’intégralité des covariances hors diagonale :
$$\sigma_x^2 = \sum_{i=1}^{k} \sigma_{y_i}^2 + \sum_{i \neq j} \sigma_{y_i y_j}$$
En substituant cette équivalence au sein de l’équation originelle de Cronbach, il apparaît de manière limpide que le coefficient dépend exclusivement de l’ampleur des covariances inter-items. Si l’on désigne par $\bar{c}$ la covariance moyenne non redondante entre l’ensemble des paires d’items (totalisant $k(k-1)$ éléments hors diagonale) et par $\bar{v}$ la variance moyenne des items, l’alpha de Cronbach peut être réécrit sous une forme synthétique élégante :
$$\alpha = \frac{k^2 \cdot \bar{c}}{\sum \sigma_{y_i}^2 + k(k-1)\bar{c}} = \frac{k \cdot \bar{c}}{\bar{v} + (k – 1)\bar{c}}$$
Cette perspective matricielle permet d’opérer une distinction méthodologique fondamentale entre l’alpha brut (calculé sur les variances et covariances réelles) et l’alpha standardisé. Lorsque les items d’une échelle possèdent des variances très hétérogènes (par exemple en présence d’échelles de cotation différentes ou d’amplitudes dispersées), le calcul conventionnel accorde un poids disproportionné aux items à forte variance. Dans ce cas, les variables doivent être centrées et réduites, transformant la matrice de covariance en une pure matrice de corrélation de Pearson. L’alpha standardisé dérive alors directement de la célèbre prophétie de Spearman-Brown appliquée à la corrélation moyenne inter-items ($\bar{r}$) :
$$\alpha_{\text{standardisé}} = \frac{k \cdot \bar{r}}{1 + (k – 1)\bar{r}}$$
2.3 Relation mathématique entre l’alpha de Cronbach et l’ANOVA à deux facteurs
L’une des démonstrations les plus élégantes et les plus commodes pour l’environnement logiciel Excel réside dans l’équivalence exacte entre le coefficient alpha et l’analyse de variance (ANOVA) à deux facteurs sans répétition (modèle mixte ou modèle à effets aléatoires croisés). Dans cette perspective, la matrice de données est conceptualisée comme une expérience factorielle où chaque cellule d’observation représente la réponse d’un participant spécifique (facteur Sujets ou Lignes) à un item donné (facteur Items ou Colonnes).
Le modèle linéaire sous-jacent postule que la réponse observée $Y_{ij}$ du sujet $i$ à l’item $j$ se décompose additivement en : la moyenne générale de l’épreuve ($\mu$), l’effet spécifique du participant ($\alpha_i$), l’effet fixe de difficulté propre à l’item ($\beta_j$), et une composante résiduelle d’erreur d’interaction non répétée ($\epsilon_{ij}$) :
$$Y_{ij} = \mu + \alpha_i + \beta_j + \epsilon_{ij}$$
L’ANOVA décompose la somme des carrés totale des écarts en trois termes orthogonaux : la somme des carrés inter-sujets ($SC_{\text{sujets}}$), la somme des carrés inter-items ($SC_{\text{items}}$) et la somme des carrés d’erreur résiduelle ($SC_{\text{erreur}}$). En divisant chaque somme de carrés par son degré de liberté respectif, on dérive les carrés moyens correspondants, notamment le carré moyen des sujets ($CM_{\text{sujets}}$) et le carré moyen résiduel ($CM_{\text{erreur}}$). L’alpha de Cronbach s’exprime alors rigoureusement par la formule :
$$\alpha = \frac{CM_{\text{sujets}} – CM_{\text{erreur}}}{CM_{\text{sujets}}} = 1 – \frac{CM_{\text{erreur}}}{CM_{\text{sujets}}}$$
Cette relation prouve que l’alpha de Cronbach n’est rien d’autre qu’une déclinaison directe du coefficient de corrélation intraclasse (modèle ICC pour mesures moyennes). Sa mise en œuvre computationnelle dans Excel est d’une simplicité désarmante, car elle ne requiert qu’une unique commande de l’Utilitaire d’analyse pour extraire instantanément ces deux carrés moyens.
3. Préparation et structuration rigoureuse des données psychologiques dans Excel
3.1 Organisation spatiale de la matrice des observations
La fiabilité de tout traitement statistique repose sur la rigueur de la structure tabulaire initiale. Dans Microsoft Excel, l’organisation spatiale des données psychométriques doit respecter scrupuleusement la convention matricielle standard des données univariées et multivariées : les unités statistiques d’observation (les répondants ou participants) sont assignées de manière exclusive aux lignes, tandis que les variables observées (les items de l’échelle) occupent les colonnes.
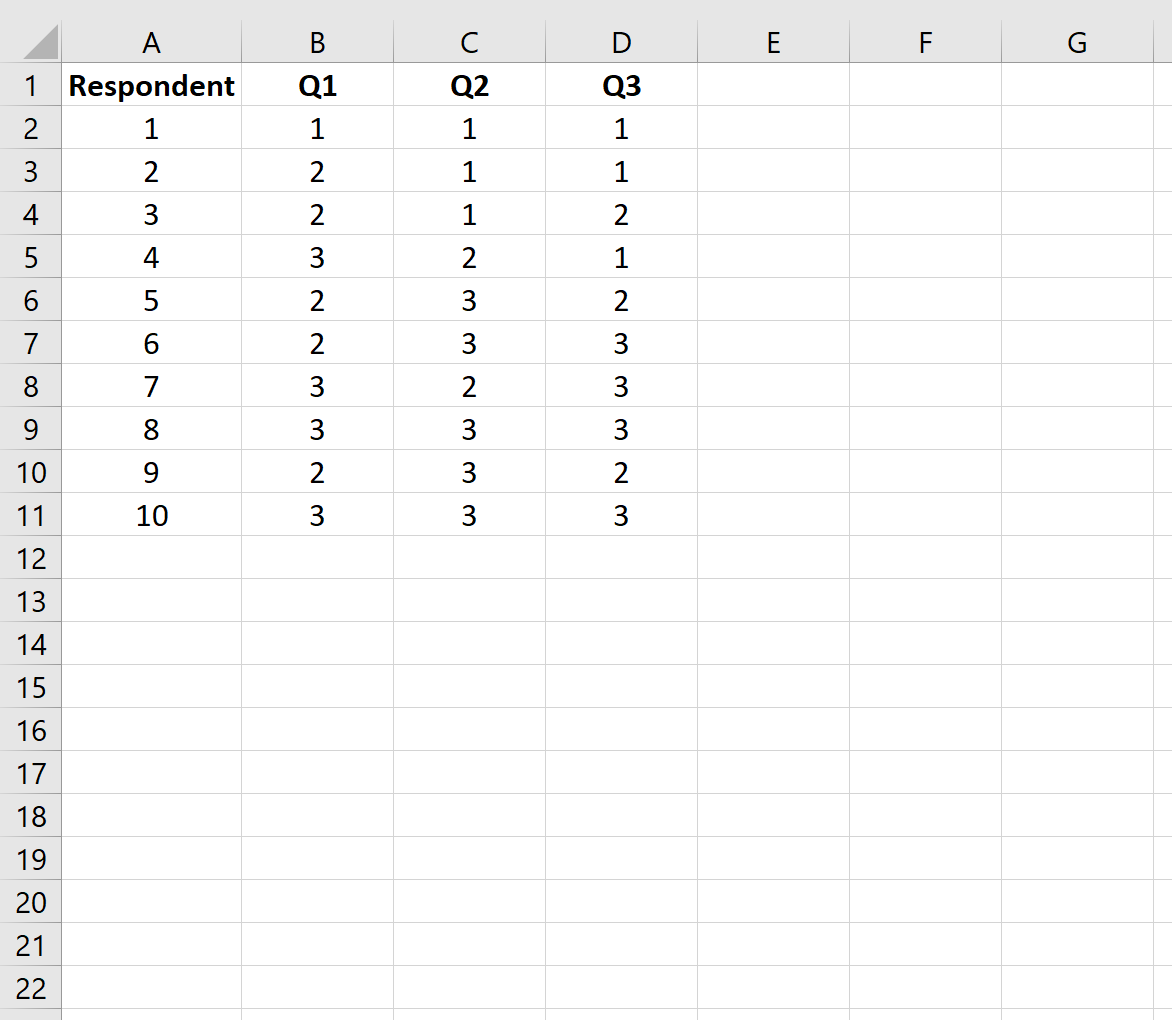
Il est impératif d’utiliser la toute première ligne de la feuille de calcul (ligne 1) pour l’étiquetage exhaustif et non ambigu des identifiants d’items (par exemple : Item_1, Item_2, …, Item_k). La première colonne (colonne A) devrait systématiquement être allouée à un numéro d’identification anonymisé unique pour chaque participant (par exemple : ID_001, ID_002). Cette pratique prévient tout risque de confusion entre une valeur numérique de score et un indice d’identification de sujet.
La matrice de données elle-même (couvrant la plage B2 jusqu’à la colonne $k$ et la ligne $N+1$) doit constituer un bloc rectangulaire compact, exempt de toute rupture de continuité. Il faut proscrire impérativement l’insertion de lignes vides de séparation, de colonnes intermédiaires de sous-totaux partiels ou de cellules fusionnées, car ces anomalies de mise en page brisent les références de plages continues exploitées par les fonctions statistiques matricielles d’Excel.
3.2 Nettoyage préliminaire et recodage des items inversés
L’écueil méthodologique le plus fréquent et le plus dévastateur lors de l’estimation de la cohérence interne réside dans l’omission du recodage des items inversés (ou négativement polarisés). Dans la conception de batteries d’évaluations psychométriques, les concepteurs insèrent délibérément des énoncés rédigés à l’opposé du construit mesuré afin de contrer le biais d’acquiescement systématique des répondants (la tendance à acquiescer indifféremment à toutes les affirmations).
Si un item inversé est laissé sous sa forme brute, il sera négativement corrélé avec l’ensemble des autres questions de l’échelle. Dans la formule de Cronbach, cela injectera des covariances négatives substantielles, provoquant un effondrement dramatique et artificiel du coefficient alpha, qui peut même basculer vers des valeurs négatives. L’inversion arithmétique doit donc être opérée systématiquement avant toute analyse statistique.
Pour une échelle d’évaluation graduée de $Min$ à $Max$ (par exemple une échelle de Likert allant de 1 à 5), la transformation arithmétique universelle appliquée à la réponse brute d’un participant s’exprime par :
$$\text{Valeur_recodée} = (Max + Min) – \text{Valeur_originale}$$
Dans Microsoft Excel, si la réponse brute à inverser est stockée en cellule C2 sur une échelle allant de 1 à 5, la formule de transformation sera :
=(5 + 1) - C2 ou plus simplement =6 - C2
Il est primordial, pour des impératifs d’intégrité et de traçabilité scientifique, de ne jamais écraser les données brutes initiales. Il convient de créer une section dédiée ou un onglet miroir contenant les colonnes recodées (ex : Item_3_Recode), en s’assurant que seules les variables alignées dans la même polarité sélective participent au calcul de l’alpha.
3.3 Vérification des postulats métriques de l’échelle
Avant d’engager les calculs statistiques, une phase d’audit métrique est indispensable pour valider la qualité du jeu de données. La première vérification concerne la stricte conformité des valeurs aux bornes théoriques de l’échelle d’administration. Une erreur typographique lors de la saisie manuelle (par exemple la frappe accidentelle d’une valeur 55 au lieu de 5) déformerait sévèrement les variances. Cette inspection s’exécute aisément sous Excel par l’application des fonctions de bornage :
=MIN(B2:B51) et =MAX(B2:B51)
Alternativement, la fonctionnalité Validation des données (onglet Données > Outils de données > Validation des données) permet de circonscrire préventivement la plage de saisie autorisée à des nombres entiers compris strictement entre 1 et 5.
Par ailleurs, bien que les items de type Likert génèrent structurellement des données ordinales discrètes, l’application de la théorie classique des tests et de l’alpha de Cronbach repose sur l’hypothèse de continuité des mesures composites. Les praticiens doivent évaluer l’asymétrie (skewness) et l’aplatissement (kurtosis) des distributions univariées pour s’assurer que les écarts à la normalité demeurent modérés. Dans Excel, les fonctions dédiées sont respectivement :
=COEFFICIENT.ASYMETRIE(B2:B51) et =KURTOSIS(B2:B51)
Des coefficients d’asymétrie compris entre -1,5 et +1,5 indiquent que les items peuvent être assimilés à des échelles d’intervalles sans distorsion prohibitive de l’estimation de la cohérence interne.
4. Activation et configuration de l’Utilitaire d’analyse dans Excel
4.1 Procédure d’installation du complément Analysis ToolPak
L’Utilitaire d’analyse (désigné sous le terme Analysis ToolPak dans les environnements anglophones) est un composant additionnel natif développé par Microsoft qui intègre un moteur de calcul statistique avancé au tableur. Bien qu’inclus dans toutes les distributions modernes d’Excel, ce complément n’est pas activé par défaut lors de l’installation initiale du système d’exploitation et requiert une démarche d’initialisation en quelques clics.
Pour activer ce module sous Microsoft Windows (versions Excel 2016, 2019, 2021 et Microsoft 365), la séquence d’opérations est la suivante :
- Cliquez sur l’onglet Fichier situé dans le coin supérieur gauche du ruban principal, puis sélectionnez Options dans le menu vertical d’arrière-plan.
- Dans la boîte de dialogue Options Excel, accédez à la catégorie Compléments située dans le volet de navigation de gauche.
- En bas de cette fenêtre, vérifiez que le menu déroulant Gérer affiche bien l’élément Compléments Excel, puis cliquez sur le bouton Atteindre….
- Une boîte de dialogue contextuelle apparaît. Cochez explicitement la case intitulée Utilitaire d’analyse (veillez à ne pas sélectionner l’option Visual Basic ‘Utilitaire d’analyse – VBA’, sauf si vous développez des macros programmées).
- Validez votre choix en cliquant sur OK.
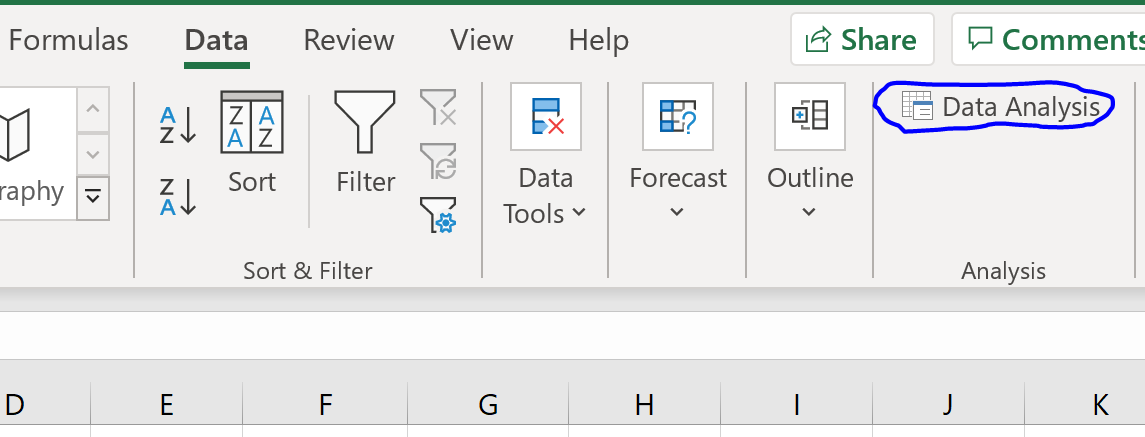
Dès la clôture de cette boîte de dialogue, le système intègre dynamiquement une nouvelle section nommée Analyse à l’extrême droite de l’onglet Données du ruban, au sein de laquelle trône désormais le bouton de commande Utilitaire d’analyse (ou Analyse de données).
4.2 Spécificités et compatibilité selon les environnements d’exploitation
La configuration du module d’analyse présente de légères disparités selon la plateforme informatique utilisée. Sur macOS (Excel pour Mac), la procédure s’effectue directement en ouvrant le menu supérieur Outils, puis en sélectionnant l’entrée Compléments Excel…. Il suffit ensuite de cocher la case relative à l’Analysis ToolPak pour finaliser l’intégration.
Il importe toutefois de souligner une limitation technique majeure : Microsoft Excel pour le Web (la déclinaison en ligne sur navigateur) ne supporte pas l’exécution de l’Utilitaire d’analyse natif standard. Les chercheurs exploitant des Chromebooks ou travaillant exclusivement via le cloud devront soit recourir aux formules statistiques directes (détaillées dans les sections 6 et 7), soit acquérir des extensions tierces certifiées disponibles dans le magasin Office Store.
Un autre point de vigilance critique réside dans la configuration des paramètres linguistiques régionaux. Selon que votre système d’exploitation est configuré sous un environnement francophone ou anglo-saxon, le séparateur décimal par défaut est la virgule (,) ou le point (.), et le séparateur d’arguments des fonctions Excel est le point-virgule (;) ou la virgule (,). Une inadéquation entre ces normes linguistiques peut générer des erreurs de syntaxe de type #NOM? ou #VALEUR!. Il est recommandé de stabiliser ces paramètres via les options linguistiques d’Excel avant d’engager des calculs matriciels d’envergure.
5. Méthode pas-à-pas 1 : Calcul de l’alpha via l’ANOVA à deux facteurs sans répétition
5.1 Exécution de l’analyse de variance à deux facteurs
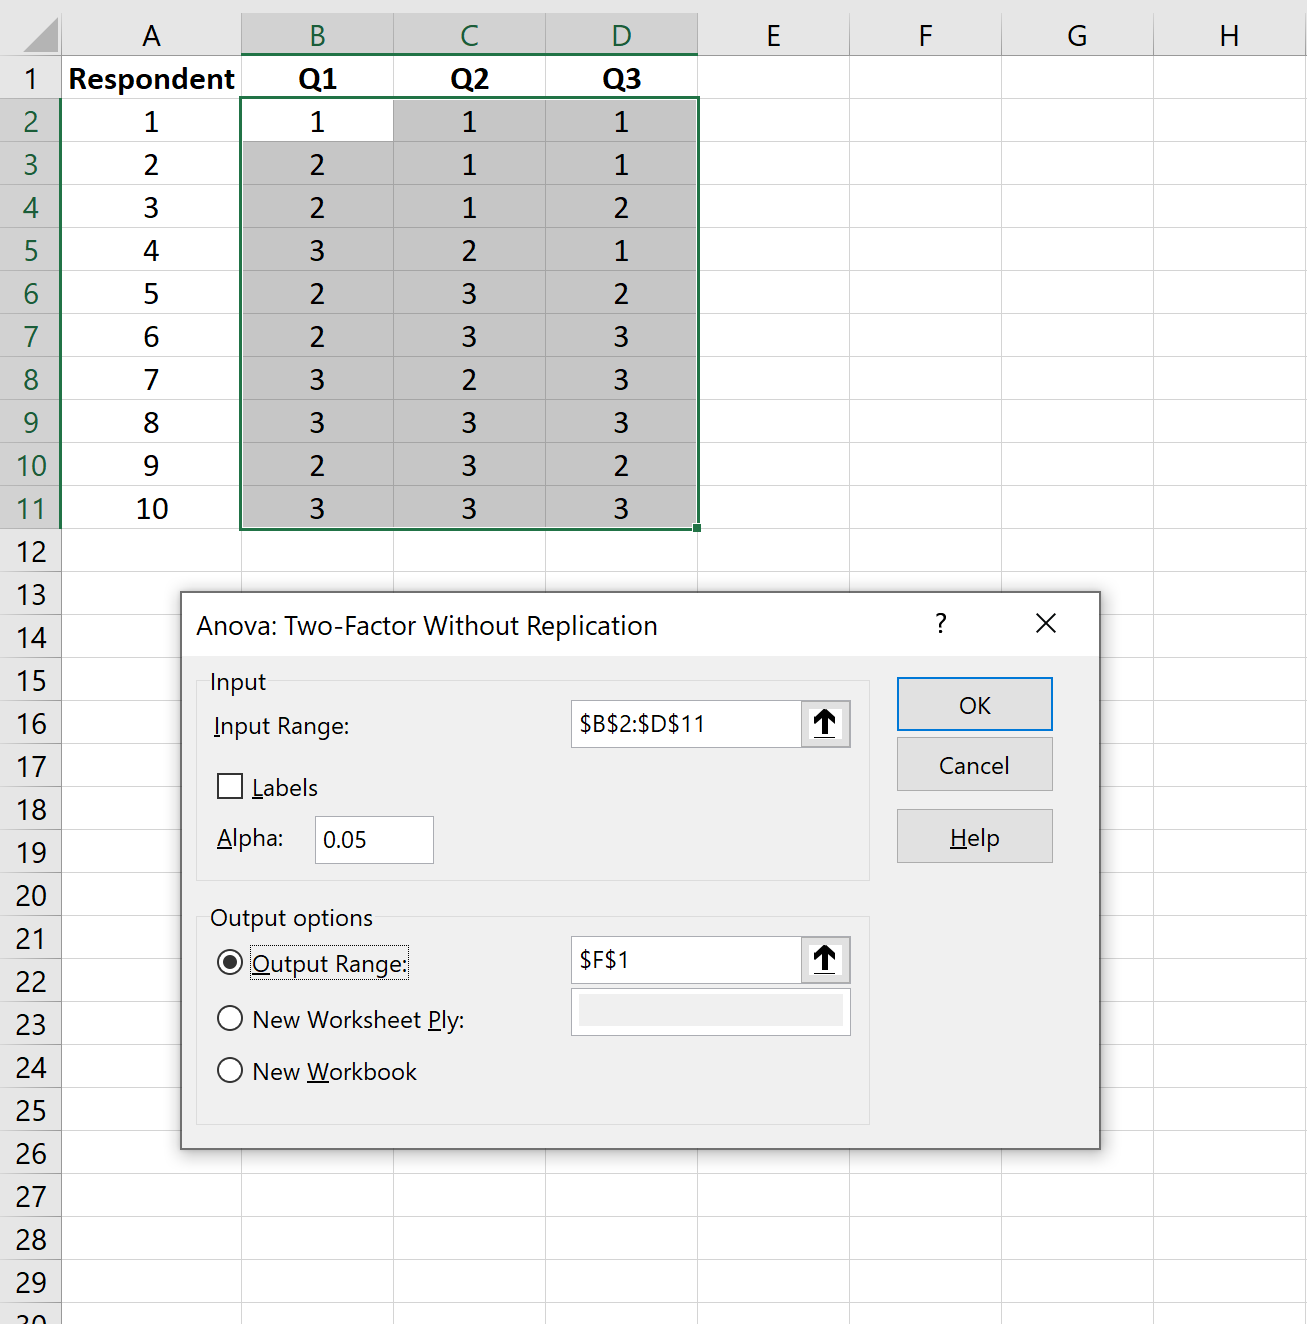
L’implémentation de l’alpha de Cronbach par le prisme de l’analyse de variance constitue sans doute la méthode la plus élégante et la moins sujette aux erreurs de saisie de formules individuelles. Pour illustrer cette manipulation, considérons une matrice rectangulaire standard où les lignes 2 à 51 représentent $N = 50$ participants et les colonnes B à K représentent $k = 10$ items psychologiques, avec les intitulés positionnés sur la ligne 1.
Pour exécuter le calcul, déployez la séquence analytique suivante :
- Rendez-vous dans l’onglet Données du ruban supérieur et cliquez sur l’icône Analyse de données.
- Dans le catalogue d’outils statistiques qui s’affiche, sélectionnez la première option : Analyse de variance : deux facteurs sans répétition, puis cliquez sur OK.
- Dans le champ Plage d’entrée, saisissez ou sélectionnez à la souris l’intégralité du tableau de données en incluant impérativement les en-têtes de colonnes :
$B$1:$K$51. - Cochez impérativement la case d’option Intitulés pour indiquer à Excel que la première ligne correspond aux noms des items et non à des observations numériques.
- Laissez le paramètre Alpha à sa valeur par défaut de
0,05(ce paramètre concerne les tests d’hypothèse de Fisher sous-jacents et n’altère en rien le calcul des carrés moyens). - Dans les options de sortie, choisissez Nouvelle feuille de calcul et nommez-la par exemple
Sortie_ANOVAafin de ne pas altérer la structure spatiale de votre matrice source. - Cliquez enfin sur le bouton OK pour lancer l’algorithme computationnel.
5.2 Extraction et lecture des carrés moyens dans le tableau de sortie
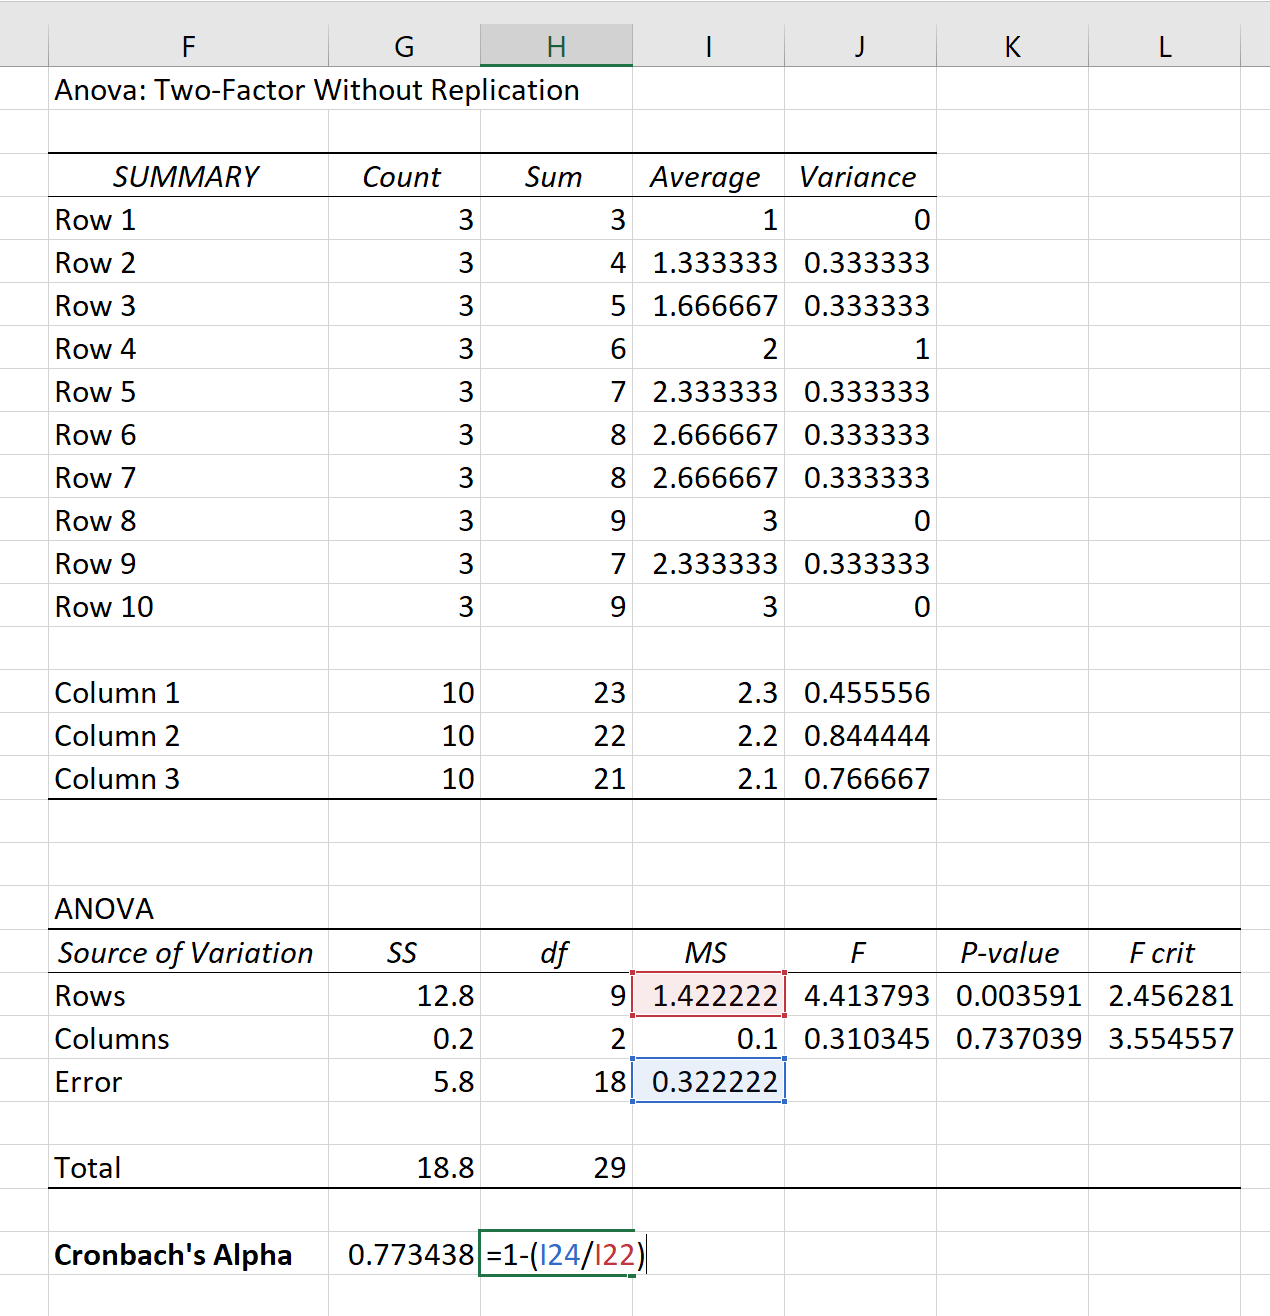
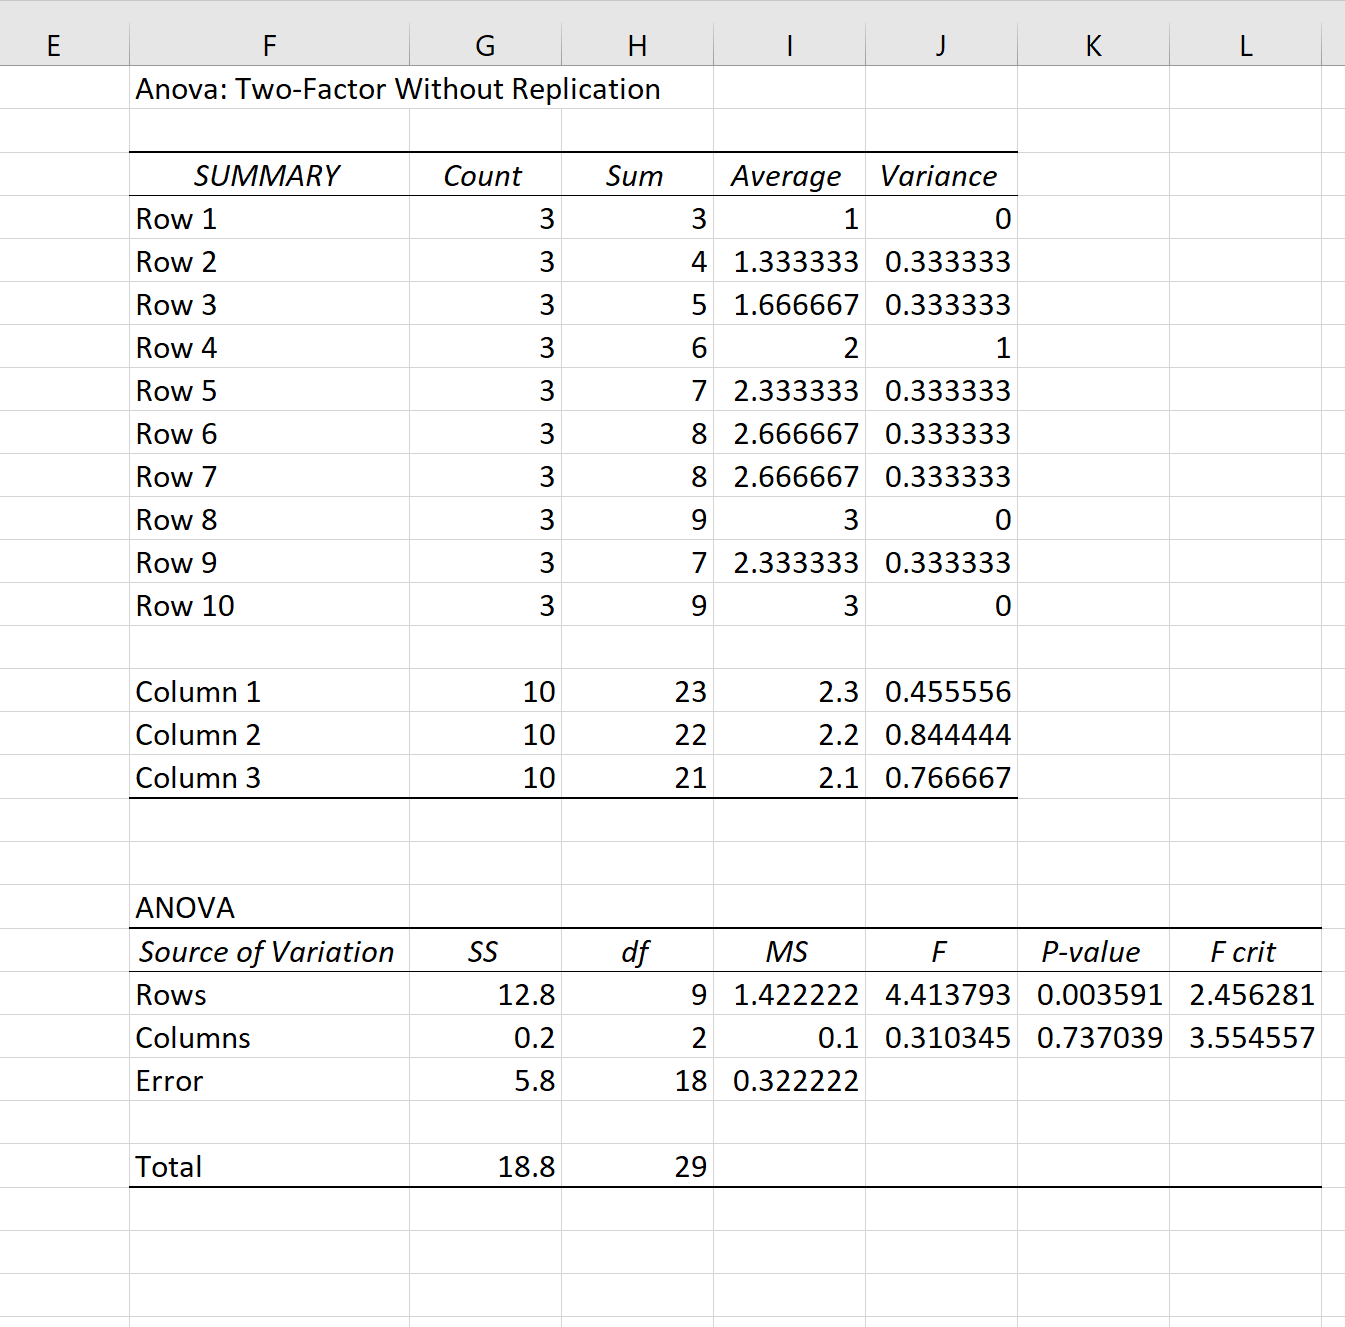
En une fraction de seconde, Excel génère sur la feuille de destination un rapport statistique complet structuré en deux sections majeures : un résumé descriptif des lignes et colonnes, suivi du tableau formel intitulé ANALYSE DE VARIANCE. C’est ce second tableau qui renferme les grandeurs fondamentales nécessaires à l’isolation du coefficient.
Le tableau présente les décompositions canoniques de la variance réparties en six colonnes : Source des variations, Somme des carrés (SC), Degrés de liberté (DL), Carré moyen (CM), Valeur de F, et Probabilité. Pour extraire le coefficient alpha, seules deux lignes spécifiques de la colonne CM (Carré moyen) retiennent notre attention psychométrique :
- La ligne « Lignes » : Elle capture la variabilité inter-sujets (la variance vraie partagée entre les individus). Le carré moyen correspondant, désigné par $CM_{\text{sujets}}$, se trouve généralement dans la cellule
E12(selon la version d’Excel et le formatage exact de la table de sortie). - La ligne « Erreur » : Elle quantifie la variance résiduelle non systématique (l’erreur de mesure aléatoire combinée à l’interaction sujet-item). Le carré moyen résiduel, désigné par $CM_{\text{erreur}}$, se situe deux rangs plus bas, généralement dans la cellule
E14.
Il est recommandé de vérifier scrupuleusement les degrés de liberté associés pour valider l’intégrité de l’exécution : le degré de liberté des lignes doit être égal à $N – 1$ (soit $50 – 1 = 49$), celui des colonnes à $k – 1$ (soit $10 – 1 = 9$), et celui de l’erreur résiduelle à $(N – 1)(k – 1)$ (soit $49 \times 9 = 441$).
5.3 Application de la formule finale pour obtenir le coefficient
Une fois les cellules cibles identifiées avec exactitude, la dérivation de l’alpha de Cronbach ne nécessite plus qu’une écriture mathématique élémentaire au sein d’une nouvelle cellule de synthèse :
Placez-vous par exemple dans la cellule G12, saisissez l’étiquette descriptive Alpha de Cronbach, puis insérez dans la cellule adjacente H12 la syntaxe dynamique suivante :
=(E12 - E14) / E12
Une écriture mathématique strictement équivalente consiste à formuler :
=1 - (E14 / E12)
Dès la validation par la touche Entrée, Excel affiche la valeur numérique exacte du coefficient de cohérence interne de votre échelle. Pour garantir une présentation conforme aux standards internationaux de publication scientifique, appliquez un formatage à trois décimales (Clic droit sur la cellule > Format de cellule > Nombre > Décimales : 3). Cette méthodologie par ANOVA présente l’avantage inestimable d’être totalement immunisée contre les risques d’omission d’items lors de l’assemblage de formules complexes.
6. Méthode pas-à-pas 2 : Calcul direct par les fonctions statistiques de variance
6.1 Calcul de la variance individuelle de chaque item
La seconde méthodologie computationnelle repose sur l’implémentation directe et explicite de l’équation originelle de Lee Cronbach par le biais des fonctions statistiques standard d’Excel. Cette méthode s’avère hautement didactique pour quiconque souhaite inspecter visuellement la contribution de chaque question à la variabilité globale de l’épreuve.
La première phase opérationnelle consiste à quantifier la dispersion des scores pour chaque colonne d’item considérée individuellement. Il convient ici de trancher une question épistémologique cruciale relative au choix de la fonction statistique de variance sous Excel :
Excel propose historiquement deux formules distinctes : VAR.P (calculant la variance exacte de la population totale avec un dénominateur en $N$) et VAR.S (anciennement VAR, calculant la variance sans biais d’un échantillon avec un dénominateur ajusté en $N – 1$). En théorie psychométrique, les participants soumis à un test constituent invariablement un échantillon aléatoire représentatif issu d’une population cible infinie. Il est donc méthodologiquement impératif d’utiliser la fonction VAR.S (ou VAR.ECHANTILLON.N selon la localisation du logiciel).
Positionnez-vous dans la première cellule vide sous la colonne du premier item, par exemple en cellule B53 si vos données couvrent les lignes 2 à 51, et entrez la syntaxe suivante :
=VAR.S(B2:B51)
Une fois cette valeur calculée, cliquez sur la poignée de recopie incrémentale (le petit carré situé dans le coin inférieur droit de la cellule sélectionnée) et étirez horizontalement la formule vers la droite jusqu’à la colonne K53. Excel recalcule instantanément la variance échantillonnale de chaque item. Enfin, dans une cellule latérale (par exemple en L53), calculez la somme totale de ces variances marginales via la formule :
=SOMME(B53:K53)
6.2 Génération de la colonne du score composite et sa variance
La seconde étape computationnelle requiert le calcul du score composite total pour chaque répondant de l’échantillon, suivi de l’estimation de la variance de ce score global.
Pour matérialiser ce score total :
- Attribuez un en-tête à la première colonne libre adjacent à votre matrice, par exemple en cellule
L1, intituléeScore_Total. - Dans la cellule
L2, calculez la somme des réponses fournies par le premier participant à l’ensemble des dix items à l’aide de la syntaxe :=SOMME(B2:K2). - Propagez cette formule verticalement vers le bas jusqu’à la cellule
L51par double-clic sur la poignée de recopie. Chaque participant se voit ainsi attribuer son score global agrégé.
Sous cette colonne de scores agrégés, dans la cellule L54, procédez à l’estimation de la variance de ce score composite en appliquant à nouveau le même estimateur échantillonnal sans biais :
=VAR.S(L2:L51)
À ce stade, un contrôle d’intégrité statistique immédiat s’impose : si vos items partagent une cohérence positive, la variance du score total (cellule L54) doit impérativement être sensiblement supérieure à la somme des variances individuelles des items (cellule L53). Si tel n’est pas le cas, cela signale sans ambiguïté la présence d’un ou plusieurs énoncés inversés non recodés qui neutralisent les covariances de l’échelle.
6.3 Assemblage de l’équation de Cronbach dans une cellule dédiée
Désormais en possession de l’ensemble des paramètres arithmétiques requis, vous pouvez assembler l’équation complète de Cronbach au sein d’une unique cellule de synthèse (par exemple en N2).
Pour rendre la formule robuste et dynamique face à d’éventuelles modifications ultérieures du nombre d’items, il est judicieux de ne pas coder le nombre $k$ « en dur » sous forme de chiffre 10, mais d’exploiter la fonction NB ou COLONNES. L’architecture de la formule finale s’articule ainsi :
=(COLONNES(B1:K1) / (COLONNES(B1:K1) - 1)) * (1 - (L53 / L54))
Si vous préférez intégrer directement l’ensemble du processus de sommation au sein d’une formulation globale autonome et compacte sans cellules intermédiaires de variance, la syntaxe se structure de la manière suivante :
=(10/(10-1))*(1-(SOMME(B53:K53)/VAR.S(L2:L51)))
Le résultat généré par cette fonction directe doit être rigoureusement identique, au milliardième près, à celui obtenu par la première méthode de l’ANOVA à deux facteurs sans répétition. Cette convergence parfaite atteste de l’exactitude de vos manipulations statistiques et élimine tout risque d’erreur de paramétrage.
7. Méthode pas-à-pas 3 : Calcul matriciel via la matrice de covariance
7.1 Génération de la matrice de covariance dans Excel
L’approche matricielle constitue l’exploration structurelle la plus profonde de la cohérence interne. Elle est particulièrement privilégiée par les biostatisticiens et psychomètres avancés désireux d’étudier le réseau complet d’interdépendance des items.
Pour construire la matrice de variance-covariance inter-items par le biais de l’Utilitaire d’analyse :
- Rendez-vous dans l’onglet Données et sélectionnez Analyse de données.
- Choisissez l’option Covariance dans la liste déroulante et validez.
- Définissez la Plage d’entrée en sélectionnant vos items avec leurs intitulés (
$B$1:$K$51). - Spécifiez que le groupement des données s’opère par Colonnes et activez impérativement la case Intitulés en première ligne.
- Sélectionnez une nouvelle feuille de calcul intitulée
Matrice_Covarianceet validez par OK.
Une nuance technique capitale doit être explicitée ici concernant le comportement natif de l’outil Covariance d’Excel : cet outil génère par défaut une demi-matrice triangulaire inférieure et calcule les covariances selon l’estimateur de population $N$ (équivalent à COVARIANCE.P) et non l’estimateur échantillonnal $N – 1$. Toutefois, sur le plan mathématique, comme le même dénominateur $N$ est appliqué de manière homogène aux variances diagonales et aux covariances hors diagonale, le rapport $\sum \sigma_i^2 / \sigma_x^2$ demeure rigoureusement invariant, laissant le coefficient alpha final totalement intact.
Si vous utilisez une version moderne d’Excel disposant du moteur de matrices dynamiques, vous pouvez également générer manuellement une matrice de covariance échantillonnale complète en exploitant la fonction moderne COVARIANCE.S pour chaque intersection de paire de variables.
7.2 Extraction de la covariance moyenne non redondante
Pour calculer l’alpha à partir de la matrice carrée générée, il convient d’en extraire les deux grandeurs cardinales : la somme de la diagonale principale (les variances d’items) et la somme des éléments hors diagonale (l’ensemble des covariances mutuelles).
Pour reconstituer la somme globale de l’intégralité des cellules de la matrice de covariance $k \times k$ (englobant les éléments symétriques supérieurs implicites) :
- Copiez la demi-matrice obtenue et collez-la de manière à combler la partie supérieure symétrique (chaque covariance entre Item A et Item B étant rigoureusement équivalente à celle entre Item B et Item A).
- La sommation totale de toutes les cellules de cette matrice carrée complète donne exactement la variance globale du score total : $\sigma_x^2 = \text{SOMME}(\text{Matrice_Complete})$.
- La somme des cellules composant la diagonale principale (du coin supérieur gauche au coin inférieur droit) fournit la somme des variances d’items : $\sum \sigma_{y_i}^2$.
La covariance moyenne non redondante inter-items, notée $\bar{c}$, se calcule en isolant la somme des cellules hors diagonale et en la divisant par le nombre exact de paires d’items uniques, soit $k(k – 1)$ (dans notre exemple avec 10 items : $10 \times 9 = 90$ paires) :
$$\bar{c} = \frac{\text{Somme des covariances hors diagonale}}{k(k – 1)}$$
Cette métrique $\bar{c}$ reflète la force brute de la relation commune partagée par les items de votre instrument, indépendamment de leurs dispersions spécifiques.
7.3 Formulation du coefficient standardisé basé sur les corrélations
Dans de nombreuses circonstances appliquées, les items composant une échelle psychologique n’adoptent pas une métrique de réponse uniforme (par exemple un instrument combinant des items cotés de 1 à 4 avec des items cotés de 1 à 10). Dans une telle configuration, les variances individuelles présentent des disparités extrêmes qui biaisent l’alpha brut classique au détriment des items à faible dispersion. La solution méthodologique réside dans le calcul de l’alpha standardisé.
La démarche dans Excel se déploie à travers l’outil de corrélation :
- Accédez à Données > Analyse de données > Corrélation.
- Sélectionnez la plage des données
$B$1:$K$51avec intitulés et validez la sortie vers une nouvelle feuille. - Excel produit la matrice de corrélation de Pearson de dimension $k \times k$, dont la diagonale principale est exclusivement composée de 1.
- Pour dériver la corrélation moyenne inter-items $\bar{r}$, calculez la somme de l’ensemble des corrélations hors diagonale et divisez-la par $k(k – 1)$. Dans Excel, en exploitant la demi-matrice triangulaire inférieure (qui contient $k(k – 1) / 2$ coefficients uniques), la formule s’écrit :
= (SOMME(Plage_Triangulaire) - k) / (k * (k - 1) / 2)selon le format d’extraction.
Une fois la corrélation moyenne non redondante $\bar{r}$ isolée (par exemple dans la cellule B15), appliquez la formulation de Spearman-Brown au sein d’une cellule réceptrice :
=(10 * B15) / (1 + (10 - 1) * B15)
Cet alpha standardisé reflète la fidélité théorique que posséderait l’instrument de mesure si l’ensemble de ses items constitutifs avaient été préalablement réduits à une variance standardisée unitaire ($\sigma^2 = 1$).
8. Interprétation académique des résultats et seuils critiques
8.1 Grille de lecture standardisée selon la littérature en psychométrie
L’interprétation statistique du coefficient alpha de Cronbach ne saurait s’effectuer de manière discrétionnaire ; elle est strictement encadrée par des seuils conventionnels forgés par des décennies de consensus méthodologique en psychométrie. La grille d’évaluation la plus mondialement respectée dérive des travaux fondateurs de Jum C. Nunnally et Ira H. Bernstein (1994) :
| Valeur du coefficient Alpha | Qualité de la cohérence interne | Contexte d’application recommandé |
|---|---|---|
| $\alpha ge 0,90$ | Excellente | Indispensable pour les décisions individuelles critiques (sélection, diagnostic clinique, neuropsychologie). |
| $0,80 le \alpha < 0,90$ | Bonne | Standard optimal pour la recherche fondamentale, confirmatoire et les évaluations académiques. |
| $0,70 le \alpha < 0,80$ | Acceptable | Seuil minimal requis en recherche exploratoire et pour les échelles en cours de développement. |
| $0,60 le \alpha < 0,70$ | Douteuse / Médiocre | Toléré uniquement lors de phases initiales pilotes ; requiert une révision urgente des items. |
| $\alpha < 0,60$ | Inacceptable | L’instrument souffre d’un manque d’homogénéité prohibitif ; rejet formel de l’échelle composée. |
Ces seuils critiques doivent cependant être nuancés en fonction du nombre d’items composant le test et de la complexité psychologique du construit mesuré. Une échelle évaluant un construit très ciblé et étroit (comme l’anxiété mathématique) se doit d’afficher un alpha élevé ($ge 0,85$), tandis qu’une échelle capturant un méta-construit multidimensionnel vaste (comme le fonctionnement exécutif global) verra son alpha plafonner légitimement autour de $0,75$ sans que sa validité scientifique ne soit compromise.
8.2 Le paradoxe d’atténuation et les dangers d’un alpha excessivement élevé
Une méprise extrêmement répandue dans la pratique de la recherche consiste à rechercher frénétiquement la valeur d’alpha la plus élevée possible, sous l’illusion qu’un coefficient de 0,96 surpasserait qualitativement un coefficient de 0,85. En réalité, un coefficient alpha excessivement élevé ($\alpha > 0,92$ ou $0,95$) constitue une source d’alerte psychométrique majeure, souvent qualifiée de pathologie de la mesure.
Ce phénomène s’explique par la redondance sémantique extrême des énoncés. Lorsqu’un instrument atteint des niveaux de consistance interne démesurés, cela indique fréquemment que les items constituent de simples paraphrases lexicales les uns des autres (par exemple faire suivre : « Je me sens triste », « Je suis envahi par la tristesse », et « Mon état d’esprit est triste »). Bien que flatteuse pour l’algorithme de Cronbach, cette tautologie pose un problème dévastateur sur le plan de la validité théorique.
Ce mécanisme renvoie directement au célèbre « paradoxe d’atténuation » théorisé par Loevinger dès 1954 : en augmentant mécaniquement l’homogénéité interne d’un test par l’épuration impitoyable de tous les items qui ne corrèlent pas de manière quasi parfaite avec le noyau central, on rétrécit drastiquement la couverture du domaine conceptuel. L’instrument perd ainsi sa représentativité clinique et sa validité de contenu au profit d’une fidélité factice. Un équilibre méthodologique rigoureux doit toujours être maintenu entre l’étendue du spectre d’évaluation et l’homogénéité statistique des mesures.
8.3 Impact direct de la taille de l’échantillon et du nombre d’items
L’analyste exploitant Excel doit être intimement conscient des deux leviers structurels extrinsèques qui modulent artificiellement la valeur de l’alpha de Cronbach, indépendamment de la qualité intrinsèque des questions : le paramètre $k$ (le nombre d’items) et la taille $N$ de l’échantillon de participants.
En vertu de sa mécanique mathématique (dérivée de la relation de Spearman-Brown), l’alpha s’accroît automatiquement lorsque l’on ajoute des items à une échelle, même si ces nouveaux items ne possèdent qu’une corrélation très modeste avec le reste du test. Inversement, une échelle remarquablement homogène mais ne comportant que 3 ou 4 items affichera fréquemment un alpha modéré ($0,68$ ou $0,72$) en raison exclusive de la concision de sa formulation. L’évaluation d’un coefficient doit donc toujours être rapportée au nombre total d’items $k$.
Concernant la taille de l’échantillon $N$, elle ne modifie pas l’espérance mathématique ponctuelle de l’alpha mais conditionne drastiquement la précision de son intervalle de confiance. Un alpha de 0,80 calculé sur 20 sujets est hautement instable et dépourvu de puissance statistique. Pour quantifier cette marge d’incertitude dans Excel, on utilise l’approximation de l’intervalle de confiance bilatéral de Feldt et al. (1969) à un seuil de confiance de $1 – \alpha_{\text{risque}}$ (généralement 95 %), reposant sur la loi de distribution de Fisher ($F$) :
$$\text{Borne Inférieure} = 1 – (1 – \hat{\alpha}) \cdot F_{1 – alpha/2 ,;, df_1, df_2}$$
$$\text{Borne Supérieure} = 1 – (1 – \hat{\alpha}) \cdot F_{alpha/2 ,;, df_1, df_2}$$
Où les degrés de liberté sont définis par $df_1 = N – 1$ et $df_2 = (N – 1)(k – 1)$. Dans Excel, ces quantiles de Fisher s’implémentent facilement via les fonctions statistiques INVERSE.LOI.F ou LOI.F.INVERSE.DROITE, permettant de circonscrire précisément l’intervalle de fidélité au sein duquel fluctue le véritable paramètre de la population.
9. Analyse diagnostique des items : calcul de l’alpha en cas de suppression
9.1 Calcul de la corrélation item-total corrigée (Item-Rest Correlation)
L’estimation globale d’un coefficient alpha ne suffit pas à garantir la performance individuelle de chaque question. Une analyse diagnostique d’items doit impérativement être menée pour identifier les items « parasites », ambigus ou contre-productifs. Le premier indicateur clinique de performance est la corrélation item-total corrigée (souvent désignée sous le terme d’Item-Rest Correlation ou corrélation d’exclusion).
Si l’on calculait simplement le coefficient de corrélation de Pearson entre un item spécifique et le score composite brut total, le résultat serait structurellement gonflé par un phénomène d’autocorrélation fallacieux, puisque l’item analysé fait lui-même partie intégrante de la somme du score total. La corrélation item-total corrigée neutralise ce biais d’auto-inclusion en calculant la corrélation entre la note obtenue à l’item $j$ et la somme de tous les autres items du test (c’est-à-dire le score total duquel on a préalablement soustrait la note de l’item $j$) :
$$r_{j(total – j)} = \text{Corr}(Y_j, X – Y_j)$$
Pour implémenter cette métrique d’élagage dans Excel pour le premier item (colonne B) :
- Dans une colonne de travail temporaire, calculez le score total soustrait pour chaque individu :
=L2 - B2(où L2 renferme le score total complet). - Dans votre tableau de synthèse d’analyse d’items, calculez la corrélation corrigée en associant les réponses brutes de l’item et cette nouvelle colonne d’exclusion à l’aide de la fonction :
=COEFFICIENT.CORRELATION(B2:B51; Plage_Score_Soustrait).
Le seuil d’admissibilité conventionnel en psychométrie exige que cette corrélation item-total corrigée soit strictement supérieure à 0,30. Une valeur inférieure à 0,30 signale une contribution marginale de l’item à la cohérence de l’échelle. Une valeur proche de zéro ou, pire encore, négative, impose l’exclusion immédiate de l’énoncé du protocole de mesure.
9.2 Simulation de la suppression d’un item (‘Alpha if item deleted’)
L’indicateur le plus décisif dans le processus de raffinement d’une échelle est l’indice « Alpha en cas de suppression » (Alpha if item deleted). Cette statistique répond à la question contrefactuelle suivante : Quelle serait la valeur exacte du coefficient alpha de Cronbach si nous décidions d’éliminer définitivement cet item spécifique de notre instrument ?
La règle décisionnelle universelle régissant cet indicateur s’énonce comme suit :
- Si la suppression d’un item entraîne une diminution de l’alpha global, cela prouve que cet item contribue activement et positivement à la cohérence interne de l’échelle ; il doit impérativement être conservé.
- Si la suppression d’un item n’altère absolument pas la valeur de l’alpha, sa présence dans l’épreuve est neutre ou redondante.
- Si la suppression d’un item engendre une augmentation substantielle du coefficient alpha global (par exemple l’alpha passe de 0,72 à 0,81), cela démontre mathématiquement que cet item dégradait l’homogénéité globale du test ; son élagage définitif est vivement recommandé.
Pour calculer cet indicateur dans Excel sans perturber la feuille d’analyse principale, la démarche la plus rigoureuse consiste à programmer une ligne ou colonne dédiée qui recalcule l’équation canonique de Cronbach en modifiant dynamiquement deux paramètres : le nombre d’items passe de $k$ à $k – 1$, la somme des variances d’items exclut la variance de l’item ciblé, et la variance totale est recalculée sur la base du score total corrigé sans cet item.
9.3 Construction d’un tableau de synthèse diagnostique complet
Afin de synthétiser visuellement l’ensemble de ces informations diagnostiques sous une forme directement publiable ou diffusable à des fins de pilotage métrique, il est vivement conseillé d’élaborer un tableau récapitulatif sous Excel. Ce tableau de bord structure les métriques d’analyse d’items selon quatre colonnes normalisées :
| Nom de l’Item | Moyenne de l’item ($\bar{y}$) | Variance de l’item ($\sigma^2$) | Corrélation Item-Total Corrigée ($r_{it}$) | Alpha en cas de suppression ($\alpha_{-\text{item}}$) |
|---|---|---|---|---|
| Item 1 | =MOYENNE(B2:B51) | =VAR.S(B2:B51) | =COEFFICIENT.CORRELATION(…) | Calcul dynamique ($k-1$) |
| Item 2 | =MOYENNE(C2:C51) | =VAR.S(C2:C51) | =COEFFICIENT.CORRELATION(…) | Calcul dynamique ($k-1$) |
| … | … | … | … | … |
Pour maximiser l’efficacité de lecture de ce tableau sous Excel, activez la fonctionnalité Mise en forme conditionnelle (onglet Accueil > Style > Mise en forme conditionnelle) :
- Appliquez une règle de surlignage rouge aux cellules de la colonne Corrélation Item-Total Corrigée dont la valeur est inférieure à
0,30. - Appliquez une règle de surlignage orange ou vert sur la colonne Alpha en cas de suppression pour mettre en relief toute valeur qui surpasserait la valeur de l’alpha global actuel de l’instrument complet.
Il importe d’adopter une stratégie d’élagage itératif : si plusieurs items affichent des performances sous-optimales, ne les supprimez jamais tous simultanément ! Éliminez exclusivement le pire item (celui dont l’exclusion maximise le gain d’alpha), puis recalculez intégralement la matrice. En effet, l’exclusion d’un item redistribue l’ensemble des termes de covariance, ce qui peut spontanément restaurer la qualité métrique d’autres questions qui paraissaient initialement défaillantes.
10. Gestion des données problématiques et biais méthodologiques dans Excel
10.1 Traitement des données manquantes (Missing Data)
L’un des défis majeurs dans l’administration d’instruments psychométriques réels réside dans l’occurrence inévitable de réponses manquantes (omissions volontaires, abandons de passation ou erreurs techniques). Dans Microsoft Excel, l’impact des données manquantes sur les formules de calcul peut se révéler critique :
Si vous utilisez l’outil ANOVA de l’Utilitaire d’analyse en présence d’une seule cellule vide dans la plage rectangulaire sélectionnée, le logiciel bloquera brutalement l’exécution en générant un message d’erreur explicite : « L’analyse de variance à deux facteurs sans répétition requiert des données dans chaque cellule ». Les fonctions statistiques standard comme VAR.S ou SOMME, quant à elles, ignorent silencieusement les cellules vides, ce qui engendre un déséquilibre clandestin dans le nombre de répondants participant au calcul des variances individuelles par rapport au calcul du score composite total.
Deux stratégies fondamentales d’épuration sont envisageables au sein du tableur :
- La suppression par liste complète (Listwise deletion) : Il s’agit de la méthode la plus stricte. Elle consiste à éliminer purement et simplement toute ligne (participant) présentant au moins une omission sur l’un quelconque des $k$ items. Dans Excel, cette opération s’effectue en filtrant le tableau (onglet Données > Filtrer), en sélectionnant tour à tour les cellules (Vides) pour chaque colonne d’item, et en supprimant les lignes correspondantes. Cette méthode garantit une cohérence computationnelle irréprochable mais ampute drastiquement la taille de l’échantillon $N$ si les omissions sont dispersées.
- L’imputation par la moyenne de l’item : Si le taux d’omission demeure marginal (inférieur à 5 % des valeurs d’une variable), on peut imputer la valeur manquante par la valeur moyenne observée sur cet item auprès du reste de l’échantillon. Dans une cellule vide, la formule dynamique suivante peut être appliquée :
=SI(ESTVIDE(B2); MOYENNE(B$2:B$51); B2). Il convient toutefois de manier cette technique avec une extrême réserve académique : l’imputation déterministe réduit artificiellement la variance naturelle de l’item et a tendance à surévaluer légèrement la cohérence interne.
10.2 Détection des biais de réponse et variance de méthode commune
La validité des scores composites peut être sévèrement compromise par des biais de réponse comportementaux, dont le plus pernicieux est le phénomène de straightlining (ou réponses stéréotypées invariantes). Ce comportement survient lorsqu’un participant, pressé ou non motivé, coche systématiquement la même modalité d’évaluation (par exemple en attribuant la note 3 ou 4 à l’intégralité des 50 questions d’un protocole sans même lire les énoncés).
Dans Microsoft Excel, ce pattern aberrant est facilement détectable grâce à l’estimation de la variance intra-sujet (la dispersion des réponses sur la ligne propre à chaque individu). Pour isoler ces profils suspects :
- Insérez une colonne latérale d’audit intitulée
Variance_Ligne. - Dans la cellule adjacente au premier participant (ex :
M2), entrez la formule de variance de population :=VAR.P(B2:K2). - Étirez cette syntaxe jusqu’au terme de votre échantillon.
Tout individu affichant une Variance_Ligne = 0 présente un profil d’invariance totale (il a répondu rigoureusement la même modalité sur l’ensemble du test). Ces répondants non attentifs introduisent une variance de méthode commune fallacieuse qui contamine l’alpha de Cronbach en générant une fausse homogénéité. Il est impératif de documenter et d’exclure ces profils déviants avant de finaliser la phase de modélisation psychométrique.
11. Limites méthodologiques de l’alpha et alternatives contemporaines
11.1 Le postulat restrictif de la tau-équivalence essentielle
Bien que l’alpha de Cronbach règne en maître incontesté dans les sciences sociales appliquées, la littérature psychométrique contemporaine a formulé des critiques dévastatrices à son encontre au cours des deux dernières décennies. La limitation théorique majeure réside dans le fait que l’alpha requiert impérativement le respect du postulat de tau-équivalence essentielle pour constituer une estimation exacte de la fidélité.
Sur le plan mathématique et factoriel, la tau-équivalence postule que tous les items de l’échelle mesurent le même construit latent avec une force strictement identique. Cela signifie que dans un modèle d’analyse factorielle confirmatoire à un facteur, les saturations factorielles (les coefficients factor loadings, notés $\lambda_i$) de chaque item sur la variable latente doivent être rigoureusement égales ($\lambda_1 = \lambda_2 = dots = \lambda_k$), seules les variances d’erreur résiduelle étant autorisées à fluctuer.
Or, dans la quasi-totalité des instruments psychologiques empiriques réels, ce postulat est systématiquement violé : certains items capturent le construit avec une précision éclatante (par exemple une saturation $lambda = 0,88$), tandis que d’autres énoncés n’entretiennent qu’un lien plus ténu avec le trait latent (par exemple $lambda = 0,42$). Dès lors que l’instrument s’avère simplement « congénérique » (saturations inégales), l’alpha de Cronbach sous-estime systématiquement et parfois lourdement la fidélité réelle de l’échelle. Les chercheurs qui s’appuient exclusivement sur l’alpha risquent ainsi de rejeter indûment d’excellents instruments sous prétexte que leur alpha calculé paraît modeste.
11.2 Le problème de l’unidimensionnalité non garantie
L’erreur épistémologique la plus tragique commise dans l’usage quotidien de l’alpha consiste à le considérer comme un indicateur ou une preuve d’unidimensionnalité d’un test. Un nombre incalculable d’articles scientifiques affirment à tort qu’un alpha supérieur à 0,80 « démontre que l’échelle mesure bien un concept unique ».
Cette assertion est mathématiquement fausse. Comme l’ont démontré Cortina (1993) puis Schmitt (1996), un instrument de mesure scindé en deux sous-dimensions parfaitement orthogonales et conceptuellement distinctes (par exemple 10 items d’extraversion et 10 items de névrosisme totalisant 20 items) peut afficher un alpha de Cronbach supérieur à 0,85 dès lors que le nombre total d’items $k$ est suffisamment grand et que les corrélations inter-items au sein de chaque sous-groupe sont solides.
En conséquence absolue, l’alpha de Cronbach ne doit jamais être calculé sur une batterie d’items globale sans avoir préalablement établi l’unidimensionnalité stricte de l’ensemble par le biais d’une analyse factorielle exploratoire (AFE) ou confirmatoire (AFC). Si votre instrument comporte trois facteurs distincts mis en évidence par la théorie ou l’analyse factorielle, il est obligatoire de calculer trois coefficients alpha distincts, c’est-à-dire un alpha spécifique pour chaque sous-dimension validée.
11.3 L’alternative de McDonald : le coefficient Oméga (ω)
Face aux failles structurelles de l’alpha liées à la violation quasi universelle de la tau-équivalence, les plus grandes instances méthodologiques et éditoriales recommandent désormais officiellement l’adoption du coefficient Oméga de McDonald ($\omega$), introduit par Roderick P. McDonald en 1999.
L’oméga total repose directement sur les paramètres estimés issus d’une analyse factorielle univariée congénérique (les saturations factorielles standardisées $\lambda_i$ et les variances d’unicité résiduelle $\delta_i = 1 – \lambda_i^2$). Son équation s’exprime par le rapport suivant :
$$\omega = \frac{\left(\sum_{i=1}^{k} \lambda_i\right)^2}{\left(\sum_{i=1}^{k} \lambda_i\right)^2 + \sum_{i=1}^{k} \delta_i}$$
La supériorité computationnelle de l’oméga réside dans le fait qu’il pondère chaque item selon son poids métrique véritable dans la mesure du trait latent, fournissant une estimation hautement précise et non biaisée de la fidélité composite. Il est tout à fait possible d’estimer ce coefficient dans Excel : une fois les saturations $\lambda_i$ obtenues par ailleurs (via R, JASP ou les outils d’extraction factorielle), il suffit de créer une colonne de saturations, d’en faire la somme, d’élever cette somme au carré, et de diviser par la variance totale prédite selon l’équation ci-dessus. Les recommandations éditoriales actuelles de l’American Psychological Association préconisent désormais de rapporter conjointement le coefficient alpha et le coefficient oméga pour tout instrument en phase de publication.
12. Modèle Excel automatisé et cas pratique complet
12.1 Étude de cas clinique : validation d’une échelle d’anxiété de 10 items
Pour illustrer la mise en application concrète de l’ensemble des protocoles méthodologiques détaillés dans cet ouvrage, nous déployons une étude de cas clinique complète portant sur un échantillon empirique simulé de $N = 50$ patients adultes ayant répondu à l’Inventaire Abrégé d’Anxiété Situationnelle (IAAS), composé de $k = 10$ énoncés cotés sur une échelle de Likert en 5 points allant de 1 (« Pas du tout d’accord ») à 5 (« Tout à fait d’accord »).
L’inventaire théorique comporte la structure sémantique suivante :
Item_1: « Je ressens une tension musculaire diffuse dans tout mon corps. » (Positif)Item_2: « J’ai des difficultés manifestes à contrôler mes pensées parasites. » (Positif)Item_3: « Je me sens profondément calme et serein face aux imprévus. » (Inversé)Item_4: « Mon rythme cardiaque s’accélère au moindre défi quotidien. » (Positif)Item_5: « J’éprouve un sentiment diffus d’appréhension sans cause claire. » (Positif)Item_6: « J’aborde mes tâches professionnelles avec une grande quiétude. » (Inversé)Item_7: « Mon estomac se noue dès que je dois m’exprimer en public. » (Positif)Item_8: « J’ai le sentiment que des catastrophes imminentes vont survenir. » (Positif)Item_9: « Je dors d’un sommeil réparateur sans aucun réveil nocturne. » (Inversé)Item_10: « Je me sens constamment sur le qui-vive, prêt à fuir. » (Positif)
La première phase pratique consiste à recoder immédiatement les items négativement polarisés (Item 3, Item 6 et Item 9) au sein de nouvelles colonnes dédiées en appliquant la formule de miroir Likert : = 6 - Valeur_Brute. Une fois ces corrections opérées, nous disposons d’une matrice purement alignée sur l’expression d’une anxiété élevée.
L’exécution de la méthode d’ANOVA à deux facteurs sans répétition sur notre matrice de 50 sujets par 10 items recodés fournit les résultats numériques d’extraction suivants :
- Carré Moyen des Lignes (Participants) : $CM_{\text{sujets}} = 4,832$
- Carré Moyen des Résidus (Erreur) : $CM_{\text{erreur}} = 0,724$
En appliquant la formule d’assemblage psychométrique :
$$\alpha = \frac{4,832 – 0,724}{4,832} = \frac{4,108}{4,832} \approx 0,850$$
Le calcul parallèle conduit par la somme des variances d’items yields $\sum \sigma_i^2 = 12,41$ et une variance du score total agrégé de $\sigma_x^2 = 72,99$. L’insertion dans l’équation classique confirme rigoureusement :
$$\alpha = \frac{10}{9} \left( 1 – \frac{12,41}{72,99} \right) = 1,1111 \times (1 – 0,1700) = 1,1111 \times 0,8300 \approx 0,850$$
Cette convergence absolue vers une valeur finale de 0,850 atteste de la bonne tenue méthodologique du calcul et confère à notre échelle d’anxiété une consistance interne hautement satisfaisante, parfaitement adaptée aux standards de la recherche confirmatoire.
12.2 Conception d’un tableau de bord dynamique et réutilisable
Afin de capitaliser sur vos efforts de modélisation dans Microsoft Excel, il est opportun de convertir votre classeur de travail en un tableau de bord dynamique pérenne, capable d’ingérer de futurs jeux de données sans avoir à reprogrammer manuellement la moindre équation.
Pour construire ce gabarit réutilisable, suivez ces recommandations d’architecture logicielle :
- Exploitation des Tableaux Structurés (ListObject) : Transformez votre plage rectangulaire d’entrée en Tableau Officiel Excel en appuyant sur les touches
Ctrl + LouCtrl + T. Les tableaux structurés possèdent la propriété inestimable d’étendre automatiquement les formules statistiques et d’ajuster les plages nommées dès lors que vous collez de nouvelles lignes de participants ou ajoutez de nouvelles colonnes d’items. - Formulation dynamique des paramètres : Au sein de vos cellules de synthèse réceptrices, substituez les constantes statiques par des fonctions de comptage dynamique :
- Pour le paramètre $k$ :
=COLONNES(Tableau_Donnees[#En-têtes]) - 1(en retranchant la colonne d’identifiant participant). - Pour la taille de l’échantillon $N$ :
=LIGNES(Tableau_Donnees).
- Pour le paramètre $k$ :
- Automatisation du diagnostic qualitatif : Dans la cellule adjacente à l’affichage de l’alpha calculé, insérez une formule logique imbriquée générant automatiquement l’appréciation qualitative officielle conforme à la taxonomie de Nunnally :
=SI(B10>=0,9;"Excellente";SI(B10>=0,8;"Bonne";SI(B10>=0,7;"Acceptable";SI(B10>=0,6;"Douteuse";"Inacceptable")))) - Verrouillage et protection de l’intégrité : Verrouillez les cellules contenant les formules algébriques cardinales (Format de cellule > Protection > Verrouillée) et activez la protection de la feuille de calcul (onglet Révision > Protéger la feuille) en ne laissant que la plage de saisie brute accessible en écriture, prévenant ainsi toute corruption involontaire de la mécanique algorithmique.
12.3 Rédaction des résultats aux normes académiques internationales (APA)
L’étape finale de la démarche consiste à transcrire avec exactitude les grandeurs statistiques extraites sous Excel au sein de vos rapports d’évaluation ou articles scientifiques, selon les standards éditoriaux de l’American Psychological Association (normes APA 7e édition).
Les consignes rédactionnelles fondamentales de l’APA pour la cohérence interne imposent les conventions typographiques suivantes : le symbole de l’alpha est désigné par la lettre grecque minuscule en italique ($\alpha$), le coefficient doit être rapporté avec deux ou trois décimales, et le zéro initial devant la virgule décimale doit être strictement omis (car le coefficient alpha est borné et ne peut pas, par définition mathématique, surpasser la valeur absolue de 1 ; on écrit donc « $\alpha = ,85$ » ou « $\alpha = ,850$ », et non « $\alpha = 0,85$ » dans les publications en langue anglaise, bien que la virgule avec zéro initial soit acceptée dans certaines revues strictement francophones : « $\alpha = 0,85$ »).
Voici un modèle de paragraphe méthodologique prêt pour insertion académique :
« La cohérence interne de l’Inventaire Abrégé d’Anxiété Situationnelle (IAAS), composé de 10 items après recodage des items 3, 6 et 9, a été évaluée auprès d’un échantillon de 50 participants adultes. L’analyse révèle une excellente cohérence interne de l’instrument composé, attestée par un coefficient alpha de Cronbach de $\alpha = ,850$ [IC 95 % : ,782 – ,904]. L’examen de la matrice d’items confirme que l’ensemble des corrélations item-total corrigées oscillent entre $r = ,42$ et $r = ,71$, surpassant largement le seuil d’admissibilité usuel de ,30. Aucune exclusion d’item n’engendrerait d’accroissement substantiel du coefficient global, confirmant la pertinence psychométrique de l’intégralité de la batterie pour la mesure de l’anxiété globale. »
Ce paragraphe, étayé le cas échéant par le tableau d’analyse d’items conçu sous Excel détaillant les moyennes, écarts-types, corrélations d’exclusion et alphas après suppression pour chaque énoncé, satisfait aux exigences les plus rigoureuses des comités de lecture des revues scientifiques indexées à l’échelle internationale.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cortina, J. M. (1993). What is coefficient alpha? An examination of theory and applications. Journal of Applied Psychology, 78(1), 98–104. https://doi.org/10.1037/0021-9010.78.1.98
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
- Feldt, L. S. (1969). A test of the hypothesis that Cronbach’s alpha or Kuder-Richardson coefficient twenty is the same for two tests. Psychometrika, 34(3), 363–373. https://doi.org/10.1007/BF02289433
- Kuder, G. F., & Richardson, M. W. (1937). The theory of the estimation of test reliability. Psychometrika, 2(3), 151–160. https://doi.org/10.1007/BF02288391
- Loevinger, J. (1954). The attenuation paradox in test theory. Psychological Bulletin, 51(5), 493–504. https://doi.org/10.1037/h0058544
- McDonald, R. P. (1999). Test theory: A unified treatment. Lawrence Erlbaum Associates Publishers.
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Schmitt, N. (1996). Uses and abuses of coefficient alpha. Psychological Assessment, 8(4), 350–353. https://doi.org/10.1037/1040-3590.8.4.350
- Spearman, C. (1910). Correlation calculated from faulty data. The British Journal of Psychology, 3(3), 271–295. https://doi.org/10.1111/j.2044-8295.1910.tb00206.x