
Dans le domaine de l’ingénierie des données et de l’analyse scientifique, la restitution visuelle ne constitue pas un simple artifice esthétique mais un instrument d’inférence statistique et de communication cognitive. Le langage Python s’est imposé comme le standard de facto de cet écosystème, principalement grâce à la robustesse et à l’extensibilité de sa bibliothèque historique, Matplotlib. Au sein de cette architecture logicielle, le diagramme de dispersion occupe une place nodale, permettant de confronter deux dimensions continues sur un plan orthogonal. Néanmoins, limiter la représentation à ces deux seules dimensions cartésiennes bride considérablement l’épaisseur sémantique du rendu graphique. L’introduction d’un encodage géométrique additionnel, notamment par la modulation de la taille des marqueurs, permet de superposer des métriques quantitatives supplémentaires sans altérer la lisibilité globale de la figure.
L’ajustement de la dimension spatiale des glyphes graphiques pose toutefois des défis théoriques et pratiques complexes. Sur le plan informatique, le moteur de rendu doit manipuler des structures d’objets distinctes selon les fonctions convoquées, impliquant des arbitrages de performance critiques lorsqu’il s’agit de traiter plusieurs centaines de milliers d’observations. Sur le plan métrologique, l’expression de la taille varie radicalement selon que l’on manipule des diamètres linéaires, exprimés en points typographiques, ou des surfaces bidimensionnelles proportionnelles à l’amplitude des variables mesurées. Une mécompréhension de ces principes sous-jacents conduit fréquemment à des visualisations biaisées, voire erronées, masquant la véritable distribution des données ou saturant l’espace graphique par des phénomènes massifs de recouvrement.
Le présent article propose une exploration exhaustive, théorique et opérationnelle des méthodologies d’ajustement de la taille des marqueurs au sein de Matplotlib. À travers une analyse comparative des fonctions fondamentales, des transformations mathématiques indispensables et des considérations psychophysiques liées à la perception visuelle humaine, cette étude fournit aux chercheurs, analystes et ingénieurs les fondements nécessaires pour concevoir des visualisations scientifiquement rigoureuses, esthétiquement équilibrées et computationnellement optimisées.
1. Introduction aux principes fondamentaux du traçage avec Matplotlib et au rôle du dimensionnement
1.1 Émergence de la sémiologie graphique en programmation scientifique
L’intégration de la visualisation de données dans le flux de travail computationnel moderne trouve ses origines dans les travaux fondateurs de John D. Hunter, qui initia le développement de Matplotlib au début des années 2000 afin d’émuler l’environnement de tracé de MATLAB au sein de l’interpréteur Python. Cette transition logicielle coïncidait avec un besoin impérieux de formalisation théorique de la transcription visuelle des données numériques. À cet égard, la programmation scientifique s’est nourrie des principes de la sémiologie graphique théorisés par le cartographe et géographe français Jacques Bertin. Dans son traité magistral, Bertin identifie huit variables visuelles fondamentales, qualifiées de variables rétiniennes, parmi lesquelles la taille occupe une fonction privilégiée en raison de sa capacité immédiate à signifier une relation d’ordre quantitatif absolu ou relatif.
Dans l’arsenal sémiotique, la variable rétinienne de taille se distingue de la forme, de l’orientation ou de la couleur par son caractère dissociable et ordonné. Un marqueur de dimensions accrues attire instantanément l’attention fovéale du lecteur, établissant une hiérarchie visuelle non ambiguë avant même que l’esprit n’ait procédé à la lecture des axes ou des valeurs numériques. Lorsque cette propriété géométrique est couplée à des coordonnées spatiales sur un plan cartésien, le diagramme acquiert la capacité de communiquer un gradient d’intensité ou une magnitude pondérale. La fidélité représentationnelle dépend dès lors de l’adéquation stricte entre la progression mathématique de la valeur sous-jacente et l’expansion géométrique de l’élément graphique.
L’impact de cette précision géométrique sur l’interprétabilité cognitive des diagrammes scientifiques s’avère considérable. Une mauvaise calibration de l’échelle des tailles engendre des distorsions interprétatives majeures, pouvant amener l’observateur à surestimer la prévalence d’un phénomène ou, inversement, à oblitérer des tendances sous-jacentes du fait d’une compression excessive des faibles valeurs. La transcription graphique ne saurait ainsi être abandonnée aux valeurs par défaut des moteurs de rendu, mais exige au contraire une maîtrise déterministe de chaque unité typographique projetée sur la figure.
1.2 Architecture sous-jacente des objets graphiques et marqueurs
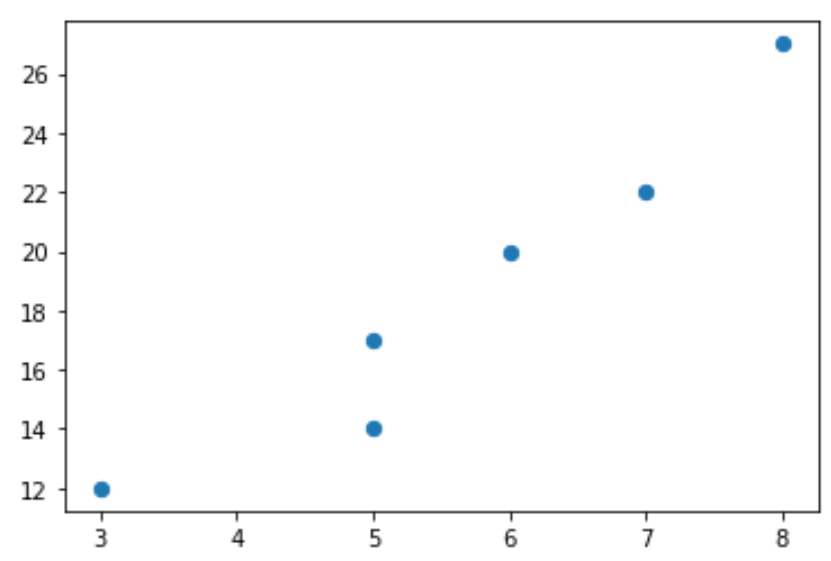
Pour comprendre comment Matplotlib calibre la dimension de ses glyphes, il convient de disséquer la hiérarchie structurelle de son modèle orienté objet. Au sommet de cette arborescence trône l’instance de la classe Figure, qui encapsule l’intégralité du canevas graphique. Cette figure héberge un ou plusieurs objets Axes, lesquels délimitent l’espace de coordonnées où s’opère la projection mathématique. Au sein de ces axes, les données ne sont pas simplement tracées sous forme de pixels bruts, mais sont instanciées en tant qu’éléments spécialisés dénommés Artists. Les marqueurs de dispersion sont regroupés au sein d’une sous-classe éminemment optimisée nommée PathCollection, issue du module des collections vectorielles de la bibliothèque.
D’un point de vue structurel, un marqueur n’est pas une image matricielle figée, mais une primitive géométrique vectorielle définie par un chemin fermé composé de sommets reliés par des segments de droites ou des courbes de Bézier. Lorsqu’un utilisateur invoque une fonction de traçage, Matplotlib instancie une définition unique de ce chemin vectoriel, puis applique une matrice de transformation affine pour positionner, orienter et redimensionner cette primitive à chaque coordonnée spécifiée. Cette vectorisation garantit que l’objet conserve sa netteté intrinsèque indépendamment du niveau d’agrandissement ou de la résolution d’affichage cible.
Cette approche vectorielle soulève une dichotomie fondamentale lors de la phase finale de pixellisation par le moteur de rendu sous-jacent. Matplotlib prend en charge deux grandes familles de moteurs de rendu : les moteurs matriciels, à l’instar de la bibliothèque Anti-Grain Geometry (dédiée aux sorties matricielles de type PNG ou affichage direct sur écran), et les moteurs vectoriels purs générant des fichiers aux formats PDF, PostScript ou SVG. Alors que les moteurs vectoriels préservent les commandes géométriques élémentaires pour chaque marqueur, le moteur matriciel doit rasteriser ces chemins vectoriels continus sur une grille discrète de pixels. Durant cette rastérisation, la taille théorique du marqueur, mesurée en grandeurs physiques continues, subit une discrétisation qui peut altérer subtilement le rapport de surface réel si la densité de points par pouce n’est pas rigoureusement calibrée.
2. Anatomie technique de la fonction scatter et du paramètre s
2.1 Définition mathématique et métrologie du paramètre s
L’interface de traçage de nuages de points est principalement opérée via l’instruction de méthode scatter rattachée à l’objet Axes. L’argument central régissant le gabarit dimensionnel des observations est le paramètre désigné par la lettre s. Contrairement à une intuition géométrique intuitive qui porterait à croire que ce paramètre contrôle le rayon ou le diamètre linéaire du glyphe, la documentation formelle de Matplotlib stipule que s quantifie la surface du marqueur, exprimée précisément en points typographiques au carré. Cette unité de mesure hérite directement des conventions séculaires de la typographie occidentale, formalisées dans l’écosystème numérique par le système d’impression PostScript.
Dans ce cadre normatif, un point typographique correspond exactement à un soixante-douzième de pouce international, soit approximativement 0,3527 millimètre. Dès lors, lorsqu’une valeur scalaire ou vectorielle est transmise à l’argument s, l’interpréteur graphique calcule l’aire délimitée par l’enveloppe extérieure du marqueur sous la forme de cette fraction surfacique d’un pouce carré. Pour un marqueur circulaire standard, l’aire surfacique est régie par la relation géométrique classique reliant la surface au carré du rayon. Par conséquent, le diamètre effectif du cercle projeté sur l’écran ou la page imprimée n’évolue pas linéairement avec s, mais selon la racine carrée de la valeur fournie, divisée par la constante pi.
La conversion de ces grandeurs typographiques en pixels physiques repose sur la résolution de sortie du canevas, désignée par l’acronyme DPI (Dots Per Inch). Pour une résolution d’affichage standard de soixante-douze points par pouce, un point typographique correspond rigoureusement à un pixel physique, et une valeur de s égale à cent génère une surface projetée de cent pixels carrés. En revanche, pour un rendu destiné à l’impression scientifique en haute fidélité, couramment fixé à trois cents ou six cents DPI, le nombre de pixels physiques alloués à chaque point typographique croît de manière quadratique proportionnellement au rapport de résolution. La maîtrise de cette chaîne métrique est impérative pour anticiper la lisibilité d’un tracé lors de son exportation finale dans des revues spécialisées.
2.2 Signature formelle et passage d’arguments à plt.scatter
L’invocation formelle de la méthode de dispersion s’articule autour d’une signature syntaxique exigeante, nécessitant la fourniture séquentielle ou nominale des vecteurs de positionnement cartésien horizontaux et verticaux, conventionnellement libellés x et y. Directement consécutif à ces données géographiques primaires, l’argument de taille s s’insère au côté des paramètres chromatiques c, des spécifications géométriques de contour edgecolors et du coefficient de transparence alpha. L’analyse du code source de Matplotlib révèle une gestion polymorphique sophistiquée de l’argument s, qui accepte indistinctement une constante scalaire unique ou une collection itérable de dimensions.
Lorsque le paramètre s reçoit une valeur scalaire isolée, telle qu’un entier ou un flottant, le moteur applique cette grandeur de façon globale et uniforme à l’ensemble des coordonnées présentes dans les vecteurs x et y. En revanche, dès lors qu’une structure séquentielle est passée en argument, celle-ci doit obligatoirement présenter une cardinalité strictement équivalente à celle des tableaux de coordonnées. Le moteur procède alors à un appariement terme à terme par indexation, affectant à chaque n-ième observation sa dimension volumétrique spécifique. Cette flexibilité structurelle constitue le pivot technique permettant de représenter un troisième canal quantitatif sur un espace bidimensionnel.
La gestion interne des types de données opère une coercition automatique des structures natives de Python vers des tableaux unidimensionnels standardisés sous le moteur NumPy. Ainsi, que l’utilisateur transmette une liste Python native, un vecteur ndarray issu de NumPy ou une série indicée issue d’une structure de données de type DataFrame via la bibliothèque Pandas, la méthode extrait le tampon de mémoire contigu sous-jacent. Il importe de souligner que la présence de valeurs non numériques, de chaînes de caractères orphelines ou de marqueurs de données manquantes au sein de ce vecteur déclenche des exceptions d’incompatibilité de type ou des alertes d’exécution qu’il convient de prémunir par des procédures rigoureuses d’assainissement préalable des données.
3. Définition d’une taille de marqueur uniforme pour l’ensemble des observations
3.1 Implémentation d’un dimensionnement scalaire global
La configuration la plus élémentaire, mais néanmoins fréquente dans l’analyse exploratoire de données, consiste à fixer un gabarit invariable pour l’intégralité des observations représentées. Cette approche élimine toute ambiguïté sémiotique liée à la variation surfacique et recentre l’effort analytique de l’observateur sur la dispersion spatiale brute, la détection de groupements naturels et l’identification de corrélations bivariées. L’implémentation requiert simplement d’assigner une valeur constante au paramètre de surface lors de l’appel de la fonction de tracé.
Dans les faits, le choix de la valeur scalaire par défaut, qui s’établit conventionnellement à une surface de vingt ou trente-six points typographiques carrés selon les versions historiques et les feuilles de style de Matplotlib, doit être adapté en fonction du ratio d’aspect du graphique et de la densité du semis de points. Un dimensionnement fixé à une valeur standard de quarante points carrés assure généralement une reconnaissance morphologique satisfaisante sans générer d’empâtement visuel sur des échantillons comptant entre cinquante et quelques centaines d’enregistrements. L’équilibre esthétique dépend directement de l’espacement moyen séparant les centroïdes de chaque élément vectoriel.
L’analyse de la densité spatiale montre que pour des distributions clairsemées, un calibre trop modeste transforme les marqueurs en micropoints difficilement discernables par l’œil humain, particulièrement sur des moniteurs modernes à très haute densité de pixels. À l’inverse, dans un espace cartésien restreint, l’accumulation de points uniformément calibrés mais surdimensionnés sature le champ visuel, réduisant à néant la capacité de l’observateur à distinguer les variations de concentration locale des points. Le dimensionnement scalaire global relève ainsi d’un compromis minutieux entre la résolution du support et la dispersion intrinsèque des coordonnées d’observation.
3.2 Évaluation comparative des grandeurs : passage d’un seuil minimal à maximal
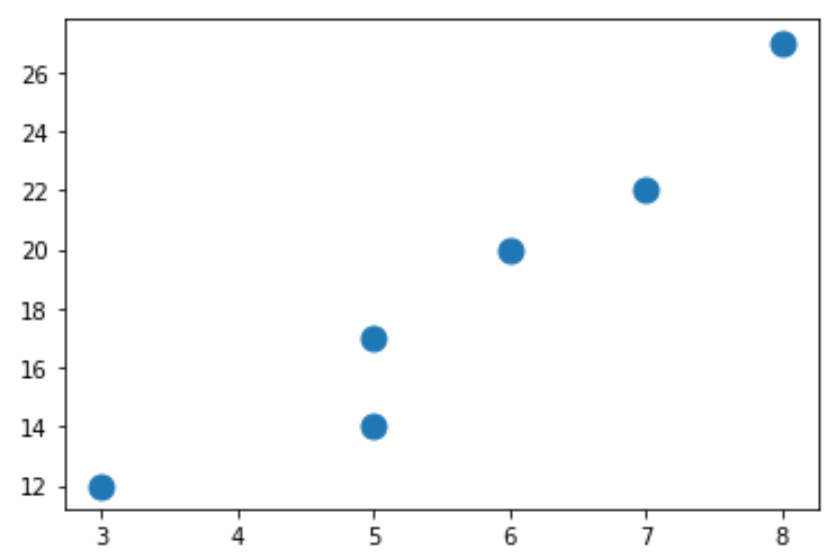
L’exploration empirique des limites supérieures du calibrage scalaire met en évidence des contraintes d’encombrement spatial déterminantes pour la qualité graphique. Lorsque la valeur de surface passe de grandeurs médianes à des échelles substantielles, telles que cent-vingt, deux-cent-cinquante ou cinq-cents points carrés, la surface occupée par chaque primitive vectorielle croît de manière disproportionnée par rapport aux marges inter-points. Cette augmentation volumétrique modifie en profondeur la dynamique de lecture de l’information statistique.
À des niveaux dimensionnels extrêmes, le phénomène de masquage partiel ou total, connu dans la littérature sous le terme d’occlusion ou de chevauchement visuel, se manifeste avec une intensité destructrice. Les glyphes situés au premier plan recouvrent totalement les observations sous-jacentes, masquant l’existence même de données critiques et faussant l’évaluation intuitive de la distribution de masse de l’échantillon. En outre, la juxtaposition de marqueurs très volumineux déplace le centre d’intérêt cognitif : le regard ne perçoit plus une constellation de mesures isolées, mais une masse fusionnée continue dont les contours extérieurs constituent des artefacts graphiques dénués de toute signification scientifique.
Pour prévenir cette dégradation sémiologique, des recommandations ergonomiques précises dictent le choix d’un calibre optimal corrélé au volume total de l’échantillon. Pour des jeux de données denses excédant dix mille éléments, l’utilisation de surfaces infinitésimales, voire l’abandon des marqueurs surfaciques au profit de représentations par pixels unitaires, s’impose comme une nécessité absolue. Inversement, pour des échantillons restreints comprenant moins de trente unités d’observation, l’adoption de grandes dimensions permet d’incorporer des informations secondaires au sein du marqueur, telles que des étiquettes textuelles internes ou des variations de bordures hautement contrastées.
4. Distinction technique entre plt.scatter et plt.plot pour le dimensionnement
4.1 Le paramètre markersize dans l’environnement plt.plot
L’une des ambiguïtés les plus répandues dans le développement d’applications scientifiques avec Matplotlib réside dans la confusion entre la méthode de tracé de courbes, accessible via la fonction plot, et la méthode de dispersion statistique opérée par scatter. Bien que la fonction plot soit primitivement destinée à relier des coordonnées successives par des segments linéaires, elle offre également la possibilité de supprimer les lignes d’interconnexion et d’afficher des marqueurs isolés au niveau de chaque vertex. Dans ce contexte, l’ajustement géométrique des symboles ne s’opère pas via le paramètre s, mais au moyen de l’argument explicite markersize, fréquemment abrégé sous la forme syntaxique ms.
La divergence entre ces deux interfaces n’est pas uniquement syntaxique ; elle repose sur un paradigme mathématique profondément divergent. Alors que l’argument s de la fonction scatter régit la surface bidimensionnelle en points carrés, le paramètre markersize de la fonction plot quantifie une dimension strictement linéaire, à savoir le diamètre ou la largeur transversale du glyphe, mesurée en points typographiques simples. Dès lors, assigner une valeur numérique identique, par exemple vingt, à markersize dans un tracé de ligne et à s dans un nuage de dispersion engendre un contraste visuel spectaculaire. Un marqueur de markersize égal à vingt possédera un diamètre physique de vingt points, correspondant à une surface circulaire approximative de plus de trois cents points carrés, le rendant plus de quinze fois plus vaste qu’un point tracé via scatter avec un paramètre s équivalent à vingt.
Cette distinction métrologique fondamentale induit de fréquentes erreurs d’étalonnage lors de la refactorisation de routines graphiques ou lors de la combinaison de plusieurs couches d’information sur un même axe. L’assimilation involontaire d’une mesure de rayon ou de diamètre à une unité surfacique produit des aberrations d’échelle colossales, faussant la comparabilité directe des figures au sein d’un même rapport technique ou d’une communication académique.
4.2 Arbitrage computationnel entre Line2D et PathCollection
Au-delà de la discordance dimensionnelle entre surface et longueur linéaire, le choix entre plot et scatter implique des conséquences computationnelles structurelles majeures. Lorsqu’un tracé est généré au moyen de la commande plot, Matplotlib instancie un unique objet de bas niveau appartenant à la classe Line2D. Cet objet regroupe la totalité des coordonnées vectorielles au sein d’un tampon mémoire contigu et unifié. Le moteur de rendu réplique la forme du marqueur à chaque sommet en utilisant une seule et même matrice de style partagée, sans allouer d’espace mémoire individuel pour chaque point du semis.
En contrepartie de cette légèreté architecturale, la fonction plot impose une rigidité absolue : l’ensemble des marqueurs d’une instance Line2D doit partager rigoureusement la même taille, la même teinte, la même opacité et la même typologie géométrique. Il est rigoureusement impossible de vectoriser le paramètre markersize pour faire varier la dimension des glyphes au sein d’un même tracé linéaire. L’affichage d’un nuage de points dont les tailles diffèrent dynamiquement selon les observations exige impérativement le recours à l’objet PathCollection instancié par la méthode scatter.
Cette souplesse morphologique propre à la collection de chemins vectoriels a un coût computationnel considérable. Le moteur doit instancier et maintenir en mémoire des matrices de propriétés individualisées pour chaque observation, gérant séparément les décalages, les facteurs d’échelle surfacique et les attributions colorimétriques. Sur des volumes massifs de données, le temps d’exécution requis pour la phase d’instanciation et de rastérisation d’un PathCollection dépasse d’un ou plusieurs ordres de grandeur celui nécessaire au traitement d’un simple objet Line2D. L’ingénieur doit par conséquent réserver scatter aux situations requérant impérativement un encodage multivarié de la taille ou de la couleur, et privilégier systématiquement plot pour les rendus uniformes à haute volumétrie.
5. Attribution dynamique de tailles de marqueurs individualisées par observation
5.1 Vectorisation du paramètre s à l’aide de collections unidimensionnelles
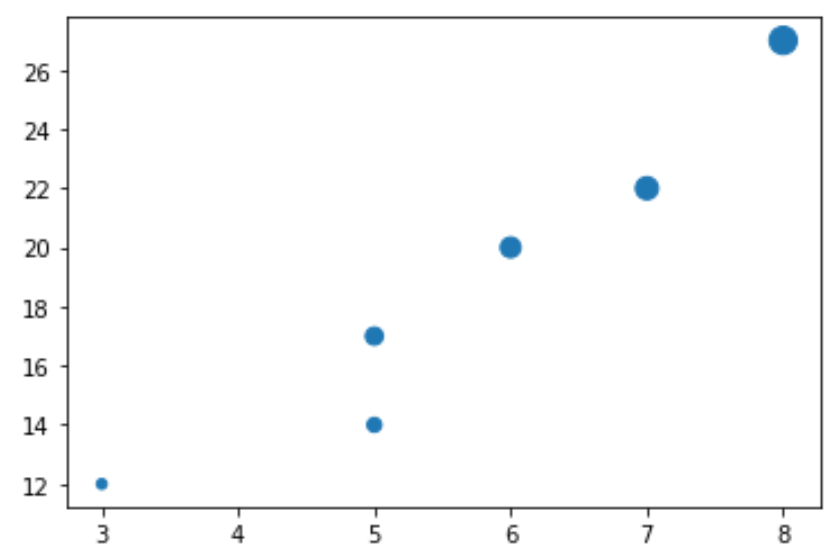
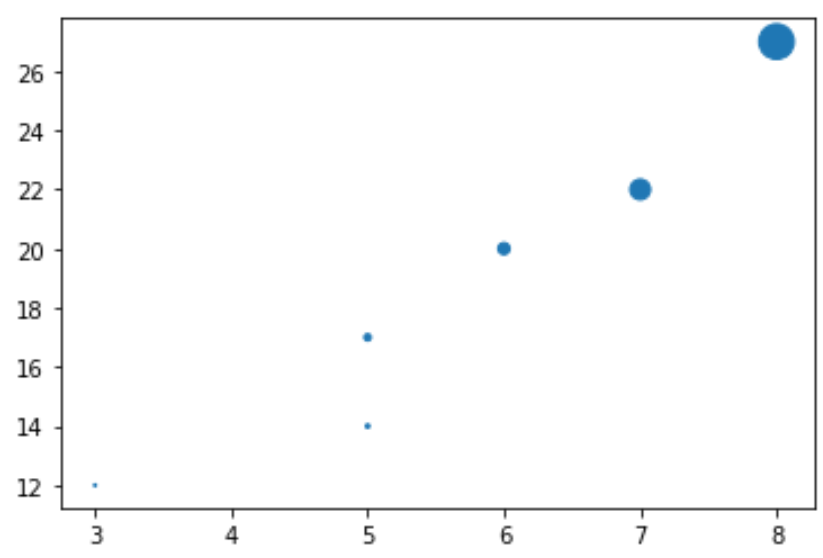
L’extension analytique majeure offerte par la fonction scatter réside dans sa capacité à traiter des structures itérables vectorisées au sein du paramètre s. Cette fonctionnalité permet de dépasser la contrainte bidimensionnelle du plan cartésien traditionnel en encodant une troisième variable statistique quantitative directement au niveau de chaque observation graphique. L’implémentation opérationnelle nécessite l’acheminement d’une séquence unidimensionnelle dont la cardinalité correspond de façon exacte au nombre de points définis sur les axes des abscisses et des ordonnées.
Le respect de cette contrainte dimensionnelle est impératif sous peine de provoquer une interruption de compilation lors de l’exécution du script graphique. Si un utilisateur transmet un vecteur de taille comptant un nombre d’éléments différent de celui des vecteurs de positionnement cartésien, Matplotlib lève une exception d’incompatibilité de forme. Lorsque la correspondance dimensionnelle est strictement respectée, le moteur interne itère de manière synchronisée sur les tableaux de données, cartographiant chaque quantum surfacique sur son ancrage spatial respectif sans exiger l’écriture de boucles de traitement manuelles au niveau du code applicatif.
Cette vectorisation surfacique ouvre la voie à une interprétation visuelle immédiate de phénomènes complexes. Dans les analyses biométriques, climatiques ou macroéconomiques, l’adjonction de cette dimension scalaire permet de révéler des interactions d’ordre supérieur, telles que l’influence conjointe de la masse corporelle sur deux biomarqueurs spécifiques, ou l’impact de la démographie nationale sur la relation entre produit intérieur brut et espérance de vie. La représentation visuelle condense ainsi une matrice de données tridimensionnelle au sein d’une projection plane hautement lisible et synthétique.
5.2 Liaison directe avec des structures NumPy et des DataFrames Pandas
Dans l’écosystème moderne de la science des données, les jeux d’observations sont rarement manipulés sous forme de listes natives Python, mais résident plutôt au sein de structures tabulaires de haut niveau gérées par la bibliothèque Pandas ou de matrices numériques optimisées issues de NumPy. L’interopérabilité directe entre ces conteneurs de données et l’API de Matplotlib facilite grandement l’extraction et l’assignation de colonnes tierces à la géométrie des marqueurs.
L’extraction d’une série numérique issue d’un DataFrame s’opère de manière transparente via l’indexation par étiquette de colonne, dont le résultat est directement passé à l’argument s. Matplotlib accède de manière sous-jacente au tampon de données contigu de la colonne sélectionnée, éliminant les latences de conversion de type et garantissant une efficacité d’exécution optimale. Il convient toutefois d’accorder une vigilance accrue à la présence d’irrégularités statistiques au sein des séries sélectionnées, notamment les valeurs nulles, les valeurs aberrantes négatives ou les marqueurs de valeurs manquantes désignés sous le terme conventionnel de NaN (Not a Number).
Dans le paradigme géométrique, une surface ne peut conceptuellement adopter une grandeur négative. Lorsque des valeurs strictement inférieures à zéro subsistent dans le vecteur de dimensionnement, le compilateur graphique réagit soit par l’émission d’avertissements de calcul flottant, soit par l’interruption pure et simple de la procédure de rendu graphique. De même, la survenue de valeurs manquantes peut provoquer des distorsions imprévisibles lors du calcul des limites d’axes ou engendrer l’omission silencieuse d’observations connexes. La phase de liaison de données exige par conséquent une étape rigoureuse de prétraitement, consistant à imputer les observations incomplètes, à filtrer les singularités mathématiques et à borner strictement le domaine de définition de la variable de pondération.
6. Normalisation mathématique et mise à l’échelle des données pour l’argument s
6.1 Mise à l’échelle linéaire par la méthode Min-Max
Il est extrêmement rare que l’amplitude numérique brute d’une variable physique ou économique corresponde spontanément aux ordres de grandeur requis pour un affichage graphique harmonieux sur un canevas Matplotlib. À titre d’exemple, si une variable analytique mesure le revenu individuel en dizaines de milliers d’unités monétaires ou la population nationale en centaines de millions de citoyens, l’injection directe de ces grandeurs brutes dans le paramètre s générerait des marqueurs dont la surface excéderait de plusieurs milliers de fois la dimension totale de l’écran. Inversement, une variable mesurant une concentration molaire ou un taux de croissance infinitésimal générerait des marqueurs aux dimensions inférieures au millième de point typographique, les rendant rigoureusement invisibles. Il est par conséquent indispensable de procéder à une normalisation mathématique systématique.
La méthode la plus directe et la plus répandue pour opérer cet étalonnage est la projection linéaire par la transformation Min-Max. Cette opération géométrique consiste à transposer l’intervalle continu originel des données, délimité par sa valeur minimale et sa valeur maximale constatées, vers un intervalle arbitraire strictement défini par des bornes surfaciques perceptibles et équilibrées, généralement désignées comme la taille minimale et la taille maximale souhaitées sur la figure. La formulation analytique calcule pour chaque observation la proportion relative de son écart au minimum global, puis multiplie cette fraction par l’amplitude du domaine de visibilité cible avant de lui additionner la borne minimale retenue.
Cette transformation garantit que l’observation la plus modeste du jeu de données recevra exactement la dimension minimale définie, assurant sa parfaite détectabilité optique, tandis que l’observation la plus volumineuse sera plafonnée à la dimension maximale, empêchant toute obstruction disproportionnée de l’espace de coordonnées. L’opération peut être implémentée au moyen d’opérations vectorielles natives sur tableaux NumPy ou par l’entremise de transformateurs dédiés disponibles dans les bibliothèques d’apprentissage automatique spécialisées, à l’image du module de prétraitement de Scikit-Learn. Le choix délibéré des bornes minimale et maximale constitue un paramètre de conception graphique crucial qui conditionne la lisibilité finale de l’ensemble du graphique.
6.2 Transformations non linéaires : approches logarithmique et exponentielle
Bien que la mise à l’échelle linéaire par transformation Min-Max présente l’avantage d’une simplicité conceptuelle incontestable, elle échoue dramatiquement dès lors que la variable de pondération suit une distribution statistique asymétrique caractérisée par une forte dispersion ou des queues de distribution épaisses, typiques des lois de puissance ou des phénomènes de Pareto. Dans une telle configuration, une poignée infime de valeurs colossales capte l’écrasante majorité de la plage surfacique disponible, reléguant la quasi-totalité des observations intermédiaires et faibles à une échelle uniforme et écrasée sur la borne minimale. Cette distorsion oblitère totalement les variations quantitatives sous-jacentes au sein du corps principal de l’échantillon.
Pour remédier à cette pathologie graphique, l’analyste doit convoquer des transformations fonctionnelles non linéaires préalablement à l’étape d’injection dans le paramètre s. L’approche la plus efficiente repose sur l’application d’une fonction logarithmique népérienne ou décimale, souvent complétée par une constante d’ajustement unitaire pour prévenir les instabilités asymptotiques au voisinage de zéro. La compression logarithmique resserre les écarts d’amplitude de plusieurs ordres de grandeur, permettant de rendre visibles les différentiels relatifs parmi les cohortes de faible intensité tout en jugulant l’expansion spatiale des valeurs extrêmes.
Une alternative mathématiquement fondamentale, directement issue des principes de la géométrie euclidienne, consiste à appliquer une transformation par racine carrée. Étant donné que le paramètre s gouverne l’aire surfacique du cercle et que l’œil humain perçoit avant tout l’extension radiale ou diamétrale de l’objet, l’application d’une racine carrée à la variable permet de linéariser la perception du diamètre linéaire. Ainsi, un doublement de la valeur métrique se traduit par une extension diamétrale proportionnelle, neutralisant l’effet d’amplification exponentielle naturellement induit par le calcul quadratique de la surface. Le tableau ci-dessous illustre la typologie des transformations et leurs contextes d’application privilégiés :
- Mise à l’échelle linéaire Min-Max : Indiquée pour les distributions statistiques normales ou uniformes dénuées de valeurs aberrantes prononcées.
- Transformation par racine carrée : Recommandée pour compenser la perception géométrique du diamètre et préserver une sensation de proportionnalité linéaire.
- Transformation logarithmique : Indispensable pour les distributions hautement asymétriques, les phénomènes de concentration de richesse ou les cinétiques virales exponentielles.
- Transformation par rang percentile : Adaptée aux visualisations qualitatives cherchant à éliminer totalement les biais d’amplitude au profit d’un étalement d’ordre purement ordinal.
7. Psychophysique de la perception visuelle et sémiologie graphique
7.1 Lois de Weber-Fechner et de Stevens appliquées à l’évaluation des surfaces
La représentation quantitative de grandeurs numériques par l’intermédiaire de surfaces circulaires n’est pas neutre sur le plan cognitif. L’interface entre le diagramme et l’esprit du lecteur est gouvernée par les lois fondamentales de la psychophysique expérimentale, initialement formulées par Ernst Heinrich Weber et Gustav Fechner, puis considérablement affinées par Stanley Smith Stevens. La loi de puissance de Stevens postule que l’intensité de la sensation psychologique perçue n’est pas proportionnelle à l’intensité physique du stimulus, mais varie selon une fonction de puissance régie par un exposant empirique propre à chaque modalité sensorielle.
Dans le domaine de l’évaluation visuelle, l’exposant associé à l’estimation de longueurs linéaires unidimensionnelles est rigoureusement proche de un, ce qui confère aux graphiques en barres ou aux alignements cartésiens une fidélité perceptive quasi parfaite. En revanche, l’exposant psychophysique régissant la perception des aires surfaciques bidimensionnelles oscille généralement entre 0,6 et 0,8. Cette discordance neurophysiologique signifie que le cerveau humain sous-estime systématiquement l’accroissement relatif des surfaces géométriques : face à deux cercles dont l’un présente une aire objectivement deux fois plus vaste que le premier, un observateur non averti estime intuitivement que le second n’est plus grand que d’environ soixante à soixante-dix pour cent.
Pour corriger cette distorsion cognitive récurrente, le cartographe James J. Flannery a formulé une méthode de compensation empirique, largement adoptée en sémiologie spatiale, connue sous le nom d’ajustement de Flannery. Cette correction consiste à élever la variable quantitative à un exposant correctif inverse, généralement calibré autour de 0,57 pour le rayon linéaire ou 1,14 pour la surface brute, avant d’opérer la projection géométrique. En surdimensionnant délibérément et scientifiquement les marqueurs de forte intensité au-delà de la proportionnalité euclidienne pure, l’ingénieur permet à l’observateur d’aboutir à une reconstitution mentale subjectivement exacte des rapports quantitatifs réels.
7.2 Facteurs d’interférence et clarté cognitive
L’exactitude interprétative d’un nuage de points gradués n’est pas seulement affectée par la psychophysique des surfaces, mais également par les interférences géométriques et environnementales contextuelles. La morphologie du marqueur sélectionné au sein du moteur Matplotlib exerce une influence immédiate sur l’évaluation de son encombrement spatial. La substitution d’un marqueur circulaire par un carré, un triangle isocèle ou une croix orthogonale modifie drastiquement le rapport entre l’enveloppe circonscrite et la surface d’encre réellement imprimée sur le support.
Un marqueur carré configuré avec un paramètre s équivalent à celui d’un cercle couvre une surface géométrique strictement identique, mais ses angles proéminents et sa base rectiligne renforcent son impact visuel, le faisant paraître plus imposant à l’œil qu’une forme circulaire close. Les polygones aux arêtes acérées génèrent des artefacts d’alignement visuel parasites et saturent plus rapidement les zones de forte densité que les formes douces et convexes. C’est la raison pour laquelle le cercle plein, désigné par la lettre o dans la syntaxe de Matplotlib, demeure la forme canonique privilégiée pour l’encodage proportionnel de données d’amplitude continue.
Par ailleurs, l’illusion contextuelle d’Ebbinghaus illustre la vulnérabilité de l’estimation de taille face au voisinage spatial immédiat. Un marqueur de dimension moyenne semblera significativement plus petit s’il est enserré au milieu de points volumineux, et inversement apparaîtra disproportionnellement grand s’il est isolé au sein d’un semis de micropoints. Pour préserver la clarté cognitive et réduire la charge mentale requise pour décoder ces distorsions, il est impératif d’adopter des règles de conception strictes fondées sur la parcimonie graphique. Il convient d’espacer les éléments critiques, de modérer les contrastes de taille maximaux et de stabiliser le contexte graphique afin que les relations numériques sous-jacentes soient restituées avec une transparence analytique irréprochable.
8. Interaction synergique : taille, palette chromatique et opacité
8.1 Combinaison multidimensionnelle avec les arguments c et cmap
L’un des atouts les plus remarquables de Matplotlib réside dans son aptitude à marier harmonieusement plusieurs canaux de transmission sémiotique au sein d’un même appel de fonction. En conjuguant le dimensionnement volumétrique via le paramètre s avec la modulation chromatique assurée par les arguments c et cmap, le diagramme de dispersion s’élève au statut de projection quadri-dimensionnelle, restituant simultanément les coordonnées spatiales x et y, une troisième variable scalaire par l’envergure du point, et une quatrième dimension continue ou discrète via le spectre chromatique.
Une telle stratification sémiotique exige cependant une discipline rigoureuse dans le choix des palettes de couleurs. L’emploi de spectres perceptuellement non uniformes, tels que la palette arc-en-ciel historique désignée sous le terme de jet, introduit des fausses discontinuités et des illusions d’optique délétères qui viennent parasiter l’interprétation conjointe de la taille. L’état de l’art en visualisation scientifique préconise l’utilisation exclusive de palettes uniformes au regard de la physiologie humaine, à l’instar des spectres Viridis, Plasma, Inferno ou Cividis. Ces palettes garantissent une progression monotone et continue de la luminance, assurant que la lisibilité de la variable de couleur ne masque ni ne biaise l’estimation volumétrique portée par le marqueur.
Il est également envisageable d’exploiter la redondance informative délibérée. Dans cette configuration, la même variable statistique est encodée simultanément dans la taille du marqueur et dans son intensité chromatique. Cette double codification renforce la perception des gradients faibles, pallie les limitations sensorielles des observateurs atteints de dyschromatopsies partielles, et améliore considérablement la restitution lors d’une impression monochrome ou en niveaux de gris. L’équilibre perceptif global dépend de la juste mesure : l’encodage redondant doit être réservé aux variables maîtresses de l’étude afin d’éviter toute surcharge cognitive stérile.
8.2 Modulation du paramètre alpha face au chevauchement (overplotting)
L’accroissement substantiel de la taille des marqueurs engendre inéluctablement une aggravation dramatique du phénomène de chevauchement géométrique dès lors que la densité locale des observations s’intensifie. Lorsque des centaines de glyphes opaques convergent vers le même bassin d’attraction sur le plan cartésien, la figure se résume rapidement à une agglomération indistincte d’encre ou de pixels, dissimulant complètement la structure interne du nuage de données et l’existence d’éventuelles concentrations modales. Le levier de régulation technique fondamental pour juguler cette saturation réside dans la modulation du coefficient de transparence à travers l’argument alpha.
Le paramètre alpha accepte une valeur scalaire continue bornée strictement entre zéro, correspondant à une invisibilité optique totale, et un, représentant une opacité pigmentaire absolue. En réduisant ce coefficient à des valeurs modérées, généralement comprises entre 0,2 et 0,6 selon la cardinalité de l’échantillon, le moteur graphique opère un mélange additif des composantes de couleur lors du tracé de chaque couche vectorielle superposée. Les zones clairsemées conservent une tonalité diaphane et évanescente, tandis que les régions caractérisées par une haute densité d’occurrences se superposent itérativement pour générer une saturation chromatique intense.
Cette technique de fusion optique transforme le défaut initial du chevauchement géométrique en un vecteur analytique puissant, révélant intuitivement les estimations de densité par noyau sous-jacentes. Pour des échantillons massifs, une formule heuristique robuste consiste à indexer la valeur de alpha de manière inversement proportionnelle à la racine carrée ou au logarithme du nombre total d’observations projetées. Cette calibration déterministe garantit que l’accumulation de marqueurs élargis converge toujours vers une dynamique de contraste optimale, sans jamais basculer dans l’opacité impénétrable.
8.3 Personnalisation des bordures avec edgecolors et linewidths
L’utilisation intensive de la transparence via le paramètre alpha peut induire un effet pervers secondaire : l’évanescence des contours extérieurs des marqueurs et la perte de définition de leurs limites géométriques, tout particulièrement lorsque le fond du canevas présente une tonalité claire ou blanche standard. Pour préserver l’acuité visuelle et délimiter avec une précision chirurgicale l’étendue surfacique de chaque point, Matplotlib met à disposition les arguments edgecolors et linewidths.
Le paramètre edgecolors permet de spécifier la teinte du liseré périphérique encerclant le corps du marqueur, tandis que linewidths quantifie l’épaisseur physique de ce trait en points typographiques. L’attribution d’un contour sombre, tel qu’un noir pur ou un gris anthracite profond, confère une excellente lisibilité en créant une barrière optique nette qui sépare les marqueurs contigus lors des recouvrements partiels. Même en présence d’une opacité interne très diffuse, l’observateur conserve une perception claire du diamètre réel et de la localisation précise du centre de gravité de chaque élément.
Cependant, une disproportion dans l’épaisseur du contour peut gravement vicier la métrologie du tracé. Si l’argument linewidths est réglé sur une valeur excessive par rapport à la taille intrinsèque du marqueur, le trait de contour envahit l’espace interne et accroît l’aire totale apparente du symbole d’une fraction non négligeable. Pour les marqueurs de faibles dimensions, le contour peut purement et simplement masquer la surface colorée intérieure, annihilant l’encodage chromatique initial. Il est par conséquent impératif de dimensionner l’épaisseur de bordure de manière dynamique ou de la maintenir à une fraction modeste, typiquement entre 0,5 et 1,5 point typographique, pour garantir la fidélité de l’exportation vectorielle en haute définition.
9. Construction de légendes proportionnelles et échelles de référence
9.1 Défis inhérents aux légendes de scatterplots pour le paramètre s
La transmission rigoureuse d’une information statistique par l’intermédiaire d’une variable graphique impose impérativement la présence d’une clé de décodage métrique explicite : la légende. Dans le cadre de tracés de courbes standard ou d’encodages chromatiques continus, Matplotlib propose des mécanismes d’automatisation extrêmement performants, à l’instar de la méthode d’adjonction de barres de couleur continues. En revanche, l’architecture native du logiciel se heurte à une lacune historique substantielle s’agissant de l’échelle des tailles générées par le paramètre s d’un nuage de dispersion.
En l’absence d’une routine intégrée de génération automatique de légende pour les grandeurs surfaciques continues, l’utilisateur se retrouve confronté à un graphique muet sur le plan dimensionnel. Si l’œil appréhende sans difficulté qu’un point est substantiellement plus grand qu’un autre, il s’avère rigoureusement impossible pour l’observateur d’assigner une valeur chiffrée concrète à ces différentes envergures sans la présence d’une échelle graduée de référence. Cette absence transforme une métrique scientifique quantitative en une simple indication impressionniste qualitative, ruinant les exigences de reproductibilité et de précision propres aux publications scientifiques.
La conception d’une échelle de référence proportionnelle requiert la sélection méthodique de points d’ancrage représentatifs. Il est méthodologiquement erroné de présenter une constellation exhaustive de toutes les tailles existantes, sous peine d’encombrer inutilement l’espace graphique. L’analyste doit au contraire extraire un ensemble restreint de valeurs remarquables, généralement réparties sur des quantiles stratégiques, tels que le premier quartile, la médiane et le troisième quartile, ou centrées sur des valeurs rondes et mémorables de l’échelle des grandeurs mesurées. Ces étalons géométriques doivent être juxtaposés avec leurs équivalents numériques textuels dans un encadré dédié, à la fois discret et parfaitement accessible.
9.2 Stratégie des points fantômes (dummy scatter points)
Pour contourner l’absence d’automatisation native de la légende dimensionnelle dans les versions usuelles de Matplotlib, la méthodologie la plus élégante et la plus robuste repose sur le patron de conception dit des « points fantômes » ou marqueurs mandataires (proxy artists). Cette approche consiste à injecter dans la structure de gestion de légende de l’axe des objets géométriques artificiels, déconnectés des données primaires, calibrés explicitement pour correspondre aux seuils métriques sélectionnés pour la légende.
Sur le plan opérationnel, le développeur instancie une série d’appels à la méthode scatter en transmettant des listes vides pour les coordonnées x et y, ou en positionnant les points en dehors du champ de visibilité cartésien délimité par les limites des axes. Pour chacun de ces appels fictifs, le paramètre s reçoit la dimension exacte correspondant à la valeur étalon choisie, préalablement passée par la fonction de normalisation mathématique utilisée pour le tracé principal. L’argument label est simultanément renseigné avec la formulation textuelle formalisant la grandeur physique correspondante.
Lors de l’appel subséquent de la commande de composition de légende sur l’objet Axes, Matplotlib collecte ces identifiants mandataires et trace dans l’encart de légende des symboles dont le calibre surfacique correspond au pixel près aux marqueurs effectivement présents sur le graphique. Cette technique offre un contrôle total sur l’esthétique du cartouche de légende, permettant de figer une couleur neutre, comme un gris d’intensité médiane, et de fixer des bordures nettes afin que l’attention du lecteur se focalise exclusivement sur la discrimination des calibres géométriques sans distraction chromatique.
9.3 Automatisation via des gestionnaires de légende personnalisés
Bien que la stratégie des marqueurs fantômes apporte une solution pragmatique incontestable, l’ingénierie logicielle avancée privilégie l’utilisation de mécanismes natifs d’extraction de métadonnées lorsque les versions de Matplotlib le permettent. Les versions récentes de la bibliothèque ont introduit au sein de l’objet PathCollection une méthode hautement spécialisée dénommée pour générer de façon quasi automatique les poignées de légende relatives aux variations d’échelle et de chrominance.
Cette méthode analyse la distribution interne des valeurs vectorisées appliquées au paramètre s et propose un échantillonnage déterministe de marqueurs représentatifs. L’utilisateur dispose de leviers de paramétrage permettant de stipuler le nombre désiré d’échelons dans la graduation, ainsi que des fonctions de formatage textuel personnalisées pour adjoindre des unités de mesure ou des préfixes scientifiques aux étiquettes générées. Le résultat renvoyé par cette fonction est ensuite injecté directement dans l’argument des éléments de la commande générale de légende.
Sur le plan de la disposition géométrique au sein du cartouche de légende, deux grandes écoles typographiques s’affrontent. La disposition séparée aligne verticalement ou horizontalement les symboles étalons accompagnés de leurs légendes respectives dans des couloirs distincts. La seconde approche, particulièrement prisée en cartographie thématique, recourt à des cercles concentriques ou imbriqués alignés sur leur bordure inférieure. Cette disposition en nid d’abeille réduit drastiquement l’emprise spatiale de la légende tout en accentuant la perception différentielle des rayons. L’implémentation de cette dernière nécessite cependant une surcharge manuelle des décalages verticaux des symboles, attestant une nouvelle fois du haut degré de personnalisation offert par le sous-système graphique de Matplotlib.
10. Considérations de performance computationnelle et rendu à grande échelle
10.1 Limites de plt.scatter face aux volumes massifs (Big Data)
L’exploration visuelle moderne manipule de manière croissante des jeux d’enregistrements volumineux, issus du séquençage génomique, de l’astrophysique observationnelle, de la télémétrie industrielle ou des flux financiers à haute fréquence. Dans ces régimes de calcul intensif, où le volume d’observations dépasse allègrement les centaines de milliers d’unités pour atteindre couramment le million d’enregistrements, la fonction scatter révèle de sévères goulots d’étranglement architecturaux.
La dégradation drastique des performances temporelles et la saturation exponentielle de la mémoire vive trouvent leur origine dans la gestion interne de la collection d’objets vectoriels PathCollection. Pour chaque observation cartographiée, le moteur doit conserver et manipuler les matrices de transformation d’échelle, les coordonnées locales, ainsi que les vecteurs d’ombrage et de coloration. Le calcul à la volée des chemins polygonaux pour un million de marqueurs circulaires décentralisés impose une charge phénoménale à la boucle de rendu du processeur central. L’opération d’agrandissement dynamique d’un canevas interactif devient alors saccadée, voire provoque le blocage complet du processus par épuisement des ressources système.
Des tests de profilage de mémoire démontrent que l’empreinte mémoire d’un nuage de dispersion instancié via scatter est considérablement plus lourde que celle générée par des approches graphiques monolithiques. Cette consommation structurelle s’explique par la dispersion des références d’objets dans l’espace mémoire de Python, entraînant une surcharge substantielle pour le ramasse-miettes (garbage collector) lors de la réactualisation continue des scènes graphiques. L’ingénieur doit par conséquent savoir identifier ce palier d’inefficience critique afin de bifurquer vers des stratégies de substitution adaptées aux volumétries massives.
10.2 Alternatives et optimisations haute performance
Dès lors que le profilage applicatif met en lumière les limites computationnelles de scatter, plusieurs stratégies de contournement doivent être déployées pour préserver la réactivité du système tout en conservant la pertinence analytique du diagnostic graphique. La première mesure d’optimisation, particulièrement efficace si la modulation de la taille des marqueurs n’est pas strictement requise pour l’ensemble des données, consiste à revenir à l’usage de la méthode plot paramétrée avec un marqueur sans ligne d’interconnexion. Comme souligné précédemment, la compacité de l’objet Line2D permet d’afficher sans difficulté plusieurs millions de points sur des configurations matérielles standard.
Lorsque la taille variable par observation est un impératif analytique non négociable, la stratégie la plus pérenne réside dans l’intégration de bibliothèques spécialisées de rastérisation haute performance conçues pour s’interfacer avec Matplotlib, au premier rang desquelles figure Datashader. Cet écosystème adopte un paradigme inversé : au lieu de projeter des millions de primitives vectorielles géométriques sur un canevas, Datashader agrège préalablement les coordonnées dans une matrice de pixels via des algorithmes optimisés compilés avec Numba ou exécutés sur cartes graphiques. Le résultat de cette condensation matricielle est ensuite réinjecté dans Matplotlib sous la forme d’une image bidimensionnelle ultralégère, insensible à la cardinalité initiale du jeu de données.
Une troisième voie d’optimisation repose sur l’échantillonnage statistique en amont de l’affichage. L’utilisation d’algorithmes de sous-échantillonnage préservant la topologie spatiale, tels que l’échantillonnage par réservoir (reservoir sampling) ou la décimation géométrique fondée sur des grilles spatiales, permet de réduire la masse brute des données de plusieurs ordres de grandeur. Si une cellule de grille héberge des centaines d’observations quasi superposées, il est mathématiquement fondé de substituer à cette grappe un marqueur unique synthétique, dont la taille reflétera la densité cumulée d’observations sous-jacentes. Cette démarche rétablit des temps d’exécution optimaux tout en évitant la redondance d’information visuelle.
11. Diagnostics, pièges fréquents et solutions d’ingénierie logicielle
11.1 Divergences dimensionnelles et incohérences de types de données
L’exploitation avancée du paramètre s confronte régulièrement le développeur à des anomalies d’exécution dont les causes résident dans des subtilités de manipulation des structures matricielles. L’erreur la plus ubiquitaire et frustrante est incontestablement l’exception d’incompatibilité de dimensions, formalisée par l’alerte d’exécution stipulant que le paramètre de surface doit être un scalaire ou présenter la même dimensionnalité que les coordonnées spatiales associées. Cette erreur surgit généralement lors de la manipulation de structures de données bidimensionnelles asymétriques ou après des opérations de filtrage booléen mal répercutées.
Pour prévenir ces dysfonctionnements au sein d’environnements de production logicielle exigeants, l’ingénierie préconise la mise en œuvre de procédures de validation défensive préalablement à toute instruction d’affichage graphique. Ces vérifications consistent à contrôler la conformité des formes vectorielles à l’aide d’instructions de confirmation ou d’assertions explicites vérifiant que la longueur du tableau transmis à s coïncide rigoureusement avec celle des tableaux des abscisses et des ordonnées. De plus, il est crucial d’aplatir systématiquement les matrices multidimensionnelles en vecteurs stricts à une seule dimension par l’entremise des fonctions d’aplatissement de NumPy pour neutraliser les dimensions résiduelles orphelines.
Un second écueil critique concerne la contamination du vecteur de taille par des types de données non numériques, tels que des chaînes de caractères orphelines ou des objets non convertibles, souvent générés lors d’une mauvaise interprétation des fichiers sources par les moteurs d’ingestion de données. L’injection d’un format textuel dans l’argument s paralyse le sous-système de calcul géométrique de Matplotlib. Il est impératif de contraindre le typage du conteneur de données vers un format de nombres flottants à double précision, tout en interceptant en amont les éventuelles valeurs manquantes pour les remplacer par des grandeurs nulles ou par la valeur minimale de l’échelle d’affichage.
11.2 Comportement du dimensionnement lors du zoom et du redimensionnement
Une source majeure d’incompréhension conceptuelle chez les praticiens concerne le comportement invariant des marqueurs vectoriels lors des manipulations interactives de la fenêtre d’affichage, notamment les opérations d’agrandissement spatial et de recadrage des axes cartésiens. Lorsqu’un utilisateur effectue un zoom avant sur une région spécifique d’un nuage de dispersion, les coordonnées spatiales des données se dilatent, augmentant l’espacement visuel entre les points. En revanche, le calibre volumétrique des marqueurs demeure rigoureusement immuable sur l’écran.
Cette invariance résulte de la séparation stricte opérée par Matplotlib entre les différents espaces de coordonnées. Les positions des observations sont calculées au sein de l’espace des données, soumis aux transformations projectives dynamiques régies par les limites cartésiennes des axes. À l’opposé, les dimensions géométriques assignées via le paramètre s ou le paramètre markersize sont nativement ancrées dans l’espace d’affichage ou l’espace typographique du canevas. Un marqueur configuré pour mesurer cent points carrés occupera invariablement cent points carrés sur le moniteur, que la fenêtre cartésienne englobe l’intégralité du domaine statistique ou se focalise sur une fraction infinitésimale de celui-ci.
Dans certaines applications d’ingénierie physique ou d’analyse territoriale, cette propriété standard constitue une limitation bloquante. Il est parfois requis que la taille du marqueur représente une entité physique réelle sur le plan cartésien, par exemple le rayon d’impact d’une antenne ou l’envergure spatiale d’une particule en mouvement, exigeant que le glyphe s’élargisse proportionnellement lors du zoom avant. Pour implémenter ce comportement spécifique, il devient nécessaire de délaisser la méthode scatter traditionnelle et de recourir à l’instanciation manuelle d’objets de type Patch ou Circle au sein d’une collection spécialisée de polygones. Les dimensions de ces primitives géométriques sont alors expressément déclarées en unités de données réelles, assurant un facteur d’échelle parfaitement solidaire du repère spatial cartésien.
12. Applications pratiques et études de cas empiriques
12.1 Visualisation de données multidimensionnelles en recherche empirique
L’application rigoureuse des concepts méthodologiques détaillés précédemment trouve une illustration canonique dans l’analyse macroéconomique et démographique internationale. Considérons l’exploration d’un corpus d’observations synthétisant les données socio-économiques mondiales contemporaines, au sein duquel chaque entité nationale est caractérisée par son produit intérieur brut par habitant, son espérance de vie globale, le volume brut de sa population résidente et sa région d’appartenance continentale. Cette étude de cas reproduit le paradigme visuel rendu célèbre par les présentations didactiques de Hans Rosling.
Dans ce contexte analytique, l’abscisse cartésienne est assignée au niveau de revenu moyen, généralement soumis à une compression logarithmique préalable pour respecter la distribution des richesses, tandis que l’ordonnée accueille la mesure continue de l’espérance de vie en années. L’identité continentale est traduite par un encodage catégoriel géré par l’argument de couleur c, couplé à une palette discrète et hautement contrastée. La variable démographique, dont l’amplitude oscille entre quelques dizaines de milliers d’habitants pour les micro-États insulaires et plus d’un milliard pour les géants continentaux, est projetée de manière ciblée au niveau du paramètre de surface s.
L’injection brute de la démographie aboutirait à une catastrophe sémiologique, rendant les puissances continentales omniprésentes au détriment de l’ensemble du tissu étatique mondial. L’analyste procède donc à une transformation par racine carrée pour stabiliser le rapport diamétral, suivie d’une normalisation Min-Max restreinte au sein d’un intervalle visuel borné entre trente et deux mille points typographiques carrés. Un coefficient de transparence modéré et une fine bordure sombre sont appliqués pour contenir les recouvrements massifs sur les régions émergentes. Le résultat graphique permet d’appréhender d’un seul regard les regroupements régionaux, la corrélation logarithmique positive entre développement économique et longévité, tout en restituant immédiatement le poids démographique relatif de chaque pôle de développement.
12.2 Visualisation de trajectoires et de séries temporelles pondérées
Un second champ d’application empirique de grande importance concerne la restitution de dynamiques cinétiques, telles que les trajectoires de particules, les déplacements écologiques d’animaux équipés de balises télémétriques, ou les séries temporelles bivariées issues d’indicateurs macroprudentiels. L’enjeu graphique réside ici dans la capacité à communiquer visuellement l’orientation du flux temporel et les accélérations locales le long d’un tracé sinueux sans saturer l’espace par des flèches directionnelles denses et disgracieuses.
Pour matérialiser l’écoulement chronologique de manière continue, l’analyste peut coupler le tracé de la trajectoire spatiale avec une modulation croissante et monotone de la taille des marqueurs disposés à chaque station d’enregistrement. Les premières étapes temporelles de l’expérience sont associées à des surfaces de marqueurs extrêmement réduites, tandis que la succession des pas de mesure s’accompagne d’une expansion volumétrique progressive et déterministe. Dès lors, le regard suit naturellement la trajectoire du plus petit point vers le plus volumineux, restituant la flèche du temps avec une clarté immédiate.
De surcroît, si la fréquence d’échantillonnage de la trajectoire est uniforme dans le temps, la proximité relative des centroïdes combinée à l’expansion surfacique révèle instantanément les régimes de vitesse et les phases de stationnarité : des marqueurs élargis et fortement superposés traduisent une immobilisation prolongée du système en un lieu circonscrit, tandis que des marqueurs nettement dissociés signalent une phase de translation cinétique rapide. Ce raffinement graphique, lorsqu’il est exécuté en stricte conformité avec les canons de la sémiologie graphique et les règles de mise à l’échelle rigoureuses exposées dans cet article, constitue un standard de communication scientifique parfaitement aligné sur les exigences de rigueur éditoriale des revues académiques internationales à comité de lecture.
Références
Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphic methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
Few, S. (2009). Now you see it: Simple visualization techniques for quantitative analysis. Analytics Press.
Flannery, J. J. (1971). The relative effectiveness of graduated circles in cartography. The Canadian Cartographer, 8(2), 96-109. https://doi.org/10.3138/J570-5374-3211-1N21
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
Stevens, S. S. (1957). On the psychophysical law. Psychological Review, 64(3), 153-181. https://doi.org/10.1037/h0046162
Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
Waskom, M. L. (2021). seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021