
La visualisation de données quantitatives continues constitue l’un des piliers fondamentaux de l’analyse exploratoire et de l’inférence statistique moderne. Dès lors qu’un chercheur, un ingénieur ou un analyste fait face à une collection d’observations empiriques non structurées, la première démarche analytique consiste invariablement à examiner la morphologie de la distribution sous-jacente. Cette morphologie — qu’elle révèle une symétrie idéale, une asymétrie positive prononcée, une bimodalité latente ou la présence de queues de distribution épaisses — dicte la validité des modèles paramétriques ultérieurs et oriente les choix méthodologiques fondamentaux. Dans cet écosystème, l’histogramme demeure la représentation graphique la plus intuitive et la plus universellement déployée. Pourtant, sous cette apparente simplicité opératoire se dissimule un processus complexe d’estimation non paramétrique de densité dont l’exactitude dépend d’un facteur hautement sensible : le partitionnement de l’espace des données en classes, communément appelées « bacs » ou bins.
Dans l’environnement de programmation scientifique Python, la bibliothèque Matplotlib s’est imposée comme le standard de facto pour la génération de graphiques publiables et rigoureux. Sa fonction phare, plt.hist() (ou son pendant orienté objet ax.hist()), fournit une interface puissante permettant de transformer un vecteur continu d’observations en une série d’intervalles discrets contigus surmontés de rectangles verticaux. Toutefois, l’utilisation naïve des paramètres par défaut de cet outil expose l’analyste à des illusions visuelles majeures. Un histogramme paramétré de manière inadéquate peut masquer des sous-populations cliniques distinctes, introduire des modes artificiels générés par le simple bruit d’échantillonnage, ou encore altérer dramatiquement l’évaluation visuelle de la variance d’un phénomène.
Le contrôle rigoureux de la taille, du nombre et de l’alignement des bacs ne relève donc pas d’une simple coquetterie esthétique, mais d’un impératif épistémologique et méthodologique. Cet article propose une exploration exhaustive, théorique et appliquée, des mécanismes de discrétisation offerts par Matplotlib. Des fondements mathématiques de l’erreur quadratique intégrée moyenne jusqu’aux implémentations vectorisées avancées avec NumPy, en passant par les règles heuristiques optimales et le traitement de données cliniques asymétriques, ce guide dresse le panorama complet des techniques indispensables pour maîtriser la granularité de vos histogrammes et garantir l’intégrité de vos interprétations scientifiques.
1. Fondements théoriques de la discrétisation et rôle des bacs dans la visualisation de données
1.1 Définition mathématique et conceptuelle du bac (bin)
Sur le plan mathématique, la construction d’un histogramme repose sur le partitionnement d’un ensemble compact ou semi-compact de la droite réelle $\mathbb{R}$, sur lequel se déploie une variable aléatoire continue $X$. Soit un échantillon de données unidimensionnelles $\mathcal{D} = {x_1, x_2, dots, x_N}$ issu d’une population parente gouvernée par une fonction de densité de probabilité inconnue $f(x)$. Le processus de discrétisation consiste à diviser le support observé de la variable en un ensemble ordonné de $K$ sous-intervalles mutuellement exclusifs et exhaustivement couvrants, désignés sous le terme de bacs (ou bins en anglais) :
$$B_k = [e_{k-1}, e_k) \quad \text{pour } k in {1, 2, dots, K}$$
où les grandeurs scalaires ${e_0, e_1, dots, e_K}$ représentent les limites ou frontières de classe (bin edges). Par construction axiomatique de la théorie des ensembles, ces intervalles vérifient l’absence de chevauchement :
$$B_j \cap B_k = \emptyset \quad \forall j \neq k$$
et leur union forme un recouvrement continu de l’étendue des données observées. Pour chaque bac $B_k$, on définit sa largeur intrinsèque par la différence géométrique $\Delta_k = e_k – e_{k-1}$, ainsi qu’un effectif empirique $n_k$ correspondant au nombre total d’observations tombant à l’intérieur des bornes de l’intervalle :
$$n_k = \sum_{i=1}^N \mathbb{I}(x_i in B_k)$$
où $\mathbb{I}$ désigne la fonction indicatrice standard. La relation entre la fréquence observée $n_k$, la largeur $\Delta_k$ et la hauteur de la barre graphique érigée au-dessus de $B_k$ constitue l’un des points de rupture conceptuels les plus fréquents dans l’analyse de données. Dans un histogramme de fréquences absolues, la hauteur correspond directement à $n_k$. En revanche, dès lors que l’on cherche à estimer la densité de probabilité sous-jacente, la hauteur $h_k$ de la barre doit impérativement être normalisée par la largeur du bac et la taille globale de l’échantillon :
$$h_k = \frac{n_k}{N \cdot \Delta_k}$$
Cette distinction met en exergue la divergence structurelle entre un diagramme en barres catégoriel (bar chart) et un histogramme continu. Le diagramme en barres représente des entités qualitatives discrètes, nominales ou ordinales, pour lesquelles la largeur des barres est purement conventionnelle et arbitraire, sans signification géométrique. Dans un histogramme, la surface de chaque rectangle représente la proportion de la masse de probabilité contenue dans l’intervalle considéré. Modifier arbitrairement la largeur sans ajuster la hauteur détruit instantanément la relation géométrique de proportionnalité, faussant irrémédiablement l’estimation de la fonction de densité $f(x)$.
1.2 Le compromis biais-variance dans le choix de la largeur des bacs
L’estimation non paramétrique de densité par histogramme est intimement régie par le dilemme universel du compromis biais-variance. La largeur de classe $\Delta$ (ou $h$ dans la littérature statistique anglo-saxonne) agit comme un paramètre de lissage qui gouverne l’équilibre entre la fidélité aux données observées et la généralisation à la loi de probabilité théorique génératrice.
Le phénomène de sous-lissage (under-smoothing) se produit lorsque la largeur des bacs est excessivement faible par rapport à la dispersion locale des observations. Dans cette configuration, le nombre de bacs $K$ devient disproportionnellement élevé, et chaque bac ne recueille qu’un nombre infime d’observations, souvent compris entre zéro et deux. L’histogramme qui en résulte présente une silhouette hautement déchiquetée, dominée par des fluctuations stochastiques aléatoires propres à l’échantillon fini plutôt que par la structure macroscopique de la population. Sur le plan statistique, le modèle souffre d’une variance excessive : deux échantillons indépendants tirés de la même loi généreront des histogrammes aux profils radicalement hétérogènes. Cette variabilité parasite masque les modes réels de la distribution et piège l’observateur dans l’interprétation d’artéfacts de mesure sans validité externe.
À l’opposé, le sur-lissage (over-smoothing) découle d’un partitionnement composé de bacs excessivement larges. Dans ce cas de figure, une portion substantielle de la dynamique distributionnelle est agrégée au sein d’un contingent restreint d’intervalles massifs. Si cette approche garantit une variance d’échantillonnage quasi nulle en stabilisant les fréquences d’un prélèvement à l’autre, elle introduit un biais systématique catastrophique. Les détails morphologiques fins, tels que l’asymétrie locale, l’aplatissement (kurtosis) ou la présence critique de distributions bimodales dissimulant deux sous-groupes fonctionnels distincts, sont totalement anéantis par l’effet d’écrasement spatial.
Afin de formaliser rigoureusement ce compromis, les statisticiens recourent au critère de l’Erreur Quadratique Intégrée Moyenne, couramment abrégée en MISE (Mean Integrated Squared Error). Pour un estimateur par histogramme $\hat{f}(x)$, la MISE s’exprime comme l’intégrale sur tout le support du carré de l’espérance de l’écart à la densité réelle :
$$\text{MISE}(\hat{f}) = \mathbb{E} \left[ \int_{-\infty}^{+\infty} (\hat{f}(x) – f(x))^2 , dx \right] = \int \text{Biais}^2(\hat{f}(x)) , dx + \int \text{Var}(\hat{f}(x)) , dx$$
L’analyse asymptotique démontre que pour une largeur de bac uniforme $\Delta$, le terme de biais intégré converge vers zéro à une vitesse d’ordre $\mathcal{O}(\Delta^2)$, tandis que la variance intégrée diverge à l’ordre $\mathcal{O}\left(\frac{1}{N\Delta}\right)$ lorsque $\Delta to 0$. L’optimisation globale de la MISE impose ainsi de trouver la racine d’une fonction dérivée où l’augmentation de la variance compense exactement la réduction du biais. Ce point d’inflexion conditionne la transition entre une représentation illusoire et une estimation scientifique valide.
1.3 Applications empiriques dans les sciences comportementales et psychologiques
L’impact de la discrétisation se manifeste avec une acuité particulière dans le domaine des sciences comportementales, cognitives et psychologiques. Dans ces disciplines, les grandeurs mesurées résultent fréquemment de processus neuronaux complexes dont les signatures distributionnelles constituent le cœur même des hypothèses scientifiques testées.
Considérons l’analyse des temps de réaction (TR) dans des paradigmes de décision lexicale ou de détection visuelle chronométrée. Les temps de réaction ne suivent pratiquement jamais une loi normale centrée et symétrique ; ils sont remarquablement bien modélisés par la distribution ex-gaussienne, issue de la convolution mathématique d’une loi gaussienne (représentant les étapes sensorielles et motrices périphériques) et d’une distribution exponentielle (reflétant les processus décisionnels centraux). Cette loi présente une longue queue positive vers les latences élevées. Un choix arbitraire de bacs trop larges dans Matplotlib écrase cette traîne asymptotique, masquant les variations subtiles induites par une charge cognitive expérimentale ou par des déficits attentionnels pathologiques. Inversement, des bacs excessivement fins créent des modes multiples et artificiels qui pourraient conduire le chercheur à postuler erronément l’existence de plusieurs sous-processus cognitifs séquentiels là où il n’existe qu’un unique mécanisme stochastique unimodal.
Un enjeu méthodologique analogue émerge lors de l’examen des scores psychométriques issus de questionnaires cliniques agrégés sur des échelles de type Likert (par exemple, le Beck Depression Inventory ou les sous-échelles d’anxiété du STAI). Bien que ces scores dérivent de réponses discrètes ordonnées, ils sont traités dans la pratique clinique et épidémiologique comme des approximations continues d’un trait latent sous-jacent. Si la taille du bac est fixée sans tenir compte de la métrique intrinsèque de l’instrument de mesure, des distorsions majeures peuvent survenir, telles que l’agrégation inégale de catégories de réponse ou le masquage des effets d’ancrage psychologique.
Enfin, le diagnostic visuel précis des « effets de plancher » (floor effects) et des « effets de plafond » (ceiling effects) dépend intimement de la résolution choisie. Dans les bilans neuropsychologiques évaluant des atteintes mnésiques ou exécutives, une accumulation anormale de sujets au score minimal ou maximal renseigne sur l’insensibilité du test à discriminer des altérations sévères ou des capacités préservées d’élite. Un histogramme doté de bacs trop larges englobera ces scores limites au sein d’intervalles plus vastes, neutralisant la capacité du clinicien à diagnostiquer l’inadéquation instrumentale du protocole évaluatif.
2. Architecture technique de la fonction plt.hist() dans Matplotlib
2.1 Anatomie de la méthode plt.hist() et paramètres clés
Au cœur de l’écosystème graphique de Matplotlib réside la fonction plt.hist(), encapsulée au niveau le plus fondamental au sein de la classe matplotlib.axes.Axes.hist(). Cette méthode prend en charge à la fois le calcul mathématique de la discrétisation et l’instanciation des éléments vectoriels de bas niveau nécessaires au rendu visuel. L’architecture de cette commande repose sur une structure de paramètres hautement paramétrables, dont le rôle et la nature doivent être parfaitement appréhendés par l’analyste.
Le paramètre déterminant le découpage de l’axe réel est l’argument formel bins. Cet argument se caractérise par une remarquable polyvalence polymorphique, acceptant trois grandes catégories de types de données :
- Un entier strictement positif ($k in \mathbb{N}^*$) : Spécifie le nombre total de bacs à générer uniformément entre les valeurs extrêmes de l’échantillon ou de la plage définie.
- Une séquence numérique ordonnée (liste Python, tableau unidimensionnel
numpy.ndarray) : Définit de façon explicite la totalité des bornes de séparation $[e_0, e_1, dots, e_K]$. Cette approche autorise tant les pas uniformes que les découpages à largeur variable. - Une chaîne de caractères (string) : Active un algorithme automatisé de sélection de la taille des bacs pris en charge nativement par le moteur sous-jacent de NumPy (tels que
'auto','fd','scott','sturges','doane', etc.).
L’exécution de la méthode plt.hist() ne se limite pas à la génération d’un tracé statique sur le canevas ; elle procède au calcul analytique et retourne un triplet de structures de données extrêmement utile pour le contrôle programmatique ultérieur :
$$\text{Sortie} = (n, \text{bins}, \text{patches})$$
Le premier élément, $n$, correspond à un tableau NumPy unidimensionnel (ou une liste de tableaux dans le cas de séries multiples superposées) contenant les décomptes scalaires ou les valeurs de densité calculées pour chaque intervalle. Le deuxième élément, $\text{bins}$, est un tableau de dimension $K+1$ listant de façon exhaustive les coordonnées cartésiennes de toutes les frontières d’intervalles. Le troisième élément, $\text{patches}$, est une collection ordonnée d’objets graphiques de type matplotlib.patches.Rectangle (ou Polygon selon le type d’affichage). Ces conteneurs graphiques encapsulent les attributs visuels de chaque barre individuelle, incluant leur couleur de remplissage, leur transparence, leur motif de hachure et la géométrie exacte de leur contour.
La morphologie des hauteurs calculées dans le vecteur $n$ est intimement modulée par trois paramètres auxiliaires cruciaux : range, density et weights. Le paramètre range, attendant un tuple de deux réels (min, max), contraint le calcul de la discrétisation à une fenêtre spatiale bornée, rejetant temporairement les observations extérieures. Le paramètre booléen density, lorsqu’il est instancié à True, ordonne la division mathématique des fréquences de manière à ce que la somme des surfaces des rectangles soit strictement égale à l’unité ($\sum_{k=1}^K n_k \Delta_k = 1$). Enfin, l’argument weights permet d’assigner à chaque point de données un coefficient scalaire d’importance statistique, modifiant la sommation indicatrice au profit d’une somme pondérée, mécanisme indispensable pour l’analyse d’échantillons stratifiés ou l’ajustement de données de sondage pondérées.
2.2 Le comportement par défaut de Matplotlib
D’un point de vue historique et architectural, le comportement par défaut de Matplotlib a fait l’objet d’évolutions significatives. Pendant de nombreuses années, jusqu’aux versions de la branche 1.x, Matplotlib appliquait une heuristique universelle immuable : l’attribution d’un nombre fixe de dix bacs (bins=10) d’égale largeur, couvrant l’amplitude totale observée de l’échantillon, définie par $[\min(\mathcal{D}), \max(\mathcal{D})]$. Cette approche arbitraire, calquée sur des standards historiques hérités d’anciennes versions de MATLAB, présentait des faiblesses statistiques évidentes, conduisant quasi systématiquement à un sur-lissage catastrophique sur des cohortes massives, ou à un sous-lissage aberrant sur des micro-échantillons de moins de vingt observations.
À partir de la version 2.0 de Matplotlib, une refonte substantielle a été opérée afin de converger vers les conventions analytiques modernes. Bien que la valeur par défaut de l’argument formel bins soit restée fixée à l’entier 10 dans la signature de base pour des raisons impérieuses de compatibilité ascendante, l’architecture a été profondément interconnectée avec les estimateurs dynamiques de la bibliothèque NumPy. Ainsi, lorsque le paramètre bins est omis dans les interfaces de haut niveau ou explicitement configuré sur 'auto', le système délègue le calcul optimal de partitionnement au moteur statistique de NumPy via la méthode interne numpy.histogram_bin_edges().
Un aspect fondamental de la mécanique interne concerne la gestion des valeurs minimales et maximales par rapport aux bornes extérieures. Par convention algorithmique dans Matplotlib, les intervalles sont fermés à gauche et ouverts à droite :
$$B_k = [e_{k-1}, e_k) \quad \forall k in {1, 2, dots, K-1}$$
Cependant, pour garantir l’inclusion intégrale de la valeur maximale observée $x_{\max} = \max(\mathcal{D})$ sans exiger la création d’un bac infinitésimal supplémentaire, le tout dernier bac de la série déroge à cette convention et adopte un intervalle fermé des deux côtés :
$$B_K = [e_{K-1}, e_K]$$
Cette asymétrie de fermeture est essentielle à connaître lorsque des données discrètes ou semi-discrètes touchent exactement les frontières théoriques, sous peine de commettre des erreurs d’interprétation sur la localisation exacte des observations extrêmes.
3. Méthode 1 : Définition explicite du nombre entier de bacs
3.1 Syntaxe fondamentale avec un argument entier
L’approche la plus élémentaire pour moduler la granularité d’un histogramme consiste à fournir un entier scalaire $k$ à l’argument bins. La syntaxe opérationnelle s’énonce simplement sous la forme plt.hist(data, bins=k), où $k in \mathbb{N}^*$.
Dès la réception de cet argument scalaire, l’algorithme sous-jacent de Matplotlib détermine l’étendue globale des données par l’évaluation des valeurs extrêmes observées, notées $x_{\min} = \min(data)$ et $x_{\max} = \max(data)$ (ou bornées par le paramètre optionnel range si celui-ci est fourni). L’espace continu délimité par l’intervalle fermé $[x_{\min}, x_{\max}]$ est alors scindé de manière déterministe en $k$ sous-intervalles de largeur parfaitement uniforme $\Delta$, calculée selon la formule :
$$\Delta = \frac{x_{\max} – x_{\min}}{k}$$
Les coordonnées vectorielles des $k+1$ limites de bacs résultantes sont ensuite générées de manière séquentielle par la suite arithmétique :
$$e_i = x_{\min} + i \cdot \Delta \quad \text{pour } i in {0, 1, dots, k}$$
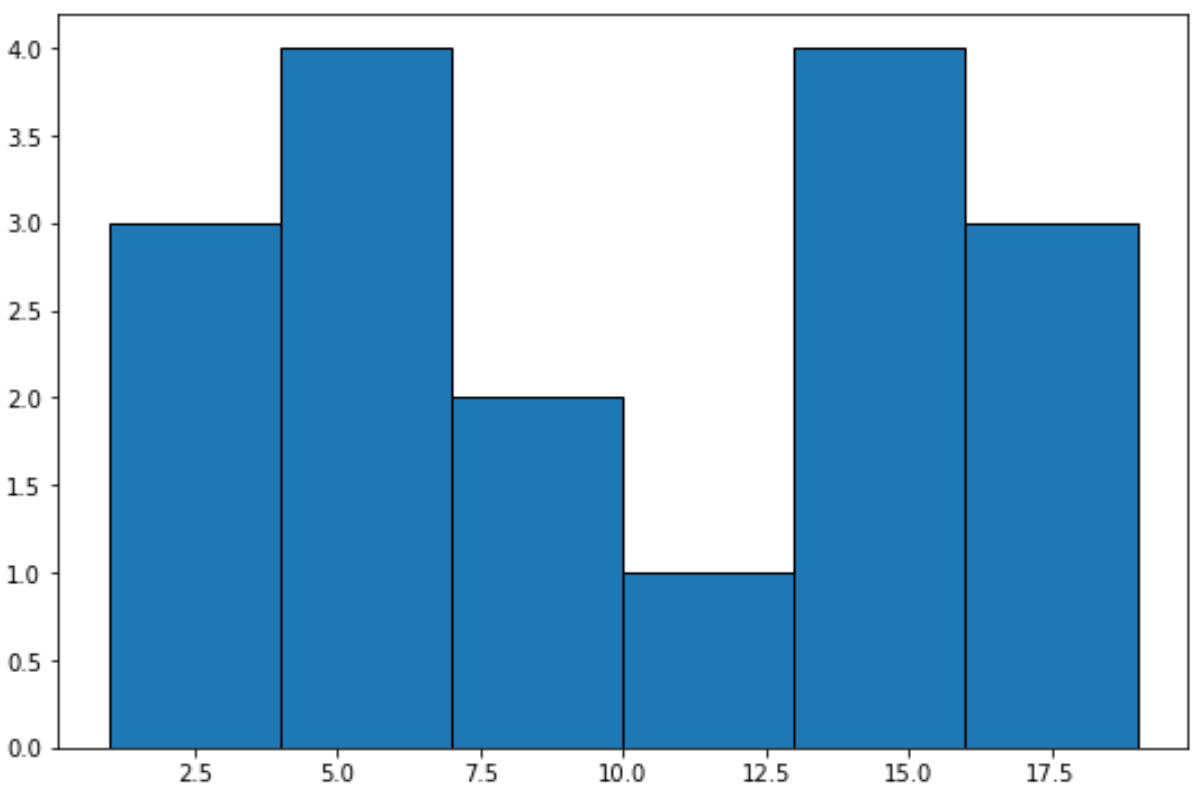
Pour illustrer ce mécanisme avec un cas concret, considérons une série expérimentale restreinte d’évaluation cognitive comprenant dix observations : ${12, 14, 15, 18, 19, 21, 22, 25, 28, 32}$. L’amplitude totale observée est ici de $32 – 12 = 20$. Si l’analyste spécifie délibérément bins=4, la largeur de chaque sous-intervalle sera de $\Delta = 20 / 4 = 5.0$. Les limites de bacs générées seront ainsi positionnées aux valeurs $[12.0, 17.0, 22.0, 27.0, 32.0]$. Les observations sont alors réparties mécaniquement dans ces quatre compartiments : trois points dans $[12, 17)$, quatre points dans $[17, 22)$, deux points dans $[22, 27)$, et un point dans $[27, 32]$.
L’incrémentation successive de la valeur entière $k$ produit un raffinement visuel progressif de la morphologie de la distribution. En augmentant $k$, on passe progressivement d’une vision synthétique et globale à une représentation détaillée des micro-variations de l’échantillon. Toutefois, cette augmentation mécanique doit être manipulée avec précaution pour éviter d’atteindre le seuil critique de sous-lissage mentionné précédemment.
3.2 Délimitation du contour avec l’argument edgecolor
Un écueil ergonomique et perceptif récurrent lors de l’utilisation de Matplotlib découle de la politique d’affichage graphique par défaut des barres de l’histogramme. Par défaut, les rectangles contigus sont dessinés avec une couleur de fond monochrome (le traditionnel bleu acier tab:blue) sans aucune ligne de séparation périphérique, ou avec une bordure de couleur identique au corps du polygone. Dès lors que deux bacs consécutifs possèdent des hauteurs similaires ou que l’histogramme présente une séquence continue de barres de même niveau, la discrimination visuelle des frontières de classe devient impossible pour l’œil humain.
Pour restaurer l’intégrité sémiologique de la représentation, il est fortement recommandé d’utiliser systématiquement l’argument formel edgecolor (pouvant être abrégé en ec), combiné de manière optimale avec l’épaisseur de ligne linewidth (ou lw). L’inclusion explicite de edgecolor='black' (ou d’une nuance de gris sombre comme edgecolor='#333333') permet de tracer une démarcation nette et contrastée entre chaque intervalle :
Cette délimitation typographique procure des avantages analytiques immédiats. Premièrement, elle permet d’identifier sans ambiguïté l’existence de bacs d’effectif nul ($n_k = 0$). Dans une distribution continue sans bordures visibles, un bac vide se traduit par un espace vierge sur l’axe horizontal que le système perceptif humain tend naturellement à interpréter comme un saut d’échelle ou un artefact d’alignement plutôt que comme une classe de fréquence zéro. Deuxièmement, la délimitation graphique souligne la régularité ou l’irrégularité du maillage, facilitant la comparaison de la densité relative entre classes adjacentes.
3.3 Limites et approximations de l’attribution d’un entier fixe
Bien que l’assignation d’un entier fixe $k$ constitue une démarche rapide et intuitive pour l’exploration superficielle, elle souffre de limitations mathématiques et pratiques majeures dès lors que la rigueur de publication est exigée. La première faiblesse structurelle réside dans le fait que l’algorithme sous-jacent ignore superbement la sémantique de l’unité de mesure. En divisant aveuglément l’amplitude $x_{\max} – x_{\min}$ par $k$, les limites résultantes $e_i$ correspondent presque toujours à des nombres décimaux irrationnels ou dotés de longues traînes flottantes. Par exemple, diviser une amplitude d’âge de 18 à 65 ans par 7 bacs génère des classes d’une largeur de $6.71428…$ années, positionnant les frontières à $24.71, 31.42, 38.14…$ ans, ce qui s’avère totalement inexploitable sur le plan interprétatif.
Ce phénomène s’avère particulièrement préjudiciable lors de l’analyse de variables discrètes prenant des valeurs entières strictes, comme le nombre d’erreurs commises à une tâche, le nombre d’enfants par foyer, ou le score obtenu à une épreuve cognitive brève. Lorsque des unités insécables sont découpées par des largeurs de bacs décimales arbitraires, certains bacs finissent par englober deux valeurs entières possibles (par exemple, les scores 3 et 4) tandis que d’autres bacs adjacents n’en englobent qu’une seule (par exemple, le score 5). Il en résulte une distorsion dramatique sous forme d’un profil en « peigne » ou d’artéfacts en dents de scie où l’alternance des hauteurs de barres ne traduit pas une propriété de la distribution sous-jacente, mais simplement une incohérence arithmétique de la discrétisation.
Enfin, l’attribution d’un entier fixe est excessivement sensible à la présence de valeurs aberrantes (outliers). Si un échantillon contient une unique valeur extrême située à plusieurs écarts-types de la masse centrale, l’amplitude $x_{\max} – x_{\min}$ est démesurément étirée. Avec un $k$ constant, cet étirement force l’élargissement de tous les bacs, provoquant un sur-lissage involontaire et dévastateur de la zone centrale d’intérêt où se concentre la quasi-totalité des effectifs.
4. Méthode 2 : Définition explicite des bornes d’intervalles par liste ou séquence
4.1 Syntaxe par vecteur de coordonnées limites
Pour pallier intégralement les approximations de l’entier fixe et reprendre le contrôle rigoureux du maillage, l’architecture de Matplotlib autorise la transmission directe d’une séquence numérique ordonnée à l’argument bins. La syntaxe fondamentale prend alors la forme d’un conteneur vectoriel :
$$\text{bins} = [e_0, e_1, e_2, dots, e_n]$$
Dans ce paradigme de paramétrage, l’utilisateur spécifie non pas le nombre total de bacs, mais l’ensemble complet et exhaustif de leurs coordonnées limites. Dès lors, si la séquence transmise comprend $n+1$ éléments scalaires ordonnés, Matplotlib construira exactement $n$ rectangles graphiques sur l’axe des abscisses. La condition fondamentale d’intégrité exige que le vecteur soit strictement monotone croissant :
$$e_0 < e_1 < e_2 < dots < e_n$$
L’introduction d’un vecteur non trié provoquera invariablement la levée d’une exception de type ValueError par le moteur de validation de Matplotlib.
Cette approche manuelle permet d’adapter parfaitement les coupures de l’histogramme à des seuils cliniques normalisés, à des découpages réglementaires ou à des constantes théoriques reconnues. Par exemple, lors de l’étude de l’Indice de Masse Corporelle (IMC), les frontières de classification de l’Organisation Mondiale de la Santé ne reposent pas sur des divisions équidistantes abstraites, mais sur des coupures catégorielles fonctionnelles : sous-poids ($< 18.5$), corpulence normale ($[18.5, 25)$), surpoids ($[25, 30)$), obésité modérée ($[30, 35)$) et obésité sévère ($[35, 40]$). En transmettant la liste explicite bins=[15, 18.5, 25, 30, 35, 40], l’analyste fait correspondre chaque barre de l’histogramme à une entité nosologique directement interprétable.
La convention de fermeture des intervalles est pilotée par le paramètre optionnel right de la fonction plt.hist(), qui prend par défaut la valeur False (c’est-à-dire des intervalles de type semi-ouvert $[e_{k-1}, e_k)$ avec inclusion de la limite inférieure). En configurant right=True, l’utilisateur inverse cette logique mathématique pour adopter des intervalles fermés à droite et ouverts à gauche :
$$B_k = (e_{k-1}, e_k] \quad \text{pour } k in {2, dots, n}$$
le premier bac de la séquence devenant alors exceptionnellement fermé des deux côtés ($B_1 = [e_0, e_1]$) afin d’inclure rigoureusement la valeur minimale.
4.2 Création de bacs uniformes à l’aide de structures Python natives
Lorsque l’objectif est d’obtenir des bacs de largeur parfaitement constante alignés sur des valeurs entières significatives sans recourir à des bibliothèques externes, les structures génératrices natives du langage Python, en particulier la fonction range(), offrent une solution élégante et légère.
La fonction native range(start, stop, step) produit une séquence immuable d’entiers réguliers. Dans le contexte de l’alimentation du paramètre bins de Matplotlib, cette structure présente l’avantage d’éliminer toute imprécision liée à l’arithmétique flottante pour les variables discrètes. Considérons le cas d’une épreuve chronométrée standardisée où les scores bruts sont distribués entre 0 et 100 points, et pour laquelle le protocole scientifique impose une granularité par tranches de 10 points. Le vecteur de bornes est immédiatement généré et transmis de la manière suivante :
Une vigilance technique absolue s’impose quant à la borne de fermeture de la fonction range(). Par définition intrinsèque à la conception de Python, l’argument stop est exclusif. Par conséquent, pour créer un histogramme couvrant une variable susceptible d’atteindre la valeur 100 avec un pas de 10, l’argument d’arrêt doit être paramétré à 101 (ou toute valeur strictement comprise entre 100 et 110). Si l’on programmait par inadvertance range(0, 100, 10), le dernier élément du vecteur de bornes serait 90. Toutes les observations empiriques comprises entre 90 et 100 seraient alors irrémédiablement tronquées et rejetées hors de la visualisation.
L’utilisation conjointe de min() et max() couplés aux fonctions mathématiques d’arrondi math.floor() et math.ceil() permet de concevoir des générateurs de bornes automatiques garantissant la couverture intégrale du spectre empirique :
4.3 Isolation et exclusion ciblée de plages de données
L’un des comportements les plus puissants — mais également les plus risqués — de la spécification de bornes explicites réside dans la gestion implicite des données situées hors-cadre. Contrairement à d’autres outils statistiques qui étendent automatiquement les limites pour englober toutes les données fournies, Matplotlib applique un principe de filtrage géométrique strict lorsque des bornes explicites sont fournies.
Soit un vecteur de bornes $\text{bins} = [e_0, e_1, dots, e_n]$. Toute observation empirique $x_i$ appartenant au jeu de données $\mathcal{D}$ telle que :
$$x_i e_n$$
est purement et simplement exclue du calcul des fréquences et de la représentation graphique. L’observation ne fait l’objet d’aucun message d’erreur, ni d’aucun avertissement (warning) dans la console d’exécution : elle disparaît silencieusement de la visualisation.
Cette propriété offre un outil particulièrement commode pour isoler délibérément le « cœur » d’une distribution sans devoir préalablement créer une copie tronquée du tableau de données en mémoire vive. Par exemple, si une distribution de latences comportementales s’étend de 150 ms à plusieurs dizaines de secondes en raison d’inattentions passagères de quelques sujets, restreindre l’observation à la fenêtre physiologique d’intérêt clinique en fixant bins=np.arange(150, 1050, 50) permet de zoomer instantanément sur l’intervalle $[150, 1000]$ ms, les valeurs au-delà de 1000 ms étant automatiquement neutralisées.
Toutefois, cette commodité technique engage la responsabilité méthodologique du chercheur. Omettre de déclarer dans une publication que des valeurs extrêmes ont été tronquées visuellement constitue une faute d’intégrité scientifique majeure. De surcroît, si le paramètre density=True est activé conjointement avec un vecteur de bornes restreint, la normalisation de la densité s’effectuera uniquement sur le sous-ensemble des données incluses entre $e_0$ et $e_n$. L’intégrale de la zone visible sera bien égale à 1, mais elle ne représentera plus la véritable densité de probabilité de l’ensemble de l’échantillon initial, surestimant mécaniquement la probabilité relative de la région centrale.
5. Méthode 3 : Contrôle précis de la largeur exacte des bacs avec NumPy
5.1 Formulation mathématique via np.arange()
Dans la pratique scientifique rigoureuse, l’exigence méthodologique ne s’exprime que très rarement en termes de « nombre total de rectangles » à répartir sur le canevas. Elle s’énonce presque systématiquement en termes de « largeur de classe constante » possédant une signification physique, biologique ou psychologique immédiate : par exemple, des tranches exactes de 100 millisecondes, des paliers de 5 points de QI, ou des segments d’âge de 5 années pleines. La formulation mathématique idéale requiert donc de piloter directement la grandeur scalaire $\Delta$.
L’instrument privilégié pour implémenter ce contrôle direct sous l’environnement scientifique Python est la fonction numpy.arange(). La syntaxe générale pour générer la grille de discrétisation s’énonce comme suit :
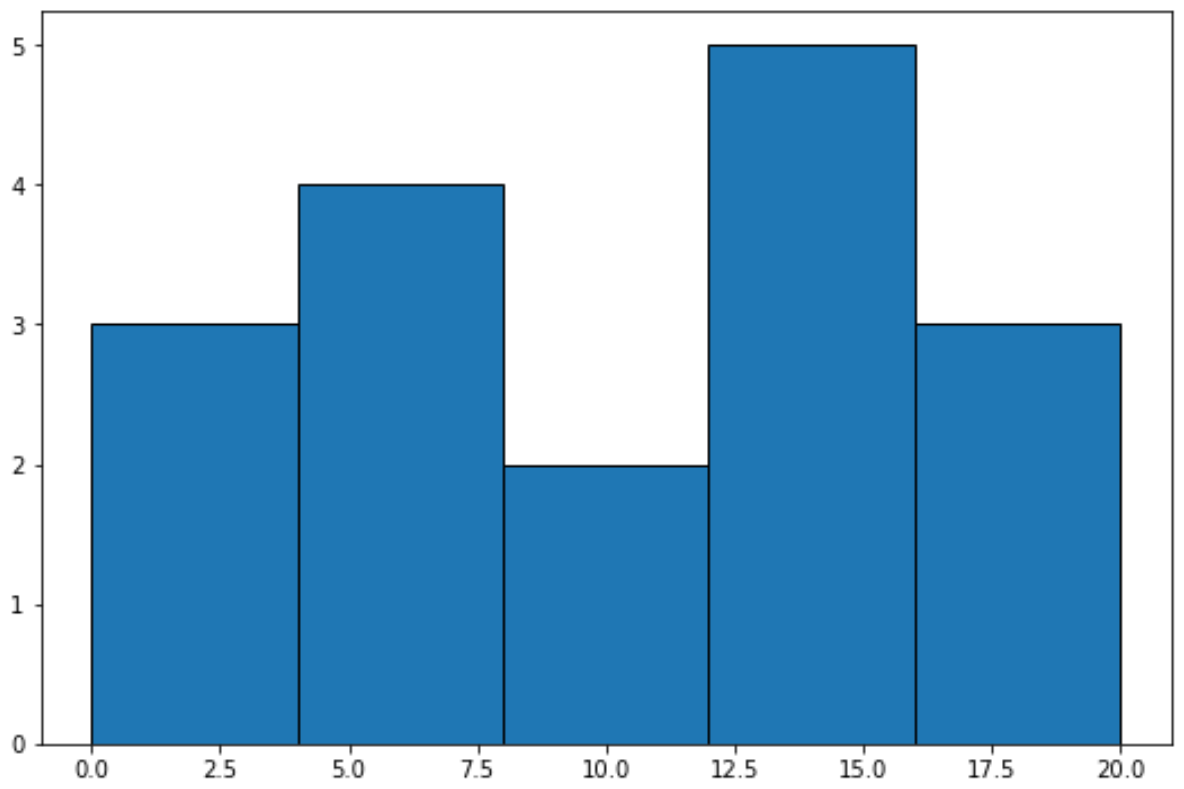
L’attention du programmeur doit se concentrer impérativement sur le second argument de la fonction : val_max + largeur_bac. Tout comme la fonction native range(), np.arange() applique une exclusion stricte de son argument d’arrêt (stop). Par conséquent, si l’on spécifie simplement np.arange(val_min, val_max, largeur_bac), et que l’étendue $val_{\max} – val_{\min}$ s’avère être un multiple exact de la largeur $\Delta$, la coordonnée $val_{\max}$ ne figurera pas dans le tableau résultant. Le dernier sous-intervalle calculé s’arrêtera à $val_{\max} – \Delta$. Il s’ensuit que l’observation maximale présente dans l’échantillon sera évincée de l’histogramme en raison du mécanisme d’exclusion décrit au paragraphe précédent.
L’ajout explicite du terme $+\Delta$ (ou d’une marge fractionnaire $\Delta + \epsilon$) au point d’arrêt garantit que la borne supérieure finale soit rigoureusement supérieure ou égale à la valeur maximale observée. Cette construction confère une reproductibilité absolue aux analyses comparatives : en fixant $\Delta$ à une constante invariante pour différentes cohortes ou différentes conditions expérimentales, l’analyste élimine tout biais d’échelle lié aux fluctuations de taille d’échantillon.
5.2 Alternative avec np.linspace() pour des subdivisions régulières
Bien que np.arange() constitue la méthode la plus naturelle pour fixer la largeur $\Delta$, la fonction numpy.linspace() représente une alternative analytique puissante fondée sur une logique complémentaire : le contrôle rigoureux du nombre total de points d’évaluation sur un segment continu prédéfini $[a, b]$.
La signature de cette fonction, numpy.linspace(start, stop, num), prend en charge la génération d’un tableau unidimensionnel de $num$ valeurs équidistantes débutant exactement à $start$ et se terminant exactement à $stop$ (l’argument optionnel endpoint=True étant actif par défaut). La distinction conceptuelle majeure par rapport à np.arange() réside dans le statut des paramètres :
- Avec
np.arange(), la largeur $\Delta$ est fixée de manière rigide, tandis que le nombre final de bacs est une variable dépendante de l’amplitude globale. - Avec
np.linspace(), le nombre d’intervalles $K = num – 1$ et les bornes extrêmes absolues sont rigidement verrouillés, tandis que la largeur effective de chaque bac est calculée automatiquement par division : $\Delta = \frac{stop – start}{num – 1}$.
Un avantage technique décisif de np.linspace() réside dans sa totale immunité contre les anomalies arithmétiques de la virgule flottante qui affectent parfois np.arange(). Dans la norme IEEE 754 régissant les calculs flottants sur microprocesseur, l’accumulation récursive d’un pas décimal comme $0.1$ ou $0.01$ engendre de légères imprécisions d’arrondi binaire. Ces micro-résidus peuvent amener np.arange() à inclure ou exclure de façon imprévisible le dernier élément d’un vecteur selon que l’arrondi excède ou non la borne de coupure. La fonction np.linspace(), en calculant chaque coordonnée par interpolation linéaire directe :
$$e_i = a + i \cdot \left(\frac{b – a}{num – 1}\right)$$
échappe à cette dérive cumulative et garantit un positionnement rigoureux des frontières extrêmes.
5.3 Gestion des pas décimaux et des micro-intervalles
L’exploration de données physiologiques, électrophysiologiques ou neuro-imageriques (telles que les latences de potentiels évoqués visuels ou les durées d’ondes cérébrales sur tracé EEG) requiert fréquemment l’analyse de signaux variant sur des micro-intervalles temporels, imposant des largeurs de bacs fractionnaires d’ordre décimal ou millimétrique (par exemple, $\Delta = 0.05$ s ou $\Delta = 0.001$ s).
Dans ce contexte à haute résolution, plusieurs précautions méthodologiques doivent être scrupuleusement respectées :
D’une part, la dérive arithmétique binaire doit être activement neutralisée. Pour concevoir une série de bacs décimaux sans fluctuation marginale imprévue, il est souvent préférable de construire la séquence sur une échelle d’entiers redimensionnée, puis de diviser l’ensemble du vecteur par le facteur d’échelle correspondant. Par exemple, pour obtenir des bacs de $0.05$ s s’étendant de $0.0$ s à $2.0$ s, l’écriture vectorielle :
fournit une précision numérique rigoureuse exempte de tout artéfact résiduel.
D’autre part, lorsque la densité de rectangles devient excessivement dense sur le graphique (plusieurs centaines de bacs sur une largeur d’axe restreinte), le rendu visuel peut être totalement oblitéré par l’épaisseur des bordures. Si l’argument edgecolor='black' est conservé avec sa largeur de ligne par défaut (généralement 1 pixel), la surface globale de l’histogramme apparaîtra comme une masse sombre informe où les lignes de contour finissent par recouvrir entièrement les couleurs de remplissage. Dans ces configurations de micro-intervalles, il devient impératif soit de désactiver la bordure (edgecolor='none'), soit de réduire son épaisseur à des valeurs sub-pixel (linewidth=0.3), soit de basculer vers un mode de tracé filaire continu à l’aide de l’argument histtype='step' ou histtype='stepfilled'.
6. Sélection algorithmique automatisée de la taille des bacs
6.1 La règle de Sturges et ses limites
L’automatisation du calcul du nombre de bacs constitue un champ d’investigation statistique ancien. La méthode la plus universellement répandue — et paradoxalement la plus critiquée de la littérature contemporaine — est la célèbre règle formulée par Herbert Sturges en 1926. Conçue à une époque où le calcul manuel imposait des contraintes sévères, la formulation de Sturges repose sur la modélisation d’une distribution symétrique par le développement des coefficients binomiaux issus du triangle de Pascal. Pour un échantillon de taille $N$, le nombre idéal de bacs $k$ est donné par l’équation :
$$k = \lceil 1 + \log_2(N) \rceil = \lceil 1 + 3.322 \cdot \log_{10}(N) \rceil$$
La règle de Sturges s’active dans Matplotlib via l’argument bins='sturges'.
Bien que cette équation fournisse une approximation commode pour des cohortes de taille très modeste ($N < 200$) issues de populations distribuées de façon strictement gaussienne, elle présente des défaillances structurelles majeures dès que ces conditions idéales ne sont plus satisfaites. Son premier défaut rédhibitoire concerne sa convergence logarithmique extrêmement lente face aux grands échantillons. Par exemple, pour une base de données moderne de $N = 10,000$ observations, la règle de Sturges ne propose que 15 bacs ; pour $N = 1,000,000$ d'observations, elle ne prescrit que 21 bacs. Cette stagnation du découpage engendre un phénomène massif et systématique de sur-lissage, anéantissant l'immense gain de précision et de résolution que permettrait normalement un grand échantillon.
Le second écueil réside dans son inaptitude totale à appréhender les distributions asymétriques ou plurimodales. La dérivation mathématique de Sturges supposant implicitement une forme binomiale parfaitement symétrique, son application à des distributions dotées d’une asymétrie marquée (telles que des lois log-normales ou des lois de Pareto) conduit à une sous-estimation dramatique du nombre de bacs requis pour résoudre correctement la région du mode.
6.2 La règle de Scott : Prise en compte de la variance de l’échantillon
Afin de pallier les insuffisances théoriques de la formule de Sturges, le statisticien David Scott a proposé en 1979 une dérivation asymptotique rigoureuse fondée sur la minimisation formelle de l’erreur quadratique intégrée moyenne (MISE). En postulant que la distribution sous-jacente continue $f(x)$ est une densité normale théorique de variance $\sigma^2$, Scott démontre mathématiquement que la largeur optimale de bac $\Delta^*$ obéit à la relation de proportionnalité :
$$\Delta^* = \frac{3.49 \cdot s}{N^{1/3}}$$
où $s$ représente l’estimateur sans biais de l’écart-type de l’échantillon empirique :
$$s = \sqrt{\frac{1}{N-1}\sum_{i=1}^N (x_i – \bar{x})^2}$$
La règle de Scott s’exécute directement dans Matplotlib par le passage de l’argument bins='scott'.
L’apport de cette formulation est substantiel. Contrairement à la règle de Sturges, la largeur de bac rétrécit ici en proportion de $N^{-1/3}$, assurant que le nombre total de bacs croît à l’ordre $\mathcal{O}(N^{1/3})$. Cette dynamique garantit une véritable convergence asymptotique : plus la puissance de l’échantillonnage s’accroît, plus l’histogramme affine sa résolution pour révéler des détails structurels fins, tout en préservant le contrôle de la variance d’estimation.
Cependant, la vulnérabilité de la méthode de Scott se situe dans sa dépendance directe envers l’écart-type empirique $s$. L’écart-type constitue une métrique de dispersion notoirement non-robuste, dont la valeur peut être disproportionnellement dilatée par la présence d’une seule donnée aberrante dans l’échantillon. En cas de contamination sévère par des valeurs extrêmes, $s$ augmente artificiellement, entraînant un élargissement indu de $\Delta^*$ et, par voie de conséquence, un sur-lissage non désiré du cœur de la distribution.
6.3 La règle de Freedman-Diaconis : Robustesse aux valeurs aberrantes
Pour immuniser l’estimation optimale de la largeur de bac contre la sensibilité aux valeurs aberrantes, David Freedman et Persi Diaconis ont publié en 1981 une amélioration majeure de la règle de Scott. La règle de Freedman-Diaconis substitue à l’écart-type classique une statistique d’ordre robuste : l’écart interquartile (Interquartile Range ou IQR), défini par la différence entre le troisième quartile ($Q_3$, 75e centile) et le premier quartile ($Q_1$, 25e centile) :
$$\text{IQR} = Q_3 – Q_1$$
La largeur optimale du bac selon Freedman-Diaconis est alors formulée comme suit :
$$\Delta_{\text{FD}} = \frac{2 \cdot \text{IQR}(X)}{N^{1/3}}$$
Cette règle heuristique est appelée nativement dans Matplotlib par le biais de la chaîne bins='fd'.
La robustesse mathématique de cet estimateur est considérable. L’écart interquartile possède un point de rupture (breakdown point) de 25 %, ce qui signifie qu’un quart des observations de l’échantillon peuvent être arbitrairement altérées ou projetées à l’infini sans que la valeur de l’IQR ne subisse d’explosion asymptotique. Ainsi, en présence de queues de distribution extrêmement allongées, de processus de mesure bruités ou de données asymétriques lourdes (très courantes en psychologie et en neurosciences computationnelles), la règle de Freedman-Diaconis conserve un maillage parfaitement ajusté à la zone centrale de forte densité, ignorant les distorsions provoquées par les valeurs périphériques.
Pour cette raison, la règle de Freedman-Diaconis est quasi universellement considérée par la communauté statistique appliquée comme le choix algorithmique automatisé par défaut le plus fiable et le plus sécurisant pour des variables continues non strictement gaussiennes.
6.4 Algorithmes spécialisés : Knuth, Wand et Auto
Au-delà des trois grands classiques, l’écosystème NumPy/Matplotlib intègre d’autres paradigmes algorithmiques raffinés. Le plus notable est le sélecteur adaptatif bins='auto'. Loin de correspondre à une heuristique rigide unique, le mode 'auto' applique une logique de sélection conditionnelle fondée sur un arbitrage entre Freedman-Diaconis et Sturges :
$$\Delta_{\text{auto}} = \begin{\cases} \Delta_{\text{FD}} &a\mp; \text{si } \text{IQR}(X) > 0 \text{ et } N ge 100 \Delta_{\text{Sturges}} &a\mp; \text{dans le cas contraire} \end{\cases}$$
Le basculement vers la règle de Sturges s’avère indispensable lorsque l’écart interquartile s’effondre à zéro. Cette anomalie statistique se produit couramment sur des données fortement discrétisées ou caractérisées par une concentration massive de plus de 50 % des observations sur une valeur identique : dans ce cas, $Q_1$ et $Q_3$ coïncident, ce qui annulerait l’IQR et entraînerait une division par zéro dans la formule de Freedman-Diaconis. Le sélecteur 'auto' gère cette contingence en basculant automatiquement vers une heuristique alternative stable.
Dans la littérature computationnelle avancée, d’autres approches méritent d’être signalées, bien qu’elles exigent des bibliothèques tierces (telles que Astropy) pour être directement déployées :
- La règle bayésienne de Knuth (Knuth’s Rule) : Formulée par Kevin Knuth en 2006, cette approche traite l’optimisation des bacs comme un problème d’inférence bayésienne non paramétrique. Elle calcule la probabilité a posteriori du nombre de bacs en supposant une vraisemblance multinomiale combinée à une loi a priori non informative de Dirichlet, optimisant l’histogramme par maximisation de l’évidence du modèle.
- L’estimateur de Wand (Wand’s Plug-in Rule) : Développé par Matt Wand en 1997, cet algorithme utilise des méthodes dites « plug-in » d’ordre supérieur basées sur l’estimation non paramétrique des dérivées fonctionnelles de la densité sous-jacente, éliminant ainsi toute hypothèse préalable de normalité même sur des distributions à modes multiples complexes.
7. Gestion des bacs à largeur variable (non uniforme)
7.1 Construction d’intervalles non équidistants
L’ensemble des développements précédents reposait sur le postulat implicite d’une discrétisation uniforme où chaque bac partage rigoureusement la même largeur spatiale $\Delta$. Cependant, une telle régularité géométrique s’avère profondément inadaptée à la description de nombreux phénomènes naturels et comportementaux régis par des dynamiques d’échelle, des lois de puissance ou des distributions exponentielles étalées sur plusieurs ordres de grandeur.
Dans de tels contextes, imposer un maillage uniforme confronte l’analyste à un dilemme insoluble : soit les bacs sont dimensionnés pour capturer les variations infinitésimales de la région d’origine (ce qui génère des milliers de bacs vides le long de la queue de distribution), soit ils sont calibrés pour agréger la queue (ce qui écrase irrémédiablement le mode initial en un unique rectangle massif). La solution analytique réside dans la mise en œuvre de bacs à largeur variable (non uniforme), où le pas spatial s’élargit progressivement à mesure que l’on s’éloigne de la masse centrale.
Cette géométrie non uniforme est directement supportée par Matplotlib par la transmission d’une séquence de limites non linéaires. L’approche standard pour les lois de puissance ou les phénomènes multi-échelles (comme les temps d’attente sur un serveur ou les seuils de détection auditive en décibels) consiste à utiliser une progression géométrique ou logarithmique via numpy.logspace() ou numpy.geomspace() :
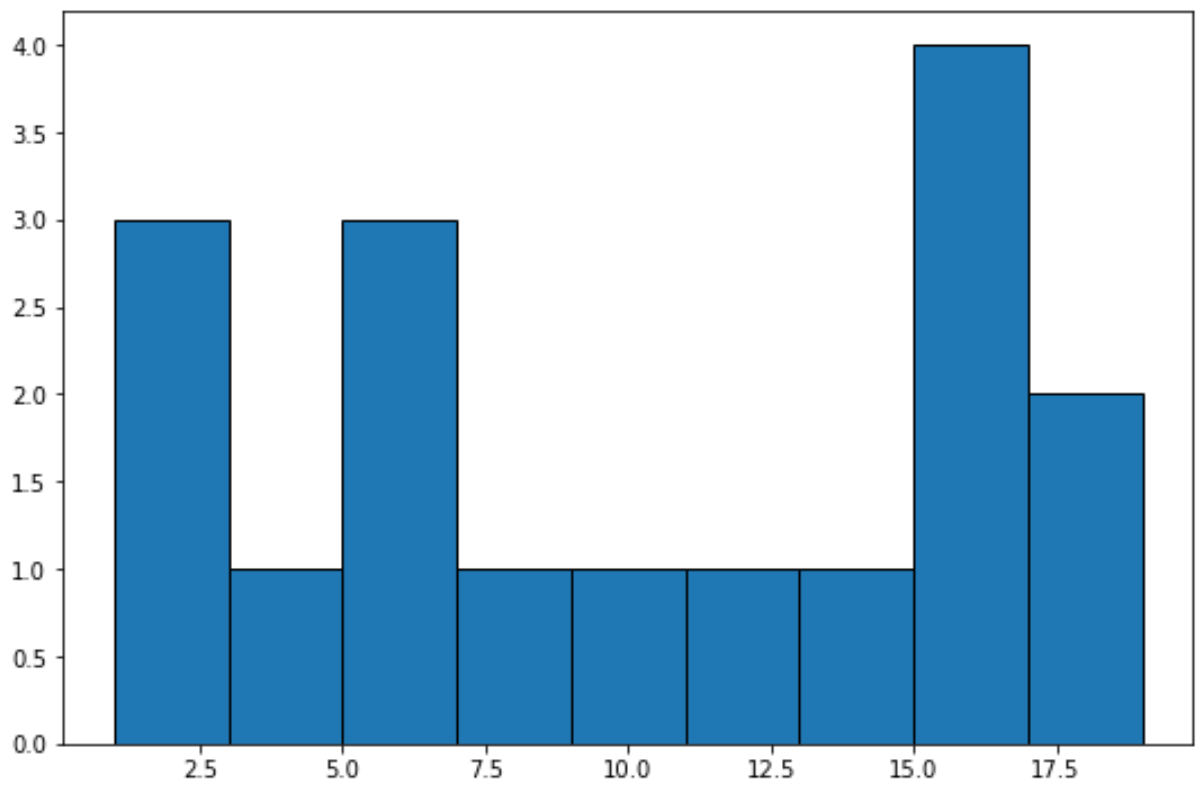
Une seconde approche, particulièrement pertinente en analyse socio-économique ou psychométrique comparative, repose sur le découpage par quantiles empiriques. À l’aide de numpy.quantile() ou numpy.percentile(), l’analyste peut déterminer les frontières de classes de telle sorte que chaque bac contienne initialement une proportion rigoureusement identique d’observations (par exemple, des déciles contenant chacun exactement 10 % de la population totale). Dans ce cas précis, la variabilité des largeurs $\Delta_k$ renseigne directement sur la densité locale : des bacs très resserrés signalent une forte concentration de points, tandis que des bacs très larges indiquent une raréfaction de l’échantillon.
7.2 Impératif méthodologique : L’utilisation de density=True
L’introduction d’intervalles à largeur variable soulève un piège méthodologique absolu d’une gravité exceptionnelle. Si l’on trace un histogramme à bacs variables en conservant les fréquences absolues sur l’axe vertical (le mode de fonctionnement par défaut de Matplotlib), la représentation graphique viole le principe sémiologique fondamental formulé par Jacques Bertin : l’aire d’un symbole visuel doit être rigoureusement proportionnelle à la quantité quantitative qu’elle transcrit.
Considérons deux bacs successifs : un premier bac $B_1$ de largeur $\Delta_1 = 1.0$ contenant 100 observations, et un second bac $B_2$ de largeur $\Delta_2 = 10.0$ contenant également 100 observations. Si Matplotlib trace ces données en effectifs bruts, la hauteur des deux barres sera rigoureusement identique ($y = 100$). Cependant, en raison de l’élargissement décuplé de la base du rectangle, la surface géométrique de la seconde barre sera dix fois plus vaste que celle de la première ($1000$ unités de surface contre $100$). L’observateur humain, dont la perception cognitive intègre inconsciemment les aires surfaciques, percevra le second intervalle comme étant dix fois plus important ou plus représenté dans la population que le premier, ce qui constitue une distorsion visuelle majeure.
Pour conjurer cette falsification involontaire, l’analyste a l’obligation mathématique d’activer le paramètre density=True :
Sous cette commande, Matplotlib abandonne le décompte absolu pour calculer la densité empirique locale $h_k$ sur chaque segment :
$$h_k = \frac{n_k}{N \cdot \Delta_k} = \frac{\text{Fréquence Relative}_k}{\Delta_k}$$
Dans cette configuration, l’aire géométrique $A_k$ de chaque rectangle correspond rigoureusement à l’intégration de la hauteur sur sa largeur :
$$A_k = h_k \cdot \Delta_k = \left(\frac{n_k}{N \cdot \Delta_k}\right) \cdot \Delta_k = \frac{n_k}{N}$$
La surface de la barre redevient ainsi strictement proportionnelle à la probabilité empirique d’appartenance à cette classe. De surcroît, la sommation des aires de l’ensemble de l’histogramme vérifie rigoureusement la condition d’unitarité propre aux fonctions de densité de probabilité :
$$\sum_{k=1}^K A_k = \sum_{k=1}^K \left(\frac{n_k}{N}\right) = \frac{1}{N} \sum_{k=1}^K n_k = \frac{N}{N} = 1$$
L’utilisation d’histogrammes à bacs variables sans normalisation de densité constitue l’une des erreurs d’analyse les plus sévèrement sanctionnées lors des relectures par les pairs dans les revues académiques de premier rang.
8. Impact perceptif et biais cognitifs liés au choix des bacs
8.1 Le biais d’ancrage et la manipulation visuelle de la forme
L’acte graphique n’est jamais neutre sur le plan cognitif. L’ajustement de la taille des bacs dans un histogramme possède un pouvoir de suggestion visuelle si puissant qu’il est possible, à partir d’un unique jeu de données invariant, de produire des représentations suggérant des conclusions scientifiques mutuellement exclusives. Ce phénomène est connu sous le terme de manipulation de la modalité perceptive.
En modifiant simplement le paramètre $\Delta$ (ou $k$), un analyste peut aisément convertir visuellement une distribution unimodale asymétrique en une distribution suggérant l’existence de plusieurs pics distincts (bimodalité ou trimodalité) par l’introduction d’un sous-lissage délibéré capturant le bruit d’échantillonnage. Inversement, et de manière bien plus pernicieuse dans la recherche biomédicale et psychologique, un sur-lissage excessif est capable d’unifier deux sous-populations réelles en un unique dôme central lisse et symétrique.
Imaginons une cohorte clinique hétérogène de patients diagnostiqués pour un trouble de l’humeur, au sein de laquelle coexistent sans distinction a priori deux sous-groupes étiologiques : une première sous-population dont le profil de réponse à une molécule antidépressive est rapide et substantiel, et une seconde sous-population caractérisée par une résistance pharmacologique. L’évaluation de l’amélioration clinique sur une échelle continue produit une distribution bimodale sous-jacente, révélant la superposition de deux courbes en cloche décalées sur l’axe des abscisses. Si le chercheur trace un histogramme avec un nombre arbitrairement restreint de bacs (par exemple, la valeur par défaut bins=10 sur un échantillon modéré), le gouffre séparant les deux dômes sera totalement comblé par l’agrégation spatiale. L’analyste conclura à tort à une efficacité uniformément distribuée de la thérapeutique avec une simple variance interindividuelle modérée, occultant l’existence cruciale d’un groupe réfractaire nécessitant une stratégie d’intervention alternative.
8.2 Sensibilité à l’origine (phase) des bacs
Alors que l’attention des praticiens se focalise quasi exclusivement sur la largeur de classe $\Delta$, une vulnérabilité beaucoup plus subtile et méconnue concerne la localisation spatiale de l’origine du partitionnement, désignée en théorie du traitement du signal sous le concept de « phase » des bacs.
Soit une largeur de bac parfaitement optimale et fixe $\Delta$. Le positionnement de la grille de discrétisation sur la droite réelle nécessite de déterminer un point de départ arbitraire $x_0$. Les limites des bacs sont alors définies par :
$$e_k = x_0 + k \cdot \Delta \quad \text{a\vec } x_0 le \min(\mathcal{D})$$
Si l’on décale ce point d’ancrage d’une fraction infinitésimale de la largeur (par exemple en choisissant $x_0′ = x_0 + \frac{\Delta}{3}$), sans altérer d’un iota la largeur $\Delta$ ni la valeur des données, le profil morphologique de l’histogramme peut subir des métamorphoses spectaculaires. Des observations groupées qui tombaient auparavant au sein d’un même bac peuvent se retrouver scindées de part et d’autre d’une frontière de classe nouvellement déplacée, créant l’illusion de l’émergence soudaine d’un second mode ou de la disparition d’un creux distributionnel.
Ce phénomène d’instabilité par déphasage est particulièrement aigu sur les petits échantillons ($N < 100$). Pour neutraliser ce biais cognitif, deux pratiques de standardisation s'imposent :
- Ancrer systématiquement l’origine $x_0$ sur des valeurs rondes ou des seuils cardinaux possédant une justification physique externe (par exemple, zéro absolu, niveau du hasard expérimental, ou moyenne théorique de standardisation).
- Moyonner les représentations à travers plusieurs déphasages successifs, principe mathématique qui a directement inspiré l’estimateur par polygone de fréquences déphasé et, ultimement, l’estimation non paramétrique par noyau de convolution (Kernel Density Estimation).
8.3 Bonnes pratiques éthiques pour la communication scientifique
Face à la plasticité morphologique des histogrammes, la communauté scientifique internationale formule des exigences déontologiques de plus en plus rigoureuses quant à la publication de visualisations de distributions empiriques :
La première règle déontologique consiste en la transparence méthodologique absolue. Il est formellement prohibé dans un article scientifique d’insérer un histogramme sans expliciter dans la légende du graphique ou dans la section méthodologique le protocole de discrétisation employé (par exemple : « L’histogramme a été généré sous Matplotlib avec une largeur de bac constante de 2.5 unités selon la règle de Freedman-Diaconis »). Cette mention garantit la reproductibilité des résultats par des équipes tierces.
La deuxième recommandation préconise le recours à la double visualisation, combinant la nature discrète de l’histogramme avec la continuité d’un estimateur de densité par noyau (KDE). La superposition d’une courbe KDE lissée permet de distinguer immédiatement si un décrochage local de l’histogramme constitue un saut structurel corroboré par le noyau ou s’il s’agit d’un artefact imputable au découpage spatial des barres.
Enfin, l’insertion d’un diagramme en tapis (rug plot) en bordure inférieure de l’axe des abscisses représente une pratique ergonomique d’une rare élégance. Le rug plot trace chaque observation individuelle sous la forme d’un trait vertical microscopique. Ce dispositif maintient l’accès visuel direct aux données brutes non agrégées, permettant au lecteur de vérifier instantanément si un rectangle volumineux repose sur un cluster dense de dizaines de points ou sur une observation unique isolée au milieu du vide.
9. Personnalisation esthétique et optimisation de la lisibilité des bacs
9.1 Ajustement de l’espacement relatif et typologie des barres
La transmission efficace de l’information quantitative dépend de l’ergonomie visuelle du tracé. Matplotlib offre un large éventail d’arguments d’ajustement permettant de transcender le rendu austère des graphiques natifs.
L’argument formel rwidth (relative width) permet de rompre délibérément la contiguïté géométrique des rectangles. Par défaut, rwidth=1.0, ce qui implique que chaque rectangle occupe 100 % de l’espace alloué par la largeur $\Delta_k$, les barres se touchant mutuellement sans solution de continuité. En fixant rwidth=0.85, chaque barre n’occupe plus que 85 % de sa largeur théorique, laissant un espace blanc vertical équivalant à 15 % entre les blocs consécutifs :
Bien que cette disposition doive être maniée avec précaution pour ne pas confondre le graphe avec un diagramme en barres catégoriel, elle est souvent appréciée pour alléger la charge visuelle lors de présentations orales ou sur des supports numériques à haute luminosité.
Le paramètre histtype redéfinit fondamentalement la typologie du rendu vectoriel. Il accepte quatre valeurs fondamentales :
'bar'(défaut) : Rectangles traditionnels individuels avec remplissage complet.'barstacked': Piles verticales de barres positionnées les unes sur les autres pour décomposer des effectifs multicatégories au sein d’une même classe.'step': Tracé purement filaire monochrome ne dessinant que le contour supérieur extérieur de l’histogramme, sans lignes verticales internes ni remplissage. Cette option est idéale pour superposer cinq ou six distributions expérimentales concurrentes sans aucune obstruction visuelle.'stepfilled': Variante fermée de la ligne polygonale extérieure combinant un remplissage uniforme interne et l’absence de démarcations verticales inter-classes.
Enfin, lorsque deux conditions expérimentales distinctes (par exemple, groupe contrôle versus groupe traité) doivent être comparées sur le même axe avec des barres pleines, le contrôle de la transparence par l’argument scalaire alpha (compris entre 0.0 pour une transparence totale et 1.0 pour une opacité complète, typiquement calibré à alpha=0.6) s’avère indispensable pour observer les zones de chevauchement mutuel.
9.2 Alignement et graduation des axes sur les limites des bacs
L’une des sources majeures d’ambiguïté pour le lecteur d’un histogramme provient de la dissonance cognitive entre les graduations automatiques de l’axe des abscisses (les repères de l’axe $X$, ou ticks) et les véritables limites géométriques des bacs. Par défaut, le moteur de placement de Matplotlib configure les graduations à des intervalles arrondis indépendants (par exemple, des marques tous les 10 points : 10, 20, 30), alors que les bacs ont pu être calculés sur des frontières non alignées (par exemple : 12.3, 22.3, 32.3). Il devient dès lors particulièrement ardu de déterminer dans quel intervalle tombe précisément une valeur intermédiaire.
La solution programmatique optimale consiste à forcer explicitement la synchronisation des graduations de l’axe sur le vecteur des limites de bacs retourné par l’appel à plt.hist() :
En assignant bin_edges à la commande plt.xticks(), chaque repère visuel et chaque étiquette numérique viennent se verrouiller mathématiquement sous la ligne de démarcation exacte de chaque rectangle. L’ambiguïté de lecture est ainsi éradiquée : le lecteur visualise instantanément que le premier bac couvre rigoureusement la plage $[0, 15]$, le second $[15, 30]$, et ainsi de suite.
Si la densité de bacs est élevée, provoquant une superposition illisible des chiffres sur l’axe horizontal, deux raffinements typographiques peuvent être mis en œuvre :
- L’application d’une rotation angulaire aux étiquettes via
plt.xticks(bin_edges, rotation=45). - Le sous-échantillonnage régulier des étiquettes affichées tout en conservant les repères visuels mineurs :
9.3 Coloration conditionnelle et mise en valeur de bacs spécifiques
Sur le plan de l’analyse sélective et de la communication didactique, il est fréquemment souhaitable de diriger l’attention de l’audience vers une fraction spécifique de la distribution : un intervalle de risque pathologique, un seuil d’admissibilité à un concours, ou une zone de rupture thermique. La structure orientée objet de Matplotlib permet d’atteindre ce degré de personnalisation microscopique grâce au triplet retourné par la fonction.
Le troisième conteneur issu de l’exécution, patches, est une instance de matplotlib.container.BarContainer contenant la liste ordonnée des objets vectoriels représentant chaque rectangle. En itérant séquentiellement sur cette collection à l’aide d’une boucle Python standard, l’analyste peut inspecter la géométrie de chaque bac et appliquer des règles de coloration conditionnelle :
Cette technique permet de transformer un graphique purement descriptif en un puissant instrument d’aide à la décision visuelle. L’adjonction de repères verticaux globaux à l’aide de la commande plt.axvline() permet de contextualiser immédiatement cette mise en valeur par rapport aux paramètres centraux de la population :
10. Cas d’usage spécifiques : Variables discrètes et données complexes
10.1 Ajustement pour données discrètes et échelles de Likert
L’application non critique d’un algorithme de discrétisation continue à des variables intrinsèquement discrètes constitue l’une des sources d’erreurs les plus courantes dans la recherche en psychologie sociale et en sciences de l’éducation. Les instruments psychométriques reposent massivement sur des échelles de type Likert en 5 ou 7 points (par exemple : 1 = Pas du tout d’accord, jusqu’à 5 = Tout à fait d’accord).
Si un analyste transmet de telles données à Matplotlib avec une commande naïve du type plt.hist(scores_likert, bins=5), les limites automatiques seront calculées sur l’intervalle $[1, 5]$. Avec $k=5$, la largeur de classe sera de $\Delta = (5 – 1)/5 = 0.8$. Les sous-intervalles résultants seront ainsi : $[1.0, 1.8)$, $[1.8, 2.6)$, $[2.6, 3.4)$, $[3.4, 4.2)$, et $[4.2, 5.0]$. En examinant attentivement ces frontières, on constate avec stupéfaction que :
- Le premier bac recueille uniquement le score 1.
- Le deuxième bac recueille uniquement le score 2.
- Le troisième bac recueille uniquement le score 3.
- Le quatrième bac recueille uniquement le score 4.
- Le cinquième bac recueille les scores 5 mais son comportement marginal est asymétrique en raison de la fermeture fermée des deux côtés.
Si l’amplitude des données réelles s’étend de 1 à 7 et que l’on applique $k=5$, certains bacs vont regrouper deux entiers tandis que d’autres n’en recevront qu’un seul, ruinant instantanément la représentativité de la fréquence observée.
Pour représenter rigoureusement des variables discrètes prenant des valeurs entières isolées $S = {1, 2, dots, M}$, la règle absolue consiste à centrer les bacs sur les entiers en décalant les frontières de classe d’une demi-unité ($\pm 0.5$) :
Sous cette formulation, le score entier $x$ est positionné au centre géométrique exact du rectangle d’évaluation $[x – 0.5, x + 0.5]$. Chaque bac possède une largeur unitaire stricte de $1.0$, éliminant toute ambiguïté de répartition et garantissant une symétrie parfaite de l’estimation des fréquences.
10.2 Traitement des valeurs extrêmes et distributions à queue lourde
Les distributions financières (rendements boursiers, distribution des revenus), démographiques ou comportementales (temps de fixation oculaire, temps de pause lors d’une tâche de frappe au clavier) présentent régulièrement des queues lourdes (heavy-tailed distributions) ou des étalements asymptotiques extrêmes sur plusieurs ordres de grandeur.
Dans ce contexte, deux méthodologies avancées permettent de préserver la lisibilité de la visualisation sans compromettre l’intégrité de l’échantillon :
La première stratégie repose sur la discrétisation semi-logarithmique à l’aide de la fonction numpy.logspace(). Cette technique génère des bacs dont la largeur croît de façon exponentielle avec la distance à l’origine. L’histogramme qui en résulte doit être couplé à une mise à l’échelle logarithmique de l’axe horizontal via plt.xscale('log'), transformant la représentation en un espace perceptif où la loi de puissance sous-jacente apparaît sous une forme linéaire aisément quantifiable.
La seconde stratégie, largement exploitée en analyse actuarielle et épidémiologique, consiste en l’agrégation terminale en bacs ouverts (technique dite de winsorisation visuelle ou de clipping). Lorsque quelques observations aberrantes s’étendent de manière démesurée sans apporter d’information morphologique pertinente, l’analyste peut redimensionner artificiellement ces valeurs limites vers un seuil plafond prédéfini :
Le dernier bac de l’histogramme recueille alors la totalité de la masse de probabilité contenue au-delà du seuil de 500 unités. L’impératif éthique exige ici de modifier explicitement l’étiquette de ce dernier rectangle (par exemple en annotant l’axe avec la mention « $ge 500$ ») afin d’avertir explicitement le lecteur que la barre terminale constitue un compartiment d’accumulation ouvert.
10.3 Comparaison de distributions multigroupes et bacs harmonisés
L’analyse comparative de deux ou plusieurs sous-populations expérimentales (par exemple, cohorte saine versus cohorte pathologique, ou groupe contrôle versus groupe interventionnel) représente un cas d’usage clinique omniprésent. Dans ce scénario, une erreur méthodologique gravissime consiste à générer les histogrammes de chaque groupe de façon totalement autonome en laissant Matplotlib déterminer les bacs séparément pour chaque sous-échantillon.
Si le groupe A présente une amplitude de $[10, 40]$ et que le groupe B s’étale sur $[15, 60]$, des appels indépendants à plt.hist() calculeront des limites de bacs divergentes et asynchrones pour les deux séries. Tenter de superposer ou de comparer côte à côte de telles figures induit en erreur le clinicien : un décalage apparent de position ou de hauteur peut résulter simplement du fait que les observations du groupe A sont divisées en tranches de 3 unités tandis que celles du groupe B sont segmentées en tranches de 4.5 unités.
Le principe fondamental de comparabilité exige l’harmonisation stricte et centralisée des bacs. Une grille unique et commune de discrétisation doit être calculée à l’échelle de l’union globale de toutes les cohortes, puis appliquée identiquement à chaque sous-ensemble :
L’activation du paramètre density=True est ici d’autant plus cruciale si les deux groupes possèdent des effectifs inégaux ($N_A \neq N_B$). Sans cette normalisation surfacique unitaire, la cohorte la plus nombreuse écraserait visuellement la cohorte restreinte, empêchant d’apprécier si les lois distributionnelles sous-jacentes partagent ou non des paramètres de forme et de position identiques.
11. Approche orientée objet avec Matplotlib : Méthode ax.hist()
11.1 Transition de l’interface fonctionnelle (pyplot) à l’interface orientée objet
Dans l’architecture logicielle de Matplotlib, il existe une distinction fondamentale entre deux paradigmes de programmation : l’interface fonctionnelle basée sur l’état global courant (incarnée par le module matplotlib.pyplot, calqué historiquement sur l’ergonomie séquentielle de MATLAB) et l’interface orientée objet (OO) explicite. Si l’approche fonctionnelle (plt.hist()) convient parfaitement à l’exploration rapide dans un carnet interactif de type Jupyter Notebook, le développement de pipelines de traitement automatisés, modulaires et robustes destinés à la recherche scientifique reproductible impose impérativement l’adoption du paradigme orienté objet.
Dans le paradigme orienté objet, la hiérarchie graphique est formellement instanciée par la décomposition entre un canevas global (l’objet Figure) et un ou plusieurs systèmes de coordonnées cartésiennes indépendants (les objets Axes). La création canonique de la structure s’opère via la fonction de fabrique :
L’exécution de la discrétisation est alors déléguée à la méthode dédiée de l’axe : ax.hist(). Cette méthode accepte l’intégralité rigoureuse des arguments formels analysés dans les sections antérieures (bins, range, density, edgecolor, etc.), mais garantit que le rendu s’opère exclusivement au sein du conteneur topologique spécifié :
Cette dissociation structurelle entre la figure globale et l’axe de projection permet d’intégrer sans friction l’analyse par histogramme au sein d’architectures logicielles industrielles, de micro-services web ou de suites de tests unitaires automatisées, le graphe pouvant être manipulé, sérialisé ou exporté vectoriellement sans jamais dépendre d’un état global de session susceptible d’être corrompu par d’autres threads d’exécution.
11.2 Histogrammes à panneaux multiples (Subplots) avec bacs synchronisés
La puissance du paradigme orienté objet se révèle pleinement lors de la construction de graphiques à panneaux multiples (subplots ou small multiples selon la terminologie d’Edward Tufte). Cette méthodologie visuelle consiste à comparer plusieurs conditions expérimentales, profils démographiques ou tranches chronologiques au moyen d’une grille de graphiques distincts juxtaposés sur une même planche de publication.
La réussite méthodologique d’un tel agencement repose sur une contrainte absolue : la synchronisation spatiale intégrale des axes et des bacs. Si l’échelle des abscisses ou la segmentation des bacs fluctue d’un panneau à l’autre au sein d’une même planche, le cerveau humain applique spontanément une comparaison analogique directe, induisant des contresens massifs d’interprétation clinique.
L’implémentation robuste de ce principe en syntaxe orientée objet nécessite de conjuguer le calcul centralisé d’un vecteur de bornes invariant avec les mécanismes de verrouillage d’axes de Matplotlib :
L’activation des arguments sharex=True et sharey=True garantit que toutes les sous-fenêtres partagent rigoureusement les mêmes dimensions physiques sur le plan cartésien. Couplée au vecteur unique bornes_globales, cette configuration assure que chaque barre d’un panneau correspond au même intervalle spatial et à la même unité de masse que sur les panneaux adjacents, permettant une comparaison immédiate de la dérive des moyennes, de l’élargissement des variances ou de l’émergence d’asymétries au fil du vieillissement cognitif.
12. Synthèse pratique, erreurs fréquentes et guide de dépannage
12.1 Diagnostic des erreurs classiques de paramétrage
La pratique quotidienne de la discrétisation sous Matplotlib expose les praticiens à une série d’anomalies récurrentes dont l’identification et la résolution exigent une compréhension fine de la tuyauterie logicielle sous-jacente.
1. L’omission silencieuse des données terminales : Comme exploré dans les sections antérieures, l’utilisation de np.arange(data.min(), data.max(), step) exclut structurellement la valeur maximale si l’amplitude est un multiple exact de $step$. Cette erreur ne provoque aucune levée d’exception, mais fausse systématiquement les calculs de densité et de fréquence cumulée. Remède : Toujours ajouter une unité de pas au terme de fin : np.arange(min, max + step, step).
2. La violation de monotonicité : L’envoi à l’argument bins d’une liste de coordonnées non triées par ordre croissant (par exemple issue d’une opération d’ensemble sans ordonnancement déterministe) lève immédiatement l’exception fatale :
Remède : Encapsuler systématiquement la séquence de bornes personnalisées dans un tri vectoriel : bins = np.sort(bornes).
3. La présence de valeurs manquantes (NaN) ou infinies : Par défaut, si le vecteur de données transmis à plt.hist() contient ne serait-ce qu’une seule valeur non numérique de type np.nan ou une divergence asymptotique de type np.inf, le moteur d’évaluation de Matplotlib échoue avec un message d’erreur explicite :
L’algorithme de calcul des bornes est incapable de statuer sur le minimum et le maximum d’une série contaminée par des données manquantes. Remède : Appliquer une exclusion booléenne stricte en amont du tracé graphique à l’aide de l’indexation NumPy :
4. Le conflit entre les paramètres range et bins séquentiels : Si l’utilisateur fournit simultanément un tableau explicite de bornes à l’argument bins et un tuple restrictif à l’argument range, Matplotlib ignorera généralement le paramètre range ou pourra déclencher un comportement inattendu selon les versions de la bibliothèque. Remède : Réserver range exclusivement aux appels utilisant un entier scalaire pour bins ; lorsque l’on emploie un vecteur séquentiel, le contrôle des limites doit s’effectuer directement au sein des coordonnées transmises.
12.2 Arbre décisionnel pour le choix de la méthode d’ajustement
Afin de guider méthodologiquement le choix de l’analyste face à la multiplicité des options de discrétisation présentées, le tableau décisionnel suivant synthétise les recommandations opérationnelles en fonction de la nature des données empiriques et de l’objectif scientifique visé :
| Type de Données & Contexte | Méthode Recommandée | Syntaxe Python Exemplaire | Justification Méthodologique |
|---|---|---|---|
| Exploration initiale aveugle (Taille d’échantillon inconnue, distribution libre) | Sélection adaptative automatisée | bins='auto' |
Compromis optimal entre Freedman-Diaconis et Sturges ; évite l’écueil du sur-lissage des cohortes massives. |
| Données continues asymétriques ou avec valeurs aberrantes (ex. temps de réaction) | Règle de Freedman-Diaconis | bins='fd' |
Exploite l’écart interquartile (IQR) ; résistance exceptionnelle à la contamination par les queues de distribution. |
| Données continues gaussiennes de taille modérée sans outliers ($N < 1000$) | Règle de Scott | bins='scott' |
Minimise mathématiquement l’erreur quadratique intégrée moyenne (MISE) sous l’hypothèse de normalité. |
| Variables discrètes entières (Scores psychométriques, échelles de Likert 1-5 ou 1-7) | Bornes manuelles décalées d’une demi-unité | bins=np.arange(0.5, max+1.5, 1.0) |
Centre rigoureusement chaque entier $x$ au milieu de son bac $[x-0.5, x+0.5]$ ; neutralise les artéfacts de discrétisation. |
| Unités physiques / cliniques signifiantes (Paliers d’âge de 5 ans, pas de 100 ms) | Largeur de pas fixe vectorisée via NumPy | bins=np.arange(min, max+w, w) |
Garantit une interprétabilité directe et immédiate des intervalles pour la communication scientifique et clinique. |
| Distributions à loi de puissance / Multi-échelles (Données financières, latences étendues) | Bacs à progression logarithmique | bins=np.logspace(a, b, num) + density=True |
Résout simultanément la forte concentration à l’origine et la raréfaction asymptotique dans la queue. |
| Comparaison de cohortes multiples ($N_A \neq N_B$, sous-groupes indépendants) | Grille globale invariante unifiée | bins=bornes_unifiees + density=True |
Élimine tout biais d’échelle géométrique entre les panneaux comparés ; rend les aires comparables. |
12.3 Perspectives et alternatives modernes pour la densité empirique
Bien que l’histogramme classique demeure un instrument historique indispensable, les développements récents de la science des données visuelle offrent des alternatives et des compléments structuraux de haut niveau qu’il convient de maîtriser pour enrichir sa pratique analytique.
Dans l’écosystème Python, la bibliothèque Seaborn, bâtie au sommet des primitives graphiques de Matplotlib, propose la fonction moderne sns.histplot(). Cette méthode introduit deux arguments formels d’une rare commodité ergonomique : binwidth et binrange. Plutôt que de devoir instancier des vecteurs NumPy complexes via np.arange(), l’utilisateur peut déclarer directement binwidth=5 et binrange=(0, 100), Seaborn prenant automatiquement en charge la vectorisation sous-jacente, la fermeture des intervalles et la gestion sécurisée des bornes marginales.
Au-delà de l’histogramme, l’estimation de densité par noyau (Kernel Density Estimation – KDE) s’affranchit totalement du partitionnement par bacs. En remplaçant chaque observation ponctuelle par une fonction continue gaussienne (ou noyau régulateur) de variance $h$ (la bande passante ou bandwidth) et en sommant l’ensemble de ces contributions élémentaires, le KDE produit une courbe de densité parfaitement lisse, exempte des artéfacts d’ancrage spatial et de phase qui affectent inévitablement les histogrammes. L’affichage conjoint de l’histogramme et du tracé KDE (facilement activable via l’argument kde=True dans Seaborn) représente aujourd’hui le standard de référence pour l’exploration de distributions complexes.
Enfin, lorsque l’analyse s’étend à la comparaison de dizaines de groupes simultanés, l’histogramme s’efface généralement au profit des tracés en boîte à moustaches (boxplots) et des tracés en violon (violin plots). Les violons, qui intègrent la densité empirique de façon symétrique le long d’un axe catégoriel, permettent d’appréhender d’un coup d’œil la position, la dispersion, l’asymétrie et la multimodalité de multiples cohortes sans que le graphique ne sombre dans la saturation visuelle inhérente à la superposition d’une multitude de rectangles contigus.
Références
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: $L_2$ theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Knuth, K. H. (2006). Optimal data-based binning for histograms. arXiv preprint physics/0605197. https://arxiv.org/abs/physics/0605197
- Matplotlib Development Team. (2023). matplotlib.axes.Axes.hist Documentation (Version 3.8). Matplotlib Project. https://matplotlib.org/stable/api/_as_gen/matplotlib.axes.Axes.hist.html
- NumPy Developers. (2023). numpy.histogram_bin_edges Documentation (Version 1.26). NumPy Project. https://numpy.org/doc/stable/reference/generated/numpy.histogram_bin_edges.html
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Scott, D. W. (2015). Multivariate density estimation: Theory, practice, and visualization (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118575574
- Silverman, B. W. (1986). Density estimation for statistics and data analysis. Chapman and Hall/CRC. https://doi.org/10.1201/9781315140919
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wand, M. P. (1997). Data-based choice of histogram bin width. The American Statistician, 51(1), 59–64. https://doi.org/10.1080/00031305.1997.10473591
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021