
La visualisation de données scientifiques représente un pilier fondamental de la recherche contemporaine, conditionnant la transmission des résultats empiriques et la robustesse des interprétations statistiques. Dans l’écosystème du langage Python, la bibliothèque Seaborn s’est imposée comme une référence incontournable pour la production de représentations graphiques élégantes, informatives et directement articulées avec les structures de données tabulaires telles que les trames de données de la bibliothèque Pandas. Conçue comme une surcouche de haut niveau au-dessus du moteur graphique Matplotlib, Seaborn automatise une multitude de choix esthétiques et techniques, allant du tracé d’intervalles de confiance à la sélection des palettes de couleurs adaptées aux daltonismes. Cependant, cette abstraction procédurale dissimule fréquemment des mécanismes sous-jacents qui, lorsqu’ils échappent au contrôle du chercheur ou du statisticien, peuvent nuire à la lisibilité analytique des figures produites.
Parmi les éléments constitutifs d’une figure scientifique, les graduations d’axe, couramment désignées sous le terme anglophone de ticks, constituent les repères cardinaux permettant au système visuel humain de traduire une position géométrique spatiale en une valeur métrique précise. Un espacement inapproprié, une densité excessive ou une sous-représentation des graduations engendre une dégradation immédiate de l’intelligibilité des données. Les valeurs extrêmes risquent de se trouver privées d’ancrage textuel, tandis que des graduations trop rapprochées provoquent une superposition typographique incompatible avec les normes éditoriales académiques les plus strictes. La maîtrise de la densité des graduations ne relève donc pas d’une simple coquetterie ornementale, mais d’une rigueur méthodologique garantissant la fidélité de la restitution quantitative.
Le présent article propose une exploration approfondie et méthodique des techniques permettant de moduler, contraindre et automatiser le nombre et l’agencement des graduations au sein des graphiques générés avec Seaborn. De la manipulation procédurale directe via le module d’état global jusqu’à l’exploitation experte des localisateurs algorithmiques avancés de Matplotlib, chaque approche sera décortiquée sous l’angle de son architecture logicielle, de son ergonomie cognitive et de sa pertinence face à des structures de données complexes, qu’il s’agisse de distributions asymétriques, d’échelles logarithmiques ou de grilles multifactorielles.
1. Introduction à la personnalisation des graduations dans les visualisations Seaborn
Pour appréhender la mécanique d’ajustement des axes dans un graphique, il convient d’abord d’établir les fondements théoriques qui lient la perception visuelle de l’observateur à l’étalonnage mathématique de l’espace graphique. L’ajustement des graduations s’inscrit au carrefour de la sémiologie graphique et de l’architecture logicielle de visualisation de données.
1.1 Rôle des graduations dans la communication de données scientifiques
Les graduations d’axe remplissent une fonction sémiotique fondamentale : elles matérialisent l’étalon de mesure qui convertit l’espace géométrique continu du plan de projection en un espace de variables quantitatives ou qualitatives signifiantes. Dans le contexte de l’analyse empirique et de la modélisation psychométrique, la précision de lecture conditionne directement la capacité du lecteur à déduire des ordres de grandeur, à évaluer la dispersion des résidus ou à estimer la pente d’un modèle de régression. Une absence de repères intermédiaires contraint l’esprit à des interpolations approximatives, augmentant l’erreur d’estimation visuelle lors de la consultation des graphiques.
Toutefois, la multiplication des graduations se heurte rapidement aux limites de la mémoire de travail et aux contraintes de la perception visuelle. Un axe saturé d’étiquettes numériques déclenche une surcharge cognitive, saturant le canal visuel au détriment de l’information principale constituée par la distribution des données ou la forme de la fonction ajustée. La conception d’une visualisation scientifique exige ainsi un arbitrage rigoureux entre l’exhaustivité métrique et la clarté sélective, en sélectionnant un nombre d’ancrages suffisant pour dissiper toute ambiguïté d’échelle sans introduire de bruit typographique superflus.
Dans les disciplines quantitatives telles que l’épidémiologie, la biostatistique ou l’économétrie, la configuration des graduations doit également refléter la structure intrinsèque des variables analysées. L’omission de points de rupture théoriques, tels que la valeur zéro dans un graphique en coordonnées standardisées ou le seuil unitaire d’un rapport de cotes, peut fausser la réception des données en occultant les lignes de démarcation critiques établies par le paradigme expérimental.
1.2 Comportement algorithmique par défaut de Seaborn
Lorsqu’un utilisateur délègue à Seaborn le tracé d’une figure statistique, la bibliothèque hérite intégralement des heuristiques de détermination d’axe conçues par Matplotlib. Ces algorithmes tentent d’identifier automatiquement des intervalles qualifiés d’agréables à l’œil, en privilégiant des multiples de un, deux ou cinq au sein des puissances de dix. Ce procédé fonctionne de manière optimale sur des distributions symétriques, gaussiennes et uniformément réparties à l’intérieur d’intervalles numériques standards ne présentant pas de variations brusques d’échelle.
Cette automatisation présente néanmoins des défaillances notables lorsqu’elle est confrontée à des distributions fortement asymétriques, à des variables présentant de longues traînes ou à des jeux de données comportant des regroupements denses accompagnés de valeurs aberrantes isolées. Dans ces cas de figure, les heuristiques par défaut tendent à étendre l’empan de l’axe pour y intégrer les valeurs extrêmes, diluant l’essentiel de l’information dans un sous-espace graphique restreint tout en espaçant exagérément les graduations au sein de la zone de forte densité d’échantillonnage.
De surcroît, les revues scientifiques et les maisons d’édition académiques imposent des normes typographiques rigides quant à la taille minimale des caractères, aux contrastes d’impression et à l’interdiction stricte du chevauchement textuel. Les configurations par défaut de Seaborn, bien qu’esthétiquement soignées pour un affichage sur écran d’ordinateur portable, s’avèrent fréquemment inadaptées aux formats d’impression sur deux colonnes ou aux figures composites à volets multiples, rendant indispensable une reprise en main déterministe de la fréquence d’apparition des graduations.
2. Architecture sous-jacente : interaction structurelle entre Seaborn et Matplotlib
Pour ajuster avec précision le nombre de graduations, il est indispensable de comprendre la relation hiérarchique unissant Seaborn au moteur graphique sur lequel il repose. Seaborn n’est pas un environnement autonome de rendu vectoriel, mais une interface de programmation spécialisée qui instancie, manipule et configure des objets créés nativement par Matplotlib.
2.1 Hiérarchie des objets graphiques : Figure, Axes et Axis
L’architecture de Matplotlib repose sur un paradigme de programmation orientée objet structuré en couches hiérarchiques distinctes. Au sommet de cette arborescence se situe l’objet Figure, qui correspond au conteneur global, matérialisant la surface totale de dessin, incluant les marges, les légendes externes et l’ensemble des panneaux graphiques. À l’intérieur de cette Figure prennent place un ou plusieurs objets Axes, qui désignent la zone rectangulaire effective dans laquelle les données sont projetées et dessinées, dotée de son propre système de coordonnées.
Chaque instance d’Axes encapsule à son tour deux ou trois objets Axis, représentant physiquement l’axe des abscisses, l’axe des ordonnées et, le cas échéant, l’axe de profondeur en trois dimensions. C’est précisément au niveau de cet objet Axis que réside la machinerie algorithmique responsable des graduations. L’objet Axis gère les composants géométriques discrets : les lignes de graduation majeures et mineures, leurs étiquettes textuelles associées, la grille d’arrière-plan ainsi que les algorithmes de localisation spatiale et de mise en forme des valeurs scalaires.
Cette distinction conceptuelle met en lumière une dichotomie fondamentale au sein même de Seaborn : les fonctions de niveau axes, telles que scatterplot, histplot ou boxplot, tracent directement les données sur un objet Axes préexistant ou immédiatement retourné, tandis que les fonctions de niveau figure, comme relplot, catplot ou displot, créent et orchestrent des grilles complexes d’objets Axes au sein d’une structure spécialisée appelée FacetGrid.
2.2 Accès aux instances sous-jacentes depuis un appel Seaborn
La modification raisonnée des graduations requiert l’obtention d’une référence directe vers ces objets structuraux. Lorsqu’une fonction de niveau axes est exécutée, celle-ci renvoie systématiquement l’instance de la classe Axes de Matplotlib sur laquelle le dessin a été effectué. La conservation de cette valeur de retour au sein d’une variable assignée permet ensuite d’accéder sans ambiguïté à toute la palette de méthodes de configuration de bas niveau fournies par Matplotlib.
Une alternative largement répandue mais plus fragile repose sur l’utilisation du module pyplot, via des appels à des fonctions d’état global telles que plt.gca() pour récupérer l’axe actif courant, ou plt.gcf() pour la figure courante. Bien que commode pour des scripts séquentiels simples rédigés dans un calepin interactif, cette approche procédurale introduit des effets de bord insidieux dès lors que le flux d’exécution implique des sous-graphiques multiples ou des architectures de calcul distribuées où l’état global peut devenir instable ou être écrasé par une opération concurrente.
La reproductibilité du code analytique repose ainsi sur l’explicitation systématique des objets manipulés. En interceptant l’objet Axes issu de l’appel Seaborn, le chercheur s’assure que les modifications relatives aux graduations cibleront invariablement le tracé prévu, éliminant les aléas liés à la détermination implicite de l’axe actif et garantissant l’intégrité de la chaîne de traitement graphique.
3. Méthode procédurale directe : utilisation de plt.xticks() et plt.yticks()
L’approche procédurale s’appuie sur le paradigme historique de pyplot, conçu pour imiter la syntaxe matricielle et impérative de logiciels scientifiques plus anciens. Elle constitue la solution la plus directe pour modifier rapidement les graduations d’une figure isolée sans manipuler formellement les pointeurs d’objets.
3.1 Syntaxe fondamentale et définition des positions numériques
La fonction plt.xticks() et son pendant vertical plt.yticks() permettent de redéfinir instantanément les positions physiques des graduations majeures sur l’axe correspondant de la figure active. Dans sa signature la plus basique, la fonction accepte comme premier paramètre un itérable de nombres scalaires réels, tel qu’une liste native Python ou un tableau unidimensionnel de données numériques. Ces scalaires stipulent avec une exactitude absolue les coordonnées spatiales où les repères doivent être ancrés.
Lorsque cette commande est exécutée consécutivement au tracé d’un graphique Seaborn, le moteur graphique de Matplotlib remplace immédiatement l’ensemble des graduations générées automatiquement par la liste explicite fournie. Cela permet au praticien de resserrer ou d’élargir le pas de graduation selon les nécessités de l’étude. Si un graphique affiche des valeurs de 0 à 100 avec un pas par défaut de 20, l’injection manuelle d’une séquence arithmétique débutant à zéro et se terminant à cent avec un incrément de dix doublera immédiatement la densité des graduations visibles.
Il est impératif que les bornes de la séquence transmise demeurent cohérentes avec l’empan naturel des données représentées. Si la liste de coordonnées s’étend bien au-delà du domaine effectif des observations, Matplotlib recalculera automatiquement les limites spatiales de la figure pour intégrer l’ensemble des graduations spécifiées, provoquant un élargissement non sollicité du canevas et une compression indésirable du nuage de points ou des tracés centraux.
3.2 Dissociation des positions physiques et des libellés textuels
Une caractéristique déterminante des fonctions plt.xticks() et plt.yticks() réside dans leur capacité à découpler les coordonnées géométriques des étiquettes typographiques affichées face à ces repères. En transmettant un second paramètre sous la forme d’une collection de chaînes de caractères, l’utilisateur peut surcharger l’affichage textuel associé à chaque graduation.
Cette dissociation s’avère particulièrement utile pour introduire des libellés qualitatifs, des notations abrégées, des unités de mesure explicites ou des symboles mathématiques interprétables par le moteur de rendu typographique TeX. Par exemple, des positions définies par des multiples fractionnaires d’une constante peuvent être libellées textuellement sous forme symbolique pour faciliter la lecture théorique de la distribution.
Cependant, cette flexibilité impose une vigilance méthodologique extrême : il existe une obligation stricte de correspondance bijective entre la dimension du tableau des positions numériques et la longueur de la liste des libellés textuels. Une discordance quantitative entre ces deux structures de données produit soit une exception logicielle bloquante, soit, pire encore, un décalage silencieux d’indexation dans lequel les étiquettes se trouvent assignées à des coordonnées erronées, induisant une distorsion catastrophique de la véracité de l’information communiquée.
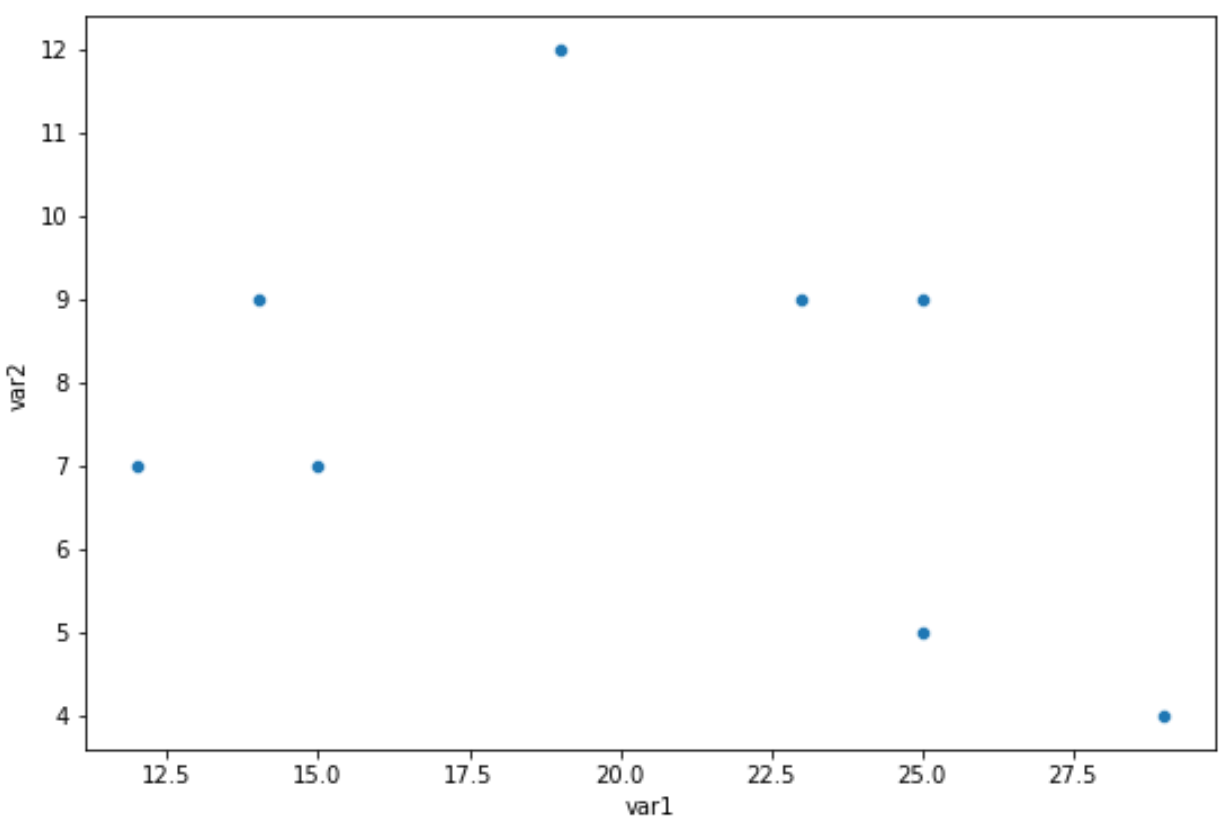
3.3 Implémentation pratique sur des diagrammes de dispersion (Scatterplots)
L’application de la méthode procédurale se prête idéalement à l’optimisation des diagrammes de dispersion réalisés via seaborn.scatterplot. Considérons une analyse biométrique étudiant la corrélation entre la masse corporelle et la dépense énergétique au repos chez un groupe de sujets expérimentaux. Par défaut, Seaborn génère une dispersion de points délimitée par des graduations espacées selon une logique générique qui peut omettre des frontières cliniques significatives.
En recourant à plt.xticks(), l’analyste peut forcer l’ancrage des graduations sur des valeurs pivots internationalement reconnues par les standards de santé, telles que les seuils d’adiposité ou de sous-poids, plutôt que sur des multiples décimaux arbitraires. De même, sur l’axe des ordonnées, plt.yticks() peut être ajusté pour refléter les paliers métaboliques d’intérêt médical direct.
L’évaluation visuelle de cette modification démontre un gain immédiat en efficacité analytique : l’observateur n’a plus besoin d’opérer mentalement une conversion entre les coordonnées décimales continues de l’axe et les classes nosologiques pertinentes. Les points individuels viennent se positionner directement par rapport aux lignes virtuelles issues des graduations cliniquement calibrées, réduisant le temps d’interprétation visuelle et éliminant les ambiguïtés de classification.
4. Approche orientée objet : manipulation via Axes.set_xticks() et Axes.set_yticks()
Si la méthode procédurale rend service dans le cadre de prototypages rapides, le développement de pipelines de traitement de données pérennes et la confection de publications académiques exigent l’emploi rigoureux de l’interface orientée objet. Cette approche élimine toute dépendance envers un état global fluctuant et garantit une modularité totale du code source.
4.1 Avantages de la méthode orientée objet en programmation modulaire
Le paradigme orienté objet repose sur la manipulation explicite de références pointant vers des instances d’objets clairement identifiées dans la mémoire d’exécution. Dans cette perspective, l’interception de l’objet Axes retourné par les fonctions de Seaborn offre une isolation absolue contre les effets de bord inhérents à pyplot, particulièrement dans les environnements de calcul asynchrones ou lors de la génération séquentielle de plusieurs dizaines de figures au sein d’une boucle d’automatisation.
Cette rigueur architecturale facilite grandement l’encapsulation de la logique de mise en page dans des fonctions dédiées au sein de modules réutilisables. Un laboratoire de recherche peut ainsi concevoir une fonction d’étalonnage des axes acceptant en entrée une instance d’Axes, un vecteur de paramètres scalaires et des directives de formatage, assurant une stricte reproductibilité stylistique à travers l’ensemble des projets de recherche de l’institution sans jamais entrer en conflit avec les états de figures ouvertes en arrière-plan.
De plus, l’orientation objet s’avère indispensable dès lors que l’on manipule des figures multi-panneaux complexes comportant des projections hétérogènes, telles que des matrices de corrélation flanquées d’histogrammes marginaux. Chaque sous-graphique conserve ainsi son autonomie géométrique, ses limites d’échelle et sa propre densité de graduations sans risque de contamination croisée.
4.2 Implémentation technique de set_xticks et set_yticks
L’implémentation opérationnelle de cette méthode repose sur l’appel direct aux méthodes membres set_xticks() et set_yticks() exposées par l’objet Axes. Ces méthodes requièrent en premier argument un conteneur itérable précisant les valeurs scalaires des positions souhaitées sur l’axe. Dans les versions modernes de Matplotlib, ces méthodes intègrent également un paramètre optionnel labels qui autorise la transmission simultanée des étiquettes textuelles correspondantes.
Cette évolution de l’API vise spécifiquement à éradiquer un avertissement d’obsolescence particulièrement fréquent rencontré par les développeurs : le redouté UserWarning émis lorsque l’on tente de modifier directement les étiquettes textuelles via set_xticklabels() sans avoir au préalable fixé formellement les positions des graduations à l’aide de set_xticks(). L’utilisation conjointe des positions et des étiquettes au sein d’une signature unique assure au moteur graphique que la disposition spatiale des repères est mathématiquement verrouillée avant que la mise en forme textuelle ne soit appliquée.
Par ailleurs, les méthodes d’accès offrent des arguments additionnels raffinés, notamment le contrôle direct de la taille de police, de la couleur de police et de la famille typographique des étiquettes, concentrant en une unique opération unifiée la reconfiguration morphologique complète de la graduation concernée.
4.3 Application ciblée sur des graphiques de régression et de distribution
L’intérêt de l’approche orientée objet se manifeste avec éclat lors de la manipulation des visualisations sophistiquées issues des fonctions seaborn.regplot et seaborn.kdeplot. Un graphique de régression linéaire intègre généralement des bandes de confiance asymptotiques dont la lecture gagne en clarté si les graduations de l’axe prédictif sont strictement calées sur les valeurs moyennes et les écarts-types de la variable explicative.
En extrayant l’instance d’Axes résultant du tracé d’un modèle de régression, le statisticien peut assigner dynamiquement des graduations positionnées précisément à la moyenne arithmétique de la population, flanquée de paliers situés à plus ou moins une et deux déviations standardisées. Une telle configuration substitue à un repérage décimal arbitraire un repérage intrinsèquement statistique, permettant de vérifier instantanément si les données empiriques s’écartent significativement du modèle prédictif dans les zones de faible densité échantillonnale.
Sur les graphiques d’estimation de densité par noyau (KDE), cette méthode offre également l’opportunité d’égaliser rigoureusement les graduations de plusieurs distributions tracées côte à côte dans des sous-figures différentes, garantissant une échelle de comparaison visuelle irréprochable exempte de distorsions d’amplitude entre les différentes cohortes étudiées.
5. Génération algorithmique d’intervalles réguliers avec NumPy
La définition manuelle de listes statiques de coordonnées scalaires présente des limites évidentes d’extensibilité et de maintenabilité logicielle. L’intégration de la bibliothèque mathématique NumPy permet d’automatiser la génération computationnelle d’intervalles arithmétiques adaptatifs en fonction de la dynamique réelle des jeux de données analysés.
5.1 Utilisation de numpy.arange pour un contrôle par pas fixe
La fonction numpy.arange constitue l’outil fondamental pour engendrer des séquences de coordonnées définies par un intervalle ou un pas d’incrémentation constant. Sa signature accepte une valeur initiale de départ, une borne terminale exclusive et un incrément d’avancement scalaire. Elle permet ainsi d’établir un espacement parfaitement rigide entre les graduations successives, quelle que soit la variabilité d’échelle globale.
Pour exploiter rigoureusement numpy.arange sur un graphique Seaborn, il est indispensable de déterminer au préalable les valeurs extrêmes effectives de la distribution des données. L’analyste doit extraire le minimum et le maximum de la variable observée, puis ajuster la borne supérieure en y ajoutant la valeur d’un pas complet pour compenser le caractère exclusif de la limite terminale de l’algorithme d’itération arithmétique, garantissant ainsi que la dernière graduation englobe bel et bien la valeur maximale observable.
Une attention mathématique particulière doit être portée au phénomène bien connu des imprécisions inhérentes à l’arithmétique à virgule flottante sous le standard IEEE 754. Lors de l’itération de pas décimaux arbitraires, des erreurs infinitésimales cumulatives peuvent survenir, générant des coordonnées légèrement décalées de leur valeur théorique, provoquant l’affichage inesthétique d’une multitude de décimales résiduelles sur les étiquettes d’axe. Il est donc recommandé d’arrondir systématiquement les vecteurs résultants ou de préférer l’approche par découpage équidistant.
5.2 Application de numpy.linspace pour un nombre prédéterminé de graduations
Lorsque l’objectif ergonomique consiste à garantir un nombre fixe et invariable de graduations sur l’axe, indépendamment de la dispersion spatiale ou des unités de mesure, la fonction numpy.linspace s’impose comme l’alternative conceptuelle idéale à arange. Au lieu de stipuler un pas incrémental, l’analyste spécifie directement la borne inférieure, la borne supérieure et le nombre exact de subdivisions discrètes souhaitées.
L’algorithme de numpy.linspace procède à une segmentation équidistante de l’intervalle spatial continu, garantissant par conception que les deux valeurs limites transmises sont explicitement incluses dans le vecteur de retour sous forme de bornes inclusives fermées. Cette propriété mathématique assure que les deux extrémités du graphique disposeront invariablement d’une graduation parfaitement positionnée sur les frontières géométriques du domaine d’étude.
Cette technique démontre toute sa pertinence méthodologique dans l’analyse d’échelles d’évaluation psychométriques ou comportementales fermées, telles que les questionnaires standardisés de Likert à cinq, sept ou dix niveaux. En fixant le paramètre de comptage de linspace sur la cardinalité exacte des modalités de réponse possibles, le chercheur synchronise sans faille l’espace géométrique du tracé Seaborn avec la structure discrète théorique de l’instrument de mesure.
6. Automatisation professionnelle avec matplotlib.ticker.MaxNLocator
Bien que les vecteurs calculés via NumPy apportent une grande rigueur, ils demeurent statiques : si la figure est redimensionnée, ou si de nouvelles données sont insérées dynamiquement dans un tableau de bord, les graduations peuvent devenir trop denses ou trop éparses. Pour surmonter cet écueil, Matplotlib met à disposition un module spécialisé nommé ticker, dont la classe MaxNLocator incarne l’état de l’art en matière d’ajustement adaptatif dynamique.
6.1 Fonctionnement mathématique du positionneur MaxNLocator
La classe MaxNLocator met en œuvre un algorithme sophistiqué d’optimisation combinatoire conçu pour sélectionner automatiquement les graduations les plus élégantes et lisibles sur le plan cognitif, tout en garantissant de ne jamais excéder un nombre maximal prédéterminé de subdivisions d’axe. Contrairement aux approches statiques, MaxNLocator n’impose pas un nombre rigide absolu mais fixe un plafond contraignant.
L’algorithme évalue dynamiquement l’étendue mathématique des données visibles et calcule des facteurs de divisibilité privilégiant les puissances décimales fondamentales ainsi que leurs sous-multiples naturels, typiquement les facteurs un, deux, deux et demi, et cinq. Si la plage de données s’étend par exemple de 13,2 à 87,6 et que le plafond est fixé à six graduations, le localisateur écartera les divisions arithmétiques complexes pour retenir un ancrage sur les dizaines entières, proposant une série telle que vingt, quarante, soixante et quatre-vingts.
Ce positionneur traite également avec une grande élégance le problème de la divisibilité entière via un paramètre dédié, assurant que si une variable correspond à un décompte d’unités insécables, telles que des sujets humains, des pulsations cardiaques ou des cycles d’épreuves, aucune graduation fractionnaire ne sera générée, préservant ainsi la nature discrète de l’observation empirique.
6.2 Configuration pratique sur les objets Axis de Seaborn
L’intégration de MaxNLocator dans un flux de travail Seaborn s’effectue via l’interface orientée objet en accédant directement au sous-système de localisation de l’axe considéré. Après avoir instancié un graphique Seaborn et conservé sa référence d’Axes, le développeur importe la classe depuis matplotlib.ticker, puis procède à son instanciation en lui transmettant ses hyperparamètres de configuration.
L’application s’opère par le biais de la méthode set_major_locator() invoquée sur l’attribut xaxis ou yaxis de l’instance d’Axes. L’argument central réside dans le paramètre nbins, qui stipule le nombre maximal de segments ou d’intervalles visuels autorisés le long de la ligne d’axe. Par exemple, la spécification de six intervalles garantit la présence d’au plus sept graduations réparties de manière équilibrée sur toute la trajectoire métrique.
Une fonctionnalité particulièrement précieuse de MaxNLocator réside dans son argument prune. Ce dernier permet d’ordonner l’élagage délibéré et automatisé de la première graduation, de la dernière graduation, ou des deux simultanément. Cette capacité s’avère indispensable pour neutraliser le risque de collision typographique entre la première graduation d’un axe horizontal et l’origine de l’axe vertical adjacent au sein de graphiques denses.
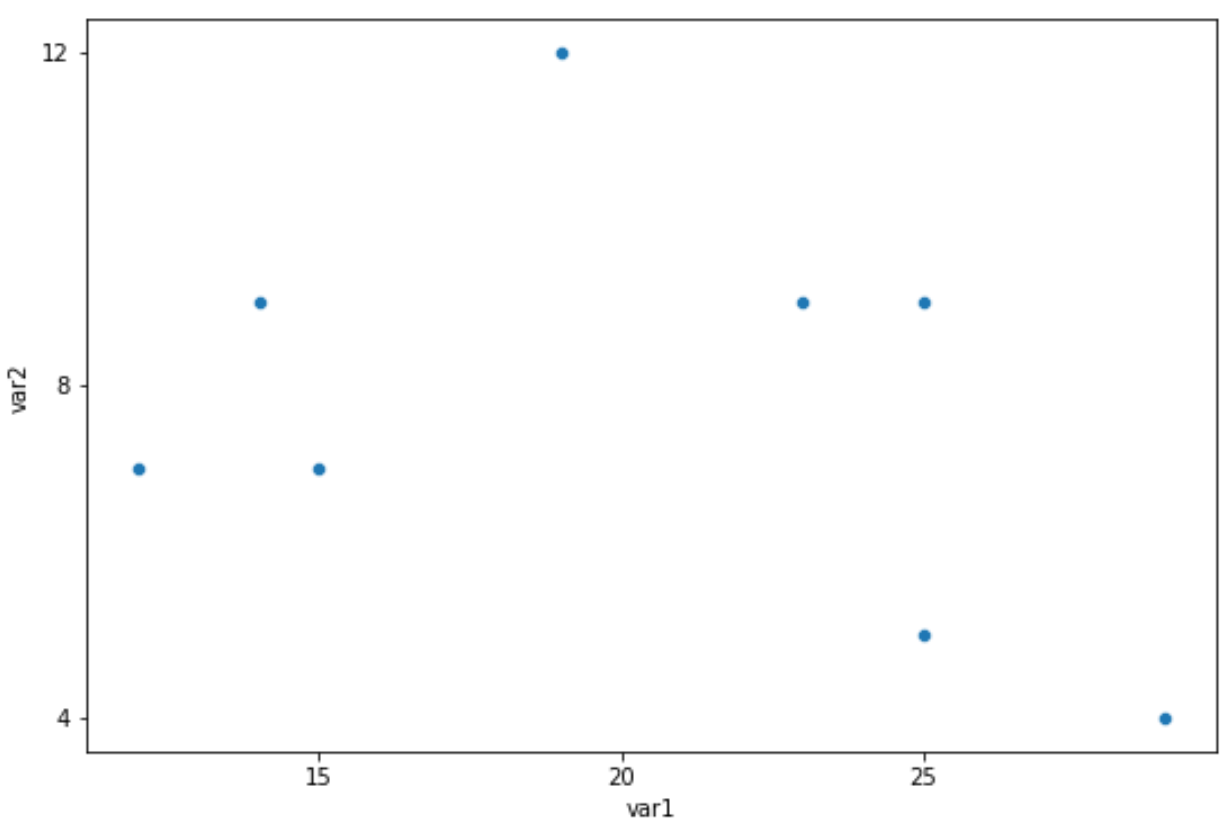
6.3 Étude comparative : fixation rigide versus MaxNLocator
La comparaison systématique entre la fixation manuelle des graduations et l’exploitation de MaxNLocator met en exergue des différences majeures en matière de résilience logicielle. La fixation rigide, bien que simple et parfaitement prévisible sur un jeu de données immuable, s’effondre dès lors que le pipeline analytique traite des données mises à jour en continu ou soumises à des filtrages interactifs de cohortes.
Dans un contexte de traitement par lots où des centaines de graphiques sont générés pour des biomarqueurs distincts dont les ordres de grandeur varient de plusieurs puissances de dix, une liste statique produit inévitablement des visualisations dégradées, caractérisées soit par une absence totale de repères dans la zone utile, soit par un empilement illisible de textes superposés. MaxNLocator s’adapte en revanche instantanément à l’empan dynamique de chaque biomarqueur sans intervention humaine.
En conséquence, la doctrine de visualisation scientifique préconise l’usage exclusif de MaxNLocator au sein des chaînes d’analyse exploratoire et des architectures de production automatisée, réservant la fixation manuelle par tableaux numériques rigides aux figures finales isolées destinées à l’impression définitive d’un manuscrit soumis pour publication.
7. Contrôle des intervalles stricts avec matplotlib.ticker.MultipleLocator
Si MaxNLocator se concentre sur le plafonnement de la densité globale des graduations, d’autres contextes expérimentaux imposent au contraire la garantie d’un espacement unitaire invariable et strict entre chaque graduation. Pour satisfaire cette exigence méthodologique, le module ticker met à disposition la classe MultipleLocator.
7.1 Principes de fonctionnement de MultipleLocator
Le positionneur MultipleLocator base l’ensemble de son calcul de projection sur un unique invariant scalaire passé à son constructeur : la valeur du pas d’incrémentation. Contrairement aux heuristiques d’adaptation dynamique, ce localisateur place inconditionnellement une graduation majeure sur chaque multiple entier de la valeur spécifiée, couvrant l’intégralité du domaine tracé par les données.
Si un axe s’étend de la valeur 3 à la valeur 47 et qu’un MultipleLocator configuré avec un pas de dix lui est assigné, les graduations apparaîtront avec une régularité absolue aux coordonnées dix, vingt, trente et quarante, indépendamment de la taille physique de l’image ou de la résolution d’affichage. Si l’utilisateur zoome sur la figure ou restreint interactivement la fenêtre d’observation spatiale, le positionneur réévalue les multiples visibles sans altérer la dimension de l’intervalle sous-jacent.
Ce déterminisme géométrique est particulièrement vertueux lorsqu’il s’agit de préserver la signification phénoménologique de l’unité de mesure. Dans de nombreuses sciences appliquées, l’observateur doit pouvoir évaluer intuitivement les distances relatives en associant mentalement un intervalle physique standard à une quantité fixe de la grandeur physique mesurée.
7.2 Cas d’application : variables temporelles et échelles standardisées
L’utilité pratique de MultipleLocator se manifeste avec éclat dans le traitement des séries chronologiques et des protocoles longitudinaux en psychologie cognitive ou en neurosciences comportementales. Lors de l’enregistrement de temps de réaction mesurés en millisecondes ou d’intervalles inter-stimuli, il est impératif que les graduations marquent des étapes temporelles rigoureuses, par exemple toutes les deux cent cinquante millisecondes ou toutes les demi-secondes complètes.
Un autre cas d’usage fondamental concerne l’affichage de distributions statistiques standardisées exprimées en scores Z ou en déviations standardisées relatives. L’assignation d’un MultipleLocator calibré sur une valeur unitaire de 1.0 garantit que chaque graduation majeure correspond exactement à un écart-type complet par rapport à la moyenne nulle de la population de référence, facilitant l’évaluation immédiate de la significativité statistique visuelle.
Enfin, dans les visualisations multi-panneaux présentant des données comparatives issues de dispositifs expérimentaux parallèles, l’application d’un MultipleLocator identique sur l’ensemble des sous-graphiques évite les illusions d’optique découlant d’échelles visuellement similaires mais métriquement désynchronisées, garantissant une intégrité comparative absolue.
8. Gestion des graduations sur les graphiques de niveau Figure (FacetGrid, relplot, catplot)
L’une des grandes forces de Seaborn réside dans sa capacité à produire des représentations multifactorielles complexes découpées selon les modalités de variables catégorielles. Toutefois, la structure sous-jacente de ces visualisations diffère profondément des figures standard, imposant des protocoles spécifiques pour le contrôle des graduations.
8.1 Différences structurelles entre AxesSubplot et FacetGrid
Tandis que les fonctions élémentaires opèrent sur une instance isolée d’Axes, les fonctions de haut niveau dites de figure, à l’instar de relplot, catplot, displot ou pairplot, génèrent un conteneur d’orchestration global dénommé FacetGrid ou PairGrid. Cette structure encapsule une matrice multidimensionnelle d’objets Axes interconnectés par des mécanismes de synchronisation d’échelle.
L’erreur la plus commune chez les praticiens consiste à invoquer les commandes procédurales globales telles que plt.xticks() consécutivement à l’appel d’un relplot. Une telle instruction n’opère en réalité que sur le tout dernier panneau tracé au sein du coin inférieur droit de la matrice de sous-figures, laissant l’intégralité des autres volets graphiques dans leur configuration par défaut non harmonisée.
De surcroît, le moteur FacetGrid gère de manière autonome le partage des axes via ses arguments structurels sharex et sharey. Par défaut, les graduations intérieures sont délibérément supprimées par Seaborn afin d’alléger la composition graphique globale et d’éviter les redondances visuelles, ce qui complique toute tentative d’ajustement local qui ignorerait cette architecture de couplage matriciel.
8.2 Utilisation de la méthode FacetGrid.set() pour un contrôle global
Pour appliquer un contrôle homogène et uniforme des graduations sur l’ensemble des panneaux d’une structure multifactorielle, l’interface de FacetGrid fournit une méthode de haut niveau particulièrement performante : set(). Cette méthode accepte en arguments des dictionnaires de propriétés ou des paramètres nommés correspondant directement aux méthodes de configuration d’axes de Matplotlib.
En assignant les paramètres xticks ou yticks au sein de la méthode set() d’une instance de FacetGrid, l’utilisateur ordonne la propagation immédiate du vecteur de graduations spécifié à travers chaque sous-graphique individuel de la grille. Le gestionnaire de facettes se charge de répercuter l’opération géométrique sur l’ensemble des panneaux tout en préservant le masquage automatique des étiquettes redondantes sur les volets intérieurs selon la topologie définie pour la figure.
Cette commande permet d’harmoniser en une unique ligne de code l’échelle métrique de dizaines de facettes expérimentales, assurant que l’observateur bénéficiera d’une référence spatiale absolument constante quel que soit le sous-groupe démographique ou clinique inspecté à travers la matrice factorielle.
8.3 Itération personnalisée sur les sous-axes individuels
Il se présente fréquemment des protocoles de recherche complexes où l’hypothèse expérimentale requiert une graduation asymétrique ou différentielle selon les facettes d’un graphique composite, notamment lorsque les axes ne sont pas partagés (sharex=False) en raison de variations d’amplitude considérables entre les sous-populations étudiées.
Dans ce scénario avancé, la manipulation globale via FacetGrid.set() s’avère inopérante. Le praticien doit alors accéder directement au tableau bidimensionnel d’objets Axes stocké au sein de l’attribut grid.axes de l’objet FacetGrid. En déployant une boucle itérative sur ce tableau matriciel, il devient possible d’examiner les propriétés de chaque volet individuel, d’identifier les conditions expérimentales associées et de paramétrer de manière ciblée les positionneurs de graduations correspondants.
Cette technique d’itération chirurgicale offre une liberté totale : elle permet d’injecter un MaxNLocator doté d’un paramétrage strict sur un panneau spécifique présentant une forte densité de points, tout en appliquant un MultipleLocator régulier sur un sous-graphique voisin dédié à une variable de contrôle, atteignant un degré de personnalisation inaccessible aux interfaces de haut niveau standardisées.
9. Ajustement des graduations sur les échelles logarithmiques et non linéaires
Les visualisations scientifiques sont fréquemment confrontées à des phénomènes physiques ou biologiques régis par des dynamiques d’échelle non linéaires, telles que des croissances exponentielles, des diffusions browniennes ou des lois de puissance. Dans ces contextes, la gestion des graduations linéaires traditionnelles devient caduque et requiert des outils d’ajustement dédiés.
9.1 Défis de graduation propres aux distributions asymétriques
Lorsqu’une variable présente une distribution fortement étalée vers la droite couvrant plusieurs ordres de grandeur, à l’instar des concentrations d’anticorps dans un sérum, des revenus financiers ou des temps de latence neuronaux, une échelle linéaire comprime l’immense majorité des observations contre l’origine tout en dédiant la majeure partie de l’espace graphique à quelques points isolés. La transformation logarithmique des axes permet de remédier à cette asymétrie spatiale.
Cependant, le comportement des graduations sur une échelle logarithmique obéit à une géométrie multiplicative et non plus additive. L’espacement géométrique implique que la distance physique séparant la graduation un de la graduation dix est rigoureusement identique à celle séparant la graduation dix de la graduation cent. Les tentatives naïves d’application de pas linéaires sur une échelle transformée génèrent des incohérences géométriques profondes et des artefacts d’affichage visuellement trompeurs.
De surcroît, le choix de la base logarithmique (base naturelle népérienne, base dix décimale ou base binaire deux) influe drastiquement sur l’interprétation des données. La sélection des graduations doit refléter fidèlement cette base mathématique sous-jacente afin que chaque palier visuel corresponde à un facteur d’échelle compréhensible pour la communauté scientifique réceptrice.
9.2 Utilisation conjointe de LogLocator et FormatStrFormatter
Pour calibrer avec une précision chirurgicale les graduations sur des axes à échelle logarithmique générés par Seaborn, il est nécessaire de faire appel aux classes spécialisées du module ticker : LogLocator pour le positionnement spatial des repères et FormatStrFormatter pour la mise en forme de leur étiquetage textuel.
La classe LogLocator prend en charge la complexité intrinsèque des puissances de dix ou de toute autre base logarithmique. Elle permet de contrôler le nombre de décades affichées, mais également d’ordonner la présence ou l’absence de graduations intermédiaires non linéaires (telles que 2, 3, 4, 5 le long de chaque décade). Le paramètre subs de LogLocator offre le contrôle exact de ces subdivisions géométriques internes, permettant d’enrichir ou d’épurer l’axe selon la densité requise.
En association étroite avec ce localisateur, un formateur typographique tel que LogFormatterMathtext ou FormatStrFormatter assure que les étiquettes ne s’afficheront pas sous forme de nombres décimaux étendus et difficiles à déchiffrer, mais sous une notation scientifique élégante respectant les puissances formelles, garantissant une lisibilité optimale et une compacité typographique maximale sur l’ensemble du canevas d’analyse.
10. Intégration et ajustement des graduations mineures (Minor Ticks)
Dans de nombreuses disciplines expérimentales de haute précision, telles que la spectroscopie, la physique des particules ou l’électrophysiologie, les graduations majeures ne suffisent pas à fournir une granularité de lecture satisfaisante sans surcharger l’axe de textes volumineux. L’adjonction méthodique de graduations mineures constitue la réponse ergonomique à ce dilemme.
10.1 Rôle des graduations mineures dans la lecture analytique
Les graduations mineures sont de petits traits de repère géométriques intercalés entre les graduations majeures, dépourvus d’étiquettes typographiques explicites. Leur rôle exclusif est de fournir un guide visuel de haute précision permettant d’estimer mentalement la fraction décimale ou fractionnaire séparant deux paliers numériques majeurs consécutifs, sans encombrer la composition globale de chiffres redondants.
D’un point de vue psychophysique, l’intégration de graduations mineures introduit une hiérarchie spatiale intuitive au sein du repère cartésien. Le système perceptif humain traite d’abord les étiquettes des graduations majeures pour ancrer l’ordre de grandeur fondamental, puis, si l’attention analytique se focalise sur un point particulier, exploite les micro-divisions mineures pour affiner l’évaluation quantitative de la coordonnée observée.
Cependant, l’introduction de repères mineurs doit répondre à des critères méthodologiques bien définis. Dans un graphique destiné à être projeté lors d’une communication orale rapide sur écran distant, les graduations mineures constituent un bruit visuel inutile et perturbateur. À l’inverse, dans un rapport technique imprimé ou un article scientifique sous format PDF vectoriel destiné à une inspection méticuleuse par les pairs, leur présence rehausse substantiellement la valeur documentaire de la figure.
10.2 Mise en œuvre technique via set_minor_locator
Pour activer et contrôler l’apparition des graduations mineures sur un graphique tracé avec Seaborn, l’opérateur doit invoquer la méthode set_minor_locator() disponible sur les objets xaxis et yaxis de l’instance d’Axes. La solution la plus automatisée repose sur l’emploi de la classe AutoMinorLocator issue du module matplotlib.ticker.
L’algorithme de AutoMinorLocator analyse dynamiquement l’intervalle séparant deux graduations majeures existantes et détermine de manière autonome le ratio de sous-divisions le plus logique, divisant généralement chaque intervalle majeur en quatre ou cinq segments mineurs réguliers selon que le pas principal est un multiple de deux ou de cinq. L’analyste peut également forcer explicitement ce découpage en fournissant un entier scalaire au paramètre n lors de l’instanciation du localisateur.
Au-delà de leur positionnement algorithmique, la morphologie visuelle des graduations mineures peut être finement personnalisée via la méthode tick_params() de l’objet Axes. Cette méthode permet de calibrer la longueur géométrique des traits de graduation, leur épaisseur de contour, leur couleur d’encrage, ainsi que leur direction spatiale, orientée vers l’extérieur de la boîte de tracé ou pointant vers l’intérieur de la zone de dessin selon les canons graphiques de la discipline scientifique visée.
11. Considérations ergonomiques et psychophysiques dans la disposition des graduations
La configuration logicielle des graduations d’axe ne peut être dissociée des principes fondamentaux de l’ergonomie visuelle et de la psychologie de la perception cognitive. Une maîtrise purement technique de la programmation reste vaine si les choix de mise en page violent les mécanismes naturels de traitement de l’information par le cortex visuel humain.
11.1 Charge cognitive et théorie de la charge visuelle de Sweller appliquée aux graphiques
La théorie de la charge cognitive développée par John Sweller, conjuguée aux principes d’économie sémiotique théorisés par Edward Tufte, offre un cadre conceptuel indispensable pour guider le dimensionnement des graduations. Tufte a formalisé le concept fondamental du ratio données/encre (data-ink ratio), postulant qu’une proportion maximale de l’encre graphique utilisée au sein d’une figure doit être dédiée à la communication de l’information empirique primaire, réduisant à leur stricte utilité fonctionnelle les éléments structurels secondaires tels que les axes et les graduations.
Dans cette perspective, un axe saturé de dizaines de repères numériques denses augmente la charge cognitive extrinsèque, imposant à la mémoire de travail un effort de filtrage visuel parasitaire qui distrait le cerveau de l’analyse des motifs relationnels sous-jacents aux données. La célèbre loi psychologique de Miller, relative aux limites de la capacité d’appréhension immédiate fixée à un empan d’environ sept éléments plus ou moins deux, fournit une règle heuristique d’une remarquable efficacité : sur un axe donné, la présence de cinq à sept graduations majeures offre généralement le compromis ergonomique parfait entre orientation métrique et fluidité perceptive.
Un excès inverse, réduisant un axe étendu à deux graduations d’extrémités isolées, engendre une sous-information quantitative dramatique, contraignant l’observateur à des interpolations approximatives dénuées de certitude mathématique. L’arbitrage ergonomique doit donc viser l’identification du seuil critique minimal de graduations suffisant pour ancrer sans incertitude l’ensemble du domaine de données représenté.
11.2 Typographie, orientation et prévention du chevauchement
L’un des désastres ergonomiques les plus fréquents rencontrés dans la littérature scientifique réside dans la collision et le chevauchement physique des étiquettes numériques consécutives sur l’axe des abscisses. Lorsque la densité de graduations est trop élevée ou que les valeurs textuelles comportent de nombreux chiffres significatifs, les chaînes de caractères se superposent, rendant la lecture purement impossible.
Pour contourner ce problème, une pratique répandue mais hautement néfaste consiste à incliner arbitrairement les étiquettes selon un angle de quarante-cinq ou quatre-vingt-dix degrés. Des recherches approfondies en psychophysique de la lecture ont démontré que l’inclinaison typographique des libellés numériques ralentit considérablement la vitesse de traitement visuel, augmente la charge cognitive et élève significativement le taux d’erreur d’association spatiale entre l’étiquette et le repère géométrique correspondant. L’orientation horizontale stricte des libellés textuels doit être systématiquement préservée pour garantir une décodabilité instantanée.
La résolution ergonomique rigoureuse de la congestion textuelle ne réside pas dans la rotation acrobatique des typographies, mais dans la réduction algorithmique du nombre total de graduations via MaxNLocator, l’élagage des décimales superflues par un formatage adapté, ou encore l’introduction d’un décalage vertical ordonné des repères successifs. L’espacement spatial minimal entre les blocs typographiques contigus ne devrait jamais descendre en deçà d’un tiers de la largeur moyenne des caractères utilisés.
12. Diagnostic des anomalies et résolution des erreurs fréquentes
Dans la pratique courante du codage statistique sous Python, l’interaction asynchrone entre Seaborn et Matplotlib génère ponctuellement des comportements déroutants pour le praticien. L’identification systématique des mécanismes d’échec permet de débloquer rapidement ces situations et de consolider la fiabilité des scripts de visualisation.
12.1 Écrasement accidentel des configurations par Seaborn
L’une des anomalies les plus frustrantes réside dans l’écrasement silencieux des paramètres de graduations personnalisés appliqués avant ou pendant l’exécution des routines Seaborn. En raison de sa vocation automatisée, Seaborn réévalue l’échelle, les limites de projection et la configuration des axes à divers stades de son processus d’exécution interne, en particulier lors de l’application dynamique de thèmes graphiques via sns.set_theme() ou lors de l’invocation de certaines fonctions de lissage statistique.
Si un chercheur configure rigoureusement ses graduations via plt.xticks() avant d’invoquer la fonction de tracé de Seaborn, cette dernière réinitialisera généralement l’objet Axis afin de l’adapter à l’empan théorique du jeu de données injecté, annulant sans préavis l’ensemble des directives manuelles antérieures. L’ordre d’exécution séquentiel du script constitue la clé absolue de résolution : la configuration des graduations doit impérativement intervenir après le tracé complet de l’ensemble des éléments de données graphiques.
Par ailleurs, pour interdire formellement à Matplotlib et Seaborn de modifier les bornes métriques après l’assignation de graduations spécifiques, l’instruction ax.autoscale(False) peut être invoquée sur l’objet Axes concerné. Ce verrouillage géométrique garantit que les limites spatiales et le positionnement des graduations demeureront inaltérés par les opérations graphiques ultérieures, telles que l’ajout d’annotations textuelles ou le tracé de lignes de démarcation manuelles.
12.2 Incompatibilités d’indexation avec les variables catégorielles
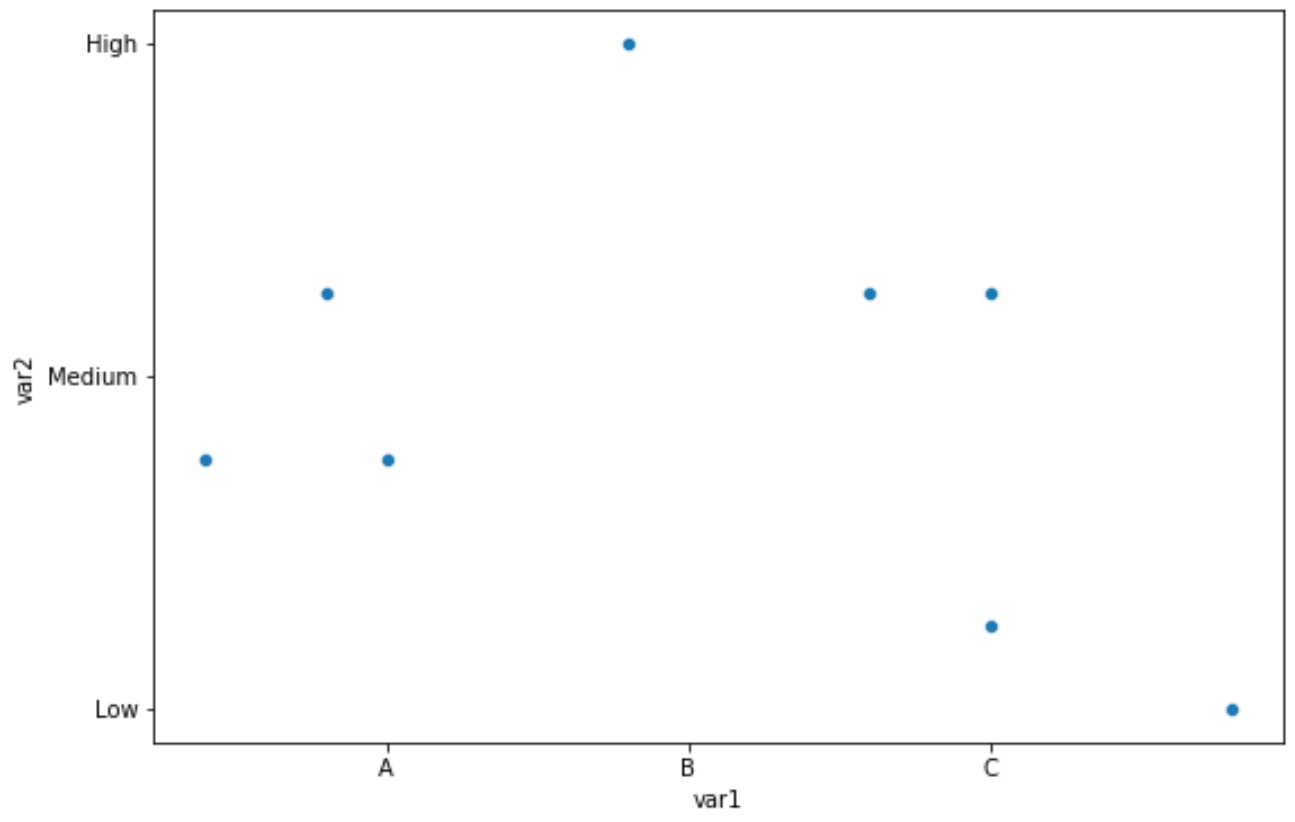
Une confusion conceptuelle majeure survient régulièrement lors de l’ajustement des graduations sur des graphiques représentant des variables discrètes ou catégorielles tracées avec des fonctions telles que seaborn.barplot, seaborn.countplot ou seaborn.boxplot. Dans ces visualisations, Seaborn ne positionne pas les catégories sous forme de coordonnées nominales arbitraires, mais projette l’ensemble des facteurs sur un système de coordonnées scalaires discrètes indexées numériquement de zéro à N-1, où N désigne le nombre total de modalités qualitatives.
Si l’analyste tente de manipuler l’axe catégoriel en transmettant directement des listes de chaînes de caractères au sein de set_xticks() en lieu et place d’indices numériques scalaires, Matplotlib générera une exception d’exécution ou produira un tracé chaotique marqué par la disparition pure et simple des repères souhaités. La méthode rigoureuse consiste à fournir à set_xticks() un vecteur d’indices scalaires entiers généré à partir de la longueur du catalogue de catégories, puis d’assigner les noms textuels correspondants via le paramètre labels.
Cette distinction est primordiale lorsque l’on souhaite délibérément sous-échantillonner un axe catégoriel comprenant un trop grand nombre d’occurrences. Par exemple, si l’on affiche un diagramme à barres de cinquante pays du monde, on ne peut pas supprimer arbitrairement des étiquettes sans sélectionner rigoureusement les coordonnées entières associées aux barres conservées, sous peine de voir les noms des premiers pays se décaler sur les barres géométriques des pays voisins.
12.3 Protocoles de validation avant soumission éditoriale
Avant de finaliser une figure pour une soumission auprès d’un comité d’évaluation par les pairs ou une publication industrielle, un protocole rigoureux de validation technique des graduations doit être exécuté. La première vérification porte sur la cohérence dimensionnelle : l’opérateur doit contrôler que les graduations extrêmes englobent rigoureusement les limites réelles des distributions sans induire un tassement artificiel des tracés dans un coin du cadre.
Le second contrôle concerne l’intégrité vectorielle du rendu lors de l’exportation vers des formats graphiques compressés ou vectoriels tels que le format PDF ou SVG. L’exécution de l’exportation via plt.savefig() doit intégrer le paramètre bbox_inches=’tight’. Cette option garantit que le moteur graphique recalculera le cadre englobant de la figure pour y inclure l’intégralité des étiquettes de graduation les plus extérieures sans jamais les rogner au niveau de la bordure du document.
Enfin, il est vivement conseillé aux structures de recherche d’encapsuler leurs protocoles de paramétrage de graduations au sein de fonctions Python dédiées, validées et documentées. Ces routines d’assistance, stockées dans un module d’ingénierie logicielle partagé, permettent d’instancier en une instruction un localisateur MaxNLocator calibré selon les exigences précises des revues visées, garantissant une conformité graphique sans faille et libérant les chercheurs des contingences de réglages répétitifs.
Références
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Miller, G. A. (1956). The magical number seven, plus or minus two: Some limits on our capacity for processing information. Psychological Review, 63(2), 81–97. https://doi.org/10.1037/h0043158
- Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257–285. https://doi.org/10.1207/s15516709cog1202_4
- Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press.
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wilkinson, L. (2005). The grammar of graphics (2e éd.). Springer. https://doi.org/10.1007/0-387-28695-0