
La visualisation de données contemporaine ne se résume pas à l’agencement géométrique de points, de barres ou de surfaces sur un repère orthogonal. Elle constitue un acte de communication sémiotique complexe où le texte et l’image doivent s’articuler avec une précision chirurgicale pour transmettre une information univoque. Dans l’écosystème scientifique de Python, la bibliothèque Seaborn s’est imposée comme un standard de facto pour l’analyse statistique exploratoire et la publication académique. Conçue pour simplifier la création de représentations visuelles élaborées, elle masque sous une interface élégante des mécanismes sous-jacents sophistiqués hérités de Matplotlib. Toutefois, cette couche d’abstraction produit fréquemment des frictions lorsqu’il s’agit d’ancrer fermement le contexte analytique par l’adjonction de métadonnées textuelles fondamentales, au premier rang desquelles figure le titre du graphique.
L’acte d’ajouter un titre à une figure générée par Seaborn soulève des questions qui dépassent la simple invocation d’une commande syntaxique. L’opération exige une compréhension intime de l’architecture logicielle de la bibliothèque, notamment la distinction cardinale entre les fonctions opérant au niveau de l’axe et celles administrant la figure dans sa globalité. Un praticien confronté à un graphique sans titre ou doté d’un libellé mal positionné s’expose à des erreurs d’interprétation méthodologique, à une dégradation de l’ergonomie cognitive de ses rapports et, in fine, à un rejet potentiel de ses conclusions lors de l’évaluation par les pairs. Cet article propose une analyse exhaustive, rigoureuse et didactique des méthodologies permettant de titrer avec exactitude tout type de tracé Seaborn, depuis le simple diagramme univarié jusqu’aux grilles multifacettes les plus intriquées.
En explorant successivement les fondements théoriques de la transmission textuelle en visualisation, les paradigmes de programmation impératif et orienté objet, la typographie avancée, le positionnement spatial micrométrique et l’automatisation algorithmique, ce guide a pour vocation de transformer une tâche perçue comme triviale en un puissant vecteur de clarté scientifique. À travers des exemples décortiqués avec soin, nous examinerons comment maîtriser l’agencement des titres principaux, des sous-titres contextuels et des annotations mathématiques de manière à conférer à vos productions graphiques une finition digne des plus hautes exigences éditoriales.
1. Introduction théorique à la visualisation de données et au titrage sous Seaborn
1.1 L’importance sémiotique et cognitive des métadonnées textuelles dans la visualisation
L’analyse sémiotique de l’information visuelle, telle que théorisée par Jacques Bertin dans sa Sémiologie Graphique, démontre que l’œil humain interprète d’abord les variations spatiales, chromatiques et géométriques avant d’en décoder la signification conceptuelle. Dans ce processus de décodage perceptif, le titre remplit une fonction d’ancrage sémantique indispensable. Sans métadonnée textuelle explicite, le système cognitif de l’observateur est contraint d’inférer la nature des variables, les unités de mesure et l’échantillon d’étude uniquement à partir des échelles et de la légende. Cette gymnastique intellectuelle induit une charge cognitive extrinsèque substantielle qui détourne l’attention de la véritable tâche analytique : la détection de tendances, d’anomalies ou de corrélations statistiques. Les travaux fondateurs de William Cleveland et Robert McGill sur la perception graphique confirment que l’efficacité d’un graphique repose sur la vitesse et la précision avec lesquelles le lecteur extrait des inférences quantitatives fiables.
Dans la communication scientifique et professionnelle, il convient de distinguer rigoureusement trois catégories de titres, chacune répondant à un objectif rhétorique déterminé :
- Le titre descriptif : Il se limite à énoncer neutralement les variables mises en relation sans préjuger du résultat (par exemple, Distribution du revenu annuel en fonction du niveau d’études). Cette typologie est particulièrement adaptée aux rapports techniques exploratoires où l’objectivité brute prime sur l’argumentation.
- Le titre interprétatif : Il oriente le regard vers une caractéristique morphologique saillante de la distribution sans formuler de conclusion définitive (par exemple, Asymétrie positive marquée des salaires chez les cadres intermédiaires). Il guide le traitement cognitif sans imposer d’inférence causale stricte.
- Le titre déclaratif : Fréquemment employé dans les synthèses exécutives et les revues de vulgarisation scientifique de haut niveau, il formule la thèse principale ou la découverte empirique sous forme d’une assertion directe (par exemple, L’accroissement du capital formation réduit la variance des écarts de rémunération).
Le choix entre ces trois régimes discursifs dicte l’approche typographique et structurelle que le data scientist doit adopter lors de l’intégration du titre au sein de l’environnement Seaborn.
1.2 L’écosystème Seaborn et son articulation structurelle avec Matplotlib
Pour appréhender la manipulation des éléments textuels dans Seaborn, il est impératif de dissiper un malentendu fréquent : Seaborn ne constitue en aucun cas un moteur de rendu graphique autonome concurrent de Matplotlib. Conçu par Michael Waskom, Seaborn opère comme une surcouche d’abstraction de haut niveau solidement amarrée sur les fondations de Matplotlib. Lorsque l’utilisateur exécute une fonction Seaborn, la bibliothèque traduit ces instructions statistiques complexes en primitives graphiques élémentaires gérées par la hiérarchie des objets de Matplotlib, notamment les classes Figure, Axes, Line2D, PolyCollection et Text.
Cette interdépendance structurelle implique que la gestion du texte, des polices de caractères, des espacements et de la rastérisation relève ultimement du moteur typographique de Matplotlib. En conséquence, les paramètres textuels acceptés par les fonctions de bas niveau de Matplotlib demeurent universellement valides au sein de l’écosystème Seaborn. Toutefois, l’abstraction introduite par Seaborn regroupe souvent plusieurs opérations de bas niveau au sein d’une seule signature fonctionnelle. Cette simplification présente l’inconvénient d’occulter le conteneur exact au sein duquel le titre doit être injecté. L’adoption d’une approche hybride, conjuguant la concision statistique de Seaborn pour le tracé des données et la puissance chirurgicale des classes de Matplotlib pour la post-synchronisation esthétique, représente la méthode la plus robuste pour maîtriser l’affichage graphique professionnel.
1.3 Taxonomie des objets graphiques : AxesSubplot versus FacetGrid
L’architecture interne de Seaborn repose sur une dichotomie fondamentale qu’il convient de maîtriser parfaitement pour éviter les erreurs d’exécution : la distinction entre les fonctions de niveau axe (Axes-level functions) et les fonctions de niveau figure (Figure-level functions). Cette taxonomie structure l’ensemble des mécanismes de retour d’objets et détermine la méthode exacte à employer pour assigner un titre.
D’un côté, les fonctions de niveau axe telles que sns.scatterplot, sns.boxplot, sns.histplot ou sns.violinplot effectuent leur tracé directement à l’intérieur d’un canevas unitaire matérialisé par une instance de la classe matplotlib.axes.Axes (ou sa sous-classe interne AxesSubplot). Ces fonctions retournent systématiquement cet objet d’axe unique, permettant un chaînage ou une modification immédiate via l’interface orientée objet canonique de Matplotlib.
De l’autre côté, les fonctions de niveau figure telles que sns.relplot, sns.catplot, sns.displot ou sns.lmplot n’opèrent pas sur un axe isolé. Elles constituent des gestionnaires de haut niveau conçus pour orchestrer la décomposition matricielle de jeux de données complexes en multiples sous-graphiques juxtaposés. Ces fonctions instancient et retournent un conteneur spécialisé nommé FacetGrid (ou plus rarement PairGrid ou JointGrid). Un objet FacetGrid encapsule une figure entière de Matplotlib et un tableau multidimensionnel d’axes individuels. Dès lors, tenter d’appliquer une méthode dévolue aux axes directement sur une instance de FacetGrid déclenche inévitablement une exception de type AttributeError. Identifier la nature formelle de l’objet renvoyé constitue donc le prérequis absolu à toute tentative de manipulation textuelle.
2. Anatomie architecturale de Seaborn : Comprendre les objets cibles pour le titrage
2.1 Le niveau Axes (Axes-level functions) et son comportement natif
Les fonctions de niveau axe sont conçues pour se comporter comme des analogues directs des fonctions de tracé natives de Matplotlib, tout en intégrant des mécanismes sophistiqués d’agrégation statistique et d’assignation automatique de palettes de couleurs. Lorsqu’une telle fonction est invoquée sans spécification explicite de l’axe récepteur via l’argument ax, elle s’insère de manière transparente dans l’axe actif du système de gestion d’état de Matplotlib (matplotlib.pyplot.gca()). Si aucun axe n’existe préalablement, la machinerie sous-jacente instancie automatiquement une nouvelle figure dotée d’un système de coordonnées standard.
Ce mode opératoire confère aux fonctions de niveau axe une très grande plasticité d’intégration. Elles peuvent s’insérer au sein de compositions complexes conçues en amont à l’aide de constructeurs géométriques tels que plt.subplots() ou matplotlib.gridspec.GridSpec. Du point de vue du titrage, l’objet cible est exclusivement l’instance matplotlib.axes.Axes retournée par la fonction. Cet objet dispose en interne d’attributs dédiés au stockage des étiquettes et du titre, matérialisés sous la forme d’instances de la classe matplotlib.text.Text. La manipulation de ce titre s’effectue dès lors au niveau des métadonnées propres à cette boîte englobante locale, sans interaction nécessaire avec les bordures supérieures de la fenêtre graphique globale.
2.2 Le niveau Figure (Figure-level functions) et l’abstraction FacetGrid
Contrairement aux fonctions uniaxiales, les fonctions de niveau figure prennent l’entière responsabilité de la topologie géométrique du canevas. Leur mission est de faciliter la visualisation de dimensions catégorielles supplémentaires par la technique du micro-cloisonnement visuel (le small multiples formalisé par Edward Tufte). L’objet FacetGrid généré par ces fonctions agit comme un coordinateur structurel : il dimensionne automatiquement la taille de la figure en fonction du nombre de facettes, synchronise les limites des axes en abscisse et en ordonnée, configure les marges intercalaires et déploie une légende unifiée externe.
Dans ce contexte architectural, la notion même de « titre » devient intrinsèquement polymorphique. On observe en effet deux strates textuelles concurrentes : d’une part, le titre global surplombant l’ensemble de la composition (communément désigné sous le terme de super-titre ou suptitle), et d’autre part, les libellés secondaires assignés individuellement à chaque sous-panneau pour expliciter la tranche de données filtrée. Confondre ces deux niveaux conduit fréquemment à des aberrations visuelles où un titre général se retrouve confiné au premier cadran d’une grille matricielle de neuf sous-graphiques, ou inversement, où les métadonnées de sous-panneaux écrasent la ligne directrice de l’analyse globale.
2.3 Conséquences architecturales sur l’attribution des titres et super-titres
La compréhension de cette hiérarchie logicielle dicte une règle de conception universelle : la méthode d’attribution du titre doit être rigoureusement adaptée à la nature de la couche réceptrice. L’erreur la plus récurrente chez les praticiens réside dans la tentative d’appel de la méthode set_title() sur un objet issu d’une commande telle que sns.catplot. L’interpréteur Python rejette immédiatement cette instruction puisque la classe FacetGrid ne possède aucun attribut portant ce nom spécifique.
Pour naviguer avec aisance dans cette hiérarchie, le tableau mental suivant doit être intériorisé :
- Pour un objet de type matplotlib.axes.Axes (généré par une fonction de niveau axe), le titrage s’opère via la méthode set_title() de l’axe ou la méthode universelle set(title=…).
- Pour un objet de type FacetGrid (généré par une fonction de niveau figure), le titrage global s’effectue obligatoirement en remontant au conteneur suprême via l’attribut figure ou fig pour appeler fig.suptitle(), tandis que les titres de colonnes et de rangées sont gouvernés par la méthode native g.set_titles().
La sélection stratégique de l’outil approprié conditionne la pérennité du code au sein des pipelines de production, la maintenabilité des scripts analytiques et l’absence de régressions lors des mises à jour des dépendances logicielles.
3. Méthode élémentaire : L’utilisation de la méthode .set() sur les objets Axes
3.1 Mécanique et syntaxe de la méthode .set(title=…)
L’approche la plus directe et la plus fréquemment documentée dans les tutoriels introductifs repose sur l’utilisation de la méthode mutatrice set(), attachée aux instances de la classe Axes de Matplotlib mais largement exploitée par les utilisateurs de Seaborn. Cette fonction a été conçue comme une interface pratique permettant d’actualiser simultanément une multitude de descripteurs géométriques et textuels en une seule instruction. Elle accepte des arguments nommés correspondant aux propriétés canoniques de l’axe, tels que xlabel, ylabel, xlim, ylim, et spécifiquement title.
Sur le plan mécanique, l’appel de ax.set(title=’…’) déclenche en coulisse une délégation d’appel vers la méthode sous-jacente set_title() de Matplotlib. L’argument textuel transmis est inspecté, converti en une chaîne de caractères conforme si nécessaire, puis encapsulé dans l’objet Text positionné au sommet de la zone de tracé. En raison de sa structure fluide, cette commande peut être directement chaînée à l’instruction d’instanciation du graphique Seaborn, évitant ainsi la création explicite d’une variable intermédiaire dans le script. Cette brièveté syntaxique en fait l’outil d’élection pour le prototypage immédiat et les phases initiales de fouille de données au sein d’environnements interactifs tels que Jupyter Notebooks.
3.2 Exemple pratique sur un diagramme en boîte (sns.boxplot)
Pour illustrer la mise en œuvre de cette technique élémentaire, considérons un scénario analytique classique impliquant l’évaluation de la performance sportive au sein d’une ligue professionnelle. Imaginons un jeu de données structuré sous la forme d’un tableau Pandas contenant des enregistrements sur les points marqués par des athlètes répartis selon leur franchise d’appartenance. L’objectif consiste à générer un diagramme en boîte comparatif et à lui assigner instantanément une signalétique explicite.
La démarche consiste à importer les modules seaborn, matplotlib.pyplot et pandas, à charger ou instancier la structure de données, puis à solliciter la fonction sns.boxplot en précisant la variable catégorielle en abscisse et la métrique numérique continue en ordonnée. En adjoignant immédiatement la terminaison .set(title=’Points par équipe’) à la commande de génération, l’interpréteur compile l’affichage visuel et applique l’étiquette textuelle dans un même souffle computationnel. Le résultat produit est un tracé équilibré où le titre surplombe harmonieusement le repère cartésien sans nécessiter de gestion manuelle des coordonnées spatiales.
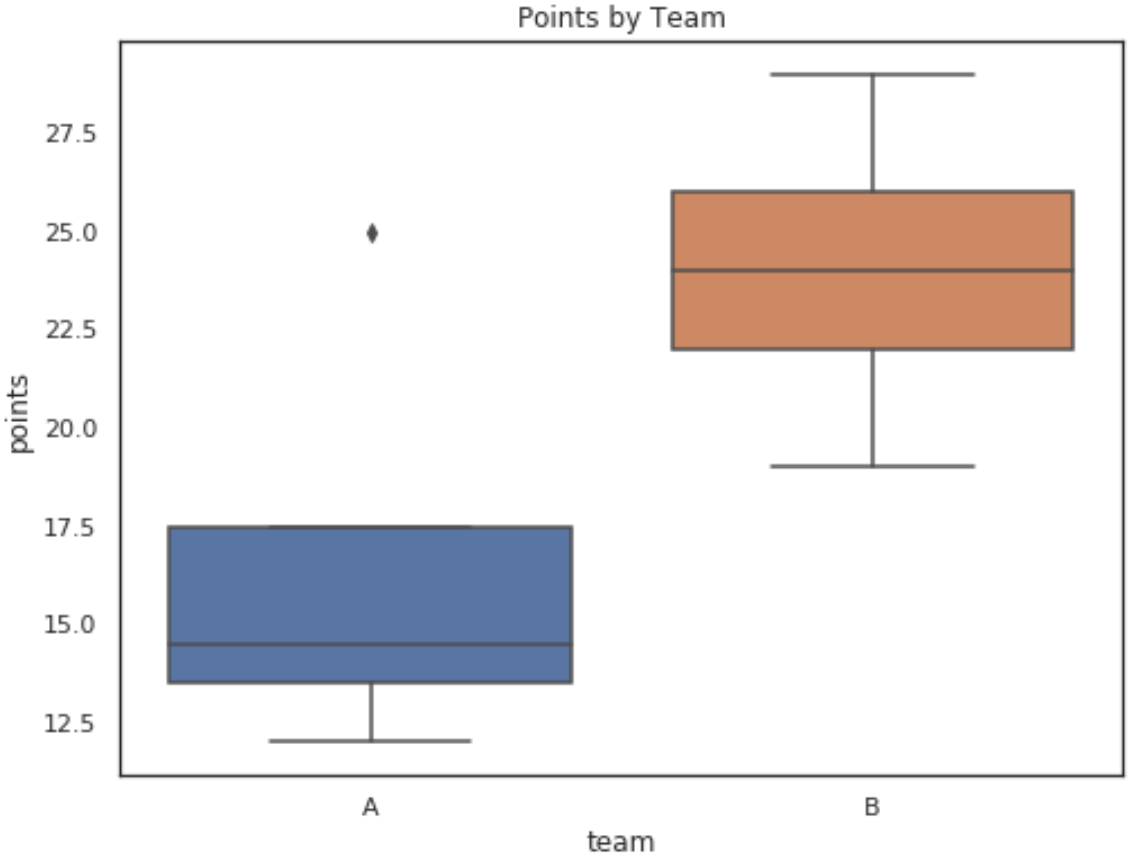
Il est important de souligner que cette méthode préserve scrupuleusement l’intégrité des labels d’axes générés par déduction statistique à partir des en-têtes de colonnes du DataFrame. L’utilisateur bénéficie ainsi d’un gain de productivité immédiat sans compromettre la lisibilité globale de la restitution.
3.3 Exemple d’application sur un nuage de points (sns.scatterplot)
La polyvalence du chaînage via .set() s’étend naturellement à l’analyse bivariée continue, modélisée classiquement par un nuage de points. Supposons que nous souhaitions examiner la relation structurelle existant entre le nombre de passes décisives distribuées et le total de points inscrits par match au cours d’une saison régulière. L’appel à sns.scatterplot avec l’assignation des variables respectives aux axes horizontal et vertical produit un tracé dispersé hautement informatif.
En chaînant l’instruction .set(title=’Points vs Passes décisives’), le conteneur d’axes applique la mise à jour nominale de manière synchrone. Cette approche garantit que l’étiquette supérieure s’ancre fidèlement au repère graphique. L’efficacité de ce paradigme est particulièrement manifeste lorsque des dimensions esthétiques supplémentaires, telles que la teinte chromatique (hue) ou la taille des marqueurs (size), sont injectées dans le nuage de points. Le titre ainsi assigné fournit le cadre référentiel indispensable à la lecture conjointe des données projetées et de la boîte de légende latérale générée automatiquement par Seaborn.
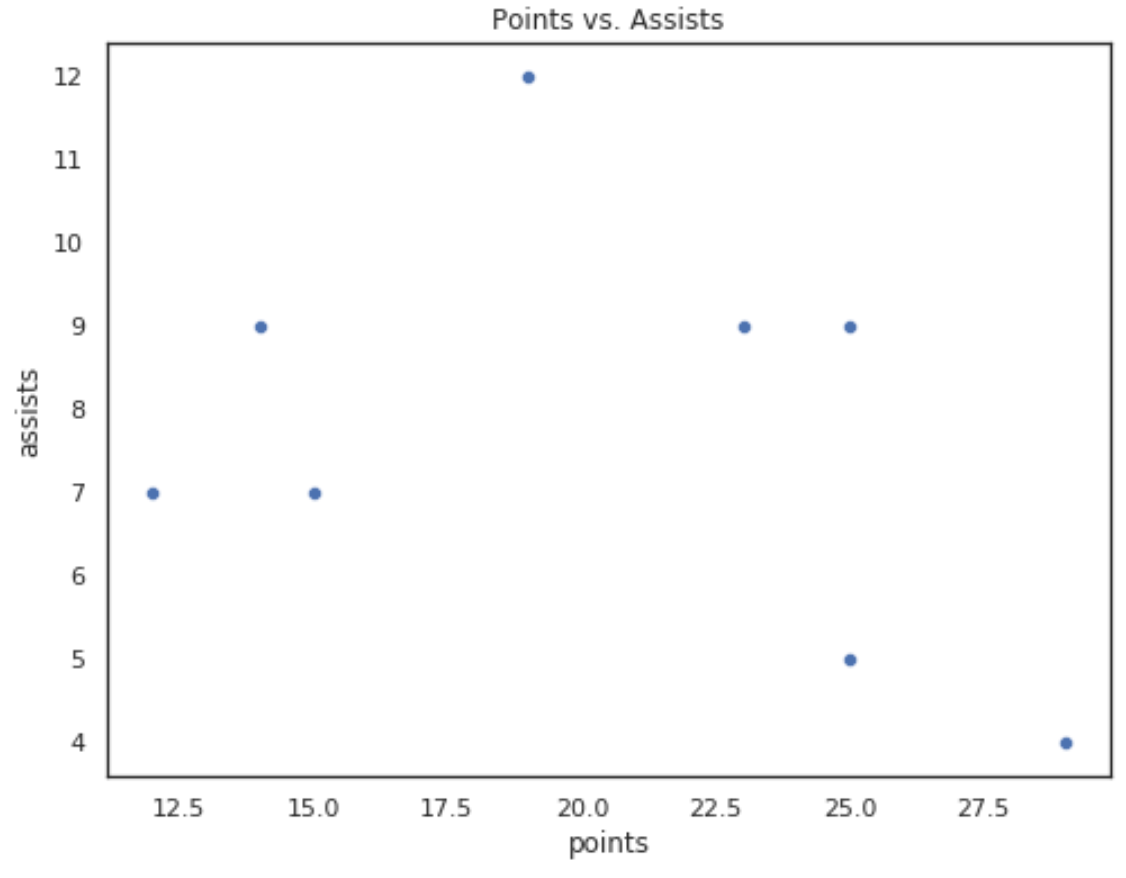
Toutefois, une inspection rigoureuse de cette méthode révèle rapidement ses frontières structurelles. Si la concision du code est incontestable, la possibilité de personnaliser finement la typographie, la chromaticité ou l’espacement relatif du titre via .set() demeure rudimentaire, justifiant l’exploration d’approches plus chirurgicales.
3.4 Avantages et limitations computationnelles de la fonction .set()
L’adoption systématique de la méthode .set(title=…) doit être soumise à une évaluation critique des contraintes du projet logiciel. Parmi ses atouts majeurs figurent sa concision extrême, sa compatibilité totale avec les pipelines d’exploration rapide et sa lisibilité syntaxique pour les programmeurs débutants. Elle élimine la verbosité du code en condensant la configuration des limites, des axes et des titres au sein d’un bloc fonctionnel unique.
Cependant, cette commodité dissimule d’importantes limites computationnelles et ergonomiques :
- Surcharge de la signature : La méthode set() utilise un mécanisme générique d’absorption des arguments par mots-clés variables (**kwargs). Cela empêche l’autocomplétion avancée et l’analyse statique de type dans les environnements de développement intégrés modernes.
- Restriction de paramétrage typographique : La transmission directe d’attributs stylistiques avancés, tels que la marge de décalage vertical (pad) ou la sélection d’une famille de polices spécifique, s’avère fastidieuse voire impossible sans surcharger illisiblement la commande.
- Rupture de la philosophie orientée objet : En encapsulant plusieurs mutations d’état distinctes au sein d’une méthode fourre-tout, elle s’écarte des bonnes pratiques de génie logiciel préconisant la séparation claire des responsabilités entre la construction géométrique et le formatage esthétique.
4. Approche alternative et bas niveau : L’interaction directe avec Matplotlib via plt.title()
4.1 Le modèle d’état séquentiel (State-machine) de Matplotlib appliqué à Seaborn
L’une des particularités les plus marquantes de la visualisation en Python réside dans la double nature de son architecture : la coexistence d’un modèle d’état séquentiel (la fameuse interface pyplot, calquée à l’origine sur la syntaxe matricielle de MATLAB) et d’une architecture orientée objet stricte. L’interface séquentielle repose sur un système global et implicite de suivi des états (state-machine). À tout moment de l’exécution d’un script, le module matplotlib.pyplot conserve en mémoire un pointeur interne désignant la « figure courante » (current figure) et l’« axe courant » (current axes).
Lorsqu’un analyste utilise une fonction de traçage Seaborn de niveau axe sans instancier explicitement de structure d’accueil, Seaborn interroge cet état global et trace les éléments géométriques dans le conteneur actuellement actif. Par voie de conséquence, si l’on invoque l’instruction plt.title() immédiatement après l’appel à une fonction Seaborn, le moteur textuel de Matplotlib rattache automatiquement le titre désigné à l’axe qui vient d’être manipulé. Cette approche jouit d’une immense popularité en raison de son caractère intuitif pour quiconque a débuté l’apprentissage de la programmation scientifique par des scripts linéaires impératifs.
4.2 Syntaxe fondamentale et paramétrage standard avec plt.title()
La commande matplotlib.pyplot.title() possède une signature enrichie offrant un contrôle direct sur les caractéristiques fondamentales du titre sans passer par des méthodes déléguées. Sa définition formelle s’articule autour de paramètres cruciaux :
- label : La chaîne de caractères textuelle constituant l’intitulé du titre, acceptant les encodages de caractères complexes ainsi que les formulations mathématiques.
- fontdict : Un dictionnaire Python standard permettant de spécifier en bloc les propriétés typographiques telles que la taille de police, la graisse, la variante et la couleur.
- loc : Une chaîne déterminant l’alignement horizontal du texte sur la boîte englobante de l’axe, acceptant rigoureusement les valeurs ‘center’, ‘left’ ou ‘right’.
- pad : Une valeur flottante quantifiant le décalage vertical (exprimé en points typographiques) entre le bord supérieur de la zone graphique et la ligne de base du titre.
L’implémentation opérationnelle s’effectue selon une séquence temporelle stricte : instanciation du tracé Seaborn, suivie immédiatement de l’appel à plt.title(‘Distribution des fréquences’, fontsize=14, loc=’left’, pad=15). Cette démarche assure une séparation textuelle claire dans le flux d’instructions tout en autorisant une personnalisation paramétrique immédiate.
4.3 Gestion des conflits de focus graphique et des contextes multi-figures
En dépit de son accessibilité séduisante, le modèle d’état implicite présente des vulnérabilités critiques dès lors que l’on quitte le cadre de scripts académiques élémentaires. Dans les environnements interactifs d’analyse de données, l’ordre d’exécution séquentiel des cellules est rarement linéaire lors des phases d’expérimentation. Si une cellule instancie une figure sans la clore, puis qu’une seconde cellule tente d’appliquer plt.title() sur un tracé indépendant, le pointeur d’axe actif peut pointer vers une figure résiduelle conservée en mémoire tampon.
Ce phénomène se traduit par des effets indésirables particulièrement insidieux : écrasement accidentel de titres sur des graphiques précédemment compilés, absence pure et simple de titre sur la figure d’intérêt, ou décalage asynchrone des métadonnées. De surcroît, lors de l’exécution de pipelines de traitement parallèle ou de génération automatisée de milliers de rapports PDF, l’utilisation de l’interface séquentielle conduit fréquemment à des fuites de mémoire substantielles. Il devient alors indispensable d’assainir scrupuleusement la pile graphique en recourant impérativement aux instructions de purge explicite plt.clf() (effacement de la figure courante), plt.cla() (effacement de l’axe courant) et plt.close(‘all’) pour libérer les ressources allouées.
4.4 Comparatif technique : ax.set_title() versus plt.title()
Sur le plan de la conception logicielle et de l’ingénierie des données, le duel entre plt.title() et son pendant orienté objet ax.set_title() penche sans ambiguïté en faveur de la seconde option. L’analyse des compromis techniques structure cette préférence de manière incontestable :
La commande plt.title() s’avère indéniablement avantageuse pour la rédaction rapide de scripts d’exploration préliminaire, les présentations orales improvisées ou l’enseignement initial des rudiments de la science des données. Sa dépendance à un état global minimise la quantité de code passe-partout requis pour visualiser rapidement une hypothèse statistique.
À l’inverse, l’approche explicite ax.set_title() garantit une robustesse logicielle optimale. En éliminant toute ambiguïté sur l’identité de l’axe récepteur, elle immunise le pipeline contre les désynchronisations de focus, facilite l’injection de dépendances et s’aligne parfaitement avec les recommandations officielles de développement édictées par les comités de pilotage de Matplotlib et de Seaborn. Dans un contexte industriel où le code est destiné à être intégré dans des microservices ou des bibliothèques logicielles partagées, l’usage exclusif de la syntaxe orientée objet s’impose comme une norme non négociable.
5. Titrage orienté objet : Maîtriser l’affectation explicite via ax.set_title()
5.1 Récupération explicite de l’objet Axes lors de l’instanciation du tracé
Le paradigme orienté objet constitue la clé de voûte d’une maîtrise aboutie de l’écosystème graphique de Python. La méthode canonique consiste à capturer formellement l’objet matplotlib.axes.Axes renvoyé par toute fonction Seaborn de niveau axe en l’assignant à une variable de référence, conventionnellement désignée par l’identifiant ax. Cette mécanique découple de manière nette et élégante l’étape de computation statistique (le calcul des estimations de densité, des régressions ou des comptages catégoriels) de la phase de composition graphique et de micro-typographie.
En assignant ax = sns.plot_function(…), le programmeur acquiert un contrôle absolu sur le nœud du graphe de scène correspondant. Cette variable fournit une passerelle d’accès direct à l’intégralité des accesseurs et mutateurs de la classe Axes. Dès cet instant, l’environnement logiciel s’affranchit totalement des aléas du modèle d’état implicite de pyplot. Les instructions ultérieures de formatage s’appliquent de manière déterministe et exclusive à cet objet ciblé, conférant au script une reproductibilité parfaite et une modularité appréciable au sein des architectures de traitement par lots.
5.2 Exemple d’application sur un tracé de régression (sns.regplot)
Afin de concrétiser cette méthodologie, analysons le déploiement d’un tracé de régression linéaire à l’aide de la fonction sns.regplot. Ce type de graphique combine un nuage de points et une estimation linéaire paramétrique par moindres carrés ordinaires, complétée par un intervalle de confiance bootstrapé. Un tracé aussi riche en informations nécessite impérativement un titre capable de synthétiser la nature de l’ajustement mathématique représenté.
Le script s’articule autour de la capture du retour : ax = sns.regplot(data=df, x=’heures_etude’, y=’score_examen’). Dans un second temps, le titrage est invoqué de manière strictement découplée par l’instruction ax.set_title(« Modélisation linéaire : Performance académique en fonction du temps d’étude », fontsize=12, fontweight=’semibold’). Lors de l’évaluation de cette ligne, la méthode renvoie une instance de l’objet matplotlib.text.Text. Cette instance peut elle-même être inspectée ou conservée dans une variable dédiée si une manipulation dynamique ultérieure de ses propriétés de rendu s’avère nécessaire dans le flux de traitement.
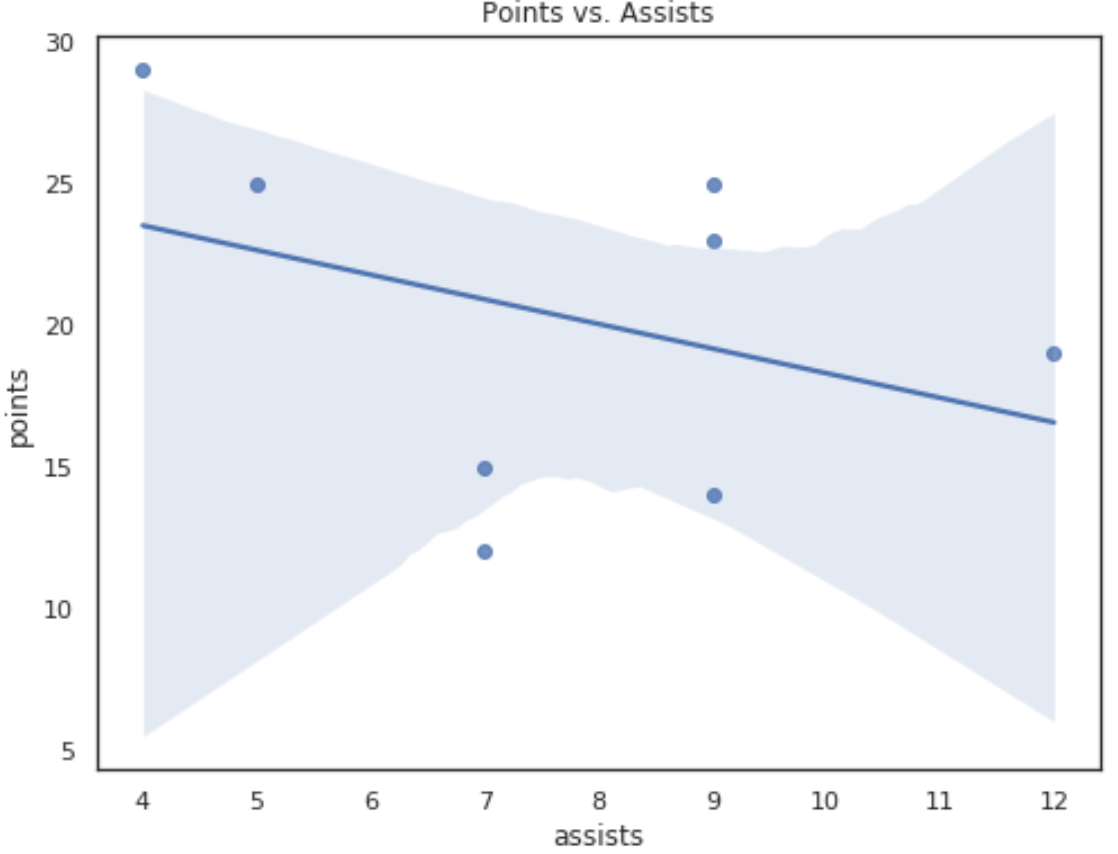
Cette approche élimine tout risque de collision avec d’autres tracés instanciés au sein du même espace de noms global et garantit une clarté irréprochable dans l’ordonnancement séquentiel des instructions de votre calepin d’analyse.
5.3 Gestion fine de la hiérarchie visuelle dans un environnement multi-axes
La puissance du paradigme orienté objet se révèle pleinement lors de l’élaboration de figures composites intégrant une multiplicité de panneaux graphiques interconnectés. Considérons la conception d’un tableau de bord scientifique comparant la distribution univariée d’une variable continue et son comportement bivarié face à un prédicteur catégoriel. La méthode d’excellence consiste à instancier en premier lieu la grille spatiale via le constructeur fig, axes = plt.subplots(nrows=1, ncols=2, figsize=(14, 5)).
Dans ce scénario, la variable axes constitue un tableau unidimensionnel d’objets Axes que l’on peut indicer numériquement. L’intégration de Seaborn s’opère en dirigeant explicitement chaque tracé vers sa cible via l’argument ax :
- Le premier panneau accueille l’estimation de densité : sns.histplot(data=df, x=’valeur’, kde=True, ax=axes[0]), immédiatement suivi de sa qualification textuelle locale : axes[0].set_title(‘A. Distribution de la densité empirique’).
- Le second panneau reçoit le diagramme d’analyse comparative : sns.violinplot(data=df, x=’groupe’, y=’valeur’, ax=axes[1]), immédiatement titré par axes[1].set_title(‘B. Dispersion comparée inter-groupes’).
Cette compartmentalisation rigoureuse garantit une indépendance totale des coordonnées, prévient tout télescopage textuel et permet d’instaurer une hiérarchie visuelle de lecture alphanumérique normalisée, indispensable à l’insertion de la figure au sein d’un manuscrit scientifique soumis à comité de lecture.
6. Titrage global des figures multifacettes : L’utilisation de .fig.suptitle()
6.1 Structure des objets Figure-level (sns.relplot, sns.catplot, sns.lmplot)
L’une des sources de perplexité les plus intenses chez les praticiens abordant les fonctions de niveau figure de Seaborn (telles que sns.relplot, sns.catplot, sns.displot ou sns.pairplot) réside dans l’incapacité d’appliquer les recettes syntaxiques habituelles dévolues aux objets d’axes. Ces fonctions n’ont pas pour vocation de générer un axe unique, mais de piloter l’instanciation conjointe d’un canevas global et d’une matrice coordonnée de sous-graphiques unifiés sous la bannière de la classe FacetGrid.
L’objet FacetGrid n’hérite pas de la classe Axes ; il en est le gestionnaire hiérarchique. En conséquence, invoquer grid.set_title() déclenche inévitablement une erreur d’exécution bloquante du type AttributeError: ‘FacetGrid’ object has no attribute ‘set_title’. Pour attribuer un titre global surplombant l’ensemble des facettes distribuées, il est nécessaire de remonter au conteneur de plus haut niveau dans la structure arborescente du graphe de scène : l’instance matplotlib.figure.Figure. Cette figure parente est accessible de manière transparente via l’attribut public .fig (ou son synonyme .figure) exposé par l’objet FacetGrid.
6.2 Implémentation pratique de .fig.suptitle() sur un FacetGrid
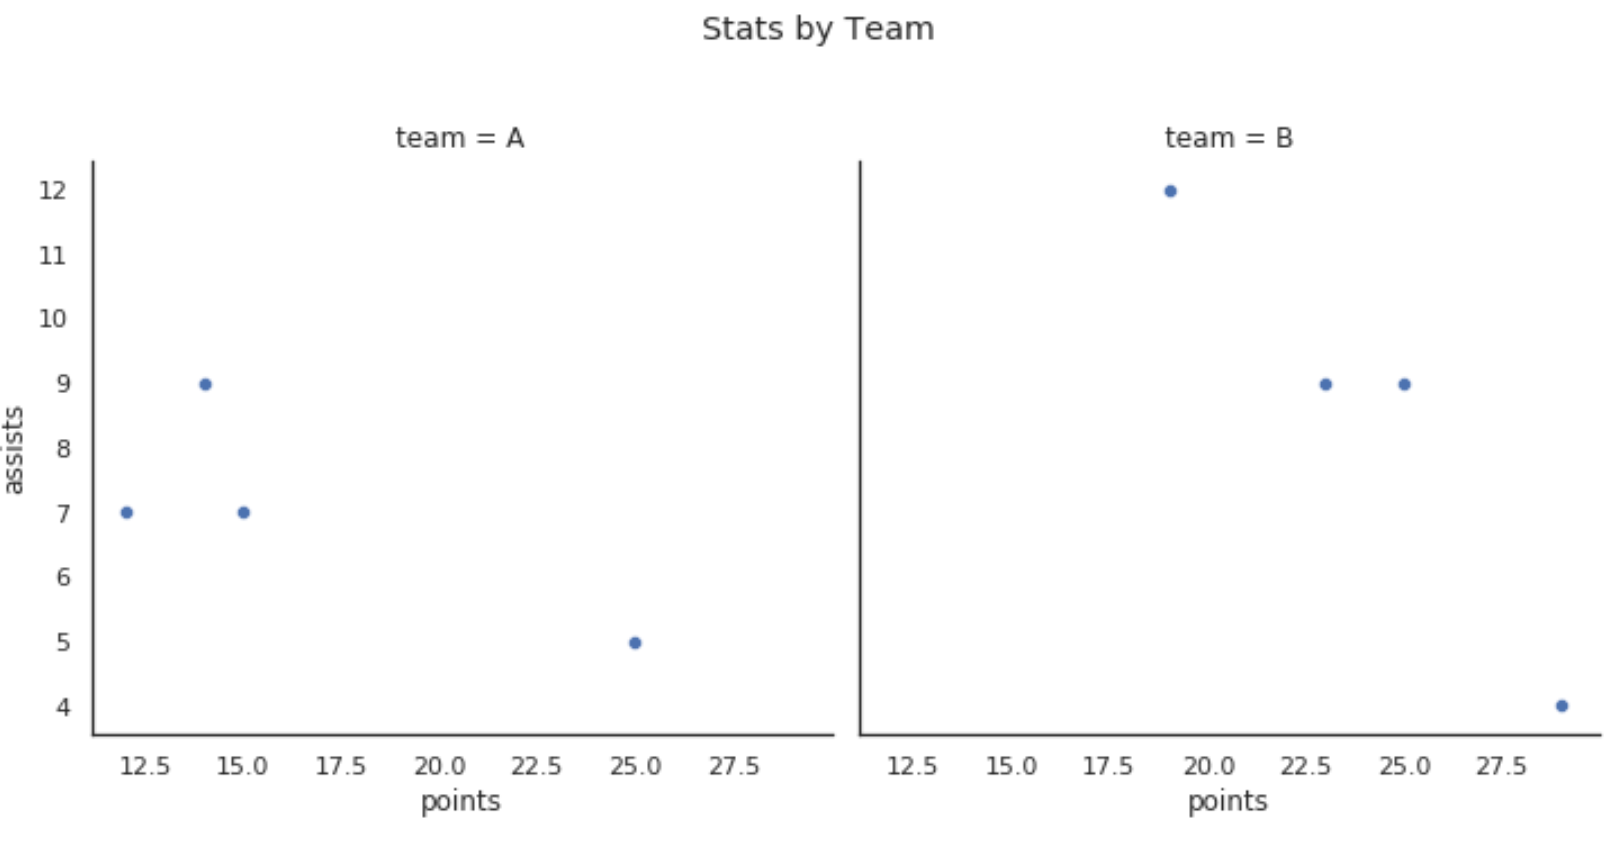
La mise en place d’un intitulé englobant sur une composition multifacettes s’effectue en sollicitant la méthode suptitle() (abréviation technique de super title) hébergée par l’objet de figure sous-jacent. Imaginons une étude démographique où l’on analyse l’évolution temporelle de la longévité en fonction du produit intérieur brut à travers une décomposition sectorielle par continent. L’appel à sns.relplot(data=df, x=’pib’, y=’esperance_vie’, col=’continent’, kind=’scatter’) génère une ligne matricielle de panneaux distincts encapsulée dans une variable que nous nommerons rel.
Pour couronner cette composition d’un intitulé unificateur, la syntaxe idoine est formulée comme suit : rel.fig.suptitle(« Trajectoires socio-économiques globales et espérance de vie par continent », fontsize=16, fontweight=’bold’). Lors de l’évaluation de cette commande, le moteur textuel positionne le bloc de caractères non pas par rapport aux marges internes d’un sous-panneau particulier, mais en référence absolue aux coordonnées normalisées du canevas supérieur.
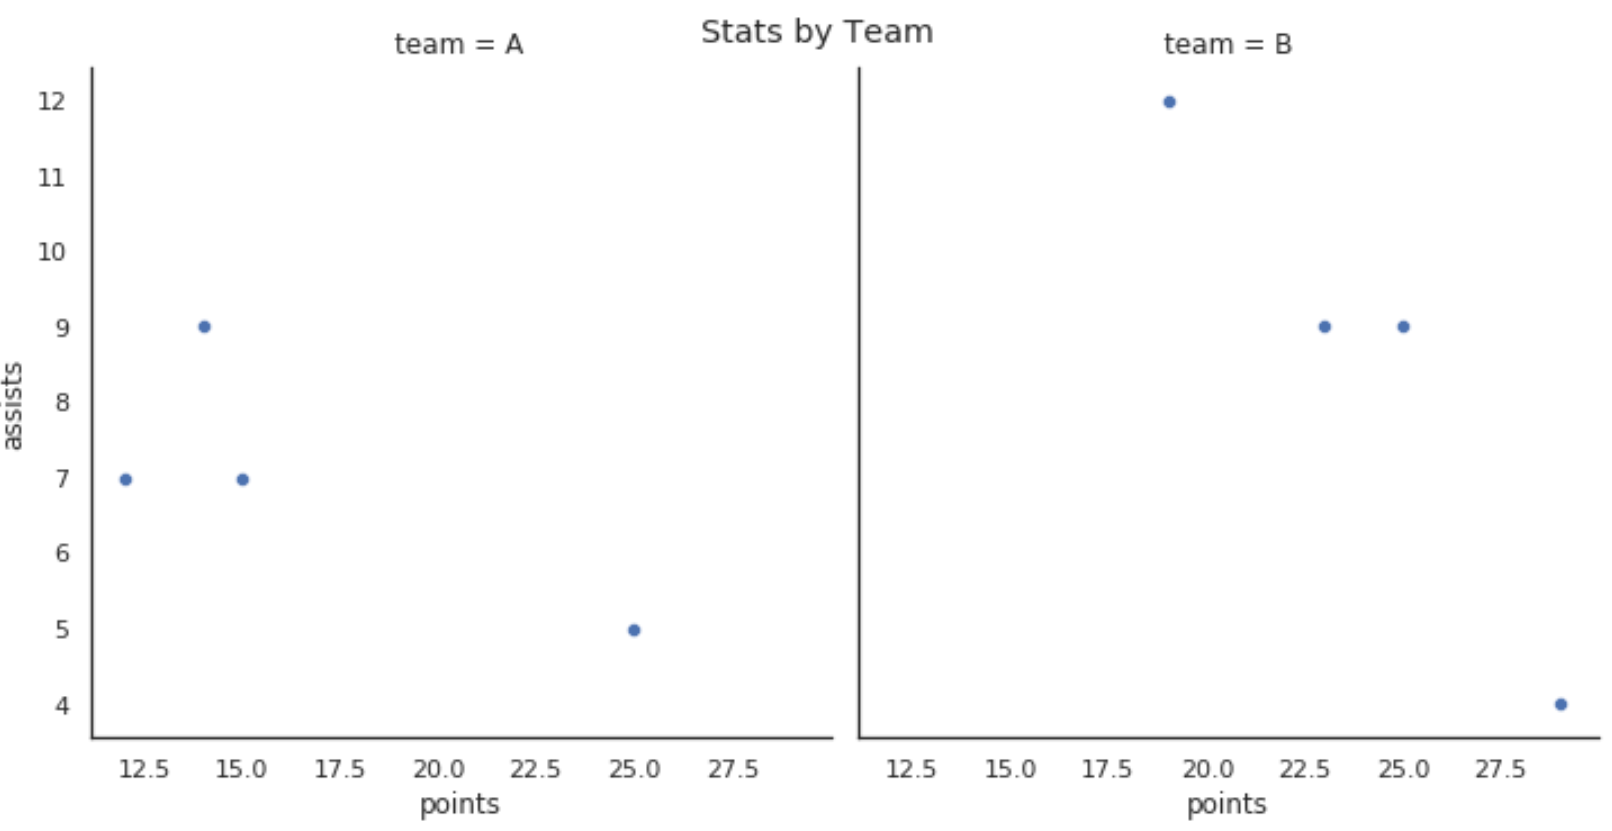
Toutefois, une inspection immédiate du tracé révèle fréquemment un défaut d’agencement spatial critique : le titre global tend à entrer en collision directe avec les en-têtes individuels des colonnes supérieures de la grille de facettes, exigeant un réétalonnage géométrique minutieux.
6.3 Ajustement des marges et résolution des chevauchements avec subplots_adjust()
Le phénomène de superposition entre le super-titre et les titres des sous-axes résulte d’un conflit de calibrage spatial. Par défaut, l’algorithme d’agencement automatique de Seaborn configure la marge supérieure de la figure pour optimiser l’espace utile alloué aux données statistiques, sans anticiper l’insertion ultérieure d’une métadonnée textuelle de grande taille au sommet de la hiérarchie. Pour remédier à cette anomalie esthétique, l’analyste doit intervenir sur la géométrie des sous-intérvals de la figure via la méthode subplots_adjust().
La commande stratégique s’articule autour de l’instruction rel.fig.subplots_adjust(top=0.85). Le paramètre top prend pour valeur un nombre flottant compris entre zéro et un, désignant la coordonnée verticale normalisée du bord supérieur des zones de tracé. En fixant cette limite à 0.85, le programmeur libère une bande d’espacement protectrice de 15 % de la hauteur totale de la figure entre le bord extrême du canevas et le sommet des graphiques facettés, permettant au super-titre de s’y déployer sans la moindre friction visuelle.
Dans les contextes où l’on sollicite l’algorithme d’optimisation tight_layout() pour harmoniser automatiquement les espacements intercalaires, il convient d’agir avec prudence : un appel direct à plt.tight_layout() écrase impitoyablement les ajustements manuels de marges. La solution réside dans le passage explicite d’un rectangle de restriction géométrique : rel.fig.tight_layout(rect=[0, 0, 1, 0.90]). Ce formalisme délimite le domaine d’optimisation automatique entre la base de la figure (ordonnée 0) et 90 % de son élévation, sanctuarisant ainsi les 10 % supérieurs pour l’ancrage serein du super-titre.
7. Titrage individuel et itératif des sous-graphiques dans une grille FacetGrid
7.1 La méthode .set_titles() native de l’objet FacetGrid
Si la méthode .fig.suptitle() résout l’attribution du chapeau sémantique global, la qualification rigoureuse de chaque sous-panneau au sein d’une structure matricielle demeure indispensable pour expliciter la variable de conditionnement statistique. Conscients de cette exigence ergonomique, les concepteurs de Seaborn ont intégré nativement à la classe FacetGrid une méthode déclarative d’une efficacité redoutable : set_titles(). Cette interface permet de reconfigurer l’ensemble des libellés de facettes de façon synchronisée, sans contraindre le développeur à écrire de fastidieuses boucles d’itération manuelle.
La méthode set_titles() intercepte les titres par défaut (qui reprennent généralement le formalisme brut nom_variable = valeur_modalité) et applique un masque de substitution textuelle harmonisé. Ce mécanisme garantit une uniformité stylistique absolue à travers toute la matrice visuelle, réduisant considérablement les risques de coquilles typographiques et assurant une lisibilité exemplaire des dimensions de facettage.
7.2 Utilisation des templates de formatage ({col_name}, {row_name})
La puissance opérationnelle de set_titles() réside dans son interpréteur interne de gabarits textuels (templates). La méthode expose des paramètres nommés template, col_template et row_template au sein desquels l’utilisateur peut injecter des balises de substitution prédéfinies que le moteur de Seaborn résout dynamiquement lors de la compilation de la figure :
- {col_name} : Cette variable d’interpolation est automatiquement remplacée par la modalité catégorielle propre à la colonne considérée dans la segmentation matricielle.
- {row_name} : Dans les grilles bidimensionnelles croisant deux variables de stratification, cette balise extrait et affiche la valeur courante de la ligne d’observation.
Considérons l’application de ce mécanisme sur une grille ventilée par tranche horaire et statut d’adhésion. L’invocation g.set_titles(col_template= »Période : {col_name} », row_template= »Profil : {row_name} », size=11, color= »navy ») transforme instantanément des en-têtes bruts et disgracieux en un appareil critique raffiné. Si l’objectif esthétique consiste à épurer radicalement le tracé en éliminant les préfixes de variables redondants, on formulera simplement g.set_titles(template= »{col_name} »), ce qui confère à la figure une présentation sobre et directe conforme aux standards des publications académiques internationales.
7.3 Parcours itératif manuel des axes (g.axes.flat) pour un titrage sur-mesure
Bien que les gabarits de set_titles() couvrent la majorité des cas d’usage nominaux, certaines analyses statistiques avancées requièrent l’injection de métadonnées spécifiques et hétérogènes au sein de chaque panneau individuel (telles qu’une valeur de p propre à chaque sous-échantillon, un coefficient de corrélation de Pearson localisé, ou la taille d’effectif effectif N). Face à ces exigences d’individualisation extrême, l’approche déclarative collective atteint ses limites et doit céder le pas au parcours itératif explicite des axes.
L’attribut g.axes d’une instance FacetGrid contient un tableau bidimensionnel NumPy encapsulant l’ensemble des objets matplotlib.axes.Axes composant la figure. L’extraction de cet agencement s’effectue via l’attribut aplatisseur g.axes.flat, qui permet de dérouler la matrice sous la forme d’un itérateur linéaire simple. Il devient dès lors aisé de structurer une boucle programmatique permettant de contextualiser chaque panneau unitairement :
L’analyste itère conjointement sur le tableau d’axes et sur une liste de métadonnées préalablement calculées à l’aide de la fonction native zip(). À chaque itération, l’instruction ax.set_title(…) est sollicitée avec une chaîne formatée dynamiquement intégrant les statistiques dévolues au sous-groupe considéré. Cette approche hybride conjugue la puissance de partitionnement spatial automatisé de FacetGrid et la flexibilité chirurgicale du paradigme orienté objet uniaxé, offrant une liberté de composition totale pour les synthèses épidémiologiques ou économétriques complexes.
8. Typographie avancée et personnalisation stylistique des titres
8.1 Contrôle de la taille de police (fontsize) et de la graisse (fontweight)
La typographie ne remplit pas un simple rôle ornemental : elle constitue le moteur primaire de la hiérarchisation perceptive de l’information. Dans une composition graphique scientifique, l’œil du lecteur doit appréhender sans hésitation l’ordonnancement structurel des éléments, progressant du titre général vers les sous-titres, puis vers les étiquettes de graduation et enfin les légendes explicatives. La maîtrise conjointe des arguments fontsize et fontweight constitue le levier fondamental de cette articulation.
Le paramètre fontsize accepte aussi bien des valeurs numériques scalaires (exprimées en points typographiques, typiquement de 8 pour les notes de bas de page à 18 pour les super-titres majeurs) que des descripteurs relatifs formalisés sous forme de chaînes de caractères (‘xx-small’, ‘small’, ‘medium’, ‘large’, ‘x-large’, ‘xx-large’). L’utilisation de scalaires numériques stricts est préconisée dans le cadre d’articles destinés à l’impression afin de garantir un ratio de réduction proportionnel lors de la mise en page finale des revues.
En complément, la graisse typographique, contrôlée par fontweight, permet d’instaurer des contrastes d’emphase marqués. Les options canoniques incluent ‘light’, ‘normal’, ‘regular’, ‘book’, ‘medium’, ‘semibold’, ‘bold’ et ‘heavy’. Un calibrage optimal consiste fréquemment à affecter un poids ‘bold’ ou ‘semibold’ au titre principal tout en maintenant les titres de facettes ou les sous-titres techniques dans une graisse ‘normal’ ou ‘medium’, instaurant ainsi une scansion visuelle équilibrée et reposante pour l’esprit de l’observateur.
8.2 Chromatisme typographique et harmonisation avec la palette de couleurs
La chromaticité appliquée au titrage joue un rôle pivot dans la cohérence esthétique et l’accessibilité d’une visualisation de données. L’application d’un noir absolu (code hexadécimal #000000) sur un fond blanc immaculé peut engendrer un contraste trop saisissant qui heurte le regard et détourne l’attention du tracé de données lui-même. De nombreux studios de design graphique éditorial (tels que ceux du Financial Times ou de The Economist) privilégient l’emploi de nuances anthracite profondes (telles que #2c3e50 ou #333333) pour adoucir la perception globale.
L’argument color (ou son alias c) accepté par l’ensemble des méthodes de titrage de Matplotlib et de Seaborn reçoit aussi bien des noms de teintes standard du consortium W3C que des spécifications hexadécimales rigoureuses ou des tuples normalisés Rouge-Vert-Bleu-Alpha (RGBA). Dans certains contextes avancés de dataviz narrative, l’analyste peut choisir d’harmoniser chromatiquement le titre avec une modalité statistique saillante du jeu de données (par exemple, colorer le titre principal dans la teinte exacte de la courbe représentant le groupe expérimental gagnant), créant ainsi un pont perceptif immédiat qui allège le besoin de recourir à une boîte de légende fastidieuse.
Il demeure toutefois primordial de veiller au respect des standards internationaux d’accessibilité visuelle (notamment les directives WCAG relatives aux ratios de contraste colorimétrique), en s’assurant que le texte se détache toujours nettement de la couleur de fond générale du canevas, tout particulièrement lors de l’exploitation de thèmes Seaborn sombres tels que sns.set_theme(style=’darkgrid’).
8.3 Intégration de polices personnalisées et gestion du rendu textuel (fontfamily)
L’identité visuelle d’un document scientifique découle en grande partie de la cohérence de sa famille typographique. Par défaut, Matplotlib et Seaborn s’appuient sur un ensemble de polices génériques libres sans empattement (principalement DejaVu Sans). Cependant, la préparation d’une publication destinée à une revue académique prestigieuse requiert souvent l’adoption stricte d’une police à empattements (famille Serif, telle que Times New Roman ou Computer Modern), tandis qu’un rapport d’entreprise contemporain exigera une fonte géométrique moderne (telle que Helvetica, Fira Sans ou Roboto).
La personnalisation de la famille de polices s’effectue au niveau unitaire via l’argument fontfamily (ou family), en transmettant des familles génériques (‘serif’, ‘sans-serif’, ‘monospace’) ou des noms de fontes système dûment enregistrées auprès du gestionnaire matplotlib.font_manager. Pour rationaliser la transmission de multiples propriétés stylistiques sans alourdir la signature de la méthode, il est vivement recommandé d’encapsuler ces descripteurs au sein d’un dictionnaire typographique dédié :
On définit en amont une structure telle que police_titre = {‘family’: ‘serif’, ‘color’: ‘#1a252f’, ‘weight’: ‘bold’, ‘size’: 14}, que l’on injecte ensuite élégamment dans l’appel d’axe via ax.set_title(‘Analyse morphométrique comparative’, fontdict=police_titre). Cette pratique de développement isole la configuration esthétique de la logique algorithmique, autorisant des modifications cosmétiques instantanées et centralisées à travers des scripts analytiques de grande envergure.
9. Positionnement spatial, alignement et gestion micro-typographique
9.1 Alignement horizontal (loc : left, center, right)
L’alignement horizontal du titre constitue un choix éditorial structurant. Historiquement, les logiciels statistiques ont imposé un centrage quasi systématique du titre par rapport à la largeur de l’axe cartésien (loc=’center’). Si cette convention prévaut encore largement dans les manuels universitaires classiques, la pratique contemporaine du journalisme de données et du design d’information privilégie désormais très nettement l’alignement unilatéral à gauche (loc=’left’).
L’alignement à gauche aligne le point de départ de la lecture textuelle avec l’origine de l’axe vertical des ordonnées, épousant ainsi le trajet oculaire naturel en « F » ou en « Z » mis en évidence par les recherches en ergonomie cognitive de Nielsen Norman Group. L’activation de cet agencement s’opère par le paramètre loc=’left’ au sein de set_title() ou de plt.title(). Cette configuration s’avère particulièrement efficace lorsque le graphique est pourvu d’un sous-titre descriptif, conférant à la composition une assise architecturale moderne, équilibrée et immédiatement intelligible.
L’alignement à droite (loc=’right’) demeure quant à lui réservé à des usages fonctionnels très spécialisés, tels que l’apposition discrète de métadonnées d’horodatage, de mentions de sources d’approvisionnement de données ou de clauses de non-responsabilité technique en marge de la figure.
9.2 Positionnement vertical et décalage relatif via l’argument y et le padding (pad)
L’ajustement de la distance physique séparant le titre de la surface utile de tracé constitue une étape micro-typographique cruciale pour éviter l’effet d’étouffement perceptif. Deux leviers distincts, mais complémentaires, gouvernent cette altitude au sein de la bibliothèque :
- Le paramètre pad : Exprimé en points typographiques absolus, l’argument pad (par exemple, pad=20) repousse verticalement le titre vers le haut à partir de la ligne supérieure de démarcation de l’axe. Il s’agit de la méthode la plus naturelle et la plus stable pour compenser la présence de graduations externes élevées, de notations en puissances de dix ou de barres d’erreurs saillantes qui risqueraient de chevaucher le texte.
- L’argument y : Ce paramètre opère dans le système de coordonnées relatives de l’axe (où 0 correspond au bord inférieur et 1 au bord supérieur du cadre). Passer une valeur supérieure à l’unité, telle que y=1.08, repositionne précisément la ligne de base du titre à 8 % au-dessus de la crête de l’axe. Cette approche mathématique offre une précision infinitésimale mais s’avère plus sensible aux modifications ultérieures du ratio d’aspect de la figure.
La calibration judicieuse de ces valeurs d’espacement prévient les collisions indésirables, en particulier lorsque des légendes sont positionnées horizontalement au sommet du tracé (loc=’upper center’, bbox_to_anchor=(0.5, 1.15)), garantissant une isolation spatiale parfaite entre chaque élément informatif du canevas.
9.3 Gestion des titres multilignes et retours à la ligne contrôlés (n)
La formulation d’un titre scientifique rigoureux exige fréquemment le déploiement d’un énoncé textuel relativement long, incluant la mention précise du phénomène observé, le périmètre géographique de la cohorte et l’intervalle temporel de mesure. Si l’on transmet une chaîne textuelle excessivement longue sur une seule ligne continue, le moteur de rendu étire le titre bien au-delà des frontières latérales de la figure, entraînant une troncature brutale du texte lors de l’exportation matricielle ou un déséquilibre visuel flagrant.
Pour juguler cette dégradation esthétique, la solution canonique consiste à fractionner manuellement la chaîne à l’aide de caractères d’échappement de saut de ligne (n). Cette segmentation délibérée permet de construire un étagement hiérarchique au sein du titre lui-même, en isolant sur la première ligne l’affirmation analytique majeure et sur la seconde ligne les modalités méthodologiques d’échantillonnage.
Lors de l’usage de titres multilignes, il est hautement recommandé d’ajuster simultanément le paramètre linespacing (l’interlignage relatif, fixé par défaut à une valeur avoisinant 1.2). Une légère réduction de ce coefficient permet de resserrer harmonieusement les blocs textuels denses, évitant que le titre n’empiète démesurément sur la surface allouée à la représentation graphique des données empiriques.
10. Intégration de notations mathématiques et scientifiques dans les titres (LaTeX)
10.1 Principes du moteur TeX intégré dans Matplotlib/Seaborn
La communication en sciences dures, en biostatistique et en économétrie impose fréquemment l’inclusion de formalismes mathématiques au sein des intitulés graphiques : symboles d’espérance conditionnelle, équations différentielles, grandeurs physiques dimensionnées ou notations d’intervalles de confiance. Pour répondre à cet impératif d’exactitude, Matplotlib intègre en son cœur son propre parseur et moteur de rendu mathématique nommé mathtext.
Ce moteur interprète un sous-ensemble riche et rigoureux de la syntaxe standard du logiciel de composition typographique TeX/LaTeX sans exiger la présence d’une distribution TeX complète installée sur le système d’exploitation de la machine hôte. L’activation de ce mode s’effectue en délimitant les segments mathématiques par des symboles de dollar ($…$). Dès que l’interpréteur rencontre ces balises au sein de la chaîne de titrage, il bascule dynamiquement vers une police mathématique vectorielle dédiée (généralement Computer Modern ou STIX), assurant un rendu impeccable des fractions, racines et symbolismes algébriques.
Pour prévenir toute interférence fâcheuse entre les séquences d’échappement natives du langage Python (telles que b, t ou n) et les commandes typographiques de TeX (telles que beta, times ou nu), il est impératif d’utiliser systématiquement des chaînes de caractères brutes (raw strings) préfixées par la lettre r (par exemple, r »Paramétrage du modèle $\alpha + \beta x$« ).
10.2 Écriture de formules, symboles grecs et indices/exposants
Le moteur mathtext prend en charge avec une fidélité remarquable l’ensemble de la nomenclature alphabétique hellénique et des opérateurs différentiels usuels. L’écriture de variables statistiques s’effectue au moyen de commandes transparentes : mu pour la moyenne théorique, sigma pour l’écart-type, lambda pour les paramètres de Poisson, ou Delta pour la quantification d’une variation marginale.
La structuration spatiale des équations mobilise les conventions canoniques de l’édition scientifique :
- Indices et exposants : L’accent circonflexe régit l’élévation en exposant ou puissance (x^2, e^{-ipi}), tandis que le tiret bas orchestre l’abaissement en indice (x_{i,j}, sigma_{pop}^2). Dès lors que l’expression indicée comporte plus d’un caractère, son encapsulation au sein d’une paire d’accolades structurelles est formellement requise.
- Fractions et racines : La commande frac{numérateur}{dénominateur} permet d’afficher des quotients statistiques élégants, tandis que sqrt[n]{terme} restitue fidèlement les opérations d’extraction radicale.
- Opérateurs et relations : Les symboles d’inégalité stricte ou large (le, ge), de proportionnalité (propto) et de sommation discrète (sum_{k=1}^N) confèrent au titre une précision sémantique absolue impossible à reproduire via de simples caractères Unicode non standardisés.
10.3 Formatage des valeurs p, coefficients de corrélation et métriques statistiques
Dans la recherche empirique contemporaine, l’affichage de métriques inférentielles directement au sein du titre de la figure constitue une pratique rigoureuse qui dispense d’encombrer le corps de l’article avec des renvois perpétuels vers des tables d’annexes. Les normes de publication de l’American Psychological Association (APA) et de la majorité des revues médicales imposent des règles typographiques strictes pour ces restitutions : les lettres désignant des statistiques de test doivent être mises en italique, tandis que les chiffres et symboles d’égalité demeurent en romain droit.
L’utilisation conjuguée des chaînes brutes et du balisage mathtext permet de respecter ces protocoles éditoriaux au millimètre près. Considérons l’intitulé suivant : ax.set_title(r »Régression multivariée : $R^2 = 0.84$, $F(2, 117) = 312.4$, $p < 0.001$", fontsize=12). L’évaluation de cette commande génère une ligne textuelle où les identifiants statistiques majeurs épousent les règles de mise en forme canoniques, projetant une impression immédiate de professionnalisme méthodologique et de rigueur formelle.
11. Automatisation et dynamisation du titrage dans les pipelines de données
11.1 Génération dynamique de titres via f-strings et métadonnées de variables
Dans les flux de travail industriels modernes d’apprentissage automatique et de science des données, les visualisations sont rarement générées manuellement une à une. Elles s’insèrent au cœur d’architectures d’évaluation automatisée analysant des centaines de modèles ou des segments de population en flux continu. Dans ce cadre algorithmique, figer les chaînes de titrage sous forme de constantes littérales manuelles constitue un anti-pattern rédhibitoire. Il convient d’automatiser l’assemblage textuel en exploitant les mécanismes d’interpolation de chaînes formatées (les f-strings introduites dans les spécifications modernes de Python).
En conjuguant l’interpolation de f-strings et la puissance de calcul vectorisé de Pandas ou NumPy, l’analyste peut calculer dynamiquement des métriques descriptives à partir du jeu de données et les injecter à la volée dans le titre lors de la compilation du tracé. Par exemple, après avoir extrait l’effectif effectif (N = len(df)), la moyenne arithmétique pondérée (mu = df[‘score’].mean()) et son écart-type (std = df[‘score’].std()), l’instruction de titrage se formule élégamment sous la forme : ax.set_title(f »Score de robustesse — Échantillon (N={N}) — Moyenne : {mu:.2f} (± {std:.2f}) »).
Cette mécanisation garantit que l’intitulé de la figure demeure perpétuellement synchronisé avec les données sous-jacentes, éliminant définitivement les discordances catastrophiques où le titre affiche des statistiques résiduelles périmées à la suite du rafraîchissement d’un flux de données amont.
11.2 Encapsulation dans des fonctions de visualisation modulaires
Pour assurer la pérennité et la réutilisabilité du code au sein d’un laboratoire de recherche ou d’un département de data engineering d’entreprise, il est impératif d’encapsuler la génération des visualisations au sein de fonctions modulaires hautement paramétrables. Cette pratique de conception logicielle garantit la stricte application du principe DRY (Don’t Repeat Yourself) et permet d’unifier la charte graphique de l’organisation.
Une fonction de tracé exemplaire doit accepter, outre la structure de données tabulaire source et les descripteurs de variables, un argument optionnel explicite dédié au titrage (par convention title: Optional[str] = None). En interne, la fonction met en œuvre une logique de sélection contextuelle : si l’utilisateur transmet une chaîne textuelle explicite, celle-ci est assignée ; dans le cas contraire, un titre par défaut est dynamiquement synthétisé à partir de l’inspection des métadonnées du DataFrame (par exemple en capitalisant le nom formel de la colonne assignée à l’ordonnée et en le croisant avec la granularité de regroupement).
De plus, cette modularisation doit intégrer la possibilité de router le tracé vers un axe préexistant (via un argument ax=None), offrant au développeur la latitude d’exploiter la fonction soit isolément pour une inspection unitaire, soit comme brique élémentaire intégrée au sein d’une vaste mosaïque multi-panneaux gérée en amont.
11.3 Internationalisation et gestion programmatique des libellés scientifiques
Dans un contexte d’analyse internationale, les équipes de recherche sont régulièrement amenées à produire des visualisations destinées à des publics cibles hétérogènes : des rapports internes rédigés dans la langue nationale et des publications scientifiques destinées à des revues internationales anglophones. Recréer manuellement les scripts de tracé pour chaque variante linguistique constitue une approche inefficace et propice aux divergences d’implémentation.
Une architecture logicielle mature résout ce défi par l’externalisation complète des couches textuelles au sein de dictionnaires d’internationalisation (i18n) ou de fichiers de configuration standardisés (tels que JSON ou YAML). Le pipeline de visualisation interroge une table de correspondance clé-valeur en fonction d’un paramètre d’environnement linguistique (par exemple LANG=’fr’ versus LANG=’en’) :
Le module extrait la traduction normalisée correspondant au descripteur de l’analyse, gère de manière native les encodages de caractères accentués conformes à la norme UTF-8 sous-jacente de Python, et injecte le libellé cible dans l’instruction de titrage de Seaborn. Cette imperméabilité structurelle entre la logique de modélisation mathématique et la restitution textuelle multilingue permet de générer des jeux complets de figures déclinés en plusieurs langues en une seule passe d’exécution automatisée.
12. Diagnostic des anomalies fréquentes et solutions d’optimisation esthétique
12.1 Résolution des coupures de titres à l’exportation (bbox_inches=’tight’)
L’une des anomalies les plus récurrentes et frustrantes lors de la finalisation d’un travail graphique réside dans la « décapitation » du titre lors de l’enregistrement de la figure sur disque sous forme de fichier image matriciel (PNG, JPEG) ou vectoriel (PDF, SVG). Alors que le titre apparaît de manière irréprochable au sein de la fenêtre d’affichage interactive du calepin Jupyter, l’exécution de la commande plt.savefig(‘output.png’) produit un document tronqué où la moitié supérieure des lettres capitales a été impitoyablement sectionnée.
Cette anomalie découle de la méthode d’échantillonnage de la zone d’exportation de Matplotlib. Par défaut, le moteur utilise les dimensions fixes de la boîte englobante standard de la figure, ignorant les éléments textuels projetés au-delà des marges prédéfinies du canevas. La remédiation absolue à ce comportement consiste à déclarer systématiquement l’argument bbox_inches=’tight’ lors de l’appel à la fonction d’exportation : plt.savefig(‘figure_haute_resolution.png’, dpi=300, bbox_inches=’tight’).
Lorsque cette option est activée, le moteur graphique recalcule exhaustivement la boîte englobante géométrique minimale englobant l’intégralité des éléments tracés (incluant les titres proéminents, les légendes externes et les annotations marginales) avant de réaliser la rastérisation ou la vectorisation, garantissant une intégrité visuelle sans faille sur tout support de diffusion.
12.2 Conflits d’écrasement entre suptitle() et titres d’axes individuels
L’orchestration conjointe d’un super-titre chapeautant une figure et de titres locaux qualifiant des sous-graphiques adjacents se heurte très fréquemment au phénomène de chevauchement destructif. L’analyste constate avec dépit que la ligne de texte de son suptitle() s’imprime exactement par-dessus les étiquettes de colonnes de ses axes supérieurs. Cette pathologie visuelle dérive d’une mauvaise chronologie d’exécution des algorithmes d’ajustement spatial au sein du script.
Pour éliminer définitivement ce conflit, un ordonnancement strict des instructions doit être observé :
- Instanciation complète de l’ensemble des tracés Seaborn et assignation des titres d’axes individuels via ax.set_title() ou set_titles().
- Appel éventuel de l’optimisation des espacements intercalaires, en veillant à sanctuariser l’espace sommital soit via fig.tight_layout(rect=[0, 0, 1, 0.92]), soit en omettant cette commande si l’on gère les marges manuellement.
- Affectation finale du super-titre via fig.suptitle(« Titre Général Englobant », y=0.98) en calibrant l’ordonnée normalisée y légèrement au-dessus du plafond supérieur des axes défini à l’étape précédente.
- Ajustement micrométrique de compensation résiduelle au moyen de fig.subplots_adjust(top=0.88) pour garantir un sas de respiration optique permanent entre le super-titre et le sommet des tracés.
L’observation rigoureuse de cette séquence chronologique immunise la composition contre toute interférence spatiale malheureuse et assure une finition éditoriale impeccable.
12.3 Bonnes pratiques pour l’accessibilité visuelle et la rigueur académique
Au terme de cette exploration méthodologique exhaustive, il convient de synthétiser les impératifs éthiques et techniques sous-tendant la production de graphiques de données professionnels. Le titrage d’une figure Seaborn ne doit jamais constituer un exercice de style décoratif isolé, mais s’inscrire dans une démarche rigoureuse d’inclusion et de transmission scientifique du savoir.
Pour garantir l’accessibilité universelle de vos travaux, veillez scrupuleusement à maintenir des ratios de contraste élevés entre la couleur typographique de vos titres et le fond du canevas, en accordant une vigilance particulière aux lecteurs atteints de déficiences de la vision chromatique (daltonisme, deutéranopie). Évitez les surcharges ornementales inutiles et veillez à éliminer impitoyablement toute redondance sémantique : si le titre principal formule explicitement la mesure affichée, il est souvent élégant et judicieux d’alléger le label de l’axe des ordonnées pour dépolluer le champ visuel de l’observateur.
Avant de soumettre une figure finalisée pour une publication académique, une présentation exécutive ou un rapport d’évaluation publique, appliquez systématiquement la liste de contrôle suivante :
- Le niveau architectural de l’objet graphique (Axes ou FacetGrid) a-t-il été identifié correctement pour prévenir les erreurs d’attribut masquées ?
- Le titre formule-t-il un ancrage informatif précis répondant clairement aux questions fondamentales : quelle métrique est observée, sur quelle population, et sous quel protocole expérimental ?
- La hiérarchie typographique (taille, graisse, couleur) guide-t-elle le regard du lecteur de manière logique et sans équivoque du général vers le particulier ?
- Les notations mathématiques et symboles statistiques respectent-ils les conventions formelles édictées par les revues de référence grâce au moteur mathtext ?
- L’exportation finale intègre-t-elle le paramètre de recadrage dynamique assurant l’intégrité absolue des bordures textuelles sans coupure aberrante ?
En intégrant ces principes méthodologiques au cœur de votre pratique quotidienne de la programmation avec Seaborn et Matplotlib, vous conférerez à vos visualisations de données la clarté analytique, l’élégance graphique et l’autorité scientifique indispensables à l’avancement serein de la connaissance.
Références
- Bertin, J. (1967). Sémiologie Graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021