
La visualisation de données quantitatives constitue un pilier fondamental de la recherche scientifique contemporaine, de la prise de décision stratégique et de la communication analytique. Si les éléments géométriques — tels que les nuages de points, les tracés de lignes, les barres d’histogrammes et les surfaces de densité — constituent le corps structurel d’une représentation graphique, ils demeurent intrinsèquement muets sans l’adjonction d’un appareil textuel rigoureux. En effet, l’observateur humain ne déduit pas des relations de causalité, des seuils de significativité ou des singularités contextuelles à partir de simples coordonnées spatiales brutes. Le texte remplit ainsi une fonction sémiotique d’ancrage, guidant l’attention visuelle, explicitant les métadonnées critiques et transformant des représentations géométriques abstraites en vecteurs de connaissances intelligibles et reproductibles.
Au sein de l’écosystème du langage Python, la bibliothèque Matplotlib s’est imposée depuis plus de deux décennies comme la référence canonique pour la génération de graphiques statiques, animés et interactifs. Conçue initialement par John D. Hunter pour reproduire la flexibilité des environnements de calcul scientifique comme MATLAB, Matplotlib repose sur un moteur de rendu modulaire et une hiérarchie d’objets extrêmement sophistiquée. Cependant, l’intégration du texte dans cet écosystème soulève des défis techniques et conceptuels souvent sous-estimés par les praticiens : manipulation de multiples systèmes de coordonnées, gestion des transformations spatiales affines, gestion typographique fine via FreeType, intégration de la syntaxe TeX et optimisation du contraste perceptif. Maîtriser l’annotation textuelle ne relève donc pas d’un simple habillage esthétique superficiel, mais procède d’une véritable ingénierie visuelle et cognitive.
Ce guide exhaustif a pour ambition d’explorer de manière systématique l’ensemble des concepts, fonctions et paradigmes sous-jacents à l’insertion et à la stylisation de texte dans Matplotlib. En articulant les fondements théoriques de la perception visuelle avec une analyse approfondie des structures internes de la bibliothèque, nous examinerons la fonction fondamentale matplotlib.pyplot.text() ainsi que sa contrepartie orientée objet au sein des axes. De l’anatomie syntaxique des paramètres canoniques aux algorithmes de détection de collision des boîtes de délimitation, en passant par le formatage mathématique avancé et les règles déontologiques d’édition scientifique, cette étude offre un cadre méthodologique complet pour concevoir des visualisations répondant aux plus hauts standards académiques et industriels.
1. Introduction aux principes d’annotation textuelle dans Matplotlib
1.1 Rôle sémiotique et cognitif du texte dans la visualisation de données
L’analyse de la charge cognitive liée à l’interprétation des données quantitatives repose sur les principes de la théorie de la charge cognitive développée par John Sweller, ainsi que sur les lois de la psychologie de la Gestalt. Lorsqu’un lecteur examine une figure scientifique complexe dépourvue de repères textuels explicites, sa mémoire de travail est lourdement sollicitée par une charge cognitive extrinsèque. Cette charge parasite provient de l’effort intellectuel nécessaire pour naviguer constamment entre les données géométriques, une légende déportée dans un coin de la figure et les explications rédigées dans le corps de texte du manuscrit. L’effet de division de l’attention (split-attention effect) qui en résulte dégrade significativement la vitesse d’assimilation et augmente le taux d’erreur d’interprétation des faits empiriques présentés.
Sur le plan sémiotique, le texte accomplit une fonction d’ancrage sémantique telle que théorisée par Roland Barthes. Alors que l’image ou la forme géométrique offre une polysémie visuelle — c’est-à-dire une multiplicité d’interprétations possibles quant à la nature des variations observées —, le texte direct sélectionne le sens visé et fixe la lecture du phénomène. Dans un nuage de points multidimensionnel, par exemple, la présence d’une annotation textuelle placée directement au contact d’un groupe d’observations atypiques indique immédiatement au lecteur s’il s’agit d’un artefact expérimental, d’une erreur de mesure instrumentale ou d’une découverte phénoménologique majeure.
D’un point de vue méthodologique, l’étiquetage direct des éléments d’intérêt clinique ou expérimental répond à un impératif d’efficacité communicative. Dans les publications biomédicales ou les comptes-rendus d’essais physiques, l’identification rapide des valeurs critiques, telles que la dose létale 50, les seuils de rupture mécanique ou les points d’inflexion cinétique, conditionne la robustesse des conclusions tirées par les pairs. Réduire la dépendance vis-à-vis des légendes périphériques en intégrant judicieusement le texte au cœur de l’espace de données constitue ainsi une stratégie ergonomique incontournable pour maximiser la clarté et l’impact de la recherche.
1.2 Présentation de l’architecture graphique de la bibliothèque Matplotlib
Pour comprendre le fonctionnement de l’annotation dans Matplotlib, il est indispensable de disséquer le modèle conceptuel qui structure son moteur de rendu graphique. L’architecture de la bibliothèque s’organise selon une stricte hiérarchie arborescente à quatre niveaux : l’objet racine Figure, le conteneur spatial Axes, les composantes scalaires Axis, et la multiplicité des entités de dessin appelées génériquement Artist. La classe Figure correspond à la fenêtre graphique globale ou à la page physique d’impression. Elle héberge un ou plusieurs objets de type Axes, qui représentent la zone rectangulaire effective où les données sont projetées au moyen d’un système de coordonnées particulier.
Chaque objet Axes contient à son tour deux ou trois objets de type Axis (axe horizontal, axe vertical et éventuellement un axe de profondeur), lesquels administrent la graduation mathématique, les étiquettes de graduation (ticks) et les limites d’affichage. Cependant, l’intégralité des éléments visibles à l’écran — des courbes aux barres d’erreur, en passant par les contours et les textes — dérive directement de la classe abstraite de base Artist. L’entité typographique est instanciée par la classe spécialisée matplotlib.text.Text, qui hérite de cette classe racine et implémente l’ensemble des mécanismes géométriques et typographiques indispensables à sa rastérisation sur un canevas (Canvas).
Cette hiérarchie impose une différenciation structurelle nette entre les éléments de navigation, les repères dimensionnels et les annotations libres. Les éléments de navigation et de repère, comme les axes ou les grilles cartésiennes, sont gérés de façon automatique par les mécanismes de bas niveau de Matplotlib afin d’assurer la cohérence d’échelle. À l’inverse, l’objet Text se comporte comme un artiste autonome, doué de propriétés intrinsèques de positionnement, de déformation affine et de restitution typographique, qui peut être greffé à n’importe quel niveau de la hiérarchie pour enrichir sémantiquement la composition graphique globale.
1.3 Distinction technique entre titres, légendes et annotations libres
Dans la pratique courante de la visualisation avec Matplotlib, les utilisateurs débutants ont fréquemment recours aux fonctions de haut niveau telles que plt.title(), plt.xlabel(), plt.ylabel() et plt.legend() pour contextualiser leurs représentations. Bien que ces fonctions soient indispensables à l’établissement du cadre référentiel du graphique, elles présentent des limites conceptuelles strictes liées à leur rigidité spatiale. Un titre principal ou un label d’axe est astreint à une zone prédéfinie, bordant la périphérie immédiate des axes cartésiens. De même, une légende standard regroupe les descripteurs sous forme d’un tableau d’étiquettes confiné dans un encadré rectangulaire, reléguant l’explication en marge du phénomène étudié.
Le texte libre, accessible via la fonction plt.text() ou la méthode d’instance ax.text(), brise cette contrainte spatiale en offrant une liberté absolue de positionnement bidimensionnel. Cette polyvalence spatiale permet d’insérer des mentions textuelles directement au sein du plan d’observation, au voisinage immédiat des données modélisées. Qu’il s’agisse d’annoter un pic chromatographique, de renseigner une équation de régression sur une asymptote ou d’indiquer une zone de tolérance industrielle, le texte libre s’affranchit des canevas standardisés pour épouser fidèlement la structure topologique des distributions observées.
Le tableau décisionnel guidant le choix entre ces différentes approches textuelles dépend essentiellement de la densité des données et de l’objectif cognitif visé. Lorsque l’information s’applique à l’ensemble du système de coordonnées, le recours aux titres et labels d’axes normalisés s’impose. Si l’objectif consiste à discriminer plusieurs séries temporelles concurrentes présentant des signatures visuelles distinctes, la légende conserve son utilité catégorielle. En revanche, dès lors qu’il s’agit de focaliser l’attention du lecteur sur un événement singulier, de documenter une discontinuité mathématique ou d’expliciter une anomalie empirique ponctuelle, l’insertion de texte libre devient la solution technique et sémiotique la plus élégante et performante.
2. Anatomie et syntaxe fondamentale de matplotlib.pyplot.text()
2.1 Décomposition des paramètres canoniques : x, y et s
L’invocation de la fonction d’annotation textuelle repose sur une signature fondamentale immuable au cœur de l’API de Matplotlib. Cette interface s’articule autour de trois arguments positionnels impératifs : x, y et s. Les deux premiers paramètres scalaires, x et y, définissent la position spatiale exacte à laquelle l’élément textuel doit être ancré. Dans le comportement par défaut de la bibliothèque, ces valeurs scalaires sont exprimées dans l’espace de coordonnées des données (data coordinates), ce qui signifie qu’elles partagent exactement la même échelle numérique que les variables projetées sur les axes horizontal et vertical du tracé en cours d’exécution.
Le troisième paramètre canonique, noté s (ou text dans les versions récentes orientées objet), correspond à la charge sémantique textuelle elle-même. Il s’agit d’une chaîne de caractères qui peut adopter diverses formes selon la nature de l’application : une chaîne littérale brute, une chaîne formatée dynamiquement par interpolation de variables numériques (notamment au moyen des chaînes littérales formatées de Python, les f-strings), ou encore une formulation mathématique encadrée par des délimiteurs spécifiques pour le moteur de rendu typographique. La gestion de la mémoire sous-jacente garantit que la chaîne transmise est convertie en un objet immuable géré par le moteur FreeType intégré à Matplotlib.
En l’absence de spécification de paramètres optionnels supplémentaires, le moteur de rendu applique un comportement par défaut standardisé. Le point de coordonnées (x, y) correspondra rigoureusement au coin inférieur gauche de la boîte englobante de la première ligne de texte, avec une taille de police déterminée globalement par la configuration système (typiquement 10 points typographiques), une couleur noire opaque et une typographie sans empattement issue des paramètres de configuration interne de la bibliothèque. Cette configuration par défaut minimale garantit une compatibilité ascendante totale tout en permettant une surcharge granulaire de chaque propriété d’affichage.
2.2 Structure et potentiel du paramètre fontdict
Pour assurer une personnalisation modulaire et éviter la prolifération excessive d’arguments par mots-clés dans les appels de fonctions, Matplotlib propose le paramètre fontdict. Ce paramètre attend comme argument un dictionnaire Python standard associant des clés de configuration typographique normalisées à leurs valeurs respectives. Les clés acceptées au sein de ce dictionnaire incluent notamment 'family' (famille typographique), 'color' (chromaticité du texte), 'weight' (graisse du tracé), 'size' (dimension en points typographiques) ou encore 'style' (déclinaison normale, italique ou oblique).
L’utilisation de fontdict offre un mécanisme puissant de surcharge sélective des paramètres globaux consignés dans le conteneur de configuration globale matplotlib.rcParams. Lorsque Matplotlib traite l’instruction d’affichage, il résout les propriétés typographiques selon un modèle de cascade : les spécifications définies dans fontdict prévalent sur les valeurs globales de rcParams, tout en permettant aux arguments directement passés par mots-clés lors de l’appel de fonction de supplanter les valeurs du dictionnaire lui-même. Cette cascade confère une flexibilité architecturale précieuse pour concevoir des thèmes visuels harmonisés au sein d’une organisation ou d’un laboratoire de recherche.
Sur le plan du génie logiciel, la centralisation des propriétés textuelles au sein de gabarits structurés sous forme de dictionnaires améliore substantiellement la maintenabilité et la lisibilité du code source. Au lieu de répéter des séquences d’arguments redondantes à chaque insertion textuelle dans un pipeline d’analyse complexe, le chercheur ou le développeur peut instancier des dictionnaires constants dédiés — par exemple, un dictionnaire pour les annotations primaires et un autre pour les métadonnées secondaires —, assurant ainsi une cohérence stylistique absolue à travers des centaines de figures générées par traitement par lots.
2.3 Paradigme procédural (pyplot.text) contre paradigme orienté objet (ax.text)
L’écosystème Matplotlib expose deux paradigmes d’interaction fondamentaux : l’interface procédurale basée sur l’état global, incarnée par le module matplotlib.pyplot, et l’interface orientée objet explicite, reposant sur l’instanciation de figures et d’axes. Dans le paradigme procédural, inspiré historiquement de l’environnement interactif MATLAB, l’appel à la fonction plt.text() recherche implicitement l’axe actif courant (current axes géré en mémoire) et y injecte l’objet textuel. Bien que commode pour des tests rapides ou des scripts exploratoires très simples dans un terminal interactif, cette approche souffre d’une forte ambiguïté dès que la figure s’enrichit de plusieurs sous-tracés simultanés.
À l’opposé, le paradigme orienté objet privilégie la clarté conceptuelle en invoquant directement la méthode text() de l’objet d’axe ciblé : ax.text(). Cette méthode lie sans équivoque l’annotation typographique au repère cartésien désigné, sans dépendre d’une variable d’état global volatile susceptible d’être altérée inopinément par une instruction intermédiaire. L’utilisation du paradigme orienté objet s’avère absolument indispensable pour construire des architectures visuelles modulaires, telles que des tableaux de bord multi-panneaux (small multiples), des matrices de corrélation complexes ou des tracés imbriqués (inset plots).
Les recommandations actuelles de bonnes pratiques de développement logiciel pour les scripts de recherche et les applications en production préconisent l’adoption exclusive du paradigme orienté objet. En dissociant clairement la création des conteneurs de rendu (via fig, ax = plt.subplots(...)) de l’application séquentielle des artistes textuels, le code gagne en déterminisme, en robustesse face aux exceptions et en facilité d’encapsulation au sein de classes ou de fonctions réutilisables. Cette discipline algorithmique évite les erreurs insidieuses de superposition textuelle sur des axes inadéquats lors de l’automatisation de rapports d’analyse de données volumineuses.
3. Implémentation basique : ajout d’un texte unique sur un nuage de points
3.1 Construction du jeu de données et instanciation du graphique
Pour illustrer de manière concrète et didactique l’insertion d’une composante textuelle fondamentale au sein d’un espace de données, considérons la mise en œuvre d’un nuage de points bidimensionnel. Dans un cadre de recherche expérimentale, un tel tracé permet de révéler les interdépendances fonctionnelles ou stochastiques reliant deux grandeurs continues, comme le volume d’une structure cérébrale mesuré par imagerie par résonance magnétique en regard de scores neuropsychologiques, ou encore la cinétique d’une réaction enzymatique soumise à des gradients thermiques progressifs.
La première phase de développement consiste à générer ou charger une distribution d’échantillons cohérente à l’aide de bibliothèques mathématiques comme NumPy. Une fois le vecteur des abscisses et celui des ordonnées définis, l’instanciation de la figure s’opère rigoureusement via le paradigme orienté objet en paramétrant les dimensions physiques du canevas en pouces ainsi que sa résolution spatiale exprimée en points par pouce (dots per inch ou DPI). Ces paramètres matériels initiaux déterminent le rapport d’aspect de la surface de travail et influent directement sur la rastérisation finale des vecteurs géométriques et typographiques.
L’affichage des observations est matérialisé par l’appel de la méthode ax.scatter(), qui convertit chaque paire scalaire en un glyphe géométrique circulaire doté d’une couleur, d’un diamètre et d’une transparence spécifiques. À ce stade du pipeline d’exécution graphique, l’ensemble des points expérimentaux est projeté sur le plan orthogonal, mais l’observateur se heurte à une indifférenciation structurelle : aucun élément distinctif ne signale visuellement une observation possédant une valeur heuristique prépondérante, rendant indispensable l’intégration d’une intervention textuelle ciblée.
3.2 Positionnement absolu d’une étiquette textuelle isolée
L’étape suivante réside dans la sélection stratégique du point empirique saillant nécessitant une clarification immédiate. Ce point critique peut correspondre au barycentre de la distribution statistique, à une observation franchissant un seuil de toxicité pharmacologique ou à une valeur singulière issue d’un profil exceptionnel. Une fois les coordonnées cartésiennes exactes (x_cible, y_cible) isolées au sein de la matrice des données, la méthode ax.text() est appelée avec ces coordonnées scalaires précises pour ancrer l’étiquette explicative.
Cependant, l’application naïve des coordonnées brutes du point comme arguments de positionnement du texte entraîne un problème d’empiètement géométrique : le coin inférieur gauche de la chaîne de caractères viendrait alors se superposer directement au centre du marqueur circulaire, obstruant la visibilité de la donnée sous-jacente. Il convient donc d’appliquer un décalage spatial (offset) positif ou négatif, calculé de façon arithmétique ou empirique, pour repousser délicatement la chaîne textuelle dans un espace adjacent non encombré de la figure.
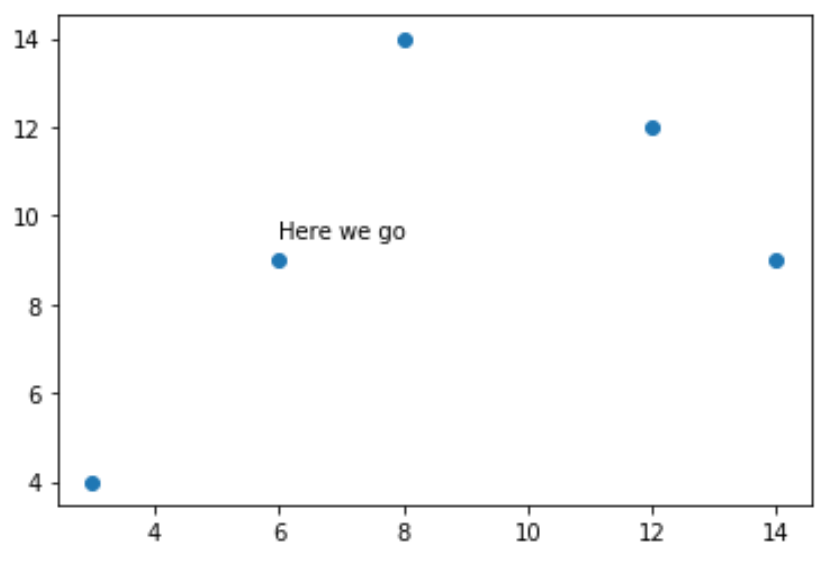
L’évaluation visuelle préliminaire impose d’analyser minutieusement l’espacement résultant entre le glyphe textuel et l’entité géométrique. Un décalage trop ténu maintient un contact optique désagréable qui altère la lecture de la forme du point, tandis qu’un éloignement excessif brise l’ancrage sémantique gestalltien de proximité spatiale, laissant planer un doute sur l’appartenance de l’étiquette au point ciblé. Un calibrage itératif fin garantit une lecture fluide, où l’annotation paraît graviter naturellement à proximité immédiate de son référent empirique.
3.3 Analyse pas à pas de l’exécution et du cycle d’affichage
L’exécution séquentielle d’une commande d’annotation textuelle déclenche une série d’opérations algorithmiques de bas niveau au sein du moteur interne de Matplotlib. Lorsque l’interpréteur Python évalue l’instruction ax.text(x, y, s), la méthode instancie un nouvel objet de la classe matplotlib.text.Text. Cet objet est immédiatement indexé dans la liste interne des artistes de l’axe ciblé (accessible via la collection ax.texts), établissant une relation d’appartenance pérenne jusqu’à une éventuelle destruction explicite de l’axe ou de la figure.
À cet instant, le texte n’est pas encore matérialisé sous forme de pixels matriciels : il réside en mémoire sous la forme d’un conteneur de données vectorielles décrivant ses coordonnées spatiales, sa chaîne de caractères brute et ses attributs stylistiques. La phase cruciale de rastérisation s’opère lorsque la fonction plt.show() ou la méthode de sérialisation fig.savefig() est sollicitée. Le canevas de rendu (par exemple l’interface AGG pour les rendus matriciels, ou les moteurs PostScript/PDF pour les tracés vectoriels) interroge l’objet Text pour convertir ses coordonnées logiques en coordonnées matérielles d’affichage via le processeur de transformation de l’axe.
Durant ce cycle de restitution, la bibliothèque typographique FreeType est sollicitée en tâche de fond pour charger les tables vectorielles de la police sélectionnée, calculer les métriques de crénage entre les glyphes successifs et rasteriser chaque caractère selon la matrice de transformation affine courante. L’objet Text participe ainsi pleinement au cycle de vie de la scène graphique : si les limites d’affichage de l’axe sont ultérieurement modifiées de manière interactive (via un zoom ou un recadrage panoramique), l’annotation est recalculée et repositionnée de manière transparente sur le canevas d’affichage interactif.
4. Gestion des textes multiples et itération programmatique
4.1 Automatisation du placement textuel via des boucles itératives
Dans de multiples contextes de recherche empirique, l’annotation ne se cantonne pas à une entité géométrique unique mais doit s’étendre systématiquement à l’ensemble des observations composant un jeu de données structuré. Cette situation se présente de manière classique lors de la visualisation de cartes génétiques, d’arbres phylogénétiques ou de projections spatiales issues d’analyses en composantes principales (ACP), où chaque observation correspond à un individu, un pays ou une souche bactérienne désigné par un code textuel univoque.
Pour orchestrer ce déploiement sans dupliquer manuellement des lignes de code rébarbatives, la programmation d’itérations élégantes au travers des structures de données natives de Python s’avère incontournable. L’utilisation conjointe des générateurs zip() et enumerate() permet de parcourir en un seul passage algorithmique les vecteurs coordonnés des abscisses, des ordonnées et de la collection séquentielle des étiquettes textuelles. À chaque itération de la boucle, les coordonnées courantes sont adjointes d’un décalage arithmétique constant sur le vecteur horizontal ou vertical, assurant une régularité géométrique parfaite de l’implantation des chaînes descriptives sur le plan.
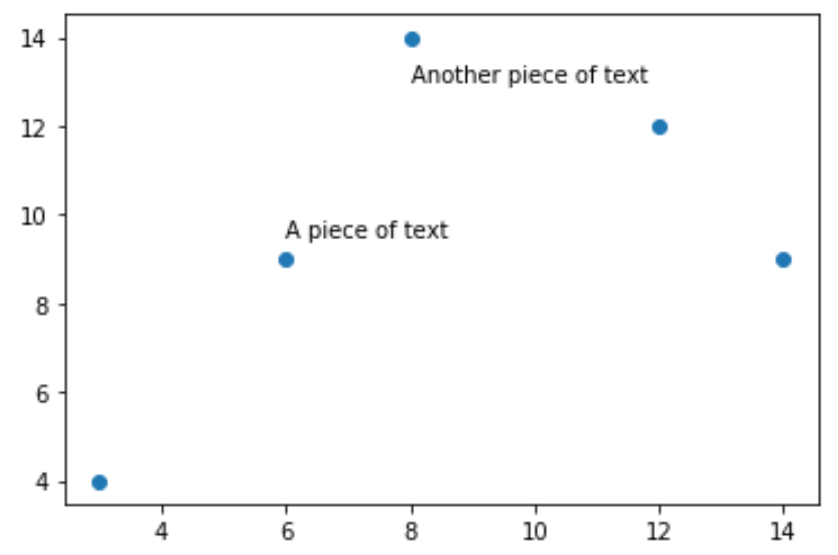
Bien que cette génération itérative d’annotations textuelles réponde avec efficacité aux jeux de données de taille modérée (comportant de quelques dizaines à quelques centaines d’échantillons), elle impose une vigilance accrue relative aux performances computationnelles. Chaque appel à ax.text() générant un objet distinct au sein de l’arborescence graphique, la multiplication incontrôlée de milliers d’artistes textuels peut rapidement dégrader les temps de rafraîchissement des canevas interactifs et surcharger la mémoire vive, nécessitant le déploiement de stratégies de sélection rationnelle en amont de la phase de tracé.
4.2 Filtrage conditionnel des étiquettes à afficher
L’affichage indiscriminé de l’intégralité des étiquettes associées à un échantillon de grande dimension engendre invariablement un phénomène de saturation visuelle aiguë (l’effet dit de « bouillie d’encre » ou visual clutter). Lorsque des centaines de chaînes de caractères se superposent et masquent la topographie des distributions statistiques sous-jacentes, le graphique perd toute capacité communicative. Pour préserver l’intelligibilité scientifique du document, le chercheur doit mettre en œuvre une logique de filtrage conditionnel rigoureuse, en n’autorisant l’affichage textuel que pour un sous-ensemble rigoureusement circonscrit de points d’intérêt critique.
Ce filtrage algorithmique repose sur l’évaluation d’expressions logiques et de seuils statistiques déterminés au préalable. Dans l’analyse de données psychométriques, cliniques ou comportementales denses, la sélection peut être restreinte aux valeurs aberrantes (outliers) situées au-delà de deux ou trois écarts-types par rapport à la moyenne du groupe, ou encore aux observations franchissant un seuil de significativité statistique préalablement corrigé pour les comparaisons multiples (par exemple via la méthode de Bonferroni ou le contrôle du taux de fausse découverte). Le script examine chaque observation et n’émet l’instruction d’annotation textuelle que si la condition mathématique stricte est vérifiée.
Cette approche sélective confère au tracé une sobriété exemplaire conforme aux préceptes modernes de la transmission de l’information quantitative. Les observations conformes aux prédictions du modèle théorique demeurent matérialisées sous forme de simples marqueurs géométriques discrets, tandis que le regard du lecteur est instantanément guidé vers les cas atypiques qui portent la charge sémantique la plus novatrice pour la discussion méthodologique ou clinique.
4.3 Algorithmes basiques de non-chevauchement des chaînes
L’un des défis les plus redoutables lors de l’automatisation de l’annotation textuelle multiple réside dans le chevauchement spatial incontrôlé entre les chaînes de caractères voisines. Lorsque deux observations empiriques présentent des valeurs de coordonnées numériques excessivement proches, leurs étiquettes textuelles respectives se recouvrent inexorablement, rendant leur décodage impossible. Pour remédier à cette collision géométrique, il devient nécessaire d’adopter des algorithmes d’évitement capables d’altérer dynamiquement les trajectoires spatiales des étiquettes sans rompre leur association d’origine.
Une première technique rustique mais efficace repose sur la détection des collisions par l’évaluation des intersections entre boîtes englobantes orthogonales (Axis-Aligned Bounding Boxes ou AABB). Si deux rectangles typographiques entrent en collision lors du calcul préliminaire des métriques, une force de répulsion proportionnelle à leur interpénétration spatiale est appliquée de manière itérative le long d’un gradient de dispersion directionnelle, décalant progressivement l’une des étiquettes vers le haut, le bas ou en diagonale jusqu’à résolution complète du conflit géométrique.
Pour les visualisations scientifiques de très haute complexité, la mise en œuvre manuelle de ces routines de recuit simulé ou de répulsion électrostatique virtuelle peut s’avérer laborieuse. Il est alors opportun de s’appuyer sur des bibliothèques d’optimisation spécialisées intégrées à l’écosystème Matplotlib, au premier rang desquelles figure adjustText. Cet outil algorithmique implémente des mécanismes avancés de relaxation itérative, repoussant automatiquement les textes à la fois les uns par rapport aux autres et par rapport aux points de données eux-mêmes, garantissant une disposition spatialement optimale exempte de tout chevauchement parasite.
5. Maîtrise avancée du paramètre fontdict et personnalisation typographique
5.1 Configuration des familles de polices, styles et graisses
La typographie constitue la voix silencieuse d’un document graphique. Dans le domaine de l’édition scientifique et technique, le choix des caractères typographiques ne répond pas à des impulsions ornementales, mais à des exigences fonctionnelles de lisibilité, de neutralité et de hiérarchie informative. Au sein de Matplotlib, la configuration typographique s’articule autour de familles génériques normalisées : serif (polices à empattements traditionnelles telles que Times New Roman ou Computer Modern), sans-serif (polices linéaires modernes telles que Helvetica, Arial ou DejaVu Sans), monospace (polices à chasse fixe dédiées à la transcription de fragments de code source ou de séquences nucléotidiques), ainsi que les familles plus décoratives mais peu usitées en science que sont cursive et fantasy.
Pour instaurer une hiérarchisation sémiotique robuste entre les différents niveaux d’annotations d’un même graphique, le contrôle de la graisse (fontweight) s’avère déterminant. Matplotlib propose une gradation sémantique standardisée s’étendant de 'ultra-light' et 'light', en passant par 'normal' et 'medium', jusqu’à 'semibold', 'bold' et 'extra-bold', parallèlement à l’acceptation de valeurs numériques entières calibrées sur les standards du Web Consortium (de 100 à 900). L’utilisation judicieuse d’une graisse accentuée (bold) doit être parcimonieuse et strictement réservée aux termes directeurs ou aux conclusions statistiques majeures.
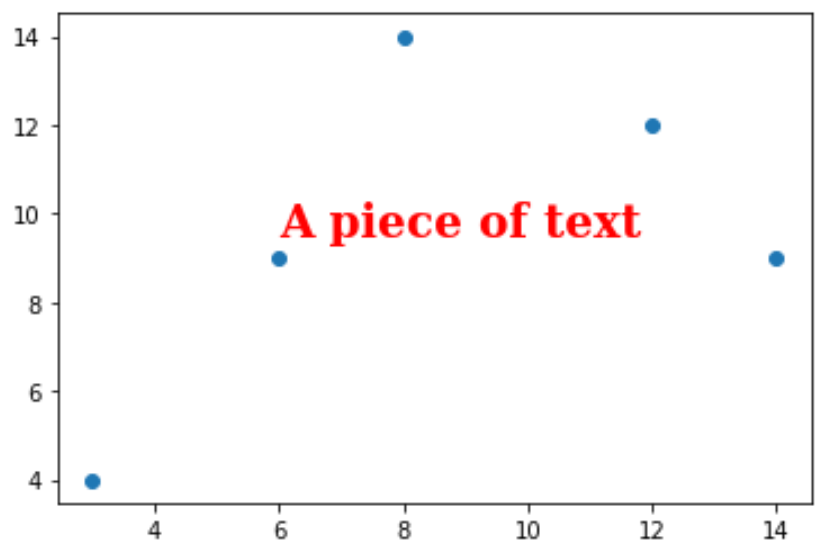
Le paramètre de style (fontstyle), permettant de basculer la graphie en 'italic' ou 'oblique', offre une modalité complémentaire de différenciation textuelle. Dans la typographie académique standardisée, l’italique est traditionnellement réservé aux mentions secondaires, aux annotations méthodologiques discrètes, aux désignations taxinomiques latines en biologie ou aux symboles de variables algébriques individuelles, évitant ainsi de perturber la lecture des descripteurs nominatifs primaires qui doivent impérativement demeurer en caractères droits et posés.
5.2 Contrôle précis de l’échelle et des tailles de caractères
Le dimensionnement des caractères typographiques constitue un facteur critique garantissant que la figure conserve son efficacité communicative aussi bien affichée en plein écran sur un moniteur haute résolution que réduite aux dimensions imposées par la mise en page d’une revue internationale imprimée sur deux colonnes. Matplotlib permet de spécifier la taille des polices (fontsize ou size) selon deux méthodologies distinctes : l’utilisation d’échelles relatives prédéfinies ou la fixation de dimensions scalaires absolues exprimées en points typographiques.
Les descripteurs d’échelle relative — s’échelonnant le long d’une échelle normalisée comprenant 'xx-small', 'x-small', 'small', 'medium', 'large', 'x-large' et 'xx-large' — adaptent automatiquement la dimension de la chaîne textuelle par rapport à la taille de base configurée au niveau global de l’axe ou du système. Bien que pratique pour préserver un équilibre proportionnel immédiat lors de prototypages exploratoires, cette approche relative manque parfois de la précision millimétrique exigée par les chartes éditoriales académiques contraignantes.
Dans un contexte de publication professionnelle, l’attribution directe de valeurs scalaires absolues (exprimées rigoureusement en points PostScript, où 1 point équivaut à 1/72 de pouce, soit environ 0,353 millimètre) est vivement recommandée. L’adoption d’une grille de tailles rigoureuse — par exemple, 12 points pour les titres d’axes majeurs, 10 points pour les annotations textuelles primaires et 8 points pour les mentions d’incertitude ou de source — permet de maintenir une homogénéité formelle sans faille lors de l’insertion finale des figures vectorielles au sein de documents rédigés sous des environnements de composition avancés.
5.3 Harmonisation chromatique et accessibilité visuelle
La sélection des teintes appliquées aux annotations textuelles doit concilier des exigences de lisibilité immédiate, d’harmonie esthétique globale et d’accessibilité universelle. Au sein de Matplotlib, la coloration du texte peut être assignée via une multiplicité de formats syntaxiques : des désignations nominales standards de l’espace Web (telles que 'darkblue' ou 'dimgray'), des triplets scalaires RVB normalisés dans l’intervalle unitaire [0, 1], des quadruplets RVBA incorporant un canal de transparence alpha, ou encore des codes hexadécimaux stricts (ex. '#2C3E50') assurant une fidélité chromatique absolue.
Sur le plan ergonomique, le concepteur d’une figure a l’obligation éthique de veiller au respect des recommandations internationales relatives à l’accessibilité visuelle, telles que définies par les directives pour l’accessibilité des contenus Web (WCAG 2.1). Celles-ci stipulent que tout élément textuel doit présenter un rapport de contraste de luminance d’au moins 4,5 pour 1 par rapport à son fond immédiat pour un corps de texte standard, et d’au moins 3 pour 1 pour les caractères de grande taille. Placer un texte gris clair sur un canevas blanc ou un texte bleu nuit sur un fond d’histogramme sombre constitue une faute ergonomique majeure qui proscrit la diffusion du document auprès de publics présentant une acuité visuelle affaiblie.
De surcroît, la prise en compte des daltonismes et autres déficiences de la vision des couleurs (dyschromatopsies affectant jusqu’à 8 % de la population masculine mondiale) impose de ne jamais utiliser la couleur comme l’unique vecteur de discrimination sémantique. L’annotation textuelle doit posséder une différenciation géométrique, typographique ou contextuelle autonome, garantissant que même convertie en niveaux de gris purs ou perçue par un observateur atteint de deutéranopie, l’information textuelle demeure distincte de son arrière-plan et conserve son entière valeur probante.
6. Systèmes de coordonnées et transformations spatiales
6.1 Espace de données versus espace relatif des axes
L’un des aspects les plus fondamentaux et pourtant les plus fréquemment source de confusions dans l’architecture interne de Matplotlib réside dans la multiplicité des systèmes de coordonnées au sein desquels un objet peut être ancré. Par défaut, la méthode ax.text(x, y, s) évalue le couple scalaire (x, y) dans l’espace de coordonnées des données (data coordinates). Dans ce mode, si l’axe horizontal représente une échelle chronologique s’étendant de l’an 1900 à l’an 2000, une annotation insérée à x=1950 demeurera indéfectiblement rivée à cette date calendaire, subissant les mêmes translations ou dilatations d’échelle que les données lors des manipulations interactives.
Il est cependant fréquent de vouloir ancrer une mention textuelle — par exemple une lettre d’identification de panneau comme « A », un cartouche méthodologique ou un indice statistique global — à un emplacement invariant d’un axe, indépendamment des variations dynamiques d’échelle des données sous-jacentes. Pour satisfaire cette exigence, Matplotlib fournit le système de transformation d’axe ax.transAxes, activé via l’argument transform=ax.transAxes. Dans ce système de coordonnées unitaire et normalisé, l’origine cartésienne (0, 0) coïncide rigoureusement avec le coin inférieur gauche du cadre de l’axe, tandis que le point (1, 1) en désigne l’angle supérieur droit.
L’exploitation judicieuse de ax.transAxes révolutionne la conception de scripts reproductibles. En positionnant systématiquement une étiquette descriptive à des coordonnées relatives fixes telles que (0.05, 0.95) avec un alignement approprié, le développeur s’assure que le texte se placera avec une constance géométrique irréprochable dans le coin supérieur gauche du panneau d’affichage, quelle que soit la dispersion statistique, l’amplitude des variables physiques ou les variations des limites imposées ultérieurement par ax.set_xlim() ou ax.set_ylim().
6.2 Utilisation de l’espace de la figure entière
Au-delà du périmètre géométrique circonscrit par un axe individuel, il devient parfois nécessaire d’orchestrer des annotations textuelles embrassant la composition graphique dans sa globalité. Cette nécessité se fait particulièrement sentir lors de l’assemblage de figures composites complexes formées de multiples sous-graphiques adjacents, où l’on souhaite apposer une légende transversale, un titre thématique commun à plusieurs colonnes d’observation ou une notice de copyright institutionnelle bordant le document.
Matplotlib répond à ce besoin architectural par l’intermédiaire du système de coordonnées de la figure entière, gouverné par la transformation fig.transFigure. De manière analogue à l’espace d’axe, ce système cartographique opère au sein d’un espace unitaire et continu normalisé dans l’intervalle [0, 1], mais dont le champ d’action s’étend désormais aux limites matérielles absolues du canevas de la fenêtre ou de la feuille de rendu. Le point (0, 0) localise l’extrême bord inférieur gauche de l’image globale générée, tandis que (1, 1) correspond à sa frontière sommitale droite.
L’utilisation de la méthode de niveau supérieur fig.text(x, y, s, transform=fig.transFigure) résout avec une parfaite élégance le défi de l’alignement inter-axes. Au lieu de tenter d’ajuster artificiellement des textes au sein d’axes séparés en subissant les décalages induits par les largeurs variables des graduations d’ordonnées, l’insertion directe à l’échelle de la figure permet d’aligner mathématiquement des blocs textuels sur une ligne de flottaison géométrique unique et pérenne à travers l’ensemble des panneaux du canevas.
6.3 Transformations mixtes et coordonnées en pixels d’affichage
L’architecture de transformation de Matplotlib brille par sa capacité à combiner différents espaces géométriques pour générer des systèmes hybrides ou transformations composites. Une transformation mixte courante consiste à lier l’une des dimensions spatiales à l’échelle des données tout en astreignant la seconde à l’espace normalisé de l’axe, par le biais du module interne matplotlib.transforms.blended_transform_factory(ax.transData, ax.transAxes). Cette disposition technique s’avère particulièrement utile pour annoter une ligne de seuil critique verticale, où l’abscisse textuelle doit épouser fidèlement la coordonnée empirique sur l’axe des x tandis que son ordonnée demeure ancrée de façon fixe au sommet absolu du cadre.
À l’échelon le plus bas de la pile d’abstraction se trouve le système de coordonnées d’affichage (display coordinates), géré par l’opérateur d’identité matérielle (None ou IdentityTransform). Dans ce référentiel, les coordonnées scalaires x et y traduisent littéralement un nombre physique de pixels d’affichage calculés à partir de l’origine de la fenêtre graphique matérielle. Bien que théoriquement mobilisable, l’ancrage direct en coordonnées d’affichage est généralement déconseillé pour les applications statiques, dans la mesure où ces coordonnées sont excessivement tributaires de la résolution matérielle de l’écran et de la valeur de DPI définie lors de l’instanciation de la session.
Toute modification ultérieure du dimensionnement de la fenêtre, qu’il s’agisse d’un redimensionnement interactif par l’utilisateur ou d’une exportation sérialisée vers des formats d’impression à très haute résolution, perturbe drastiquement les relations spatiales si l’ancrage a été formulé en pixels directs. Les développeurs chevronnés veillent donc à cantonner l’usage des coordonnées d’affichage à des extensions logicielles interactives hautement spécialisées, privilégiant continuellement les transformations relatives ou liées aux données pour assurer une pérennité absolue de leurs figures scientifiques.
7. Alignement, ancrage et rotation géométrique du texte
7.1 Paramètres d’alignement horizontal et vertical
Le positionnement textuel dans Matplotlib ne se résume pas à l’assignation d’un couple de coordonnées (x, y) ; il dépend fondamentalement de la position relative du point d’ancrage géométrique par rapport à la boîte englobante de la chaîne typographique. Cette cinématique est gouvernée par deux paramètres d’alignement orthogonaux : horizontalalignment (abrégé en ha) et verticalalignment (abrégé en va). La méconnaissance de ces deux directives constitue l’une des causes les plus courantes de décalages inesthétiques et de recouvrements textuels accidentels.
Le paramètre d’alignement horizontal propose trois options canoniques : 'left', 'center' et 'right'. Lorsqu’il est défini sur 'left' (comportement par défaut), la coordonnée spatiale x spécifiée matérialise la frontière gauche du texte, qui s’étend par conséquent vers la droite de l’axe. À l’inverse, l’assignation 'right' place la coordonnée x à la bordure droite extrême du glyphe final, étendant le bloc textuel vers la gauche. L’option 'center' répartit symétriquement la largeur totale de la boîte englobante de part et d’autre de l’abscisse d’ancrage choisie.
Sur le plan orthogonal, le paramètre verticalalignment déploie quatre variantes principales : 'top', 'center', 'bottom' et 'baseline'. Tandis que 'top' fait coïncider l’ordonnée y avec le bord supérieur de la boîte typographique et que 'bottom' l’aligne sur la base inférieure des jambages descendants, l’option 'baseline' s’avère particulièrement précieuse pour les typographes rigoureux : elle ancre l’ordonnée y sur la ligne de base fondamentale des caractères majuscules et minuscules sans hampes descendantes, garantissant ainsi un alignement visuel parfait entre des fragments de texte adjacents possédant des tailles de police hétérogènes.
7.2 Rotation angulaire et alignement sur des trajectoires
La capacité d’orienter le flux textuel selon des axes non orthogonaux est indispensable pour dynamiser la composition visuelle et optimiser l’occupation de l’espace. Le paramètre rotation autorise la spécification d’un angle arbitraire de rotation géométrique, formulé en degrés d’arc sexagésimaux (dans le sens trigonométrique direct pour les valeurs positives). Cette fonctionnalité trouve une application naturelle lors de l’alignement d’un libellé textuel le long d’une droite de régression linéaire inclinée, d’une courbe cinétique exponentielle ou d’une diagonale d’indifférence.
Cependant, l’application conjointe d’une rotation angulaire et de paramètres d’alignement engendre une interaction cinématique sophistiquée qu’il convient de maîtriser rigoureusement. Dans Matplotlib, la rotation de la boîte englobante s’effectue systématiquement autour du point d’ancrage spécifié par les coordonnées (x, y) en conjonction avec les valeurs d’alignement ha et va. Si ces attributs sont mal calibrés, l’application d’une rotation de 45 degrés peut projeter le centre de gravité textuel à une distance inattendue du point d’intérêt initialement ciblé.
Pour synchroniser fidèlement l’orientation textuelle avec la pente géométrique d’un tracé de tendance sur un écran non carré, il ne suffit pas de calculer l’arc-tangente de la dérivée mathématique première des données. Il importe de prendre en compte le rapport d’aspect physique de l’axe (le ratio effectif entre la largeur et la hauteur en pouces) ainsi que les échelles respectives des axes de données, faute de quoi l’angle textuel semblera désynchronisé de la trajectoire visuelle apparente de la courbe empirique.
7.3 Gestion des textes multilignes et alignement interne
L’insertion d’annotations denses regroupant des descriptifs méthodologiques complets ou des bilans statistiques exhaustifs requiert la structuration de chaînes de caractères sur plusieurs lignes consécutives. L’introduction de sauts de ligne s’opère de manière standardisée par l’insertion explicite du caractère d’échappement conventionnel n au sein de la chaîne transmise au paramètre textuel de Matplotlib.
Dès lors qu’une entité textuelle englobe une pluralité de lignes superposées, un nouveau degré de liberté intervient : l’alignement interne du paragraphe, gouverné par le paramètre multialignment (ou directement relayé par le comportement de horizontalalignment). Ce paramètre détermine la manière dont les lignes individuelles se justifient les unes par rapport aux autres à l’intérieur de la boîte englobante globale. L’utilisateur peut ainsi choisir de cadrer le bloc textuel à gauche, de le centrer harmonieusement ou de le justifier à droite selon les impératifs d’équilibre esthétique de la composition graphique.
Par ailleurs, la préservation de la compacité visuelle du paragraphe sans dégrader la lisibilité conceptuelle dépend du réglage de l’interlignage, accessible via le paramètre linespacing. En modulant ce facteur scalaire multiplicateur par rapport à la hauteur nominale de la police, il devient possible de densifier un tableau de paramètres numériques pour limiter son empreinte sur le tracé, ou au contraire d’aérer un texte explicatif complexe pour faciliter son décryptage par les relecteurs du manuscrit.
8. Encadrement, boîtes de délimitation et stylisation avec Bbox
8.1 Encapsulation visuelle via le dictionnaire de propriétés bbox
L’une des difficultés les plus récurrentes lors de l’insertion d’annotations textuelles au cœur d’un graphique à forte densité de données réside dans le parasitage causé par les éléments d’arrière-plan. Lorsqu’une chaîne de caractères traverse une grille cartésienne, coupe une courbe de distribution ou survole un essaim de points dispersés, la lisibilité typographique se trouve sévèrement altérée en raison de l’interférence continue entre les traits de caractères et les motifs géométriques sous-jacents.
Pour résoudre ce conflit optique de manière pérenne, Matplotlib met à disposition le paramètre bbox (abréviation de Bounding Box). Cet argument reçoit comme valeur un dictionnaire Python qui ordonne au moteur de rendu d’instancier un artiste rectangulaire dérivé de la classe matplotlib.patches.FancyBboxPatch, venant se positionner en couche géométrique intermédiaire sous les glyphes de la chaîne de caractères. Cette boîte englobante constitue un écran protecteur isolant parfaitement le texte des perturbations structurelles de l’arrière-plan.
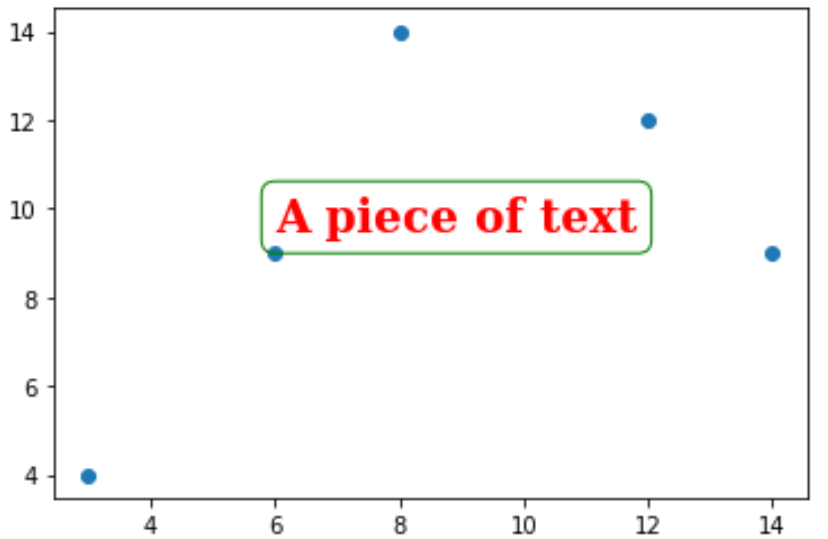
Le paramétrage fondamental de ce dictionnaire de boîte inclut l’assignation de la couleur de fond via la clé facecolor (ou fc), la couleur du contour périphérique via edgecolor (ou ec), et la modulation de l’opacité au moyen de la clé alpha. L’utilisation d’une opacité semi-transparente (par exemple alpha=0.85) représente un compromis ergonomique remarquable : elle garantit une lisibilité typographique irréprochable tout en permettant à l’observateur de deviner en filigrane le tracé des données sous-jacentes, évitant ainsi de masquer totalement des observations expérimentales critiques.
8.2 Morphologie des bordures et géométrie des bordures de boîtes
Au-delà du simple rectangle anguleux traditionnel, le dictionnaire bbox propose une grande richesse géométrique par le truchement de la directive boxstyle. Cette commande permet de transformer radicalement la silhouette de la boîte englobante pour lui conférer une morphologie adaptée aux conventions de communication du domaine scientifique considéré. Les styles prédéfinis incluent notamment 'square' (rectangle classique à angles vifs), 'round' (rectangle à angles adoucis par un rayon de courbure ajustable), 'round4' (boîte aux contours bombés), ainsi que des géométries fléchées directionnelles comme 'rarrow' ou 'larrow' et circulaires comme 'circle'.
La commande boxstyle ne se borne pas à désigner un style nominal générique ; elle autorise l’adjonction d’arguments géométriques paramétrables directement au sein de sa chaîne d’assignation, telle que 'round,pad=0.5,rounding_size=0.2'. Ce niveau de granularité offre au dessinateur la faculté d’ajuster avec une précision absolue le rayon de courbure des sommets, conférant ainsi à l’annotation une esthétique moderne et soignée qui s’intègre harmonieusement dans les formats de présentation visuelle de pointe.
Parallèlement à la forme générale, la personnalisation de la bordure externe s’enrichit par le contrôle conjoint de l’épaisseur du trait via linewidth (ou lw) et de sa texture géométrique via linestyle (ou ls). L’usage de bordures pointillées discrètes (linestyle=':') ou de traits continus ultra-fins (linewidth=0.5) permet de structurer l’espace textuel avec subtilité, sans conférer à l’encadré une présence visuelle dominante qui viendrait concurrencer l’information quantitative véhiculée par les données primaires du tracé.
8.3 Gestion des marges internes (padding) et espacements
L’équilibre visuel et la beauté typographique d’une boîte englobante dépendent au premier chef de la gestion de ses marges internes, désignées sous le vocable technique de padding. Si l’espace séparant l’extrémité des glyphes typographiques des bordures géométriques de la boîte est excessivement restreint, les caractères semblent à l’étroit et compressés dans leur conteneur, créant un sentiment de claustrophobie optique qui nuit au confort de lecture. Inversement, un espacement hypertrophié gonfle artificiellement le volume de la boîte, augmentant le risque d’occlusion inutile des données du graphique.
Le contrôle de cette métrique spatiale s’effectue au sein de la directive boxstyle par le biais de la propriété pad, qui exprime l’espacement marginal en fractions de la taille nominale de la police utilisée. Une valeur de pad=0.3 à pad=0.5 représente généralement un étalonnage ergonomique optimal pour les publications professionnelles, offrant une marge suffisante pour isoler optiquement les hampes montantes et descendantes sans générer un encombrement surfacique excessif.
L’application d’un encadrement soigné trouve toute sa pertinence dans la mise en exergue d’indices statistiques récapitulatifs à forte valeur probante, tels que le coefficient de détermination R², le coefficient de corrélation de Pearson ou les tailles d’effet issues d’analyses de variance. En encapsulant ces métriques dans un boîtier aux contours arrondis, doté d’un arrière-plan légèrement teinté et de marges calibrées, le praticien crée un point focal structurant qui valorise immédiatement la rigueur analytique de sa démarche empirique.
9. Intégration d’expressions mathématiques et formatage TeX
9.1 Syntaxe de base du moteur interne MathText
L’un des atouts prééminents de Matplotlib pour la communauté académique réside dans son moteur de rendu mathématique intégré, baptisé MathText. Ce module autonome permet d’analyser, de mettre en page et de rastériser des expressions mathématiques complexes selon les standards syntaxiques de TeX, sans exiger l’installation préalable d’une distribution externe de TeX ou LaTeX sur la machine de calcul. Cette portabilité native garantit la parfaite reproductibilité des figures enrichies d’équations à travers des environnements d’exécution hétérogènes.
L’activation de MathText s’effectue en encapsulant l’énoncé algébrique au sein de délimiteurs monétaires conventionnels $...$. En raison de la présence fréquente de caractères de barre oblique inverse (backslash ) utilisés comme préfixes de commandes mathématiques au sein de la chaîne, il est formellement impératif d’utiliser des chaînes de caractères brutes en Python (identifiées par le préfixe r'...', pour raw strings). Cette précaution syntaxique neutralise les mécanismes d’échappement par défaut de Python, prévenant ainsi les erreurs d’interprétation lors de la compilation textuelle.
Grâce à MathText, la génération d’indices via l’opérateur de soulignement (_), d’exposants au moyen de l’accent circonflexe (^), de fractions typographiques élégantes via la commande standard frac{numérateur}{dénominateur} ou d’expressions radicales à l’aide de sqrt{expression} devient d’une simplicité exemplaire. Le moteur ajuste automatiquement la taille des glyphes, la hauteur des barres de fraction et l’étagement vertical des termes mathématiques selon les canons séculaires de la typographie scientifique.
9.2 Affichage des symboles grecs et opérateurs statistiques avancés
La communication scientifique moderne requiert quotidiennement la transcription rigoureuse de concepts statistiques s’appuyant sur l’alphabet grec et une panoplie exhaustive d’opérateurs relationnels spécialisés. L’utilisation d’approximations orthographiques (comme l’écriture phonétique « alpha » ou « p-value » non formatée) dégrade la qualité formelle d’un mémoire ou d’un article de recherche. MathText comble cette attente en fournissant un support complet pour l’ensemble des lettres grecques minuscules et majuscules au moyen de leur syntaxe TeX canonique (ex. alpha, beta, mu, sigma, Delta, Omega).
De surcroît, le moteur intègre la panoplie des opérateurs relationnels indispensables à l’expression de l’incertitude et de la conformité méthodologique : les symboles d’infériorité ou de supériorité stricte ou approximative (leq, geq, ll, gg, approx, equiv), les opérateurs d’intervalles de confiance (pm), ainsi que les symboles d’intégrales multiples, de sommations discrètes (sum_{i=1}^n) et de limites analytiques. L’inclusion d’une valeur de p sous la formulation rigoureuse r'$p < 0.001$' ou d’un test d’indépendance sous la forme r'$\chi^2(2) = 14.82$' s’effectue ainsi de manière directe et irréprochable.
Cette standardisation typographique favorise une homogénéisation parfaite entre le corps rédactionnel d’une publication scientifique — généralement composé sous des environnements de pointe comme LaTeX ou typst — et le contenu textuel des graphiques associés. L’observateur bénéficie ainsi d’une continuité cognitive transparente, les variables désignées dans la discussion conceptuelle adoptant rigoureusement la même identité visuelle lorsqu’elles sont projetées sur les axes ou au contact des distributions expérimentales.
9.3 Activation de l’interpréteur externe LaTeX complet
Bien que le moteur interne MathText couvre la quasi-totalité des besoins graphiques usuels, il existe des situations de recherche pointue où l’accès à un environnement de composition complet s’avère indispensable. C’est notamment le cas lorsque le chercheur désire employer des packages typographiques spécialisés, injecter des macros personnalisées définies dans son manuscrit, ou imposer l’utilisation exclusive de la police vectorielle académique Computer Modern pour une parfaite adéquation aux standards des revues de physique théorique ou de mathématiques fondamentales.
Pour répondre à cette ambition d’excellence typographique, Matplotlib permet de déléguer l’intégralité du traitement textuel à un interpréteur LaTeX externe installé localement sur le système d’exploitation. Cette délégation s’active de manière globale en positionnant la variable d’environnement rcParams['text.usetex'] = True. Dès lors, toute chaîne de caractères soumise à un artiste textuel est encapsulée dans un document TeX temporaire, compilée en arrière-plan via le binaire système, puis réinjectée dans le canevas graphique sous la forme d’un objet vectoriel parfaitement lissé (DVI/PostScript/SVG).
Cette perfection formelle s’accompagne toutefois de contreparties techniques qu’il convient de soupeser méthodiquement. D’une part, l’activation de text.usetex exige la présence d’une distribution TeX complète et opérationnelle (comme TeX Live, MacTeX ou MiKTeX) ainsi que des utilitaires annexes comme dvipng ou Ghostscript. D’autre part, le coût computationnel induit par la compilation séquentielle de multiples fichiers TeX temporaires allonge considérablement les temps de génération des tracés, ce qui peut s’avérer pénalisant lors du rendu en temps réel de visualisations interactives ou de traitements par lots massifs.
10. Comparaison fonctionnelle : plt.text() versus plt.annotate()
10.1 Caractéristiques intrinsèques et valeur ajoutée de plt.annotate()
Si la fonction plt.text() (ou ax.text()) excelle par sa pureté conceptuelle pour l’insertion de libellés statiques, Matplotlib met à la disposition des concepteurs un outil d’une sophistication structurelle supérieure pour lier textuellement une observation à une zone spécifique du graphique : la méthode annotate() (disponible via plt.annotate() ou ax.annotate()). La valeur ajoutée primordiale de cette méthode réside dans le découplage conceptuel formel entre la coordonnée de la cible d’intérêt, notée xy, et la coordonnée où s’affiche le corps du texte descriptif, désignée par xytext.
Cette dissociation géométrique prend toute sa dimension par l’intégration d’un gestionnaire de flèches vectorielles hautement personnalisable via l’argument arrowprops. Ce dictionnaire autorise le tracé automatisé d’un vecteur fléché reliant élégamment le bloc textuel à la cible empirique, avec une gestion intelligente du contournement et de l’interruption du tracé aux frontières exactes de la boîte englobante. L’utilisateur peut opter pour des flèches simples ou des courbes de Bézier complexes (via arrowstyle='->' et connectionstyle='arc3,rad=0.2'), facilitant l’orientation du regard sans surcharger l’espace intermédiaire.
De surcroît, annotate() autorise la spécification de systèmes de coordonnées totalement différenciés pour la cible et pour l’étiquette. On peut ainsi ancrer le pointage de la cible dans l’espace physique des données (xycoords='data') tout en positionnant le texte explicatif selon un décalage calculé en points typographiques constants par rapport à cette cible (textcoords='offset points'). Cette modularité garantit que même si l’échelle des données est profondément modifiée lors d’un zoom interactif, la flèche s’adaptera automatiquement tout en préservant la distance relative de l’annotation.
10.2 Critères d’arbitrage technique en faveur de plt.text()
Face à la puissance architecturale incontestable de annotate(), on pourrait s’interroger sur la pertinence de maintenir l’usage de text() dans des projets contemporains. L’arbitrage en faveur de text() repose sur des critères d’économie conceptuelle, de simplicité de maintenance du code et de performances computationnelles pures. Lorsque l’annotation textuelle a vocation à qualifier un état global du graphique plutôt qu’un point singulier — à l’instar d’un tableau récapitulatif des effectifs, d’une mention méthodologique générale ou d’un en-tête de quadrant cartésien —, le recours à un connecteur fléché devient totalement dénué de sens.
Dans ces circonstances, text() offre une interface minimaliste épurée de toute complexité superflue. L’absence d’évaluation des relations directionnelles entre un point source et un point récepteur allège la charge mentale du développeur et réduit le volume de code boilerplate indispensable à la restitution du résultat. La syntaxe est concise, transparente et s’intègre immédiatement dans des structures de données scalaires standards sans nécessiter la construction préalable de multiples dictionnaires imbriqués de styles de connexion vectorielle.
En outre, dans les protocoles d’affichage massif impliquant la génération séquentielle de dizaines de milliers d’étiquettes typographiques (comme le rendu textuel au sein d’arbres décisionnels denses ou d’arbres d’expression syntaxique), l’empreinte mémoire d’une instance de Text est sensiblement inférieure à celle d’une instance d’Annotation, laquelle doit instancier et synchroniser des sous-artistes géométriques supplémentaires pour administrer les flèches et leurs connexions affines respectives.
10.3 Tableau synoptique des fonctionnalités et performances comparées
Afin de guider rationnellement le choix méthodologique des ingénieurs et chercheurs lors de l’élaboration de leurs pipelines graphiques, une mise en regard fonctionnelle rigoureuse des deux méthodes s’avère éclairante. Cette confrontation synthétique permet de déterminer d’un coup d’œil l’outil le plus approprié selon la nature de l’objectif communicatif et les contraintes computationnelles de l’environnement de production.
- Structure de ciblage spatial :
text()utilise un ancrage à coordonnée scalaire unique(x, y), idéal pour l’étiquetage fixe ;annotate()gère une dualité de coordonnées explicitexy(cible) etxytext(texte), spécifiquement taillée pour le pointage sélectif d’observations singulières. - Gestion des connecteurs visuels :
text()ne supporte aucun connecteur graphique natif ;annotate()intègre un sous-système complet de flèches paramétrables (styles géométriques, courbures de Bézier, rétractions automatiques). - Coordination multiréférentielle :
text()requiert une transformation univoque pour l’ensemble du bloc ;annotate()autorise l’hybridation des systèmes de coordonnées entre la cible empirique (ex. données) et l’étiquette textuelle (ex. décalage en points d’impression). - Consommation de ressources et surcharge mémoire :
text()se caractérise par une instanciation légère et rapide, parfaitement adaptée à l’itération massive ;annotate()entraîne un surcoût d’instanciation non négligeable en raison de la complexité de son graphe interne d’artistes. - Scénarios d’usage préférentiels : Privilégier
text()pour les titres internes, métriques de régression, légendes in-situ et numérotations de panneaux ; adopterannotate()pour les diagnostics d’anomalies ponctuelles, les seuils de rupture et les points d’inflexion expérimentaux.
Cette grille d’arbitrage méthodique garantit que chaque composante textuelle injectée dans le tracé le soit avec le coût algorithmique minimal et la cohérence sémiotique maximale, contribuant à l’élégance architecturale globale du script de calcul.
11. Bonnes pratiques ergonomiques et déontologie de la visualisation
11.1 Minimisation du bruit graphique (Chartjunk) selon Edward Tufte
L’enrichissement textuel d’un tracé graphique doit impérativement s’inscrire dans le cadre épistémologique posé par Edward Tufte dans ses travaux séminaux sur la conception de l’information quantitative. Le principe directeur fondamental réside dans l’optimisation du ratio données-encre (data-ink ratio), qui stipule que la quasi-totalité de l’encre (ou des pixels) mobilisée au sein d’une figure doit être vouée à la transmission directe de l’information statistique substantielle. Tout élément typographique superflu, redondant ou purement ornemental relève du bruit graphique (chartjunk) et doit être proscrit sans réserve.
Appliquée aux annotations libres, cette rigueur déontologique impose d’éliminer méthodiquement les redondances informatives. Il est parfaitement inutile, par exemple, de surcharger une étiquette textuelle en répétant le nom complet d’une variable si celui-ci figure déjà clairement explicité sur le label de l’axe cartésien correspondant. De même, la multiplication de boîtes englobantes criardes, d’ombres portées artificielles ou de polices fantaisistes disperse l’attention visuelle et nuit à la détection des structures numériques profondes que le graphique est censé révéler.
L’idéal ergonomique vers lequel doit tendre le concepteur de figures scientifiques réside dans une transparence textuelle totale. Les étiquettes doivent s’effacer en tant qu’objets graphiques autonomes pour ne laisser subsister dans l’esprit de l’observateur que la relation mathématique ou empirique qu’elles désignent. Cette retenue stylistique constitue l’authentique marque de maturité technique des visualisations scientifiques professionnelles.
11.2 Normalisation typographique conforme aux critères de publication académique
L’insertion d’éléments textuels dans une figure scientifique destinée à l’évaluation par les pairs impose une conformité rigoureuse aux guides de style internationaux établis par les grandes sociétés savantes, telles que l’American Psychological Association (APA), l’Institute of Electrical and Electronics Engineers (IEEE) ou les normes biomédicales du style Vancouver. Ces chartes académiques partagent un ensemble d’exigences formelles strictes visant à garantir la clarté et la reproductibilité universelle des publications.
La règle typographique cardinale concerne la cohérence d’échelle : la taille de police des annotations textuelles intégrées dans une figure ne doit jamais s’écarter de manière disproportionnée du corps de texte principal du manuscrit une fois la figure imprimée à sa taille finale. Une erreur classique consiste à concevoir une figure sur un écran de 27 pouces avec des textes de 14 points, qui deviennent microscopiques et parfaitement illisibles dès lors que le graphique est réduit à la largeur standard d’une colonne de revue (environ 85 millimètres). L’évaluation du résultat doit donc impérativement s’effectuer à l’échelle physique définitive d’impression.
Enfin, le choix du format d’exportation numérique conditionne la préservation de cette netteté typographique. Pour les publications formelles, l’exportation matricielle sous forme de fichiers JPEG ou PNG standard doit être rigoureusement évitée au profit de formats vectoriels normalisés tels que le PDF (Portable Document Format) ou le SVG (Scalable Vector Graphics). Dans ces formats, les chaînes de texte de Matplotlib conservent leur nature vectorielle pure et leurs glyphes typographiques réels, autorisant un agrandissement infini sans aucune pixellisation, tout en permettant aux moteurs d’indexation académique d’effectuer des recherches textuelles directes au sein même des illustrations vectorielles.
11.3 Éthique de la représentation textuelle des données psychologiques et médicales
L’annotation textuelle n’est pas neutre ; elle engage la responsabilité éthique de l’auteur quant à la restitution honnête et impartiale des faits observés. Dans des disciplines hautement sensibles telles que la recherche biomédicale, les neurosciences cliniques ou la psychologie expérimentale, la sélection des mots et des métriques adjointes aux tracés peut induire en erreur les praticiens de santé et les décideurs publics, avec des conséquences sociétales potentiellement majeures.
Une exigence déontologique impérative réside dans la transparence méthodologique entourant la déclaration de la variabilité et des incertitudes statistiques. Une étiquette textuelle indiquant la moyenne d’un groupe expérimental ne doit jamais être dissociée de la transcription formelle de son intervalle de confiance ou de son écart-type (par exemple sous la formulation standard M = 45.2, IC 95% [41.1, 49.3]). De même, la mention textuelle de la significativité statistique ne saurait se résumer à des jugements d’autorité subjectifs (« résultat très significatif ») mais doit consigner avec une neutralité chirurgicale la valeur exacte du p, la taille de l’effet observée (d de Cohen, êta-carré) et la puissance statistique associée.
Enfin, l’éthique de la visualisation réprouve catégoriquement l’occultation textuelle sélective visant à dissimuler des données manquantes, des réductions d’effectifs (attrition d’échantillon au cours d’un essai clinique longitudinal) ou des distributions non conformes aux hypothèses initiales du chercheur. Tout graphique dense a le devoir de documenter, par une annotation sobre mais explicite, le volume d’échantillons effectivement pris en compte (n = ...), garantissant ainsi que l’argumentation visuelle s’exerce dans le strict respect de la vérité scientifique empirique.
12. Diagnostic et résolution des problèmes fréquents de restitution
12.1 Résolution des textes tronqués ou débordants hors du canevas
L’un des dysfonctionnements les plus déconcertants lors de l’insertion de texte libre dans Matplotlib survient lorsqu’une annotation, pourtant correctement positionnée dans l’espace de données, se trouve brutalement tronquée, coupée par la bordure de l’axe ou carrément éjectée hors du champ visible du canevas lors de l’enregistrement final sur disque. Cette anomalie découle de la gestion rigide des marges périphériques et des mécanismes de rognage géométrique (clipping) du moteur de dessin.
Par défaut, la majorité des artistes textuels rattachés à un axe possèdent la propriété clip_on=False, ce qui autorise le texte à déborder en dehors de la surface délimitée par les axes cartésiens. Toutefois, si le texte déborde au-delà des limites physiques de la Figure globale, le moteur de rastérisation n’alloue aucun pixel supplémentaire pour le matérialiser. Pour remédier instantanément à cette troncature, l’invocation de la méthode d’optimisation d’agencement plt.tight_layout() avant la sauvegarde recalcule automatiquement les marges structurelles de la figure afin d’englober la totalité des boîtes typographiques des artistes déclarés.
Pour une robustesse maximale lors de l’appel de sérialisation fig.savefig(), la solution canonique consiste à spécifier le paramètre bbox_inches='tight'. Cette instruction commande à Matplotlib d’évaluer la boîte englobante agrégée de l’intégralité des éléments visibles (y compris les titres déportés, les légendes et les annotations libres périphériques) et d’ajuster dynamiquement les dimensions physiques de la page résultante pour y inclure chaque fragment textuel avec une marge de respiration (pad_inches) parfaitement calibrée.
12.2 Gestion des encodages de caractères non-ASCII et accents en français
La rédaction d’annotations textuelles en langue française requiert l’utilisation quotidienne de caractères diacritiques accentués (é, è, ê, à, ç, etc.) ainsi que de ligatures typographiques (œ, æ). Dans les configurations informatiques mal calibrées ou lors de l’interaction avec d’anciennes versions de moteurs de compilation, la restitution de ces glyphes spécifiques peut provoquer des erreurs d’encodage frustrantes, se matérialisant par des symboles de substitution informes (le fameux caractère de remplacement « ») ou par des exceptions Python de type UnicodeEncodeError.
Dans l’écosystème Python 3 contemporain, l’intégralité des chaînes de caractères est nativement gérée selon l’encodage universel UTF-8. Le premier levier de résolution consiste donc à s’assurer que le fichier source Python lui-même est sauvegardé sous cet encodage et que la déclaration d’en-tête # -*- coding: utf-8 -*- figure en préambule si l’environnement d’exécution le requiert. Par ailleurs, il importe de s’assurer que la police de caractères sélectionnée dans le paramètre fontdict ou dans rcParams['font.sans-serif'] possède effectivement dans ses tables vectorielles les glyphes correspondant aux caractères accentués du bloc latin étendu.
Une précaution technique supplémentaire s’impose lors de l’utilisation conjointe des caractères accentués et du moteur mathématique MathText. Si l’on souhaite intégrer un mot accentué à l’intérieur d’une formule mathématique balisée par $...$, il est impératif d’encapsuler la séquence textuelle au sein de la commande text{...} ou mathrm{...} (par exemple r'$E_{\text{cinétique}} = \frac{1}{2}mv^2$'). Omettre cette précaution amènerait MathText à interpréter la chaîne accentuée comme une suite de variables scalaires mathématiques isolées, provoquant une corruption typographique immédiate des accents.
12.3 Débogage du comportement textuel lors du redimensionnement dynamique
Un comportement souvent jugé déroutant par les scientifiques survient lors de la modification de la résolution d’exportation (DPI) ou lors du redimensionnement interactif de la fenêtre d’affichage : les éléments géométriques (comme les axes ou les surfaces de courbes) s’adaptent proportionnellement à la nouvelle échelle d’affichage, tandis que les annotations textuelles semblent acquérir une taille relative aberrante, soit en devenant minuscules, soit en enflant au point d’écraser la totalité de la composition visuelle.
Ce phénomène s’explique par la nature fondamentale des unités physiques manipulées par Matplotlib. Alors que les coordonnées spatiales sont le plus souvent relatives aux données ou aux dimensions de l’axe, la taille de police (fontsize) est exprimée de manière absolue en points typographiques (1/72 de pouce). Dès lors, si l’on double la résolution d’exportation en multipliant le DPI sans adapter conjointement la taille physique de la figure en pouces (figsize), le rapport de proportionnalité apparent entre la surface des données et le volume textuel se trouve profondément bouleversé.
Pour immuniser les scripts de génération contre ces déformations asynchrones lors des cycles d’intégration continue ou de production de rapports programmés, il est impératif d’adopter des règles de dimensionnement rigoureusement invariantes. Les tests automatisés de non-régression visuelle (s’appuyant sur des comparaisons de sommes de contrôle d’images vectorielles ou matricielles) doivent impérativement fixer de manière déterministe le triplet figsize, dpi et fontsize au sein d’une fonction de fabrique centralisée, assurant une fidélité de restitution immuable à travers toutes les plates-formes logicielles et matérielles de l’infrastructure de recherche.
Références
- Barthes, R. (1964). Rhétorique de l’image. Communications, 4(1), 40-51. https://doi.org/10.3406/comm.1964.1027
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- Knuth, D. E. (1984). The TeXbook. Addison-Wesley Professional.
- Matplotlib Development Team. (2023). Text properties and layout in Matplotlib. Matplotlib Documentation. https://matplotlib.org/stable/tutorials/text/text_props.html
- Rougier, N. P. (2021). Scientific Visualization: Python + Matplotlib. Encre Noire.
- Sweller, J., van Merriënboer, J. J., & Paas, F. G. (1998). Cognitive architecture and instructional design. Educational Psychology Review, 10(3), 251-296. https://doi.org/10.1023/A:1022193728205
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2e éd.). Graphics Press.
- W3C. (2018). Web Content Accessibility Guidelines (WCAG) 2.1. World Wide Web Consortium. https://www.w3.org/TR/WCAG21/