
La communication scientifique contemporaine repose fondamentalement sur la transmission visuelle d’observations empiriques complexes. Dans un écosystème où les volumes de données expérimentales croissent de manière exponentielle, la capacité à synthétiser graphiquement des tendances sans occulter la structure du bruit sous-jacent constitue une compétence méthodologique essentielle. Trop souvent, la présentation des résultats se résume à des estimations ponctuelles isolées, telles que des moyennes arithmétiques, qui masquent la variabilité inhérente aux phénomènes observés. Or, la fidélité de la démarche scientifique exige que toute mesure soit indissociable de son degré d’incertitude, sans quoi le lecteur est exposé à des conclusions prématurées ou fallacieuses.
L’intégration rigoureuse de barres d’erreur au sein des représentations graphiques répond à cet impératif épistémologique. Qu’il s’agisse de mesurer la dispersion intrinsèque d’un échantillon biologique, d’estimer la précision d’une moyenne dans une cohorte comportementale ou de définir les bornes d’un intervalle de confiance inférentiel, ces éléments graphiques transforment une simple illustration en un outil de diagnostic statistique. L’environnement de programmation Python, articulé autour de bibliothèques puissantes telles que Matplotlib, Seaborn, NumPy et SciPy, offre une granularité de contrôle algorithmique exceptionnelle pour formaliser visuellement cette incertitude avec une rigueur mathématique sans compromis.
Ce guide exhaustif a pour vocation d’analyser en profondeur les fondements théoriques, les mécanismes computationnels et les normes de publication régissant l’usage des barres d’erreur en Python. En explorant successivement les concepts statistiques sous-jacents, les implémentations vectorielles directes et les ajustements spécifiques aux devis expérimentaux complexes comme les mesures répétées, cet article propose un cadre méthodologique complet destiné aux chercheurs, ingénieurs et analystes désireux d’élever leurs visualisations aux plus hauts standards de l’évaluation par les pairs.
1. Introduction à la quantification de l’incertitude dans la visualisation scientifique
1.1 Rôle épistémologique de l’erreur dans la recherche empirique
Dans le domaine des sciences empiriques, l’erreur ne doit jamais être assimilée à une faute ou à une imperfection expérimentale ; elle représente l’expression quantitative fondamentale de la variabilité biologique, environnementale ou instrumentale. Toute collecte de données, qu’elle relève de la neurobiologie, de l’astrophysique ou des sciences cognitives, s’inscrit dans un univers stochastique où la mesure absolue n’existe pas. Présenter une valeur moyenne sous la forme d’un point isolé ou d’une barre pleine sans indicateur de dispersion revient à postuler implicitement une homogénéité artificielle des observations, ce qui viole les principes élémentaires de l’inférence inductive.
Les limites critiques des estimations ponctuelles se manifestent particulièrement lorsqu’un chercheur tente de comparer deux conditions expérimentales distinctes. Deux moyennes arithmétiques strictement identiques peuvent provenir de distributions radicalement différentes : l’une caractérisée par une très faible variance indiquant un phénomène déterministe et robuste, l’autre issue d’un étalement massif des données traduisant un bruit prédominant ou l’existence de sous-populations hétérogènes. Sans la quantification visuelle de cette variance, l’évaluation de la pertinence clinique ou scientifique devient impossible, ouvrant la voie à des erreurs d’interprétation de type I (faux positifs) ou de type II (faux négatifs).
Au-delà de la simple clarté descriptive, la représentation systématique de l’incertitude conditionne directement la crise de la reproductibilité qui traverse les sciences expérimentales contemporaines. Des graphiques transparents exposant fidèlement l’amplitude des résidus permettent aux pairs d’évaluer la plausibilité des tailles d’effet rapportées. La visibilité de la variabilité informe instantanément la communauté scientifique sur la puissance statistique de l’étude, incitant à une interprétation nuancée et favorisant des méta-analyses futures fondées sur des paramètres distributionnels réalistes.
1.2 Typologie des barres d’erreur dans les publications évaluées par les pairs
La confusion entre les différentes typologies de barres d’erreur constitue l’une des faiblesses méthodologiques les plus courantes dans la littérature scientifique. Il existe une frontière conceptuelle infranchissable entre les indicateurs de dispersion descriptive d’un échantillon et les métriques inférentielles de précision d’une estimation. L’écart-type illustre la variabilité concrète des données au sein du groupe étudié, documentant la manière dont les individus se dispersent autour du centre de gravité empirique. En revanche, l’erreur standard de la moyenne et les intervalles de confiance traduisent une incertitude projective concernant un paramètre théorique au sein de la population parente.
Le choix graphique doit obligatoirement s’aligner sur les objectifs démonstratifs de l’article et les directives des revues académiques internationales. Dans une étude exploratoire descriptive ou de caractérisation phénotypique, l’écart-type est impératif afin de ne pas masquer l’étendue des variations interindividuelles. À l’inverse, dans le cadre d’un essai clinique randomisé ou d’un protocole expérimental testant une hypothèse nulle spécifique, l’utilisation d’intervalles de confiance à quatre-vingt-quinze pour cent s’impose pour permettre au lecteur d’appréhender directement la signification statistique des contrastes observés.
Cette distinction théorique impose une transparence sémantique absolue dans la légende des figures. Une barre d’erreur non définie prive le tracé de toute valeur informative et induit des biais cognitifs majeurs. Face à un intervalle non spécifié, un lecteur averti peut spontanément l’interpréter comme une erreur standard, sous-estimant ainsi dramatiquement la dispersion réelle des données, ou à l’inverse le considérer comme un écart-type, faussant son jugement sur la précision de l’effet. L’explicitation sans ambiguïté de la nature de la métrique, de la taille de l’échantillon et de la méthode de calcul est la condition sine qua non de l’intégrité graphique.
1.3 Aperçu de l’écosystème Python pour le tracé scientifique
Le langage Python s’est imposé comme le standard de facto du calcul scientifique moderne grâce à la convergence synergique de plusieurs bibliothèques spécialisées formant une pile logicielle cohérente. Au niveau fondamental, la bibliothèque NumPy fournit les structures de données matricielles multidimensionnelles et les primitives de calcul vectoriel nécessaires à la manipulation performante de grands ensembles de données. Immédiatement en aval, SciPy enrichit cet environnement de modules statistiques poussés permettant d’exécuter des rééchantillonnages bootstrap, des ajustements paramétriques et des calculs d’intervalles de confiance avec une précision numérique optimale.
La couche de visualisation repose historiquement sur l’architecture robuste de la bibliothèque Matplotlib, conçue selon un paradigme orienté objet qui offre un contrôle chirurgical sur chaque élément géométrique du tracé. Matplotlib permet de paramétrer finement l’épaisseur, les empattements, la couleur, l’ordre des calques et la disposition spatiale des barres d’erreur via son interface axiale fondamentale. Par-dessus cette fondation, Seaborn introduit une couche d’abstraction statistique de haut niveau, articulée nativement avec les DataFrames de Pandas, automatisant l’agrégation, le calcul des métriques de dispersion et la génération d’intervalles d’incertitude dans des figures prêtes pour la soumission.
Pour assurer la pérennité et l’auditabilité des protocoles de recherche, les scientifiques doivent structurer leur code d’analyse de manière rigoureusement modulaire. L’isolement strict entre le pipeline de nettoyage des données, les fonctions d’estimation statistique et les routines de restitution graphique garantit qu’aucune transformation arbitraire n’intervient lors de l’appel aux fonctions de dessin. Cette organisation programmatique permet de modifier les paramètres visuels sans risquer d’altérer l’intégrité des résultats quantitatifs, assurant ainsi une reproductibilité computationnelle totale.
2. Fondements mathématiques et statistiques des métriques d’erreur
2.1 Écart-type : Mesure de la dispersion intrinsèque
L’écart-type d’échantillon constitue la mesure paramétrique fondamentale de la dispersion des observations autour de la moyenne arithmétique. Sur le plan mathématique, sa détermination implique le calcul de la somme des déviations quadratiques individuelles par rapport au centre de gravité, normalisée par le nombre de degrés de liberté. L’application de la correction de Bessel, qui consiste à diviser cette somme par l’effectif diminué d’une unité plutôt que par l’effectif brut, est impérative afin d’obtenir un estimateur sans biais de la variance de la population lorsque les données sont issues d’un échantillonnage aléatoire fini.
Dans les disciplines empiriques telles que la psychométrie ou la physiologie, l’écart-type possède une signification phénoménologique tangible : il quantifie l’ampleur des différences idiosyncrasiques entre les sujets. Contrairement aux métriques de précision de l’estimation, l’écart-type ne tend pas vers zéro lorsque la taille de l’échantillon augmente indéfiniment ; il converge au contraire vers la variabilité réelle et immuable du système étudié. Utiliser l’écart-type sur un graphique signale explicitement l’intention de documenter l’écologie de la distribution plutôt que l’exactitude mathématique de la moyenne mesurée.
L’interprétation probabiliste canonique de l’écart-type repose toutefois sur le postulat d’une distribution normale sous-jacente. Selon la règle empirique classique, environ soixante-huit pour cent des observations se concentrent dans l’intervalle délimité par une déviation standard de part et d’autre de la moyenne, et quatre-vingt-quinze pour cent dans un intervalle de deux déviations standards. Si les données présentent une asymétrie marquée ou des queues épaisses, l’utilisation symétrique de l’écart-type devient fallacieuse, car elle projette des limites virtuelles dans des zones de densité de probabilité quasi nulle ou théoriquement impossibles, comme des temps de réponse négatifs.
2.2 Erreur standard de la moyenne : Évaluation de la précision de l’échantillon
L’erreur standard de la moyenne évalue quantitativement la variabilité théorique de l’estimateur de la moyenne au fil de réplications hypothétiques infinies de l’expérience avec des échantillons de taille équivalente. Sa dérivation analytique établit une relation mathématique inverse et proportionnelle à la racine carrée de la taille d’échantillon. Ainsi, l’erreur standard s’obtient en divisant l’écart-type de l’échantillon par la racine carrée du nombre d’observations indépendantes. Cette dépendance géométrique démontre clairement qu’une réduction de moitié de l’incertitude sur la moyenne exige un quadruplement de l’effort d’échantillonnage.
Dans l’analyse des données comportementales ou médicales, l’erreur standard est fréquemment privilégiée par les auteurs en raison de sa concision visuelle, produisant des barres graphiquement plus compactes que celles de l’écart-type. Toutefois, cette pratique est susceptible d’induire le lecteur en erreur si elle vise inconsciemment à conférer une fausse impression de précision homogène. L’erreur standard ne reflète en aucun cas la plage de variation des participants individuels au protocole, mais illustre uniquement l’instabilité asymptotique de la métrique centrale résumée par l’analyste.
Il est donc essentiel d’établir une démarcation stricte entre la visée descriptive de la dispersion et la démarche inférentielle d’estimation de la moyenne. Employer l’erreur standard sans préciser l’effectif exact rend le graphique incompréhensible, puisqu’il est mathématiquement impossible de reconstituer la dispersion réelle des données individuelles sans connaître le dénominateur de la racine carrée. Les revues scientifiques les plus rigoureuses exigent désormais que le recours à l’erreur standard soit systématiquement accompagné du rappel de l’effectif ou couplé à la projection des observations individuelles sous-jacentes.
2.3 Intervalles de confiance : Approche inférentielle paramétrique
L’intervalle de confiance paramétrique constitue l’outil par excellence de l’inférence fréquentiste, fournissant une zone de valeurs plausibles pour un paramètre inconnu de la population à un seuil de confiance prédéterminé, classiquement fixé à quatre-vingt-quinze pour cent. Lorsque la variance de la population est inconnue, son calcul repose rigoureusement sur la distribution t de Student, et non sur la loi normale standard. Le demi-intervalle s’obtient en multipliant l’erreur standard de la moyenne par le quantile critique de Student approprié, calculé en fonction des degrés de liberté disponibles.
L’interprétation théorique de cet intervalle exige une extrême rigueur méthodologique afin d’éviter le contresens bayésien. Il ne signifie pas qu’il existe une probabilité de quatre-vingt-quinze pour cent que la vraie moyenne de la population se trouve à l’intérieur des bornes calculées pour un échantillon particulier. Selon le paradigme fréquentiste, la moyenne de la population est une constante fixe non aléatoire : l’intervalle calculé est la variable aléatoire. Ainsi, l’interprétation exacte énonce que si l’on répétait l’expérience un nombre infini de fois, quatre-vingt-quinze pour cent des intervalles ainsi construits recouvriraient la véritable moyenne inconnue.
Sur le plan visuel, les intervalles de confiance permettent au lecteur d’effectuer des jugements informés sur la significativité statistique des différences entre conditions. Toutefois, les déductions visuelles rapides comportent des pièges cognitifs majeurs. Deux intervalles de confiance à quatre-vingt-quinze pour cent qui se chevauchent légèrement ne traduisent pas nécessairement une absence de différence statistiquement significative au seuil alpha de cinq pour cent. Il est démontré que le chevauchement peut atteindre jusqu’à environ la moitié de la longueur d’une branche avant que la valeur p ne dépasse le seuil conventionnel de significativité dans le cas d’échantillons indépendants de variance comparable.
3. Configuration de l’environnement de calcul et préparation des données
3.1 Architecture logicielle et dépendances requises
L’élaboration d’un flux de travail reproductible pour la production de visualisations scientifiques commence par la définition d’un environnement de calcul strictement isolé et versionné. L’utilisation d’outils de gestion de dépendances tels que Conda, Poetry ou des environnements virtuels Python dédiés évite les conflits entre bibliothèques et garantit la pérennité du code sur le long terme. Les bibliothèques fondamentales indispensables à la modélisation statistique et au tracé graphique incluent NumPy pour la manipulation matricielle, Pandas pour le nettoyage tabulaire, SciPy pour les calculs de distributions théoriques, et Matplotlib associé à Seaborn pour le rendu visuel.
La standardisation du moteur de rendu graphique doit être configurée dès l’initialisation du script au moyen des paramètres globaux de configuration de Matplotlib. Les revues à comité de lecture exigent des résolutions d’impression élevées, généralement comprises entre trois cents et six cents points par pouce pour les images matricielles, ou de préférence des formats vectoriels parfaits tels que le PDF, l’EPS ou le SVG. Il est recommandé de définir au préalable la famille de polices de caractères typographiques, idéalement sans empattement comme Helvetica ou Arial, afin d’assurer une parfaite lisibilité sans recourir à des redimensionnements post-production destructeurs.
Une configuration professionnelle implique également la gestion cohérente de la mise en page via le moteur de disposition automatisé. L’activation des algorithmes de disposition contrainte ou de disposition resserrée prévient les troncatures intempestives des étiquettes d’axes ou des titres lors de l’exportation. En verrouillant l’ensemble de ces paramètres dès le préambule du code de visualisation, le chercheur s’assure que toutes les figures générées présenteront une uniformité esthétique et structurelle immédiate, facilitant leur intégration dans les manuscrits finaux.
3.2 Structuration et nettoyage des données matricielles
Avant d’initier la moindre commande de tracé, les données brutes issues de l’instrumentation expérimentale doivent faire l’objet d’une structuration rigoureuse au sein de tableaux de données Pandas. Le format privilégié pour l’analyse computationnelle moderne est la structure tidiée ou format long, dans laquelle chaque ligne représente une observation expérimentale unique et chaque colonne correspond à une variable spécifique, qu’il s’agisse de variables indépendantes catégorielles ou de mesures continues dépendantes. Ce paradigme s’oppose au format large traditionnel où différentes colonnes encodent les répétitions d’une même mesure sous diverses conditions.
Le traitement des valeurs manquantes constitue une étape déterminante qui conditionne la validité des métriques d’erreur calculées ultérieurement. L’élimination aveugle des enregistrements incomplets peut introduire des biais systématiques d’attrition si les absences ne surviennent pas de manière purement aléatoire. Selon la nature du protocole expérimental, l’analyste doit choisir entre des procédures d’exclusion explicites documentées ou des techniques d’imputation statistique sophistiquées, telles que l’imputation multiple ou l’espérance-maximisation, tout en consignant rigoureusement ces choix méthodologiques dans le rapport d’analyse.
La transformation finale des structures de données implique l’indexation hiérarchique et le regroupement vectoriel via les méthodes de division, application et combinaison de Pandas. Ces opérations permettent d’extraire les séries numériques continues conditionnellement aux facteurs expérimentaux définis dans l’étude. Cette organisation préalable garantit que les tenseurs de données fournis aux bibliothèques de bas niveau comme NumPy posséderont des dimensions harmonisées, évitant les erreurs de dimensionnement lors de l’attribution vectorielle des coordonnées de barres d’erreur.
3.3 Calcul automatisé des métriques d’erreur avec NumPy et SciPy
L’optimisation des flux d’analyse scientifique repose sur le calcul vectorisé des estimateurs statistiques, écartant toute boucle itérative superflue susceptible de dégrader les performances ou d’obscurcir la lisibilité du code. La bibliothèque NumPy offre des routines hautement performantes implémentées en C, permettant d’extraire instantanément les moyennes arithmétiques, les médianes et les écarts-types le long des axes dimensionnels appropriés. Il est primordial de spécifier explicitement le paramètre de degrés de liberté de correction lors du calcul de l’écart-type afin d’appliquer la correction de Bessel pour les estimateurs sans biais.
Pour le calcul précis de l’erreur standard de la moyenne, le recours au module des statistiques de SciPy présente l’avantage d’une implémentation validée prenant en charge de manière native la gestion des données manquantes éventuelles. Cette fonction calcule automatiquement le rapport entre l’écart-type d’échantillon corrigé et la racine carrée de l’effectif valide. Pour les intervalles de confiance inférentiels, l’utilisation conjointe des fonctions de distribution de probabilité cumulée inverse de Student permet de déterminer avec exactitude le multiplicateur critique correspondant au seuil alpha choisi, tenant compte scrupuleusement de la taille finie du jeu de données.
Avant d’injecter ces paramètres numériques dans les routines de dessin, une validation numérique préliminaire doit être systématiquement déployée par des assertions logiques. Ces vérifications automatisées s’assurent que les vecteurs d’erreur calculés ne contiennent aucune valeur infinie ou indéterminée résultant d’une division par zéro, et que l’ensemble des grandeurs de dispersion demeure strictement positif. Cette étape de validation assure une robustesse logicielle irréprochable et prévient l’apparition d’artefacts visuels silencieux sur le rendu graphique final.
4. Implémentation des barres d’erreur sur les diagrammes en barres avec Matplotlib
4.1 Construction basique d’un diagramme en barres avec paramètre yerr
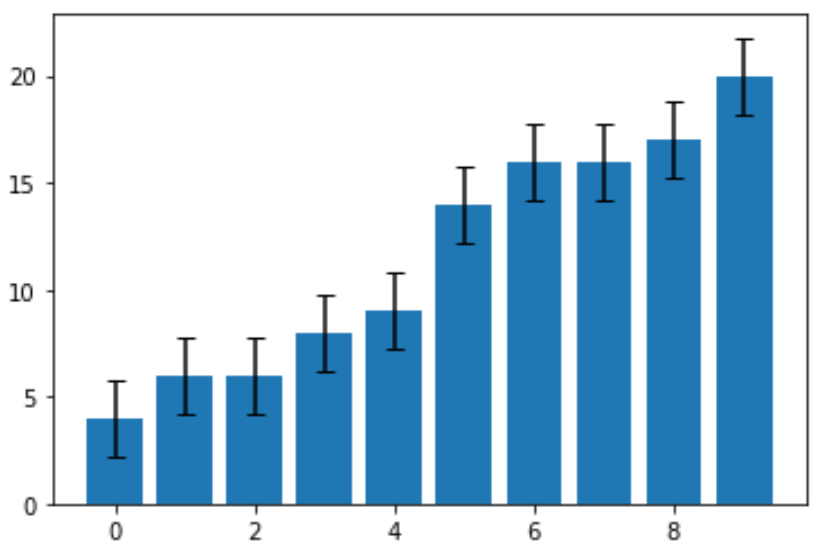
L’introduction de barres d’erreur sur un diagramme en barres élémentaire s’effectue au sein de Matplotlib par l’intermédiaire de la méthode ax.bar(), qui constitue la primitive fondamentale de tracé catégoriel. Cette méthode accepte en argument central les coordonnées scalaires ou discrètes de l’axe des abscisses ainsi que les hauteurs respectives des barres représentant les estimations ponctuelles. L’adjonction de l’incertitude se réalise via le paramètre dédié nommé yerr, qui reçoit une structure vectorielle d’amplitudes d’erreur de dimensions compatibles avec celles des observations centrales.
L’alignement spatial précis sur l’axe horizontal exige une définition rigoureuse des positions scalaires sous-jacentes. Plutôt que de s’en remettre à des indices implicites, il est méthodologiquement préférable d’allouer une séquence numérique explicite pour les emplacements horizontaux, puis de substituer ces coordonnées arithmétiques par les étiquettes textuelles appropriées au moyen des fonctions d’attribution des graduations. Cette séparation rigoureuse entre la géométrie du repère cartésien et la sémantique textuelle confère une flexibilité maximale pour les ajustements d’alignement fin.
La mise en forme des terminaisons de barres d’erreur, souvent désignées sous le terme d’empattements ou capuchons orthogonaux, est contrôlée par le paramètre capsize. Bien que certains standards visuels contemporains préconisent une esthétique minimaliste dépourvue d’empattements afin d’alléger la composition, la présence d’une courte barre horizontale perpendiculaire améliore la délimitation visuelle de l’extrémité de l’intervalle dans les contextes imprimés denses. La dimension de cet empattement doit être ajustée avec sobriété pour éviter toute surcharge cognitive.
4.2 Diagrammes en barres groupées avec incertitude expérimentale
La comparaison simultanée de plusieurs variables indépendantes nécessite le déploiement de diagrammes en barres groupées, où les modalités d’un facteur secondaire sont juxtaposées au sein de chaque niveau du facteur primaire. La réalisation de cette géométrie complexe en Matplotlib exige un calcul explicite des décalages d’indices horizontaux pour chaque série expérimentale. Chaque ensemble de barres se voit attribuer une largeur fixe, et ses coordonnées d’abscisses sont translatées d’une fraction de cette largeur par rapport au centre de la graduation nominale.
L’association différentielle des métriques d’incertitude doit être orchestrée avec une méticulosité absolue au cours de cette procédure. Chaque condition factorielle possédant ses propres paramètres de variabilité, le vecteur assigné au paramètre yerr doit correspondre strictement au sous-ensemble de données tracé. Une erreur d’indexation dans cette matrice de dispersion détruirait la véracité de l’inférence visuelle en appliquant la variance d’un groupe expérimental contrôle aux données d’un groupe sous traitement pharmacologique, créant ainsi des distorsions scientifiques dommageables.
Pour maintenir une lisibilité optimale sur les tracés multifactoriels, l’analyste doit normaliser soigneusement les contrastes de luminosité et la typographie. Le choix d’une palette de couleurs adaptée aux déficiences de la vision chromatique, comme les échelles Viridis ou cividis, garantit que les barres adjacentes demeurent immédiatement discernables. De surcroît, les empattements des barres d’erreur doivent être calibrés afin de ne jamais entrer en collision spatiale avec les barres voisines, ce qui préserve l’indépendance visuelle de chaque mesure catégorielle.
4.3 Optimisation visuelle et contrôle des éléments géométriques
L’esthétique d’une figure scientifique destinée à l’édition ne relève pas de la coquetterie visuelle, mais participe directement à la lisibilité et à la transmission non déformée des données quantitatives. Matplotlib permet un contrôle complet de chaque composante géométrique du diagramme en barres. Il est conseillé de modérer l’agressivité visuelle des barres pleines en appliquant des bordures fines et sombres associées à des couleurs de remplissage pastel ou atténuées, ce qui permet aux barres d’erreur noires ou gris foncé de ressortir avec une parfaite netteté sans être occultées par la masse colorée.
L’ajustement structurel des lignes d’incertitude s’effectue au moyen de paramètres spécialisés intégrés ou relayés via le dictionnaire d’arguments d’erreur ecolor et elinewidth. L’épaisseur des traits d’erreur doit être étalonnée en harmonie avec la largeur globale de la figure et l’épaisseur des axes du repère, se situant généralement autour d’un point typographique. L’utilisation d’une couleur d’erreur ecolor plus sombre que la teinte de remplissage de la barre prévient l’affaiblissement du signal d’incertitude dans les zones de forte intensité lumineuse.
Un aspect technique fondamental réside dans le positionnement hiérarchique des calques visuels, régi par le paramètre zorder. Par défaut, certaines routines de dessin placent les barres d’erreur sous les éléments polygonaux adjacents ou au même niveau que les grilles de fond. En attribuant explicitement une valeur de zorder supérieure aux barres d’erreur par rapport aux barres de données et aux lignes de repère d’arrière-plan, l’analyste s’assure que l’incertitude se superpose toujours avec limpidité au premier plan, sans jamais être coupée ou occultée par d’autres composants du graphique.
5. Intégration des barres d’erreur sur les graphiques linéaires et temporels
5.1 Utilisation de la fonction ax.errorbar() pour les séries continues
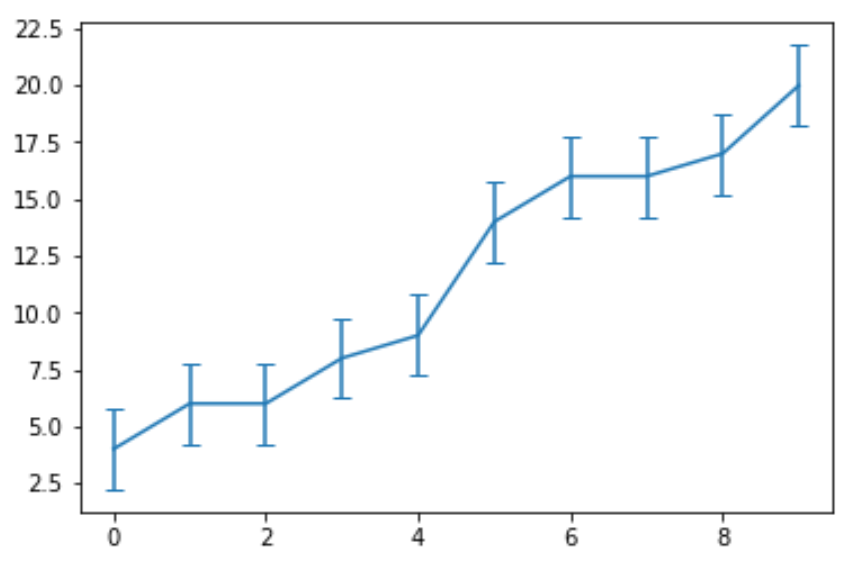
Dans le cadre du suivi de cinétiques temporelles ou de séries quantitatives continues, le recours aux diagrammes en barres devient inadapté, car il suggère fallacieusement des catégories discrètes indépendantes. La méthode ax.errorbar() constitue la fonction dédiée de Matplotlib pour ce type d’architecture graphique. Elle unifie en un appel unique le tracé de la trajectoire médiane ou moyenne, la disposition de marqueurs géométriques sur les points de capture et l’érection de tiges d’incertitude verticales et horizontales à chaque point de mesure.
Contrairement à la commande ax.plot() conventionnelle qui ignore les grandeurs stochastiques, ax.errorbar() accepte les arguments vectoriels yerr et xerr de façon parfaitement native. L’utilisateur dispose d’une liberté totale pour moduler le style des segments interpolés reliant les points : lignes continues, tiretées ou pointillés fins. L’incorporation de marqueurs géométriques distincts (cercles, carrés, triangles) aux emplacements exacts des mesures expérimentales est vivement recommandée afin que l’observateur puisse distinguer sans ambiguïté les données empiriques réelles des segments linéaires calculés par simple interpolation numérique.
La gestion des séries temporelles présentant des valeurs aberrantes ou des mesures manquantes exige une attention spécifique. Dans les situations où une série comporte des points indéterminés représentés par des valeurs nulles de NumPy, ax.errorbar() gère gracieusement la discontinuité en interrompant la ligne continue sans faire s’effondrer le tracé à zéro. Cette propriété évite de projeter artificiellement des trajectoires traversant le repère lors d’interruptions dans l’acquisition expérimentale, tout en préservant le positionnement rigoureux des barres d’erreur sur les points restants.
5.2 Représentation continue de l’incertitude via ax.fill_between()
Lorsque la densité temporelle des mesures devient très élevée, comme dans les enregistrements électrophysiologiques, la spectrométrie de masse ou les sorties d’équations différentielles, la multiplication des tiges discrètes générées par ax.errorbar() engendre un phénomène d’encombrement graphique sévère. Les empattements et segments verticaux se superposent jusqu’à former un bloc opaque indéchiffrable. Dans ce scénario précis, la méthodologie la plus élégante et rigoureuse consiste à déployer un ruban d’incertitude continu enveloppant la trajectoire centrale au moyen de la fonction ax.fill_between().
Le tracé d’un ruban d’erreur repose sur le calcul analytique préalable de deux vecteurs continus distincts : le profil de la limite inférieure, obtenu en soustrayant la métrique d’erreur de la moyenne mobile, et le profil de la limite supérieure, déterminé par l’addition de cette même métrique. La fonction ax.fill_between() prend alors en paramètres obligatoires l’axe commun des abscisses ainsi que ces deux fonctions d’enveloppe, générant un polygone continu d’incertitude qui épouse fidèlement les inflexions et les soubresauts dynamiques du signal observé.
Le succès perceptif du ruban continu réside dans le calibrage adéquat de son canal de transparence alpha, que l’on configure généralement entre une valeur de quinze et trente pour cent. Cette semi-transparence permet de visualiser l’amplitude de l’incertitude sans jamais occulter la ligne directrice centrale qui retrace la moyenne, ni masquer les lignes de quadrillage d’arrière-plan ou d’autres bandes de confiance appartenant à des conditions expérimentales concurrentes. Ce mode de représentation constitue le standard visuel absolu dans les domaines des neurosciences et de l’apprentissage automatique.
5.3 Superposition de plusieurs trajectoires expérimentales comparatives
La restitution simultanée de multiples groupes expérimentaux sur un graphique temporel unique soulève le défi de la gestion des interférences perceptives. Lorsque plusieurs rubans ou tiges d’erreur se chevauchent dans des zones de forte proximité statistique, la scène visuelle peut rapidement devenir chaotique. Pour les représentations ponctuelles basées sur ax.errorbar(), une stratégie algorithmique classique consiste à appliquer un léger décalage horizontal artificiel (jittering) à chaque condition, déplaçant subtilement les marqueurs le long de l’axe temporel pour que les tiges verticales ne se masquent pas mutuellement.
Dans le cas des rubans continus générés par ax.fill_between(), la transparence chromatique joue un rôle discriminant capital. L’analyste doit impérativement sélectionner des teintes bénéficiant de propriétés de mélange optique harmonieuses lorsqu’elles se superposent, évitant les saturations criardes qui produisent des artéfacts d’assombrissement. L’utilisation conjointe de styles de trait distincts pour les trajectoires moyennes (par exemple un trait continu pour le groupe expérimental et un trait pointillé pour le groupe témoin) renforce l’intelligibilité globale de la figure pour les lecteurs souffrant de daltonisme.
Enfin, la hiérarchisation sélective des contrastes doit guider la composition finale. Si une condition expérimentale revêt une importance théorique centrale par rapport à des séries de contrôles secondaires, il est méthodologiquement judicieux d’affecter un ruban plus affirmé et une ligne plus épaisse à cette trajectoire principale, tandis que les contrôles sont rendus avec une discrétion accrue. Ce calibrage visuel structure la lecture critique sans jamais altérer la véracité mathématique des déviations représentées.
6. Gestion des barres d’erreur asymétriques et distributions non normales
6.1 Structure matricielle des erreurs asymétriques dans Matplotlib
Dans de nombreux contextes empiriques, l’incertitude ne peut être postulée comme symétrique de part et d’autre de la tendance centrale. Des contraintes physiques ou biologiques réelles imposent fréquemment des distributions intrinsèquement asymétriques, comme dans le cas des concentrations biochimiques qui ne peuvent franchir la barrière de zéro, ou des scores psychométriques soumis à des effets de plafond. Appliquer une barre d’erreur symétrique standard dans ces situations constitue une distorsion méthodologique qui dégrade la crédibilité scientifique du travail de recherche.
Matplotlib répond de manière particulièrement élégante à cette problématique par l’intermédiaire d’une structure matricielle spécifique passée aux arguments yerr ou xerr. Plutôt que de fournir un vecteur unidimensionnel de longueur N, l’analyste peut transmettre un tableau à deux dimensions de taille strictement égale à deux fois N. La première ligne de cette matrice dimensionnelle spécifie l’amplitude des déviations inférieures mesurées entre le point central et la borne basse, tandis que la seconde ligne définit indépendamment l’amplitude des déviations supérieures s’étirant vers la borne haute.
La vigilance lors de la construction de ce tenseur à deux dimensions est primordiale : les valeurs transmises à Matplotlib ne doivent pas être les valeurs absolues des bornes inférieures et supérieures, mais bien les écarts relatifs par rapport à la valeur centrale du point estimé. Une confusion fréquente consiste à injecter directement les quantiles ou les valeurs brutes de l’intervalle dans la matrice yerr, ce qui a pour conséquence dramatique de décaler verticalement l’ensemble des tiges d’erreur sur le graphique, faussant irrémédiablement l’interprétation des lecteurs.
6.2 Visualisation robuste des intervalles interquartiles (IQR) et médianes
Face à des séries empiriques démontrant des violations sévères de l’hypothèse de normalité gaussienne, le recours aux statistiques non paramétriques s’impose comme une nécessité formelle. La moyenne arithmétique et l’écart-type perdent toute représentativité statistique en présence de données asymétriques ou polluées par des valeurs extrêmes, telles que les mesures de temps de réaction cognitive ou les temps de séjour hospitaliers. L’association de la médiane comme indicateur de position robuste et de l’intervalle interquartile comme estimateur d’échelle fournit alors une synthèse distributionnelle intègre.
La construction graphique de barres d’erreur non paramétriques exige le calcul analytique préalable des percentiles vingt-cinq, cinquante (médiane) et soixante-quinze de la distribution empirique au moyen des fonctions de quantile de NumPy. À partir de ces valeurs, l’analyste dérive l’écart inférieur, mesuré entre la médiane et le premier quartile, et l’écart supérieur, mesuré entre le troisième quartile et la médiane. Ces deux séries forment la matrice asymétrique injectée directement dans le paramètre yerr d’une fonction de tracé ax.errorbar().
L’utilisation de cette représentation présente une cohérence théorique parfaite avec la logique des diagrammes en boîte conventionnels, tout en permettant une intégration beaucoup plus fluide sur des graphiques linéaires continus ou des nuages de points complexes. Cette approche rend immédiatement visible l’asymétrie de la distribution : une tige supérieure considérablement plus étendue que la tige inférieure alerte instantanément le lecteur sur l’existence d’une traîne de données orientée vers les valeurs positives, prévenant les erreurs de modélisation paramétrique hâtives.
6.3 Estimation d’intervalles par rééchantillonnage bootstrap non paramétrique
Lorsque les distributions expérimentales s’écartent des modèles théoriques connus et que la taille d’échantillon reste modeste, la dérivation analytique des intervalles de confiance devient impraticable ou erronée. La méthode du rééchantillonnage bootstrap non paramétrique, théorisée à l’origine par Bradley Efron, contourne cette impasse en utilisant la distribution empirique elle-même comme modèle probabiliste de substitution. Le module scipy.stats.bootstrap de la bibliothèque SciPy implémente de façon moderne cet algorithme computationnel puissant.
Le mécanisme algorithmique consiste à générer de multiples rééchantillons aléatoires avec remise, de taille rigoureusement identique à l’échantillon original, généralement au nombre de plusieurs milliers d’itérations. La métrique d’intérêt (qu’il s’agisse de la médiane, d’un ratio de variance ou d’un coefficient de corrélation complexe) est recalculée sur chaque tirage, engendrant une distribution d’échantillonnage empirique. À partir de cette dernière, des intervalles de confiance corrigés des biais et accélérés (méthode BCa) sont extraits directement, produisant des bornes inférieures et supérieures asymétriques hautement précises.
L’intégration de ces intervalles bootstrap au sein de Matplotlib s’effectue en dérivant les écarts relatifs entre la métrique empirique centrale et les bornes fournies par SciPy, pour les agencer sous la forme d’une matrice bidimensionnelle d’asymétrie d’erreur. Cette technique offre aux chercheurs la capacité de projeter des incertitudes inférentielles d’une rigueur absolue sur des estimateurs non linéaires pour lesquels aucune théorie asymptotique classique ne s’applique, conférant ainsi aux résultats une validité méthodologique irréfutable.
7. Visualisation bidirectionnelle : Barres d’erreur simultanées en X et en Y
7.1 Modélisation de l’incertitude sur deux variables continues
Dans la démarche expérimentale usuelle, l’incertitude n’est que rarement confinée à la seule variable dépendante représentée sur l’axe des ordonnées. Dans de nombreuses disciplines appliquées telles que l’étalonnage instrumental, la thermodynamique ou la modélisation psychométrique, la variable indépendante déployée sur l’axe des abscisses est elle-même sujette à des erreurs de calibration, à des imprécisions de capteurs ou à une instabilité biologique inhérente. Négliger cette seconde source de stochasticité biaise profondément l’appréhension de la relation entre les facteurs.
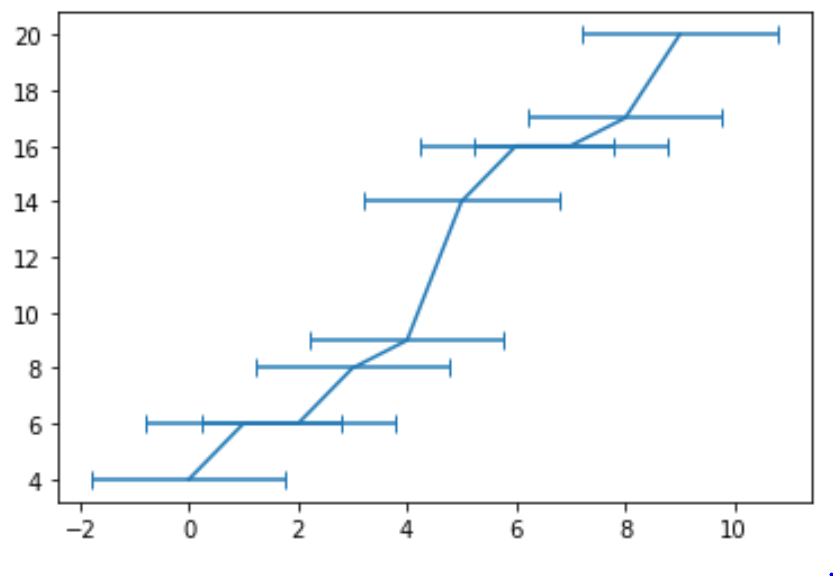
La commande ax.errorbar() de Matplotlib est spécifiquement conçue pour modéliser cette réalité bivariée par la conjonction simultanée de ses paramètres yerr et xerr. En injectant simultanément des vecteurs de dispersion pour les deux coordonnées cartésiennes de chaque observation, le moteur graphique trace une structure cruciforme orthogonale centrée sur chaque point empirique. Ces croix d’incertitude délimitent visuellement un rectangle de confiance dans l’espace bidimensionnel, indiquant au lecteur la zone au sein de laquelle la véritable coordonnée spatiale de l’événement est susceptible de se trouver.
Dans des configurations géométriques plus avancées, ces croix de dispersion peuvent être complétées ou substituées par des ellipses de confiance bivariées projetées au moyen d’objets géométriques spécialisés de Matplotlib. Lorsque la covariance entre les incertitudes sur les deux axes n’est pas nulle, c’est-à-dire lorsque l’erreur de mesure sur X est corrélée à l’erreur sur Y, la forme rectangulaire orthogonale devient insuffisante. L’orientation de l’ellipse le long des axes de variance propre permet alors de restituer fidèlement la structure multidimensionnelle de l’erreur expérimentale.
7.2 Personnalisation dissymétrique des axes de variabilité
La modélisation conjointe des erreurs horizontales et verticales exige une calibration esthétique et technique distincte pour chacun des axes de coordonnées. En effet, les dimensions physiques et les unités de mesure associées à l’axe des abscisses diffèrent fréquemment de plusieurs ordres de grandeur de celles de l’axe des ordonnées (par exemple, une concentration molaire en millimoles par litre comparée à une différence de potentiel membranaire en millivolts). Cette disparité d’échelle impose un contrôle minutieux des empattements et des épaisseurs de trait afin d’éviter des disproportions visuelles choquantes.
Matplotlib permet de paramétrer finement le comportement des empattements de manière indépendante pour les composantes xerr et yerr. Les arguments capsize et capthick influencent globalement la terminaison des barres, mais l’utilisateur averti peut manipuler directement les objets de conteneur d’erreur renvoyés par la méthode ax.errorbar(). Cet objet complexe encapsule sous forme de tuples la ligne principale, les segments de tiges d’erreur (lignes verticales et horizontales) et les empattements d’extrémités, offrant la liberté de modifier leurs propriétés graphiques séparément via des instructions programmatiques dédiées.
Une attention typographique rigoureuse doit également être portée à l’évitement de collisions graphiques au centre du nuage de points. Lorsque les amplitudes d’incertitude le long de l’un des axes sont infinitésimales par rapport à celles de l’axe perpendiculaire, les terminaisons orthogonales peuvent fusionner visuellement avec le symbole central du marqueur. Dans ce cas précis, supprimer totalement les empattements pour ne conserver que des segments linéaires purs ou moduler sélectivement la transparence des lignes horizontales permet de préserver la pureté de lecture du nuage de données.
7.3 Analyse de cas : Régression orthogonale et incertitude bivariée
L’introduction simultanée de barres d’erreur en X et en Y prend toute sa signification analytique dans le contexte des ajustements de courbes de calibration et des régressions orthogonales, telles que la régression de Deming ou le modèle des moindres carrés totaux de York. Dans ces protocoles statistiques, l’hypothèse de la régression linéaire des moindres carrés ordinaires qui postule une variable indépendante exempte de tout bruit est formellement invalidée. Chaque point d’observation possède son propre poids statistique, dicté conjointement par la variance de ses composantes horizontale et verticale.
La représentation graphique d’un tel ajustement linéaire doit faire figurer avec une clarté irréprochable la droite de tendance théorique traversant le champ des croix d’incertitude. Le chercheur peut ainsi évaluer visuellement la conformité du modèle mathématique : une régression robuste doit idéalement traverser les segments d’incertitude de la majorité des points sans s’éloigner de leurs centres de gravité de plus d’une amplitude résiduelle proportionnelle aux barres tracées. Les points dont les croix d’erreur ne croisent aucunement la droite de calibration se signalent immédiatement à l’attention comme des anomalies expérimentales potentielles.
Cette visualisation conjointe acquiert une importance clinique et biologique capitale lors du transfert de méthodes de dosage de laboratoire, où un nouvel appareil de mesure diagnostique est confronté à une méthode de référence historique établie. L’affichage transparent des tiges d’erreur croisées renseigne instantanément les praticiens sur les plages de mesure où la variabilité instrumentale devient préjudiciable pour le diagnostic, transformant le graphique en un instrument de décision médicale fondé sur la preuve quantitative.
8. Automatisation et abstraction statistique de haut niveau avec Seaborn
8.1 Génération automatique d’intervalles de confiance avec sns.barplot()
Si Matplotlib fournit une maîtrise totale de la mécanique de dessin bas niveau, la bibliothèque Seaborn a révolutionné la visualisation des données en Python en intégrant organiquement l’estimation statistique au cœur de la grammaire des graphiques. Conçue pour opérer directement sur des structures de données tabulaires au format long de Pandas, Seaborn épargne au chercheur la tâche laborieuse de calculer manuellement les regroupements, les moyennes et les déviations avant le rendu. La fonction sns.barplot() encapsule l’intégralité de cette chaîne d’opérations en une instruction descriptive élégante.
Dans les versions contemporaines de Seaborn, le contrôle des barres d’erreur s’effectue au moyen du paramètre unifié errorbar, qui remplace avantageusement les anciens arguments morcelés. Ce paramètre offre une flexibilité conceptuelle remarquable en acceptant des déclarations textuelles intuitives : l’analyste peut assigner la chaîne ‘sd’ pour projeter l’écart-type descriptif de l’échantillon, ‘se’ pour solliciter l’erreur standard de la moyenne, ou définir des intervalles de confiance probabilistes explicites sous la forme de tuples statistiques comme (‘ci’, 95) pour un intervalle inférentiel paramétrique ou bootstrap.
L’intérêt méthodologique de Seaborn réside dans son refus de masquer l’algorithme sous-jacent : par défaut, l’estimation des intervalles de confiance dans sns.barplot() ne repose pas sur une formule analytique simpliste supposant une loi normale, mais déploie un algorithme de bootstrap non paramétrique à mille itérations. Cette décision par défaut protège les analystes contre les déductions erronées en produisant des barres d’incertitude fidèles à la véritable forme distributionnelle des données d’origine, garantissant un standard de rigueur élevé dès les premières esquisses exploratoires.
8.2 Tracés longitudinaux et lissage avec sns.lineplot()
La restitution de protocoles longitudinaux ou d’expériences impliquant des séries continues trouve son expression la plus puissante dans la méthode sns.lineplot(). Lorsqu’un ensemble de données comporte plusieurs réplications indépendantes pour une même valeur temporelle ou continue, sns.lineplot() regroupe implicitement les mesures par niveau d’abscisse, extrait la trajectoire de tendance centrale et génère spontanément un ruban d’incertitude fluide enveloppant le signal moyen sans exiger une seule ligne d’algèbre vectorielle de la part de l’utilisateur.
Cette génération automatique s’appuie sur le moteur d’interpolation statistique de Seaborn, régulé par le paramètre err_style. Ce dernier permet d’alterner entre l’affichage d’un ruban continu semi-transparent (option ‘band’) et l’érection de barres d’erreur discrètes ponctuelles le long de la ligne tracée (option ‘bars’). Le recours au ruban continu est l’option de référence pour la modélisation de trajectoires denses, éliminant les discontinuités géométriques tout en offrant une restitution élégante et immédiate de l’évolution temporelle de la variance expérimentale.
Pour les devis expérimentaux impliquant des mesures répétées sur les mêmes entités au fil du temps, Seaborn autorise l’intégration de la variable d’identification des sujets via le paramètre units. Dans cette configuration, la bibliothèque prend en compte la dépendance statistique intra-individuelle lors du calcul des intervalles de rééchantillonnage bootstrap, prévenant la sous-estimation de la variance qui surviendrait si les données répétées étaient traitées comme des observations purement indépendantes, ce qui garantit une intégrité analytique sans faille aux modélisations longitudinales.
8.3 Graphiques à facettes pour la modélisation multifactorielle
L’exploration d’expériences factorielles à haute dimensionnalité, courantes en génomique, en pharmacologie ou en psychologie comportementale, excède rapidement les capacités expressives d’un panneau graphique unique. La création de matrices de sous-graphiques, ou graphiques à facettes (trellis plots), constitue la réponse méthodologique optimale pour désenchevêtrer l’effet de multiples variables indépendantes catégorielles. La fonction sns.catplot() orchestre cette spatialisation complexe en liant la structure du jeu de données tabulaire à une grille bidimensionnelle de panneaux visuels coordonnés.
L’un des bénéfices cruciaux de sns.catplot() réside dans le maintien absolu de la cohérence de l’échelle d’évaluation statistique à travers l’ensemble des facettes déployées. Les axes d’ordonnées sont automatiquement harmonisés, ce qui permet à l’œil d’effectuer des comparaisons métrologiques directes entre les différents sous-panneaux sans risque de distorsion cognitive liée à des échelles tronquées localement. L’estimation des métriques d’erreur est réalisée indépendamment au sein de chaque strate expérimentale, reflétant fidèlement l’hétéroscédasticité potentielle entre les groupes.
Bien que Seaborn opère à un niveau d’abstraction statistique élevé, les structures créées demeurent des conteneurs d’objets Matplotlib standard regroupés au sein d’une instance de classe FacetGrid. L’analyste conserve donc la possibilité d’intercepter a posteriori chaque sous-axe pour y injecter des personnalisations géométriques de bas niveau : ajustement chirurgical de l’épaisseur des barres d’erreur, incorporation d’annotations d’astérisques de significativité ou modification sélective des étiquettes typographiques, combinant ainsi la vitesse d’abstraction de Seaborn et la précision millimétrique de Matplotlib.
9. Prise en compte des devis expérimentaux intra-sujets et mesures répétées
9.1 Le biais de sur-estimation des barres d’erreur classiques en intra-sujet
L’une des erreurs méthodologiques les plus destructrices et pourtant omniprésentes dans la littérature scientifique concerne l’application aveugle de barres d’erreur indépendantes conventionnelles à des données issues de devis expérimentaux à mesures répétées ou intra-sujets. Dans ce type de protocole expérimental, les mêmes participants sont soumis à l’ensemble des conditions testées. La variance brute observée sur chaque condition englobe ainsi deux composantes fondamentales : la variance attribuable à la manipulation expérimentale elle-même, et la variance interindividuelle globale reflétant les différences stables entre les sujets de la cohorte.
Dans la majorité des systèmes empiriques, la variabilité entre les individus (certains participants étant globalement plus rapides, plus performants ou présentant des niveaux physiologiques de base plus élevés que d’autres) est considérablement plus vaste que l’effet généré par le traitement expérimental. Si un analyste calcule une erreur standard ou un intervalle de confiance classique sur chaque condition de manière indépendante, ces barres d’erreur intégreront intégralement cette variance interindividuelle massive. Les barres obtenues deviennent disproportionnées et se chevauchent abondamment, suggérant visuellement une absence d’effet du traitement.
Pourtant, un test statistique apparié, tel qu’un test t de Student pour échantillons dépendants ou une analyse de variance à mesures répétées, neutralise mathématiquement cette variance entre les sujets en isolant la variance résiduelle intra-individuelle. Il en résulte un contraste statistique hautement significatif qui est totalement contredit par l’illustration graphique brute. Ce décalage entre la statistique inférentielle et la perception visuelle constitue un paradoxe cognitif sévère qui déroute les évaluateurs et altère la crédibilité de l’analyse, rendant indispensable l’ajustement méthodologique des barres d’erreur.
9.2 Implémentation algorithmique de la méthode de Cousineau-Morey en Python
Pour restaurer l’adéquation parfaite entre la démonstration graphique et l’inférence statistique dans les devis intra-sujets, la communauté méthodologique a développé la technique de normalisation connue sous le nom de méthode de Cousineau-Morey. Cette procédure algorithmique décompose le calcul en deux transformations séquentielles rigoureuses. Dans un premier temps, chaque observation individuelle est centrée par la soustraction de la moyenne propre au sujet calculée sur toutes ses conditions, puis augmentée de la grande moyenne générale de l’expérience, purgeant ainsi le jeu de données de toute hétérogénéité de base interindividuelle.
Toutefois, comme l’a démontré Richard Morey, cette étape de centrage réduit artificiellement le nombre de degrés de liberté de l’échantillon, introduisant un biais de sous-estimation systématique dans la variance des nouvelles valeurs normalisées. La seconde étape de la méthode consiste donc à appliquer un facteur de correction mathématique précis calculé à partir du nombre total de conditions expérimentales testées, égal à la racine carrée du quotient du nombre de conditions divisé par ce même nombre diminué d’une unité. Chaque déviation normalisée est alors multipliée par ce facteur multiplicatif.
L’implémentation de cette procédure sous Python se programme de manière limpide au moyen des fonctionnalités de transformation de Pandas. Une fois les données ajustées par ce pipeline algorithmique, les erreurs standards ou les intervalles de confiance sont calculés sur les scores corrigés et injectés dans Matplotlib. Les barres d’erreur intra-sujets ainsi tracées reflètent exactement la variance d’erreur résiduelle exploitée par les tests d’hypothèse pour mesures répétées : deux conditions différant significativement au seuil de cinq pour cent afficheront alors visuellement des barres séparées, rétablissant la vérité scientifique de la figure.
9.3 Visualisation combinée des données individuelles et de l’effet agrégé
En dépit de l’élégance théorique des barres d’erreur intra-sujets ajustées, une tendance contemporaine majeure promue par les directives de publication modernes consiste à ne jamais se fier exclusivement aux métriques agrégées pour résumer une dynamique comportementale ou biologique. Toute réduction des données à une moyenne assortie d’une tige d’erreur, aussi rigoureusement calculée soit-elle, occulte la richesse des trajectoires singulières des sujets, masquant d’éventuels sous-groupes de répondeurs ou des inversions d’effets chez certains participants.
La solution graphique d’excellence réside dans la superposition d’un graphique en coordonnées parallèles, communément appelé tracé spaghetti (spaghetti plot), sous la représentation de l’effet agrégé. En utilisant une couleur neutre (par exemple un gris doux) et un niveau de transparence substantiel, le chercheur trace les segments reliant les points de données de chaque participant à travers les différentes conditions expérimentales. Cette trame d’arrière-plan expose l’intégralité du comportement empirique brut sans obstruer le premier plan du graphique.
Par-dessus ce faisceau de données individuelles, l’effet central du groupe est superposé avec une vigueur géométrique supérieure : marqueurs plus larges, ligne de liaison épaisse et contrastée, et barres d’erreur intra-sujets de Cousineau-Morey clairement apparentes. Cette composition graphique hybride offre une transparence épistémologique totale au lecteur, qui peut simultanément apprécier la cohérence directionnelle de l’effet chez chaque individu isolé et juger de la précision de l’estimation statistique agrégée au niveau de la population.
10. Conformité aux standards de publication académique et normes APA
10.1 Directives stylistiques de l’APA (7e édition) pour les figures
L’American Psychological Association établit dans la septième édition de son manuel de publication des standards typographiques et visuels particulièrement stricts qui font référence dans les sciences sociales, médicales et comportementales. Selon ces préconisations, les figures scientifiques doivent privilégier une clarté fonctionnelle absolue exempte de toute surcharge ornementale superflue, pratique désignée par Edward Tufte sous le concept critique de chartjunk. L’usage de dégradés artificiels, d’effets tridimensionnels sur les barres ou de fonds teintés est formellement banni de l’édition scientifique.
La gestion typographique impose la sélection de polices de caractères standardisées universellement disponibles, telles qu’Arial, Calibri ou Times New Roman, avec un étalonnage rigoureux des tailles de police : les dimensions ne doivent pas excéder quatorze points pour les étiquettes majeures et ne jamais descendre en dessous de huit points pour les annotations secondaires ou les valeurs de graduation. Matplotlib permet de verrouiller ces contraintes directement via son dictionnaire de configuration typographique rcParams, assurant une parfaite fidélité de restitution à l’échelle finale d’impression.
Les normes APA recommandent également une sobriété chromatique réfléchie, préconisant l’utilisation de nuances de gris ou de palettes à fort contraste capables de survivre à une reproduction monochrome dans les revues imprimées traditionnelles. Les lignes de quadrillage d’arrière-plan doivent être soit complètement désactivées, soit réduites à des pointillés d’une extrême finesse et d’un gris très discret, afin de ne jamais entrer en compétition visuelle avec les tiges de barres d’erreur ou les contours géométriques des données tracées.
10.2 Rédaction rigoureuse des légendes et notes de bas de figure
Une figure scientifique ne doit jamais dépendre exclusivement du corps du texte pour être comprise ; elle doit former une unité démonstrative autonome et auto-explicative. Cette exigence impose une rédaction méticuleuse de la note de figure placée immédiatement sous l’illustration, conformément à la syntaxe formelle de l’APA. La note débute obligatoirement par le terme générique en italique suivi d’un point, avant de détailler la nature des observations et la signification exacte des encodages graphiques déployés.
L’omission de la définition précise de la métrique d’erreur constitue un motif fréquent de rejet lors des révisions par les pairs. Il est impératif d’énoncer explicitement la formule statistique appliquée : par exemple, mentionner sans ambiguïté que les barres d’erreur représentent l’erreur standard de la moyenne (ESM) ou qu’elles correspondent à des intervalles de confiance à quatre-vingt-quinze pour cent calculés par rééchantillonnage bootstrap. Si une correction pour mesures répétées a été mise en œuvre, la référence méthodologique appropriée doit être expressément citée au sein de la note explicative.
De surcroît, la note de figure doit consigner systématiquement la taille exacte de l’échantillon N sous-jacent, le nombre de réplications techniques ou biologiques indépendantes, ainsi que la valeur alpha de référence utilisée pour la détermination des seuils critiques. Si des transformations mathématiques ont été opérées sur les données brutes avant la visualisation, telles qu’une normalisation logarithmique ou une standardisation en scores z, cette transformation doit être documentée avec une clarté irréprochable afin d’éviter toute incompréhension sur l’échelle des grandeurs représentées.
10.3 Génération de figures vectorielles haute résolution prêtes à soumettre
L’étape ultime du pipeline computationnel réside dans l’exportation du graphique depuis la mémoire de travail de Python vers un fichier physique conforme aux exigences de résolution des éditeurs académiques. L’utilisation naïve de captures d’écran ou l’exportation par défaut vers des formats compressés dégradés constitue une faute technique inadmissible. La méthode plt.savefig() de Matplotlib offre le contrôle technique requis pour paramétrer un rendu de niveau professionnel.
Pour les soumissions de manuscrits, les formats vectoriels purs tels que le Portable Document Format (PDF), l’Encapsulated PostScript (EPS) ou le Scalable Vector Graphics (SVG) doivent être systématiquement privilégiés. Contrairement aux matrices de pixels, ces formats vectoriels stockent les objets sous forme d’instructions géométriques mathématiques : les lignes, les courbes, les empattements d’erreur et les polices de caractères conservent ainsi une netteté absolue quel que soit le niveau de grossissement ou le redimensionnement opéré par l’imprimeur de la revue scientifique.
Dans les cas où une image matricielle demeure requise (notamment pour les figures intégrant des photographies de microscopie ou des cartes de densité volumineuses), la résolution doit être explicitement verrouillée à un minimum de trois cents points par pouce, et fréquemment six cents points par pouce pour les tracés au trait noir pur, via le paramètre dpi. L’adjonction systématique de l’argument bbox_inches=’tight’ est essentielle pour instruire le moteur de dessin de rogner automatiquement les marges blanches inutiles et d’empêcher le découpage accidentel des titres ou des notes de légende lors de l’écriture sur le disque.
11. Erreurs méthodologiques courantes et pièges d’interprétation
11.1 L’illusion de l’absence de chevauchement et fausses conclusions d’inférence
L’une des distorsions cognitives les plus persistantes chez les scientifiques réside dans l’application d’une règle heuristique intuitive erronée, selon laquelle deux conditions expérimentales ne diffèrent significativement que si leurs barres d’erreur respectives ne se chevauchent pas dans l’espace vertical. Cette déduction simpliste s’avère profondément trompeuse et conduit à de lourdes erreurs de jugement méthodologique lorsque les barres tracées correspondent à des intervalles de confiance à quatre-vingt-quinze pour cent ou à des erreurs standards de la moyenne.
Les travaux théoriques de Goldstein et Healy ont rigoureusement démontré que pour des échantillons indépendants de variances comparables, des intervalles de confiance à quatre-vingt-quinze pour cent peuvent se chevaucher sur une distance équivalente à environ vingt-cinq à cinquante pour cent de la longueur d’un demi-intervalle tout en maintenant une différence entre les moyennes statistiquement significative au seuil alpha conventionnel de cinq pour cent. Attendre une séparation visuelle totale des branches de l’intervalle impose en réalité une sévérité excessive équivalente à un seuil de significativité beaucoup plus conservateur avoisinant p inférieur à un millième.
Cette illusion devient encore plus dommageable lorsque le chercheur examine des devis à mesures répétées en utilisant des barres indépendantes ordinaires : dans cette situation, la corrélation positive substantielle entre les mesures d’un même sujet fait que le test apparié possède une puissance statistique considérablement supérieure à ce que le regard perçoit sur les distributions marginales. L’enseignement capital qui s’impose est qu’une barre d’erreur sur un graphique ne remplace jamais le calcul inférentiel formel : le tracé guide l’intuition, mais ne constitue pas en lui-même le test d’hypothèse.
11.2 Omission ou ambiguïté dans la spécification de la métrique d’erreur
Des enquêtes bibliométriques menées sur des corpus massifs d’articles biomédicaux ont révélé une proportion alarmante de publications dans lesquelles les barres d’erreur affichées sur les figures ne sont rigoureusement définies nulle part, ni dans la légende du graphique, ni dans la section méthodologique, ni dans le texte principal. Cette carence descriptive prive le tracé de toute teneur informationnelle vérifiable, transformant un travail empirique rigoureux en une présentation ambiguë non exploitable par la communauté scientifique.
L’impact de cette négligence sur la pratique de la méta-analyse est dévastateur. Lorsqu’un chercheur tente de compiler quantitativement les tailles d’effet issues de la littérature pour évaluer l’efficacité d’un protocole ou d’un traitement, l’impossibilité de déterminer si une tige d’incertitude représente un écart-type, une erreur standard ou un intervalle de confiance rend impossible le calcul exact des variances résiduelles nécessaires aux modèles à effets aléatoires. Ces études lacunaires doivent alors être écartées des synthèses systématiques, anéantissant l’effort de recherche initial.
Pour prévenir ces écueils, les comités de rédaction des grandes revues scientifiques imposent désormais des grilles de relecture technique strictes. Une validation croisée rigoureuse doit être instaurée dans les protocoles d’écriture de chaque laboratoire : chaque figure doit subir une vérification systématique s’assurant que la nature de la métrique, le paramètre de confiance éventuel et la taille précise des sous-groupes sont articulés de manière parfaitement redondante et concordante entre le texte d’analyse, les tableaux numériques et les annotations graphiques associées.
11.3 Déformation visuelle due aux échelles tronquées
L’intégrité de la communication visuelle dépend fondamentalement de la fidélité de l’étalonnage de l’axe des ordonnées. Une pratique méthodologiquement contestable consiste à tronquer artificiellement l’origine de l’axe vertical en amorçant la graduation au voisinage immédiat de la moyenne minimale observée plutôt qu’à la valeur zéro absolue. Sur un diagramme en barres catégoriel, cette distorsion gonfle démesurément la différence apparente entre les conditions, conférant l’illusion visuelle d’une variation spectaculaire là où l’effet réel ne représente qu’une fluctuation marginale de quelques pourcents.
Sur les diagrammes en barres, le principe d’équivalence entre la surface géométrique de l’élément dessiné et la magnitude physique de la variable observée est absolu : toute barre doit obligatoirement émerger depuis l’origine naturelle de zéro. Tronquer la base d’un histogramme viole ce contrat perceptif élémentaire et altère le positionnement subjectif de la variabilité : des barres d’erreur modestes peuvent ainsi paraître gigantesques ou minuscules selon l’artifice de zoom adopté par l’analyste sur l’axe des ordonnées.
Si la nature du signal exige de mettre en évidence des modulations fines sur un fond physiologique continu non nul, l’abandon du diagramme en barres au profit d’un graphique en points ou d’un nuage de dispersion ax.errorbar() est la règle méthodologique requise. Sur un tracé en points, l’origine de l’axe à zéro n’est pas impérative, pourvu que la rupture de l’axe soit signalée explicitement et que l’échelle choisie demeure proportionnée à la variance réelle des données observées sans amplifier artificiellement le bruit de fond de mesure.
12. Étude de cas appliquée : Visualisation d’un protocole expérimental complet
12.1 Présentation du jeu de données comportemental et hypothèses de recherche
Afin de consolider les principes théoriques et méthodologiques abordés dans cet ouvrage au sein d’une démonstration concrète, nous développons une étude de cas inspirée des protocoles classiques en psychologie cognitive et en neurobiologie comportementale. L’expérience adopte un devis factoriel complet de type deux par deux combinant une variable indépendante inter-sujets (le groupe clinique : Sujets Témoins sains contre Patients souffrant de troubles de l’attention) et une variable indépendante intra-sujets (la charge cognitive de la tâche : Condition Simple à faible charge contre Condition Complexe à forte charge de mémoire de travail).
La variable dépendante principale enregistrée lors de chaque essai chez quarante participants rigoureusement appariés est le temps de réaction moteur exprimé en millisecondes. L’hypothèse scientifique sous-jacente postule une interaction factorielle significative : si les sujets témoins doivent manifester un ralentissement modéré et homogène lors du passage de la condition simple à la condition complexe, les patients souffrant de déficits attentionnels devraient présenter une dégradation disproportionnée de leurs latences sous haute charge cognitive, accompagnée d’un accroissement substantiel de la variabilité intra-individuelle.
L’inspection préliminaire des distributions empiriques révèle les propriétés classiques des chronométries comportementales : une asymétrie positive persistante des temps de latence et une élévation de la variance résiduelle corrélée à l’allongement des temps moyens. Ces caractéristiques distributionnelles rendent inadéquate l’application d’un modèle paramétrique gaussien naïf sans ajustement statistique, exigeant un pipeline de calcul transparent combinant l’extraction de métriques descriptives robustes et la dérivation d’intervalles inférentiels adaptés au plan expérimental mixte.
12.2 Pipeline de traitement statistique complet en Python
Le traitement des données comportementales s’articule autour d’un script automatisé structurant les données tabulaires brutes au sein d’un DataFrame Pandas indexé. Dans un premier temps, les algorithmes de nettoyage éliminent les essais d’anticipation motrice prématurés et vérifient l’absence d’enregistrements manquants. Le tableau est ensuite scindé selon les sous-groupes factoriels afin d’exécuter le calcul des indicateurs statistiques fondamentaux : moyennes arithmétiques, écarts-types d’échantillon corrigés et erreurs standards via les routines vectorisées de NumPy et du module scipy.stats.
Pour la composante intra-sujets liée au facteur de charge cognitive, le script déploie l’ajustement algorithmique de Cousineau-Morey explicité précédemment. La moyenne globale de chaque participant sur les deux conditions est extraite, puis soustraite de ses mesures brutes avant la réintroduction de la grande moyenne d’expérience et l’application du multiplicateur de correction basé sur les deux niveaux de tâche. Cette normalisation purge les données de la variabilité interindividuelle de base, isolant l’incertitude spécifique de l’effet d’interaction au sein de chaque groupe clinique.
Parallèlement, une routine de bootstrap non paramétrique à deux mille itérations est instanciée via scipy.stats.bootstrap afin de dériver des intervalles de confiance à quatre-vingt-quinze pour cent corrigés des biais (BCa). Les bornes inférieures et supérieures obtenues sont alors soustraites de la moyenne centrale pour constituer les matrices de dimension deux fois N requises par Matplotlib pour le tracé d’erreurs asymétriques. L’ensemble des structures numériques résultantes est vérifié par des tests d’assertion logiques garantissant la conformité dimensionnelle des tenseurs avant l’exécution du tracé.
12.3 Création du tracé final de niveau publication avec Matplotlib
L’assemblage graphique final met en œuvre l’architecture orientée objet de Matplotlib pour produire une figure d’une rigueur absolue prête à la soumission. Au sein d’un repère cartésien calibré, les données des sujets témoins et des patients sont disposées sur l’axe horizontal avec un léger décalage spatial (jittering) pour prévenir tout risque de chevauchement optique. La commande ax.errorbar() érige pour chaque condition une tige d’incertitude portant l’intervalle de confiance bootstrap asymétrique, assortie d’un empattement discret de deux points et d’une épaisseur de ligne harmonisée avec les bordures du tracé.
Sous ces indicateurs agrégés au premier plan, les trajectoires de chaque participant entre la condition simple et la condition complexe sont projetées en arrière-plan sous la forme de traits spaghetti semi-transparents d’une teinte grise neutre. Cette superposition expose la dispersion réelle et l’homogénéité du ralentissement moteur sans perturber la lisibilité du contraste moyen. Les axes bénéficient d’un étiquetage typographique soigné exempt de quadrillage parasite, l’axe vertical des ordonnées débutant à une valeur ronde cohérente avec la distribution physiologique sans créer de distorsion perceptive artificielle.
Pour parachever la figure, des accolades vectorielles accompagnées d’annotations textuelles explicites (valeurs p exactes et astérisques de significativité) sont ancrées au-dessus des conditions expérimentales pour documenter formellement l’interaction statistique issue de l’analyse de variance à mesures répétées. La figure est enfin exportée aux formats PDF vectoriel haute résolution et PNG à six cents points par pouce via la commande plt.savefig(bbox_inches=’tight’), concluant ainsi une chaîne de visualisation exemplaire liant théorie probabiliste, rigueur algorithmique et clarté esthétique.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://apastyle.apa.org/
- Cousineau, D. (2005). Confidence intervals in within-subject designs: A simple solution to Loftus and Masson’s method. Tutorials in Quantitative Methods for Psychology, 1(1), 42–45. https://doi.org/10.20982/tqmp.01.1.p042
- Cumming, G., & Finch, S. (2005). Inference by eye: Confidence intervals and how to read pictures of data. American Psychologist, 60(2), 170–180. https://doi.org/10.1037/0003-066X.60.2.170
- Efron, B., & Tibshirani, R. J. (1994). An Introduction to the Bootstrap. Chapman and Hall/CRC. https://doi.org/10.1201/9780429246593
- Goldstein, H., & Healy, M. J. R. (1995). The graphical presentation of a collection of means. Journal of the Royal Statistical Society: Series A (Statistics in Society), 158(1), 175–177. https://doi.org/10.2307/2983411
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Morey, R. D. (2008). Confidence intervals from normalized data: A correction to Cousineau (2005). Tutorials in Quantitative Methods for Psychology, 4(2), 61–64. https://doi.org/10.20982/tqmp.04.2.p061
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021