
La visualisation des données quantitatives constitue un pilier fondamental de la démarche empirique en sciences contemporaines. Si la production de représentations graphiques permet de synthétiser des distributions complexes et de révéler des tendances latentes, l’efficacité communicationnelle d’un graphique repose sur un équilibre subtil entre abstraction visuelle et précision numérique. Dans le cadre de l’écosystème scientifique Python, la bibliothèque Seaborn s’est imposée comme une référence incontournable pour la modélisation statistique visuelle. Toutefois, la restitution brute des hauteurs ou des longueurs de barres au sein d’un diagramme laisse fréquemment l’observateur dans une approximation perceptive préjudiciable à la rigueur de l’analyse.
L’annotation textuelle directe des barres au sein d’un diagramme permet de pallier les limites intrinsèques de l’évaluation visuelle humaine, souvent biaisée par des illusions d’optique, des artéfacts d’échelle ou des résolutions graphiques insuffisantes. Afficher la valeur exacte directement sur ou au-dessus de chaque segment géométrique transforme une simple illustration descriptive en un instrument d’analyse précis, conforme aux exigences de reproductibilité et de clarté propres aux publications évaluées par des pairs. L’intégration de ces métriques au sein de flux de travail programmatiques requiert néanmoins une compréhension fine de l’architecture sous-jacente de Seaborn et de son socle technique fondamental, Matplotlib.
Ce guide propose une exploration exhaustive, théorique et appliquée, des mécanismes permettant d’extraire, de calculer et d’afficher les valeurs numériques sur des diagrammes en barres verticaux et horizontaux élaborés avec Seaborn. De la manipulation élémentaire des objets géométriques bidimensionnels à l’exploitation des interfaces modernes d’étiquetage automatique, en passant par le traitement des grilles multifactorielles complexes et l’application aux données psychométriques, cette monographie technique offre aux chercheurs et analystes de données un cadre méthodologique complet pour maîtriser la sémiologie graphique numérique.
1. Introduction méthodologique à la visualisation des données avec Seaborn
1.1 Importance de la précision numérique dans la communication graphique
L’acte de lecture d’un graphique repose sur une série de décodages cognitifs par lesquels le système visuel traduit des attributs spatiaux, tels que la position, la longueur ou l’aire, en grandeurs quantitatives. Selon les travaux pionniers de William Cleveland et Robert McGill en sémiologie graphique, l’estimation d’une grandeur numérique le long d’une échelle alignée constitue l’une des tâches de jugement visuel les plus précises. Néanmoins, dès lors que l’observateur doit extrapoler la hauteur d’une barre vers un axe orthogonal gradué, des incertitudes perceptives notables émergent, accrues par l’éloignement physique entre le sommet de la barre et l’axe de référence gradué.
La superposition explicite des métriques quantitatives à proximité immédiate des éléments graphiques élimine cette charge cognitive extrinsèque en supprimant le besoin de triangulation visuelle. Dans le cadre de la recherche quantitative, de l’économétrie ou de la psychométrie, où des différences minimes de moyennes peuvent déterminer le franchissement d’un seuil de significativité statistique, l’approximation visuelle ne saurait suffire. La transmission fidèle de l’information exige une double modalité sémiotique : la barre offre une appréciation globale immédiate des proportions relatives, tandis que l’étiquette numérique apporte la certitude analytique indispensable à la vérification empirique.
Il convient toutefois de veiller à ne pas surcharger l’espace graphique d’éléments textuels superflus. Selon le principe du ratio données-encre théorisé par Edward Tufte, chaque particule graphique ou typographique doit apporter un gain d’information substantiel. L’adjonction de valeurs chiffrées doit donc faire l’objet d’un calibrage rigoureux, évitant la redondance excessive tout en garantissant un contraste et un positionnement optimaux, de manière à soutenir le raisonnement scientifique sans obstruer la perception des structures globales de distribution.
1.2 Seaborn comme surcouche statistique de Matplotlib
Pour appréhender le positionnement d’étiquettes au sein de graphiques Seaborn, il est indispensable de comprendre la relation symbiotique que cette bibliothèque entretient avec Matplotlib. Seaborn ne constitue pas un moteur de rendu graphique autonome doté de son propre système de bas niveau ; il s’agit d’une interface de haut niveau conçue pour automatiser et enrichir la création de figures statistiques tout en déléguant l’intégralité du dessin vectoriel aux structures de base de Matplotlib. Ainsi, chaque figure Seaborn est intrinsèquement matérialisée par un objet de type Figure, contenant un ou plusieurs conteneurs d’axes dénommés AxesSubplot ou Axes.
La fonction sns.barplot opère une puissante abstraction statistique : elle reçoit un tableau de données, identifie les variables catégorielles et continues, calcule les moyennes de groupe ainsi que les intervalles d’incertitude associés par ré-échantillonnage de type bootstrap, et instancie automatiquement les coordonnées cartésiennes de chaque barre. Cependant, cette surcouche d’abstraction a historiquement omis d’intégrer des paramètres natifs dédiés à l’affichage textuel immédiat des estimations statistiques ponctuelles. L’analyste se trouve ainsi confronté à un paradoxe où Seaborn calcule avec élégance des estimateurs sophistiqués, mais requiert une descente vers les primitives géométriques de Matplotlib pour en afficher le texte explicite.
Cette articulation implique que toute démarche avancée de personnalisation graphique doit reposer sur la manipulation directe des objets retournés par les fonctions de tracé de Seaborn. L’interfaçage harmonieux entre les structures tabulaires issues de la bibliothèque Pandas et le moteur de tracé vectoriel exige une maîtrise rigoureuse de la hiérarchie des objets graphiques, condition indispensable pour injecter dynamiquement des annotations textuelles conformes à la distribution sous-jacente des données.
1.3 Objectifs du protocole et présentation du jeu de données expérimental
L’objectif de ce protocole méthodologique est d’exposer de manière didactique et reproductible les solutions algorithmiques et les approches natives permettant d’annoter fidèlement des diagrammes en barres créés sous Seaborn. Nous chercherons à établir des règles typographiques et spatiales strictes pour prévenir les chevauchements, garantir l’intégrité des représentations à travers différentes échelles, et assurer une compatibilité optimale avec les exigences de publication scientifique les plus rigoureuses, telles que les normes de l’American Psychological Association.
Afin d’illustrer nos développements sur un matériel empirique standardisé et librement accessible, nous mobiliserons le jeu de données classique nommé tips, disponible directement au sein de la distribution de Seaborn. Cette base de données compile des observations relatives à des additions de restaurant, enregistrant des variables continues fondamentales telles que le montant total de la note et le montant du pourboire, croisées avec des facteurs catégoriels nominaux et ordinaux comme le jour de la semaine, le moment du repas, le genre du payeur et le statut de fumeur des convives.
Ce jeu de données présente une hétérogénéité d’effectifs et des distributions asymétriques idéales pour tester la robustesse de nos algorithmes d’étiquetage. L’environnement d’exécution présuppose l’installation des bibliothèques fondamentales Python dédiées au calcul scientifique, notamment NumPy pour la manipulation matricielle, Pandas pour l’indexation tabulaire, Matplotlib pour le contrôle typographique fin, et Seaborn pour la structuration esthétique et statistique des visualisations.
2. Fondements théoriques et anatomie technique d’un Barplot Seaborn
2.1 Mécanisme de construction des conteneurs graphiques
Lors de l’appel à la fonction sns.barplot, le moteur graphique procède à une décomposition analytique du jeu de données. Seaborn regroupe les données selon les niveaux du facteur placé sur l’axe catégoriel, applique une fonction d’agrégation statistique (la moyenne arithmétique par défaut) et calcule la dispersion des données à l’aide d’un modèle d’échantillonnage probabiliste. Dès que ces valeurs centrales sont calculées, Seaborn sollicite la méthode bar ou barh de Matplotlib pour instancier la géométrie correspondante au sein de l’environnement graphique.
Ces éléments sont regroupés au sein d’une structure spécialisée appelée BarContainer, rattachée à l’objet Axes. Ce conteneur répertorie l’ensemble des rectangles géométriques composant le tracé, tout en conservant des métadonnées essentielles sur la séquence d’affichage et l’ordre des séries. L’axe catégoriel se voit attribuer des coordonnées discrètes implicites, indexées de zéro au nombre total de catégories moins un, tandis que l’axe continu adopte une échelle réelle continue reflétant l’amplitude de la variable quantitative dépendante.
Comprendre que les catégories textuelles sont traduites de manière sous-jacente en coordonnées scalaires entières est fondamental pour tout travail d’annotation. Une erreur classique consiste à tenter de positionner du texte en utilisant les libellés nominaux directement comme coordonnées spatiales, ce qui engendre des erreurs d’interprétation cartésienne au sein du moteur de rendu. L’analyste doit impérativement appréhender le graphique comme un repère cartésien bidimensionnel standardisé où chaque entité possède une abscisse et une ordonnée strictement numériques.
2.2 Rôle et propriétés géométriques des objets Patches
Dans l’architecture de Matplotlib, chaque barre individuelle d’un diagramme est représentée sous la forme d’un objet appartenant à la classe Rectangle, qui hérite elle-même de la classe générique Patch. Cette classe encapsule l’ensemble des primitives topologiques nécessaires au dessin vectoriel d’un polygone fermé à quatre côtés : une position d’ancrage dans l’espace cartésien, une largeur, une hauteur, ainsi que des propriétés de style telles que la couleur de remplissage, l’opacité et l’épaisseur du trait de bordure.
L’accès programmatique à ces rectangles s’effectue traditionnellement par la propriété patches attachée à l’objet Axes, laquelle renvoie une liste ordonnée de tous les patchs dessinés dans le cadre d’affichage. Pour chaque rectangle, l’interface publique met à disposition quatre méthodes analytiques fondamentales :
- get_x() : renvoie la coordonnée cartésienne minimale de la barre sur l’axe des abscisses, correspondant au bord gauche de la géométrie.
- get_y() : renvoie la coordonnée cartésienne minimale de la barre sur l’axe des ordonnées, matérialisant la base inférieure du rectangle, généralement calée sur l’origine zéro.
- get_width() : extrait la dimension scalaire du rectangle le long de l’axe horizontal.
- get_height() : extrait la dimension scalaire du rectangle le long de l’axe vertical.
La distinction entre orientation verticale et horizontale est cruciale à ce stade. Dans un diagramme à barres verticales conventionnel, get_height() exprime l’estimation statistique ponctuelle tandis que get_width() reflète l’épaisseur constante de la barre catégorielle. À l’inverse, dans une configuration horizontale, l’amplitude statistique est encodée par get_width(), tandis que la localisation spatiale de la catégorie est déterminée le long de l’axe vertical, imposant une permutation rigoureuse des variables lors de l’extraction algorithmique des métriques.
2.3 Positionnement textuel et ancrage cartésien
L’insertion d’une chaîne de caractères sur un canevas graphique s’opère via la méthode text de l’objet Axes. Cette primitive requiert la spécification impérative d’un couple de coordonnées scalaires x et y, ainsi que du texte à restituer. Néanmoins, la conformité esthétique du tracé dépend intrinsèquement des paramètres d’alignement typographique, désignés respectivement par ha (horizontal alignment) et va (vertical alignment). Ces paramètres dictent quel point de la boîte de délimitation du texte s’aligne précisément sur les coordonnées cartésiennes indiquées.
Pour un diagramme vertical, le centre de la barre sur le plan horizontal correspond mathématiquement à la coordonnée du bord gauche augmentée de la moitié de sa largeur, soit l’expression : get_x() + get_width() / 2. L’alignement horizontal doit alors impérativement être fixé à ‘center’. Si l’on choisissait un alignement par défaut ancré à gauche (‘left’), l’étiquette débuterait au milieu de la barre et déborderait asymétriquement vers la droite, créant une impression de déséquilibre visuel particulièrement inélégante.
Sur le plan vertical, l’insertion du texte immédiatement au-dessus de la barre requiert d’appliquer un décalage spatial (offset) calculé afin d’éviter que le glyphe typographique n’entre en collision physique avec le contour supérieur du rectangle. Ce décalage introduit cependant une contrainte périphérique majeure : si la barre la plus élevée atteint la frontière supérieure du graphique, l’ajout du texte au-dessus de son sommet provoquera la troncature des caractères par la bordure de la boîte englobante de l’axe. Il devient alors indispensable d’ajuster dynamiquement les limites d’axes via des fonctions de recalibrage de marges afin de préserver l’intégrité du champ typographique.
3. Développement et décomposition algorithmique de la fonction show_values
3.1 Structure globale et signature de la fonction personnalisée
Afin d’automatiser et de pérenniser le processus d’annotation à travers divers projets de modélisation statistique, la formalisation d’une fonction Python réutilisable, modulaire et polymorphique s’avère indispensable. Nous concevrons cette fonction sous le nom de show_values. Sa signature computationnelle doit intégrer une flexibilité suffisante pour gérer les spécificités spatiales et structurelles des tracés générés par Seaborn.
La signature standardisée de la fonction se structure autour de trois arguments directeurs. Le premier argument, noté axs, représente le conteneur graphique à annoter, qui peut se matérialiser sous la forme d’un objet Axes unitaire ou d’un tableau multidimensionnel d’objets Axes, tel que produit par des fonctions de grille de sous-graphes. Le second paramètre, orient, accepte une chaîne de caractères (‘v’ pour vertical ou ‘h’ pour horizontal) définissant l’axe le long duquel s’exprime la grandeur statistique. Enfin, le paramètre space introduit une constante de décalage spatial permettant de moduler avec une extrême finesse l’éloignement physique entre le sommet de la barre et l’étiquette numérique.
L’architecture interne repose sur le paradigme d’encapsulation fonctionnelle : une sous-fonction interne, désignée par convention _single, traite de manière déterministe un axe unique. La fonction parente évalue ensuite la nature de l’objet transmis via des tests de typage. Si axs se révèle être une instance de tableau NumPy (numpy.ndarray), la fonction orchestre une récursion ou une boucle de parcours pour appliquer _single à chaque élément de la matrice graphique, garantissant ainsi un traitement uniforme, quel que soit le niveau de complexité de l’agencement visuel.
3.2 Algorithme d’annotation pour l’orientation verticale
L’algorithme dédié au tracé vertical s’articule autour d’une itération systématique le long de la collection patches hébergée par l’axe de référence. Pour chaque polygone rectangulaire p rencontré au cours de cette boucle, l’algorithme procède à une série d’opérations géométriques séquentielles destinées à calculer les coordonnées exactes du centroïde textuel.
En premier lieu, l’abscisse textuelle _x est calculée selon l’équation barycentrique : _x = p.get_x() + p.get_width() / 2. Cette formulation garantit un centrage mathématique absolu de l’étiquette, indépendamment d’éventuelles variations d’épaisseur de barre induites par des paramètres de subdivision factorielle. En second lieu, l’ordonnée textuelle _y est établie en sommant la hauteur intrinsèque de la barre et la valeur d’espacement choisie : _y = p.get_y() + p.get_height() + space.
La valeur numérique extraite par p.get_height() subit ensuite une conversion typologique rigoureuse à travers une chaîne de formatage flottante, paramétrée par exemple selon le gabarit ‘{:.1f}’. Cette opération permet de convertir le scalaire brut en une représentation décimale épurée, éliminant les scories numériques issues de la précision machine en virgule flottante. Enfin, la méthode text est exécutée en spécifiant impérativement les attributs ha=’center’ et va=’bottom’, garantissant que la ligne de base inférieure du texte s’ancre avec une parfaite stabilité au-dessus du sommet de la géométrie.
3.3 Algorithme d’annotation pour l’orientation horizontale
Le traitement des diagrammes à barres horizontales impose une translation conceptuelle de notre système de coordonnées. Dans cette configuration, la grandeur statistique d’intérêt n’est plus corrélée à la hauteur géométrique, mais correspond rigoureusement à la largeur scalaire du polygone. Une tentative d’application aveugle de la logique verticale conduirait à l’affichage incongru de l’épaisseur de barre au mauvais endroit du graphique.
L’algorithme horizontal inverse donc la logique de projection spatiale. L’ordonnée d’ancrage _y doit désormais être positionnée au milieu de la face latérale de la barre. Elle est calculée selon l’expression : _y = p.get_y() + p.get_height() * 0.5. L’alignement vertical va est alors configuré sur ‘center_baseline’ ou plus simplement ‘center’, de sorte que le centre optique vertical des caractères coïncide rigoureusement avec l’axe médian horizontal de la barre.
L’abscisse _x est quant à elle déterminée par la projection de l’extrémité droite de la barre, augmentée de la constante d’espacement : _x = p.get_x() + p.get_width() + space. Pour ce tracé latéral, l’alignement horizontal ha doit être configuré sur la valeur ‘left’. De cette manière, l’étiquette textuelle s’étend vers la droite à partir du point d’ancrage, empêchant toute intrusion visuelle à l’intérieur du polygone coloré et offrant une lecture linéaire immédiate dans le sens naturel de décodage des axes cartésiens occidentaux.
4. Exemple pratique 1 : Affichage des valeurs sur un barplot vertical
4.1 Préparation des données et tracé du modèle de base
Pour illustrer la mise en application de cette méthodologie, initialisons un protocole expérimental à partir du jeu de données tips. La première étape consiste à configurer l’environnement d’analyse statistique en important les modules de calcul et de visualisation. Nous chargeons le jeu de données directement en mémoire sous la forme d’un DataFrame structuré, comprenant 244 observations ventilées selon divers paramètres transactionnels.
Nous définissons une modélisation visant à évaluer le montant moyen de l’addition totale (total_bill) en fonction des différents jours de la semaine (day), variable ordonnée comprenant quatre modalités : le jeudi, le vendredi, le samedi et le dimanche. Dans une démarche de clarté pédagogique pour ce premier exemple, nous désactivons le calcul des barres d’erreur statistiques en positionnant le paramètre errorbar à la valeur None (ou ci=None dans les versions historiques de Seaborn), ce qui restreint la sortie graphique à de simples barres représentatives de la moyenne empirique.
Le tracé brut généré par la fonction sns.barplot, bien qu’esthétiquement soigné grâce aux palettes chromatiques intégrées de Seaborn, souffre d’une lacune fonctionnelle immédiate : le lecteur perçoit distinctement que les additions du dimanche sont supérieures à celles du vendredi, mais l’estimation précise de la différence exige de projeter laborieusement le regard vers l’axe des ordonnées. Cette projection visuelle induit une marge d’erreur d’appréciation d’environ un demi-dollar, intolérable dans un rapport d’audit financier ou une étude quantitative approfondie.
4.2 Exécution de show_values en configuration standard
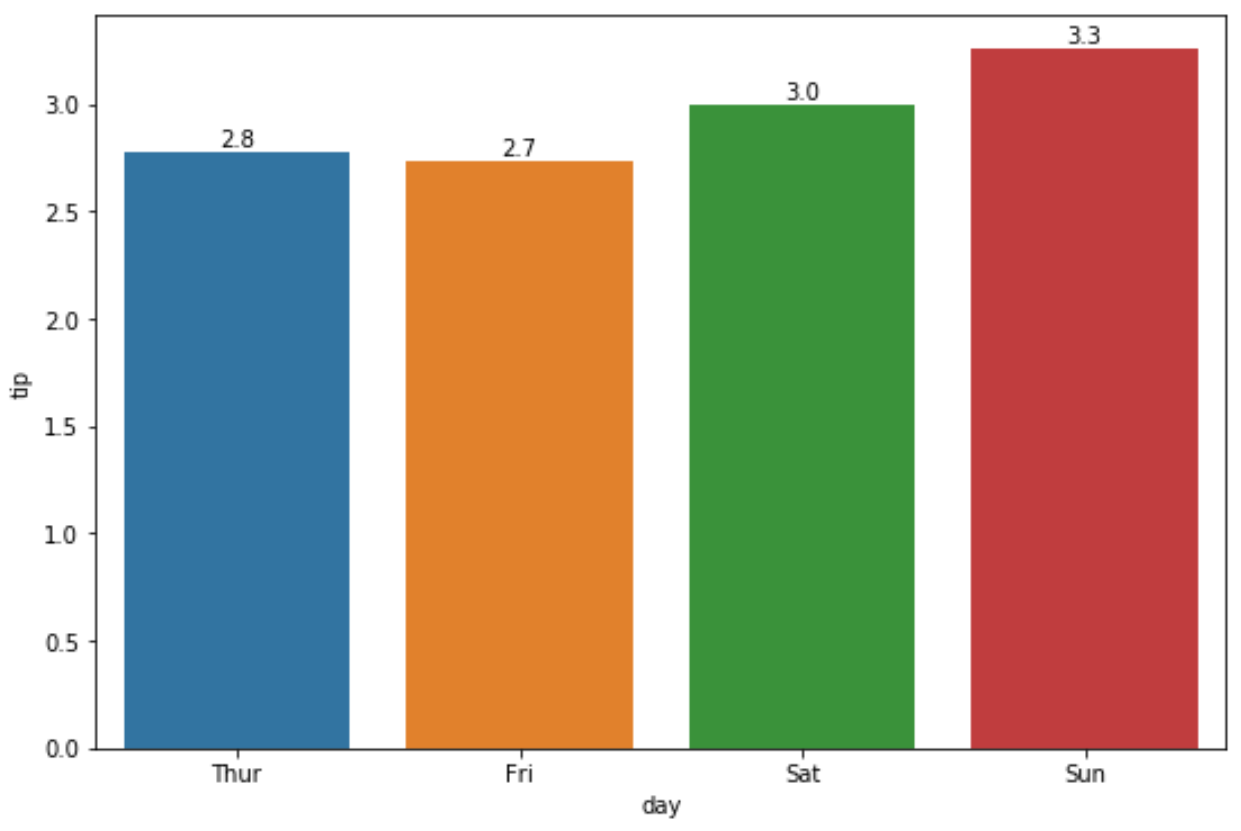
Pour remédier à cette imprécision, nous invoquons notre fonction personnalisée show_values en lui passant en argument direct l’objet Axes issu de l’étape de tracé. En fixant une valeur d’espacement préliminaire modérée, par exemple space=0.2, l’algorithme parcourt les quatre rectangles composant le diagramme, interroge leurs propriétés géométriques et calcule les positions cartésiennes idéales.
Le résultat graphique transforme radicalement l’utilité du document. Au-dessus de chaque colonne s’élève une étiquette textuelle épurée, affichant la moyenne avec une précision d’une décimale : 17.7 pour le jeudi, 17.2 pour le vendredi, 20.4 pour le samedi et 21.4 pour le dimanche. La lecture devient instantanée, sans ambiguïté interprétative. L’ancrage horizontal centré garantit que les chiffres sont parfaitement alignés avec l’axe médian de chaque barre, créant une symétrie visuelle apaisante pour le regard de l’analyste.
Ce succès initial met en évidence l’élégance de la programmation orientée objet au sein de Matplotlib. En interrogeant la méthode get_height() de chaque patch, notre fonction s’affranchit d’un ré-accès aux structures de données de Pandas. Elle extrait la valeur agrégée directement depuis le moteur de rendu graphique lui-même, garantissant une cohérence absolue et infaillible entre la hauteur physique observée sur l’écran et la métrique numérique inscrite par la typographie.
4.3 Optimisation des marges et prévention des coupures d’affichage
L’application brute des annotations textuelles met rapidement en évidence une problématique topologique récurrente : l’effet de troncature périphérique. Par défaut, Matplotlib calcule les limites de l’axe des ordonnées (ylim) de manière à englober exactement la hauteur de la barre la plus élevée du jeu de données, en ajoutant une marge standard de cinq pour cent. Cependant, lorsque l’on juxtapose une chaîne textuelle au-dessus de cette barre maximale, l’élévation cumulée de la hauteur de la barre, du paramètre space et de la hauteur intrinsèque de la boîte de délimitation de la police franchit fréquemment la limite supérieure fixée pour l’axe.
Pour pallier cette anomalie visuelle où le sommet des caractères se trouve tronqué par la ligne supérieure du cadre, l’opérateur doit procéder à une expansion délibérée de l’échelle d’affichage. L’utilisation programmatique de ax.set_ylim permet de redéfinir manuellement la borne maximale de l’axe en lui attribuant une valeur majorée d’environ 10 à 15 pour cent par rapport à la valeur maximale observée. Alternativement, l’appel à la méthode ax.margins(y=0.15) ordonne au moteur graphique d’appliquer une marge de sécurité élastique sur l’axe vertical.
Enfin, pour toute production destinée à la publication imprimée ou à l’insertion dans un manuscrit académique, la méthode plt.savefig doit impérativement être configurée avec le paramètre bbox_inches=’tight’. Cette instruction impose au moteur d’exportation vectorielle de recalculer la boîte englobante de l’ensemble de la figure avant la génération du fichier final, garantissant ainsi qu’aucun glyphe d’annotation ne soit rogné en périphérie du document.
5. Exemple pratique 2 : Affichage des valeurs sur un barplot horizontal
5.1 Configuration des variables pour l’orientation horizontale
Dans de nombreuses configurations expérimentales, l’orientation horizontale d’un diagramme en barres s’avère nettement supérieure d’un point de vue ergonomique. Ce paradigme est particulièrement recommandé lorsque les étiquettes catégorielles comportent des intitulés textuels longs, des désignations nosologiques complexes ou des descriptions d’items psychométriques qui, sur un axe horizontal conventionnel, imposeraient des rotations typographiques à 45 ou 90 degrés préjudiciables au confort de lecture.
Pour instaurer un tracé horizontal sous Seaborn, il suffit d’intervertir l’affectation des axes au sein des arguments de sns.barplot : la variable catégorielle factorielle day est désormais assignée au paramètre y, tandis que la variable métrique quantitative dépendante total_bill est confiée au paramètre x. Seaborn détecte automatiquement la nature des types de données et bascule l’orientation générale du tracé le long du plan orthogonal, dressant les barres horizontalement de la gauche vers la droite depuis l’origine cartésienne x=0.
Sur le plan topologique interne, ce basculement modifie entièrement la sémantique des objets Patch. La longueur de la barre représentant le montant moyen de la facture est désormais régie par la dimension get_width(), tandis que la hauteur get_height() se réduit à une simple constante définissant l’épaisseur de la barre le long de l’axe catégoriel ordonné. Toute routine d’étiquetage qui persisterait à sonder la hauteur pour extraire la statistique afficherait alors une succession de constantes reflétant l’épaisseur graphique, créant une aberration analytique majeure.
5.2 Déploiement de show_values avec le paramètre orient=’h’
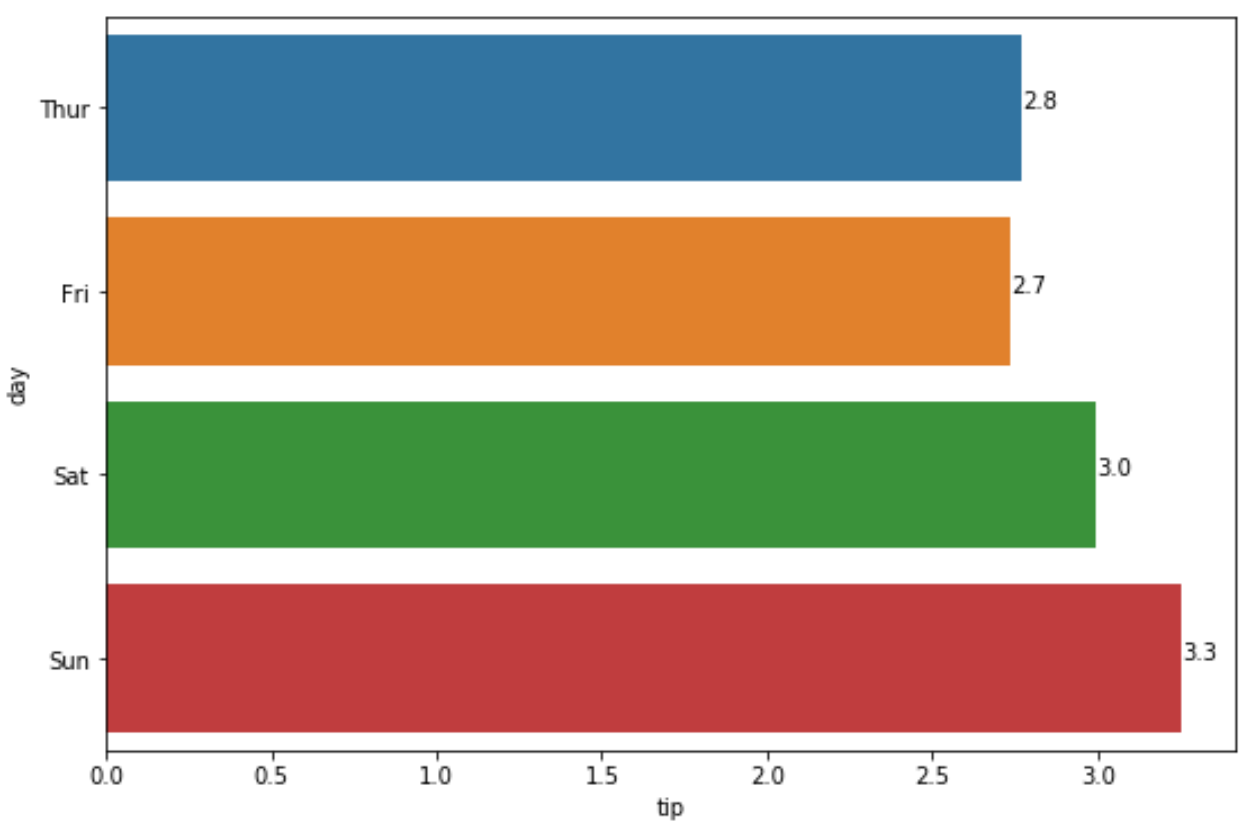
La résolution de cette contrainte géométrique réside dans l’appel de notre fonction personnalisée en spécifiant explicitement l’argument orient=’h’. Dès lors, la fonction oriente son exécution vers l’algorithme d’annotation latérale décomposé au chapitre précédent. Dans cet état d’exécution, la constante spatiale space ne s’applique plus comme une surélévation verticale, mais agit comme une marge d’éloignement horizontal le long de l’axe des abscisses.
Prenons l’instruction concrète show_values(ax, orient=’h’, space=0.4). L’algorithme calcule pour chaque barre l’ordonnée médiane _y = p.get_y() + p.get_height() / 2, garantissant un centrage parfait du texte dans l’épaisseur de la bande colorée. Conjointement, l’abscisse d’implantation est projetée à _x = p.get_x() + p.get_width() + 0.4. L’argument d’alignement horizontal ha=’left’ prend alors tout son sens : le premier caractère numérique s’implante avec une rigueur absolue à une distance constante de quatre dixièmes d’unité de données au-delà de la ligne terminale de chaque barre.
L’observateur bénéficie alors d’un tracé d’une grande fluidité cognitive. Les libellés catégoriels des jours se lisent horizontalement sans torsion céphalique sur l’axe vertical, tandis que les métriques quantitatives s’échelonnent sur le flanc droit des barres. La trajectoire visuelle suit un balayage naturel de gauche à droite, associant le nom de la condition, l’extension géométrique de la barre et la validation numérique exacte de l’estimation statistique.
5.3 Harmonisation typographique et calibrage du paramètre space
Le calibrage du paramètre space dans une configuration horizontale soulève des considérations méthodologiques relatives à la dynamique d’échelle. Dans un repère cartésien horizontal, la valeur brute attribuée à space s’exprime dans les unités de mesure de la variable quantitative représentée sur l’axe des abscisses. Ainsi, un décalage de space=0.5 s’avère parfait si les données oscillent entre 10 et 100 unités, mais se révélerait totalement inopérant sur des échelles de temps de réaction mesurées en millisecondes (où une valeur de 0.5 serait imperceptible) ou sur des proportions normalisées comprises entre 0 et 1 (où 0.5 propulserait le texte hors du champ de vision).
Une optimisation algorithmique élégante consiste à transformer space en une constante élastique calculée dynamiquement comme une fraction de l’étendue globale de l’axe cartésien. En extrayant les bornes du tracé via ax.get_xlim(), la fonction peut déterminer l’amplitude totale de l’axe (max – min) et définir l’espacement comme un pourcentage fixe de cette étendue, couramment fixé entre un et deux pour cent de la dynamique globale.
Parallèlement, la bordure droite de l’axe des abscisses doit faire l’objet d’une surveillance particulière. Si la barre la plus longue s’étend jusqu’à la limite maximale par défaut de l’axe, l’annotation latérale sera irrémédiablement tronquée par la ligne de fermeture droite du cadre de tracé. Il est donc impératif d’ajuster l’étendue de l’axe via ax.set_xlim(right=ax.get_xlim()[1] * 1.12), créant ainsi une zone de respiration graphique adéquate pour accueillir l’intégralité du texte sans encombre.
6. Gestion avancée des grilles multifactorielles et FacetGrid
6.1 Architecture matricielle des sous-graphiques sous Seaborn
L’analyse multivariée contemporaine requiert fréquemment de segmenter l’examen d’un phénomène selon plusieurs facteurs de confusion ou de modération. Seaborn excelle dans cette tâche grâce à sa fonction de haut niveau sns.catplot, qui orchestre la création d’objets de type FacetGrid. Contrairement à sns.barplot qui opère sur un conteneur Axes unitaire, sns.catplot engendre une matrice bidimensionnelle d’axes interconnectés, distribués en lignes et en colonnes selon les modalités des facteurs de conditionnement désignés par les paramètres row et col.
L’architecture interne d’un objet FacetGrid stocke ces différents sous-graphiques au sein de son attribut axes, qui prend la forme d’un tableau structuré à deux dimensions issu de la bibliothèque NumPy (numpy.ndarray). Chaque cellule de cette grille héberge un objet Axes indépendant possédant sa propre collection de patchs rectangulaires, ses propres bornes cartésiennes et ses propres étiquettes d’échelles.
Cette structure matricielle complexifie le processus d’annotation séquentielle. Une fonction d’étiquetage rudimentaire conçue exclusivement pour un axe simple échouera lamentablement si elle est appliquée directement à l’objet FacetGrid, déclenchant des erreurs d’attributs consécutives à l’absence de la méthode get_patches sur une structure matricielle NumPy. Il devient donc indispensable de concevoir un mécanisme d’exploration récursive capable de parcourir méthodiquement chaque nœud de la matrice graphique.
6.2 Application de show_values sur des figures à plusieurs volets
C’est précisément ici que la conception polymorphique de notre fonction show_values démontre toute sa robustesse logicielle. En intégrant un test conditionnel initial sur le type de l’objet transmis (isinstance(axs, np.ndarray)), la fonction intercepte la grille matricielle et déclenche une routine de décomposition multidimensionnelle. L’utilisation de l’itérateur np.ndenumerate permet d’extraire séquentiellement chaque sous-graphique individuel ainsi que ses coordonnées d’indexation spatiale.
Supposons que nous souhaitions segmenter notre analyse du montant des additions non seulement par jour de la semaine, mais également selon le statut tabagique des clients (smoker) et le moment du repas (time), générant ainsi une grille factorielle de deux lignes sur deux colonnes. L’exécution de l’instruction show_values(g.axes, orient=’v’, space=0.3) ordonne à l’algorithme de cibler successivement chaque quadrant, d’itérer sur les barres locales et de superposer les moyennes statistiques calculées spécifiquement pour chaque sous-échantillon.
Ce déploiement matriciel automatisé garantit une étanchéité absolue entre les sous-populations : les annotations d’une facette correspondent rigoureusement aux agrégations locales de cette cellule expérimentale. De surcroît, la routine gère avec une parfaite résilience les facettes qui contiendraient des cellules vides imputables à des croisements factoriels non représentés dans le jeu de données empirique, en ignorant simplement les conteneurs dépourvus de surfaces polygonales.
6.3 Stratégies d’adaptation pour les mises en page complexes
Le déploiement d’annotations textuelles sur des grilles multifactorielles denses impose de relever le défi de la promiscuité spatiale. Dans une grille comportant six à huit facettes contiguës, les dimensions effectives de chaque sous-graphique se trouvent drastiquement réduites, ce qui augmente substantiellement le risque de collisions visuelles entre les étiquettes numériques, les titres d’axes et les délimitations des facettes voisines.
Pour préserver une lisibilité irréprochable conforme aux normes éditoriales les plus strictes, plusieurs ajustements stratégiques s’imposent :
- Modulation de la taille typographique : il est impératif de réduire la taille des caractères typographiques (paramètre fontsize) proportionnellement au nombre de facettes composant la matrice d’affichage.
- Gestion des échelles partagées : par défaut, FacetGrid synchronise les limites des axes cartésiens entre toutes les facettes (sharex=True, sharey=True). Cette harmonisation implique que l’extension de sécurité calculée pour accueillir l’étiquette de la barre maximale globale doit être répercutée uniformément sur l’ensemble des sous-graphiques, sous peine de distordre la comparabilité visuelle des hauteurs de barres.
- Aération structurelle inter-graphique : l’appel final à plt.tight_layout() ou la modulation directe de subplots_adjust s’avère indispensable pour recalibrer les espaces de dégagement inter-facettes et empêcher que les textes supérieurs d’une rangée n’empiètent sur les étiquettes d’abscisses de la rangée supérieure.
7. L’approche moderne native : Utilisation de ax.bar_label de Matplotlib
7.1 Genèse et intégration de la méthode bar_label depuis Matplotlib 3.4.0
Face à la récurrence du besoin d’annotation et à la prolifération de fonctions personnalisées plus ou moins optimisées au sein de la communauté scientifique, les développeurs du projet Matplotlib ont introduit, à partir de la version 3.4.0, une méthode native standardisée intégrée directement à la classe Axes : ax.bar_label. Cette innovation architecturale visait à combler un vide fonctionnel historique en officialisant une interface directe, hautement performante et syntaxiquement concise pour étiqueter les diagrammes en barres.
L’avantage conceptuel fondamental de ax.bar_label réside dans sa capacité à dialoguer directement avec les objets BarContainer instanciés lors de la phase de tracé. Plutôt que d’imposer à l’utilisateur final une boucle impérative explicite parcourant manuellement chaque rectangle unitaire pour en extraire les barycentres géométriques, bar_label accepte directement le conteneur global et délègue au code interne hautement optimisé de Matplotlib le soin de calculer les centroïdes, d’extraire les grandeurs et de positionner la couche textuelle correspondante.
Cette approche moderne réduit considérablement le volume de code boilerplate indispensable au sein des scripts de traitement statistique, tout en apportant des gains de performance notables lors du traitement de volumétries importantes de données ou de figures intégrant des centaines de barres catégorielles subdivisées.
7.2 Mise en œuvre concrète sur graphiques verticaux et horizontaux
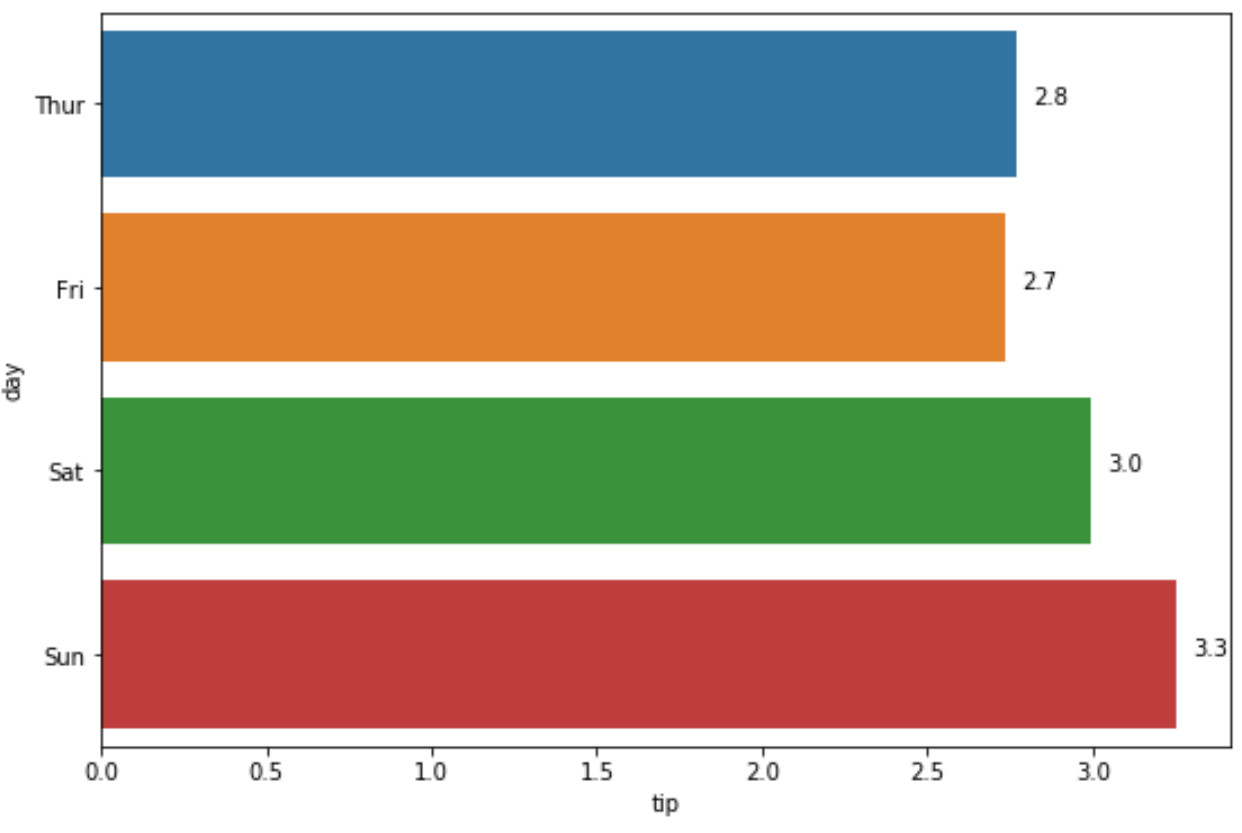
L’application de ax.bar_label sur une visualisation issue de Seaborn requiert simplement d’interroger la liste des conteneurs hébergés au sein de l’objet Axes via la propriété ax.containers. La boucle canonique d’annotation se résume alors à une syntaxe d’une remarquable concision : pour chaque conteneur présent dans cette collection, on exécute ax.bar_label(container).
La méthode met à la disposition du statisticien un ensemble de paramètres de contrôle extrêmement sophistiqués :
- fmt : définit le gabarit de formatage de la chaîne numérique sous forme de chaîne de caractères conventionnelle (par exemple fmt=’%.2f’ pour deux décimales ou fmt=’%.1f%%’ pour adjoindre un symbole de pourcentage).
- padding : remplace avantageusement notre paramètre personnalisé space en stipulant la distance géométrique exacte, exprimée en points typographiques indépendants de l’échelle des données, séparant le bord du rectangle du glyphe textuel.
- label_type : offre le choix entre deux modes de positionnement fondamentaux : ‘edge’ qui projette l’étiquette à l’extérieur de la barre sur son sommet ou son flanc terminal, et ‘center’ qui implante l’étiquette au centroïde géométrique interne de la barre.
De surcroît, la méthode gère de manière intrinsèque l’orientation du graphique sans exiger de l’utilisateur qu’il spécifie manuellement si le tracé est vertical ou horizontal. En sondant les métadonnées structurelles du BarContainer transmis, ax.bar_label déduit automatiquement la géométrie sous-jacente et adapte en temps réel les calculs trigonométriques d’alignement et de projection spatiale.
7.3 Analyse comparative : show_values versus ax.bar_label
L’émergence de ax.bar_label soulève légitimement la question du maintien des fonctions personnalisées historiques telles que show_values. Un examen comparatif rigoureux permet de dégager des critères d’arbitrage objectifs selon les contraintes spécifiques des environnements de production et de recherche.
La méthode native ax.bar_label l’emporte indéniablement sur le terrain de la concision syntaxique, de la pérennité de maintenance et de l’intégration native avec les objets de Matplotlib. Elle résout avec une élégance parfaite la quasi-totalité des besoins standards d’annotation des diagrammes simples et groupés. De plus, l’utilisation de points typographiques pour le paramètre padding immunise le décalage textuel contre les effets secondaires de distorsion d’échelle lorsque l’axe continu subit des transformations d’amplitudes extrêmes.
À l’inverse, l’approche programmatique sur mesure incarnée par show_values conserve un intérêt pédagogique et opérationnel majeur dans des scénarios de personnalisation non conventionnels. Lorsque l’analyste doit appliquer une logique d’annotation hautement conditionnelle (par exemple, afficher la valeur uniquement si elle franchit un seuil de significativité p < 0.05, ou appliquer des transformations textuelles asymétriques selon le sens de variation de la barre), l’itération directe sur la collection des patchs offre un contrôle chirurgical que l’API plus rigide de bar_label ne permet pas toujours de réaliser sans recourir à des paramètres d’étiquetage personnalisés complexes.
8. Formatage numérique avancé et personnalisation esthétique
8.1 Typographie et mise en forme des chaînes de caractères
La valeur brute d’un estimateur statistique calculé par une machine présente couramment une infinité de décimales générées par les calculs d’agrégation ou de ré-échantillonnage bootstrap. L’affichage sans filtre de telles grandeurs constitue une faute méthodologique grave, polluant le graphique d’une précision illusoire tout en dégradant la lisibilité typographique. La maîtrise du formatage numérique représente donc une exigence cardinale de la sémiologie graphique quantitative.
L’utilisation des f-strings modernes de Python ou des gabarits de formatage standard permet d’instaurer des filtres rigoureux. Dans l’espace francophone, l’écriture académique impose des conventions formelles précises, telles que l’utilisation de l’espace insécable comme séparateur de milliers et de la virgule comme séparateur décimal. Ces ajustements peuvent être réalisés de manière élégante en appliquant des méthodes de substitution de chaînes ou en mobilisant le module standard locale configuré sur l’environnement linguistique adéquat.
L’adjonction de préfixes ou de suffixes permet d’expliciter sans ambiguïté l’unité de mesure sous-jacente dès la lecture de l’étiquette, dispensant le lecteur de se référer constamment au libellé de l’axe. Qu’il s’agisse de symboles monétaires (€, $), d’unités de mesure psychométriques (ms, points d’échelle) ou de ratios de proportion (%), l’intégration contextuelle de ces marqueurs transforme une simple coordonnée spatiale en une donnée signifiante dotée d’une pleine validité sémantique.
8.2 Contrôle des attributs visuels du texte
L’intégration esthétique des étiquettes numériques au sein d’une figure obéit à des lois d’harmonie graphique destinées à soutenir l’attention sans distraire. Le choix de la typographie, de la graisse et du corps de la police doit s’inscrire en cohérence étroite avec la charte graphique de la publication visée. Les paramètres fontsize et fontweight permettent d’instaurer une hiérarchie visuelle claire : des valeurs légèrement affaiblies en graisse médium ou semi-bold garantissent une lisibilité optimale sans écraser visuellement les traits d’axes principaux.
La question du contraste chromatique s’avère particulièrement critique. Des étiquettes tracées dans un noir absolu (#000000) peuvent induire une dureté visuelle excessive lorsqu’elles côtoient des palettes Seaborn pastel ou désaturées (telles que ‘muted’ ou ‘deep’). L’adoption d’un gris anthracite sombre (#333333 ou #2b2b2b) permet d’adoucir la composition tout en préservant un indice de contraste conforme aux directives d’accessibilité numérique W3C.
Dans les configurations denses où l’écartement physique entre les barres devient ténu, la rotation angulaire des textes constitue un expédient technique salvateur. L’application d’une inclinaison de 45 ou 90 degrés via le paramètre rotation permet d’aligner les chiffres verticalement au-dessus des barres, évitant ainsi le chevauchement typographique latéral entre étiquettes contiguës tout en conservant une taille de glyphe suffisamment généreuse pour une lecture sans effort.
8.3 Positionnement intra-barre versus extra-barre
Le dilemme spatial fondamental de l’étiquetage des diagrammes en barres réside dans l’arbitrage entre un placement externe (au sommet ou sur le flanc de la barre) et un placement interne (au sein même de la zone colorée du polygone). Chacune de ces deux postures présente des avantages cognitifs et des contraintes topologiques spécifiques.
Le positionnement extra-barre constitue le modèle canonique par excellence. Il confère à la figure une grande clarté structurelle lorsque le graphique dispose de marges de dégagement généreuses et que le fond du graphique est uniformément blanc ou clair. Néanmoins, il accentue le risque de collisions avec les barres d’erreur statistiques et rend la composition vulnérable aux troncatures périphériques aux abords des limites cartésiennes.
Le positionnement intra-barre, fréquemment paramétré via label_type=’center’ sous ax.bar_label, résout radicalement les problématiques d’extension de marges en confinant l’ensemble de la couche textuelle à l’intérieur de l’empreinte géométrique du tracé. Ce choix stylistique impose toutefois de surmonter le défi du contraste colorimétrique : un texte noir devient illisible s’il est superposé à une barre saturée de bleu foncé ou de bordeaux. L’analyste doit alors concevoir des algorithmes de contraste inverse adaptatif, calculant la luminance relative de la couleur de fond du rectangle pour commuter automatiquement la couleur de la police entre le blanc pur et le noir profond.
9. Cas particuliers : Données groupées, barres empilées et barres d’erreur
9.1 Annotation des barplots groupés avec l’argument ‘hue’
L’introduction d’une variable de partitionnement supplémentaire via l’argument hue dans sns.barplot modifie substantiellement l’anatomie géométrique de la figure. Seaborn scinde alors chaque position catégorielle principale en un sous-ensemble de rectangles adjacents, un processus technique désigné sous le terme de décalage spatial (dodging). Chaque modalité du facteur de nuance hérite d’une largeur de barre proportionnellement rétrécie et d’un décalage latéral calculé dynamiquement.
Sur le plan structurel, Seaborn organise ces barres au sein de BarContainers distincts, un conteneur étant alloué à chaque niveau de la variable hue. Si l’on applique l’approche moderne de ax.bar_label, la boucle itérative standard for container in ax.containers annote avec une précision stupéfiante chaque sous-barre, calculant sans la moindre intervention manuelle le sous-décalage spatial horizontal correspondant.
Dans le cas d’une implémentation algorithmique manuelle via show_values, l’itération brute sur ax.patches requiert une rigueur mathématique sans faille. La collection des patchs ordonne les rectangles non pas nécessairement par proximité spatiale, mais souvent par série factorielle hue. Dès lors, le calcul précis du centroïde _x = p.get_x() + p.get_width() / 2 devient la seule garantie fiable permettant de ne pas attribuer l’étiquette d’une sous-population à sa voisine de cellule.
9.2 Interaction visuelle avec les barres d’erreur statistiques
L’un des atouts majeurs de Seaborn réside dans sa capacité à enrichir spontanément chaque estimation centrale par un intervalle de confiance ou un écart-type, matérialisé visuellement par une moustache d’erreur (error bar) surmontant la barre. Cette superposition statistique crée toutefois un conflit spatial aigu dès lors que l’on tente d’implanter une étiquette numérique textuelle au sommet de la même barre.
Si l’on applique un décalage standard ancré sur la hauteur pure du rectangle, le texte se retrouve dessiné directement au travers de la ligne de la barre d’erreur, provoquant un brouillage visuel inacceptable qui détruit la lisibilité tant de la valeur textuelle que de l’incertitude statistique. Pour neutraliser cette interférence, deux stratégies s’offrent à l’expérimentateur :
- L’ancrage au-dessus de l’intervalle d’incertitude : l’algorithme extrait l’ordonnée maximale atteinte par la moustache d’erreur supérieure et positionne l’étiquette au-delà de cette frontière extrême, garantissant un dégagement complet du segment statistique.
- Le compromis intra-barre : en configurant l’annotation à l’intérieur du corps de la barre, bien en dessous de l’interface supérieure, on sépare physiquement l’estimation de la moyenne (affichée au cœur de la colonne) de l’expression de sa variance (exposée à son sommet).
- L’étiquetage composite textuel : formulation avancée consistant à imprimer directement la métrique sous la forme moyenne ± incertitude (par exemple 21.4 ± 1.2) sur l’étiquette textuelle unique, autorisant dès lors la suppression pure et simple des moustaches géométriques.
9.3 Gestion des diagrammes à barres empilées (Stacked Barplots)
Bien que Seaborn privilégie conceptuellement les barplots groupés (dodged) aux diagrammes empilés (stacked), certaines modélisations quantitatives exigent la superposition cumulative des segments pour illustrer la composition interne d’un total absolu. Dans cette configuration, chaque segment rectangulaire ne repose plus sur l’axe d’origine zéro, mais s’élève à partir de l’ordonnée terminale du segment immédiatement sous-jacent.
Pour annoter convenablement un tracé empilé, l’analyste doit impérativement exploiter la méthode get_y() du rectangle, qui ne renvoie plus la valeur zéro mais la hauteur cumulée des strates inférieures. L’ordonnée médiane d’un segment empilé se calcule alors selon l’équation barycentrique : _y = p.get_y() + p.get_height() / 2. Cette formulation garantit que chaque chiffre vient se nicher avec une régularité absolue au centre de sa propre strate colorée.
Une précaution algorithmique essentielle doit être intégrée pour traiter les micro-segments : lorsqu’une modalité marginale présente une fréquence proche de zéro, la hauteur get_height() du rectangle devient inférieure à la hauteur physique de la police de caractères. L’insertion systématique d’une étiquette conduirait alors à un débordement grotesque hors des contours du segment. Il est indispensable d’introduire une clause conditionnelle de filtrage (par exemple if p.get_height() > seuil_minimal) afin de supprimer l’affichage des valeurs marginales inaudibles au profit de la clarté globale du tracé.
10. Application empirique aux sciences psychologiques et comportementales
10.1 Restitution graphique de scores psychométriques et échelles de Likert
En psychologie différentielle et en neuropsychologie clinique, la restitution des profils individuels ou collectifs repose massivement sur des batteries de questionnaires étalonnés utilisant des échelles d’évaluation ordonnées de type Likert. La représentation graphique de ces scores sous la forme de diagrammes en barres annotés constitue une modalité de communication privilégiée entre chercheurs, praticiens et patients.
La présence des valeurs exactes au sommet des barres prend ici une portée diagnostique immédiate. Dans le cadre de l’évaluation des dimensions de la personnalité selon le modèle du Big Five ou de l’estimation de la sévérité d’un état dépressif via l’inventaire de Beck, la lecture directe du score numérique moyen permet de confronter instantanément la performance observée aux seuils de significativité clinique prédéfinis (par exemple, identifier si une moyenne de 14.8 dépasse la coupure de dépression modérée située à 14.0).
Dans ce contexte, les conventions de présentation imposent une rigueur absolue quant au respect de l’intervalle de validité de l’outil de mesure. L’axe quantitatif ne doit jamais être distordu arbitrairement pour amplifier visuellement des contrastes mineurs ; il doit s’étendre sur l’amplitude théorique réelle de l’échelle (par exemple, un intervalle strict de 1 à 7 pour une échelle de Likert à sept points), les annotations textuelles venant certifier la valeur mathématique sans induire en erreur l’observateur non statisticien.
10.2 Illustration des temps de réaction et taux d’exactitude cognitive
Les paradigmes fondamentaux de la psychologie cognitive expérimentale, tels que les protocoles de Stroop, de Simon ou d’écoute dichotique, évaluent le fonctionnement exécutif à travers deux métriques interdépendantes : les temps de réaction exprimés en millisecondes et les taux d’exactitude ou d’erreur exprimés en pourcentages.
Ces deux dimensions psychologiques possèdent des échelles métriques totalement asymétriques. L’effet de facilitation ou d’interférence s’apprécie sur des écarts de quelques dizaines de millisecondes au sein d’une distribution chronométrique globale s’étendant de 400 à 800 millisecondes. L’absence d’étiquettes textuelles précises sur les barres confronte l’analyste à des difficultés majeures pour discerner à l’œil nu si un effet d’interférence cognitive s’élève à 35 millisecondes ou à 60 millisecondes.
L’annotation explicite au sommet des barres résout cette ambiguïté en inscrivant la latence exacte avec sa déviation standard. De surcroît, la mise en œuvre de visualisations à double volet, combinant sur une facette les pourcentages d’exactitude et sur l’autre les temps de réaction annotés, offre aux comités de lecture académiques une transparence analytique totale, indispensable pour vérifier l’absence d’un compromis vitesse-précision susceptible de biaiser l’interprétation des mécanismes cognitifs sous-jacents.
10.3 Communication des résultats d’essais cliniques et pré/post-tests
L’évaluation de l’efficacité d’interventions thérapeutiques, de programmes de remédiation cognitive ou de prises en charge pharmacologiques repose structurellement sur des plans expérimentaux longitudinaux comparant un groupe contrôle et un groupe expérimental avant et après traitement (designs pré/post-test).
Au sein de tels dispositifs, la simple observation visuelle de l’évolution des barres ne saurait suffire à attester de la pertinence clinique d’une amélioration. L’annotation directe des grandeurs quantitatives sur des barplots groupés permet de documenter instantanément l’amplitude de la taille d’effet observée, matérialisée par le d de Cohen ou le paramètre eta-carré partiel, en adjoignant directement le score exact de gain moyen thérapeutique au-dessus des conditions expérimentales post-interventionnelles.
Cette rigueur de présentation s’aligne rigoureusement sur les standards méthodologiques promulgués par le manuel de publication de l’American Psychological Association (APA 7th Edition). Ces directives stipulent que les représentations visuelles des données doivent être totalement explicites par elles-mêmes, permettant une interprétation autonome et sans équivoque des conclusions expérimentales sans exiger un décodage laborieux des tables numériques annexes.
11. Diagnostic des anomalies récurrentes et stratégies de résolution
11.1 Désalignement spatial et décalage des étiquettes textuelles
L’anomalie la plus communément rapportée par les analystes lors de l’automatisation d’annotations sous Seaborn réside dans le désalignement spatial : les étiquettes textuelles apparaissent décalées vers la gauche ou la droite de la barre, voire s’empilent anarchiquement au milieu de la figure. Ce comportement pathologique procède quasi systématiquement de trois causes fondamentales :
La première cause découle d’une mauvaise affectation du paramètre d’alignement horizontal ha. L’utilisation par mégarde de ha=’left’ sur un diagramme vertical contraint l’ancrage du bord gauche du texte au milieu de la barre, projetant asymétriquement les chiffres vers la périphérie droite de la colonne. La solution consiste à rétablir rigoureusement l’instruction ha=’center’.
La seconde cause est liée à l’interversion des axes cartésiens lors de l’application de barplots horizontaux. L’analyste qui oublie de spécifier orient=’h’ au sein de notre routine personnalisée continue d’injecter la largeur de barre dans l’axe vertical, aboutissant à un éparpillement erratique du texte. Enfin, l’usage d’échelles non linéaires, telles que les transformations logarithmiques (ax.set_yscale(‘log’)), brise les calculs additifs d’espacement. L’application d’un offset scalaire constant space au sommet d’une barre logarithmique produit un décalage géométrique disproportionné selon l’ordre de grandeur de la valeur, imposant de convertir le décalage en facteur multiplicatif logarithmique.
11.2 Truncature, coupure et débordement hors du cadre graphique
La troncature des étiquettes périphériques, abordée brièvement dans les premiers chapitres, constitue une défaillance visuelle fréquente qui ruine le professionnalisme d’une figure statistique. Ce dysfonctionnement trouve son origine technique dans le système de découpage vectoriel de Matplotlib, régi par l’attribut d’affichage clip_on des éléments graphiques.
Par défaut, les objets de type Text instanciés via ax.text possèdent l’attribut clip_on=False, ce qui autorise en théorie leur affichage au-delà des lignes de bordure de l’axe cartésien. Néanmoins, lors de la sérialisation du canevas final ou lors de son rendu dans un notebook Jupyter, le cadre délimitant la Figure globale opère un écrêtage destructif de tout ce qui déborde de sa surface matricielle assignée.
Pour éliminer définitivement ce défaut, l’application de la méthode ax.margins(y=0.15, x=0.15) permet de contraindre le moteur graphique à étendre ses limites internes sans distordre les coordonnées de données. Conjointement, lors de l’exportation sur disque via plt.savefig, il convient de déclarer impérativement les paramètres bbox_inches=’tight’ et pad_inches=0.1. Cette double précaution ordonne à Matplotlib de recalculer la surface d’encadrement en intégrant l’enveloppe convective de tous les glyphes typographiques périphériques.
11.3 Incohérences de typage et erreurs de formatage des données
Une source sous-estimée de plantages applicatifs lors de l’exécution de routines d’annotation réside dans la présence d’hétérogénéités structurelles au sein des données transmises à Seaborn. Les jeux de données empiriques comportent fréquemment des valeurs manquantes, encodées sous forme de marqueurs NaN (Not a Number), ou des facteurs catégoriels sans aucune observation associée.
Lorsqu’un niveau factoriel ne présente aucune observation, Seaborn instancie néanmoins un objet Rectangle dont la hauteur géométrique get_height() est mathématiquement égale à zéro ou, dans certaines configurations computationnelles, affectée à la valeur scalaire np.nan. Une tentative de formatage aveugle de cette grandeur par une chaîne f'{val:.1f}’ peut déclencher une exception de type ValueError ou inscrire inélégamment le libellé ‘nan’ au ras du plancher de l’axe cartésien.
La sécurisation de l’algorithme d’étiquetage impose d’implémenter un filtre défensif préalable au sein de la boucle de traitement. L’évaluation conditionnelle if np.isnan(height) or height == 0: continue permet d’intercepter ces artefacts d’échantillonnage et de court-circuiter l’écriture textuelle pour les catégories orphelines, préservant ainsi l’épure et la robustesse analytique de l’illustration graphique.
12. Synthèse architecturale, bonnes pratiques et reproductibilité
12.1 Établissement d’un pipeline d’annotation robuste et réutilisable
Au terme de cette exploration technique, il apparaît fondamental de synthétiser ces compétences au sein d’un pipeline de production graphique standardisé et pleinement reproductible. Dans un environnement de recherche contemporain, la multiplication d’ajustements graphiques manuels et désordonnés à même les notebooks d’analyse constitue un vecteur d’erreurs et un frein majeur à la reproductibilité computationnelle.
La bonne pratique méthodologique consiste à encapsuler la logique d’annotation au sein d’un module d’assistance graphique dédié au projet de recherche. Ce module centralise les paramètres typographiques globaux (famille de polices, tailles relatives, contrastes chromatiques) en tirant parti du dictionnaire de configuration rcParams de Matplotlib. En standardisant la fonction d’annotation textuelle pour qu’elle intercepte indifféremment des figures simples, des objets de facettage ou des tracés réorientés, le chercheur garantit une harmonie visuelle irréprochable à travers l’ensemble des chapitres d’un manuscrit de thèse ou des figures d’une publication scientifique.
De surcroît, l’automatisation intégrale de l’annotation à partir des primitives géométriques consolide l’intégrité des analyses : toute modification apportée en amont au jeu de données ou au protocole d’exclusion d’observations se répercutera instantanément et sans risque d’erreur humaine sur les valeurs numériques inscrites au sein des figures régénérées.
12.2 Critères déontologiques et intégrité de la présentation des données
L’annotation des diagrammes en barres touche intimement à des considérations d’éthique et de déontologie dans la pratique de la communication scientifique. Le diagramme en barres repose sur une métaphore visuelle puissante : l’observateur associe inconsciemment la quantité d’encre imprimée, ou l’aire du polygone coloré, à la magnitude absolue du phénomène mesuré. C’est en vertu de cette règle d’isomorphisme perceptif que l’axe quantitatif continu d’un barplot doit impérativement posséder une origine ancrée à zéro.
Tronquer l’axe continu d’un diagramme en barres pour débuter arbitrairement l’échelle au plus près des sommets constitue une dérive manipulatoire majeure, amplifiant artificiellement des variations minimes et trompant le jugement visuel du lecteur. L’adjonction d’étiquettes numériques exactes au sommet de barres dont l’axe aurait été tronqué ne compense en rien cette distorsion ; elle ne fait que créer une dissonance cognitive délétère entre le jugement perceptif faussé par la géométrie altérée et la vérité mathématique inscrite dans le chiffre.
L’intégrité de la présentation exige en outre de ne jamais dissimuler la dispersion sous-jacente des données. L’affichage textuel de la moyenne ponctuelle ne doit jamais être un prétexte pour occulter la variance, l’asymétrie ou la présence de valeurs aberrantes. Dès lors que la complexité des distributions l’exige, le chercheur avisé privilégiera des représentations complémentaires, telles que les diagrammes de dispersion superposés (strip plots) ou les distributions en violon, pour enrichir la barre annotée d’une vision complète de l’architecture empirique de ses mesures.
12.3 Perspectives et évolution de l’écosystème de visualisation Python
L’écosystème de visualisation scientifique sous Python continue d’évoluer à un rythme soutenu. L’introduction récente de la nouvelle interface objet de Seaborn (Seaborn Objects API) préfigure une transformation profonde de la manière dont les graphiques statistiques sont conceptualisés et composés. Cette architecture moderne, inspirée de la grammaire des graphiques de Leland Wilkinson, vise à dissocier plus nettement la spécification statistique formelle de son rendu géométrique concret.
Au sein de ces nouveaux paradigmes déclaratifs, l’étiquetage automatique des marques géométriques est appelé à devenir une composante native pleinement intégrée à la chaîne de traitement syntaxique, réduisant progressivement le recours aux manipulations de bas niveau des objets de type Patch. Parallèlement, l’essor des formats graphiques interactifs pilotés par des bibliothèques telles que Plotly ou Bokeh redéfinit la notion même d’annotation, en substituant aux étiquettes statiques imprimées des fenêtres contextuelles de survol (tooltips) dynamiques et réactives.
Néanmoins, pour l’immense corpus de la littérature scientifique imprimée, des mémoires universitaires et des revues internationales de premier rang, le diagramme en barres statique annoté vectoriellement demeure la forme canonique absolue de partage du savoir. La maîtrise des mécanismes théoriques et pratiques régissant la superposition des valeurs sur Seaborn et Matplotlib confère à l’analyste un avantage technique inestimable, garantissant à ses travaux une précision analytique, une clarté sémiotique et une élégance typographique conformes aux plus hauts standards de la science contemporaine.
Références
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0