
La visualisation des distributions empiriques constitue l’un des piliers méthodologiques fondamentaux de la recherche quantitative contemporaine, traversant aussi bien les sciences computationnelles que la biométrie, l’économétrie et la psychométrie. Parmi l’ensemble des instruments graphiques à la disposition des chercheurs et des analystes, l’histogramme occupe une place prépondérante depuis son introduction formelle par Karl Pearson à la fin du dix-neuvième siècle. Toutefois, la représentation conventionnelle fondée sur des effectifs bruts présente des limites structurelles majeures dès lors qu’il s’agit de comparer des sous-groupes d’échantillonnage hétérogènes, d’évaluer la représentativité relative de segments d’observations ou d’intégrer des analyses empiriques au sein de rapports scientifiques obéissant à des critères stricts de standardisation métrique. L’affichage de pourcentages et de fréquences relatives sur les histogrammes permet de surmonter ces entraves épistémologiques en convertissant des comptages bruts dépendants de la taille de l’échantillon en mesures d’intensité probabiliste et proportionnelle.
Au sein de l’écosystème du langage de programmation statistique R, l’extension ggplot2 s’est imposée comme le paradigme dominant de production graphique, en raison de son adhésion rigoureuse aux principes de la grammaire des graphiques. Néanmoins, la transition d’un axe vertical exprimant des effectifs absolus vers un axe gradué en pourcentages — enrichi, le cas échéant, d’étiquettes typographiques disposées directement au-dessus des classes de données — confronte fréquemment les praticiens à la complexité interne des couches d’abstraction de ggplot2. Cette opération ne relève pas d’un simple ajustement cosmétique, mais sollicite une compréhension fine des transformations statistiques sous-jacentes, de l’évaluation différée des variables calculées et des mécanismes d’interaction entre les fonctions de découpage géométrique et les échelles de conversion proportionnelle.
Ce guide exhaustif a pour vocation d’analyser en profondeur les soubassements théoriques, techniques et méthodologiques nécessaires pour afficher avec une précision absolue des pourcentages sur des histogrammes créés avec ggplot2. De l’architecture interne des fonctions de segmentation statistique jusqu’à la mise en conformité visuelle avec les exigences éditoriales des normes de l’American Psychological Association, ce document propose un parcours didactique rigoureux, jalonné d’explications formelles, de formulations syntaxiques optimales et de résolutions raisonnées d’anomalies fréquemment observées en pratique computationnelle.
1. Introduction méthodologique et pertinence des pourcentages dans la visualisation de données
1.1 Importance de la normalisation relative en recherche quantitative
L’interprétation de données quantitatives brutes se heurte inévitablement au problème du biais d’échelle lorsque des comparaisons doivent être conduites entre des ensembles d’observations dont les tailles globales diffèrent. Si une étude clinique ou une enquête psychométrique recense cinq cents réponses favorables dans une cohorte de mille individus et cinquante réponses identiques au sein d’un groupe pilote de cent sujets, la comparaison des hauteurs géométriques brutes suggère à tort une asymétrie d’impact d’un facteur dix. Cette distorsion visuelle, induite par l’amplification de l’effectif absolu, complique l’appréciation des équivalences structurelles. La normalisation sous forme de pourcentages permet d’annihiler l’artefact de la taille d’échantillon, en ramenant chaque observation à une métrique universelle bornée entre zéro et cent, garantissant ainsi l’invariance d’échelle indispensable aux déductions scientifiques rigoureuses.
Sur le plan cognitif, le système visuel humain est naturellement prédisposé à apprécier les rapports de proportionnalité spatiale plutôt que de calculer mentalement des quotients arithmétiques complexes à partir d’axes numériques imposants. L’évaluation empirique d’un phénomène est considérablement fluidifiée lorsque le lecteur saisit instantanément qu’un intervalle spécifique de valeurs concentre trente-cinq pour cent de l’échantillon total, plutôt que devoir mémoriser un effectif arbitraire de cent soixante-quinze observations rapporté à une base de cinq cents individus. Cette simplification cognitive réduit la charge de travail mentale et prévient les erreurs de jugement subjectif relatives à la rareté ou à la densité d’un sous-ensemble de mesures.
Dans les publications académiques, en particulier en psychologie différentielle et en épidémiologie, la standardisation des distributions empiriques sous forme de fréquences relatives est une condition sine qua non de la validité écologique des résultats présentés. Elle favorise l’établissement de comparaisons diachroniques ou inter-laboratoires, assure l’interopérabilité des banques de données partagées et permet de confronter directement les distributions observées à des modèles de probabilité théoriques continus, tels que la loi normale de Laplace-Gauss ou la loi log-normale, dont l’intégrale sous la courbe est par définition égale à un.
1.2 Rôle de ggplot2 et de la grammaire des graphiques
La bibliothèque logicielle ggplot2 repose sur la théorisation formelle proposée par Leland Wilkinson dans son ouvrage séminal, The Grammar of Graphics, perfectionnée et adaptée à l’environnement R par Hadley Wickham. Cette perspective épistémologique envisage la construction graphique non comme un assemblage empirique de tracés géométriques primitifs, mais comme une composition modulaire de couches fonctionnelles distinctes. Chaque représentation visuelle s’articule autour d’un jeu de données source, d’un système d’assignation esthétique associant les variables aux attributs graphiques, de coordonnées spatiales, de transformations statistiques intermédiaires et d’échelles de projection.
Le point névralgique de cette grammaire réside dans le découplage conceptuel entre les variables résidant initialement dans la structure de données tabulaire et les variables dérivées générées à la volée par le moteur graphique. Lorsqu’un praticien instancie un histogramme, les barres rectangulaires ne reflètent pas directement une colonne préexistante du tableau d’observations. Elles manifestent le résultat d’un algorithme de segmentation numérique qui partitionne l’axe continu en une série d’intervalles contigus et dénombre les occurrences associées à chacun d’eux. La maîtrise de cette transformation intermédiaire s’avère indispensable pour substituer aux effectifs bruts calculés des ratios de proportion unitaire.
L’intégration formelle des échelles de proportion au sein de cette architecture garantit une cohérence sémiotique irréprochable. En spécifiant explicitement les lois de conversion entre l’espace des données dérivées et l’espace visuel perçu, ggplot2 assure que chaque gradation métrique conserve une signification sémantique uniforme. Cette approche élimine les ambiguïtés interprétatives inhérentes aux logiciels de tableur conventionnels, où le passage aux pourcentages requiert souvent des manipulations manuelles préalables des données sources, altérant la traçabilité et la reproductibilité du traitement analytique.
2. Architecture interne de ggplot2 : Transformations statistiques et variables dérivées
2.1 Fonctionnement des transformations statistiques stat_bin et stat_count
Pour appréhender l’origine des grandeurs manipulées lors de la génération d’un histogramme, il est impératif d’examiner le fonctionnement des transformations statistiques intégrées, nommées stat_bin et stat_count. La fonction stat_bin constitue le composant algorithmique responsable de la discrétisation des données continues. Lorsqu’une variable quantitative continue est projetée sur l’axe des abscisses, stat_bin divise l’étendue des valeurs observées en une suite d’intervalles disjoints, également appelés compartiments ou classes statistiques. L’algorithme scanne séquentiellement chaque valeur individuelle du vecteur d’entrée, détermine l’intervalle dans lequel elle s’insère selon des conventions d’inclusion de bornes ouvertes ou fermées, et incrémente l’effectif associé à cette classe.
Il existe une frontière méthodologique essentielle entre stat_bin et stat_count. Alors que stat_bin opère une segmentation continue reposant sur une largeur d’intervalle ou un nombre arbitraire de classes, stat_count est conçue exclusivement pour les variables qualitatives ou discrètes ne nécessitant aucune coupure dimensionnelle préalable. stat_count se contente d’effectuer un dénombrement exhaustif des occurrences attachées à chaque niveau factoriel distinct. Confondre ces deux mécanismes induit des artefacts de calcul, car stat_bin recalcule dynamiquement le centre et la largeur des classes continues, alors que stat_count préserve strictement l’intégrité nominale des modalités discrètes.
Durant l’exécution du processus de rendu géométrique, ces algorithmes statistiques génèrent un jeu de données interne, éphémère et intermédiaire, doté de colonnes calculées spécifiquement. Parmi ces métriques dérivées figurent le comptage brut des occurrences au sein de l’intervalle, la densité empirique de probabilité ajustée à la largeur de classe, ainsi que le point médian de chaque rectangle. C’est précisément à cette étape de génération computationnelle intermédiaire que le chercheur doit intervenir pour intercepter la variable de comptage et imposer sa transformation arithmétique en pourcentage relatif.
2.2 Évolution syntaxique : De la notation ..count.. vers after_stat()
L’histoire du développement de ggplot2 est marquée par un raffinement progressif de la syntaxe d’accès aux variables calculées. Dans les versions originelles de la bibliothèque, l’accès aux grandeurs générées par les transformations statistiques reposait sur une notation conventionnelle entourée de doubles points, telle que ..count.. ou ..density… Bien que fonctionnelle, cette formulation masquait la nature différée de l’évaluation et engendrait de multiples ambiguïtés lexicales, notamment lorsque des colonnes du tableau de données initial portaient des dénominations similaires, ou lors de l’évaluation imbriquée de fonctions mathématiques au sein de la clause d’assignation esthétique.
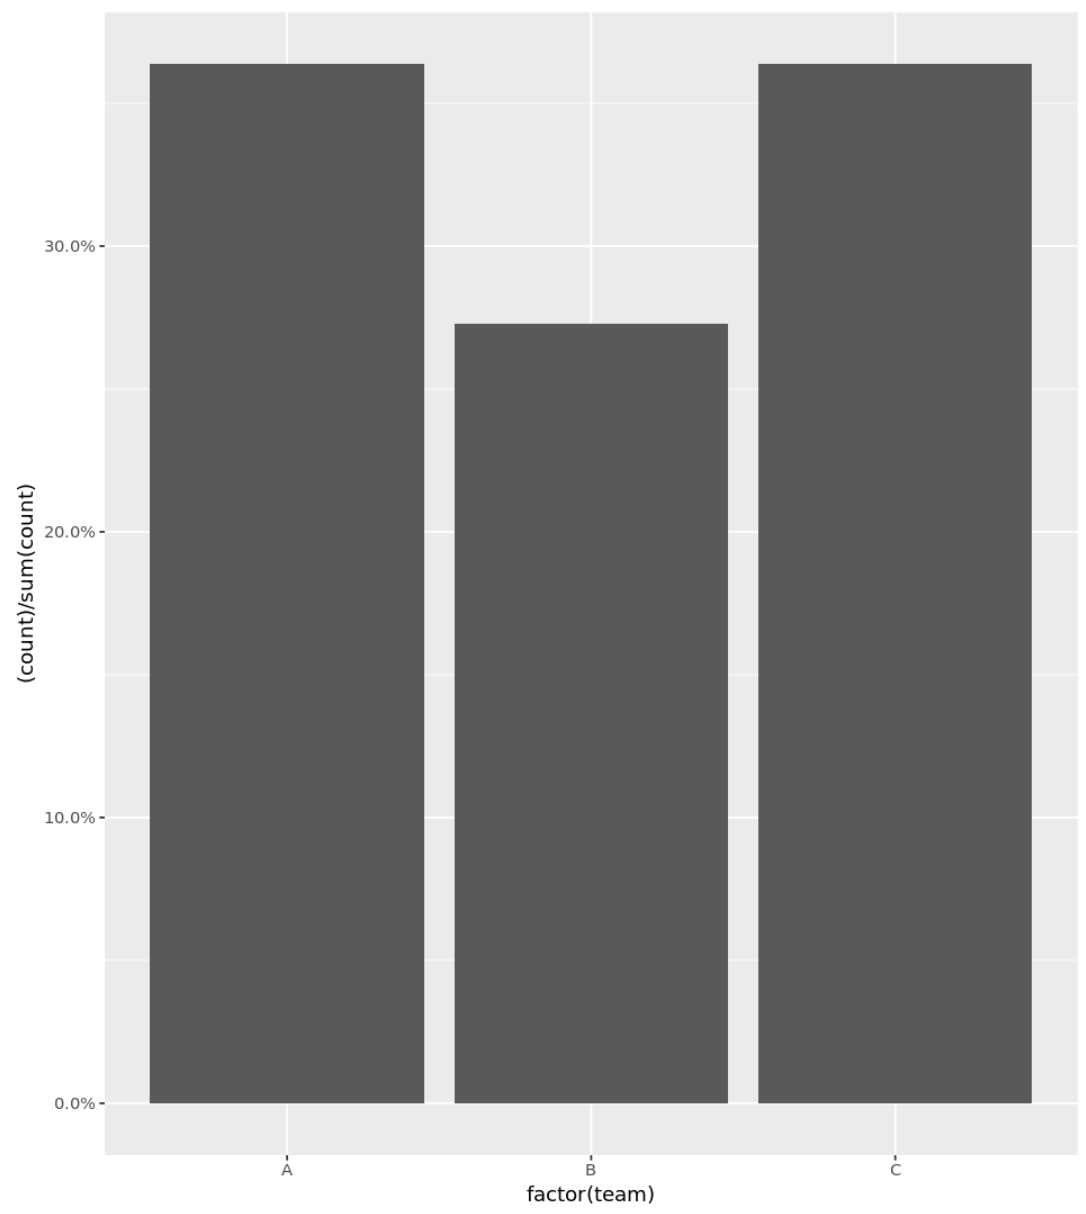
Afin d’assainir l’architecture du langage graphique et de s’aligner sur les normes de l’évaluation non standard propre à l’écosystème du tidyverse, Hadley Wickham a introduit la fonction after_stat(). Ce mécanisme novateur explicite le moment exact auquel l’évaluation de l’expression doit être différée. En stipulant after_stat(), le programmeur indique sans ambiguïté au moteur de rendu que les termes situés à l’intérieur de cette fonction ne doivent pas être recherchés dans le jeu de données d’origine lors de l’initialisation du pipeline graphique, mais doivent impérativement être extraits de la table temporaire construite à l’issue de l’étape de transformation statistique.
Dès lors, la syntaxe canonique contemporaine pour convertir un effectif absolu en une fraction relative s’exprime rigoureusement sous la forme after_stat(count / sum(count)). Cette formulation divise le nombre d’observations comptabilisées au sein de chaque compartiment spécifique par la somme arithmétique de l’ensemble des comptages de tous les compartiments générés. Le résultat de cette opération est une proportion décimale continue, comprise entre zéro et un, qui peut ensuite être projetée directement sur l’axe des ordonnées ou être formatée pour alimenter une étiquette textuelle informative.
2.3 Calcul de la somme globale par rapport aux groupements internes
La simplicité apparente de l’expression after_stat(count / sum(count)) dissimule un comportement computationnel délicat dès lors que le jeu de données fait intervenir des stratifications sous-jacentes. Par défaut, la fonction sum() appliquée à la variable interne count calcule la somme des effectifs de la classe active au sein du groupe esthétique courant. Si le graphique ne comporte aucun découpage catégoriel subsidiaire, l’ensemble des observations appartient à un groupe unique par défaut, et la sommation balaye bien l’intégralité du domaine d’échantillonnage.
Cependant, lorsque des esthétiques de distinction catégorielle telles que le remplissage chromatique (fill), la couleur de contour (color) ou le type de ligne sont assignées à une variable factorielle, ggplot2 procède implicitement à une partition des données en sous-groupes statistiques distincts. Dans une telle configuration, l’instruction sum(count) n’évalue plus la taille globale de l’échantillon N, mais calcule la taille restreinte n_k du sous-groupe k auquel la barre courante est affiliée. Ce phénomène altère fondamentalement la nature du dénominateur, transformant ce qui devait être une proportion relative à la population globale en un pourcentage conditionnel restreint à la seule strate chromatique.
Pour neutraliser ce comportement et forcer le maintien de l’espace échantillonnal universel au dénominateur, il s’avère indispensable d’intervenir sur l’esthétique de regroupement group. En assignant explicitement à l’argument group une valeur unitaire globale ou un facteur invariant au sein de la couche géométrique, le praticien rétablit l’intégrité du calcul de sommation sur l’intégralité des classes. Cette distinction entre dénominateur global et dénominateur conditionnel est l’une des sources de confusion les plus tenaces rencontrées lors de la composition d’histogrammes stratifiés.
3. Configuration de l’environnement R et préparation des structures de données
3.1 Chargement et rôle des packages essentiels
La mise en œuvre pratique d’histogrammes pourcentés sous R requiert la mobilisation d’un socle logiciel cohérent et rigoureusement documenté. Le premier composant indispensable est le paquet ggplot2, qui fournit l’ensemble des classes géométriques, des couches de coordonnées et des fonctions d’assignation esthétique. Bien que ggplot2 puisse être chargé individuellement, il s’intègre naturellement au métapaquet tidyverse, dont les principes de manipulation vectorielle et de traitement tabulaire fluidifient considérablement l’étape préalable de préparation des indicateurs.
Le second composant fondamental, trop souvent sous-estimé, est le paquet scales. Développé pour automatiser et normaliser la conversion des grandeurs numériques en chaînes de caractères lisibles par l’œil humain, scales fournit une palette exhaustive de fonctions d’ajustement d’échelles. Il permet de transformer des fractions décimales abstraites en chaînes typographiques explicites pourvues du glyphe de pourcentage, tout en gérant les conventions d’arrondi, les séparateurs de décimales et les espaces insécables indispensables aux standards éditoriaux francophones.
Il est impératif de veiller à la compatibilité ascendante de ces bibliothèques logicielles. L’utilisation de la syntaxe after_stat() exige une version de ggplot2 égale ou supérieure à la version 3.3.0, toute version antérieure requérant l’ancienne notation dépréciée. De même, les versions modernes de scales proposent des interfaces unifiées via des générateurs de formatages fonctionnels qui garantissent une exécution optimale sans distorsion des objets graphiques stockés en mémoire vive.
3.2 Structuration rigoureuse d’un jeu de données d’exemple
Afin de démontrer empiriquement les différentes configurations graphiques sans dépendre de sources externes instables, la constitution d’un tableau de données représentatif s’impose. Ce tableau doit combiner des variables quantitatives continues simulant des mesures cliniques ou expérimentales, et des variables catégorielles factorisées servant d’attributs de stratification sous-groupe. Cette dualité permet de tester simultanément les réactions de stat_bin et de stat_count face aux conversions en pourcentages.
Considérons une structure de données empirique constituée d’une cohorte fictive de mille sujets ayant passé une évaluation psychométrique. Le tableau de données intègre un score d’anxiété continu distribué selon une loi normale ajustée, un indice de performance cognitive continu positivement asymétrique, et une variable nominale représentant l’appartenance à trois groupes expérimentaux distincts, stockée sous la forme explicite d’un facteur ordonné ou non. La vérification scrupuleuse des types primitifs au sein de R constitue le premier prérequis méthodologique : une variable quantitative codée par mégarde sous forme de chaîne de caractères induirait l’échec immédiat de stat_bin.
La gestion rigoureuse des valeurs manquantes, désignées par la constante NA sous R, revêt une importance capitale pour la véracité des proportions affichées. La présence de valeurs manquantes non traitées au sein d’un vecteur continu conduit ggplot2 à les éliminer silencieusement du rendu géométrique tout en émettant un message d’avertissement. Si ces observations omises ne sont pas méthodologiquement retranchées de l’espace total N au préalable, le dénominateur de l’expression sum(count) calculera la somme des seules barres tracées, ce qui gonflera artificiellement le pourcentage de chaque classe visible par rapport à la véritable cohorte initiale. Le nettoyage en amont via les fonctions de filtrage garantit la parfaite traçabilité du dénominateur d’échantillonnage.
4. Syntaxe fondamentale pour convertir l’axe vertical en pourcentages
4.1 Construction de base avec geom_bar pour variables factorisées
Bien que le propos central de cette étude soit l’histogramme de données continues, il est indispensable de détailler la syntaxe applicable à geom_bar sur des variables discrètes, celle-ci servant fréquemment de point d’entrée didactique pour comprendre le comportement de l’ordonnée dynamique. Lorsqu’une variable nominale ou ordinale est assignée à l’axe horizontal, geom_bar mobilise stat_count pour agréger les observations par niveau catégoriel. Pour convertir la hauteur des barres en fractions relatives à la population totale, l’esthétique d’ordonnée doit être explicitement redirigée.
Dans cette configuration, l’assignation de l’axe vertical prend la forme formelle aes(y = after_stat(count / sum(count))). Le moteur graphique évalue pour chaque modalité discrète l’effectif count, calcule la somme totale des occurrences de l’échantillon, et assigne le ratio décimal résultant à la position de hauteur géométrique. La base rectangulaire de chaque catégorie s’élève alors jusqu’à une valeur comprise entre zéro et un.
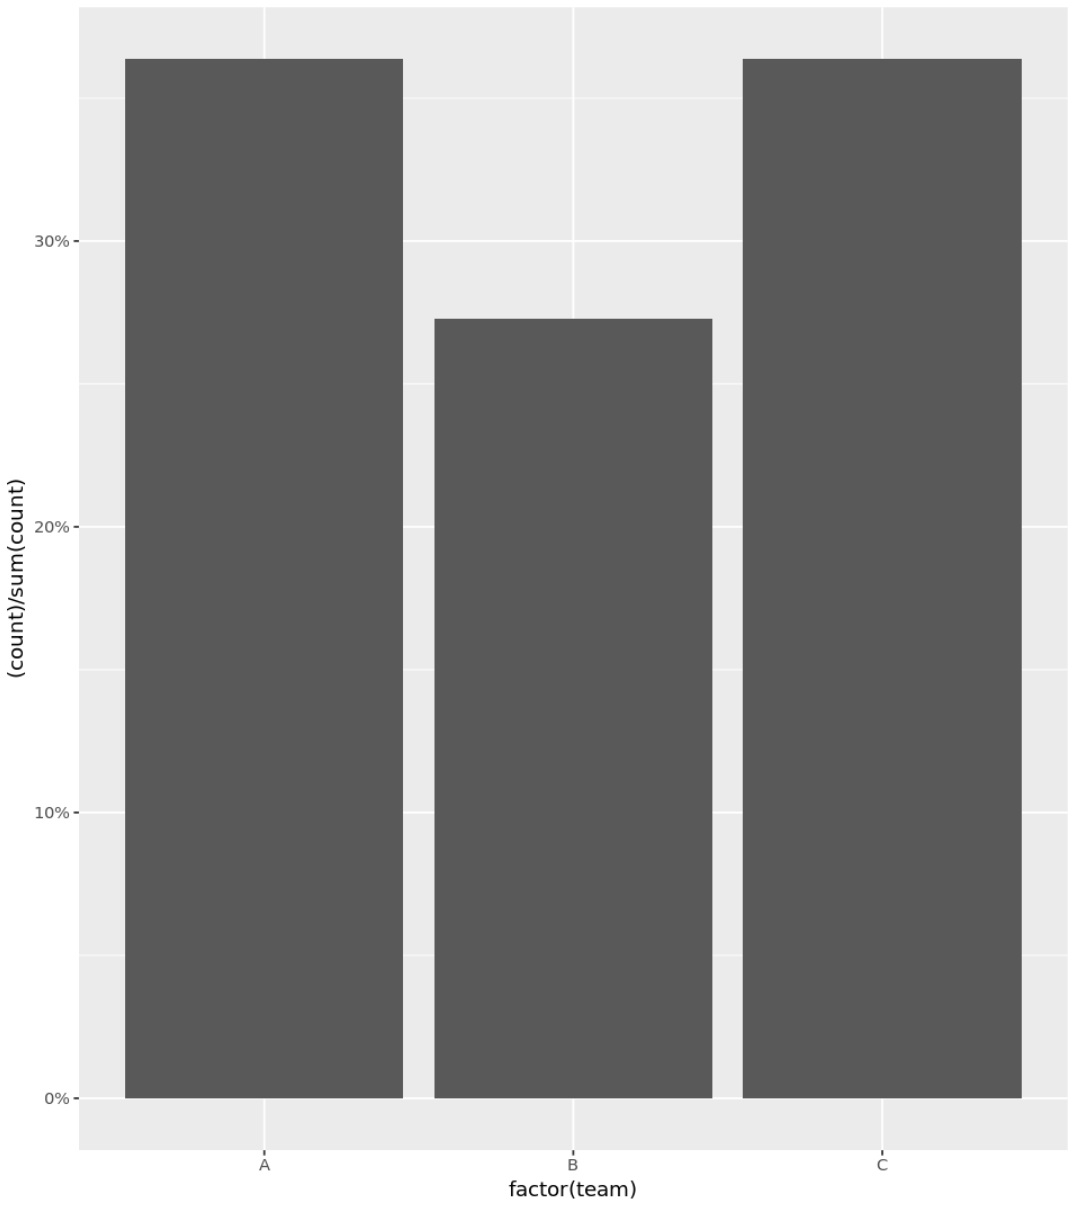
Pour transformer ces valeurs décimales brutes en étiquettes directement compréhensibles sans altérer les coordonnées internes du tracé, l’adjonction de la fonction scale_y_continuous s’avère indispensable. En spécifiant l’argument labels = scales::percent ou labels = scales::percent_format(), ggplot2 intercepte les marques numériques de graduation de l’axe vertical et leur applique la transformation multiplicative par cent, adjoignant le symbole typographique adéquat sans obliger l’utilisateur à modifier manuellement l’échelle de son équation sous after_stat().
4.2 Construction avec geom_histogram pour variables continues
La transition vers une variable quantitative continue s’opère par le remplacement de geom_bar par geom_histogram, ce qui active automatiquement le moteur stat_bin en lieu et place de stat_count. La manipulation de geom_histogram impose une vigilance accrue quant à l’argument binwidth, qui gouverne la finesse de découpage de la variable continue. Contrairement au diagramme en barres qualitatives où les catégories sont figées par la taxonomie des données, la géométrie de l’histogramme réagit dynamiquement au nombre d’intervalles sélectionnés.
L’expression syntaxique au sein de geom_histogram demeure structurellement analogue, reposant sur le mappage aes(y = after_stat(count / sum(count))). Cependant, la conséquence interprétative diffère substantiellement. La hauteur de chaque rectangle ne mesure plus la prévalence d’une étiquette abstraite, mais le pourcentage de l’échantillon dont la mesure s’inscrit au sein d’une tranche métrique spécifique, déterminée par le centre de classe et la largeur binwidth. L’addition de l’ensemble des hauteurs de ces rectangles donne rigoureusement un total de cent pour cent, ce qui assure la cohérence empirique de l’affichage.
Un aspect technique fondamental réside dans le contrôle de l’alignement des rectangles. L’usage conjoint des arguments binwidth, center ou boundary au sein de geom_histogram permet de fixer précisément l’ancrage des intervalles continus sur des bornes entières ou cliniquement signifiantes. Cet ajustement géométrique garantit que la somme des proportions calculées par after_stat() ne soit pas faussée par des classes tronquées aux extrémités du domaine de variation empirique.
4.3 Gestion des limites et ruptures de l’axe des ordonnées
L’application d’un ratio proportionnel sur l’axe des ordonnées modifie fondamentalement l’espace topologique du graphique. Alors que les effectifs bruts peuvent s’étendre sur des centaines ou des milliers d’unités, les proportions décimales s’inscrivent systématiquement dans le domaine réel compris entre zéro et un. Il est dès lors primordial de paramétrer scrupuleusement l’argument limits au sein de la fonction scale_y_continuous afin d’éviter que le tracé ne démarre à un seuil arbitraire supérieur à zéro, ce qui violerait le principe fondamental de proportionnalité visuelle.
L’argument limits = c(0, max_proportion) permet de borner explicitement l’axe vertical, en ancrant impérativement son origine à zéro absolu. Si la classe modale la plus élevée culmine à trente-deux pour cent, fixer un intervalle supérieur à quarante pour cent ménage un dégagement visuel optimal pour l’insertion ultérieure d’étiquettes textuelles au-dessus des rectangles, sans risquer de voir les caractères typographiques tronqués par la bordure supérieure de la zone de traçage.
Concomitamment, la spécification explicite des ruptures de graduation via l’argument breaks assure une lecture rythmée et professionnelle du graphique. En utilisant une séquence régulière, telle que seq(0, 0.4, by = 0.05), le chercheur implémente des graduations étalonnées tous les cinq pour cent, offrant aux évaluateurs une grille d’estimation visuelle précise et normalisée conforme aux exigences des publications scientifiques internationales.
5. Formatage typographique avancé des étiquettes d’axe via le package scales
5.1 Contrôle de la précision décimale avec percent_format
L’exploitation basique de l’argument labels = scales::percent produit souvent des résultats convenables, mais présente des limites d’adaptabilité lorsque la dispersion des données exige une granularité fine ou, inversement, une simplification radicale. La fonction scales::percent_format() agit comme une fabrique de fonctions, générant dynamiquement une fonction de formatage paramétrée selon les volontés strictes de l’utilisateur. Le paramètre pivot de cette configuration est l’argument accuracy, qui régit le seuil d’arrondi numérique.
Lorsque la taille d’échantillon est restreinte ou que les proportions observées sont relativement vastes, l’affichage de décimales est superflu et encombre inutilement l’espace visuel. En assignant la valeur 1 à l’argument accuracy au sein de percent_format(accuracy = 1), l’ensemble des graduations de l’axe vertical se trouve arrondi au pourcentage entier le plus proche, affichant une progression épurée : dix pour cent, vingt pour cent, trente pour cent. Cette configuration minimise le bruit visuel et privilégie l’intelligibilité immédiate des ordres de grandeur macroscopiques.
À l’inverse, dans les études épidémiologiques ou les analyses de distribution à queue épaisse où des classes marginales n’agrègent que de faibles fractions d’échantillon, l’arrondi entier masquerait des nuances vitales en réduisant les classes rares à une apparence de zéro pour cent. Dans ce contexte, assigner la valeur 0.1 ou 0.01 à accuracy permet d’extraire une ou deux décimales significatives, assurant une description fidèle de l’amenuisement de la distribution dans ses franges extrêmes sans rupture d’échelle.
5.2 Localisation culturelle et conventions typographiques françaises
La typographie statistique anglo-saxonne recourt conventionnellement au point comme séparateur décimal et accole sans espacement le glyphe de pourcentage à la valeur numérique, sous la forme standardisée 15.5%. Ces usages contreviennent directement aux normes orthotypographiques de la langue française, adoptées notamment par le Bureau international des poids et mesures, l’Imprimerie nationale et les revues savantes francophones. L’adaptation rigoureuse de ces conventions éditoriales impose d’ajuster simultanément le symbole de séparation et les espaces interstitiels.
Le package scales permet une conformité typographique absolue grâce à ses arguments decimal.mark, suffix et prefix. En configurant decimal.mark = « , », le point anglo-saxon est substitué par la virgule légale française. De surcroît, les règles typographiques françaises exigent l’insertion d’une espace insécable avant tout signe typographique double, y compris le symbole de pourcentage. Pour respecter scrupuleusement cette prescription sans risquer un rejet de ligne disgracieux, l’argument suffix peut être renseigné sous la forme suffix = » % » ou en recourant au caractère Unicode correspondant à l’espace fine ou insécable.
L’harmonisation de l’ensemble de ces paramètres au sein d’une fonction de formatage personnalisée garantit que l’axe vertical reflète impeccablement le professionnalisme de la publication. Non seulement les graduations s’affichent sous la forme harmonieuse 10,0 %, 20,0 % et 30,0 %, mais elles protègent le document contre toute ambiguïté sémantique pouvant découler de la confusion entre points de séparation de milliers et virgules décimales.
6. Affichage direct des étiquettes de pourcentage sur ou au-dessus des barres
6.1 Positionnement géométrique avec geom_text
Bien que l’axe des ordonnées gradué en pourcentages permette d’estimer visuellement la hauteur des rectangles, la communication scientifique gagne fréquemment en impact lorsque la valeur numérique exacte est inscrite directement à proximité immédiate du sommet de chaque barre. Cette stratégie élimine l’effort perceptif de translation orthogonale de l’œil vers l’axe latéral. Pour implémenter cette surimpression textuelle sous ggplot2, il convient de superposer une couche geom_text à la géométrie de l’histogramme initial.
La principale difficulté méthodologique de cette opération réside dans la nécessité de forcer geom_text à exécuter exactement la même transformation statistique que l’histogramme sous-jacent. Par défaut, geom_text attend des coordonnées brutes déjà présentes dans le jeu de données. Pour aligner le texte sur les barres calculées, il faut lui assigner explicitement l’argument stat = « bin », tout en lui transmettant un argument binwidth rigoureusement identique à celui de geom_histogram. L’étiquette textuelle est ensuite dérivée via l’expression aes(label = scales::percent(after_stat(count / sum(count)), accuracy = 0.1)).
Le positionnement spatial du texte requiert un réglage fin de l’argument vjust, qui gère l’ajustement vertical de l’ancrage typographique. Une valeur de vjust égale à zéro positionne la ligne de base du texte sur le sommet de la barre, tandis qu’une valeur négative, telle que vjust = -0.5, surélève le texte au-dessus du rectangle, prévenant l’empiètement des caractères sur la surface colorée de la classe statistique. Si l’on souhaite au contraire inscrire le texte à l’intérieur de la barre, un vjust positif, par exemple vjust = 1.5, associé à une couleur de police contrastée, insère harmonieusement la mention sous le bord supérieur.
6.2 Lisibilité accrue grâce aux conteneurs visuels de geom_label
Lorsque l’histogramme présente des zones d’arrière-plan complexes, comme un quadrillage dense ou des variations chromatiques de remplissage, l’utilisation de simples caractères via geom_text peut compromettre la lisibilité des mentions de pourcentage. La couche geom_label offre une alternative supérieure en encadrant chaque inscription textuelle dans un conteneur rectangulaire doté d’une couleur de fond opaque et d’une bordure paramétrable.
Le fonctionnement interne de geom_label obéit aux mêmes règles de calcul statistique que geom_text : l’argument stat = « bin » et la synchronisation de binwidth demeurent incontournables. Toutefois, geom_label enrichit la présentation par des paramètres dédiés, tels que fill, qui permet de colorer le fond de l’étiquette en blanc pur pour masquer le quadrillage sous-jacent, ou label.size, qui régule l’épaisseur du filet d’encadrement. Il en résulte un contraste optique maximal, même dans les zones où la distribution présente une forte concentration graphique.
Il convient néanmoins d’exercer une modération méthodologique lors de l’usage de geom_label sur des histogrammes comportant un nombre élevé de classes. La présence physique des boîtes d’encadrement génère un encombrement volumique bien plus important que le texte nu, ce qui peut provoquer des chevauchements d’étiquettes sur des classes contiguës étroites. Dans de telles situations, il est préférable d’ajuster la taille de police globale via l’argument size, ou de filtrer conditionnellement l’affichage pour ne préserver que les sommets de classe majeurs.
6.3 Évitement du masquage des étiquettes par le cadre supérieur du graphique
L’un des désagréments visuels les plus répandus lors de l’insertion d’étiquettes au-dessus de la classe modale d’un histogramme est le tronquage partiel ou total des caractères par la limite supérieure de la zone de coordonnées cartésiennes. ggplot2 calcule par défaut une marge d’expansion relative autour des données, mais celle-ci est fréquemment insuffisante pour absorber la hauteur additionnelle d’un libellé typographique surélevé par un vjust négatif.
Pour remédier à cette anomalie de manière élégante et systématique, deux approches complémentaires peuvent être mobilisées. La première consiste à calibrer l’argument expand au sein de la fonction scale_y_continuous, en utilisant la fonction utilitaire expansion(). En spécifiant par exemple expansion(mult = c(0, 0.15)), le chercheur ordonne à ggplot2 d’annihiler toute expansion sous l’axe de zéro pour garantir un contact parfait des barres avec la ligne de base, tout en réservant une extension de quinze pour cent de l’espace vertical au-delà de la valeur maximale observée. Cette réserve spatiale accueille parfaitement les étiquettes textuelles sans aucun risque de collision avec le cadre supérieur.
La seconde solution, plus directe sur le plan géométrique, réside dans l’utilisation de la fonction coord_cartesian(clip = « off »). Par défaut, l’argument clip est réglé sur « on », ce qui ordonne au moteur graphique de trancher net tout élément textuel ou géométrique dont les coordonnées déborderaient de la boîte englobante des axes. En désactivant ce découpage au moyen de « off », les étiquettes positionnées au ras du plafond graphique sont autorisées à s’étendre librement au-dessus du panneau de traçage, préservant l’intégrité de chaque caractère typographique quel que soit le ratio d’exportation de l’image.
7. Distinction théorique et technique : geom_histogram versus geom_bar
7.1 Nature de la variable sous-jacente : Échelles continues versus nominales
L’assimilation abusive entre l’histogramme et le diagramme en barres constitue une faute épistémologique fréquente dans la littérature appliquée. Bien que leurs apparences géométriques partagent l’usage de rectangles dressés orthogonalement, leurs fondements mathématiques diffèrent radicalement. Le diagramme en barres, associé à geom_bar, représente des variables catégorielles nominales ou ordinales. L’axe horizontal n’y possède aucune continuité métrique intrinsèque : les rectangles sont conventionnellement disjoints, séparés par un intervalle d’espace vide, et leur ordre de succession peut être modifié sans altérer le sens physique de la mesure sous-jacente.
À l’opposé, l’histogramme, incarné par geom_histogram, est l’opérateur de visualisation exclusif des variables quantitatives continues mesurées sur des échelles d’intervalles ou de rapports. L’axe des abscisses représente une droite numérique réelle ininterrompue. Par conséquent, les classes statistiques doivent impérativement être contiguës, sans le moindre espacement graphique entre les rectangles, afin de matérialiser visuellement la continuité de l’espace topologique sous-jacent. Réordonner les classes d’un histogramme est conceptuellement impossible, l’ordonnancement étant imposé par la relation d’ordre naturelle des nombres réels.
Cette distinction conceptuelle dicte la nature de la transformation en pourcentage. Dans le cas du diagramme en barres, la somme des pourcentages équivaut à la partition stricte d’un ensemble discret fini. Pour l’histogramme, la surface totale occupée par l’ensemble des rectangles converge, à la limite infinitésimale de la largeur d’intervalle et pour un échantillon tendant vers l’infini, vers la surface unitaire sous la courbe d’une fonction de densité de probabilité continue. Confondre l’histogramme avec un simple graphique en barres discrètes appauvrit la perception de cette convergence stochastique.
7.2 Sensibilité au choix de la largeur des intervalles (binwidth)
L’architecture de l’histogramme pourcenté présente une dépendance critique vis-à-vis du paramètre binwidth, c’est-à-dire la largeur numérique de la fenêtre d’agrégation continue. Modifier la largeur d’intervalle ne se contente pas de lisser ou de fragmenter l’aspect visuel de la courbe empirique : cela modifie directement la magnitude absolue des pourcentages assignés à chaque classe. Si une fenêtre d’agrégation est doublée en amplitude, elle capture mathématiquement environ deux fois plus d’observations, ce qui double mécaniquement la hauteur du pourcentage calculé sur l’axe vertical.
Pour éviter des distorsions interprétatives majeures, le choix de ce paramètre ne saurait être abandonné à l’arbitraire de l’utilisateur ou aux réglages par défaut de ggplot2, qui segmente invariablement les données en trente compartiments sans considérer la structure probabiliste sous-jacente. Il est vivement recommandé d’asseoir le choix de binwidth sur des règles statistiques éprouvées, telles que la formule de Freedman-Diaconis, basée sur l’écart interquartile et la taille d’échantillon, ou la règle de Scott, qui repose sur l’écart-type. Ces heuristiques minimisent l’erreur quadratique moyenne intégrée entre l’histogramme empirique et la véritable densité théorique sous-jacente.
Un histogramme sous-lissé, présentant des classes excessivement étroites, affichera des pourcentages minuscules pour chaque compartiment, créant un paysage fragmenté dominé par le bruit d’échantillonnage et les fluctuations aléatoires. À l’inverse, un histogramme sur-lissé, pourvu d’intervalles démesurément larges, condensera cinquante ou soixante pour cent des observations dans une barre unique centrale, masquant des asymétries cruciales ou une éventuelle bimodalité de la distribution clinique étudiée. L’explicitation du binwidth retenu doit donc accompagner systématiquement toute communication graphique rigoureuse.
8. Gestion des histogrammes stratifiés et représentations multi-groupes
8.1 Pourcentages globaux versus pourcentages conditionnels intra-groupes
L’investigation scientifique contemporaine requiert couramment la comparaison de la distribution d’une même variable continue au travers de plusieurs sous-groupes ou conditions expérimentales. Lorsque l’on introduit une variable factorielle dans l’esthétique de remplissage fill d’un histogramme en appliquant l’argument position = « dodge », les rectangles de chaque groupe sont disposés côte à côte pour chaque classe de valeurs. Cette configuration pose un problème mathématique fondamental quant à la définition du dénominateur employé dans l’équation de normalisation.
Si l’on applique l’expression conventionnelle after_stat(count / sum(count)), le comportement de ggplot2 dépend étroitement de la gestion des regroupements. Par défaut, l’adjonction de l’esthétique fill scinde le calcul en sous-groupes indépendants : chaque barre reflète alors le pourcentage d’individus appartenant à cette classe au sein de son propre groupe d’appartenance. Les barres associées à chaque groupe totalisent indépendamment cent pour cent, ce qui permet d’évaluer immédiatement si un traitement déplace le centre de gravité de la distribution par rapport au groupe témoin, indépendamment de leurs effectifs respectifs.
Si l’objectif scientifique est à l’opposé de montrer la contribution relative de chaque sous-groupe à la population générale, le dénominateur de la fraction doit impérativement correspondre à la taille globale de la cohorte universelle N. Pour imposer ce comportement de pourcentage global partagé, il convient d’inhiber le regroupement automatique de la transformation statistique en assignant l’argument group = 1 au sein de geom_histogram, tout en préservant fill pour la différentiation visuelle. Dans ce second cas, la sommation de toutes les barres de l’ensemble des groupes totalisera précisément cent pour cent.
8.2 Histogrammes empilés et normalisation complète via position = ‘fill’
Une alternative graphique couramment exploitée pour analyser les proportions relatives de sous-populations à travers les strates d’une variable quantitative consiste à recourir à l’empilement complet au moyen de position = « fill ». Dans cette architecture, les barres représentant les différents niveaux catégoriels ne sont pas juxtaposées sur l’axe horizontal, mais superposées verticalement au sein de chaque compartiment continu, avant d’être normalisées de manière à occuper uniformément l’intégralité de la hauteur verticale disponible.
L’utilisation de position = « fill » transforme l’histogramme en une mesure directe de composition relative conditionnelle. L’axe vertical s’étend invariablement de zéro à cent pour cent, et la démarcation interne au sein de chaque rectangle indique précisément comment varie la composition proportionnelle d’un groupe en fonction de l’augmentation ou de la diminution du score mesuré sur l’axe des abscisses. Cette approche est particulièrement prisée en sociologie quantitative et en économie pour révéler des effets de seuil ou des gradients continus de prévalence d’un statut au fil d’une variable métrique.
Toutefois, la lecture critique de cette représentation exige une grande vigilance méthodologique. L’histogramme normalisé à cent pour cent occulte totalement l’information relative à la densité absolue des observations : une classe située dans les queues de distribution, ne contenant que deux individus isolés, occupera une surface verticale visuelle rigoureusement identique à une classe centrale regroupant cinq cents sujets. Pour prévenir toute méprise interprétative, ce type de tracé doit obligatoirement être flanqué d’annotations ou d’un tracé de densité marginale signalant la rareté des effectifs aux bornes de l’espace échantillonnal.
8.3 Décomposition en facettes avec facet_wrap et facet_grid
Face à la complexité visuelle croissante induite par la multiplication des sous-groupes ou par des chevauchements de barres inextricables, la décomposition en petits multiples via les fonctions facet_wrap et facet_grid constitue la solution méthodologique la plus robuste. En séparant les cohortes dans des panneaux graphiques disjoints mais spatialement synchronisés, la facettisation restaure une clarté d’analyse irréprochable.
La question du dénominateur se pose avec une acuité renouvelée au sein de l’environnement facetté. Par défaut, la transformation statistique stat_bin opère de manière autonome au sein de chaque panneau individuel. En conséquence, l’instruction after_stat(count / sum(count)) produit des pourcentages strictement intra-facettes : la distribution représentée dans chaque panneau s’additionne pour atteindre cent pour cent, ce qui autorise une comparaison directe de la morphologie et de l’étalement des lois de probabilité empiriques entre les cohortes, même si un panneau représente dix mille patients et un autre seulement cinquante.
Si la problématique de recherche requiert au contraire d’illustrer visuellement la sous-représentation absolue d’un groupe par rapport à l’autre au sein de l’échantillon globalisé, les proportions doivent être calculées préalablement dans une table agrégée avant le passage dans ggplot2, ou nécessitent l’utilisation d’expressions analytiques plus complexes pour injecter le dénominateur universel à travers les facettes. Le maintien d’échelles d’axes coordonnées et fixes entre tous les panneaux via scales = « fixed » demeure alors la règle d’or pour préserver l’honnêteté perceptive des comparaisons inter-cohortes.
9. Optimisation graphique et mise en conformité avec les normes académiques APA
9.1 Épuration du thème et suppression des éléments graphiques superflus
Les normes éditoriales de l’American Psychological Association (APA), adoptées par une immense majorité de revues scientifiques internationales, imposent une sobriété visuelle rigoureuse visant à maximiser le ratio de données utiles par rapport à l’encre mobilisée, conformément aux préceptes théoriques d’Edward Tufte. L’apparence par défaut de ggplot2, caractérisée par un arrière-plan gris tramé de lignes de quadrillage blanches épaisses, s’avère totalement inadaptée à une soumission éditoriale formelle et doit être impérativement remplacée.
La mise en conformité débute par l’application de thèmes épurés natifs tels que theme_classic() ou theme_minimal(), complétés par des ajustements chirurgicaux au sein de la fonction theme(). Le fond du graphique doit être d’une blancheur intégrale, libre de tout ombrage parasite. Les grilles secondaires ou mineures doivent être systématiquement désactivées. Quant aux axes géométriques, l’usage académique commande de tracer des lignes de repères noires d’une épaisseur fine mais distincte, munies de graduations orientées vers l’extérieur du tracé pour ne pas interférer avec la base des rectangles de l’histogramme.
La typographie générale doit également faire l’objet d’une standardisation méticuleuse. Les polices vectorielles sans empattement universelles telles que Arial ou Helvetica, ou avec empattement comme Times New Roman, doivent être uniformément convoquées sur l’ensemble des éléments textuels. La hiérarchie visuelle doit être strictement maintenue en différenciant la taille de corps de police entre les libellés de graduations, les titres d’axes et les éventuelles annotations, en proscrivant les contrastes de graisses excessifs ou l’italique non motivé méthodologiquement.
9.2 Palette de couleurs accessible et contrastée
L’utilisation de la couleur dans un histogramme scientifique ne doit jamais obéir à des considérations purement ornementales. Chaque variation chromatique doit porter une charge informationnelle univoque tout en demeurant accessible aux personnes atteintes d’anomalies de la vision des couleurs, telles que le daltonisme sous ses différentes formes (deutéranopie, protanopie, tritanopie). Le recours aux palettes scientifiques certifiées, comme celles offertes par les packages viridis ou ColorBrewer, s’impose comme un standard méthodologique incontournable.
Lorsque l’histogramme est monochrome, représentant une cohorte unique, l’usage de couleurs criardes ou totalement saturées est à proscrire. Un remplissage gris acier ou bleu sourd, adossé à un contour noir ou gris sombre via les arguments fill = « grey75 » et color = « black », offre une définition spatiale parfaite de chaque intervalle tout en assurant une reproduction sans la moindre altération lors de l’impression sur support physique en noir et blanc.
Dans le cas d’histogrammes stratifiés nécessitant plusieurs teintes, la palette sélectionnée doit maintenir un différentiel de luminance perceptuellement uniforme à travers l’ensemble des nuances retenues. De surcroît, le contraste entre la teinte de remplissage de la barre et la couleur des étiquettes de pourcentage disposées au-dessus ou à l’intérieur du rectangle doit impérativement respecter les ratios de contraste prescrits par les normes d’accessibilité numérique, afin que l’information chiffrée soit immédiatement déchiffrable par tout relecteur.
9.3 Rédaction des légendes, titres et annotations contextuelles
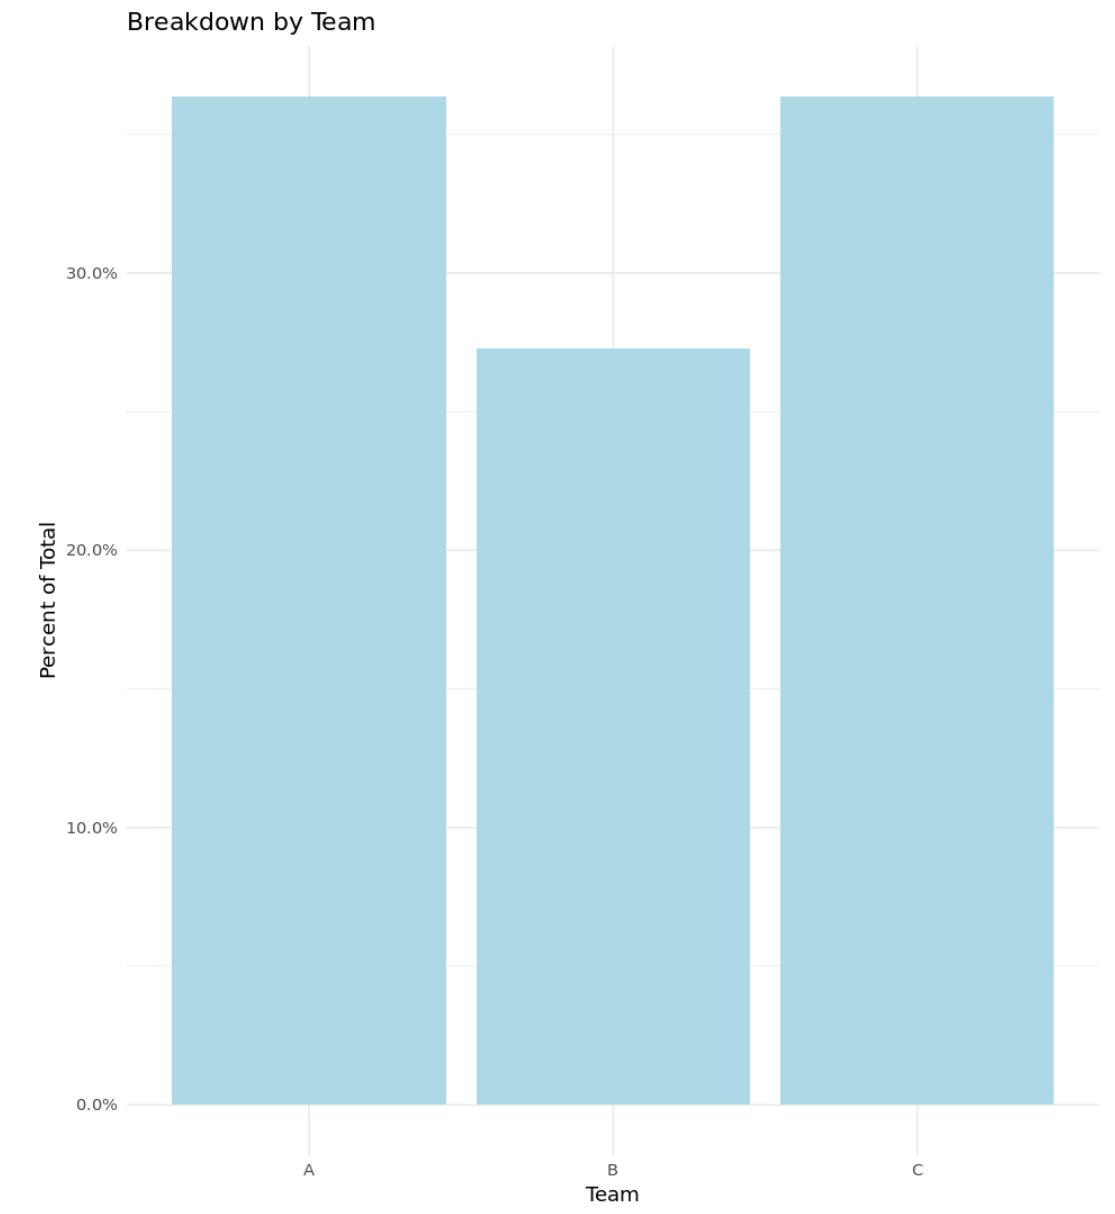
Une figure scientifique doit être intrinsèquement auto-porteuse : le lecteur doit être en mesure d’en déchiffrer exhaustivement la signification sans devoir se référer continuellement au corps du manuscrit textuel. Cette autonomie repose sur la précision rédactionnelle des métadonnées entourant la zone de traçage. Les titres d’axes méritent une attention primordiale : l’axe des ordonnées ne doit jamais afficher une dénomination brute issue du code source, mais mentionner formellement le concept mesuré, par exemple Pourcentage de répondants (%) ou Fréquence relative (%).
L’axe horizontal doit stipuler rigoureusement le nom de la variable mesurée, accompagné systématiquement de son unité physique ou psychométrique d’étalonnage entre parenthèses, comme par exemple Score d’anxiété état (STAI-Y, score brut). L’omission de l’unité de mesure affaiblit substantiellement la portée empirique de la représentation et complique les méta-analyses futures.
Conformément aux préconisations de la septième édition des normes APA, la figure s’accompagne d’un numéro de figure formel, d’un titre en italique concis mais descriptif placé au-dessus du tracé, et se clôture par une note de figure située sous le graphique. Cette note doit mentionner explicitement la taille globale de l’échantillon N, la méthode de calcul des pourcentages employée, ainsi que la largeur retenue pour les intervalles de coupure (binwidth), assurant ainsi une reproductibilité computationnelle immédiate pour la communauté des pairs.
10. Diagnostic et résolution des erreurs courantes lors du calcul des pourcentages
10.1 Anomalie des pourcentages ne totalisant pas 100%
L’une des déconvenues les plus alarmantes en pratique computationnelle survient lorsqu’un histogramme pourcenté affiche une sommation totale de ses classes distincte de cent pour cent, culminant par exemple à quatre-vingt-douze pour cent ou excédant cent huit pour cent. Cette distorsion n’est pas imputable à un dysfonctionnement algorithmique de ggplot2, mais trouve son origine dans des biais méthodologiques induits lors de l’épuration ou du découpage dimensionnel des données.
La première cause réside dans l’élimination discrète de valeurs aberrantes par le paramétrage restrictif des limites spatiales de l’axe des abscisses. Si l’on applique scale_x_continuous(limits = c(min, max)), ggplot2 supprime de l’analyse toutes les observations situées en dehors de cet intervalle avant d’exécuter stat_bin. Dès lors, le calcul interne sum(count) s’exécute sur le sous-ensemble tronqué, modifiant le dénominateur à l’insu de l’analyste. Pour borner la visualisation sans altérer le calcul des fréquences relatives universelles, il est impératif d’utiliser coord_cartesian(xlim = c(min, max)), qui effectue un zoom géométrique a posteriori tout en préservant l’intégralité de l’échantillon au dénominateur.
La seconde cause tient aux erreurs d’arrondi typographique cumulées. Lorsque chaque classe est arrondie individuellement à l’entier le plus proche via percent_format(accuracy = 1), l’accumulation d’imprécisions fractionnaires sur vingt ou trente barres peut conduire visuellement à un total s’écartant légèrement de cent pour cent. Pour désamorcer ce paradoxe arithmétique sans sacrifier la netteté du graphique, l’analyste se doit d’ajouter une note explicative mentionnant que la somme des pourcentages peut diverger marginalement de cent en raison des arrondis conventionnels.
10.2 Conflits d’évaluation entre stat() et after_stat() selon la version de ggplot2
L’exécution de scripts hérités ou le partage de routines analytiques entre collaborateurs disposant d’environnements R hétérogènes génère régulièrement des alertes de dépréciation syntaxique ou des interruptions d’exécution. Les messages d’avertissement pointant vers l’obsolescence de ..count.. ou de la macro stat() signalent une friction d’évaluation non standard liée à la mise à jour des moteurs d’analyse de ggplot2.
L’introduction d’after_stat() a clarifié le périmètre d’exécution mais expose les praticiens à des erreurs de portée lexicale. Une anomalie fréquente consiste à imbriquer des fonctions personnalisées externes au sein d’after_stat() sans tenir compte de la vectorisation de ces dernières. Lorsque le moteur interne évalue une expression telle que after_stat(ma_fonction(count)), il attend que ma_fonction accepte un vecteur numérique complet et retourne un vecteur de longueur rigoureusement identique.
La sécurisation des chaînes de traitement nécessite de standardiser le parc logiciel des équipes de recherche en imposant une version moderne de ggplot2 via un gestionnaire de dépendances déterministe comme renv. La substitution systématique des notations archaïques par after_stat() garantit non seulement l’éradication des messages d’avertissement polluant les consoles de calcul, mais prémunit également le code source contre toute rupture de compatibilité lors des futures évolutions majeures de l’écosystème R.
10.3 Chevauchement et masquage des valeurs nulles ou infinitésimales
Lorsqu’un histogramme couvre une variable dont la distribution présente des zones lacunaires ou des queues très étendues, plusieurs compartiments calculés par stat_bin peuvent présenter un effectif rigoureusement égal à zéro, ou agrégant une fraction minuscule d’observations ne justifiant pas l’affichage d’une étiquette textuelle complète. Si geom_text est appliqué sans discernement, le graphique se retrouve encombré d’une multitude de mentions 0,0 % alignées au ras de l’axe horizontal, ce qui dégrade l’esthétique générale.
La parade algorithmique consiste à injecter une conditionnelle de filtrage vectoriel directement au sein de l’assignation de l’étiquette. En mobilisant la structure ifelse() au niveau de l’esthétique label, le chercheur neutralise l’affichage textuel pour les compartiments insignifiants : label = after_stat(ifelse(count == 0, « », scales::percent(count / sum(count), accuracy = 0.1))). Cette clause commande de substituer une chaîne de caractères vide à toute valeur nulle, libérant immédiatement l’axe de tout encombrement parasite.
Pour les pourcentages très faibles mais non nuls, situés entre zéro et deux pour cent, un problème de chevauchement avec la ligne d’axe persiste souvent. Une solution consiste à définir un seuil minimal de visibilité textuelle, en ne lettrant que les classes dont le contingent excède par exemple trois pour cent de la cohorte, tout en précisant dans la légende de la figure que les classes minoritaires n’ont pas été étiquetées individuellement afin de préserver la lisibilité de l’ensemble.
11. Applications pratiques : Cas d’études empiriques en psychologie quantitative
11.1 Cas 1 : Distribution normalisée de scores d’anxiété (inventaire de Spielberger)
Pour illustrer la mise en pratique de l’ensemble des concepts théoriques exposés, examinons le traitement d’une cohorte clinique de huit cent cinquante patients soumis à l’évaluation de l’anxiété-état au moyen de l’inventaire psychométrique de Spielberger (STAI-Y). Cette échelle produit un score global continu s’étendant théoriquement de vingt à quatre-vingts points, les scores élevés signalant une intensité pathologique supérieure. Les impératifs de la publication exigent de visualiser la proportion de patients s’inscrivant dans chaque tranche de cinq points de score, tout en positionnant clairement les étiquettes de pourcentages et en surimposant une courbe théorique normale de référence.
La démarche algorithmique s’articule autour de geom_histogram, en fixant l’argument binwidth = 5 et en ancrant boundary = 20 afin que les compartiments épousent exactement les tranches cliniques [20-25[, [25-30[, et ainsi de suite. L’axe vertical est assigné à after_stat(count / sum(count)). scale_y_continuous est mobilisé pour étalonner les graduations par pas de cinq pour cent, avec labels = scales::percent_format(accuracy = 1, decimal.mark = « , », suffix = » % »), et une borne supérieure étendue pour autoriser le placement d’étiquettes textuelles au moyen d’expansion(mult = c(0, 0.18)).
L’enrichissement analytique se parachève par la projection d’une courbe de densité gaussienne théorique, paramétrée par la moyenne et l’écart-type empiriques de l’échantillon. Pour que la fonction stat_function puisse se caler sur l’axe des pourcentages et non sur celui d’une densité différentielle standard, son ordonnée doit être multipliée par la largeur de classe binwidth (soit 5). Cette harmonisation dimensionnelle produit une superposition parfaite entre l’histogramme proportionnel empirique et le modèle mathématique théorique, offrant aux épidémiologistes un outil diagnostique immédiat pour évaluer la normalité de la distribution.
11.2 Cas 2 : Répartition des réponses sur une échelle de Likert à 7 points
Le second cas d’étude aborde l’analyse des patrons de réponse recueillis auprès de mille deux cents sujets sur une échelle de Likert à sept degrés, allant de pas du tout d’accord (degré un) à tout à fait d’accord (degré sept). Bien que certains chercheurs traitent abusivement ces échelles comme des grandeurs strictement continues, la méthodologie psychométrique la plus rigoureuse impose de respecter leur statut de variable ordinale discrète. Ce traitement exige de mobiliser les variables calculées sous l’angle de stat_count.
La variable est préalablement convertie sous la forme d’un facteur ordonné comprenant sept niveaux étiquetés. La couche géométrique centrale repose ici sur geom_bar, paramétré avec aes(y = after_stat(count / sum(count))), garantissant que la hauteur de chaque modalité représente sa contribution relative au volume global des réponses. L’adjonction de geom_text permet de faire figurer au-dessus de chaque degré la proportion chiffrée, formatée à une décimale au moyen de scales::percent_format(accuracy = 0.1, decimal.mark = « , », suffix = » % »).
Le thème graphique est soigneusement épuré pour répondre aux critères académiques : le quadrillage d’arrière-plan est totalement abrogé, les étiquettes de l’axe des abscisses sont clairement identifiées par les libellés verbaux des degrés extrêmes et médians, et le titre de l’ordonnée explicite la nature proportionnelle de la métrique. Cette représentation offre une synthèse limpide des asymétries d’adhésion cognitive des participants envers l’item évalué, prévenant les erreurs de surinterprétation inhérentes aux simples moyennes statistiques condensées.
12. Synthèse procédurale, reproductibilité et bonnes pratiques de programmation
12.1 Création d’une fonction personnalisée et réutilisable
La récurrence de la tâche d’édition graphique au sein d’un laboratoire ou d’un département d’analyse justifie pleinement l’encapsulation de la chaîne de commandes ggplot2 au sein d’une fonction R personnalisée, modulaire et hautement paramétrable. La programmation défensive et la modularité logicielle évitent la duplication de code fastidieuse et assurent l’application homogène des normes graphiques à travers l’ensemble des projets scientifiques d’une équipe.
Pour concevoir une fonction robuste compatible avec l’évaluation non standard de l’écosystème tidyverse, il convient de recourir aux mécanismes du métaprogramme rlang, notamment l’opérateur d’injection double accolade, communément désigné sous le terme d’opérateur d’accolade embrassante. En encapsulant les arguments désignant la variable cible et la variable de stratification sous la forme {{ variable }}, la fonction personnalisée peut être invoquée directement avec les noms bruts des colonnes non entourés de guillemets, préservant une fluidité ergonomique totale pour l’utilisateur final.
Cette fonction générique peut accepter des arguments optionnels pilotant la largeur d’intervalle binwidth, le degré de précision décimale accuracy, la présence ou l’absence d’étiquettes textuelles géométriques, ainsi que l’application stricte des conventions typographiques locales. En standardisant la gestion des dénominateurs et l’application des thèmes d’épuration éditoriale, une telle abstraction logicielle réduit drastiquement les risques d’anomalies visuelles ou de tronquages typographiques lors de la génération de rapports à grande échelle.
12.2 Intégration dans un flux de travail reproductible (R Markdown et Quarto)
L’insertion des histogrammes pourcentés dans un environnement d’édition computationnelle dynamique, tel que R Markdown ou Quarto, représente l’ultime étape de la démarche d’assurance qualité scientifique. L’objectif d’un tel dispositif est de fusionner le code de calcul, la génération graphique et la rédaction discursive au sein d’un unique document maître, garantissant la reproductibilité intégrale de l’expérience depuis les données brutes jusqu’au document final soumis aux revues.
La gestion des dimensions d’exportation au sein des options de blocs de code (chunks) revêt une incidence déterminante sur la lisibilité finale des pourcentages. Des paramètres tels que fig.width, fig.height et fig.dpi doivent être calibrés avec rigueur : une largeur de figure excessive par rapport à la taille de police par défaut rendra les étiquettes de pourcentage minuscules et illisibles, tandis qu’un format trop restreint provoquera l’écrasement mutuel des conteneurs de geom_label. La fixation explicite d’une résolution minimale de 300 points par pouce (dpi) constitue le standard technique universellement imposé par les éditeurs scientifiques pour les sorties matricielles haute fidélité.
Pour les soumissions éditoriales haut de gamme, l’exportation des visualisations doit privilégier les formats vectoriels purs tels que le PDF (Portable Document Format) ou le SVG (Scalable Vector Graphics). Contrairement aux images matricielles compressées de type JPEG ou PNG, les formats vectoriels conservent une netteté mathématique absolue de chaque glyphe typographique et de chaque filet géométrique, quelle que soit la puissance d’agrandissement appliquée lors de la composition typographique finale du manuscrit imprimé.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
Pearson, K. (1895). Contributions to the mathematical theory of evolution.—II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343–414. https://doi.org/10.1098/rsta.1895.0010
Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
Spielberger, C. D., Gorsuch, R. L., Lushene, R., Vagg, P. R., & Jacobs, G. A. (1983). Manual for the State-Trait Anxiety Inventory. Consulting Psychologists Press.
Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
Wickham, H., & Grolemund, G. (2017). R for data science: Import, tidy, transform, visualize, and model data. O’Reilly Media.
Wickham, H., & Seidel, D. (2022). scales: Scale functions for visualization (Version 1.3.0). CRAN. https://cran.r-project.org/package=scales
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer Science+Business Media. https://doi.org/10.1007/0-387-28695-0